import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.metrics import accuracy_score, roc_auc_score, confusion_matrix, roc_curve
import statsmodels.api as sm

SEMILLA = 2026
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (8, 4)22 Modelos lineales generalizados (GLM): regresión logística
estadistica
glm
regresion-logistica
Cuando la respuesta es sí o no
Hasta ahora, de la regresión lineal a los splines y los kernels, predijiste números continuos: un tiempo, un flujo, un costo. Muchas preguntas, en cambio, tienen respuesta binaria: si esta entrega llegará a tiempo, si este cliente se irá o se quedará, si esta transacción es fraude. Para eso, la regresión lineal no es la herramienta adecuada: en este capítulo, una recta predice una “probabilidad” de 1.10 o de −0.17, que no significan nada.
La regresión logística resuelve esto. Es el primer paso hacia los modelos lineales generalizados (GLM): en vez de predecir el valor directamente, predice la probabilidad de que ocurra el sí y garantiza que quede siempre entre 0 y 1. La construyes sobre un caso de logística de entregas con datos simulados, la pregunta que dejó planteada el caso de entregas con kernel: predecir si una entrega llegará a tiempo.
- Tiempo estimado de lectura: 75 minutos (unas 2 horas y media si ejecutas el código y resuelves el repaso)
- Nivel: Avanzado
- Conocimientos previos recomendados: la regresión lineal y la clasificación y sus métricas del nivel Básico, y la regularización y el caso de entregas con kernel del nivel Avanzado.
- Tecnologías mencionadas: Python, NumPy, pandas, Matplotlib, scikit-learn (
LogisticRegression,roc_auc_score), statsmodels (Logit) y PyTorch.
Todos los datos son hipotéticos o simulados. La tabla de 200 entregas del repaso es inventada; las 800 entregas del caso se simulan con la regla y la semilla central (SEMILLA = 2026) declaradas en el código, y los 20 vehículos del ejemplo resuelto son ilustrativos. Ninguno procede de clientes. Los diagramas conceptuales son imágenes de la carpeta del capítulo. Todo corre en CPU, y las versiones se imprimen en la celda de preparación del entorno.
Objetivos
Al terminar este capítulo vas a ser capaz de:
- calcular proporción, momio, log-momio y razón de momios desde una tabla 2×2, y relacionarlos con los coeficientes de una regresión logística;
- reconocer cuándo una variable respuesta es binaria y por qué una regresión lineal no respeta su distribución;
- seguir los seis pasos generales para construir un GLM y aplicarlos a una respuesta binaria;
- describir las tres piezas de un GLM logístico: respuesta Bernoulli, predictor lineal y función de enlace logit;
- distinguir probabilidad, momio (odds) y log-momio, y convertir coeficientes en razones de momios (odds ratios);
- ajustar una regresión logística y obtener probabilidades para observaciones nuevas;
- explicar cómo un umbral convierte probabilidades en clases y cómo afecta los tipos de error;
- evaluar el modelo con matriz de confusión, exactitud y área bajo la curva ROC (AUC);
- distinguir el uso de
scikit-learnpara predicción y destatsmodelspara inferencia.
22.1 Repaso: de una tabla 2×2 a la regresión logística
Antes de la simulación del capítulo, empieza con una tabla pequeña del mismo caso. Una empresa de reparto hipotética registró 200 entregas de una semana, 100 fuera de hora pico y 100 en hora pico, y anotó si cada una llegó a tiempo. Los datos son inventados para este ejercicio; no corresponden a una empresa. Cada celda cuenta entregas, no probabilidades.
| Franja | A tiempo | Tarde | Total |
|---|---|---|---|
| Fuera de hora pico | 70 | 30 | 100 |
| Hora pico | 45 | 55 | 100 |
| Total | 115 | 85 | 200 |
Resuelve tres preguntas:
- Calcula, para cada franja, la proporción de entregas a tiempo, su momio y su log-momio.
- ¿Por cuánto multiplica la hora pico el momio de llegar a tiempo? Compara esa razón de momios con el cociente y con la diferencia de proporciones.
- Comprueba que una regresión logística con la hora pico como único predictor recupera esos mismos números.
Define \(Y\) como 1 si la entrega llega a tiempo y 0 si no, y \(x\) como 1 en hora pico y 0 fuera de ella. Para el ejercicio supones entregas independientes. La tabla no registra la distancia, así que la diferencia entre franjas puede mezclar el efecto de la hora pico con el de rutas más largas o más cortas.
Proporción, momio y log-momio
Fuera de hora pico llegaron a tiempo 70 de 100 entregas: \(\hat p_0=70/100=0.70\). En hora pico llegaron 45 de 100: \(\hat p_1=0.45\).
El momio compara, dentro de una misma franja, las entregas a tiempo con las tardías:
\[ \text{momio}_0=\frac{\hat p_0}{1-\hat p_0}=\frac{0.70}{0.30}=\frac{70}{30}\approx2.3333, \qquad \text{momio}_1=\frac{0.45}{0.55}=\frac{45}{55}\approx0.8182. \]
Fuera de hora pico llegan unas 2.33 entregas a tiempo por cada entrega tardía; en hora pico, 0.82, menos de una. El momio se puede calcular directamente con los conteos: entregas a tiempo entre entregas tardías.
El log-momio es su logaritmo natural: \(\log 2.3333\approx0.8473\) y \(\log 0.8182\approx-0.2007\). Es positivo cuando la proporción supera 0.5 y negativo cuando queda por debajo, como en hora pico.
No uses el total de la tabla para esta pregunta: la proporción global, \(115/200=0.575\), mezcla las dos franjas y no describe ninguna de ellas.
La razón de momios
La razón de momios divide el momio de una franja entre el de la otra:
\[ \text{OR}=\frac{\text{momio}_1}{\text{momio}_0}=\frac{45/55}{70/30}=\frac{45\times30}{55\times70}=\frac{1350}{3850}\approx0.3506. \]
La hora pico multiplica el momio de llegar a tiempo por 0.35: lo reduce cerca de un 65 %. El producto cruzado \((45\times30)/(55\times70)\) es la forma rápida de obtenerla.
La razón de momios no coincide con el cociente de proporciones ni con su diferencia. El cociente es \(0.45/0.70\approx0.6429\): en hora pico llega a tiempo un 64 % de lo que llega fuera de ella. La diferencia es \(0.45-0.70=-0.25\), es decir, 25 puntos porcentuales menos. Las tres cifras describen la misma tabla en escalas distintas, y la regresión logística trabaja en la del momio.
De la tabla al coeficiente
Una regresión logística con un único predictor binario tiene dos coeficientes: \(\operatorname{logit}(p)=\beta_0+\beta_1x\).
- Fuera de hora pico, \(x=0\) y el modelo se reduce a \(\beta_0\): el log-momio de esa franja, 0.8473.
- En hora pico, \(x=1\) y el modelo vale \(\beta_0+\beta_1\): el log-momio de esa franja, −0.2007.
Al restar, \(\beta_1=-0.2007-0.8473=-1.0480\), el logaritmo de la razón de momios. Su exponencial devuelve la tabla: \(e^{\beta_1}\approx0.3506\). Con dos grupos, el modelo tiene un parámetro por grupo y la máxima verosimilitud reproduce exactamente las proporciones observadas: la sigmoide de \(\beta_0+\beta_1\) vale 0.45.
El cálculo anticipa lo que encontrarás en el resto del capítulo: el coeficiente de una variable binaria es un logaritmo de la razón de momios, y su exponencial es la razón de momios. En la simulación de 800 entregas, la hora pico se ajusta junto con la distancia, que es continua; su razón de momios compara entregas a la misma distancia, y la de la distancia se lee como el factor que multiplica el momio por cada kilómetro. Esa comparación ya no cabe en una tabla 2×2: para eso hace falta el modelo.
Profundización: intervalo de confianza de la razón de momios
La razón de momios es una estimación con incertidumbre. El método de Woolf calcula el error estándar de su logaritmo con los cuatro conteos de la tabla:
\[ \operatorname{EE}\big(\log\widehat{\text{OR}}\big)=\sqrt{\frac{1}{70}+\frac{1}{30}+\frac{1}{45}+\frac{1}{55}}\approx0.2967. \]
El intervalo de 95 % se construye en la escala logarítmica y se devuelve con la exponencial:
\[ \exp\big(-1.0480\pm1.96\times0.2967\big)\quad\Longrightarrow\quad 0.1960\ \text{a}\ 0.6272. \]
El intervalo queda completo por debajo de 1: con esta tabla, la reducción del momio en hora pico se distingue de «sin efecto», bajo el supuesto de entregas independientes. En este modelo de dos grupos, el intervalo de Wald de la regresión logística coincide con el de Woolf. El fundamento de las pruebas con tablas de contingencia está en Pruebas de hipótesis para datos categóricos.
22.2 Preparación del entorno
La celda carga las librerías y fija una semilla central, SEMILLA = 2026, de la que salen la simulación de los datos y la partición en entrenamiento y prueba.
# Versiones de referencia: ejecuta esta celda y guarda el notebook.
import sys
import importlib.metadata as metadatos
print('Python:', sys.version.split()[0])
for paquete in ['numpy', 'pandas', 'matplotlib', 'scikit-learn', 'statsmodels', 'torch']:
    print(paquete + ':', metadatos.version(paquete))
print('Ejecución en CPU, sin GPU.')
Python: 3.13.14
numpy: 2.5.1
pandas: 3.0.5
matplotlib: 3.11.1
scikit-learn: 1.9.0
statsmodels: 0.14.6
torch: 2.13.0
Ejecución en CPU, sin GPU.22.3 Verificación del repaso con Python
La siguiente celda reconstruye la tabla, calcula proporciones, momios y la razón de momios, y ajusta la regresión logística sobre las 200 entregas expandidas, una fila por entrega. No usa números aleatorios, así que no altera la secuencia de rng con la que después se simulan las 800 entregas.
# Tabla hipotética del repaso: 200 entregas de una semana.
tabla_repaso = pd.DataFrame(
    {'a_tiempo': [70, 45], 'tarde': [30, 55]},
    index=['fuera de hora pico', 'hora pico'],
)
tabla_repaso['total'] = tabla_repaso['a_tiempo'] + tabla_repaso['tarde']
tabla_repaso['proporcion'] = tabla_repaso['a_tiempo'] / tabla_repaso['total']
tabla_repaso['momio'] = tabla_repaso['a_tiempo'] / tabla_repaso['tarde']
tabla_repaso['log_momio'] = np.log(tabla_repaso['momio'])
print(tabla_repaso.round(4).to_string())

momio_fuera = tabla_repaso.loc['fuera de hora pico', 'momio']
momio_pico = tabla_repaso.loc['hora pico', 'momio']
or_repaso = momio_pico / momio_fuera
p_fuera = tabla_repaso.loc['fuera de hora pico', 'proporcion']
p_pico = tabla_repaso.loc['hora pico', 'proporcion']
print(f"\nRazón de momios (hora pico / fuera): {or_repaso:.4f}; logaritmo: {np.log(or_repaso):.4f}")
print(f"Cociente de proporciones: {p_pico / p_fuera:.4f}; diferencia: {p_pico - p_fuera:.2f}")

# Una fila por entrega: hora pico (0/1) y llegada a tiempo (0/1).
hora_pico_repaso = np.repeat([0, 0, 1, 1], [70, 30, 45, 55])
a_tiempo_repaso = np.repeat([1, 0, 1, 0], [70, 30, 45, 55])
logit_repaso = sm.Logit(a_tiempo_repaso, sm.add_constant(hora_pico_repaso)).fit(disp=0)
b0_repaso, b1_repaso = logit_repaso.params
ic_repaso = np.exp(logit_repaso.conf_int()[1])
print(f"\nRegresión logística: β0 = {b0_repaso:.4f}; β1 = {b1_repaso:.4f}; exp(β1) = {np.exp(b1_repaso):.4f}")
print(f"Sigmoide de β0 + β1: {1 / (1 + np.exp(-(b0_repaso + b1_repaso))):.4f}")
print(f"IC 95 % de exp(β1): {ic_repaso[0]:.4f} a {ic_repaso[1]:.4f}")
a_tiempo tarde total proporcion momio log_momio
fuera de hora pico 70 30 100 0.70 2.3333 0.8473
hora pico 45 55 100 0.45 0.8182 -0.2007
Razón de momios (hora pico / fuera): 0.3506; logaritmo: -1.0480
Cociente de proporciones: 0.6429; diferencia: -0.25
Regresión logística: β0 = 0.8473; β1 = -1.0480; exp(β1) = 0.3506
Sigmoide de β0 + β1: 0.4500
IC 95 % de exp(β1): 0.1960 a 0.6272La salida confirma las cuentas a mano: proporciones de 0.70 y 0.45, momios de 2.3333 y 0.8182, y una razón de momios de 0.3506. La regresión logística estima \(\beta_0=0.8473\), el log-momio fuera de hora pico, y \(\beta_1=-1.0480\), el logaritmo de la razón de momios; la sigmoide de su suma devuelve 0.4500, la proporción observada en hora pico. El intervalo de 95 % de statsmodels para \(e^{\beta_1}\), de 0.1960 a 0.6272, coincide con el de Woolf.
22.4 El mapa: qué es un GLM y dónde trabajarás
Un modelo lineal generalizado (GLM) es la regresión lineal adaptada al tipo de respuesta. La parte lineal que ya conoces, \(\beta_0+\beta_1x_1+\cdots\), no cambia. Cambian dos cosas: qué clase de valores puede tomar la respuesta y cómo se conecta esa suma lineal con ella.
Por eso un GLM no es un único modelo, sino una familia. Según la pregunta que quieras responder (¿cuánto?, ¿sí o no?, ¿cuántas veces?) eliges un miembro distinto. El siguiente diagrama muestra la estructura común y los miembros más usados.
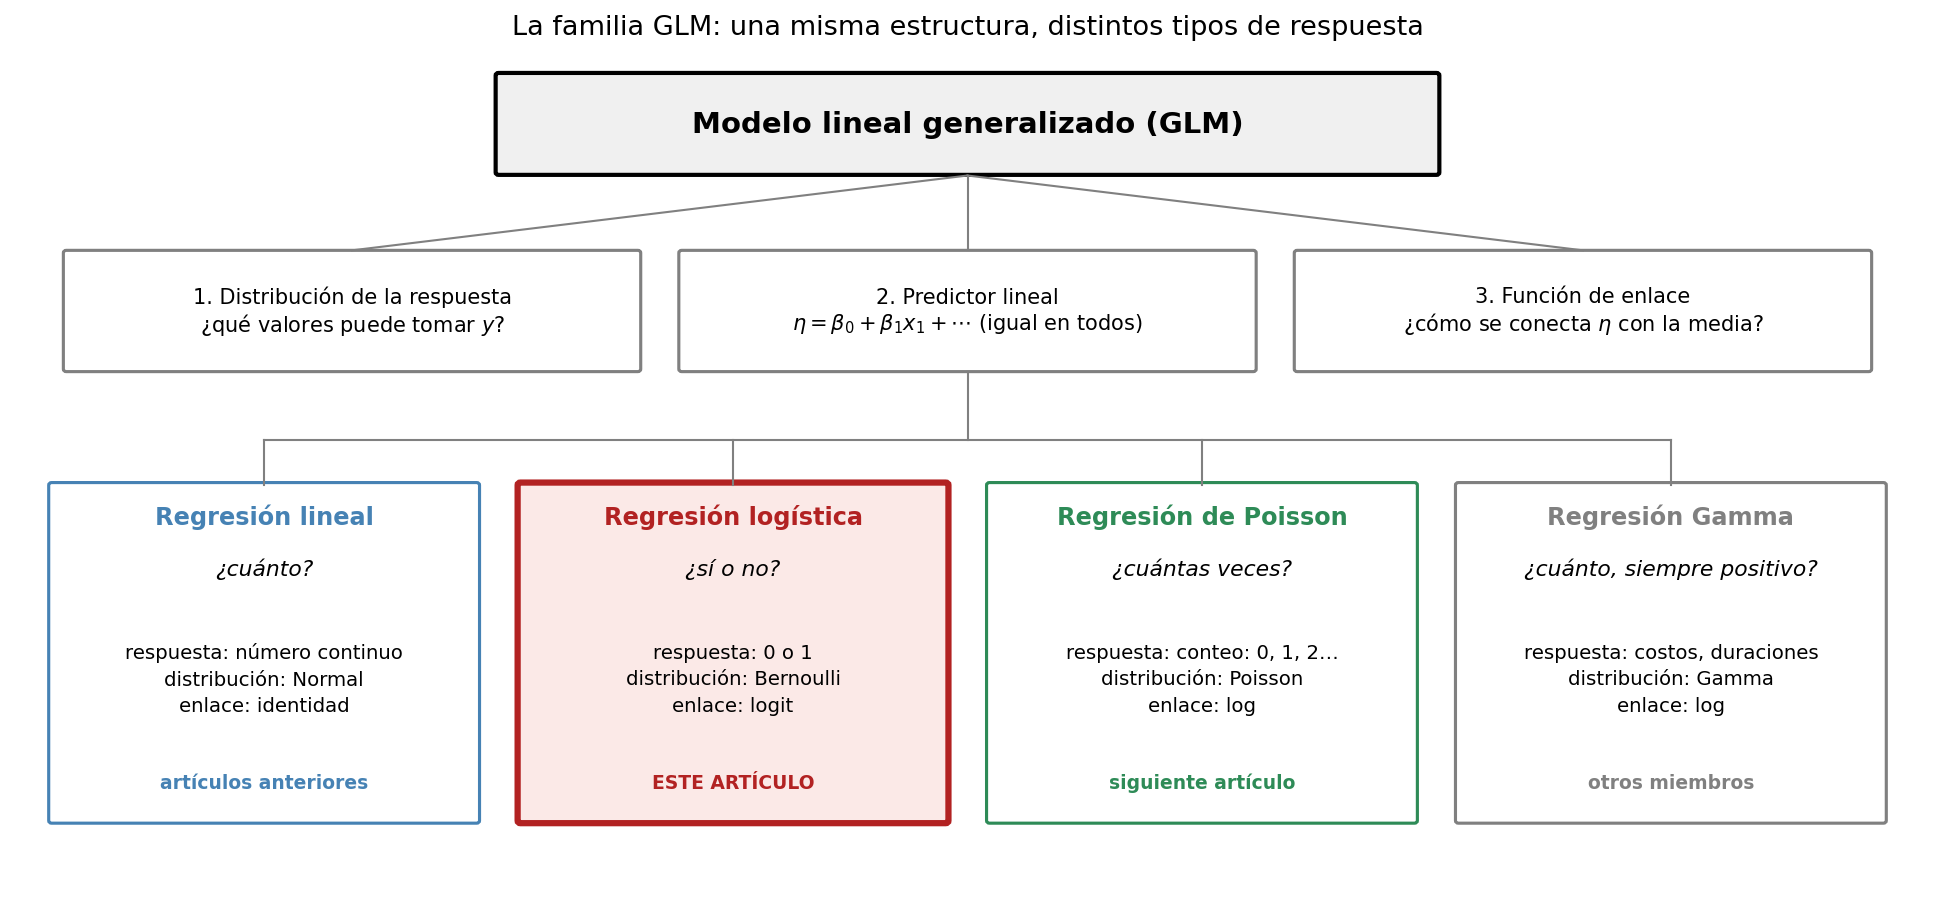
El diagrama se lee de arriba hacia abajo. Todo GLM se arma con los mismos tres ingredientes: una distribución para la respuesta, un predictor lineal y una función de enlace que conecta ambos. El predictor lineal es el mismo en todos los miembros; lo que distingue a un modelo de otro es la pareja distribución + enlace.
- La regresión lineal, simple y múltiple, ya era un GLM: respuesta normal y enlace identidad, es decir, sin transformación.
- La regresión logística, resaltada, es el miembro de este capítulo: la respuesta solo vale 0 o 1, su distribución es Bernoulli y el enlace es el logit.
- La regresión de Poisson es el miembro del siguiente capítulo: la respuesta es un conteo.
- La regresión Gamma aparece para recordar que la familia no termina ahí: sirve para cantidades continuas y siempre positivas, como costos o duraciones.
Todavía no hace falta entender qué es un logit ni por qué la distribución es Bernoulli: eso es lo que construyes a continuación. Quédate con la idea de que vas a aprender un miembro de una familia, y que lo que aprendas sobre distribución y enlace se reutiliza en los demás.
22.5 Las distribuciones de la familia
Antes del método conviene conocer a los protagonistas. Una distribución de probabilidad describe qué valores puede tomar una variable y con qué frecuencia aparece cada uno. Elegir un GLM empieza por reconocer cuál de estas formas se parece a tu respuesta.
La figura tiene dos filas. La de arriba muestra cada distribución: qué valores toma \(y\) y con qué frecuencia. La de abajo muestra cómo se ven los datos cuando \(y\) sigue esa distribución y su media depende de un predictor \(x\): los puntos grises son observaciones y la curva es la media de \(y\) para cada valor de \(x\). Son ejemplos: la forma de esa curva depende de cada problema, no de la distribución.
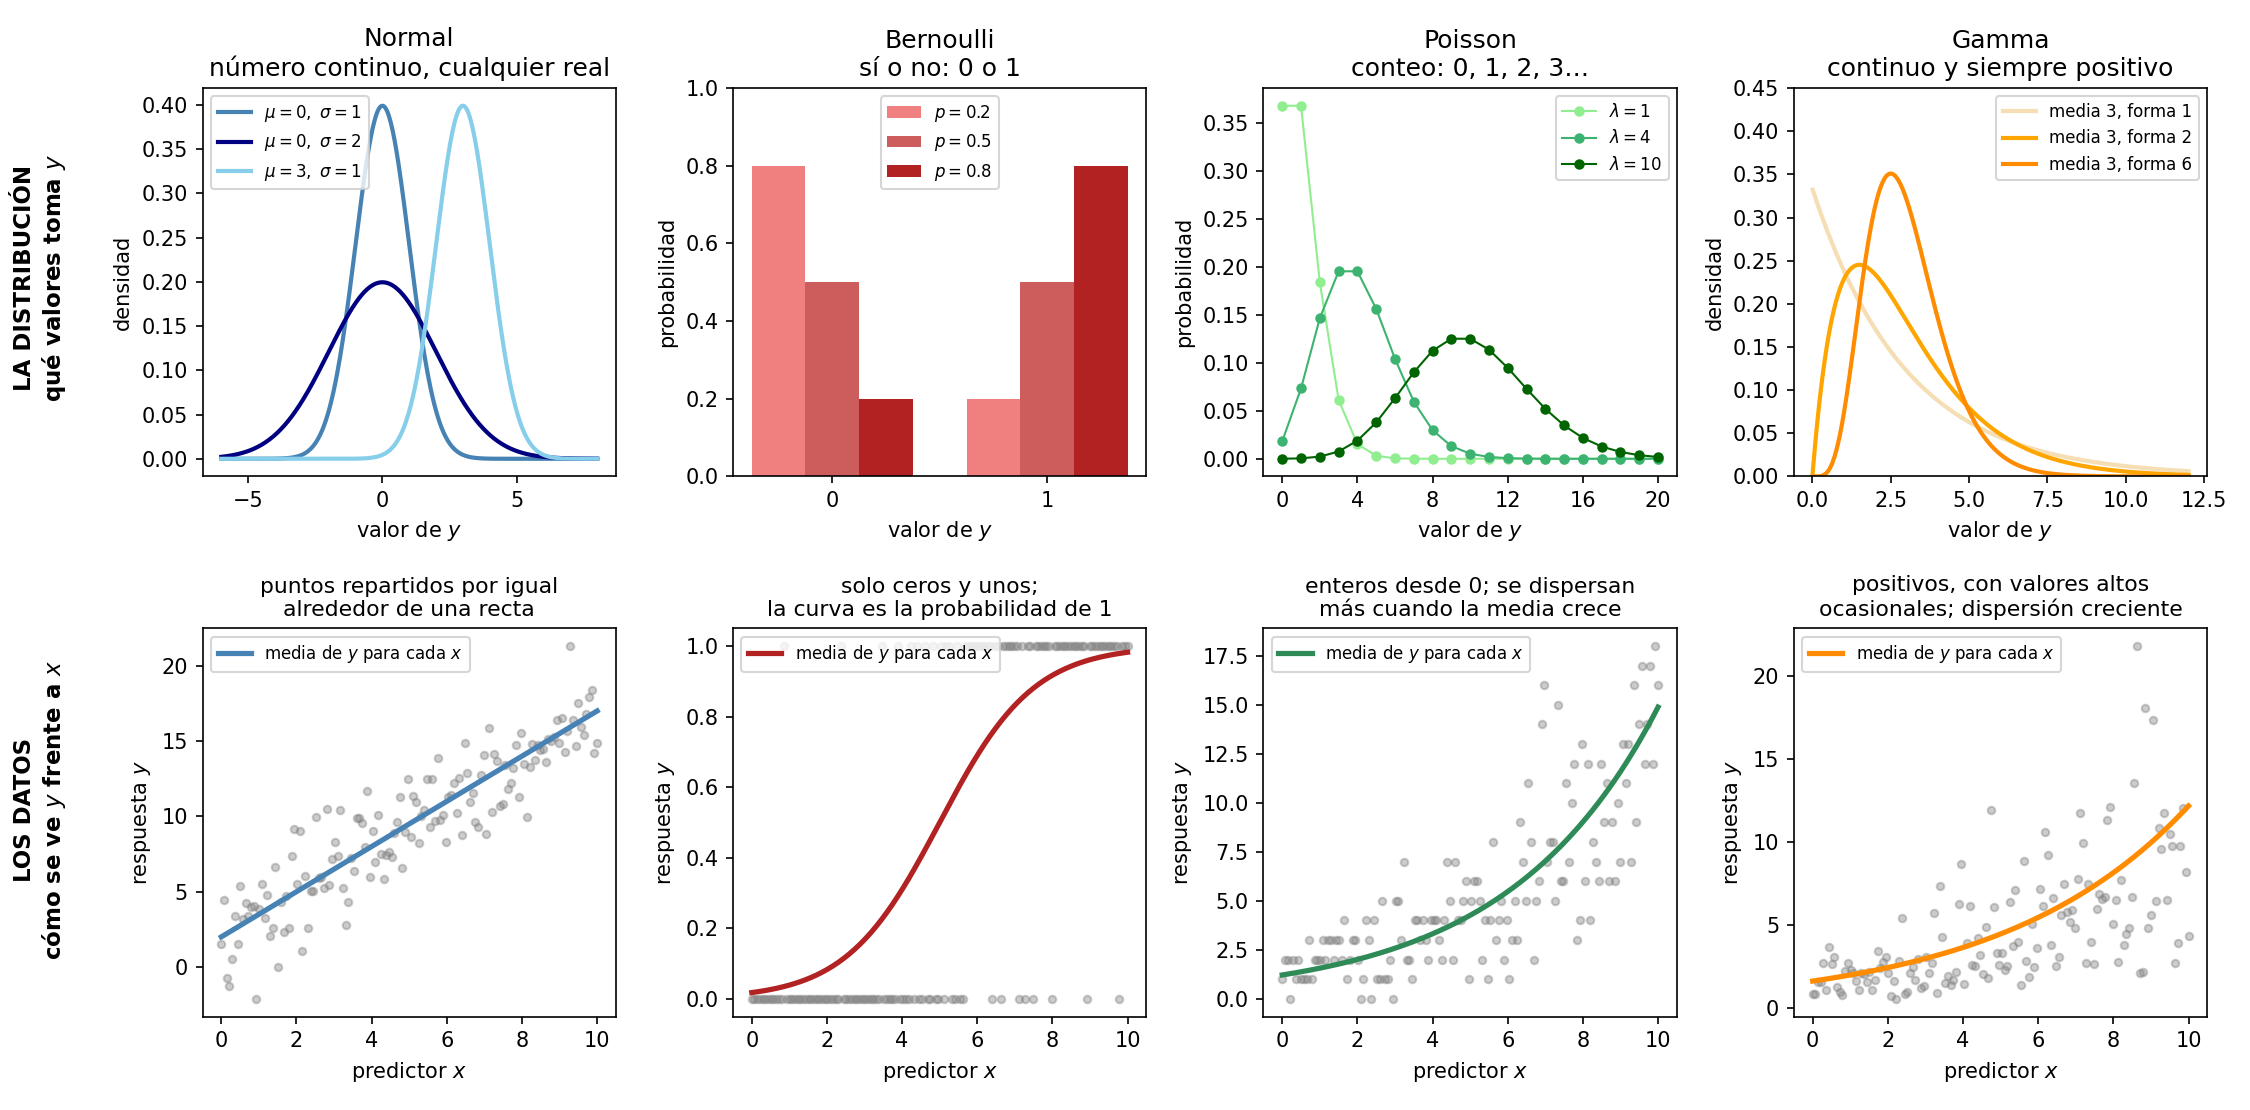
Normal. Describe un número continuo que puede tomar cualquier valor, positivo o negativo, y que se reparte de forma simétrica alrededor de su media.
- Parámetros: la media \(\mu\) ubica el centro de la campana; la desviación \(\sigma\) controla su ancho.
- Ejemplo: la variación diaria de un precio, un error de medición.
- En la figura: cambiar \(\mu\) desplaza la campana; cambiar \(\sigma\) la ensancha. El ancho no depende de dónde esté el centro: la varianza es constante.
- En los datos: los puntos forman una nube alrededor de una recta, con el mismo grosor de principio a fin. Es el caso de la regresión lineal.
Bernoulli. Describe un único resultado de sí o no: 1 si el evento ocurre, 0 si no.
- Parámetro: uno solo, \(p\), la probabilidad de que ocurra el 1.
- Ejemplo: la entrega llega a tiempo, el cliente compra, la transacción es fraude.
- En la figura: solo hay dos barras. Con \(p=0.2\) casi todo el peso está en el 0; con \(p=0.8\), en el 1; con \(p=0.5\) se reparte por igual.
- En los datos: solo hay puntos en 0 y en 1. No se ve una nube: lo que cambia con \(x\) es cuántos puntos caen arriba, y eso es lo que dibuja la curva de probabilidad.
Poisson. Describe un conteo: cuántas veces ocurre algo en un intervalo de tiempo o de espacio.
- Parámetro: uno solo, \(\lambda\), el número promedio de eventos.
- Ejemplo: incidencias en un día, llamadas en una hora, pedidos por zona.
- En la figura: solo toma valores enteros desde 0. Con \(\lambda\) pequeño se amontona cerca de cero y es asimétrica; al crecer \(\lambda\) se desplaza a la derecha y se ensancha, porque su varianza es igual a su media.
- En los datos: los puntos caen en filas horizontales (los enteros) y se abren en abanico a medida que la media sube.
Gamma. Describe una cantidad continua que solo puede ser positiva y que suele tener una cola larga hacia la derecha.
- Parámetros: la media y un parámetro de forma que controla la asimetría.
- Ejemplo: un costo, la duración de un servicio, un tiempo de espera.
- En la figura: las tres curvas tienen la misma media, 3. Con forma pequeña la cola es muy larga; con forma grande la curva se parece más a una campana.
- En los datos: todos los puntos son positivos, con algunos valores muy altos, y la dispersión crece con la media.
En la fila de abajo, solo los datos normales siguen una recta con dispersión pareja; en los otros tres la media es una curva y la dispersión cambia. Por eso la regresión lineal no es el modelo adecuado para ellos. Las cuatro difieren en los valores que admiten (cualquier real, solo 0 y 1, enteros desde 0, reales positivos) y en cómo se comporta su dispersión. Esas dos cosas son las que deciden qué modelo usar. Este capítulo trabaja con la Bernoulli; el siguiente, con la Poisson.
22.6 La metodología general: seis pasos para construir un GLM
Antes de construir la regresión logística conviene ver el método completo. Todo GLM, sea cual sea la respuesta, se arma con la misma idea:
\[ \boxed{\text{Distribución}\;\rightarrow\;\text{Cambio de variable}\;\rightarrow\;\text{Modelo lineal}\;\rightarrow\;\text{Cambio inverso}} \]
Lo que cambia de un modelo a otro es la distribución de \(Y\), la función de enlace y la interpretación de la predicción. Esa idea se desarrolla en seis pasos:
| Paso | Pregunta guía | Qué se hace |
|---|---|---|
| 1. Naturaleza de \(Y\) | ¿Qué quiero predecir? | Identificar si es continua, binaria, un conteo, una proporción o un valor positivo |
| 2. Distribución | ¿Cómo se distribuye \(Y\)? | Elegir Normal, Bernoulli, Poisson, Binomial, Gamma… |
| 3. Enlace | ¿Qué cambio de variable necesito? | Elegir identidad, logit, log u otro |
| 4. Modelo | ¿Cómo se relaciona con \(X\)? | Estimar \(g(\mu)=X\beta\) |
| 5. Inversa | ¿Cómo regreso a la escala original? | Calcular \(\mu=g^{-1}(X\beta)\) |
| 6. Predicción | ¿Qué significa el resultado? | Interpretar, validar y decidir cuando corresponda |
Primero recorres los seis pasos para el caso general y después los aterrizas, uno por uno, en la respuesta binaria de este capítulo.
Paso 1. Identificar la naturaleza de la variable respuesta \(Y\)
La primera decisión es determinar qué valores puede tomar la variable que quieres predecir.
| Tipo de respuesta | Ejemplo | Valores posibles |
|---|---|---|
| Continua | temperatura, variación de un precio | números reales |
| Binaria | la entrega llega a tiempo o no | 0 o 1 |
| Conteo | número de incidencias en un día | 0, 1, 2, 3… |
| Proporción de éxitos | entregas puntuales de un lote de 50 | entre 0 y 1 |
| Continua positiva | costo, duración de un servicio | mayores que 0 |
Conviene separar dos ideas: el tipo de variable (qué valores puede tomar \(Y\)) y la forma de la relación (cómo cambia \(Y\) cuando cambia \(X\)). Este paso solo responde la primera.
Paso 2. Elegir la distribución de probabilidad
Con la naturaleza de \(Y\) identificada, se elige una distribución compatible con ella, entre las que acabas de ver.
| Tipo de \(Y\) | Distribución candidata | Media \(\mu\) | Varianza |
|---|---|---|---|
| Continua | Normal | cualquier real | \(\sigma^2\), constante |
| Binaria | Bernoulli | \(p\) | \(p(1-p)\) |
| Conteo | Poisson | \(\lambda\) | \(\lambda\) |
| Proporción de éxitos en \(n\) ensayos | Binomial, para el número de éxitos | \(p\), para la proporción | \(p(1-p)/n\), para la proporción |
| Continua positiva | Gamma | \(\mu>0\) | \(\phi\mu^2\) |
Son distribuciones candidatas, no reglas automáticas. Tres precisiones: la distribución se elige para \(Y\) dado \(X\), no para el histograma de todos los datos juntos; se supone que las observaciones son independientes entre sí; y la elección se comprueba después con el ajuste, no se da por buena de antemano. Las distribuciones de esta tabla pertenecen a la llamada familia exponencial, que es la que cubren los GLM. La pregunta de este paso es: ¿qué distribución representa razonablemente el comportamiento de \(Y\) para cada valor de \(X\)? Fíjate en la última columna: solo en la Normal la varianza es constante. En las demás depende de la media: es una de las razones por las que la regresión lineal, pensada para una varianza constante, no es el modelo adecuado para ellas.
Paso 3. Elegir el cambio de variable: la función de enlace
Este es el corazón del método. La media \(\mu\) suele tener límites (una probabilidad vive entre 0 y 1, un conteo esperado es positivo) y un modelo lineal puede dar cualquier número. La función de enlace \(g\) es el cambio de variable que lleva la media a una escala sin límites:
\[ \eta=g(\mu). \]
| Distribución | Enlace habitual | Cambio de variable | Qué logra |
|---|---|---|---|
| Normal | identidad | \(\eta=\mu\) | nada que corregir: la media ya es cualquier real |
| Bernoulli, Binomial | logit | \(\eta=\log\dfrac{p}{1-p}\) | lleva \((0,1)\) a toda la recta real |
| Poisson | log | \(\eta=\log\mu\) | lleva los positivos a toda la recta real |
| Gamma | log | \(\eta=\log\mu\) | lleva los positivos a toda la recta real |
El cociente \(p/(1-p)\) que aparece en el logit se llama momio (odds): cuántas veces es más probable que el evento ocurra a que no ocurra. Se desarrolla más adelante, al aterrizar este paso en el caso binario.
El cambio de variable se aplica a la media, no a los datos. Se transforma \(\mu=\mathbb{E}(Y\mid X)\), no cada valor observado de \(Y\). Con una respuesta binaria no podría ser de otra forma: los datos valen 0 o 1 y el logit de 0 o de 1 no existe. Tampoco equivale a transformar la respuesta y ajustar una recta: \(\log(\mathbb{E}(Y))\) no es lo mismo que \(\mathbb{E}(\log Y)\).
Paso 4. Construir y estimar el predictor lineal
En este paso todos los modelos comparten la misma estructura:
\[ \eta=\beta_0+\beta_1x_1+\beta_2x_2+\cdots+\beta_kx_k=X\beta. \]
Lo que se modela linealmente es la media transformada: \(g(\mathbb{E}(Y\mid X))=X\beta\). Los coeficientes se estiman por máxima verosimilitud, usando la distribución elegida en el paso 2. En el caso Normal con enlace identidad, el resultado coincide con los mínimos cuadrados que ya conoces.
Paso 5. Aplicar el cambio de variable inverso
Con los coeficientes estimados, el predictor lineal \(\hat\eta=X\hat\beta\) todavía está en la escala del enlace. Para volver a la escala de la respuesta se aplica la inversa:
\[ \hat\mu=g^{-1}(\hat\eta). \]
| Modelo | Cambio inverso | Resultado |
|---|---|---|
| Normal, identidad | \(\mu=\eta\) | cualquier valor real |
| Bernoulli o Binomial, logit | \(p=\dfrac{1}{1+e^{-\eta}}\) | una probabilidad entre 0 y 1 |
| Poisson o Gamma, log | \(\mu=e^{\eta}\) | una media positiva |
La figura muestra los tres cambios inversos. En cada panel entra el mismo número por el eje horizontal y se lee el resultado en el eje vertical:
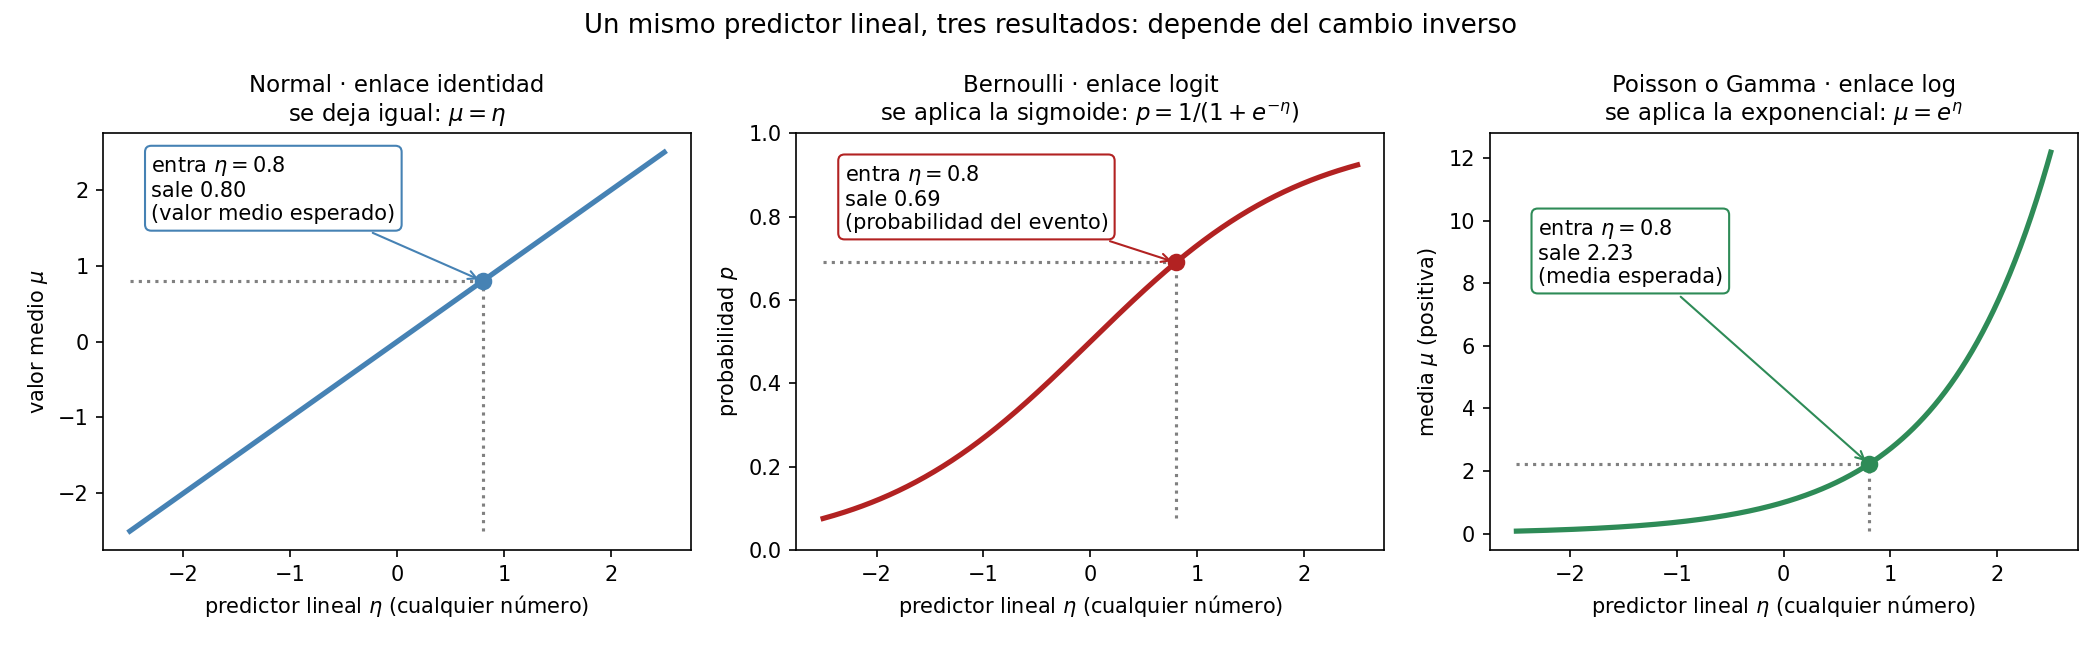
En la figura, el eje horizontal es el predictor lineal \(\eta\), que puede ser cualquier número. La curva de cada panel es el cambio inverso de ese modelo. Sigue la línea punteada desde \(\eta=0.8\) hasta la curva y de ahí al eje vertical:
- Normal: la identidad no cambia nada; sale 0.80.
- Bernoulli: la sigmoide lo comprime entre 0 y 1; sale 0.69, una probabilidad.
- Poisson o Gamma: la exponencial lo vuelve positivo; sale 2.23, una media.
Paso 6. Predecir, interpretar y validar
Supón que, para un caso nuevo, el predictor lineal vale \(\hat\eta=0.8\). El mismo número significa cosas distintas según el modelo:
| Modelo | Predicción | Cómo se lee |
|---|---|---|
| Normal | 0.80 | valor medio esperado |
| Bernoulli | 0.69 | probabilidad de que ocurra el evento |
| Poisson | 2.23 | número esperado de eventos |
| Gamma, enlace log | 2.23 | valor positivo esperado |
Poisson y Gamma dan la misma media, pero no la misma incertidumbre: son distribuciones distintas. Después de predecir hay que validar con métricas acordes a la respuesta: error cuadrático para una respuesta continua, exactitud, log-pérdida y AUC para una binaria. Y solo en el caso binario tiene sentido convertir la predicción en una decisión mediante un umbral.
La idea de fondo es que no se cambian arbitrariamente los datos para forzar una regresión: se elige una distribución y un cambio de variable de su media que permita relacionarla con los predictores, respetando la naturaleza de la respuesta.
22.7 Del caso general al caso Bernoulli
Con el método completo, ahora lo aterrizas en un problema concreto: predecir si una entrega llega a tiempo. La tabla muestra qué significa cada paso en este caso y en qué sección se desarrolla:
| Paso | En general | En este capítulo | Dónde aparece |
|---|---|---|---|
| 1. Naturaleza de \(Y\) | ¿qué valores toma? | a_tiempo vale 0 o 1: binaria |
«Los datos» |
| 2. Distribución | elegir una compatible | Bernoulli, con media \(p\) | «Por qué la regresión lineal no sirve aquí» |
| 3. Enlace | \(\eta=g(\mu)\) | logit: \(\eta=\log\dfrac{p}{1-p}\) | «El enlace», partes 1 y 2 |
| 4. Modelo | estimar \(g(\mu)=X\beta\) | \(\eta=\beta_0+\beta_1\,\text{distancia}+\beta_2\,\text{hora pico}\), por máxima verosimilitud | «Cómo se estiman los coeficientes» y «Ajustar el modelo predictivo» |
| 5. Inversa | \(\mu=g^{-1}(\eta)\) | sigmoide: \(p=\dfrac{1}{1+e^{-\eta}}\) | «El cambio inverso» y «Visualizar el ajuste» |
| 6. Predicción | interpretar, validar, decidir | razones de momios, umbral, exactitud y AUC | de «Modelo inferencial» en adelante |
Una aclaración sobre el orden: el paso 5 aparece antes que el 4. Conviene conocer la sigmoide antes de estimar los coeficientes que la definen.
22.8 Los datos: ¿la entrega llega a tiempo?
La celda simula 800 entregas. De cada una conoces la distancia (km) y si se hizo en hora pico, y quieres predecir si llegó a tiempo (1) o no (0). Por construcción, la probabilidad de llegar a tiempo baja con la distancia y baja también en hora pico, como en la tabla del repaso. En la práctica no conocerías esa regla: la infieres de los datos.
n = 800
distancia = rng.uniform(1, 25, n)          # km
hora_pico = rng.integers(0, 2, n)          # 1 = hora pico

# Regla oculta (log-odds de llegar a tiempo): baja con distancia y en hora pico
logit = 3.2 - 0.18 * distancia - 1.1 * hora_pico
prob = 1 / (1 + np.exp(-logit))
a_tiempo = rng.binomial(1, prob)

X = np.column_stack([distancia, hora_pico])
y = a_tiempo
print(f'{n} entregas | llegaron a tiempo: {y.mean():.1%}')
pd.DataFrame({'distancia': distancia[:5], 'hora_pico': hora_pico[:5], 'a_tiempo': y[:5]})
800 entregas | llegaron a tiempo: 56.4%| distancia | hora_pico | a_tiempo | |
|---|---|---|---|
| 0 | 5.294436 | 0 | 1 |
| 1 | 16.357916 | 1 | 0 |
| 2 | 12.214442 | 0 | 0 |
| 3 | 9.892013 | 1 | 0 |
| 4 | 9.518016 | 0 | 1 |
El 56.4% de las entregas llega a tiempo, así que las clases están razonablemente equilibradas (ni todo sí ni todo no). La variable objetivo es 0 o 1: no hay valores intermedios. Con eso queda resuelto el paso 1: la respuesta es binaria.
22.9 Por qué la regresión lineal no sirve aquí
El paso 2 pide elegir una distribución. Antes de aceptar la Bernoulli, comprueba por qué no sirve la Normal de la regresión lineal, la herramienta conocida. Para aislar el problema, la celda usa únicamente las entregas realizadas fuera de hora pico y ajusta una regresión lineal de a_tiempo contra distancia. Así, la demostración es univariada y la forma del gráfico no mezcla el efecto de la segunda variable.
mascara_normal = hora_pico == 0
distancia_normal = distancia[mascara_normal]
y_normal = y[mascara_normal]

lin = LinearRegression().fit(distancia_normal.reshape(-1, 1), y_normal)
grid_lineal = np.linspace(0, 40, 250).reshape(-1, 1)
pred_grid_lineal = lin.predict(grid_lineal)

plt.scatter(distancia_normal, y_normal, s=12, alpha=0.3, label='entregas fuera de hora pico')
plt.plot(grid_lineal, pred_grid_lineal, color='firebrick', linewidth=2, label='regresión lineal')
plt.axhline(0, color='gray', ls=':'); plt.axhline(1, color='gray', ls=':')
plt.axvline(distancia_normal.max(), color='gray', ls='--', alpha=0.6, label='máximo observado')
plt.xlabel('distancia (km)'); plt.ylabel('¿llegó a tiempo?'); plt.legend(loc='center right')
plt.title('La recta produce "probabilidades" fuera de [0, 1]'); plt.show()

for km in [0, 30, 40]:
    print(f'Predicción de la recta a {km:>2} km: {lin.predict([[km]])[0]:.2f}')

print(f'Distancias observadas: {distancia_normal.min():.1f} a {distancia_normal.max():.1f} km')
print(f'La recta cruza 1 a {(1 - lin.intercept_) / lin.coef_[0]:.1f} km y 0 a {-lin.intercept_ / lin.coef_[0]:.1f} km')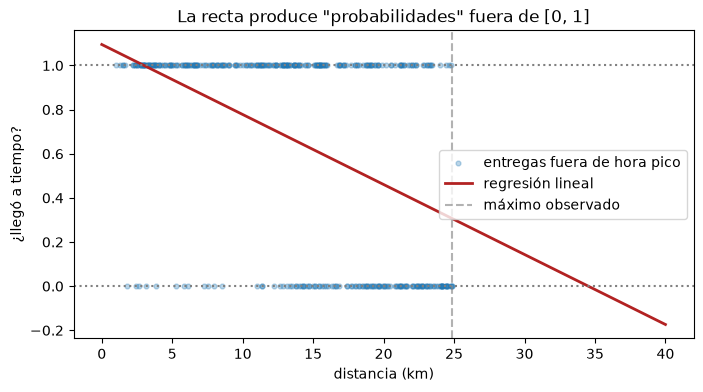
Predicción de la recta a  0 km: 1.10
Predicción de la recta a 30 km: 0.14
Predicción de la recta a 40 km: -0.17
Distancias observadas: 1.0 a 24.9 km
La recta cruza 1 a 3.0 km y 0 a 34.5 km
La recta resume una tendencia descendente, pero no respeta los límites de una probabilidad. Ya dentro del rango observado (1.0 a 24.9 km) supera 1: cruza ese valor a 3.0 km, así que para las entregas más cortas predice más de 1 (1.10 si se prolonga hasta 0 km). Más allá de los datos sigue bajando y cruza 0 a 34.5 km: a 40 km predice −0.17. Ninguno de esos valores puede interpretarse como una probabilidad.
El segundo fallo: la varianza no es constante
Salirse de 0 y 1 es el fallo más visible, pero no el único. Para ver el segundo hay que entender dos ideas.
Primera idea: qué clase de dato es la respuesta. Una variable que solo puede tomar dos valores, 1 (ocurre) o 0 (no ocurre), se describe con la distribución de Bernoulli. Piensa en una moneda que no necesariamente es justa: cae en 1 con probabilidad \(p\) y en 0 con probabilidad \(1-p\). Cada entrega es una de esas monedas, y su \(p\) es la probabilidad de llegar a tiempo.
\[ Y\sim\operatorname{Bernoulli}(p), \qquad \mathbb{E}(Y)=p, \qquad \operatorname{Var}(Y)=p(1-p). \]
Cada símbolo nombra una pieza distinta.
\(Y\sim\operatorname{Bernoulli}(p)\) describe el tipo de resultado: cada entrega es un ensayo que sale 1 o 0, con la misma lógica de esa moneda.
\(\mathbb{E}(Y)=p\) dice que el promedio de muchos ensayos con la misma \(p\) es esa probabilidad. Si \(p=0.8\), de cada 100 entregas parecidas se esperan unas 80 a tiempo.
\(\operatorname{Var}(Y)=p(1-p)\) es la varianza: cuánta incertidumbre cabe en un solo resultado. Depende de \(p\), y lo hace de forma simétrica. Es pequeña cuando el desenlace ya se anticipa, y alcanza su máximo cuando el resultado es un cara o cruz.
| Probabilidad de llegar a tiempo | Varianza \(p(1-p)\) | Qué significa |
|---|---|---|
| 0.95 | 0.0475 | casi siempre llega: el resultado se anticipa |
| 0.50 | 0.25 | es un cara o cruz: no hay forma de anticiparlo |
| 0.05 | 0.0475 | casi nunca llega: también se anticipa |
Segunda idea: qué le exige la regresión lineal a los datos. El supuesto se llama homocedasticidad: la dispersión de la respuesta alrededor de su media es la misma para cualquier valor de \(x\). A 5 km y a 20 km, la banda vertical tiene el mismo grosor, y la recta está hecha para ese caso.
La heterocedasticidad es una dispersión que cambia con \(x\). En la regresión lineal apareció como un abanico de residuales. En una respuesta que solo vale 0 o 1, esa dispersión es \(p(1-p)\): estrecha cuando el desenlace se anticipa y máxima cuando \(p=0.5\).
Para mirar los residuales de una regresión, el gráfico útil es el de residuales frente a valores ajustados. La siguiente figura pone lado a lado la banda constante y el embudo, con datos ilustrativos de una respuesta continua.
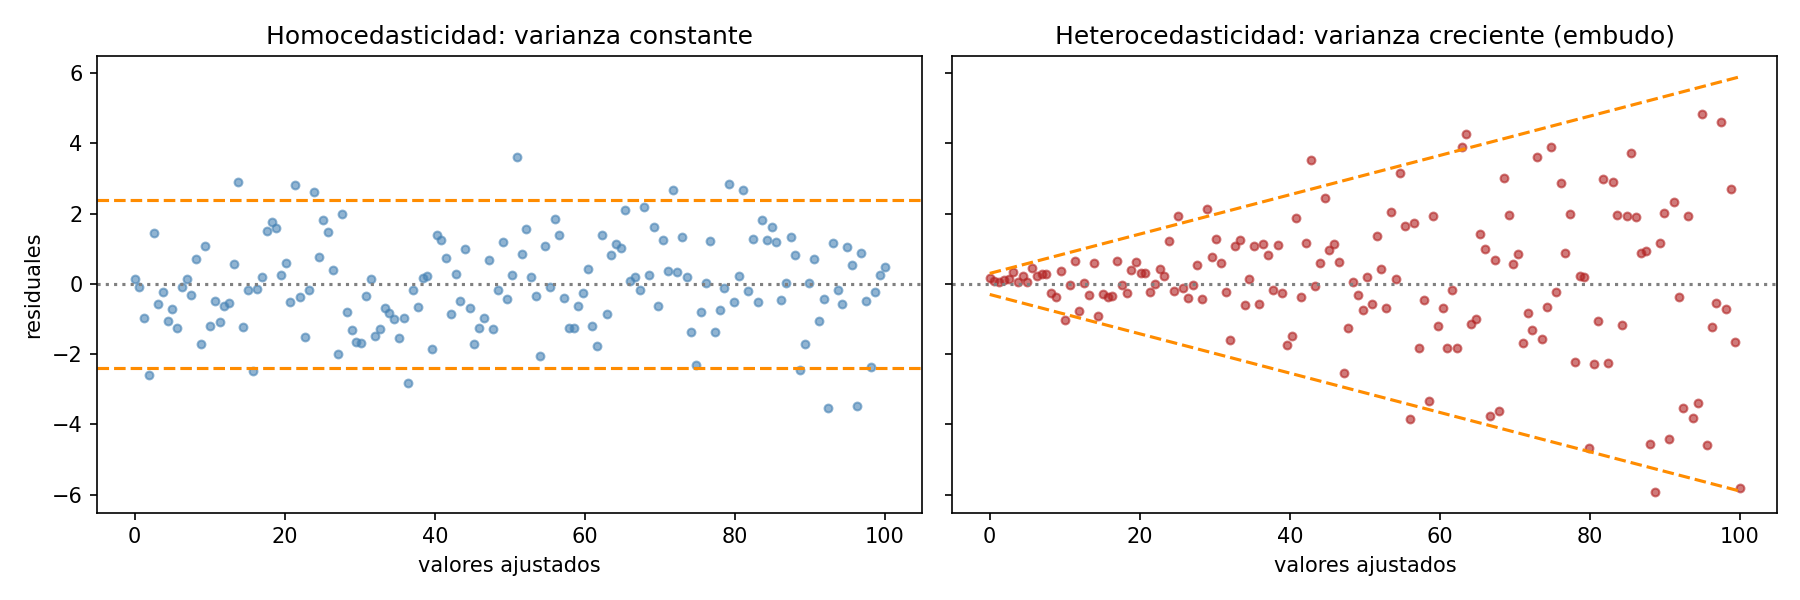
Homocedasticidad: varianza constante (panel izquierdo). Los residuales se reparten al azar dentro de una banda horizontal. La dispersión vertical es la misma al inicio, en el medio y al final del eje de valores ajustados.
Heterocedasticidad: varianza variable (panel derecho). Los residuales dibujan un embudo, el llamado efecto megáfono. Con valores ajustados bajos los puntos están juntos. Al avanzar hacia la derecha, la dispersión vertical se abre: el error crece con el valor ajustado.
En la práctica, la lectura es esta:
- Si tu gráfico se parece al panel izquierdo, la dispersión es compatible con varianza constante. Sobre ese supuesto descansan los errores estándar de los coeficientes y las pruebas del modelo lineal, dentro de las condiciones de Gauss-Markov.
- Si tu gráfico se parece al panel derecho, la varianza cambia con el valor ajustado. Cuando la respuesta es continua, los remedios habituales son transformar la variable, por ejemplo con un logaritmo, o estimar errores estándar robustos, como los de White.
- Aquí
a_tiemposolo vale 0 o 1 y su varianza es \(p(1-p)\). Esa dispersión cambia con la probabilidad por construcción, así que el paso siguiente es un modelo hecho para una respuesta binaria.
Con esto se resuelve el paso 2. La recta se puede ajustar, pero sus predicciones no son probabilidades y su inferencia supone una varianza constante que aquí no existe. La distribución adecuada es la Bernoulli. Hace falta un modelo construido sobre ella y que garantice \(0\leq p\leq 1\).
22.10 Las tres piezas del GLM logístico y los seis pasos en un diagrama
Los pasos 1 y 2 quedaron resueltos: la respuesta es binaria y su distribución es Bernoulli. Con el predictor lineal y el enlace, la regresión logística queda definida por tres piezas, las mismas tres del mapa:
\[ Y_i\sim\operatorname{Bernoulli}(p_i), \]
\[ \eta_i=\beta_0+\beta_1x_{i1}+\cdots+\beta_kx_{ik}=X_i\beta, \]
\[ \operatorname{logit}(p_i)=\log\!\left(\frac{p_i}{1-p_i}\right)=\eta_i. \]
El diagrama pone en fila los seis pasos de la metodología con lo que cada uno significa en la regresión logística:
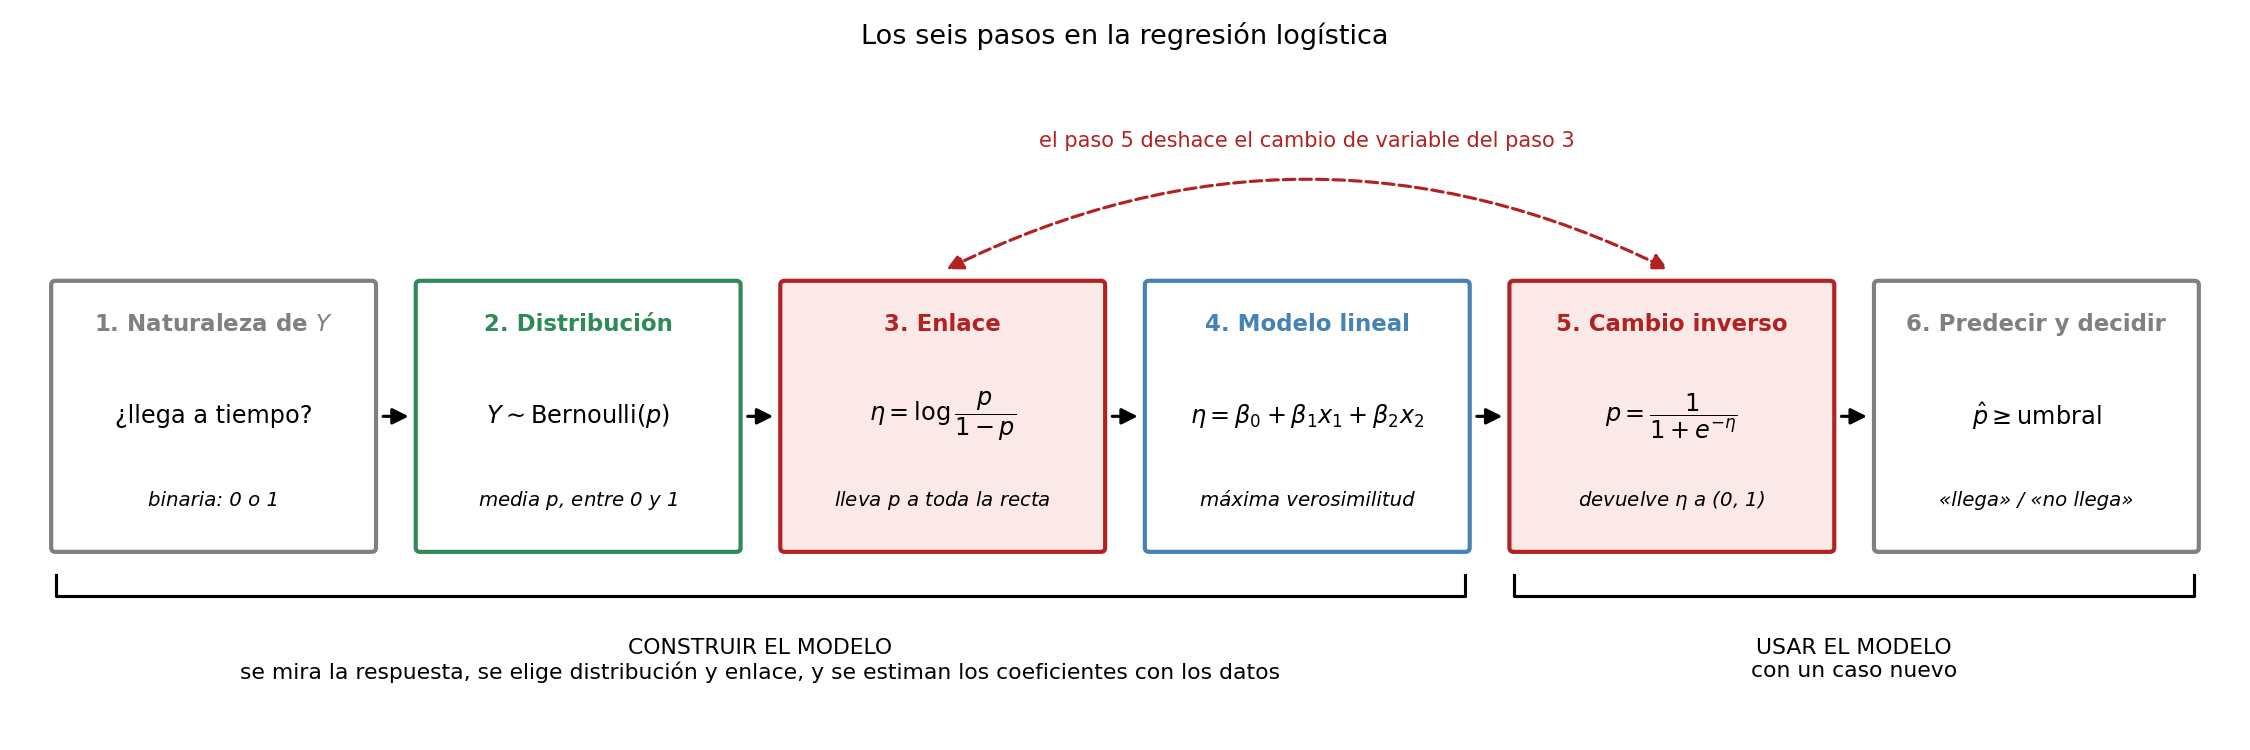
El diagrama va de izquierda a derecha y tiene dos tramos:
- Construir el modelo (pasos 1 a 4). Se mira la respuesta (binaria), se elige la distribución (Bernoulli), se elige el enlace (logit) y se estiman los coeficientes del modelo lineal con los datos, por máxima verosimilitud. Esto se hace una sola vez.
- Usar el modelo (pasos 5 y 6). Para cada entrega nueva se calcula \(\eta\) con los coeficientes ya estimados, la sigmoide lo convierte en una probabilidad y, si hace falta decidir, se compara con un umbral.
La flecha punteada une los pasos 3 y 5 porque son la misma operación en sentidos opuestos: el enlace lleva la probabilidad a la escala del modelo y el cambio inverso la trae de vuelta. El umbral del paso 6 no hace parte del GLM: es una regla que se añade después.
La parte lineal sigue ahí, pero ya no intenta predecir directamente un cero o un uno. Predice en la escala logit y después regresa a una probabilidad. Falta construir el cambio de variable y su inversa, empezando por el enlace.
22.11 El enlace, parte 1: de la probabilidad al momio
El momio (en inglés odds, el nombre que verás en el código y en las tablas) tiene aquí un significado estrictamente matemático. No tiene que ver con ganancias de dinero, sino con una forma de medir la probabilidad de que ocurra el evento de interés: el 1 de la distribución de Bernoulli que revisaste antes.
Matemáticamente, si \(p\) es la probabilidad de que el evento ocurra (un valor entre 0 y 1), el momio es el cociente entre la probabilidad de que ocurra y la probabilidad de que no ocurra:
\[ \operatorname{momio}(p)=\frac{p}{1-p}. \]
El momio dice cuántas veces es más probable que el evento ocurra frente a que no ocurra.
Por ejemplo, si la probabilidad de que una entrega llegue a tiempo es \(p=0.8\) (80%), la de que no llegue es \(1-p=0.2\) (20%):
\[ \operatorname{momio}(0.8)=\frac{0.8}{0.2}=4. \]
Es 4 veces más probable que la entrega llegue a tiempo a que no llegue: los momios están 4 a 1 a su favor, cuatro entregas puntuales por cada entrega tardía. Con \(p=0.5\) el momio vale 1, un empate. Mientras \(p\) vive entre 0 y 1, el momio va de 0 a infinito. En la tabla del repaso, los momios de 2.33 y 0.82 corresponden a proporciones de 0.70 y 0.45.
La siguiente tabla calcula el momio de varias probabilidades.
probs = np.array([0.1, 0.25, 0.5, 0.75, 0.9])
odds_ejemplo = probs / (1 - probs)
pd.DataFrame({
    'probabilidad': probs,
    'odds = p/(1-p)': odds_ejemplo,
}).round(3)| probabilidad | odds = p/(1-p) | |
|---|---|---|
| 0 | 0.10 | 0.111 |
| 1 | 0.25 | 0.333 |
| 2 | 0.50 | 1.000 |
| 3 | 0.75 | 3.000 |
| 4 | 0.90 | 9.000 |
La columna odds es el momio. Cuando \(p=0.5\), el momio vale 1. Por encima de 0.5 crece con rapidez: \(p=0.9\) equivale a un momio de 9. Por debajo de 0.5 está entre 0 y 1. Nunca es negativo, así que no cubre todo el rango de valores que puede tomar un predictor lineal, y para eso falta aplicar el logaritmo.
22.12 El enlace, parte 2: del momio al log-momio
El momio no basta. El problema de las probabilidades es que están acotadas entre 0 y 1, y un modelo lineal puede arrojar cualquier número. El momio quita el techo, pero todavía no puede ser negativo.
La regresión logística lo resuelve con una función de enlace llamada logit, que es simplemente el logaritmo natural del momio, y lo iguala a la combinación lineal:
\[ \operatorname{logit}(p)=\log\!\left(\frac{p}{1-p}\right)=\beta_0+\beta_1x_1+\cdots+\beta_kx_k. \]
Al transformar la probabilidad en un momio y luego en un log-momio (log-odds), el rango pasa de \((0,1)\) a \((-\infty,+\infty)\). Así, \(p=0.5\) corresponde a un log-momio de 0; probabilidades mayores producen valores positivos y probabilidades menores, negativos. Esta es la escala donde el modelo lineal puede trabajar sin romper las reglas de la probabilidad.
Una consecuencia: los coeficientes \(\beta\) quedan expresados en log-momios, una escala difícil de leer a simple vista. Más adelante los conviertes en razones de momios para interpretarlos.
grid_p = np.linspace(0.001, 0.999, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))
ax[0].plot(grid_p, grid_p / (1 - grid_p), color='steelblue', linewidth=2)
ax[0].set(title='Odds (eje cortado en 20)', xlabel='probabilidad', ylabel='p/(1-p)', ylim=(0, 20))
ax[1].plot(grid_p, np.log(grid_p / (1 - grid_p)), color='seagreen', linewidth=2)
ax[1].axhline(0, color='gray', ls=':')
ax[1].set(title='Log-odds o logit', xlabel='probabilidad', ylabel='log(p/(1-p))')
plt.tight_layout()
plt.show()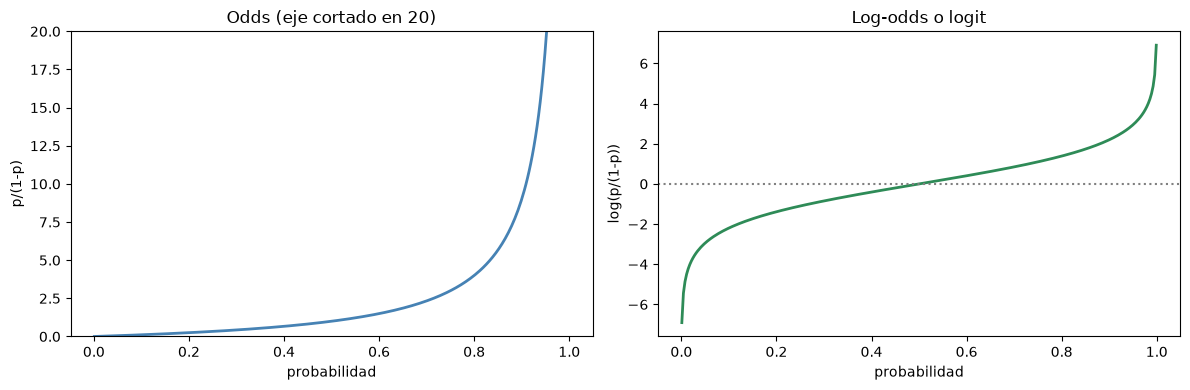
A la izquierda, el momio (odds en la figura) se dispara cuando \(p\) se acerca a 1: en \(p=0.999\) vale 999, por eso el eje se corta en 20. A la derecha, el logit reparte esa escala de forma simétrica alrededor de cero (\(p\) y \(1-p\) dan log-momios opuestos). El modelo trabaja en ese eje; falta el camino de vuelta a la probabilidad.
22.13 El cambio inverso: volver a la probabilidad con la sigmoide
La inversa del logit es la función logística:
\[ p_i=\operatorname{logit}^{-1}(\eta_i)=\frac{1}{1+e^{-\eta_i}}. \]
Esta transformación toma cualquier valor real de \(\eta_i=X_i\beta\) y lo devuelve al intervalo abierto \((0,1)\): se acerca a 0 y a 1 sin alcanzarlos. Esa es la curva en forma de S que reemplaza a la recta fallida del inicio.
z = np.linspace(-8, 8, 200)
plt.plot(z, 1 / (1 + np.exp(-z)), color='steelblue', linewidth=2)
plt.axhline(0, color='gray', ls=':'); plt.axhline(1, color='gray', ls=':')
plt.axhline(0.5, color='firebrick', ls='--', alpha=0.6)
plt.xlabel('η = combinación lineal'); plt.ylabel('probabilidad')
plt.title('La función logística (sigmoide): siempre entre 0 y 1'); plt.show()

eta_ejemplo = np.array([-2.0, 0.0, 2.0])
p_ejemplo = 1 / (1 + np.exp(-eta_ejemplo))
tabla_escalas = pd.DataFrame({
    'η = log-odds': eta_ejemplo,
    'odds = exp(η)': np.exp(eta_ejemplo),
    'probabilidad': p_ejemplo,
})
tabla_escalas.round(3)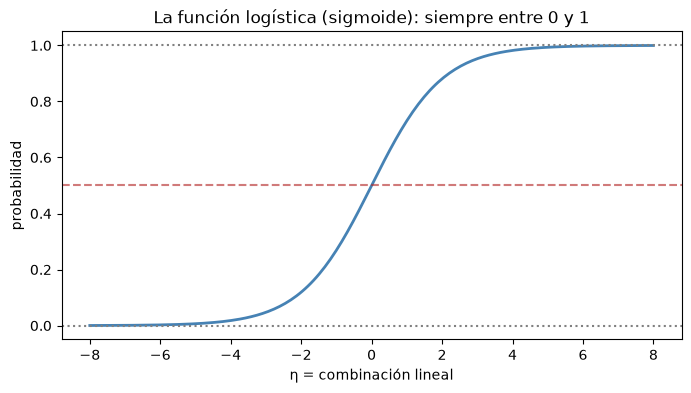
| η = log-odds | odds = exp(η) | probabilidad | |
|---|---|---|---|
| 0 | -2.0 | 0.135 | 0.119 |
| 1 | 0.0 | 1.000 | 0.500 |
| 2 | 2.0 | 7.389 | 0.881 |
La curva en forma de S nunca sale del intervalo \((0,1)\). Cuando \(\eta=0\), el momio es \(e^0=1\): el evento y el no evento tienen la misma posibilidad, por lo que \(p=0.5\). Cuando \(\eta=2\), el momio es aproximadamente 7.39 a 1 y la probabilidad es cercana a 0.881. Cuando \(\eta=-2\), el momio es aproximadamente 0.135 y la probabilidad baja a 0.119.
Las tres escalas expresan la misma predicción, pero responden preguntas distintas:
| Escala | Expresión | Qué expresa |
|---|---|---|
| Probabilidad | \(p\) | proporción esperada de eventos |
| Momio (odds) | \(p/(1-p)\) | eventos esperados por cada no evento |
| Log-momio (log-odds) | \(\log(p/(1-p))\) | escala lineal donde actúan los coeficientes |
La probabilidad es la escala más natural para comunicar una predicción. El momio y el log-momio son las escalas que permiten formular e interpretar el modelo.
La figura siguiente aísla dos efectos en un modelo con una sola variable: en el panel izquierdo cambia el coeficiente \(\beta_1\) (0.5, 1.0 y 3.0) y en el derecho, solo el intercepto \(\beta_0\) (−3, 0 y 3). Antes de mirarla, anticipa qué le ocurre a la inclinación de la sigmoide cuando el coeficiente cambia de magnitud y qué cambia cuando se modifica únicamente el intercepto.
z_param = np.linspace(-6, 6, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))

for beta_1 in [0.5, 1.0, 3.0]:
    ax[0].plot(z_param, 1 / (1 + np.exp(-(beta_1 * z_param))), label=rf'$\beta_1={beta_1}$')
ax[0].set(title='La pendiente controla la transición', xlabel='x', ylabel='probabilidad')
ax[0].legend()

for beta_0 in [-3.0, 0.0, 3.0]:
    ax[1].plot(z_param, 1 / (1 + np.exp(-(z_param + beta_0))), label=rf'$\beta_0={beta_0}$')
ax[1].set(title='El intercepto desplaza el punto medio', xlabel='x', ylabel='probabilidad')
ax[1].legend()

plt.tight_layout()
plt.show()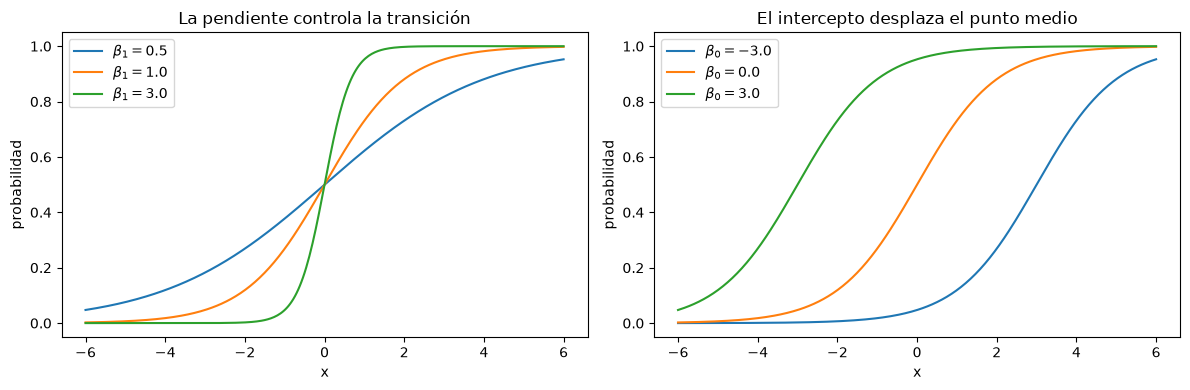
En el panel izquierdo, al pasar \(\beta_1\) de 0.5 a 3.0 la transición se vuelve más abrupta; su signo determina si la probabilidad sube o baja. En el derecho, el intercepto \(\beta_0\) (−3, 0 y 3) desplaza el punto donde \(p=0.5\). En esta figura los valores de \(\beta\) se eligieron a mano. Falta saber cómo se obtienen a partir de los datos.
22.14 Cómo se estiman los coeficientes: máxima verosimilitud
La regresión lineal estimaba sus coeficientes por mínimos cuadrados. La regresión logística, y toda la familia GLM, usa otro criterio: la máxima verosimilitud.
La verosimilitud es la probabilidad que el modelo, con unos coeficientes \(\beta\) dados, le asigna a los datos que realmente se observaron. Mide qué tan creíbles son esos coeficientes a la luz de los datos.
Para calcularla, cada entrega aporta un factor:
- si llegó a tiempo (\(y_i=1\)), aporta \(p_i\), la probabilidad que el modelo le daba a llegar;
- si no llegó (\(y_i=0\)), aporta \(1-p_i\), la probabilidad que el modelo le daba a no llegar.
Como las entregas son independientes, los factores se multiplican:
\[ L(\beta)=\prod_{i=1}^{n}p_i^{\,y_i}(1-p_i)^{\,1-y_i}. \]
Los exponentes solo dejan activo el factor que corresponde: \(p_i\) cuando \(y_i=1\) y \(1-p_i\) cuando \(y_i=0\).
Por ejemplo, supón tres entregas observadas: llegó, llegó, no llegó.
| Modelo | Probabilidad de llegar que asigna a cada una | Verosimilitud |
|---|---|---|
| A | 0.9, 0.8, 0.2 | \(0.9\times0.8\times(1-0.2)=0.576\) |
| B | 0.6, 0.5, 0.5 | \(0.6\times0.5\times(1-0.5)=0.150\) |
El modelo A les dio probabilidad alta a las entregas que llegaron y baja a la que no llegó: hace más creíble lo que ocurrió. Máxima verosimilitud busca, entre todos los \(\beta\) posibles, los que producen la verosimilitud más alta.
En la práctica se maximiza su logaritmo, porque multiplicar cientos de números entre 0 y 1 da valores diminutos. El logaritmo convierte el producto en una suma y no cambia dónde está el máximo:
\[ \ell(\beta)=\sum_{i=1}^{n}\Big[y_i\log p_i+(1-y_i)\log(1-p_i)\Big]. \]
Con el signo cambiado y promediada, esta cantidad es la log-pérdida (log-loss o entropía cruzada), la cantidad que minimiza scikit-learn; LogisticRegression le suma, por defecto, una penalización L2.
Frente a los mínimos cuadrados hay dos diferencias:
- No hay fórmula cerrada. Un algoritmo parte de unos \(\beta\) iniciales y los mejora paso a paso hasta que la verosimilitud deja de aumentar. Por eso el software habla de iteraciones y de convergencia.
- Es el mismo principio, no uno nuevo. En la regresión lineal con errores normales, mínimos cuadrados y máxima verosimilitud dan los mismos coeficientes. Lo que cambia aquí es la distribución: Bernoulli en lugar de normal.
22.15 Ajustar el modelo predictivo
Antes de ajustar tomas cuatro decisiones, cada una con su razón:
- Separar entrenamiento y prueba (70% y 30%). El modelo aprende solo con el entrenamiento y se evalúa con entregas que no vio.
- Estratificar la partición.
stratify=yconserva en ambos conjuntos aproximadamente la misma proporción de entregas puntuales. - Usar
scikit-learncon propósito predictivo. Interesan las probabilidades y las decisiones sobre el conjunto de prueba, no los p-valores. - Dejar la penalización por defecto.
LogisticRegressionaplica una penalización L2, la misma de Ridge, conC=1.0.Ces el inverso de la fuerza de la penalización: unCpequeño penaliza más. Eso ayuda a estabilizar los coeficientes. Aquí no se ajustaCpor validación cruzada porque el objetivo es ilustrar el modelo, no optimizarlo.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEMILLA, stratify=y
)

modelo_predictivo = LogisticRegression().fit(X_tr, y_tr)
prob_te = modelo_predictivo.predict_proba(X_te)[:, 1]
UMBRAL = 0.5
pred_te = (prob_te >= UMBRAL).astype(int)

print('Coeficientes predictivos (distancia, hora_pico):', modelo_predictivo.coef_[0].round(3))
print('Intercepto predictivo:', round(modelo_predictivo.intercept_[0], 3))
print(f'Probabilidades en prueba: {prob_te.min():.3f} a {prob_te.max():.3f}')
Coeficientes predictivos (distancia, hora_pico): [-0.171 -1.045]
Intercepto predictivo: 3.228
Probabilidades en prueba: 0.109 a 0.944Los signos (−0.171 para distancia y −1.045 para hora pico) son coherentes con el caso: una mayor distancia y estar en hora pico reducen el log-momio y, por tanto, la probabilidad de llegar a tiempo, manteniendo constante la otra variable.
No interpretes estos valores como puntos porcentuales: están en la escala del enlace. Su lectura mediante razones de momios llega más adelante, con el modelo inferencial.
Para una predicción calculada a mano, aplica los pasos 4, 5 y 6 a una entrega de 15 km en hora pico:
- Predictor lineal: \(\eta=3.228-0.171\times15-1.045\times1=-0.382\).
- Momio: \(e^{-0.382}\approx0.682\).
- Probabilidad: \(p=\dfrac{0.682}{1+0.682}\approx0.406\).
- Decisión con umbral 0.5: como \(0.406<0.5\), el modelo declara «no llega a tiempo».
Eso es exactamente lo que hace predict_proba. Más adelante, la tabla de perfiles muestra 0.404 para esta misma entrega; la pequeña diferencia viene de los redondeos de este cálculo a mano.
22.16 Visualizar el ajuste
Antes de interpretar las razones de momios, la figura dibuja la probabilidad estimada según la distancia para una entrega fuera de hora pico y para una entrega en hora pico. Las dos curvas proceden del mismo modelo; solo cambia el indicador hora_pico.
distancia_grid = np.linspace(0, 30, 300)
for indicador_pico, color, etiqueta in [
    (0, 'seagreen', 'fuera de hora pico'),
    (1, 'firebrick', 'hora pico'),
]:
    X_grid = np.column_stack([distancia_grid, np.full_like(distancia_grid, indicador_pico)])
    plt.plot(
        distancia_grid,
        modelo_predictivo.predict_proba(X_grid)[:, 1],
        color=color, linewidth=2, label=etiqueta,
    )

plt.axhline(0.5, color='gray', ls='--', alpha=0.6)
plt.xlabel('distancia (km)')
plt.ylabel('probabilidad de llegar a tiempo')
plt.title('Probabilidad estimada según distancia y hora pico')
plt.legend()
plt.show()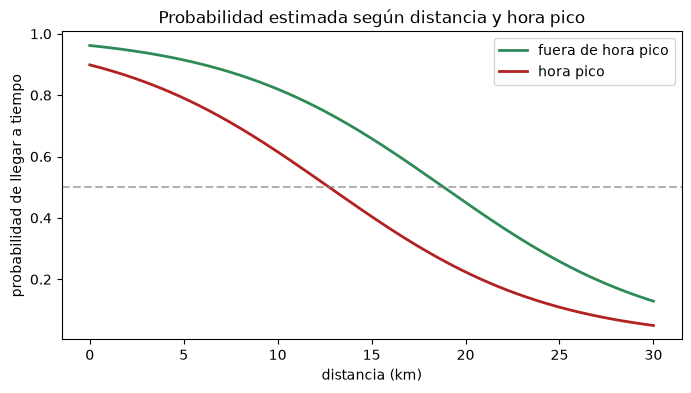
Son dos sigmoides con la misma pendiente en la escala logit y distinto intercepto. En la escala de probabilidad se ven desplazadas, pero su separación vertical no es constante. A igual distancia, la curva de hora pico asigna una menor probabilidad de llegar a tiempo. La línea horizontal marca el umbral 0.5: fuera de hora pico la curva lo cruza cerca de los 18.8 km y en hora pico cerca de los 12.7 km. Esos 6.1 km de diferencia son el efecto de hora_pico expresado en distancia: \(1.045/0.171\approx6.1\).
22.17 Modelo inferencial y razones de momios
Ahora ajustas statsmodels sobre el mismo conjunto de entrenamiento. Su propósito es inferencial: obtener coeficientes, razones de momios y p-valores.
LogisticRegression usa regularización L2 por defecto; sm.Logit no regulariza. Por eso sus coeficientes pueden diferir aunque vean las mismas observaciones. Si necesitas coeficientes comparables, ajusta scikit-learn sin penalización con LogisticRegression(C=np.inf) (el parámetro penalty está obsoleto desde la versión 1.8).
Los coeficientes \(\beta\) están expresados en log-momios. Para interpretarlos se aplica la función exponencial y se obtiene la razón de momios (odds ratio, OR):
\[ \mathrm{OR}_j=e^{\beta_j}. \]
El OR dice cómo cambia el momio por cada unidad que aumenta \(x_j\), manteniendo constantes las demás variables:
- Si el OR = 1: la variable no cambia el momio; no tiene efecto sobre la probabilidad del evento.
- Si el OR > 1: por cada unidad que aumenta \(x_j\), el momio se multiplica por ese valor. El evento se vuelve más probable.
- Si el OR < 1: por cada unidad que aumenta \(x_j\), el momio disminuye. El evento se vuelve menos probable.
Para un cambio de \(d\) unidades, el factor acumulado es \((e^{\beta_j})^d\). En la tabla que sigue, la columna odds ratio es la razón de momios.
X_tr_sm = sm.add_constant(X_tr)
modelo_inferencial = sm.Logit(y_tr, X_tr_sm).fit(disp=0)

nombres = ['intercepto', 'distancia', 'hora_pico']
coeficientes = pd.Series(modelo_inferencial.params, index=nombres)
odds_ratios = np.exp(coeficientes)
p_valores = pd.Series(modelo_inferencial.pvalues, index=nombres)

ic_or = np.exp(modelo_inferencial.conf_int())   # IC 95% en escala de odds ratio

tabla_inferencia = pd.DataFrame({
    'coeficiente': coeficientes.round(4),
    'odds ratio': odds_ratios.round(4),
    'OR IC95% inf': ic_or[:, 0].round(3),
    'OR IC95% sup': ic_or[:, 1].round(3),
    'p-valor': p_valores.map(lambda v: f'{v:.1e}'),
})
display(tabla_inferencia)

or_distancia_10km = odds_ratios['distancia'] ** 10
print(f"OR acumulado para 10 km adicionales: {or_distancia_10km:.3f}")

perfiles = pd.DataFrame({
    'distancia_km': [5, 5, 15, 15, 25, 25],
    'hora_pico': [0, 1, 0, 1, 0, 1],
})
X_perfiles = perfiles[['distancia_km', 'hora_pico']].to_numpy()
perfiles['probabilidad_llegar_a_tiempo'] = modelo_predictivo.predict_proba(X_perfiles)[:, 1]
display(perfiles.round(3))| coeficiente | odds ratio | OR IC95% inf | OR IC95% sup | p-valor | |
|---|---|---|---|---|---|
| intercepto | 3.2675 | 26.2451 | 14.257 | 48.315 | 9.2e-26 |
| distancia | -0.1724 | 0.8416 | 0.814 | 0.870 | 1.2e-24 |
| hora_pico | -1.0893 | 0.3364 | 0.225 | 0.504 | 1.3e-07 |
OR acumulado para 10 km adicionales: 0.178| distancia_km | hora_pico | probabilidad_llegar_a_tiempo | |
|---|---|---|---|
| 0 | 5 | 0 | 0.915 |
| 1 | 5 | 1 | 0.790 |
| 2 | 15 | 0 | 0.659 |
| 3 | 15 | 1 | 0.404 |
| 4 | 25 | 0 | 0.258 |
| 5 | 25 | 1 | 0.109 |
- La razón de momios estimada para distancia es 0.8416 por kilómetro (IC 95%: 0.814 a 0.870): cada kilómetro adicional multiplica el momio de llegar a tiempo por 0.84, es decir, lo reduce cerca de un 16%. Para 10 km, el efecto acumulado es \(0.8416^{10}\approx0.178\): el momio queda en menos de una quinta parte.
- A igual distancia, hora pico multiplica el momio de llegar a tiempo por 0.336 (IC 95%: 0.225 a 0.504), una reducción cercana al 66%, parecida a la de la tabla del repaso (0.351), aunque aquí compara entregas a la misma distancia. El efecto acumulado de distancia depende de cuántos kilómetros compares, así que no corresponde ordenar ambos factores usando cambios en unidades distintas.
- El IC 95% es el rango de valores de la razón de momios compatibles con los datos, bajo los supuestos del modelo. El 95% describe el procedimiento: en muestras repetidas, 95 de cada 100 intervalos construidos así contendrían el valor real. La referencia es el 1, que significa «sin efecto». Aquí los dos intervalos quedan completos por debajo de 1 (0.814 a 0.870 y 0.225 a 0.504): ambas variables reducen el momio y su efecto se distingue de «sin efecto». Si un intervalo incluyera el 1, no se podría descartar que la variable deje el momio igual.
- El p-valor responde otra pregunta: si la variable no tuviera efecto (coeficiente cero), ¿qué tan raro sería observar un efecto tan grande como este, o mayor? Aquí todos son del orden de \(10^{-7}\) o menores: muy raro, así que hay evidencia contra «sin efecto», bajo los supuestos del modelo. Un p-valor pequeño no demuestra causalidad ni importancia práctica.
La tabla de perfiles, calculada con el modelo predictivo, devuelve la conversación a la escala más fácil de comunicar: a 5 km la probabilidad de llegar a tiempo es 0.915 fuera de hora pico y 0.790 en hora pico; a 25 km baja a 0.258 y 0.109. La brecha por hora pico es de unos 12 puntos porcentuales a 5 km, 25 a 15 km y 15 a 25 km: la misma razón de momios produce diferencias distintas en la escala de probabilidad, como anticipaban las curvas. De paso, la penalización por defecto de scikit-learn casi no se nota con 560 observaciones de entrenamiento: su intercepto (3.228) y sus pendientes (−0.171 y −1.045) quedan muy cerca de los de statsmodels (3.268, −0.172 y −1.089).
22.18 De la probabilidad a la decisión
El modelo estima la probabilidad de que la entrega llegue a tiempo. Para convertirla en una decisión se usa un umbral: con 0.5, el modelo declara “llega a tiempo” cuando \(\hat p\geq0.5\).
Al comparar la decisión con lo que realmente ocurrió hay cuatro resultados posibles. Juntos forman la matriz de confusión:
| Predicción «llega a tiempo» | Predicción «no llega a tiempo» | |
|---|---|---|
| Sí llegó a tiempo | Verdadero positivo (TP): promesa cumplida | Falso negativo (FN): alerta innecesaria |
| No llegó a tiempo | Falso positivo (FP): falsa promesa | Verdadero negativo (TN): alerta acertada |
Las siglas vienen del inglés (true/false positive/negative) y son las que usa el código. La matriz que imprime scikit-learn trae los mismos cuatro números, pero con el «no» en la primera fila y la primera columna.
Los dos errores no pesan igual: una falsa promesa (falso positivo) y una alerta innecesaria (falso negativo) tienen costos distintos para el negocio.
Un umbral alto exige más evidencia antes de prometer puntualidad: reduce falsas promesas, pero genera más alertas innecesarias. Un umbral bajo declara más entregas como puntuales: aumenta la cobertura de los casos que sí llegan, pero puede producir más falsas promesas.
Primero comparas la exactitud (proporción de entregas clasificadas correctamente) con una línea base (baseline): la regla ingenua que siempre predice la clase mayoritaria. Después observas cómo cambian los errores al mover el umbral y usas el AUC (área bajo la curva ROC) para evaluar la capacidad de ordenar casos sin fijar un único corte.
acc = accuracy_score(y_te, pred_te)
auc = roc_auc_score(y_te, prob_te)
accuracy_base = max(y_te.mean(), 1 - y_te.mean())

cm = confusion_matrix(y_te, pred_te)
print(f'Matriz de confusión con umbral = {UMBRAL:.2f}:')
display(pd.DataFrame(cm, index=['real: no', 'real: sí'], columns=['pred: no', 'pred: sí']))
print(f'Exactitud del modelo: {acc:.3f}')
print(f'Línea base (siempre la clase mayoritaria): {accuracy_base:.3f}')
print(f'Mejora absoluta sobre la línea base: {acc - accuracy_base:.3f}')
print(f'AUC: {auc:.3f}')

filas_umbral = []
for umbral in [0.3, 0.5, 0.7]:
    pred_umbral = (prob_te >= umbral).astype(int)
    tn, fp, fn, tp = confusion_matrix(y_te, pred_umbral).ravel()
    filas_umbral.append({
        'umbral': umbral,
        '% declarado puntual': pred_umbral.mean(),
        'falsas promesas (FP)': fp,
        'alertas innecesarias (FN)': fn,
        'exactitud': accuracy_score(y_te, pred_umbral),
    })

tabla_umbrales = pd.DataFrame(filas_umbral)
display(tabla_umbrales.round(3))
Matriz de confusión con umbral = 0.50:| pred: no | pred: sí | |
|---|---|---|
| real: no | 70 | 35 |
| real: sí | 35 | 100 |
Exactitud del modelo: 0.708
Línea base (siempre la clase mayoritaria): 0.562
Mejora absoluta sobre la línea base: 0.146
AUC: 0.800| umbral | % declarado puntual | falsas promesas (FP) | alertas innecesarias (FN) | exactitud | |
|---|---|---|---|---|---|
| 0 | 0.3 | 0.804 | 64 | 6 | 0.708 |
| 1 | 0.5 | 0.562 | 35 | 35 | 0.708 |
| 2 | 0.7 | 0.333 | 14 | 69 | 0.654 |
La exactitud del modelo solo es informativa al compararla con una regla ingenua. La línea base responde: “¿qué lograría si siempre eligiera la clase más frecuente?”. Aquí el modelo acierta 0.708 frente a 0.562 de la línea base: 14.6 puntos porcentuales por encima de la regla ingenua.
La tabla de umbrales muestra que una misma exactitud puede esconder errores operativamente distintos: con umbral 0.3 y con umbral 0.5 el modelo acierta 0.708, pero el primero comete 64 falsas promesas y 6 alertas innecesarias, y el segundo 35 y 35. Subir el umbral reduce cuántas entregas se declaran puntuales (del 80.4% con 0.3 al 33.3% con 0.7) y nunca aumenta las falsas promesas (64 → 35 → 14), a costa de más alertas innecesarias (6 → 35 → 69). La elección debe reflejar cuál de esos errores cuesta más. Esta tabla se calcula sobre el conjunto de prueba solo para ilustrar: si quisieras elegir el umbral, hazlo con validación cruzada sobre el entrenamiento, como con cualquier hiperparámetro.
22.19 Evaluar sin fijar un único umbral: ROC y AUC
La curva ROC (receiver operating characteristic) recorre todos los umbrales posibles y, para cada uno, dibuja dos tasas:
- Tasa de verdaderos positivos (eje vertical): \(\text{TP}/(\text{TP}+\text{FN})\). De las entregas que sí llegaron a tiempo, qué fracción declaró puntuales el modelo. Con umbral 0.5 es \(100/135=0.741\).
- Tasa de falsos positivos (eje horizontal): \(\text{FP}/(\text{FP}+\text{TN})\). De las entregas tardías, qué fracción declaró puntuales: las falsas promesas. Con umbral 0.5 es \(35/105=0.333\).
En la curva:
- La esquina superior izquierda es el ideal: todas las entregas puntuales detectadas y ninguna falsa promesa.
- La diagonal es el azar: un modelo que no distingue una entrega puntual de una tardía.
- Cuanto más se acerca la curva a la esquina superior izquierda, mejor separa el modelo.
El AUC es el área bajo esa curva. Su valor se interpreta después de la figura.
fpr, tpr, _ = roc_curve(y_te, prob_te)
plt.plot(fpr, tpr, color='steelblue', linewidth=2, label=f'AUC = {auc:.3f}')
plt.plot([0, 1], [0, 1], 'k--', alpha=0.5, label='azar')
plt.xlabel('tasa de falsos positivos'); plt.ylabel('tasa de verdaderos positivos')
plt.title('Curva ROC'); plt.legend(); plt.show()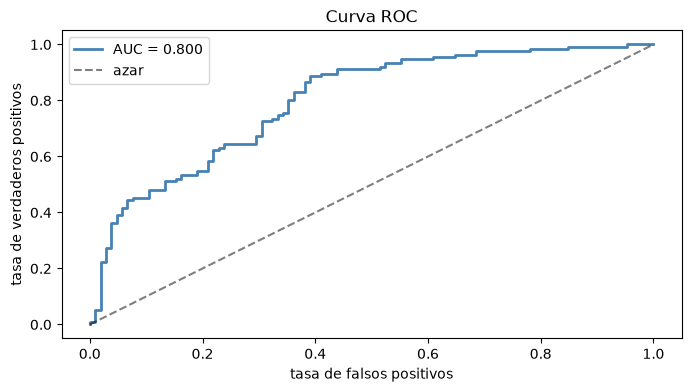
Un AUC de 0.800 significa que, al elegir una entrega puntual y una tardía, el modelo asigna una probabilidad mayor de llegar a tiempo a la entrega puntual aproximadamente el 80% de las veces. Un AUC de 0.5 corresponde al azar, un ordenamiento sin capacidad discriminativa, y uno de 1 a un ordenamiento perfecto.
La exactitud evalúa una decisión concreta bajo un umbral; el AUC evalúa el ordenamiento a través de todos los umbrales. Ninguna de las dos determina qué umbral conviene al negocio, y ninguna mide la calibración. Discriminación y calibración son preguntas distintas: el AUC responde si el modelo ordena bien los casos; la calibración, si cuando el modelo anuncia 0.80 aproximadamente 80 de cada 100 casos comparables llegan a tiempo. En este capítulo el AUC se usa para medir discriminación; evaluar la calibración sería un paso adicional antes de desplegar probabilidades operativas.
22.20 Ejemplo resuelto paso a paso: ¿fallará el vehículo en ruta?
Para cerrar, resuelves un caso nuevo de principio a fin siguiendo los seis pasos de la metodología general. Los datos son tan pequeños que caben en la pantalla: el propósito es repasar el razonamiento, no optimizar el código.
Una empresa de reparto registró 20 vehículos: la antigüedad de cada uno, en años, y si tuvo una falla en ruta durante el último mes (1) o no (0). Quiere saber cómo cambia el riesgo de falla con la antigüedad y qué vehículos enviar a revisión preventiva, con datos ilustrativos construidos para el ejemplo.
Hay dos diferencias deliberadas con el caso de las entregas: aquí el 1 es una mala noticia (el vehículo falla) y el efecto de la variable va en sentido contrario (más antigüedad, más riesgo).
Paso 1. Identificar la naturaleza de la respuesta
La primera pregunta es qué valores puede tomar \(Y\).
flota = pd.DataFrame({
    'antiguedad': [1, 1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7, 7, 8, 8, 9, 9, 10, 10],
    'fallo':      [0, 0, 0, 0, 0, 1, 0, 0, 1, 0, 0, 1, 1, 0, 1, 1, 1, 1, 1, 1],
})

print('Valores distintos de la respuesta:', sorted(flota['fallo'].unique().tolist()))
print(f"Proporción de vehículos con falla: {flota['fallo'].mean():.2f}")

grupo = np.where(flota['antiguedad'] <= 5, '1 a 5 años', '6 a 10 años')
print('\nProporción de fallas por grupo de antigüedad:')
print(flota.groupby(grupo)['fallo'].mean().to_string())
Valores distintos de la respuesta: [0, 1]
Proporción de vehículos con falla: 0.50
Proporción de fallas por grupo de antigüedad:
1 a 5 años 0.2
6 a 10 años 0.8La respuesta solo vale 0 o 1: es binaria. La mitad de los vehículos falló (0.50), pero no por igual: falla el 20% de los que tienen entre 1 y 5 años y el 80% de los que tienen entre 6 y 10, una relación que vale la pena modelar.
Paso 2. Elegir la distribución
La pregunta ahora es qué distribución describe una respuesta así.
Una respuesta binaria es un ensayo de Bernoulli: \(Y_i\sim\operatorname{Bernoulli}(p_i)\), donde \(p_i\) es la probabilidad de que el vehículo \(i\) falle. Su media es \(p_i\) y su varianza es \(p_i(1-p_i)\). Una regresión lineal queda descartada por las razones del inicio: se saldría de 0 y 1 y la varianza no sería constante.
Paso 3. Elegir el cambio de variable: la función de enlace
La pregunta es cómo llevar una probabilidad a una escala sin límites.
La media \(p_i\) vive entre 0 y 1; un predictor lineal puede dar cualquier número. El enlace logit hace el cambio de variable:
\[ \eta_i=\operatorname{logit}(p_i)=\log\!\left(\frac{p_i}{1-p_i}\right). \]
El cambio se le aplica a la probabilidad \(p_i\), no a los datos: el logit de un 0 o de un 1 observado no existe.
Paso 4. Construir y estimar el predictor lineal
La pregunta es qué coeficientes hacen más creíbles estos 20 resultados.
El predictor lineal es \(\eta_i=\beta_0+\beta_1\cdot\text{antigüedad}_i\). Antes de ajustar conviene anticipar el resultado: si los vehículos más viejos fallan más, \(\beta_1\) debe salir positivo, y los coeficientes se estiman por máxima verosimilitud.
X_flota = sm.add_constant(flota[['antiguedad']])
modelo_flota = sm.Logit(flota['fallo'], X_flota).fit()

b0, b1 = modelo_flota.params
print(f'\nIntercepto: {b0:.3f} | Coeficiente de antigüedad: {b1:.3f}')
Optimization terminated successfully.
Current function value: 0.397547
Iterations 7
Intercepto: -4.209 | Coeficiente de antigüedad: 0.765El mensaje de statsmodels muestra la máxima verosimilitud en acción: el algoritmo necesitó 7 iteraciones para dejar de mejorar, y el valor 0.398 es la log-pérdida promedio en ese punto.
El coeficiente de antigüedad es 0.765, positivo, como se anticipaba: cada año adicional suma 0.765 al log-momio de fallar. Ese número está en la escala del enlace, no en probabilidad.
Paso 5. Aplicar el cambio de variable inverso
La pregunta es qué probabilidad de fallar tiene un vehículo de 7 años. El predictor lineal responde en log-momios; la inversa del enlace, la sigmoide, lo devuelve a una probabilidad.
anios = 7

eta = b0 + b1 * anios              # 1. predictor lineal
momio = np.exp(eta)                # 2. del log-momio al momio
p = momio / (1 + momio)            # 3. del momio a la probabilidad

print(f'1. Predictor lineal: η = {b0:.3f} + {b1:.3f} × {anios} = {eta:.3f}')
print(f'2. Momio: exp(η) = {momio:.2f}')
print(f'3. Probabilidad: momio / (1 + momio) = {p:.3f}')
print(f'\nComprobación con el modelo: {modelo_flota.predict([[1, anios]])[0]:.3f}')
1. Predictor lineal: η = -4.209 + 0.765 × 7 = 1.148
2. Momio: exp(η) = 3.15
3. Probabilidad: momio / (1 + momio) = 0.759
Comprobación con el modelo: 0.759El predictor lineal vale 1.148; como es positivo, ya se sabe que la probabilidad supera 0.5. El momio es 3.15: para un vehículo de 7 años, fallar es unas tres veces más probable que no fallar. La probabilidad es 0.759, la misma que devuelve el modelo. No hay nada oculto en predict: son estas tres cuentas.
Si repites el cambio inverso para todas las antigüedades, aparece la curva completa.
grid_anios = np.linspace(0, 11, 200)
p_grid = modelo_flota.predict(sm.add_constant(grid_anios))

plt.scatter(flota['antiguedad'], flota['fallo'], s=40, alpha=0.4, color='gray', label='vehículos observados')
plt.plot(grid_anios, p_grid, color='firebrick', linewidth=2, label='probabilidad estimada de falla')
plt.axhline(0.5, color='gray', ls='--', alpha=0.6)
plt.xlabel('antigüedad (años)'); plt.ylabel('probabilidad de falla')
plt.title('La sigmoide ajustada a los 20 vehículos'); plt.legend(loc='lower right'); plt.show()

print(f'La probabilidad cruza 0.5 a los {-b0 / b1:.1f} años')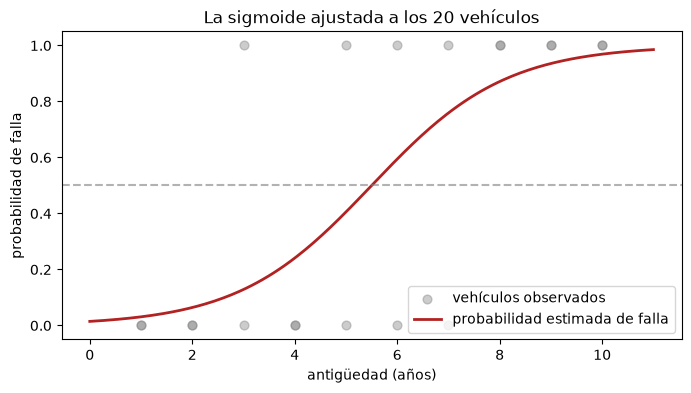
La probabilidad cruza 0.5 a los 5.5 añosEn la figura, los 20 vehículos solo aparecen en 0 y en 1; la curva es la probabilidad que el modelo estima entre ellos y nunca sale de ese rango. Cruza 0.5 a los 5.5 años: por debajo de esa antigüedad lo más probable es que el vehículo no falle, y por encima, que falle. La zona más empinada, alrededor de ese punto, es donde un año de más cambia más la probabilidad.
Paso 6. Predecir, interpretar y validar
Para interpretar, la pregunta es cuánto cambia el riesgo por cada año.
razon_momios = np.exp(b1)
ic_inf, ic_sup = np.exp(modelo_flota.conf_int().loc['antiguedad'])

print(f'Razón de momios por año: {razon_momios:.3f}')
print(f'IC 95%: {ic_inf:.3f} a {ic_sup:.3f}')
print(f"p-valor: {modelo_flota.pvalues['antiguedad']:.3f}")
Razón de momios por año: 2.149
IC 95%: 1.159 a 3.987
p-valor: 0.015La razón de momios es 2.149: cada año adicional multiplica el momio de fallar por 2.15, es decir, lo deja en algo más del doble. Es mayor que 1, así que la antigüedad vuelve la falla más probable.
El intervalo de confianza va de 1.159 a 3.987. No incluye el 1, de modo que el efecto se distingue de «sin efecto», y el p-valor de 0.015 apunta en la misma dirección. Pero el intervalo es ancho: con solo 20 vehículos, los datos aportan evidencia de que el riesgo crece con la antigüedad, con mucha incertidumbre sobre cuánto.
Para decidir, la pregunta es qué vehículos enviar a revisión. El punto de partida es el umbral 0.5, con los aciertos y errores contados en una matriz de confusión. Todas las métricas de este paso se calculan sobre los mismos 20 vehículos con que se ajustó el modelo: son resultados aparentes, más favorables de lo que se vería con datos nuevos.
umbral = 0.5
flota['p_falla'] = modelo_flota.predict(X_flota)
flota['prediccion'] = (flota['p_falla'] >= umbral).astype(int)

tn, fp, fn, tp = confusion_matrix(flota['fallo'], flota['prediccion']).ravel()
matriz = pd.DataFrame([[tp, fn], [fp, tn]],
                      index=['falló', 'no falló'],
                      columns=['predijo falla', 'predijo no falla'])
display(matriz)

exactitud = (tp + tn) / len(flota)
linea_base = max(flota['fallo'].mean(), 1 - flota['fallo'].mean())
print(f'Exactitud: {exactitud:.2f} | Línea base: {linea_base:.2f}')
print(f'Sensibilidad (fallas detectadas): {tp / (tp + fn):.2f}')
print(f'Especificidad (no fallas reconocidas): {tn / (tn + fp):.2f}')
print(f'Precisión (alertas que eran una falla real): {tp / (tp + fp):.2f}')| predijo falla | predijo no falla | |
|---|---|---|
| falló | 8 | 2 |
| no falló | 2 | 8 |
Exactitud: 0.80 | Línea base: 0.50
Sensibilidad (fallas detectadas): 0.80
Especificidad (no fallas reconocidas): 0.80
Precisión (alertas que eran una falla real): 0.80
Con umbral 0.5 la regla señala para revisión los vehículos de 6 años o más. Es una clasificación retrospectiva: dice a cuáles habría señalado la regla, no que una revisión hubiera evitado la falla, y la matriz reúne los cuatro resultados posibles:
- 8 verdaderos positivos: fallaron y la regla los señalaba.
- 2 falsos negativos: fallaron y la regla no los señalaba.
- 2 falsos positivos: no fallaron y la regla los señalaba.
- 8 verdaderos negativos: no fallaron y la regla no los señalaba.
La exactitud es 0.80 frente a 0.50 de la línea base (decir siempre lo mismo acertaría la mitad): en estos datos, el modelo aporta. La sensibilidad de 0.80 dice que detecta 8 de cada 10 fallas; la especificidad de 0.80, que reconoce 8 de cada 10 vehículos sanos; la precisión de 0.80, que de cada 10 alertas 8 eran fallas reales. Que las tres coincidan es una casualidad de estos datos, no una regla.
Para analizar los errores, la pregunta es en cuáles vehículos se equivocó el modelo y por qué: contar errores no basta, hay que mirarlos.
errores = flota[flota['fallo'] != flota['prediccion']].copy()
errores['tipo de error'] = np.where(errores['prediccion'] == 1, 'falso positivo', 'falso negativo')
display(errores[['antiguedad', 'fallo', 'p_falla', 'prediccion', 'tipo de error']].round(3))| antiguedad | fallo | p_falla | prediccion | tipo de error | |
|---|---|---|---|---|---|
| 5 | 3 | 1 | 0.129 | 0 | falso negativo |
| 8 | 5 | 1 | 0.406 | 0 | falso negativo |
| 10 | 6 | 0 | 0.594 | 1 | falso positivo |
| 13 | 7 | 0 | 0.759 | 1 | falso positivo |
Los 4 errores de la tabla, 2 falsos negativos y 2 falsos positivos, no son iguales:
- Tres tenían probabilidades intermedias. Los vehículos de 5, 6 y 7 años tenían probabilidades de 0.406, 0.594 y 0.759. Con probabilidades así, una parte de los casos sale al revés de lo predicho: no es un defecto del modelo, es lo que significa una probabilidad.
- Uno tenía probabilidad baja. Un vehículo de 3 años falló con una probabilidad estimada de 0.129. También es compatible con el modelo: de cada 100 vehículos así se esperan unas 13 fallas. Un solo caso no prueba que falte información, pero deja una hipótesis para investigar: si variables que no están en los datos (kilometraje, mantenimiento, tipo de ruta) ayudarían a anticipar fallas como esa.
Esa es la utilidad del análisis de errores: no explica por sí solo cada fallo, pero muestra dónde duda el modelo y qué preguntas vale la pena hacerse.
Para mover el umbral, la pregunta es qué pasa si una falla en ruta cuesta más que una revisión de más.
for umbral in [0.5, 0.3]:
    revisar = (flota['p_falla'] >= umbral).astype(int)
    tabla = pd.crosstab(flota['fallo'], revisar, rownames=['falló'], colnames=['enviado a revisión'])
    print(f'Umbral {umbral} | vehículos enviados a revisión: {revisar.sum()}')
    print(tabla.to_string(), '\n')
Umbral 0.5 | vehículos enviados a revisión: 10
enviado a revisión 0 1
falló
0 8 2
1 2 8
Umbral 0.3 | vehículos enviados a revisión: 12
enviado a revisión 0 1
falló
0 7 3
1 1 9
Con umbral 0.5 se revisan 10 vehículos. De los 10 que fallaron, la regla señaló 8 y dejó pasar 2 (falsos negativos). De los 10 que no fallaron, señaló 2 (falsos positivos).
Con umbral 0.3 se revisan 12 vehículos. Las fallas no señaladas bajan de 2 a 1, a cambio de que los vehículos sanos señalados suban de 2 a 3.
Ninguno de los dos umbrales es «el correcto» por sí solo. Si una falla en ruta cuesta mucho más que una revisión de más, conviene el umbral bajo. Esa es una decisión del negocio, no del modelo.
Para validar sin fijar un umbral, la pregunta es qué tan bien ordena el modelo a los vehículos. La curva ROC recorre todos los umbrales a la vez.
fpr_flota, tpr_flota, _ = roc_curve(flota['fallo'], flota['p_falla'], drop_intermediate=False)
auc_flota = roc_auc_score(flota['fallo'], flota['p_falla'])

plt.plot(fpr_flota, tpr_flota, 'o-', color='firebrick', linewidth=2, label=f'AUC = {auc_flota:.3f}')
plt.plot([0, 1], [0, 1], 'k--', alpha=0.5, label='azar')
plt.xlabel('tasa de falsos positivos'); plt.ylabel('tasa de verdaderos positivos')
plt.title('Curva ROC de los 20 vehículos'); plt.legend(); plt.show()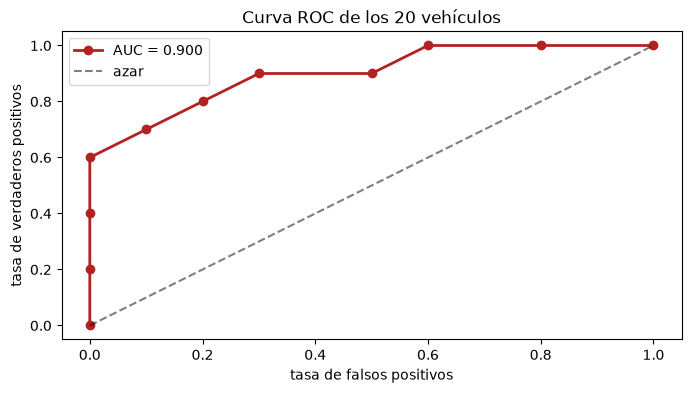
El AUC es 0.900. De los 100 pares posibles formados por un vehículo que falló y uno que no, el modelo le asigna mayor probabilidad al que falló en 88 y empata en 4, que son pares de la misma antigüedad. Cada empate cuenta como medio acierto: \((88+0.5\times4)/100=0.90\): en estos datos, el modelo ordena bien.
Cada punto de la curva es un umbral posible. El umbral 0.5 es el punto (0.2, 0.8): señala al 80% de los vehículos que fallaron y al 20% de los que no fallaron. El umbral 0.3 es el punto (0.3, 0.9): señala al 90% de los que fallaron y al 30% de los que no fallaron (3 de 10). La curva tiene pocos puntos porque solo hay diez antigüedades distintas y, por tanto, diez probabilidades distintas.
Con 20 vehículos, el modelo se evalúa sobre los mismos datos con que se ajustó, y eso tiende a mostrarlo mejor de lo que es. En un caso real hacen falta más datos y un conjunto de prueba aparte, como en el caso de las entregas.
El ejemplo repite los seis pasos del caso de las entregas: cambiaron los datos y el signo del efecto, y el método se mantuvo. Ver que la respuesta solo valía 0 o 1 decidió la distribución y el enlace. Se estima en la escala del enlace y se comunica en probabilidades: la razón de momios de 2.149 resume el efecto, y la probabilidad de 0.759 para un vehículo de 7 años es la cifra que entiende quien decide. El umbral es una decisión según el costo de cada error, y los cuatro errores analizados muestran dónde duda el modelo y qué variables convendría investigar.
22.21 Errores comunes en regresión logística
- Interpretar un coeficiente como cambio directo en probabilidad. \(\beta_j\) cambia el log-momio y \(e^{\beta_j}\) multiplica el momio.
- Confundir la clase positiva. En el caso de las entregas, 1 significa “llega a tiempo”; en el de los vehículos, 1 significa “falla”. Antes de leer una probabilidad, confirma qué evento representa el 1.
- Confundir probabilidad con decisión. El umbral convierte una estimación continua en una clase y debe responder al costo de los errores.
- Evaluar solamente con exactitud. Compárala con una línea base y revisa qué tipos de error produce cada umbral.
- Interpretar asociación como causalidad. Un coeficiente ajustado no demuestra que intervenir sobre la variable cause el cambio.
- Leer un p-valor como tamaño o importancia del efecto. El p-valor y la razón de momios responden preguntas diferentes.
- Comparar coeficientes regularizados y no regularizados como si fueran idénticos. scikit-learn y statsmodels pueden estimar valores distintos aun usando el mismo entrenamiento.
- Confundir discriminación con calibración. Un AUC alto no garantiza probabilidades bien calibradas.
22.22 Dónde aparece esto en inteligencia artificial
Nada de lo anterior es solo estadística clásica. Las mismas piezas están dentro de los modelos de aprendizaje automático y de las redes neuronales, con otros nombres.
Una regresión logística es exactamente una neurona con activación sigmoide:
| En este capítulo | En redes neuronales |
|---|---|
| predictor lineal \(\eta=X\beta\) | preactivación, o logit |
| coeficientes \(\beta_j\) e intercepto \(\beta_0\) | pesos y sesgo |
| inversa del enlace (sigmoide) | función de activación de la capa de salida |
| log-pérdida, la log-verosimilitud con signo cambiado | entropía cruzada binaria, la función de pérdida |
| máxima verosimilitud por iteraciones | entrenamiento por descenso de gradiente |
| penalización L2 | weight decay (equivalentes con descenso de gradiente simple; no con optimizadores adaptativos como Adam) |
Algunos usos concretos:
- Capa de salida de un clasificador. Una configuración habitual para clasificar en dos clases es terminar la red en una sigmoide y entrenarla con entropía cruzada: es una regresión logística aplicada a las características que aprendió la red. Con más de dos clases se usa la función softmax, la generalización del logit a varias categorías.
- Modelos de lenguaje. Los números que un modelo de lenguaje produce antes de elegir la siguiente palabra se llaman logits: son puntuaciones sin límites, como el predictor lineal de este capítulo, y la softmax las convierte en probabilidades. La diferencia entre dos logits es el logaritmo del cociente de sus probabilidades, la misma idea del log-momio.
- Entrenar es maximizar verosimilitud. Minimizar la entropía cruzada equivale a maximizar la verosimilitud de una Bernoulli (o de una categórica). Minimizar el error cuadrático equivale a hacerlo con una Normal. Elegir la función de pérdida es elegir la distribución: los pasos 2 y 4 de la metodología.
- Pérdidas para conteos y montos. Las librerías de boosting y de redes ofrecen pérdidas de Poisson, Gamma y Tweedie para predecir demanda, siniestros o costos. No son GLM, porque su predictor no es una suma lineal, pero usan la misma distribución y la misma función de pérdida.
- Calibración de probabilidades. El método de Platt ajusta una regresión logística sobre las puntuaciones de otro modelo para mejorar su calibración; necesita datos aparte y una evaluación independiente. El escalado por temperatura hace algo análogo en redes profundas.
- Predicción de clics y sistemas de recomendación. La regresión logística a gran escala fue durante años el modelo de base para estimar la probabilidad de clic en publicidad, y sigue siendo la referencia contra la que se comparan modelos más complejos.
- Interpretabilidad. Las sondas lineales son regresiones logísticas entrenadas sobre las activaciones internas de una red para averiguar qué información contiene cada capa.
- Línea base interpretable. En decisiones reguladas, como el riesgo de crédito, la regresión logística se prefiere porque sus razones de momios se pueden explicar y auditar.
Saberlo tiene una consecuencia práctica: quien entiende distribución, enlace y verosimilitud entiende por qué una red usa cierta activación de salida y cierta función de pérdida, y puede detectar cuándo esa elección no corresponde al tipo de respuesta.
Ejemplo básico: una neurona en PyTorch aprende la misma regresión logística
La tabla de equivalencias se puede comprobar con PyTorch, una de las librerías más usadas para construir redes neuronales. Defines una sola neurona y la entrenas sobre los 20 vehículos del ejemplo resuelto. Cada línea corresponde a una pieza de este capítulo:
nn.Linear(1, 1)es el predictor lineal: un peso y un sesgo.nn.BCEWithLogitsLoss()es la entropía cruzada binaria. Su nombre lo dice: recibe logits, es decir, el predictor lineal, y aplica la sigmoide por dentro.torch.optim.SGDes el descenso de gradiente: corrige peso y sesgo paso a paso para reducir la pérdida.
Si la equivalencia es cierta y el entrenamiento converge, la neurona debe terminar, salvo diferencias numéricas pequeñas, en los mismos coeficientes que estimó statsmodels, que no aplica penalización.
import torch
from torch import nn

# Datos como tensores: una columna de entradas y una de respuestas 0/1
x_t = torch.tensor(flota[['antiguedad']].to_numpy(), dtype=torch.float64)
y_t = torch.tensor(flota[['fallo']].to_numpy(), dtype=torch.float64)

neurona = nn.Linear(1, 1).double()        # predictor lineal: un peso y un sesgo
nn.init.zeros_(neurona.weight)            # la neurona empieza sin saber nada
nn.init.zeros_(neurona.bias)

perdida_fn = nn.BCEWithLogitsLoss()                             # entropía cruzada binaria sobre logits
optimizador = torch.optim.SGD(neurona.parameters(), lr=0.05)    # descenso de gradiente

for paso in range(1, 20_001):
    logits = neurona(x_t)                 # 1. predictor lineal η (los logits)
    perdida = perdida_fn(logits, y_t)     # 2. qué tan mal predice
    optimizador.zero_grad()
    perdida.backward()                    # 3. en qué dirección corregir
    optimizador.step()                    # 4. corrige peso y sesgo
    if paso in (1, 10, 100, 1_000, 10_000, 20_000):
        print(f'paso {paso:>6}: pérdida = {perdida.item():.4f} | '
              f'sesgo = {neurona.bias.item():7.3f} | peso = {neurona.weight.item():.3f}')

with torch.no_grad():
    p_7 = torch.sigmoid(neurona(torch.tensor([[7.0]], dtype=torch.float64))).item()

print(f'\nNeurona:     sesgo = {neurona.bias.item():.3f}      | peso = {neurona.weight.item():.3f}')
print(f'statsmodels: intercepto = {b0:.3f} | coeficiente = {b1:.3f}')
print(f'Probabilidad de falla de un vehículo de 7 años según la neurona: {p_7:.3f}')
paso 1: pérdida = 0.6931 | sesgo = 0.000 | peso = 0.050
paso 10: pérdida = 0.6327 | sesgo = -0.055 | peso = 0.116
paso 100: pérdida = 0.5612 | sesgo = -0.614 | peso = 0.200
paso 1000: pérdida = 0.4117 | sesgo = -2.945 | peso = 0.563
paso 10000: pérdida = 0.3975 | sesgo = -4.207 | peso = 0.765
paso 20000: pérdida = 0.3975 | sesgo = -4.209 | peso = 0.765
Neurona: sesgo = -4.209 | peso = 0.765
statsmodels: intercepto = -4.209 | coeficiente = 0.765
Probabilidad de falla de un vehículo de 7 años según la neurona: 0.759En el primer paso la pérdida es 0.6931, que es \(\log 2\): la pérdida de quien responde 0.5 para todo. A medida que la neurona corrige su peso y su sesgo, la pérdida baja hasta 0.3975, el mismo valor que reportó statsmodels al ajustar el modelo. Los parámetros finales también coinciden: sesgo −4.209 y peso 0.765. Y para el vehículo de 7 años la neurona da 0.759, la misma probabilidad que calculaste a mano.
No es una coincidencia. La neurona y la regresión logística son el mismo modelo (predictor lineal más sigmoide) y minimizan la misma cantidad (la entropía cruzada es la log-verosimilitud con el signo cambiado). Solo cambia el algoritmo: statsmodels llegó en 7 iteraciones con un método que usa más información en cada paso; el descenso de gradiente necesitó miles de pasos pequeños.
Una red neuronal profunda es esta misma neurona al final, precedida de capas que aprenden qué variables entregarle. La capa de salida, la función de pérdida y la lógica de entrenamiento de esa red son las de este ejemplo.
22.23 Preguntas de comprensión
- En la tabla del repaso, la razón de momios de hora pico es 0.351 y el cociente de proporciones, 0.643. ¿Por qué no coinciden, y cuándo se parecerían?
- Fuera de hora pico, la recta predice 1.10 a 0 km y −0.17 a 40 km. ¿Bastaría con recortar sus predicciones a 0 y 1?
- La razón de momios de hora pico es la misma a cualquier distancia, pero la brecha en probabilidad es de unos 12, 25 y 15 puntos porcentuales a 5, 15 y 25 km. ¿Cómo es posible?
- Con umbral 0.3 y con umbral 0.5 la exactitud en prueba es 0.708. ¿Cuál elegirías, y con qué datos lo decidirías?
- El modelo de las 800 entregas tiene un AUC de 0.800. ¿Garantiza eso que, cuando anuncia una probabilidad de 0.80, lleguen a tiempo unas 80 de cada 100 entregas comparables?
TipOrientaciones
- La razón de momios compara momios (\(p/(1-p)\)) y el cociente compara proporciones. Con proporciones de 0.70 y 0.45, los denominadores \(1-p\) (0.30 y 0.55) son muy distintos y separan las dos medidas. Se parecen cuando el evento es raro en ambos grupos, porque entonces \(1-p\) es cercano a 1.
- No. Recortar evita valores imposibles, pero deja una forma lineal que no sigue la curva en S, y la inferencia seguiría suponiendo una varianza constante cuando la varianza de una respuesta binaria es \(p(1-p)\).
- La razón de momios actúa en la escala del momio. Al pasar a probabilidad con la sigmoide, el mismo factor produce cambios mayores cerca de \(p=0.5\) (a 15 km, 0.659 frente a 0.404) y menores en los extremos (a 5 km, 0.915 frente a 0.790).
- Depende del costo de cada error: con 0.3 hay 64 falsas promesas y 6 alertas innecesarias, y con 0.5, 35 y 35. Para elegir, usa validación cruzada sobre el entrenamiento con una métrica que refleje esos costos; el conjunto de prueba solo sirve para la evaluación final.
- No. El AUC mide cuánto ordena el modelo las entregas puntuales por encima de las tardías (discriminación). Que 0.80 signifique 80 de cada 100 es una pregunta de calibración, que se evalúa aparte.
22.24 Referencias para profundizar
Modelos lineales generalizados
- Nelder, J. A. y Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society, Series A, 135(3), 370–384. El artículo que definió la familia.
- McCullagh, P. y Nelder, J. A. (1989). Generalized Linear Models (2.ª ed.). Chapman & Hall. La referencia clásica.
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. Wiley.
- Hosmer, D. W., Lemeshow, S. y Sturdivant, R. X. (2013). Applied Logistic Regression (3.ª ed.). Wiley.
Tablas de contingencia y razón de momios
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. El error estándar del logaritmo de la razón de momios usado en el repaso.
- Agresti, A. (2013). Categorical Data Analysis (3.ª ed.). Wiley. Tablas 2×2, razones de momios y su relación con la regresión logística.
Aprendizaje estadístico y aprendizaje automático
- James, G., Witten, D., Hastie, T., Tibshirani, R. y Taylor, J. (2023). An Introduction to Statistical Learning with Applications in Python. Springer. Capítulo 4, clasificación.
- Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. Capítulo 4.
- Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. Capítulo 4.
- Murphy, K. P. (2022). Probabilistic Machine Learning: An Introduction. MIT Press. Capítulos sobre regresión logística y modelos lineales generalizados.
- Goodfellow, I., Bengio, Y. y Courville, A. (2016). Deep Learning. MIT Press. Capítulo 6: unidades de salida y máxima verosimilitud.
Usos en inteligencia artificial
- Platt, J. (1999). Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. En Advances in Large Margin Classifiers. MIT Press.
- Guo, C., Pleiss, G., Sun, Y. y Weinberger, K. Q. (2017). On calibration of modern neural networks. Proceedings of the 34th International Conference on Machine Learning, PMLR 70, 1321–1330.
- McMahan, H. B. et al. (2013). Ad click prediction: a view from the trenches. Proceedings of the 19th ACM SIGKDD Conference.
- Alain, G. y Bengio, Y. (2016). Understanding intermediate layers using linear classifier probes. arXiv:1610.01644.
Documentación de las librerías
- scikit-learn,
LogisticRegression: https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LogisticRegression.html - statsmodels,
Logit: https://www.statsmodels.org/stable/generated/statsmodels.discrete.discrete_model.Logit.html - statsmodels,
GLM: https://www.statsmodels.org/stable/generated/statsmodels.genmod.generalized_linear_model.GLM.html - PyTorch,
BCEWithLogitsLoss: https://pytorch.org/docs/stable/generated/torch.nn.BCEWithLogitsLoss.html
22.25 Lo que debes llevarte de este capítulo
La regresión logística modela la probabilidad de un sí con un predictor lineal en la escala del log-momio; sus coeficientes se leen como razones de momios, y la decisión depende de un umbral que refleja el costo de los errores.
- En la tabla del repaso, la razón de momios de hora pico (0.3506) es exactamente \(e^{\beta_1}\) de una logística con ese único predictor.
- Una recta no respeta los límites de una probabilidad: fuera de hora pico supera 1 desde los 3.0 km y predice −0.17 a 40 km.
- El logit lleva la probabilidad a toda la recta real y la sigmoide la devuelve; \(\eta=0\) corresponde a \(p=0.5\).
- Cada kilómetro multiplica el momio de llegar a tiempo por 0.8416, y la hora pico por 0.336, comparando entregas a la misma distancia.
- La misma razón de momios produce brechas distintas en probabilidad: unos 12, 25 y 15 puntos porcentuales a 5, 15 y 25 km.
- En prueba, el modelo acierta 0.708 frente a 0.562 de la línea base, con un AUC de 0.800; los umbrales 0.3 y 0.5 dan la misma exactitud con errores muy distintos.
- Una neurona con sigmoide y entropía cruzada llega a los mismos coeficientes que
statsmodels(−4.209 y 0.765).
La cadena completa de los seis pasos, aplicada a una respuesta binaria, queda así:
1. naturaleza de Y     → binaria: 0 o 1
2. distribución        → Bernoulli(p)
3. cambio de variable  → enlace logit: η = log(p / (1 − p))
4. modelo lineal       → η = Xβ, estimado por máxima verosimilitud
5. cambio inverso      → sigmoide: p = 1 / (1 + e^(−η))
6. predecir y decidir  → razones de momios, umbral según costos, validación
La regresión lineal es el GLM más simple: respuesta normal y enlace identidad.
22.26 Puente hacia los siguientes capítulos
La regresión de Poisson aplica los mismos seis pasos a otra respuesta: en lugar de preguntar si una entrega llega a tiempo, pregunta cuántos eventos ocurren. Cambian la distribución (Poisson) y el enlace (log), y el método se mantiene.
Después, los modelos aditivos generalizados conservan la distribución y el enlace de un GLM y reemplazan los efectos lineales por curvas suaves, como los splines, sin perder la estructura interpretable del modelo.