La prueba \(t\) del capítulo 9 compara medias. Muchas preguntas de un equipo de datos no tienen una media que comparar, porque lo que observas es una categoría: la respuesta fue correcta, incorrecta o venció el tiempo; el request cayó en la réplica 1, 2, 3 o 4; el usuario aceptó la recomendación o no. Con categorías trabajas contando, y la pregunta pasa a ser si los conteos observados se parecen a los que esperarías bajo una hipótesis.
En este capítulo recorres la familia de pruebas que responde esa pregunta. Todas comparten una idea: medir la distancia entre lo observado y lo esperado, y compararla con la que produciría el azar.
El contexto es el servicio de inferencia del capítulo 9: un balanceador que reparte requests, un A/B entre la versión actual del modelo y una cuantizada, y la distribución de clases que predice un clasificador en producción. Los datos son simulados: la mayoría se generan con rng.multinomial o rng.binomial a partir de proporciones que declara cada etapa, y unos pocos ejemplos pequeños son tablas escritas a mano.
Tiempo estimado de lectura: 75 minutos (unas 3 horas si ejecutas el código y resuelves los ejercicios)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 9 (hipótesis, p-value, errores tipo I y II, intervalos), el capítulo 8 (binomial, normal y teorema del límite central) y el capítulo 7 (independencia).
Tecnologías mencionadas: Python 3.13, NumPy, pandas, SciPy (scipy.stats) y Matplotlib.
Objetivos
Al terminar este capítulo vas a ser capaz de:
reconocer cuándo una pregunta es de conteos y no de medias, y elegir la prueba que le corresponde;
explicar de dónde sale la distribución chi-cuadrado y qué son los grados de libertad;
calcular a mano las frecuencias esperadas y el estadístico \(\chi^2\), y verificarlos con SciPy;
aplicar la prueba de bondad de ajuste, la de independencia y la comparación de dos proporciones;
revisar el supuesto de frecuencias esperadas, usar la prueba exacta de Fisher cuando no se cumple y la de McNemar cuando las muestras son pareadas;
acompañar todo p-value con un tamaño del efecto (V de Cramér, diferencia de proporciones) y con los residuos que dicen dónde está la discrepancia.
Ejecuta las celdas en orden: las etapas comparten variables y el generador aleatorio rng.
10.1 El lenguaje de las pruebas con conteos
Repaso: los cinco pasos de toda prueba
El capítulo 9 presentó \(H_0\), \(H_1\), \(\alpha\), el p-value y los errores tipo I y II; aquí los usas sin volver a definirlos. Toda prueba de este capítulo y del siguiente recorre los mismos cinco pasos, y solo cambian el estadístico y su distribución.
Paso
Qué haces
En la prueba \(t\)
En este capítulo
1. Hipótesis
Escribes \(H_0\) y \(H_1\) antes de mirar el resultado
\(H_0:\mu=\mu_0\)
\(H_0\): las proporciones son las indicadas, o las dos variables son independientes
2. Estadístico
Resumes en un número cuánto se alejan los datos de \(H_0\)
\(t\)
\(\chi^2\)
3. Distribución de referencia
Sabes cómo se comporta ese número cuando \(H_0\) es cierta
\(t\) de Student
chi-cuadrado
4. p-value y decisión
Área de cola más allá del valor observado, comparada con \(\alpha\)
dos colas
cola derecha
5. Tamaño del efecto
Dices cuánto, en unidades que se entiendan
diferencia en ms
diferencia de proporciones, V de Cramér
El quinto paso forma parte de la prueba: un p-value pequeño dice que el azar explica mal los datos, pero no si la diferencia es grande.
Variable categórica y tabla de frecuencias
Una variable categórica toma valores que son etiquetas, no cantidades: correcta, incorrecta, timeout. Su resumen natural es la tabla de frecuencias, que cuenta cuántas observaciones cayeron en cada categoría, con conteos (frecuencias absolutas) y proporciones (frecuencias relativas). Las pruebas trabajan con los conteos, no con los porcentajes: el 60% de 10 casos y el 60% de 10 000 no pesan lo mismo. Por ejemplo, si de 600 requests 178 fueron a la réplica 1, el conteo es 178 y la proporción \(178/600=0.297\).
Frecuencia observada y frecuencia esperada
La frecuencia observada\(O_i\) es lo que contaste en la categoría \(i\). La frecuencia esperada\(E_i\) es lo que contarías, en promedio, si \(H_0\) fuera cierta: es la referencia contra la que mides la sorpresa, y puede tener decimales aunque un conteo real no los tenga. Si el balanceador reparte por igual entre 4 réplicas, de 600 requests esperas \(600\times 0.25=150\) en cada una.
El estadístico chi-cuadrado
El estadístico suma, sobre todas las categorías, la distancia entre observado y esperado:
\[
\chi^2=\sum_{i}\frac{(O_i-E_i)^2}{E_i}.
\]
Cada parte de la fórmula tiene una razón:
\(O_i-E_i\) es la discrepancia de la categoría;
el cuadrado impide que las discrepancias positivas y negativas se cancelen;
dividir por \(E_i\) pone la discrepancia en escala: fallar por 10 cuando esperabas 20 es mucho, y fallar por 10 cuando esperabas 2000 es poco.
Si \(H_0\) es cierta, \(\chi^2\) tiende a tomar valores moderados, cercanos a sus grados de libertad, y cuanto más se alejan los datos de \(H_0\), más crece. Por eso la prueba mira solo la cola derecha. Una categoría con \(O=178\) y \(E=150\) aporta \((178-150)^2/150=5.23\) al estadístico.
La distribución chi-cuadrado y los grados de libertad
La distribución chi-cuadrado con \(k\) grados de libertad, \(\chi^2_k\), es la distribución de la suma de \(k\) normales estándar independientes elevadas al cuadrado:
\[
Z_1^2+Z_2^2+\dots+Z_k^2\sim\chi^2_k .
\]
Solo toma valores positivos, es asimétrica hacia la derecha y su media es \(k\). Los grados de libertad cuentan cuántas discrepancias pueden variar libremente: con 4 categorías y un total fijo de 600, conocidas tres frecuencias la cuarta queda determinada, así que hay \(4-1=3\) grados de libertad.
Aparece aquí porque, con \(n\) grande, cada término \((O_i-E_i)/\sqrt{E_i}\) se comporta aproximadamente como una normal, y el estadístico es una suma de sus cuadrados. Son \(k\) términos, pero no independientes: como los conteos suman \(n\), las discrepancias suman 0 y una queda determinada por las demás. Esa restricción quita un grado de libertad y deja \(\chi^2_{k-1}\). La palabra aproximadamente importa: es una aproximación para muestras grandes, y la etapa 3 muestra cuándo falla.
Tres preguntas, un mismo estadístico
Pregunta
Prueba
\(H_0\)
Grados de libertad
¿Una variable se reparte según las proporciones que esperabas?
Bondad de ajuste
\(p_i=p_{i,0}\) para toda categoría
\(k-1\)
¿Dos variables categóricas están relacionadas?
Independencia
Las dos variables son independientes
\((f-1)(c-1)\)
¿Dos grupos tienen la misma proporción de éxitos?
Dos proporciones
\(p_A=p_B\)
1
En la tabla, \(k\) es el número de categorías, \(f\) el de filas y \(c\) el de columnas. La tercera prueba es el caso \(2\times 2\) de la segunda.
Frecuencias esperadas bajo independencia
En una tabla de contingencia, si las dos variables fueran independientes, la frecuencia esperada de cada celda sería
\[
E_{ij}=\frac{(\text{total de la fila } i)\times(\text{total de la columna } j)}{n}.
\]
Es la regla del producto de probabilidades independientes del capítulo 7, \(P(A\cap B)=P(A)\,P(B)\), escrita con conteos: si el 10% de las respuestas es incorrecto y la versión no influye, esperas un 10% de incorrectas en cada versión. Con 1000 requests en la versión A, 168 respuestas incorrectas en total y \(n=2000\), esperas \(1000\times 168/2000=84\) incorrectas en A.
Supuestos
Observaciones independientes. Cada caso aporta a una sola celda y no influye en los demás. Si el mismo caso se mide dos veces (dos modelos sobre el mismo conjunto de prueba), los datos son pareados y la prueba es otra (etapa 9).
Conteos, no porcentajes ni promedios. La fórmula necesita frecuencias absolutas.
Frecuencias esperadas suficientes. La regla habitual pide \(E\ge 5\) en todas las celdas (o al menos en el 80% de ellas, y ninguna menor que 1). Revisas las esperadas, no las observadas.
Tamaño del efecto
Con \(n\) grande, discrepancias muy pequeñas terminan dando un p-value pequeño. Estas medidas acompañan a la prueba:
La diferencia de proporciones, con su intervalo de confianza, cuando comparas dos grupos. Es la más fácil de comunicar.
Va de 0 (sin asociación) a 1 (asociación perfecta) y no crece sistemáticamente con \(n\); en muestras pequeñas es imprecisa y tiende a sobrestimar.
La \(w\) de Cohen, para la bondad de ajuste: \(w=\sqrt{\chi^2/n}\). Se lee con la misma escala que \(V\); en una tabla con dos filas o dos columnas, \(V=w\).
Los residuos estandarizados ajustados, que dicen qué celdas se apartan de lo esperado:
donde \(p_{i\cdot}\) y \(p_{\cdot j}\) son las proporciones de la fila y de la columna. Bajo \(H_0\) se comportan aproximadamente como una normal estándar, así que valores más allá de \(\pm 2\) señalan las celdas que más contribuyen.
El mapa: qué prueba usar
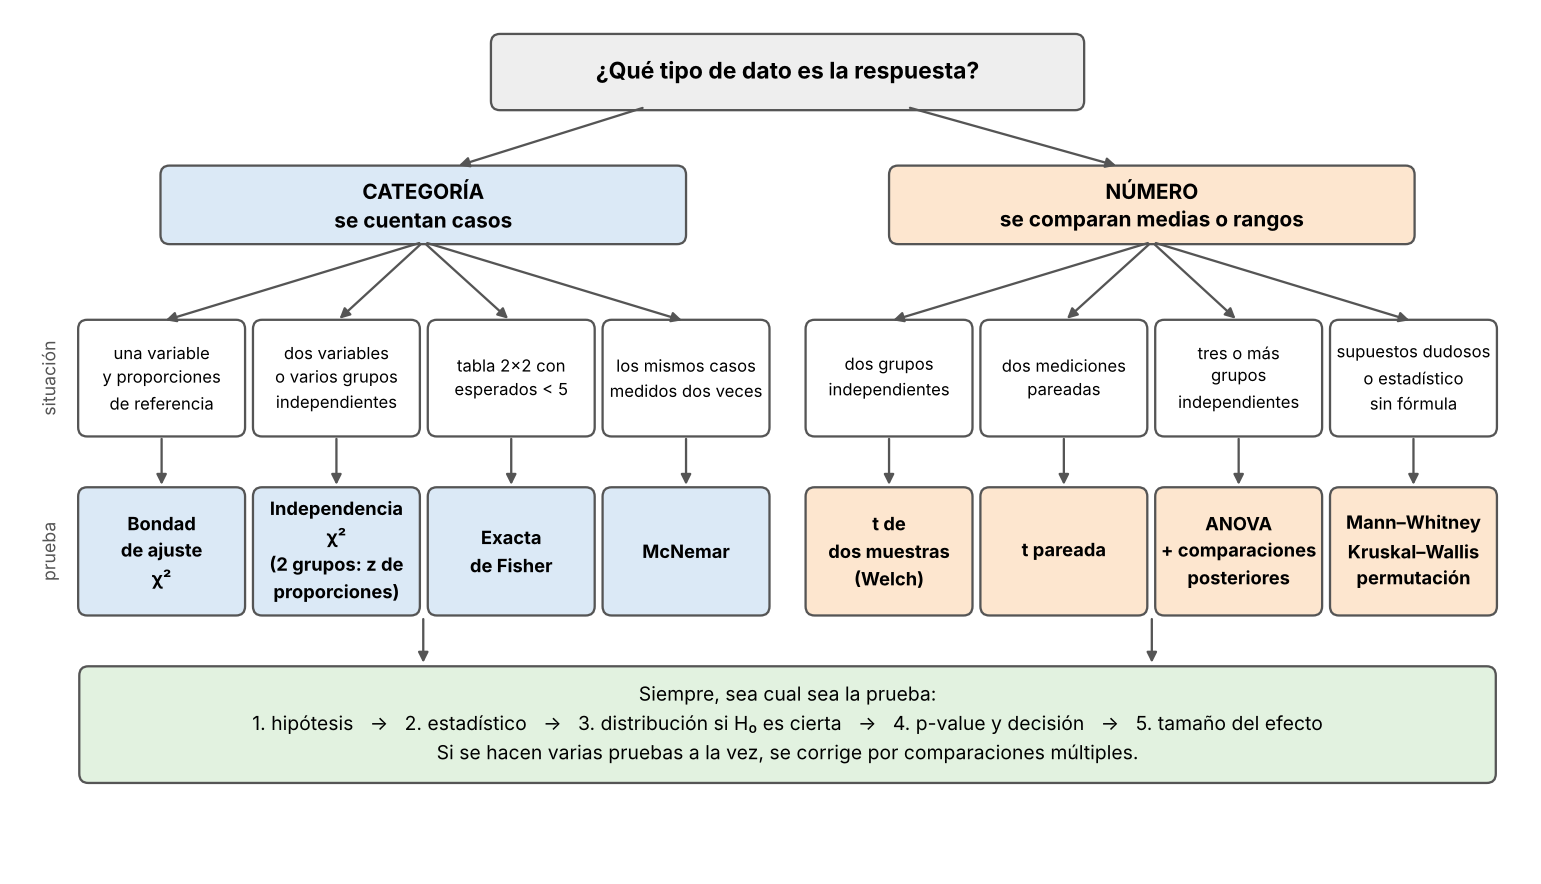
Mapa de pruebas de hipótesis según el tipo de dato y el diseño. Este capítulo recorre la rama de datos categóricos; el siguiente, la de datos numéricos.
Dos preguntas ordenan todo el mapa: qué tipo de dato es la respuesta (categoría o número) y cómo se obtuvieron los grupos (independientes o pareados).
10.2 Por qué importa en IA y machine learning
Buena parte de lo que produce y consume un sistema de aprendizaje automático es categórico:
Las etiquetas y las predicciones de un clasificador son categorías. Comparar la distribución de clases de referencia con la de producción es una prueba de bondad de ajuste (etapa 12).
La evaluación de un clasificador es un conteo. Aciertos, errores y la matriz de confusión del capítulo 14 son tablas de frecuencias.
Comparar dos modelos sobre el mismo conjunto de prueba es un problema de datos pareados, que resuelve McNemar (etapa 9). Lo mismo vale al comparar dos modelos de lenguaje o dos versiones de un prompt sobre el mismo conjunto de preguntas de evaluación.
Los experimentos A/B de producto suelen medir una proporción: clics, conversiones, aceptación de una recomendación.
El análisis exploratorio pregunta todo el tiempo si una variable categórica se relaciona con la etiqueta.
La auditoría de un modelo compara tasas de error entre segmentos de usuarios, otra tabla de contingencia.
Si lo que mides es una categoría, partes de una tabla de conteos y de una pregunta sobre lo esperado; la proporción ocupa el lugar que tenía la media.
10.3 Flujo recomendado de trabajo
Identifica la variable de respuesta y confirma que es categórica.
Decide si las muestras son independientes o pareadas.
Escribe \(H_0\) y \(H_1\) y fija \(\alpha\) antes de calcular.
Construye la tabla de frecuencias observadas.
Calcula las frecuencias esperadas bajo \(H_0\) y revisa que sean suficientes.
Calcula el estadístico, los grados de libertad y el p-value.
Si rechazas \(H_0\), mira los residuos para ubicar la discrepancia.
Reporta el tamaño del efecto y redacta la conclusión en términos del problema:
«En [población], con \(n=\)[valor], se cruzó [variable 1] con [variable 2]. La frecuencia esperada mínima fue [valor]. Se probó [H0]: χ²([gl]) = [valor], p = [valor]. A α = [valor] se [rechaza o no se rechaza] H0. El tamaño del efecto es [V o diferencia de proporciones con IC]. La discrepancia se concentra en [celdas]. Limitación: [n, esperados pequeños, varias pruebas o diseño observacional].»
Mira siempre la tabla de esperados antes que el p-value. La etapa 10 llena esta plantilla con el A/B de resultados.
10.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib y el módulo stats de SciPy, fija un estilo de gráficos y crea el generador rng con la semilla 42, del que salen todas las simulaciones.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy import statsSEMILLA =42# semilla central del capítulorng = np.random.default_rng(SEMILLA)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25
Python: 3.13.14
El entorno queda con Python 3.13.14.
La siguiente celda, plegada en la versión web, define las funciones de gráficos. Solo dibujan: ningún cálculo estadístico ocurre dentro de ellas, y los números se obtienen a la vista en cada etapa.
Las 12 etapas siguen el orden del mapa: primero la distribución de referencia, después una variable (bondad de ajuste), luego dos variables (independencia y proporciones) y tres situaciones que cambian la lectura o la prueba: pocos datos, una muestra enorme y datos pareados. Las tres últimas aplican todo a un reporte, a un cálculo a mano y a la vigilancia de un clasificador en producción.
Etapa 1: De dónde sale la distribución chi-cuadrado
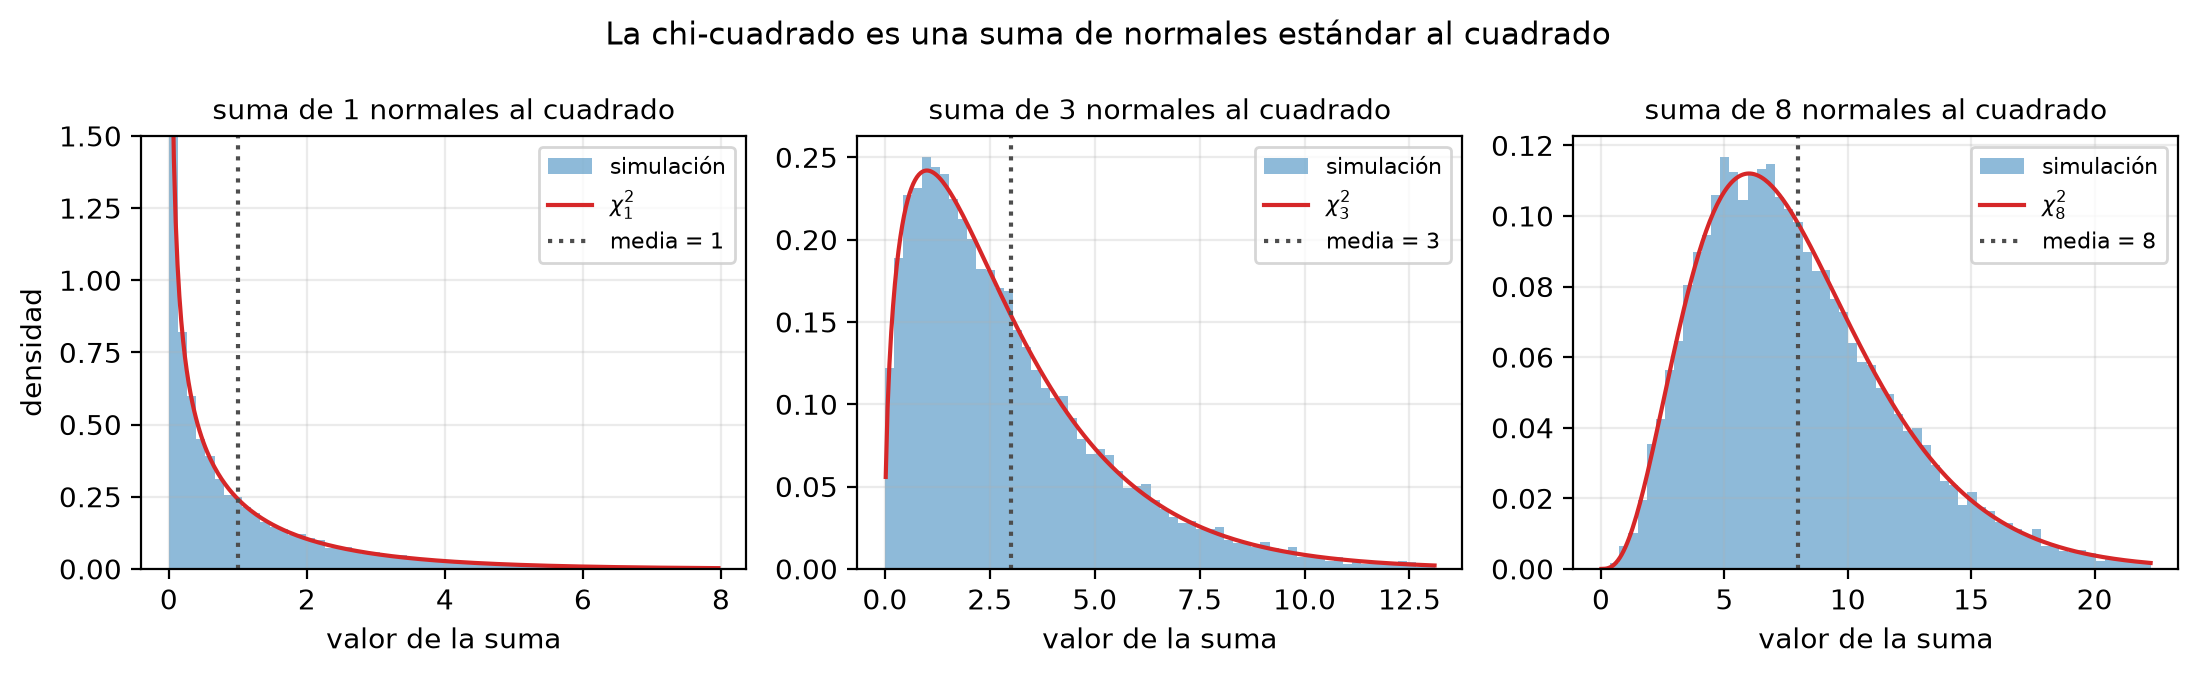
Antes de usar la distribución conviene verla nacer. Generas 20 000 grupos de \(k\) normales estándar con rng.normal, para \(k=1\), 3 y 8, elevas cada una al cuadrado y sumas las de cada grupo. El histograma de esas sumas debería coincidir con la densidad \(\chi^2_k\).
sumas = {}for k in (1, 3, 8): z = rng.normal(size=(20_000, k)) sumas[k] = (z **2).sum(axis=1)print(f"k = {k}: media simulada = {sumas[k].mean():.3f} (teórica {k})",f" percentil 95 simulado = {np.quantile(sumas[k], 0.95):.2f}",f"(teórico {stats.chi2.ppf(0.95, k):.2f})")graficar_suma_cuadrados(sumas, "La chi-cuadrado es una suma de normales estándar al cuadrado")
k = 1:  media simulada = 1.009 (teórica 1)   percentil 95 simulado = 3.87 (teórico 3.84)
k = 3:  media simulada = 3.013 (teórica 3)   percentil 95 simulado = 7.89 (teórico 7.81)
k = 8:  media simulada = 8.009 (teórica 8)   percentil 95 simulado = 15.63 (teórico 15.51)
Las tres simulaciones siguen la curva teórica. La media simulada coincide con los grados de libertad (1.009, 3.013 y 8.009 frente a 1, 3 y 8), y el percentil 95 simulado queda cerca del teórico (3.87 frente a 3.84, 7.89 frente a 7.81, 15.63 frente a 15.51). En la figura, la curva de \(k=1\) se dispara cerca de 0 y las de 3 y 8 tienen su pico cada vez más a la derecha.
Dos rasgos se usan en todo el capítulo: la distribución solo toma valores positivos, porque es una suma de cuadrados, y se corre hacia la derecha al aumentar los grados de libertad. Por eso un mismo valor del estadístico, por ejemplo 8, es raro con 3 grados de libertad y típico con 8: un \(\chi^2\) se lee siempre junto con sus grados de libertad.
Etapa 2: Bondad de ajuste, ¿el balanceador reparte por igual?
Un balanceador distribuye los requests entre 4 réplicas del servicio y está configurado para repartir por igual. Registras 600 requests y cuentas cuántos recibió cada réplica. Los conteos se simulan con rng.multinomial a partir de un reparto real de 0.28, 0.26, 0.25 y 0.21, que quien analiza no conoce.
\[
H_0: p_1=p_2=p_3=p_4=0.25,\qquad H_1:\text{al menos una } p_i\neq 0.25,\qquad \alpha=0.05.
\]
Bajo \(H_0\) esperas \(600\times 0.25=150\) requests por réplica, con \(4-1=3\) grados de libertad.
replicas = ["réplica 1", "réplica 2", "réplica 3", "réplica 4"]n_req =600p_diseno = np.array([0.28, 0.26, 0.25, 0.21]) # el reparto real, desconocido para quien analizaobs = rng.multinomial(n_req, p_diseno)p_h0 = np.full(4, 0.25)esp = n_req * p_h0aporte = (obs - esp) **2/ espchi2_obs = aporte.sum()gl =len(obs) -1p_manual = stats.chi2.sf(chi2_obs, gl)tabla_ba = pd.DataFrame({"observado": obs, "esperado": esp, "O − E": obs - esp, "(O − E)²/E": aporte.round(3)}, index=replicas)print(tabla_ba.to_string())print()print("χ² a mano =", round(chi2_obs, 3), " gl =", gl)print("valor crítico (α = 0.05) =", round(stats.chi2.ppf(0.95, gl), 3))print("p-value a mano =", round(p_manual, 5))res = stats.chisquare(obs, f_exp=esp)print("SciPy chisquare: χ² =", round(res.statistic, 3), " p =", round(res.pvalue, 5))print("¿Rechazar H0 a α = 0.05?", res.pvalue <0.05)graficar_obs_esp(replicas, obs, esp, "Requests por réplica: observado frente a esperado (n = 600)")graficar_cola_chi2(chi2_obs, gl, "Dónde cae el estadístico observado si el reparto fuera uniforme")
           observado  esperado  O − E  (O − E)²/E
réplica 1        178     150.0   28.0       5.227
réplica 2        155     150.0    5.0       0.167
réplica 3        161     150.0   11.0       0.807
réplica 4        106     150.0  -44.0      12.907

χ² a mano = 19.107   gl = 3
valor crítico (α = 0.05) = 7.815
p-value a mano = 0.00026
SciPy chisquare: χ² = 19.107   p = 0.00026
¿Rechazar H0 a α = 0.05? True
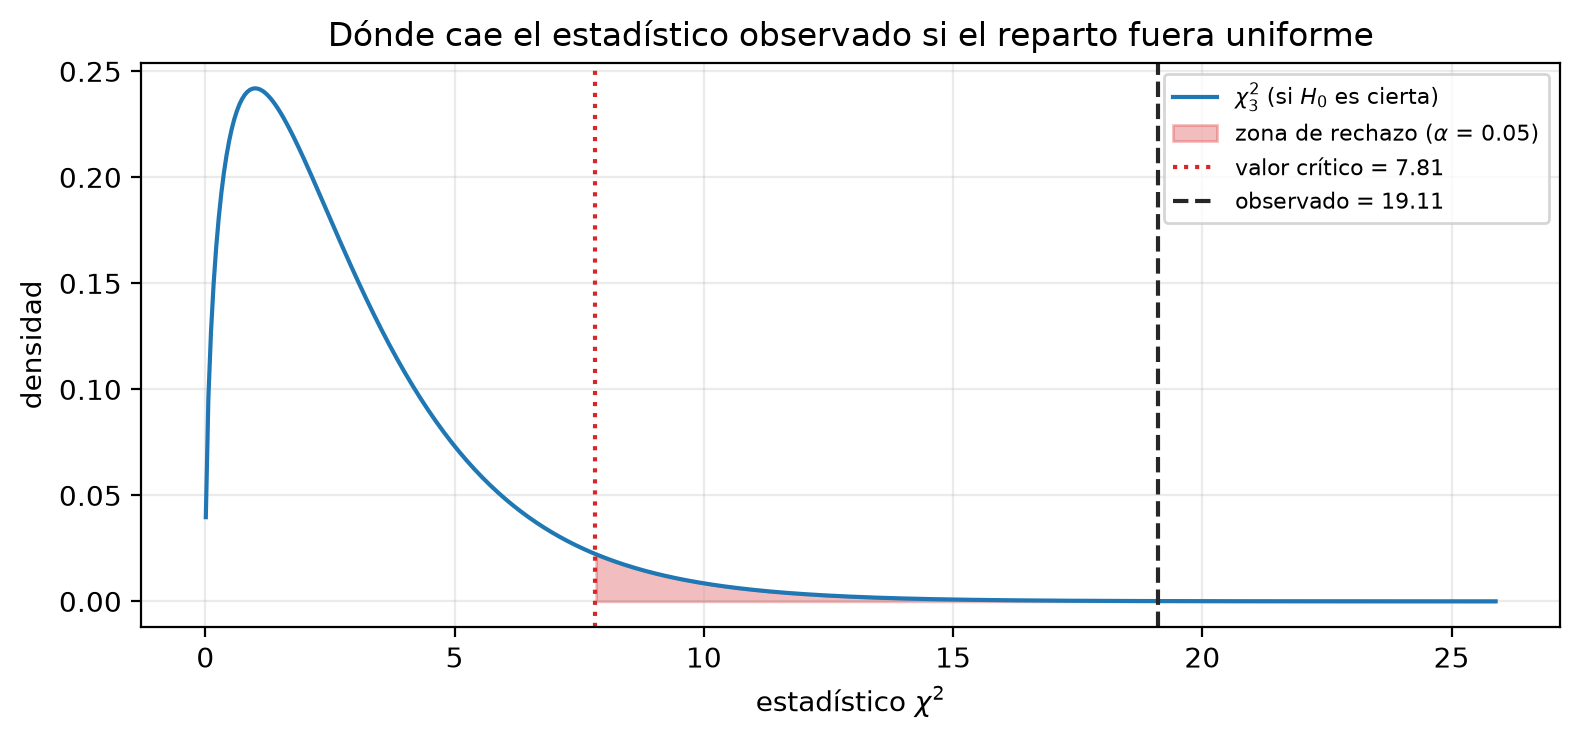
El estadístico vale 19.11 con 3 grados de libertad. El valor crítico al 5% es 7.81 y el p-value es 0.00026: si el reparto fuera uniforme, una discrepancia así o mayor aparecería en menos de 3 de cada 10 000 muestras. Rechazas \(H_0\), y en la segunda figura la línea del valor observado queda muy a la derecha de la zona de rechazo.
La tabla dice además dónde está la discrepancia. La réplica 4 aporta 12.91 y la réplica 1, 5.23: entre las dos suman 18.13 de los 19.11 puntos del estadístico. La réplica 4 recibió 106 requests (17.7%) y la réplica 1, 178 (29.7%), cuando esperabas un 25% en cada una.
La prueba detecta que el reparto observado no es compatible con uno uniforme, pero no dice por qué: la causa puede estar en la configuración, en revisiones de salud que sacan una réplica de rotación o en otra cosa que estos datos no registran.
Etapa 3: ¿Cuándo puedes confiar en la aproximación?
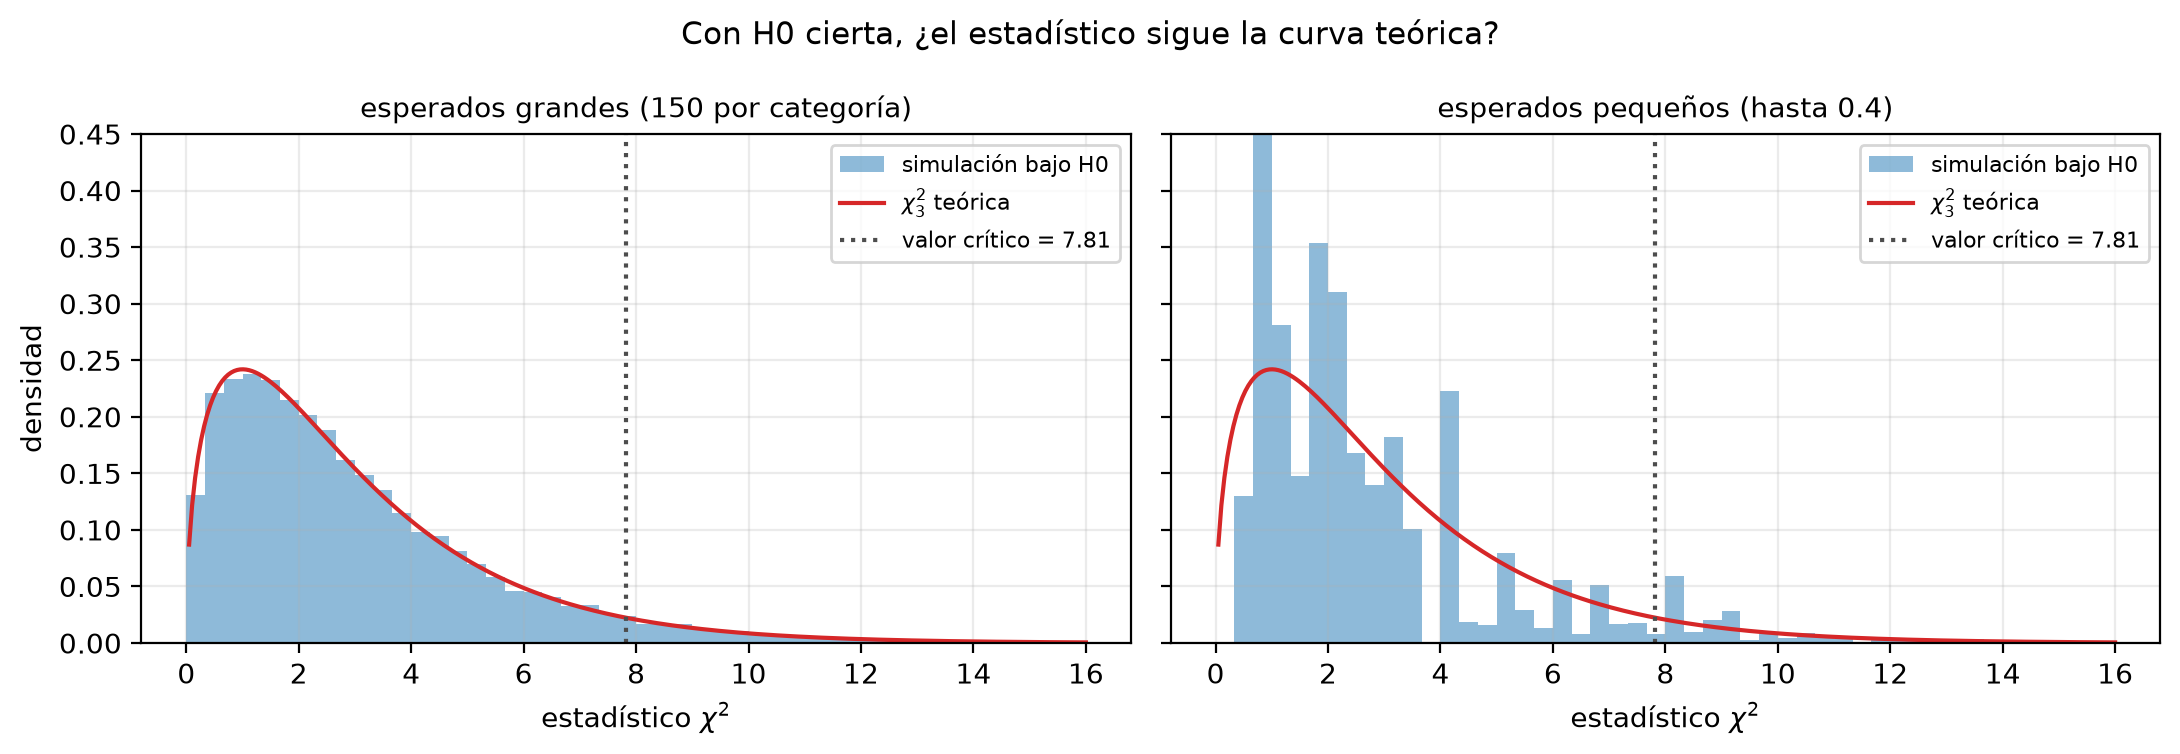
La distribución \(\chi^2\) es una aproximación para muestras grandes. Lo compruebas simulando 20 000 experimentos en los que \(H_0\) es cierta y contando cuántas veces la prueba rechaza: si la aproximación funciona, debe rechazar cerca del 5% de las veces. Comparas dos escenarios con 4 categorías y 3 grados de libertad:
Esperados grandes: 600 requests repartidos por igual, con un esperado de 150 por categoría.
Esperados pequeños: 20 requests clasificados en cuatro tipos de respuesta con proporciones 0.70, 0.20, 0.08 y 0.02, cuyos esperados son 14, 4, 1.6 y 0.4.
def chi2_bajo_h0(n, p, n_rep=20_000): p = np.asarray(p) conteos = rng.multinomial(n, p, size=n_rep) esperado = n * preturn ((conteos - esperado) **2/ esperado).sum(axis=1)critico = stats.chi2.ppf(0.95, 3)sim_grande = chi2_bajo_h0(600, [0.25, 0.25, 0.25, 0.25])sim_chico = chi2_bajo_h0(20, [0.70, 0.20, 0.08, 0.02])print("Valor crítico χ²(3) al 5% =", round(critico, 3))print("Esperados grandes (150 por categoría): P(rechazar | H0) =", round((sim_grande >= critico).mean(), 4))print("Esperados pequeños (14, 4, 1.6, 0.4): P(rechazar | H0) =", round((sim_chico >= critico).mean(), 4))print("Valores distintos del estadístico: grandes =", len(np.unique(sim_grande.round(6)))," pequeños =", len(np.unique(sim_chico.round(6))))graficar_calibracion( sim_grande, sim_chico, 3,"esperados grandes (150 por categoría)", "esperados pequeños (hasta 0.4)","Con H0 cierta, ¿el estadístico sigue la curva teórica?",)
Valor crítico χ²(3) al 5% = 7.815
Esperados grandes (150 por categoría):  P(rechazar | H0) = 0.0474
Esperados pequeños (14, 4, 1.6, 0.4):   P(rechazar | H0) = 0.0663
Valores distintos del estadístico:  grandes = 860   pequeños = 198
Con esperados de 150 por categoría, la prueba rechaza en el 4.74% de las simulaciones, muy cerca del 5% nominal, y el histograma sigue la curva. Con esperados de 14, 4, 1.6 y 0.4 rechaza en el 6.63%: la prueba anuncia una tasa de falsas alarmas del 5% y en este escenario comete alrededor de un tercio más.
El panel derecho muestra dos fenómenos a la vez. El estadístico es discreto y avanza a saltos: en 20 000 simulaciones tomó 198 valores distintos, frente a 860 en el otro escenario, y el histograma forma barras altas y separadas. Y la categoría con esperado 0.4 lo dispara: una sola observación allí aporta \((1-0.4)^2/0.4=0.9\), y dos aportan \((2-0.4)^2/0.4=6.4\). Una curva continua describe mal esa cola.
De aquí sale la regla práctica de esperados de al menos 5. Es empírica y no una frontera exacta, porque la aproximación se degrada de forma gradual. Cuando no se cumple tienes cuatro salidas: reunir más datos; juntar categorías con un criterio definido de antemano; calcular el p-value por simulación, generando muchas muestras bajo \(H_0\) como en esta etapa y contando en qué fracción el estadístico iguala o supera al observado; o, en tablas \(2\times 2\), usar una prueba exacta (etapa 7).
Etapa 4: Independencia, ¿el resultado depende de la versión?
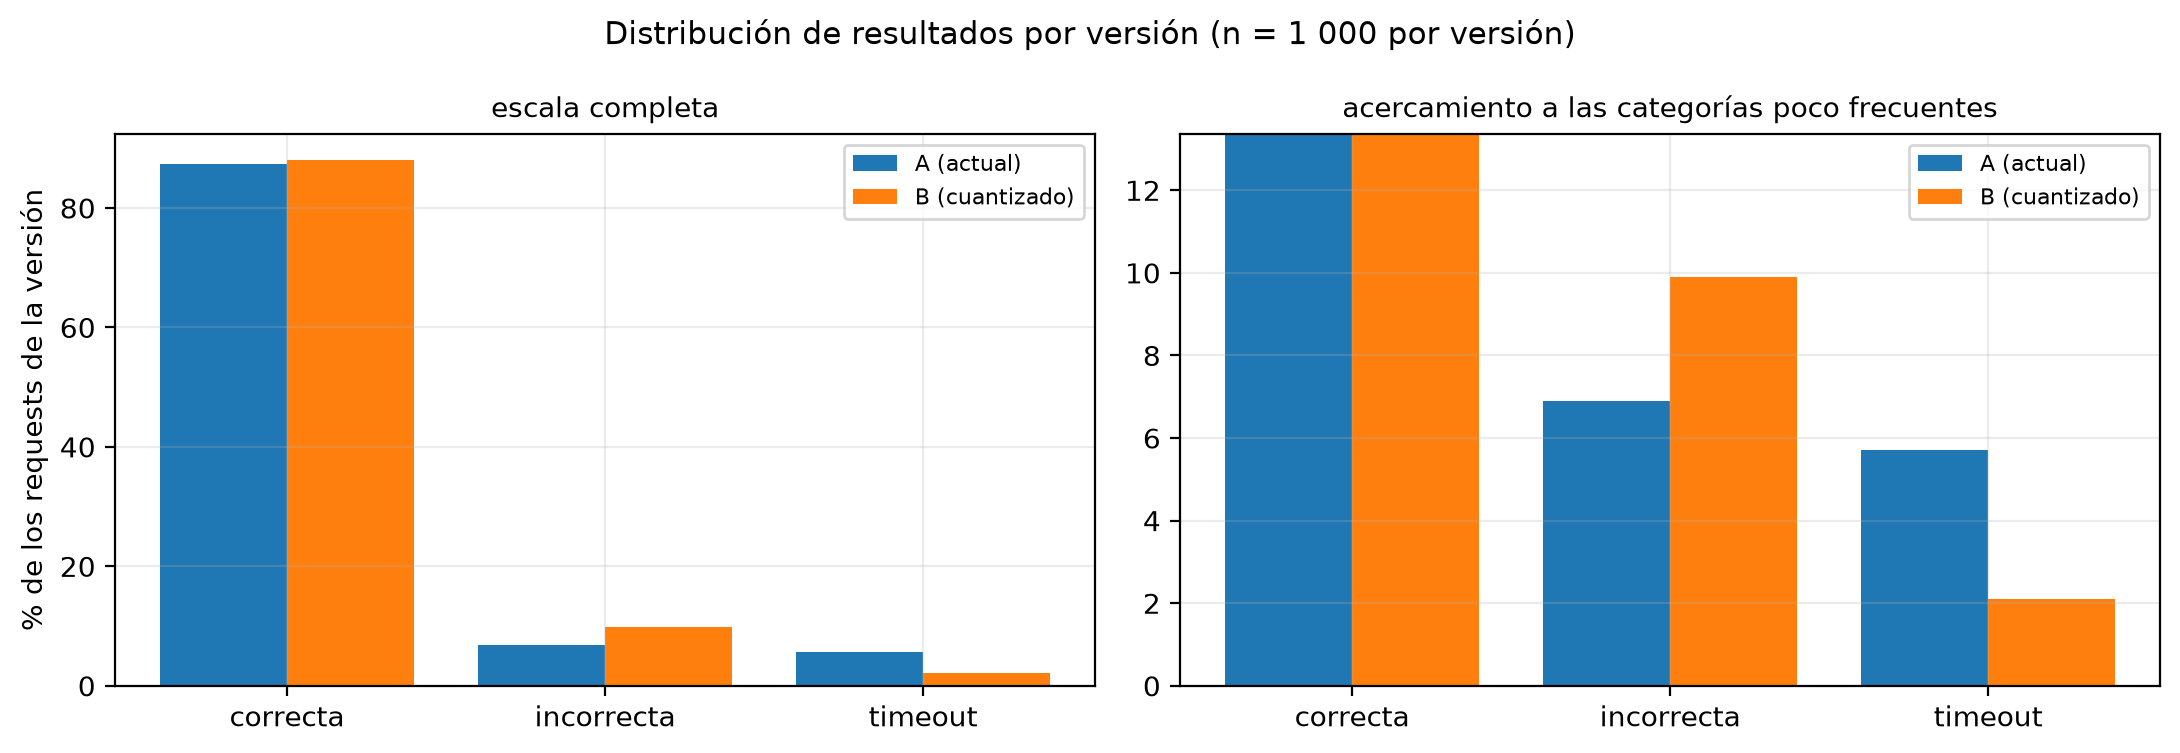
En el A/B entre la versión actual (A) y la cuantizada (B), cada request termina en uno de tres resultados: respuesta correcta, respuesta incorrecta o timeout. Asignas 1000 requests al azar a cada versión, y los resultados se simulan con proporciones de diseño de 0.88, 0.07 y 0.05 en A y de 0.86, 0.115 y 0.025 en B.
\[
H_0:\text{el resultado es independiente de la versión},\qquad H_1:\text{la distribución de resultados cambia con la versión},\qquad \alpha=0.05.
\]
La tabla tiene 2 filas y 3 columnas, así que hay \((2-1)(3-1)=2\) grados de libertad.
Como el tamaño de cada versión se fijó de antemano (1000 y 1000), el nombre técnico es prueba de homogeneidad: preguntas si las dos versiones tienen la misma distribución de resultados. El cálculo es idéntico al de la prueba de independencia, y por eso suelen presentarse juntas.
resultados = ["correcta", "incorrecta", "timeout"]n_a = n_b =1000conteo_a = rng.multinomial(n_a, [0.88, 0.07, 0.05])conteo_b = rng.multinomial(n_b, [0.86, 0.115, 0.025])tabla = pd.DataFrame([conteo_a, conteo_b], index=["A (actual)", "B (cuantizado)"], columns=resultados)print("Frecuencias observadas")print(tabla.assign(total=tabla.sum(axis=1)).to_string())print()print("Porcentaje por versión")print((tabla.div(tabla.sum(axis=1), axis=0) *100).round(1).to_string())# Esperados a mano: (total fila × total columna) / nO = tabla.valuesn_total = O.sum()E = np.outer(O.sum(axis=1), O.sum(axis=0)) / n_totalchi2_ind = ((O - E) **2/ E).sum()gl_ind = (O.shape[0] -1) * (O.shape[1] -1)print()print("Frecuencias esperadas bajo independencia")print(pd.DataFrame(E, index=tabla.index, columns=resultados).round(2).to_string())print("Esperado mínimo =", round(E.min(), 2), " (regla: al menos 5)")print()print("χ² a mano =", round(chi2_ind, 3), " gl =", gl_ind, " p =", f"{stats.chi2.sf(chi2_ind, gl_ind):.2e}")chi2_sp, p_sp, gl_sp, E_sp = stats.chi2_contingency(O, correction=False)print("SciPy chi2_contingency: χ² =", round(chi2_sp, 3), " gl =", gl_sp, " p =", f"{p_sp:.2e}")print("¿Rechazar H0 a α = 0.05?", p_sp <0.05)graficar_perfiles(tabla, "Distribución de resultados por versión (n = 1 000 por versión)")
Frecuencias observadas
                correcta  incorrecta  timeout  total
A (actual)           874          69       57   1000
B (cuantizado)       880          99       21   1000

Porcentaje por versión
                correcta  incorrecta  timeout
A (actual)          87.4         6.9      5.7
B (cuantizado)      88.0         9.9      2.1

Frecuencias esperadas bajo independencia
                correcta  incorrecta  timeout
A (actual)         877.0        84.0     39.0
B (cuantizado)     877.0        84.0     39.0
Esperado mínimo = 39.0   (regla: al menos 5)

χ² a mano = 21.993   gl = 2   p = 1.68e-05
SciPy chi2_contingency: χ² = 21.993   gl = 2   p = 1.68e-05
¿Rechazar H0 a α = 0.05? True
El esperado mínimo es 39, muy por encima de 5, así que la aproximación es confiable. El estadístico vale 21.99 con 2 grados de libertad y el p-value es \(1.7\times10^{-5}\): rechazas \(H_0\), porque con estos datos la distribución de resultados no es la misma en las dos versiones.
Los porcentajes muestran algo que la prueba global no dice. La proporción de respuestas correctas es parecida (87.4% en A y 88.0% en B); la diferencia está en cómo fallan: B tiene más respuestas incorrectas (9.9% frente a 6.9%) y menos timeouts (2.1% frente a 5.7%). En el panel derecho de la figura, que acerca las categorías poco frecuentes, las barras naranjas de B suben en incorrecta y bajan en timeout. Comparar solo la tasa de respuestas correctas habría escondido ese cambio.
Ver los porcentajes no basta para afirmar qué celdas se apartan de lo esperado más de lo que explica el azar. Eso lo responden los residuos.
Etapa 5: ¿Dónde está la diferencia y qué tan grande es?
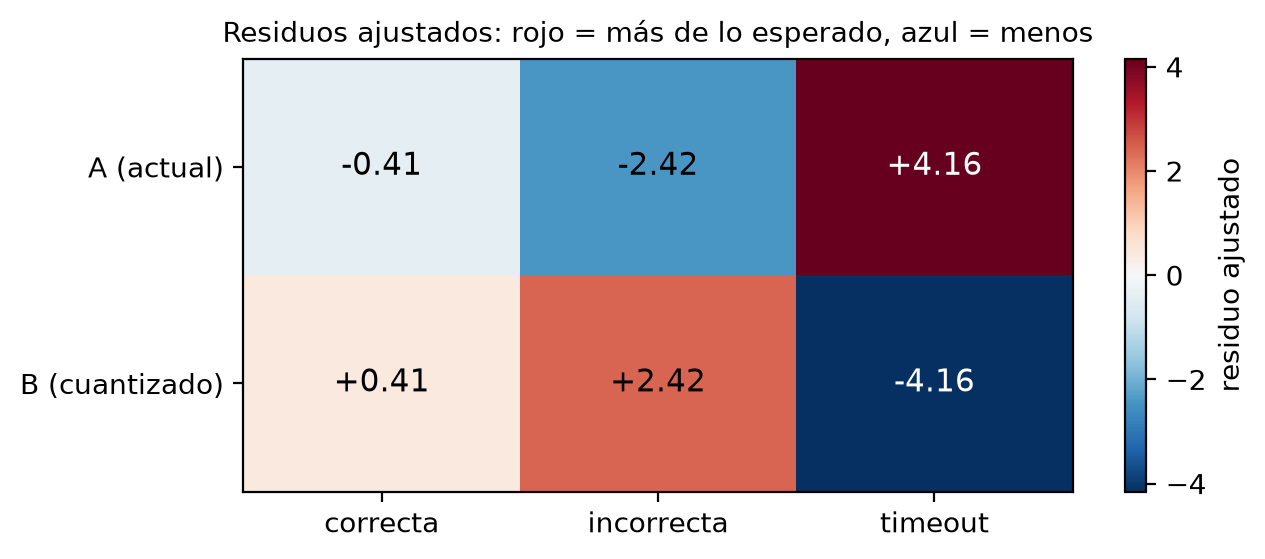
La prueba global dice que la tabla no se parece a la esperada, pero no en qué celdas. Dos herramientas completan la lectura: los residuos ajustados, que dicen dónde, y la V de Cramér, que dice cuánto. También calculas el intervalo de la diferencia en la tasa de respuestas correctas, la columna que no se aparta.
p_fila = O.sum(axis=1, keepdims=True) / n_totalp_col = O.sum(axis=0, keepdims=True) / n_totalresiduos = pd.DataFrame((O - E) / np.sqrt(E * (1- p_fila) * (1- p_col)), index=tabla.index, columns=resultados)aportes = pd.DataFrame((O - E) **2/ E, index=tabla.index, columns=resultados)print("Residuos ajustados (|r| > 2 señala una celda que se aparta de lo esperado)")print(residuos.round(2).to_string())print()print("Aporte de cada celda al χ²")print(aportes.round(2).to_string())print("Aporte por columna:", aportes.sum(axis=0).round(2).to_dict())m =min(O.shape)v_cramer = np.sqrt(chi2_ind / (n_total * (m -1)))print()print("V de Cramér =", round(v_cramer, 3))# La columna que no se aparta: ¿qué tan bien se conoce la diferencia en la tasa de respuestas correctas?pc_a, pc_b = O[0, 0] / O[0].sum(), O[1, 0] / O[1].sum()se_pc = np.sqrt(pc_a * (1- pc_a) / O[0].sum() + pc_b * (1- pc_b) / O[1].sum())print("Tasa de correctas, B − A =", round((pc_b - pc_a) *100, 1), "puntos IC 95%: [",round((pc_b - pc_a -1.96* se_pc) *100, 1), ",", round((pc_b - pc_a +1.96* se_pc) *100, 1), "]")graficar_residuos(residuos, "Residuos ajustados: rojo = más de lo esperado, azul = menos")
Residuos ajustados (|r| > 2 señala una celda que se aparta de lo esperado)
                correcta  incorrecta  timeout
A (actual)         -0.41       -2.42     4.16
B (cuantizado)      0.41        2.42    -4.16

Aporte de cada celda al χ²
                correcta  incorrecta  timeout
A (actual)          0.01        2.68     8.31
B (cuantizado)      0.01        2.68     8.31
Aporte por columna: {'correcta': 0.02, 'incorrecta': 5.36, 'timeout': 16.62}

V de Cramér = 0.105
Tasa de correctas, B − A = 0.6 puntos   IC 95%: [ -2.3 , 3.5 ]
Los residuos ajustados de las 6 celdas ordenan las tres columnas:
Timeout: +4.16 en A y −4.16 en B. Es la discrepancia más marcada y aporta 16.62 de los 21.99 puntos del estadístico.
Incorrecta: −2.42 en A y +2.42 en B. Supera el umbral orientativo de 2 y aporta 5.36.
Correcta: ±0.41. No se aparta de lo esperado y aporta 0.02. Eso no equivale a decir que las tasas sean iguales: el IC 95% de la diferencia B − A va de −2.3 a +3.5 puntos, así que estos datos no descartan una diferencia de un par de puntos en cualquier dirección.
En la figura, la celda de timeout de A es la más roja y la de B la más azul. En una tabla de dos filas, los residuos de una columna son iguales y de signo opuesto: lo que una versión tiene de más, la otra lo tiene de menos.
La V de Cramér es 0.105. Con las referencias habituales (alrededor de 0.1 pequeño, 0.3 mediano y 0.5 grande) es una asociación pequeña. Esas referencias son orientativas y vienen de otras disciplinas; lo que decide es el costo de cada tipo de fallo. Aquí el p-value es muy pequeño y el efecto también, y las dos cosas son ciertas a la vez porque con 2000 requests se detectan diferencias modestas.
Miras los residuos después de la prueba global y son varios a la vez: sirven para ubicar la discrepancia, no son seis pruebas independientes.
Etapa 6: Dos proporciones, el A/B de aceptación
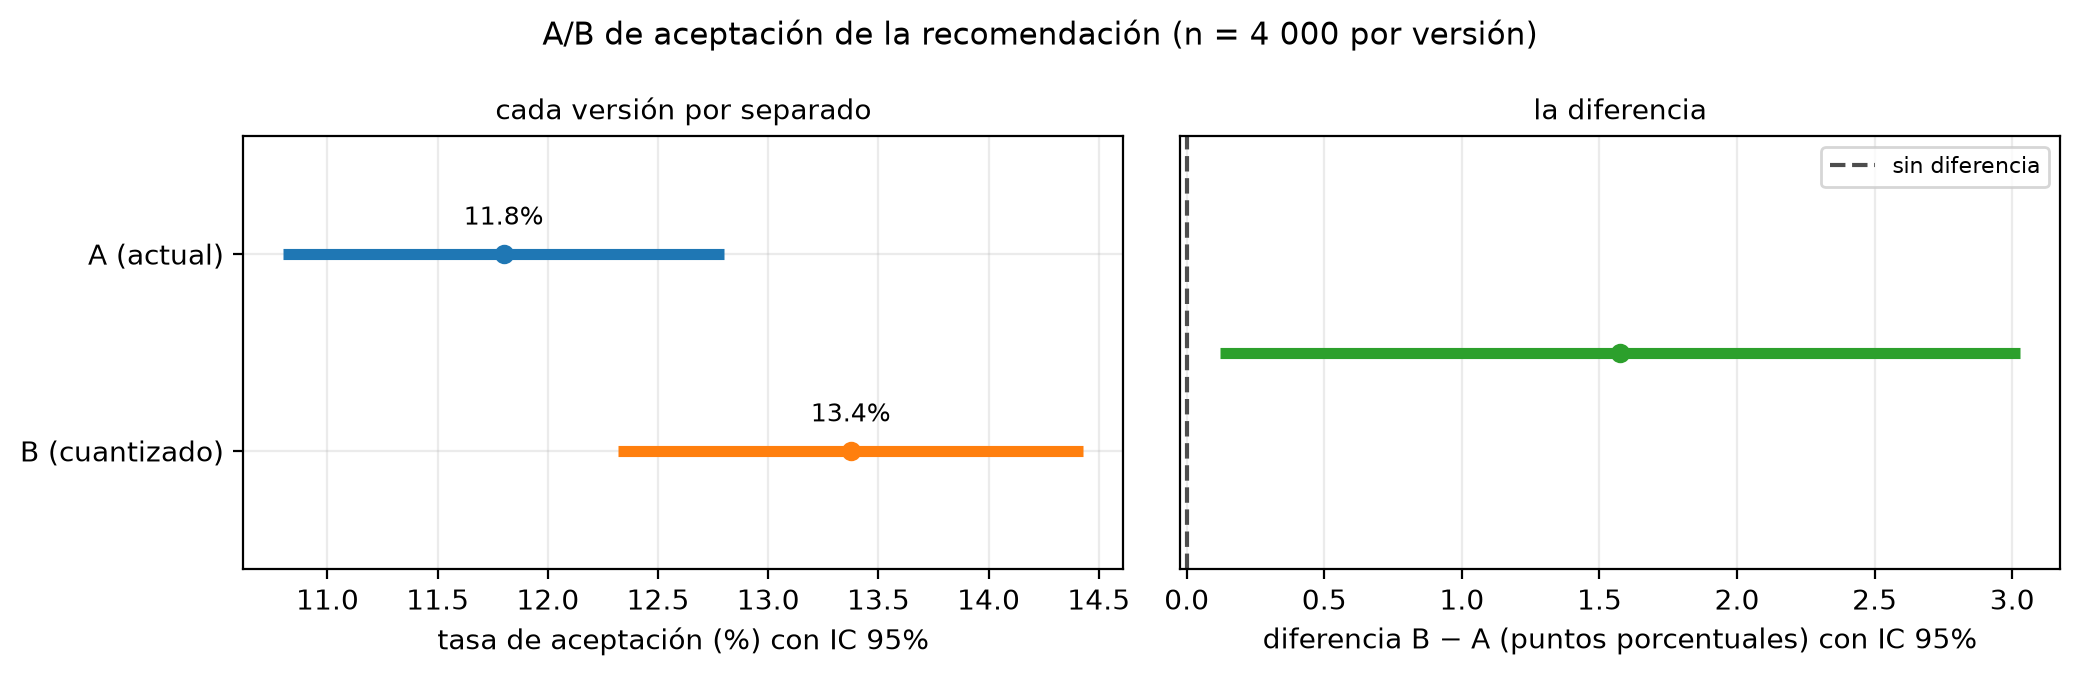
El caso más frecuente en producto tiene dos versiones y un resultado de sí o no. Mides si el usuario aceptó la recomendación del modelo, con 4000 usuarios asignados al azar a cada versión; las aceptaciones se simulan con rng.binomial y tasas de diseño de 11.0% en A y 13.5% en B.
El estadístico es una \(z\): la diferencia de proporciones dividida por su error estándar. Bajo \(H_0\) las dos versiones comparten una misma proporción, que estimas juntando los datos (proporción combinada, \(\hat p\)):
A: aceptaron 472 de 4000  → 11.8 %
B: aceptaron 535 de 4000  → 13.38 %
Proporción combinada = 0.12587
Diferencia B − A = 1.58 puntos porcentuales
IC 95% de la diferencia: [ 0.12 , 3.03 ] puntos
Cambio relativo = 13.3 % sobre la tasa de A
z = 2.123   p-value = 0.0337

La misma pregunta como tabla 2×2:  χ² = 4.509   p = 0.0337
z² = 4.509   ← coincide con χ²
La aceptación fue de 11.80% en A (472 de 4000) y de 13.38% en B (535 de 4000). La diferencia es de 1.58 puntos porcentuales, con IC 95% de 0.12 a 3.03 puntos. El estadístico es \(z=2.12\) y el p-value 0.034, así que rechazas la igualdad de proporciones a \(\alpha=0.05\).
La prueba y el intervalo coinciden. El intervalo no contiene el 0 y el p-value es menor que 0.05. Usan errores estándar algo distintos (combinado en la prueba, separado en el intervalo), así que en casos muy ajustados podrían no coincidir.
El intervalo es ancho. Va de una mejora casi nula (0.12 puntos) a una de 3 puntos: en el panel derecho, el extremo izquierdo de la barra verde casi toca la línea de 0. El resultado es compatible con un efecto irrelevante y con uno considerable; el experimento detecta que hay diferencia mejor de lo que la mide.
Absoluto y relativo. «1.58 puntos porcentuales» y «13.3% más aceptación» describen el mismo resultado; el segundo suena mayor porque la tasa base es baja. Un reporte honesto da los dos.
Planteada como tabla \(2\times 2\), la misma pregunta da \(\chi^2=4.509\) y el mismo p-value. La igualdad \(z^2=\chi^2\) se cumple siempre que hay 1 grado de libertad, porque una \(\chi^2_1\) es una normal estándar al cuadrado (etapa 1). La prueba \(z\) conserva algo que la \(\chi^2\) pierde: el signo, que dice cuál de las dos versiones es mayor.
Etapa 7: Pocas observaciones, la prueba exacta de Fisher
Antes del A/B grande se hizo un piloto con 8 usuarios por versión; la tabla está escrita a mano. Es una tabla \(2\times 2\) con conteos pequeños, y la regla de la etapa 3 anticipa el problema: tienes que mirar los esperados.
La prueba exacta de Fisher no usa la aproximación \(\chi^2\). Fija los totales de filas y columnas, enumera todas las tablas posibles con esos totales y suma la probabilidad de las que son tan extremas como la observada o más, calculada con la distribución hipergeométrica. Es un cálculo exacto: vale con cualquier tamaño de muestra, sin exigir esperados grandes.
piloto = pd.DataFrame([[7, 1], [3, 5]], index=["B (cuantizado)", "A (actual)"], columns=["aceptó", "no aceptó"])print(piloto.to_string())chi2_p, p_chi, _, E_piloto = stats.chi2_contingency(piloto.values, correction=False)chi2_y, p_yates, _, _ = stats.chi2_contingency(piloto.values, correction=True)fisher = stats.fisher_exact(piloto.values)print()print("Frecuencias esperadas:")print(pd.DataFrame(E_piloto, index=piloto.index, columns=piloto.columns).to_string())print("Esperado mínimo =", E_piloto.min(), " ← por debajo de 5")print()print("χ² sin corrección: χ² =", round(chi2_p, 3), " p =", round(p_chi, 4))print("χ² con corrección de Yates: χ² =", round(chi2_y, 3), " p =", round(p_yates, 4))print("Prueba exacta de Fisher: p =", round(fisher.pvalue, 4))print("Prueba exacta de Barnard: p =", round(stats.barnard_exact(piloto.values).pvalue, 4))
                aceptó  no aceptó
B (cuantizado)       7          1
A (actual)           3          5

Frecuencias esperadas:
                aceptó  no aceptó
B (cuantizado)     5.0        3.0
A (actual)         5.0        3.0
Esperado mínimo = 3.0   ← por debajo de 5

χ² sin corrección:        χ² = 4.267   p = 0.0389
χ² con corrección de Yates: χ² = 2.4   p = 0.1213
Prueba exacta de Fisher:              p = 0.1189
Prueba exacta de Barnard:             p = 0.0573
En el piloto aceptaron 7 de 8 usuarios en B (87.5%) y 3 de 8 en A (37.5%). La diferencia muestral es enorme, pero los esperados son 5 y 3: el supuesto no se cumple, y las pruebas no concuerdan. La \(\chi^2\) sin corrección da \(p=0.039\) y llevaría a rechazar \(H_0\). La prueba exacta de Fisher da \(p=0.119\) y no rechaza. La corrección de Yates, que resta 0.5 al valor absoluto de cada discrepancia antes de elevar al cuadrado, da \(p=0.121\), cerca de la de Fisher.
Con esperados pequeños conviene una prueba exacta, porque no depende de una aproximación. La de Fisher es además conservadora: con tan pocos datos rechaza menos del 5% de las veces aun con \(H_0\) cierta. Otra prueba exacta, la de Barnard, que no fija los totales de columna, da aquí \(p=0.057\). Ninguna de las dos rechaza a \(\alpha=0.05\): con 16 usuarios no puedes descartar que la diferencia se deba al azar. Eso tampoco muestra que no haya diferencia, porque con tan pocos datos la potencia es baja, y el A/B de la etapa 6 sí la detectó con 4000 usuarios por versión.
chi2_contingency aplica la corrección de Yates por defecto en tablas \(2\times 2\). En este capítulo se usa correction=False para que el resultado coincida con la fórmula hecha a mano. Con muestras grandes la corrección casi no cambia nada; con muestras pequeñas, usa Fisher.
Etapa 8: Muestra enorme, asociación mínima
El contraste que viste con medias en el capítulo 9 vale igual para conteos. Simulas dos experimentos con el mismo efecto real: la tasa de respuestas incorrectas pasa de 10.0% en A a 10.5% en B, medio punto porcentual.
Un experimento pequeño, con 500 requests por versión.
Un experimento enorme, con 500 000 requests por versión.
def experimento_error(n): a = rng.multinomial(n, [0.900, 0.100]) b = rng.multinomial(n, [0.895, 0.105]) chi2_e, p_e, _, _ = stats.chi2_contingency([a, b], correction=False)return {"n por versión": n,"error A (%)": a[1] / n *100,"error B (%)": b[1] / n *100,"diferencia (puntos)": (b[1] - a[1]) / n *100,"chi2": chi2_e,"p-value": p_e,"V de Cramér": np.sqrt(chi2_e / (2* n)), }comparacion = pd.DataFrame([experimento_error(500), experimento_error(500_000)])print(comparacion.round({"error A (%)": 2, "error B (%)": 2, "diferencia (puntos)": 2, "chi2": 2, "V de Cramér": 4}) .to_string(index=False, formatters={"p-value": "{:.2e}".format}))
 n por versión  error A (%)  error B (%)  diferencia (puntos)  chi2  p-value  V de Cramér
           500         9.40        11.40                 2.00  1.07 3.00e-01       0.0328
        500000         9.98        10.57                 0.59 93.77 3.54e-22       0.0097
En el experimento pequeño la diferencia observada es de 2.00 puntos y el p-value 0.30, así que no rechazas \(H_0\). En el enorme, la diferencia observada es de 0.59 puntos y el p-value \(3.5\times10^{-22}\): el experimento con la diferencia observada más pequeña es el que tiene el p-value más extremo.
La V de Cramér del experimento enorme es 0.0097, una asociación casi nula. El p-value mide qué tan compatible es la diferencia con el azar solo; con un millón de requests el azar explica muy poco, y medio punto se detecta sin dificultad. La V del experimento pequeño (0.033) es mayor solo porque su diferencia observada, 2 puntos, salió alta por azar. Si medio punto de error importa es una pregunta sobre el costo de un error, y la responde el negocio.
El experimento pequeño tampoco contradice al grande. Con 500 requests por versión, medio punto es indetectable, y la diferencia de 2.00 puntos que observaste es compatible con el efecto real de 0.5 y también con ningún efecto.
Etapa 9: Los mismos casos, dos modelos, la prueba de McNemar
Para comparar la exactitud de A y B, lo habitual es pasar el mismo conjunto de prueba por los dos modelos. Eso rompe el primer supuesto de la prueba chi-cuadrado: las observaciones ya no son independientes, porque cada caso aparece dos veces. Un caso difícil tiende a fallar en los dos modelos, y uno fácil, a acertar en los dos.
Con datos pareados, la tabla correcta no cruza modelo con acierto. Cruza el resultado de A con el de B, caso por caso:
B acierta
B falla
A acierta
ambos aciertan
\(b\): solo A acierta
A falla
\(c\): solo B acierta
ambos fallan
Los casos en que los dos modelos coinciden no dicen nada sobre cuál es mejor; toda la información está en los discordantes, \(b\) y \(c\). Si los dos modelos fueran igual de buenos, un caso discordante favorecería a A o a B con la misma probabilidad:
\[
H_0: P(\text{solo A acierta})=P(\text{solo B acierta}),\qquad \chi^2_{\text{McNemar}}=\frac{(b-c)^2}{b+c}\ \text{ con 1 grado de libertad}.
\]
La versión exacta usa la distribución binomial: bajo \(H_0\), \(b\sim\text{Binomial}(b+c,\,0.5)\). Los conteos de los 400 casos de prueba están escritos a mano.
n_casos =400# Conteos diseñados. Cada caso cae en una de cuatro situaciones:# ambos aciertan, solo A acierta, solo B acierta, ambos fallanambos, solo_a, solo_b, ninguno =318, 28, 12, 42pareada = pd.DataFrame([[ambos, solo_a], [solo_b, ninguno]], index=["A acierta", "A falla"], columns=["B acierta", "B falla"])print("Tabla pareada (cada caso cuenta una sola vez)")print(pareada.to_string())acc_a = (ambos + solo_a) / n_casosacc_b = (ambos + solo_b) / n_casosprint()print("Exactitud A =", round(acc_a *100, 2), "% Exactitud B =", round(acc_b *100, 2), "%")print("Diferencia A − B =", round((acc_a - acc_b) *100, 2), "puntos = (b − c)/n =", round((solo_a - solo_b) / n_casos *100, 2))se_par = np.sqrt(solo_a + solo_b - (solo_a - solo_b) **2/ n_casos) / n_casos # error estándar con datos pareadosprint("IC 95% de la diferencia pareada: [", round((acc_a - acc_b -1.96* se_par) *100, 2), ",",round((acc_a - acc_b +1.96* se_par) *100, 2), "] puntos")b, c =int(solo_a), int(solo_b)chi2_mc = (b - c) **2/ (b + c)print()print("Discordantes: b =", b, " c =", c)print("McNemar: χ² =", round(chi2_mc, 3), " p =", round(stats.chi2.sf(chi2_mc, 1), 4))print("McNemar exacta (binomial): p =", round(stats.binomtest(b, b + c, 0.5).pvalue, 4))# El análisis equivocado: tratar los 800 resultados como si fueran de casos distintosmal = np.array([[ambos + solo_a, n_casos - ambos - solo_a], [ambos + solo_b, n_casos - ambos - solo_b]])chi2_mal, p_mal, _, _ = stats.chi2_contingency(mal, correction=False)print()print("Chi-cuadrado ignorando el pareo: χ² =", round(chi2_mal, 3), " p =", round(p_mal, 4))
Tabla pareada (cada caso cuenta una sola vez)
           B acierta  B falla
A acierta        318       28
A falla           12       42

Exactitud A = 86.5 %   Exactitud B = 82.5 %
Diferencia A − B = 4.0 puntos  = (b − c)/n = 4.0
IC 95% de la diferencia pareada: [ 0.93 , 7.07 ] puntos

Discordantes: b = 28  c = 12
McNemar:  χ² = 6.4   p = 0.0114
McNemar exacta (binomial): p = 0.0166

Chi-cuadrado ignorando el pareo: χ² = 2.443   p = 0.118
La exactitud es 86.5% en A y 82.5% en B: 4 puntos de diferencia sobre los mismos 400 casos.
Análisis equivocado. Tratar los 800 resultados como independientes da \(\chi^2=2.44\) y \(p=0.118\), y no rechazarías \(H_0\).
Análisis correcto. McNemar usa solo los 40 casos discordantes: A acierta sola en 28 y B acierta sola en 12. El estadístico es \((28-12)^2/40=6.4\), con \(p=0.011\) (\(p=0.017\) en la versión exacta), y rechazas \(H_0\). El IC 95% de la diferencia pareada va de 0.9 a 7.1 puntos.
La diferencia de exactitud es la misma en los dos análisis, porque \((b-c)/n=16/400=4\) puntos; lo que cambia es contra qué variabilidad la comparas. Los resultados de A y B sobre un mismo caso están correlacionados: coinciden en 360 de 400 (318 aciertos comunes y 42 fallos comunes), presumiblemente porque hay casos fáciles y difíciles para ambos. El análisis pareado aprovecha esa correlación; el otro la ignora y sobrestima el error estándar de la diferencia.
En este ejemplo, ignorar el pareo vuelve la prueba menos sensible. No siempre ocurre en esa dirección, pero el p-value calculado siempre deja de corresponder al diseño real. Ten presente también que McNemar compara dos modelos sobre un conjunto de prueba, y no considera la variación que habría al reentrenarlos con otros datos.
Etapa 10: Reportar una prueba con conteos
El reporte sigue siete pasos, los del capítulo 9 con dos propios de los conteos:
Población y variables: qué cuentas, en quién y con qué categorías.
Diseño:\(n\), grupos, independientes o pareados, y \(\alpha\).
Tabla: frecuencias observadas y porcentajes por grupo.
Supuesto: frecuencia esperada mínima.
Prueba:\(H_0\), estadístico, grados de libertad, p-value y decisión.
Efecto y ubicación: tamaño del efecto y celdas que se apartan.
Relevancia y límites: qué significa para la decisión y qué amenaza la lectura.
Los aplicas al A/B de resultados de las etapas 4 y 5.
Población y variables. Requests de un servicio de inferencia. Variables: versión del modelo (A, B) y resultado (correcta, incorrecta, timeout).
Diseño. 1000 requests por versión, asignados al azar, muestras independientes, \(\alpha=0.05\).
Tabla. A: 874 correctas, 69 incorrectas y 57 timeouts. B: 880, 99 y 21. En porcentaje: 87.4, 6.9 y 5.7 frente a 88.0, 9.9 y 2.1.
Supuesto. Frecuencia esperada mínima: 39.
Prueba.\(H_0\): la distribución de resultados es la misma en las dos versiones. \(\chi^2(2)=21.99\), \(p=1.7\times10^{-5}\). Se rechaza \(H_0\).
Efecto y ubicación. V de Cramér de 0.105 (pequeña). Residuos ajustados: timeout ±4.16, incorrecta ±2.42, correcta ±0.41.
Relevancia y límites. Con B hay menos timeouts y más respuestas incorrectas, y no se detecta diferencia en la tasa de respuestas correctas (el intervalo admite un par de puntos en cualquier dirección). Los datos no dicen si son los mismos tipos de request los que pasan de una categoría a la otra, y cuál de los dos fallos cuesta más depende del uso. Limitaciones: datos simulados, una sola corrida y residuos leídos después de la prueba global.
En un A/B con 1000 requests por versión, la distribución de resultados difiere entre versiones (\(\chi^2(2)=22.0\), \(p<0.001\); esperado mínimo 39; V de Cramér de 0.11). No se detecta diferencia en la proporción de respuestas correctas (87.4% en A, 88.0% en B). La versión cuantizada tiene menos timeouts (2.1% frente a 5.7%) y más respuestas incorrectas (9.9% frente a 6.9%). La recomendación depende del costo relativo de un timeout y de una respuesta incorrecta, que estos datos no miden.
Etapa 11: Un cálculo completo a mano
Con un ejemplo pequeño y números redondos puedes hacer todo a mano y dejar el código como verificación. Quieres saber si la aceptación de la recomendación se relaciona con el tipo de dispositivo, en una muestra escrita a mano de 120 sesiones de usuarios distintos, 60 desde móvil y 60 desde escritorio:
aceptó
no aceptó
total
móvil
18
42
60
escritorio
30
30
60
total
48
72
120
Hipótesis.\(H_0\): aceptar la recomendación es independiente del dispositivo. \(H_1\): la proporción de aceptación cambia con el dispositivo. \(\alpha=0.05\).
Frecuencias esperadas. Si el dispositivo no importara, las dos filas tendrían la proporción de aceptación del total, \(48/120=0.40\):
\[
E_{\text{móvil, aceptó}}=\frac{60\times 48}{120}=24,\qquad E_{\text{móvil, no aceptó}}=\frac{60\times 72}{120}=36,
\]
y lo mismo para escritorio, porque las dos filas tienen 60 sesiones. El esperado mínimo es 24, así que el supuesto se cumple.
Estadístico. En las cuatro celdas la discrepancia vale 6, con signo distinto:
celda
\(O\)
\(E\)
\(O-E\)
\((O-E)^2/E\)
móvil, aceptó
18
24
\(-6\)
\(36/24=1.5\)
móvil, no aceptó
42
36
\(+6\)
\(36/36=1.0\)
escritorio, aceptó
30
24
\(+6\)
\(36/24=1.5\)
escritorio, no aceptó
30
36
\(-6\)
\(36/36=1.0\)
\[
\chi^2=1.5+1.0+1.5+1.0=5.0 .
\]
Distribución de referencia y decisión. La tabla es \(2\times 2\), con \((2-1)(2-1)=1\) grado de libertad. El valor crítico de \(\chi^2_1\) al 5% es 3.84; como \(5.0>3.84\), rechazas \(H_0\). El p-value es el área de \(\chi^2_1\) a la derecha de 5.0.
Tamaño del efecto. La aceptación es \(18/60=30\%\) en móvil y \(30/60=50\%\) en escritorio, 20 puntos porcentuales de diferencia, y
Esperadas:
            aceptó  no aceptó
móvil         24.0       36.0
escritorio    24.0       36.0

χ² a mano = 5.0   valor crítico χ²(1) al 5% = 3.841
p-value = 0.0253
V de Cramér = 0.204

SciPy sin corrección:   χ² = 5.0   p = 0.0253
SciPy con Yates:        χ² = 4.201   p = 0.0404
Fisher exacta:          p = 0.0399

Diferencia escritorio − móvil = 20.0 puntos   IC 95%: [ 2.8 , 37.2 ]
El código reproduce cada número del cálculo a mano: esperados de 24 y 36, \(\chi^2=5.0\) y \(V=0.204\). El p-value es 0.025: si el dispositivo no se relacionara con la aceptación, una tabla tan alejada de la esperada o más aparecería en alrededor de 25 de cada 1000 muestras.
La decisión no depende de la variante. Con corrección de Yates \(p=0.040\) y con Fisher \(p=0.040\); las tres rechazan a \(\alpha=0.05\). No es evidencia adicional, porque son los mismos datos, pero indica que la conclusión no cambia con la variante elegida. Si discreparan, tendrías que reportarlo.
El efecto se estima con poca precisión. La diferencia observada es de 20 puntos (\(V=0.20\), entre pequeña y mediana con las referencias de la etapa 5), y el IC 95% va de 2.8 a 37.2 puntos. Con 60 sesiones por grupo, los datos apoyan que hay diferencia y dicen poco sobre su tamaño.
Es una asociación. Las sesiones no se asignaron al azar a un dispositivo. Quienes usan escritorio pueden diferir de quienes usan móvil en muchas otras cosas (hora, tipo de tarea, tipo de usuario), y la tabla no permite separar esas explicaciones.
En 120 sesiones (60 por dispositivo), la aceptación fue de 30% en móvil y 50% en escritorio. La diferencia es de 20 puntos porcentuales (IC 95%: 2.8 a 37.2). \(\chi^2(1)=5.0\), \(p=0.025\), esperado mínimo 24, V de Cramér de 0.20. Los datos son observacionales: muestran asociación entre dispositivo y aceptación, sin establecer la causa.
Ejercicio
Con la misma tabla, calcula a mano la prueba \(z\) de dos proporciones de la etapa 6 (con la proporción combinada) y comprueba que \(z^2\) coincide con el \(\chi^2\) de 5.0.
TipOrientaciones
La proporción combinada es \(\hat p=48/120=0.40\), y el error estándar bajo \(H_0\) es \(\sqrt{0.40\times 0.60\times(1/60+1/60)}=\sqrt{0.008}\approx 0.0894\). La diferencia es \(0.50-0.30=0.20\), así que \(z=0.20/0.0894\approx 2.236\) y \(z^2=5.0\), igual que el \(\chi^2\). El p-value bilateral de \(z=2.236\) es 0.025, el mismo de la celda.
Etapa 12: Vigilar la deriva de un clasificador en producción
Un clasificador se entrena con una distribución de clases, y en producción esa distribución puede cambiar: aparece un producto nuevo, cambia la temporada, cambia el tipo de usuario. Ese cambio se llama deriva (drift) y puede degradar el modelo sin que se note a tiempo, porque en producción casi nunca tienes pronto la etiqueta verdadera.
Lo que sí tienes es lo que el modelo predice, y vigilar la distribución de las clases predichas es una prueba de bondad de ajuste. Las proporciones de referencia son las de las predicciones del modelo sobre un conjunto de validación amplio y reciente; no se usan las etiquetas del entrenamiento, porque un modelo imperfecto no reproduce exactamente su distribución. Los conteos observados son las predicciones de cada semana.
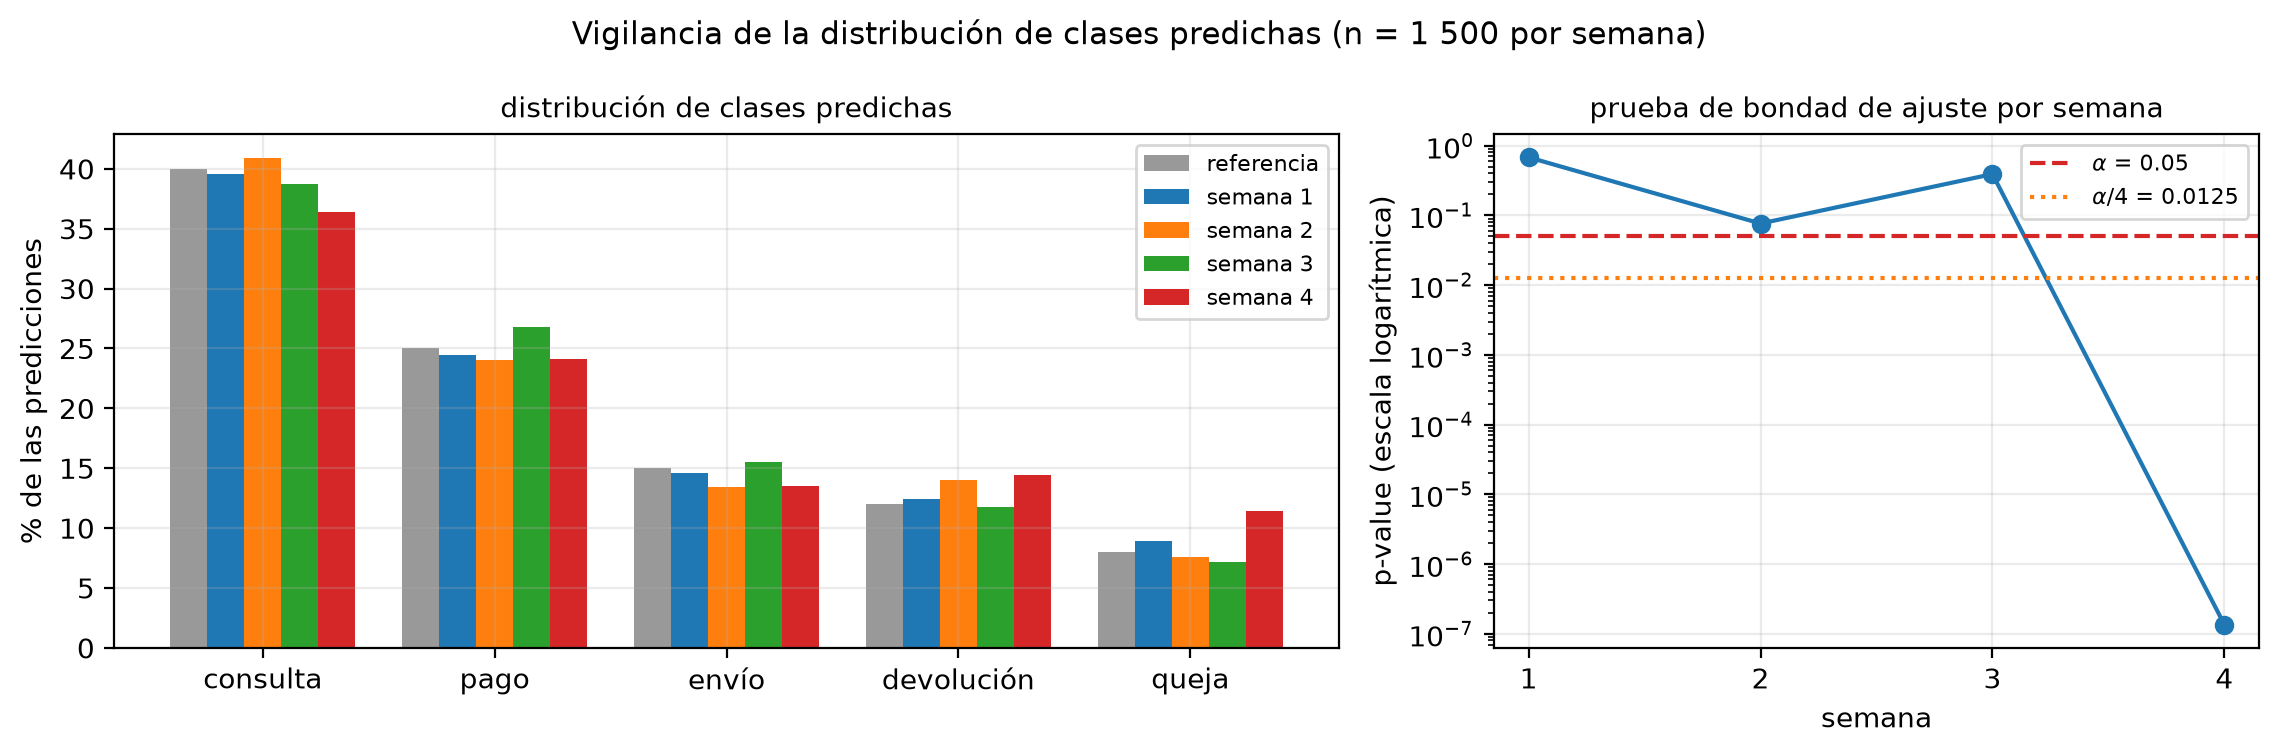
Un clasificador de intención ficticio asigna cada mensaje de soporte a una de cinco clases. En validación, sus predicciones se repartieron en proporciones 0.40, 0.25, 0.15, 0.12 y 0.08. Revisas cuatro semanas de producción, con 1500 mensajes cada una. Las tres primeras se simulan con esa distribución de referencia. En la cuarta, por diseño, queja sube de 8% a 12% y el resto se reacomoda: consulta baja de 40% a 36%, pago de 25% a 24% y devolución sube de 12% a 13%. Simulas directamente los conteos de predicciones con rng.multinomial; no hay un modelo entrenado detrás.
\[
H_0:\text{las predicciones de la semana siguen las proporciones de referencia}.
\]
clases = ["consulta", "pago", "envío", "devolución", "queja"]p_ref = np.array([0.40, 0.25, 0.15, 0.12, 0.08])p_semana4 = np.array([0.36, 0.24, 0.15, 0.13, 0.12])n_sem =1500filas, proporciones = [], []for semana, p_real inenumerate([p_ref, p_ref, p_ref, p_semana4], start=1): conteos = rng.multinomial(n_sem, p_real) esperado = n_sem * p_ref prueba = stats.chisquare(conteos, f_exp=esperado) resid = (conteos - esperado) / np.sqrt(esperado * (1- p_ref)) # residuo ajustado, como en la sección 1.9 proporciones.append(conteos / n_sem) filas.append({"semana": semana,**dict(zip(clases, conteos)),"chi2": round(prueba.statistic, 2),"p-value": prueba.pvalue,"w": round(np.sqrt(prueba.statistic / n_sem), 3),"mayor residuo": f"{clases[np.abs(resid).argmax()]} ({resid[np.abs(resid).argmax()]:+.2f})", })monitoreo = pd.DataFrame(filas)print("Esperado por semana:", dict(zip(clases, (n_sem * p_ref).astype(int).tolist())))print()print(monitoreo.to_string(index=False, formatters={"p-value": lambda p: f"{p:.4f}"if p >=0.0001elsef"{p:.1e}"}))print()print("Residuos ajustados de la semana 4:", dict(zip(clases, resid.round(2).tolist())))print("Semanas con p < 0.05: ", monitoreo.loc[monitoreo["p-value"] <0.05, "semana"].tolist())print("Semanas con p < 0.05/4 = 0.0125:", monitoreo.loc[monitoreo["p-value"] <0.05/4, "semana"].tolist())graficar_deriva(clases, p_ref, proporciones, monitoreo["p-value"].values,"Vigilancia de la distribución de clases predichas (n = 1 500 por semana)")
Esperado por semana: {'consulta': 600, 'pago': 375, 'envío': 225, 'devolución': 180, 'queja': 120}

 semana  consulta  pago  envío  devolución  queja  chi2 p-value     w      mayor residuo
      1       593   367    219         187    134  2.32  0.6775 0.039      queja (+1.33)
      2       613   361    202         210    114  8.46  0.0762 0.075 devolución (+2.38)
      3       581   402    233         176    108  4.12  0.3901 0.052       pago (+1.61)
      4       546   362    203         217    172 37.60 1.4e-07 0.158      queja (+4.95)

Residuos ajustados de la semana 4: {'consulta': -2.85, 'pago': -0.78, 'envío': -1.59, 'devolución': 2.94, 'queja': 4.95}
Semanas con p < 0.05:         [4]
Semanas con p < 0.05/4 = 0.0125: [4]
En las tres primeras semanas, generadas sin deriva, los p-values son 0.68, 0.076 y 0.39: ninguna alarma. En la cuarta, \(\chi^2=37.6\) y \(p=1.4\times10^{-7}\). El mayor residuo corresponde a queja, con 172 predicciones cuando esperabas 120 (11.5% frente a 8%; residuo de +4.95). También se apartan devolución (+2.94) y consulta (−2.85), que cambiaron por diseño, pero la prueba no distingue cuál es el cambio de origen y cuál el reacomodo. La columna w resume la magnitud: de 0.04 a 0.08 en las semanas sin deriva y 0.16 en la cuarta. En el panel derecho de la figura, el p-value de la semana 4 cae por debajo de \(10^{-6}\), muy lejos de las dos líneas de umbral.
La semana 2 merece atención. Su p-value es 0.076 y un residuo llega a +2.38 (devolución), aunque se generó sin deriva. Si miraras solo ese residuo, verías una señal donde no la hay: los residuos son varios, y alguno pasa de 2 por azar.
Varias semanas son varias pruebas. Con \(\alpha=0.05\) por semana y sin deriva alguna, la probabilidad de al menos una falsa alarma en cuatro semanas es \(1-0.95^4=0.185\). Un ajuste simple es exigir \(p<0.05/4=0.0125\), la línea punteada de la figura, y la semana 4 lo pasa con holgura; el capítulo 11 desarrolla este problema.
Este uso de la prueba tiene tres límites:
Detecta cambio, no daño. Que cambie la distribución de las predicciones no dice si el modelo acierta menos: puede haber cambiado la mezcla real de mensajes y el modelo seguir clasificando bien. La prueba te indica dónde mirar, y la respuesta exige etiquetar una muestra.
Con mucho volumen todo es significativo. Con un millón de predicciones por semana, cambios de décimas de punto darían p-values diminutos (etapa 8). En sistemas grandes conviene vigilar el tamaño del efecto y fijar un umbral sobre él.
Las observaciones deben ser independientes. Si un mismo usuario envía veinte mensajes seguidos sobre el mismo problema, los conteos sobrestiman la información disponible.
El ejemplo usa la misma prueba de la etapa 2: las réplicas del balanceador son ahora las clases del modelo, y el reparto uniforme, la distribución de referencia.
Errores que conviene nombrar
Aplicar la prueba a porcentajes. La fórmula necesita conteos; usar porcentajes equivale a suponer \(n=100\), sea cual sea la muestra real.
Revisar las frecuencias observadas en lugar de las esperadas. El supuesto es sobre \(E\), y una celda puede tener 0 observados y cumplirlo.
Usar chi-cuadrado con datos pareados. Dos modelos sobre el mismo conjunto de prueba, o un antes y un después de los mismos usuarios, piden McNemar: en la etapa 9, ignorar el pareo llevó de \(p=0.011\) a \(p=0.118\).
Leer el p-value como fuerza de la asociación. Para eso están la V de Cramér y la diferencia de proporciones.
Detenerse en la prueba global. Rechazar \(H_0\) en una tabla de varias categorías no dice cuál cambió.
Leer cada residuo como una prueba confirmatoria. Son varias celdas a la vez, y sirven de guía para ubicar la discrepancia.
Fusionar o eliminar categorías después de ver los datos hasta que el resultado sea significativo. Las categorías se definen antes.
Olvidar que SciPy corrige por defecto las tablas \(2\times 2\).chi2_contingency aplica la corrección de Yates salvo que indiques correction=False; di cuál usaste.
Concluir causalidad a partir de una asociación observada. La prueba detecta relación; solo la asignación al azar del experimento permite atribuirla a la versión.
10.6 Guía rápida: ¿qué prueba usar?
Situación
Qué usar
En SciPy
Una variable categórica frente a proporciones conocidas
Bondad de ajuste, \(k-1\) gl
stats.chisquare(obs, f_exp=esp)
Dos variables categóricas, muestras independientes
Independencia, \((f-1)(c-1)\) gl
stats.chi2_contingency(tabla) (en \(2\times 2\) aplica Yates salvo correction=False)
Dos grupos, respuesta sí o no
\(z\) de dos proporciones o \(\chi^2\) en tabla \(2\times 2\)
stats.chi2_contingency(tabla, correction=False)
Tabla \(2\times 2\) con esperados menores que 5
Prueba exacta de Fisher
stats.fisher_exact(tabla)
Los mismos casos medidos dos veces, respuesta sí o no
Al reportar, sigue este orden: tabla observada, esperado mínimo, estadístico con sus grados de libertad, p-value y tamaño del efecto.
10.7 Preguntas de comprensión
Un analista compara la tasa de clics de dos versiones con una tabla de porcentajes (12% y 15%) y obtiene un \(\chi^2\) que no es significativo. ¿Qué hizo mal?
Una tabla \(3\times 4\) tiene una celda con 0 observados. ¿Eso basta para descartar la prueba chi-cuadrado?
Evalúas dos modelos de lenguaje sobre las mismas 200 preguntas: el primero acierta 150 y el segundo 138. ¿Qué datos necesitas para saber si la diferencia es significativa, y qué prueba usas?
Una prueba de independencia sobre 2 millones de sesiones da \(p<10^{-10}\) y una V de Cramér de 0.008. ¿Cómo lo reportarías?
En una vigilancia semanal de deriva con \(\alpha=0.05\), ¿cuántas falsas alarmas esperas en un año sin deriva real?
TipOrientaciones
Usó porcentajes en lugar de conteos. La prueba necesita las frecuencias absolutas, porque el mismo 12% frente a 15% pesa muy distinto con 100 usuarios que con 10 000; usar porcentajes equivale a suponer \(n=100\) por grupo.
No. El supuesto se revisa sobre las frecuencias esperadas, no sobre las observadas. Si todas las esperadas son al menos 5 (o casi todas, y ninguna menor que 1), la prueba sigue siendo válida aunque una celda tenga 0.
Necesitas la tabla pareada: en cuántas preguntas acierta solo el primero (\(b\)) y en cuántas solo el segundo (\(c\)). Los totales no bastan, porque son los mismos casos. Usas McNemar, \((b-c)^2/(b+c)\), o su versión exacta con binomtest(b, b + c, 0.5). La diferencia \(b-c\) es necesariamente \(150-138=12\), pero la significancia depende de cuántos casos discordantes hay.
Como una asociación estadísticamente detectable y prácticamente despreciable: con 2 millones de sesiones el azar explica casi nada, y cualquier diferencia minúscula sale significativa (etapa 8). El reporte debe dar la V y las diferencias de proporciones con su intervalo, y la decisión depende de si esa magnitud importa para el negocio.
Con 52 semanas, esperas \(52\times 0.05=2.6\) falsas alarmas al año, y la probabilidad de al menos una es \(1-0.95^{52}\approx 0.93\). Conviene ajustar el umbral por comparaciones múltiples o vigilar el tamaño del efecto (etapa 12).
10.8 Referencias para profundizar
Agresti, A. (2019). An Introduction to Categorical Data Analysis (3.ª ed.). Wiley. La referencia estándar para tablas de contingencia, residuos y pruebas exactas.
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, 50(302), 157–175. El artículo que introdujo la prueba chi-cuadrado.
McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. La prueba para proporciones pareadas.
Dietterich, T. G. (1998). Approximate statistical tests for comparing supervised classification learning algorithms. Neural Computation, 10(7), 1895–1923. Por qué McNemar es una opción razonable para comparar dos clasificadores sobre un mismo conjunto de prueba.
Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2.ª ed.). Lawrence Erlbaum. Origen de la medida de efecto \(w\) y de sus valores orientativos.
Rabanser, S., Günnemann, S. y Lipton, Z. C. (2019). Failing loudly: An empirical study of methods for detecting dataset shift. Advances in Neural Information Processing Systems, 32. Comparación de pruebas estadísticas para detectar deriva.
Una prueba con conteos compara lo observado con lo que esperarías bajo \(H_0\): el estadístico \(\chi^2\) mide esa distancia, la distribución chi-cuadrado dice cuánta distancia produce el azar, los residuos ubican la discrepancia y el tamaño del efecto dice si importa.
La chi-cuadrado es una suma de normales al cuadrado, con media igual a sus grados de libertad; un \(\chi^2\) se lee siempre con ellos.
Bondad de ajuste, independencia y dos proporciones son la misma idea: el balanceador dio \(\chi^2(3)=19.11\), el A/B de resultados \(\chi^2(2)=21.99\) y la aceptación \(z=2.12\), con \(z^2=\chi^2\).
La aproximación necesita esperados de al menos 5: con esperados de hasta 0.4, la prueba rechazó el 6.63% de las veces en lugar del 5%. Con tablas pequeñas, Fisher (en el piloto, \(p=0.119\) frente al 0.039 de la aproximación).
El p-value no mide la fuerza de la asociación: con 500 000 requests por versión, medio punto dio \(p=3.5\times10^{-22}\) y una V de 0.0097.
Con los mismos casos en dos modelos, la prueba es McNemar sobre los discordantes (28 frente a 12, \(p=0.011\)); ignorar el pareo dio \(p=0.118\).
Vigilar la distribución de las predicciones es una bondad de ajuste semanal: detecta un cambio (queja de 8% a 11.5%), no un daño, y varias semanas son varias pruebas.
10.10 Puente hacia los siguientes capítulos
Este capítulo cubrió la rama del mapa en la que la respuesta es una categoría. El capítulo 11 recorre la otra rama, en la que la respuesta es un número: qué hacer con mediciones pareadas, con más de dos grupos (ANOVA), con distribuciones muy asimétricas (pruebas no paramétricas y de permutación) y cuando haces muchas pruebas a la vez, un problema que ya asomó en la etapa 12, donde cuatro semanas eran cuatro oportunidades de una falsa alarma.
La distribución chi-cuadrado vuelve en el nivel Avanzado, en los modelos lineales generalizados, donde sirve para comparar modelos y medir qué tan bien se ajustan a los datos. Y las tablas de conteos reaparecen en el capítulo 14 como matrices de confusión.