import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy.stats import poisson as poisson_dist
from sklearn.model_selection import train_test_split, GridSearchCV, KFold
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression, PoissonRegressor
from sklearn.metrics import mean_absolute_error, mean_poisson_deviance
import statsmodels.api as sm

SEMILLA = 7
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (8, 4)
plt.rcParams['axes.spines.top'] = False
plt.rcParams['axes.spines.right'] = False23 GLM: regresión de Poisson
estadistica
glm
regresion-poisson
Cuando lo que cuentas son eventos
En el capítulo de modelos lineales generalizados la respuesta era sí o no. Ahora la respuesta es un conteo: cuántas incidencias tuvo una ruta, cuántos pedidos llegaron en una hora o cuántas llamadas recibió un centro de soporte. Son números enteros, nunca negativos, y a menudo con muchos ceros.
Usar una regresión lineal para conteos produce predicciones imposibles: en este capítulo, una recta asigna a rutas de prueba hasta −1.052 incidencias. La regresión de Poisson, otro modelo lineal generalizado (GLM, por sus siglas en inglés), modela la tasa a la que ocurren los eventos y garantiza predicciones positivas. La construyes sobre un caso de transporte: predecir el número de incidencias por ruta.
El método es el del capítulo anterior, con los mismos seis pasos para construir un GLM; aquí lo aplicas a otra clase de respuesta.
- Tiempo estimado de lectura: 60 minutos (unas 2 horas si ejecutas el código y resuelves el repaso)
- Nivel: Avanzado
- Conocimientos previos recomendados: el GLM y la regresión logística, la regularización y la validación cruzada k-fold del nivel Avanzado, y las variables aleatorias y distribuciones y las pruebas para datos categóricos del nivel Básico.
- Tecnologías mencionadas: Python, NumPy, pandas, Matplotlib, SciPy, scikit-learn (
PoissonRegressor,GridSearchCV), statsmodels (GLM) y PyTorch.
Todos los datos son hipotéticos o simulados. La tabla de 100 intervalos del repaso es inventada; las 700 rutas se simulan con la regla y la semilla central (SEMILLA = 7) declaradas en el código, y los 20 conductores del ejemplo resuelto son ilustrativos. Ninguno procede de clientes. Todo corre en CPU, y las versiones se imprimen en la celda de preparación del entorno.
Objetivos
Al terminar este capítulo vas a ser capaz de:
- calcular media y varianza desde una tabla de frecuencias, estimar probabilidades de Poisson y evaluar su bondad de ajuste;
- reconocer cuándo una respuesta es un conteo y por qué una regresión lineal puede producir predicciones imposibles;
- aplicar los seis pasos generales de un GLM a una respuesta de conteo;
- describir las tres piezas de un GLM de Poisson: distribución, predictor lineal y enlace log;
- explicar por qué la función exponencial garantiza una tasa esperada positiva;
- ajustar un modelo predictivo con
PoissonRegressor, elegir su regularización por validación cruzada y evaluarlo sobre datos de prueba; - interpretar coeficientes como cocientes de tasas de incidencia (IRR), incluidos cambios de varias unidades;
- distinguir el propósito predictivo de scikit-learn del propósito inferencial de statsmodels;
- comparar el modelo con una línea base de media constante mediante la deviance de Poisson;
- reconocer el supuesto de equidispersión y la señal básica de sobredispersión.
23.1 Repaso: de una tabla de frecuencias al modelo de Poisson
Un centro de soporte hipotético registra cuántas solicitudes llegan en cada intervalo de 30 minutos. La tabla resume 100 intervalos de igual duración. Los datos son inventados para este ejercicio; no corresponden a una empresa. La frecuencia indica cuántos intervalos tuvieron cada conteo, no cuántas solicitudes llegaron en total.
| Solicitudes en 30 minutos \(x\) | Frecuencia: número de intervalos \(f\) | \(xf\) | \(x^2f\) |
|---|---|---|---|
| 0 | 14 | 0 | 0 |
| 1 | 19 | 19 | 19 |
| 2 | 28 | 56 | 112 |
| 3 | 17 | 51 | 153 |
| 4 | 13 | 52 | 208 |
| 5 | 6 | 30 | 150 |
| 6 | 3 | 18 | 108 |
| Más de 6 | 0 | 0 | 0 |
| Total | 100 | 226 | 750 |
Resuelve tres preguntas:
- Calcula la media y la varianza. ¿Son compatibles, como primera revisión, con un modelo de Poisson?
- Bajo ese modelo, ¿cuáles son las probabilidades de recibir exactamente 1, exactamente 2 y exactamente 3 solicitudes en un nuevo intervalo de 30 minutos?
- Comprueba los cálculos y evalúa formalmente si la distribución de los conteos es compatible con Poisson.
Define \(Y\) como el número de solicitudes en 30 minutos. Para el ejercicio supones intervalos sin superposición, llegadas independientes y una tasa estable. La tabla de frecuencias no conserva el orden temporal: no permite comprobar por sí sola la independencia ni la estabilidad de la tasa.
Media y varianza a partir de frecuencias
Primero suma las frecuencias: \(n=\sum f=100\) intervalos. El total de solicitudes es \(\sum xf=226\), así que la media se calcula ponderando cada conteo por su frecuencia:
\[ \widehat{\lambda}=\bar y=\frac{\sum xf}{n} =\frac{226}{100}=2.26\quad\text{solicitudes por intervalo de 30 minutos}. \]
No promedies simplemente los valores 0, 1, 2, 3, 4, 5 y 6: aparecen con frecuencias diferentes. En Poisson, \(\mathbb{E}(Y)=\lambda\); el sombrero de \(\widehat{\lambda}\) indica que estimaste la media poblacional desconocida con estos datos.
Para describir la dispersión de los 100 intervalos, usa la columna \(x^2f\):
\[ v_n=\frac{\sum x^2f}{n}-\bar y^2 =\frac{750}{100}-(2.26)^2 =7.5-5.1076=2.3924. \]
Esta varianza descriptiva divide entre \(n\). Si buscas la varianza muestral con corrección por grados de libertad, divides la suma de desviaciones cuadradas entre \(n-1\):
\[ s^2=\frac{750-100(2.26)^2}{99} =\frac{239.24}{99}\approx2.4166. \]
La media es 2.26 y la varianza muestral, 2.4166; su cociente es aproximadamente 1.0693. En una Poisson la media y la varianza poblacionales coinciden, pero sus estimaciones muestrales pueden diferir. La cercanía observada permite considerar Poisson como candidata; no basta para confirmarla.
Probabilidades de una, dos y tres solicitudes
La función de probabilidad de Poisson es
\[ P(Y=k)=\frac{e^{-\lambda}\lambda^k}{k!},\qquad k=0,1,2,\ldots \]
\(e\approx2.71828\) es la base de la función exponencial. El factorial multiplica los enteros desde 1 hasta \(k\): \(3!=3\times2\times1=6\), y por convenio \(0!=1\).
Sustituye \(\lambda\) por su estimación 2.26. Las probabilidades siguientes son estimadas bajo ese modelo y no incorporan la incertidumbre de la media estimada:
| Pregunta | Sustitución | Probabilidad estimada |
|---|---|---|
| Exactamente 1 solicitud | \(e^{-2.26}(2.26)^1/1!\) | 0.235832 = 23.58 % |
| Exactamente 2 solicitudes | \(e^{-2.26}(2.26)^2/2!\) | 0.266490 = 26.65 % |
| Exactamente 3 solicitudes | \(e^{-2.26}(2.26)^3/3!\) | 0.200756 = 20.08 % |
Por ejemplo, para 2 solicitudes, \(2!=2\) y obtienes \(e^{-2.26}\times5.1076/2\approx0.266490\). Conserva decimales durante el cálculo y redondea al final.
Si preguntas por 1, 2 o 3 solicitudes, sumas esos tres casos excluyentes: \(P(1\leq Y\leq3)\approx0.703078\), es decir, 70.31 %. La suma de estas tres probabilidades no debe dar 1: faltan 0 y todos los conteos mayores que 3.
Comparar frecuencias observadas y esperadas
Ahora convierte las probabilidades en números esperados de intervalos. La frecuencia observada es la que cuentas en la tabla original; la esperada es la que predice el modelo para el mismo total de 100 intervalos:
\[ f_{\text{esperada},k}=n\,P(Y=k)=100\,P(Y=k). \]
Por ejemplo, la probabilidad estimada de 2 solicitudes es 0.266490. Al multiplicarla por los 100 intervalos, obtienes
\[ f_{\text{esperada},2}=100\times0.266490\approx26.6490. \]
Observaste 28 intervalos con 2 solicitudes; el modelo espera aproximadamente 26.65 intervalos con 2 solicitudes. La comparación se refiere al número de intervalos, no al total de solicitudes.
Repite la multiplicación para cada categoría. Agrupas 4 o más para que esta misma tabla pueda usarse después en la prueba de ajuste. Su probabilidad se calcula por complemento: \(P(Y\geq4)=1-[P(Y=0)+P(Y=1)+P(Y=2)+P(Y=3)]\). Incluye también conteos mayores que 6, aunque ninguno aparezca en los datos.
| Solicitudes | Probabilidad Poisson | Cálculo: \(100\times P\) | Frecuencia observada \(O\) | Frecuencia esperada \(E\) |
|---|---|---|---|---|
| 0 | 0.104350 | \(100\times0.104350\) | 14 | 10.4350 |
| 1 | 0.235832 | \(100\times0.235832\) | 19 | 23.5832 |
| 2 | 0.266490 | \(100\times0.266490\) | 28 | 26.6490 |
| 3 | 0.200756 | \(100\times0.200756\) | 17 | 20.0756 |
| 4 o más | 0.192571 | \(100\times0.192571\) | 22 | 19.2571 |
| Total | 1 | \(100\times1\) | 100 | 100 |
Las columnas muestran valores redondeados; los cálculos se realizan conservando todos los decimales. Por eso la suma de las cifras impresas puede diferir ligeramente de los totales exactos.
Para 1 solicitud, observaste 19 intervalos y el modelo espera 23.58; para 3, observaste 17 y espera 20.08. Los esperados pueden tener decimales porque representan promedios teóricos, aunque cada intervalo real tenga un conteo entero. No redondees esos esperados a enteros antes de evaluar las diferencias.
Esta tabla comprueba cómo se obtienen las frecuencias esperadas y permite compararlas con las observadas. Las diferencias no tienen que ser cero: los conteos varían entre muestras. Para juzgar si la discrepancia es grande bajo el modelo, continúa con la prueba siguiente.
Profundización: prueba de bondad de ajuste
La prueba chi-cuadrado de bondad de ajuste resume las diferencias entre observados y esperados. Su fundamento se desarrolla en Pruebas de hipótesis para datos categóricos.
- \(H_0\): los conteos de intervalos comparables e independientes proceden de una Poisson con una media común, estimada a partir de la muestra.
- \(H_1\): la distribución de los conteos difiere de esa familia.
- Nivel de significación fijado para el ejercicio: \(\alpha=0.05\).
Los cinco esperados de la tabla superan 5. El estadístico de Pearson mide la discrepancia:
\[ T=\sum_{j=1}^{5}\frac{(O_j-E_j)^2}{E_j} \approx3.038969. \]
Por ejemplo, la categoría de 0 solicitudes aporta \((14-10.4350)^2/10.4350\approx1.2179\) al total. Se calcula con esperados sin redondear.
Como estimaste la media con la misma muestra y agrupaste la cola, obtienes el p-value mediante simulación paramétrica: generas 20 000 muestras de 100 intervalos bajo la Poisson ajustada, vuelves a estimar la media en cada muestra y repites exactamente la comparación. El p-value estima qué proporción de esas discrepancias alcanza o supera la observada. Esta calibración considera el ajuste de la media y evita tratarla como un parámetro conocido.
Con la semilla del capítulo, el resultado es p ≈ 0.3948. Al ser mayor que 0.05, no rechazas Poisson con esta tabla y esta prueba. No significa que el modelo tenga un 39.48 % de probabilidad de ser correcto, ni demuestra independencia: una tabla sin orden temporal no permite evaluar esa condición.
Qué se comprobó y qué queda pendiente
La suma ponderada da 226 solicitudes; media y varianza se calcularon con sus denominadores explícitos. Las probabilidades de 1, 2 y 3 se verifican por sustitución y con Python. La bondad de ajuste no detecta una discrepancia suficiente para rechazar Poisson en estos datos hipotéticos.
Para datos reales todavía revisarías el registro temporal, las diferencias por horario y las llegadas agrupadas por un mismo incidente. Esta es una evaluación descriptiva sobre la misma muestra usada para estimar la media; no mide el desempeño predictivo en intervalos nuevos.
En la regresión de Poisson que sigue, el modelo estima un \(\lambda_i\) para cada observación según sus predictores. Se conserva la fórmula de probabilidad y cambia la manera de obtener la media.
23.2 Preparación del entorno
# Versiones de referencia: ejecuta esta celda y guarda el notebook.
import sys
import importlib.metadata as metadatos
print('Python:', sys.version.split()[0])
for paquete in ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'statsmodels', 'torch']:
    print(paquete + ':', metadatos.version(paquete))
print('Ejecución en CPU, sin GPU.')
Python: 3.13.14
numpy: 2.5.1
pandas: 3.0.5
matplotlib: 3.11.1
scipy: 1.18.0
scikit-learn: 1.9.0
statsmodels: 0.14.6
torch: 2.13.0
Ejecución en CPU, sin GPU.23.3 Verificación del repaso con Python
La siguiente celda verifica la tabla, las probabilidades y el estadístico del repaso antes de construir la regresión. La simulación usa su propio generador, creado con la misma SEMILLA, para no consumir la secuencia de rng con la que después se simulan las rutas. En cada muestra simulada se vuelve a estimar la media; las cinco categorías son siempre 0, 1, 2, 3 y 4 o más.
# Tabla hipotética: conteos y número de intervalos.
x_repaso = np.arange(7)
f_repaso = np.array([14, 19, 28, 17, 13, 6, 3])
n_repaso = int(f_repaso.sum())
media_repaso = float((x_repaso * f_repaso).sum() / n_repaso)
suma_cuadrados_repaso = float((x_repaso**2 * f_repaso).sum())
var_descriptiva_repaso = suma_cuadrados_repaso / n_repaso - media_repaso**2
var_muestral_repaso = (suma_cuadrados_repaso - n_repaso * media_repaso**2) / (n_repaso - 1)
p_repaso = poisson_dist.pmf([1, 2, 3], media_repaso)
print(f"Intervalos: {n_repaso}; solicitudes: {(x_repaso * f_repaso).sum()}")
print(f"Media: {media_repaso:.4f}; varianza descriptiva: {var_descriptiva_repaso:.4f}; varianza muestral: {var_muestral_repaso:.4f}")
for k_repaso, prob_repaso in zip([1, 2, 3], p_repaso):
    print(f"P(Y={k_repaso}) = {prob_repaso:.6f} ({100 * prob_repaso:.2f} %)")
print(f"P(1 <= Y <= 3) = {p_repaso.sum():.6f}")

observados_repaso = np.r_[f_repaso[:4], f_repaso[4:].sum()]
esperados_repaso = n_repaso * np.r_[poisson_dist.pmf(np.arange(4), media_repaso), poisson_dist.sf(3, media_repaso)]
estadistico_repaso = float(((observados_repaso - esperados_repaso)**2 / esperados_repaso).sum())
print(pd.DataFrame({"solicitudes": ["0", "1", "2", "3", "4 o más"], "observados": observados_repaso, "esperados": esperados_repaso}).to_string(index=False, float_format=lambda v: f"{v:.4f}"))

# Calibración bajo H0: reestimar la media en cada réplica.
rng_repaso = np.random.default_rng(SEMILLA)
B_repaso = 20_000
muestras_repaso = rng_repaso.poisson(media_repaso, size=(B_repaso, n_repaso))
medias_sim_repaso = muestras_repaso.mean(axis=1)
obs_sim_repaso = np.column_stack([(muestras_repaso == k).sum(axis=1) for k in range(4)] + [(muestras_repaso >= 4).sum(axis=1)])
esp_sim_repaso = n_repaso * np.column_stack([poisson_dist.pmf(k, medias_sim_repaso) for k in range(4)] + [poisson_dist.sf(3, medias_sim_repaso)])
t_sim_repaso = ((obs_sim_repaso - esp_sim_repaso)**2 / esp_sim_repaso).sum(axis=1)
p_ajuste_repaso = (1 + np.count_nonzero(t_sim_repaso >= estadistico_repaso)) / (B_repaso + 1)
print(f"Estadístico de Pearson: {estadistico_repaso:.6f}; p-value simulado: {p_ajuste_repaso:.4f}")
Intervalos: 100; solicitudes: 226
Media: 2.2600; varianza descriptiva: 2.3924; varianza muestral: 2.4166
P(Y=1) = 0.235832 (23.58 %)
P(Y=2) = 0.266490 (26.65 %)
P(Y=3) = 0.200756 (20.08 %)
P(1 <= Y <= 3) = 0.703078
solicitudes observados esperados
0 14 10.4350
1 19 23.5832
2 28 26.6490
3 17 20.0756
4 o más 22 19.2571
Estadístico de Pearson: 3.038969; p-value simulado: 0.3948La salida confirma una media de 2.2600 y una varianza muestral de 2.4166. Las probabilidades de 1, 2 y 3 son 0.235832, 0.266490 y 0.200756. El estadístico 3.038969 y el p-value simulado de 0.3948 corresponden a las cinco categorías agrupadas; no permiten rechazar el ajuste al nivel 0.05.
23.4 Los seis pasos, ahora con una respuesta de conteo
En el capítulo anterior construiste un GLM en seis pasos: naturaleza de la respuesta, distribución, enlace, modelo lineal, cambio inverso y predicción. El método se mantiene; lo que cambia son las respuestas a cuatro de esos pasos:
| Paso | Regresión logística | Regresión de Poisson (este capítulo) | Dónde aparece |
|---|---|---|---|
| 1. Naturaleza de \(Y\) | binaria: 0 o 1 | conteo: 0, 1, 2, 3… | «Los datos» y «La forma de una variable de conteo» |
| 2. Distribución | Bernoulli, con media \(p\) | Poisson, con media \(\lambda\) | «La distribución de Poisson» y «Por qué la regresión lineal falla con conteos» |
| 3. Enlace | logit | log: \(\eta=\log\lambda\) | «El enlace log y su cambio inverso» |
| 4. Modelo | \(\eta=X\beta\), por máxima verosimilitud | el mismo | «Cómo se estiman los coeficientes» y «Ajustar el modelo predictivo» |
| 5. Inversa | sigmoide | exponencial: \(\lambda=e^{\eta}\) | «El enlace log y su cambio inverso» y «Visualizar la tasa ajustada» |
| 6. Predicción | razones de momios, umbral, AUC | cocientes de tasas, línea base, dispersión | de «Modelo inferencial» en adelante |

En el diagrama, los pasos 1 a 4 construyen el modelo una sola vez, con los datos. Los pasos 5 y 6 lo usan con cada caso nuevo. La flecha punteada une los pasos 3 y 5 porque son la misma operación en sentidos opuestos: el logaritmo lleva la tasa a la escala del modelo y la exponencial la trae de vuelta.
Hay una diferencia con la logística en el paso 6: aquí no hay umbral ni decisión de sí o no. La predicción es una tasa, un número esperado de eventos, y se usa tal cual.
23.5 Los datos: incidencias por ruta
La celda simula 700 rutas. De cada una conoces su longitud (km) y si tuvo clima adverso, y cuentas cuántas incidencias (retrasos, fallos, novedades) ocurrieron. Por construcción, la tasa de incidencias sube con la longitud y con el mal clima.
n = 700
longitud = rng.uniform(5, 60, n)
clima_adverso = rng.integers(0, 2, n)

# Regla oculta: la tasa media crece con longitud y clima adverso.
tasa_real = np.exp(-1.0 + 0.045 * longitud + 0.6 * clima_adverso)
incidencias = rng.poisson(tasa_real)

X = np.column_stack([longitud, clima_adverso])
y = incidencias

print(f'Rutas: {n}')
print(f'Media de incidencias: {y.mean():.3f}')
print(f'Varianza de incidencias: {y.var(ddof=1):.3f}')
print(f'Máximo observado: {y.max()}')
print(f'Rutas sin incidencias: {np.mean(y == 0):.1%}')
pd.DataFrame({
    'longitud_km': longitud[:6],
    'clima_adverso': clima_adverso[:6],
    'incidencias': y[:6],
}).round(2)
Rutas: 700
Media de incidencias: 2.934
Varianza de incidencias: 7.544
Máximo observado: 19
Rutas sin incidencias: 16.1%| longitud_km | clima_adverso | incidencias | |
|---|---|---|---|
| 0 | 39.38 | 1 | 4 |
| 1 | 54.35 | 1 | 10 |
| 2 | 47.66 | 1 | 8 |
| 3 | 17.39 | 1 | 2 |
| 4 | 21.51 | 1 | 3 |
| 5 | 53.05 | 1 | 5 |
La salida confirma primero la naturaleza de la respuesta: solo aparecen enteros no negativos, desde rutas sin incidencias hasta unas pocas rutas con conteos altos. La media global es 2.934 y la varianza 7.544, unas 2.6 veces mayor; pero ambas cifras resumen una mezcla de rutas cortas, largas y con climas distintos, así que no son todavía una prueba del supuesto de Poisson. La dispersión se evalúa más adelante, después de explicar esas diferencias con el modelo.
23.6 La forma de una variable de conteo
Un conteo no llena una recta continua: toma valores \(0,1,2,\ldots\). Además, suele ser asimétrico, acumular observaciones cerca de cero y extender una cola hacia valores grandes. Mira la distribución de incidencias antes de elegir un modelo.
valores = np.arange(y.max() + 1)
frecuencias = pd.Series(y).value_counts().reindex(valores, fill_value=0)

plt.bar(valores, frecuencias, color='steelblue', edgecolor='white')
plt.xlabel('número de incidencias')
plt.ylabel('número de rutas')
plt.title('Conteos discretos, asimétricos y con una cola a la derecha')
plt.xticks(valores)
plt.show()

print(f'Moda observada (número de incidencias): {frecuencias.idxmax()}')
print(f'Rutas con 0, 1 o 2 incidencias: {np.mean(y <= 2):.1%}')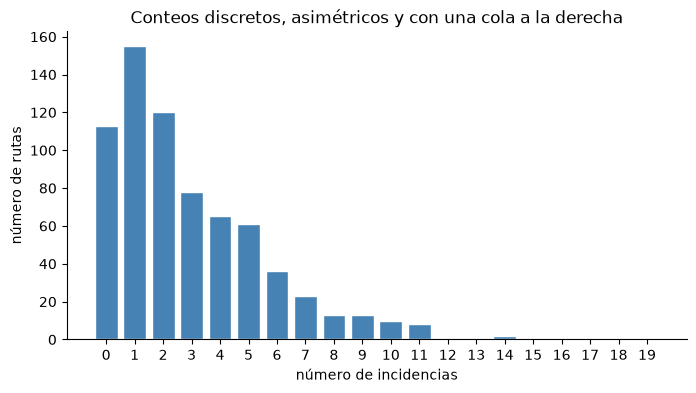
Moda observada (número de incidencias): 1
Rutas con 0, 1 o 2 incidencias: 55.4%
El histograma de las 700 rutas no es una campana continua: son barras separadas para \(0,1,2,\ldots\), con mayor concentración en conteos bajos y una cola hacia la derecha. El conteo más frecuente es 1 y el 55.4% de las rutas tiene como máximo dos incidencias, mientras la cola llega hasta 19. Esa geometría pide una distribución definida sobre enteros no negativos. Con eso queda resuelto el paso 1: la respuesta es un conteo.
23.7 La distribución de Poisson
El paso 2 pide elegir una distribución. Para un conteo, la candidata natural es la Poisson, que acabas de usar en el repaso inicial.
Una variable Poisson cuenta eventos que ocurren en una unidad de exposición: la ventana en la que se cuenta, como una ruta, una hora o un año. Su parámetro \(\lambda>0\) es a la vez su media y su varianza. En un modelo de regresión, la condición se escribe dados los predictores \(X\):
\[ Y\mid X\sim\operatorname{Poisson}(\lambda), \qquad \mathbb{E}(Y\mid X)=\lambda, \qquad \operatorname{Var}(Y\mid X)=\lambda. \]
Esa igualdad entre media y varianza condicionales se llama equidispersión; al final del capítulo compruebas si los datos la respetan.
No significa que todos los conteos tengan la misma media. En una regresión, cada ruta recibe su propia \(\lambda_i\) según sus características.
k = np.arange(0, 21)
for lambda_valor, color in [(1, 'steelblue'), (4, 'seagreen'), (10, 'firebrick')]:
    plt.plot(
        k, poisson_dist.pmf(k, mu=lambda_valor),
        marker='o', linewidth=2, color=color, label=rf'$\lambda={lambda_valor}$',
    )
plt.xlabel(r'conteo $y$')
plt.ylabel(r'$P(Y=y)$')
plt.title('La forma de Poisson cambia con la tasa esperada')
plt.legend()
plt.show()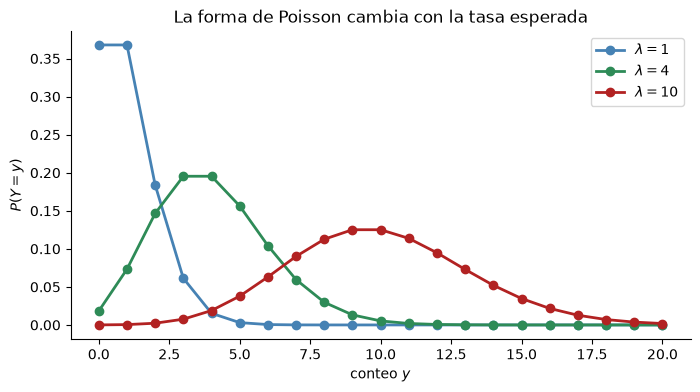
Con \(\lambda=1\), casi toda la masa está cerca de cero. Al subir a 4 y 10, el centro se desplaza a la derecha y la distribución se ensancha. En regresión no eliges una sola de estas curvas para todas las rutas: estimas una tasa \(\lambda_i\) distinta para cada combinación de longitud y clima.
23.8 Por qué la regresión lineal falla con conteos
Antes de aceptar la Poisson, comprueba por qué no sirve la Normal de la regresión lineal. La celda divide los datos en entrenamiento (70 %) y prueba (30 %) y ajusta una regresión lineal ingenua con longitud y clima. Para visualizar el problema sin mezclar grupos, dibuja su predicción para clima normal y la compara con rutas de entrenamiento bajo esa misma condición.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEMILLA
)

modelo_lineal = LinearRegression().fit(X_tr, y_tr)
pred_lineal_te = modelo_lineal.predict(X_te)

longitud_grid = np.linspace(0, 65, 300)
X_grid_normal = np.column_stack([longitud_grid, np.zeros_like(longitud_grid)])
pred_lineal_grid = modelo_lineal.predict(X_grid_normal)
mascara_normal_tr = X_tr[:, 1] == 0

plt.scatter(
    X_tr[mascara_normal_tr, 0], y_tr[mascara_normal_tr],
    s=14, alpha=0.25, color='steelblue', label='rutas con clima normal',
)
plt.plot(longitud_grid, pred_lineal_grid, color='firebrick', linewidth=2, label='regresión lineal')
plt.axhline(0, color='gray', ls=':')
plt.xlabel('longitud de la ruta (km)')
plt.ylabel('incidencias')
plt.title('La recta puede predecir conteos negativos')
plt.legend()
plt.show()

print(f'Predicción lineal a 0 km, clima normal: {modelo_lineal.predict([[0, 0]])[0]:.3f}')
print(f'Predicción mínima en prueba: {pred_lineal_te.min():.3f}')
print(f'Rutas de prueba con predicción negativa: {(pred_lineal_te < 0).sum()}')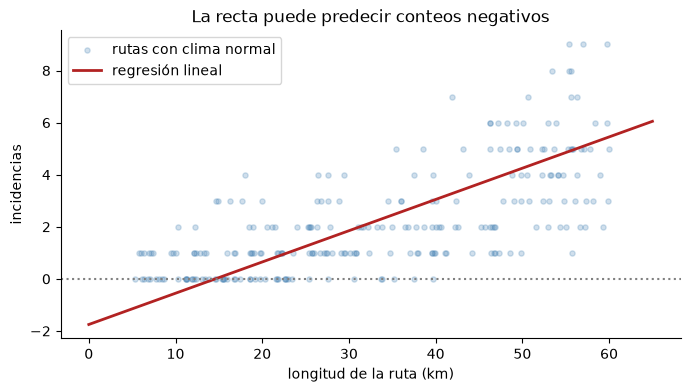
Predicción lineal a 0 km, clima normal: -1.752
Predicción mínima en prueba: -1.052
Rutas de prueba con predicción negativa: 16
La recta no conoce la frontera natural en cero. Para rutas cortas con clima normal prolonga la tendencia hasta valores negativos: 16 rutas de prueba reciben predicciones imposibles, la menor de ellas −1.052 incidencias. El valor a 0 km (−1.752) es una extrapolación, porque ninguna ruta mide menos de 5 km, pero las predicciones negativas de prueba sí ocurren dentro del rango observado. El problema no se resuelve recortando los negativos a cero: hace falta una forma funcional cuya media sea positiva por construcción.
Con esto se resuelve el paso 2: la recta se puede ajustar, pero no garantiza predicciones positivas, y la candidata adecuada para estos conteos es la Poisson, que pones a prueba con el diagnóstico de dispersión.
23.9 Las tres piezas del GLM de Poisson
Los pasos 1 y 2 quedaron resueltos: la respuesta es un conteo y su distribución es Poisson. Con el predictor lineal y el enlace, el modelo queda definido por las mismas tres piezas de la logística:
\[ Y_i\sim\operatorname{Poisson}(\lambda_i), \]
\[ \eta_i=\beta_0+\beta_1x_{i1}+\cdots+\beta_kx_{ik}=X_i\beta, \]
\[ \log(\lambda_i)=\eta_i. \]
Como \(\lambda_i=e^{\eta_i}\), la tasa esperada siempre es positiva.
23.10 El enlace log y su cambio inverso: la exponencial
Son los pasos 3 y 5. La tasa \(\lambda\) es el número esperado de eventos por unidad de exposición. Aquí la unidad es la ruta completa: \(\lambda\) es el número esperado de incidencias por ruta, no por kilómetro ni por hora. Esa tasa no puede ser negativa, pero el predictor \(\eta=X\beta\) sí puede tomar cualquier valor real, y el enlace log conecta las dos escalas:
\[ \log(\lambda)=\eta \quad\Longleftrightarrow\quad \lambda=e^\eta. \]
La exponencial es la función inversa del enlace. Convierte toda la recta real en valores estrictamente positivos y transforma cambios aditivos en \(\eta\) en cambios multiplicativos sobre la tasa.
El cambio se aplica a la media, no a los datos. Se transforma la tasa \(\lambda\), no cada conteo observado. Muchas rutas tienen 0 incidencias y el logaritmo de 0 no existe: por eso no sirve el atajo de sacarle logaritmo a los conteos y ajustar una recta.
eta_grid = np.linspace(-3, 3, 300)
lambda_grid = np.exp(eta_grid)

plt.plot(eta_grid, lambda_grid, color='seagreen', linewidth=2)
plt.axhline(0, color='gray', ls=':')
plt.axvline(0, color='gray', ls=':')
plt.scatter([0], [1], color='firebrick', zorder=3, label=r'$e^0=1$')
plt.xlabel(r'predictor lineal $\eta=X\beta$')
plt.ylabel(r'tasa esperada $\lambda=e^\eta$')
plt.title('La exponencial transforma cualquier valor real en una tasa positiva')
plt.legend()
plt.show()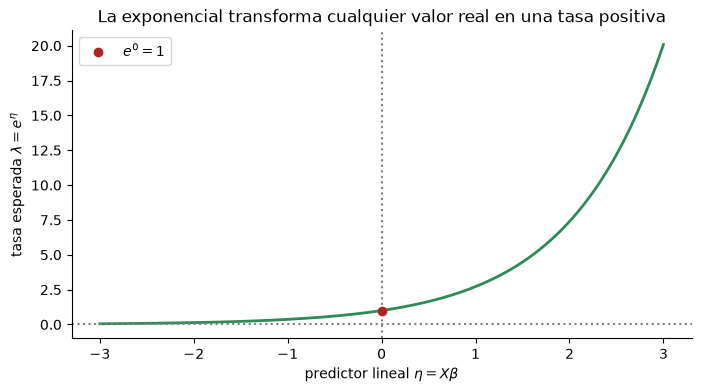
En la figura, cuando \(\eta=0\) la tasa esperada es 1 (el punto rojo). Valores negativos de \(\eta\) producen tasas entre 0 y 1; valores positivos producen tasas mayores que 1. La curva nunca cruza cero. Además, un incremento fijo en \(\eta\) multiplica la tasa, en lugar de sumarle siempre la misma cantidad.
La figura siguiente varía un coeficiente a la vez: en el panel izquierdo, la pendiente \(\beta_1\) (0.02, 0.045 y 0.07); en el derecho, el intercepto \(\beta_0\) (−1.6, −1.0 y −0.4). Antes de mirarla, anticipa si una pendiente mayor acelera o frena el crecimiento de la tasa con la longitud, si cambiar solo \(\beta_0\) altera la forma de la curva o su nivel, y qué efecto tendría sumar un coeficiente positivo cuando el clima es adverso.
x_coef = np.linspace(0, 60, 300)
fig, ax = plt.subplots(1, 2, figsize=(12, 4))

for beta_1 in [0.02, 0.045, 0.07]:
    ax[0].plot(x_coef, np.exp(-1 + beta_1 * x_coef), label=rf'$\beta_1={beta_1}$')
ax[0].set(title='La pendiente controla el ritmo de crecimiento', xlabel='longitud', ylabel='tasa esperada')
ax[0].legend()

for beta_0, etiqueta in [(-1.6, 'nivel bajo'), (-1.0, 'nivel medio'), (-0.4, 'nivel alto')]:
    ax[1].plot(x_coef, np.exp(beta_0 + 0.045 * x_coef), label=etiqueta)
ax[1].set(title='El intercepto cambia el nivel de la tasa', xlabel='longitud', ylabel='tasa esperada')
ax[1].legend()

plt.tight_layout()
plt.show()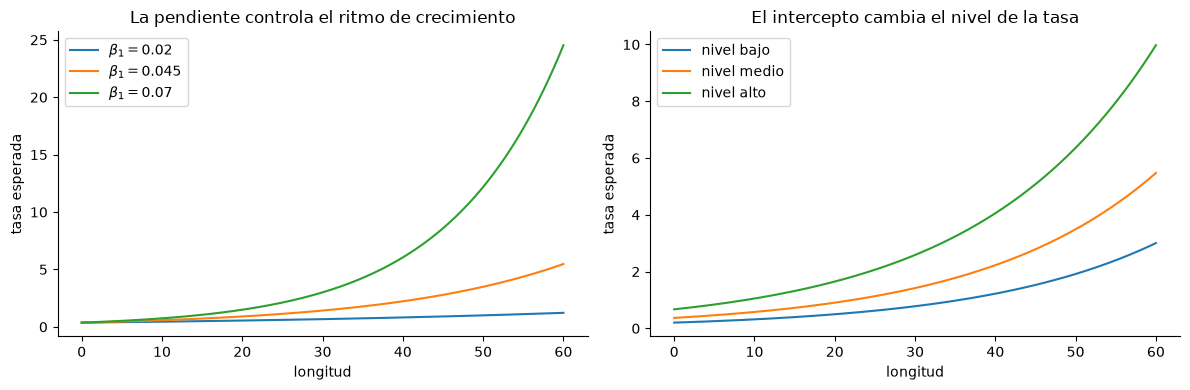
En el panel izquierdo, la pendiente de 0.07 acelera el crecimiento multiplicativo de la tasa con la longitud frente a la de 0.02. En el derecho, cambiar el intercepto eleva o reduce toda la curva. Una variable binaria como clima adverso actúa de forma parecida a un cambio de nivel: cuando vale 1, suma su coeficiente en la escala log y multiplica la tasa por \(e^{\beta_{\text{clima}}}\).
23.11 Cómo se estiman los coeficientes: la verosimilitud de Poisson
Es el paso 4. El criterio es el mismo del capítulo anterior, la máxima verosimilitud: elegir los coeficientes \(\beta\) que hacen más creíbles los datos observados. Lo único que cambia es lo que aporta cada observación, porque cambió la distribución.
Cada ruta aporta la probabilidad que la Poisson le asigna a su conteo:
\[ P(Y=y_i)=\frac{e^{-\lambda_i}\,\lambda_i^{\,y_i}}{y_i!}, \qquad \lambda_i=e^{X_i\beta}. \]
Por ejemplo, supón una ruta con 2 incidencias.
| Modelo | Tasa que le asigna | Lo que aporta esa ruta |
|---|---|---|
| A | \(\lambda=2\) | \(e^{-2}\times2^2/2!=0.271\) |
| B | \(\lambda=6\) | \(e^{-6}\times6^2/2!=0.045\) |
El modelo A hace más creíble lo que ocurrió. La verosimilitud multiplica esos factores para todas las rutas; en la práctica se suma su logaritmo:
\[ \ell(\beta)=\sum_{i=1}^{n}\Big[y_i\log\lambda_i-\lambda_i-\log(y_i!)\Big]. \]
La deviance de Poisson, que usas para evaluar, mide cuánto le falta a esa log-verosimilitud para igualar la de un modelo que acertara cada conteo. Sin penalización, minimizar la deviance y maximizar la verosimilitud son la misma tarea; el modelo predictivo de la sección siguiente añade, además, una penalización L2. Como en la logística, no hay fórmula cerrada: el software llega por iteraciones.
23.12 Ajustar el modelo predictivo
Antes de ajustar tomas cuatro decisiones, cada una con su razón:
- Usar
scikit-learncon propósito predictivo. El modelo aprende únicamente con el entrenamiento y se evalúa sobre el conjunto de prueba. - Aceptar la penalización L2.
PoissonRegressorincluye una penalización L2, la misma idea de Ridge, cuya intensidad controlaalpha. Su valor por defecto,alpha=1.0, no tiene nada de especial para estos datos. - Elegir
alphapor validación cruzada. Se trata como cualquier hiperparámetro: 5 particiones (folds), solo sobre el entrenamiento, en una malla de 11 valores entre \(10^{-4}\) y \(10\). - Estandarizar antes los predictores. La penalización L2 depende de la escala: sin estandarizar, contraería mucho más el coeficiente del clima (una variable 0/1) que el de la longitud (medida en km).
Para evaluar usas la deviance media de Poisson, que compara cada conteo observado \(y_i\) con su tasa predicha \(\hat\lambda_i\):
\[ D=\frac{2}{n}\sum_{i=1}^{n}\left[y_i\log\frac{y_i}{\hat\lambda_i}-(y_i-\hat\lambda_i)\right], \]
con la convención \(y_i\log(y_i/\hat\lambda_i)=0\) cuando \(y_i=0\). Vale 0 si cada predicción coincide con su conteo y crece con la discrepancia: cuanto menor, mejor. La complementas con el error absoluto medio (MAE), el promedio de \(|y_i-\hat\lambda_i|\), que se lee directamente en incidencias por ruta.
alphas = np.logspace(-4, 1, 11)
busqueda = GridSearchCV(
    make_pipeline(StandardScaler(), PoissonRegressor(max_iter=1000)),
    {'poissonregressor__alpha': alphas},
    cv=KFold(n_splits=5, shuffle=True, random_state=SEMILLA),
    scoring='neg_mean_poisson_deviance',
).fit(X_tr, y_tr)
modelo_predictivo = busqueda.best_estimator_
pred_poisson_te = modelo_predictivo.predict(X_te)

alpha_opt = busqueda.best_params_['poissonregressor__alpha']
print(f'alpha elegido por CV: {alpha_opt:.4g} (rango probado: {alphas[0]:.0e} a {alphas[-1]:.0e})')
print('¿Cae en el borde del rango?', alpha_opt in (alphas[0], alphas[-1]))
print(f'Deviance media de CV con ese alpha: {-busqueda.best_score_:.3f}')
print(f'Predicción mínima en prueba: {pred_poisson_te.min():.3f}')
print(f'Predicción máxima en prueba: {pred_poisson_te.max():.3f}')
print(f'Deviance de Poisson en prueba: {mean_poisson_deviance(y_te, pred_poisson_te):.3f}')
print(f'MAE en prueba: {mean_absolute_error(y_te, pred_poisson_te):.3f}')
alpha elegido por CV: 0.01 (rango probado: 1e-04 a 1e+01)
¿Cae en el borde del rango? False
Deviance media de CV con ese alpha: 1.052
Predicción mínima en prueba: 0.490
Predicción máxima en prueba: 10.140
Deviance de Poisson en prueba: 1.063
MAE en prueba: 1.216La validación cruzada eligió \(\alpha=\) 0.01, dentro del rango probado y no en su borde: una penalización pequeña, razonable con solo dos predictores y 490 rutas de entrenamiento.
Todas las predicciones de prueba son positivas, entre 0.490 y 10.140 incidencias, porque el modelo regresa a la escala de conteos mediante la exponencial. En prueba, la deviance media es 1.063 y el MAE, 1.216 incidencias por ruta; la comparación con la línea base indica si eso es mucho o poco.
Este modelo sirve para generar predicciones, no para construir p-valores; de eso se encarga el modelo inferencial de más adelante.
23.13 Visualizar la tasa ajustada
La figura dibuja la tasa esperada según longitud para clima normal y adverso. Los puntos son los conteos observados de las 700 rutas, de entrenamiento y de prueba; por eso permanecen dispersos alrededor de cada curva: el modelo estima la media condicional, no pretende pasar por cada observación.
longitud_grid = np.linspace(5, 60, 300)
for indicador_clima, color, etiqueta in [
    (0, 'seagreen', 'clima normal'),
    (1, 'firebrick', 'clima adverso'),
]:
    X_grid = np.column_stack([longitud_grid, np.full_like(longitud_grid, indicador_clima)])
    tasa_grid = modelo_predictivo.predict(X_grid)
    plt.plot(longitud_grid, tasa_grid, color=color, linewidth=2.5, label=etiqueta)
    mascara = clima_adverso == indicador_clima
    plt.scatter(longitud[mascara], y[mascara], s=12, alpha=0.15, color=color)

plt.xlabel('longitud de la ruta (km)')
plt.ylabel('incidencias observadas / tasa esperada')
plt.title('Tasa estimada según longitud y clima')
plt.legend()
plt.show()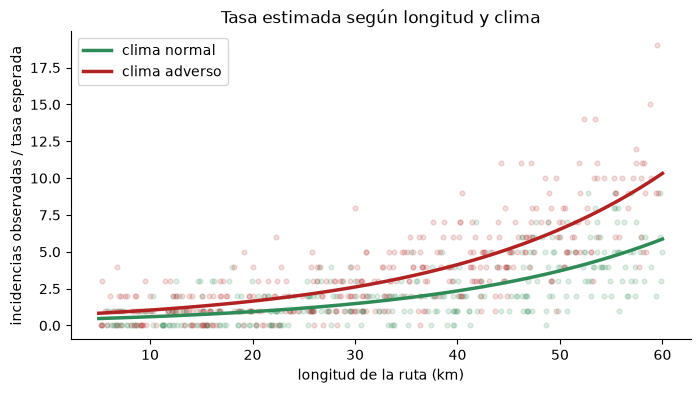
En la figura, la tasa aumenta con la longitud y la curva de clima adverso queda por encima de la curva de clima normal. La separación es multiplicativa: a igual longitud, pasar a clima adverso multiplica la tasa por un factor constante, \(e^{\beta_{\text{clima}}}\). Como el eje vertical está en escala de conteos (no logarítmica), ese mismo factor se ve como una distancia entre curvas que crece con la longitud. La dispersión vertical de los puntos recuerda que una tasa esperada no es una predicción exacta del conteo individual.
23.14 Modelo inferencial y cocientes de tasas
Ajustas con statsmodels un GLM de Poisson sobre el mismo conjunto de entrenamiento. Su propósito es inferencial: estimar coeficientes, cocientes de tasas de incidencia (IRR) y p-valores.
El modelo predictivo de scikit-learn usa una penalización L2 (pequeña, elegida por CV) sobre predictores estandarizados; este GLM de statsmodels no regulariza y trabaja con las variables en sus unidades originales. Aunque ambos reciben las mismas observaciones, sus coeficientes no son directamente comparables mientras estén en escalas distintas; lo que se compara sin más son sus predicciones.
Los coeficientes están en la escala log. Su exponencial es el cociente de tasas de incidencia (incidence rate ratio, IRR):
\[ \operatorname{IRR}_j=e^{\beta_j}. \]
El IRR dice por cuánto se multiplica la tasa esperada cuando \(x_j\) aumenta una unidad, manteniendo fijas las demás variables:
- Si el IRR = 1: la variable no cambia la tasa.
- Si el IRR > 1: cada unidad multiplica la tasa por ese valor. Se esperan más eventos.
- Si el IRR < 1: cada unidad reduce la tasa. Se esperan menos eventos.
Es el equivalente de la razón de momios de la logística: allá se multiplicaba el momio, aquí se multiplica la tasa. Un cambio de \(d\) unidades multiplica la tasa por \(e^{d\beta_j}=(e^{\beta_j})^d\).
X_tr_sm = sm.add_constant(X_tr)
modelo_inferencial = sm.GLM(
    y_tr, X_tr_sm, family=sm.families.Poisson()
).fit()

nombres = ['intercepto', 'longitud', 'clima_adverso']
coeficientes = pd.Series(modelo_inferencial.params, index=nombres)
irr = np.exp(coeficientes)
p_valores = pd.Series(modelo_inferencial.pvalues, index=nombres)

tabla_inferencia = pd.DataFrame({
    'coeficiente': coeficientes,
    'IRR': irr,
    'p-valor': p_valores,
})
display(tabla_inferencia.round(4))

irr_10_km = np.exp(10 * coeficientes['longitud'])
print(f'IRR acumulado para 10 km adicionales: {irr_10_km:.3f}')| coeficiente | IRR | p-valor | |
|---|---|---|---|
| intercepto | -0.9907 | 0.3713 | 0.0 |
| longitud | 0.0460 | 1.0471 | 0.0 |
| clima_adverso | 0.5675 | 1.7638 | 0.0 |
IRR acumulado para 10 km adicionales: 1.585En el GLM inferencial, cada kilómetro adicional multiplica la tasa esperada por 1.047, es decir, la aumenta cerca de 4.7% manteniendo fijo el clima. Al acumular 10 km, el factor es 1.585: aproximadamente 58.5% más. A igual longitud, el clima adverso multiplica la tasa por 1.764, cerca de 76.4% más que el clima normal. Como los datos son simulados, puedes contrastarlo con la regla oculta: \(e^{0.045}\approx1.046\) por kilómetro y \(e^{0.6}\approx1.822\) para el clima; el modelo recupera ambos efectos con buena aproximación.
Los p-valores son tan pequeños que la tabla los muestra como 0.0 al redondear a cuatro decimales; aportan evidencia contra la hipótesis de coeficiente nulo bajo los supuestos del modelo; no demuestran causalidad ni importancia práctica. Tampoco corresponde ordenar cuál factor es “más importante” comparando cambios expresados en unidades diferentes.
Esta interpretación corresponde al modelo sin regularización ajustado en entrenamiento, y sus errores estándar y p-valores suponen equidispersión: se verifica en la sección de dispersión. A continuación, los perfiles usan el modelo predictivo; como su penalización es pequeña, sus predicciones quedan muy cerca de las del GLM.
Para una predicción calculada a mano, aplica los pasos 4 y 5 a una ruta de 30 km con clima adverso, con los coeficientes de la tabla:
- Predictor lineal: \(\eta=-0.9907+0.0460\times30+0.5675\times1=0.957\).
- Tasa esperada: \(e^{0.957}\approx2.60\) incidencias.
La tabla de perfiles que sigue da 2.611 para esa misma ruta. La pequeña diferencia viene de que los perfiles usan el modelo predictivo, con su penalización.
23.15 Tasas esperadas para rutas concretas
La tabla compara rutas cortas, medias y largas bajo clima normal y adverso, y lleva los coeficientes a la escala que necesita quien toma decisiones: número esperado de incidencias por ruta.
perfiles = pd.DataFrame({
    'tipo_ruta': ['corta', 'corta', 'media', 'media', 'larga', 'larga'],
    'longitud_km': [10, 10, 30, 30, 55, 55],
    'clima': ['normal', 'adverso', 'normal', 'adverso', 'normal', 'adverso'],
    'clima_adverso': [0, 1, 0, 1, 0, 1],
})
X_perfiles = perfiles[['longitud_km', 'clima_adverso']].to_numpy()
perfiles['incidencias_esperadas'] = modelo_predictivo.predict(X_perfiles)
display(perfiles[['tipo_ruta', 'longitud_km', 'clima', 'incidencias_esperadas']].round(3))| tipo_ruta | longitud_km | clima | incidencias_esperadas | |
|---|---|---|---|---|
| 0 | corta | 10 | normal | 0.594 |
| 1 | corta | 10 | adverso | 1.044 |
| 2 | media | 30 | normal | 1.484 |
| 3 | media | 30 | adverso | 2.611 |
| 4 | larga | 55 | normal | 4.665 |
| 5 | larga | 55 | adverso | 8.209 |
En el modelo predictivo, una ruta de 30 km pasa de 1.484 incidencias esperadas con clima normal a 2.611 con clima adverso. Para 55 km, las predicciones son 4.665 y 8.209, respectivamente. En ambas longitudes el cociente adverso/normal es el mismo, cerca de 1.76, próximo al IRR de 1.764 del GLM: el clima actúa como un factor multiplicativo constante.
Estas cifras son medias esperadas: predecir 2.611 incidencias no significa observar una fracción de incidencia, sino que muchas rutas comparables promediarían aproximadamente 2.611 eventos.
23.16 Comparar contra una línea base
Una métrica aislada no dice si el modelo aporta valor. La línea base (baseline) más simple ignora longitud y clima y predice para todas las rutas la media de conteos observada en entrenamiento. La celda compara ambos con la misma deviance de Poisson y con MAE sobre prueba.
pred_baseline = np.full(y_te.shape, y_tr.mean(), dtype=float)

deviance_modelo = mean_poisson_deviance(y_te, pred_poisson_te)
deviance_baseline = mean_poisson_deviance(y_te, pred_baseline)
mae_modelo = mean_absolute_error(y_te, pred_poisson_te)
mae_baseline = mean_absolute_error(y_te, pred_baseline)
reduccion_deviance = 1 - deviance_modelo / deviance_baseline

tabla_comparacion = pd.DataFrame({
    'modelo': ['media de entrenamiento', 'regresión de Poisson'],
    'deviance_poisson': [deviance_baseline, deviance_modelo],
    'MAE': [mae_baseline, mae_modelo],
})
display(tabla_comparacion.round(3))
print(f'Reducción relativa de deviance frente al baseline: {reduccion_deviance:.1%}')| modelo | deviance_poisson | MAE | |
|---|---|---|---|
| 0 | media de entrenamiento | 2.553 | 2.123 |
| 1 | regresión de Poisson | 1.063 | 1.216 |
Reducción relativa de deviance frente al baseline: 58.4%En prueba, la regresión de Poisson reduce la deviance de 2.553 a 1.063 y el MAE de 2.123 a 1.216 frente a la línea base. La reducción relativa de deviance es 58.4%, de modo que longitud y clima sí aportan información predictiva fuera de entrenamiento.
Ese 58.4% mide mejora respecto a esta referencia concreta; no es un porcentaje de incidencias explicadas ni garantiza el mismo desempeño en otra población.
23.17 Revisar el supuesto de dispersión
En una Poisson ideal, la varianza condicional coincide con la media condicional. Una comprobación diagnóstica habitual es la razón de dispersión de Pearson:
\[ \widehat\phi=\frac{\chi^2_{\text{Pearson}}}{\text{grados de libertad residuales}}. \]
Valores cercanos a 1 son compatibles con la dispersión Poisson; valores claramente mayores sugieren sobredispersión y la necesidad de revisar el modelo o considerar alternativas como binomial negativa.
dispersion_pearson = modelo_inferencial.pearson_chi2 / modelo_inferencial.df_resid
ajuste_train = modelo_inferencial.fittedvalues
residuos_pearson = modelo_inferencial.resid_pearson

plt.scatter(ajuste_train, residuos_pearson, s=16, alpha=0.45, color='steelblue')
plt.axhline(0, color='firebrick', ls='--')
plt.xlabel('tasa ajustada en entrenamiento')
plt.ylabel('residuo de Pearson')
plt.title('Residuos de Pearson frente a la tasa ajustada')
plt.show()

print(f'Razón de dispersión de Pearson: {dispersion_pearson:.3f}')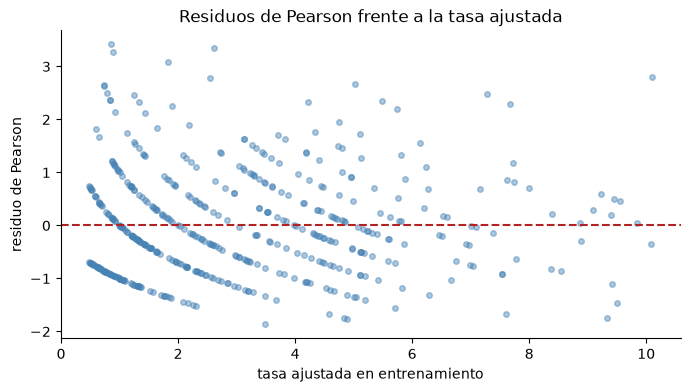
Razón de dispersión de Pearson: 0.983La razón de dispersión de Pearson es 0.983, muy próxima a 1; no aparece una señal global de sobredispersión en este ejemplo. Compárala con los datos crudos del inicio, donde la varianza (7.544) era unas 2.6 veces la media (2.934): ese exceso aparente venía de mezclar rutas con tasas distintas y desaparece cuando el modelo tiene en cuenta la longitud y el clima. Las bandas curvas del gráfico son esperables porque el conteo observado solo toma valores enteros, mientras la tasa ajustada es continua.
Este diagnóstico es orientativo, no una prueba automática. Una razón claramente superior a 1 o una estructura adicional de los residuos indicaría variabilidad o patrones que la Poisson no está capturando.
23.18 Ejemplo resuelto paso a paso: ¿cuántos incidentes tendrá un conductor?
Para cerrar, resuelves un caso nuevo de principio a fin siguiendo los seis pasos de la metodología general. Los datos caben en la pantalla: el propósito es repasar el razonamiento, no optimizar el código.
Una empresa de transporte registró 20 conductores: sus años de experiencia y cuántos incidentes de tránsito tuvieron en el último año. Quiere saber cómo cambia el número esperado de incidentes con la experiencia, con datos ilustrativos construidos para el ejemplo.
Hay una diferencia deliberada con el caso de las rutas: aquí el efecto va en sentido contrario (más experiencia, menos incidentes), así que el cociente de tasas será menor que 1.
Paso 1. Identificar la naturaleza de la respuesta
La primera pregunta es qué valores puede tomar \(Y\).
conductores = pd.DataFrame({
    'experiencia': [1, 1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7, 7, 8, 8, 9, 9, 10, 10],
    'incidentes':  [4, 3, 3, 4, 2, 3, 2, 1, 1, 2, 1, 0, 1, 0, 3, 0, 0, 1, 0, 0],
})

print('Valores distintos de la respuesta:', sorted(conductores['incidentes'].unique().tolist()))
print(f"Media de incidentes: {conductores['incidentes'].mean():.2f}")

grupo = np.where(conductores['experiencia'] <= 5, '1 a 5 años', '6 a 10 años')
print('\nMedia y varianza por grupo de experiencia:')
print(conductores.groupby(grupo)['incidentes'].agg(['mean', 'var']).round(2).to_string())
Valores distintos de la respuesta: [0, 1, 2, 3, 4]
Media de incidentes: 1.55
Media y varianza por grupo de experiencia:
mean var
1 a 5 años 2.5 1.17
6 a 10 años 0.6 0.93La respuesta toma los valores 0, 1, 2, 3 y 4: enteros, nunca negativos. Es un conteo. El promedio general es 1.55 incidentes, pero cambia mucho con la experiencia: 2.5 entre quienes llevan de 1 a 5 años y 0.6 entre quienes llevan de 6 a 10.
Paso 2. Elegir la distribución
La pregunta ahora es qué distribución describe un conteo así.
Para un conteo de eventos en un periodo fijo, la candidata inicial es la Poisson: \(Y_i\sim\operatorname{Poisson}(\lambda_i)\), donde \(\lambda_i\) es el número esperado de incidentes del conductor \(i\) en un año. La Poisson supone que, para cada nivel de experiencia, la varianza es igual a la media. La tabla anterior no sirve para comprobarlo, porque cada grupo mezcla experiencias distintas; lo revisas en el paso 6 con el diagnóstico de dispersión.
Una regresión lineal no garantiza predicciones positivas: con una tendencia decreciente como esta, puede asignar un número negativo de incidentes a los conductores con más experiencia.
Paso 3. Elegir el cambio de variable: la función de enlace
La pregunta es cómo llevar una media positiva a una escala sin límites.
La media \(\lambda_i\) es positiva; un predictor lineal puede dar cualquier número. El enlace log hace el cambio de variable:
\[ \eta_i=\log(\lambda_i). \]
El cambio se le aplica a la media \(\lambda_i\), no a los datos: hay conductores con 0 incidentes y el logaritmo de 0 no existe.
Paso 4. Construir y estimar el predictor lineal
La pregunta es qué coeficientes hacen más creíbles estos 20 conteos.
El predictor lineal es \(\eta_i=\beta_0+\beta_1\cdot\text{experiencia}_i\). Si la experiencia reduce los incidentes, \(\beta_1\) debe salir negativo, y los coeficientes se estiman por máxima verosimilitud.
X_cond = sm.add_constant(conductores[['experiencia']])
modelo_cond = sm.GLM(conductores['incidentes'], X_cond, family=sm.families.Poisson()).fit()

g0, g1 = modelo_cond.params
print(f"Iteraciones del algoritmo: {modelo_cond.fit_history['iteration']}")
print(f'Intercepto: {g0:.3f} | Coeficiente de experiencia: {g1:.3f}')
Iteraciones del algoritmo: 5
Intercepto: 1.633 | Coeficiente de experiencia: -0.268El algoritmo de máxima verosimilitud necesitó 5 iteraciones. El coeficiente de experiencia es −0.268, negativo, como se anticipaba: cada año adicional resta 0.268 al logaritmo de la tasa. Ese número está en la escala del enlace, no en incidentes.
Paso 5. Aplicar el cambio de variable inverso
La pregunta es cuántos incidentes se esperan de un conductor con 3 años de experiencia. El predictor lineal responde en la escala log; la inversa del enlace, la exponencial, lo devuelve a incidentes.
anios_exp = 3

eta_cond = g0 + g1 * anios_exp        # 1. predictor lineal, en escala log
tasa_cond = np.exp(eta_cond)          # 2. cambio inverso: la exponencial

print(f'1. Predictor lineal: η = {g0:.3f} + ({g1:.3f}) × {anios_exp} = {eta_cond:.3f}')
print(f'2. Tasa esperada: exp(η) = {tasa_cond:.3f} incidentes al año')
print(f'\nComprobación con el modelo: {modelo_cond.predict([[1, anios_exp]])[0]:.3f}')
1. Predictor lineal: η = 1.633 + (-0.268) × 3 = 0.828
2. Tasa esperada: exp(η) = 2.289 incidentes al año
Comprobación con el modelo: 2.289El predictor lineal vale 0.828 y su exponencial, 2.289: de un conductor con 3 años de experiencia se esperan unos 2.3 incidentes al año, el mismo valor que devuelve el modelo. No es que alguien vaya a tener 2.289 incidentes: es el promedio de muchos conductores con esa experiencia.
Si repites el cambio inverso para todas las experiencias, aparece la curva completa.
grid_exp = np.linspace(0, 11, 200)
tasa_grid_exp = modelo_cond.predict(sm.add_constant(grid_exp))

plt.scatter(conductores['experiencia'], conductores['incidentes'], s=40, alpha=0.4, color='gray', label='conductores observados')
plt.plot(grid_exp, tasa_grid_exp, color='seagreen', linewidth=2, label='tasa esperada de incidentes')
plt.xlabel('experiencia (años)'); plt.ylabel('incidentes en el año')
plt.title('La curva exponencial ajustada a los 20 conductores'); plt.legend(); plt.show()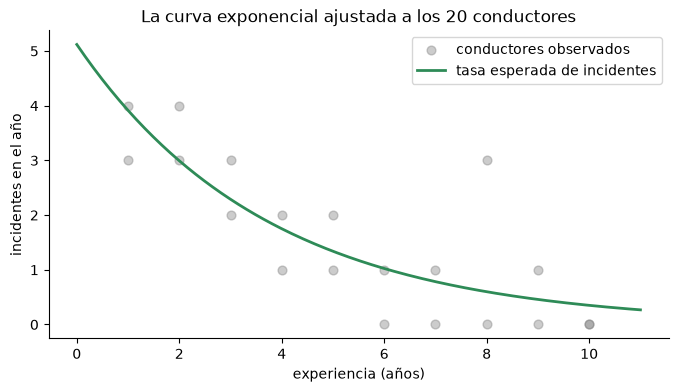
En la figura, los 20 conductores solo aparecen en valores enteros, de 0 a 4 incidentes; la curva es la tasa esperada y puede tomar cualquier valor positivo. Baja con la experiencia, cada vez más despacio, y se acerca a cero sin cruzarlo: el modelo nunca predice un número negativo de incidentes.
Paso 6. Predecir, interpretar y validar
Para interpretar, la pregunta es cuánto cambia la tasa por cada año de experiencia.
irr_cond = np.exp(g1)
ic_inf, ic_sup = np.exp(modelo_cond.conf_int().loc['experiencia'])

print(f'Cociente de tasas (IRR) por año: {irr_cond:.3f}')
print(f'IC 95%: {ic_inf:.3f} a {ic_sup:.3f}')
print(f"p-valor: {modelo_cond.pvalues['experiencia']:.4f}")
print(f'IRR acumulado para 5 años adicionales: {np.exp(5 * g1):.3f}')
Cociente de tasas (IRR) por año: 0.765
IC 95%: 0.662 a 0.884
p-valor: 0.0003
IRR acumulado para 5 años adicionales: 0.262El cociente de tasas es 0.765: cada año adicional de experiencia multiplica la tasa esperada de incidentes por 0.765, es decir, la reduce cerca de un 23.5%. Es menor que 1: más experiencia se asocia con una media menor de incidentes. Es una asociación en estos datos, no la prueba de un efecto causal. En 5 años el efecto acumulado es 0.262: la tasa queda en poco más de una cuarta parte.
El intervalo de confianza va de 0.662 a 0.884. No incluye el 1, de modo que el efecto se distingue de «sin efecto», y el p-valor de 0.0003 apunta en la misma dirección.
Para validar, la pregunta es si el modelo aporta algo frente a no usar la experiencia. La celda lo compara con una línea base que predice para todos el promedio general y revisa el supuesto de dispersión. Las métricas se calculan sobre los mismos 20 conductores con que se ajustó el modelo: son resultados aparentes, más favorables de lo que se vería con datos nuevos.
conductores['tasa_esperada'] = modelo_cond.fittedvalues
pred_base_cond = np.full(len(conductores), conductores['incidentes'].mean())

dev_modelo_cond = mean_poisson_deviance(conductores['incidentes'], conductores['tasa_esperada'])
dev_base_cond = mean_poisson_deviance(conductores['incidentes'], pred_base_cond)
mae_modelo_cond = mean_absolute_error(conductores['incidentes'], conductores['tasa_esperada'])
mae_base_cond = mean_absolute_error(conductores['incidentes'], pred_base_cond)

print(f'Deviance de Poisson | línea base: {dev_base_cond:.3f} | modelo: {dev_modelo_cond:.3f}')
print(f'MAE                 | línea base: {mae_base_cond:.3f} | modelo: {mae_modelo_cond:.3f}')
print(f'Reducción de deviance frente a la línea base: {1 - dev_modelo_cond / dev_base_cond:.1%}')
print(f'Razón de dispersión de Pearson: {modelo_cond.pearson_chi2 / modelo_cond.df_resid:.3f}')
Deviance de Poisson | línea base: 1.485 | modelo: 0.705
MAE | línea base: 1.205 | modelo: 0.588
Reducción de deviance frente a la línea base: 52.5%
Razón de dispersión de Pearson: 0.860Usar la experiencia reduce la deviance de 1.485 a 0.705, un 52.5% menos, y el error absoluto medio de 1.205 a 0.588 incidentes por conductor: en estos datos, el modelo aporta. La razón de dispersión es 0.860, cercana a 1, sin señal de sobredispersión; con 20 observaciones es un indicio, no una comprobación.
Para analizar los errores, la pregunta es en cuáles conductores se equivocó más el modelo y por qué. Como aquí no se clasifica, no hay matriz de confusión: los errores se miran con los residuos de Pearson, que miden cuánto se aleja cada conteo de su tasa esperada en unidades comparables.
conductores['residuo_pearson'] = modelo_cond.resid_pearson
mayores = conductores.reindex(conductores['residuo_pearson'].abs().sort_values(ascending=False).index).head(4)
display(mayores[['experiencia', 'incidentes', 'tasa_esperada', 'residuo_pearson']].round(3))| experiencia | incidentes | tasa_esperada | residuo_pearson | |
|---|---|---|---|---|
| 14 | 8 | 3 | 0.599 | 3.103 |
| 11 | 6 | 0 | 1.024 | -1.012 |
| 13 | 7 | 0 | 0.783 | -0.885 |
| 17 | 9 | 1 | 0.458 | 0.801 |
Un conductor destaca: tiene 8 años de experiencia y 3 incidentes, cuando el modelo esperaba 0.599. Su residuo de 3.10 es tres veces mayor que el siguiente. Los otros tres residuos rondan 1 en valor absoluto, lo normal en un conteo: son conductores con 0 o 1 incidente donde se esperaba cerca de uno.
Ese caso aislado no invalida el modelo. Con una tasa esperada de 0.599, tener 3 incidentes es poco probable, pero puede ocurrir por azar. También puede haber algo que no está en los datos: más horas al volante, es decir, más exposición, el tipo de ruta o el vehículo. Son hipótesis para investigar, no conclusiones. Si aparecieran muchos residuos así, sería señal de sobredispersión o de una variable faltante.
Con 20 conductores, el modelo se evalúa sobre los mismos datos con que se ajustó, y eso tiende a mostrarlo mejor de lo que es. En un caso real hacen falta más datos y un conjunto de prueba aparte, como en el caso de las rutas.
El ejemplo repite los seis pasos del caso de las rutas y de la regresión logística: cambian la distribución y el enlace, y el método se mantiene. Los enteros no negativos sugirieron la Poisson y el enlace log, y la razón de dispersión de 0.860 no la contradijo. Se estima en la escala log y se comunica en tasas: el IRR de 0.765 resume el efecto, y los 2.289 incidentes esperados a los 3 años son la cifra que entiende quien decide. La validación compara con una línea base y revisa la dispersión, sin umbral ni matriz de confusión, porque no se clasifica.
23.19 Errores comunes en regresión de Poisson
- Tratar cualquier entero como conteo Poisson. Debe representar eventos no negativos observados bajo una exposición comparable.
- Interpretar \(\beta_j\) como cambio aditivo en incidencias. El efecto es multiplicativo sobre la tasa; se interpreta con \(e^{\beta_j}\).
- Comparar IRR de variables con unidades distintas como si midieran importancia. Primero fija cambios relevantes, como 10 km frente a un cambio de clima.
- Reportar una deviance sin modelo de referencia (baseline). El modelo debe superar una predicción trivial sobre datos de prueba.
- Usar p-valores como prueba causal. Dependen de los supuestos y no sustituyen el tamaño ni la relevancia práctica del efecto.
- Ignorar la sobredispersión. Si la variabilidad excede claramente lo permitido por Poisson, los errores estándar y conclusiones pueden ser inadecuados.
- Confundir tasa esperada con conteo observado. Una predicción como 2.4 es una media para rutas comparables, no una incidencia fraccionaria.
- Olvidar la exposición. Si unas rutas representan más tiempo o distancia de observación que otras, puede necesitarse un offset: un término \(\log E_i\), con la exposición \(E_i\) conocida, que se suma al predictor con coeficiente fijo en 1. Así \(\log\lambda_i=\log E_i+X_i\beta\) y el modelo estima eventos por unidad de exposición.
23.20 Dónde aparece esto en inteligencia artificial
El capítulo anterior mostró que una regresión logística es una neurona con activación sigmoide entrenada con entropía cruzada. Con los conteos ocurre lo mismo, cambiando dos piezas:
| En este capítulo | En una red neuronal |
|---|---|
| predictor lineal \(\eta=X\beta\) | salida lineal de la última capa |
| inversa del enlace log (exponencial) | activación exponencial en la salida |
| log-verosimilitud de Poisson, con signo cambiado | pérdida de Poisson |
| tasa esperada \(\lambda\) | predicción del modelo |
Con los modelos de boosting la conexión es más corta: no tienen predictor lineal ni capas, pero se pueden entrenar con la misma pérdida de Poisson.
Algunos usos concretos:
- Pronóstico de demanda. Cuántas unidades se venderán o cuántos pedidos llegarán son conteos. Las librerías de boosting como XGBoost y LightGBM traen un objetivo de Poisson, y redes de pronóstico como DeepAR usan en su salida una distribución de conteo: la binomial negativa, pariente de la Poisson que admite sobredispersión.
- Seguros y riesgo. La frecuencia de siniestros se modela con Poisson y su costo con Gamma; la familia Tweedie, en su caso de Poisson compuesta con Gamma, modela directamente el costo total.
- Analítica web y recomendación. Número de clics, visitas o reproducciones por usuario.
- Neurociencia computacional. Los GLM de Poisson describen cuántos impulsos emite una neurona biológica ante un estímulo.
Saberlo tiene una consecuencia práctica: elegir la pérdida de Poisson en una red es elegir la distribución (paso 2). El enlace (paso 3) lo decide la salida de la red: en el ejemplo que sigue, una salida lineal que se interpreta como \(\log\lambda\). Entrenar un modelo de conteos con error cuadrático y salida sin restricción no impide estimar una media, pero pesa igual un error de dos incidencias en una ruta tranquila que en una muy cargada, y puede predecir valores negativos.
Ejemplo básico: una neurona en PyTorch aprende la misma regresión de Poisson
Entrenas una sola neurona sobre los 20 conductores del ejemplo resuelto. Cada línea corresponde a una pieza de este capítulo:
nn.Linear(1, 1)es el predictor lineal: un peso y un sesgo.nn.PoissonNLLLoss(log_input=True)es la log-verosimilitud de Poisson con el signo cambiado.log_input=Trueindica que la neurona entrega \(\log\lambda\), es decir, el predictor lineal \(\eta\); la pérdida aplica la exponencial por dentro.torch.optim.SGDes el descenso de gradiente.
Si la equivalencia es cierta y el entrenamiento converge, la neurona debe terminar, salvo diferencias numéricas pequeñas, en los mismos coeficientes que estimó statsmodels, que no aplica penalización.
import torch
from torch import nn

# Datos como tensores: una columna de entradas y una de conteos
x_t = torch.tensor(conductores[['experiencia']].to_numpy(), dtype=torch.float64)
y_t = torch.tensor(conductores[['incidentes']].to_numpy(), dtype=torch.float64)

neurona = nn.Linear(1, 1).double()        # predictor lineal: un peso y un sesgo
nn.init.zeros_(neurona.weight)            # la neurona empieza sin saber nada
nn.init.zeros_(neurona.bias)

perdida_fn = nn.PoissonNLLLoss(log_input=True)                  # pérdida de Poisson sobre log(λ)
optimizador = torch.optim.SGD(neurona.parameters(), lr=0.02)    # descenso de gradiente

for paso in range(1, 5_001):
    log_tasa = neurona(x_t)               # 1. predictor lineal η = log(λ)
    perdida = perdida_fn(log_tasa, y_t)   # 2. qué tan mal predice
    optimizador.zero_grad()
    perdida.backward()                    # 3. en qué dirección corregir
    optimizador.step()                    # 4. corrige peso y sesgo
    if paso in (1, 10, 100, 1_000, 5_000):
        print(f'paso {paso:>5}: pérdida = {perdida.item():.4f} | '
              f'sesgo = {neurona.bias.item():6.3f} | peso = {neurona.weight.item():.3f}')

with torch.no_grad():
    tasa_3 = torch.exp(neurona(torch.tensor([[3.0]], dtype=torch.float64))).item()

print(f'\nNeurona:     sesgo = {neurona.bias.item():.3f}      | peso = {neurona.weight.item():.3f}')
print(f'statsmodels: intercepto = {g0:.3f} | coeficiente = {g1:.3f}')
print(f'Incidentes esperados de un conductor con 3 años según la neurona: {tasa_3:.3f}')
paso 1: pérdida = 1.0000 | sesgo = 0.011 | peso = -0.001
paso 10: pérdida = 0.9472 | sesgo = 0.107 | peso = -0.015
paso 100: pérdida = 0.6160 | sesgo = 0.859 | peso = -0.130
paso 1000: pérdida = 0.4809 | sesgo = 1.633 | peso = -0.268
paso 5000: pérdida = 0.4809 | sesgo = 1.633 | peso = -0.268
Neurona: sesgo = 1.633 | peso = -0.268
statsmodels: intercepto = 1.633 | coeficiente = -0.268
Incidentes esperados de un conductor con 3 años según la neurona: 2.289La pérdida empieza en 1.0000, la de quien predice una tasa de 1 para todos, y baja hasta 0.4809. Los parámetros finales son los que estimó statsmodels: sesgo 1.633 y peso −0.268. Para el conductor con 3 años de experiencia la neurona da 2.289 incidentes, lo mismo que calculaste a mano.
La neurona y la regresión de Poisson son el mismo modelo (predictor lineal más exponencial) y optimizan la misma cantidad. Solo cambia el algoritmo: statsmodels llegó en 5 iteraciones; el descenso de gradiente necesitó cientos de pasos pequeños.
Un detalle: 0.4809 no es la deviance del ejemplo resuelto (0.705), y no tiene por qué serlo. La pérdida de PyTorch es la log-verosimilitud promedio con el signo cambiado, sin el término \(\log(y_i!)\), que no depende de los coeficientes. La deviance es otra escala de la misma cantidad: dos veces la distancia entre esa log-verosimilitud y la de un modelo que acertara cada conteo, y las dos se minimizan con los mismos coeficientes.
23.21 Preguntas de comprensión
- En la tabla del repaso, la media es 2.26 y la varianza muestral, 2.4166. ¿Basta esa cercanía para aceptar el modelo de Poisson?
- En los datos crudos de las rutas, la varianza (7.544) es unas 2.6 veces la media (2.934), pero la razón de dispersión del modelo es 0.983. ¿Por qué no hay contradicción?
- Muchas rutas tienen 0 incidencias. ¿Por qué no sirve el atajo de tomar el logaritmo de los conteos y ajustar una recta?
- El clima adverso multiplica la tasa por 1.764. ¿Por qué, en la figura de tasas ajustadas, la distancia entre las dos curvas crece con la longitud?
- El conductor con 8 años de experiencia y 3 incidentes tiene un residuo de Pearson de 3.10. ¿Lo eliminarías del análisis?
TipOrientaciones
- No. La cercanía convierte a Poisson en candidata. La prueba de bondad de ajuste (estadístico 3.038969, p ≈ 0.3948) no la rechaza, pero eso tampoco la demuestra, y la tabla sin orden temporal no permite revisar la independencia ni la estabilidad de la tasa.
- La varianza cruda mezcla rutas con tasas distintas por longitud y clima. Una vez que el modelo asigna a cada ruta su propia \(\lambda_i\), la variabilidad que queda es compatible con la Poisson.
- El logaritmo de 0 no existe, y el enlace se aplica a la media \(\lambda\), no a cada conteo observado. La Poisson trabaja con los conteos tal como son.
- El efecto es multiplicativo sobre la tasa. Un mismo factor de 1.764 se traduce en más incidencias absolutas cuando la tasa de partida es mayor: a 30 km los perfiles dan 1.484 frente a 2.611, y a 55 km, 4.665 frente a 8.209.
- No por ese solo motivo. Con una tasa esperada de 0.599, tener 3 incidentes es poco probable pero posible; conviene investigar la exposición o el tipo de ruta y evaluar con más datos y una prueba aparte, porque las métricas de este ejemplo son in-sample.
23.22 Referencias para profundizar
Modelos lineales generalizados y datos de conteo
- Nelder, J. A. y Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society, Series A, 135(3), 370–384.
- McCullagh, P. y Nelder, J. A. (1989). Generalized Linear Models (2.ª ed.). Chapman & Hall.
- Cameron, A. C. y Trivedi, P. K. (2013). Regression Analysis of Count Data (2.ª ed.). Cambridge University Press. La referencia sobre conteos, sobredispersión y alternativas a la Poisson.
- Hilbe, J. M. (2014). Modeling Count Data. Cambridge University Press.
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. Wiley.
Aprendizaje estadístico y aprendizaje automático
- James, G., Witten, D., Hastie, T., Tibshirani, R. y Taylor, J. (2023). An Introduction to Statistical Learning with Applications in Python. Springer. Capítulo 4, sección sobre modelos lineales generalizados.
- Murphy, K. P. (2022). Probabilistic Machine Learning: An Introduction. MIT Press. Capítulo 12, modelos lineales generalizados.
Usos en inteligencia artificial
- Chen, T. y Guestrin, C. (2016). XGBoost: a scalable tree boosting system. Proceedings of the 22nd ACM SIGKDD Conference.
- Ke, G. et al. (2017). LightGBM: a highly efficient gradient boosting decision tree. Advances in Neural Information Processing Systems 30.
- Salinas, D., Flunkert, V., Gasthaus, J. y Januschowski, T. (2020). DeepAR: probabilistic forecasting with autoregressive recurrent networks. International Journal of Forecasting, 36(3), 1181–1191.
- Pillow, J. W. et al. (2008). Spatio-temporal correlations and visual signalling in a complete neuronal population. Nature, 454, 995–999.
Documentación de las librerías
- scikit-learn,
PoissonRegressor: https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.PoissonRegressor.html - statsmodels,
GLM: https://www.statsmodels.org/stable/generated/statsmodels.genmod.generalized_linear_model.GLM.html - PyTorch,
PoissonNLLLoss: https://pytorch.org/docs/stable/generated/torch.nn.PoissonNLLLoss.html
Bondad de ajuste
- NIST/SEMATECH. e-Handbook of Statistical Methods, sección 1.3.5.15: Chi-Square Goodness-of-Fit Test. Frecuencias observadas y esperadas, agrupación y estimación de parámetros. El repaso calibra el estadístico por simulación con reestimación de la media.
23.23 Lo que debes llevarte de este capítulo
La regresión de Poisson modela la tasa de un conteo con un predictor lineal y la exponencial: sus efectos son multiplicativos, y su validación compara con una línea base y revisa la dispersión.
- En el repaso, la media de 2.26 y la varianza muestral de 2.4166 hicieron de Poisson una candidata, y la bondad de ajuste (p ≈ 0.3948) no la rechazó.
- Una recta predice conteos imposibles: 16 rutas de prueba recibieron valores negativos, el menor de −1.052.
- El enlace log y la exponencial mantienen la tasa positiva: las predicciones de prueba quedaron entre 0.490 y 10.140.
- Los coeficientes se leen como cocientes de tasas: cada kilómetro multiplica la tasa por 1.047, diez kilómetros por 1.585 y el clima adverso por 1.764.
- Frente a la media de entrenamiento, el modelo redujo la deviance de prueba de 2.553 a 1.063, un 58.4 % menos.
- La razón de dispersión de 0.983 no muestra sobredispersión; la varianza cruda, 2.6 veces la media, venía de mezclar rutas con tasas distintas.
- Una neurona con salida \(\log\lambda\) y pérdida de Poisson llega a los mismos coeficientes que el GLM (1.633 y −0.268).
La cadena completa de los seis pasos, aplicada a una respuesta de conteo, queda así:
1. naturaleza de Y     → conteo: 0, 1, 2, 3…
2. distribución        → Poisson(λ)
3. cambio de variable  → enlace log: η = log(λ)
4. modelo lineal       → η = Xβ, estimado por máxima verosimilitud
5. cambio inverso      → exponencial: λ = exp(η)
6. predecir y validar  → cocientes de tasas, línea base, dispersión
Frente a la regresión logística cambiaron la distribución (Poisson en lugar de Bernoulli), el enlace (log en lugar de logit) y la lectura del resultado (una tasa en lugar de una probabilidad).
23.24 Puente hacia los siguientes capítulos
Hasta aquí, longitud y clima entran con efectos lineales en la escala log. Una relación real puede curvarse: quizá el riesgo crece lentamente en rutas medianas y se acelera en rutas muy largas.
Los modelos aditivos generalizados (GAM) combinan la distribución y el enlace de un GLM con la flexibilidad de los splines, y permiten efectos no lineales sin perder la estructura interpretable del modelo.