Dos conjuntos pueden tener la misma media e incluso una desviación estándar parecida y, aun así, mostrar formas distintas: sesgo, colas largas, uno o varios picos. Esa diferencia cambia cómo interpretas los datos, qué valores llamas extremos y qué preprocesamiento y qué algoritmo eliges.
En este capítulo trabajas la forma de la distribución: qué es una distribución, la normal como referencia, la asimetría, la curtosis, la detección de anomalías con z-score e IQR y las transformaciones que cambian la escala o la forma.
Todos los datos son simulados con NumPy dentro del capítulo: muestras de distribuciones normales, exponenciales, de Poisson, lognormales, uniformes y de Laplace, un conjunto normal con cinco anomalías sembradas a mano y un ejemplo de dos variables para el algoritmo de k vecinos más cercanos.
Tiempo estimado de lectura: 60 minutos (unas 2 horas y media si ejecutas el código)
Nivel: Básico
Conocimientos previos recomendados: los capítulos 2 (media y mediana) y 3 (desviación estándar y z-score).
Tecnologías mencionadas: Python 3.13, pandas 3.0, NumPy 2.5 y Matplotlib.
Objetivos
Al terminar este capítulo vas a ser capaz de:
explicar qué es una distribución y cómo se lee en una muestra;
distinguir distribuciones discretas y continuas;
interpretar simetría, sesgo y colas, y medirlos con la asimetría y la curtosis;
usar la normal como referencia, sabiendo cuándo deja de servir;
detectar anomalías con z-score e IQR y elegir entre ellos;
relacionar la forma de los datos con decisiones de preprocesamiento en machine learning y deep learning.
Ejecuta las celdas en orden: este capítulo fija una semilla global al inicio y cada simulación depende de las anteriores.
4.1 La media no describe la forma
La media resume el centro y la varianza el ancho. Ninguna de las dos dice cómo se reparten los datos.
Distribución
Describe qué valores son frecuentes, cuáles son raros y con qué perfil aparecen: un pico o varios, simetría o sesgo, colas cortas o pesadas.
Asimetría (sesgo)
Una distribución simétrica se equilibra a ambos lados del centro. Una sesgada a la derecha concentra los valores bajos y alarga la cola hacia los altos; una sesgada a la izquierda hace lo contrario.
Colas y curtosis
Las colas indican qué tan frecuentes son los valores extremos. Con colas pesadas aparecen más valores atípicos y las pérdidas cuadráticas se vuelven más sensibles a ellos.
Cuartiles e IQR
Los cuartiles dividen los datos ordenados en cuatro partes iguales: \(Q_1\) (25%), \(Q_2\) (50%, la mediana del capítulo 2) y \(Q_3\) (75%). El rango intercuartílico\(\text{IQR} = Q_3 - Q_1\) es el ancho del 50% central. A diferencia de la desviación estándar (capítulo 3), casi no se mueve con los extremos: es una medida de dispersión robusta, la base del boxplot y de la regla de anomalías de la etapa 9.
Pregunta
Qué observar
¿Dónde está el centro?
Media o mediana
¿Qué tan anchos son los datos?
Desviación estándar o IQR
¿Hay un lado más largo?
Asimetría
¿Hay extremos frecuentes?
Colas / curtosis
¿Hay más de un pico?
Multimodalidad
4.2 Por qué importa en IA y machine learning
Un modelo se entrena mejor cuando conoces de antemano cómo se reparten las variables de entrada y los errores:
Preprocesamiento: el sesgo y las colas deciden el escalamiento, las transformaciones y el tratamiento de los extremos. En la etapa 10 ves que estandarizar no cambia una asimetría de 2.19 y que el logaritmo la lleva a −0.13.
Algoritmos por distancia: k vecinos más cercanos y clustering son sensibles a la escala; en la etapa 10, sin estandarizar, el vecino más cercano acierta la clase el 51.5% de las veces, casi como tirar una moneda, frente al 96.0% con los datos estandarizados.
Pérdidas cuadráticas: un valor en la cola pesa mucho más que uno del centro.
Detección de anomalías: la regla que elijas (z-score o IQR) depende de la forma; en la etapa 9 cada una gana en un escenario distinto.
Idea central: media y varianza no bastan. Dos conjuntos pueden compartir esos resúmenes y pedir decisiones de modelado distintas (etapa 1).
4.3 Flujo recomendado de trabajo
Mira la forma, no solo el centro. Compara histogramas o curvas de densidad de conjuntos con media parecida.
Identifica el tipo de variable. Si es discreta, lees frecuencias por valor; si es continua, frecuencias por intervalo o densidad.
Usa la normal como referencia. La regla 68–95–99.7 te ayuda a leer rareza solo si la forma es aproximadamente normal.
Describe el sesgo y las colas. Decide si conviene la media o la mediana, y si un valor extremo es plausible o anómalo.
Detecta anomalías con más de un criterio. Compara z-score e IQR y revisa el dominio antes de eliminar nada.
Traduce la forma a una decisión de modelado. Escala, transforma, cambia la pérdida o revisa el algoritmo.
Redacta el reporte:
“Para [variable], la distribución es [simétrica/sesgada]. Se reporta [medida] porque [justificación]. Implicación para el modelo: [escalar/transformar/revisar atípicos].”
4.4 Preparar el entorno
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltprint("pandas:", pd.__version__, "| numpy:", np.__version__)SEMILLA =42# semilla central del capítulorng = np.random.default_rng(SEMILLA)
Python: 3.13.14
pandas: 3.0.5 | numpy: 2.5.1
4.5 Desarrollo por etapas
El entorno queda con Python 3.13.14, pandas 3.0.5 y NumPy 2.5.1, y una semilla central (SEMILLA = 42) con un solo generador rng para todas las simulaciones.
Avanzas en este orden: compruebas con un ejemplo que la forma importa, defines qué es una distribución, usas la normal como referencia, mides asimetría y curtosis, comparas tres gráficos de la misma variable, detectas anomalías y terminas con las consecuencias para machine learning.
Marco conceptual: de la muestra a la distribución
Población y muestra se definieron en el capítulo 1. Aquí se agregan dos términos:
Variable aleatoria \(X\): la magnitud incierta antes de observarla (el tiempo de la próxima solicitud, la nota del próximo estudiante).
Realización \(x\): el valor concreto que queda registrado en una fila de la tabla.
La distribución de \(X\) describe qué valores son plausibles y con qué frecuencia relativa. Con datos, la aproximas con histogramas y frecuencias: cada columna numérica es una muestra de realizaciones.
Este capítulo usa la lectura empírica de una distribución: frecuencias, histogramas y resúmenes. La versión formal (probabilidad, función de masa, densidad y esperanza) se desarrolla en los capítulos 7 y 8.
Etapa 1: Misma media, distinta forma
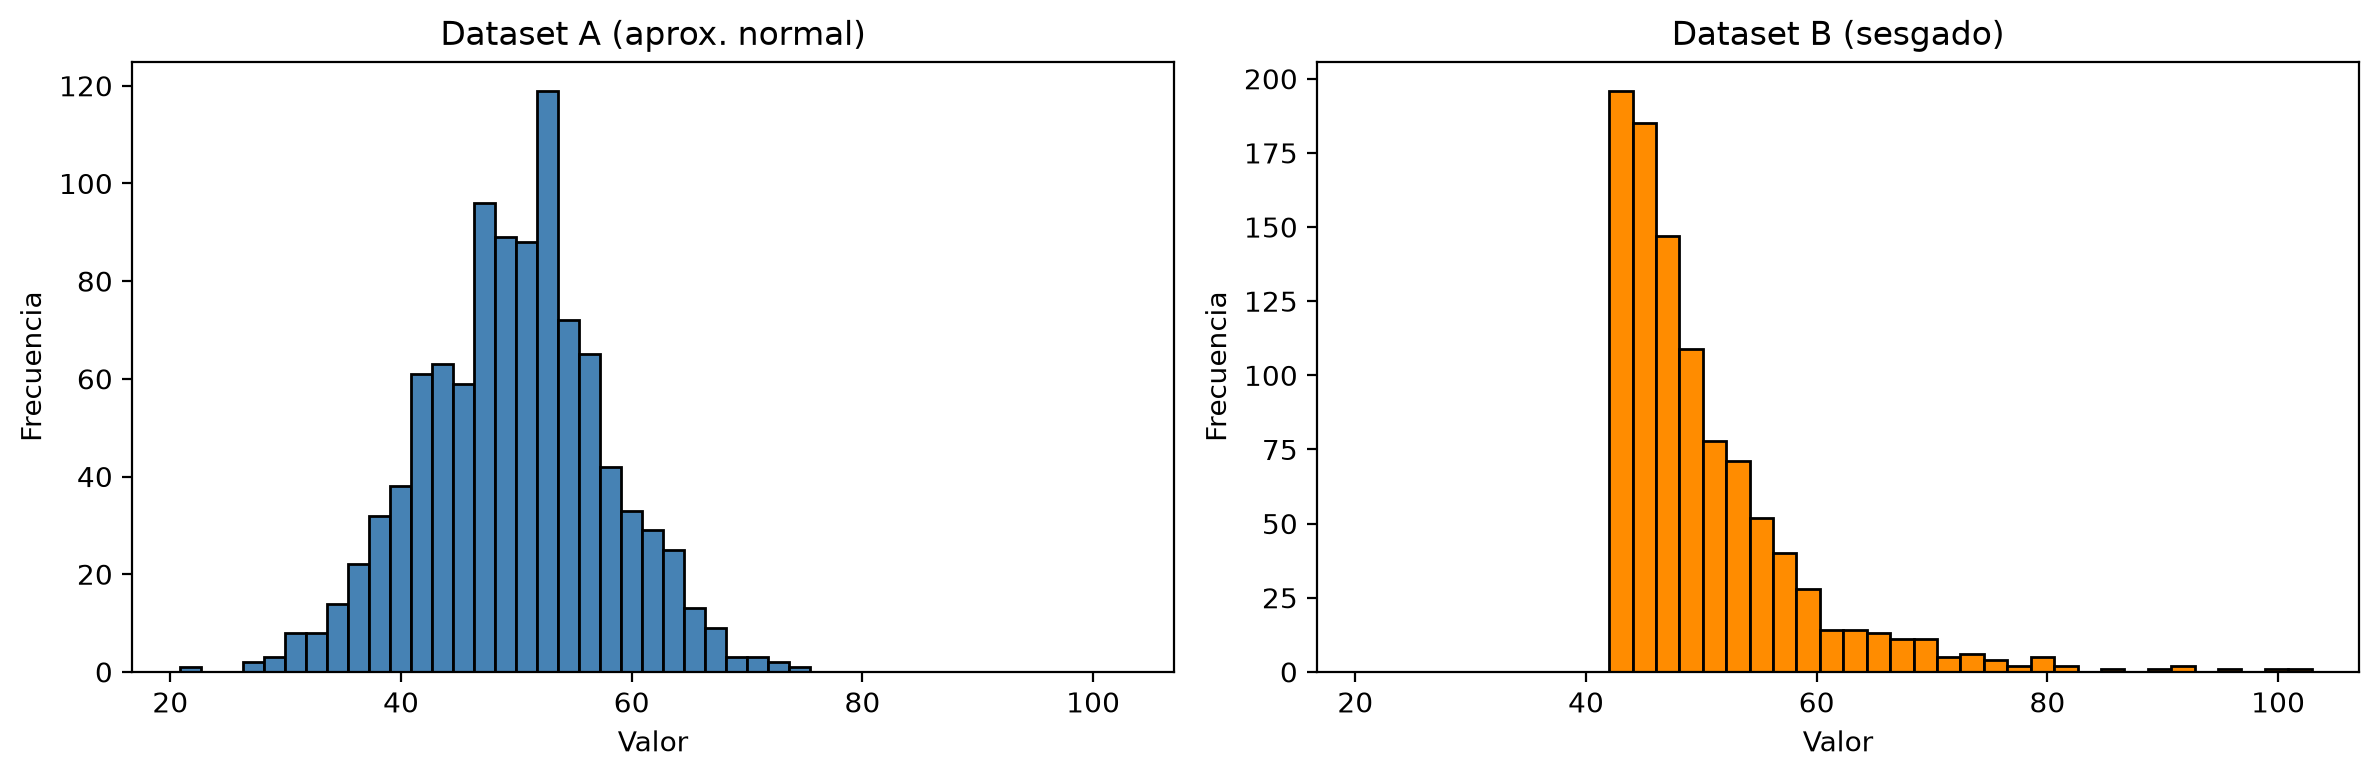
Simulas 1000 valores normales con media 50 y desviación 8, y 1000 valores exponenciales con escala 8 desplazados en 42. Las dos distribuciones tienen, en teoría, media 50 y desviación 8. Al ver los histogramas, fíjate en el número de picos, la simetría y si hay colas largas o valores aislados.
datos_a = rng.normal(loc=50, scale=8, size=1000) # aproximadamente simétricodatos_b = rng.exponential(scale=8, size=1000) +42# sesgado a la derechaprint(f"Media datos A: {datos_a.mean():.2f}")print(f"Media datos B: {datos_b.mean():.2f}")print(f"Desv. estándar A: {datos_a.std(ddof=1):.2f} | Desv. estándar B: {datos_b.std(ddof=1):.2f}")fig, ax = plt.subplots(1, 2, figsize=(12, 4), sharex=True) # mismo eje x: se comparan formasax[0].hist(datos_a, bins=30, color='steelblue', edgecolor='black')ax[0].set_title('Dataset A (aprox. normal)')ax[1].hist(datos_b, bins=30, color='darkorange', edgecolor='black')ax[1].set_title('Dataset B (sesgado)')for a in ax: a.set_xlabel('Valor') a.set_ylabel('Frecuencia')plt.tight_layout()plt.show()
Media datos A: 49.77
Media datos B: 50.12
Desv. estándar A: 7.91 | Desv. estándar B: 8.21
Las medias son 49.77 y 50.12 y las desviaciones 7.91 y 8.21: con lo visto en los capítulos 2 y 3, los dos conjuntos serían indistinguibles. Sin embargo, el A es simétrico alrededor de 50 y el B empieza abruptamente en 42, acumula ahí la mayoría de sus valores (el 80% queda por debajo de 55) y se extiende con una cola hacia la derecha. Un mismo valor de 70 sería raro en los dos, pero por razones distintas: en A está a 2.5 desviaciones de una campana simétrica; en B es parte de una cola larga que aparece con regularidad.
En machine learning, esa diferencia cambia los umbrales de anomalía, el escalamiento conveniente y el peso que tienen unas observaciones frente a otras en la función de pérdida.
Etapa 2: ¿Qué es una distribución?
La distribución de una variable describe qué valores toma y con qué frecuencia relativa. Según el tipo de variable la resumes de dos maneras:
Discreta: una tabla o un gráfico de barras con la frecuencia de cada valor.
Continua: un histograma, que cuenta cuántos datos caen en cada intervalo.
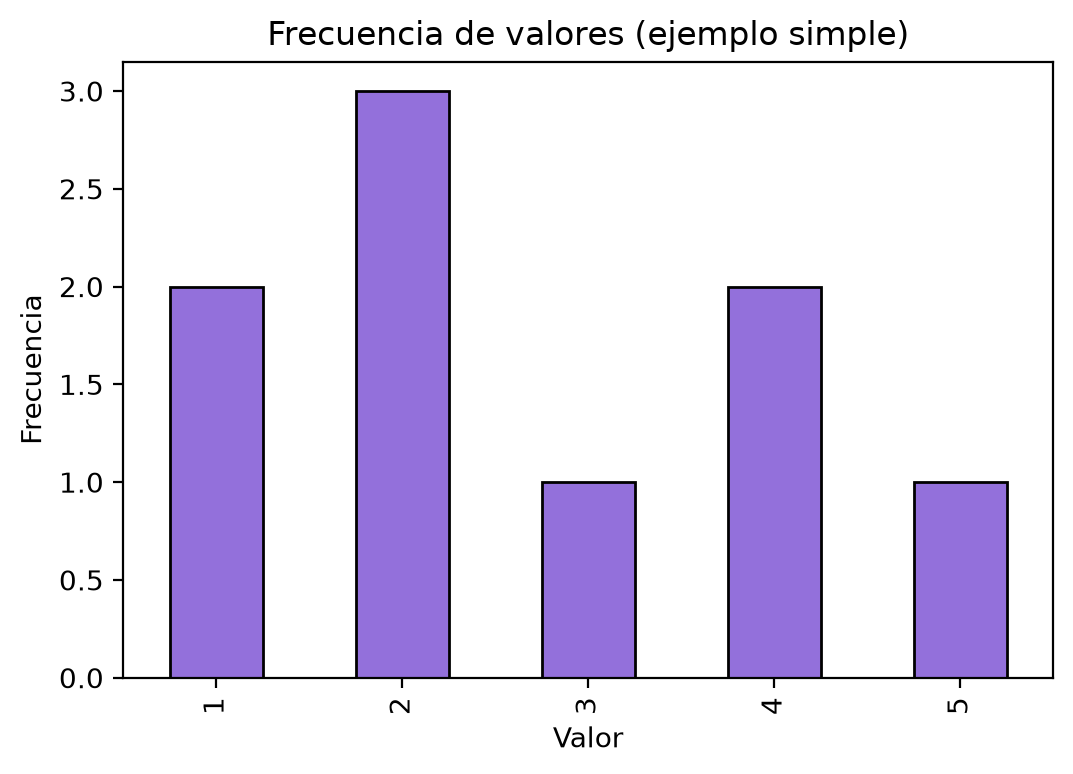
Lo que ves en una muestra es una aproximación al comportamiento de fondo de la variable; cuánto se le parece depende del tamaño de la muestra y de cómo se obtuvo. El modelo teórico se construye en el capítulo 8. Empiezas con nueve valores enteros.
El valor 2 es el más frecuente (3 de 9), los valores 1 y 4 aparecen 2 veces y los valores 3 y 5 una. Esa tabla ya es la distribución empírica de la muestra. Antes de modelar, identificar qué valores dominan y qué zonas son raras te dice qué esperar de cada variable.
Etapa 3: Distribuciones discretas
Una variable discreta toma valores que se pueden contar: 0, 1, 2… Su distribución se lee en una tabla de frecuencias relativas, que suman 1. El capítulo 8 formaliza tres situaciones típicas:
un resultado de sí o no (Bernoulli);
el número de éxitos en una cantidad fija de intentos (binomial);
el número de eventos en un intervalo (Poisson), como en esta etapa.
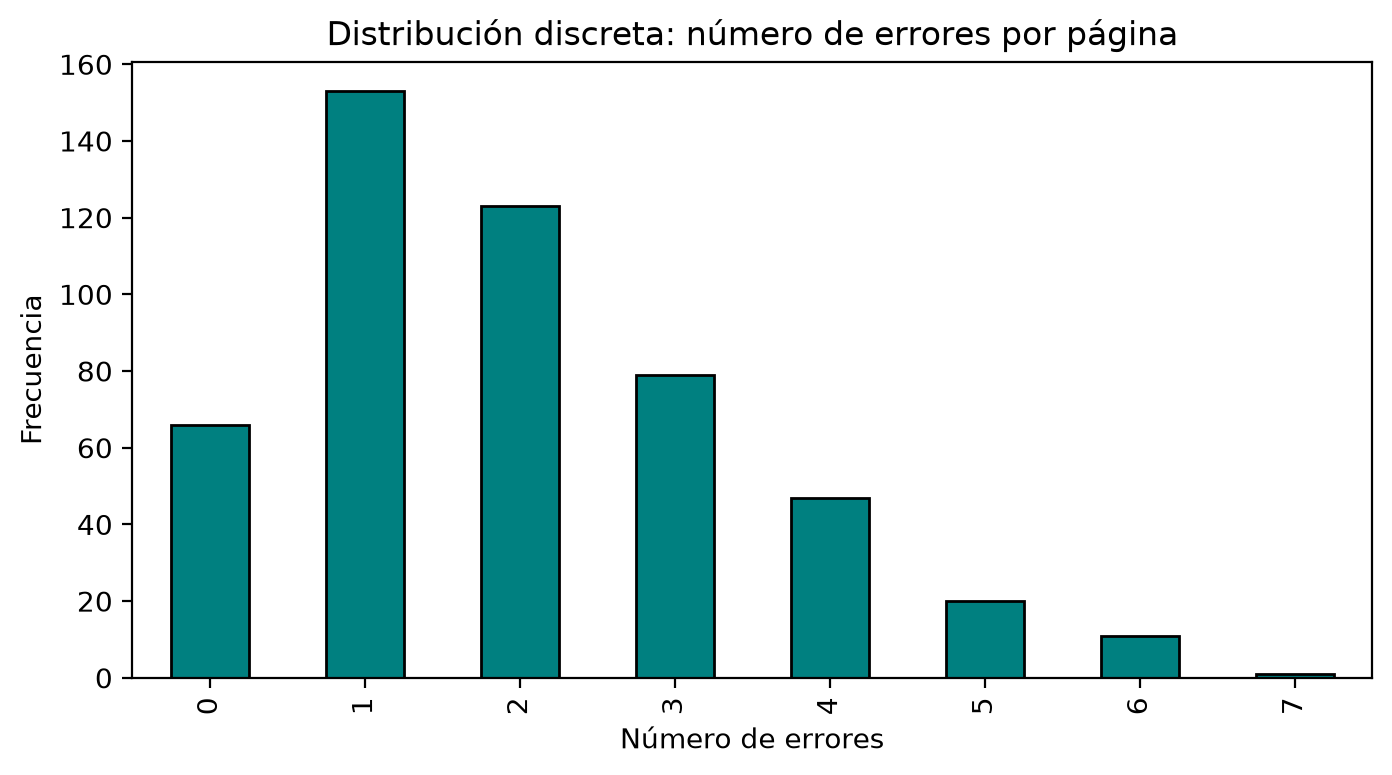
Simulas el número de errores en 500 páginas con una distribución de Poisson de media 2.
errores = rng.poisson(lam=2, size=500)freq_errores = pd.Series(errores).value_counts().sort_index()freq_errores.plot(kind='bar', color='teal', edgecolor='black', figsize=(8, 4))plt.title('Distribución discreta: número de errores por página')plt.xlabel('Número de errores')plt.ylabel('Frecuencia')plt.show()
La barra más alta está en 1 error (153 páginas), seguida de 2 (123); 66 páginas no tienen errores y solo 12 tienen 6 o 7. La distribución es asimétrica: no puede bajar de 0, pero sí se extiende hacia la derecha. En machine learning, variables así aparecen como conteos (clics, reclamos, eventos por hora) y como objetivos de clasificación o de regresión de Poisson.
Etapa 4: Distribuciones continuas
Una variable continua puede tomar cualquier valor de un rango y casi ningún valor exacto se repite. Por eso no cuentas cuántas veces aparece cada valor, sino cuántos datos caen en cada intervalo: eso es un histograma.
La curva suave que a veces se dibuja sobre el histograma se llama densidad. Su altura indica dónde se concentran los datos, pero no es una probabilidad; el capítulo 8 explica por qué. Formas frecuentes: normal (simétrica, en campana), exponencial (tiempos entre eventos), uniforme (todos los valores del rango por igual) y lognormal (valores positivos con cola larga a la derecha).
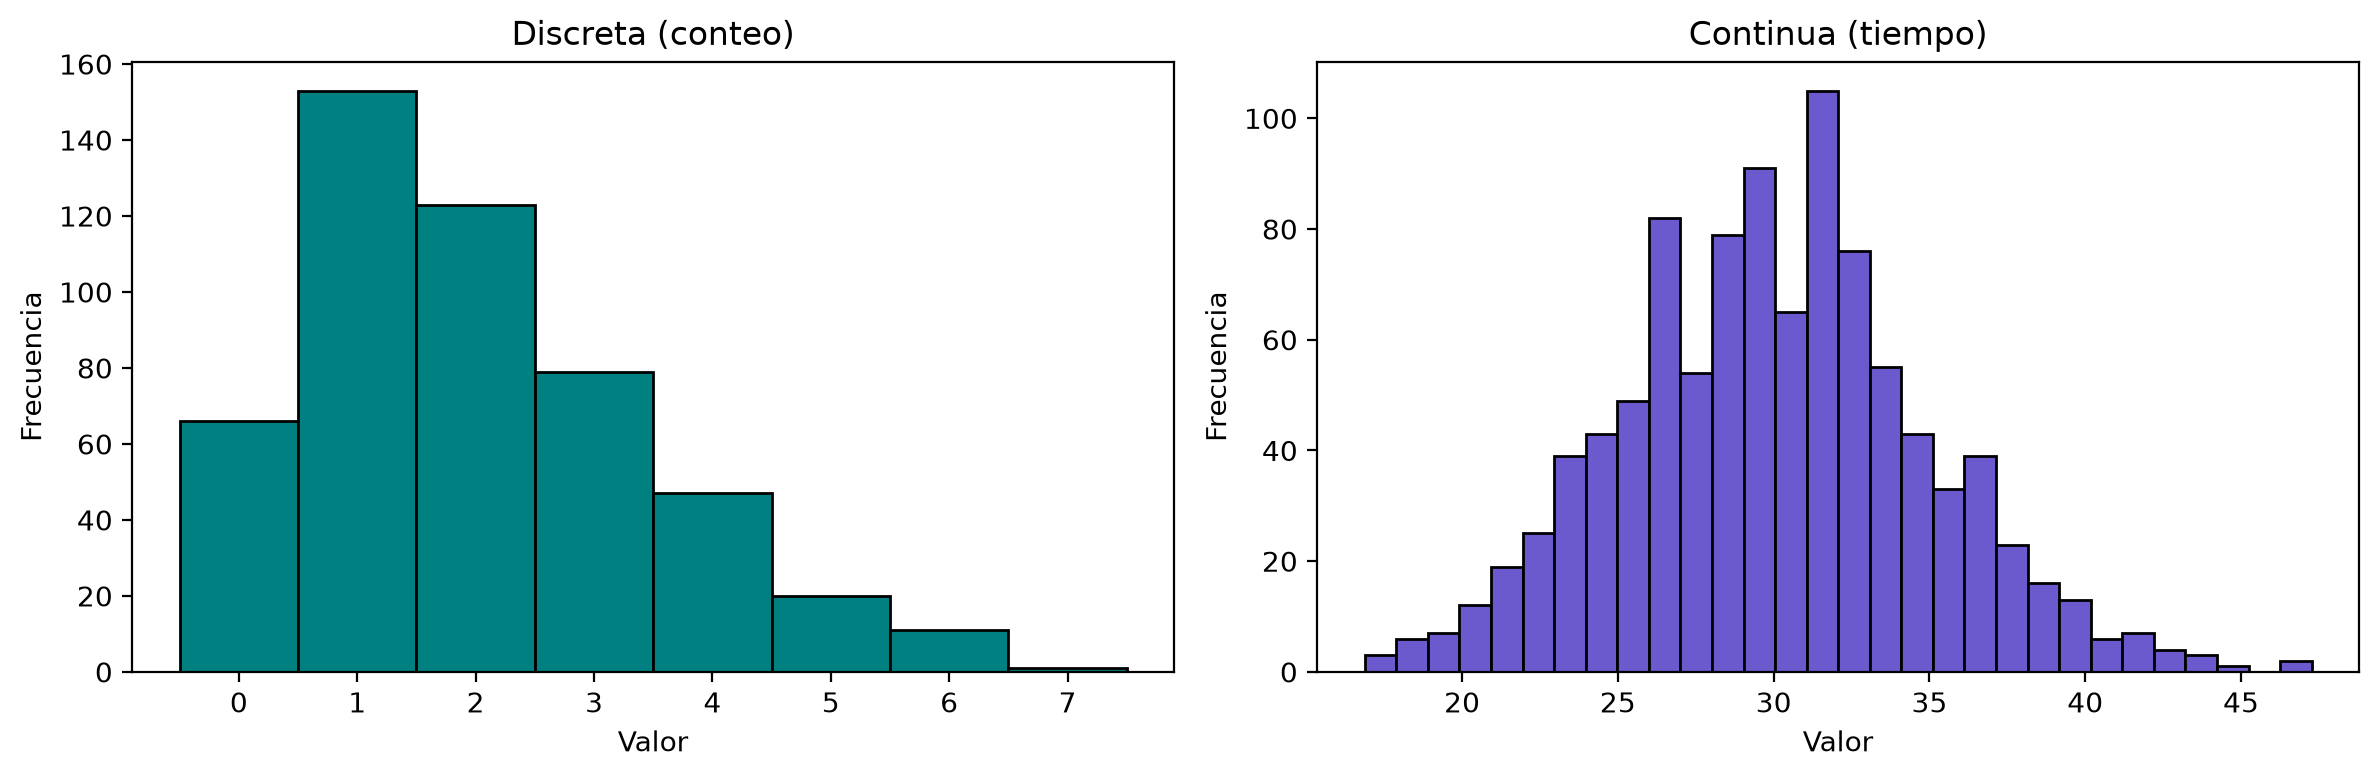
Comparas los conteos de la etapa 3 con 1000 tiempos simulados de una normal con media 30 y desviación 5.
A la izquierda, cada barra corresponde a un valor entero de errores (de 0 a 7), sin valores intermedios. A la derecha, los tiempos ocupan un rango continuo, aproximadamente de 17 a 47, agrupados en 30 intervalos con forma de campana alrededor de 30. Muchas variables de entrada en machine learning son continuas, y examinar sus distribuciones es un paso habitual del análisis exploratorio.
Etapa 5: Distribución normal
La normal tiene forma de campana, es simétrica, y en ella media, mediana y moda coinciden (en una muestra quedan muy cerca).
Advertencia: no todos los datos reales siguen una distribución normal. Ingresos, tiempos de espera, conteos o proporciones suelen ser asimétricos o tener varios picos. La normal es un modelo de referencia para razonar y comparar, no una regla que puedas asumir sin comprobar.
Una variable continua \(X\) sigue una distribución normal con media \(\mu\) y varianza \(\sigma^2\), \(X \sim \mathcal{N}(\mu, \sigma^2)\), si su densidad es la campana simétrica fijada por esos dos parámetros. Tres propiedades útiles:
Simetría: la densidad es simétrica respecto de \(\mu\) y tiene un solo pico, así que media, mediana y moda coinciden en \(\mu\).
Colas que caen rápido: los valores muy alejados de \(\mu\) son raros, y eso justifica usar bandas \(\mu \pm k\sigma\) como referencia.
Modelo de referencia: describe bien el ruido que resulta de sumar muchas causas pequeñas, y por eso varios métodos postulan errores normales. La mayoría de los conjuntos reales no son exactamente normales.
Si asumes normalidad sin verificarla, los umbrales basados en desviaciones estándar pueden subestimar o sobrestimar la rareza, la inferencia de la regresión lineal clásica pierde fiabilidad con residuos muy asimétricos y la limpieza por z-score puede eliminar observaciones legítimas o dejar pasar errores.
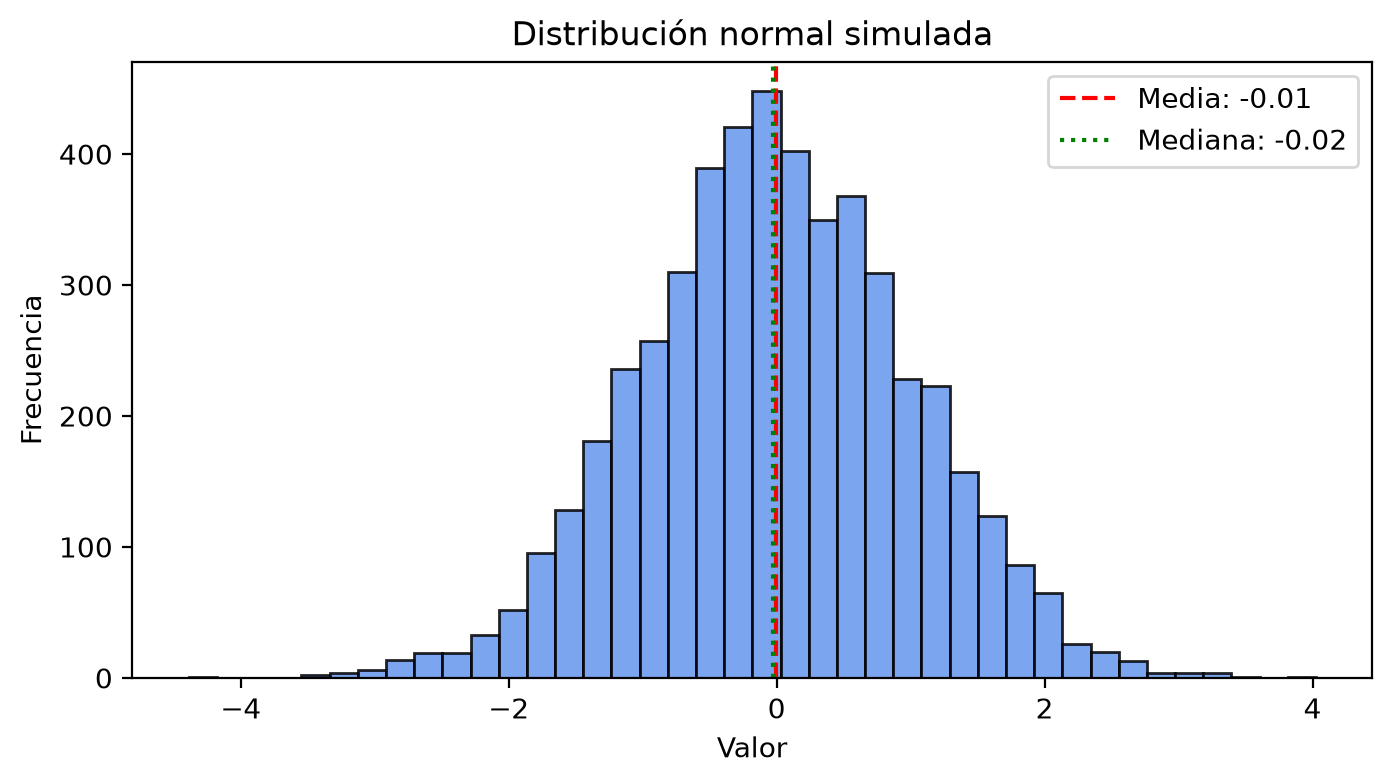
Simulas 5000 valores de una normal estándar y marcas su media y su mediana.
La campana es simétrica alrededor de 0 y casi todos los valores caen entre −3 y 3. La media (−0.01) y la mediana (−0.02) quedan superpuestas, como corresponde a una distribución simétrica. Úsala como referencia para calibrar qué esperar de las colas: cuando tus datos se alejan de esta forma, conviene adaptar las transformaciones, la pérdida (por ejemplo, pasar del error cuadrático a uno más robusto) o el modelo.
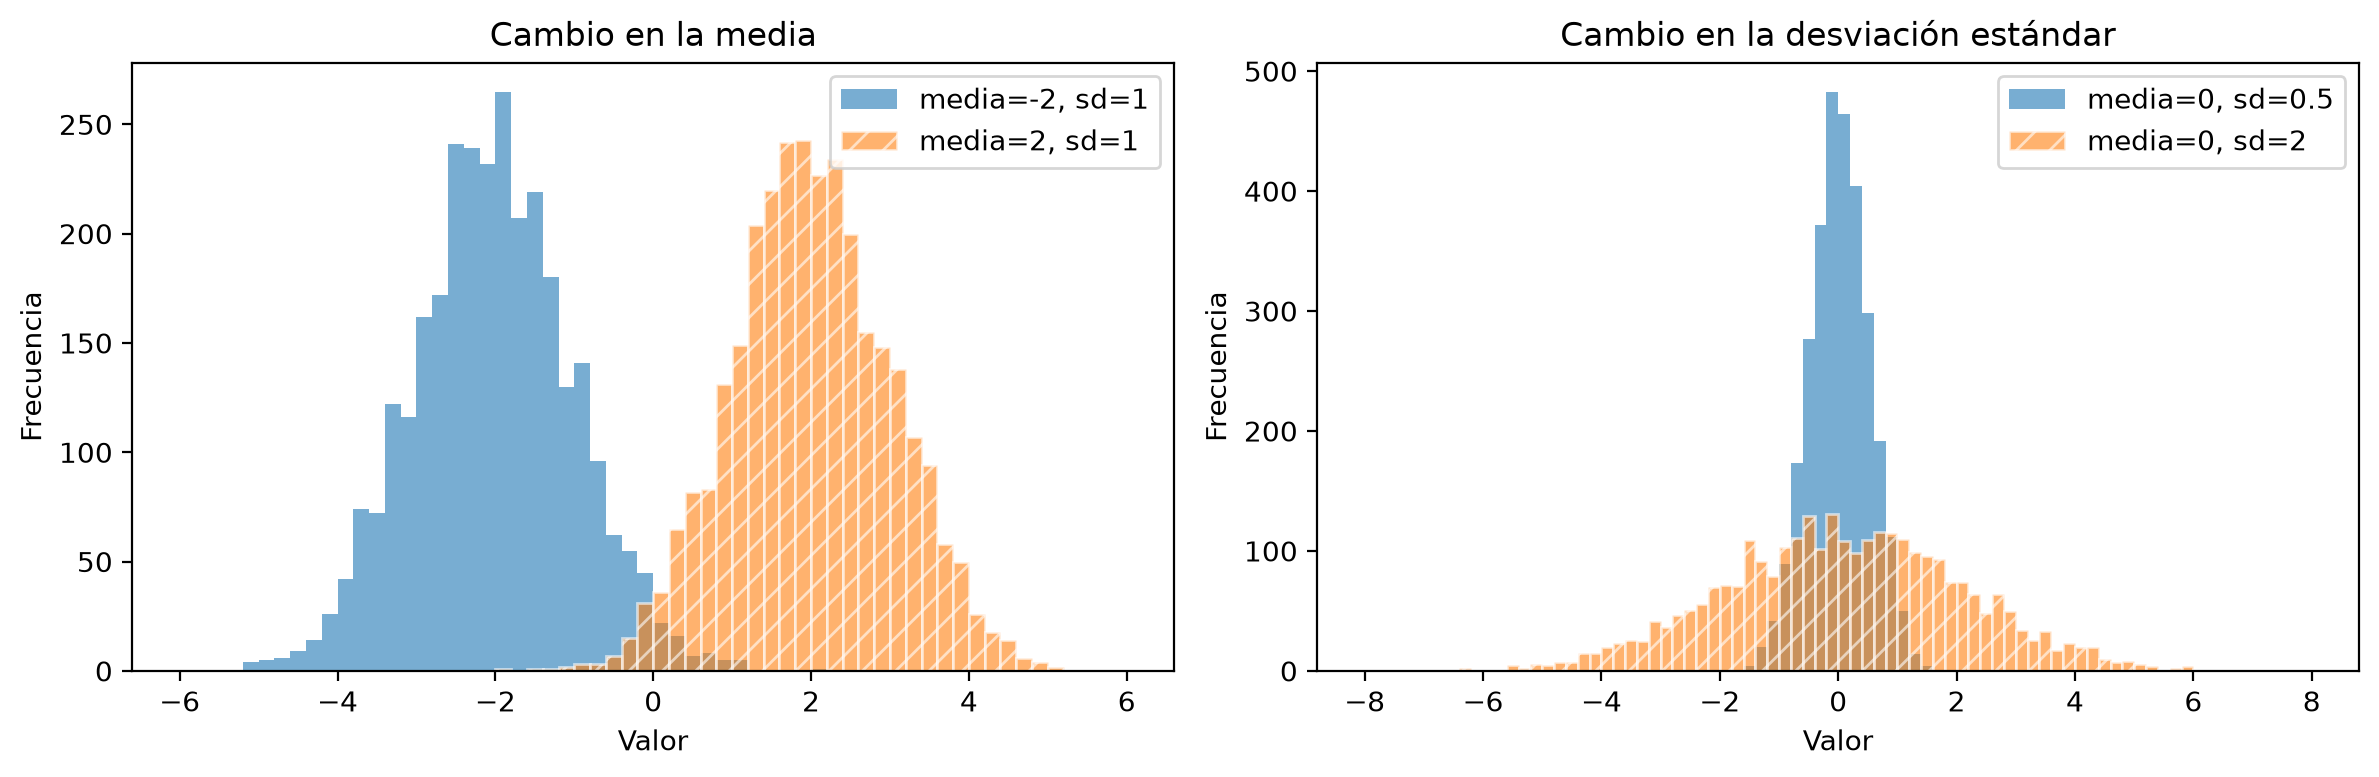
Ahora cambias por separado los dos parámetros: a la izquierda, dos normales con desviación 1 y medias −2 y 2; a la derecha, dos con media 0 y desviaciones 0.5 y 2, con los mismos intervalos para que las alturas sean comparables.
# Parámetros de la normal: efecto de media y desviación estándarx1 = rng.normal(loc=-2, scale=1, size=3000)x2 = rng.normal(loc=2, scale=1, size=3000)x3 = rng.normal(loc=0, scale=0.5, size=3000)x4 = rng.normal(loc=0, scale=2, size=3000)fig, ax = plt.subplots(1, 2, figsize=(12, 4))bins_media = np.linspace(-6, 6, 61) # mismos intervalos para ambas seriesax[0].hist(x1, bins=bins_media, alpha=0.6, label='media=-2, sd=1')ax[0].hist(x2, bins=bins_media, alpha=0.6, hatch='//', edgecolor='white', label='media=2, sd=1')ax[0].set_title('Cambio en la media')ax[0].legend()bins_sd = np.linspace(-8, 8, 81) # con intervalos distintos, las alturas no serían comparablesax[1].hist(x3, bins=bins_sd, alpha=0.6, label='media=0, sd=0.5')ax[1].hist(x4, bins=bins_sd, alpha=0.6, hatch='//', edgecolor='white', label='media=0, sd=2')ax[1].set_title('Cambio en la desviación estándar')ax[1].legend()for a in ax: a.set_xlabel('Valor') a.set_ylabel('Frecuencia')plt.tight_layout()plt.show()
Cambiar la media desplaza toda la campana sin cambiar su forma: las dos curvas de la izquierda son iguales y están 4 unidades separadas. Cambiar la desviación estándar la estrecha o la ensancha alrededor del mismo centro: con 3000 valores en cada serie, la campana de desviación 0.5 es mucho más alta, porque reparte la misma cantidad de observaciones en un tramo cuatro veces más corto que la de desviación 2.
Sumar una constante a los datos y multiplicarlos por otra hace exactamente eso. Es lo que ocurre al estandarizar: restas la media, divides por la desviación y la forma se conserva.
La regla 68–95–99.7
Para una variable \(X \sim \mathcal{N}(\mu, \sigma^2)\), la probabilidad de caer dentro de bandas centradas en \(\mu\) es aproximadamente:
\(P(\mu-\sigma \le X \le \mu+\sigma) \approx 0.68\)
\(P(\mu-2\sigma \le X \le \mu+2\sigma) \approx 0.95\)
\(P(\mu-3\sigma \le X \le \mu+3\sigma) \approx 0.997\)
Estas proporciones valen solo si la variable es aproximadamente normal: unimodal, simétrica y sin colas más pesadas que la gaussiana. Con sesgo fuerte, mezclas de subpoblaciones o colas pesadas, las proporciones reales se alejan de ellas. Tampoco sirven si calculas \(\bar{x}\) y \(s\) con datos contaminados por atípicos, ni justifican llamar “error” a un valor más allá de \(3\sigma\) sin mirar el dominio.
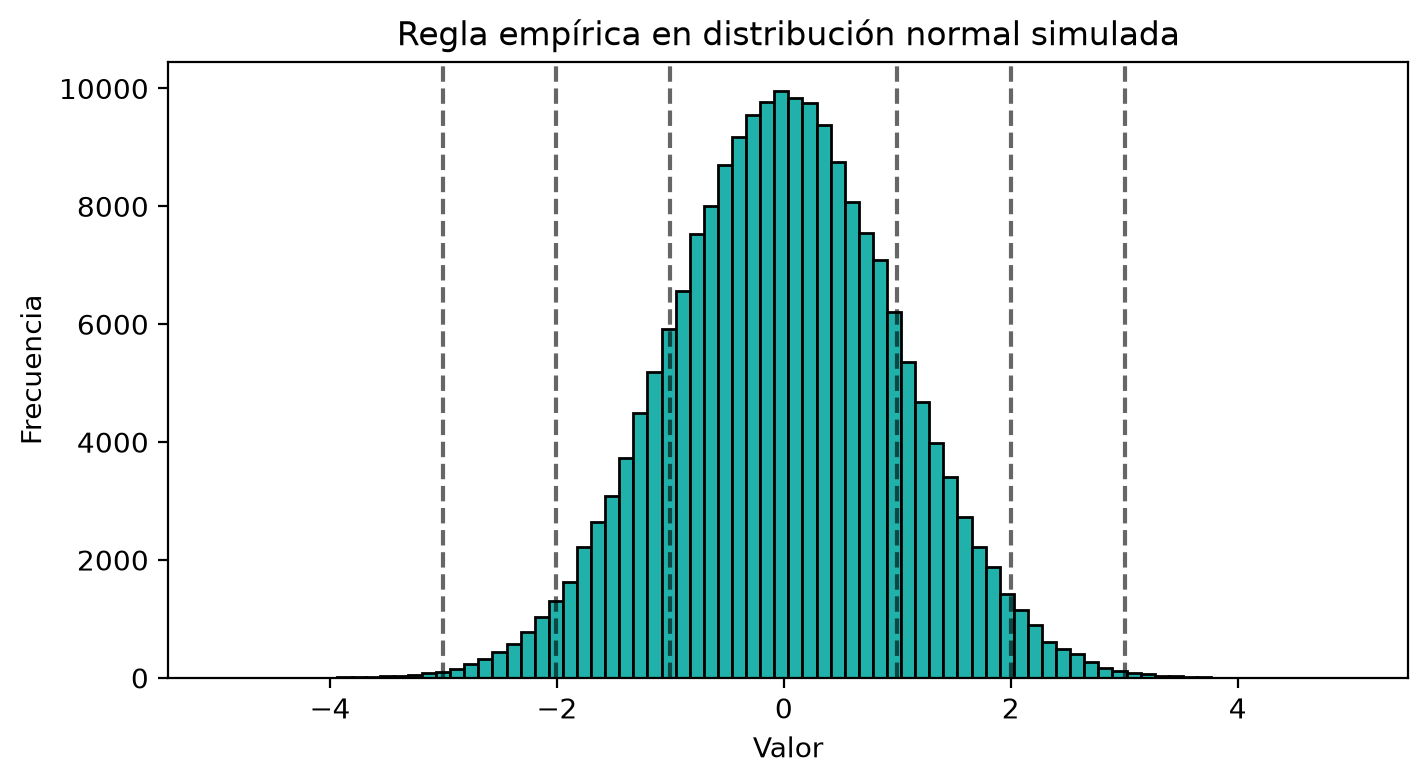
Lo compruebas con 200 000 valores normales simulados.
# Regla empírica 68%-95%-99.7%z = rng.normal(loc=0, scale=1, size=200000)m, s = z.mean(), z.std()p1 = np.mean((z >= m -1*s) & (z <= m +1*s))p2 = np.mean((z >= m -2*s) & (z <= m +2*s))p3 = np.mean((z >= m -3*s) & (z <= m +3*s))print(f'Dentro de ±1σ: {p1*100:.2f}%')print(f'Dentro de ±2σ: {p2*100:.2f}%')print(f'Dentro de ±3σ: {p3*100:.2f}%')plt.figure(figsize=(8,4))plt.hist(z, bins=80, color='lightseagreen', edgecolor='black')for k in [1,2,3]: plt.axvline(m-k*s, color='black', linestyle='--', alpha=0.6) plt.axvline(m+k*s, color='black', linestyle='--', alpha=0.6)plt.title('Regla empírica en distribución normal simulada')plt.xlabel('Valor')plt.ylabel('Frecuencia')plt.show()
Dentro de ±1σ: 68.38%
Dentro de ±2σ: 95.42%
Dentro de ±3σ: 99.73%
Dentro de ±1σ cae el 68.38% de los valores; dentro de ±2σ, el 95.42%; dentro de ±3σ, el 99.73%. Con 200 000 datos normales, la regla se cumple casi al décimo. Bajo normalidad aproximada, esto te dice qué tan raro es un valor según cuántas desviaciones está del centro, y es la base de la lectura de los z-scores. Si la forma no es normal, estos porcentajes dejan de calibrar la rareza y conviene usar cuantiles o el IQR.
Etapa 6: Asimetría (sesgo)
La asimetría mide la falta de simetría de una distribución alrededor de su media.
Simétrica: la distribución se parece a su reflejo a ambos lados de la media; media y mediana quedan muy próximas.
Asimetría positiva (sesgo a la derecha): la cola larga va hacia los valores mayores; en distribuciones de un solo pico suele cumplirse media > mediana, porque los valores grandes arrastran la media.
Asimetría negativa (sesgo a la izquierda): la cola va hacia los valores menores; suele cumplirse media < mediana.
Se calcula como el promedio de los z-scores al cubo, \(\frac{1}{n}\sum z_i^3\): el cubo conserva el signo y da mucho peso a los valores lejanos. Si media y mediana se separan mucho, resumir solo con la media puede ser engañoso; cita ambas o explica la transformación aplicada. El signo y la magnitud orientan transformaciones como el logaritmo, la raíz o las familias de Box–Cox y Yeo–Johnson.
Comparas 4000 valores normales, 4000 exponenciales y 4000 exponenciales con el signo cambiado.
La normal tiene asimetría 0.06, con media y mediana superpuestas en 0. La exponencial tiene asimetría 2.03: casi todos sus valores están cerca de 0 y la cola llega hasta 8, así que la media (1.00) queda a la derecha de la mediana (0.68). La versión negativa es su reflejo, con asimetría −2.02 y la media a la izquierda de la mediana.
En machine learning, una variable sesgada pesa en el aprendizaje: en una regresión con pérdida cuadrática, unos pocos valores de la cola influyen mucho en el ajuste; en k vecinos más cercanos y en clustering, una variable muy sesgada y mal escalada domina las distancias. Las transformaciones monótonas, como el logaritmo de una variable positiva con cola derecha, suelen acercar la forma a la que suponen los métodos lineales.
Curtosis: colas ligeras frente a colas pesadas
La curtosis compara cuánta masa tienen las colas con la de una normal de la misma varianza. Se calcula como el promedio de los z-scores a la cuarta menos 3 (curtosis de exceso), de modo que la normal tiene 0: valores positivos indican colas más pesadas que la normal y valores negativos, colas más ligeras.
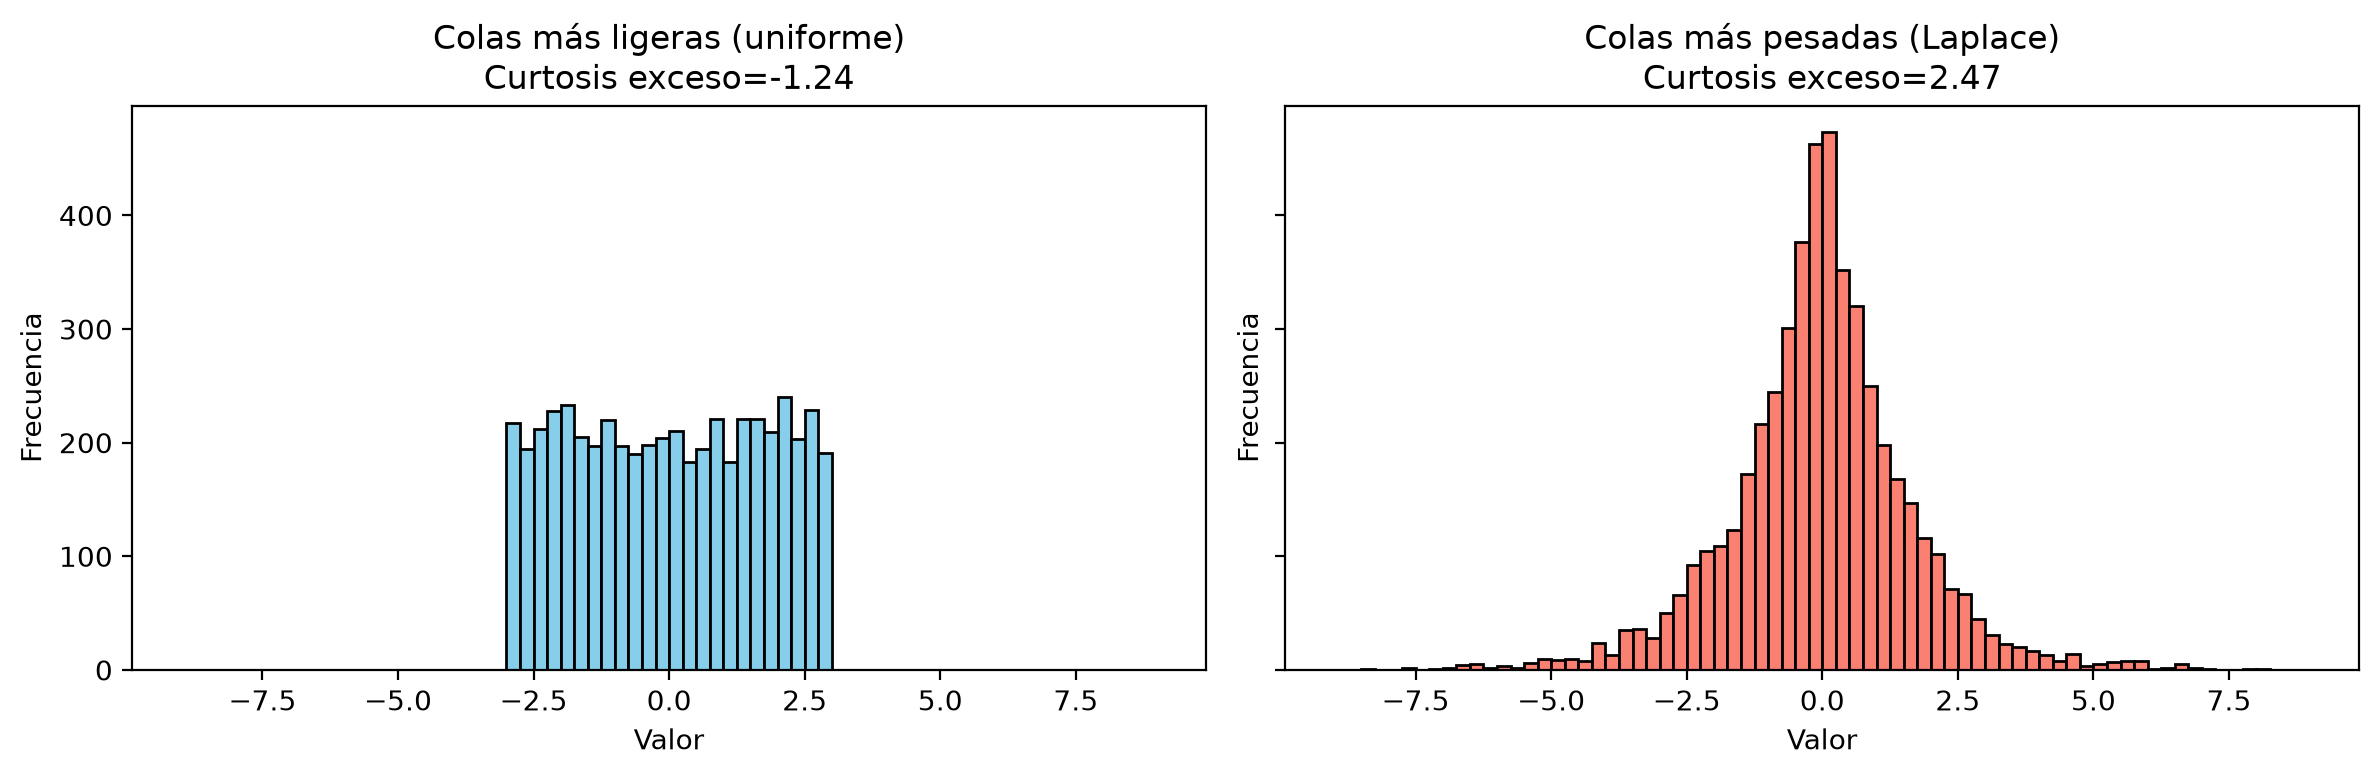
Comparas una uniforme entre −3 y 3 y una Laplace, elegidas para tener la misma varianza (3). Los dos histogramas comparten ejes: fíjate en la extensión de las colas.
# Curtosis: colas ligeras vs colas pesadas, con la MISMA varianzadef curtosis_exceso(x): mu = np.mean(x) sigma = np.std(x)return np.mean(((x - mu) / sigma) **4) -3colas_ligeras = rng.uniform(-3, 3, 5000) # uniforme: varianza = 6²/12 = 3colas_pesadas = rng.laplace(0, np.sqrt(1.5), 5000) # Laplace: varianza = 2·b² = 3print(f"Varianza: ligeras {colas_ligeras.var():.2f} | pesadas {colas_pesadas.var():.2f}")print(f"Valores con |x| > 4: ligeras {100* np.mean(np.abs(colas_ligeras) >4):.1f}% | "f"pesadas {100* np.mean(np.abs(colas_pesadas) >4):.1f}%")bins = np.linspace(-9, 9, 73)fig, ax = plt.subplots(1, 2, figsize=(12, 4), sharex=True, sharey=True)ax[0].hist(colas_ligeras, bins=bins, color='skyblue', edgecolor='black')ax[0].set_title(f'Colas más ligeras (uniforme)\nCurtosis exceso={curtosis_exceso(colas_ligeras):.2f}')ax[1].hist(colas_pesadas, bins=bins, color='salmon', edgecolor='black')ax[1].set_title(f'Colas más pesadas (Laplace)\nCurtosis exceso={curtosis_exceso(colas_pesadas):.2f}')for a in ax: a.set_xlabel('Valor') a.set_ylabel('Frecuencia')plt.tight_layout()plt.show()
Con varianzas parecidas (3.05 y 2.81), la uniforme no tiene ningún valor más allá de ±3, mientras que el 3.4% de los valores de la Laplace cae más allá de ±4. La curtosis de exceso lo resume: −1.24 para la uniforme y 2.47 para la Laplace en esta muestra (los valores teóricos son −1.2 y 3). La Laplace tiene además un pico más alto, pero lo que mide la curtosis es la masa en las colas.
Colas ligeras: los extremos son raros incluso comparados con la normal. Eso no descarta errores de medición.
Colas pesadas: aparecen más valores atípicos e influyentes; en métodos cuadráticos crece la varianza del error de predicción y el entrenamiento puede volverse menos estable.
Ante colas pesadas, revisa las pérdidas robustas, el escalamiento robusto (mediana e IQR) o las reglas de negocio antes de eliminar datos.
Etapa 7: Dispersión, asimetría y curtosis
Las tres medidas se construyen con potencias de las desviaciones respecto a la media \(\mu\):
Varianza (orden 2): \(\mathrm{Var}(X) = E[(X-\mu)^2]\). Mide la dispersión en unidades al cuadrado; la desviación estándar \(\sigma = \sqrt{\mathrm{Var}(X)}\) vuelve a las unidades originales.
Asimetría (orden 3): \(E\big[\big(\frac{X-\mu}{\sigma}\big)^3\big]\). Indica hacia dónde se extiende la cola más larga.
Curtosis de exceso (orden 4): \(E\big[\big(\frac{X-\mu}{\sigma}\big)^4\big] - 3\). Compara el peso de las colas con el de la normal.
La tabla resume qué pregunta responde cada una y su efecto en machine learning.
tabla_comparativa = pd.DataFrame({'Concepto': ['Dispersión', 'Asimetría', 'Curtosis'],'Pregunta clave': ['¿Qué tan separados están los datos?','¿Hacia qué lado se inclina la distribución?','¿Qué tan pesadas son las colas?' ],'Indicador común': ['Desviación estándar', 'Skewness', 'Curtosis (exceso)'],'Impacto en ML': ['Afecta escalamiento y distancias','Puede requerir transformaciones','Aumenta sensibilidad a valores extremos' ]})tabla_comparativa
Concepto
Pregunta clave
Indicador común
Impacto en ML
0
Dispersión
¿Qué tan separados están los datos?
Desviación estándar
Afecta escalamiento y distancias
1
Asimetría
¿Hacia qué lado se inclina la distribución?
Skewness
Puede requerir transformaciones
2
Curtosis
¿Qué tan pesadas son las colas?
Curtosis (exceso)
Aumenta sensibilidad a valores extremos
La columna Impacto en ML resume lo que viste en las etapas 3 a 6: la dispersión afecta el escalamiento y las distancias, la asimetría puede pedir una transformación y las colas pesadas aumentan la sensibilidad a los valores extremos.
Etapa 8: Visualización
El histograma, el boxplot y la curva de densidad muestran la misma variable desde ángulos distintos:
Histograma: agrupa los datos en intervalos. El ancho del intervalo cambia lo que ves: intervalos anchos suavizan, intervalos angostos muestran ruido.
Boxplot: resume la variable con la mediana y los cuartiles. La caja es el IQR y los puntos fuera de los bigotes son los candidatos a atípicos según la regla de 1.5 × IQR.
KDE (estimación de densidad por núcleos): suma una pequeña campana centrada en cada observación y produce una curva suave. El resultado depende del ancho de banda\(h\): uno grande suaviza demasiado; uno pequeño muestra fluctuaciones de la muestra.
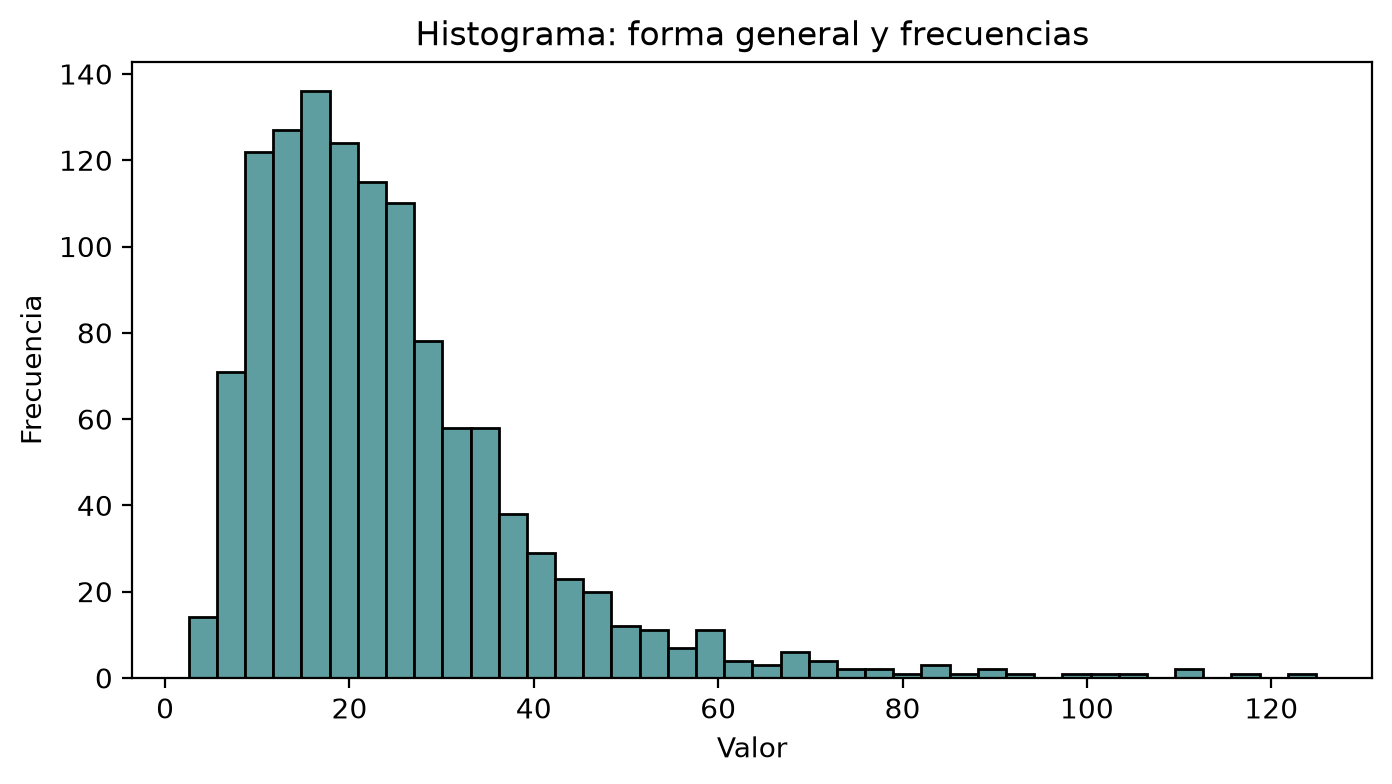
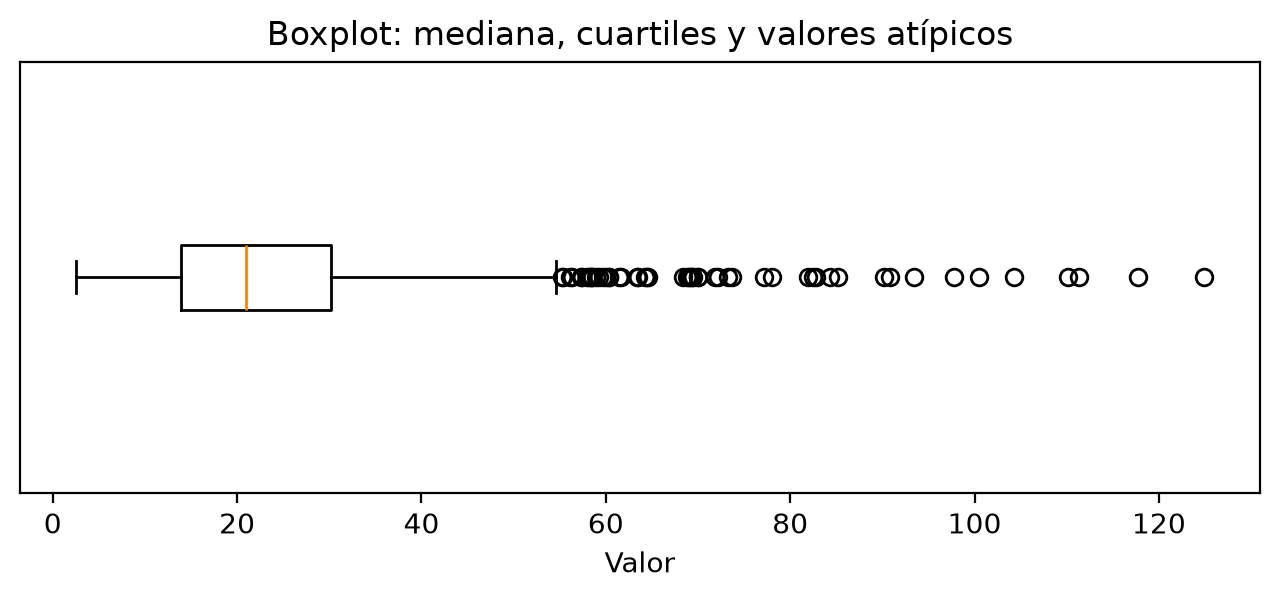
Simulas 1200 valores lognormales, positivos y con cola a la derecha, y los ves primero con un histograma y un boxplot.
# Datos de ejemplo para visualizaciónx = rng.lognormal(mean=3.0, sigma=0.6, size=1200)# Histogramaplt.figure(figsize=(8,4))plt.hist(x, bins=40, color='cadetblue', edgecolor='black')plt.title('Histograma: forma general y frecuencias')plt.xlabel('Valor')plt.ylabel('Frecuencia')plt.show()# Boxplotplt.figure(figsize=(8,2.8))plt.boxplot(x, orientation='horizontal')plt.yticks([])plt.title('Boxplot: mediana, cuartiles y valores atípicos')plt.xlabel('Valor')plt.show()
El histograma tiene un solo pico, entre 10 y 20, y una cola larga a la derecha que llega hasta cerca de 125. El boxplot lo resume con una caja que va de unos 14 a 30 y una mediana cerca de 21; a la derecha del bigote aparecen 53 puntos individuales, desde unos 55 hasta 125. El boxplot no reemplaza al histograma, pero facilita comparar escalas y atípicos entre grupos.
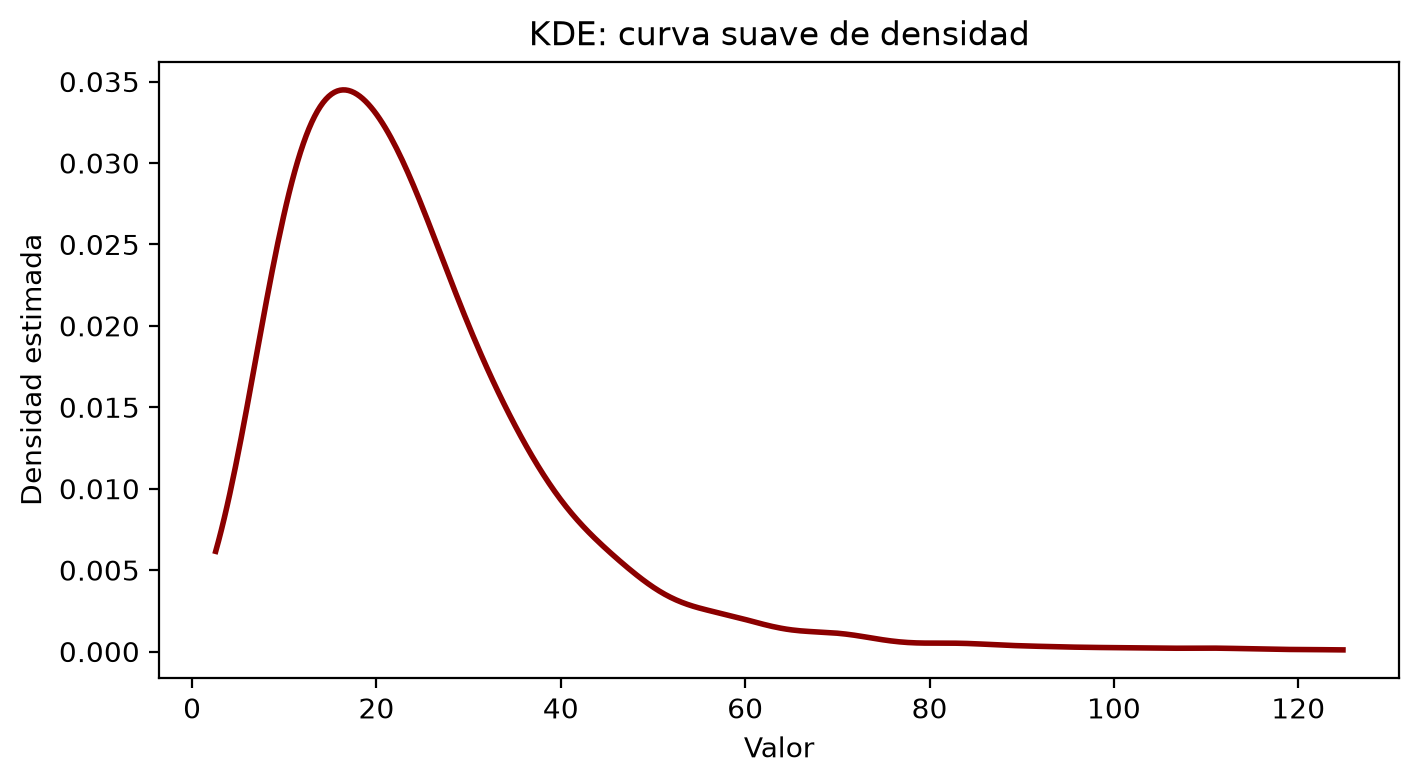
Ahora estimas la densidad con un núcleo gaussiano y el ancho de banda de la regla de Silverman, \(h = 1.06\, s\, n^{-1/5}\).
# KDE (estimación de densidad) sin seaborndef kde_gaussiana(muestra, puntos=400): muestra = np.asarray(muestra) n =len(muestra) sigma = np.std(muestra) h =1.06* sigma * n ** (-1/5) # regla de Silverman grid = np.linspace(np.min(muestra), np.max(muestra), puntos) densidad = np.zeros_like(grid)for xi in muestra: densidad += np.exp(-0.5* ((grid - xi) / h) **2) densidad /= (n * h * np.sqrt(2* np.pi))return grid, densidadgx, dx = kde_gaussiana(x)plt.figure(figsize=(8,4))plt.plot(gx, dx, color='darkred', linewidth=2)plt.title('KDE: curva suave de densidad')plt.xlabel('Valor')plt.ylabel('Densidad estimada')plt.show()
La curva tiene un solo pico cerca de 16 y baja lentamente hacia la derecha, casi plana desde 60: es la forma del histograma sin los escalones de los intervalos. Una curva con varios picos sugeriría una mezcla de grupos (subpoblaciones, regímenes distintos) que un solo modelo representa mal; colas que se extienden lejos implican riesgo de valores influyentes en métodos sensibles a extremos.
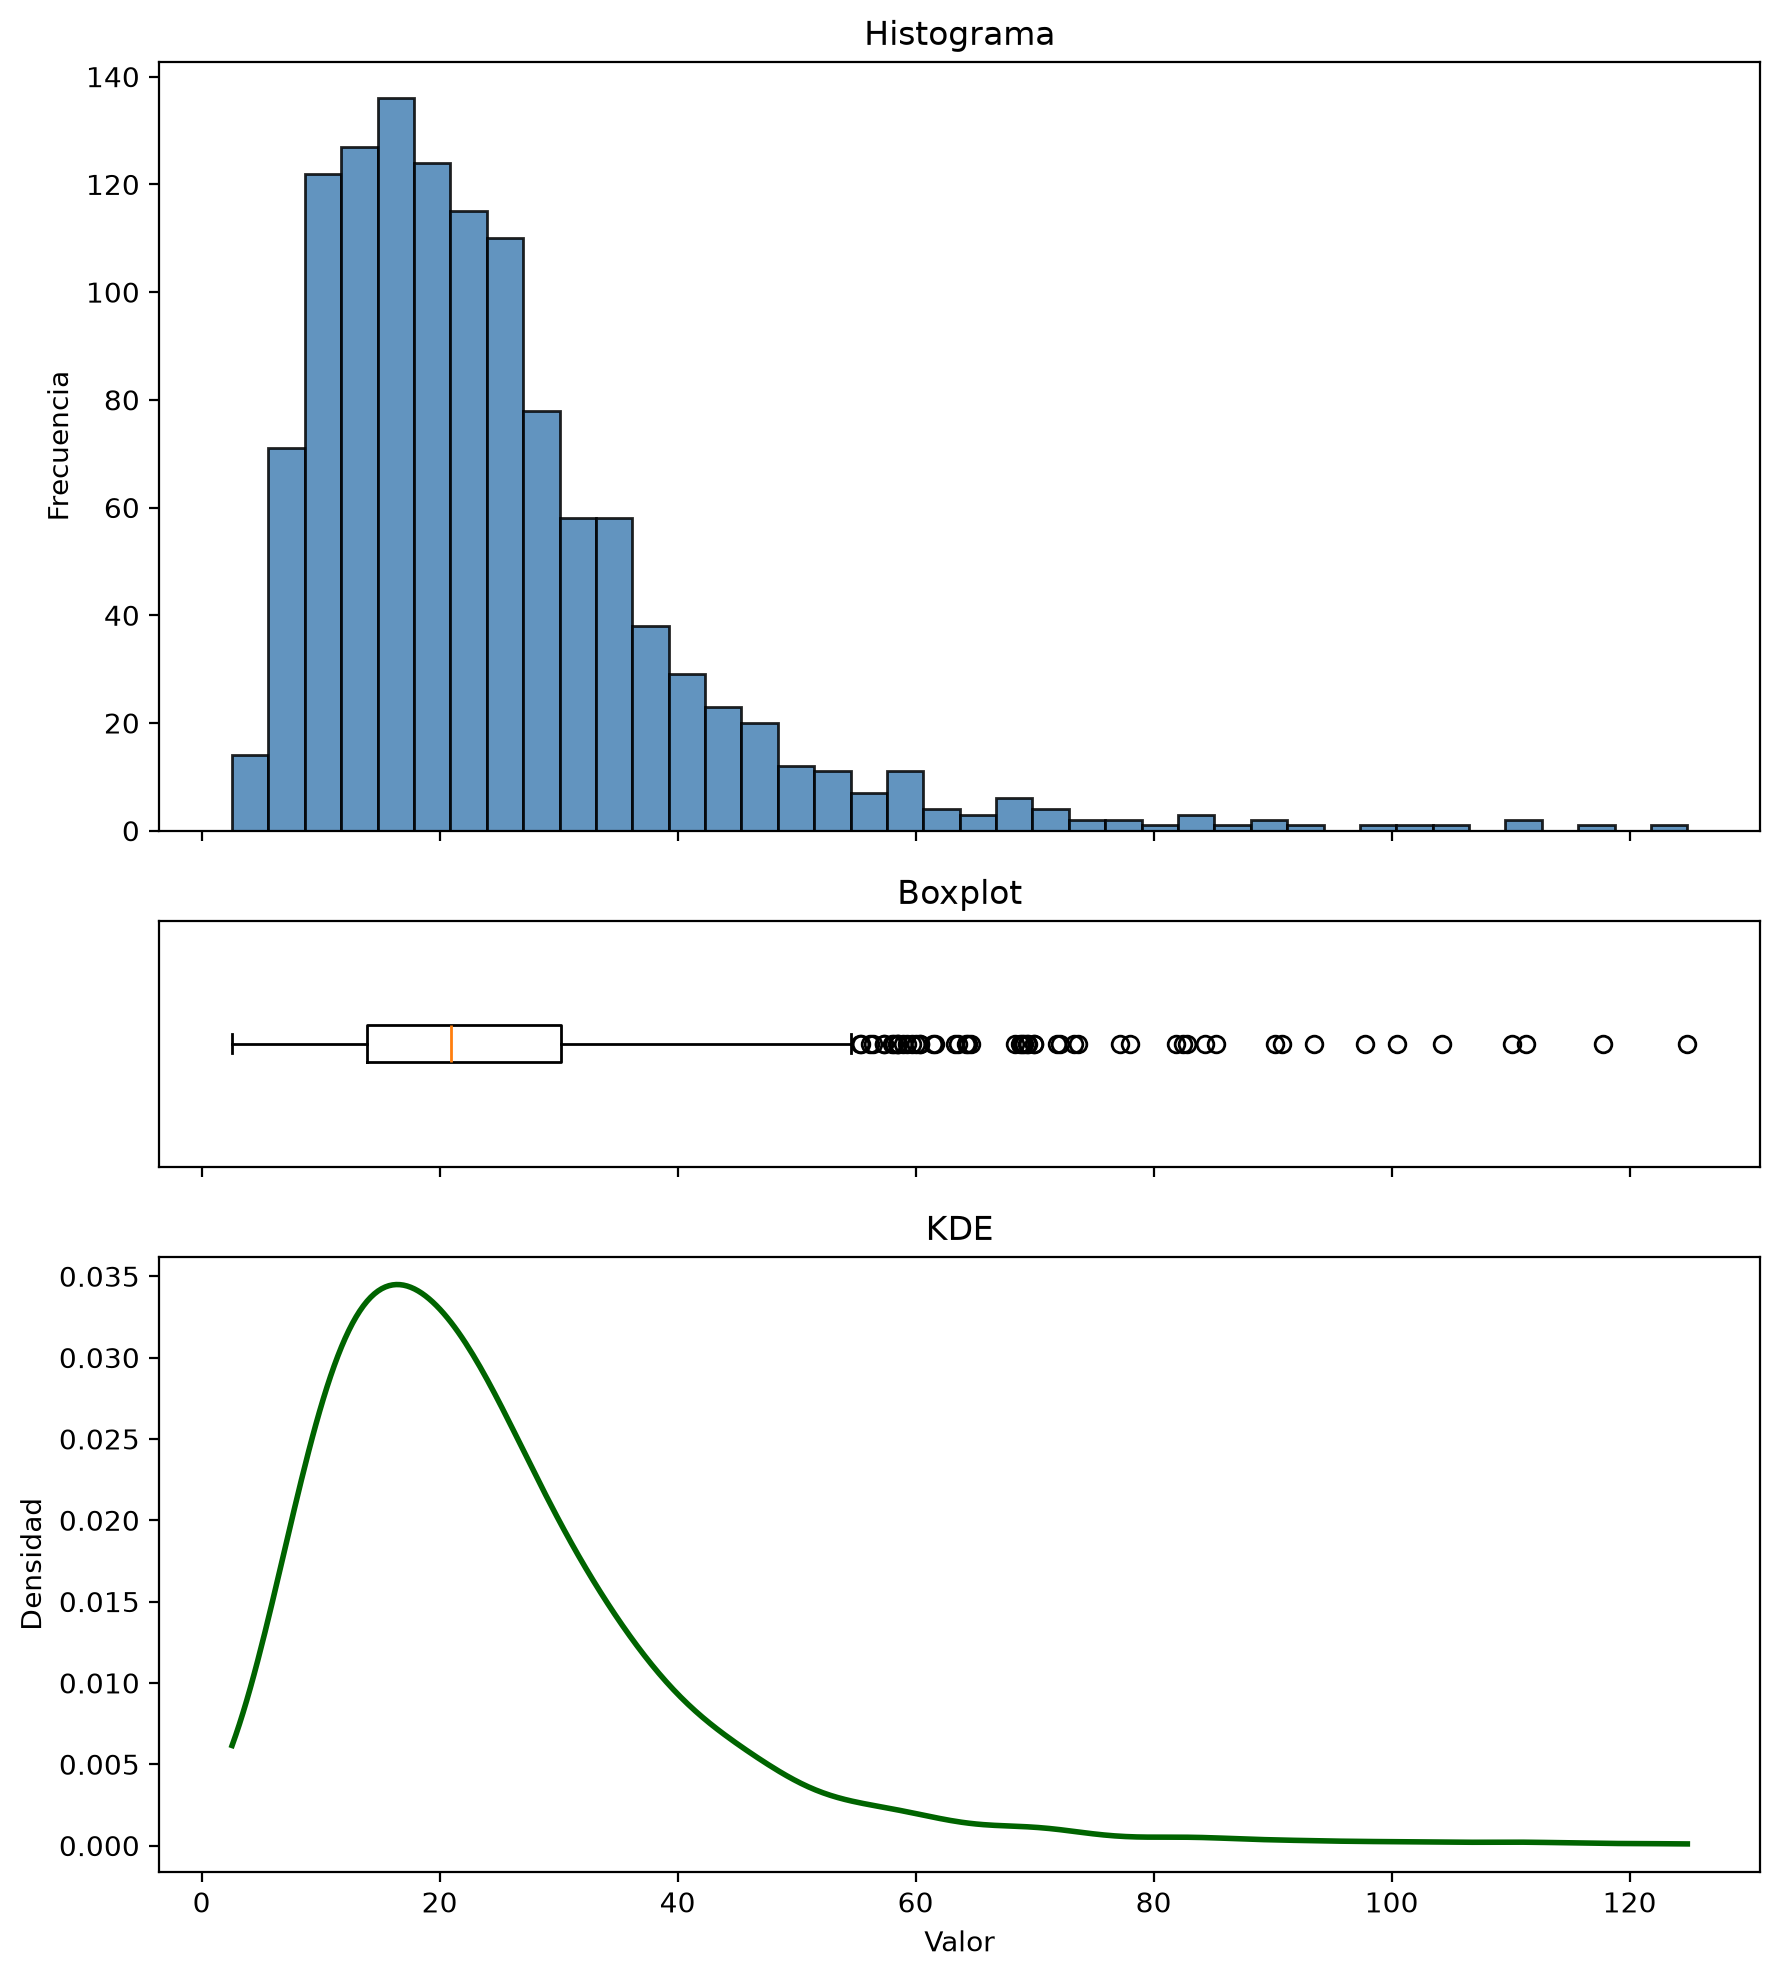
Por último, juntas las tres vistas con el mismo eje horizontal.
Las tres vistas coinciden: el pico del histograma entre 10 y 20 es el máximo de la curva de densidad y queda dentro de la caja del boxplot; la cola que llega hasta cerca de 125 aparece como barras bajas, como curva casi plana y como puntos sueltos a la derecha del bigote. Cuando las tres vistas señalan lo mismo (aquí, sesgo a la derecha y cola larga), la evidencia es más sólida que con un solo gráfico, y orienta el preprocesamiento: escalamiento robusto, logaritmo o revisión de los extremos.
Etapa 9: Anomalías
Una anomalía es un valor que se aleja de forma notable del comportamiento habitual. No todas son errores: algunas son justamente la información que buscas (un fraude, una falla de un sensor, un evento médico raro).
Valor atípico estadístico: se aleja del patrón mayoritario según un criterio, como la distancia en desviaciones estándar o la posición respecto del IQR. Puede ser legítimo (un evento raro pero real) o espurio (un error de medición, de registro o de unidad).
Novedad: a veces interesa distinguir un atípico de un patrón nuevo que merece tratamiento aparte (un cambio de régimen, una nueva cohorte de usuarios).
Contexto de dominio: el mismo valor puede ser anómalo en un escenario y normal en otro. La estadística aporta señales; la decisión integra el conocimiento del problema.
Los métodos de esta etapa son exploratorios; en producción se combinan con reglas de negocio, modelos supervisados o controles de calidad de datos.
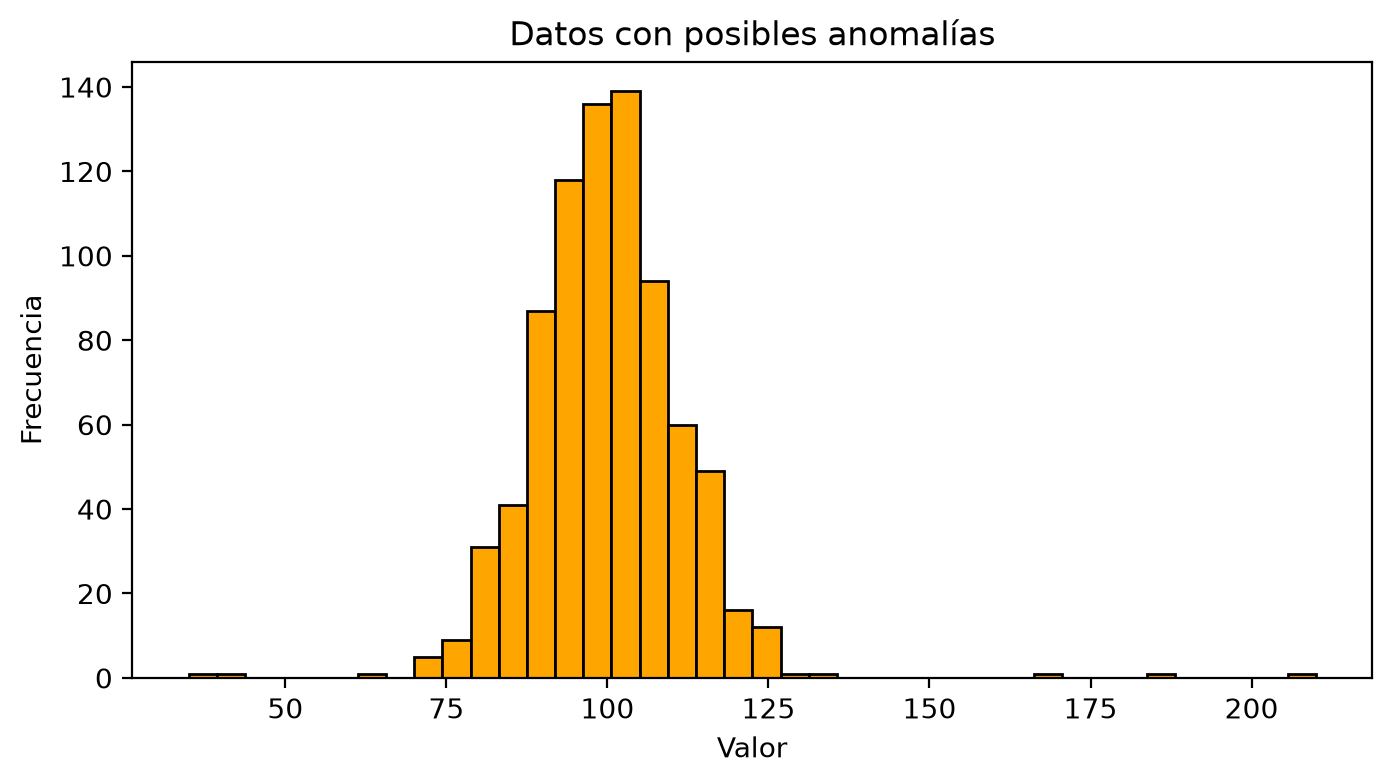
Simulas 800 valores normales con media 100 y desviación 10 y les agregas a mano cinco anomalías: 35, 40, 170, 185 y 210.
# Datos sintéticos con anomalías añadidas de forma deliberadabase = rng.normal(100, 10, 800)anomalias_manual = np.array([35, 40, 170, 185, 210])y = np.concatenate([base, anomalias_manual])plt.figure(figsize=(8,4))plt.hist(y, bins=40, color='orange', edgecolor='black')plt.title('Datos con posibles anomalías')plt.xlabel('Valor')plt.ylabel('Frecuencia')plt.show()
El núcleo es una campana entre unos 64 y 134, centrada en 100. Las cinco anomalías sembradas aparecen como barras aisladas: dos a la izquierda (35 y 40) y tres a la derecha (170, 185 y 210). Aquí sabes cuáles son porque las sembraste; con datos reales, cada una podría ser un fraude, una falla de un sensor o un evento raro pero válido. Las dos celdas siguientes cuentan cuántas marcan el z-score (\(|z| > 3\)) y la regla del IQR.
# Comparación de métodos: z-score vs IQRcomparacion = pd.DataFrame({'Metodo': ['z-score (|z|>3)', 'IQR (1.5*IQR)'],'Cantidad_anomalias': [len(anom_z), len(anom_iqr)]})comparacion
Metodo
Cantidad_anomalias
0
z-score (|z|>3)
5
1
IQR (1.5*IQR)
13
Aquí el núcleo es normal y solo hay 5 anomalías sembradas. El z-score encontró exactamente las 5. El IQR marcó 13: las 5 sembradas y 8 valores legítimos del núcleo, entre 64.0 y 73.0 y entre 126.8 y 133.5, el 1% de 800. Con datos normales, la regla de 1.5 × IQR marca por construcción alrededor del 0.7% de los valores legítimos (aquí, los límites quedaron en 73.23 y 126.44). En este escenario el z-score funcionó mejor. La ventaja del IQR aparece en otro: cuando los propios extremos inflan la media y la desviación estándar.
Enmascaramiento: cuando los extremos esconden a los extremos
Con una muestra pequeña y varios valores anómalos juntos, la media y la desviación estándar se desplazan hacia ellos y el z-score deja de verlos; los cuartiles casi no se mueven. Lo compruebas con 50 valores normales (media 100, desviación 10) y cinco extremos entre 300 y 380.
rng_mask = rng # mismo generador centralnucleo = rng_mask.normal(100, 10, 50)extremos = np.array([300, 320, 340, 360, 380])y_mask = np.concatenate([nucleo, extremos])z_mask = (y_mask - y_mask.mean()) / y_mask.std()q1_m, q3_m = np.percentile(y_mask, [25, 75])iqr_m = q3_m - q1_mfuera_iqr = (y_mask < q1_m -1.5* iqr_m) | (y_mask > q3_m +1.5* iqr_m)print(f"Media {y_mask.mean():.1f} | desv. estándar {y_mask.std():.1f} (el núcleo tiene media ≈100 y desv. ≈10)")print(f"z-score de los 5 extremos: {np.round(z_mask[-5:], 2)}")print(f"Extremos detectados con |z| > 3: {int(np.sum(np.abs(z_mask[-5:]) >3))} de 5")print(f"Extremos detectados con IQR: {int(np.sum(fuera_iqr[-5:]))} de 5")
Media 120.3 | desv. estándar 70.7  (el núcleo tiene media ≈100 y desv. ≈10)
z-score de los 5 extremos: [2.54 2.82 3.11 3.39 3.67]
Extremos detectados con |z| > 3: 3 de 5
Extremos detectados con IQR:     5 de 5
Los 5 extremos suben la media a 120.3 y la desviación estándar a 70.7, cuando el núcleo tiene cerca de 100 y 10: inflan la escala con la que se los mide. Con \(|z|>3\), el z-score solo detecta 3 de los 5 (300 y 320 quedan con z de 2.54 y 2.82); el IQR detecta los 5. El IQR es más robusto ante datos contaminados porque su centro y su escala no los fijan los mismos valores que quieres detectar.
Cuándo usar cada criterio:
z-score (\(|z|>3\)): funciona bien cuando la variable es aproximadamente normal y la media y la desviación estándar representan el núcleo de los datos, como en el primer escenario (5 de 5, sin falsos positivos).
IQR (1.5 × IQR): se basa en cuartiles y resiste mejor la contaminación, como en el enmascaramiento (5 de 5 frente a 3 de 5). Con datos normales limpios marca algunos valores legítimos (8 de 800).
Datos sesgados: las dos reglas suponen una forma más o menos simétrica. En una variable con cola larga, las dos marcan valores legítimos de la cola: en el caso aplicado, el 4.4% de una lognormal sale fuera de 1.5 × IQR. Ahí conviene transformar primero (por ejemplo, con el logaritmo) o fijar el umbral con criterio de dominio.
Con pocas observaciones, los cuartiles y las colas empíricas son ruidosos. En la exploración inicial, aplica ambos criterios y compara. La decisión de eliminar, acotar, ponderar o conservar un atípico depende del dominio y del costo de equivocarte en cada sentido.
Etapa 10: Machine learning y deep learning
La forma de los datos condiciona el modelo en tres pasos: la forma (sesgo, colas, varios picos, atípicos) describe cómo se reparten los datos; el preprocesamiento (escalado, transformaciones, reglas de extremos) la adapta al algoritmo; y el comportamiento del modelo depende de cómo reacciona a ella, por la geometría (distancias), por la pérdida (cuadrática o robusta) o por su sensibilidad a valores influyentes.
Machine learning
Un algoritmo supervisado minimiza una función de pérdida sobre los datos de entrenamiento. Las colas pesadas o los valores extremos del objetivo pesan mucho en una pérdida cuadrática (MSE); las pérdidas absoluta (MAE) o de Huber son menos sensibles a ellos. La regresión lineal con MSE es el ejemplo típico de sensibilidad a atípicos (capítulo 13).
Modelos lineales (regresión, regularización L1/L2): la inferencia clásica supone errores con varianza homogénea y colas moderadas. Un sesgo fuerte puede pedir transformar el objetivo o los predictores.
k vecinos más cercanos: compara observaciones con distancias; si una variable tiene una escala mucho mayor, domina la métrica (lo ves a continuación).
Clustering (por ejemplo, K-means): las variables con mayor varianza o colas largas arrastran a los grupos.
Árboles y ensambles (random forest, gradient boosting): solo usan el orden de cada variable para dividir, así que una transformación monótona como el logaritmo no cambia sus particiones. Sí les afectan el ruido extremo en el objetivo y las clases desbalanceadas.
Las transformaciones se ajustan con el entrenamiento y se aplican igual a validación y prueba; si las ajustas con todos los datos hay fuga de información y sobreestimas el rendimiento (capítulo 15). Además, la distribución en producción puede cambiar respecto a la del entrenamiento.
Deep learning
Escala y estabilidad: las redes combinan productos de matrices y funciones no lineales; con entradas de órdenes de magnitud muy distintos cuesta elegir una tasa de aprendizaje estable y los gradientes pueden volverse demasiado grandes o pequeños. Por eso es habitual centrar y escalar las entradas.
Normalización interna:batch normalization y técnicas similares estabilizan la distribución de las activaciones entre capas; complementan el preprocesamiento, no lo reemplazan.
Saturación: la sigmoide y la tangente hiperbólica se saturan con entradas muy grandes; con datos mal escalados, el aprendizaje se frena.
Clases desbalanceadas: si una clase domina las etiquetas, el modelo tiende a favorecerla; se compensa con ponderación, remuestreo o ajuste del umbral.
Preprocesamiento y transformaciones
Enfoque
Efecto principal
Sensibilidad a atípicos
Estandarización (media 0, desv. 1)
Compara variables en unidades de desviación estándar
La media y la desviación se distorsionan con colas pesadas
Min–max a \([0,1]\)
Acota el rango observado
Muy sensible: un solo extremo redefine el denominador
Escalado robusto (mediana, IQR)
Centra y escala con estadísticos resistentes
Menos influencia de las colas
Log / log1p
Reduce la cola derecha de variables positivas
Requiere \(x>0\) (o un desplazamiento); cambia la escala de interpretación
Yeo–Johnson / Box–Cox
Familias que buscan simetría o varianza estable
Sus parámetros se estiman solo con el entrenamiento
El preprocesamiento es parte del modelo: sus parámetros se estiman con el entrenamiento y se aplican fijos en la inferencia. Tratar toda variable como normal sin mirarla lleva a z-scores mal calibrados, limpiezas que eliminan rarezas informativas o conservan errores, e intervalos con supuestos falsos. Las dos celdas siguientes muestran dos efectos: cómo la escala cambia las distancias en k vecinos más cercanos y cómo la normalización, la estandarización y el logaritmo modifican una variable sesgada.
Ejemplo ilustrativo: escala de variables y distancias
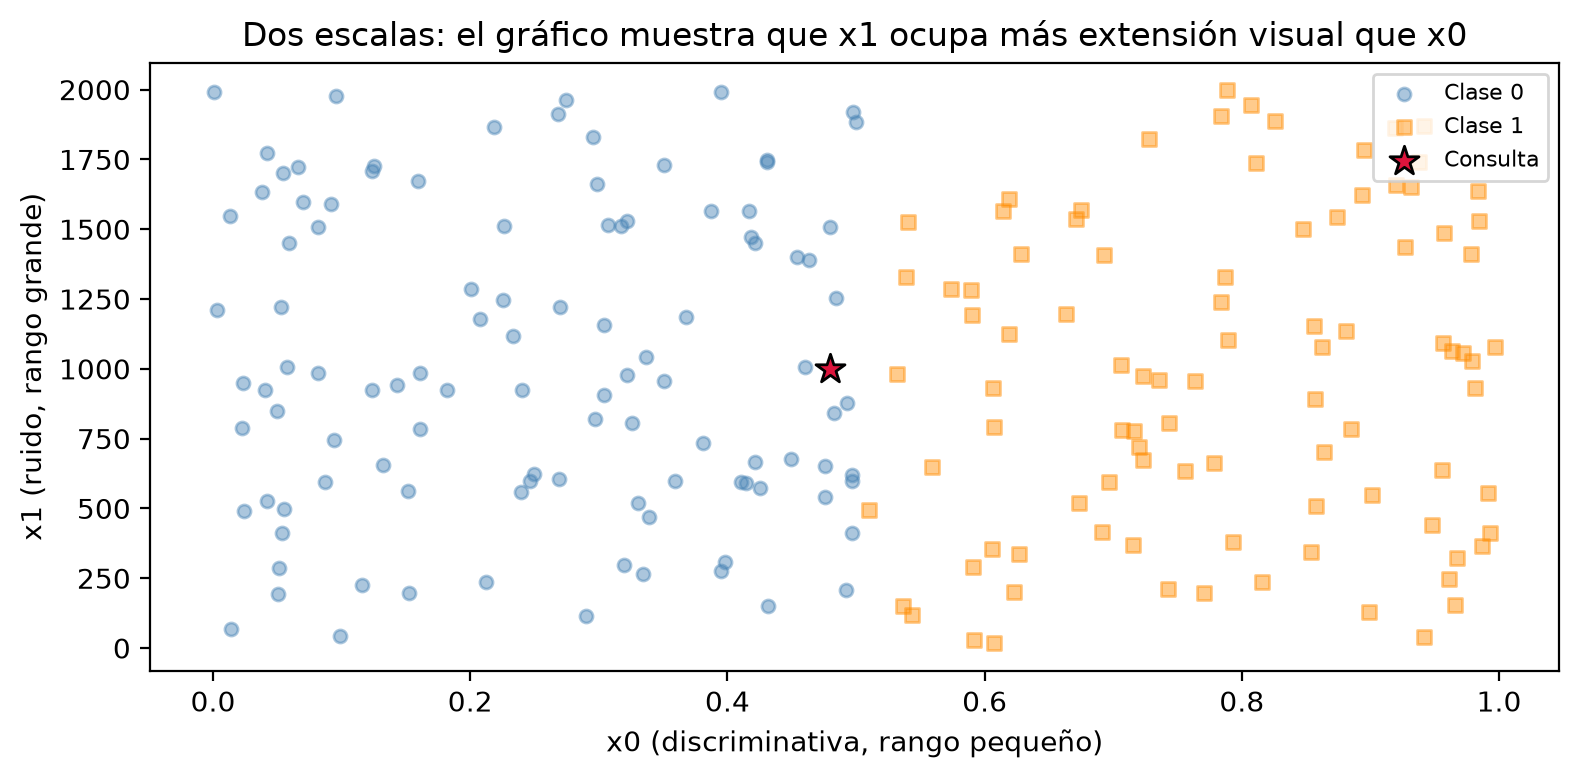
En k vecinos más cercanos y en otros métodos basados en distancias (la distancia euclídea se formaliza en el capítulo 6), una variable con rango numérico grande puede dominar la métrica aunque otra sea la que separa las clases. Simulas 200 puntos con dos variables: x0, entre 0 y 1, define la clase (clase 1 si x0 ≥ 0.5), y x1, entre 0 y 2000, es ruido. Buscas el vecino más cercano del punto (0.48, 1000), que por su x0 es de clase 0, primero con los datos originales y después estandarizando cada columna con su media y su desviación.
# Ejemplo: una variable discrimina la clase; otra tiene rango grande y es ruidon =200x0 = rng.random(n) # discriminativa: etiqueta según umbral en 0.5x1 = rng.uniform(0, 2000, size=n) # rango grande, independiente de la clase (ruido)y = (x0 >=0.5).astype(int)X = np.column_stack([x0, x1])# Punto de consulta: cerca del umbral en x0 (debería parecerse más a la clase 0)q = np.array([[0.48, 1000.0]])def vecino_mas_cercano(X_train, y_train, punto): dist = np.sqrt(((X_train - punto) **2).sum(axis=1)) i =int(np.argmin(dist))return y_train[i], i, dist[i]pred_sin, idx_sin, d_sin = vecino_mas_cercano(X, y, q)print('Sin estandarizar → clase predicha:', int(pred_sin),'| distancia mínima:', f'{d_sin:.1f}','| x0 del vecino:', f'{X[idx_sin, 0]:.3f}', '| x1 del vecino:', f'{X[idx_sin, 1]:.1f}')# Estandarización con estadísticos del entrenamiento (solo train; aquí todo es train de juguete)media = X.mean(axis=0)std = X.std(axis=0, ddof=0)std = np.where(std <1e-12, 1.0, std)X_std = (X - media) / stdq_std = (q - media) / stdpred_std, idx_std, d_std = vecino_mas_cercano(X_std, y, q_std)print('Estandarizado → clase predicha:', int(pred_std),'| distancia mínima:', f'{d_std:.3f}','| x0 del vecino:', f'{X[idx_std, 0]:.3f}', '| x1 del vecino:', f'{X[idx_std, 1]:.1f}')print('\nEtiqueta de referencia (solo por x0 < 0.5): clase 0 para el punto de consulta.')# Una sola consulta puede acertar o fallar por azar: se mide en 1000 consultas nuevasn_prueba =1000x0_p = rng.random(n_prueba)X_p = np.column_stack([x0_p, rng.uniform(0, 2000, size=n_prueba)])y_p = (x0_p >=0.5).astype(int)acierto_sin = np.mean([vecino_mas_cercano(X, y, fila)[0] == yi for fila, yi inzip(X_p, y_p)])acierto_std = np.mean([vecino_mas_cercano(X_std, y, (fila - media) / std)[0] == yi for fila, yi inzip(X_p, y_p)])print(f'\nExactitud del vecino más cercano en {n_prueba} consultas nuevas: 'f'sin estandarizar {acierto_sin:.3f} | estandarizado {acierto_std:.3f}')fig, ax = plt.subplots(1, 1, figsize=(8, 4))ax.scatter(X[y ==0, 0], X[y ==0, 1], alpha=0.45, label='Clase 0', color='steelblue', s=22)ax.scatter(X[y ==1, 0], X[y ==1, 1], alpha=0.45, label='Clase 1', color='darkorange', marker='s', s=22)ax.scatter(q[0, 0], q[0, 1], color='crimson', s=120, marker='*', edgecolors='black', label='Consulta', zorder=5)ax.set_xlabel('x0 (discriminativa, rango pequeño)')ax.set_ylabel('x1 (ruido, rango grande)')ax.set_title('Dos escalas: el gráfico muestra que x1 ocupa más extensión visual que x0')ax.legend(loc='upper right', fontsize=8)plt.tight_layout()plt.show()
Sin estandarizar → clase predicha: 0 | distancia mínima: 5.6 | x0 del vecino: 0.058 | x1 del vecino: 1005.6
Estandarizado   → clase predicha: 0 | distancia mínima: 0.066 | x0 del vecino: 0.460 | x1 del vecino: 1006.2

Etiqueta de referencia (solo por x0 < 0.5): clase 0 para el punto de consulta.

Exactitud del vecino más cercano en 1000 consultas nuevas: sin estandarizar 0.515 | estandarizado 0.960
Sin estandarizar, el vecino más cercano está a una distancia de 5.6 y tiene x0 = 0.058: lo eligió porque su x1 (1005.6) casi coincide con el de la consulta, aunque en x0 está lejos. La predicción, clase 0, sale correcta por casualidad, porque ese vecino también tiene x0 < 0.5. Estandarizado, el vecino tiene x0 = 0.460 y x1 = 1006.2, cerca en las dos variables, y la predicción también es la clase 0.
Una sola consulta puede acertar o fallar por azar, así que la celda mide además la exactitud en 1000 consultas nuevas, simuladas igual que los datos: sin estandarizar, el vecino más cercano acierta el 51.5% de las veces, casi como tirar una moneda, porque decide casi solo por x1, que es ruido; estandarizado, acierta el 96.0%, porque las dos variables compiten en unidades comparables y x0, que es la que separa las clases, vuelve a pesar.
Este razonamiento motiva el escalamiento en k vecinos más cercanos, máquinas de soporte vectorial y K-means. La media y la desviación (o el mínimo y el máximo) se calculan solo con el entrenamiento y se aplican iguales a validación y prueba; aquí todo el conjunto hace de entrenamiento porque es un ejemplo de juguete.
Tres transformaciones de una variable sesgada
Estandarización:\(z_i = (x_i - \bar{x}) / s\). Es una transformación afín (resta y divide): homogeneiza escalas, pero no cambia la forma.
Normalización min–max:\(x'_i = (x_i - x_{\min}) / (x_{\max} - x_{\min})\). El rango del entrenamiento define el mapa; en prueba o en producción, un valor fuera de ese rango queda fuera de \([0,1]\).
Logaritmo (para \(x_i > 0\)): comprime la cola derecha; para volver a la escala original aplicas la exponencial.
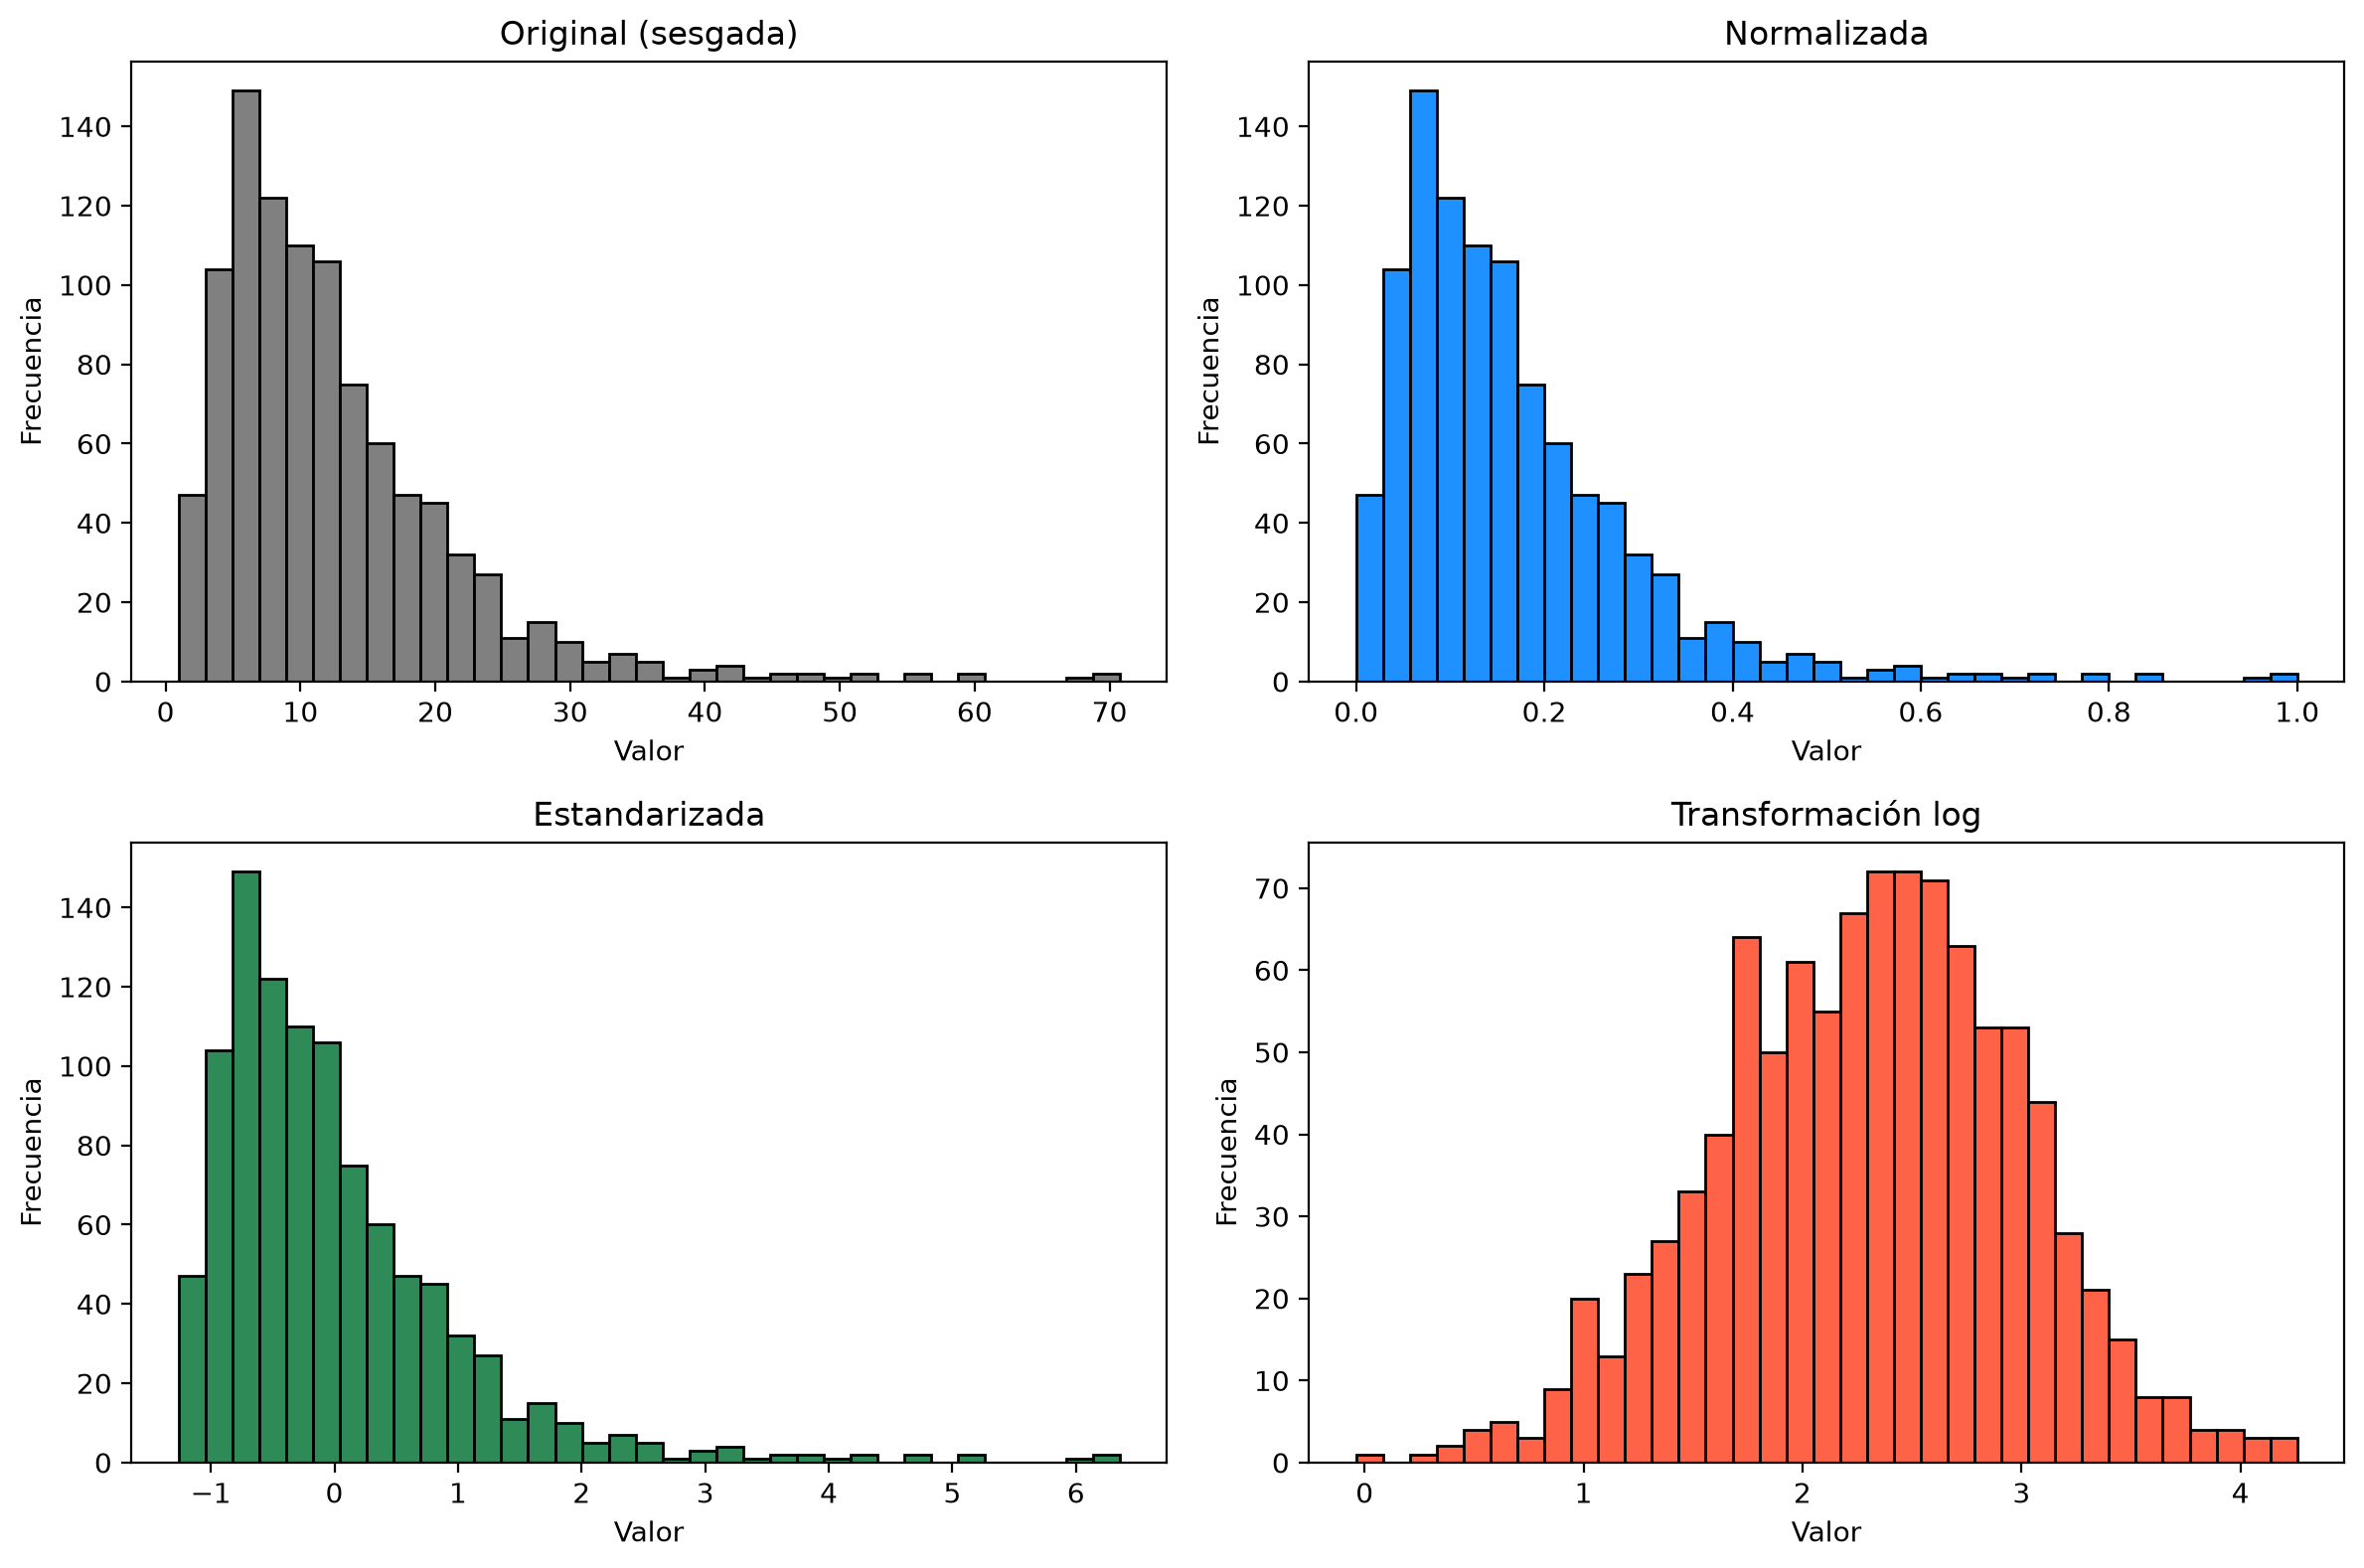
Las aplicas a 1000 valores lognormales y comparas los histogramas y la asimetría.
v = rng.lognormal(mean=2.3, sigma=0.7, size=1000)v_norm = (v - v.min()) / (v.max() - v.min())v_std = (v - v.mean()) / v.std()v_log = np.log(v)fig, ax = plt.subplots(2, 2, figsize=(12, 8))ax = ax.ravel()ax[0].hist(v, bins=35, color='gray', edgecolor='black'); ax[0].set_title('Original (sesgada)')ax[1].hist(v_norm, bins=35, color='dodgerblue', edgecolor='black'); ax[1].set_title('Normalizada')ax[2].hist(v_std, bins=35, color='seagreen', edgecolor='black'); ax[2].set_title('Estandarizada')ax[3].hist(v_log, bins=35, color='tomato', edgecolor='black'); ax[3].set_title('Transformación log')for a in ax: a.set_xlabel('Valor') a.set_ylabel('Frecuencia')plt.tight_layout()plt.show()for nombre, serie in [('original', v), ('min-max', v_norm), ('estandarizada', v_std), ('log', v_log)]:print(f"Asimetría {nombre:>13}: {skewness(serie):.2f}")
Min–max y estandarización son transformaciones afines: cambian los números del eje (de 0 a 1, o de −1.3 a 6.4), pero la asimetría queda idéntica, 2.19 en las tres. Solo el logaritmo cambia la forma: el histograma pasa a ser una campana entre 0 y 4.3 y la asimetría baja a −0.13. Escalar no vuelve simétrica una variable sesgada; si el modelo necesita una forma más simétrica, hace falta una transformación no lineal.
Caso aplicado: reportar la forma de una variable
Aplicas el flujo de Sección 4.3 a la variable sesgada de la etapa 8 (x, 1200 valores positivos).
n = 1200 | media = 24.34 | mediana = 20.97 | IQR = 16.28
Asimetría = 2.06 | curtosis de exceso = 6.78
Valores fuera de 1.5×IQR: 53 (4.4%)
Asimetría tras log: -0.05
“Para x (\(n=1200\)), la distribución es sesgada a la derecha (asimetría 2.06) y de colas pesadas (curtosis de exceso 6.78). Se reportan la mediana (20.97) y el IQR (16.28) en lugar de la media (24.34), que la cola desplaza. El 4.4% de los valores queda fuera de 1.5 × IQR: forman parte de la cola de una variable sesgada, no necesariamente son errores, así que no se eliminan sin revisar el dominio. Implicación para el modelo: aplicar log (la asimetría baja a −0.05) antes de métodos lineales o por distancia, estimando la transformación solo con el entrenamiento.”
Errores que conviene nombrar
Resumir solo con media y desviación estándar. En la etapa 1, dos conjuntos con ambas casi iguales tienen formas opuestas.
Asumir normalidad sin mirar. La regla 68–95–99.7 y el z-score solo calibran bien si la forma se parece a la gaussiana.
Leer una densidad como la probabilidad de un punto. En variables continuas, la probabilidad está en los intervalos.
Comparar histogramas con intervalos o ejes distintos. Las alturas dejan de ser comparables.
Creer que el IQR siempre es mejor que el z-score. Con datos normales marca falsos positivos; su ventaja es la robustez ante contaminación.
Eliminar todo lo que una regla marca como atípico. Una anomalía puede ser un error o la señal que buscas (fraude, fallas).
Creer que estandarizar corrige el sesgo. Min–max y z-score cambian la escala, no la forma.
Ajustar transformaciones con todos los datos. Los parámetros se estiman con el entrenamiento y se aplican igual a validación y prueba.
4.6 Guía rápida: ¿qué mirar en la forma?
Situación
Qué reportar
Justificación
Misma media y comportamiento distinto
Histograma o KDE
El centro no distingue sesgo, colas ni varios picos.
Variable aproximadamente simétrica
Media y desviación estándar
La normal es una referencia útil.
Variable sesgada o con extremos
Mediana e IQR
Son menos sensibles a la cola.
Buscar anomalías con datos contaminados
IQR
Sus cuartiles no los fijan los valores que buscas.
Buscar anomalías en datos sesgados
IQR o z-score tras transformar
Sin transformar, ambas reglas marcan valores legítimos de la cola.
Comparar rareza en una normal
Regla 68–95–99.7
Solo es fiable si la forma se parece a la gaussiana.
Regla de comunicación: indica la variable, la forma observada y la decisión de modelado que se deriva.
4.7 Preguntas de comprensión
Dos variables tienen media 50 y desviación 8. ¿Qué gráfico harías para saber si pueden tratarse igual, y qué buscarías en él?
En una distribución con asimetría positiva, ¿esperas que la media quede por encima o por debajo de la mediana? ¿Por qué?
La uniforme y la Laplace de la etapa 6 tienen la misma varianza. ¿Por qué una tiene el 3.4% de sus valores más allá de ±4 y la otra ninguno?
En la etapa 9, ¿por qué el IQR marcó 13 valores cuando solo había 5 anomalías, y por qué en el enmascaramiento ganó al z-score?
Estandarizas una variable con asimetría 2.19. ¿Cuánto vale su asimetría después? ¿Qué harías si el modelo necesita una variable más simétrica?
TipOrientaciones
Un histograma o una curva de densidad de cada una, con los mismos ejes. Buscarías el número de picos, la simetría y la longitud de las colas: en la etapa 1, la normal y la exponencial desplazada comparten media y desviación y tienen formas opuestas.
Por encima: la cola larga hacia la derecha arrastra la media, mientras la mediana solo depende de la posición central. En la etapa 6, la exponencial tiene media 1.00 y mediana 0.68.
Porque la varianza no dice cómo se reparte la masa. La uniforme reparte sus valores por igual entre −3 y 3 y no tiene colas; la Laplace concentra muchos valores en el centro y compensa con colas largas. La curtosis de exceso lo resume: −1.24 frente a 2.47.
Con datos normales, la regla de 1.5 × IQR marca por construcción alrededor del 0.7% de los valores legítimos: 8 de 800, más las 5 sembradas. En el enmascaramiento, los 5 extremos inflaron la media (120.3) y la desviación (70.7), y el z-score dejó de ver dos; los cuartiles casi no se movieron.
Sigue en 2.19: la estandarización resta y divide, no cambia la forma. Para una variable positiva con cola derecha, aplica el logaritmo (en la etapa 10 llevó la asimetría a −0.13) o una transformación de Yeo–Johnson, ajustada solo con el entrenamiento.
4.8 Referencias para profundizar
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley. Origen del boxplot y de la regla de 1.5 × IQR para señalar valores lejanos.
Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman & Hall. Estimación de densidad por núcleos y la regla del ancho de banda usada en la etapa 8.
Westfall, P. H. (2014). Kurtosis as peakedness, 1905–2014. R.I.P. The American Statistician, 68(3), 191–195. Por qué la curtosis mide las colas y no la altura del pico.
Yeo, I.-K. y Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. La transformación de Yeo–Johnson.
Documentación de scikit-learn, Preprocessing data: StandardScaler, MinMaxScaler, RobustScaler y PowerTransformer.
4.9 Lo que debes llevarte de este capítulo
La forma de una distribución decide cómo interpretas, limpias y transformas una variable, y la media y la desviación estándar no la muestran.
Una normal y una exponencial desplazada, con media 50 y desviación 8 las dos, tienen formas opuestas.
La normal es una referencia: con 200 000 datos normales, la regla 68–95–99.7 se cumple casi al décimo, pero solo calibra la rareza si la forma se parece a la gaussiana.
La asimetría dice hacia dónde va la cola (2.03 en la exponencial, con media 1.00 y mediana 0.68); la curtosis, cuánta masa hay en las colas (−1.24 en la uniforme y 2.47 en la Laplace con varianzas parecidas).
Histograma, boxplot y curva de densidad muestran la misma variable desde tres ángulos; cuando coinciden, la evidencia es más sólida.
El z-score acierta con datos normales limpios (5 de 5) y falla cuando los extremos inflan la escala (3 de 5); el IQR resiste la contaminación, pero marca valores legítimos en datos normales y en colas largas.
Estandarizar o normalizar no cambia la forma (asimetría 2.19 en los tres casos); el logaritmo sí (−0.13). Sin escalar, el vecino más cercano acertó el 51.5% de las clases; estandarizado, el 96.0%. Las transformaciones se ajustan solo con el entrenamiento.
4.10 Puente hacia los siguientes capítulos
Ya describes una variable por su centro, su ancho y su forma. En el capítulo 5 pasas a dos variables a la vez: covarianza, correlación, fuerza de la asociación y el riesgo de confundir correlación con causalidad.