Entrenaste un modelo, lo evaluaste en un conjunto de prueba y obtuviste un \(R^2\) de 0.61. Lo presentas, y un colega toma los mismos datos, ajusta el mismo modelo y obtiene 0.39. Ninguno de los dos se equivocó: cada uno reservó un grupo distinto de observaciones para la prueba, y la puntuación depende de qué filas se reservaron para evaluar y de cuáles se usaron para ajustar. Con una sola partición estás apostando a una carta.
La validación cruzada k-fold (validación cruzada en \(k\) bloques) es la forma sistemática de dejar de apostar. En vez de una sola división, rotas qué bloque queda fuera, mides \(k\) veces y reportas un promedio con su dispersión. Con cross_val_score y un recorrido manual de los folds vas a ver qué filas se usan en cada paso y cómo interpretar las puntuaciones de una recta y de una regresión con varias variables.
Tiempo estimado de lectura: 60 minutos (unas 2 horas si ejecutas el código y respondes las preguntas)
Tecnologías mencionadas: Python 3.13, NumPy, pandas, Matplotlib, scikit-learn y statsmodels.
Los dos primeros conjuntos son simulados y pequeños a propósito, para que puedas dibujar cada observación: una nube lineal de 80 puntos, otra de 20 y una de 40 ordenada por \(x\), y 120 apartamentos con precio \(= 28 + 1.80\cdot\text{metros} + \varepsilon\), ruido creciente y tres tasaciones atípicas. El conjunto real es Diabetes, de 442 pacientes, usado por Efron, Hastie, Johnstone y Tibshirani (2004) y cargado desde scikit-learn, cuya distribución se publica bajo BSD de tres cláusulas. Todo corre en CPU, con la semilla central SEMILLA, y las versiones se imprimen en la primera celda de código.
Objetivos
Al terminar este capítulo vas a ser capaz de:
explicar con un dibujo qué hace k-fold y por qué cada observación se usa exactamente una vez como prueba;
distinguir lo que k-fold estima (el error de predicción esperado del procedimiento) de lo que no estima (el error de un modelo ya congelado);
elegir \(k\) con criterio y detectar el error de no barajar cuando los datos vienen ordenados;
interpretar el promedio y la dispersión entre folds, y localizar qué observaciones explican los errores mayores de cada fold;
aplicar k-fold a una regresión simple y a una multivariable, comparando con una línea base y revisando la estabilidad de los coeficientes.
Ejecuta las celdas en orden: las secciones comparten variables y el generador rng.
19.1 Preparación del entorno
La celda carga NumPy, pandas, Matplotlib, scikit-learn y statsmodels, fija la semilla SEMILLA y crea el generador rng, para que los gráficos y los números salgan iguales cada vez que ejecutes el notebook.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom matplotlib.patches import Patchfrom matplotlib.colors import ListedColormapfrom sklearn.linear_model import LinearRegressionfrom sklearn.model_selection import KFold, train_test_split, cross_val_scorefrom sklearn.metrics import mean_absolute_error, mean_squared_error, r2_scorefrom sklearn.datasets import load_diabetesimport statsmodels.api as smSEMILLA =2026rng = np.random.default_rng(SEMILLA)plt.rcParams['figure.dpi'] =110plt.rcParams['axes.spines.top'] =Falseplt.rcParams['axes.spines.right'] =FalseCOLOR_TRAIN ='#4C78A8'COLOR_TEST ='#E45756'COLOR_LINEA ='#333333'colores = ['#4C78A8', '#F58518', '#E45756', '#54A24B', '#B279A2']# Versiones del entorno usado para ejecutar este capítulo.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'statsmodels']:print(paquete +':', metadatos.version(paquete))import matplotlib.pyplot as pltfrom cycler import cyclerplt.rcParams['axes.prop_cycle'] = cycler(color=['#1786B3', '#EE5400', '#487A35', '#7851A9']) + cycler(linestyle=['-', '--', '-.', ':'])plt.rcParams['font.size'] =10
El entorno queda con Python 3.13.14, NumPy 2.5.1, pandas 3.0.5, scikit-learn 1.9.0 y statsmodels 0.14.6.
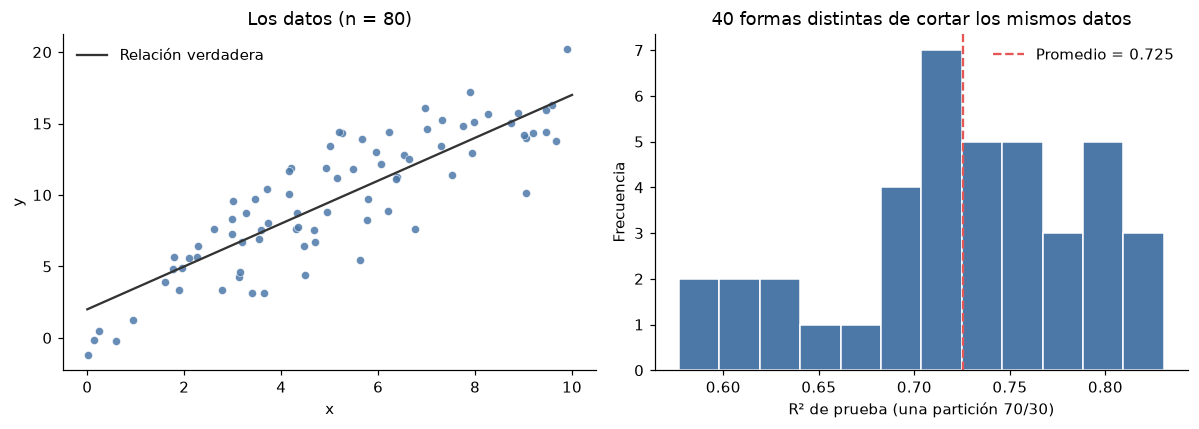
Toma un conjunto simulado pequeño, 80 puntos con \(y = 2 + 1.5x + \varepsilon\), pártelo 70/30 de 40 formas distintas y guarda el \(R^2\) de prueba de cada partición. Si el número “del modelo” fuera estable, esos 40 valores se parecerían y el histograma se vería como un clavo.
A la izquierda no hay ningún misterio: una nube lineal con ruido. A la derecha, el mismo modelo y los mismos 80 puntos producen un \(R^2\) de prueba que va de 0.58 a 0.83 (rango de 0.25) según qué 24 observaciones cayeron en la prueba.
Si te hubiera tocado la partición de 0.83, reportarías un modelo claramente mejor de lo que es. Si te tocara el de 0.58, lo subestimarías. Ninguno de los dos extremos es “el” desempeño, el centro está cerca de 0.73. k-fold existe para estimar ese centro de forma ordenada, y para mostrarte, fold a fold, cuánto varía el error, sin 40 particiones improvisadas.
19.3 Qué es k-fold, en una frase y en fórmulas
Divides las \(n\) observaciones en \(k\) bloques (folds) de tamaño parecido. En la ronda \(j\) entrenas con todos los bloques menos el \(j\) y evalúas solo en el \(j\). Rotas \(j = 1, \dots, k\). Al final, cada observación fue prueba exactamente una vez y entrenamiento en las otras \(k-1\) rondas.
Si \(e_j\) es el error (o el \(R^2\)) medido en el fold \(j\), el estimador de validación cruzada es el promedio:
Dos precisiones que importan más de lo que parecen:
\(\mathrm{CV}_k\) estima el error de predicción esperado del procedimiento (el algoritmo + el tamaño de muestra de entrenamiento), no el error futuro de un modelo ya ajustado con el 100% de los datos. Son primos, no gemelos.
\(s_{\mathrm{CV}}\) describe cuánto varía el error entre bloques. No es, en sentido estricto, el error estándar de \(\mathrm{CV}_k\): los folds no son independientes, porque comparten observaciones de entrenamiento. Úsalo como termómetro de estabilidad, no como un error estándar para construir intervalos de confianza.
El valor por defecto en la práctica es \(k=5\) o \(k=10\). Con \(k=5\) cada modelo se entrena con el 80% de los datos; con \(k=10\), con el 90%. \(k=n\) es el caso extremo (leave-one-out): entrenas \(n\) veces dejando una sola observación fuera. Casi no tiene sesgo por tamaño de entrenamiento, pero su varianza puede ser mayor y exige \(n\) ajustes (en regresión lineal existe un atajo exacto, pero no en general).
19.4 Las particiones, dibujadas
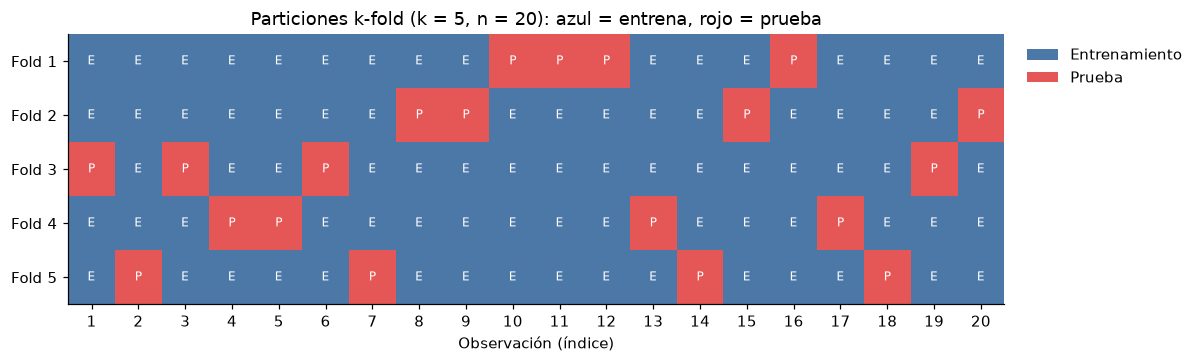
Antes del código de scikit-learn, mira quién queda fuera en cada ronda. Con \(n=20\) y \(k=5\) cada fold de prueba tiene 4 observaciones: lo suficientemente pequeño para que puedas seguir cada punto. El código imprime, fold a fold, el índice de las observaciones de prueba y comprueba que cada una aparece exactamente una vez.
n_demo =20k =5x_demo = np.sort(rng.uniform(1, 10, size=n_demo))y_demo =2.0+1.5* x_demo + rng.normal(0, 1.1, size=n_demo)kf_demo = KFold(n_splits=k, shuffle=True, random_state=SEMILLA)matriz = np.zeros((k, n_demo))for j, (_, te) inenumerate(kf_demo.split(x_demo)): matriz[j, te] =1print(f'Fold {j+1}: prueba en observaciones {[int(i) +1for i in te]} 'f'(n_train={n_demo -len(te)}, n_test={len(te)})')print()print('Comprobación: cada observación aparece exactamente una vez como prueba:')print('veces en prueba =', matriz.sum(axis=0).astype(int))
Fold 1: prueba en observaciones [10, 11, 12, 16] (n_train=16, n_test=4)
Fold 2: prueba en observaciones [8, 9, 15, 20] (n_train=16, n_test=4)
Fold 3: prueba en observaciones [1, 3, 6, 19] (n_train=16, n_test=4)
Fold 4: prueba en observaciones [4, 5, 13, 17] (n_train=16, n_test=4)
Fold 5: prueba en observaciones [2, 7, 14, 18] (n_train=16, n_test=4)

Comprobación: cada observación aparece exactamente una vez como prueba:
veces en prueba = [1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1]
Dibujar la cuadrícula de particiones
La figura tiene 5 filas y 20 columnas: cada fila es una ronda y cada columna una observación. Las letras E y P identifican entrenamiento y prueba además del color. Si el contrato de k-fold se cumple, en cada columna hay un solo rojo.
Los cuadrados rojos nunca se superponen en la misma columna: si la observación 7 es prueba en el fold 5, en los otros cuatro folds es entrenamiento. Eso es el contrato de k-fold.
Ver el proceso: ajustar con el azul y medir el residual del rojo
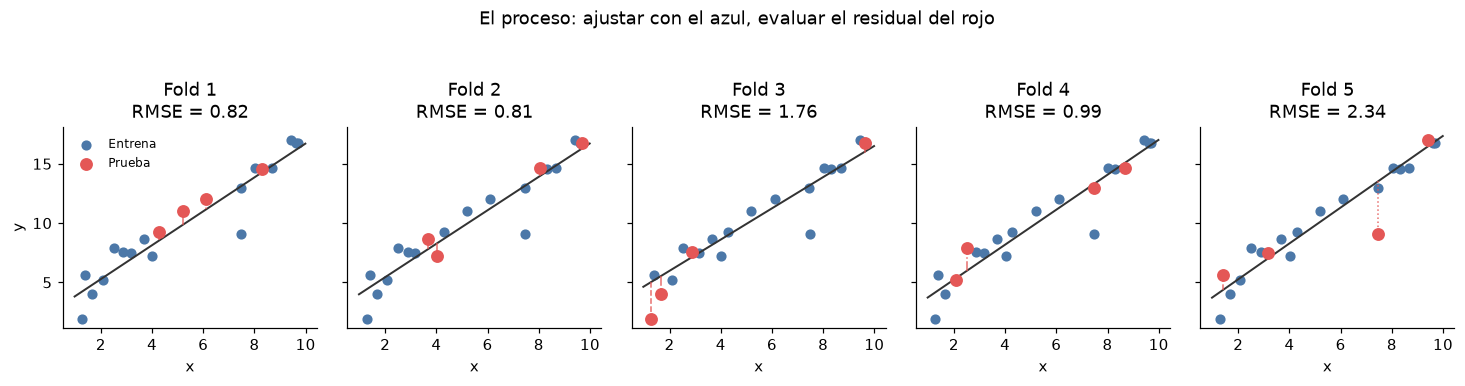
La siguiente figura es el proceso, no solo la etiqueta: cinco paneles, uno por fold. En cada uno la recta se ajusta solo con los puntos azules y el error se mide solo en los rojos. Las rayas verticales son los residuales de prueba: la distancia entre lo que predice el modelo, que no vio ese punto, y lo que realmente se midió.
En los 5 paneles, observa cómo cambia la recta y qué errores producen los puntos reservados:
La recta cambia de un fold a otro, porque cada ronda deja fuera 4 puntos distintos. Eso es normal: estás viendo la variabilidad del estimador.
El RMSE de prueba (raíz del error cuadrático medio, en las unidades de \(y\), del capítulo de evaluación) no es idéntico en cada panel: va de 0.81 (fold 2) a 2.34 (fold 5). Un fold sale peor cuando sus puntos rojos son ruidosos: en el fold 5, la observación con \(x \approx 7.5\) queda más de 4 unidades por debajo de su recta; en el fold 3, la de \(x \approx 1.3\), unas 3 unidades.
Ningún punto rojo se usó para trazar su propia recta. Por eso este error es más honesto que el error de entrenamiento.
Esa rotación, cinco modelos, cinco pruebas, un promedio, es todo k-fold. El resto de este capítulo es aprender a leerla cuando los datos dejan de caber en veinte puntos.
19.5 Por qué hay que barajar (salvo que el orden importe)
KFold por defecto no baraja: parte por orden de índice, en bloques consecutivos. Si tus filas están ordenadas por tiempo, por tamaño o por el valor de \(y\), cada fold deja de ser una muestra del mismo fenómeno. Uno se queda con los valores pequeños de \(x\); otro, con los grandes. Entonces no estás midiendo estabilidad del modelo: estás midiendo que los extremos no se parecen al centro.
Cuando las observaciones se pueden considerar intercambiables (el caso habitual en corte transversal), usa shuffle=True y fija random_state para que el resultado sea reproducible. Cuando el orden es la información, series de tiempo, mediciones repetidas del mismo paciente, k-fold aleatorio deja de ser válido y hace falta otro diseño (bloques temporales, agrupado). En este capítulo te quedas en el caso i.i.d. (observaciones independientes e idénticamente distribuidas); los capítulos de series temporales y de datos longitudinales tratan los otros dos.
Comparar k-fold sin barajar y con shuffle
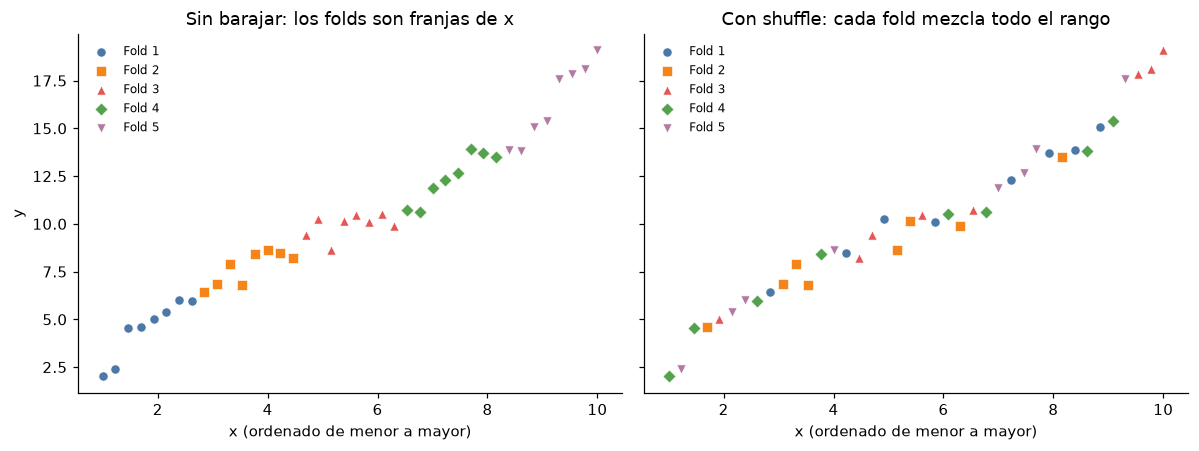
Los datos van ordenados de menor a mayor \(x\). Sin shuffle, cada fold de prueba es una franja del eje; con shuffle, cada color se mezcla a lo largo de todo el rango.
n_ord =40x_ord = np.linspace(1, 10, n_ord)y_ord =2.0+1.5* x_ord + rng.normal(0, 1.0, size=n_ord)kf_no = KFold(n_splits=5, shuffle=False)kf_si = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)fold_no = np.empty(n_ord, dtype=int)fold_si = np.empty(n_ord, dtype=int)for j, (_, te) inenumerate(kf_no.split(x_ord)): fold_no[te] = j +1for j, (_, te) inenumerate(kf_si.split(x_ord)): fold_si[te] = j +1fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), sharex=True, sharey=True)for ax, folds, titulo in [ (axes[0], fold_no, 'Sin barajar: los folds son franjas de x'), (axes[1], fold_si, 'Con shuffle: cada fold mezcla todo el rango'),]:for j inrange(1, 6): mask = folds == j ax.scatter(x_ord[mask], y_ord[mask], c=colores[j -1], marker=['o', 's', '^', 'D', 'v'][j-1], s=36, label=f'Fold {j}', edgecolors='white', linewidths=0.4) ax.set_xlabel('x (ordenado de menor a mayor)') ax.set_title(titulo) ax.legend(frameon=False, fontsize=8, loc='upper left')axes[0].set_ylabel('y')plt.tight_layout()plt.show()print('Media de x en cada fold de prueba')resumen_fold = pd.DataFrame({'fold': np.arange(1, 6),'media_x_sin_barajar': [x_ord[fold_no == j].mean() for j inrange(1, 6)],'media_x_con_shuffle': [x_ord[fold_si == j].mean() for j inrange(1, 6)],})print(resumen_fold.round(2).to_string(index=False))
Media de x en cada fold de prueba
 fold  media_x_sin_barajar  media_x_con_shuffle
    1                 1.81                 6.28
    2                 3.65                 4.58
    3                 5.50                 6.57
    4                 7.35                 4.92
    5                 9.19                 5.15
A la izquierda, el fold 1 prueba solo la zona baja de \(x\) y el fold 5 solo la zona alta. En esos dos folds le estás pidiendo al modelo que extrapole, así que su error mide otra cosa que el de los folds centrales. Aquí la relación verdadera es lineal y el costo es pequeño; con un modelo mal especificado (una curva ajustada con una recta), extrapolar en los extremos dispara el error. A la derecha, cada color está mezclado a lo largo de todo el eje. Esa es la partición que quieres cuando asumes que las filas son intercambiables.
La tabla lo dice en números: sin barajar, la media de \(x\) en prueba camina de forma monótona; con shuffle, las cinco medias se parecen.
19.6 Cómo elegir \(k\) (y qué no esperar de esa elección)
La elección de \(k\) depende del diseño y del tamaño de muestra. El compromiso es este:
\(k\) pequeño (2 o 3): entrenas con pocos datos, el modelo de cada ronda es peor que el que ajustarías con \(n\), y \(\mathrm{CV}_k\) tiende a ser un poco pesimista. Barato de computar.
\(k=5\) o \(k=10\): el estándar. Entrenamiento al 80–90%, sesgo pequeño, varianza razonable, costo aceptable.
\(k=n\) (leave-one-out): cada modelo se entrena con \(n-1\) filas, así que el sesgo de tamaño casi desaparece. A cambio, las \(n\) medidas están muy correlacionadas y el estimador puede tener más varianza; además entrenas \(n\) veces.
Para \(n\) de unos cientos, \(k=5\) es una elección seria, no una pereza. Más adelante, en los ejemplos, vas a comparar \(k=5\) y \(k=10\) sobre los mismos datos para ver cuánto se mueve el número, adelanto: mucho menos de lo que se movía una sola partición 70/30 en la primera sección.
Un error frecuente: usar k-fold para elegir el modelo (o un hiperparámetro) y reportar ese mismo \(\mathrm{CV}_k\) como desempeño final. Ese número queda optimista. La versión honesta es validación cruzada anidada, o una prueba que no haya participado en la elección. En este capítulo el modelo está fijo (una regresión lineal), así que un solo k-fold sí es una estimación honesta de su error de predicción.
19.7 Por qué importa en IA y machine learning
La validación cruzada es la herramienta con la que se toman casi todas las decisiones de un proyecto de aprendizaje automático:
Elegir hiperparámetros.GridSearchCV, que usaste en el capítulo de regularización, entrena y evalúa cada candidato con k-fold; el promedio decide y la dispersión entre folds dice si la diferencia entre candidatos es mayor que el vaivén de las particiones.
Comparar modelos con los mismos bloques. Evaluar dos algoritmos con los mismos folds da diferencias pareadas, más informativas que dos promedios calculados con particiones distintas.
Evitar la fuga de datos. El preprocesamiento (escalar, imputar, seleccionar variables) se ajusta dentro de cada fold; si lo haces antes de partir, el promedio sale optimista.
Reportar con honestidad. Si usaste k-fold para elegir, ese mismo promedio queda optimista como desempeño final, y necesitas una validación cruzada anidada o una prueba que no participó en la elección.
Respetar la estructura de los datos. Con varios registros por usuario o por paciente, o con datos en el tiempo, k-fold al azar mezcla información del futuro o del mismo grupo en entrenamiento y prueba; existen GroupKFold y TimeSeriesSplit para esos diseños.
Los dos ejemplos del capítulo muestran lo que el promedio esconde: en los apartamentos, un solo fold con los tres atípicos llevó su RMSE a 22.7 frente a 14–16 en los demás.
19.8 Ejemplo 1. Regresión lineal simple: precio a partir de los metros
Hasta aquí el dibujo. Ahora un problema con unidades. En el ejemplo de tasación simulado tienes los metros cuadrados para predecir el precio (en miles de dólares). La relación verdadera, que en la vida real no conoces, y aquí sí, porque los datos son simulados, es
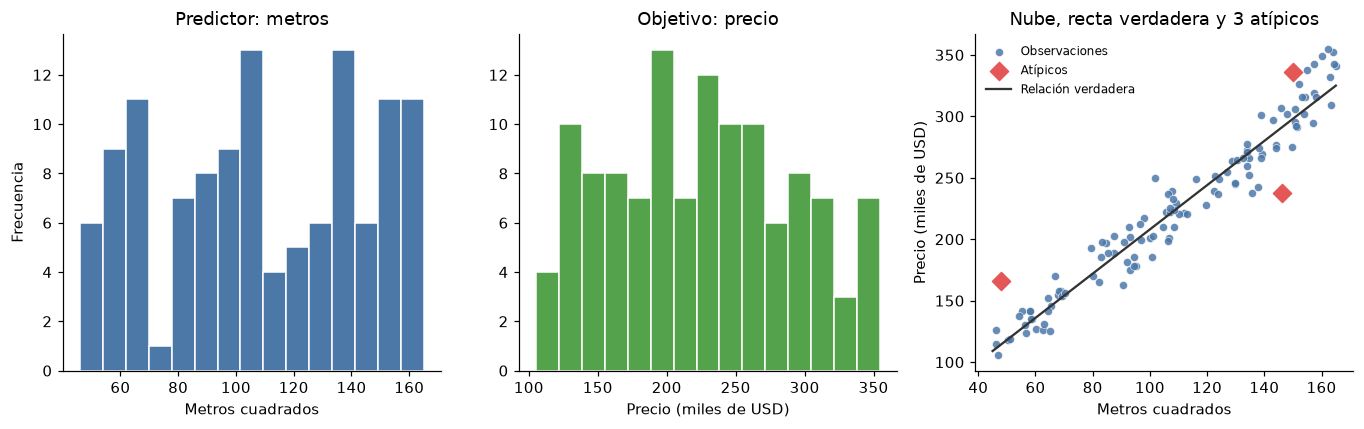
con un ruido que crece un poco en los apartamentos grandes y con tres tasaciones atípicas. k-fold tiene que convivir con eso: no con una nube de laboratorio. El código simula 120 apartamentos e imprime un describe, los tres atípicos y la correlación entre metros y precio.
       metros  precio
count  120.00  120.00
mean   109.14  225.59
std     35.32   65.65
min     46.11  105.50
25%     82.67  173.71
50%    107.87  223.10
75%    138.92  273.01
max    164.93  354.44

Apartamentos atípicos (índice, metros, precio):
     metros  precio
18    150.1   336.4
61    146.0   237.2
104    47.9   166.1

Correlación metros–precio: 0.969
Explorar metros, precio y la nube con la recta verdadera
La figura de los 120 apartamentos muestra el histograma del predictor y el del objetivo, y la nube con la recta que sí conoces (porque los datos son simulados) y los atípicos marcados.
Los metros cubren de ~45 a ~165 m², sin huecos raros. El precio se reparte de forma bastante pareja entre ~105 y ~355 mil USD, sin una cola marcada. Los atípicos marcados en rojo no son extremos del precio (336, 237 y 166 mil USD: uno arriba, otro en la mitad y otro en la parte baja del rango): son atípicos dado su tamaño, es decir, se alejan de la recta, no del histograma. En el diagrama de dispersión la tendencia es lineal y clara, la correlación sale 0.97, pero el abanico se abre a la derecha: los apartamentos grandes tienen más ruido. Los tres diamantes señalan observaciones extremas inyectadas a propósito en la simulación. k-fold los va a poner, en alguna ronda, del lado de la prueba. Eso es bueno: quieres saber cuánto duele un punto así cuando el modelo no lo ha visto.
Agregar el intercepto y ajustar OLS con toda la muestra
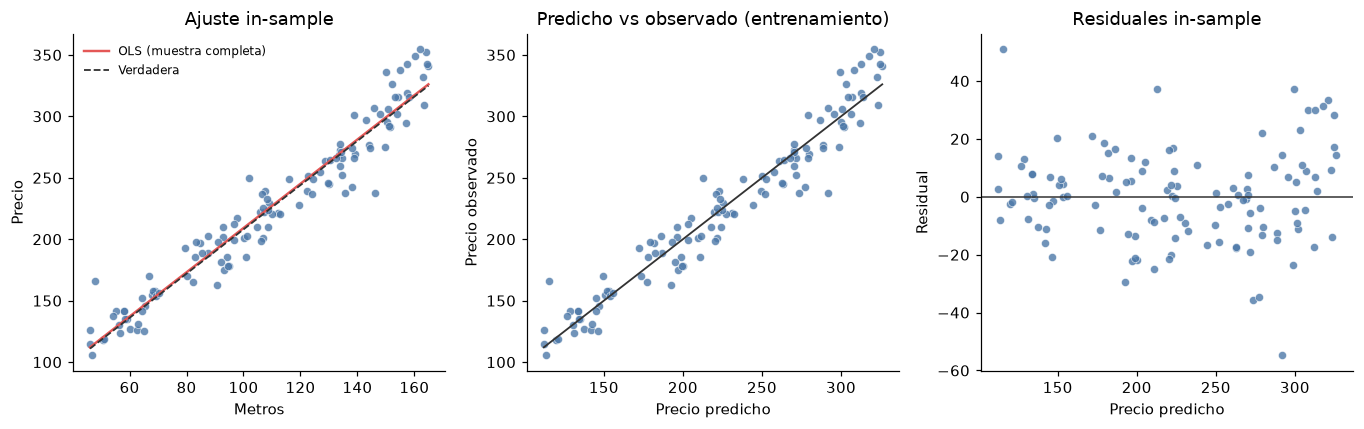
Antes de rotar folds, ajusta la recta con todos los datos. X1 son solo los metros. statsmodels no pone ordenada al origen solo: add_constant agrega una columna de unos, y con esa matriz se estima la recta por mínimos cuadrados ordinarios (OLS, por sus siglas en inglés). El summary() describe el ajuste in-sample (sobre los mismos datos con que se estimó), todavía no k-fold: útil como referencia, optimista como evaluación.
El intercepto y la pendiente deberían acercarse a 28 y 1.80. No van a caer encima: hay ruido y tres atípicos. El \(R^2\) de esta salida es in-sample: dice qué tanto la recta describe estos 120 puntos, no qué tanto predeciría 120 apartamentos nuevos. Las predicciones de k-fold permitirán estudiar el error fuera del ajuste sobre los mismos datos.
Diagnosticar ese ajuste in-sample
Tres scatters: la recta estimada contra la verdadera, predicho vs observado, y residuales vs predicho. Sirven de referencia; el veredicto honesto viene con los folds.
La recta estimada se aproxima a la relación generadora de pendiente 1.80 en los 120 apartamentos. El gráfico predicho vs observado se pega a la diagonal, con tres puntos que se salen. Los residuales se abren un poco a la derecha: la heterocedasticidad suave que puso la simulación. Nada de esto es todavía una evaluación honesta. Ahora sí: k-fold manual, para ver cada bloque.
Recorrer los 5 folds a mano y tabular el resultado de cada bloque
En cada ronda entrenas con el 80% y evalúas en el 20% que sobra. La tabla guarda, por fold, rango de metros, intercepto, pendiente, MAE (error absoluto medio), RMSE, \(R^2\) y cuántos atípicos cayeron en prueba.
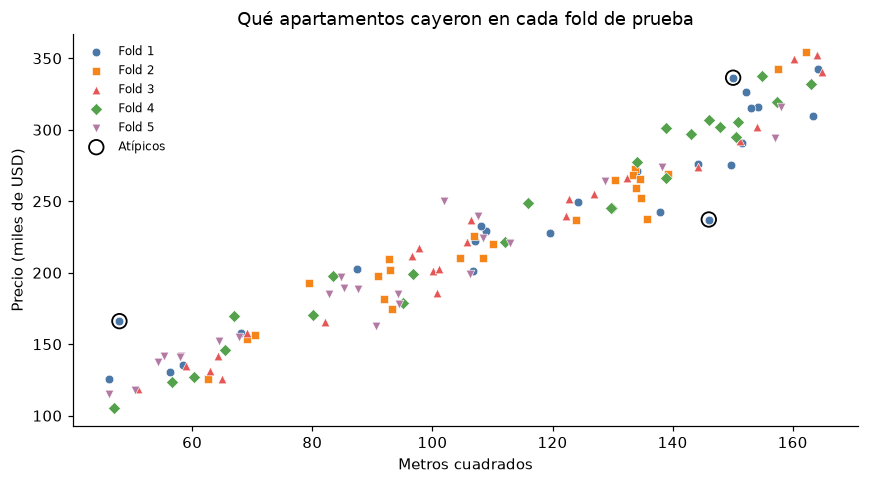
El scatter coloreado te dice si el shuffle funcionó: cada color debe cubrir el rango de metros, no un pedazo. Los círculos negros son los atípicos; anota en qué fold de prueba cayeron (columna n_atipicos_en_prueba de la tabla). El fold que se los lleve debería mostrar un RMSE más alto o un \(R^2\) más bajo. Si ese bloque muestra mayor error, podrás relacionarlo con la presencia de atípicos en su prueba.
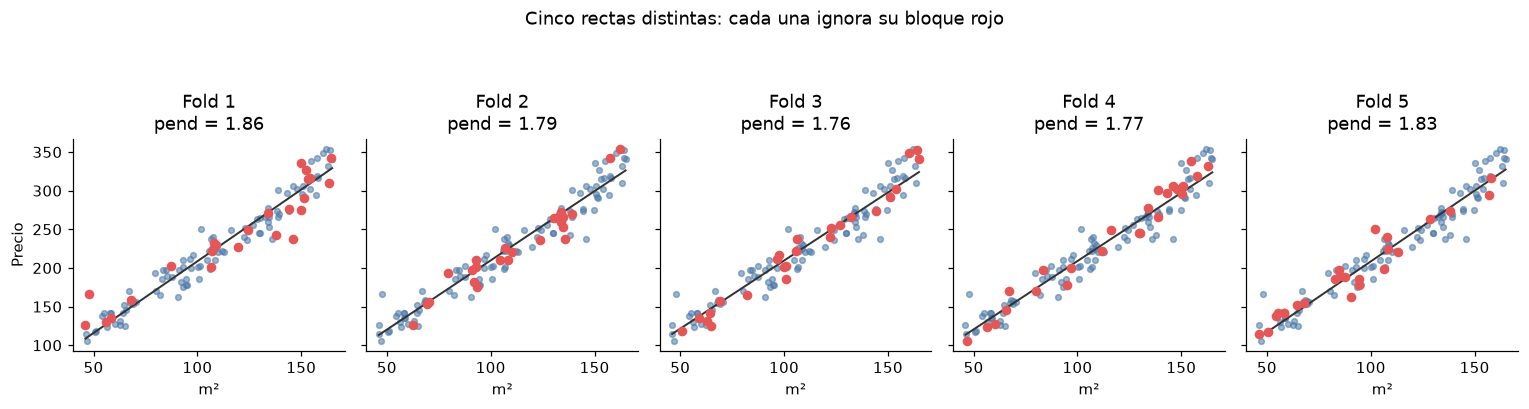
Ver las cinco rectas: cada una ignora su bloque rojo
Mismo scatter, cinco veces. Los rojos no participaron en trazar esa recta. La pendiente de cada panel debería oscilar cerca de 1.80.
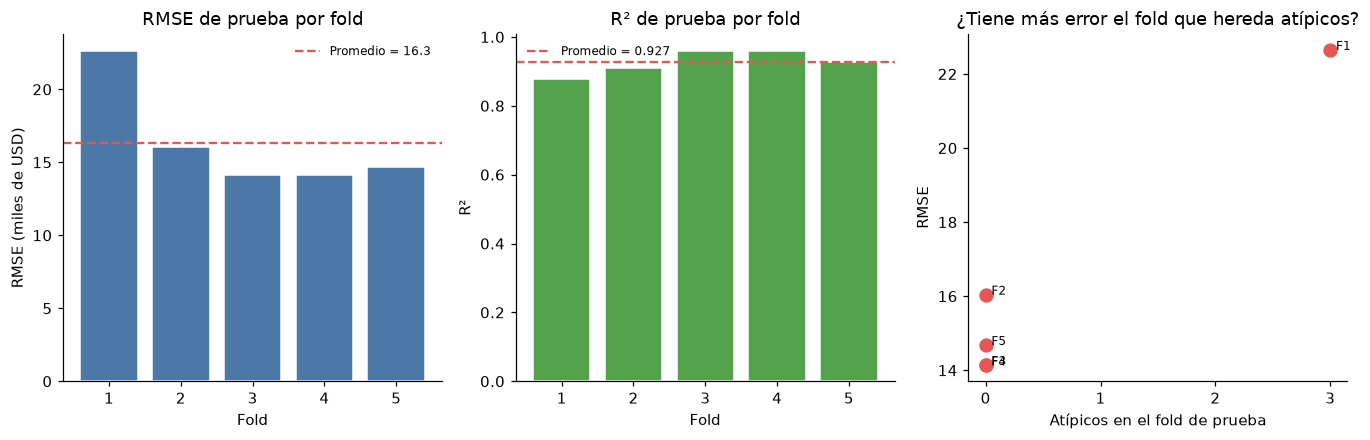
Barras del error y del \(R^2\) de cada bloque, y un scatter que cruza el RMSE con el número de atípicos en prueba: la hipótesis es que el fold que se los lleva tiene más error.
fig, axes = plt.subplots(1, 3, figsize=(12.5, 4.1))ax = axes[0]ax.bar(tab1['fold'], tab1['RMSE'], color=COLOR_TRAIN, edgecolor='white')ax.axhline(tab1['RMSE'].mean(), color=COLOR_TEST, ls='--', label=f'Promedio = {tab1["RMSE"].mean():.1f}')ax.set_xlabel('Fold')ax.set_ylabel('RMSE (miles de USD)')ax.set_title('RMSE de prueba por fold')ax.set_xticks(tab1['fold'])ax.legend(frameon=False, fontsize=8)ax = axes[1]ax.bar(tab1['fold'], tab1['R2'], color='#54A24B', edgecolor='white')ax.axhline(tab1['R2'].mean(), color=COLOR_TEST, ls='--', label=f'Promedio = {tab1["R2"].mean():.3f}')ax.set_xlabel('Fold')ax.set_ylabel('R²')ax.set_title('R² de prueba por fold')ax.set_xticks(tab1['fold'])ax.legend(frameon=False, fontsize=8)ax = axes[2]ax.scatter(tab1['n_atipicos_en_prueba'], tab1['RMSE'], c=COLOR_TEST, s=70, zorder=3)for _, r in tab1.iterrows(): ax.annotate(f'F{int(r["fold"])}', (r['n_atipicos_en_prueba'] +0.05, r['RMSE']), fontsize=8)ax.set_xlabel('Atípicos en el fold de prueba')ax.set_ylabel('RMSE')ax.set_title('¿Tiene más error el fold que hereda atípicos?')ax.set_xticks([0, 1, 2, 3])plt.tight_layout()plt.show()
No empieces por el promedio: empieza por el fold peor y el mejor, y busca una causa en las columnas de contexto (n_atipicos_en_prueba, rango de metros, desviación del precio en prueba).
El fold 1 se llevó los tres atípicos y su RMSE sube a 22.7, contra 14–16 en los otros cuatro. k-fold no está “siendo inestable porque sí”: te está avisando de sensibilidad a puntos influyentes.
La pendiente, aun así, se queda entre 1.76 y 1.86, pegada a la verdadera (1.80). La recta es estable; lo que se mueve es el error de predicción cuando los diamantes quedan fuera.
El \(R^2\) del fold 1 baja a 0.88 y el resto se queda en 0.91–0.96. Parte de esa caída es el RMSE más alto, no una población distinta de metros (el fold 1 cubre casi todo el rango, 46–164 m²).
El número que reportas es el promedio: RMSE 16.3 ± 3.2. El diagnóstico fold a fold es lo que te dice si te fías de ese promedio, y aquí el ±3.2 viene, sobre todo, de un solo bloque.
Ver predicciones y residuales cuando cada punto era prueba
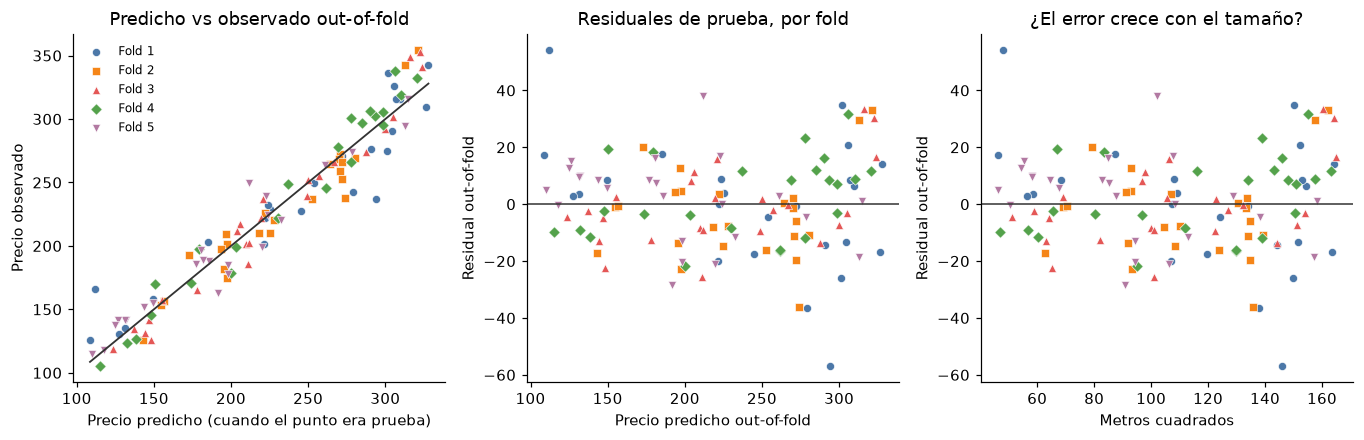
Tres diagramas de dispersión out-of-fold (cada predicción se hizo cuando el punto estaba en el fold de prueba), coloreados por fold: predicho vs observado, residual vs predicho y residual vs metros. Cada punto fue evaluado por un modelo que no lo había visto.
fig, axes = plt.subplots(1, 3, figsize=(12.5, 4.1))ax = axes[0]for j inrange(1, 6): mask = fold_id == j ax.scatter(pred_cv[mask], y1[mask], c=colores[j -1], marker=['o', 's', '^', 'D', 'v'][j-1], s=28, label=f'Fold {j}', edgecolors='white', linewidths=0.4)lo, hi = pred_cv.min(), pred_cv.max()ax.plot([lo, hi], [lo, hi], color=COLOR_LINEA, lw=1.2)ax.set_xlabel('Precio predicho (cuando el punto era prueba)')ax.set_ylabel('Precio observado')ax.set_title('Predicho vs observado out-of-fold')ax.legend(frameon=False, fontsize=8)ax = axes[1]for j inrange(1, 6): mask = fold_id == j ax.scatter(pred_cv[mask], resid_cv[mask], c=colores[j -1], marker=['o', 's', '^', 'D', 'v'][j-1], s=28, edgecolors='white', linewidths=0.4)ax.axhline(0, color=COLOR_LINEA, lw=1.0)ax.set_xlabel('Precio predicho out-of-fold')ax.set_ylabel('Residual out-of-fold')ax.set_title('Residuales de prueba, por fold')ax = axes[2]for j inrange(1, 6): mask = fold_id == j ax.scatter(X1[mask, 0], resid_cv[mask], c=colores[j -1], marker=['o', 's', '^', 'D', 'v'][j-1], s=28, edgecolors='white', linewidths=0.4)ax.axhline(0, color=COLOR_LINEA, lw=1.0)ax.set_xlabel('Metros cuadrados')ax.set_ylabel('Residual out-of-fold')ax.set_title('¿El error crece con el tamaño?')plt.tight_layout()plt.show()print('Residual out-of-fold de los atípicos:')for i in idx_atipicos:print(f' obs {i}: metros={X1[i,0]:.1f}, precio={y1[i]:.1f}, 'f'pred_cv={pred_cv[i]:.1f}, residual={resid_cv[i]:.1f} 'f'(fold {fold_id[i]})')
Estos tres diagramas reúnen las predicciones y los residuos fuera de muestra de los 120 apartamentos. Cada punto está pintado con el fold en el que fue prueba: su predicción la hizo un modelo que no lo había visto.
Los colores se mezclan alrededor de la diagonal: ningún bloque quedó sistemáticamente sesgado. Los tres puntos que más se alejan son los atípicos, todos del fold 1, con residuales de 34.8, −56.8 y 54.2: entre dos y tres veces y media el RMSE típico (~16). Eso explica el RMSE de 22.7 de ese fold.
Los residuales vs predicho no deberían dibujar un patrón en U (eso sería no linealidad). Un abanico a la derecha es la heterocedasticidad que ya viste en el ajuste con toda la muestra.
Residual vs metros: si la nube se abre en los m² altos, el RMSE global está siendo empujado por los apartamentos grandes. En un proyecto real, eso invita a ponderar, transformar o aceptar que el error no es constante.
Contrastar in-sample con k-fold (k=5 y k=10)
Calculas el RMSE y el \(R^2\) de entrenamiento y los comparas con cross_val_score a 5 y a 10 folds. El in-sample es la referencia optimista; los dos CV deberían coincidir en el promedio.
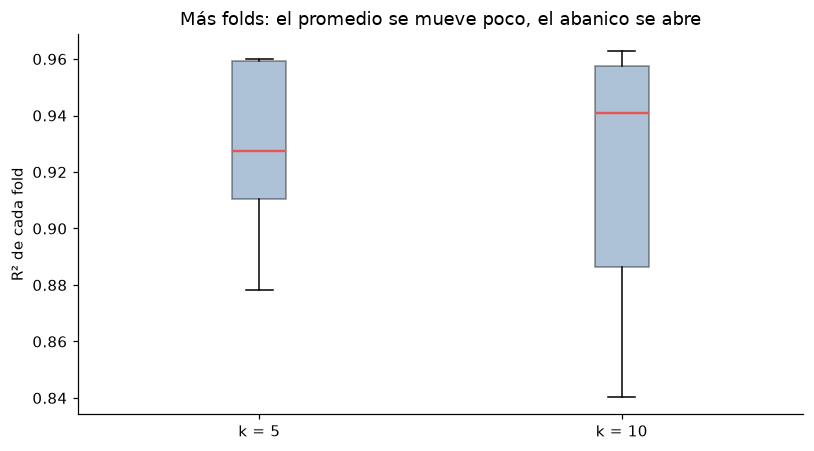
Un boxplot por esquema: el promedio debería parecerse; lo que cambia es cuánto baila cada fold (con \(k=10\) cada prueba es más pequeña y más ruidosa).
fig, ax = plt.subplots(figsize=(7.5, 4.2))ax.boxplot( [r2_cv5, r2_cv10], tick_labels=['k = 5', 'k = 10'], patch_artist=True, boxprops=dict(facecolor=COLOR_TRAIN, alpha=0.45), medianprops=dict(color=COLOR_TEST, lw=1.6),)ax.set_ylabel('R² de cada fold')ax.set_title('Más folds: el promedio se mueve poco, el abanico se abre')plt.tight_layout()plt.show()
El RMSE in-sample (16.2) y el de CV con \(k=5\) (16.3) están casi pegados: en este reparto la brecha observada es pequeña. La baja complejidad de una recta ayuda, pero la cercanía de dos métricas no demuestra ausencia de sobreajuste. Lo que sí aparece es la dispersión entre folds (±3.2), empujada por el bloque de los atípicos. Con \(k=10\), el promedio de los RMSE por fold (16.08) sale incluso un poco por debajo del in-sample (16.17). No es que la validación cruzada se vuelva optimista: promediar los RMSE de los folds no es lo mismo que calcular un RMSE con todos los residuales de prueba juntos. Como la raíz cuadrada es cóncava, el promedio de las raíces queda por debajo de la raíz del promedio, y el efecto crece cuando los folds son pequeños (~12 puntos) y dispares. Con los 120 residuales out-of-fold juntos, el RMSE de \(k=10\) es 16.47, por encima del in-sample, como se espera. Los promedios de \(k=5\) y \(k=10\) casi coinciden (\(R^2\) de 0.927 y 0.919); lo que cambia es el abanico entre folds, que con \(k=10\) es más ancho (desviación de 0.045 contra 0.031, con un fold en 0.84), porque cada prueba es más pequeña y más ruidosa.
Pasa ahora a varias variables. Ahí k-fold no solo mueve el error: mueve todo el vector de coeficientes.
19.9 Ejemplo 2. Regresión multivariable: progresión de diabetes
El dataset diabetes de scikit-learn tiene 442 pacientes y 10 variables clínicas (edad, sexo, IMC, presión arterial y seis marcadores de sangre) para predecir un índice cuantitativo de progresión de la enfermedad un año después. Las columnas ya vienen centradas y escaladas, cada una tiene media 0 y suma de cuadrados 1; por eso su desviación estándar es 0.048 y no 1: los valores son desviaciones respecto al promedio en una escala artificial y no conservan unidades clínicas como kg/m² o mmHg. Por eso los coeficientes salen en cientos: una unidad de esa escala equivale a unas 21 desviaciones estándar de la variable. El objetivo, en cambio, está en su escala original.
Con una sola variable podías mirar la recta. Con diez, k-fold se vuelve el instrumento para responder dos preguntas distintas: ¿cuánto error de predicción espero? y ¿los coeficientes se mantienen cuando cambio el bloque de pacientes que dejo fuera?
Cargar diabetes y mirar el resumen de las 10 variables
442 pacientes, 10 predictoras ya estandarizadas y un índice de progresión. La celda imprime el describe y la correlación de cada variable con el objetivo.
datos = load_diabetes(as_frame=True)X2 = datos.data.copy()y2 = datos.target.copy()df2 = X2.copy()df2['progreso'] = y2print(f'Observaciones: {len(df2)} | Predictoras: {X2.shape[1]}')print('Variables:', list(X2.columns))print()print(df2.describe().round(3).T.to_string())print()print('Correlación de cada predictora con la progresión:')print(X2.corrwith(y2).sort_values(ascending=False).round(3).to_string())
Dibujar la relación marginal de bmi, s5 y bp con la progresión
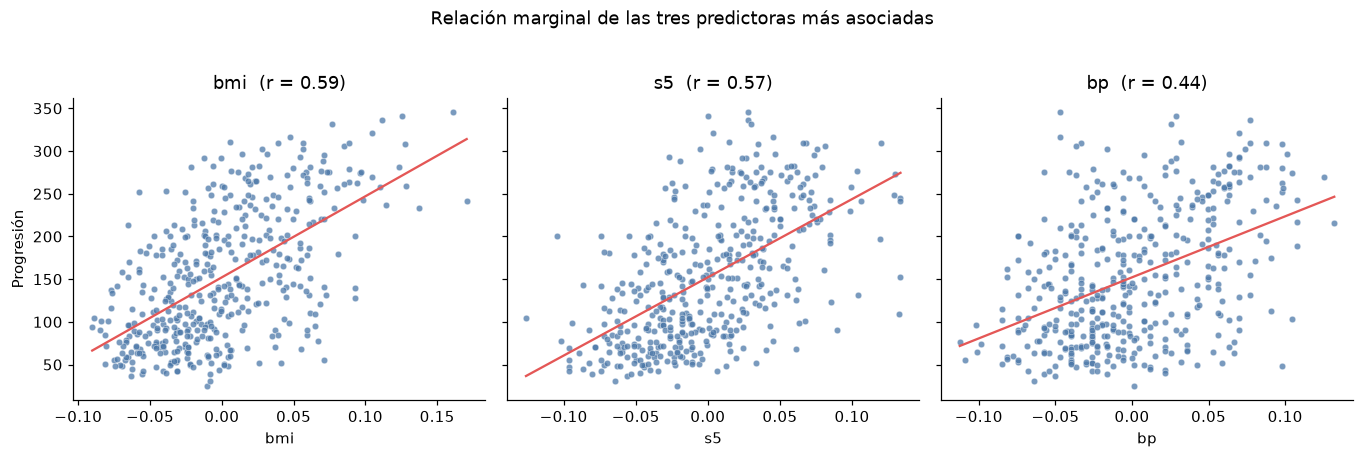
Los tres paneles muestran bmi, s5 y bp frente a progresión, cada uno con su recta simple. Ninguna variable sola va a explicar el fenómeno; el modelo multivariable suma esas señales débiles.
top = ['bmi', 's5', 'bp']fig, axes = plt.subplots(1, 3, figsize=(12.5, 4.0), sharey=True)for ax, col inzip(axes, top): ax.scatter(X2[col], y2, c=COLOR_TRAIN, s=18, alpha=0.75, edgecolors='white', linewidths=0.3) m = LinearRegression().fit(X2[[col]].values, y2.values) xs = np.linspace(X2[col].min(), X2[col].max(), 50) ax.plot(xs, m.predict(xs.reshape(-1, 1)), color=COLOR_TEST, lw=1.5) r = X2[col].corr(y2) ax.set_xlabel(col) ax.set_title(f'{col} (r = {r:.2f})')axes[0].set_ylabel('Progresión')fig.suptitle('Relación marginal de las tres predictoras más asociadas', y=1.03)plt.tight_layout()plt.show()
El progreso cubre un rango amplio (de 25 a 346), es asimétrico a la derecha (media 152.1, mediana 140.5) y no está partido en dos nubes: tiene sentido tratarlo como regresión, no como clasificación disfrazada. En el mapa de correlaciones hay un bloque entre s1 y s2 (marcadores de sangre muy alineados): multicolinealidad. Eso no rompe las predicciones de una lineal, pero sí infla la varianza de esos coeficientes y, por tanto, los va a hacer bailar más de fold a fold. El scatter bmi vs s5 coloreado por el objetivo sugiere que las dos empujan en la misma dirección, sin un grupo raro que un fold pudiera acaparar.
Las nubes marginales de bmi, s5 y bp son lineales y ruidosas: ninguna variable sola va a entregar un \(R^2\) alto. El modelo multivariable existe precisamente para sumar esas señales débiles. k-fold dirá si esa suma se sostiene en pacientes que el modelo no vio.
Ajustar OLS multivariable con intercepto, muestra completa
Igual que en el ejemplo 1: add_constant pone la columna de unos y OLS estima los 10 coeficientes más el intercepto. El summary() es otra vez una referencia in-sample, no el veredicto.
Mira tres cosas del summary, no todas sus filas por igual. Primero, el \(R^2\)in-sample (0.518), que es un techo optimista. Segundo, qué coeficientes tienen un intervalo al 95% que no cruza cero: sex, bmi, bp y s5. Tercero, la multicolinealidad: aquí statsmodels no imprime su aviso (el número de condición es 227), pero el síntoma está en la tabla. s1 y s2, con correlación de 0.90 entre sí, salen con coeficientes grandes y de signo opuesto (−792 y 477) y, aun así, ninguno es significativo al 5% (p = 0.058 y 0.160): su error estándar está inflado (417 y 339, contra ~65 de bmi). k-fold va a mostrar cuánto se mueven esos coeficientes cuando cambias el bloque de pacientes que dejas fuera.
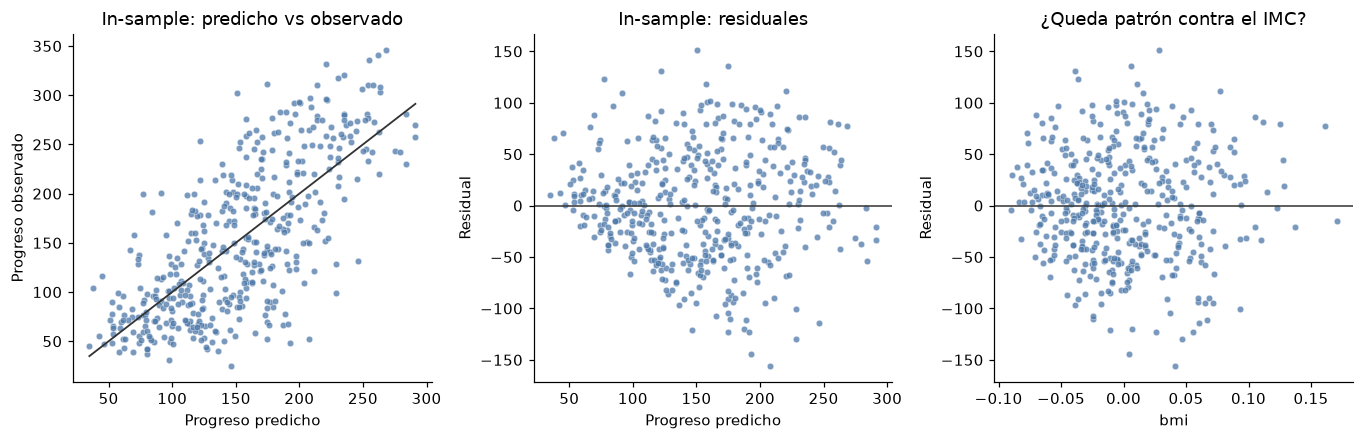
Diagnosticar el OLS in-sample y medirlo contra predecir la media
Predicho vs observado, residuales vs predicho y residuales vs IMC. Al final, el RMSE de “predecir siempre el promedio”: la línea base que k-fold tiene que ganar.
R2 in-sample:   0.518
RMSE in-sample: 53.48
RMSE de predecir la media: 77.01
En la figura de diabetes no aparece una curva evidente en los residuos contra bmi: la linealidad, en esa dirección, es razonable. El RMSE de “predecir siempre la media” es la línea base. Si en k-fold el modelo no le gana a esa línea de forma clara, el modelo multivariable no está pagando su complejidad.
Correr k-fold a mano: métricas, coeficientes y línea base por fold
Cinco rondas. En cada una se guarda MAE, RMSE, \(R^2\), el RMSE de predecir la media del entrenamiento, y el vector de 10 coeficientes. Con esos coeficientes ves después si el modelo es estable entre folds.
Comparar el modelo contra la línea base, fold a fold
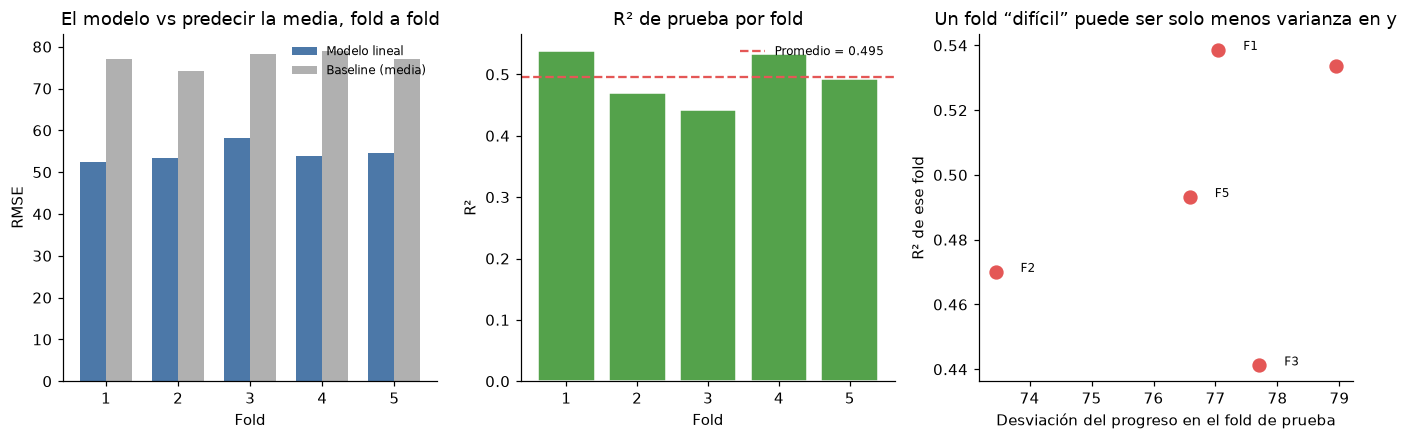
Barras de RMSE (modelo vs media), barras de \(R^2\), y un scatter de \(R^2\) contra la desviación del progreso en ese fold: para no confundir un bloque “difícil” con uno que simplemente varía menos.
fig, axes = plt.subplots(1, 3, figsize=(12.5, 4.1))ax = axes[0]ancho =0.36ax.bar(tab2['fold'] - ancho /2, tab2['RMSE'], width=ancho, color=COLOR_TRAIN, label='Modelo lineal')ax.bar(tab2['fold'] + ancho /2, tab2['RMSE_baseline'], width=ancho, color='#B0B0B0', label='Baseline (media)')ax.set_xlabel('Fold')ax.set_ylabel('RMSE')ax.set_title('El modelo vs predecir la media, fold a fold')ax.set_xticks(tab2['fold'])ax.legend(frameon=False, fontsize=8)ax = axes[1]ax.bar(tab2['fold'], tab2['R2'], color='#54A24B', edgecolor='white')ax.axhline(tab2['R2'].mean(), color=COLOR_TEST, ls='--', label=f'Promedio = {tab2["R2"].mean():.3f}')ax.set_xlabel('Fold')ax.set_ylabel('R²')ax.set_title('R² de prueba por fold')ax.set_xticks(tab2['fold'])ax.legend(frameon=False, fontsize=8)ax = axes[2]ax.scatter(tab2['progreso_sd'], tab2['R2'], c=COLOR_TEST, s=70, zorder=3)for _, r in tab2.iterrows(): ax.annotate(f'F{int(r["fold"])}', (r['progreso_sd'] +0.4, r['R2']), fontsize=8)ax.set_xlabel('Desviación del progreso en el fold de prueba')ax.set_ylabel('R² de ese fold')ax.set_title('Un fold “difícil” puede ser solo menos varianza en y')plt.tight_layout()plt.show()
El modelo le gana a la línea base en todos los folds (RMSE ~52–58 contra ~74–79). No es un empate afortunado de un solo split. Esta mejora frente a la media se sostiene en los cinco bloques de este diseño.
El \(R^2\) de CV (0.495) queda por debajo del in-sample (0.518). La brecha es el precio de generalizar; si fuera enorme, habría sobreajuste. Una lineal con 10 variables y 442 filas casi no tiene capacidad de memorizar, y la brecha es de apenas 0.02: señal de poco sobreajuste. Si el modelo es bueno o mediocre no lo dice esa brecha: lo dice la comparación con la línea base.
El scatter de la derecha es una trampa clásica de lectura: un fold con poca varianza en \(y\) tiene un \(SS_{tot}\) pequeño, y el \(R^2\) se vuelve inestable o bajo aunque el RMSE sea parecido. El fold 3, el de peor \(R^2\) (0.44), no tiene la desviación más baja; su RMSE sí es el más alto (58.1). Ahí el modelo predice peor de verdad, no es un artefacto del denominador.
Ver la tabla de coeficientes por fold
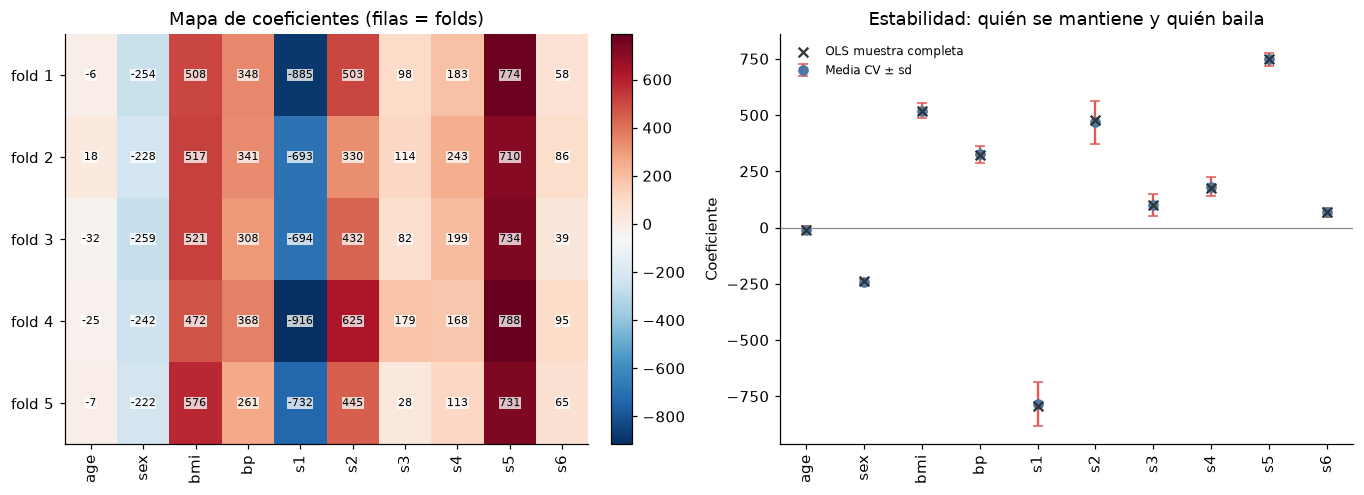
Diez columnas, cinco filas. Una columna estable es un efecto que sobrevive al cambio de pacientes; una que cambia de magnitud o de signo es un efecto frágil (o colineal).
print('Coeficientes por fold:')print(coefs.round(1).to_string())print()print('Media ± sd entre folds:')estabilidad = pd.DataFrame({'media': coefs.mean(),'sd': coefs.std(ddof=0),'min': coefs.min(),'max': coefs.max(),'ols_completo': ols2.params.drop('const').values,})print(estabilidad.round(1).to_string())
A la izquierda, la figura muestra los 10 coeficientes de diabetes en los 5 folds, con valores numéricos sobre el mapa. A la derecha, la media entre folds ± su desviación, con el OLS de la muestra completa encima. Si la cruz cae dentro de la banda, el ajuste con toda la muestra es coherente con los de cada fold.
En el mapa, una columna de color uniforme es un efecto que sobrevive al cambio de pacientes: bmi (media 519, sd 34), s5 (747, sd 29) y sex (−241, sd 14). Una columna que cambia de intensidad, s1 y s2, con sd cercana a 97, es el síntoma de dos marcadores que se cuentan la misma historia: el OLS de la muestra completa les pone coeficientes grandes y de signo opuesto. k-fold muestra que el signo opuesto sí se repite en los cinco bloques (s1 entre −916 y −693; s2 entre 330 y 625): lo que se mueve es la magnitud. La única variable que cambia de signo entre folds es age (de −31.9 a 17.6), coherente con su intervalo del summary, que cruza cero.
El panel de la derecha resume lo mismo con barras de error. Las cruces del OLS completo caen dentro de la banda de k-fold, pero eso era de esperar: los folds comparten el 75% de sus filas de entrenamiento, así que la desviación entre folds subestima la incertidumbre real de cada coeficiente (para s1, 96.5 entre folds contra un error estándar de 417 en el summary). La estabilidad entre folds es una condición necesaria para interpretar un coeficiente, no una prueba de que el efecto exista. La decisión práctica se parte en dos. Para predecir, el modelo sirve: RMSE de CV ~54 contra línea base ~77. Para interpretar, quédate con bmi, bp, s5 y sex; no leas un relato clínico sobre s1 y s2 como si fueran efectos separados.
Ver predicciones out-of-fold y si algún fold se llevó otra población
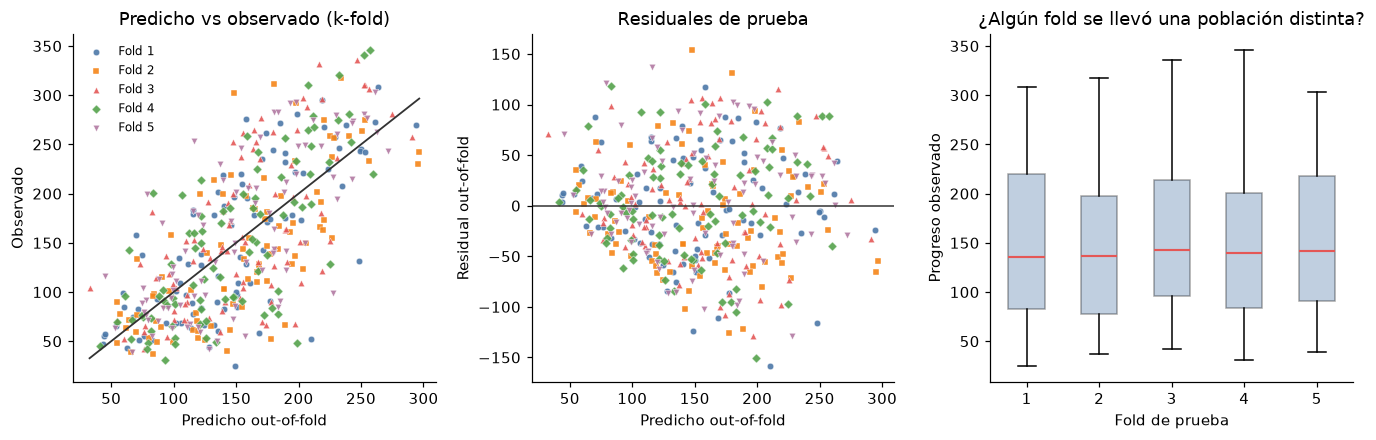
Predicho vs observado (ahora sí, honesto), residuales de prueba, y boxplots del progreso observado en cada bloque. Los boxplots deberían parecerse: si un fold se llevó solo a los pacientes graves, su RMSE no es comparable.
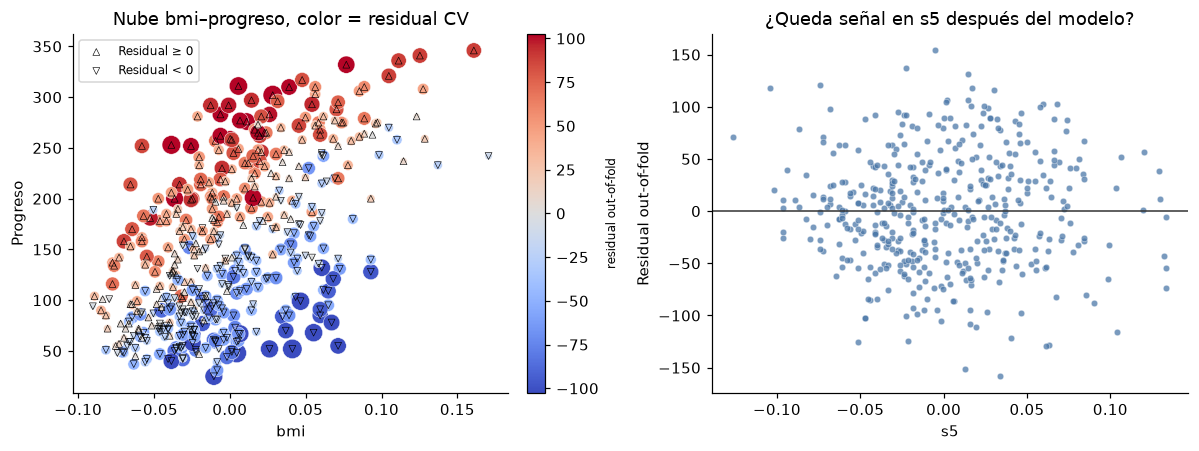
Nube bmi–progreso coloreada por el residual CV, residual vs s5, y los cinco pacientes con mayor |residual| cuando fueron prueba. El RMSE es un promedio; aquí se ven las colas.
Cinco pacientes con mayor |residual| cuando fueron prueba:
       bmi     bp     s5  progreso  residual_cv  fold
56   0.041 -0.026  0.034      52.0     -158.315     1
102  0.028 -0.016 -0.005     302.0      153.959     2
92   0.005  0.098  0.013      48.0     -150.868     4
304 -0.039  0.053 -0.023     253.0      136.885     5
359  0.006  0.032  0.015     311.0      131.012     2
El predicho vs observado out-of-fold es más honesto que el in-sample: la nube se abre un poco más: es la brecha entre el \(R^2\)in-sample (0.518) y el de CV (0.495). Los boxplots del progreso por fold se parecen (medias entre 143.8 y 159.9): ningún bloque se llevó solo a los pacientes graves, así que sus RMSE son comparables.
Los dos scatters de la celda anterior cierran el diagnóstico:
Colorear la nube bmi–progreso por el residual CV te dice dónde se equivoca el modelo. El degradado vertical (rojo arriba, azul abajo) es esperable por construcción: el residual es \(y - \hat{y}\), así que los valores altos de \(y\) tienden a quedar subestimados. Lo que delataría un patrón no capturado es una franja de un solo color a lo largo de bmi (no linealidad, un subgrupo).
Residual vs s5: la ortogonalidad exacta de OLS vale para los residuos del ajuste, no para estas predicciones fuera de muestra. Aquí debes buscar tanto una tendencia lineal como curvatura y diferencias entre grupos. Una nube sin patrón visual evidente tampoco demuestra que la especificación esté completa.
Los cinco pacientes con mayor |residual| out-of-fold son casos con grandes discrepancias entre respuesta y predicción. En un proyecto, los abrirías uno a uno (dato mal cargado, comorbilidad, un perfil clínico distinto). Aquí sirven para recordar que el RMSE de CV es un promedio que esconde colas: el peor residual (−158.3) es casi tres veces el RMSE de CV (54.5).
Confirmar con scikit-learn: in-sample, k=5, k=10 y la línea base
Una tabla con \(R^2\) y RMSE de los cuatro esquemas, más el vector de \(R^2\) de cada fold. Es el mismo k-fold de arriba, ahora con cross_val_score.
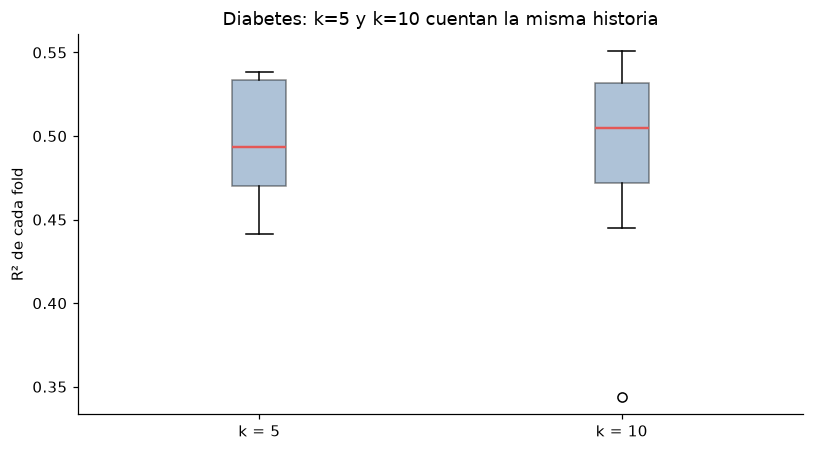
Boxplot final del ejemplo multivariable. Con \(n=442\) el promedio debería coincidir; el abanico de \(k=10\) suele ser más ancho porque cada prueba es más pequeña.
fig, ax = plt.subplots(figsize=(7.5, 4.2))ax.boxplot( [r2_cv5_b, r2_cv10_b], tick_labels=['k = 5', 'k = 10'], patch_artist=True, boxprops=dict(facecolor=COLOR_TRAIN, alpha=0.45), medianprops=dict(color=COLOR_TEST, lw=1.6),)ax.set_ylabel('R² de cada fold')ax.set_title('Diabetes: k=5 y k=10 cuentan la misma historia')plt.tight_layout()plt.show()
In-sample gana en \(R^2\) (0.518) y pierde en honestidad. \(k=5\) y \(k=10\) coinciden en el promedio (~0.49). El abanico de \(k=10\) es más ancho (aparece un fold en 0.34), no más fino: cada prueba tiene ~44 pacientes y el \(R^2\) de un bloque pequeño es más ruidoso. Ese abanico describe folds individuales, no la precisión del promedio: los dos promedios son defendibles. Aquí reportarías el de \(k=5\) (0.495) y usarías el de \(k=10\) (0.490) para confirmar que el resultado no dependía de haber cortado en cinco.
Y ese 0.49 solo es interesante porque gana a predecir la media (RMSE 54 contra 77). Esa mejora frente a la media es predictiva dentro de este conjunto; para justificar un uso clínico faltan criterios de decisión, costos de error y validación en la población de destino.
19.10 Preguntas de comprensión
¿Por qué el promedio de los RMSE por fold puede diferir del RMSE calculado con todos los residuos fuera de fold?
¿Cinco folds sobre pacientes distintos demuestran utilidad clínica del modelo de diabetes?
En los apartamentos, la desviación del RMSE entre folds fue ±3.24. ¿Es un error estándar del promedio de 16.33? ¿Qué la explica?
Usas k-fold para elegir entre diez valores de un hiperparámetro y reportas el mejor promedio como desempeño esperado. ¿Qué problema tiene ese número y cómo lo corriges?
En diabetes, s1 y s2 cambian mucho de magnitud entre folds (desviación de unas 97 unidades) y bmi casi no (33.5). ¿Qué te dice eso para interpretar el modelo y qué no te dice?
TipOrientaciones
Porque la raíz cuadrada no es lineal: promediar raíces no equivale a tomar la raíz del promedio de los errores cuadrados, y por ser cóncava el promedio de raíces queda por debajo. En los apartamentos con \(k=10\), el promedio por fold fue 16.08 y el RMSE de los 120 residuos juntos, 16.47. Si los folds tienen tamaños distintos, además debes ponderar.
No. Estiman el desempeño predictivo dentro de esta muestra y de este diseño de partición (RMSE de 54.5 frente a 77.1 de la media). La utilidad clínica requiere definir la decisión, la población de destino y el costo de los errores, y validar en esa población.
No en sentido estricto, porque los folds comparten observaciones de entrenamiento y no son independientes. Aquí la dispersión la explica sobre todo un bloque: el fold 1 se llevó los tres atípicos y tuvo un RMSE de 22.65, frente a 14.1–16.0 en los otros cuatro.
Queda optimista, porque elegiste justamente el candidato que mejor salió en esas mismas particiones. Lo corriges con validación cruzada anidada (la elección dentro de cada fold externo) o con una prueba reservada que no participó en la elección.
Que no debes leer s1 y s2 como efectos separados, porque con correlación de 0.90 el modelo reparte entre ellos una misma señal; bmi, bp, s5 y sex son más estables. No te dice que esos efectos existan ni que sean causales, y la desviación entre folds subestima la incertidumbre real (96.5 frente a un error estándar de 417 para s1).
19.11 Referencias para profundizar
Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B, 36(2), 111–147. Uno de los artículos fundacionales de la validación cruzada.
Kohavi, R. (1995). A study of cross-validation and bootstrap for accuracy estimation and model selection. En Proceedings of the 14th International Joint Conference on Artificial Intelligence (vol. 2, pp. 1137–1145). La recomendación empírica de \(k=10\).
Bengio, Y. y Grandvalet, Y. (2004). No unbiased estimator of the variance of K-fold cross-validation. Journal of Machine Learning Research, 5, 1089–1105. Por qué la dispersión entre folds no es un error estándar.
Varma, S. y Simon, R. (2006). Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 7, 91. El optimismo de reportar la misma validación cruzada que eligió el modelo.
Bates, S., Hastie, T. y Tibshirani, R. (2024). Cross-validation: What does it estimate and how well does it do it? Journal of the American Statistical Association, 119(546), 1434–1445. Qué estima el promedio de k-fold.
Efron, B., Hastie, T., Johnstone, I. y Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. Origen del conjunto Diabetes.
k-fold mide el error de predicción de un procedimiento sin apostar a una sola partición, y el promedio solo se interpreta junto a los folds que lo forman y a una línea base.
Una sola partición 70/30 de 80 puntos dio \(R^2\) entre 0.577 y 0.831 según qué 24 filas quedaron en la prueba.
Cada observación es prueba exactamente una vez, y sin shuffle los folds de datos ordenados reservan franjas del eje (medias de \(x\) de 1.81 a 9.19).
En los apartamentos, el RMSE fue 16.33 ± 3.24 con \(k=5\), y la dispersión la explicó un solo fold con los tres atípicos (22.65); la pendiente se mantuvo entre 1.76 y 1.86.
\(k=5\) y \(k=10\) dieron promedios casi iguales (\(R^2\) de 0.927 y 0.919 en los apartamentos, 0.495 y 0.490 en diabetes), con más dispersión entre folds con \(k=10\).
En diabetes, el modelo superó a la media en los cinco folds (RMSE de 54.5 frente a 77.1), y la estabilidad de los coeficientes separó los efectos estables (bmi, s5, sex) de los colineales (s1, s2).
Si usas la validación cruzada para elegir, no reportes ese mismo número como desempeño final.
19.13 Puente hacia los siguientes capítulos
El capítulo anterior dio el panorama completo de la evaluación (métricas, una partición, validación cruzada y bootstrap), y este se quedó en una sola herramienta para verla por dentro. En el capítulo de splines, k-fold pasa a su uso más frecuente: elegir, solo con el entrenamiento, cuánta flexibilidad darle a un modelo, en ese caso el número de nodos de una curva por tramos.