En los capítulos anteriores describiste cada variable por separado: centro, dispersión y forma. Un modelo, en cambio, aprende de todas las columnas a la vez: de cómo se mueven juntas, de si repiten información y de si una relación es lineal o solo lo parece.
En este capítulo trabajas la covarianza, la correlación de Pearson y la de Spearman, la fuerza y dirección de una asociación, la matriz de correlación y su heatmap, la multicolinealidad y la diferencia entre correlación y causalidad.
Los datos son sintéticos: 600 personas con horas de lectura y de práctica, horas de sueño, un índice de distracción, una puntuación de examen y una variable de ruido sin relación con nada, generadas con relaciones conocidas para que puedas comprobar lo que miden los coeficientes. Varias etapas usan además conjuntos pequeños simulados y el cuarteto de Anscombe.
Tiempo estimado de lectura: 60 minutos (unas 2 horas y media si ejecutas el código y resuelves los ejercicios)
Nivel: Básico
Conocimientos previos recomendados: los capítulos 3 (varianza y desviación estándar) y 4 (forma, atípicos y z-score).
Tecnologías mencionadas: Python 3.13, pandas 3.0, NumPy 2.5 y Matplotlib.
Objetivos
Al terminar este capítulo vas a ser capaz de:
explicar qué miden la covarianza y la correlación de Pearson, y calcularlas con NumPy y pandas;
leer \(r\) y \(r^2\) con su dirección, su fuerza y sus límites;
reconocer cuándo Pearson engaña: el cuarteto de Anscombe, las relaciones no lineales y los valores atípicos, y cuándo conviene Spearman;
construir y leer una matriz de correlación y un heatmap;
identificar multicolinealidad y anticipar su efecto en los coeficientes de un modelo lineal;
distinguir asociación de causalidad y relacionar estas ideas con la selección de variables y el modelado.
Ejecuta las celdas en orden: el capítulo fija una semilla global al inicio y el dataset de la etapa 1 se usa hasta el final.
5.1 Dos variables se mueven juntas
Una variable aislada resume un eje. Una relación resume cómo cambian dos ejes al mismo tiempo.
Covarianza
Indica si, cuando una variable sube respecto a su media, la otra tiende a subir o a bajar. Sus unidades son el producto de las dos escalas: sirve para el signo, no para comparar magnitudes entre pares de variables.
Correlación de Pearson
Estandariza la covarianza. Queda entre \(-1\) y \(1\) y describe la dirección y la fuerza lineal de la relación.
Advertencia
Una correlación alta no prueba un mecanismo. Puede reflejar redundancia, un tercer factor oculto o una relación no lineal que Pearson resume mal.
5.2 Por qué importa en IA y machine learning
Los algoritmos operan sobre la geometría conjunta de las variables, no sobre columnas sueltas:
En regresión lineal, dos predictores muy correlacionados reparten entre sí el mismo efecto y sus coeficientes se vuelven difíciles de interpretar (etapa 12 y su ejercicio).
En k vecinos más cercanos y clustering, la redundancia y la escala cambian qué observaciones resultan “cercanas”.
En selección de variables, filtrar por \(|r|\) con el objetivo puede borrar señal no lineal (etapa 6).
En PCA (análisis de componentes principales), la estructura compartida entre variables es justo lo que se comprime.
Idea central: medir relaciones orienta el análisis exploratorio; no sustituye la validación ni el juicio de dominio.
5.3 Flujo recomendado de trabajo
Mira el diagrama de dispersión antes de confiar en un coeficiente.
Calcula covarianza y correlación e interpreta signo y fuerza.
Revisa la forma y los atípicos: si la relación es curva o un punto la domina, compara Pearson con Spearman.
Lee la matriz y el heatmap para ver bloques de variables redundantes.
Separa asociación de causa antes de recomendar una política o una variable.
Decide si hace falta eliminar, combinar, regularizar, escalar o reducir dimensión.
Redacta el reporte:
“Para [variables], se observa [hallazgo]. Se reporta [medida/gráfico] porque [justificación]. Implicación para el modelo: [decisión].”
5.4 Preparar el entorno
La celda fija la semilla global y un estilo de gráficos común para todo el capítulo.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltSEMILLA =42# semilla central del capítulorng = np.random.default_rng(SEMILLA)# Estilo simple y legibleplt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("Entorno listo: numpy, pandas, matplotlib.")print("pandas:", pd.__version__, "| numpy:", np.__version__)
El entorno queda con Python 3.13.14, pandas 3.0.5 y NumPy 2.5.1. Avanzas en este orden: construyes el dataset, miras las relaciones en gráficos, las mides con covarianza y correlación, compruebas tres situaciones en que Pearson engaña, lees la matriz de correlación, diagnosticas multicolinealidad y separas correlación de causa.
Etapa 1: Dataset sintético de hábitos y desempeño
Construyes 600 registros ficticios de hábitos de estudio y desempeño. No buscas predecir la realidad, sino tener variables con relaciones conocidas para ver qué miden los coeficientes:
horas_lectura_semana: normal con media 6 y desviación 2, recortada en 0.
horas_practica_semana: 0.75 × lectura más ruido normal (desviación 1.2), recortada en 0; queda asociada a la lectura a propósito.
horas_sueno_dia: normal con media 7 y desviación 0.9.
indice_distraccion: normal con media 5 y desviación 1.5 (mayor = más distracción).
Las seis columnas son numéricas (float64) y ninguna tiene faltantes. La lectura promedia 5.95 horas y la práctica 4.44; la puntuación tiene media 43.99 y desviación 15.09, entre 2.27 y 90.62. El mínimo de la práctica es exactamente 0 por el recorte (5 registros); el de la lectura, 0.07. Estos resúmenes describen cada columna, pero no dicen cómo se mueven dos de ellas juntas: eso empieza en la etapa 2.
Etapa 2: Por qué no basta mirar cada variable sola
Dos variables pueden tener distribuciones razonables por separado y ocultar una estructura conjunta importante: redundancia entre variables, inestabilidad de algunos algoritmos o interpretaciones engañosas.
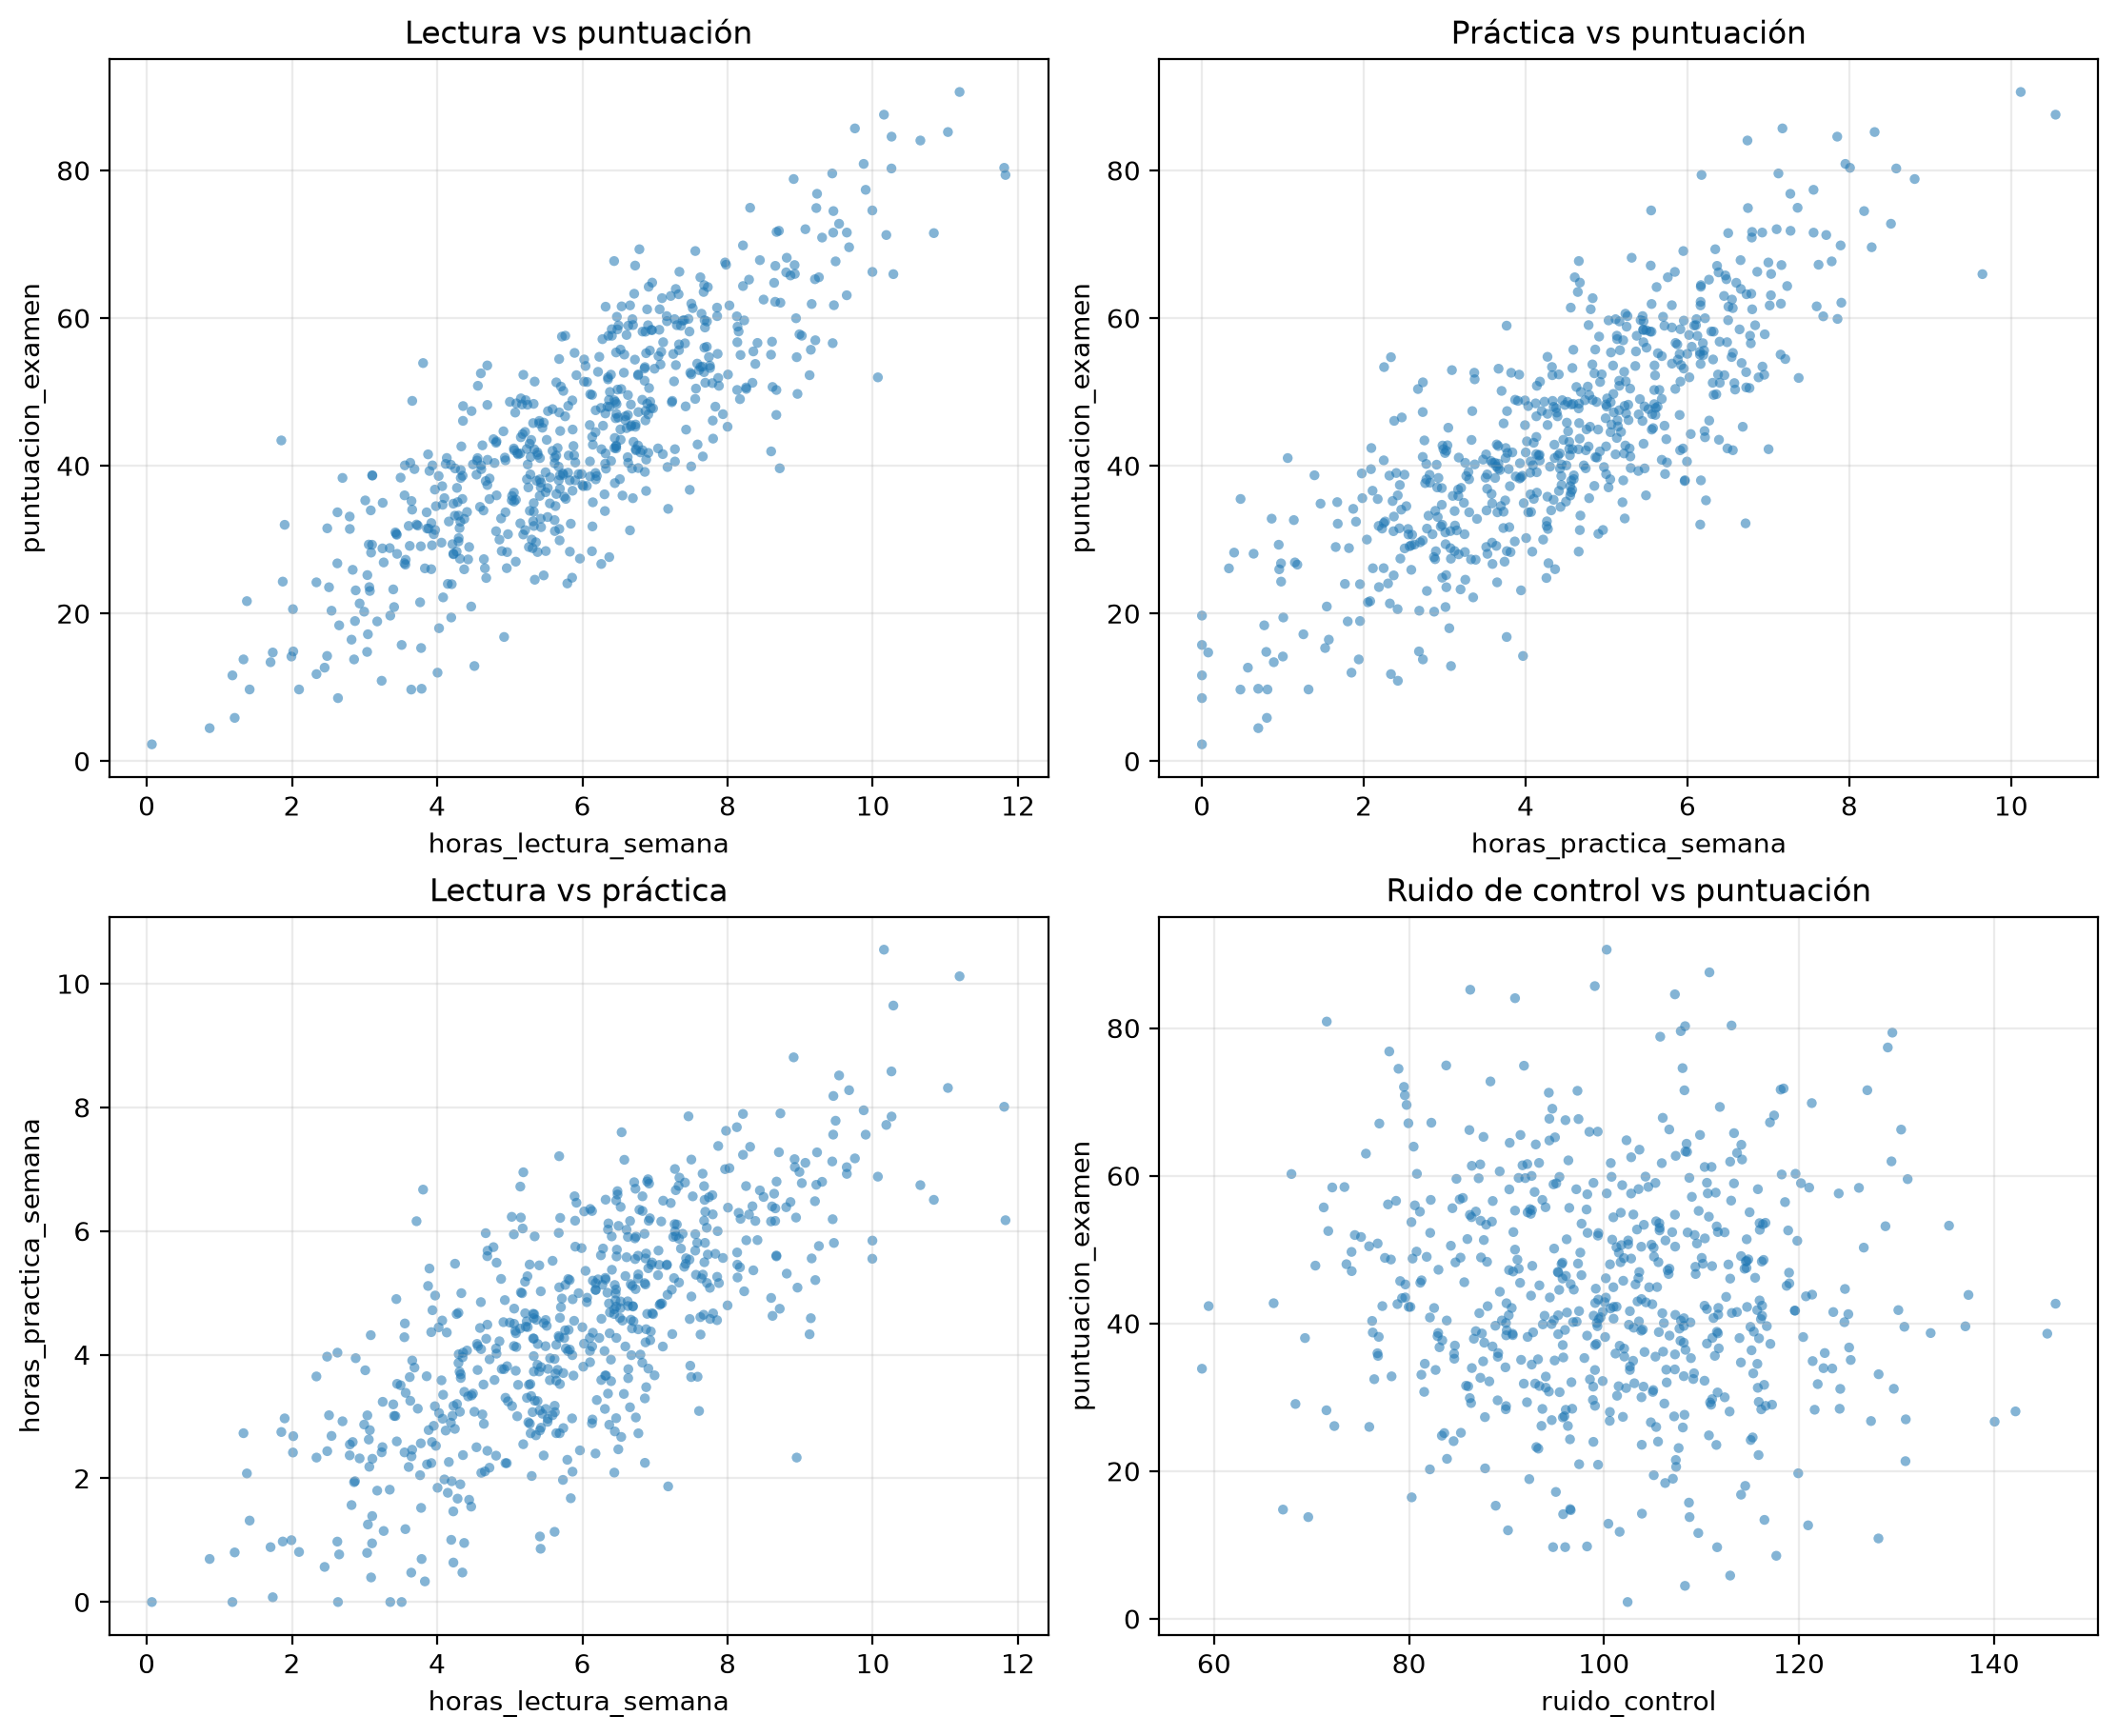
La primera herramienta es el diagrama de dispersión: cada punto es una fila, ubicada por el valor de dos variables. Graficas cuatro pares: lectura y práctica frente a la puntuación, lectura frente a práctica, y la variable de ruido frente a la puntuación. En cada panel, fíjate si la nube crece o decrece, si es estrecha o ancha y si hay puntos aislados.
pares = [ ("horas_lectura_semana", "puntuacion_examen", "Lectura vs puntuación"), ("horas_practica_semana", "puntuacion_examen", "Práctica vs puntuación"), ("horas_lectura_semana", "horas_practica_semana", "Lectura vs práctica"), ("ruido_control", "puntuacion_examen", "Ruido de control vs puntuación"),]fig, axs = plt.subplots(2, 2, figsize=(11, 9), constrained_layout=True)axs = axs.ravel()for ax, (x, y, titulo) inzip(axs, pares): ax.scatter(df[x], df[y], s=14, alpha=0.55, edgecolors="none") ax.set_title(titulo) ax.set_xlabel(x) ax.set_ylabel(y)plt.show()
Los tres primeros paneles muestran nubes crecientes y alargadas: a más horas de lectura o de práctica, mayor puntuación, y quien lee más también practica más. El panel de ruido_control es un manchón sin dirección, como corresponde a una variable que no interviene en la puntuación.
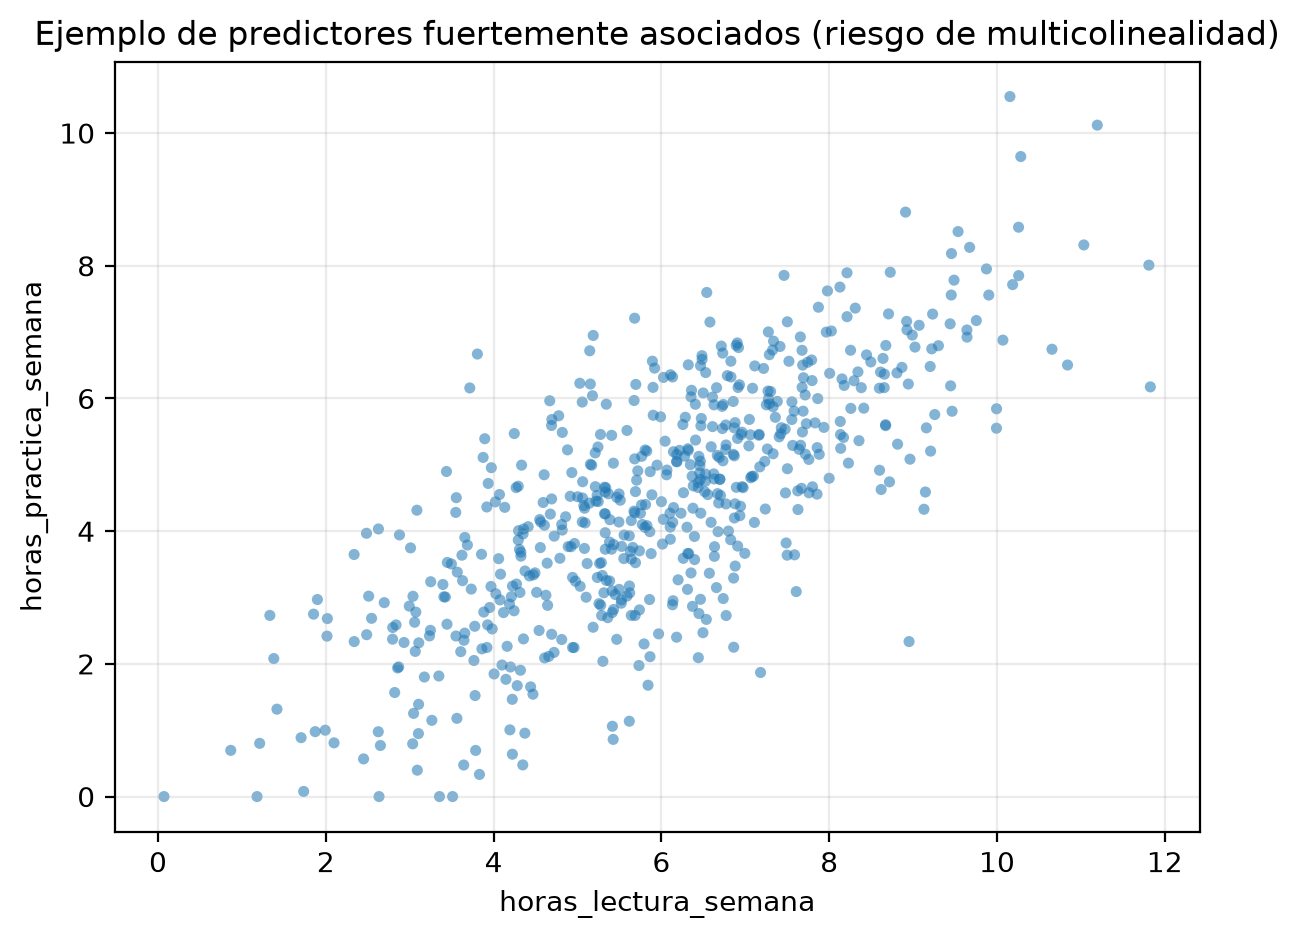
Una tendencia clara frente al objetivo sugiere señal para un modelo, y también obliga a preguntar si dos predictores repiten la misma información, como lectura y práctica (panel inferior izquierdo).
Un patrón difuso no prueba que la variable sea inútil: puede haber relaciones no lineales o interacciones.
Estos gráficos orientan el análisis exploratorio: transformaciones, atípicos conjuntos y si una recta es una línea base razonable.
Etapa 3: Covarianza
La covarianza mide si las dos variables se alejan de sus medias en el mismo sentido (positiva), en sentidos opuestos (negativa) o sin regularidad (cerca de cero). Es el promedio del producto de las desviaciones:
El denominador \(n-1\) es el de la versión muestral, como en la varianza del capítulo 3; la versión poblacional divide entre \(N\) y usa las medias poblacionales.
Positiva: las desviaciones suelen tener el mismo signo.
Negativa: suelen tener signos opuestos.
Magnitud: depende de las unidades de las dos variables. Por eso no puedes comparar la covarianza de horas con puntos con la de otro par medido en otras unidades.
La covarianza indica la dirección, pero no sirve para comparar la fuerza de relaciones entre variables con distintas unidades; para eso se estandariza en la correlación (etapa 4). Aun así, aparece detrás de muchas operaciones con matrices de datos, como la PCA.
# Covarianza muestral (pandas usa ddof=1 por defecto en .cov())cov_lp = df["horas_lectura_semana"].cov(df["puntuacion_examen"])cov_pr = df["horas_practica_semana"].cov(df["puntuacion_examen"])cov_lr = df["horas_lectura_semana"].cov(df["ruido_control"])print(f"Cov(lectura, puntuación) = {cov_lp: .3f}")print(f"Cov(práctica, puntuación) = {cov_pr: .3f}")print(f"Cov(lectura, ruido_control) = {cov_lr: .3f}")# Matriz de covarianza completacov_mat = df.cov(numeric_only=True)cov_mat
La covarianza de lectura con puntuación es 24.73 y la de práctica con puntuación 22.00, ambas positivas; la de lectura con ruido_control es −1.06, pequeña frente a las anteriores aunque el ruido tiene una varianza mucho mayor. En la matriz completa, la diagonal es la varianza de cada variable (227.68 para la puntuación, 209.03 para el ruido), y fuera de ella están las covarianzas de cada par. Que 24.73 sea mayor que 1.81 (sueño con puntuación) mezcla dos cosas: la fuerza de la relación y las unidades de cada variable.
Ejercicio
Multiplica puntuacion_examen por 10 (como si la escala fuera de 0 a 1000) y vuelve a calcular la covarianza y la correlación con la lectura. ¿Qué cambia?
TipOrientaciones
La covarianza pasa de 24.73 a 247.32, diez veces más, aunque la relación es la misma; la correlación sigue en 0.842. La covarianza hereda las unidades de las variables; la correlación no.
Etapa 4: Correlación de Pearson
La correlación de Pearson divide la covarianza por las dos desviaciones estándar:
\[
r_{XY} = \frac{s_{XY}}{s_X\, s_Y}
\]
Así obtienes un número entre −1 y 1 que no depende de las unidades y mide la asociación lineal:
\(r > 0\): relación creciente; \(r < 0\): decreciente.
\(|r|\) cerca de 1: los puntos se alinean en una recta.
\(|r|\) cerca de 0: poca asociación lineal, aunque puede haber una relación curva que Pearson no capta (etapa 6).
Al leer un \(r\), pregúntate por su dirección (signo), su fuerza (qué tan estrecha es la nube alrededor de una recta) y si tiene sentido esperar linealidad en el dominio. Entre predictores, una correlación alta indica que dos variables aportan información parecida: no obliga a eliminar una, pero sí a decidir qué hacer con la redundancia.
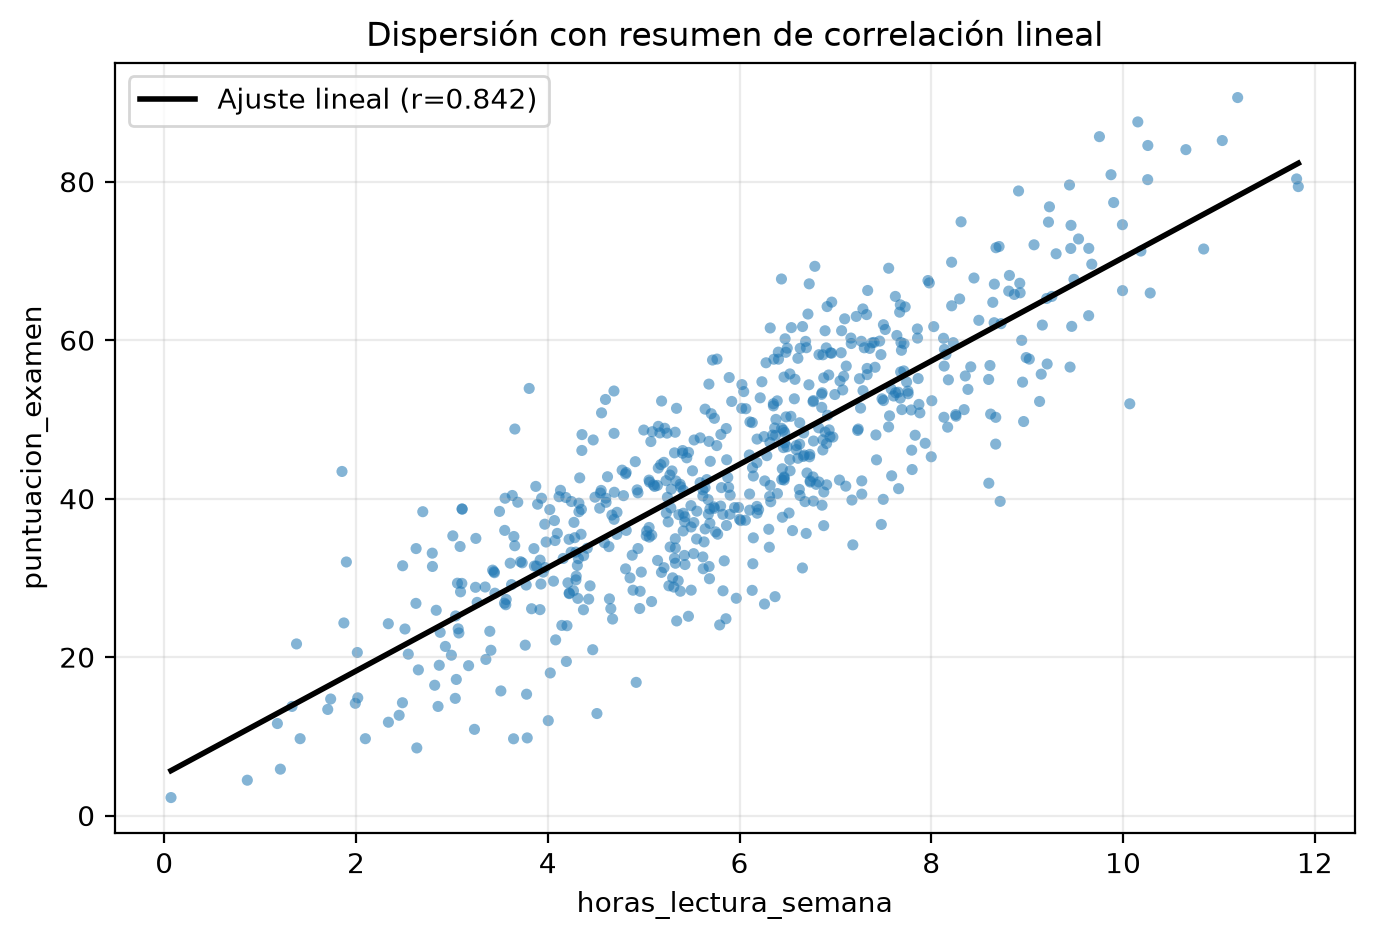
# Gráfico de apoyo: misma nube, pero con anotación del coeficientex = df["horas_lectura_semana"]y = df["puntuacion_examen"]r = x.corr(y)plt.figure(figsize=(8, 5))plt.scatter(x, y, s=16, alpha=0.55, edgecolors="none")plt.title("Dispersión con resumen de correlación lineal")plt.xlabel("horas_lectura_semana")plt.ylabel("puntuacion_examen")# Línea de regresión simple (grado 1) como apoyo visualm, b = np.polyfit(x, y, 1)xs = np.linspace(x.min(), x.max(), 200)plt.plot(xs, m * xs + b, color="black", linewidth=2, label=f"Ajuste lineal (r={r:.3f})")plt.legend()plt.show()
La correlación de lectura con puntuación es 0.842 y la de práctica con puntuación 0.813; la de lectura con ruido_control es −0.038. np.corrcoef devuelve la matriz 2 × 2 con el mismo 0.842 fuera de la diagonal. En el gráfico, la recta ajustada sigue la nube, que se mantiene estrecha alrededor de ella en todo el rango de horas.
Pearson responde una pregunta acotada: ¿hay una tendencia lineal? No dice cuál es la causa ni si la relación es curva. Con el objetivo, un \(|r|\) alto señala candidatas para un modelo lineal; entre predictores, señala redundancia.
Ejercicio
Calcula la correlación entre horas_lectura_semana y puntuacion_examen**2. ¿Es una medida adecuada para describir esa relación?
TipOrientaciones
Da 0.820, apenas menos que el 0.842 original, porque elevar al cuadrado valores positivos conserva el orden. El número sigue siendo alto, pero la relación con el cuadrado ya no es lineal: la nube se curva hacia arriba. Un \(r\) alto no garantiza que la recta sea el resumen correcto; para eso miras el gráfico.
\(r^2\): proporción de varianza compartida linealmente
El cuadrado de la correlación, \(r^2\), es la proporción de la varianza de una variable que comparte linealmente con la otra. Por ejemplo, \(r = 0.7\) da \(r^2 = 0.49\): una recta da cuenta de cerca del 49% de la variación de una variable a partir de la otra, y el resto queda como residuo. Es la misma \(R^2\) que reaparece en el capítulo 13 como bondad de ajuste de una regresión.
# r y r² para los pares ya calculados en esta etapapares_r2 = pd.DataFrame( {"par": ["lectura vs puntuación","práctica vs puntuación","lectura vs ruido_control", ],"r": [r_lp, r_pr, r_lr], })pares_r2["r2"] = pares_r2["r"] **2print(pares_r2.round(3).to_string(index=False))
                     par      r    r2
   lectura vs puntuación  0.842 0.708
  práctica vs puntuación  0.813 0.661
lectura vs ruido_control -0.038 0.001
Lectura y práctica, con \(r\) de 0.842 y 0.813, comparten con la puntuación el 70.8% y el 66.1% de su varianza; ruido_control, el 0.1%. Un \(r\) que parece alto puede corresponder a un \(r^2\) apenas moderado (0.7 da 0.49), así que conviene reportar ambos. En una línea base lineal con una sola variable, \(r^2\) anticipa cuánta señal capturaría una recta.
Por último compruebas que pandas calcula exactamente la fórmula de esta etapa: la covarianza dividida por las dos desviaciones estándar, con ddof=1.
cov(x,y) = 24.732222
s_x = 1.947610 | s_y = 15.089073
r manual  = 0.841586
r pandas  = 0.841586
¿Coinciden? True
La covarianza (24.732222) dividida entre las desviaciones (1.947610 y 15.089073) da 0.841586, el mismo valor que .corr(), y np.isclose lo confirma. Pearson es la covarianza expresada en unidades de desviación estándar.
Etapa 5: Cuarteto de Anscombe: el mismo \(r\), cuatro historias
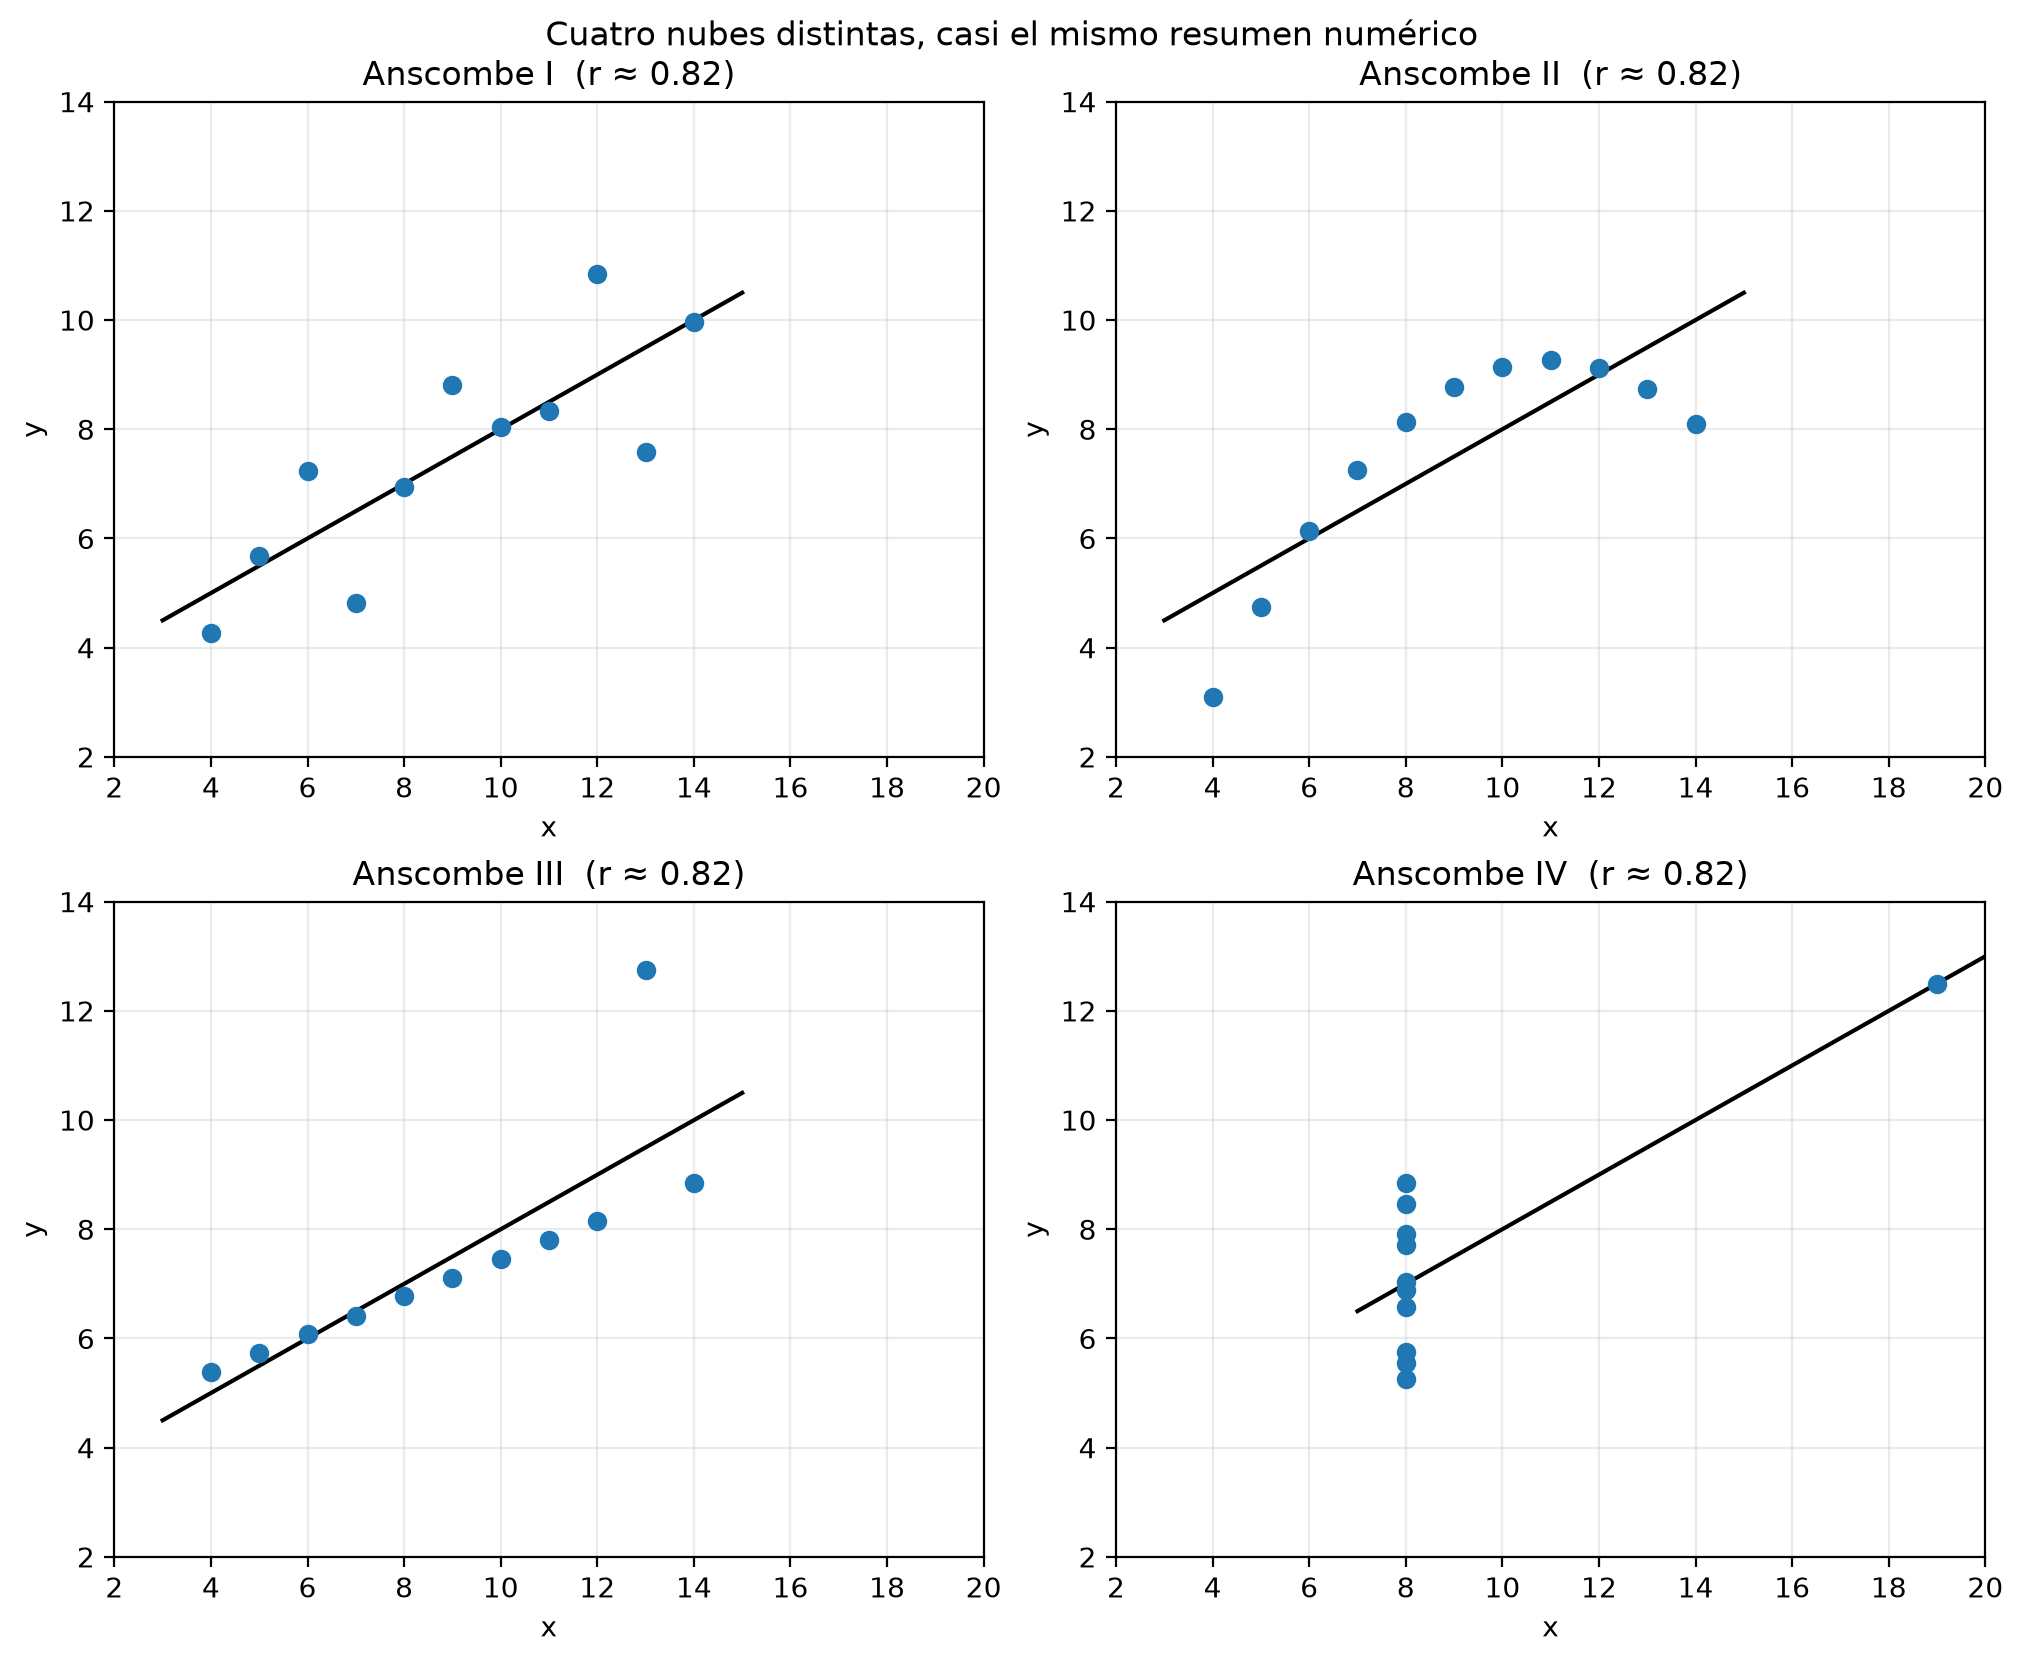
En 1973, Francis Anscombe construyó cuatro conjuntos de once puntos cada uno. Comparten casi la misma media de \(x\) y de \(y\), la misma correlación de Pearson (\(r \approx 0.82\)) y la misma recta de regresión. Al graficarlos, las formas son opuestas.
conjunto  media_x  media_y     r  pendiente  intercepto
       I      9.0    7.501 0.816        0.5       3.000
      II      9.0    7.501 0.816        0.5       3.001
     III      9.0    7.500 0.816        0.5       3.002
      IV      9.0    7.501 0.817        0.5       3.002
La tabla lo confirma: los cuatro conjuntos tienen media de \(x\) 9.0, media de \(y\) 7.50, \(r\) de 0.816 o 0.817 y la recta \(y = 3.0 + 0.5x\). Los gráficos cuentan otra cosa: el I es una nube aproximadamente lineal; el II, una curva; el III, una recta casi perfecta con un punto que tira de la pendiente; el IV, diez puntos en \(x = 8\) y uno solo en \(x = 19\) que fija la recta. Si solo leyeras \(r \approx 0.82\), ajustarías una recta en los cuatro casos, y en tres de ellos sería un mal resumen. Grafica siempre antes de confiar en el coeficiente.
Etapa 6: Relación fuerte con \(r \approx 0\)
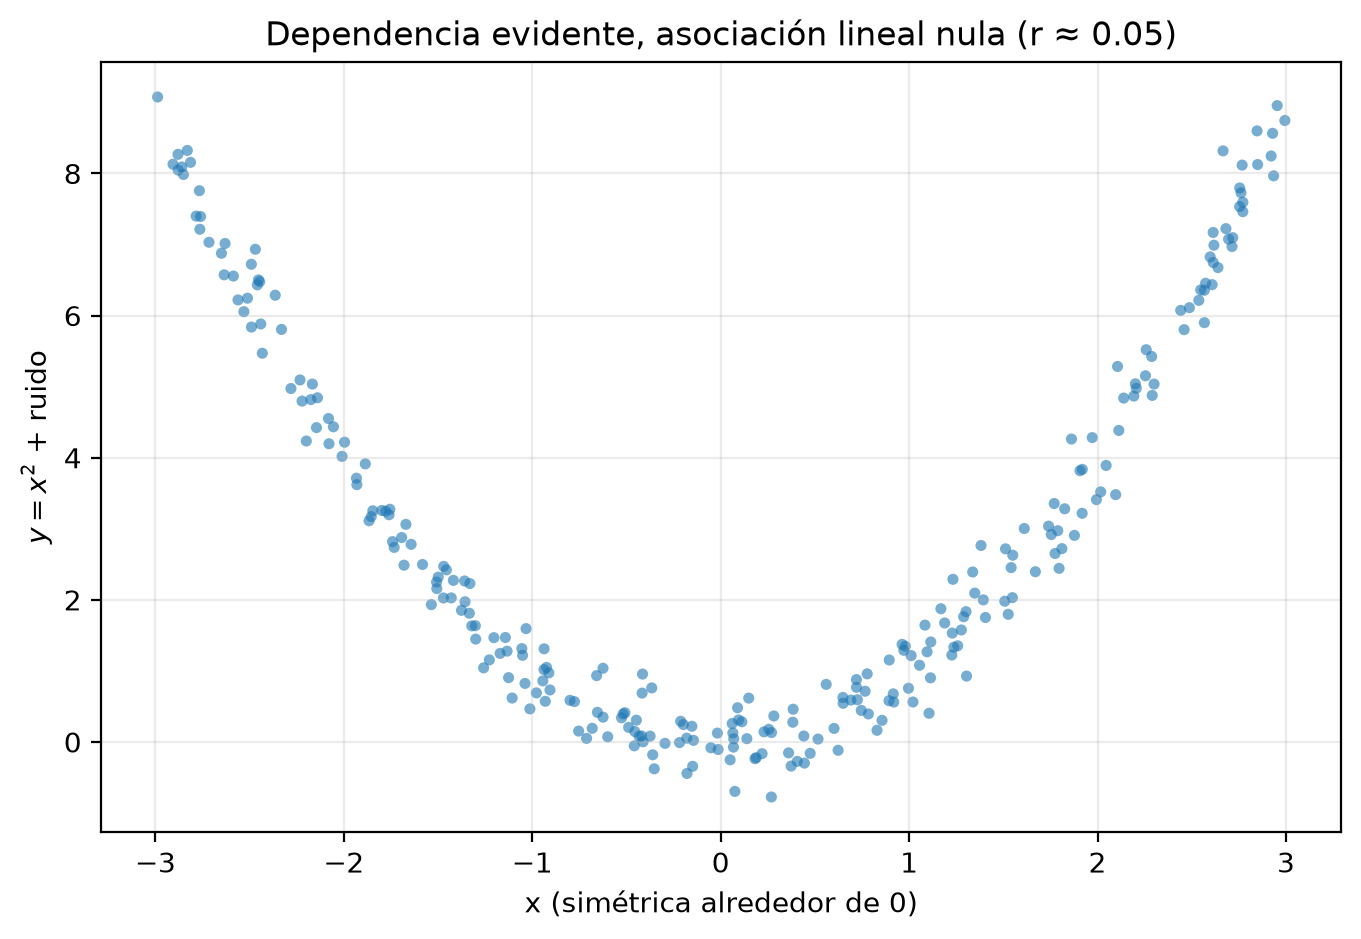
Pearson responde una pregunta estrecha: ¿hay tendencia lineal? Una dependencia clara, como una parábola, puede dar \(r\) cercano a 0 si \(x\) es simétrica alrededor de cero: la rama izquierda baja y la derecha sube, y se cancelan. Simulas 280 valores de \(x\) entre −3 y 3 con \(y = x^2\) más un ruido pequeño.
# Relación determinista no lineal + ruido pequeñorng_u = rng # mismo generador centralx_u = rng_u.uniform(-3.0, 3.0, size=280)y_u = x_u **2+ rng_u.normal(0.0, 0.35, size=x_u.size)r_u =float(np.corrcoef(x_u, y_u)[0, 1])print(f"r de Pearson (x vs x² + ruido) ≈ {r_u:.3f}")plt.figure(figsize=(8, 5))plt.scatter(x_u, y_u, s=16, alpha=0.6, edgecolors="none")plt.title(f"Dependencia evidente, asociación lineal nula (r ≈ {r_u:.2f})")plt.xlabel("x (simétrica alrededor de 0)")plt.ylabel(r"$y = x^2$+ ruido")plt.show()
r de Pearson (x vs x² + ruido) ≈ 0.046
La nube tiene forma de U, sin ambigüedad: \(y\) crece cuando \(|x|\) crece. Aun así, \(r = 0.046\), porque ninguna recta resume una U. Un \(r\) cercano a 0 no prueba independencia; prueba poca asociación lineal.
Un filtro de variables que descarte columnas con \(|r|\) bajo respecto al objetivo borraría esta señal. Spearman (etapa 7) tampoco la recupera, porque la U no es monótona: primero baja y después sube. Lo que funciona es mirar el gráfico y elegir una transformación (\(|x|\) o \(x^2\)) o un modelo no lineal.
Ejercicio
Calcula la correlación de Spearman entre x_u y y_u, y la de Pearson entre np.abs(x_u) y y_u. ¿Qué te dicen los dos números?
TipOrientaciones
Spearman da 0.038: también cerca de 0, porque solo capta relaciones monótonas. Pearson entre \(|x|\) y \(y\) da 0.961: al transformar \(x\) según la forma que muestra el gráfico, la relación se vuelve casi lineal.
Etapa 7: Spearman frente a Pearson
La correlación de Spearman (\(\rho\)) es Pearson calculado sobre los rangos, es decir, sobre el puesto de cada valor y no sobre su magnitud. Por eso:
capta relaciones monótonas aunque no sean lineales: que siempre crecen, o siempre decrecen, aunque la curva se acelere;
es más robusta a atípicos, porque un valor extremo solo puede ocupar el último puesto, mientras que en Pearson pesa por su distancia.
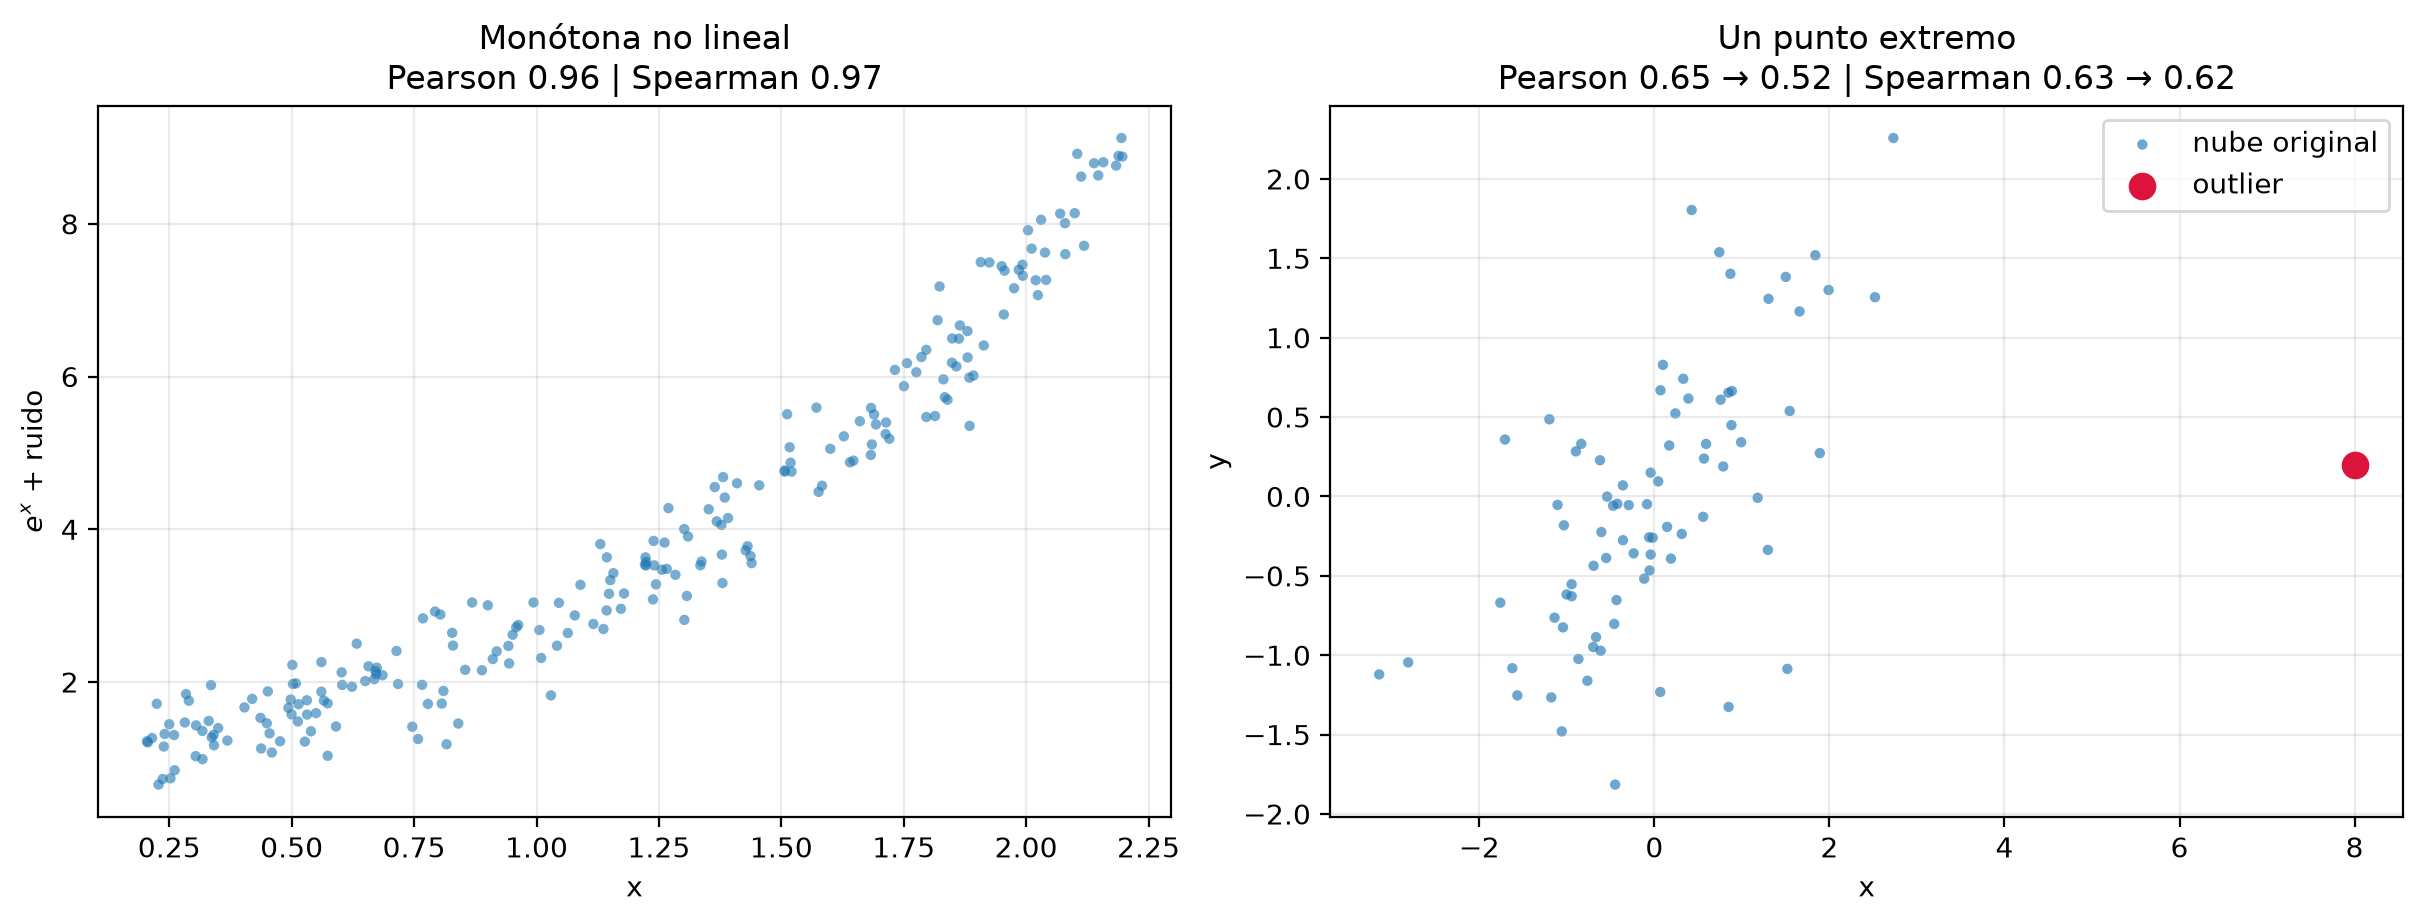
En pandas: df["a"].corr(df["b"], method="spearman"). Lo compruebas en dos casos: 220 puntos con \(y = e^x\) más ruido, y 80 puntos con una relación lineal moderada a los que agregas un punto extremo en (8, 0.2).
rng_s = rng # mismo generador central# (a) monótona no lineal: y = exp(x) + ruidox_m = rng_s.uniform(0.2, 2.2, size=220)y_m = np.exp(x_m) + rng_s.normal(0.0, 0.4, size=x_m.size)s_m = pd.Series(x_m)t_m = pd.Series(y_m)r_pear_m = s_m.corr(t_m, method="pearson")r_spear_m = s_m.corr(t_m, method="spearman")print("(a) monótona no lineal y = exp(x)")print(f" Pearson r = {r_pear_m:.3f}")print(f" Spearman ρ = {r_spear_m:.3f}")# (b) un par lineal + UN outlier extremo (la etapa siguiente repite el experimento con la recta ajustada)x_lin = rng_s.normal(0.0, 1.0, size=80)y_lin =0.55* x_lin + rng_s.normal(0.0, 0.7, size=80)x_out = np.append(x_lin, 8.0)y_out = np.append(y_lin, 0.2)r_pear_0 = pd.Series(x_lin).corr(pd.Series(y_lin), method="pearson")r_spear_0 = pd.Series(x_lin).corr(pd.Series(y_lin), method="spearman")r_pear_1 = pd.Series(x_out).corr(pd.Series(y_out), method="pearson")r_spear_1 = pd.Series(x_out).corr(pd.Series(y_out), method="spearman")print("(b) impacto de un outlier")print(f" sin outlier Pearson={r_pear_0:.3f} Spearman={r_spear_0:.3f}")print(f" con outlier Pearson={r_pear_1:.3f} Spearman={r_spear_1:.3f}")fig, axs = plt.subplots(1, 2, figsize=(12, 4.5), constrained_layout=True)axs[0].scatter(x_m, y_m, s=14, alpha=0.6, edgecolors="none")axs[0].set_title(f"Monótona no lineal\nPearson {r_pear_m:.2f} | Spearman {r_spear_m:.2f}")axs[0].set_xlabel("x")axs[0].set_ylabel(r"$e^{x}$+ ruido")axs[1].scatter(x_lin, y_lin, s=14, alpha=0.65, edgecolors="none", label="nube original")axs[1].scatter([8.0], [0.2], s=80, c="crimson", zorder=4, label="outlier")axs[1].set_title(f"Un punto extremo\nPearson {r_pear_0:.2f} → {r_pear_1:.2f} | Spearman {r_spear_0:.2f} → {r_spear_1:.2f}")axs[1].set_xlabel("x")axs[1].set_ylabel("y")axs[1].legend()plt.show()
(a) monótona no lineal  y = exp(x)
    Pearson  r = 0.956
    Spearman ρ = 0.971
(b) impacto de un outlier
    sin outlier  Pearson=0.649  Spearman=0.628
    con outlier  Pearson=0.523  Spearman=0.625
En el caso exponencial, la nube es creciente y curva: Pearson da 0.956 y Spearman 0.971. La diferencia es pequeña porque la curva es suave en ese rango, pero va en el sentido esperado: Spearman no penaliza la curvatura mientras la relación siga creciendo. En el caso del punto extremo, Pearson cae de 0.649 a 0.523 con un solo dato, y Spearman apenas pasa de 0.628 a 0.625.
Si la relación es monótona pero no lineal, o hay atípicos, Spearman es más fiel que un umbral de Pearson para filtrar variables. Si no es monótona, como la U de la etapa 6, ninguno de los dos sirve.
Etapa 8: Impacto de un atípico en \(r\)
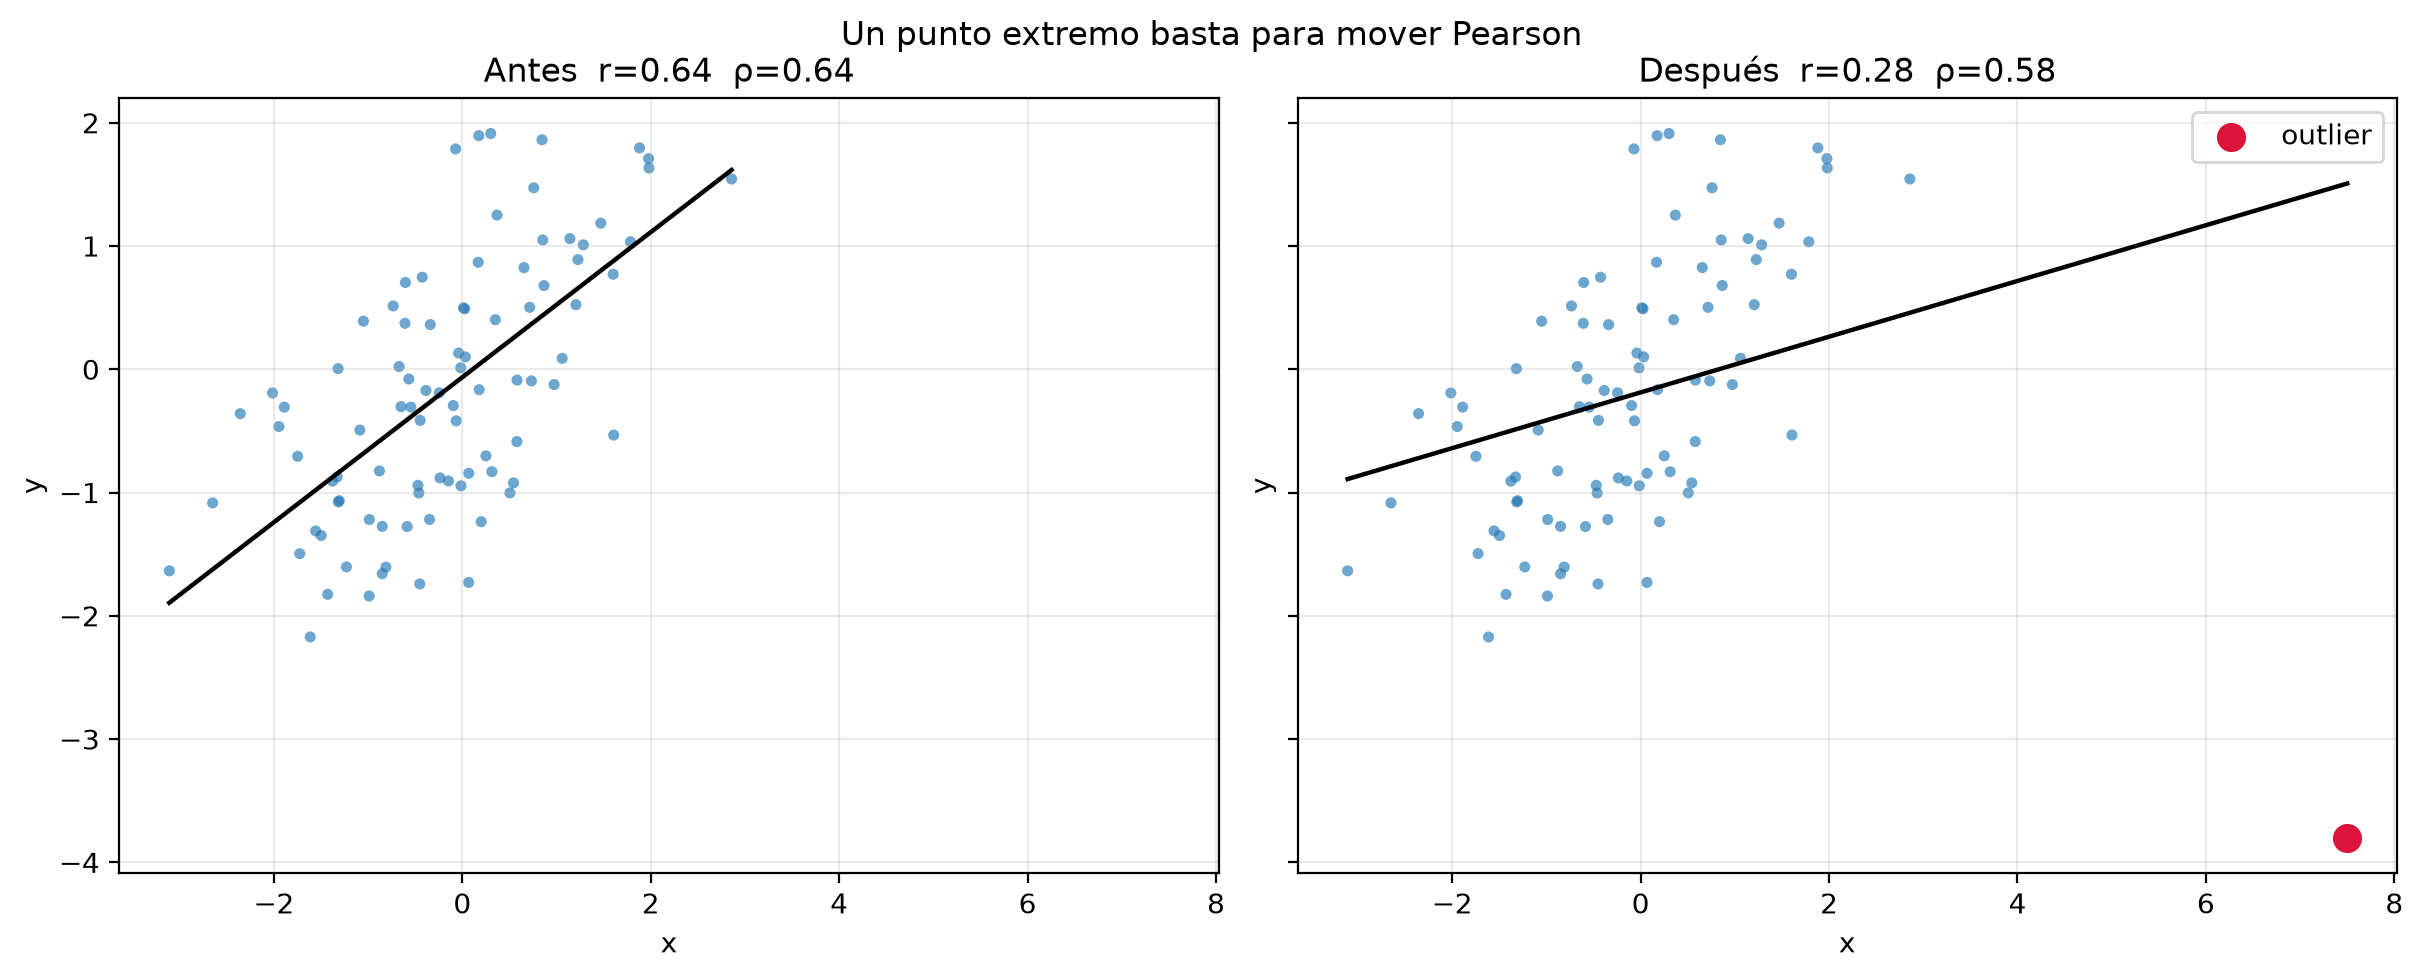
Un solo punto extremo puede crear una correlación de Pearson que no estaba o destruir una que sí estaba. Es la misma sensibilidad de la media y la desviación estándar de los capítulos 3 y 4, ahora en una medida de dos variables. Simulas 90 puntos con una relación lineal moderada y agregas uno en (7.5, −3.8), contrario a la tendencia; los dos paneles comparten ejes y muestran la recta ajustada.
Sin outlier: Pearson r=0.636 | Spearman ρ=0.636
Con outlier: Pearson r=0.283 | Spearman ρ=0.583
Cambio Pearson:  -0.353
Cambio Spearman: -0.053
Sin el atípico, Pearson y Spearman valen 0.636. Con él, Pearson cae a 0.283 (−0.353) y Spearman a 0.583 (−0.053): un dato entre 91 se llevó más de la mitad de la correlación de Pearson. En el panel derecho, la recta se aplana para acercarse al punto rojo. Una variable con colas pesadas puede inflar o apagar su \(|r|\) con el objetivo; antes de ordenar variables por Pearson, revisa los atípicos.
Etapa 9: Fuerza y dirección de la relación
La dirección es el signo de la asociación: positiva (suben juntas) o negativa (una sube y la otra baja). La fuerza es qué tan estrecha está la nube alrededor de la recta: \(|r|\) alto, nube delgada; \(|r|\) bajo, nube ancha.
\(|r|\)
Lectura orientativa
\(< 0.1\)
Nula o despreciable
\(0.1\)–\(0.3\)
Débil
\(0.3\)–\(0.5\)
Moderada
\(0.5\)–\(0.7\)
Considerable
\(0.7\)–\(0.9\)
Fuerte
\(> 0.9\)
Muy fuerte
Estos umbrales no viajan entre disciplinas. En física o metrología, \(|r| = 0.9\) puede ser poco (se esperan relaciones casi deterministas); en ciencias sociales, \(|r| = 0.4\) ya puede ser relevante. Usa la tabla para comunicar, no como regla. Una correlación débil tampoco significa inutilidad: puede haber señal no lineal o interacciones.
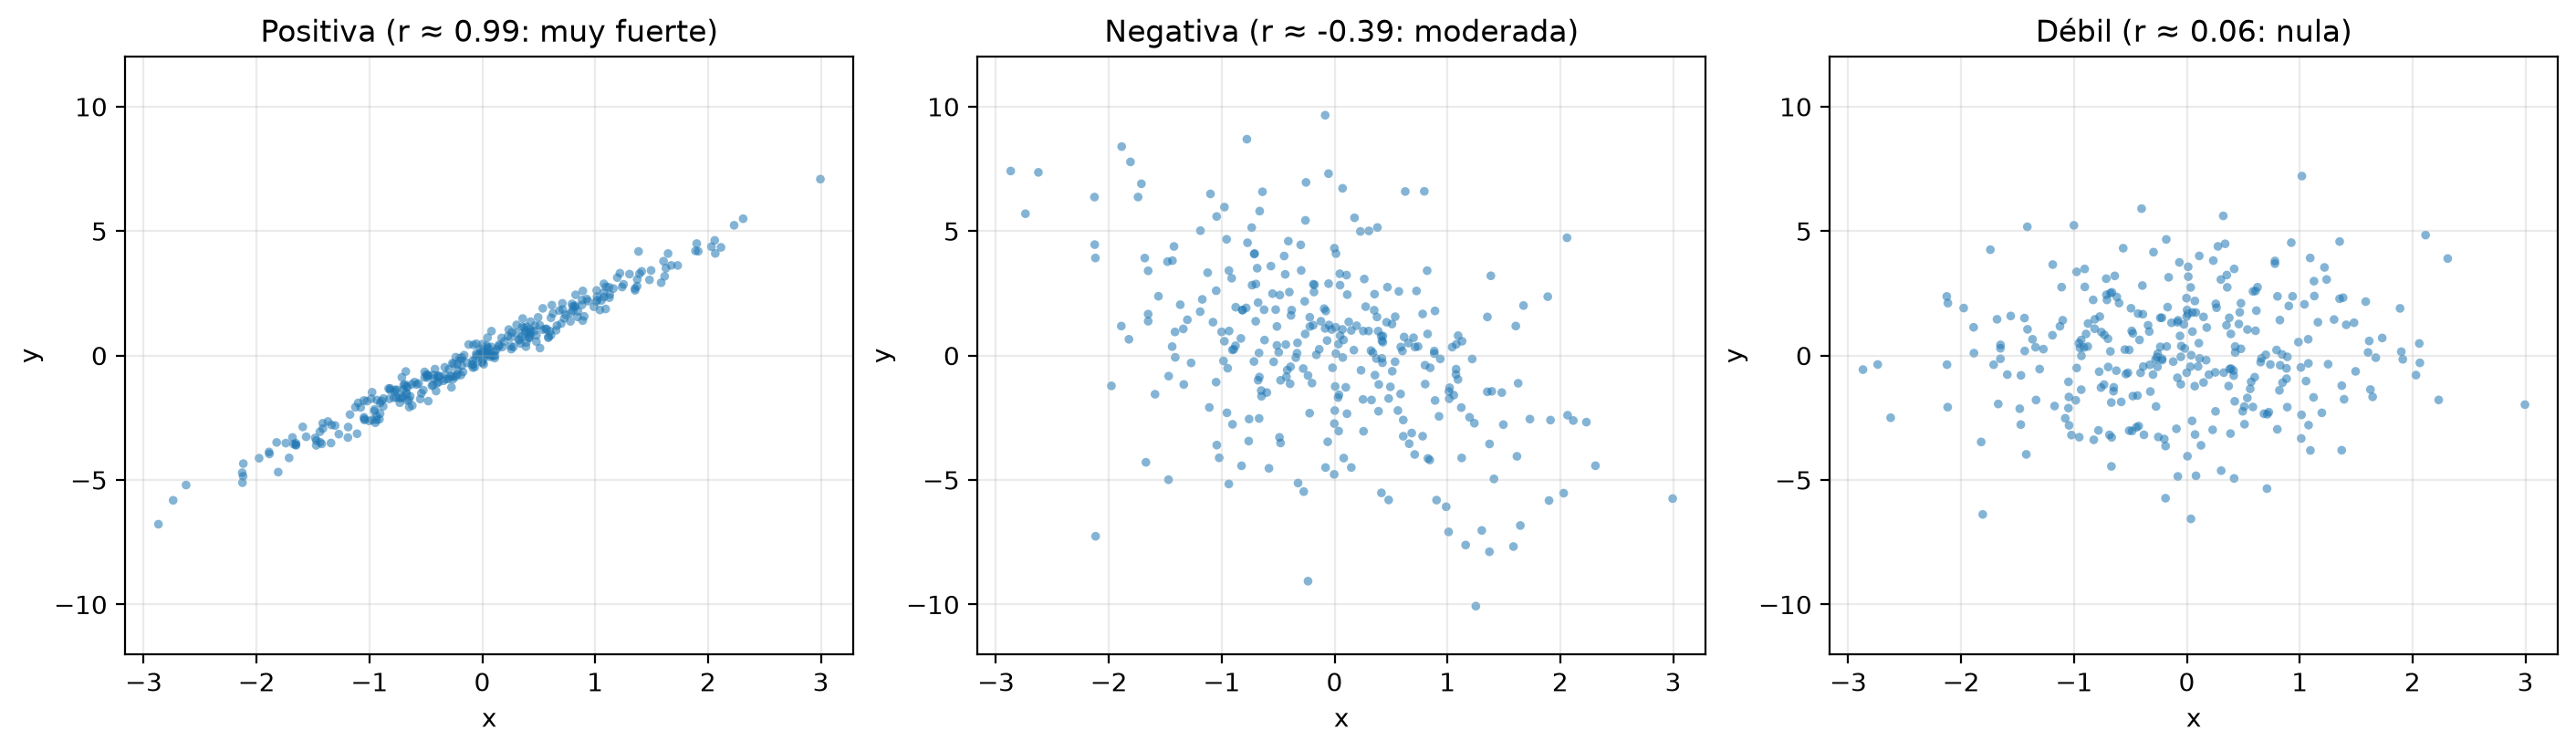
Generas tres nubes de 300 puntos con el mismo \(x\): una positiva con poco ruido, una negativa con mucho ruido y una casi plana. Los tres paneles comparten el eje vertical.
mue =300x0 = rng.normal(size=mue)# Positiva muy fuertey_pos =2.2* x0 + rng.normal(scale=0.35, size=mue)# Negativa moderaday_neg =-1.4* x0 + rng.normal(scale=3.0, size=mue)# Débil (mucho ruido)y_weak =0.15* x0 + rng.normal(scale=2.2, size=mue)def pearson(a, b):returnfloat(np.corrcoef(a, b)[0, 1])def lectura_r(r):"""Lectura orientativa de |r| según la tabla de esta etapa."""for limite, texto in [(0.1, "nula"), (0.3, "débil"), (0.5, "moderada"), (0.7, "considerable"), (0.9, "fuerte")]:ifabs(r) < limite:return textoreturn"muy fuerte"r_pos, r_neg, r_weak = pearson(x0, y_pos), pearson(x0, y_neg), pearson(x0, y_weak)fig, axs = plt.subplots(1, 3, figsize=(14, 4), constrained_layout=True)axs[0].scatter(x0, y_pos, s=12, alpha=0.55, edgecolors="none")axs[0].set_title(f"Positiva (r ≈ {r_pos:.2f}: {lectura_r(r_pos)})")axs[1].scatter(x0, y_neg, s=12, alpha=0.55, edgecolors="none")axs[1].set_title(f"Negativa (r ≈ {r_neg:.2f}: {lectura_r(r_neg)})")axs[2].scatter(x0, y_weak, s=12, alpha=0.55, edgecolors="none")axs[2].set_title(f"Débil (r ≈ {r_weak:.2f}: {lectura_r(r_weak)})")for ax in axs: ax.set_xlabel("x") ax.set_ylabel("y") ax.set_ylim(-12, 12) # misma escala: el ancho de la nube se compara a simple vistaplt.show()
La nube positiva (\(r = 0.99\), muy fuerte) es casi una recta. La negativa (\(r = -0.39\), moderada) baja, pero ocupa casi todo el alto del panel. La tercera (\(r = 0.06\)) es un manchón donde una recta explicaría alrededor del 0.4% de la varianza, y la tabla la clasifica como nula aunque se generó con una pendiente real de 0.15: con tanto ruido, 300 puntos apenas la registran. Las tres tienen una pendiente real distinta de cero; la fuerza la decide el ruido, no la pendiente.
Con una relación débil, una línea base lineal explica poco y la señal se pierde con facilidad entre otras variables ruidosas; en k vecinos más cercanos o en clustering, una variable así aporta poca separación entre grupos.
Etapa 10: Matriz de correlación
La matriz de correlación reúne en una tabla cuadrada la correlación de Pearson de cada par de variables: el elemento \((i, j)\) es la correlación entre la variable \(i\) y la \(j\), la diagonal vale 1 y la matriz es simétrica. Buscas valores altos en valor absoluto fuera de la diagonal y distingues dos familias: entre predictores, sugieren redundancia; entre un predictor y el objetivo, sugieren señal.
Calculas la matriz del dataset y ordenas los 15 pares por \(|r|\).
R = df.corr(numeric_only=True, method="pearson")R
horas_lectura_semana
horas_practica_semana
horas_sueno_dia
indice_distraccion
puntuacion_examen
ruido_control
horas_lectura_semana
1.000000
0.749473
0.005526
-0.036692
0.841586
-0.037707
horas_practica_semana
0.749473
1.000000
0.009757
-0.027870
0.813026
-0.042926
horas_sueno_dia
0.005526
0.009757
1.000000
-0.035646
0.128254
-0.012366
indice_distraccion
-0.036692
-0.027870
-0.035646
1.000000
-0.230536
0.004642
puntuacion_examen
0.841586
0.813026
0.128254
-0.230536
1.000000
-0.048453
ruido_control
-0.037707
-0.042926
-0.012366
0.004642
-0.048453
1.000000
# Análisis de pares relevantes (fuera de diagonal, por magnitud)vars_ = R.columns.to_list()pares_corr = []for i, vi inenumerate(vars_):for j inrange(i +1, len(vars_)): vj = vars_[j] pares_corr.append((vi, vj, float(R.loc[vi, vj])))pares_df = pd.DataFrame(pares_corr, columns=["var_i", "var_j", "r"]).sort_values("r", key=lambda s: s.abs(), ascending=False)pares_df.head(10)
var_i
var_j
r
3
horas_lectura_semana
puntuacion_examen
0.841586
7
horas_practica_semana
puntuacion_examen
0.813026
0
horas_lectura_semana
horas_practica_semana
0.749473
12
indice_distraccion
puntuacion_examen
-0.230536
10
horas_sueno_dia
puntuacion_examen
0.128254
14
puntuacion_examen
ruido_control
-0.048453
8
horas_practica_semana
ruido_control
-0.042926
4
horas_lectura_semana
ruido_control
-0.037707
2
horas_lectura_semana
indice_distraccion
-0.036692
9
horas_sueno_dia
indice_distraccion
-0.035646
Los tres pares más fuertes son lectura–puntuación (0.842), práctica–puntuación (0.813) y lectura–práctica (0.749). Después hay un salto: distracción–puntuación (−0.231) y sueño–puntuación (0.128) son débiles, y todos los demás pares quedan por debajo de 0.05 en valor absoluto. Es exactamente lo que se construyó en la etapa 1: lectura y práctica asociadas entre sí y con la puntuación, sueño y distracción con efectos pequeños, y ruido_control sin relación con nada.
Etapa 11: Heatmap de correlación
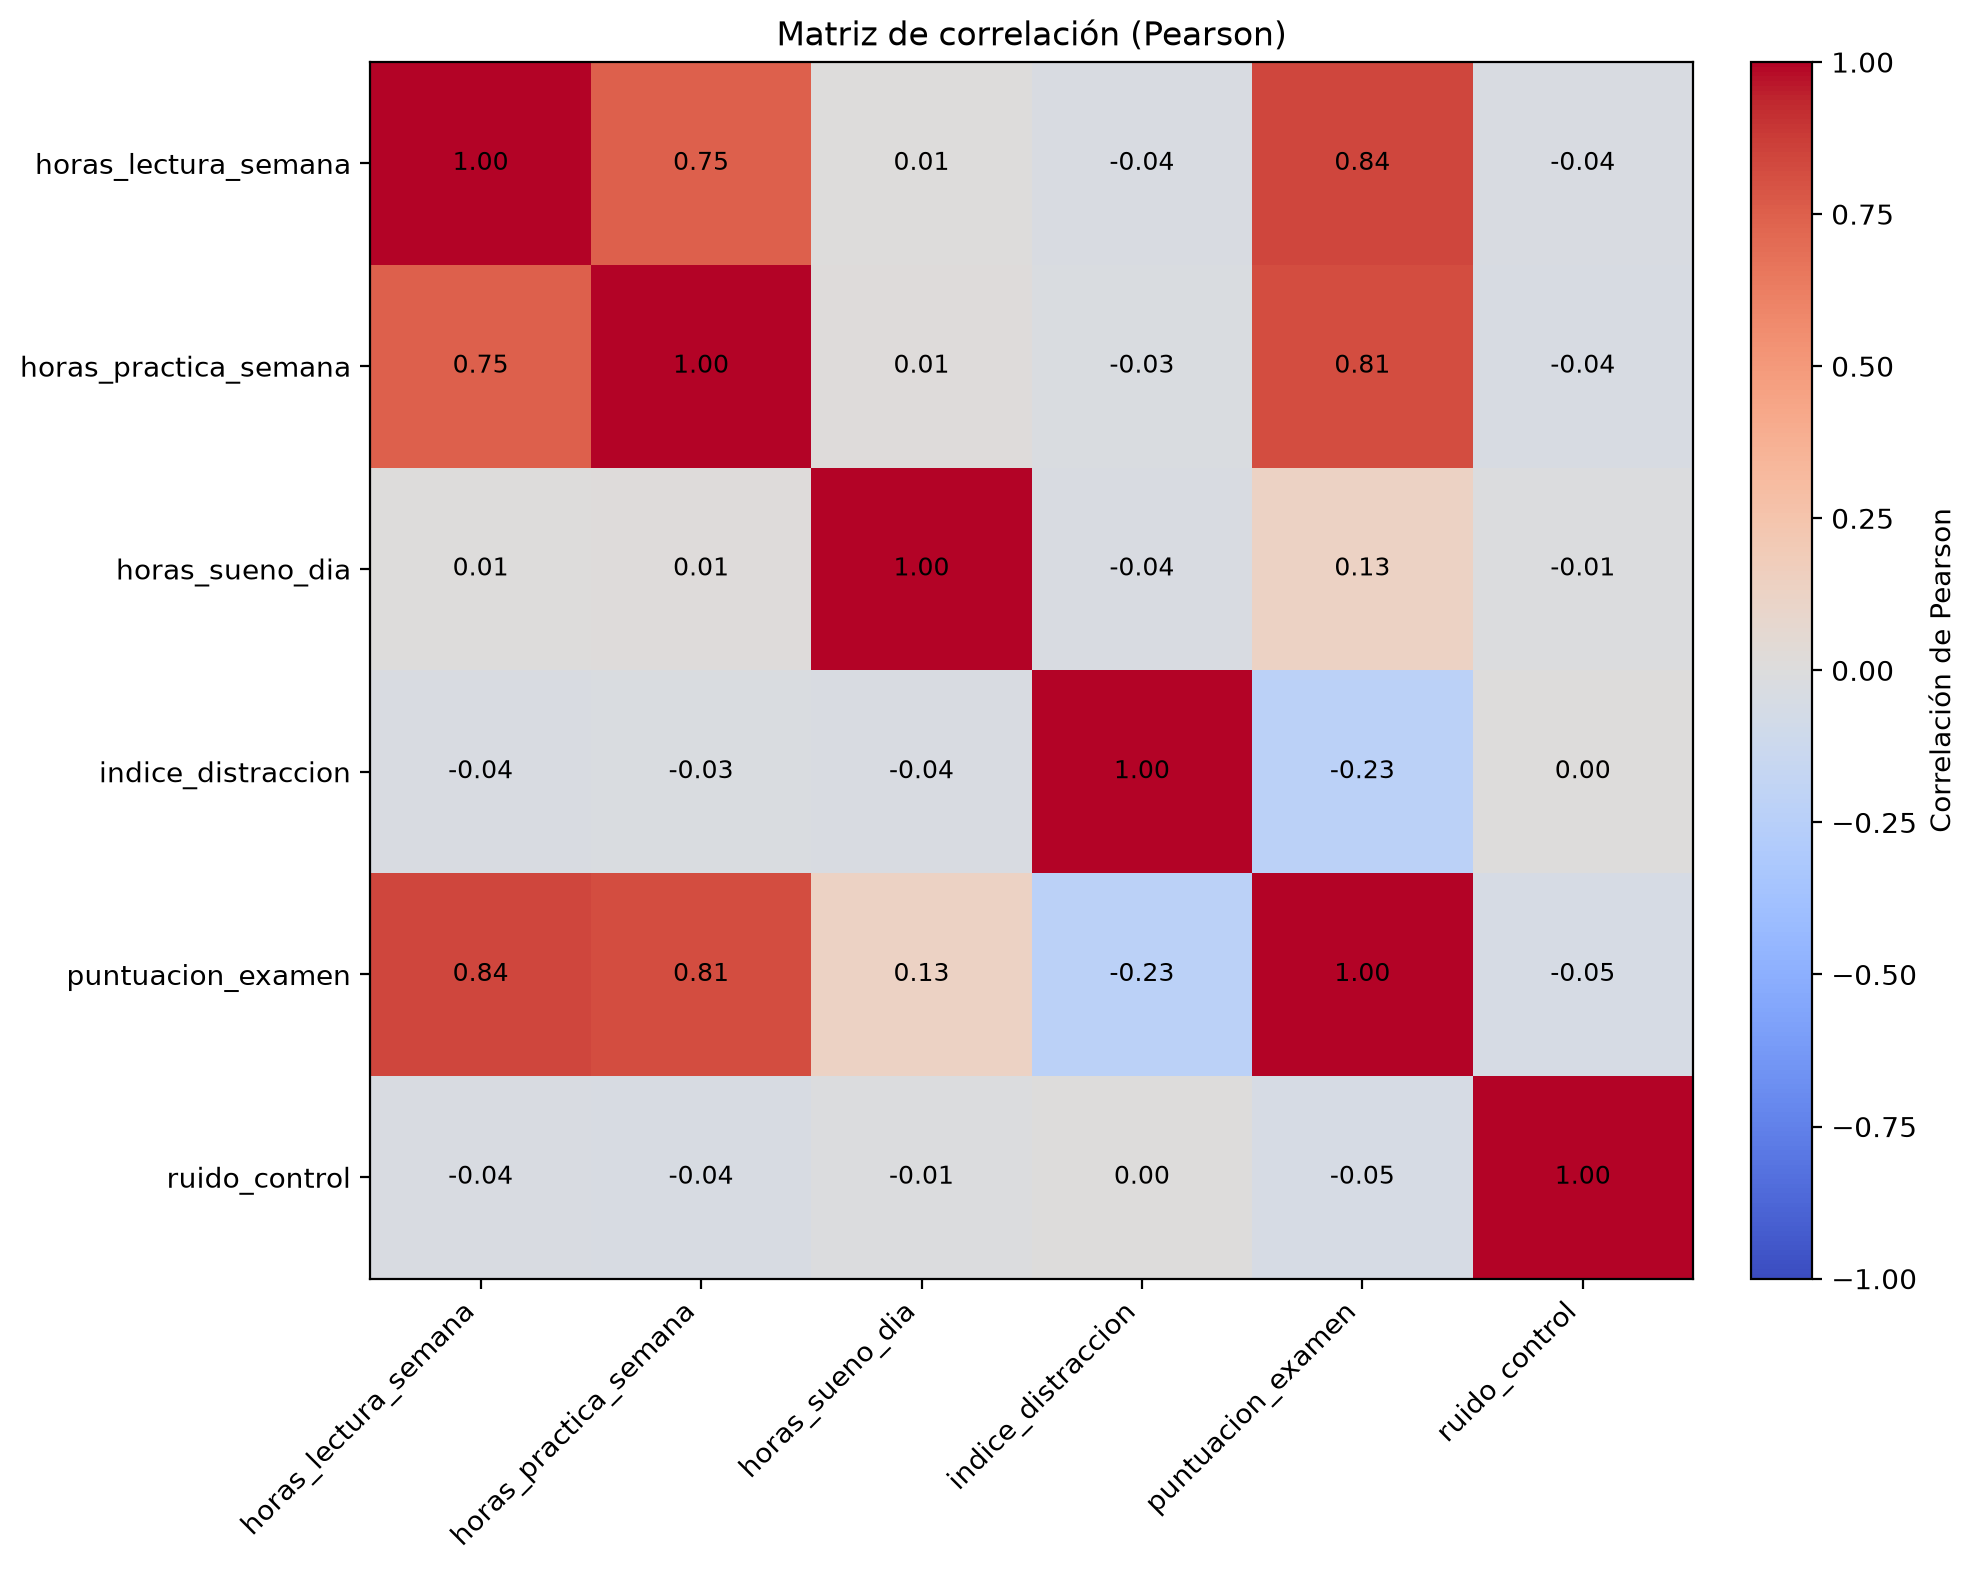
Un heatmap convierte la matriz en una imagen donde el color codifica la correlación. Para correlaciones se usa un mapa divergente, centrado en 0, con los límites fijos en −1 y 1, para distinguir el signo y no exagerar diferencias pequeñas. Cada celda lleva además su valor escrito, para no depender solo del color.
Al leerlo, ignora la diagonal (cada variable consigo misma), busca pares con \(|r|\) alto fuera de ella y separa las relaciones entre predictores (redundancia) de las relaciones con el objetivo (señal, sin garantía de causa).
def plot_corr_heatmap(corr: pd.DataFrame, title: str="Matriz de correlación (Pearson)"): labels = corr.columns.to_list() M = corr.to_numpy() fig, ax = plt.subplots(figsize=(10, 8))# Mapa divergente centrado en 0 im = ax.imshow(M, cmap="coolwarm", vmin=-1, vmax=1, aspect="auto") ax.grid(False) # la cuadrícula global cruzaría las celdas ax.set_xticks(np.arange(len(labels))) ax.set_yticks(np.arange(len(labels))) ax.set_xticklabels(labels, rotation=45, ha="right") ax.set_yticklabels(labels) ax.set_title(title)# Anotaciones numéricasfor i inrange(M.shape[0]):for j inrange(M.shape[1]): ax.text(j, i, f"{M[i, j]:.2f}", ha="center", va="center", color="black", fontsize=9) cbar = fig.colorbar(im, ax=ax, fraction=0.046, pad=0.04) cbar.set_label("Correlación de Pearson") plt.tight_layout() plt.show()plot_corr_heatmap(R)
Los colores intensos fuera de la diagonal forman un bloque: lectura, práctica y puntuación, con 0.75, 0.84 y 0.81. Sueño y distracción tienen tonos tenues frente a la puntuación (0.13 y −0.23), y la fila de ruido_control es neutra de punta a punta. Un bloque intenso entre variables de entrada, como lectura y práctica, es la señal para preguntarte si el modelo necesita regularización, reducción de dimensionalidad o una decisión explícita de selección.
Etapa 12: Multicolinealidad
La multicolinealidad ocurre cuando dos o más predictores están fuertemente correlacionados entre sí. No es un error del dataset: puede ser una propiedad natural, como dos medidas del mismo hábito.
En una regresión lineal donde lees los coeficientes como efectos parciales, los predictores colineales compiten por explicar la misma variación. Los coeficientes pueden volverse inestables ante pequeños cambios de los datos, cambiar mucho al agregar o quitar una variable y tener una incertidumbre grande. La predicción puede seguir siendo útil; lo que se vuelve frágil es la atribución: cuánto aporta cada variable por separado.
Qué hacer depende del objetivo:
Predicción: regularización (Ridge o Lasso), reducción de dimensionalidad, o conservar ambas variables si la validación lo respalda.
Interpretación de coeficientes: eliminar o combinar las variables redundantes, o construir un índice.
En el dataset, lectura y práctica son el caso típico.
r_lect_pract = df["horas_lectura_semana"].corr(df["horas_practica_semana"])print(f"r(lectura, práctica) = {r_lect_pract:.3f}")plt.figure(figsize=(7, 5))plt.scatter(df["horas_lectura_semana"], df["horas_practica_semana"], s=16, alpha=0.55, edgecolors="none")plt.title("Ejemplo de predictores fuertemente asociados (riesgo de multicolinealidad)")plt.xlabel("horas_lectura_semana")plt.ylabel("horas_practica_semana")plt.show()
r(lectura, práctica) = 0.749
La correlación entre lectura y práctica es 0.749 (\(r^2 = 0.56\)): la nube se alarga en una dirección, porque la práctica es casi una función lineal de la lectura más ruido. Las dos aportan información sobre la puntuación, pero buena parte de esa información es compartida.
Ejercicio
Ajusta por mínimos cuadrados (np.linalg.lstsq) la puntuación con solo la lectura, y luego con lectura y práctica. Compara el coeficiente de la lectura en los dos modelos.
Repite el segundo ajuste en muchas muestras bootstrap (filas tomadas al azar con reemplazo) y compara la variabilidad del coeficiente de la lectura con la del primer modelo.
TipOrientaciones
Con solo la lectura, su coeficiente es 6.52; con la práctica al lado, baja a 4.11, y la práctica recibe 3.50. Los datos se generaron con 4.2 y 3.1: el primer modelo atribuye a la lectura parte del efecto de la práctica, porque una arrastra a la otra (\(6.52 \approx 4.2 + 0.75 \times 3.1 = 6.53\)).
Con 500 muestras bootstrap (generador np.random.default_rng(SEMILLA)), la desviación del coeficiente de la lectura pasa de 0.173 a 0.226 (un 31% más) al incluir la práctica, y los dos coeficientes quedan correlacionados en −0.76: cuando uno sube, el otro baja. Esa es la inestabilidad que produce la colinealidad, aquí con \(r = 0.75\); con correlaciones más altas crece mucho más.
Etapa 13: Correlación frente a causalidad
Una correlación alta no implica causalidad. Un diagrama muy lineal prueba co-movimiento bajo las condiciones del dataset, no un mecanismo. Establecer una causa exige algo más: un diseño experimental, el control de los factores de confusión o supuestos explícitos que una tabla de números no garantiza.
Causas frecuentes de correlación sin relación causal directa:
Variable de confusión: dos variables se mueven juntas porque ambas dependen de un tercer factor que no está en el gráfico.
Asociación espuria: un patrón que aparece en una muestra, o en series con tendencia, sin mecanismo estable.
Relación indirecta:\(A\) influye en \(B\) y \(B\) en \(C\), así que \(A\) y \(C\) correlacionan aunque no haya un camino directo entre ellas.
En proyectos de machine learning, esto se traduce en tres errores: atribuir a una variable un “efecto” solo porque correlaciona con el objetivo, intervenir (en un producto, un precio, una política) a partir de una asociación espuria, e ignorar la fuga de información, que infla correlaciones entre entrenamiento y evaluación.
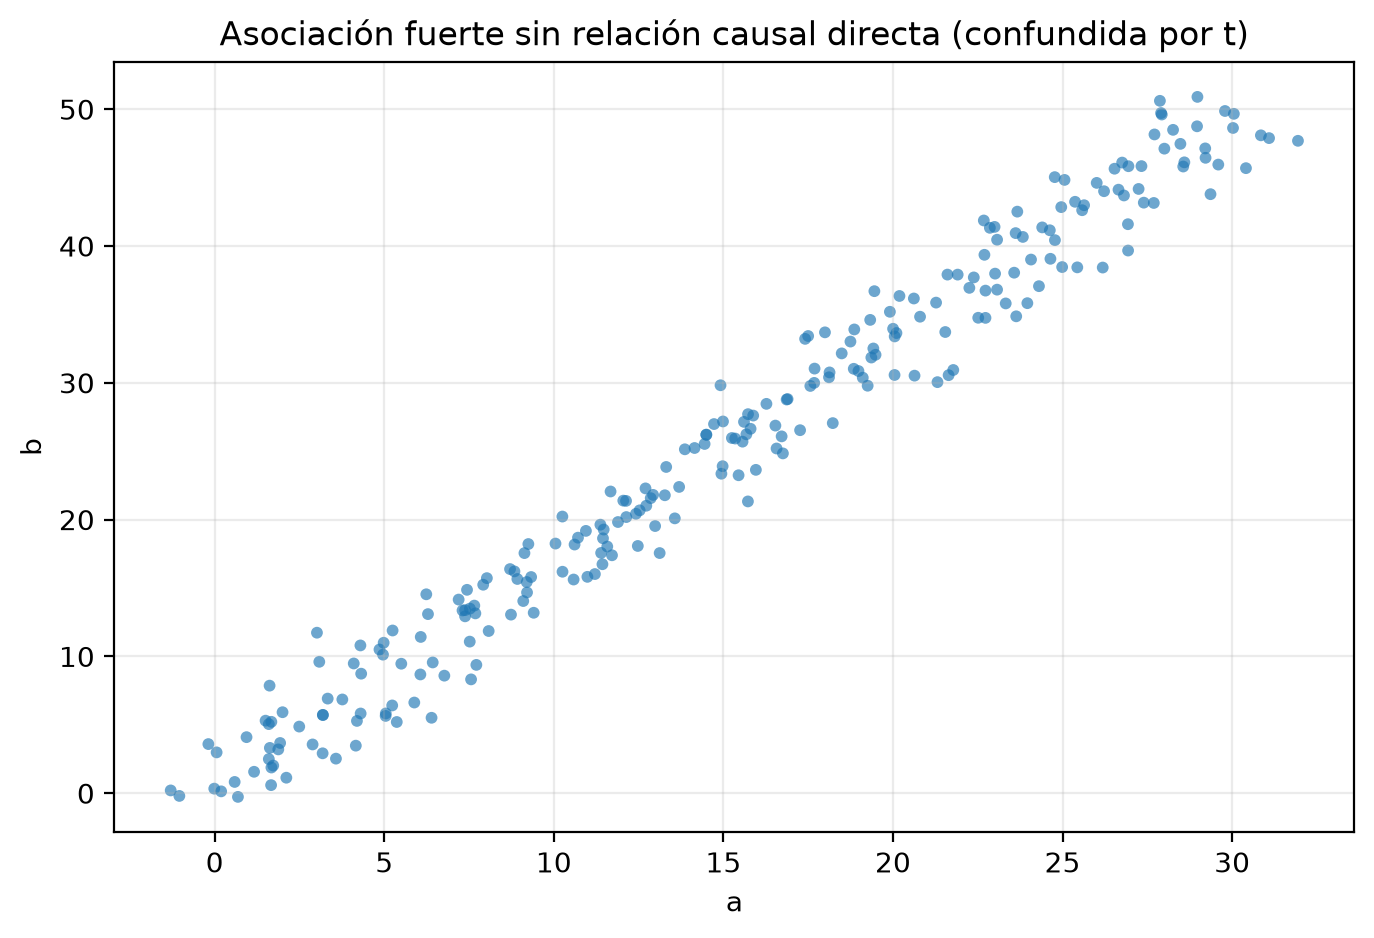
Simulas dos variables, a y b, que crecen con un tiempo \(t\) oculto sin que ninguna actúe sobre la otra.
rng_c = rng # mismo generador centralt = np.linspace(0, 10, 250)a =3* t + rng_c.normal(scale=1.2, size=t.size)b =5* t + rng_c.normal(scale=1.2, size=t.size)r_spur =float(np.corrcoef(a, b)[0, 1])print(f"Correlación espuria (por variable oculta t): r ≈ {r_spur:.3f}")plt.figure(figsize=(8, 5))plt.scatter(a, b, s=18, alpha=0.65, edgecolors="none")plt.title("Asociación fuerte sin relación causal directa (confundida por t)")plt.xlabel("a")plt.ylabel("b")plt.show()
Correlación espuria (por variable oculta t): r ≈ 0.987
La correlación entre a y b es 0.987, y el gráfico parece una recta casi perfecta. Sin embargo, ninguna causa a la otra: las dos dependen de \(t\). Si manipularas a esperando cambiar b, no pasaría nada. Un modelo puede aprovechar esa correlación para predecir mientras \(t\) siga actuando igual; eso no la convierte en una explicación válida para decidir.
Ejercicio
Calcula la correlación de a y de b con t, y después la correlación entre los residuos de a y de b una vez que les quitas la tendencia lineal en t (ajusta cada una contra t con np.polyfit y resta la recta).
TipOrientaciones
a y b correlacionan con t en 0.990 y 0.997. La correlación entre sus residuos es 0.046: una vez que descuentas \(t\), no queda prácticamente ninguna relación. Esa es la idea de la correlación parcial, y la razón por la que un experimento aleatorizado (que rompe la dependencia con los factores ocultos) apoya la causalidad mejor que un diagrama observacional.
Etapa 14: Integración con machine learning
La correlación te ayuda a detectar redundancia lineal entre variables. Si dos miden casi lo mismo, puedes conservar una, construir un índice o regularizar para estabilizar los coeficientes. Pero la selección no debería basarse solo en correlaciones: también cuentan el costo de medir cada variable, el riesgo de fuga y el desempeño fuera de la muestra (capítulo 15).
Regresión lineal y modelos interpretables: la redundancia fuerte complica la lectura de los coeficientes y los vuelve sensibles al muestreo.
k vecinos más cercanos y métodos por distancias: variables redundantes cuentan dos veces la misma información en la distancia, y las escalas distintas la distorsionan.
Clustering: un bloque de variables correlacionadas puede dominar la formación de grupos.
PCA: construye variables nuevas, combinaciones lineales de las originales, que no están correlacionadas entre sí y concentran la varianza en menos dimensiones; es útil cuando hay muchas variables correlacionadas.
Un modelo puede aprovechar correlaciones porque reducen su error aunque la estructura causal sea otra. En aplicaciones sensibles, separa el desempeño predictivo (validado con rigor) de las explicaciones causales (que exigen diseño y conocimiento del dominio).
Como ejercicio de conexión, ordenas las variables por \(|r|\) con la puntuación. No es una definición general de importancia, solo una lectura lineal.
target ="puntuacion_examen"features = [c for c in df.columns if c != target]imp_lineal = pd.Series({f: abs(df[f].corr(df[target])) for f in features}, name="|r| con objetivo").sort_values( ascending=False)imp_lineal.to_frame()
|r| con objetivo
horas_lectura_semana
0.841586
horas_practica_semana
0.813026
indice_distraccion
0.230536
horas_sueno_dia
0.128254
ruido_control
0.048453
El orden es lectura (0.842), práctica (0.813), distracción (0.231), sueño (0.128) y ruido (0.048). Coincide con la construcción de la etapa 1, pero el ranking no lo dice todo: lectura y práctica correlacionan 0.749 entre sí, así que buena parte de su señal es la misma, y en la ecuación que generó los datos el sueño pesa 2.0 por hora y la distracción −1.8 por punto. Un ranking por \(|r|\) mira cada variable sola; un modelo las mira juntas.
Errores que conviene nombrar
Asumir causalidad a partir de una correlación o de un diagrama convincente. En la etapa 13, \(r = 0.987\) sin relación causal entre a y b.
Confiar en \(r\) sin mirar el gráfico. Los cuatro conjuntos de Anscombe tienen el mismo \(r\) y formas opuestas.
Leer \(r \approx 0\) como independencia. La U de la etapa 6 tiene \(r = 0.046\) y una dependencia evidente.
Ignorar un atípico. En la etapa 8, un solo punto bajó Pearson de 0.636 a 0.283.
Comparar covarianzas de pares con unidades distintas. Para comparar fuerzas está la correlación.
Ignorar la multicolinealidad cuando vas a interpretar coeficientes. Los coeficientes se reparten el efecto compartido y se vuelven inestables.
Descartar variables solo por baja correlación lineal con el objetivo. Pueden aportar en modelos no lineales, como los árboles, o en interacción con otras.
5.6 Guía rápida: ¿qué medida usar?
Situación
Qué reportar
Justificación
Signo de una asociación en la misma escala
Covarianza
Indica dirección, no magnitud comparable.
Fuerza lineal entre dos numéricas
Correlación de Pearson
Está acotada y no depende de las unidades.
Cuánto de la varianza se comparte linealmente
\(r^2\)
Traduce \(r\) a una proporción; puente con la regresión.
Relación monótona no lineal, o con atípicos
Spearman
Pearson sobre los rangos; más robusta.
Relación no monótona (por ejemplo, en U)
Gráfico y transformación
Pearson y Spearman dan cerca de 0.
Mismo \(r\), duda sobre la forma
Diagrama de dispersión
El coeficiente no sustituye al gráfico (Anscombe).
Varias variables a la vez
Matriz y heatmap
Muestran los bloques redundantes.
Predictores muy alineados
Diagnóstico de multicolinealidad
Afecta la interpretación y la estabilidad de los coeficientes.
Relación alta y decisión de negocio
No inferir causa
Hace falta diseño, dominio y validación.
5.7 Preguntas de comprensión
Vas a entregar a un cliente un modelo interpretable (con coeficientes legibles) que usa horas_lectura_semana y horas_practica_semana. ¿Qué harías con ese par? ¿Cambia tu respuesta si el objetivo fuera solo predecir?
¿Por qué el cuarteto de Anscombe es un argumento para graficar siempre antes de reportar un \(r\)?
Una variable tiene \(r = 0.02\) con el objetivo. ¿Puedes eliminarla del modelo con seguridad?
En un clustering exploratorio, el heatmap muestra un bloque de cinco variables de entrada con correlaciones de 0.9 entre sí. ¿Qué riesgo tiene usarlas todas tal cual?
Dos indicadores de una empresa correlacionan en 0.9. ¿Qué evidencia, además del número, necesitarías para decidir que cambiar uno cambiará el otro?
TipOrientaciones
Con \(r = 0.75\) entre ellas, sus coeficientes se reparten el efecto compartido y cambian al quitar una (6.52 frente a 4.11 para la lectura en el ejercicio de la etapa 12). Para interpretar, combínalas en un índice o quédate con una y explica la decisión. Si solo importa predecir, puedes conservar ambas, con regularización y validación cruzada.
Porque los cuatro conjuntos tienen \(r\) de 0.816 o 0.817 y la misma recta, y solo uno es una nube lineal. El número no distingue una curva, un atípico que fija la recta o un grupo vertical.
No. Un \(r\) bajo descarta una relación lineal, no cualquier relación: la U de la etapa 6 tenía \(r = 0.046\). Mira el gráfico, prueba transformaciones o deja que un modelo no lineal la evalúe.
Que el bloque domine las distancias: las cinco variables cuentan casi la misma información cinco veces, y los grupos reflejarán sobre todo ese bloque. Conviene quedarse con una, combinarlas o aplicar PCA antes de agrupar.
Un mecanismo plausible en el dominio, el control de factores que afecten a los dos (como el tiempo en la etapa 13) y, si es posible, un experimento o una intervención controlada. La correlación sola es compatible con una causa común.
5.8 Referencias para profundizar
Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. El cuarteto de la etapa 5.
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. El origen de la correlación por rangos.
James, G., Witten, D., Hastie, T. y Tibshirani, R. (2021). An Introduction to Statistical Learning (2.ª ed.). Springer. Capítulo 3: la colinealidad en la regresión lineal y su efecto sobre los coeficientes.
Pearl, J., Glymour, M. y Jewell, N. P. (2016). Causal Inference in Statistics: A Primer. Wiley. Factores de confusión y por qué la correlación no basta para establecer una causa.
5.9 Lo que debes llevarte de este capítulo
Una correlación resume cómo se mueven dos variables en línea recta, y nada más: no dice si la relación es curva, si un punto la fabrica ni si una variable causa la otra.
La covarianza da el signo y depende de las unidades; Pearson la estandariza: lectura y puntuación correlacionan 0.842 y comparten el 70.8% de su varianza.
El mismo \(r\) puede esconder formas opuestas (Anscombe, \(r \approx 0.82\) en los cuatro conjuntos), y \(r \approx 0\) puede esconder una dependencia clara (la U, \(r = 0.046\)).
Un solo atípico bajó Pearson de 0.636 a 0.283; Spearman, que usa rangos, pasó de 0.636 a 0.583. Spearman capta relaciones monótonas, no las que suben y bajan.
La matriz y el heatmap muestran los bloques redundantes: lectura y práctica correlacionan 0.749 entre sí.
La multicolinealidad no impide predecir, pero vuelve inestables los coeficientes: con la práctica en el modelo, el de la lectura pasa de 6.52 a 4.11.
Dos variables que dependen de un factor oculto pueden correlacionar 0.987 sin que ninguna cause la otra.
5.10 Puente hacia los siguientes capítulos
Este capítulo preguntó cómo se mueven dos o más variables juntas. En el capítulo 6 cambias de mirada: cada fila se lee como un vector en \(\mathbb{R}^D\) y comparas observaciones con el producto interno, la norma, la distancia y el coseno, que es la base de los métodos por distancias de este capítulo. El \(r^2\) reaparece en el capítulo 13 como bondad de ajuste de una regresión.