def graficar_faltantes(faltantes_crudo, faltantes_reales, titulo):
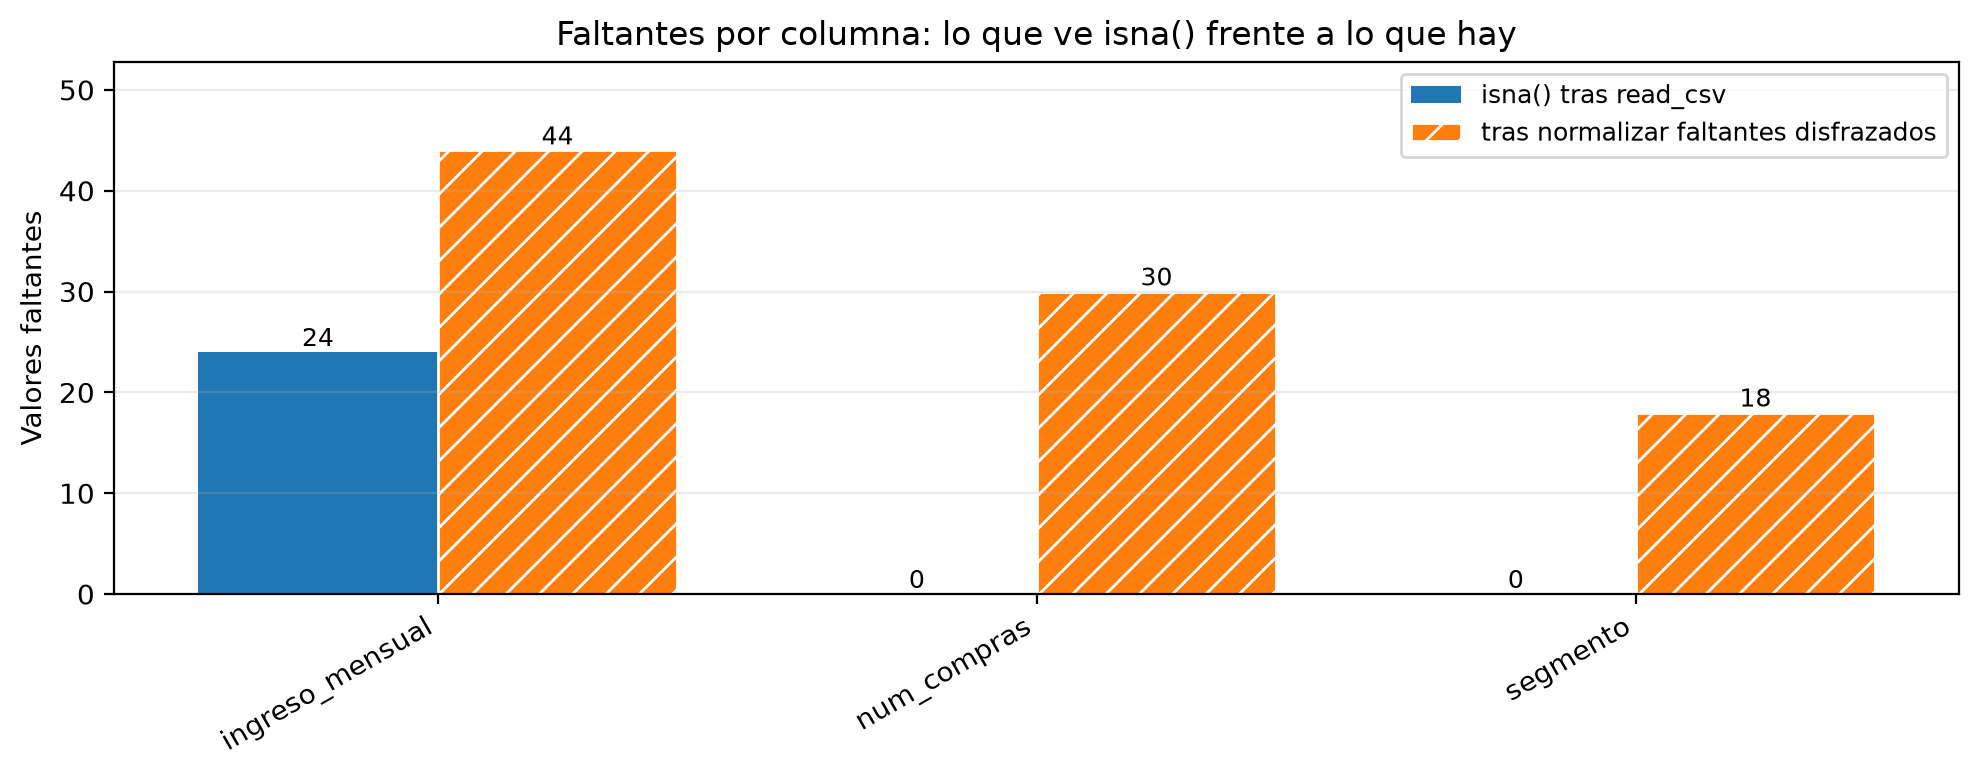
    """Faltantes por columna: lo que ve isna() tras read_csv frente a lo que hay de verdad."""
    cols = faltantes_reales.index
    x = np.arange(len(cols))
    w = 0.4
    fig, ax = plt.subplots(figsize=(10, 4))
    b1 = ax.bar(x - w / 2, faltantes_crudo.reindex(cols).values, width=w, label="isna() tras read_csv")
    b2 = ax.bar(x + w / 2, faltantes_reales.values, width=w, hatch="//", edgecolor="white", label="tras normalizar faltantes disfrazados")
    ax.bar_label(b1, fontsize=9)
    ax.bar_label(b2, fontsize=9)
    ax.set_ylim(0, faltantes_reales.max() * 1.2)
    ax.set_xticks(x)
    ax.set_xticklabels(cols, rotation=30, ha="right")
    ax.set_ylabel("Valores faltantes")
    ax.set_title(titulo)
    ax.grid(axis="y", alpha=0.25)
    ax.legend(fontsize=9)
    plt.tight_layout()
    plt.show()


def graficar_rango_plausible(valores, lim_inf, lim_sup, variable, unidad):
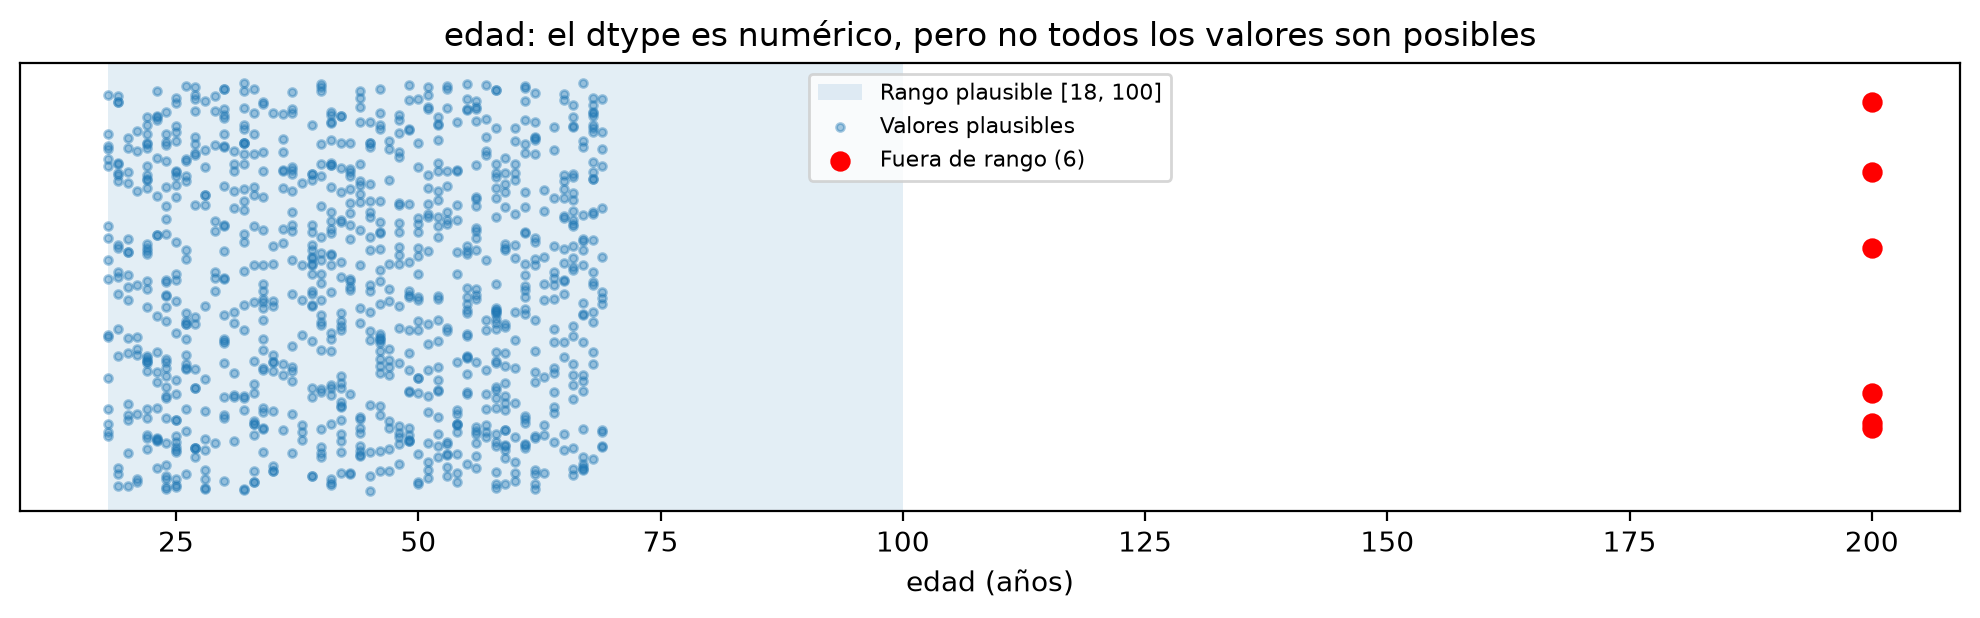
    """Puntos de una variable con la franja de valores plausibles; fuera de ella, en rojo."""
    valores = np.asarray(valores, dtype=float)
    fuera = (valores < lim_inf) | (valores > lim_sup)
    rng_jit = np.random.default_rng(SEMILLA)  # generador local, solo para separar los puntos del gráfico
    y = rng_jit.uniform(-0.25, 0.25, size=len(valores))
    fig, ax = plt.subplots(figsize=(10, 3.2))
    ax.axvspan(lim_inf, lim_sup, alpha=0.12, label=f"Rango plausible [{lim_inf}, {lim_sup}]")
    ax.scatter(valores[~fuera], y[~fuera], s=8, alpha=0.4, label="Valores plausibles")
    ax.scatter(valores[fuera], y[fuera], s=40, color="red", label=f"Fuera de rango ({fuera.sum()})")
    ax.set_yticks([])
    ax.set_xlabel(f"{variable} ({unidad})")
    ax.set_title(f"{variable}: el dtype es numérico, pero no todos los valores son posibles")
    ax.legend(fontsize=8, loc="upper center")
    plt.tight_layout()
    plt.show()


def graficar_por_tipo(serie_nominal, serie_discreta, serie_continua):
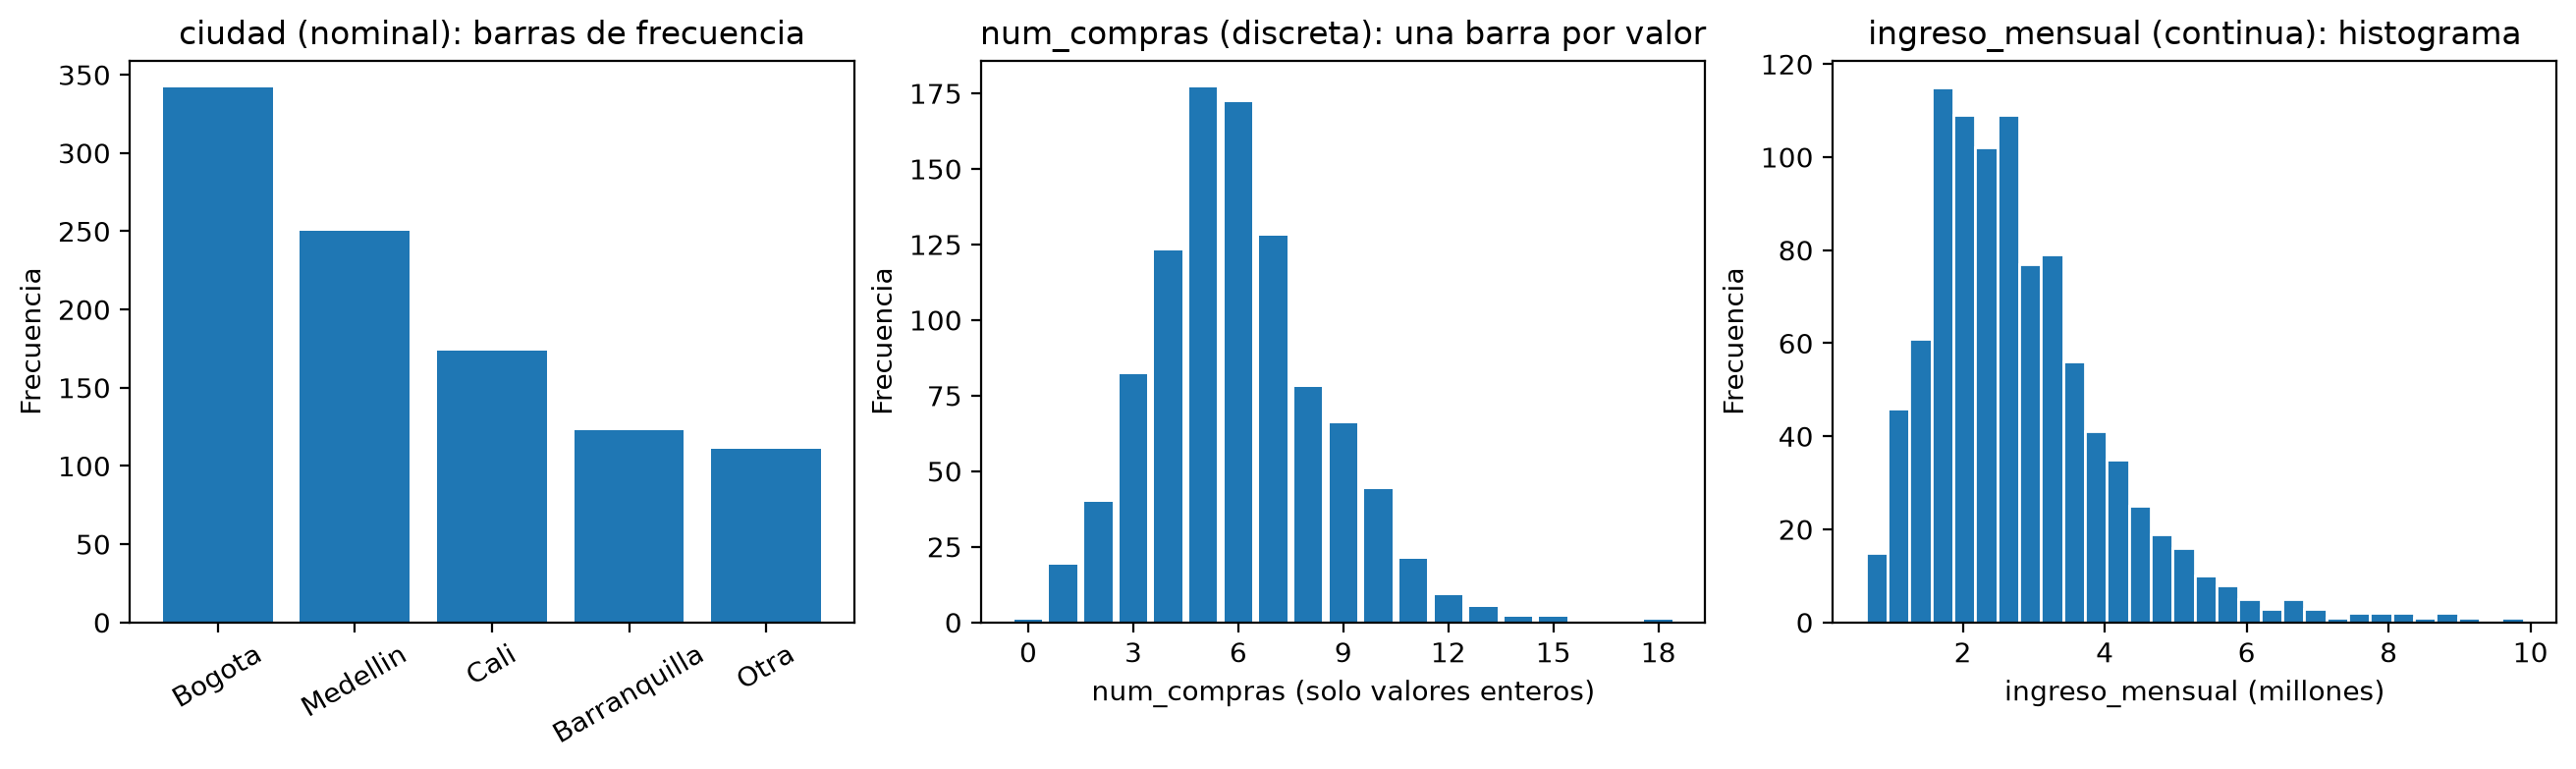
    """Un gráfico adecuado para cada tipo: barras (nominal), barras por valor (discreta), histograma (continua)."""
    fig, axes = plt.subplots(1, 3, figsize=(13, 3.8), constrained_layout=True)
    conteo = serie_nominal.value_counts()
    axes[0].bar(conteo.index.astype(str), conteo.values)
    axes[0].set_title(f"{serie_nominal.name} (nominal): barras de frecuencia")
    axes[0].tick_params(axis="x", rotation=30)
    axes[0].set_ylabel("Frecuencia")

    conteo_d = serie_discreta.value_counts().sort_index()
    axes[1].bar(conteo_d.index, conteo_d.values, width=0.8)
    axes[1].set_title(f"{serie_discreta.name} (discreta): una barra por valor")
    axes[1].set_xlabel(f"{serie_discreta.name} (solo valores enteros)")
    axes[1].set_ylabel("Frecuencia")
    axes[1].xaxis.set_major_locator(MaxNLocator(integer=True))

    axes[2].hist(serie_continua.dropna() / 1e6, bins=30, edgecolor="white")
    axes[2].set_title(f"{serie_continua.name} (continua): histograma")
    axes[2].set_xlabel(f"{serie_continua.name} (millones)")
    axes[2].set_ylabel("Frecuencia")
    plt.show()


def graficar_medias_muestrales(medias_por_n, mu, titulo):
    """Histogramas de medias muestrales para varios tamaños n, con la media poblacional."""
    fig, ax = plt.subplots(figsize=(9, 4))
    todas = np.concatenate(list(medias_por_n.values())) / 1e6
    bins = np.linspace(todas.min(), todas.max(), 50)  # mismos intervalos para comparar alturas
    for (n_muestra, medias), trama in zip(medias_por_n.items(), ["", "//"]):
        ax.hist(medias / 1e6, bins=bins, alpha=0.55, hatch=trama, edgecolor="white", label=f"n = {n_muestra}")
    ax.axvline(mu / 1e6, color="black", linestyle="--", linewidth=1.5, label=f"μ (parámetro) = {mu / 1e6:.2f} M")
    ax.set_xlabel("Media muestral x̄ del ingreso, en millones (estadístico)")
    ax.set_ylabel("Frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=9)
    plt.tight_layout()
    plt.show()


def graficar_sesgo_seleccion(tamanos, medias_aleatorias, medias_sesgadas, mu):
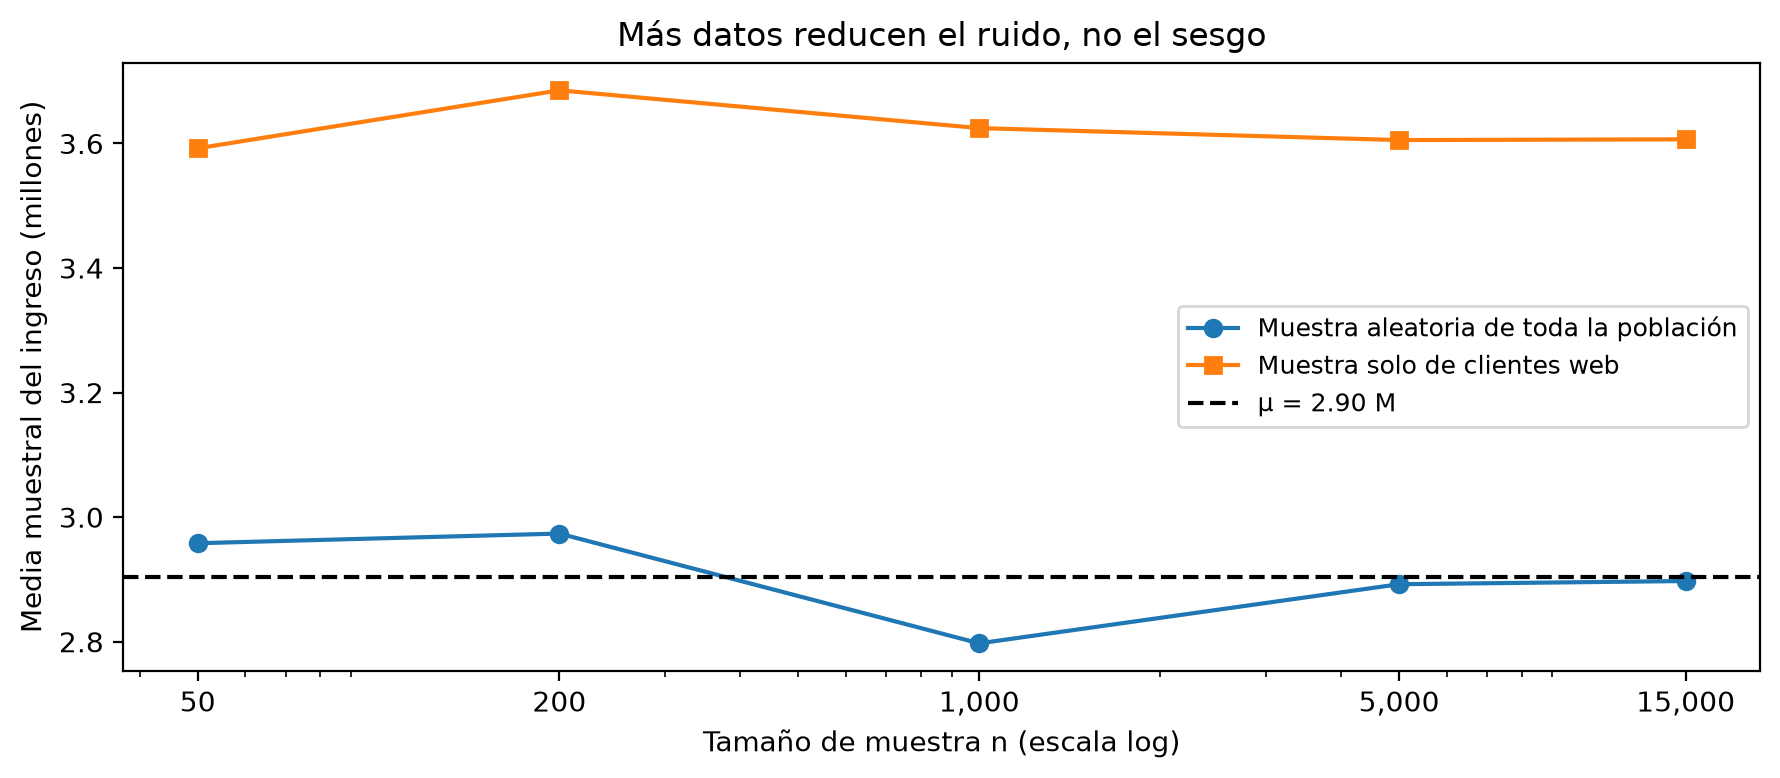
    """Media estimada frente al tamaño de muestra: aleatoria vs sesgada."""
    fig, ax = plt.subplots(figsize=(9, 4))
    ax.plot(tamanos, np.array(medias_aleatorias) / 1e6, marker="o", label="Muestra aleatoria de toda la población")
    ax.plot(tamanos, np.array(medias_sesgadas) / 1e6, marker="s", label="Muestra solo de clientes web")
    ax.axhline(mu / 1e6, color="black", linestyle="--", linewidth=1.5, label=f"μ = {mu / 1e6:.2f} M")
    ax.set_xscale("log")
    ax.set_xticks(tamanos)
    ax.set_xticklabels([f"{t:,}" for t in tamanos])
    ax.set_xlabel("Tamaño de muestra n (escala log)")
    ax.set_ylabel("Media muestral del ingreso (millones)")
    ax.set_title("Más datos reducen el ruido, no el sesgo")
    ax.legend(fontsize=9)
    plt.tight_layout()
    plt.show()