27Métodos de reducción de dimensionalidad: más allá de PCA
estadistica
reduccion-dimensionalidad
tsne
umap
manifold-learning
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
2 de octubre de 2026
De varianza e independencia a vecindad y estructura
En el capítulo anterior viste ICA: una alternativa a PCA que busca componentes estadísticamente independientes en vez de solo no correlacionados. PCA e ICA comparten algo importante: las dos son transformaciones lineales — el nuevo sistema de coordenadas es una combinación lineal (una rotación o un cizallamiento) de las variables originales.
Ese supuesto de linealidad es también su límite. Cuando la estructura real de los datos vive sobre una superficie curva — una variedad (manifold) de menor dimensión, enredada dentro del espacio original —, ninguna rotación lineal la desenreda bien. Este capítulo cierra el bloque de reducción de dimensionalidad mirando qué pasa cuando se abandona la linealidad, y qué se gana y qué se pierde al hacerlo.
Objetivos de aprendizaje
Al terminar este capítulo vas a ser capaz de:
explicar qué es la maldición de la dimensionalidad y por qué distorsiona las distancias;
distinguir selección de variables de proyección de variables;
describir la intuición de MDS, t-SNE y UMAP, y qué tipo de estructura preserva cada uno;
elegir entre reducir para visualizar y reducir para predecir;
reconocer los riesgos de sobre-interpretar una proyección no lineal.
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\tqdm\auto.py:21: TqdmWarning: IProgress not found. Please update jupyter and ipywidgets. See https://ipywidgets.readthedocs.io/en/stable/user_install.html
  from .autonotebook import tqdm as notebook_tqdm
La maldición de la dimensionalidad
A medida que agregamos variables, el espacio donde viven los datos crece mucho más rápido de lo que crecen los datos mismos. Dos consecuencias prácticas de esto:
Los datos se vuelven ralos. Para cubrir un espacio de \(p\) dimensiones con la misma densidad que lográs en 2 dimensiones, necesitás un número de observaciones que crece exponencialmente con \(p\).
Las distancias dejan de discriminar. En dimensión alta, la distancia entre el punto más cercano y el más lejano a un punto de referencia tiende a volverse casi igual — todos los puntos terminan “igual de lejos”. Esto es un problema serio para cualquier método (como \(k\) vecinos más cercanos, o el propio t-SNE que vas a ver más abajo) que depende de distinguir “cerca” de “lejos”.
La columna contraste_relativo es \((d_{\max} - d_{\min}) / d_{\min}\): qué tanto más lejos está el punto más distante que el más cercano, en proporción. En dimensión 2 ese contraste es grande (36.5213): hay puntos claramente cerca y otros claramente lejos. A medida que \(d\) crece hasta 300, el contraste cae hacia 0.2392 — cerca y lejos se vuelven casi lo mismo. Ningún método de reducción puede devolver información que esta pérdida de contraste ya borró; lo que sí puede hacer es encontrar la combinación de variables donde el contraste real (la estructura que importa) sigue siendo detectable.
Los datos: los mismos trece vinos del capítulo anterior
Para que las comparaciones de este capítulo sean justas, usamos el mismo conjunto de datos que en PCA e ICA: 178 vinos italianos de tres cultivos distintos, descritos por 13 mediciones químicas. Volvemos a cargarlo y a estandarizarlo exactamente igual que antes.
Mismo dataset que en PCA: 178 observaciones, 13 variables numéricas, tres clases de vino. X_std queda estandarizado (media 0, desviación 1 por columna) porque todos los métodos de este capítulo, igual que PCA, son sensibles a la escala: una variable medida en una unidad con rango más amplio dominaría la distancia entre observaciones si no se corrige.
Punto de partida: la proyección lineal que ya conocés
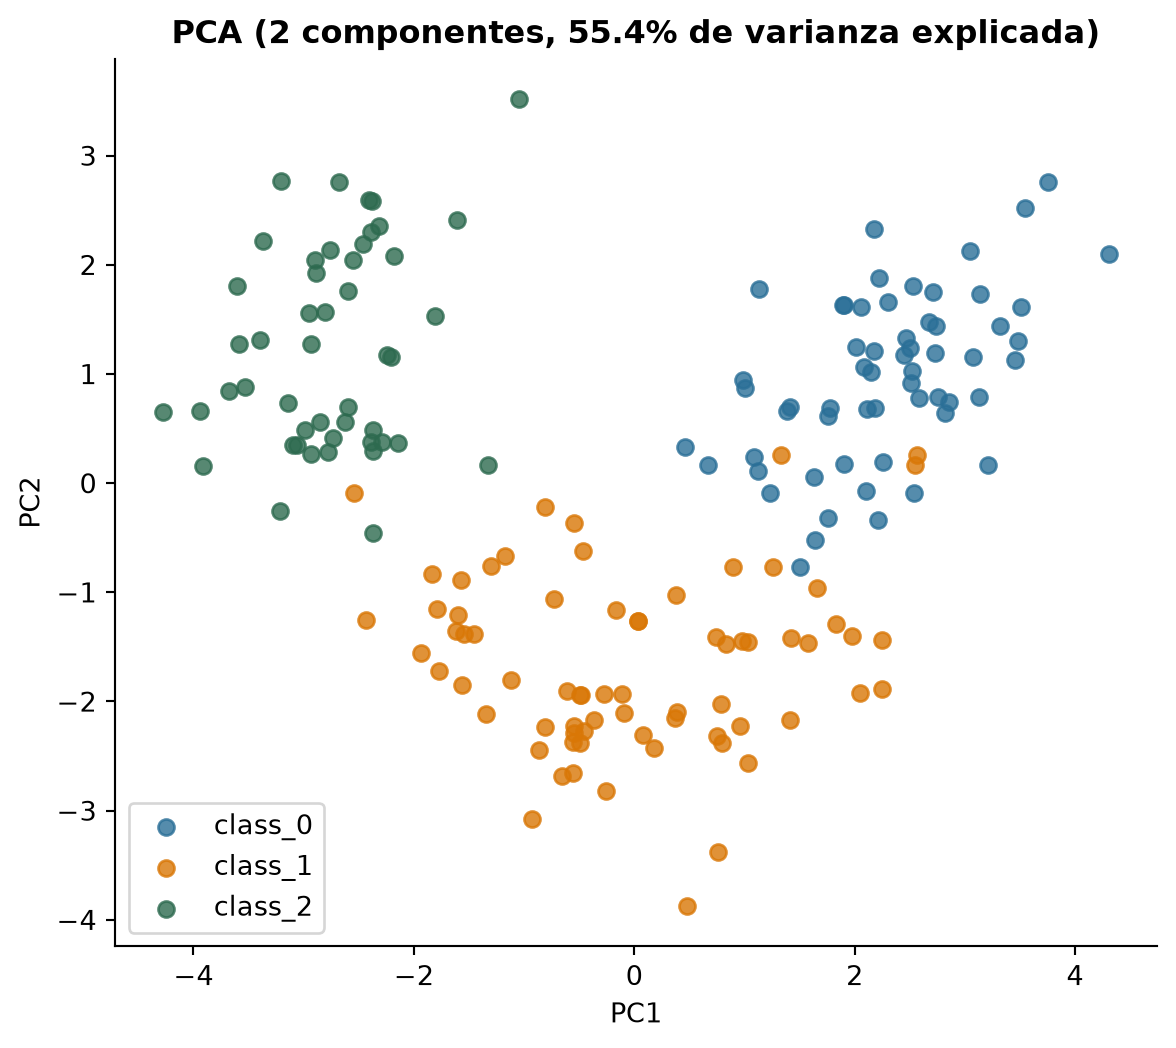
Antes de ver métodos no lineales, proyectamos los mismos datos con PCA a 2 dimensiones, igual que en el capítulo anterior. Esta proyección queda como referencia para comparar visualmente contra MDS, t-SNE y UMAP más abajo — no es una repetición del análisis completo de PCA, que ya hiciste a fondo.
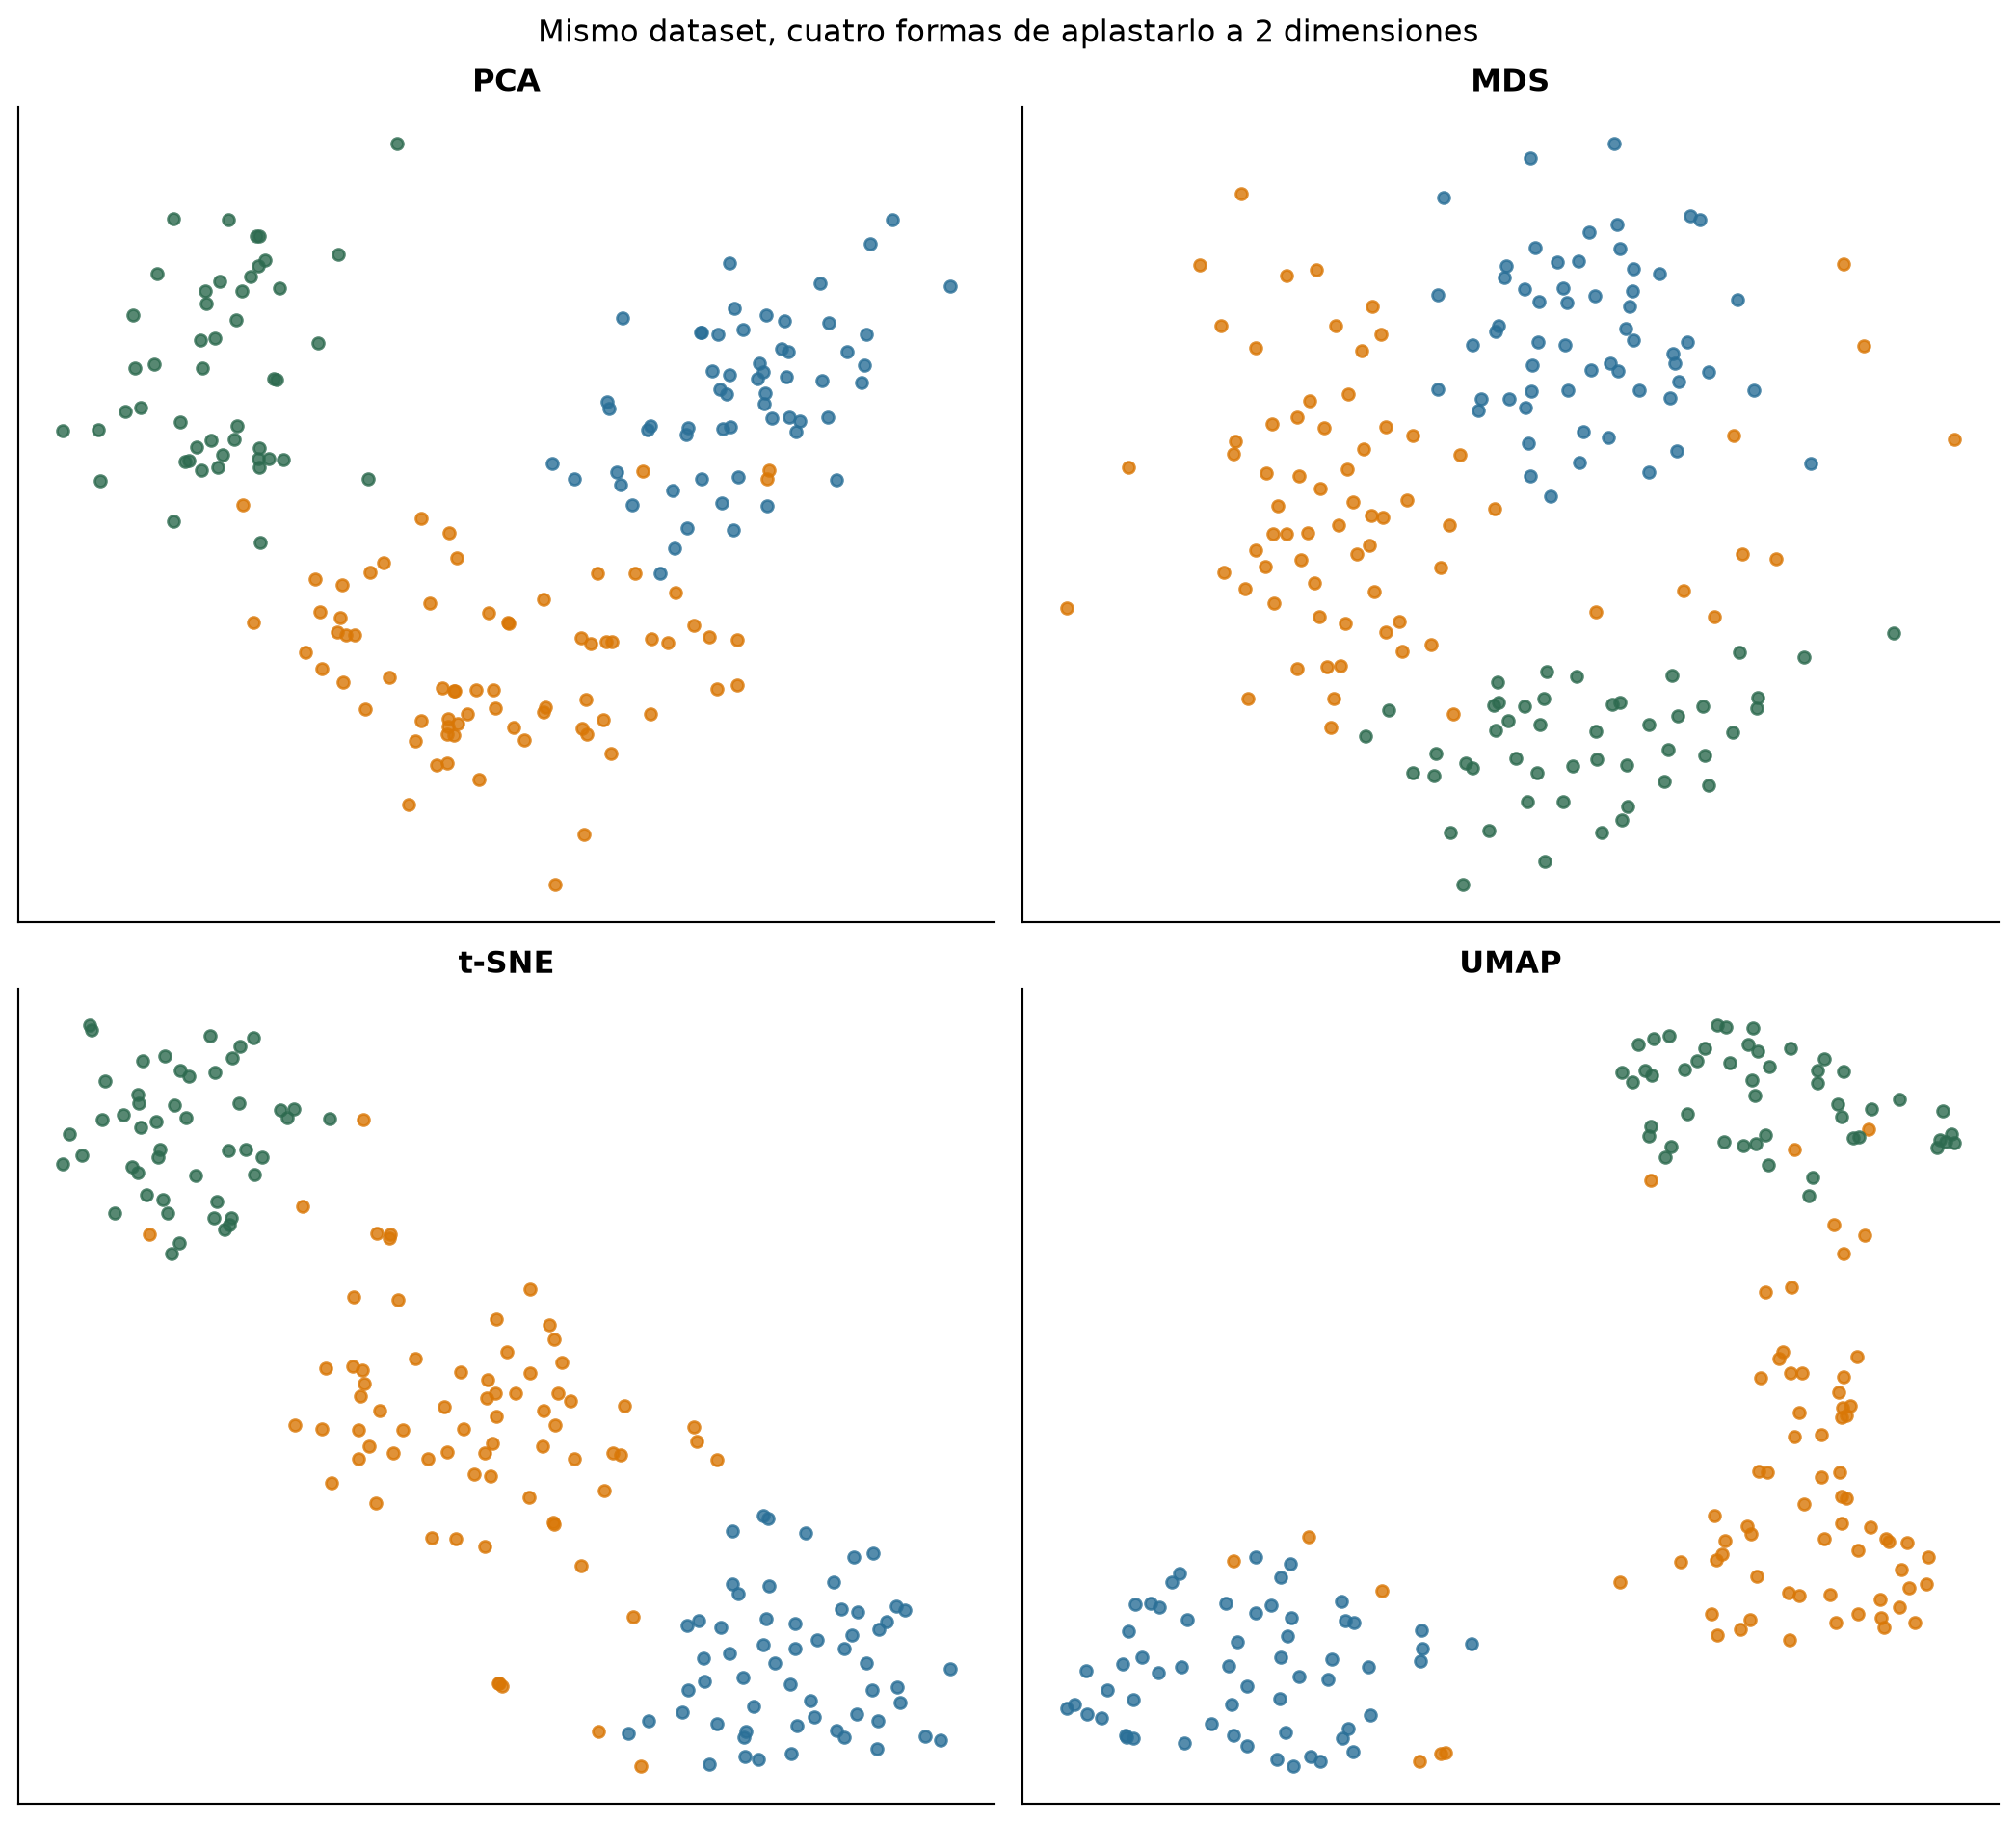
Con 2 componentes, PCA conserva el 55.4% de la varianza total — frente al 73.60% que alcanzaba con 4 componentes en el capítulo anterior. Dos componentes alcanzan para separar visualmente las clases, pero es una compresión más agresiva que la que usamos antes para el modelo predictivo. Las tres clases de vino ya se separan razonablemente bien con una transformación puramente lineal; guardá esta imagen en la cabeza como referencia para las que siguen.
Selección de variables frente a proyección de variables
Reducir dimensiones no siempre significa proyectar. Hay dos familias de estrategias y conviene no confundirlas:
Selección de variables: conservas un subconjunto de las columnas originales (por ejemplo, las 4 más correlacionadas con la variable objetivo) y descartas el resto. El resultado sigue siendo interpretable en las unidades originales — “alcohol” sigue siendo “alcohol” — pero puedes perder información que solo aparecía combinada entre variables descartadas.
Proyección de variables: construyes nuevas variables como función de todas las originales (PCA, ICA, MDS, t-SNE, UMAP entran aquí). Usas toda la información disponible, pero el resultado — “componente 1”, “dimensión UMAP 2” — ya no tiene una unidad ni un significado directo.
Este capítulo trata exclusivamente de proyección. Si tu objetivo es mantener variables interpretables para alguien que va a actuar sobre ellas (un médico, un auditor, un regulador), selección de variables puede ser preferible aunque “explique menos varianza” en el papel.
Métodos no lineales: la idea general
PCA busca una rotación que maximice varianza global. Los métodos de esta sección, en cambio, parten de las distancias o las vecindades entre observaciones y buscan una representación en pocas dimensiones que las reproduzca lo mejor posible — sin exigir que la transformación sea una combinación lineal de las variables originales. Eso les da más flexibilidad para seguir curvas y superficies, pero a cambio pierden varias propiedades cómodas de PCA: no hay una fórmula cerrada única, el resultado depende de un proceso de optimización (y por lo tanto de la semilla), y — salvo UMAP, como vas a ver — no siempre hay una forma clara de aplicar la misma transformación a una observación nueva.
MDS: preservar distancias globales
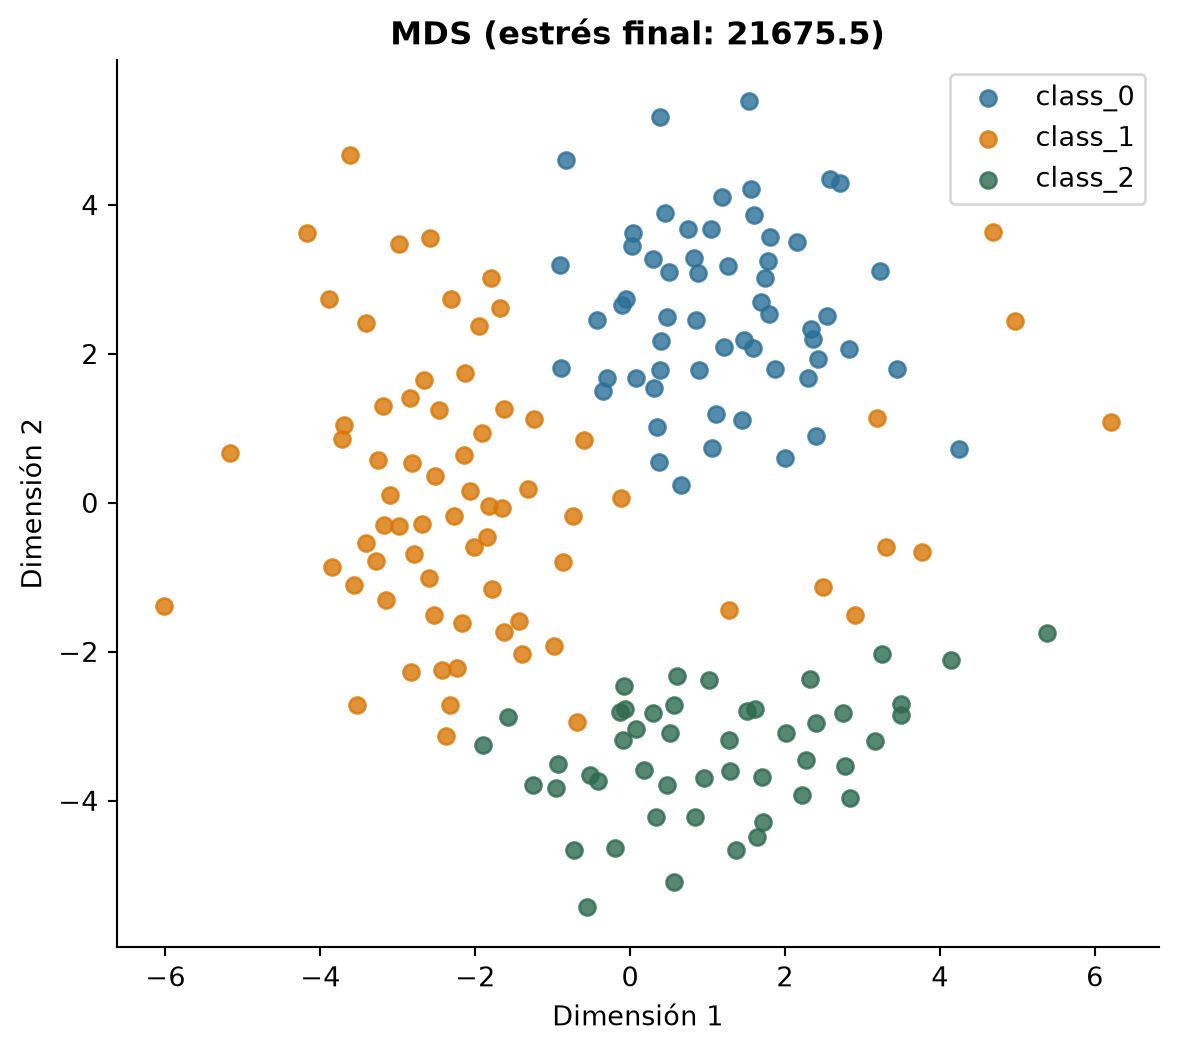
El escalamiento multidimensional (multidimensional scaling, MDS) parte de todas las distancias por pares entre observaciones en el espacio original y busca coordenadas en 2 dimensiones que reproduzcan esas distancias lo más fielmente posible. Formalmente, minimiza una función de “estrés”:
donde \(d_{ij}\) es la distancia original entre las observaciones \(i\) y \(j\), y \(\hat{d}_{ij}\) es la distancia entre sus proyecciones en 2D. A diferencia de PCA, MDS no pasa por una matriz de covarianza ni por componentes ortogonales: trabaja directamente sobre la matriz de distancias, lo que le permite —en principio— capturar relaciones no lineales si se usa una noción de distancia no euclidiana. En su versión más simple (la que usamos acá), con distancia euclidiana, MDS clásico da un resultado muy cercano a PCA; su verdadero valor aparece con otras métricas de distancia o con datos ya dados como una matriz de disimilitud.
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\sklearn\manifold\_mds.py:735: FutureWarning: The default value of `init` will change from 'random' to 'classical_mds' in 1.10. To suppress this warning, provide some value of `init`.
  warnings.warn(
Cómo leer esta proyección
El estrés final (21675.5) es la versión sin normalizar ( resuelve a estrés crudo cuando, como acá, se usa MDS métrico): no es una fracción entre 0 y 1, crece con el número de observaciones y con la magnitud de las distancias, así que la cifra por sí sola no dice “bueno” o “malo” — solo sirve para comparar entre corridas o entre números de dimensiones sobre el mismo conjunto de datos. Con datos euclidianos como estos, esperá una forma parecida a la de PCA: es el mismo tipo de objetivo (preservar distancias/varianza global), resuelto con un algoritmo distinto.
t-SNE: preservar vecindades locales
t-SNE (t-distributed Stochastic Neighbor Embedding) cambia el objetivo: en vez de intentar reproducir todas las distancias por igual, se concentra en preservar quién es vecino de quién. Para cada observación, construye una distribución de probabilidad sobre “cuáles son sus vecinos cercanos” en el espacio original, y busca una configuración en 2D donde esa misma distribución de vecindad se mantenga lo más parecida posible.
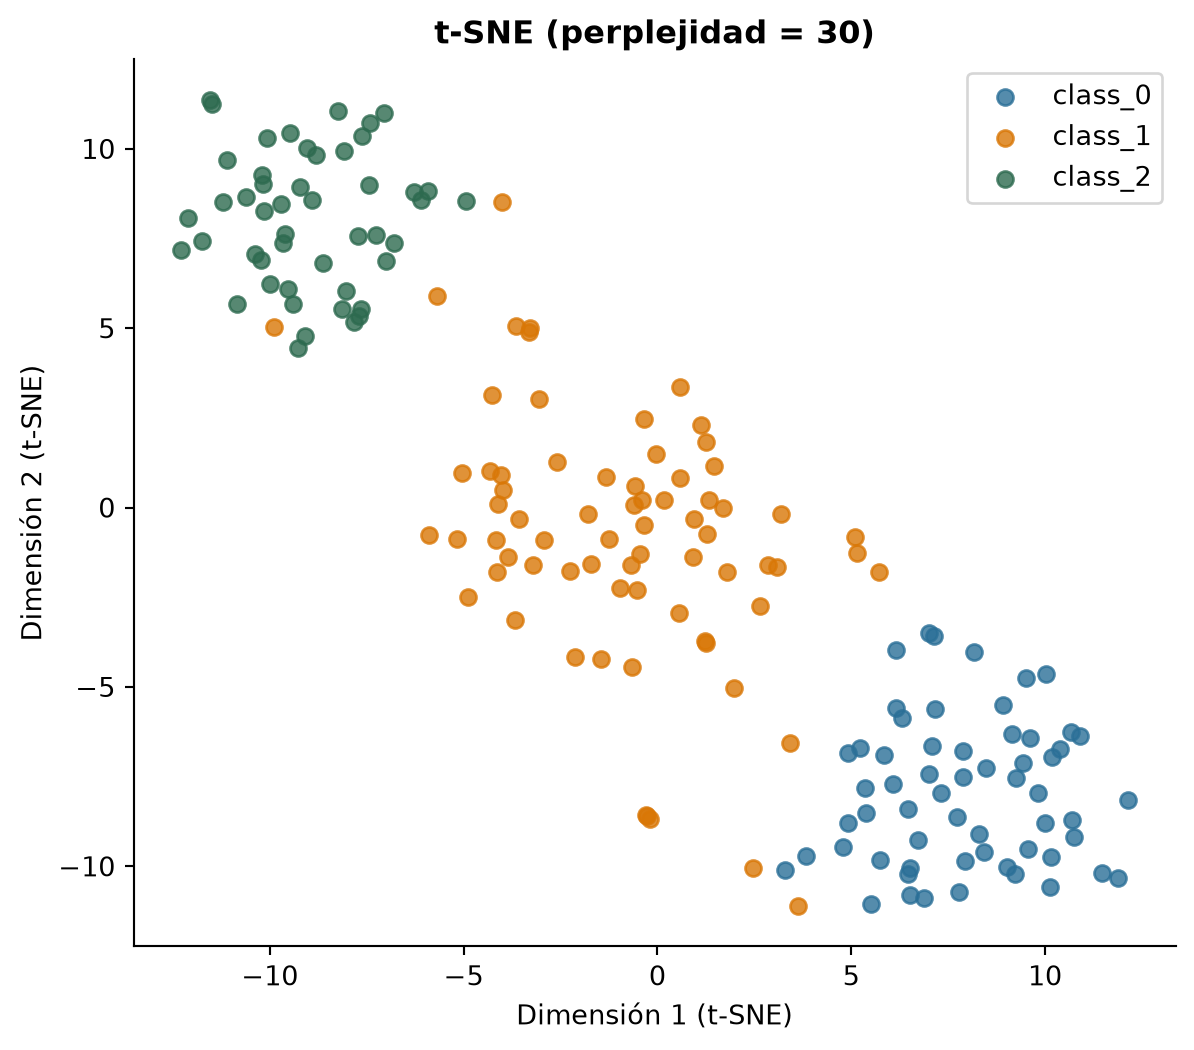
El hiperparámetro central es la perplejidad, que fija de manera aproximada cuántos vecinos efectivos considera cada punto — perplejidades bajas priorizan estructura muy local (grupos pequeños), perplejidades altas priorizan estructura más amplia. t-SNE no tiene una solución única: el proceso de optimización es no convexo, así que el resultado cambia con la semilla y con la perplejidad, y no existe una forma de aplicar la misma transformación a una observación nueva — solo sabe proyectar el conjunto completo con el que fue ajustado. Esto importa más adelante, en el caso aplicado, cuando comparemos qué tan útil es cada método para un modelo de producción.
Advertencia importante, y no una curiosidad menor: en un gráfico de t-SNE, ni el tamaño de un grupo ni la distancia entre dos grupos tienen un significado confiable. t-SNE puede dibujar un grupo compacto como grande o uno disperso como pequeño, y puede acercar o alejar grupos en el plano sin que eso refleje qué tan parecidos son en el espacio original — lo único que intenta preservar con cuidado es quién es vecino cercano de quién dentro de cada grupo. Lo que sí puedes leer con confianza es la separación cualitativa entre clases: las tres clases forman grupos distinguibles — class_0 abajo a la derecha, class_2 arriba a la izquierda y class_1 al centro, más alargado, con unos pocos puntos naranjas metidos en los otros dos grupos.
UMAP: vecindades locales con más estructura global
UMAP (Uniform Manifold Approximation and Projection) persigue un objetivo parecido al de t-SNE — preservar vecindades locales —, pero parte de una formulación distinta, basada en topología de variedades, que en la práctica tiende a conservar algo más de la estructura global (la posición relativa entre grupos lejanos) que t-SNE, además de ser considerablemente más rápido en datasets grandes.
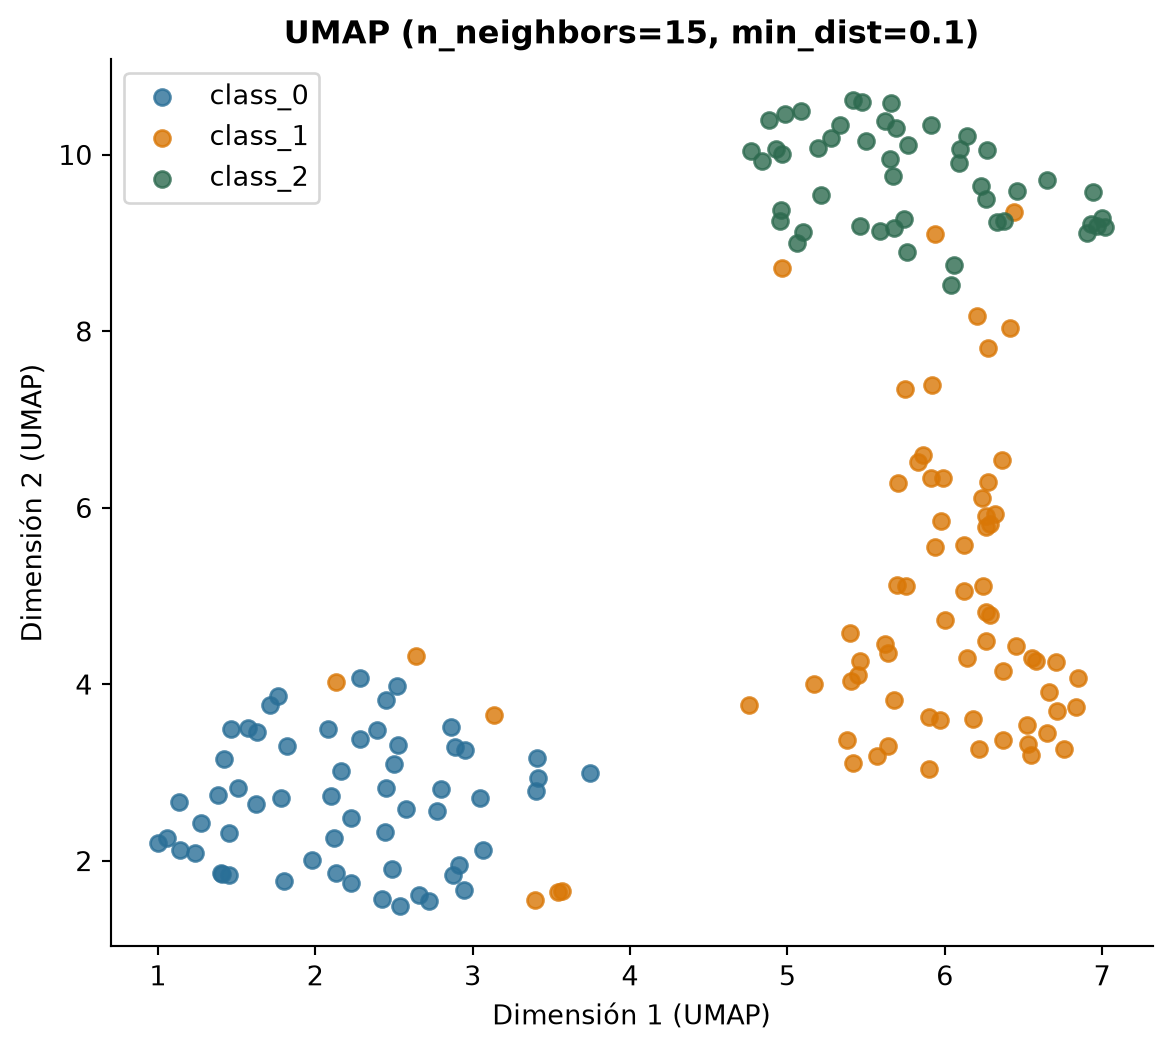
Sus dos hiperparámetros principales son n_neighbors (cuántos vecinos considera al construir el grafo de vecindad local — el equivalente aproximado a la perplejidad de t-SNE) y min_dist (qué tan apretados deja los puntos dentro de un mismo grupo en la proyección final). A diferencia de t-SNE, UMAP sí aprende una función de proyección reutilizable: una vez ajustado, se puede llamar .transform() sobre observaciones nuevas sin tener que reajustar todo el modelo. Esa diferencia técnica, aparentemente pequeña, es la que determina si un método sirve solo para explorar datos o también para un pipeline de producción.
C:\Users\wilde\.conda\envs\ANALITICA\Lib\site-packages\umap\umap_.py:1952: UserWarning: n_jobs value 1 overridden to 1 by setting random_state. Use no seed for parallelism.
  warn(
Cómo leer esta proyección
Igual que con t-SNE, las distancias entre grupos no son literales — son una guía aproximada, no una medida. Lo que conviene comparar acá es la compacidad de cada clase y si la separación entre clases coincide cualitativamente con lo que viste en PCA, MDS y t-SNE: UMAP también deja tres grupos y el mismo orden cualitativo que t-SNE y PCA (class_0 compacto y separado, class_2 apretado, class_1 más extendido, con algunos naranjas cerca de los otros). Los grupos se ven más compactos que en MDS.
Las cuatro proyecciones, lado a lado
proyecciones = [ ('PCA', proy_pca), ('MDS', proy_mds), ('t-SNE', proy_tsne), ('UMAP', proy_umap),]fig, ejes = plt.subplots(2, 2, figsize=(11, 10))for ax, (nombre, proy) inzip(ejes.ravel(), proyecciones):for clase, color inzip(range(3), COLORES): mascara = y == clase ax.scatter(proy[mascara, 0], proy[mascara, 1], c=color, alpha=0.8, s=20) ax.set_title(nombre) ax.set_xticks([]) ax.set_yticks([])fig.suptitle('Mismo dataset, cuatro formas de aplastarlo a 2 dimensiones')plt.tight_layout()plt.show()
Cómo leer esta comparación
Las cuatro parten exactamente de los mismos 178 vinos estandarizados. PCA y MDS, al preservar distancias/varianza global, producen formas más parecidas entre sí. t-SNE y UMAP, al priorizar vecindades locales, suelen mostrar grupos más compactos y mejor separados — pero recuerda la advertencia de más arriba: esa separación más “limpia” no significa que el método haya encontrado más información real; significa que optimiza para otra cosa (vecindad local en vez de distancia global).
Reducir para visualizar frente a reducir para predecir
Esta distinción organiza todo lo que viste hasta acá:
Reducir para visualizar: el objetivo es que una persona entienda la estructura de los datos de un vistazo. Acá t-SNE y UMAP suelen ganar — producen imágenes más legibles, con grupos más definidos — siempre que quien las lea conozca sus límites (distancias y tamaños no literales).
Reducir para predecir: el objetivo es alimentar un modelo supervisado con menos columnas sin perder poder predictivo, dentro de un pipeline reproducible que después va a recibir datos nuevos. Acá importan otras dos cosas que visualizar no exige: que el método tenga una forma honesta de transformar observaciones nuevas (ver la advertencia sobre t-SNE más arriba), y que exista algún criterio objetivo — como la varianza explicada de PCA — para decidir cuántas dimensiones retener, en vez de fijar 2 solo porque es lo que cabe en una pantalla.
El caso aplicado de este capítulo retoma exactamente esta distinción con números concretos.
Riesgos: distorsión e inestabilidad
Tres riesgos concretos a tener presentes antes de usar cualquiera de estos métodos para sacar una conclusión:
Distorsión de distancias. Ya lo viste: en t-SNE y UMAP, ni el tamaño de un grupo ni la distancia entre grupos son literales. Tratarlos como si lo fueran — “el grupo A está más lejos del B que del C, entonces A y B son más distintos” — es sobre-interpretar la imagen.
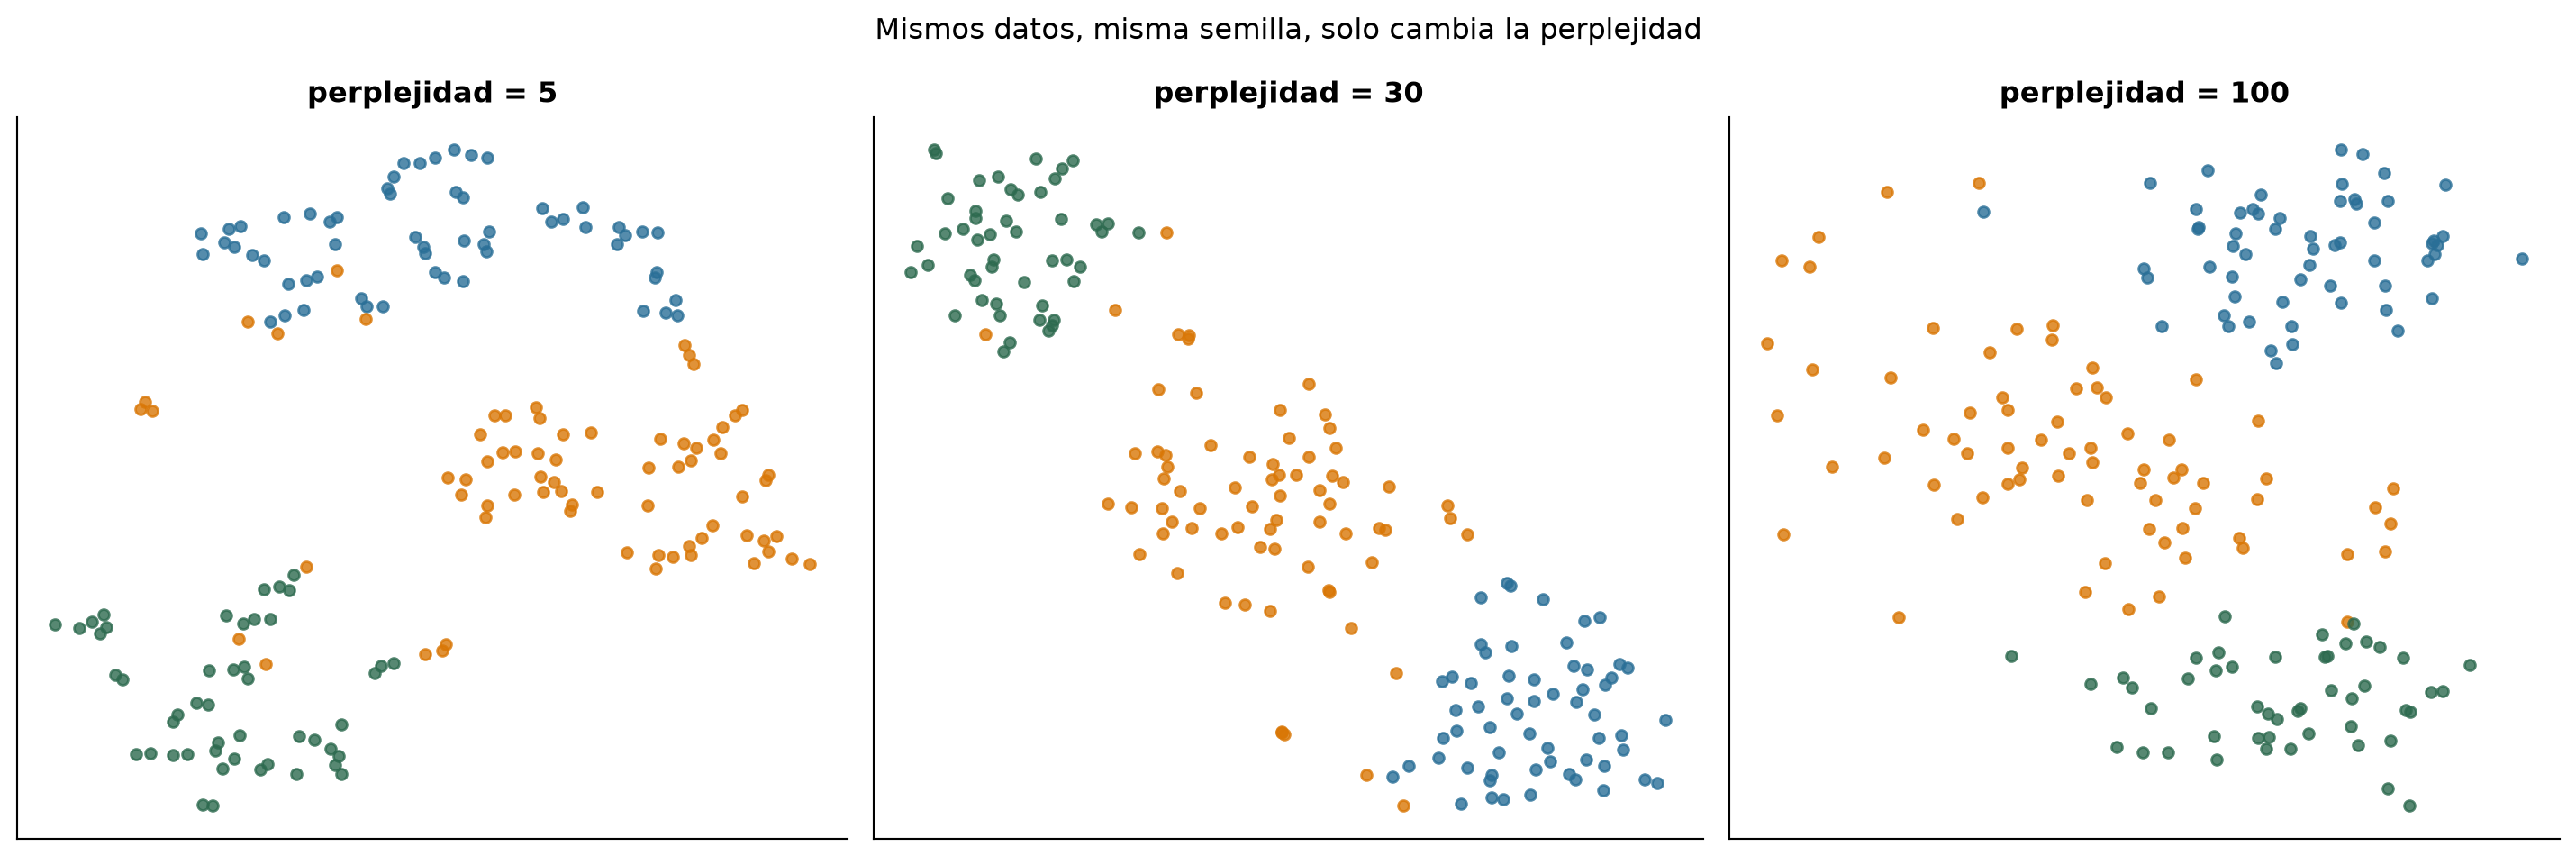
Inestabilidad frente a hiperparámetros. La forma de la proyección de t-SNE y UMAP cambia con la perplejidad o n_neighbors. Un cambio de hiperparámetro puede hacer aparecer o desaparecer grupos que no reflejan ninguna estructura real adicional en los datos — solo un ajuste distinto del algoritmo.
Las tres imágenes vienen exactamente de los mismos datos y la misma semilla; lo único que cambió es la perplejidad. Con perplejidad 5 los grupos se fragmentan: class_0 se parte en dos nubes y hay más mezcla con class_1. Con 30 aparecen tres bloques claros, la misma lectura del gráfico principal. Con 100 los tres cultivos siguen ocupando regiones distintas, pero más difusas y menos apretadas. La estructura de tres clases se sostiene; cambia cuán partidos o extendidos se dibujan los grupos. Esa sensibilidad es la razón práctica para probar más de un valor de hiperparámetro antes de quedarte con una sola imagen como si fuera “la” respuesta — y para nunca reportar una proyección de t-SNE sin decir con qué perplejidad se generó.
Falta de reproducibilidad entre corridas. Si no fijás la semilla, dos ejecuciones con los mismos datos y los mismos hiperparámetros pueden dar proyecciones visualmente distintas (aunque preserven la misma estructura de vecindad). En este capítulo fijamos random_state=SEMILLA en MDS, t-SNE y UMAP por la misma razón que en bootstrap o validación cruzada: para que el resultado sea reproducible.
Lo que debes llevarte de este capítulo
Método
Preserva
Determinista
Proyecta datos nuevos (.transform)
PCA
Varianza global, relaciones lineales
Sí
Sí
MDS
Distancias globales por pares
No (optimización iterativa)
No
t-SNE
Vecindades locales
No
No
UMAP
Vecindades locales + algo de estructura global
No (semilla fija ayuda)
Sí
Ningún método de esta tabla “gana” en todos los criterios. La elección depende de la pregunta: si necesitás entender visualmente cómo se agrupan tus datos, t-SNE o UMAP suelen ser más informativos; si necesitás una transformación reproducible dentro de un pipeline predictivo, PCA o UMAP son las opciones honestas; MDS rinde más cuando el punto de partida ya es una matriz de distancias (no necesariamente euclidianas) en vez de variables numéricas crudas.
Qué sigue
Hasta acá, todo el libro trabajó con observaciones que podían reordenarse libremente — filas intercambiables de una tabla. El siguiente capítulo cambia esa premisa: entran los datos donde el orden sí importa, porque cada observación depende de las anteriores en el tiempo.