Predecir un número a partir de otro (una latencia, un precio, una puntuación) es la tarea más corta del modelado, y su primera herramienta es una recta. El modelo lineal simple escribe esa recta, la ajusta por mínimos cuadrados y resume el error con el MSE. Su pendiente indica cuánto cambia \(y\) por cada unidad de \(x\), dentro del modelo y del rango observado.
En este capítulo construyes el modelo y sus supuestos, lo ajustas a mano y con scikit-learn, calculas el MSE, lees \(\beta_0\) y \(\beta_1\) en unidades del problema y haces inferencia sobre la pendiente: su error estándar, su intervalo de confianza y su prueba de hipótesis. A lo largo del capítulo vuelve un resultado clásico, el cuarteto de Anscombe: cuatro nubes distintas pueden compartir la misma pendiente y el mismo error. Por eso lees siempre el coeficiente junto al diagrama y a los residuos.
Los datos son de tres tipos. Las etapas 1 a 10 usan nubes simuladas con rng a partir de reglas que declara cada etapa (\(y=2.5+1.8x+\varepsilon\), una parábola y un punto agregado a mano), y la etapa 9 usa los once puntos publicados por Anscombe (1973). La etapa 11 simula la latencia de un servicio frente al tamaño de lote. La etapa 12 usa datos reales: el conjunto Diabetes de 442 pacientes incluido en scikit-learn.
Tiempo estimado de lectura: 70 minutos (unas 3 horas si ejecutas el código y resuelves los ejercicios)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 5 (covarianza y correlación), el capítulo 6 (vectores y matrices de datos N×D), el capítulo 9 (error estándar, intervalos y pruebas) y el capítulo 12 (máxima verosimilitud).
escribir el modelo lineal simple\(y=\beta_0+\beta_1 x+\varepsilon\) y nombrar cada pieza;
enunciar sus supuestos (linealidad, independencia y varianza constante, más normalidad para la inferencia con muestras pequeñas) y revisarlos con los residuos;
ajustar la recta por mínimos cuadrados a mano y reproducir el resultado con LinearRegression;
calcular el MSE y distinguirlo de la varianza residual \(s^2\);
hacer inferencia sobre la pendiente: error estándar, intervalo de confianza y prueba de \(H_0:\beta_1=0\);
distinguir el intervalo de confianza de la recta del intervalo de predicción de una observación nueva;
interpretar \(\hat\beta_0\) y \(\hat\beta_1\) en unidades del problema, sin convertirlos en efectos causales.
Ejecuta las celdas en orden: las etapas comparten variables y el generador aleatorio rng.
13.1 El modelo y la recta
Modelo lineal simple
Observas pares \((x_i,\,y_i)\), y el modelo afirma
\(\beta_0\) es el intercepto: el valor esperado de \(y\) cuando \(x=0\), si \(x=0\) tiene sentido en el problema.
\(\beta_1\) es la pendiente: el cambio esperado de \(y\) por una unidad de \(x\).
\(\varepsilon_i\) es el error: lo que la recta no explica, es decir, variables no medidas y variación aleatoria.
La predicción en un \(x\) es \(\hat y=\hat\beta_0+\hat\beta_1 x\), y el residuo es \(e_i=y_i-\hat y_i\), lo que quedó sin explicar en esta muestra después de ajustar. \(x\) es la variable explicativa (feature) e \(y\), la respuesta (target). El modelo es simple porque hay una sola \(x\); con varias se llama regresión múltiple y sigue la misma idea.
Qué se minimiza: mínimos cuadrados
Dos puntos determinan una recta. Con \(n\) puntos que no están alineados tienes \(n\) ecuaciones y solo dos incógnitas, y ninguna recta pasa por todos, así que buscas la recta que quede lo más cerca posible de todos a la vez y tienes que decidir cómo medir esa cercanía. Los mínimos cuadrados ordinarios (OLS, por ordinary least squares) eligen \(\hat\beta_0,\hat\beta_1\) que minimizan la suma de residuos al cuadrado:
y la recta pasa por el punto\((\bar x,\bar y)\). Elevar al cuadrado penaliza más los residuos grandes, de modo que un solo punto extremo puede inclinar la pendiente (etapa 10).
Sumar los residuos tal cual no sirve, porque los positivos y los negativos se cancelan y una recta pésima puede sumar cero. Sumar valores absolutos es una opción legítima, que da otra recta, más resistente a los valores extremos, pero sin fórmula cerrada. La suma de cuadrados tiene dos ventajas: es derivable en todo punto y, si \(x\) no es constante, es estrictamente convexa como función de \((\beta_0,\beta_1)\), con forma de cuenco y un único mínimo que obtienes igualando a cero sus derivadas. Por eso la solución es una fórmula y no hace falta un procedimiento iterativo. Hay además una razón estadística: si los errores son normales, independientes y de igual varianza, la recta de mínimos cuadrados es también la de máxima verosimilitud del capítulo 12.
La pendiente como covarianza
Si divides numerador y denominador por \(n-1\), aparecen las medidas del capítulo 5:
La pendiente es la covarianza medida en unidades de la varianza de \(x\), o la correlación reescalada por las desviaciones estándar.
Forma matricial
Con \(X\) la matriz de \(n\times 2\) formada por una columna de unos y la columna \(x\), el modelo completo se escribe \(\hat{\mathbf y}=X\hat{\boldsymbol\beta}\) y la solución es
Es la misma recta, escrita como solución de las ecuaciones normales\(X^\top X\hat{\boldsymbol\beta}=X^\top\mathbf y\). Esta forma no cambia al agregar variables: con \(D\) variables explicativas, \(X\) es de \(N\times(D+1)\) (la columna de unos y una por variable) y la fórmula es idéntica. La única condición es que \(X^\top X\) se pueda invertir, es decir, que ninguna columna sea combinación lineal exacta de las otras; con una sola \(x\) es la condición de antes, porque una \(x\) constante es un múltiplo de la columna de unos. En la práctica las bibliotecas no calculan la inversa, sino que usan métodos numéricamente más estables que llegan al mismo resultado.
Está en unidades de \(y\) al cuadrado. Su raíz (RMSE) vuelve a las unidades de \(y\) y la comparas con el rango de la respuesta. La función mean_squared_error de scikit-learn usa ese divisor \(n\).
La varianza residual que usa la inferencia divide por \(n-2\), porque se pierden dos grados de libertad al estimar el intercepto y la pendiente:
\[
s^2=\frac{1}{n-2}\sum_i e_i^2.
\]
Son números distintos: el MSE mide el ajuste, y \(s^2\) estima \(\mathrm{Var}(\varepsilon)\) bajo el modelo.
El \(R^2\) compara el error de la recta con el de predecir siempre \(\bar y\):
Es la fracción de la variación de \(y\) que la recta recoge. Con una sola \(x\) e intercepto, y calculado sobre los mismos datos del ajuste, \(R^2=r^2\).
Supuestos: lo que la recta pide
OLS siempre produce una recta. Los supuestos dicen cuándo esa recta es una descripción honesta y cuándo un intervalo o una prueba sobre \(\beta_1\) son válidos.
Supuesto
En palabras
Cómo lo revisas
Linealidad
\(E[y\mid x]=\beta_0+\beta_1 x\)
Residuos contra \(\hat y\) o contra \(x\): no debe quedar una curva
Independencia
Los \(\varepsilon_i\) no se arrastran (tiempo, grupos)
Residuos contra el orden; el modelo simple no sabe de series
Varianza constante (homocedasticidad)
\(\mathrm{Var}(\varepsilon\mid x)\) no crece ni se estrecha con \(x\)
Residuos contra \(\hat y\): la nube no debe abrirse en embudo
Normalidad de \(\varepsilon\)
Hace exacta la inferencia con \(t\); con \(n\) grande vale como aproximación aunque los errores no sean normales, y no hace falta para obtener \(\hat\beta\)
Histograma o gráfico Q–Q de los residuos
La homocedasticidad significa que la varianza de los residuos es más o menos igual a lo largo de \(x\). Lo contrario es la heterocedasticidad: el error es pequeño a la izquierda y ancho a la derecha, o al revés.
El teorema de Gauss–Markov dice que, si la media es lineal y los errores no están correlacionados y tienen varianza constante, OLS es el estimador de menor varianza entre los insesgados que son combinación lineal de las \(y_i\). La normalidad no interviene.
Inferencia sobre la pendiente
\(\hat\beta_1\) sale de una muestra, y con otra muestra del mismo fenómeno saldría otro valor. El capítulo 9 respondió esa pregunta para una media; aquí la respondes para una pendiente, con las mismas tres piezas.
El error estándar mide cuánto varía \(\hat\beta_1\) de una muestra a otra:
La pendiente se estima mejor cuando hay menos ruido (\(s\) pequeño), más datos y valores de \(x\)más dispersos, porque una nube estirada a lo largo de \(x\) fija mejor la inclinación.
El intervalo de confianza, con \(n-2\) grados de libertad, es
La prueba de hipótesis habitual tiene como nula que no hay relación lineal:
\[
H_0:\beta_1=0,\qquad t=\frac{\hat\beta_1}{\mathrm{EE}(\hat\beta_1)}\sim t_{n-2}\ \text{ si } H_0 \text{ es cierta}.
\]
Las tres piezas dependen de los supuestos anteriores, y valen las advertencias de siempre: un p-value pequeño dice que la pendiente se distingue de cero, no que sea grande ni que la relación sea causal.
Intervalo de la recta e intervalo de predicción
El intervalo de confianza de la recta en un punto \(x_0\) dice dónde está la media de \(y\) para ese \(x_0\), y se estrecha al crecer \(n\). El intervalo de predicción dice dónde caerá una observación nueva: incluye además el ruido \(\varepsilon\), es siempre más ancho y no se reduce a cero por muchos datos que tengas. Sus errores estándar son
y cada intervalo es \(\hat y(x_0)\pm t_{n-2,\,0.975}\,\mathrm{EE}\). Los dos crecen al alejarse \(x_0\) de \(\bar x\), y el \(1\) dentro de la segunda raíz es el ruido de la observación nueva.
Interpretar coeficientes
Supón \(\hat\beta_1=2.5\) con \(x\) = tamaño de lote e \(y\) = latencia en ms, un valor ilustrativo cercano al de la etapa 11. Lo lees así: en esta muestra, y bajo este modelo, un lote una unidad mayor se asocia a \(2.5\) ms más de latencia media. No lo lees como si aumento el lote, la latencia subirá \(2.5\) ms, porque esa es una afirmación causal y la recta sola no la respalda.
\(\hat\beta_0\) es la latencia predicha con lote \(0\). Si el lote \(0\) no existe, el intercepto solo sirve para fijar la altura de la recta.
Lo que los resúmenes no muestran
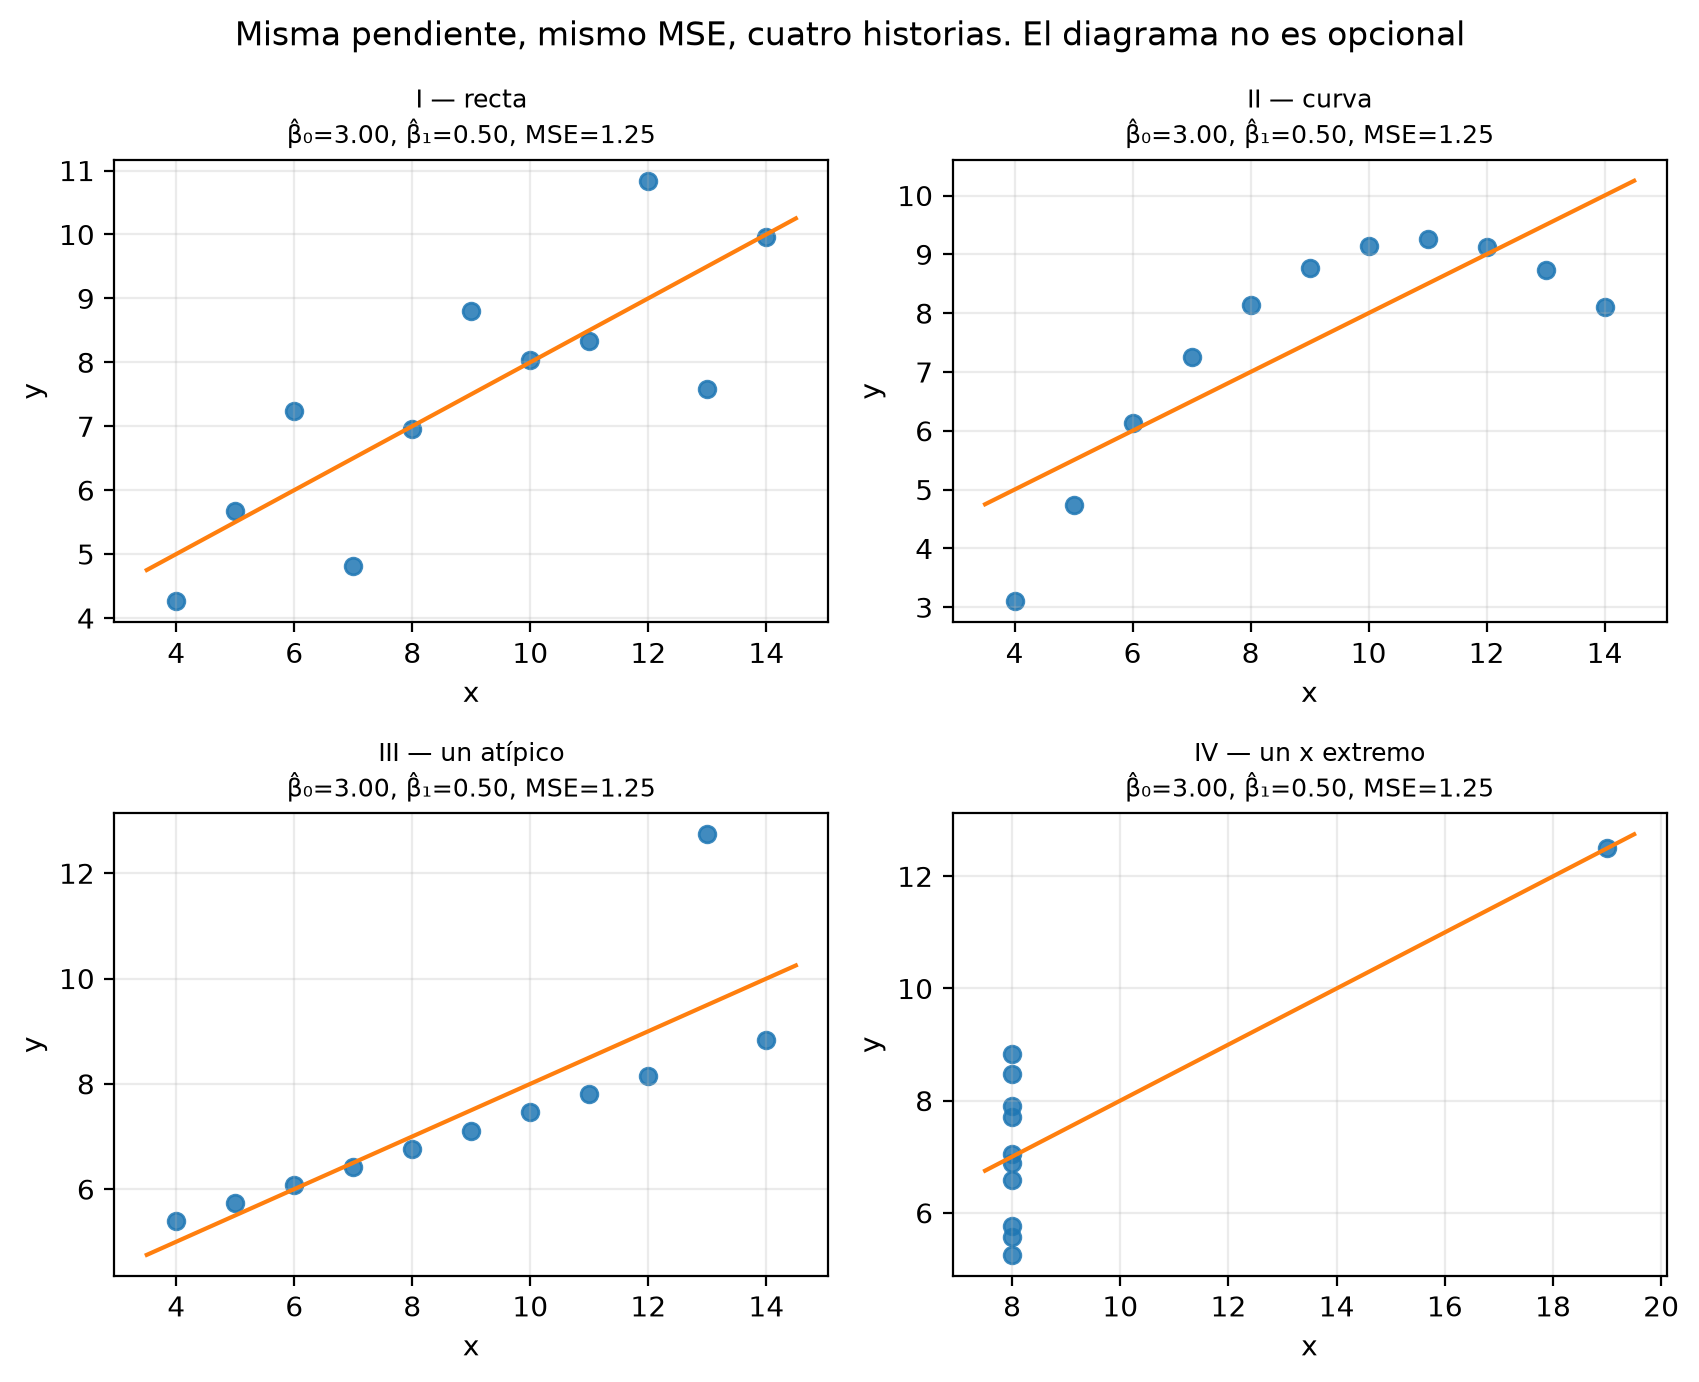
Pendiente, intercepto y MSE son resúmenes. El cuarteto de Anscombe (1973) construye cuatro nubes con los mismos resúmenes y cuatro geometrías: una recta, una curva, una recta más un atípico y un \(x\) constante salvo un punto que apalanca la pendiente, es decir, un \(x\) muy lejos de \(\bar x\) que decide por sí solo la inclinación.
Pregunta
Herramienta
¿Qué recta resume \(y\) frente a \(x\)?
Modelo lineal simple
¿Cómo eliges \(\beta_0\) y \(\beta_1\)?
Mínimos cuadrados
¿Cuánto error queda, en unidades de \(y^2\)?
MSE
¿La recta es la forma de la nube?
Residuos y diagrama de dispersión
¿Cuánto cambia \(y\) por unidad de \(x\)?
\(\hat\beta_1\) (asociación, no causa)
¿Con qué precisión conoces esa pendiente?
Error estándar, intervalo y prueba \(t\)
13.2 Por qué importa en IA y machine learning
Casi todo modelo paramétrico que vas a estudiar después empieza aquí, con una predicción que es combinación lineal de features. La regresión logística del capítulo 14 aplica una recta a una transformación de la probabilidad, y una red neuronal sin funciones de activación es una recta en muchas dimensiones.
Línea base. Antes de un modelo complejo, la recta (o un modelo lineal con las \(x\) sin transformar) fija el MSE a vencer.
Interpretación. En producto se pregunta cuánto mueve \(y\) una feature, y \(\hat\beta_1\) es la respuesta más corta y la más fácil de sobreinterpretar.
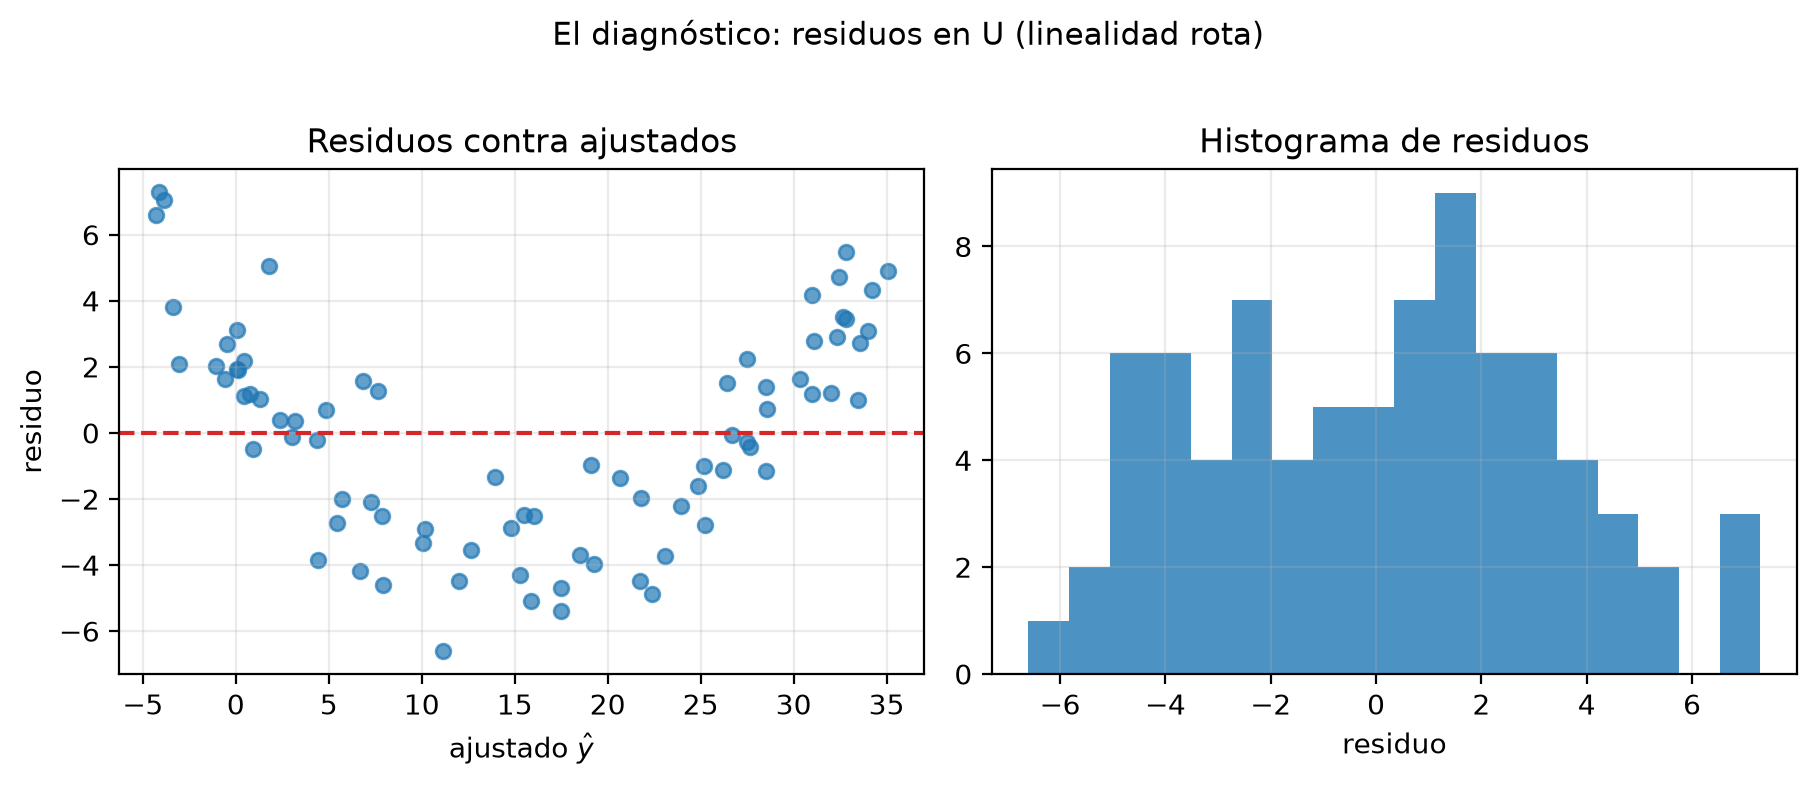
Diagnóstico. Un residuo en U indica que la forma lineal no corresponde a los datos (etapa 8), y el remedio es cambiar la forma del modelo.
Pérdida. El MSE es la función de pérdida \(L_2\); entenderla en una recta es entender qué minimizan muchos ajustes.
El coeficiente resume una recta, y los residuos dicen si esa recta era la pregunta correcta.
13.3 Flujo recomendado de trabajo
Dibuja \((x,y)\) antes de ajustar. El diagrama muestra si una recta es una descripción plausible.
Ajusta por OLS (fórmula o LinearRegression) y anota \(\hat\beta_0\) y \(\hat\beta_1\) con sus unidades.
Predice \(\hat y\) y calcula el MSE, y el RMSE para leerlo en unidades de \(y\).
Diagnostica los residuos contra \(\hat y\) y, si vas a hacer inferencia, su forma.
Cuantifica la incertidumbre de la pendiente: error estándar e intervalo de confianza.
Interpreta la pendiente como asociación en el rango de \(x\), sin extrapolar a \(x=0\) si \(0\) no existe.
Desconfía de un MSE o de una pendiente sin el diagrama (Anscombe).
Redacta la conclusión:
«En [población], con \(n=\)[valor], se ajustó \(y=\beta_0+\beta_1 x+\varepsilon\) por OLS. \(\hat\beta_1=\)[valor][unidades de y] por [unidad de x] (IC 95%: [extremos]). RMSE = [valor]. Residuos: [banda / U / embudo / punto con apalancamiento]. Se interpreta como asociación en \(x\in\)[rango], no como efecto causal. Limitación: [una sola x, atípico, extrapolación u otra].»
Reporta todo \(\hat\beta\) junto al diagrama de dispersión y a los residuos. La etapa 11 llena esta plantilla con el caso de latencia, y la etapa 12, con los datos de diabetes.
13.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib, el módulo stats de SciPy, statsmodels y las piezas de scikit-learn que usa el capítulo (LinearRegression, mean_squared_error, r2_score y load_diabetes). Crea el generador rng con la semilla central SEMILLA = 42, del que salen las nubes simuladas, y fija una segunda semilla, SEMILLA_COBERTURA = 7, para el experimento de cobertura de la etapa 6, que así no altera los datos de las demás etapas. Los ejemplos corren en CPU; con otras versiones de las bibliotecas pueden aparecer diferencias pequeñas en los últimos decimales.
El entorno queda con Python 3.13.14, NumPy 2.5.1, pandas 3.0.5, SciPy 1.18.0, statsmodels 0.14.6 y scikit-learn 1.9.0.
La siguiente celda, plegada en la versión web, define ajustar_ols, que aplica las fórmulas de la sección anterior, y cuatro funciones de gráficos (ajuste, residuos, curva frente a recta y cuarteto de Anscombe). Los coeficientes y las métricas los calculas a la vista en cada etapa.
Las 12 etapas van de lo diseñado a lo real. Primero ajustas una nube simulada para que la recta sea la respuesta correcta, con su error, sus residuos y la inferencia sobre su pendiente (etapas 1 a 7). Después rompes la linealidad, miras el cuarteto de Anscombe y agregas un punto extremo (etapas 8 a 10). Los dos casos finales son la latencia frente al tamaño de lote, con datos simulados y un reporte completo, y la progresión de la diabetes frente al índice de masa corporal, con datos reales.
Conoces los parámetros verdaderos porque los elegiste al generar los datos, pero el ajuste no los ve: solo ve la muestra.
n =80x = rng.uniform(1, 10, size=n)y =2.5+1.8* x + rng.normal(0, 1.2, size=n)df = pd.DataFrame({"x": x, "y": y})print(df.describe().round(3))print()print("Parámetros de diseño: β0 = 2.5, β1 = 1.8, σ = 1.2")
            x       y
count  80.000  80.000
mean    5.559  12.358
std     2.447   4.690
min     1.066   3.235
25%     3.579   8.899
50%     5.632  12.159
75%     7.830  16.606
max     9.781  20.328

Parámetros de diseño: β0 = 2.5,  β1 = 1.8,  σ = 1.2
\(x\) va de 1.07 a 9.78 y \(y\), de 3.2 a 20.3, con medias de 5.56 y 12.36. Como \(x\) nunca vale 0, el intercepto \(\beta_0=2.5\) es una extrapolación fuera del rango observado, y por eso vas a leer \(\hat\beta_0\) con cuidado.
Etapa 2: Mínimos cuadrados a mano
Aplicas las fórmulas de \(\hat\beta_1\) y \(\hat\beta_0\) y la vía matricial, que deben coincidir.
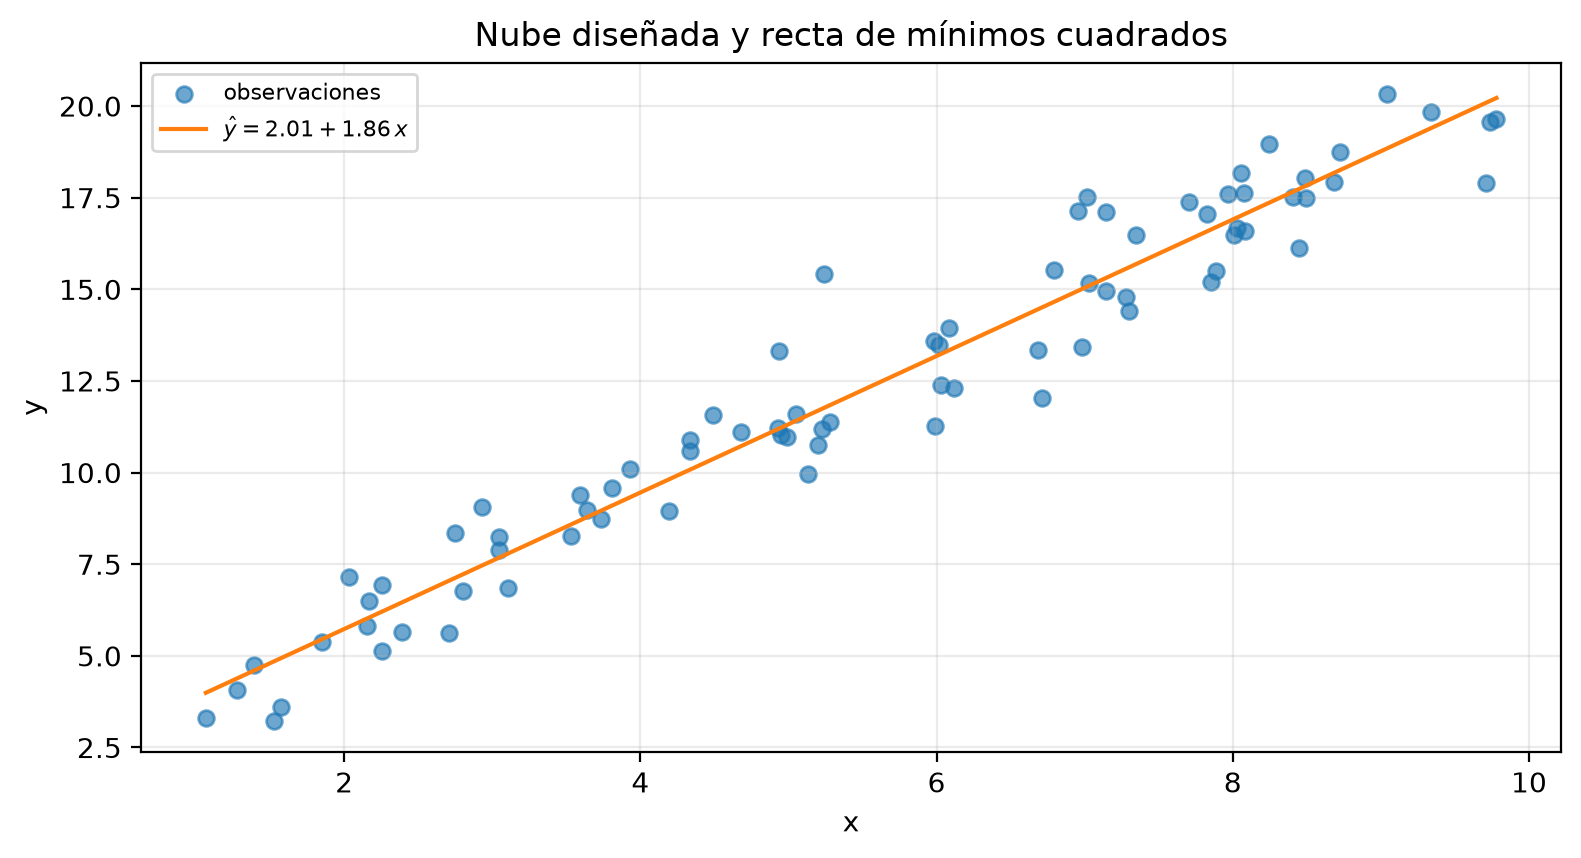
Las dos vías dan \(\hat\beta_0=2.0071\) y \(\hat\beta_1=1.8621\). La pendiente quedó cerca de \(1.8\), y el intercepto a medio punto de 2.5; esa distancia se debe al muestreo, y con \(n\) pequeño o \(\sigma\) grande el mismo diseño produciría estimaciones más lejanas.
La fórmula promete la recta con la menor suma de residuos al cuadrado (SCE), y puedes ponerlo a prueba: calculas la SCE de la recta ajustada y la de cuatro rectas vecinas, moviendo un poco la pendiente o el intercepto. Si la fórmula es correcta, todas las alternativas deben dar una SCE mayor.
def sce(beta0, beta1, x, y):return np.sum((y - beta0 - beta1 * x) **2)sce_ols = sce(fit["beta0"], fit["beta1"], x, y)alternativas = {"recta de mínimos cuadrados": (0.0, 0.0),"pendiente + 0.10": (0.0, 0.10),"pendiente − 0.10": (0.0, -0.10),"intercepto + 0.50": (0.50, 0.0),"intercepto − 0.50": (-0.50, 0.0),}for nombre, (d0, d1) in alternativas.items(): valor = sce(fit["beta0"] + d0, fit["beta1"] + d1, x, y)print(f"{nombre:<28} SCE = {valor:8.2f} aumento = {valor - sce_ols:6.2f}")print()print("Aumento previsto al mover el intercepto en 0.5: n·δ² =", round(n *0.5**2, 2))print("Aumento previsto al mover la pendiente en 0.1: δ²·Σx² =", round(0.1**2* np.sum(x **2), 2))# Lectura de la pendiente como covarianza / varianza y como r·s_y/s_xr_xy = np.corrcoef(x, y)[0, 1]print()print("Cov(x, y) / Var(x) =", round(np.cov(x, y, ddof=1)[0, 1] / x.var(ddof=1), 4))print("r · s_y / s_x =", round(r_xy * y.std(ddof=1) / x.std(ddof=1), 4), " con r =", round(r_xy, 4), " y r² =", round(r_xy **2, 4))
recta de mínimos cuadrados   SCE =    98.40   aumento =   0.00
pendiente + 0.10             SCE =   127.85   aumento =  29.45
pendiente − 0.10             SCE =   127.85   aumento =  29.45
intercepto + 0.50            SCE =   118.40   aumento =  20.00
intercepto − 0.50            SCE =   118.40   aumento =  20.00

Aumento previsto al mover el intercepto en 0.5:  n·δ² = 20.0
Aumento previsto al mover la pendiente en 0.1:   δ²·Σx² = 29.45

Cov(x, y) / Var(x) = 1.8621
r · s_y / s_x      = 1.8621    con r = 0.9713  y r² = 0.9434
La recta de mínimos cuadrados deja una SCE de \(98.40\), y las cuatro alternativas dan más: mover la pendiente en \(0.10\) la sube a \(127.85\) y mover el intercepto en \(0.50\), a \(118.40\), en cualquiera de los dos sentidos.
Los aumentos son exactos y simétricos, y puedes predecirlos. Como los residuos de la recta óptima suman cero y no están correlacionados con \(x\), desplazar el intercepto en \(\delta\) agrega \(n\,\delta^2=80\times0.25=20\) a la SCE, y cambiar la pendiente en \(\delta\) agrega \(\delta^2\sum x_i^2=29.45\). Es la forma de cuenco de la sección sobre mínimos cuadrados: alejarte del mínimo en cualquier dirección cuesta, y cuesta lo mismo hacia los dos lados.
Probar cuatro rectas no demuestra que no exista una mejor. La garantía viene de la derivación, y la comparación solo la ilustra.
La pendiente también sale de las otras dos fórmulas: \(\mathrm{Cov}(x,y)/\mathrm{Var}(x)\) y \(r\,s_y/s_x\) dan el mismo \(1.8621\). La correlación es \(r=0.9713\) y su cuadrado, \(0.9434\), es el \(R^2\) que aparece en la etapa 4.
Etapa 3: La misma recta con scikit-learn
LinearRegression estima el intercepto por defecto: coef_ contiene \(\hat\beta_1\) e intercept_, \(\hat\beta_0\). El código sigue un patrón de tres pasos que se repite en todos los modelos de scikit-learn:
Instanciar.LinearRegression() crea un objeto que todavía no ha visto datos y solo declara qué tipo de modelo vas a usar.
Ajustar..fit(X, y) resuelve el problema de mínimos cuadrados y guarda el resultado en el objeto. Los atributos que terminan en guion bajo (intercept_, coef_) son los que se calcularon al ajustar.
Predecir..predict(X_nuevo) evalúa la recta ya ajustada en valores nuevos, sin volver a calcular nada.
scikit-learn espera que X sea una tabla de dos dimensiones, de \(N\times D\) (filas = observaciones, columnas = variables), aunque haya una sola variable: por eso x.reshape(-1, 1) convierte el vector en una matriz de \(n\) filas y una columna. Y coef_ es un arreglo con un coeficiente por variable; con una sola, la pendiente es coef_[0].
modelo = LinearRegression()modelo.fit(x.reshape(-1, 1), y)print("sklearn β̂0 =", round(modelo.intercept_, 4), " β̂1 =", round(float(modelo.coef_[0]), 4))print("a mano β̂0 =", round(fit["beta0"], 4), " β̂1 =", round(fit["beta1"], 4))print("¿Coinciden?", np.allclose([modelo.intercept_, modelo.coef_[0]], [fit["beta0"], fit["beta1"]]))graficar_recta( x, y, fit["beta0"], fit["beta1"],"Nube diseñada y recta de mínimos cuadrados",)
sklearn  β̂0 = 2.0071   β̂1 = 1.8621
a mano   β̂0 = 2.0071   β̂1 = 1.8621
¿Coinciden? True
scikit-learn devuelve los mismos \(\hat\beta_0=2.0071\) y \(\hat\beta_1=1.8621\) de la etapa 2, porque aplica el mismo criterio. En la figura, la recta \(\hat y=2.01+1.86\,x\) atraviesa la nube por el centro en todo el rango de \(x\). Lo que aporta la biblioteca es una interfaz común para ajustar y predecir, la misma que usan sus demás modelos.
Recuerda que mean_squared_error usa el divisor \(n\) y que \(s^2\) usa \(n-2\).
yhat = modelo.predict(x.reshape(-1, 1))e = y - yhatmse_mano = np.mean(e **2)mse_sk = mean_squared_error(y, yhat)s2 = np.sum(e **2) / (n -2)rmse = np.sqrt(mse_sk)r2 = r2_score(y, yhat)print("MSE a mano =", round(mse_mano, 4))print("MSE sklearn =", round(mse_sk, 4))print("s² (divisor n-2) =", round(s2, 4), " ← no es el MSE")print("s = √s² =", round(float(np.sqrt(s2)), 4), " (unidades de y)")print("RMSE =", round(rmse, 4), " (unidades de y)")print("R² =", round(r2, 4), " (1 − SCres/SCtot; no sustituye al diagrama)")
MSE a mano     = 1.23
MSE sklearn    = 1.23
s² (divisor n-2) = 1.2615   ← no es el MSE
s = √s²        = 1.1232   (unidades de y)
RMSE           = 1.109   (unidades de y)
R²             = 0.9434   (1 − SCres/SCtot; no sustituye al diagrama)
El MSE vale \(1.23\) a mano y con scikit-learn, y \(s^2=1.2615\) con el divisor \(n-2\). El RMSE (\(1.109\)) y \(s\) (\(1.123\)) quedan cerca de \(\sigma=1.2\), algo por debajo; es variación de muestreo, y el RMSE con divisor \(n\) tiende además a subestimar \(\sigma\). Un RMSE muy inferior sí sería sospechoso, porque indicaría un error en el cálculo o un modelo que se ajusta al ruido de estos 80 puntos. El \(R^2=0.9434\) aparece en todos los reportes, y lo lees siempre junto a los residuos.
Etapa 5: Residuos cuando el modelo es el correcto
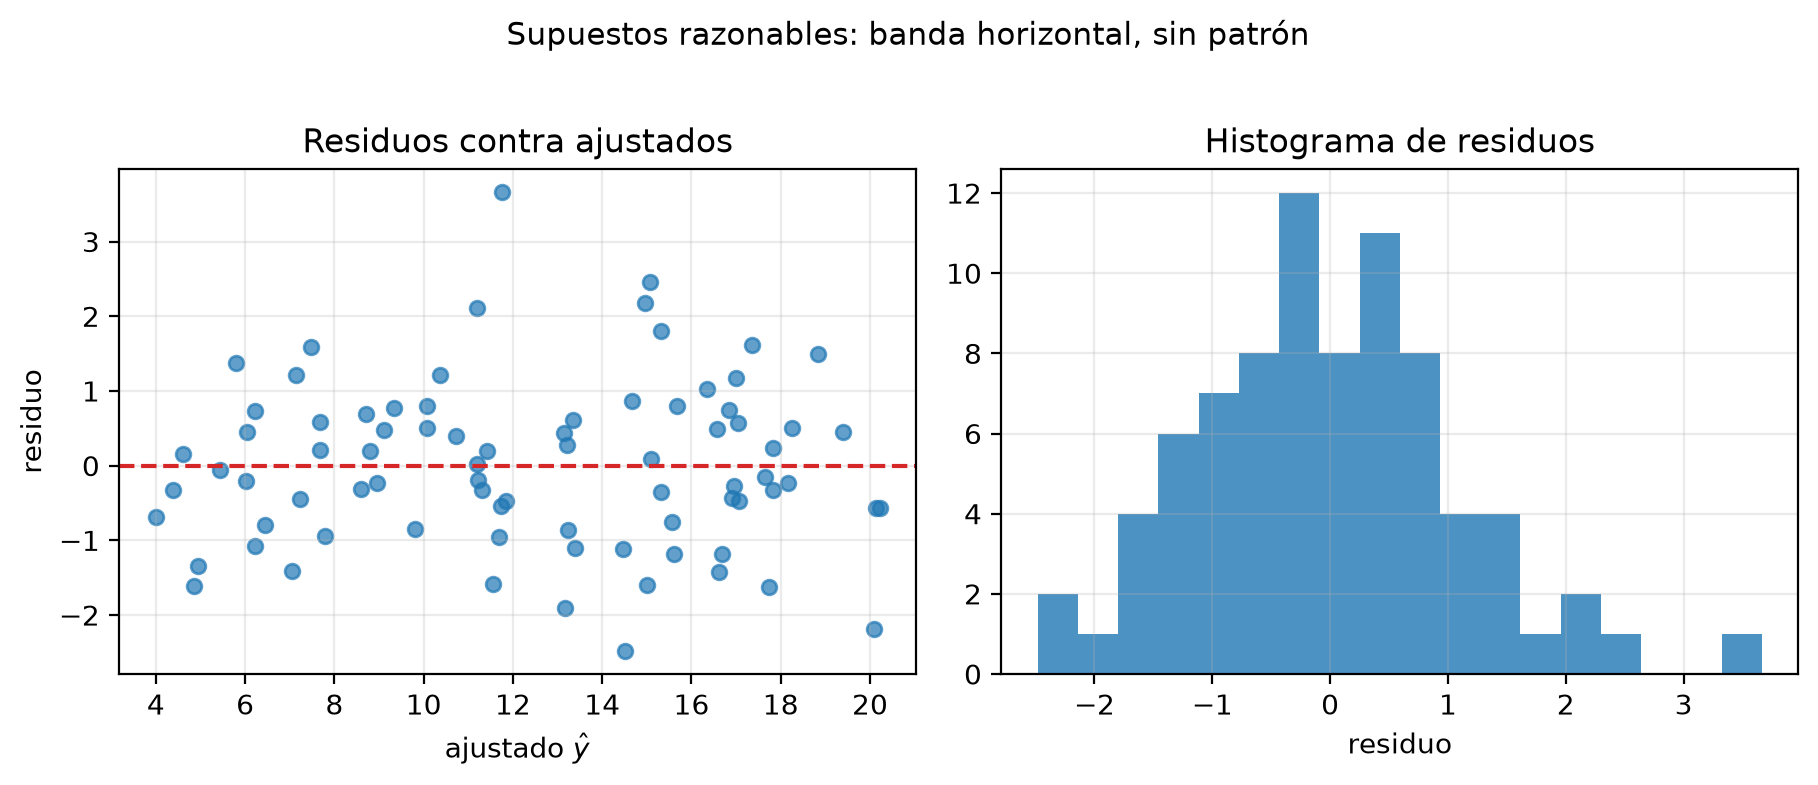
Si \(E[y\mid x]\) es lineal y la varianza es constante, los residuos contra \(\hat y\) forman una banda horizontal alrededor de 0, sin curva y sin embudo.
graficar_residuos(yhat, e, "Supuestos razonables: banda horizontal, sin patrón")# abs() evita que un cero con signo negativo se imprima como -0.0print("Media de residuos, en valor absoluto (debe ~ 0):", round(abs(e.mean()), 6))print("Correlación(x, e), en valor absoluto (OLS la anula):", round(abs(np.corrcoef(x, e)[0, 1]), 8))
Media de residuos, en valor absoluto (debe ~ 0): 0.0
Correlación(x, e), en valor absoluto (OLS la anula): 0.0
En la figura, los residuos forman una banda horizontal entre unos \(-2.5\) y \(+3.7\), sin curva ni embudo a lo largo de \(\hat y\) (de 4 a 20), y el histograma es aproximadamente simétrico y centrado en 0, compatible con errores normales. La media de \(e\) es \(0\) por construcción del intercepto, y \(\mathrm{corr}(x,e)=0\) también, porque OLS usa la pendiente hasta agotar la asociación lineal con \(x\). Eso no prueba que no quede estructura no lineal; aquí no queda porque el diseño era lineal.
Etapa 6: Inferencia sobre la pendiente, ¿qué tan bien conoces \(\beta_1\)?
La muestra dio \(\hat\beta_1=1.862\) y el diseño era \(1.8\). Calculas el error estándar de la pendiente con el \(s^2\) de la etapa 4, el intervalo de confianza del 95% y la prueba de \(H_0:\beta_1=0\), a mano y con scipy.stats.linregress, y los dos intervalos en \(x_0=4\).
Después compruebas qué significa ese 95%. Como aquí conoces el valor verdadero, repites el experimento 2 000 veces con muestras nuevas del mismo diseño, generadas con SEMILLA_COBERTURA, y cuentas cuántos intervalos contienen a \(1.8\).
sxx = np.sum((x - x.mean()) **2)s = np.sqrt(s2)ee_b1 = s / np.sqrt(sxx)t_crit = stats.t.ppf(0.975, df=n -2)ic_b1 = (fit["beta1"] - t_crit * ee_b1, fit["beta1"] + t_crit * ee_b1)t_b1 = fit["beta1"] / ee_b1p_b1 =2* stats.t.sf(abs(t_b1), df=n -2)print("s (desviación residual) =", round(s, 4), " Σ(x − x̄)² =", round(sxx, 2))print("EE(β̂1) a mano =", round(ee_b1, 4))print("t crítico (78 gl) =", round(t_crit, 4))print("IC 95% para β1: [", round(ic_b1[0], 4), ",", round(ic_b1[1], 4), "] ¿contiene 1.8?", ic_b1[0] <=1.8<= ic_b1[1])print("H0: β1 = 0 t =", round(t_b1, 2), " p-value =", f"{p_b1:.2e}")lr = stats.linregress(x, y)print()print("scipy.stats.linregress: pendiente =", round(lr.slope, 4), " EE =", round(lr.stderr, 4)," p-value =", f"{lr.pvalue:.2e}", " EE del intercepto =", round(lr.intercept_stderr, 4))# Dos intervalos en x0 = 4: el de la media de y y el de una observación nuevax0 =4.0y0 = fit["beta0"] + fit["beta1"] * x0ee_media = s * np.sqrt(1/ n + (x0 - x.mean()) **2/ sxx)ee_pred = s * np.sqrt(1+1/ n + (x0 - x.mean()) **2/ sxx)print()print(f"En x0 = {x0}: ŷ = {y0:.3f}")print(f" IC 95% de la media de y: [{y0 - t_crit * ee_media:.3f}, {y0 + t_crit * ee_media:.3f}] ancho = {2* t_crit * ee_media:.2f}")print(f" Intervalo de predicción al 95%: [{y0 - t_crit * ee_pred:.3f}, {y0 + t_crit * ee_pred:.3f}] ancho = {2* t_crit * ee_pred:.2f}")print(f" Razón entre los dos anchos = {ee_pred / ee_media:.1f}")print(f"EE de la recta en x̄ (s/√n) = {s / np.sqrt(n):.4f} frente al EE del intercepto (la recta en x = 0) = {lr.intercept_stderr:.4f}")# ¿Qué significa el 95%? Se repite el experimento con un generador aparterng_inf = np.random.default_rng(SEMILLA_COBERTURA)n_rep, cubre, pendientes =2000, 0, []for _ inrange(n_rep): xs_ = rng_inf.uniform(1, 10, size=n) ys_ =2.5+1.8* xs_ + rng_inf.normal(0, 1.2, size=n) r_ = stats.linregress(xs_, ys_) pendientes.append(r_.slope) cubre +=abs(r_.slope -1.8) <= t_crit * r_.stderrprint()print("En 2 000 muestras del mismo diseño:")print(" desviación estándar de las pendientes =", round(float(np.std(pendientes, ddof=1)), 4), " (el EE de esta muestra era", round(ee_b1, 4), ")")cobertura = cubre / n_repprint(" intervalos del 95% que contienen 1.8 =", round(cobertura, 4))print(" error estándar de simulación de esa proporción =", round(float(np.sqrt(cobertura * (1- cobertura) / n_rep)), 4))# Mismo modelo inferencial con statsmodels; las fórmulas anteriores se conservan.modelo_sm = sm.OLS(y, sm.add_constant(x)).fit()assert np.allclose(modelo_sm.params, [fit["beta0"], fit["beta1"]])assert np.allclose(modelo_sm.conf_int()[1], ic_b1)print("statsmodels: pendiente =", round(modelo_sm.params[1], 4)," EE =", round(modelo_sm.bse[1], 4))
s (desviación residual) = 1.1232    Σ(x − x̄)² = 472.88
EE(β̂1) a mano = 0.0516
t crítico (78 gl) = 1.9908
IC 95% para β1: [ 1.7592 , 1.9649 ]   ¿contiene 1.8? True
H0: β1 = 0   t = 36.05   p-value = 2.14e-50

scipy.stats.linregress:  pendiente = 1.8621   EE = 0.0516   p-value = 2.14e-50   EE del intercepto = 0.3134

En x0 = 4.0:  ŷ = 9.455
  IC 95% de la media de y:        [9.158, 9.752]   ancho = 0.59
  Intervalo de predicción al 95%: [7.200, 11.711]   ancho = 4.51
  Razón entre los dos anchos = 7.6
EE de la recta en x̄ (s/√n) = 0.1256   frente al EE del intercepto (la recta en x = 0) = 0.3134

En 2 000 muestras del mismo diseño:
  desviación estándar de las pendientes = 0.0518   (el EE de esta muestra era 0.0516 )
  intervalos del 95% que contienen 1.8  = 0.956
  error estándar de simulación de esa proporción = 0.0046
statsmodels: pendiente = 1.8621  EE = 0.0516
El error estándar de la pendiente es \(0.0516\). El intervalo de confianza del 95% va de \(1.759\) a \(1.965\) y contiene el valor de diseño, \(1.8\). La prueba de \(H_0:\beta_1=0\) da \(t=36.05\) y un p-value de \(2\times10^{-50}\), así que los datos son incompatibles con una pendiente nula. linregress y statsmodels reproducen la pendiente de 1.862 y su error estándar de 0.0516.
Cada número responde una pregunta distinta:
el intervalo responde entre qué valores está la pendiente, y es lo que conviene reportar: entre \(1.76\) y \(1.96\) unidades de \(y\) por unidad de \(x\);
la prueba responde una pregunta más pobre, si la pendiente es distinta de cero, y con una nube tan marcada la respuesta era evidente desde el diagrama;
el intercepto tiene un error estándar de \(0.313\), mientras que la misma recta evaluada en \(\bar x\) tiene \(s/\sqrt n=0.126\): en \(x=0\), fuera del rango observado, está dos veces y media peor determinada.
En \(x_0=4\) la recta predice \(9.455\). La media de \(y\) para ese \(x\) está entre \(9.16\) y \(9.75\), un intervalo de ancho \(0.59\). Una observación nueva caerá entre \(7.20\) y \(11.71\), un intervalo de ancho \(4.51\), unas \(7.6\) veces mayor. El primero mide cuánto desconoces la recta; el segundo suma el ruido de cada observación, que ningún aumento de \(n\) elimina.
En 2 000 muestras nuevas del mismo diseño, las pendientes tienen una desviación estándar de \(0.0518\), prácticamente el error estándar que calculaste con una sola muestra (\(0.0516\)). Y el 95.6% de los intervalos contiene a \(1.8\); con 2 000 repeticiones el error de simulación es de cerca de medio punto porcentual (\(0.0046\)), así que el resultado es compatible con el 95% nominal.
Aquí los supuestos se cumplen por construcción. Si los residuos mostraran una curva, un embudo o dependencia entre observaciones, el error estándar estaría mal calculado y el intervalo dejaría de cubrir el 95%; por eso el diagnóstico de la etapa 5 va antes que la inferencia.
Etapa 7: Interpretar \(\hat\beta_0\) y \(\hat\beta_1\)
\(x\) está en unidades de \(x\) e \(y\), en unidades de \(y\), así que la pendiente hereda las unidades de \(y\) por unidad de \(x\).
b0, b1 = fit["beta0"], fit["beta1"]print(f"β̂0 = {b0:.3f} → predicción en x = 0 (fuera del rango [{x.min():.2f}, {x.max():.2f}])")print(f"β̂1 = {b1:.3f} → Δŷ por cada +1 en x")print()x0 =4.0print(f"ŷ(x={x0}) = {b0 + b1 * x0:.3f}")
β̂0 = 2.007  → predicción en x = 0 (fuera del rango [1.07, 9.78])
β̂1 = 1.862  → Δŷ por cada +1 en x

ŷ(x=4.0) = 9.455
\(\hat\beta_0=2.007\) es la predicción en \(x=0\), fuera del rango observado de \([1.07,\,9.78]\), y \(\hat\beta_1=1.862\) es el cambio de \(\hat y\) por cada unidad más de \(x\); en \(x=4\) la recta predice \(9.455\). Esa predicción dice qué esperas en nubes como esta para \(x=4\), y no qué valdría \(y\) si forzaras \(x=4\).
La pendiente es una asociación condicional al modelo. Cambiar \(x\) en el mundo puede mover otras variables (confusores) que la recta simple no ve, y sin un diseño experimental o un argumento causal \(\hat\beta_1\) no es el efecto de una intervención.
Etapa 8: Cuando la nube es una curva, la recta igual se dibuja
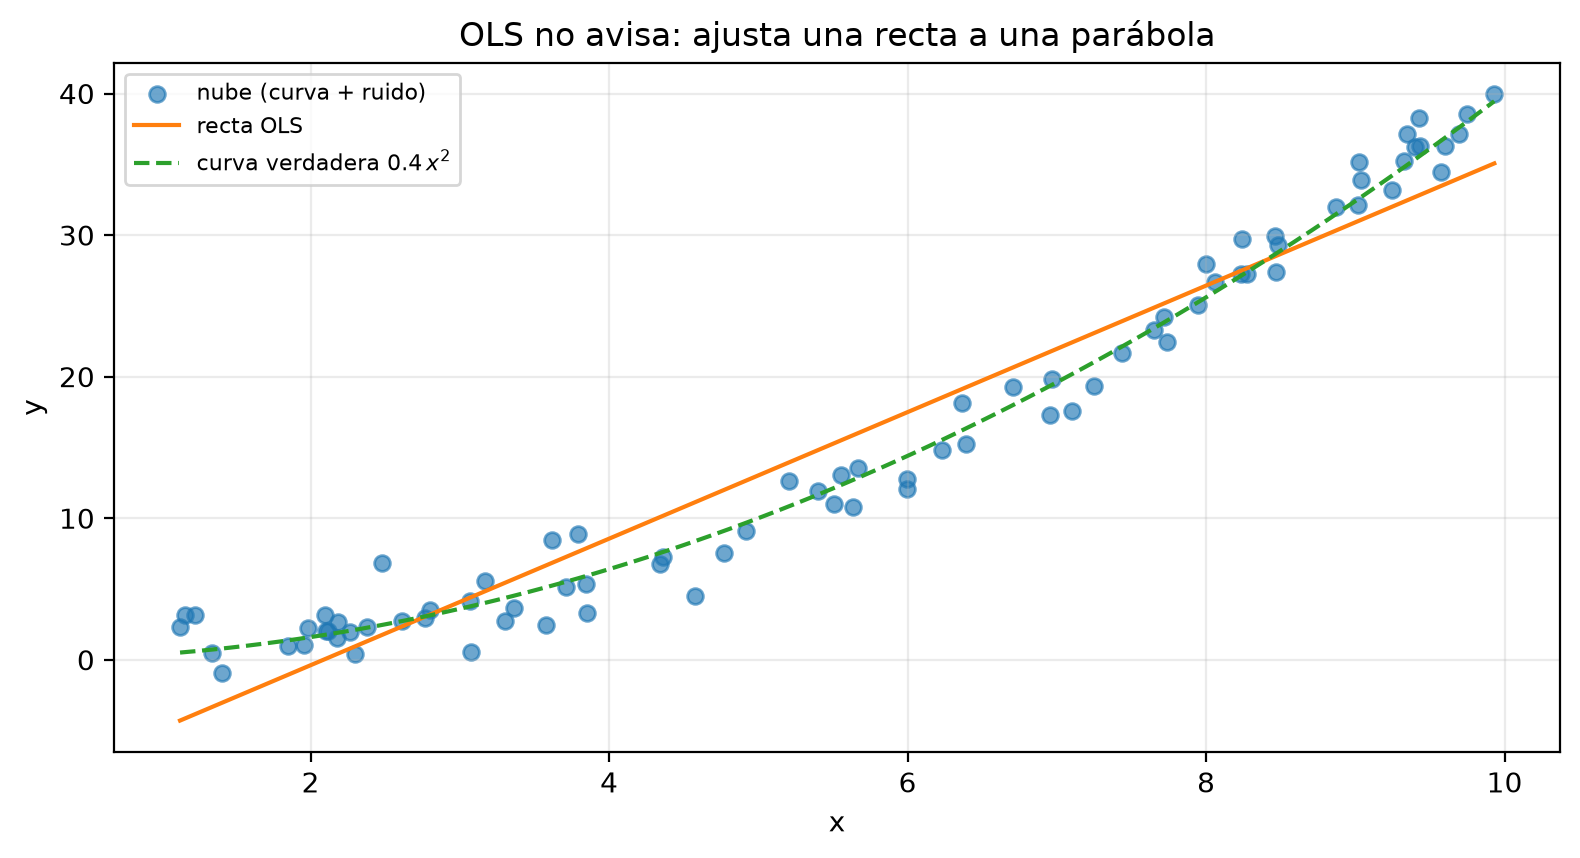
Generas \(y=0.4\,x^2+\varepsilon\), con ruido normal de desviación 1.5, en el mismo rango de \(x\). OLS entrega una pendiente como antes, y sus resúmenes numéricos no avisan del problema. Comparas el \(R^2\) con el de la nube lineal y miras la recta sobre la nube y los residuos.
x_c = rng.uniform(1, 10, size=n)y_c =0.4* x_c **2+ rng.normal(0, 1.5, size=n)fit_c = ajustar_ols(x_c, y_c)print("Curva ajustada con una recta: β̂0 =", round(fit_c["beta0"], 3), " β̂1 =", round(fit_c["beta1"], 3))print("MSE (recta sobre curva) =", round(fit_c["mse"], 3))print("MSE de la nube lineal (etapa 4) =", round(mse_sk, 3), " ← no son comparables: y distinta")print("R² (recta sobre curva) =", round(r2_score(y_c, fit_c["yhat"]), 3), " R² de la nube lineal (etapa 4) =", round(r2, 3))
Curva ajustada con una recta: β̂0 = -9.327   β̂1 = 4.47
MSE (recta sobre curva) = 10.297
MSE de la nube lineal (etapa 4) = 1.23   ← no son comparables: y distinta
R² (recta sobre curva) = 0.938    R² de la nube lineal (etapa 4) = 0.943
graficar_curva_vs_recta( x_c, y_c, fit_c["beta0"], fit_c["beta1"],"OLS no avisa: ajusta una recta a una parábola", curva=lambda v: 0.4* v **2, etiqueta_curva=r"curva verdadera $0.4\,x^2$",)
graficar_residuos(fit_c["yhat"], fit_c["e"], "El diagnóstico: residuos en U (linealidad rota)")
La recta ajustada a la parábola es \(\hat y=-9.33+4.47\,x\), con un MSE de 10.30 (que no puedes comparar con el 1.23 de la etapa 4, porque la \(y\) es otra) y un \(R^2\) de \(0.938\), casi el de la nube lineal (\(0.943\)). Ninguno de los dos números certifica linealidad. En la primera figura la recta corta la curva verdadera en dos puntos, y en la de residuos estos quedan en U: por encima de cero en los dos extremos de \(\hat y\) (hasta \(+7\)) y por debajo en el centro (hasta \(-6.6\)).
El gráfico de residuos forma parte del ajuste. En IA, un modelo lineal sobre una relación con umbral o con saturación deja un patrón parecido en los residuos y un coeficiente de apariencia interpretable.
Etapa 9: El cuarteto de Anscombe
Ajustas cuatro conjuntos con los valores que publicó Anscombe en 1973. Todos tienen \(n=11\), casi el mismo \(\hat\beta_0\approx 3\), el mismo \(\hat\beta_1\approx 0.5\) y el mismo MSE, y cuatro geometrías distintas.
anscombe = [ ( np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]), np.array([8.04, 6.95, 7.58, 8.81, 8.33, 9.96, 7.24, 4.26, 10.84, 4.82, 5.68]), ), ( np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]), np.array([9.14, 8.14, 8.74, 8.77, 9.26, 8.10, 6.13, 3.10, 9.13, 7.26, 4.74]), ), ( np.array([10.0, 8, 13, 9, 11, 14, 6, 4, 12, 7, 5]), np.array([7.46, 6.77, 12.74, 7.11, 7.81, 8.84, 6.08, 5.39, 8.15, 6.42, 5.73]), ), ( np.array([8.0, 8, 8, 8, 8, 8, 8, 19, 8, 8, 8]), np.array([6.58, 5.76, 7.71, 8.84, 8.47, 7.04, 5.25, 12.50, 5.56, 7.91, 6.89]), ),]fits_a = [ajustar_ols(x_a, y_a) for x_a, y_a in anscombe]tab = pd.DataFrame( {"conjunto": ["I", "II", "III", "IV"],"beta0": [f["beta0"] for f in fits_a],"beta1": [f["beta1"] for f in fits_a],"MSE": [f["mse"] for f in fits_a],"R2": [r2_score(y_a, f["yhat"]) for (x_a, y_a), f inzip(anscombe, fits_a)], })print(tab.round(3).to_string(index=False))graficar_anscombe( anscombe, fits_a,"Misma pendiente, mismo MSE, cuatro historias. El diagrama no es opcional",)
conjunto  beta0  beta1   MSE    R2
       I  3.000    0.5 1.251 0.667
      II  3.001    0.5 1.252 0.666
     III  3.002    0.5 1.251 0.666
      IV  3.002    0.5 1.249 0.667
La tabla da \(\hat\beta_0\) entre 3.000 y 3.002, \(\hat\beta_1=0.5\), un MSE de 1.25 y un \(R^2\) de 0.67 en los cuatro conjuntos, y la figura muestra cuatro historias. El I es una recta ruidosa. El II es una curva, y la pendiente promedia una inclinación que cambia a lo largo de \(x\). El III es una recta más un punto que inclina\(\hat\beta_1\), porque OLS eleva al cuadrado su residuo. El IV tiene \(x\) constante en 8 salvo un punto en \(x=19\) que apalanca la pendiente: sin ese punto no habría recta que estimar.
Si reportas \(\hat\beta_1=0.5\) sin decir a cuál de las cuatro nubes corresponde, dejas al lector sin la información principal.
Etapa 10: Un punto extremo inclina la recta
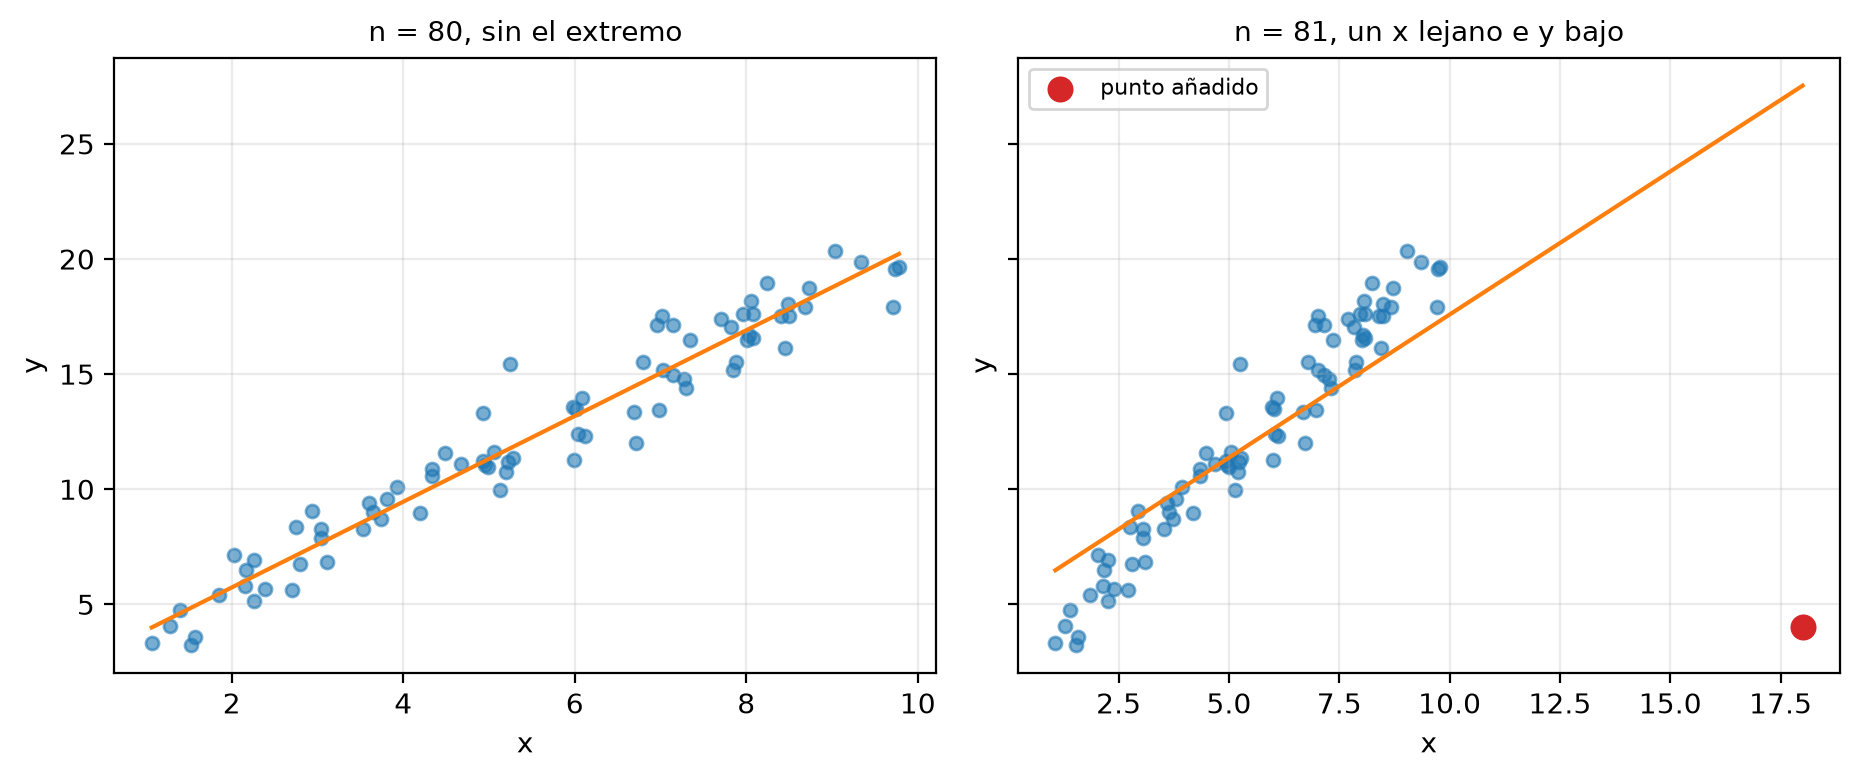
Partes de la nube lineal de la etapa 1 y agregas a mano un punto \((x,y)=(18,\,4)\), con \(x\) lejos de \(\bar x\) e \(y\) bajo, y comparas las pendientes.
x_ext = np.append(x, 18.0)y_ext = np.append(y, 4.0)fit_ext = ajustar_ols(x_ext, y_ext)print("Sin el punto: β̂1 =", round(fit["beta1"], 3), " MSE =", round(fit["mse"], 3))print("Con el punto: β̂1 =", round(fit_ext["beta1"], 3), " MSE =", round(fit_ext["mse"], 3))print("Δβ̂1 =", round(fit_ext["beta1"] - fit["beta1"], 3))fig, axes = plt.subplots(1, 2, figsize=(9.4, 4.0), sharey=True)for ax, xx, yy, ft, tit in [ (axes[0], x, y, fit, "n = 80, sin el extremo"), (axes[1], x_ext, y_ext, fit_ext, "n = 81, un x lejano e y bajo"),]: ax.scatter(xx, yy, s=22, alpha=0.6) xs = np.linspace(xx.min(), xx.max(), 60) ax.plot(xs, ft["beta0"] + ft["beta1"] * xs, color="C1") ax.set_title(tit, fontsize=10) ax.set_xlabel("x") ax.set_ylabel("y")axes[1].scatter([18], [4], s=70, color="C3", zorder=3, label="punto añadido")axes[1].legend(fontsize=8)plt.tight_layout()plt.show()
Sin el punto:  β̂1 = 1.862   MSE = 1.23
Con el punto:  β̂1 = 1.243   MSE = 10.372
Δβ̂1 = -0.619
Un solo punto entre 81 baja la pendiente de \(1.862\) a \(1.243\) (\(-0.619\)) y multiplica el MSE por más de ocho, de \(1.23\) a \(10.37\). En el panel derecho de la figura, la recta deja de pasar por el centro de la nube: queda por encima de los puntos de la izquierda y por debajo de los de la derecha.
Ese punto tiene apalancamiento, porque está lejos en \(x\) y mueve \(\hat\beta_1\) mucho más que un punto cerca de \(\bar x\). No lo borres por reflejo, ya que puede ser un fallo real del sistema; repórtalo y ajusta también sin él, para ver cuánto depende la conclusión de esa fila.
Etapa 11: Latencia frente a tamaño de lote
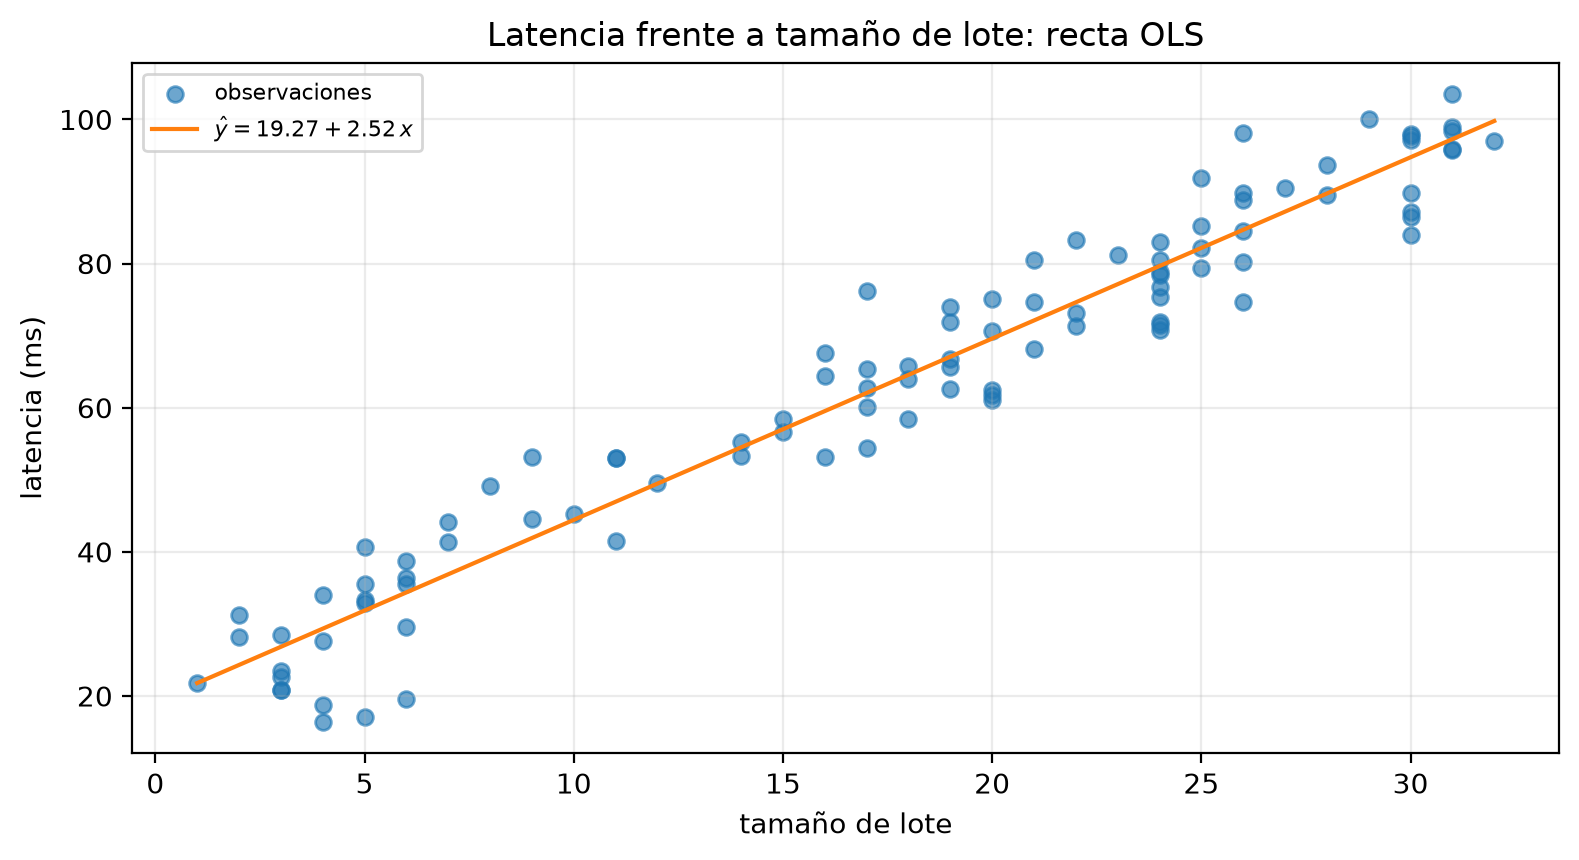
Un servicio de inferencia agrupa los requests en lotes. \(x\) es el tamaño de lote (de 1 a 32) e \(y\), la latencia en ms. Simulas \(n=100\) requests con lotes enteros al azar y la regla
Ajustas con scikit-learn, lees \(\hat\beta_1\) en ms por unidad de lote y calculas su intervalo con linregress. Las dos figuras siguientes muestran la recta sobre la nube y los residuos.
β̂0 (ms, lote=0) = 19.274
β̂1 (ms por +1 de lote) = 2.516   (diseño 2.6)
MSE = 35.311   RMSE = 5.942 ms  (σ diseño = 6)
R² = 0.939

Predicción en lote 8:  39.4 ms
Predicción en lote 32: 99.78 ms

EE(β̂1) = 0.0649   IC 95% para β1: [ 2.387 , 2.645 ]  p-value = 3.0e-61
graficar_recta( lote, latencia, mod_lat.intercept_, float(mod_lat.coef_[0]),"Latencia frente a tamaño de lote: recta OLS", xlabel="tamaño de lote", ylabel="latencia (ms)",)
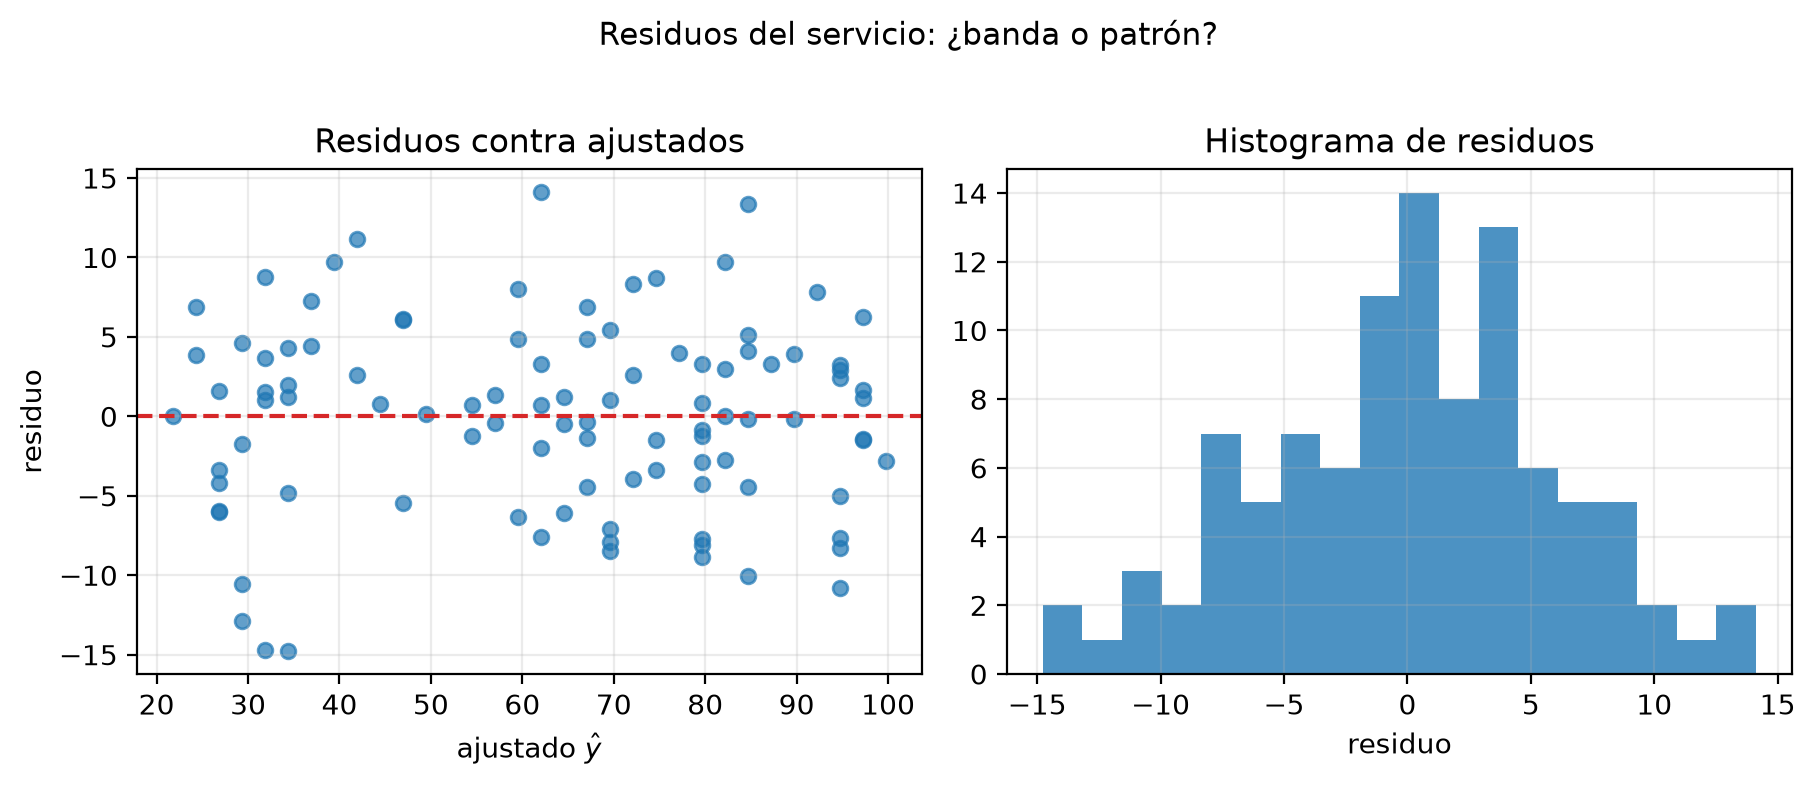
graficar_residuos(yhat_lat, e_lat, "Residuos del servicio: ¿banda o patrón?")
La pendiente estimada es \(2.516\) ms por unidad de lote, con IC 95% de \(2.387\) a \(2.645\), y el intervalo contiene el valor de diseño, \(2.6\). Es una asociación en el rango de 1 a 32: la recta predice 39.4 ms con lote 8 y 99.8 ms con lote 32, y no te dice nada sobre un lote de 256, fuera del rango observado. El intercepto, \(19.27\) ms, se parece a una latencia fija (carga del modelo, red), pero el lote \(0\) no se midió, así que esa lectura es una extrapolación.
En la figura de residuos, estos forman una banda horizontal entre unos \(-15\) y \(+14\) ms a lo largo de todo el rango de \(\hat y\) (de 20 a 100 ms), sin curva ni embudo, y el histograma está centrado en 0. El RMSE de \(5.94\) ms coincide con el ruido de diseño (\(\sigma=6\)), una cercanía propia de esta muestra simulada. Un RMSE de ajuste menor que 6 no demostraría por sí solo sobreajuste; para evaluar la generalización necesitas datos reservados (capítulo 15).
Para reportar la recta sigues siete pasos:
Respuesta y explicativa:\(y\), \(x\), unidades y rango de \(x\).
Modelo y ajuste: lineal simple, OLS y \(n\).
Coeficientes:\(\hat\beta_0\) y \(\hat\beta_1\) en unidades, con la frase de asociación.
Incertidumbre: error estándar e intervalo de confianza de \(\hat\beta_1\).
Error: MSE y RMSE.
Diagnóstico: si los residuos forman una banda, una U, un embudo o tienen un punto que apalanca.
Límites: causalidad, extrapolación y una sola \(x\).
Los aplicas al caso de latencia que acabas de ajustar.
Respuesta y explicativa.\(y\) = latencia de inferencia (ms); \(x\) = tamaño de lote (1 a 32); \(n=100\).
Modelo y ajuste.\(y=\beta_0+\beta_1 x+\varepsilon\), OLS con LinearRegression.
Coeficientes.\(\hat\beta_1=2.516\) ms por cada unidad de lote. \(\hat\beta_0=19.27\) ms es la predicción en lote 0, que no se observó.
Incertidumbre. Error estándar de la pendiente de \(0.065\); IC 95% de \(2.39\) a \(2.64\) ms por unidad de lote.
Error. RMSE de \(5.94\) ms, coherente con el ruido del diseño; \(R^2=0.939\).
Diagnóstico. Los residuos forman una banda horizontal, sin curva ni embudo, y su histograma está centrado en 0, sin colas marcadas; en este rango la recta describe bien la nube.
Límites. No se afirma que subir el lote cause 2.5 ms más (puede haber colas, uso de GPU u otro tráfico), no se predice el lote 256 y hay una sola feature.
En \(n=100\) solicitudes, la latencia media se asocia a \(+2.52\) ms por cada unidad de lote (IC 95%: \(2.39\) a \(2.64\); OLS). RMSE \(=5.9\) ms. Los residuos no muestran patrón. La recta sirve para interpolar entre lotes 1 y 32, no para decidir un cambio de infraestructura sin un experimento. Limitaciones: una sola \(x\) y ruido gaussiano de diseño; no se analizan las latencias más altas.
Etapa 12: Un caso con datos reales, diabetes e índice de masa corporal
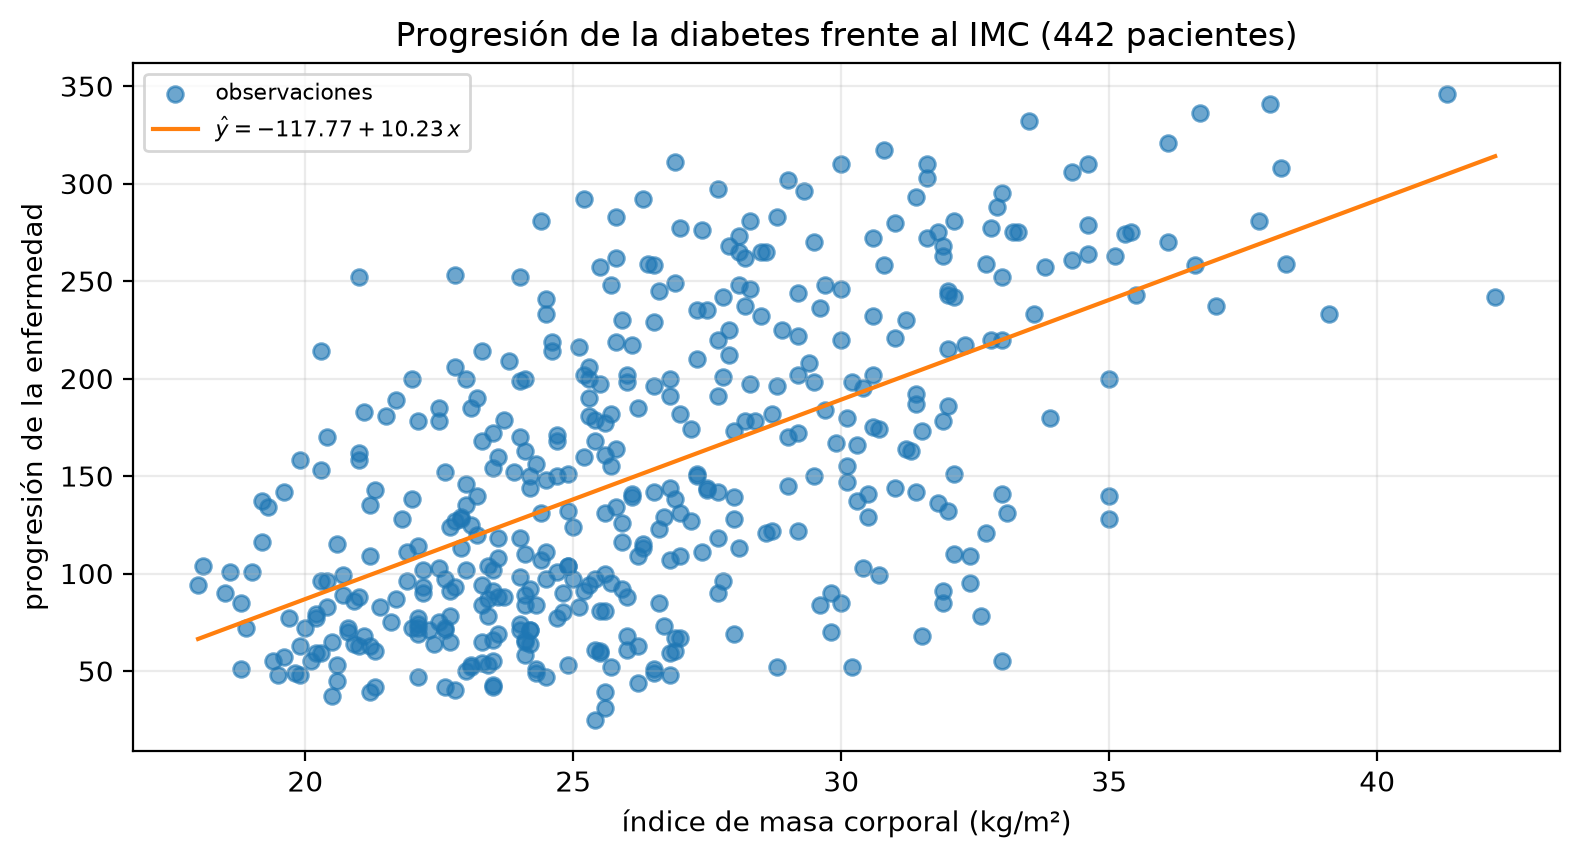
Todos los datos anteriores se simularon, y estos no: es el conjunto Diabetes de Efron, Hastie, Johnstone y Tibshirani (2004), incluido en scikit-learn. Tiene 442 pacientes, con diez mediciones al inicio del estudio para cada uno y una medida cuantitativa de la progresión de la enfermedad un año después, un índice sin unidad física que va de 25 a 346.
Usas una sola variable explicativa, el índice de masa corporal (IMC, en kg/m²). Con datos reales no tienes parámetros de diseño contra los cuales comparar, así que examinas los residuos y comparas la incertidumbre clásica con una estimación robusta HC3 (MacKinnon y White, 1985), que no supone varianza constante.
Ajustas y describes la misma muestra de 442 pacientes, de modo que el RMSE y el \(R^2\) que siguen son de ajuste y no estimaciones de desempeño fuera de muestra. Además, load_diabetes(scaled=False) entrega las variables en sus unidades originales; por defecto scikit-learn las entrega centradas y reescaladas, y con ellas no podrías leer la pendiente en kg/m².
diabetes = load_diabetes(as_frame=True, scaled=False)imc = diabetes.data["bmi"].to_numpy()progresion = diabetes.target.to_numpy()n_dia =len(imc)print("Pacientes:", n_dia)print("IMC (kg/m²): mínimo =", imc.min(), " media =", round(imc.mean(), 2), " máximo =", imc.max())print("Progresión: mínimo =", progresion.min(), " media =", round(progresion.mean(), 1), " máximo =", progresion.max())mod_dia = LinearRegression().fit(imc.reshape(-1, 1), progresion)yhat_dia = mod_dia.predict(imc.reshape(-1, 1))e_dia = progresion - yhat_dialr_dia = stats.linregress(imc, progresion)t_dia = stats.t.ppf(0.975, df=n_dia -2)print()print("β̂0 =", round(mod_dia.intercept_, 2), " β̂1 =", round(float(mod_dia.coef_[0]), 3), "puntos de progresión por cada kg/m²")print("EE(β̂1) =", round(lr_dia.stderr, 3), " IC 95%: [", round(lr_dia.slope - t_dia * lr_dia.stderr, 2), ",",round(lr_dia.slope + t_dia * lr_dia.stderr, 2), "] p-value =", f"{lr_dia.pvalue:.1e}")rmse_dia =float(np.sqrt(mean_squared_error(progresion, yhat_dia)))print("RMSE =", round(rmse_dia, 2)," desviación estándar de la progresión =", round(progresion.std(ddof=1), 2))print("Reducción del error típico al conocer el IMC =", f"{1- rmse_dia / progresion.std(ddof=1):.1%}")print("R² =", round(r2_score(progresion, yhat_dia), 3), " r =", round(lr_dia.rvalue, 3))# ¿La dispersión de los residuos cambia con el valor ajustado?# Ordenar por IMC equivale a ordenar por valor ajustado, porque la pendiente es positiva.# kind="stable" fija el orden entre pacientes con el mismo IMC.orden_dia = np.argsort(imc, kind="stable")tercios = np.array_split(e_dia[orden_dia], 3)print("Desviación estándar de los residuos por tercios de ŷ (bajo, medio, alto):", [round(float(t.std(ddof=1)), 1) for t in tercios])# Predicción y sus dos intervalos (fórmulas de la sección 1.5) para tres valores de IMCs_dia = np.sqrt(np.sum(e_dia **2) / (n_dia -2))sxx_dia = np.sum((imc - imc.mean()) **2)imc_0 = np.array([22.0, 26.0, 30.0])pred_0 = mod_dia.predict(imc_0.reshape(-1, 1))ee_media_0 = s_dia * np.sqrt(1/ n_dia + (imc_0 - imc.mean()) **2/ sxx_dia)ee_pred_0 = s_dia * np.sqrt(1+1/ n_dia + (imc_0 - imc.mean()) **2/ sxx_dia)print()print("Predicción, IC 95% de la media e intervalo de predicción al 95%:")for v, p, em, ep inzip(imc_0, pred_0, ee_media_0, ee_pred_0):print(f" IMC {v:.0f}: ŷ = {p:5.1f} media: [{p - t_dia * em:5.1f}, {p + t_dia * em:5.1f}]"f" predicción: [{p - t_dia * ep:5.1f}, {p + t_dia * ep:5.1f}] semiancho = {t_dia * ep:.1f}")# El mismo intervalo de predicción, evaluado en el IMC de cada pacienteee_pred_dia = s_dia * np.sqrt(1+1/ n_dia + (imc - imc.mean()) **2/ sxx_dia)lim_inf_dia = yhat_dia - t_dia * ee_pred_diaprint("Pacientes con límite inferior de predicción por debajo de 25 (mínimo observado):",int(np.sum(lim_inf_dia <25)), "de", n_dia)# Inferencia clásica y robusta HC3 con statsmodels, sobre las mismas filas.modelo_dia_sm = sm.OLS(progresion, sm.add_constant(imc)).fit()modelo_dia_hc3 = modelo_dia_sm.get_robustcov_results(cov_type="HC3", use_t=True)tabla_inferencia = pd.DataFrame({"modelo": ["OLS clásico", "OLS con covarianza HC3"],"pendiente": [modelo_dia_sm.params[1], modelo_dia_hc3.params[1]],"error_estandar": [modelo_dia_sm.bse[1], modelo_dia_hc3.bse[1]],"IC_95_inferior": [modelo_dia_sm.conf_int()[1, 0], modelo_dia_hc3.conf_int()[1, 0]],"IC_95_superior": [modelo_dia_sm.conf_int()[1, 1], modelo_dia_hc3.conf_int()[1, 1]],})print("Comparación de incertidumbre de la pendiente (misma estimación OLS):")print(tabla_inferencia.round(4).to_string(index=False))assert np.allclose(modelo_dia_sm.params, [mod_dia.intercept_, mod_dia.coef_[0]])assert np.isclose(modelo_dia_sm.bse[1], lr_dia.stderr)
Pacientes: 442
IMC (kg/m²):  mínimo = 18.0   media = 26.38   máximo = 42.2
Progresión:   mínimo = 25.0   media = 152.1   máximo = 346.0

β̂0 = -117.77    β̂1 = 10.233 puntos de progresión por cada kg/m²
EE(β̂1) = 0.674   IC 95%: [ 8.91 , 11.56 ]  p-value = 3.5e-42
RMSE = 62.37    desviación estándar de la progresión = 77.09
Reducción del error típico al conocer el IMC = 19.1%
R² = 0.344    r = 0.586
Desviación estándar de los residuos por tercios de ŷ (bajo, medio, alto): [49.4, 68.0, 68.4]

Predicción, IC 95% de la media e intervalo de predicción al 95%:
  IMC 22:  ŷ = 107.4   media: [ 99.1, 115.6]   predicción: [-15.8, 230.5]   semiancho = 123.1
  IMC 26:  ŷ = 148.3   media: [142.4, 154.2]   predicción: [ 25.3, 271.3]   semiancho = 123.0
  IMC 30:  ŷ = 189.2   media: [181.7, 196.8]   predicción: [ 66.1, 312.3]   semiancho = 123.1
Pacientes con límite inferior de predicción por debajo de 25 (mínimo observado): 232 de 442
Comparación de incertidumbre de la pendiente (misma estimación OLS):
                modelo  pendiente  error_estandar  IC_95_inferior  IC_95_superior
           OLS clásico    10.2331          0.6738          8.9089         11.5574
OLS con covarianza HC3    10.2331          0.6181          9.0183         11.4480
graficar_recta(imc, progresion, mod_dia.intercept_, float(mod_dia.coef_[0]),"Progresión de la diabetes frente al IMC (442 pacientes)", xlabel="índice de masa corporal (kg/m²)", ylabel="progresión de la enfermedad")
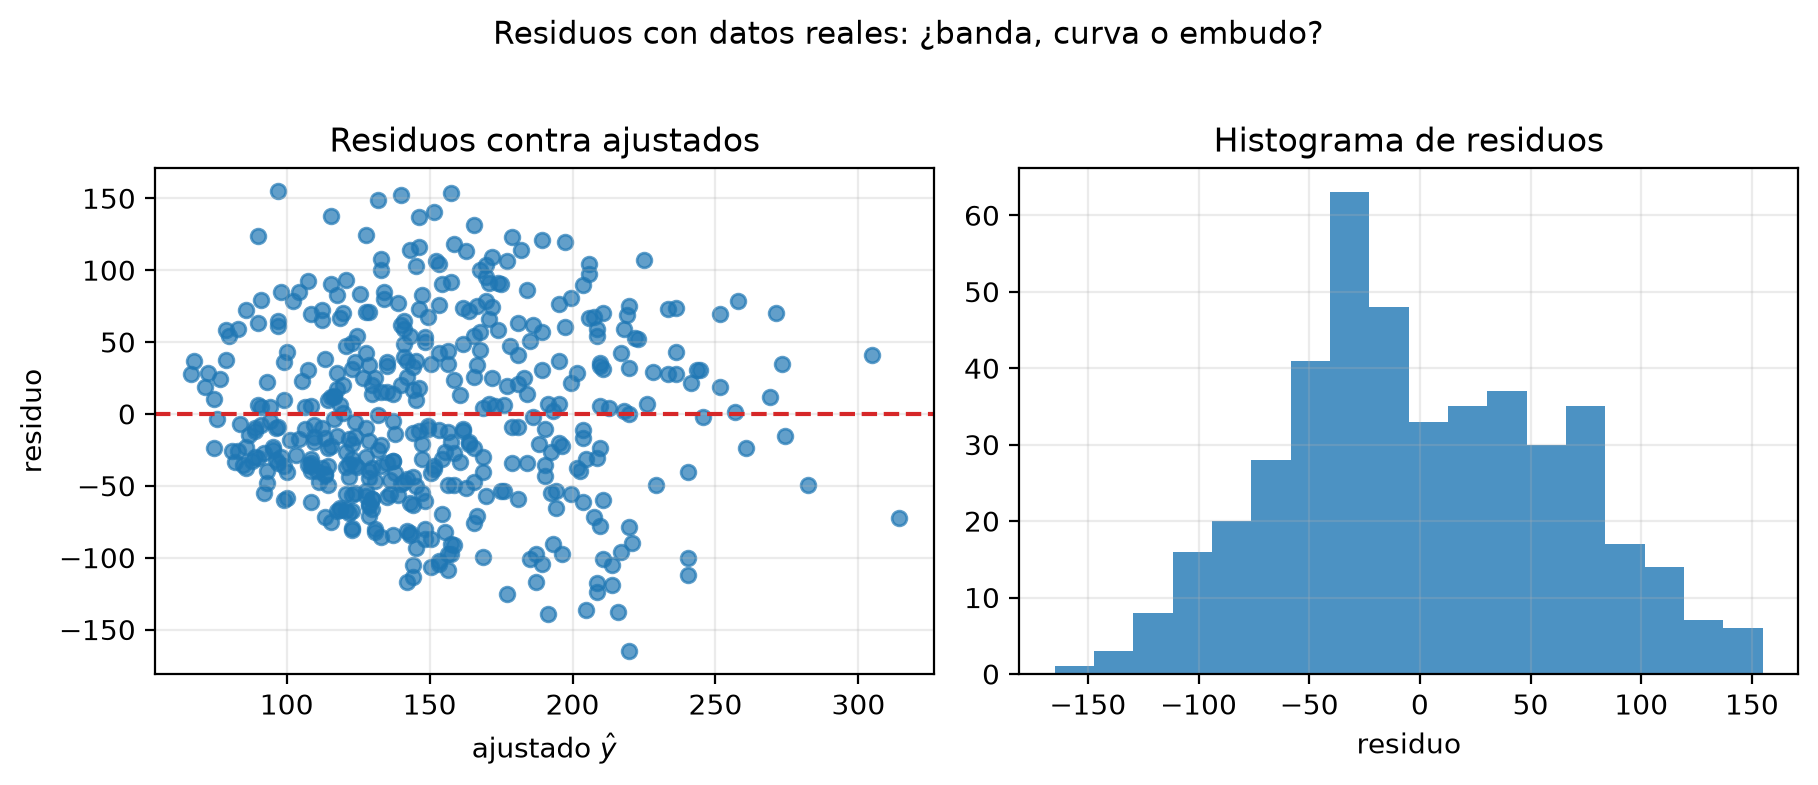
graficar_residuos(yhat_dia, e_dia, "Residuos con datos reales: ¿banda, curva o embudo?")
Cada kg/m² adicional de IMC se asocia con \(10.2\) puntos más de progresión de la enfermedad (IC 95%: \(8.9\) a \(11.6\)). La pendiente está bien determinada: su error estándar es \(0.67\) y el p-value es del orden de \(10^{-42}\). En la primera figura, la recta \(\hat y=-117.77+10.23\,x\) sube con el IMC entre 18 y 42 kg/m², y la nube que la rodea es muy ancha. Estos datos enseñan tres cosas que los simulados no mostraban.
La primera es que una pendiente muy “significativa” puede venir con un ajuste modesto. \(R^2=0.344\): el IMC se asocia con un tercio de la variación de la progresión, y dos tercios quedan sin explicar. El RMSE es \(62.4\) frente a una desviación estándar de la respuesta de \(77.1\), así que conocer el IMC reduce el error típico en un 19%. Las dos afirmaciones son compatibles: con 442 pacientes la pendiente se estima con precisión, y aun así la predicción para un paciente concreto es muy incierta. Para un IMC de 22, 26 y 30 la recta predice \(107.4\), \(148.3\) y \(189.2\) puntos. La media de la progresión con IMC 26 se conoce bien, con un IC del 95% de \(142.4\) a \(154.2\), mientras que el intervalo de predicción para un paciente con ese IMC va de \(25.3\) a \(271.3\), unos \(123\) puntos a cada lado, en una escala que va de 25 a 346. Ese intervalo supone errores normales y de varianza constante, y da límites inferiores por debajo de 25, el valor más bajo observado, para \(232\) de los 442 pacientes; con IMC 22 el límite es incluso negativo (\(-15.8\)). Léelo como una medida gruesa de la incertidumbre y no como un rango creíble. El p-value habla de la pendiente, y el RMSE, de la utilidad para predecir.
La segunda es que los residuos no forman una banda limpia. Ordenados por valor ajustado, su desviación estándar es de cerca de \(49\) en el tercio bajo y de \(68\) en los otros dos, un indicio de heterocedasticidad: la progresión es más variable entre pacientes con IMC medio y alto. En la figura de residuos aparece además un borde diagonal inferior, porque la progresión observada no baja de 25; ese mínimo muestral no demuestra un límite teórico de la respuesta, y la relación entre el rango observado y el patrón residual es una hipótesis descriptiva que tendrías que contrastar con el proceso de medición. El histograma es algo asimétrico, con el máximo a la izquierda de 0 y una meseta ancha a la derecha hasta cerca de 80, aunque las dos colas llegan a distancias parecidas (de \(-165\) a \(+155\)). La tabla de statsmodels conserva la pendiente de 10.2331 en los dos cálculos: el error estándar clásico es 0.6738 y el HC3, 0.6181, con intervalos de [8.9089, 11.5574] y [9.0183, 11.4480]. En estos datos HC3 da un intervalo algo más estrecho, lo que muestra que una corrección robusta no tiene por qué ensancharlo. HC3 no corrige una media mal especificada ni la dependencia entre pacientes, y no convierte los intervalos de predicción clásicos en robustos. La recta sigue siendo una descripción razonable de la tendencia, y el error estándar y los intervalos anteriores, que suponen varianza constante, los lees como aproximados.
La tercera es que se trata de un estudio observacional. Nadie asignó el IMC de cada paciente, y los pacientes con mayor IMC pueden diferir en edad, presión arterial o perfil de lípidos, que también se relacionan con la progresión. La pendiente de \(10.2\) mezcla el papel del IMC con el de todo lo que lo acompaña, y no te permite afirmar que bajar un punto de IMC reduzca la progresión en 10 puntos.
El intercepto, \(-117.8\), es la predicción para un IMC de cero, un valor imposible y muy lejos del rango observado (18 a 42); solo sirve para ubicar la recta.
En 442 pacientes, la progresión de la enfermedad a un año se asocia con el IMC inicial: \(+10.2\) puntos por cada kg/m² (IC 95%: \(8.9\) a \(11.6\); OLS). \(R^2=0.34\); RMSE \(=62\). Los residuos son menos dispersos en el tercio de valores ajustados más bajos, y el error estándar robusto HC3 (0.62) es parecido al clásico (0.67). La asociación es observacional y no descuenta otras variables. Estas cifras se calcularon sobre los mismos datos del ajuste.
Ejercicios
Los cinco ejercicios usan el conjunto de la etapa 12: diabetes.data contiene las diez variables en sus unidades originales y progresion es la respuesta.
Repetir el procedimiento con otra variable. Ajusta la progresión frente a bp (presión arterial media). Calcula \(\hat\beta_0\) y \(\hat\beta_1\) con las fórmulas, verifica con LinearRegression, dibuja la nube con la recta y obtén el intervalo de confianza de la pendiente con stats.linregress. Redacta el resultado con la plantilla del flujo de trabajo.
Tres pacientes. Toma los percentiles 10, 50 y 90 del IMC como tres pacientes plausibles. Predice su progresión con la recta de la etapa 12 y calcula para cada uno el intervalo de predicción del 95% y el IC de la media, como hace el código de la etapa 12 para IMC 22, 26 y 30. ¿Cuál de los dos intervalos cambia más con la distancia a \(\bar x\), y por qué el de predicción casi no cambia? ¿Algún límite cae fuera del rango observado de la respuesta (25 a 346), y qué supuesto sobre los errores lo permite?
Una variable a la vez. Ajusta una regresión simple para cada una de las diez variables y ordénalas por su \(R^2\). Compara el orden con el de las correlaciones \(|r|\) con la respuesta. ¿Por qué coinciden? Ten presente que estos \(R^2\) se calculan sobre los mismos datos del ajuste.
Ecuaciones normales. Elige la variable que quedó segunda en el ejercicio anterior. Construye la matriz \(X\) con una columna de unos y esa variable, resuelve \(X^\top X\hat{\boldsymbol\beta}=X^\top\mathbf y\) con NumPy y comprueba que coincide con LinearRegression.
Menos datos, menos certeza. Toma al azar 30 de los 442 pacientes y repite el ajuste de la etapa 12. Compara la pendiente y, sobre todo, el ancho de su intervalo de confianza con los obtenidos con todos los datos. Repítelo con varias submuestras: ¿cuánto cambia la pendiente de una a otra, y se parece ese cambio al error estándar que reporta cada ajuste?
TipOrientaciones
Usa las unidades originales de bp, agrega el intercepto y comprueba que las fórmulas y LinearRegression coinciden. En statsmodels, sm.OLS(progresion, sm.add_constant(bp)).fit() entrega la pendiente y su intervalo. El coeficiente expresa una asociación por unidad de presión arterial, sin lectura causal automática.
Los dos intervalos se ensanchan al alejarse de la media del IMC, pero en el de predicción domina el término 1 de la raíz, que representa la variación individual, y por eso cambia menos en términos relativos: en la etapa 12, su semiancho fue de 123.0 a 123.1 entre IMC 22 y 30. Un límite fuera del rango observado señala que el modelo gaussiano con varianza constante permite valores que no aparecieron en esta muestra; el mínimo observado no es un límite teórico.
En una regresión simple con intercepto, calculada sobre las mismas filas, \(R^2=r^2\), y el orden coincide con el de \(|r|\) por esa identidad. No es una evaluación de utilidad fuera de muestra, y elegir variables con estos resultados exigiría después una evaluación separada.
Construye X = np.column_stack([np.ones(len(v)), v]) y resuelve con np.linalg.solve(X.T @ X, X.T @ progresion) o con np.linalg.lstsq(X, progresion, rcond=None)[0], sin formar la inversa; compara con intercept_ y coef_ de LinearRegression.
Crea un generador propio, rng_ej = np.random.default_rng(SEMILLA), y extrae índices sin reemplazo con rng_ej.choice(442, size=30, replace=False). Informa el tamaño de muestra y compara errores estándar e intervalos, no solo pendientes. Con 30 pacientes el error estándar suele ser unas \(\sqrt{442/30}\approx 3.8\) veces mayor que con todos, aunque una sola extracción no garantiza ese valor; repetir el muestreo muestra su variabilidad.
Errores que conviene nombrar
Leer \(\hat\beta_1\) como un efecto causal sin un diseño que lo sostenga; en la etapa 12, los 10.2 puntos por kg/m² mezclan el IMC con todo lo que lo acompaña.
Extrapolar a \(x=0\) o más allá del rango, como con el intercepto o el lote 256.
Reportar el MSE o el \(R^2\) sin el diagrama de dispersión. Las cuatro nubes de Anscombe tienen el mismo \(R^2\) de 0.67.
Ignorar residuos en U o en embudo. La recta se calcula igual, pero el modelo está mal especificado.
Confundir el MSE (divisor \(n\)) con \(s^2\) (divisor \(n-2\)).
Borrar el atípico por costumbre. Informa el ajuste con y sin él.
Tomar un \(R^2\) alto como prueba de que el modelo es bueno. La parábola de la etapa 8 dio \(R^2=0.938\) con residuos en U, y el \(R^2\) tampoco mide la utilidad de la predicción fuera de muestra.
Leer un p-value pequeño de la pendiente como una relación fuerte. Dice que la pendiente se distingue de cero; el tamaño lo dan \(\hat\beta_1\) y su intervalo.
Confundir el intervalo de confianza de la recta con el de predicción. El primero habla de la media de \(y\) y el segundo de una observación nueva, que en la etapa 6 era 7.6 veces más ancho.
Leer coeficientes de variables reescaladas como si estuvieran en sus unidades. Antes de leer una pendiente, averigua en qué unidad entró \(x\).
13.6 Guía rápida: ¿qué fórmula usar?
Situación
Qué usar
Por qué
Una \(x\) y una \(y\) numéricas, con forma de recta
\(y=\beta_0+\beta_1 x+\varepsilon\)
Modelo lineal simple
Elegir la recta
OLS: fórmulas o LinearRegression
Minimiza \(\sum e_i^2\)
Error de ajuste en unidades de \(y^2\)
MSE \(=n^{-1}\sum e_i^2\)
Pérdida \(L_2\)
Error en unidades de \(y\)
RMSE \(=\sqrt{\mathrm{MSE}}\)
Comparable con \(\sigma\) y con \(y\)
¿La nube es una recta?
Residuos contra \(\hat y\)
Detecta U, embudo o atípicos
¿Cuánto se asocia \(y\) a una unidad más de \(x\)?
\(\hat\beta_1\)
Asociación, no causa
¿Qué tan precisa es la pendiente?
Error estándar, IC y prueba \(t\) con \(n-2\) gl (stats.linregress)
Al reportar, incluye las unidades de \(\hat\beta_1\), su intervalo de confianza, el rango de \(x\), el RMSE y una frase sobre los residuos.
13.7 Preguntas de comprensión
En el caso de latencia, ¿qué pasaría con \(\hat\beta_1=2.516\), con su p-value y con el \(R^2\) si midieras la latencia en segundos en lugar de milisegundos?
Un colega reporta \(R^2=0.94\) y concluye que la relación es lineal. Con lo que viste en la etapa 8, ¿qué le pedirías?
¿Por qué el intervalo de predicción en \(x_0=4\) fue 7.6 veces más ancho que el de la media, y qué pasaría con esa razón si tuvieras 8 000 puntos en lugar de 80?
En los datos de diabetes, la pendiente tiene \(p\approx10^{-42}\) y el \(R^2\) es 0.34. ¿Hay contradicción?
Agregas un punto a una nube y la pendiente cambia de 1.862 a 1.243. ¿Qué características del punto explican un cambio tan grande, y qué haces con él?
TipOrientaciones
La pendiente pasaría a \(0.002516\) segundos por unidad de lote, porque hereda las unidades de \(y\) por unidad de \(x\); el error estándar se divide por el mismo factor de 1 000, así que el estadístico \(t\), el p-value y el \(R^2\) no cambian.
El gráfico de residuos contra \(\hat y\). La parábola de la etapa 8 dio \(R^2=0.938\), casi el de la nube lineal, y sus residuos formaban una U clara; el \(R^2\) mide cuánta variación recoge la recta, no si la forma es la correcta.
El intervalo de predicción suma el ruido de una observación nueva (\(s\), el 1 dentro de la raíz), mientras que el de la media solo refleja la incertidumbre sobre la recta, que en \(x_0\) cercano a \(\bar x\) es del orden de \(s/\sqrt n\). Con 8 000 puntos el de la media se estrecharía unas 10 veces y el de predicción casi nada, así que la razón crecería a cerca de 76.
No. El p-value dice que la pendiente se distingue de cero, y con 442 pacientes se estima con precisión (EE de 0.67). El \(R^2\) dice que el IMC solo recoge un tercio de la variación entre pacientes. Una pendiente precisa puede convivir con predicciones individuales muy inciertas, como el intervalo de predicción de unos 123 puntos a cada lado.
El punto está lejos de \(\bar x\) en \(x\) (18 frente a una media de 5.6), así que tiene apalancamiento, y su \(y\) (4) queda muy por debajo de lo que la recta predice ahí, alrededor de 35.5. No lo borras por reflejo: investigas si es un error de registro o un fenómeno real, y reportas el ajuste con y sin él (etapa 10).
13.8 Referencias para profundizar
Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. El origen del cuarteto de la etapa 9.
Efron, B., Hastie, T., Johnstone, I. y Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. El artículo que presentó el conjunto Diabetes de la etapa 12.
MacKinnon, J. G. y White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. Origen del error estándar HC3.
James, G., Witten, D., Hastie, T. y Tibshirani, R. (2021). An Introduction to Statistical Learning (2.ª ed.). Springer. El capítulo 3 desarrolla la regresión lineal simple y múltiple con el mismo enfoque de este capítulo.
Montgomery, D. C., Peck, E. A. y Vining, G. G. (2021). Introduction to Linear Regression Analysis (6.ª ed.). Wiley. Diagnóstico de residuos, apalancamiento e intervalos de predicción en detalle.
scikit-learn. Documentación de LinearRegression y de load_diabetes, con la procedencia y el escalamiento de las variables.
Los datos Diabetes se cargan desde scikit-learn, con la atribución a sus autores. El cuarteto de Anscombe se atribuye al artículo citado y se representa con figuras producidas por este capítulo.
13.9 Lo que debes llevarte de este capítulo
Una pendiente se publica con sus unidades, su intervalo, el diagrama de la nube y los residuos, porque los resúmenes numéricos solos no distinguen una recta de una curva ni una asociación de una causa.
Mínimos cuadrados da una fórmula cerrada: en la nube de la etapa 1, \(\hat\beta_1=1.862\) frente a 1.8 de diseño, con la misma cifra a mano, en forma matricial y con scikit-learn.
El MSE (1.23, divisor \(n\)) y \(s^2\) (1.26, divisor \(n-2\)) son números distintos, y el RMSE (1.11) se lee en unidades de \(y\).
La pendiente se conoce con un error estándar: \(0.0516\), con IC 95% de \(1.76\) a \(1.96\), y en 2 000 muestras el 95.6% de los intervalos cubrió el valor verdadero.
El intervalo de predicción de una observación nueva fue 7.6 veces más ancho que el de la media, porque suma el ruido individual.
Un \(R^2\) alto no certifica linealidad: la parábola dio 0.938 con residuos en U, y las cuatro nubes de Anscombe comparten \(\hat\beta_1=0.5\) y \(R^2=0.67\).
Un solo punto con apalancamiento bajó la pendiente de 1.862 a 1.243.
Con datos reales, una pendiente precisa (10.2 puntos por kg/m², \(p\approx10^{-42}\)) convivió con un ajuste modesto (\(R^2=0.34\)), residuos heterocedásticos y una asociación solo observacional.
13.10 Puente hacia los siguientes capítulos
La recta predice un número. El capítulo 14 pasa a predecir una clase: la pérdida deja de ser el MSE y pasan a importar los umbrales y los costos de cada error. El capítulo 15 muestra que el MSE calculado sobre la misma muestra es optimista, y que tienes que medirlo fuera de las filas que ajustaron \(\hat\beta\).
Varias \(x\) a la vez son la misma pérdida \(L_2\) en un espacio de más dimensiones, con los mismos supuestos y el mismo diagnóstico de residuos. Ese es el punto de partida del nivel Avanzado: la regresión lineal múltiple usa las mismas ecuaciones normales con más columnas en \(X\), y la tabla de coeficientes con error estándar, \(t\) y p-value que construiste aquí para una pendiente se lee allí para cada variable.