9  Inferencia estadística

estadistica
inferencia
intervalos
Autor/a

Wilder Ramírez Delgado

Fecha de publicación

25 de septiembre de 2026

De la muestra a la población, con margen

La media de 25 latencias no es la media de todos los requests de un servicio. Es un estadístico, un número calculado en la muestra. El parámetro, el número de la población, no se ve. La inferencia te permite hablar del parámetro y declarar cuánta incertidumbre tienes sobre él.

El capítulo 8 terminó en que el promedio de \(n\) observaciones es aproximadamente normal, con desviación \(\sigma/\sqrt n\). En este capítulo partes de ahí para construir la estimación puntual, el error estándar, el intervalo de confianza, la prueba de hipótesis, el nivel de significancia, el p-value y los errores tipo I y tipo II. La práctica es simular: fabricas una población, extraes muestras y compruebas qué cubre el intervalo y qué rechaza la prueba. El resultado más útil para un equipo de producto es este: un efecto minúsculo con \(n\) enorme sale «significativo», y un efecto útil con \(n\) pequeño puede no salir.

El ejemplo es la latencia de un servicio de inferencia, en milisegundos, y un experimento A/B entre dos versiones del modelo. Todos los datos son simulados con distribuciones normales cuyos parámetros declara cada etapa.

  • Tiempo estimado de lectura: 50 minutos (unas 2 horas si ejecutas el código y resuelves los ejercicios)
  • Nivel: Básico
  • Conocimientos previos recomendados: el capítulo 8 (distribución normal, error estándar y teorema del límite central), el capítulo 7 (probabilidad condicional) y el capítulo 3 (desviación estándar).
  • Tecnologías mencionadas: Python 3.13, NumPy 2.3, pandas, SciPy 1.16 (scipy.stats) y Matplotlib.

Objetivos

Al terminar este capítulo vas a ser capaz de:

  • distinguir parámetro, estadístico y distribución muestral;
  • calcular una estimación puntual y su error estándar;
  • construir e interpretar un intervalo de confianza para la media y explicar qué significa el 95%;
  • plantear \(H_0\) y \(H_1\), fijar \(\alpha\) y calcular el p-value con SciPy;
  • estimar por simulación las tasas de error tipo I y tipo II y la potencia;
  • distinguir significancia estadística de relevancia práctica y redactar un reporte de inferencia con estimación, intervalo, prueba, decisión y limitación.

Ejecuta las celdas en orden: la población y la muestra de la etapa 1 se usan hasta la etapa 6, y todas las simulaciones comparten el generador rng.

9.1 El lenguaje de la inferencia

Parámetro y estadístico

El parámetro \(\theta\) describe la población: una media \(\mu\), una proporción \(p\), una diferencia de medias. No se observa; se estima. El estadístico \(\hat\theta\) se calcula en la muestra, como \(\bar x\), \(\hat p\) o \(\bar x_B-\bar x_A\), y cambia si cambia la muestra. Por eso \(\hat\theta\) es una variable aleatoria.

Distribución muestral

La distribución muestral de \(\hat\theta\) es la distribución que tendría ese estadístico si repitieras el muestreo muchas veces. Si el estimador es insesgado, su centro coincide con \(\theta\), y su dispersión baja cuando \(n\) crece.

Esa dispersión se resume con el error estándar (SE): la desviación estándar de \(\hat\theta\), no la de una observación. Para la media, si las observaciones son independientes y \(s\) estima \(\sigma\),

\[ \mathrm{SE}(\bar x)=\frac{s}{\sqrt n}. \]

\(s\) mide cuánto varían las filas; el SE mide cuánto varía la media de una muestra a otra.

Estimación puntual

Una estimación puntual es un solo número, como \(\hat\theta=\bar x\). Es el mejor resumen puntual y es incompleto: sin el SE no sabes si \(\bar x=201\) con \(n=8\) y con \(n=8000\) son el mismo tipo de afirmación.

Intervalo de confianza

Un intervalo de confianza de nivel \(1-\alpha\) es un rango aleatorio que, al repetir el muestreo, cubre el parámetro en una fracción \(1-\alpha\) de las veces. Para la media, con \(\sigma\) desconocida y datos aproximadamente normales (o \(n\) no demasiado pequeño),

\[ \bar x \;\pm\; t_{n-1,\,1-\alpha/2}\,\frac{s}{\sqrt n}. \]

\(t_{n-1,1-\alpha/2}\) es el cuantil de la t de Student con \(n-1\) grados de libertad. Si conocieras \(\sigma\), usarías el cuantil \(z_{1-\alpha/2}\) de la normal estándar (1.96 cuando \(\alpha=0.05\)); en la práctica \(\sigma\) no se conoce, y por eso se usa \(t\).

En la lectura frecuentista, el procedimiento cubre \(\mu\) el 95% de las veces. Este intervalo, ya calculado, cubre a \(\mu\) o no lo cubre, porque \(\mu\) no es aleatorio. Decir «hay 95% de probabilidad de que \(\mu\) esté aquí» mezcla el procedimiento con el número ya observado.

Prueba de hipótesis

Una prueba contrasta dos afirmaciones sobre el parámetro:

  • \(H_0\), la hipótesis nula: ningún efecto o un valor de referencia, por ejemplo \(\mu=200\) o \(\mu_B=\mu_A\);
  • \(H_1\), la alternativa: bilateral, como \(\mu\neq 200\), o unilateral, como \(\mu<200\).

El estadístico de prueba mide cuánto se aleja la muestra de \(H_0\) en unidades de error estándar. Para la media,

\[ t=\frac{\bar x-\mu_0}{s/\sqrt n}. \]

Nivel de significancia y p-value

El nivel de significancia \(\alpha\) es la probabilidad de rechazar \(H_0\) por azar cuando \(H_0\) es cierta. Es una tasa de error que tú eliges; 0.05 es una costumbre, no un teorema.

El p-value es la probabilidad, suponiendo \(H_0\) cierta, de obtener un estadístico tan extremo como el observado o más. Tampoco es \(P(H_0\mid \text{datos})\) ni la probabilidad de que haya efecto. Es un área en la cola de la distribución que tendría el estadístico si no hubiera efecto.

La regla operativa es: si el p-value es menor o igual que \(\alpha\), rechazas \(H_0\) al nivel \(\alpha\); si no, no la rechazas. No rechazar \(H_0\) no la demuestra.

Errores tipo I, tipo II y potencia

Error Qué ocurre Control
Tipo I Rechazas \(H_0\) siendo cierta Su tasa, si \(H_0\) es cierta, es \(\alpha\)
Tipo II No rechazas \(H_0\) siendo falsa Su tasa se llama \(\beta\)

La potencia es \(1-\beta\), la probabilidad de detectar el efecto cuando existe. Sube con \(n\), con el tamaño del efecto y con una \(\sigma\) menor, y baja si haces \(\alpha\) más estricto.

Significativo no quiere decir importante

En estadística, «significativo» quiere decir que el azar, bajo \(H_0\), rara vez produce algo tan extremo. No quiere decir grande, útil ni listo para producción. Con \(n\) enorme, un efecto de 0.4 ms puede tener un p-value muy pequeño (etapa 9); con \(n\) pequeño, un efecto de 15 ms puede no rechazar \(H_0\) (etapa 8).

Pregunta Herramienta
¿Qué número de la muestra uso para \(\theta\)? Estimación puntual
¿Cuánto varía ese número entre muestras? Error estándar
¿Qué rangos produce el procedimiento? Intervalo de confianza
¿Los datos son raros si \(H_0\) es cierta? p-value y prueba
¿Cuánto error de falsa alarma acepto? \(\alpha\)
¿Detectaría este efecto si existiera? Potencia

9.2 Por qué importa en IA y machine learning

Un modelo en validación entrega números de muestra: accuracy de 0.81, latencia de 118 ms, mejora de 1.4% en conversión. Sin inferencia, esos números se leen como propiedades del sistema, cuando son propiedades de esas filas.

  • Un A/B de producto es una prueba de hipótesis sobre \(\mu_B-\mu_A\) o \(p_B-p_A\). El p-value no decide el despliegue: informa si el azar basta para explicar la diferencia.
  • El intervalo da el rango plausible del efecto. Un p-value pequeño con un intervalo de \((0.001,\,0.004)\) en conversión no es el mismo hallazgo que uno de \((0.04,\,0.11)\).
  • En selección de modelos, comparar dos accuracies medidas en 80 casos de prueba y declarar un ganador es una inferencia hecha sin decirlo, y casi siempre mal hecha; el capítulo 15 trata la validación.
  • Cuando comparas varios modelos o variantes de un prompt sobre el mismo conjunto de evaluación, cada comparación es una prueba, y con muchas comparaciones alguna saldrá «significativa» por azar.
  • \(\alpha\) y la potencia son costos: un falso positivo despliega un cambio inútil, y un falso negativo descarta un cambio bueno.

El p-value responde a \(H_0\), no a si el cambio vale la pena; esa segunda pregunta la contestan el intervalo y el tamaño del efecto.

9.3 Flujo recomendado de trabajo

  1. Escribe el parámetro y la población: la latencia media, la diferencia de conversión.
  2. Estima \(\hat\theta\) y su SE.
  3. Calcula el intervalo con el nivel declarado (casi siempre 95%) e interprétalo como cobertura del procedimiento.
  4. Haz la prueba: \(H_0\), \(H_1\), \(\alpha\), estadístico y p-value, sin invertir el condicional.
  5. Mira \(n\) y el efecto: ¿la significancia viene del tamaño de la muestra o de un cambio que importa?
  6. Decide con costos, no solo con \(p<0.05\).
  7. Redacta el reporte:

«En [población], con \(n=\) [valor], la estimación de [parámetro] es [θ̂] (SE [valor]). El IC [nivel] es [rango]. Se prueba [H0] frente a [H1]: estadístico [valor], p = [valor]. A α = [valor] se [rechaza o no se rechaza] H0. El efecto, en [unidades], [es o no es] relevante porque [razón]. Limitación: [n, potencia, una sola métrica o muchas pruebas].»

Un p-value sin intervalo, sin \(n\) y sin las unidades del efecto no basta para decidir. La etapa 11 llena esta plantilla con el A/B de la etapa 10.

9.4 Preparar el entorno

La celda carga NumPy, pandas, Matplotlib y el módulo stats de SciPy, fija un estilo de gráficos y crea el generador rng con la semilla 42, del que salen todas las simulaciones.

%matplotlib inline
%config InlineBackend.figure_format = "retina"
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

SEMILLA = 42  # semilla central del capítulo
rng = np.random.default_rng(SEMILLA)

plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25

print("scipy:", __import__("scipy").__version__, "| numpy:", np.__version__)
Python: 3.13.14
scipy: 1.18.0 | numpy: 2.5.1

El entorno queda con Python 3.13.9, SciPy 1.16.3 y NumPy 2.3.5.

La siguiente celda define seis funciones de gráficos: la distribución muestral, una muestra con su intervalo, la cobertura de muchos intervalos, la distribución de los p-values, las áreas de los errores tipo I y II, y la comparación A/B. Cada etapa las llama en pocas líneas.

def graficar_dist_muestral(medias_nchico, medias_ngrande, mu, n_chico, n_grande, titulo):
    fig, ax = plt.subplots(figsize=(8.4, 4.3))
    ax.hist(medias_nchico, bins=28, density=True, alpha=0.55, label=f"n = {n_chico}")
    ax.hist(medias_ngrande, bins=28, density=True, alpha=0.55, label=f"n = {n_grande}")
    ax.axvline(mu, color="C3", linestyle="--", label=fr"$\mu$ = {mu:g}")
    ax.set_xlabel("media muestral")
    ax.set_ylabel("densidad")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_una_muestra(muestra, mu, low, high, titulo):
    fig, ax = plt.subplots(figsize=(8.2, 3.6))
    ax.scatter(muestra, np.zeros_like(muestra), alpha=0.45, s=28, label="observaciones")
    ax.axvline(mu, color="C3", linestyle="--", label=fr"$\mu$ = {mu:g}")
    ax.axvline(muestra.mean(), color="C0", label=fr"$\bar x$ = {muestra.mean():.2f}")
    ax.hlines(0.35, low, high, color="C0", linewidth=4, label="IC 95%")
    ax.set_yticks([])
    ax.set_xlabel("latencia (ms)")
    ax.set_title(titulo)
    ax.legend(fontsize=8, loc="upper right")
    plt.tight_layout()
    plt.show()


def graficar_cobertura(intervalos, mu, titulo):
    fig, ax = plt.subplots(figsize=(8.4, 5.2))
    cubre = 0
    for i, (lo, hi) in enumerate(intervalos):
        ok = lo <= mu <= hi
        cubre += int(ok)
        ax.hlines(i, lo, hi, color="C0" if ok else "C3", linewidth=1.1)
    ax.axvline(mu, color="0.2", linestyle="--", label=fr"$\mu$ = {mu:g}")
    ax.set_xlabel("intervalo de confianza 95% para la media")
    ax.set_ylabel("réplica")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()
    return cubre


def graficar_pvalores(p_h0, p_h1, titulo):
    fig, ax = plt.subplots(figsize=(8.2, 4.2))
    ax.hist(p_h0, bins=20, range=(0, 1), density=True, alpha=0.55, label="bajo H0 (debe verse plano)")
    ax.hist(p_h1, bins=20, range=(0, 1), density=True, alpha=0.55, label="bajo H1 (se acumula a la izquierda)")
    ax.axvline(0.05, color="C3", linestyle="--", label=r"$\alpha$ = 0.05")
    ax.set_xlabel("p-value")
    ax.set_ylabel("densidad")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_tipo_i_ii(mu0, mu1, se, alpha, titulo):
    z = stats.norm.ppf(1 - alpha / 2)
    crit_lo, crit_hi = mu0 - z * se, mu0 + z * se
    xs = np.linspace(mu0 - 4.5 * se, mu1 + 4.5 * se, 400)
    f0 = stats.norm.pdf(xs, mu0, se)
    f1 = stats.norm.pdf(xs, mu1, se)
    fig, ax = plt.subplots(figsize=(8.6, 4.4))
    ax.plot(xs, f0, label=fr"muestral si $H_0$ ($\mu$={mu0:g})")
    ax.plot(xs, f1, label=fr"muestral si $H_1$ ($\mu$={mu1:g})")
    ax.axvline(crit_lo, color="0.35", linestyle=":")
    ax.axvline(crit_hi, color="0.35", linestyle=":", label="umbrales de rechazo")
    ax.fill_between(xs, f0, where=(xs <= crit_lo) | (xs >= crit_hi), alpha=0.35, color="C3", label="tipo I (rechazar H0 cierta)")
    ax.fill_between(xs, f1, where=(xs > crit_lo) & (xs < crit_hi), alpha=0.35, color="C1", label="tipo II (no rechazar H0 falsa)")
    ax.set_xlabel(r"media muestral $\bar x$")
    ax.set_ylabel("densidad")
    ax.set_title(titulo)
    ax.legend(fontsize=7, loc="upper right")
    plt.tight_layout()
    plt.show()
    return crit_lo, crit_hi


def graficar_ab(a, b, titulo):
    fig, ax = plt.subplots(figsize=(8.0, 4.2))
    ax.boxplot([a, b], tick_labels=["A (actual)", "B (cuantizado)"], showfliers=False)
    ax.scatter(np.ones(len(a)) + rng.normal(0, 0.04, len(a)), a, s=10, alpha=0.25)
    ax.scatter(np.full(len(b), 2) + rng.normal(0, 0.04, len(b)), b, s=10, alpha=0.25)
    ax.set_ylabel("latencia (ms)")
    ax.set_title(titulo)
    plt.tight_layout()
    plt.show()
9.5 Desarrollo por etapas

Primero fabricas una población de latencias con \(\mu\) conocida, para ver si el intervalo cubre y si la prueba se equivoca. Después pasas a un A/B en el que \(\mu\) ya no se conoce como en el laboratorio: la estimas y la reportas.

Etapa 1: Población, muestra y estadístico

Simulas una población de \(N=20\,000\) latencias normales con \(\mu=200\) ms y \(\sigma=40\) ms, y extraes una muestra de \(n=25\) sin reemplazo. El parámetro no cambia; \(\bar x\) sí cambiaría con otra muestra.

mu, sigma, N = 200.0, 40.0, 20_000
poblacion = rng.normal(mu, sigma, size=N)
print("Parámetro μ (población) =", round(poblacion.mean(), 3), "  (diseño: 200)")
print("σ poblacional =", round(poblacion.std(ddof=0), 3))

n = 25
muestra = rng.choice(poblacion, size=n, replace=False)
print()
print("n =", n)
print("x̄  =", round(muestra.mean(), 3), "  ← estadístico, no es μ")
print("s  =", round(muestra.std(ddof=1), 3), "  ← estima σ")
print("La muestra no 'es' la población: x̄ − μ =", round(muestra.mean() - poblacion.mean(), 3))
Parámetro μ (población) = 200.202   (diseño: 200)
σ poblacional = 40.188

n = 25
x̄  = 194.439   ← estadístico, no es μ
s  = 35.769   ← estima σ
La muestra no 'es' la población: x̄ − μ = -5.763

La población simulada tiene media 200.20 y desviación 40.19, muy cerca del diseño. La muestra da \(\bar x=194.44\) y \(s=35.77\): la media muestral se quedó 5.76 ms por debajo de la poblacional. Esa diferencia se debe al muestreo, y la inferencia consiste en cuantificarla.

Etapa 2: Distribución muestral, el estadístico también tiene forma

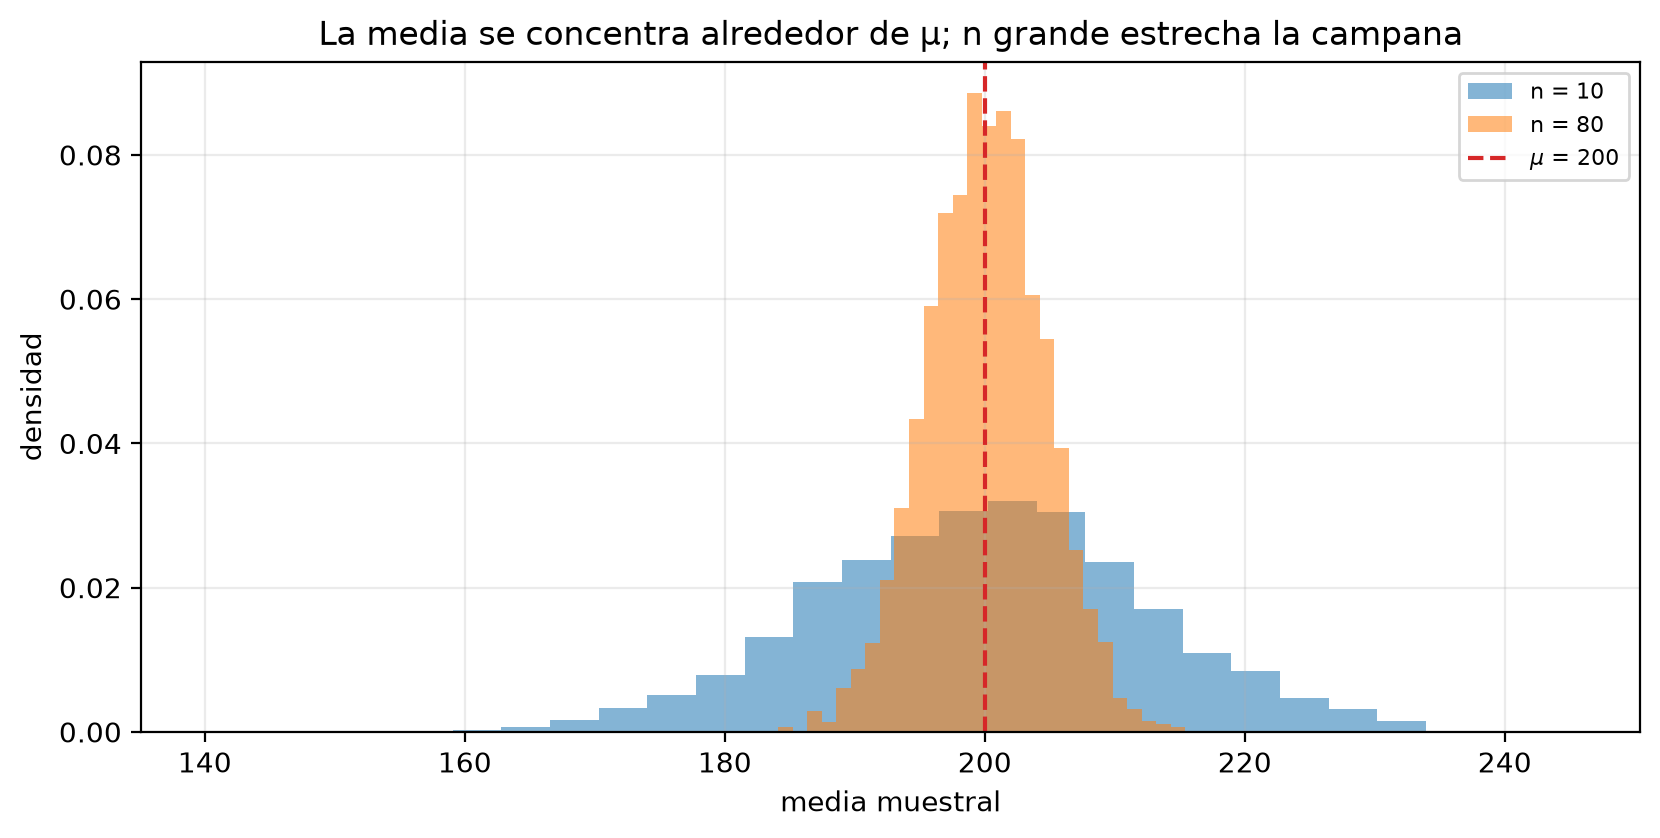
Repites el muestreo 4000 veces con \(n=10\) y otras 4000 con \(n=80\), y guardas la media de cada muestra. El histograma de esas medias muestra la distribución de la media, distinta de la de las latencias.

def medias_muestrales(n, n_rep=4000):
    idx = rng.integers(0, N, size=(n_rep, n))
    return poblacion[idx].mean(axis=1)

medias_10 = medias_muestrales(10)
medias_80 = medias_muestrales(80)
print("n=10:  media de x̄ =", round(medias_10.mean(), 3), "  DE de x̄ =", round(medias_10.std(ddof=1), 3), "  (σ/√n =", round(sigma / np.sqrt(10), 3), ")")
print("n=80:  media de x̄ =", round(medias_80.mean(), 3), "  DE de x̄ =", round(medias_80.std(ddof=1), 3), "  (σ/√n =", round(sigma / np.sqrt(80), 3), ")")

graficar_dist_muestral(
    medias_10, medias_80, mu, 10, 80,
    "La media se concentra alrededor de μ; n grande estrecha la campana",
)
n=10:  media de x̄ = 199.842   DE de x̄ = 12.701   (σ/√n = 12.649 )
n=80:  media de x̄ = 200.062   DE de x̄ = 4.492   (σ/√n = 4.472 )

Dos histogramas superpuestos de 4000 medias muestrales cada uno, centrados en la línea discontinua de μ = 200 ms. El de n = 10 es ancho y va aproximadamente de 160 a 240 ms; el de n = 80 es mucho más angosto, aproximadamente de 185 a 215 ms.

Con \(n=10\), las medias tienen centro 199.84 y desviación 12.70, frente a \(\sigma/\sqrt{10}=12.65\); con \(n=80\), centro 200.06 y desviación 4.49, frente a 4.47. En la figura, las dos campanas están centradas en 200 y la de \(n=80\) es mucho más angosta. Esa anchura es el error estándar cuando \(\sigma\) es conocida. Una sola muestra de latencias no te muestra esto; hace falta el experimento repetido, aquí simulado.

Etapa 3: Estimación puntual y error estándar

Para la muestra de \(n=25\),

\[ \hat\mu=\bar x,\qquad \mathrm{SE}=\frac{s}{\sqrt n}. \]

El SE mide el error típico de la media, no el de cada medición.

xbar = muestra.mean()
s = muestra.std(ddof=1)
se = s / np.sqrt(n)
print("Estimación puntual μ̂ = x̄ =", round(xbar, 3))
print("s =", round(s, 3))
print("SE = s/√n =", round(se, 3), "   (si se usara σ: ", round(sigma / np.sqrt(n), 3), ")")
print()
print(f"Un intervalo grosero x̄ ± 2·SE = [{xbar - 2 * se:.2f}, {xbar + 2 * se:.2f}]")
Estimación puntual μ̂ = x̄ = 194.439
s = 35.769
SE = s/√n = 7.154    (si se usara σ:  8.0 )

Un intervalo grosero x̄ ± 2·SE = [180.13, 208.75]

La estimación es \(\bar x=194.44\), con \(s=35.77\) y \(\mathrm{SE}=35.77/\sqrt{25}=7.15\) (con la \(\sigma\) verdadera sería 8.0). El rango aproximado \(\bar x\pm 2\,\mathrm{SE}\) va de 180.13 a 208.75 ms. Reportar 194.4 sin el SE invita a leerlo como si fuera \(\mu\); con un SE de 7.2, 194.4 y 200 son compatibles, porque están a menos de un error estándar. El número suelto exagera la precisión.

Etapa 4: Intervalo de confianza para la media

Con \(\sigma\) desconocida usas la \(t\) de Student con \(n-1=24\) grados de libertad y \(\alpha=0.05\):

\[ \bar x \pm t_{24,\,0.975}\,\mathrm{SE}. \]

Lo calculas a mano y con stats.t.interval; las dos vías deben coincidir.

alpha = 0.05
gl = n - 1
t_crit = stats.t.ppf(1 - alpha / 2, df=gl)
low = xbar - t_crit * se
high = xbar + t_crit * se
low_sp, high_sp = stats.t.interval(1 - alpha, df=gl, loc=xbar, scale=se)

print("t crítico (gl=24, 97.5%) =", round(t_crit, 4), "  (z sería 1.960)")
print("IC 95% a mano:   [", round(low, 2), ",", round(high, 2), "]")
print("IC 95% SciPy:    [", round(low_sp, 2), ",", round(high_sp, 2), "]")
print("¿Cubre μ = 200?", low <= mu <= high)
print("Anchura =", round(high - low, 2), "ms")

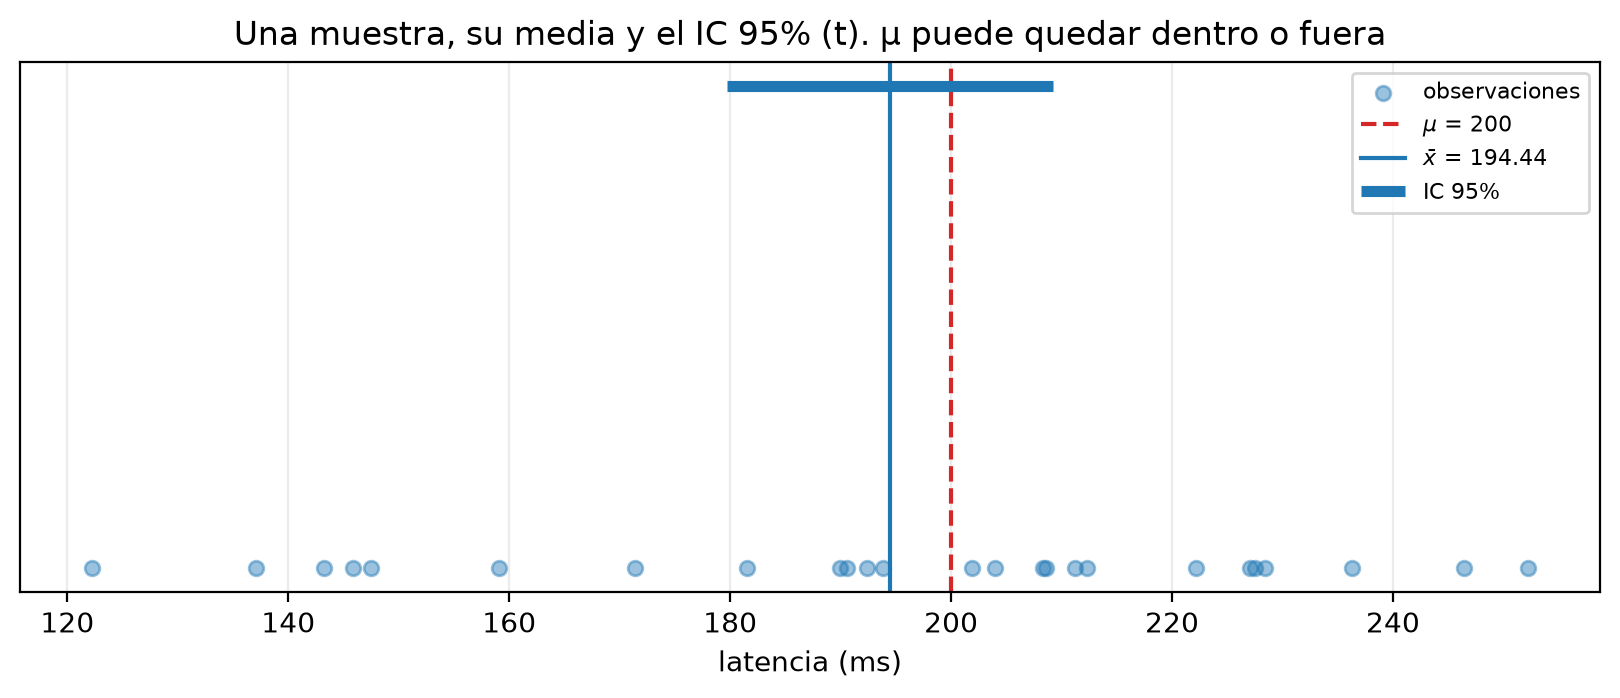
graficar_una_muestra(
    muestra, mu, low, high,
    "Una muestra, su media y el IC 95% (t). μ puede quedar dentro o fuera",
)
t crítico (gl=24, 97.5%) = 2.0639   (z sería 1.960)
IC 95% a mano:   [ 179.67 , 209.2 ]
IC 95% SciPy:    [ 179.67 , 209.2 ]
¿Cubre μ = 200? True
Anchura = 29.53 ms

Las 25 latencias de la muestra como puntos sobre un eje de 120 a 252 ms, con una línea azul en la media muestral de 194.44, una línea roja discontinua en μ = 200 y una barra horizontal gruesa para el intervalo al 95%, de 179.7 a 209.2 ms, que contiene a μ.

El valor crítico es \(t_{24,0.975}=2.064\), un poco mayor que el 1.96 de la normal porque estimas \(\sigma\) con solo 25 datos. El intervalo al 95% va de 179.67 a 209.20 ms, con una anchura de 29.53 ms, y las dos vías dan lo mismo. Esta vez cubre \(\mu=200\): en la figura, la línea roja discontinua de \(\mu\) cae dentro de la barra del intervalo.

El intervalo es un rango para \(\mu\), no para el 95% de las latencias. El 95% de las observaciones cae cerca de \(\mu\pm 2\sigma\), unos \(\pm 80\) ms: en la figura, los puntos van de 122 a 252 ms, mucho más allá del intervalo. Confundir el intervalo de la media con el rango de los datos es hablar de cada fila cuando la afirmación es sobre el centro.

Etapa 5: Qué significa el 95%, la cobertura

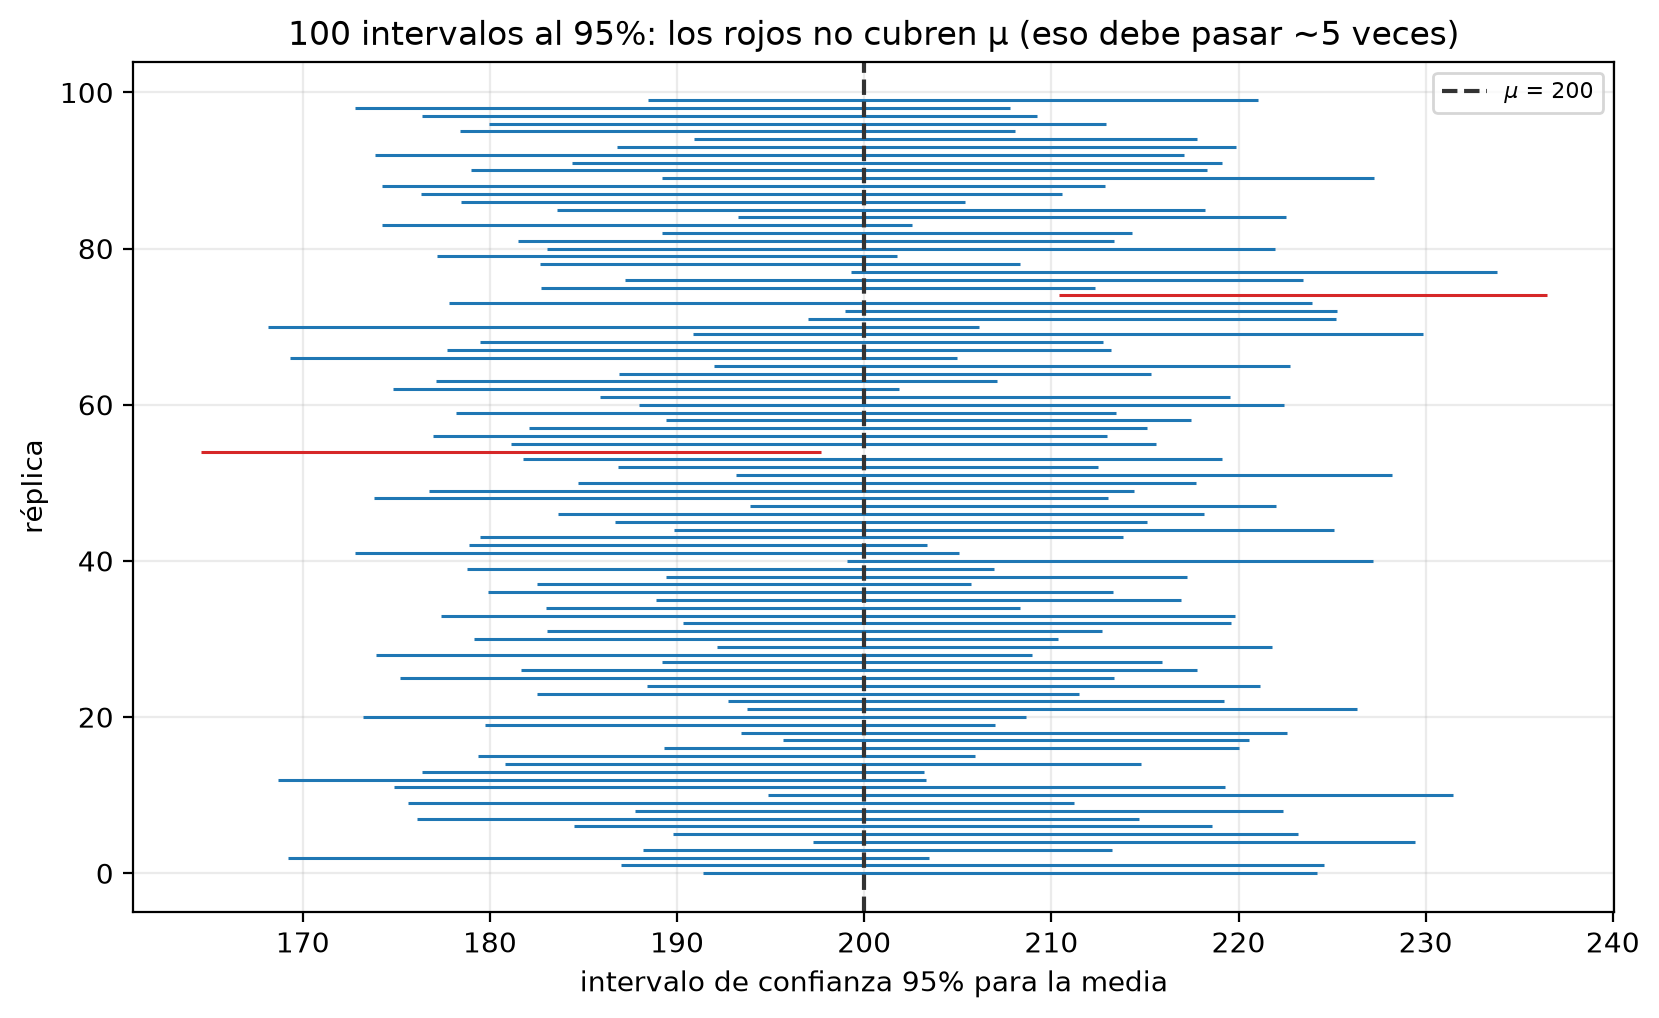
Construyes 100 intervalos, cada uno con su propia muestra de \(n=25\) extraída de la población. En teoría, alrededor de 95 cubren \(\mu\). Los que fallan, en rojo en la figura, no están mal calculados: son el 5% que el procedimiento acepta perder.

n_rep = 100
intervalos = []
for _ in range(n_rep):
    m = rng.choice(poblacion, size=n, replace=False)
    xb, ss = m.mean(), m.std(ddof=1)
    lo, hi = stats.t.interval(0.95, df=n - 1, loc=xb, scale=ss / np.sqrt(n))
    intervalos.append((lo, hi))

cubre = graficar_cobertura(
    intervalos, mu,
    "100 intervalos al 95%: los rojos no cubren μ (eso debe pasar ~5 veces)",
)
print("Intervalos que cubren μ:", cubre, "de", n_rep)
print("Cobertura empírica:", cubre / n_rep)

Cien segmentos horizontales, uno por réplica, que representan intervalos al 95% para la media, con una línea vertical discontinua en μ = 200. Noventa y ocho son azules y cruzan la línea; dos son rojos: uno queda entero a la izquierda de 200 y otro entero a la derecha.

Intervalos que cubren μ: 98 de 100
Cobertura empírica: 0.98

Esta vez, 98 de los 100 intervalos cubren \(\mu=200\), una cobertura empírica de 0.98; con 100 réplicas, cualquier valor entre unos 91 y 99 es compatible con el 95% nominal. En la figura, los dos intervalos rojos quedan uno por completo a la izquierda de 200 y otro por completo a la derecha.

Después de ver la figura, un intervalo al 95% \((a, b)\) se redacta así: un procedimiento que, usado una y otra vez, cubre \(\mu\) en el 95% de las muestras produjo este rango. No significa que \(\mu\) sea aleatorio y esté ahí con probabilidad 0.95; esa lectura pertenece al enfoque bayesiano del capítulo 12. Aquí \(\mu\) es fijo y lo que se mueve es el intervalo.

Etapa 6: Prueba de hipótesis, \(H_0\): \(\mu=200\)

Usas la misma muestra de la etapa 1 para preguntar si es compatible con un objetivo de servicio de 200 ms:

\[ H_0:\mu=200,\qquad H_1:\mu\neq 200,\qquad \alpha=0.05. \]

\[ t=\frac{\bar x-200}{s/\sqrt n},\qquad \text{p-value}=P\big(|T_{24}|\ge |t|\big). \]

mu0 = 200.0
t_obs = (xbar - mu0) / se
p_manual = 2 * stats.t.sf(abs(t_obs), df=gl)
tt = stats.ttest_1samp(muestra, popmean=mu0)

print("t observado =", round(t_obs, 4))
print("p-value a mano =", round(p_manual, 4))
print("SciPy ttest_1samp: t =", round(tt.statistic, 4), "  p =", round(tt.pvalue, 4))
print("α = 0.05. ¿Rechazar H0?", tt.pvalue < 0.05)
print()
print("IC 95% y prueba bilateral a α=0.05 son la misma frontera:")
print("  200 está en el IC  ↔  p > 0.05  →", (low <= mu0 <= high), "y p =", round(tt.pvalue, 4))
t observado = -0.7774
p-value a mano = 0.4445
SciPy ttest_1samp: t = -0.7774   p = 0.4445
α = 0.05. ¿Rechazar H0? False

IC 95% y prueba bilateral a α=0.05 son la misma frontera:
  200 está en el IC  ↔  p > 0.05  → True y p = 0.4445

El estadístico es \(t=-0.777\) y el p-value 0.4445, igual a mano y con ttest_1samp, así que no rechazas \(H_0\): una media muestral de 194.4 es compatible con \(\mu=200\). Eso tampoco demuestra que \(\mu\) valga 200, porque el intervalo admite cualquier valor entre 179.7 y 209.2 ms. Y si hubieras rechazado, tampoco probarías que \(\mu\) vale \(\bar x\); solo dirías que 200 explica mal los datos. En la prueba bilateral a \(\alpha=0.05\), rechazas \(H_0\) si y solo si \(\mu_0\) queda fuera del intervalo al 95%: aquí 200 está dentro y \(p>0.05\).

Etapa 7: El p-value no es \(P(H_0\mid \text{datos})\)

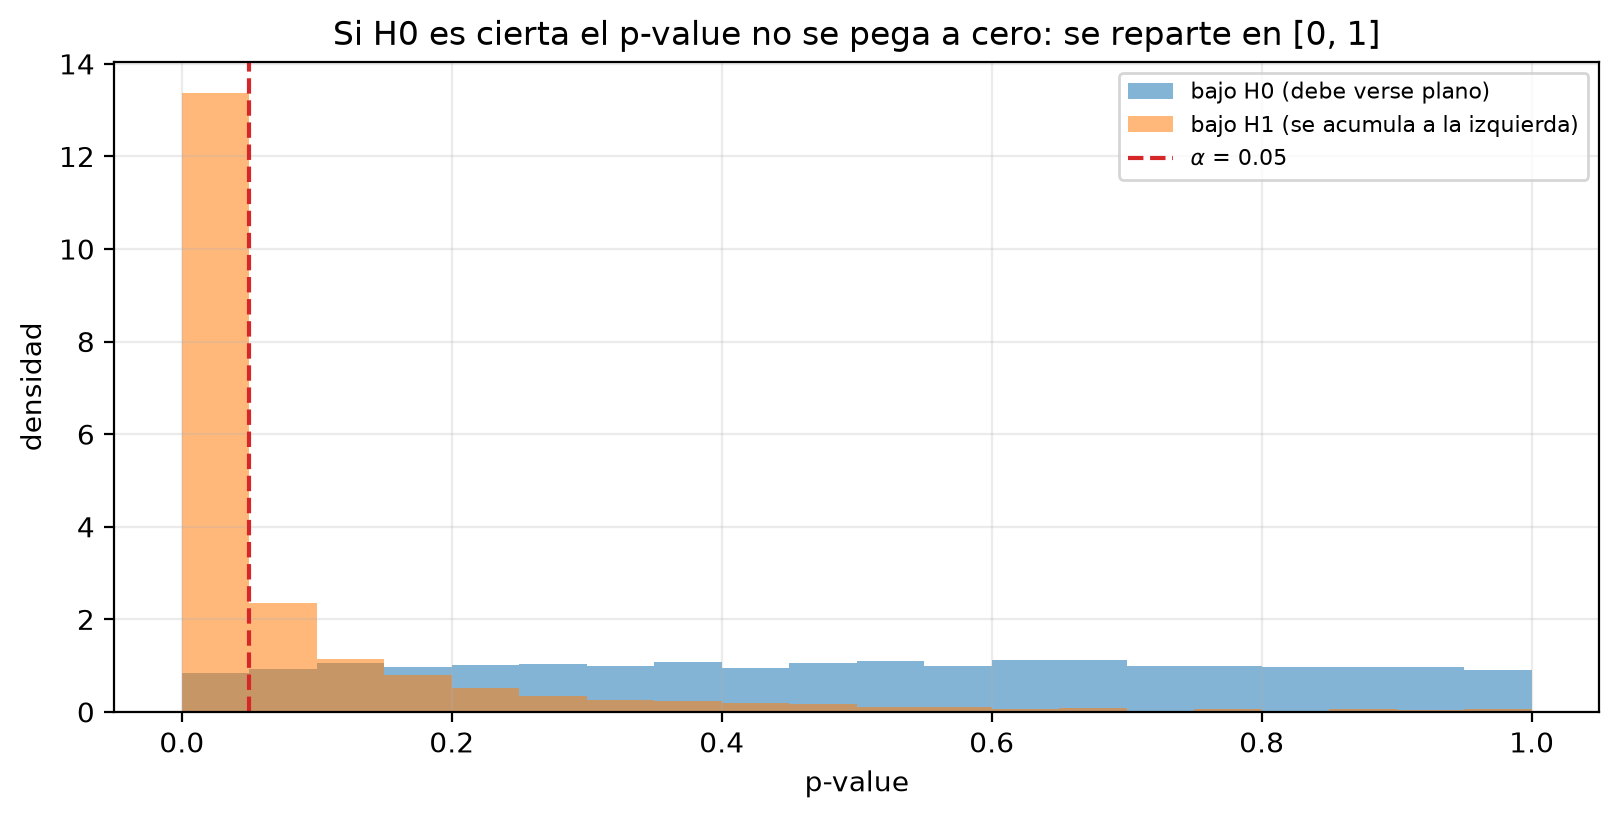
Si \(H_0\) es cierta, el p-value de una prueba bien calibrada se reparte casi uniforme entre 0 y 1. Por eso el 5% de las réplicas tiene \(p\le 0.05\) aunque \(H_0\) sea cierta: es la definición de \(\alpha\). Si \(H_1\) es cierta, los p-values se acumulan cerca de 0.

Simulas 3000 muestras de 25 latencias con \(\mu=200\) (bajo \(H_0\)) y otras 3000 con \(\mu=220\) (bajo \(H_1\)), y pruebas en cada una \(H_0:\mu=200\).

def pvalores_unamuestra(mu_true, n=25, n_rep=3000, mu0=200.0):
    datos = rng.normal(mu_true, sigma, size=(n_rep, n))
    return stats.ttest_1samp(datos, popmean=mu0, axis=1).pvalue

p_h0 = pvalores_unamuestra(200.0)
p_h1 = pvalores_unamuestra(220.0)
print("Bajo H0:  P(p ≤ 0.05) =", round((p_h0 <= 0.05).mean(), 4), "  ← debe ≈ α = 0.05")
print("Bajo H0:  media de p  =", round(p_h0.mean(), 3), "  ← uniforme ⇒ cerca de 0.50")
print("Bajo H1 (μ=220): P(p ≤ 0.05) =", round((p_h1 <= 0.05).mean(), 4), "  ← potencia")

graficar_pvalores(
    p_h0, p_h1,
    "Si H0 es cierta el p-value no se pega a cero: se reparte en [0, 1]",
)
Bajo H0:  P(p ≤ 0.05) = 0.0417   ← debe ≈ α = 0.05
Bajo H0:  media de p  = 0.502   ← uniforme ⇒ cerca de 0.50
Bajo H1 (μ=220): P(p ≤ 0.05) = 0.669   ← potencia

Dos histogramas de p-values entre 0 y 1 con una línea en α = 0.05. El de 3000 pruebas bajo H0 es plano a lo largo de todo el rango; el de 3000 pruebas bajo H1, con μ = 220, se concentra en la primera barra, cerca de 0.

Bajo \(H_0\), el 4.17% de los p-values queda por debajo de 0.05, cerca del 5% nominal, y su media es 0.502, la de una uniforme. Bajo \(H_1\), con \(\mu=220\), el 66.9% de las pruebas rechaza: esa es la potencia para un efecto de 20 ms con \(n=25\). En la figura, el histograma bajo \(H_0\) es plano y el de \(H_1\) se amontona a la izquierda de la línea de 0.05.

El p-value no es la probabilidad de que se cumpla el objetivo de servicio, ni 1 menos la confianza, ni el tamaño del efecto. Es un área de cola condicionada a \(H_0\). Leer \(p=0.03\) como «hay 3% de probabilidad de que no haya efecto» es el mismo error que confundir \(P(E\mid +)\) con \(P(+\mid E)\) en el capítulo 7.

Etapa 8: Tipo I, tipo II y potencia

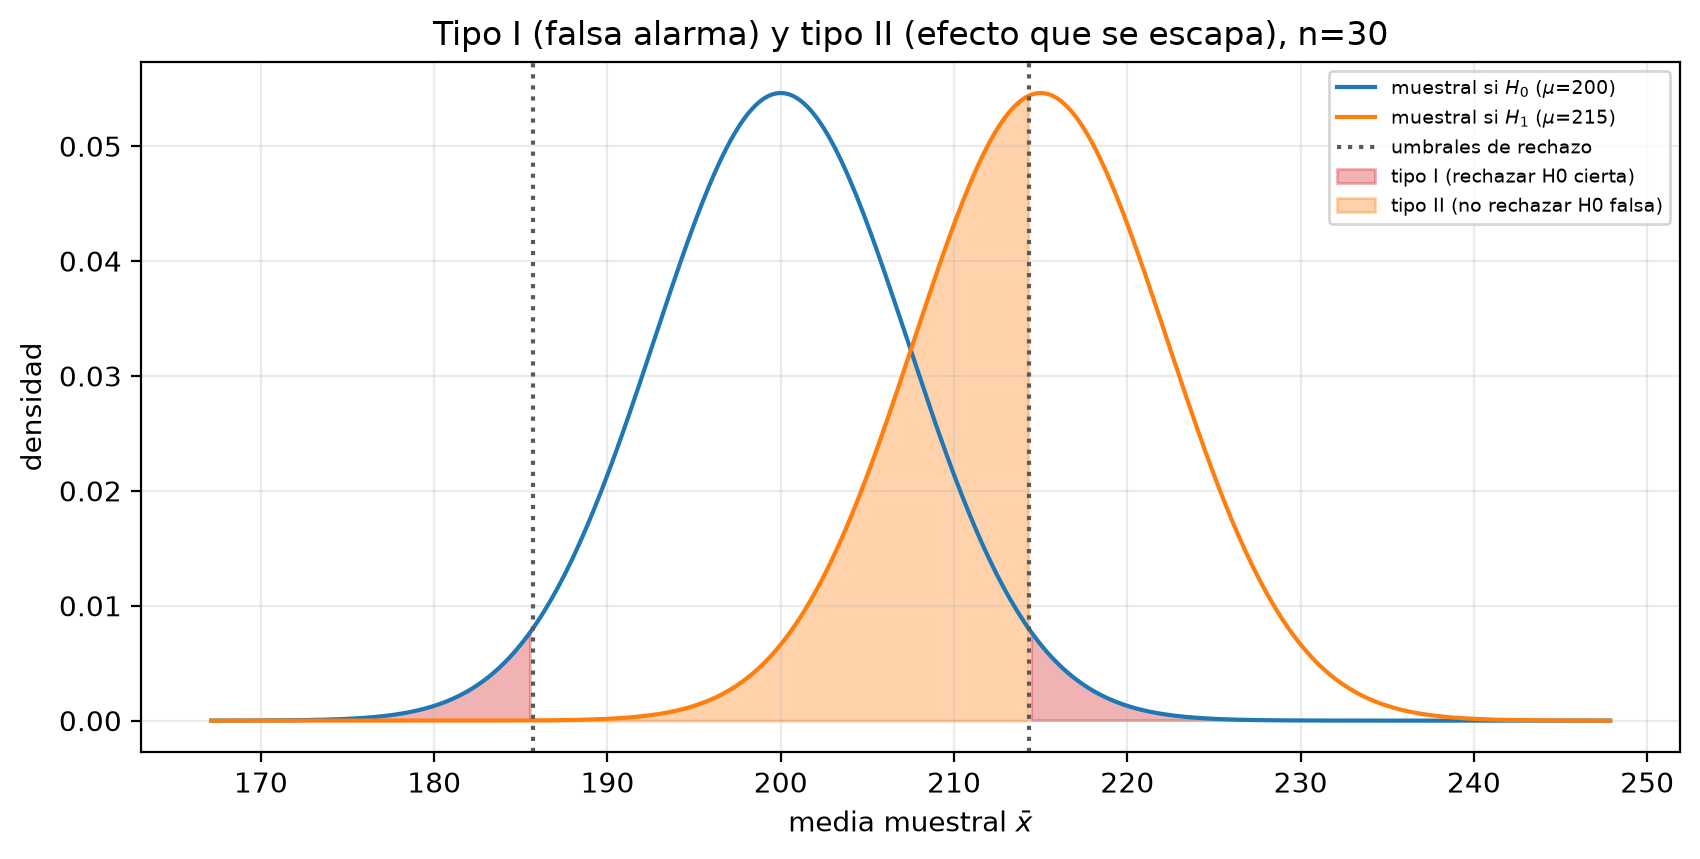
Para dibujar el argumento usas \(\sigma\) conocida, la normal y umbrales en \(\pm z_{1-\alpha/2}\,\mathrm{SE}\). La hipótesis nula es \(H_0:\mu=200\), la alternativa dibujada es \(\mu=215\), con \(n=30\) y \(\alpha=0.05\).

  • El área roja, bajo la campana de \(H_0\) y fuera de los umbrales, es el error tipo I.
  • El área naranja, bajo la campana de \(H_1\) y entre los umbrales, es el error tipo II.

Después compruebas los números simulando 4000 pruebas \(t\) con \(\sigma\) desconocida, con \(n=30\) y con \(n=80\).

n_pot, mu1, alpha = 30, 215.0, 0.05
se_con = sigma / np.sqrt(n_pot)
crit_lo, crit_hi = graficar_tipo_i_ii(
    200.0, mu1, se_con, alpha,
    "Tipo I (falsa alarma) y tipo II (efecto que se escapa), n=30",
)
z = stats.norm.ppf(1 - alpha / 2)
# Tipo I teórico (bilateral, H0 cierta) = alpha
# Tipo II: P(crit_lo < Xbar < crit_hi | μ=215)
beta = stats.norm.cdf(crit_hi, loc=mu1, scale=se_con) - stats.norm.cdf(crit_lo, loc=mu1, scale=se_con)
print("SE (σ conocida) =", round(se_con, 3))
print("Umbrales de x̄: [", round(crit_lo, 2), ",", round(crit_hi, 2), "]")
print("α (tipo I, teoría) =", alpha)
print("β (tipo II, μ=215) =", round(beta, 3), "  potencia =", round(1 - beta, 3))

# Simulación t (σ desconocida), más realista
def tasa_rechazo(mu_true, n=30, n_rep=4000, mu0=200.0, alpha=0.05):
    x = rng.normal(mu_true, sigma, size=(n_rep, n))
    p = stats.ttest_1samp(x, popmean=mu0, axis=1).pvalue
    return (p <= alpha).mean()

print()
print("Simulación t, n=30:  P(rechazar | H0) =", round(tasa_rechazo(200.0), 4), "  ← tipo I ≈ 0.05")
print("Simulación t, n=30:  P(rechazar | μ=215) =", round(tasa_rechazo(215.0), 4), "  ← potencia")
print("Simulación t, n=80:  P(rechazar | μ=215) =", round(tasa_rechazo(215.0, n=80), 4), "  ← más n, más potencia")

Dos campanas normales de la media muestral con n = 30: la de H0 centrada en 200 y la de H1 centrada en 215, con líneas punteadas en los umbrales de rechazo, 185.7 y 214.3. Las colas de la campana de H0 fuera de los umbrales están sombreadas en rojo (error tipo I) y la parte de la campana de H1 entre los umbrales, en naranja (error tipo II), casi la mitad de su área.

SE (σ conocida) = 7.303
Umbrales de x̄: [ 185.69 , 214.31 ]
α (tipo I, teoría) = 0.05
β (tipo II, μ=215) = 0.463   potencia = 0.537

Simulación t, n=30:  P(rechazar | H0) = 0.046   ← tipo I ≈ 0.05
Simulación t, n=30:  P(rechazar | μ=215) = 0.4985   ← potencia
Simulación t, n=80:  P(rechazar | μ=215) = 0.9132   ← más n, más potencia

Con \(\mathrm{SE}=40/\sqrt{30}=7.30\), los umbrales de rechazo para \(\bar x\) quedan en 185.69 y 214.31 ms. Si \(\mu=215\), la media cae entre los umbrales con probabilidad \(\beta=0.463\), así que la potencia es solo 0.537: casi la mitad de las veces no detectarías un efecto de 15 ms. La simulación con la prueba \(t\) da un error tipo I de 0.046 y una potencia de 0.499 con \(n=30\), que sube a 0.913 con \(n=80\). En la figura, la campana naranja de \(H_1\) tiene casi la mitad de su área entre las dos líneas punteadas.

Bajar \(\alpha\) (exigir \(p<0.01\)) aleja los umbrales: encoge la zona roja y agranda la naranja, con menos falsas alarmas y más efectos perdidos. Subir \(n\) estrecha las dos campanas y aumenta la potencia sin tocar \(\alpha\). En un A/B, «no salió significativo» puede significar un \(\beta\) alto, no ausencia de efecto.

Ejercicio

¿Cuántas observaciones necesitas para detectar un efecto de 15 ms con potencia de 0.80, si \(\sigma=40\) y \(\alpha=0.05\) bilateral? Usa la aproximación normal \(n\approx\left(\frac{(z_{0.975}+z_{0.80})\,\sigma}{\delta}\right)^2\).

Con \(z_{0.975}=1.96\) y \(z_{0.80}=0.842\): \(n\approx\left(\frac{2.802\times 40}{15}\right)^2=7.47^2\approx 55.8\), es decir, unas 56 observaciones. Es casi el doble de las 30 de la figura, con las que la potencia era 0.537. Puedes comprobarlo con tasa_rechazo(215.0, n=56), que debería dar cerca de 0.8 (algo menos, porque la prueba \(t\) es un poco más conservadora que la normal).

Etapa 9: Con \(n\) grande, un efecto pequeño no se vuelve importante

Simulas dos experimentos A/B con el mismo efecto verdadero, \(\delta=0.4\) ms, irrelevante para un servicio de unos 200 ms, y \(\sigma=8\) ms en cada grupo:

  • un experimento pequeño, con \(n=20\) por grupo;
  • un experimento enorme, con \(n=4000\) por grupo.

Lo que te interesa es qué afirma cada p-value sobre su experimento.

delta, sigma_c = 0.4, 8.0

def experimento(n, delta=delta, sigma=sigma_c):
    a = rng.normal(200.0, sigma, size=n)
    b = rng.normal(200.0 + delta, sigma, size=n)
    tt = stats.ttest_ind(a, b, equal_var=True)
    dif = b.mean() - a.mean()
    se_d = np.sqrt(a.var(ddof=1) / n + b.var(ddof=1) / n)
    lo, hi = stats.t.interval(0.95, df=2 * n - 2, loc=dif, scale=se_d)
    return {
        "n": n,
        "dif": dif,
        "p": tt.pvalue,
        "lo": lo,
        "hi": hi,
        "rechaza": tt.pvalue < 0.05,
    }

e_chico = experimento(20)
e_grande = experimento(4000)
tab = pd.DataFrame([e_chico, e_grande]).round(4)
print(tab.to_string(index=False))
print()
print("n=20:   rechaza H0 (igualdad de medias) =", e_chico["rechaza"])
print("n=4000: rechaza H0 =", e_grande["rechaza"], "  pero el IC sigue siendo de décimas de ms.")
   n    dif      p      lo     hi  rechaza
  20 2.2581 0.3852 -2.9451 7.4612    False
4000 0.6133 0.0006  0.2636 0.9629     True

n=20:   rechaza H0 (igualdad de medias) = False
n=4000: rechaza H0 = True   pero el IC sigue siendo de décimas de ms.

El efecto de diseño es de 0.4 ms, imperceptible para un usuario. Con \(n=20\), la diferencia observada es 2.26 ms, con \(p=0.385\) y un intervalo de −2.95 a 7.46 ms: no rechazas \(H_0\), y el intervalo es tan ancho que admite desde una pequeña mejora hasta un empeoramiento. Con \(n=4000\), la diferencia es 0.61 ms, con \(p=0.0006\) y un intervalo de 0.26 a 0.96 ms: rechazas \(H_0\). El azar ya no explica la diferencia, pero el intervalo muestra que el efecto es de décimas de milisegundo. Desplegar B por \(p<0.05\) sería decidir por el sello; lo que decide es el efecto en milisegundos y su costo.

Etapa 10: A/B de un servicio de inferencia

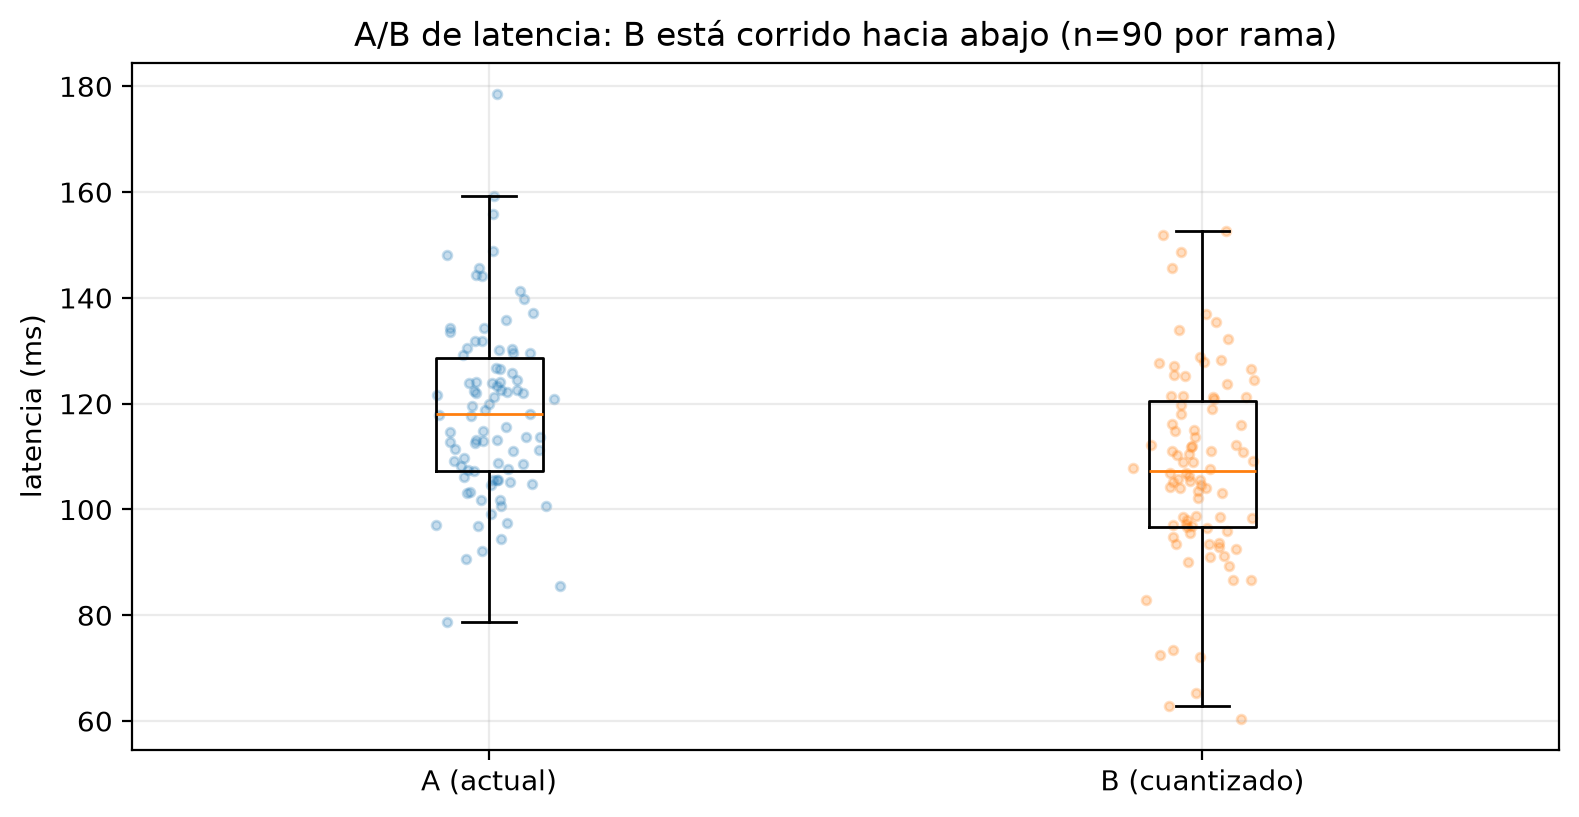
La versión A es el modelo actual y la B, un modelo cuantizado. Simulas 90 latencias por rama con normales de medias \(\mu_A=120\) ms y \(\mu_B=108\) ms y desviación \(\sigma=18\) ms en las dos. Aquí el efecto de diseño, 12 ms, sí importa para la experiencia del usuario y el costo. Comparas las dos ramas con ttest_ind y un intervalo \(t\) para la diferencia.

n_ab = 90
lat_a = rng.normal(120, 18, size=n_ab)
lat_b = rng.normal(108, 18, size=n_ab)

tt_ab = stats.ttest_ind(lat_b, lat_a, equal_var=True)   # B − A: mismo signo que la diferencia
dif_ab = lat_b.mean() - lat_a.mean()
se_ab = np.sqrt(lat_a.var(ddof=1) / n_ab + lat_b.var(ddof=1) / n_ab)
lo_ab, hi_ab = stats.t.interval(0.95, df=2 * n_ab - 2, loc=dif_ab, scale=se_ab)

print("A: x̄ =", round(lat_a.mean(), 2), "  s =", round(lat_a.std(ddof=1), 2))
print("B: x̄ =", round(lat_b.mean(), 2), "  s =", round(lat_b.std(ddof=1), 2))
print("B − A =", round(dif_ab, 2), "ms   SE =", round(se_ab, 2))
print("IC 95% para μB − μA: [", round(lo_ab, 2), ",", round(hi_ab, 2), "]")
print("t =", round(tt_ab.statistic, 3), "  p =", float(f"{tt_ab.pvalue:.2e}"))
print("¿Rechazar igualdad de medias a α=0.05?", tt_ab.pvalue < 0.05)

graficar_ab(lat_a, lat_b, "A/B de latencia: B está corrido hacia abajo (n=90 por rama)")
A: x̄ = 118.61   s = 16.78
B: x̄ = 107.85   s = 18.47
B − A = -10.76 ms   SE = 2.63
IC 95% para μB − μA: [ -15.95 , -5.57 ]
t = -4.091   p = 6.5e-05
¿Rechazar igualdad de medias a α=0.05? True

Diagramas de caja con los puntos individuales de 90 latencias por rama. La rama A (actual) tiene mediana cerca de 118 ms y valores entre 79 y 178; la rama B (cuantizada) tiene mediana cerca de 107 ms y valores entre 61 y 153. Las cajas están desplazadas unos 10 ms, pero las nubes de puntos se solapan mucho.

La rama A tiene media 118.61 ms (\(s=16.78\)) y la B, 107.85 ms (\(s=18.47\)). La diferencia \(\bar x_B-\bar x_A\) es −10.76 ms, con SE de 2.63, e intervalo al 95% de −15.95 a −5.57 ms. La prueba da \(t=-4.09\) y \(p=6.5\times10^{-5}\), así que rechazas la igualdad de medias. En la figura, la caja de B está corrida hacia abajo unos 10 ms respecto de la de A, aunque las dos nubes de puntos se solapan mucho.

El intervalo queda entero por debajo de 0 y su magnitud es de varios milisegundos, no de décimas. A diferencia de la etapa 9, aquí coinciden significancia y relevancia. No siempre pasa, y por eso reportas las dos.

Etapa 11: Reportar una inferencia

El reporte sigue seis pasos:

  1. Población y parámetro: qué mides, en quién y qué \(\theta\) discutes.
  2. Diseño: \(n\), grupos, \(\alpha\) y si la prueba es unilateral o bilateral.
  3. Estimación: \(\hat\theta\) y su SE.
  4. Intervalo: nivel y rango, en las unidades del problema.
  5. Prueba: \(H_0\), \(H_1\), estadístico, p-value y decisión a ese \(\alpha\).
  6. Relevancia y límites: si el efecto importa y qué amenaza la lectura (\(n\) pequeño, \(\sigma\) alta, muchas pruebas).

Los aplicas al A/B de la etapa 10.

  1. Población. Requests de un servicio de inferencia. Parámetro: \(\mu_B-\mu_A\), la diferencia de latencia media en ms.
  2. Diseño. 90 requests por rama, analizadas como dos muestras independientes, \(\alpha=0.05\) y alternativa bilateral.
  3. Estimación. \(\bar x_B-\bar x_A=-10.76\) ms, con SE de 2.63 ms.
  4. Intervalo. Intervalo \(t\) al 95% para la diferencia: de −15.95 a −5.57 ms, entero por debajo de 0.
  5. Prueba. \(H_0:\mu_B=\mu_A\) frente a \(H_1:\mu_B\neq\mu_A\). ttest_ind da \(t=-4.09\) y \(p=6.5\times10^{-5}\); se rechaza \(H_0\).
  6. Relevancia y límites. La mejora es del orden de 10 ms sobre unos 120 ms, alrededor de un 9%, relevante para la experiencia del usuario y el costo de cómputo. Limitaciones: datos simulados, varianzas tratadas como iguales, una sola métrica (la media, sin percentiles altos) y ninguna corrección por pruebas múltiples.

En un A/B de latencia con 90 observaciones por versión, la diferencia muestral \(\bar x_B-\bar x_A\) es de −10.8 ms (IC 95%: −16.0 a −5.6 ms); el intervalo no cruza 0 y se rechaza la igualdad de medias a \(\alpha=0.05\). Se recomienda B por el tamaño del efecto en milisegundos, no solo por el p-value. Limitación: una sola métrica, sin percentil 95 ni costo, y \(n\) fijado de antemano (la prueba no se detuvo en el primer \(p<0.05\)).

Errores que conviene nombrar

  1. Leer el p-value como \(P(H_0\mid \text{datos})\). Es la probabilidad de un dato tan extremo si \(H_0\) es cierta.
  2. Leer el intervalo al 95% como una probabilidad sobre \(\mu\). El 95% es la cobertura del procedimiento: 98 de 100 intervalos en la etapa 5.
  3. Confundir el intervalo de la media con el rango del 95% de las observaciones. En la etapa 4, el intervalo medía 29.5 ms y los datos se repartían en unos 130.
  4. Concluir que no hay efecto porque no salió significativo. Puede ser falta de potencia: con \(n=30\), un efecto de 15 ms se escapa casi la mitad de las veces.
  5. Concluir que el efecto importa porque salió significativo. Con \(n=4000\), un efecto de 0.4 ms dio \(p=0.0006\).
  6. Tratar \(\alpha=0.05\) como una ley. Es el costo de falsa alarma que decides aceptar.
  7. Mirar el p-value a cada rato durante un A/B y parar en el primer 0.049. Esa práctica infla el error tipo I.

9.6 Guía rápida: ¿qué fórmula usar?

Situación Qué usar Por qué
Un número para \(\mu\) o \(p\) \(\bar x\), \(\hat p\) Estimación puntual.
Precisión de esa media \(s/\sqrt n\) Error estándar, no \(s\).
Rango para \(\mu\) con \(\sigma\) desconocida \(\bar x\pm t_{n-1}\,s/\sqrt n\) Intervalo de confianza de la media.
\(\sigma\) conocida o \(n\) grande \(\bar x\pm z_{1-\alpha/2}\,\sigma/\sqrt n\) Aproximación normal.
¿Estos datos son raros si \(\mu=\mu_0\)? \(t\) y ttest_1samp Prueba de una media.
¿Dos grupos difieren? ttest_ind (o \(z\) de proporciones) A/B de medias.
¿Cuántas alarmas falsas acepto? \(\alpha\) Error tipo I.
¿Detectaría este \(\delta\) con este \(n\)? Potencia \(1-\beta\) Error tipo II.

Al reportar, sigue este orden: parámetro, \(n\), estimación, intervalo, p-value y unidades del efecto.

9.7 Preguntas de comprensión

  1. Un compañero escribe: «El IC 95% de la latencia media es [180, 209] ms, así que hay un 95% de probabilidad de que la media real esté ahí». ¿Cómo corregirías la frase?
  2. Un A/B con 40 usuarios por rama da \(p=0.21\) para una mejora observada de 6% en conversión. ¿Puedes concluir que la nueva versión no sirve?
  3. Un A/B con 2 millones de usuarios por rama da \(p=10^{-6}\) para una mejora de 0.02 puntos porcentuales. ¿Qué información, además del p-value, necesitas para decidir?
  4. Si haces 20 pruebas independientes a \(\alpha=0.05\) y en todas \(H_0\) es cierta, ¿cuántos rechazos esperas por azar?
  5. ¿Por qué el intervalo de la etapa 4 usó 2.064 en lugar de 1.96?
  1. El 95% describe el procedimiento: si repitieras el muestreo muchas veces, el 95% de los intervalos construidos así cubriría la media real. Este intervalo concreto la cubre o no. Una frase correcta: «con un procedimiento que acierta el 95% de las veces, obtuvimos el rango de 180 a 209 ms».
  2. No. Con 40 usuarios por rama la potencia es baja, y el intervalo de la diferencia será ancho, probablemente desde una pérdida hasta una ganancia grande. «No significativo» no es «sin efecto»; conviene calcular el \(n\) necesario para detectar una mejora que te importe, como en el ejercicio de la etapa 8.
  3. El intervalo de la diferencia en unidades del negocio y el costo de desplegar el cambio. Una mejora de 0.02 puntos puede no compensar el esfuerzo; con \(n\) tan grande casi cualquier diferencia sale significativa, como en la etapa 9.
  4. \(20\times 0.05=1\) rechazo en promedio, y la probabilidad de al menos uno es \(1-0.95^{20}\approx 0.64\). Por eso las comparaciones múltiples necesitan una corrección, que trata el capítulo 11.
  5. Porque \(\sigma\) era desconocida y la estimaste con \(s\) a partir de 25 datos. La \(t\) de Student con 24 grados de libertad tiene colas más anchas que la normal para incorporar esa incertidumbre extra; con \(n\) grande, \(t\) se acerca a 1.96.

9.8 Referencias para profundizar

  • Student [Gosset, W. S.] (1908). The probable error of a mean. Biometrika, 6(1), 1–25. El origen de la distribución \(t\) para muestras pequeñas.
  • Wasserman, L. (2004). All of Statistics: A Concise Course in Statistical Inference. Springer. Capítulos 6 y 10: estimación, intervalos de confianza y pruebas de hipótesis.
  • Wasserstein, R. L. y Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. Qué significa y qué no significa un p-value, según la Asociación Estadounidense de Estadística.
  • Kohavi, R., Tang, D. y Xu, Y. (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press. Diseño y análisis de experimentos A/B en producto, incluidos los riesgos de mirar los resultados antes de tiempo.
  • SciPy. Documentación de scipy.stats.ttest_1samp, scipy.stats.ttest_ind y scipy.stats.t: https://docs.scipy.org/doc/scipy/reference/stats.html.

9.9 Lo que debes llevarte de este capítulo

La inferencia declara la incertidumbre de un número de muestra: el error estándar y el intervalo miden cuánto varía \(\hat\theta\), el p-value mide qué tan raro es el dato bajo \(H_0\), y ninguno de los dos dice por sí solo si un cambio vale la pena.

  • El estadístico cambia de muestra en muestra; su desviación es el error estándar, \(s/\sqrt n\): 7.15 ms con 25 latencias.
  • Un intervalo al 95% es un procedimiento que cubre el parámetro el 95% de las veces (98 de 100 en la etapa 5), y habla de la media, no de cada observación.
  • El p-value es una probabilidad calculada suponiendo \(H_0\) cierta; bajo \(H_0\) se reparte uniforme y cae por debajo de 0.05 en torno al 5% de las veces.
  • La potencia depende de \(n\), del efecto y de \(\sigma\): para 15 ms con \(\sigma=40\), 0.537 con 30 observaciones y 0.913 con 80.
  • Con \(n=4000\) por grupo, un efecto de 0.4 ms sale significativo (\(p=0.0006\)) y sigue siendo irrelevante.
  • En el A/B, la versión cuantizada redujo la latencia en 10.8 ms (IC de −16.0 a −5.6): significativo y relevante a la vez, y reportado con intervalo y unidades.

9.10 Puente hacia los siguientes capítulos

Este capítulo probó hipótesis sobre una media y sobre la diferencia de dos medias. Los dos capítulos siguientes amplían el repertorio con la misma lógica: el capítulo 10 trata los datos categóricos, con pruebas chi-cuadrado y de proporciones, y el capítulo 11, la comparación de grupos, con datos pareados, ANOVA, pruebas no paramétricas y comparaciones múltiples.

La inferencia de estos tres capítulos es frecuentista: el parámetro es fijo, los datos varían y el 95% es cobertura. Otra lectura trata \(\theta\) como incierta y actualiza \(P(\theta\mid \text{datos})\); el capítulo 12 compara la máxima verosimilitud, el MAP y la distribución posterior. Los modelos de regresión del capítulo 13 vuelven a estimar parámetros con error estándar e intervalo, y a exigir que no confundas un p-value pequeño con un efecto importante.