import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import SplineTransformer
from sklearn.pipeline import make_pipeline
from sklearn.metrics import roc_auc_score, accuracy_score, roc_curve
import statsmodels.api as sm
from scipy.stats import chi2

SEMILLA = 2026
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (8, 4)24 Modelos aditivos generalizados (GAM)
estadistica
glm
gam
Cuando el efecto no es una recta
En los capítulos anteriores el GLM te dio una arquitectura clara: eliges una distribución para \(Y\), una función de enlace y un predictor lineal. Eso cubre el sí/no (logística) y los conteos (Poisson). La pieza que queda rígida es el predictor: cada variable entra con una pendiente constante. Si el efecto sube y luego baja, esa recta no tiene cómo contarlo. Es la pregunta que dejó abierta el capítulo de Poisson: un riesgo que crece despacio en rutas medianas y se acelera en las muy largas.
Los splines del capítulo de suavización ya resolvieron la forma flexible para una media continua. Un modelo aditivo generalizado (GAM) junta las dos ideas: conserva la distribución y el enlace del GLM, pero reemplaza el predictor lineal por una suma de funciones suaves. El resultado sigue siendo interpretable —puedes dibujar el efecto de cada variable— y ya no exige que ese efecto sea monótono.
Objetivos de aprendizaje
Al terminar este capítulo vas a ser capaz de:
- Escribir un GAM como un GLM en el que el predictor lineal se reemplaza por una suma de funciones suaves.
- Reconocer un efecto no monótono en los datos y explicar por qué una logística lineal no puede capturarlo.
- Conectar el spline de la suavización con el ingrediente que le da flexibilidad al GLM.
- Elegir el número de nodos (knots) del spline por validación cruzada sobre el entrenamiento, sin usar el conjunto de prueba.
- Comparar de forma justa un GLM lineal, un GAM y un modelo de referencia trivial (baseline) sobre datos reservados.
- Leer la curva del efecto parcial: dónde sube, dónde baja y qué implica para el problema.
- Interpretar con prudencia un contraste de verosimilitud entre el predictor lineal y el suave, sin confundirlo con causalidad.
El GAM como un GLM con predictor suave
Un modelo lineal generalizado combina tres piezas: la distribución de \(Y\), un predictor y una función de enlace \(g\) que conecta la media con ese predictor. En el GLM clásico el predictor es lineal:
\[ g(\mathbb{E}[Y])=\beta_0+\beta_1 x_1+\beta_2 x_2+\cdots \]
Un GAM cambia una sola pieza: cada término \(\beta_j x_j\) puede volverse una función suave \(f_j\), estimada con un spline:
\[ g(\mathbb{E}[Y])=\beta_0+f_1(x_1)+f_2(x_2)+\cdots \]
Cada \(f_j\) es flexible: no fijas de antemano que el efecto sea una recta ni una parábola. El spline aprende la forma a partir de los datos, con la cantidad de flexibilidad que tú controles —aquí, con el número de knots.
Lo que no cambia es el resto del GLM. Si \(Y\) es binaria, sigues usando Bernoulli y el enlace logit. Si \(Y\) es un conteo, sigues usando Poisson y el enlace log. El GAM no es una familia distinta: es el mismo esqueleto con un predictor aditivo en lugar de uno lineal.
De GLM lineal a GAM
El camino es una sola flecha:
GLM (logística, Poisson: distribución + enlace + predictor lineal) \(\rightarrow\) añade forma flexible (cada \(x_j\) entra con un spline \(f_j\)) \(\rightarrow\) GAM.
| Pieza | GLM lineal (logística, Poisson) | GAM |
|---|---|---|
| Distribución de \(Y\) | Bernoulli, Poisson, … | la misma |
| Función de enlace \(g\) | logit, log, … | la misma |
| Predictor | \(\beta_0+\beta_1 x_1+\beta_2 x_2+\cdots\) | \(\beta_0+f_1(x_1)+f_2(x_2)+\cdots\) |
| Forma de cada efecto | recta en la escala del enlace | curva suave (spline) |
| Qué estima | probabilidad del sí (logística), tasa esperada de eventos (Poisson) | lo mismo, con forma flexible |
| Qué interpretas | un número (el coeficiente) | una función (el efecto parcial) |
La aditividad es lo que conserva la interpretabilidad. Como las \(f_j\) se suman, puedes dibujar \(f_1\) contra \(x_1\) dejando fijas las demás variables y leer el efecto de esa variable a lo largo de su rango. Una caja negra puede acertar predicciones sin mostrarte dónde el efecto sube o baja; el GAM te deja ver esa forma. Por eso es la herramienta natural cuando sospechas no linealidad y aún quieres explicar el resultado, no solo predecirlo.
En este capítulo nos concentramos en una respuesta binaria y una variable continua, para que la curva se vea sin mezclas. La fórmula de arriba sigue valiendo con varias \(f_j\); cada una se dibuja por separado.
Aunque cambie la respuesta, el enlace o la forma del predictor, la cadena conceptual es la misma. Ahora vamos a un caso donde esa forma flexible no es un lujo: es la diferencia entre un modelo casi inútil y uno que describe lo que ocurre.
Preparación del entorno
Cargamos scikit-learn para ajustar y comparar modelos predictivos, statsmodels para la inferencia del final y una constante global SEMILLA que fija toda la aleatoriedad del capítulo.
Los datos: conversión según la edad
Simulamos 900 clientes. De cada uno conocemos la edad y si convierte (compra: 1) o no (0). La regla oculta es deliberada: la probabilidad de conversión sube hacia las edades intermedias y baja en los extremos —un pico, no una rampa. En la práctica no conoces esa regla; la infieres de lo que observas.
Ese patrón no monótono es el escenario donde el GAM demuestra su valor. Un modelo que asuma “a más edad, siempre más (o siempre menos) conversión” va a chocar con los datos.
n = 900
edad = rng.uniform(18, 75, n)

# Regla oculta: log-odds sube y baja con la edad (pico, no rampa).
logit_real = -6 + 0.30 * edad - 0.0034 * edad**2
prob_real = 1 / (1 + np.exp(-logit_real))
convierte = rng.binomial(1, prob_real)

X = edad.reshape(-1, 1)
y = convierte

print(f'{n} clientes | tasa de conversión: {y.mean():.1%}')
print(f'Convierten: {int(y.sum())} | no convierten: {int((1 - y).sum())}')
pd.DataFrame({'edad': edad[:5], 'convierte': y[:5]}).round(3)
900 clientes | tasa de conversión: 44.4%
Convierten: 400 | no convierten: 500| edad | convierte | |
|---|---|---|
| 0 | 28.199 | 1 |
| 1 | 54.475 | 0 |
| 2 | 44.634 | 1 |
| 3 | 39.119 | 1 |
| 4 | 38.230 | 1 |
Cómo leer este resultado
La tasa global de conversión es 44.4%: 400 clientes convierten y 500 no. Las clases están razonablemente equilibradas, así que una regla ingenua (“nadie convierte”) acertaría el 55.6% de las veces —ese será el baseline más adelante.
La variable respuesta es 0 o 1. El predictor es una edad continua entre 18 y 75 años. Lo que todavía no ves es cómo se relaciona la conversión con la edad. Para eso hay que mirar la tasa por tramos, no el promedio global.
La tasa observada no es monótona
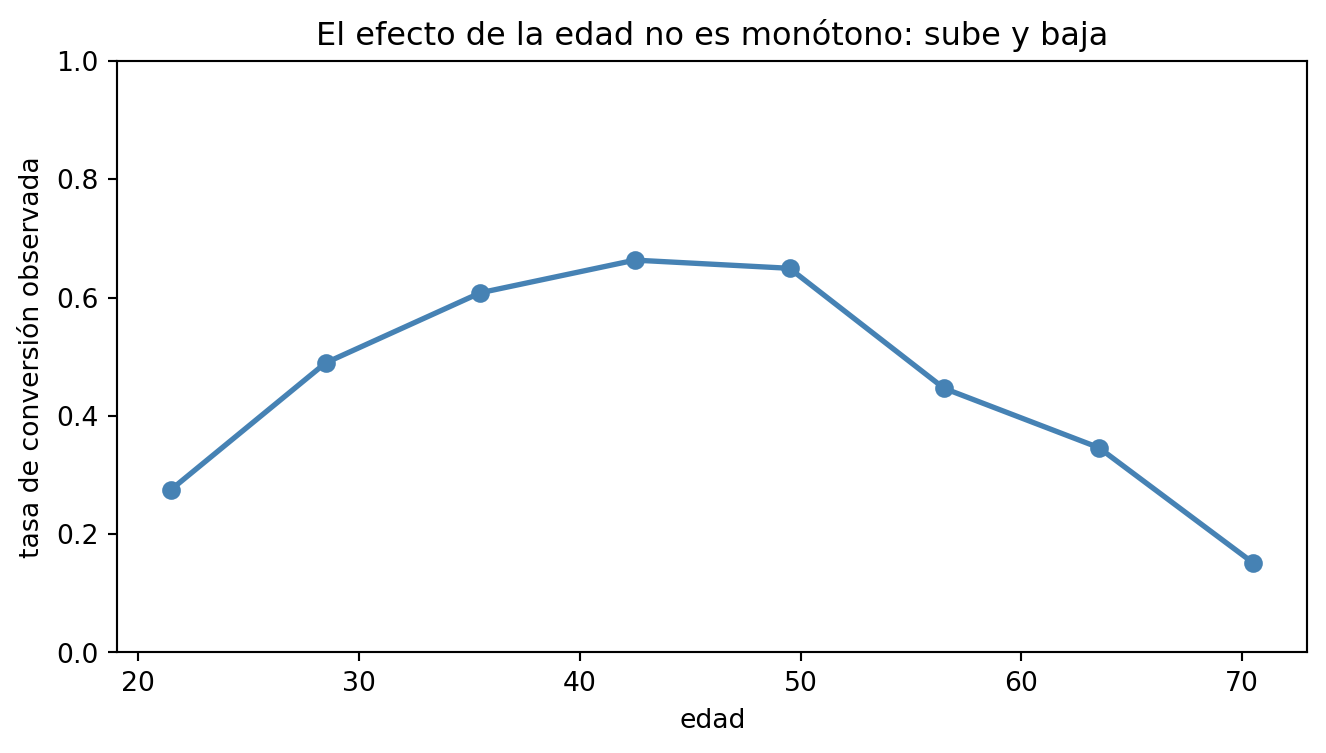
Si el efecto de la edad fuera una rampa, al agrupar por tramos verías una secuencia que siempre sube o siempre baja. Calculemos la tasa de conversión en ventanas de 7 años, de 18 a 74 (los 17 clientes de 74 a 75 años quedan fuera de los tramos), y dibujémosla.
bins = np.arange(18, 81, 7)
centros = (bins[:-1] + bins[1:]) / 2
tasas = []
ns = []
for a, b in zip(bins[:-1], bins[1:]):
    mascara = (edad >= a) & (edad < b)
    ns.append(int(mascara.sum()))
    tasas.append(y[mascara].mean())

tabla_tramos = pd.DataFrame({
    'edad (centro)': centros,
    'n': ns,
    'tasa observada': tasas,
})
display(tabla_tramos.round(3))

plt.plot(centros, tasas, marker='o', color='steelblue', linewidth=2)
plt.xlabel('edad')
plt.ylabel('tasa de conversión observada')
plt.title('El efecto de la edad no es monótono: sube y baja')
plt.ylim(0, 1)
plt.show()| edad (centro) | n | tasa observada | |
|---|---|---|---|
| 0 | 21.5 | 98 | 0.276 |
| 1 | 28.5 | 98 | 0.490 |
| 2 | 35.5 | 97 | 0.608 |
| 3 | 42.5 | 104 | 0.663 |
| 4 | 49.5 | 137 | 0.650 |
| 5 | 56.5 | 103 | 0.447 |
| 6 | 63.5 | 127 | 0.346 |
| 7 | 70.5 | 119 | 0.151 |
Cómo leer este resultado
La tasa sube hasta un máximo y después cae. En el tramo de 18–25 años convierte el 27.6%; hacia 39–46 años llega al 66.3%; en 67–74 años baja al 15.1%. No es una pendiente: es un pico, con el máximo observado entre los 39 y los 53 años (66.3% y 65.0% en los dos tramos centrales).
Ese es el detalle que lo cambia todo. Un modelo obligado a elegir una sola dirección —siempre más conversión con la edad, o siempre menos— no puede seguir una curva que cambia de sentido. Veamos el fracaso de esa herramienta antes de cambiar de idea.
Entrenamiento y prueba, antes de modelar
Separamos el 30% de los clientes como conjunto de prueba y lo reservamos. Todo ajuste, toda comparación de complejidad y toda validación cruzada ocurrirán solo en entrenamiento. La prueba entra al final, una vez, para reportar.
X_tr, X_te, y_tr, y_te = train_test_split(
    X, y, test_size=0.3, random_state=SEMILLA, stratify=y
)
edad_tr = X_tr.ravel()
edad_te = X_te.ravel()

print(f'Entrenamiento: {len(y_tr)} clientes | tasa: {y_tr.mean():.1%}')
print(f'Prueba:        {len(y_te)} clientes | tasa: {y_te.mean():.1%}')
Entrenamiento: 630 clientes | tasa: 44.4%
Prueba: 270 clientes | tasa: 44.4%Intento 1: regresión logística lineal
Ajustamos primero el GLM que ya conoces: una logística estándar. En la escala logit, asume que el efecto de la edad es una recta —siempre en la misma dirección. En la escala de probabilidad eso produce una sigmoide monótona. Si los datos forman un pico, este modelo tiene que aplanarlo.
lineal = LogisticRegression(max_iter=1000).fit(X_tr, y_tr)

grid = np.linspace(18, 75, 300).reshape(-1, 1)
prob_lin_grid = lineal.predict_proba(grid)[:, 1]

# Tasas observadas en entrenamiento, para no mezclar con la prueba.
tasas_tr = []
for a, b in zip(bins[:-1], bins[1:]):
    mascara = (edad_tr >= a) & (edad_tr < b)
    tasas_tr.append(y_tr[mascara].mean() if mascara.sum() else np.nan)

plt.plot(centros, tasas_tr, marker='o', color='gray', alpha=0.7,
         label='tasa observada (entrenamiento)')
plt.plot(grid, prob_lin_grid, color='firebrick', linewidth=2,
         label='logística lineal')
plt.xlabel('edad')
plt.ylabel('probabilidad de conversión')
plt.title('Logística lineal: una sola dirección, una rampa suave')
plt.ylim(0, 1)
plt.legend()
plt.show()

print(f'Coeficiente de la edad: {lineal.coef_[0, 0]:.3f}')
print(f'Intercepto:             {lineal.intercept_[0]:.3f}')
print(f'Probabilidades a lo largo de la edad: {prob_lin_grid.min():.3f} a {prob_lin_grid.max():.3f}')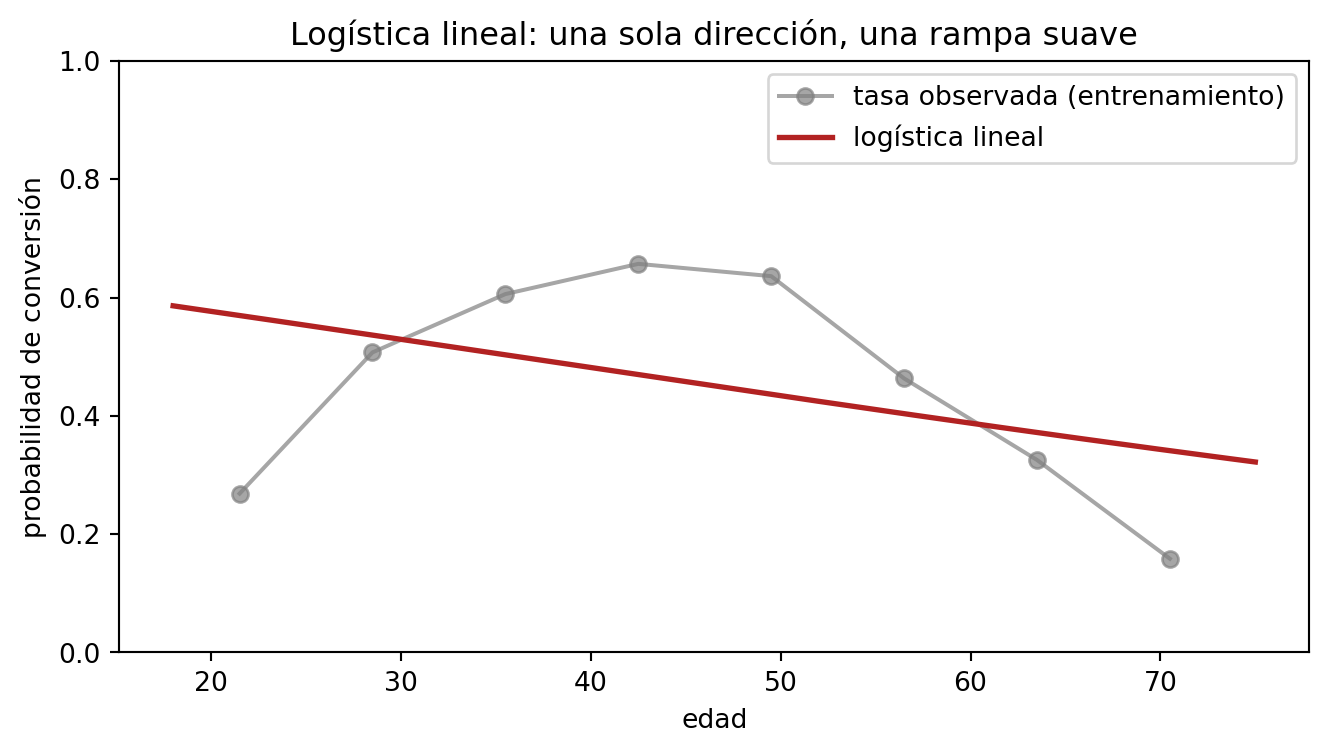
Coeficiente de la edad: -0.019
Intercepto:             0.693
Probabilidades a lo largo de la edad: 0.322 a 0.586
Cómo leer este resultado
La curva roja es una rampa suave y descendente: a lo largo de las edades, las probabilidades van apenas de 0.586 (18 años) a 0.322 (75 años), mientras que las tasas observadas por tramo recorren de 15.1% a 66.3%. La logística lineal, obligada a una sola dirección, elige una pendiente levemente negativa (coeficiente -0.019 por año) porque la cola derecha —clientes mayores, con baja conversión— arrastra la pendiente hacia abajo. No puede subir hacia los 40 y bajar después: tiene que elegir un compromiso, y ese compromiso asigna su probabilidad más alta (0.586) justo a los clientes de 18 años, uno de los grupos que menos convierte (27.6% en el tramo de 18–25).
El modelo no falla porque la edad no importe: falla porque importa con una forma que este GLM no puede representar. Cuánto pierde en discriminación lo mediremos en prueba, cuando el GAM ya tenga su número de knots fijado.
Repaso: el spline es la pieza que da flexibilidad
En el capítulo de suavización con splines ya usaste uno para una media continua: SplineTransformer expandía \(X\) en una base local y LinearRegression estimaba los pesos. El truco no era cambiar de algoritmo; era cambiar el espacio de características.
Un spline cúbico parte el rango de la variable en tramos definidos por knots (nodos) y, en cada tramo, ajusta un polinomio de grado 3. En los knots las piezas se empalman de modo que la curva, su pendiente y su curvatura coincidan. El resultado es una función suave, capaz de subir y bajar, sin que tú le impongas una parábola ni una recta.
En scikit-learn, n_knots cuenta también los extremos. Con n_knots=5 hay tres knots internos; degree=3 es el cúbico de siempre. include_bias=False deja el intercepto en manos del clasificador, igual que en ese capítulo.
La novedad aquí es el compañero de esa expansión: en vez de LinearRegression (media continua), usamos LogisticRegression (probabilidad). El spline sigue siendo el mismo objeto; ahora vive dentro de un GLM.
Un detalle que importa más adelante: en scikit-learn, LogisticRegression penaliza por defecto los pesos con una penalización L2 (C=1.0), la misma idea de Ridge. Sobre la edad sin transformar su efecto es mínimo, pero sobre las bases del spline encoge los pesos y suaviza la curva. Es la misma lógica de los GAM de uso profesional, que combinan knots con una penalización de suavidad: la flexibilidad efectiva depende de las dos cosas, no solo del número de knots.
spline_demo = SplineTransformer(n_knots=5, degree=3, include_bias=False)
bases_grid = spline_demo.fit(X_tr).transform(grid)

print(f'Columnas que fabrica SplineTransformer(n_knots=5): {bases_grid.shape[1]}')

for j in range(bases_grid.shape[1]):
    plt.plot(grid, bases_grid[:, j], linewidth=2, label=f'base {j + 1}')
plt.xlabel('edad')
plt.ylabel('valor de la base')
plt.title('Cada columna del spline actúa en un tramo de la edad')
plt.legend()
plt.show()
Columnas que fabrica SplineTransformer(n_knots=5): 6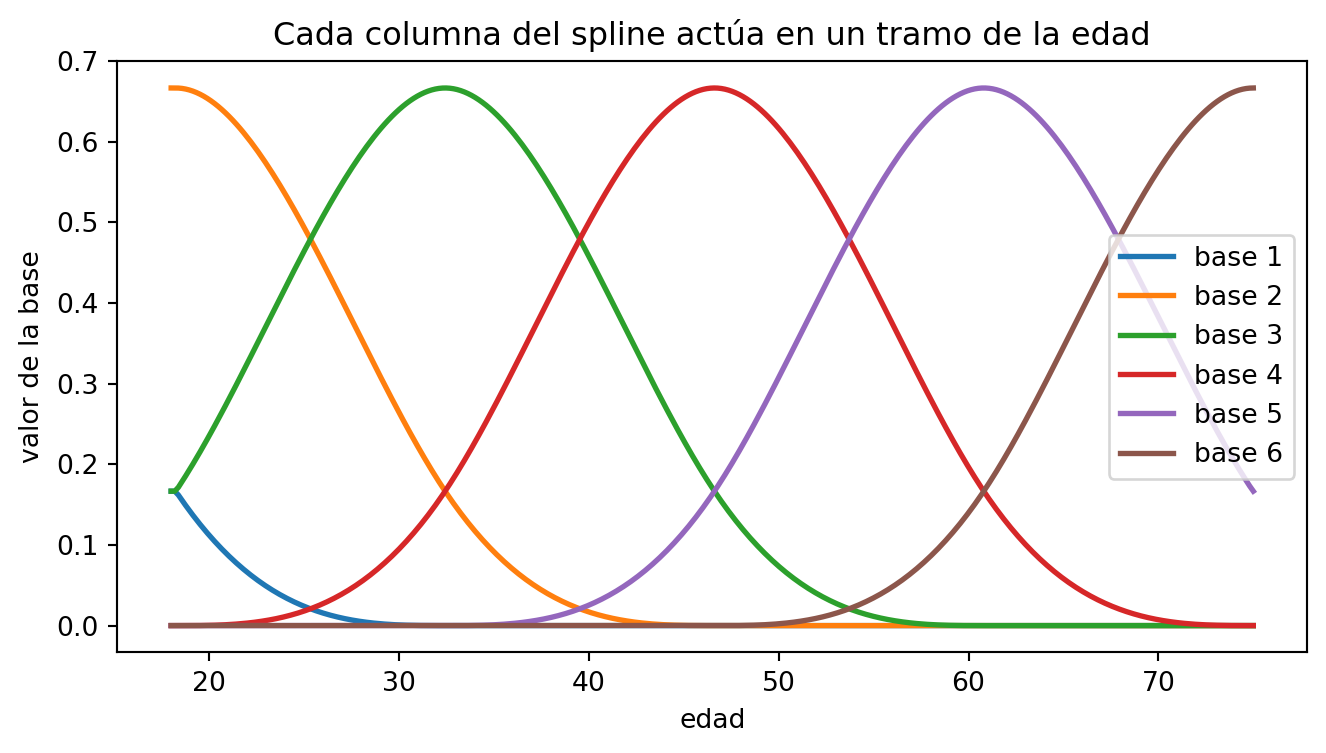
Cómo leer estas bases
Cada curva es una columna: vale más en un tramo de la edad y se apaga fuera de él. El modelo no estima “un coeficiente de la edad”; estima un peso por base. Al combinarlas con esos pesos, la contribución de la edad puede subir en un tramo y bajar en otro. Eso era imposible con un único \(\beta\).
Con n_knots=5, degree=3 e include_bias=False, scikit-learn fabrica 6 columnas: \(n_{\mathrm{knots}}+\mathrm{degree}-2=5+3-2=6\). Más knots significan tramos más cortos y más capacidad de doblarse —también más riesgo de seguir el ruido. Esa tensión es la que resolveremos con validación cruzada. Antes, veamos en una figura qué ocurre cuando cambias la flexibilidad a mano.
Intento 2: el GAM (spline + logística)
Un GAM logístico es, en la práctica, exactamente esa cadena de pasos (pipeline): expandir la edad con un spline y ajustar una logística sobre las columnas resultantes. La distribución sigue siendo Bernoulli; el enlace sigue siendo logit; lo único que se volvió flexible es el predictor.
\[ \operatorname{logit}(p)=\beta_0+f(\text{edad}). \]
\(f\) es la combinación lineal de las bases del spline. Todavía no elegimos cuántos knots usar: primero vamos a ver qué cambia con su número. Ajustamos tres GAM sobre el mismo entrenamiento, con tres valores de n_knots: 2 (sin knots internos: un único polinomio cúbico), 5 (flexibilidad moderada) y 15 (muy flexible). Las curvas se dibujan contra la tasa observada en entrenamiento. Ninguna de estas tres configuraciones se evalúa aún en prueba: esto es un experimento visual, no la selección del modelo.
fig, ejes = plt.subplots(1, 3, figsize=(12, 4), sharey=True)
configuraciones = [
    (2, 'poca flexibilidad'),
    (5, 'flexibilidad moderada'),
    (15, 'mucha flexibilidad'),
]

for ax, (k, etiqueta) in zip(ejes, configuraciones):
    modelo_k = make_pipeline(
        SplineTransformer(n_knots=k, degree=3, include_bias=False),
        LogisticRegression(max_iter=1000),
    ).fit(X_tr, y_tr)
    ax.plot(centros, tasas_tr, marker='o', color='gray', alpha=0.7,
            label='tasa observada')
    ax.plot(grid, modelo_k.predict_proba(grid)[:, 1],
            color='seagreen', linewidth=2, label=f'GAM, n_knots={k}')
    ax.set_title(f'{k} knots: {etiqueta}')
    ax.set_xlabel('edad')
    ax.set_ylim(0, 1)

ejes[0].set_ylabel('probabilidad de conversión')
ejes[0].legend(loc='upper right', fontsize=8)
plt.tight_layout()
plt.show()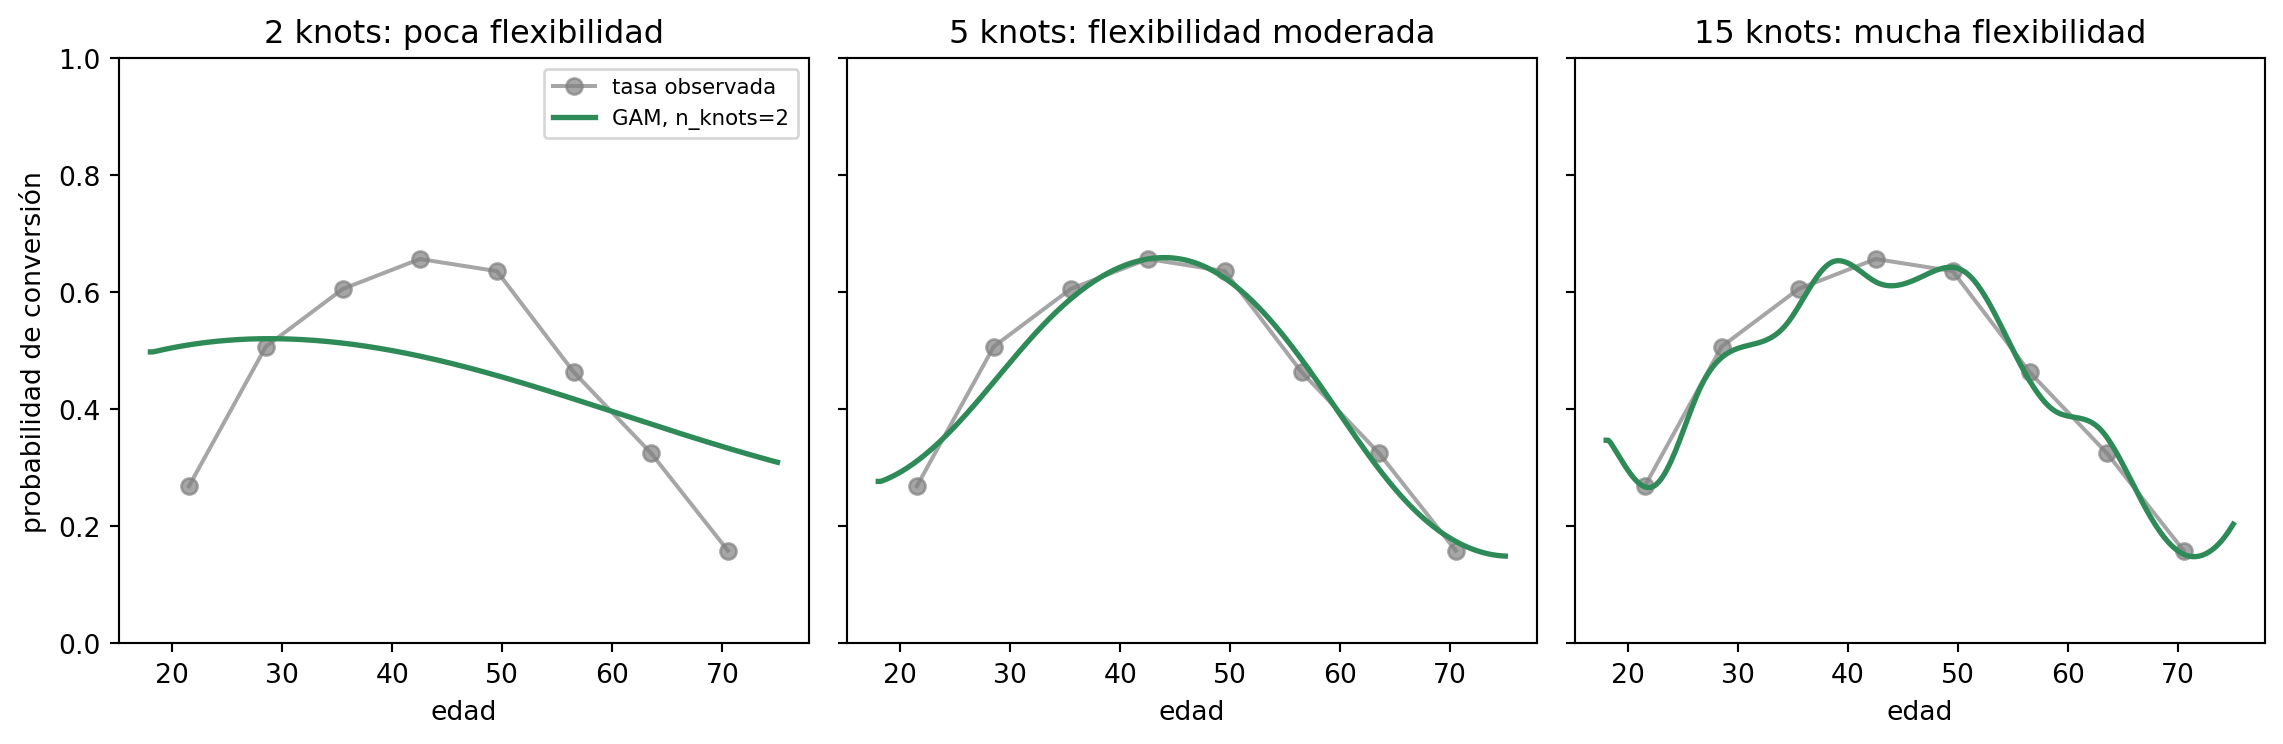
Cómo leer esta figura
A la izquierda, con 2 knots, la curva es casi plana: forma un pico tenue, desplazado hacia los 29 años y que no pasa de 0.52. Conviene precisar la causa. Con n_knots=2 no hay knots internos y el spline es un único polinomio cúbico en todo el rango de edad, que sí podría dibujar el pico. Lo que lo aplana es la penalización L2 que LogisticRegression aplica por defecto (C=1.0): con bases tan anchas, formar el pico exige pesos grandes, y la penalización los encoge. El resultado es subajuste —demasiada rigidez efectiva—, producido por la penalización más que por la falta de knots; sin penalización, este mismo spline recupera el pico, con máximo cerca de los 41 años.
Al centro, con 5 knots, la curva sigue el pico: sube hacia las edades intermedias y baja en los extremos. Esa es la forma que los tramos observados estaban pidiendo.
A la derecha, con 15 knots, la curva se vuelve más inquieta: persigue subidas y bajadas locales que pueden ser ruido del entrenamiento. Es el sobreajuste: tanta flexibilidad que el modelo empieza a memorizar fluctuaciones que no se van a repetir.
La figura te da la intuición. No te da el número con el que debes quedarte. Ese número no se elige a simple vista ni mirando la prueba.
Antes de seguir, pregúntate
- Si eliges
n_knotscomo el valor que mejor ajusta la curva verde a los puntos grises de entrenamiento, ¿estás midiendo ajuste o generalización? - Si el óptimo de validación cruzada cayera en el borde del rango que probaste —el más rígido o el más flexible—, ¿qué harías antes de declararlo ganador?
- ¿Por qué el conjunto de prueba no puede participar en esta decisión?
La siguiente celda responde las tres: validación cruzada dentro del entrenamiento, un rango que deja ver ambos extremos, y la prueba todavía intacta.
Elegir el número de knots por validación cruzada
Recorremos n_knots de 2 a 15. Para cada valor armamos el mismo pipeline (SplineTransformer + LogisticRegression) y estimamos el AUC promedio (área bajo la curva ROC: la probabilidad de que el modelo asigne mayor probabilidad a un cliente que convierte que a uno que no) con validación cruzada (CV, por cross-validation) de 5 pliegues (folds) estratificados sobre el entrenamiento. El SplineTransformer vive dentro del pipeline: los knots se calculan en cada fold de ajuste, no con el entrenamiento completo y mucho menos con la prueba.
La métrica es AUC, no exactitud: queremos un modelo que ordene bien quién convierte, sin fijar todavía un umbral.
Si el máximo cayera en el borde del rango, ampliaríamos los candidatos. Un óptimo en el borde no es una elección: es una señal de que no exploraste suficiente.
candidatos = [2, 3, 4, 5, 6, 8, 10, 12, 15]
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)

filas_cv = []
for n_knots in candidatos:
    aucs_fold = []
    for idx_ajuste, idx_valid in cv.split(X_tr, y_tr):
        modelo_cv = make_pipeline(
            SplineTransformer(n_knots=n_knots, degree=3, include_bias=False),
            LogisticRegression(max_iter=1000),
        )
        modelo_cv.fit(X_tr[idx_ajuste], y_tr[idx_ajuste])
        prob_valid = modelo_cv.predict_proba(X_tr[idx_valid])[:, 1]
        aucs_fold.append(roc_auc_score(y_tr[idx_valid], prob_valid))
    filas_cv.append({
        'n_knots': n_knots,
        'AUC_CV': np.mean(aucs_fold),
        'desv_AUC': np.std(aucs_fold, ddof=1),
    })

tabla_cv = pd.DataFrame(filas_cv)
mejor_n_knots = int(tabla_cv.loc[tabla_cv['AUC_CV'].idxmax(), 'n_knots'])
en_borde = mejor_n_knots in (candidatos[0], candidatos[-1])

display(tabla_cv.round(3))
print(f'Mejor n_knots según AUC de CV: {mejor_n_knots}')
print(f'Rango explorado: {candidatos[0]} a {candidatos[-1]}')
print(f'¿El óptimo cae en el borde del rango? {"sí" if en_borde else "no"}')

plt.plot(tabla_cv['n_knots'], tabla_cv['AUC_CV'], marker='o', color='steelblue', linewidth=2)
plt.errorbar(
    tabla_cv['n_knots'], tabla_cv['AUC_CV'], yerr=tabla_cv['desv_AUC'],
    fmt='none', ecolor='steelblue', alpha=0.5, capsize=4,
)
plt.axvline(mejor_n_knots, color='seagreen', ls='--', label=f'elegido: {mejor_n_knots}')
plt.xlabel('n_knots')
plt.ylabel('AUC de validación cruzada')
plt.title('La flexibilidad se elige en entrenamiento, no en prueba')
plt.legend()
plt.show()| n_knots | AUC_CV | desv_AUC | |
|---|---|---|---|
| 0 | 2 | 0.607 | 0.035 |
| 1 | 3 | 0.707 | 0.049 |
| 2 | 4 | 0.706 | 0.049 |
| 3 | 5 | 0.706 | 0.049 |
| 4 | 6 | 0.703 | 0.049 |
| 5 | 8 | 0.700 | 0.052 |
| 6 | 10 | 0.697 | 0.052 |
| 7 | 12 | 0.698 | 0.049 |
| 8 | 15 | 0.693 | 0.042 |
Mejor n_knots según AUC de CV: 3
Rango explorado: 2 a 15
¿El óptimo cae en el borde del rango? no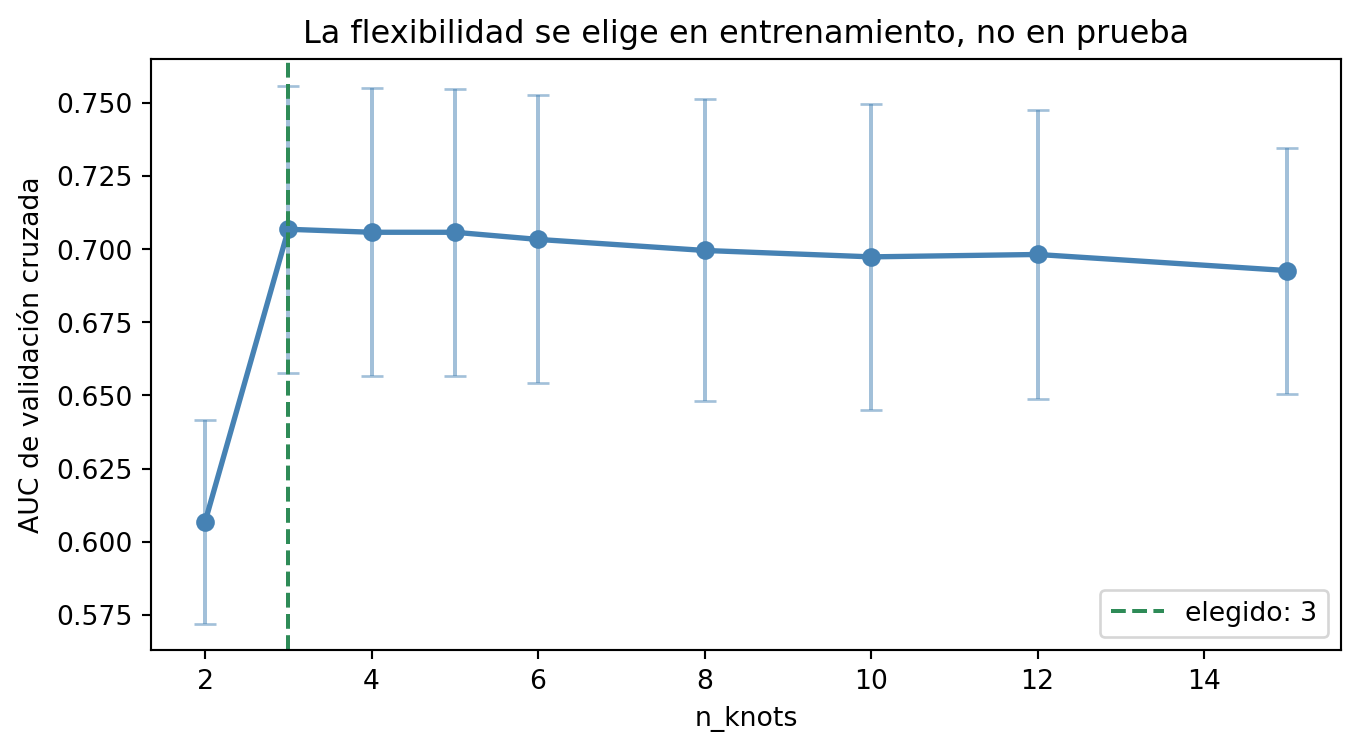
Cómo leer esta validación cruzada
El peor extremo es n_knots=2, con AUC de CV 0.607: es la rigidez efectiva que viste en la figura anterior, causada sobre todo por la penalización L2 por defecto sobre bases muy anchas (sin penalización, el mismo spline de 2 knots alcanza un AUC de CV de 0.705). El máximo está en n_knots=3, con AUC de CV 0.707. A partir de ahí el AUC se estanca o baja levemente: con 15 knots cae a 0.693, una diferencia de 0.014 que queda dentro de la variación entre folds (desviación estándar de 0.042 a 0.052). Más flexibilidad no trae más acierto esperado; a partir de cierto punto solo agrega varianza.
El óptimo no cae en el borde: el rango iba de 2 a 15, y 3 queda en el interior. No hace falta ampliar candidatos. La lección es la misma del capítulo de splines: la forma verdadera es un pico suave, y la validación cruzada elige un spline modesto, no el más flexible.
Las barras son la desviación estándar del AUC entre folds. Cuando dos valores tienen medias casi iguales y barras que se solapan, conviene el más simple. Aquí 3, 4 y 5 están prácticamente empatados (0.707, 0.706 y 0.706); el máximo, 3, es además el más simple de los tres, así que nos quedamos con él y lo fijamos antes de tocar la prueba.
El GAM elegido, frente a la logística lineal
Reajustamos el pipeline con n_knots=3 en todo el entrenamiento —los folds ya cumplieron su papel— y dibujamos las dos curvas sobre la misma tasa observada. Las métricas numéricas de prueba llegan en la siguiente sección; esta figura es para ver si el GAM, ya con el hiperparámetro fijado, recupera el pico.
gam = make_pipeline(
    SplineTransformer(n_knots=mejor_n_knots, degree=3, include_bias=False),
    LogisticRegression(max_iter=1000),
).fit(X_tr, y_tr)

prob_gam_grid = gam.predict_proba(grid)[:, 1]

plt.plot(centros, tasas_tr, marker='o', color='gray', alpha=0.7,
         label='tasa observada (entrenamiento)')
plt.plot(grid, prob_lin_grid, color='firebrick', linewidth=2, alpha=0.55,
         label='logística lineal')
plt.plot(grid, prob_gam_grid, color='seagreen', linewidth=2,
         label=f'GAM (n_knots={mejor_n_knots})')
plt.xlabel('edad')
plt.ylabel('probabilidad de conversión')
plt.title('El GAM recupera el pico; la logística lineal lo aplana')
plt.ylim(0, 1)
plt.legend()
plt.show()

edad_pico = float(grid[np.argmax(prob_gam_grid), 0])
print(f'Pico de la curva GAM: edad {edad_pico:.1f} años, probabilidad {prob_gam_grid.max():.3f}')
print(f'Rango de la curva GAM: {prob_gam_grid.min():.3f} a {prob_gam_grid.max():.3f}')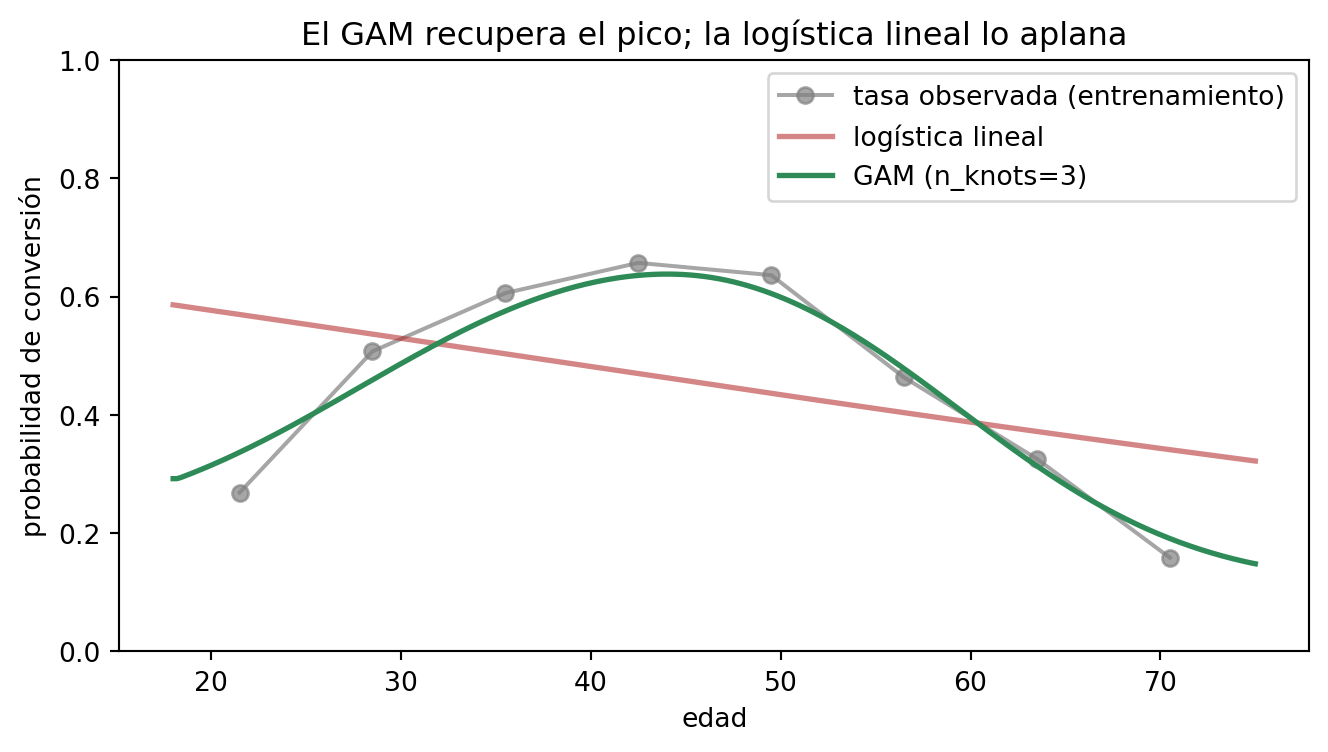
Pico de la curva GAM: edad 43.9 años, probabilidad 0.638
Rango de la curva GAM: 0.148 a 0.638
Cómo leer este resultado
La curva verde sigue el pico: sube desde los 18 años, alcanza su máximo cerca de 43.9 años (probabilidad 0.638) y baja hasta 0.148 en el extremo derecho. La roja sigue siendo la rampa descendente de 0.586 a 0.322.
Esa es la esencia del GAM: conservas la estructura del GLM —Bernoulli, logit, un efecto por variable que puedes dibujar— y liberas la forma de ese efecto. Todavía no celebres el gráfico: un modelo puede lucir bien en entrenamiento y no generalizar.
Comparación justa: lineal vs GAM vs baseline
Tres reglas, el mismo conjunto de prueba, las mismas métricas:
- Baseline trivial: siempre predice la clase mayoritaria del entrenamiento (aquí, “no convierte”). Como su marcador es constante, su AUC es 0.5: no ordena.
- Logística lineal: el GLM con predictor rígido.
- GAM: el mismo GLM, con el spline cuyo
n_knotsse eligió por CV en entrenamiento.
El AUC mide discriminación (ordenar quién convierte). La exactitud mide aciertos con umbral 0.5. Ninguna de las dos se usó para elegir knots sobre la prueba.
prob_lin_te = lineal.predict_proba(X_te)[:, 1]
auc_lineal = roc_auc_score(y_te, prob_lin_te)
acc_lineal = accuracy_score(y_te, lineal.predict(X_te))

prob_gam_te = gam.predict_proba(X_te)[:, 1]
auc_gam = roc_auc_score(y_te, prob_gam_te)
acc_gam = accuracy_score(y_te, gam.predict(X_te))

clase_mayoritaria = 1 if y_tr.mean() >= 0.5 else 0
pred_base = np.full_like(y_te, clase_mayoritaria)
acc_base = accuracy_score(y_te, pred_base)
# Un marcador constante no ordena: el AUC de referencia es 0.5.
auc_base = 0.5

comparacion = pd.DataFrame({
    'modelo': [
        'Baseline (clase mayoritaria)',
        'Logística lineal',
        f'GAM (n_knots={mejor_n_knots})',
    ],
    'AUC prueba': [auc_base, auc_lineal, auc_gam],
    'exactitud prueba': [acc_base, acc_lineal, acc_gam],
})
display(comparacion.round(3))

print(f'Clase mayoritaria en entrenamiento: {clase_mayoritaria} '
      f'({"convierte" if clase_mayoritaria == 1 else "no convierte"})')
print(f'AUC  — baseline {auc_base:.3f} | lineal {auc_lineal:.3f} | GAM {auc_gam:.3f}')
print(f'Acc. — baseline {acc_base:.3f} | lineal {acc_lineal:.3f} | GAM {acc_gam:.3f}')| modelo | AUC prueba | exactitud prueba | |
|---|---|---|---|
| 0 | Baseline (clase mayoritaria) | 0.500 | 0.556 |
| 1 | Logística lineal | 0.599 | 0.507 |
| 2 | GAM (n_knots=3) | 0.718 | 0.674 |
Clase mayoritaria en entrenamiento: 0 (no convierte)
AUC  — baseline 0.500 | lineal 0.599 | GAM 0.718
Acc. — baseline 0.556 | lineal 0.507 | GAM 0.674
Cómo leer la comparación
En prueba, el GAM alcanza un AUC de 0.718 frente a 0.599 de la logística lineal y 0.500 del baseline. La mejora no es un retoque: es la diferencia entre ordenar apenas mejor que el azar y recuperar la forma que realmente discrimina.
En exactitud el contraste es todavía más claro. El baseline (siempre “no convierte”) acierta el 55.6%. La logística lineal baja a 50.7%: peor que ignorar la edad. El GAM sube a 67.4%. Un predictor mal especificado no es “un poco peor”; puede destruir incluso la ventaja de la clase mayoritaria, porque el umbral 0.5 se aplica sobre probabilidades que no describen el fenómeno.
Estas cifras salen de 270 clientes que el modelo no usó ni para estimar coeficientes ni para elegir knots. Por eso la comparación es justa.
Discriminación a lo largo de todos los umbrales: ROC
El AUC resume la curva ROC. Dibujar las tres reglas juntas deja ver dónde gana el GAM, no solo el número agregado.
fpr_lin, tpr_lin, _ = roc_curve(y_te, prob_lin_te)
fpr_gam, tpr_gam, _ = roc_curve(y_te, prob_gam_te)

plt.plot(fpr_gam, tpr_gam, color='seagreen', linewidth=2,
         label=f'GAM (AUC = {auc_gam:.3f})')
plt.plot(fpr_lin, tpr_lin, color='firebrick', linewidth=2,
         label=f'logística lineal (AUC = {auc_lineal:.3f})')
plt.plot([0, 1], [0, 1], 'k--', alpha=0.5, label='baseline / azar (AUC = 0.500)')
plt.xlabel('tasa de falsos positivos')
plt.ylabel('tasa de verdaderos positivos')
plt.title('Curva ROC en prueba: la ventaja del GAM está en los umbrales exigentes')
plt.legend()
plt.show()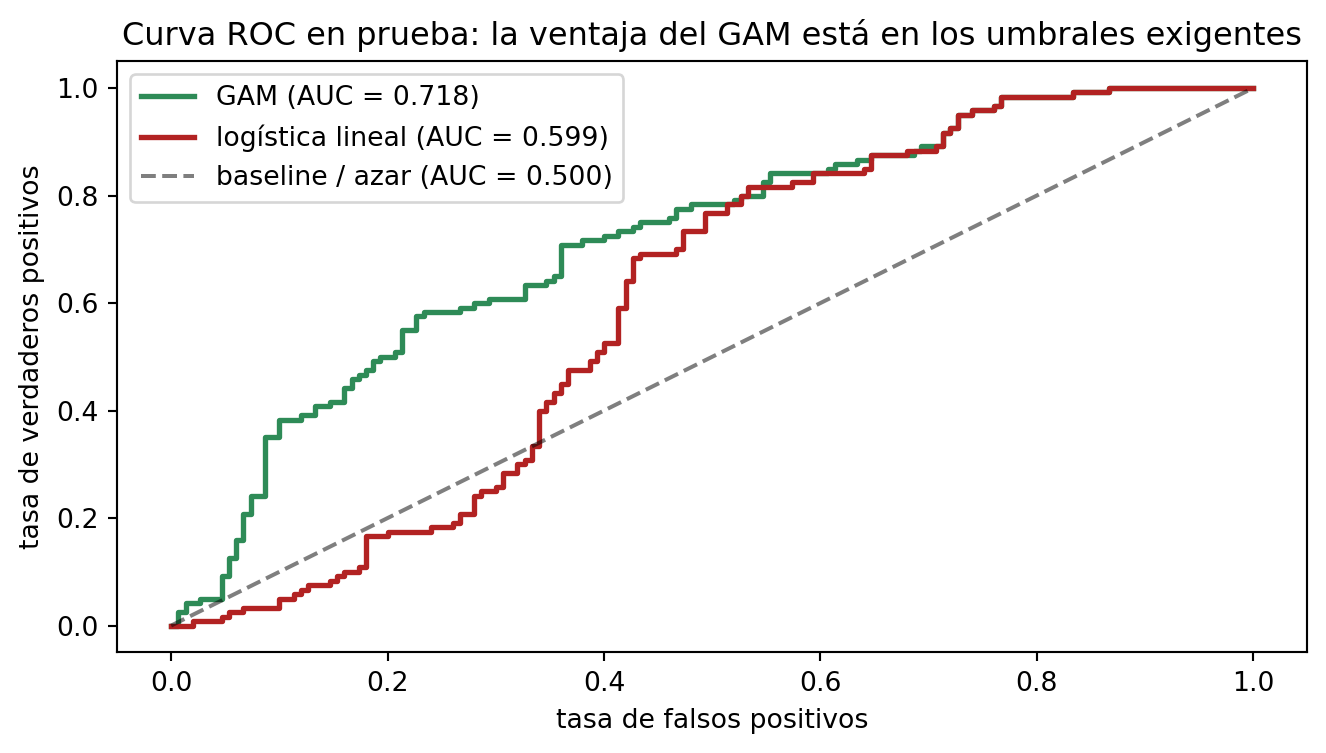
Cómo leer la curva ROC
Un AUC de 0.718 significa que, al tomar al azar un cliente que convierte y uno que no, el GAM asigna mayor probabilidad al que sí convierte aproximadamente el 72% de las veces. La curva de la logística lineal (0.599) incluso queda por debajo de la diagonal hasta una tasa de falsos positivos cercana a 0.33: sus primeros puestos los ocupan los clientes más jóvenes, a quienes asigna la probabilidad más alta aunque convierten poco. La ventaja del GAM se concentra en los umbrales exigentes: con tasas de falsos positivos entre 0.1 y 0.4, su tasa de verdaderos positivos supera a la de la lineal en unos 0.2 a 0.35. A partir de una tasa de falsos positivos de 0.5, las dos curvas prácticamente coinciden.
Recuerda la distinción de la logística: el AUC mide discriminación (ordenar), no calibración (si anunciar 0.60 se traduce en 60 de cada 100). Para desplegar probabilidades operativas haría falta un chequeo extra de calibración. Aquí nos basta con confirmar que la forma flexible mejora el ordenamiento sobre la prueba.
La ventaja interpretativa: leer la forma del efecto
Un buen AUC no explica qué hace la edad. El GAM sí puede. Como el predictor es \(f(\text{edad})\), podemos dibujar esa contribución a lo largo del rango: la curva de efecto parcial.
En la escala de probabilidad ves el mensaje para el negocio: en qué edades la conversión esperada es alta o baja. En la escala logit ves \(f\) centrada —la pieza aditiva del modelo—, sin mezclarla con el intercepto. Las dos cuentan la misma historia; cambian las unidades.
spline = gam.named_steps['splinetransformer']
clf = gam.named_steps['logisticregression']
bases_efecto = spline.transform(grid)
# Contribución de la edad en log-odds, centrada para leer forma y no nivel.
f_logit = bases_efecto @ clf.coef_[0]
f_logit = f_logit - f_logit.mean()

fig, ejes = plt.subplots(1, 2, figsize=(12, 4))

ejes[0].plot(grid, prob_gam_grid, color='seagreen', linewidth=2)
ejes[0].axvline(edad_pico, color='gray', ls='--', alpha=0.7)
ejes[0].set(
    xlabel='edad',
    ylabel='probabilidad de conversión estimada',
    title='Escala de probabilidad',
    ylim=(0, 1),
)

ejes[1].plot(grid, f_logit, color='steelblue', linewidth=2)
ejes[1].axhline(0, color='gray', ls=':')
ejes[1].axvline(edad_pico, color='gray', ls='--', alpha=0.7)
ejes[1].set(
    xlabel='edad',
    ylabel='f(edad) centrada (log-odds)',
    title='Escala del predictor aditivo',
)

plt.tight_layout()
plt.show()

print(f'Máximo de f(edad) en {edad_pico:.1f} años')
print(f'f(edad) en 20 años: {np.interp(20, grid.ravel(), f_logit):.3f}')
print(f'f(edad) en 44 años: {np.interp(44, grid.ravel(), f_logit):.3f}')
print(f'f(edad) en 70 años: {np.interp(70, grid.ravel(), f_logit):.3f}')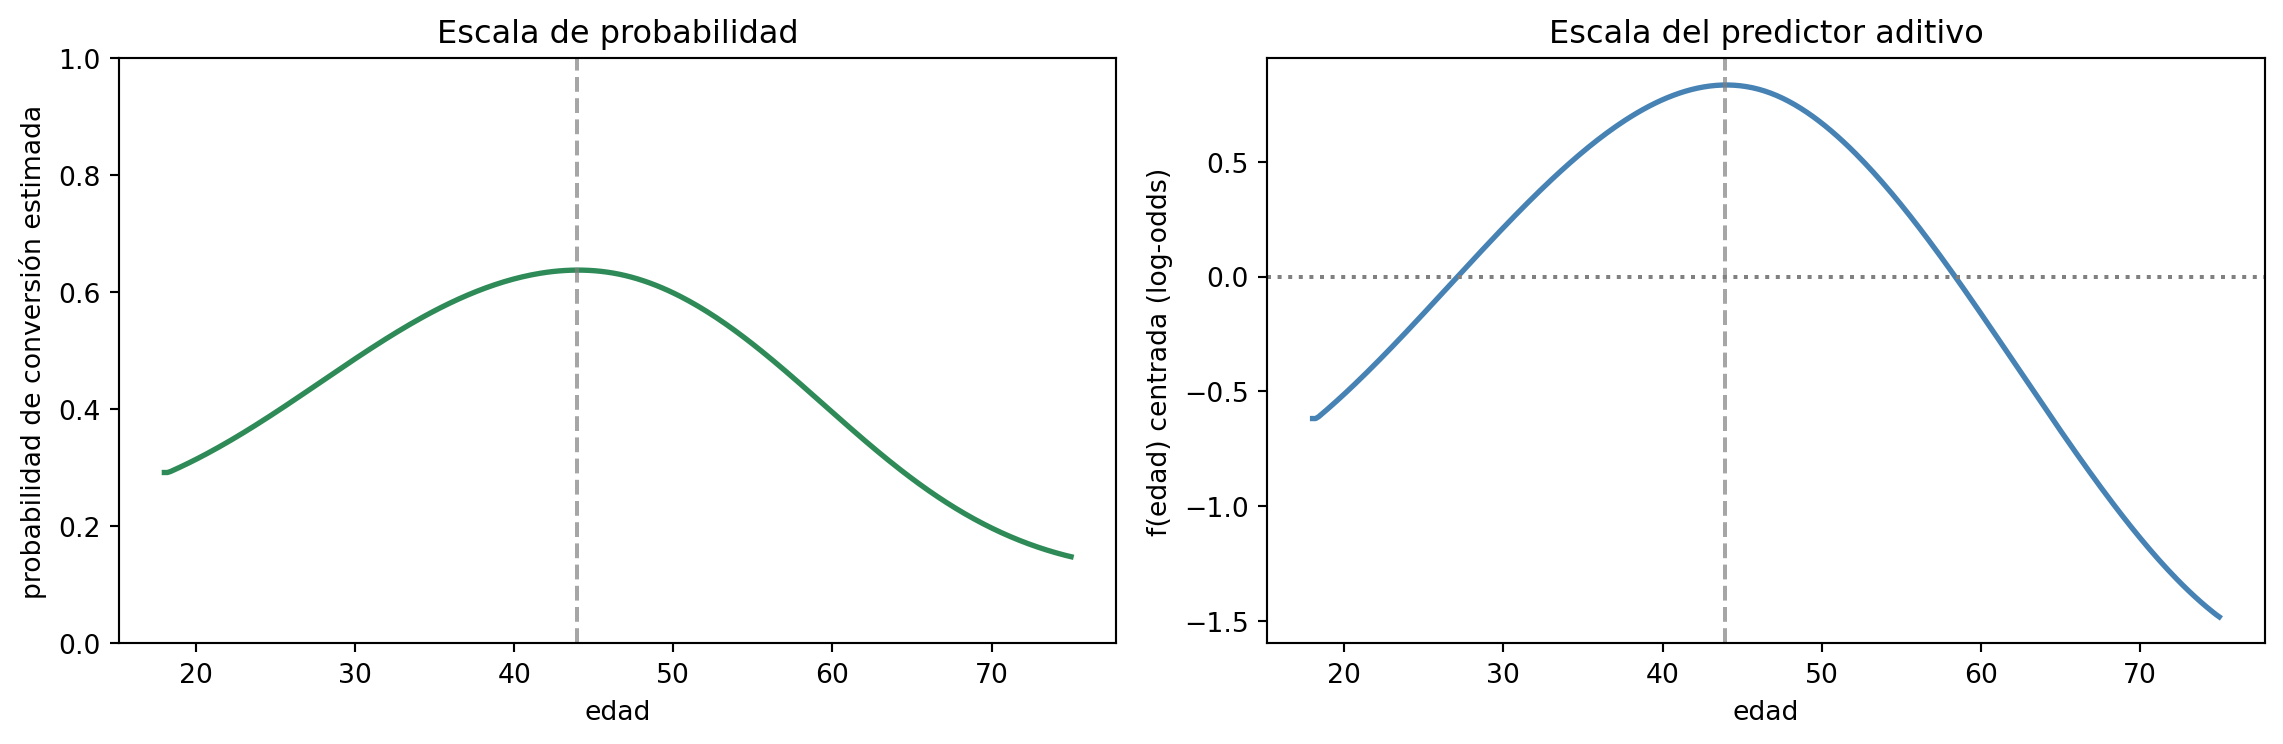
Máximo de f(edad) en 43.9 años
f(edad) en 20 años: -0.511
f(edad) en 44 años: 0.834
f(edad) en 70 años: -1.136
Cómo leer el efecto parcial
En probabilidad, la conversión estimada sube desde los 18 años hasta cerca de 44, y baja con claridad después de los 50, hasta valores bajos alrededor de los 70. No es “los mayores convierten menos” como lema global: los más jóvenes también convierten menos que el grupo intermedio. El GAM te deja decir dónde ocurre cada tramo, no solo el signo de un coeficiente.
En log-odds, \(f(\text{edad})\) está por debajo de cero en los extremos —\(f(20)=-0.511\), \(f(70)=-1.136\)— y por encima cerca del pico —\(f(44)=0.834\). Como la centraste, el cero es el nivel medio de la curva, no “efecto nulo”. Lo útil no es un p-valor de cada base: es esta forma. Frente a una caja negra, esta es la ventaja que viniste a buscar —la misma variable, el mismo modelo probabilístico, y un dibujo que puedes explicar.
¿Hay evidencia de que la forma suave mejora el ajuste?
El AUC de prueba ya respondió en clave predictiva. En clave inferencial, sobre el mismo entrenamiento, comparamos dos GLM binomiales sin penalización (a diferencia del pipeline de scikit-learn, que aplica la L2 por defecto; por eso sus coeficientes no coinciden con los de gam):
- reducido: \(\operatorname{logit}(p)=\beta_0+\beta_1\,\text{edad}\)
- GAM: \(\operatorname{logit}(p)=\beta_0+\) bases del spline con el
n_knotsya elegido
El contraste de verosimilitud (LRT) pregunta si las bases extra mejoran el ajuste lo bastante como para no atribuirlo al azar, bajo los supuestos del modelo. Las bases del spline, junto con el intercepto, reproducen exactamente cualquier recta dentro del rango de entrenamiento, así que el modelo lineal es un caso particular (anidado) del suave y el LRT es legítimo; el AIC (criterio de información de Akaike, \(-2\log L+2k\), donde menor es mejor), que no exige anidamiento, apunta en la misma dirección. Un p-valor pequeño no demuestra que la edad cause la conversión, ni que 3 knots sea la verdad del fenómeno, ni que el modelo deba desplegarse. Es una evidencia de asociación con forma no lineal, en esta muestra de entrenamiento. Además, n_knots se eligió con estos mismos datos, así que el p-valor es algo optimista.
# GLM lineal (statsmodels, sin regularizar), sobre entrenamiento.
X_lin_sm = sm.add_constant(X_tr)
glm_lineal = sm.GLM(y_tr, X_lin_sm, family=sm.families.Binomial()).fit()

# GAM: las mismas bases que el pipeline, también sobre entrenamiento.
bases_tr = spline.transform(X_tr)
X_gam_sm = sm.add_constant(bases_tr)
glm_gam = sm.GLM(y_tr, X_gam_sm, family=sm.families.Binomial()).fit()

stat_lrt = 2 * (glm_gam.llf - glm_lineal.llf)
gl_lrt = int(glm_gam.df_model - glm_lineal.df_model)
p_lrt = chi2.sf(stat_lrt, gl_lrt)

tabla_lineal = pd.DataFrame({
    'coeficiente': glm_lineal.params,
    'p-valor': glm_lineal.pvalues,
}, index=['intercepto', 'edad'])

tabla_bases = pd.DataFrame({
    'coeficiente': glm_gam.params[1:],
    'p-valor': glm_gam.pvalues[1:],
}, index=[f'base spline {j + 1}' for j in range(bases_tr.shape[1])])

print('Logística lineal (entrenamiento, statsmodels):')
display(tabla_lineal.round(4))
print('Coeficientes de cada base del spline (no se interpretan uno a uno):')
display(tabla_bases.round(4))
print(f'LRT (GAM vs lineal): estadístico = {stat_lrt:.2f}, gl = {gl_lrt}, p-valor = {p_lrt:.2e}')
print(f'AIC lineal: {glm_lineal.aic:.1f} | AIC GAM: {glm_gam.aic:.1f}')
Logística lineal (entrenamiento, statsmodels):| coeficiente | p-valor | |
|---|---|---|
| intercepto | 0.6932 | 0.0068 |
| edad | -0.0192 | 0.0002 |
Coeficientes de cada base del spline (no se interpretan uno a uno):| coeficiente | p-valor | |
|---|---|---|
| base spline 1 | 1.1782 | 0.8478 |
| base spline 2 | 2.3356 | 0.7491 |
| base spline 3 | 6.0880 | 0.3105 |
| base spline 4 | 0.9347 | 0.9022 |
LRT (GAM vs lineal): estadístico = 75.59, gl = 3, p-valor = 2.71e-16
AIC lineal: 855.2 | AIC GAM: 785.6
Cómo leer estos p-valores
En el GLM lineal, el coeficiente de la edad es -0.0192 con p-valor 0.0002. Eso no significa que el modelo lineal sea el correcto. Significa que, si el efecto fuera una recta, hay evidencia contra pendiente cero. Los datos también son compatibles con un pico cuya cola derecha arrastra la recta hacia abajo: un coeficiente significativo puede convivir con una forma mal especificada.
Los p-valores de las bases del spline (0.8478, 0.7491, 0.3105, 0.9022) no se leen como “esta base no importa”. Las columnas están correlacionadas; cada una cubre un tramo y el nivel se comparte con el intercepto. Preguntar por una base aislada es la pregunta equivocada. La pregunta correcta es conjunta: el LRT vale 75.59 con 3 grados de libertad y p-valor 2.71×10⁻¹⁶. Bajo los supuestos del GLM binomial, hay evidencia muy fuerte de que el predictor suave describe mejor el entrenamiento que la recta. El AIC apunta en la misma dirección: 785.6 frente a 855.2.
Ninguno de estos números establece causalidad. Aquí la edad determina la conversión porque así lo programamos en la simulación; el LRT solo confirma que una forma suave describe esa regla mejor que una recta. En datos reales nadie asigna edades al azar, y el mismo LRT sería evidencia de asociación no lineal, no de un mecanismo.
Cuándo usar un GAM
Usa un GAM cuando la respuesta pide un GLM —binaria, de conteo, etc.— y al menos un predictor continuo no se deja resumir con una pendiente. Señales típicas: la tasa observada sube y baja, un diagnóstico residual muestra curvatura sistemática, o un término polinómico ayuda pero no quieres fijar el grado a mano.
No es el primer recurso. Si la logística lineal ya captura el fenómeno y el gráfico del efecto es una rampa razonable, añadir splines solo suma varianza. Tampoco sustituye a un modelo que necesite interacciones complejas o cientos de predictores: el GAM brilla con pocas variables cuyo efecto quieres dibujar.
Errores comunes al pasar de un GLM a un GAM
- Elegir los knots mirando la prueba o el gráfico final. La complejidad se decide por validación cruzada en entrenamiento. Si el óptimo cae en el borde, se amplía el rango; no se declara ganador un extremo no explorado.
- Preprocesar el spline fuera del pipeline. Ajustar
SplineTransformercon todo \(X\) y después hacer CV es fuga: los folds de validación ya influyeron en los knots. - Leer cada coeficiente de la base como si fuera una pendiente. El objeto interpretable es la curva \(f_j\), no \(\beta\) de la columna 3.
- Confundir un p-valor del término lineal con una forma correcta. Un coeficiente de la edad puede ser “significativo” y aun así aplanar un pico.
- Interpretar el LRT o el AUC como causalidad. Ambos responden a asociación y a predicción, no a “si cambio la edad, causa la conversión”.
- Olvidar el baseline. Un AUC de 0.60 parece un número; frente a 0.50 y a 0.72 se entiende lo que vale.
- Tratar el GAM como caja negra porque usa un spline. La aditividad está para dibujarse. Si no miras \(f_j\), desperdicias la ventaja del modelo.
- Identificar flexibilidad con calidad. En este ejemplo, 15 knots no mejoran a 3 en CV (AUC de 0.693 frente a 0.707, una diferencia dentro de la variación entre folds). Más knots no es más modelo: es más capacidad de memorizar.
Lo que debes llevarte de este capítulo
La cadena del GLM, ahora completa, es:
respuesta (binaria, conteo, …)
→ distribución (Bernoulli, Poisson, …)
→ predictor: lineal Xβ  o  aditivo β₀ + Σ fⱼ(xⱼ)
→ función de enlace (logit, log, …)
→ media: probabilidad, tasa, …
Tres capítulos, una sola idea. La logística adaptó la distribución y el enlace a una respuesta Bernoulli: el predictor seguía siendo lineal y la salida, una probabilidad. La Poisson hizo lo mismo con un conteo: enlace log, tasa positiva. El GAM deja intactas distribución y enlace y abre el predictor: sustituye \(\beta_j x_j\) por \(f_j(x_j)\). Por eso el gráfico de este capítulo se parece al de la logística —una probabilidad entre 0 y 1— y a la vez al de un spline —una curva que sube y baja—. No hubo que inventar una familia nueva: bastó con cambiar la pieza del predictor y elegir su complejidad sin fugar la prueba.
| Modelo | Qué cambia respecto al GLM gaussiano clásico |
|---|---|
| Logística | distribución Bernoulli + enlace logit |
| Poisson | distribución Poisson + enlace log |
| GAM | el predictor deja de ser lineal en cada \(x_j\), que puede entrar con \(f_j\) (sigue siendo lineal en los pesos de las bases) |
Si recuerdas esa tabla, puedes reconocer el siguiente problema real por el tipo de \(Y\) y por la forma del efecto, no por el nombre del método. El spline que ya conocías del capítulo de suavización es el mecanismo que estima cada \(f_j\). El número de knots no se adivina: se elige por validación cruzada, se verifica que no quede en el borde, y se evalúa una sola vez en prueba contra un GLM lineal y contra un baseline trivial.
Para comunicar el modelo, dibuja \(f_j\). Ese dibujo es la razón de haber usado un GAM y no una caja negra.
¿Qué sigue?
Hasta aquí la pregunta era: dada \(Y\) y dadas unas \(X\) observables, ¿cómo modelar la media con una distribución, un enlace y —si hace falta— una forma suave? En el próximo tema la pregunta se da la vuelta.
A menudo no quieres predecir una respuesta, sino encontrar estructura oculta dentro de muchas variables a la vez: direcciones que concentran la varianza, componentes que se mezclan, factores que no mediste de forma directa. Ahí entran las variables latentes, con herramientas como PCA e ICA, y la reducción de dimensionalidad.
El hilo no se rompe: sigues buscando una representación interpretable de los datos. Cambia el objeto. Ya no es \(f(\text{edad})\); son las direcciones o las fuentes que el conjunto está usando sin nombrarte.