import warnings
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from statsmodels.tsa.seasonal import seasonal_decompose
from statsmodels.tsa.stattools import adfuller, acf
from statsmodels.tsa.holtwinters import ExponentialSmoothing
from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

SEMILLA = 2026
rng = np.random.default_rng(SEMILLA)
plt.rcParams['figure.figsize'] = (9, 4)
warnings.filterwarnings('ignore', category=FutureWarning)28 Series de tiempo
estadistica
series-temporales
Un cambio de paradigma: las observaciones ya no son independientes
Hasta ahora, casi todos los métodos que usaste partían de un supuesto silencioso: cada fila es independiente de las demás. Una entrega no informaba sobre la siguiente; un vino no informaba sobre el otro. Podías barajar las filas, partir al azar en entrenamiento y prueba, y los p-valores seguían queriendo decir lo que aparentaban.
Ese supuesto se cae en cuanto los datos vienen ordenados en el tiempo. El número de pasajeros de este mes se parece al del mes pasado. La demanda de envíos de diciembre se parece a la de diciembre anterior. Si ignoras esa dependencia, ocurren tres fallos graves:
- los errores estándar salen demasiado pequeños y los p-valores se vuelven optimistas;
- un corte aleatorio entrenamiento/prueba filtra el futuro hacia el pasado;
- el modelo “aprende” patrones que en producción nunca tendría a mano.
Este capítulo abre el territorio de los datos dependientes. El primer caso es una sola serie observada a lo largo del tiempo. Trabajarás con el clásico de pasajeros aéreos (1949-1960) para aprender los conceptos, y luego con una demanda mensual de envíos para aplicar el mismo flujo a un problema de planificación logística.
Objetivos de aprendizaje
Al terminar este capítulo vas a ser capaz de:
- Explicar por qué una serie de tiempo no se puede barajar ni partir al azar sin romper el orden.
- Descomponer una serie en tendencia, estacionalidad y residuo, y decidir si el patrón es aditivo o multiplicativo.
- Reconocer la no estacionariedad (media o varianza que se escapan) y aplicar la prueba de Dickey–Fuller aumentada sin sobreinterpretar el p-valor.
- Transformar una serie (logaritmo, diferencias regular y estacional) y comprobar si la transformación basta.
- Leer la ACF y la PACF, incluyendo los picos en rezagos estacionales.
- Ajustar un pronóstico de Holt–Winters eligiendo la especificación con validación temporal sobre el pasado, y reportar el error solo en el futuro reservado.
- Trasladar el mismo flujo a una serie de demanda de envíos para anticipar picos de temporada.
Preparación del entorno
Cargamos numpy, pandas, matplotlib y las herramientas de series de tiempo de statsmodels, y fijamos una semilla global SEMILLA para que el barajado, el corte aleatorio y la simulación de envíos sean reproducibles.
Qué hace única a una serie de tiempo
Una serie de tiempo es una sucesión \(\{Y_t\}_{t=1}^{T}\) indexada por el calendario. El subíndice \(t\) no es un identificador cosmético: es el orden en el que ocurrieron los hechos. La propiedad que la define es la dependencia temporal:
\[ \mathrm{Corr}(Y_t, Y_{t-k}) \neq 0 \quad \text{para algún rezago } k \geq 1. \]
En el mundo independiente que venías usando,
\[ \mathbb{P}(Y_t \mid Y_{t-1},\ldots,Y_1) = \mathbb{P}(Y_t). \]
Aquí esa igualdad no vale: conocer el ayer cambia lo que esperas del hoy. Por eso no puedes:
- Barajar las filas. Destruirías la única estructura que hace que la serie sea una serie.
- Hacer un
train_test_splitaleatorio. Algunos puntos de 1960 acabarían en entrenamiento y algunos de 1949 en prueba. Estarías usando el futuro para “predecir” el pasado.
El corte honesto es temporal: entrenas con el pasado y reservas los últimos periodos para evaluar. En producción nunca tendrás el futuro dentro del entrenamiento. Vamos a verlo con datos, no solo con el argumento.
Los datos: pasajeros aéreos, 1949-1960
El conjunto Air Passengers registra el total mensual de pasajeros de líneas aéreas internacionales, en miles, de enero de 1949 a diciembre de 1960. Es el ejemplo canónico de Box y Jenkins: una tendencia clara de crecimiento y un ciclo anual que se amplifica con el nivel. Lo usamos precisamente porque esos dos ingredientes —tendencia y estacionalidad— son los que rompen los métodos pensados para observaciones independientes.
# Air Passengers (1949-1960) embebido para que el notebook sea autocontenido (sin internet).
# Serie clásica de pasajeros aéreos internacionales mensuales, en miles.
_ap = [112,118,132,129,121,135,148,148,136,119,104,118,115,126,141,135,125,149,170,170,158,133,114,140,145,150,178,163,172,178,199,199,184,162,146,166,171,180,193,181,183,218,230,242,209,191,172,194,196,196,236,235,229,243,264,272,237,211,180,201,204,188,235,227,234,264,302,293,259,229,203,229,242,233,267,269,270,315,364,347,312,274,237,278,284,277,317,313,318,374,413,405,355,306,271,306,315,301,356,348,355,422,465,467,404,347,305,336,340,318,362,348,363,435,491,505,404,359,310,337,360,342,406,396,420,472,548,559,463,407,362,405,417,391,419,461,472,535,622,606,508,461,390,432]
pasajeros = pd.Series(
    np.array(_ap, dtype=float),
    index=pd.date_range('1949-01-01', periods=len(_ap), freq='MS'),
    name='pasajeros',
)

anual = (
    pasajeros.groupby(pasajeros.index.year)
    .agg(media='mean', desv='std', minimo='min', maximo='max')
)
print(f'{len(pasajeros)} meses | {pasajeros.index.min().date()} → {pasajeros.index.max().date()}')
print(f'mínimo = {pasajeros.min():.0f}   máximo = {pasajeros.max():.0f}')
print()
print(anual.round(1))

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(pasajeros.index, pasajeros.values, color='steelblue')
ax.set_xlabel('tiempo')
ax.set_ylabel('pasajeros (miles)')
ax.set_title('Pasajeros aéreos internacionales, 1949-1960')
plt.tight_layout()
plt.show()
144 meses | 1949-01-01 → 1960-12-01
mínimo = 104 máximo = 622
media desv minimo maximo
1949 126.7 13.7 104.0 148.0
1950 139.7 19.1 114.0 170.0
1951 170.2 18.4 145.0 199.0
1952 197.0 23.0 171.0 242.0
1953 225.0 28.5 180.0 272.0
1954 238.9 34.9 188.0 302.0
1955 284.0 42.1 233.0 364.0
1956 328.2 47.9 271.0 413.0
1957 368.4 57.9 301.0 467.0
1958 381.0 64.5 310.0 505.0
1959 428.3 69.8 342.0 559.0
1960 476.2 77.7 390.0 622.0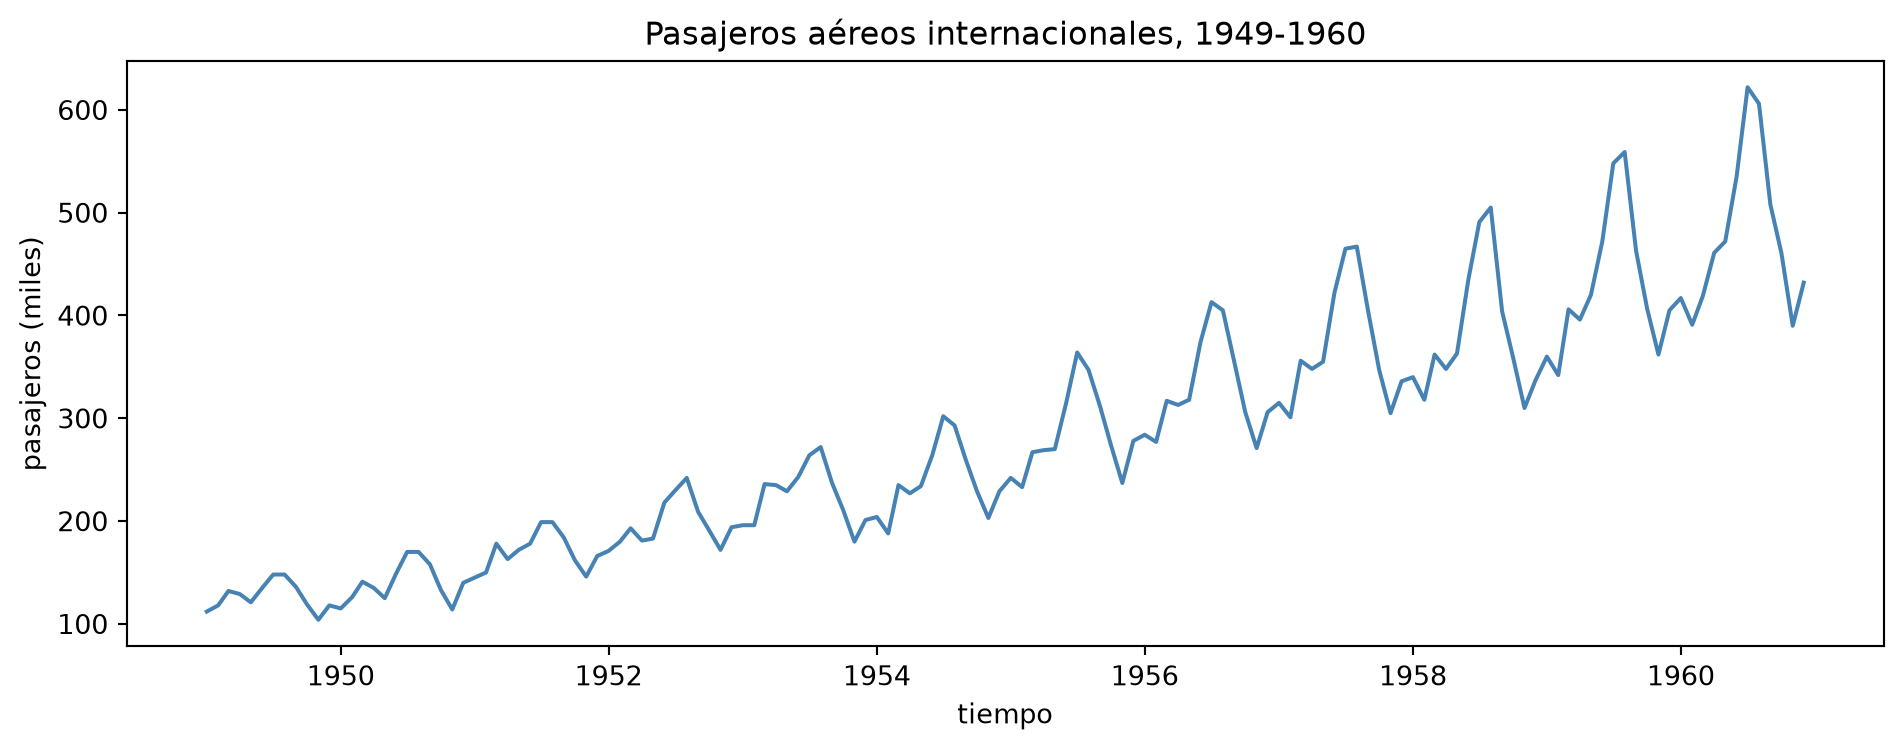
Cómo leer este resultado
Son 144 meses (enero 1949 a diciembre 1960). El mínimo es 104 miles de pasajeros y el máximo 622. La media anual pasa de 126.7 en 1949 a 476.2 en 1960: la serie no oscila alrededor de un nivel fijo, sube. Fíjate también en la columna desv: 13.7 al inicio y 77.7 al final. No solo crece el nivel; crece la amplitud de las oscilaciones. Ese abanico que se abre es la firma de una estacionalidad multiplicativa: los picos de verano son cada vez más altos porque el negocio es cada vez más grande.
Experimento: qué se rompe si barajas el tiempo
Toma los mismos 144 números y ponlos en orden aleatorio, dejando el eje de fechas intacto. Si el tiempo fuera solo una etiqueta, las dos gráficas contarían la misma historia. No la cuentan. Para medirlo usamos la autocorrelación (ACF, por autocorrelation function): la correlación de la serie con ella misma desplazada \(k\) meses, lo que se llama el rezago \(k\). Más adelante la verás con detalle.
pasajeros_barajados = pd.Series(
    rng.permutation(pasajeros.to_numpy()),
    index=pasajeros.index,
)

acf_orig = acf(pasajeros, nlags=12, fft=True)
acf_baraj = acf(pasajeros_barajados, nlags=12, fft=True)
print(f'ACF lag 1  | original = {acf_orig[1]:.3f}  | barajada = {acf_baraj[1]:.3f}')
print(f'ACF lag 12 | original = {acf_orig[12]:.3f} | barajada = {acf_baraj[12]:.3f}')

fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True, sharey=True)
axes[0].plot(pasajeros.index, pasajeros.values, color='steelblue')
axes[0].set_ylabel('pasajeros (miles)')
axes[0].set_title('Serie original: el orden cuenta')
axes[1].plot(pasajeros_barajados.index, pasajeros_barajados.values, color='gray')
axes[1].set_ylabel('pasajeros (miles)')
axes[1].set_xlabel('tiempo')
axes[1].set_title('Mismos valores, orden aleatorio')
plt.tight_layout()
plt.show()
ACF lag 1 | original = 0.948 | barajada = -0.162
ACF lag 12 | original = 0.760 | barajada = -0.136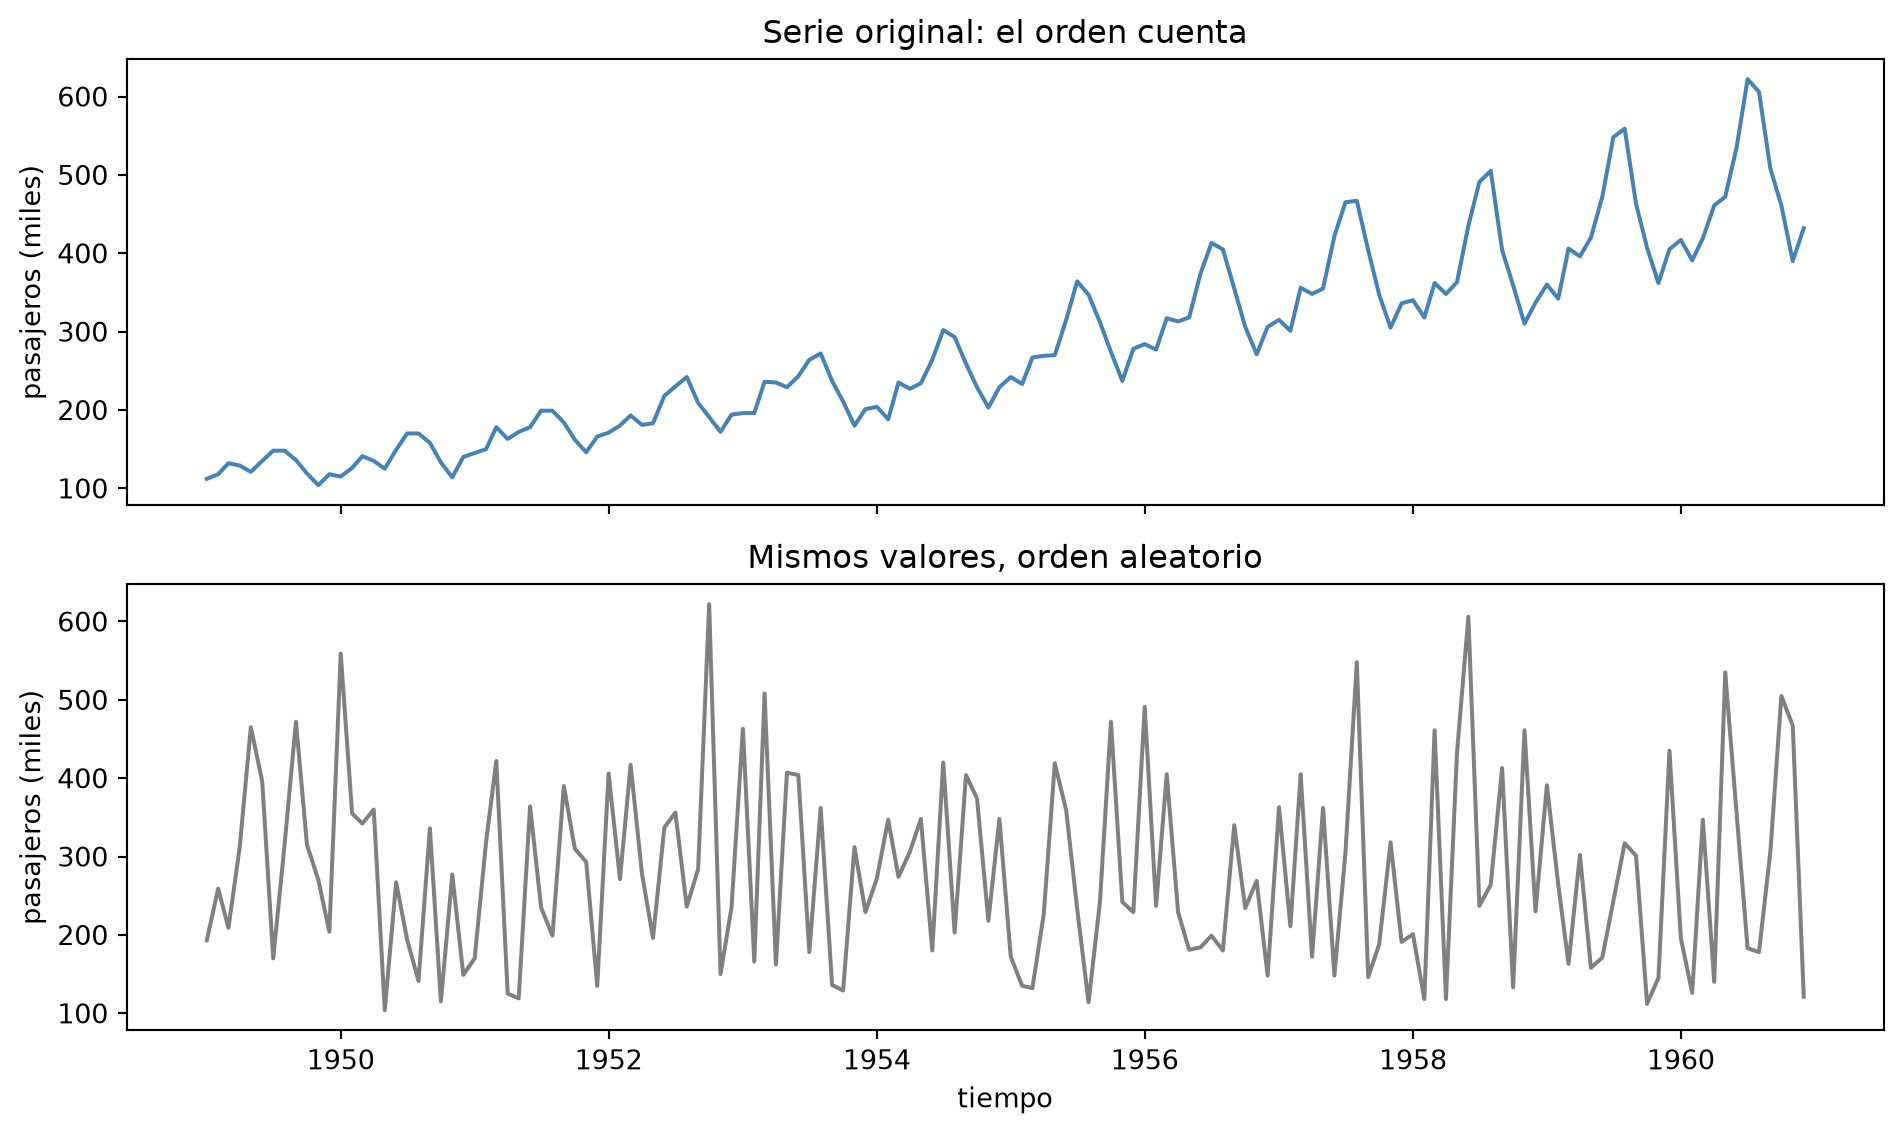
Cómo leer este resultado
En la serie original, la autocorrelación en el rezago 1 es 0.948: cada mes se parece muchísimo al anterior. En el rezago 12 es 0.760: cada julio se parece al julio previo. Al barajar, esas cifras caen a -0.162 y -0.136, compatibles con ruido (con 144 datos, la banda aproximada del 95% para una serie sin dependencia es ±0.16). No perdiste datos; perdiste el orden. Una serie de tiempo sin su orden es un histograma, no un proceso.
El corte entrenamiento/prueba también tiene que respetar el tiempo
El mismo argumento se aplica a cómo evalúas un modelo. Si reservas 12 meses al azar como “prueba”, algunos serán de 1949 y otros de 1959 —o, peor, de 1960—. El modelo podría entrenarse viendo el futuro y luego “predecir” el pasado. Eso no es pronóstico: es filtrar información que en producción no tendrías.
El único corte honesto es temporal: los últimos \(N\) periodos quedan fuera, intactos, hasta el reporte final. Cualquier decisión de modelo (aditivo o multiplicativo, cuántas diferencias, qué rezagos) se toma solo con el pasado.
n_prueba = 12
idx_tiempo = np.arange(len(pasajeros))
es_prueba_temporal = idx_tiempo >= (len(pasajeros) - n_prueba)
es_prueba_aleatoria = np.zeros(len(pasajeros), dtype=bool)
es_prueba_aleatoria[rng.choice(idx_tiempo, size=n_prueba, replace=False)] = True

fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True, sharey=True)
paneles = [
    (es_prueba_temporal, 'Corte temporal: los últimos 12 meses son prueba'),
    (es_prueba_aleatoria, 'Corte aleatorio: la prueba aparece en cualquier año'),
]
for ax, (mask, titulo) in zip(axes, paneles):
    ax.plot(pasajeros.index[~mask], pasajeros.values[~mask],
            color='steelblue', label='entrenamiento')
    ax.plot(pasajeros.index[mask], pasajeros.values[mask],
            'o', color='firebrick', label='prueba', zorder=3)
    ax.set_title(titulo)
    ax.set_ylabel('pasajeros (miles)')
    ax.legend(loc='upper left')
axes[1].set_xlabel('tiempo')
plt.tight_layout()
plt.show()

anios_aleatorios = sorted(pasajeros.index[es_prueba_aleatoria].year.tolist())
anios_temporales = sorted(pasajeros.index[es_prueba_temporal].year.unique().tolist())
print('Años que caerían en la prueba aleatoria:', anios_aleatorios)
print('Años en la prueba temporal:            ', anios_temporales)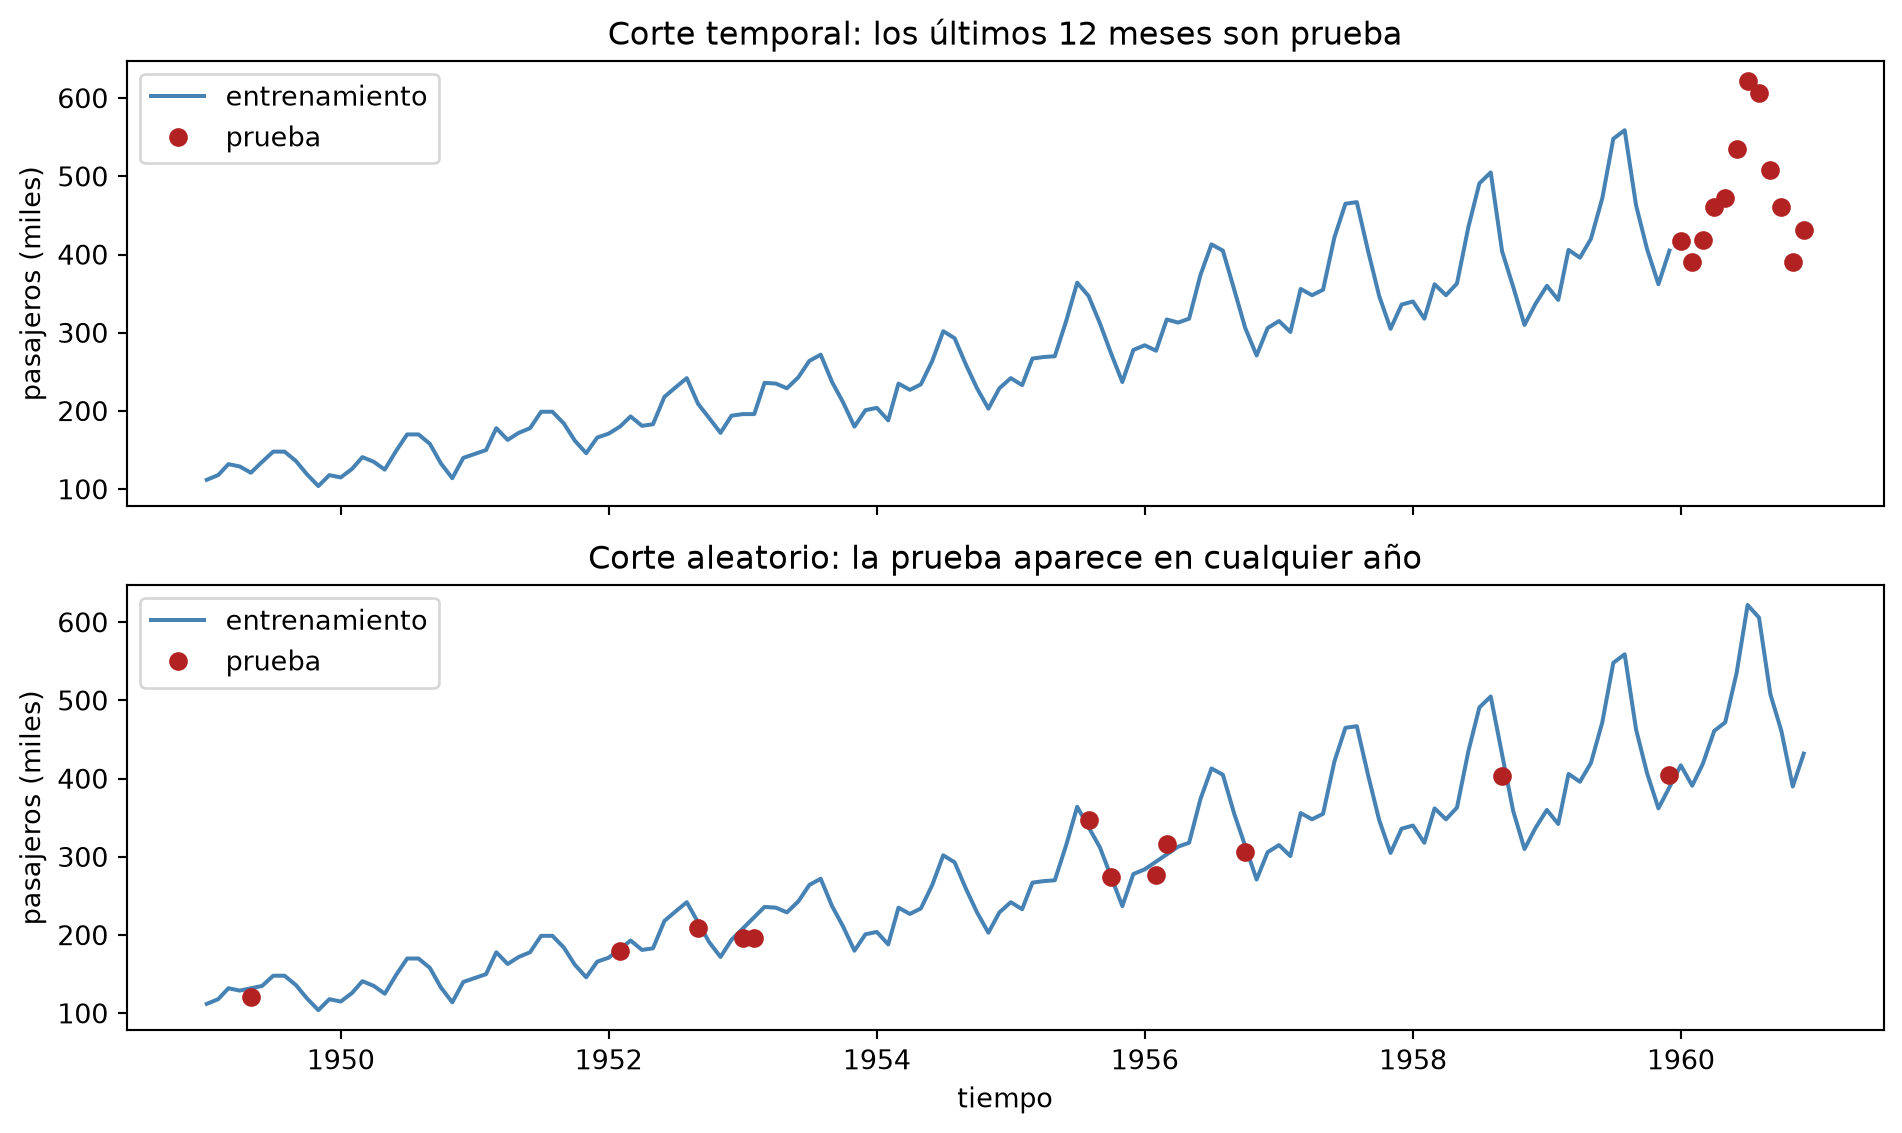
Años que caerían en la prueba aleatoria: [1949, 1952, 1952, 1953, 1953, 1955, 1955, 1956, 1956, 1956, 1958, 1959]
Años en la prueba temporal:             [1960]
Cómo leer este resultado
En el corte temporal, toda la prueba es 1960: el año que un pronóstico real tendría que adivinar. En el corte aleatorio, los 12 puntos rojos caen en 1949, 1952, 1953, 1955, 1956, 1958 y 1959. Ninguno es de 1960: el futuro queda dentro del entrenamiento y el pasado, en la prueba. Un modelo así puede “acertar” 1949 porque ya vio 1959. Eso no se sostiene el día en que tengas que publicar el número del mes que todavía no ocurrió.
Punto clave. En series de tiempo, barajar y partir al azar no son atajos inocentes: rompen la dependencia y filtran el futuro. El protocolo es siempre el mismo: el pasado entrena, el futuro reciente valida, el último tramo se reserva para el error que sí vas a reportar.
Los tres componentes: tendencia, estacionalidad y residuo
Una forma útil de mirar una serie es partirla en tres piezas:
- Tendencia \(T_t\): el movimiento de fondo, lento. Aquí, el crecimiento del tráfico aéreo.
- Estacionalidad \(S_t\): el patrón que se repite cada \(m\) periodos. Con datos mensuales, \(m=12\): veranos altos, inviernos bajos.
- Residuo \(R_t\): lo que no explican los dos anteriores.
En una descomposición aditiva, \(Y_t = T_t + S_t + R_t\). En una multiplicativa, \(Y_t = T_t \cdot S_t \cdot R_t\). La segunda es la natural cuando la amplitud de la estación crece con el nivel: el pico de julio no suma siempre la misma cantidad de pasajeros (una descomposición aditiva le asignaría unos 64 mil cada julio, lo mismo en 1949 que en 1960); multiplica la tendencia por un factor cercano a 1.23.
seasonal_decompose de statsmodels estima esas tres piezas con medias móviles. No es un modelo de pronóstico; es una radiografía.
decomp_mul = seasonal_decompose(pasajeros, model='multiplicative', period=12)
decomp_add = seasonal_decompose(pasajeros, model='additive', period=12)

fig, axes = plt.subplots(4, 1, figsize=(10, 8), sharex=True)
piezas = [
    (pasajeros, 'Observada'),
    (decomp_mul.trend, 'Tendencia'),
    (decomp_mul.seasonal, 'Estacionalidad'),
    (decomp_mul.resid, 'Residuo'),
]
for ax, (serie, nombre) in zip(axes, piezas):
    ax.plot(serie.index, serie.values, color='steelblue')
    ax.set_ylabel(nombre)
axes[-1].set_xlabel('tiempo')
fig.suptitle('Descomposición multiplicativa, periodo = 12 meses')
plt.tight_layout()
plt.show()

factor = decomp_mul.seasonal.groupby(decomp_mul.seasonal.index.month).first()
factor.index = ['ene', 'feb', 'mar', 'abr', 'may', 'jun',
                'jul', 'ago', 'sep', 'oct', 'nov', 'dic']
print('Factor estacional (multiplicativo):')
print(factor.round(3).to_string())
tendencia_valida = decomp_mul.trend.dropna()
print()
print(f'Tendencia en {tendencia_valida.index[0].strftime("%Y-%m")}: '
      f'{tendencia_valida.iloc[0]:.1f}')
print(f'Tendencia en {tendencia_valida.index[-1].strftime("%Y-%m")}: '
      f'{tendencia_valida.iloc[-1]:.1f}')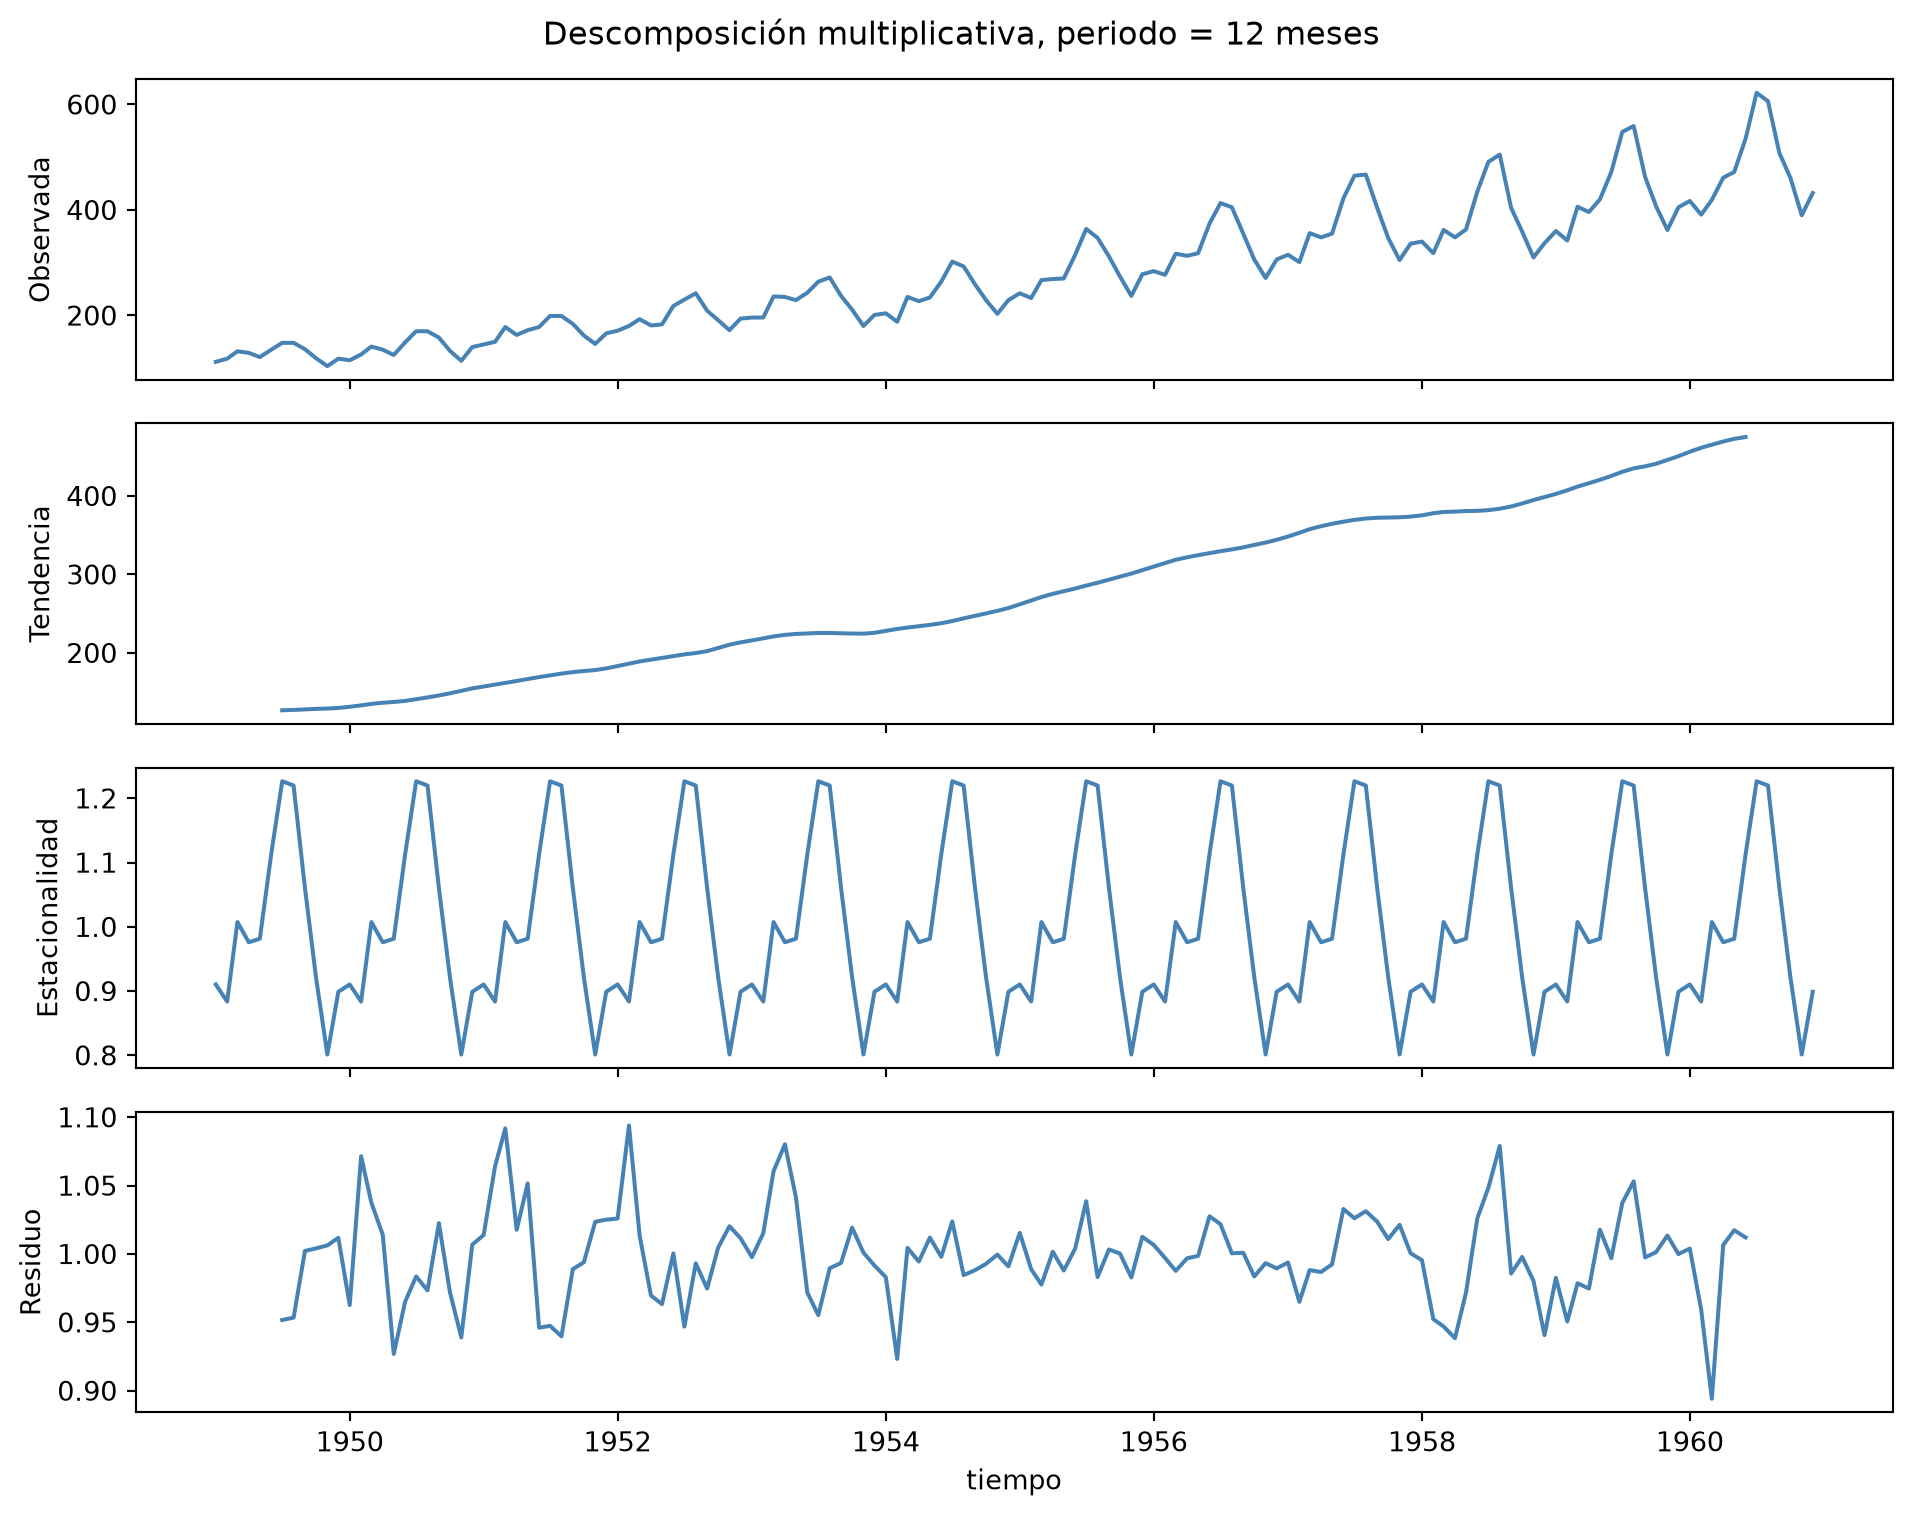
Factor estacional (multiplicativo):
ene    0.910
feb    0.884
mar    1.007
abr    0.976
may    0.981
jun    1.113
jul    1.227
ago    1.220
sep    1.060
oct    0.922
nov    0.801
dic    0.899

Tendencia en 1949-07: 126.8
Tendencia en 1960-06: 475.0
Cómo leer este resultado
La tendencia sube de 126.8 en julio de 1949 a 475.0 en junio de 1960 (los extremos se pierden porque la media móvil de 12 meses necesita vecindario a ambos lados). El factor estacional de julio es 1.227: ese mes está un 23% por encima de la tendencia. Noviembre es 0.801: un 20% por debajo. Agosto (1.220) acompaña a julio; febrero (0.884) es el otro valle. El residuo oscila cerca de 1, que es el “cero” de una descomposición multiplicativa: un 1.03 significa un 3% no explicado por tendencia ni estación.
Esa radiografía ya te sirve para planear: si operas una aerolínea, julio no es un mes con “un poco más de tráfico”; es sistemáticamente un 23% más que el nivel de fondo.
¿Aditiva o multiplicativa?
Si la estación suma la misma cantidad cada año, el residuo aditivo debería verse estable. Si multiplica, el residuo aditivo se abre en abanico a medida que crece el nivel, y el multiplicativo se ve más parejo. Comparemos los dos residuos sobre la misma serie.
fig, axes = plt.subplots(1, 2, figsize=(10, 4), sharex=True)
axes[0].plot(decomp_add.resid.index, decomp_add.resid.values, color='steelblue')
axes[0].axhline(0, color='gray', ls=':')
axes[0].set_title('Residuo aditivo')
axes[0].set_ylabel('pasajeros (miles)')
axes[1].plot(decomp_mul.resid.index, decomp_mul.resid.values, color='steelblue')
axes[1].axhline(1, color='gray', ls=':')
axes[1].set_title('Residuo multiplicativo')
axes[1].set_ylabel('cociente')
for ax in axes:
    ax.set_xlabel('tiempo')
plt.tight_layout()
plt.show()

print(f'Desv. residual aditiva:         {decomp_add.resid.std():.2f}')
print(f'Desv. residual multiplicativa:  {decomp_mul.resid.std():.3f}  (centrada en 1)')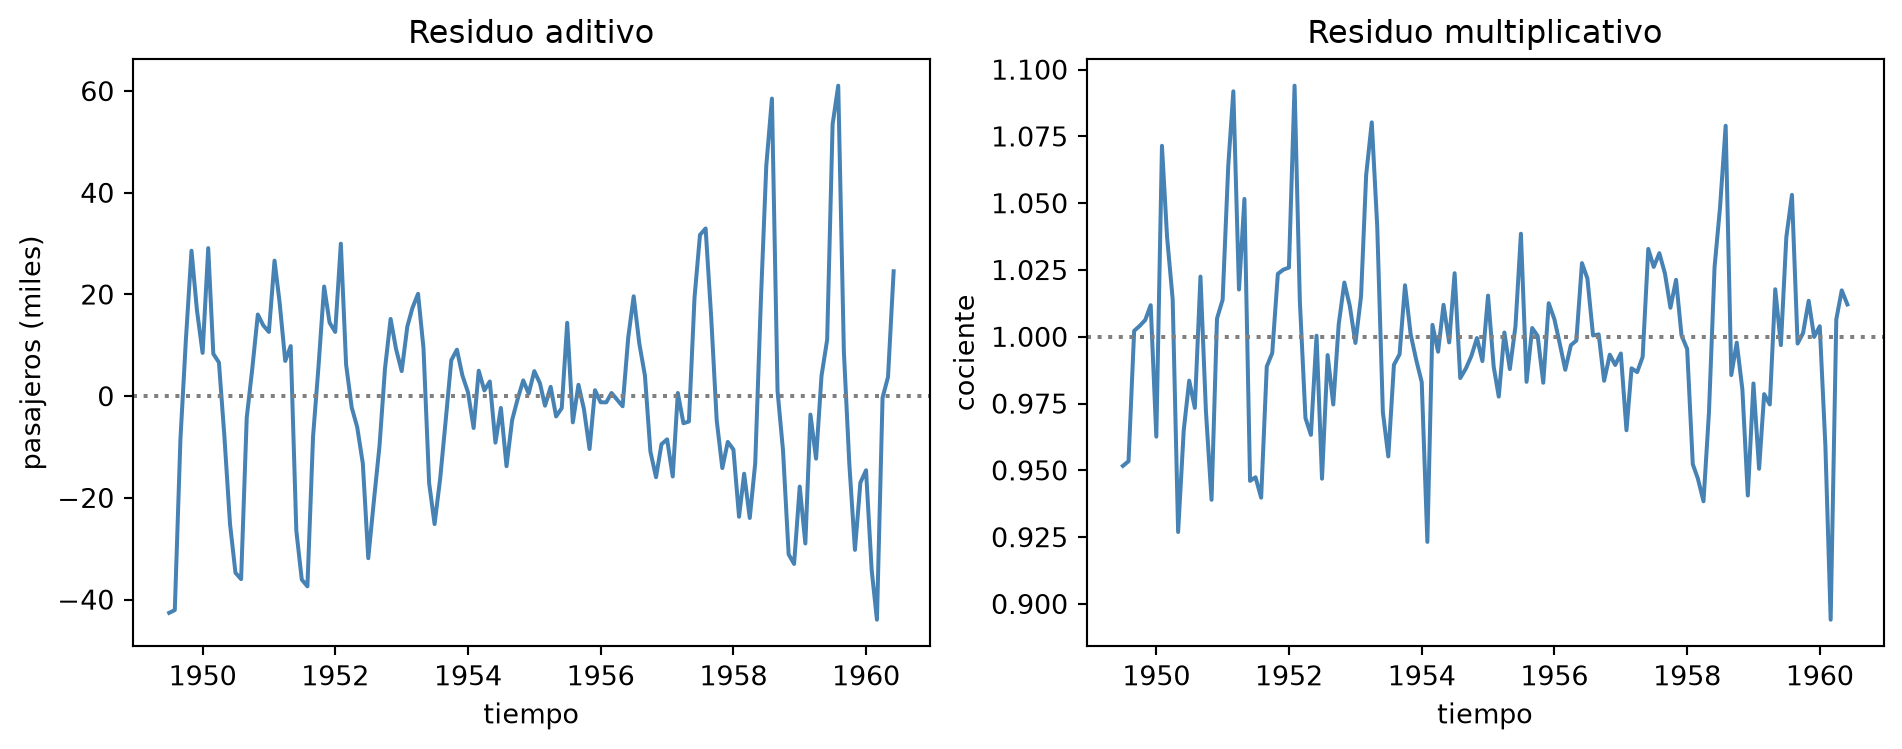
Desv. residual aditiva:         19.34
Desv. residual multiplicativa:  0.033  (centrada en 1)
Cómo leer este resultado
El residuo aditivo es amplio en los extremos y alcanza sus mayores valores en 1958–1960 (picos cercanos a 60 mil pasajeros), justo cuando los veranos son más altos: un pico estacional de tamaño fijo no alcanza a explicar veranos cada vez mayores. El multiplicativo no crece con el nivel: se mantiene dentro de ±10% alrededor de 1 (desviación 0.033), y sus oscilaciones más amplias están, de hecho, al inicio (1950–1953), no al final. Las dos desviaciones no se comparan en la misma unidad —19.34 miles de pasajeros frente a un cociente—, así que la comparación es visual y modesta: el residuo aditivo conserva parte del patrón que depende del nivel; el multiplicativo, no. El argumento más fuerte sigue siendo la tabla anual, con una desviación que pasa de 13.7 a 77.7. Nos quedamos con la versión multiplicativa.
Estacionariedad: media y varianza que no se escapan
Muchos modelos de series —los autorregresivos (AR), los de medias móviles (MA) y su combinación ARMA— están derivados bajo estacionariedad débil (la familia ARIMA, que verás mencionada más adelante, primero diferencia la serie para llegar a esa condición):
- \(\mathbb{E}(Y_t)=\mu\) constante,
- \(\mathrm{Var}(Y_t)=\sigma^2\) constante,
- \(\mathrm{Cov}(Y_t, Y_{t-k})=\gamma(k)\) que depende solo del rezago, no de \(t\).
Si la media crece, “el promedio de la serie” no existe como ancla. Si la varianza crece, un error de 20 pasajeros no significa lo mismo en 1949 que en 1960. Antes de modelar, hay que ver si la serie se queda quieta y, si no, transformarla.
Una media móvil de 12 meses y una desviación móvil de 12 meses hacen visible lo que la tabla anual ya sugería.
media_mov = pasajeros.rolling(12).mean()
desv_mov = pasajeros.rolling(12).std()

fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)
axes[0].plot(pasajeros.index, pasajeros.values, color='steelblue',
             alpha=0.45, label='serie')
axes[0].plot(media_mov.index, media_mov.values, color='firebrick',
             label='media móvil (12 meses)')
axes[0].legend(loc='upper left')
axes[0].set_ylabel('pasajeros (miles)')
axes[0].set_title('La media no se queda quieta')
axes[1].plot(desv_mov.index, desv_mov.values, color='firebrick')
axes[1].set_ylabel('desv. móvil (12 meses)')
axes[1].set_xlabel('tiempo')
axes[1].set_title('La dispersión tampoco')
plt.tight_layout()
plt.show()

print(f'Media 1949: {pasajeros.loc["1949"].mean():.1f}  |  '
      f'media 1960: {pasajeros.loc["1960"].mean():.1f}')
print(f'Desv. 1949: {pasajeros.loc["1949"].std():.1f}   |  '
      f'desv. 1960: {pasajeros.loc["1960"].std():.1f}')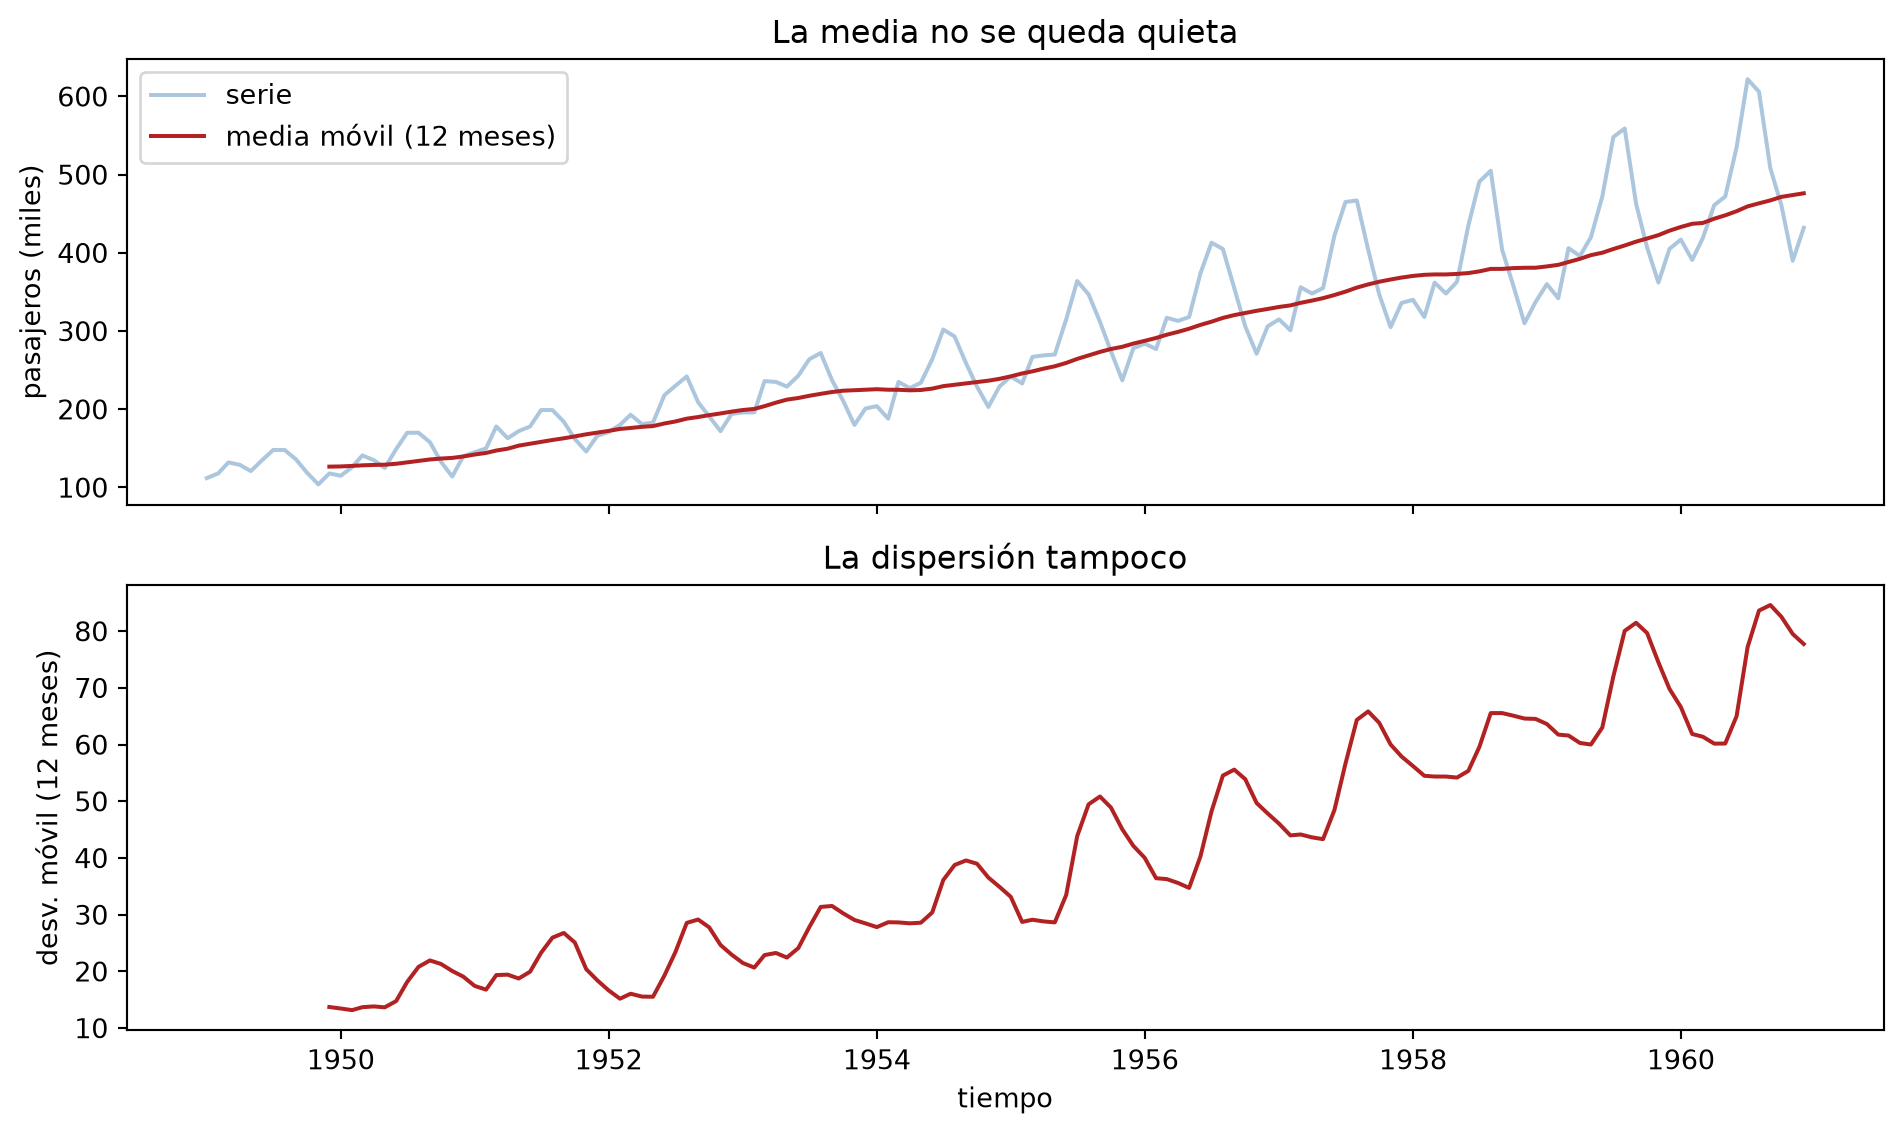
Media 1949: 126.7  |  media 1960: 476.2
Desv. 1949: 13.7   |  desv. 1960: 77.7
Cómo leer este resultado
Las dos curvas móviles confirman lo que ya mostraba la tabla anual, ahora sin saltos entre años: la media pasa de 126.7 miles en 1949 a 476.2 en 1960, y la desviación, de 13.7 a 77.7. Air Passengers no es estacionaria: ni la media ni la varianza son propiedades de “la serie”, sino de en qué año la mires. Un ARMA ajustado sobre esto interpretaría tendencia como persistencia y te daría pronósticos e intervalos engañosos.
La prueba de Dickey–Fuller aumentada
La inspección visual ya basta para no tratar esta serie como estacionaria. La prueba de Dickey–Fuller aumentada (ADF) pone números a esa intuición, y hay que leerla con cuidado.
La versión más simple de una raíz unitaria es el paseo aleatorio
\[ Y_t = Y_{t-1} + \varepsilon_t, \]
donde cada choque se acumula y la serie no vuelve a una media. La ADF estima una regresión aumentada con rezagos de \(\Delta Y_t\) para controlar autocorrelación. En la especificación con constante que usa adfuller por defecto:
\[ \Delta Y_t = \alpha + \gamma Y_{t-1} + \sum_{j=1}^{p} \delta_j \Delta Y_{t-j} + \varepsilon_t. \]
- H0: \(\gamma = 0\) (hay raíz unitaria; la serie no es estacionaria).
- H1: \(\gamma < 0\) (la serie es estacionaria alrededor de un nivel).
Un p-valor pequeño es evidencia en contra de H0, es decir, a favor de estacionariedad. Un p-valor grande no demuestra que haya raíz unitaria: solo dice que no hay evidencia suficiente para rechazarla. El número de rezagos \(p\) lo elige el criterio de información de Akaike (AIC), que es la opción por defecto de adfuller (autolag='AIC'), dentro de un máximo que la función fija según el tamaño de la muestra.
Vamos a aplicar la prueba a la serie original y a transformaciones sucesivas: logaritmo (para la varianza), primera diferencia (para la tendencia) y diferencia estacional de 12 meses (para el ciclo anual).
def resumen_adf(serie, etiqueta):
    serie = pd.Series(serie).dropna()
    estadistico, p_valor, rezagos, n_obs, criticos, _ = adfuller(serie, autolag='AIC')
    print(f'{etiqueta}')
    print(f'  n = {n_obs}   rezagos (AIC) = {rezagos}')
    print(f'  estadístico ADF = {estadistico:7.3f}   crítico 5% = {criticos["5%"]:.3f}')
    print(f'  p-valor         = {p_valor:.4g}')
    return p_valor


log_pax = np.log(pasajeros)
d1 = pasajeros.diff()
log_d1 = log_pax.diff()
log_d1_est = log_d1.diff(12)

print('H0: la serie tiene raíz unitaria (no estacionaria).\n')
resumen_adf(pasajeros, 'Original (regresión con constante)')
_, p_ct, *_ = adfuller(pasajeros.dropna(), regression='ct', autolag='AIC')
print('Original (constante y tendencia determinística)')
print(f'  p-valor         = {p_ct:.4g}')
print()
resumen_adf(log_pax, 'Logaritmo')
resumen_adf(d1, 'Primera diferencia')
resumen_adf(log_d1, 'Log + primera diferencia')
_ = resumen_adf(log_d1_est, 'Log + 1ª diferencia + diferencia estacional (12)')
H0: la serie tiene raíz unitaria (no estacionaria).
Original (regresión con constante)
n = 130 rezagos (AIC) = 13
estadístico ADF = 0.815 crítico 5% = -2.884
p-valor = 0.9919
Original (constante y tendencia determinística)
p-valor = 0.5457
Logaritmo
n = 130 rezagos (AIC) = 13
estadístico ADF = -1.717 crítico 5% = -2.884
p-valor = 0.4224
Primera diferencia
n = 130 rezagos (AIC) = 12
estadístico ADF = -2.829 crítico 5% = -2.884
p-valor = 0.05421
Log + primera diferencia
n = 128 rezagos (AIC) = 14
estadístico ADF = -2.717 crítico 5% = -2.884
p-valor = 0.07112
Log + 1ª diferencia + diferencia estacional (12)
n = 118 rezagos (AIC) = 12
estadístico ADF = -4.443 crítico 5% = -2.886
p-valor = 0.0002486Cómo leer estos p-valores
El p-valor de la serie original es 0.9919: no hay evidencia contra H0. Eso no prueba que exista una raíz unitaria; la prueba simplemente no la rechaza. Aun permitiendo una tendencia determinística (regression='ct'), el p-valor sigue alto (0.5457). Junto con la media que pasa de 126.7 a 476.2, es razonable tratarla como no estacionaria.
El logaritmo deja el p-valor en 0.4224: homogeneiza la varianza, pero la deriva permanece. La primera diferencia cae a 0.05421 y el log más la primera diferencia a 0.07112. Ambos están en el borde de 0.05. Un umbral de significancia no es un interruptor: 0.054 y 0.049 no cuentan historias opuestas. Todavía queda el ciclo anual.
Después de logaritmo, primera diferencia y diferencia estacional de 12 meses, el p-valor es 0.0002486. Ahora sí hay evidencia fuerte contra H0: la serie transformada es compatible con estacionariedad. Ese es el tratamiento clásico de esta serie (el de los “modelos de aerolínea”).
fig, axes = plt.subplots(3, 1, figsize=(10, 7), sharex=True)
axes[0].plot(log_pax.index, log_pax.values, color='steelblue')
axes[0].set_title('Logaritmo: la varianza se homogeneiza, la tendencia permanece')
axes[1].plot(log_d1.index, log_d1.values, color='steelblue')
axes[1].set_title('Log + primera diferencia: se va la deriva, queda la estación')
axes[2].plot(log_d1_est.index, log_d1_est.values, color='steelblue')
axes[2].axhline(0, color='gray', ls=':')
axes[2].set_title('Log + diferencia regular y estacional: ya no hay deriva evidente')
axes[2].set_xlabel('tiempo')
plt.tight_layout()
plt.show()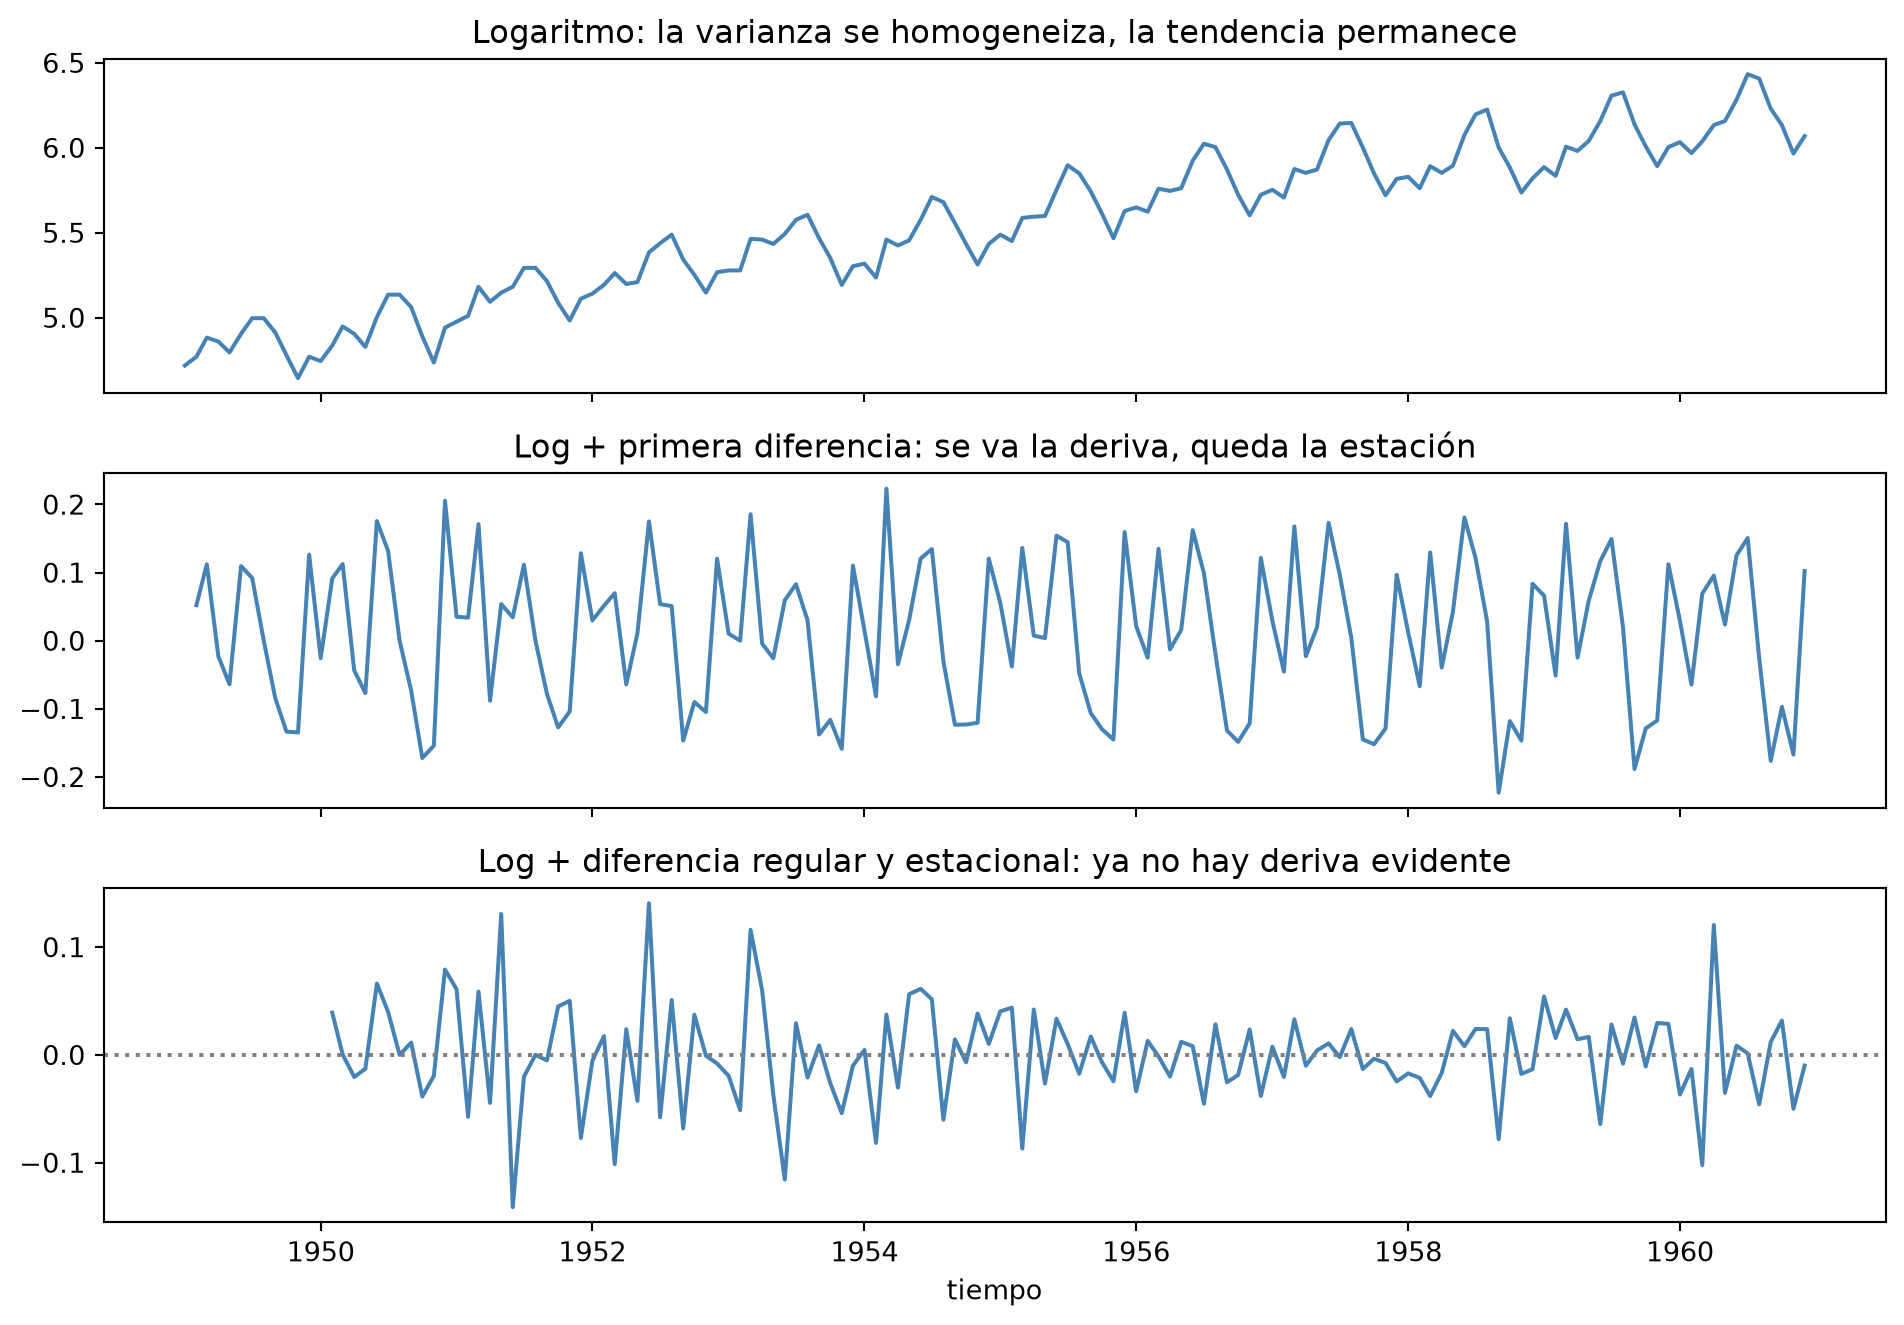
Cómo leer esta transformación
El logaritmo aplana el abanico: los veranos grandes ya no dominan la escala. La primera diferencia quita la rampa, pero sigue viéndose un diente de sierra cada año. La diferencia estacional (\(\Delta_{12}\)) elimina ese diente de sierra: la serie resultante oscila alrededor de cero, que es exactamente el aspecto de algo que podrías modelar con un ARMA. Transformar no es un rito; es conseguir que media y varianza dejen de ser funciones del tiempo.
Antes de seguir, pregúntate
Si la media crece y la ADF no rechaza la raíz unitaria, ¿puedes leer un pico de la ACF como “la correlación real” de la serie, o estás mezclando tendencia con dependencia? En el siguiente bloque vas a ver las dos ACF: la de la serie cruda y la de la serie ya diferenciada. La diferencia entre ambas es precisamente esa mezcla.
Autocorrelación: la serie contra sí misma
La función de autocorrelación (ACF) en el rezago \(k\) es la correlación de \(Y_t\) con \(Y_{t-k}\):
\[ \rho(k) = \frac{\mathrm{Cov}(Y_t, Y_{t-k})}{\mathrm{Var}(Y_t)}. \]
La PACF (autocorrelación parcial) mide lo mismo después de quitar el efecto lineal de los rezagos intermedios \(1,\ldots,k-1\). Sirve para no contar dos veces la misma persistencia: si \(Y_t\) se parece a \(Y_{t-1}\) y \(Y_{t-1}\) se parece a \(Y_{t-2}\), la ACF en el rezago 2 saldrá alta aunque no haya un canal directo de dos meses.
En una serie con tendencia, la ACF decae muy lento (todo se parece a todo porque todos están subiendo). En una serie con estacionalidad mensual, aparecen picos en 12, 24, 36, …. Esos picos son el ciclo anual escrito en lenguaje de rezagos.
fig, axes = plt.subplots(2, 2, figsize=(10, 7))
plot_acf(pasajeros, lags=36, ax=axes[0, 0], title='ACF — original')
plot_pacf(pasajeros, lags=36, ax=axes[0, 1], title='PACF — original')
plot_acf(log_d1.dropna(), lags=36, ax=axes[1, 0], title='ACF — log + diferencia')
plot_pacf(log_d1.dropna(), lags=36, ax=axes[1, 1], title='PACF — log + diferencia')
plt.tight_layout()
plt.show()

acf_orig36 = acf(pasajeros, nlags=36, fft=True)
acf_d = acf(log_d1.dropna(), nlags=36, fft=True)
print(f'Original | lag 1 = {acf_orig36[1]:.3f}   lag 12 = {acf_orig36[12]:.3f}   '
      f'lag 24 = {acf_orig36[24]:.3f}')
print(f'Log-diff | lag 1 = {acf_d[1]:.3f}   lag 12 = {acf_d[12]:.3f}   '
      f'lag 24 = {acf_d[24]:.3f}')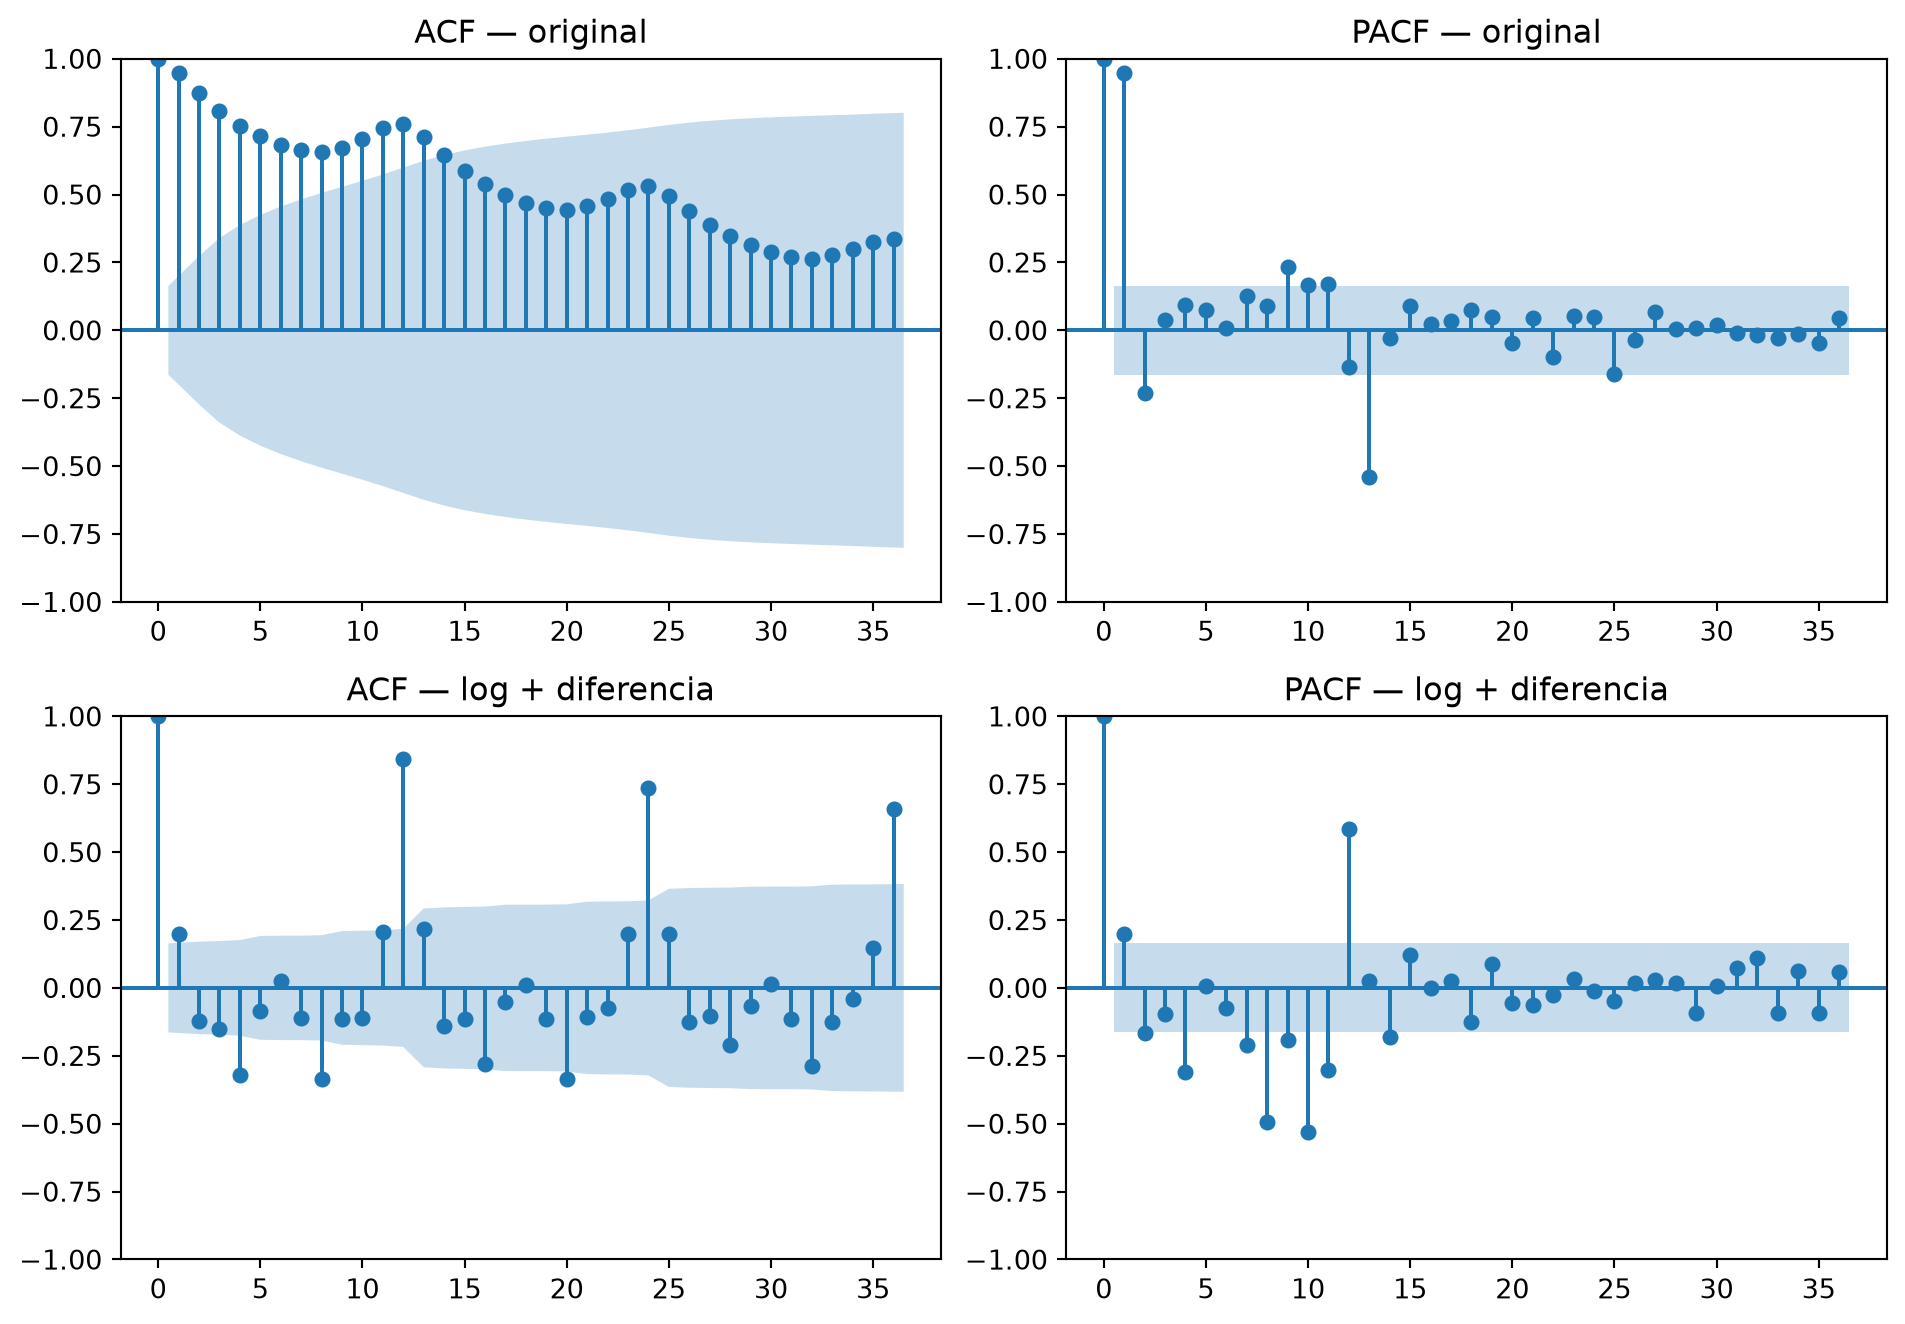
Original | lag 1 = 0.948   lag 12 = 0.760   lag 24 = 0.532
Log-diff | lag 1 = 0.200   lag 12 = 0.841   lag 24 = 0.737
Cómo leer estos correlogramas
En la serie original, el rezago 1 vale 0.948, el 12 vale 0.760 y el 24 todavía 0.532. Esa cola larga no es “memoria de dos años”: es sobre todo la tendencia disfrazada de correlación, con ondulaciones en 12 y 24 que delatan la estación. La PACF original está dominada por el primer rezago (cerca de 0.95), lo que es coherente con una raíz unitaria; el otro pico claro es negativo, en el rezago 13, y es la huella del ciclo anual.
Después del log y la primera diferencia, el rezago 1 baja a 0.200 —ya no hay esa rampa— pero el rezago 12 sube a 0.841. Quitaste la tendencia y apareció el ciclo anual, que estaba tapado. Ese pico en el rezago estacional es exactamente lo que un modelo tiene que respetar: o con una diferencia \(\Delta_{12}\), o con un factor estacional explícito, como el de Holt–Winters.
Un modelo sencillo de pronóstico: Holt–Winters
Holt–Winters (suavizamiento exponencial con tendencia y estación) es el modelo natural después de descomponer. Trabaja con tres estados que ya conoces:
- un nivel \(\ell_t\),
- una tendencia \(b_t\),
- un factor estacional \(s_t\) de periodo \(m=12\).
Por ejemplo, con tendencia aditiva y estacionalidad multiplicativa, el pronóstico a \(h \le m\) pasos es
\[ \hat{y}_{t+h} = (\ell_t + h b_t)\, s_{t+h-m}. \]
(para horizontes mayores que \(m\) se reutiliza el factor del último ciclo observado). Nivel, pendiente y estación se actualizan cada mes con pesos de suavizamiento entre 0 y 1, que el ajuste estima con los datos: más peso al dato reciente, menos a un pasado lejano. Si un peso sale 0, ese estado queda fijo. No necesitas decidir “cuántos rezagos AR”; el modelo trabaja con las mismas piezas de la descomposición.
La familia SARIMA (ARIMA estacional) cuenta la misma historia en el lenguaje de diferencias y rezagos. El clásico de esta serie es el “modelo de aerolínea” \(\mathrm{SARIMA}(0,1,1)(0,1,1)_{12}\). Aquí nos quedamos con Holt–Winters porque puedes leerlo con lo que ya viste: nivel, tendencia y factor mensual.
Validación temporal: el futuro no se usa para elegir el modelo
Hay cuatro combinaciones simples de tendencia y estacionalidad (add / mul). Elegir mirando el error de 1960 sería hacer trampa: 1960 es el examen. El protocolo es:
- Reservar 1960 entero (12 meses) como prueba, intocable.
- Sobre 1949-1959, hacer pronósticos a 12 meses con origen expansivo (tras 8, 9 y 10 años de historia). Eso son tres pliegues (folds), todos dentro del entrenamiento.
- Quedarse con la especificación de menor MAE medio en esos pliegues. El MAE (error absoluto medio) es el promedio de \(|y_t - \hat{y}_t|\), en miles de pasajeros; más adelante reportamos también el RMSE (raíz del error cuadrático medio, que castiga más los errores grandes) y el MAPE (error porcentual absoluto medio: el error absoluto como porcentaje del valor real, promediado).
- Reajustar esa especificación con todo 1949-1959 y entonces evaluar 1960.
Como punto de referencia, dos pronósticos ingenuos: predecir siempre la media del entrenamiento, y copiar el mismo mes del año anterior (ingenuo estacional, seasonal naive; en las salidas aparece como naive estacional). Si Holt–Winters no gana a “lo mismo que el año pasado”, no vale la pena.
n_prueba = 12
train = pasajeros.iloc[:-n_prueba]
test = pasajeros.iloc[-n_prueba:]
print(f'Entrenamiento: {train.index.min().strftime("%Y-%m")} → '
      f'{train.index.max().strftime("%Y-%m")}  ({len(train)} meses)')
print(f'Prueba:        {test.index.min().strftime("%Y-%m")} → '
      f'{test.index.max().strftime("%Y-%m")}  ({len(test)} meses)')

naive_media = pd.Series(np.full(len(test), train.mean()), index=test.index)
naive_estacional = pd.Series(train.iloc[-12:].to_numpy(), index=test.index)


def mae(y_real, y_pred):
    return np.mean(np.abs(np.asarray(y_real) - np.asarray(y_pred)))


def rmse(y_real, y_pred):
    return np.sqrt(np.mean((np.asarray(y_real) - np.asarray(y_pred)) ** 2))


def mape(y_real, y_pred):
    y_real = np.asarray(y_real)
    y_pred = np.asarray(y_pred)
    return 100 * np.mean(np.abs(y_real - y_pred) / y_real)


horizonte = 12
min_train = 96
origenes = list(range(min_train, len(train) - horizonte + 1, 12))

print('\nValidación temporal (MAE medio a 12 meses, solo entrenamiento):')
resultados = []
for tendencia in ['add', 'mul']:
    for estacional in ['add', 'mul']:
        errores = []
        for origen in origenes:
            modelo_cv = ExponentialSmoothing(
                train.iloc[:origen],
                trend=tendencia,
                seasonal=estacional,
                seasonal_periods=12,
            ).fit()
            pred_cv = modelo_cv.forecast(horizonte)
            errores.append(mae(train.iloc[origen:origen + horizonte], pred_cv))
        mae_medio = float(np.mean(errores))
        resultados.append((mae_medio, tendencia, estacional))
        print(f'  tendencia={tendencia}  estacional={estacional}  '
              f'MAE medio = {mae_medio:.2f}   por pliegue = {np.round(errores, 2).tolist()}')

mejor_mae, mejor_tendencia, mejor_estacional = min(resultados)
print(f'\nElegida: tendencia={mejor_tendencia}, estacional={mejor_estacional} '
      f'(MAE de validación = {mejor_mae:.2f})')

modelo_hw = ExponentialSmoothing(
    train,
    trend=mejor_tendencia,
    seasonal=mejor_estacional,
    seasonal_periods=12,
).fit()
pred_hw = modelo_hw.forecast(n_prueba)

print('\nError en el tramo de PRUEBA (1960), no usado para elegir:')
print(f'  MAE  media global      = {mae(test, naive_media):.2f}')
print(f'  MAE  naive estacional  = {mae(test, naive_estacional):.2f}')
print(f'  MAE  Holt-Winters      = {mae(test, pred_hw):.2f}')
print(f'  RMSE Holt-Winters      = {rmse(test, pred_hw):.2f}')
print(f'  MAPE Holt-Winters      = {mape(test, pred_hw):.2f}%')
print(f'  MAPE naive estacional  = {mape(test, naive_estacional):.2f}%')

comparacion = pd.DataFrame({
    'real': test.astype(int),
    'holt_winters': pred_hw.round(1),
    'naive_estacional': naive_estacional.astype(int),
})
print()
print(comparacion.to_string())

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(train.index, train.values, color='steelblue', label='entrenamiento')
ax.plot(test.index, test.values, color='black', label='prueba (real)')
ax.plot(pred_hw.index, pred_hw.values, color='firebrick', ls='--',
        label='Holt-Winters')
ax.axvline(test.index[0], color='gray', ls=':')
ax.set_xlabel('tiempo')
ax.set_ylabel('pasajeros (miles)')
ax.set_title('Pronóstico de 1960 entrenado solo con 1949-1959')
ax.legend(loc='upper left')
plt.tight_layout()
plt.show()
Entrenamiento: 1949-01 → 1959-12 (132 meses)
Prueba: 1960-01 → 1960-12 (12 meses)
Validación temporal (MAE medio a 12 meses, solo entrenamiento):
tendencia=add estacional=add MAE medio = 19.37 por pliegue = [12.66, 24.62, 20.82]
tendencia=add estacional=mul MAE medio = 16.78 por pliegue = [14.57, 15.56, 20.22]
tendencia=mul estacional=add MAE medio = 20.23 por pliegue = [11.12, 37.36, 12.22]
tendencia=mul estacional=mul MAE medio = 19.48 por pliegue = [8.0, 39.05, 11.38]
Elegida: tendencia=add, estacional=mul (MAE de validación = 16.78)
Error en el tramo de PRUEBA (1960), no usado para elegir:
MAE media global = 213.67
MAE naive estacional = 47.83
MAE Holt-Winters = 10.30
RMSE Holt-Winters = 15.81
MAPE Holt-Winters = 2.21%
MAPE naive estacional = 9.99%
real holt_winters naive_estacional
1960-01-01 417 417.3 360
1960-02-01 391 394.1 342
1960-03-01 419 462.4 406
1960-04-01 461 448.6 396
1960-05-01 472 471.9 420
1960-06-01 535 539.9 472
1960-07-01 622 623.8 548
1960-08-01 606 631.2 559
1960-09-01 508 515.6 463
1960-10-01 461 449.9 407
1960-11-01 390 394.3 362
1960-12-01 432 422.5 405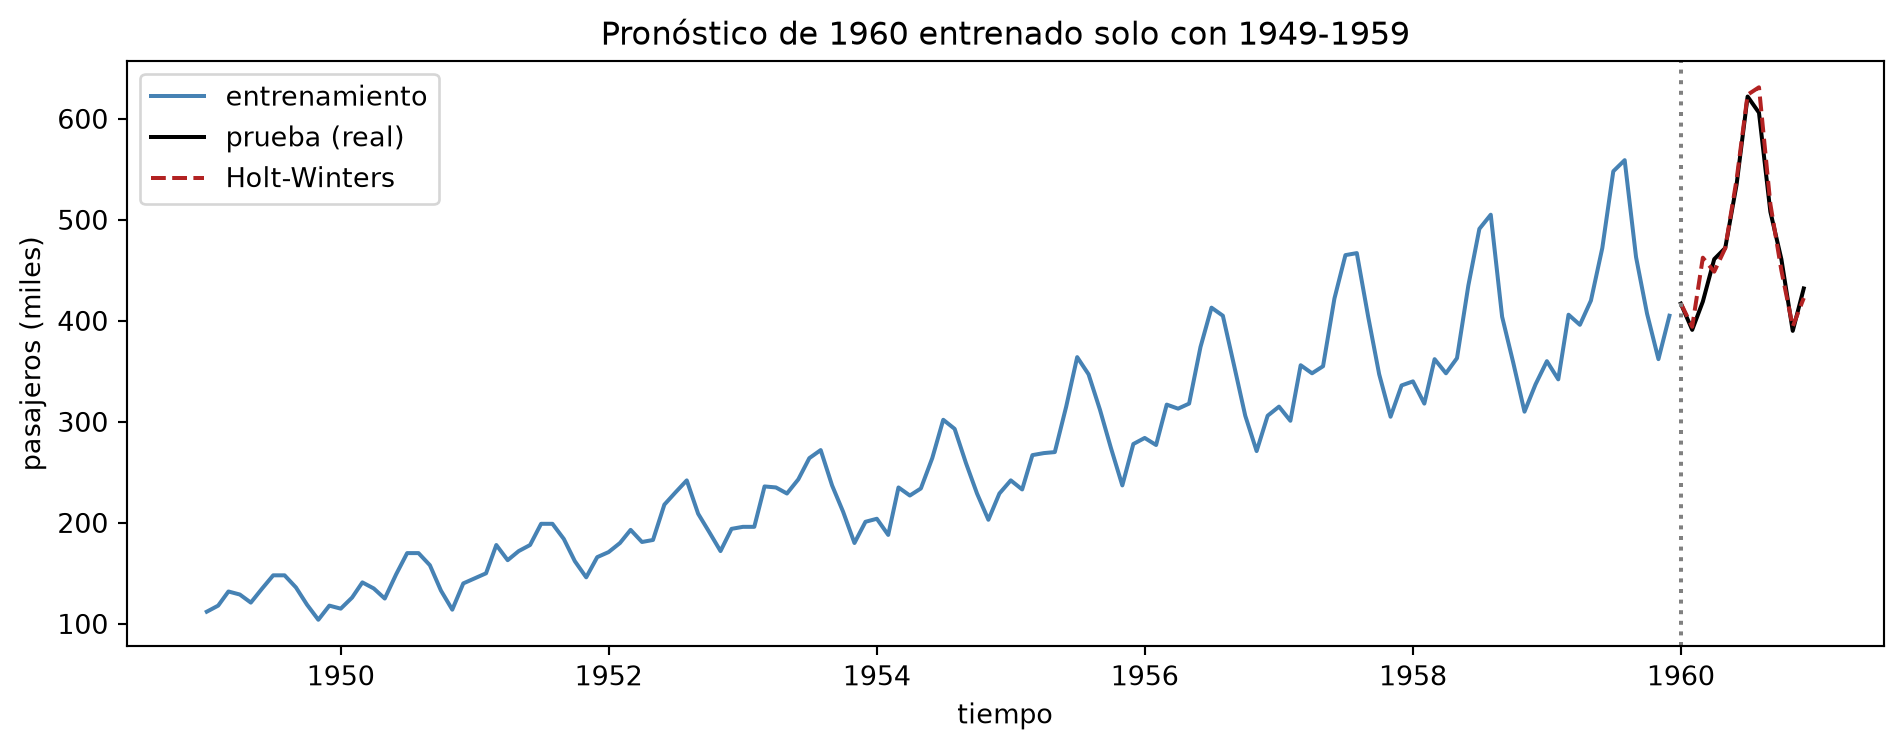
Cómo leer el pronóstico
La validación temporal, sin mirar 1960, elige tendencia aditiva y estacionalidad multiplicativa: MAE medio de 16.78 frente a 19.37, 20.23 y 19.48 de las otras tres. Gana en promedio, no en cada pliegue: en los orígenes de 1957 y 1959 la variante multiplicativa-multiplicativa tiene menor error (8.0 y 11.38, frente a 14.57 y 20.22 de la elegida), y la ventaja de la elegida viene sobre todo del pliegue de 1958, donde las dos variantes de tendencia multiplicativa se disparan (37.36 y 39.05, frente a 15.56). Con tres pliegues, la elección es razonable, no concluyente. El óptimo no está en un borde de un rango continuo: es una de cuatro especificaciones.
En el año reservado, Holt–Winters obtiene MAE = 10.30, RMSE = 15.81 y MAPE = 2.21%. El ingenuo estacional (copiar 1959) llega a un MAE de 47.83 y un MAPE de 9.99%. La media global, que ignora tiempo y estación, queda en MAE 213.67: un recordatorio de lo que se pierde al tratar la serie como un conjunto de números sin orden.
El mayor desajuste es marzo de 1960: real 419 frente a 462.4. Julio, el pico, sale casi exacto (622 frente a 623.8). Un MAPE del 2.21% con un horizonte de un año, con el ciclo y la rampa incluidos, es un pronóstico usable. Y lo importante del protocolo: 1960 no participó en la elección del modelo.
De aviones a envíos: un caso logístico
El mismo trío —tendencia, estación, ruido— aparece en operación. Simulamos 84 meses de demanda de un operador de envíos (enero 2018 a diciembre 2024), con semilla fija. La regla oculta, que en la práctica no verías, es:
- una tendencia creciente (el volumen del negocio se expande);
- un ciclo anual con picos de temporada: noviembre y diciembre (fin de año), un pico menor en mayo (Día de la Madre) y un valle en enero (contracción tras la temporada alta);
- ruido multiplicativo pequeño.
El objetivo no es redescubrir la receta. Es repetir el flujo —descomponer, preguntarse por la estacionariedad, pronosticar respetando el tiempo— y leer el resultado como capacidad que hay que tener lista antes del pico.
n = 84
idx_envios = pd.date_range('2018-01-01', periods=n, freq='MS')
t = np.arange(n)
factor_mes = np.array([
    0.82, 0.88, 0.96, 0.94, 1.18, 1.06,
    0.98, 0.97, 1.02, 1.08, 1.28, 1.42,
])
estacional = factor_mes[idx_envios.month - 1]
tendencia = 8500 + 55 * t + 0.35 * t ** 2
rng_envios = np.random.default_rng(SEMILLA)
ruido = rng_envios.normal(0, 0.035, n)
envios = pd.Series(
    tendencia * estacional * (1 + ruido),
    index=idx_envios,
    name='envios',
).asfreq('MS')

print(f'{len(envios)} meses | {envios.index.min().date()} → {envios.index.max().date()}')
print(f'mínimo = {envios.min():.0f}   máximo = {envios.max():.0f}')
print(f'media 2018 = {envios.loc["2018"].mean():.0f}  |  '
      f'media 2024 = {envios.loc["2024"].mean():.0f}')

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(envios.index, envios.values, color='steelblue')
ax.set_xlabel('tiempo')
ax.set_ylabel('envíos mensuales')
ax.set_title('Demanda mensual de envíos, 2018-2024')
plt.tight_layout()
plt.show()
84 meses | 2018-01-01 → 2024-12-01
mínimo = 6777 máximo = 22334
media 2018 = 9295 | media 2024 = 15845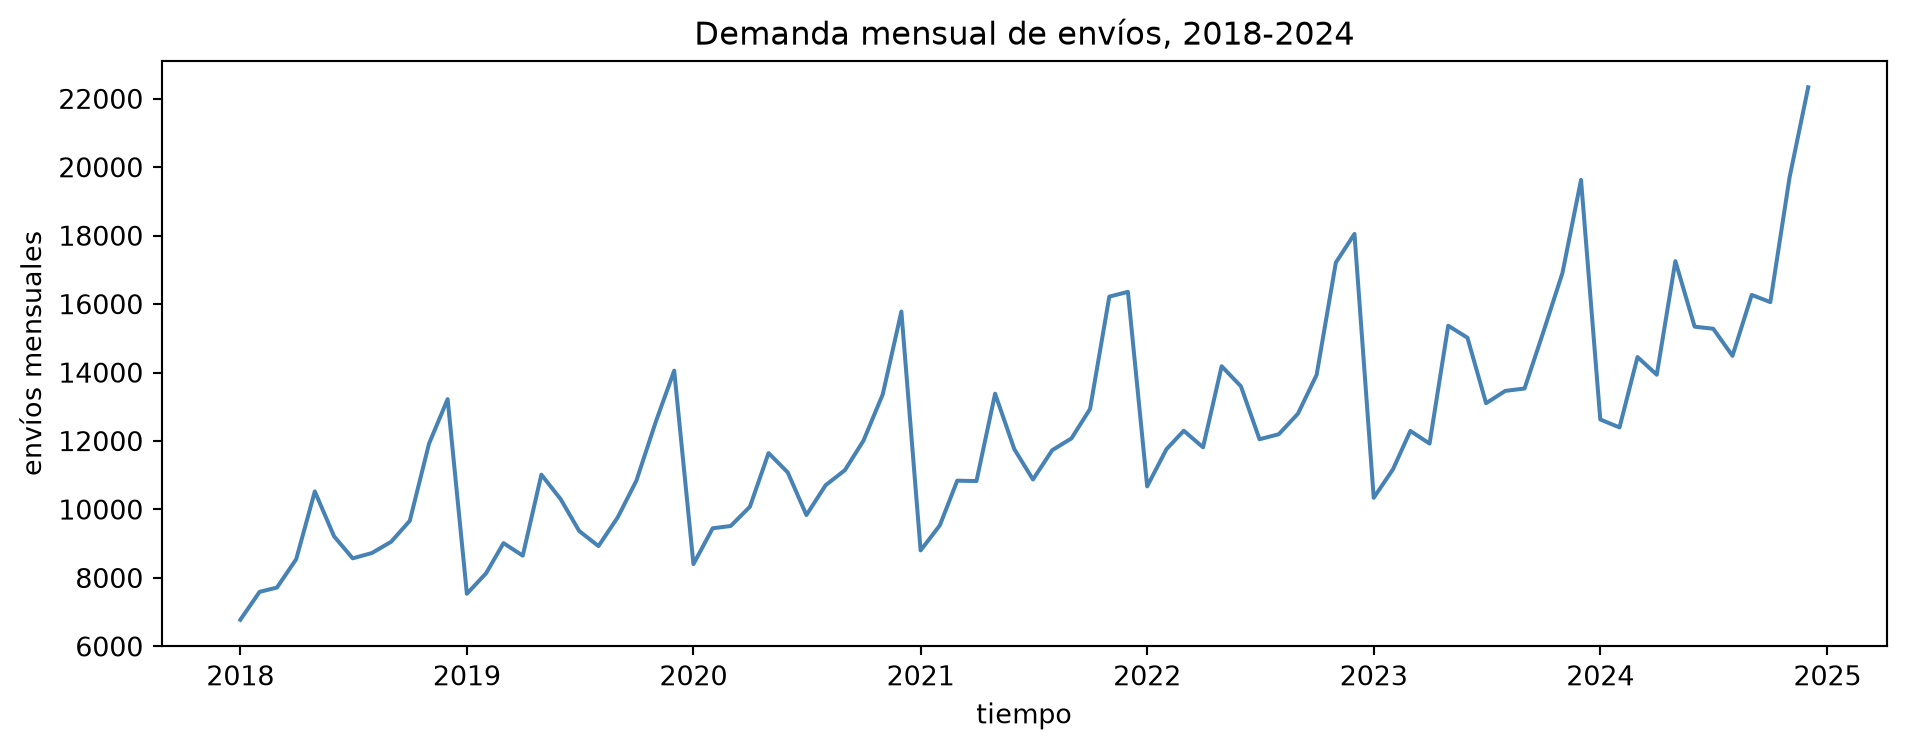
Cómo leer este resultado
Son 84 meses. El volumen medio pasa de 9295 envíos en 2018 a 15845 en 2024, con un mínimo de 6777 y un máximo de 22334. La forma recuerda a la de Air Passengers: rampa hacia arriba y dientes de sierra cada vez más altos. Si operas la red, esa gráfica ya te dice que el diciembre de este año no se parece al de hace seis: planear con el promedio histórico te deja sin capacidad suficiente en temporada alta.
decomp_envios = seasonal_decompose(envios, model='multiplicative', period=12)
factor_e = decomp_envios.seasonal.groupby(decomp_envios.seasonal.index.month).first()
factor_e.index = ['ene', 'feb', 'mar', 'abr', 'may', 'jun',
                  'jul', 'ago', 'sep', 'oct', 'nov', 'dic']
print('Factor estacional estimado:')
print(factor_e.round(3).to_string())
print()
resumen_adf(envios, 'Envíos original')
resumen_adf(np.log(envios).diff(), 'Envíos log + primera diferencia')
resumen_adf(np.log(envios).diff().diff(12),
            'Envíos log + diferencia regular y estacional')

fig, axes = plt.subplots(3, 1, figsize=(10, 7), sharex=True)
axes[0].plot(envios.index, envios.values, color='steelblue', label='demanda')
axes[0].plot(decomp_envios.trend.index, decomp_envios.trend.values,
             color='firebrick', label='tendencia')
axes[0].legend(loc='upper left')
axes[0].set_title('Demanda y tendencia')
axes[1].plot(decomp_envios.seasonal.index, decomp_envios.seasonal.values,
             color='steelblue')
axes[1].set_title('Estacionalidad anual (picos de temporada)')
axes[2].plot(decomp_envios.resid.index, decomp_envios.resid.values,
             color='steelblue')
axes[2].axhline(1, color='gray', ls=':')
axes[2].set_title('Residuo')
axes[2].set_xlabel('tiempo')
plt.tight_layout()
plt.show()
Factor estacional estimado:
ene 0.797
feb 0.850
mar 0.922
abr 0.901
may 1.100
jun 1.015
jul 0.911
ago 0.931
sep 0.964
oct 1.042
nov 1.226
dic 1.341
Envíos original
n = 72 rezagos (AIC) = 11
estadístico ADF = 2.583 crítico 5% = -2.903
p-valor = 0.9991
Envíos log + primera diferencia
n = 72 rezagos (AIC) = 10
estadístico ADF = -18.123 crítico 5% = -2.903
p-valor = 2.518e-30
Envíos log + diferencia regular y estacional
n = 59 rezagos (AIC) = 11
estadístico ADF = -2.226 crítico 5% = -2.912
p-valor = 0.1969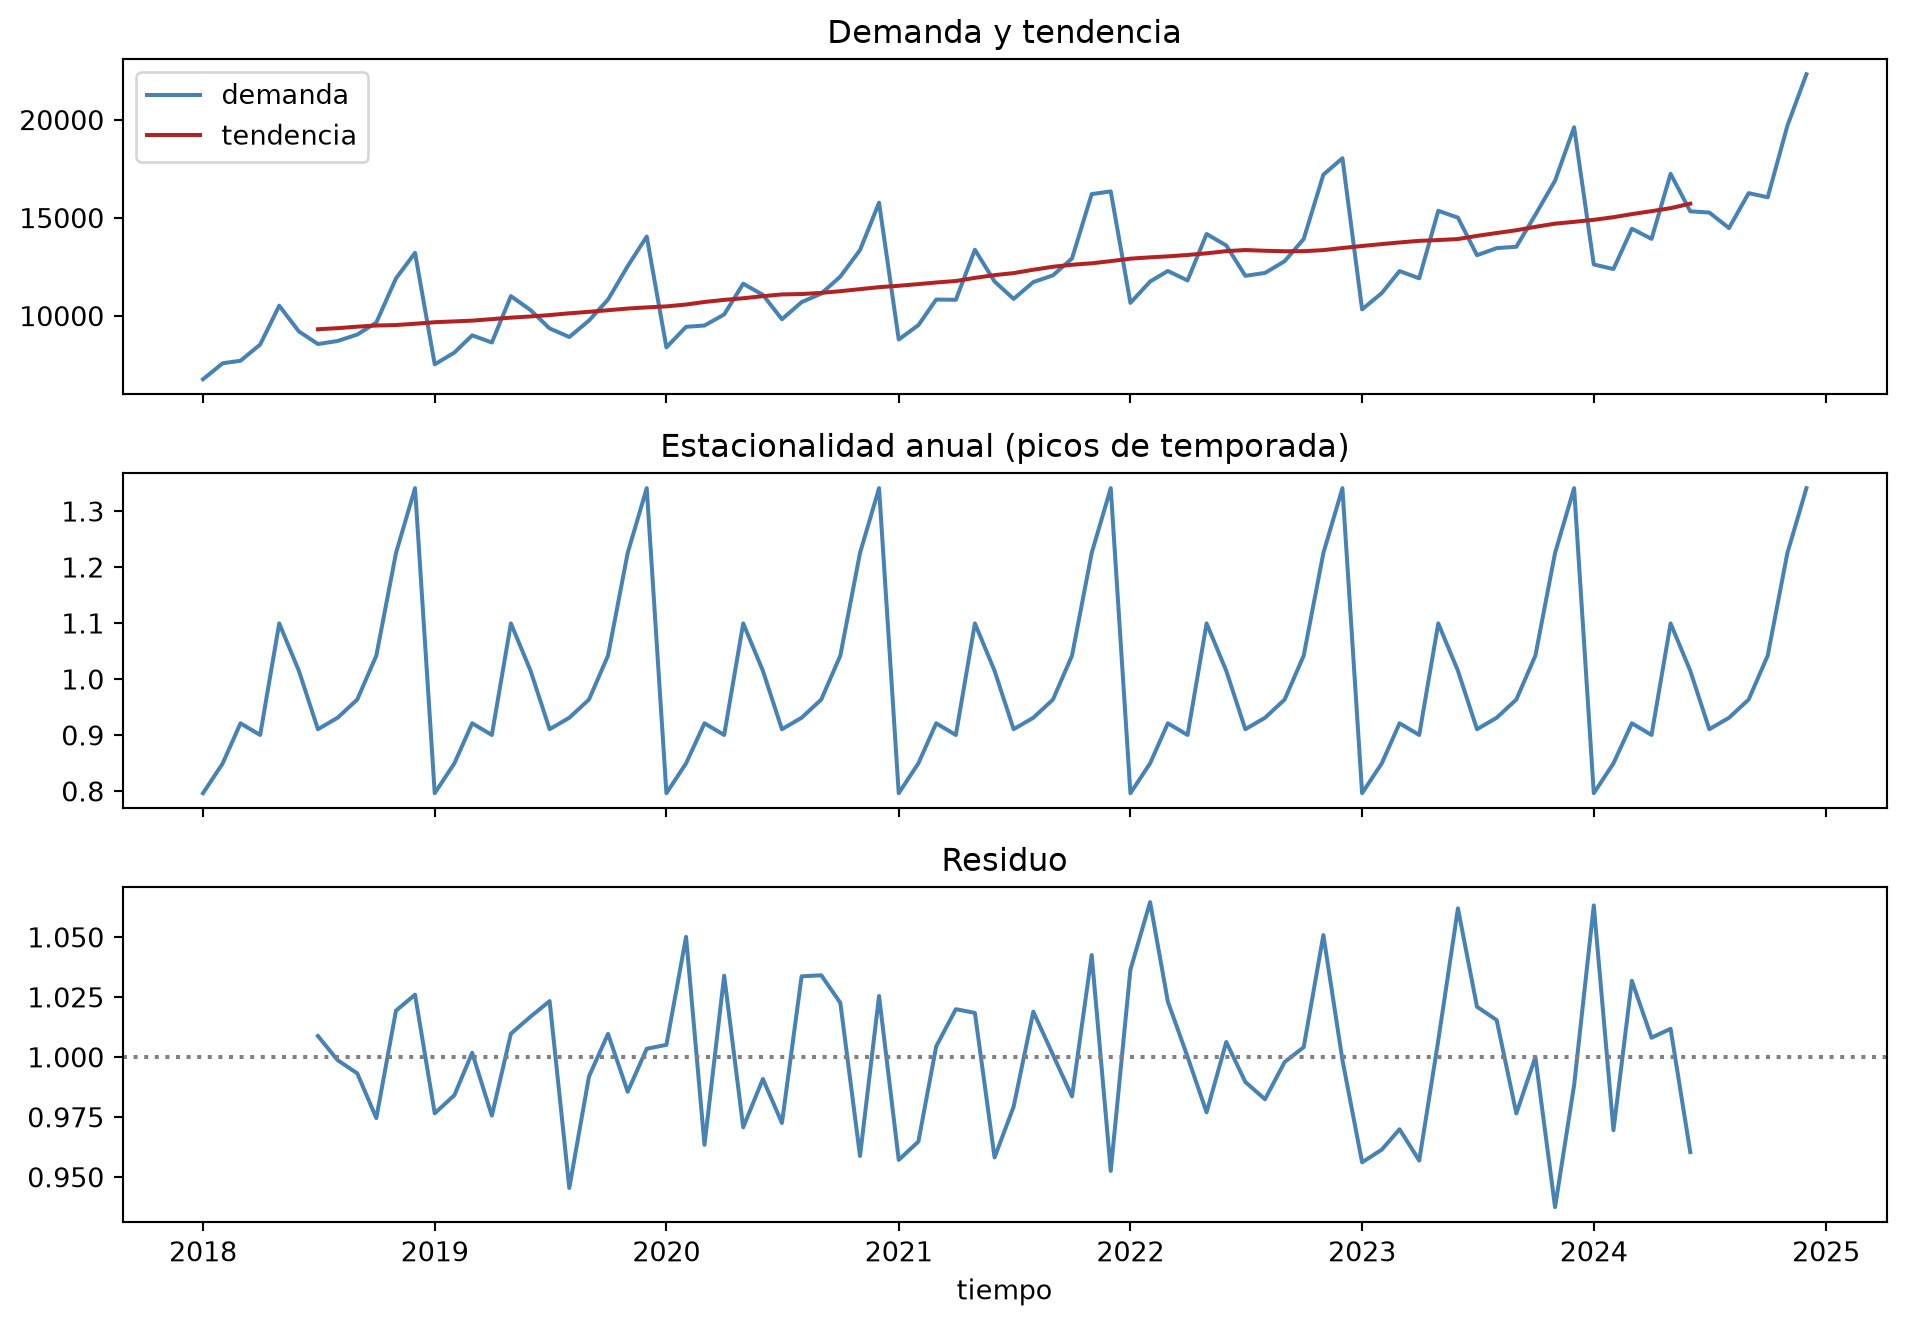
Cómo leer esta descomposición
El factor de diciembre es 1.341 (un 34% por encima de la tendencia) y el de noviembre, 1.226. Mayo, el otro pico operativo, queda en 1.100. Enero cae a 0.797: después de temporada alta, el volumen se contrae. La ADF de la serie original da p-valor 0.9991: no hay evidencia contra la raíz unitaria. Tras logaritmo y primera diferencia, el p-valor es 2.518e-30: la prueba rechaza con holgura la raíz unitaria. Eso no convierte la serie en estacionaria sin más: el patrón mensual sigue ahí (cada mes tiene su propia media), solo que ahora es un patrón fijo que un factor estacional explícito, como el de Holt–Winters, puede absorber.
Con la diferencia estacional adicional, el p-valor sube a 0.1969. No leas ese número como prueba de sobre-diferenciación: la ADF no está diseñada para detectarla y, con 59 observaciones y 11 rezagos, tiene poca potencia. Lo que sí sabemos —porque simulamos la serie— es que la estación de los envíos es fija: cada diciembre multiplica la tendencia por el mismo factor. En ese caso \(\Delta_{12}\) sobra: elimina un patrón que no cambia y, a cambio, introduce una dependencia artificial en la serie (eso es la sobre-diferenciación). En Air Passengers, en cambio, \(\Delta_{12}\) es el tratamiento clásico, y ahí la ADF solo rechazó con claridad después de aplicarla. La prueba y el gráfico orientan, pero no sustituyen el razonamiento sobre de dónde viene el patrón.
Falta el pronóstico. Repetimos la validación temporal de Air Passengers: reservamos 2024 como prueba y elegimos la especificación de Holt–Winters solo con 2018-2023.
n_prueba = 12
train_e = envios.iloc[:-n_prueba]
test_e = envios.iloc[-n_prueba:]
naive_e = pd.Series(train_e.iloc[-12:].to_numpy(), index=test_e.index)

horizonte = 12
min_train = 48
origenes_e = list(range(min_train, len(train_e) - horizonte + 1, 12))
resultados_e = []
print('Validación temporal en envíos (solo entrenamiento):')
for tendencia in ['add', 'mul']:
    for estacional in ['add', 'mul']:
        errores = []
        for origen in origenes_e:
            modelo_cv = ExponentialSmoothing(
                train_e.iloc[:origen],
                trend=tendencia,
                seasonal=estacional,
                seasonal_periods=12,
            ).fit()
            pred_cv = modelo_cv.forecast(horizonte)
            errores.append(mae(train_e.iloc[origen:origen + horizonte], pred_cv))
        mae_medio = float(np.mean(errores))
        resultados_e.append((mae_medio, tendencia, estacional))
        print(f'  tendencia={tendencia}  estacional={estacional}  '
              f'MAE medio = {mae_medio:.1f}')

mejor_mae_e, mejor_t_e, mejor_s_e = min(resultados_e)
print(f'\nElegida: tendencia={mejor_t_e}, estacional={mejor_s_e} '
      f'(MAE de validación = {mejor_mae_e:.1f})')

modelo_e = ExponentialSmoothing(
    train_e, trend=mejor_t_e, seasonal=mejor_s_e, seasonal_periods=12
).fit()
pred_e = modelo_e.forecast(n_prueba)

print('\nError en prueba (2024):')
print(f'  MAE  naive estacional = {mae(test_e, naive_e):.1f}')
print(f'  MAE  Holt-Winters     = {mae(test_e, pred_e):.1f}')
print(f'  RMSE Holt-Winters     = {rmse(test_e, pred_e):.1f}')
print(f'  MAPE Holt-Winters     = {mape(test_e, pred_e):.2f}%')
print(f'  Diciembre 2024 real = {test_e.loc["2024-12-01"]:.0f}  '
      f'pronosticado = {pred_e.loc["2024-12-01"]:.0f}')
print(f'  Mayo 2024 real      = {test_e.loc["2024-05-01"]:.0f}  '
      f'pronosticado = {pred_e.loc["2024-05-01"]:.0f}')
print(f'  Meses con pronóstico por debajo del real: '
      f'{int((test_e > pred_e).sum())} de {len(test_e)}')

fig, ax = plt.subplots(figsize=(10, 4))
ax.plot(train_e.index, train_e.values, color='steelblue', label='entrenamiento')
ax.plot(test_e.index, test_e.values, color='black', label='prueba (real)')
ax.plot(pred_e.index, pred_e.values, color='firebrick', ls='--',
        label='Holt-Winters')
ax.axvline(test_e.index[0], color='gray', ls=':')
ax.set_xlabel('tiempo')
ax.set_ylabel('envíos mensuales')
ax.set_title('Pronóstico de demanda 2024 entrenado solo con 2018-2023')
ax.legend(loc='upper left')
plt.tight_layout()
plt.show()
Validación temporal en envíos (solo entrenamiento):
tendencia=add estacional=add MAE medio = 615.0
tendencia=add estacional=mul MAE medio = 441.6
tendencia=mul estacional=add MAE medio = 624.0
tendencia=mul estacional=mul MAE medio = 540.7
Elegida: tendencia=add, estacional=mul (MAE de validación = 441.6)
Error en prueba (2024):
MAE naive estacional = 1851.9
MAE Holt-Winters = 778.6
RMSE Holt-Winters = 954.5
MAPE Holt-Winters = 4.86%
Diciembre 2024 real = 22334 pronosticado = 20803
Mayo 2024 real = 17255 pronosticado = 16479
Meses con pronóstico por debajo del real: 10 de 12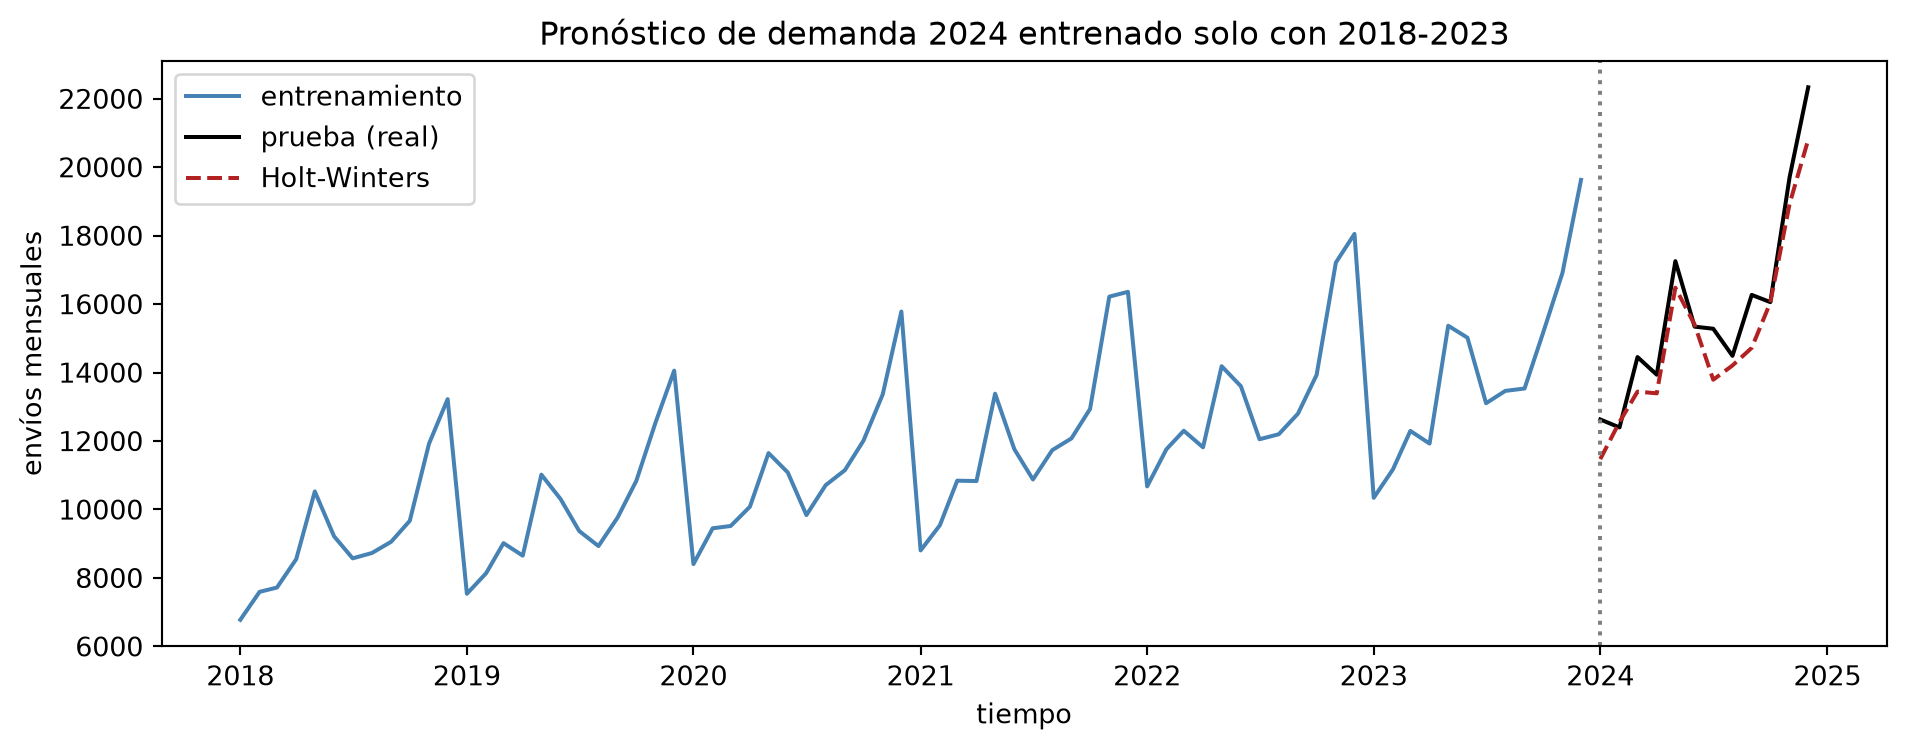
Cómo leer el valor práctico
Otra vez la especificación se elige sin ver 2024, aquí con solo dos pliegues (orígenes tras 4 y 5 años de historia): gana tendencia aditiva y estacionalidad multiplicativa, con MAE de validación 441.6. En prueba, Holt–Winters baja el MAE de 1851.9 (ingenuo estacional) a 778.6 y deja un MAPE de 4.86% (RMSE 954.5). Diciembre, el mes más exigente para la operación, sale 22334 real frente a 20803 pronosticado: el modelo anticipa el orden de magnitud del pico, aunque se queda corto. Mayo, el segundo pico, es 17255 real frente a 16479 pronosticado.
Ese faltante no es casual: el pronóstico queda por debajo del valor real en 10 de 12 meses. La demanda simulada crece con aceleración (su tendencia tiene un término cuadrático) y la tendencia de este Holt–Winters es lineal. Es un sesgo que conviene vigilar: si la demanda real acelera, el pronóstico tiende a quedarse corto justo en temporada alta.
Eso es lo que justifica el flujo. Con meses de antelación puedes dimensionar turnos, cupo de última milla y inventario de empaque para un diciembre de al menos 21 mil envíos, no para el promedio del año, y con un margen para el sesgo hacia abajo que acabas de ver. Un faltante de unos 1500 envíos en el pico (22334 frente a 20803) es mucho más manejable que descubrir en diciembre que el volumen superó la capacidad.
Errores comunes en series de tiempo
- Barajar las observaciones o hacer un corte aleatorio. Rompes el orden y filtras el futuro. El único corte honesto es temporal.
- Leer un p-valor grande de la ADF como prueba de raíz unitaria. H0 no se “acepta”; simplemente no se rechaza. Combínalo con el gráfico de media y varianza.
- Tratar 0.049 y 0.054 como veredictos opuestos. La primera diferencia de Air Passengers quedó en el borde: el ciclo anual todavía estaba ahí.
- Diferenciar por inercia. En los envíos, cuya estación es fija por construcción, \(\Delta_{12}\) sobraba. La transformación se justifica con la serie que tienes y con el origen de su patrón, no con una receta.
- Elegir el modelo mirando el error de prueba. La prueba se reserva para el reporte. La especificación se decide en validación temporal sobre el pasado.
- Interpretar la ACF de una serie con tendencia como memoria pura. La cola larga de Air Passengers era la rampa, no un AR de orden 24.
- Evaluar solo contra la media global. El ingenuo estacional es el punto de referencia mínimo; si no lo ganas, el modelo no aporta.
- Confundir descomposición con pronóstico.
seasonal_decomposeexplica el pasado; Holt–Winters (o SARIMA) proyecta el futuro.
Lo que debes llevarte de este capítulo
La cadena completa es:
serie ordenada en el tiempo
→ no barajar ni partir al azar
→ descomponer: tendencia, estacionalidad, residuo
→ preguntarse si es estacionaria (gráfico + ADF)
→ transformar (log, diferencias) solo lo necesario
→ leer ACF / PACF, incluidos los rezagos estacionales
→ elegir el modelo con validación TEMPORAL
→ pronosticar el tramo futuro y reportar el error solo ahí
En Air Passengers, ese protocolo eligió Holt–Winters aditivo-multiplicativo y entregó un MAPE del 2.21% en 1960, frente al 9.99% de copiar el año anterior (ingenuo estacional). En envíos, el mismo flujo redujo el MAE de prueba de 1851.9 (ingenuo estacional) a 778.6 y anticipó el orden de magnitud del pico de diciembre (20803 pronosticado frente a 22334 real).
La lección de fondo no es el nombre del modelo. Es que el tiempo es estructura, no un índice más.
¿Qué sigue?
Aquí la dependencia era de una sola serie consigo misma: hoy con ayer, este diciembre con el pasado. Hay otra forma, igual de frecuente y distinta en el modelo: datos longitudinales (o de panel). Varias mediciones del mismo individuo —un cliente, un repartidor, una ruta— a lo largo del tiempo. Las observaciones de una misma unidad se parecen entre sí, aunque las unidades sean independientes.
Eso pide otra familia de herramientas: efectos aleatorios, modelos mixtos, el cuidado de no tratar 10 observaciones de 50 personas como si fueran 500 independientes. Es el próximo capítulo, y el otro lado de los datos dependientes.