El capítulo 9 te dejó un aparato completo: estimador, error estándar, intervalo y prueba. Ese aparato es frecuentista, porque trata el parámetro \(\theta\) como un número fijo y a la muestra como lo aleatorio. Hay otra lectura, la bayesiana, que trata a \(\theta\) como incierto antes de ver los datos y actualiza esa incertidumbre, \(p(\theta\mid x)\), cuando llegan. La moneda es la misma; cambia de qué es la probabilidad.
En este capítulo construyes los dos marcos sobre el mismo objeto: verosimilitud, máxima verosimilitud (MLE), prior, evidencia, posterior y MAP. El contraste que te interesa es operativo. Con una muestra pequeña, un prior concentrado puede desplazar el MAP; con un prior fijo adecuado y datos informativos, MLE y MAP suelen acercarse al crecer la muestra; y con un prior uniforme sobre una Bernoulli, el modo del posterior coincide con el MLE cuando la solución es interior.
El contexto tiene dos partes. Una moneda simulada con rng.binomial y una probabilidad de cara de 0.62, fijada por diseño, te permite ver las curvas y comparar cada estimación con el valor verdadero. Después, un filtro de correo de una palabra, con conteos escritos a mano y una simulación de 400 correos, muestra cómo el MLE asigna probabilidad 0 a un evento no visto y fuerza probabilidades extremas.
Tiempo estimado de lectura: 45 minutos (unas 2 horas si ejecutas el código y resuelves el ejercicio)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 9 (estimadores, error estándar e intervalos), el capítulo 8 (Bernoulli, binomial y densidades) y el capítulo 7 (probabilidad condicional y teorema de Bayes).
Tecnologías mencionadas: Python 3.13, NumPy, pandas, SciPy (scipy.stats), statsmodels y Matplotlib; scikit-learn aparece solo como referencia (Naive Bayes).
Objetivos
Al terminar este capítulo vas a ser capaz de:
distinguir qué pregunta hace el marco frecuentista y cuál el bayesiano sobre el mismo parámetro;
escribir la verosimilitud\(\mathcal L(\theta;x)=p(x\mid\theta)\) sin confundirla con \(p(\theta\mid x)\);
calcular el MLE a mano y ubicarlo sobre la curva de \(\ell(\theta)\);
actualizar un prior a un posterior y explicar qué es la evidencia\(p(x)\);
obtener el MAP y leerlo como un MLE penalizado por \(\log p(\theta)\);
contrastar un intervalo de confianza con un intervalo creíble calculados sobre la misma muestra;
distinguir el MAP de la media posterior y usar esta última para evitar probabilidades nulas en un clasificador.
Ejecuta las celdas en orden: las etapas comparten variables y el generador aleatorio rng.
12.1 Dos maneras de tratar al parámetro
La pregunta no es la misma
Tienes un parámetro \(\theta\) (la \(p\) de una Bernoulli, una media, un peso de un modelo) y observas \(x=(x_1,\ldots,x_n)\).
En el marco frecuentista, \(\theta\) es fijo y desconocido, y \(x\) es aleatoria. La pregunta es: si \(\theta\) fuera este valor, ¿qué tan rara sería esta muestra? De ahí salen el MLE, el error estándar, el intervalo de confianza y el p-value.
En el marco bayesiano, \(\theta\) tiene una distribución previa\(p(\theta)\), el prior, que resume la creencia o la regularidad que aceptas antes del dato. Después de ver \(x\), la pregunta es cómo se actualiza esa creencia, y la respuesta es el posterior\(p(\theta\mid x)\).
Los dos enfoques pueden estimar el mismo parámetro. Difieren en cómo representan la incertidumbre y en las propiedades con las que evalúan sus procedimientos.
Verosimilitud
\[
\mathcal L(\theta;x)=p(x\mid\theta).
\]
Es una función de \(\theta\) con \(x\) fija. No tiene por qué integrar a 1 respecto de \(\theta\), y por eso no la leas como “la probabilidad del parámetro”; mide qué tan compatible es cada \(\theta\) con lo que viste.
Si las observaciones son independientes e idénticamente distribuidas (i.i.d.),
Maximizas \(\ell\) en lugar de \(\mathcal L\) porque el logaritmo es monótono, de modo que el máximo queda en el mismo lugar, y convierte productos en sumas.
En una Bernoulli(\(p\)) con \(k=\sum x_i\) caras en \(n\) lanzamientos,
\[
\hat p_{\mathrm{MLE}}=\frac{k}{n}.
\]
El MLE usa solo la muestra. Si \(k=0\), entonces \(\hat p=0\) y el modelo afirma que el próximo resultado es imposible. En un clasificador de texto, una palabra que nunca apareció en spam deja \(P(\text{palabra}\mid\text{spam})=0\) y anula el producto de Naive Bayes.
\(p(x)\) es la evidencia o verosimilitud marginal. Normaliza el posterior y es la predicción de los datos promediando sobre el prior.
\(p(\theta\mid x)\) es el posterior, una distribución sobre \(\theta\) que integras para calcular probabilidades, cuantiles y predicciones de datos nuevos.
Para una Bernoulli, el prior conjugado es \(\mathrm{Beta}(\alpha,\beta)\). Después de \(k\) éxitos en \(n\) ensayos,
\[
p\mid x \;\sim\; \mathrm{Beta}(\alpha+k,\;\beta+n-k).
\]
Un prior es conjugado cuando el posterior queda en la misma familia que el prior. En el par Beta–Bernoulli, la conjugación te permite escribir el posterior de forma analítica: los parámetros del prior funcionan como conteos previos de éxitos y fracasos.
El MAP es un MLE con una penalización\(\log p(\theta)\). Con un prior plano, el MAP coincide con el MLE; con un prior concentrado, el máximo se desplaza hacia la creencia previa.
Para \(\mathrm{Beta}(\alpha,\beta)\) y una Bernoulli, el modo del posterior, definido si \(\alpha+k>1\) y \(\beta+n-k>1\), es
Con \(\alpha=\beta=1\) (uniforme) y \(0<k<n\), el modo interior coincide con \(k/n\); si \(k=0\) o \(k=n\), el máximo queda en la frontera. El suavizado de Laplace, \(\hat p=(k+1)/(n+2)\), es la media posterior de \(\mathrm{Beta}(1,1)\) y no su modo. En texto se usa esa media, o un \(\alpha\) pequeño, justamente para no escribir nunca un 0.
Intervalo de confianza frente a intervalo creíble
Intervalo de confianza
Intervalo creíble
Qué es aleatorio
Los extremos (la muestra)
\(\theta\) (según el posterior)
Cómo se lee
El procedimiento cubre \(\theta\) en el 95% de las réplicas
El 95% de la masa posterior cae en el intervalo
Usa prior
No
Sí
La misma muestra produce dos rangos que no tienen por qué coincidir. Si escribes “el intervalo del 95%” sin decir cuál de los dos es, mezclas dos lecturas distintas.
Fijo, con masa cerca del valor verdadero y condiciones regulares
MAP y MLE suelen acercarse; conviene comprobar las condiciones
Cualquiera
Plano
El MAP coincide con el MLE
El prior declara información o regularización sobre el parámetro. Un prior fijo que excluya valores compatibles con los datos, o un modelo no identificable, puede impedir que el MAP se acerque al MLE aunque \(n\) crezca.
Buena parte del entrenamiento de modelos es estimación por verosimilitud, con o sin prior:
La regresión lineal por mínimos cuadrados coincide con la máxima verosimilitud cuando los errores son normales, independientes y de varianza constante (capítulo 13). Puedes usar el mismo ajuste sin suponer normalidad; lo que cambia es su lectura probabilística y la inferencia.
Una penalización sobre los parámetros puede leerse como un MAP si explicitas un prior cuya log-densidad produce esa penalización y el posterior está bien definido; la regularización del nivel Avanzado desarrolla ese vínculo.
El suavizado de conteos de un clasificador como Naive Bayes es una media posterior: en el filtro de este capítulo, cero correos legítimos con «premio» producen un MLE nulo, y la media posterior con Beta(1,1) lo suaviza (etapas 8 y 9).
El prior de clase\(P(y=1)\) es la frecuencia base del clasificador, un objeto distinto del prior sobre el parámetro que estima \(P(w\mid y)\).
Los rangos de incertidumbre que acompañan a una métrica o a una predicción pueden ser intervalos de confianza (cobertura del procedimiento) o intervalos creíbles (masa posterior condicionada al modelo, al prior y a los datos).
Las ponderaciones class_weight cambian el objetivo de entrenamiento y no son automáticamente un prior sobre los parámetros; para darles una lectura bayesiana tendrías que especificar el modelo correspondiente.
12.3 Flujo recomendado de trabajo
Nombra \(\theta\) y el modelo\(p(x\mid\theta)\).
Escribe \(\ell(\theta)\) y, si trabajas en el marco frecuentista, el MLE y su incertidumbre (error estándar e intervalo de confianza).
Si tienes información previa o necesitas evitar ceros, escribe el prior y el posterior, o el MAP.
Distingue “este rango es un intervalo de confianza” de “este rango es un intervalo creíble”.
Predice un dato nuevo con la predictiva \(p(x_{\mathrm{nuevo}}\mid x)\), en lugar de sustituir \(\hat\theta\) sin más, sobre todo si \(n\) es pequeño.
Traduce al modelo: si un conteo vale 0, ¿lo estás tratando como MLE?; si sumas 1, ¿qué prior implica?
Redacta la conclusión con el marco a la vista:
«Se modeló [variable] como [Bernoulli u otra], con \(n=\)[valor]. MLE = [valor]. MAP o media posterior con prior [Beta(α, β) u otro] = [valor]. Intervalo [de confianza de Wald / creíble] del 95% = [extremos]. Para predecir se usó [sustitución del estimador / predictiva posterior]. [Basta el MLE / hace falta el prior porque…]. Limitación: [n pequeño, prior no elicitado u otra].»
Un \(\hat\theta\) publicado sin decir si es MLE o MAP, y sin \(n\), no permite evaluar cuánto pesó el prior. La etapa 10 llena esta plantilla con el filtro de correo.
12.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib, el módulo stats de SciPy y statsmodels, fija un estilo de gráficos y crea el generador rng con la semilla central SEMILLA = 42, del que salen todas las simulaciones. Los ejemplos corren en CPU; con otras versiones de las bibliotecas pueden aparecer diferencias pequeñas en los últimos decimales.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy import statsSEMILLA =42rng = np.random.default_rng(SEMILLA)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("scipy:", __import__("scipy").__version__, "| numpy:", np.__version__)import scipyimport matplotlibimport statsmodelsimport statsmodels.api as smfor nombre, modulo in [("NumPy", np), ("pandas", pd), ("Matplotlib", matplotlib), ("SciPy", scipy), ("statsmodels", statsmodels)]:print(f"{nombre}: {modulo.__version__}")
El entorno queda con Python 3.13.14, NumPy 2.5.1, pandas 3.0.5, SciPy 1.18.0 y statsmodels 0.14.6.
La siguiente celda, plegada en la versión web, define cuatro funciones de cálculo (log-verosimilitud, MLE, MAP y media posterior de la Beta–Bernoulli) y tres de gráficos. Las de cálculo son las fórmulas de la sección anterior escritas en código, y las verás aplicadas en cada etapa.
Funciones y gráficos auxiliares
def logverosimilitud_bernoulli(p, k, n): p = np.clip(np.asarray(p, dtype=float), 1e-12, 1-1e-12)return k * np.log(p) + (n - k) * np.log(1- p)def mle_bernoulli(k, n):return k / ndef map_beta(k, n, alpha, beta):return (alpha + k -1) / (alpha + beta + n -2)def media_posterior_beta(k, n, alpha, beta):return (alpha + k) / (alpha + beta + n)def graficar_loglik(k, n, titulo): p = np.linspace(0.01, 0.99, 400) ell = logverosimilitud_bernoulli(p, k, n) fig, ax = plt.subplots(figsize=(8.0, 4.1)) ax.plot(p, ell, color="C0") ax.axvline(k / n, color="C3", linestyle="--", label=fr"MLE = {k / n:.3f}") ax.set_xlabel("p") ax.set_ylabel(r"$\ell(p)$") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_prior_post(k, n, alpha, beta, titulo): p = np.linspace(0.001, 0.999, 500) prior = stats.beta.pdf(p, alpha, beta) post = stats.beta.pdf(p, alpha + k, beta + n - k) lik = np.exp(logverosimilitud_bernoulli(p, k, n) - logverosimilitud_bernoulli(k / n, k, n)) fig, ax = plt.subplots(figsize=(8.2, 4.3)) ax.plot(p, prior / prior.max(), linestyle="--", label=fr"prior Beta({alpha:g},{beta:g})") ax.plot(p, lik, color="C0", alpha=0.85, label="verosimilitud (escala 1)") ax.plot(p, post / post.max(), color="C2", linestyle="-.", label=fr"posterior Beta({alpha+k:g},{beta+n-k:g})") ax.axvline(k / n, color="C3", linestyle=":", label=f"MLE = {k / n:.3f}") ax.set_xlabel("p") ax.set_ylabel("escala relativa (máximo = 1)") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_mle_vs_map(ns, k_de_n, alpha, beta, p_true, titulo): mles = np.array([k / n for n, k inzip(ns, k_de_n)]) maps = np.array([map_beta(k, n, alpha, beta) for n, k inzip(ns, k_de_n)]) fig, ax = plt.subplots(figsize=(8.0, 4.2)) ax.plot(ns, mles, marker="o", label="MLE") ax.plot(ns, maps, marker="s", label=fr"MAP (Beta({alpha:g},{beta:g}))") ax.axhline(p_true, color="0.3", linestyle="--", label=fr"$p$ de diseño = {p_true}") ax.set_xlabel("n") ax.set_ylabel("estimación de p") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()
12.5 Desarrollo por etapas
Las 10 etapas usan dos ejemplos. En las siete primeras simulas una moneda con \(p=0.62\), un valor que fijas por diseño y que el estimador no conoce; así puedes ver cuándo el MLE se acerca por muestreo y cuándo el prior desplaza el MAP. En las etapas 8 y 9 pasas a un filtro de correo con los conteos de una palabra, donde el cero del MLE choca con el suavizado. La etapa 10 reúne todo en un reporte.
Etapa 1: El dato y el MLE
Simulas \(n=40\) lanzamientos de una moneda con \(p=0.62\) y cuentas el número de caras, \(k\). El MLE es \(k/n\) y no usa el 0.62: el ajuste no ve el valor con que se generaron los datos.
k = 21   n = 40
MLE  p̂ = k/n = 0.525    (diseño p = 0.62)
Salieron 21 caras en 40 lanzamientos, y el MLE es \(\hat p=0.525\), a casi 0.10 del 0.62 de diseño porque \(n\) es finito. \(\hat p_{\mathrm{MLE}}\) es un estadístico que cambia de muestra en muestra, y el 0.62 es el parámetro; confundirlos es el mismo error del capítulo 9, ahora con una \(p\) de Bernoulli.
Etapa 2: La curva de \(\ell(p)\), donde el máximo se ve
\[
\ell(p)=k\log p+(n-k)\log(1-p).
\]
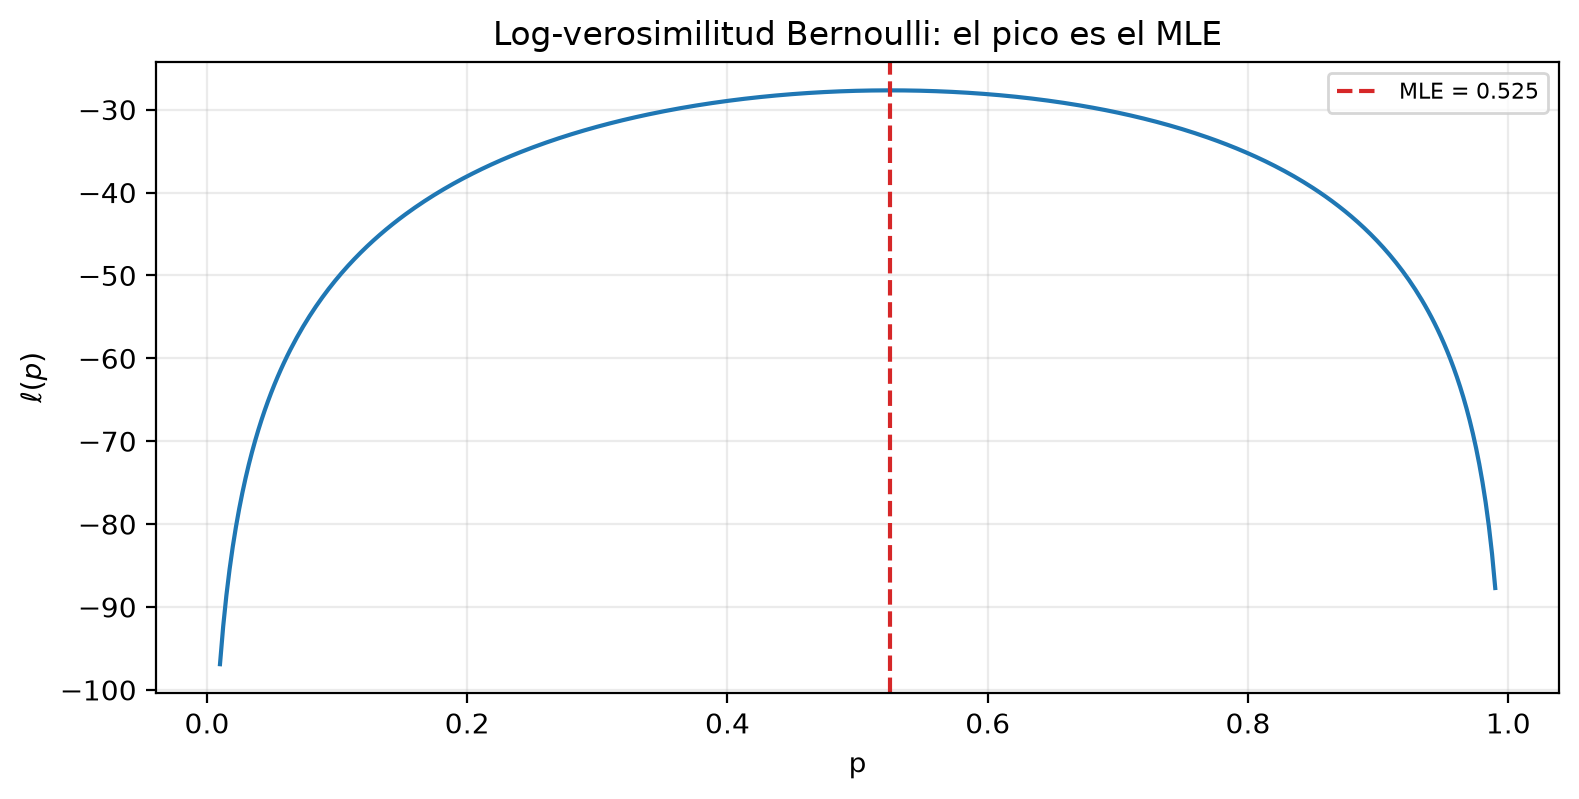
El MLE es el \(p\) donde esa curva alcanza su pico. Si evalúas la curva sobre una grilla de valores de \(p\) no necesitas derivar, y la derivada confirma que el máximo está en \(k/n\).
p_grid = np.linspace(0.05, 0.95, 181)ell = logverosimilitud_bernoulli(p_grid, k, n)p_max_num = p_grid[int(np.argmax(ell))]print("Máximo numérico de ℓ en la grilla =", round(p_max_num, 4))print("MLE analítico k/n =", round(p_mle, 4))graficar_loglik(k, n, r"Log-verosimilitud Bernoulli: el pico es el MLE")
Máximo numérico de ℓ en la grilla = 0.525
MLE analítico k/n                 = 0.525
El máximo numérico sobre la grilla y el MLE analítico coinciden en \(0.525\), y la figura muestra el pico de la curva justo en la línea discontinua. Ten presente que la verosimilitud no es una densidad sobre \(p\): el área bajo la curva no vale 1, y en la figura los valores de \(\ell\) ni siquiera están en escala de densidad. El pico responde qué \(p\) hace más probable esta muestra, y no cuánta creencia asignas a cada \(p\).
Etapa 3: Prior plano, el posterior se parece a la verosimilitud
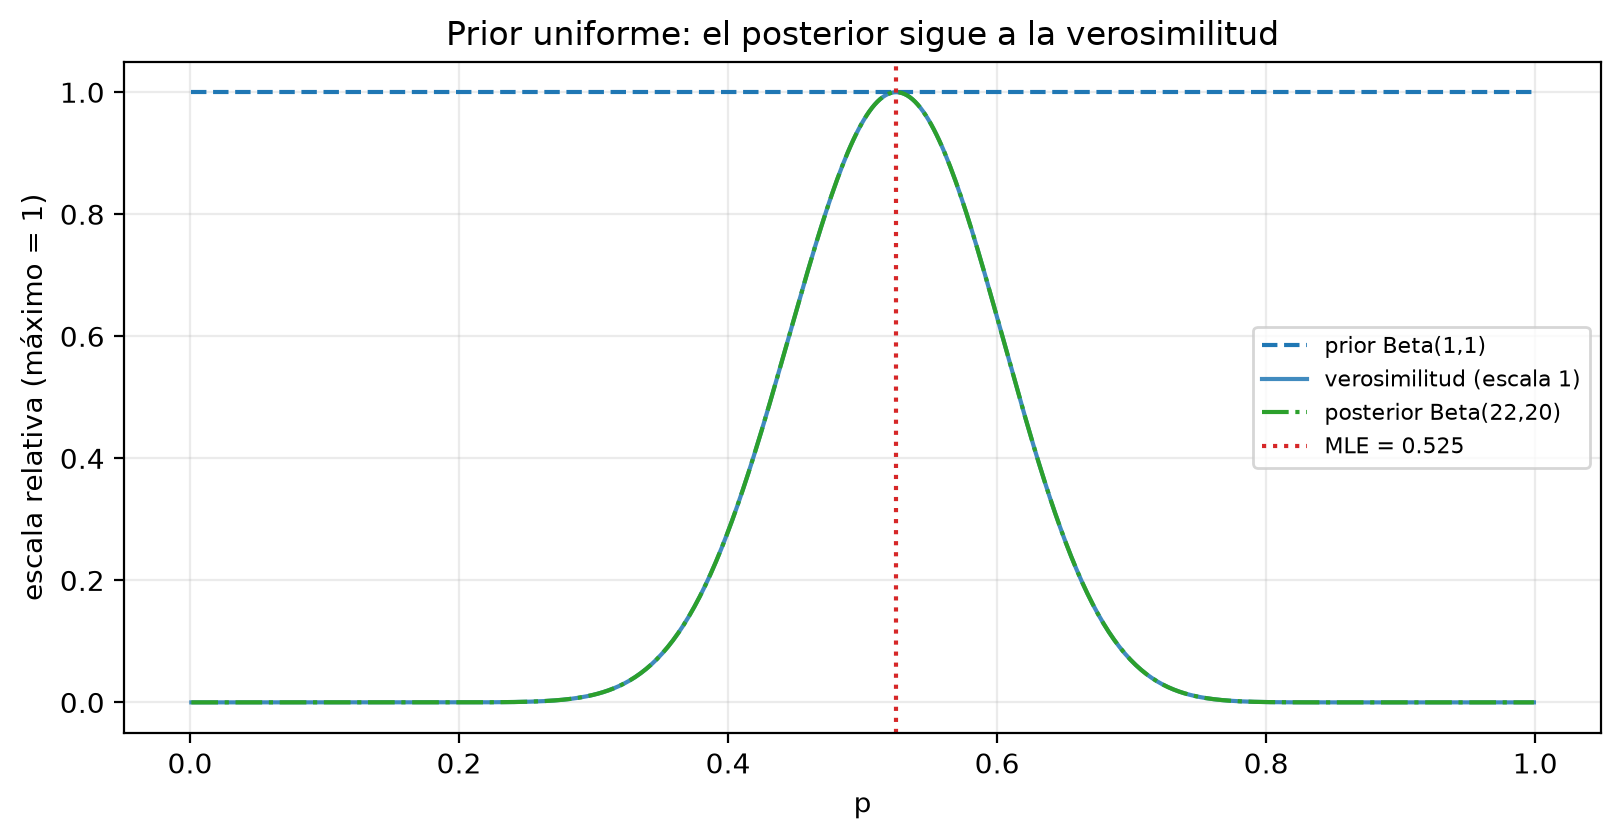
\(\mathrm{Beta}(1,1)\) es la distribución uniforme en \((0,1)\). Con \(k=21\) y \(n=40\), el posterior es \(\mathrm{Beta}(1+k,\,1+n-k)\), y su modo coincide con el MLE.
print("Prior Beta(1,1) → posterior Beta(", 1+ k, ",", 1+ n - k, ")", sep="")print("MAP (modo) =", round(map_beta(k, n, 1, 1), 4), " MLE =", round(p_mle, 4))print("Media posterior =", round(media_posterior_beta(k, n, 1, 1), 4), " (Laplace: (k+1)/(n+2))")graficar_prior_post(k, n, 1, 1, "Prior uniforme: el posterior sigue a la verosimilitud")
El posterior es \(\mathrm{Beta}(22,20)\), su modo (el MAP) vale \(0.525\), igual que el MLE, y en la figura la curva del posterior cae encima de la verosimilitud. Con un prior plano, actualizar equivale a reescalar la verosimilitud hasta que integre 1, y el MAP no aporta nada distinto del MLE. La media posterior sí se corre un poco hacia 0.5, a \(0.5238\), porque \((k+1)/(n+2)=22/42\) y no \(21/40\).
Etapa 4: El contraste, prior concentrado y \(n\) pequeño
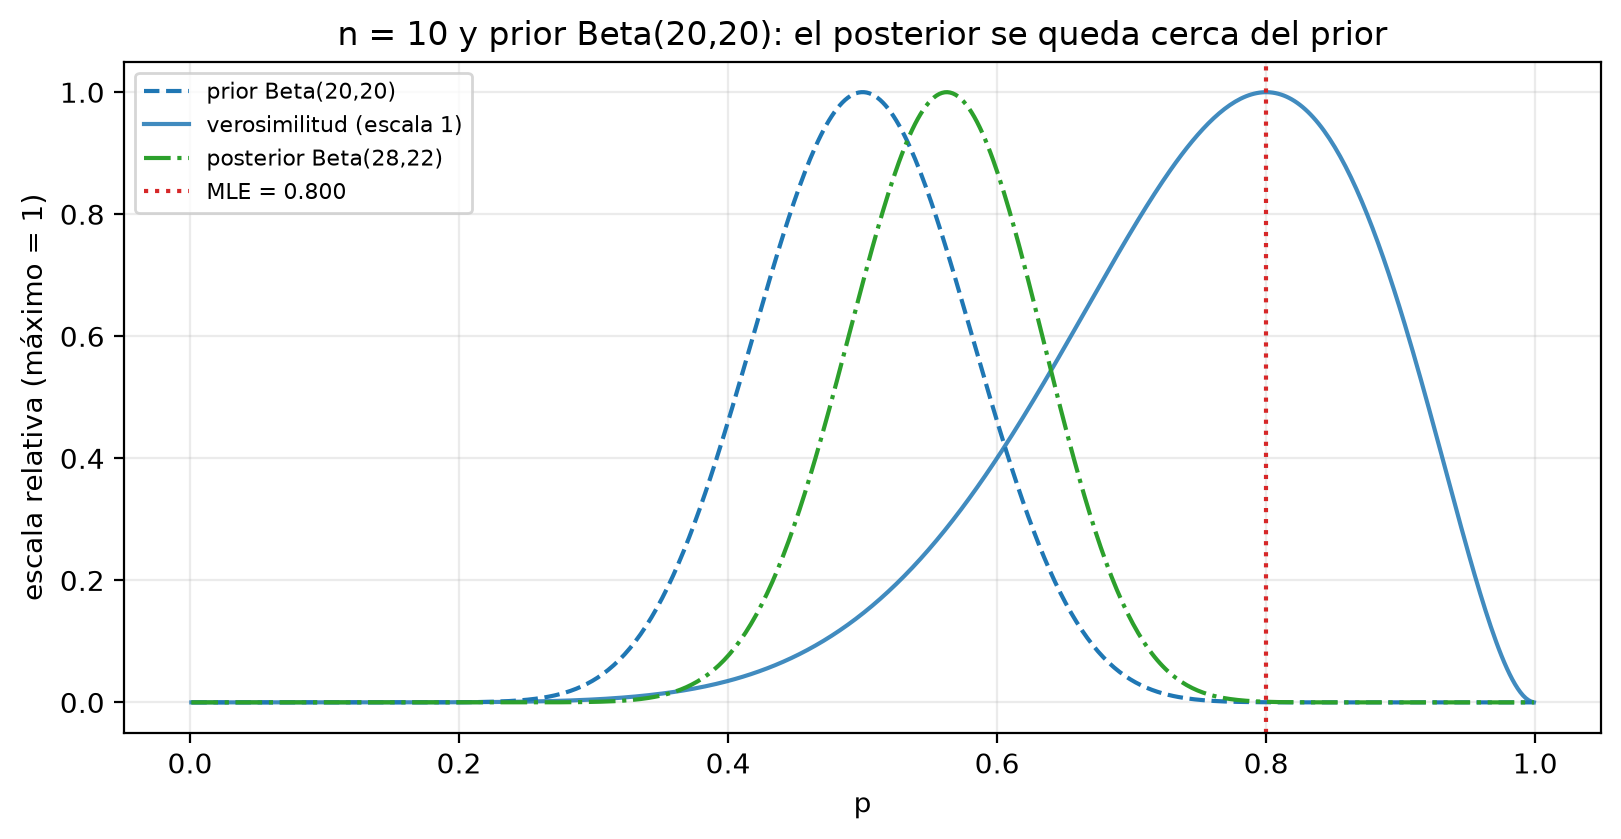
El prior \(\mathrm{Beta}(20,20)\) pone mucha masa cerca de \(1/2\), como si dijeras “creo que la moneda es casi honesta”. Aporta una concentración \(\alpha+\beta=40\) a la media posterior, y en el MAP sus conteos previos son \(\alpha-1=19\) y \(\beta-1=19\). El MAP debe acercarse a 0.5 respecto del MLE.
Lo aplicas a la muestra de la etapa 1 (\(n=40\)) y a una muestra pequeña, escrita a mano, de 8 caras en 10 tiradas, cuyo MLE (0.8) está lejos de 0.5.
a_f, b_f =20, 20print("Muestra de la etapa 1 (k=21, n=40):")print(" MLE =", round(p_mle, 4), " MAP prior fuerte =", round(map_beta(k, n, a_f, b_f), 4))print()k_c, n_c =8, 10# muestra chica y lejos de 0.5print("Muestra chica (k=8, n=10):")print(" MLE =", round(mle_bernoulli(k_c, n_c), 4))print(" MAP prior plano =", round(map_beta(k_c, n_c, 1, 1), 4))print(" MAP prior fuerte =", round(map_beta(k_c, n_c, a_f, b_f), 4), " (se desplaza hacia 0.5)")print(" Media post fuerte=", round(media_posterior_beta(k_c, n_c, a_f, b_f), 4))graficar_prior_post(k_c, n_c, a_f, b_f, "n = 10 y prior Beta(20,20): el posterior se queda cerca del prior")
Muestra de la etapa 1 (k=21, n=40):
  MLE = 0.525   MAP prior fuerte = 0.5128

Muestra chica (k=8, n=10):
  MLE              = 0.8
  MAP prior plano  = 0.8
  MAP prior fuerte = 0.5625   (se desplaza hacia 0.5)
  Media post fuerte= 0.56
Con la muestra de la etapa 1, el MAP con el prior concentrado es \(0.5128\) frente a un MLE de \(0.525\): casi no se nota, porque el MLE ya estaba cerca de 0.5. Con 8 caras en 10 tiradas, el MLE es 0.80, el MAP con Beta(20,20) es 0.5625 y la media posterior, 0.56. En la figura, el posterior \(\mathrm{Beta}(28,22)\) queda entre el prior (centrado en 0.5) y la verosimilitud (centrada en 0.8), mucho más cerca del prior.
MAP y media posterior son resúmenes distintos: el primero maximiza la densidad posterior y la segunda la promedia. El prior concentra la estimación cerca de 0.5, y su elección tienes que justificarla con conocimiento del proceso y un análisis de sensibilidad. Si sabes que las monedas de esa máquina suelen estar cerca de 0.5, compara las predicciones bajo Beta(1,1) y Beta(20,20) y declara cuál elegiste y por qué.
Etapa 5: \(n\) grande, el dato gana
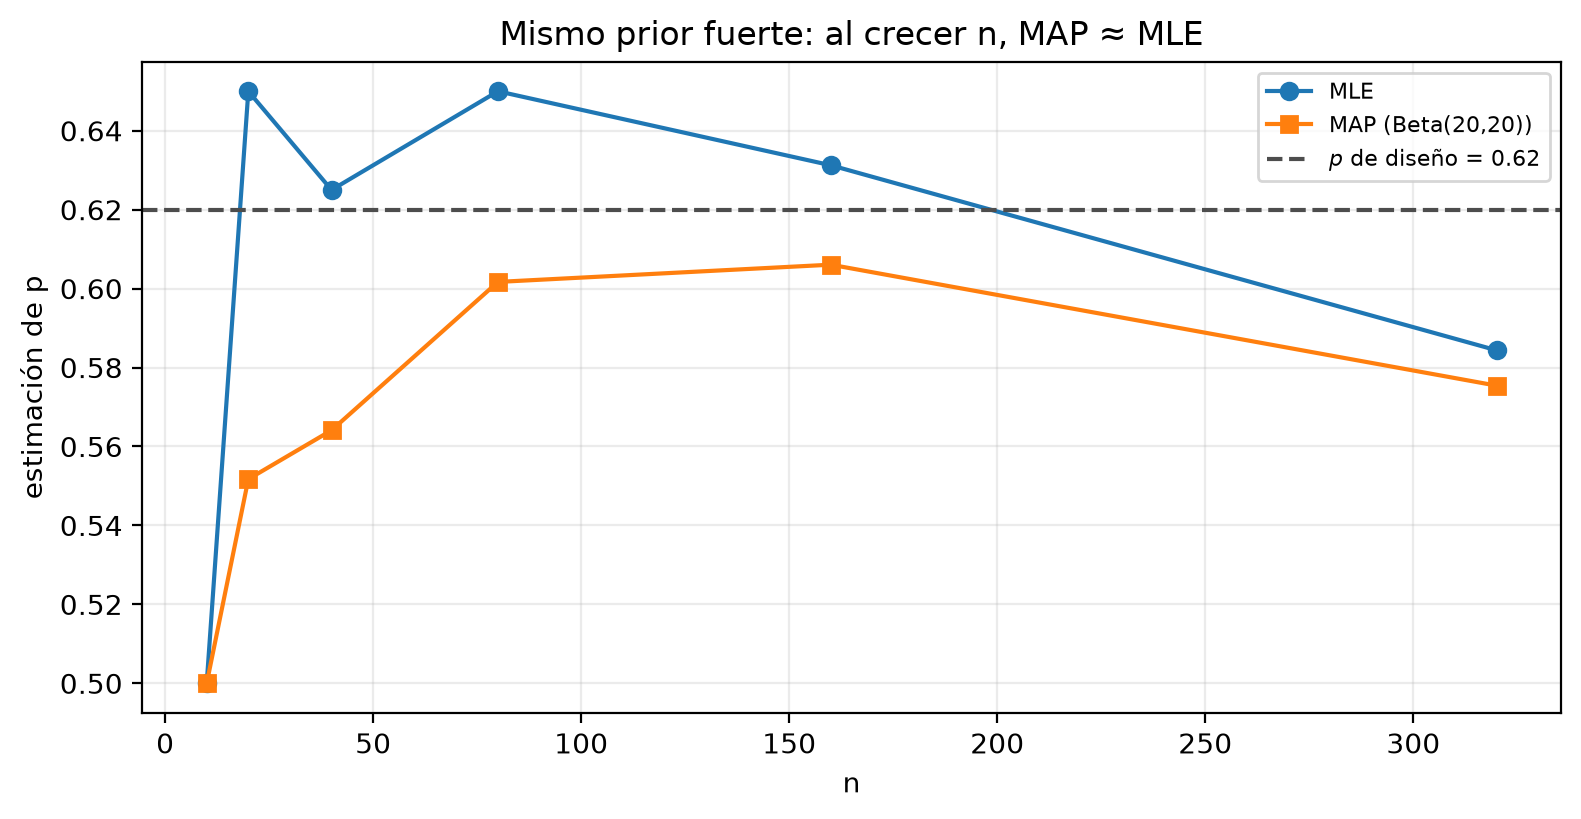
Simulas muestras crecientes de la misma moneda, de 10 a 320 lanzamientos, y mantienes fijo el prior concentrado \(\mathrm{Beta}(20,20)\). MLE y MAP deberían juntarse a medida que crece \(n\).
ns = np.array([10, 20, 40, 80, 160, 320])ks = []for ni in ns: ks.append(int(rng.binomial(1, p_true, size=int(ni)).sum()))graficar_mle_vs_map(ns, ks, 20, 20, p_true, "Mismo prior fuerte: al crecer n, MAP ≈ MLE")print(pd.DataFrame({"n": ns,"k": ks,"MLE": [round(k_ / n_, 3) for n_, k_ inzip(ns, ks)],"MAP": [round(map_beta(k_, n_, 20, 20), 3) for n_, k_ inzip(ns, ks)],}).to_string(index=False))
El prior no se apaga por decreto. Se diluye, porque en \(\alpha+k\) y \(\beta+n-k\) los conteos terminan pesando mucho más que los 20 del prior. Con \(n=20\), MLE y MAP difieren en casi 0.10 (0.650 frente a 0.552); con \(n=320\), en 0.009 (0.584 frente a 0.575), y la figura muestra las dos curvas cada vez más juntas. Con \(n=10\) coinciden por azar: salieron 5 caras, justo el centro del prior.
Que la diferencia sea pequeña con \(n=320\) en este experimento no garantiza que lo sea en todos. Su relevancia depende de la decisión, y otros priors, otros modelos o preguntas sobre las colas pueden conservar sensibilidad al prior.
Etapa 6: El 95% no es el mismo objeto
Con la misma muestra de la etapa 1 calculas dos rangos del 95%:
el intervalo de confianza de Wald (frecuentista, aproximación normal), \(\hat p\pm 1.96\sqrt{\hat p(1-\hat p)/n}\);
el intervalo creíble central, con los cuantiles 2.5% y 97.5% de \(\mathrm{Beta}(1+k,1+n-k)\).
Agregas el intervalo creíble con el prior concentrado y compruebas el de Wald con statsmodels. No esperas que coincidan.
se = np.sqrt(p_mle * (1- p_mle) / n)z = stats.norm.ppf(0.975)ic_lo, ic_hi = p_mle - z * se, p_mle + z * secred_lo, cred_hi = stats.beta.ppf([0.025, 0.975], 1+ k, 1+ n - k)print("Muestra: k =", k, " n =", n, " MLE =", round(p_mle, 4))print("IC Wald 95% = [", round(ic_lo, 3), ",", round(ic_hi, 3), "] ← cobertura del procedimiento")print("Creíble 95% (plano) = [", round(cred_lo, 3), ",", round(cred_hi, 3), "] ← masa del posterior")cred2 = stats.beta.ppf([0.025, 0.975], 20+ k, 20+ n - k)print("Creíble 95% (fuerte) = [", round(cred2[0], 3), ",", round(cred2[1], 3), "] ← el prior encoge el rango")print()# La implementación frecuentista se comprueba con statsmodels.from statsmodels.stats.proportion import proportion_confintic_sm = proportion_confint(k, n, alpha=0.05, method="normal")assert np.allclose(ic_sm, [ic_lo, ic_hi])print("IC Wald con statsmodels =", np.round(ic_sm, 3))
Muestra: k = 21  n = 40   MLE = 0.525
IC Wald 95%          = [ 0.37 , 0.68 ]  ← cobertura del procedimiento
Creíble 95% (plano)  = [ 0.374 , 0.671 ]  ← masa del posterior
Creíble 95% (fuerte) = [ 0.404 , 0.621 ]  ← el prior encoge el rango

IC Wald con statsmodels = [0.37 0.68]
Con \(k=21\) y \(n=40\), el intervalo de Wald es \([0.370,\,0.680]\) y el creíble con Beta(1,1) es \([0.374,\,0.671]\), y statsmodels reproduce el de Wald. Su cercanía numérica no iguala sus lecturas: el primero sale de un método con cobertura frecuentista y el segundo contiene el 95% de la masa posterior.
Con el prior Beta(20,20) el intervalo creíble es \([0.404,\,0.621]\), más estrecho porque añade información previa, y por eso mismo depende de que ese prior sea adecuado. El intervalo de Wald puede tener mala cobertura cerca de 0 o de 1; aquí lo usas para comparar los dos marcos, y en la práctica conviene un intervalo de Wilson o de Agresti–Coull (Brown, Cai y DasGupta, 2001).
Etapa 7: Evidencia y predicción del próximo lanzamiento
La predictiva posterior Beta–Bernoulli integra el parámetro y, para un ensayo nuevo, coincide con la media posterior:
Con Beta(1,1), \(k=21\) y \(n=40\), vale \(22/42\), mientras que el MLE vale \(21/40\). Las dos fórmulas pueden dar valores parecidos con ciertos conteos, pero son distintas.
La evidencia también depende de qué observas. Para una secuencia concreta de \(n\) ensayos con \(k\) éxitos,
Esta última es la probabilidad beta-binomial, y el factor combinatorio es lo que distingue el conteo de una secuencia concreta. La celda calcula las dos predicciones, repite el cálculo con 0 caras en 8 tiradas y comprueba la relación entre las dos evidencias.
def pred_cara(k, n, alpha, beta):return (alpha + k) / (alpha + beta + n)print("P(próxima = cara | x)")print(" con MLE (plug-in) =", round(p_mle, 4), " ← trata p̂ como si fuera p")print(" predictiva, prior 1,1 =", round(pred_cara(k, n, 1, 1), 4))print(" predictiva, prior 20,20 =", round(pred_cara(k, n, 20, 20), 4))print()print("Si k=0, n=8:")print(" MLE plug-in =", 0.0, " ← 'la próxima cara es imposible'")print(" predictiva Laplace =", round(pred_cara(0, 8, 1, 1), 4), " ← nunca 0")from scipy.special import betaln, gammalnlog_evidencia_secuencia = betaln(1+ k, 1+ n - k) - betaln(1, 1)log_combinaciones = gammaln(n +1) - gammaln(k +1) - gammaln(n - k +1)log_evidencia_conteo = stats.betabinom.logpmf(k, n, 1, 1)print("Log-evidencia de la secuencia =", round(float(log_evidencia_secuencia), 6))print("Log-probabilidad del conteo =", round(float(log_evidencia_conteo), 6))assert np.isclose(log_evidencia_conteo, log_evidencia_secuencia + log_combinaciones)
P(próxima = cara | x)
  con MLE (plug-in)     = 0.525   ← trata p̂ como si fuera p
  predictiva, prior 1,1 = 0.5238
  predictiva, prior 20,20 = 0.5125

Si k=0, n=8:
  MLE plug-in           = 0.0   ← 'la próxima cara es imposible'
  predictiva Laplace   = 0.1   ← nunca 0
Log-evidencia de la secuencia = -29.314189
Log-probabilidad del conteo = -3.713572
Para la muestra de 21 caras en 40 tiradas, la predicción que sustituye el MLE es 0.525, la predictiva con Beta(1,1) es 0.5238 y con Beta(20,20), 0.5125. Con cero caras en ocho tiradas, la sustitución asigna 0 a la próxima cara y la predictiva asigna 0.1, porque incorpora la incertidumbre sobre el parámetro al integrar sobre el posterior.
La log-evidencia de la secuencia es \(-29.31\) y la log-probabilidad del conteo, \(-3.71\). La diferencia, unos 25.6 en escala logarítmica, es el logaritmo de \(\binom{40}{21}\), el número de secuencias que comparten ese conteo, y la celda lo comprueba con un assert. La predicción de un ensayo y la evidencia de los datos son cantidades distintas.
Ejercicio
Con 3 caras en 12 tiradas y un prior \(\mathrm{Beta}(2,2)\), calcula a mano el MLE, el MAP, la media posterior y la probabilidad predictiva de que el próximo lanzamiento sea cara. Después obtén con stats.beta.ppf el intervalo creíble central del 95% y explica por qué el MAP queda entre el MLE y 0.5.
TipOrientaciones
El posterior es \(\mathrm{Beta}(2+3,\,2+9)=\mathrm{Beta}(5,11)\). El MLE es \(3/12=0.25\); el MAP, \((2+3-1)/(2+2+12-2)=4/14=0.286\); la media posterior y la predictiva coinciden en \(5/16=0.3125\). El intervalo creíble es stats.beta.ppf([0.025, 0.975], 5, 11), aproximadamente \([0.118,\,0.551]\). El prior \(\mathrm{Beta}(2,2)\) tiene su modo en 0.5 y aporta un conteo previo de una cara y una cruz al MAP, así que tira de la estimación hacia 0.5 sin llegar a ella, porque los 12 lanzamientos pesan más que esos dos conteos.
Etapa 8: Clasificación, el MLE pone un 0 y se rompe
Construyes un filtro de una palabra con conteos escritos a mano. La clase \(y=1\) es spam. En entrenamiento, la palabra «premio» aparece en 8 de 40 correos spam y en 0 de 80 correos legítimos (ham), y el prior de clase de spam es 0.30. Un correo de prueba trae «premio».
Con Naive Bayes de una palabra,
\[
P(y\mid w)\propto P(w\mid y)\,P(y).
\]
El MLE da \(P(w\mid y=0)=0/80=0\), así que el ham queda anulado y el correo tiene que ser spam aunque el prior de spam sea bajo. La media posterior con suavizado de Laplace usa \((c+1)/(n+2)\).
# Conteos de diseño (una palabra)c_spam, n_spam =8, 40c_ham, n_ham =0, 80prior_spam =0.30prior_ham =0.70p_w_spam_mle = c_spam / n_spamp_w_ham_mle = c_ham / n_ham# Laplace = media posterior Beta(1,1)p_w_spam_media = media_posterior_beta(c_spam, n_spam, 1, 1)p_w_ham_media = media_posterior_beta(c_ham, n_ham, 1, 1)def posterior_spam(p_w_spam, p_w_ham): num = p_w_spam * prior_spam den = num + p_w_ham * prior_hamreturn num / den if den >0else np.nanprint("P(palabra | spam) MLE =", p_w_spam_mle, " Laplace =", round(p_w_spam_media, 4))print("P(palabra | ham) MLE =", p_w_ham_mle, " Laplace =", round(p_w_ham_media, 4))print()print("P(spam | palabra) MLE =", posterior_spam(p_w_spam_mle, p_w_ham_mle)," ← 1.0 forzado: ham quedó en 0")print("P(spam | palabra) Laplace =", round(posterior_spam(p_w_spam_media, p_w_ham_media), 4))
El suavizado asigna \(P(w\mid\mathrm{ham})=1/82=0.0122\) en lugar de 0, y \(P(w\mid\mathrm{spam})=9/42=0.2143\) en lugar de 0.2. Combinado con el prior de clase de 0.30, produce \(P(\mathrm{spam}\mid w)=0.8828\), frente al 1.0 forzado del MLE. El resultado depende de los conteos y del prior Beta(1,1), y otros priors producirían otras probabilidades.
En este ejemplo conservas el suavizado y evitas leer el cero muestral como una imposibilidad. Su calidad predictiva la evalúas después, con datos separados y métricas probabilísticas.
Etapa 9: Simular el filtro con los correos que traen la palabra
Generas 400 correos con las tasas verdaderas de diseño: el 30% es spam, y «premio» aparece en el 20% del spam y en el 1% del ham (el 0 del entrenamiento fue mala suerte de muestra con \(n\) pequeño). Entre los correos que traen la palabra comparas la probabilidad que afirma cada regla con la frecuencia real de spam, y la decisión al umbral habitual \(\tau=0.5\).
n_mail =400es_spam = rng.random(n_mail) <0.30tiene = np.where(es_spam, rng.random(n_mail) <0.20, rng.random(n_mail) <0.01)y = es_spam[tiene].astype(int) # solo los correos que traen la palabrapost_l = posterior_spam(p_w_spam_media, p_w_ham_media)print("Correos con la palabra:", len(y), " spam:", int(y.sum()), " ham:", int(len(y) - y.sum()))print("Frecuencia real de spam entre ellos =", round(y.mean(), 3))print("MLE afirma P(spam | palabra) = 1.0 ← declara imposibles a los ham")print("Laplace afirma P(spam | palabra) =", round(post_l, 3))print()tau =0.5yhat = np.full_like(y, int(post_l >= tau)) # a τ = 0.5, MLE (1.0) y Laplace (0.883) alertan igualvp =int(((y ==1) & (yhat ==1)).sum())fp =int(((y ==0) & (yhat ==1)).sum())print(f"A τ = {tau}, las dos reglas alertan en los {len(y)} correos: VP = {vp}, FP = {fp}")
Correos con la palabra: 30   spam: 28   ham: 2
Frecuencia real de spam entre ellos  = 0.933
MLE afirma     P(spam | palabra) = 1.0   ← declara imposibles a los ham
Laplace afirma P(spam | palabra) = 0.883

A τ = 0.5, las dos reglas alertan en los 30 correos: VP = 28, FP = 2
De los 30 correos con la palabra, 28 eran spam (93.3%). El MLE afirma certeza (1.0) y declara imposibles a los 2 ham que sí aparecieron; Laplace afirma 0.883, una cifra discutible pero posible. A \(\tau=0.5\) las dos reglas deciden igual (28 verdaderos positivos y 2 falsos positivos), así que la diferencia no se ve en la matriz de confusión.
Se ve cuando usas la probabilidad como probabilidad: al combinar varias palabras, donde un solo 0 anula todo el producto; al fijar el umbral por costos; o al medir la calibración. Una métrica probabilística como la pérdida logarítmica castiga con un error infinito a quien dijo 1.0 y se equivocó.
De aquí no se sigue que Laplace sea el mejor prior. Es una elección sencilla que evita ceros en este modelo, y cualquier Beta con parámetros positivos también los evita en la media posterior; un \(\mathrm{Beta}(2,8)\) para el ham sería otra creencia y daría otra probabilidad.
Etapa 10: Reportar un MLE o un MAP
El reporte sigue seis pasos:
Parámetro y modelo: qué es \(\theta\) y qué \(p(x\mid\theta)\) usas.
Marco: frecuentista (MLE e intervalo de confianza) o bayesiano (prior, posterior o MAP).
Prior, si existe: familia, parámetros y justificación (plano, regularización o conocimiento del dominio).
Números:\(\hat\theta\), \(n\) y el intervalo, diciendo de qué tipo es.
Predicción: sustitución del estimador o predictiva posterior, y si aparecen ceros.
Decisión y límites: para qué uso sirve y qué cambiaría con otro \(n\).
Los aplicas al filtro de las etapas 8 y 9.
Parámetro y modelo.\(P(\text{«premio»}\mid \text{spam})\) y \(P(\text{«premio»}\mid \text{ham})\), cada una una Bernoulli por correo.
Marco. Comparas el MLE con la media posterior de \(\mathrm{Beta}(1,1)\) (Laplace).
Prior. Plano en \(p\), equivalente a un conteo previo de una presencia y una ausencia. La justificación es evitar la probabilidad 0, no un estudio del dominio.
Números. MLE para ham, \(0/80=0\); Laplace, \((0+1)/(80+2)=0.0122\). \(P(\text{spam}\mid\text{palabra})\) vale 1.0 con el MLE y 0.883 con Laplace.
Predicción. El MLE asigna probabilidad cero a ham cuando aparece la palabra, y Laplace le asigna una probabilidad positiva; a umbral 0.5, las dos reglas clasifican como spam los 30 correos de la simulación, 2 de ellos ham.
Decisión y límites. Descartas el MLE crudo para este clasificador y aceptas Laplace, o un prior mejor fundado, como mínimo. Limitaciones: una sola palabra, un prior no elicitado con el negocio y un umbral de 0.5 elegido por costumbre.
En un filtro con una palabra nunca vista en ham, el MLE asigna \(P(w\mid\mathrm{ham})=0\) y fuerza una probabilidad de spam de 1. Con suavizado de Laplace la probabilidad es 0.883 y el modelo deja de colapsar. Se reportan el prior \(\mathrm{Beta}(1,1)\), \(n_{\mathrm{ham}}=80\) y que el 1.0 del MLE refleja un conteo nulo en ham y no una certeza validada. Limitación: una sola variable y un umbral sin calibrar.
Errores que conviene nombrar
Tratar \(\mathcal L(\theta;x)\) como \(p(\theta\mid x)\). La verosimilitud no tiene por qué integrar a 1 respecto de \(\theta\).
Publicar un MAP sin el prior. Impide evaluar qué información previa intervino; en la etapa 4, el mismo conteo de 8 en 10 dio 0.80 o 0.5625 según el prior.
Leer el intervalo de confianza como “\(\theta\) está aquí con probabilidad 0.95”. Esa lectura corresponde a un intervalo creíble.
Leer el intervalo creíble como la cobertura de un procedimiento que se repite.
Tomar un MLE con \(k=0\) como una imposibilidad. En un clasificador de texto, anula el producto y fuerza probabilidades de 0 o 1.
Elegir un marco por moda. Frecuentista y bayesiano responden preguntas distintas; eliges según la pregunta y la información previa que puedas justificar.
Confundir este tema con el teorema de Bayes del capítulo 7. Allí invertías un condicional entre eventos (el 16.7% de la prueba médica); aquí eliges cómo tratar a un parámetro \(\theta\).
12.6 Guía rápida: ¿qué marco usar?
Situación
Qué usar
Por qué
Solo la muestra, un valor puntual
MLE
Maximiza \(p(x\mid\theta)\)
Hay información previa o necesitas regularizar
MAP o posterior
Suma \(\log p(\theta)\)
Evitar \(P=0\) en conteos
Laplace, media posterior de \(\mathrm{Beta}(1,1)\)
Nunca da 0
Rango con la lectura “el procedimiento cubre”
Intervalo de confianza
Frecuentista
Rango con la lectura “creo que \(\theta\) está aquí”
Intervalo creíble
Posterior
Predecir el próximo \(x\) con \(n\) pequeño
Predictiva posterior
Promedia sobre \(\theta\) en lugar de sustituir \(\hat\theta\)
\(n\) muy grande y un prior razonable
MLE o MAP, que casi coinciden
Los datos dominan al prior
Al reportar, incluye \(\hat\theta\), \(n\), si es MLE o MAP, el prior si existe y el tipo de intervalo.
12.7 Preguntas de comprensión
Con \(k=0\), \(n=8\) y prior Beta(1,1), calcula el MLE, el MAP de frontera y la media posterior. ¿Cuál usas para predecir un ensayo nuevo?
Con \(k=8\) y \(n=10\), compara el MAP y la media posterior bajo Beta(20,20). ¿Por qué no tienen que coincidir?
¿Por qué la evidencia del conteo y la de una secuencia concreta difieren en un factor?
En el filtro, ¿cómo pueden el MLE y Laplace dar las mismas etiquetas y probabilidades diferentes?
Con \(k=0\) y \(n=8\), ¿qué intervalo de Wald del 95% obtienes, y qué da el intervalo creíble con Beta(1,1)?
TipOrientaciones
El MLE y el modo, que queda en la frontera, valen 0. La media posterior y la probabilidad predictiva valen \(1/10=0.1\). La fórmula del modo interior no se aplica porque el posterior es \(\mathrm{Beta}(1,9)\) y su primer parámetro no supera 1. Para predecir usas la predictiva, 0.1.
El MAP vale \(27/48=0.5625\) y la media, \(28/50=0.56\). El modo maximiza la densidad y la media la promedia; solo coinciden si el posterior es simétrico.
El conteo reúne las \(\binom nk\) secuencias que tienen la misma probabilidad, y la secuencia concreta es una sola de ellas. En la etapa 7, la diferencia entre \(-3.71\) y \(-29.31\) es el logaritmo de \(\binom{40}{21}\).
Las probabilidades 1.0 y 0.883 superan las dos el umbral 0.5, así que las etiquetas coinciden. Difieren en la pérdida logarítmica, que es infinita para el 1.0 ante un ham, y en las decisiones con otros costos u otro umbral.
Con \(\hat p=0\), el error estándar de Wald vale 0 y el intervalo es \([0,0]\), una conclusión absurda con 8 datos. El creíble con \(\mathrm{Beta}(1,9)\) es aproximadamente \([0.003,\,0.336]\) y refleja que una probabilidad de hasta un tercio es compatible con 0 caras en 8 tiradas.
12.8 Referencias para profundizar
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A. y Rubin, D. B. (2013). Bayesian Data Analysis (3.ª ed.). CRC Press. La referencia estándar del análisis bayesiano; el capítulo 2 trata el modelo Beta–binomial.
Wasserman, L. (2004). All of Statistics: A Concise Course in Statistical Inference. Springer. Los capítulos 9 y 11 presentan la máxima verosimilitud y la inferencia bayesiana lado a lado.
Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer. La sección 2.1 desarrolla la Beta–Bernoulli y la diferencia entre MLE, MAP y predictiva.
Murphy, K. P. (2022). Probabilistic Machine Learning: An Introduction. MIT Press. Estimación por máxima verosimilitud, MAP y Naive Bayes con suavizado.
Brown, L. D., Cai, T. T. y DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. Por qué el intervalo de Wald tiene mala cobertura y qué usar en su lugar.
statsmodels. Documentación de proportion_confint, con el intervalo de Wald y sus alternativas.
scikit-learn. Documentación de Naive Bayes, con los modelos de conteos y el parámetro de suavizado alpha.
12.9 Lo que debes llevarte de este capítulo
Un estimador se publica con su marco: dices si es un MLE o un MAP, cuál fue el prior y qué tipo de intervalo lo acompaña, porque la misma muestra produce números distintos en cada caso.
La verosimilitud mide compatibilidad y no es una distribución sobre \(\theta\): con 21 caras en 40, su máximo está en \(\hat p=0.525\).
Con un prior plano, el MAP coincide con el MLE (0.525) y la media posterior se corre a 0.5238.
Con \(n\) pequeño, un prior concentrado domina: 8 caras en 10 dieron un MLE de 0.80 y un MAP de 0.5625 con Beta(20,20).
Al crecer \(n\), el prior se diluye: la diferencia entre MLE y MAP bajó de 0.10 con \(n=20\) a 0.009 con \(n=320\).
Un intervalo de confianza y uno creíble pueden parecerse (\([0.370,\,0.680]\) y \([0.374,\,0.671]\)) y se leen distinto.
La predictiva no escribe ceros: con 0 caras en 8, la sustitución dio 0 y la predictiva, 0.1.
En el filtro, el MLE forzó una probabilidad de spam de 1.0 y Laplace dio 0.883, con las mismas decisiones a \(\tau=0.5\) y una pérdida logarítmica muy distinta.
12.10 Puente hacia los siguientes capítulos
La regresión lineal del capítulo 13 retoma la verosimilitud: la recta de mínimos cuadrados es el MLE cuando el ruido es gaussiano, y las regresiones penalizadas del nivel Avanzado son el MAP con un prior sobre los coeficientes.
El capítulo 14 evalúa clasificadores como el filtro de las etapas 8 y 9. Un clasificador que multiplica \(P(x\mid y)\) hereda el 0 del MLE o el suavizado de la media posterior, y las métricas y la validación se aplican igual en los dos marcos: el prior se elige sin mirar el conjunto de prueba, porque el marco de \(\theta\) no sustituye a los datos no vistos.