En el capítulo anterior la dependencia venía del orden temporal de una sola serie: hoy se parece a ayer. Aquí aparece el otro lado de los datos dependientes. Imagina que registras varias entregas de cada repartidor. Cada fila parece una observación nueva, pero las filas de una misma persona comparten experiencia, ritmo, conocimiento de la zona y forma de trabajar. Esa historia común crea correlación intraindividual.
Una regresión clásica supone que, una vez incluidas las variables explicativas, sus errores son independientes. Aquí esa suposición se rompe: dos entregas del mismo repartidor se parecen más que dos entregas elegidas al azar. Si ignoras quién hizo cada entrega, puedes confundir muchas filas con mucha evidencia independiente.
Objetivos de aprendizaje
Al terminar este capítulo vas a ser capaz de:
Reconocer mediciones repetidas y explicar por qué generan dependencia.
Detectar la variabilidad sistemática entre individuos con tablas y gráficos.
Explicar por qué una regresión pooled (todas las filas apiladas en una sola regresión, sin identificar al individuo) puede distorsionar la incertidumbre y el efecto estimado.
Distinguir efectos fijos de efectos aleatorios.
Ajustar e interpretar un modelo mixto con intercepto aleatorio usando MixedLM.
Comparar el modelo ingenuo y el mixto sin convertir asociación en causalidad.
Preparación del entorno
Usaremos datos sintéticos para conocer la regla que los generó y comprobar si cada modelo logra recuperarla. En datos reales esa regla nunca está disponible. La semilla fija hace reproducible cada número y cada figura.
import warningsimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport statsmodels.api as smimport statsmodels.formula.api as smfwarnings.filterwarnings('ignore', category=UserWarning, module='statsmodels')SEMILLA =2169rng = np.random.default_rng(SEMILLA)pd.options.display.float_format ='{:.3f}'.formatplt.rcParams.update({'figure.figsize': (9, 4.8),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})print(f'NumPy {np.__version__} | pandas {pd.__version__} | statsmodels {sm.__version__}')
NumPy 2.5.1 | pandas 3.0.5 | statsmodels 0.14.6
Los datos: entregas repetidas por repartidor
Generaremos 30 repartidores con 16 entregas cada uno. La distancia cambia entre entregas, pero cada persona recibe un desplazamiento propio en minutos: algunos son sistemáticamente más rápidos y otros más lentos.
La regla oculta usa una pendiente común de 1.65 minutos por kilómetro, un efecto individual con desviación estándar de 7 minutos y ruido por entrega con desviación estándar de 2.7 minutos. La columna efecto_real_min se conserva únicamente para auditar la simulación; no existiría en una aplicación real.
Antes de modelar, verifica la unidad de análisis. Una fila representa una entrega, pero la unidad que se repite es el repartidor. Mostraremos ambas cantidades y algunas filas de tres personas.
conteos = datos.groupby('repartidor').size()print(f'Entregas: {len(datos)}')print(f'Repartidores: {datos["repartidor"].nunique()}')print(f'Entregas por repartidor: {conteos.min()} a {conteos.max()}')display(datos[datos['repartidor'].isin(['R01', 'R02', 'R03'])].groupby('repartidor').head(4).round(2))
Entregas: 480
Repartidores: 30
Entregas por repartidor: 16 a 16
repartidor
entrega
distancia_km
tiempo_min
efecto_real_min
0
R01
1
12.370
51.700
2.930
1
R01
2
16.770
56.210
2.930
2
R01
3
14.880
57.600
2.930
3
R01
4
13.080
53.990
2.930
16
R02
1
6.000
41.450
6.440
17
R02
2
6.170
48.910
6.440
18
R02
3
6.640
45.990
6.440
19
R02
4
6.540
50.100
6.440
32
R03
1
11.440
51.440
7.780
33
R03
2
12.190
58.350
7.780
34
R03
3
9.130
47.800
7.780
35
R03
4
10.290
56.470
7.780
Cómo leer este resultado
Hay 480 entregas, pero solo 30 repartidores; cada uno aporta exactamente 16 mediciones. Por eso 480 no equivale a 480 fuentes independientes de información. En la tabla, las cuatro filas de R01 comparten el mismo efecto individual (2.93 min), las de R02 otro (6.44) y las de R03 otro (7.78), aunque la distancia y el tiempo cambien de una entrega a otra.
Qué hace longitudinal a estos datos
Un conjunto es longitudinal (o de panel) cuando observas repetidamente la misma unidad a lo largo del tiempo: personas, vehículos, tiendas o rutas. En este capítulo nos concentramos en la consecuencia más inmediata de esa repetición, la semejanza entre mediciones de una misma unidad, y dejamos de lado el orden de las entregas; cuando ese orden importa, hay que añadir estructura temporal (lo retomamos al cierre). Los índices importan: \(i\) identifica al repartidor y \(j\) identifica una entrega suya.
Primero vamos a verla.
Seis historias individuales
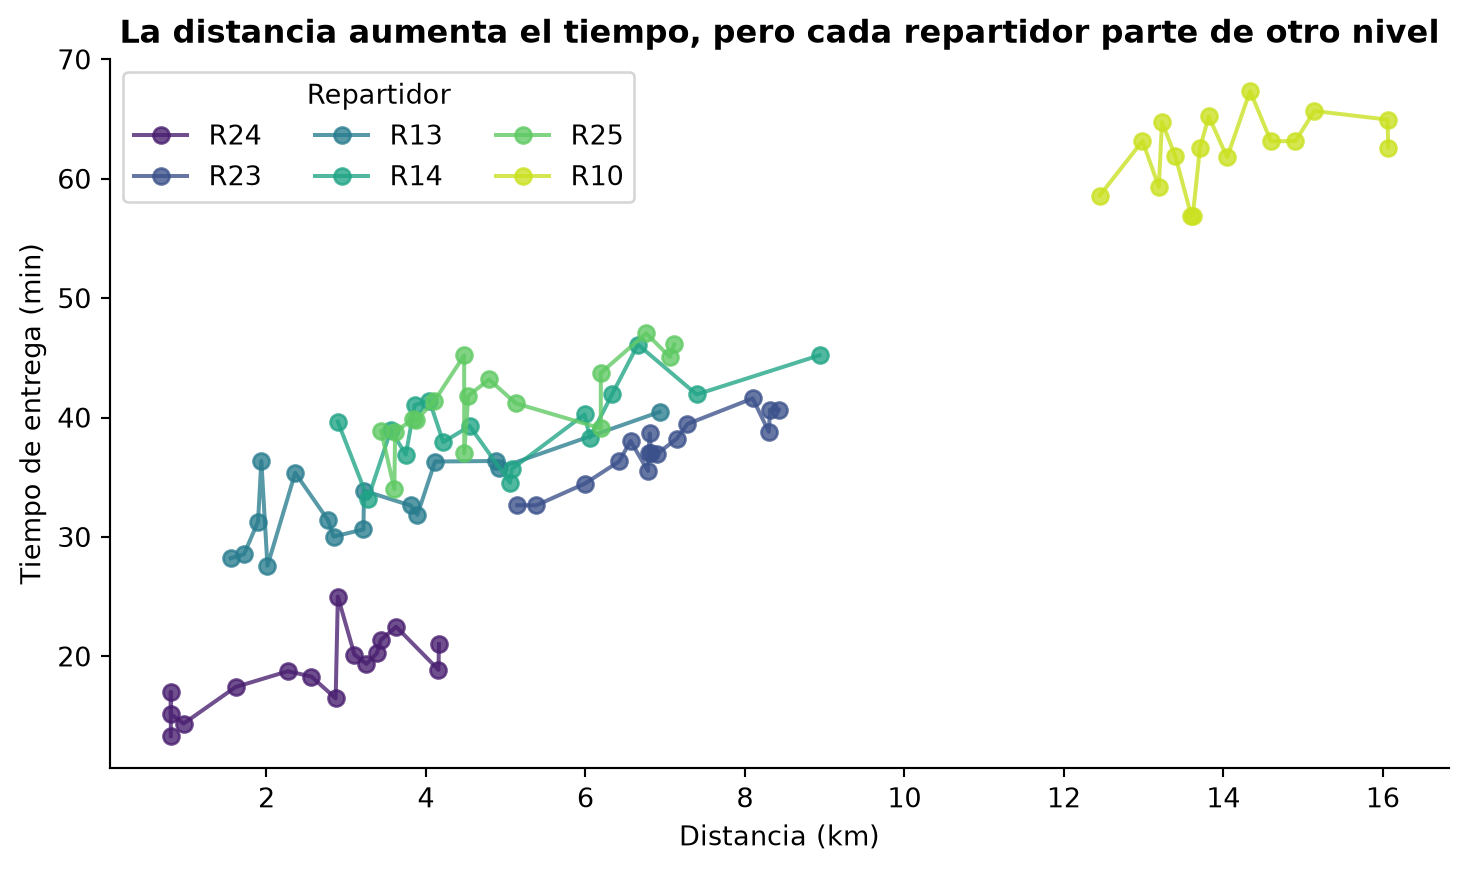
Una nube global puede esconder la estructura. Seleccionemos seis repartidores distribuidos a lo largo del rango de efectos reales y unamos sus entregas ordenadas por distancia. Las líneas no representan tiempo cronológico: ayudan a seguir visualmente a cada persona.
orden_efectos = (datos.groupby('repartidor')['efecto_real_min'].first().sort_values())posiciones = np.linspace(0, len(orden_efectos) -1, 6, dtype=int)seleccionados = orden_efectos.index[posiciones]colores = plt.cm.viridis(np.linspace(0.08, 0.92, len(seleccionados)))for repartidor, color inzip(seleccionados, colores): parte = datos[datos['repartidor'] == repartidor].sort_values('distancia_km') plt.plot(parte['distancia_km'], parte['tiempo_min'], 'o-', color=color, alpha=0.78, label=repartidor)plt.xlabel('Distancia (km)')plt.ylabel('Tiempo de entrega (min)')plt.title('La distancia aumenta el tiempo, pero cada repartidor parte de otro nivel')plt.legend(ncol=3, title='Repartidor')plt.show()
Cómo leer esta figura
Dentro de cada color, el tiempo tiende a crecer con la distancia. Entre colores hay desplazamientos verticales persistentes: a una distancia parecida, dos repartidores pueden tardar tiempos distintos. Esa separación vertical es la señal visual de un intercepto propio por persona.
Cuánta variabilidad hay entre personas
Resumiremos cada repartidor por su distancia y tiempo medios. Si el nivel individual importa, las medias de tiempo deberían ocupar un rango amplio, incluso después de reconocer que no todos recorren las mismas distancias.
resumen_repartidor = ( datos.groupby('repartidor') .agg( entregas=('entrega', 'size'), distancia_media_km=('distancia_km', 'mean'), tiempo_medio_min=('tiempo_min', 'mean'), efecto_real_min=('efecto_real_min', 'first'), ) .sort_values('tiempo_medio_min'))display(resumen_repartidor.head(4).round(2))display(resumen_repartidor.tail(4).round(2))print(f'Rango de medias individuales: {resumen_repartidor.tiempo_medio_min.min():.1f} a {resumen_repartidor.tiempo_medio_min.max():.1f} min')corr_distancia_efecto = resumen_repartidor['distancia_media_km'].corr(resumen_repartidor['efecto_real_min'])print(f'Correlación entre distancia media y efecto real (auditoría): {corr_distancia_efecto:.3f}')
entregas
distancia_media_km
tiempo_medio_min
efecto_real_min
repartidor
R24
16
2.540
18.710
-12.600
R20
16
3.700
25.000
-8.910
R16
16
3.740
28.700
-5.520
R17
16
5.770
30.000
-7.970
entregas
distancia_media_km
tiempo_medio_min
efecto_real_min
repartidor
R03
16
11.660
54.600
7.780
R01
16
14.550
55.500
2.930
R15
16
12.680
56.000
7.410
R10
16
14.070
62.370
12.760
Rango de medias individuales: 18.7 a 62.4 min
Correlación entre distancia media y efecto real (auditoría): 0.288
Cómo leer este resultado
Las medias individuales van de 18.7 a 62.4 minutos. Parte de esa diferencia proviene de las distancias habituales y parte del efecto propio de cada repartidor. La amplitud ya advierte que una única recta, sin identidad individual, tendrá que mezclar niveles muy distintos.
La auditoría revela además un detalle que importará más adelante: la correlación entre la distancia media de cada repartidor y su efecto real es 0.288. La simulación sortea ambas cosas de forma independiente, pero en esta muestra, por azar, los repartidores con rutas más largas resultaron algo más lentos.
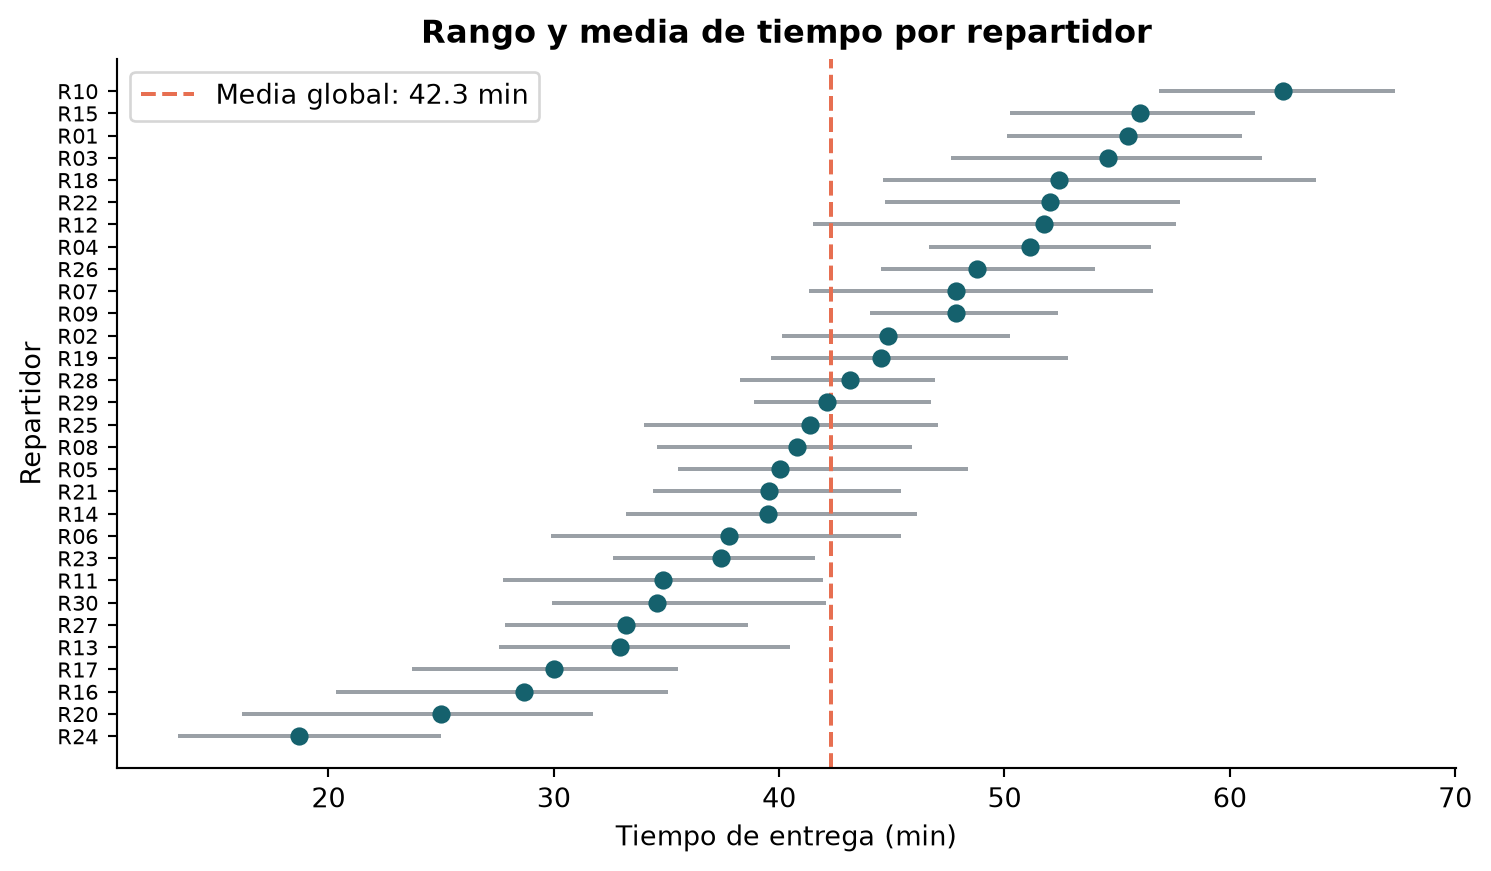
Ordenar las medias permite distinguir una fluctuación aislada de una diferencia persistente. En la siguiente figura, las barras muestran el rango observado de cada persona y el punto marca su media.
rangos = datos.groupby('repartidor')['tiempo_min'].agg(['min', 'mean', 'max'])rangos = rangos.sort_values('mean')y_pos = np.arange(len(rangos))plt.hlines(y_pos, rangos['min'], rangos['max'], color='#9aa0a6', linewidth=1.5)plt.scatter(rangos['mean'], y_pos, color='#15616d', s=34, zorder=3)plt.axvline(datos['tiempo_min'].mean(), color='#e76f51', linestyle='--', label=f'Media global: {datos.tiempo_min.mean():.1f} min')plt.yticks(y_pos, rangos.index, fontsize=8)plt.xlabel('Tiempo de entrega (min)')plt.ylabel('Repartidor')plt.title('Rango y media de tiempo por repartidor')plt.legend()plt.show()
Cómo leer esta figura
Los rangos individuales se escalonan alrededor de la media global de 42.3 min: las medias van de 18.7 (R24) a 62.4 min (R10), y muchos rangos completos quedan a un solo lado de la línea discontinua. No estás viendo 480 puntos intercambiables: estás viendo 30 conjuntos con centros propios. El siguiente modelo ignorará deliberadamente esa información para mostrar qué sale mal.
El error de ignorar la estructura
El modelo pooled apila todas las entregas y ajusta una sola recta:
La fórmula no contiene al repartidor. Al ajustarla por mínimos cuadrados ordinarios (OLS, por sus siglas en inglés), el modelo tratará los 480 residuos como independientes, aunque cada bloque de 16 comparte un componente omitido.
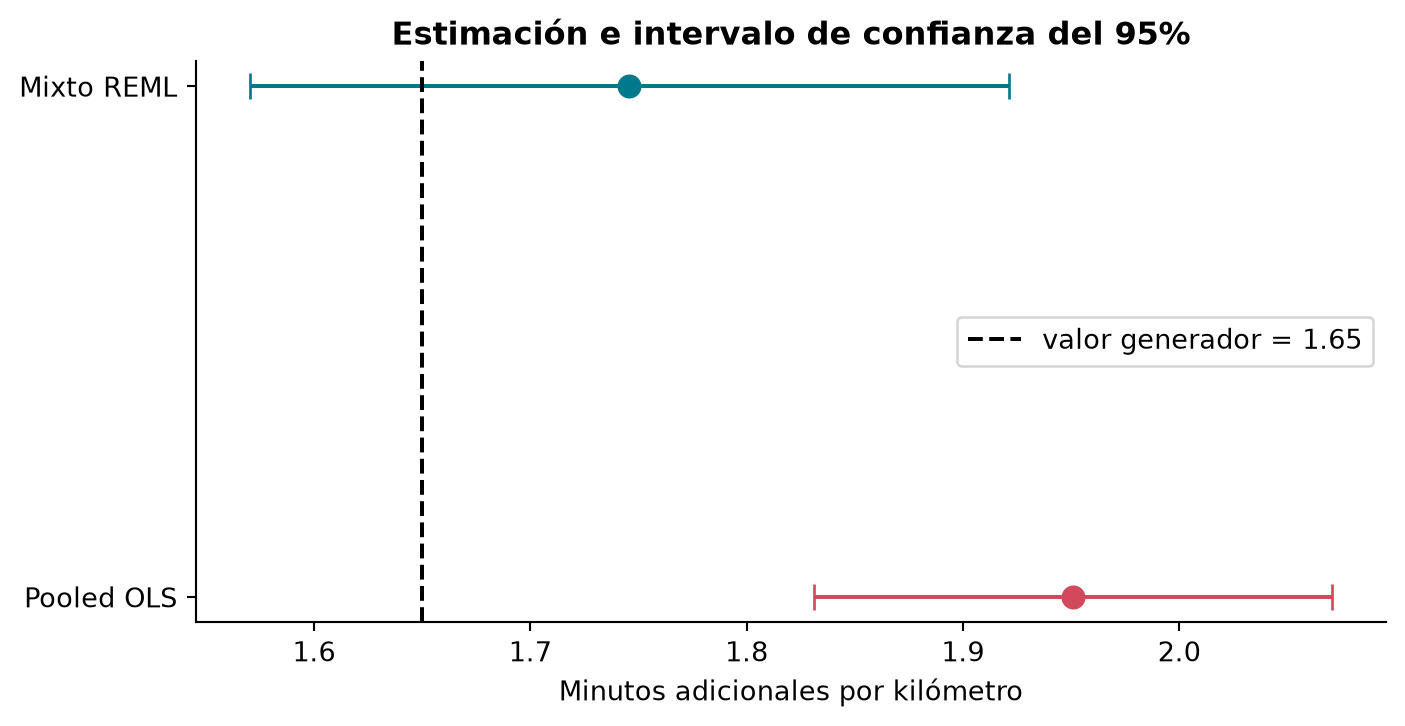
La recta pooled estima 1.951 min/km, con error estándar 0.061 e intervalo de confianza del 95% (IC 95%) [1.831, 2.071]. El p-valor es menor que 0.001 y \(R^2=0.682\). Parece una estimación extraordinariamente precisa, pero el intervalo ni siquiera contiene el valor generador 1.65.
Un p-valor pequeño solo evalúa el coeficiente bajo el modelo supuesto. No repara la independencia falsa, no mide importancia práctica y no demuestra que aumentar la distancia cause exactamente ese cambio.
Antes de seguir, pregúntate
Si un repartidor aporta 16 entregas, ¿aporta 16 historias independientes o 16 variaciones de una misma historia?
¿Qué parte del tiempo cambia con la distancia y qué parte pertenece a la persona?
Si mañana observas otra entrega de R01, ¿esperas que se parezca más a otra entrega de R01 o a una entrega al azar?
Estas preguntas cambian la unidad de razonamiento: la fila sigue siendo útil, pero el grupo ya no puede desaparecer del modelo.
Los residuos revelan la dependencia
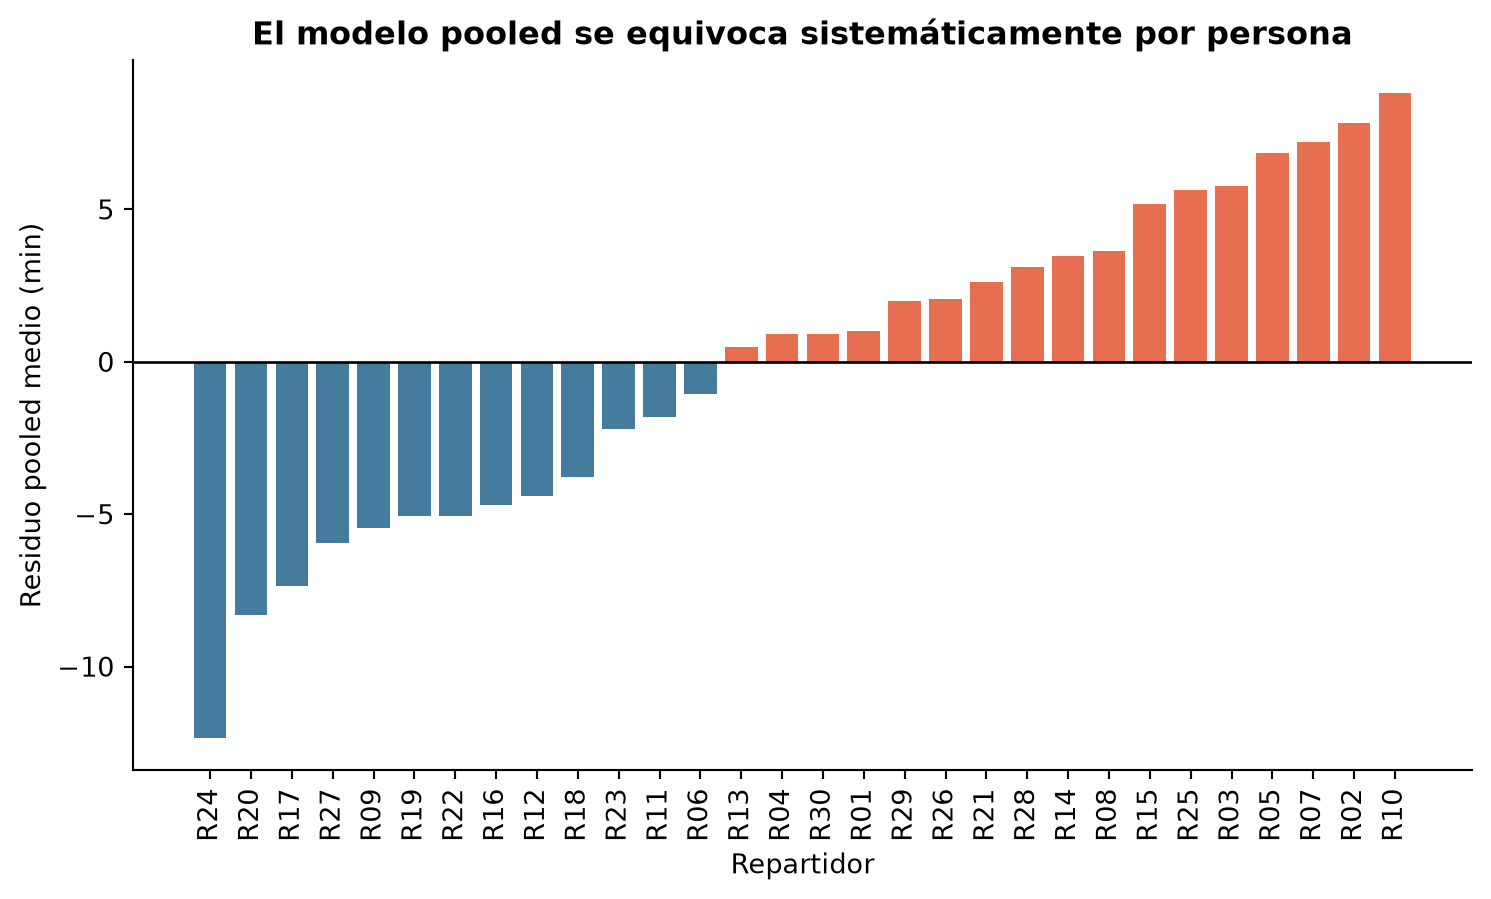
Si OLS hubiera absorbido la estructura relevante, la media de sus residuos sería cercana a cero no solo globalmente, sino también para cada repartidor. Calcularemos esas medias y las ordenaremos.
datos['residuo_pooled'] = modelo_pooled.residresiduos_por_repartidor = datos.groupby('repartidor')['residuo_pooled'].mean().sort_values()colores_residuo = np.where(residuos_por_repartidor <0, '#457b9d', '#e76f51')plt.bar(residuos_por_repartidor.index, residuos_por_repartidor, color=colores_residuo)plt.axhline(0, color='black', linewidth=1)plt.xticks(rotation=90)plt.ylabel('Residuo pooled medio (min)')plt.xlabel('Repartidor')plt.title('El modelo pooled se equivoca sistemáticamente por persona')plt.show()print(f'Residuos medios por repartidor: {residuos_por_repartidor.min():.1f} a {residuos_por_repartidor.max():.1f} min')
Residuos medios por repartidor: -12.3 a 8.8 min
Cómo leer este resultado
Aunque el residuo medio global de OLS es cero por construcción, las medias por repartidor van de −12.3 a 8.8 minutos. Los bloques completos por debajo o por encima de cero muestran que los errores conservan información sobre la identidad. Eso contradice la idea de errores independientes e intercambiables.
El problema no es que una recta sea incapaz de describir el efecto medio de la distancia; es que el modelo atribuye toda desviación a ruido independiente y usa también diferencias entre repartidores para estimar una relación que queremos leer dentro de cada repartidor. En esta muestra eso tiene un costo visible: como la distancia media y el efecto individual quedaron correlacionados (0.288), la comparación entre personas empuja la pendiente hacia arriba. Si esa correlación fuera nula, la recta pooled seguiría centrada, en promedio, en el valor correcto y el problema sería sobre todo la incertidumbre.
Medir la semejanza: correlación intraclase
La correlación intraclase (ICC) cuantifica qué proporción de la variabilidad no explicada por el modelo corresponde a diferencias entre repartidores (\(\sigma_b^2\), varianza entre repartidores) y qué parte a la variación de una entrega a otra (\(\sigma^2\), varianza dentro de cada repartidor). Primero ajustaremos un modelo nulo, sin distancia, para describir la dependencia bruta:
Con grupos del mismo tamaño \(m\), \(1+(m-1)\,\mathrm{ICC}\) es el factor de diseño aproximado: indica cuántas veces se infla la varianza de una media calculada con \(N\) filas agrupadas respecto de la misma media con \(N\) observaciones independientes. Por eso \(N/[1+(m-1)\,\mathrm{ICC}]\) se lee como un tamaño efectivo.
Varianza entre repartidores: 100.63
Varianza dentro de repartidores: 12.36
ICC bruta: 0.891
Factor de diseño aproximado: 14.36
Tamaño efectivo aproximado: 33.4
Cómo leer este resultado
La ICC bruta es 0.891: antes de ajustar por distancia, cerca del 89.1% de la variación se asocia con diferencias entre repartidores. Con 16 entregas por persona, el factor de diseño aproximado es 14.36 y las 480 filas equivalen, de manera muy aproximada, a 33.4 observaciones independientes para cantidades dominadas por esa correlación.
No uses este tamaño efectivo como sustituto universal de un modelo. Sirve para hacer visible por qué contar filas exagera la información disponible.
La idea de un modelo de efectos mixtos
Un modelo mixto combina dos fuentes:
Efectos fijos: parámetros comunes a toda la población, como la pendiente media de la distancia.
Efectos aleatorios: desviaciones específicas de cada grupo, como el nivel propio de cada repartidor.
Aquí mantendremos una pendiente común y permitiremos que el intercepto cambie. Es el modelo más pequeño capaz de representar la estructura que vimos.
\(\beta_1\) es el cambio medio en minutos por kilómetro; \(b_{0i}\) desplaza la recta del repartidor \(i\). Condicionalmente a \(b_{0i}\), los errores \(\varepsilon_{ij}\) se suponen independientes; los \(b_{0i}\) son independientes entre repartidores y de los \(\varepsilon_{ij}\). También suponemos que los efectos aleatorios son independientes de las covariables; si la asignación de distancias dependiera sistemáticamente de la rapidez no observada, habría que enriquecer el modelo.
Ajustaremos el modelo por máxima verosimilitud restringida (REML), el método habitual para estimar componentes de varianza con menos sesgo que la máxima verosimilitud (ML) ordinaria.
Varianza entre repartidores: 29.582
Varianza residual: 7.274
ICC ajustada por distancia: 0.803
Convergió: True
Cómo leer este resultado
El modelo mixto estima 1.746 min/km, con error estándar 0.089 e IC 95% [1.570, 1.921]. Ese intervalo sí contiene el valor generador 1.65. El p-valor es menor que 0.001: aporta evidencia de una asociación positiva bajo los supuestos del modelo, no prueba causalidad.
Después de ajustar por distancia, la varianza entre repartidores es 29.582 y la residual 7.274; la ICC ajustada es 0.803. Dos entregas de la misma persona siguen compartiendo una fracción grande de variabilidad, precisamente la estructura que OLS omitía.
Los interceptos propios y la contracción parcial
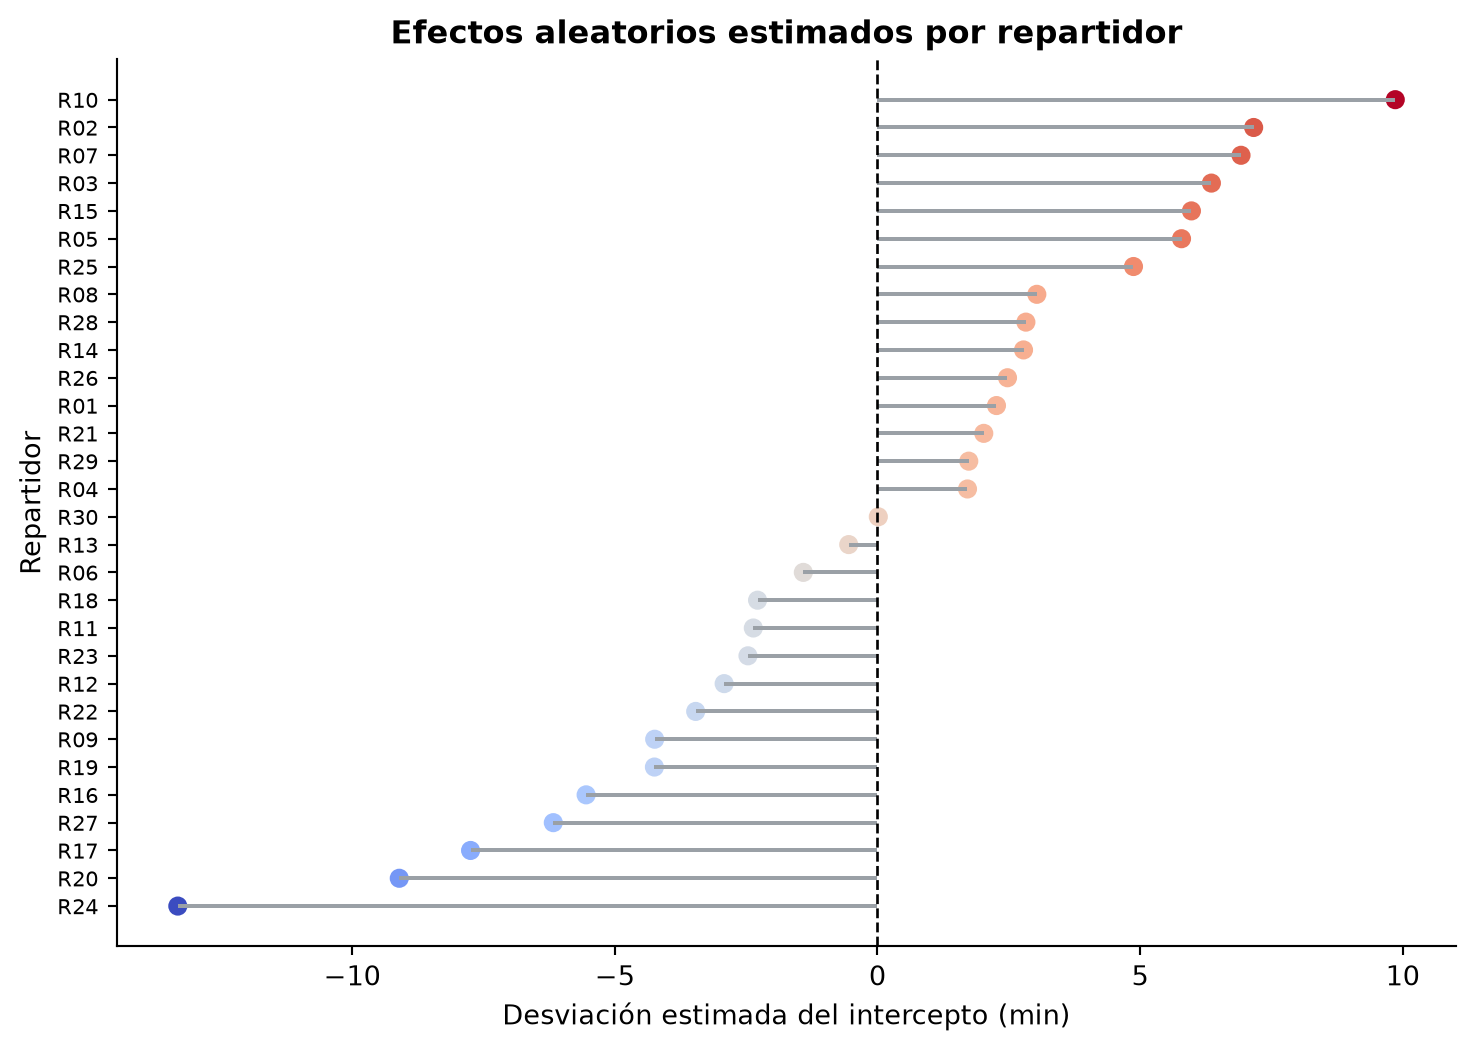
MixedLM estima un efecto aleatorio para cada repartidor. Estas estimaciones se conocen como BLUP (best linear unbiased predictor, mejor predictor lineal insesgado) y aplican contracción parcial: combinan la información individual con la distribución del conjunto. Un grupo con poca información sería atraído más hacia cero; uno con evidencia consistente conservaría una desviación mayor.
efectos_estimados = pd.Series({ repartidor: float(np.asarray(valor)[0])for repartidor, valor in modelo_mixto.random_effects.items()}, name='efecto_estimado_min').sort_values()efectos_reales = datos.groupby('repartidor')['efecto_real_min'].first()auditoria_efectos = pd.concat([efectos_estimados, efectos_reales], axis=1).sort_values('efecto_estimado_min')display(pd.concat([auditoria_efectos.head(3), auditoria_efectos.tail(3)]).round(2))plt.figure(figsize=(9, 6))plt.hlines(np.arange(len(efectos_estimados)), 0, efectos_estimados, color='#9aa0a6')plt.scatter(efectos_estimados, np.arange(len(efectos_estimados)), c=efectos_estimados, cmap='coolwarm', s=38)plt.axvline(0, color='black', linestyle='--', linewidth=1)plt.yticks(np.arange(len(efectos_estimados)), efectos_estimados.index, fontsize=8)plt.xlabel('Desviación estimada del intercepto (min)')plt.ylabel('Repartidor')plt.title('Efectos aleatorios estimados por repartidor')plt.show()print(f'Rango estimado: {efectos_estimados.min():.1f} a {efectos_estimados.max():.1f} min')print(f'Correlación con efectos reales simulados: {efectos_estimados.corr(efectos_reales):.3f}')
efecto_estimado_min
efecto_real_min
R24
-13.320
-12.600
R20
-9.100
-8.910
R17
-7.750
-7.970
R07
6.920
7.750
R02
7.160
6.440
R10
9.860
12.760
Rango estimado: -13.3 a 9.9 min
Correlación con efectos reales simulados: 0.985
Cómo leer este resultado
Los interceptos estimados van de −13.3 a 9.9 minutos respecto del nivel común. La correlación con los efectos reales simulados es 0.985, una auditoría posible solo porque fabricamos los datos. Con 16 entregas por persona la contracción es mínima: \(\hat\sigma_b^2/(\hat\sigma_b^2+\hat\sigma^2/16)=29.582/(29.582+7.274/16)\approx 0.985\), así que cada BLUP conserva cerca del 98.5% de la desviación media observada del repartidor. Diferencias como la de R10 (9.86 estimado frente a 12.76 real) no se deben a la contracción, sino al ruido y a los pequeños errores de la parte fija. En una aplicación real interpretarías estas desviaciones estimadas y su incertidumbre, pero nunca conocerías el efecto verdadero.
Un valor negativo describe a una persona sistemáticamente más rápida que el promedio condicionado por distancia; no es una calificación absoluta ni una causa identificada.
Una recta común, varios niveles
El efecto fijo produce una predicción poblacional para un repartidor promedio. Al sumar cada BLUP obtenemos una predicción específica para una persona ya observada. Dibujaremos cuatro casos para ver ambas capas.
Las cinco rectas son paralelas porque supusimos una pendiente común de 1.746 min/km. La línea discontinua representa a un repartidor promedio; las líneas de color incorporan su historial mediante el intercepto aleatorio. Si las inclinaciones también variaran claramente entre personas, el siguiente paso sería un modelo con pendiente aleatoria.
Comparación: pooled frente a mixto
Pondremos ambos intervalos en la misma escala. Para reportar el criterio de información de Akaike (AIC) del modelo mixto ajustaremos además una copia por ML: statsmodels no calcula AIC para ajustes REML, porque la verosimilitud restringida no es comparable entre modelos con distintos efectos fijos. El ajuste REML sigue siendo el principal para estimar componentes de varianza. Con ambos modelos ajustados por ML, la comparación de AIC es legítima (OLS es el caso particular \(\sigma_b^2=0\)), pero no es el argumento central: la elección parte del diseño con mediciones repetidas.
modelo_mixto_ml = smf.mixedlm('tiempo_min ~ distancia_km', data=datos, groups=datos['repartidor']).fit(reml=False)comparacion = pd.DataFrame({'modelo': ['Pooled OLS', 'Mixto REML'],'pendiente': [modelo_pooled.params['distancia_km'], modelo_mixto.params['distancia_km']],'error_estandar': [modelo_pooled.bse['distancia_km'], modelo_mixto.bse['distancia_km']],'IC_95_inf': [ci_pooled.iloc[0], ci_mixto.iloc[0]],'IC_95_sup': [ci_pooled.iloc[1], ci_mixto.iloc[1]],'p_valor': [modelo_pooled.pvalues['distancia_km'], modelo_mixto.pvalues['distancia_km']],'contiene_1.65': [ci_pooled.iloc[0] <= pendiente_real <= ci_pooled.iloc[1], ci_mixto.iloc[0] <= pendiente_real <= ci_mixto.iloc[1]],})display(comparacion.round(4))print(f'AIC pooled: {modelo_pooled.aic:.1f}')print(f'AIC mixto ML: {modelo_mixto_ml.aic:.1f}')fig, ax = plt.subplots(figsize=(8, 3.8))for posicion, fila in comparacion.iterrows(): ax.errorbar(fila['pendiente'], posicion, xerr=[[fila['pendiente'] - fila['IC_95_inf']], [fila['IC_95_sup'] - fila['pendiente']]], fmt='o', markersize=8, capsize=5, color=['#d1495b', '#00798c'][posicion])ax.axvline(pendiente_real, color='black', linestyle='--', label='valor generador = 1.65')ax.set_yticks([0, 1], comparacion['modelo'])ax.set_xlabel('Minutos adicionales por kilómetro')ax.set_title('Estimación e intervalo de confianza del 95%')ax.legend()plt.show()assert datos.shape == (480, 6), 'Cambió el número esperado de filas o columnas'assert datos['repartidor'].nunique() ==30assert modelo_mixto.converged and modelo_mixto_ml.convergedassert0< icc_ajustada <1assertnot comparacion.loc[0, 'contiene_1.65']assert comparacion.loc[1, 'contiene_1.65']assert np.isfinite(comparacion.select_dtypes('number').to_numpy()).all()print('Verificaciones numéricas superadas: estructura, convergencia, ICC y contraste.')
modelo
pendiente
error_estandar
IC_95_inf
IC_95_sup
p_valor
contiene_1.65
0
Pooled OLS
1.951
0.061
1.831
2.071
0.000
False
1
Mixto REML
1.746
0.089
1.570
1.921
0.000
True
AIC pooled: 3071.0
AIC mixto ML: 2446.4
Verificaciones numéricas superadas: estructura, convergencia, ICC y contraste.
Cómo leer esta comparación
OLS desplaza la pendiente hasta 1.951 y reporta un IC [1.831, 2.071], demasiado estrecho y alejado del valor generador. El mixto estima 1.746, amplía el error estándar de 0.061 a 0.089 y produce un IC [1.570, 1.921] que sí contiene 1.65. Reconocer los grupos cambia sobre todo la honestidad de la incertidumbre y, en esta muestra, también el centro. El desplazamiento de OLS no es inevitable: proviene de la correlación casual entre distancia media y efecto individual (0.288), que la recta pooled mezcla con el efecto de la distancia. El mixto lo atenúa porque su estimador se apoya sobre todo en la variación dentro de cada repartidor, pero no es inmune: si esa correlación fuera sistemática, convendría un modelo de efectos fijos por repartidor.
El AIC baja de 3071.0 en OLS a 2446.4 en el mixto ML, coherente con la fuerte heterogeneidad observada, aunque el argumento principal no es ganar una competencia de AIC: el diseño contiene mediciones repetidas y requiere representarlas. Los errores estándar robustos por conglomerado (cluster-robust) de OLS podrían corregir parcialmente la inferencia, pero no estimarían la varianza entre personas ni producirían interceptos individuales.
Antes de usar este modelo revisa sus límites: suficientes grupos, residuos razonables, posibles pendientes aleatorias, orden temporal y autocorrelación, datos faltantes y relación entre efectos individuales y covariables. Este ejemplo gaussiano con intercepto aleatorio es un punto de partida, no una licencia para afirmar causalidad.
Lo que debes llevarte de este capítulo
Cuando varias filas pertenecen a la misma persona, primero identifica qué se repite, luego visualiza la variación dentro y entre grupos, cuantifica la dependencia y elige una estructura que la represente. Un intercepto aleatorio sirve cuando cada individuo tiene un nivel propio; una pendiente aleatoria entra en juego cuando también cambia la respuesta a la covariable.
El recorrido completo del libro queda conectado: empezaste con regresión y regularización para estimar relaciones estables; aprendiste a evaluar si generalizan; usaste suavización para abandonar formas rígidas; extendiste la respuesta con GLM; representaste dimensiones no observadas con variables latentes; y terminaste reconociendo que el orden temporal y las mediciones repetidas hacen dependientes a los datos. La idea que une todo es sencilla: el modelo debe respetar cómo se generó la información, no solo ajustarse a una tabla.
¿Hay mediciones repetidas por unidad?
├─ No  → un modelo de observaciones independientes puede ser suficiente
└─ Sí  → identifica el grupo y examina la dependencia
        ├─ cambia el nivel entre grupos      → intercepto aleatorio
        ├─ cambia también la pendiente       → pendiente aleatoria
        └─ importa el orden dentro del grupo → añade estructura temporal