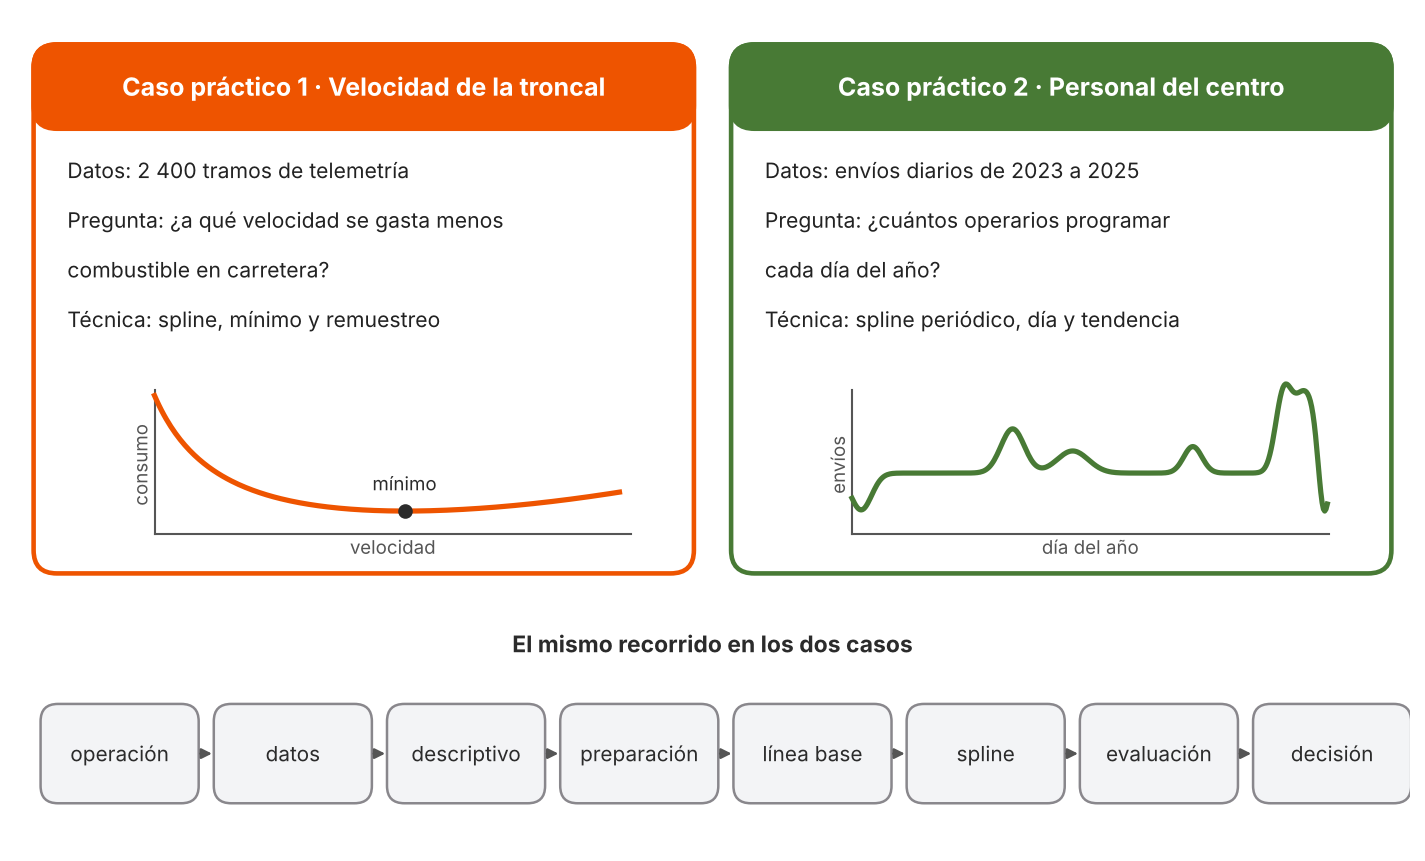
En el capítulo de splines aprendiste las piezas: los knots, SplineTransformer, la elección de la flexibilidad con validación cruzada y el spline periódico. Este capítulo las pone a trabajar en dos problemas como los que enfrenta una empresa de mensajería. Cada caso se resuelve de principio a fin: el problema de la operación, los datos, el análisis descriptivo, la preparación, una línea base, el spline, la evaluación y la decisión que se toma con él.
Caso
Problema de la operación
Técnica
Datos
1. Velocidad de la troncal
A qué velocidad conviene programar los camiones que viajan de noche entre ciudades para gastar menos combustible
Spline sobre la velocidad, búsqueda del mínimo y remuestreo para medir su incertidumbre
Sintéticos: 2 400 tramos de telemetría de la flota
2. Personal del centro de clasificación
Cuántos operarios programar cada día, según la temporada y el día de la semana
Spline periódico sobre el día del año, unido al día de la semana y a una tendencia
Sintéticos: envíos diarios de 2023 a 2025
Los dos casos van más allá del capítulo de splines en tres puntos: en el primero buscas el mínimo de una curva y no una predicción, con datos desbalanceados que dejan pocas observaciones justo donde está ese mínimo; en el segundo combinas un spline con otras variables en un mismo modelo y lo evalúas en un año que no vio.
Los dos casos son independientes: cada uno tiene su propia configuración, sus datos y su código, y se puede leer y ejecutar sin el otro.
Dos casos independientes, el mismo recorrido.
Tiempo estimado de lectura: unos 40 minutos por caso; la ejecución completa tarda menos de un minuto en una CPU.
Nivel: Avanzado; aplica lo visto en el capítulo de splines y no presenta técnicas nuevas.
Traducir un problema de la operación a una curva que un spline pueda estimar, y decidir qué variable va en el eje horizontal.
Mirar los datos antes de ajustar y usar lo que encuentres (la forma de la nube, dónde hay pocos datos, qué patrón se repite) para diseñar el spline.
Comparar el spline con una línea base honesta: la curva más simple que se le ocurriría a cualquiera o la regla que usa hoy la operación.
Elegir la flexibilidad del spline con datos que no se usaron para ajustarlo, con una partición adecuada al problema.
Llevar la curva a una decisión de operación expresada en litros, operarios y pesos, y decir hasta dónde llega esa decisión.
TipLo que necesitas recordar
Este capítulo no vuelve a definir lo que ya está en el capítulo de splines. Si alguno de estos términos no te resulta familiar, repásalo en el lugar indicado.
Caso práctico 1: A qué velocidad conviene que viajen los camiones de la troncal
AdvertenciaEmpresa y datos ficticios
BITLogística es una empresa ficticia. Los tramos, los consumos, los precios y los costos de este caso se generan o se suponen dentro del propio caso y no corresponden a BIT, a ningún transportador ni a ningún fabricante de camiones. Las reglas del simulador están en el código de la sección de datos.
El problema en la operación
Cada noche, ocho camiones de BITLogística salen a las 20:00 de Bogotá por una troncal, la carretera principal entre dos ciudades, con la carga que debe estar en el centro de clasificación de destino a las 6:00, cuando empieza el turno de la mañana. El viaje es de 420 km. Llegar antes de las 6:00 no sirve de nada: la carga espera en el patio hasta que abre el centro.
El combustible es el gasto que más pesa en esos viajes, y el jefe de flota sabe por experiencia que ir más rápido gasta más. También sabe que ir muy despacio no ayuda: en el trancón de la ciudad, con arranques y frenadas, los camiones consumen todavía más. Entre los dos extremos tiene que haber una velocidad que gaste lo menos posible. Hoy la regla es solo un tope: «máximo 80 km/h». Los conductores viajan, en promedio, a unos 76 km/h.
La pregunta del caso es concreta:
¿A qué velocidad conviene programar los viajes troncales para gastar menos combustible y llegar antes de las 6:00?
Equivocarse cuesta en las dos direcciones. Si la velocidad recomendada es demasiado alta, se sigue gastando combustible de más todas las noches. Si es demasiado baja, no se ahorra y además los camiones podrían llegar tarde. Y si la curva que estima el consumo está mal hecha justo en la zona del mínimo, la recomendación entera queda en el aire.
Los datos
Cada camión lleva un equipo de telemetría que registra su recorrido y su consumo. La operación agrupa ese registro en tramos y, para cada tramo, guarda la velocidad promedio y el consumo en litros por cada 100 km. Hay tres tipos de tramo, según por dónde circula el camión:
reparto: calles de la ciudad, con paradas, semáforos y trancón;
acceso: las salidas y entradas a las ciudades, a velocidad intermedia;
troncal: la carretera entre ciudades.
La celda siguiente simula ese registro en cinco pasos:
Define la curva verdadera del consumo según la velocidad. Tiene dos términos: uno que crece cuando el camión va despacio (el costo de arrancar y frenar) y otro que crece cuando va rápido (la resistencia del aire). En un proyecto real esa curva no se conoce; aquí sirve para comprobar si el spline la encuentra.
Elige al azar el tipo de 2 400 tramos: 72 % de reparto, 6 % de acceso y 22 % de troncal, porque la flota pasa casi todo su tiempo repartiendo en la ciudad.
Asigna la velocidad de cada tramo según su tipo: unos 22 km/h en reparto, entre 45 y 65 en los accesos y unos 76 en la troncal.
Calcula el consumo medido: la curva verdadera con una variación del 7 % de un tramo a otro, que representa la carga, las pendientes, el conductor y el error del medidor.
Guarda todo en una tabla, una fila por tramo.
# Caso práctico 1 · Configuración: herramientas, semilla y colores del caso.%matplotlib inline%config InlineBackend.figure_format ="retina"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.preprocessing import SplineTransformer, PolynomialFeaturesfrom sklearn.linear_model import LinearRegressionfrom sklearn.pipeline import Pipelinefrom sklearn.model_selection import train_test_split, KFold, cross_val_scorefrom sklearn.metrics import mean_squared_errorSEMILLA =2026# semilla central del librorng = np.random.default_rng(SEMILLA)# Un color por tipo de tramo, el mismo en todas las figuras del caso.COLOR_TIPO = {'reparto': '#1786B3', 'acceso': '#7851A9', 'troncal': '#EE5400'}COLOR_SPLINE ='#487A35'COLOR_PARABOLA ='#89878C'plt.rcParams.update({'figure.figsize': (9, 5),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# Versiones del entorno con el que se ejecutó el caso.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scikit-learn']:print(paquete +':', metadatos.version(paquete))
La salida muestra las versiones del entorno con que se ejecutó el caso, con Python 3.13. Todo corre en CPU.
# 1. La curva verdadera del simulador: litros por cada 100 km según la velocidad (km/h).# 600 / v -> el costo de arrancar y frenar: pesa mucho cuando el camión va despacio.# 0.0016 v² -> la resistencia del aire: pesa mucho cuando el camión va rápido.# En un proyecto real esta fórmula no se conoce; aquí sirve para comprobar el resultado.def consumo_verdadero(velocidad):return6+600/ velocidad +0.0016* velocidad **2# 2. Cuántos tramos registra la telemetría y de qué tipo es cada uno.# reparto: calles de la ciudad; acceso: salidas y entradas a la ciudad; troncal: carretera.n_tramos =2400tipo = rng.choice(['reparto', 'acceso', 'troncal'], size=n_tramos, p=[0.72, 0.06, 0.22])# 3. Velocidad promedio de cada tramo, según su tipo.velocidad = np.empty(n_tramos)es_reparto = tipo =='reparto'es_acceso = tipo =='acceso'es_troncal = tipo =='troncal'velocidad[es_reparto] = np.clip(rng.lognormal(np.log(22), 0.33, es_reparto.sum()), 8, 50) # ciudad: unos 22 km/hvelocidad[es_acceso] = rng.uniform(45, 65, es_acceso.sum()) # accesos: 45 a 65 km/hvelocidad[es_troncal] = np.clip(rng.normal(76, 7, es_troncal.sum()), 60, 95) # carretera: unos 76 km/h# 4. Consumo medido: la curva verdadera con un 7 % de variación de un tramo a otro# (carga, pendiente, estilo del conductor, error del medidor).consumo = consumo_verdadero(velocidad) * (1+ rng.normal(0, 0.07, n_tramos))# 5. La tabla de telemetría: una fila por tramo.tramos = pd.DataFrame({'tipo': tipo,'velocidad': velocidad.round(1),'consumo': consumo.round(2),})print('Tramos registrados:', len(tramos))display(tramos.head())
Tramos registrados: 2400
tipo
velocidad
consumo
0
reparto
15.5
48.08
1
reparto
31.4
25.85
2
reparto
38.8
23.03
3
reparto
29.3
26.54
4
reparto
20.4
39.24
La tabla tiene 2 400 filas con tres columnas: el tipo de tramo, la velocidad promedio en km/h y el consumo en litros por cada 100 km. En las primeras filas ya se ve la relación que interesa: el tramo de reparto a 15.5 km/h consumió 48.08 litros por 100 km, y el de 38.8 km/h, solo 23.03.
Análisis descriptivo
Antes de ajustar cualquier curva hay que ver dos cosas: qué forma tiene la relación entre velocidad y consumo, y cuántos tramos hay a cada velocidad. La segunda importa tanto como la primera, porque una curva solo es confiable donde hay datos que la sostengan.
Para ello, la celda sigue estos pasos, en este orden:
Resume cada tipo de tramo: cuántos hay, su velocidad media y su consumo medio.
Dibuja la nube de consumo frente a velocidad, coloreada por tipo, y el histograma de velocidades.
Cuenta los tramos en cuatro franjas de velocidad.
# 1. Resumen por tipo de tramo: cuántos hay, a qué velocidad van y cuánto consumen.resumen = tramos.groupby('tipo').agg( tramos=('velocidad', 'size'), velocidad_media=('velocidad', 'mean'), consumo_medio=('consumo', 'mean'),).round(1)display(resumen.loc[['reparto', 'acceso', 'troncal']])# 2. Dos gráficas: la nube consumo-velocidad y cuántos tramos hay a cada velocidad.fig, ax = plt.subplots(1, 2, figsize=(13, 5))for nombre in ['reparto', 'acceso', 'troncal']: parte = tramos[tramos['tipo'] == nombre] ax[0].scatter(parte['velocidad'], parte['consumo'], s=10, alpha=0.4, color=COLOR_TIPO[nombre], label=nombre)ax[0].set_xlabel('velocidad promedio del tramo (km/h)')ax[0].set_ylabel('consumo (litros por 100 km)')ax[0].set_title('Consumo según la velocidad')ax[0].legend(title='tipo de tramo')ax[1].hist(tramos['velocidad'], bins=np.arange(5, 100, 5), color='#457B9D', edgecolor='white')ax[1].set_xlabel('velocidad promedio del tramo (km/h)')ax[1].set_ylabel('número de tramos')ax[1].set_title('Cuántos tramos hay a cada velocidad')plt.tight_layout()plt.show()# 3. Cuántos tramos caen en cada franja de velocidad.franjas = pd.cut(tramos['velocidad'], bins=[0, 45, 60, 85, 100], right=False, labels=['menos de 45', '45 a 60', '60 a 85', '85 o más'])print(franjas.value_counts().sort_index())
tramos
velocidad_media
consumo_medio
tipo
reparto
1702
23.2
35.8
acceso
152
55.3
21.9
troncal
546
76.4
23.4
velocidad
menos de 45    1676
45 a 60         138
60 a 85         535
85 o más         51
Name: count, dtype: int64
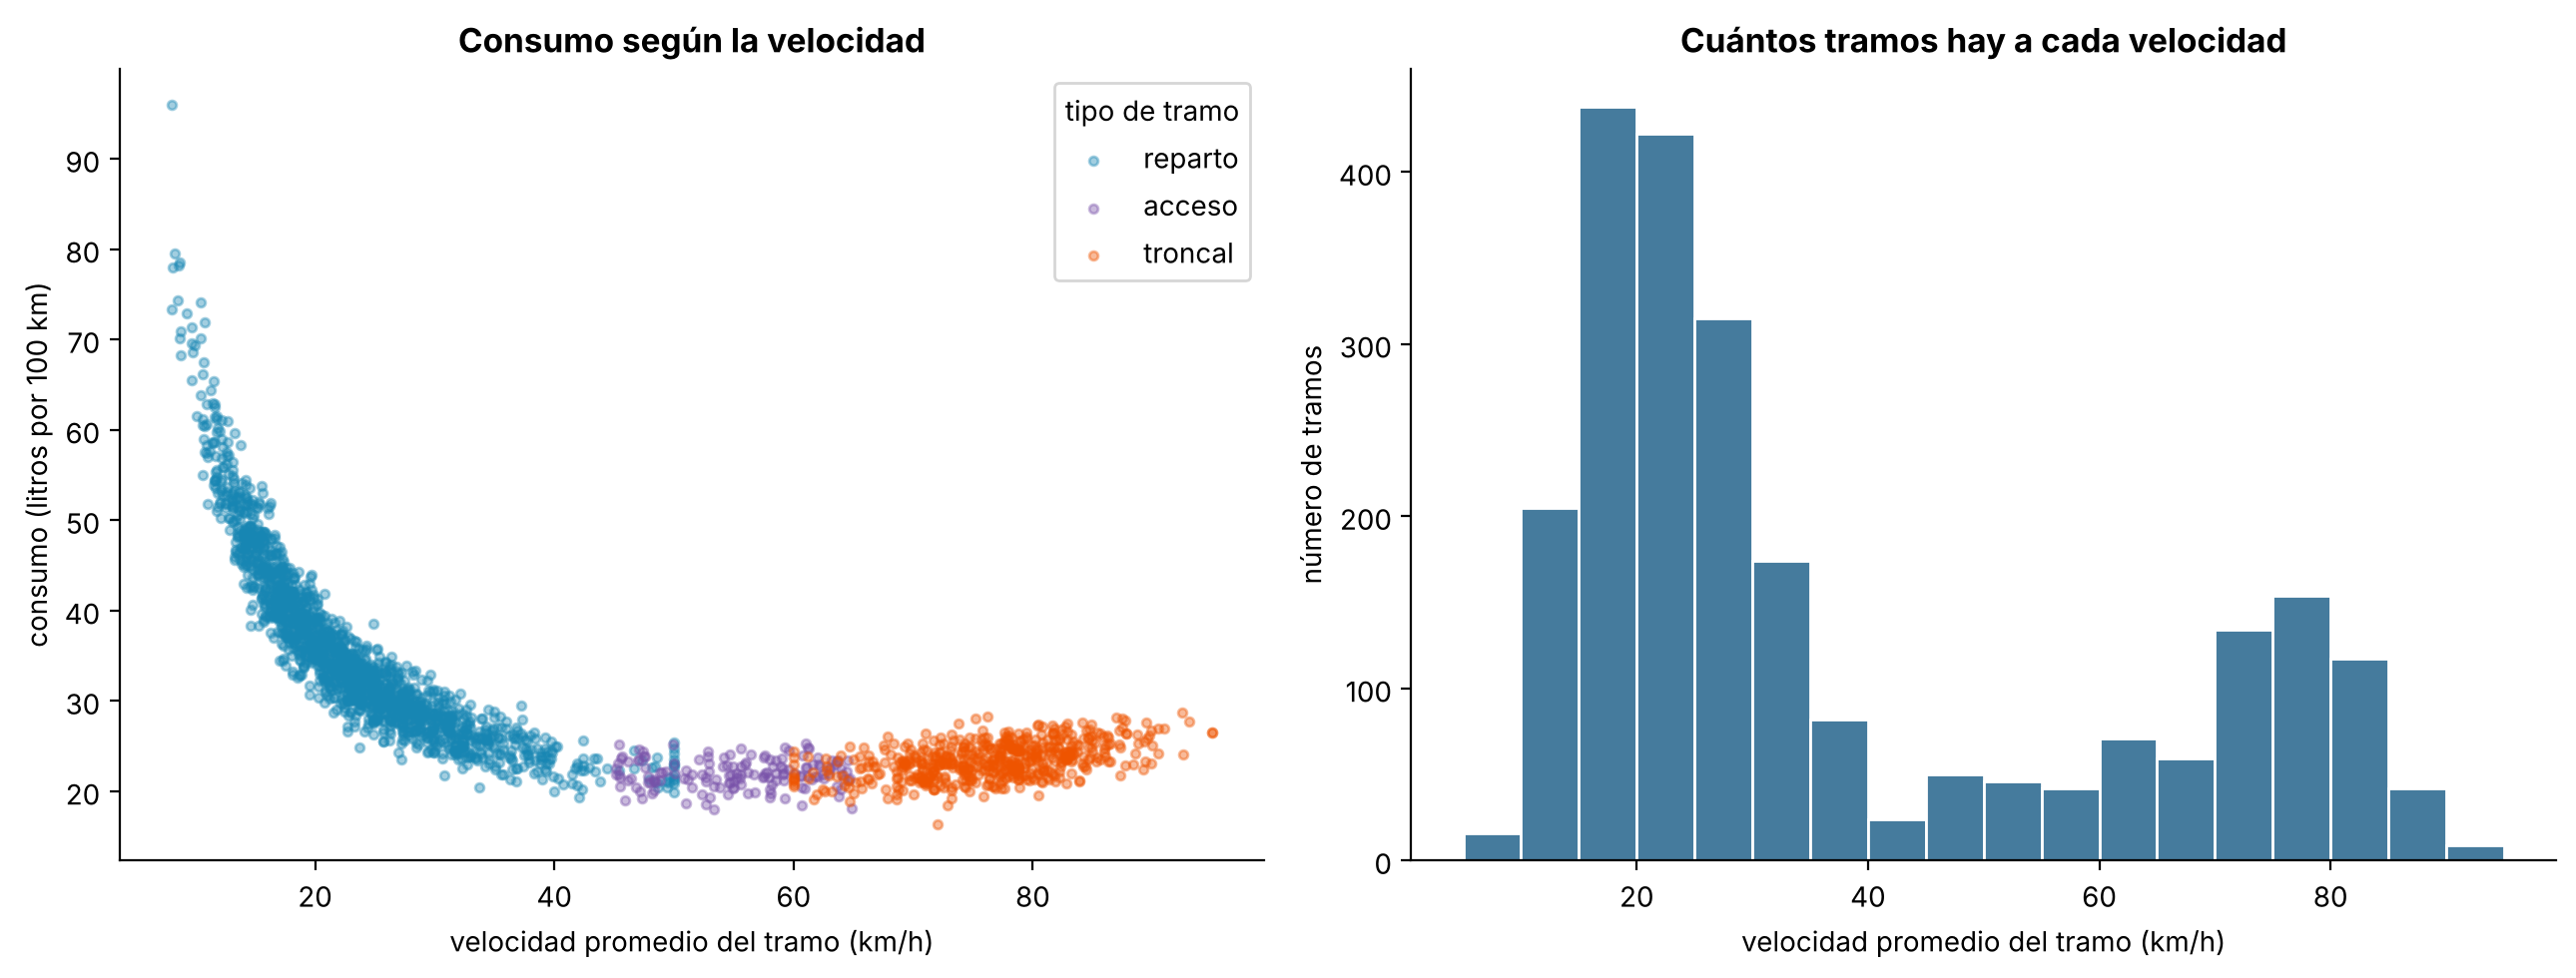
En el panel izquierdo de la figura aparece la forma de U que el jefe de flota intuía. A la izquierda, los tramos de reparto, en azul, consumen mucho: el promedio de los 1 702 tramos de reparto es 35.8 litros por 100 km, y los más lentos pasan de 70. El consumo baja rápido al subir la velocidad, toca fondo en la zona de los accesos, en morado, con 21.9 litros en promedio, y vuelve a subir en la troncal, en naranja, con 23.4 litros a una velocidad media de 76.4 km/h.
El panel derecho muestra el problema de este caso. La flota registra muchísimos tramos lentos y pocos a velocidad intermedia: 1 676 tramos van a menos de 45 km/h, 535 entre 60 y 85, y solo 138 entre 45 y 60, justo donde la nube parece tocar fondo. Por encima de 85 km/h hay apenas 51. Los datos están desbalanceados: abundan donde la operación pasa más tiempo, no donde está la respuesta que buscas.
Dos consecuencias guían el resto del caso:
La curva tiene una forma asimétrica: baja muy empinada desde la izquierda y sube suave hacia la derecha. Una parábola, que es simétrica, no podrá seguirla bien.
El mínimo está en una zona con pocos tramos, así que no basta con ajustar la curva: también hay que medir qué tan seguro es el mínimo que se encuentre.
Preparación de los datos
Separas un 25 % de los tramos como prueba antes de ajustar nada. Con stratify las dos partes conservan la misma mezcla de reparto, acceso y troncal, de modo que la prueba también tenga tramos en la zona escasa de 45 a 60 km/h.
La partición es por tramo. En una flota real, los tramos de un mismo camión o de una misma noche se parecen entre sí, y lo prudente sería separar por camión o por semana; el simulador genera tramos independientes, así que aquí basta con separar tramos.
# Separar 25 % de los tramos como prueba. stratify=tipo mantiene la misma mezcla# de reparto, acceso y troncal en las dos partes.entrenamiento, prueba = train_test_split( tramos, test_size=0.25, random_state=SEMILLA, stratify=tramos['tipo'])print('Tramos de entrenamiento:', len(entrenamiento))print('Tramos de prueba (guardados hasta la evaluación):', len(prueba))# scikit-learn espera las variables explicativas como tabla de una columna.X_entrenamiento = entrenamiento[['velocidad']]y_entrenamiento = entrenamiento['consumo']X_prueba = prueba[['velocidad']]y_prueba = prueba['consumo']
Tramos de entrenamiento: 1800
Tramos de prueba (guardados hasta la evaluación): 600
Quedan 1 800 tramos para ajustar y elegir el modelo, y 600 guardados para la evaluación.
Una línea base: la parábola
Si le pides a cualquiera una curva con forma de U, propondrá una parábola: una regresión con la velocidad y la velocidad al cuadrado. Es la línea base natural, y además tiene un mínimo fácil de calcular. Para ello, la celda sigue estos pasos, en este orden:
Ajusta la parábola con el entrenamiento.
Evalúa la curva cada 0.5 km/h entre 10 y 95 km/h y busca el punto más bajo. Esa rejilla de velocidades es la misma que usarás con el spline.
Mide su error con validación cruzada de 5 bloques dentro del entrenamiento.
# 1. La parábola: regresión lineal sobre velocidad y velocidad al cuadrado.parabola = Pipeline([ ('potencias', PolynomialFeatures(degree=2)), ('regresion', LinearRegression()),])parabola.fit(X_entrenamiento, y_entrenamiento)# 2. Su mínimo: evaluamos la curva cada 0.5 km/h entre 10 y 95 y buscamos el valor más bajo.rejilla = pd.DataFrame({'velocidad': np.arange(10, 95.01, 0.5)})curva_parabola = parabola.predict(rejilla)posicion = np.argmin(curva_parabola)print(f'Mínimo de la parábola: {rejilla["velocidad"][posicion]:.1f} km/h, 'f'con {curva_parabola[posicion]:.2f} litros por 100 km')# 3. Su error por tipo de tramo, con validación cruzada dentro del entrenamiento.bloques = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)rmse_parabola =-cross_val_score(parabola, X_entrenamiento, y_entrenamiento, cv=bloques, scoring='neg_root_mean_squared_error').mean()print(f'RMSE de validación cruzada: {rmse_parabola:.3f} litros por 100 km')
Mínimo de la parábola: 58.0 km/h, con 17.36 litros por 100 km
RMSE de validación cruzada: 3.980 litros por 100 km
La parábola pone su mínimo en 58.0 km/h, una ubicación razonable, pero con un consumo de 17.36 litros por 100 km, muy por debajo de los 21.9 litros que muestran los tramos de acceso en el análisis descriptivo. Su error de validación cruzada es de 3.980 litros por 100 km. La causa es la forma: para seguir la caída empinada de la izquierda, la parábola tiene que curvarse mucho, y como es simétrica, esa misma curvatura la hunde en el centro y la levanta demasiado a la derecha. Acierta dónde está el fondo casi por casualidad y se equivoca en cuánto se gasta allí.
El spline: knots donde están los datos
Un spline cúbico puede ser empinado a la izquierda y suave a la derecha, porque cada tramo entre knots tiene su propio polinomio. Faltan dos decisiones: cuántos knots y dónde ponerlos.
El histograma del análisis descriptivo pesa en la segunda decisión. Con knots uniformes, a la misma distancia entre 8 y 95 km/h, algunos quedan en la zona de 45 a 60 km/h, donde hay pocos tramos para estimar su polinomio. Con knots en los cuantiles, los knots siguen a los datos: muchos en la ciudad, donde la curva baja empinada, y pocos en la carretera, donde cambia despacio. Ninguna opción es correcta de antemano, así que las comparas con validación cruzada.
Para ello, la celda sigue estos pasos, en este orden:
Prueba las dos ubicaciones con 4 a 15 knots, con los mismos 5 bloques de la parábola, y guarda el error de cada combinación.
Elige la combinación con menor error y muestra la tabla completa.
Ajusta el spline elegido con todo el entrenamiento y muestra dónde quedaron sus knots.
# 1. Probar las dos formas de ubicar los knots y entre 4 y 15 knots.# uniform: knots a la misma distancia entre la velocidad mínima y la máxima.# quantile: knots en los cuantiles, es decir, donde hay más tramos.resultados = []for ubicacion in ['uniform', 'quantile']:for n_knots inrange(4, 16): spline = Pipeline([ ('bases', SplineTransformer(n_knots=n_knots, degree=3, knots=ubicacion)), ('regresion', LinearRegression()), ]) rmse =-cross_val_score(spline, X_entrenamiento, y_entrenamiento, cv=bloques, scoring='neg_root_mean_squared_error').mean() resultados.append({'ubicacion': ubicacion, 'n_knots': n_knots, 'rmse_cv': rmse})resultados = pd.DataFrame(resultados)# 2. La mejor combinación: el menor RMSE de validación cruzada.mejor = resultados.loc[resultados['rmse_cv'].idxmin()]UBICACION = mejor['ubicacion']N_KNOTS =int(mejor['n_knots'])print(f'Mejor combinación: knots "{UBICACION}", n_knots = {N_KNOTS}, RMSE CV = {mejor["rmse_cv"]:.4f}')print()print('RMSE de validación cruzada (filas: n_knots; columnas: ubicación de los knots)')display(resultados.pivot(index='n_knots', columns='ubicacion', values='rmse_cv').round(4).T)# 3. Ajustar el spline elegido con todo el entrenamiento y ver dónde quedaron sus knots.spline = Pipeline([ ('bases', SplineTransformer(n_knots=N_KNOTS, degree=3, knots=UBICACION)), ('regresion', LinearRegression()),])spline.fit(X_entrenamiento, y_entrenamiento)knots_elegidos = spline.named_steps['bases'].bsplines_[0].t[3:-3] # solo los knots dentro del rangoprint('Knots del spline elegido (km/h):', np.round(knots_elegidos, 1))
Mejor combinación: knots "quantile", n_knots = 9, RMSE CV = 2.3578

RMSE de validación cruzada (filas: n_knots; columnas: ubicación de los knots)
La mejor combinación usa knots en los cuantiles, con n_knots = 9, y un error de validación cruzada de 2.358 litros por 100 km, frente a los 3.980 de la parábola. La tabla muestra algo importante: casi todas las combinaciones quedan entre 2.358 y 2.381; solo los knots uniformes con 4 knots se alejan, con 2.437. Una vez que el spline tiene la flexibilidad suficiente, el error ya no depende mucho de los detalles, y no conviene leer diferencias de milésimas como mejoras reales.
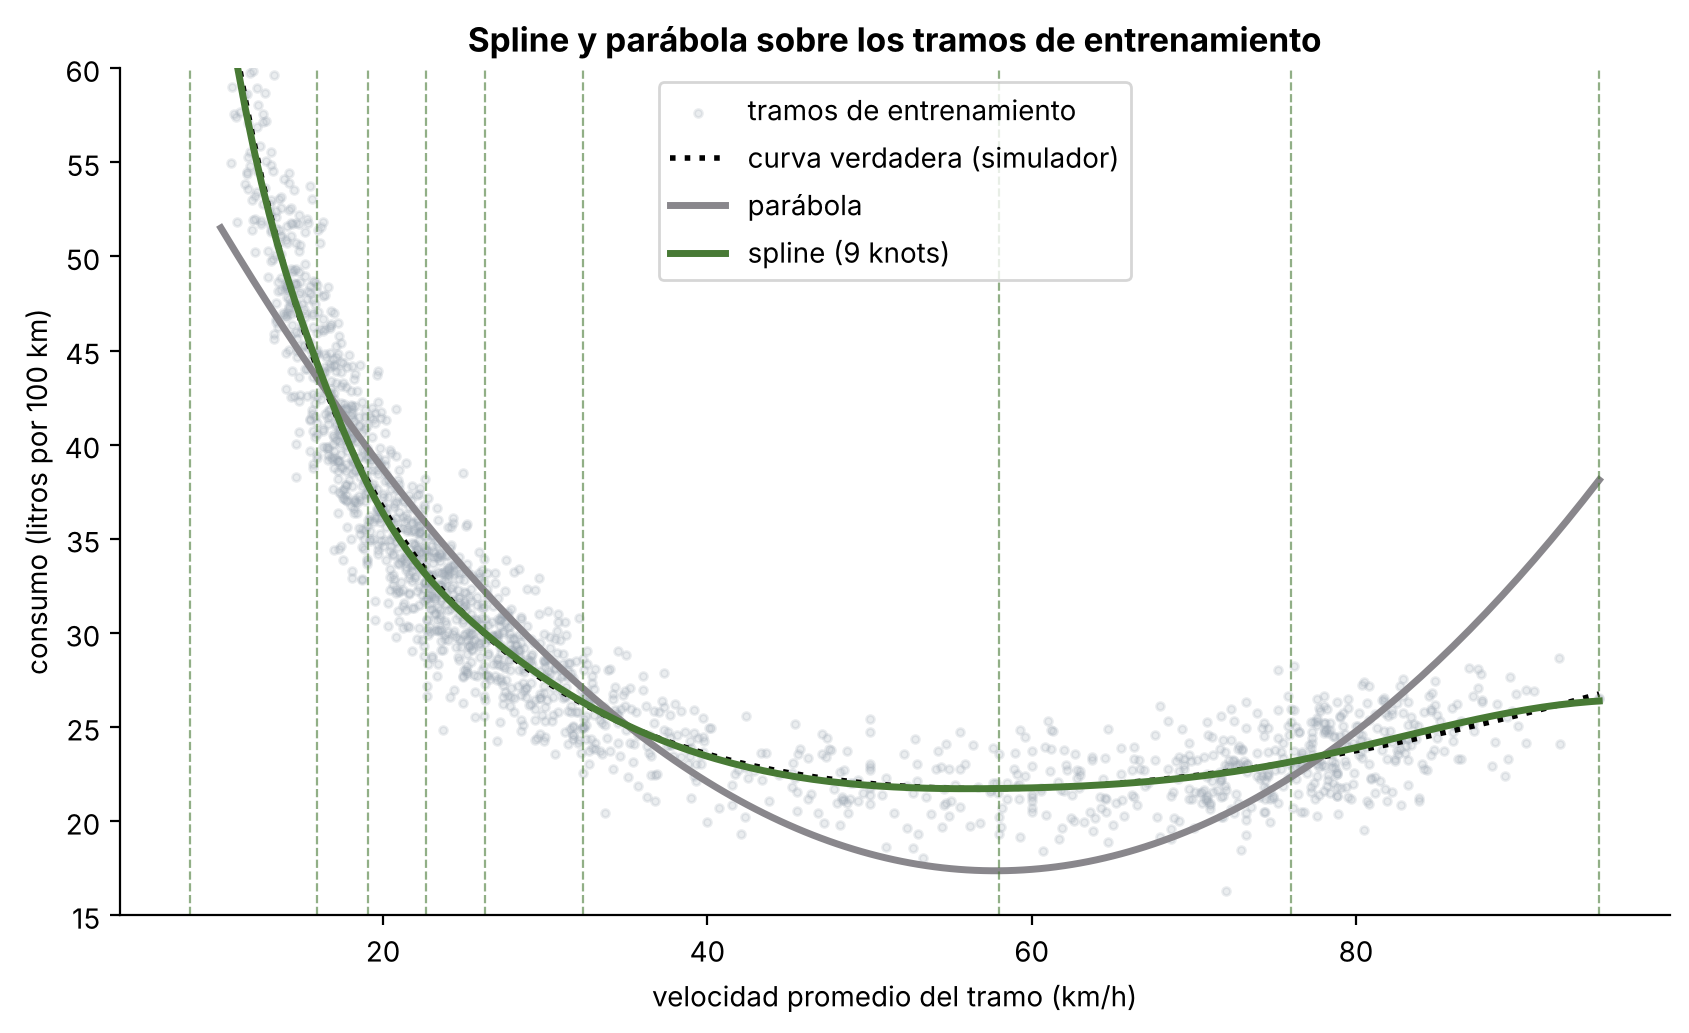
La lista de knots muestra qué hicieron los cuantiles: seis knots entre 8.1 y 32.3 km/h, donde están dos de cada tres tramos y la curva baja más rápido, y solo tres en el resto del rango: 58.0, 76.0 y 95.0 km/h. Entre 32.3 y 58.0 km/h no hay ningún knot, de modo que un solo polinomio cubre la zona del mínimo. Es una consecuencia del desbalance: los cuantiles no ponen knots donde hay pocos datos.
Evaluación
Ahora comparas las dos curvas con la verdadera del simulador y las evalúas en los 600 tramos de prueba. Como la decisión del caso se toma en la carretera, no basta con el error total: la celda lo separa por tipo de tramo.
Para ello, la celda sigue estos pasos, en este orden:
Dibuja la nube de entrenamiento con la curva verdadera, la parábola y el spline, y marca los knots.
Calcula el error de cada modelo en la prueba, en total y por tipo de tramo.
Busca el mínimo del spline en la rejilla, igual que con la parábola.
# 1. Las dos curvas sobre la rejilla de velocidades, junto con la verdadera del simulador.curva_spline = spline.predict(rejilla)curva_verdadera = consumo_verdadero(rejilla['velocidad'])fig, ax = plt.subplots(figsize=(10, 5.5))ax.scatter(X_entrenamiento['velocidad'], y_entrenamiento, s=8, alpha=0.2, color='#9AA5B1', label='tramos de entrenamiento')ax.plot(rejilla['velocidad'], curva_verdadera, color='black', ls=':', lw=2, label='curva verdadera (simulador)')ax.plot(rejilla['velocidad'], curva_parabola, color=COLOR_PARABOLA, lw=2.5, label='parábola')ax.plot(rejilla['velocidad'], curva_spline, color=COLOR_SPLINE, lw=2.5, label=f'spline ({N_KNOTS} knots)')for knot in knots_elegidos: ax.axvline(knot, color=COLOR_SPLINE, ls='--', lw=0.8, alpha=0.6)ax.set_ylim(15, 60)ax.set_xlabel('velocidad promedio del tramo (km/h)')ax.set_ylabel('consumo (litros por 100 km)')ax.set_title('Spline y parábola sobre los tramos de entrenamiento')ax.legend()plt.show()# 2. Error en la prueba, en total y por tipo de tramo.filas = []for nombre, modelo in [('parábola', parabola), ('spline', spline)]: prediccion = modelo.predict(X_prueba) fila = {'modelo': nombre,'RMSE total': np.sqrt(mean_squared_error(y_prueba, prediccion))}for tipo_tramo in ['reparto', 'acceso', 'troncal']: es_tipo = (prueba['tipo'] == tipo_tramo).to_numpy() fila[f'RMSE {tipo_tramo}'] = np.sqrt(mean_squared_error(y_prueba[es_tipo], prediccion[es_tipo])) filas.append(fila)display(pd.DataFrame(filas).set_index('modelo').round(3))# 3. El mínimo del spline, buscado igual que el de la parábola.posicion = np.argmin(curva_spline)VELOCIDAD_MINIMA = rejilla['velocidad'][posicion]print(f'Mínimo del spline: {VELOCIDAD_MINIMA:.1f} km/h, con {curva_spline[posicion]:.2f} litros por 100 km')print(f'Mínimo de la curva verdadera: {rejilla["velocidad"][np.argmin(curva_verdadera)]:.1f} km/h')
RMSE total
RMSE reparto
RMSE acceso
RMSE troncal
modelo
parábola
4.391
4.644
4.283
3.529
spline
2.450
2.714
1.460
1.686
Mínimo del spline: 56.0 km/h, con 21.72 litros por 100 km
Mínimo de la curva verdadera: 57.0 km/h
En la figura, el spline en verde queda casi encima de la curva verdadera en todo el rango. La parábola en gris no puede: queda por encima de la nube entre 20 y 35 km/h, por debajo entre 40 y 75 km/h, y pasado 85 km/h sube muy por encima de los tramos, hasta unos 38 litros a 95 km/h, cuando los tramos marcan cerca de 27.
La tabla de prueba lo cuantifica. El spline tiene un error total de 2.450 litros por 100 km frente a 4.391 de la parábola. En los tramos troncales, los que importan para la decisión, el spline se equivoca en 1.686 litros y la parábola en 3.529, más del doble. En los tramos de reparto el error del spline es mayor, 2.714, porque allí el consumo es más alto y la variación del 7 % pesa más en litros.
El mínimo del spline está en 56.0 km/h, con 21.72 litros por 100 km; el de la curva verdadera, en 57.0 km/h. El spline encontró el fondo de la U a 1 km/h del real.
¿Qué tan seguro es el mínimo?
En un proyecto real no tienes la curva verdadera para comprobar el mínimo, y el análisis descriptivo mostró que está en una zona con pocos tramos. Para saber cuánto podría moverse, usas el bootstrap: repites el ajuste muchas veces, cada vez con un remuestreo con reemplazo del entrenamiento, y miras cuánto varían la curva y su mínimo.
Para ello, la celda sigue estos pasos, en este orden:
Ajusta 200 splines, con los mismos knots y la misma ubicación, cada uno sobre un remuestreo del entrenamiento, y guarda su curva y la velocidad de su mínimo.
Dibuja las 200 curvas entre 40 y 95 km/h y el histograma de los 200 mínimos.
Calcula el intervalo que contiene el 95 % de los mínimos y el ancho de la banda de curvas en cuatro velocidades.
# 1. Repetir el ajuste 200 veces, cada vez con un remuestreo con reemplazo del entrenamiento.generador = np.random.default_rng(SEMILLA)curvas_remuestreo = []minimos_remuestreo = []for repeticion inrange(200): filas_elegidas = generador.integers(0, len(entrenamiento), len(entrenamiento)) # con reemplazo remuestra = entrenamiento.iloc[filas_elegidas] spline_r = Pipeline([ ('bases', SplineTransformer(n_knots=N_KNOTS, degree=3, knots=UBICACION)), ('regresion', LinearRegression()), ]) spline_r.fit(remuestra[['velocidad']], remuestra['consumo']) curva_r = spline_r.predict(rejilla) curvas_remuestreo.append(curva_r) minimos_remuestreo.append(rejilla['velocidad'][np.argmin(curva_r)])curvas_remuestreo = np.array(curvas_remuestreo)minimos_remuestreo = np.array(minimos_remuestreo)# 2. Dibujar las 200 curvas y la distribución de sus mínimos.fig, ax = plt.subplots(1, 2, figsize=(13, 5))for curva_r in curvas_remuestreo: ax[0].plot(rejilla['velocidad'], curva_r, color=COLOR_SPLINE, alpha=0.05, lw=1)ax[0].plot(rejilla['velocidad'], curva_verdadera, color='black', ls=':', lw=2, label='curva verdadera')ax[0].set_xlim(40, 95)ax[0].set_ylim(19, 30)ax[0].set_xlabel('velocidad (km/h)')ax[0].set_ylabel('consumo (litros por 100 km)')ax[0].set_title('200 splines ajustados a remuestreos')ax[0].legend()ax[1].hist(minimos_remuestreo, bins=np.arange(50, 66, 0.5), color=COLOR_SPLINE, edgecolor='white')ax[1].set_xlabel('velocidad del mínimo (km/h)')ax[1].set_ylabel('remuestreos')ax[1].set_title('Dónde cae el mínimo en cada remuestreo')plt.tight_layout()plt.show()# 3. Intervalo del 95 % para la velocidad del mínimo y ancho de la banda en tres velocidades.inferior, superior = np.percentile(minimos_remuestreo, [2.5, 97.5])print(f'Velocidad del mínimo: 95 % de los remuestreos entre {inferior:.1f} y {superior:.1f} km/h')for v in [30, 55, 76, 92]: columna = np.argmin(np.abs(rejilla['velocidad'].to_numpy() - v)) bajo, alto = np.percentile(curvas_remuestreo[:, columna], [2.5, 97.5])print(f' a {v} km/h, el consumo estimado va de {bajo:.2f} a {alto:.2f} litros (ancho {alto - bajo:.2f})')
Velocidad del mínimo: 95 % de los remuestreos entre 53.5 y 61.5 km/h
  a 30 km/h, el consumo estimado va de 27.33 a 27.77 litros (ancho 0.45)
  a 55 km/h, el consumo estimado va de 21.45 a 22.00 litros (ancho 0.55)
  a 76 km/h, el consumo estimado va de 22.92 a 23.36 litros (ancho 0.44)
  a 92 km/h, el consumo estimado va de 25.51 a 26.94 litros (ancho 1.43)
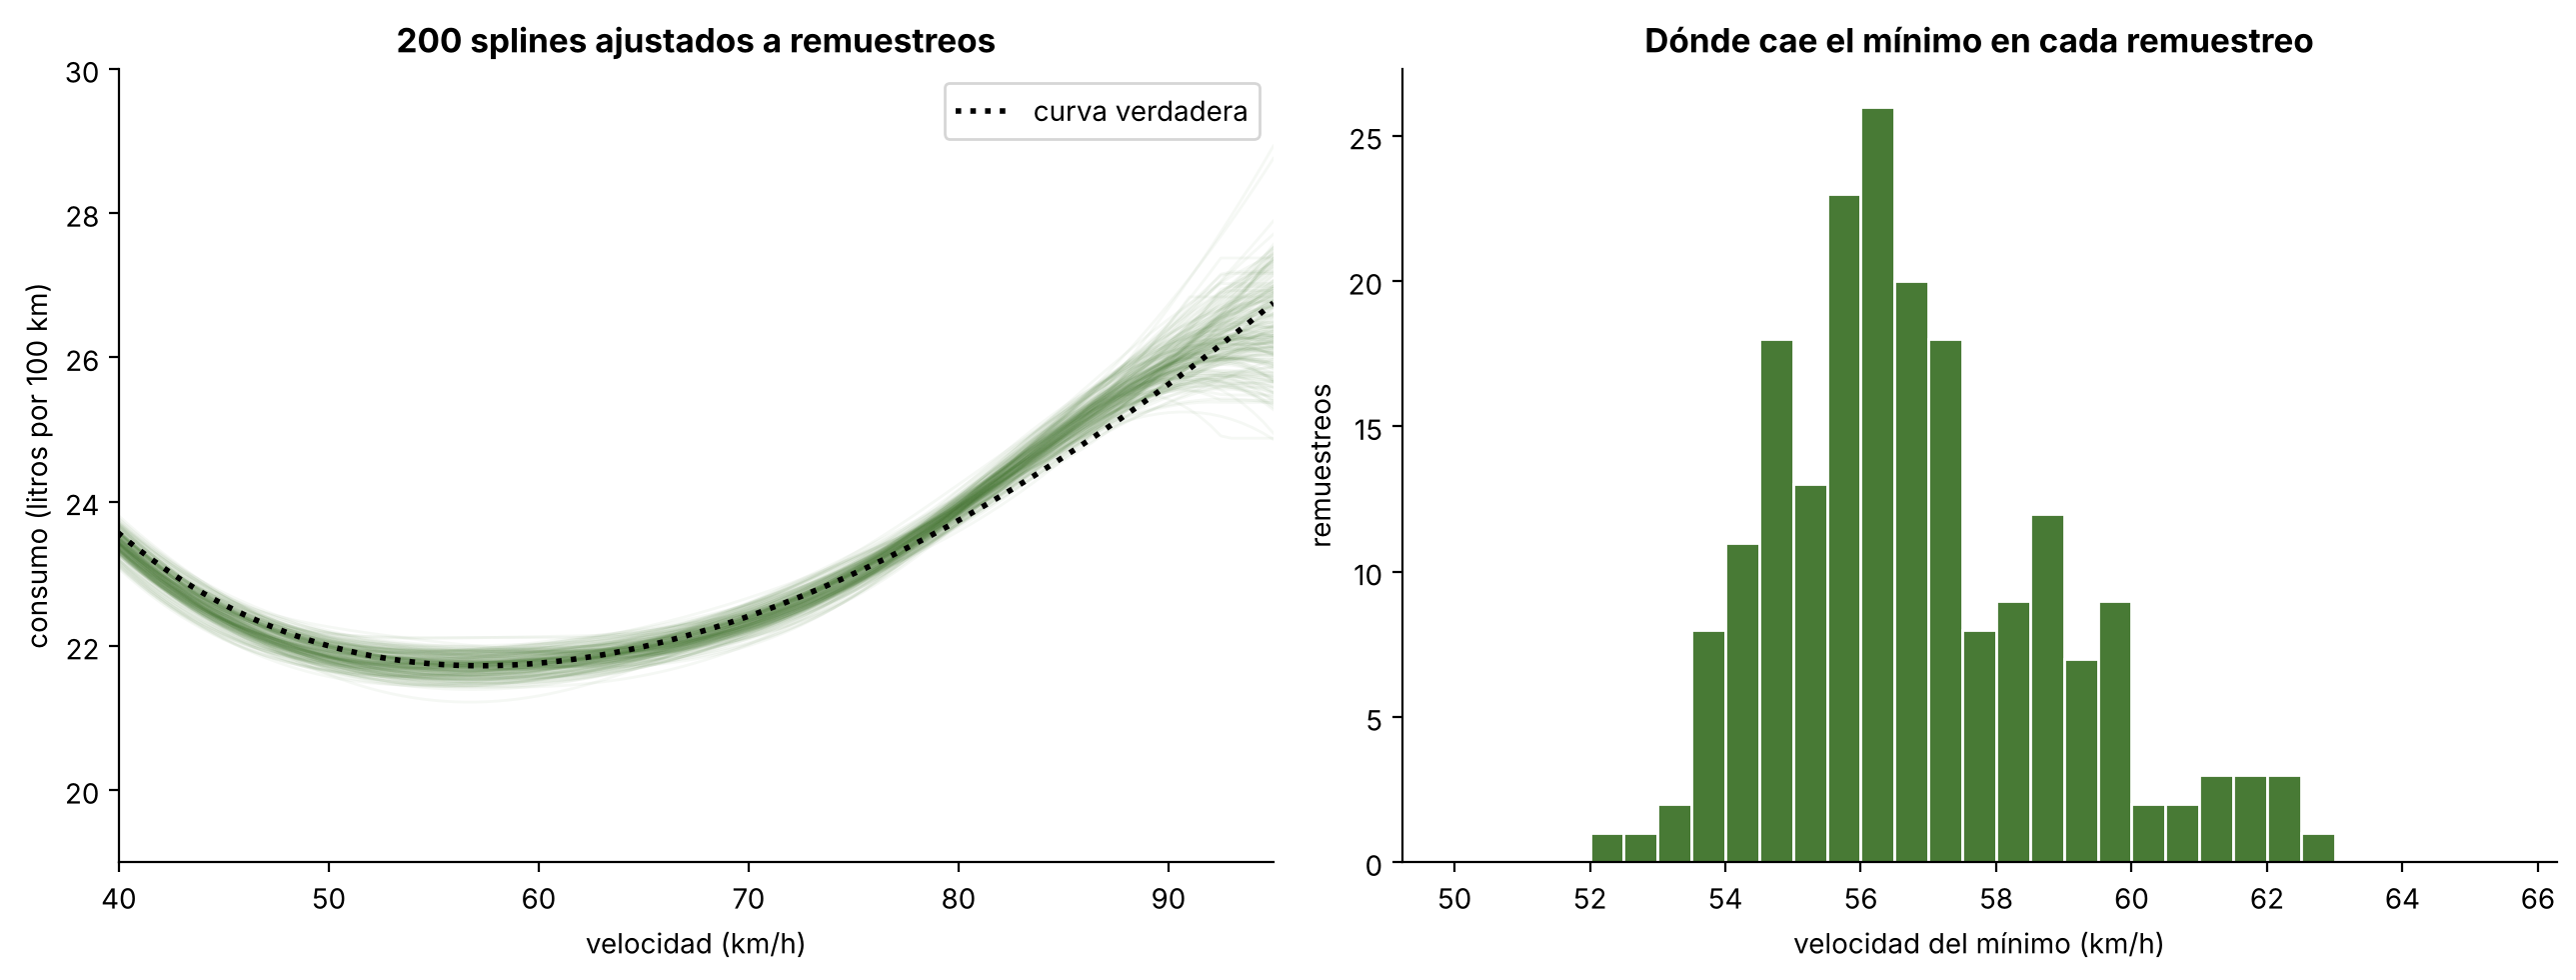
En el panel izquierdo de la figura, las 200 curvas forman una banda angosta alrededor de la curva verdadera en casi todo el rango y se abren hacia los 92 km/h, donde quedan pocos tramos. La salida lo confirma con números: la banda mide 0.45 litros de ancho a 30 km/h, 0.55 a 55 km/h y 0.44 a 76 km/h, pero 1.43 a 92 km/h.
En el panel derecho, el mínimo de los remuestreos cae entre 53.5 y 61.5 km/h en el 95 % de los casos. Ese es el margen honesto de la respuesta: el fondo de la U está en algún lugar de ese intervalo, y los datos no permiten precisarlo más. Como el fondo es plano, la diferencia de consumo dentro del intervalo es pequeña, y eso hace que la decisión siguiente sea robusta.
De la predicción a la decisión de operación
La curva dice cuánto se gasta a cada velocidad; la operación necesita una velocidad para programar. La celda convierte la curva en esa decisión con supuestos explícitos del caso:
Fija los supuestos: 8 viajes por noche, 26 noches al mes, 420 km por viaje, un precio de 2 800 pesos por litro de ACPM y 9 horas disponibles para manejar (de 20:00 a 6:00, menos una hora de paradas).
Estima el consumo de hoy pasando por el spline la velocidad real de cada tramo troncal del entrenamiento.
Calcula, para tres velocidades candidatas de 60, 65 y 70 km/h, el consumo, los litros y pesos ahorrados al mes y las horas de viaje.
Las candidatas empiezan en 60 y no en 56 por dos razones: 60 está dentro del intervalo del bootstrap, donde el consumo es casi el mismo que en el mínimo, y es una velocidad que un conductor puede sostener y un jefe de flota puede controlar.
# 1. Supuestos de la operación troncal (los declara el caso; no son cifras de BIT).VIAJES_POR_NOCHE =8# camiones que salen cada noche por la troncalNOCHES_POR_MES =26KM_POR_VIAJE =420# distancia de un viaje troncalPRECIO_LITRO =2800# pesos por litro de ACPM, supuesto del casoHORAS_DISPONIBLES =9# de 20:00 a 6:00, menos una hora de paradaskm_mes = VIAJES_POR_NOCHE * NOCHES_POR_MES * KM_POR_VIAJEprint(f'Kilómetros troncales por mes: {km_mes:,}')# 2. El consumo de hoy: la velocidad real de cada tramo troncal del entrenamiento,# pasada por el spline, y su promedio.velocidades_hoy = entrenamiento.loc[entrenamiento['tipo'] =='troncal', ['velocidad']]consumo_hoy = spline.predict(velocidades_hoy).mean()print(f'Velocidad troncal media hoy: {velocidades_hoy["velocidad"].mean():.1f} km/h, 'f'consumo medio estimado {consumo_hoy:.2f} litros por 100 km')# 3. Tres velocidades candidatas para programar los viajes.filas = []for velocidad_programada in [60, 65, 70]: consumo_programado = spline.predict(pd.DataFrame({'velocidad': [velocidad_programada]}))[0] litros_ahorrados = (consumo_hoy - consumo_programado) /100* km_mes horas_de_viaje = KM_POR_VIAJE / velocidad_programada filas.append({'velocidad programada (km/h)': velocidad_programada,'consumo (L/100 km)': round(consumo_programado, 2),'litros ahorrados al mes': round(litros_ahorrados),'pesos ahorrados al mes (millones)': round(litros_ahorrados * PRECIO_LITRO /1e6, 2),'horas de viaje': round(horas_de_viaje, 1),'llega antes de las 6:00': horas_de_viaje <= HORAS_DISPONIBLES, })display(pd.DataFrame(filas))
Kilómetros troncales por mes: 87,360
Velocidad troncal media hoy: 76.4 km/h, consumo medio estimado 23.42 litros por 100 km
velocidad programada (km/h)
consumo (L/100 km)
litros ahorrados al mes
pesos ahorrados al mes (millones)
horas de viaje
llega antes de las 6:00
0
60
21.77
1440
4.03
7.0
True
1
65
21.96
1271
3.56
6.5
True
2
70
22.35
931
2.61
6.0
True
La troncal recorre 87 360 km al mes. Hoy los camiones van a 76.4 km/h en promedio y consumen, según el spline, 23.42 litros por 100 km.
Programar los viajes a 60 km/h baja el consumo a 21.77 litros: son 1 440 litros menos al mes, unos 4.03 millones de pesos, alrededor del 7 % del combustible de la troncal. El viaje dura 7.0 horas, dentro de las 9 disponibles, así que los camiones siguen llegando antes de las 6:00. A 65 km/h el ahorro es de 1 271 litros y a 70 km/h, de 931: cada 5 km/h adicionales cuestan entre 169 y 340 litros al mes.
La recomendación del caso es programar los viajes troncales a 60 km/h. Funciona porque en estos viajes llegar antes no aporta nada. En un viaje donde el tiempo sí tiene valor, como un envío urgente o un conductor que cobra por hora, la decisión tendría que sumar el costo del tiempo al del combustible, y la velocidad conveniente subiría.
Errores frecuentes en este caso
Tres errores son fáciles de cometer con esta curva. Los dos primeros se provocan en el código.
Error 1: buscar el mínimo con un polinomio global. Si la parábola se queda corta, la tentación es subir el grado. Con grado 3 el polinomio ya no es simétrico y podría seguir la caída empinada de la izquierda.
# Error 1: buscar el mínimo con un polinomio global de grado 3.cubico = Pipeline([ ('potencias', PolynomialFeatures(degree=3)), ('regresion', LinearRegression()),])cubico.fit(X_entrenamiento, y_entrenamiento)curva_cubico = cubico.predict(rejilla)print(f'Mínimo del polinomio de grado 3: {rejilla["velocidad"][np.argmin(curva_cubico)]:.1f} km/h')print(f'Consumo que predice a 60 y a 95 km/h: 'f'{cubico.predict(pd.DataFrame({"velocidad": [60]}))[0]:.2f} y 'f'{cubico.predict(pd.DataFrame({"velocidad": [95]}))[0]:.2f} litros por 100 km')print(f'Curva verdadera a 60 y a 95 km/h: {consumo_verdadero(60):.2f} y {consumo_verdadero(95):.2f}')
Mínimo del polinomio de grado 3: 95.0 km/h
Consumo que predice a 60 y a 95 km/h: 21.50 y 19.42 litros por 100 km
Curva verdadera a 60 y a 95 km/h: 21.76 y 26.76
El polinomio de grado 3 pone su mínimo en 95.0 km/h, el borde de la rejilla, y predice que a 95 km/h se gastan 19.42 litros por 100 km, menos que a 60 km/h (21.50). La curva verdadera dice lo contrario: 26.76 litros a 95 km/h. Para seguir la caída de la izquierda, el término cúbico dobla la curva hacia abajo en el otro extremo, donde hay pocos tramos que lo contradigan. Con esta curva, la recomendación sería ir lo más rápido posible. Es el mismo problema de los polinomios globales que viste en el capítulo de splines: un término que ayuda en una zona descompone otra.
Error 2: pedirle al spline velocidades que no están en los datos. Alguien pregunta cuánto gastaría un camión a 105 o a 120 km/h.
# Error 2: pedirle al spline velocidades fuera del rango de los datos.maxima_observada = X_entrenamiento['velocidad'].max()print(f'Velocidad máxima en el entrenamiento: {maxima_observada:.1f} km/h')for v in [95, 105, 120]: estimado = spline.predict(pd.DataFrame({'velocidad': [v]}))[0]print(f' a {v} km/h: spline {estimado:.2f} litros por 100 km | curva verdadera {consumo_verdadero(v):.2f}')
Velocidad máxima en el entrenamiento: 95.0 km/h
  a 95 km/h: spline 26.38 litros por 100 km | curva verdadera 26.76
  a 105 km/h: spline 26.38 litros por 100 km | curva verdadera 29.35
  a 120 km/h: spline 26.38 litros por 100 km | curva verdadera 34.04
La velocidad máxima del entrenamiento es 95.0 km/h. A partir de allí, SplineTransformer con su opción por defecto, extrapolation='constant', deja la curva plana: responde 26.38 litros a 95, a 105 y a 120 km/h. La curva verdadera sube a 29.35 y a 34.04. El spline no sabe nada de lo que pasa fuera de los datos, y su respuesta allí no es una estimación.
Error 3: elegir la velocidad con el error total. El error total de la evaluación mezcla los tres tipos de tramo, y siete de cada diez son de reparto. Un modelo podría tener un error total muy bueno y equivocarse en la carretera, que es donde se toma la decisión. Por eso la evaluación separó el error por tipo de tramo y el caso midió la incertidumbre del mínimo con el bootstrap: la pregunta del caso se responde en una zona concreta de la curva, y es allí donde hay que medir.
Conclusiones del caso
La relación entre velocidad y consumo tiene forma de U asimétrica, y una parábola no puede seguirla: su error en la troncal fue de 3.529 litros por 100 km, frente a 1.686 del spline.
Los knots en los cuantiles se concentraron donde estaban los datos (seis por debajo de 32.3 km/h) y el spline encontró el mínimo en 56.0 km/h, a 1 km/h del verdadero.
El bootstrap convirtió ese punto en un intervalo, de 53.5 a 61.5 km/h, y mostró que la curva es menos confiable donde hay pocos tramos.
Programar los viajes troncales a 60 km/h ahorraría unos 1 440 litros y 4.03 millones de pesos al mes, y los camiones seguirían llegando antes de las 6:00.
¿Qué te llevas de este caso? Cuando la pregunta es dónde está el mínimo de una curva, el spline es útil porque no impone una forma simétrica y porque su mínimo se puede buscar en una rejilla. Pero el resultado vale lo que valen los datos cerca de ese mínimo: hay que mirar cuántos hay, medir la incertidumbre con remuestreo y no extrapolar.
Los límites del caso son claros. Los datos son simulados, con una variación del 7 % que no depende de la carga ni de la pendiente; en una flota real, un camión lleno subiendo una cordillera consume mucho más que uno vacío en plano, y la curva debería separar esos efectos, por ejemplo con un spline por tipo de carga o con un modelo aditivo. El precio del combustible y los volúmenes de la troncal son supuestos del caso.
Ejercicios del caso
Repite la búsqueda de knots solo con knots uniformes. ¿Cuántos knots elige la validación cruzada y dónde pone el mínimo? ¿Cambia la recomendación?
Cambia el número de remuestreos del bootstrap de 200 a 50 y a 500. ¿Cuánto se mueve el intervalo del mínimo?
Supón que el tiempo de manejo cuesta 30 000 pesos por hora. Escribe el costo por kilómetro como el combustible más el tiempo, búscalo en la rejilla con el spline y encuentra la velocidad que lo minimiza. ¿Por qué sube?
¿Qué pasaría con la recomendación si la carga tuviera que llegar a las 3:00 y no a las 6:00?
Propón una forma de recoger más tramos entre 45 y 60 km/h sin cambiar la operación de reparto.
TipOrientaciones
La tabla de la sección del spline ya tiene la respuesta: con knots uniformes, el menor error está en 13 knots (2.359). Ajusta ese spline y busca su mínimo en la rejilla. Como el fondo de la curva es plano, el mínimo debería quedar dentro del intervalo del bootstrap, y la recomendación de 60 km/h no tendría por qué cambiar.
Con 50 remuestreos el intervalo será más irregular, porque los percentiles se calculan con pocos valores; con 500 será más estable. El centro no debería moverse mucho.
El costo por kilómetro es consumo / 100 * PRECIO_LITRO + 30000 / velocidad. El segundo término baja al subir la velocidad, así que el mínimo del costo total queda a la derecha del mínimo del consumo: ir más rápido ahorra horas de conductor a cambio de más combustible.
Habría 6 horas disponibles en lugar de 9. A 60 km/h el viaje dura 7.0 horas y no alcanzaría; a 70 km/h dura 6.0 horas, justo en el límite. La velocidad mínima viable sería de 70 km/h, y el ahorro bajaría a unos 931 litros al mes.
Por ejemplo, programar que algunos camiones de reparto hagan sus traslados entre bodegas por vías rápidas, o pedir a la troncal que registre por separado los tramos de salida y entrada a la ciudad. Lo importante es tener datos donde está el mínimo.
Caso práctico 2: Cuántos operarios programar en el centro de clasificación
AdvertenciaEmpresa y datos ficticios
BITLogística es una empresa ficticia. Los envíos diarios, las temporadas, la productividad y los costos de este caso se generan o se suponen dentro del propio caso y no corresponden a BIT ni a ningún cliente. Las reglas del simulador están en el código de la sección de datos.
El problema en la operación
El centro de clasificación de BITLogística en Bogotá recibe cada día decenas de miles de envíos que hay que separar por destino antes de despacharlos. Cada operario clasifica unos 1 100 envíos por turno. La jefa del centro programa los turnos con una semana de anticipación, porque los operarios necesitan saber cuándo trabajan.
Hoy la programación sigue una regla sencilla: para cada día, el promedio del mismo día de la semana en las cuatro semanas anteriores. Si los últimos cuatro lunes llegaron unos 50 000 envíos, el próximo lunes se programan operarios para 50 000. La regla funciona en las semanas tranquilas y falla en las temporadas: cuando empieza el pico de Navidad, las cuatro semanas anteriores todavía son normales y se programa poca gente; cuando el pico termina, las cuatro semanas anteriores son de pico y sobra gente en enero.
¿Cuántos operarios conviene programar cada día del año, según la temporada y el día de la semana?
Equivocarse cuesta en las dos direcciones. Un operario programado de más cobra su turno sin tener qué clasificar: 150 000 pesos perdidos. Un operario que falta se cubre con horas extra, que cuestan 112 500 pesos más que un turno normal.
Los datos
El registro del centro tiene una fila por día con el número de envíos recibidos. La celda siguiente simula tres años, de 2023 a 2025, en cinco pasos:
Crea los días y, para cada uno, el día del año (de 1 a 365, o 366 en los años bisiestos), el día de la semana (0 es lunes) y los años transcurridos desde el inicio.
Define las temporadas como «jorobas» sobre el día del año: cada una tiene un centro, un ancho en días y una altura. Suben el volumen el Día de la Madre, la prima de mitad de año, Amor y Amistad, Black Friday y la Navidad; lo bajan la primera semana de enero y los días entre Navidad y Año Nuevo.
Define el peso de cada día de la semana: el lunes llega lo acumulado del fin de semana, el sábado se trabaja a media marcha y el domingo casi no se opera.
Calcula el volumen: una base de 42 000 envíos que crece 7 % al año, multiplicada por la temporada y el día de la semana, con una variación aleatoria del 6 % de un día a otro.
Guarda todo en una tabla, una fila por día.
Las temporadas se fijan en el mismo día del año todos los años. En la realidad, fechas como Black Friday o el Día de la Madre cambian unos días de un año a otro; es uno de los límites del caso.
# Caso práctico 2 · Configuración: herramientas, semilla y colores del caso.%matplotlib inline%config InlineBackend.figure_format ="retina"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.preprocessing import SplineTransformerfrom sklearn.linear_model import LinearRegressionSEMILLA =2026# semilla central del librorng = np.random.default_rng(SEMILLA)COLOR_REAL ='#2B2B2B'COLOR_SPLINE ='#487A35'COLOR_REGLA ='#EE5400'NOMBRES_DIA = ['lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado', 'domingo']plt.rcParams.update({'figure.figsize': (11, 4.5),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# Versiones del entorno con el que se ejecutó el caso.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scikit-learn']:print(paquete +':', metadatos.version(paquete))
La salida muestra las versiones del entorno con que se ejecutó el caso, con Python 3.13.
# 1. Los días del registro: tres años completos.fechas = pd.date_range('2023-01-01', '2025-12-31', freq='D')dia_del_anio = fechas.dayofyear.to_numpy() # 1 = 1 de enero, 365 o 366 = 31 de diciembredia_semana = fechas.dayofweek.to_numpy() # 0 = lunes, 6 = domingoanios = (fechas - fechas[0]).days.to_numpy() /365.25# años transcurridos desde el inicio# 2. Una temporada es una "joroba" centrada en un día del año, con un ancho en días# y una altura que sube (o baja, si es negativa) el volumen en ese porcentaje.def joroba(dia, centro, ancho, altura):return altura * np.exp(-0.5* ((dia - centro) / ancho) **2)temporadas = (1- joroba(dia_del_anio, 8, 8, 0.25) # primera semana de enero: baja+ joroba(dia_del_anio, 124, 9, 0.30) # Día de la Madre (comienzos de mayo)+ joroba(dia_del_anio, 170, 12, 0.15) # prima de mitad de año (junio)+ joroba(dia_del_anio, 262, 7, 0.18) # Amor y Amistad (septiembre)+ joroba(dia_del_anio, 331, 6, 0.45) # Black Friday (finales de noviembre)+ joroba(dia_del_anio, 348, 10, 0.55) # temporada de Navidad- joroba(dia_del_anio, 362, 4, 0.45) # entre Navidad y Año Nuevo: baja)# 3. Peso de cada día de la semana: el lunes llega lo acumulado del fin de semana; el domingo casi no se opera.peso_dia = np.array([1.12, 1.05, 1.02, 1.02, 1.06, 0.62, 0.18])[dia_semana]# 4. Volumen: base de 42 000 envíos que crece 7 % al año, por temporada, por día de la semana,# con una variación aleatoria de un día a otro del 6 %.volumen =42000*1.07** anios * temporadas * peso_dia * np.exp(rng.normal(0, 0.06, len(fechas)))# 5. La tabla: una fila por día.dias = pd.DataFrame({'fecha': fechas,'dia_del_anio': dia_del_anio,'dia_semana': dia_semana,'anios': anios,'envios': volumen.round().astype(int),})print('Días registrados:', len(dias), '| desde', dias['fecha'].min().date(), 'hasta', dias['fecha'].max().date())display(dias.head(8))
Días registrados: 1096 | desde 2023-01-01 hasta 2025-12-31
fecha
dia_del_anio
dia_semana
anios
envios
0
2023-01-01
1
6
0.000000
5980
1
2023-01-02
2
0
0.002738
38725
2
2023-01-03
3
1
0.005476
31275
3
2023-01-04
4
2
0.008214
36325
4
2023-01-05
5
3
0.010951
34165
5
2023-01-06
6
4
0.013689
33177
6
2023-01-07
7
5
0.016427
19239
7
2023-01-08
8
6
0.019165
5782
La tabla tiene 1 096 días, del 1 de enero de 2023 al 31 de diciembre de 2025. Las primeras filas muestran el patrón semanal: el domingo 1 de enero llegaron 5 980 envíos y el lunes 2, 38 725.
Análisis descriptivo
Antes de ajustar nada, miras la historia: 2023 y 2024. Los días de 2025 quedan apartados desde ahora, porque serán la prueba. Para ello, la celda sigue estos pasos, en este orden:
Dibuja la serie diaria completa de 2023 y 2024.
Calcula y dibuja el promedio de envíos por día de la semana.
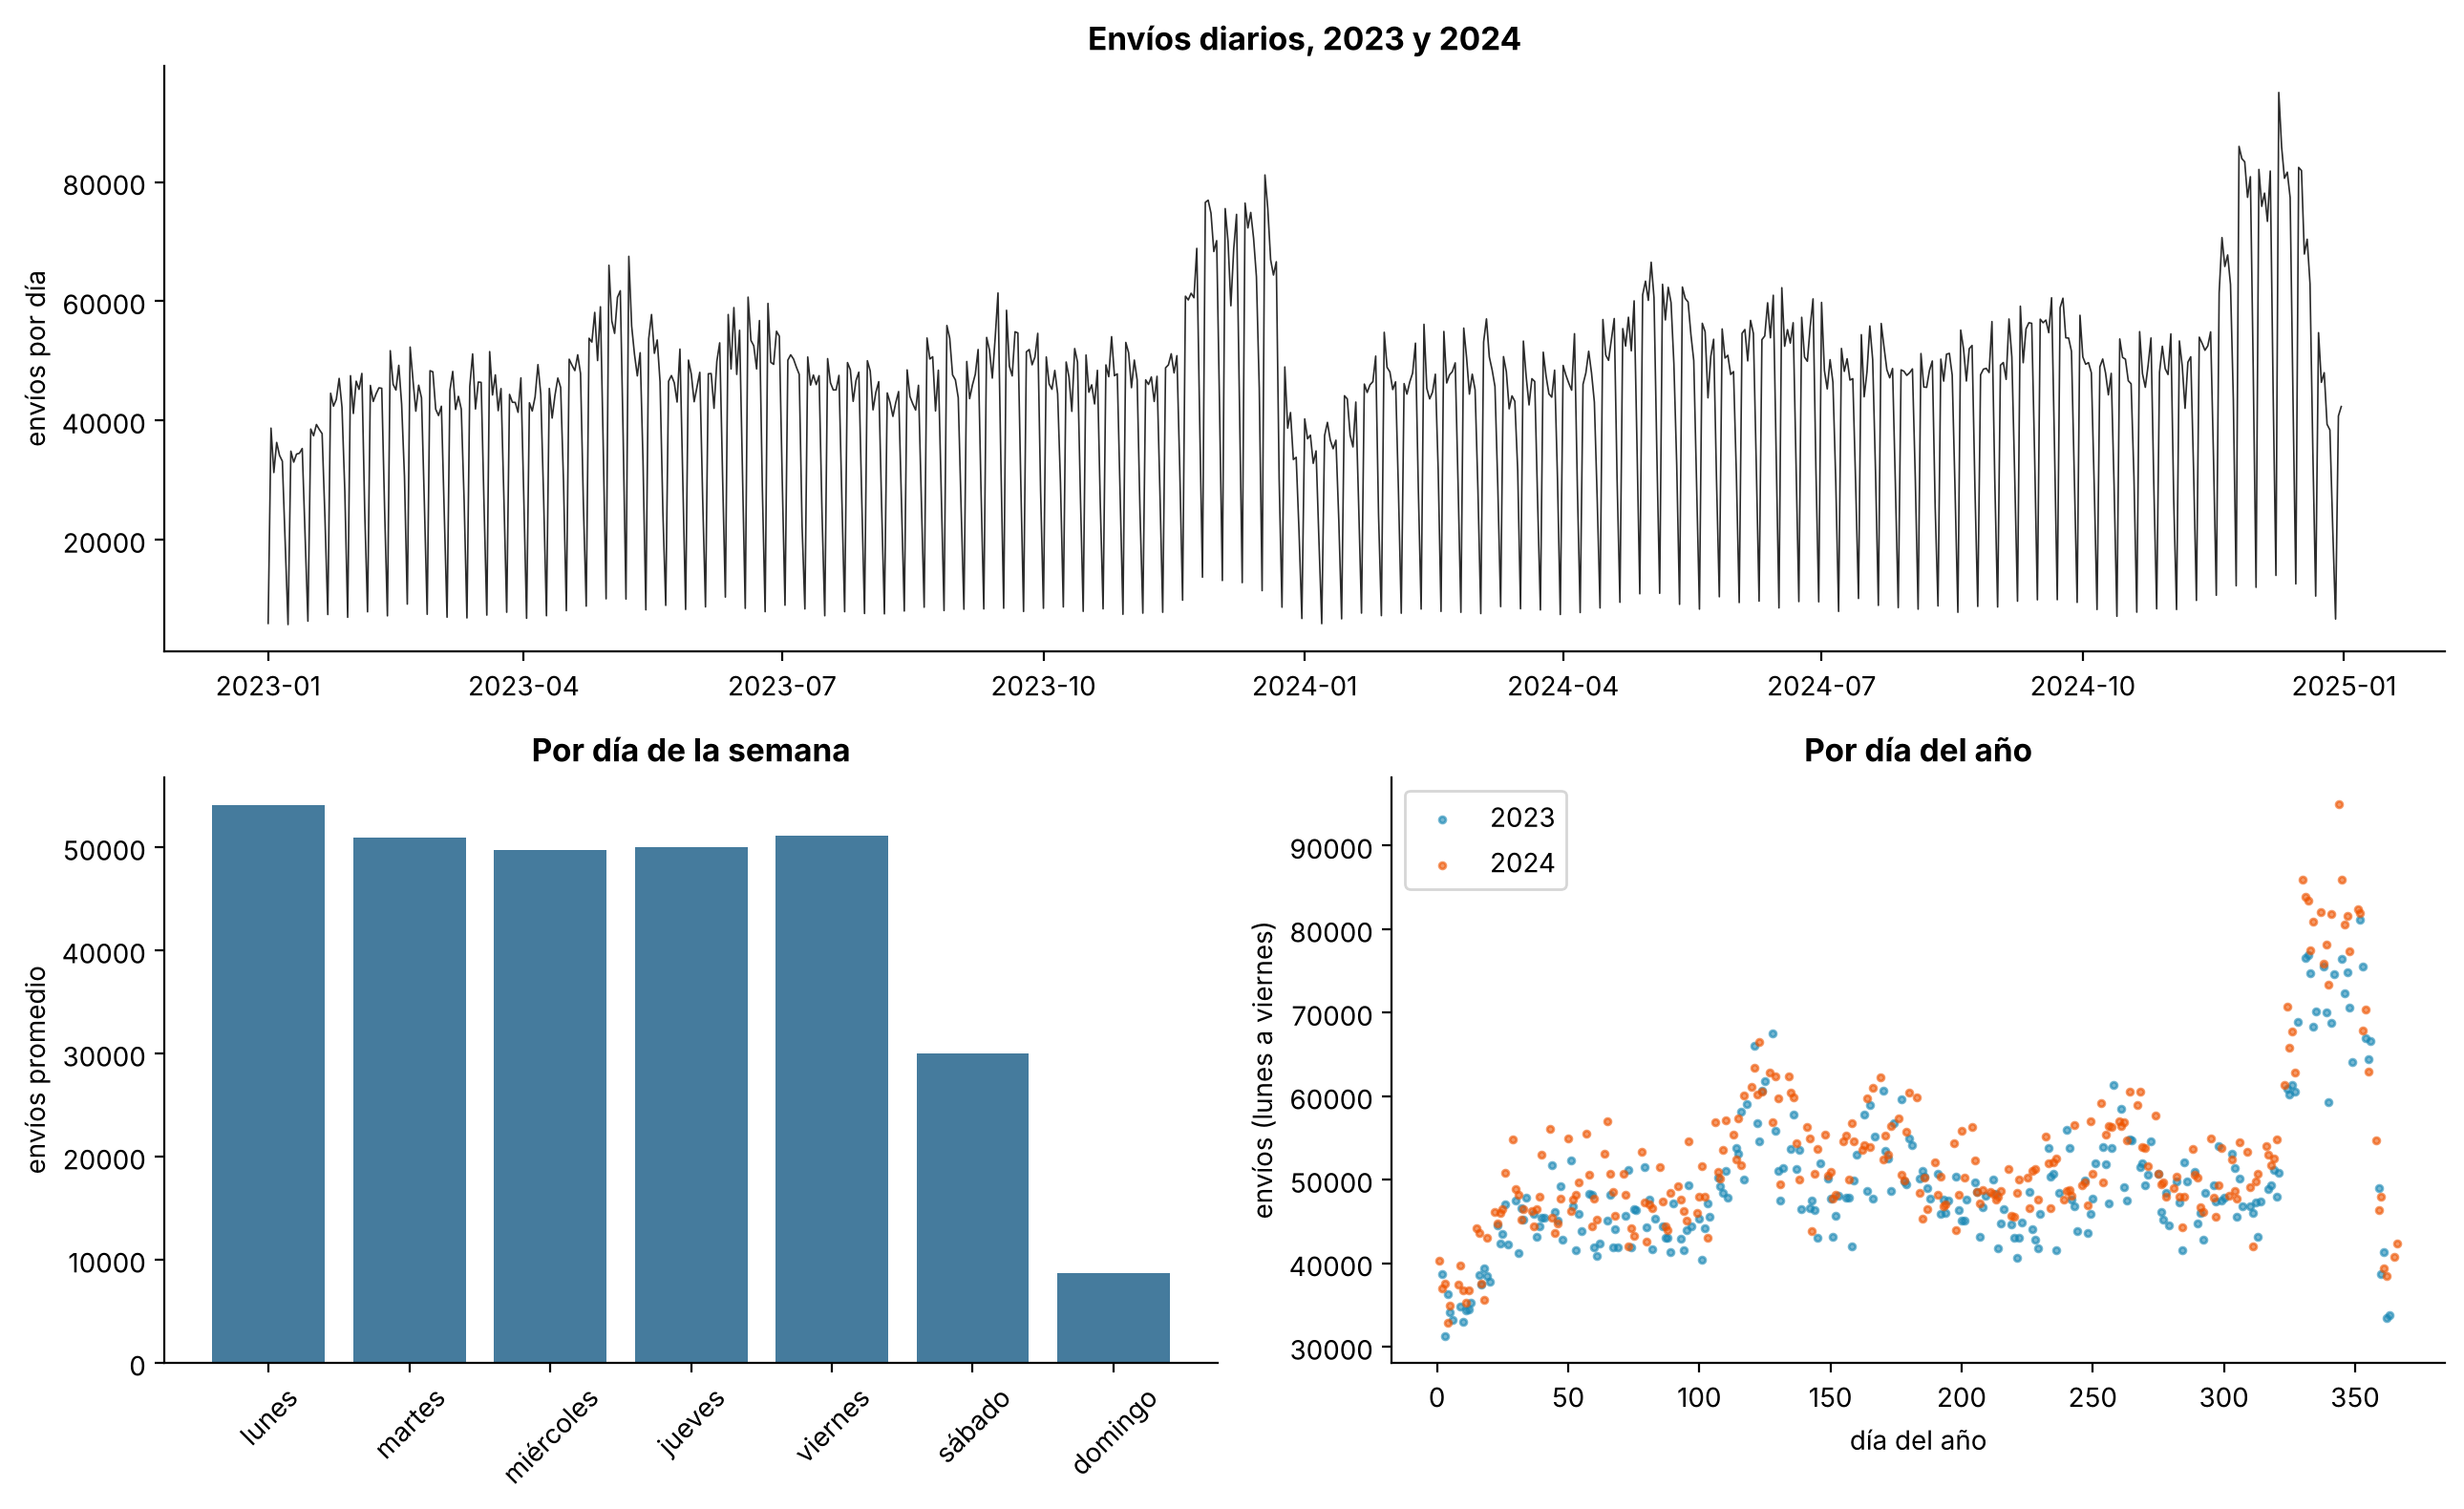
Dibuja los envíos de lunes a viernes según el día del año, un color por año, para ver si la forma se repite.
Imprime las cifras de la figura.
historia = dias[dias['fecha'] <'2025-01-01'] # 2025 queda guardado para la pruebafig = plt.figure(figsize=(13, 8))arriba = fig.add_subplot(2, 1, 1)izquierda = fig.add_subplot(2, 2, 3)derecha = fig.add_subplot(2, 2, 4)# 1. La serie completa de 2023 y 2024.arriba.plot(historia['fecha'], historia['envios'], color=COLOR_REAL, lw=0.6)arriba.set_ylabel('envíos por día')arriba.set_title('Envíos diarios, 2023 y 2024')# 2. El promedio por día de la semana.promedio_dia = historia.groupby('dia_semana')['envios'].mean()izquierda.bar(NOMBRES_DIA, promedio_dia, color='#457B9D')izquierda.set_ylabel('envíos promedio')izquierda.set_title('Por día de la semana')izquierda.tick_params(axis='x', rotation=45)# 3. Solo de lunes a viernes, según el día del año, un color por año.for anio, color in [(2023, '#1786B3'), (2024, '#EE5400')]: habiles = historia[(historia['fecha'].dt.year == anio) & (historia['dia_semana'] <=4)] derecha.scatter(habiles['dia_del_anio'], habiles['envios'], s=6, alpha=0.6, color=color, label=str(anio))derecha.set_xlabel('día del año')derecha.set_ylabel('envíos (lunes a viernes)')derecha.set_title('Por día del año')derecha.legend()plt.tight_layout()plt.show()# 4. Las cifras de la figura.print('Promedio por día de la semana (2023 y 2024):')print(promedio_dia.set_axis(NOMBRES_DIA).round(0))print()print('Promedio diario por año:', historia.groupby(historia['fecha'].dt.year)['envios'].mean().round(0).to_dict())mensual = historia.groupby(historia['fecha'].dt.month)['envios'].mean()print(f'Mes más bajo: {mensual.idxmin()} ({mensual.min():.0f}) | mes más alto: {mensual.idxmax()} ({mensual.max():.0f})')
Promedio por día de la semana (2023 y 2024):
lunes        54083.0
martes       50944.0
miércoles    49716.0
jueves       49978.0
viernes      51076.0
sábado       29959.0
domingo       8713.0
Name: envios, dtype: float64

Promedio diario por año: {2023: 40641.0, 2024: 43455.0}
Mes más bajo: 1 (33064) | mes más alto: 12 (52478)
La figura muestra dos patrones superpuestos.
Un serrucho semanal. En el panel superior la serie parece una banda gruesa, porque cada semana sube y baja. El panel de la izquierda lo explica: de lunes a viernes llegan entre 49 716 y 54 083 envíos en promedio, el sábado 29 959 y el domingo solo 8 713. El lunes es el día más alto.
Una curva anual que se repite. En el panel de la derecha, que muestra solo los días hábiles, las nubes de 2023 y 2024 casi coinciden: bajan en enero, suben a comienzos de mayo, tienen una joroba en septiembre y crecen con fuerza desde finales de noviembre hasta mediados de diciembre. El mes más bajo es enero, con 33 064 envíos diarios en promedio, y el más alto diciembre, con 52 478.
Hay un tercer detalle: la nube de 2024 está un poco por encima de la de 2023. El promedio diario pasó de 40 641 a 43 455 envíos, un crecimiento cercano al 7 %.
Estas observaciones definen el modelo. La curva anual pide un spline sobre el día del año, y como el 31 de diciembre y el 1 de enero son días seguidos, el spline debe ser periódico. El serrucho semanal no es una curva sino siete niveles, uno por día, así que va como columnas del día de la semana. Y el crecimiento va como una tendencia en los años transcurridos.
Preparación de los datos
Este problema es un pronóstico: con lo que ya pasó, planeas lo que viene. Por eso la partición tiene que respetar el tiempo. Si eligieras días al azar para validar, el modelo aprendería de días posteriores a los que valida, algo que nunca podrás hacer cuando planees de verdad.
La celda separa tres periodos:
ajuste, de enero de 2023 a junio de 2024: para estimar los modelos mientras eliges el número de knots;
validación, de julio a diciembre de 2024: para elegir el número de knots;
prueba, todo 2025: se abre una sola vez, al final.
El periodo de ajuste incluye un año y medio para que la tendencia se pueda separar de la curva anual: con un solo año, el crecimiento y la forma del año se confundirían.
# Tres partes en el tiempo, sin mezclar días:# ajuste: enero de 2023 a junio de 2024 -> para estimar los modelos al elegir los knots# validación: julio a diciembre de 2024 -> para elegir el número de knots# prueba: todo 2025 -> se abre una sola vez, al finalajuste = dias[dias['fecha'] <'2024-07-01']validacion = dias[(dias['fecha'] >='2024-07-01') & (dias['fecha'] <'2025-01-01')]prueba = dias[dias['fecha'] >='2025-01-01'].copy()for nombre, parte in [('ajuste', ajuste), ('validación', validacion), ('prueba', prueba)]:print(f'{nombre:<11}{len(parte):>4} días, del {parte["fecha"].min().date()} al {parte["fecha"].max().date()}')
ajuste       547 días, del 2023-01-01 al 2024-06-30
validación   184 días, del 2024-07-01 al 2024-12-31
prueba       365 días, del 2025-01-01 al 2025-12-31
Quedan 547 días de ajuste, 184 de validación y 365 de prueba. La validación incluye la temporada de Black Friday y Navidad de 2024, la más difícil del año.
Una línea base: la regla actual
La línea base es la regla que usa hoy el centro: para planear el día \(d\), el promedio de los días \(d-7\), \(d-14\), \(d-21\) y \(d-28\). Usa solo datos de semanas anteriores, igual que el plan real. La celda la calcula para cada día de 2025 y mide su error absoluto medio: el promedio, en envíos, de la diferencia entre lo pronosticado y lo que llegó.
# La regla actual: el promedio del mismo día de la semana en las cuatro semanas anteriores# a la semana del plan. Para planear el día d se usan d-7, d-14, d-21 y d-28.envios_por_fecha = dias.set_index('fecha')['envios']pronostico_regla = []for fecha in prueba['fecha']: mismas_semanas = [fecha - pd.Timedelta(days=7* semanas) for semanas in [1, 2, 3, 4]] pronostico_regla.append(envios_por_fecha[mismas_semanas].mean())prueba['regla'] = pronostico_reglaerror_regla = (prueba['regla'] - prueba['envios']).abs().mean()print(f'Error absoluto medio de la regla en 2025: {error_regla:,.0f} envíos por día')
Error absoluto medio de la regla en 2025: 5,673 envíos por día
La regla se equivoca en 5 673 envíos por día en promedio durante 2025, el trabajo de unos cinco operarios. La sección de evaluación muestra en qué meses se concentra ese error.
El modelo: una curva del año, el día de la semana y una tendencia
El modelo suma tres bloques de columnas, uno por cada patrón del análisis descriptivo:
la curva del año: las columnas de un spline periódico sobre el día del año, con los knots repartidos de manera uniforme entre el día 1 y el 366;
el día de la semana: seis columnas que valen 1 si el día es martes, miércoles, jueves, viernes, sábado o domingo, y 0 si no; el lunes es la referencia;
la tendencia: los años transcurridos desde el inicio.
Hay un detalle más: el modelo no aprende los envíos sino su logaritmo. Los efectos de este problema se multiplican: el domingo tiene una fracción del volumen del lunes tanto en marzo como en diciembre, y la temporada de Navidad sube el volumen de todos los días en el mismo porcentaje. El logaritmo convierte esas multiplicaciones en sumas, que es lo que una regresión lineal sabe estimar. Para volver a envíos se aplica la exponencial a la predicción.
La celda define dos funciones:
columnas_del_modelo fabrica los tres bloques de columnas para una tabla de días.
crear_bases_anio fabrica un spline periódico con el número de knots que se le pida.
Al final arma la tabla del modelo con 12 knots, como ejemplo, para ver cuántas columnas tiene.
# Fabrica las columnas del modelo para una tabla de días.# bases_anio: el spline periódico que ya se ajustó (sabe dónde están sus knots).def columnas_del_modelo(tabla, bases_anio):# 1. Curva del año: una columna por cada base del spline periódico. columnas_anio = bases_anio.transform(tabla[['dia_del_anio']])# 2. Día de la semana: una columna por día de martes a domingo (el lunes es la referencia). columnas_dia = np.column_stack([(tabla['dia_semana'] == d).to_numpy().astype(float) for d inrange(1, 7)])# 3. Tendencia: los años transcurridos, para el crecimiento de la empresa. columna_tendencia = tabla[['anios']].to_numpy()return np.column_stack([columnas_anio, columnas_dia, columna_tendencia])# Un spline periódico de ejemplo con 12 knots, para ver cuántas columnas produce.def crear_bases_anio(n_knots): knots = np.linspace(1, 366, n_knots).reshape(-1, 1) # knots repartidos en todo el añoreturn SplineTransformer(knots=knots, degree=3, extrapolation='periodic')ejemplo = crear_bases_anio(12).fit(ajuste[['dia_del_anio']])X_ejemplo = columnas_del_modelo(ajuste, ejemplo)print('Filas y columnas de la tabla del modelo (12 knots):', X_ejemplo.shape)print(' columnas del año:', ejemplo.transform(ajuste[['dia_del_anio']].head(1)).shape[1],'| columnas del día de la semana: 6 | columna de tendencia: 1')
Filas y columnas de la tabla del modelo (12 knots): (547, 18)
  columnas del año: 11 | columnas del día de la semana: 6 | columna de tendencia: 1
Con 12 knots, la tabla del periodo de ajuste tiene 547 filas y 18 columnas: 11 de la curva del año, 6 del día de la semana y 1 de tendencia. Un spline periódico con 12 knots produce 11 columnas porque el primer knot y el último son el mismo punto del ciclo.
Elegir el número de knots
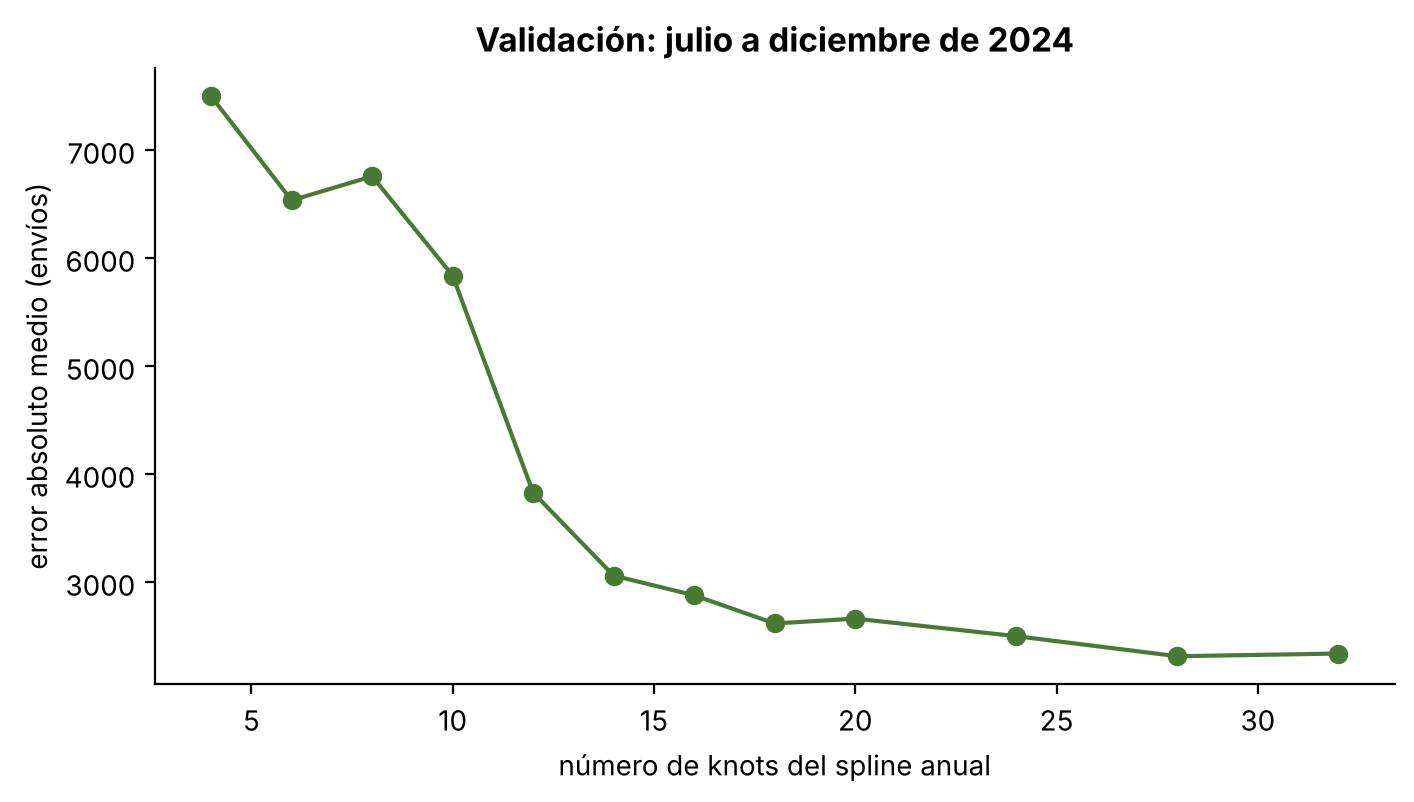
Las temporadas de este problema son estrechas: Black Friday dura unos días. Para seguirlas, la curva del año necesita knots cercanos entre sí, pero con demasiados knots empezaría a seguir el ruido de un año en particular. La celda prueba entre 4 y 32 knots; para cada número ajusta el modelo con el periodo de ajuste, pronostica la validación y mide el error absoluto medio.
# 1. Para cada número de knots: ajustar con el periodo de ajuste y medir en validación.# El modelo aprende el logaritmo de los envíos (ver el texto) y la predicción se devuelve con exp.candidatos = [4, 6, 8, 10, 12, 14, 16, 18, 20, 24, 28, 32]errores_validacion = []for n_knots in candidatos: bases = crear_bases_anio(n_knots).fit(ajuste[['dia_del_anio']]) modelo = LinearRegression().fit(columnas_del_modelo(ajuste, bases), np.log(ajuste['envios'])) prediccion = np.exp(modelo.predict(columnas_del_modelo(validacion, bases))) errores_validacion.append(np.abs(prediccion - validacion['envios']).mean())# 2. El número de knots con menor error en validación.N_KNOTS = candidatos[int(np.argmin(errores_validacion))]for n_knots, error inzip(candidatos, errores_validacion): marca =' <- elegido'if n_knots == N_KNOTS else''print(f'n_knots = {n_knots:2d}: error absoluto medio = {error:,.0f} envíos{marca}')plt.figure(figsize=(8, 4))plt.plot(candidatos, errores_validacion, marker='o', color=COLOR_SPLINE)plt.xlabel('número de knots del spline anual')plt.ylabel('error absoluto medio (envíos)')plt.title('Validación: julio a diciembre de 2024')plt.show()
n_knots =  4: error absoluto medio = 7,499 envíos
n_knots =  6: error absoluto medio = 6,534 envíos
n_knots =  8: error absoluto medio = 6,757 envíos
n_knots = 10: error absoluto medio = 5,838 envíos
n_knots = 12: error absoluto medio = 3,828 envíos
n_knots = 14: error absoluto medio = 3,060 envíos
n_knots = 16: error absoluto medio = 2,878 envíos
n_knots = 18: error absoluto medio = 2,617 envíos
n_knots = 20: error absoluto medio = 2,662 envíos
n_knots = 24: error absoluto medio = 2,499 envíos
n_knots = 28: error absoluto medio = 2,314 envíos  <- elegido
n_knots = 32: error absoluto medio = 2,339 envíos
En la figura, el error de validación baja de 7 499 envíos con 4 knots a 2 314 con 28, y sube apenas con 32 (2 339). Con pocos knots, la curva del año no alcanza a seguir las temporadas: los picos estrechos quedan aplastados. El gran descenso ocurre entre 10 y 16 knots, cuando los knots quedan a menos de un mes de distancia y la curva empieza a distinguir el Día de la Madre y Black Friday. Desde 18 knots, las diferencias entre un número de knots y el siguiente son pequeñas.
Con 28 knots, uno cada 13 o 14 días, queda elegido el modelo.
Ajustar el modelo final y leerlo
Con el número de knots fijado, ajustas el modelo con 2023 y 2024 completos. Antes de pronosticar, conviene mirar qué aprendió: a diferencia de muchos modelos, este se puede leer por partes. Para ello, la celda sigue estos pasos, en este orden:
Ajusta el modelo final con toda la historia.
Separa sus coeficientes en los tres bloques.
Reconstruye la curva del año sumando las columnas del spline por sus pesos, y la expresa como porcentaje frente al promedio del año.
Expresa el efecto de cada día de la semana como porcentaje frente al lunes.
Dibuja las dos partes e imprime sus cifras.
# 1. Ajuste final con 2023 y 2024 completos (ajuste + validación) y el número de knots elegido.historia = dias[dias['fecha'] <'2025-01-01']bases_anio = crear_bases_anio(N_KNOTS).fit(historia[['dia_del_anio']])modelo = LinearRegression().fit(columnas_del_modelo(historia, bases_anio), np.log(historia['envios']))# 2. Separar los coeficientes por bloque de columnas.n_bases = bases_anio.transform(historia[['dia_del_anio']].head(1)).shape[1]coef_anio = modelo.coef_[:n_bases]coef_dia = modelo.coef_[n_bases:n_bases +6]coef_tendencia = modelo.coef_[-1]# 3. La curva del año: la suma de las bases por sus pesos, centrada en su promedio y pasada a porcentaje.dias_rejilla = pd.DataFrame({'dia_del_anio': np.arange(1, 367)})curva_log = bases_anio.transform(dias_rejilla) @ coef_aniocurva_porcentaje = (np.exp(curva_log - curva_log.mean()) -1) *100# 4. El efecto de cada día frente al lunes, en porcentaje.efecto_dia = (np.exp(np.r_[0, coef_dia]) -1) *100fig, ax = plt.subplots(1, 2, figsize=(13, 4.5), gridspec_kw={'width_ratios': [2, 1]})ax[0].plot(dias_rejilla['dia_del_anio'], curva_porcentaje, color=COLOR_SPLINE, lw=2)ax[0].axhline(0, color='gray', lw=0.8)ax[0].set_xlabel('día del año')ax[0].set_ylabel('% frente al promedio del año')ax[0].set_title(f'Curva del año (spline periódico, {N_KNOTS} knots)')ax[1].bar(NOMBRES_DIA, efecto_dia, color='#457B9D')ax[1].set_ylabel('% frente al lunes')ax[1].set_title('Efecto del día de la semana')ax[1].tick_params(axis='x', rotation=45)plt.tight_layout()plt.show()# 5. Las cifras de la figura.print(f'Crecimiento anual estimado: {(np.exp(coef_tendencia) -1) *100:.1f} %')print('Efecto frente al lunes (%):', dict(zip(NOMBRES_DIA, efecto_dia.round(1))))for nombre, dia in [('7 de enero', 7), ('4 de mayo', 124), ('27 de noviembre', 331), ('14 de diciembre', 348)]:print(f' curva del año el {nombre}: {curva_porcentaje[dia -1]:+.0f} %')print(f' 31 de diciembre: {curva_porcentaje[365]:+.1f} % | 1 de enero: {curva_porcentaje[0]:+.1f} %')
Crecimiento anual estimado: 6.5 %
Efecto frente al lunes (%): {'lunes': np.float64(0.0), 'martes': np.float64(-5.9), 'miércoles': np.float64(-8.3), 'jueves': np.float64(-7.8), 'viernes': np.float64(-5.8), 'sábado': np.float64(-44.8), 'domingo': np.float64(-83.9)}
  curva del año el 7 de enero: -31 %
  curva del año el 4 de mayo: +22 %
  curva del año el 27 de noviembre: +39 %
  curva del año el 14 de diciembre: +49 %
  31 de diciembre: -29.1 % | 1 de enero: -29.1 %
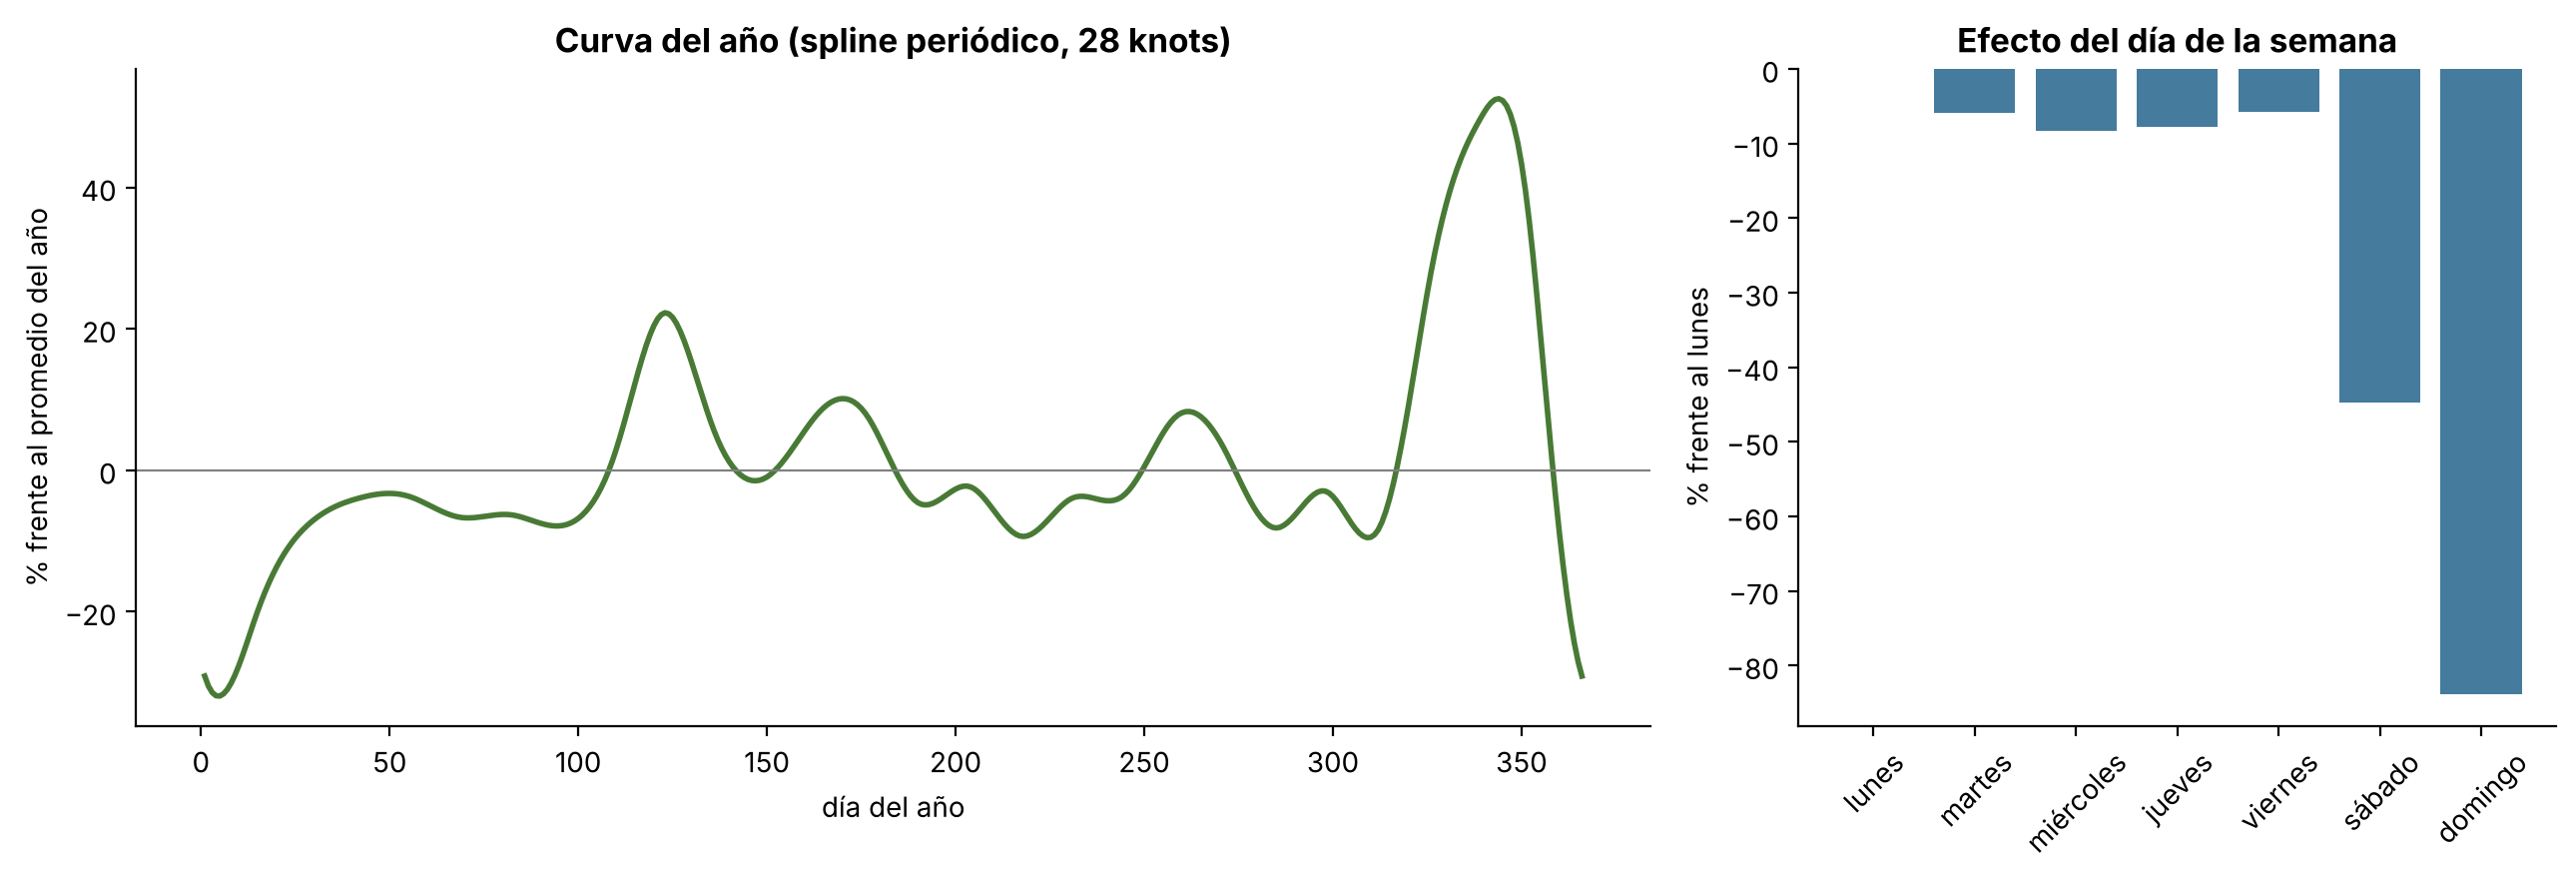
El panel izquierdo de la figura es la curva del año que encontró el spline: baja a −31 % frente al promedio el 7 de enero, sube a +22 % el 4 de mayo, tiene una joroba en septiembre y llega a +39 % el 27 de noviembre y a +49 % el 14 de diciembre. El 31 de diciembre y el 1 de enero tienen el mismo valor, −29.1 %: el spline periódico une el final del año con el comienzo.
El panel derecho muestra el efecto del día de la semana frente al lunes: de martes a viernes entre −5.8 % y −8.3 %, el sábado −44.8 % y el domingo −83.9 %. El crecimiento anual estimado es de 6.5 %, cerca del 7 % del simulador.
Cada parte del modelo corresponde a un patrón que viste en el análisis descriptivo. Esa lectura por partes es la idea de los modelos aditivos, que verás más adelante.
Evaluación en 2025
Ahora abres 2025. El modelo pronostica cada día del año usando solo el día del año, el día de la semana y la tendencia; no necesita conocer las semanas anteriores, así que el plan se puede hacer con la anticipación que se quiera. Para ello, la celda sigue estos pasos, en este orden:
Calcula el pronóstico del modelo para cada día de 2025.
Mide el error absoluto medio del modelo y de la regla, en todo el año y mes por mes.
Dibuja los envíos reales de 2025 con los dos pronósticos.
# 1. Pronóstico del modelo para 2025 (sin haber visto ningún día de 2025).prueba['spline'] = np.exp(modelo.predict(columnas_del_modelo(prueba, bases_anio)))# 2. Error absoluto medio de las dos alternativas, en todo el año y por mes.error_spline = (prueba['spline'] - prueba['envios']).abs().mean()print(f'Error absoluto medio en 2025: spline {error_spline:,.0f} | regla {error_regla:,.0f} envíos por día')por_mes = prueba.assign(mes=prueba['fecha'].dt.month).groupby('mes').apply(lambda d: pd.Series({'spline': (d['spline'] - d['envios']).abs().mean(),'regla': (d['regla'] - d['envios']).abs().mean(), })).round(0)display(por_mes.T)# 3. La serie de 2025 con los dos pronósticos.fig, ax = plt.subplots(figsize=(13, 4.5))ax.plot(prueba['fecha'], prueba['envios'], color=COLOR_REAL, lw=0.8, label='envíos reales')ax.plot(prueba['fecha'], prueba['regla'], color=COLOR_REGLA, lw=1, alpha=0.8, label='regla actual')ax.plot(prueba['fecha'], prueba['spline'], color=COLOR_SPLINE, lw=1, alpha=0.9, label='spline')ax.set_ylabel('envíos por día')ax.set_title('2025: envíos reales y los dos pronósticos')ax.legend(loc='upper left')plt.show()
Error absoluto medio en 2025: spline 2,413 | regla 5,673 envíos por día
mes
1
2
3
4
5
6
7
8
9
10
11
12
spline
2271.0
1917.0
1694.0
2366.0
2879.0
2475.0
2457.0
1932.0
2317.0
1949.0
3127.0
3539.0
regla
10799.0
3021.0
1525.0
4709.0
6749.0
3832.0
3987.0
2321.0
3302.0
3665.0
8522.0
15309.0
El modelo se equivoca en 2 413 envíos por día en promedio, frente a 5 673 de la regla: menos de la mitad del error.
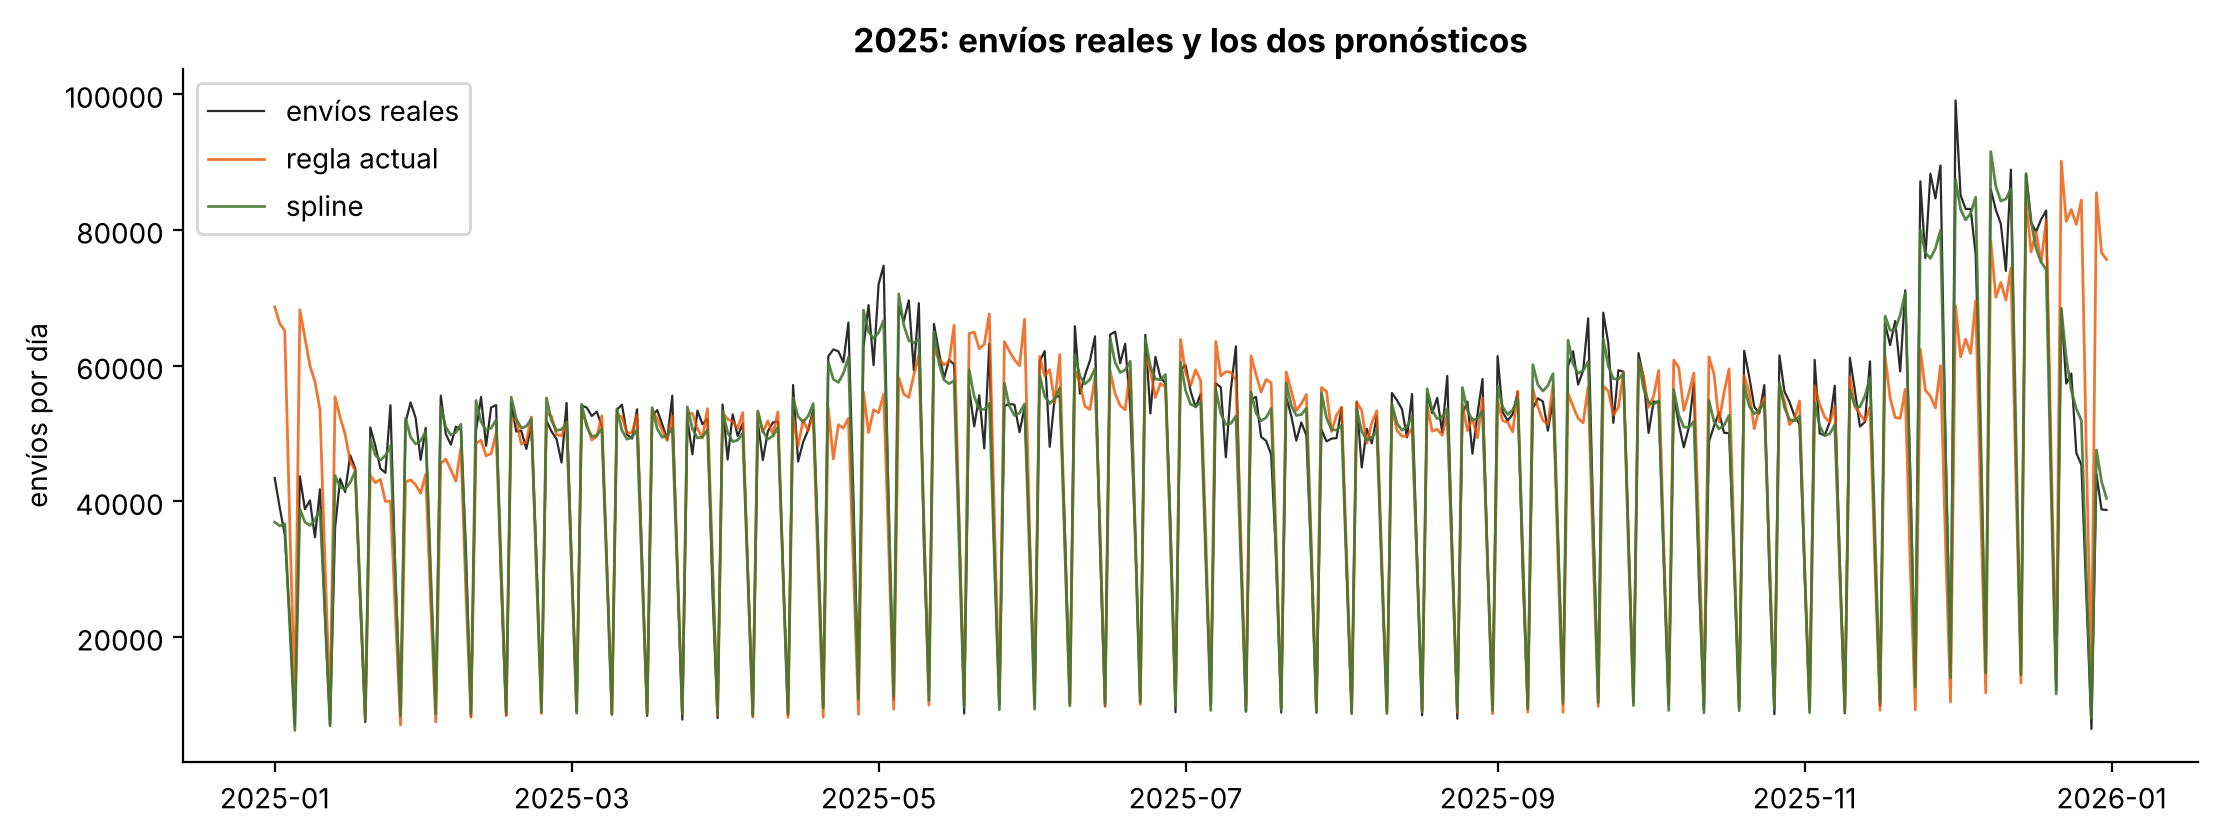
La tabla por mes muestra dónde está la diferencia. La regla falla sobre todo en las temporadas y justo después: 15 309 envíos por día en diciembre, 10 799 en enero, 8 522 en noviembre y 6 749 en mayo. En la figura se ve por qué: la línea naranja de la regla llega tarde a cada pico, porque promedia semanas que todavía no eran de temporada, y en enero sigue alta porque promedia las semanas de Navidad. El spline, en verde, sube y baja con los picos porque ya aprendió su forma de los dos años anteriores. Su peor mes es diciembre, con 3 539 envíos.
La regla le gana al modelo en un solo mes: marzo, con 1 525 frente a 1 694. En un mes tranquilo, el promedio de las semanas recientes es un buen pronóstico.
De la predicción a la decisión de operación
El centro no programa envíos sino operarios. La celda traduce cada pronóstico en turnos y mide el costo de equivocarse, con supuestos explícitos del caso:
Fija los supuestos: 1 100 envíos por operario y turno, 150 000 pesos por turno programado y un sobrecosto de 112 500 pesos por cada turno faltante que se cubre con horas extra.
Calcula los operarios necesarios cada día con los envíos reales.
Para cada alternativa, calcula los operarios programados con su pronóstico, los turnos sobrantes y faltantes, y el costo de esos errores en 2025.
El costo de los errores no incluye los turnos bien programados, que se pagan igual con cualquier alternativa; solo mide lo que se pierde por programar de más o de menos.
# 1. Supuestos de la operación (los declara el caso; no son cifras de BIT).ENVIOS_POR_OPERARIO =1100# envíos que clasifica un operario en un turnoCOSTO_TURNO =150_000# pesos por operario programadoSOBRECOSTO_HORA_EXTRA =112_500# pesos adicionales por cada operario faltante cubierto con horas extra# 2. Operarios necesarios cada día según los envíos reales.necesarios = np.ceil(prueba['envios'] / ENVIOS_POR_OPERARIO)filas = []for alternativa in ['regla', 'spline']:# 3. Operarios programados según el pronóstico de cada alternativa. programados = np.ceil(prueba[alternativa] / ENVIOS_POR_OPERARIO) sobrantes = np.clip(programados - necesarios, 0, None) # pagados sin trabajo faltantes = np.clip(necesarios - programados, 0, None) # cubiertos con horas extra costo_errores = sobrantes * COSTO_TURNO + faltantes * SOBRECOSTO_HORA_EXTRA filas.append({'alternativa': alternativa,'turnos sobrantes': int(sobrantes.sum()),'turnos faltantes': int(faltantes.sum()),'días con faltantes': int((faltantes >0).sum()),'costo de los errores (millones)': round(costo_errores.sum() /1e6, 1), })display(pd.DataFrame(filas).set_index('alternativa'))print('Turnos necesarios en 2025:', int(necesarios.sum()))
turnos sobrantes
turnos faltantes
días con faltantes
costo de los errores (millones)
alternativa
regla
921
964
175
246.6
spline
360
445
166
104.1
Turnos necesarios en 2025: 15573
En 2025 se necesitaban 15 573 turnos. Con la regla actual sobran 921 turnos y faltan 964, y los errores cuestan 246.6 millones de pesos en el año. Con el modelo sobran 360 y faltan 445, y el costo baja a 104.1 millones: unos 142 millones de pesos menos al año.
Los días con faltantes son casi los mismos (175 con la regla y 166 con el modelo), pero con el modelo faltan muchos menos operarios cada vez. La recomendación del caso es programar los turnos con el modelo y revisar a mano las semanas de temporada, donde el error del modelo es mayor.
Errores frecuentes en este caso
Los tres errores siguientes se provocan en el código.
Error 1: poner el spline sobre la fecha y no sobre el día del año. Parece más directo: un spline sobre los días corridos desde el 1 de enero de 2023 sigue toda la historia, con sus temporadas y su crecimiento.
# Error 1: poner el spline sobre la fecha (días corridos desde el inicio) en lugar del día del año.# Un spline sobre la fecha aprende la forma de 2023 y 2024, pero no sabe que el año se repite.dias_corridos = (dias['fecha'] - dias['fecha'].min()).dt.dayshistoria_fecha = pd.DataFrame({'dias_corridos': dias_corridos[dias['fecha'] <'2025-01-01']})prueba_fecha = pd.DataFrame({'dias_corridos': dias_corridos[dias['fecha'] >='2025-01-01']})bases_fecha = SplineTransformer(n_knots=40, degree=3).fit(historia_fecha) # knots cada ~19 díasdef columnas_con_fecha(tabla_fecha, tabla_dias): columnas_dia = np.column_stack([(tabla_dias['dia_semana'] == d).to_numpy().astype(float) for d inrange(1, 7)])return np.column_stack([bases_fecha.transform(tabla_fecha), columnas_dia])modelo_fecha = LinearRegression().fit(columnas_con_fecha(historia_fecha, historia), np.log(historia['envios']))prediccion_fecha = np.exp(modelo_fecha.predict(columnas_con_fecha(prueba_fecha, prueba)))print(f'Error absoluto medio en 2025 con el spline sobre la fecha: 'f'{np.abs(prediccion_fecha - prueba["envios"]).mean():,.0f} envíos')comparacion = pd.DataFrame({'real': prueba['envios'].to_numpy(),'spline sobre la fecha': prediccion_fecha,}).groupby(prueba['fecha'].dt.month.to_numpy()).mean().round(0)display(comparacion.T)
Error absoluto medio en 2025 con el spline sobre la fecha: 16,673 envíos
1
2
3
4
5
6
7
8
9
10
11
12
real
37296.0
42137.0
41589.0
46119.0
49872.0
47955.0
44581.0
42347.0
48328.0
44989.0
51443.0
60121.0
spline sobre la fecha
30301.0
29743.0
28982.0
30133.0
29850.0
29243.0
30300.0
28910.0
30240.0
30301.0
28671.0
30397.0
El spline sobre la fecha se equivoca en 16 673 envíos por día en 2025, casi siete veces más que el modelo. La tabla muestra por qué: pronostica entre 28 671 y 30 397 envíos en todos los meses, mientras los reales van de 37 296 en enero a 60 121 en diciembre. Todo 2025 está fuera del rango de la fecha con que se ajustó el spline, y allí la curva se queda plana en el valor del 31 de diciembre de 2024, uno de los días más bajos del año. El spline sobre la fecha aprendió la forma de 2023 y 2024, pero no sabe que esa forma se repite. El día del año sí lo sabe: el 4 de mayo de 2025 está en el mismo lugar de la curva que el 4 de mayo de 2024.
Error 2: elegir los knots con días tomados al azar. En lugar de validar con el segundo semestre de 2024, se toma un 25 % de días al azar de 2023 y 2024.
# Error 2: elegir el número de knots con días tomados al azar en lugar de un periodo posterior.generador = np.random.default_rng(SEMILLA)al_azar = generador.random(len(historia)) <0.25# 25 % de los días de 2023 y 2024 al azarajuste_azar = historia[~al_azar]validacion_azar = historia[al_azar]errores_azar = []for n_knots in candidatos: bases = crear_bases_anio(n_knots).fit(ajuste_azar[['dia_del_anio']]) m = LinearRegression().fit(columnas_del_modelo(ajuste_azar, bases), np.log(ajuste_azar['envios'])) p = np.exp(m.predict(columnas_del_modelo(validacion_azar, bases))) errores_azar.append(np.abs(p - validacion_azar['envios']).mean())elegido_azar = candidatos[int(np.argmin(errores_azar))]print(f'Con días al azar se elige n_knots = {elegido_azar}, 'f'con error de validación {min(errores_azar):,.0f} envíos')print(f'Con el periodo posterior se eligió n_knots = {N_KNOTS}, 'f'con error de validación {min(errores_validacion):,.0f} envíos')print(f'Error real en 2025 del modelo elegido: {error_spline:,.0f} envíos')
Con días al azar se elige n_knots = 32, con error de validación 1,940 envíos
Con el periodo posterior se eligió n_knots = 28, con error de validación 2,314 envíos
Error real en 2025 del modelo elegido: 2,413 envíos
Con días al azar se eligen 32 knots y la validación promete un error de 1 940 envíos. El error real del modelo en 2025 es de 2 413. La validación al azar es optimista porque cada día validado tiene a su lado, en el ajuste, el día anterior y el siguiente de la misma temporada y del mismo año; cuando planeas 2025 no tienes ningún día de 2025. Una promesa de error demasiado baja lleva a programar sin margen y a confiar en el modelo más de lo que merece.
Error 3: olvidar el día de la semana. El modelo con solo la curva del año y la tendencia parece más simple.
# Error 3: olvidar el día de la semana y dejar solo la curva del año y la tendencia.X_sin_dia = np.column_stack([bases_anio.transform(historia[['dia_del_anio']]), historia[['anios']].to_numpy()])modelo_sin_dia = LinearRegression().fit(X_sin_dia, np.log(historia['envios']))X_prueba_sin_dia = np.column_stack([bases_anio.transform(prueba[['dia_del_anio']]), prueba[['anios']].to_numpy()])prediccion_sin_dia = np.exp(modelo_sin_dia.predict(X_prueba_sin_dia))errores = np.abs(prediccion_sin_dia - prueba['envios'])print(f'Error absoluto medio en 2025 sin el día de la semana: {errores.mean():,.0f} envíos')for d in [0, 5, 6]: es_dia = (prueba['dia_semana'] == d).to_numpy()print(f' {NOMBRES_DIA[d]}: real promedio {prueba["envios"][es_dia].mean():,.0f} | 'f'pronóstico promedio {prediccion_sin_dia[es_dia].mean():,.0f}')
Error absoluto medio en 2025 sin el día de la semana: 16,920 envíos
  lunes: real promedio 59,347 | pronóstico promedio 40,471
  sábado: real promedio 32,885 | pronóstico promedio 40,459
  domingo: real promedio 9,658 | pronóstico promedio 40,465
Sin el día de la semana, el error sube a 16 920 envíos por día. El modelo pronostica casi lo mismo para todos los días de la semana, unos 40 460 envíos en promedio: se queda corto los lunes, que reciben 59 347, y se pasa por mucho los domingos, que reciben 9 658. Un spline sobre el día del año no puede representar un patrón que se repite cada siete días; ese patrón necesita su propia variable.
Conclusiones del caso
Los envíos combinan una curva anual, un serrucho semanal y un crecimiento, y cada patrón entró al modelo como un bloque de columnas: un spline periódico de 28 knots, seis columnas del día de la semana y una tendencia.
El modelo se puede leer por partes: el pico del 14 de diciembre está 49 % sobre el promedio del año, el domingo tiene 83.9 % menos envíos que el lunes y el volumen crece 6.5 % al año.
En 2025, el error bajó de 5 673 envíos por día con la regla actual a 2 413 con el modelo, y el costo de programar de más o de menos, de 246.6 a 104.1 millones de pesos.
La validación respetó el tiempo: los knots se eligieron con el segundo semestre de 2024 y 2025 se abrió una sola vez.
¿Qué te llevas de este caso? Un spline puede ser una pieza de un modelo más grande. La forma de cada pieza sale del análisis descriptivo: una curva que se repite cada año pide un spline periódico sobre el día del año, y un patrón de siete niveles pide columnas del día de la semana. Y en un pronóstico, la validación tiene que imitar el uso real: ajustar con el pasado y medir en el futuro.
Los límites del caso: las temporadas del simulador caen el mismo día cada año, y en la realidad Black Friday, el Día de la Madre o la Semana Santa se mueven; los festivos, que en Colombia suelen caer en lunes, tampoco están en los datos. Un modelo real necesitaría columnas para esos eventos. Los costos y la productividad son supuestos del caso.
Ejercicios del caso
Repite la elección de knots con la validación de julio a diciembre de 2024, pero con knots en los cuantiles del día del año. ¿Tiene sentido usar cuantiles en este problema?
El modelo comete su mayor error en diciembre. Propón una columna adicional que ayude en esa temporada y explica qué patrón capturaría.
Con los costos del caso, un turno de más cuesta 150 000 pesos y uno de menos, 112 500. ¿Conviene programar un poco por debajo o un poco por encima del pronóstico? Pruébalo multiplicando el pronóstico por 0.97 y por 1.03 antes de calcular los operarios.
¿Qué pasaría con el pronóstico de 2025 si quitaras la columna de tendencia?
¿Por qué el modelo no necesita las semanas anteriores para pronosticar, y qué ventaja tiene eso para la planeación?
TipOrientaciones
Los días del año están repartidos de manera pareja, porque hay uno por cada fecha, así que los cuantiles quedarían casi en el mismo lugar que los knots uniformes. Los cuantiles ayudan cuando los datos se concentran en una zona, como las velocidades del caso 1.
Por ejemplo, una columna que valga 1 en la semana de Black Friday de cada año, aunque cambie de fecha, o una que cuente los días que faltan para Navidad. Capturarían eventos que el spline sobre el día del año no puede ubicar con precisión.
Como un turno de más cuesta más que uno de menos, programar un poco por debajo del pronóstico debería bajar el costo total. El factor que más lo reduce se elige con la validación, no con 2025.
El modelo pronosticaría 2025 con el nivel promedio de 2023 y 2024, sin el crecimiento, y se quedaría corto casi todos los días.
Porque sus entradas son el día del año, el día de la semana y los años transcurridos, que se conocen para cualquier fecha futura. Por eso el plan se puede hacer con un mes o un trimestre de anticipación, algo que la regla de las cuatro semanas no permite.
Referencias para profundizar
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. El capítulo 5 trata las expansiones de base y los splines.
James, G., Witten, D., Hastie, T., Tibshirani, R. y Taylor, J. (2023). An Introduction to Statistical Learning with Applications in Python. Springer. El capítulo 7 cubre splines y modelos aditivos.
Hyndman, R. J. y Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3.ª ed.). OTexts. https://otexts.com/fpp3/. Pronóstico con estacionalidad, variables de calendario y validación en el tiempo.
Efron, B. y Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall.
Un spline sirve para muchas preguntas de la operación, siempre que la variable del eje horizontal, la ubicación de los knots y la forma de validar salgan del problema y de los datos.
En la troncal, un spline con knots en los cuantiles siguió la U asimétrica del consumo (error de 1.686 litros por 100 km en la carretera, frente a 3.529 de la parábola) y encontró el mínimo en 56.0 km/h.
El bootstrap convirtió ese mínimo en un intervalo, de 53.5 a 61.5 km/h, y mostró que la curva es menos confiable donde hay pocos datos; programar a 60 km/h ahorraría unos 1 440 litros al mes.
En el centro de clasificación, un spline periódico sobre el día del año, unido al día de la semana y a una tendencia, bajó el error de 5 673 a 2 413 envíos por día y el costo de los errores de programación de 246.6 a 104.1 millones de pesos en 2025.
Un polinomio global, un spline usado fuera del rango de sus datos o un spline sobre la fecha en lugar del día del año dan respuestas que parecen precisas y no lo son.
Puente hacia los siguientes capítulos
En los dos casos el spline construyó la curva con polinomios por tramos. El capítulo de métodos de kernel estima una curva de otra forma: promediando los puntos cercanos a cada valor de \(X\), con un ancho de ventana en lugar de knots. Y el segundo caso adelantó la idea del capítulo de modelos aditivos: sumar una función flexible por cada variable y leer el modelo por partes.