BITLogística es una empresa ficticia. Las entregas, las zonas, los indicadores y los costos de este caso se generan o se suponen dentro del propio caso y no corresponden a BIT, a ningún cliente ni a ninguna ciudad real. Las reglas del simulador están en el código del paso 1.
En BITLogística, una de cada cinco entregas falla en el primer intento porque no hay nadie que reciba el paquete. Cada fallo obliga a un reintento: otro viaje, otra manipulación del paquete y un cliente que espera un día más. La operación tiene una herramienta barata para evitarlo: el centro de contacto puede llamar al cliente antes de que salga el conductor para confirmar que habrá alguien o cambiar la franja. Pero llamar a todos cuesta, y la mayoría de las entregas no iban a fallar.
Se debe estimar, para cada entrega, la probabilidad de que falle en el primer intento, y usarla para decidir a qué clientes llamar antes de salir.
Para cada entrega se conocen la hora programada de la visita, la distancia al centro de distribución, si el cliente paga al recibir y diez indicadores de la zona de destino. Cada herramienta entra por una razón concreta:
Herramienta
Qué parte del problema resuelve
Capítulo
Regresión logística (GLM)
La respuesta es sí o no (la entrega falló o no) y la decisión necesita una probabilidad
Los códigos priorizan la claridad sobre la eficiencia: usan nombres largos, bucles explícitos y comentarios numerados, para que puedas seguir cada operación línea por línea.
Tiempo estimado de lectura: 50 minutos (alrededor de una hora y cuarto si ejecutas el código)
Los datos son simulados con las reglas y la semilla central (SEMILLA = 2026) declaradas en el código del paso 1: 6 000 entregas en 150 zonas. Todo corre en CPU y las versiones se imprimen en la primera celda de código.
Objetivos
Al terminar este caso vas a ser capaz de:
reconocer en el análisis descriptivo qué parte de un problema pide un spline, cuál pide PCA y cuál un GLM;
incluir un spline y un PCA dentro de una regresión logística, con un ColumnTransformer y un Pipeline que evitan la fuga de información;
elegir a la vez el número de knots y de componentes con validación cruzada y la regla de un error estándar;
comparar modelos por su pérdida logarítmica, su AUC, su calibración y la estabilidad de sus coeficientes;
convertir la probabilidad del modelo en una decisión de operación con un umbral derivado de los costos;
usar un GAM completo como diagnóstico para comprobar qué variables necesitan curva.
Ejecuta las celdas en orden: cada paso usa variables creadas en los anteriores.
El plan de trabajo
El caso sigue once pasos. Los tres primeros preparan y miran los datos; del cuarto al séptimo se construye el modelo pieza por pieza; del octavo al décimo se evalúa, se interpreta y se lleva a una decisión, y el último lo comprueba con un GAM completo.
Paso
Qué haces
Herramienta
1
Conocer los datos de entregas y zonas
simulador del caso
2
Reservar la prueba
train_test_split
3
Mirar la hora y los indicadores de la zona
tasas por media hora y matriz de correlaciones
4
Construir dos líneas base
tasa global y regresión logística con las variables crudas
5
Resumir la zona en pocos componentes
StandardScaler y PCA
6
Dejar que la hora tenga forma propia
SplineTransformer dentro de la logística
7
Armar el modelo integrado y elegir knots y componentes
ColumnTransformer, Pipeline, validación cruzada
8
Evaluar en la prueba
pérdida logarítmica, AUC y calibración
9
Leer el modelo
razones de momios y estabilidad de los coeficientes
10
Pasar de la probabilidad a la decisión
umbral según los costos
11
Comprobar si otras variables necesitan curva
GAM completo y efectos parciales
Preparación del entorno
La celda carga las librerías, fija la semilla central y define los colores de las figuras.
%matplotlib inline%config InlineBackend.figure_format ="retina"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_scorefrom sklearn.preprocessing import SplineTransformer, StandardScalerfrom sklearn.decomposition import PCAfrom sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipelinefrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import log_loss, roc_auc_score, accuracy_scoreSEMILLA =2026# semilla central del librorng = np.random.default_rng(SEMILLA)COLOR_DATOS ='#457B9D'COLOR_SPLINE ='#487A35'COLOR_RECTA ='#EE5400'COLOR_VERDAD ='#2B2B2B'plt.rcParams.update({'figure.figsize': (9, 5),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# Versiones del entorno con el que se ejecutó el caso.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scikit-learn']:print(paquete +':', metadatos.version(paquete))
La salida muestra las versiones del entorno con que se ejecutó el caso, con Python 3.13.
C.1 Paso 1. Conocer los datos
El simulador genera los datos en cuatro bloques:
Las zonas. Cada una de las 150 zonas tiene dos rasgos que nadie mide directamente: qué tanto predominan los edificios con portería, donde alguien recibe el paquete aunque el cliente no esté, y qué tanto se vacían los hogares durante el día, porque sus habitantes trabajan fuera. Lo que sí se mide son diez indicadores, cada uno una mezcla ruidosa de esos rasgos: el porcentaje de apartamentos, de edificios con portería, los pisos promedio, la densidad de hogares, el estrato, los hogares unipersonales, los adultos que trabajan fuera, los hogares con un adulto mayor, los hogares con niños y los comercios por km².
Las entregas. 6 000 entregas, cada una con su zona, una hora de visita entre las 8:00 y las 19:00, una distancia de 1 a 25 km y un 30 % con pago contraentrega.
El riesgo verdadero, en la escala logit de la regresión logística: un efecto de la hora con dos picos (media mañana y media tarde) y una caída al final del día, un aumento si el pago es contraentrega, uno pequeño con la distancia, una baja en zonas de edificios con portería y una subida en zonas que se vacían de día. Con ese riesgo se sortea si cada entrega falla.
La tabla final, una fila por entrega con los indicadores de su zona.
En un proyecto real no conocerías el riesgo verdadero; aquí sirve para comprobar si el modelo lo recupera.
# ---------- 1. Las zonas de entrega y sus indicadores ----------# Cada zona tiene dos rasgos que no se miden directamente:# edificios: qué tanto predominan los edificios con portería (alguien recibe el paquete);# ausencia: qué tanto se vacían los hogares durante el día (nadie recibe).# Los 10 indicadores que sí se miden son mezclas ruidosas de esos dos rasgos.n_zonas =150edificios = rng.normal(0, 1, n_zonas)ausencia = rng.normal(0, 1, n_zonas)def indicador(peso_edificios, peso_ausencia, promedio, escala, ruido):"""Un indicador medido: promedio + escala * (mezcla de los dos rasgos + ruido).""" mezcla = peso_edificios * edificios + peso_ausencia * ausencia + rng.normal(0, ruido, n_zonas)return promedio + escala * mezclazonas = pd.DataFrame({'zona': np.arange(n_zonas),'pct_apartamentos': indicador(1, 0, 55, 14, 0.35), # % de viviendas que son apartamentos'pct_porteria': indicador(1, 0, 35, 12, 0.35), # % de edificios con portería'pisos_promedio': indicador(1, 0, 6, 2.0, 0.40), # pisos por edificio'densidad_hogares': indicador(1, 0, 9000, 2500, 0.45), # hogares por km²'estrato_promedio': indicador(0.8, 0, 3.3, 0.8, 0.50), # estrato socioeconómico medio'pct_unipersonales': indicador(0, 1, 18, 5, 0.40), # % de hogares de una persona'pct_trabajan_fuera': indicador(0, 1, 62, 8, 0.35), # % de adultos que trabajan fuera de casa'pct_adulto_mayor': indicador(0, -1, 22, 6, 0.40), # % de hogares con un adulto mayor'pct_con_ninos': indicador(0, -0.8, 30, 7, 0.45), # % de hogares con niños'comercios_km2': rng.normal(120, 35, n_zonas), # comercios por km² (no depende de los rasgos)})# ---------- 2. Las entregas ----------n_entregas =6000zona = rng.integers(0, n_zonas, n_entregas) # zona de cada entregahora = rng.uniform(8, 19, n_entregas) # hora de la visita, de 8:00 a 19:00distancia = rng.uniform(1, 25, n_entregas) # km desde el centro de distribucióncontraentrega = (rng.random(n_entregas) <0.3).astype(int) # 1 si el cliente paga al recibir# ---------- 3. El riesgo verdadero de que la entrega falle (escala logit) ----------# Efecto de la hora: sube a media mañana y a media tarde, baja al final del día.def efecto_hora(h):return (1.4* np.exp(-0.5* ((h -10.3) /1.4) **2)+1.2* np.exp(-0.5* ((h -15.6) /1.4) **2)-0.9* np.exp(-0.5* ((h -18.5) /0.8) **2))logit = (-2.7+ efecto_hora(hora) +0.55* contraentrega +0.01* distancia-0.65* edificios[zona] +0.55* ausencia[zona])probabilidad =1/ (1+ np.exp(-logit))fallo = (rng.random(n_entregas) < probabilidad).astype(int) # 1 = nadie recibió# ---------- 4. La tabla final: una fila por entrega, con los indicadores de su zona ----------entregas = pd.DataFrame({'zona': zona, 'hora': hora.round(2), 'distancia': distancia.round(1),'contraentrega': contraentrega, 'fallo': fallo,}).merge(zonas, on='zona', how='left')INDICADORES = [c for c in zonas.columns if c !='zona']print('Entregas:', len(entregas), '| zonas:', n_zonas, '| indicadores por zona:', len(INDICADORES))print(f'Entregas fallidas: {entregas["fallo"].sum()} ({entregas["fallo"].mean():.1%})')display(entregas.head().round(2))
El simulador produjo 6 000 entregas en 150 zonas, con 10 indicadores por zona. Fallaron 1 226 entregas, el 20.4 %, cerca de la «una de cada cinco» de la operación. Las primeras filas muestran la estructura de la tabla: la hora con decimales (13.62 son las 13:37), la distancia en km, la marca de contraentrega, el resultado y, a continuación, los indicadores de la zona, repetidos en todas las entregas de esa zona.
C.2 Paso 2. Reservar la prueba
Antes de mirar los datos separas un 25 % de las entregas como prueba. Con stratify las dos partes conservan la misma proporción de fallos. Todas las decisiones del caso (cuántos knots, cuántos componentes, qué umbral) se tomarán con el entrenamiento; la prueba se abrirá una sola vez, en el paso 8.
La partición es por entrega, así que las zonas aparecen en las dos partes. Eso corresponde al uso real: el modelo se usará con entregas nuevas en zonas que la empresa ya atiende. Si la pregunta fuera cómo se comporta en zonas nuevas, habría que separar por zona.
# Separar 25 % de las entregas como prueba, con la misma proporción de fallos en las dos partes.entrenamiento, prueba = train_test_split( entregas, test_size=0.25, random_state=SEMILLA, stratify=entregas['fallo'])y_entrenamiento = entrenamiento['fallo']y_prueba = prueba['fallo']print('Entrenamiento:', len(entrenamiento), f'entregas ({y_entrenamiento.mean():.1%} fallidas)')print('Prueba: ', len(prueba), f'entregas ({y_prueba.mean():.1%} fallidas)')
Quedan 4 500 entregas de entrenamiento, con 20.4 % de fallos, y 1 500 de prueba, con 20.5 %.
C.3 Paso 3. Mirar la hora y la zona
El análisis descriptivo decide qué herramienta necesita cada variable. Aquí miras las dos que generan dudas: la hora y los indicadores de la zona.
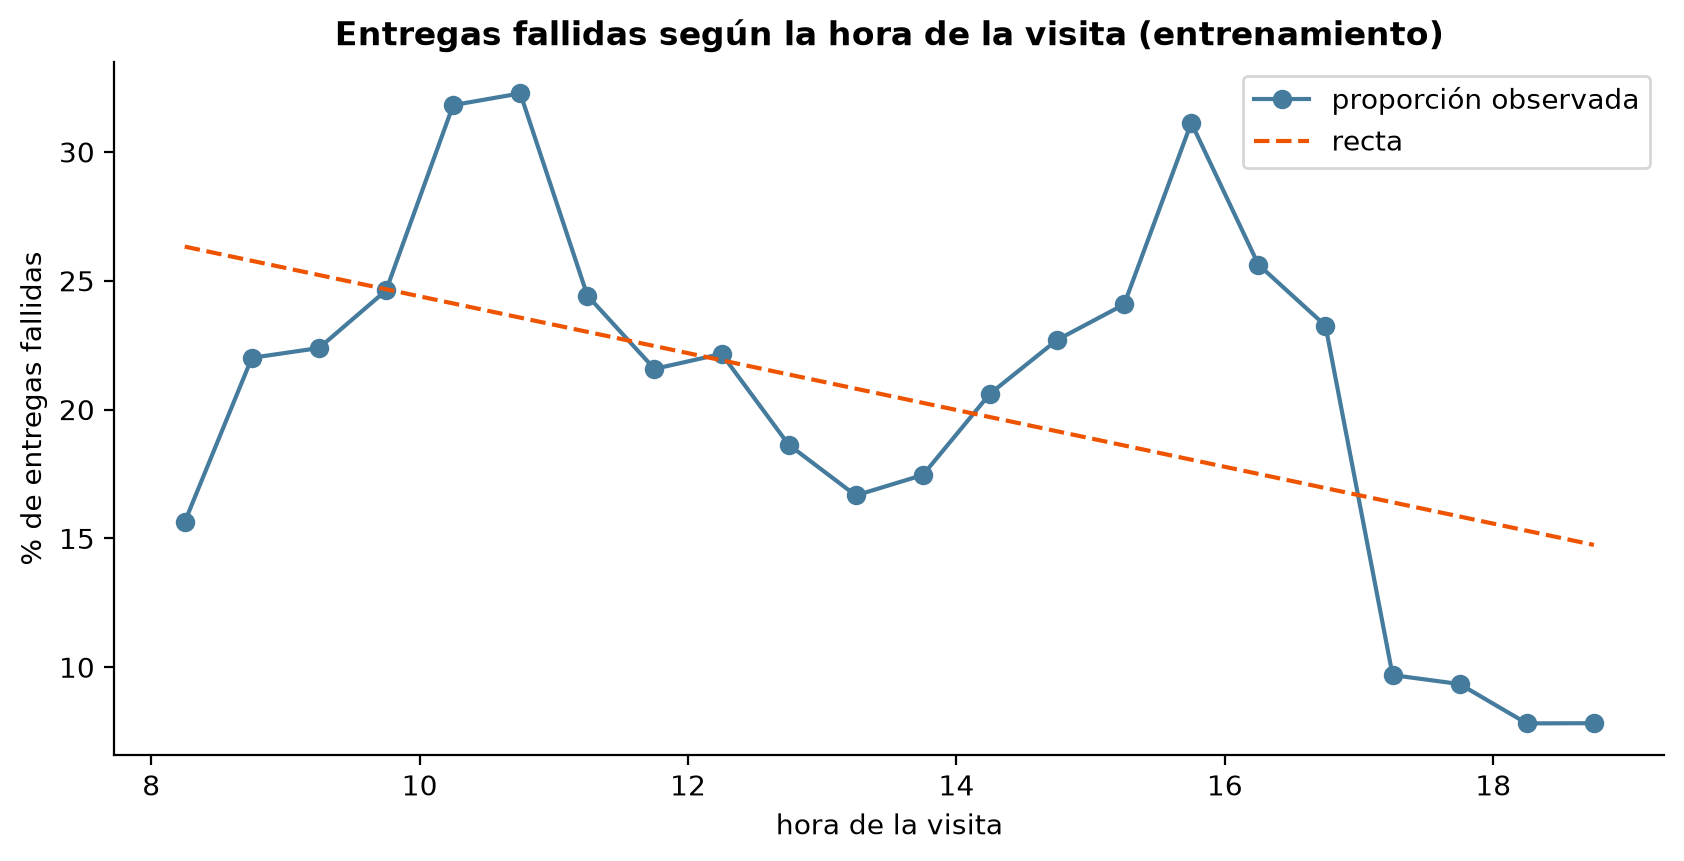
La primera celda agrupa las entregas de entrenamiento por media hora de visita, calcula la proporción de fallos en cada media hora y la dibuja junto con una recta ajustada a esas proporciones.
# 1. Agrupar las entregas por media hora de visita y calcular la proporción de fallos.franja = (entrenamiento['hora'] //0.5) *0.5# 8.0, 8.5, 9.0, ... (inicio de cada media hora)franja = franja.clip(upper=18.5) # las visitas de las 19:00 en punto van a la última media horapor_franja = entrenamiento.groupby(franja)['fallo'].agg(['mean', 'size'])centros = por_franja.index +0.25# centro de cada media hora# 2. Una recta de mínimos cuadrados sobre esas proporciones, solo para comparar la forma.pendiente, intercepto = np.polyfit(centros, por_franja['mean'], 1)plt.figure(figsize=(10, 4.5))plt.plot(centros, por_franja['mean'] *100, marker='o', color=COLOR_DATOS, label='proporción observada')plt.plot(centros, (intercepto + pendiente * centros) *100, color=COLOR_RECTA, ls='--', label='recta')plt.xlabel('hora de la visita')plt.ylabel('% de entregas fallidas')plt.title('Entregas fallidas según la hora de la visita (entrenamiento)')plt.legend()plt.show()# 3. Las cifras de la figura.print(f'Entregas por media hora: entre {por_franja["size"].min()} y {por_franja["size"].max()}')for inicio in [8.0, 10.0, 12.5, 15.5, 18.5]:print(f' {inicio:4.1f} h: {por_franja.loc[inicio, "mean"]:.1%} de fallos')print(f'Pendiente de la recta: {pendiente *100:+.2f} puntos porcentuales por hora')
Entregas por media hora: entre 179 y 243
   8.0 h: 15.6% de fallos
  10.0 h: 31.8% de fallos
  12.5 h: 18.6% de fallos
  15.5 h: 31.1% de fallos
  18.5 h: 7.8% de fallos
Pendiente de la recta: -1.10 puntos porcentuales por hora
En la figura, la proporción de fallos sube y baja dos veces a lo largo del día. Empieza en 15.6 % a las 8:00, llega a 31.8 % a las 10:00, baja a 18.6 % a las 12:30, vuelve a subir a 31.1 % a las 15:30 y cae a 7.8 % a las 18:30. Cada media hora tiene entre 179 y 243 entregas, así que la forma no es ruido de grupos pequeños. La explicación operativa es razonable: a media mañana y a media tarde la gente está en el trabajo; al mediodía algunos almuerzan en casa, y al final del día ya volvieron.
La recta naranja resume todo eso con una pendiente de −1.10 puntos porcentuales por hora: dice que el riesgo baja un poco a lo largo del día y pierde los dos picos. En una regresión logística, la hora como número haría lo mismo, porque le impone un solo efecto para todo el día. La hora pide un spline, igual que el tráfico del capítulo de splines.
La segunda celda mira los diez indicadores de la zona: dibuja su matriz de correlaciones, calculada con una fila por zona, y cuenta los pares con correlación mayor que 0.7 en valor absoluto.
# 1. Correlaciones entre los indicadores, calculadas con las zonas (una fila por zona).correlaciones = zonas[INDICADORES].corr()fig, ax = plt.subplots(figsize=(8.5, 7))imagen = ax.imshow(correlaciones, cmap='RdBu_r', vmin=-1, vmax=1)ax.set_xticks(range(len(INDICADORES)))ax.set_xticklabels(INDICADORES, rotation=60, ha='right')ax.set_yticks(range(len(INDICADORES)))ax.set_yticklabels(INDICADORES)for fila inrange(len(INDICADORES)):for columna inrange(len(INDICADORES)): valor = correlaciones.iloc[fila, columna] ax.text(columna, fila, f'{valor:.2f}', ha='center', va='center', fontsize=7, color='white'ifabs(valor) >0.6else'black')fig.colorbar(imagen, ax=ax, label='correlación')ax.set_title('Correlaciones entre los indicadores de las zonas')plt.tight_layout()plt.show()# 2. Cuántos pares de indicadores tienen una correlación mayor que 0.7 en valor absoluto.pares =0pares_altos =0for i inrange(len(INDICADORES)):for j inrange(i +1, len(INDICADORES)): pares = pares +1ifabs(correlaciones.iloc[i, j]) >0.7: pares_altos = pares_altos +1print(f'Pares con |correlación| > 0.7: {pares_altos} de {pares}')print(f'Apartamentos y portería: {correlaciones.loc["pct_apartamentos", "pct_porteria"]:.2f}')print(f'Trabajan fuera y adulto mayor: {correlaciones.loc["pct_trabajan_fuera", "pct_adulto_mayor"]:.2f}')
Pares con |correlación| > 0.7: 16 de 45
Apartamentos y portería: 0.90
Trabajan fuera y adulto mayor: -0.89
El mapa de correlaciones muestra dos bloques. En el primero, apartamentos, portería, pisos, densidad y estrato se mueven juntos: la correlación entre apartamentos y portería es 0.90. En el segundo, hogares unipersonales y adultos que trabajan fuera suben juntos y bajan cuando suben los hogares con adulto mayor o con niños: la correlación entre trabajan fuera y adulto mayor es −0.89. Los comercios por km² no se relacionan con ningún otro indicador. En total, 16 de los 45 pares superan 0.7 en valor absoluto.
Diez columnas que en realidad cuentan dos historias son el caso típico para PCA. Y son, también, un problema para una regresión logística, como muestra el paso siguiente.
C.4 Paso 4. Dos líneas base
Antes de construir el modelo con spline y PCA, necesitas saber cuánto hay que superar. Comparas los modelos con la pérdida logarítmica (log-loss), la medida natural para probabilidades: castiga más cuanto más confiada y equivocada es una predicción, y cuanto más baja, mejor. Si dices 0.9 de probabilidad de fallo y la entrega no falla, pierdes mucho; si dices 0.5, pierdes menos.
La celda construye dos líneas base:
Define los cinco bloques de la validación cruzada y una función que mide la pérdida logarítmica media de un modelo en esos bloques.
Línea base A: predecir para todas las entregas la tasa de fallo del entrenamiento. Es lo que haría alguien sin modelo.
Línea base B: una regresión logística con todo lo disponible, tal cual: la hora como número, los diez indicadores estandarizados, la distancia y la contraentrega. Con C=np.inf es la regresión logística sin penalización del capítulo de GLM.
Muestra los coeficientes de los diez indicadores en la logística cruda.
# 1. Cinco bloques estratificados para la validación cruzada (la misma en todo el caso).bloques = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)def perdida_cv(modelo):"""Pérdida logarítmica media de validación cruzada en el entrenamiento (menor es mejor)."""return-cross_val_score(modelo, entrenamiento, y_entrenamiento, cv=bloques, scoring='neg_log_loss').mean()# 2. Línea base A: predecir para todas las entregas la tasa de fallo del entrenamiento.tasa = y_entrenamiento.mean()print(f'Línea base A (tasa global {tasa:.3f}): pérdida en entrenamiento 'f'{log_loss(y_entrenamiento, np.full(len(y_entrenamiento), tasa)):.4f}')# 3. Línea base B: regresión logística con la hora como número y los 10 indicadores estandarizados.# C=np.inf: sin penalización, la regresión logística del capítulo de GLM.columnas_cruda = ColumnTransformer([ ('hora', 'passthrough', ['hora']), ('zona', StandardScaler(), INDICADORES), ('resto', 'passthrough', ['distancia', 'contraentrega']),])logistica_cruda = Pipeline([ ('columnas', columnas_cruda), ('logistica', LogisticRegression(C=np.inf, max_iter=10000)),])print(f'Línea base B (logística cruda): pérdida CV {perdida_cv(logistica_cruda):.4f}')# 4. Los coeficientes de los indicadores en la logística cruda.logistica_cruda.fit(entrenamiento, y_entrenamiento)nombres = logistica_cruda.named_steps['columnas'].get_feature_names_out()coeficientes_crudos = pd.Series(logistica_cruda.named_steps['logistica'].coef_[0], index=nombres)print()print('Coeficientes de los indicadores (por desviación estándar del indicador):')print(coeficientes_crudos[[f'zona__{c}'for c in INDICADORES]].round(3).to_string())
Línea base A (tasa global 0.204): pérdida en entrenamiento 0.5062
Línea base B (logística cruda): pérdida CV 0.4536

Coeficientes de los indicadores (por desviación estándar del indicador):
zona__pct_apartamentos     -0.191
zona__pct_porteria         -0.160
zona__pisos_promedio       -0.239
zona__densidad_hogares     -0.081
zona__estrato_promedio      0.001
zona__pct_unipersonales     0.192
zona__pct_trabajan_fuera    0.121
zona__pct_adulto_mayor     -0.146
zona__pct_con_ninos        -0.123
zona__comercios_km2        -0.033
La línea base A tiene una pérdida de 0.5062 en el entrenamiento; la logística cruda baja a 0.4536 en la validación cruzada. Los datos sí tienen información sobre el fallo.
Los coeficientes de los indicadores muestran el problema de la redundancia. Como cada indicador está estandarizado, cada coeficiente es el cambio en el logit por una desviación estándar del indicador, manteniendo los demás fijos. Pero «manteniendo los demás fijos» no tiene sentido cuando apartamentos y portería se mueven juntos en el 90 % de los casos: el modelo reparte el efecto de los edificios entre cinco columnas de forma arbitraria. Por eso el estrato, que forma parte del mismo bloque, queda con un coeficiente de 0.001, como si no importara, mientras que los pisos promedio se llevan −0.239. El paso 9 muestra que esos coeficientes cambian mucho si se repite el ajuste con otra muestra.
C.5 Paso 5. Resumir la zona con PCA
PCA reemplaza los diez indicadores correlacionados por unos pocos componentes que no están correlacionados entre sí. Como los indicadores tienen escalas muy distintas (la densidad está en miles de hogares por km² y el estrato va de 1 a 6), primero se estandarizan, como viste en el capítulo de PCA.
La celda:
Ajusta el estandarizador y PCA con los indicadores de las entregas de entrenamiento y muestra la varianza que explica cada componente.
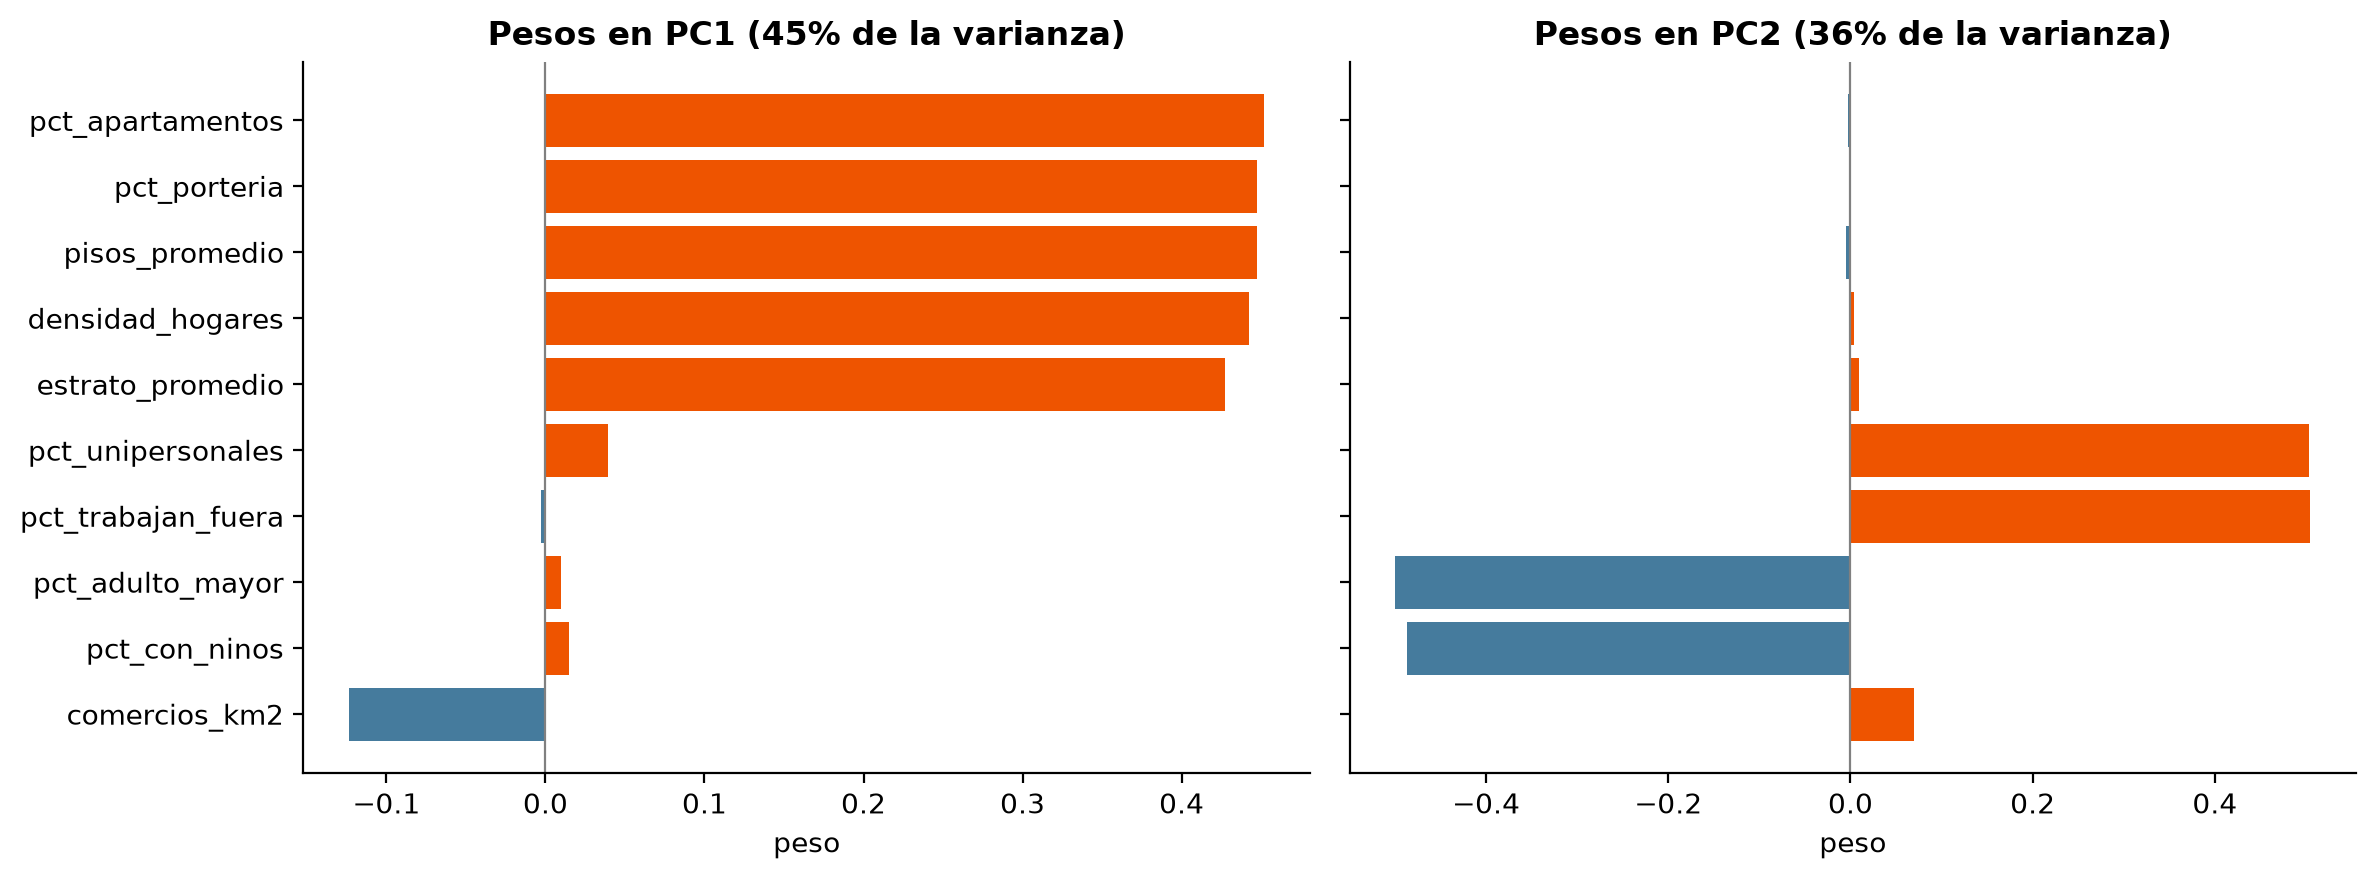
Dibuja los pesos de cada indicador en PC1 y PC2 y los muestra en una tabla.
# 1. PCA sobre los 10 indicadores estandarizados de las entregas de entrenamiento.pca_zona = Pipeline([ ('estandarizar', StandardScaler()), ('pca', PCA(svd_solver='full')),])pca_zona.fit(entrenamiento[INDICADORES])varianza = pca_zona.named_steps['pca'].explained_variance_ratio_print('Varianza explicada por componente:', np.round(varianza[:5], 3))print('Acumulada: ', np.round(np.cumsum(varianza)[:5], 3))# 2. Pesos de cada indicador en PC1 y PC2.cargas = pd.DataFrame(pca_zona.named_steps['pca'].components_[:2].T, index=INDICADORES, columns=['PC1', 'PC2'])fig, ax = plt.subplots(1, 2, figsize=(12, 4.5), sharey=True)for panel, componente inzip(ax, ['PC1', 'PC2']): colores = [COLOR_RECTA if peso >0else COLOR_DATOS for peso in cargas[componente]] panel.barh(INDICADORES, cargas[componente], color=colores) panel.axvline(0, color='gray', lw=0.8) panel.set_title(f'Pesos en {componente} ({varianza[["PC1", "PC2"].index(componente)]:.0%} de la varianza)') panel.set_xlabel('peso')ax[0].invert_yaxis()plt.tight_layout()plt.show()display(cargas.round(2).T)
Los dos primeros componentes conservan el 80.8 % de la varianza de los diez indicadores: PC1 el 44.5 % y PC2 el 36.3 %. El tercero agrega 9.4 % y los siguientes, menos del 3 % cada uno.
Los pesos de la figura tienen una lectura muy limpia:
PC1 pesa casi lo mismo, entre 0.43 y 0.45, en apartamentos, portería, pisos, densidad y estrato, y casi nada en el resto. Una zona con PC1 alto es una zona de edificios con portería.
PC2 pesa +0.50 en hogares unipersonales y adultos que trabajan fuera, y −0.50 y −0.49 en hogares con adulto mayor y con niños. Una zona con PC2 alto es una zona de hogares que se vacían de día.
PCA recuperó, sin conocerlos, los dos rasgos con que el simulador construyó las zonas. Los comercios por km², que no tienen relación con ninguno, casi no pesan en los dos componentes. El signo de cada componente es arbitrario; aquí quedó positivo en la dirección de los nombres, lo que facilita la lectura.
En este paso ajustaste PCA por fuera del modelo solo para mirarlo. En el modelo integrado del paso 7 irá dentro del Pipeline, para que en la validación cruzada se ajuste solo con los bloques de entrenamiento.
C.6 Paso 6. Dejar que la hora tenga forma propia
Ahora comparas dos regresiones logísticas que solo se diferencian en cómo entra la hora. Las dos usan ya los dos componentes de la zona, la distancia y la contraentrega:
en la primera, la hora entra como número, con una sola pendiente para todo el día;
en la segunda, la hora entra con un spline cúbico de 5 knots, que fabrica varias columnas a partir de la hora y deja que la logística estime un peso para cada una.
include_bias=False le pide a SplineTransformer que no fabrique la columna que repetiría el intercepto de la logística; sin penalización, esa columna repetida dejaría los coeficientes sin una solución única.
La celda:
Construye las dos logísticas y compara su pérdida en la validación cruzada.
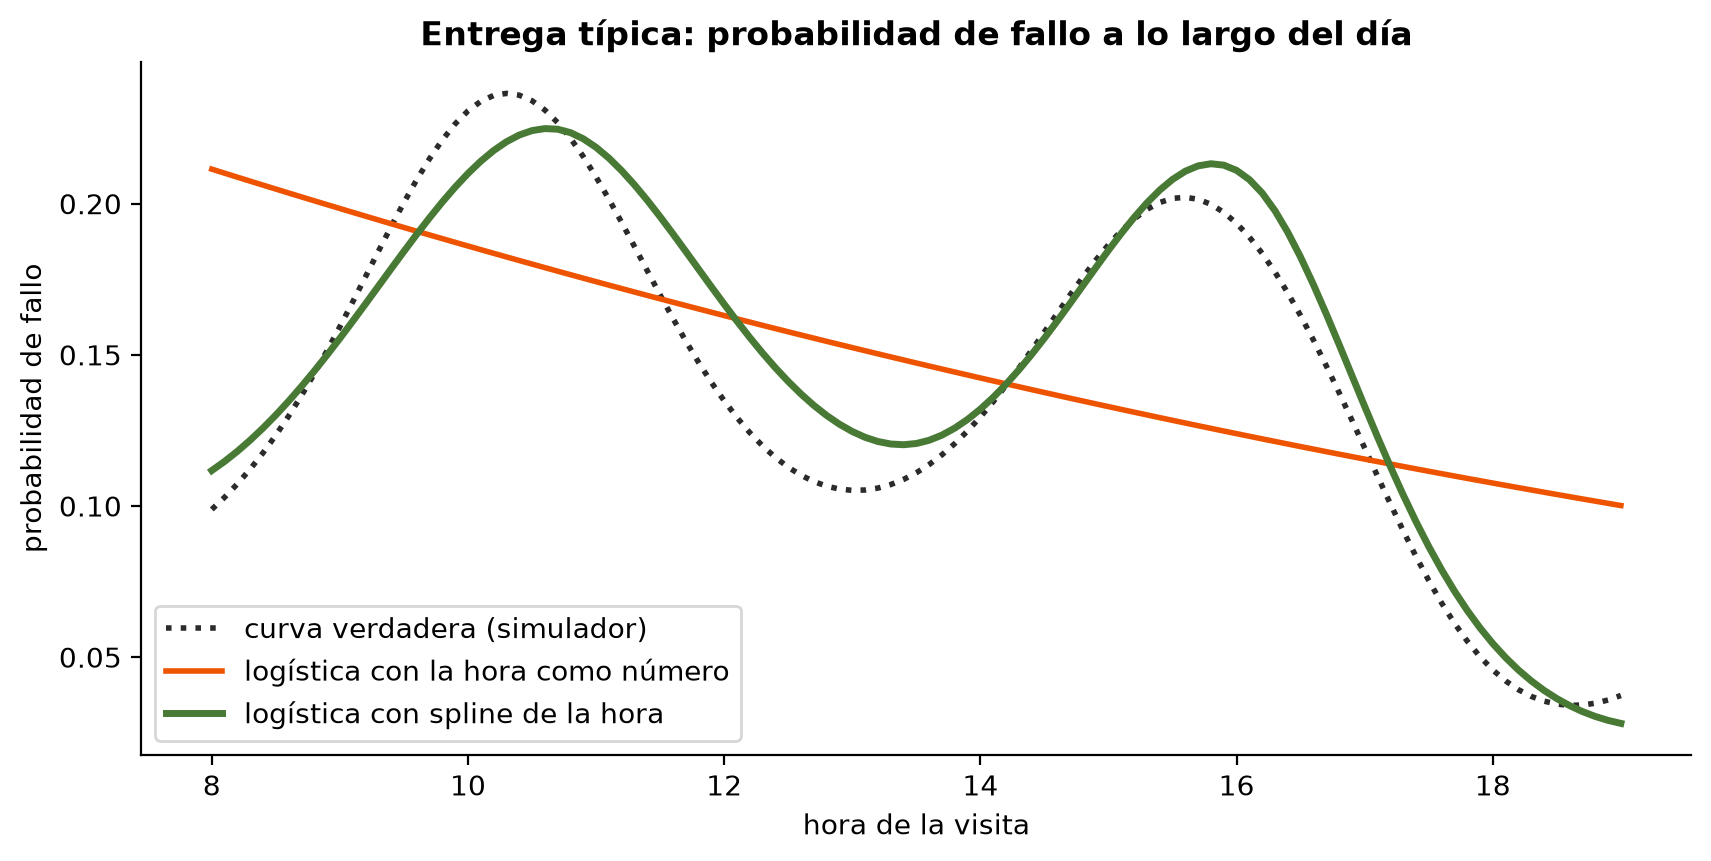
Calcula la probabilidad de fallo a lo largo del día para una entrega típica del entrenamiento (distancia mediana, sin contraentrega, indicadores promedio) con cada modelo, y la dibuja junto con la curva verdadera del simulador.
# 1. Dos logísticas que solo se diferencian en cómo entra la hora:# como número (una pendiente para todo el día) o con un spline cúbico de 5 knots.def logistica_con(columna_hora): columnas = ColumnTransformer([ ('hora', columna_hora, ['hora']), ('zona', Pipeline([('estandarizar', StandardScaler()), ('pca', PCA(n_components=2, svd_solver='full'))]), INDICADORES), ('resto', 'passthrough', ['distancia', 'contraentrega']), ])return Pipeline([('columnas', columnas), ('logistica', LogisticRegression(C=np.inf, max_iter=10000))])hora_recta = logistica_con('passthrough')# include_bias=False: la logística ya tiene su intercepto, así se evita una columna repetida.hora_spline = logistica_con(SplineTransformer(n_knots=5, degree=3, include_bias=False))print(f'Pérdida CV con la hora como número: {perdida_cv(hora_recta):.4f}')print(f'Pérdida CV con un spline de la hora: {perdida_cv(hora_spline):.4f}')# 2. Probabilidad de fallo a lo largo del día para una entrega típica del entrenamiento:# distancia mediana, sin contraentrega y con los indicadores promedio de las zonas.hora_recta.fit(entrenamiento, y_entrenamiento)hora_spline.fit(entrenamiento, y_entrenamiento)horas = np.linspace(8, 19, 111)tipica = pd.DataFrame({'hora': horas,'distancia': entrenamiento['distancia'].median(),'contraentrega': 0})for indicador_zona in INDICADORES: tipica[indicador_zona] = entrenamiento[indicador_zona].mean()prob_recta = hora_recta.predict_proba(tipica)[:, 1]prob_spline = hora_spline.predict_proba(tipica)[:, 1]logit_verdad =-2.7+ efecto_hora(horas) +0.01* entrenamiento['distancia'].median()prob_verdad =1/ (1+ np.exp(-logit_verdad)) # zona promedio: rasgos en 0plt.figure(figsize=(10, 4.5))plt.plot(horas, prob_verdad, color=COLOR_VERDAD, ls=':', lw=2, label='curva verdadera (simulador)')plt.plot(horas, prob_recta, color=COLOR_RECTA, lw=2, label='logística con la hora como número')plt.plot(horas, prob_spline, color=COLOR_SPLINE, lw=2.5, label='logística con spline de la hora')plt.xlabel('hora de la visita')plt.ylabel('probabilidad de fallo')plt.title('Entrega típica: probabilidad de fallo a lo largo del día')plt.legend()plt.show()for h in [8, 10, 12.5, 15.5, 18.5]: i = np.argmin(np.abs(horas - h))print(f' {h:4.1f} h: spline {prob_spline[i]:.3f} | recta {prob_recta[i]:.3f} | verdad {prob_verdad[i]:.3f}')
Pérdida CV con la hora como número: 0.4535
Pérdida CV con un spline de la hora: 0.4410
La pérdida de validación cruzada baja de 0.4535 con la hora como número a 0.4410 con el spline. Es la mejora más grande de todo el caso, y la figura muestra de dónde viene.
La curva verde del spline sigue a la curva verdadera, en negro punteado: para la entrega típica, la probabilidad de fallo es 0.112 a las 8:00, sube a 0.210 a las 10:00, baja a 0.141 a las 12:30, sube a 0.208 a las 15:30 y cae a 0.036 a las 18:30; el simulador dice 0.099, 0.231, 0.113, 0.202 y 0.034. La logística con la hora como número, en naranja, solo puede bajar de forma suave, de 0.211 a las 8:00 a 0.104 a las 18:30: sobrestima el riesgo temprano y tarde, y lo subestima en los dos picos.
Un spline dentro de una regresión logística sigue siendo una regresión logística: las columnas del spline son variables explicativas como cualquier otra, y el modelo estima un coeficiente para cada una. La curva de la figura es la suma de esas columnas por sus coeficientes, pasada por la función logística.
C.7 Paso 7. El modelo integrado
Ahora juntas las tres piezas en un solo modelo. Un ColumnTransformer trata cada grupo de columnas a su manera y pega el resultado; un Pipeline encadena eso con la regresión logística:
Este modelo es un modelo aditivo generalizado (GAM) como los del capítulo de modelos aditivos: suma una función suave de la hora y efectos lineales de las demás variables, y pasa todo por la función logística. Tiene un solo término suave; el paso 11 comprobará si hacen falta más.
Al estar todo dentro del Pipeline, la validación cruzada ajusta el spline, el estandarizador y PCA de nuevo en cada bloque, solo con sus datos de entrenamiento.
Quedan dos números por decidir: los knots del spline y los componentes de PCA. Los decides juntos, con validación cruzada, y aplicas la regla de un error estándar que viste en el capítulo de splines: entre las combinaciones cuya pérdida no supera la mejor más su error estándar, eliges la más simple. Las diferencias pequeñas de pérdida entre modelos parecidos pueden deberse al azar de los bloques, y un modelo más simple es más fácil de leer y de mantener.
La celda:
Define una función que fabrica el modelo integrado con un número de knots y de componentes.
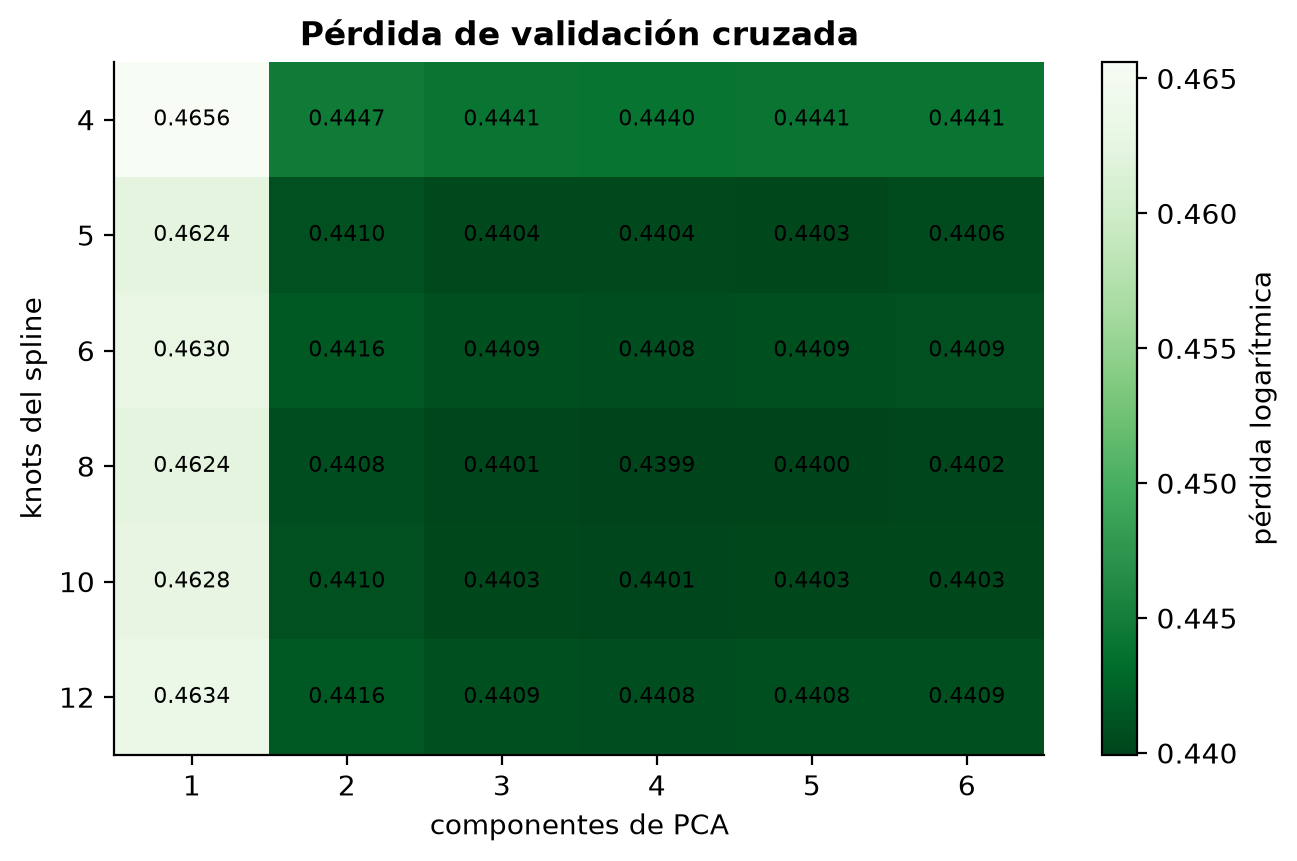
Mide la pérdida de validación cruzada y su error estándar para 6 valores de knots y 6 de componentes: 36 combinaciones.
Aplica la regla de un error estándar, usando como medida de complejidad la suma de knots y componentes.
Dibuja la grilla de pérdidas.
# 1. El modelo integrado: spline de la hora + PCA de la zona + distancia y contraentrega -> logística.def modelo_integrado(n_knots, n_componentes): columnas = ColumnTransformer([ ('hora', SplineTransformer(n_knots=n_knots, degree=3, include_bias=False), ['hora']), ('zona', Pipeline([('estandarizar', StandardScaler()), ('pca', PCA(n_components=n_componentes, svd_solver='full'))]), INDICADORES), ('resto', 'passthrough', ['distancia', 'contraentrega']), ])return Pipeline([('columnas', columnas), ('logistica', LogisticRegression(C=np.inf, max_iter=10000))])# 2. Probar todas las combinaciones de knots y componentes con la misma validación cruzada.filas = []for n_knots in [4, 5, 6, 8, 10, 12]:for n_componentes in [1, 2, 3, 4, 5, 6]: perdidas =-cross_val_score(modelo_integrado(n_knots, n_componentes), entrenamiento, y_entrenamiento, cv=bloques, scoring='neg_log_loss') filas.append({'n_knots': n_knots, 'n_componentes': n_componentes,'perdida': perdidas.mean(),'error_estandar': perdidas.std(ddof=1) / np.sqrt(len(perdidas))})grilla = pd.DataFrame(filas)# 3. Regla de un error estándar: entre las combinaciones cuya pérdida no supera# la mejor + su error estándar, elegir la más simple (menos knots + componentes).mejor = grilla.loc[grilla['perdida'].idxmin()]limite = mejor['perdida'] + mejor['error_estandar']aceptables = grilla[grilla['perdida'] <= limite].copy()aceptables['complejidad'] = aceptables['n_knots'] + aceptables['n_componentes']elegida = aceptables.sort_values(['complejidad', 'perdida']).iloc[0]N_KNOTS =int(elegida['n_knots'])N_COMPONENTES =int(elegida['n_componentes'])print(f'Mejor combinación: {int(mejor["n_knots"])} knots y {int(mejor["n_componentes"])} componentes, 'f'pérdida {mejor["perdida"]:.4f} (error estándar {mejor["error_estandar"]:.4f})')print(f'Límite de la regla: {limite:.4f}')print(f'Elegida: {N_KNOTS} knots y {N_COMPONENTES} componentes, pérdida {elegida["perdida"]:.4f}')# 4. La grilla como mapa de color.tabla = grilla.pivot(index='n_knots', columns='n_componentes', values='perdida')fig, ax = plt.subplots(figsize=(7.5, 4.5))imagen = ax.imshow(tabla, cmap='Greens_r', aspect='auto')ax.set_xticks(range(tabla.shape[1]))ax.set_xticklabels(tabla.columns)ax.set_yticks(range(tabla.shape[0]))ax.set_yticklabels(tabla.index)for fila inrange(tabla.shape[0]):for columna inrange(tabla.shape[1]): ax.text(columna, fila, f'{tabla.iloc[fila, columna]:.4f}', ha='center', va='center', fontsize=8)ax.set_xlabel('componentes de PCA')ax.set_ylabel('knots del spline')ax.set_title('Pérdida de validación cruzada')fig.colorbar(imagen, ax=ax, label='pérdida logarítmica')plt.show()
Mejor combinación: 8 knots y 4 componentes, pérdida 0.4399 (error estándar 0.0022)
Límite de la regla: 0.4422
Elegida: 5 knots y 2 componentes, pérdida 0.4410
La menor pérdida, 0.4399, la tiene la combinación de 8 knots y 4 componentes, con un error estándar de 0.0022. El límite de la regla es 0.4422, y la combinación más simple que queda por debajo es 5 knots y 2 componentes, con 0.4410. Esa es la elegida.
En la grilla de la figura se ve por qué la regla tiene sentido. Con un solo componente, la pérdida sube a entre 0.462 y 0.466 con cualquier número de knots: un componente no alcanza para describir la zona, porque deja fuera la ausencia de los hogares. Desde dos componentes, todas las combinaciones quedan entre 0.4399 y 0.4447, y las diferencias son de unas milésimas. El tercer componente y los siguientes recogen sobre todo el ruido de los indicadores, y más knots no cambian mucho la curva de la hora. Dos componentes coinciden con los dos rasgos que PCA encontró en el paso 5.
C.8 Paso 8. Evaluar en la prueba
Ahora abres las 1 500 entregas de prueba. Para ver cuánto aporta cada pieza, evalúas cinco modelos, todos entrenados con el entrenamiento completo:
A, la tasa global;
B, la logística cruda del paso 4;
B + spline, la logística cruda con la hora en un spline de 5 knots y los diez indicadores tal cual;
B + PCA, con la hora como número y los dos componentes de la zona;
el modelo integrado, con spline y PCA.
Además de la pérdida logarítmica, la tabla muestra el AUC, la probabilidad de que el modelo le asigne más riesgo a una entrega que falló que a una que no (0.5 es azar, 1 es perfecto), y el número de coeficientes que estima cada modelo.
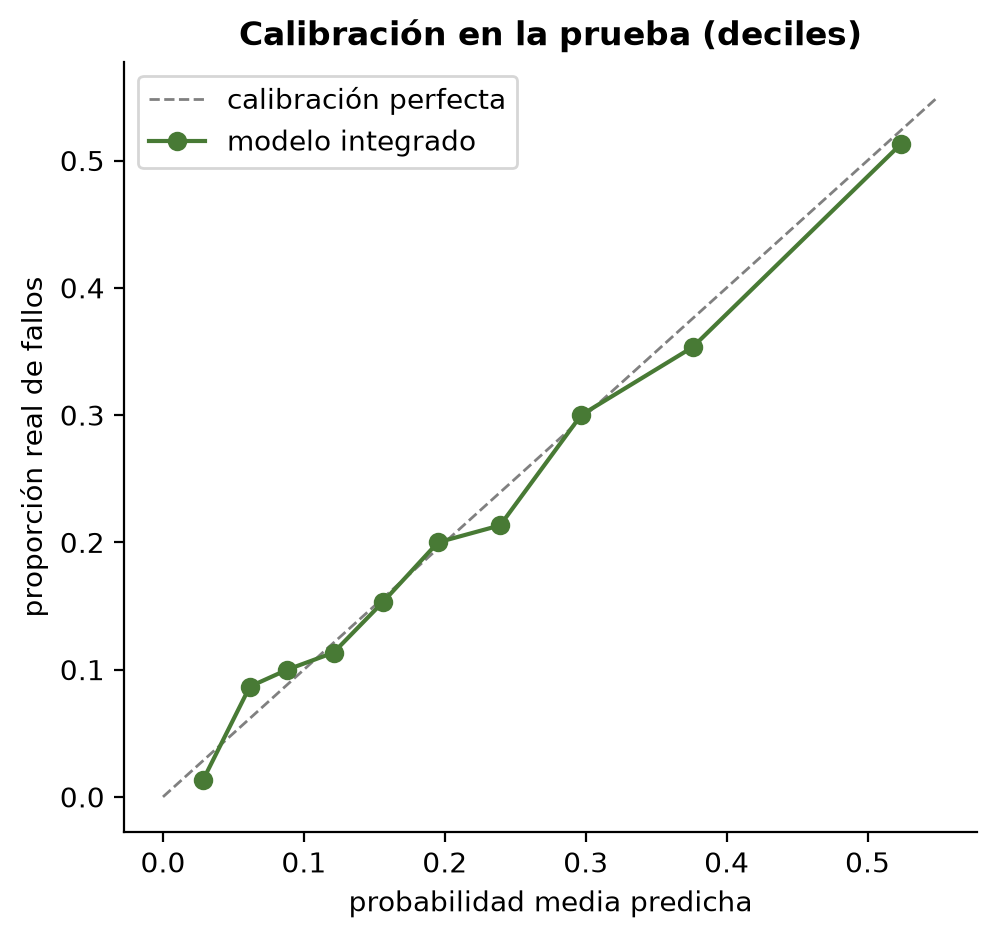
La segunda parte de la celda revisa la calibración del modelo integrado: ordena las entregas de prueba por su probabilidad predicha, las divide en diez grupos del mismo tamaño y compara en cada grupo la probabilidad media predicha con la proporción real de fallos. Para tomar decisiones con probabilidades, estas deben significar lo que dicen.
# 1. Los cinco modelos, entrenados con todo el entrenamiento y evaluados una sola vez en la prueba.modelos = {'A. tasa global': None,'B. logística cruda': logistica_cruda,'B + spline de la hora': Pipeline([ ('columnas', ColumnTransformer([ ('hora', SplineTransformer(n_knots=N_KNOTS, degree=3, include_bias=False), ['hora']), ('zona', StandardScaler(), INDICADORES), ('resto', 'passthrough', ['distancia', 'contraentrega'])])), ('logistica', LogisticRegression(C=np.inf, max_iter=10000))]),'B + PCA de la zona': logistica_con('passthrough'),'integrado (spline + PCA)': modelo_integrado(N_KNOTS, N_COMPONENTES),}filas = []for nombre, modelo in modelos.items():if modelo isNone: probabilidad_prueba = np.full(len(prueba), tasa) n_coeficientes =1else: modelo.fit(entrenamiento, y_entrenamiento) probabilidad_prueba = modelo.predict_proba(prueba)[:, 1] n_coeficientes = modelo.named_steps['logistica'].coef_.size +1# + intercepto filas.append({'modelo': nombre, 'coeficientes': n_coeficientes,'pérdida logarítmica': log_loss(y_prueba, probabilidad_prueba),'AUC': roc_auc_score(y_prueba, probabilidad_prueba) if modelo isnotNoneelse0.5})display(pd.DataFrame(filas).set_index('modelo').round(4))# 2. Calibración del modelo integrado: ¿cuando dice 30 %, fallan cerca del 30 %?integrado = modelos['integrado (spline + PCA)']probabilidad_integrado = integrado.predict_proba(prueba)[:, 1]decil = pd.qcut(probabilidad_integrado, 10, labels=False)calibracion = pd.DataFrame({'predicha': probabilidad_integrado, 'real': y_prueba.to_numpy(), 'decil': decil})calibracion = calibracion.groupby('decil').mean()plt.figure(figsize=(5.5, 5))plt.plot([0, 0.55], [0, 0.55], color='gray', ls='--', lw=1, label='calibración perfecta')plt.plot(calibracion['predicha'], calibracion['real'], marker='o', color=COLOR_SPLINE, label='modelo integrado')plt.xlabel('probabilidad media predicha')plt.ylabel('proporción real de fallos')plt.title('Calibración en la prueba (deciles)')plt.legend()plt.show()print(calibracion.round(3).T)
La tabla de los 5 modelos separa el aporte de cada pieza:
El spline aporta la mejora de predicción. Pasar de la logística cruda a la cruda con spline baja la pérdida de 0.4549 a 0.4423 y sube el AUC de 0.7245 a 0.7451.
PCA no mejora la predicción, pero tampoco la empeora de forma apreciable, y simplifica el modelo. Con la hora como número, pasar de los diez indicadores a dos componentes cambia la pérdida de 0.4549 a 0.4568 con 8 coeficientes menos.
El modelo integrado queda con una pérdida de 0.4444 y un AUC de 0.7410, a 0.0021 de pérdida del modelo con spline y diez indicadores, pero con 11 coeficientes en lugar de 19. La diferencia es menor que el error estándar de la validación cruzada del paso 7.
Si solo importara predecir, el spline con los diez indicadores sería igual de bueno. Lo que PCA agrega se ve en el paso 9: coeficientes estables que se pueden leer.
La figura de calibración muestra que el modelo integrado dice la verdad con sus probabilidades. Los diez puntos siguen la diagonal: en el grupo de menor riesgo predice 0.028 y fallan 0.013; en el del medio predice 0.195 y fallan 0.200; en el de mayor riesgo predice 0.524 y fallan 0.513. Con un AUC de 0.741 el modelo no separa a la perfección las entregas que fallarán, pero sus probabilidades son confiables, y eso es lo que necesita la decisión del paso 10.
C.9 Paso 9. Leer el modelo
Un GLM se puede leer a través de sus coeficientes. En una regresión logística, \(e^{\beta}\) es la razón de momios: cuántas veces se multiplican los momios de fallo cuando la variable aumenta en una unidad, como viste en el capítulo de GLM.
La celda:
Muestra el coeficiente y la razón de momios de los dos componentes, de la contraentrega y de la distancia (esta última por cada 10 km), y la desviación estándar de los dos componentes, que da la escala de «una unidad».
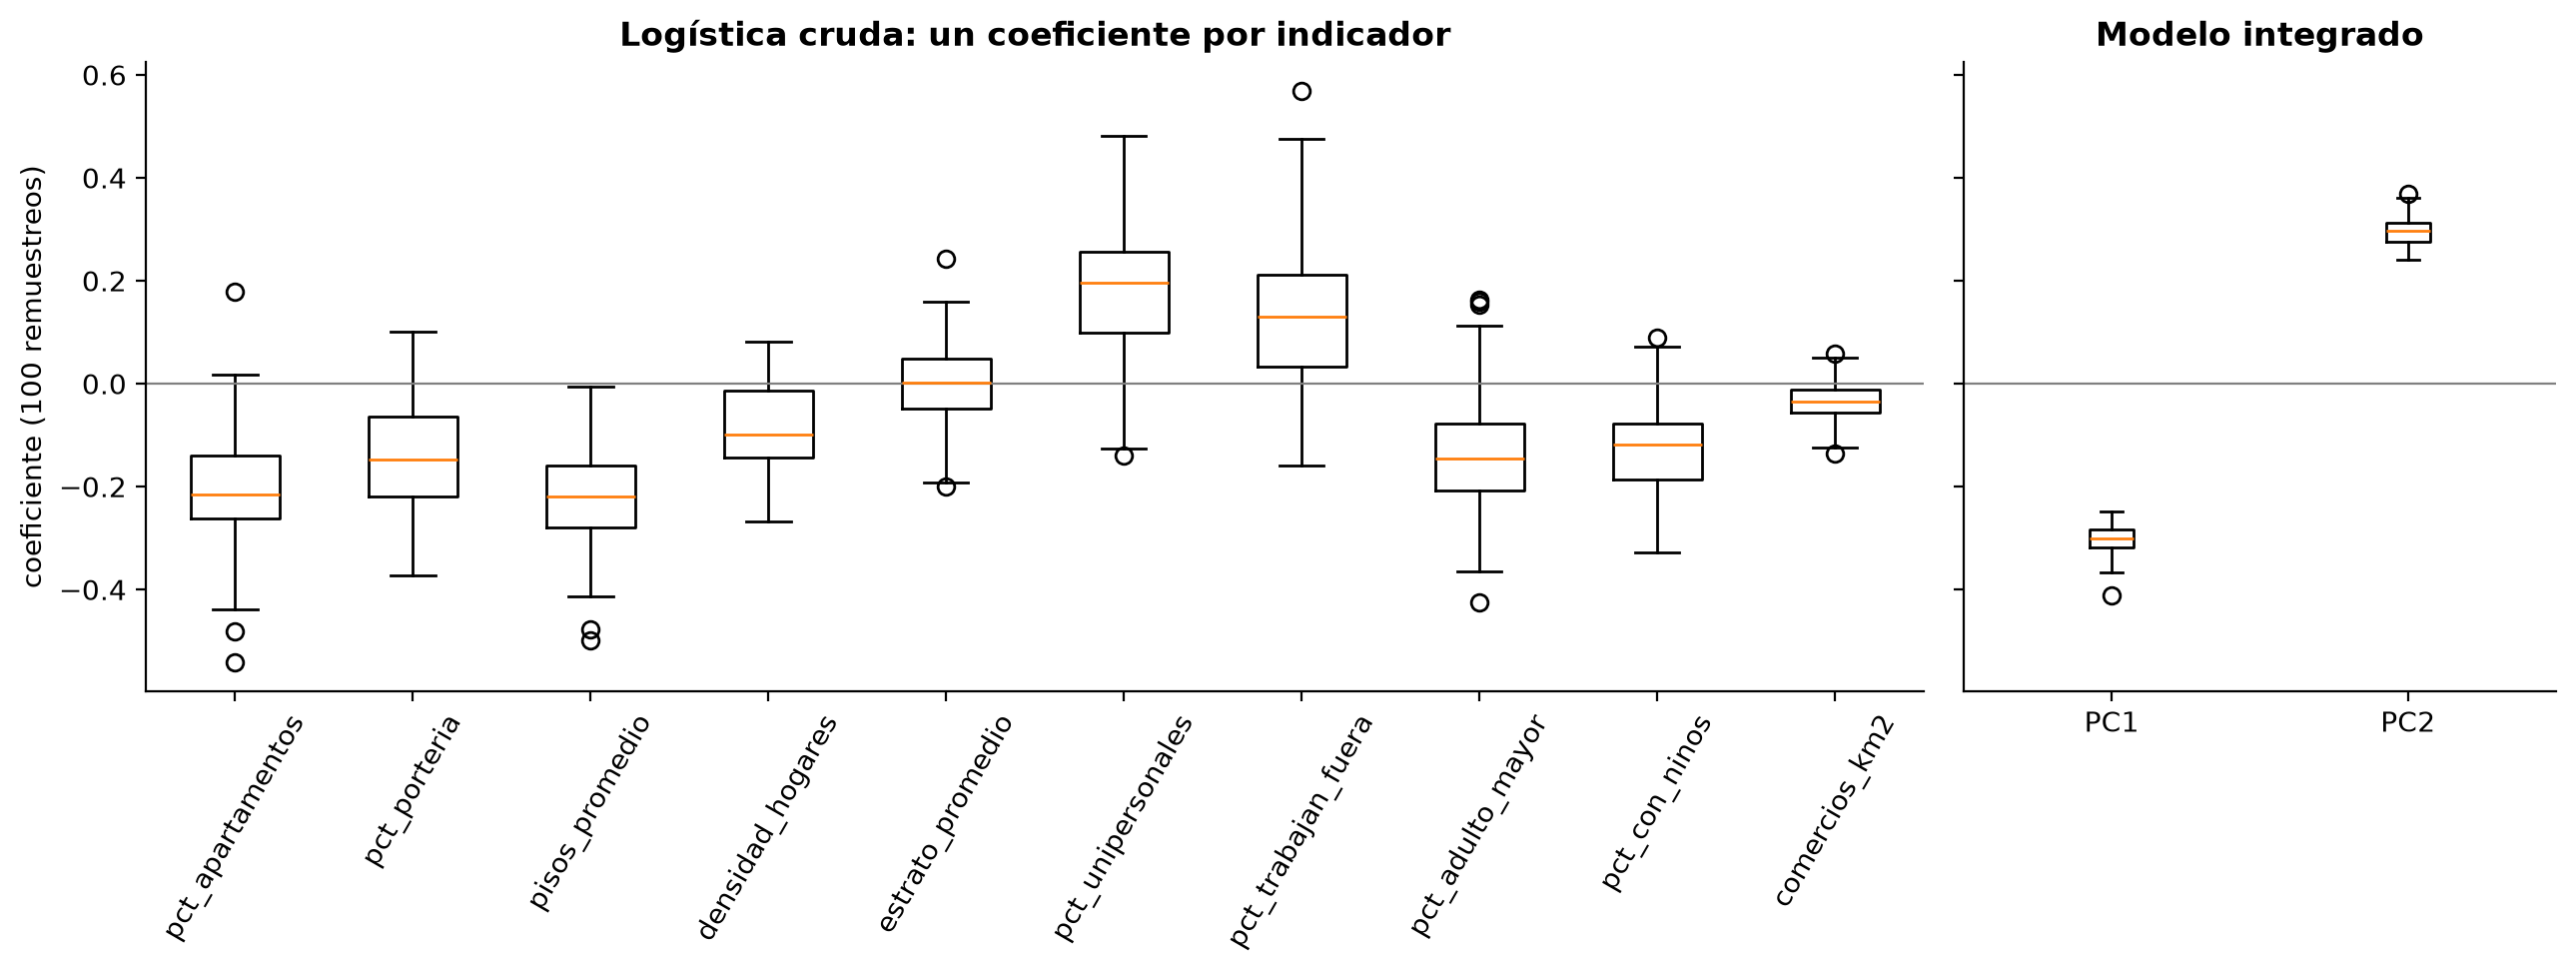
Repite el ajuste 100 veces sobre remuestreos con reemplazo del entrenamiento, con la logística cruda y con el modelo integrado, y guarda los coeficientes de la zona.
Dibuja la variación de esos coeficientes y cuenta en qué porcentaje de los remuestreos cada uno salió positivo.
# 1. Coeficientes del modelo integrado, convertidos en razones de momios.nombres = integrado.named_steps['columnas'].get_feature_names_out()coeficientes = pd.Series(integrado.named_steps['logistica'].coef_[0], index=nombres)for nombre, etiqueta, unidad in [('zona__pca0', 'PC1 (edificios con portería)', 'por 1 unidad del componente'), ('zona__pca1', 'PC2 (hogares vacíos de día)', 'por 1 unidad del componente'), ('resto__contraentrega', 'contraentrega', 'frente a pago previo'), ('resto__distancia', 'distancia', 'por cada 10 km')]: beta = coeficientes[nombre] * (10if nombre =='resto__distancia'else1)print(f'{etiqueta:30s} coeficiente {beta:+.3f} | razón de momios {np.exp(beta):.2f}{unidad}')# Escala de los componentes: cuánto varían los valores de PC1 y PC2 entre las entregas.valores_pc = integrado.named_steps['columnas'].named_transformers_['zona'].transform(entrenamiento[INDICADORES])print(f'Desviación estándar de PC1: {valores_pc[:, 0].std():.2f} | de PC2: {valores_pc[:, 1].std():.2f}')print()# 2. Estabilidad: 100 ajustes con remuestreos del entrenamiento, logística cruda frente a integrado.generador = np.random.default_rng(SEMILLA)crudos, integrados = [], []for repeticion inrange(100): filas_elegidas = generador.integers(0, len(entrenamiento), len(entrenamiento)) remuestra = entrenamiento.iloc[filas_elegidas] m_cruda = logistica_cruda.fit(remuestra, remuestra['fallo']) crudos.append(pd.Series(m_cruda.named_steps['logistica'].coef_[0], index=m_cruda.named_steps['columnas'].get_feature_names_out())) m_int = modelo_integrado(N_KNOTS, N_COMPONENTES).fit(remuestra, remuestra['fallo']) integrados.append(pd.Series(m_int.named_steps['logistica'].coef_[0], index=m_int.named_steps['columnas'].get_feature_names_out()))crudos = pd.DataFrame(crudos)[[f'zona__{c}'for c in INDICADORES]]integrados = pd.DataFrame(integrados)[['zona__pca0', 'zona__pca1']]fig, ax = plt.subplots(1, 2, figsize=(13, 5), gridspec_kw={'width_ratios': [3, 1]}, sharey=True)ax[0].boxplot(crudos.to_numpy(), tick_labels=INDICADORES)ax[0].tick_params(axis='x', rotation=60)ax[0].set_title('Logística cruda: un coeficiente por indicador')ax[1].boxplot(integrados.to_numpy(), tick_labels=['PC1', 'PC2'])ax[1].set_title('Modelo integrado')for panel in ax: panel.axhline(0, color='gray', lw=0.8)ax[0].set_ylabel('coeficiente (100 remuestreos)')plt.tight_layout()plt.show()# 3. Cuántas veces cambia de signo cada coeficiente.resumen = pd.DataFrame({'media': pd.concat([crudos, integrados], axis=1).mean(),'desviación': pd.concat([crudos, integrados], axis=1).std(),'% positivos': (pd.concat([crudos, integrados], axis=1) >0).mean() *100,}).round(3)display(resumen)integrado.fit(entrenamiento, y_entrenamiento) # dejar el modelo ajustado con todo el entrenamiento
PC1 (edificios con portería)   coeficiente -0.305 | razón de momios 0.74 por 1 unidad del componente
PC2 (hogares vacíos de día)    coeficiente +0.295 | razón de momios 1.34 por 1 unidad del componente
contraentrega                  coeficiente +0.597 | razón de momios 1.82 frente a pago previo
distancia                      coeficiente +0.109 | razón de momios 1.12 por cada 10 km
Desviación estándar de PC1: 2.11 | de PC2: 1.91
In a Jupyter environment, please rerun this cell to show the HTML representation or trust the notebook. On GitHub, the HTML representation is unable to render, please try loading this page with nbviewer.org.
Las razones de momios del modelo integrado, que van de 0.74 a 1.82, se leen así:
PC1, edificios con portería: 0.74. Cada unidad adicional de PC1 multiplica los momios de fallo por 0.74, una reducción del 26 %. Como PC1 tiene una desviación estándar de 2.11, pasar de una zona típica a una con una desviación más de edificios con portería reduce los momios a cerca de la mitad (\(0.74^{2.11} \approx 0.53\)).
PC2, hogares vacíos de día: 1.34. Cada unidad de PC2 multiplica los momios por 1.34, un aumento del 34 %.
Contraentrega: 1.82. Cuando el cliente paga al recibir, los momios de fallo casi se duplican frente al pago previo.
Distancia: 1.12 por cada 10 km. Un efecto pequeño.
La figura de remuestreos muestra lo que gana el modelo con PCA. En la logística cruda, los coeficientes de los diez indicadores forman cajas anchas, y varios cruzan el cero: el del estrato salió positivo en 52 % de los remuestreos y negativo en el resto; el de la densidad, positivo en 20 %. Con esos coeficientes no puedes decir si el estrato sube o baja el riesgo. En el modelo integrado, el coeficiente de PC1 tiene media −0.303 y desviación 0.028, y salió negativo en el 100 % de los remuestreos; el de PC2 tiene media 0.296 y desviación 0.026, y salió positivo en el 100 %. La información de los diez indicadores es la misma; PCA la reorganizó en dos direcciones no correlacionadas que el modelo sí puede estimar con precisión.
Estas razones de momios describen asociaciones en los datos. Que las zonas de edificios con portería tengan menos fallos es coherente con la explicación operativa (el portero recibe), pero el modelo no lo demuestra: un componente es una combinación de indicadores, no una causa.
C.10 Paso 10. De la probabilidad a la decisión
La operación necesita una regla: ¿a qué entregas se llama antes de salir? Con una probabilidad bien calibrada, la regla sale de los costos, sin ajustar nada con la prueba.
Llamar a una entrega cuesta 600 pesos. Si la entrega iba a fallar, la llamada evita el fallo 7 de cada 10 veces, y cada fallo evitado ahorra un reintento de 9 000 pesos. Para una entrega con probabilidad de fallo \(p\), el ahorro esperado de llamar es \(p \times 0.7 \times 9\,000\), y conviene llamar cuando supera el costo de la llamada:
\[
p \times 0.7 \times 9\,000 > 600 \quad\Longleftrightarrow\quad p > \frac{600}{0.7 \times 9\,000} \approx 0.095.
\]
La celda:
Fija los supuestos de costos del caso.
Calcula el umbral de llamada.
Compara el costo de tres políticas sobre las entregas de prueba, con los fallos reales: no llamar a nadie, llamar a todos y llamar solo a las entregas cuya probabilidad supera el umbral.
# 1. Supuestos de la operación (los declara el caso; no son cifras de BIT).COSTO_REINTENTO =9000# pesos: un viaje más y la manipulación del paqueteCOSTO_LLAMADA =600# pesos: una llamada del centro de contacto antes de salirEFECTIVIDAD_LLAMADA =0.7# de cada 10 fallos que se iban a dar, la llamada evita 7# 2. Umbral: conviene llamar cuando el ahorro esperado supera el costo de la llamada.# p * EFECTIVIDAD * COSTO_REINTENTO > COSTO_LLAMADA -> p > umbralumbral = COSTO_LLAMADA / (EFECTIVIDAD_LLAMADA * COSTO_REINTENTO)print(f'Umbral de llamada: probabilidad de fallo mayor que {umbral:.3f}')# 3. Costo esperado de tres políticas sobre las entregas de prueba, con los fallos reales.def costo_politica(llamar):"""Costo de llamadas más reintentos que quedan (cada llamada evita el 70 % de los fallos).""" llamadas = llamar.sum() * COSTO_LLAMADA fallos_no_llamados = y_prueba[~llamar].sum() fallos_llamados = y_prueba[llamar].sum() * (1- EFECTIVIDAD_LLAMADA)return llamadas + (fallos_no_llamados + fallos_llamados) * COSTO_REINTENTOpoliticas = {'no llamar a nadie': np.zeros(len(prueba), dtype=bool),'llamar a todos': np.ones(len(prueba), dtype=bool),'llamar según el modelo': probabilidad_integrado > umbral,}filas = []for nombre, llamar in politicas.items(): costo = costo_politica(llamar) filas.append({'política': nombre, 'llamadas': int(llamar.sum()),'costo total (miles de pesos)': round(costo /1000),'costo por 1 000 entregas (miles)': round(costo /len(prueba) *1000/1000)})display(pd.DataFrame(filas).set_index('política'))
Umbral de llamada: probabilidad de fallo mayor que 0.095
llamadas
costo total (miles de pesos)
costo por 1 000 entregas (miles)
política
no llamar a nadie
0
2763
1842
llamar a todos
1500
1729
1153
llamar según el modelo
1088
1639
1093
Con el umbral de 0.095, el modelo indica llamar a 1 088 de las 1 500 entregas de prueba. Los costos por cada 1 000 entregas son:
no llamar a nadie: 1 842 000 pesos, todo en reintentos;
llamar a todos: 1 153 000 pesos;
llamar según el modelo:1 093 000 pesos.
Llamar según el modelo cuesta 41 % menos que no llamar y 5 % menos que llamar a todos, con 412 llamadas menos en la prueba, que el centro de contacto puede dedicar a otra cosa. La diferencia frente a llamar a todos es pequeña porque, con estos costos, el umbral es bajo y conviene llamar a la mayoría; si la llamada costara más o fuera menos efectiva, el umbral subiría y el modelo ahorraría más llamadas.
La recomendación del caso es llamar antes de salir a las entregas con probabilidad de fallo mayor que 0.095 y revisar el umbral cuando cambien los costos o la efectividad de la llamada. Esa regla solo funciona porque las probabilidades están calibradas: si el modelo dijera 0.2 donde en realidad fallan 0.1, el umbral llevaría a llamar a quien no lo necesita.
C.11 Paso 11. Comprobar el modelo con un GAM completo
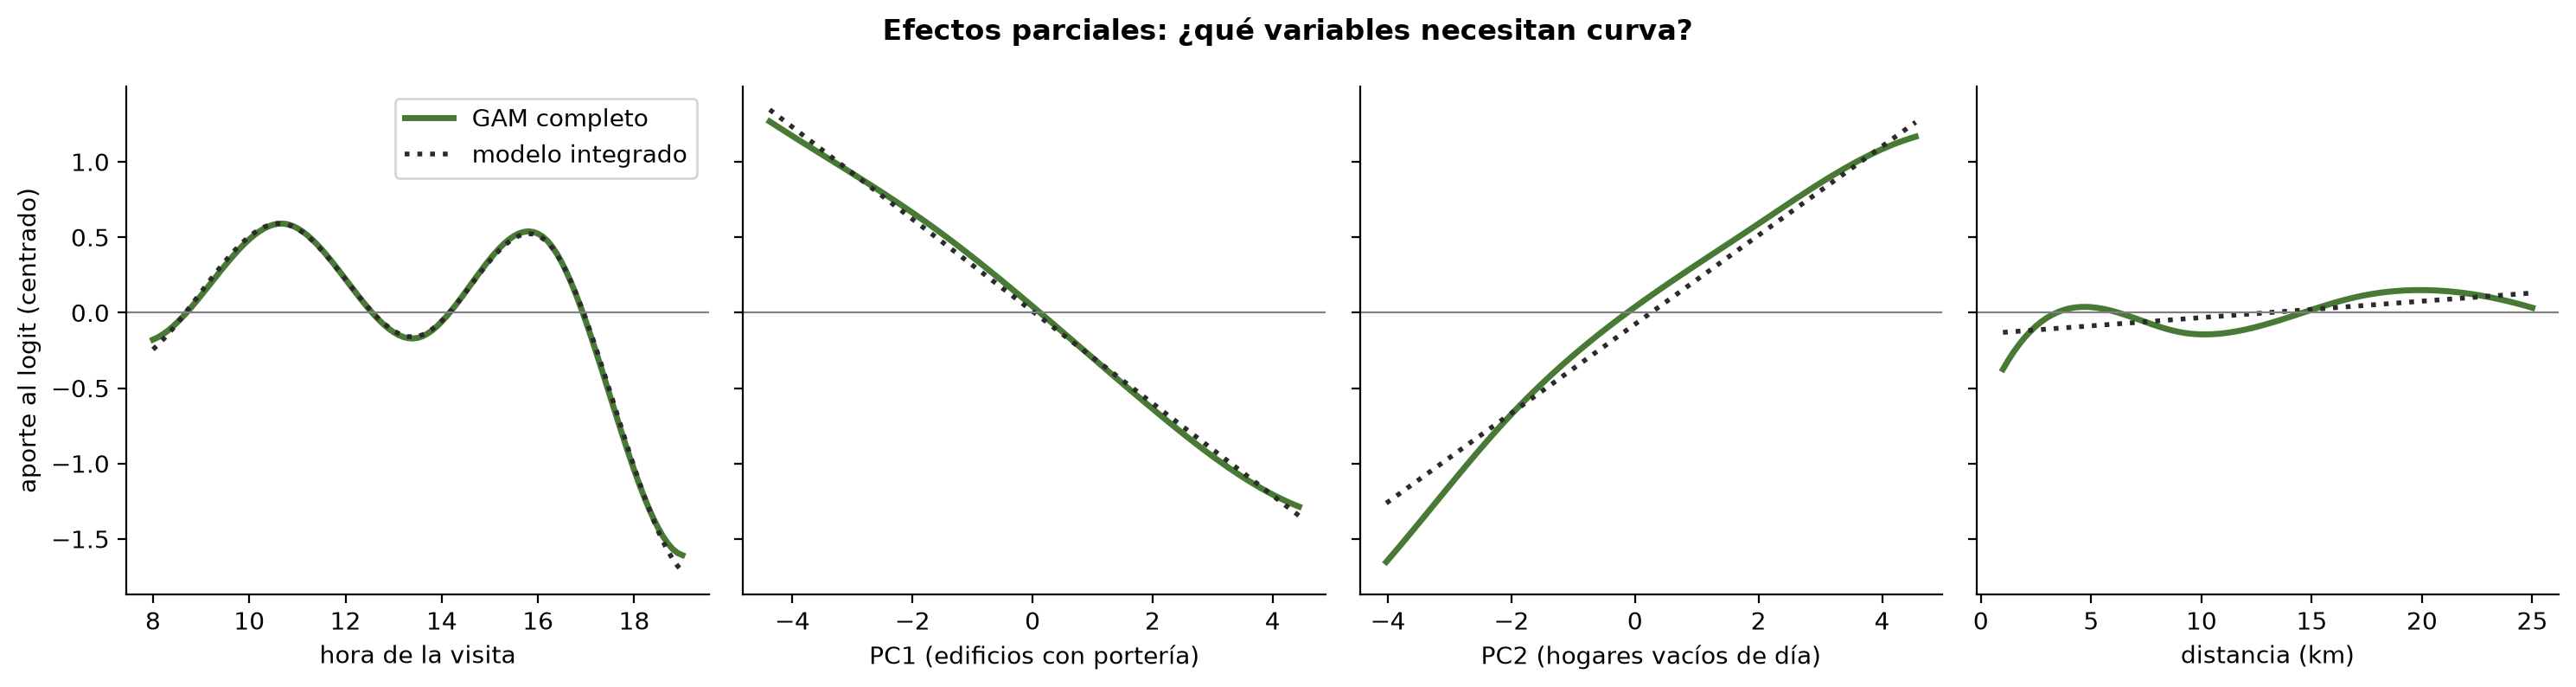
El modelo integrado le dio curva a la hora porque el análisis descriptivo la pedía, y dejó rectos los efectos de PC1, PC2 y la distancia. Esa segunda parte es un supuesto que no se ha comprobado. Un GAM completo, con un término suave para cada variable continua, permite revisarlo: si alguna de esas variables necesitara curva, el GAM completo predeciría mejor y su efecto parcial se vería curvo.
Un efecto parcial es lo que un término suma al logit a medida que cambia su variable, con las demás fijas. En un GAM se pueden dibujar uno por uno, y esa es su gran ventaja interpretativa: el modelo se lee como una suma de curvas.
La celda:
Define el GAM completo: la hora con sus 5 knots, y un spline de 4, 5 o 6 knots para PC1, PC2 y la distancia. La contraentrega sigue lineal porque solo vale 0 o 1.
Compara con validación cruzada el modelo integrado y los tres GAM completos, con su número de coeficientes.
Calcula los efectos parciales del GAM completo con 4 knots: las columnas de cada spline multiplicadas por sus coeficientes. Para un componente, varía ese componente y deja el otro en 0, su promedio.
Calcula los mismos efectos en el modelo integrado: la curva de la hora y rectas para los demás.
Dibuja los cuatro efectos, cada uno centrado en su promedio porque solo interesa su forma, y mide cuánto se separan las curvas de los dos modelos.
# 1. El GAM completo: un spline para cada variable continua.# La hora conserva sus 5 knots; PC1, PC2 y la distancia reciben n_knots knots cada una.def gam_completo(n_knots): zona = Pipeline([ ('estandarizar', StandardScaler()), ('pca', PCA(n_components=N_COMPONENTES, svd_solver='full')), ('spline', SplineTransformer(n_knots=n_knots, degree=3, include_bias=False)), # un spline por componente ]) columnas = ColumnTransformer([ ('hora', SplineTransformer(n_knots=N_KNOTS, degree=3, include_bias=False), ['hora']), ('zona', zona, INDICADORES), ('distancia', SplineTransformer(n_knots=n_knots, degree=3, include_bias=False), ['distancia']), ('resto', 'passthrough', ['contraentrega']), ])return Pipeline([('columnas', columnas), ('logistica', LogisticRegression(C=np.inf, max_iter=10000))])# 2. Comparar con validación cruzada: el modelo integrado y el GAM completo con 4, 5 y 6 knots.filas = []candidatos = {'integrado (curva solo en la hora)': modelo_integrado(N_KNOTS, N_COMPONENTES)}for n_knots in [4, 5, 6]: candidatos[f'GAM completo, {n_knots} knots'] = gam_completo(n_knots)for nombre, modelo in candidatos.items(): perdidas =-cross_val_score(modelo, entrenamiento, y_entrenamiento, cv=bloques, scoring='neg_log_loss') filas.append({'modelo': nombre, 'coeficientes': None, 'pérdida CV': perdidas.mean(),'error estándar': perdidas.std(ddof=1) / np.sqrt(len(perdidas))}) modelo.fit(entrenamiento, y_entrenamiento) filas[-1]['coeficientes'] = modelo.named_steps['logistica'].coef_.size +1display(pd.DataFrame(filas).set_index('modelo').round(4))# 3. Efectos parciales del GAM completo con 4 knots: cuánto suma cada término al logit.gam = candidatos['GAM completo, 4 knots']pasos = gam.named_steps['columnas'].named_transformers_nombres = gam.named_steps['columnas'].get_feature_names_out()coef = pd.Series(gam.named_steps['logistica'].coef_[0], index=nombres)def aporte(bloque, columnas_base):"""Columnas del spline de un bloque multiplicadas por sus coeficientes.""" pesos = coef[[n for n in nombres if n.startswith(bloque +'__')]].to_numpy()return columnas_base @ pesosrejilla_hora = np.linspace(8, 19, 111)rejilla_dist = np.linspace(1, 25, 97)valores_pc = pasos['zona'][:-1].transform(entrenamiento[INDICADORES]) # PC1 y PC2 del entrenamientorejilla_pc1 = np.linspace(np.percentile(valores_pc[:, 0], 2), np.percentile(valores_pc[:, 0], 98), 100)rejilla_pc2 = np.linspace(np.percentile(valores_pc[:, 1], 2), np.percentile(valores_pc[:, 1], 98), 100)efecto_hora_gam = aporte('hora', pasos['hora'].transform(pd.DataFrame({'hora': rejilla_hora})))efecto_dist_gam = aporte('distancia', pasos['distancia'].transform(pd.DataFrame({'distancia': rejilla_dist})))# Para un componente se varía ese componente y el otro se deja en 0 (su promedio).spline_pc = pasos['zona'].named_steps['spline']efecto_pc1_gam = aporte('zona', spline_pc.transform(np.column_stack([rejilla_pc1, np.zeros(100)])))efecto_pc2_gam = aporte('zona', spline_pc.transform(np.column_stack([np.zeros(100), rejilla_pc2])))# 4. Los mismos efectos en el modelo integrado (rectas para PC1, PC2 y distancia).coef_int = pd.Series(integrado.named_steps['logistica'].coef_[0], index=integrado.named_steps['columnas'].get_feature_names_out())spline_hora_int = integrado.named_steps['columnas'].named_transformers_['hora']pesos_hora_int = coef_int[[n for n in coef_int.index if n.startswith('hora__')]].to_numpy()efecto_hora_int = spline_hora_int.transform(pd.DataFrame({'hora': rejilla_hora})) @ pesos_hora_intpaneles = [ ('hora de la visita', rejilla_hora, efecto_hora_gam, efecto_hora_int), ('PC1 (edificios con portería)', rejilla_pc1, efecto_pc1_gam, coef_int['zona__pca0'] * rejilla_pc1), ('PC2 (hogares vacíos de día)', rejilla_pc2, efecto_pc2_gam, coef_int['zona__pca1'] * rejilla_pc2), ('distancia (km)', rejilla_dist, efecto_dist_gam, coef_int['resto__distancia'] * rejilla_dist),]fig, ax = plt.subplots(1, 4, figsize=(15, 4), sharey=True)for panel, (titulo, x, gam_y, int_y) inzip(ax, paneles):# Cada curva se centra en su promedio sobre la rejilla: solo importa su forma. panel.plot(x, gam_y - gam_y.mean(), color=COLOR_SPLINE, lw=2.5, label='GAM completo') panel.plot(x, int_y - int_y.mean(), color=COLOR_VERDAD, ls=':', lw=2, label='modelo integrado') panel.axhline(0, color='gray', lw=0.8) panel.set_xlabel(titulo)ax[0].set_ylabel('aporte al logit (centrado)')ax[0].legend()plt.suptitle('Efectos parciales: ¿qué variables necesitan curva?', fontweight='bold')plt.tight_layout()plt.show()# 5. Cuánto se separa cada curva del GAM de la del modelo integrado.for titulo, x, gam_y, int_y in paneles: diferencia = np.abs((gam_y - gam_y.mean()) - (int_y - int_y.mean())).max() rango = (gam_y.max() - gam_y.min())print(f'{titulo:30s} recorrido del efecto en el GAM: {rango:.2f} | mayor separación del integrado: {diferencia:.2f}')
coeficientes
pérdida CV
error estándar
modelo
integrado (curva solo en la hora)
11
0.4410
0.0024
GAM completo, 4 knots
23
0.4424
0.0023
GAM completo, 5 knots
26
0.4429
0.0023
GAM completo, 6 knots
29
0.4433
0.0024
hora de la visita              recorrido del efecto en el GAM: 2.20 | mayor separación del integrado: 0.11
PC1 (edificios con portería)   recorrido del efecto en el GAM: 2.55 | mayor separación del integrado: 0.08
PC2 (hogares vacíos de día)    recorrido del efecto en el GAM: 2.82 | mayor separación del integrado: 0.39
distancia (km)                 recorrido del efecto en el GAM: 0.52 | mayor separación del integrado: 0.24
La tabla responde la pregunta. El GAM completo no predice mejor: su pérdida de validación cruzada es de 0.4424 con 4 knots, 0.4429 con 5 y 0.4433 con 6, todas por encima de los 0.4410 del modelo integrado, y con 23 a 29 coeficientes en lugar de 11. Los términos suaves de más no encuentran ningún patrón que se repita en los bloques de validación.
La figura muestra por qué:
Hora: las dos curvas casi coinciden, con los dos picos y la caída final; la mayor separación entre ellas es de 0.11 en la escala logit, sobre un recorrido de 2.20. La hora sí necesitaba curva, y el modelo integrado ya la tenía.
PC1: la curva del GAM es casi una recta descendente, encima de la del modelo integrado (separación máxima 0.08).
PC2: casi una recta ascendente; se separa un poco más, 0.39, solo en el extremo izquierdo, donde hay pocas zonas.
Distancia: la curva del GAM ondula alrededor de una recta casi plana, con un recorrido de solo 0.52. Esas ondas no son un patrón sino el ruido que el spline alcanzó a seguir, y la validación cruzada lo confirma.
El GAM completo funcionó aquí como un diagnóstico: confirmó que solo la hora necesitaba curva y que el modelo integrado, más simple, era el adecuado. En un problema real, si una de esas curvas hubiera mostrado una forma clara y la validación cruzada hubiera mejorado, la habrías incorporado al modelo.
C.12 Errores comunes en este caso
Los dos primeros errores se provocan en el código.
Error 1: aplicar PCA a los indicadores sin estandarizarlos. La celda arma el mismo modelo integrado, pero con PCA directamente sobre los indicadores originales.
# Error 1: aplicar PCA a los indicadores sin estandarizarlos.sin_escalar = Pipeline([ ('columnas', ColumnTransformer([ ('hora', SplineTransformer(n_knots=N_KNOTS, degree=3, include_bias=False), ['hora']), ('zona', PCA(n_components=N_COMPONENTES, svd_solver='full'), INDICADORES), # sin StandardScaler ('resto', 'passthrough', ['distancia', 'contraentrega'])])), ('logistica', LogisticRegression(C=np.inf, max_iter=10000)),])sin_escalar.fit(entrenamiento, y_entrenamiento)pca_sin_escalar = sin_escalar.named_steps['columnas'].named_transformers_['zona']cargas_sin_escalar = pd.DataFrame(pca_sin_escalar.components_.T, index=INDICADORES, columns=['PC1', 'PC2'])print('Pesos sin estandarizar:')print(cargas_sin_escalar.round(3).T.to_string())print(f'Pérdida en la prueba sin estandarizar: {log_loss(y_prueba, sin_escalar.predict_proba(prueba)[:, 1]):.4f} 'f'| con estandarización: {log_loss(y_prueba, probabilidad_integrado):.4f}')
Pesos sin estandarizar:
     pct_apartamentos  pct_porteria  pisos_promedio  densidad_hogares  estrato_promedio  pct_unipersonales  pct_trabajan_fuera  pct_adulto_mayor  pct_con_ninos  comercios_km2
PC1             0.005         0.004           0.001             1.000             0.000              0.000               0.000             0.000          0.000         -0.002
PC2            -0.017        -0.002          -0.001             0.002            -0.002              0.016               0.036            -0.021         -0.014          0.999
Pérdida en la prueba sin estandarizar: 0.4725 | con estandarización: 0.4444
Sin estandarizar, PC1 tiene peso 1.000 en la densidad de hogares y casi 0 en todo lo demás, y PC2 tiene peso 0.999 en los comercios por km². La densidad está en miles y los comercios en cientos, así que sus varianzas dominan; los dos componentes terminan siendo esas dos columnas, y la información de la ausencia de los hogares se pierde. La pérdida en la prueba sube de 0.4444 a 0.4725, peor que la logística cruda. Es el mismo error que viste con proline en el capítulo de PCA, ahora con consecuencias en la predicción.
Error 2: juzgar el modelo por la exactitud con el umbral de 0.5.
# Error 2: juzgar el modelo con la exactitud y el umbral de 0.5.prediccion_05 = (probabilidad_integrado >0.5).astype(int)print(f'Exactitud del modelo con umbral 0.5: {accuracy_score(y_prueba, prediccion_05):.3f}')print(f'Exactitud de decir siempre "no falla": {accuracy_score(y_prueba, np.zeros(len(y_prueba))):.3f}')print(f'Entregas que el modelo marca como fallo con 0.5: {prediccion_05.sum()} de {len(y_prueba)}')
Exactitud del modelo con umbral 0.5: 0.799
Exactitud de decir siempre "no falla": 0.795
Entregas que el modelo marca como fallo con 0.5: 83 de 1500
Con el umbral de 0.5, el modelo acierta el 79.9 % de las entregas de prueba, casi lo mismo que decir siempre «no falla» (79.5 %). Solo marca 83 de 1 500 entregas como fallo. Con un 20 % de fallos, pocas entregas pasan de 0.5 de probabilidad, y la exactitud no ve nada del valor del modelo. La decisión correcta no usa 0.5 sino el umbral de los costos, y el modelo se juzga por sus probabilidades: pérdida logarítmica, AUC y calibración.
Otros errores frecuentes al integrar estas herramientas:
Síntoma
Causa probable
Solución
La validación cruzada da una pérdida más baja que la prueba
el estandarizador, PCA o el spline se ajustaron antes de validar, con todos los datos
meter todas las piezas en el Pipeline y validarlo completo
Advertencias de convergencia o coeficientes enormes del spline
el spline fabrica una columna que repite el intercepto de la logística
usar include_bias=False en SplineTransformer
Se elige el modelo con más knots y componentes porque tiene la menor pérdida
diferencias menores que el error estándar
aplicar la regla de un error estándar
Se lee una razón de momios de un componente como un efecto causal
confundir asociación con mecanismo
describir la asociación y buscar evidencia externa antes de hablar de causas
Un GAM completo muestra ondas en una variable, como la distancia
el spline ajusta el ruido de los datos
comparar con validación cruzada y quedarse con la recta si la curva no mejora
C.13 Preguntas de comprensión
¿Qué observaste en el paso 3 que justificaba usar un spline para la hora y PCA para la zona?
En el paso 8, el modelo con spline y los diez indicadores tiene una pérdida un poco menor que el integrado. ¿Por qué el caso prefiere el integrado?
¿Por qué es importante que el spline, el estandarizador y PCA estén dentro del Pipeline en la validación cruzada del paso 7?
El umbral de llamada es 0.095 y no 0.5. ¿De dónde sale y qué pasaría con él si cada llamada costara 1 500 pesos?
Si la empresa empieza a atender una ciudad nueva, ¿qué cambiarías en la partición de los datos para evaluar el modelo allí?
En el paso 11, la curva de la distancia del GAM completo tiene ondas. ¿Por qué no se incorporan al modelo?
TipOrientaciones
La proporción de fallos por media hora sube y baja dos veces (31.8 % a las 10:00, 18.6 % a las 12:30, 31.1 % a las 15:30), y una recta no puede representar esa forma. Los indicadores formaban dos bloques muy correlacionados, con 16 de 45 pares por encima de 0.7: diez columnas que cuentan dos historias.
Porque la diferencia, 0.0021, es menor que el error estándar de la validación cruzada, y el integrado usa 11 coeficientes en lugar de 19. Además, sus coeficientes de la zona son estables (el de PC1 salió negativo en los 100 remuestreos), mientras que los de los indicadores sueltos cambian de signo.
Porque así cada pieza se ajusta solo con los bloques de entrenamiento de cada partición. Si se ajustaran antes con las 4 500 entregas, cada bloque de validación habría participado en el cálculo de las medias, los componentes y los knots, y la pérdida de validación saldría optimista.
Sale de comparar el ahorro esperado de llamar (\(p \times 0.7 \times 9\,000\)) con el costo de la llamada. Con 1 500 pesos por llamada, el umbral sería \(1\,500 / 6\,300 \approx 0.238\): se llamaría a menos entregas, solo a las de mayor riesgo.
Separaría por zona o por ciudad, de modo que las zonas de prueba no aparezcan en el entrenamiento. Así se mediría cómo funciona el modelo con zonas que nunca vio, que es la situación de una ciudad nueva.
Porque el GAM completo tiene una pérdida de validación cruzada mayor que el modelo integrado (0.4424 frente a 0.4410) con más del doble de coeficientes. Las ondas de la distancia son ruido que el spline ajustó, no un patrón que se repita en datos nuevos.
C.14 Referencias para profundizar
James, G., Witten, D., Hastie, T., Tibshirani, R. y Taylor, J. (2023). An Introduction to Statistical Learning with Applications in Python. Springer. Los capítulos 4, 7 y 12 cubren la regresión logística, los splines y PCA.
Hastie, T. y Tibshirani, R. (1990). Generalized Additive Models. Chapman & Hall. El texto fundacional de los GAM.
Wood, S. N. (2017). Generalized Additive Models: An Introduction with R (2.ª ed.). CRC Press. Efectos parciales y elección de la suavidad.
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. El capítulo 5 trata las expansiones de base, incluidos los splines dentro de modelos lineales.
Agresti, A. (2013). Categorical Data Analysis (3.ª ed.). Wiley. Regresión logística y razones de momios.
Jolliffe, I. T. y Cadima, J. (2016). Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A, 374(2065), 20150202. Incluye el uso de componentes principales en regresión.
Cada herramienta resolvió una parte distinta del mismo problema: el GLM dio probabilidades para decidir, el spline le dio forma a la hora, PCA convirtió diez indicadores redundantes en dos componentes estables y el GAM completo confirmó que solo la hora necesitaba curva.
El análisis descriptivo decidió las herramientas: la hora tenía dos picos (31.8 % y 31.1 % de fallos) y los indicadores formaban dos bloques con 16 de 45 pares por encima de 0.7.
El spline aportó la mejora de predicción: la pérdida logarítmica bajó de 0.4549 a 0.4423 en la prueba frente a la logística cruda.
PCA no mejoró la predicción, pero redujo el modelo de 19 a 11 coeficientes y dejó coeficientes estables: el de PC1 salió negativo en los 100 remuestreos, mientras el del estrato cambió de signo en la mitad.
La regla de un error estándar eligió 5 knots y 2 componentes, los mismos dos rasgos con que se construyeron las zonas.
Con probabilidades calibradas, el umbral salió de los costos (0.095), y llamar según el modelo costó 41 % menos que no llamar.
El GAM completo, con curva en todas las variables, no mejoró la validación cruzada (0.4424 frente a 0.4410): sus efectos parciales de PC1 y PC2 salieron casi rectos y la curva de la distancia solo siguió el ruido.
C.16 Puente hacia los siguientes capítulos
Este caso usó el GAM de dos maneras: como modelo final, con un solo término suave, y como diagnóstico, con un término suave por variable. El capítulo de modelos aditivos generalizados desarrolla la idea con más detalle, incluida la comparación formal entre un efecto lineal y uno suave. Si quieres otro caso de PCA dentro de un clasificador, el taller con biopsias de mama lo muestra con 30 medidas reales, y los casos de splines en logística usan el spline para buscar un mínimo y para pronosticar.