El capítulo de series de tiempo enseñó el flujo de trabajo de diez pasos con un laboratorio clásico (los pasajeros aéreos de 1949-1960) y un caso simulado (los envíos). Este capítulo lo aplica a dos series reales de Colombia, descargadas de fuentes oficiales, que plantean preguntas muy distintas:
Caso 1: energía
Caso 2: dengue
Serie
Demanda de energía del Sistema Interconectado Nacional, mensual, 2013-2026
Casos de dengue notificados, semanales, 2007-2022
Fuente
XM, operador del sistema eléctrico
SIVIGILA, Instituto Nacional de Salud
Pregunta
¿Cuánta energía demandará el país en 2027?
¿Cuándo una semana sale de lo esperado y hay que dar la alerta?
Ejemplo básico
Holt-Winters y SARIMA, como en el capítulo de series de tiempo
Pronóstico a cuatro semanas frente al ingenuo
Lo nuevo
Variables externas: un SARIMAX con El Niño
Canal endémico: alerta temprana con percentiles
Cada caso tiene dos partes. La primera repite, de forma condensada, los pasos del capítulo de series de tiempo; la segunda enseña una herramienta que ese capítulo no cubre. Las dos series son, además, un contraste útil: la demanda de energía tiene tendencia y estacionalidad marcadas, y el dengue casi no tiene estación, pero sí epidemias que llegan cada pocos años.
Tiempo estimado de lectura: 90 minutos (unas 3 horas si ejecutas el código y respondes las preguntas)
Nivel: Avanzado
Conocimientos previos: el capítulo de series de tiempo completo, en especial la validación temporal, el SARIMA de aerolínea y los intervalos de pronóstico.
Tecnologías: Python 3.13, NumPy, pandas, Matplotlib, SciPy y statsmodels (ExponentialSmoothing, SARIMAX con variables externas, acorr_ljungbox).
Los datos. Los tres archivos están en la carpeta datos/ de este capítulo, para que funcione sin internet:
demanda_sin_mensual_xm.csv: la demanda de energía del SIN por mes, en GWh, con el número de días con dato. Se construyó sumando los archivos históricos diarios que XM publica en su portal Sinergox (sección Demandas y Fronteras, históricos «Demanda_Energia_SIN»), de enero de 2013 a noviembre de 2026.
oni_noaa_2005_2026.csv: el índice ONI de El Niño, publicado por el Centro de Predicción Climática de la NOAA en oni.ascii.txt.
dengue_sivigila_semanal_2007_2022.csv: los casos de dengue (evento 210) por semana epidemiológica, sumados a escala nacional desde el conjunto «Datos de Vigilancia en Salud Pública de Colombia» del SIVIGILA en datos.gov.co.
Los totales de cada año de los tres archivos se verificaron contra la fuente original.
Objetivos
Al terminar este capítulo vas a ser capaz de:
aplicar el flujo de diez pasos del capítulo de series de tiempo a datos reales, con sus imperfecciones;
normalizar una serie mensual por el número de días para quitar el efecto del calendario;
incorporar variables externas a un SARIMA (un SARIMAX), interpretar sus coeficientes y comprobar si mejoran el pronóstico;
explicar por qué una variable externa solo ayuda si también se conoce o se puede pronosticar su futuro, y construir pronósticos por escenarios;
reconocer una serie sin estacionalidad útil y aceptar que el pronóstico ingenuo puede ser difícil de superar;
construir un canal endémico con cuartiles, aplicarlo como regla de alerta temprana y evaluar su anticipación y sus falsas alarmas.
Preparación del entorno
La celda carga las librerías del caso. Las de análisis de series vienen de statsmodels, y cada una cumple una función en el flujo de trabajo:
Importación
Qué hace
Paso del flujo
seasonal_decompose
Parte la serie en tendencia, estacionalidad y residuo
3. Explorar y descomponer
adfuller
Aplica la prueba de Dickey-Fuller aumentada: ¿la serie es estacionaria?
4. Revisar la estacionariedad
acf
Calcula la autocorrelación de la serie en cada rezago
5. Leer la ACF
plot_acf
Dibuja el correlograma, con su banda del 95 %
5. Leer la ACF
ExponentialSmoothing
Ajusta y pronostica con Holt-Winters
6 y 7. Candidatos y validación
SARIMAX
Ajusta y pronostica con SARIMA, y con variables externas (SARIMAX)
6 y 7. Candidatos y validación
acorr_ljungbox
Aplica la prueba de Ljung-Box: ¿los residuos de un modelo son ruido?
8. Revisar los residuos
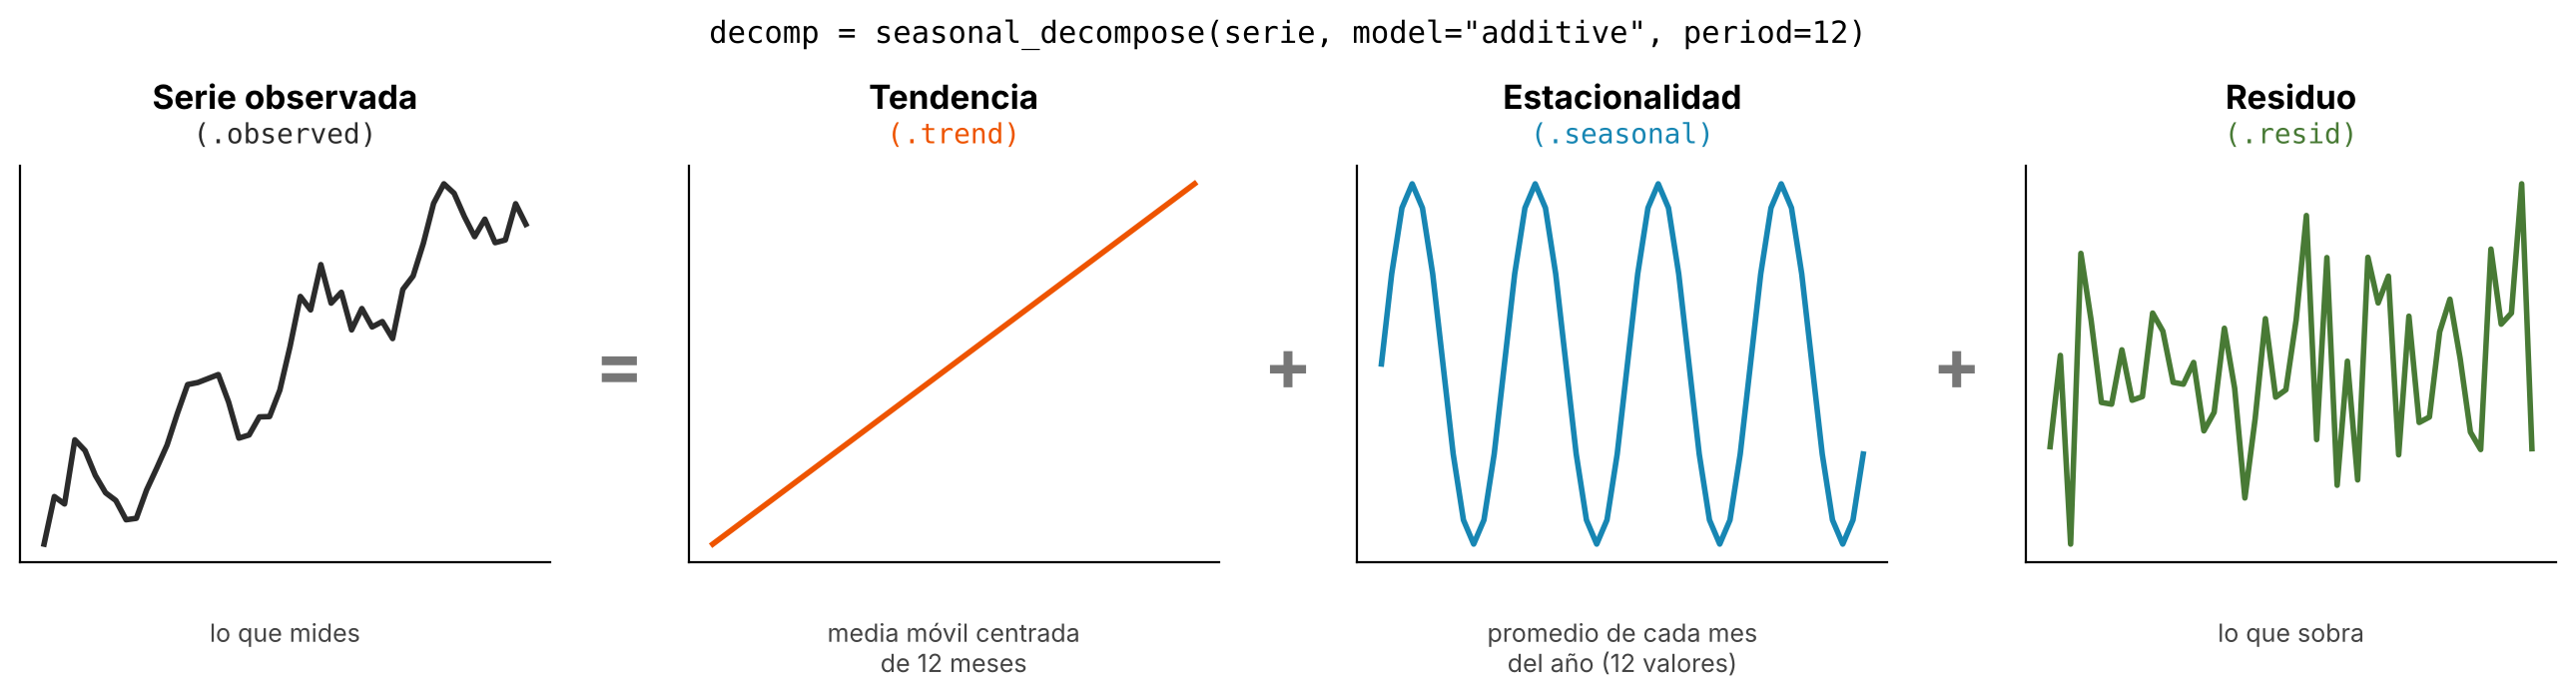
La primera es la que más se usa para entender una serie antes de modelarla. seasonal_decompose toma la serie observada y la separa en tres piezas que, sumadas, la reconstruyen:
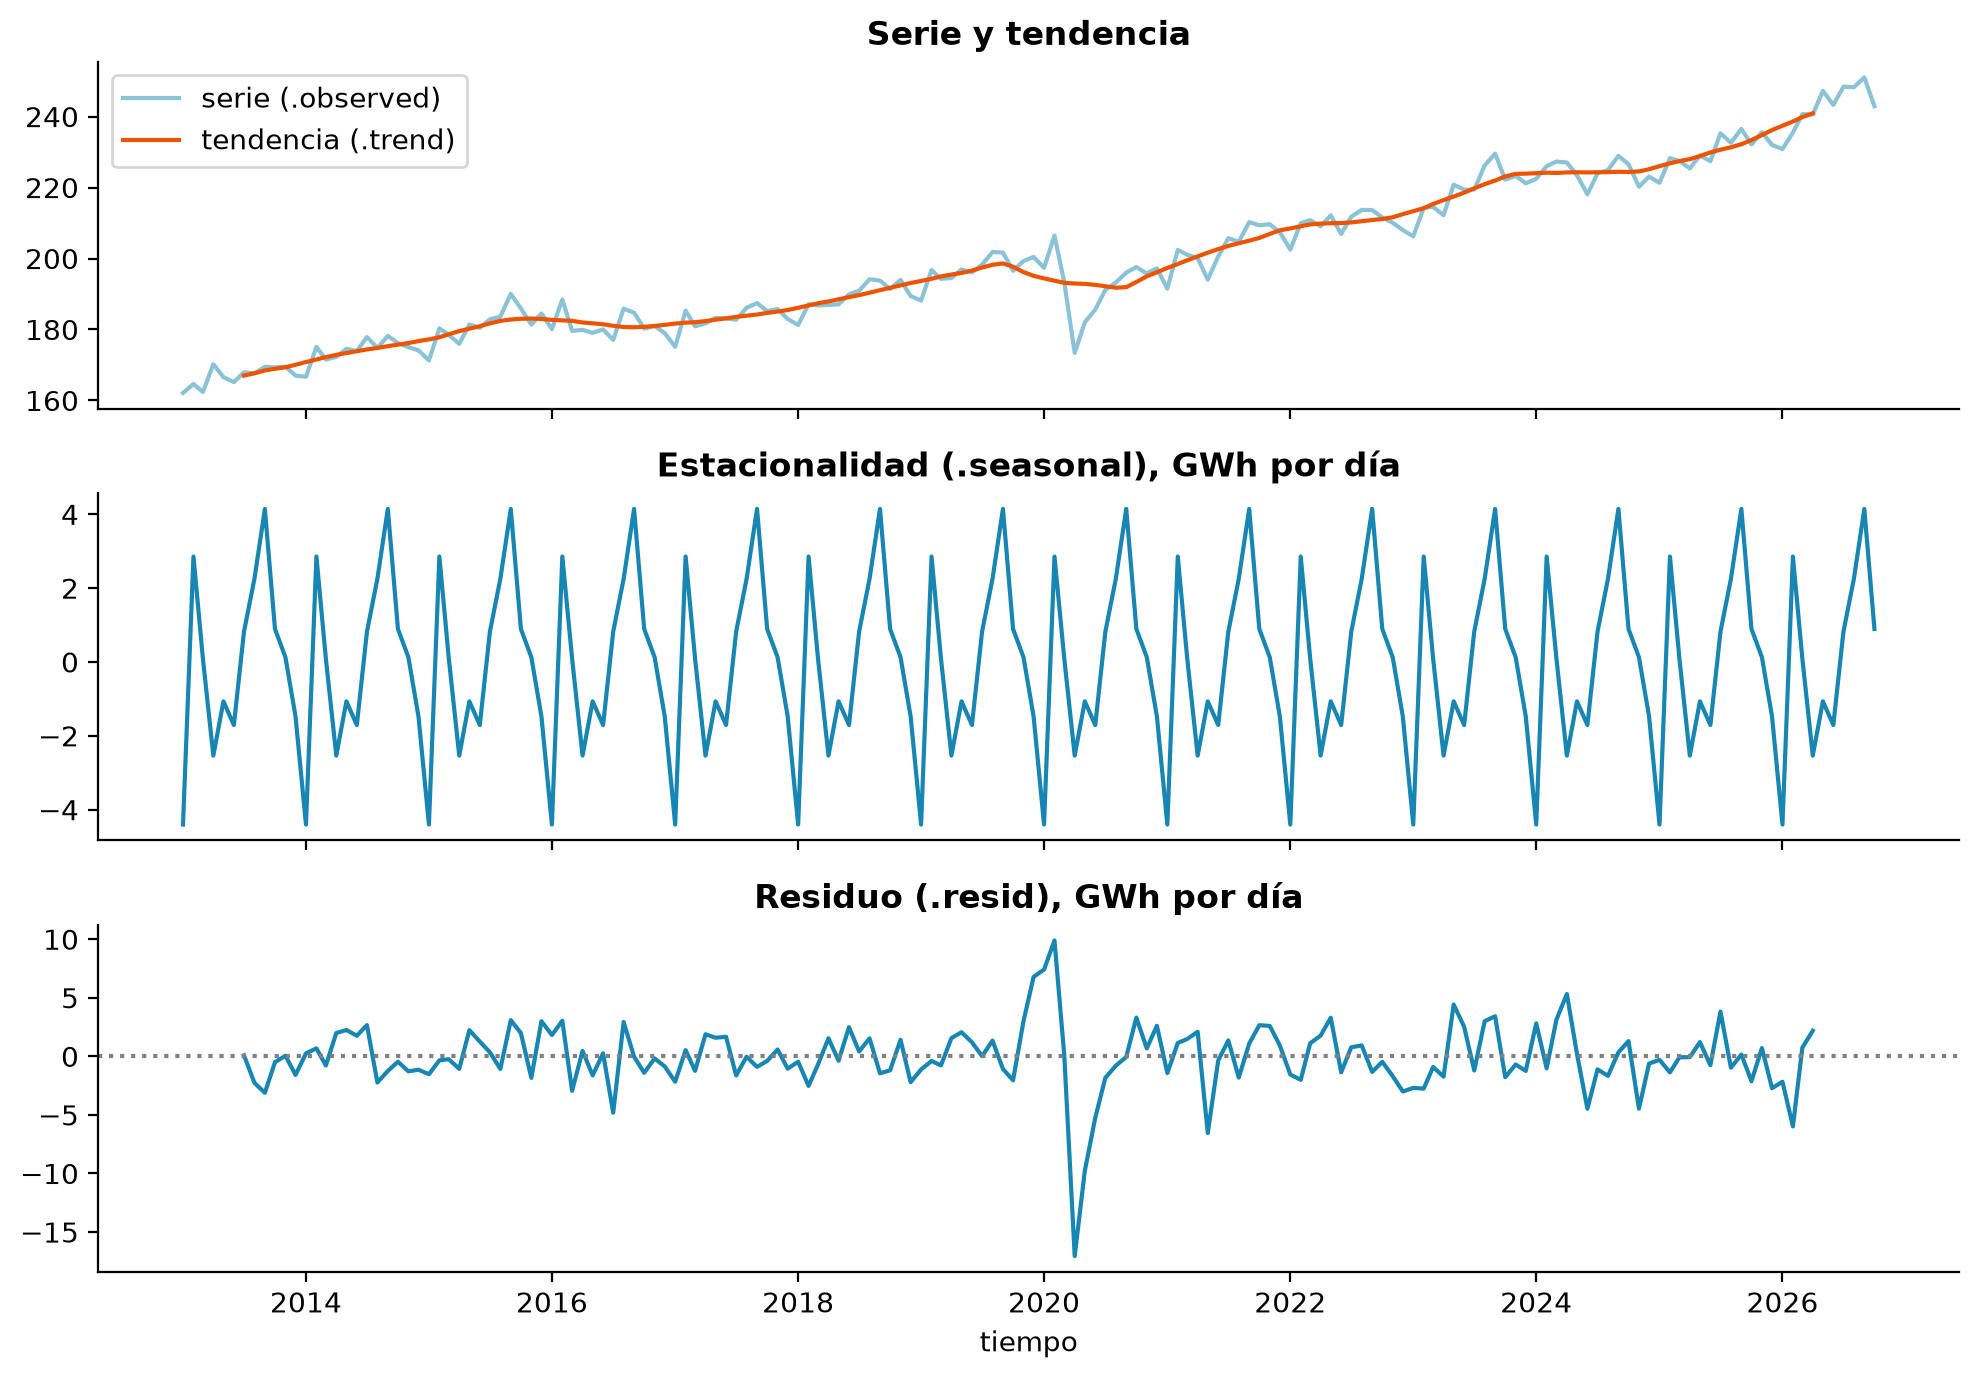
Lo que hace seasonal_decompose con una serie mensual: la serie observada es la suma de una tendencia, una estacionalidad que se repite cada 12 meses y un residuo. Cada panel tiene su propia escala vertical.
Tendencia: se estima con una media móvil centrada de 12 meses; al promediar un año completo, las subidas y bajadas de cada temporada se cancelan y queda el movimiento de fondo.
Estacionalidad: a la serie se le quita la tendencia y se promedia lo que queda por mes calendario (todos los eneros, todos los febreros…); el resultado son 12 valores que se repiten igual cada año.
Residuo: lo que sobra, la parte que ni la tendencia ni el calendario explican.
La descomposición describe el pasado; no pronostica. Sirve para ver la estructura de la serie y elegir después los modelos que sí pronostican.
Para ello, la celda sigue estos pasos, en este orden:
Carga las librerías y silencia los avisos de convergencia del optimizador, que en algunos ajustes son frecuentes y no cambian los resultados.
Define los colores y el estilo de las figuras, los mismos del capítulo de series de tiempo.
Define las métricas MAE y MAPE.
Imprime las versiones con las que se obtuvieron las cifras del texto.
%matplotlib inline%config InlineBackend.figure_format ="retina"import warningsimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom statsmodels.tsa.seasonal import seasonal_decomposefrom statsmodels.tsa.stattools import adfuller, acffrom statsmodels.tsa.holtwinters import ExponentialSmoothingfrom statsmodels.tsa.statespace.sarimax import SARIMAXfrom statsmodels.stats.diagnostic import acorr_ljungboxfrom statsmodels.graphics.tsaplots import plot_acf# 1. Semilla central y avisos: el optimizador de statsmodels avisa de convergencia en algunos ajustes.SEMILLA =2026warnings.filterwarnings('ignore')# 2. Colores y estilo de las figuras (los mismos del capítulo de series de tiempo).COLOR_SERIE ='#1786B3'# la serie observadaCOLOR_HW ='#EE5400'# Holt-Winters y zonas de alertaCOLOR_SARIMA ='#487A35'# SARIMA y SARIMAXCOLOR_REAL ='#2B2B2B'# valores reales del tramo de pruebaplt.rcParams.update({'figure.figsize': (10, 4),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# 3. Las dos métricas de error del capítulo de series de tiempo.def mae(y_real, y_pred):returnfloat(np.mean(np.abs(np.asarray(y_real) - np.asarray(y_pred))))def mape(y_real, y_pred): y_real = np.asarray(y_real)returnfloat(100* np.mean(np.abs(y_real - np.asarray(y_pred)) / y_real))# 4. Versiones de referencia.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'statsmodels']:print(f'{paquete}: {metadatos.version(paquete)}')
El encargo. Es noviembre de 2026. El fenómeno de El Niño está en su punto más fuerte desde 2015-2016, la demanda de energía marca máximos históricos y el área de planeación de una empresa del sector te pide el pronóstico mensual de la demanda de energía del país hasta diciembre de 2027, con su incertidumbre, y una respuesta a una pregunta concreta: ¿cuánto cambia ese pronóstico según lo que haga El Niño?
El encargo fija la variable (demanda mensual del SIN), el horizonte (14 meses, de noviembre de 2026 a diciembre de 2027) y lo que se espera del análisis: un pronóstico con bandas y una comparación de escenarios. Antes de usarlo para el futuro, el método se pone a prueba en el pasado reciente: ¿cómo le habría ido al pronóstico hecho hace un año, en octubre de 2025?
Paso 2: preparar los datos
Nota¿Qué es un GWh?
La energía eléctrica se mide en vatios-hora (Wh): un aparato de 1 vatio de potencia encendido durante 1 hora consume 1 Wh. Las unidades más grandes se forman con los prefijos habituales: 1 kilovatio-hora (kWh) son 1000 Wh, la unidad que aparece en la factura de un hogar, y 1 gigavatio-hora (GWh) son 1000 millones de Wh, es decir, 1 millón de kWh. Un bombillo LED de 10 W encendido 100 horas consume 1 kWh; para consumir 1 GWh harían falta 1 millón de esos bombillos encendidos 100 horas. La demanda del país se mide en GWh: en octubre de 2026 fue de 7530 GWh en el mes, unos 243 GWh cada día.
No hay que confundir energía con potencia. La potencia (W, kW, MW) es la velocidad a la que se consume en un instante; la energía (Wh, kWh, GWh) es lo que se acumula durante un tiempo. Este caso trabaja con energía.
Antes de transformar nada, conviene mirar los datos tal como llegan: cuántas filas tienen, si faltan meses, si faltan días dentro de algún mes y si hay valores vacíos. Es la parte del paso 2 que el capítulo de series de tiempo no necesitaba, porque sus datos estaban completos, y que en datos reales nunca se omite.
El archivo tiene una fila por mes con tres columnas: mes, demanda_gwh (la energía total del mes) y dias (cuántos días de ese mes tienen dato en los archivos diarios de XM). Para ello, la celda sigue estos pasos, en este orden:
Lee el archivo, cuenta sus filas y valores vacíos, y muestra sus cinco primeras filas con head().
Compara las fechas del archivo con el calendario completo, para detectar meses faltantes.
Compara, en cada mes, los días con dato con los días que tiene el mes, y lista los meses incompletos.
Dibuja la energía total de cada mes y los días con dato, con los meses incompletos marcados.
# 1. Leer el archivo tal como viene: una fila por mes, con el total de energía y los días con dato.crudo = pd.read_csv('datos/demanda_sin_mensual_xm.csv', parse_dates=['mes'])print('Filas y columnas:', crudo.shape)print('Valores vacíos por columna:', crudo.isna().sum().to_dict())display(crudo.head()) # las cinco primeras filas, tal como vienen en el archivo# 2. ¿Falta algún mes? Se compara con el calendario completo entre el primer y el último mes.calendario = pd.date_range(crudo['mes'].min(), crudo['mes'].max(), freq='MS')meses_faltantes = calendario.difference(crudo['mes'])print(f'\nMeses del calendario: {len(calendario)} | meses en el archivo: {len(crudo)} | 'f'meses faltantes: {len(meses_faltantes)}')# 3. ¿Faltan días? Se compara, mes a mes, los días con dato con los días que tiene ese mes.crudo['dias_del_mes'] = crudo['mes'].dt.days_in_monthcrudo['dias_faltantes'] = crudo['dias_del_mes'] - crudo['dias']incompletos = crudo[crudo['dias_faltantes'] >0]print('\nMeses con días faltantes:')print(incompletos[['mes', 'dias', 'dias_del_mes', 'dias_faltantes']].to_string(index=False))# 4. La figura: el total de cada mes (arriba) y los días con dato (abajo), con los meses incompletos marcados.fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)axes[0].plot(crudo['mes'], crudo['demanda_gwh'], color=COLOR_SERIE)axes[0].plot(incompletos['mes'], incompletos['demanda_gwh'], 'X', ms=10, color=COLOR_HW, label='mes incompleto')axes[0].set_ylabel('GWh en el mes')axes[0].set_title('Datos crudos: energía total de cada mes')axes[0].legend(loc='upper left')axes[1].bar(crudo['mes'], crudo['dias'], width=25, color='lightgray', label='días con dato')axes[1].plot(incompletos['mes'], incompletos['dias'], 'X', ms=10, color=COLOR_HW, label='mes incompleto')axes[1].set_ylim(10, 32)axes[1].set_ylabel('días con dato')axes[1].set_title('Días con dato en cada mes')axes[1].legend(loc='lower left')plt.tight_layout()plt.show()
Filas y columnas: (167, 3)
Valores vacíos por columna: {'mes': 0, 'demanda_gwh': 0, 'dias': 0}
mes
demanda_gwh
dias
0
2013-01-01
5025.202
31
1
2013-02-01
4609.686
28
2
2013-03-01
5033.037
31
3
2013-04-01
5106.221
30
4
2013-05-01
5163.348
31
Meses del calendario: 167 | meses en el archivo: 167 | meses faltantes: 0

Meses con días faltantes:
       mes  dias  dias_del_mes  dias_faltantes
2015-12-01    30            31               1
2026-11-01    15            30              15
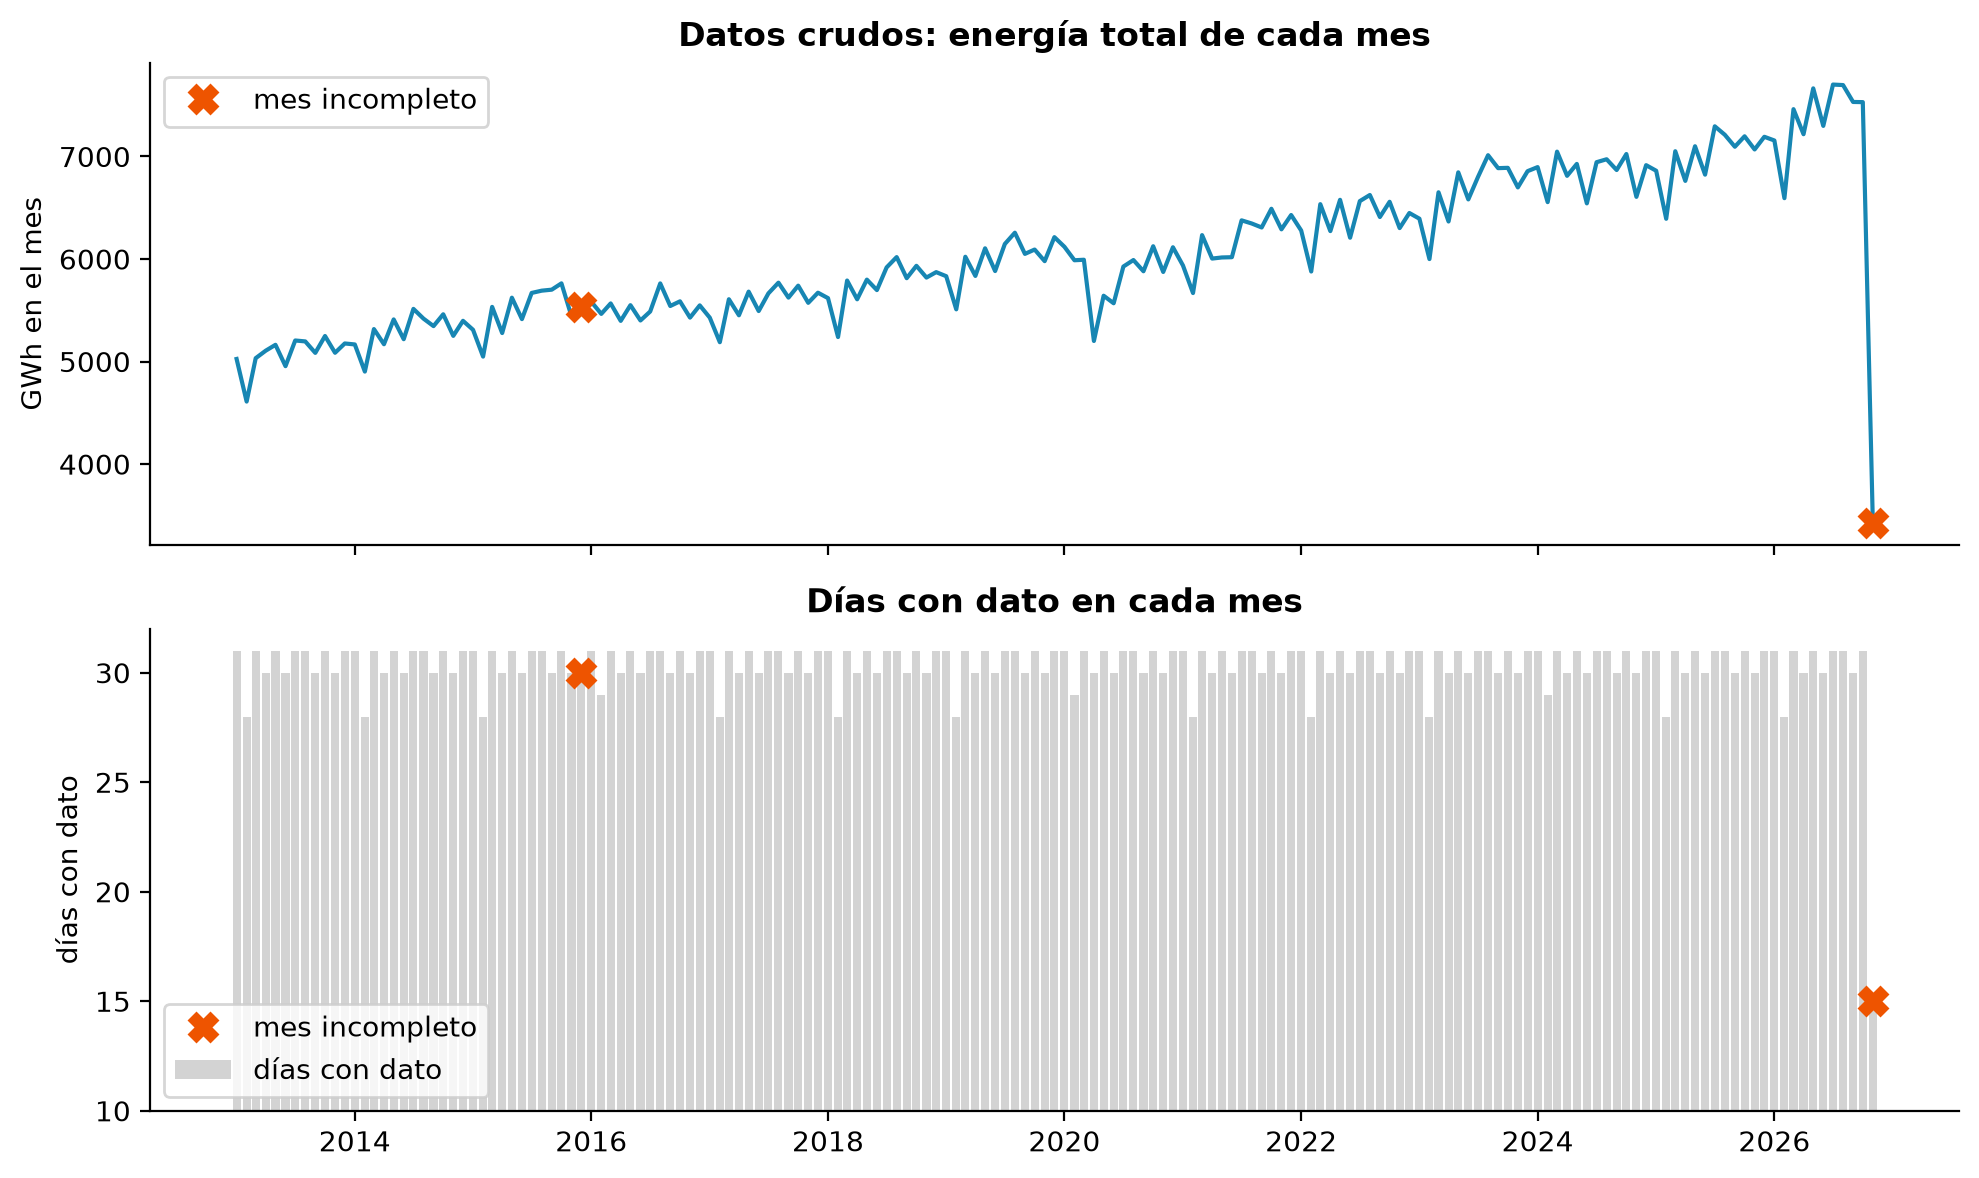
El archivo tiene 167 filas y ningún valor vacío. Las primeras filas muestran su forma: cada mes aparece con su energía total (5025.202 GWh en enero de 2013) y sus días con dato (31). Además, y no falta ningún mes: el calendario de enero de 2013 a noviembre de 2026 tiene 167 meses y el archivo los tiene todos. Lo que sí hay son días faltantes en dos meses:
diciembre de 2015 tiene 30 días con dato de 31: le falta uno en los archivos de XM;
noviembre de 2026 tiene solo 15 días de 30, porque los datos se descargaron a mitad de ese mes.
La figura muestra el efecto de esos huecos: noviembre de 2026 aparece como una caída abrupta, de unos 7530 a 3429 GWh, que no es un desplome de la demanda, sino medio mes sin datos. Diciembre de 2015 apenas se nota en el total, pero también quedó por debajo de lo que fue en realidad. El panel de abajo revela un tercer asunto, que no es un error de los datos: los meses no tienen la misma cantidad de días (28, 29, 30 o 31), y eso también mueve el total.
El efecto del calendario
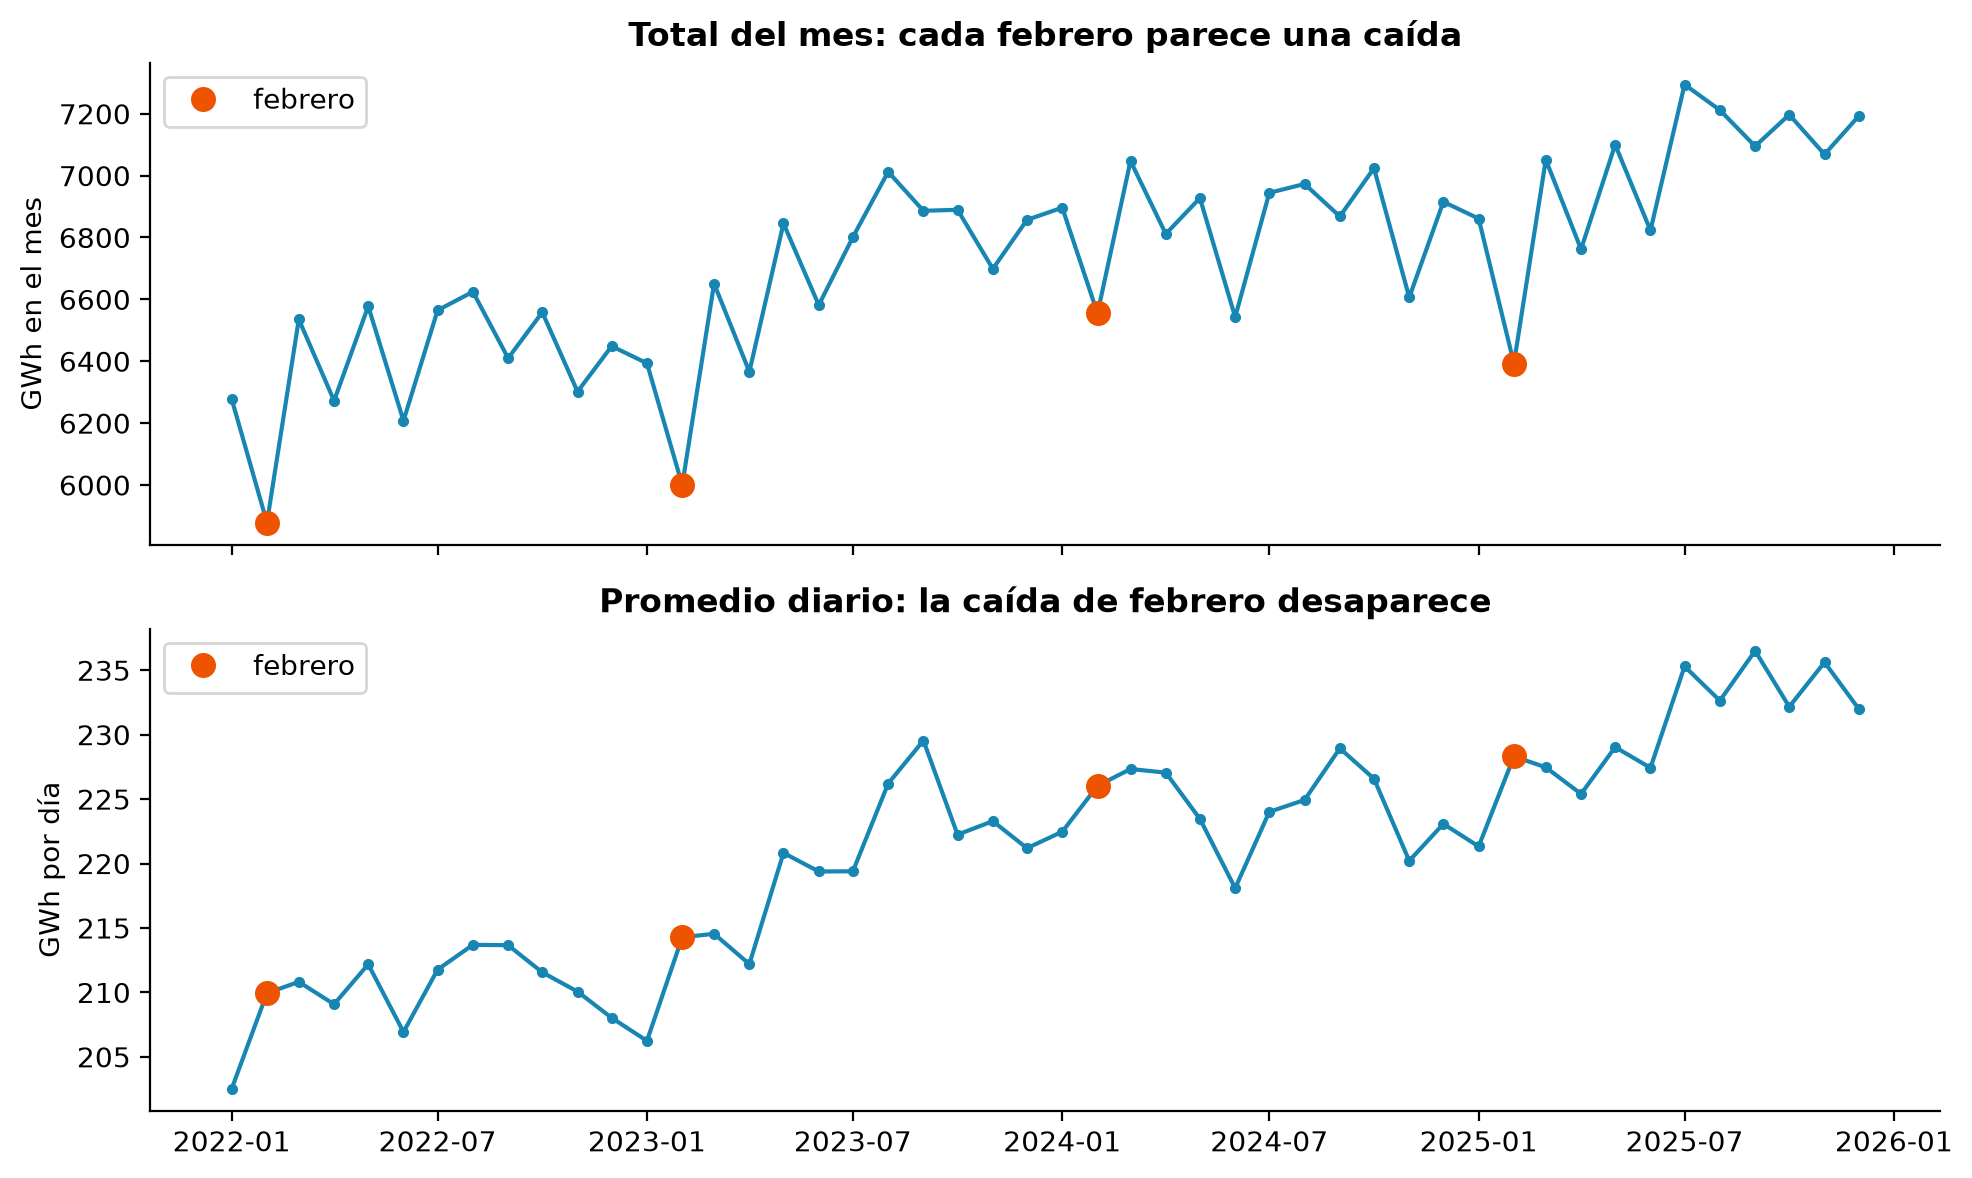
Si el total del mes depende de cuántos días tiene, febrero, con 28 o 29 días, siempre saldrá más bajo que enero, con 31, aunque el país consuma lo mismo cada día. Un modelo que reciba los totales verá esa caída cada año y la tomará por un patrón de consumo. La solución es expresar cada mes como promedio diario: la energía total dividida entre los días con dato. Esa misma división corrige diciembre de 2015, porque divide entre los 30 días que sí tienen dato.
Para ver la diferencia, la celda compara febrero con enero cada año con las dos medidas. Para ello, sigue estos pasos, en este orden:
Calcula el promedio diario de cada mes.
Recorre los años de 2013 a 2026 y calcula el cociente febrero/enero con el total y con el promedio diario; cuenta en cuántos años febrero queda por debajo de enero con cada medida.
Dibuja los meses de 2022 a 2025 como total y como promedio diario, con los febreros marcados.
# 1. El promedio diario de cada mes: el total dividido entre los días con dato.crudo['gwh_dia'] = crudo['demanda_gwh'] / crudo['dias']# 2. Febrero frente a enero, cada año, con las dos medidas.# Un cociente menor que 1 indica que febrero parece más bajo que enero.print('Año feb./ene. (total) feb./ene. (promedio diario)')anios_feb_bajo_total =0anios_feb_bajo_diario =0for anio inrange(2013, 2027): enero = crudo[crudo['mes'] ==f'{anio}-01-01'].iloc[0] febrero = crudo[crudo['mes'] ==f'{anio}-02-01'].iloc[0] cociente_total = febrero['demanda_gwh'] / enero['demanda_gwh'] cociente_diario = febrero['gwh_dia'] / enero['gwh_dia'] anios_feb_bajo_total += cociente_total <1 anios_feb_bajo_diario += cociente_diario <1print(f'{anio}{cociente_total:.3f}{cociente_diario:.3f}')print(f'\nAños en que febrero queda por debajo de enero | total: {anios_feb_bajo_total} de 14 | 'f'promedio diario: {anios_feb_bajo_diario} de 14')# 3. La figura: los mismos meses de 2022 a 2025, como total y como promedio diario.tramo = crudo[(crudo['mes'] >='2022-01-01') & (crudo['mes'] <='2025-12-01')]febreros = tramo[tramo['mes'].dt.month ==2]fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)axes[0].plot(tramo['mes'], tramo['demanda_gwh'], 'o-', ms=3, color=COLOR_SERIE)axes[0].plot(febreros['mes'], febreros['demanda_gwh'], 'o', ms=8, color=COLOR_HW, label='febrero')axes[0].set_ylabel('GWh en el mes')axes[0].set_title('Total del mes: cada febrero parece una caída')axes[0].legend(loc='upper left')axes[1].plot(tramo['mes'], tramo['gwh_dia'], 'o-', ms=3, color=COLOR_SERIE)axes[1].plot(febreros['mes'], febreros['gwh_dia'], 'o', ms=8, color=COLOR_HW, label='febrero')axes[1].set_ylabel('GWh por día')axes[1].set_title('Promedio diario: la caída de febrero desaparece')axes[1].legend(loc='upper left')plt.tight_layout()plt.show()
Año   feb./ene. (total)   feb./ene. (promedio diario)
2013        0.917                 1.016
2014        0.949                 1.050
2015        0.951                 1.053
2016        0.979                 1.046
2017        0.956                 1.058
2018        0.932                 1.032
2019        0.945                 1.046
2020        0.979                 1.046
2021        0.955                 1.057
2022        0.936                 1.037
2023        0.938                 1.039
2024        0.950                 1.016
2025        0.932                 1.032
2026        0.921                 1.020

Años en que febrero queda por debajo de enero | total: 14 de 14 | promedio diario: 0 de 14
Con el total, febrero queda por debajo de enero en 14 de 14 años, con cocientes entre 0.917 y 0.979. Con el promedio diario, en 0 de 14: febrero queda por encima de enero todos los años, con cocientes entre 1.016 y 1.058. El total no solo exageraba la diferencia; la invertía. Lo que de verdad pasa es que enero es un mes de baja actividad (vacaciones, menos producción industrial) y cada día de febrero se consume más que cada día de enero. La figura lo muestra: los puntos naranjas de febrero son valles en el total y desaparecen como valles en el promedio diario.
La serie que usa el caso
Con los dos hallazgos resueltos, queda construir la serie definitiva. Para ello, la celda sigue estos pasos, en este orden:
Quita noviembre de 2026, que con 15 días no se compara con los demás meses.
Construye la serie del promedio diario, con la fecha como índice y frecuencia mensual.
Resume la serie por año.
Dibuja la serie.
# 1. Quitar noviembre de 2026: solo tiene 15 días y un mes a medias no se compara con los demás.crudo = crudo[crudo['mes'] <'2026-11-01']# 2. La serie que usa el resto del caso: el promedio diario, con la fecha como índice y frecuencia mensual.energia = pd.Series(crudo['gwh_dia'].to_numpy(), index=crudo['mes'], name='gwh_dia').asfreq('MS')print(f'{len(energia)} meses, de {energia.index[0]:%Y-%m} a {energia.index[-1]:%Y-%m}')# 3. Promedio de cada año.anual = energia.groupby(energia.index.year).mean()print('\nGWh por día, promedio anual:')print(anual.round(1).to_string())# 4. La serie.fig, ax = plt.subplots()ax.plot(energia.index, energia.values, color=COLOR_SERIE)ax.set_xlabel('tiempo')ax.set_ylabel('GWh por día')ax.set_title('Demanda de energía del SIN, promedio diario de cada mes')plt.tight_layout()plt.show()
166 meses, de 2013-01 a 2026-10

GWh por día, promedio anual:
mes
2013    166.8
2014    174.2
2015    181.3
2016    181.2
2017    183.3
2018    189.4
2019    197.1
2020    192.4
2021    203.1
2022    210.0
2023    219.1
2024    224.3
2025    230.3
2026    242.9
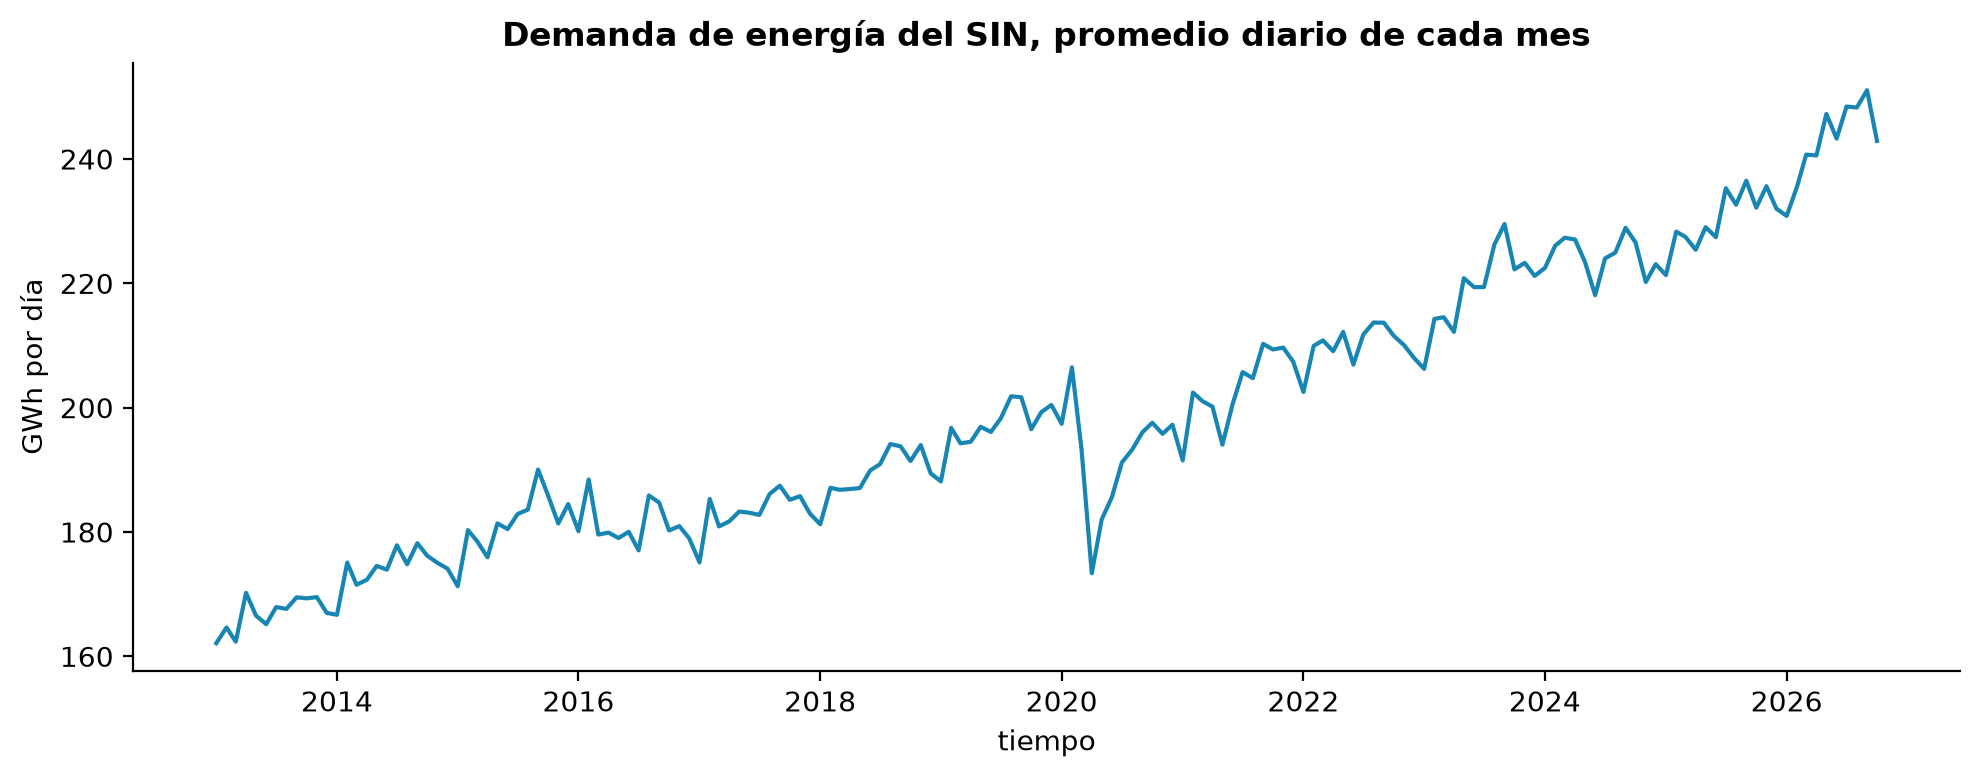
Quedan 166 meses, de enero de 2013 a octubre de 2026. La demanda promedio pasa de 166.8 GWh por día en 2013 a 242.9 en 2026, un crecimiento de cerca del 46 % en 13 años. La gráfica ya no tiene los dientes de febrero ni la caída artificial de noviembre de 2026, y muestra los dos rasgos reales que el análisis tendrá que tratar: la caída brusca de abril de 2020 y la aceleración de 2026.
Pasos 3 a 5: explorar la serie
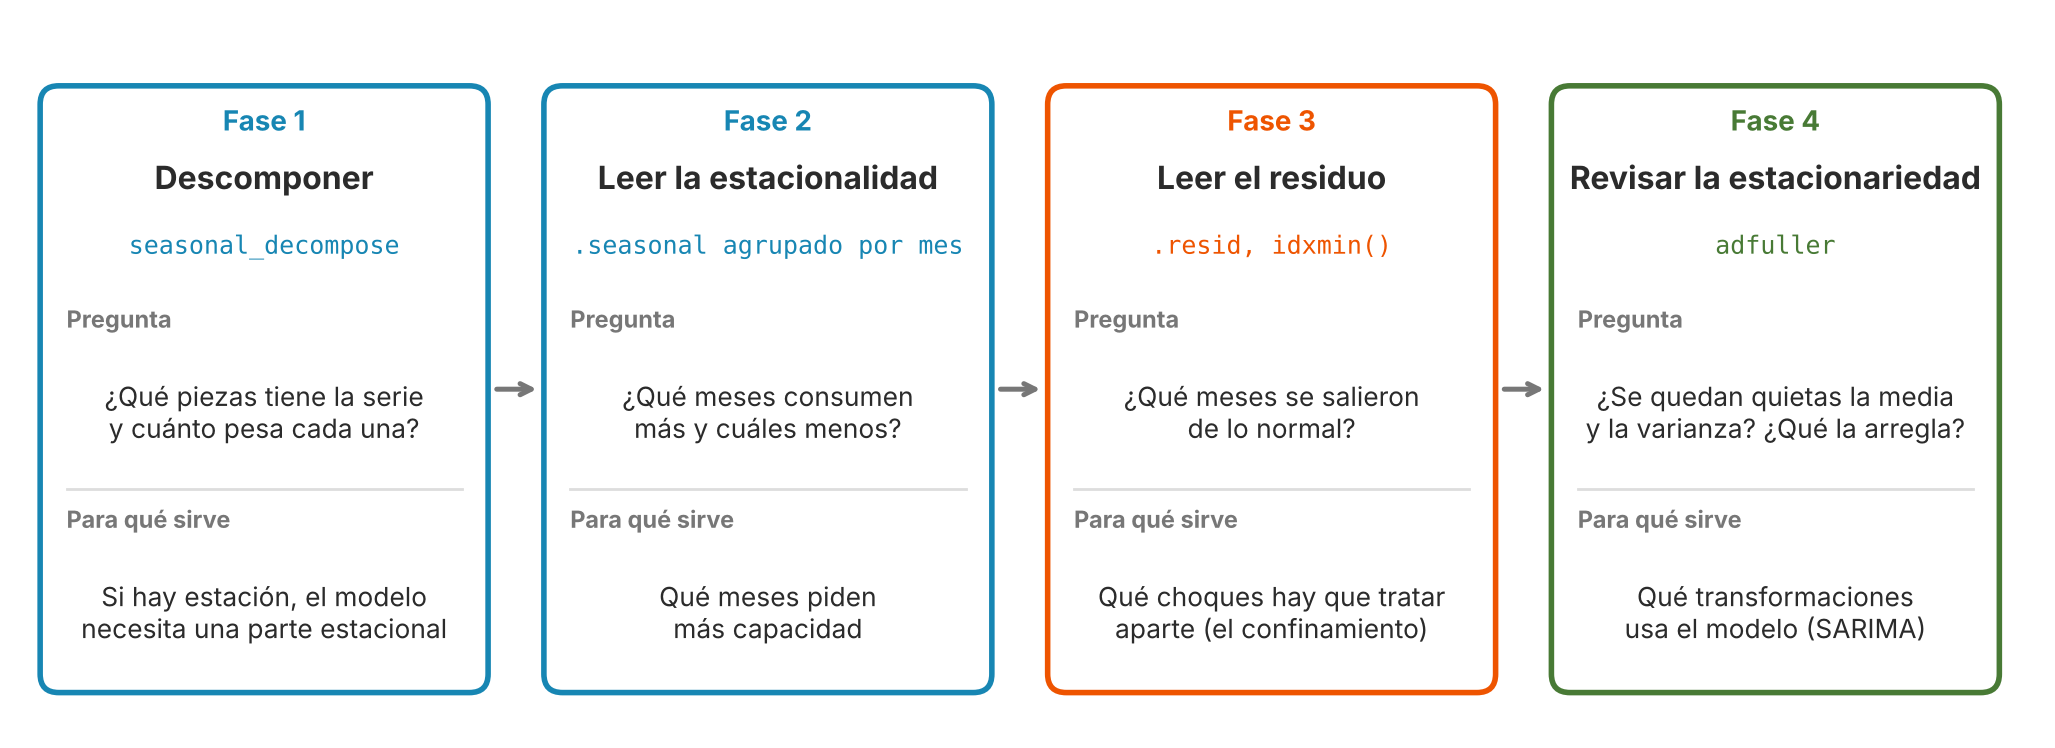
Explorar la serie es hacerle cuatro preguntas antes de elegir un modelo. Cada una tiene su herramienta y su razón de ser:
Las cuatro fases de la exploración: qué pregunta responde cada una y para qué sirve su respuesta en el resto del caso.
Las cuatro fases van en celdas separadas, cada una con la explicación de su código.
Fase 1: descomponer la serie
Qué hace el código. Una sola línea hace todo el trabajo:
energia es la serie que se descompone: la demanda en GWh por día, un valor por mes.
model='additive' indica que las piezas se suman: serie = tendencia + estacionalidad + residuo. Se elige aditiva porque el ciclo anual de la energía es pequeño frente al nivel y su amplitud no crece en abanico, como sí ocurría con los pasajeros aéreos.
period=12 indica que el ciclo se repite cada 12 observaciones, porque los datos son mensuales y el ciclo es anual.
El resultado, decomp_e, es un objeto con cuatro series del mismo largo que energia: .observed (la serie original), .trend (la tendencia), .seasonal (la estacionalidad) y .resid (el residuo), las mismas del esquema de la preparación del entorno. Los 6 primeros y los 6 últimos meses de .trend y .resid quedan vacíos (NaN), porque la media móvil centrada de 12 meses necesita 6 meses a cada lado.
El resto de la celda dibuja las tres piezas en tres paneles que comparten el eje del tiempo (sharex=True), para leerlas una debajo de la otra. Para ello, la celda sigue estos pasos, en este orden:
Descompone la serie de forma aditiva con periodo de 12 meses.
Cuenta los meses sin tendencia en los extremos.
Dibuja la serie con su tendencia, la estacionalidad y el residuo.
# 1. Descomposición aditiva con periodo de 12 meses: serie = tendencia + estacionalidad + residuo.decomp_e = seasonal_decompose(energia, model='additive', period=12)# 2. Cuántos meses quedan sin tendencia y desde/hasta cuándo hay tendencia.# Importa porque en esos meses tampoco hay residuo: los 6 meses más recientes,# los que más interesan para pronosticar, quedan fuera de la descomposición.print(f'Meses sin tendencia (NaN): {decomp_e.trend.isna().sum()} de {len(energia)}')print(f'Tendencia en {decomp_e.trend.first_valid_index():%Y-%m}: {decomp_e.trend.dropna().iloc[0]:.1f} GWh/día | 'f'en {decomp_e.trend.last_valid_index():%Y-%m}: {decomp_e.trend.dropna().iloc[-1]:.1f} GWh/día')# 3. Las tres piezas, una debajo de la otra, con el mismo eje de tiempo.fig, axes = plt.subplots(3, 1, figsize=(10, 7), sharex=True)axes[0].plot(energia.index, energia.values, color=COLOR_SERIE, alpha=0.5, label='serie (.observed)')axes[0].plot(decomp_e.trend.index, decomp_e.trend.values, color=COLOR_HW, label='tendencia (.trend)')axes[0].legend(loc='upper left')axes[0].set_title('Serie y tendencia')axes[1].plot(decomp_e.seasonal.index, decomp_e.seasonal.values, color=COLOR_SERIE)axes[1].set_title('Estacionalidad (.seasonal), GWh por día')axes[2].plot(decomp_e.resid.index, decomp_e.resid.values, color=COLOR_SERIE)axes[2].axhline(0, color='gray', ls=':')axes[2].set_title('Residuo (.resid), GWh por día')axes[2].set_xlabel('tiempo')plt.tight_layout()plt.show()
Meses sin tendencia (NaN): 12 de 166
Tendencia en 2013-07: 167.0 GWh/día | en 2026-04: 240.9 GWh/día
Solo 12 de los 166 meses quedan sin tendencia, los seis de cada extremo, y conviene saberlo por tres razones:
Define qué tramo describe la descomposición. La tendencia existe de julio de 2013 a abril de 2026; los meses de mayo a octubre de 2026, los más recientes, no tienen tendencia ni residuo. Justo los meses más cercanos al futuro quedan fuera, y esa es una de las razones por las que la descomposición sirve para explorar y no para pronosticar: el pronóstico lo hacen después Holt-Winters y SARIMA, que sí usan hasta el último mes.
Advierte de los valores vacíos. Cualquier cálculo con .trend o .resid (una correlación, un promedio, una gráfica) debe ignorar esos NaN; por eso, más adelante, la correlación entre el residuo y El Niño se calcula después de quitarlos con .dropna().
Permite medir el crecimiento de fondo con los extremos válidos. La tendencia sube de 167.0 GWh por día en julio de 2013 a 240.9 en abril de 2026, un 44 % en casi 13 años, con un descenso visible en 2020.
El panel de la estacionalidad repite la misma onda cada año, y el del residuo oscila alrededor de 0, salvo por una caída honda en 2020 que las fases 2 y 3 examinan con números.
Fase 2: leer la estacionalidad
Cómo funciona el código.decomp_e.seasonal tiene 166 valores, uno por mes de la serie, pero solo 12 son distintos. Ese resultado lo produce el método, y no los datos: la descomposición clásica calcula un único efecto por mes del calendario (el promedio de todos los eneros, de todos los febreros, y así) y lo repite igual cada año. Lo que cada enero concreto se aparta de ese promedio queda en el residuo. Si el efecto de un mes cambiara con los años, este método no lo mostraría; para eso existen alternativas como STL (statsmodels.tsa.seasonal.STL), que permite una estacionalidad que evoluciona. Como aquí los 12 valores se repiten, para leerlos basta con quedarse con un valor por mes:
decomp_e.seasonal.index.month toma la fecha de cada uno de los 166 valores y extrae su número de mes: 1 para enero, 2 para febrero, …, 12 para diciembre.
.groupby(...) reúne los 166 valores en 12 grupos según ese número: todos los eneros juntos (14 valores, uno por año), todos los febreros juntos, y así.
.first() toma el primer valor de cada grupo. Como todos los valores de un grupo son iguales, el primero basta; .mean() daría el mismo resultado.
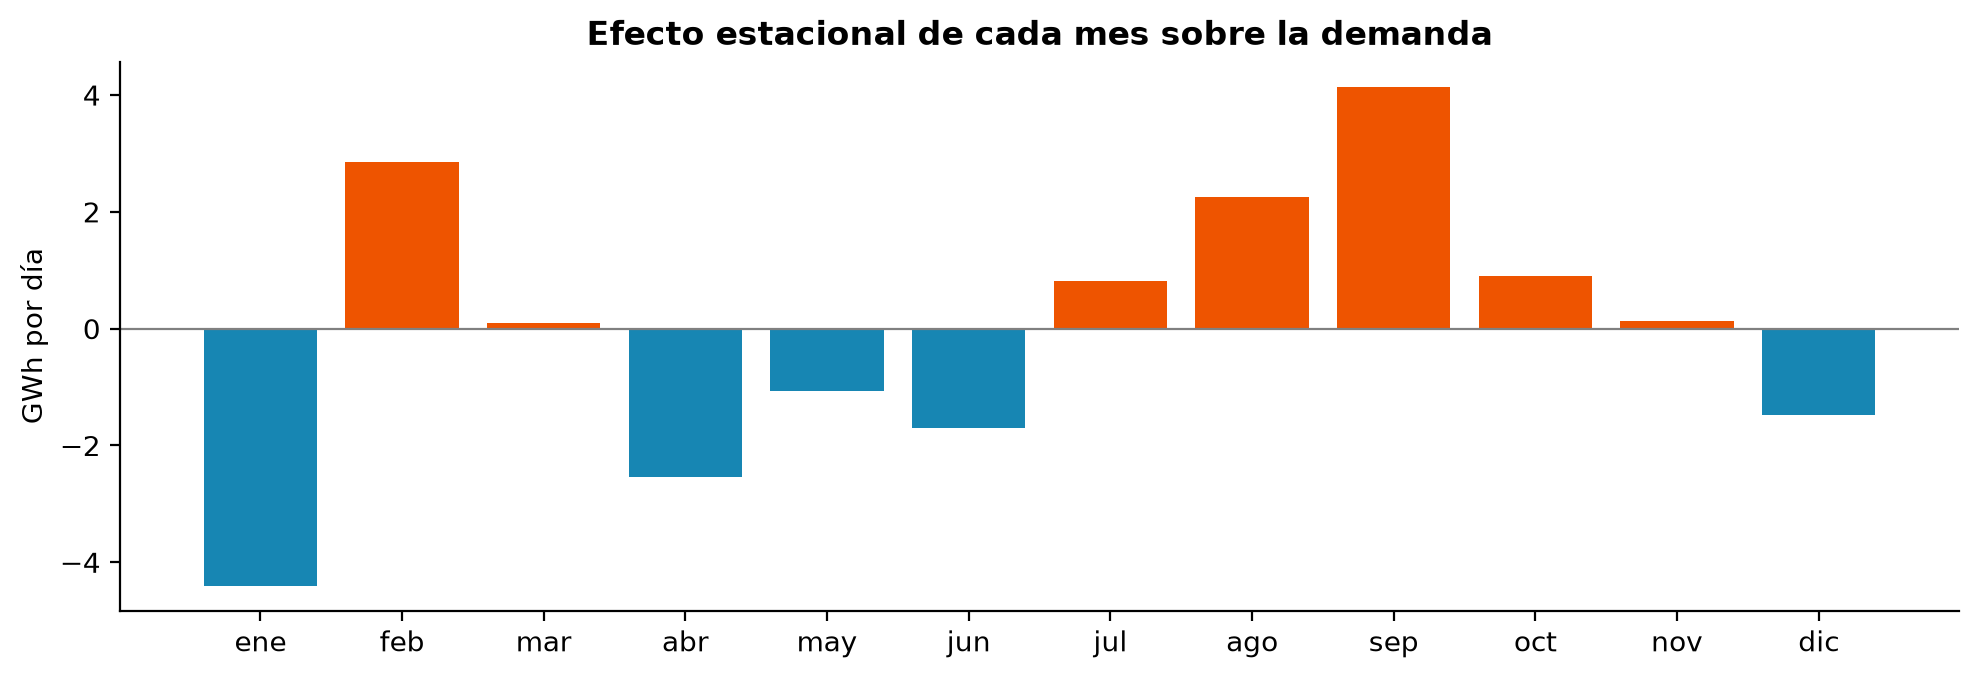
El resultado es una serie de 12 valores, el efecto de cada mes en GWh por día. La línea siguiente reemplaza los números 1 a 12 por los nombres de los meses para que la tabla se lea mejor. Un efecto positivo significa que ese mes, por el calendario, consume por encima de la tendencia; uno negativo, por debajo, y por construcción los 12 efectos suman 0.
Para ello, la celda sigue estos pasos, en este orden:
Agrupa la estacionalidad por mes y se queda con un valor por mes.
Cambia los números de mes por sus nombres e imprime la tabla y la suma de los 12 efectos.
Dibuja los 12 efectos como barras.
# 1. Un valor por mes: los 166 valores de .seasonal se agrupan por número de mes y se toma el primero de cada grupo.efecto_mes = decomp_e.seasonal.groupby(decomp_e.seasonal.index.month).first()# 2. Nombres de los meses en lugar de 1 a 12.efecto_mes.index = ['ene', 'feb', 'mar', 'abr', 'may', 'jun', 'jul', 'ago', 'sep', 'oct', 'nov', 'dic']print('Efecto estacional (GWh por día):')print(efecto_mes.round(2).to_string())print(f'Suma de los 12 efectos: {efecto_mes.sum():.2f}')# 3. Los 12 efectos como barras: naranja si el mes consume por encima de la tendencia, azul si por debajo.fig, ax = plt.subplots(figsize=(10, 3.5))colores = [COLOR_HW if v >0else COLOR_SERIE for v in efecto_mes.values]ax.bar(efecto_mes.index, efecto_mes.values, color=colores)ax.axhline(0, color='gray', lw=0.8)ax.set_ylabel('GWh por día')ax.set_title('Efecto estacional de cada mes sobre la demanda')plt.tight_layout()plt.show()
Efecto estacional (GWh por día):
ene   -4.40
feb    2.86
mar    0.09
abr   -2.54
may   -1.07
jun   -1.71
jul    0.82
ago    2.25
sep    4.15
oct    0.89
nov    0.13
dic   -1.48
Suma de los 12 efectos: -0.00
El efecto va de -4.40 GWh por día en enero (vacaciones, menos actividad industrial) a +4.15 en septiembre, y los 12 efectos suman 0.00, como exige la descomposición aditiva. Abril también queda bajo (-2.54, con la Semana Santa en marzo o abril según el año), y febrero alto (+2.86), el mismo hallazgo del promedio diario en el paso 2. El rango completo, unos 8.5 GWh por día, es pequeño frente a la tendencia, que sube unos 6 GWh por día cada año: la estación existe y hay que modelarla, pero la tendencia domina.
Fase 3: leer el residuo
Las funciones que usa. El residuo es lo que ni la tendencia ni la estación explican, así que un valor muy alejado de 0 señala un mes que se salió de lo normal.
decomp_e.resid.idxmin() devuelve la fecha del residuo más bajo (el índice del mínimo); decomp_e.resid.min() devuelve su valor.
energia["2020-04-01"] toma la demanda de un mes concreto por su fecha. La variación porcentual frente al mismo mes del año anterior se calcula como \(100 \times (\text{abril 2020} / \text{abril 2019} - 1)\). Comparar con el mismo mes del año anterior evita que la estación se mezcle en la comparación.
Para ello, la celda sigue estos pasos, en este orden:
Encuentra la fecha y el valor del residuo más bajo.
Compara abril de 2020 con abril de 2019.
# 1. El residuo más bajo: su fecha (idxmin) y su valor (min).print(f'Residuo más bajo: {decomp_e.resid.idxmin():%Y-%m} ({decomp_e.resid.min():.1f} GWh por día)')# 2. Abril de 2020 frente al mismo mes del año anterior, en porcentaje.variacion =100* (energia['2020-04-01'] / energia['2019-04-01'] -1)print(f'Abril de 2019: {energia["2019-04-01"]:.1f} GWh/día | abril de 2020: {energia["2020-04-01"]:.1f} GWh/día | 'f'variación: {variacion:.1f} %')
Residuo más bajo: 2020-04 (-17.1 GWh por día)
Abril de 2019: 194.5 GWh/día | abril de 2020: 173.4 GWh/día | variación: -10.9 %
El residuo más bajo de toda la serie es abril de 2020, con -17.1 GWh por día. Ese mes, el confinamiento llevó la demanda de 194.5 GWh por día en abril de 2019 a 173.4, una caída del 10.9 %. Es un choque que ningún componente regular explica: si se deja sin tratar, el modelo lo confundirá con la tendencia o con la estación. Por eso la segunda parte del caso lo trata con una variable indicadora.
Fase 4: revisar la estacionariedad
ImportanteResumen: estacionariedad y la prueba ADF
Una serie es estacionaria cuando su media y su varianza no cambian con el tiempo y la relación entre dos meses depende solo de cuántos meses los separan, no de la fecha. Muchos modelos de series, como el SARIMA, suponen esa condición, así que antes de modelar hay que comprobarla. La forma típica de no cumplirla es la raíz unitaria: cada sorpresa se suma de forma permanente y la serie no vuelve a un nivel fijo, como pasa con una demanda que crece año tras año.
La función adfuller aplica la prueba de Dickey-Fuller aumentada (ADF), cuya hipótesis nula es justamente que la serie tiene raíz unitaria, es decir, que no es estacionaria. Su resultado se lee con el p-valor: la probabilidad de observar datos como estos si la hipótesis nula fuera cierta. Un p-valor pequeño (por convención, menor que 0.05) es evidencia contra la hipótesis nula y, por tanto, a favor de la estacionariedad; uno grande solo dice que no hay evidencia suficiente para rechazarla, no que la serie tenga raíz unitaria con certeza. El argumento autolag='AIC' deja que la función elija cuántos rezagos incluir en la prueba con el criterio de información de Akaike.
Cuando la serie no es estacionaria, se transforma y se vuelve a probar: el logaritmo estabiliza la varianza, la primera diferencia (\(Y_t - Y_{t-1}\)) quita la tendencia y la diferencia estacional (\(Y_t - Y_{t-12}\)) quita el ciclo anual. Las transformaciones que hacen falta para que la ADF rechace la raíz unitaria indican qué diferencias debe incluir el modelo.
El código, línea por línea. La prueba de Dickey-Fuller aumentada (ADF) se aplica dos veces: a la serie tal como está y a una versión transformada.
p_orig = adfuller(energia, autolag='AIC')[1]
adfuller(...) aplica la prueba. Su hipótesis nula es que la serie tiene raíz unitaria, es decir, que no es estacionaria.
autolag='AIC' deja que la función elija cuántos rezagos incluir, con el criterio de información de Akaike.
[1]: adfuller devuelve varios resultados en una tupla (estadístico, p-valor, rezagos usados, número de observaciones, valores críticos…); la posición 1 es el p-valor, el único que se guarda.
Antes de la prueba, la serie pasa por cuatro transformaciones encadenadas, que se leen de izquierda a derecha:
np.log(energia): el logaritmo, que estabiliza la varianza y convierte los cambios en proporciones.
.diff(): la primera diferencia, \(Y_t - Y_{t-1}\), el cambio de un mes al siguiente; quita la tendencia.
.diff(12): la diferencia estacional, \(Y_t - Y_{t-12}\), el cambio frente al mismo mes del año anterior; quita la estacionalidad.
.dropna(): quita los valores vacíos que dejan las diferencias, porque el primer mes no tiene mes anterior y los 12 siguientes no tienen año anterior. La prueba no acepta valores vacíos.
La celda imprime cuántos meses quedan después de cada transformación, para ver ese efecto. Para ello, sigue estos pasos, en este orden:
Aplica la ADF a la serie original.
Construye la serie transformada paso a paso y cuenta los meses con dato en cada paso.
Aplica la ADF a la serie transformada e imprime los dos p-valores.
# 1. ADF sobre la serie original; [1] toma el p-valor.p_orig = adfuller(energia, autolag='AIC')[1]# 2. Las transformaciones, una a una, para ver cuántos meses con dato quedan en cada paso.paso_log = np.log(energia)paso_dif = paso_log.diff() # cambio frente al mes anteriorpaso_dif12 = paso_dif.diff(12) # cambio frente al mismo mes del año anteriortransformada = paso_dif12.dropna() # sin los valores vacíos del inicioprint(f'Meses con dato | log: {paso_log.notna().sum()} | + diferencia: {paso_dif.notna().sum()} | 'f'+ diferencia estacional: {paso_dif12.notna().sum()}')# 3. ADF sobre la serie transformada.p_dd = adfuller(transformada, autolag='AIC')[1]print(f'ADF p-valor | original: {p_orig:.4f} log + diferencia regular y estacional: {p_dd:.4g}')
Meses con dato | log: 166 | + diferencia: 165 | + diferencia estacional: 153
ADF p-valor | original: 0.9896   log + diferencia regular y estacional: 3.731e-06
Las transformaciones dejan 153 meses con dato de los 166: la primera diferencia quita uno y la estacional, 12 más. En la serie original, la ADF da p = 0.9896: los datos son muy compatibles con la hipótesis de raíz unitaria y no hay evidencia de estacionariedad, como era de esperar en una serie que sube año tras año. Con logaritmo y diferencias regular y estacional, p = 3.731e-06, es decir, 0.0000037: la prueba rechaza la raíz unitaria con holgura y la serie transformada es estacionaria.
La fase 4 cierra la exploración con una conclusión de modelado. Logaritmo, una diferencia regular y una estacional son exactamente las piezas del SARIMA de aerolínea, \((0,1,1)(0,1,1)_{12}\) sobre el logaritmo, y por eso ese modelo es un candidato natural en el paso siguiente, junto a Holt-Winters, cuya parte estacional justifica la fase 2.
Pasos 6 a 8: el pronóstico básico y su verificación
El ejemplo básico repite el protocolo del capítulo de series de tiempo. Tiene tres piezas, y conviene distinguirlas antes de ver el código:
Candidatos: los modelos que compiten. Aquí son tres: Holt-Winters con tendencia y estación aditivas (add/add), Holt-Winters con tendencia aditiva y estación multiplicativa (add/mul) y el SARIMA de aerolínea sobre el logaritmo, el que sugirió la fase 4 de la exploración.
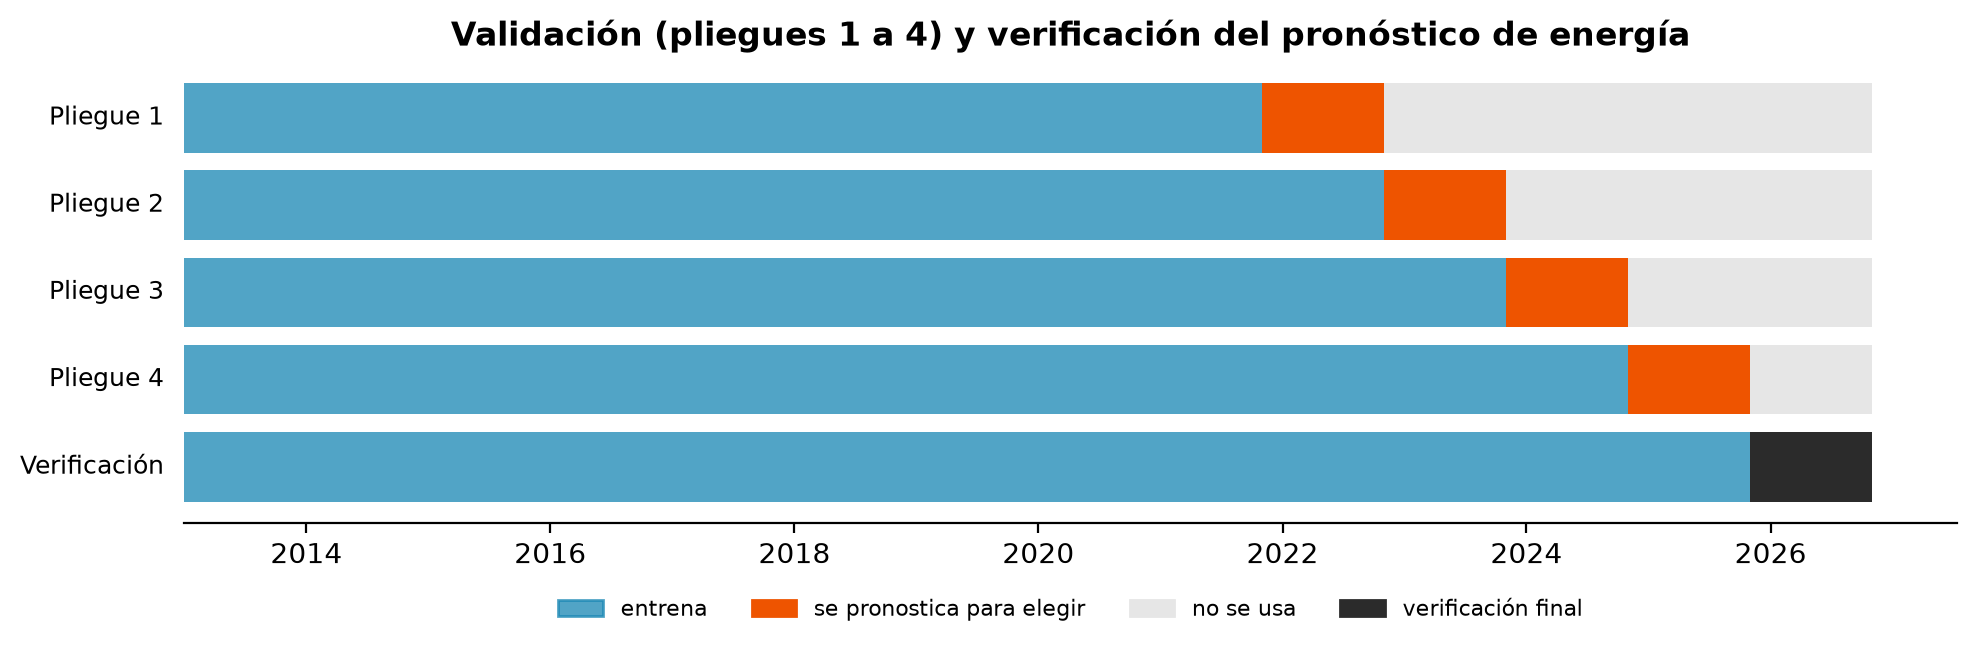
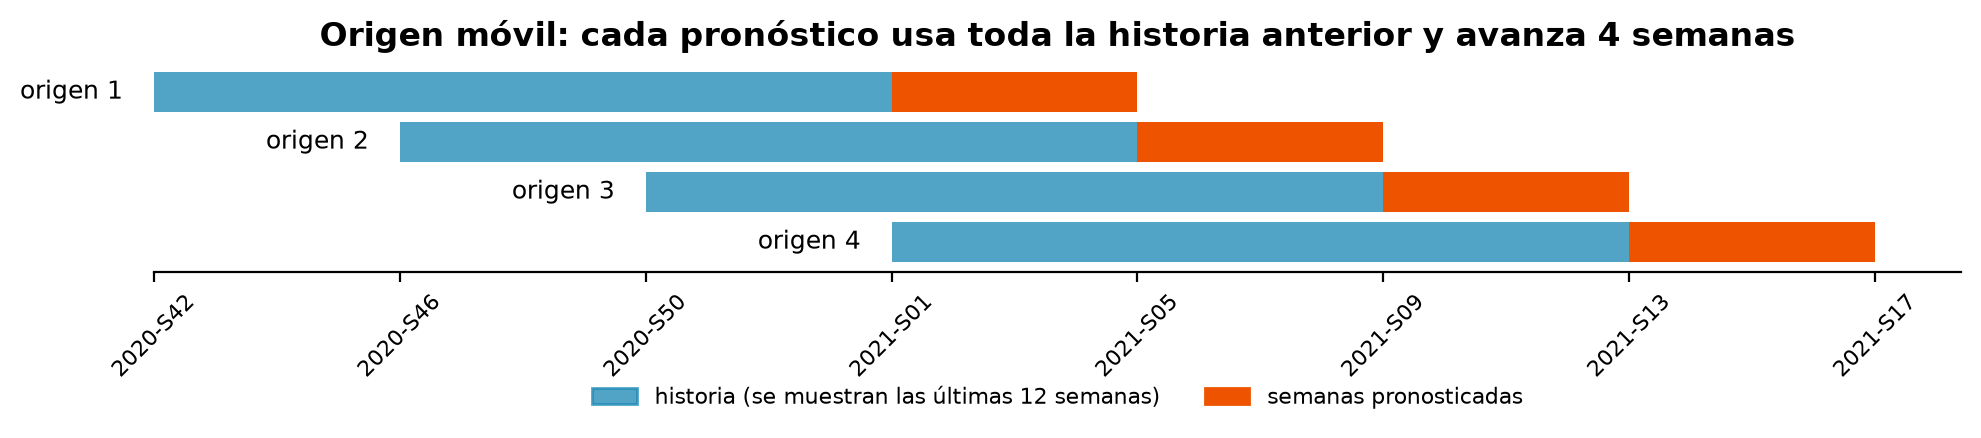
Validación: la prueba que elige entre los candidatos, usando solo el pasado. Se simula cuatro veces que es octubre (de 2021, 2022, 2023 y 2024): cada candidato se entrena con los datos hasta ese mes, el origen, pronostica los 12 meses siguientes y se mide su error. Cada una de esas cuatro rondas es un pliegue. Gana el candidato con menor error promedio.
Verificación: el examen final. Los últimos 12 meses (noviembre de 2025 a octubre de 2026) no participan en la elección; se usan al final para responder cómo le habría ido al pronóstico hecho hace un año.
El error se mide con el MAE (error absoluto medio: el promedio de |real − pronóstico|, en GWh por día) y el MAPE (el mismo error como porcentaje del valor real). Se agrega el sesgo, el promedio de real − pronóstico con su signo: si es positivo, el modelo se queda corto de forma sistemática; si es cercano a 0, sus errores se compensan.
La primera celda dibuja el esquema de esos cortes sobre los años de la serie. Para ello, sigue estos pasos, en este orden:
Define el último año de entrenamiento y los meses que se pronostican en cada fila: cuatro pliegues y la verificación.
Dibuja cada fila como barras sobre el tiempo: lo que se entrena, lo que se pronostica y lo que no se usa.
# 1. Las filas del esquema: (nombre, fin del entrenamiento, color del tramo que se pronostica).filas = [('Pliegue 1', pd.Timestamp('2021-10-01'), COLOR_HW), ('Pliegue 2', pd.Timestamp('2022-10-01'), COLOR_HW), ('Pliegue 3', pd.Timestamp('2023-10-01'), COLOR_HW), ('Pliegue 4', pd.Timestamp('2024-10-01'), COLOR_HW), ('Verificación', pd.Timestamp('2025-10-01'), COLOR_REAL)]inicio, final = energia.index[0], energia.index[-1] + pd.DateOffset(months=1)# 2. Cada fila: entrenamiento hasta el origen, 12 meses pronosticados y el resto sin usar.fig, ax = plt.subplots(figsize=(10, 3.4))for i, (nombre, origen, color) inenumerate(filas): y =len(filas) -1- i ini_pron = origen + pd.DateOffset(months=1) # primer mes pronosticado fin_pron = origen + pd.DateOffset(months=13) # mes siguiente al último pronosticado ax.barh(y, (ini_pron - inicio).days, left=inicio, color=COLOR_SERIE, alpha=0.75) ax.barh(y, (fin_pron - ini_pron).days, left=ini_pron, color=color)if fin_pron < final: ax.barh(y, (final - fin_pron).days, left=fin_pron, color='#E6E6E6') ax.text(inicio - pd.DateOffset(months=2), y, nombre, ha='right', va='center', fontsize=9)ax.set_yticks([])ax.spines['left'].set_visible(False)ax.set_title('Validación (pliegues 1 a 4) y verificación del pronóstico de energía')ax.legend(handles=[plt.Rectangle((0, 0), 1, 1, color=COLOR_SERIE, alpha=0.75), plt.Rectangle((0, 0), 1, 1, color=COLOR_HW), plt.Rectangle((0, 0), 1, 1, color='#E6E6E6'), plt.Rectangle((0, 0), 1, 1, color=COLOR_REAL)], labels=['entrena', 'se pronostica para elegir', 'no se usa', 'verificación final'], loc='upper center', bbox_to_anchor=(0.5, -0.12), ncol=4, frameon=False, fontsize=8)plt.tight_layout()plt.show()
Los cuatro pliegues crecen hacia la derecha: el entrenamiento del pliegue 1 tiene 106 meses (enero de 2013 a octubre de 2021) y el del pliegue 4, 142. Ningún pliegue toca el tramo gris oscuro: noviembre de 2025 a octubre de 2026 queda fuera de toda decisión y solo aparece en la última fila, cuando el modelo ya está elegido.
Cómo funciona el código de la celda siguiente. La función pronosticar_e encapsula «entrenar y pronosticar» para que el mismo ciclo sirva para cualquier candidato:
recibe el nombre del candidato, la serie de entrenamiento (serie) y las fechas que hay que pronosticar (fechas);
si el candidato es Holt-Winters, separa el texto 'add/add' en el tipo de tendencia y de estación, ajusta ExponentialSmoothing con .fit() y pronostica con .forecast(h), donde h es el número de meses;
si es el SARIMA, lo ajusta sobre np.log(serie) y devuelve np.exp(...) del pronóstico, para volver de logaritmo a GWh por día;
los argumentos exog y exog_futuro quedan vacíos (None) en esta parte; se usan en la sección de variables externas.
El ciclo de validación recorre los candidatos y, para cada uno, los cuatro orígenes. En cada origen, entreno_e.loc[:origen] toma la historia hasta ese mes, y entreno_e.loc[origen + 1 mes : origen + 12 meses] toma los 12 meses que se pronostican; mae(real, pronóstico) mide el error de ese pliegue.
Para ello, la celda sigue estos pasos, en este orden:
Separa el tramo de verificación del entrenamiento.
Define los cuatro orígenes y la función pronosticar_e.
Valida los tres candidatos y reporta el MAE de cada pliegue y su promedio.
Compara los pronósticos de Holt-Winters y SARIMA con lo que realmente pasó: MAE, MAPE, sesgo y meses por debajo del real.
Dibuja los pronósticos frente a la demanda real.
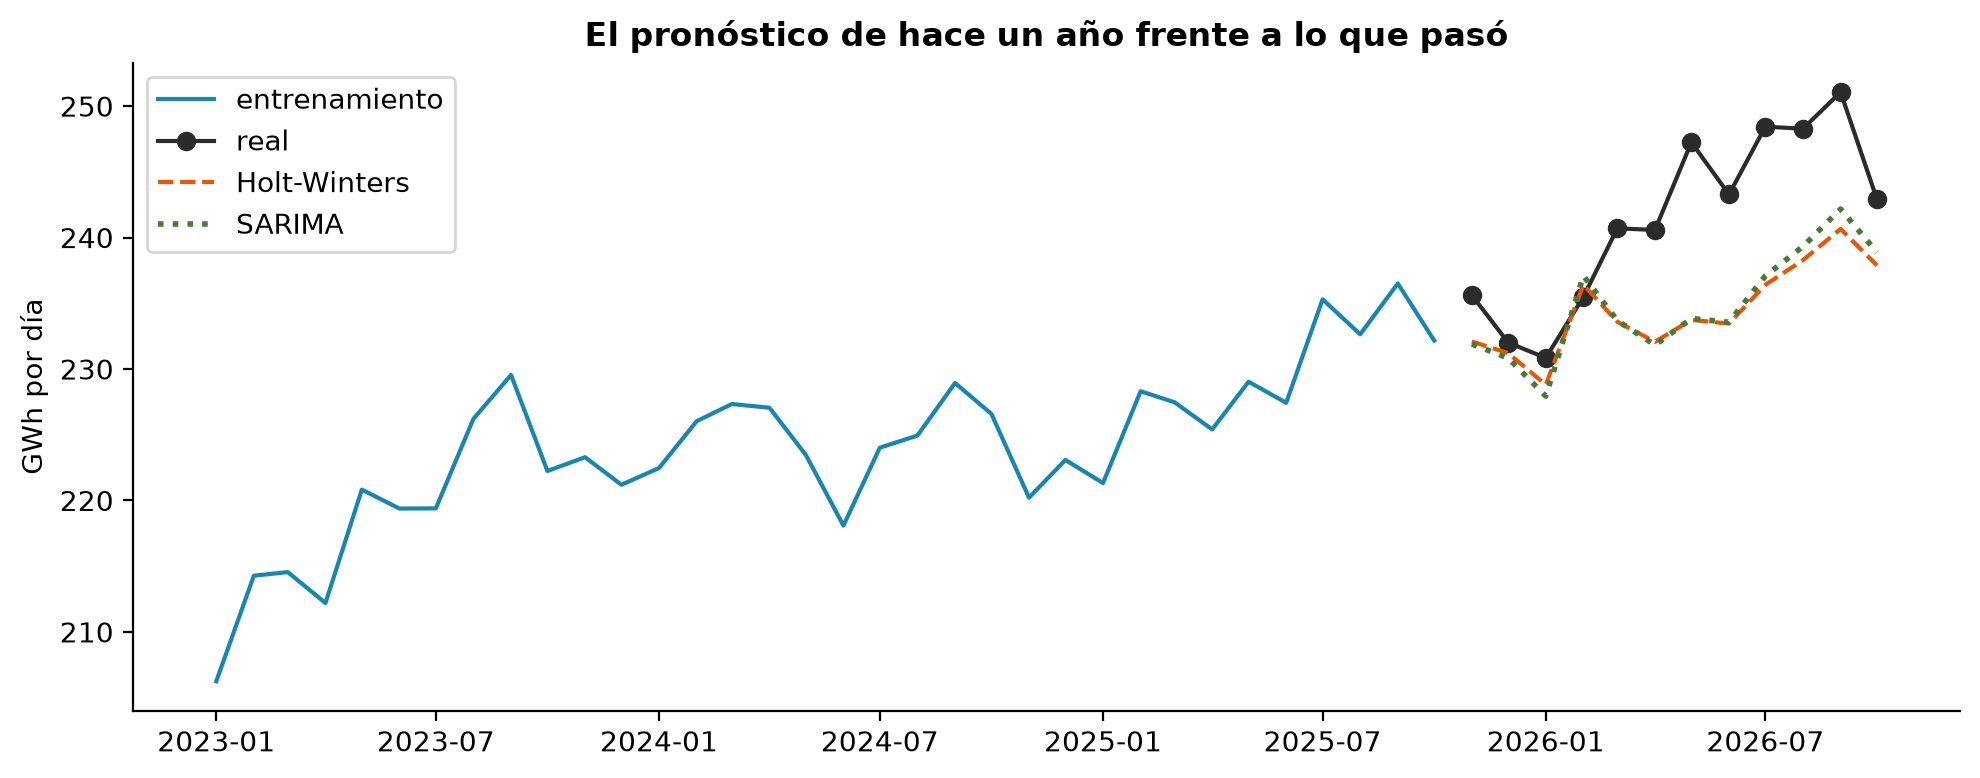
# 1. Reservar los últimos 12 meses (noviembre 2025 a octubre 2026): el pronóstico que se habría hecho hace un año.prueba_e = energia.loc['2025-11-01':]entreno_e = energia.loc[:'2025-10-01']# 2. Cuatro orígenes de validación dentro del entrenamiento: octubre de 2021, 2022, 2023 y 2024.origenes_e = pd.date_range('2021-10-01', '2024-10-01', freq='12MS')def pronosticar_e(candidato, serie, fechas, exog=None, exog_futuro=None):"""Ajusta un candidato con 'serie' y pronostica las 'fechas' siguientes.""" h =len(fechas)if candidato.startswith('Holt-Winters'): tendencia, estacional = candidato.split()[1].split('/') ajuste = ExponentialSmoothing(serie, trend=tendencia, seasonal=estacional, seasonal_periods=12).fit()return pd.Series(np.asarray(ajuste.forecast(h)), index=fechas)# SARIMA de aerolínea sobre el logaritmo; con exog se convierte en SARIMAX. ajuste = SARIMAX(np.log(serie), exog=exog, order=(0, 1, 1), seasonal_order=(0, 1, 1, 12)).fit(disp=False)return pd.Series(np.exp(np.asarray(ajuste.forecast(h, exog=exog_futuro))), index=fechas)# 3. Validación temporal de los candidatos del capítulo de series de tiempo.candidatos_e = ['Holt-Winters add/add', 'Holt-Winters add/mul', 'SARIMA']print('Validación (MAE medio a 12 meses, GWh por día):')for candidato in candidatos_e: errores = []for origen in origenes_e: historia = entreno_e.loc[:origen] real = entreno_e.loc[origen + pd.DateOffset(months=1):origen + pd.DateOffset(months=12)] errores.append(mae(real, pronosticar_e(candidato, historia, real.index)))print(f' {candidato:22s}{np.mean(errores):.2f} por pliegue = {np.round(errores, 2).tolist()}')# 4. El pronóstico de hace un año, frente a lo que pasó.pred_hw_e = pronosticar_e('Holt-Winters add/add', entreno_e, prueba_e.index)pred_sarima_e = pronosticar_e('SARIMA', entreno_e, prueba_e.index)print('\nNoviembre 2025 a octubre 2026 (no usado para elegir):')for nombre, pred in [('Holt-Winters add/add', pred_hw_e), ('SARIMA', pred_sarima_e)]: sesgo =float(np.mean(prueba_e - pred))print(f' {nombre:22s} MAE = {mae(prueba_e, pred):.2f} | MAPE = {mape(prueba_e, pred):.2f} % | 'f'sesgo medio (real menos pronóstico) = {sesgo:+.2f} | meses por debajo del real: 'f'{int((prueba_e > pred).sum())} de 12')# 5. La figura.fig, ax = plt.subplots()ax.plot(entreno_e.loc['2023-01-01':].index, entreno_e.loc['2023-01-01':].values, color=COLOR_SERIE, label='entrenamiento')ax.plot(prueba_e.index, prueba_e.values, 'o-', color=COLOR_REAL, label='real')ax.plot(pred_hw_e.index, pred_hw_e.values, '--', color=COLOR_HW, label='Holt-Winters')ax.plot(pred_sarima_e.index, pred_sarima_e.values, ':', lw=2, color=COLOR_SARIMA, label='SARIMA')ax.set_ylabel('GWh por día')ax.set_title('El pronóstico de hace un año frente a lo que pasó')ax.legend(loc='upper left')plt.tight_layout()plt.show()
Validación (MAE medio a 12 meses, GWh por día):
  Holt-Winters add/add   2.84   por pliegue = [1.79, 4.89, 2.74, 1.94]
  Holt-Winters add/mul   2.92   por pliegue = [1.91, 4.97, 2.89, 1.91]
  SARIMA                 3.01   por pliegue = [2.44, 4.74, 3.25, 1.61]

Noviembre 2025 a octubre 2026 (no usado para elegir):
  Holt-Winters add/add   MAE = 6.98 | MAPE = 2.85 % | sesgo medio (real menos pronóstico) = +6.82 | meses por debajo del real: 11 de 12
  SARIMA                 MAE = 6.80 | MAPE = 2.78 % | sesgo medio (real menos pronóstico) = +6.53 | meses por debajo del real: 11 de 12
La validación favorece por poco a Holt-Winters aditivo (MAE de 2.84 GWh por día, frente a 2.92 y 3.01 del SARIMA), y los tres candidatos sufren en el mismo pliegue, el que pronostica los 12 meses siguientes a octubre de 2022 (errores de 4.74 a 4.97). La diferencia entre ellos es menor que la variación entre pliegues.
La verificación es la parte importante. En noviembre de 2025 a octubre de 2026, los dos modelos se quedan cortos en 11 de 12 meses, con un sesgo de +6.82 GWh por día (Holt-Winters) y +6.53 (SARIMA), y un MAPE cercano al 2.8 %. Un error de casi 3 % parece pequeño, pero es sistemático: los modelos proyectaron el crecimiento de los años anteriores y la demanda de 2026 creció más rápido. Algo que no está en la propia serie empujó la demanda hacia arriba, y la segunda parte del caso pone a prueba un sospechoso: El Niño.
Lo nuevo: variables externas
La idea
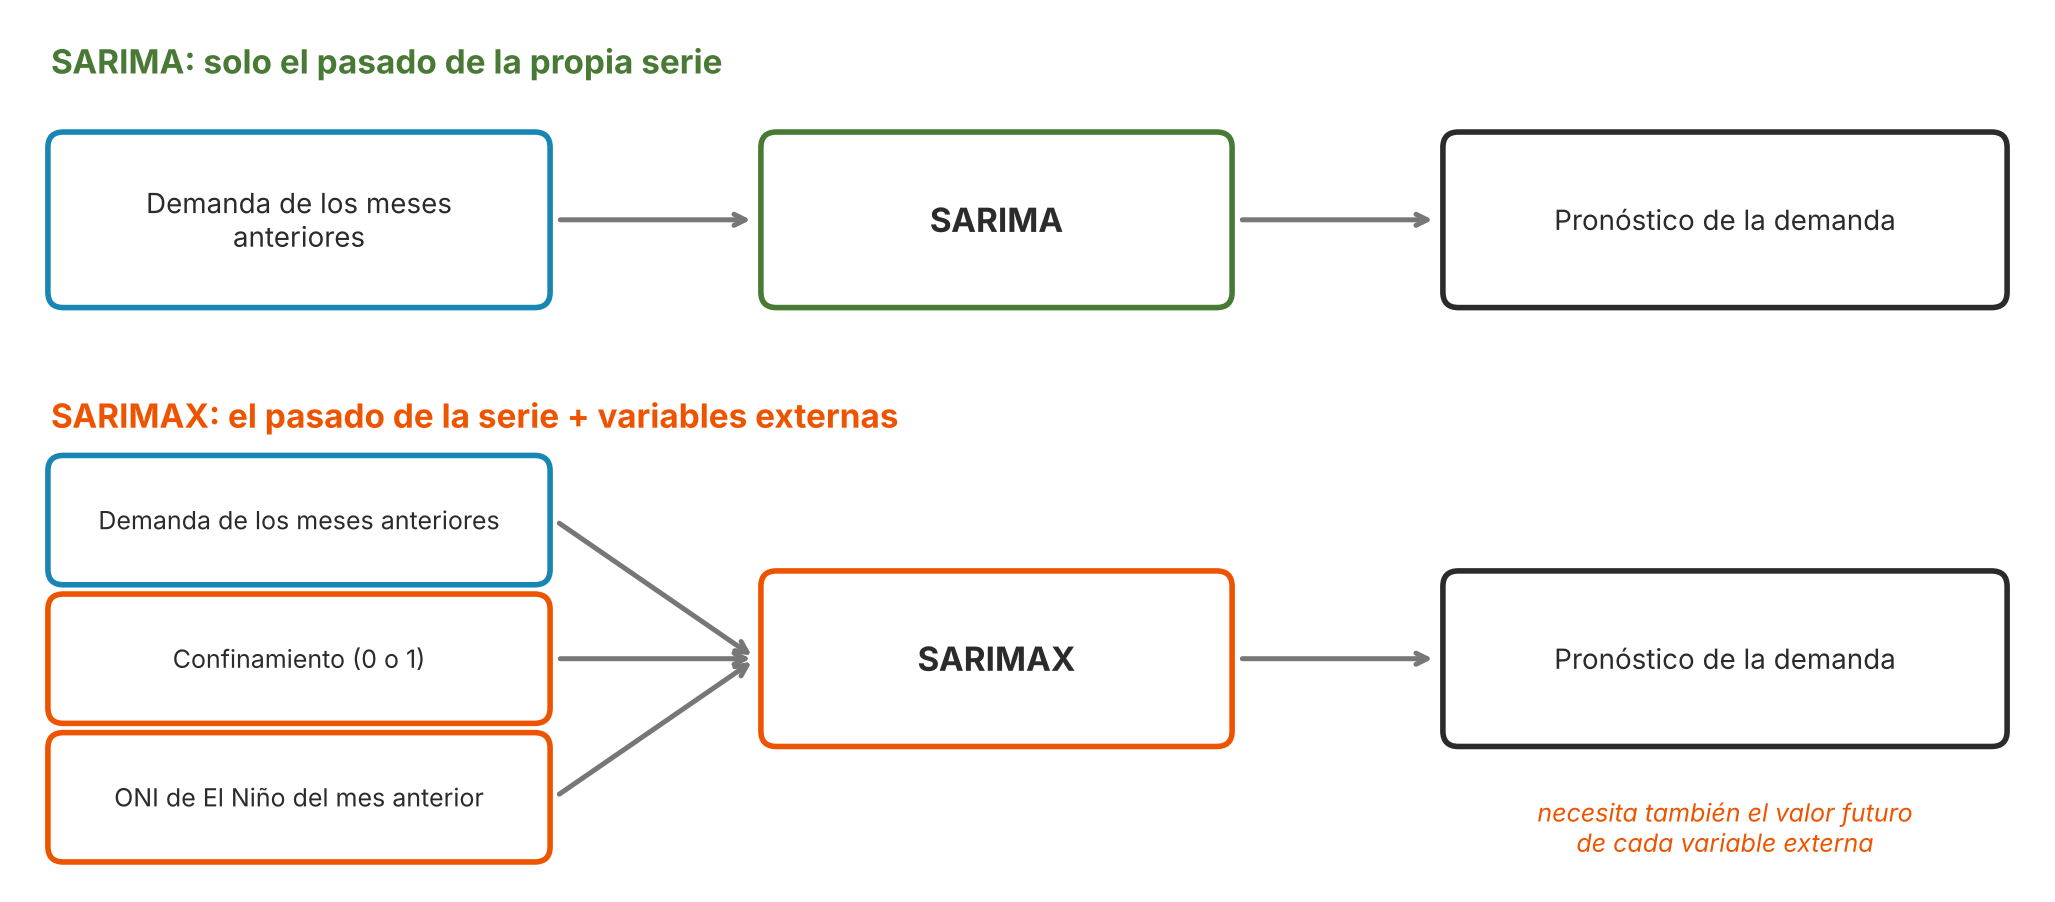
Hasta aquí, cada modelo pronosticó la demanda solo con su propio pasado: lo que pasó en los meses anteriores. Pero la demanda de energía no se mueve sola. Responde a causas que se miden por separado: el clima, la actividad económica, los festivos, una cuarentena. Una variable externa (o exógena) es una de esas causas, medida aparte, que se le entrega al modelo como información adicional.
Un ejemplo cotidiano: para pronosticar las ventas de helado de mañana, sirve saber cuánto se vendió hoy (el pasado de la serie), pero sirve todavía más saber qué temperatura hará mañana (una variable externa). El modelo que usa las dos fuentes de información es un SARIMAX: un SARIMA con variables externas (la X viene de exogenous).
Diferencia entre un SARIMA, que pronostica solo con el pasado de la serie, y un SARIMAX, que además recibe variables externas; para pronosticar, el SARIMAX necesita también el valor futuro de esas variables.
Este caso usa dos variables externas, cada una con un propósito distinto:
Confinamiento: vale 1 en los meses de abril a agosto de 2020 y 0 en todos los demás. Es una variable indicadora (o dummy): no mide una cantidad, marca un periodo. Le dice al modelo que esos meses fueron excepcionales, para que no confunda la caída de la pandemia con la tendencia ni con la estación.
ONI de El Niño: el índice ONI (Oceanic Niño Index) mide cuánto se calienta o se enfría la superficie del océano Pacífico tropical respecto a lo normal, en grados Celsius, promediado en tres meses. Un valor de 0.5 o más sostenido indica El Niño; uno de -0.5 o menos, La Niña. En Colombia, El Niño trae temperaturas más altas y menos lluvia, y sube el consumo de aire acondicionado y refrigeración, sobre todo en la región Caribe. Es la variable que se pone a prueba: ¿la demanda crece más en los meses con ONI alto?
Preparar el ONI
La NOAA publica el ONI por trimestres móviles: DJF (diciembre, enero y febrero), JFM (enero, febrero y marzo), y así. La demanda es mensual, de modo que cada trimestre se convierte en un mes con dos ajustes, uno de calendario y otro de disponibilidad del dato:
Cada trimestre se asigna a su mes central: DJF a enero, JFM a febrero, …, NDJ a diciembre.
El modelo usa el ONI del mes anterior, \(\text{ONI}_{t-1}\). El ONI centrado en el mes \(t\) promedia \(t-1\), \(t\) y \(t+1\), así que incluye un mes que todavía no ha ocurrido; el centrado en \(t-1\) promedia \(t-2\), \(t-1\) y \(t\), y termina justo con el mes que se modela. Es la versión más reciente del índice que no usa meses futuros, aunque la NOAA la publica a comienzos del mes siguiente. Para pronosticar meses que aún no ocurren esa diferencia no importa, porque el ONI futuro hay que suponerlo de todos modos (la sección sobre el futuro de la variable externa lo trata).
Antes de construir el modelo, conviene comprobar con los datos si la hipótesis tiene algún sustento: si el residuo de la descomposición (lo que la tendencia y la estación no explican) tiende a ser mayor cuando el ONI es alto. Para ello, la celda siguiente sigue estos pasos, en este orden:
Lee el ONI y asigna cada trimestre a su mes central.
Construye el ONI del mes anterior con .shift(1), que corre la serie un mes hacia adelante, e imprime los últimos valores y los meses de El Niño desde 2013.
Calcula la correlación entre el residuo de la descomposición y el ONI del mes anterior, sin los meses de 2020.
Dibuja el ONI y la nube de residuo contra ONI.
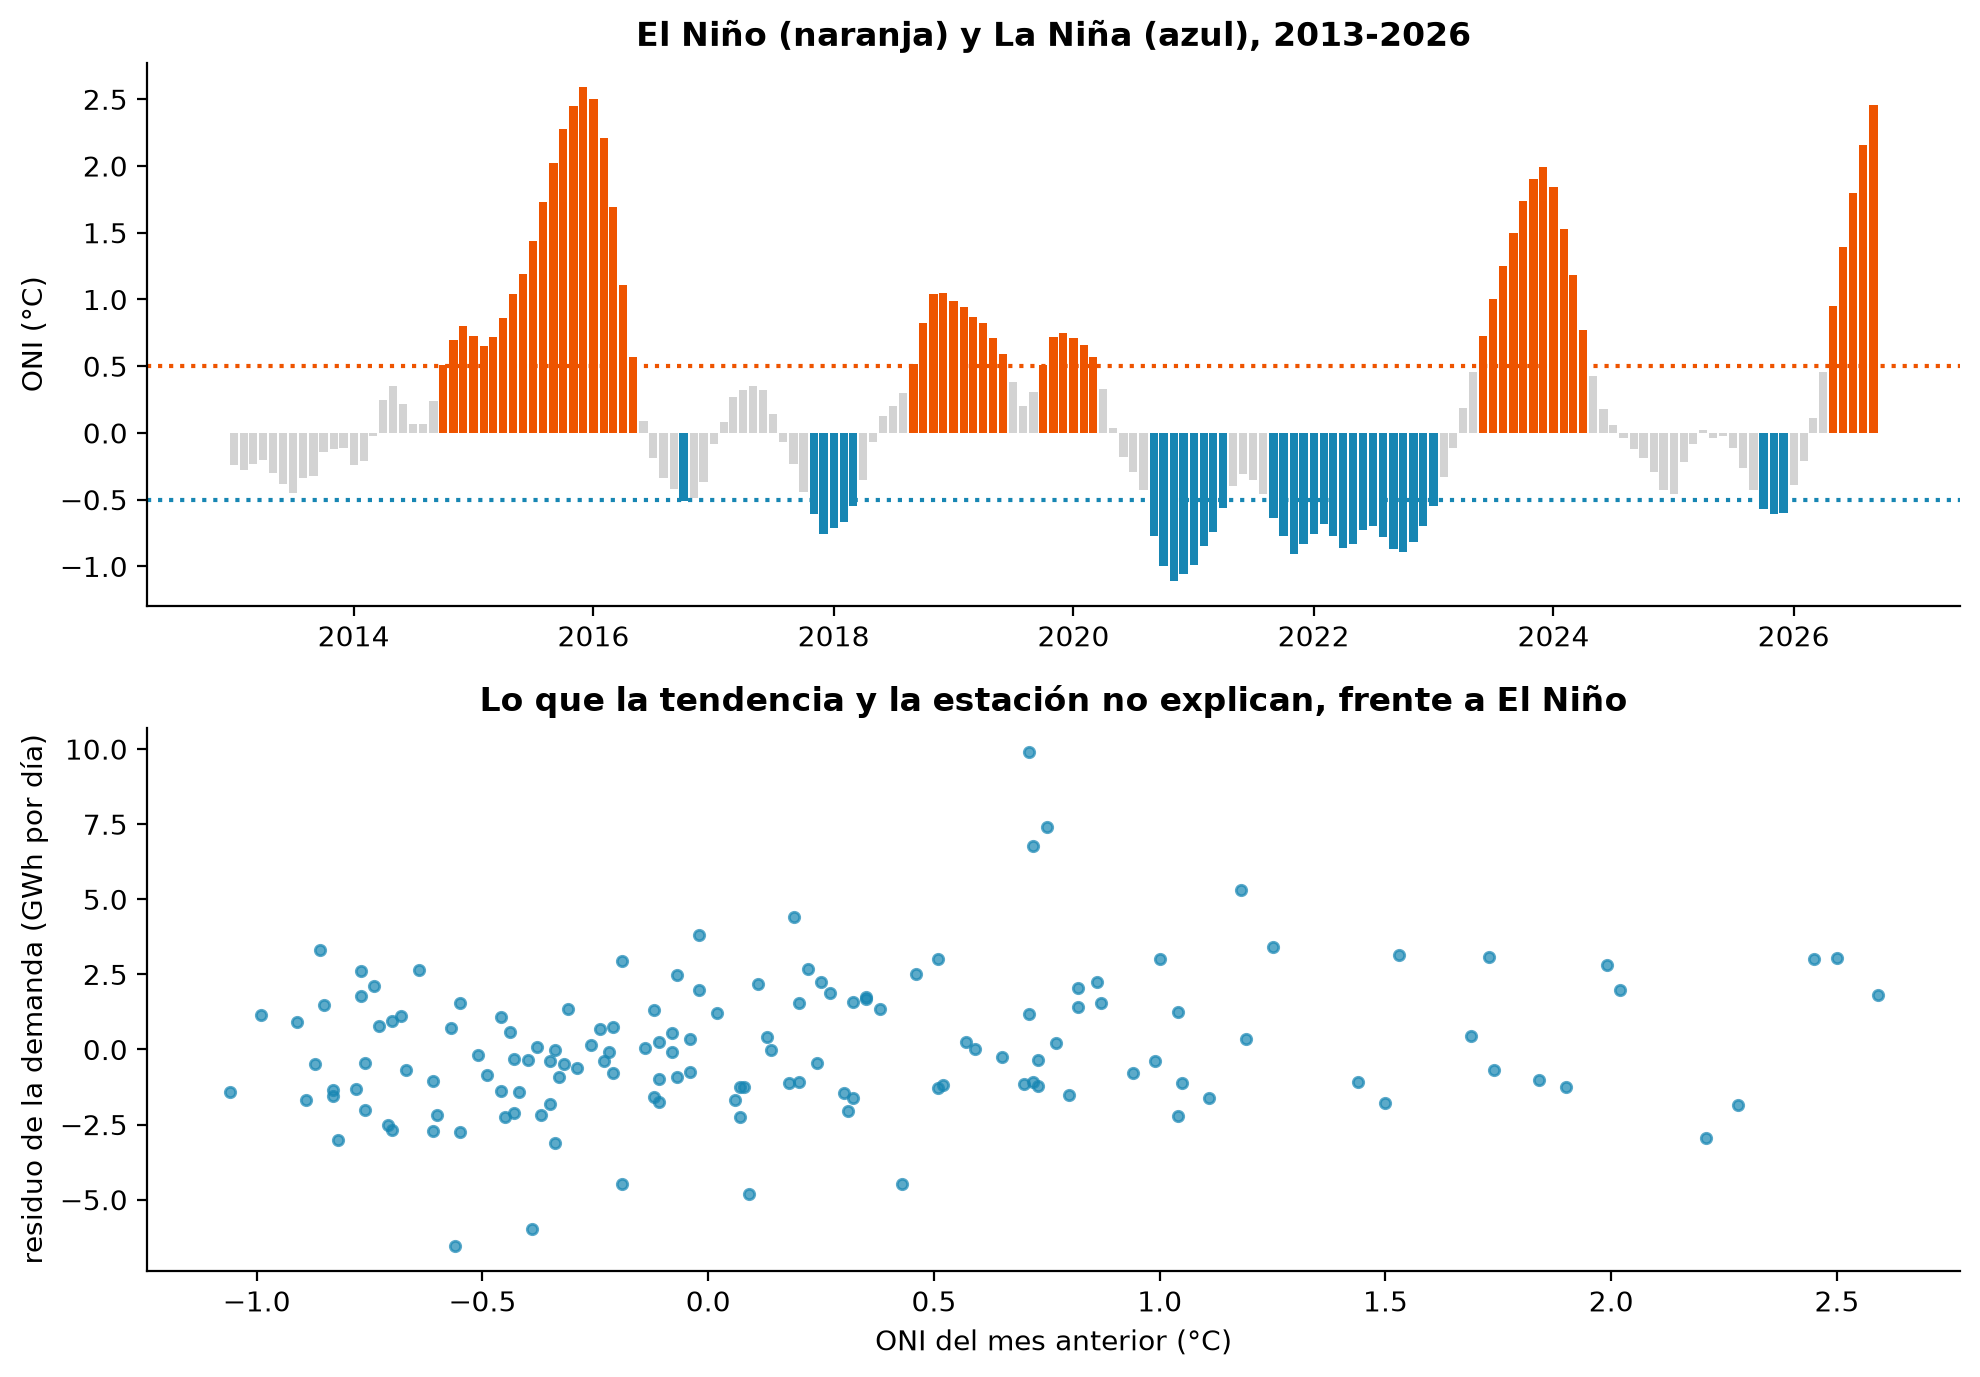
# 1. Leer el ONI: un valor por trimestre móvil (DJF, JFM, ...), que se asigna a su mes central.oni_tabla = pd.read_csv('datos/oni_noaa_2005_2026.csv')trimestres = ['DJF', 'JFM', 'FMA', 'MAM', 'AMJ', 'MJJ', 'JJA', 'JAS', 'ASO', 'SON', 'OND', 'NDJ']oni_tabla['mes'] = oni_tabla['trimestre'].map({t: i +1for i, t inenumerate(trimestres)})oni = pd.Series(oni_tabla['oni'].to_numpy(), index=pd.to_datetime(dict(year=oni_tabla['anio'], month=oni_tabla['mes'], day=1)), name='oni').asfreq('MS')# 2. Usar el ONI del mes anterior: el trimestre centrado en t-1 termina en el mes t y no usa meses futuros.oni_rezagado = oni.reindex(pd.date_range('2005-01-01', '2027-12-01', freq='MS')).shift(1)print('Últimos valores del ONI:', oni.tail(3).round(2).to_dict())print(f'Meses de 2013 a 2026 con El Niño (ONI de 0.5 o más): {int((oni["2013":] >=0.5).sum())}')# 3. ¿Se mueve el residuo de la demanda con El Niño? Correlación entre el residuo y el ONI del mes anterior.pareja = pd.concat([decomp_e.resid, oni_rezagado], axis=1, keys=['residuo', 'oni']).dropna()pareja_sin_covid = pareja.drop(pd.date_range('2020-03-01', '2020-12-01', freq='MS'), errors='ignore')print(f'Correlación residuo-ONI (sin 2020): {pareja_sin_covid.corr().iloc[0, 1]:.3f} (n = {len(pareja_sin_covid)})')# 4. La figura.fig, axes = plt.subplots(2, 1, figsize=(10, 7))o = oni['2013':]axes[0].bar(o.index, o.values, width=25, color=np.where(o.values >=0.5, COLOR_HW, np.where(o.values <=-0.5, COLOR_SERIE, 'lightgray')))axes[0].axhline(0.5, color=COLOR_HW, ls=':')axes[0].axhline(-0.5, color=COLOR_SERIE, ls=':')axes[0].set_ylabel('ONI (°C)')axes[0].set_title('El Niño (naranja) y La Niña (azul), 2013-2026')axes[1].scatter(pareja_sin_covid['oni'], pareja_sin_covid['residuo'], s=14, color=COLOR_SERIE, alpha=0.7)axes[1].set_xlabel('ONI del mes anterior (°C)')axes[1].set_ylabel('residuo de la demanda (GWh por día)')axes[1].set_title('Lo que la tendencia y la estación no explican, frente a El Niño')plt.tight_layout()plt.show()
Últimos valores del ONI: {Timestamp('2026-07-01 00:00:00'): 1.8, Timestamp('2026-08-01 00:00:00'): 2.16, Timestamp('2026-09-01 00:00:00'): 2.46}
Meses de 2013 a 2026 con El Niño (ONI de 0.5 o más): 52
Correlación residuo-ONI (sin 2020): 0.236  (n = 144)
El ONI de los últimos meses confirma el contexto del encargo: 1.80 en junio-agosto, 2.16 en julio-septiembre y 2.46 en agosto-octubre de 2026, un El Niño fuerte, cercano al máximo de 2015-2016 (2.59). De 2013 a 2026 hubo 52 meses con El Niño. La correlación entre el residuo de la demanda y el ONI del mes anterior es 0.236 (144 meses, sin 2020): positiva, como dice la hipótesis, pero modesta. El Niño no domina la demanda, que la tendencia y la estación explican en su mayor parte; lo que se pregunta es si explica parte de lo que queda.
Las variables externas, una tabla
El modelo recibe las variables externas como una tabla con una columna por variable y una fila por mes, alineada con las fechas de la demanda. La celda construye esa tabla y muestra dos tramos para ver qué contiene. Para ello, la celda sigue estos pasos, en este orden:
Crea el indicador de confinamiento: una serie de ceros de 2005 a 2027 con unos de abril a agosto de 2020.
Une el confinamiento y el ONI del mes anterior en una tabla de dos columnas con pd.concat(..., axis=1).
Muestra la tabla de febrero a septiembre de 2020 y de mayo a octubre de 2026.
# 1. Indicador de confinamiento: 0 en todos los meses y 1 de abril a agosto de 2020.covid = pd.Series(0.0, index=pd.date_range('2005-01-01', '2027-12-01', freq='MS'), name='covid')covid['2020-04-01':'2020-08-01'] =1.0# 2. Las dos variables externas en una sola tabla: una columna por variable, una fila por mes.externas = pd.concat([covid, oni_rezagado], axis=1)# 3. Dos tramos de la tabla: la pandemia y el El Niño de 2026.print('Febrero a septiembre de 2020:')print(externas.loc['2020-02-01':'2020-09-01'].round(2).to_string())print('\nMayo a octubre de 2026:')print(externas.loc['2026-05-01':'2026-10-01'].round(2).to_string())
Febrero a septiembre de 2020:
            covid   oni
2020-02-01    0.0  0.71
2020-03-01    0.0  0.66
2020-04-01    1.0  0.57
2020-05-01    1.0  0.33
2020-06-01    1.0  0.04
2020-07-01    1.0 -0.18
2020-08-01    1.0 -0.29
2020-09-01    0.0 -0.43

Mayo a octubre de 2026:
            covid   oni
2026-05-01    0.0  0.46
2026-06-01    0.0  0.95
2026-07-01    0.0  1.39
2026-08-01    0.0  1.80
2026-09-01    0.0  2.16
2026-10-01    0.0  2.46
En 2020, la columna covid cambia de 0 a 1 en abril y vuelve a 0 en septiembre, mientras el ONI pasa de 0.71 a valores negativos, el inicio de La Niña de 2020-2023. En 2026, covid vale 0 y el ONI del mes anterior sube de 0.46 en mayo a 2.46 en octubre; el valor de octubre es el del trimestre agosto-octubre, centrado en septiembre. Cada fila es lo que el modelo recibe de las dos variables en ese mes.
\(\log Y_t\) es el logaritmo de la demanda del mes \(t\), la misma escala que usó el SARIMA;
\(\beta_1\) y \(\beta_2\) son los coeficientes: cuánto cambia el logaritmo de la demanda por cada unidad de cada variable externa; el modelo los estima con los datos;
\(\eta_t\) es todo lo demás (tendencia, estación y dependencia entre meses), y sigue el mismo SARIMA de aerolínea, \((0,1,1)(0,1,1)_{12}\).
Es una regresión y un SARIMA a la vez: la regresión explica lo que se debe a las variables externas y el SARIMA explica el resto.
Cómo se lee un coeficiente. Como la demanda está en logaritmo, un coeficiente \(\beta\) equivale a un cambio porcentual de \(100(e^{\beta}-1)\) % por cada unidad de la variable. Por ejemplo, si \(\beta_2 = 0.012\), cada grado de ONI se asocia con \(100(e^{0.012}-1) \approx 1.2\) % más de demanda; con un ONI de 2.5, el efecto es \(100(e^{0.012 \times 2.5}-1) \approx 3\) %. Para el confinamiento, que vale 0 o 1, el coeficiente da directamente el cambio porcentual de los meses de confinamiento frente a los demás.
Las piezas de la celda siguiente.
El diccionario versiones asocia cada versión del modelo con las columnas de externas que usa: None (ninguna), ['covid'] o ['covid', 'oni']. Así, un solo ciclo valida las tres versiones.
En cada pliegue, externas.loc[historia.index, columnas] toma las filas de la tabla que corresponden a los meses de entrenamiento, y externas.loc[real.index, columnas], las de los 12 meses que se pronostican. Las dos se entregan a pronosticar_e como exog y exog_futuro.
Después de ajustar el modelo completo, modelo_x.params contiene los coeficientes estimados y modelo_x.pvalues, sus p-valores; la celda los pone en una tabla y agrega la columna efecto_% con la fórmula \(100(e^{\beta}-1)\).
La prueba de Ljung-Box se aplica a los residuos sin sus 13 primeros meses (.iloc[13:]), que la doble diferencia del SARIMA consume, y con model_df=4, porque el modelo estimó cuatro parámetros: los dos coeficientes de las variables externas y los dos términos de media móvil.
La celda compara el modelo con y sin variables externas en la misma validación. Para ello, la celda sigue estos pasos, en este orden:
Valida tres versiones del modelo con los mismos cuatro orígenes: el SARIMA sin externas, el SARIMAX con el confinamiento y el SARIMAX con el confinamiento y el ONI. En cada pliegue, exog recibe las filas de la tabla que corresponden a la historia y exog_futuro, las de los 12 meses que se pronostican. En esta validación se usa el ONI que realmente ocurrió, una ventaja que la sección siguiente discute.
Ajusta el modelo completo con todo el entrenamiento, imprime sus coeficientes con el efecto porcentual y revisa los residuos con Ljung-Box.
# 1. Tres versiones del SARIMA: sin externas, con el confinamiento, y con el confinamiento y El Niño.# En la validación se usa el ONI que realmente ocurrió (el caso ideal; la sección siguiente lo discute).versiones = {'SARIMA': None,'SARIMAX confinamiento': ['covid'],'SARIMAX confinamiento + ONI': ['covid', 'oni'],}print('Validación (MAE medio a 12 meses, GWh por día):')for nombre, columnas in versiones.items(): errores = []for origen in origenes_e: historia = entreno_e.loc[:origen] real = entreno_e.loc[origen + pd.DateOffset(months=1):origen + pd.DateOffset(months=12)] ex =Noneif columnas isNoneelse externas.loc[historia.index, columnas] ex_f =Noneif columnas isNoneelse externas.loc[real.index, columnas] errores.append(mae(real, pronosticar_e('SARIMA', historia, real.index, ex, ex_f)))print(f' {nombre:30s}{np.mean(errores):.2f} por pliegue = {np.round(errores, 2).tolist()}')# 2. El modelo completo, ajustado con todo el entrenamiento: ¿cuánto pesa cada variable externa?modelo_x = SARIMAX(np.log(entreno_e), exog=externas.loc[entreno_e.index, ['covid', 'oni']], order=(0, 1, 1), seasonal_order=(0, 1, 1, 12)).fit(disp=False)tabla = pd.DataFrame({'coef': modelo_x.params, 'p_valor': modelo_x.pvalues}).loc[['covid', 'oni']]tabla['efecto_%'] =100* (np.exp(tabla['coef']) -1)print('\nCoeficientes (en logaritmo) y su efecto porcentual sobre la demanda:')print(tabla.round(4).to_string())lb = acorr_ljungbox(modelo_x.resid.iloc[13:], lags=[12, 24], model_df=4)['lb_pvalue']print(f'Ljung-Box de los residuos: rezago 12 = {lb.iloc[0]:.3f} | rezago 24 = {lb.iloc[1]:.3f}')
Validación (MAE medio a 12 meses, GWh por día):
  SARIMA                         3.01   por pliegue = [2.44, 4.74, 3.25, 1.61]
  SARIMAX confinamiento          2.81   por pliegue = [2.01, 4.08, 3.58, 1.57]
  SARIMAX confinamiento + ONI    2.52   por pliegue = [3.4, 2.31, 2.53, 1.85]

Coeficientes (en logaritmo) y su efecto porcentual sobre la demanda:
         coef  p_valor  efecto_%
covid -0.0715      0.0   -6.8971
oni    0.0120      0.0    1.2104
Ljung-Box de los residuos: rezago 12 = 0.055 | rezago 24 = 0.386
Cada variable externa mejora la validación: el MAE medio baja de 3.01 (SARIMA) a 2.81 con el confinamiento y a 2.52 con el confinamiento y El Niño, una reducción del 16 %. La mejora más visible está en el pliegue que había fallado a todos los modelos: de 4.74 a 2.31 GWh por día.
Los coeficientes tienen el signo esperado y son claramente distintos de cero (p-valores por debajo de 0.001). El confinamiento redujo la demanda un 6.9 % en los meses en que estuvo vigente. Cada grado de ONI se asocia con un 1.21 % más de demanda: con el ONI de 2.46 de 2026, eso es cerca de un 3 % por encima de un año neutro, aproximadamente el sesgo que tuvieron los modelos sin El Niño. Ljung-Box da p = 0.055 en el rezago 12 y 0.386 en el 24: en el borde para el primer ciclo, sin evidencia clara de dependencia que quede sin explicar.
Un coeficiente significativo no es una relación causal demostrada. El ONI puede estar correlacionado con otras cosas que también mueven la demanda en esos años; lo que el análisis sí muestra es que, como predictor, aporta información que la serie sola no tiene.
El futuro de la variable externa
Hay una trampa en la validación anterior: para pronosticar la demanda de un mes futuro, el SARIMAX necesita el ONI de ese mes futuro, y en los pliegues se le dio el que realmente ocurrió. En la práctica ese valor no se conoce; hay que suponerlo o pronosticarlo.
ImportanteResumen: variables externas
Una variable externa es información medida aparte de la serie que se pronostica (el clima, un festivo, una cuarentena) y que el modelo usa como causa adicional. En un SARIMAX, cada variable externa entra con un coeficiente que dice cuánto cambia la serie por cada unidad de esa variable; el resto de la dinámica la sigue explicando el SARIMA. Hay dos momentos distintos:
Para entrenar, el modelo usa los valores pasados de la variable, que ya se conocen.
Para pronosticar, necesita sus valores futuros, que casi nunca se conocen: hay que suponerlos, pronosticarlos o plantear escenarios.
Por eso una variable externa vale lo que vale su pronóstico. Las mejores son las que tienen un futuro conocido con certeza (los festivos, los días hábiles de cada mes); las que hay que pronosticar, como el ONI, solo ayudan en la medida en que ese pronóstico sea bueno.
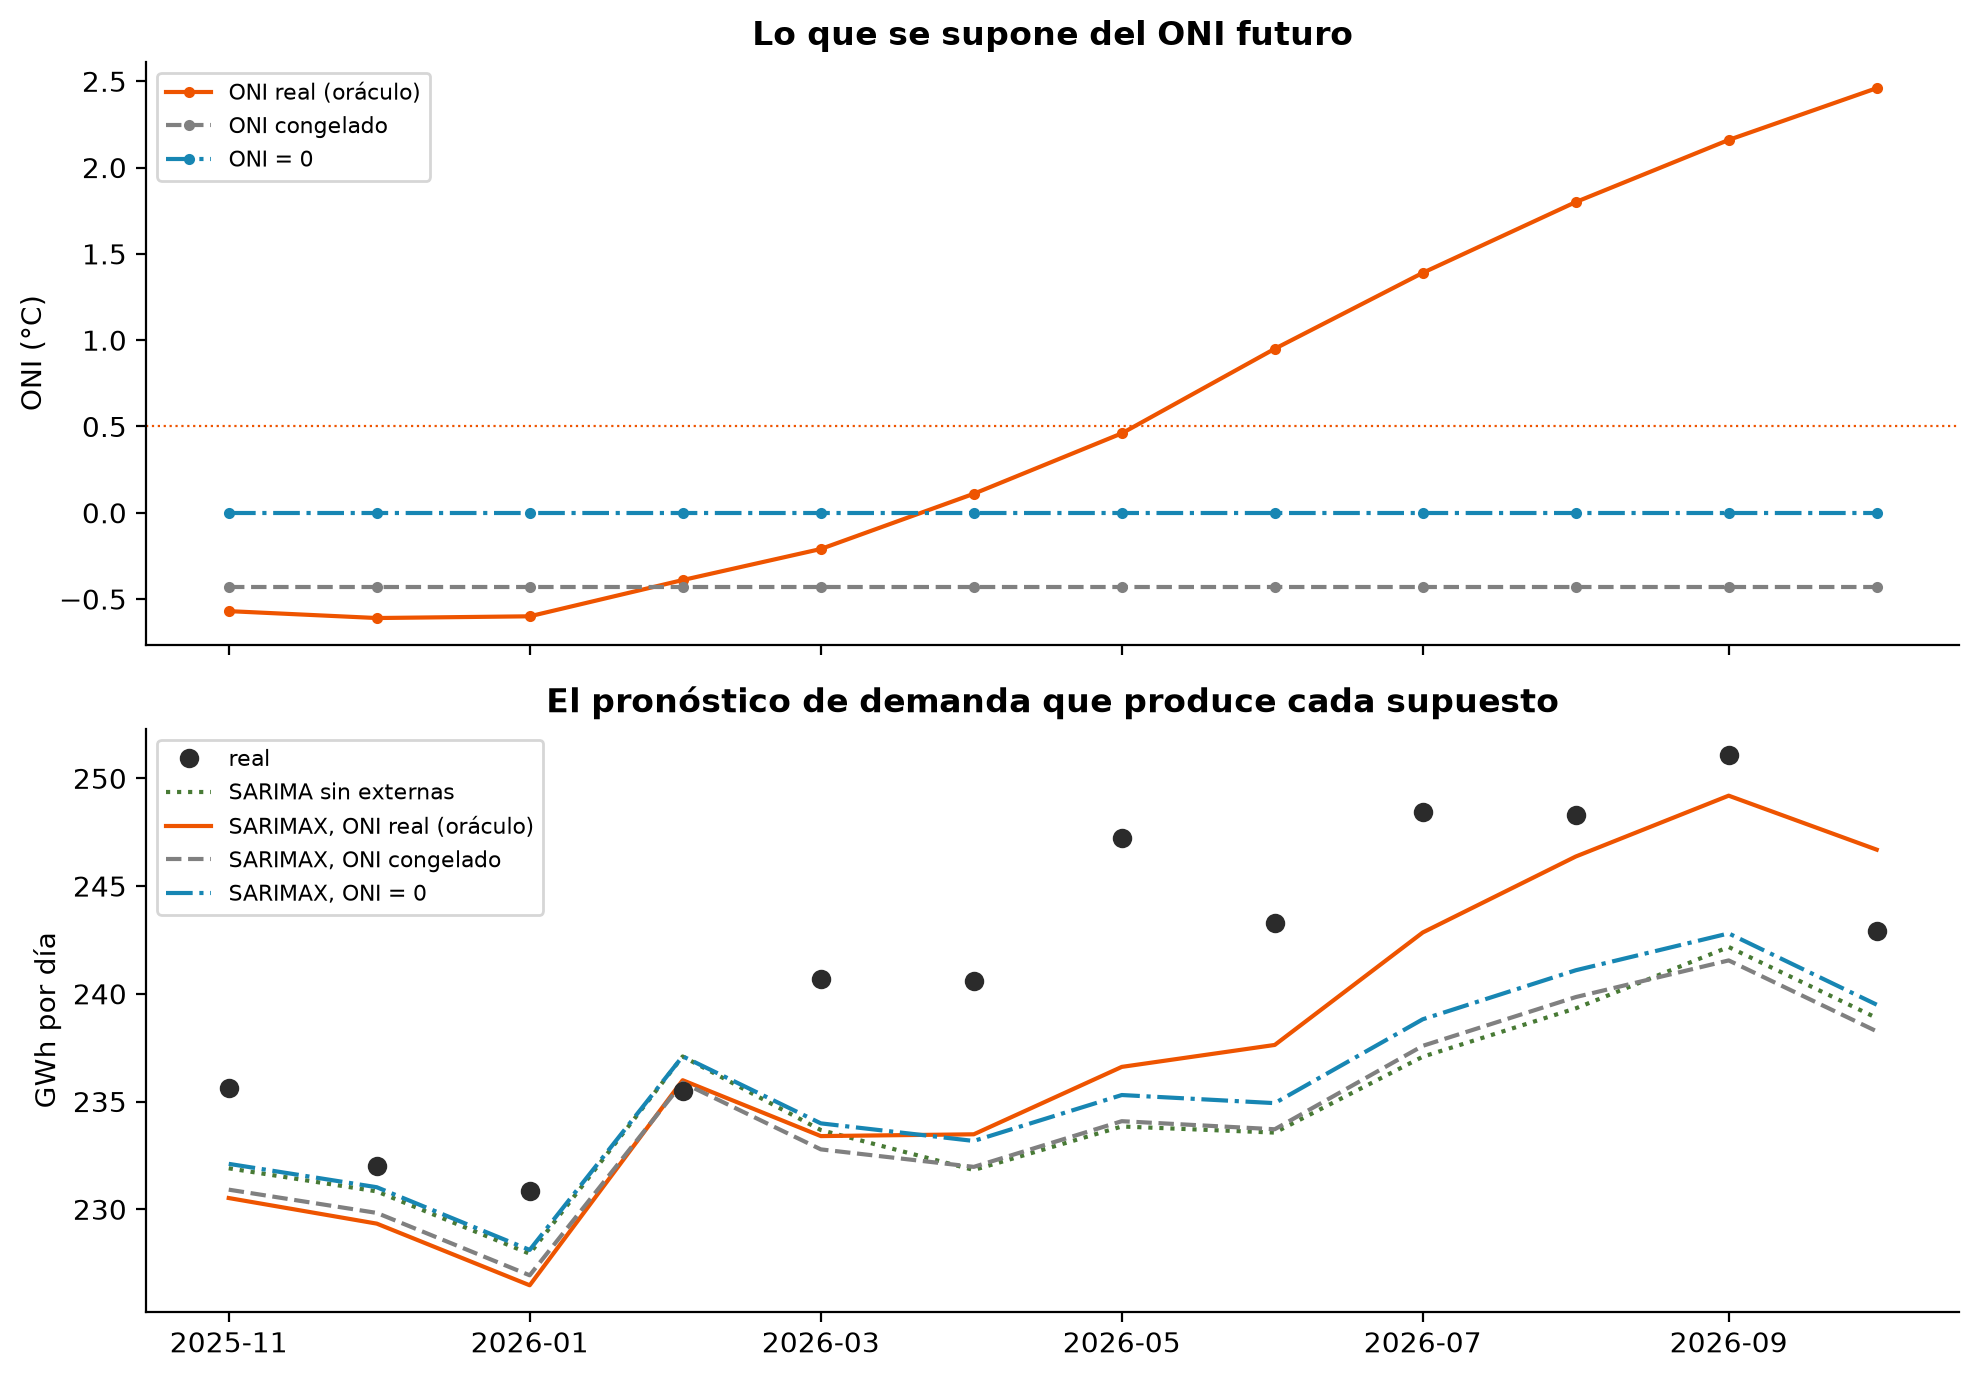
La celda siguiente repite el pronóstico de hace un año (noviembre de 2025 a octubre de 2026) con tres supuestos sobre el ONI futuro, para medir cuánto cambia el resultado según lo que se suponga:
Supuesto
Qué ONI recibe el modelo de noviembre de 2025 a octubre de 2026
¿Se podía usar en octubre de 2025?
Oráculo
El que realmente ocurrió
No: es información del futuro
Congelado
El último conocido en octubre de 2025, repetido todos los meses
Sí
Neutro
0 en todos los meses
Sí
Qué hace .assign.ex_real toma de la tabla externas las filas de los 12 meses que se pronostican, con el ONI que ocurrió. Las otras dos versiones se construyen a partir de ella con .assign(oni=valor), que devuelve una copia de la tabla con la columna oni reemplazada por ese valor en todas las filas; la columna covid queda igual (0, porque no hubo confinamiento). Cada versión se entrega como exog_futuro a la misma función pronosticar_e.
Para ello, la celda sigue estos pasos, en este orden:
Construye los tres caminos del ONI e imprime el último valor conocido y el rango del que ocurrió.
Pronostica con cada camino y mide el error frente a la demanda real, junto con el SARIMA sin externas.
Dibuja los caminos del ONI (arriba) y los pronósticos de demanda que produce cada uno (abajo).
# 1. El pronóstico de hace un año con El Niño, según qué se suponga del ONI futuro.ex_hist = externas.loc[entreno_e.index, ['covid', 'oni']]ex_real = externas.loc[prueba_e.index, ['covid', 'oni']] # el ONI que ocurrió (oráculo)ex_congelado = ex_real.assign(oni=ex_hist['oni'].iloc[-1]) # el último ONI conocido se mantieneex_neutro = ex_real.assign(oni=0.0) # sin El Niño ni La Niñaprint(f'Último ONI conocido en octubre de 2025: {ex_hist["oni"].iloc[-1]:.2f}')print(f'ONI que ocurrió de nov. 2025 a oct. 2026: de {ex_real["oni"].min():.2f} a {ex_real["oni"].max():.2f}')escenarios = {'SARIMA sin externas': pred_sarima_e,'SARIMAX, ONI real (oráculo)': pronosticar_e('SARIMA', entreno_e, prueba_e.index, ex_hist, ex_real),'SARIMAX, ONI congelado': pronosticar_e('SARIMA', entreno_e, prueba_e.index, ex_hist, ex_congelado),'SARIMAX, ONI = 0': pronosticar_e('SARIMA', entreno_e, prueba_e.index, ex_hist, ex_neutro),}# 2. El error de cada uno en noviembre 2025 a octubre 2026.print('\nNoviembre 2025 a octubre 2026:')for nombre, pred in escenarios.items():print(f' {nombre:30s} MAE = {mae(prueba_e, pred):.2f} | MAPE = {mape(prueba_e, pred):.2f} % | 'f'sesgo = {float(np.mean(prueba_e - pred)):+.2f}')# 3. La figura: los caminos del ONI (arriba) y los pronósticos que produce cada uno (abajo).fig, axes = plt.subplots(2, 1, figsize=(10, 7), sharex=True)caminos = [('ONI real (oráculo)', ex_real['oni'], COLOR_HW, '-'), ('ONI congelado', ex_congelado['oni'], 'gray', '--'), ('ONI = 0', ex_neutro['oni'], COLOR_SERIE, '-.')]for nombre, camino, color, ls in caminos: axes[0].plot(camino.index, camino.values, ls=ls, color=color, marker='o', ms=3, label=nombre)axes[0].axhline(0.5, color=COLOR_HW, ls=':', lw=0.8)axes[0].set_ylabel('ONI (°C)')axes[0].set_title('Lo que se supone del ONI futuro')axes[0].legend(loc='upper left', fontsize=8)estilos = [(COLOR_SARIMA, ':'), (COLOR_HW, '-'), ('gray', '--'), (COLOR_SERIE, '-.')]axes[1].plot(prueba_e.index, prueba_e.values, 'o', color=COLOR_REAL, label='real', zorder=3)for (nombre, pred), (color, ls) inzip(escenarios.items(), estilos): axes[1].plot(pred.index, pred.values, ls=ls, color=color, label=nombre)axes[1].set_ylabel('GWh por día')axes[1].set_title('El pronóstico de demanda que produce cada supuesto')axes[1].legend(loc='upper left', fontsize=8)plt.tight_layout()plt.show()
Último ONI conocido en octubre de 2025: -0.43
ONI que ocurrió de nov. 2025 a oct. 2026: de -0.61 a 2.46

Noviembre 2025 a octubre 2026:
  SARIMA sin externas            MAE = 6.80 | MAPE = 2.78 % | sesgo = +6.53
  SARIMAX, ONI real (oráculo)    MAE = 4.71 | MAPE = 1.95 % | sesgo = +3.99
  SARIMAX, ONI congelado         MAE = 6.99 | MAPE = 2.87 % | sesgo = +6.93
  SARIMAX, ONI = 0               MAE = 5.98 | MAPE = 2.45 % | sesgo = +5.71
El resultado es la lección del caso. Con el ONI que realmente ocurrió, el SARIMAX baja el MAPE de 2.78 % a 1.95 % y el sesgo de +6.53 a +3.99 GWh por día: El Niño explica más de un tercio de la sorpresa de 2026. Pero en octubre de 2025 el último ONI conocido era -0.43, un valor cercano a La Niña, y nadie podía saber que en 2026 subiría hasta 2.46. Con ese valor congelado, el SARIMAX es peor que el SARIMA sin externas (MAPE de 2.87 %), porque el modelo «cree» que el clima reducirá la demanda. Con un ONI de 0, queda en el medio (2.45 %).
La conclusión práctica: una variable externa mejora el pronóstico en la medida en que su propio futuro se conozca. Hay variables cuyo futuro se conoce con certeza (los festivos, los días hábiles de cada mes), otras que se pronostican bien a pocos meses (el ONI, que la NOAA pronostica con unos meses de anticipación) y otras que solo admiten escenarios. Por eso el pronóstico de 2027 se presenta por escenarios y no como un solo número.
Paso 9: pronosticar 2027 con escenarios
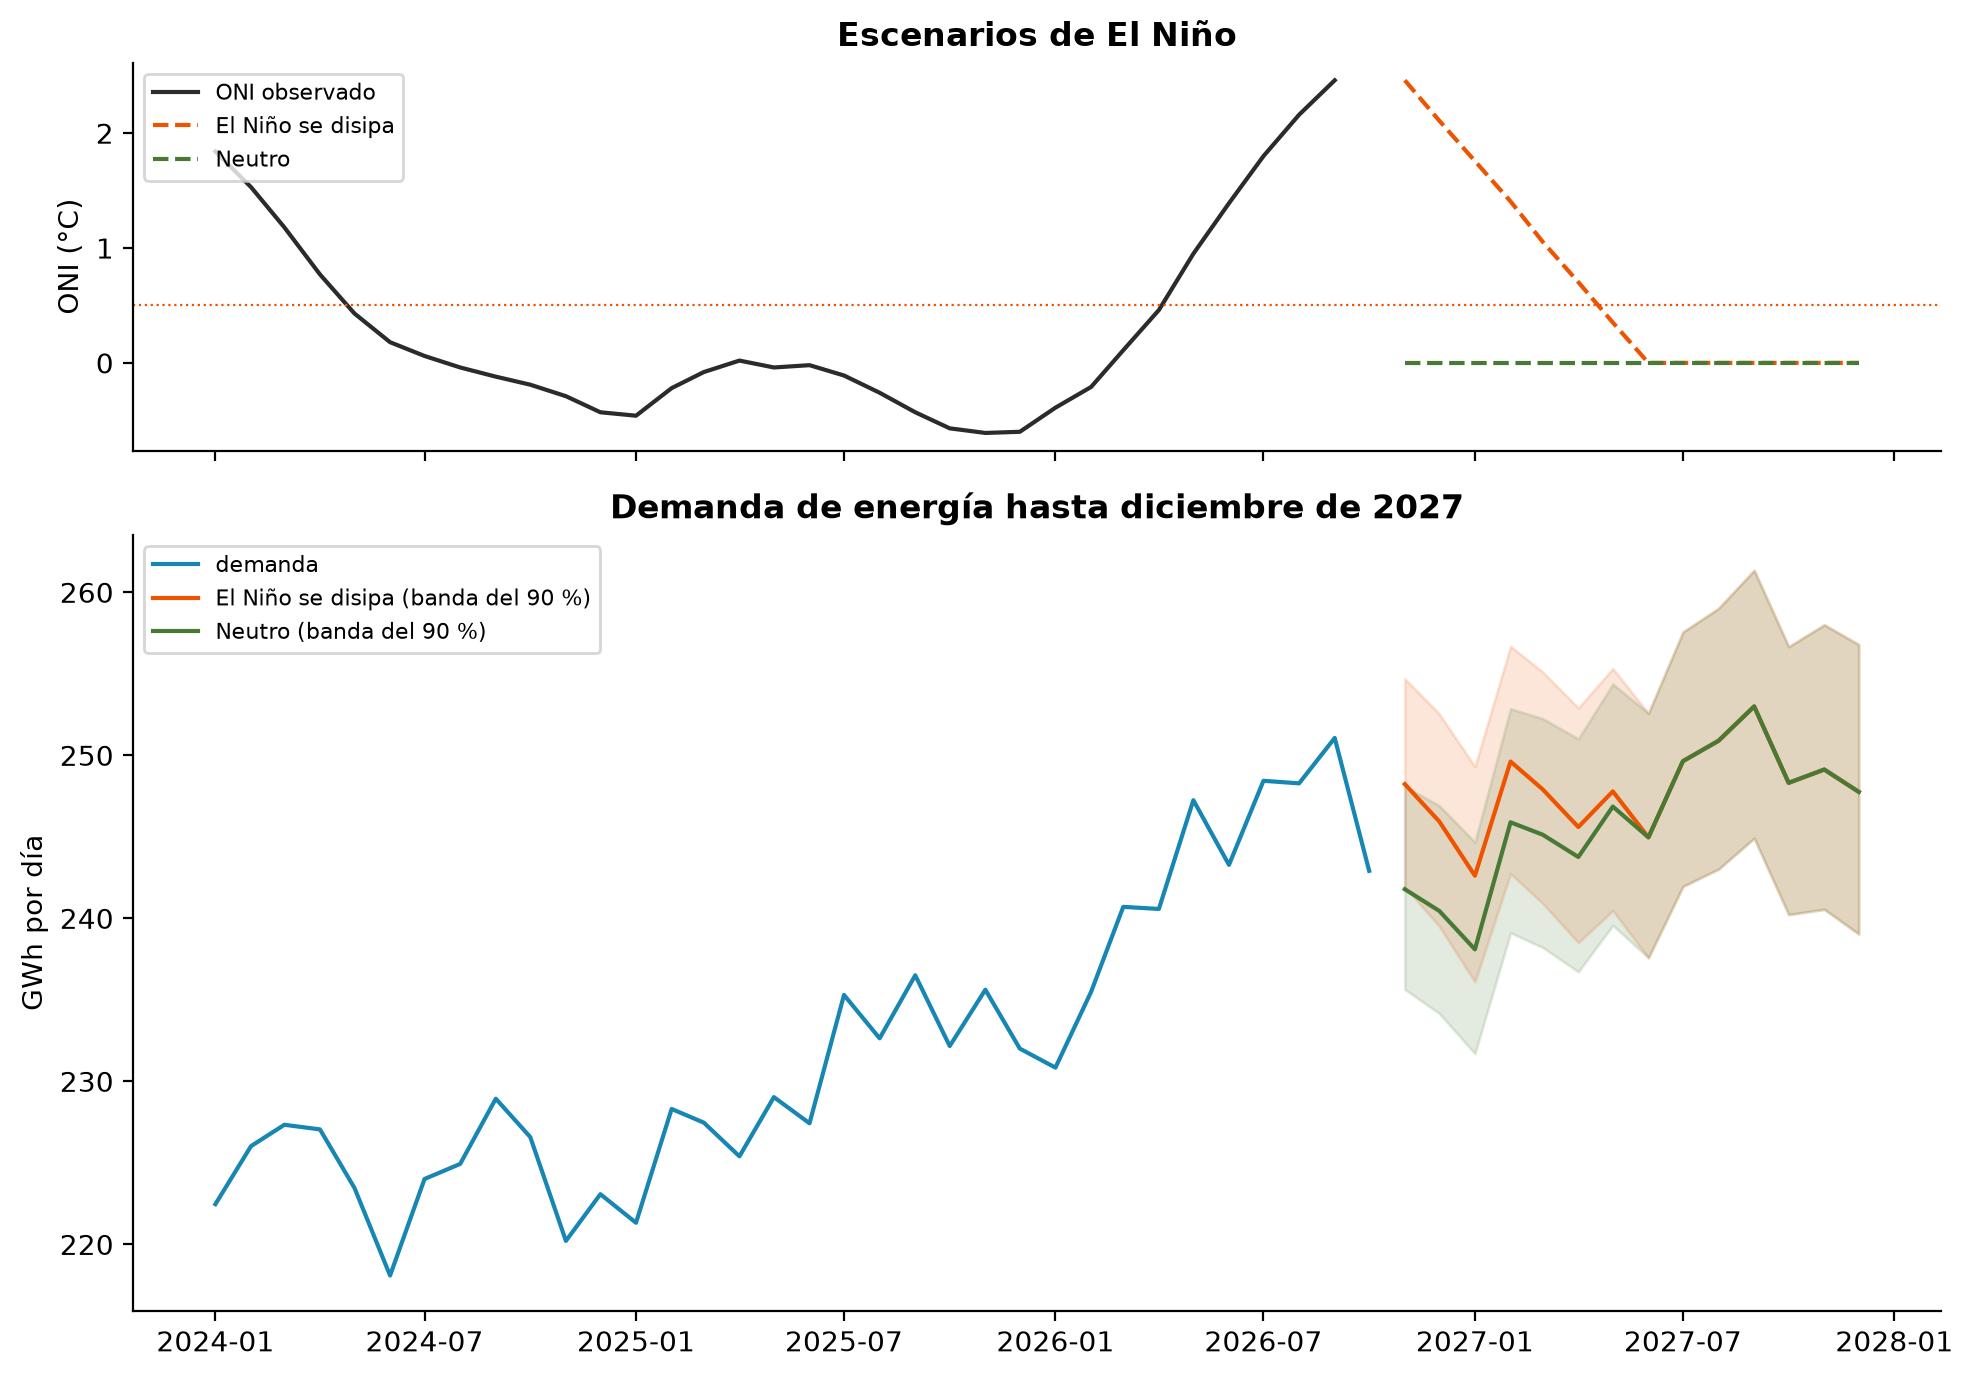
Para responder el encargo, el SARIMAX se reajusta con todos los datos hasta octubre de 2026 y pronostica 14 meses bajo dos escenarios de El Niño:
El Niño se disipa: el ONI baja en línea recta desde 2.46 hasta 0 en junio de 2027, una trayectoria típica de los eventos fuertes, que suelen terminar en el primer semestre del año siguiente;
Neutro: el ONI vale 0 desde noviembre de 2026; es la referencia sin efecto climático.
Las funciones del pronóstico final.
np.interp(x, [0, 7], [2.46, 0]) construye la línea recta del escenario «El Niño se disipa»: para cada posición x de los 14 meses futuros (0 es noviembre de 2026, 7 es junio de 2027) devuelve el valor intermedio entre 2.46 y 0; desde la posición 7 en adelante, devuelve 0.
modelo_final.get_forecast(14, exog=ex_f) pronostica 14 meses con los valores futuros de las variables externas de cada escenario. El resultado trae dos cosas: .predicted_mean, el pronóstico central, y .conf_int(alpha=0.10), los límites de la banda del 90 % (alpha es la probabilidad que queda fuera de la banda).
Como el modelo trabaja en logaritmo, np.exp(...) devuelve el pronóstico y la banda a GWh por día.
El total de 2027 se obtiene multiplicando el pronóstico de cada mes, en GWh por día, por los días de ese mes (days_in_month) y sumando: es el camino inverso del paso 2.
Para ello, la celda sigue estos pasos, en este orden:
Reajusta el SARIMAX con todos los datos.
Construye los dos caminos del ONI.
Pronostica con banda del 90 % en cada escenario, e imprime enero de 2027 y el total de 2027.
Mide la diferencia entre escenarios mes a mes.
Dibuja los dos caminos del ONI (arriba) y la historia reciente con los dos pronósticos y sus bandas (abajo).
# 1. Reajustar el SARIMAX con todos los datos hasta octubre de 2026.ex_todo = externas.loc[energia.index, ['covid', 'oni']]modelo_final = SARIMAX(np.log(energia), exog=ex_todo, order=(0, 1, 1), seasonal_order=(0, 1, 1, 12)).fit(disp=False)futuro = pd.date_range('2026-11-01', '2027-12-01', freq='MS')# 2. Dos escenarios para el ONI futuro.# a) El Niño se disipa: baja en línea recta desde el último valor (2.46) hasta 0 en junio de 2027.# b) Neutro: el ONI vale 0 desde noviembre de 2026.ultimo_oni = oni.iloc[-1]oni_disipa = pd.Series(np.interp(np.arange(len(futuro)), [0, 7], [ultimo_oni, 0.0]), index=futuro)oni_escenarios = {'El Niño se disipa': oni_disipa, 'Neutro': pd.Series(0.0, index=futuro)}# 3. Pronóstico con banda del 90 % para cada escenario (el confinamiento vale 0 en el futuro).resultados_2027 = {}for nombre, camino in oni_escenarios.items(): ex_f = pd.DataFrame({'covid': 0.0, 'oni': camino.to_numpy()}, index=futuro) pron = modelo_final.get_forecast(len(futuro), exog=ex_f) banda = np.exp(pron.conf_int(alpha=0.10)) resultados_2027[nombre] = (np.exp(pron.predicted_mean), banda) total_2027 = (np.exp(pron.predicted_mean)['2027'] * futuro[futuro.year ==2027].days_in_month).sum()print(f'{nombre:18s} | ene. 2027 = {np.exp(pron.predicted_mean).iloc[2]:.1f} GWh/día | 'f'total 2027 = {total_2027:,.0f} GWh'.replace(',', ' '))dif = resultados_2027['El Niño se disipa'][0] - resultados_2027['Neutro'][0]print(f'Diferencia entre escenarios: máxima {dif.max():.1f} GWh/día ({dif.idxmax():%Y-%m}), 'f'desde {dif[dif <0.5].index.min():%Y-%m} menor que 0.5')# 4. La figura: los escenarios del ONI (arriba) y la demanda con sus pronósticos (abajo).fig, axes = plt.subplots(2, 1, figsize=(10, 7), sharex=True, gridspec_kw={'height_ratios': [1, 2]})o_hist = oni.loc['2024-01-01':]axes[0].plot(o_hist.index, o_hist.values, color=COLOR_REAL, label='ONI observado')for (nombre, camino), color inzip(oni_escenarios.items(), [COLOR_HW, COLOR_SARIMA]): axes[0].plot(camino.index, camino.values, '--', color=color, label=nombre)axes[0].axhline(0.5, color=COLOR_HW, ls=':', lw=0.8)axes[0].set_ylabel('ONI (°C)')axes[0].set_title('Escenarios de El Niño')axes[0].legend(loc='upper left', fontsize=8)axes[1].plot(energia.loc['2024-01-01':].index, energia.loc['2024-01-01':].values, color=COLOR_SERIE, label='demanda')for (nombre, (centro, banda)), color inzip(resultados_2027.items(), [COLOR_HW, COLOR_SARIMA]): axes[1].fill_between(futuro, banda.iloc[:, 0], banda.iloc[:, 1], color=color, alpha=0.15) axes[1].plot(futuro, centro, color=color, label=f'{nombre} (banda del 90 %)')axes[1].set_ylabel('GWh por día')axes[1].set_title('Demanda de energía hasta diciembre de 2027')axes[1].legend(loc='upper left', fontsize=8)plt.tight_layout()plt.show()
El Niño se disipa  | ene. 2027 = 242.6 GWh/día | total 2027 = 90 552 GWh
Neutro             | ene. 2027 = 238.1 GWh/día | total 2027 = 90 137 GWh
Diferencia entre escenarios: máxima 6.4 GWh/día (2026-11), desde 2027-06 menor que 0.5
En el escenario en que El Niño se disipa, la demanda de enero de 2027 sería de 242.6 GWh por día, frente a 238.1 en el neutro. La diferencia máxima entre escenarios es 6.4 GWh por día, en noviembre de 2026, y se reduce hasta quedar por debajo de 0.5 desde junio de 2027, cuando los dos caminos del ONI se juntan. En el total del año 2027, la diferencia es de unos 415 GWh (90 552 frente a 90 137 GWh), concentrada en el primer semestre.
Respuesta al encargo. La demanda de energía del país seguiría creciendo en 2027, con un total de unos 90 100 a 90 600 GWh según el escenario, y un promedio diario que oscila entre unos 238 y 253 GWh según el mes. El Niño importa sobre todo en los meses inmediatos: de noviembre de 2026 a marzo de 2027 suma entre unos 3 y 6.4 GWh por día frente a un año neutro, justo cuando la sequía presiona la generación hidroeléctrica. Las bandas del 90 % miden unos 13 GWh por día de ancho al inicio y unos 18 al final de 2027, más que la diferencia entre escenarios: la incertidumbre propia de la serie pesa más que la de El Niño en el segundo semestre. El pronóstico debe rehacerse cada mes con la demanda y el ONI nuevos, y conviene sustituir los escenarios por el pronóstico oficial de El Niño de la NOAA cuando se actualice.
Caso 2: dengue y alerta temprana
Paso 1: plantear la pregunta
El encargo. Es comienzo de 2019. Trabajas en el grupo de vigilancia de enfermedades transmitidas por vectores y te hacen dos preguntas: ¿qué tan bien se puede pronosticar el número de casos de dengue de las próximas semanas? y, sobre todo, ¿con qué regla se puede detectar, semana a semana, que los casos salieron de lo esperado, para activar la respuesta antes del pico de una epidemia?
NotaDengue, SIVIGILA y semana epidemiológica
El dengue es una enfermedad viral que transmite el mosquito Aedes aegypti, presente en buena parte de Colombia por debajo de unos 2200 metros de altitud. Los casos se reportan al SIVIGILA (Sistema Nacional de Vigilancia en Salud Pública), que coordina el Instituto Nacional de Salud: cada caso que atiende un servicio de salud se notifica con su fecha, su municipio y su clasificación. Este caso usa el evento 210, dengue sin signos de gravedad y con signos de alarma.
El SIVIGILA cuenta el tiempo en semanas epidemiológicas: semanas de domingo a sábado, numeradas desde la primera semana del año. La mayoría de los años tienen 52; algunos, 53. Trabajar por semanas y no por meses permite detectar cambios con más rapidez, que es lo que exige una alerta temprana.
La segunda pregunta cambia la naturaleza del problema. No pide un número para el futuro; pide una decisión binaria cada semana (alerta o no alerta), que se juzga por su anticipación y por sus falsas alarmas. Los datos llegan hasta 2022, de modo que la regla se puede evaluar en la epidemia de 2019 y en los años tranquilos que la rodean.
Paso 2: preparar los datos
Como con la energía, primero se miran los datos tal como llegan. El archivo tiene una fila por semana con tres columnas: anio, semana (la semana epidemiológica) y casos_dengue (los casos notificados esa semana en todo el país). Hay que comprobar tres cosas: que no falten semanas, cuántas semanas tiene cada año y si hay valores que impidan usar logaritmos (ceros o negativos).
Para ello, la celda sigue estos pasos, en este orden:
Lee el archivo, cuenta sus filas y valores vacíos, y muestra sus cinco primeras filas con head().
Cuenta las semanas de cada año y busca saltos en la numeración: dentro de cada año, la diferencia entre una semana y la anterior debe ser siempre 1.
Revisa el mínimo y el máximo de los casos y cuenta las semanas con 0 casos.
Dibuja la serie en escala lineal y en escala logarítmica.
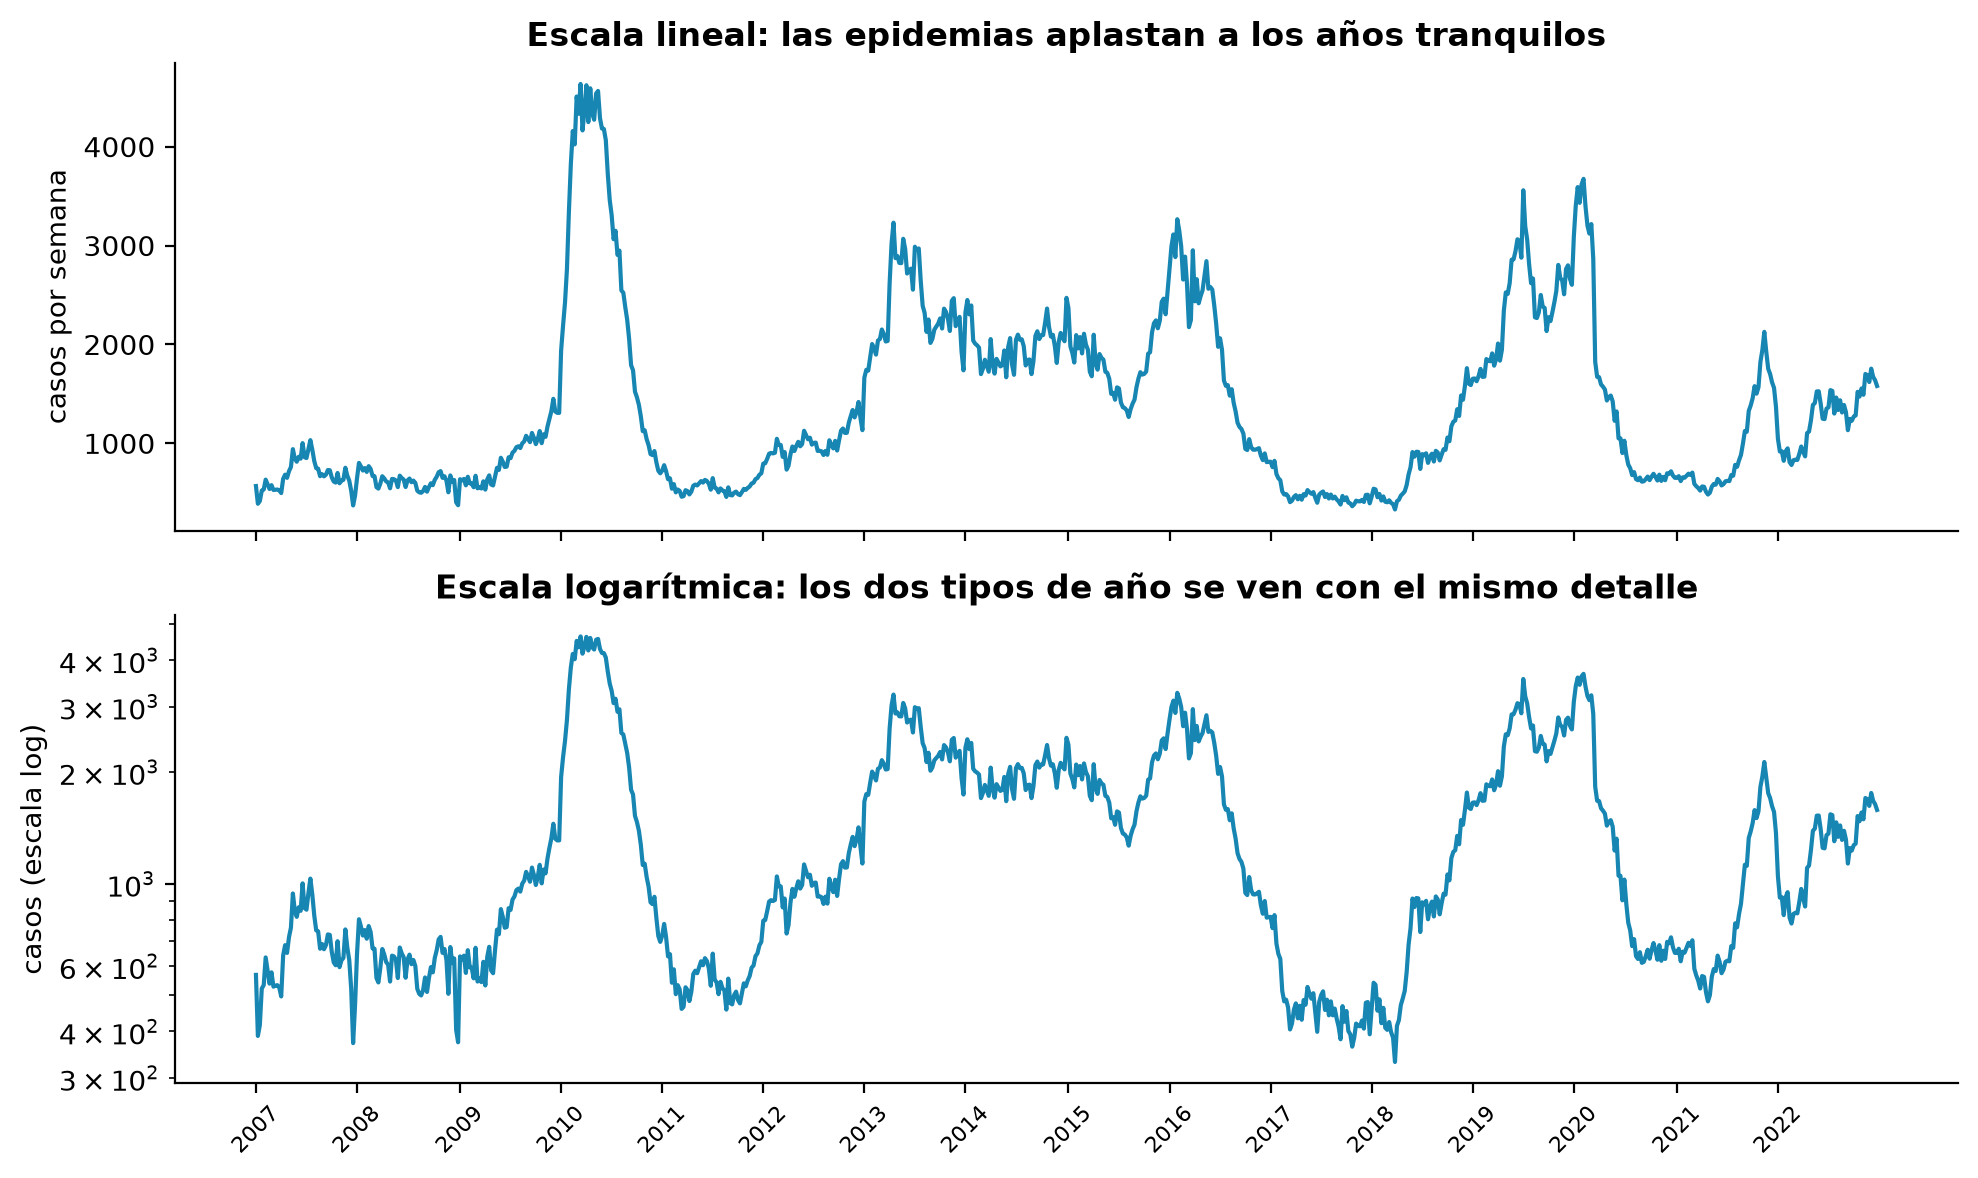
# 1. Leer el archivo tal como viene: una fila por semana epidemiológica.dengue_tabla = pd.read_csv('datos/dengue_sivigila_semanal_2007_2022.csv')print('Filas y columnas:', dengue_tabla.shape)print('Valores vacíos por columna:', dengue_tabla.isna().sum().to_dict())display(dengue_tabla.head())# 2. ¿Faltan semanas? Cuántas tiene cada año y si la numeración salta (debe avanzar de 1 en 1).semanas_por_anio = dengue_tabla.groupby('anio')['semana'].count()print('Años según su número de semanas:', semanas_por_anio.value_counts().to_dict())print('Años con semana 53:', semanas_por_anio.index[semanas_por_anio ==53].tolist())saltos =0for anio, grupo in dengue_tabla.groupby('anio'): saltos +=int((grupo['semana'].diff().dropna() !=1).sum())print('Saltos en la numeración de semanas:', saltos)# 3. ¿Hay ceros o negativos? El logaritmo no admite ninguno de los dos.casos = dengue_tabla['casos_dengue']print(f'Casos por semana | mínimo: {casos.min()} | máximo: {casos.max()} | semanas con 0 casos: {(casos ==0).sum()}')# 4. La misma serie en escala lineal y en escala logarítmica.posicion = np.arange(len(dengue_tabla))inicios = dengue_tabla.index[dengue_tabla['semana'] ==1]fig, axes = plt.subplots(2, 1, figsize=(10, 6), sharex=True)axes[0].plot(posicion, casos, color=COLOR_SERIE)axes[0].set_ylabel('casos por semana')axes[0].set_title('Escala lineal: las epidemias aplastan a los años tranquilos')axes[1].plot(posicion, casos, color=COLOR_SERIE)axes[1].set_yscale('log')axes[1].set_ylabel('casos (escala log)')axes[1].set_title('Escala logarítmica: los dos tipos de año se ven con el mismo detalle')axes[1].set_xticks(inicios, dengue_tabla.loc[inicios, 'anio'], fontsize=8, rotation=45)plt.tight_layout()plt.show()
Filas y columnas: (835, 3)
Valores vacíos por columna: {'anio': 0, 'semana': 0, 'casos_dengue': 0}
anio
semana
casos_dengue
0
2007
1
568
1
2007
2
389
2
2007
3
416
3
2007
4
522
4
2007
5
533
Años según su número de semanas: {52: 13, 53: 3}
Años con semana 53: [2008, 2014, 2020]
Saltos en la numeración de semanas: 0
Casos por semana | mínimo: 331 | máximo: 4634 | semanas con 0 casos: 0
El archivo tiene 835 filas y ningún valor vacío. Las primeras filas muestran su forma: la semana 1 de 2007 tuvo 568 casos notificados, la semana 2, 389. 13 años tienen 52 semanas y 3 (2008, 2014 y 2020) tienen 53, y no hay ningún salto en la numeración: no falta ninguna semana. Los casos van de 331 a 4634 por semana, sin ceros, así que el logaritmo se puede aplicar directamente.
La figura justifica la escala logarítmica. En escala lineal, las epidemias ocupan casi todo el alto del gráfico y los años tranquilos quedan comprimidos en la franja de abajo, donde sus subidas apenas se distinguen; en escala logarítmica, una misma distancia vertical representa una misma proporción, y se ve con igual detalle que un año tranquilo pasa de 400 a 800 casos (se duplica) que una epidemia pasa de 2000 a 4000. Como una epidemia crece multiplicando los casos semana a semana, esa es la escala natural para analizarla.
La serie y su resumen por año
El resumen, paso a paso. El resumen por año usa groupby('anio')['casos_dengue'].idxmax(), que devuelve, para cada año, el número de fila de la semana con más casos. Con esas filas, .loc recupera el año, la semana y los casos del pico. El total de cada año se agrega con groupby('anio')['casos_dengue'].sum().
Para ello, la celda sigue estos pasos, en este orden:
Construye la serie de casos con un índice consecutivo, una posición por semana.
Resume cada año con su total, la semana del pico y los casos en el pico.
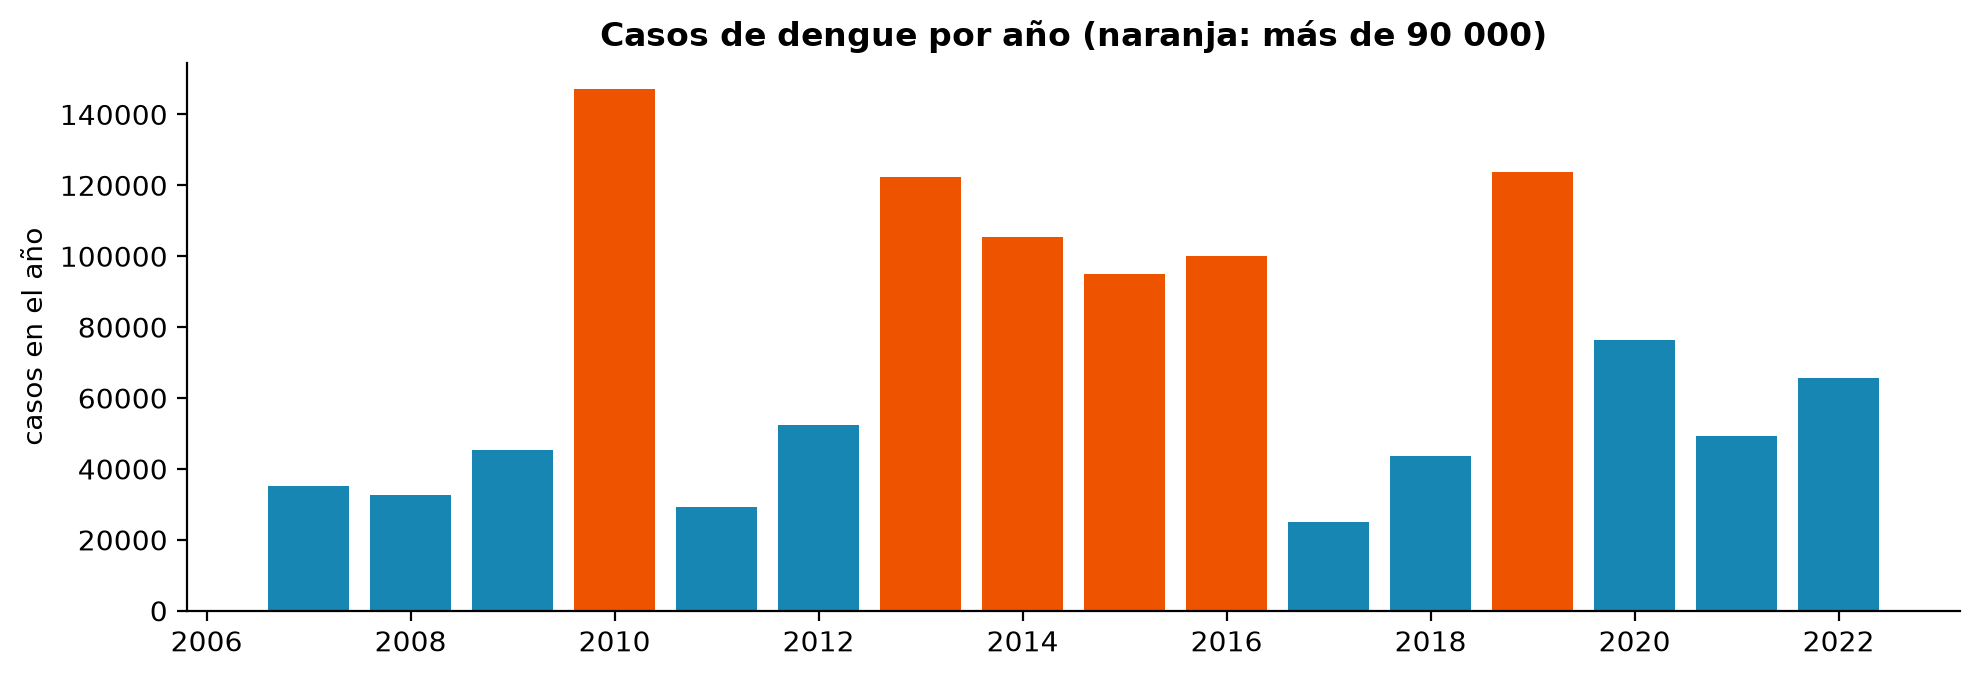
Dibuja el total de cada año, con los años de más de 90 000 casos marcados.
# 1. La serie de casos, con un índice consecutivo (una posición por semana).dengue = dengue_tabla['casos_dengue'].astype(float)# 2. Resumen por año: total, semana del pico y casos en el pico.filas_pico = dengue_tabla.groupby('anio')['casos_dengue'].idxmax() # fila de la semana con más casosresumen = dengue_tabla.loc[filas_pico, ['anio', 'semana', 'casos_dengue']]resumen = resumen.rename(columns={'semana': 'semana_pico', 'casos_dengue': 'casos_pico'}).set_index('anio')resumen.insert(0, 'total', dengue_tabla.groupby('anio')['casos_dengue'].sum())print(resumen.to_string())# 3. El total de cada año: en naranja, los años de más de 90 000 casos.colores = [COLOR_HW if total >90000else COLOR_SERIE for total in resumen['total']]fig, ax = plt.subplots(figsize=(10, 3.5))ax.bar(resumen.index, resumen['total'], color=colores)ax.set_ylabel('casos en el año')ax.set_title('Casos de dengue por año (naranja: más de 90 000)')plt.tight_layout()plt.show()
La tabla del resumen muestra la naturaleza de esta serie: años tranquilos con 25 a 52 mil casos (2007, 2008, 2011, 2012, 2017, 2018) y años epidémicos que los triplican o cuadruplican, como 2010 (147 224 casos, pico de 4634 en la semana 11), 2013 (122 441) y 2019 (123 641, pico de 3559 en la semana 27). La semana del pico cambia mucho de un año a otro: semana 2, 11, 16, 27, 49, 53. La figura de barras lo resume: 6 de los 16 años superan los 90 000 casos, y entre ellos hay tramos tranquilos de uno a tres años.
Pasos 3 a 5: explorar la serie
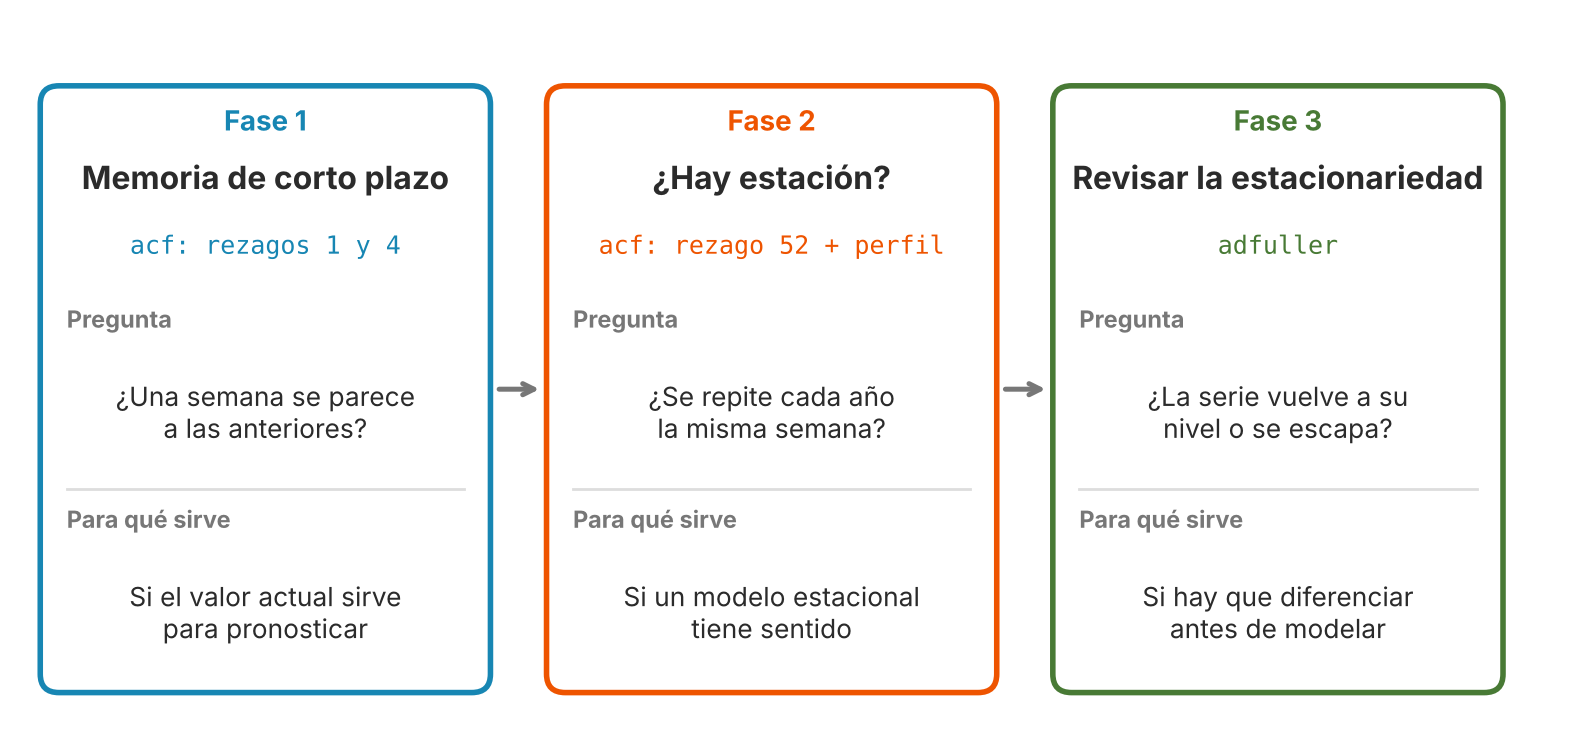
La exploración del dengue hace tres preguntas, distintas de las de la energía porque la serie es semanal y está dominada por epidemias:
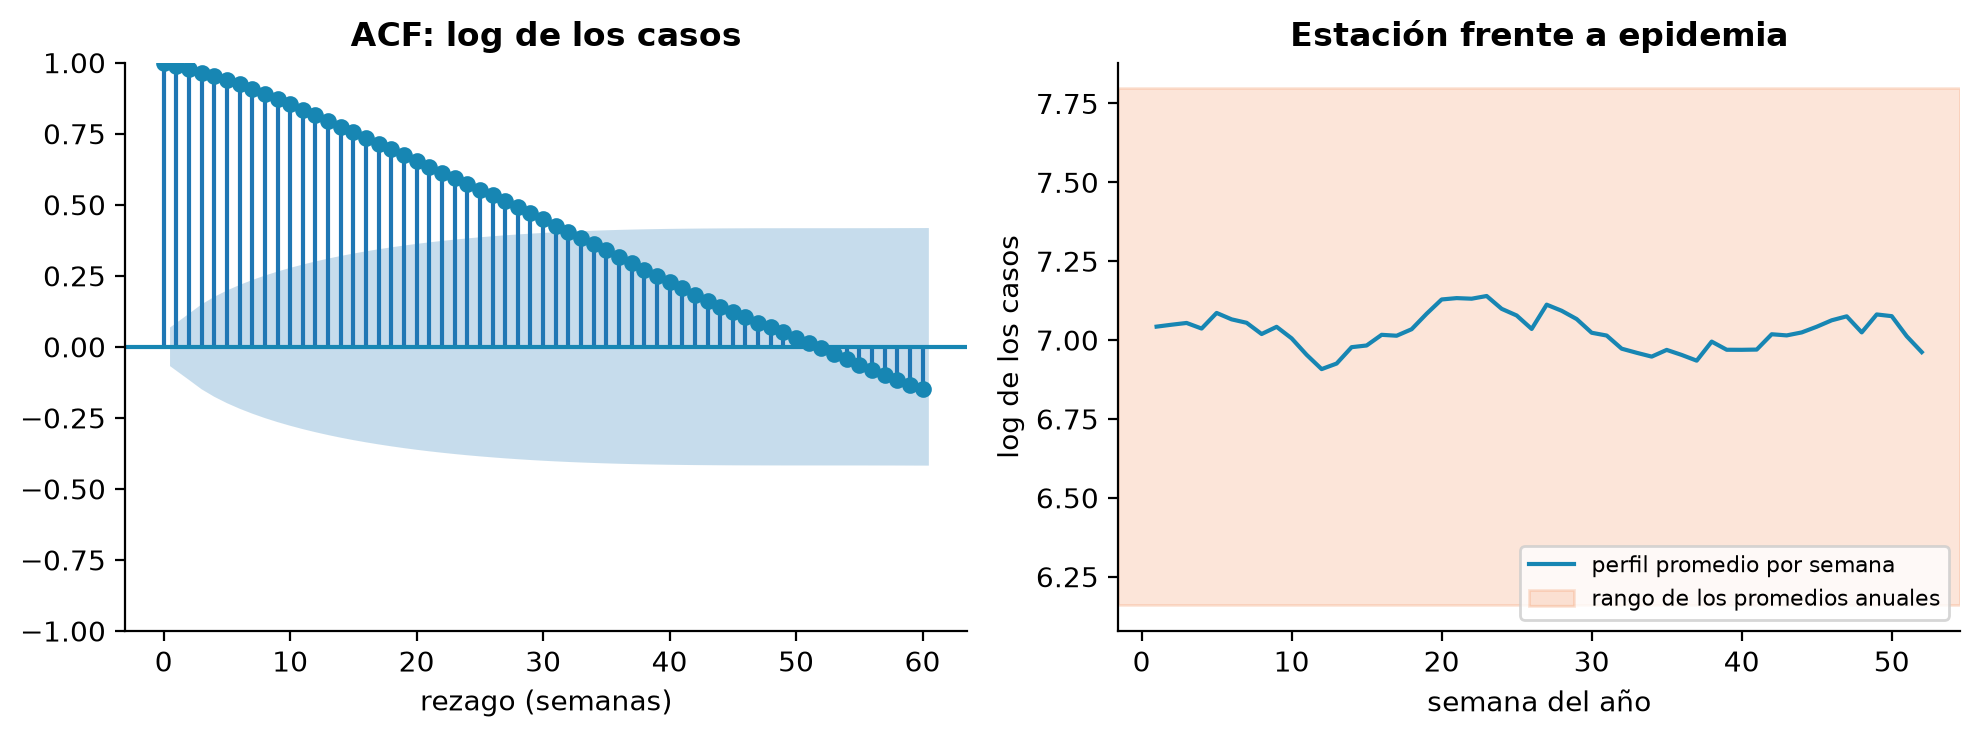
Las tres fases de la exploración del dengue: qué pregunta responde cada una y para qué sirve su respuesta.
No se usa seasonal_decompose: con un ciclo de 52 semanas y epidemias que no respetan el calendario, la estacionalidad que calcularía sería casi plana y la tendencia absorbería las epidemias. Las mismas preguntas se responden con medidas más directas.
Las herramientas de la exploración.
np.log(dengue) toma el logaritmo de los casos; las tres fases trabajan en esa escala, por lo visto en el paso 2.
acf(log_dengue, nlags=60) calcula la autocorrelación hasta el rezago 60, y el diccionario {k: round(r[k], 3) for k in [...]} extrae solo los rezagos que interesan: 1 y 4 (una semana y un mes antes), 13 y 26 (un trimestre y medio año) y 52 (un año).
El perfil semanal se obtiene con log_dengue.groupby(dengue_tabla['semana']).mean(): el promedio, sobre los 16 años, del logaritmo de cada semana del año. Si hubiera estación, ese perfil subiría y bajaría con fuerza.
El promedio de cada año se obtiene igual, agrupando por anio. Comparar el rango del perfil semanal con el rango entre años dice qué pesa más: el calendario o la diferencia entre años tranquilos y epidémicos.
En la figura, axhspan sombrea la franja entre el promedio anual más bajo y el más alto, para comparar a simple vista.
Para ello, la celda sigue estos pasos, en este orden:
Toma el logaritmo de los casos.
Calcula la autocorrelación del logaritmo en los rezagos 1, 4, 13, 26 y 52 semanas.
Compara el rango del perfil promedio por semana del año con el rango entre los promedios anuales.
Aplica la ADF al logaritmo.
Dibuja la ACF y el perfil semanal frente al rango entre años.
# 1. Logaritmo de los casos: las epidemias multiplican los casos, no los suman.log_dengue = np.log(dengue)# 2. Autocorrelación en rezagos clave: una, cuatro, 13, 26 y 52 semanas.r = acf(log_dengue, nlags=60, fft=True)print('ACF del logaritmo:', {k: round(r[k], 3) for k in [1, 4, 13, 26, 52]})# 3. ¿Hay estacionalidad anual? Comparar la variación entre semanas del año con la variación entre años.perfil_semana = log_dengue.groupby(dengue_tabla['semana']).mean().loc[1:52]media_anio = log_dengue.groupby(dengue_tabla['anio']).mean()print(f'Rango del perfil semanal (log): {perfil_semana.max() - perfil_semana.min():.2f}')print(f'Rango entre años (log): {media_anio.max() - media_anio.min():.2f}')# 4. Estacionariedad del logaritmo.print(f'ADF p-valor del logaritmo: {adfuller(log_dengue, autolag="AIC")[1]:.4f}')# 5. La figura.fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))plot_acf(log_dengue, lags=60, ax=axes[0], title='ACF: log de los casos', color=COLOR_SERIE)axes[0].set_xlabel('rezago (semanas)')axes[1].plot(perfil_semana.index, perfil_semana.values, color=COLOR_SERIE, label='perfil promedio por semana')axes[1].axhspan(media_anio.min(), media_anio.max(), color=COLOR_HW, alpha=0.15, label='rango de los promedios anuales')axes[1].set_xlabel('semana del año')axes[1].set_ylabel('log de los casos')axes[1].set_title('Estación frente a epidemia')axes[1].legend(loc='lower right', fontsize=8)plt.tight_layout()plt.show()
ACF del logaritmo: {1: np.float64(0.988), 4: np.float64(0.954), 13: np.float64(0.796), 26: np.float64(0.534), 52: np.float64(-0.004)}
Rango del perfil semanal (log): 0.23
Rango entre años (log):         1.64
ADF p-valor del logaritmo: 0.0224
La ACF del logaritmo es 0.988 en el rezago 1 y 0.954 en el 4: una semana se parece muchísimo a las anteriores, porque las epidemias crecen y decrecen despacio. Pero en el rezago 52 vale -0.004: una semana no se parece a la misma semana del año anterior. Es lo contrario de la energía y de los pasajeros. El perfil promedio por semana del año varía apenas 0.23 en logaritmo, mientras que los promedios anuales varían 1.64: la diferencia entre un año tranquilo y uno epidémico es unas siete veces mayor que la diferencia entre semanas del año. El dengue en Colombia, a escala nacional, no tiene una estación útil para pronosticar; tiene ciclos de varios años.
La ADF rechaza la raíz unitaria en el logaritmo (p = 0.0224): la serie sube en las epidemias, pero vuelve a su nivel, y no se escapa como la demanda de energía.
Pasos 6 a 8: el pronóstico básico
Para la primera pregunta del encargo se comparan cuatro candidatos, con pronósticos a 1, 2, 3 y 4 semanas:
Candidato
Qué pronostica
Qué supone
Ingenuo
Repite la última semana
Lo mejor que se sabe de la próxima semana es la actual
Ingenuo estacional
Repite las mismas semanas del año anterior
Hay estación anual
ARIMA(1,1,0) en log
Modela el cambio semanal del logaritmo como dependiente del cambio anterior
Si los casos vienen subiendo, siguen subiendo un poco
Holt amortiguado en log
Proyecta el nivel y una pendiente que se va aplanando
Hay tendencia de corto plazo, pero no indefinida
La evaluación usa origen móvil en 2021-2022: se simula que estás en una semana concreta, se pronostican las 4 siguientes con toda la historia anterior, se mide el error, y el origen avanza 4 semanas para que los pronósticos no se solapen. La celda siguiente dibuja los primeros orígenes para ver el mecanismo. Para ello, sigue estos pasos, en este orden:
Define el horizonte de 4 semanas y la posición de la primera semana de 2021.
Dibuja los cuatro primeros orígenes: la historia que usa cada uno y las 4 semanas que pronostica.
# 1. Horizonte de 4 semanas y posición de la primera semana de 2021 (el primer origen).H =4inicio_prueba =int(dengue_tabla.index[dengue_tabla['anio'] ==2021][0])# 2. Los cuatro primeros orígenes: historia hasta el origen y 4 semanas pronosticadas.fig, ax = plt.subplots(figsize=(10, 2.8))for i inrange(4): origen = inicio_prueba + i * H y =3- i ax.barh(y, 12, left=origen -12, color=COLOR_SERIE, alpha=0.75) # las últimas 12 semanas de historia ax.barh(y, H, left=origen, color=COLOR_HW) # las 4 semanas que se pronostican ax.text(origen -12.5, y, f'origen {i +1}', ha='right', va='center', fontsize=9)etiquetas =range(inicio_prueba -12, inicio_prueba +4* H +1, 4)ax.set_xticks(list(etiquetas), [f"{dengue_tabla.loc[p, 'anio']}-S{dengue_tabla.loc[p, 'semana']:02d}"for p in etiquetas], fontsize=8, rotation=45)ax.set_yticks([])ax.spines['left'].set_visible(False)ax.set_title('Origen móvil: cada pronóstico usa toda la historia anterior y avanza 4 semanas')ax.legend(handles=[plt.Rectangle((0, 0), 1, 1, color=COLOR_SERIE, alpha=0.75), plt.Rectangle((0, 0), 1, 1, color=COLOR_HW)], labels=['historia (se muestran las últimas 12 semanas)', 'semanas pronosticadas'], loc='upper center', bbox_to_anchor=(0.5, -0.45), ncol=2, frameon=False, fontsize=8)plt.tight_layout()plt.show()
El primer origen es la semana 1 de 2021: con la historia hasta la semana 52 de 2020 se pronostican las semanas 1 a 4 de 2021, se mide el error y el origen pasa a la semana 5. En 2021-2022 caben 26 orígenes así.
Lo que hace la celda de evaluación.
pronosticar_d(candidato, historia) devuelve 4 valores, uno por semana pronosticada:
el ingenuo usa np.repeat(historia.iloc[-1], H), que repite 4 veces el último valor;
el ingenuo estacional usa historia.iloc[-52:-52 + H], las 4 semanas que empiezan 52 posiciones antes del final, es decir, las mismas semanas del año anterior;
los dos modelos se ajustan sobre np.log(historia) y devuelven np.exp(...) del pronóstico, para volver a casos.
range(inicio_prueba, len(dengue) - H + 1, H) genera las posiciones de los orígenes, de 4 en 4.
Para cada candidato, la celda arma una matriz errores de 26 filas (una por origen) y 4 columnas (una por semana pronosticada). errores[:, 0].mean() es el MAE a una semana y errores[:, 3].mean(), a cuatro; errores.mean() promedia todo.
Para ello, la celda sigue estos pasos, en este orden:
Define la función pronosticar_d con los cuatro candidatos.
Evalúa cada candidato en los 26 orígenes de 2021-2022 y reporta el MAE a 1 y a 4 semanas y el MAE medio.
# 1. Candidatos para pronosticar las 4 semanas siguientes (H = 4 se definió en la celda anterior).def pronosticar_d(candidato, historia):if candidato =='ingenuo': # repetir la última semanareturn np.repeat(historia.iloc[-1], H)if candidato =='ingenuo estacional': # repetir las mismas semanas del año anteriorreturn historia.iloc[-52:-52+ H].to_numpy() lz = np.log(historia)if candidato =='ARIMA(1,1,0) en log':return np.exp(SARIMAX(lz, order=(1, 1, 0)).fit(disp=False).forecast(H)).to_numpy()if candidato =='Holt amortiguado en log':return np.exp(ExponentialSmoothing(lz, trend='add', damped_trend=True).fit().forecast(H)).to_numpy()# 2. Evaluación con origen móvil en 2021-2022: un pronóstico cada 4 semanas, sin solaparse.origenes_d =range(inicio_prueba, len(dengue) - H +1, H)print(f'Pronósticos evaluados: {len(origenes_d)} (cada uno a 1, 2, 3 y 4 semanas)')print('MAE por horizonte (casos por semana):')for candidato in ['ingenuo', 'ingenuo estacional', 'ARIMA(1,1,0) en log', 'Holt amortiguado en log']: errores = np.array([np.abs(dengue.iloc[o:o + H].to_numpy() - pronosticar_d(candidato, dengue.iloc[:o]))for o in origenes_d])print(f' {candidato:24s} h1 = {errores[:, 0].mean():5.0f} | h4 = {errores[:, 3].mean():5.0f} | 'f'medio = {errores.mean():5.1f}')
Pronósticos evaluados: 26 (cada uno a 1, 2, 3 y 4 semanas)
MAE por horizonte (casos por semana):
  ingenuo                  h1 =    66 | h4 =   166 | medio = 113.6
  ingenuo estacional       h1 =   810 | h4 =   714 | medio = 753.9
  ARIMA(1,1,0) en log      h1 =    68 | h4 =   168 | medio = 115.8
  Holt amortiguado en log  h1 =    69 | h4 =   176 | medio = 116.6
Con 26 pronósticos evaluados, el ingenuo queda primero, con un MAE medio de 113.6 casos por semana, y el ARIMA (115.8) y el Holt amortiguado (116.6) quedan prácticamente empatados con él. El ingenuo estacional es el peor por mucho: 753.9, unas siete veces más error, porque la misma semana del año anterior puede estar en otra fase del ciclo epidémico. El error crece con el horizonte: de 66 casos a una semana a 166 a cuatro semanas en el ingenuo.
Que un modelo no supere al ingenuo no es un fracaso del análisis: es una conclusión. Cuando una serie se mueve despacio y sin estación, lo mejor que se sabe de la semana próxima es la semana actual, y los modelos lineales solo pueden igualarlo. Para la segunda pregunta del encargo, entonces, no sirve pronosticar con más precisión; sirve comparar cada semana con lo esperado y decidir cuándo la diferencia es una señal de alarma.
Lo nuevo: el canal endémico
ImportanteResumen: el canal endémico
El canal endémico describe, para cada semana del año, cuántos casos son «normales» según los años anteriores, y divide los valores posibles en cuatro zonas con los cuartiles de esos años:
éxito: por debajo del primer cuartil (Q1), menos casos que en tres de cada cuatro años de referencia;
seguridad: entre Q1 y la mediana;
alerta: entre la mediana y el tercer cuartil (Q3);
epidemia: por encima de Q3, más casos que en tres de cada cuatro años de referencia.
Cada semana del año que se vigila se compara con su zona. La regla de alerta convierte esa comparación en una decisión: aquí, alertar cuando hay dos semanas seguidas en la zona de epidemia. Es la misma idea de los percentiles del caso de envíos del capítulo de series de tiempo, aplicada a otra decisión: allá se trataba de cuánta capacidad preparar, aquí de cuándo dar la alarma.
El canal se construye con los siete años anteriores al año que se vigila. Antes de automatizarlo, conviene calcularlo a mano para una sola semana. La celda siguiente lo hace con la semana 18 de 2019, la semana en que el canal dio la alerta. Para ello, sigue estos pasos, en este orden:
Reorganiza los casos en una tabla de años por semanas (semanas 1 a 52) con pivot, y muestra un trozo.
Toma la semana 18 de los siete años de referencia (2012 a 2018), los ordena y calcula sus cuartiles.
Compara los casos de la semana 18 de 2019 con esos cuartiles y dice en qué zona quedan.
# 1. Tabla de años por semanas: una fila por año, una columna por semana (la 53 se deja fuera).tabla = dengue_tabla[dengue_tabla['semana'] <=52].pivot(index='anio', columns='semana', values='casos_dengue')print('Forma de la tabla:', tabla.shape)print(tabla.loc[2016:2019, 15:20].to_string())# 2. La semana 18 en los siete años de referencia (2012 a 2018), ordenada de menor a mayor.semana =18referencia = tabla.loc[2012:2018, semana]print(f'\nSemana {semana}, años de referencia ordenados:', referencia.sort_values().to_dict())q1, mediana, q3 = referencia.quantile([0.25, 0.50, 0.75])print(f'Q1 = {q1:.0f} | mediana = {mediana:.0f} | Q3 = {q3:.0f}')# 3. ¿En qué zona cae la semana 18 de 2019?observado = tabla.loc[2019, semana]if observado > q3: zona ='epidemia'elif observado > mediana: zona ='alerta'elif observado > q1: zona ='seguridad'else: zona ='éxito'print(f'2019, semana {semana}: {observado} casos -> zona de {zona}')
La tabla tiene 16 filas (los años) y 52 columnas (las semanas); cada celda son los casos de una semana de un año. En la semana 18, los siete años de referencia van de 486 casos (2017) a 2894 (2013), y sus cuartiles son Q1 = 744, mediana = 1815 y Q3 = 2206. La semana 18 de 2019 tuvo 2526 casos, por encima de Q3: zona de epidemia. La semana 17 también había quedado por encima de su propio Q3 (2342 casos frente a 2196), así que la semana 18 completa dos seguidas y dispara la alerta.
Del cálculo a mano al canal completo. Repite ese cálculo para todas las semanas y todos los años:
canal_endemico(anio, k=7) toma las filas de los 7 años anteriores, tabla.loc[anio - 7:anio - 1], y calcula con .quantile([0.25, 0.50, 0.75]) los tres cuartiles de cada columna, es decir, de cada semana. El resultado tiene los cuartiles en filas y las semanas en columnas; .T lo transpone y set_axis nombra las columnas q1, mediana y q3.
primera_alerta(observado, limite) aplica la regla de las dos semanas:
encima = observado > limite marca con True las semanas sobre Q3;
encima.shift(1, fill_value=False) corre esa marca una semana, de modo que en cada posición queda la marca de la semana anterior (la primera semana, que no tiene anterior, recibe False);
encima & encima.shift(1) es True solo donde la semana actual y la anterior están sobre Q3;
.idxmax() devuelve la primera semana donde eso ocurre. Por ejemplo, si encima es [No, Sí, No, Sí, Sí], la corrida es [No, No, Sí, No, Sí] y la conjunción solo es Sí en la quinta semana: la alerta se da en la semana 5.
La columna primera_alerta se convierte al tipo Int64 de pandas, que admite valores vacíos (<NA>) para los años sin alerta.
Para ello, la celda sigue estos pasos, en este orden:
Define el canal de un año como los cuartiles semana a semana de los siete años anteriores, y la regla de las dos semanas.
Aplica el canal a cada año de 2014 a 2022: total, semanas en zona de epidemia, primera alerta y semana del pico.
Dibuja el canal de 2019 con los casos de ese año y la semana de la alerta.
# 1. El canal de un año: cuartiles semana a semana de los k años anteriores (tabla viene de la celda anterior).def canal_endemico(anio, k=7):"""Cuartiles por semana de los k años anteriores: las fronteras de las cuatro zonas.""" previos = tabla.loc[anio - k:anio -1]return previos.quantile([0.25, 0.50, 0.75]).T.set_axis(['q1', 'mediana', 'q3'], axis=1)# 2. Regla de alerta: dos semanas seguidas por encima del tercer cuartil (zona de epidemia).def primera_alerta(observado, limite): encima = observado > limite dos_seguidas = encima & encima.shift(1, fill_value=False)returnint(dos_seguidas.idxmax()) if dos_seguidas.any() elseNone# 3. Aplicar el canal a cada año de 2014 a 2022.filas = []for anio inrange(2014, 2023): canal = canal_endemico(anio) obs = tabla.loc[anio] filas.append({'anio': anio, 'total': int(obs.sum()), 'semanas_en_epidemia': int((obs > canal['q3']).sum()),'primera_alerta': primera_alerta(obs, canal['q3']), 'semana_pico': int(obs.idxmax())})evaluacion = pd.DataFrame(filas).set_index('anio')evaluacion['primera_alerta'] = evaluacion['primera_alerta'].astype('Int64') # Int64 admite años sin alertaprint(evaluacion.to_string())# 4. El canal de 2019, el año de la epidemia.canal_2019 = canal_endemico(2019)semanas = canal_2019.indexfig, ax = plt.subplots()ax.fill_between(semanas, 0, canal_2019['q1'], color=COLOR_SARIMA, alpha=0.25, label='éxito (bajo Q1)')ax.fill_between(semanas, canal_2019['q1'], canal_2019['mediana'], color=COLOR_SARIMA, alpha=0.10, label='seguridad')ax.fill_between(semanas, canal_2019['mediana'], canal_2019['q3'], color=COLOR_HW, alpha=0.20, label='alerta')ax.plot(semanas, canal_2019['q3'], color=COLOR_HW, lw=1, label='Q3: por encima, epidemia')ax.plot(semanas, tabla.loc[2019], 'o-', ms=3, color=COLOR_REAL, label='casos 2019')alerta_2019 = evaluacion.loc[2019, 'primera_alerta']ax.axvline(alerta_2019, color=COLOR_HW, ls='--', label=f'alerta: semana {alerta_2019}')ax.set_xlabel('semana epidemiológica')ax.set_ylabel('casos por semana')ax.set_title('Canal endémico de 2019 (cuartiles de 2012-2018)')ax.legend(loc='upper left', fontsize=8)plt.tight_layout()plt.show()
En 2019, el canal construido con 2012-2018 da la alerta en la semana 18, y el pico llega en la semana 27: 9 semanas de anticipación, tiempo para intensificar el control del mosquito, preparar camas y reforzar la atención. Ese año pasa 36 semanas en la zona de epidemia.
La tabla muestra también los límites de la regla:
Años tranquilos sin falsas alarmas. En 2017 y 2021 no hay ninguna alerta, y en 2022 solo 3 semanas sueltas por encima de Q3, sin dos seguidas.
Alertas en la semana 2. En 2014, 2015, 2016 y 2020, la alerta llega en la segunda semana porque el año empezó en plena epidemia, heredada del año anterior. La regla no anticipa nada ahí: confirma lo que ya se sabía.
Subidas que no alertan. A finales de 2018 los casos subieron de unos 400 a 1760 por semana, el inicio de la epidemia de 2019, y el canal no lo marcó. El motivo: los siete años de referencia incluían las epidemias de 2010 y 2013-2016, que inflan el tercer cuartil. Un canal construido con años epidémicos «se acostumbra» a las epidemias y pierde sensibilidad.
¿Cuánto depende la alerta de la receta?
El canal endémico no tiene una sola receta. Otra muy usada es la media geométrica de los cinco años anteriores con su intervalo de confianza del 95 %. Para cada semana del año:
donde \(\bar{z}\) y \(s_z\) son la media y la desviación estándar de \(z\) en los cinco años de referencia, y \(t_{0.975,\,4} \approx 2.78\) es el valor de la \(t\) de Student con 4 grados de libertad que deja un 2.5 % en cada cola. Tres detalles de la fórmula:
se promedia en logaritmo y se vuelve con la exponencial: el resultado es la media geométrica, que no se deja arrastrar por un solo año epidémico tanto como la media común;
se suma 1 a los casos antes del logaritmo para que una semana con 0 casos no rompa el cálculo, y se resta 1 al final;
se usa la \(t\) de Student, y no la normal, porque con solo cinco años la desviación estándar se estima con mucha incertidumbre.
La alerta se da con la misma regla: dos semanas seguidas por encima del límite. Para ello, la celda sigue estos pasos, en este orden:
Define el límite de la media geométrica con t_student.ppf(0.975, 4), el valor crítico de la \(t\) de Student.
Compara, año a año, la semana de la primera alerta y las semanas en zona de epidemia con cada receta.
Calcula la anticipación de cada receta en 2019.
# 1. El mismo canal con otra receta: media geométrica de 5 años con su intervalo del 95 %.from scipy.stats import t as t_studentdef limite_media_geometrica(anio, k=5): previos = np.log(tabla.loc[anio - k:anio -1] +1) margen = t_student.ppf(0.975, k -1) * previos.std(ddof=1) / np.sqrt(k)return np.exp(previos.mean() + margen) -1# 2. Comparar las dos recetas: semana de la primera alerta y semanas en zona de epidemia.comparacion = pd.DataFrame({'alerta_cuartiles': evaluacion['primera_alerta'],'semanas_cuartiles': evaluacion['semanas_en_epidemia'],'alerta_media_geom': [primera_alerta(tabla.loc[a], limite_media_geometrica(a)) for a in evaluacion.index],'semanas_media_geom': [int((tabla.loc[a] > limite_media_geometrica(a)).sum()) for a in evaluacion.index],'semana_pico': evaluacion['semana_pico'],})comparacion['alerta_media_geom'] = comparacion['alerta_media_geom'].astype('Int64')print(comparacion.to_string())# 3. Anticipación en 2019: semanas entre la alerta y el pico.for receta in ['alerta_cuartiles', 'alerta_media_geom']:print(f'2019, {receta}: alerta en la semana {comparacion.loc[2019, receta]}, 'f'{comparacion.loc[2019, "semana_pico"] - comparacion.loc[2019, receta]} semanas antes del pico')
Las dos recetas coinciden en los años tranquilos (sin alertas en 2017, 2018 y 2021) y difieren en lo que importa. Con la media geométrica, 2019 da la alerta en la semana 23, 4 semanas antes del pico, frente a 9 con los cuartiles, y pasa 17 semanas en zona de epidemia en lugar de 36. Su límite es más alto, porque el intervalo de una media de 5 años con una \(t\) de 4 grados de libertad es ancho, y por eso es más conservadora: menos semanas marcadas y menos anticipación.
Respuesta al encargo. El número de casos de las próximas semanas se pronostica mejor con el valor actual (error medio de unos 66 casos a una semana y 166 a cuatro); ningún modelo lineal lo supera de forma clara. Para la alerta temprana, el canal endémico de cuartiles con siete años de referencia y la regla de dos semanas seguidas sobre Q3 habría detectado la epidemia de 2019 9 semanas antes de su pico, sin falsas alarmas en los años tranquilos de 2017, 2018 y 2021. La regla tiene un punto ciego conocido: no detecta el comienzo de una epidemia cuando los años de referencia incluyen epidemias recientes. Conviene complementarla con un canal construido sin años epidémicos (ver las preguntas) y con la tasa de crecimiento semanal de los casos.
Lo que enseñan los dos casos juntos
Energía
Dengue
Estacionalidad
Clara (efecto mensual de -4.4 a +4.2 GWh por día)
Casi nula (ACF en 52 semanas: -0.004)
Tendencia
Creciente y estable
Ciclos de varios años, sin tendencia
Mejor pronóstico básico
Holt-Winters o SARIMA, con MAPE de 2.8 %
El ingenuo, difícil de superar
Herramienta nueva
Variable externa (SARIMAX con El Niño)
Percentiles como regla de decisión (canal endémico)
Lección central
Una variable externa vale lo que vale su pronóstico
Pronosticar y vigilar son tareas distintas
Los dos casos recorren los mismos diez pasos y llegan a conclusiones opuestas sobre qué tan pronosticable es su serie. Esa es la razón de empezar siempre por explorar (pasos 3 a 5): la estructura de la serie, y no la preferencia por un modelo, decide qué herramienta conviene.
Errores comunes
Modelar totales mensuales sin mirar el calendario. En 2024, el total de febrero fue un 5 % menor que el de enero, pero su consumo por día fue un 1.6 % mayor.
Dejar que un choque como la pandemia contamine la tendencia. Sin el indicador de confinamiento, el modelo trata abril de 2020 (-10.9 %) como parte del comportamiento normal de la serie.
Validar un modelo con variables externas usando sus valores reales futuros y reportar ese error como si fuera alcanzable. Con el ONI real, el MAPE fue 1.95 %; con el ONI que se conocía en octubre de 2025, 2.87 %.
Leer un coeficiente significativo como una causa demostrada. El efecto de 1.21 % por grado de ONI es una asociación útil para pronosticar, no una medición experimental.
Forzar una estación donde no la hay. El ingenuo estacional del dengue tuvo siete veces más error que el ingenuo simple.
Descartar un análisis porque el modelo no supera al ingenuo. En el dengue, esa es la conclusión correcta, y cambia la pregunta de pronosticar a vigilar.
Construir el canal endémico con años epidémicos sin advertirlo. El canal de 2019 no marcó la subida de finales de 2018, porque su referencia incluía las epidemias de 2010 y 2013-2016.
Evaluar una regla de alerta solo por el año en que acertó. La regla también debe juzgarse por sus falsas alarmas y por las alertas que solo confirman una epidemia ya en curso.
Preguntas de comprensión
¿Por qué el promedio diario resuelve a la vez el efecto de febrero y el día faltante de diciembre de 2015?
En la validación, el SARIMAX con El Niño baja el MAE de 3.01 a 2.52. ¿Por qué esa mejora no se puede reportar como el error esperado de un pronóstico real?
Con el ONI congelado en -0.43, el SARIMAX fue peor que el SARIMA sin externas. Explica por qué una variable que aporta información puede empeorar un pronóstico.
El efecto del ONI es de 1.21 % por grado. ¿Qué variables podrías agregar al modelo que, a diferencia del ONI, sí tienen un futuro conocido con certeza?
¿Qué indica una ACF de 0.988 en el rezago 1 y de -0.004 en el rezago 52 sobre cómo pronosticar el dengue?
En 2014, 2015, 2016 y 2020 la alerta llega en la semana 2. ¿Es un acierto de la regla? ¿Cómo la modificarías para distinguir una epidemia que continúa de una que empieza?
Ejercicio: construye el canal de cuartiles excluyendo de la referencia los años con más de 90 000 casos. ¿Detecta la subida de finales de 2018? ¿Cuántas semanas marca en 2019 y en 2022? ¿Qué ganas y qué pierdes?
Ejercicio: en el caso de la energía, agrega como variable externa el número de días hábiles de cada mes (días que no son domingo ni festivo) y compara la validación. ¿Mejora? ¿Su futuro se conoce?
TipOrientaciones
Los dos problemas vienen de que el total del mes depende de cuántos días tiene con dato: febrero tiene menos días y a diciembre de 2015 le falta uno. Dividir entre los días con dato pone todos los meses en la misma unidad, GWh por día.
Porque en cada pliegue el modelo recibió el ONI que realmente ocurrió en los 12 meses que pronosticaba, información que no existe en el momento de pronosticar. Es una cota optimista: dice cuánto ayudaría El Niño si se conociera su futuro.
Porque el modelo traduce el valor supuesto del ONI en un efecto sobre la demanda. Con -0.43, «creyó» que La Niña reduciría el consumo, justo en el año en que El Niño lo aumentó; el error del supuesto se sumó al error del modelo.
Los días hábiles, los festivos (incluida la Semana Santa, que cae en marzo o abril según el año), las horas de luz o una variable de tarifas ya anunciadas. Todas se conocen antes del mes que se pronostica.
Que la mejor información sobre la semana próxima son las semanas recientes, y que el calendario no ayuda: la misma semana del año anterior puede estar en otra fase del ciclo epidémico. Por eso el ingenuo es difícil de superar y el ingenuo estacional falla.
No es un acierto de anticipación: la epidemia venía del año anterior y la regla solo la confirma. Se puede exigir, además de estar sobre Q3, que los casos crezcan durante varias semanas seguidas, o evaluar la regla de forma continua a través del cambio de año en lugar de reiniciarla cada enero.
Excluir los años epidémicos baja el tercer cuartil y hace la regla más sensible: detecta la subida de 2018 (alerta en la semana 23 de 2018) y marca casi todas las semanas de 2019 y 2022. Ganas anticipación y pierdes especificidad, con más semanas en alerta. La elección depende del costo de una falsa alarma frente al de una epidemia detectada tarde.
Es un buen candidato porque su futuro se conoce con certeza, de modo que la validación no es optimista. Si la mejora es pequeña, se debe a que el promedio diario ya corrige buena parte del efecto del calendario.
Bortman, M. (1999). Elaboración de corredores o canales endémicos mediante planillas de cálculo. Revista Panamericana de Salud Pública, 5(1), 1–8. El método de cuartiles del canal endémico.
Hyndman, R. J. y Athanasopoulos, G. (2021). Forecasting: Principles and Practice (3.ª ed.), capítulo 10, «Dynamic regression models». Regresión con errores ARIMA, el modelo que este capítulo llama SARIMAX, y el problema de pronosticar las variables externas.
Los mismos diez pasos llevan a herramientas distintas según la serie: una serie con tendencia, estación y causas medibles se pronostica mejor con variables externas, siempre que su futuro se conozca; una serie dominada por epidemias se vigila con percentiles, y la regla de alerta se juzga por su anticipación y por sus falsas alarmas.
Pasar la demanda a GWh por día quitó el efecto del calendario: febrero de 2024 pasó de parecer un 5 % más bajo que enero a ser un 1.6 % más alto.
Holt-Winters y SARIMA se quedaron cortos en 11 de 12 meses de 2026, con un sesgo de unos +6.5 GWh por día.
El SARIMAX con confinamiento y El Niño bajó el MAE de validación de 3.01 a 2.52; cada grado de ONI se asocia con un 1.21 % más de demanda.
Con el ONI real, el MAPE de 2026 habría sido 1.95 %; con el ONI conocido en octubre de 2025, 2.87 %, peor que no usarlo.
El dengue no tiene estación útil (ACF de -0.004 en 52 semanas), y el ingenuo igualó a los modelos a 1-4 semanas.
El canal endémico de cuartiles detectó la epidemia de 2019 en la semana 18, 9 semanas antes del pico, sin falsas alarmas en 2017, 2018 y 2021, pero no marcó el inicio de la epidemia a finales de 2018.
Puente hacia los siguientes capítulos
Los dos casos trabajaron con una serie en el tiempo, observada a escala nacional. El capítulo de datos longitudinales da el paso siguiente: muchas unidades (personas, municipios, clientes) observadas varias veces cada una. Allí, la dependencia temporal aparece dentro de cada unidad y se combina con las diferencias entre unidades; por ejemplo, el dengue por municipio en lugar del total del país.