Apéndice B — Caso aplicado: un clasificador con PCA para biopsias de mama
estadistica
variables-latentes
pca
caso-practico
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
6 de noviembre de 2026
El objetivo del taller
En el capítulo de PCA aprendiste la teoría con vinos. En este taller la usas para construir algo concreto: un clasificador de biopsias que trabaja con componentes principales en lugar de las medidas originales.
Los datos provienen de biopsias de masas mamarias tomadas con aguja fina. De cada muestra se obtuvo una imagen digital al microscopio y, sobre ella, se midieron los núcleos de las células: su tamaño, su textura, lo irregular de su borde y otras características. El resultado son 30 medidas por biopsia y un diagnóstico confirmado: maligno o benigno.
Muchas de esas 30 medidas dicen casi lo mismo: si un núcleo tiene un radio grande, también tendrá un perímetro y un área grandes. PCA puede resumirlas en unos pocos componentes, y el clasificador puede trabajar con ellos. Todo el taller responde una sola pregunta:
¿Con cuántos componentes puedes construir un clasificador que distinga tumores malignos de benignos, y qué tan bien funciona con biopsias que no vio?
Los códigos priorizan la claridad sobre la eficiencia: usan nombres largos, bucles explícitos y comentarios numerados, para que puedas seguir cada operación línea por línea.
Tiempo estimado de lectura: 35 minutos (alrededor de 50 minutos si ejecutas el código)
Los datos son el conjunto Breast Cancer Wisconsin (Diagnostic) del UCI Machine Learning Repository (CC BY 4.0), descrito por Street, Wolberg y Mangasarian (1993), en la copia que distribuye scikit-learn y que se carga sin conexión. Ya lo usaste en el capítulo de métricas de clasificación del nivel Básico. Los repartos usan la semilla central SEMILLA = 2026, todo corre en CPU y las versiones se imprimen en la primera celda de código.
Este caso es un ejercicio de análisis de datos. Ningún modelo de esta página es una herramienta de diagnóstico médico.
Objetivos
Al terminar este taller vas a ser capaz de:
justificar el uso de PCA en un problema de clasificación a partir de la redundancia y las escalas de las variables;
armar un clasificador como un Pipeline que estandariza, aplica PCA y clasifica;
elegir el número de componentes con validación cruzada, sin fuga de información;
examinar el PCA del clasificador entrenado: cuántas medidas recibe, cuántos componentes entrega y cuánta varianza conservan;
evaluar el clasificador una sola vez en la prueba y usarlo para diagnosticar una biopsia nueva.
Ejecuta las celdas en orden: cada paso usa variables creadas en los anteriores.
El plan de trabajo
El taller sigue ocho pasos en tres bloques: preparar los datos, construir el clasificador con PCA, y evaluarlo y usarlo.
Bloque
Paso
Qué haces
Herramienta
Preparar
1
Conocer la tabla
load_breast_cancer, shape
2
Reservar la prueba para la evaluación final
train_test_split
3
Comprobar por qué conviene PCA
matriz de correlaciones y desviaciones estándar
Construir
4
Armar el clasificador: estandarizar, PCA y regresión logística
Pipeline
5
Elegir cuántos componentes usa
validación cruzada
6
Entrenarlo y ver qué hizo PCA dentro
fit, named_steps['pca'], transform
Evaluar y usar
7
Evaluarlo una sola vez en la prueba
exactitud, sensibilidad, matriz de confusión
8
Diagnosticar una biopsia nueva
predict_proba
Preparación del entorno
La celda carga las librerías, fija la semilla central y define un color para cada diagnóstico, que se mantendrá en todas las figuras.
%matplotlib inline%config InlineBackend.figure_format ="retina"# Librerías de trabajoimport numpy as npimport pandas as pdimport matplotlib.pyplot as plt# Piezas de scikit-learn que usa el casofrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split, StratifiedKFold, cross_validatefrom sklearn.preprocessing import StandardScalerfrom sklearn.decomposition import PCAfrom sklearn.linear_model import LogisticRegressionfrom sklearn.pipeline import Pipelinefrom sklearn.metrics import accuracy_score, recall_score, confusion_matrix, make_scorer# Semilla central: con ella, cualquier persona obtiene los mismos repartos.SEMILLA =2026# Colores fijos para los dos diagnósticos en todas las figuras.COLOR_MALIGNO ='#B42318'COLOR_BENIGNO ='#2A6F97'plt.rcParams.update({'figure.figsize': (9, 5),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# Versiones del entorno con el que se ejecutó el caso.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scikit-learn']:print(paquete +':', metadatos.version(paquete))
Antes de calcular nada, mira qué contiene la tabla: cuántas filas y columnas tiene, cómo está codificado el diagnóstico y qué significa cada columna. En load_breast_cancer, la etiqueta 0 es maligno y la 1 es benigno.
La celda siguiente hace cuatro cosas:
Carga el conjunto como tabla de pandas.
Imprime cuántas biopsias y cuántas medidas hay.
Cuenta cuántas biopsias hay de cada diagnóstico.
Imprime los nombres de las 30 columnas, separados en sus tres bloques.
# 1. Cargar el conjunto. as_frame=True lo entrega como tabla de pandas.biopsias = load_breast_cancer(as_frame=True)X_completo = biopsias.data # las 30 medidas de cada biopsiay_completo = biopsias.target # el diagnóstico: 0 = maligno, 1 = benigno# 2. Tamaño de la tabla: filas = biopsias, columnas = medidas.print('Biopsias:', X_completo.shape[0])print('Medidas por biopsia:', X_completo.shape[1])# 3. Cuántas biopsias hay de cada diagnóstico.print('Malignas:', (y_completo ==0).sum())print('Benignas:', (y_completo ==1).sum())# 4. Las 30 columnas se organizan en 3 bloques de 10.# Imprimimos los nombres de cada bloque por separado para verlo.nombres =list(X_completo.columns)print()print('Bloque 1, promedio (mean): ', nombres[0:10])print('Bloque 2, error estándar (se):', nombres[10:20])print('Bloque 3, peores (worst): ', nombres[20:30])
La salida muestra 569 biopsias con 30 medidas cada una: 212 malignas y 357 benignas. Los nombres revelan cómo se construyeron las 30 columnas. Sobre cada imagen se midieron 10 características de los núcleos celulares, y de cada una se guardaron tres versiones:
promedio (mean): el valor medio de esa característica entre todos los núcleos de la imagen;
error estándar (error): cuánto varía esa característica de un núcleo a otro;
peor (worst): el promedio de los tres valores más grandes, es decir, de los núcleos más extremos.
Las 10 características son estas:
Nombre en los datos
Qué mide
radius
radio: distancia media del centro al borde del núcleo
texture
textura: variación de los tonos de gris dentro del núcleo
perimeter
perímetro del núcleo
area
área del núcleo
smoothness
suavidad: variación local de la longitud del radio
compactness
compacidad: perímetro² / área − 1
concavity
concavidad: profundidad de las partes cóncavas del borde
concave points
puntos cóncavos: número de partes cóncavas del borde
symmetry
simetría del núcleo
fractal dimension
dimensión fractal: complejidad del borde
Las medidas se calcularon sobre la imagen digitalizada, y la documentación del conjunto no fija sus unidades físicas. Para este taller basta con saber que son números comparables entre biopsias. La tabla ya anticipa redundancia: radio, perímetro y área describen el mismo tamaño, y cada característica aparece tres veces.
B.2 Paso 2. Reservar la prueba antes de mirar
Antes de calcular correlaciones, escalas o componentes, separas un 30 % de las biopsias y no las tocas hasta el final. Si exploraras los datos completos, cualquier decisión que tomes después, como cuántos componentes usar, estaría influida por las biopsias con las que luego vas a evaluar, y la evaluación saldría optimista. Esa fuga de información es la misma que estudiaste en la validación cruzada.
El argumento stratify hace que la proporción de malignas sea casi igual en el entrenamiento y en la prueba.
# Separar 30 % de las biopsias como prueba.# stratify=y_completo mantiene la misma proporción de malignas y benignas en ambos grupos.X, X_prueba, y, y_prueba = train_test_split( X_completo, y_completo, test_size=0.30, random_state=SEMILLA, stratify=y_completo,)print('Entrenamiento:', len(X), 'biopsias')print('Prueba (guardada hasta el final):', len(X_prueba), 'biopsias')print()print('Proporción de malignas en entrenamiento:', round((y ==0).mean(), 3))print('Proporción de malignas en prueba: ', round((y_prueba ==0).mean(), 3))
Entrenamiento: 398 biopsias
Prueba (guardada hasta el final): 171 biopsias

Proporción de malignas en entrenamiento: 0.372
Proporción de malignas en prueba:        0.374
Quedan 398 biopsias de entrenamiento y 171 de prueba. La proporción de malignas es 0.372 en el entrenamiento y 0.374 en la prueba, casi idéntica gracias a la estratificación. Desde aquí, todos los cálculos usan solo X e y, el entrenamiento. X_prueba e y_prueba se abrirán en el paso 7.
B.3 Paso 3. Comprobar por qué conviene PCA
Antes de meter PCA en el clasificador, comprueba que tiene sentido. PCA es útil cuando varias medidas repiten información, porque entonces unos pocos componentes pueden reemplazarlas sin perder mucho. Y como PCA busca las direcciones de mayor varianza, exige que las medidas estén en escalas comparables. Este paso revisa las dos cosas con el entrenamiento.
La primera celda mide la redundancia con la matriz de correlaciones. Una matriz de 30 × 30 tiene 900 casillas y es difícil de leer, así que la celda:
Toma las 10 primeras columnas, los promedios, y calcula sus correlaciones.
Dibuja la matriz como un mapa de color: rojo para correlaciones cercanas a +1 y azul para cercanas a −1.
Escribe el valor de cada correlación dentro de su casilla.
Recorre los 435 pares distintos de las 30 medidas y cuenta los que superan 0.9 en valor absoluto.
# 1. Tomar solo el bloque de promedios (las 10 primeras columnas) para que el mapa se lea bien.promedios = X.iloc[:, 0:10]correlaciones = promedios.corr()# 2. Dibujar la matriz de correlaciones como un mapa de color.# Rojo intenso = correlación cercana a +1; azul = cercana a -1.fig, ax = plt.subplots(figsize=(8, 7))imagen = ax.imshow(correlaciones, cmap='RdBu_r', vmin=-1, vmax=1)nombres_cortos = [nombre.replace('mean ', '') for nombre in promedios.columns]ax.set_xticks(range(10))ax.set_xticklabels(nombres_cortos, rotation=60, ha='right')ax.set_yticks(range(10))ax.set_yticklabels(nombres_cortos)# 3. Escribir el valor de cada correlación dentro de su casilla.for fila inrange(10):for columna inrange(10): valor = correlaciones.iloc[fila, columna] color_texto ='white'ifabs(valor) >0.7else'black' ax.text(columna, fila, f'{valor:.2f}', ha='center', va='center', fontsize=7, color=color_texto)fig.colorbar(imagen, ax=ax, label='correlación')ax.set_title('Correlaciones entre las 10 medidas promedio (entrenamiento)')plt.tight_layout()plt.show()# 4. Contar, entre las 30 medidas, cuántos pares tienen correlación mayor que 0.9 en valor absoluto.todas = X.corr()pares_totales =0pares_muy_correlacionados =0for i inrange(30):for j inrange(i +1, 30): # j > i: cada par se cuenta una sola vez pares_totales = pares_totales +1ifabs(todas.iloc[i, j]) >0.9: pares_muy_correlacionados = pares_muy_correlacionados +1print('Pares de medidas distintas:', pares_totales)print('Pares con |correlación| > 0.9:', pares_muy_correlacionados)print('Correlación radio-perímetro (promedios):', round(todas.loc['mean radius', 'mean perimeter'], 3))print('Correlación radio-área (promedios): ', round(todas.loc['mean radius', 'mean area'], 3))
Pares de medidas distintas: 435
Pares con |correlación| > 0.9: 21
Correlación radio-perímetro (promedios): 0.998
Correlación radio-área (promedios):      0.987
En el mapa de correlaciones, la esquina superior izquierda forma un bloque rojo intenso: radius, perimeter y area tienen correlaciones de 0.99 o más entre sí. La salida confirma que radio y perímetro tienen correlación 0.998, y radio y área, 0.987: las tres columnas miden el tamaño del núcleo. Hay otro grupo de casillas rojas entre compactness, concavity y concave points, las medidas de irregularidad del borde.
Entre las 30 medidas, 21 de los 435 pares tienen correlación mayor que 0.9 en valor absoluto. Hay mucha información repetida, y esa es la razón para usar PCA: el clasificador puede trabajar con unos pocos componentes en lugar de 30 columnas que dicen casi lo mismo.
La segunda celda revisa las escalas: calcula la desviación estándar de cada medida, muestra las tres mayores y las tres menores, y calcula cuántas veces cabe la menor en la mayor.
# 1. Desviación estándar de cada medida en el entrenamiento, de mayor a menor.desviaciones = X.std().sort_values(ascending=False)# 2. Las tres medidas que más varían y las tres que menos.print('Las 3 medidas con MAYOR desviación estándar:')print(desviaciones.head(3).round(3))print()print('Las 3 medidas con MENOR desviación estándar:')print(desviaciones.tail(3).round(4))print()# 3. Cuántas veces cabe la desviación más pequeña en la más grande.print('Cociente entre la mayor y la menor:', round(desviaciones.iloc[0] / desviaciones.iloc[-1]))
Las 3 medidas con MAYOR desviación estándar:
worst area    584.214
mean area     362.563
area error     49.906
dtype: float64

Las 3 medidas con MENOR desviación estándar:
concave points error       0.0059
smoothness error           0.0029
fractal dimension error    0.0025
dtype: float64

Cociente entre la mayor y la menor: 233693
Las desviaciones estándar van de 584.2 en worst area a 0.0025 en fractal dimension error: la mayor es unas 233 693 veces la menor. Las áreas tienen valores de cientos y miles porque se miden en unidades cuadradas de la imagen, mientras que la dimensión fractal y la suavidad son índices con decimales. Sin estandarizar, PCA tomaría las áreas como la dirección principal solo por su escala, como viste en el capítulo de PCA. Por eso el clasificador estandarizará antes de aplicar PCA.
B.4 Paso 4. Armar el clasificador
El paso 3 dejó dos decisiones: estandarizar y aplicar PCA. El clasificador las encadena en un Pipeline, una tubería de tres piezas por la que pasa cada biopsia:
Estandarizar (StandardScaler): resta a cada medida su media y la divide por su desviación, ambas aprendidas con el entrenamiento.
PCA: convierte las 30 medidas estandarizadas en \(k\) componentes. Es la pieza central del taller: el clasificador nunca ve las medidas originales, solo este resumen.
Regresión logística: el clasificador que conoces del nivel Básico. Recibe los \(k\) componentes y calcula la probabilidad de cada diagnóstico.
Armar las tres piezas en un Pipeline tiene una ventaja importante. Cuando entrenas el Pipeline, las tres piezas aprenden solo de los datos que le das; cuando predices, las tres aplican lo aprendido. Así, ni la media del escalador ni las direcciones de PCA pueden contener información de las biopsias con las que luego evalúas.
Todavía falta decidir \(k\). Como lo necesitarás varias veces, la celda define una función, crear_clasificador(k), que fabrica un clasificador nuevo con \(k\) componentes, y muestra cómo queda armado con \(k = 3\).
# Una función que fabrica el clasificador. La usaremos varias veces:# para probar distintos k en la validación cruzada y para el modelo final.def crear_clasificador(k):"""Devuelve un clasificador nuevo, sin entrenar, que trabaja con k componentes de PCA.""" clasificador = Pipeline([# Pieza 1: deja cada medida con media 0 y desviación 1. ('estandarizar', StandardScaler()),# Pieza 2: resume las 30 medidas estandarizadas en k componentes principales. ('pca', PCA(n_components=k, svd_solver='full')),# Pieza 3: decide maligno o benigno a partir de esos k números. ('clasificar', LogisticRegression(max_iter=5000)), ])return clasificador# Ver cómo está armado, por ejemplo con k = 3.ejemplo = crear_clasificador(3)for nombre, pieza in ejemplo.steps:print(f'{nombre:13s} -> {pieza}')
La salida muestra las tres piezas en orden: estandarizar, pca con n_components=3 y clasificar. Cambiar \(k\) solo cambia la pieza del medio. El paso siguiente usa esta función para probar varios valores de \(k\).
B.5 Paso 5. Elegir cuántos componentes usa el clasificador
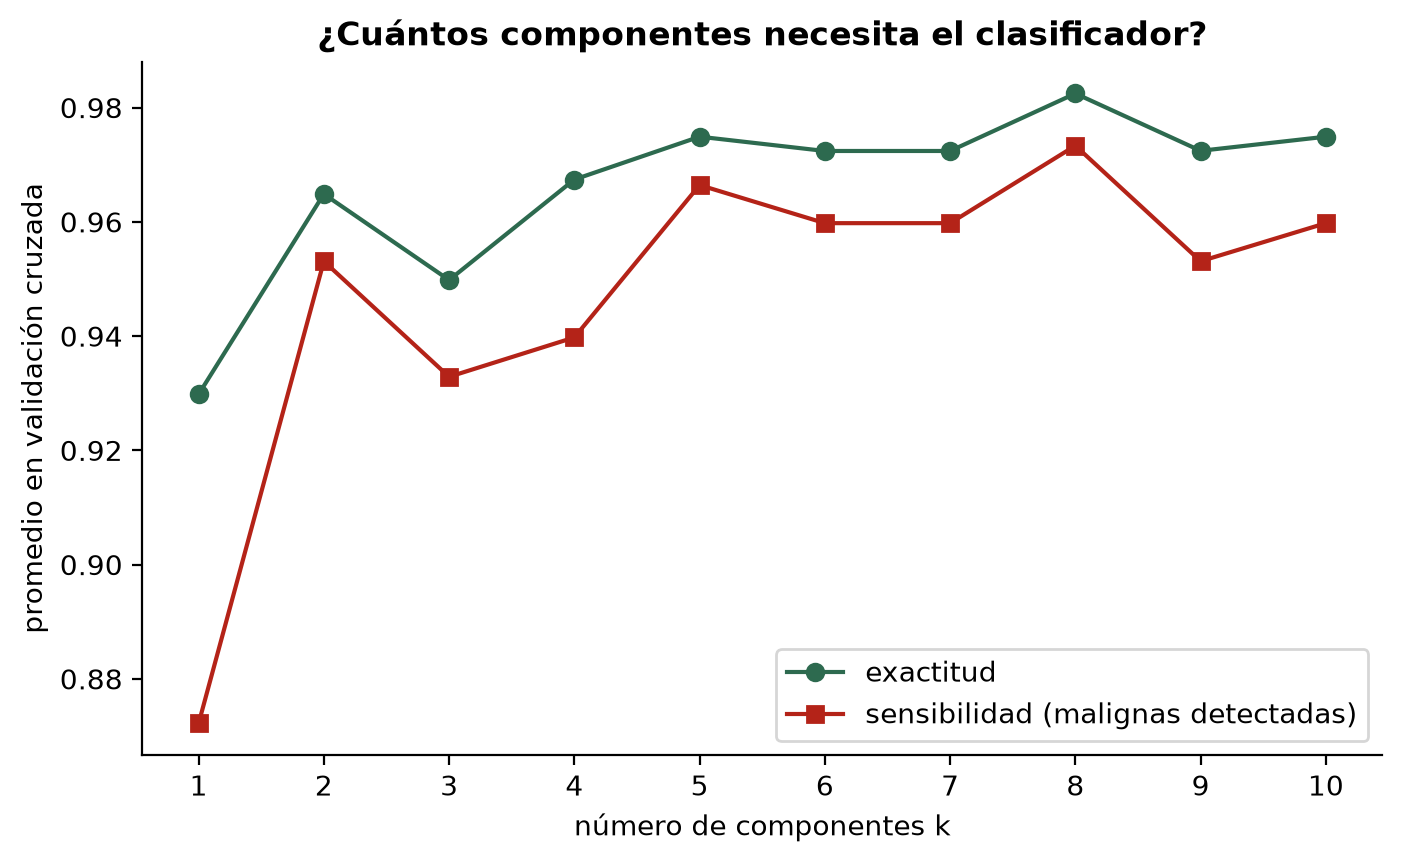
¿Cuántos componentes debe recibir el clasificador? Con muy pocos, PCA podría descartar información útil para distinguir los diagnósticos; con muchos, se pierde la ventaja de resumir. Lo decides con validación cruzada de 5 bloques sobre el entrenamiento: para cada \(k\) entre 1 y 10, fabricas un clasificador con crear_clasificador(k) y mides cómo clasifica las biopsias que quedan fuera en cada bloque.
cross_validate entrena el Pipeline completo dentro de cada bloque, así que el escalador y PCA se ajustan de nuevo cada vez, sin ver el bloque de validación. Mides dos cosas, porque en este problema los errores no pesan lo mismo:
la exactitud, la proporción de biopsias bien clasificadas;
la sensibilidad, la proporción de malignas que el clasificador detecta.
La celda:
Define los 5 bloques estratificados.
Define las dos métricas.
Mide la exactitud y la sensibilidad para \(k = 1, 2, \ldots, 10\).
Dibuja las dos métricas frente a \(k\).
Elige el \(k\) con la mayor exactitud y muestra su sensibilidad.
# 1. Los 5 bloques de la validación cruzada (siempre con la misma semilla).bloques = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)# 2. Dos métricas por cada k:# - exactitud: proporción de biopsias bien clasificadas;# - sensibilidad: proporción de malignas detectadas (la clase maligna es la 0).metricas = {'exactitud': 'accuracy','sensibilidad': make_scorer(recall_score, pos_label=0),}# 3. Probar el clasificador con k = 1, 2, ..., 10 componentes.# cross_validate entrena el Pipeline completo dentro de cada bloque,# así el bloque de validación nunca participa en el ajuste.exactitudes = []sensibilidades = []for k inrange(1, 11): resultado = cross_validate(crear_clasificador(k), X, y, cv=bloques, scoring=metricas) exactitudes.append(resultado['test_exactitud'].mean()) sensibilidades.append(resultado['test_sensibilidad'].mean())print(f'k = {k:2d} -> exactitud = {exactitudes[-1]:.4f} | sensibilidad = {sensibilidades[-1]:.4f}')# 4. Graficar las dos métricas frente a k.plt.figure(figsize=(8, 4.5))plt.plot(range(1, 11), exactitudes, marker='o', color='#2D6A4F', label='exactitud')plt.plot(range(1, 11), sensibilidades, marker='s', color=COLOR_MALIGNO, label='sensibilidad (malignas detectadas)')plt.xlabel('número de componentes k')plt.ylabel('promedio en validación cruzada')plt.title('¿Cuántos componentes necesita el clasificador?')plt.xticks(range(1, 11))plt.legend()plt.show()# 5. Elegir el k con la mayor exactitud. Recorremos la lista y guardamos el mejor.k_elegido =1for k inrange(2, 11):if exactitudes[k -1] > exactitudes[k_elegido -1]: k_elegido = kprint()print(f'k elegido: {k_elegido} componentes')print(f' exactitud CV: {exactitudes[k_elegido -1]:.4f}')print(f' sensibilidad CV: {sensibilidades[k_elegido -1]:.4f}')
k elegido: 8 componentes
  exactitud CV:    0.9825
  sensibilidad CV: 0.9733
En la figura, las dos curvas arrancan bajas con un solo componente: exactitud de 0.9298 y sensibilidad de 0.8722. Con solo PC1, el clasificador ya acierta 93 de cada 100 biopsias, pero deja sin detectar casi 13 de cada 100 malignas. Con dos componentes, la sensibilidad sube a 0.9531. Desde el quinto, la exactitud se mueve entre 0.972 y 0.983.
El máximo de exactitud está en \(k = 8\), con 0.9825, y ahí también está el máximo de sensibilidad, 0.9733. Ocho componentes dan el clasificador que más acierta y el que más malignas detecta en esta validación, así que \(k = 8\) es la elección.
La curva no sube de forma pareja: con 3 componentes la exactitud baja a 0.9498. Cada bloque de validación tiene unas 80 biopsias, así que una biopsia mal clasificada mueve la exactitud media en unas 0.25 unidades porcentuales. Entre 5 y 10 componentes las diferencias son de una a cuatro biopsias; valores cercanos a 8 rendirían de forma parecida.
B.6 Paso 6. Entrenar el clasificador y ver qué hizo PCA
Con \(k = 8\) decidido, fabricas el clasificador final y lo entrenas con las 398 biopsias de entrenamiento. Después lo abres para ver qué hizo PCA dentro de él. Este es el centro del taller: el PCA que examinas aquí es exactamente el que usará el clasificador con cada biopsia nueva.
La celda:
Fabrica y entrena el clasificador con 8 componentes.
Saca la pieza de PCA con named_steps['pca'] y muestra la forma de sus componentes.
Muestra cuánta varianza de las 30 medidas guarda cada componente y el acumulado.
Transforma las biopsias de entrenamiento para ver lo que recibe la regresión logística.
Dibuja dos paneles: la varianza de los 8 componentes y las biopsias en PC1 y PC2, coloreadas por diagnóstico.
Calcula dónde queda cada diagnóstico sobre PC1.
# 1. Fabricar el clasificador con k_elegido componentes y entrenarlo con las 398 biopsias.clasificador_final = crear_clasificador(k_elegido)clasificador_final.fit(X, y)# 2. Sacar la pieza de PCA del clasificador ya entrenado.pca_final = clasificador_final.named_steps['pca']print('Forma de los componentes (componentes x medidas):', pca_final.components_.shape)# 3. Cuánta varianza de las 30 medidas guarda cada componente, y el acumulado.varianza = pca_final.explained_variance_ratio_acumulada = np.cumsum(varianza)display(pd.DataFrame({'componente': [f'PC{i}'for i inrange(1, k_elegido +1)],'varianza': np.round(varianza, 4),'acumulada': np.round(acumulada, 4),}))# 4. Lo que recibe la regresión logística: cada biopsia convertida en k números.# clasificador_final[:-1] es el Pipeline sin su último paso (estandarizar -> PCA).scores = clasificador_final[:-1].transform(X)print('Entrada del clasificador:', X.shape, '->', scores.shape)# 5. Dos paneles: la varianza por componente y las biopsias en PC1 y PC2.es_maligna = (y ==0).to_numpy()es_benigna = (y ==1).to_numpy()fig, ax = plt.subplots(1, 2, figsize=(13, 5))numeros = np.arange(1, k_elegido +1)ax[0].bar(numeros, varianza, color='#457B9D', label='varianza de cada componente')ax[0].plot(numeros, acumulada, marker='o', color='#2D6A4F', label='varianza acumulada')ax[0].set_title(f'Los {k_elegido} componentes del clasificador')ax[0].set_xlabel('componente')ax[0].set_ylabel('proporción de varianza')ax[0].set_xticks(numeros)ax[0].set_ylim(0, 1.03)ax[0].legend()ax[1].scatter(scores[es_benigna, 0], scores[es_benigna, 1], s=30, alpha=0.6, color=COLOR_BENIGNO, marker='o', label='benigna')ax[1].scatter(scores[es_maligna, 0], scores[es_maligna, 1], s=30, alpha=0.6, color=COLOR_MALIGNO, marker='^', label='maligna')ax[1].axhline(0, color='gray', lw=0.8, alpha=0.5)ax[1].axvline(0, color='gray', lw=0.8, alpha=0.5)ax[1].set_xlabel(f'PC1 ({varianza[0]:.1%} de la varianza)')ax[1].set_ylabel(f'PC2 ({varianza[1]:.1%} de la varianza)')ax[1].set_title('Biopsias de entrenamiento en PC1 y PC2')ax[1].legend(title='diagnóstico')plt.tight_layout()plt.show()# 6. Dónde queda cada diagnóstico sobre PC1.print('Centro de las malignas en PC1:', round(scores[es_maligna, 0].mean(), 2))print('Centro de las benignas en PC1:', round(scores[es_benigna, 0].mean(), 2))print('Malignas con PC1 > 0:', (scores[es_maligna, 0] >0).sum(), 'de', es_maligna.sum())print('Benignas con PC1 < 0:', (scores[es_benigna, 0] <0).sum(), 'de', es_benigna.sum())
Forma de los componentes (componentes x medidas): (8, 30)
componente
varianza
acumulada
0
PC1
0.4469
0.4469
1
PC2
0.1803
0.6271
2
PC3
0.0993
0.7265
3
PC4
0.0671
0.7936
4
PC5
0.0559
0.8495
5
PC6
0.0376
0.8871
6
PC7
0.0233
0.9104
7
PC8
0.0155
0.9259
Entrada del clasificador: (398, 30) -> (398, 8)
Centro de las malignas en PC1: 3.8
Centro de las benignas en PC1: -2.25
Malignas con PC1 > 0: 135 de 148
Benignas con PC1 < 0: 234 de 250
La forma de los componentes, (8, 30), dice qué aprendió PCA: 8 direcciones, cada una con un peso para cada una de las 30 medidas. Cada componente es una combinación de las 30 medidas estandarizadas, y la salida de la transformación lo confirma: la entrada del clasificador pasa de 398 × 30 a 398 × 8. La regresión logística decide con esos 8 números por biopsia.
En la tabla y en el panel izquierdo de la figura, PC1 guarda el 44.69 % de la varianza y PC2, el 18.03 %; a partir del tercero, cada componente aporta menos del 10 %. Los 8 juntos conservan el 92.59 %. PCA eliminó 22 columnas y conservó más del 90 % de la variación de las medidas.
El panel derecho muestra por qué este resumen sirve para clasificar. PCA calculó los componentes sin ver el diagnóstico, y aun así las benignas, en azul, se agrupan a la izquierda, y las malignas, en rojo, se extienden hacia la derecha. El centro de las malignas está en PC1 = 3.80 y el de las benignas, en PC1 = −2.25. 135 de las 148 malignas tienen PC1 positivo, y 234 de las 250 benignas tienen PC1 negativo. Cerca de PC1 = 0 las dos clases se mezclan, y para esas biopsias el clasificador se apoya en los otros siete componentes. Eso explica que en el paso 5 la sensibilidad subiera al añadir componentes.
B.7 Paso 7. Evaluar el clasificador en la prueba
Ahora abres por fin las 171 biopsias reservadas en el paso 2 y evalúas el clasificador una sola vez. Ya no se cambia ninguna decisión con lo que salga aquí. El clasificador aplica a cada biopsia de prueba lo que aprendió: la estandariza con las medias y desviaciones del entrenamiento, la proyecta sobre los 8 componentes y decide con la regresión logística.
La celda:
Predice el diagnóstico de las biopsias de prueba.
Calcula la exactitud.
Calcula la sensibilidad, la proporción de malignas detectadas.
Muestra la matriz de confusión, con el diagnóstico real en las filas y el predicho en las columnas.
Cuenta por separado los dos tipos de error: malignas no detectadas y benignas marcadas como malignas.
# 1. Predecir el diagnóstico de las 171 biopsias de prueba, que el clasificador nunca vio.prediccion = clasificador_final.predict(X_prueba)# 2. Exactitud: proporción de biopsias de prueba bien clasificadas.exactitud_prueba = accuracy_score(y_prueba, prediccion)# 3. Sensibilidad: proporción de malignas que el clasificador detecta (clase 0).sensibilidad_prueba = recall_score(y_prueba, prediccion, pos_label=0)print(f'Exactitud en prueba: {exactitud_prueba:.2%}')print(f'Sensibilidad en prueba: {sensibilidad_prueba:.2%}')print()# 4. Matriz de confusión: filas = diagnóstico real, columnas = diagnóstico predicho.matriz = confusion_matrix(y_prueba, prediccion, labels=[0, 1])display(pd.DataFrame( matriz, index=['real: maligna', 'real: benigna'], columns=['predicha: maligna', 'predicha: benigna'],))# 5. Los dos errores posibles, contados por separado.print('Malignas detectadas: ', matriz[0, 0], 'de', matriz[0].sum())print('Malignas no detectadas: ', matriz[0, 1])print('Benignas marcadas como malignas:', matriz[1, 0], 'de', matriz[1].sum())
Exactitud en prueba:    98.25%
Sensibilidad en prueba: 96.88%
predicha: maligna
predicha: benigna
real: maligna
62
2
real: benigna
1
106
Malignas detectadas:             62 de 64
Malignas no detectadas:          2
Benignas marcadas como malignas: 1 de 107
El clasificador acierta el 98.25 % de las biopsias de prueba y detecta el 96.88 % de las malignas. La matriz de confusión muestra el detalle: detecta 62 de las 64 malignas, deja 2 sin detectar y marca 1 de las 107 benignas como maligna. En total se equivoca en 3 de 171 biopsias. El encargo del taller queda cumplido: un clasificador que solo recibe 8 componentes principales, en lugar de 30 medidas, distingue muy bien los dos diagnósticos en biopsias que no vio.
La exactitud de prueba, 0.9825, coincide con la de la validación cruzada del paso 5, y la sensibilidad, 0.9688, queda cerca de la estimada, 0.9733. Con una sola partición no se puede afirmar más, pero esa coincidencia es una buena señal: la validación cruzada, hecha sin fuga de información, no sobrestimó el desempeño.
Estas cifras corresponden a un único reparto de 171 biopsias de prueba, en el que cada biopsia vale 0.58 puntos porcentuales de exactitud. Otro reparto daría valores algo distintos. En una aplicación médica real harían falta además validación externa, análisis del costo de cada tipo de error y revisión clínica.
B.8 Paso 8. Diagnosticar una biopsia nueva
El clasificador ya está entrenado y evaluado. Usarlo con una biopsia nueva es una sola llamada, porque el Pipeline guarda todo lo que aprendió: las 30 medias y desviaciones del escalador, las 8 direcciones de PCA y los coeficientes de la regresión logística. Para simularlo, tomas la primera biopsia de la prueba como si acabara de llegar al laboratorio.
La celda:
Toma la biopsia como una tabla de una fila y 30 columnas.
Muestra sus coordenadas en los 8 componentes: es PCA trabajando sobre una biopsia que no participó en el entrenamiento.
Calcula la probabilidad de cada diagnóstico con predict_proba.
Compara el diagnóstico predicho con el real.
# 1. Tomar una biopsia de la prueba como si acabara de llegar al laboratorio.# Doble corchete [[0]]: se conserva como tabla de 1 fila y 30 columnas.biopsia_nueva = X_prueba.iloc[[0]]print('Medidas recibidas:', biopsia_nueva.shape[1])# 2. Lo que recibe la regresión logística: la biopsia estandarizada con las medias# del entrenamiento y proyectada sobre los k componentes.# clasificador_final[:-1] es el Pipeline sin su último paso (estandarizar -> PCA).componentes_biopsia = clasificador_final[:-1].transform(biopsia_nueva)print(f'Coordenadas en los {k_elegido} componentes:', np.round(componentes_biopsia[0], 2))print()# 3. Probabilidad de cada diagnóstico. La columna 0 es maligno y la 1, benigno.probabilidades = clasificador_final.predict_proba(biopsia_nueva)[0]print(f'Probabilidad de maligno: {probabilidades[0]:.3f}')print(f'Probabilidad de benigno: {probabilidades[1]:.3f}')print()# 4. Diagnóstico predicho frente al real.nombres_diagnostico = {0: 'maligno', 1: 'benigno'}diagnostico_predicho = clasificador_final.predict(biopsia_nueva)[0]print('Diagnóstico predicho:', nombres_diagnostico[diagnostico_predicho])print('Diagnóstico real: ', nombres_diagnostico[y_prueba.iloc[0]])
Medidas recibidas: 30
Coordenadas en los 8 componentes: [ 2.92  4.29 -2.88  0.01  1.11  1.2  -1.97 -0.62]

Probabilidad de maligno: 0.975
Probabilidad de benigno: 0.025

Diagnóstico predicho: maligno
Diagnóstico real:     maligno
La biopsia llega con 30 medidas, pero la regresión logística recibe solo 8 números: sus coordenadas en los componentes. La primera, PC1 = 2.92, es positiva, del lado del plano donde, en la figura del paso 6, se agrupaban las malignas.
El clasificador le asigna una probabilidad de maligno de 0.975 y de benigno de 0.025. predict elige el diagnóstico con mayor probabilidad, que equivale a un umbral de 0.5, así que la clasifica como maligna, y ese es su diagnóstico real. La probabilidad dice además cuán segura es la decisión: 0.975 está muy lejos del umbral.
Con este paso el clasificador queda completo: recibe las 30 medidas de cualquier biopsia nueva, las estandariza y las resume en 8 componentes con lo aprendido en el entrenamiento, y devuelve una probabilidad y un diagnóstico.
B.9 Resultado del taller
Aspecto
Resultado
Por qué PCA
21 de 435 pares de medidas con correlación mayor que 0.9
Componentes del clasificador
8, elegidos por validación cruzada (exactitud 0.9825, sensibilidad 0.9733)
Lo que hizo PCA
30 medidas → 8 componentes que conservan el 92.59 % de la varianza
Exactitud en las 171 biopsias de prueba
98.25 %
Malignas detectadas
62 de 64 (sensibilidad 96.88 %)
Benignas marcadas como malignas
1 de 107
El procedimiento sirve para construir un clasificador con PCA sobre cualquier tabla numérica: reservar la prueba, comprobar la redundancia y las escalas, armar un Pipeline que estandariza, aplica PCA y clasifica, elegir el número de componentes con validación cruzada, examinar el PCA del clasificador entrenado y evaluar una sola vez en la prueba.
B.10 Errores comunes al construir un clasificador con PCA
Síntoma
Causa probable
Solución
PC1 explica casi el 100 % y lo domina una sola medida
variables sin estandarizar, con escalas muy distintas
estandarizar antes de PCA, dentro del Pipeline
La validación cruzada da una exactitud más alta que la prueba
el escalador o PCA se ajustaron con todos los datos antes de validar
meter las tres piezas en un Pipeline y validarlo completo
Se eligen los componentes por porcentaje de varianza
confundir conservar varianza con clasificar bien
elegir \(k\) por el desempeño del clasificador en validación cruzada
Se elige \(k\) mirando la exactitud en la prueba
la prueba se usó para decidir
elegir \(k\) con validación cruzada y abrir la prueba una sola vez
Se reporta solo la exactitud
ignorar que los dos errores no pesan lo mismo
reportar también la sensibilidad para la clase que importa detectar
B.11 Preguntas de comprensión
En el paso 3, ¿qué dos condiciones comprobaste para justificar el uso de PCA en el clasificador?
¿Por qué el escalador y PCA van dentro del Pipeline y no se ajustan por separado antes de la validación cruzada?
Con un solo componente, la exactitud de validación es 0.9298 pero la sensibilidad es 0.8722. ¿Qué te dice esa diferencia?
La validación cruzada dio 0.9749 de exactitud con 5 componentes y 0.9825 con 8. ¿Puedes afirmar que 8 componentes son mejores que 5?
Si tuvieras que reducir al mínimo las malignas no detectadas, ¿qué cambiarías además del número de componentes?
TipOrientaciones
Que las medidas repiten información (21 pares con correlación mayor que 0.9), de modo que pocos componentes pueden resumirlas, y que sus escalas son muy distintas, de modo que hay que estandarizar antes de PCA.
Porque así el escalador y PCA se ajustan de nuevo dentro de cada bloque, solo con sus datos de entrenamiento. Si se ajustaran antes con las 398 biopsias, cada bloque de validación habría participado en el cálculo de las medias y de los componentes, y la validación saldría optimista.
Que con solo PC1 el clasificador acierta muchas biopsias en conjunto, pero se le escapan más malignas que benignas: casi 13 de cada 100 malignas quedan sin detectar. Por eso conviene mirar la sensibilidad además de la exactitud.
No con seguridad. La diferencia, 0.0076, equivale a unas tres biopsias de entrenamiento y puede deberse al azar de los bloques. Elegir el máximo es una regla razonable, pero 5 componentes darían un clasificador casi igual de bueno y más simple.
Podrías bajar el umbral de probabilidad a partir del cual el clasificador declara una biopsia maligna, como en el capítulo de métricas de clasificación, aceptando a cambio más falsas alarmas.
B.12 Referencias para profundizar
Street, W. N., Wolberg, W. H. y Mangasarian, O. L. (1993). Nuclear feature extraction for breast tumor diagnosis. Biomedical Image Processing and Biomedical Visualization, SPIE 1905, 861–870. Describe cómo se midieron las características de los núcleos.
Wolberg, W., Mangasarian, O., Street, N. y Street, W. (1993). Breast Cancer Wisconsin (Diagnostic). UCI Machine Learning Repository. https://doi.org/10.24432/C5DW2B.
James, G., Witten, D., Hastie, T. y Tibshirani, R. (2023). An Introduction to Statistical Learning with Applications in Python. Springer. El capítulo 12 trata PCA y la elección del número de componentes.
PCA se aplica a un clasificador como una pieza de un Pipeline: estandarizar, resumir las medidas en componentes y clasificar con ellos, con el número de componentes elegido por validación cruzada.
Las 30 medidas de las biopsias repiten mucha información (21 pares con correlación mayor que 0.9) y tienen escalas muy distintas: dos razones para estandarizar y aplicar PCA.
Dentro del clasificador, PCA convirtió 30 medidas en 8 componentes que conservan el 92.59 % de la varianza.
PCA calculó los componentes sin ver el diagnóstico, y aun así en PC1 las malignas y las benignas quedan a lados opuestos.
La validación cruzada eligió 8 componentes, con la mayor exactitud (0.9825) y la mayor sensibilidad (0.9733).
En la prueba, el clasificador acertó el 98.25 % de las biopsias y detectó 62 de 64 malignas.
B.14 Puente hacia los siguientes capítulos
En este taller PCA eligió sus direcciones sin mirar el diagnóstico, y funcionó porque la mayor variación de las medidas coincidía con la diferencia entre tumores. El contraejemplo del capítulo de PCA muestra qué pasa cuando no coincide. El capítulo de reducción de dimensionalidad compara PCA con métodos no lineales como t-SNE y UMAP, y el caso de comparación evalúa cuál conviene cuando el objetivo es alimentar un modelo predictivo.