4Fundamentos de Big Data: por qué una máquina no alcanza
big-data
fundamentos
sistemas-distribuidos
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
26 de octubre de 2026
El problema que vas a resolver
En el capítulo 2 contaste peticiones de raw/accesos.log con una tubería de Bash. El archivo tenía 24 líneas, de dos días, y cada comando respondía al instante. Ese registro viene de la API de una tienda: ventas, clientes, inventario y acceso (/login). En producción, la misma API no recibe 24 peticiones en dos días, sino unas 2 000 por segundo.
Con ese ritmo, la tubería del capítulo 2 sigue siendo correcta, pero deja de ser práctica. El archivo de un año no cabe en el disco de un portátil, leerlo tarda horas y un solo disco dañado puede perderlo. Este capítulo calcula, con cifras y con un poco de Python, en qué momento una máquina deja de alcanzar y qué ideas usan las plataformas Big Data para seguir respondiendo. Son las ideas que Hadoop, HDFS, YARN, MapReduce y Spark convierten en software en los capítulos siguientes.
Ficha
En este capítulo
Pregunta
¿Cuándo deja de alcanzar una máquina y qué ideas permiten seguir?
Datos
Las 24 peticiones de accesos.log del capítulo 2 y un escenario de producción de 2 000 peticiones por segundo
Tiempo estimado de lectura
40 minutos
Nivel
Básico
Conocimientos previos recomendados
La terminal y el wordcount con tuberías (capítulo 2); leer código Python sencillo
Tecnologías mencionadas
Python (biblioteca estándar y matplotlib), a nivel de ideas: HDFS, YARN, MapReduce, Spark y Kafka
Objetivos de aprendizaje
Al terminar este capítulo podrás:
Estimar el volumen y la velocidad de un flujo de datos a partir de una muestra pequeña.
Explicar las cinco V con un ejemplo concreto y decir cuál presiona más en cada caso.
Distinguir escalar en vertical de escalar en horizontal y explicar por qué agregar nodos no acelera sin límite.
Calcular por qué los fallos de disco son rutina en un clúster y por qué se guardan copias.
Explicar por qué conviene llevar el cómputo a los datos y no al revés.
Dividir un cálculo en partes, transformar cada una y agregar los resultados sin errores.
Distinguir el procesamiento por lotes del procesamiento en flujo, y las cargas OLTP de las OLAP.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Campos de accesos.log
Fecha, hora, IP, método, ruta, código, bytes y milisegundos, separados por espacios.
Las celdas se ejecutaron con Python 3.13.14 y matplotlib 3.11.1. La primera celda guarda las 24 líneas del capítulo 2 y las convierte en una lista de diccionarios, uno por petición, con los ocho campos y un campo momento que une fecha y hora. El texto ocupa 1 401 bytes, los mismos que mostró ls -l en el capítulo 2. La primera petición es un GET /api/ventas de las 08:00:01 que respondió 200, con 5 120 bytes, en 34 ms.
1. De 24 líneas a terabytes
El primer cálculo se puede hacer a mano. Si 24 líneas ocupan 1 401 bytes, cada línea ocupa en promedio 1 401 / 24 ≈ 58.4 bytes. En producción llegan 2 000 peticiones por segundo; un día tiene 86 400 segundos. Por día son 2 000 × 86 400 = 172.8 millones de líneas, y 172.8 millones × 58.4 bytes ≈ 10 GB.
Diez gigabytes al día parece poco. Pero el registro no se borra: el equipo de seguridad lo guarda un año y el de analítica quiere comparar contra el año anterior. La celda siguiente hace la cuenta completa.
NotaBig Data
Big Data no es un tamaño fijo. Es la situación en la que el volumen, la velocidad o la variedad de los datos superan lo que una máquina y sus herramientas habituales pueden manejar a tiempo. 10 GB caben en un portátil; 3.7 TB que hay que leer cada noche, ya no tan fácilmente.
bytes_por_linea =len(ACCESOS.encode("utf-8")) /len(lineas)PETICIONES_POR_SEGUNDO =2_000lineas_dia = PETICIONES_POR_SEGUNDO *86_400gb_dia = lineas_dia * bytes_por_linea /1e9tb_anio = gb_dia *365/1e3print(f"Bytes por línea: {bytes_por_linea:.2f}")print(f"Líneas por día: {lineas_dia:,}")print(f"Volumen por día: {gb_dia:.2f} GB | por año: {tb_anio:.2f} TB")
Bytes por línea: 58.38
Líneas por día: 172,800,000
Volumen por día: 10.09 GB | por año: 3.68 TB
Cada línea ocupa 58.38 bytes en promedio. A 2 000 peticiones por segundo son 172 800 000 líneas al día, 10.09 GB diarios y 3.68 TB al año. Ninguna de esas cifras es exótica: un disco de 4 TB guarda el año. El problema empieza cuando hay que leer, procesar y proteger ese año, como muestran las secciones siguientes.
2. Las cinco V
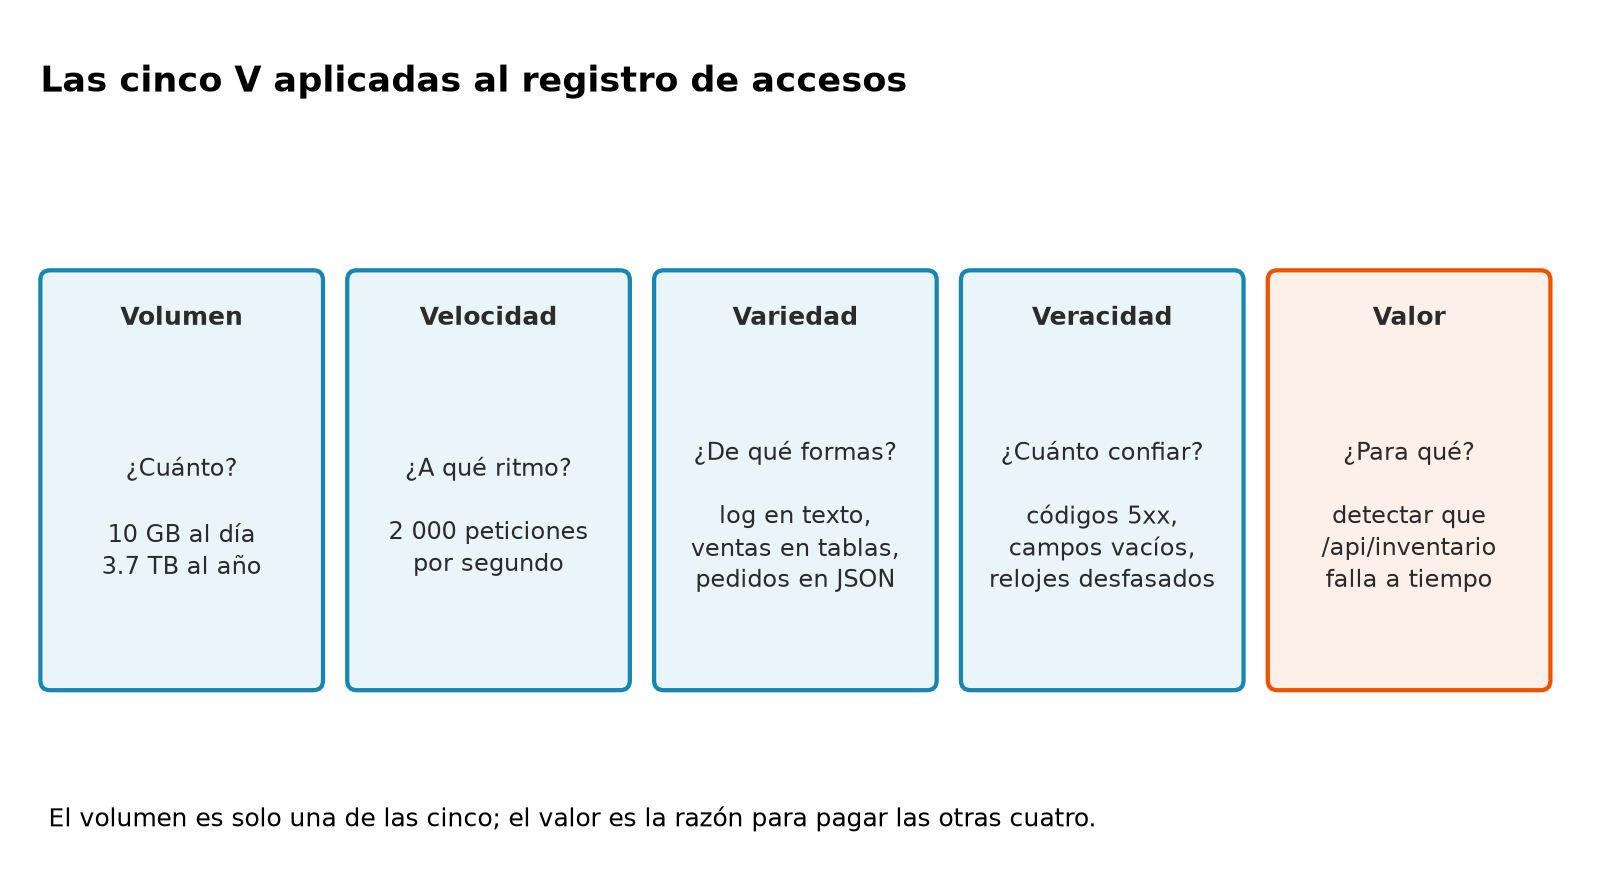
El volumen es lo primero que se nota, pero no es lo único que complica el trabajo. La industria resume las dificultades en cinco V.
Las cinco V con el registro de accesos.
V
Pregunta
En el registro de la tienda
Volumen
¿Cuánto?
10 GB al día, 3.7 TB al año.
Velocidad
¿A qué ritmo llega y cuándo hay que responder?
2 000 peticiones por segundo; una caída de inventario hay que verla en minutos.
Variedad
¿En cuántas formas llega?
El log es texto; las ventas viven en tablas; los pedidos de la aplicación móvil llegan en JSON.
Veracidad
¿Cuánto se puede confiar?
Hay errores 5xx, líneas cortadas y servidores con el reloj desfasado.
Valor
¿Para qué sirve todo lo anterior?
Detectar a tiempo que /api/inventario falla y cuánto cuesta.
NotaLas cinco V
Las cinco V son volumen, velocidad, variedad, veracidad y valor. Las tres primeras describen por qué los datos son difíciles de manejar; la veracidad, cuánto se puede confiar en ellos, y el valor, por qué vale la pena el esfuerzo. Algunos autores agregan más V; estas cinco son las más citadas.
La celda siguiente busca el valor en las 24 líneas: qué rutas responden con errores del servidor (códigos 500 a 599) y cuánto tardan.
errores_servidor = [p for p in peticiones if p["codigo"] >=500]for p in errores_servidor:print(p["fecha"], p["hora"], p["ruta"], p["codigo"], p["ms"], "ms")print("Errores 5xx:", len(errores_servidor), "de", len(peticiones),"| Rutas afectadas:", sorted({p["ruta"] for p in errores_servidor}))
2026-10-01 08:02:45 /api/inventario 500 1203 ms
2026-10-01 08:12:09 /api/inventario 503 3001 ms
2026-10-02 09:03:47 /api/inventario 500 1450 ms
Errores 5xx: 3 de 24 | Rutas afectadas: ['/api/inventario']
De las 24 peticiones, 3 son errores del servidor, y las tres son de /api/inventario: un 500 a las 08:02:45 y un 503 a las 08:12:09 del 1 de octubre, y otro 500 a las 09:03:47 del 2 de octubre. Además, esos errores tardaron entre 1 203 y 3 001 ms, cuando las peticiones normales responden en decenas de milisegundos. Ese patrón es el valor: una ruta concreta que falla y se vuelve lenta. Con 2 000 peticiones por segundo, encontrarlo exige resolver primero las otras cuatro V.
3. Una máquina no alcanza: escalar en vertical o en horizontal
Supón que cada noche hay que leer el año completo de registros para recalcular un reporte. Un disco duro lee en secuencia, en números redondos, unos 200 MB por segundo (un disco de estado sólido, más; para el razonamiento da igual). Leer 3.68 TB a ese ritmo toma 3.68 × 10¹² / (200 × 10⁶) ≈ 18 400 segundos: más de cinco horas solo en leer, sin calcular nada.
Hay dos salidas.
NotaEscalar en vertical y escalar en horizontal
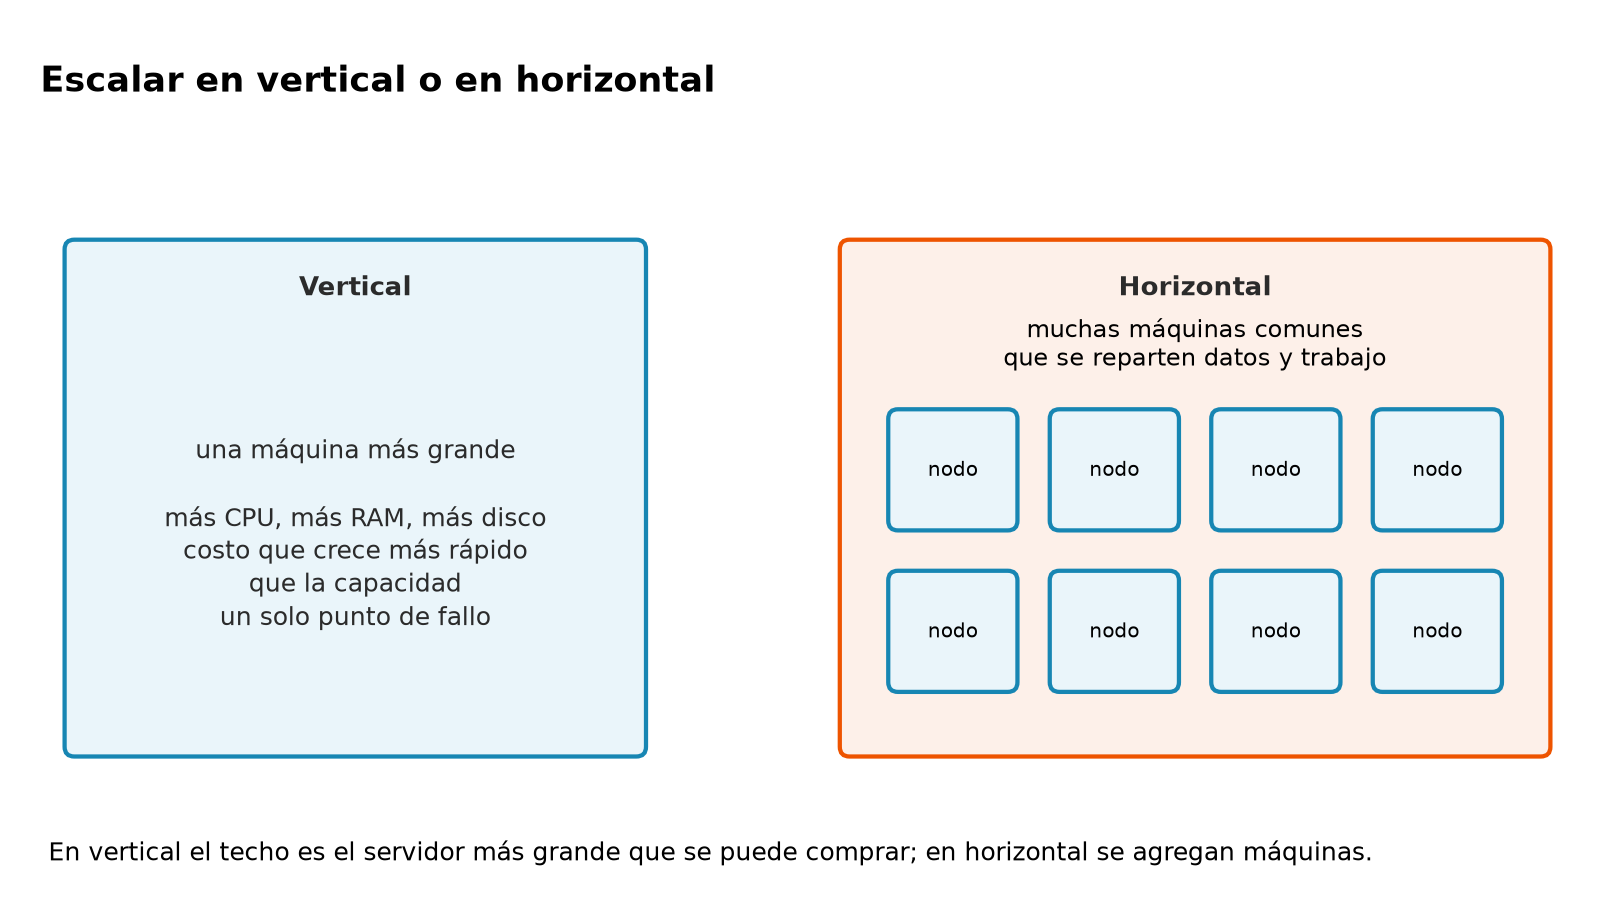
Escalar en vertical es cambiar la máquina por una más grande: más núcleos, más memoria, discos más rápidos. Escalar en horizontal es agregar máquinas y repartir entre ellas los datos y el trabajo. Las plataformas Big Data escalan en horizontal con hardware común (commodity): servidores estándar, baratos y reemplazables, en lugar de equipos especiales.
Escalar en vertical frente a escalar en horizontal.
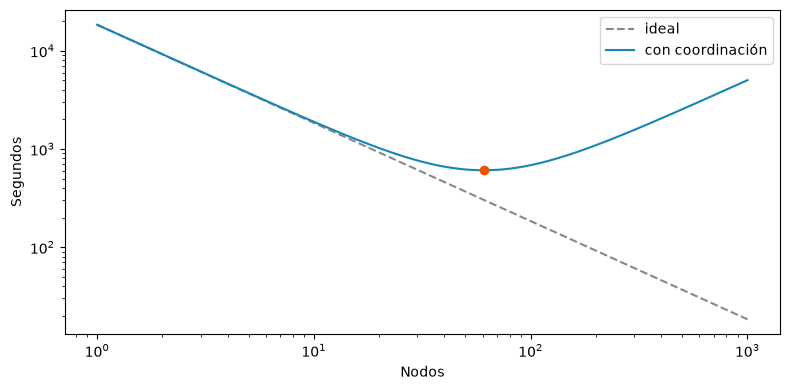
Con 50 nodos, cada uno lee 1/50 del año y la lectura baja a unos 6 minutos. Pero repartir no sale gratis: alguien tiene que dividir el trabajo, vigilar los nodos y juntar los resultados, y ese costo crece con el número de nodos. La celda siguiente usa un modelo de juguete con ese costo: tiempo = lectura / nodos + 5 segundos de coordinación por nodo. El 5 es una suposición para ver la forma de la curva, no una medición.
LECTURA_MB_S =200COORDINACION_S =5lectura_s = tb_anio *1e12/ (LECTURA_MB_S *1e6)nodos = [1, 2, 5, 10, 20, 50, 60, 100, 200, 500, 1000]for n in nodos: ideal = lectura_s / nprint(f"{n:>5} nodos | ideal {ideal:>8.0f} s | con coordinación {ideal + COORDINACION_S * n:>8.0f} s")mejor = math.sqrt(lectura_s / COORDINACION_S)print(f"Lectura con 1 disco: {lectura_s:,.0f} s ({lectura_s /3600:.1f} h)")print(f"Mínimo del modelo: {mejor:.0f} nodos, {2* math.sqrt(lectura_s * COORDINACION_S):.0f} s")rango =range(1, 1001)figura, eje = plt.subplots(figsize=(8, 4))eje.plot(rango, [lectura_s / n for n in rango], "--", color="#89878C", label="ideal")eje.plot(rango, [lectura_s / n + COORDINACION_S * n for n in rango], color="#1786B3", label="con coordinación")eje.plot([mejor], [2* math.sqrt(lectura_s * COORDINACION_S)], "o", color="#EE5400")eje.set(xscale="log", yscale="log", xlabel="Nodos", ylabel="Segundos")eje.legend()figura.tight_layout()plt.show()
    1 nodos | ideal    18409 s | con coordinación    18414 s
    2 nodos | ideal     9205 s | con coordinación     9215 s
    5 nodos | ideal     3682 s | con coordinación     3707 s
   10 nodos | ideal     1841 s | con coordinación     1891 s
   20 nodos | ideal      920 s | con coordinación     1020 s
   50 nodos | ideal      368 s | con coordinación      618 s
   60 nodos | ideal      307 s | con coordinación      607 s
  100 nodos | ideal      184 s | con coordinación      684 s
  200 nodos | ideal       92 s | con coordinación     1092 s
  500 nodos | ideal       37 s | con coordinación     2537 s
 1000 nodos | ideal       18 s | con coordinación     5018 s
Lectura con 1 disco: 18,409 s (5.1 h)
Mínimo del modelo: 61 nodos, 607 s
Figura 4.1: Tiempo de lectura del año de registros según el número de nodos (modelo de juguete)
Con un solo disco, leer el año toma 18 409 segundos, 5.1 horas. En el modelo ideal, cada vez que duplicas los nodos el tiempo baja a la mitad: 368 segundos con 50 nodos y 18 con 1 000. Con el costo de coordinación, la historia cambia. El tiempo baja hasta un mínimo de 607 segundos con unos 61 nodos, y a partir de ahí sube: con 1 000 nodos, la coordinación suma 5 000 segundos y la lectura tarda 5 018, más que con 4 nodos sin coordinación (4 602 segundos).
La forma de la curva es la lección, no las cifras exactas. Repartir acelera mucho al principio, y después cada nodo nuevo aporta menos de lo que cuesta coordinarlo. Por eso los sistemas reales trabajan para que la coordinación sea barata, y por eso nadie lanza mil nodos para un trabajo que resuelven sesenta.
4. Los discos fallan, y en un clúster fallan a diario
Escalar en horizontal con hardware común tiene una consecuencia: con muchas máquinas, algo se daña casi siempre. Supón que cada disco tiene una probabilidad de 1.5 % de fallar en un año. Es una cifra del orden de las que publican los centros de datos, pero aquí es una suposición redonda. La probabilidad diaria de un disco es pequeña; la de que alguno de mil falle hoy, no tanto.
La cuenta a mano usa el complemento: si un disco sobrevive el día con probabilidad q, mil discos sobreviven todos con probabilidad q¹⁰⁰⁰, y la probabilidad de que falle al menos uno es 1 − q¹⁰⁰⁰.
FALLO_ANUAL =0.015p_dia =1- (1- FALLO_ANUAL) ** (1/365)print(f"Probabilidad de fallo de un disco en un día: {p_dia:.6f}")for discos in [1, 100, 1_000, 10_000]: alguno_hoy =1- (1- p_dia) ** discosprint(f"{discos:>6} discos | algún fallo hoy: {alguno_hoy:6.2%} | fallos esperados al año: {discos * FALLO_ANUAL:7.1f}")print(f"Perder las 3 copias de un bloque el mismo día (fallos independientes): {p_dia **3:.1e}")
Probabilidad de fallo de un disco en un día: 0.000041
     1 discos | algún fallo hoy:  0.00% | fallos esperados al año:     0.0
   100 discos | algún fallo hoy:  0.41% | fallos esperados al año:     1.5
  1000 discos | algún fallo hoy:  4.06% | fallos esperados al año:    15.0
 10000 discos | algún fallo hoy: 33.90% | fallos esperados al año:   150.0
Perder las 3 copias de un bloque el mismo día (fallos independientes): 7.1e-14
Con 1.5 % al año, un disco falla en un día dado con probabilidad 0.000041: para un solo disco, el riesgo diario es despreciable. Con 100 discos, la probabilidad de que alguno falle hoy es 0.41 %; con 1 000, 4.06 %, y se esperan 15 fallos al año, más de uno al mes; con 10 000, 33.90 %: un fallo cada dos o tres días, 150 al año. En un clúster grande, cambiar discos es parte del trabajo de cada semana.
La última línea muestra por qué la replicación resuelve el problema. Si un bloque tiene tres copias en tres discos distintos y los fallos son independientes, perder las tres el mismo día tiene probabilidad 7.1 × 10⁻¹⁴. En la práctica los fallos no son del todo independientes (un rack entero puede quedarse sin energía), y por eso HDFS además reparte las copias entre racks.
NotaTolerancia a fallos y replicación
La tolerancia a fallos es la capacidad de un sistema de seguir funcionando cuando una parte se daña. La forma más común en Big Data es la replicación: guardar cada bloque de datos en varias máquinas. Si un disco muere, el sistema lee otra copia y crea una nueva en otro lugar. HDFS guarda tres copias por defecto; lo verás en el capítulo de HDFS.
5. Llevar el cómputo a los datos
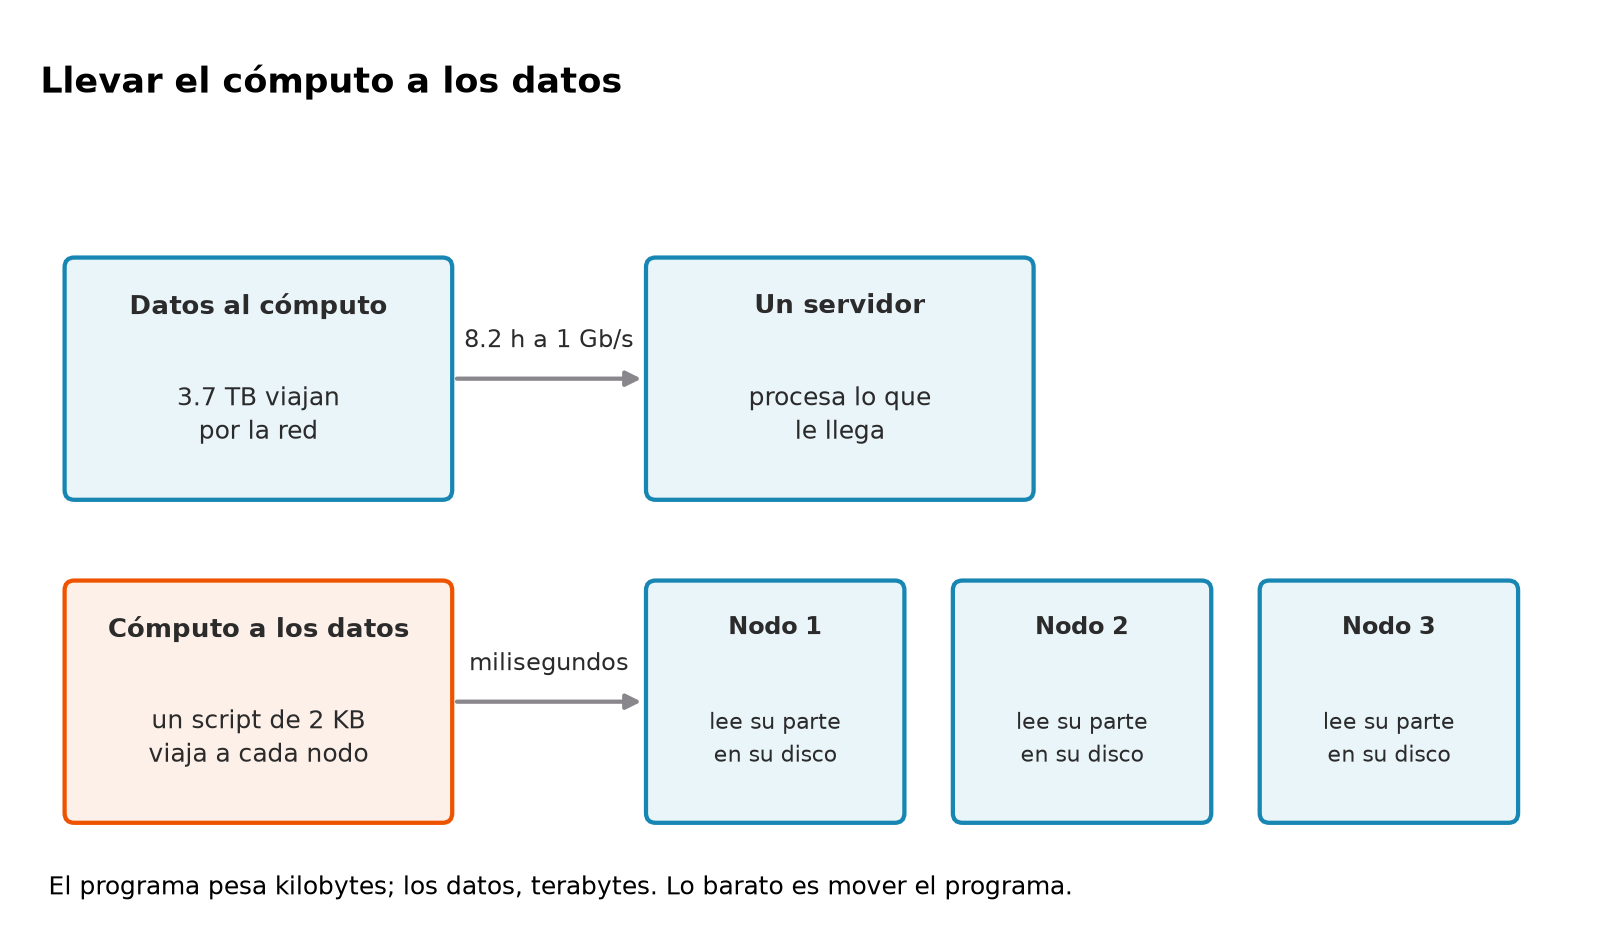
Repartir los datos entre muchas máquinas cambia también dónde conviene calcular. Una red de 1 Gb/s mueve unos 125 MB por segundo. Pasar por un solo enlace el año de registros, 3.68 TB, toma 3.68 × 10¹² / (125 × 10⁶) ≈ 29 400 segundos, más de 8 horas. En cambio, el programa que cuenta errores por ruta pesa un par de kilobytes.
Mover los datos hacia el programa o el programa hacia los datos.
NotaLocalidad de los datos
La localidad de los datos (data locality) es el principio de ejecutar cada parte del cálculo en la máquina que ya tiene esos datos en su disco. Se resume en una frase: llevar el cómputo a los datos, no los datos al cómputo. YARN la aplica al decidir en qué nodo corre cada tarea; lo verás en el capítulo de YARN.
RED_MB_S =125script_kb =2datos_s = tb_anio *1e12/ (RED_MB_S *1e6)script_s = script_kb *1e3/ (RED_MB_S *1e6)print(f"Mover el año de datos por un enlace de 1 Gb/s: {datos_s:,.0f} s ({datos_s /3600:.1f} h)")print(f"Mover un script de {script_kb} KB: {script_s *1000:.3f} ms")print(f"Un día de datos (10 GB) por el mismo enlace: {gb_dia *1e9/ (RED_MB_S *1e6):.0f} s")
Mover el año de datos por un enlace de 1 Gb/s: 29,455 s (8.2 h)
Mover un script de 2 KB: 0.016 ms
Un día de datos (10 GB) por el mismo enlace: 81 s
Mover el año de registros por un enlace de 1 Gb/s toma 29 455 segundos, 8.2 horas, más que leerlo de un disco (5.1 horas). Incluso un solo día, 10 GB, ocupa el enlace 81 segundos. El script de 2 KB viaja en 0.016 milisegundos. La diferencia es de seis órdenes de magnitud a favor de mover el programa, y es la razón por la que HDFS y YARN están diseñados para que cada nodo procese los bloques que ya guarda.
6. Dividir, transformar y agregar
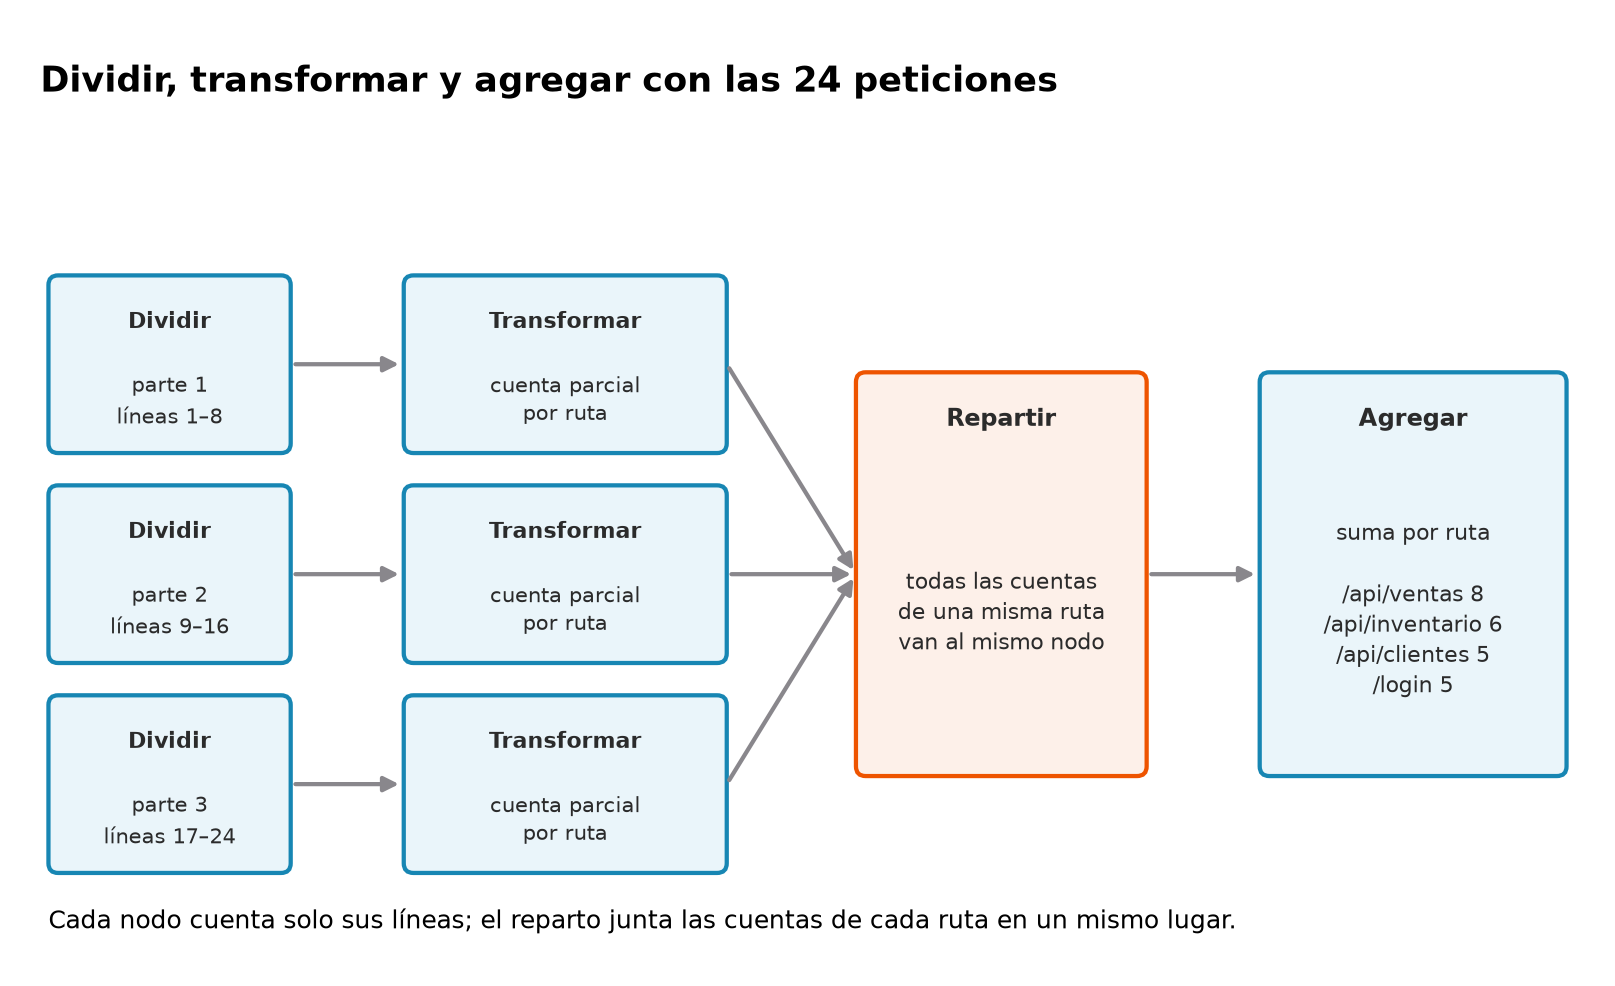
Si cada máquina tiene una parte de los datos, el cálculo también se parte. En el capítulo 2, tr | sort | uniq -c contó palabras en tres pasos: separar, ordenar para juntar las iguales y contar. Un clúster hace lo mismo a gran escala, en tres fases:
Dividir: cada nodo recibe una parte de las líneas.
Transformar: cada nodo calcula un resultado parcial con lo suyo, sin hablar con los demás.
Agregar: los resultados parciales de una misma llave se juntan y se combinan.
Entre la transformación y la agregación hay un paso de reparto (shuffle): todas las cuentas parciales de /api/ventas tienen que llegar al mismo nodo para poder sumarlas.
Dividir, transformar, repartir y agregar con las 24 peticiones.
A mano, con la primera parte (líneas 1 a 8): /api/ventas aparece en las líneas 1, 3 y 5, tres veces; /login, en las líneas 6, 7 y 8, tres veces; /api/clientes e /api/inventario, una vez cada una. La celda siguiente hace lo mismo con las tres partes y comprueba que el resultado coincide con contar todo junto.
partes = [peticiones[i:i +8] for i inrange(0, len(peticiones), 8)]parciales = []for numero, parte inenumerate(partes, start=1): cuenta = Counter(p["ruta"] for p in parte) parciales.append(cuenta)print(f"Nodo {numero}:", dict(sorted(cuenta.items())))repartido = defaultdict(list)for cuenta in parciales:for ruta, n in cuenta.items(): repartido[ruta].append(n)print("Después del reparto:", dict(sorted(repartido.items())))total = {ruta: sum(valores) for ruta, valores insorted(repartido.items())}print("Agregado:", total)print("Igual que contar todo junto:", total ==dict(sorted(Counter(p["ruta"] for p in peticiones).items())))
Cada nodo contó solo sus 8 líneas. El nodo 1 vio 3 peticiones a /api/ventas y 3 a /login, como en la cuenta a mano; el nodo 3 no vio ninguna de /login. Después del reparto, cada ruta tiene su lista de cuentas parciales: /api/ventas reúne [3, 2, 3] y /login solo [3, 2], porque el nodo 3 no aportó nada para esa llave. La suma da 8 ventas, 6 de inventario, 5 de clientes y 5 de acceso (/login), y la última línea confirma que es exactamente lo que se obtiene contando las 24 líneas juntas.
Funciona porque contar es asociativo: no importa cómo se agrupen las partes, la suma de sumas es la suma total. Esa propiedad es la que permite partir el trabajo entre nodos sin cambiar el resultado.
NotaLlave y reparto
Una llave es el valor por el que se agrupa: aquí, la ruta. El reparto (shuffle) envía todos los resultados parciales con la misma llave al mismo nodo. Es el paso más caro de un cálculo distribuido, porque es el único en que los datos viajan entre máquinas. MapReduce y Spark lo llaman igual; lo verás en el capítulo de MapReduce.
Un error al agregar: el promedio de promedios
Contar se agrega fácil: la suma de las cuentas parciales es la cuenta total. Con un promedio no pasa lo mismo. Si cada nodo calcula el tiempo medio de respuesta de sus líneas y después se promedian los tres promedios, el resultado sale mal cuando las partes tienen distinta cantidad de peticiones de cada tipo. La celda siguiente provoca el error con el tiempo medio de /api/inventario.
promedios_parciales, sumas, cuentas = [], 0, 0for numero, parte inenumerate(partes, start=1): tiempos = [p["ms"] for p in parte if p["ruta"] =="/api/inventario"] promedio =sum(tiempos) /len(tiempos) promedios_parciales.append(promedio) sumas, cuentas = sumas +sum(tiempos), cuentas +len(tiempos)print(f"Nodo {numero}: {len(tiempos)} peticiones a inventario, suma {sum(tiempos)} ms, promedio {promedio:.1f} ms")print(f"Promedio de los promedios (incorrecto): {sum(promedios_parciales) /len(promedios_parciales):.1f} ms")print(f"Suma total / cuenta total (correcto): {sumas / cuentas:.1f} ms")todos = [p["ms"] for p in peticiones if p["ruta"] =="/api/inventario"]print(f"Comprobación con las 6 peticiones juntas: {sum(todos) /len(todos):.1f} ms")
Nodo 1: 1 peticiones a inventario, suma 1203 ms, promedio 1203.0 ms
Nodo 2: 3 peticiones a inventario, suma 4546 ms, promedio 1515.3 ms
Nodo 3: 2 peticiones a inventario, suma 189 ms, promedio 94.5 ms
Promedio de los promedios (incorrecto): 937.6 ms
Suma total / cuenta total (correcto): 989.7 ms
Comprobación con las 6 peticiones juntas: 989.7 ms
Los tres nodos tienen 1, 3 y 2 peticiones a inventario, con promedios de 1 203.0, 1 515.3 y 94.5 ms. Promediar esos tres números da 937.6 ms, pero el tiempo medio real de las 6 peticiones es 989.7 ms: 5 938 ms en total divididos entre 6. El error viene de dar el mismo peso al nodo 1, que tiene una sola petición, que al nodo 2, que tiene tres.
La corrección es agregar lo que sí es asociativo: cada nodo entrega su suma y su cuenta (1 203 y 1, 4 546 y 3, 189 y 2), y la división se hace una sola vez al final. Es el mismo truco que usan MapReduce y Spark para calcular promedios distribuidos.
7. Por lotes o en flujo
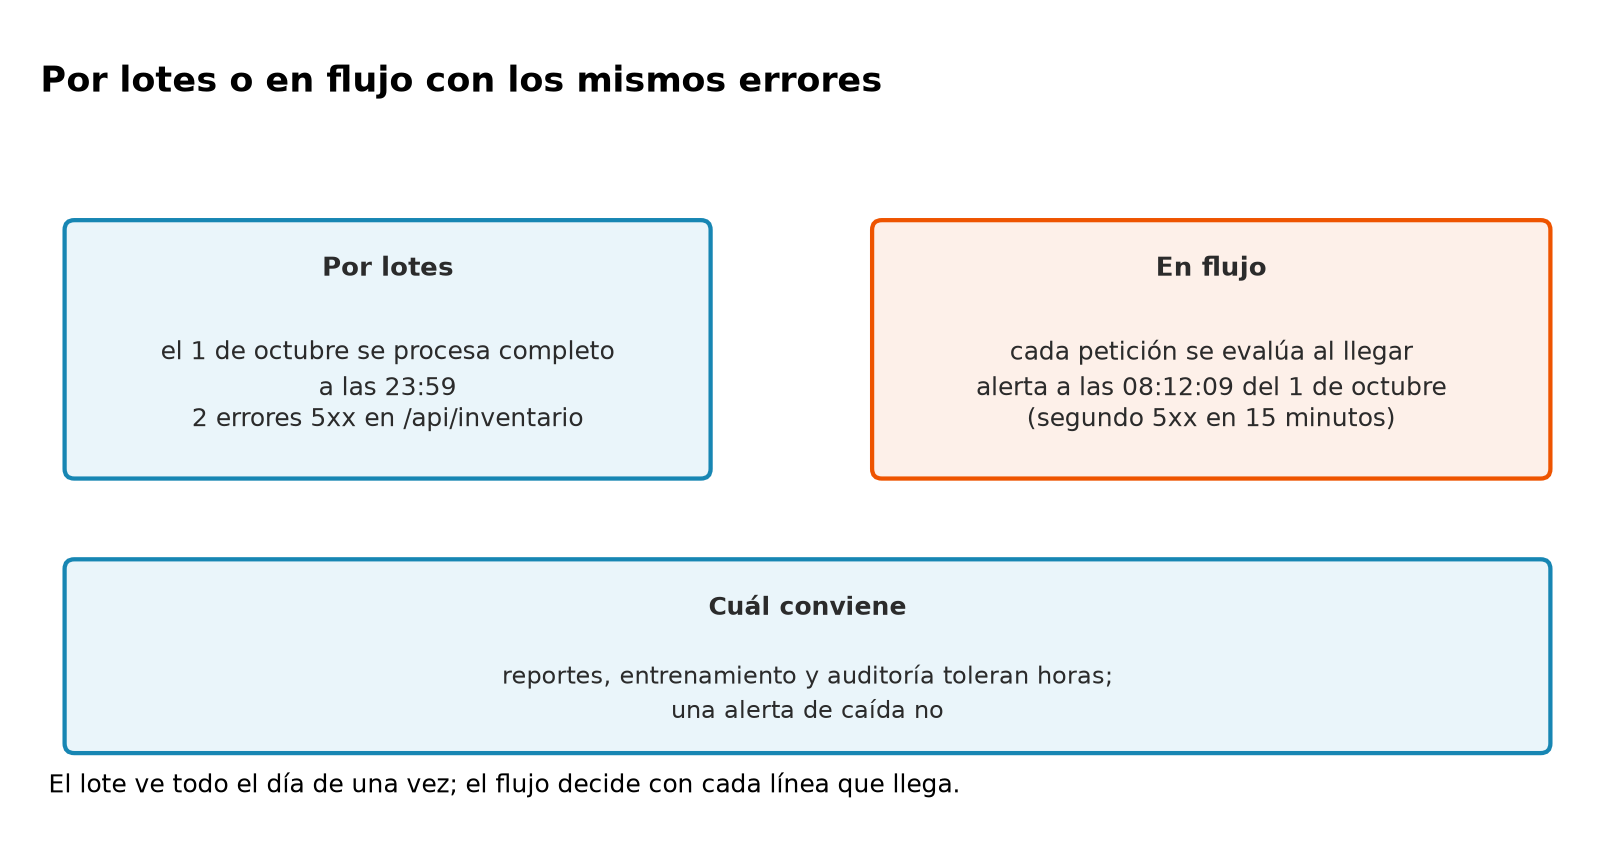
Hasta aquí todos los cálculos esperan a tener los datos completos: el día, el año. Ese es el procesamiento por lotes. Pero algunas preguntas no pueden esperar. Si /api/inventario empieza a fallar a las 8 de la mañana, el reporte de medianoche llega tarde: la tienda pasó el día vendiendo productos que no sabía si tenía.
NotaProcesamiento por lotes y en flujo
El procesamiento por lotes (batch) toma un conjunto de datos ya completo, lo procesa y entrega un resultado: el reporte del día, el modelo de la semana. El procesamiento en flujo (streaming) evalúa cada dato cuando llega y actualiza el resultado de forma continua. Una ventana es el intervalo de tiempo sobre el que el flujo calcula, por ejemplo los últimos 15 minutos.
El mismo registro procesado por lotes y en flujo.
La regla de alerta de la celda siguiente es sencilla: avisar cuando una ruta acumula dos errores 5xx en una ventana de 15 minutos. El código recorre las peticiones en orden, como si llegaran una a una, y guarda solo los errores recientes de cada ruta.
VENTANA = timedelta(minutes=15)recientes = defaultdict(list)for p in peticiones:if p["codigo"] <500:continue ruta = p["ruta"] recientes[ruta] = [t for t in recientes[ruta] if p["momento"] - t <= VENTANA] + [p["momento"]]iflen(recientes[ruta]) >=2:print("ALERTA", p["momento"], ruta, "->", len(recientes[ruta]), "errores 5xx en 15 minutos")else:print("aviso ", p["momento"], ruta, "-> primer error en la ventana")for fecha insorted({p["fecha"] for p in peticiones}): del_dia = [p for p in errores_servidor if p["fecha"] == fecha]print(f"Reporte por lotes del {fecha} (a las 23:59): {len(del_dia)} errores 5xx")
aviso   2026-10-01 08:02:45 /api/inventario -> primer error en la ventana
ALERTA 2026-10-01 08:12:09 /api/inventario -> 2 errores 5xx en 15 minutos
aviso   2026-10-02 09:03:47 /api/inventario -> primer error en la ventana
Reporte por lotes del 2026-10-01 (a las 23:59): 2 errores 5xx
Reporte por lotes del 2026-10-02 (a las 23:59): 1 errores 5xx
La regla vio el primer error de inventario a las 08:02:45 y emitió la alerta a las 08:12:09 del 1 de octubre, cuando llegó el segundo 5xx, 9 minutos y 24 segundos después, dentro de la ventana de 15 minutos. El error del 2 de octubre, a las 09:03:47, quedó solo en su ventana y no disparó alerta. El reporte por lotes cuenta los mismos 2 errores del 1 de octubre, pero a las 23:59: casi 16 horas más tarde.
Los dos procesamientos ven los mismos datos y llegan a la misma conclusión. Lo que cambia es cuándo llega la respuesta, y si ese retraso importa para la decisión.
8. Escribir una venta o analizar millones: OLTP y OLAP
La API de la tienda hace dos tipos de trabajo muy distintos con los mismos datos. Cuando alguien compra, POST /api/ventas escribe una venta y tiene que confirmarla en milisegundos. Cuando el equipo de analítica pregunta cuánto tardó cada ruta durante el año, la consulta lee millones de líneas, pero solo dos columnas: la ruta y los milisegundos.
NotaOLTP y OLAP
OLTP (online transaction processing) son las cargas transaccionales: muchas operaciones pequeñas que leen o escriben pocas filas completas, como registrar una venta. OLAP (online analytical processing) son las cargas analíticas: pocas consultas grandes que recorren muchas filas y agregan pocas columnas, como el tiempo medio por ruta en un año. Cada una se sirve mejor con sistemas distintos.
OLTP
OLAP
Ejemplo en la tienda
Registrar la venta de POST /api/ventas
Tiempo medio por ruta durante el año
Filas por operación
Una o pocas
Millones
Columnas que usa
Todas las de la fila
Pocas: aquí 2 de 8
Lo que importa
Responder en milisegundos y no perder la operación
Recorrer mucho volumen en poco tiempo
Sistema típico
Base de datos relacional (PostgreSQL, MySQL)
Motor analítico sobre archivos por columnas (Spark, Hive, almacenes en la nube)
La celda siguiente muestra por qué el formato importa en OLAP. Si los datos se guardan por filas, la consulta analítica tiene que leer las 8 columnas de cada línea; si se guardan por columnas, solo las 2 que usa.
columnas_usadas = ["ruta", "ms"]bytes_por_columna = {c: sum(len(p_linea.split()[i]) +1for p_linea in lineas)for i, c inenumerate(CAMPOS)}total_bytes =sum(bytes_por_columna.values())usados =sum(bytes_por_columna[c] for c in columnas_usadas)print("Bytes por columna en las 24 líneas:", bytes_por_columna)print(f"Por filas se leen {total_bytes} bytes; por columnas, {usados} ({usados / total_bytes:.1%})")print(f"Con el año completo: {tb_anio:.2f} TB por filas frente a {tb_anio * usados / total_bytes:.2f} TB por columnas")
Bytes por columna en las 24 líneas: {'fecha': 264, 'hora': 216, 'ip': 240, 'metodo': 104, 'ruta': 297, 'codigo': 96, 'bytes': 107, 'ms': 77}
Por filas se leen 1401 bytes; por columnas, 374 (26.7%)
Con el año completo: 3.68 TB por filas frente a 0.98 TB por columnas
Las 8 columnas ocupan entre 77 bytes (ms) y 297 (ruta) en las 24 líneas. La consulta analítica usa solo ruta y ms, 374 de los 1 401 bytes: el 26.7 %. Con el año completo, leer por filas obliga a recorrer 3.68 TB; leer por columnas, 0.98 TB. Por eso los motores analíticos guardan los datos por columnas, en formatos como Parquet, que verás en el capítulo de PySpark.
9. Dónde vive cada idea en el resto del libro
Las ideas de este capítulo son las que la industria convirtió en software. El capítulo siguiente presenta el mapa completo; esta tabla adelanta dónde encontrarás cada una.
Ojo con un nombre que confunde: Hadoop Streaming no es procesamiento en flujo. Es la forma de escribir trabajos MapReduce en cualquier lenguaje que lea la entrada estándar, y sigue procesando por lotes.
Errores frecuentes
Lo que se piensa
Qué pasa en realidad
Cómo se corrige
«Big Data es tener muchos datos.»
El problema aparece cuando volumen, velocidad o variedad superan lo que una máquina resuelve a tiempo.
Pregunta qué V presiona y qué plazo hay que cumplir.
«Más nodos, siempre más rápido.»
Coordinar cuesta; en el modelo de la sección 3, pasar de 60 a 1 000 nodos hace la lectura más lenta.
Mide y busca el punto en que agregar nodos deja de ayudar.
«Tres copias son un respaldo.»
Las réplicas protegen del fallo de un disco, no de borrar un archivo por error: el borrado se replica.
Mantén respaldos aparte de la replicación.
Promediar los promedios de cada nodo
Da un número equivocado cuando las partes tienen tamaños distintos (sección 6).
Agrega sumas y cuentas, y divide al final.
«El flujo siempre es mejor que los lotes.»
El flujo es más complejo de operar y no hace falta para un reporte mensual.
Elige según el plazo de la decisión, no por moda.
«Hadoop Streaming es procesamiento en tiempo real.»
Es MapReduce por lotes escrito en otro lenguaje.
Para flujo continuo, usa un motor de streaming.
Preguntas de comprensión
Si la tienda pasa de 2 000 a 5 000 peticiones por segundo, ¿cuánto ocupa el registro de un año? Hazlo primero a mano con 58.4 bytes por línea.
En el modelo de juguete de la sección 3, ¿qué pasa con el número óptimo de nodos si la coordinación cuesta 20 segundos por nodo en lugar de 5? Calcúlalo con la fórmula de la celda.
¿Cuántos fallos de disco al año esperarías en un clúster de 3 000 discos, con 1.5 % de fallo anual? ¿Qué le pasaría a un archivo guardado en una sola copia?
Calcula a mano, con la primera parte de 8 líneas, el total de bytes enviados por ruta. ¿Se puede agregar como la cuenta o como el promedio?
Clasifica como lotes o flujo: el reporte mensual de ventas, el bloqueo de una tarjeta ante un fraude, el reentrenamiento semanal de un modelo y el tablero de pedidos abiertos.
Clasifica como OLTP u OLAP: actualizar la dirección de un cliente, contar los clientes por ciudad, consultar el saldo de una cuenta y calcular el tiempo medio de entrega por mes.
TipOrientaciones
5 000 × 86 400 × 58.4 ≈ 25.2 GB por día y unos 9.2 TB por año: 2.5 veces más, porque el volumen crece en proporción al ritmo.
El óptimo es √(18 400 / 20) ≈ 30 nodos, con unos 1 213 segundos. Cuanto más cara la coordinación, menos nodos conviene usar.
3 000 × 0.015 = 45 fallos al año, casi uno por semana. Un archivo en una sola copia se perdería en cuanto falle el disco que lo tiene; por eso HDFS replica.
/api/ventas: 5 120 + 256 + 4 096 = 9 472; /login: 1 024 + 64 + 512 = 1 600; /api/clientes: 2 048; /api/inventario: 128. Los bytes se agregan como la cuenta: la suma de sumas parciales es la suma total.
Lotes: el reporte mensual y el reentrenamiento semanal. Flujo: el bloqueo por fraude y el tablero de pedidos abiertos.
OLTP: actualizar la dirección y consultar el saldo. OLAP: clientes por ciudad y tiempo medio de entrega por mes.
Glosario
Término
Significado en este capítulo
Big Data
Situación en la que los datos superan lo que una máquina maneja a tiempo.
Cinco V
Volumen, velocidad, variedad, veracidad y valor.
Escalar en vertical
Cambiar la máquina por una más grande.
Escalar en horizontal
Agregar máquinas y repartir datos y trabajo.
Hardware común (commodity)
Servidores estándar, baratos y reemplazables.
Tolerancia a fallos
Capacidad de seguir funcionando cuando una parte se daña.
Replicación
Guardar cada bloque de datos en varias máquinas.
Localidad de los datos
Ejecutar el cálculo en la máquina que ya tiene los datos.
Llave
Valor por el que se agrupan los resultados parciales.
Reparto (shuffle)
Envío de los resultados con la misma llave al mismo nodo.
Procesamiento por lotes
Procesar un conjunto de datos ya completo.
Procesamiento en flujo
Evaluar cada dato cuando llega.
Ventana
Intervalo de tiempo sobre el que calcula el flujo.
OLTP
Cargas transaccionales: muchas operaciones pequeñas sobre filas completas.
OLAP
Cargas analíticas: consultas grandes que agregan pocas columnas.
Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media. Capítulos 3 (OLTP y OLAP), 10 (lotes) y 11 (flujo).
Barroso, L. A., Hölzle, U. y Ranganathan, P. (2019). The Datacenter as a Computer (3.ª ed.). Springer. Fallos de hardware a escala de centro de datos.
Apache Hadoop. HDFS Architecture: supuestos de diseño sobre fallos de hardware y localidad.
Resumen
Con las 24 líneas del capítulo 2 estimaste que la API de la tienda produce unos 10 GB de registros al día y 3.7 TB al año, y viste que leerlos en un solo disco toma más de cinco horas. Repartir entre nodos acelera, pero la coordinación pone un límite. Con diez mil discos, algún disco falla cada dos o tres días; por eso las plataformas replican los datos. Mover terabytes por la red cuesta horas y mover el programa, milisegundos: el cómputo va a los datos. Dividiste el conteo por ruta en tres nodos, comprobaste que el agregado coincide y provocaste el error del promedio de promedios. Por último, distinguiste lotes de flujo con una alerta que llega horas antes que el reporte, y OLTP de OLAP con una consulta que solo necesita 2 de 8 columnas.
El capítulo siguiente, Ecosistema Hadoop, muestra cómo la industria organizó estas ideas en una plataforma: quién guarda, quién reparte recursos y quién calcula.