Apéndice A — Operar el clúster: encender, comprobar, apagar y diagnosticar
El problema que vas a resolver
Terminaste el laboratorio del cliente Spark un viernes. El lunes reinicias el computador, abres la terminal y quieres seguir con el taller de MapReduce Streaming. ¿Qué enciendes primero? ¿Qué comando usas, docker compose o dc? ¿Cuándo está listo HDFS para recibir un trabajo? ¿De dónde sale el notebook del taller? Y si algo falla, ¿es un error de verdad o el clúster todavía está arrancando?
Las respuestas están repartidas en los laboratorios de HDFS, YARN y el cliente Spark, que explican cómo se construye el clúster. Este apéndice las reúne en un solo lugar para operarlo cada día, con los avisos y errores que aparecieron al ejecutar esos laboratorios.
| Ficha | En este apéndice |
|---|---|
| Pregunta | ¿Cómo enciendo, compruebo, uso y apago el clúster sin perder datos? |
| Punto de partida | El clúster completo del laboratorio del cliente Spark, en ~/hdfs-docker-lab |
| Tiempo estimado de lectura | 25 minutos; después, para consulta |
| Nivel | Básico |
| Conocimientos previos recomendados | Haber hecho los laboratorios de HDFS, YARN y el cliente Spark; la terminal del capítulo 2 |
| Tecnologías mencionadas | Docker y Docker Compose, Hadoop 3.4.1 (HDFS y YARN), Spark 3.5.3, Jupyter Notebook |
Objetivos de aprendizaje
Al terminar este apéndice podrás:
- Nombrar los ocho contenedores del clúster, qué hace cada uno y qué puertos publica.
- Explicar por qué se usa siempre el atajo
dcy qué se rompe sin él. - Encender el clúster en orden y reconocer cuándo HDFS y YARN están listos.
- Llevar los notebooks de los talleres a Jupyter.
- Apagar sin perder datos y leer los códigos de salida de los contenedores.
- Diagnosticar los errores conocidos con una tabla de síntoma, causa y arreglo.
- Practicar la operación de Spark sobre YARN: enviar, observar, encolar y cancelar aplicaciones.
| Concepto | En una línea | Dónde se explica |
|---|---|---|
| Contenedor e imagen | La imagen es la plantilla; el contenedor, el proceso que corre a partir de ella. | Capítulo 3 |
| Modo seguro de HDFS | Al arrancar, el NameNode no acepta escrituras hasta tener suficientes bloques reportados. | HDFS |
| NodeManager | El agente de YARN que lanza contenedores de trabajo en su nodo. | YARN |
| Overlay de Compose | Un segundo archivo que se aplica encima del primero y agrega o cambia servicios. | Cliente Spark |
Todos los comandos de este apéndice se ejecutan en la terminal de Ubuntu (WSL2 o Linux), dentro de ~/hdfs-docker-lab, salvo que se diga otra cosa.
1. El mapa del clúster
El clúster tiene ocho contenedores en un mismo proyecto de Compose llamado hdfs-lab. Siete los crea compose.yaml (HDFS y YARN) y el octavo, spark-client, lo agrega compose.spark.yaml.
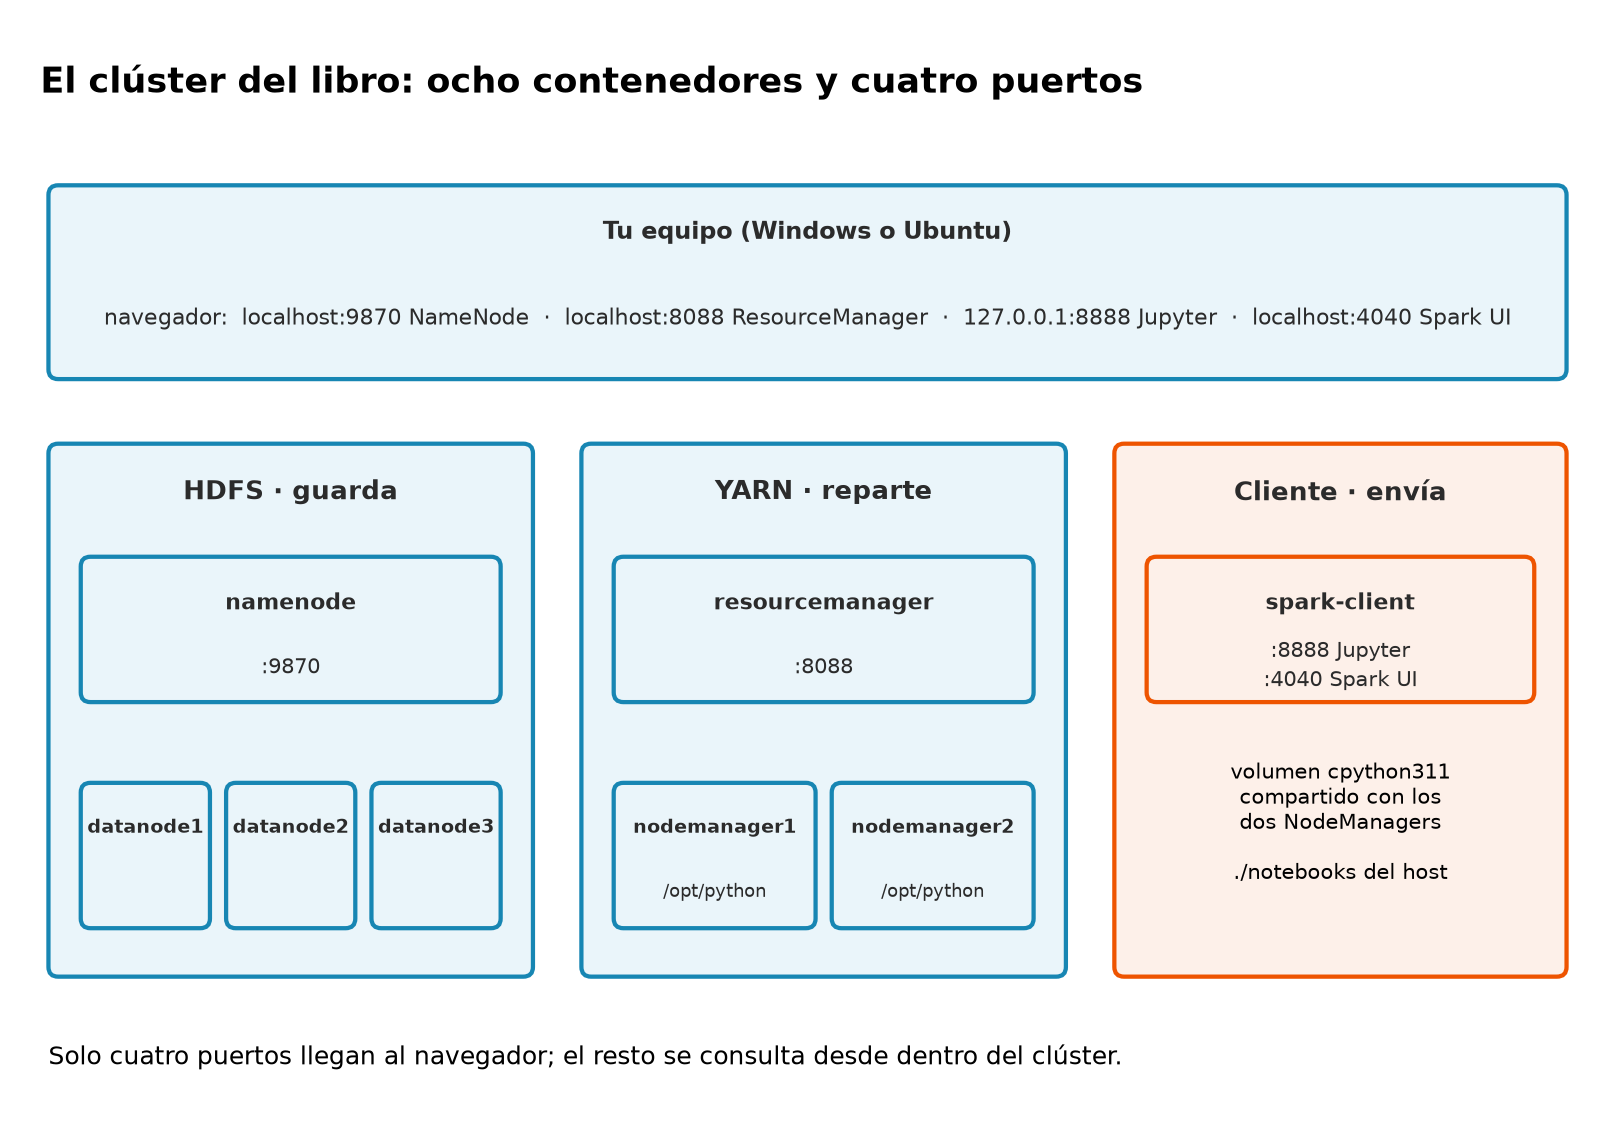
| Contenedor | Pieza | Qué hace | Puerto en tu equipo |
|---|---|---|---|
namenode |
HDFS | Guarda los metadatos: qué archivos hay y dónde están sus bloques. | localhost:9870 |
datanode1, datanode2, datanode3 |
HDFS | Guardan los bloques, tres copias de cada uno. | ninguno |
resourcemanager |
YARN | Reparte memoria y CPU entre las aplicaciones. | localhost:8088 |
nodemanager1, nodemanager2 |
YARN | Lanzan los contenedores de trabajo; tienen montado el Python 3.11 del clúster. | ninguno |
spark-client |
Cliente | Envía trabajos de Spark y MapReduce, y aloja Jupyter. | 127.0.0.1:8888 y localhost:4040 |
Un volumen con nombre es un espacio de disco que Docker administra aparte de los contenedores. Sobrevive cuando un contenedor se detiene o se elimina, y solo se borra si lo pides. El clúster usa cinco: namenode_data y datanode1_data a datanode3_data guardan HDFS, y cpython311 guarda el Python 3.11.10 que comparten spark-client y los NodeManagers. La carpeta ./notebooks no es un volumen: es una carpeta de tu equipo montada en el contenedor.
2. Por qué siempre dc
El clúster se describe con dos archivos de Compose. Si un comando lee solo el primero, Compose cree que los NodeManagers deben quedar como los define compose.yaml, sin el volumen de Python, y los recrea así sin avisar: la salida dice Started como siempre. Todo parece normal hasta que un trabajo de Python falla en los nodos.
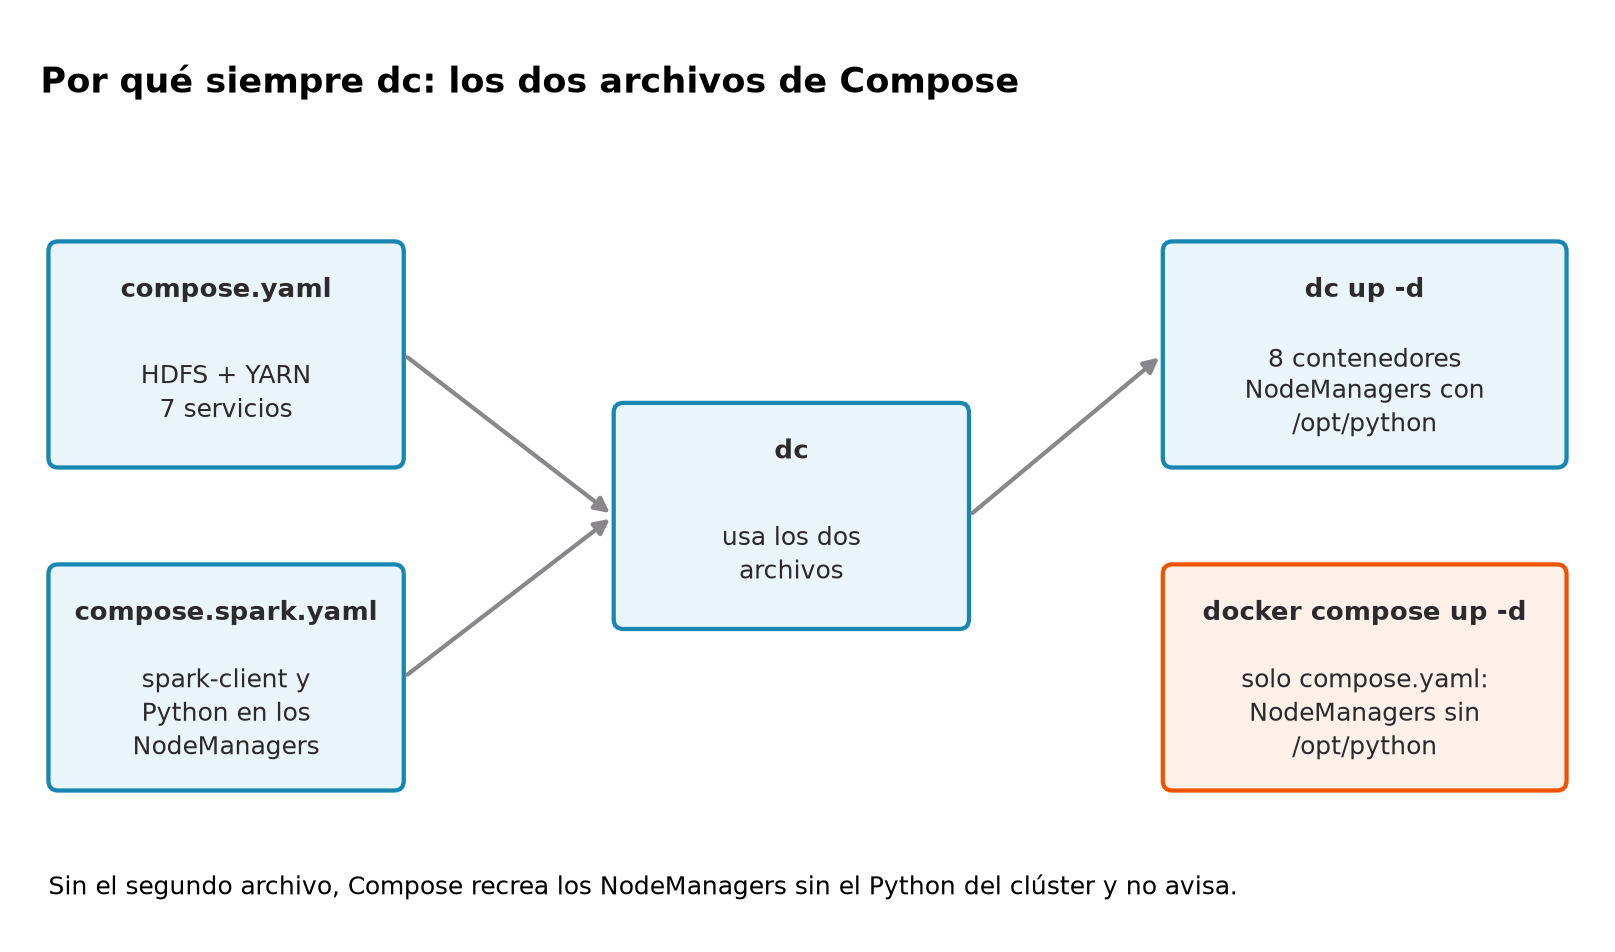
Por eso todos los laboratorios desde el cliente Spark usan el atajo dc. Defínelo en cada terminal nueva:
cd ~/hdfs-docker-lab
dc() { docker compose -f compose.yaml -f compose.spark.yaml "$@"; }
dc config --services
Salida esperada: los ocho servicios, uno por línea, en el orden que decida Compose; lo importante es que aparezca spark-client.
namenode
datanode1
datanode2
datanode3
resourcemanager
nodemanager1
nodemanager2
spark-client
Si no quieres definirlo cada vez, agrega la línea dc() { … } al final de ~/.bashrc (o ~/.zshrc si usas zsh). Como el atajo usa rutas relativas, funciona solo dentro de ~/hdfs-docker-lab.
docker compose a secas
Si encendiste con docker compose up -d y el taller de MapReduce Streaming falla con Cannot run program "/opt/python/bin/python3": error=2, No such file or directory, los NodeManagers perdieron el Python. Se arregla sin perder datos: dc up -d recrea solo los dos NodeManagers con el volumen. Espera después a que yarn node -list muestre los dos en RUNNING (sección 3).
3. Encender en orden
Encender es una secuencia: cada paso necesita que el anterior haya terminado. Los contenedores arrancan en segundos, pero HDFS y YARN tardan un poco más en estar listos.
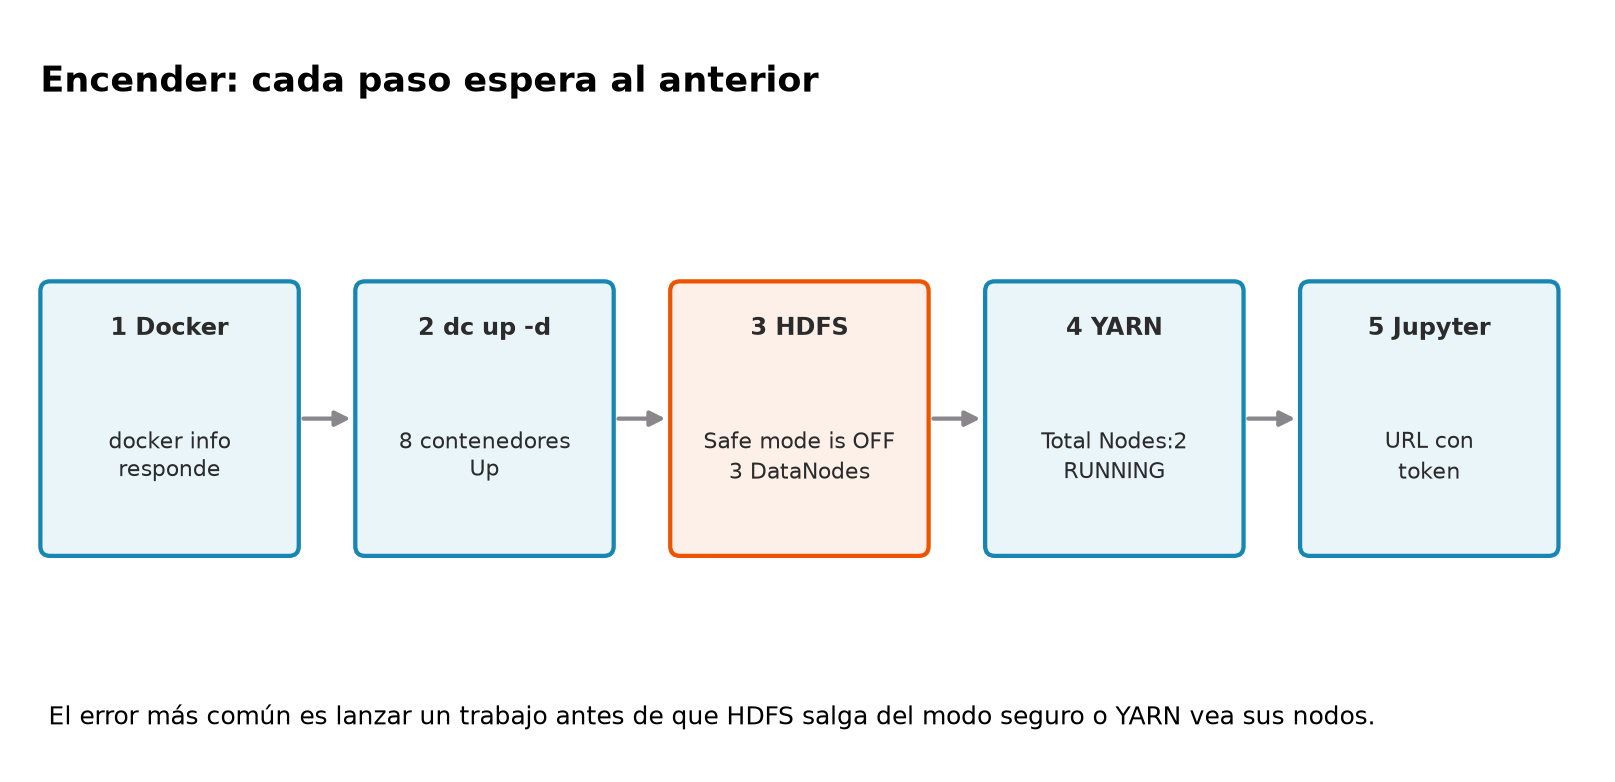
Paso 1: Docker
docker info --format '{{.ServerVersion}}'Si imprime una versión (por ejemplo 29.1.3), Docker está listo. Si responde Cannot connect to the Docker daemon, enciéndelo según cómo lo instalaste:
| Instalación | Cómo encender Docker |
|---|---|
| Docker Desktop en Windows | Abre Docker Desktop y espera a que diga que el motor está corriendo. |
Docker Engine dentro de Ubuntu (instalado con apt) |
sudo service docker start (o sudo systemctl start docker si tu WSL usa systemd). |
Paso 2: los contenedores
Primero confirma que el proyecto existe. docker compose ls muestra solo los proyectos con contenedores corriendo; con el clúster apagado no lo verás. Agrega -a:
docker compose ls -a
dc up -d
dc ps -a
Señal de éxito: hdfs-lab en la lista de proyectos, con estado exited si estaba apagado, y después de dc up -d los ocho contenedores en estado Up. Si dc ps -a muestra un servicio en Exited justo después de encender, mira su registro con dc logs --tail 30 <servicio>.
Paso 3: HDFS fuera del modo seguro
dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -safemode wait
dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -report | grep -E 'Live datanodes|Missing blocks'
Salida esperada: Safe mode is OFF en el primer comando y Live datanodes (3): en el segundo, con Missing blocks: 0. El aviso WARNING: log4j.properties is not found que acompaña a cada comando es inofensivo.
Si lanzas estos comandos en los primeros segundos después de dc up -d, puede salir Connection refused: el NameNode todavía no escucha. Espera unos segundos y repite. Es normal, no es un fallo del clúster. Después de un arranque, el modo seguro se extiende unos 30 segundos más aunque ya estén todos los bloques; -safemode wait espera por ti.
Paso 4: YARN con sus dos nodos
dc exec spark-client /opt/hadoop/bin/yarn node -listSalida esperada: Total Nodes:2, con nodemanager1 y nodemanager2 en estado RUNNING. Si sale Total Nodes:0, los NodeManagers todavía se están registrando: repite en 10 o 20 segundos. Los números de puerto de cada nodo (nodemanager1:35895, por ejemplo) cambian en cada arranque; lo que importa es el nombre y el estado.
Paso 5: Jupyter
Jupyter es un proceso dentro de spark-client, no un servicio de Compose: no arranca solo. Ábrelo en otra terminal (define dc también allí) y déjala abierta:
dc exec spark-client /opt/python/bin/jupyter notebook \
  --ip=0.0.0.0 --port=8888 --no-browser --allow-root \
  --ServerApp.root_dir=/opt/spark/work-dir
En la terminal aparecen varias líneas de registro y una URL de la forma http://127.0.0.1:8888/tree?token=…. Ábrela en el navegador con el token de tu terminal; cada arranque genera uno nuevo. Si la URL dice http://spark-client:8888/…, cambia solo el nombre por 127.0.0.1. En Jupyter, elige siempre el kernel Python del clúster.
4. Las interfaces web
| Dirección | Qué muestra | Cuándo está disponible |
|---|---|---|
http://localhost:9870 |
NameNode: DataNodes vivos, capacidad, explorador de archivos de HDFS (Utilities → Browse the file system). | Con namenode encendido. |
http://localhost:8088 |
ResourceManager: nodos, aplicaciones y su estado (RUNNING, FINISHED, FAILED). |
Con resourcemanager encendido. |
http://127.0.0.1:8888 |
Jupyter. | Solo mientras corre el servidor del paso 5. |
http://localhost:4040 |
Spark UI: trabajos, etapas y tareas de una aplicación Spark. | Solo mientras hay una SparkSession abierta en spark-client; desaparece con spark.stop(). |
Un puerto publicado es un puerto del contenedor que Compose conecta con uno de tu equipo, como 127.0.0.1:8088:8088. Solo esos cuatro llegan al navegador. Las páginas de cada NodeManager (puerto 8042), de cada DataNode (9864) y el historial de trabajos MapReduce (19888) existen dentro de la red del clúster, pero no se publican: la página del ResourceManager enlaza a ellas y el enlace no abrirá. Para ver lo que hizo una aplicación, usa yarn logs -applicationId <id> desde spark-client.
5. Llevar los talleres a Jupyter
Los talleres de MapReduce Streaming, Spark con ejemplos y PySpark, y los capítulos de almacenamiento analítico, Spark SQL y DataFrames, ingesta, calidad, optimización, MLlib, Airflow, Iceberg, Kafka, Structured Streaming y seguridad, son notebooks que se ejecutan dentro de spark-client. Jupyter muestra la carpeta /opt/spark/work-dir del contenedor, que es ~/hdfs-docker-lab/notebooks en tu equipo, así que basta con dejar ahí esos archivos.
Descarga talleres-notebooks.zip. Trae taller_streaming.ipynb, taller_spark.ipynb, taller_pyspark.ipynb, taller_almacenamiento.ipynb, taller_spark_sql.ipynb, taller_ingesta.ipynb, taller_calidad.ipynb, taller_optimizacion.ipynb, taller_mllib.ipynb, taller_airflow.ipynb, taller_iceberg.ipynb, taller_kafka.ipynb, taller_streaming_kafka.ipynb y taller_seguridad.ipynb sin salidas, listos para ejecutar, y generar_envios.py, el programa que crea los datos del taller de PySpark y de los capítulos de ingesta y calidad. Trae además taller_databricks.ipynb, del capítulo de la nube, que no se ejecuta en este Jupyter sino en Databricks. El de seguridad necesita además preparar el NameNode (registro de auditoría con compose.seguridad.yaml, la función dcs y los usuarios del caso); los pasos están en su sección «Antes de empezar». Desde WSL, la carpeta Descargas de Windows está en /mnt/c/Users/<tu-usuario>/Downloads/:
cd ~/hdfs-docker-lab
cp /mnt/c/Users/<tu-usuario>/Downloads/talleres-notebooks.zip .
unzip -o talleres-notebooks.zip -d notebooks
ls notebooks
Cambia <tu-usuario> por tu usuario de Windows. Si Ubuntu no tiene unzip, instálalo con sudo apt install -y unzip. -o sobrescribe sin preguntar: si ya tenías una copia del taller con tus respuestas, renómbrala antes.
Comprobación: generar_envios.py, taller_airflow.ipynb, taller_almacenamiento.ipynb, taller_calidad.ipynb, taller_iceberg.ipynb, taller_ingesta.ipynb, taller_kafka.ipynb, taller_mllib.ipynb, taller_optimizacion.ipynb, taller_pyspark.ipynb, taller_seguridad.ipynb, taller_spark_sql.ipynb, taller_spark.ipynb, taller_streaming.ipynb y taller_streaming_kafka.ipynb en la lista, junto con lo que ya tenías en notebooks (por ejemplo jupyter-paquetes.txt). En el navegador aparecen en el árbol de Jupyter sin reiniciar nada.
6. Apagar sin perder nada
Apagar también tiene niveles. La diferencia está en qué se conserva.
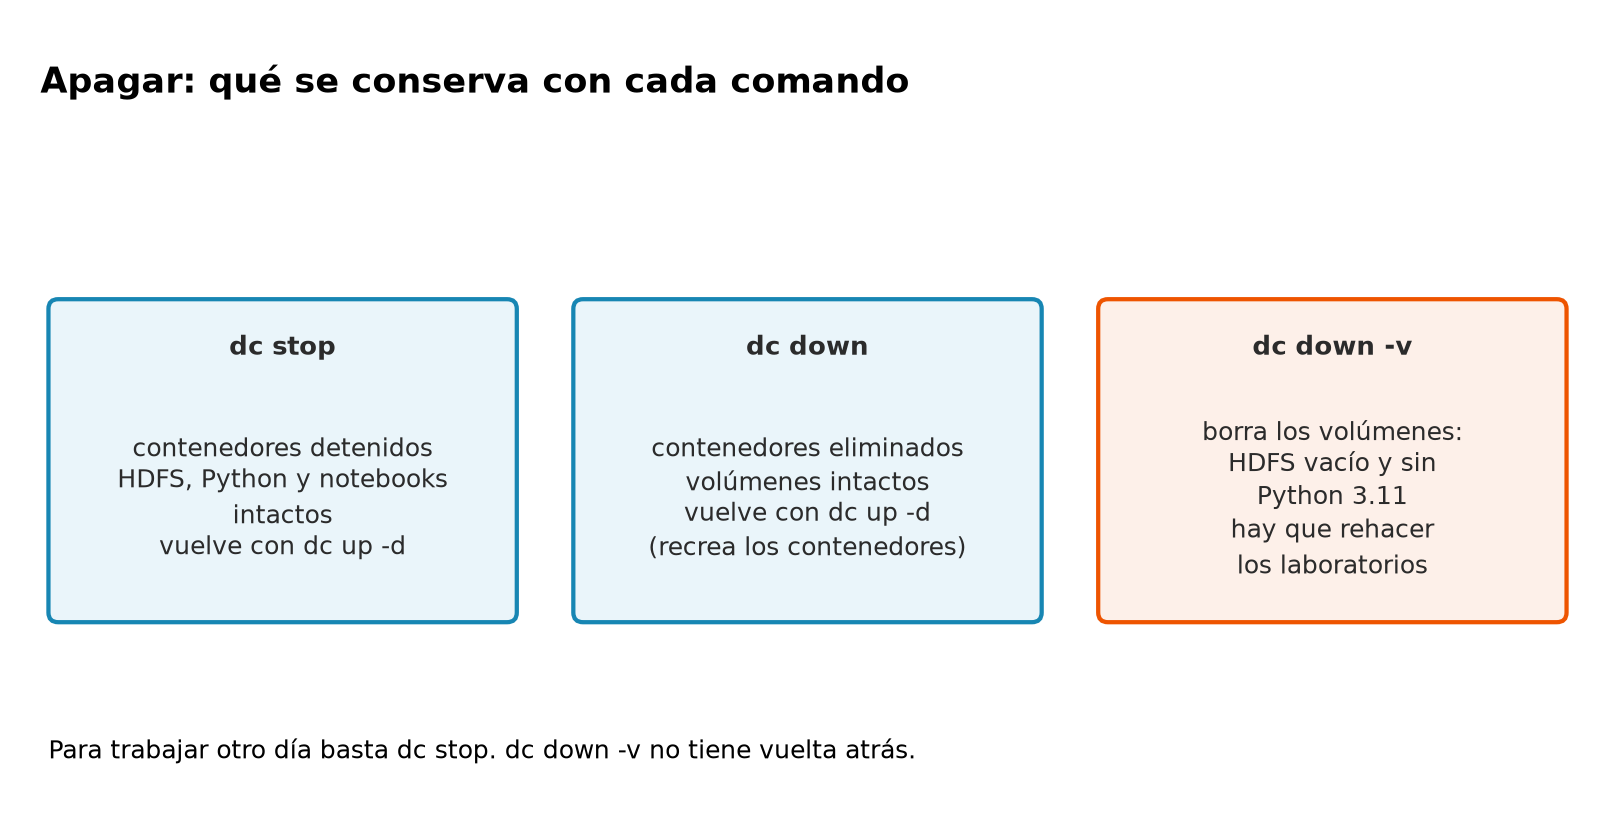
Antes de apagar, guarda los notebooks (Ctrl+S) y cierra las SparkSession abiertas con spark.stop(). Después:
- Ctrl+C en la terminal de Jupyter, y confirma con
ysi lo pide. dc stopen la otra terminal.
dc stop
dc ps -a
Resultado: los ocho contenedores en estado Exited, cada uno con un código entre paréntesis. El código cuenta cómo terminó:
| Código | Qué significa | ¿Hay que preocuparse? |
|---|---|---|
Exited (143) |
El proceso recibió la señal de apagado (SIGTERM, 128 + 15) y terminó. | No: es el apagado normal de los servicios de Hadoop. |
Exited (137) |
El proceso no terminó a tiempo y Docker lo forzó (SIGKILL, 128 + 9). | No para spark-client: su sleep infinity ignora la señal de apagado y Docker lo detiene a los 10 segundos. |
Exited (255) |
El contenedor terminó de forma abrupta, por ejemplo porque se apagó WSL o el computador sin dc stop. |
Normalmente no: dc up -d lo recupera. Si HDFS reporta bloques faltantes después, revisa el paso 3. |
Exited (0) |
El proceso terminó por su cuenta sin error. | No en los servicios de este clúster, que no terminan solos: mira dc logs. |
dc down elimina además los contenedores, pero conserva los volúmenes: el siguiente dc up -d los recrea con los mismos datos. dc down -v borra los volúmenes: HDFS queda vacío y se pierde el Python 3.11 de cpython311. No lo uses mientras sigas el libro.
7. Errores conocidos
Esta tabla reúne los síntomas que aparecieron al ejecutar los laboratorios y talleres del libro.
| Síntoma | Causa | Arreglo |
|---|---|---|
Cannot connect to the Docker daemon |
Docker no está encendido. | Sección 3, paso 1. |
docker compose ls no muestra hdfs-lab |
El proyecto está apagado y ls solo lista los que corren. |
docker compose ls -a. |
Connection refused o Total Nodes:0 justo después de encender |
NameNode o NodeManagers todavía arrancando. | Esperar unos segundos y repetir. |
Safe mode is ON o Name node is in safe mode al escribir |
HDFS todavía no salió del modo seguro. | hdfs dfsadmin -safemode wait. |
Found orphan containers ([hdfs-lab-spark-client-1]) |
Se usó docker compose sin el segundo archivo y Compose no reconoce a spark-client. |
Es solo un aviso: usa dc. No uses --remove-orphans, que borraría el cliente. |
Cannot run program "/opt/python/bin/python3": error=2 en las tareas |
Los NodeManagers se recrearon sin el volumen de Python. | dc up -d y esperar dos nodos RUNNING. |
Aplicación en ACCEPTED que no avanza |
YARN no tiene memoria libre para su ApplicationMaster: hay otra aplicación Spark abierta. | Cierra la otra SparkSession o mata la aplicación con yarn application -kill <id>. |
AssertionError al comprobar Python en el notebook |
Kernel equivocado. | Elige Python del clúster en Jupyter. |
127.0.0.1:8888 no abre |
El servidor de Jupyter no está corriendo o se cerró su terminal. | Sección 3, paso 5. |
localhost:4040 no abre |
No hay ninguna SparkSession abierta. |
Abre una sesión en el notebook; la página existe mientras dure. |
Aviso de buildx al ejecutar dc build |
Falta el componente de construcción moderno de Docker. | Inofensivo para el laboratorio. Si quieres quitarlo y Docker Engine viene del repositorio oficial de Docker, sudo apt install docker-buildx-plugin. |
WARNING: log4j.properties is not found |
Hadoop no encuentra su archivo de configuración de registros en el cliente. | Inofensivo; ignóralo. |
Antes de sumar servicios nuevos al clúster, conviene saber cuánta memoria usa. Con los ocho contenedores encendidos, docker stats --no-stream muestra la memoria de cada uno; anótala para compararla después.
8. Ejercicios de operación de Spark sobre YARN
El taller de Spark con ejemplos mira el motor desde el código. Estos trece ejercicios lo miran desde la operación: envías aplicaciones con spark-submit, las sigues en el portal de YARN y en la Spark UI, ubicas al driver y a los executors, y provocas a propósito una aplicación en ACCEPTED y otra en KILLED. Se hacen en la terminal y en el navegador, sin Jupyter, y sirven para practicar lo que este apéndice explica.
Cada ejercicio da un objetivo, qué debes lograr y un análisis; tú construyes las órdenes. Las soluciones de referencia están al final de la sección: úsalas para comprobar tu trabajo después de intentarlo. Resolver un ejercicio es poder explicar por qué YARN y Spark respondieron como respondieron, no solo que la orden no dé error.
Tu herramienta de referencia:
spark-submit --help,yarn application -help,yarn node -help. Saber leerla es parte del ejercicio.
Datos que ya dejó el laboratorio del cliente Spark:
| Dato | Valor |
|---|---|
| Atajo Compose (los dos YAML) | dc() { docker compose -f compose.yaml -f compose.spark.yaml "$@"; } |
| JAR de ejemplos | /opt/spark/examples/jars/spark-examples_2.12-3.5.3.jar |
| SparkPi | clase org.apache.spark.examples.SparkPi |
| Wordcount Java | clase org.apache.spark.examples.JavaWordCount |
| Texto de los laboratorios | hdfs://namenode:9000/yarn/entrada/texto.txt |
| Portal YARN | http://localhost:8088 |
| UI del driver | http://localhost:4040 mientras el driver vive |
Requisitos previos:
- Laboratorio del cliente Spark terminado (
spark-client,dc, SparkPi de comprobación). - MapReduce y su taller de Streaming: sabes leer el tipo
MAPREDUCEy unpart-r-*. - Teoría de Spark: DAG, evaluación perezosa, driver, executors, aplicación / job / etapa / tarea.
Dónde se ejecuta cada orden:
- HOST — Bash en
~/hdfs-docker-lab. Aquí definesdc(se pierde al cerrar la ventana). - CLIENTE — órdenes Spark y Hadoop dentro de
spark-client(dc exec spark-client ...). - NAVEGADOR — ResourceManager
:8088. La UI Spark:4040solo existe con el driver arriba.
docker composea secas no vespark-client. Sidc psno lista ese servicio, el atajo no está leyendo el segundo YAML.
Mapa de los ejercicios:
| # | Ejercicio | Frente | Concepto | Dificultad |
|---|---|---|---|---|
| 0 | Clúster y cliente arriba | Infra | dc, no rehacer HDFS |
Básico |
| 1 | SparkPi y tipo SPARK |
Motor | Mismo YARN, otro tipo | Básico |
| 2 | Historia: MAPREDUCE frente a SPARK |
Motor | Dos motores, un portal | Básico |
| 3 | Wordcount Spark sobre el mismo texto | Motor | Shuffle en Spark | Intermedio |
| 4 | Comparar con el wordcount MapReduce | Motor | Mismo conteo, otro job | Intermedio |
| 5 | Aplicación, job, etapa, tarea | Modelo | Jerarquía de la teoría | Intermedio |
| 6 | Dónde está el driver | Arquitectura | Modo client | Intermedio |
| 7 | Dónde están los executors | Arquitectura | Contenedor YARN ≠ Docker | Medio-alto |
| 8 | Un Pi más largo y :4040 |
Observación | UI del driver | Medio-alto |
| 9 | Job en ACCEPTED |
Recursos | 2 GB por NodeManager | Medio-alto |
| 10 | Matar una aplicación Spark | Operación | KILLED vs SUCCEEDED |
Medio-alto |
| 11 | SparkPi no lee HDFS | Modelo | MapReduce π vs SparkPi | Intermedio |
| 12 | Reto integrador | Mixto | Explicar un DAG con evidencias | Alto |
Ejercicio 0. Clúster y cliente arriba
Objetivo: trabajar sobre el clúster ya montado, sin crear otro proyecto Compose.
Qué debes lograr:
- Estar en
~/hdfs-docker-labcon el atajodcactivo. - Ocho servicios, incluido
spark-client, en marcha (o arrancarlos sin recrear volúmenes). - Modo seguro OFF, tres DataNodes vivos, dos NodeManagers
RUNNING. /yarn/entrada/texto.txttodavía tiene las cuatro líneas de los laboratorios.
Análisis: ¿por qué docker compose ps a secas, sin el segundo archivo, no lista spark-client aunque el contenedor esté en marcha? Si el texto falta, ¿lo subes otra vez desde el cliente o desde el NameNode, y qué cambia?
Ejercicio 1. SparkPi y tipo SPARK
Objetivo: enviar SparkPi y reconocer el motor en el portal.
Qué debes lograr:
- Lanzar SparkPi con
spark-submiten modo client, masteryarn, desdespark-client. - Ver en la terminal una estimación cercana a 3,14.
- En
:8088, una aplicación de nombre tipo Spark Pi, tipoSPARK, estadoFINISHED / SUCCEEDED.
Análisis: en el laboratorio del cliente ya corriste SparkPi para comprobar que el contenedor hablaba con YARN. ¿Qué pregunta responde ahora, en este taller? ¿Por qué el tipo no es MAPREDUCE si YARN es el mismo?
Ejercicio 2. Historia: MAPREDUCE frente a SPARK
Objetivo: el portal mezcla motores. Tú los separas.
Qué debes lograr:
- Listar aplicaciones en todos los estados (
ALL). - Identificar al menos una
MAPREDUCE(π o wordcount de MapReduce) y unaSPARK(SparkPi). - Anotar Application ID, tipo y estado final de cada una.
Análisis: ¿qué pieza decide el tipo que ves: el ResourceManager, el ApplicationMaster o el JAR que enviaste? Si alguien dice “el job corrió en Hadoop”, ¿cómo contestas con esta tabla?
Ejercicio 3. Wordcount Spark sobre el mismo texto
Objetivo: un cálculo con shuffle (reagrupar por clave a través de la red), no solo π.
Qué debes lograr:
- Enviar
JavaWordCountsobrehdfs://namenode:9000/yarn/entrada/texto.txt. - Recuperar el conteo (este programa imprime en la salida estándar del driver; no tiene por qué dejar
part-*en HDFS). - Confirmar en
:8088otra aplicación tipoSPARK.
Análisis: ¿por qué este ejemplo sí necesita el archivo de HDFS y SparkPi no? Relaciónalo con las tres fases de MapReduce: ¿dónde está aquí el equivalente de map, shuffle y reduce?
Ejercicio 4. Comparar con el wordcount MapReduce
Objetivo: el mismo diccionario, dos motores.
Qué debes lograr:
- Releer un
part-r-*de MapReduce que ya tengas (/yarn/salida_wc,/yarn/teoria_mr_wco la salida de Streaming). - Poner lado a lado las seis claves: datos, hadoop, hdfs, mapreduce, spark, yarn.
- Si una salida MapReduce no existe, no montes un clúster nuevo: relanza el JAR de ejemplos Hadoop desde el cliente que ya usas, a un directorio de salida nuevo.
Análisis: si los números coinciden, ¿qué quedó demostrado y qué no? (pista: coincidir no prueba que Spark “sea MapReduce por dentro”.)
Ejercicio 5. Aplicación, job, etapa, tarea
Objetivo: usar los cuatro términos de la teoría con una corrida real.
Qué debes lograr:
- Para una aplicación Spark que hayas lanzado, decir: cuál es la aplicación YARN (
application_…), cuándo nació el job (qué acción lo disparó), si hubo más de una etapa, y qué es una tarea. - Apoyarte en
:8088(detalle de la app) y, si alcanzas a abrirla, en:4040(Jobs / Stages).
Análisis: SparkPi y el wordcount, ¿cuántos jobs YARN ves (uno o dos) y cuántas aplicaciones? ¿Por qué esa diferencia importa cuando alguien dice “lanzé dos jobs”?
Ejercicio 6. Dónde está el driver
Objetivo: modo client no es un adorno del YAML.
Qué debes lograr:
- Explicar, con evidencia, que el driver (quien arma el plan y recoge el resultado) no corre como contenedor YARN de los NodeManagers.
- Relacionarlo con
spark.submit.deployMode/--deploy-mode clienty con el hostnamespark-client.
Análisis: si el driver estuviera en un contenedor YARN (cluster mode), ¿podrías usar Jupyter con el kernel en spark-client como en el laboratorio del cliente? ¿Por qué sí o por qué no?
Ejercicio 7. Dónde están los executors
Objetivo: contenedor YARN ≠ contenedor Docker.
Qué debes lograr:
- Localizar en qué NodeManagers corrieron contenedores de tu aplicación Spark (intento, AM, executors).
- Comprobar que no apareció un
docker compose/dc psnuevo: siguen los mismos ocho servicios.
Análisis: un executor pide heap + overhead (en el laboratorio: 512 MiB + 384 MiB). ¿Cuántos executors caben a la vez en un NodeManager de 2 GB si también hay que alojar el ApplicationMaster? Muestra la cuenta.
Ejercicio 8. Un Pi más largo y :4040
Objetivo: la UI Spark no es el portal de YARN.
Qué debes lograr:
- Lanzar SparkPi con más slices (el entero al final del JAR) para que dure lo suficiente.
- Mientras corre, abrir http://localhost:4040 y anotar al menos: nombre de la app, número de executors, una etapa o un job.
- En
:8088, el estado durante la corrida (RUNNING) y al terminar (FINISHED).
Análisis: al acabar el spark-submit, :4040 deja de responder. :8088 sigue. ¿Qué proceso servía la 4040 y por qué muere con el driver en modo client?
Ejercicio 9. Job en ACCEPTED
Objetivo: YARN aceptó la app y aún no le dio contenedores.
Qué debes lograr:
- Dejar una aplicación Spark viva (un Pi largo, o no cerrar otra app) y lanzar otra Spark a la vez.
- Capturar el síntoma
ACCEPTED(portal oyarn application -list). - Liberar recursos y ver que la segunda pasa a
RUNNINGo que decides no lanzarla.
Análisis: ¿el cuello es HDFS, el cliente o la memoria de los NodeManagers? ¿Qué harías antes de subir spark.executor.memory?
Ejercicio 10. Matar una aplicación Spark
Objetivo: distinguir KILLED, FAILED y FINISHED / SUCCEEDED.
Qué debes lograr:
- Lanzar un SparkPi largo.
- Desde otra terminal, matar esa aplicación YARN por su
application_…. - Dejar evidencia del estado final y de que los contenedores volvieron al pool (
yarn node -list/ métricas de:8088).
Análisis: ¿matar la aplicación YARN mata el spark-submit del driver? ¿Qué verías en la terminal del cliente?
Ejercicio 11. SparkPi no lee HDFS
Objetivo: no todo trabajo Spark es “leer un txt y contar”.
Qué debes lograr:
- Contrastar SparkPi (sin
-inputde texto) con el wordcount Spark y con el π de MapReduce (QuasiMonteCarlo). - Una frase por cada uno: ¿lee HDFS? ¿hay shuffle de palabras? ¿para qué sirve en este libro?
Análisis: “Spark siempre trabaja en memoria sobre archivos de HDFS”. Con estas tres corridas, ¿dónde se rompe esa frase?
Ejercicio 12. Reto integrador
Diseña una corrida (SparkPi o wordcount) y entrega un párrafo con evidencias, no un diario de comandos, que cubra:
- Qué aplicación YARN fue (ID, tipo
SPARK, estado). - Quién fue el driver y quiénes los executors (máquinas / servicios).
- Si hubo shuffle o no, y cómo lo sabes.
- Qué habría sido otro job MapReduce si hubieras encadenado dos pasos, y por qué Spark lo cuenta como un DAG de etapas.
- Qué no demostraste (por ejemplo: DataFrames, SQL, que “todo cabe en RAM”).
Diagnóstico
| Síntoma | Hacia dónde mirar |
|---|---|
dc no lista spark-client |
Atajo sin el segundo YAML; ventana de terminal nueva |
Connection refused a 9000 u 8088 |
Clúster HDFS/YARN no listo; no es un fallo de Spark |
ACCEPTED eterno |
Otra Spark viva; 2 GB por NM; spark.stop / matar apps |
:4040 no abre |
El spark-submit ya terminó (el driver se fue) |
| Wordcount “Path does not exist” | Falta /yarn/entrada/texto.txt (laboratorio del cliente o de YARN) |
Tipo MAPREDUCE cuando esperabas Spark |
Enviaste el JAR de Hadoop, no spark-submit |
Listo cuando: tienes al menos una app SPARK de SparkPi y una de wordcount, sabes separarlas de las MAPREDUCE del portal, y puedes decir dónde corrió el driver y dónde los executors.
Soluciones de referencia
Consulta esta sección después de intentar cada ejercicio. Los comandos se ejecutan en HOST, dentro de ~/hdfs-docker-lab, con el atajo dc definido. Los identificadores application_… y las cifras exactas cambian en cada corrida.
Para no repetir las rutas largas, define también estas variables en la misma terminal:
dc() { docker compose -f compose.yaml -f compose.spark.yaml "$@"; }
SUBMIT="/opt/spark/bin/spark-submit --master yarn --deploy-mode client"
JAR=/opt/spark/examples/jars/spark-examples_2.12-3.5.3.jar
Ejercicio 0
cd ~/hdfs-docker-lab
dc ps
dc start        # solo si hay servicios detenidos; no recrea volúmenes
dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -safemode get
dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -report | grep "Live datanodes"
dc exec spark-client /opt/hadoop/bin/yarn node -list
dc exec spark-client /opt/hadoop/bin/hdfs dfs -cat /yarn/entrada/texto.txt
Análisis. docker compose a secas lee solo compose.yaml, que describe HDFS y YARN; spark-client está definido en compose.spark.yaml, así que no aparece. Si falta el texto, súbelo desde el cliente (paso 8 del laboratorio del cliente Spark): el resultado en HDFS es el mismo, solo cambia desde qué contenedor se ejecuta el comando.
Ejercicio 1
dc exec spark-client $SUBMIT --class org.apache.spark.examples.SparkPi $JAR 10Busca Pi is roughly 3.14… entre los mensajes. En :8088, la aplicación se llama Spark Pi, tipo SPARK, FINISHED / SUCCEEDED.
Análisis. En el laboratorio, SparkPi respondía “¿el cliente habla con YARN?”. Aquí responde “¿qué motor usó YARN?”: el mismo ResourceManager registra la aplicación con otro tipo porque la envió otro cliente.
Ejercicio 2
dc exec spark-client /opt/hadoop/bin/yarn application -list -appStates ALLAnálisis. El tipo lo declara el cliente que envía la aplicación: spark-submit la registra como SPARK y el cliente de MapReduce (yarn jar con un JAR de MapReduce) como MAPREDUCE. El ResourceManager solo lo anota. “Corrió en Hadoop” no dice nada: la pregunta útil es qué motor la envió y en qué cola corrió.
Ejercicio 3
dc exec spark-client $SUBMIT --class org.apache.spark.examples.JavaWordCount $JAR \
  hdfs://namenode:9000/yarn/entrada/texto.txt
Salida esperada (el orden de las líneas puede variar, y van mezcladas con mensajes de log):
hadoop: 3
hdfs: 1
yarn: 3
mapreduce: 1
spark: 1
datos: 3
Análisis. SparkPi genera sus números al azar; el wordcount necesita un archivo que leer. En el programa, partir las líneas en palabras y formar pares (palabra, 1) es el map; reduceByKey provoca el shuffle y la suma es el reduce.
Ejercicio 4
dc exec spark-client /opt/hadoop/bin/hdfs dfs -ls /yarn
dc exec spark-client /opt/hadoop/bin/hdfs dfs -cat /yarn/salida_wc/part-r-00000
Si no existe ninguna salida de MapReduce, genera una nueva desde el mismo cliente:
dc exec spark-client /opt/hadoop/bin/yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  wordcount /yarn/entrada/texto.txt /yarn/taller_spark_mr_wc
dc exec spark-client /opt/hadoop/bin/hdfs dfs -cat /yarn/taller_spark_mr_wc/part-r-00000
Análisis. Que los conteos coincidan demuestra que ambos motores calcularon bien el mismo problema. No demuestra que Spark use MapReduce por dentro: son motores distintos que comparten HDFS, YARN y la idea de agrupar por clave.
Ejercicio 5
Análisis. Cada spark-submit es una aplicación YARN. SparkPi dispara un job (la acción reduce final) con una etapa, porque no hay shuffle: cada tarea suma sus dardos y el driver combina los resultados. El wordcount dispara un job (la acción collect) con dos etapas, separadas por el shuffle de reduceByKey. Una tarea es una etapa aplicada a una partición: SparkPi con 10 crea diez tareas en su única etapa. “Lancé dos jobs” suele querer decir “dos aplicaciones”: en la UI de Spark, cada una tiene su propia lista de jobs.
Ejercicio 6
Mientras corre una aplicación (por ejemplo, la del ejercicio 8), abre http://localhost:4040, pestaña Environment, y busca spark.submit.deployMode = client y spark.driver.host = spark-client. En :8088, el contenedor del ApplicationMaster de una aplicación en modo client no ejecuta tu programa: solo pide executors.
Análisis. En modo cluster el driver correría dentro de un contenedor YARN, en un NodeManager. El kernel de Jupyter necesita el driver en su propio proceso para devolver resultados a las celdas, así que no podrías trabajar interactivamente desde spark-client.
Ejercicio 7
Con una aplicación en marcha:
dc exec spark-client /opt/hadoop/bin/yarn applicationattempt -list <application_id>
dc exec spark-client /opt/hadoop/bin/yarn container -list <appattempt_id>
dc ps
Verás tres contenedores YARN —el ApplicationMaster y dos executors— repartidos entre nodemanager1 y nodemanager2, y los mismos ocho servicios de siempre en dc ps. Para una aplicación terminada, la misma información está en el detalle de la aplicación en :8088.
Análisis. Cada executor pide 512 MiB de heap + 384 MiB de overhead = 896 MiB. YARN redondea cada petición al múltiplo de yarn.scheduler.minimum-allocation-mb (256 MiB) inmediatamente superior: 1024 MiB. Un NodeManager ofrece 2048 MiB, así que caben dos contenedores por nodo: el que aloja al ApplicationMaster (512 + 384 MiB, también redondeado a 1024) solo tiene sitio para un executor más. En todo el clúster caben cuatro contenedores; una aplicación usa tres.
Ejercicio 8
dc exec spark-client $SUBMIT --class org.apache.spark.examples.SparkPi $JAR 2000Mientras corre, abre http://localhost:4040: nombre Spark Pi, dos executors en Executors y una etapa con 2000 tareas en Stages. En :8088 la aplicación aparece RUNNING y, al terminar, FINISHED.
Análisis. La UI del puerto 4040 la sirve el driver. En modo client el driver es el proceso spark-submit dentro de spark-client: cuando termina, el puerto deja de responder. El portal de YARN lo sirve el ResourceManager, que sigue vivo.
Ejercicio 9
En una terminal, lanza un SparkPi largo (2000 o más). Mientras corre, en otra terminal (define otra vez dc, SUBMIT y JAR):
dc exec spark-client $SUBMIT --class org.apache.spark.examples.SparkPi $JAR 100
dc exec spark-client /opt/hadoop/bin/yarn application -list
La segunda aplicación queda en ACCEPTED. En su detalle en :8088, o con yarn application -status, el diagnóstico dice Queue's AM resource limit exceeded, con AM Resource Request = <memory:1024, vCores:1>. Cuando la primera termina, la segunda pasa a RUNNING.
Análisis. El cuello no es HDFS ni el cliente: es la capacidad de YARN. La cola default reserva solo una fracción del clúster para ApplicationMasters y la primera aplicación ya ocupa tres de los cuatro contenedores posibles. Antes de subir spark.executor.memory, revisa qué otras aplicaciones siguen vivas: subir la memoria hace que quepan menos contenedores.
Ejercicio 10
dc exec spark-client /opt/hadoop/bin/yarn application -list
dc exec spark-client /opt/hadoop/bin/yarn application -kill <application_id>
dc exec spark-client /opt/hadoop/bin/yarn application -status <application_id>
El estado final es KILLED. En :8088, las métricas del clúster vuelven a mostrar la memoria libre.
Análisis. Sí: al morir el ApplicationMaster, el driver pierde a sus executors y el spark-submit termina con un error que indica que la aplicación ya terminó o fue cancelada. KILLED significa que alguien la canceló; FAILED, que falló por sí misma; FINISHED / SUCCEEDED, que terminó bien.
Ejercicio 11
| Corrida | ¿Lee datos de HDFS? | ¿Shuffle de palabras? | Para qué sirve en este libro |
|---|---|---|---|
| SparkPi | No; genera números al azar | No | Probar que spark-submit habla con YARN y observar el motor sin datos |
| Wordcount Spark | Sí, el texto de cuatro líneas | Sí, en reduceByKey |
Ver un DAG de dos etapas con shuffle |
π de MapReduce (QuasiMonteCarlo) |
No lee un texto; usa HDFS para sus archivos de trabajo | No hay palabras; un reduce combina los resultados | Ver las fases map y reduce del motor clásico |
Análisis. La frase falla dos veces: SparkPi no lee archivos de HDFS, y el wordcount, aunque cabe en memoria, necesita shuffle, que pasa por disco y red.
Ejercicio 12
Un ejemplo de párrafo con el wordcount:
La aplicación
application_…_0012, de tipoSPARK, terminóFINISHED / SUCCEEDED. El driver corrió enspark-clienten modo client (spark.submit.deployMode = clienten la pestaña Environment), y los dos executors ennodemanager1ynodemanager2, como contenedores YARN. Hubo shuffle: la UI muestra dos etapas, y la segunda leyó los datos que escribió la primera (Shuffle Read en Stages). En MapReduce, añadir un segundo paso —por ejemplo, ordenar las palabras por frecuencia— exigiría otro trabajo que leyera de HDFS la salida del primero; Spark lo añade como una etapa más del mismo DAG. No demostré nada sobre DataFrames ni SQL, ni que los datos quepan siempre en memoria.
Hoja de referencia
| Para | Comando |
|---|---|
| Definir el atajo | dc() { docker compose -f compose.yaml -f compose.spark.yaml "$@"; } |
| Ver el proyecto, aunque esté apagado | docker compose ls -a |
| Encender todo | dc up -d |
| Estado de los contenedores | dc ps -a |
| Esperar a HDFS | dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -safemode wait |
| DataNodes vivos | dc exec spark-client /opt/hadoop/bin/hdfs dfsadmin -report |
| Nodos de YARN | dc exec spark-client /opt/hadoop/bin/yarn node -list |
| Aplicaciones de YARN | dc exec spark-client /opt/hadoop/bin/yarn application -list -appStates ALL |
| Registros de una aplicación | dc exec spark-client /opt/hadoop/bin/yarn logs -applicationId <id> |
| Listar HDFS | dc exec spark-client /opt/hadoop/bin/hdfs dfs -ls / |
| Registro de un contenedor | dc logs --tail 30 <servicio> |
| Abrir una terminal en el cliente | dc exec spark-client bash |
| Memoria por contenedor | docker stats --no-stream |
| Apagar sin borrar | dc stop |
Lista de verificación
dcestá definido en cada terminal que usas.dc ps -amuestra ocho contenedores enUp.- HDFS dice
Safe mode is OFFy tiene tres DataNodes vivos. - YARN tiene dos NodeManagers en
RUNNING. - Jupyter usa el kernel Python del clúster.
- Al terminar: notebooks guardados,
spark.stop(), Ctrl+C a Jupyter ydc stop.
Prácticas
- Apaga el clúster con
dc stop, vuelve a encenderlo con los pasos de la sección 3 y comprueba condc exec spark-client /opt/hadoop/bin/hdfs dfs -cat /yarn/entrada/texto.txtque el archivo del laboratorio del cliente Spark sigue ahí. - Ejecuta
dc ps -adespués de apagar y explica el código de salida denamenodey el despark-client. - Abre una
SparkSessionen Jupyter, entra alocalhost:4040y ubica el nombre de la aplicación. Cierra la sesión conspark.stop()y vuelve a cargar la página. ¿Qué pasa? - Explica con tus palabras por qué
docker compose up -ddeja el clúster encendido pero rompe el taller de MapReduce Streaming.
- El archivo debe mostrar sus cuatro líneas:
dc stopno toca los volúmenes de HDFS. SicatdiceNo such file or directory, revisa que estés en el proyectohdfs-labcondocker compose ls -a. - Lo esperado es
Exited (143)ennamenode, apagado normal por SIGTERM, yExited (137)enspark-client, que Docker detiene a la fuerza después de 10 segundos porquesleep infinityignora la señal. - La página muestra la aplicación mientras la sesión está abierta. Después de
spark.stop()el navegador no conecta: la Spark UI vive dentro del driver y se apaga con él. El ResourceManager, enlocalhost:8088, sí conserva la aplicación comoFINISHED. docker compose up -dlee solocompose.yaml, donde los NodeManagers no montancpython311. Compose ve una configuración distinta, recrea los dos NodeManagers sin el volumen y los deja funcionando. YARN los ve sanos, pero cuando Hadoop Streaming intenta lanzar/opt/python/bin/python3en ellos, el archivo no existe.
Glosario
| Término | Significado en este apéndice |
|---|---|
| Proyecto de Compose | Conjunto de contenedores, redes y volúmenes que Compose maneja con un nombre; aquí, hdfs-lab. |
| Overlay | Segundo archivo de Compose que se aplica sobre el primero. |
dc |
Atajo que llama a Compose con los dos archivos del clúster. |
| Volumen con nombre | Disco administrado por Docker que sobrevive a los contenedores. |
| Puerto publicado | Puerto del contenedor conectado con uno de tu equipo. |
| Modo seguro | Estado de arranque en el que HDFS no acepta escrituras. |
| Código de salida | Número con el que termina un proceso; 128 + n indica que lo terminó la señal n. |
| SIGTERM y SIGKILL | Señales de apagado: la primera pide terminar; la segunda obliga. |
| Token de Jupyter | Código de un solo arranque que autoriza al navegador a entrar en Jupyter. |
Referencias para profundizar
- Docker. Merge Compose files.
- Docker. docker compose stop y docker compose down.
- Apache Hadoop 3.4.1. HDFS Commands Guide: dfsadmin.
- Apache Hadoop 3.4.1. YARN Commands.
- Apache Spark 3.5.3. Monitoring and Instrumentation: la Spark UI y el puerto 4040.
Resumen
El clúster son ocho contenedores en el proyecto hdfs-lab, descritos por dos archivos de Compose; el atajo dc los usa siempre juntos y evita que los NodeManagers pierdan el Python del clúster. Encender es una secuencia: Docker, dc up -d, HDFS fuera del modo seguro con tres DataNodes, YARN con dos nodos y, en otra terminal, Jupyter. Los talleres llegan a Jupyter copiándolos en ~/hdfs-docker-lab/notebooks. Para apagar basta dc stop, que conserva todo; dc down -v borra los datos. Y cuando algo falla, la tabla de la sección 7 distingue lo que es arranque normal de lo que necesita arreglo. Los trece ejercicios de la sección 8 sirven para practicar todo eso con aplicaciones Spark reales.