%%writefile pipeline_envios.py
"""Pipeline de ingesta incremental de BITLogística (empresa ficticia, datos sintéticos).

Lo escribe el capítulo «Pipelines de ingesta y cargas incrementales» y lo reutilizan
los capítulos de calidad y de orquestación.
"""
from datetime import datetime

from pyspark.sql import Window
from pyspark.sql import functions as F

COLUMNAS = ["guia", "fecha_admision", "hora_admision", "origen", "destino", "distancia_km",
            "servicio", "canal", "operador", "peso_kg", "valor_declarado", "intentos_entrega",
            "estado", "fecha_hora_entrega"]

CIUDADES = ["Bogotá", "Medellín", "Cali", "Barranquilla", "Cartagena", "Bucaramanga",
            "Pereira", "Manizales", "Ibagué", "Villavicencio", "Santa Marta", "Neiva",
            "Cúcuta", "Montería", "Pasto"]
REMOTAS = ["Cúcuta", "Montería", "Pasto"]
ALIAS_CIUDAD = {"bogota d.c.": "Bogotá", "santiago de cali": "Cali", "b/quilla": "Barranquilla"}
ALIAS_SERVICIO = {"express": "Express", "expres": "Express",
                  "estandar": "Estándar", "economico": "Económico"}
PROMESA_HORAS = {"Express": 24, "Estándar": 72, "Económico": 120}
DIAS = ["domingo", "lunes", "martes", "miércoles", "jueves", "viernes", "sábado"]

REGLAS = [
    ("guia_vacia", "guia IS NULL"),
    ("peso_fuera_de_rango", "peso_kg IS NULL OR peso_kg < 0.01 OR peso_kg > 150"),
    ("distancia_no_positiva", "distancia_km IS NULL OR distancia_km <= 0"),
    ("ciudad_desconocida", "origen IS NULL OR destino IS NULL"),
    ("servicio_desconocido", "servicio IS NULL"),
    ("admision_invalida", "admision IS NULL"),
    ("entregado_sin_fecha", "estado = 'entregado' AND entrega IS NULL"),
    ("entrega_antes_de_admision", "entrega < admision"),
]


def llave(columna):
    """Texto comparable: sin espacios a los lados, en minúsculas y sin tildes."""
    return F.translate(F.lower(F.trim(columna)), "áéíóú", "aeiou")


def _mapa(pares):
    return F.create_map(*[F.lit(x) for par in pares.items() for x in par])


MAPA_CIUDAD = {**{c.lower().translate(str.maketrans("áéíóú", "aeiou")): c for c in CIUDADES}, **ALIAS_CIUDAD}


# ---------------------------------------------------------------- archivos
def sistema(spark, ruta):
    camino = spark.sparkContext._jvm.org.apache.hadoop.fs.Path(ruta)
    return camino, camino.getFileSystem(spark.sparkContext._jsc.hadoopConfiguration())


def existe(spark, ruta):
    camino, fs = sistema(spark, ruta)
    return fs.exists(camino)


def archivos_en_llegada(spark, llegada):
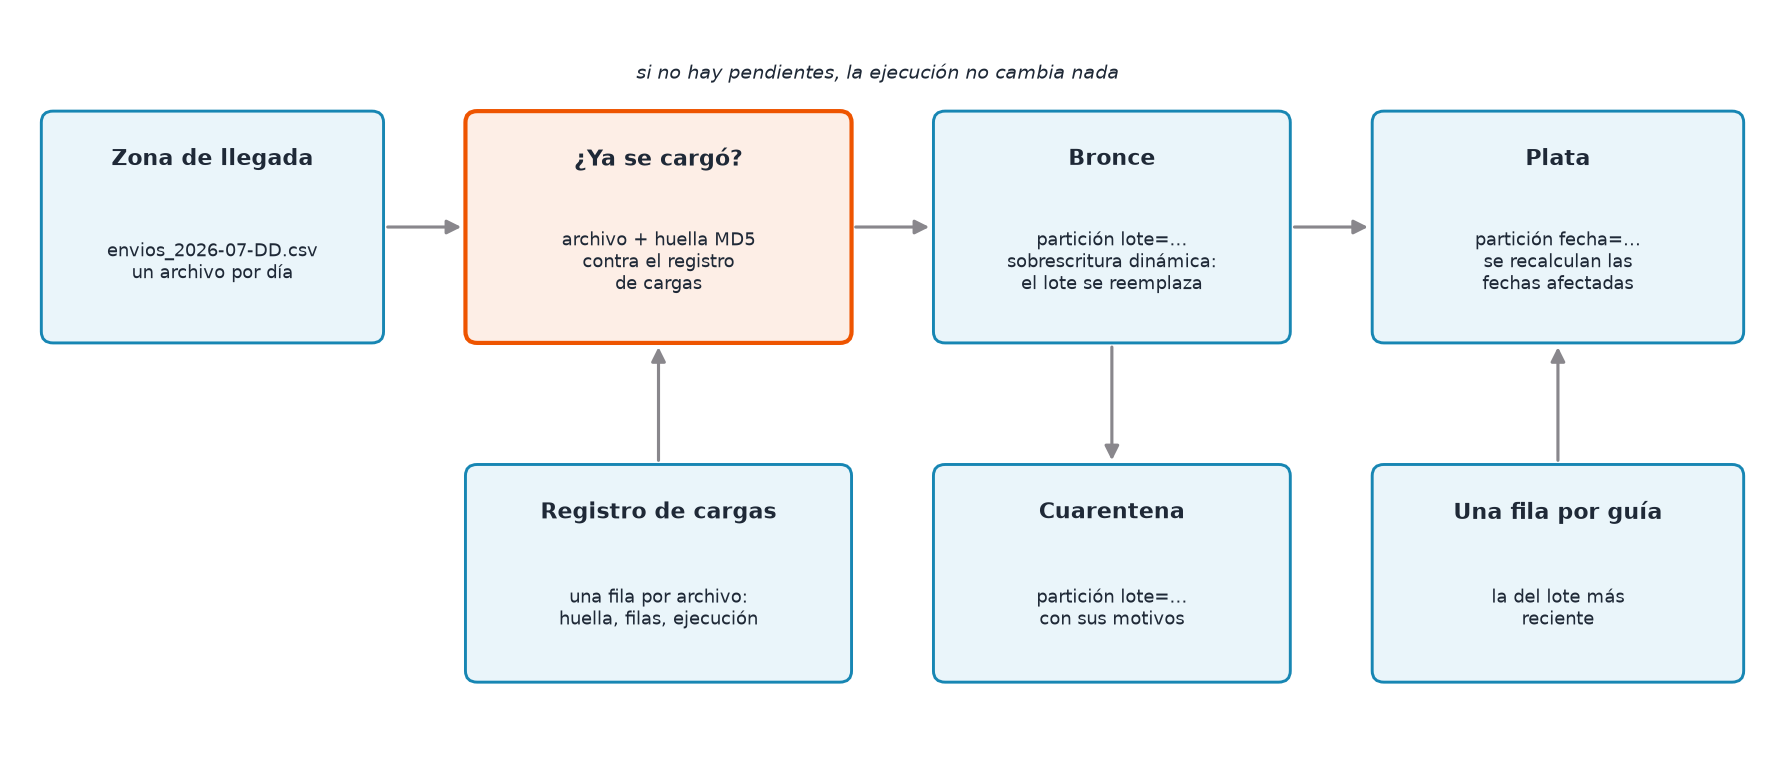
    """Una fila por CSV en la zona de llegada, con su lote y la huella MD5 de su contenido."""
    return (
        spark.read.format("binaryFile").option("pathGlobFilter", "envios_*.csv").load(llegada)
        .select(
            F.element_at(F.split("path", "/"), -1).alias("archivo"),
            F.regexp_extract("path", r"envios_(\d{4}-\d{2}-\d{2})", 1).alias("lote"),
            F.col("length").alias("bytes"),
            F.md5("content").alias("huella"),
            "path",
        )
    )


def pendientes(spark, rutas):
    """Archivos que no están en el registro de cargas con esa misma huella."""
    llegados = archivos_en_llegada(spark, rutas["llegada"])
    if not existe(spark, rutas["control"]):
        return llegados
    cargados = spark.read.parquet(rutas["control"]).select("archivo", "huella")
    return llegados.join(cargados, ["archivo", "huella"], "left_anti")


# ---------------------------------------------------------------- transformaciones
def leer_lote(spark, ruta, archivo, lote, id_ejecucion):
    """Bronce: el CSV tal como llegó, todo como texto, con su procedencia."""
    return (
        spark.read.option("header", True).csv(ruta)
        .select(*[F.col(c).cast("string") for c in COLUMNAS])
        .withColumn("archivo_origen", F.lit(archivo))
        .withColumn("id_ejecucion", F.lit(id_ejecucion))
        .withColumn("fecha_carga", F.current_timestamp())
        .withColumn("lote", F.to_date(F.lit(lote)))
    )


def normalizar(bronce):
    """Corrige variantes de escritura y convierte los tipos. Lo que no se reconoce queda nulo."""
    ciudades, servicios = _mapa(MAPA_CIUDAD), _mapa(ALIAS_SERVICIO)
    return (
        bronce
        .withColumn("guia", F.trim("guia"))
        .withColumn("origen", ciudades[llave(F.col("origen"))])
        .withColumn("destino", ciudades[llave(F.col("destino"))])
        .withColumn("servicio", servicios[llave(F.col("servicio"))])
        .withColumn("admision", F.to_timestamp(F.concat_ws(" ", "fecha_admision", "hora_admision"),
                                               "yyyy-MM-dd HH:mm"))
        .withColumn("entrega", F.to_timestamp("fecha_hora_entrega", "yyyy-MM-dd HH:mm"))
        .withColumn("peso_kg", F.col("peso_kg").cast("double"))
        .withColumn("distancia_km", F.col("distancia_km").cast("int"))
        .withColumn("valor_declarado", F.col("valor_declarado").cast("long"))
        .withColumn("intentos_entrega", F.col("intentos_entrega").cast("int"))
        .withColumn("operador", F.coalesce(F.col("operador"), F.lit("Sin operador")))
    )


def validar(normalizada, reglas=REGLAS):
    """Agrega la columna motivos con el nombre de cada regla que la fila incumple."""
    marcas = [F.when(F.expr(condicion), F.lit(nombre)) for nombre, condicion in reglas]
    return normalizada.withColumn("motivos", F.array_compact(F.array(*marcas)))


def quitar_duplicados(validos):
    """Una fila por guía: la del lote más reciente y, dentro de él, la del archivo más reciente."""
    orden = Window.partitionBy("guia").orderBy(F.desc("lote"), F.desc("archivo_origen"))
    return validos.withColumn("n", F.row_number().over(orden)).filter("n = 1").drop("n")


def a_plata(validos):
    """Columnas de negocio, iguales a las de la plata del taller de PySpark, más la procedencia."""
    promesa = _mapa(PROMESA_HORAS)
    return (
        validos
        .select("guia", "admision", "entrega", "origen", "destino", "distancia_km", "servicio",
                "canal", "operador", "peso_kg", "valor_declarado", "intentos_entrega", "estado",
                "archivo_origen", "lote", "id_ejecucion")
        .withColumn("promesa_horas", promesa[F.col("servicio")])
        .withColumn("horas_transito",
                    F.round((F.unix_timestamp("entrega") - F.unix_timestamp("admision")) / 3600, 1))
        .withColumn("a_tiempo", F.when(F.col("estado") == "entregado",
                                       F.col("horas_transito") <= F.col("promesa_horas")))
        .withColumn("ruta", F.concat_ws(" - ", "origen", "destino"))
        .withColumn("dia_semana", F.element_at(F.array(*[F.lit(d) for d in DIAS]), F.dayofweek("admision")))
        .withColumn("fin_de_semana", F.dayofweek("admision").isin(1, 6, 7))
        .withColumn("destino_remoto", F.col("destino").isin(*REMOTAS))
        .withColumn("fecha", F.to_date("admision"))
    )


# ---------------------------------------------------------------- una ejecución
def cargar_pendientes(spark, rutas, id_ejecucion):
    """Carga incremental e idempotente de los archivos nuevos o cambiados de la zona de llegada."""
    inicio = datetime.now()
    nuevos = pendientes(spark, rutas).orderBy("lote", "archivo").collect()
    if not nuevos:
        return {"id_ejecucion": id_ejecucion, "archivos": 0, "lotes": [], "fechas_recalculadas": 0}

    # Si llegaron dos versiones del mismo lote, gana la última por nombre (…_v2 después de …)
    por_lote = {}
    for archivo in nuevos:
        por_lote[archivo["lote"]] = archivo
    lotes = sorted(por_lote)

    # Fechas que tenían estos lotes antes de reemplazarlos: también hay que recalcularlas
    fechas = set()
    if existe(spark, rutas["bronce"]):
        anteriores = spark.read.parquet(rutas["bronce"]).filter(F.col("lote").isin(lotes))
        fechas |= {f[0] for f in anteriores.select("fecha_admision").distinct().collect()}

    # 1. Bronce: cada lote reemplaza su propia partición (sobrescritura dinámica)
    tablas = [leer_lote(spark, a["path"], a["archivo"], a["lote"], id_ejecucion) for a in por_lote.values()]
    bronce_nuevo = tablas[0]
    for tabla in tablas[1:]:
        bronce_nuevo = bronce_nuevo.unionByName(tabla)
    bronce_nuevo.write.mode("overwrite").partitionBy("lote").parquet(rutas["bronce"])
    bronce = spark.read.parquet(rutas["bronce"])
    nuevo = bronce.filter(F.col("lote").isin(lotes))
    fechas |= {f[0] for f in nuevo.select("fecha_admision").distinct().collect()}
    fechas = sorted(f for f in fechas if f)

    # 2. Cuarentena de los lotes nuevos
    validada_nueva = validar(normalizar(nuevo))
    (validada_nueva.filter(F.size("motivos") > 0)
     .write.mode("overwrite").partitionBy("lote").parquet(rutas["cuarentena"]))

    # 3. Plata: se recalculan completas las fechas afectadas, con filas de todos los lotes
    afectadas = validar(normalizar(bronce.filter(F.col("fecha_admision").isin(fechas))))
    plata = a_plata(quitar_duplicados(afectadas.filter(F.size("motivos") == 0)))
    plata.write.mode("overwrite").partitionBy("fecha").parquet(rutas["plata"])

    # 4. Registro de cargas: una fila por archivo procesado
    resumen = (
        validada_nueva.groupBy("archivo_origen", "lote")
        .agg(F.count("*").alias("filas_leidas"),
             F.sum(F.when(F.size("motivos") > 0, 1).otherwise(0)).alias("filas_cuarentena"))
    )
    huellas = spark.createDataFrame([(a["archivo"], a["huella"], a["bytes"]) for a in nuevos],
                                    "archivo string, huella string, bytes long")
    registro = (
        huellas.join(resumen.withColumnRenamed("archivo_origen", "archivo"), "archivo", "left")
        .withColumn("id_ejecucion", F.lit(id_ejecucion))
        .withColumn("inicio", F.lit(inicio))
        .withColumn("fin", F.current_timestamp())
        .na.fill(0, ["filas_leidas", "filas_cuarentena"])
    )
    registro.write.mode("append").parquet(rutas["control"])
    return {"id_ejecucion": id_ejecucion, "archivos": len(nuevos), "lotes": lotes,
            "fechas_recalculadas": len(fechas)}