18Spark SQL y DataFrames: transformaciones y modelado de datos
big-data
ingenieria-datos
spark-sql
pyspark
modelado
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de octubre de 2026
El problema que vas a resolver
En BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) trabajan dos equipos sobre los mismos datos. Los analistas escriben SQL desde hace años y quieren hacer sus propias preguntas a la capa plata sin pedirle código a nadie. Los ingenieros de datos escriben Python y mantienen los procesos que llevan los archivos de la zona de llegada hasta el oro. Cada equipo pregunta lo mismo: ¿tengo que aprender la herramienta del otro?, ¿cuál de las dos formas es más rápida?, ¿no sería más simple bajar los datos a pandas?
Este capítulo responde con mediciones en el clúster. Spark SQL es el motor de Spark para datos en tablas, y desde Python se usa de dos maneras: escribiendo SQL o encadenando métodos de DataFrame. Las dos llegan al mismo optimizador y al mismo plan. Después, con ese motor, construyes el modelo que los dos equipos van a compartir: una tabla de hechos de envíos y sus dimensiones, registradas como tablas que se consultan por nombre.
Ficha
En este capítulo
Pregunta
¿Por qué Spark SQL es la forma recomendada de transformar y consultar datos en Spark, y cómo se construye con él un modelo que el negocio pueda consultar?
Datos
Las capas bronce, cuarentena y plata del caso BITLogística: 32 064 envíos limpios, y una copia multiplicada por diez para medir
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_spark_sql.ipynb dentro de talleres-notebooks.zip. Necesita las capas /bitlogistica/bronce, /bitlogistica/cuarentena y /bitlogistica/plata del taller de PySpark: si borraste /bitlogistica, vuelve a ejecutar ese taller hasta la etapa 5.
El capítulo escribe el modelo en /bitlogistica/modelo, menos de 2 MB que se conservan para los capítulos siguientes, y unos 8 MB de pruebas en /bitlogistica/laboratorio_sql, que la última celda borra.
Los tiempos de las salidas se midieron en el clúster de los laboratorios, con dos executors de un núcleo, y cambian de una ejecución a otra. Importa la comparación entre variantes en la misma ejecución, no la cifra exacta.
1. La sesión y las funciones de apoyo
La sesión se abre con una opción nueva, spark.sql.warehouse.dir, que dice dónde guarda Spark las tablas que crea por su cuenta.
NotaBodega de tablas (warehouse)
La bodega de tablas es la carpeta donde Spark guarda los archivos de las tablas que crea sin que le digas dónde. Por defecto es spark-warehouse en la carpeta local del driver, que los executors de otros contenedores no ven. En un clúster se apunta a HDFS: aquí, /bitlogistica/warehouse.
import platformimport reimport statisticsimport timeimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdimport pysparkfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as FBASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"MODELO = BASE +"/modelo"LAB = BASE +"/laboratorio_sql"spark = ( SparkSession.builder .appName("spark-sql-modelado") .config("spark.ui.showConsoleProgress", "false") .config("spark.sql.warehouse.dir", BASE +"/warehouse") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"print("Python", platform.python_version(), "| Spark", spark.version, "| pandas", pd.__version__)print("master:", sc.master, "| aplicación:", sc.applicationId)print("catálogo:", spark.conf.get("spark.sql.catalogImplementation"),"| bodega:", spark.conf.get("spark.sql.warehouse.dir"))
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/10/27 15:00:15 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
26/10/27 15:00:18 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
La sesión quedó en YARN (master: yarn), con Spark 3.5.3. La última línea muestra dos datos que se usan en la sección 10: el catálogo es in-memory y la bodega está en HDFS, en /bitlogistica/warehouse.
La segunda celda define cuatro funciones de apoyo y registra la plata como vista:
existe(ruta) y borrar(ruta) consultan y eliminan carpetas de HDFS con la API de Hadoop.
medir(funcion) ejecuta una acción tres veces y devuelve la mediana de los segundos, como en el capítulo de almacenamiento.
plan_fisico(tabla) devuelve el plan físico que eligió el optimizador, como texto. Le quita los números internos que Spark agrega a cada columna (servicio#6), que cambian entre una consulta y otra aunque el plan sea el mismo; así dos planes se pueden comparar con ==.
createOrReplaceTempView("plata") le da a la plata un nombre que SQL puede usar.
Path = spark._jvm.org.apache.hadoop.fs.PathCONF = sc._jsc.hadoopConfiguration()def existe(ruta): carpeta = Path(ruta)return carpeta.getFileSystem(CONF).exists(carpeta)def borrar(ruta): carpeta = Path(ruta)return carpeta.getFileSystem(CONF).delete(carpeta, True)def medir(funcion, repeticiones=3):"""Ejecuta la función varias veces y devuelve la mediana de los segundos.""" tiempos = []for _ inrange(repeticiones): inicio = time.perf_counter() funcion() tiempos.append(time.perf_counter() - inicio)return statistics.median(tiempos)def plan_fisico(tabla):"""Plan físico elegido por Catalyst, sin los números internos de las columnas (#123).""" texto = tabla._jdf.queryExecution().sparkPlan().toString()return re.sub(r"#\d+L?", "", texto)plata = spark.read.parquet(PLATA)plata.createOrReplaceTempView("plata")print("Filas en plata:", plata.count())print("Vistas temporales:", [t.name for t in spark.catalog.listTables()])
Filas en plata: 32064
Vistas temporales: ['plata']
La plata tiene 32 064 envíos y la sesión ya conoce una vista, plata. Desde aquí, la misma tabla se puede consultar como variable de Python (plata) o como nombre en SQL (FROM plata).
2. Qué es Spark SQL y frente a qué se compara
NotaSpark SQL
Spark SQL es el módulo de Spark para datos con estructura de tabla. Recibe consultas, las optimiza y las ejecuta en el clúster. Tiene dos puertas de entrada que en Python se usan con la misma sesión: el lenguaje SQL, con spark.sql("SELECT …"), y la API de DataFrames, con métodos como filter, groupBy y las funciones de pyspark.sql.functions. Cuando se habla de «PySpark SQL», se habla de este módulo usado desde Python.
NotaConsulta declarativa y Catalyst
Una consulta declarativa dice qué resultado se quiere y no cómo calcularlo. SQL es declarativo, y la API de DataFrames también, aunque se escriba con métodos de Python. Eso permite que un optimizador decida el cómo. El de Spark se llama Catalyst: convierte la consulta en un plan lógico, lo reescribe con reglas (leer solo las columnas necesarias, filtrar lo antes posible, eliminar cálculos que nadie usa) y elige un plan físico, por ejemplo qué tipo de unión usar.
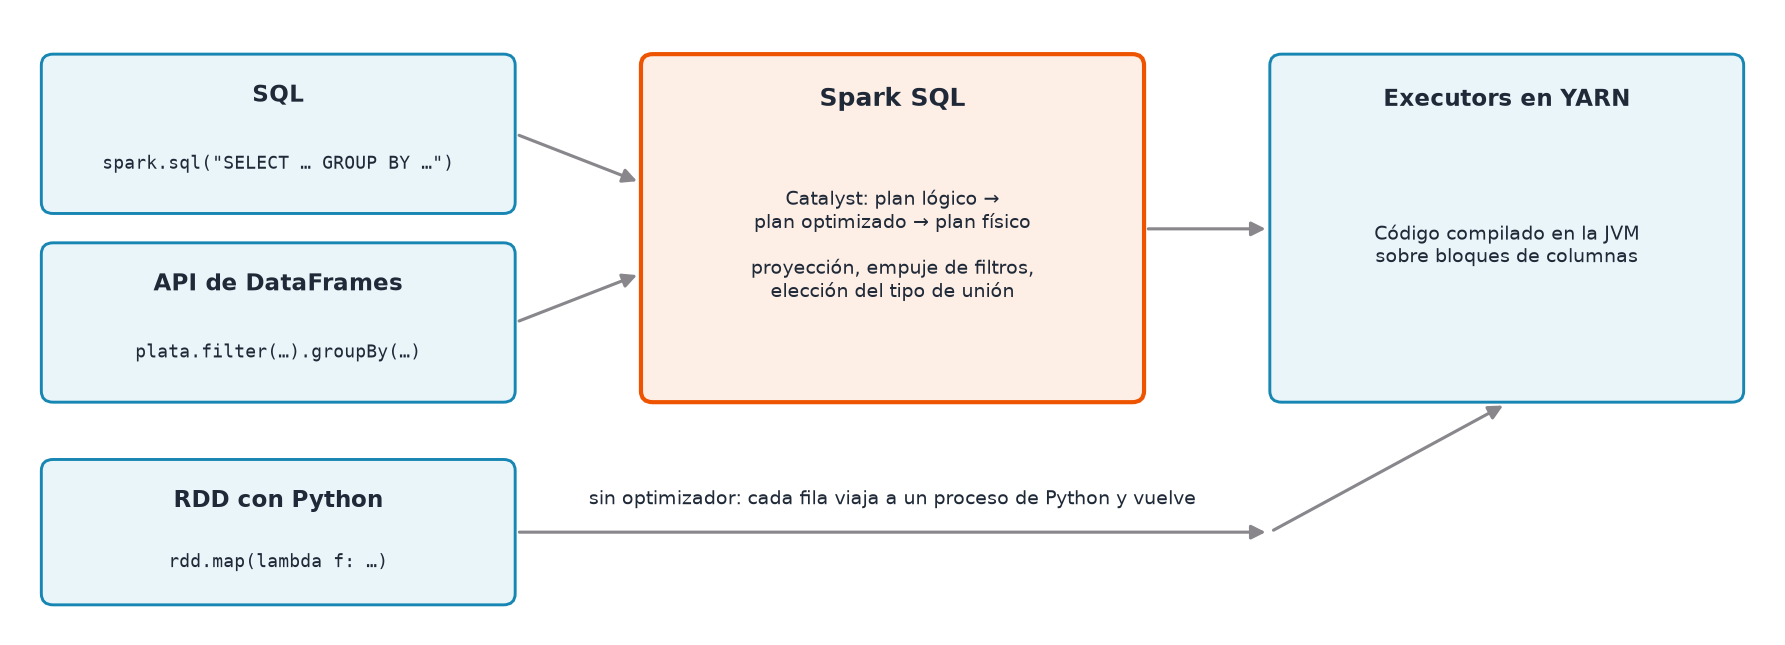
SQL y DataFrames entran al mismo motor; los RDD con funciones de Python no pasan por el optimizador.
La figura resume la diferencia que el capítulo mide. SQL y DataFrames son dos formas de escribir lo mismo: llegan a Catalyst y terminan en el mismo plan, que los executors ejecutan dentro de la JVM. Un RDD con funciones lambda le entrega a Spark código de Python que no puede analizar, así que no hay nada que optimizar, y cada fila tiene que salir de la JVM hacia un proceso de Python y volver.
Spark SQL no es la única forma de consultar tablas con Python. Esta es la comparación con las alternativas que un equipo de datos suele considerar:
Alternativa
Dónde corre
Hasta qué volumen
Optimizador
Cuándo conviene
Spark SQL (SQL o DataFrames)
Clúster, o una sola máquina en modo local
De megabytes a cientos de terabytes
Catalyst y ejecución adaptativa
Datos que no caben en una máquina, procesos que deben crecer, equipos que mezclan SQL y Python
API de RDD con Python
Clúster
Grande, pero lento
No
Casi nunca para tablas; solo para lógica que no se puede expresar con columnas
pandas
Memoria de una sola máquina
Lo que quepa en la RAM, con holgura
No (ejecuta paso a paso)
Resultados ya pequeños: gráficos, informes, exploración de una muestra
Polars o DuckDB
Una sola máquina, varios núcleos
Decenas o cientos de gigabytes en un buen servidor
Sí
Análisis en un portátil o un servidor, sin clúster
Hive sobre MapReduce o Tez
Clúster Hadoop
Muy grande
Sí, más limitado
Plataformas heredadas; hoy suele reemplazarse por Spark SQL o Trino
Trino (antes Presto)
Clúster propio de consulta
Muy grande
Sí
Consultas interactivas de SQL sobre muchas fuentes, sin programar transformaciones en Python
Las ventajas de Spark SQL que este capítulo comprueba en el clúster son seis:
Un motor, dos lenguajes. SQL y DataFrames producen el mismo plan, así que cada equipo usa el que lee mejor sin pagar en rendimiento (sección 3).
Un optimizador que corrige. Catalyst reescribe consultas mal escritas: lee solo las columnas necesarias y empuja los filtros a la lectura (sección 4).
Ejecución dentro de la JVM. Las funciones integradas no salen a Python; frente a RDD y UDF de Python, la diferencia crece con el volumen (secciones 5 y 6).
Escala sin cambiar el código. La misma consulta corre igual con 32 000 envíos que con 320 000, y con 300 millones solo cambian los recursos; pandas, en cambio, depende de la memoria de una máquina (sección 5).
Estrategias de unión automáticas. Spark elige difundir las tablas pequeñas sin que se lo pidas (sección 8).
Un catálogo de tablas sobre el data lake. Las tablas se consultan por nombre y quedan sobre archivos Parquet que cualquier otra herramienta puede leer (sección 10).
3. Un motor, dos lenguajes
La primera pregunta de los analistas de BITLogística es la de siempre: cumplimiento y horas promedio por servicio en mayo. La celda la escribe dos veces, en SQL y con la API de DataFrames, y compara los resultados y los planes físicos.
CONSULTA =""" SELECT servicio, COUNT(*) AS envios, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo, ROUND(AVG(horas_transito), 1) AS horas_promedio FROM plata WHERE mes = 5 GROUP BY servicio ORDER BY servicio"""con_sql = spark.sql(CONSULTA)con_api = ( plata.filter(F.col("mes") ==5) .groupBy("servicio") .agg( F.count("*").alias("envios"), F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo"), F.round(F.avg("horas_transito"), 1).alias("horas_promedio"), ) .orderBy("servicio"))con_sql.show()print("Tipo de lo que devuelve spark.sql:", type(con_sql).__name__)print("Mismo resultado:", con_sql.collect() == con_api.collect())print("Mismo plan físico:", plan_fisico(con_sql) == plan_fisico(con_api))
+---------+------+------------+--------------+
| servicio|envios|pct_a_tiempo|horas_promedio|
+---------+------+------------+--------------+
|Económico|  1324|        89.0|          80.7|
| Estándar|  3622|        88.5|          47.8|
|  Express|  1573|        74.3|          19.8|
+---------+------+------------+--------------+

Tipo de lo que devuelve spark.sql: DataFrame
Mismo resultado: True
Mismo plan físico: True
En mayo, Express cumplió el 74.3 % de 1 573 envíos con 19.8 horas promedio; Estándar, el 88.5 % de 3 622, y Económico, el 89.0 % de 1 324. spark.sql devolvió un DataFrame, el mismo tipo que la API, y las dos formas dieron el mismo resultado y el mismo plan físico (True en las dos comparaciones). Esa igualdad es la base del capítulo: escribir en SQL o con métodos es una elección de legibilidad, no de rendimiento.
explain() muestra ese plan para la versión SQL. Se lee de abajo hacia arriba.
El plan empieza en FileScan parquet, que lee solo cuatro columnas (ReadSchema: struct<servicio, horas_transito, a_tiempo, mes>) de las 23 de la plata, y le pasa el filtro al lector (PushedFilters: [IsNotNull(mes), EqualTo(mes,5)]). Sigue una agregación parcial (partial_count, partial_avg) en cada partición, un Exchange hashpartitioning(servicio) que reúne cada servicio en un mismo lugar, la agregación final y un segundo Exchange para ordenar. AdaptiveSparkPlan isFinalPlan=false indica que la ejecución adaptativa (AQE) puede ajustar el plan al ejecutar, por ejemplo, juntando las 200 particiones del shuffle en pocas cuando los datos son pequeños.
4. El optimizador trabaja por ti
En un equipo real no todas las consultas se escriben bien. La celda escribe la misma pregunta de la forma más descuidada: lee todas las columnas con SELECT *, calcula una columna horas_doble que nadie usa, agrupa por mes y servicio y solo al final filtra mayo, desde afuera de la subconsulta. Luego compara lo que llega a la lectura del archivo en las dos versiones.
desordenada = spark.sql(""" SELECT servicio, envios, pct_a_tiempo, horas_promedio FROM ( SELECT mes, servicio, COUNT(*) AS envios, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo, ROUND(AVG(horas_transito), 1) AS horas_promedio, MAX(horas_doble) AS sin_uso FROM (SELECT *, horas_transito * 2 AS horas_doble FROM plata) GROUP BY mes, servicio ) WHERE mes = 5 ORDER BY servicio""")for nombre, tabla in [("ordenada", con_sql), ("desordenada", desordenada)]: plan = plan_fisico(tabla) lectura = [l for l in plan.split("\n") if"FileScan"in l][0] columnas = lectura.split("ReadSchema: ")[1] filtros = lectura.split("PushedFilters: ")[1].split("], ")[0] +"]"print(f"{nombre:12s} lee: {columnas}")print(f"{'':12s} filtros en la lectura: {filtros}")print(f"{'':12s} calcula horas_doble: {'horas_doble'in plan}")print("Mismo resultado:", desordenada.collect() == con_sql.collect())
ordenada     lee: struct<servicio:string,horas_transito:double,a_tiempo:boolean,mes:int>
             filtros en la lectura: [IsNotNull(mes), EqualTo(mes,5)]
             calcula horas_doble: False
desordenada  lee: struct<servicio:string,horas_transito:double,a_tiempo:boolean,mes:int>
             filtros en la lectura: [IsNotNull(mes), EqualTo(mes,5)]
             calcula horas_doble: False
Mismo resultado: True
Las dos versiones leen las mismas cuatro columnas, con el mismo filtro de mayo empujado hasta el archivo, y en ninguna aparece horas_doble en el plan. Catalyst aplicó tres reglas sin que nadie se lo pidiera: eliminó la columna que no se usa (poda de columnas), bajó el filtro mes = 5 desde fuera de la agregación hasta la lectura (empuje de predicados) y redujo SELECT * a las columnas necesarias (proyección). El resultado es el mismo (True).
En pandas o con RDD, el orden en que se escriben los pasos es el orden en que se ejecutan: si filtras al final, se procesan antes todas las filas y columnas. Con Spark SQL, el orden de escritura importa para quien lee el código, no para el motor.
5. Frente a las alternativas, medido
Para medir, la celda vuelve a crear la plata multiplicada por diez, como en el capítulo de almacenamiento, y la guarda en la carpeta de laboratorio.
Hay dos tamaños para comparar: la plata, con 32 064 filas, y la copia de 320 640.
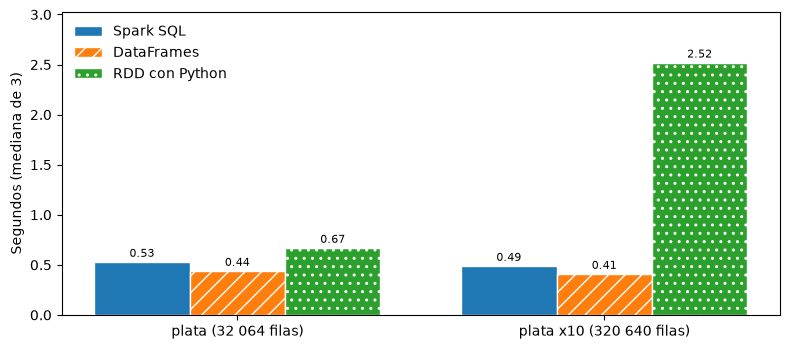
La celda siguiente resuelve la consulta de mayo con tres métodos, sobre los dos tamaños: Spark SQL, la API de DataFrames y la API de RDD con funciones de Python (filter, map y reduceByKey con lambda). Antes de medir, comprueba con assert que los tres dan exactamente el mismo resultado.
CONSULTA_MAYO =""" SELECT servicio, COUNT(*) AS envios, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo, ROUND(AVG(horas_transito), 1) AS horas_promedio FROM envios WHERE mes = 5 GROUP BY servicio ORDER BY servicio"""def con_spark_sql(ruta): spark.read.parquet(ruta).createOrReplaceTempView("envios")return [tuple(f) for f in spark.sql(CONSULTA_MAYO).collect()]def con_dataframes(ruta): resultado = ( spark.read.parquet(ruta) .filter(F.col("mes") ==5) .groupBy("servicio") .agg( F.count("*").alias("envios"), F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo"), F.round(F.avg("horas_transito"), 1).alias("horas_promedio"), ) .orderBy("servicio") )return [tuple(f) for f in resultado.collect()]def con_rdd(ruta): filas = spark.read.parquet(ruta).rdd # cada fila viaja a un proceso de Pythondef a_par(f): medido = f.a_tiempo isnotNonereturn f.servicio, (1, int(medido), int(bool(f.a_tiempo)), f.horas_transito if medido else0.0)def sumar(a, b):returntuple(x + y for x, y inzip(a, b)) totales = filas.filter(lambda f: f.mes ==5).map(a_par).reduceByKey(sumar).collect()returnsorted( (servicio, n, round(100* a_tiempo / medidos, 1), round(horas / medidos, 1))for servicio, (n, medidos, a_tiempo, horas) in totales )medidas = []for nombre, ruta in RUTAS.items(): referencia = con_spark_sql(ruta)for metodo, funcion in [("Spark SQL", con_spark_sql), ("DataFrames", con_dataframes), ("RDD con Python", con_rdd)]:assert funcion(ruta) == referencia, metodo medidas.append((nombre, metodo, round(medir(lambda: funcion(ruta)), 2)))tabla_tiempos = pd.DataFrame(medidas, columns=["datos", "metodo", "segundos"])print(tabla_tiempos.pivot(index="metodo", columns="datos", values="segundos").loc[ ["Spark SQL", "DataFrames", "RDD con Python"], ["plata", "plata x10"]].to_string())print()print("Los tres métodos dieron el mismo resultado:", referencia)
datos           plata  plata x10
metodo
Spark SQL        0.53       0.49
DataFrames       0.44       0.41
RDD con Python   0.67       2.52

Los tres métodos dieron el mismo resultado: [('Económico', 13240, 89.0, 80.7), ('Estándar', 36220, 88.5, 47.8), ('Express', 15730, 74.3, 19.8)]
Los tres métodos dieron el mismo resultado, y en la copia ampliada los envíos de mayo son diez veces los de la plata: Express 15 730, Estándar 36 220 y Económico 13 240. Los tiempos sí cambian. Con la plata, Spark SQL y DataFrames tardaron 0.53 y 0.44 segundos, y RDD con Python, 0.67: casi lo mismo. Con diez veces más datos, Spark SQL y DataFrames siguieron por debajo de medio segundo (0.49 y 0.41), mientras RDD subió a 2.52 segundos, entre cinco y seis veces lo de los otros dos.
pivote = tabla_tiempos.pivot(index="datos", columns="metodo", values="segundos").loc[ ["plata", "plata x10"], ["Spark SQL", "DataFrames", "RDD con Python"]]figura, eje = plt.subplots(figsize=(8, 3.6))ancho =0.26for i, (metodo, trama) inenumerate(zip(pivote.columns, ["", "//", ".."])): posiciones = [x + (i -1) * ancho for x inrange(len(pivote))] eje.bar(posiciones, pivote[metodo], width=ancho, label=metodo, hatch=trama, edgecolor="white")for x, valor inzip(posiciones, pivote[metodo]): eje.text(x, valor +0.05, f"{valor:.2f}", ha="center", fontsize=8)eje.set_xticks(range(len(pivote)), ["plata (32 064 filas)", "plata x10 (320 640 filas)"])eje.set_ylabel("Segundos (mediana de 3)")eje.set_ylim(0, pivote.values.max() *1.2)eje.legend(frameon=False, loc="upper left")plt.tight_layout()plt.show()
Figura 18.1: Mediana de segundos de la consulta de mayo por servicio con tres formas de programarla en Spark
DataFrames salió algo más rápido que Spark SQL en las dos medidas, pero los dos ejecutan el mismo plan: la diferencia es ruido de medición y del orden de ejecución, porque Spark SQL se midió primero en cada tamaño. Al repetir la celda, el orden entre ellos puede invertirse. La diferencia con RDD crece con el volumen porque su costo es por fila: cada envío se convierte en un objeto de Python, viaja al proceso de Python del executor, pasa por las lambda y vuelve a la JVM. Las funciones integradas, en cambio, procesan bloques de columnas con código que Spark compila para la JVM.
¿Y pandas? Es la alternativa más usada en Python, y con datos pequeños es muy rápida. La celda siguiente lleva la plata completa al driver con toPandas(), resuelve la misma consulta con pandas y mide la memoria que ocupa la tabla.
inicio = time.perf_counter()tabla_pandas = spark.read.parquet(PLATA).toPandas()segundos_traer = time.perf_counter() - iniciodef con_pandas(): mayo = tabla_pandas[tabla_pandas["mes"] ==5].assign(at=lambda t: t["a_tiempo"].astype(float))return mayo.groupby("servicio").agg( envios=("guia", "size"), pct_a_tiempo=("at", "mean"), horas_promedio=("horas_transito", "mean"), )resumen = con_pandas()print(resumen.assign(pct_a_tiempo=lambda t: (100* t["pct_a_tiempo"]).round(1), horas_promedio=lambda t: t["horas_promedio"].round(1)).to_string())print()memoria_mb = tabla_pandas.memory_usage(deep=True).sum() /1e6print(f"Traer la plata al driver con toPandas(): {segundos_traer:.2f} s")print(f"Calcular con pandas, ya en memoria: {medir(con_pandas):.3f} s")print(f"Memoria del DataFrame de pandas: {memoria_mb:.1f} MB para {len(tabla_pandas):,d} filas".replace(",", " "))print(f"Proyección a 100 millones de envíos: {memoria_mb *1e8/len(tabla_pandas) /1e3:.0f} GB en una sola máquina")
           envios  pct_a_tiempo  horas_promedio
servicio
Económico    1324          89.0            80.7
Estándar     3622          88.5            47.8
Express      1573          74.3            19.8

Traer la plata al driver con toPandas(): 2.02 s
Calcular con pandas, ya en memoria:      0.010 s
Memoria del DataFrame de pandas:         26.9 MB para 32 064 filas
Proyección a 100 millones de envíos:     84 GB en una sola máquina
pandas dio las mismas cifras de mayo y, con los datos ya en memoria, calculó en 0.010 segundos, mucho menos que cualquier método de Spark. Con 32 064 filas, una sola máquina gana: no hay tareas que lanzar ni datos que repartir. El costo apareció antes: traer la plata al driver tardó 2.02 segundos, y la tabla ocupa 26.9 MB de memoria, cuando en Parquet son menos de 1 MB.
La proyección de la última línea muestra el límite. Con la misma memoria por fila, 100 millones de envíos necesitarían unos 84 GB de RAM en una sola máquina, solo para tener la tabla cargada. Spark SQL reparte esos datos entre los executors y lee del disco solo las columnas y las particiones que la consulta necesita. La regla práctica es la del capítulo 16: Spark reduce los datos y pandas trabaja con el resultado pequeño, para gráficos e informes.
6. Funciones propias: UDF de Python frente a SQL
NotaUDF de Python
Una UDF (user-defined function) es una función que escribe el usuario para usarla dentro de una consulta. Una UDF de Python se ejecuta fuera de la JVM, en un proceso de Python del executor, igual que las lambda de un RDD. Catalyst la trata como una caja cerrada: no sabe qué hace por dentro, así que no puede optimizarla.
La gerencia quiere el volumen de envíos por franja de peso. La celda la calcula dos veces sobre la copia ampliada: con una UDF de Python registrada para usarse en SQL (franja_peso_py) y con CASE WHEN, una expresión de SQL que Spark ejecuta dentro de la JVM.
@F.udf("string")def franja_peso(kg):if kg isNone:returnNoneif kg <1:return"a. menos de 1 kg"if kg <5:return"b. 1 a 5 kg"if kg <20:return"c. 5 a 20 kg"return"d. 20 kg o más"spark.udf.register("franja_peso_py", franja_peso)spark.read.parquet(LAB +"/ampliada").createOrReplaceTempView("ampliada")CON_UDF ="SELECT franja_peso_py(peso_kg) AS franja, COUNT(*) AS envios FROM ampliada GROUP BY 1 ORDER BY 1"CON_CASE =""" SELECT CASE WHEN peso_kg < 1 THEN 'a. menos de 1 kg' WHEN peso_kg < 5 THEN 'b. 1 a 5 kg' WHEN peso_kg < 20 THEN 'c. 5 a 20 kg' ELSE 'd. 20 kg o más' END AS franja, COUNT(*) AS envios FROM ampliada GROUP BY 1 ORDER BY 1"""spark.sql(CON_CASE).show()print("Mismo resultado:", spark.sql(CON_UDF).collect() == spark.sql(CON_CASE).collect())print("La UDF sale a Python (BatchEvalPython en el plan):", "BatchEvalPython"in plan_fisico(spark.sql(CON_UDF)))print("Segundos con la UDF de Python:", round(medir(lambda: spark.sql(CON_UDF).collect()), 2))print("Segundos con CASE WHEN: ", round(medir(lambda: spark.sql(CON_CASE).collect()), 2))
+----------------+------+
|          franja|envios|
+----------------+------+
|a. menos de 1 kg| 81360|
|     b. 1 a 5 kg|198850|
|    c. 5 a 20 kg| 39180|
|  d. 20 kg o más|  1250|
+----------------+------+

Mismo resultado: True
La UDF sale a Python (BatchEvalPython en el plan): True
Segundos con la UDF de Python: 0.5
Segundos con CASE WHEN:        0.3
Las dos versiones dieron el mismo conteo: 198 850 envíos entre 1 y 5 kg, 81 360 de menos de 1 kg, 39 180 entre 5 y 20 kg y 1 250 de 20 kg o más. El plan de la versión con UDF contiene BatchEvalPython, el paso en que Spark envía los valores a Python y los recibe de vuelta. Ese viaje se nota: la UDF tardó 0.5 segundos y CASE WHEN, 0.3. Con 320 640 filas y una función de cuatro comparaciones, la UDF ya necesitó dos tercios más de tiempo; la diferencia crece con el volumen y con lo que haga la función, porque cada valor hace el viaje de ida y vuelta.
Antes de escribir una UDF, conviene buscar la función en SQL o en pyspark.sql.functions, que tienen cientos de funciones de texto, fechas, arreglos y matemáticas. Si la lógica de verdad no existe, Spark ofrece las UDF vectorizadas de pandas (pandas_udf), que envían bloques completos en lugar de valores sueltos; requieren la biblioteca PyArrow en el driver y en los executors, y no se usan en este capítulo.
7. El modelo dimensional de BITLogística
La plata tiene una fila por envío y repite en cada una los textos de la ciudad, el servicio y el operador. Para los analistas, el formato que mejor se consulta es un modelo dimensional.
NotaHechos, dimensiones y granularidad
Un modelo dimensional separa los datos en dos tipos de tablas. La tabla de hechos guarda los eventos que se miden, con sus cantidades: aquí, cada envío con su peso, su distancia, sus horas de tránsito y si llegó a tiempo. Las tablas de dimensiones guardan las descripciones con las que se filtra y agrupa: la fecha, la ciudad, el servicio, el operador. La granularidad es lo que representa una fila de la tabla de hechos; aquí, un envío.
NotaLlave sustituta y esquema en estrella
Una llave sustituta es un número sin significado de negocio que identifica cada fila de una dimensión, como servicio_id = 1 para Express. La tabla de hechos guarda ese número en lugar del texto. Si mañana el servicio cambia de nombre, se corrige una fila de la dimensión y no millones de hechos. Cuando la tabla de hechos queda en el centro, unida a cada dimensión por su llave, el diseño se llama esquema en estrella.
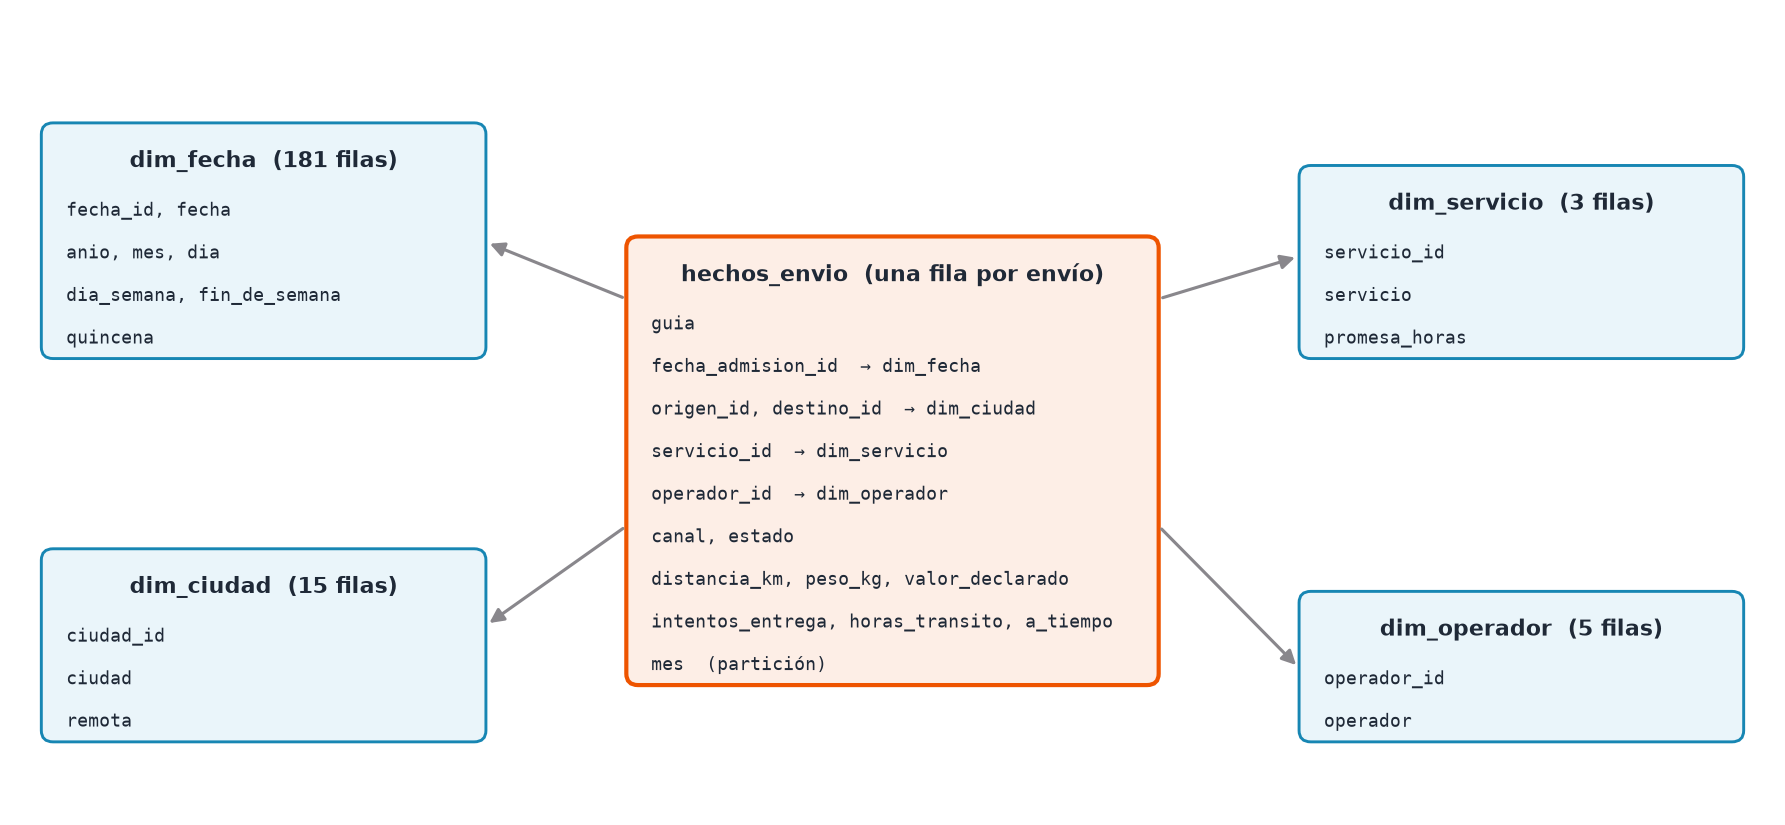
Modelo en estrella de BITLogística.
dim_ciudad cumple dos papeles: la misma tabla describe la ciudad de origen y la de destino. canal y estado se quedan en los hechos como texto, porque tienen dos o tres valores y no tienen atributos que describir.
La celda crea una base de datos bitlogistica en el catálogo y las cuatro dimensiones, todas en SQL:
dim_fecha genera los 181 días de enero a junio con SEQUENCE y EXPLODE, y deriva de cada fecha el mes, el día de la semana, el fin de semana (viernes a domingo, la regla del taller) y la quincena. Su llave es la fecha escrita como número, 20260501, una práctica común en dimensiones de fecha porque se lee sin consultar la tabla.
dim_ciudad junta orígenes y destinos con UNION ALL y marca si la ciudad es destino remoto.
dim_servicio y dim_operador toman los valores distintos de la plata.
Las llaves sustitutas salen de ROW_NUMBER() OVER (ORDER BY …), una función de ventana que numera las filas en el orden indicado; la sección 9 explica las ventanas.
guardar_tabla escribe cada tabla como Parquet en /bitlogistica/modelo/<nombre> y la registra en el catálogo con saveAsTable.
spark.sql("CREATE DATABASE IF NOT EXISTS bitlogistica")dim_fecha = spark.sql(""" SELECT CAST(date_format(fecha, 'yyyyMMdd') AS INT) AS fecha_id, fecha, YEAR(fecha) AS anio, MONTH(fecha) AS mes, DAY(fecha) AS dia, ELEMENT_AT(ARRAY('domingo', 'lunes', 'martes', 'miércoles', 'jueves', 'viernes', 'sábado'), DAYOFWEEK(fecha)) AS dia_semana, DAYOFWEEK(fecha) IN (1, 6, 7) AS fin_de_semana, IF(DAY(fecha) <= 15, 1, 2) AS quincena FROM (SELECT EXPLODE(SEQUENCE(DATE'2026-01-01', DATE'2026-06-30', INTERVAL 1 DAY)) AS fecha)""")dim_ciudad = spark.sql(""" WITH ciudades AS ( SELECT origen AS ciudad, FALSE AS remota FROM plata UNION ALL SELECT destino, destino_remoto FROM plata ) SELECT ROW_NUMBER() OVER (ORDER BY ciudad) AS ciudad_id, ciudad, BOOL_OR(remota) AS remota FROM ciudades GROUP BY ciudad""")dim_servicio = spark.sql(""" SELECT ROW_NUMBER() OVER (ORDER BY MAX(promesa_horas)) AS servicio_id, servicio, MAX(promesa_horas) AS promesa_horas FROM plata GROUP BY servicio""")dim_operador = spark.sql(""" SELECT ROW_NUMBER() OVER (ORDER BY operador) AS operador_id, operador FROM plata GROUP BY operador""")def guardar_tabla(tabla, nombre, particion=None): escritor = tabla.write.mode("overwrite").option("path", f"{MODELO}/{nombre}")if particion: escritor = escritor.partitionBy(particion) escritor.saveAsTable(f"bitlogistica.{nombre}")return spark.table(f"bitlogistica.{nombre}").count()for nombre, tabla in [("dim_fecha", dim_fecha), ("dim_ciudad", dim_ciudad), ("dim_servicio", dim_servicio), ("dim_operador", dim_operador)]:print(f"{nombre:13s}{guardar_tabla(tabla, nombre):4d} filas")spark.table("bitlogistica.dim_servicio").show()spark.table("bitlogistica.dim_fecha").filter("dia IN (1, 2, 3) AND mes = 5").show()
Quedaron 181 fechas, 15 ciudades, 3 servicios y 5 operadores (los cuatro operadores y «Sin operador»). dim_servicio numeró los servicios por su promesa: Express es el 1, con 24 horas; Estándar, el 2, con 72, y Económico, el 3, con 120. En dim_fecha, el 1 de mayo de 2026 tiene la llave 20260501 y cayó viernes, así que cuenta como fin de semana según la regla de BITLogística.
La tabla de hechos se arma con una sola consulta: la plata unida a las cinco dimensiones (la de ciudad, dos veces) para cambiar cada texto por su llave. Se guarda particionada por mes, como recomendó el capítulo de almacenamiento.
CONSULTA_HECHOS =""" SELECT p.guia, f.fecha_id AS fecha_admision_id, co.ciudad_id AS origen_id, cd.ciudad_id AS destino_id, s.servicio_id, o.operador_id, p.canal, p.estado, p.distancia_km, p.peso_kg, p.valor_declarado, p.intentos_entrega, p.horas_transito, p.a_tiempo, p.mes FROM plata p JOIN bitlogistica.dim_fecha f ON f.fecha = TO_DATE(p.admision) JOIN bitlogistica.dim_ciudad co ON co.ciudad = p.origen JOIN bitlogistica.dim_ciudad cd ON cd.ciudad = p.destino JOIN bitlogistica.dim_servicio s ON s.servicio = p.servicio JOIN bitlogistica.dim_operador o ON o.operador = p.operador"""hechos = spark.sql(CONSULTA_HECHOS)print("Filas en hechos_envio:", guardar_tabla(hechos, "hechos_envio", particion="mes"), "| filas en plata:", plata.count())( spark.table("bitlogistica.hechos_envio") .select("guia", "fecha_admision_id", "origen_id", "destino_id", "servicio_id", "operador_id", "a_tiempo", "mes") .show(3))
hechos_envio tiene 32 064 filas, las mismas que la plata: ninguna unión perdió ni duplicó envíos. Ese cuadre es la prueba mínima de un modelo dimensional. Si una dimensión no tuviera un valor que está en los hechos, la unión interna lo descartaría y el conteo bajaría; si una dimensión tuviera la misma ciudad dos veces, los hechos se duplicarían. Las filas de muestra ya no tienen textos, solo llaves: el primer envío salió de la ciudad 4 hacia la 2, con el servicio 2 (Estándar).
8. Uniones: lo que Spark decide por ti
NotaUnión por difusión y unión por ordenamiento y mezcla
Para unir dos tablas distribuidas, Spark tiene que poner juntas las filas con la misma llave. En una unión por ordenamiento y mezcla (sort-merge join), reparte las dos tablas por la red según la llave (un shuffle por tabla), las ordena y las recorre a la par. En una unión por difusión (broadcast join), envía una copia completa de la tabla pequeña a cada executor y une sin mover la tabla grande. Spark elige la difusión cuando estima que una tabla ocupa menos de spark.sql.autoBroadcastJoinThreshold, 10 MB por defecto.
La celda cuenta en el plan de la consulta de hechos qué tipo de unión eligió Spark, la ejecuta y mide. Luego desactiva la difusión poniendo el umbral en -1, repite y restaura el valor. Para ejecutar sin traer filas al driver, usa el formato de escritura noop, que recorre todos los datos y no escribe nada.
def tipos_de_union(tabla): plan = plan_fisico(tabla)return {tipo: plan.count(tipo) for tipo in ["BroadcastHashJoin", "SortMergeJoin"]}print("Con el umbral por defecto (", spark.conf.get("spark.sql.autoBroadcastJoinThreshold"), "):", tipos_de_union(spark.sql(CONSULTA_HECHOS)))con_difusion = medir(lambda: spark.sql(CONSULTA_HECHOS).write.format("noop").mode("overwrite").save())spark.conf.set("spark.sql.autoBroadcastJoinThreshold", -1)print("Con la difusión desactivada:", tipos_de_union(spark.sql(CONSULTA_HECHOS)))sin_difusion = medir(lambda: spark.sql(CONSULTA_HECHOS).write.format("noop").mode("overwrite").save())spark.conf.unset("spark.sql.autoBroadcastJoinThreshold")print(f"Segundos con difusión: {con_difusion:.2f} | con reparto y ordenamiento: {sin_difusion:.2f}")
Con el umbral por defecto ( 10485760b ): {'BroadcastHashJoin': 5, 'SortMergeJoin': 0}
Con la difusión desactivada: {'BroadcastHashJoin': 0, 'SortMergeJoin': 5}
Segundos con difusión: 0.67 | con reparto y ordenamiento: 1.50
Con el umbral por defecto (10485760b, los 10 MB), las cinco uniones fueron por difusión: las dimensiones pesan unos pocos kilobytes. Nadie lo pidió en la consulta. Con la difusión desactivada, las cinco pasaron a ordenamiento y mezcla, y el tiempo subió de 0.67 a 1.50 segundos, porque cada unión necesita repartir y ordenar la tabla de hechos. En un modelo en estrella, con dimensiones pequeñas y hechos grandes, esta decisión automática es una de las ventajas más útiles de Spark SQL. Si las estadísticas fallan, se puede forzar con una pista en la consulta: SELECT /*+ BROADCAST(s) */ ….
NotaUnión anti
Una unión anti (LEFT ANTI JOIN) devuelve las filas de la tabla izquierda que no tienen pareja en la derecha. Sirve para encontrar huérfanos: registros que se perdieron entre una capa y otra, o hechos sin dimensión. Su pareja, la unión semi (LEFT SEMI JOIN), devuelve las que sí tienen pareja, sin agregar columnas.
La celda siguiente usa una unión anti para auditar el taller de PySpark: ¿cuántas guías de bronce no llegaron a plata?, ¿coinciden con la cuarentena?
spark.read.parquet(BASE +"/bronce").createOrReplaceTempView("bronce")spark.read.parquet(BASE +"/cuarentena").createOrReplaceTempView("cuarentena")spark.sql(""" SELECT (SELECT COUNT(*) FROM bronce) AS filas_bronce, (SELECT COUNT(*) FROM bronce b LEFT ANTI JOIN plata p ON b.guia = p.guia) AS sin_pareja_en_plata, (SELECT COUNT(*) FROM cuarentena) AS filas_cuarentena""").show()
Bronce tiene 34 239 filas. 1 855 de ellas no tienen pareja en plata, exactamente las 1 855 de la cuarentena. El resto de la diferencia con los 32 064 envíos de plata son duplicados: tienen una guía que sí está en plata, así que la unión anti no los cuenta. La auditoría cuadra en una consulta de tres líneas, sin traer ningún dato a Python.
9. Funciones de ventana
NotaFunción de ventana
Una función de ventana calcula un valor para cada fila mirando un grupo de filas relacionadas, sin juntarlas en una sola como hace GROUP BY. La ventana se define con OVER (PARTITION BY … ORDER BY … ROWS BETWEEN …): PARTITION BY dice qué filas forman el grupo, ORDER BY las ordena dentro de él, y ROWS BETWEEN limita cuántas filas vecinas entran en el cálculo. Las más usadas son ROW_NUMBER, RANK, LAG y LEAD (la fila anterior y la siguiente), y SUM o AVG sobre la ventana.
La gerencia pide un ranking mensual de operadores por cumplimiento, con la variación frente al mes anterior. La consulta agrega por mes y operador en una subconsulta WITH, y sobre ese resultado aplica dos ventanas: RANK() por mes, ordenado por cumplimiento, y LAG() por operador, ordenado por mes.
ranking = spark.sql(""" WITH mensual AS ( SELECT h.mes, o.operador, COUNT(*) AS envios, ROUND(100 * AVG(CAST(h.a_tiempo AS INT)), 1) AS pct_a_tiempo FROM bitlogistica.hechos_envio h JOIN bitlogistica.dim_operador o ON h.operador_id = o.operador_id WHERE o.operador <> 'Sin operador' GROUP BY h.mes, o.operador ) SELECT mes, operador, envios, pct_a_tiempo, RANK() OVER (PARTITION BY mes ORDER BY pct_a_tiempo DESC) AS puesto, ROUND(pct_a_tiempo - LAG(pct_a_tiempo) OVER (PARTITION BY operador ORDER BY mes), 1) AS cambio_vs_mes_anterior FROM mensual ORDER BY mes, puesto""")ranking.show(24)
El orden no cambió en ningún mes: OP-A primero, OP-B segundo, OP-D tercero y OP-C último. Fuera de mayo, OP-A cumplió entre 93.2 % y 95.2 % y OP-C, entre 82.2 % y 84.4 %. La columna de variación muestra lo que el ranking oculta: en mayo todos cayeron, OP-A 4.2 puntos y OP-C 8.4, hasta 73.8 %, y en junio todos recuperaron casi lo mismo que perdieron. La caída de mayo fue general y no de un operador. En enero la variación es NULL porque no hay mes anterior.
La segunda ventana trabaja por día. La consulta parte de dim_fecha con una unión izquierda hacia los hechos, para que un día sin envíos aparezca con 0 en lugar de desaparecer, y calcula el acumulado desde el 1 de enero y la media móvil de los últimos siete días.
diario = spark.sql(""" WITH por_dia AS ( SELECT f.fecha, f.dia_semana, COUNT(h.guia) AS envios FROM bitlogistica.dim_fecha f LEFT JOIN bitlogistica.hechos_envio h ON h.fecha_admision_id = f.fecha_id GROUP BY f.fecha, f.dia_semana ) SELECT fecha, dia_semana, envios, SUM(envios) OVER (ORDER BY fecha ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) AS acumulado, ROUND(AVG(envios) OVER (ORDER BY fecha ROWS BETWEEN 6 PRECEDING AND CURRENT ROW), 1) AS media_movil_7 FROM por_dia ORDER BY fecha""")serie = diario.toPandas()print(serie.head(8).to_string(index=False))print("...")print(serie.tail(2).to_string(index=False, header=False))print()print("Días en la serie:", len(serie), "| días sin envíos:", int((serie["envios"] ==0).sum()))print("Media móvil mínima y máxima:", serie["media_movil_7"].iloc[6:].min(), "y", serie["media_movil_7"].max())
     fecha dia_semana  envios  acumulado  media_movil_7
2026-01-01     jueves     156        156          156.0
2026-01-02    viernes     163        319          159.5
2026-01-03     sábado     161        480          160.0
2026-01-04    domingo     168        648          162.0
2026-01-05      lunes     158        806          161.2
2026-01-06     martes     159        965          160.8
2026-01-07  miércoles     160       1125          160.7
2026-01-08     jueves     152       1277          160.1
...
2026-06-29  lunes 193 31899 178.9
2026-06-30 martes 165 32064 173.0

Días en la serie: 181 | días sin envíos: 0
Media móvil mínima y máxima: 154.1 y 217.9
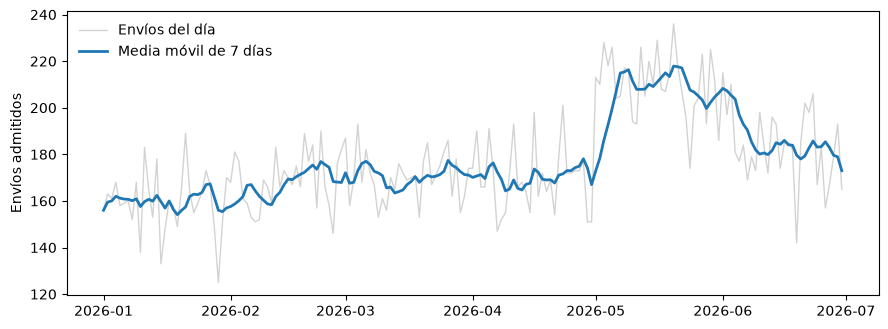
La serie tiene los 181 días y ninguno quedó sin envíos. El 1 de enero, la media móvil es igual al valor del día (156) porque no hay días anteriores; desde el séptimo día ya promedia una semana completa. El acumulado del 30 de junio es 32 064, el total de la plata, otra comprobación de que la serie está completa. La media móvil de siete días osciló entre 154.1 y 217.9 envíos diarios.
Figura 18.2: Envíos admitidos por día y media móvil de siete días, enero a junio de 2026
La serie diaria salta de un día a otro, y la media móvil deja ver la tendencia: crece despacio de enero a abril, de unos 160 a unos 175 envíos diarios, sube hasta casi 218 en mayo y vuelve a unos 180 en junio. Es la temporada que explica la caída de cumplimiento de todos los operadores en mayo. Calcular esto con pandas habría exigido traer las 32 064 filas al driver; con la ventana en SQL, al driver llegaron 181 filas.
10. El catálogo: tablas sobre el data lake
NotaCatálogo, tabla gestionada y tabla externa
El catálogo es el registro de bases de datos, tablas y vistas que Spark conoce por nombre, con su esquema, su formato y su ubicación. Una tabla gestionada (managed) guarda sus archivos en la bodega de tablas, y Spark es su dueño: DROP TABLE borra la entrada del catálogo y los archivos. Una tabla externa apunta a archivos en una ubicación elegida por el usuario: DROP TABLE borra solo la entrada, y los archivos quedan.
La celda lista las tablas de la base bitlogistica y muestra la descripción extendida de los hechos.
spark.sql("SHOW TABLES IN bitlogistica").show()( spark.sql("DESCRIBE TABLE EXTENDED bitlogistica.hechos_envio") .filter("col_name IN ('Type', 'Provider', 'Location', 'Partition Provider')") .show(truncate=False))
SHOW TABLES muestra las cinco tablas del modelo en la base bitlogistica, y abajo, sin base y con isTemporary en true, las vistas temporales creadas en el capítulo, como plata y bronce. Las vistas viven solo en la sesión; las tablas tienen archivos detrás. hechos_envio es EXTERNAL, en formato parquet, y su ubicación es /bitlogistica/modelo/hechos_envio: saveAsTable con la opción path crea tablas externas.
La celda siguiente compara los dos tipos. Crea una tabla gestionada con CREATE TABLE … AS SELECT y la borra; después borra la tabla externa dim_servicio, comprueba que sus archivos siguen en HDFS y la vuelve a registrar sobre ellos.
spark.sql(""" CREATE TABLE bitlogistica.resumen_servicio USING parquet AS SELECT s.servicio, COUNT(*) AS envios FROM bitlogistica.hechos_envio h JOIN bitlogistica.dim_servicio s ON h.servicio_id = s.servicio_id GROUP BY s.servicio""")ubicacion = (spark.sql("DESCRIBE TABLE EXTENDED bitlogistica.resumen_servicio") .filter("col_name = 'Location'").first()["data_type"])print("Tabla gestionada en:", ubicacion)spark.sql("DROP TABLE bitlogistica.resumen_servicio")print("Tras DROP TABLE de la gestionada, ¿quedan sus archivos?", existe(ubicacion))spark.sql("DROP TABLE bitlogistica.dim_servicio")print("Tras DROP TABLE de la externa, ¿quedan sus archivos? ", existe(MODELO +"/dim_servicio"))spark.sql(f"CREATE TABLE bitlogistica.dim_servicio USING parquet LOCATION '{MODELO}/dim_servicio'")print("Registrada de nuevo sobre los mismos archivos:", spark.table("bitlogistica.dim_servicio").count(), "filas")
Tabla gestionada en: hdfs://namenode:9000/bitlogistica/warehouse/bitlogistica.db/resumen_servicio
Tras DROP TABLE de la gestionada, ¿quedan sus archivos? False
Tras DROP TABLE de la externa, ¿quedan sus archivos?    True
Registrada de nuevo sobre los mismos archivos: 3 filas
La tabla gestionada quedó en la bodega, dentro de bitlogistica.db/resumen_servicio, y DROP TABLE borró sus archivos (False). La externa conservó los suyos (True), y bastó un CREATE TABLE … LOCATION para tener otra vez dim_servicio con sus 3 filas, sin escribir un solo dato.
Esta diferencia importa por el tipo de catálogo de la sección 1: in-memory. El catálogo de esta sesión vive en la memoria del driver y desaparece con spark.stop(): en la próxima sesión, bitlogistica.hechos_envio no existirá, aunque sus archivos sigan en HDFS. Por eso el modelo se guardó como tablas externas, que se vuelven a registrar con una línea. Para que el catálogo sobreviva entre sesiones y lo compartan varios usuarios, las empresas usan un metastore persistente, como el de Hive, o un catálogo de tablas como el de Apache Iceberg, que se trata en el capítulo de lakehouse con Iceberg.
11. SQL y Python en la misma consulta
La mayor ventaja práctica de usar Spark SQL desde Python es que los dos lenguajes se mezclan sin fricción: spark.sql devuelve un DataFrame, y un DataFrame se puede usar dentro de SQL. Desde Spark 3.4, spark.sql acepta además parámetros.
NotaConsulta con parámetros
Una consulta con parámetros deja huecos con nombre, como :mes, y recibe los valores aparte, en args. Spark los trata siempre como valores, nunca como parte del texto SQL. Construir la consulta pegando texto con un f-string (f"WHERE operador = '{nombre}'") es frágil y peligroso: si el valor viene de un usuario y contiene una comilla, puede cambiar la consulta; ese ataque se llama inyección de SQL.
La celda resuelve una pregunta de la gerencia para Express en mayo. Pasa el mes y el servicio como parámetros, y las tablas como DataFrames con {hechos} y {operadores}. Después sigue en Python con el DataFrame que devuelve SQL: filtra los operadores con al menos 50 envíos y calcula la brecha frente a la meta de 90 %.
id_express = spark.table("bitlogistica.dim_servicio").filter("servicio = 'Express'").first()["servicio_id"]express_mayo = spark.sql(""" SELECT o.operador, COUNT(*) AS envios, ROUND(100 * AVG(CAST(h.a_tiempo AS INT)), 1) AS pct_a_tiempo FROM {hechos} h JOIN {operadores} o ON h.operador_id = o.operador_id WHERE h.mes = :mes AND h.servicio_id = :servicio GROUP BY o.operador """, args={"mes": 5, "servicio": id_express}, hechos=spark.table("bitlogistica.hechos_envio"), operadores=spark.table("bitlogistica.dim_operador"),)( express_mayo .filter(F.col("envios") >=50) .withColumn("brecha_vs_meta", F.round(F.col("pct_a_tiempo") -90, 1)) .orderBy("pct_a_tiempo") .show())
Ningún operador llegó a la meta en Express durante mayo. OP-C cumplió el 64.6 % de 329 envíos, 25.4 puntos por debajo; OP-D, el 73.4 %; OP-B, el 75.4 %, y OP-A, el mejor, el 80.1 % de 488, todavía 9.9 puntos por debajo. Express en temporada alta es el punto débil del caso, el mismo hallazgo del informe del taller de PySpark, ahora respondido con el modelo dimensional y en una consulta.
La consulta tiene SQL donde SQL se lee mejor (la unión y la agregación) y Python donde Python es más cómodo (los parámetros, el filtro final y una columna calculada). Es la forma habitual de trabajar con Spark SQL en un equipo de datos.
12. Qué usar en cada caso
Situación
Qué usar
Por qué
Transformaciones de un proceso de datos
Spark SQL, en SQL o con DataFrames, según quién mantenga el código
Mismo plan y mismo rendimiento; se elige por legibilidad
Consultas de analistas sobre el modelo
SQL sobre tablas del catálogo
Lenguaje conocido y tablas con nombre, sin rutas de archivos
Lógica que se arma con código: columnas en un bucle, reglas guardadas como datos
API de DataFrames
Se construye con estructuras de Python
Valores que vienen de fuera de la consulta
spark.sql con args
Evita la inyección de SQL
Una regla que parece necesitar una UDF
Primero CASE WHEN o pyspark.sql.functions
Se ejecuta en la JVM y Catalyst la optimiza
Gráficos, informes y resultados pequeños
pandas, después de agregar en Spark
Rápido con pocos datos; toPandas() solo del resumen
Datos que caben en una máquina y no van a crecer
pandas, Polars o DuckDB
Sin el costo fijo de lanzar tareas en un clúster
Tablas con API de RDD
Evitarlas
Sin optimizador y con cada fila pasando por Python
Para BITLogística, la recomendación queda así: los procesos de la zona de llegada al oro, en DataFrames, mantenidos por ingeniería; el modelo en estrella, como tablas externas sobre /bitlogistica/modelo, y las consultas de los analistas, en SQL sobre ese modelo. Los dos equipos usan el mismo motor y leen los mismos archivos.
Limpiar
La celda borra la carpeta de pruebas /bitlogistica/laboratorio_sql y la bodega de tablas gestionadas, y cierra la sesión. El modelo en /bitlogistica/modelo se conserva para los capítulos siguientes, junto con las capas del taller de PySpark.
print("Laboratorio borrado:", borrar(LAB))print("Bodega de tablas gestionadas borrada:", borrar(BASE +"/warehouse"))spark.stop()print("Sesión cerrada. El modelo queda en /bitlogistica/modelo con cinco tablas;","plata y oro siguen intactas.")
Laboratorio borrado: True
Bodega de tablas gestionadas borrada: True
Sesión cerrada. El modelo queda en /bitlogistica/modelo con cinco tablas; plata y oro siguen intactas.
Las dos carpetas se borraron (True). Para usar el modelo en otra sesión, se registra de nuevo cada tabla sobre sus archivos, por ejemplo:
spark.sql("CREATE DATABASE IF NOT EXISTS bitlogistica")spark.sql("CREATE TABLE IF NOT EXISTS bitlogistica.dim_servicio USING parquet ""LOCATION 'hdfs://namenode:9000/bitlogistica/modelo/dim_servicio'")
Para hechos_envio, que está particionada, el mismo CREATE TABLE deduce la columna mes de las carpetas, pero la tabla queda sin particiones registradas y cuenta 0 filas. Después hay que ejecutar MSCK REPAIR TABLE bitlogistica.hechos_envio, que registra en el catálogo las carpetas mes=1 a mes=6.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1, 3 y 7 (la sesión, las funciones, la vista de la plata y el modelo).
La misma pregunta, dos lenguajes. Escribe en SQL y con la API de DataFrames el volumen y el cumplimiento por canal en junio. Comprueba con plan_fisico que los planes son iguales.
Otra vez el optimizador. Escribe una consulta que una la plata con dim_servicio y filtre mes = 6 después de la unión. ¿El filtro llega a la lectura de la plata? Búscalo en PushedFilters.
Ruta más lenta del mes. Con los hechos y dim_ciudad usada dos veces, encuentra para cada mes la ruta con más horas promedio entre las que tienen al menos 50 envíos. Usa RANK() con PARTITION BY mes.
Una UDF que no hace falta. Escribe una UDF de Python que devuelva "remoto" o "no remoto" según destino_remoto y reemplázala por una expresión de SQL. Compara tiempos sobre la copia ampliada.
Huérfanos a propósito. Crea una vista con dim_ciudad sin Pasto y une los hechos con ella con unión interna. ¿Cuántos envíos se pierden? Encuéntralos con una unión anti.
Catálogo nuevo. Cierra la sesión, abre otra y registra de nuevo las cinco tablas del modelo sobre /bitlogistica/modelo. Comprueba que hechos_envio tiene 32 064 filas.
TipOrientaciones
En SQL: SELECT canal, COUNT(*), ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) FROM plata WHERE mes = 6 GROUP BY canal. Con DataFrames: filter, groupBy("canal") y agg con las mismas funciones. Si los planes salen distintos, revisa que los nombres de las columnas de salida y el redondeo coincidan.
Sí: Catalyst empuja el filtro por debajo de la unión hasta la lectura de la plata, porque mes es una columna de esa tabla. PushedFilters incluye EqualTo(mes,6) en el FileScan de la plata.
Agrega por mes, co.ciudad y cd.ciudad con HAVING COUNT(*) >= 50, y sobre ese resultado aplica RANK() OVER (PARTITION BY mes ORDER BY horas_promedio DESC) y filtra puesto = 1 en una consulta exterior. Salen rutas largas entre la costa y el interior, como Barranquilla a Cali en mayo, con más de 60 horas promedio.
La expresión es IF(destino_remoto, 'remoto', 'no remoto') o un CASE WHEN. La UDF aparece como BatchEvalPython en el plan y tarda más que la expresión de SQL.
Pasto aparece como destino en 645 envíos de la plata; la unión interna los descarta y el conteo baja de 32 064 a 31 419. La unión anti de los hechos contra la vista, por destino_id, los devuelve.
Usa los comandos de la sección Limpiar. Para los hechos, CREATE TABLE … LOCATION y después MSCK REPAIR TABLE; sin la reparación, la tabla se registra pero no ve las particiones y el conteo da 0.
Errores frecuentes
Síntoma
Causa
Arreglo
TABLE_OR_VIEW_NOT_FOUND en una consulta SQL
La vista temporal no se creó en esta sesión, o la tabla se registró en otra sesión con catálogo en memoria.
createOrReplaceTempView o volver a registrar la tabla externa.
saveAsTable falla en el clúster con un error de ruta file:/opt/spark/work-dir/spark-warehouse
La bodega de tablas quedó en la carpeta local del driver.
spark.sql.warehouse.dir apuntando a HDFS al crear la sesión.
Una consulta con UDF es varias veces más lenta que el resto
La UDF de Python saca cada valor de la JVM.
Reemplazarla por una función integrada o CASE WHEN.
El conteo de la tabla de hechos es menor que el de la plata
Una dimensión no tiene alguno de los valores y la unión interna descarta esas filas.
Buscar los huérfanos con LEFT ANTI JOIN y completar la dimensión.
El conteo de la tabla de hechos es mayor que el de la plata
Una dimensión tiene valores repetidos y la unión duplica filas.
Revisar que cada llave natural aparezca una sola vez en la dimensión.
toPandas() agota la memoria del driver
Se trajo una tabla grande en lugar de un resultado agregado.
Agregar en Spark y llevar a pandas solo el resumen.
DROP TABLE borró datos que se querían conservar
La tabla era gestionada.
Usar tablas externas (path o LOCATION) para datos del data lake.
Preguntas de comprensión
Si SQL y DataFrames producen el mismo plan, ¿por qué existen las dos formas?
¿Por qué Catalyst puede optimizar una consulta con CASE WHEN y no una con una UDF de Python?
En la comparación con pandas, ¿quién ganó con la plata y por qué ese resultado no contradice la recomendación de usar Spark SQL?
¿Qué pasaría con la unión por difusión si dim_ciudad tuviera 50 millones de filas?
¿Por qué el modelo de BITLogística se guardó con tablas externas y no gestionadas?
TipOrientaciones
Porque sirven a personas y tareas distintas. SQL es el lenguaje que conocen los analistas y el más fácil de leer para una consulta fija. La API de DataFrames permite construir consultas con código: bucles, funciones reutilizables, reglas guardadas en listas. Como el motor es el mismo, se puede mezclar dentro de un proceso.
Porque CASE WHEN es una expresión que Catalyst entiende: sabe qué columnas usa, qué tipo devuelve y puede compilarla junto con el resto. Una UDF de Python es código opaco; Catalyst solo sabe que entra un valor y sale otro, y tiene que enviarlo a Python para obtenerlo.
pandas, con 0.010 segundos una vez cargada la tabla, porque con 32 064 filas no hay nada que repartir. No contradice la recomendación porque cargar la tabla costó más que la consulta en Spark, la tabla ocupó 26.9 MB en memoria, y con cien millones de envíos necesitaría unos 84 GB en una sola máquina. pandas sirve para el resultado pequeño, no para la tabla completa.
Superaría el umbral de 10 MB y Spark usaría una unión por ordenamiento y mezcla, con shuffle de las dos tablas. Forzar la difusión con una pista podría agotar la memoria de los executors, porque cada uno recibiría una copia completa.
Porque el catálogo de la sesión es en memoria y se pierde al cerrarla. Con tablas externas, los archivos quedan en /bitlogistica/modelo, se vuelven a registrar con una línea y no se borran por accidente con DROP TABLE.
Glosario
Término
Significado en este capítulo
Spark SQL
Módulo de Spark que recibe consultas en SQL o con DataFrames, las optimiza y las ejecuta.
Consulta declarativa
Consulta que dice qué resultado se quiere, no cómo calcularlo.
Catalyst
Optimizador de Spark SQL: reescribe la consulta y elige el plan físico.
Ejecución adaptativa (AQE)
Ajustes que Spark hace al plan durante la ejecución, con estadísticas reales.
Bodega de tablas
Carpeta donde Spark guarda las tablas gestionadas.
UDF de Python
Función del usuario que se ejecuta en un proceso de Python, fuera de la JVM.
Modelo dimensional
Diseño con una tabla de hechos y tablas de dimensiones.
Tabla de hechos
Tabla con los eventos que se miden y sus cantidades.
Dimensión
Tabla con las descripciones para filtrar y agrupar.
Granularidad
Lo que representa una fila de la tabla de hechos.
Llave sustituta
Número sin significado de negocio que identifica una fila de una dimensión.
Esquema en estrella
Tabla de hechos en el centro unida a cada dimensión por su llave.
Unión por difusión
Unión que copia la tabla pequeña a cada executor.
Unión por ordenamiento y mezcla
Unión que reparte y ordena las dos tablas por la llave.
Unión anti
Unión que devuelve las filas sin pareja en la otra tabla.
Función de ventana
Cálculo por fila sobre un grupo de filas relacionadas, sin agruparlas.
Catálogo
Registro de bases de datos, tablas y vistas con su esquema y ubicación.
Tabla gestionada
Tabla cuyos archivos pertenecen a Spark y se borran con DROP TABLE.
Tabla externa
Tabla que apunta a archivos que se conservan al borrarla del catálogo.
Metastore
Servicio que guarda el catálogo de forma persistente y compartida.
Inyección de SQL
Alterar una consulta metiendo texto SQL en un valor que se pega a ella.
Kimball, R. y Ross, M. (2013). The Data Warehouse Toolkit, 3.ª ed. Wiley. El texto de referencia del modelo dimensional.
Resumen
Spark SQL es un solo motor con dos lenguajes. La consulta de mayo dio el mismo resultado y el mismo plan físico escrita en SQL y con DataFrames, y Catalyst llevó una versión descuidada, con SELECT *, una columna inútil y el filtro al final, al mismo plan que la versión bien escrita. Medido en el clúster, con 320 640 envíos, Spark SQL y DataFrames respondieron en menos de medio segundo y RDD con Python en 2.52 segundos; una UDF de Python tardó dos tercios más que CASE WHEN. pandas fue el más rápido con la plata ya en memoria, pero ocupó 26.9 MB para 32 064 filas, unos 84 GB para cien millones. Con el mismo motor construiste el modelo en estrella de BITLogística: 32 064 hechos y cuatro dimensiones, unidos por difusión sin pedirlo, auditados con una unión anti que cuadró con las 1 855 filas de la cuarentena, y consultados con funciones de ventana que mostraron la caída general de mayo y la temporada alta detrás de ella. El modelo quedó como tablas externas en /bitlogistica/modelo.