El pipeline de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) ya tiene sus piezas. El capítulo de ingesta carga los archivos nuevos de forma idempotente y el capítulo de calidad retiene los lotes dañados antes de publicarlos. Pero alguien tiene que ejecutarlas: todas las noches, en orden, solo cuando llegó el archivo del día, sin cargar un lote que la puerta de calidad rechazó, y con una forma de volver a procesar una semana completa si se corrige un error. Hoy ese alguien es una persona con un notebook abierto.
Este capítulo agrega Apache Airflow al clúster y escribe un DAG que hace ese trabajo: espera el archivo, revisa su calidad, lo carga a plata y recalcula el oro, con cada paso de Spark lanzado sobre YARN. Con los archivos del 1 al 12 de julio, el DAG procesa un día, lo repite sin duplicar, rellena nueve días de una vez, se detiene ante el archivo dañado del 11 y lo termina cuando llega la versión corregida.
Ficha
En este capítulo
Pregunta
¿Quién lanza cada paso del pipeline, en qué orden, y qué pasa cuando uno falla?
Datos
Doce archivos diarios de envíos del 1 al 12 de julio de 2026, 3 102 filas en total, con el archivo del 11 dañado y su versión corregida
Tiempo estimado de lectura
60 minutos, más la práctica; el notebook tarda entre 20 y 30 minutos en ejecutarse
Airflow corre en un contenedor propio, airflow, construido con la misma imagen de spark-client. Así trae Spark, el cliente de Hadoop y la configuración del clúster sin instalar nada más, y puede lanzar spark-submit a YARN igual que el notebook. Airflow se instala la primera vez que arranca el contenedor, en un entorno de Python propio que queda guardado en un volumen.
En la terminal de Ubuntu, en la carpeta del clúster:
cd ~/hdfs-docker-labcat> compose.airflow.yaml <<'EOF'# Capa que agrega Apache Airflow al clúster del libro, con la imagen de spark-client.services: airflow: image: hdfs-lab/spark-client:3.5.3-hadoop3.4.1 hostname: airflow user: "0:0" entrypoint: ["/bin/bash", "-c"] command: - | set -e if [ ! -x /opt/airflow-venv/bin/airflow ]; then /opt/python/bin/python3 -m venv /opt/airflow-venv /opt/airflow-venv/bin/pip install --no-cache-dir "apache-airflow==3.3.2" --constraint https://raw.githubusercontent.com/apache/airflow/constraints-3.3.2/constraints-3.11.txt fi exec airflow standalone environment: SPARK_HOME: /opt/spark HADOOP_HOME: /opt/hadoop HADOOP_CONF_DIR: /opt/cluster-conf SPARK_CONF_DIR: /opt/cluster-conf HADOOP_USER_NAME: root PYSPARK_PYTHON: /opt/python/bin/python3 PYSPARK_DRIVER_PYTHON: /opt/python/bin/python3 PATH: /opt/airflow-venv/bin:/opt/python/bin:/opt/hadoop/bin:/opt/spark/bin:/opt/java/openjdk/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin AIRFLOW_HOME: /opt/spark/work-dir/airflow AIRFLOW__CORE__LOAD_EXAMPLES: "False" AIRFLOW__CORE__SIMPLE_AUTH_MANAGER_ALL_ADMINS: "True" AIRFLOW__CORE__PARALLELISM: "2" AIRFLOW__API__WORKERS: "1" AIRFLOW__DAG_PROCESSOR__REFRESH_INTERVAL: "20" ports: - "127.0.0.1:8080:8080" volumes: - ./config:/opt/cluster-conf:ro - ./notebooks:/opt/spark/work-dir - cpython311:/opt/python - airflow_venv:/opt/airflow-venvvolumes: airflow_venv:EOFdca(){docker compose -f compose.yaml -f compose.spark.yaml -f compose.airflow.yaml "$@";}dca up -d airflowdca logs -f airflow
La primera vez, el registro muestra durante varios minutos la instalación de Airflow y sus dependencias. Cuando aparecen líneas de api-server, scheduler, dag-processor y triggerer, y una que dice Uvicorn running on http://0.0.0.0:8080, Airflow está listo: sal del registro con Ctrl+C (el contenedor sigue corriendo). Los arranques siguientes tardan menos de un minuto, porque el entorno queda en el volumen airflow_venv.
Comprobación: abre http://localhost:8080 en el navegador. Aparece la interfaz de Airflow, sin pedir usuario, con la lista de DAG vacía.
Cada variable tiene una razón:
AIRFLOW_HOME es la carpeta de Airflow: su base de datos, sus registros y la subcarpeta dags. Queda dentro de notebooks, así que el notebook escribe ahí el DAG y tú ves los registros desde tu equipo en ~/hdfs-docker-lab/notebooks/airflow.
SIMPLE_AUTH_MANAGER_ALL_ADMINS entra a la interfaz y a la API sin contraseña, como administrador. Solo sirve para un laboratorio en tu equipo: el puerto se publica en 127.0.0.1, que no es visible desde otras máquinas.
PARALLELISM = 2 y API__WORKERS = 1 limitan los procesos de Airflow para que use menos de 1 GB de memoria.
REFRESH_INTERVAL = 20 hace que Airflow busque DAG nuevos cada 20 segundos, en lugar de cada 5 minutos.
Mientras trabajes con Airflow, usa dca en lugar de dc. El capítulo se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster (en el apéndice «Operar el clúster» están el arranque y la descarga; el archivo se llama taller_airflow.ipynb dentro de talleres-notebooks.zip). Necesita en la carpeta notebooks los módulos pipeline_envios.py y calidad_envios.py, que escriben los capítulos de ingesta y calidad, y generar_envios.py, que viene en el zip. No necesita los datos de esos capítulos: trabaja en su propia zona de HDFS, /bitlogistica/orquestacion.
1. Qué hace un orquestador
Una tarea programada con cron ejecuta un comando a una hora. Para un pipeline de datos eso deja varias preguntas sin respuesta: ¿qué pasa si el archivo todavía no llegó?, ¿y si el paso 2 falla, se ejecuta igual el paso 3?, ¿cómo se procesa otra vez el martes pasado?, ¿dónde quedó el registro de lo que pasó? Un orquestador responde esas preguntas para un conjunto de pasos con dependencias.
NotaDAG
Un DAG (grafo dirigido acíclico) es el conjunto de tareas de un pipeline con sus dependencias: «cargar plata» depende de «revisar calidad», que depende de «esperar archivo». Dirigido porque cada dependencia tiene un sentido; acíclico porque ninguna tarea puede depender, directa o indirectamente, de sí misma. En Airflow, un DAG es un archivo de Python en la carpeta dags.
NotaTarea, operador y sensor
Una tarea es un paso del DAG. Se crea con un operador, una clase que sabe hacer un tipo de trabajo: BashOperator ejecuta un comando de terminal, PythonOperator una función. Un sensor es un operador especial que espera a que algo se cumpla, como que exista un archivo, y revisa cada cierto tiempo hasta que pasa o se acaba el plazo.
NotaEjecución y fecha lógica
Una ejecución (DAG run) es una corrida del DAG completo para una fecha lógica: la fecha de los datos que procesa, no la fecha en que corre. La ejecución del 1 de julio procesa el archivo del 1 de julio aunque se lance en noviembre. Dentro de las tareas, la fecha lógica está en la plantilla { ds }, con la forma 2026-07-01.
Airflow tiene cuatro procesos, que airflow standalone arranca juntos en el contenedor: el dag-processor lee los archivos de dags; el scheduler decide qué tareas pueden correr y las entrega al ejecutor; el api-server atiende la interfaz web y la API REST; y el triggerer atiende las esperas largas. Guarda todo su estado (ejecuciones, intentos, duraciones) en una base de datos, aquí un archivo SQLite.
Airflow no mueve datos: ordena y vigila. Cada tarea lanza un trabajo de Spark que lee y escribe en HDFS; Airflow solo sabe si terminó bien o mal.
2. Conectar con Airflow
El notebook habla con Airflow por su API REST, la misma que usa la interfaz web: cada operación es una petición HTTP a http://airflow:8080/api/v2. La función api arma la petición con la biblioteca estándar urllib y devuelve la respuesta como diccionario. Todo lo que hace el notebook se puede hacer también con clics en http://localhost:8080.
La celda comprueba que estén los módulos de los capítulos anteriores y deja el escenario limpio: borra el historial del DAG en Airflow, sus registros y la zona /bitlogistica/orquestacion de HDFS, para que el notebook dé los mismos resultados cada vez.
import csvimport jsonimport osimport platformimport randomimport shutilimport subprocessimport timeimport urllib.requestfrom collections import Counter, defaultdictimport matplotlib.pyplot as pltimport pandas as pdimport generar_envios as genAIRFLOW ="http://airflow:8080/api/v2"# la API REST del servicio airflowCARPETA ="/opt/spark/work-dir"# la carpeta notebooks, vista desde los contenedoresBASE ="hdfs://namenode:9000/bitlogistica/orquestacion"# zona propia de este capítulo en HDFSHDFS ="/opt/hadoop/bin/hdfs"DAG_ID ="envios_diario"# 1. El capítulo reutiliza los módulos de los capítulos de ingesta y de calidadfor archivo in ["pipeline_envios.py", "calidad_envios.py", "generar_envios.py"]:assert os.path.exists(os.path.join(CARPETA, archivo)), f"Falta {archivo}: ejecuta antes los capítulos de ingesta y de calidad"os.makedirs(os.path.join(CARPETA, "trabajos"), exist_ok=True)os.makedirs(os.path.join(CARPETA, "airflow", "dags"), exist_ok=True)def api(metodo, ruta, datos=None):"""Llama a la API REST de Airflow y devuelve la respuesta JSON como diccionario.""" cuerpo = json.dumps(datos).encode() if datos isnotNoneelseNone pedido = urllib.request.Request(AIRFLOW + ruta, data=cuerpo, method=metodo, headers={"Content-Type": "application/json", "Accept": "application/json"})with urllib.request.urlopen(pedido, timeout=60) as respuesta: texto = respuesta.read().decode()return json.loads(texto) if texto else {}def hdfs(*argumentos):"""Ejecuta hdfs dfs con los argumentos dados y devuelve el código de salida."""return subprocess.run([HDFS, "dfs", *argumentos], capture_output=True, text=True).returncodeversion = api("GET", "/version")print("Python", platform.python_version(), "| Airflow", version["version"])# 2. Empezar desde cero: sin ejecuciones anteriores del DAG ni datos en la zona de este capítulotry:for relleno in api("GET", f"/backfills?dag_id={DAG_ID}")["backfills"]:if relleno["completed_at"] isNone: api("PUT", f"/backfills/{relleno['id']}/cancel") # cancelar un backfill que quedó a mediasfor corrida in api("GET", f"/dags/{DAG_ID}/dagRuns?limit=100")["dag_runs"]:if corrida["state"] notin ("success", "failed"): # Airflow no borra un DAG con ejecuciones vivas api("PATCH", f"/dags/{DAG_ID}/dagRuns/{corrida['dag_run_id']}", {"state": "failed"}) api("DELETE", f"/dags/{DAG_ID}")print("Historial anterior del DAG borrado")except urllib.error.HTTPError as error:if error.code !=404:raiseprint("No había historial del DAG")hdfs("-rm", "-r", "-f", BASE)shutil.rmtree(os.path.join(CARPETA, "airflow", "logs", f"dag_id={DAG_ID}"), ignore_errors=True) # registros viejosprint("Zona de trabajo en HDFS:", BASE)
Python 3.11.10 | Airflow 3.3.2
Historial anterior del DAG borrado
Zona de trabajo en HDFS: hdfs://namenode:9000/bitlogistica/orquestacion
Airflow respondió con su versión, 3.3.2. En la primera ejecución no hay historial que borrar; en las siguientes, la celda cancela los backfill a medias, marca como fallidas las ejecuciones que hayan quedado vivas (Airflow no borra un DAG con ejecuciones en curso) y borra el historial.
3. Los archivos de julio
Los archivos salen del mismo generador del taller de PySpark: los envíos admitidos del 1 al 12 de julio, con las impurezas habituales del sistema de admisión, en un archivo por día. El del 11 llega dañado: un cambio en el sistema de admisión dejó vacío el destino de cerca de un tercio de las filas. Más tarde llega su versión corregida, envios_2026-07-11_v2.csv.
Los archivos quedan en entregas_orquestacion, dentro de la carpeta del notebook. La función llega hace de sistema de admisión: copia un archivo a HDFS, en la carpeta de llegada de su fecha, /bitlogistica/orquestacion/llegada/2026-07-01/. Una carpeta por fecha permite que cada ejecución del DAG mire solo su día.
rng = random.Random(2343)LOCAL = os.path.join(CARPETA, "entregas_orquestacion")os.makedirs(LOCAL, exist_ok=True)for viejo in os.listdir(LOCAL): os.remove(os.path.join(LOCAL, viejo))# 3. Envíos del 1 al 12 de julio, con las impurezas habituales del sistema de admisiónjulio = [gen.generar_envio(rng, 7, n) for n inrange(20001, 28001)]julio = gen.ensuciar(rng, [f for f in julio ifint(f["fecha_admision"][8:10]) <=12], defaultdict(int))por_dia = defaultdict(list)for fila in julio: por_dia[fila["fecha_admision"]].append(fila)def escribir(nombre, filas):withopen(os.path.join(LOCAL, nombre), "w", newline="", encoding="utf-8") as f: escritor = csv.DictWriter(f, fieldnames=gen.COLUMNAS) escritor.writeheader() escritor.writerows(filas)for fecha, filas insorted(por_dia.items()): escribir(f"envios_{fecha}.csv", filas)# 4. El 11 llega dañado: un cambio en el sistema de admisión dejó vacío el destino del 35 % de las filasdañado = [dict(f, destino="") if rng.random() <0.35else f for f in por_dia["2026-07-11"]]escribir("envios_2026-07-11.csv", dañado)escribir("envios_2026-07-11_v2.csv", por_dia["2026-07-11"]) # la versión corregida, que llega despuésfor nombre insorted(os.listdir(LOCAL)):withopen(os.path.join(LOCAL, nombre), encoding="utf-8") as f:print(f" {nombre:28s}{sum(1for _ in f) -1:4d} filas")def llega(nombre):"""Simula que el sistema de admisión deja un archivo en la zona de llegada de su fecha.""" fecha = nombre[7:17] hdfs("-mkdir", "-p", f"{BASE}/llegada/{fecha}") hdfs("-put", "-f", os.path.join(LOCAL, nombre), f"{BASE}/llegada/{fecha}/{nombre}")returnf"{BASE}/llegada/{fecha}/{nombre}".replace(BASE, "…")
Hay doce archivos diarios, de 236 a 301 filas, más la versión corregida del 11. El 11 dañado y su versión corregida tienen las mismas 264 filas: solo cambia el destino vacío.
4. Los trabajos de Spark
Cada tarea de Spark del DAG es un programa de Python que se envía al clúster con spark-submit, no una celda de notebook. Recibe la fecha como argumento, crea su sesión, hace su parte y termina. Así cada paso es independiente: se puede repetir solo, y si falla, su error queda en su propio registro.
Los cuatro archivos van a la carpeta trabajos. El primero, comun.py, tiene lo que comparten: las rutas, con la llegada y los retenidos de la fecha, y la sesión. Cada trabajo imprime sus resultados en líneas que empiezan por RESULTADO, para encontrarlos fácil en el registro de la tarea.
%%writefile trabajos/comun.py"""Rutas y sesión comunes a los trabajos de Spark que lanza Airflow. Reciben la fecha como argumento."""import sysfrom pyspark.sql import SparkSessionBASE ="hdfs://namenode:9000/bitlogistica/orquestacion"def rutas(fecha):"""Las rutas del pipeline de ingesta, con la zona de llegada y de retenidos de una fecha."""return {"llegada": f"{BASE}/llegada/{fecha}","retenidos": f"{BASE}/retenidos/{fecha}","bronce": BASE +"/bronce","cuarentena": BASE +"/cuarentena","plata": BASE +"/plata","oro": BASE +"/oro/kpi_dia","control": BASE +"/control/cargas","calidad": BASE +"/control/calidad", }def sesion(nombre):"""Crea la sesión de Spark del trabajo y lee la fecha del primer argumento.""" fecha = sys.argv[1] spark = ( SparkSession.builder .appName(f"airflow-{nombre}-{fecha}") .config("spark.ui.showConsoleProgress", "false") .config("spark.sql.sources.partitionOverwriteMode", "dynamic") .getOrCreate() ) spark.sparkContext.setLogLevel("ERROR")print("RESULTADO aplicación", spark.sparkContext.applicationId, "| fecha", fecha)return spark, fecha, rutas(fecha)
Overwriting trabajos/comun.py
El segundo es la puerta de calidad. Usa revisar_pendientes del capítulo de calidad, que mide los archivos nuevos de la fecha y aparta los que incumplen un umbral. Luego decide:
Si retuvo un archivo, falla.
Si no queda nada por cargar ni se cargó antes nada de esa fecha, también falla: la fecha no tiene un archivo aprobado.
En otro caso, termina bien.
La segunda regla importa para los reintentos. Sin ella, si alguien vuelve a ejecutar la tarea después de un rechazo, la puerta ya no encuentra archivos pendientes (el dañado se movió a retenidos) y daría la fecha por buena sin datos. sys.exit con un mensaje termina el programa con código 1, y spark-submit le pasa ese código a Airflow, que marca la tarea como fallida.
%%writefile trabajos/revisar_calidad.py"""Puerta de calidad de una fecha: falla si no queda ningún archivo aprobado para cargar."""import sysfrom pyspark.sql import functions as Fimport calidad_envios as ceimport pipeline_envios as pefrom comun import sesionspark, fecha, rutas = sesion("calidad")fallas, retenidos = ce.revisar_pendientes(spark, rutas, id_ejecucion=f"airflow-{fecha}")for archivo, metrica, valor, umbral in fallas:print(f"RESULTADO incumple {archivo}: {metrica} = {valor} (umbral {umbral})")por_cargar = [f["archivo"] for f in pe.pendientes(spark, rutas).collect()]ya_cargados =0if pe.existe(spark, rutas["control"]): ya_cargados = spark.read.parquet(rutas["control"]).filter(F.col("lote") == F.lit(fecha).cast("date")).count()print("RESULTADO retenidos:", retenidos, "| por cargar:", por_cargar, "| ya cargados antes:", ya_cargados)spark.stop()if retenidos ornot (por_cargar or ya_cargados): sys.exit(f"La fecha {fecha} no tiene un archivo aprobado: no se carga")
Overwriting trabajos/revisar_calidad.py
El tercero carga los archivos aprobados de la fecha con cargar_pendientes del capítulo de ingesta, sin cambios: bronce, cuarentena, plata y registro de cargas, de forma incremental e idempotente. El cuarto recalcula los indicadores de oro por fecha y servicio a partir de toda la plata y reescribe solo las fechas que hay, con sobrescritura dinámica de particiones.
%%writefile trabajos/cargar_plata.py"""Carga incremental de los archivos aprobados de una fecha a bronce, cuarentena y plata."""from pyspark.sql import functions as Fimport pipeline_envios as pefrom comun import sesionspark, fecha, rutas = sesion("carga")resultado = pe.cargar_pendientes(spark, rutas, id_ejecucion=f"airflow-{fecha}")plata = spark.read.parquet(rutas["plata"])print("RESULTADO archivos cargados:", resultado["archivos"], "| fechas recalculadas:", resultado["fechas_recalculadas"])print("RESULTADO plata:", plata.count(), "filas |", plata.filter(F.col("fecha") == fecha).count(), "de la fecha")spark.stop()
Overwriting trabajos/cargar_plata.py
%%writefile trabajos/calcular_oro.py"""Indicadores diarios por servicio a partir de la plata. Reescribe solo las fechas que hay en la plata."""from pyspark.sql import functions as Ffrom comun import sesionspark, fecha, rutas = sesion("oro")kpi = ( spark.read.parquet(rutas["plata"]) .groupBy("fecha", "servicio") .agg(F.count("*").alias("envios"), F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo")))kpi.write.mode("overwrite").partitionBy("fecha").parquet(rutas["oro"])del_dia = spark.read.parquet(rutas["oro"]).filter(F.col("fecha") == fecha).orderBy("servicio").collect()print("RESULTADO oro de la fecha:", [(f["servicio"], f["envios"], f["pct_a_tiempo"]) for f in del_dia])spark.stop()
Overwriting trabajos/calcular_oro.py
Ninguno de los cuatro sabe que existe Airflow. Se pueden probar a mano desde spark-client, por ejemplo spark-submit trabajos/cargar_plata.py 2026-07-01, y eso es una buena práctica: el orquestador decide cuándo y en qué orden; la lógica vive en los trabajos.
5. El DAG
El DAG es un archivo de Python en airflow/dags. Airflow lo lee cada 20 segundos y registra el grafo de tareas que define. Sus decisiones, una por línea:
schedule="0 23 * * *": corre todos los días a las 23:00, con el formato de cron. La ejecución de las 23:00 del 1 de julio tiene fecha lógica 1 de julio y procesa el archivo de ese día.
start_date y end_date: el DAG solo tiene fechas del 1 al 12 de julio de 2026.
catchup=False: al activarlo, Airflow no crea ejecuciones para las fechas pasadas por su cuenta. Las fechas viejas se piden a mano o con un backfill.
max_active_runs=1: una ejecución a la vez. Cada trabajo de Spark pide un contenedor para el driver y dos executors de 896 MB, y el clúster tiene memoria para un trabajo; dos al mismo tiempo dejarían al segundo esperando en ACCEPTED.
default_args: un reintento a los 20 segundos para todas las tareas, salvo la puerta de calidad, que tiene retries=0.
Las tareas usan spark-submit con dos agregados. --conf spark.driver.host=airflow cambia la dirección del driver: la configuración del clúster dice spark-client, pero aquí el driver corre en el contenedor airflow, y los executors tienen que poder llamarlo. --py-files manda los tres módulos con el trabajo, para que el driver los encuentre.
El sensor revisa cada 15 segundos si existe la carpeta de llegada de la fecha, con hdfs dfs -test -d, y se rinde a los 30 minutos. Con mode="reschedule", entre revisiones devuelve su lugar al ejecutor, en lugar de ocuparlo esperando.
La última línea, esperar_archivo >> revisar_calidad >> cargar_plata >> calcular_oro, son las dependencias: cada tarea empieza solo cuando la anterior terminó bien.
%%writefile airflow/dags/envios_diario.py"""DAG diario de BITLogística (empresa ficticia): espera el archivo del día, revisa su calidad,lo carga a plata y recalcula el oro. Cada tarea de Spark es un spark-submit sobre YARN."""from datetime import datetime, timedeltafrom airflow.providers.standard.operators.bash import BashOperatorfrom airflow.providers.standard.sensors.bash import BashSensorfrom airflow.sdk import DAGBASE ="hdfs://namenode:9000/bitlogistica/orquestacion"CARPETA ="/opt/spark/work-dir"SPARK = ("/opt/spark/bin/spark-submit"" --conf spark.driver.host=airflow"# el driver corre en este contenedor, no en spark-clientf" --py-files {CARPETA}/pipeline_envios.py,{CARPETA}/calidad_envios.py,{CARPETA}/trabajos/comun.py")with DAG( dag_id="envios_diario", schedule="0 23 * * *", # todos los días a las 23:00, con el lote del día start_date=datetime(2026, 7, 1), end_date=datetime(2026, 7, 12, 23, 59), catchup=False, # no ponerse al día solo: las fechas viejas se piden a mano max_active_runs=1, # una ejecución a la vez: el clúster tiene memoria para un trabajo default_args={"retries": 1, "retry_delay": timedelta(seconds=20)}, tags=["bitlogistica"],) as dag: esperar_archivo = BashSensor( task_id="esperar_archivo", bash_command="/opt/hadoop/bin/hdfs dfs -test -d "+ BASE +"/llegada/{{ ds }}", mode="reschedule", # entre revisiones libera su lugar de trabajo poke_interval=15, timeout=1800, ) revisar_calidad = BashOperator( task_id="revisar_calidad", bash_command=SPARK +f" {CARPETA}/trabajos/revisar_calidad.py "+"{{ ds }}", retries=0, # un error de datos no se arregla reintentando ) cargar_plata = BashOperator( task_id="cargar_plata", bash_command=SPARK +f" {CARPETA}/trabajos/cargar_plata.py "+"{{ ds }}", ) calcular_oro = BashOperator( task_id="calcular_oro", bash_command=SPARK +f" {CARPETA}/trabajos/calcular_oro.py "+"{{ ds }}", ) esperar_archivo >> revisar_calidad >> cargar_plata >> calcular_oro
Overwriting airflow/dags/envios_diario.py
La celda siguiente espera a que Airflow registre el DAG, muestra sus tareas y lo activa.
# 5. Esperar a que Airflow lea el archivo del DAG (lo revisa cada 20 segundos)limite = time.time() +300while time.time() < limite:try: dag = api("GET", f"/dags/{DAG_ID}")breakexcept urllib.error.HTTPError: time.sleep(5)print("DAG registrado:", dag["dag_id"], "| pausado:", dag["is_paused"], "| errores de importación:", api("GET", "/importErrors")["total_entries"])FLUJO = ["esperar_archivo", "revisar_calidad", "cargar_plata", "calcular_oro"]tareas = {t["task_id"]: t for t in api("GET", f"/dags/{DAG_ID}/tasks")["tasks"]}print(pd.DataFrame([{"tarea": n, "operador": tareas[n]["operator_name"], "reintentos": int(tareas[n]["retries"]),"siguiente": ", ".join(tareas[n]["downstream_task_ids"])} for n in FLUJO]).to_string(index=False))api("PATCH", f"/dags/{DAG_ID}", {"is_paused": False})print("Pausado después de activarlo:", api("GET", f"/dags/{DAG_ID}")["is_paused"])
DAG registrado: envios_diario | pausado: True | errores de importación: 0
          tarea     operador  reintentos       siguiente
esperar_archivo   BashSensor           1 revisar_calidad
revisar_calidad BashOperator           0    cargar_plata
   cargar_plata BashOperator           1    calcular_oro
   calcular_oro BashOperator           1
Pausado después de activarlo: False
Airflow leyó el archivo sin errores de importación. El DAG nace pausado: es la configuración por defecto, para que un DAG nuevo no empiece a correr por accidente. Las cuatro tareas están con su operador y su tarea siguiente; calcular_oro es la última. revisar_calidad tiene 0 reintentos y las demás, 1. Después del PATCH, el DAG quedó activo. Como catchup es False y su última fecha ya pasó, activarlo no crea ninguna ejecución: solo permite las que se pidan.
En la interfaz, en http://localhost:8080, el DAG envios_diario aparece en la lista; en la vista Graph se ven las cuatro cajas unidas por flechas.
6. La primera ejecución
Cuatro funciones de ayuda envuelven la API: lanzar pide una ejecución para una fecha, tareas_de lista el estado de cada tarea, esperar espera a que la ejecución termine y resultados lee del registro de una tarea las líneas RESULTADO que escribió el trabajo de Spark.
def lanzar(fecha):"""Pide una ejecución del DAG para una fecha (fecha lógica a las 23:00) y devuelve su identificador.""" corrida = api("POST", f"/dags/{DAG_ID}/dagRuns", {"dag_run_id": f"manual__{fecha}", "logical_date": f"{fecha}T23:00:00Z"})return corrida["dag_run_id"]def tareas_de(corrida):"""Estado, intento y duración de cada tarea de una ejecución.""" filas = api("GET", f"/dags/{DAG_ID}/dagRuns/{corrida}/taskInstances")["task_instances"]return (pd.DataFrame([{"tarea": t["task_id"], "estado": t["state"] or"sin iniciar", "intento": t["try_number"],"segundos": round(t["duration"] or0, 1)} for t in filas]) .set_index("tarea").loc[FLUJO].reset_index())def esperar(corrida, limite=1200):"""Espera a que la ejecución termine y devuelve su estado final.""" fin = time.time() + limitewhile time.time() < fin: estado = api("GET", f"/dags/{DAG_ID}/dagRuns/{corrida}")["state"]if estado in ("success", "failed"):return estado time.sleep(10)return"sin terminar"def resultados(corrida, tarea, intento=None):"""Las líneas RESULTADO que el trabajo de Spark escribió en el registro (log) de la tarea."""if intento isNone: intento =next(t["try_number"] for t in api("GET", f"/dags/{DAG_ID}/dagRuns/{corrida}/taskInstances")["task_instances"]if t["task_id"] == tarea) registro = api("GET", f"/dags/{DAG_ID}/dagRuns/{corrida}/taskInstances/{tarea}/logs/{intento}?full_content=true") lineas = [r.get("event", "") ifisinstance(r, dict) elsestr(r) for r in registro["content"]]return [l[l.index("RESULTADO") +10:] for l in lineas if"RESULTADO"in l]
La celda pide la ejecución del 1 de julio antes de que llegue el archivo, mira el estado a los 45 segundos, deja llegar el archivo y espera el final.
# 6. La ejecución del 1 de julio empieza antes de que llegue el archivocorrida = lanzar("2026-07-01")time.sleep(45)print("Ejecución", corrida, "->", api("GET", f"/dags/{DAG_ID}/dagRuns/{corrida}")["state"])print(tareas_de(corrida).to_string(index=False))print()print("Llega:", llega("envios_2026-07-01.csv"))print("Estado final:", esperar(corrida))print(tareas_de(corrida).to_string(index=False))for tarea in ["revisar_calidad", "cargar_plata", "calcular_oro"]:print(f"{tarea}:")for linea in resultados(corrida, tarea):print(" ", linea)
Ejecución manual__2026-07-01 -> running
          tarea            estado  intento  segundos
esperar_archivo up_for_reschedule        1       1.3
revisar_calidad       sin iniciar        0       0.0
   cargar_plata       sin iniciar        0       0.0
   calcular_oro       sin iniciar        0       0.0

Llega: …/llegada/2026-07-01/envios_2026-07-01.csv
Estado final: success
          tarea  estado  intento  segundos
esperar_archivo success        1       1.5
revisar_calidad success        1      34.9
   cargar_plata success        1      29.8
   calcular_oro success        1      20.7
revisar_calidad:
    aplicación application_1794440555456_0001 | fecha 2026-07-01
    retenidos: [] | por cargar: ['envios_2026-07-01.csv'] | ya cargados antes: 0
cargar_plata:
    aplicación application_1794440555456_0002 | fecha 2026-07-01
    archivos cargados: 1 | fechas recalculadas: 1
    plata: 235 filas | 235 de la fecha
calcular_oro:
    aplicación application_1794440555456_0003 | fecha 2026-07-01
    oro de la fecha: [('Económico', 41, 94.9), ('Estándar', 136, 97.0), ('Express', 58, 89.7)]
A los 45 segundos, la ejecución estaba en running y el sensor en up_for_reschedule: revisó, no encontró la carpeta del 1 de julio y quedó programado para revisar otra vez. Las otras tres tareas seguían sin iniciar. Cuando llegó el archivo, el sensor lo encontró y las tres tareas de Spark corrieron una tras otra, cada una como una aplicación de YARN distinta, como muestra la línea de aplicación de cada registro.
La puerta aprobó envios_2026-07-01.csv. La carga dejó 235 filas en plata, todas del 1 de julio, y el oro calculó los indicadores del día por servicio: Estándar con 136 envíos y 97.0 % a tiempo, Económico con 41 y 94.9 %, Express con 58 y 89.7 %. La columna de segundos muestra el costo de lanzar trabajos separados: cada uno paga el arranque de una aplicación de Spark en YARN, más que su propio cálculo.
7. Repetir una ejecución
En Airflow, repetir una ejecución es limpiarla (clear): sus tareas vuelven a quedar sin estado y el scheduler las ejecuta otra vez, con la misma fecha lógica. Es lo que se hace cuando se corrige un trabajo y hay que reprocesar una fecha.
# 7. Limpiar la ejecución completa la vuelve a encolar desde la primera tareaapi("POST", f"/dags/{DAG_ID}/clearTaskInstances", {"dry_run": False, "dag_run_id": corrida, "only_failed": False, "reset_dag_runs": True})print("Estado final de la repetición:", esperar(corrida))print(tareas_de(corrida).to_string(index=False))for tarea in ["revisar_calidad", "cargar_plata"]:print(f"{tarea}:")for linea in resultados(corrida, tarea):print(" ", linea)
Estado final de la repetición: success
          tarea  estado  intento  segundos
esperar_archivo success        2       1.3
revisar_calidad success        2      22.4
   cargar_plata success        2      21.3
   calcular_oro success        2      20.3
revisar_calidad:
    aplicación application_1794440555456_0004 | fecha 2026-07-01
    retenidos: [] | por cargar: [] | ya cargados antes: 1
cargar_plata:
    aplicación application_1794440555456_0005 | fecha 2026-07-01
    archivos cargados: 0 | fechas recalculadas: 0
    plata: 235 filas | 235 de la fecha
Todas las tareas corrieron una segunda vez: el intento es 2 en las cuatro. La puerta no encontró archivos pendientes, pero sí uno ya cargado de esa fecha, así que aprobó. La carga no cargó ningún archivo y la plata siguió con 235 filas. Repetir no duplicó nada porque los trabajos son idempotentes: el registro de cargas del capítulo de ingesta sabe que envios_2026-07-01.csv, con esa huella, ya está.
Esta es la condición para que un orquestador sirva: si repetir una ejecución pudiera duplicar datos, nadie se atrevería a usar el botón de limpiar.
8. Rellenar fechas pasadas con un backfill
NotaBackfill
Un backfill (relleno) crea de una vez las ejecuciones de un rango de fechas pasadas. Se usa al poner en marcha un DAG con historia, o para reprocesar un periodo después de corregir un trabajo. Cada fecha es una ejecución independiente, con su fecha lógica, que corre igual que si se hubiera ejecutado en su día.
Llegan los archivos del 2 al 10 de julio y se pide un backfill de esas nueve fechas con POST /backfills. Dos opciones importan: max_active_runs: 1 (una fecha a la vez) y reprocess_behavior: none (no repetir fechas que ya tengan una ejecución).
# 8. Llegan los archivos del 2 al 10 y se piden esas nueve fechas de una vezfor dia inrange(2, 11): llega(f"envios_2026-07-{dia:02d}.csv")relleno = api("POST", "/backfills", {"dag_id": DAG_ID,"from_date": "2026-07-02T00:00:00Z","to_date": "2026-07-10T23:59:59Z","max_active_runs": 1,"reprocess_behavior": "none", # no repetir fechas que ya tienen ejecución"run_backwards": False,})print("Backfill", relleno["id"], "creado para", relleno["from_date"][:10], "a", relleno["to_date"][:10])inicio = time.time()while time.time() - inicio <3600: corridas = api("GET", f"/dags/{DAG_ID}/dagRuns?order_by=logical_date&limit=50")["dag_runs"] del_relleno = [c for c in corridas if c["run_type"] =="backfill"]iflen(del_relleno) ==9andall(c["state"] in ("success", "failed") for c in del_relleno):break time.sleep(15)tabla = pd.DataFrame([{"fecha": c["logical_date"][:10], "tipo": c["run_type"], "estado": c["state"],"minutos": round((pd.Timestamp(c["end_date"]) - pd.Timestamp(c["start_date"])).total_seconds() /60, 1),} for c in corridas])print(tabla.to_string(index=False))print("Minutos en total del backfill:", round((time.time() - inicio) /60, 1))ultima = del_relleno[-1]["dag_run_id"]print("Plata después del 10:", resultados(ultima, "cargar_plata")[-1])
Backfill 1 creado para 2026-07-02 a 2026-07-10
     fecha     tipo  estado  minutos
2026-07-01   manual success      1.1
2026-07-02 backfill success      1.7
2026-07-03 backfill success      2.3
2026-07-04 backfill success      1.8
2026-07-05 backfill success      1.7
2026-07-06 backfill success      2.0
2026-07-07 backfill success      1.8
2026-07-08 backfill success      1.6
2026-07-09 backfill success      2.0
2026-07-10 backfill success      2.0
Minutos en total del backfill: 17.3
Plata después del 10: plata: 2413 filas | 221 de la fecha
Las nueve ejecuciones del backfill terminaron en success, una por fecha, en orden y una a la vez. La tabla también muestra la ejecución manual del 1 de julio: el backfill la respetó. Al terminar el 10, la plata tiene 2 413 filas.
El tiempo total muestra el límite de este diseño en un clúster pequeño: tres trabajos de Spark por fecha, uno detrás de otro. Con un clúster más grande se podría subir max_active_runs para correr varias fechas a la vez; aquí bajaría el tiempo solo si se juntaran los tres pasos en un trabajo, a cambio de perder la separación entre ellos.
9. Un fallo: el archivo dañado del 11
NotaReintento
Un reintento vuelve a ejecutar una tarea fallida, de forma automática, después de una espera. Sirve para errores pasajeros: un servicio que no respondió, un contenedor que YARN no alcanzó a asignar, una red que se cortó. No sirve para errores de datos: un archivo dañado sigue dañado en el segundo intento.
Por eso el DAG tiene un reintento en las tareas de Spark y ninguno en la puerta de calidad. La celda deja llegar el archivo dañado del 11 y lanza su ejecución.
# 9. El archivo del 11 llega dañadoprint("Llega:", llega("envios_2026-07-11.csv"))corrida_11 = lanzar("2026-07-11")print("Estado final:", esperar(corrida_11))print(tareas_de(corrida_11).to_string(index=False))print("revisar_calidad:")for linea in resultados(corrida_11, "revisar_calidad"):print(" ", linea)
La ejecución del 11 terminó en failed. La puerta de calidad falló en su primer intento, sin reintentar, con dos incumplimientos: 41.29 % de destinos vacíos frente a un umbral de 3 %, y 42.8 % de filas en cuarentena frente a 12 %. El archivo quedó retenido. Las dos tareas siguientes quedaron en upstream_failed: nunca corrieron, porque la que las precede falló. La plata no recibió ni una fila del archivo dañado.
En la interfaz, la vista Grid muestra la columna del 11 con la puerta en rojo y las dos tareas siguientes en naranja. Ahí se abre el registro de la tarea con el mismo mensaje.
# 10. Llega la versión corregida y se limpian solo las tareas que fallaron y las que siguenprint("Llega:", llega("envios_2026-07-11_v2.csv"))api("POST", f"/dags/{DAG_ID}/clearTaskInstances", {"dry_run": False, "dag_run_id": corrida_11, "only_failed": True,"include_downstream": True, "reset_dag_runs": True})print("Estado final:", esperar(corrida_11))print(tareas_de(corrida_11).to_string(index=False))for tarea in ["revisar_calidad", "cargar_plata"]:print(f"{tarea}:")for linea in resultados(corrida_11, tarea):print(" ", linea)# 11. Y el 12 llega bienprint()print("Llega:", llega("envios_2026-07-12.csv"))corrida_12 = lanzar("2026-07-12")print("Estado final del 12:", esperar(corrida_12))print("Plata:", resultados(corrida_12, "cargar_plata")[-1])
Llega: …/llegada/2026-07-11/envios_2026-07-11_v2.csv
Estado final: success
          tarea  estado  intento  segundos
esperar_archivo success        1       1.3
revisar_calidad success        2      36.1
   cargar_plata success        1      38.4
   calcular_oro success        1      32.4
revisar_calidad:
    aplicación application_1794440555456_0035 | fecha 2026-07-11
    retenidos: [] | por cargar: ['envios_2026-07-11_v2.csv'] | ya cargados antes: 0
cargar_plata:
    aplicación application_1794440555456_0036 | fecha 2026-07-11
    archivos cargados: 1 | fechas recalculadas: 1
    plata: 2664 filas | 251 de la fecha

Llega: …/llegada/2026-07-12/envios_2026-07-12.csv
Estado final del 12: success
Plata: plata: 2901 filas | 237 de la fecha
Cuando llegó la versión corregida, la celda limpió solo la tarea fallida y las que siguen (only_failed e include_downstream), sin repetir el sensor, que ya había terminado bien. La puerta corrió su segundo intento y aprobó envios_2026-07-11_v2.csv; la carga lo llevó a plata, 251 filas del 11 de un total de 2 664, y la ejecución terminó en success. El sensor siguió en su primer intento. El 12 llegó bien y su ejecución dejó la plata en 2 901 filas.
Este es el ciclo de un fallo de datos en producción: el pipeline se detiene sin publicar, alguien corrige la fuente y se retoma la ejecución desde el punto donde falló, no desde el principio.
10. El resultado
Con Airflow ya sin trabajos en curso, el notebook abre su propia sesión de Spark para revisar lo que dejó el DAG: la plata, el registro de cargas y el oro.
from pyspark.sql import SparkSessionfrom pyspark.sql import functions as F# 12. Ahora sí una sesión de Spark en el notebook: Airflow ya no está usando el clústerspark = SparkSession.builder.appName("orquestacion-revision").config("spark.ui.showConsoleProgress", "false").getOrCreate()spark.sparkContext.setLogLevel("ERROR")plata = spark.read.parquet(BASE +"/plata")print("Plata:", plata.count(), "filas |", plata.select("guia").distinct().count(), "guías distintas")registro = spark.read.parquet(BASE +"/control/cargas")registro.select("archivo", "filas_leidas", "filas_cuarentena", "id_ejecucion").orderBy("archivo").show(20, truncate=False)oro = (spark.read.parquet(BASE +"/oro/kpi_dia") .groupBy("fecha").pivot("servicio", ["Express", "Estándar", "Económico"]).agg(F.first("pct_a_tiempo")) .orderBy("fecha").toPandas())oro["fecha"] = oro["fecha"].astype(str).str[5:]print(oro.to_string(index=False))spark.stop()
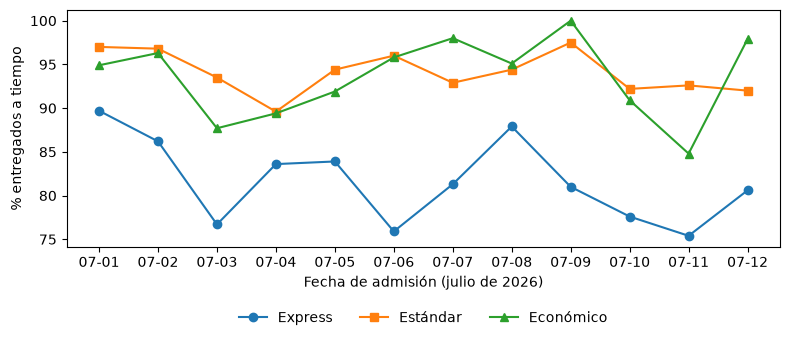
La plata tiene 2 901 filas y 2 901 guías distintas: ningún envío quedó repetido después de doce fechas, una repetición y un fallo. El registro de cargas tiene un archivo por día, todos cargados por la ejecución de su fecha (airflow-2026-07-01 a airflow-2026-07-12). El 11 aparece con su versión corregida, _v2; el dañado no está, porque nunca se cargó. El oro tiene una fila por fecha y servicio, con el porcentaje a tiempo de cada uno.
figura, eje = plt.subplots(figsize=(8, 3.6))for servicio, marca in [("Express", "o"), ("Estándar", "s"), ("Económico", "^")]: eje.plot(oro["fecha"], oro[servicio], marker=marca, label=servicio)eje.set_xlabel("Fecha de admisión (julio de 2026)")eje.set_ylabel("% entregados a tiempo")eje.legend(frameon=False, ncol=3, loc="upper center", bbox_to_anchor=(0.5, -0.22))plt.tight_layout()plt.show()
Figura 23.1: Porcentaje de envíos entregados a tiempo por día y servicio, del oro que calculó el DAG
En la figura, Estándar y Económico se mueven casi siempre entre 85 % y 100 %, y Express va más abajo, entre 75 % y 90 %: es el mismo patrón del taller de PySpark, ahora calculado cada noche por el DAG sin que nadie abra un notebook.
11. Airflow frente a cron
Pregunta
cron y un script
Airflow
¿Cuándo corre?
A una hora
A una hora, para una fecha lógica
¿Espera a que lleguen los datos?
No
Con un sensor
¿Qué pasa si un paso falla?
El script decide
Las tareas siguientes no corren
¿Reintenta?
Solo si se programa
Por tarea, con espera
¿Cómo se reprocesa una fecha?
Se ejecuta a mano con la fecha
Se limpia su ejecución
¿Y un mes completo?
Un ciclo a mano
Un backfill
¿Dónde está lo que pasó?
En los archivos de registro que deje el script
Estado, duración, intentos y registro de cada tarea
¿Qué cuesta?
Nada
Un servicio con base de datos, alrededor de 1 GB de memoria
En producción, Airflow usa una base de datos PostgreSQL en lugar de SQLite, un ejecutor que reparte las tareas entre varias máquinas y autenticación real. Las alternativas más conocidas son Dagster y Prefect, con ideas parecidas, y los orquestadores de las plataformas de nube, como los Jobs de Databricks.
Limpiar
La celda pausa el DAG para que no se ejecute nada más. Los datos de /bitlogistica/orquestacion quedan en HDFS y el historial queda en Airflow, para consultarlo en la interfaz.
api("PATCH", f"/dags/{DAG_ID}", {"is_paused": True})corridas = api("GET", f"/dags/{DAG_ID}/dagRuns?limit=50")["dag_runs"]print("DAG pausado:", api("GET", f"/dags/{DAG_ID}")["is_paused"])print("Ejecuciones registradas:", len(corridas), "| estados:", dict(Counter(c["state"] for c in corridas)))
DAG pausado: True
Ejecuciones registradas: 12 | estados: {'success': 12}
El DAG quedó pausado, con doce ejecuciones exitosas: la del 1, las nueve del backfill, la del 11 y la del 12. Para apagar Airflow sin perder nada: dca stop airflow. El historial vive en notebooks/airflow/airflow.db y el entorno de Python en el volumen airflow_venv, así que el siguiente dca up -d airflow arranca en menos de un minuto. Para borrar la zona de HDFS de este capítulo: dc exec spark-client /opt/hadoop/bin/hdfs dfs -rm -r /bitlogistica/orquestacion.
Práctica
Para hacer estos ejercicios, con Airflow encendido, ejecuta de nuevo las celdas de las secciones 2 a 6.
Un sensor que se rinde. Lanza la ejecución de una fecha sin archivo, el 13 de julio, y observa en la interfaz cómo el sensor revisa cada 15 segundos. Cámbiale el timeout a 120 segundos en el DAG: ¿en qué estado termina?
Un error pasajero. Detén un NodeManager (dc stop nodemanager2) mientras corre la carga de una fecha. ¿La tarea falla? ¿El reintento la salva? Vuelve a encender el NodeManager al terminar.
Un paso más. Agrega al DAG una tarea informe con un BashOperator que, después del oro, escriba con hdfs dfs -cat las líneas del oro de la fecha en el registro.
Dos fechas a la vez. Sube max_active_runs a 2 y repite el backfill con reprocess_behavior: completed. ¿Cuánto tarda? Mira en http://localhost:8088 cuántas aplicaciones quedan en ACCEPTED.
Ramas en paralelo. Cambia las dependencias para que, después de cargar_plata, corran en paralelo calcular_oro y la tarea informe del ejercicio 3. Escribe la línea de dependencias con una lista: cargar_plata >> [calcular_oro, informe].
El calendario real. Si el DAG no tuviera end_date y tuviera catchup=True, ¿cuántas ejecuciones crearía Airflow al activarlo hoy? Razónalo antes de probarlo.
TipOrientaciones
El sensor queda en up_for_reschedule entre revisiones. Con timeout=120, a los dos minutos termina en failed (un sensor que se rinde falla) y las tareas siguientes quedan en upstream_failed. Si en lugar de fallar quieres que la ejecución quede como omitida, el sensor acepta soft_fail=True, que lo deja en skipped.
Depende del momento. Si YARN pierde el nodo a mitad de un trabajo, Spark suele recuperar las tareas en el otro nodo y el trabajo termina bien. Si el trabajo falla, el reintento de 20 segundos lo vuelve a lanzar y, con un solo NodeManager, puede terminar más lento. Es el tipo de error para el que existen los reintentos.
BashOperator(task_id="informe", bash_command="/opt/hadoop/bin/hdfs dfs -ls " + BASE + "/oro/kpi_dia/fecha={{ ds }}") muestra los archivos del oro de la fecha. Para leer su contenido hace falta Spark, porque es Parquet: otra vez un spark-submit.
Con dos ejecuciones a la vez, dos trabajos de Spark piden memoria al mismo tiempo. El clúster no alcanza para los dos, así que uno espera en ACCEPTED hasta que el otro termina: el tiempo total casi no baja. Más paralelismo en el orquestador no sirve si el clúster no tiene recursos.
La interfaz muestra cargar_plata con dos flechas de salida. Las dos tareas pueden correr a la vez, pero con PARALLELISM = 2 y un clúster pequeño, la segunda puede esperar recursos de YARN.
Una por cada día desde el 1 de julio de 2026 hasta hoy, porque con catchup=True Airflow crea todas las fechas pendientes desde start_date. Por eso catchup viene en False en Airflow 3 y conviene activarlo solo con un end_date o con cuidado.
Errores frecuentes
Síntoma
Causa
Arreglo
Connection refused al llamar a http://airflow:8080
Airflow no está encendido, todavía se está instalando o se encendió con dc sin el archivo de Airflow.
dca up -d airflow y esperar Uvicorn running en dca logs airflow.
El DAG no aparece después de escribirlo
Airflow lee la carpeta cada 20 segundos, o el archivo tiene un error de Python.
Esperar; revisar GET /importErrors o el aviso rojo en la interfaz.
Una ejecución queda en queued y no avanza
El DAG está pausado.
Activarlo con el interruptor de la interfaz o con PATCH /dags/envios_diario.
La tarea de Spark queda mucho tiempo en running y en YARN la aplicación está en ACCEPTED
Otra aplicación ocupa la memoria del clúster, por ejemplo una sesión abierta en un notebook.
Cerrar la otra sesión con spark.stop(); mantener max_active_runs=1.
Los executors no conectan con el driver
Falta --conf spark.driver.host=airflow y el driver se anuncia como spark-client.
Agregar la opción al spark-submit del DAG.
ModuleNotFoundError: No module named 'pipeline_envios' en una tarea
Falta el módulo en notebooks o falta en --py-files.
Ejecutar antes el capítulo de ingesta; revisar la lista de --py-files.
409 Conflict al borrar el DAG
Tiene ejecuciones en curso.
Marcarlas como fallidas antes, como hace la sección 2.
Una fecha rechazada pasa a verde al limpiarla sin archivo nuevo
La puerta no exige un archivo aprobado.
Fallar si la fecha no tiene archivos por cargar ni cargados, como revisar_calidad.py.
Preguntas de comprensión
¿Por qué la puerta de calidad no tiene reintentos y las tareas de Spark sí?
¿Qué diferencia hay entre la fecha lógica de una ejecución y la fecha en que corrió?
¿Por qué el DAG lanza tres trabajos de Spark separados en lugar de uno que haga todo?
¿Qué tendría que pasar para que limpiar una ejecución duplicara datos en la plata?
¿Por qué el notebook no abre su sesión de Spark hasta la sección 10?
TipOrientaciones
Porque reintentar sirve para errores pasajeros, que en el segundo intento pueden no estar. Un archivo dañado sigue dañado en cualquier intento, así que reintentar solo gasta tiempo y retrasa la alerta. En cambio, un trabajo de Spark puede fallar por un contenedor que YARN no asignó o una red que se cortó.
La fecha lógica es la de los datos que procesa la ejecución, la que reciben los trabajos en { ds }; la fecha en que corrió es cuándo pasó. En el backfill, las ejecuciones del 2 al 10 de julio corrieron en noviembre, pero cada una procesó su fecha de julio.
Para que cada paso tenga su estado, su registro y sus reintentos, y se pueda repetir solo. Si la carga falla, no hace falta repetir la puerta de calidad. El costo es el arranque de tres aplicaciones de Spark por fecha, visible en la columna de segundos.
Que la carga no fuera idempotente: por ejemplo, que agregara las filas del archivo a la plata sin revisar el registro de cargas. Entonces cada limpieza agregaría el archivo otra vez.
Porque una sesión abierta en el notebook ocupa memoria de YARN, un driver y dos executors, y los trabajos que lanza Airflow se quedarían esperando en ACCEPTED. El clúster del libro tiene memoria para una aplicación a la vez.
Glosario
Término
Significado en este capítulo
Orquestador
Servicio que ejecuta los pasos de un pipeline en orden, a su hora, y registra lo que pasó.
DAG
Grafo dirigido acíclico de tareas con sus dependencias; en Airflow, un archivo de Python.
Tarea
Un paso del DAG.
Operador
Clase que define un tipo de tarea, como BashOperator.
Sensor
Operador que espera a que algo se cumpla y revisa cada cierto tiempo.
Ejecución (DAG run)
Una corrida del DAG completo para una fecha lógica.
Fecha lógica
Fecha de los datos que procesa una ejecución, disponible como { ds }.
Scheduler
Proceso de Airflow que decide qué tareas pueden correr.
Limpiar (clear)
Devolver tareas a «sin estado» para que se ejecuten otra vez.
Backfill
Creación de ejecuciones para un rango de fechas pasadas.
Catchup
Opción para que Airflow cree solo las ejecuciones de fechas pendientes desde start_date.
Reintento
Nueva ejecución automática de una tarea fallida, después de una espera.
upstream_failed
Estado de una tarea que no corrió porque falló una tarea de la que depende.
API REST
Interfaz HTTP del servicio, la misma que usa la interfaz web.
Apache Airflow. Buenas prácticas: tareas idempotentes y código de alto nivel en los DAG.
Reis, J. y Housley, M. (2022). Fundamentals of Data Engineering. O’Reilly Media. Capítulo 2, orquestación como corriente de fondo.
Resumen
Agregaste Airflow al clúster en un contenedor con la imagen de spark-client y escribiste el DAG envios_diario: un sensor que espera el archivo del día y tres tareas que lanzan con spark-submit la puerta de calidad, la carga a plata y el oro, reutilizando sin cambios los módulos de los capítulos de ingesta y calidad. La ejecución del 1 de julio esperó a que llegara su archivo y dejó 235 envíos en plata; repetirla no duplicó nada. Un backfill procesó del 2 al 10 en nueve ejecuciones, una a la vez. El archivo dañado del 11, con 41.29 % de destinos vacíos, detuvo su ejecución en la puerta de calidad sin reintentos y sin tocar la plata; con la versión corregida, la ejecución se retomó desde la tarea fallida. Al final, la plata tiene 2 901 envíos sin repetidos, el registro de cargas un archivo por fecha y el oro los indicadores de cada día, todo producido por el orquestador.