El pipeline de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) ya carga, valida, orquesta y publica los envíos. Un día llega un requerimiento con tres preguntas:
¿Quién consultó los datos de los destinatarios de mayo, y quién lo intentó sin permiso?
Un cliente pidió que se borraran sus datos. ¿Se borraron de verdad, o siguen en algún lado?
Si mañana falla un servidor o alguien borra un archivo por error, ¿qué pasa con los datos?
Con el clúster del libro, tal como está, ninguna tiene respuesta. Todos los notebooks se ejecutan como root, cualquier proceso puede leer cualquier carpeta, nadie registra quién abrió qué archivo y un borrado es definitivo. Funciona para aprender, pero en una organización real no pasaría una auditoría.
Este capítulo prepara el clúster para responder las tres preguntas. Separa zonas con permisos y ACL, limita el espacio con cuotas, agrega a los envíos un directorio ficticio de destinatarios para practicar con datos personales (seudonimizarlos, enmascararlos y medir cuánto cuesta reidentificarlos), borra a una persona de una tabla Iceberg y comprueba dónde queda su rastro, activa el registro de auditoría del NameNode y recupera un archivo borrado con un snapshot. Al final, una tabla relaciona cada práctica con los controles de ISO/IEC 27002 y con la Ley 1581 de 2012 de protección de datos personales.
Ficha
En este capítulo
Pregunta
¿Quién puede ver qué dato, cómo se demuestra y cómo se opera la plataforma día a día?
Datos
Los 6 519 envíos de mayo de la plata del taller de PySpark y un directorio ficticio de 3 210 destinatarios con nombre, documento, teléfono y dirección sintéticos
HDFS 3.4.1 (permisos, ACL, cuotas, snapshots, registro de auditoría), Kerberos, Spark 3.5.3, Apache Iceberg 1.6.1, Unity Catalog; como alternativas: Apache Ranger y Apache Atlas
Objetivos de aprendizaje
Al terminar este capítulo podrás:
Distinguir autenticación, autorización, auditoría, gobierno y operación, y explicar por qué la autenticación simple de Hadoop no protege nada sin Kerberos.
Separar zonas de datos en HDFS con dueños, grupos y permisos, y agregar excepciones con ACL.
Limitar una carpeta con cuotas de nombres y de espacio, y entender por qué un archivo pequeño puede no caber.
Clasificar las columnas de una tabla según el riesgo para las personas, y seudonimizar, enmascarar y minimizar datos personales con PySpark.
Medir el riesgo de reidentificar a una persona con cuasi-identificadores y reducirlo generalizando.
Borrar los datos de una persona en una tabla Iceberg y verificar que no queden en el historial.
Documentar una tabla en el catálogo, leer el registro de auditoría del NameNode y recuperar un archivo con un snapshot.
Relacionar estas prácticas con los controles de ISO/IEC 27002 y con la Ley 1581 de 2012.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
NameNode y metadatos
El NameNode guarda el árbol de carpetas, los dueños y los permisos de cada archivo.
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_seguridad.ipynb dentro de talleres-notebooks.zip. Necesita la plata del taller de PySpark y el .jar de Iceberg del capítulo de Iceberg en notebooks/jars.
Hay dos preparativos que no se pueden hacer desde el notebook, porque tocan el contenedor del NameNode. Se hacen una vez, en la terminal de WSL.
1. Activar el registro de auditoría. El NameNode puede escribir una línea por cada operación sobre el sistema de archivos, pero en la imagen de Hadoop ese registro viene apagado: su log4j.properties solo envía mensajes a la consola. Se enciende con dos archivos. El primero es un log4j.properties que conserva la consola y agrega un destino RFAAUDIT para el registro de auditoría; el segundo, un archivo Compose adicional que lo monta en el NameNode, igual que el laboratorio ya monta core-site.xml, y deja el registro en la carpeta notebooks/auditoria, donde el notebook lo puede leer:
Salida esperada: una línea como 2026-… INFO FSNamesystem.audit: allowed=true ugi=root (auth:SIMPLE) ip=/172.… cmd=listStatus src=/ …. --force-recreate obliga a recrear el NameNode con el archivo nuevo; sus datos están en un volumen y no se pierden. El segundo dcs up -d levanta los DataNodes y spark-client si estaban apagados: sin DataNodes, el NameNode no sale del modo seguro. La función dcs dura lo que dure la terminal; para tenerla siempre, agrega esa línea al final de ~/.zshrc.
2. Crear los usuarios del caso. Con la autenticación simple, HDFS averigua los grupos de un usuario preguntándole al sistema operativo del NameNode. Por eso los usuarios y grupos se crean en ese contenedor: Ana es analista, Luis trabaja en el equipo de protección de datos y Sofía es auditora.
dcs exec namenode bash -c'for g in analistas datos_personales auditoria; do groupadd -f "$g"; doneid ana >/dev/null 2>&1 || useradd -M -G analistas anaid luis >/dev/null 2>&1 || useradd -M -G datos_personales luisid sofia >/dev/null 2>&1 || useradd -M -G auditoria sofiaid ana; id luis; id sofia'
Salida esperada: tres líneas uid=… gid=… groups=…, con analistas, datos_personales y auditoria respectivamente.
Los usuarios viven dentro del contenedor del NameNode: si el contenedor se recrea (por ejemplo, con un dc up -d que no incluya compose.seguridad.yaml), se pierden y hay que repetir este paso. Mientras trabajes en este capítulo, usa dcs en lugar de dc.
1. Las cinco preguntas de la seguridad de datos
Las tres preguntas del requerimiento se ordenan en cinco, y cada sección del capítulo responde una:
Pregunta
Nombre
Dónde se resuelve en el capítulo
¿Quién eres?
Autenticación
Sección 2
¿Qué puedes hacer?
Autorización
Secciones 3, 4 y 5
¿Qué hiciste?
Auditoría
Sección 9
¿Qué es cada dato, de quién es y cuánto tiempo se guarda?
Gobierno
Secciones 6, 7 y 8
¿Sigue funcionando y se puede recuperar?
Operación
Sección 10
NotaDato personal
Un dato personal es cualquier información vinculada o que pueda asociarse a una persona natural determinada o determinable. Así lo define la Ley 1581 de 2012 en Colombia, y en términos parecidos el Reglamento General de Protección de Datos (RGPD) en Europa. El nombre y el documento lo son, pero también una dirección, un teléfono o una combinación de destino, fecha y peso que solo corresponde a un envío.
La primera celda prepara la sesión. Además de la sesión de Spark, define la función hdfs, que ejecuta un comando de HDFS como el usuario que se le indique. Con ella, el mismo notebook actúa como Ana, como Luis o como Sofía. La sesión agrega un catálogo Iceberg llamado privado, que guarda sus tablas dentro de la zona protegida de la sección 3, y borra la zona de una ejecución anterior.
# 1. Librerías del notebookimport hashlibimport osimport platformimport randomimport reimport subprocessimport timeimport matplotlib.pyplot as pltimport pandas as pdfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as F# 2. Rutas del capítuloBASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"# la plata del taller de PySparkZONA ="/bitlogistica/seguridad"# zona propia de este capítulo en HDFSHDFS_BIN ="/opt/hadoop/bin/hdfs"AUDITORIA ="auditoria/hdfs-audit.log"# registro de auditoría del NameNode (ver «Antes de empezar»)JAR = os.path.abspath("jars/iceberg-spark-runtime-3.5_2.12-1.6.1.jar")assert os.path.isfile(JAR), "Falta el .jar de Iceberg en notebooks/jars: revisa el capítulo de Iceberg"assert os.path.isfile(AUDITORIA), "No está el registro de auditoría: revisa «Antes de empezar»"def hdfs(*argumentos, usuario="root"):"""Ejecuta un comando hdfs como el usuario indicado y devuelve (código de salida, texto).""" entorno =dict(os.environ, HADOOP_USER_NAME=usuario) # con autenticación simple, esto ES la identidad resultado = subprocess.run([HDFS_BIN, *argumentos], capture_output=True, text=True, errors="replace", env=entorno) # -cat de un Parquet devuelve bytes lineas = (resultado.stdout + resultado.stderr).splitlines() texto ="\n".join(l for l in lineas if"WARN"notin l and"log4j"notin l)return resultado.returncode, texto.strip()# 3. Sesión de Spark con un catálogo Iceberg que guarda sus tablas DENTRO de la zona protegidaspark = ( SparkSession.builder .appName("seguridad-gobierno") .config("spark.ui.showConsoleProgress", "false") .config("spark.jars", JAR) .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions") .config("spark.sql.catalog.privado", "org.apache.iceberg.spark.SparkCatalog") .config("spark.sql.catalog.privado.type", "hadoop") .config("spark.sql.catalog.privado.warehouse", BASE +"/seguridad/personales/lago") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")# 4. Empezar siempre desde cero: quitar snapshots y la zona de una ejecución anteriorhdfs("dfsadmin", "-disallowSnapshot", ZONA +"/personales")hdfs("dfs", "-rm", "-r", "-f", "-skipTrash", ZONA)print("Python", platform.python_version(), "| Spark", spark.version, "| master:", spark.sparkContext.master)print(hdfs("version")[1].splitlines()[0])
La sesión corre en YARN con Spark 3.5.3 y el cliente de HDFS es el 3.4.1 del clúster. La zona /bitlogistica/seguridad empieza vacía en cada ejecución.
2. Identidad: por qué el clúster del libro confía en cualquiera
HDFS revisa permisos en cada operación, pero antes tiene que saber quién la pide. En el clúster del libro, esa pregunta se responde con la autenticación simple: el cliente le dice al NameNode quién es, y el NameNode le cree. El nombre sale de la variable HADOOP_USER_NAME o, si no existe, del usuario del sistema operativo que ejecuta el cliente.
La celda pide crear una carpeta dentro de la plata, que pertenece a root, tres veces: como ana, como un nombre inventado y como root.
# 1. Tres «usuarios» intentan crear una carpeta en la plata, que es de rootfor usuario in ["ana", "cualquier_nombre", "root"]: codigo, texto = hdfs("dfs", "-mkdir", f"/bitlogistica/plata/_prueba_{usuario}", usuario=usuario)print(f"{usuario:17s} ->", "creó la carpeta"if codigo ==0else texto.splitlines()[-1].split(": ", 1)[-1][:120])# 2. Limpiar: la carpeta de prueba de «root» no debe quedar en la platahdfs("dfs", "-rm", "-r", "-f", "-skipTrash", "/bitlogistica/plata/_prueba_root")
ana               -> Permission denied: user=ana, access=WRITE, inode="/bitlogistica/plata":root:supergroup:drwxr-xr-x
cualquier_nombre  -> Permission denied: user=cualquier_nombre, access=WRITE, inode="/bitlogistica/plata":root:supergroup:drwxr-xr-x
root              -> creó la carpeta
(0, 'Deleted /bitlogistica/plata/_prueba_root')
ana y cualquier_nombre reciben Permission denied: los permisos funcionan, y el mensaje dice qué se pidió (access=WRITE), sobre qué carpeta y con qué dueño y permisos (root:supergroup:drwxr-xr-x). Pero el tercer intento creó la carpeta, y no hubo que demostrar nada: bastó con decir que se era root. Cualquier proceso que pueda conectarse al puerto 9000 del NameNode puede hacer lo mismo. Con autenticación simple, los permisos protegen contra errores, no contra alguien que quiera saltárselos.
NotaKerberos
Kerberos es el protocolo de autenticación de Hadoop en producción. Cada usuario y cada servicio tienen una identidad, llamada principal (ana@BITLOGISTICA.CO, nn/namenode@BITLOGISTICA.CO), registrada en un servidor central, el KDC (Key Distribution Center). Para entrar, el usuario demuestra que conoce su contraseña y recibe un ticket con vigencia limitada; los servicios, que no pueden escribir contraseñas, usan un archivo de claves llamado keytab. El NameNode solo acepta peticiones con un ticket válido, así que HADOOP_USER_NAME deja de tener efecto.
El clúster del libro no instala Kerberos: necesitaría un servidor más, principales para cada contenedor y keytabs montados en todos ellos, y complicaría cada capítulo anterior. En una empresa, activarlo (hadoop.security.authentication=kerberos en core-site.xml) es el primer paso, sin el cual todo lo demás de este capítulo se puede evadir. En la nube, el proveedor resuelve la identidad con su propio sistema de cuentas, como viste con el correo de tu cuenta en Databricks.
3. Permisos en HDFS: zonas con dueño y grupo
Los permisos de HDFS siguen el modelo de Linux: cada archivo y carpeta tiene un dueño, un grupo y tres juegos de permisos (r leer, w escribir, x entrar a una carpeta) para el dueño, para el grupo y para los demás. El superusuario es quien arrancó el NameNode, aquí root, y no está sujeto a permisos.
La celda crea dos zonas con un criterio sencillo: cada una pertenece al grupo que la usa, y los demás no tienen ningún permiso (770). Antes muestra los grupos que el NameNode resuelve para cada usuario.
# 1. Los grupos que el NameNode encuentra para cada usuario (los creó «Antes de empezar»)USUARIOS = ["ana", "luis", "sofia"]for usuario in USUARIOS:print(hdfs("groups", usuario)[1])# 2. Dos zonas: cada una con un grupo dueño y sin acceso para los demás (770)ZONAS = {"analitica": "analistas", "personales": "datos_personales"}hdfs("dfs", "-mkdir", "-p", *[f"{ZONA}/{z}"for z in ZONAS])hdfs("dfs", "-chmod", "755", ZONA)for zona, grupo in ZONAS.items(): hdfs("dfs", "-chown", f"root:{grupo}", f"{ZONA}/{zona}") hdfs("dfs", "-chmod", "770", f"{ZONA}/{zona}")print()print(hdfs("dfs", "-ls", ZONA)[1])
ana : ana analistas
luis : luis datos_personales
sofia : sofia auditoria

Found 2 items
drwxrwx---   - root analistas                 0 2026-11-12 16:13 /bitlogistica/seguridad/analitica
drwxrwx---   - root datos_personales          0 2026-11-12 16:13 /bitlogistica/seguridad/personales
hdfs groups confirma que el NameNode encontró a los tres usuarios creados en «Antes de empezar», cada uno con su grupo propio y el del caso. En el listado, las dos zonas tienen permisos drwxrwx---: dueño root, grupo analistas o datos_personales, y nada para los demás.
La celda siguiente prueba la matriz completa: cada usuario intenta listar cada zona.
def acceso(usuario, zona):"""«lee» si el usuario puede listar la zona; «denegado» si HDFS lo rechaza.""" codigo, _ = hdfs("dfs", "-ls", f"{ZONA}/{zona}", usuario=usuario)return"lee"if codigo ==0else"denegado"def matriz():return pd.DataFrame({z: [acceso(u, z) for u in USUARIOS] for z in ZONAS}, index=USUARIOS)# 1. Quién entra a qué, con los permisos de la celda anteriorprint(matriz().to_string())# 2. El mensaje completo de un rechazoprint()print(hdfs("dfs", "-ls", f"{ZONA}/personales", usuario="ana")[1].splitlines()[-1])
      analitica personales
ana         lee   denegado
luis   denegado        lee
sofia  denegado   denegado

ls: Permission denied: user=ana, access=READ_EXECUTE, inode="/bitlogistica/seguridad/personales":root:datos_personales:drwxrwx---
La matriz es la esperada: Ana entra a la zona analítica y no a la personal, Luis al revés, y Sofía, que no pertenece a ninguno de los dos grupos, no entra a ninguna. El rechazo trae access=READ_EXECUTE: para listar una carpeta hacen falta r y x, y Ana no tiene ninguno de los dos sobre personales.
4. ACL: excepciones sin romper el esquema
Sofía es auditora: debe poder leer la zona personal, pero no pertenece al equipo de protección de datos ni debe poder escribir allí. Con permisos simples habría dos salidas malas: meterla en el grupo datos_personales (le daría escritura) o abrir la carpeta a los demás (la abriría para todos).
NotaACL
Una lista de control de acceso (ACL, Access Control List) agrega a un archivo o carpeta permisos para usuarios o grupos concretos, además de los de dueño, grupo y demás. Una entrada default en una carpeta se hereda a lo que se cree dentro de ella después. HDFS las admite desde Hadoop 2.4.
# 1. Una ACL: el grupo auditoria puede leer la zona personales, y lo que se cree dentro (default)PERSONALES =f"{ZONA}/personales"codigo, texto = hdfs("dfs", "-setfacl", "-m", "group:auditoria:r-x,default:group:auditoria:r-x", PERSONALES)print("setfacl:", "aplicada"if codigo ==0else texto)print(hdfs("dfs", "-getfacl", PERSONALES)[1])# 2. La matriz otra vez: solo cambió sofia en personales; ls marca con «+» la carpeta con ACLprint()print(matriz().to_string())print()print(hdfs("dfs", "-ls", ZONA)[1])
setfacl: aplicada
# file: /bitlogistica/seguridad/personales
# owner: root
# group: datos_personales
user::rwx
group::rwx
group:auditoria:r-x
mask::rwx
other::---
default:user::rwx
default:group::rwx
default:group:auditoria:r-x
default:mask::rwx
default:other::---

      analitica personales
ana         lee   denegado
luis   denegado        lee
sofia  denegado        lee

Found 2 items
drwxrwx---   - root analistas                 0 2026-11-12 16:13 /bitlogistica/seguridad/analitica
drwxrwx---+  - root datos_personales          0 2026-11-12 16:13 /bitlogistica/seguridad/personales
getfacl muestra la carpeta con dos capas de permisos. Las entradas normales dicen quién entra hoy: el dueño y el grupo con rwx, el grupo auditoria con r-x y los demás sin nada. Las entradas default son las que heredarán los archivos que se escriban dentro, como la tabla de destinatarios de la sección 6. La línea mask es el tope de permisos para las entradas con nombre.
En la matriz solo cambió una celda: Sofía ahora lee personales. En el listado, la carpeta muestra drwxrwx---+: el + final avisa que tiene una ACL, algo fácil de pasar por alto si solo se miran los permisos.
5. Cuotas: cuánto puede ocupar una zona
Una zona sin límite puede llenar el clúster con una carga equivocada y detener todo lo demás. HDFS ofrece dos cuotas por carpeta: la de nombres limita cuántos archivos y carpetas puede haber debajo, incluida la propia carpeta, y la de espacio limita los bytes, contando las réplicas.
La celda crea la carpeta cargas, le pone una cuota de 4 nombres e intenta subir cuatro veces el mismo archivo de 39 bytes. Después cambia a una cuota de espacio de 300 MB y prueba otra vez.
CARGAS =f"{ZONA}/cargas"hdfs("dfs", "-mkdir", "-p", CARGAS)withopen("lote_pequeno.csv", "w", encoding="utf-8") as archivo: archivo.write("guia,estado\nBL-202605-000001,entregado\n")print("Tamaño del archivo:", os.path.getsize("lote_pequeno.csv"), "bytes")def cargar(nombre): codigo, texto = hdfs("dfs", "-put", "-f", "lote_pequeno.csv", f"{CARGAS}/{nombre}")return"cargado"if codigo ==0else texto.splitlines()[-1].split(": ", 1)[-1][:150]# 1. Cuota de nombres: 4 nombres, y la carpeta cuenta como unohdfs("dfsadmin", "-setQuota", "4", CARGAS)for i inrange(1, 5):print(f"lote_{i}.csv ->", cargar(f"lote_{i}.csv"))print(hdfs("dfs", "-count", "-q", "-h", "-v", CARGAS)[1])# 2. Cuota de espacio de 300 MB: el mismo archivo pequeño ya no cabehdfs("dfsadmin", "-clrQuota", CARGAS)hdfs("dfs", "-rm", "-f", "-skipTrash", f"{CARGAS}/*")hdfs("dfsadmin", "-setSpaceQuota", "300m", CARGAS)print()print("Con 300 MB ->", cargar("lote_5.csv"))hdfs("dfsadmin", "-setSpaceQuota", "1g", CARGAS)print("Con 1 GB ->", cargar("lote_5.csv"))print(hdfs("dfs", "-count", "-q", "-h", "-v", CARGAS)[1])os.remove("lote_pequeno.csv")
Tamaño del archivo: 39 bytes
lote_1.csv -> cargado
lote_2.csv -> cargado
lote_3.csv -> cargado
lote_4.csv -> The NameSpace quota (directories and files) of directory /bitlogistica/seguridad/cargas is exceeded: quota=4 file count=5
QUOTA       REM_QUOTA     SPACE_QUOTA REM_SPACE_QUOTA    DIR_COUNT   FILE_COUNT       CONTENT_SIZE PATHNAME
           4               0            none             inf            1            3                117 /bitlogistica/seguridad/cargas

Con 300 MB  -> The DiskSpace quota of /bitlogistica/seguridad/cargas is exceeded: quota = 314572800 B = 300 MB but diskspace consumed = 402653184 B = 384 MB
Con 1 GB    -> cargado
QUOTA       REM_QUOTA     SPACE_QUOTA REM_SPACE_QUOTA    DIR_COUNT   FILE_COUNT       CONTENT_SIZE PATHNAME
        none             inf             1 G           1.0 G            1            1                 39 /bitlogistica/seguridad/cargas
Con la cuota de 4 nombres entraron tres archivos: la carpeta misma ocupa uno. El cuarto falló con NSQuotaExceededException, y -count -q muestra la cuota agotada (QUOTA 4, REM_QUOTA 0) con 1 carpeta y 3 archivos.
La cuota de espacio da la sorpresa: un archivo de 39 bytes no cabe en 300 MB. El mensaje lo explica: el consumo que HDFS calcula es de 402 653 184 bytes, es decir, 384 MB. Al empezar a escribir un archivo, HDFS reserva un bloque completo de 128 MB multiplicado por las 3 réplicas, porque todavía no sabe cuánto va a pesar. Solo al cerrar el archivo cuenta su tamaño real, 39 bytes × 3 = 117 bytes. Con 1 GB, la reserva cabe y el archivo entra. La regla práctica: una cuota de espacio debe dejar libre al menos un bloque por réplica (384 MB con la configuración del libro) para cada archivo que se escriba al mismo tiempo.
6. Datos personales: clasificar, seudonimizar y enmascarar
Los envíos de la plata no tienen datos personales: guía, ciudades, servicio, peso y fechas. Un operador real, en cambio, guarda quién recibe cada envío, porque sin una dirección no hay entrega. La celda construye ese directorio para los envíos de mayo, con nombres, documentos, teléfonos y direcciones inventados a partir de una semilla, y lo guarda en la zona personales. Una misma persona puede recibir varios envíos, como en la realidad.
Antes de proteger un dato hay que saber qué es. La celda termina con la clasificación de cada columna:
NotaIdentificador directo y cuasi-identificador
Un identificador directo señala a una persona por sí solo: su nombre, su documento o su teléfono. Un cuasi-identificador no la señala solo, pero combinado con otros puede hacerlo: la ciudad de destino, la fecha y el peso de un paquete. Los datos no personales, como el tipo de servicio, no ayudan a identificar a nadie.
# 1. Los envíos de mayo de la plata, y un directorio ficticio de destinatariosmayo = (spark.read.parquet(PLATA).filter(F.col("mes") ==5) .select("guia", "admision", "destino", "peso_kg", "servicio", "estado"))guias =sorted(r.guia for r in mayo.select("guia").collect())rng = random.Random(2828)NOMBRES = ["Ana", "Luis", "María", "Jorge", "Carolina", "Andrés", "Paula", "Camilo", "Diana", "Felipe","Laura", "Santiago", "Valentina", "Julián", "Natalia", "Mateo", "Sofía", "Daniel", "Lucía", "Óscar"]APELLIDOS = ["Gómez", "Rodríguez", "Martínez", "López", "García", "Pérez", "Sánchez", "Ramírez", "Torres","Díaz", "Vargas", "Rojas", "Castro", "Ortiz", "Moreno", "Jiménez", "Herrera", "Suárez", "Mejía", "Ruiz"]VIAS = ["Calle", "Carrera", "Avenida", "Transversal", "Diagonal"]personas = [(str(rng.randint(1_000_000_000, 1_099_999_999)),f"{rng.choice(NOMBRES)}{rng.choice(APELLIDOS)}{rng.choice(APELLIDOS)}",f"3{rng.randint(100_000_000, 249_999_999)}",f"{rng.choice(VIAS)}{rng.randint(1, 180)} # {rng.randint(1, 99)}-{rng.randint(1, 99)}")for _ inrange(4000)]filas = [(g, *rng.choice(personas)) for g in guias] # una persona puede recibir varios envíosdestinatarios = spark.createDataFrame(filas, "guia string, documento string, nombre string, telefono string, direccion string")# 2. Guardarlo en la zona personales y contar lo que hayRUTA_DEST =f"hdfs://namenode:9000{ZONA}/personales/destinatarios"destinatarios.write.mode("overwrite").parquet(RUTA_DEST)destinatarios = spark.read.parquet(RUTA_DEST)print("Envíos de mayo:", len(guias), "| destinatarios distintos:", destinatarios.select("documento").distinct().count())destinatarios.orderBy("guia").show(3, truncate=False)# 3. La clasificación de cada columnaclasificacion = pd.DataFrame([ ("documento", "identificador directo", "no sale de la zona personales; seudónimo con clave"), ("nombre", "identificador directo", "enmascarar"), ("telefono", "identificador directo", "enmascarar"), ("direccion", "identificador directo", "solo para entregar; no entra a la analítica"), ("destino", "cuasi-identificador", "generalizar si se publica"), ("admision", "cuasi-identificador", "generalizar (día, semana o mes)"), ("peso_kg", "cuasi-identificador", "generalizar en rangos"), ("servicio, estado", "no personal", "sin restricción"),], columns=["columna", "tipo", "tratamiento"])print(clasificacion.to_string(index=False))
Envíos de mayo: 6519 | destinatarios distintos: 3210
+----------------+----------+--------------------+----------+---------------------+
|guia            |documento |nombre              |telefono  |direccion            |
+----------------+----------+--------------------+----------+---------------------+
|BL-202605-000001|1064064417|María Herrera Moreno|3107007578|Diagonal 28 # 54-87  |
|BL-202605-000002|1067565238|Andrés Castro Mejía |3116206423|Calle 58 # 65-2      |
|BL-202605-000003|1037296836|Felipe Gómez López  |3162999065|Transversal 6 # 80-83|
+----------------+----------+--------------------+----------+---------------------+
only showing top 3 rows

         columna                  tipo                                        tratamiento
       documento identificador directo no sale de la zona personales; seudónimo con clave
          nombre identificador directo                                         enmascarar
        telefono identificador directo                                         enmascarar
       direccion identificador directo        solo para entregar; no entra a la analítica
         destino   cuasi-identificador                          generalizar si se publica
        admision   cuasi-identificador                    generalizar (día, semana o mes)
         peso_kg   cuasi-identificador                              generalizar en rangos
servicio, estado           no personal                                    sin restricción
Los 6 519 envíos de mayo quedaron asociados a 3 210 destinatarios distintos: la mitad de las personas recibió más de un paquete. Las tres filas de muestra tienen todo lo que hace falta para llamar o visitar a alguien, y por eso el directorio vive en la zona personales, que solo Luis y la auditora pueden abrir.
La clasificación decide el tratamiento de cada columna. Los identificadores directos no deben salir de la zona: el documento se reemplaza por un seudónimo, el nombre y el teléfono se enmascaran y la dirección solo sirve para entregar. Los cuasi-identificadores pueden ir a la analítica, pero generalizados si los datos se van a compartir.
Seudonimizar: un hash solo no basta
NotaSeudonimización y anonimización
Seudonimizar es reemplazar un identificador por un código que no permite reconocer a la persona sin información adicional que se guarda aparte, como una clave. Anonimizar es transformar los datos de modo que ya no se pueda identificar a nadie por ningún medio razonable. Un dato seudonimizado sigue siendo personal; uno anonimizado deja de serlo.
La tentación es reemplazar el documento por su hash SHA-256: parece irreversible. Pero los documentos son números de 10 dígitos dentro de un rango conocido, y quien tenga el hash puede calcular el de todos los números posibles hasta encontrar el que coincide. La celda lo hace con el documento más bajo del directorio y mide cuánto tardaría recorrer el rango completo. Después construye el seudónimo con clave, que sin la clave no se puede reproducir, la vista enmascarada para quien atiende reclamos y la vista mínima para analítica.
# 1. Un hash SIN clave: el atacante solo tiene que probar todos los documentos posiblesvictima = destinatarios.agg(F.min("documento")).first()[0]huella = hashlib.sha256(victima.encode()).hexdigest()for numero inrange(1_000_000_000, 1_100_000_000):if hashlib.sha256(str(numero).encode()).hexdigest() == huella:breakprint(f"Hash sin clave revertido: {str(numero) == victima} tras {numero -1_000_000_000+1:,} intentos")inicio = time.perf_counter()for numero inrange(1_000_000_000, 1_001_000_000): # un millón de hashes, para medir la velocidad hashlib.sha256(str(numero).encode()).hexdigest()por_segundo =1_000_000/ (time.perf_counter() - inicio)print(f"Velocidad: {por_segundo:,.0f} hashes por segundo en un núcleo")print(f"Recorrer los 100 millones de documentos posibles: {100_000_000/ por_segundo:.0f} segundos")# 2. Seudónimo con clave: sin la clave, probar documentos no sirveCLAVE = os.environ.get("CLAVE_SEUDONIMO", "clave-de-ejemplo-guardala-fuera-del-codigo")seudonimo = F.substring(F.sha2(F.concat(F.lit(CLAVE), F.lit("|"), F.col("documento")), 256), 1, 16)# 3. Enmascarar para quien solo necesita reconocer el registrovista_operativa = destinatarios.select("guia", seudonimo.alias("id_destinatario"), F.concat(F.substring("nombre", 1, 1), F.lit(". ***")).alias("nombre"), F.concat(F.lit("*******"), F.substring("telefono", -3, 3)).alias("telefono"),)vista_operativa.orderBy("guia").show(3, truncate=False)# 4. La vista mínima para analítica: envíos con seudónimo, sin ningún identificador directoanalitica = mayo.join(destinatarios.select("guia", seudonimo.alias("id_destinatario")), "guia")analitica.write.mode("overwrite").parquet(f"hdfs://namenode:9000{ZONA}/analitica/envios_mayo")print("Columnas de la vista analítica:", analitica.columns)
Hash sin clave revertido: True tras 14,313 intentos
Velocidad: 908,174 hashes por segundo en un núcleo
Recorrer los 100 millones de documentos posibles: 110 segundos
+----------------+----------------+------+----------+
|guia            |id_destinatario |nombre|telefono  |
+----------------+----------------+------+----------+
|BL-202605-000001|f6264dc98125d643|M. ***|*******578|
|BL-202605-000002|91d7ad4ecc438a9d|A. ***|*******423|
|BL-202605-000003|7832566d46dc5695|F. ***|*******065|
+----------------+----------------+------+----------+
only showing top 3 rows

Columnas de la vista analítica: ['guia', 'admision', 'destino', 'peso_kg', 'servicio', 'estado', 'id_destinatario']
El hash sin clave se revirtió en pocos miles de intentos, y la velocidad medida alcanza para recorrer los 100 millones de documentos posibles en poco más de un minuto con un solo núcleo: un hash simple de un documento es, en la práctica, el documento. El seudónimo con clave cambia la situación: el atacante tendría que conocer CLAVE, que se guarda fuera del código (aquí se lee de la variable de entorno CLAVE_SEUDONIMO; en producción, de un gestor de secretos). Spark no tiene una función HMAC, la construcción estándar de hash con clave; concatenar la clave antes del dato y aplicar SHA-256 sirve para el ejemplo, y en producción conviene una función HMAC-SHA256 propia.
La vista operativa muestra lo justo para reconocer un registro al teléfono (la inicial del nombre y los tres últimos dígitos) y la vista analítica no tiene ningún identificador directo: guía, fecha, destino, peso, servicio, estado y el seudónimo, con el que se pueden contar envíos por persona sin saber quién es. Esa vista va a la zona analitica, donde trabaja Ana.
¿Se puede reidentificar a alguien sin su nombre?
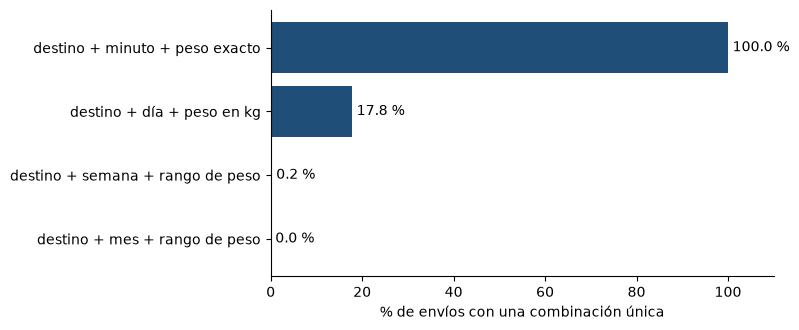
Quitar los identificadores directos no basta si los cuasi-identificadores son demasiado precisos. Si alguien sabe que su vecina recibió un paquete de 2.37 kg en Pasto el 14 de mayo a las 10:42, encuentra la fila en la vista analítica aunque no tenga nombre. La celda cuenta cuántos envíos quedan solos con su combinación de cuasi-identificadores, desde la versión exacta hasta la más generalizada.
Notak-anonimato
Un conjunto de datos es k-anónimo si cada combinación de cuasi-identificadores aparece al menos k veces: quien busque a una persona encontrará al menos k candidatos. Con k = 1, hay al menos una fila única, y esa persona se puede encontrar.
# 1. ¿Cuántos envíos quedan solos con su combinación de cuasi-identificadores?analitica = spark.read.parquet(f"hdfs://namenode:9000{ZONA}/analitica/envios_mayo")RANGOS = F.when(F.col("peso_kg") <1, "<1").when(F.col("peso_kg") <5, "1-5").when(F.col("peso_kg") <20, "5-20").otherwise("20+")NIVELES = {"destino + minuto + peso exacto": [F.col("destino"), F.date_format("admision", "yyyy-MM-dd HH:mm"), F.col("peso_kg")],"destino + día + peso en kg": [F.col("destino"), F.to_date("admision"), F.round("peso_kg")],"destino + semana + rango de peso": [F.col("destino"), F.weekofyear("admision"), RANGOS],"destino + mes + rango de peso": [F.col("destino"), F.month("admision"), RANGOS],}total = analitica.count()filas = []for nombre, columnas in NIVELES.items(): grupos = analitica.groupBy(*[c.alias(f"c{i}") for i, c inenumerate(columnas)]).count() unicos = grupos.filter("count = 1").count() k = grupos.agg(F.min("count")).first()[0] filas.append((nombre, unicos, round(100* unicos / total, 1), k))riesgo = pd.DataFrame(filas, columns=["cuasi-identificadores", "envíos únicos", "% únicos", "k mínimo"])print("Envíos en la vista analítica:", total)print(riesgo.to_string(index=False))
Envíos en la vista analítica: 6519
           cuasi-identificadores  envíos únicos  % únicos  k mínimo
  destino + minuto + peso exacto           6519     100.0         1
      destino + día + peso en kg           1163      17.8         1
destino + semana + rango de peso             15       0.2         1
   destino + mes + rango de peso              3       0.0         1
Con destino, minuto y peso exacto, los 6 519 envíos son únicos: el 100 %. Basta generalizar la hora al día y el peso al kilogramo para bajar a 1 163 envíos únicos (17.8 %), y con la semana y cuatro rangos de peso quedan 15 (0.2 %). Aun con el mes y los rangos de peso quedan 3 envíos únicos, y k sigue siendo 1: en una ciudad con pocos envíos, una combinación rara sigue señalando a alguien.
figura, eje = plt.subplots(figsize=(8, 3.4))eje.barh(riesgo["cuasi-identificadores"][::-1], riesgo["% únicos"][::-1], color="#1f4e79")for posicion, valor inenumerate(riesgo["% únicos"][::-1]): eje.text(valor +1, posicion, f"{valor:.1f} %", va="center")eje.set_xlabel("% de envíos con una combinación única")eje.set_xlim(0, 110)eje.spines[["top", "right"]].set_visible(False)plt.tight_layout()plt.show()
Figura 28.1: Porcentaje de envíos de mayo que quedan solos con su combinación de cuasi-identificadores, según cuánto se generalizan
En la figura se ve que la mayor parte del riesgo desaparece con el primer nivel de generalización, pero no todo. Por eso la vista analítica se queda dentro de la zona analitica y no se publica tal cual: para compartirla fuera hay que generalizar más, suprimir las filas raras o agregar los datos por grupos.
7. Retención y derecho de supresión
La Ley 1581 de 2012 le da a cada persona el derecho a pedir que se supriman sus datos cuando no hay una razón legal para conservarlos. En un archivo Parquet, borrar una persona obliga a reescribir los archivos que la contienen. En una tabla Iceberg basta con un DELETE, pero el capítulo de Iceberg mostró que cada escritura deja una instantánea, y que las anteriores se pueden consultar. ¿Qué pasa entonces con los datos borrados?
La celda guarda el directorio de destinatarios como tabla Iceberg en el catálogo privado, que vive dentro de la zona protegida, elige a la persona con más envíos como solicitante y la borra.
TABLA ="privado.bitlogistica.destinatarios"spark.sql("CREATE NAMESPACE IF NOT EXISTS privado.bitlogistica")destinatarios.writeTo(TABLA).create()# 1. La persona que pide la supresión: la que más envíos tieneSOLICITANTE = (spark.table(TABLA).groupBy("documento").count() .orderBy(F.desc("count"), "documento").first()["documento"])contar =lambda df: df.filter(F.col("documento") == SOLICITANTE).count()INSTANTANEA = spark.sql(f"SELECT snapshot_id FROM {TABLA}.snapshots").first()[0]print("Filas de la persona antes del DELETE:", contar(spark.table(TABLA)))# 2. Borrar: la tabla actual ya no la tiene, pero la instantánea anterior síspark.sql(f"DELETE FROM {TABLA} WHERE documento = '{SOLICITANTE}'")print("Después del DELETE, en la tabla actual:", contar(spark.table(TABLA)))print("Después del DELETE, viajando a la instantánea anterior:", contar(spark.read.option("snapshot-id", INSTANTANEA).table(TABLA)))# 3. Expirar las instantáneas viejas: ahora sí desaparecen los archivos que la conteníantime.sleep(1)limite = spark.sql("SELECT current_timestamp()").first()[0].strftime("%Y-%m-%d %H:%M:%S")resultado = spark.sql(f"""CALL privado.system.expire_snapshots( table => 'bitlogistica.destinatarios', older_than => TIMESTAMP '{limite}', retain_last => 1)""")print("Archivos de datos borrados al expirar:", resultado.first()["deleted_data_files_count"])try: contar(spark.read.option("snapshot-id", INSTANTANEA).table(TABLA))exceptExceptionas error:print("Viaje a la instantánea anterior:", type(error).__name__, "-", str(error).splitlines()[0][:90])
Filas de la persona antes del DELETE: 7
Después del DELETE, en la tabla actual: 0
Después del DELETE, viajando a la instantánea anterior: 7
Archivos de datos borrados al expirar: 2
Viaje a la instantánea anterior: IllegalArgumentException - Cannot find snapshot with ID 4629265912960497806
Antes del DELETE, la persona tenía 7 filas, una por envío. Después, la tabla actual devuelve 0, pero la instantánea anterior todavía devuelve las 7: el DELETE creó una versión nueva sin ella y dejó intacta la anterior, con los archivos que contienen su nombre, documento, teléfono y dirección. Para el negocio, la persona fue borrada; para el disco, no.
Solo expire_snapshots borra de verdad: elimina las instantáneas anteriores al límite y los archivos de datos que ya ninguna instantánea usa. Después de expirar, el viaje a la instantánea anterior falla porque ya no existe. Un procedimiento de supresión completo en un lakehouse tiene, por lo tanto, dos pasos (borrar y expirar) y debe revisar también los otros lugares donde puede quedar el dato: snapshots de HDFS (sección 10), la papelera, las copias de respaldo y las tablas derivadas.
8. Catálogo: qué es cada tabla, de quién es y cuánto se guarda
Para responder el requerimiento, alguien tiene que saber qué tablas tienen datos personales sin abrirlas una por una. Esa información vive en el catálogo: el registro de las tablas, su esquema y su documentación. La celda anota la tabla de destinatarios con cuatro propiedades (responsable, clasificación, plazo de retención y finalidad) y comenta las dos columnas más sensibles.
# 1. Quién responde por la tabla, qué contiene y cuánto tiempo se guardaspark.sql(f"""ALTER TABLE {TABLA} SET TBLPROPERTIES ( 'responsable' = 'Equipo de protección de datos de BITLogística', 'clasificacion' = 'dato personal', 'retencion' = '24 meses después de la entrega', 'finalidad' = 'entregar el envío y atender reclamos')""")for columna, nota in [("documento", "Identificador directo. No sale de la zona personales."), ("direccion", "Identificador directo. Solo para la entrega.")]: spark.sql(f"ALTER TABLE {TABLA} ALTER COLUMN {columna} COMMENT '{nota}'")# 2. El catálogo responde sin abrir los datos(spark.sql(f"SHOW TBLPROPERTIES {TABLA}") .filter(F.col("key").isin("responsable", "clasificacion", "retencion", "finalidad")).show(truncate=False))spark.sql(f"DESCRIBE TABLE {TABLA}").show(truncate=False)
+-------------+---------------------------------------------+
|key          |value                                        |
+-------------+---------------------------------------------+
|clasificacion|dato personal                                |
|finalidad    |entregar el envío y atender reclamos         |
|responsable  |Equipo de protección de datos de BITLogística|
|retencion    |24 meses después de la entrega               |
+-------------+---------------------------------------------+

+---------+---------+-----------------------------------------------------+
|col_name |data_type|comment                                              |
+---------+---------+-----------------------------------------------------+
|guia     |string   |NULL                                                 |
|documento|string   |Identificador directo. No sale de la zona personales.|
|nombre   |string   |NULL                                                 |
|telefono |string   |NULL                                                 |
|direccion|string   |Identificador directo. Solo para la entrega.         |
+---------+---------+-----------------------------------------------------+
SHOW TBLPROPERTIES responde sin leer una sola fila: quién responde por la tabla, que contiene datos personales, cuánto tiempo se guardan y para qué. DESCRIBE TABLE muestra los comentarios junto a cada columna, así que cualquiera que consulte el esquema ve la advertencia antes de usar documento o direccion.
En el clúster del libro estas propiedades son solo documentación: nada impide leer la tabla por no haberlas consultado. Las plataformas de gobierno van más allá. Apache Atlas (catálogo y linaje para Hadoop) y Apache Ranger (políticas de acceso centralizadas) usan las etiquetas para decidir: una política de Ranger puede enmascarar automáticamente toda columna etiquetada como personal. En Databricks, Unity Catalog hace lo mismo con etiquetas, máscaras de columna y filtros de fila, como muestra la sección 11. El linaje, la otra mitad del gobierno, ya lo tienes: el registro de cargas del capítulo de calidad dice de qué archivo y de qué ejecución salió cada fila de la plata.
9. Auditoría: quién leyó qué y cuándo
Es la primera pregunta del requerimiento. Con el registro que se activó en «Antes de empezar», el NameNode escribe una línea por cada operación: hora, si se permitió, quién la pidió, desde qué dirección, qué operación y sobre qué ruta. La celda anota hasta dónde llega el registro, hace que Ana, Luis y Sofía intenten leer un archivo de destinatarios, y lee solo las líneas nuevas.
# 1. Recordar dónde termina el registro y generar actividad sobre la zona personalesdesde = os.path.getsize(AUDITORIA)archivo = hdfs("dfs", "-ls", "-C", RUTA_DEST)[1].splitlines()[-1] # un archivo Parquet de destinatariosfor usuario in ["ana", "luis", "sofia"]: hdfs("dfs", "-cat", archivo, usuario=usuario)time.sleep(3)# 2. Leer solo las líneas nuevas del registro del NameNodewithopen(AUDITORIA, encoding="utf-8") as registro: registro.seek(desde) nuevas = registro.read().splitlines()PATRON = re.compile(r"^(\S+\S+).*?allowed=(\w+)\s+ugi=(\S+).*?cmd=(\S+)\s+src=(\S+)")eventos = pd.DataFrame([m.groups() for m inmap(PATRON.match, nuevas) if m], columns=["hora", "permitido", "usuario", "operacion", "ruta"])print("Líneas nuevas en el registro:", len(nuevas))print(nuevas[-1][:160])# 3. La pregunta del requerimiento: quién intentó leer datos personales, y si pudopersonales = eventos[eventos["ruta"].str.startswith(PERSONALES) & eventos["operacion"].isin(["open", "getfileinfo"])]print()print(personales.groupby(["usuario", "operacion", "permitido"]).size().rename("eventos").reset_index().to_string(index=False))
Líneas nuevas en el registro: 7
2026-11-12 16:16:09,225 INFO FSNamesystem.audit: allowed=true   ugi=sofia (auth:SIMPLE) ip=/172.19.0.6  cmd=open    src=/bitlogistica/seguridad/personales/destinatari

usuario   operacion permitido  eventos
    ana getfileinfo     false        1
   luis getfileinfo      true        1
   luis        open      true        1
   root getfileinfo      true        1
  sofia getfileinfo      true        1
  sofia        open      true        1
La línea de ejemplo muestra el formato: allowed, ugi (el usuario), ip, cmd (la operación) y src (la ruta). El resumen responde la pregunta para este ejercicio: Luis y Sofía abrieron el archivo (open con allowed=true). Ana lo intentó y fue rechazada antes de abrirlo: HDFS revisa los permisos al consultar el archivo (getfileinfo), y allí quedó su allowed=false, así que nunca llegó al open. La fila de root es el listado con que el notebook buscó el archivo. El intento fallido queda registrado igual que el acceso, y en una auditoría suele ser lo más importante.
El registro tiene dos límites. Dice quién pidió la operación, pero con autenticación simple ese «quién» es lo que el cliente declaró, así que la auditoría vale tanto como la autenticación. Y registra el acceso a archivos, no qué filas se leyeron: para eso hacen falta las herramientas de un motor de consultas, como el registro de auditoría de Unity Catalog. En producción, el registro se envía a un sistema central donde nadie del equipo de datos pueda modificarlo.
10. Operación: salud, capacidad y recuperación
La tercera pregunta del requerimiento es de operación: qué pasa si falla un servidor o si alguien borra un archivo. La primera celda revisa la salud del clúster con las dos herramientas de siempre: dfsadmin -report, el informe del NameNode sobre los DataNodes, y fsck, que recorre los archivos y cuenta bloques con problemas. También consulta si la papelera está activa.
# 1. Salud del clúster: DataNodes vivos, capacidad y bloquesdef resumen(texto, claves):"""Imprime la primera aparición de cada línea que empieza con una de las claves.""" vistas =set()for linea in texto.splitlines(): linea = linea.strip() nombre = linea.split(":")[0]if linea.startswith(claves) and nombre notin vistas: vistas.add(nombre)print(linea)resumen(hdfs("dfsadmin", "-report")[1], ("Configured Capacity", "DFS Used%", "Under replicated", "Missing blocks", "Live datanodes"))print()resumen(hdfs("fsck", "/bitlogistica")[1], ("Status:", "Total files", "Total blocks", "Under-replicated", "Default replication"))# 2. Papelera: con 0 minutos, un borrado no pasa por la papeleraprint()print("fs.trash.interval =", hdfs("getconf", "-confKey", "fs.trash.interval")[1].splitlines()[-1], "minutos")
Los tres DataNodes están vivos, la capacidad usada es pequeña y fsck informa HEALTHY, sin bloques con menos réplicas de las debidas ni bloques perdidos. Si un DataNode se detiene, el NameNode lo marca como muerto tras unos 10 minutos sin noticias y copia sus bloques a los otros dos; mientras tanto, fsck cuenta esos bloques como under-replicated. El ejercicio 6 de la práctica lo provoca.
La papelera está apagada (fs.trash.interval = 0): en el clúster del libro, un hdfs dfs -rm borra en el acto y no hay forma de recuperar el archivo. En producción se configura un intervalo, por ejemplo 1 440 minutos, para que los borrados pasen un día en .Trash antes de desaparecer.
Snapshots de HDFS
NotaSnapshot de HDFS
Un snapshot de HDFS es una copia de solo lectura de una carpeta en un instante. No duplica los bloques: el NameNode guarda la lista de archivos de ese momento, y los bloques de un archivo borrado se conservan mientras algún snapshot los necesite. Se consulta en la carpeta oculta .snapshot.
La celda habilita snapshots en la zona personales, toma uno, borra un archivo «por error» y lo recupera copiándolo desde .snapshot.
POLITICA =f"{PERSONALES}/politica_retencion.txt"withopen("politica_retencion.txt", "w", encoding="utf-8") as archivo: archivo.write("Datos de destinatarios: 24 meses después de la entrega.\n")hdfs("dfs", "-put", "-f", "politica_retencion.txt", POLITICA)os.remove("politica_retencion.txt")# 1. Habilitar snapshots en la zona y tomar unoprint(hdfs("dfsadmin", "-allowSnapshot", PERSONALES)[1])print(hdfs("dfs", "-createSnapshot", PERSONALES, "antes")[1])# 2. Un borrado por error, y la recuperación desde el snapshothdfs("dfs", "-rm", "-skipTrash", POLITICA)print("¿Existe después de borrarlo?", hdfs("dfs", "-test", "-e", POLITICA)[0] ==0)hdfs("dfs", "-cp", f"{PERSONALES}/.snapshot/antes/politica_retencion.txt", POLITICA)print("¿Existe después de recuperarlo?", hdfs("dfs", "-test", "-e", POLITICA)[0] ==0)print(hdfs("dfs", "-cat", POLITICA)[1])# 3. El snapshot también guarda los datos personales: hay que contarlo en la supresiónprint()print(hdfs("dfs", "-count", "-h", f"{PERSONALES}/.snapshot/antes")[1])
Allowing snapshot on /bitlogistica/seguridad/personales succeeded
Created snapshot /bitlogistica/seguridad/personales/.snapshot/antes
¿Existe después de borrarlo? False
¿Existe después de recuperarlo? True
Datos de destinatarios: 24 meses después de la entrega.

7           15            365.1 K /bitlogistica/seguridad/personales/.snapshot/antes
El archivo de política desapareció con el -rm y volvió con la copia desde .snapshot/antes, con el mismo contenido. Un snapshot cuesta casi nada al crearlo y protege contra el error humano más común, que es borrar lo que no se debía. No reemplaza un respaldo en otro lugar: si se pierde el clúster, se pierden también sus snapshots.
La última línea conecta con la sección 7: el snapshot cuenta los archivos de la zona tal como estaban, incluidos los destinatarios y la tabla Iceberg con la persona que pidió la supresión. Un dato borrado sigue en el disco mientras un snapshot lo referencie, así que la política de retención tiene que incluir cuánto se guardan los snapshots.
11. Lo mismo en Databricks
En Databricks, el catálogo y los permisos son una sola pieza: Unity Catalog. Lo que en el clúster del libro se hizo con grupos del sistema operativo, ACL de HDFS, propiedades de tabla y un registro de auditoría, allí se expresa en SQL sobre las tablas del capítulo de la nube. El código siguiente es de referencia y no se ejecuta en este notebook. Algunas de estas funciones requieren grupos de usuarios o planes que Databricks Free Edition limita, así que conviene probarlas en un espacio de trabajo de la empresa:
-- Permisos sobre objetos del catálogo, no sobre carpetasGRANTUSESCHEMAONSCHEMA workspace.bitlogistica TO `analistas`;GRANTSELECTONTABLE workspace.bitlogistica.plata_envios TO `analistas`;-- Etiquetas de clasificación, consultables en el catálogoALTERTABLE workspace.bitlogistica.destinatarios SET TAGS ('clasificacion'='dato personal');-- Máscara de columna: quien no pertenece al grupo ve el teléfono enmascaradoCREATEFUNCTION workspace.bitlogistica.enmascarar_telefono(telefono STRING)RETURNCASEWHEN is_account_group_member('datos_personales') THEN telefonoELSEconcat('*******', right(telefono, 3)) END;ALTERTABLE workspace.bitlogistica.destinatariosALTERCOLUMN telefono SET MASK workspace.bitlogistica.enmascarar_telefono;-- Auditoría: quién consultó qué, en las tablas del sistemaSELECT event_time, user_identity.email, action_name, request_paramsFROMsystem.access.auditWHERE service_name ='unityCatalog'AND event_date >=current_date() -7;
La diferencia de fondo es dónde se aplica el control. En HDFS, los permisos protegen archivos: quien puede leer el Parquet ve todas sus columnas, y el enmascaramiento hay que hacerlo con una vista aparte, como en la sección 6. En Unity Catalog, el control está en el motor de consultas: la misma tabla se ve completa para Luis y enmascarada para Ana, y la auditoría registra la consulta, no solo el archivo.
12. Del clúster a la norma
Las prácticas del capítulo implementan controles concretos de ISO/IEC 27002:2022, el catálogo de controles que acompaña a ISO/IEC 27001:2022, la norma de sistemas de gestión de seguridad de la información:
Lo que hiciste
Control de ISO/IEC 27002:2022
Qué faltaría en una organización real
Identidad simple y Kerberos (sección 2)
5.17 Información de autenticación · 8.5 Autenticación segura
Kerberos o un proveedor de identidad central; gestión de altas y bajas
Zonas con permisos y ACL (secciones 3 y 4)
5.15 Control de acceso · 5.18 Derechos de acceso · 8.2 Derechos de acceso privilegiado
Política de acceso aprobada; revisión periódica de quién tiene qué; root solo para administrar
Cuotas (sección 5)
8.6 Gestión de la capacidad
Monitoreo del crecimiento y umbrales de alerta
Clasificación de columnas (sección 6)
5.12 Clasificación de la información
Esquema de clasificación de toda la empresa, con responsables
Seudonimización, enmascaramiento y vista mínima (sección 6)
8.11 Enmascaramiento de datos · 5.34 Privacidad y protección de datos personales
Claves en un gestor de secretos; evaluación de impacto antes de publicar datos
Supresión y expiración (sección 7)
8.10 Eliminación de información
Procedimiento que cubra respaldos, snapshots y tablas derivadas, con evidencia
Catálogo con responsables (sección 8)
5.9 Inventario de información y otros activos
Catálogo completo con dueños y finalidades
Registro de auditoría (sección 9)
8.15 Registro de eventos · 8.16 Actividades de monitoreo
Registro centralizado y protegido contra modificación; revisión y alertas
Snapshots y salud del clúster (sección 10)
8.13 Respaldo de la información · 5.24 a 5.26 Gestión de incidentes
Respaldos fuera del clúster y pruebas de restauración; procedimiento de incidentes
Tres normas complementan ese marco. ISO/IEC 27701:2025 define el sistema de gestión de la privacidad; desde su versión de 2025 es una norma independiente y ya no una extensión de la 27001. ISO/IEC 20889:2018 describe las técnicas de desidentificación (seudonimización, enmascaramiento, generalización y supresión) y cómo medir el riesgo que dejan, el tema de la sección 6. ISO/IEC 27018 trata la protección de datos personales en la nube pública, el caso de Databricks.
En Colombia, el marco legal es la Ley 1581 de 2012, reglamentada por el Decreto 1377 de 2013 (hoy incorporado en el Decreto 1074 de 2015), con la Superintendencia de Industria y Comercio como autoridad. Exige, entre otros principios, finalidad, acceso y circulación restringida, seguridad y confidencialidad, y reconoce a cada persona los derechos de conocer, actualizar, rectificar y suprimir sus datos. Las secciones 3 a 9 son las herramientas técnicas para cumplir esos principios en una plataforma de datos.
AdvertenciaTécnica no es cumplimiento
Aplicar estas técnicas no equivale a certificarse en ISO/IEC 27001 ni a cumplir la Ley 1581. Una certificación exige un sistema de gestión con políticas, roles, evaluación de riesgos, evidencias y auditorías; el cumplimiento legal exige además análisis jurídico de cada tratamiento. El capítulo enseña la parte técnica, que es necesaria pero no suficiente.
Limpiar
La celda borra el snapshot, la zona /bitlogistica/seguridad con todo lo que el capítulo creó (las zonas, la tabla Iceberg del catálogo privado y las vistas) y cierra la sesión. Los usuarios del NameNode y el registro de auditoría quedan. Para volver a la configuración de los capítulos anteriores, recrea el NameNode con dc up -d --force-recreate namenode: se apaga el registro y se pierden los usuarios del caso.
# 1. Borrar el snapshot, la zona del capítulo y cerrar la sesiónhdfs("dfs", "-deleteSnapshot", PERSONALES, "antes")hdfs("dfsadmin", "-disallowSnapshot", PERSONALES)codigo, _ = hdfs("dfs", "-rm", "-r", "-skipTrash", ZONA)print("Zona del capítulo borrada:", codigo ==0)spark.stop()print("Sesión cerrada. Los usuarios ana, luis y sofia siguen en el NameNode hasta que se recree su contenedor.")
Zona del capítulo borrada: True
Sesión cerrada. Los usuarios ana, luis y sofia siguen en el NameNode hasta que se recree su contenedor.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1 a 6 (la sesión, las zonas y los datos personales).
Grupo de lectura. Crea en el NameNode un usuario marta en un grupo nuevo lectores y dale, con una ACL, lectura sobre la zona analitica sin escritura. Comprueba con la matriz que Marta lee pero no puede crear archivos.
ACL heredada. Escribe un archivo nuevo en personales después de la ACL de la sección 4 y revisa con getfacl si Sofía puede leerlo. ¿Qué entrada de la ACL lo hace posible?
Cuota justa. ¿Cuál es la cuota de espacio mínima para que entren dos archivos pequeños escritos uno después del otro? ¿Y si se escriben al mismo tiempo desde dos procesos?
Reducir el riesgo. Agrega a la tabla de reidentificación un nivel con destino, mes y servicio, sin el peso. ¿Cuántos envíos únicos quedan? Suprime de la vista los envíos con combinación única y calcula el nuevo k.
Supresión completa. Repite la sección 7 con otra persona y además toma un snapshot de HDFS de la zona antes del DELETE. Después de expire_snapshots, ¿siguen los archivos con sus datos en .snapshot?
Un DataNode caído. Desde WSL, detén un DataNode con dcs stop datanode3, espera 11 minutos y ejecuta hdfs fsck /bitlogistica y hdfs dfsadmin -report. ¿Cuántos DataNodes vivos hay y qué pasa con los bloques? Enciéndelo de nuevo con dcs start datanode3.
TipOrientaciones
useradd -M -G lectores marta en el NameNode y hdfs dfs -setfacl -m group:lectores:r-x sobre la zona. Al intentar -put, Marta recibe access=WRITE.
La entrada default:group:auditoria:r-x de la carpeta se copió como ACL del archivo nuevo: getfacl muestra group:auditoria:r-x en el archivo.
Escritos uno tras otro, basta con un bloque reservado (384 MB) más lo que ocupan los archivos ya cerrados. Escritos al mismo tiempo, cada uno reserva su bloque: hacen falta 768 MB.
Sin el peso, las combinaciones de destino, mes y servicio son pocas (15 ciudades × 3 servicios en un mes) y casi ningún envío queda único. Suprimir las filas únicas lleva k a 2 o más.
Sí. El snapshot de HDFS conserva los archivos de datos que Iceberg borró al expirar, porque el NameNode no libera bloques que un snapshot referencia. La supresión exige borrar también ese snapshot.
Tras unos 10 minutos y medio, el NameNode marca el DataNode como muerto: el informe muestra 2 vivos y fsck cuenta bloques under-replicated, porque con dos DataNodes no se pueden mantener tres réplicas. El estado sigue HEALTHY, porque no se perdió ningún bloque. Al encender el DataNode, los bloques vuelven a tener tres réplicas.
Errores frecuentes
Síntoma
Causa
Arreglo
No está el registro de auditoría al iniciar
No se creó compose.seguridad.yaml o el NameNode no se recreó con él.
Repetir el paso 1 de «Antes de empezar» y comprobar que exista notebooks/auditoria/hdfs-audit.log.
hdfs groups ana devuelve ana : sin grupos
Los usuarios no existen en el contenedor del NameNode, o se recreó el contenedor.
Repetir el paso 2 de «Antes de empezar».
La matriz muestra «lee» para todos
El notebook ejecutó las pruebas como root, el superusuario.
Pasar el usuario con usuario= en la función hdfs.
AclException: … Support for ACLs has been disabled
dfs.namenode.acls.enabled está en false en hdfs-site.xml.
Ponerla en true y reiniciar el NameNode.
DSQuotaExceededException con un archivo pequeño
La cuota de espacio es menor que un bloque por réplica (384 MB).
Subir la cuota o escribir con un tamaño de bloque menor.
Cannot delete … snapshottable … snapshots al limpiar
La carpeta todavía tiene snapshots.
-deleteSnapshot y -disallowSnapshot antes de borrarla.
El viaje a una instantánea de Iceberg sigue funcionando después del DELETE
Falta expirar las instantáneas.
CALL … expire_snapshots(…) con un límite posterior al DELETE.
Los usuarios del caso desaparecen al día siguiente
cluster_on o dc up -d recrearon el NameNode sin compose.seguridad.yaml.
Usar dcs mientras trabajas en el capítulo, o repetir «Antes de empezar».
Preguntas de comprensión
¿Por qué los permisos de HDFS no protegen contra un usuario malintencionado en el clúster del libro, y qué cambia con Kerberos?
Sofía necesita leer la zona personal sin escribir en ella. ¿Por qué una ACL es mejor que agregarla al grupo datos_personales?
Un archivo de 39 bytes no cupo en una cuota de 300 MB. ¿Qué cuenta HDFS al empezar a escribir y qué al terminar?
¿Por qué el hash SHA-256 de un documento no es un seudónimo seguro, y qué agrega la clave?
Después de un DELETE en Iceberg, ¿dónde siguen los datos de la persona y qué hay que hacer para borrarlos?
TipOrientaciones
Con autenticación simple, la identidad es la que declara el cliente: basta con HADOOP_USER_NAME=root para ser superusuario. Kerberos exige un ticket emitido por el KDC, que solo obtiene quien demuestra conocer la clave del principal.
El grupo le daría también escritura (rwx) y la incluiría en todo lo que se le permita a ese grupo en el futuro. La ACL le da exactamente r-x sobre esa carpeta, y la entrada default lo extiende a lo que se cree dentro.
Al empezar, HDFS reserva un bloque completo por réplica: 128 MB × 3 = 384 MB, más que la cuota. Al cerrar el archivo, cuenta su tamaño real por las réplicas: 39 × 3 = 117 bytes.
Porque el rango de documentos es pequeño y conocido: calcular el hash de los 100 millones de valores posibles toma minutos. La clave hace que el atacante no pueda calcular los seudónimos de los candidatos sin conocerla.
En las instantáneas anteriores, que el viaje en el tiempo todavía consulta, y en sus archivos de datos. expire_snapshots las elimina junto con los archivos que ninguna instantánea usa. También hay que revisar snapshots de HDFS, respaldos y tablas derivadas.
Glosario
Término
Significado en este capítulo
Autenticación
Comprobar quién hace una petición.
Autorización
Decidir qué puede hacer quien ya se identificó.
Autenticación simple
Modo de Hadoop en el que el cliente declara su usuario y el NameNode le cree.
Kerberos
Protocolo de autenticación con tickets emitidos por un servidor central (KDC).
Principal
Identidad de un usuario o servicio en Kerberos.
Keytab
Archivo con las claves de un principal, para que un servicio se autentique sin contraseña.
Superusuario
El usuario que arrancó el NameNode; no está sujeto a permisos.
ACL
Lista de permisos adicionales para usuarios o grupos concretos.
Cuota de nombres
Límite de archivos y carpetas debajo de una carpeta, incluida ella.
Cuota de espacio
Límite de bytes de una carpeta, contando réplicas.
Dato personal
Información vinculada o que puede asociarse a una persona natural determinada o determinable.
Identificador directo
Dato que señala a una persona por sí solo.
Cuasi-identificador
Dato que, combinado con otros, puede señalar a una persona.
Seudonimización
Reemplazar un identificador por un código que no permite reconocer a la persona sin información guardada aparte.
Anonimización
Transformación tras la cual ya no se puede identificar a nadie por medios razonables.
Enmascaramiento
Ocultar parte de un dato para quien no necesita verlo completo.
k-anonimato
Propiedad de un conjunto en el que cada combinación de cuasi-identificadores aparece al menos k veces.
Supresión
Eliminación de los datos de una persona a su solicitud.
Registro de auditoría
Registro de cada operación con hora, usuario, operación, ruta y si se permitió.
Snapshot de HDFS
Copia de solo lectura de una carpeta en un instante, sin duplicar bloques.
Databricks. Unity Catalog: permisos, etiquetas, máscaras de columna y tablas de auditoría.
ISO/IEC 27001:2022 e ISO/IEC 27002:2022. Seguridad de la información, ciberseguridad y protección de la privacidad.
ISO/IEC 27701:2025. Sistema de gestión de la información de privacidad.
ISO/IEC 20889:2018. Terminología y clasificación de técnicas de desidentificación que mejoran la privacidad.
McCallister, E., Grance, T. y Scarfone, K. (2010). Guide to Protecting the Confidentiality of Personally Identifiable Information (PII). NIST SP 800-122.
Sweeney, L. (2002). k-anonymity: a model for protecting privacy. International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems, 10(5), 557–570.
Congreso de Colombia. Ley Estatutaria 1581 de 2012, por la cual se dictan disposiciones generales para la protección de datos personales; Decreto 1377 de 2013, incorporado en el Decreto 1074 de 2015.
Resumen
Con los envíos de BITLogística preparaste el clúster para responder tres preguntas que antes no tenían respuesta. La identidad del clúster del libro es declarativa: bastó con decir root para saltarse los permisos, y por eso Kerberos es el primer requisito en producción. Las zonas analitica y personales separaron el acceso por grupo, una ACL le dio a la auditora lectura sin escritura, y las cuotas mostraron que un archivo de 39 bytes necesita 384 MB libres al empezar a escribirse.
El directorio ficticio de 3 210 destinatarios sirvió para practicar con datos personales. Un hash sin clave se revirtió en segundos, así que el seudónimo usa una clave guardada aparte; la vista analítica no tiene identificadores directos, pero con destino, minuto y peso exacto el 100 % de los envíos era único, y aun generalizados quedaron 3. Borrar a una persona de una tabla Iceberg no la borró del disco hasta expirar las instantáneas, y un snapshot de HDFS también la conserva. El catálogo documentó la tabla, el registro de auditoría del NameNode mostró quién abrió el archivo y quién lo intentó sin permiso, y un snapshot recuperó un archivo borrado por error. La sección 12 relacionó cada práctica con su control de ISO/IEC 27002 y con la Ley 1581 de 2012.
Con este capítulo termina la segunda etapa del libro. El apéndice «Operar el clúster» reúne el arranque, el apagado y el diagnóstico del clúster con el que trabajaste en todos los capítulos.