21Optimización de Spark: particiones, uniones y memoria
big-data
ingenieria-datos
spark
optimizacion
rendimiento
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de octubre de 2026
El problema que vas a resolver
El equipo de datos de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) tiene una consulta que tarda demasiado: une los envíos con la tabla de clientes y responde tres preguntas sobre el servicio Express. Nadie la escribió mal a propósito, pero tarda varias veces más de lo necesario. Antes de pedir más máquinas, hay que saber por qué tarda.
Este capítulo mide, sobre veinte copias de la plata de enero a junio, los factores que más pesan en el tiempo de un trabajo de Spark: cuántas tareas lanza y de qué tamaño, cómo une las tablas, si los datos están repartidos de forma pareja y cuánta memoria tiene cada executor. Cada ajuste se mide antes y después, en el clúster de los laboratorios.
Ficha
En este capítulo
Pregunta
¿Por qué un trabajo de Spark tarda lo que tarda y qué se puede cambiar para que tarde menos?
Datos
La plata de BITLogística copiada veinte veces, más de 640 000 envíos, con un cliente corporativo que concentra el 70 %
Tiempo estimado de lectura
55 minutos, más la práctica
Nivel
Intermedio a avanzado
Conocimientos previos recomendados
Driver, executors, etapas y shuffle en Spark; contenedores en YARN; uniones por difusión y por ordenamiento en Spark SQL y DataFrames
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_optimizacion.ipynb dentro de talleres-notebooks.zip. Necesita la capa /bitlogistica/plata del taller de PySpark. Escribe unos 17 MB de pruebas en /bitlogistica/laboratorio_optimizacion, que la última celda borra.
Los tiempos cambian de una ejecución a otra, y más en un clúster con dos executors de un núcleo cada uno, que es muy pequeño. Importa la comparación entre variantes medidas en la misma ejecución. Mientras corren las celdas, puedes abrir la Spark UI en http://localhost:4040 para ver cada trabajo.
1. La sesión y los recursos del clúster
La celda abre la sesión con la configuración por defecto del clúster y muestra los valores que más influyen en el rendimiento.
import platformimport statisticsimport timeimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as FBASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"LAB = BASE +"/laboratorio_optimizacion"spark = ( SparkSession.builder .appName("optimizacion-spark") .config("spark.ui.showConsoleProgress", "false") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"print("Python", platform.python_version(), "| Spark", spark.version)print("master:", sc.master, "| aplicación:", sc.applicationId)print("Spark UI del driver:", sc.uiWebUrl)print()for clave, defecto in [ ("spark.executor.instances", "(sin fijar)"), ("spark.executor.cores", "1"), ("spark.executor.memory", "1g"), ("spark.executor.memoryOverhead", "(384 MB o 10 %)"), ("spark.memory.fraction", "0.6"), ("spark.sql.shuffle.partitions", "200"), ("spark.sql.adaptive.enabled", "true"), ("spark.sql.autoBroadcastJoinThreshold", "10485760b"),]:print(f"{clave:40s}{spark.conf.get(clave, defecto)}")
Cada executor tiene 1 núcleo y 512 MB de memoria, y hay 2: en todo el clúster solo pueden correr dos tareas a la vez. Las particiones del shuffle están en 200 y la ejecución adaptativa (AQE) está activa, que son los valores por defecto de Spark 3.5. La difusión se usa con tablas de menos de 10 MB.
NotaSpark UI
La Spark UI es la página web del driver que muestra cada trabajo mientras corre y después: la pestaña Jobs lista los trabajos; Stages, las etapas con sus tareas y el tiempo de cada una (mínimo, mediana y máximo); SQL / DataFrame, el plan físico con las filas que pasó por cada paso; Storage, lo que está en caché; y Executors, la memoria y el tiempo de cada executor. En el clúster de los laboratorios se abre en http://localhost:4040 mientras la sesión esté abierta. Si ya había otra sesión de Spark abierta en spark-client, la nueva usa el puerto siguiente (4041, 4042…), que no está publicado: la línea «Spark UI del driver» de la primera celda dice cuál le tocó, y conviene cerrar los otros notebooks antes de empezar. En este notebook, las mismas cifras se leen con código para que queden en las salidas.
2. La memoria de un executor
Antes de medir tiempos, conviene saber cuánta memoria tiene cada executor para trabajar. No es la cifra de spark.executor.memory: una parte la reserva Spark, otra queda para los objetos del programa y, por fuera, YARN suma una sobrecarga.
NotaMemoria unificada y desborde a disco
La memoria unificada es la parte del heap de la JVM del executor que Spark usa para ejecutar (ordenar, agrupar, unir) y para la caché, compartida entre las dos. Se calcula como (memoria del executor − 300 MB reservados) × spark.memory.fraction, que vale 0.6. Si una tarea necesita más memoria de ejecución de la que hay, Spark escribe parte de los datos a disco y los vuelve a leer después: es un desborde (spill). El trabajo termina, pero más lento.
def a_mb(texto): texto = texto.strip().lower() unidades = {"g": 1024, "m": 1, "k": 1/1024}returnfloat(texto[:-1]) * unidades[texto[-1]] if texto[-1] in unidades elsefloat(texto) /2**20memoria_executor = a_mb(spark.conf.get("spark.executor.memory", "1g"))sobrecarga =max(384, 0.10* memoria_executor)reservada =300fraccion =float(spark.conf.get("spark.memory.fraction", "0.6"))unificada = (memoria_executor - reservada) * fraccionprint(f"Memoria del executor (heap de la JVM): {memoria_executor:6.0f} MB")print(f"Sobrecarga fuera del heap (memoryOverhead): {sobrecarga:6.0f} MB")print(f"Contenedor que se le pide a YARN: {memoria_executor + sobrecarga:6.0f} MB")print(f"Reservada por Spark: {reservada:6.0f} MB")print(f"Memoria unificada (ejecución + caché): {unificada:6.0f} MB")print(f"Memoria para objetos del usuario: {memoria_executor - reservada - unificada:6.0f} MB")
Memoria del executor (heap de la JVM):           512 MB
Sobrecarga fuera del heap (memoryOverhead):      384 MB
Contenedor que se le pide a YARN:                896 MB
Reservada por Spark:                             300 MB
Memoria unificada (ejecución + caché):           127 MB
Memoria para objetos del usuario:                 85 MB
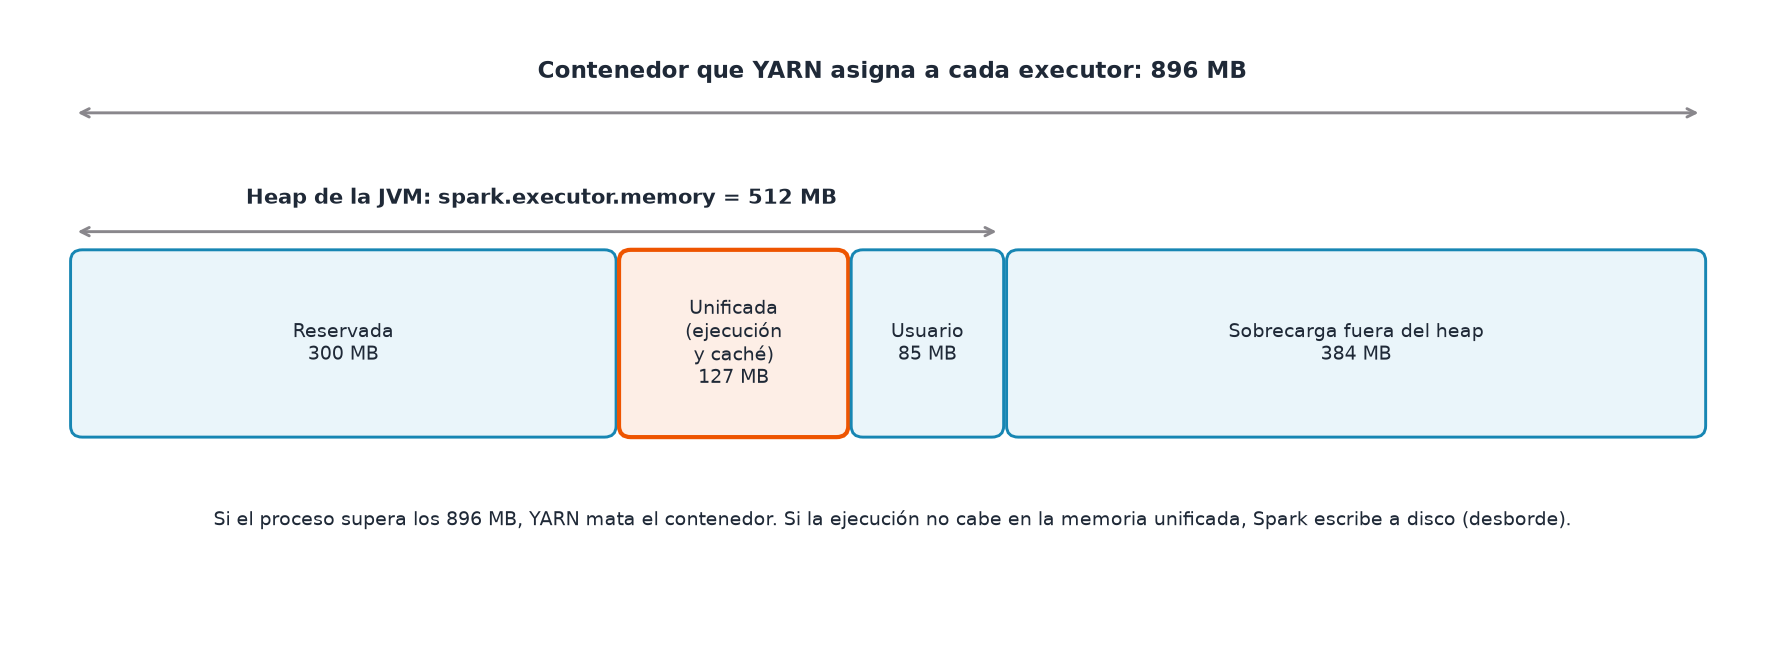
Con 512 MB por executor, YARN le asigna un contenedor de 896 MB: los 512 del heap más 384 de sobrecarga, el mínimo. Del heap, 300 MB quedan reservados y la memoria unificada es de apenas 127 MB; 85 MB quedan para los objetos del programa.
Reparto de la memoria de un executor de los laboratorios.
Dos errores comunes salen de este reparto. Si el proceso completo pasa de 896 MB, por ejemplo por objetos de Python en una UDF, YARN mata el contenedor con el mensaje Container killed by YARN for exceeding memory limits; se arregla subiendo spark.executor.memoryOverhead. Si lo que no cabe es la ejecución, Spark desborda a disco; se ve en la pestaña Stages de la Spark UI, en las columnas Spill (Memory) y Spill (Disk), y se reduce con más particiones o más memoria.
La celda siguiente define las funciones de apoyo del capítulo. anatomia ejecuta una acción y cuenta las etapas que corrieron y sus tareas, con el statusTracker de Spark, el mismo registro que alimenta la Spark UI.
def medir(accion, repeticiones=3):"""Mediana de los segundos de varias ejecuciones.""" tiempos = []for _ inrange(repeticiones): inicio = time.perf_counter() accion() tiempos.append(time.perf_counter() - inicio)returnround(statistics.median(tiempos), 2)ultima_etapa = [-1]def etapas_nuevas():"""Etapas que Spark registró desde la última consulta (los números de etapa son consecutivos).""" seguidor, numero, nuevas, huecos = sc.statusTracker(), ultima_etapa[0] +1, [], 0while huecos <5: info = seguidor.getStageInfo(numero)if info isNone: huecos +=1else: nuevas.append(info) ultima_etapa[0], huecos = numero, 0 numero +=1return nuevasdef anatomia(accion):"""Ejecuta una vez y cuenta las etapas que corrieron y sus tareas, con el statusTracker de Spark.""" etapas_nuevas() accion() corridas = [e for e in etapas_nuevas() if e.numCompletedTasks >0]return {"etapas": len(corridas), "tareas": sum(e.numCompletedTasks for e in corridas),"tareas_por_etapa": [e.numCompletedTasks for e in corridas]}def filas_por_particion(tabla):"""Cuántas filas tiene cada partición de un DataFrame."""return [f["count"] for f in tabla.groupBy(F.spark_partition_id().alias("p")).count().orderBy("p").collect()]def ejecutar(tabla):"""Recorre todo el resultado sin traerlo al driver.""" tabla.write.format("noop").mode("overwrite").save()def borrar(ruta): camino = spark._jvm.org.apache.hadoop.fs.Path(ruta)return camino.getFileSystem(sc._jsc.hadoopConfiguration()).delete(camino, True)print("Funciones listas: medir, anatomia, filas_por_particion, ejecutar, borrar")
Las cinco funciones quedan listas: medir para los tiempos, anatomia para contar etapas y tareas, filas_por_particion para ver cómo quedaron repartidos los datos, ejecutar para recorrer un resultado sin traerlo al driver y borrar para la limpieza.
3. Los datos del experimento
La celda copia veinte veces la plata y agrega una columna cliente. El 70 % de los envíos queda asignado a un solo cliente corporativo, CORP-0001, y el resto se reparte entre 2 000 clientes pequeños. Es una distribución común: en muchas empresas un puñado de clientes grandes concentra la mayor parte del volumen. También crea la tabla de clientes con su segmento.
Hay 641 280 envíos y 2 001 clientes. CORP-0001 tiene 448 752 envíos, el 70 %, y los otros 2 000 clientes suman 192 528. Al leer, Spark repartió los ocho archivos en 2 particiones: junta archivos pequeños hasta llenar trozos de un tamaño razonable para las tareas.
4. Anatomía de un trabajo
La celda ejecuta la misma agregación por mes y servicio dos veces, sin y con AQE, y cuenta etapas y tareas.
NotaEjecución adaptativa (AQE)
La ejecución adaptativa (Adaptive Query Execution) deja que Spark ajuste el plan durante la ejecución, con el tamaño real de los datos de cada shuffle. Hace tres cosas: junta particiones del shuffle que quedaron pequeñas en menos tareas, cambia una unión por ordenamiento a una por difusión si una tabla resultó pequeña, y parte en varias tareas una partición que quedó mucho más grande que las demás.
Sin AQE, el trabajo corrió 4 etapas con 420 tareas: 2 para leer, 200 para agrupar, otras 200 para preparar el ordenamiento y 18 para ordenar. Con AQE, las mismas 4 etapas corrieron con 5 tareas en total: después de leer, Spark vio que el shuffle tenía unos pocos kilobytes y juntó las 200 particiones en una. El resultado es el mismo: 20 160 envíos Económico en enero, con 70.6 horas promedio, y así para cada mes y servicio.
Cada tarea tiene un costo fijo: el driver la planifica, la envía, el executor la arranca y reporta al terminar. Con 200 tareas de unos pocos kilobytes cada una, ese costo fijo es casi todo el tiempo.
5. Particiones del shuffle
¿Cuánto pesan esas tareas de más? La celda agrega los envíos por ruta y mes con 200, 16 y 2 particiones del shuffle, sin y con AQE, y mide cada combinación.
    aqe  shuffle_partitions  tareas  segundos
sin AQE                 200     202      0.78
sin AQE                  16      18      0.26
sin AQE                   2       4      0.21
con AQE                 200       3      0.20
con AQE                  16       3      0.13
con AQE                   2       3      0.14
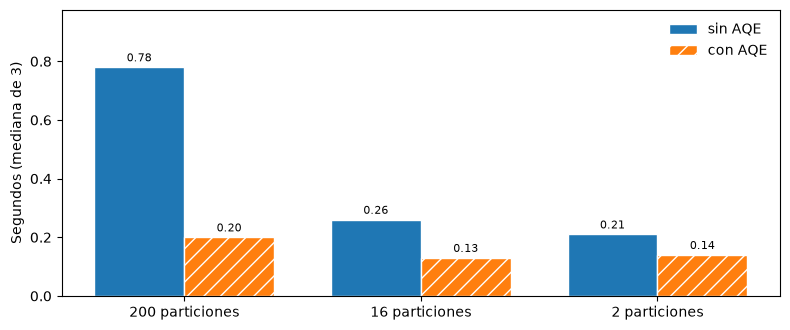
Sin AQE, el tiempo depende de las particiones: con 200 tardó 0.78 segundos y con 16, 0.26, tres veces menos con el mismo resultado. Bajar a 2 apenas ganó un poco más (0.21). Con AQE, las tres configuraciones corrieron con 3 tareas y tardaron entre 0.13 y 0.20 segundos: Spark ajustó las particiones al tamaño real y el número configurado dejó de importar.
pivote = tabla_particiones.pivot(index="shuffle_partitions", columns="aqe", values="segundos").loc[[200, 16, 2]]figura, eje = plt.subplots(figsize=(8, 3.4))ancho =0.38for i, (columna, trama) inenumerate(zip(["sin AQE", "con AQE"], ["", "//"])): posiciones = [x + (i -0.5) * ancho for x inrange(len(pivote))] eje.bar(posiciones, pivote[columna], width=ancho, label=columna, hatch=trama, edgecolor="white")for x, valor inzip(posiciones, pivote[columna]): eje.text(x, valor +0.02, f"{valor:.2f}", ha="center", fontsize=8)eje.set_xticks(range(len(pivote)), [f"{p} particiones"for p in pivote.index])eje.set_ylabel("Segundos (mediana de 3)")eje.set_ylim(0, pivote.values.max() *1.25)eje.legend(frameon=False, loc="upper right")plt.tight_layout()plt.show()
Figura 21.1: Segundos (mediana de 3) de la agregación por ruta y mes según las particiones del shuffle, sin y con ejecución adaptativa
La lección práctica tiene dos partes. Con AQE activa, como en Spark 3.5 por defecto, spark.sql.shuffle.partitions funciona como un máximo y Spark junta las que sobran. Sin AQE, o en versiones anteriores, hay que ajustar ese número al volumen: una regla común es apuntar a tareas de 100 a 200 MB cada una. Con datos grandes, el error contrario también existe: pocas particiones enormes que no caben en la memoria unificada y desbordan a disco.
6. Sesgo de llaves
NotaSesgo de llaves
Hay sesgo (skew) cuando una llave de agrupación o de unión tiene muchas más filas que las demás. Como el shuffle envía todas las filas de una llave a la misma partición, esa partición queda mucho más grande, su tarea tarda mucho más que el resto y el trabajo completo espera por ella. En la Spark UI se reconoce en la pestaña Stages: el tiempo máximo de las tareas es muchas veces la mediana.
La celda reparte los envíos por cliente en 16 particiones y cuenta las filas de cada una.
repartido = envios.repartition(16, "cliente")tamanos = filas_por_particion(repartido)print("Filas por partición al repartir por cliente en 16:", tamanos)print(f"Máximo {max(tamanos)} | mediana {statistics.median(tamanos):.0f} | "f"la más grande tiene {max(tamanos) / statistics.median(tamanos):.0f} veces la mediana")
Filas por partición al repartir por cliente en 16: [12574, 12155, 11892, 12329, 12048, 12659, 10535, 12158, 13930, 11204, 460155, 11215, 12421, 11839, 13042, 11124]
Máximo 460155 | mediana 12156 | la más grande tiene 38 veces la mediana
Quince particiones tienen entre 10 535 y 13 930 filas, y una tiene 460 155, 38 veces la mediana: es la de CORP-0001, con los envíos de algún cliente pequeño que cayó en la misma partición. La tarea que procese esa partición hará casi tres cuartas partes del trabajo sola.
La celda siguiente une los envíos con los clientes y agrupa por segmento, con la difusión desactivada para forzar una unión por ordenamiento y mezcla, y mide cuatro variantes:
Unión con sesgo: la unión tal cual, con 16 particiones del shuffle.
AQE divide la partición sesgada: con spark.sql.adaptive.skewJoin.enabled, Spark parte la partición grande en varias tareas. Por defecto solo actúa sobre particiones de más de 256 MB, así que la celda baja los umbrales a 64 KB para que actúe con estos datos, y lee los archivos en 16 trozos para que haya por dónde partir.
Sal en la llave: se agrega a cada envío un número al azar del 0 al 7, la sal, y se copian los clientes ocho veces, una por valor de sal. La unión se hace por cliente y sal, así que los envíos de CORP-0001 se reparten en ocho llaves distintas.
Difusión de la tabla pequeña: la tabla de clientes tiene 2 001 filas; difundirla evita el shuffle de los envíos.
union_clientes = ( envios.join(clientes, "cliente") .groupBy("segmento") .agg(F.count("*").alias("envios"), F.round(F.avg("horas_transito"), 1).alias("horas")))spark.conf.set("spark.sql.files.maxPartitionBytes", "2MB") # 8 tareas de lectura, una por archivospark.conf.set("spark.sql.autoBroadcastJoinThreshold", -1)spark.conf.set("spark.sql.shuffle.partitions", 16)spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "false")spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "false")resultados = []conteo = anatomia(lambda: ejecutar(union_clientes))print("Tareas por etapa con sesgo: ", conteo["tareas_por_etapa"])resultados.append(("unión con sesgo", conteo["tareas"], medir(lambda: ejecutar(union_clientes))))spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes", "64KB")spark.conf.set("spark.sql.adaptive.skewJoin.skewedPartitionFactor", "2")spark.conf.set("spark.sql.adaptive.advisoryPartitionSizeInBytes", "64KB")conteo = anatomia(lambda: ejecutar(union_clientes))print("Tareas por etapa con AQE para el sesgo:", conteo["tareas_por_etapa"])resultados.append(("AQE divide la partición sesgada", conteo["tareas"], medir(lambda: ejecutar(union_clientes))))spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "false")SAL =8con_sal = ( envios.withColumn("sal", (F.rand(3) * SAL).cast("int")) .join(clientes.crossJoin(spark.range(SAL).withColumnRenamed("id", "sal")), ["cliente", "sal"]) .groupBy("segmento") .agg(F.count("*").alias("envios"), F.round(F.avg("horas_transito"), 1).alias("horas")))conteo = anatomia(lambda: ejecutar(con_sal))resultados.append(("sal en la llave (8 valores)", conteo["tareas"], medir(lambda: ejecutar(con_sal))))spark.conf.unset("spark.sql.autoBroadcastJoinThreshold")conteo = anatomia(lambda: ejecutar(union_clientes))resultados.append(("difusión de la tabla pequeña", conteo["tareas"], medir(lambda: ejecutar(union_clientes))))for clave in ["spark.sql.files.maxPartitionBytes", "spark.sql.shuffle.partitions", "spark.sql.adaptive.coalescePartitions.enabled","spark.sql.adaptive.skewJoin.enabled", "spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes","spark.sql.adaptive.skewJoin.skewedPartitionFactor", "spark.sql.adaptive.advisoryPartitionSizeInBytes"]: spark.conf.unset(clave)tabla_sesgo = pd.DataFrame(resultados, columns=["variante", "tareas", "segundos"])print(tabla_sesgo.to_string(index=False))print()print("Mismo resultado con sal y sin sal:",sorted(con_sal.collect()) ==sorted(union_clientes.collect()))union_clientes.orderBy("segmento").show()
Tareas por etapa con sesgo:               [16, 3, 16, 16]
Tareas por etapa con AQE para el sesgo: [16, 3, 23, 16]
                       variante  tareas  segundos
                unión con sesgo      51      0.80
AQE divide la partición sesgada      58      0.52
    sal en la llave (8 valores)      54      0.80
   difusión de la tabla pequeña      35      0.29

Mismo resultado con sal y sin sal: True
+-----------+------+-----+
|   segmento|envios|horas|
+-----------+------+-----+
|corporativo|448752| 42.3|
|    persona| 64301| 42.1|
|       pyme| 64077| 42.3|
|     tienda| 64150| 42.3|
+-----------+------+-----+
Con sesgo, la etapa de la unión corrió 16 tareas; con AQE, 23, porque Spark partió la partición de CORP-0001 en varias. Los resultados son iguales con y sin sal: corporativo tiene 448 752 envíos y los otros tres segmentos unos 64 000 cada uno, con 42.1 a 42.3 horas promedio.
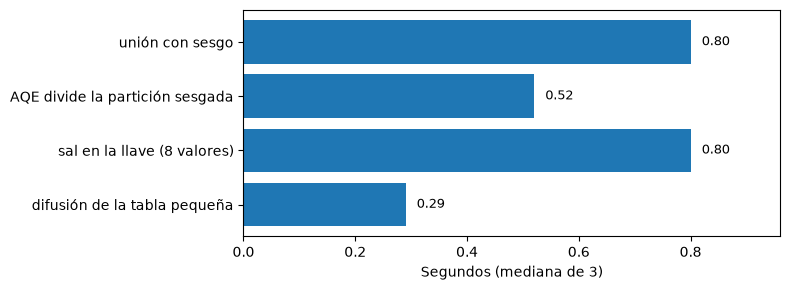
En tiempo, la unión con sesgo tardó 0.80 segundos y con AQE, 0.52: partir la partición de CORP-0001 permitió que los dos executors trabajaran en ella a la vez, en lugar de que uno la procesara solo mientras el otro esperaba. La sal no ganó nada (0.80): reparte igual que AQE, pero multiplica por ocho la tabla de clientes y agrega trabajo. Con solo dos tareas a la vez, la ganancia de partir tiene un techo; en un clúster con decenas de núcleos, la tarea sesgada es la que fija el tiempo de todo el trabajo y estos remedios pesan mucho más. La difusión fue la más rápida: 0.29 segundos, casi un tercio, porque elimina el shuffle de los envíos.
datos = tabla_sesgo.iloc[::-1]figura, eje = plt.subplots(figsize=(8, 3))barras = eje.barh(datos["variante"], datos["segundos"])for barra, valor inzip(barras, datos["segundos"]): eje.text(valor +0.02, barra.get_y() + barra.get_height() /2, f"{valor:.2f}", va="center", fontsize=9)eje.set_xlabel("Segundos (mediana de 3)")eje.set_xlim(0, datos["segundos"].max() *1.2)plt.tight_layout()plt.show()
Figura 21.2: Segundos (mediana de 3) de la unión de envíos con clientes, con un cliente que concentra el 70 % de los envíos
En la figura, la difusión es la barra más corta, con 0.29 segundos, y la sal empata con la unión sesgada en 0.80. Cuando la tabla pequeña cabe en la memoria de los executors, la difusión es el primer remedio para el sesgo en una unión: no hay partición sesgada si la tabla grande no se reparte. AQE y la sal quedan para cuando las dos tablas son grandes. La sal tiene un costo: multiplica la tabla pequeña por el número de valores de sal y complica el código.
7. Caché: cuándo ayuda
NotaCaché
Guardar en caché (cache()) un DataFrame le pide a Spark que, la primera vez que lo calcule, guarde el resultado en la memoria de los executors para reutilizarlo en las acciones siguientes. Solo conviene si el DataFrame se usa varias veces y calcularlo cuesta más que guardarlo y leerlo de memoria. Ocupa memoria unificada, la misma que necesita la ejecución.
La celda prepara los envíos Express entregados con una columna de retraso y responde tres preguntas sobre ellos: sin caché, y con caché después de llenarla.
express = envios.filter((F.col("servicio") =="Express") & (F.col("estado") =="entregado")) \ .withColumn("retraso_horas", F.greatest(F.col("horas_transito") - F.col("promesa_horas"), F.lit(0.0)))def tres_preguntas(): express.groupBy("mes").agg(F.avg("retraso_horas")).collect() express.groupBy("operador").agg(F.avg("retraso_horas")).collect() express.groupBy("destino_remoto").agg(F.avg("retraso_horas")).collect()sin_cache = medir(tres_preguntas)express.cache()inicio = time.perf_counter()filas_express = express.count() # la primera acción llena la cachéllenar = time.perf_counter() - iniciocon_cache = medir(tres_preguntas)guardado = [(r.name(), r.numCachedPartitions(), r.memSize() /1e6) for r in sc._jsc.sc().getRDDStorageInfo()]express.unpersist()print(f"Envíos Express entregados: {filas_express}")print(f"Tres preguntas sin caché: {sin_cache} s | llenar la caché: {llenar:.2f} s | tres preguntas con caché: {con_cache} s")for nombre, particiones, mb in guardado:print(f"En caché: {particiones} particiones, {mb:.1f} MB en memoria")
Envíos Express entregados: 155700
Tres preguntas sin caché: 0.46 s | llenar la caché: 1.44 s | tres preguntas con caché: 0.33 s
En caché: 2 particiones, 13.3 MB en memoria
Hay 155 700 envíos Express entregados. Las tres preguntas tardaron 0.46 segundos sin caché y 0.33 con caché. Pero llenar la caché costó 1.44 segundos, más que las tres preguntas juntas sin ella: con tres usos, la caché no se paga. Ocupa 13.3 MB en memoria, en 2 particiones.
Spark lee Parquet por columnas y con estadísticas, así que releerlo es barato; la caché paga cuando el DataFrame sale de un cálculo caro (uniones grandes, ventanas, limpieza compleja) y se reutiliza muchas veces, por ejemplo en un análisis interactivo o en las iteraciones de un algoritmo de MLlib.
8. La consulta lenta, antes y después
Ahora la consulta del problema: unir los envíos con los clientes, filtrar Express y responder tres preguntas por segmento. La versión original corre sin AQE y sin difusión, como en un clúster configurado con valores antiguos. La celda la compara con dos versiones ajustadas: con AQE y difusión, y además con caché de la unión.
                  versión  segundos frente_a_la_original
      Sin AQE ni difusión      5.53                 100%
       Con AQE y difusión      0.69                  12%
Con AQE, difusión y caché      1.30                  24%
La versión sin ajustes tardó 5.53 segundos; con AQE y difusión, 0.69, el 12 % del tiempo original. Agregar la caché la empeoró: 1.30 segundos, porque llenarla cuesta más que repetir tres veces una unión por difusión. La mayor parte de la ganancia vino de no lanzar 200 tareas por shuffle y de no repartir los envíos para unirlos: son los dos ajustes que más pesan en la mayoría de los trabajos.
9. Cómo diagnosticar un trabajo lento
Este es el orden de revisión que resume el capítulo, de lo más frecuente a lo menos:
Síntoma en la Spark UI o en el código
Causa probable
Ajuste
Cientos de tareas de milisegundos en una etapa
Demasiadas particiones del shuffle para el volumen
Activar AQE o bajar spark.sql.shuffle.partitions
Una tarea tarda muchas veces la mediana
Sesgo de una llave
Difundir la tabla pequeña; si no se puede, AQE para sesgo o sal
SortMergeJoin con una tabla pequeña
La difusión está desactivada o las estadísticas no conocen el tamaño
F.broadcast(tabla) o la pista /*+ BROADCAST(t) */
Columnas Spill con valores
La ejecución no cabe en la memoria unificada
Más particiones, o más memoria por executor
Container killed by YARN for exceeding memory limits
El proceso completo supera el contenedor, a menudo por Python
Subir spark.executor.memoryOverhead; evitar UDF de Python
La misma lectura y limpieza aparece en varios trabajos
Se recalcula un resultado caro
cache() si se reutiliza muchas veces; si no, guardarlo en Parquet
Pocas tareas grandes en la lectura
Archivos grandes en formato no divisible, o maxPartitionBytes alto
Dos reglas generales cierran la lista. La primera: medir antes y después de cada ajuste, uno a la vez, como en este capítulo; un ajuste que ayuda en un clúster puede no ayudar en otro, como la sal en este. La segunda: antes de ajustar Spark, revisar los datos y el código. Leer menos columnas, filtrar antes, guardar en Parquet particionado y evitar UDF de Python suelen ganar más que cualquier parámetro.
Limpiar
La celda borra /bitlogistica/laboratorio_optimizacion y cierra la sesión.
print("Laboratorio borrado:", borrar(LAB))spark.stop()print("Sesión cerrada. Las capas de /bitlogistica no se tocaron.")
Laboratorio borrado: True
Sesión cerrada. Las capas de /bitlogistica no se tocaron.
True confirma que la carpeta de pruebas se borró. Las capas de /bitlogistica quedan como estaban.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1 a 3 (la sesión, la memoria, las funciones y los datos).
Mira la Spark UI. Con la sesión abierta, ejecuta la agregación por ruta y mes sin AQE y con 200 particiones, y abre http://localhost:4040. En la pestaña Stages, anota la mediana y el máximo de duración de las tareas.
Sesgo al agrupar. Agrupa los envíos por cliente y cuenta. ¿Hay sesgo en la agregación? Revisa en el plan si Spark hizo una agregación parcial antes del shuffle.
Más sal. Repite la variante con sal usando 2 y 32 valores. ¿Qué pasa con las tareas y el tiempo?
Caché que sí paga. Haz que el DataFrame express dependa de una unión con los clientes sin difusión y responde diez preguntas en lugar de tres. ¿Cuándo empieza a pagar la caché?
Una partición. Agrega los envíos por ruta y mes con spark.sql.shuffle.partitions en 1 y AQE desactivada. ¿Cuántas tareas corre la etapa del shuffle? ¿Cambia el tiempo?
Desborde. Con la difusión desactivada y 1 partición del shuffle, une los envíos consigo mismos por ruta y cuenta. Mira en la pestaña Stages si aparecen columnas Spill. Detén la celda si tarda más de un par de minutos.
TipOrientaciones
Sin AQE, la etapa de agregación tiene 200 tareas de milisegundos: la mediana y el máximo son casi iguales y muy pequeños, y la etapa tarda mucho más que la suma de su trabajo útil. Es la señal de demasiadas particiones.
No se nota tanto como en la unión: Spark agrega parcialmente en cada partición de lectura antes del shuffle (partial_count en el plan), así que de CORP-0001 viaja una fila por partición de lectura, no 448 752. Las agregaciones toleran el sesgo mucho mejor que las uniones.
Con 2 valores, la partición grande se parte en dos; con 32, en muchas más, y la tabla de clientes se multiplica por 32. En este clúster de dos núcleos el tiempo casi no mejora y puede empeorar; el número de tareas crece con la sal.
Cuanto más caro sea calcular express y más veces se use, antes paga la caché. Con una unión por ordenamiento detrás y diez preguntas, el costo de llenarla se reparte entre más usos y suele compensar.
Una sola tarea en la etapa del shuffle, que hace todo el trabajo de agregación. Con estos datos puede tardar poco, pero el paralelismo desaparece: con datos grandes, esa tarea sería la más lenta y la que más memoria necesita.
La unión de una tabla consigo misma por una llave con pocos valores produce muchísimas filas. Con una partición y 127 MB de memoria unificada, es probable ver desborde a disco. Es un experimento para mirar la Spark UI, no para esperar el resultado.
Errores frecuentes
Síntoma
Causa
Arreglo
Un ajuste con spark.conf.set no cambia nada
El DataFrame ya se había ejecutado y Spark reutilizó su plan.
Volver a construir el DataFrame después de cambiar la configuración.
Los tiempos cambian mucho entre ejecuciones
La primera ejecución carga clases y arranca procesos; el clúster comparte recursos.
Medir varias veces y usar la mediana.
cache() no acelera nada
La caché se llena con la primera acción, no al llamar a cache(); o recalcular era barato.
Medir el costo de llenarla y cuántas veces se reutiliza.
La Spark UI no abre
La sesión está cerrada: la UI vive mientras viva el driver.
Abrirla con la sesión activa, o revisar el historial con yarn logs.
Container killed by YARN
El executor superó su contenedor.
Más memoryOverhead o menos memoria por tarea.
Una tarea tarda minutos y las demás segundos
Sesgo de una llave.
Difusión, AQE para sesgo o sal.
Preguntas de comprensión
¿Por qué 200 particiones del shuffle son un problema con datos pequeños y pueden ser pocas con datos grandes?
¿Por qué el sesgo afecta mucho más a una unión que a una agregación?
En este clúster, AQE para sesgo ganó poco más de un tercio y la sal nada. ¿Qué cambiaría en un clúster con 40 núcleos?
¿Por qué la caché empeoró la consulta de la sección 8?
Si un executor tiene 4 GB, ¿cuánta memoria unificada tiene y qué tamaño de contenedor pide a YARN?
TipOrientaciones
Cada partición es una tarea con un costo fijo. Con unos pocos megabytes, 200 tareas reparten casi nada y el costo fijo domina. Con 2 TB, 200 particiones serían de 10 GB cada una, que no caben en la memoria de un executor y desbordan a disco; ahí hacen falta miles.
En una agregación, Spark combina las filas de cada llave en cada partición antes del shuffle, así que viaja una fila por llave y partición. En una unión no puede combinar: todas las filas de la llave tienen que encontrarse con su pareja en la misma partición.
Con 40 núcleos, las otras particiones terminarían rápido en paralelo y el trabajo esperaría solo por la tarea de CORP-0001. Partirla en ocho o más tareas las repartiría entre núcleos libres y el tiempo total se acercaría al de un reparto parejo.
Porque la unión con difusión ya era barata: calcularla tres veces costó menos que calcularla una vez, guardar el resultado en memoria y leerlo tres veces. La caché agrega trabajo; solo compensa si evita un cálculo más caro.
Memoria unificada: (4 096 − 300) × 0.6 ≈ 2 278 MB. La sobrecarga es el máximo entre 384 MB y el 10 %, unos 410 MB, así que el contenedor es de unos 4 506 MB.
Glosario
Término
Significado en este capítulo
Tarea
Unidad de trabajo que procesa una partición en un núcleo de un executor.
Etapa
Grupo de tareas que corren sin shuffle entre ellas.
Particiones del shuffle
Número de particiones en que Spark reparte los datos en un shuffle de SQL.
Ejecución adaptativa (AQE)
Ajustes que Spark hace al plan durante la ejecución, con los tamaños reales.
Spark UI
Página web del driver con trabajos, etapas, tareas, planes, caché y executors.
Sesgo
Llave con muchas más filas que las demás, que deja una partición mucho más grande.
Sal
Valor al azar agregado a una llave sesgada para repartir sus filas en varias particiones.
Caché
Resultado guardado en la memoria de los executors para reutilizarlo.
Memoria unificada
Parte del heap del executor para ejecución y caché.
Sobrecarga de memoria
Memoria fuera del heap que YARN suma al contenedor del executor.
Desborde a disco
Escritura temporal a disco cuando la ejecución no cabe en memoria.
Referencias para profundizar
Apache Spark 3.5.3. Performance Tuning: AQE, particiones del shuffle, difusión y sesgo.
Apache Spark 3.5.3. Tuning Spark: memoria, serialización y caché.
Apache Spark 3.5.3. Running on YARN: memoryOverhead y contenedores.
Chambers, B. y Zaharia, M. (2018). Spark: The Definitive Guide. O’Reilly Media. Parte IV, aplicaciones en producción.
Resumen
Sobre 641 280 envíos de BITLogística, en un clúster de dos executors de un núcleo, mediste de dónde sale el tiempo de un trabajo de Spark. Cada executor tiene un contenedor de 896 MB y apenas 127 MB de memoria unificada. Sin AQE, una agregación lanzó 420 tareas; con AQE, 5, y la agregación por ruta pasó de 0.78 segundos a entre 0.13 y 0.20 con cualquier número de particiones. Un cliente con el 70 % de los envíos dejó una partición 38 veces más grande que la mediana. AQE la partió en más tareas y la unión bajó de 0.80 a 0.52 segundos; la sal no ganó nada, y la difusión de la tabla de clientes fue la mejor, 0.29, al evitar el shuffle. La caché costó más de lo que ahorró con tres preguntas. La consulta lenta del problema pasó de 5.53 a 0.69 segundos solo con AQE y difusión.
El capítulo siguiente, MLlib, usa las capas de BITLogística para entrenar modelos que predicen si un envío llegará a tiempo.