Hasta aquí, todo el libro corrió en un clúster que montaste tú mismo con Docker. Ese clúster sirve para aprender porque deja ver cada pieza, pero obliga a hacer a mano un trabajo que no es analizar datos:
encender los contenedores en orden y esperar a que HDFS salga del modo seguro;
ajustar la memoria de YARN para que quepan los executors;
descargar e instalar librerías, como los .jar de Iceberg y de Kafka;
reparar lo que falle.
El problema crece con los datos. Si BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) pasara de 34 000 envíos por semestre a 34 millones, con un clúster propio habría que comprar más máquinas y discos, dedicar más horas a administrarlos y pagarlos todo el tiempo, aunque pasen la noche sin trabajar.
La alternativa que usa la mayoría de las empresas es la nube: alquilar a un proveedor el almacenamiento y el cómputo, dejar que él se encargue de las máquinas y pagar solo por lo que se usa. Para Spark, una de las plataformas en la nube más usadas es Databricks.
El capítulo tiene cuatro partes:
Teoría (secciones 1 y 2): qué cambia cuando el clúster deja de ser tuyo: dónde se guardan los datos, quién administra las máquinas y cómo se paga.
Primeros pasos (sección 3): diez ejemplos guiados y resueltos para conocer el notebook de Databricks y PySpark con datos pequeños: crear DataFrames, filtrar, agrupar, consultar con SQL, guardar una tabla y ver su historial.
Spark SQL y MLlib (secciones 4 y 5): cinco consultas de Spark SQL y cinco ejemplos de aprendizaje automático con MLlib sobre los seis meses de envíos de BITLogística, ya limpios; el último registra los modelos en MLflow.
Caso completo (sección 6): ejecutas en Databricks el mismo pipeline del taller de PySpark: bronce, plata y oro. Las cifras del taller sirven de prueba: con los mismos datos y la misma lógica, Databricks tiene que dar exactamente lo que dio el clúster de Docker, 32 064 envíos en la capa plata y 89.7 % entregados a tiempo. Si da otra cosa, algo cambió al pasar el código.
La sección 7 muestra cómo programar el notebook como trabajo, y la 8 cierra comparando los dos entornos: qué cambió en el código y qué cambia en el trabajo diario.
Ficha
En este capítulo
Pregunta
¿Qué cambia cuando el clúster deja de ser propio, y qué hay que cambiar en el código de PySpark para correrlo en un servicio gestionado?
Datos
Para los primeros pasos, seis envíos escritos a mano y la tabla de ejemplo samples.nyctaxi.trips; para Spark SQL y MLlib, los seis meses de envíos sin errores; para el caso completo, los seis meses de envíos del taller de PySpark (34 239 filas), generados dentro de Databricks con el mismo generar_envios.py
Tiempo estimado de lectura
100 minutos, más 90 de práctica en Databricks
Nivel
Inicial en Databricks; intermedio en el caso completo
Databricks Free Edition, cómputo serverless, Unity Catalog, volúmenes, Delta Lake, Spark Connect, Spark SQL, MLlib, MLflow; como referencia: Amazon S3, Google Cloud Storage, Azure Data Lake Storage, Amazon EMR, Google Dataproc
Objetivos de aprendizaje
Al terminar este capítulo podrás:
Explicar las diferencias entre HDFS y un almacenamiento de objetos, y por qué la nube separa el almacenamiento del cómputo.
Distinguir un clúster propio, un servicio gestionado y el cómputo serverless por lo que administra cada parte.
Usar un notebook de Databricks: crear DataFrames, elegir columnas, filtrar, agrupar, consultar con SQL y ver los resultados con display.
Crear una cuenta de Databricks Free Edition, un esquema y un volumen de Unity Catalog, y subir archivos al volumen.
Responder preguntas de negocio con Spark SQL sobre las tablas del catálogo: agrupaciones, CASE, uniones, funciones de ventana y vistas.
Entrenar y evaluar con MLlib un modelo de clasificación y uno de regresión, y registrar sus resultados en MLflow.
Llevar un pipeline de PySpark del clúster del libro a Databricks y nombrar lo que cambia: la sesión, las rutas, el nombre del archivo de origen y el modo ANSI.
Guardar las capas como tablas Delta del catálogo y consultarlas con PySpark y con SQL.
Leer el historial de una tabla Delta, corregir filas con MERGE y consultar una versión anterior.
Describir cómo se programa un notebook como trabajo en Databricks y compararlo con el DAG de Airflow.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Bronce, plata y oro
Datos como llegaron, datos limpios y datos agregados para decidir.
Este capítulo no usa el clúster de Docker. Se ejecuta en Databricks Free Edition, la versión gratuita y permanente de Databricks para aprender, que reemplazó a la antigua Community Edition en 2025. Solo necesitas un correo personal y el navegador.
Entra a la página de registro de Free Edition, https://login.databricks.com/?intent=CE_SIGN_UP (el enlace también está en la documentación de Free Edition). Puedes registrarte con tu correo (recibes un código de verificación), con Google o con Microsoft. Databricks crea un espacio de trabajo para ti en uno o dos minutos.
Descarga talleres-notebooks.zip y descomprímelo en tu equipo. Vas a usar dos archivos: taller_databricks.ipynb, el notebook de este capítulo, y generar_envios.py, el generador de datos.
En el espacio de trabajo, abre Workspace en la barra lateral, entra a tu carpeta de usuario (Home), elige Import en el menú de la carpeta y sube taller_databricks.ipynb. Databricks lo convierte en un notebook propio.
Abre el notebook. Arriba a la derecha, en el selector de cómputo, elige Serverless y conéctate. No hay nada que configurar: no eliges máquinas, memoria ni número de executors.
La subida de generar_envios.py se hace al comienzo de la sección 4, porque necesita el volumen que crea el notebook en el paso 9.
Free Edition tiene límites que conviene conocer antes de empezar:
Solo cómputo serverless. No se pueden crear clústeres clásicos con máquinas elegidas por ti. Hay un solo SQL warehouse, de tamaño 2X-Small.
Cuota diaria por cuenta. Databricks no publica la cifra; la regula una política de uso justo. Si la superas, el cómputo se apaga hasta el día siguiente, pero tus datos y notebooks no se borran. El taller completo usa una fracción pequeña de la cuota.
Solo Python y SQL. R y Scala no están disponibles, ni la API de RDD.
Uso personal y de aprendizaje. No sirve para fines comerciales, y Databricks puede borrar cuentas inactivas durante mucho tiempo.
Para probar clústeres clásicos, con tamaño y configuración a tu elección, Databricks ofrece además una prueba gratuita de 14 días en una nube (AWS, Azure o Google Cloud). No hace falta para este capítulo.
1. Del clúster propio a la nube
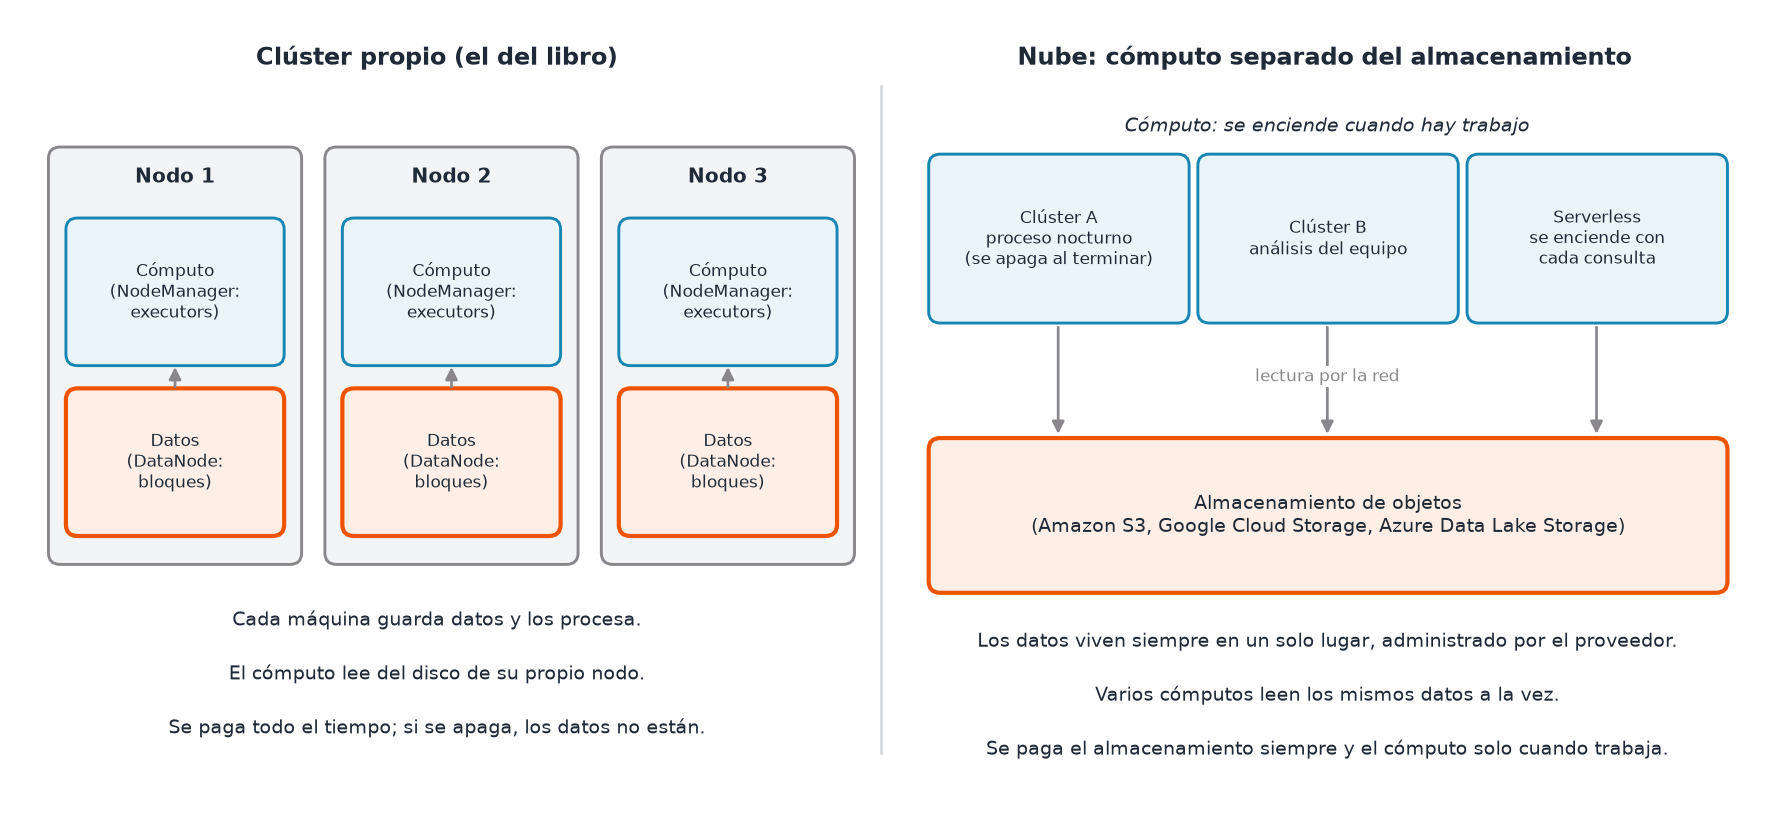
En el clúster del libro, los mismos contenedores guardan los datos y los procesan: los DataNodes guardan bloques y los NodeManagers corren executors, y si se apaga el clúster, se apagan los dos. Esa unión viene del diseño original de Hadoop: llevar el cómputo a donde están los datos, porque mover terabytes por la red de 2006 era lo más caro. En la nube, la red interna del proveedor es rápida y el almacenamiento se paga aparte del cómputo, así que esa unión dejó de convenir.
El clúster propio une datos y cómputo en cada máquina; en la nube, los datos viven en un almacenamiento de objetos y el cómputo se enciende cuando hay trabajo.
En la figura, la diferencia está en dónde quedan los datos cuando no hay trabajo. A la izquierda, datos y cómputo viajan juntos: para conservar los datos hay que mantener encendidas las máquinas. A la derecha, los datos tienen su propio lugar y el cómputo es intercambiable: se puede encender un clúster grande para un proceso pesado, uno pequeño para consultas, o ninguno.
NotaAlmacenamiento de objetos
Un almacenamiento de objetos guarda archivos (objetos) con un nombre dentro de un contenedor (bucket), y se usa a través de una API por HTTP: Amazon S3, Google Cloud Storage y Azure Data Lake Storage son los principales. A diferencia de HDFS, no lo administra quien lo usa: el proveedor se encarga de las réplicas y de la durabilidad, y se paga por lo que se guarda, sin máquinas encendidas.
Objetos, buckets y prefijos
En un almacenamiento de objetos no hay carpetas de verdad. Un objeto es un archivo más su nombre completo, llamado llave (key), y unos metadatos (tamaño, fecha, tipo). La llave puede tener barras, como landing/2026/envios_2026_01.csv, y las consolas web las muestran como carpetas por comodidad, pero para el servicio es un solo nombre largo. A la parte inicial de una llave, como landing/2026/, se le llama prefijo. Por eso «renombrar una carpeta» significa copiar y borrar cada objeto que empieza con ese prefijo.
Todo se hace con unas pocas operaciones por HTTP: guardar un objeto (PUT), leerlo (GET), listar los que empiezan con un prefijo (LIST) y borrarlo (DELETE). No se puede modificar un pedazo de un objeto: para cambiarlo se reescribe completo. Esa es la misma regla que siguen Parquet, Iceberg y Delta, que nunca modifican un archivo existente.
Los tres proveedores grandes de nube tienen su propio servicio, con la misma idea y nombres distintos:
Spark lee estas rutas igual que lee hdfs://namenode:9000/...: con un conector que se instala aparte (hadoop-aws, el conector de Google Cloud Storage o hadoop-azure) y las credenciales de la cuenta. El código de PySpark no cambia; cambia el comienzo de la ruta. Para practicar sin una cuenta de nube existe MinIO, un almacenamiento de objetos de código abierto, compatible con S3, que se puede correr en Docker como el clúster del libro.
En Databricks casi nunca se escriben estas rutas a mano. Unity Catalog guarda dónde está cada tabla, y en el código se usa su nombre (workspace.bitlogistica.plata_envios) o una ruta de volumen (/Volumes/...). Debajo, los archivos siguen siendo objetos en uno de estos servicios.
NotaCómputo separado del almacenamiento
Separar cómputo y almacenamiento significa que los datos viven en el almacenamiento de objetos y las máquinas que los procesan se encienden solo cuando hay trabajo. Un clúster puede crecer para un proceso pesado y apagarse al terminar (un clúster efímero), y varios clústeres pueden leer los mismos datos a la vez. Lo que se pierde es la localidad: cada lectura viaja por la red del proveedor, que hoy es lo bastante rápida para que valga la pena.
HDFS en el clúster del libro
Almacenamiento de objetos
Quién lo administra
Tú: NameNode, DataNodes, réplicas, discos
El proveedor
Cómo se paga
Máquinas encendidas, uses o no el espacio
Por gigabyte guardado y por operación
Durabilidad
Tres réplicas en tus discos
Réplicas del proveedor en varios centros de datos
Renombrar una carpeta
Una operación de metadatos en el NameNode
En muchos casos, copiar y borrar cada objeto
Listar millones de archivos
Rápido, en la memoria del NameNode
Lento: llamadas a la API por páginas
Localidad de datos
Sí: el executor lee del disco de su nodo
No: todo se lee por la red
Las dos filas del medio explican por qué los formatos de tabla como Iceberg y Delta se volvieron indispensables en la nube: en lugar de renombrar carpetas y listar archivos, que son operaciones lentas sobre objetos, guardan en sus metadatos la lista exacta de archivos de cada versión.
NotaServicio gestionado y serverless
Un servicio gestionado de Spark crea y administra el clúster por ti: eliges el tamaño y la versión, y el proveedor instala, configura y repara las máquinas. Amazon EMR, Google Dataproc y los clústeres clásicos de Databricks son de este tipo. En el cómputo serverless ni siquiera eliges el tamaño: envías el trabajo y el servicio decide cuántas máquinas usar, las enciende en segundos y las apaga al terminar. Se paga por el cómputo usado, no por el tiempo que el clúster pasa encendido.
Quién administra…
Clúster del libro
Servicio gestionado
Serverless
Máquinas y red
Tú (Docker)
El proveedor
El proveedor
Instalar Spark, Hadoop y Python
Tú
El proveedor (eliges la versión)
El proveedor
Tamaño y memoria de executors
Tú (spark-defaults.conf)
Tú
El servicio
Encender y apagar
Tú (dc up, dc stop)
Tú o una regla de apagado
El servicio
Datos y código
Tú
Tú
Tú
2. Databricks en cinco piezas
Databricks es una empresa y una plataforma de datos fundada en 2013 por el grupo de la Universidad de California en Berkeley que creó Spark. No es una nube propia: funciona sobre AWS, Azure o Google Cloud, y agrega encima lo que el libro montó a mano: un lugar para escribir y programar notebooks, cómputo que se crea y se apaga solo, un catálogo con permisos y un formato de tabla con transacciones. Es la idea del lakehouse del capítulo de Iceberg: datos en archivos abiertos sobre almacenamiento de objetos, con las garantías de una bodega de datos.
Plano de control y plano de cómputo
NotaPlano de control y plano de cómputo
Databricks se divide en dos partes. El plano de control es lo que administra Databricks: el sitio web del espacio de trabajo, los notebooks guardados, la programación de los trabajos y el catálogo. El plano de cómputo es donde corren las máquinas de Spark que leen y procesan los datos. Con los clústeres clásicos, ese plano está en la cuenta de nube de la empresa, que paga sus máquinas; con serverless, Databricks lo pone en su propia cuenta y lo enciende a pedido. En los dos casos, los datos quedan en el almacenamiento de objetos.
En el clúster del libro no había esa división: Jupyter, YARN y HDFS corrían en los mismos contenedores de tu equipo. En Free Edition no tienes una cuenta de nube propia: Databricks pone el plano de control, el cómputo serverless y el almacenamiento, y tú solo ves el espacio de trabajo.
Las cinco piezas
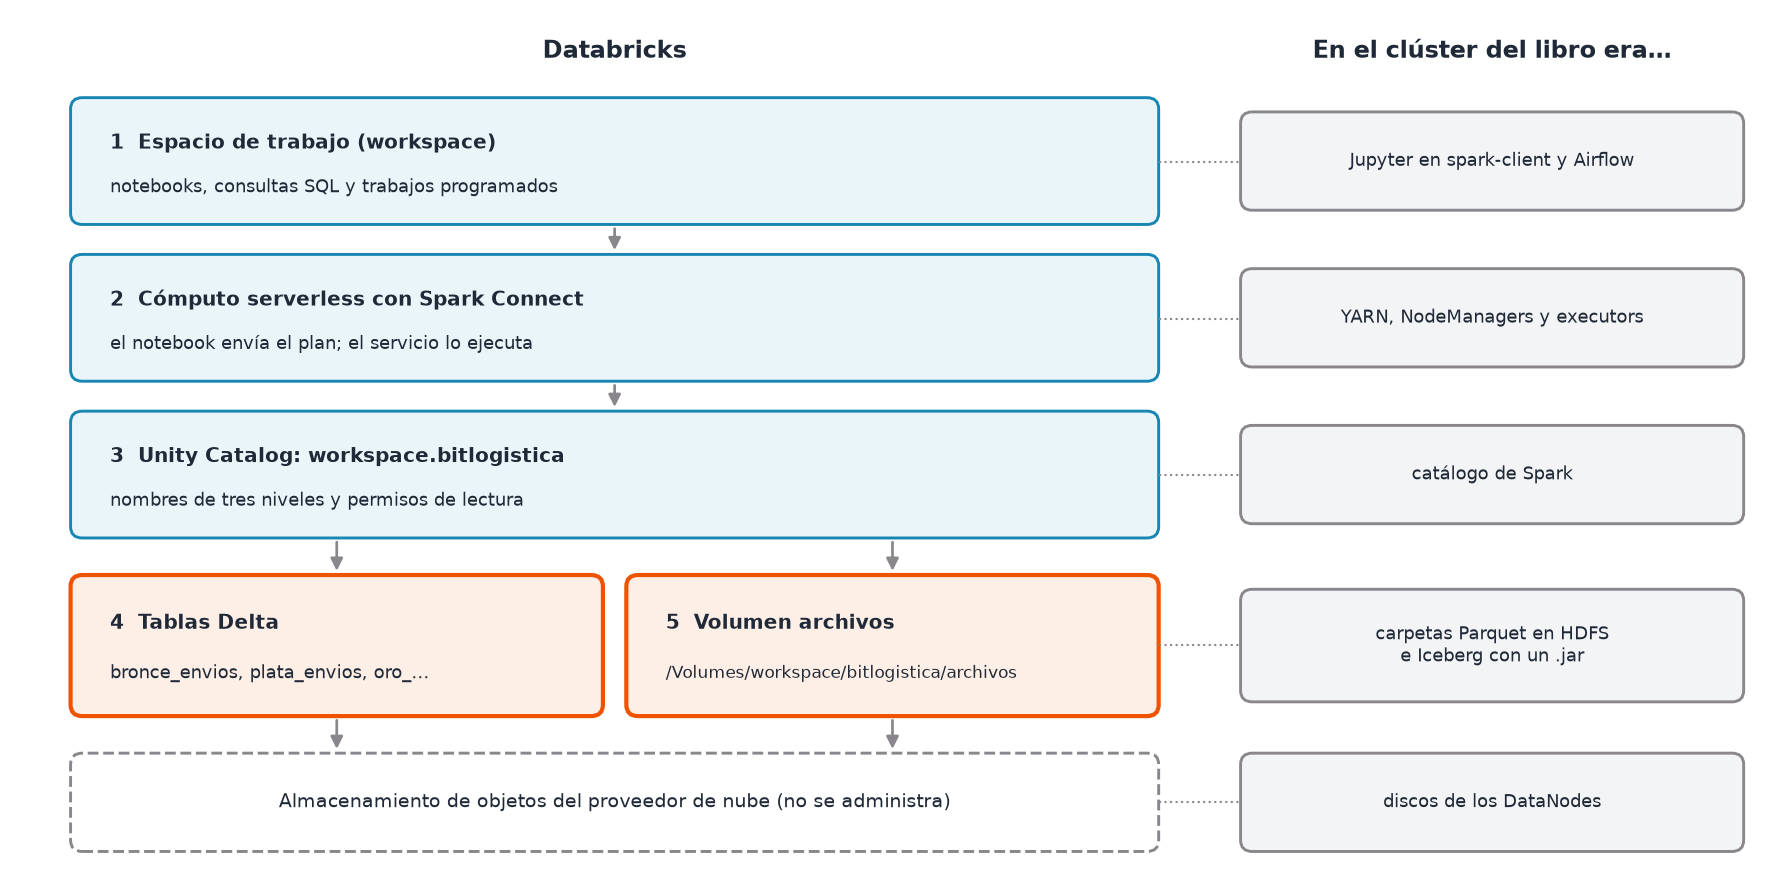
Sobre esa división, Databricks agrega cinco piezas que reemplazan buena parte de lo que el libro montó a mano, como muestra la figura.
Las cinco piezas de Databricks, de arriba abajo, y la pieza del clúster del libro que reemplaza cada una.
Se lee de arriba abajo, como un pedido: desde el espacio de trabajo, un notebook envía una consulta al cómputo serverless; el cómputo busca en Unity Catalog qué es workspace.bitlogistica.plata_envios y dónde están sus archivos; la tabla Delta o el volumen guardan los datos en el almacenamiento de objetos del proveedor. Los recuadros siguientes definen cada pieza.
NotaEspacio de trabajo, Unity Catalog y volumen
El espacio de trabajo (workspace) es el sitio web donde viven los notebooks, las consultas y los trabajos. Unity Catalog es el catálogo de datos de Databricks: organiza las tablas en tres niveles, catálogo.esquema.tabla, y controla quién puede leer qué. Un volumen es una carpeta de archivos dentro de un esquema del catálogo, para los datos que no son tablas: CSV recibidos, imágenes o código. Se usa con rutas /Volumes/<catálogo>/<esquema>/<volumen>/….
NotaDelta Lake
Delta Lake es el formato de tabla de Databricks, de código abierto, equivalente a Apache Iceberg: archivos Parquet más un registro de transacciones con el historial de versiones. Ese registro es una carpeta _delta_log junto a los datos, con un archivo JSON por versión: escribir en la tabla es agregar un archivo a esa carpeta. En Databricks, toda tabla es Delta por defecto, así que MERGE, el historial y el viaje en el tiempo del capítulo de Iceberg vienen incluidos, sin .jar ni configuración.
NotaSpark Connect
Spark Connect separa el programa de PySpark del motor de Spark: el notebook construye el plan de la consulta y lo envía por la red a un servidor que lo ejecuta. El cómputo serverless de Databricks funciona así. Por eso la API de DataFrames y SQL funciona igual, pero no existen las piezas que dependían de tener el motor en el mismo proceso: spark.sparkContext, la API de RDD y la Spark UI.
Unity Catalog por dentro
Unity Catalog nombra todo con tres niveles, más uno que lo contiene:
Nivel
Qué es
En este capítulo
Metastore
El registro de todo el catálogo de una región; uno por cuenta
El de tu cuenta de Free Edition
Catálogo
Primer nivel de nombres; suele separar ambientes (desarrollo, producción) o áreas
workspace
Esquema
Grupo de tablas, vistas y volúmenes de un tema
bitlogistica
Tabla, vista, volumen o función
Lo que se consulta o se usa
plata_envios, el volumen archivos
Las tablas pueden ser de dos tipos, como en el capítulo de Spark SQL. En una tabla administrada, Unity Catalog decide dónde guardar los archivos y los borra con DROP TABLE; es la que usa este capítulo. En una tabla externa, los archivos están en una ruta de almacenamiento de objetos que se indica al crearla, y DROP TABLE solo borra el nombre.
Los permisos se dan con SQL, por ejemplo GRANT SELECT ON TABLE workspace.bitlogistica.plata_envios TO analistas, y Unity Catalog registra quién consultó qué. También guarda el linaje: qué tablas se usaron para escribir cada tabla, lo que el capítulo de calidad construyó a mano.
Los tipos de cómputo
Databricks ofrece varios tipos de cómputo para distintos usos:
Tipo
Para qué sirve
Quién elige el tamaño
En Free Edition
Clúster de propósito general (all-purpose)
Trabajo interactivo en notebooks, compartido por un equipo
Tú
No disponible
Clúster de trabajo (job compute)
Un trabajo programado; se crea al empezar y se borra al terminar
Tú
No disponible
SQL warehouse
Consultas SQL, tableros y herramientas de BI
Tú, por tallas (2X-Small, Small…)
Uno, de talla 2X-Small
Serverless para notebooks y trabajos
Notebooks y trabajos sin configurar máquinas
El servicio
Sí: es el de este capítulo
NotaDatabricks Runtime
Cada cómputo de Databricks corre una versión del Databricks Runtime: Apache Spark con librerías ya instaladas (pandas, matplotlib, Delta Lake y otras) y mejoras propias, como Photon, un motor escrito en C++ que acelera las consultas de SQL y DataFrames. En serverless, la versión la elige y la actualiza Databricks; por eso el paso 1 imprime la versión de Spark en lugar de fijarla.
Del clúster del libro a Databricks
La tabla resume qué pieza de Databricks reemplaza a cada pieza del clúster que montaste:
En el clúster del libro
En Databricks
HDFS (hdfs://namenode:9000/…)
Almacenamiento de objetos del proveedor, a través de tablas y volúmenes
PySpark es la forma de usar Spark desde Python. Todo empieza en una sesión, la variable spark, que envía el trabajo al cómputo. Los datos se manejan como DataFrames: tablas con columnas de nombre y tipo, repartidas entre las máquinas. Sobre un DataFrame se encadenan transformaciones (select, filter, withColumn, groupBy), que solo describen el trabajo, y acciones (show, count, display), que lo ejecutan y traen el resultado. El mismo DataFrame se puede consultar con SQL si se le da un nombre. El notebook de Databricks agrega lo propio: celdas que se ejecutan contra el cómputo serverless, display para ver tablas y gráficos, y un catálogo donde guardar tablas por nombre. La teoría completa está en el capítulo de PySpark, y su práctica en el clúster, en el taller de PySpark.
Antes de Spark SQL, MLlib y el caso completo, diez pasos cortos para conocer el notebook de Databricks y la API de PySpark con datos que caben en la pantalla. Cada paso es una celda: la ejecutas con Shift+Enter (o con el botón de reproducir a la izquierda de la celda) y ves el resultado debajo. Los primeros seis usan seis envíos escritos a mano; el paso 8 consulta datos de ejemplo que trae Databricks; los pasos 9 y 10 crean tus primeras tablas en el catálogo.
Paso
Qué aprendes
1
La sesión spark ya está lista
2
Crear un DataFrame y ver su esquema
3
Elegir columnas, filtrar filas y ordenar
4
Crear columnas nuevas con condiciones
5
Agrupar y resumir
6
Hacer la misma pregunta en SQL
7
Ver resultados con display
8
Consultar una tabla grande de ejemplo
9
Crear tu esquema, un volumen y una tabla desde un archivo
10
Una tabla Delta en miniatura: cambiar, ver el historial y volver atrás
Si ya usaste PySpark en los talleres del libro, los pasos 2 a 6 te van a resultar conocidos: es el mismo PySpark. Lo nuevo está en cómo se trabaja en Databricks.
Paso 1. La sesión ya está lista
En el clúster del libro, cada notebook empezaba creando una sesión con SparkSession.builder. En Databricks no hace falta: al conectar el notebook a Serverless, la sesión ya existe y se llama spark. La primera celda importa lo que usarán los pasos siguientes, muestra la versión de Spark y crea el DataFrame más simple posible: los números del 1 al 5.
import osfrom pyspark.sql import functions as Fprint("Spark", spark.version)numeros = spark.range(1, 6) # un DataFrame con una columna, id, del 1 al 5numeros.show()print("Filas:", numeros.count())
spark.range(1, 6) crea una columna llamada id con los números del 1 al 5 (el 6 no se incluye, como en range de Python). show() imprime las filas como una tabla de texto y count() las cuenta: 5. No hubo que elegir máquinas ni esperar a que arrancara un clúster: el cómputo serverless se encendió al ejecutar la celda.
NotaDataFrame
Un DataFrame es una tabla con columnas de nombre y tipo conocidos, repartida entre las máquinas del cómputo. Se parece a una tabla de pandas o a una hoja de cálculo, con una diferencia: las operaciones no se ejecutan una por una, sino que Spark arma un plan y lo ejecuta cuando se le pide un resultado, por ejemplo con show() o count().
Paso 2. Un DataFrame con seis envíos
Ahora un DataFrame con datos parecidos a los de BITLogística, escritos a mano: seis envíos con su guía, origen, destino, servicio, peso, horas de tránsito y estado. createDataFrame recibe las filas y un esquema que dice el nombre y el tipo de cada columna, y printSchema() lo muestra después de crear la tabla.
La tabla tiene las seis filas y las siete columnas. El envío BL-0006 fue devuelto y su columna horas muestra NULL: en Spark, un valor que falta es un nulo, no un cero ni un texto vacío. En el esquema, las columnas de texto son string, las numéricas double y todas aceptan nulos (nullable = true).
Paso 3. Elegir columnas, filtrar filas y ordenar
Tres operaciones que se usan en casi todas las consultas:
select elige columnas.
filter deja las filas que cumplen una condición. Las condiciones se escriben con F.col("columna") y se combinan con & (y) y | (o), cada una entre paréntesis.
orderBy ordena; F.desc ordena de mayor a menor.
print("Solo tres columnas:")envios.select("guia", "servicio", "horas").show()print("Solo los Express:")envios.filter(F.col("servicio") =="Express").show()print("Salen de Bogotá y pesan menos de 5 kg:")envios.filter((F.col("origen") =="Bogotá") & (F.col("peso_kg") <5)).select("guia", "destino", "peso_kg").show()print("Los tres envíos más lentos:")envios.orderBy(F.desc("horas")).select("guia", "servicio", "horas").show(3)
Solo tres columnas:
+-------+---------+-----+
|   guia| servicio|horas|
+-------+---------+-----+
|BL-0001|  Express| 20.0|
|BL-0002| Estándar| 50.0|
|BL-0003|  Express| 31.5|
|BL-0004|Económico| 98.0|
|BL-0005| Estándar| 80.5|
|BL-0006|  Express| NULL|
+-------+---------+-----+

Solo los Express:
+-------+--------+--------+--------+-------+-----+---------+
|   guia|  origen| destino|servicio|peso_kg|horas|   estado|
+-------+--------+--------+--------+-------+-----+---------+
|BL-0001|  Bogotá|Medellín| Express|    2.5| 20.0|entregado|
|BL-0003|Medellín|   Pasto| Express|    1.2| 31.5|entregado|
|BL-0006|  Bogotá|  Cúcuta| Express|    0.8| NULL| devuelto|
+-------+--------+--------+--------+-------+-----+---------+

Salen de Bogotá y pesan menos de 5 kg:
+-------+--------+-------+
|   guia| destino|peso_kg|
+-------+--------+-------+
|BL-0001|Medellín|    2.5|
|BL-0006|  Cúcuta|    0.8|
+-------+--------+-------+

Los tres envíos más lentos:
+-------+---------+-----+
|   guia| servicio|horas|
+-------+---------+-----+
|BL-0004|Económico| 98.0|
|BL-0005| Estándar| 80.5|
|BL-0002| Estándar| 50.0|
+-------+---------+-----+
only showing top 3 rows
Hay tres envíos Express: BL-0001, BL-0003 y BL-0006. De Bogotá con menos de 5 kg salen dos, BL-0001 a Medellín y BL-0006 a Cúcuta. El más lento es BL-0004, un Económico de 98 horas, seguido de BL-0005 con 80.5 y BL-0002 con 50. show(3) muestra solo las tres primeras filas; el envío sin horas queda al final del orden. Ninguna de estas operaciones cambió envios: cada una devuelve un DataFrame nuevo.
Paso 4. Columnas nuevas con condiciones
withColumn agrega una columna calculada. F.when(...).otherwise(...) es el «si… entonces… si no» de PySpark. La celda agrega la promesa de entrega de cada servicio (24, 72 o 120 horas), si el envío llegó a tiempo y las horas convertidas en días.
Tres envíos llegaron a tiempo (BL-0001, BL-0002 y BL-0004) y dos tarde: BL-0003, un Express de 31.5 horas frente a una promesa de 24, y BL-0005, un Estándar de 80.5 frente a 72. BL-0006 tiene a_tiempo en NULL: comparar un nulo con un número da nulo, y así debe ser, porque un envío devuelto no llegó ni a tiempo ni tarde. La columna dias pasa las horas a días: BL-0004, el más lento, tardó 4.1 días.
Paso 5. Agrupar y resumir
groupBy forma grupos con las filas que tienen el mismo valor, y agg calcula un resumen por grupo. Aquí, por servicio: cuántos envíos, el promedio de horas y cuántos llegaron a tiempo, con alias para darle nombre a cada resultado.
Hay tres grupos. Express tiene 3 envíos, con 25.8 horas de promedio y 1 a tiempo; Estándar 2 envíos, 65.3 horas y 1 a tiempo; Económico 1 envío, 98 horas y 1 a tiempo. El promedio de Express es (20 + 31.5) / 2 = 25.8: avg no cuenta el nulo de BL-0006, aunque count("*") sí lo cuenta como envío. Para sumar los a_tiempo, la columna lógica se convierte en número con cast("int"): verdadero vale 1 y falso 0.
Paso 6. La misma pregunta en SQL
Un DataFrame se puede registrar como vista temporal con un nombre, y desde ahí se consulta con SQL. spark.sql devuelve otro DataFrame. La consulta es la del paso 5, escrita en SQL.
con_promesa.createOrReplaceTempView("envios_demo")spark.sql(""" SELECT servicio, COUNT(*) AS envios, ROUND(AVG(horas), 1) AS horas_promedio, SUM(CAST(a_tiempo AS INT)) AS a_tiempo FROM envios_demo GROUP BY servicio ORDER BY servicio""").show()
El resultado es idéntico al del paso 5, fila por fila: en Spark, SQL y DataFrames son dos formas de escribir el mismo plan, como se vio en el capítulo de Spark SQL. En Databricks hay una tercera forma: una celda que empieza con %sql contiene solo la consulta, sin spark.sql ni comillas, y muestra el resultado como tabla. El libro usa spark.sql para que el notebook se lea igual fuera de Databricks.
NotaVista temporal
Una vista temporal es un nombre que apunta a un DataFrame mientras dura la sesión. No copia datos ni queda en el catálogo: al cerrar la sesión, desaparece. Sirve para consultar con SQL un resultado intermedio.
Paso 7. Ver resultados con display
show() imprime texto. Databricks tiene además display(), que muestra el DataFrame como una tabla interactiva: se puede ordenar por cualquier columna haciendo clic en su nombre, descargar como CSV y, con el botón + que aparece encima de la tabla, crear un gráfico (barras, líneas, mapas) sin escribir código.
display(resumen)
servicio
envios
horas_promedio
a_tiempo
Económico
1
98.0
1
Estándar
2
65.3
1
Express
3
25.8
1
En el notebook, la salida es la tabla del paso 5 con controles. Prueba el botón + de la salida, elige Visualization y un gráfico de barras con servicio en el eje X y horas_promedio en el eje Y: Databricks lo dibuja y lo guarda con el notebook. display() existe solo en Databricks; en el clúster del libro se usaba show() o un gráfico de matplotlib, que en Databricks también funcionan.
Paso 8. Una tabla grande de ejemplo
Los espacios de trabajo de Databricks traen un catálogo de solo lectura, samples, con tablas de ejemplo. Una de ellas, samples.nyctaxi.trips, tiene viajes reales de taxi de Nueva York. spark.table abre una tabla del catálogo por su nombre. La celda cuenta los viajes, muestra el esquema y agrupa por hora de recogida. Si tu espacio de trabajo no tuviera esa tabla, la celda lo dice en lugar de fallar.
TAXIS ="samples.nyctaxi.trips"try: taxis = spark.table(TAXIS)print("Viajes:", taxis.count()) taxis.printSchema() por_hora = ( taxis.groupBy(F.hour("tpep_pickup_datetime").alias("hora")) .agg(F.count("*").alias("viajes"), F.round(F.avg("trip_distance"), 2).alias("millas_promedio"), F.round(F.avg("fare_amount"), 2).alias("tarifa_promedio")) .orderBy("hora") ) por_hora.show(24)exceptExceptionas error:print("Este espacio de trabajo no tiene la tabla", TAXIS, "->", type(error).__name__)
La tabla tiene 21 932 viajes, con horas de recogida y llegada, distancia, tarifa y códigos postales de origen y destino. Por hora, las 18:00 son la hora con más viajes (1 455); de madrugada hay pocos, pero son más largos: a las 5:00, 220 viajes de 4.26 millas y 14.90 dólares en promedio. El código es el mismo de los pasos anteriores; lo único distinto es de dónde vienen los datos: una tabla del catálogo en lugar de filas escritas a mano. Ese es el patrón de Databricks: los datos se consultan por su nombre, sin saber en qué archivos están.
Paso 9. Tu esquema, un volumen y una tabla desde un archivo
Hasta aquí, nada se guardó: los DataFrames vivían en la sesión. Este paso crea tu espacio en el catálogo y guarda una tabla.
CREATE SCHEMA crea el esquema bitlogistica dentro del catálogo workspace, el que Free Edition trae para tu espacio de trabajo.
CREATE VOLUME crea dentro del esquema un volumen, archivos, para guardar archivos.
Python escribe en el volumen un CSV pequeño con las tarifas de cada servicio, como si fuera una carpeta de tu equipo.
Spark lee el CSV, lo une con los envíos del paso 4 y guarda las tarifas como tabla con saveAsTable.
IF NOT EXISTS hace que repetir la celda no falle.
CATALOGO ="workspace"ESQUEMA ="bitlogistica"spark.sql(f"CREATE SCHEMA IF NOT EXISTS {CATALOGO}.{ESQUEMA}")spark.sql(f"CREATE VOLUME IF NOT EXISTS {CATALOGO}.{ESQUEMA}.archivos")# El volumen se usa como una carpeta: Python escribe un archivo en élCARPETA =f"/Volumes/{CATALOGO}/{ESQUEMA}/archivos/primeros_pasos"os.makedirs(CARPETA, exist_ok=True)withopen(f"{CARPETA}/tarifas.csv", "w", encoding="utf-8") as archivo: archivo.write("servicio,promesa_horas,tarifa_base\n") archivo.write("Express,24,18000\nEstándar,72,9500\nEconómico,120,6000\n")# Spark lee el mismo archivo y lo une con los envíos del paso 4tarifas = spark.read.csv(f"{CARPETA}/tarifas.csv", header=True, inferSchema=True)tarifas.printSchema()con_promesa.join(tarifas.select("servicio", "tarifa_base"), "servicio").select("guia", "servicio", "tarifa_base").orderBy("guia").show()# Guardar las tarifas como tabla del catálogotarifas.write.mode("overwrite").saveAsTable(f"{CATALOGO}.{ESQUEMA}.tarifas")spark.sql(f"SHOW TABLES IN {CATALOGO}.{ESQUEMA}").filter("NOT isTemporary").select("tableName").show()
inferSchema=True le pide a Spark que adivine los tipos al leer: promesa_horas y tarifa_base quedaron como enteros y servicio como texto. La unión (join) por la columna servicio le pone a cada envío su tarifa: los tres Express, 18 000; los dos Estándar, 9 500; el Económico, 6 000. Al final, SHOW TABLES lista las tablas del esquema bitlogistica, sin las vistas temporales: ahí está tarifas. Búscala en Catalog, en la barra lateral: está en workspace → bitlogistica, con su esquema, una muestra de filas y su historial. El archivo también está ahí, en Volumes → archivos → primeros_pasos.
Paso 10. Una tabla Delta en miniatura
Toda tabla que se guarda en Databricks es una tabla Delta, con historial. Este paso lo muestra con los seis envíos del paso 2: los guarda como tabla demo_envios, corrige con UPDATE las horas de un envío, mira el historial y consulta la versión anterior a la corrección con VERSION AS OF. Es, en pequeño, lo que el caso completo hace en la sección 6 con 32 064 envíos.
DEMO =f"{CATALOGO}.{ESQUEMA}.demo_envios"spark.sql(f"DROP TABLE IF EXISTS {DEMO}") # empezar de cero: el historial tendrá solo esta ejecuciónenvios.write.mode("overwrite").saveAsTable(DEMO)# Corregir un envío: BL-0003 en realidad tardó 22 horas, no 31.5spark.sql(f"UPDATE {DEMO} SET horas = 22.0 WHERE guia = 'BL-0003'")historial = spark.sql(f"DESCRIBE HISTORY {DEMO}")historial.select("version", "operation").orderBy("version").show(truncate=False)antes = historial.filter("operation = 'UPDATE'").agg(F.max("version")).first()[0] -1print("Ahora:")spark.sql(f"SELECT guia, horas FROM {DEMO} WHERE guia = 'BL-0003'").show()print(f"En la versión {antes}, antes del UPDATE:")spark.sql(f"SELECT guia, horas FROM {DEMO} VERSION AS OF {antes} WHERE guia = 'BL-0003'").show()
+-------+---------------------------------+
|version|operation                        |
+-------+---------------------------------+
|0      |CREATE OR REPLACE TABLE AS SELECT|
|1      |UPDATE                           |
+-------+---------------------------------+

Ahora:
+-------+-----+
|   guia|horas|
+-------+-----+
|BL-0003| 22.0|
+-------+-----+

En la versión 0, antes del UPDATE:
+-------+-----+
|   guia|horas|
+-------+-----+
|BL-0003| 31.5|
+-------+-----+
El historial tiene una fila por cada cambio de la tabla, con su número de versión y la operación: la escritura de los seis envíos (versión 0, que Delta registra como CREATE OR REPLACE TABLE AS SELECT) y el UPDATE (versión 1). A veces aparece además un OPTIMIZE, que Databricks ejecuta por su cuenta para compactar los archivos de la tabla. Hoy BL-0003 tiene 22 horas, y en la versión 0 sigue teniendo 31.5: la corrección no borró el valor viejo, creó una versión nueva. La celda borra la tabla antes de crearla, así que el historial empieza de cero cada vez que la ejecutas.
Con estos diez pasos ya usaste todo lo que necesita el caso completo: la sesión, DataFrames, columnas nuevas, agrupaciones, SQL, el catálogo, un volumen y una tabla Delta. Las secciones siguientes lo juntan en el pipeline de BITLogística.
4. Spark SQL en Databricks: cinco consultas
TipLas bases de Spark SQL
Spark SQL es el módulo de Spark que consulta DataFrames y tablas con SQL. Una consulta SQL y la misma operación escrita con métodos de PySpark producen el mismo plan de ejecución, así que se elige la forma que se lea mejor. Las tablas guardadas en el catálogo se consultan por su nombre, que en Unity Catalog tiene tres niveles: catálogo.esquema.tabla. En Databricks, el SQL se escribe con spark.sql(...) desde Python, en celdas %sql o en el editor de SQL. Las piezas de esta sección son WHERE y HAVING, CASE WHEN, percentiles, JOIN, funciones de ventana y vistas. El capítulo de Spark SQL y DataFrames las explica en el clúster del libro, junto con el catálogo y el plan de ejecución.
Preparar los datos
Las consultas de esta sección y los modelos de la siguiente usan los seis meses de envíos de BITLogística, ya limpios: sin los errores de captura que el caso completo de la sección 6 aprende a corregir.
Primero sube el generador. En la barra lateral, abre Catalog, despliega workspace, luego bitlogistica y Volumes, y entra al volumen archivos que creaste en el paso 9. Elige Upload to this volume y sube generar_envios.py, el archivo que descomprimiste al comienzo. Al terminar, el archivo aparece en la lista del volumen.
La celda carga el generador desde el volumen con importlib, sin instalarlo, y usa su función generar_envio, que crea cada envío limpio antes de que el generador le agregue errores. Con esos envíos arma un DataFrame, calcula las columnas de análisis (horas de tránsito, si llegó a tiempo, ruta, mes y si el destino es remoto) y lo guarda como la tabla envios_limpios.
import importlib.utilimport osimport randomimport sysimport pandas as pd# Los nombres del esquema, la tabla y el volumen; IF NOT EXISTS permite repetir la celdaCATALOGO ="workspace"ESQUEMA ="bitlogistica"spark.sql(f"CREATE SCHEMA IF NOT EXISTS {CATALOGO}.{ESQUEMA}")spark.sql(f"CREATE VOLUME IF NOT EXISTS {CATALOGO}.{ESQUEMA}.archivos")ESQ =f"{CATALOGO}.{ESQUEMA}"# prefijo de las tablas: workspace.bitlogistica.<tabla>VOLUMEN =f"/Volumes/{CATALOGO}/{ESQUEMA}/archivos"# carpeta de archivos del volumen# Cargar el generador desde el volumen, sin instalarloGENERADOR = VOLUMEN +"/generar_envios.py"assert os.path.exists(GENERADOR), "Sube generar_envios.py al volumen archivos (comienzo de la sección 4)"sys.dont_write_bytecode =True# no dejar una carpeta __pycache__ en el volumenespecificacion = importlib.util.spec_from_file_location("generar_envios", GENERADOR)gen = importlib.util.module_from_spec(especificacion)especificacion.loader.exec_module(gen)# Los seis meses de envíos, limpios: generar_envio crea cada envío antes de que se le agreguen erroresrng = random.Random(gen.SEMILLA)filas = [gen.generar_envio(rng, mes, n)for mes, cantidad in gen.ENVIOS_POR_MES.items() for n inrange(1, cantidad +1)]PROMESA = F.when(F.col("servicio") =="Express", 24).when(F.col("servicio") =="Estándar", 72).otherwise(120)limpios = ( spark.createDataFrame(pd.DataFrame(filas)) .withColumn("admision", F.to_timestamp(F.concat_ws(" ", "fecha_admision", "hora_admision"), "yyyy-MM-dd HH:mm")) .withColumn("entrega", F.try_to_timestamp("fecha_hora_entrega", F.lit("yyyy-MM-dd HH:mm"))) .withColumn("promesa_horas", PROMESA) .withColumn("horas_transito", F.round((F.unix_timestamp("entrega") - F.unix_timestamp("admision")) /3600, 1)) .withColumn("a_tiempo", F.when(F.col("estado") =="entregado", F.col("horas_transito") <= F.col("promesa_horas"))) .withColumn("ruta", F.concat_ws(" - ", "origen", "destino")) .withColumn("mes", F.month("admision")) .withColumn("destino_remoto", F.col("destino").isin("Cúcuta", "Montería", "Pasto")) .drop("fecha_admision", "hora_admision", "fecha_hora_entrega"))limpios.write.mode("overwrite").saveAsTable(f"{ESQ}.envios_limpios")envios_limpios = spark.table(f"{ESQ}.envios_limpios")print("Envíos:", envios_limpios.count())(envios_limpios.groupBy("mes") .agg(F.count("*").alias("envios"), F.sum((F.col("estado") =="entregado").cast("int")).alias("entregados"), F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo")) .orderBy("mes").show())
La tabla tiene 33 900 envíos, entre 5 000 en febrero y 6 900 en mayo. La diferencia con las 34 239 filas del bronce del caso son las 339 guías que los archivos del caso repiten a propósito; además, aquí ningún envío tiene valores nulos ni imposibles. Mayo es el mes difícil: 85.6 % a tiempo, frente a más de 90 % en los otros cinco meses. Es la temporada alta del Día de la Madre, y va a aparecer en varias consultas y modelos.
Cada consulta va dentro de spark.sql(f"""..."""). La f permite escribir {ESQ} en lugar de workspace.bitlogistica, y las tres comillas, partir la consulta en varias líneas. En una celda %sql de Databricks se escribiría solo el texto de la consulta, con el nombre completo de la tabla.
Consulta 1. Las rutas con peor cumplimiento
WHERE filtra filas antes de agrupar y HAVING filtra grupos después de agrupar: aquí, solo las rutas con 50 entregas o más, para no sacar conclusiones de rutas con tres envíos.
spark.sql(f""" SELECT ruta, COUNT(*) AS entregados, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo, ROUND(AVG(horas_transito), 1) AS horas_promedio FROM {ESQ}.envios_limpios WHERE estado = 'entregado' GROUP BY ruta HAVING COUNT(*) >= 50 ORDER BY pct_a_tiempo LIMIT 10""").show(truncate=False)
Barranquilla - Pasto es la peor ruta entre las que tienen 50 entregas o más: 37.8 % a tiempo y 73.0 horas de promedio, casi 30 puntos por debajo de la siguiente, Medellín - Pasto, con 66.9 %. Ocho de las diez llegan a Pasto, Cúcuta, Montería o Santa Marta, los destinos lejanos que ya señaló el taller de PySpark. Sin el HAVING, la lista se llenaría de rutas con dos o tres envíos, en las que un solo retraso baja el porcentaje a la mitad.
Consulta 2. Clasificar con CASE y medir con percentiles
CASE WHEN crea una categoría a partir de una condición, como F.when en el paso 4. La primera consulta agrupa los envíos en cuatro bandas de peso; la segunda usa percentile_approx para dar la mediana y el percentil 90 de las horas de tránsito por servicio, que dicen más que el promedio cuando hay envíos muy demorados.
spark.sql(f""" SELECT CASE WHEN peso_kg < 1 THEN '1. menos de 1 kg' WHEN peso_kg < 5 THEN '2. de 1 a 5 kg' WHEN peso_kg < 20 THEN '3. de 5 a 20 kg' ELSE '4. 20 kg o más' END AS banda_peso, COUNT(*) AS envios, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo FROM {ESQ}.envios_limpios GROUP BY 1 ORDER BY 1""").show()spark.sql(f""" SELECT servicio, promesa_horas, percentile_approx(horas_transito, 0.5) AS mediana_horas, percentile_approx(horas_transito, 0.9) AS p90_horas FROM {ESQ}.envios_limpios WHERE estado = 'entregado' GROUP BY servicio, promesa_horas ORDER BY promesa_horas""").show()
+----------------+------+------------+
|      banda_peso|envios|pct_a_tiempo|
+----------------+------+------------+
|1. menos de 1 kg|  8516|        89.9|
|  2. de 1 a 5 kg| 21228|        89.8|
| 3. de 5 a 20 kg|  4026|        89.8|
|  4. 20 kg o más|   130|        88.4|
+----------------+------+------------+

+---------+-------------+-------------+---------+
| servicio|promesa_horas|mediana_horas|p90_horas|
+---------+-------------+-------------+---------+
|  Express|           24|         14.7|     33.1|
| Estándar|           72|         38.8|     65.7|
|Económico|          120|         66.2|    109.5|
+---------+-------------+-------------+---------+
El peso casi no cambia el cumplimiento: las tres primeras bandas están entre 89.8 % y 89.9 %, y solo los 130 envíos de 20 kg o más bajan a 88.4 %. Los percentiles muestran dónde está el problema. En Express, la mediana es de 14.7 horas, pero el percentil 90 llega a 33.1, por encima de la promesa de 24; en Estándar (65.7 frente a 72) y en Económico (109.5 frente a 120), el percentil 90 todavía cabe en la promesa. El retraso se concentra en una cola de envíos Express, no en el envío típico.
Consulta 3. Unir dos tablas del catálogo
JOIN combina filas de dos tablas que comparten una columna. Aquí se une la plata con la tabla tarifas que creaste en el paso 9, para estimar cuánto facturó cada servicio cada mes: envíos por la tarifa base. (Si saltaste los primeros pasos, ejecuta antes la celda del paso 9.)
spark.sql(f""" SELECT p.mes, p.servicio, COUNT(*) AS envios, t.tarifa_base, COUNT(*) * t.tarifa_base AS ingreso_estimado FROM {ESQ}.envios_limpios AS p JOIN {ESQ}.tarifas AS t ON p.servicio = t.servicio GROUP BY p.mes, p.servicio, t.tarifa_base ORDER BY p.mes, p.servicio""").show(18)
Estándar es el servicio que más factura todos los meses, por volumen: en junio, sus 3 206 envíos suman 30 457 000 pesos, frente a 25 992 000 de los 1 444 Express. Mayo es el mes más alto en los tres servicios, con 36 271 000 solo en Estándar. La cifra es una estimación con la tarifa base del paso 9; el ingreso real dependería del peso y la distancia de cada envío.
Consulta 4. Comparar con funciones de ventana
NotaFunción de ventana
Una función de ventana calcula un valor para cada fila mirando otras filas de su mismo grupo, sin juntarlas en una sola como hace GROUP BY. La cláusula OVER define la ventana: PARTITION BY dice qué filas forman el grupo y ORDER BY, en qué orden se recorren.
RANK() OVER (PARTITION BY mes ORDER BY pct DESC) da el puesto de cada operador dentro de su mes, y LAG(pct) OVER (PARTITION BY operador ORDER BY mes) trae el valor del mes anterior del mismo operador, para calcular cuánto cambió. La consulta usa WITH para calcular primero el cumplimiento por operador y mes, y sobre ese resultado aplica las ventanas.
La segunda consulta usa QUALIFY, una cláusula de Databricks que filtra por el resultado de una ventana: aquí, quedarse solo con el operador en el puesto 1 de cada mes.
POR_OPERADOR =f""" WITH operador_mes AS ( SELECT mes, operador, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct FROM {ESQ}.envios_limpios WHERE estado = 'entregado' GROUP BY mes, operador )"""spark.sql(POR_OPERADOR +""" SELECT mes, operador, pct, RANK() OVER (PARTITION BY mes ORDER BY pct DESC) AS puesto, ROUND(pct - LAG(pct) OVER (PARTITION BY operador ORDER BY mes), 1) AS cambio FROM operador_mes ORDER BY mes, puesto""").show(24)print("El mejor operador de cada mes:")spark.sql(POR_OPERADOR +""" SELECT mes, operador, pct FROM operador_mes QUALIFY RANK() OVER (PARTITION BY mes ORDER BY pct DESC) = 1 ORDER BY mes""").show()
OP-A ocupa el puesto 1 los seis meses y OP-C el 4, con una distancia entre ellos de 9 a 17 puntos. La columna cambio muestra que mayo afectó a todos: OP-C cayó 9.3 puntos, y los otros tres, entre 3.7 y 4.9; en junio, los cuatro volvieron a subir, entre 3.5 y 9.8 puntos. Una caída que golpea a todos los operadores el mismo mes apunta a algo del mes, como el volumen, y no a un operador en particular. La primera fila de cada operador tiene cambio en NULL porque enero no tiene mes anterior.
Consulta 5. Una vista para el negocio
NotaVista del catálogo
Una vista del catálogo es una consulta guardada con nombre en Unity Catalog, creada con CREATE VIEW. No copia datos: cada vez que alguien la consulta, se calcula con los datos del momento. A diferencia de la vista temporal del paso 6, no desaparece al cerrar la sesión.
La vista es la forma de dejarle al equipo de negocio una pregunta lista para consultar desde un notebook, el editor de SQL o un tablero.
spark.sql(f""" CREATE OR REPLACE VIEW {ESQ}.vista_cumplimiento_mensual AS SELECT mes, servicio, COUNT(*) AS entregados, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo FROM {ESQ}.envios_limpios WHERE estado = 'entregado' GROUP BY mes, servicio""")print("Meses y servicios por debajo de 85 % a tiempo:")spark.sql(f""" SELECT * FROM {ESQ}.vista_cumplimiento_mensual WHERE pct_a_tiempo < 85 ORDER BY pct_a_tiempo""").show()spark.sql(f"SHOW VIEWS IN {ESQ}").filter("NOT isTemporary").select("viewName").show(truncate=False)
Meses y servicios por debajo de 85 % a tiempo:
+---+--------+----------+------------+
|mes|servicio|entregados|pct_a_tiempo|
+---+--------+----------+------------+
|  5| Express|      1705|        74.2|
|  6| Express|      1435|        78.9|
|  1| Express|      1253|        79.3|
|  3| Express|      1388|        79.4|
|  4| Express|      1351|        79.8|
|  2| Express|      1215|        79.8|
+---+--------+----------+------------+

+--------------------------+
|viewName                  |
+--------------------------+
|vista_cumplimiento_mensual|
+--------------------------+
Los seis casos por debajo de 85 % son de Express, desde 74.2 % en mayo hasta 79.8 % en febrero y abril; Estándar y Económico no aparecen nunca. SHOW VIEWS confirma que la vista quedó en el esquema. Desde ahora, cualquiera con permiso sobre el esquema puede consultarla, y si mañana se corrigen los datos, la vista mostrará la cifra corregida sin volver a crearla.
5. MLlib en Databricks: cinco ejemplos
TipLas bases de MLlib
MLlib es la librería de aprendizaje automático de Spark: entrena modelos con los datos repartidos entre las máquinas del cómputo, con la misma API en el clúster del libro y en Databricks. Un modelo aprende de ejemplos: unas variables de entrada (lo que se sabe de cada envío) y una variable objetivo (lo que se quiere predecir). Si la variable objetivo es una categoría, como «llegó tarde» o «llegó a tiempo», el problema es de clasificación; si es un número, como las horas de tránsito, es de regresión. Los datos se dividen en dos partes: con el entrenamiento el modelo aprende, y con la prueba, que no vio, se mide qué tan bien predice. En MLlib, la preparación de los datos y el modelo se encadenan en un Pipeline, y las métricas las calculan los evaluadores. El capítulo de MLlib explica los algoritmos, la validación cruzada y la búsqueda de parámetros en el clúster del libro.
Esta sección aplica esas ideas a los envíos limpios de BITLogística en cinco pasos: preparar los datos, un modelo de clasificación, un segundo modelo para comparar, un modelo de regresión y el registro de los resultados en MLflow, la herramienta de Databricks para guardar y comparar experimentos.
La pregunta de los tres primeros ejemplos es la del área de servicio al cliente: ¿este envío va a llegar tarde? Para que el modelo sirva en la práctica, solo puede usar lo que se sabe en el momento de la admisión: servicio, operador, canal, distancia, peso, si el destino es remoto y si se admitió en fin de semana. Las horas de tránsito o los intentos de entrega no sirven como entrada, porque se conocen cuando el envío ya llegó.
El cómputo serverless de Free Edition admite MLlib, con dos topes: 100 MB por modelo y 1 GB de modelos por sesión. Los modelos de esta sección ocupan una fracción mínima de eso.
Ejemplo 1. Preparar los datos
Un modelo de MLlib espera una sola columna con todas las entradas en forma de vector de números. La celda hace cuatro cosas:
Deja solo los envíos entregados y crea la columna que se quiere predecir, tarde (1 si llegó tarde, 0 si no), más dos entradas numéricas: remoto y fin_de_semana.
Separa los datos por tiempo: aprende con enero a mayo y se evalúa con junio, como si el modelo se usara de verdad con los envíos del mes siguiente.
Convierte las columnas de texto en números: StringIndexer le da un número a cada categoría y OneHotEncoder la vuelve un vector de ceros y unos.
VectorAssembler junta todo en la columna caracteristicas.
from pyspark.ml import Pipelinefrom pyspark.ml.feature import OneHotEncoder, StringIndexer, VectorAssemblerdatos = ( spark.table(f"{ESQ}.envios_limpios") .filter(F.col("estado") =="entregado") .withColumn("tarde", (~F.col("a_tiempo")).cast("double")) .withColumn("remoto", F.col("destino_remoto").cast("double")) .withColumn("fin_de_semana", F.dayofweek("admision").isin(1, 7).cast("double")) .select("guia", "mes", "servicio", "operador", "canal", "distancia_km", "peso_kg","remoto", "fin_de_semana", "tarde", "horas_transito"))entrenamiento = datos.filter("mes <= 5")prueba = datos.filter("mes = 6")for nombre, parte in [("Entrenamiento (ene-may)", entrenamiento), ("Prueba (jun)", prueba)]: fila = parte.agg(F.count("*").alias("n"), F.round(100* F.avg("tarde"), 1).alias("pct")).first()print(f"{nombre}: {fila['n']} envíos, {fila['pct']} % tarde")CATEGORICAS = ["servicio", "operador", "canal"]NUMERICAS = ["distancia_km", "peso_kg", "remoto", "fin_de_semana"]preparacion = [StringIndexer(inputCol=c, outputCol=c +"_idx") for c in CATEGORICAS] + [ OneHotEncoder(inputCols=[c +"_idx"for c in CATEGORICAS], outputCols=[c +"_vec"for c in CATEGORICAS]), VectorAssembler(inputCols=[c +"_vec"for c in CATEGORICAS] + NUMERICAS, outputCol="caracteristicas"),]ejemplo = Pipeline(stages=preparacion).fit(entrenamiento).transform(entrenamiento)ejemplo.orderBy("guia").select("servicio", "operador", "canal", "distancia_km", "caracteristicas").show(3, truncate=False)
Entrenamiento (ene-may): 27912 envíos, 10.4 % tarde
Prueba (jun): 5756 envíos, 9.4 % tarde
+---------+--------+-----------+------------+-------------------------------------------+
|servicio |operador|canal      |distancia_km|caracteristicas                            |
+---------+--------+-----------+------------+-------------------------------------------+
|Económico|OP-D    |corporativo|167         |(11,[7,8,10],[167.0,5.0,1.0])              |
|Económico|OP-D    |web        |521         |(11,[5,7,8],[1.0,521.0,3.31])              |
|Estándar |OP-D    |web        |1190        |(11,[0,5,7,8,10],[1.0,1.0,1190.0,1.07,1.0])|
+---------+--------+-----------+------------+-------------------------------------------+
only showing top 3 rows
El entrenamiento tiene 27 912 entregas, 10.4 % tarde, y la prueba 5 756 de junio, 9.4 % tarde. Un modelo que dijera siempre «llega a tiempo» acertaría 9 de cada 10 veces sin servir para nada; por eso los ejemplos siguientes miden con el AUC y no con el porcentaje de aciertos. La columna caracteristicas se muestra comprimida: un vector de 11 posiciones del que solo se escriben las que no son cero, con su posición y su valor. Las primeras 7 son ceros y unos de las categorías; las 4 últimas, la distancia, el peso, si el destino es remoto y si fue fin de semana.
Ejemplo 2. Regresión logística en un Pipeline
NotaPipeline y AUC
Un Pipeline de MLlib encadena pasos: la preparación del ejemplo 1 y el modelo al final. Al entrenarlo con fit, cada paso aprende de los datos de entrenamiento (por ejemplo, qué número le toca a cada operador) y el resultado se aplica igual a los datos nuevos con transform. El AUC (área bajo la curva ROC) mide qué tan bien ordena el modelo los envíos por riesgo: 0.5 es lo mismo que adivinar al azar y 1.0 es ordenar perfecto, con todos los tardíos arriba.
La regresión logística es un modelo de clasificación que calcula, para cada envío, una probabilidad de llegar tarde. La celda la entrena, mide el AUC con junio y luego usa la probabilidad como alerta: marca los envíos con 20 % o más de probabilidad y compara cuántos de ellos llegaron tarde frente a los no marcados.
AUC de la regresión logística en junio: 0.801
+------+------+--------------+
|alerta|envios|pct_tarde_real|
+------+------+--------------+
| false|  4946|           6.2|
|  true|   810|          28.5|
+------+------+--------------+
El AUC es 0.801: si se toma al azar un envío que llegó tarde y uno que llegó a tiempo, 80 de cada 100 veces el modelo le da más probabilidad al tardío. La alerta lo vuelve útil: marca 810 de los 5 756 envíos de junio, y de ellos el 28.5 % llegó tarde, más de cuatro veces que entre los no marcados (6.2 %). Servicio al cliente podría revisar esos 810 envíos con anticipación en lugar de los 5 756.
Ejemplo 3. Bosque aleatorio y qué variables pesan
NotaBosque aleatorio e importancia de variables
Un árbol de decisión clasifica con preguntas encadenadas, como «¿es Express?» y luego «¿va a más de 600 km?». Un bosque aleatorio (random forest) entrena muchos árboles, cada uno con una parte distinta de los datos, y promedia sus respuestas. Capta combinaciones que la regresión logística no ve, como «Express hacia un destino remoto». La importancia de cada variable mide cuánto ayudó a separar los envíos tardíos de los puntuales; las importancias suman 1.
La celda lo entrena con la misma preparación, compara su AUC con el de la logística y muestra las seis variables más importantes, con su nombre legible.
from pyspark.ml.classification import RandomForestClassifierbosque = Pipeline(stages=preparacion + [ RandomForestClassifier(featuresCol="caracteristicas", labelCol="tarde", numTrees=50, maxDepth=6, seed=27)])modelo_rf = bosque.fit(entrenamiento)auc_rf = evaluador.evaluate(modelo_rf.transform(prueba))print(f"AUC en junio: logística {auc_log:.3f} | bosque aleatorio {auc_rf:.3f}")# Nombre de cada posición del vector: una por categoría (menos la última de cada columna) y las numéricasnombres = []for etapa, columna inzip(modelo_rf.stages[:len(CATEGORICAS)], CATEGORICAS): nombres += [f"{columna} = {etiqueta}"for etiqueta in etapa.labels[:-1]]nombres += NUMERICASimportancias = modelo_rf.stages[-1].featureImportances.toArray()for nombre, valor insorted(zip(nombres, importancias), key=lambda x: -x[1])[:6]:print(f"{nombre:24s}{valor:.3f}")
El bosque aleatorio casi no mejora a la logística: su AUC en junio es 0.802, frente a 0.801. Cuando un modelo más complejo apenas supera a uno simple, conviene quedarse con el simple, que se entrena más rápido y se explica mejor. Las importancias sí aportan: la distancia (0.286) y el servicio Express (0.283) pesan más que todo lo demás, seguidos de OP-C (0.189) y el destino remoto (0.107). Es lo mismo que mostraron las consultas 1, 2 y 4, ahora medido por el modelo; el peso del envío no aparece entre las seis primeras, como anticipaba la consulta 2.
Ejemplo 4. Regresión: cuántas horas va a tardar
Además de «¿llegará tarde?», el área de servicio quiere poder decirle al cliente cuántas horas tardará su envío. Eso es un problema de regresión: predecir un número. La regresión lineal usa las mismas entradas. Para saber si aprendió algo, se compara con una referencia simple: predecir para todos el promedio de horas del entrenamiento.
NotaRMSE, MAE y R²
Las tres miden qué tan lejos quedan las predicciones de los valores reales. El MAE (error absoluto medio) es el error promedio, en horas. El RMSE (raíz del error cuadrático medio) también está en horas, pero castiga más los errores grandes. El R² es la parte de la variación de las horas que el modelo explica: 1 es perfecto y 0 es lo mismo que predecir siempre el promedio.
RMSE modelo   15.97 | referencia (promedio)   25.06
MAE  modelo   12.05 | referencia (promedio)   19.45
R2   modelo    0.59 | referencia (promedio)   -0.00
+----------------+---------+------------+--------------+----------+
|            guia| servicio|distancia_km|horas_transito|prediccion|
+----------------+---------+------------+--------------+----------+
|BL-202606-000001| Estándar|          23|          29.6|      32.4|
|BL-202606-000002| Estándar|           9|          32.8|      30.5|
|BL-202606-000003|Económico|         557|          44.5|      73.1|
|BL-202606-000004| Estándar|         477|          31.1|      43.4|
|BL-202606-000005|  Express|         557|           9.0|       8.7|
+----------------+---------+------------+--------------+----------+
only showing top 5 rows
El modelo reduce el error frente a la referencia: 15.97 horas de RMSE frente a 25.06, y 12.05 de MAE frente a 19.45. El R² es 0.59, contra cerca de 0 de la referencia. Aun así, 12 horas de error promedio es mucho para prometerle una hora al cliente, como se ve en las cinco primeras guías: BL-202606-000003 tardó 44.5 horas y el modelo predijo 73.1. Para una promesa de entrega harían falta más variables, como la carga del operador ese día.
Ejemplo 5. Registrar los modelos en MLflow
NotaMLflow
MLflow es una herramienta de código abierto para registrar experimentos de aprendizaje automático, creada por Databricks y ya integrada en cada espacio de trabajo. Cada entrenamiento se registra como una ejecución (run) con sus parámetros (qué se probó), sus métricas (qué tan bien salió) y, si se quiere, el modelo. Las ejecuciones de un notebook se agrupan en un experimento, y la interfaz permite compararlas en una tabla o en gráficos.
En los ejemplos 2 y 3, las cifras quedaron impresas en el notebook y nada más: si mañana alguien prueba otro modelo, no hay dónde compararlo. La celda primero elige el experimento con mlflow.set_experiment: bitlogistica_envios_tarde, dentro de tu carpeta de usuario, que se crea la primera vez. Darle un nombre propio evita depender del experimento automático del notebook, que se borra si se borra el notebook. Luego registra las dos clasificaciones como ejecuciones de ese experimento, con sus parámetros y su AUC, y las busca con mlflow.search_runs para mostrarlas lado a lado.
import mlflow# Un experimento con nombre propio en tu carpeta de usuario; set_experiment lo crea si no existeusuario = spark.sql("SELECT current_user()").first()[0]mlflow.set_experiment(f"/Users/{usuario}/bitlogistica_envios_tarde")ejecuciones = [ ("logistica", {"modelo": "LogisticRegression", "maxIter": 50}, auc_log), ("bosque_aleatorio", {"modelo": "RandomForestClassifier", "numTrees": 50, "maxDepth": 6}, auc_rf),]for nombre, parametros, auc in ejecuciones:with mlflow.start_run(run_name=nombre): mlflow.log_params({**parametros, "entrenamiento": "ene-may", "prueba": "jun"}) mlflow.log_metric("auc_junio", auc)registro = mlflow.search_runs(order_by=["start_time DESC"], max_results=2)print(registro[["tags.mlflow.runName", "params.modelo", "metrics.auc_junio"]].to_string(index=False))
La tabla muestra las dos ejecuciones con su modelo y su AUC de junio: 0.8022 el bosque y 0.8008 la logística. Las mismas ejecuciones aparecen en la interfaz de Databricks: en la barra lateral, Experiments lista los experimentos del espacio de trabajo, y al abrir bitlogistica_envios_tarde se ven sus ejecuciones. Desde ahí se pueden marcar las dos ejecuciones y elegir Compare para ver parámetros y métricas lado a lado. Si mañana alguien entrena un tercer modelo, queda en la misma lista, con su fecha y su autor.
6. El caso completo de BITLogística
TipLas bases del caso completo
Un pipeline de datos lleva los archivos desde que llegan hasta las tablas que se usan para decidir. El del libro sigue la arquitectura medallón: el bronce guarda los datos tal como llegaron, más el archivo y la hora de carga; la plata los limpia y valida con reglas de calidad, y manda a una cuarentena las filas que no las cumplen, con su motivo; el oro agrega la plata en indicadores para el negocio. Las tres capas se guardan como tablas Delta, un formato de tabla con historial y transacciones como el Iceberg del libro. El pipeline completo se construyó en el clúster en el taller de PySpark; el diseño del data lake está en el capítulo de almacenamiento, las reglas y la cuarentena en el capítulo de calidad, y el historial y MERGE en el capítulo de Iceberg.
Las secciones 4 y 5 trabajaron con envíos limpios. Los archivos reales no llegan así: abril trae otro formato, hay nulos, valores imposibles, ciudades mal escritas y guías repetidas. Esta sección ejecuta en Databricks el mismo pipeline del taller de PySpark sobre los archivos con esos errores, y las cifras del taller sirven de prueba: con los mismos datos y la misma lógica, Databricks tiene que dar lo mismo que el clúster de Docker.
6.1 La sesión y el espacio de BITLogística
La primera celda importa lo que usa el caso y confirma la sesión, como en el paso 1, con dos datos más: el catálogo actual y el modo ANSI, que se explica en la sección 6.4.
import importlib.utilimport osimport platformimport sysimport matplotlib.pyplot as pltimport pandas as pdfrom pyspark.sql import functions as F# 2. En Databricks la sesión ya existe: se llama spark y no se crea con SparkSession.builderprint("Python", platform.python_version(), "| Spark", spark.version)print("Catálogo actual:", spark.catalog.currentCatalog())print("Modo ANSI:", spark.conf.get("spark.sql.ansi.enabled"))try: spark.sparkContextprint("sparkContext disponible")exceptExceptionas error:print("sparkContext no disponible:", type(error).__name__)
Python 3.12.3 | Spark 4.2.0
Catálogo actual: workspace
Modo ANSI: true
sparkContext no disponible: PySparkAttributeError
La celda muestra las versiones de Python y de Spark del cómputo serverless (Databricks las actualiza con el tiempo, así que tu salida puede tener números mayores), el catálogo actual, workspace, y el modo ANSI activado. La última línea confirma lo que dice el recuadro de Spark Connect: spark.sparkContext no existe, y pedirlo es un error. En el clúster del libro, los talleres lo usaban para el número de la aplicación de YARN y para setLogLevel; aquí no hacen falta.
La siguiente celda define los nombres del caso. El esquema bitlogistica y el volumen archivos ya existen desde el paso 9; gracias a IF NOT EXISTS, crearlos otra vez no falla, y la celda sirve igual si alguien ejecuta el caso sin las secciones anteriores.
# 1. Un esquema para el caso y un volumen para sus archivos, dentro del catálogo del espacio de trabajoCATALOGO ="workspace"ESQUEMA ="bitlogistica"spark.sql(f"CREATE SCHEMA IF NOT EXISTS {CATALOGO}.{ESQUEMA}")spark.sql(f"CREATE VOLUME IF NOT EXISTS {CATALOGO}.{ESQUEMA}.archivos")ESQ =f"{CATALOGO}.{ESQUEMA}"# prefijo de las tablas: workspace.bitlogistica.<tabla>VOLUMEN =f"/Volumes/{CATALOGO}/{ESQUEMA}/archivos"# carpeta de archivos del volumenprint("Esquema:", ESQ)print("Volumen:", VOLUMEN)
Las tablas del capítulo se llamarán workspace.bitlogistica.<tabla> y los archivos vivirán bajo /Volumes/workspace/bitlogistica/archivos.
El generador ya está en el volumen desde la sección 4. Si ejecutas el caso sin las secciones anteriores, súbelo como se explica allí. Las celdas de esta sección se pueden repetir sin problema.
6.2 Generar los datos en el volumen
En el taller de PySpark, el generador corría en spark-client y los CSV se copiaban a HDFS con hdfs dfs -put. Aquí el volumen ya es almacenamiento compartido: Python puede leer y escribir en /Volumes/… como si fuera una carpeta local, y Spark lee de la misma ruta. La celda carga el generador desde el volumen, como en la sección 4, y esta vez llama a su función main, que escribe los seis meses con errores en la carpeta landing del volumen.
GENERADOR = VOLUMEN +"/generar_envios.py"LANDING = VOLUMEN +"/landing"assert os.path.exists(GENERADOR), "Sube generar_envios.py al volumen archivos (comienzo de la sección 4)"# 3. Cargar el generador desde el volumen y escribir los seis meses en la zona landingsys.dont_write_bytecode =True# no dejar una carpeta __pycache__ en el volumenespecificacion = importlib.util.spec_from_file_location("generar_envios", GENERADOR)gen = importlib.util.module_from_spec(especificacion)especificacion.loader.exec_module(gen)gen.main(LANDING)archivos =sorted(n for n in os.listdir(LANDING) if n.startswith("envios_"))for nombre in archivos:print(f"{nombre}: {os.path.getsize(os.path.join(LANDING, nombre)) /1024:.0f} KB")
En el volumen quedaron los seis CSV de enero a junio, con los mismos tamaños aproximados del taller de PySpark: el generador usa la semilla 2026, así que los datos son idénticos a los del clúster. Abril sigue llegando con el formato distinto (punto y coma, coma decimal y fechas dd/mm/aaaa).
6.3 Bronce como tabla Delta
La lectura es la del taller: los meses normales con coma y abril aparte con sep=";", unidos con unionByName. Cambian dos cosas.
El archivo de origen. El taller usaba input_file_name(), que no está disponible en Unity Catalog. Su reemplazo es la columna oculta _metadata, que Spark agrega a toda lectura de archivos: _metadata.file_path tiene la ruta completa, y de ahí sale el nombre. Funciona igual en el Spark de código abierto desde la versión 3.3.
Dónde se guarda. En lugar de write.parquet(ruta), write.saveAsTable("workspace.bitlogistica.bronce_envios"). La tabla es administrada: Unity Catalog decide dónde viven sus archivos en el almacenamiento de objetos, y se la nombra por su nombre, no por una ruta.
def leer(rutas, **opciones):"""CSV como texto, con el nombre del archivo de origen tomado de la columna oculta _metadata."""return ( spark.read.csv(rutas, header=True, **opciones) .withColumn("archivo_origen", F.element_at(F.split(F.col("_metadata.file_path"), "/"), -1)) )normales = leer([f"{LANDING}/{n}"for n in archivos if n !="envios_2026_04.csv"])abril = leer(f"{LANDING}/envios_2026_04.csv", sep=";").withColumnRenamed("fecha_recepcion", "fecha_admision")bronce = normales.unionByName(abril).withColumn("fecha_carga", F.current_timestamp())bronce.write.mode("overwrite").saveAsTable(f"{ESQ}.bronce_envios") # tabla Delta administradabronce = spark.table(f"{ESQ}.bronce_envios")bronce.groupBy("archivo_origen").count().orderBy("archivo_origen").show()print("Filas en bronce:", bronce.count())
El bronce tiene 34 239 filas, repartidas en los seis archivos igual que en el clúster: 5 252, 5 050, 5 656, 5 454, 6 969 y 5 858. La tabla ya está en el catálogo: en Catalog, dentro de bitlogistica, aparece bronce_envios con su esquema, una muestra de filas y su historial.
6.4 Plata: el mismo código, con ANSI
NotaModo ANSI
El modo ANSI hace que Spark SQL se comporte como dice el estándar SQL: convertir un texto que no es número, o leer una fecha con un formato que no corresponde, es un error, no un nulo silencioso. Está activado por defecto en Spark 4 y en el cómputo serverless de Databricks. En el Spark 3.5 del clúster del libro estaba desactivado, y el taller de PySpark aprovechaba esos nulos para detectar valores malos.
La celda siguiente lo muestra con una sola fila: un peso con coma decimal y una fecha en el formato de abril.
# 4. Con ANSI activado, un texto que no es número o una fecha con otro formato son un error, no un nuloprueba = spark.createDataFrame([("12,5", "13/04/2026 08:30")], ["peso_kg", "admision"])try: prueba.select(F.col("peso_kg").cast("double")).show()exceptExceptionas error:print("cast falló:", type(error).__name__)prueba.select( F.col("peso_kg").try_cast("double").alias("try_cast"), F.try_to_timestamp("admision", F.lit("yyyy-MM-dd HH:mm")).alias("formato_iso"), F.try_to_timestamp("admision", F.lit("dd/MM/yyyy HH:mm")).alias("formato_abril"),).show()
cast("double") sobre "12,5" falló con un error de formato numérico: con ANSI, Spark se niega a adivinar. try_cast hace lo que hacía cast antes: devuelve nulo cuando no puede convertir. Con las fechas pasa lo mismo: try_to_timestamp con el formato ISO da nulo para 13/04/2026 08:30, y con el formato de abril da la fecha correcta. Por eso la plata de este capítulo usa try_cast y try_to_timestamp: el resto de la lógica es la del taller.
La celda de plata repite las correcciones de ciudad y servicio, las ocho reglas de calidad, la cuarentena y la quita de duplicados, y escribe dos tablas: cuarentena_envios y plata_envios. Para las equivalencias de ciudades usa un mapa (create_map) en lugar de la tabla de equivalencias del taller: el resultado es el mismo y no hace falta una unión. Al final hace el mismo cuadre del taller.
CIUDADES = ["Bogotá", "Medellín", "Cali", "Barranquilla", "Cartagena", "Bucaramanga","Pereira", "Manizales", "Ibagué", "Villavicencio", "Santa Marta", "Neiva","Cúcuta", "Montería", "Pasto"]ALIAS_CIUDAD = {"bogota d.c.": "Bogotá", "santiago de cali": "Cali", "b/quilla": "Barranquilla"}ALIAS_SERVICIO = {"express": "Express", "expres": "Express", "estandar": "Estándar", "economico": "Económico"}REGLAS = [ ("guia_vacia", "guia IS NULL"), ("peso_fuera_de_rango", "peso_kg IS NULL OR peso_kg < 0.01 OR peso_kg > 150"), ("distancia_no_positiva", "distancia_km IS NULL OR distancia_km <= 0"), ("ciudad_desconocida", "origen_ok IS NULL OR destino_ok IS NULL"), ("servicio_desconocido", "servicio_ok IS NULL"), ("admision_invalida", "admision IS NULL"), ("entregado_sin_fecha", "estado = 'entregado' AND entrega IS NULL"), ("entrega_antes_de_admision", "entrega < admision"),]def llave(columna):"""Texto comparable: sin espacios a los lados, en minúsculas y sin tildes."""return F.translate(F.lower(F.trim(columna)), "áéíóú", "aeiou")def fecha_hora(columna):"""Acepta los dos formatos de fecha que llegan; si no es ninguno, queda nula (no es un error)."""return F.coalesce(F.try_to_timestamp(columna, F.lit("yyyy-MM-dd HH:mm")), F.try_to_timestamp(columna, F.lit("dd/MM/yyyy HH:mm")))catalogo_ciudad = {c.lower().translate(str.maketrans("áéíóú", "aeiou")): c for c in CIUDADES}mapa_ciudad = F.create_map(*[F.lit(x) for par in {**catalogo_ciudad, **ALIAS_CIUDAD}.items() for x in par])mapa_servicio = F.create_map(*[F.lit(x) for par in ALIAS_SERVICIO.items() for x in par])# 5. Las mismas correcciones y reglas del taller de PySpark, con try_cast y try_to_timestampvalidada = ( bronce .withColumn("origen_ok", mapa_ciudad[llave(F.col("origen"))]) .withColumn("destino_ok", mapa_ciudad[llave(F.col("destino"))]) .withColumn("servicio_ok", mapa_servicio[llave(F.col("servicio"))]) .withColumn("admision", fecha_hora(F.concat_ws(" ", "fecha_admision", "hora_admision"))) .withColumn("entrega", fecha_hora(F.col("fecha_hora_entrega"))) .withColumn("peso_kg", F.regexp_replace("peso_kg", ",", ".").try_cast("double")) .withColumn("distancia_km", F.col("distancia_km").try_cast("int")) .withColumn("valor_declarado", F.col("valor_declarado").try_cast("long")) .withColumn("intentos_entrega", F.col("intentos_entrega").try_cast("int")) .withColumn("operador", F.coalesce(F.col("operador"), F.lit("Sin operador"))) .withColumn("motivos", F.array_compact(F.array(*[F.when(F.expr(c), F.lit(n)) for n, c in REGLAS]))))validada.filter(F.size("motivos") >0).write.mode("overwrite").saveAsTable(f"{ESQ}.cuarentena_envios")DIAS = ["domingo", "lunes", "martes", "miércoles", "jueves", "viernes", "sábado"]PROMESA = F.when(F.col("servicio") =="Express", 24).when(F.col("servicio") =="Estándar", 72).otherwise(120)validos = validada.filter(F.size("motivos") ==0)plata = ( validos.dropDuplicates(["guia"]) .select("guia", "admision", "entrega", F.col("origen_ok").alias("origen"), F.col("destino_ok").alias("destino"),"distancia_km", F.col("servicio_ok").alias("servicio"), "canal", "operador", "peso_kg","valor_declarado", "intentos_entrega", "estado", "archivo_origen") .withColumn("promesa_horas", PROMESA) .withColumn("horas_transito", F.round((F.unix_timestamp("entrega") - F.unix_timestamp("admision")) /3600, 1)) .withColumn("a_tiempo", F.when(F.col("estado") =="entregado", F.col("horas_transito") <= F.col("promesa_horas"))) .withColumn("ruta", F.concat_ws(" - ", "origen", "destino")) .withColumn("mes", F.month("admision")) .withColumn("dia_semana", F.element_at(F.array(*[F.lit(d) for d in DIAS]), F.dayofweek("admision"))) .withColumn("destino_remoto", F.col("destino").isin("Cúcuta", "Montería", "Pasto")))plata.write.mode("overwrite").saveAsTable(f"{ESQ}.plata_envios")filas_bronce = bronce.count()filas_cuarentena = spark.table(f"{ESQ}.cuarentena_envios").count()filas_plata = spark.table(f"{ESQ}.plata_envios").count()duplicados = validos.count() - filas_plataprint(f"Bronce {filas_bronce} = plata {filas_plata} + cuarentena {filas_cuarentena} + duplicados {duplicados}:", filas_bronce == filas_plata + filas_cuarentena + duplicados)
El cuadre da True: 34 239 filas de bronce son 32 064 de plata, 1 855 en cuarentena y 320 duplicados quitados. Son exactamente las cifras del taller de PySpark en el clúster de Docker. El mismo código de transformación, con los cuatro cambios de este capítulo (la sesión, _metadata, saveAsTable y las funciones try_), dio el mismo resultado en otra plataforma.
6.5 Oro y SQL sobre el catálogo
Los indicadores son los del taller: envíos, entregados, porcentaje a tiempo y percentiles de las horas de tránsito, por mes y por servicio. Cada uno queda como una tabla del catálogo con prefijo oro_.
def indicadores(tabla, *por):"""Envíos, entregados, % a tiempo y horas de tránsito por grupo."""return ( tabla.groupBy(*por) .agg(F.count("*").alias("envios"), F.sum((F.col("estado") =="entregado").cast("int")).alias("entregados"), F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo"), F.percentile_approx("horas_transito", 0.5).alias("horas_mediana"), F.percentile_approx("horas_transito", 0.95).alias("horas_p95")) )plata = spark.table(f"{ESQ}.plata_envios")indicadores(plata, "mes").orderBy("mes").write.mode("overwrite").saveAsTable(f"{ESQ}.oro_kpi_mes")indicadores(plata, "servicio", "promesa_horas").orderBy("promesa_horas").write.mode("overwrite").saveAsTable(f"{ESQ}.oro_kpi_servicio")total = plata.agg(F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct")).first()["pct"]print("Cumplimiento total:", total, "%")spark.table(f"{ESQ}.oro_kpi_mes").orderBy("mes").show()spark.table(f"{ESQ}.oro_kpi_servicio").orderBy("promesa_horas").show()
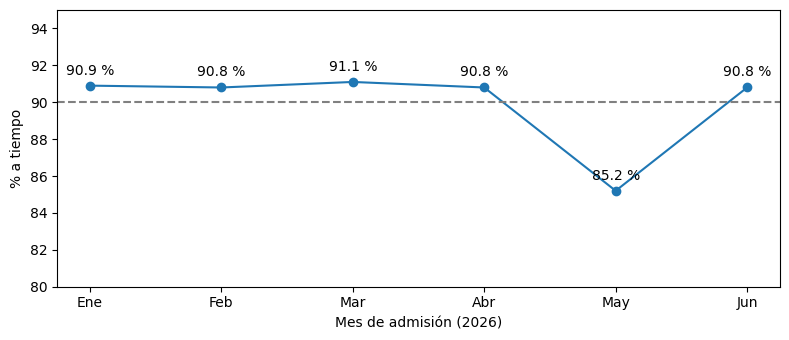
El cumplimiento total es 89.7 %, apenas por debajo de la meta de 90 %, como en el taller. Mayo es el único mes claramente bajo, con 85.2 % y un percentil 95 de 102.9 horas, por la temporada alta del Día de la Madre. Por servicio, Express cumple 78.7 % con un percentil 95 de 37.6 horas frente a una promesa de 24; Estándar 93.2 % y Económico 93.4 %.
Como las tablas viven en el catálogo, cualquier usuario del espacio de trabajo con permiso las consulta por su nombre, desde un notebook, desde el editor de SQL o desde un tablero, sin saber en qué archivos están. En un notebook de Databricks también se puede escribir una celda que empiece con %sql y contenga solo la consulta; aquí se usa spark.sql para que el notebook se lea igual fuera de Databricks.
# 6. Las tablas del catálogo se consultan con SQL desde cualquier notebook, consulta o tablero del espacio de trabajospark.sql(f""" SELECT operador, COUNT(*) AS entregados, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_a_tiempo FROM {ESQ}.plata_envios WHERE estado = 'entregado' AND operador <> 'Sin operador' GROUP BY operador ORDER BY pct_a_tiempo""").show()spark.sql(f"SHOW TABLES IN {ESQ}").filter("NOT isTemporary").select("tableName").show()
OP-C es el operador más bajo, 81.0 %, y OP-A el más alto, 93.6 %: las cifras del taller. SHOW TABLES lista todo lo que hay en el esquema bitlogistica: las cinco tablas del caso, envios_limpios, las dos tablas de los primeros pasos y la vista de la sección 4.
6.6 Delta: historial, MERGE y una versión anterior
Las tablas de Databricks son Delta, así que traen lo que el capítulo de Iceberg obtuvo con un .jar y cuatro opciones de sesión. La celda lee el historial de la plata, guarda el número de la última versión, aplica con MERGE las mismas 300 correcciones del capítulo de Iceberg (entregas de mayo que llegaron 12 horas más tarde) y compara el cumplimiento de mayo antes y después con VERSION AS OF.
# 7. Las tablas de Databricks son Delta: cada escritura queda en el historialhistorial = spark.sql(f"DESCRIBE HISTORY {ESQ}.plata_envios")historial.select("version", "operation", F.col("operationMetrics")["numOutputRows"].alias("filas_escritas")).show()version_antes = historial.agg(F.max("version")).first()[0]# Las mismas 300 correcciones del capítulo de Iceberg: entregas de mayo que llegaron 12 horas más tardecorrecciones = ( spark.table(f"{ESQ}.plata_envios") .filter((F.col("mes") ==5) & (F.col("estado") =="entregado")) .orderBy("guia").limit(300) .withColumn("entrega", F.col("entrega") + F.expr("INTERVAL 12 HOURS")) .withColumn("horas_transito", F.col("horas_transito") +12) .withColumn("a_tiempo", F.col("horas_transito") <= F.col("promesa_horas")))correcciones.createOrReplaceTempView("correcciones")spark.sql(f""" MERGE INTO {ESQ}.plata_envios AS t USING correcciones AS s ON t.guia = s.guia WHEN MATCHED THEN UPDATE SET t.entrega = s.entrega, t.horas_transito = s.horas_transito, t.a_tiempo = s.a_tiempo""").show()mayo ="SELECT ROUND(100 * AVG(CAST(a_tiempo AS INT)), 2) AS pct FROM {tabla} WHERE mes = 5"ahora = spark.sql(mayo.format(tabla=f"{ESQ}.plata_envios")).first()["pct"]antes = spark.sql(mayo.format(tabla=f"{ESQ}.plata_envios VERSION AS OF {version_antes}")).first()["pct"]print(f"Mayo a tiempo: {ahora} % ahora | {antes} % en la versión {version_antes}")
+-------+--------------------+--------------+
|version|           operation|filas_escritas|
+-------+--------------------+--------------+
|      6|CREATE OR REPLACE...|         32064|
|      5|               MERGE|           300|
|      4|CREATE OR REPLACE...|         32064|
|      3|               MERGE|           300|
|      2|CREATE OR REPLACE...|         32064|
|      1|               MERGE|           300|
|      0|CREATE OR REPLACE...|         32064|
+-------+--------------------+--------------+

+-----------------+----------------+----------------+-----------------+
|num_affected_rows|num_updated_rows|num_deleted_rows|num_inserted_rows|
+-----------------+----------------+----------------+-----------------+
|              300|             300|               0|                0|
+-----------------+----------------+----------------+-----------------+

Mayo a tiempo: 84.14 % ahora | 85.16 % en la versión 6
El historial muestra la escritura de la plata con sus 32 064 filas. El MERGE informó 300 filas actualizadas y ninguna insertada ni borrada. El cumplimiento de mayo bajó de 85.16 % a 84.14 % con las correcciones, y la versión anterior, consultada con VERSION AS OF, sigue dando el valor de antes: es el mismo viaje en el tiempo del capítulo de Iceberg, con la sintaxis de Delta. Si ejecutas el notebook más de una vez, el historial crece, porque cada saveAsTable con overwrite es una versión nueva de la misma tabla; la celda compara siempre contra la versión anterior al MERGE.
6.7 El gráfico, como en el taller
Los resultados pequeños se pasan a pandas con toPandas y se grafican con matplotlib, igual que en el clúster. Databricks tiene además su propia función display(df), que muestra una tabla interactiva con un botón para crear gráficos sin código; es cómoda para explorar, pero el libro usa matplotlib para que la figura sea la misma en cualquier entorno.
serie = spark.table(f"{ESQ}.oro_kpi_mes").orderBy("mes").toPandas()figura, eje = plt.subplots(figsize=(8, 3.5))eje.plot(serie["mes"], serie["pct_a_tiempo"], marker="o")for mes, valor inzip(serie["mes"], serie["pct_a_tiempo"]): eje.annotate(f"{valor:.1f} %", (mes, valor), textcoords="offset points", xytext=(0, 8), ha="center")eje.axhline(90, linestyle="--", color="gray")eje.set_xticks(serie["mes"], ["Ene", "Feb", "Mar", "Abr", "May", "Jun"])eje.set_ylim(80, 95)eje.set_xlabel("Mes de admisión (2026)")eje.set_ylabel("% a tiempo")plt.tight_layout()plt.show()
Figura 27.1: Porcentaje de envíos entregados a tiempo por mes, calculado en Databricks, frente a la meta del 90 %
La figura repite la del taller de PySpark: todos los meses alrededor de 91 %, salvo mayo, por debajo de la meta.
7. Programar el notebook como trabajo
En el capítulo de Airflow, un DAG lanzaba cada noche los trabajos de Spark con spark-submit y el orquestador vivía en otro contenedor. En Databricks, la pieza equivalente son los trabajos (Lakeflow Jobs): un trabajo ejecuta uno o varios notebooks, en orden, con un calendario, reintentos y avisos. No hay que instalar nada.
Para programar este notebook:
Arriba a la derecha del notebook, elige Schedule (o, en la barra lateral, Jobs & Pipelines y luego Create job).
Elige la frecuencia, por ejemplo todos los días a las 23:00 en tu zona horaria, y el cómputo Serverless.
Guarda. El trabajo aparece en Jobs & Pipelines, con el historial de cada ejecución, su duración y su salida.
Un trabajo puede tener varias tareas con dependencias, como el DAG del capítulo de Airflow: una para el bronce, otra para la plata que espera a la primera, y otra para el oro. Free Edition permite hasta cinco tareas de trabajos corriendo a la vez por cuenta. Airflow sigue teniendo sentido cuando el pipeline cruza varios sistemas (una base de datos, Kafka, un servicio externo y Databricks); para un pipeline que vive dentro de Databricks, los trabajos nativos bastan.
8. Clúster propio frente a Databricks
Lo que cambió en el código para pasar el pipeline del clúster a Databricks cabe en una tabla:
En el clúster del libro
En Databricks serverless
Por qué
SparkSession.builder…getOrCreate()
spark, ya creada
La plataforma crea la sesión
spark.sparkContext y sc.setLogLevel
No existen
Spark Connect: el motor no está en el proceso del notebook
hdfs://namenode:9000/bitlogistica/landing
/Volumes/workspace/bitlogistica/archivos/landing
Los archivos viven en un volumen del catálogo
hdfs dfs -put desde Python
Escribir en /Volumes/… con Python
El volumen se usa como una carpeta
input_file_name()
_metadata.file_path
Unity Catalog no admite la función antigua
cast y to_timestamp
try_cast y try_to_timestamp
Modo ANSI activado
write.parquet(ruta)
write.saveAsTable("catálogo.esquema.tabla")
Tablas Delta administradas por el catálogo
Spark UI en localhost:4040
Perfil de consulta
No hay Spark UI en serverless
Todo lo demás, que es casi todo el código, quedó igual: groupBy, agg, when, create_map, dropDuplicates, percentile_approx, unionByName, Spark SQL, pandas y matplotlib. Esa es la promesa de aprender Spark sobre un clúster propio: lo que se entiende ahí sirve en cualquier plataforma.
Lo que no se ve en el código es lo que más cambia:
Pregunta
Clúster del libro
Databricks
¿Cuánto tarda en estar listo?
Minutos: encender en orden, esperar HDFS y YARN
Segundos: elegir Serverless
¿Qué pasa si los datos crecen 1 000 veces?
Comprar máquinas y reconfigurar
El servicio usa más cómputo; se paga más
¿Quién arregla un nodo caído?
Tú
El proveedor
¿Cuánto cuesta en reposo?
Las máquinas, encendidas o no
Solo el almacenamiento
¿Cuánto control tienes?
Total: versiones, memoria, .jar, Java
El que permita la plataforma
¿Qué aprendes?
Cómo funciona cada pieza por dentro
Cómo se usa una plataforma de trabajo real
La dependencia de un proveedor es el costo menos visible. Los datos en Delta o Iceberg y el código en PySpark se pueden llevar a otra plataforma; los trabajos, los permisos del catálogo y las integraciones propias de cada servicio, mucho menos.
Limpiar
La celda lista lo que el capítulo dejó en tu espacio de trabajo. No borra nada: las tablas ocupan poco y sirven para los ejercicios. Para borrar todo el esquema, con sus tablas y su volumen, ejecuta en una celda spark.sql("DROP SCHEMA workspace.bitlogistica CASCADE"). El cómputo serverless se apaga solo cuando dejas de usarlo.
# 8. Lo que quedó en el catálogo: las tablas Delta, la vista y el volumen# isTemporary deja fuera la vista temporal correcciones del MERGE: no es una tabla del catálogofor fila in spark.sql(f"SHOW TABLES IN {ESQ}").filter("NOT isTemporary").orderBy("tableName").collect():print(f"{ESQ}.{fila['tableName']}: {spark.table(f'{ESQ}.{fila.tableName}').count()} filas")print("Archivos en el volumen:", sorted(os.listdir(VOLUMEN)))
Quedan ocho tablas Delta: las dos de los primeros pasos (tarifas y demo_envios), envios_limpios de la sección 4 y las cinco del caso (bronce con 34 239 filas, cuarentena con 1 855, plata con 32 064 y las dos de oro). También quedan la vista de la sección 4 y el volumen con el generador y las carpetas landing y primeros_pasos. Las ejecuciones de MLflow quedan en el experimento bitlogistica_envios_tarde de tu carpeta de usuario.
Práctica
Haz estos ejercicios en el mismo notebook de Databricks, después de ejecutarlo completo. Están en tres niveles: los del nivel 1 usan solo lo de los diez primeros pasos; los del nivel 2, las secciones de Spark SQL y MLlib; los del nivel 3, el caso completo.
Nivel 1: primeros pasos
Filtrar y ordenar. Con el DataFrame envios del paso 2, muestra los envíos de más de 2 kg, ordenados del más pesado al más liviano.
Una columna con condición. Agrega a envios una columna pesado que diga "sí" cuando el peso es de 5 kg o más y "no" en otro caso, y cuenta cuántos envíos hay de cada tipo.
Agrupar con SQL. Sobre la vista envios_demo del paso 6, escribe una consulta SQL que dé, por ciudad de origen, cuántos envíos salen y su peso promedio.
Explorar los taxis. Con la tabla samples.nyctaxi.trips del paso 8, calcula cuántos viajes tienen más de 10 millas y cuál es su tarifa promedio, y compárala con la tarifa promedio de todos los viajes.
Borrar y volver. En la tabla demo_envios del paso 10, borra el envío devuelto con DELETE FROM … WHERE estado = 'devuelto', mira el historial y cuenta las filas de la versión actual y de la anterior.
Nivel 2: Spark SQL y MLlib
El ingreso mes a mes. Sobre la consulta 3 de la sección 4, usa LAG para calcular, por servicio, cuánto cambió el ingreso estimado frente al mes anterior, y di en qué mes cayó más cada servicio.
Una vista de riesgo. Crea la vista workspace.bitlogistica.vista_riesgo_ruta con las rutas de 50 entregas o más y su porcentaje de envíos tarde, y consulta las que pasan de 25 %.
Otra variable. Agrega al modelo logístico del ejemplo 2 de la sección 5 la hora de admisión (F.hour("admision")) como variable numérica y compara el AUC de junio con el anterior.
Otro umbral. Cambia el umbral de alerta del ejemplo 2 a 0.1 y a 0.3. Para cada uno, anota cuántos envíos se marcan y qué porcentaje de ellos llegó tarde, y explica qué umbral elegirías si servicio al cliente solo puede revisar 500 envíos al mes.
La regresión en MLflow. Registra el modelo de regresión del ejemplo 4 como una ejecución regresion_horas con su RMSE y su MAE, y búscala con mlflow.search_runs.
Nivel 3: el caso completo
Una tabla de oro más. Crea oro_kpi_canal con los indicadores por canal y mes, y encuentra el canal y el mes con peor cumplimiento.
Una vista para el negocio. Crea con SQL una vista workspace.bitlogistica.envios_tarde con los envíos entregados fuera de plazo y consúltala desde el editor de SQL de Databricks (SQL Editor en la barra lateral).
Deshacer el MERGE. Usa RESTORE TABLE workspace.bitlogistica.plata_envios TO VERSION AS OF <versión> para volver a la versión anterior a las correcciones, y comprueba el cumplimiento de mayo y el historial.
Un trabajo de dos tareas. Divide el notebook en dos: uno que construye bronce y plata, y otro que construye el oro. Crea un trabajo con dos tareas, la segunda dependiente de la primera, y ejecútalo a mano.
El perfil de consulta. Ejecuta la consulta de operadores de la sección 6.5, abre su perfil de consulta (el enlace que aparece bajo la salida de la celda) y busca cuántas filas leyó y cuánto tiempo tardó.
Lo que no funciona. Intenta spark.sparkContext.parallelize([1, 2, 3]) y bronce.rdd.count(). Anota los errores y escribe cómo lo resolverías con la API de DataFrames.
TipOrientaciones
envios.filter(F.col("peso_kg") > 2).orderBy(F.desc("peso_kg")).show(). Quedan cuatro envíos: BL-0004 (15 kg), BL-0002 (8 kg), BL-0005 (3.3 kg) y BL-0001 (2.5 kg).
envios.withColumn("pesado", F.when(F.col("peso_kg") >= 5, "sí").otherwise("no")).groupBy("pesado").count().show(). Hay 2 envíos pesados, BL-0002 y BL-0004, y 4 que no lo son.
SELECT origen, COUNT(*) AS envios, ROUND(AVG(peso_kg), 2) AS peso_promedio FROM envios_demo GROUP BY origen ORDER BY envios DESC. Bogotá tiene 3 envíos con 3.77 kg de promedio; Medellín, Cali y Barranquilla, uno cada una.
taxis.filter("trip_distance > 10").agg(F.count("*"), F.avg("fare_amount")) y lo mismo sin el filtro. Los viajes largos son pocos, pero su tarifa promedio es varias veces la del total: la distancia es lo que más pesa en la tarifa.
spark.sql(f"DELETE FROM {DEMO} WHERE estado = 'devuelto'"). El historial agrega una fila con la operación DELETE; la versión actual tiene 5 filas y la anterior 6. Como en el paso 10, borrar crea una versión nueva y la anterior sigue consultable con VERSION AS OF.
Envuelve la consulta 3 en un WITH ingreso AS (...) y calcula ingreso_estimado - LAG(ingreso_estimado) OVER (PARTITION BY servicio ORDER BY mes). Los tres servicios caen más en junio, después del pico de mayo; en Estándar, la caída es de 5 814 000 pesos.
La vista es la consulta 1 con ROUND(100 - 100 * AVG(CAST(a_tiempo AS INT)), 1) AS pct_tarde y sin LIMIT. Quedan las rutas que en la consulta 1 tenían menos de 75 % a tiempo, encabezadas por Barranquilla - Pasto.
Agrega .withColumn("hora", F.hour("admision").cast("double")) a datos y "hora" a NUMERICAS, y vuelve a ejecutar el ejemplo 2. El AUC queda prácticamente igual, en 0.801: la hora de admisión no ayuda a predecir el retraso en estos datos. Agregar variables no siempre mejora un modelo.
Con 0.1 se marcan unos 1 800 envíos y algo más del 21 % llega tarde; con 0.3, unos 410 y cerca del 34 %. Subir el umbral marca menos envíos, pero con más aciertos. Si solo se pueden revisar 500, conviene el umbral de 0.3.
Dentro de with mlflow.start_run(run_name="regresion_horas"):, usa mlflow.log_param("modelo", "LinearRegression") y mlflow.log_metric con el RegressionEvaluator del ejemplo 4. La ejecución aparece en la misma lista que las dos clasificaciones, con métricas distintas.
indicadores(plata, "canal", "mes").orderBy("pct_a_tiempo"), guardado con saveAsTable. El canal web es el de peor cumplimiento todos los meses, y su peor mes es mayo, el mismo que marcó el gráfico de la sección 6.7.
CREATE OR REPLACE VIEW workspace.bitlogistica.envios_tarde AS SELECT * FROM workspace.bitlogistica.plata_envios WHERE estado = 'entregado' AND NOT a_tiempo. La vista no copia datos: guarda la consulta en el catálogo.
RESTORE crea una versión nueva cuyo contenido es el de la versión pedida; el historial no se borra. El cumplimiento de mayo vuelve al valor anterior al MERGE.
En Jobs & Pipelines, crea el trabajo con la primera tarea (tipo Notebook) y agrega la segunda con Depends on apuntando a la primera. Es el mismo grafo del capítulo de Airflow, sin sensor.
El perfil muestra el plan como un grafo con las filas y el tiempo de cada operador. La lectura de la plata es de 32 064 filas; el tiempo depende de la carga del servicio.
Los dos fallan porque Spark Connect no expone el contexto ni la API de RDD. spark.range(1, 4) o spark.createDataFrame([(1,), (2,), (3,)], ["n"]) reemplazan a parallelize, y bronce.count() reemplaza a bronce.rdd.count().
Errores frecuentes
Síntoma
Causa
Arreglo
AssertionError: Sube generar_envios.py al volumen
El generador no está en el volumen archivos, o quedó en otra carpeta.
Subirlo con Upload to this volume en el volumen, no en una subcarpeta.
[CAST_INVALID_INPUT] o [CANNOT_PARSE_TIMESTAMP]
cast o to_timestamp con modo ANSI sobre un valor mal escrito.
Usar try_cast y try_to_timestamp.
Error al usar input_file_name()
Código del clúster sin adaptar: Unity Catalog no la admite.
Usar _metadata.file_path.
[JVM_ATTRIBUTE_NOT_SUPPORTED] o error al usar sparkContext
Spark Connect no expone el contexto.
Quitar sc; usar la API de DataFrames.
[SCHEMA_NOT_FOUND]
No se ejecutó la celda que crea el esquema, o se cambió el catálogo.
Ejecutar el paso 9 o la sección 4.
La celda no se ejecuta y pide elegir un cómputo
El notebook no está conectado.
Elegir Serverless en el selector de cómputo, arriba a la derecha.
[UNRESOLVED_COLUMN]
Un nombre de columna mal escrito, o una columna que se creó en otro paso.
Revisar el nombre con printSchema() y ejecutar los pasos en orden.
[TABLE_OR_VIEW_NOT_FOUND] con envios_demo
La vista temporal se perdió al reiniciar la sesión.
Ejecutar otra vez los pasos 2 a 6.
NameError: name 'display' is not defined
El notebook se ejecuta fuera de Databricks.
Usar show(); display() solo existe en Databricks.
El cómputo no arranca y avisa de un límite de uso
Se superó la cuota diaria de Free Edition.
Esperar al día siguiente; los datos no se pierden.
MERGE falla con varias coincidencias
El origen tiene la misma guía dos veces.
Quitar duplicados del origen antes del MERGE.
[TABLE_OR_VIEW_NOT_FOUND] con envios_limpios
No se ejecutó la celda que prepara los datos.
Ejecutar la primera celda de la sección 4.
[TABLE_OR_VIEW_NOT_FOUND] con tarifas en la consulta 3
No se ejecutaron los primeros pasos.
Ejecutar la celda del paso 9.
[NOT_SUPPORTED_WITH_DB_SQL] o error de sintaxis cerca de QUALIFY
La consulta se ejecutó en un motor que no admite QUALIFY.
Filtrar el puesto en una consulta externa: SELECT * FROM (...) WHERE puesto = 1.
IllegalArgumentException en VectorAssembler por valores nulos
Una variable de entrada tiene filas con NULL.
Filtrar esas filas o crear el ensamblador con handleInvalid="skip".
RESOURCE_DOES_NOT_EXIST en MLflow: el experimento está en estado deleted
La sesión apunta a un experimento borrado, por ejemplo el de un notebook que se eliminó.
Elegir el experimento con mlflow.set_experiment, como en el ejemplo 5, o reiniciar la sesión desde el selector de cómputo.
Error de tamaño de modelo al entrenar
El cómputo serverless de Free Edition admite hasta 100 MB por modelo y 1 GB por sesión.
Bajar numTrees o maxDepth, o reiniciar la sesión desde el selector de cómputo.
Preguntas de comprensión
¿Por qué el diseño original de Hadoop unía almacenamiento y cómputo, y por qué la nube los separa?
¿Qué operaciones son baratas en HDFS y caras en un almacenamiento de objetos, y cómo ayudan Delta e Iceberg?
¿Qué diferencia hay entre un servicio gestionado y el cómputo serverless desde el punto de vista de quien escribe el código?
¿Por qué el mismo pipeline dio 32 064 filas en los dos entornos, si cambiaron cuatro cosas del código?
¿Cuándo convendría seguir con un clúster propio en lugar de una plataforma en la nube?
¿Por qué el modelo de los envíos tardíos se evalúa con junio y no con una muestra al azar de los seis meses, y por qué con el AUC y no con el porcentaje de aciertos?
TipOrientaciones
En 2006, mover terabytes por la red era más lento y caro que procesarlos en el disco donde estaban, así que Hadoop llevó el cómputo a los datos. Hoy la red de los proveedores es rápida y el almacenamiento de objetos es barato y duradero; separar permite encender cómputo solo cuando hay trabajo, escalarlo por separado y compartir los mismos datos entre varios clústeres.
Renombrar carpetas y listar muchos archivos, que en HDFS son operaciones de metadatos en el NameNode y sobre objetos son copias y llamadas paginadas a la API. Delta e Iceberg guardan la lista de archivos de cada versión en sus metadatos, así que leer una tabla no necesita listar carpetas y confirmar una escritura no necesita renombrar nada.
En un servicio gestionado, quien escribe el código también decide el tamaño del clúster, la versión y la memoria de los executors. En serverless solo envía el código y el servicio decide el resto; a cambio pierde control sobre la configuración y sobre las piezas que dependen del motor, como sparkContext.
Porque los cuatro cambios no tocan la lógica: dónde está la sesión, cómo se llama la columna del archivo de origen, cómo se guarda una tabla y qué función tolera valores mal escritos. Las reglas, las correcciones y las agregaciones son las mismas, y los datos también, porque el generador usa la misma semilla.
Cuando el volumen es estable y alto todo el tiempo, y el costo de máquinas propias es menor que el de pagar cómputo por uso; cuando hay reglas que obligan a mantener los datos en instalaciones propias; o cuando se necesita un control de versiones y configuración que la plataforma no permite. Para aprender cómo funciona Spark por dentro, el clúster propio también es mejor: por eso el libro lo construyó.
Porque el modelo se usará con envíos futuros: entrenar con enero a mayo y medir con junio simula ese uso, y una muestra al azar dejaría al modelo aprender de días vecinos a los de prueba. El porcentaje de aciertos engaña cuando solo 1 de cada 10 envíos llega tarde: decir siempre «a tiempo» acierta el 90 % sin servir. El AUC mide si el modelo ordena bien los envíos por riesgo, que es lo que usa la alerta.
Glosario
Término
Significado en este capítulo
Almacenamiento de objetos
Servicio que guarda archivos por nombre en contenedores y se usa por una API, como S3, GCS o ADLS.
Separar cómputo y almacenamiento
Guardar los datos en un servicio y encender el cómputo solo cuando hay trabajo.
Clúster efímero
Clúster que se crea para un trabajo y se apaga al terminar.
Servicio gestionado
Servicio que crea y administra el clúster de Spark por ti.
Serverless
Cómputo en el que el servicio decide el tamaño, lo enciende y lo apaga.
Databricks Free Edition
Versión gratuita y permanente de Databricks para aprender, solo con cómputo serverless.
DataFrame
Tabla con columnas de nombre y tipo conocidos, repartida entre las máquinas del cómputo.
Vista temporal
Nombre que apunta a un DataFrame durante la sesión, para consultarlo con SQL.
display
Función de Databricks que muestra un DataFrame como tabla interactiva y permite graficarlo.
Catálogo samples
Catálogo de solo lectura con tablas de ejemplo que traen los espacios de trabajo de Databricks.
Espacio de trabajo
Sitio de Databricks donde viven notebooks, consultas y trabajos.
Unity Catalog
Catálogo de Databricks con tres niveles (catálogo, esquema, tabla) y permisos.
Volumen
Carpeta de archivos dentro de un esquema de Unity Catalog.
Tabla administrada
Tabla cuyos archivos ubica y administra el catálogo.
Delta Lake
Formato de tabla de Databricks, con historial, transacciones y MERGE.
Spark Connect
Forma de usar Spark en la que el cliente envía planes a un servidor remoto.
Modo ANSI
Comportamiento de Spark SQL que convierte en error las conversiones inválidas.
_metadata
Columna oculta con datos del archivo de origen de cada fila.
Trabajo (job)
Ejecución programada de uno o varios notebooks en Databricks.
Perfil de consulta
Vista de Databricks con el plan, las filas y el tiempo de cada paso de una consulta.
Función de ventana
Función de SQL que calcula un valor para cada fila mirando otras filas de su grupo, como RANK o LAG.
QUALIFY
Cláusula de Databricks SQL que filtra filas por el resultado de una función de ventana.
Vista del catálogo
Consulta guardada con nombre en Unity Catalog; se calcula con los datos del momento en que se usa.
MLlib
Librería de aprendizaje automático de Spark.
Variable objetivo
Lo que el modelo aprende a predecir; aquí, si un envío llega tarde o cuántas horas tarda.
Pipeline
Secuencia de pasos de preparación y un modelo que se entrenan juntos y se aplican igual a datos nuevos.
StringIndexer y OneHotEncoder
Pasos de MLlib que convierten una columna de texto en números y luego en un vector de ceros y unos.
VectorAssembler
Paso de MLlib que junta las variables de entrada en una sola columna de tipo vector.
Regresión logística
Modelo de clasificación que calcula la probabilidad de que algo ocurra.
Bosque aleatorio
Modelo que promedia muchos árboles de decisión entrenados con partes distintas de los datos.
AUC
Área bajo la curva ROC: mide qué tan bien ordena un clasificador; 0.5 es azar y 1.0 es perfecto.
RMSE, MAE y R²
Métricas de regresión: dos errores en las unidades de la variable y la parte de la variación explicada.
MLflow
Herramienta para registrar y comparar ejecuciones de aprendizaje automático, integrada en Databricks.
Ejecución (run)
Registro de MLflow de un entrenamiento, con sus parámetros y sus métricas.
Llevaste PySpark del clúster de Docker a Databricks Free Edition. La nube separa el almacenamiento, que vive en un servicio de objetos, del cómputo, que en serverless se enciende solo cuando hay trabajo y lo administra el proveedor. Diez pasos guiados te mostraron el notebook de Databricks con seis envíos escritos a mano: la sesión ya lista, DataFrames, filtros, columnas nuevas, agrupaciones, SQL, display, la tabla de ejemplo de taxis, tu primera tabla en el catálogo y una tabla Delta con su historial.
Con los seis meses de envíos de BITLogística sin errores, cinco consultas de Spark SQL respondieron preguntas de negocio: las peores rutas, el efecto del peso, el ingreso estimado, el puesto de cada operador con funciones de ventana y una vista del catálogo para el equipo de negocio. Con MLlib entrenaste modelos para predecir qué envíos llegarán tarde y cuántas horas tardarán, y MLflow guardó sus resultados para compararlos.
El caso completo llevó el pipeline del taller de PySpark, con los archivos sucios, a Databricks. El código de transformación funcionó con cuatro cambios: la sesión ya creada, _metadata.file_path en lugar de input_file_name, saveAsTable en lugar de rutas Parquet, y try_cast y try_to_timestamp por el modo ANSI. El resultado fue idéntico al del clúster: 34 239 filas de bronce, 32 064 de plata, 1 855 en cuarentena y 89.7 % a tiempo. Las tablas Delta trajeron sin configuración el historial, el MERGE y el viaje en el tiempo del capítulo de Iceberg, y un trabajo de Databricks puede programar el notebook como lo hacía el DAG de Airflow.
El capítulo siguiente, Seguridad, gobierno y operación, trata lo que una plataforma como esta tiene que resolver antes de llevar datos reales: quién puede leer qué, cómo se protegen los datos personales y cómo se audita cada acceso.