24Lakehouse con Apache Iceberg: tablas con transacciones sobre el data lake
big-data
ingenieria-datos
iceberg
lakehouse
spark
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
8 de noviembre de 2026
El problema que vas a resolver
El pipeline de ingesta de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) funciona, pero el capítulo de ingesta terminó con una lista de cosas que los archivos Parquet simples no resuelven. Para corregir unas pocas filas hay que reescribir fechas completas. Si una escritura falla a la mitad, la tabla puede quedar con una parte nueva y otra vieja. No hay forma de ver la tabla como estaba ayer, ni de deshacer un DELETE equivocado. Agregar una columna obliga a que todos los lectores sepan pedir mergeSchema.
Este capítulo resuelve esa lista con Apache Iceberg, un formato de tabla abierto que funciona sobre los mismos archivos Parquet y el mismo HDFS, sin servidores nuevos. Con los envíos de BITLogística, la tabla recibe junio y 300 correcciones de mayo en una sola operación, se consulta como estaba antes, sobrevive a un lote dañado, recupera un borrado por error y cambia de esquema y de partición sin reescribir el pasado.
Ficha
En este capítulo
Pregunta
¿Cómo se consigue sobre un data lake lo que da una base de datos: actualizar filas, transacciones, historial y cambios de esquema seguros?
Datos
La plata del taller de PySpark: 26 566 envíos de enero a mayo para crear la tabla, y junio más 300 correcciones como lote nuevo
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_iceberg.ipynb dentro de talleres-notebooks.zip. Necesita la capa /bitlogistica/plata del taller de PySpark.
Iceberg no viene incluido en Spark: es una librería de unos 40 MB que se descarga una vez. El capítulo usa la versión 1.6.1, la última que funciona con Java 8: el cliente de Spark corre con Java 11, pero los executors corren en los NodeManagers, que usan Java 8, y las versiones 1.7 en adelante exigen Java 11. Desde la terminal de Ubuntu, en tu equipo:
Salida esperada: un archivo iceberg-spark-runtime-3.5_2.12-1.6.1.jar de unos 40 MB. La carpeta notebooks es la que spark-client ve como /opt/spark/work-dir, así que el notebook encuentra el archivo en jars/. El nombre dice para qué versiones sirve: Spark 3.5, Scala 2.12 e Iceberg 1.6.1.
La tabla vive en /bitlogistica/lakehouse y ocupa menos de 2 MB. Se conserva al final para los capítulos siguientes; la primera celda la borra si existe, para que el notebook empiece siempre desde cero.
1. Formato de archivo, formato de tabla y lakehouse
NotaFormato de tabla
Un formato de archivo, como Parquet, dice cómo se guardan las filas dentro de un archivo. Un formato de tabla, como Apache Iceberg, dice qué archivos forman la tabla en cada momento. Lo hace con un registro aparte, los metadatos: la lista de archivos de datos, el esquema, la forma de particionar y el historial de cambios. Una carpeta con archivos Parquet es una tabla solo por convención; con Iceberg, la tabla es lo que dicen sus metadatos, aunque en la carpeta haya otros archivos.
NotaInstantánea
Una instantánea (snapshot) es el estado completo de la tabla después de una escritura: la lista exacta de archivos de datos que la forman en ese momento. Cada escritura crea una instantánea nueva y no modifica las anteriores. La tabla «actual» es la instantánea a la que apunta el catálogo.
NotaLakehouse
Un lakehouse es un data lake que, gracias a un formato de tabla, ofrece lo que antes solo daba una bodega de datos: transacciones, actualizaciones de filas, esquema controlado e historial. Los datos siguen siendo archivos abiertos en almacenamiento barato (HDFS o un almacenamiento de objetos) y cualquier motor que entienda el formato puede leerlos: Spark, Trino, Flink o pandas.
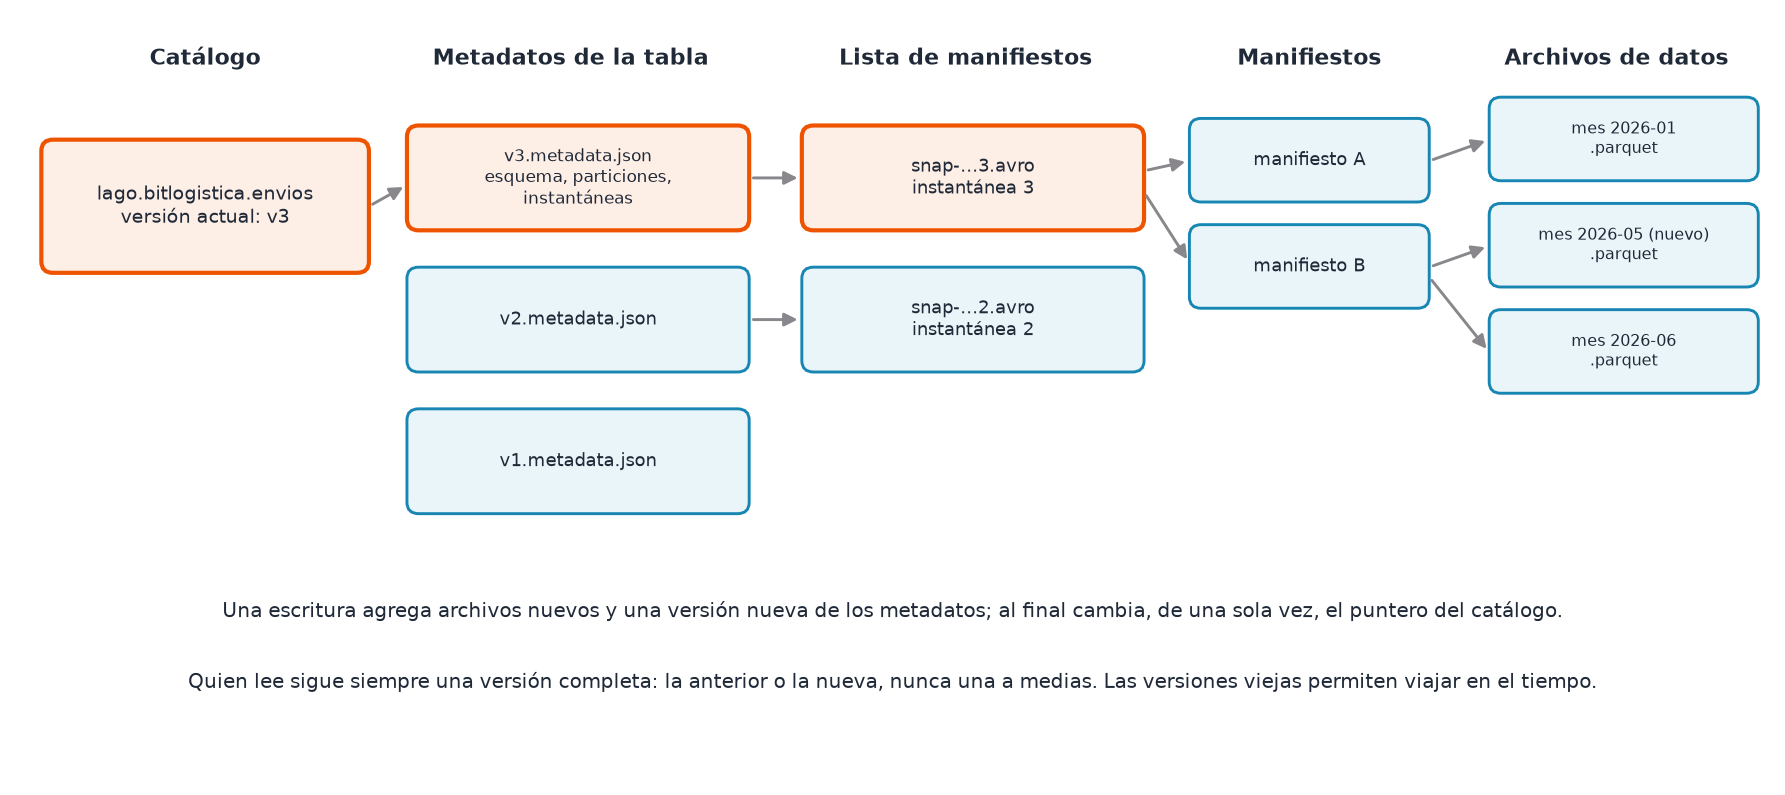
Cómo encuentra Iceberg los archivos de una tabla.
La figura muestra el camino de una lectura: el catálogo apunta al archivo de metadatos vigente; ese archivo nombra la instantánea actual; la instantánea tiene una lista de manifiestos, y cada manifiesto lista archivos de datos con estadísticas por columna (mínimos, máximos, nulos). Una escritura nunca toca archivos existentes: escribe archivos nuevos y una versión nueva de los metadatos, y al final cambia el puntero. Ese último paso es atómico. De ahí salen las transacciones y el viaje en el tiempo de este capítulo.
Iceberg no es el único formato de tabla. Delta Lake y Apache Hudi resuelven lo mismo con diseños parecidos. El libro usa Iceberg porque es independiente de un proveedor, funciona con Spark 3.5 con un solo .jar y no necesita servicios nuevos en el clúster.
2. La sesión con un catálogo Iceberg
La sesión agrega cuatro opciones a las de siempre:
spark.jars apunta al .jar de Iceberg. El driver lo carga y YARN lo copia a los executors.
spark.sql.extensions agrega a Spark SQL las instrucciones de Iceberg: MERGE INTO, CALL para los procedimientos de mantenimiento y los ALTER TABLE de particiones.
spark.sql.catalog.lago crea un catálogo llamado lago, con tipo hadoop: guarda el registro de tablas como archivos en HDFS, bajo la carpeta warehouse, sin metastore ni servicio aparte. En producción se usan catálogos con servidor (Hive Metastore, un catálogo REST o el de la nube) para que varios motores compartan las tablas; el tipo hadoop basta para un solo clúster.
Las tablas de este catálogo se nombran con tres partes: lago.bitlogistica.envios es la tabla envios del espacio de nombres bitlogistica del catálogo lago.
# 1. Librerías del notebookimport datetimeimport osimport platformimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as F# 2. Rutas: la plata del taller de PySpark y la bodega de tablas IcebergBASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"LAGO = BASE +"/lakehouse"# aquí vivirán los datos y metadatos de las tablas Iceberg# 3. El .jar de Iceberg: se descargó una vez en notebooks/jars (ver «Antes de empezar»)JAR = os.path.abspath("jars/iceberg-spark-runtime-3.5_2.12-1.6.1.jar")assert os.path.isfile(JAR), "Falta el .jar de Iceberg en notebooks/jars: revisa «Antes de empezar»"# 4. La sesión: cuatro opciones agregan Iceberg a Sparkspark = ( SparkSession.builder .appName("lakehouse-iceberg") .config("spark.ui.showConsoleProgress", "false") .config("spark.jars", JAR) # el driver lo carga y YARN lo reparte .config("spark.sql.extensions", # habilita MERGE, CALL y ALTER de Iceberg"org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions") .config("spark.sql.catalog.lago", "org.apache.iceberg.spark.SparkCatalog") # un catálogo llamado «lago» .config("spark.sql.catalog.lago.type", "hadoop") # que guarda su registro en archivos de HDFS .config("spark.sql.catalog.lago.warehouse", LAGO) # bajo esta carpeta .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"# 5. Borrar la bodega de una ejecución anterior, para empezar siempre desde ceroPath = spark._jvm.org.apache.hadoop.fs.PathCONF = sc._jsc.hadoopConfiguration()carpeta = Path(LAGO)print("Bodega de una ejecución anterior borrada:", carpeta.getFileSystem(CONF).delete(carpeta, True))print("Python", platform.python_version(), "| Spark", spark.version, "| master:", sc.master)print("Catálogo lago:", spark.conf.get("spark.sql.catalog.lago.type"), "en", spark.conf.get("spark.sql.catalog.lago.warehouse"))
26/11/08 05:01:49 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/11/08 05:01:50 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
Bodega de una ejecución anterior borrada: True
Python 3.11.10 | Spark 3.5.3 | master: yarn
Catálogo lago: hadoop en hdfs://namenode:9000/bitlogistica/lakehouse
La sesión quedó en YARN con el catálogo lago de tipo hadoop sobre /bitlogistica/lakehouse. La primera línea dice True si había una bodega de una ejecución anterior y la borró.
3. Crear la tabla con partición oculta
NotaPartición oculta
En el capítulo de almacenamiento, particionar por mes obligó a crear una columna mes y a filtrar por ella: quien consultaba con admision no aprovechaba la partición. Iceberg particiona con una transformación de una columna existente, como months(admision) o days(admision), y la guarda en los metadatos. Quien consulta filtra por admision, como pensaría cualquiera, e Iceberg traduce el filtro a particiones. Por eso se llama partición oculta: el lector no necesita conocerla.
La celda crea lago.bitlogistica.envios con los envíos de enero a mayo, particionada por el mes de admision. La columna mes de la plata se deja fuera, porque Iceberg la deriva. writeTo(...).create() es la forma de crear una tabla con la API de DataFrames; el equivalente en SQL es CREATE TABLE … USING iceberg PARTITIONED BY (months(admision)).
# 1. Un espacio de nombres (como una base de datos) dentro del catálogospark.sql("CREATE NAMESPACE IF NOT EXISTS lago.bitlogistica")TABLA ="lago.bitlogistica.envios"# 2. La plata de enero a mayo; «mes» sobra porque Iceberg la deriva de «admision»plata = spark.read.parquet(PLATA)enero_mayo = plata.filter(F.col("mes") <=5).drop("mes")# 3. Crear la tabla particionada por el MES de la fecha de admisión (partición oculta)enero_mayo.writeTo(TABLA).partitionedBy(F.months("admision")).create()# 4. Lo que quedó: filas y una fila por partición, desde las tablas de metadatos de Icebergprint("Filas en la tabla:", spark.table(TABLA).count())spark.sql(f"SELECT partition, record_count, file_count FROM {TABLA}.partitions ORDER BY partition").show()
La tabla tiene 26 566 envíos en cinco particiones, una por mes, con un archivo de datos cada una. La partición aparece como un número: {672} es enero de 2026, porque months cuenta los meses desde enero de 1970. Mayo, {676}, es la más grande, con 6 519 envíos, la temporada alta del taller de PySpark.
La celda siguiente recorre la carpeta de la tabla en HDFS para ver qué escribió Iceberg.
# 1. Recorrer la carpeta de la tabla en HDFS y clasificar cada archivoraiz = Path(LAGO +"/bitlogistica/envios")iterador = raiz.getFileSystem(CONF).listFiles(raiz, True)archivos = []while iterador.hasNext(): estado = iterador.next() ruta = estado.getPath().toString().split("/bitlogistica/envios/")[1] archivos.append((ruta.split("/")[0], ruta, estado.getLen()))# 2. Resumen: cuántos archivos y bytes hay en metadata/ y en data/tabla_archivos = pd.DataFrame(archivos, columns=["zona", "ruta", "bytes"])print(tabla_archivos.groupby("zona").agg(archivos=("ruta", "count"), bytes=("bytes", "sum")).to_string())print()# 3. Los archivos de metadatos, uno por uno, y un archivo de datos de ejemplofor ruta insorted(tabla_archivos.loc[tabla_archivos["zona"] =="metadata", "ruta"]):print(ruta)print(sorted(tabla_archivos.loc[tabla_archivos["zona"] =="data", "ruta"])[0])
          archivos   bytes
zona
data             5  640159
metadata         4   18499

metadata/74fb51da-f99e-4d3d-8baa-cf43881e4a7a-m0.avro
metadata/snap-2512792261418552131-1-74fb51da-f99e-4d3d-8baa-cf43881e4a7a.avro
metadata/v1.metadata.json
metadata/version-hint.text
data/admision_month=2026-01/00001-4-3ace7777-b46c-4259-b803-4dff037df7eb-0-00003.parquet
Hay 5 archivos de datos, unos 640 KB, y 4 archivos de metadatos, unos 18 KB: los metadatos ocupan el 3 % de la tabla. Cada archivo de metadatos es una pieza de la figura de la sección 1:
v1.metadata.json es la primera versión de los metadatos de la tabla, y version-hint.text le dice al catálogo hadoop cuál es la versión vigente.
snap-….avro es la lista de manifiestos de la primera instantánea.
…-m0.avro es el manifiesto con la lista de los 5 archivos de datos y sus estadísticas.
Los datos quedan en carpetas por partición, data/admision_month=2026-01/, igual que con partitionBy. La diferencia es que Spark no lee la carpeta para saber qué archivos hay: lo lee en los metadatos.
4. MERGE: insertar y actualizar en una sola operación
Llega el lote de junio, y con él una noticia: el sistema de admisión registró mal la hora de entrega de 300 envíos de mayo, que en realidad se entregaron 12 horas más tarde. Las 300 cifras son una muestra de los envíos entregados en mayo, elegida con semilla fija para que la ejecución sea reproducible; las 12 horas bastan para que algunos pasen de «a tiempo» a «tarde».
NotaMERGE INTO
MERGE INTO destino USING origen ON condición compara cada fila del origen con el destino. WHEN MATCHED THEN UPDATE dice qué hacer con las que ya existen; WHEN NOT MATCHED THEN INSERT, con las nuevas. Se conoce también como upsert (actualizar o insertar). La operación es una sola transacción: termina completa o no cambia nada.
La celda arma el lote del día: los envíos de junio, que son nuevos, más las 300 correcciones, que ya están en la tabla.
# 1. Las 300 correcciones: envíos de mayo cuya entrega se registró 12 horas antes de lo realcorrecciones = ( plata.filter((F.col("mes") ==5) & (F.col("estado") =="entregado")) .sample(fraction=0.06, seed=24).limit(300) .withColumn("entrega", F.col("entrega") + F.expr("INTERVAL 12 HOURS")) .withColumn("horas_transito", F.round(F.col("horas_transito") +12, 1)) .withColumn("a_tiempo", F.col("horas_transito") <= F.col("promesa_horas")))# 2. El lote del día: todos los envíos de junio (nuevos) más las correcciones (ya existen)lote = plata.filter(F.col("mes") ==6).unionByName(correcciones).drop("mes")lote.createOrReplaceTempView("lote")# 3. Cuántas guías del lote ya están en la tabla y cuántas son nuevasexistentes = lote.join(spark.table(TABLA).select("guia"), "guia", "left_semi").count()print(f"Filas del lote: {lote.count()} | ya están en la tabla: {existentes} | nuevas: {lote.count() - existentes}")print("Correcciones que pasan de a tiempo a tarde:", correcciones.join(plata.select("guia", F.col("a_tiempo").alias("antes")), "guia") .filter(F.col("antes") &~F.col("a_tiempo")).count())
Filas del lote: 5798 | ya están en la tabla: 300 | nuevas: 5498
Correcciones que pasan de a tiempo a tarde: 52
El lote tiene 5 798 filas: 300 guías que ya están en la tabla y 5 498 nuevas, los envíos de junio. De las 300 correcciones, 52 pasan de «a tiempo» a «tarde» con las 12 horas reales.
La celda siguiente guarda la instantánea inicial y ejecuta el MERGE. La condición ON t.guia = s.guia usa la guía como llave, porque identifica a cada envío. La cláusula WHEN MATCHED AND (t.entrega <> s.entrega OR t.estado <> s.estado) solo actualiza las filas que cambiaron de verdad, para que repetir el lote no cuente como cambio.
# 1. Guardar el estado antes del MERGE para compararlo despuésfilas_antes = spark.table(TABLA).count()INSTANTANEA_INICIAL = spark.sql(f"SELECT snapshot_id FROM {TABLA}.snapshots").first()[0]# 2. Una sola instrucción: actualiza las guías que existen y agrega las nuevasMERGE =f"""MERGE INTO {TABLA} AS tUSING lote AS sON t.guia = s.guiaWHEN MATCHED AND (t.entrega <> s.entrega OR t.estado <> s.estado) THEN UPDATE SET *WHEN NOT MATCHED THEN INSERT *"""spark.sql(MERGE)# 3. Resultadoprint(f"Filas antes: {filas_antes} | después: {spark.table(TABLA).count()}")print("Instantánea inicial:", INSTANTANEA_INICIAL)
La tabla pasó de 26 566 a 32 064 filas: entraron los 5 498 envíos de junio y las 300 correcciones reemplazaron a sus versiones de mayo sin agregar filas. En el capítulo de ingesta, lo mismo exigía recalcular las fechas afectadas a partir de todo el bronce; aquí es una instrucción.
El historial de instantáneas dice qué hizo cada operación.
RESUMEN =f"""SELECT snapshot_id, operation AS operacion, summary['added-records'] AS filas_agregadas, summary['deleted-records'] AS filas_quitadas, summary['added-data-files'] AS archivos_agregados, summary['deleted-data-files'] AS archivos_quitados, summary['changed-partition-count'] AS particiones_tocadasFROM {TABLA}.snapshots ORDER BY committed_at"""spark.sql(RESUMEN).show(truncate=False)
Hay dos instantáneas. La primera es la creación, un append de 26 566 filas en 5 archivos. La segunda, el MERGE, es un overwrite que agregó 12 017 filas y quitó 6 519, en 2 archivos agregados y 1 quitado, tocando 2 particiones. Las cuentas cuadran: el archivo de mayo, con sus 6 519 filas, se reemplazó por uno nuevo con las mismas 6 519 filas, 300 de ellas corregidas; y junio agregó un archivo de 5 498 filas. 6 519 + 5 498 = 12 017.
NotaCopiar al escribir
Iceberg no modifica archivos Parquet: cuando una fila cambia, reescribe el archivo completo que la contiene. Esta estrategia se llama copiar al escribir (copy-on-write) y es la que usa por defecto MERGE en Spark. Es rápida para leer y lenta para escribir cambios pequeños sobre archivos grandes. La alternativa, fusionar al leer (merge-on-read), escribe solo archivos pequeños que marcan las filas borradas, y deja la combinación para la lectura; se activa con la propiedad de tabla write.merge.mode.
¿Qué pasa si el mismo lote llega dos veces, como en el capítulo de ingesta?
# 1. El mismo lote, otra vez: ¿se duplica algo?spark.sql(MERGE)print("Filas después de repetir el MERGE:", spark.table(TABLA).count())print("Guías distintas:", spark.table(TABLA).select("guia").distinct().count())spark.sql(RESUMEN).show(truncate=False)
La tabla sigue con 32 064 filas y 32 064 guías distintas: el MERGE repetido no duplicó nada, porque las guías de junio ya existen y la condición de actualización no encontró cambios. Pero el historial muestra un costo: una tercera instantánea que agregó y quitó 12 017 filas, reescribiendo los archivos de mayo y junio con los mismos datos. Con copiar al escribir, basta con que una fila del archivo coincida con el origen para reescribirlo, aunque la condición WHEN MATCHED no la cambie. En un pipeline real conviene dejar en el lote solo las filas que de verdad cambiaron, con una unión anti contra la tabla, antes del MERGE; es uno de los ejercicios de la Práctica.
5. Viaje en el tiempo
Como las instantáneas viejas no se borran, la tabla se puede consultar como estaba en cualquiera de ellas. La celda calcula el cumplimiento de mayo con la tabla actual y con la instantánea inicial, antes de las correcciones. VERSION AS OF recibe el número de una instantánea; TIMESTAMP AS OF recibe una fecha y hora, y usa la instantánea vigente en ese momento.
CUMPLIMIENTO_MAYO ="""SELECT COUNT(*) AS envios_mayo, ROUND(100 * AVG(CAST(a_tiempo AS INT)), 2) AS pct_a_tiempoFROM {origen}WHERE admision >= '2026-05-01' AND admision < '2026-06-01'"""# 1. La tabla como está ahoraspark.sql(CUMPLIMIENTO_MAYO.format(origen=TABLA)).show()# 2. La misma tabla como estaba en la instantánea inicial, antes de las correccionesspark.sql(CUMPLIMIENTO_MAYO.format(origen=f"{TABLA} VERSION AS OF {INSTANTANEA_INICIAL}")).show()# 3. También se puede viajar con DataFrames, por instantáneaantes = spark.read.option("snapshot-id", INSTANTANEA_INICIAL).table(TABLA)print("Filas en la instantánea inicial:", antes.count(), "| filas hoy:", spark.table(TABLA).count())
Mayo tiene 6 519 envíos en las dos versiones, pero su cumplimiento bajó de 85.16 % a 84.36 % con las correcciones: 0.80 puntos, los 52 envíos que pasaron a «tarde» de 6 519. Si un informe de la semana pasada mostró 85.16 %, el viaje en el tiempo permite reproducirlo exactamente y explicar la diferencia con el de hoy. La instantánea inicial tiene 26 566 filas y la actual 32 064: con la API de DataFrames, la opción snapshot-id da el mismo viaje.
6. Transacciones: una escritura que falla no deja rastro
NotaTransacción atómica
Una operación es atómica si se aplica completa o no se aplica: no existe un estado intermedio visible. En Iceberg, una escritura escribe primero todos sus archivos y al final cambia el puntero a la nueva instantánea. Si falla antes de ese último paso, el puntero no se mueve y la tabla queda exactamente como estaba; los archivos que alcanzó a escribir quedan huérfanos, fuera de cualquier instantánea, hasta que el mantenimiento los borra.
La celda prepara un lote dañado: sube 1 kg el peso de todo junio, pero una fila provoca un error a mitad del trabajo con raise_error, como haría un dato que no se puede convertir. Antes y después del intento compara la instantánea actual y la suma de pesos de toda la tabla. Los mensajes de error de los executors se silencian durante el intento, para que el notebook quede legible; el error llega igual al driver.
# 1. Un lote dañado: aumenta 1 kg el peso de todo junio, pero una fila provoca un error a mitad del trabajoguia_mala = lote.orderBy("guia").first()["guia"]lote_malo = lote.withColumn("peso_kg", F.when(F.col("guia") == guia_mala, F.raise_error(F.lit("fila inválida en el lote"))) .otherwise(F.col("peso_kg") +1),)lote_malo.createOrReplaceTempView("lote_malo")# 2. Estado antes del intentoactual_antes = spark.sql(f"SELECT snapshot_id FROM {TABLA}.snapshots ORDER BY committed_at DESC").first()[0]peso_antes = spark.table(TABLA).agg(F.round(F.sum("peso_kg"), 2)).first()[0]# 3. El MERGE falla: los errores del executor se silencian para que el notebook quede legiblesc.setLogLevel("OFF")try: spark.sql(MERGE.replace("USING lote", "USING lote_malo").replace("t.estado <> s.estado", "t.peso_kg <> s.peso_kg"))exceptExceptionas error:print("El MERGE falló:", "fila inválida en el lote"instr(error))sc.setLogLevel("ERROR")# 4. Estado después del intentoactual_despues = spark.sql(f"SELECT snapshot_id FROM {TABLA}.snapshots ORDER BY committed_at DESC").first()[0]print("¿Cambió la instantánea actual?", actual_antes != actual_despues)print("Suma de pesos antes y después:", peso_antes, spark.table(TABLA).agg(F.round(F.sum("peso_kg"), 2)).first()[0])
El MERGE falló: True
¿Cambió la instantánea actual? False
Suma de pesos antes y después: 85483.92 85483.92
El MERGE falló con el error esperado, la instantánea actual no cambió (False) y la suma de pesos es la misma antes y después, 85 483.92 kg: ningún envío de junio quedó con el peso aumentado, aunque algunas tareas alcanzaron a escribir sus archivos antes del error. Con los archivos Parquet simples del capítulo de ingesta, un fallo a mitad de la escritura de la plata podía dejar unas fechas nuevas y otras viejas; aquí no hay estado intermedio.
7. Deshacer un error
Los errores de operación son más comunes que los fallos técnicos. Alguien quiere borrar unos envíos Express de prueba y escribe un DELETE sin la condición completa. La celda lo simula, mide el daño y vuelve a la instantánea anterior con el procedimiento rollback_to_snapshot. Los procedimientos de Iceberg se ejecutan con CALL lago.system.<nombre>(…).
# 1. La instantánea buena, antes del errorbuena = spark.sql(f"SELECT snapshot_id FROM {TABLA}.snapshots ORDER BY committed_at DESC").first()[0]# 2. El error: alguien borra todos los Express, cuando quería borrar solo los de pruebaspark.sql(f"DELETE FROM {TABLA} WHERE servicio = 'Express'")print("Filas después del DELETE:", spark.table(TABLA).count())# 3. Volver a la instantánea buena: no se copian datos, solo se mueve el punterospark.sql(f"CALL lago.system.rollback_to_snapshot('bitlogistica.envios', {buena})").show()print("Filas después de deshacer:", spark.table(TABLA).count())# 4. El historial conserva el DELETE, pero ya no forma parte de la línea actualspark.sql(f"""SELECT h.snapshot_id, s.operation AS operacion, h.is_current_ancestor AS en_la_linea_actualFROM {TABLA}.history h JOIN {TABLA}.snapshots s ON h.snapshot_id = s.snapshot_idORDER BY h.made_current_at""").show(truncate=False)
Filas después del DELETE: 24219
+--------------------+-------------------+
|previous_snapshot_id|current_snapshot_id|
+--------------------+-------------------+
| 8688154552080599216|7185803558959816085|
+--------------------+-------------------+

Filas después de deshacer: 32064
+-------------------+---------+------------------+
|snapshot_id        |operacion|en_la_linea_actual|
+-------------------+---------+------------------+
|2512792261418552131|append   |true              |
|5083678134533792060|overwrite|true              |
|7185803558959816085|overwrite|true              |
|8688154552080599216|overwrite|false             |
|7185803558959816085|overwrite|true              |
+-------------------+---------+------------------+
El DELETE dejó la tabla con 24 219 filas: se fueron los 7 845 envíos Express. El procedimiento devolvió el puntero a la instantánea anterior, y la tabla volvió a 32 064 filas en una fracción de segundo, porque no copió datos: los archivos de esa instantánea nunca se borraron. La tabla history lo cuenta así: la instantánea del DELETE sigue registrada, pero con en_la_linea_actual en false, y la instantánea buena aparece otra vez como actual.
Deshacer solo es posible mientras la instantánea buena exista. La sección 9 muestra cuándo deja de existir.
8. Evolución del esquema y de la partición
NotaEvolución del esquema y de la partición
Iceberg identifica cada columna por un número interno, no por su nombre ni por su posición. Por eso puede agregar, renombrar o borrar columnas cambiando solo los metadatos: los archivos viejos no tienen la columna nueva y se leen con nulos. De la misma forma, la especificación de partición (partition spec) puede cambiar: los archivos viejos conservan la que tenían y los nuevos usan la nueva. Las consultas funcionan sobre las dos a la vez.
El área comercial quiere marcar la prioridad de los envíos. La celda agrega la columna prioridad, le da el valor alta a los Express de junio y compara el esquema actual con el de la instantánea inicial.
# 1. Agregar una columna: solo cambia los metadatos, no reescribe ningún archivoarchivos_antes = spark.sql(f"SELECT count(*) FROM {TABLA}.files").first()[0]spark.sql(f"ALTER TABLE {TABLA} ADD COLUMN prioridad STRING")print("Archivos de datos antes y después de ALTER TABLE:", archivos_antes, spark.sql(f"SELECT count(*) FROM {TABLA}.files").first()[0])# 2. Darle valor solo a los Express de juniospark.sql(f"UPDATE {TABLA} SET prioridad = 'alta' WHERE servicio = 'Express' AND admision >= '2026-06-01'")spark.sql(f"SELECT prioridad, COUNT(*) AS envios FROM {TABLA} GROUP BY prioridad ORDER BY prioridad").show()# 3. Una instantánea anterior conserva su esquema: no tiene la columna nuevaprint("Columnas hoy:", len(spark.table(TABLA).columns), "| en la instantánea inicial:",len(spark.sql(f"SELECT * FROM {TABLA} VERSION AS OF {INSTANTANEA_INICIAL}").columns))
Archivos de datos antes y después de ALTER TABLE: 6 6
+---------+------+
|prioridad|envios|
+---------+------+
|     NULL| 30756|
|     alta|  1308|
+---------+------+

Columnas hoy: 23 | en la instantánea inicial: 22
ALTER TABLE no reescribió nada: la tabla tenía 6 archivos de datos antes y después. Después del UPDATE, 1 308 envíos Express de junio tienen prioridad alta y los otros 30 756 la tienen nula, incluidos todos los anteriores a junio, que nunca se reescribieron. La tabla actual tiene 23 columnas; la instantánea inicial, 22: cada instantánea conserva el esquema con el que se escribió.
Ahora la partición. Con más envíos por día, un mes completo por archivo se vuelve demasiado grande, y BITLogística decide particionar por día desde julio. La celda cambia la especificación y simula diez lotes pequeños de julio, como si llegaran cada pocas horas. Como el caso solo tiene datos hasta junio, el experimento usa copias de los envíos del 1 al 3 de junio corridas 30 días, con la guía marcada -JUL; sirven para ver cómo se guardan, no para sacar conclusiones de negocio.
# 1. Desde julio la tabla se particiona por día; lo anterior queda como estaba, por messpark.sql(f"ALTER TABLE {TABLA} REPLACE PARTITION FIELD admision_month WITH days(admision)")# 2. Diez lotes pequeños de «julio», como si llegaran cada pocas horas:# para el experimento, copias de los envíos del 1 al 3 de junio corridas 30 díasbase_julio = (plata.drop("mes") .filter("admision >= '2026-06-01' AND admision < '2026-06-04'") .withColumn("prioridad", F.lit(None).cast("string")) .withColumn("guia", F.concat("guia", F.lit("-JUL"))) .withColumn("admision", F.col("admision") + F.expr("INTERVAL 30 DAYS")) .withColumn("entrega", F.col("entrega") + F.expr("INTERVAL 30 DAYS")) .withColumn("lote", (F.abs(F.hash("guia")) %10).cast("int")))for numero inrange(10): base_julio.filter(F.col("lote") == numero).drop("lote").writeTo(TABLA).append()# 3. Los archivos de datos según su especificación de partición: por mes (spec 0) o por día (spec 1)spark.sql(f"""SELECT spec_id, COUNT(DISTINCT partition) AS particiones, SUM(record_count) AS filas, COUNT(*) AS archivosFROM {TABLA}.files GROUP BY spec_id ORDER BY spec_id""").show()# 4. Una consulta por fecha usa las dos particiones sin que quien consulta sepa cuálspark.sql(f"""SELECT date_format(admision, 'yyyy-MM') AS mes, COUNT(*) AS enviosFROM {TABLA} WHERE admision >= '2026-06-01' GROUP BY 1 ORDER BY 1""").show()
Los archivos de la tabla quedaron con dos especificaciones de partición. La 0, por mes, conserva los 6 archivos de enero a junio, con 32 064 filas en 6 particiones. La 1, por día, tiene las 622 filas de julio en 3 particiones diarias, pero en 30 archivos: cada uno de los diez lotes escribió un archivo en cada día. La consulta por mes no sabe nada de eso: filtra por admision y cuenta 5 498 envíos en junio y 622 en julio.
Treinta archivos para 622 filas es el problema de los archivos pequeños del capítulo de almacenamiento, ahora causado por cargas frecuentes. La sección siguiente lo resuelve.
9. Mantenimiento: compactar y expirar
Una tabla Iceberg acumula dos cosas con el tiempo: archivos pequeños, por las cargas frecuentes, e instantáneas, una por escritura, con todos los archivos que cada una mantiene vivos. Dos procedimientos las controlan:
rewrite_data_filescompacta: junta los archivos pequeños de cada partición en archivos más grandes, en una nueva instantánea, sin cambiar los datos. La celda lo limita a julio con where, porque en una tabla grande se compacta lo reciente y no todo; y usa min-input-files en 2 porque, por defecto, Iceberg solo compacta una partición si tiene al menos 5 archivos en un mismo grupo de reescritura, un umbral pensado para tablas mucho más grandes.
expire_snapshotsexpira las instantáneas anteriores a una fecha y borra los archivos que solo ellas usaban. La celda conserva solo la última para que el efecto se vea completo; en producción se conservan varios días, para poder viajar en el tiempo y deshacer errores dentro de ese plazo.
DESDE_JULIO ="admision >= '2026-07-01'"# 1. Antes: archivos de julio e instantáneas acumuladasdef contar(): archivos_julio = spark.sql(f"SELECT count(*) FROM {TABLA}.files WHERE spec_id = 1").first()[0] # spec 1 = julio instantaneas = spark.sql(f"SELECT count(*) FROM {TABLA}.snapshots").first()[0]return archivos_julio, instantaneasprint("Antes de mantener -> archivos de julio: %d | instantáneas: %d"% contar())POR_DIA = (f"SELECT date_format(partition.admision_day, 'dd-MM') AS dia, COUNT(*) AS file_count "f"FROM {TABLA}.files WHERE spec_id = 1 GROUP BY 1 ORDER BY 1")por_dia_antes = spark.sql(POR_DIA).toPandas()# 2. Compactar solo julio: juntar los archivos pequeños de cada partición diariaspark.sql(f"""CALL lago.system.rewrite_data_files( table => 'bitlogistica.envios', where => "{DESDE_JULIO}", options => map('min-input-files', '2'))""").show()# 3. Expirar instantáneas: conservar solo la últimaahora = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")spark.sql(f"""CALL lago.system.expire_snapshots( table => 'bitlogistica.envios', older_than => TIMESTAMP '{ahora}', retain_last => 1)""").select("deleted_data_files_count", "deleted_manifest_files_count", "deleted_manifest_lists_count").show()print("Después de mantener -> archivos de julio: %d | instantáneas: %d"% contar())# 4. El costo: la instantánea inicial ya no existetry: spark.sql(f"SELECT COUNT(*) FROM {TABLA} VERSION AS OF {INSTANTANEA_INICIAL}").show()exceptExceptionas error:print("Viaje a la instantánea inicial:", str(error).split("\n")[0][:110])
Antes de mantener  -> archivos de julio: 30 | instantáneas: 15
+--------------------------+----------------------+---------------------+-----------------------+
|rewritten_data_files_count|added_data_files_count|rewritten_bytes_count|failed_data_files_count|
+--------------------------+----------------------+---------------------+-----------------------+
|                        30|                     3|               238938|                      0|
+--------------------------+----------------------+---------------------+-----------------------+

+------------------------+----------------------------+----------------------------+
|deleted_data_files_count|deleted_manifest_files_count|deleted_manifest_lists_count|
+------------------------+----------------------------+----------------------------+
|                      40|                          20|                          15|
+------------------------+----------------------------+----------------------------+

Después de mantener -> archivos de julio: 3 | instantáneas: 1
Viaje a la instantánea inicial: Cannot find snapshot with ID 2512792261418552131
Antes del mantenimiento, julio tenía 30 archivos y la tabla, 15 instantáneas: la creación, los dos MERGE, el DELETE, el UPDATE y los diez lotes de julio. El rollback no creó una instantánea, solo movió el puntero, y los ALTER TABLE cambiaron metadatos sin escribir datos.
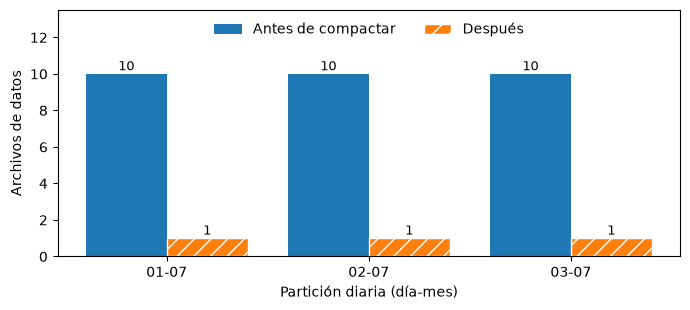
La compactación reescribió los 30 archivos de julio, unos 239 KB, en 3, uno por día. La expiración borró 40 archivos de datos que ya no pertenecían a ninguna instantánea conservada (las versiones viejas de mayo y junio, el DELETE deshecho y los 30 archivos pequeños de julio), 20 manifiestos y 15 listas de manifiestos. Quedó 1 instantánea. El costo se ve en la última línea: la instantánea inicial ya no existe, y el viaje en el tiempo de la sección 5 ahora falla con Cannot find snapshot.
antes_compactar = por_dia_antes.rename(columns={"file_count": "antes"})antes_compactar["despues"] = spark.sql(POR_DIA).toPandas()["file_count"].valuesfigura, eje = plt.subplots(figsize=(7, 3.2))x =range(len(antes_compactar))eje.bar([i -0.2for i in x], antes_compactar["antes"], width=0.4, label="Antes de compactar")eje.bar([i +0.2for i in x], antes_compactar["despues"], width=0.4, label="Después", hatch="//", edgecolor="white")for i, (a, d) inenumerate(zip(antes_compactar["antes"], antes_compactar["despues"])): eje.text(i -0.2, a +0.2, str(a), ha="center", fontsize=9) eje.text(i +0.2, d +0.2, str(d), ha="center", fontsize=9)eje.set_xticks(list(x), antes_compactar["dia"])eje.set_xlabel("Partición diaria (día-mes)")eje.set_ylabel("Archivos de datos")eje.set_ylim(0, antes_compactar["antes"].max() *1.35)eje.legend(frameon=False, loc="upper center", ncol=2)plt.tight_layout()plt.show()
Figura 24.1: Archivos de datos de cada partición diaria de julio antes y después de compactar
En la figura, cada día de julio pasó de 10 archivos a 1. La regla práctica es compactar las particiones recientes con frecuencia, por ejemplo cada noche, y expirar instantáneas con un plazo acordado con el negocio: tantos días como se quiera poder reproducir un informe o deshacer un error. Un tercer procedimiento, remove_orphan_files, borra los archivos huérfanos de escrituras fallidas, como las de la sección 6.
10. Parquet simple frente a Iceberg
Necesidad
Parquet simple (capítulo de ingesta)
Iceberg
Actualizar unas filas
Recalcular particiones completas
MERGE, UPDATE y DELETE
Escritura que falla a la mitad
Puede quedar a medias
La tabla no cambia
Ver la tabla como estaba
No
VERSION AS OF y TIMESTAMP AS OF
Deshacer un error
Restaurar un respaldo, si existe
rollback_to_snapshot
Agregar una columna
mergeSchema en cada lectura
ALTER TABLE, sin reescribir
Cambiar la partición
Reescribir toda la tabla
Cambiar la especificación; lo viejo queda como estaba
Filtrar por fecha
Hay que conocer la columna de partición
Partición oculta
Qué archivos forman la tabla
Lo que haya en la carpeta
Lo que digan los metadatos
Costo
Ninguno adicional
Un .jar, metadatos y mantenimiento periódico
Los archivos Parquet simples siguen siendo una buena opción para datos que solo se agregan, nunca se corrigen y tienen un solo escritor, como un registro de eventos crudos en la zona de llegada. Para las capas que se corrigen y que leen muchos (plata y oro), un formato de tabla evita la mayor parte de los problemas que el capítulo de ingesta resolvió con código propio.
Limpiar
La celda cierra la sesión. La tabla lago.bitlogistica.envios queda en /bitlogistica/lakehouse para los capítulos siguientes. Para borrarla a mano: dc exec spark-client /opt/hadoop/bin/hdfs dfs -rm -r /bitlogistica/lakehouse.
spark.stop()print("Sesión cerrada. La tabla Iceberg queda en /bitlogistica/lakehouse para los capítulos siguientes.")
Sesión cerrada. La tabla Iceberg queda en /bitlogistica/lakehouse para los capítulos siguientes.
La sesión quedó cerrada. En la siguiente sesión, la tabla se lee con el mismo catálogo lago: basta con repetir las cuatro opciones de la sesión de la sección 2.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 2 a 4 (la sesión, la tabla y el lote).
MERGE sin reescrituras inútiles. Antes de repetir el MERGE de la sección 4, quita del lote las filas que ya están iguales en la tabla con una unión anti por guía, entrega y estado. ¿Cuántas filas quedan? ¿Qué muestra el historial?
Viajar por fecha. Usa TIMESTAMP AS OF con la hora de la instantánea inicial (columna committed_at de la tabla snapshots) y comprueba que da el mismo cumplimiento de mayo que VERSION AS OF.
Borrar con condición correcta. Borra solo los envíos de julio de prueba (guia LIKE '%-JUL') y comprueba en el historial cuántas filas quitó la operación.
Fusionar al leer. Crea una copia de la tabla con TBLPROPERTIES ('write.merge.mode' = 'merge-on-read') y repite el MERGE de las correcciones. Compara en la tabla files cuántos archivos de datos y de borrados se escribieron.
Renombrar una columna. Renombra prioridad a nivel_servicio con ALTER TABLE … RENAME COLUMN y comprueba que las filas conservan sus valores.
Expirar con un plazo. En lugar de conservar solo la última instantánea, expira las de más de una hora. ¿Cuántas quedan?
TipOrientaciones
Con lote.join(spark.table(TABLA).select("guia", "entrega", "estado"), ["guia", "entrega", "estado"], "left_anti") no queda ninguna fila después del primer MERGE, porque todo el lote ya está igual en la tabla. Con un lote vacío, el MERGE no reescribe nada; según la versión, Iceberg no crea instantánea o crea una sin archivos agregados ni quitados.
SELECT … FROM tabla TIMESTAMP AS OF '<committed_at>' da 85.16 % para mayo, igual que la versión inicial. Si la hora pedida es anterior a la primera instantánea, Iceberg responde que no hay instantánea en esa fecha.
El historial muestra una operación delete u overwrite que quita 622 filas, las de julio. Con particiones diarias y todas las filas de un día por borrar, Iceberg puede quitar archivos completos sin reescribir ninguno.
Con fusionar al leer, el MERGE escribe un archivo de borrados pequeño (en la tabla files, content = 1) y un archivo con las 300 filas nuevas, en lugar de reescribir las 6 519 filas de mayo. La lectura combina los dos; por eso conviene compactar más seguido.
ALTER TABLE lago.bitlogistica.envios RENAME COLUMN prioridad TO nivel_servicio. Los 1 308 valores alta siguen ahí: Iceberg los encuentra por el número interno de la columna, no por el nombre.
Depende de cuánto tardaste: quedan las instantáneas de la última hora. Si todas son de la última hora, expire_snapshots no borra ninguna.
Errores frecuentes
Síntoma
Causa
Arreglo
Falta el .jar de Iceberg en notebooks/jars
No se descargó la librería o quedó en otra carpeta.
La sesión se creó antes de agregar spark.jars, o el kernel tenía otra sesión abierta.
Reiniciar el kernel y crear la sesión con las cuatro opciones.
UnsupportedClassVersionError: … class file version 55.0 … up to 52.0 al crear la tabla
Se descargó Iceberg 1.7 o posterior, compilado para Java 11, y los executors de los NodeManagers corren con Java 8.
Usar iceberg-spark-runtime-3.5_2.12-1.6.1.jar, reiniciar el kernel y volver a ejecutar.
MERGE INTO TABLE is not supported temporarily
Falta spark.sql.extensions de Iceberg.
Agregar la opción y reiniciar el kernel.
Cannot find snapshot with ID
La instantánea se expiró.
Expirar con un plazo que cubra los viajes en el tiempo que se necesiten.
La tabla acumula cientos de archivos pequeños
Cargas frecuentes con pocas filas por partición.
rewrite_data_files periódico sobre las particiones recientes.
Un MERGE que no cambia nada reescribe archivos
Copiar al escribir reescribe todo archivo con filas que coinciden.
Dejar en el lote solo las filas que cambiaron.
MERGE falla con cannot be performed with multiple matches
El origen tiene la misma guía dos veces.
Quitar duplicados del lote antes, como en el capítulo de ingesta.
Preguntas de comprensión
¿Por qué una escritura que falla no cambia una tabla Iceberg, aunque haya alcanzado a escribir archivos?
¿Qué diferencia hay entre la partición oculta de Iceberg y la columna mes del capítulo de almacenamiento?
Si el MERGE de la sección 4 solo cambió 300 filas, ¿por qué el historial dice que quitó 6 519?
¿Qué se gana y qué se pierde al expirar instantáneas?
¿Cuándo bastan los archivos Parquet simples, sin formato de tabla?
TipOrientaciones
Porque la tabla es lo que dicen sus metadatos, y los metadatos solo cambian en el último paso, cuando el catálogo pasa a apuntar a la nueva versión. Los archivos escritos antes del fallo no figuran en ninguna instantánea: existen en HDFS, pero no forman parte de la tabla.
La columna mes era una columna más, que había que crear, mantener y usar en los filtros para que la partición sirviera. La partición oculta se define como una transformación de admision en los metadatos; quien consulta filtra por admision e Iceberg aplica la partición por su cuenta, y la transformación se puede cambiar sin tocar las consultas.
Por copiar al escribir: Iceberg no modifica archivos, así que reemplazó el archivo de mayo completo, con sus 6 519 filas, por uno nuevo con las 300 corregidas. En el historial cuenta como quitar 6 519 filas y agregar 6 519, más las 5 498 de junio.
Se gana espacio y metadatos más livianos, porque se borran los archivos que solo usaban las instantáneas viejas. Se pierde la posibilidad de viajar en el tiempo y de deshacer operaciones anteriores al plazo de expiración.
Cuando los datos solo se agregan, nunca se corrigen, hay un solo proceso que escribe y nadie necesita consultar versiones anteriores, como en una zona de llegada o un registro de eventos crudos.
Glosario
Término
Significado en este capítulo
Formato de tabla
Registro de qué archivos forman una tabla, con su esquema, particiones e historial.
Lakehouse
Data lake con transacciones, actualizaciones e historial gracias a un formato de tabla.
Metadatos de la tabla
Archivos JSON y Avro que describen la tabla y sus instantáneas.
Instantánea
Estado completo de la tabla después de una escritura.
Manifiesto
Archivo de metadatos con una lista de archivos de datos y sus estadísticas.
Partición oculta
Partición definida como transformación de una columna, que el lector no necesita conocer.
MERGE INTO
Instrucción que actualiza las filas existentes e inserta las nuevas en una sola operación.
Copiar al escribir
Estrategia que reescribe completo cada archivo que tiene filas cambiadas.
Fusionar al leer
Estrategia que escribe archivos de borrados y combina al leer.
Viaje en el tiempo
Consulta de la tabla como estaba en una instantánea anterior.
Transacción atómica
Operación que se aplica completa o no se aplica.
Rollback
Volver a una instantánea anterior moviendo el puntero de la tabla.
Especificación de partición
Forma de particionar vigente para un grupo de archivos.
Compactar
Juntar archivos pequeños en archivos más grandes.
Expirar instantáneas
Borrar instantáneas viejas y los archivos que solo ellas usaban.
Archivo huérfano
Archivo en la carpeta de la tabla que no pertenece a ninguna instantánea.
Referencias para profundizar
Apache Iceberg. Documentación de Spark: configuración, escrituras, MERGE INTO, consultas e instantáneas.
Apache Iceberg. Procedimientos de Spark: rollback_to_snapshot, rewrite_data_files, expire_snapshots, remove_orphan_files.
Reis, J. y Housley, M. (2022). Fundamentals of Data Engineering. O’Reilly Media. Capítulo 6, almacenamiento.
Resumen
Con los envíos de BITLogística convertiste la plata en una tabla Iceberg sobre el mismo HDFS, sin servicios nuevos. La tabla nació con 26 566 envíos de enero a mayo, particionada por mes sin columna mes, y sus metadatos ocuparon el 3 % del tamaño de los datos. Un solo MERGE agregó los 5 498 envíos de junio y aplicó 300 correcciones de mayo; repetirlo no duplicó nada, aunque reescribió archivos sin necesidad. El viaje en el tiempo reprodujo el cumplimiento de mayo antes de las correcciones, 85.16 %, frente al 84.36 % de después. Un MERGE que falló a mitad de camino no cambió ni un kilo de la tabla, y un DELETE equivocado que borró 7 845 envíos se deshizo con un rollback. La columna prioridad y la partición diaria de julio llegaron sin reescribir los datos anteriores. La compactación juntó los 30 archivos de julio en 3 y la expiración dejó una sola instantánea, con el costo visible de perder el viaje al pasado.
El capítulo siguiente, Kafka y eventos, cambia de ritmo: en lugar de archivos que llegan cada día, envíos que se publican uno por uno en el momento en que se admiten.