El pipeline del capítulo anterior carga cada noche los archivos de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) sin duplicar ni perder envíos. Pero que el pipeline no falle no significa que los datos estén bien. Un archivo puede llegar con la mitad de los destinos vacíos y el pipeline lo cargará sin quejarse: las filas malas irán a la cuarentena y los informes del día mostrarán la mitad de los envíos. Alguien puede cambiar una regla de validación y nadie se enterará hasta que un número no cuadre. Y cuando la gerencia pregunte de dónde salió un porcentaje, habrá que poder responder con archivos y versiones, no con suposiciones.
Este capítulo agrega al pipeline lo que un equipo de datos necesita para confiar en él: métricas de calidad por lote, cuadres entre capas, un contrato del esquema, pruebas automáticas de las transformaciones, una puerta que detiene la publicación de un archivo dañado y un registro de linaje que dice de dónde salió cada dato.
Ficha
En este capítulo
Pregunta
¿Cómo se sabe que los datos que entrega un pipeline son correctos, y de dónde salió cada número?
Datos
La zona de ingesta del capítulo anterior (diez lotes de julio) y dos archivos nuevos: el 11 de julio, dañado, y el 12, normal
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_calidad.ipynb dentro de talleres-notebooks.zip. Necesita lo que dejó el capítulo de ingesta: /bitlogistica/ingesta en HDFS y, en la carpeta del notebook, pipeline_envios.py, generar_envios.py y la carpeta entregas_julio/. Si no están, ejecuta primero ese capítulo completo.
El notebook escribe calidad_envios.py en la carpeta del notebook y agrega a /bitlogistica/ingesta los registros de calidad y linaje, un lote más en la plata y una carpeta de archivos retenidos. Para repetir este capítulo desde cero, ejecuta antes otra vez el de ingesta, que reinicia /bitlogistica/ingesta.
1. La sesión
La sesión es la del capítulo de ingesta: YARN y sobrescritura dinámica de particiones. Importa pipeline_envios y agrega a las rutas tres zonas nuevas, calidad, linaje y retenidos. Antes de seguir, comprueba que exista la plata de julio.
import csvimport hashlibimport importlibimport osimport platformimport randomfrom collections import defaultdictfrom datetime import datetimeimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as Fimport pipeline_envios as peBASE ="hdfs://namenode:9000/bitlogistica"INGESTA = BASE +"/ingesta"RUTAS = {"llegada": INGESTA +"/llegada","bronce": INGESTA +"/bronce","cuarentena": INGESTA +"/cuarentena","plata": INGESTA +"/plata","control": INGESTA +"/control/cargas","calidad": INGESTA +"/control/calidad","linaje": INGESTA +"/control/linaje","retenidos": INGESTA +"/retenidos",}spark = ( SparkSession.builder .appName("calidad-trazabilidad") .config("spark.ui.showConsoleProgress", "false") .config("spark.sql.sources.partitionOverwriteMode", "dynamic") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"assert pe.existe(spark, RUTAS["plata"]), "Falta /bitlogistica/ingesta: ejecuta antes el capítulo de ingesta"print("Python", platform.python_version(), "| Spark", spark.version)print("master:", sc.master, "| aplicación:", sc.applicationId)print("Plata de julio:", spark.read.parquet(RUTAS["plata"]).count(), "filas |","archivos en el registro de cargas:", spark.read.parquet(RUTAS["control"]).count())
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/10/27 19:32:54 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
26/10/27 19:32:55 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
Python 3.11.10 | Spark 3.5.3
master: yarn | aplicación: application_1793129130315_0004
Plata de julio: 1802 filas | archivos en el registro de cargas: 11
La sesión quedó en YARN y encontró la plata de julio con 1 802 envíos y 11 archivos en el registro de cargas, el estado en que la dejó el capítulo de ingesta.
2. Qué es la calidad de un dato
NotaDimensiones de calidad
La calidad de los datos se mide en dimensiones, cada una con su pregunta. Completitud: ¿están los valores que deberían estar? Validez: ¿cumplen las reglas del negocio? Unicidad: ¿cada envío aparece una sola vez? Consistencia: ¿cuadran las cifras entre una capa y otra? Oportunidad: ¿llegaron a tiempo? Una métrica de calidad mide una dimensión con un número, por ejemplo el porcentaje de filas sin destino.
NotaUmbral y puerta de calidad
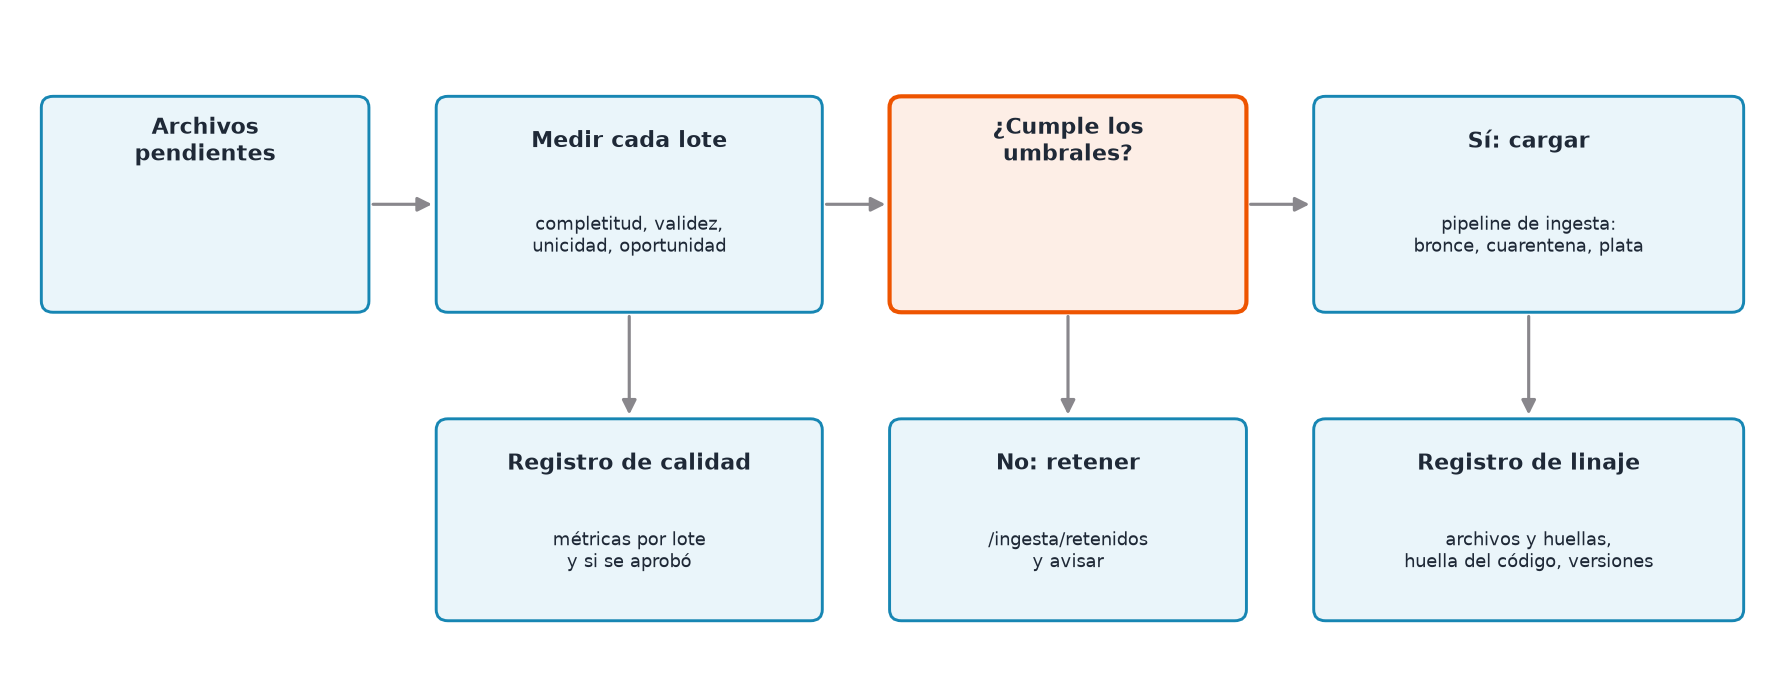
Un umbral es el valor que una métrica no debe cruzar, como «a lo sumo 3 % de destinos vacíos». Una puerta de calidad es un paso del pipeline que mide cada lote antes de publicarlo y lo retiene si incumple algún umbral: el lote no llega a la plata, queda apartado para revisión y el resto de los lotes sigue su camino.
La puerta de calidad dentro del pipeline.
Las funciones de calidad van en un segundo módulo, calidad_envios.py, junto al del pipeline:
UMBRALES fija el umbral de cada métrica: al menos 100 filas por lote, a lo sumo 3 % de destinos vacíos, 12 % de filas en cuarentena, 3 % de guías repetidas y 10 % de envíos tardíos. Los valores salen de lo normal en los lotes de julio, con margen.
medir_calidad calcula las métricas de cada lote en una sola agregación: los destinos vacíos se cuentan en el dato crudo, antes de normalizar; la cuarentena, con las reglas del pipeline; las guías repetidas, comparando guías distintas con filas; los tardíos, comparando la fecha de admisión con la del lote.
evaluar compara cada métrica con su umbral y devuelve los incumplimientos.
revisar_pendientes es la puerta: mide los archivos pendientes, guarda las métricas en el registro de calidad y mueve los que fallan a la carpeta de retenidos.
huella_codigo calcula la huella MD5 de los archivos del pipeline, para el linaje.
%%writefile calidad_envios.py"""Métricas de calidad, puerta de publicación y huellas de código para el pipeline de BITLogística."""import hashlibfrom pyspark.sql import functions as Fimport pipeline_envios as pe# Umbral de cada métrica por lote: (comparación, valor). Si un lote lo incumple, no se publica.UMBRALES = {"filas": (">=", 100),"pct_destino_vacio": ("<=", 3.0),"pct_cuarentena": ("<=", 12.0),"pct_guias_repetidas": ("<=", 3.0),"pct_tardios": ("<=", 10.0),}def medir_calidad(bronce):"""Una fila por lote con las métricas de completitud, validez, unicidad y oportunidad.""" marcada = ( bronce .withColumn("destino_vacio", F.col("destino").isNull().cast("int")) .withColumn("tardio", (F.col("fecha_admision") != F.col("lote")).cast("int")) ) validada = pe.validar(pe.normalizar(marcada))return ( validada.groupBy("lote", "archivo_origen") .agg( F.count("*").alias("filas"), F.round(100* F.avg("destino_vacio"), 2).alias("pct_destino_vacio"), F.round(100* F.avg((F.size("motivos") >0).cast("int")), 2).alias("pct_cuarentena"), F.round(100* (1- F.countDistinct("guia") / F.count("*")), 2).alias("pct_guias_repetidas"), F.round(100* F.avg("tardio"), 2).alias("pct_tardios"), ) )def evaluar(metricas, umbrales=UMBRALES):"""Lista de incumplimientos: (archivo, métrica, valor, umbral).""" fallas = []for fila in metricas.collect():for metrica, (comparacion, umbral) in umbrales.items(): valor = fila[metrica] cumple = valor >= umbral if comparacion ==">="else valor <= umbralifnot cumple: fallas.append((fila["archivo_origen"], metrica, valor, f"{comparacion}{umbral}"))return fallasdef revisar_pendientes(spark, rutas, id_ejecucion, umbrales=UMBRALES):"""Puerta de calidad: mide cada archivo pendiente y aparta los que incumplen algún umbral.""" pendientes = pe.pendientes(spark, rutas).collect()ifnot pendientes:return [], [] tablas = [pe.leer_lote(spark, a["path"], a["archivo"], a["lote"], id_ejecucion) for a in pendientes] bronce = tablas[0]for tabla in tablas[1:]: bronce = bronce.unionByName(tabla) metricas = medir_calidad(bronce).cache() fallas = evaluar(metricas, umbrales) retenidos =sorted({archivo for archivo, *_ in fallas}) (metricas.withColumn("id_ejecucion", F.lit(id_ejecucion)) .withColumn("aprobado", ~F.col("archivo_origen").isin(retenidos) if retenidos else F.lit(True)) .write.mode("append").parquet(rutas["calidad"])) destino, fs = pe.sistema(spark, rutas["retenidos"]) fs.mkdirs(destino)for archivo in retenidos: origen, _ = pe.sistema(spark, rutas["llegada"] +"/"+ archivo) anterior, _ = pe.sistema(spark, rutas["retenidos"] +"/"+ archivo) fs.delete(anterior, False) fs.rename(origen, destino) metricas.unpersist()return fallas, retenidosdef huella_codigo(*rutas_locales):"""Huella MD5 de los archivos de código del pipeline, para saber qué versión produjo cada dato.""" md5 = hashlib.md5()for ruta in rutas_locales:withopen(ruta, "rb") as f: md5.update(f.read())return md5.hexdigest()
Writing calidad_envios.py
Writing calidad_envios.py (u Overwriting, si el archivo ya existía) confirma que el módulo quedó escrito. La celda siguiente lo importa junto con el del pipeline y muestra los umbrales.
import calidad_envios as ceimportlib.reload(pe)importlib.reload(ce)for metrica, (comparacion, umbral) in ce.UMBRALES.items():print(f"{metrica:22s}{comparacion}{umbral}")
Son cinco umbrales, uno por métrica: uno de volumen, al menos 100 filas por lote, y cuatro de proporción, con «a lo sumo»: 3.0 % de destinos vacíos, 12.0 % de cuarentena, 3.0 % de guías repetidas y 10.0 % de tardíos.
3. La línea base: los lotes ya cargados
Antes de usar la puerta, conviene saber cómo son los lotes normales. La celda mide los diez lotes de bronce, guarda las métricas en el registro de calidad como revision-inicial y las evalúa contra los umbrales.
bronce = spark.read.parquet(RUTAS["bronce"])linea_base = ce.medir_calidad(bronce).orderBy("lote")linea_base.drop("archivo_origen").show()(linea_base.withColumn("id_ejecucion", F.lit("revision-inicial")).withColumn("aprobado", F.lit(True)) .write.mode("overwrite").parquet(RUTAS["calidad"]))print("Incumplimientos en los lotes ya cargados:", ce.evaluar(linea_base))
Ningún lote de los diez incumple un umbral. Los destinos vacíos van de 0 % a 2.5 %, la cuarentena de 3.88 % a 8.11 %, las guías repetidas de 0 % a 1.67 % y los tardíos de 0 % a 7 %. El lote del 1 de julio no tiene tardíos porque no hay días anteriores en el mes; el del 4 tiene más (7 %) porque su archivo corregido trajo envíos de los días 2 y 3. Estos rangos son la referencia para leer las métricas de un lote nuevo.
4. Cuadres entre capas
NotaCuadre
Un cuadre (reconciliation) comprueba que las cantidades que entran a un paso del pipeline sean iguales a las que salen más las que se apartaron con motivo. Es la prueba de consistencia más simple y la que más errores atrapa: una unión que pierde filas, un filtro que se aplicó dos veces o una escritura que quedó a medias.
La celda hace tres cuadres sobre todo lo cargado: bronce contra válidas más cuarentena, la cuarentena calculada contra la guardada, y las guías válidas distintas contra las filas de la plata.
Los tres cuadres dan True. Bronce tiene 1 937 filas, las mismas que generó el capítulo de ingesta: 1 820 válidas y 117 en cuarentena. La cuarentena guardada tiene también 117. Las 1 820 válidas son 1 802 guías distintas, exactamente las filas de la plata; las 18 restantes eran copias repetidas que el pipeline descartó. Cada fila de bronce está explicada.
5. El esquema como contrato
NotaContrato de datos
Un contrato de datos es el compromiso de una tabla con quienes la usan: qué columnas tiene, de qué tipo y qué significan. Si el pipeline cambia una columna sin avisar, los informes y modelos que dependen de ella pueden romperse, o peor, seguir funcionando con números equivocados. Revisar el esquema contra el contrato en cada ejecución detecta esos cambios antes de que lleguen a los usuarios.
La celda define el contrato de la plata (nombre y tipo de cada columna) y lo compara con la plata real y con una versión que alguien modificó sin cuidado: el peso redondeado a entero y una columna de prueba olvidada.
CONTRATO_PLATA = {"guia": "string", "admision": "timestamp", "entrega": "timestamp", "origen": "string","destino": "string", "distancia_km": "int", "servicio": "string", "canal": "string","operador": "string", "peso_kg": "double", "valor_declarado": "bigint","intentos_entrega": "int", "estado": "string", "archivo_origen": "string", "lote": "date","id_ejecucion": "string", "promesa_horas": "int", "horas_transito": "double","a_tiempo": "boolean", "ruta": "string", "dia_semana": "string", "fin_de_semana": "boolean","destino_remoto": "boolean", "fecha": "date",}def revisar_contrato(tabla, contrato): real =dict(tabla.dtypes) faltan =sorted(set(contrato) -set(real)) sobran =sorted(set(real) -set(contrato)) tipo_distinto =sorted(c for c in contrato if c in real and real[c] != contrato[c])return {"faltan": faltan, "sobran": sobran, "tipo_distinto": tipo_distinto}print("Plata frente al contrato:", revisar_contrato(spark.read.parquet(RUTAS["plata"]), CONTRATO_PLATA))# Un cambio descuidado: alguien guarda el peso redondeado a entero y agrega una columna de pruebacambiada = (spark.read.parquet(RUTAS["plata"]) .withColumn("peso_kg", F.round("peso_kg").cast("int")) .withColumn("columna_de_prueba", F.lit(1)))print("Versión cambiada frente al contrato:", revisar_contrato(cambiada, CONTRATO_PLATA))
Plata frente al contrato: {'faltan': [], 'sobran': [], 'tipo_distinto': []}
Versión cambiada frente al contrato: {'faltan': [], 'sobran': ['columna_de_prueba'], 'tipo_distinto': ['peso_kg']}
La plata real cumple el contrato: no faltan, no sobran ni cambiaron columnas. La versión modificada tiene una columna que sobra, columna_de_prueba, y una con el tipo distinto, peso_kg, que pasó de double a int. Ese segundo cambio no rompería ninguna consulta, pero todos los pesos menores de 0.5 kg pasarían a 0 y la regla de peso mínimo los mandaría a la cuarentena en la siguiente lectura. El contrato lo detecta antes.
6. Pruebas de las transformaciones
NotaPrueba unitaria y caso límite
Una prueba unitaria ejecuta una función con una entrada pequeña, preparada a mano, y comprueba con assert que la salida sea la esperada. Un caso límite es una entrada justo en el borde de una regla, como un envío que tarda exactamente 24 horas en un servicio de 24 horas: ahí es donde los errores de < frente a <= se esconden. Las pruebas no usan los datos reales: usan pocas filas cuya respuesta correcta se conoce de antemano.
Para escribir pruebas cómodas hace falta construir tablas de bronce pequeñas. bronce_de parte de una fila válida, BASE_FILA, y crea una fila por cada diccionario de cambios que recibe.
BASE_FILA = {"guia": "BL-PRUEBA-1", "fecha_admision": "2026-07-03", "hora_admision": "08:00","origen": "Bogotá", "destino": "Cali", "distancia_km": "460", "servicio": "Express","canal": "web", "operador": "OP-A", "peso_kg": "2.5", "valor_declarado": "120000","intentos_entrega": "1", "estado": "entregado", "fecha_hora_entrega": "2026-07-03 20:00",}def bronce_de(*cambios, lote="2026-07-03"):"""Tabla de bronce pequeña: una fila por diccionario de cambios sobre BASE_FILA.""" filas = []for i, cambio inenumerate(cambios): fila = {**BASE_FILA, "guia": f"BL-PRUEBA-{i +1}", **cambio} fila.update({"archivo_origen": cambio.get("archivo_origen", f"envios_{lote}.csv"),"lote": cambio.get("lote", lote), "id_ejecucion": "prueba"}) filas.append(fila) columnas = pe.COLUMNAS + ["archivo_origen", "lote", "id_ejecucion"] tabla = spark.createDataFrame([[f[c] for c in columnas] for f in filas],", ".join(f"{c} string"for c in columnas))return tabla.withColumn("lote", F.to_date("lote"))bronce_de({}, {"origen": "BOGOTA", "servicio": "Expres"}).select("guia", "origen", "servicio", "peso_kg").show()
Con dos diccionarios, bronce_de creó dos filas: la primera igual a la base y la segunda con el origen y el servicio mal escritos, como llegan del sistema de admisión. Así, cada prueba describe solo lo que cambia.
La celda siguiente define siete pruebas, una función por comportamiento del pipeline, y un ejecutor que las corre y reporta cuáles pasan:
prueba_corrige_variantes: «BOGOTA», « cali», «B/quilla», «Bogota D.C.» y «Expres» se corrigen a sus nombres oficiales.
prueba_rechaza_ciudad_inventada: un destino que no está en el catálogo va a la cuarentena con el motivo ciudad_desconocida, y solo con ese.
prueba_limites_de_peso: 0.01 y 150 kg son válidos; 150.01 y 0 no. Son los cuatro casos límite de la regla.
prueba_entrega_antes_de_admision: una entrega anterior a la admisión se rechaza.
prueba_a_tiempo_en_el_limite: un Express de exactamente 24.0 horas está a tiempo; uno de 24.1, no.
prueba_devuelto_no_cuenta: un envío devuelto sin fecha de entrega es válido y no cuenta ni a favor ni en contra del cumplimiento.
prueba_gana_el_lote_mas_reciente: si una guía aparece en dos lotes, queda la del más reciente.
                          prueba resultado detalle
        prueba_corrige_variantes      pasa
 prueba_rechaza_ciudad_inventada      pasa
          prueba_limites_de_peso      pasa
prueba_entrega_antes_de_admision      pasa
    prueba_a_tiempo_en_el_limite      pasa
       prueba_devuelto_no_cuenta      pasa
prueba_gana_el_lote_mas_reciente      pasa

Segundos: 3.4
Las siete pruebas pasan. Tardaron 3.4 segundos, casi todo en lanzar pequeñas tareas de Spark; con datos de pocas filas, una prueba es rápida aunque use el motor completo.
¿Para qué sirven si ya pasan? Para el día en que alguien cambie el código. La celda siguiente simula un cambio que parece inofensivo: en la regla de peso, peso_kg > 150 se reescribe como peso_kg >= 150. Con esas reglas cambiadas, vuelve a correr las pruebas.
reglas_cambiadas = [ (nombre, "peso_kg IS NULL OR peso_kg < 0.01 OR peso_kg >= 150"if nombre =="peso_fuera_de_rango"else condicion)for nombre, condicion in pe.REGLAS]resultado = ejecutar_pruebas(reglas_cambiadas)print(resultado[resultado["resultado"] =="FALLA"].to_string(index=False))
Una prueba falla, prueba_limites_de_peso, y el detalle dice exactamente qué cambió: ahora solo se acepta el peso de 0.01 kg, y el de 150 kg, que el negocio considera válido, se rechaza. Ese error de un carácter es una regresión: algo que funcionaba dejó de funcionar por un cambio. Sin la prueba, el pipeline habría seguido corriendo y los envíos de 150 kg habrían ido a la cuarentena en silencio.
En un proyecto real, estas funciones van en un archivo test_pipeline_envios.py y se ejecutan con pytest, la herramienta estándar de pruebas en Python, cada vez que alguien propone un cambio al código. El formato es el mismo: funciones que empiezan por test_ o prueba_ y usan assert.
7. La puerta de calidad en acción
Llegan dos archivos nuevos. El del 12 de julio es normal. El del 11 viene de un día en que el sistema de admisión falló: cerca del 40 % de los envíos llegó sin destino. Los dos se generan con el mismo generador, con guías que no chocan con las del capítulo anterior, y se dejan en la zona de llegada.
import generar_envios as genrng = random.Random(1112)CARPETA = os.path.abspath("entregas_julio")nuevos = [gen.generar_envio(rng, 7, n) for n inrange(10001, 16001)]def escribir(nombre, filas):withopen(os.path.join(CARPETA, nombre), "w", newline="", encoding="utf-8") as f: escritor = csv.DictWriter(f, fieldnames=gen.COLUMNAS) escritor.writeheader() escritor.writerows(filas)dia_11 = gen.ensuciar(rng, [f for f in nuevos if f["fecha_admision"] =="2026-07-11"], defaultdict(int))dia_12 = gen.ensuciar(rng, [f for f in nuevos if f["fecha_admision"] =="2026-07-12"], defaultdict(int))for fila in dia_11: # una falla en el sistema de origen deja sin destino a muchos envíosif rng.random() <0.40: fila["destino"] =""escribir("envios_2026-07-11.csv", dia_11)escribir("envios_2026-07-12.csv", dia_12)camino, fs = pe.sistema(spark, RUTAS["llegada"])for nombre in ["envios_2026-07-11.csv", "envios_2026-07-12.csv"]: origen = spark._jvm.org.apache.hadoop.fs.Path("file://"+ os.path.join(CARPETA, nombre)) fs.copyFromLocalFile(False, True, origen, camino)print("Pendientes:", [f["archivo"] for f in pe.pendientes(spark, RUTAS).collect()],"| filas:", len(dia_11), "y", len(dia_12))
Pendientes: ['envios_2026-07-12.csv', 'envios_2026-07-11.csv'] | filas: 193 y 221
Hay dos archivos pendientes, el del 11 de julio con 193 filas y el del 12 con 221. Sin la puerta, el pipeline cargaría los dos.
La celda siguiente pasa los pendientes por la puerta de calidad y después ejecuta la carga normal del capítulo de ingesta con lo que quedó en la zona de llegada.
ID ="2026-07-12T23:00"fallas, retenidos = ce.revisar_pendientes(spark, RUTAS, ID)print("Incumplimientos:")for archivo, metrica, valor, umbral in fallas:print(f" {archivo}: {metrica} = {valor} (umbral {umbral})")print("Archivos retenidos:", retenidos)print("Siguen pendientes para cargar:", [f["archivo"] for f in pe.pendientes(spark, RUTAS).collect()])antes = spark.read.parquet(RUTAS["plata"]).count()print(pe.cargar_pendientes(spark, RUTAS, ID))print("Plata antes y después:", antes, spark.read.parquet(RUTAS["plata"]).count())
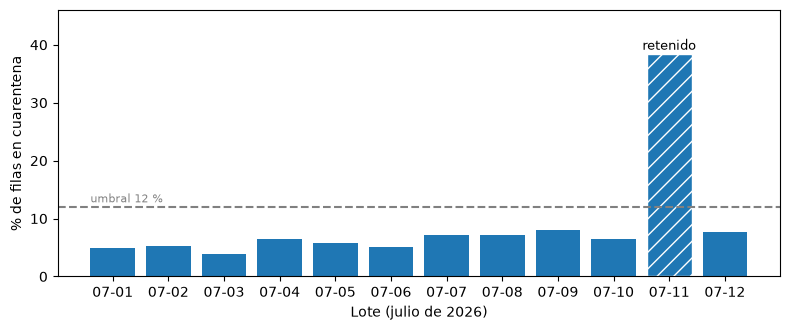
El archivo del 11 de julio incumplió dos umbrales: 33.68 % de destinos vacíos frente a un máximo de 3 %, y 38.34 % de filas en cuarentena frente a 12 %. La puerta lo movió a la carpeta de retenidos, así que ya no está pendiente. El del 12 pasó, la carga lo procesó y la plata pasó de 1 802 a 2 005 envíos. El pipeline no se detuvo: un lote malo quedó apartado y el bueno se publicó.
Sin la puerta, el lote del 11 habría entrado a bronce, el 38 % de sus filas habría ido a la cuarentena y la plata de ese día habría mostrado unos 120 envíos de los 193 recibidos. Un informe de volumen habría reportado una caída que no existió.
El registro de calidad guarda las métricas de cada lote, del 1 al 12 de julio, con el resultado de la puerta.
Figura 20.1: Porcentaje de filas en cuarentena por lote, con el umbral de la puerta de calidad
La barra del 11 de julio se sale de la escala de los demás lotes. Un archivo retenido no es un problema resuelto: alguien tiene que pedirle al sistema de origen el archivo corregido. Cuando llegue, con otro nombre o con otra huella, el registro de cargas lo verá como pendiente, pasará por la puerta y, si cumple, se cargará como en el capítulo anterior. En producción, la puerta también envía un aviso por correo o por chat; el capítulo de orquestación con Airflow se ocupa de eso.
8. Trazabilidad: de dónde salió cada número
NotaLinaje
El linaje (data lineage) es el registro de dónde viene cada dato: de qué archivos de entrada, por qué ejecución, con qué versión del código y de las herramientas. Permite responder «¿de dónde salió este número?» y también la pregunta inversa: «si este archivo estaba mal, ¿qué tablas e informes quedaron afectados?».
El pipeline ya guarda una parte del linaje en cada fila de la plata: archivo_origen, lote e id_ejecucion (la ejecución que cargó ese archivo). Falta el linaje por ejecución. La celda escribe una fila con las entradas de la ejecución del 12 de julio (archivos y huellas), las zonas que escribió, la huella del código de los dos módulos y las versiones de Spark y Python.
codigo = ce.huella_codigo("pipeline_envios.py", "calidad_envios.py")registro = spark.read.parquet(RUTAS["control"]).filter(F.col("id_ejecucion") == ID)linaje = ( registro.agg(F.collect_list(F.concat_ws(":", "archivo", F.substring("huella", 1, 10))).alias("entradas")) .withColumn("id_ejecucion", F.lit(ID)) .withColumn("salidas", F.array(*[F.lit(RUTAS[z].replace(BASE, "/bitlogistica")) for z in ["bronce", "cuarentena", "plata"]])) .withColumn("huella_codigo", F.lit(codigo)) .withColumn("version_spark", F.lit(spark.version)) .withColumn("version_python", F.lit(platform.python_version())) .withColumn("registrado", F.current_timestamp()))linaje.write.mode("append").parquet(RUTAS["linaje"])fila = spark.read.parquet(RUTAS["linaje"]).first()for campo in ["id_ejecucion", "entradas", "salidas", "huella_codigo", "version_spark", "version_python"]:print(f"{campo:15s}{fila[campo]}")
La ejecución 2026-07-12T23:00 tuvo una entrada, envios_2026-07-12.csv, con el comienzo de su huella; escribió en bronce, cuarentena y plata; y la huella del código identifica la versión exacta de los dos módulos. Si mañana alguien cambia una regla, la huella cambiará y quedará claro qué datos se produjeron con cada versión.
Ahora, la pregunta de la gerencia: ¿cuántos envíos Express se admitieron el 5 de julio y qué porcentaje llegó a tiempo? Y, sobre todo, ¿de dónde sale esa cifra?
El 5 de julio se admitieron 44 envíos Express y el 84.1 % llegó a tiempo. La cifra sale de dos archivos. 42 envíos vinieron en envios_2026-07-05.csv, cargado por la ejecución 2026-07-05T23:00, y 2 llegaron tarde en envios_2026-07-06.csv, cargado por la ejecución 2026-07-10T23:00. Cada archivo aparece con su huella, que identifica su contenido exacto. Si el sistema de admisión dijera que el archivo del 6 tenía un error, se sabría de inmediato que esta cifra lo incluye.
9. Herramientas especializadas
El capítulo construyó cada pieza con PySpark para que se vea cómo funciona. En un equipo de datos, varias de estas piezas se toman de herramientas hechas para eso:
Necesidad
En el capítulo
Herramientas habituales
Pruebas de funciones
Funciones prueba_* y un ejecutor propio
pytest, con un SparkSession local compartido entre pruebas
Reglas y métricas de calidad declaradas
UMBRALES, medir_calidad, evaluar
Great Expectations, Deequ (PyDeequ en Python), Soda
Pruebas sobre tablas de un modelo SQL
Cuadres con consultas
Pruebas de dbt (unique, not_null, relationships)
Contrato del esquema
Diccionario CONTRATO_PLATA
Esquemas versionados; formatos de tabla que validan el esquema al escribir, como Iceberg
Linaje
Columnas de procedencia y registro por ejecución
OpenLineage, con Marquez o el catálogo de la plataforma
Lo que no cambia con la herramienta es el diseño: medir cada lote, comparar contra umbrales que salen de lo normal, apartar sin detener todo, probar los casos límite y poder rastrear cada cifra hasta su origen.
Limpiar
La celda cierra la sesión. /bitlogistica/ingesta queda con los registros de cargas, calidad y linaje, y el archivo del 11 de julio en la carpeta de retenidos, para el capítulo de orquestación.
spark.stop()print("Sesión cerrada. /bitlogistica/ingesta queda con los registros de cargas, calidad y linaje;","calidad_envios.py queda en la carpeta del notebook.")
Sesión cerrada. /bitlogistica/ingesta queda con los registros de cargas, calidad y linaje; calidad_envios.py queda en la carpeta del notebook.
La sesión quedó cerrada. En la carpeta del notebook quedan los dos módulos, pipeline_envios.py y calidad_envios.py.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1 y 2 (la sesión y los módulos) y, para los ejercicios 2 a 4, la de la sección 6 que define bronce_de y las pruebas.
Una métrica de validez más. Agrega a medir_calidad el porcentaje de filas con servicio_desconocido y un umbral de 2 %. ¿Algún lote de julio lo incumple?
Una prueba nueva. Escribe prueba_operador_vacio: un envío sin operador debe quedar en la plata con «Sin operador».
Una regresión distinta. Cambia la promesa de Express de 24 a 23 horas en una copia de PROMESA_HORAS y escribe una prueba que lo detecte.
Prueba del cuadre. Escribe una prueba que construya un bronce de cinco filas (dos válidas, una repetida y dos en cuarentena) y compruebe que bronce = válidas + cuarentena y que la plata tiene dos filas.
El archivo corregido. Genera una versión del archivo del 11 de julio con todos los destinos, llámala envios_2026-07-11_v2.csv, hazla llegar y pásala por la puerta y por la carga. ¿Cuántos envíos tiene la plata del 11 de julio?
Rastrear hacia adelante. Para el archivo envios_2026-07-04_v2.csv, lista las fechas de la plata que tienen envíos que vinieron de él y cuántos de cada una.
TipOrientaciones
Agrega F.round(100 * F.avg(F.array_contains("motivos", "servicio_desconocido").cast("int")), 2) a la agregación y la entrada correspondiente a UMBRALES. El generador pone un servicio inválido en cerca del 0.3 % de las filas, así que ningún lote debería incumplir un 2 %.
bronce_de({"operador": None}), después normalizar, validar y a_plata; comprueba que motivos esté vacío y operador sea «Sin operador».
La prueba de 24.0 horas fallaría con la promesa cambiada, porque 24 > 23. Basta con reutilizar prueba_a_tiempo_en_el_limite; para inyectar la promesa, cambia pe.PROMESA_HORAS dentro de la prueba y restáurala al final.
Usa bronce_de con una fila base, otra con su misma guía, una con peso 9999 y una con destino inventado. Cuenta con validar las de motivos vacío y lleno, y aplica quitar_duplicados y a_plata a las válidas.
El archivo corregido pasa la puerta: sus métricas vuelven a los rangos normales. La plata del 11 de julio queda con unas 180 filas, el total del archivo menos la cuarentena normal y los duplicados.
plata.filter(F.col("archivo_origen") == "envios_2026-07-04_v2.csv").groupBy("fecha").count(). Salen el 2, el 3 y el 4 de julio, porque el archivo traía envíos tardíos de los dos días anteriores.
Errores frecuentes
Síntoma
Causa
Arreglo
Falta /bitlogistica/ingesta al iniciar
No se ejecutó el capítulo de ingesta o se borró su zona.
Ejecutar ese capítulo completo antes de este.
La puerta retiene lotes normales
Los umbrales son más estrictos que la variación normal de los datos.
Fijarlos a partir de la línea base, con margen.
Una prueba pasa aunque el código esté mal
La prueba no cubre el caso límite donde está el error.
Probar los bordes de cada regla: justo dentro y justo fuera.
El cuadre no da, pero no hay errores visibles
Una unión interna perdió filas o una escritura quedó a medias.
Cuadrar paso por paso hasta encontrar dónde se pierden.
Las pruebas tardan mucho
Cada prueba crea su propia sesión de Spark o lee datos reales.
Una sesión compartida y tablas de pocas filas creadas en memoria.
No se sabe con qué versión del código se produjo un dato
No se registró la huella del código en cada ejecución.
Guardar la huella de los módulos en el registro de linaje.
Preguntas de comprensión
¿Por qué el porcentaje de destinos vacíos se mide en el dato crudo y no después de normalizar?
¿Qué diferencia hay entre apartar una fila en la cuarentena y retener un archivo completo?
¿Por qué las pruebas usan datos preparados a mano y no los archivos reales de julio?
Si la puerta retiene un archivo, ¿qué impide que la siguiente ejecución lo cargue sin revisar?
¿Qué preguntas responde el linaje que no responden las columnas archivo_origen y lote de la plata?
TipOrientaciones
Porque después de normalizar, un destino vacío y uno inventado («Ciudad Gótica») quedan iguales, nulos. Medido en el crudo, el porcentaje de vacíos describe un problema concreto del sistema de origen, distinto de un error de escritura.
La cuarentena aparta filas sueltas que incumplen reglas, mientras el resto del archivo se publica: es la calidad normal del día a día. Retener un archivo completo es para cuando el problema es del lote entero, como un sistema que dejó de enviar destinos: publicar sus filas buenas daría una imagen falsa del día.
Porque con datos preparados se conoce de antemano la respuesta correcta y se pueden construir los casos límite a propósito. Con los datos reales, una prueba no sabría qué esperar, tardaría más y cambiaría su resultado cada vez que llegaran datos nuevos.
Que la puerta lo mueve fuera de la zona de llegada, a la carpeta de retenidos. La carga solo mira la zona de llegada, así que no lo verá hasta que alguien deje allí una versión corregida.
Las columnas dicen de qué archivo vino cada fila. El registro de linaje agrega con qué versión del código y de las herramientas se procesó, qué zonas escribió cada ejecución y la huella exacta de cada entrada. Con eso se puede saber si dos cifras son comparables o si se produjeron con reglas distintas.
Glosario
Término
Significado en este capítulo
Dimensión de calidad
Aspecto que se mide de un dato: completitud, validez, unicidad, consistencia u oportunidad.
Métrica de calidad
Número que mide una dimensión, como el porcentaje de destinos vacíos.
Umbral
Valor que una métrica no debe cruzar.
Línea base
Valores normales de las métricas, medidos en lotes que se sabe que están bien.
Puerta de calidad
Paso que mide cada lote y retiene los que incumplen algún umbral.
Lote retenido
Archivo apartado por la puerta, que no se publica hasta revisarlo.
Cuadre
Comprobación de que lo que entra a un paso es igual a lo que sale más lo apartado.
Contrato de datos
Compromiso sobre las columnas, tipos y significado de una tabla.
Prueba unitaria
Ejecución de una función con una entrada pequeña y una salida esperada conocida.
Caso límite
Entrada justo en el borde de una regla.
Regresión
Algo que funcionaba y dejó de funcionar por un cambio.
Linaje
Registro de dónde viene cada dato: entradas, ejecución, código y versiones.
Referencias para profundizar
Wang, R. Y. y Strong, D. M. (1996). Beyond Accuracy: What Data Quality Means to Data Consumers. Journal of Management Information Systems, 12(4). El origen de las dimensiones de calidad.
OpenLineage: estándar abierto para registrar linaje.
Reis, J. y Housley, M. (2022). Fundamentals of Data Engineering. O’Reilly Media. Capítulo 2, sobre calidad y gobierno de datos.
Resumen
Sobre el pipeline de ingesta de BITLogística mediste la calidad de cada lote en una sola agregación: en los diez lotes de julio, la cuarentena estuvo entre 3.88 % y 8.11 % y ningún umbral se incumplió. Los cuadres explicaron cada fila: 1 937 en bronce = 1 820 válidas + 117 en cuarentena, y 1 802 guías distintas = 1 802 filas de plata. El contrato del esquema detectó un peso convertido a entero y una columna olvidada. Siete pruebas con datos pequeños comprobaron las reglas, incluidos los casos límite, y una de ellas detectó la regresión de cambiar > por >= en la regla de peso. La puerta de calidad retuvo el archivo del 11 de julio, con 33.68 % de destinos vacíos, y dejó pasar el del 12, que llevó la plata a 2 005 envíos. El linaje rastreó el 84.1 % de cumplimiento Express del 5 de julio hasta dos archivos, sus huellas y las ejecuciones que los cargaron.
El capítulo siguiente, Optimización de Spark, cambia de pregunta: ya no si los datos están bien, sino por qué un trabajo tarda lo que tarda y qué se puede cambiar para que tarde menos.