26Spark Structured Streaming: del tópico de Kafka al lago, a medida que llegan los eventos
big-data
ingenieria-datos
spark
streaming
kafka
databricks
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
8 de noviembre de 2026
El problema que vas a resolver
En el capítulo de Kafka, los eventos de los envíos de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) llegaban a un tópico segundos después de ocurrir, y un consumidor de Python mantenía el estado de cada guía en un diccionario. Funcionaba para 624 eventos, pero ese consumidor no escala a millones por hora, no guarda nada en el lago y, si se cae, pierde el diccionario.
El área de operaciones quiere dos cosas: los eventos por hora (admisiones, salidas a ruta y entregas), escritos en el lago a medida que cada hora termina, y una tabla con el último estado de cada envío, siempre al día. Este capítulo las construye con Spark Structured Streaming: la misma API de DataFrames de todo el libro, aplicada a datos que no terminan de llegar. La consulta lee el tópico de Kafka en el clúster, procesa por micro-lotes, recuerda lo que ya leyó en un checkpoint, descarta los eventos que llegan demasiado tarde y escribe en Parquet y en una tabla Iceberg. Al final, el mismo modelo en Databricks, con Auto Loader.
Ficha
En este capítulo
Pregunta
¿Cómo se procesan con Spark datos que no terminan de llegar, sin perder ni repetir eventos y sin esperar al final del día?
Datos
Los 624 eventos de los 208 envíos admitidos el 13 de julio, publicados en tres tandas, más tres eventos tardíos y dos de prueba
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster (el archivo se llama taller_streaming_kafka.ipynb dentro de talleres-notebooks.zip; el arranque y la descarga están en el apéndice «Operar el clúster»). Necesita tres cosas de capítulos anteriores, pero no sus datos:
El broker de Kafka y el cliente confluent-kafka, de «Antes de empezar» del capítulo de Kafka. Enciende el clúster con dck, que incluye el archivo compose.kafka.yaml: dck up -d.
generar_envios.py en la carpeta notebooks, que viene en el zip.
Además, Spark necesita el conector de Kafka, que no viene incluido: cuatro .jar que se descargan una vez. Desde la terminal de Ubuntu:
cd ~/hdfs-docker-lab/notebooks/jars &&M=https://repo1.maven.org/maven2 &&curl-LO$M/org/apache/spark/spark-sql-kafka-0-10_2.12/3.5.3/spark-sql-kafka-0-10_2.12-3.5.3.jar &&curl-LO$M/org/apache/spark/spark-token-provider-kafka-0-10_2.12/3.5.3/spark-token-provider-kafka-0-10_2.12-3.5.3.jar &&curl-LO$M/org/apache/kafka/kafka-clients/3.4.1/kafka-clients-3.4.1.jar &&curl-LO$M/org/apache/commons/commons-pool2/2.11.1/commons-pool2-2.11.1.jar &&ls-l
Salida esperada: los cuatro archivos nuevos junto al de Iceberg. El primero es el conector; los otros tres son sus dependencias: el cliente de Kafka para Java, la gestión de credenciales y un grupo de conexiones reutilizables. Las versiones van amarradas a Spark 3.5.3 y funcionan con el Java 8 de los NodeManagers.
El capítulo trabaja en su propio tópico, envios-vivo, y en su propia carpeta de HDFS, /bitlogistica/streaming. La primera celda borra lo que haya de una ejecución anterior.
1. El modelo: una tabla que no termina
NotaStructured Streaming
Structured Streaming es la forma de Spark de procesar datos que siguen llegando. La idea central es tratar el flujo como una tabla sin fin: cada evento nuevo es una fila que se agrega al final. La consulta se escribe con la misma API de DataFrames o SQL que una consulta normal, y Spark la ejecuta una y otra vez sobre las filas nuevas, actualizando el resultado.
NotaMicro-lote, disparador y checkpoint
Spark procesa el flujo en micro-lotes: toma las filas que llegaron desde la última vez, las procesa como un trabajo normal y actualiza el resultado. El disparador (trigger) decide cuándo hay un micro-lote: availableNow procesa todo lo que hay y se detiene; processingTime="5 seconds" revisa cada cinco segundos, sin detenerse. El checkpoint es una carpeta donde la consulta anota qué leyó en cada micro-lote y el estado que necesita para seguir; con ella, una consulta detenida sigue donde iba.
NotaFuente, sumidero y modo de salida
La fuente (source) es de donde se lee: Kafka, una carpeta donde aparecen archivos, una tabla. El sumidero (sink) es donde se escribe el resultado: archivos, una tabla, la memoria, o una función propia con foreachBatch. El modo de salida dice qué filas del resultado se escriben en cada micro-lote: complete escribe el resultado completo, append solo las filas nuevas que ya no van a cambiar, y update las filas que cambiaron.
La diferencia con el consumidor de Python del capítulo de Kafka es que Spark se encarga de lo difícil: reparte la lectura de las particiones entre los executors, lleva los offsets en el checkpoint, mantiene el estado de las agregaciones entre micro-lotes y, con un sumidero idempotente o transaccional, garantiza que cada evento cuente exactamente una vez.
2. La sesión y el tópico del capítulo
La sesión carga los cinco .jar (el conector de Kafka con sus tres dependencias y el de Iceberg) y define el catálogo lago del capítulo de Iceberg. Dos opciones son propias de streaming:
spark.sql.shuffle.partitions = 4: cada micro-lote es pequeño; con las 200 particiones por defecto, cada agregación lanzaría 200 tareas casi vacías por lote.
spark.sql.session.timeZone = UTC: las horas de los eventos vienen sin zona horaria y las ventanas se cortan por hora; fijar la zona hace que el resultado no dependa del contenedor.
import jsonimport osimport platformimport randomimport threadingimport timefrom collections import Counterfrom datetime import datetime, timedeltaimport matplotlib.pyplot as pltimport pandas as pdfrom confluent_kafka import Producerfrom confluent_kafka.admin import AdminClient, NewTopicfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as Ffrom pyspark.sql.types import StringType, StructField, StructTypefrom pyspark.sql.window import Windowimport generar_envios as genBROKER ="kafka:9092"TOPICO ="envios-vivo"# tópico propio de este capítuloBASE ="hdfs://namenode:9000/bitlogistica/streaming"# resultados y checkpointsJARS_KAFKA = ["spark-sql-kafka-0-10_2.12-3.5.3.jar", "spark-token-provider-kafka-0-10_2.12-3.5.3.jar","kafka-clients-3.4.1.jar", "commons-pool2-2.11.1.jar"]JAR_ICEBERG ="iceberg-spark-runtime-3.5_2.12-1.6.1.jar"JARS = [os.path.abspath("jars/"+ nombre) for nombre in JARS_KAFKA + [JAR_ICEBERG]]for jar in JARS:assert os.path.exists(jar), f"Falta {os.path.basename(jar)} en notebooks/jars (sección Antes de empezar)"spark = ( SparkSession.builder .appName("structured-streaming") .config("spark.jars", ",".join(JARS)) .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions") .config("spark.sql.catalog.lago", "org.apache.iceberg.spark.SparkCatalog") .config("spark.sql.catalog.lago.type", "hadoop") .config("spark.sql.catalog.lago.warehouse", "hdfs://namenode:9000/bitlogistica/lakehouse") .config("spark.sql.catalog.lago.cache-enabled", "false") # ver al instante lo que escribe cada micro-lote .config("spark.sql.shuffle.partitions", "4") # micro-lotes pequeños: pocas particiones .config("spark.sql.session.timeZone", "UTC") # las horas de los eventos no traen zona .config("spark.ui.showConsoleProgress", "false") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"# 1. Empezar desde cero: sin resultados ni checkpoints de una ejecución anteriorruta = sc._jvm.org.apache.hadoop.fs.Path(BASE)print("Zona de una ejecución anterior borrada:", ruta.getFileSystem(sc._jsc.hadoopConfiguration()).delete(ruta, True))spark.sql("DROP TABLE IF EXISTS lago.bitlogistica.estado_envios")print("Python", platform.python_version(), "| Spark", spark.version, "| aplicación", sc.applicationId)
26/11/10 19:53:20 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/11/10 19:53:22 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
Zona de una ejecución anterior borrada: False
Python 3.11.10 | Spark 3.5.3 | aplicación application_1794339532453_0001
La sesión quedó en YARN. La primera línea dice True si había una carpeta de una ejecución anterior y la borró.
La siguiente celda recrea el tópico envios-vivo con tres particiones, genera los mismos 624 eventos del capítulo de Kafka (semilla 2513, envíos admitidos el 13 de julio) y los separa en tres tandas por la hora del evento: la mañana del 13, la tarde del 13 y los días siguientes. Publica solo la mañana: el resto llegará más adelante, como en un día real.
admin = AdminClient({"bootstrap.servers": BROKER})if TOPICO in admin.list_topics(timeout=15).topics: admin.delete_topics([TOPICO])[TOPICO].result()while TOPICO in admin.list_topics(timeout=15).topics: time.sleep(1)admin.create_topics([NewTopic(TOPICO, num_partitions=3, replication_factor=1)])[TOPICO].result()# 2. Los mismos eventos del capítulo de Kafka: envíos admitidos el 13 de juliorng = random.Random(2513)envios = [e for e in (gen.generar_envio(rng, 7, n) for n inrange(1, 6001)) if e["fecha_admision"] =="2026-07-13"]def eventos_de(envio): admision = datetime.strptime(envio["fecha_admision"] +" "+ envio["hora_admision"], "%Y-%m-%d %H:%M")if envio["estado"] =="entregado": final = datetime.strptime(envio["fecha_hora_entrega"], "%Y-%m-%d %H:%M") tipo_final, ciudad_final ="entregado", envio["destino"]else: final = admision + timedelta(hours=96) tipo_final, ciudad_final ="devuelto", envio["origen"] salida = admision +min(timedelta(minutes=rng.randint(60, 240)), (final - admision) /2) comun = {k: envio[k] for k in ["guia", "servicio", "operador", "origen", "destino"]}return [ {**comun, "tipo": "admitido", "momento": admision.isoformat(), "ciudad": envio["origen"]}, {**comun, "tipo": "en_ruta", "momento": salida.isoformat(), "ciudad": envio["origen"]}, {**comun, "tipo": tipo_final, "momento": final.isoformat(), "ciudad": ciudad_final}, ]eventos =sorted((ev for e in envios for ev in eventos_de(e)), key=lambda ev: ev["momento"])productor = Producer({"bootstrap.servers": BROKER, "acks": "all", "enable.idempotence": True,"partitioner": "murmur2_random"})def publicar(lista):for ev in lista: productor.produce(TOPICO, key=ev["guia"], value=json.dumps(ev, ensure_ascii=False)) productor.poll(0) productor.flush(30)manana = [ev for ev in eventos if ev["momento"] <"2026-07-13T12:00:00"]tarde = [ev for ev in eventos if"2026-07-13T12:00:00"<= ev["momento"] <"2026-07-14T00:00:00"]despues = [ev for ev in eventos if ev["momento"] >="2026-07-14T00:00:00"]publicar(manana)print("Eventos:", len(eventos), "| mañana del 13:", len(manana), "| tarde del 13:", len(tarde), "| días siguientes:", len(despues))print("Publicados los de la mañana en", TOPICO)
Eventos: 624 | mañana del 13: 134 | tarde del 13: 302 | días siguientes: 188
Publicados los de la mañana en envios-vivo
De los 624 eventos, 134 son de la mañana del 13, 302 de la tarde y 188 de los días siguientes. El tópico tiene, por ahora, los 134 de la mañana.
3. Leer el tópico como un DataFrame
spark.readStream es el spark.read de streaming. Con el formato kafka, cada mensaje del tópico es una fila con columnas fijas: key y value (en bytes), topic, partition, offset y timestamp (la hora de publicación). La función leer_eventos convierte el valor en texto, lo interpreta como JSON con from_json y un esquema, y deja una fila por evento con sus columnas de negocio. startingOffsets = earliest dice desde dónde empezar la primera vez que una consulta lee el tópico; después manda el checkpoint.
ESQUEMA = StructType([StructField(c, StringType()) for c in ["guia", "servicio", "operador", "origen", "destino", "tipo", "momento", "ciudad"]])def leer_eventos():"""El tópico como tabla sin fin: una fila por mensaje, con el valor JSON ya convertido en columnas.""" crudo = ( spark.readStream.format("kafka") .option("kafka.bootstrap.servers", BROKER) .option("subscribe", TOPICO) .option("startingOffsets", "earliest") # la primera vez, desde el principio del tópico .load() )return ( crudo.select(F.col("partition").alias("particion"), "offset", F.col("timestamp").alias("publicado"), F.from_json(F.col("value").cast("string"), ESQUEMA).alias("ev")) .select("particion", "offset", "publicado", "ev.*") .withColumn("momento", F.to_timestamp("momento")) )eventos_df = leer_eventos()print("¿Es un stream?", eventos_df.isStreaming)eventos_df.printSchema()
isStreaming es True: el DataFrame describe un flujo, no datos ya leídos. Por eso no tiene sentido eventos_df.count() ni show(): no hay un final hasta donde contar. Para ver resultados hay que iniciar una consulta con writeStream. El esquema tiene la partición, el offset y la hora de publicación de Kafka, y las ocho columnas del evento, con momento ya convertido en marca de tiempo.
# 3. Primera consulta: cuántos eventos de cada tipo, en una tabla en memoriaconteo = ( eventos_df.groupBy("tipo").count() .writeStream .format("memory").queryName("conteo_tipos") # el resultado queda como tabla temporal .outputMode("complete") # en cada micro-lote, la tabla completa .trigger(availableNow=True) # procesa lo que hay y se detiene .start())conteo.awaitTermination()spark.table("conteo_tipos").orderBy("tipo").show()print("Micro-lotes:", len(conteo.recentProgress), "| filas leídas:", sum(p["numInputRows"] for p in conteo.recentProgress))
La consulta leyó los 134 eventos de la mañana en un solo micro-lote: 92 admisiones y 42 salidas a ruta; todavía no hay entregas. Con outputMode("complete"), la tabla en memoria conteo_tipos tiene siempre el conteo completo, y con availableNow la consulta se detuvo sola al terminar lo que había. El sumidero de memoria sirve para mirar y probar; no guarda nada si se cierra la sesión.
4. Ventanas por la hora del evento y marca de agua
Las admisiones por hora se cuentan por la hora en que ocurrió cada admisión, el campo momento, no por la hora en que llegó a Kafka. Eso se llama agrupar por hora del evento.
NotaVentana
Una ventana agrupa los eventos por intervalos de tiempo. F.window("momento", "1 hour") asigna cada evento a la hora a la que pertenece: un evento de las 09:05 cae en la ventana de 09:00 a 10:00. Es una columna más del groupBy.
NotaMarca de agua
La marca de agua (watermark) es la respuesta a una pregunta que el streaming no puede evitar: ¿hasta cuándo esperar a los eventos atrasados? Con withWatermark("momento", "1 hour"), Spark lleva la cuenta del evento más reciente que ha visto y fija la marca una hora antes. Una ventana que termina antes de la marca se da por cerrada: se escribe y su estado se borra. Un evento que llega con una hora anterior a la marca se descarta.
La consulta de la celda cuenta los eventos por ventana de una hora y por tipo, y los escribe en Parquet, en /bitlogistica/streaming/eventos_por_hora, con modo append: solo se escriben ventanas cerradas, que ya no van a cambiar. Su checkpoint queda en /bitlogistica/streaming/checkpoints/eventos_por_hora. La función resumen lee el progreso de cada micro-lote: cuántas filas leyó y con qué marca de agua trabajó; escritas muestra las ventanas ya escritas, una fila por hora y una columna por tipo.
La consulta agrupa por tipo en lugar de filtrar solo las admisiones antes de agrupar, y la razón es la marca de agua: Spark la calcula con los eventos que llegan a la agregación. Si se filtraran solo las admisiones, las entregas y salidas a ruta de la noche no la moverían, y las últimas ventanas de admisiones no se cerrarían nunca.
# 4. Eventos por hora del evento y tipo, con una marca de agua de una hora, escritos en Parquetdef lanzar_ventanas(): por_hora = ( eventos_df .withWatermark("momento", "1 hour") # esperar hasta una hora a los eventos tardíos .groupBy(F.window("momento", "1 hour").alias("ventana"), "tipo") .count() .select(F.col("ventana.start").alias("desde"), F.col("ventana.end").alias("hasta"),"tipo", F.col("count").alias("eventos")) )return ( por_hora.writeStream .format("parquet") .option("path", BASE +"/eventos_por_hora") .option("checkpointLocation", BASE +"/checkpoints/eventos_por_hora") .outputMode("append") # solo ventanas cerradas por la marca de agua .trigger(availableNow=True) .start() )def resumen(consulta):"""Por micro-lote: filas leídas y marca de agua al terminar."""return pd.DataFrame([{"lote": p["batchId"], "filas": p["numInputRows"],"marca_de_agua": p["eventTime"].get("watermark", "")[:16]}for p in consulta.recentProgress])def escritas():"""Las ventanas ya escritas, una fila por hora y una columna por tipo de evento.""" tabla = spark.read.parquet(BASE +"/eventos_por_hora").toPandas()if tabla.empty:return tabla tabla["hora"] = tabla["desde"].dt.strftime("%m-%d %H")return tabla.pivot_table(index="hora", columns="tipo", values="eventos", fill_value=0).astype(int)consulta = lanzar_ventanas()consulta.awaitTermination()print(resumen(consulta).to_string(index=False))print(escritas().to_string())
La consulta hizo dos micro-lotes. El lote 0 leyó los 134 eventos con la marca de agua todavía en el origen del tiempo, 1970, porque no había visto ningún evento. Al terminar, el evento más reciente era de las 11:59, así que la marca quedó en 10:59. Como cambió la marca, Spark corrió el lote 1, sin filas nuevas, solo para cerrar las ventanas que ya habían quedado atrás: las de 7, 8 y 9, con 18 admisiones cada una y 0, 3 y 10 salidas a ruta. La ventana de las 10 termina a las 11:00, después de la marca, y queda abierta en el estado, esperando eventos atrasados.
5. Seguir donde iba: la tarde del 13
La celda publica los 302 eventos de la tarde y lanza la misma consulta con el mismo checkpoint. No hay que decirle desde qué offset leer.
# 5. Llega la tarde del 13. La misma consulta, con el mismo checkpoint, sigue donde ibapublicar(tarde)consulta = lanzar_ventanas()consulta.awaitTermination()print(resumen(consulta).to_string(index=False))tabla = escritas()print("Horas escritas:", len(tabla), "| admisiones:", int(tabla["admitido"].sum()))print(tabla.tail(4).to_string())
Los lotes siguieron la numeración: el lote 2 leyó solo los 302 eventos nuevos, empezando con la marca que había dejado la ejecución anterior, 10:59, y el lote 3 cerró las ventanas que la nueva marca, 22:57, dejó atrás. Hay 15 horas escritas, de las 7 a las 21, con las 208 admisiones del día: la última fue a las 18. Las ventanas de las 22 y las 23 siguen abiertas, con salidas a ruta y entregas que todavía podrían recibir eventos atrasados.
Ese es el trabajo del checkpoint: la consulta se detuvo, la sesión pudo haberse cerrado, y al volver leyó desde el siguiente offset de cada partición, con el estado de las ventanas abiertas intacto.
6. Eventos tardíos
Un problema real: el sistema de una oficina estuvo sin conexión y manda ahora tres admisiones de las 9 de la mañana. Con ellas llegan dos entregas del día siguiente. Las guías llevan un sufijo, -T y -N, para distinguirlas de las originales.
# 6. Eventos tardíos: tres admisiones de las 9 de la mañana que llegan ahoratardios = [dict(ev, guia=ev["guia"] +"-T") for ev in eventos if ev["tipo"] =="admitido"and ev["momento"].startswith("2026-07-13T09")][:3]nuevos = [dict(ev, guia=ev["guia"] +"-N") for ev in despues[:2]] # y dos eventos del día siguientepublicar(tardios + nuevos)print("Momento de los tardíos:", [ev["momento"][11:16] for ev in tardios])antes = escritas()consulta = lanzar_ventanas()consulta.awaitTermination()print(resumen(consulta).to_string(index=False))ahora = escritas()print("Horas escritas antes:", len(antes), "| después:", len(ahora),"| admisiones de las 9:", int(ahora.loc["07-13 09", "admitido"]))print(ahora.tail(4).to_string())
Momento de los tardíos: ['09:05', '09:05', '09:09']
 lote  filas    marca_de_agua
    4      5 2026-07-13T22:57
    5      0 2026-07-13T23:39
Horas escritas antes: 15 | después: 16 | admisiones de las 9: 18
tipo      admitido  en_ruta  entregado
hora
07-13 19         0       17          5
07-13 20         0       16          0
07-13 21         0        8          4
07-13 22         0        2          5
Los tres eventos tardíos tienen hora 09:05, 09:05 y 09:09, y la marca de agua estaba en 22:57. La consulta los leyó (el lote 4 tiene 5 filas: los 3 tardíos y las 2 entregas) pero los descartó: la ventana de las 9 sigue con 18 admisiones. Las dos entregas del 14, de las 00:12 y las 00:39, sí movieron la marca a las 23:39, y el lote 5, sin filas, cerró la ventana de las 22: ahora hay 16 horas escritas.
La marca de agua es un compromiso. Con una marca de una hora, una ventana se escribe una hora después de terminar, y un evento con más de una hora de atraso se pierde para esta consulta. Con una marca de un día, casi ningún evento se pierde, pero cada ventana tarda un día en escribirse y el estado guarda un día de ventanas abiertas. El valor sale del negocio: cuánto atraso es normal y cuánto se puede esperar un resultado. Los eventos descartados no desaparecen: siguen en Kafka, y una consulta por lotes puede recalcular el día completo, como en el capítulo de ingesta.
7. Qué guarda el checkpoint
La celda lista la carpeta del checkpoint y lee el registro de offsets del último lote.
# 7. Qué guarda el checkpoint: lo leído de cada partición, lote por lotehadoop = sc._jvm.org.apache.hadoop.fsfs = hadoop.Path(BASE).getFileSystem(sc._jsc.hadoopConfiguration())carpeta = BASE +"/checkpoints/eventos_por_hora"print("Carpetas:", sorted(e.getPath().getName() for e in fs.listStatus(hadoop.Path(carpeta))))lotes =sorted(int(e.getPath().getName()) for e in fs.listStatus(hadoop.Path(carpeta +"/offsets"))if e.getPath().getName().isdigit())ultimo = carpeta +f"/offsets/{lotes[-1]}"lector = sc._jvm.java.io.BufferedReader(sc._jvm.java.io.InputStreamReader(fs.open(hadoop.Path(ultimo))))lineas = []linea = lector.readLine()while linea isnotNone: lineas.append(linea) linea = lector.readLine()lector.close()print("Lotes registrados:", lotes)print(f"offsets/{lotes[-1]} (última línea):", lineas[-1])
El checkpoint tiene cinco partes: metadata, con el identificador de la consulta; sources, con la descripción de la fuente; offsets, con un archivo por lote que dice hasta qué offset de cada partición del tópico se leyó; commits, con un archivo por lote terminado; y state, con el estado de las ventanas abiertas. Están registrados los lotes 0 a 5. La última línea de offsets/5 es un JSON con el offset siguiente de cada partición de envios-vivo, {"envios-vivo":{"2":127,"1":178,"0":136}}: lo que la próxima ejecución empezará a leer. Las tres cifras suman 441, los 436 eventos del 13 más los 5 de la sección 6.
El orden importa. Spark escribe primero en offsets lo que va a leer, procesa el lote, escribe el resultado y solo al final escribe en commits. Si se cae en el medio, al volver encuentra un lote en offsets sin su commit y lo repite completo, con los mismos offsets. Con un sumidero que tolera repetir un lote (los archivos del sumidero Parquet se confirman en un registro propio, y un MERGE es idempotente), el resultado cuenta cada evento exactamente una vez.
8. foreachBatch: el último estado de cada envío en Iceberg
Ningún sumidero incluido hace «actualizar la fila de cada guía». Para eso está foreachBatch: Spark llama a una función propia con cada micro-lote como un DataFrame normal, y la función puede hacer cualquier cosa con él. Aquí, actualizar_estado se queda con el evento más reciente de cada guía dentro del lote y lo aplica con MERGE sobre la tabla Iceberg lago.bitlogistica.estado_envios: actualiza si el evento es más reciente que el guardado e inserta si la guía es nueva.
La condición s.momento > t.momento hace el MERGE idempotente y a prueba de desorden: si un lote se repite después de una caída, o si un evento viejo llega después de uno nuevo, el estado no retrocede. La opción cache-enabled = false del catálogo, en la sesión, hace que cada lectura de la tabla vea la última escritura de los micro-lotes.
# 8. El último estado de cada guía en una tabla Iceberg, actualizado con MERGE en cada micro-lotespark.sql(""" CREATE TABLE lago.bitlogistica.estado_envios ( guia STRING, tipo STRING, momento TIMESTAMP, ciudad STRING, servicio STRING, lote BIGINT) USING iceberg""")def actualizar_estado(lote, id_lote):"""foreachBatch: Spark llama a esta función con cada micro-lote como un DataFrame normal.""" ultimo = ( lote.withColumn("orden", F.row_number().over(Window.partitionBy("guia").orderBy(F.desc("momento")))) .filter("orden = 1") .select("guia", "tipo", "momento", "ciudad", "servicio", F.lit(id_lote).alias("lote")) ) ultimo.createOrReplaceTempView("cambios") ultimo.sparkSession.sql(""" MERGE INTO lago.bitlogistica.estado_envios AS t USING cambios AS s ON t.guia = s.guia WHEN MATCHED AND s.momento > t.momento THEN UPDATE SET * WHEN NOT MATCHED THEN INSERT * """)def lanzar_estado(disparador):return ( eventos_df.writeStream .foreachBatch(actualizar_estado) .option("checkpointLocation", BASE +"/checkpoints/estado_envios") .trigger(**disparador) .start() )consulta = lanzar_estado({"availableNow": True})consulta.awaitTermination()estado = spark.table("lago.bitlogistica.estado_envios")print("Guías en la tabla:", estado.count())estado.groupBy("tipo").count().orderBy("tipo").show()
Guías en la tabla: 213
+---------+-----+
|     tipo|count|
+---------+-----+
| admitido|    3|
|  en_ruta|  188|
|entregado|   22|
+---------+-----+
La tabla tiene 213 guías: los 208 envíos del 13, las 3 guías tardías (-T) y las 2 de prueba (-N). Esta consulta tiene su propio checkpoint, así que leyó el tópico completo desde el principio, y como no agrupa por ventanas no tiene marca de agua: los tres eventos tardíos sí entraron, como admitido. Las 188 guías restantes están en_ruta y 22 están entregadas: las 20 entregas del mismo 13 y las 2 de prueba.
9. En vivo: un disparador cada cinco segundos
Hasta aquí, cada consulta procesó lo que había y se detuvo. La celda siguiente lanza la consulta de estado con processingTime="5 seconds" y, al mismo tiempo, un hilo publica los 188 eventos de los días siguientes en tandas de 20, cada 2 segundos. Mientras tanto, el notebook muestra el progreso de cada micro-lote con filas: cuándo ocurrió, cuántas filas leyó y a qué ritmo las procesó. Al terminar la publicación, detiene la consulta con stop().
# 9. En vivo: la consulta revisa el tópico cada 5 segundos mientras otro hilo publica los días siguientesdef publicar_despacio(lista, por_tanda=20, pausa=2.0):for i inrange(0, len(lista), por_tanda): publicar(lista[i:i + por_tanda]) time.sleep(pausa)resto = despues # entregas y devoluciones del 14 en adelantehilo = threading.Thread(target=publicar_despacio, args=(resto,))consulta = lanzar_estado({"processingTime": "5 seconds"})hilo.start()inicio = time.time()vistos =set()while time.time() - inicio <60:for p in consulta.recentProgress:if p["batchId"] notin vistos and p["numInputRows"] >0: vistos.add(p["batchId"])print(f"{time.time() - inicio:5.1f} s | lote {p['batchId']:2d} | filas {p['numInputRows']:3d} | "f"{p['processedRowsPerSecond']:6.1f} filas/s")ifnot hilo.is_alive() and consulta.status["isDataAvailable"] isFalseandlen(vistos) >0\and time.time() - inicio >20:break time.sleep(1)hilo.join()consulta.stop()print()print("Publicados en vivo:", len(resto))spark.table("lago.bitlogistica.estado_envios").groupBy("tipo").count().orderBy("tipo").show()
Cada cinco segundos hubo un micro-lote con las tandas que habían llegado desde el anterior, de 40 a 120 filas, procesadas a un ritmo de 13 a 42 filas por segundo, que en este clúster está dominado por el costo fijo de cada micro-lote (planear, lanzar las tareas en YARN y confirmar el MERGE en Iceberg). Los números exactos cambian en cada ejecución, porque dependen de cuántas tandas alcanzan a llegar entre un disparo y el siguiente. Al final, la tabla quedó con 205 envíos entregados, 3 devueltos, 3 tardíos admitidos y las 2 guías de prueba entregadas: el mismo estado final del consumidor del capítulo de Kafka, ahora guardado en una tabla del lago.
Con processingTime, la latencia (cuánto tarda un evento en aparecer en la tabla) es el intervalo del disparador más lo que dure el micro-lote: unos segundos. Bajar el intervalo baja la latencia pero aumenta el número de micro-lotes y de archivos pequeños en la tabla, que habrá que compactar como en el capítulo de Iceberg.
# 10. Con los eventos de los días siguientes, la marca de agua avanza y cierra las últimas ventanas del 13consulta = lanzar_ventanas()consulta.awaitTermination()print(resumen(consulta).to_string(index=False))tabla = escritas()del_13 = tabla[tabla.index.str.startswith("07-13")]print("Horas escritas en total:", len(tabla), "| del 13:", len(del_13))print("Admisiones del 13:", int(del_13["admitido"].sum()), "| envíos admitidos el 13:", len(envios))print(tabla.sum().to_string())
 lote  filas    marca_de_agua
    6    188 2026-07-13T23:39
    7      0 2026-07-19T22:57
Horas escritas en total: 85 | del 13: 17
Admisiones del 13: 208 | envíos admitidos el 13: 208
tipo
admitido     208
devuelto       3
en_ruta      208
entregado    206
El lote 6 leyó los 188 eventos de los días siguientes y movió la marca de agua hasta el 19 de julio, así que el lote 7, sin filas, cerró todas las ventanas que quedaban atrás: hay 85 horas escritas, 17 de ellas del 13, de las 7 a las 23. El 13 tiene 208 admisiones, una por cada envío admitido: los 3 tardíos no están. En el total hay 208 salidas a ruta, 206 entregas y 3 devoluciones: falta una de las 207 entregas porque su ventana, la última del 19, sigue abierta.
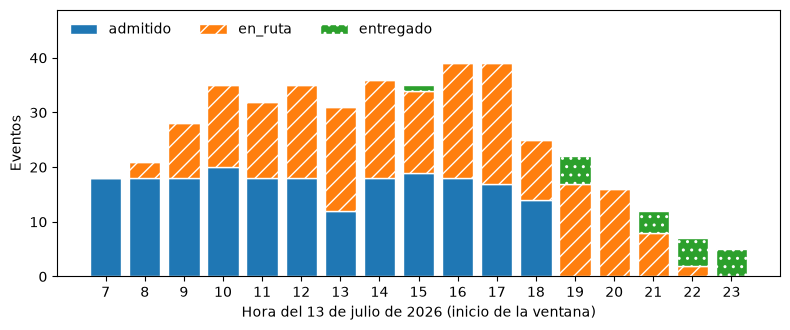
del_13 = escritas()del_13 = del_13[del_13.index.str.startswith("07-13")]horas = del_13.index.str[-2:].astype(int)figura, eje = plt.subplots(figsize=(8, 3.4))base =Nonefor tipo, rayado in [("admitido", ""), ("en_ruta", "//"), ("entregado", "..")]: eje.bar(horas, del_13[tipo], bottom=base, label=tipo, hatch=rayado, edgecolor="white") base = del_13[tipo] if base isNoneelse base + del_13[tipo]eje.set_xticks(horas)eje.legend(frameon=False, ncol=3, loc="upper left")eje.set_ylim(0, base.max() *1.25)eje.set_xlabel("Hora del 13 de julio de 2026 (inicio de la ventana)")eje.set_ylabel("Eventos")plt.tight_layout()plt.show()
Figura 26.1: Eventos del 13 de julio por ventana de una hora y tipo, escritos por la consulta de streaming
Las admisiones forman la base de las barras de las 7 a las 18, entre 12 y 20 por hora; las salidas a ruta aparecen desde las 8 y siguen hasta las 22; las entregas del mismo día son pocas, desde las 15. La barra de las 9 tiene las 18 admisiones que llegaron a tiempo, sin los 3 tardíos.
10. El mismo modelo en Databricks: Auto Loader
En Databricks, el streaming funciona igual, con una restricción y una herramienta propia. La restricción: el cómputo serverless de Free Edition solo admite el disparador availableNow, así que las consultas procesan lo nuevo y se detienen, y se programan como trabajos cada cierto tiempo. La herramienta es Auto Loader, una fuente de streaming que detecta los archivos nuevos que llegan a una carpeta (por ejemplo, un volumen) y los procesa una sola vez, con un checkpoint como el de la sección 7. Es la forma más común de cargar archivos de forma incremental en Databricks.
Prueba este código en el notebook del capítulo de la nube, después de ejecutarlo completo: usa las variables ESQ y VOLUMEN de ese notebook y la tabla de plata que creó. La función llegan simula que un sistema deja en el volumen un archivo JSON con las admisiones de un día; la función cargar las lee con Auto Loader y las agrega a una tabla Delta.
from pyspark.sql import functions as FEVENTOS = VOLUMEN +"/eventos"def llegan(dia):"""Un archivo JSON nuevo con las admisiones de un día, en la carpeta de eventos del volumen.""" (spark.table(f"{ESQ}.plata_envios") .filter(F.to_date("admision") == dia) .select("guia", "servicio", "operador", "origen", "destino", F.lit("admitido").alias("tipo"), F.col("admision").cast("string").alias("momento")) .coalesce(1).write.mode("append").json(EVENTOS))def cargar():"""Auto Loader con availableNow: procesa solo los archivos nuevos y se detiene.""" consulta = ( spark.readStream.format("cloudFiles") .option("cloudFiles.format", "json") .option("cloudFiles.schemaLocation", VOLUMEN +"/autoloader/esquema") .load(EVENTOS) .writeStream .option("checkpointLocation", VOLUMEN +"/autoloader/checkpoint") .trigger(availableNow=True) .toTable(f"{ESQ}.eventos_bronce") ) consulta.awaitTermination()return spark.table(f"{ESQ}.eventos_bronce").count()llegan("2026-06-01")print("Después del 1 de junio:", cargar())llegan("2026-06-02")print("Después del 2 de junio:", cargar())print("Sin archivos nuevos:", cargar())
La primera llamada carga las admisiones del 1 de junio; la segunda, solo las del 2, que se suman; la tercera no encuentra archivos nuevos y la tabla no cambia. cloudFiles.schemaLocation es donde Auto Loader guarda el esquema que dedujo de los archivos, para que no cambie entre ejecuciones; las columnas que no coinciden con ese esquema van a una columna _rescued_data en lugar de perderse. Programado como trabajo cada 15 minutos, este notebook es un pipeline incremental sin código de control propio: ni registro de cargas, ni huellas, ni marca de agua por archivo, lo que el capítulo de ingesta construyó a mano.
Databricks también puede leer de Kafka con format("kafka"), igual que en este capítulo, si el broker es accesible desde internet; el broker del clúster de Docker no lo es, porque vive en tu equipo.
11. Consumidor de Python frente a Structured Streaming
Pregunta
Consumidor de Python (capítulo de Kafka)
Structured Streaming
¿Dónde vive el estado?
En la memoria del programa
En el checkpoint y en el sumidero
¿Qué pasa si se cae?
Pierde el estado; retoma desde el offset guardado
Retoma el lote pendiente con el mismo estado
¿Cómo escala?
Un proceso por partición, a mano
Spark reparte las particiones entre los executors
¿Ventanas y eventos tardíos?
Hay que programarlos
window y withWatermark
¿Dónde queda el resultado?
Donde el programa lo escriba
Archivos, tablas Delta o Iceberg, o foreachBatch
¿Latencia?
Milisegundos por evento
Segundos: un micro-lote
¿Cuándo conviene?
Reaccionar a cada evento (una alerta, un correo)
Llevar el flujo al lago y mantener agregados
Structured Streaming también tiene un modo continuo, de milisegundos, pero es experimental y admite pocas operaciones. En la práctica, cuando se necesita reaccionar evento por evento se usa un consumidor como el del capítulo de Kafka o un motor como Apache Flink; cuando se quiere llevar el flujo al lago con agregaciones, Structured Streaming con micro-lotes.
Limpiar
La celda detiene cualquier consulta que siga activa, cierra el productor y la sesión. Quedan en HDFS los eventos por hora, los checkpoints y la tabla Iceberg lago.bitlogistica.estado_envios; el tópico envios-vivo queda en Kafka. Para borrar todo: dck exec spark-client /opt/hadoop/bin/hdfs dfs -rm -r /bitlogistica/streaming y, en una sesión con el catálogo lago, DROP TABLE lago.bitlogistica.estado_envios.
for activa in spark.streams.active: activa.stop()print("Consultas activas:", len(spark.streams.active))productor.flush(10)spark.stop()print("Sesión cerrada. Quedan en HDFS los eventos por hora, los checkpoints y la tabla lago.bitlogistica.estado_envios.")
Consultas activas: 0
Sesión cerrada. Quedan en HDFS los eventos por hora, los checkpoints y la tabla lago.bitlogistica.estado_envios.
No quedó ninguna consulta activa. Una consulta de streaming que se deja corriendo sigue ocupando sus executors en YARN aunque no lleguen datos; por eso conviene detenerlas explícitamente con stop() antes de cerrar la sesión.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 2 y 3 (la sesión, el tópico y leer_eventos) y usa checkpoints nuevos para no mezclar con los del capítulo.
Ventanas de 15 minutos. Cambia la ventana a 15 minutos y la marca de agua a 30 minutos. ¿Hasta qué hora cierra ventanas la consulta con los eventos de la mañana?
Modo update. Escribe el conteo por ventana en la memoria con outputMode("update") y sin marca de agua. ¿Qué filas aparecen en cada micro-lote?
Una marca más generosa. Repite las secciones 4 a 6 con una marca de agua de 18 horas. ¿Entran ahora los tres eventos tardíos? ¿Qué ventanas quedan sin escribir?
Ventanas por ciudad. Cuenta las admisiones por ventana de una hora y ciudad de origen. ¿Qué ciudad tiene la hora con más admisiones?
Romper el checkpoint. Lanza la consulta de ventanas con un checkpoint nuevo y el mismo path de salida. ¿Qué pasa con las ventanas ya escritas?
Auto Loader con un archivo malo. En Databricks, deja en la carpeta de eventos un archivo con una columna de más y vuelve a ejecutar cargar. Busca la columna _rescued_data.
TipOrientaciones
Con la mañana, el evento más reciente es de las 11:59 y la marca queda en las 11:29: cierra las ventanas de 15 minutos que terminan hasta esa hora, la última de las 11:00 a las 11:15. Ventanas más cortas dan más filas y más estado que guardar.
Sin marca de agua, en modo update cada micro-lote escribe solo las ventanas que cambiaron. Ninguna ventana se cierra nunca: el estado crece sin límite, por eso las consultas largas con agregaciones necesitan marca de agua.
Con 18 horas, la marca después de la tarde queda en las 5:57 del 13 y los tardíos de las 9 sí entran: la ventana de las 9 sube a 21 admisiones. A cambio, con solo los eventos del 13 no se cierra ninguna ventana del día, porque todas terminan después de las 5:57; se escriben recién cuando llegan los eventos del 14 en adelante.
Se agrega "origen" al groupBy junto a la ventana. Bogotá tiene la mayor parte de las admisiones, porque concentra el 40 % de los envíos del generador.
El checkpoint nuevo no sabe nada de lo leído: empieza otra vez desde earliest y escribe ventanas repetidas en la misma carpeta. Un checkpoint pertenece a una consulta y a un sumidero; no se comparte ni se cambia.
Auto Loader no falla: guarda el valor de la columna desconocida dentro de _rescued_data, como texto JSON. Con la opción cloudFiles.schemaEvolutionMode se puede pedir que agregue la columna nueva al esquema.
Errores frecuentes
Síntoma
Causa
Arreglo
Failed to find data source: kafka
Faltan los .jar del conector, o la sesión se creó sin ellos.
Descargarlos (Antes de empezar) y reiniciar el kernel.
NoClassDefFoundError: org/apache/kafka/... o .../pool2/...
Falta una de las dependencias del conector.
Revisar que estén los cuatro .jar en notebooks/jars.
Queries with streaming sources must be executed with writeStream.start()
Se usó count() o show() sobre un DataFrame de streaming.
Iniciar una consulta con writeStream, por ejemplo con el sumidero de memoria.
Append output mode not supported when there are streaming aggregations … without watermark
Agregación con modo append y sin marca de agua.
Agregar withWatermark o usar complete o update.
Una consulta no escribe nada en modo append
Las ventanas siguen abiertas: la marca de agua no las ha pasado.
Esperar más eventos o revisar la marca de agua en el progreso.
La consulta lee todo otra vez
Se cambió o borró la carpeta del checkpoint.
Mantener el mismo checkpointLocation para la misma consulta.
Some data may have been lost because they are not available in Kafka any more
La retención del tópico borró offsets que el checkpoint esperaba.
Leer más seguido que la retención, o failOnDataLoss=false sabiendo lo que se pierde.
Otra aplicación queda en ACCEPTED
Una consulta de streaming sigue activa y ocupa los executors.
Detenerla con stop().
Preguntas de comprensión
¿Por qué no se puede hacer count() sobre un DataFrame de streaming, y qué se hace en su lugar?
¿Qué diferencia hay entre agrupar por la hora del evento y por la hora de publicación, y cuál usó el capítulo?
¿Por qué el lote 1 de la sección 4 no leyó filas y aun así escribió tres ventanas, y por qué la consulta agrupa por tipo en lugar de filtrar las admisiones?
¿Qué pasaría si el notebook se cayera justo después de escribir las ventanas de un lote y antes de escribir su commit?
¿Cuándo usarías availableNow programado cada 15 minutos en lugar de una consulta con processingTime siempre activa?
TipOrientaciones
Porque el DataFrame describe un flujo sin final: no hay un momento en que el conteo esté completo. Se inicia una consulta con writeStream que mantiene el conteo actualizado en un sumidero, y se lee el sumidero.
La hora del evento es cuándo ocurrió (momento); la de publicación, cuándo llegó a Kafka. Con eventos atrasados o reenviados son distintas. El capítulo agrupó por la hora del evento, porque el negocio pregunta cuántas admisiones hubo a las 9, no cuántas llegaron a Kafka a las 9.
Porque el lote 0 movió la marca de agua de 1970 a las 10:59. Spark corre un lote sin datos cuando la marca cambia, para cerrar y escribir las ventanas que quedaron atrás: las de 7, 8 y 9. Agrupa por tipo porque la marca se calcula con los eventos que llegan a la agregación: con solo las admisiones, la última de las 18:57 la dejaría quieta y las ventanas de la tarde no se cerrarían con los eventos de la noche.
Al volver, Spark encuentra el lote en offsets sin su commit y lo repite con los mismos offsets. El sumidero Parquet registra qué lotes ya escribió y no duplica los archivos; un MERGE como el de la sección 8 deja el mismo resultado si se repite. El resultado es exactamente una vez.
Cuando una latencia de 15 minutos basta y el volumen no justifica tener executors ocupados todo el tiempo: se paga cómputo solo cuando hay una ejecución. Es lo único posible en Databricks serverless de Free Edition. Una consulta siempre activa conviene cuando la latencia tiene que ser de segundos.
Glosario
Término
Significado en este capítulo
Structured Streaming
Procesamiento de flujos de Spark con la API de DataFrames, como una tabla sin fin.
Micro-lote
Grupo de filas nuevas que Spark procesa como un trabajo normal.
Disparador (trigger)
Regla que decide cuándo se ejecuta un micro-lote.
availableNow
Disparador que procesa todo lo disponible y detiene la consulta.
processingTime
Disparador que ejecuta un micro-lote cada cierto intervalo, sin detenerse.
Fuente
De donde lee una consulta de streaming.
Sumidero (sink)
Donde escribe una consulta de streaming.
Modo de salida
Qué filas del resultado se escriben en cada micro-lote: complete, append o update.
Checkpoint
Carpeta con los offsets leídos, los lotes confirmados y el estado de una consulta.
Hora del evento
Momento en que ocurrió el hecho, que viaja dentro del mensaje.
Ventana
Intervalo de tiempo con el que se agrupan los eventos.
Marca de agua (watermark)
Límite de espera a los eventos atrasados; cierra ventanas y descarta tardíos.
Evento tardío
Evento que llega después de que la marca de agua pasó su hora.
foreachBatch
Sumidero que entrega cada micro-lote a una función propia.
Auto Loader
Fuente de Databricks que procesa una sola vez cada archivo nuevo de una carpeta.
Latencia
Tiempo entre que ocurre un evento y su efecto aparece en el resultado.
Leíste el tópico de Kafka con Spark como una tabla sin fin y procesaste los eventos de BITLogística por micro-lotes, sobre YARN. Una primera consulta contó los 134 eventos de la mañana del 13 en memoria. La consulta de eventos por hora agrupó por la hora del evento con una marca de agua de una hora y escribió en Parquet solo las ventanas cerradas: 3 con la mañana, 15 con la tarde y, al llegar los días siguientes, las 17 horas del 13 con sus 208 admisiones. Gracias al checkpoint, cada ejecución siguió donde iba, sin releer ni repetir, y los tres eventos tardíos de las 9 se descartaron porque llegaron con la ventana ya cerrada. Con foreachBatch y un MERGE idempotente, el último estado de cada envío quedó en una tabla Iceberg, y una consulta con disparador de cinco segundos la mantuvo al día mientras llegaban los eventos. En Databricks, Auto Loader con availableNow hace lo mismo con los archivos que llegan a un volumen.
El capítulo 27, De Hadoop a la nube, lleva el pipeline de PySpark del libro a Databricks y explica qué cambia cuando el clúster deja de ser propio.