BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) ya sabe, por el informe del taller de PySpark, que el 89.7 % de sus envíos llega a tiempo y qué rutas, operadores y meses cumplen peor. La gerencia quiere dar el paso siguiente: saber en el momento de admitir un envío si corre riesgo de llegar tarde, para avisar al cliente o asignarle otro operador. También quiere entender de qué depende el número de intentos de entrega, agrupar las rutas por su comportamiento y, en el área comercial, saber qué servicio adicional ofrecerle a cada cliente.
Este capítulo resuelve esas cuatro preguntas con MLlib, la biblioteca de aprendizaje automático de Spark, sobre la plata de enero a junio, y termina usando el modelo guardado para marcar en riesgo los envíos de julio que cargó el pipeline de ingesta.
Ficha
En este capítulo
Pregunta
¿Cómo se entrena un modelo cuando los datos no caben en una sola máquina, y cómo se usa después?
Datos
La plata de BITLogística (enero a junio de 2026), la plata de julio del pipeline de ingesta y los usos de servicios adicionales de 2 000 clientes
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_mllib.ipynb dentro de talleres-notebooks.zip. Necesita /bitlogistica/plata, del taller de PySpark, y /bitlogistica/ingesta/plata, del capítulo de ingesta. Si no ejecutaste el capítulo de ingesta, el notebook corre igual: en la sección 11 puntúa los envíos de junio en lugar de los de julio. Guarda el modelo final en /bitlogistica/modelos/riesgo_tarde, menos de 1 MB.
Es el notebook más pesado del libro hasta aquí: en el clúster de los laboratorios tarda varios minutos, casi todos en el gradient boosting y la validación cruzada.
1. Qué es MLlib
NotaMLlib
MLlib es la biblioteca de aprendizaje automático de Spark. Su API actual, pyspark.ml, trabaja con DataFrames y reparte el entrenamiento entre los executors: cada uno calcula sobre sus particiones, por ejemplo los gradientes de una regresión logística, y el driver combina los resultados en cada iteración. Por eso puede entrenar con datos que no caben en la memoria de una máquina.
MLlib
scikit-learn
Dónde corre
Repartido en el clúster
Una sola máquina
Volumen
Mientras quepa en el clúster
Mientras quepa en la memoria de una máquina
Algoritmos
Los principales: lineales, árboles, boosting, k-means, ALS
Muchos más, y más opciones en cada uno
Costo fijo
Alto: lanzar tareas, repartir datos
Casi nulo
Conviene cuando
Los datos ya están en Spark y son grandes, o hay que puntuar millones de filas
Los datos caben en una máquina, o se trabaja con una muestra
Con los 32 064 envíos de BITLogística, scikit-learn sería más rápido. El capítulo usa MLlib porque el mismo código sirve igual con 300 millones, y porque los datos ya viven en HDFS y el modelo se aplicará dentro de los pipelines de Spark.
import mathimport platformimport randomimport timeimport matplotlibimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as FBASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"PLATA_JULIO = BASE +"/ingesta/plata"MODELOS = BASE +"/modelos"spark = ( SparkSession.builder .appName("mllib-bitlogistica") .config("spark.ui.showConsoleProgress", "false") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"print("Python", platform.python_version(), "| Spark", spark.version)print("master:", sc.master, "| aplicación:", sc.applicationId)
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/10/27 20:35:50 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
26/10/27 20:35:52 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
La sesión quedó en YARN (master: yarn), con Python 3.11.10 y Spark 3.5.3.
2. Los datos y tres reglas para no engañarse
Antes de entrenar, tres conceptos que deciden si un modelo sirve o solo lo parece.
NotaFuga de información
Hay fuga de información (data leakage) cuando el modelo usa una variable que no estará disponible en el momento de predecir. La plata tiene horas_transito y entrega, que definen si el envío llegó tarde, pero no se conocen al admitirlo. Un modelo que las use acierta casi siempre en la evaluación y no sirve para nada en la operación. Aquí solo se usan variables conocidas en la admisión: servicio, operador, canal, distancia, peso, valor declarado, si el destino es remoto, si es fin de semana y si es temporada alta.
NotaSeparación temporal
Para evaluar un modelo hay que probarlo con datos que no vio al entrenar. Si los datos tienen fecha, conviene separarlos por tiempo: entrenar con el pasado y probar con lo que vino después, como pasará en la operación. Aquí se entrena con enero a mayo y se prueba con junio.
NotaClase desbalanceada
Una clase está desbalanceada cuando una de sus categorías es mucho más frecuente que la otra. Si el 90 % de los envíos llega a tiempo, un «modelo» que siempre dice «a tiempo» acierta el 90 % y no detecta ningún retraso. Por eso la exactitud (porcentaje de aciertos) no sirve para evaluarlo, y se usan medidas que miran la clase rara.
La función variables agrega las variables derivadas y la etiqueta tarde (1 si llegó tarde, 0 si a tiempo). Solo entran los envíos entregados, porque los devueltos no tienen etiqueta, y se dejan fuera los 173 envíos sin operador.
def variables(tabla):"""Variables que se conocen al admitir el envío, más la etiqueta tarde (1) o a tiempo (0)."""return ( tabla .withColumn("mes", F.month("admision")) .withColumn("temporada_alta", (F.col("mes") ==5).cast("double")) .withColumn("remoto", F.col("destino_remoto").cast("double")) .withColumn("fin_semana", F.col("fin_de_semana").cast("double")) .withColumn("log_valor", F.log10("valor_declarado")) .withColumn("tarde", (~F.col("a_tiempo")).cast("double")) )plata = variables(spark.read.parquet(PLATA))entregados = plata.filter(F.col("a_tiempo").isNotNull() & (F.col("operador") !="Sin operador"))entrenamiento = entregados.filter(F.col("mes") <=5).cache()prueba = entregados.filter(F.col("mes") ==6).cache()for nombre, tabla in [("entrenamiento (enero a mayo)", entrenamiento), ("prueba (junio)", prueba)]: fila = tabla.agg(F.count("*").alias("n"), F.avg("tarde").alias("t")).first()print(f"{nombre:30s}{fila['n']:6d} envíos | {100* fila['t']:.1f} % tarde")
entrenamiento (enero a mayo)    26230 envíos | 10.5 % tarde
prueba (junio)                   5439 envíos | 9.3 % tarde
Hay 26 230 envíos para entrenar, de enero a mayo, con 10.5 % de tardíos, y 5 439 para probar, de junio, con 9.3 %. El porcentaje de entrenamiento es más alto porque incluye mayo, la temporada alta. En los dos conjuntos, alrededor de nueve de cada diez envíos llegan a tiempo: la clase está desbalanceada.
3. Un pipeline de MLlib
Los algoritmos de MLlib reciben una sola columna de tipo vector con todas las variables numéricas, llamada features. Llegar a ella desde columnas de texto y números requiere varios pasos, y MLlib los encadena en un pipeline.
NotaTransformador, estimador y pipeline
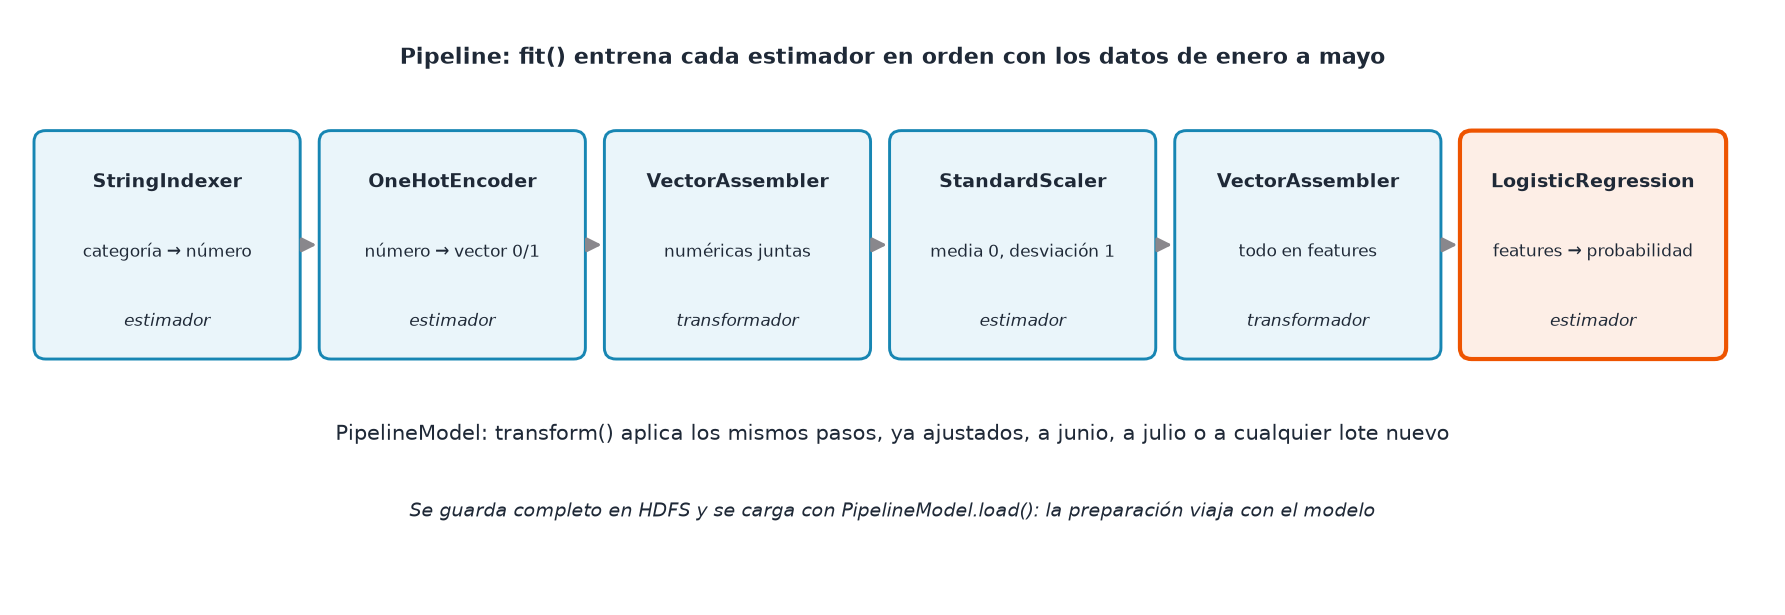
Un transformador recibe un DataFrame y devuelve otro con columnas nuevas, con transform(); por ejemplo, VectorAssembler junta columnas en un vector. Un estimador primero aprende algo de los datos con fit() y devuelve un transformador; por ejemplo, StandardScaler aprende la media y la desviación de cada columna, y LogisticRegression aprende los coeficientes. Un pipeline es una lista de pasos: su fit() ajusta cada estimador en orden y devuelve un PipelineModel, que aplica todos los pasos ya ajustados a cualquier DataFrame nuevo.
El pipeline del modelo de riesgo de llegar tarde.
Los pasos del pipeline son estos:
StringIndexer convierte cada categoría en un número: OP-A, OP-B… pasan a 3, 2…; con alphabetDesc, la primera en orden alfabético recibe el número más alto.
OneHotEncoder convierte cada número en un vector de ceros y unos, uno por categoría, menos la última, que queda como categoría de referencia: los coeficientes de las demás se leen comparados con ella.
VectorAssembler y StandardScaler juntan las variables numéricas y las llevan a media 0 y desviación 1, para que sus coeficientes sean comparables.
Un segundo VectorAssembler arma features con todo, y LogisticRegression aprende a partir de ella.
La celda muestra si cada paso es transformador o estimador, y cómo queda features en tres envíos.
from pyspark.ml import Pipelinefrom pyspark.ml.classification import LogisticRegressionfrom pyspark.ml.feature import OneHotEncoder, StandardScaler, StringIndexer, VectorAssemblerCATEGORICAS = ["servicio", "operador", "canal"]NUMERICAS = ["distancia_km", "peso_kg", "log_valor"]BINARIAS = ["remoto", "fin_semana", "temporada_alta"]indexar = StringIndexer(inputCols=CATEGORICAS, outputCols=[c +"_i"for c in CATEGORICAS], stringOrderType="alphabetDesc")codificar = OneHotEncoder(inputCols=[c +"_i"for c in CATEGORICAS], outputCols=[c +"_v"for c in CATEGORICAS])juntar_numericas = VectorAssembler(inputCols=NUMERICAS, outputCol="numericas")escalar = StandardScaler(inputCol="numericas", outputCol="numericas_esc", withMean=True, withStd=True)juntar = VectorAssembler(inputCols=[c +"_v"for c in CATEGORICAS] + ["numericas_esc"] + BINARIAS, outputCol="features")logistica = LogisticRegression(labelCol="tarde", featuresCol="features", maxIter=50)pasos = [indexar, codificar, juntar_numericas, escalar, juntar]for paso in pasos + [logistica]: tipo ="estimador"ifhasattr(paso, "fit") else"transformador"print(f"{type(paso).__name__:20s}{tipo}")preparado = Pipeline(stages=pasos).fit(entrenamiento).transform(entrenamiento)preparado.select("servicio", "operador", "canal", "distancia_km", "remoto", "features").show(3, truncate=60)
Cuatro pasos son estimadores, porque aprenden algo de los datos: los dos de categorías aprenden la lista de valores; el escalador, medias y desviaciones; la regresión, los coeficientes. Los dos VectorAssembler son transformadores: solo juntan columnas. El vector features tiene 13 posiciones. Para el primer envío (Estándar, OP-D, web, 319 km, destino remoto) se muestra completo; los otros dos se guardan en formato disperso, (13,[2,6,7,8,9],[…]), que lista solo las posiciones distintas de cero, porque la mayoría de las variables de categoría valen 0.
4. Regresión logística: ¿llegará tarde?
La celda entrena el pipeline completo con enero a mayo y lo evalúa con junio.
NotaAUC y matriz de confusión
El modelo da a cada envío una probabilidad de llegar tarde. El AUC (área bajo la curva ROC) mide qué tan bien esas probabilidades ordenan los envíos: es la probabilidad de que un envío tarde elegido al azar reciba una probabilidad más alta que uno a tiempo elegido al azar. Vale 0.5 para un modelo que adivina y 1 para uno perfecto, y no depende del desbalance. La matriz de confusión cuenta, para un umbral dado, cuántos envíos de cada clase real quedaron en cada clase predicha.
from pyspark.ml.evaluation import BinaryClassificationEvaluatorinicio = time.perf_counter()modelo = Pipeline(stages=pasos + [logistica]).fit(entrenamiento)segundos_logistica = time.perf_counter() - iniciopredicciones = modelo.transform(prueba).cache()auc = BinaryClassificationEvaluator(labelCol="tarde", metricName="areaUnderROC")print(f"Entrenamiento: {segundos_logistica:.1f} s | AUC en junio: {auc.evaluate(predicciones):.3f}")print()tasa_tarde = prueba.agg(F.avg("tarde")).first()[0]print(f"Línea base «siempre a tiempo»: exactitud {1- tasa_tarde:.1%}, encuentra 0 % de los tardíos")matriz = predicciones.groupBy("tarde", "prediction").count().toPandas()matriz = matriz.pivot(index="tarde", columns="prediction", values="count").fillna(0).astype(int)matriz.index = ["real: a tiempo", "real: tarde"][: len(matriz)]matriz.columns = [{0.0: "predice: a tiempo", 1.0: "predice: tarde"}[c] for c in matriz.columns]print(matriz.to_string())exactitud = predicciones.filter(F.col("tarde") == F.col("prediction")).count() / predicciones.count()print(f"\nExactitud del modelo con umbral 0.5: {exactitud:.1%}")
Entrenamiento: 4.9 s | AUC en junio: 0.817

Línea base «siempre a tiempo»: exactitud 90.7%, encuentra 0 % de los tardíos
                predice: a tiempo  predice: tarde
real: a tiempo               4891              44
real: tarde                   463              41

Exactitud del modelo con umbral 0.5: 90.7%
El modelo se entrenó en 4.9 segundos y tiene un AUC de 0.817 en junio: ordena bien los envíos por riesgo. Pero la matriz de confusión con el umbral por defecto de 0.5 muestra el efecto del desbalance: de 504 envíos que llegaron tarde, el modelo marcó solo 41, y su exactitud, 90.7 %, es igual a la de decir siempre «a tiempo». Con 0.5, el modelo casi nunca se atreve a predecir «tarde», porque pocas veces la probabilidad pasa de la mitad. El umbral es una decisión de negocio, y se elige en la sección 6.
5. El modelo descubre las reglas del generador
Los datos de BITLogística son sintéticos, y eso permite algo que en un caso real no se puede: comparar lo que aprendió el modelo con la verdad. El generador alarga el tiempo de tránsito con OP-C (×1.30), los destinos remotos (×1.2), los envíos de viernes a domingo (×1.25), mayo (×1.15), la distancia y el peso. ¿Lo encontró la regresión?
La celda muestra cada coeficiente y su exponencial, que es cuántas veces se multiplica la chance de llegar tarde (probabilidad de tarde dividida por probabilidad de a tiempo) frente a la categoría de referencia, o por cada desviación estándar en las variables numéricas.
nombres, referencias = [], []for categoria, etiquetas inzip(CATEGORICAS, modelo.stages[0].labelsArray): nombres += [f"{categoria}={valor}"for valor in etiquetas[:-1]] referencias.append(f"{categoria}={etiquetas[-1]}")nombres += [f"{c} (+1 desviación)"for c in NUMERICAS] + BINARIAScoeficientes = pd.DataFrame({"variable": nombres, "coeficiente": modelo.stages[-1].coefficients.toArray()})coeficientes["veces_la_chance"] = np.exp(coeficientes["coeficiente"])print("Categorías de referencia:", ", ".join(referencias))print(coeficientes.round(2).sort_values("coeficiente", ascending=False).to_string(index=False))
Las referencias son Económico, OP-A y el canal corporativo, y el coeficiente más alto, 1.54, es el de Express. Los coeficientes recuperan las reglas del generador en el orden esperado:
OP-C multiplica la chance de llegar tarde por 4.30 frente a OP-A; OP-D, por 1.89, y OP-B, por 1.47. El orden es el de los factores del generador: 1.30, 1.05, 1.00 y 0.90 para OP-A.
Destino remoto: ×3.42. Fin de semana: ×2.52. Temporada alta (mayo): ×1.87. Distancia: ×1.87 por cada desviación estándar.
Express tiene la chance más alta, ×4.69 frente a Económico, aunque es el más rápido: su promesa de 24 horas deja menos margen que las 120 de Económico.
El canal web aparece con ×1.61: en el generador, el canal web tiene más intentos de entrega, y cada intento extra suma 20 horas.
Peso y valor declarado quedan cerca de 1 (×1.05 y ×0.99). El peso sí está en el generador, pero su efecto es pequeño (0.4 % más de tiempo por kilo) y la mayoría de los envíos pesan pocos kilos; el valor declarado no influye.
Los coeficientes no son los factores del generador, porque estos multiplican horas y aquellos multiplican chances, pero el modelo encontró las mismas causas y su orden de importancia. Con datos reales no hay verdad para comparar; la lectura de los coeficientes sirve para revisar que el modelo tenga sentido de negocio.
6. El umbral de alerta
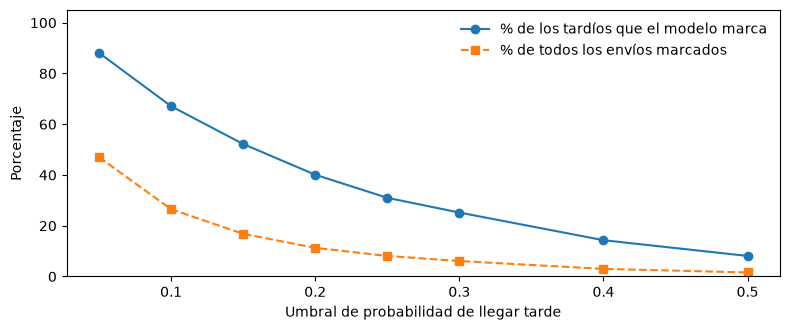
El modelo da probabilidades; el negocio decide desde qué probabilidad un envío se marca «en riesgo». Un umbral bajo marca muchos envíos y captura casi todos los tardíos, pero el equipo de servicio no puede revisar la mitad de los envíos del día. Un umbral alto marca pocos y deja escapar muchos.
La celda calcula, para varios umbrales, qué porcentaje de los envíos de junio se marca, qué porcentaje de los tardíos queda capturado y qué porcentaje de los marcados realmente llegó tarde.
Con umbral 0.05 se marca el 47 % de los envíos y se captura el 88.1 % de los tardíos, pero solo el 17.4 % de los marcados llega tarde. Con 0.20 se marca el 11.3 %, se captura el 40.1 % de los tardíos y uno de cada tres marcados (32.7 %) llega tarde. Con 0.50, el de la sección 4, se marca el 1.6 % y se captura el 8.1 %.
figura, eje = plt.subplots(figsize=(8, 3.4))eje.plot(tabla_umbral["umbral"], tabla_umbral["pct_tardios_capturados"], marker="o", label="% de los tardíos que el modelo marca")eje.plot(tabla_umbral["umbral"], tabla_umbral["pct_marcados"], marker="s", linestyle="--", label="% de todos los envíos marcados")eje.set_xlabel("Umbral de probabilidad de llegar tarde")eje.set_ylabel("Porcentaje")eje.set_ylim(0, 105)eje.legend(frameon=False, loc="upper right")plt.tight_layout()plt.show()
Figura 22.1: Envíos de junio marcados en riesgo y tardíos capturados según el umbral de probabilidad
La figura muestra el compromiso. Si el equipo de servicio puede revisar uno de cada nueve envíos, el umbral 0.20 marca el 11.3 % y encuentra cuatro de cada diez tardíos, casi tres veces la tasa de tardíos de junio (32.7 % frente a 9.3 %). Ese es el umbral que usa la sección 11 con los envíos de julio.
7. Otro modelo y validación cruzada
¿Un modelo más flexible ordenaría mejor los envíos? La celda entrena un gradient boosting de árboles (GBTClassifier), que combina 30 árboles pequeños, cada uno corrigiendo los errores de los anteriores, y compara su AUC con el de la regresión. Después ajusta los parámetros de la regresión con validación cruzada.
NotaValidación cruzada y pliegue
La validación cruzada elige los parámetros de un modelo sin tocar los datos de prueba. Divide los datos de entrenamiento en kpliegues (folds) del mismo tamaño; para cada combinación de parámetros entrena k veces, cada vez dejando un pliegue afuera para medir, y promedia. Gana la combinación con mejor promedio, y con ella se entrena un modelo final con todos los datos. En MLlib, CrossValidator(numFolds=3) usa tres pliegues. Un pliegue no tiene que ver con las particiones de Spark: es una división de los datos para evaluar.
La rejilla prueba 4 combinaciones de dos parámetros de regularización de la regresión: regParam (cuánto se penalizan los coeficientes grandes) y elasticNetParam (qué tipo de penalización). Con 3 pliegues son 12 modelos, más el final. parallelism=2 entrena dos a la vez, uno por executor.
from pyspark.ml.classification import GBTClassifierfrom pyspark.ml.tuning import CrossValidator, ParamGridBuilderarboles = GBTClassifier(labelCol="tarde", featuresCol="features", maxIter=30, maxDepth=4, seed=22)inicio = time.perf_counter()modelo_gbt = Pipeline(stages=pasos + [arboles]).fit(entrenamiento)segundos_gbt = time.perf_counter() - inicioauc_gbt = auc.evaluate(modelo_gbt.transform(prueba))rejilla = (ParamGridBuilder() .addGrid(logistica.regParam, [0.0, 0.01]) .addGrid(logistica.elasticNetParam, [0.0, 0.5]) .build())validacion = CrossValidator(estimator=Pipeline(stages=pasos + [logistica]), estimatorParamMaps=rejilla, evaluator=auc, numFolds=3, parallelism=2, seed=22)inicio = time.perf_counter()modelo_cv = validacion.fit(entrenamiento)segundos_cv = time.perf_counter() - iniciomejor =int(np.argmax(modelo_cv.avgMetrics))print(f"Regresión logística: AUC en junio {auc.evaluate(predicciones):.3f} | entrenamiento {segundos_logistica:.1f} s")print(f"Gradient boosting: AUC en junio {auc_gbt:.3f} | entrenamiento {segundos_gbt:.1f} s")print()print(f"Validación cruzada: {len(rejilla)} combinaciones x 3 pliegues = {len(rejilla) *3} modelos + 1 final, {segundos_cv:.1f} s")for parametros, metrica inzip(rejilla, modelo_cv.avgMetrics): valores = {p.name: v for p, v in parametros.items()}print(f" regParam={valores['regParam']:<5} elasticNetParam={valores['elasticNetParam']:<4} AUC promedio {metrica:.4f}")print(f"Mejor combinación: la {mejor +1} | AUC en junio con ella: {auc.evaluate(modelo_cv.transform(prueba)):.3f}")
Regresión logística: AUC en junio 0.817 | entrenamiento 4.9 s
Gradient boosting:   AUC en junio 0.823 | entrenamiento 9.6 s

Validación cruzada: 4 combinaciones x 3 pliegues = 12 modelos + 1 final, 13.5 s
  regParam=0.0   elasticNetParam=0.0  AUC promedio 0.8173
  regParam=0.0   elasticNetParam=0.5  AUC promedio 0.8173
  regParam=0.01  elasticNetParam=0.0  AUC promedio 0.8171
  regParam=0.01  elasticNetParam=0.5  AUC promedio 0.8161
Mejor combinación: la 2 | AUC en junio con ella: 0.817
El gradient boosting llegó a un AUC de 0.823, apenas por encima del 0.817 de la regresión, y tardó el doble en entrenarse (9.6 s frente a 4.9). Como las reglas del generador son multiplicativas y sin interacciones complicadas, una regresión ya las captura casi todas; la ganancia del modelo más flexible no compensa perder coeficientes legibles.
La validación cruzada entrenó 13 modelos en 13.5 segundos. Las cuatro combinaciones quedaron entre 0.8161 y 0.8173 de AUC promedio: con 26 230 envíos y 13 variables, la regularización casi no cambia nada. Ganó la segunda, sin penalización fuerte, y su AUC en junio fue 0.817, el mismo del modelo inicial. Es un resultado frecuente y útil: confirma que el modelo no estaba sobreajustado.
8. Regresión de Poisson: los intentos de entrega
La segunda pregunta es de qué depende el número de intentos de entrega. Es un conteo (0, 1, 2… intentos extra), y para conteos se usa la regresión de Poisson, que MLlib ofrece en GeneralizedLinearRegression con family="poisson". En el generador, los intentos extra siguen una distribución de Poisson con media 0.12, más 0.20 si el destino es remoto y 0.08 si el canal es web. La celda ajusta el modelo con esas dos variables, sobre todos los envíos, y compara por grupo la media observada, la del modelo y la del generador.
Intercepto -2.129 | coeficientes remoto 0.853, web 0.498

remoto web  envios  observado  modelo  generador
    no  no   16295      0.116   0.119       0.12
    no  sí   13583      0.199   0.196       0.20
    sí  no    1227      0.315   0.279       0.32
    sí  sí     959      0.414   0.459       0.40
El modelo estimó coeficientes de 0.853 para destino remoto y 0.498 para web, en escala logarítmica: multiplican la media de intentos extra por 2.35 y 1.65. En los dos grupos grandes, el modelo coincide con el generador: 0.119 frente a 0.12 sin remoto ni web, y 0.196 frente a 0.20 con web. En los grupos remotos se separa algo: predice 0.279 para remoto sin web, cuando el generador usa 0.32, y 0.459 para remoto con web, cuando usa 0.40. La razón es que el generador suma los efectos (0.12 + 0.20 + 0.08) y la regresión de Poisson los multiplica. Las medias observadas (0.315 y 0.414) siguen al generador. Un modelo puede tener las causas correctas y la forma equivocada; comparar por grupos lo muestra.
9. k-means: rutas que se comportan igual
La tercera pregunta no tiene etiqueta: agrupar las rutas por su comportamiento.
Notak-means y silueta
k-means es un algoritmo de agrupamiento (clustering): reparte los puntos en k grupos de modo que cada punto quede cerca del centro de su grupo. Hay que elegir k. La silueta mide qué tan bien separados quedan los grupos: para cada punto compara su distancia media a los de su grupo con la distancia media al grupo vecino. Va de −1 a 1, y más alto es mejor.
La celda resume cada ruta con al menos 50 envíos con cuatro números (fracción de la promesa que tarda en promedio, porcentaje a tiempo, intentos promedio y distancia), los escala y prueba k de 2 a 6.
from pyspark.ml.clustering import KMeansfrom pyspark.ml.evaluation import ClusteringEvaluatorrutas = ( plata.groupBy("ruta") .agg(F.count("*").alias("envios"), F.avg(F.col("horas_transito") / F.col("promesa_horas")).alias("fraccion_promesa"), F.avg(F.col("a_tiempo").cast("int")).alias("pct_a_tiempo"), F.avg("intentos_entrega").alias("intentos"), F.avg("distancia_km").alias("distancia"), F.max(F.col("destino_remoto").cast("int")).alias("remota")) .filter("envios >= 50"))preparar_rutas = Pipeline(stages=[ VectorAssembler(inputCols=["fraccion_promesa", "pct_a_tiempo", "intentos", "distancia"], outputCol="crudo"), StandardScaler(inputCol="crudo", outputCol="features", withMean=True, withStd=True),]).fit(rutas)rutas_vec = preparar_rutas.transform(rutas).cache()silueta = ClusteringEvaluator()siluetas = {}for k inrange(2, 7): siluetas[k] = silueta.evaluate(KMeans(k=k, seed=22).fit(rutas_vec).transform(rutas_vec))print(f"k={k}: silueta {siluetas[k]:.3f}")print("Rutas con al menos 50 envíos:", rutas_vec.count(), "| k con mayor silueta:", max(siluetas, key=siluetas.get))
k=2: silueta 0.589
k=3: silueta 0.609
k=4: silueta 0.751
k=5: silueta 0.609
k=6: silueta 0.611
Rutas con al menos 50 envíos: 87 | k con mayor silueta: 4
Hay 87 rutas con al menos 50 envíos. La silueta más alta es la de k = 4, con 0.751; las demás quedan entre 0.589 y 0.611. La celda siguiente usa el k con mayor silueta y describe cada grupo.
K =max(siluetas, key=siluetas.get)grupos_rutas = KMeans(k=K, seed=22).fit(rutas_vec).transform(rutas_vec)resumen_rutas = ( grupos_rutas.groupBy("prediction") .agg(F.count("*").alias("rutas"), F.sum("remota").alias("remotas"), F.sum("envios").alias("envios"), F.round(F.avg("distancia")).alias("km"), F.round(100* F.avg("pct_a_tiempo"), 1).alias("pct_a_tiempo"), F.round(F.avg("fraccion_promesa"), 2).alias("fraccion_promesa"), F.round(F.avg("intentos"), 2).alias("intentos")) .orderBy("pct_a_tiempo"))resumen_rutas.show()peor = resumen_rutas.first()["prediction"]print("Rutas del grupo con menor cumplimiento:")grupos_rutas.filter(F.col("prediction") == peor).orderBy("pct_a_tiempo") \ .select("ruta", "envios", F.round(100* F.col("pct_a_tiempo"), 1).alias("pct_a_tiempo")).show(8, truncate=False)
Los cuatro grupos, con 1, 10, 31 y 45 rutas, se leen como un mapa operativo:
45 rutas cortas (345 km en promedio) con el 93.7 % a tiempo y 21 132 envíos: la operación normal, dos tercios del volumen.
31 rutas largas (1 097 km) con el 83.4 % a tiempo.
10 rutas de 759 km con el 74.9 % a tiempo y 1.37 intentos promedio, más que el resto: las diez van a destinos remotos (Cúcuta, Montería o Pasto), donde la entrega cuesta más intentos.
Una sola ruta, Barranquilla a Pasto, con el 39.7 % a tiempo y 1 901 km: la peor ruta del informe del taller de PySpark, que k-means separó sola.
k-means no sabe qué es un destino remoto ni cuál es la peor ruta; los encontró en los números. Para el área de operaciones, cada grupo pide una acción distinta.
10. Recomendación de servicios adicionales con ALS
BITLogística vende, junto con el envío, ocho servicios adicionales: seguro, empaque, recogida a domicilio, entrega programada, pago contra entrega, aviso por SMS, devolución gestionada y almacenamiento temporal. El área comercial quiere saber cuál ofrecerle a cada cliente.
NotaSistema de recomendación, preferencia implícita y ALS
Un sistema de recomendación sugiere a cada usuario productos que todavía no usa, a partir de lo que usan él y otros parecidos. Cuando no hay calificaciones, solo registros de uso (cuántas veces cada cliente usó cada servicio), se habla de preferencia implícita: el uso indica interés, y no usar no significa rechazo. ALS (Alternating Least Squares, mínimos cuadrados alternados) es el algoritmo de recomendación de MLlib: aprende un vector corto de números para cada cliente y otro para cada servicio, de modo que los clientes queden cerca de los servicios que usan, y recomienda los servicios cuyo vector se parece más al del cliente.
La celda genera, con una semilla fija, los usos de 2 000 clientes en el semestre. Cada cliente tiene un perfil que el modelo no ve: tienda en línea (pago contra entrega, aviso por SMS y devolución gestionada), empresa (recogida a domicilio, entrega programada y almacenamiento temporal), persona (empaque y seguro) o pyme (recogida a domicilio, seguro y aviso por SMS). Cada cliente usa cada servicio de su perfil con probabilidad 0.75 y, de vez en cuando, uno que no es de su perfil.
SERVICIOS = ["seguro", "empaque", "recogida a domicilio", "entrega programada","pago contra entrega", "aviso por SMS", "devolución gestionada", "almacenamiento temporal"]PERFILES = {"tienda en línea": ["pago contra entrega", "aviso por SMS", "devolución gestionada"],"empresa": ["recogida a domicilio", "entrega programada", "almacenamiento temporal"],"persona": ["empaque", "seguro"],"pyme": ["recogida a domicilio", "seguro", "aviso por SMS"],}rng = random.Random(2222)usos, perfil_real = [], {}for cliente inrange(1, 2001): perfil = rng.choices(list(PERFILES), weights=[30, 15, 35, 20])[0] perfil_real[cliente] = perfilfor servicio in SERVICIOS:if servicio in PERFILES[perfil] and rng.random() <0.75: usos.append((cliente, SERVICIOS.index(servicio), rng.randint(2, 30)))elif servicio notin PERFILES[perfil] and rng.random() <0.04: usos.append((cliente, SERVICIOS.index(servicio), rng.randint(1, 3)))usos = spark.createDataFrame(usos, "cliente int, servicio int, veces int")celdas =2000*len(SERVICIOS)print(f"Clientes con algún uso: {usos.select('cliente').distinct().count()} | filas cliente-servicio: {usos.count()}"f" de {celdas} posibles ({usos.count() / celdas:.0%})")(usos.groupBy("servicio").agg(F.count("*").alias("clientes"), F.sum("veces").alias("usos")) .withColumn("servicio", F.element_at(F.array(*[F.lit(s) for s in SERVICIOS]), F.col("servicio") +1)) .orderBy(F.desc("clientes")).show(truncate=False))
Hay 4 421 combinaciones cliente-servicio con algún uso, de 16 000 posibles: la tabla está ocupada en un 28 %, y en datos reales suele ser mucho menos. Seguro y aviso por SMS son los más usados, con 869 y 816 clientes, porque aparecen en dos perfiles; entrega programada y almacenamiento temporal, los menos, con 274 y 287.
Para evaluar se esconde, a cada cliente que usa al menos dos servicios, uno de ellos elegido al azar. ALS se entrena sin esos usos y después se mira si el servicio escondido aparece entre sus 3 primeras recomendaciones.
from pyspark.sql import Windowcon_dos = usos.withColumn("n", F.count("*").over(Window.partitionBy("cliente"))).filter("n >= 2")azar = Window.partitionBy("cliente").orderBy(F.rand(22))marcada = con_dos.withColumn("orden", F.row_number().over(azar))escondidos = marcada.filter("orden = 1").select("cliente", "servicio")entrenar_als = usos.join(escondidos, ["cliente", "servicio"], "left_anti").cache()print("Clientes evaluados (un servicio escondido cada uno):", escondidos.count())print("Filas para entrenar:", entrenar_als.count())
Clientes evaluados (un servicio escondido cada uno): 1580
Filas para entrenar: 2841
Quedan 1 580 clientes para evaluar, cada uno con un servicio escondido, y 2 841 filas para entrenar.
La celda siguiente entrena ALS con implicitPrefs=True, que trata veces como intensidad de uso y no como calificación. rank=3 es el largo de los vectores; regParam y alpha controlan la regularización y cuánto pesa el uso intenso. Esos valores salen de probar varias combinaciones, como en la validación cruzada. Para cada cliente, la celda toma las 3 mejores recomendaciones entre los servicios que no usa y las compara con una línea base: recomendar a todos los 3 servicios más populares que todavía no usa.
from pyspark.ml.recommendation import ALSals = ALS(userCol="cliente", itemCol="servicio", ratingCol="veces", implicitPrefs=True, rank=3, regParam=1.0, alpha=1.0, maxIter=15, coldStartStrategy="drop", seed=22)inicio = time.perf_counter()modelo_als = als.fit(entrenar_als)print(f"ALS entrenado en {time.perf_counter() - inicio:.1f} s")usados = entrenar_als.groupBy("cliente").agg(F.collect_set("servicio").alias("usados"))recomendado = ( modelo_als.recommendForAllUsers(len(SERVICIOS)) .join(usados, "cliente") .withColumn("top3", F.slice(F.expr("filter(recommendations.servicio, s -> NOT array_contains(usados, s))"), 1, 3)))populares = [f["servicio"] for f in entrenar_als.groupBy("servicio").count().orderBy(F.desc("count")).collect()]popularidad = F.slice(F.array_except(F.array(*[F.lit(s) for s in populares]), F.col("usados")), 1, 3)evaluacion = (escondidos.join(recomendado.select("cliente", "top3", "usados"), "cliente") .withColumn("acierta_als", F.array_contains("top3", F.col("servicio"))) .withColumn("acierta_popularidad", F.array_contains(popularidad, F.col("servicio"))))fila = evaluacion.agg(F.avg(F.col("acierta_als").cast("int")).alias("als"), F.avg(F.col("acierta_popularidad").cast("int")).alias("pop"), F.count("*").alias("n")).first()print(f"El servicio escondido aparece entre las 3 recomendaciones: ALS {fila['als']:.1%} | "f"los 3 más populares {fila['pop']:.1%} ({fila['n']} clientes)")
ALS entrenado en 7.1 s
El servicio escondido aparece entre las 3 recomendaciones: ALS 90.8% | los 3 más populares 66.5% (1580 clientes)
ALS se entrenó en 7.1 segundos y el servicio escondido apareció entre sus 3 recomendaciones para el 90.8 % de los clientes. La línea base de popularidad acertó el 66.5 %. La popularidad acierta bastante porque, con ocho servicios, tres recomendaciones cubren buena parte del catálogo; ALS gana porque recomienda según el perfil de cada cliente.
La celda siguiente muestra, para un cliente de cada perfil, lo que usa, lo que ALS le recomienda y su perfil real.
ejemplos = []for perfil in PERFILES: cliente =next(c for c insorted(perfil_real) if perfil_real[c] == perfil and c >100) ejemplos.append(cliente)muestra = recomendado.filter(F.col("cliente").isin(ejemplos)).select("cliente", "usados", "top3").toPandas()muestra["perfil_real"] = muestra["cliente"].map(perfil_real)muestra["ya_usa"] = muestra["usados"].map(lambda lista: ", ".join(SERVICIOS[s] for s insorted(lista)))muestra["recomendado"] = muestra["top3"].map(lambda lista: ", ".join(SERVICIOS[s] for s in lista))pd.set_option("display.max_colwidth", 80)print(muestra[["cliente", "perfil_real", "ya_usa", "recomendado"]].to_string(index=False))
 cliente     perfil_real                                                                 ya_usa                                                  recomendado
     101 tienda en línea empaque, aviso por SMS, devolución gestionada, almacenamiento temporal            pago contra entrega, recogida a domicilio, seguro
     102         empresa                                             seguro, entrega programada recogida a domicilio, almacenamiento temporal, aviso por SMS
     104            pyme                                           seguro, recogida a domicilio   aviso por SMS, entrega programada, almacenamiento temporal
     105         persona                                                                 seguro                 recogida a domicilio, empaque, aviso por SMS
Para el cliente 101, de tienda en línea, que ya usa aviso por SMS y devolución gestionada, la primera recomendación es pago contra entrega, el servicio de su perfil que le falta. Al de empresa le recomienda primero recogida a domicilio y almacenamiento temporal, los dos de su perfil que no usa. Al de pyme, aviso por SMS, también de su perfil. Al cliente persona, que solo usa seguro, le recomienda primero recogida a domicilio y después empaque, el de su perfil: con un solo servicio usado, y uno que comparten dos perfiles, la información para ubicarlo es poca.
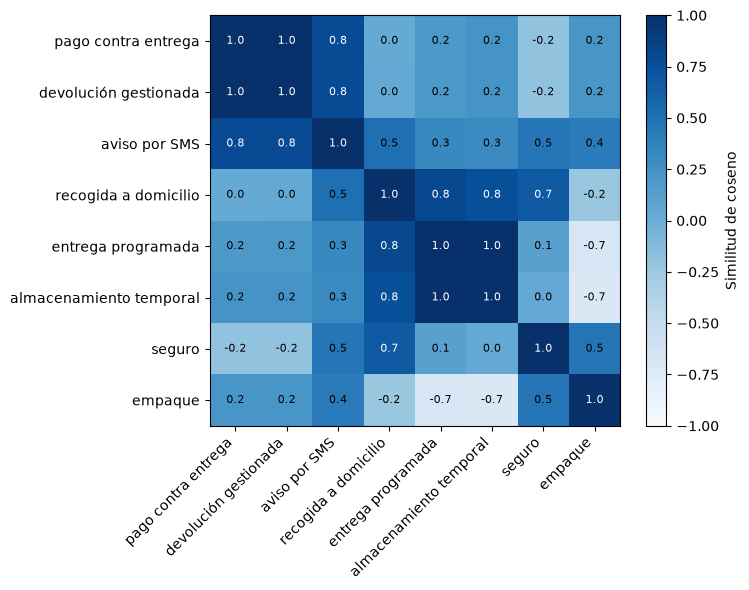
¿Qué aprendió ALS sobre los servicios? Los vectores de cada servicio se pueden comparar entre sí con la similitud de coseno, que vale 1 si dos vectores apuntan en la misma dirección y 0 si no tienen relación.
vectores = modelo_als.itemFactors.orderBy("id").toPandas()matriz = np.array(vectores["features"].tolist())normas = np.linalg.norm(matriz, axis=1, keepdims=True)similitud = (matriz / normas) @ (matriz / normas).Torden = [SERVICIOS.index(s) for s in ["pago contra entrega", "devolución gestionada", "aviso por SMS","recogida a domicilio", "entrega programada", "almacenamiento temporal","seguro", "empaque"]]similitud = similitud[np.ix_(orden, orden)]etiquetas = [SERVICIOS[i] for i in orden]print("Pares de servicios más parecidos según ALS:")pares =sorted(((similitud[i, j], etiquetas[i], etiquetas[j]) for i inrange(8) for j inrange(i +1, 8)), reverse=True)for valor, a, b in pares[:5]:print(f" {valor:.2f}{a} / {b}")
Pares de servicios más parecidos según ALS:
  1.00  pago contra entrega / devolución gestionada
  1.00  entrega programada / almacenamiento temporal
  0.81  recogida a domicilio / entrega programada
  0.79  devolución gestionada / aviso por SMS
  0.78  pago contra entrega / aviso por SMS
Los pares más parecidos son pago contra entrega con devolución gestionada, y entrega programada con almacenamiento temporal, los dos con similitud 1.00. Siguen recogida a domicilio con entrega programada (0.81) y aviso por SMS con devolución gestionada y con pago contra entrega (0.79 y 0.78). ALS reconstruyó los perfiles de tienda en línea y de empresa sin verlos.
Figura 22.2: Similitud entre los servicios adicionales según los vectores que aprendió ALS
En la figura se ven dos bloques oscuros sobre la diagonal: el de tienda en línea, arriba a la izquierda, y el de empresa, en el centro. Seguro y empaque, el perfil persona, quedan con 0.5 entre sí, un bloque más débil: seguro también es parte del perfil pyme, así que su vector queda entre los dos. Empaque tiene −0.7 con entrega programada y almacenamiento, los servicios de empresa: los clientes que usan uno casi nunca usan los otros.
ALS tiene un límite conocido, el del arranque en frío: un cliente nuevo no tiene usos, así que no tiene vector y el modelo no puede recomendarle nada.
nuevo = spark.createDataFrame([(5000,)], "cliente int")print("Recomendaciones para un cliente sin historial:", modelo_als.recommendForUserSubset(nuevo, 3).count())print("Recomendación de respaldo, los 3 servicios más usados:", [SERVICIOS[s] for s in populares[:3]])
Recomendaciones para un cliente sin historial: 0
Recomendación de respaldo, los 3 servicios más usados: ['seguro', 'aviso por SMS', 'recogida a domicilio']
Para un cliente sin historial, ALS devolvió 0 recomendaciones. La práctica habitual es recurrir a la popularidad (aquí, seguro, aviso por SMS y recogida a domicilio) o a reglas del negocio, como el tipo de cliente declarado al registrarse, hasta que acumule usos.
11. Guardar el modelo y usarlo con julio
Un modelo sirve cuando se usa con datos nuevos. La celda guarda en HDFS el pipeline completo que eligió la validación cruzada, con sus pasos de preparación, lo vuelve a cargar en otra variable, como haría otro proceso al día siguiente, y lo aplica a los envíos de julio que cargó el pipeline de ingesta. Marca en riesgo los que tienen probabilidad de 0.20 o más, el umbral de la sección 6, y compara con lo que realmente pasó.
ruta_modelo = MODELOS +"/riesgo_tarde"modelo_cv.bestModel.write().overwrite().save(ruta_modelo)from pyspark.ml import PipelineModelcargado = PipelineModel.load(ruta_modelo)print("Modelo guardado en", ruta_modelo.replace(BASE, "/bitlogistica"), "y cargado de nuevo:", [type(p).__name__for p in cargado.stages])camino = spark._jvm.org.apache.hadoop.fs.Path(PLATA_JULIO)if camino.getFileSystem(sc._jsc.hadoopConfiguration()).exists(camino): julio = variables(spark.read.parquet(PLATA_JULIO)).filter( F.col("a_tiempo").isNotNull() & (F.col("operador") !="Sin operador"))else:print("No está la plata de julio del capítulo de ingesta: se puntúa junio como lote de ejemplo.") julio = pruebaUMBRAL =0.20puntuado = (cargado.transform(julio) .withColumn("p_tarde", vector_to_array("probability")[1]) .withColumn("en_riesgo", F.col("p_tarde") >= UMBRAL))(puntuado.groupBy("en_riesgo") .agg(F.count("*").alias("envios"), F.round(100* F.avg("tarde"), 1).alias("pct_llego_tarde")) .orderBy("en_riesgo").show())
Modelo guardado en /bitlogistica/modelos/riesgo_tarde y cargado de nuevo: ['StringIndexerModel', 'OneHotEncoderModel', 'VectorAssembler', 'StandardScalerModel', 'VectorAssembler', 'LogisticRegressionModel']
+---------+------+---------------+
|en_riesgo|envios|pct_llego_tarde|
+---------+------+---------------+
|    false|  1589|            5.3|
|     true|   190|           32.1|
+---------+------+---------------+
El modelo cargado tiene los seis pasos del pipeline: la preparación viaja con él, así que julio se transforma igual que se transformó el entrenamiento. De los 1 779 envíos de julio, el modelo marcó 190 en riesgo, y el 32.1 % de ellos llegó tarde. De los 1 589 no marcados, llegó tarde el 5.3 %. Con datos que el modelo nunca vio, los marcados tienen seis veces la tasa de retraso de los demás, y la proporción coincide con la que se esperaba en junio para ese umbral (32.7 %).
Puntuar un lote así es una transformación más de Spark: se puede agregar al pipeline de ingesta para que cada envío nuevo de la plata llegue con su probabilidad de llegar tarde.
12. Lo que MLlib no hace y lo que sigue
Necesidad
MLlib
Qué se usa
Redes neuronales profundas, imágenes, texto
Solo un perceptrón multicapa simple
PyTorch o TensorFlow, con Spark para preparar los datos
Muchos algoritmos y opciones finas
Los principales
scikit-learn sobre una muestra, o XGBoost y LightGBM, que tienen versiones para Spark
Modelos que aprenden con cada dato nuevo
No: se reentrena por lotes
Reentrenar cada cierto tiempo con un orquestador
Puntuar envíos en el momento en que llegan
Sí, con Structured Streaming y el PipelineModel guardado
El mismo modelo, aplicado a un flujo
Dos capítulos de esta segunda etapa continúan desde aquí. El capítulo de orquestación con Airflow programa el reentrenamiento mensual del modelo después de la ingesta y la puerta de calidad. El de Structured Streaming aplica el mismo PipelineModel a los envíos a medida que se admiten.
Limpiar
La celda libera los DataFrames que quedaron en caché y cierra la sesión. El modelo de riesgo queda en /bitlogistica/modelos/riesgo_tarde para los capítulos de orquestación y de flujo.
for tabla in [entrenamiento, prueba, predicciones, rutas_vec, entrenar_als]: tabla.unpersist()spark.stop()print("Sesión cerrada. El modelo de riesgo queda en /bitlogistica/modelos/riesgo_tarde.")
Sesión cerrada. El modelo de riesgo queda en /bitlogistica/modelos/riesgo_tarde.
La sesión quedó cerrada, y el modelo quedó en /bitlogistica/modelos/riesgo_tarde con sus 6 pasos.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1 a 3 (la sesión, los datos y el pipeline).
Fuga de información a propósito. Agrega horas_transito a las variables numéricas y entrena de nuevo. ¿Qué AUC sale en junio? ¿Por qué ese modelo no sirve?
Separación al azar. Entrena con un 80 % de los envíos de enero a junio elegidos al azar (randomSplit) y prueba con el 20 % restante. ¿El AUC cambia frente a la separación por tiempo?
Otro umbral. Si el equipo de servicio solo puede revisar el 5 % de los envíos, ¿qué umbral usarías y qué porcentaje de tardíos capturaría?
Poisson con más variables. Agrega el operador y el servicio a la regresión de Poisson. ¿Sus coeficientes son cercanos a cero, como en el generador?
ALS con otros parámetros. Entrena ALS con rank=6 y alpha=10. ¿Qué pasa con el acierto del servicio escondido? ¿Por qué un modelo más grande puede acertar menos?
Puntuar la plata de julio dentro del pipeline. Escribe una función que reciba la plata de julio, cargue el modelo y guarde en /bitlogistica/ingesta/riesgo la guía y la probabilidad, particionado por fecha.
TipOrientaciones
El AUC se acerca a 1, porque horas_transito comparada con la promesa casi define la etiqueta. No sirve porque al admitir el envío las horas de tránsito no existen: el modelo solo funciona en la evaluación.
Puede subir un poco, porque la prueba al azar incluye envíos de mayo, que el modelo ya conoce por la variable de temporada, y mezcla meses parecidos. La separación por tiempo es más exigente y más honesta: imita lo que pasará en la operación.
En la tabla de la sección 6, el 5 % queda entre los umbrales 0.30 (6.1 % marcados) y 0.40 (3.0 %). Con algo más de 0.30 se capturaría alrededor de una cuarta parte de los tardíos.
Sí: el generador solo usa destino remoto y canal web para los intentos, así que los demás coeficientes deberían quedar cerca de cero, con intervalos que incluyan el cero. Es una forma de comprobar que el modelo no inventa efectos.
En las pruebas para el capítulo, con rank=6 y alpha=10 el acierto bajó a cerca del 60 %. Con ocho servicios y pocos usos por cliente, vectores más largos tienen más números que aprender que información disponible: el modelo se ajusta al ruido. Más grande no es mejor.
PipelineModel.load, transform, vector_to_array("probability")[1] y escribir con partitionBy("fecha") y sobrescritura dinámica, como en el pipeline de ingesta.
Errores frecuentes
Síntoma
Causa
Arreglo
IllegalArgumentException: Column features must be of type vector
El algoritmo recibió columnas sueltas.
Juntar las variables con VectorAssembler en una columna features.
Unseen label al aplicar el modelo a datos nuevos
Apareció una categoría que no estaba en el entrenamiento, como «Sin operador».
Filtrarla, o handleInvalid="keep" en StringIndexer y OneHotEncoder.
AUC cercano a 1
Fuga de información: una variable revela la etiqueta.
Usar solo variables conocidas al momento de predecir.
Exactitud alta pero no detecta ningún caso
Clase desbalanceada y umbral de 0.5.
Evaluar con AUC y elegir el umbral según el negocio.
El modelo cargado da resultados distintos
Se guardó solo el último paso y la preparación se rehízo con otros datos.
Guardar el PipelineModel completo.
ALS no recomienda nada a un cliente
Arranque en frío: el cliente no estaba en el entrenamiento.
Recomendación de respaldo por popularidad o reglas.
La validación cruzada tarda mucho
Entrena combinaciones × pliegues modelos.
Rejillas pequeñas, parallelism igual al número de executors.
Preguntas de comprensión
¿Por qué StandardScaler es un estimador y VectorAssembler un transformador?
Si el modelo tiene un AUC de 0.817, ¿por qué con el umbral de 0.5 detecta tan pocos tardíos?
¿Qué ventaja da tener datos sintéticos para evaluar un modelo, y qué no se puede trasladar a datos reales?
¿Por qué la regresión de Poisson se separa del generador en los grupos remotos?
¿Por qué ALS necesita preferencia implícita con los datos de BITLogística?
TipOrientaciones
Porque para escalar necesita aprender de los datos la media y la desviación de cada columna, y esos valores se fijan con el entrenamiento y se aplican iguales a los datos nuevos. VectorAssembler solo junta columnas y no aprende nada.
Porque el AUC mide cómo ordena el modelo, no dónde corta. Con 9 % de tardíos, pocas probabilidades pasan de 0.5 aunque el orden sea bueno. Bajar el umbral aprovecha ese orden.
Permite comparar lo aprendido con la verdad: aquí los coeficientes recuperaron las causas del retraso y su orden. Con datos reales no hay verdad conocida; lo que sí se traslada es el método: separación por tiempo, métricas adecuadas y revisar que los coeficientes tengan sentido de negocio.
Porque el generador suma los efectos sobre la media (0.12 + 0.20 + 0.08) y la regresión de Poisson con enlace logarítmico los multiplica. En los grupos con un solo efecto ajusta bien; en el que combina los dos, la multiplicación exagera.
Porque BITLogística no tiene calificaciones: solo sabe cuántas veces cada cliente usó cada servicio. La preferencia implícita interpreta el uso como señal de interés con distinta confianza según la intensidad, y no trata el no uso como rechazo.
Glosario
Término
Significado en este capítulo
MLlib
Biblioteca de aprendizaje automático de Spark, con entrenamiento repartido.
Transformador
Paso que agrega columnas a un DataFrame con transform().
Estimador
Paso que aprende de los datos con fit() y devuelve un transformador.
Pipeline
Secuencia de transformadores y estimadores que se ajusta y aplica como una unidad.
features
Columna de tipo vector con todas las variables de entrada.
Categoría de referencia
Categoría sin columna propia contra la que se comparan las demás.
Fuga de información
Uso de una variable que no estará disponible al momento de predecir.
Separación temporal
Entrenar con el pasado y probar con lo posterior.
Clase desbalanceada
Etiqueta con una categoría mucho más frecuente que la otra.
AUC
Probabilidad de que el modelo ordene un caso positivo por encima de uno negativo.
Umbral
Probabilidad desde la que un caso se clasifica como positivo.
Chance
Probabilidad de un evento dividida por la de que no ocurra.
Validación cruzada
Evaluación repetida dejando afuera cada vez un pliegue de los datos.
Pliegue
Cada una de las partes en que la validación cruzada divide los datos.
Gradient boosting
Combinación de muchos árboles pequeños, cada uno corrigiendo a los anteriores.
Regresión de Poisson
Modelo para conteos con media que depende de las variables.
k-means
Agrupamiento que reparte los puntos en k grupos alrededor de sus centros.
Silueta
Medida de qué tan separados quedan los grupos.
Preferencia implícita
Interés deducido del uso, sin calificaciones.
ALS
Algoritmo de recomendación que aprende un vector por usuario y otro por producto.
Similitud de coseno
Medida de cuánto apuntan dos vectores en la misma dirección.
Arranque en frío
Imposibilidad de recomendar a un usuario o producto sin historial.
Hu, Y., Koren, Y. y Volinsky, C. (2008). Collaborative Filtering for Implicit Feedback Datasets. IEEE ICDM. El método de ALS con preferencia implícita.
James, G., Witten, D., Hastie, T. y Tibshirani, R. (2021). An Introduction to Statistical Learning, 2.ª ed. Springer. Capítulos 4 (clasificación), 5 (validación cruzada) y 12 (agrupamiento).
Resumen
Con MLlib resolviste cuatro preguntas de BITLogística sobre la plata de enero a junio. Una regresión logística, armada como pipeline de transformadores y estimadores y evaluada con junio, ordenó los envíos por riesgo con un AUC de 0.817. Sus coeficientes recuperaron las causas que puso el generador: OP-C, destino remoto, fin de semana, mayo y distancia. Con el umbral de 0.5, su exactitud (90.7 %) no superaba la de decir siempre «a tiempo»; con 0.20, marcó el 11.3 % de los envíos y capturó el 40.1 % de los tardíos. El gradient boosting apenas mejoró el AUC (0.823) y la validación cruzada confirmó que la regresión no estaba sobreajustada. La regresión de Poisson encontró los efectos de destino remoto y canal web en los intentos de entrega. k-means separó 87 rutas en cuatro grupos, uno de ellos solo con Barranquilla a Pasto. ALS recomendó servicios adicionales con 90.8 % de acierto frente a 66.5 % de la popularidad, y reconstruyó los perfiles de cliente sin verlos. El modelo guardado marcó en riesgo 190 envíos de julio, de los que llegó tarde el 32.1 %, frente al 5.3 % de los no marcados.