En los capítulos anteriores, los datos de BITLogística (empresa ficticia; los datos son sintéticos y no corresponden a BIT ni a ningún cliente) llegan una vez al día, en un archivo por fecha. El pipeline de ingesta los carga por la noche y el tablero de la mañana muestra lo que pasó ayer. Para el área de servicio al cliente eso es tarde: cuando un cliente llama a las 3 de la tarde, quieren saber si su envío ya salió a ruta, no si salió ayer.
Para eso, los sistemas de admisión, despacho y entrega tienen que publicar cada evento en el momento en que ocurre, y el tablero tiene que leerlos a medida que llegan. Además, otros sistemas (facturación, auditoría, el modelo de riesgo) quieren los mismos eventos, cada uno a su ritmo, y nadie quiere que una caída de su programa haga perder o duplicar eventos. Este capítulo agrega Apache Kafka al clúster y publica los eventos de los envíos admitidos el 13 de julio: 208 envíos y 624 eventos.
Ficha
En este capítulo
Pregunta
¿Cómo llegan los datos cuando no esperan al final del día, y cómo los leen varios sistemas sin perder ni repetir eventos?
Datos
624 eventos (admitido, en ruta, entregado o devuelto) de 208 envíos admitidos el 13 de julio de 2026, hechos con el generador del taller de PySpark
Kafka es un servicio nuevo, así que va en un archivo Compose propio, igual que el cliente Spark. En la terminal de Ubuntu, en la carpeta del clúster:
cd ~/hdfs-docker-labcat> compose.kafka.yaml <<'EOF'# Capa que agrega un broker de Kafka al clúster del libro.# Un solo nodo hace de broker (guarda los mensajes) y de controlador (lleva los metadatos), sin ZooKeeper.services: kafka: image: apache/kafka:4.1.0 hostname: kafka environment: KAFKA_NODE_ID: 1 KAFKA_PROCESS_ROLES: broker,controller KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093 KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://kafka:9092 KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093 KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1 KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 1 KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 1 KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS: 0 KAFKA_NUM_PARTITIONS: 3 KAFKA_HEAP_OPTS: "-Xmx512m -Xms512m"EOFdck(){docker compose -f compose.yaml -f compose.spark.yaml -f compose.kafka.yaml "$@";}dck up -d kafkadck ps kafka
Mientras trabajes con Kafka, usa dck en lugar de dc: es la misma función con el tercer archivo. Con dc, Compose no ve el servicio kafka y avisa que hay un contenedor huérfano (orphan); el aviso es inofensivo.
Salida esperada: el contenedor hdfs-lab-kafka-1 en estado Up. Para comprobar que el broker responde:
Salida esperada: una lista de campos que incluye LeaderId: 1 y CurrentVoters con el nodo 1. Las primeras veces, mientras el broker arranca, puede responder TimeoutException: espera unos segundos y repite.
Las variables KAFKA_* son la configuración del broker. KAFKA_ADVERTISED_LISTENERS es la dirección que el broker entrega a los clientes para que se conecten: kafka:9092, el nombre del servicio en la red de Docker, que spark-client resuelve. Las tres que terminan en REPLICATION_FACTOR o MIN_ISR bajan a 1 las réplicas de los tópicos internos, porque hay un solo broker. El broker no publica puertos en tu equipo: los programas del libro lo usan desde spark-client.
El notebook usa el cliente confluent-kafka para Python. Se instala una vez en el Python del clúster:
Salida esperada:Successfully installed confluent-kafka-2.16.0. El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster; en el apéndice «Operar el clúster» están el arranque y la descarga (el archivo se llama taller_kafka.ipynb dentro de talleres-notebooks.zip). Usa generar_envios.py, que viene en el mismo zip, en la carpeta notebooks. No usa Spark ni HDFS: solo Python y el broker.
1. Eventos, tópicos, particiones y offsets
NotaEvento
Un evento es el registro de algo que pasó, en el momento en que pasó: «la guía BL-202607-000065 fue admitida en Bogotá a las 08:12». No se modifica después: si el envío sale a ruta, eso es otro evento. Un archivo diario es la foto de un día; una secuencia de eventos es la película.
NotaBroker y tópico
Un broker es un servidor de Kafka: recibe mensajes, los guarda en disco y los entrega a quien los pide. Un tópico es una secuencia de mensajes con nombre, como envios-eventos. Los programas que escriben en un tópico son productores; los que leen, consumidores. Productores y consumidores no se conocen entre sí: solo conocen el tópico.
NotaPartición y offset
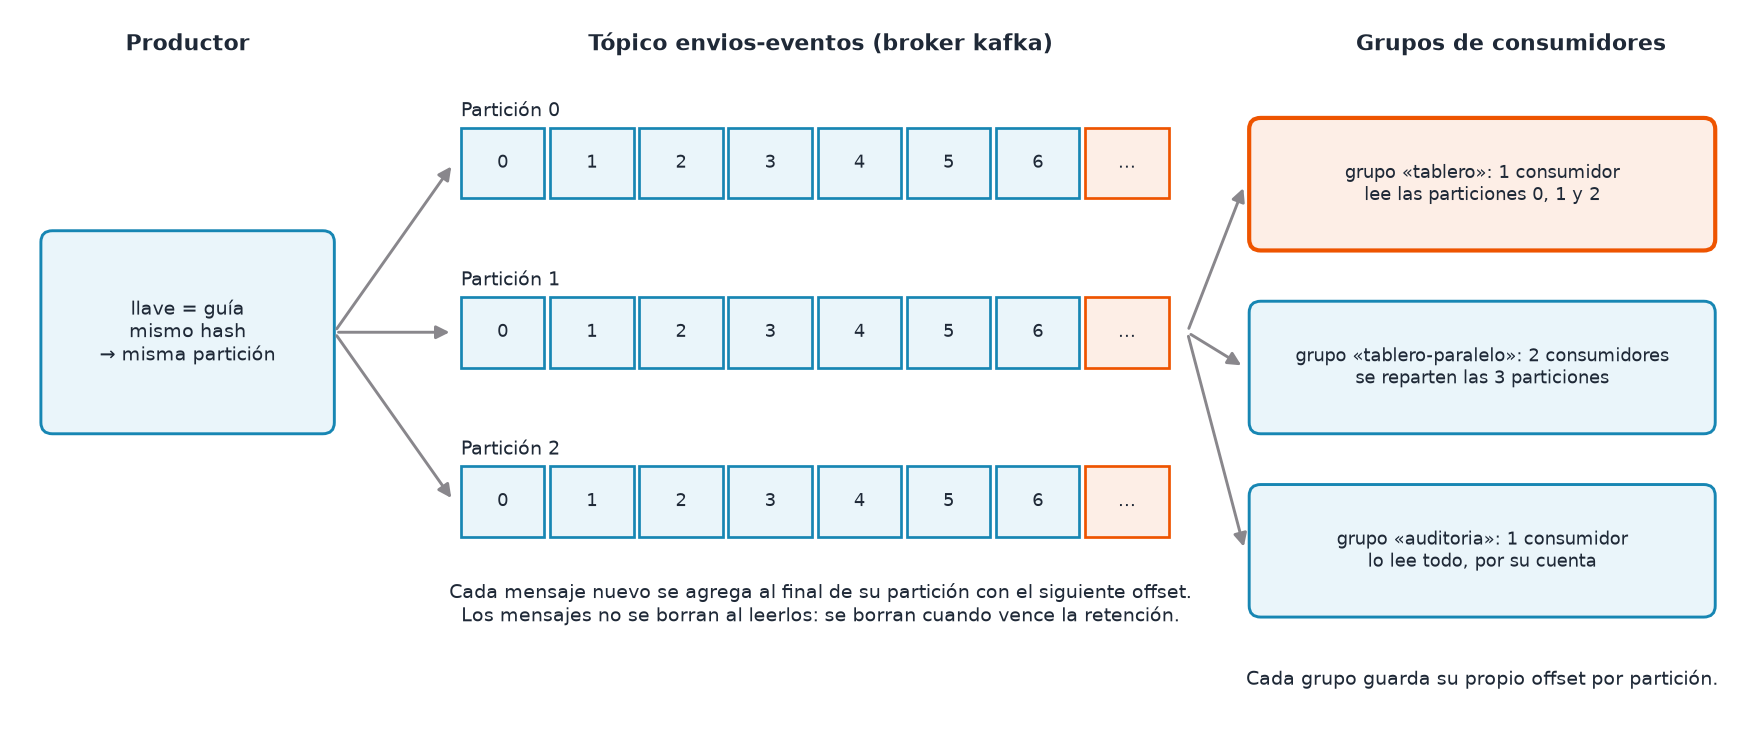
Un tópico se divide en particiones. Cada partición es un registro donde los mensajes solo se agregan al final y cada uno recibe un número consecutivo, su offset, que empieza en 0. El orden está garantizado dentro de una partición, no entre particiones. Las particiones son la unidad de reparto: un tópico de tres particiones puede repartirse entre tres brokers y leerse con tres consumidores en paralelo.
Un tópico con tres particiones, un productor que reparte por llave y tres grupos de consumidores.
La diferencia con una cola de mensajes clásica está en la parte de abajo de la figura: Kafka no borra un mensaje cuando alguien lo lee. Lo guarda durante un tiempo, la retención, y cada consumidor lleva la cuenta de hasta dónde leyó. Por eso varios sistemas pueden leer el mismo tópico a ritmos distintos, y un sistema nuevo puede leer todo desde el principio.
Kafka no reemplaza al data lake. Lo alimenta: los eventos que hoy llegan en el archivo diario pueden llegar por Kafka durante el día y aterrizar en el lago cada pocos minutos, como hará el capítulo de Structured Streaming.
2. Conectar con el broker y crear el tópico
La primera celda importa el cliente, se conecta al broker y deja el escenario limpio: si hay tópicos o grupos de consumidores de una ejecución anterior, los borra, para que el notebook dé siempre los mismos resultados.
import jsonimport platformimport randomimport timefrom collections import Counterfrom datetime import datetime, timedeltaimport confluent_kafkaimport matplotlib.pyplot as pltimport pandas as pdfrom confluent_kafka import Consumer, KafkaException, Producer, TopicPartitionfrom confluent_kafka.admin import AdminClient, ConfigResource, NewTopicimport generar_envios as genBROKER ="kafka:9092"# nombre del servicio en la red de Docker y su puertoTOPICO ="envios-eventos"# el tópico de los eventos de los envíosTOPICO_AJUSTES ="envios-ajustes"# tópico auxiliar para la sección de transaccionesadmin = AdminClient({"bootstrap.servers": BROKER})metadatos = admin.list_topics(timeout=15)# 1. Si quedan tópicos de una ejecución anterior, se borran para empezar desde ceroviejos = [t for t in (TOPICO, TOPICO_AJUSTES) if t in metadatos.topics]if viejos:for futuro in admin.delete_topics(viejos).values(): futuro.result()whileany(t in admin.list_topics(timeout=15).topics for t in viejos): time.sleep(1) # el borrado es asíncrono: esperar a que desaparezcan# 2. Y los grupos de consumidores de este capítulo, con sus offsets guardadosGRUPOS = ["tablero", "tablero-paralelo", "auditoria", "repaso", "tablero-v2", "al-menos-una-vez","como-maximo-una-vez", "lector-read_committed", "lector-read_uncommitted"]registrados = {g.group_id for g in admin.list_consumer_groups().result().valid}borrar = [g for g in GRUPOS if g in registrados]if borrar:for futuro in admin.delete_consumer_groups(borrar).values(): futuro.result()print("Python", platform.python_version(), "| confluent-kafka", confluent_kafka.__version__,"| librdkafka", confluent_kafka.libversion()[0])print("Brokers:", {b.id: f"{b.host}:{b.port}"for b in metadatos.brokers.values()})print("Tópicos de una ejecución anterior borrados:", viejos, "| grupos borrados:", len(borrar))
Python 3.11.10 | confluent-kafka 2.16.0 | librdkafka 2.16.0
Brokers: {1: 'kafka:9092'}
Tópicos de una ejecución anterior borrados: [] | grupos borrados: 0
El cliente encontró un broker, el 1, en kafka:9092. En la primera ejecución no hay nada que borrar; en las siguientes, la lista muestra los tópicos borrados.
AdminClient es la parte del cliente que administra: crea y borra tópicos, lee configuraciones y lista grupos. El tópico se crea con tres particiones y una sola réplica, porque el clúster tiene un solo broker. En producción se usan tres réplicas en brokers distintos, para que la caída de uno no pierda mensajes.
# 3. Tres particiones y una sola réplica (el laboratorio tiene un solo broker)nuevo = NewTopic(TOPICO, num_partitions=3, replication_factor=1, config={"retention.ms": str(7*24*3600*1000)}) # 7 días en milisegundosadmin.create_topics([nuevo])[TOPICO].result()descripcion = admin.list_topics(TOPICO, timeout=15).topics[TOPICO]for numero, particion insorted(descripcion.partitions.items()):print(f"Partición {numero}: líder broker {particion.leader} | réplicas {particion.replicas}")recurso = ConfigResource(ConfigResource.Type.TOPIC, TOPICO)configuracion = admin.describe_configs([recurso])[recurso].result()for clave in ["retention.ms", "cleanup.policy", "segment.bytes"]:print(f"{clave:15s}{configuracion[clave].value}")
Las tres particiones tienen como líder al broker 1, el único. La retención quedó en 604 800 000 milisegundos, siete días: pasado ese plazo, Kafka borra los mensajes más viejos aunque nadie los haya leído. cleanup.policy = delete es esa forma de limpiar por tiempo. segment.bytes, 1 GB, es el tamaño de los archivos en que Kafka parte cada partición en disco; la retención borra segmentos completos, nunca mensajes sueltos.
3. Producir eventos con llave
Los eventos salen del mismo generador del taller de PySpark: de 6 000 envíos de julio se quedan los admitidos el 13. Cada envío produce tres eventos: admitido a la hora de admisión, en_ruta entre una y cuatro horas después, y entregado a la hora de entrega o devuelto cuatro días después. Cada evento es un diccionario que viaja como texto JSON.
rng = random.Random(2513)DIA ="2026-07-13"# 4. Los envíos admitidos el 13 de julio, con el mismo generador del taller de PySparkenvios = [gen.generar_envio(rng, 7, n) for n inrange(1, 6001)]envios = [e for e in envios if e["fecha_admision"] == DIA]def eventos_de(envio):"""Tres eventos por envío: admitido, en_ruta y entregado (o devuelto).""" admision = datetime.strptime(envio["fecha_admision"] +" "+ envio["hora_admision"], "%Y-%m-%d %H:%M")if envio["estado"] =="entregado": final = datetime.strptime(envio["fecha_hora_entrega"], "%Y-%m-%d %H:%M") tipo_final, ciudad_final ="entregado", envio["destino"]else: final = admision + timedelta(hours=96) # un devuelto vuelve a su origen en cuatro días tipo_final, ciudad_final ="devuelto", envio["origen"] salida = admision +min(timedelta(minutes=rng.randint(60, 240)), (final - admision) /2) comun = {k: envio[k] for k in ["guia", "servicio", "operador", "origen", "destino"]}return [ {**comun, "tipo": "admitido", "momento": admision.isoformat(), "ciudad": envio["origen"]}, {**comun, "tipo": "en_ruta", "momento": salida.isoformat(), "ciudad": envio["origen"]}, {**comun, "tipo": tipo_final, "momento": final.isoformat(), "ciudad": ciudad_final}, ]eventos =sorted((ev for e in envios for ev in eventos_de(e)), key=lambda ev: ev["momento"])corte ="2026-07-14T00:00:00"lote_13 = [ev for ev in eventos if ev["momento"] < corte] # lo que pasó el 13lote_despues = [ev for ev in eventos if ev["momento"] >= corte] # lo que pasa del 14 en adelanteprint("Envíos admitidos el", DIA, ":", len(envios), "| eventos:", len(eventos))print("Eventos del 13:", len(lote_13), "| de los días siguientes:", len(lote_despues))print("Tipos el 13:", dict(Counter(ev["tipo"] for ev in lote_13)))print(json.dumps(lote_13[0], ensure_ascii=False))
Envíos admitidos el 2026-07-13 : 208 | eventos: 624
Eventos del 13: 436 | de los días siguientes: 188
Tipos el 13: {'admitido': 208, 'en_ruta': 208, 'entregado': 20}
{"guia": "BL-202607-005065", "servicio": "Estándar", "operador": "OP-A", "origen": "Bogotá", "destino": "Barranquilla", "tipo": "admitido", "momento": "2026-07-13T07:00:00", "ciudad": "Bogotá"}
Se admitieron 208 envíos el 13 de julio, que producen 624 eventos. Hasta la medianoche del 13 pasaron 436: los 208 admitido, los 208 en_ruta y solo 20 entregado, porque casi todos los envíos tardan más de un día. Los 188 eventos restantes, entregas y devoluciones de los días siguientes, se publican en la sección 5. El primer evento del día es una admisión en Bogotá a las 07:00, de un envío Estándar hacia Barranquilla.
NotaLlave de un mensaje
Cada mensaje de Kafka tiene una llave opcional y un valor. El productor elige la partición con un cálculo sobre la llave (un hash): la misma llave cae siempre en la misma partición. Aquí la llave es la guía, así que los tres eventos de un envío quedan juntos y en orden.
El productor se configura con cuatro opciones, cada una con una razón:
acks = all: el broker confirma un mensaje cuando lo guardaron todas las réplicas sincronizadas, no solo el líder.
enable.idempotence = True: si un envío se reintenta porque la confirmación se perdió en la red, el broker reconoce el duplicado y no lo guarda dos veces.
partitioner = murmur2_random: el cálculo de la llave que usan los clientes de Java, Spark y Kafka Connect. El cliente de Python usa otro por defecto; con este, un programa en otro lenguaje que publique la misma guía la manda a la misma partición.
linger.ms = 20: espera hasta 20 milisegundos para juntar mensajes y enviarlos en bloque.
produce no envía de inmediato: deja el mensaje en una memoria intermedia. poll(0) atiende las confirmaciones que ya llegaron y flush espera las que faltan. La función al_confirmar se ejecuta una vez por mensaje, con la partición y el offset que el broker le asignó.
productor = Producer({"bootstrap.servers": BROKER,"acks": "all", # confirmar cuando todas las réplicas sincronizadas lo guardaron"enable.idempotence": True, # los reintentos no duplican mensajes"partitioner": "murmur2_random", # el mismo reparto por llave que los clientes de Java y Spark"linger.ms": 20, # juntar mensajes hasta 20 ms para enviarlos en bloque})confirmados = [] # (partición, offset, guía) de cada mensaje que Kafka confirmódef al_confirmar(error, mensaje):"""Kafka llama a esta función una vez por mensaje, cuando lo guardó o cuando falló."""if error isnotNone:raise KafkaException(error) confirmados.append((mensaje.partition(), mensaje.offset(), mensaje.key().decode()))def publicar(lista):for ev in lista: productor.produce(TOPICO, key=ev["guia"], value=json.dumps(ev, ensure_ascii=False), on_delivery=al_confirmar) productor.poll(0) # atender las confirmaciones que ya llegaron pendientes = productor.flush(30) # esperar las que faltanassert pendientes ==0, f"{pendientes} mensajes sin confirmar"inicio = time.perf_counter()publicar(lote_13)segundos = time.perf_counter() - inicioprint(f"Publicados {len(confirmados)} eventos en {segundos:.2f} s")print("Mensajes por partición:", dict(sorted(Counter(p for p, _, _ in confirmados).items())))print("Primeras confirmaciones (partición, offset, guía):", confirmados[:4])
%4|1794339799.848|GETPID|rdkafka#producer-2| [thrd:main]: Failed to acquire idempotence PID from broker kafka:9092/1: Broker: Coordinator load in progress: retrying
La línea que empieza con %4| es un aviso del cliente, no un error: el productor idempotente pidió su identificador al broker mientras este todavía preparaba sus tópicos internos, y reintentó solo. Los 436 eventos se publicaron en alrededor de un segundo y quedaron repartidos en 136, 174 y 126 mensajes por partición: el cálculo sobre la llave reparte las guías de forma parecida, no exacta. Las primeras confirmaciones son los offsets 0, 1, 2 y 3 de una misma partición, cada uno de una guía distinta: el productor envía en bloques por partición, y la partición que confirma primero puede cambiar de una ejecución a otra.
4. El orden: por llave, no global
# 5. Todos los eventos de una guía caen en la misma partición, en el orden en que se publicaronguia =next(ev["guia"] for ev in lote_13 if ev["tipo"] =="entregado")tipos = [ev["tipo"] for ev in lote_13 if ev["guia"] == guia]posiciones =sorted((p, o) for p, o, g in confirmados if g == guia)print("Guía", guia, "->", list(zip(tipos, posiciones)))tabla = pd.DataFrame(confirmados, columns=["particion", "offset", "guia"])print("Guías con eventos en más de una partición:",int((tabla.groupby("guia")["particion"].nunique() >1).sum()), "de", tabla["guia"].nunique())# Cada partición cuenta sus offsets por separado, desde 0print(tabla.groupby("particion")["offset"].agg(["min", "max", "count"]).to_string())
Guía BL-202607-000065 -> [('admitido', (0, 7)), ('en_ruta', (0, 28)), ('entregado', (0, 77))]
Guías con eventos en más de una partición: 0 de 208
           min  max  count
particion
0            0  135    136
1            0  173    174
2            0  125    126
Los tres eventos de la guía BL-202607-000065 (admitido, en_ruta y entregado) están en la partición 0, en los offsets 7, 28 y 77: en el mismo orden en que ocurrieron. Ninguna de las 208 guías tiene eventos en más de una partición. Cada partición cuenta sus offsets por separado, desde 0 hasta 135, 173 y 125: el offset 7 de la partición 0 y el offset 7 de la partición 1 son mensajes distintos, sin relación de orden entre ellos.
Esa es la regla que hay que diseñar con cuidado: Kafka ordena dentro de una partición. Si el orden importa por envío, la llave es la guía. Si importara el orden de todos los eventos de un cliente, la llave sería el cliente. Un tópico con una sola partición tiene orden total, pero no se puede leer en paralelo.
5. Consumir y guardar la posición
NotaGrupo de consumidores y offset guardado
Un consumidor se une a un grupo con un nombre (group.id). Kafka guarda, por grupo y por partición, el offset hasta donde el grupo leyó: el offset guardado (committed offset). Si el programa se detiene y vuelve a arrancar con el mismo nombre de grupo, sigue desde ahí. Guardar la posición se llama hacer commit.
NotaLag
El lag de un grupo en una partición es la diferencia entre el último offset del tópico y el offset guardado del grupo: cuántos mensajes le faltan por leer. Es la medida principal de salud de un consumidor. Un lag que crece sin parar significa que el consumidor no alcanza a leer al ritmo en que se produce.
El tablero de servicio al cliente es un consumidor del grupo tablero. Para cada mensaje actualiza el estado de la guía con su último evento. Dos opciones de la función consumidor deciden su comportamiento:
auto.offset.reset = earliest: si el grupo no tiene offsets guardados, empieza por el primer mensaje que se conserve. Con latest, empezaría por los mensajes que lleguen desde ahora.
enable.auto.commit = False: el programa decide cuándo guardar su posición, con commit, después de procesar. La sección 8 muestra por qué importa el momento.
La función leer hace poll hasta que pasan tres segundos sin mensajes nuevos, y la función retraso consulta el offset guardado y el último offset de cada partición.
def consumidor(grupo, **ajustes):"""Un consumidor de un grupo, que empieza por el principio si el grupo no tiene offsets guardados."""return Consumer({"bootstrap.servers": BROKER,"group.id": grupo,"auto.offset.reset": "earliest", # sin offset guardado: desde el primer mensaje que se conserve"enable.auto.commit": False, # el programa decide cuándo guardar su posición**ajustes, })def leer(consumidores, inactividad=3.0, limite=60):"""Lee de uno o varios consumidores hasta que pasen `inactividad` segundos sin mensajes nuevos.""" leidos = {id(c): [] for c in consumidores} ultimo = time.time() fin = time.time() + limitewhile time.time() < fin:ifnotall(c.assignment() for c in consumidores): ultimo = time.time() # la espera cuenta desde que todos tienen particiones hubo =Falsefor c in consumidores: mensaje = c.poll(0.5)if mensaje isNone:continueif mensaje.error():raise KafkaException(mensaje.error()) leidos[id(c)].append(mensaje) hubo =Trueif hubo: ultimo = time.time()elif time.time() - ultimo > inactividad andall(c.assignment() for c in consumidores):breakreturn [leidos[id(c)] for c in consumidores]def retraso(grupo):"""Por partición: offset guardado del grupo, último offset del tópico y la diferencia (lag).""" c = consumidor(grupo) guardados = c.committed([TopicPartition(TOPICO, p) for p inrange(3)], timeout=15) filas = []for tp in guardados: _, alto = c.get_watermark_offsets(tp, timeout=15) posicion = tp.offset if tp.offset >=0else0 filas.append({"particion": tp.partition, "guardado": tp.offset, "fin": alto, "lag": alto - posicion}) c.close()return pd.DataFrame(filas)tablero = consumidor("tablero")tablero.subscribe([TOPICO])(mensajes,) = leer([tablero])estado = {} # último evento de cada guíafor m in mensajes: ev = json.loads(m.value()) estado[ev["guia"]] = ev["tipo"]tablero.commit(asynchronous=False) # guardar la posición después de procesarprint("Mensajes leídos:", len(mensajes))print("Estado de los envíos al final del 13:", dict(Counter(estado.values())))print(retraso("tablero").to_string(index=False))
Mensajes leídos: 436
Estado de los envíos al final del 13: {'en_ruta': 188, 'entregado': 20}
 particion  guardado  fin  lag
         0       136  136    0
         1       174  174    0
         2       126  126    0
El tablero leyó los 436 mensajes. Al final del 13, 188 envíos estaban en ruta y 20 entregados. Después del commit, el offset guardado de cada partición es igual a su último offset (136, 174 y 126) y el lag es 0 en las tres: el tablero está al día.
marca =int(time.time() *1000) # hora de Kafka antes de publicar: sirve en la sección 8publicar(lote_despues)print("Publicados los eventos de los días siguientes:", len(lote_despues))print(retraso("tablero").to_string(index=False))(nuevos,) = leer([tablero]) # el mismo consumidor sigue donde ibafor m in nuevos: ev = json.loads(m.value()) estado[ev["guia"]] = ev["tipo"]tablero.commit(asynchronous=False)print("Mensajes nuevos leídos:", len(nuevos))print("Estado de los envíos:", dict(Counter(estado.values())))print("Lag después de leer:", retraso("tablero")["lag"].tolist())
Publicados los eventos de los días siguientes: 188
 particion  guardado  fin  lag
         0       136  192   56
         1       174  252   78
         2       126  180   54
Mensajes nuevos leídos: 188
Estado de los envíos: {'entregado': 205, 'devuelto': 3}
Lag después de leer: [0, 0, 0]
Al publicar los 188 eventos de los días siguientes, el lag del tablero subió a 56, 78 y 54 mensajes por partición, que suman 188: Kafka sabe exactamente cuánto le falta a cada grupo. El mismo consumidor siguió desde su offset guardado y leyó solo los 188 nuevos, sin repetir los 436 anteriores. Con ellos, el estado final es de 205 envíos entregados y 3 devueltos, y el lag volvió a 0 en las tres particiones.
6. Grupos: repartir la lectura y leer en paralelo
Dos consumidores con el mismo group.id se reparten las particiones: cada partición la lee un solo consumidor del grupo. Un consumidor de otro grupo lee todo por su cuenta, con sus propios offsets.
# 6. Dos consumidores del mismo grupo se reparten las particionesfin_particion = {p: retraso("tablero").set_index("particion").loc[p, "fin"] for p inrange(3)}uno, dos = consumidor("tablero-paralelo"), consumidor("tablero-paralelo")uno.subscribe([TOPICO])dos.subscribe([TOPICO])vistos = {"uno": set(), "dos": set()} # (partición, offset) que leyó cada consumidordef particiones(c):return {tp.partition for tp in c.assignment()}def terminado():"""Cada consumidor leyó completas las particiones que tiene asignadas, y no comparten ninguna.""" a, b = particiones(uno), particiones(dos)ifnot a ornot b or a & b:returnFalsereturnall(len({o for p, o in vistos[n] if p == q}) == fin_particion[q]for n, c in [("uno", uno), ("dos", dos)] for q in particiones(c))limite = time.time() +60whilenot terminado() and time.time() < limite:for nombre, c in [("uno", uno), ("dos", dos)]: m = c.poll(0.2)if m isnotNoneandnot m.error(): vistos[nombre].add((m.partition(), m.offset()))for nombre, c in [("uno", uno), ("dos", dos)]: propias = particiones(c) leidos =sum(1for p, _ in vistos[nombre] if p in propias)print(f"Consumidor {nombre}: particiones {sorted(propias)} | mensajes {leidos}")uno.close()dos.close()# 7. Otro grupo lee todo por su cuenta, sin quitarle nada al primeroauditoria = consumidor("auditoria")auditoria.subscribe([TOPICO])(todos,) = leer([auditoria])auditoria.close()print("Grupo auditoria:", len(todos), "mensajes | total en el tópico:", len(lote_13) +len(lote_despues))
Consumidor uno: particiones [2] | mensajes 180
Consumidor dos: particiones [0, 1] | mensajes 444
Grupo auditoria: 624 mensajes | total en el tópico: 624
Los dos consumidores del grupo tablero-paralelo se repartieron las tres particiones: uno tomó dos y el otro una, sin compartir ninguna, y cada uno leyó completas solo las suyas. Las particiones tienen 192, 252 y 180 mensajes, así que el reparto de trabajo depende de cuáles le tocaron a cada uno: Kafka reparte particiones, no mensajes. El grupo auditoria leyó los 624 mensajes del tópico por su cuenta, sin mover los offsets de los otros grupos.
El número de consumidores útiles de un grupo tiene un tope: el número de particiones. Un tercer consumidor tomaría una partición y un cuarto quedaría sin nada. Cuando un consumidor entra o sale, Kafka reequilibra el grupo y reparte de nuevo las particiones; durante esos segundos, el grupo no lee. Por eso la celda espera a que el reparto se estabilice antes de dar los conteos.
7. Reprocesar: volver a leer desde una hora o desde el principio
Como Kafka no borra lo leído, volver atrás es cambiar el offset desde donde se lee. Hay dos formas habituales:
Desde una hora. Cada mensaje tiene una marca de tiempo de Kafka, la hora en que se publicó. offsets_for_times traduce una hora al primer offset posterior en cada partición. Antes de publicar los eventos de los días siguientes, la sección 5 guardó la hora en la variable marca.
Desde el principio. Un grupo nuevo, sin offsets guardados, empieza por el primer mensaje con auto.offset.reset = earliest.
En el primer caso, el consumidor no se suscribe al tópico: se asigna las particiones con assign, con el offset de inicio de cada una. Así no participa en ningún grupo ni reparto.
# 8. Volver a leer desde una hora: Kafka traduce la hora al primer offset posteriorrepaso = consumidor("repaso")desde = repaso.offsets_for_times([TopicPartition(TOPICO, p, marca) for p inrange(3)], timeout=15)print("Offset de inicio por partición:", {tp.partition: tp.offset for tp in desde})repaso.assign(desde)(releidos,) = leer([repaso])repaso.close()print("Mensajes releídos desde la marca:", len(releidos))# 9. O desde el principio, con un grupo nuevo (auto.offset.reset = earliest)desde_cero = consumidor("tablero-v2")desde_cero.subscribe([TOPICO])(todo,) = leer([desde_cero])desde_cero.close()print("Grupo nuevo desde el principio:", len(todo), "mensajes")
Offset de inicio por partición: {0: 136, 1: 174, 2: 126}
Mensajes releídos desde la marca: 188
Grupo nuevo desde el principio: 624 mensajes
La marca se tradujo en los offsets 136, 174 y 126: justo donde empezaban los eventos de los días siguientes en cada partición. Desde ahí se releyeron 188 mensajes, los mismos de la sección 5. El grupo nuevo tablero-v2 leyó los 624 desde el principio. Es la operación que se usa cuando se corrige un error en un consumidor: se despliega la versión corregida con un grupo nuevo, lee toda la historia que conserve el tópico y reemplaza a la vieja cuando se pone al día.
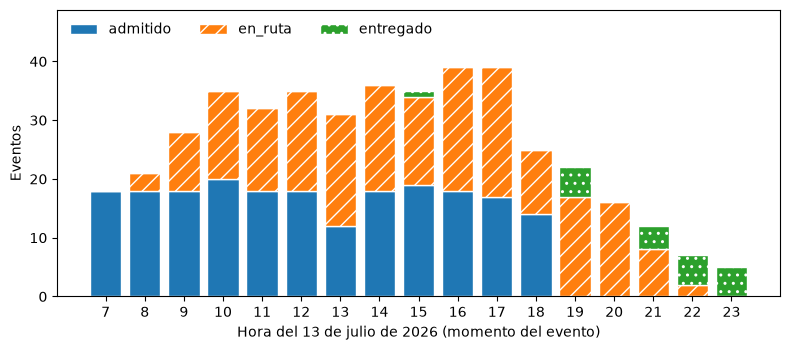
Hay dos horas distintas en cada evento. La marca de tiempo de Kafka es la hora de publicación, y es la que usa offsets_for_times. La hora de negocio viaja dentro del valor, en el campo momento. El capítulo de Structured Streaming trabaja con la segunda. La tabla y la figura agrupan por momento los eventos del 13 que leyó el grupo nuevo.
horas = pd.DataFrame([json.loads(m.value()) for m in todo])horas["momento"] = pd.to_datetime(horas["momento"])del_13 = horas[horas["momento"].dt.strftime("%Y-%m-%d") == DIA]por_hora = del_13.groupby([del_13["momento"].dt.hour, "tipo"]).size().unstack(fill_value=0)por_hora = por_hora.reindex(columns=["admitido", "en_ruta", "entregado"], fill_value=0)print(por_hora.T.to_string())
figura, eje = plt.subplots(figsize=(8, 3.6))base =Nonefor tipo, rayado in [("admitido", ""), ("en_ruta", "//"), ("entregado", "..")]: eje.bar(por_hora.index, por_hora[tipo], bottom=base, label=tipo, hatch=rayado, edgecolor="white") base = por_hora[tipo] if base isNoneelse base + por_hora[tipo]eje.set_xlabel("Hora del 13 de julio de 2026 (momento del evento)")eje.set_ylabel("Eventos")eje.set_xticks(por_hora.index)eje.set_ylim(0, por_hora.sum(axis=1).max() *1.25) # espacio para la leyendaeje.legend(frameon=False, ncol=3, loc="upper left")plt.tight_layout()plt.show()
Figura 25.1: Eventos del 13 de julio por hora, según su tipo
Las admisiones van de las 7 a las 18 horas, entre 12 y 20 por hora. Las salidas a ruta empiezan una hora después y se extienden hasta las 22, con el pico de 22 a las 17 horas. Las entregas del mismo día son pocas, 20, todas desde las 15 horas: casi todos los envíos tardan más de un día en llegar. Un tablero que lee de Kafka ve crecer estas barras durante el día; uno que espera el archivo nocturno las ve completas al día siguiente.
8. Garantías de entrega: cuándo se guarda la posición
NotaGarantías de entrega
Las garantías de entrega dicen qué pasa con los mensajes cuando algo falla:
Como máximo una vez (at most once): ningún mensaje se procesa dos veces, pero algunos pueden perderse.
Al menos una vez (at least once): ningún mensaje se pierde, pero algunos pueden procesarse dos veces.
Exactamente una vez (exactly once): cada mensaje produce su efecto una sola vez, aunque haya fallos.
Del lado del consumidor, la garantía depende del momento del commit. La celda simula un consumidor que lee en bloques de 100 mensajes, procesa el primer bloque completo y se cae a la mitad del segundo, después de procesar 50. Luego un reemplazo del mismo grupo retoma desde el offset guardado. Se prueba dos veces: guardando la posición después de procesar cada bloque y guardándola antes.
# 10. Un consumidor procesa en bloques de 100 y se cae a mitad del segundo bloquedef bloque(c, n=100):"""Los siguientes n mensajes del consumidor.""" mensajes = []whilelen(mensajes) < n: mensajes += [m for m in c.consume(num_messages=n -len(mensajes), timeout=1.0) ifnot m.error()]return mensajesdef caida(grupo, guardar_antes):"""Devuelve cuántos mensajes procesó antes de caerse y cuántos leyó después su reemplazo.""" c = consumidor(grupo) c.subscribe([TOPICO]) procesados =0for numero in (1, 2): mensajes = bloque(c)if guardar_antes: c.commit(asynchronous=False) # guarda la posición ANTES de procesar el bloquefor i, m inenumerate(mensajes):if numero ==2and i ==50:break# la caída: el proceso muere a mitad del bloque 2 procesados +=1else:ifnot guardar_antes: c.commit(asynchronous=False) # guarda la posición DESPUÉS de procesar el bloque c.close() reemplazo = consumidor(grupo) # otro proceso del mismo grupo retoma lo guardado reemplazo.subscribe([TOPICO]) (resto,) = leer([reemplazo]) reemplazo.close()return procesados, len(resto)total =len(lote_13) +len(lote_despues)procesados, despues = caida("al-menos-una-vez", guardar_antes=False)print(f"Al menos una vez: procesó {procesados}, el reemplazo leyó {despues} de {total}",f"-> {procesados + despues - total} procesados dos veces")procesados, despues = caida("como-maximo-una-vez", guardar_antes=True)print(f"Como máximo una vez: procesó {procesados}, el reemplazo leyó {despues} de {total}",f"-> {total - procesados - despues} nunca procesados")
Al menos una vez:    procesó 150, el reemplazo leyó 524 de 624 -> 50 procesados dos veces
Como máximo una vez: procesó 150, el reemplazo leyó 424 de 624 -> 50 nunca procesados
Con el commit después de procesar, el consumidor alcanzó a guardar el primer bloque, y el reemplazo empezó en el mensaje 101: leyó 524 de 624, y los 50 mensajes que el primero procesó del segundo bloque se procesaron dos veces. Es al menos una vez. Con el commit antes de procesar, el consumidor guardó los dos bloques apenas los recibió, y el reemplazo empezó en el mensaje 201: leyó 424, y los otros 50 del segundo bloque no los procesó nadie. Es como máximo una vez.
La práctica habitual es al menos una vez, con un procesamiento idempotente: si el tablero guarda «último estado por guía», procesar dos veces el mismo evento deja el mismo estado. Es la misma idea del capítulo de ingesta: no evitar la repetición, sino hacer que repetir no cause daño. Para un consumidor que suma (facturación, por ejemplo), los duplicados sí hacen daño, y se necesita algo más.
9. Transacciones: publicar un grupo de mensajes completo o nada
NotaTransacción en Kafka
Una transacción de Kafka agrupa varios mensajes, incluso en varios tópicos, para que los lectores los vean todos o ninguno. El productor la abre con begin_transaction y la cierra con commit_transaction o abort_transaction. Los consumidores eligen qué ver con isolation.level: read_committed solo entrega mensajes de transacciones confirmadas; read_uncommitted, el valor por defecto, entrega todo.
Facturación necesita publicar un recargo de 1 500 pesos para 50 guías, todos o ninguno. La celda abre una transacción, publica los 50 mensajes en el tópico auxiliar envios-ajustes y la aborta, como si algo hubiera fallado. Después repite la operación y la confirma. Al final, cuenta lo que ve un lector con cada nivel de aislamiento.
# 11. Transacciones: un grupo de mensajes se publica completo o no se publicaadmin.create_topics([NewTopic(TOPICO_AJUSTES, num_partitions=1, replication_factor=1)])[TOPICO_AJUSTES].result()transaccional = Producer({"bootstrap.servers": BROKER, "transactional.id": "ajustes-tarifa"})transaccional.init_transactions(30)ajustes = [{"guia": ev["guia"], "recargo": 1500} for ev in lote_13 if ev["tipo"] =="admitido"][:50]transaccional.begin_transaction()for a in ajustes: transaccional.produce(TOPICO_AJUSTES, key=a["guia"], value=json.dumps(a))transaccional.flush(30)transaccional.abort_transaction(30) # algo falló: se descarta el grupo completotransaccional.begin_transaction()for a in ajustes: transaccional.produce(TOPICO_AJUSTES, key=a["guia"], value=json.dumps(a))transaccional.commit_transaction(30) # esta vez se confirmadef contar(aislamiento): c = consumidor(f"lector-{aislamiento}", **{"isolation.level": aislamiento}) c.subscribe([TOPICO_AJUSTES]) (leidos,) = leer([c]) c.close()returnlen(leidos)_, alto = Consumer({"bootstrap.servers": BROKER, "group.id": "x"}).get_watermark_offsets( TopicPartition(TOPICO_AJUSTES, 0), timeout=15)print("Offsets ocupados en el tópico de ajustes:", alto)print("Lector read_uncommitted:", contar("read_uncommitted"), "mensajes")print("Lector read_committed: ", contar("read_committed"), "mensajes")
%4|1794339881.997|GETPID|rdkafka#producer-19| [thrd:main]: Failed to acquire transactional PID from broker TxnCoordinator/1: Broker: Not coordinator: retrying
%4|1794339882.493|GETPID|rdkafka#producer-19| [thrd:main]: Failed to acquire transactional PID from broker TxnCoordinator/1: Broker: Not coordinator: retrying
Offsets ocupados en el tópico de ajustes: 102
Lector read_uncommitted: 100 mensajes
Lector read_committed:   50 mensajes
Los avisos %4| de la salida son del mismo tipo que los de la sección 3: el productor transaccional pidió su identificador antes de que el broker terminara de crear su tópico interno de transacciones, y reintentó. El tópico de ajustes tiene 102 offsets ocupados: 50 mensajes de la transacción abortada, 50 de la confirmada y 2 marcas de control, una por cada cierre de transacción. El lector read_uncommitted ve 100 mensajes, incluidos los 50 abortados. El lector read_committed ve solo los 50 confirmados.
Así se construye exactamente una vez en Kafka: un programa que lee de un tópico y escribe en otro guarda en la misma transacción los mensajes que produce y el offset del consumidor (con send_offsets_to_transaction). Si se cae a la mitad, la transacción se aborta completa: ni los mensajes de salida ni la posición avanzan, y el reemplazo repite el trabajo sin que nadie vea duplicados. La garantía vale dentro de Kafka. Si el efecto es fuera de Kafka (un correo, una fila en una base de datos), hace falta que ese destino también sea idempotente o transaccional.
10. Kafka frente al archivo diario
Pregunta
Archivo diario y carga nocturna
Kafka
¿Cuándo se ve un evento?
Al día siguiente
Segundos después de ocurrir
¿Qué pasa si llegan tarde?
Se recalcula la fecha afectada
Se publican cuando llegan; el consumidor decide qué hacer
¿Varios sistemas leen lo mismo?
Cada uno lee los archivos
Cada grupo lee el tópico con sus propios offsets
¿Cómo se reprocesa?
Se vuelven a cargar los archivos
Se cambia el offset de inicio
¿Dónde está el orden?
En las columnas de fecha
Por partición, según la llave
¿Cuánto se conserva?
Lo que se guarde en el lago
La retención del tópico, días o semanas
¿Qué cuesta?
Un proceso por la noche
Un servicio que corre siempre, con réplicas en producción
Kafka no es un almacenamiento histórico: su retención es de días o semanas, y el lago guarda los años. La arquitectura habitual combina los dos: los eventos entran por Kafka, un consumidor los escribe en el lago cada pocos minutos y los análisis históricos se hacen sobre el lago. Ese consumidor es el trabajo del capítulo de Structured Streaming.
Limpiar
La celda cierra el consumidor del tablero y borra el tópico auxiliar de ajustes. El tópico envios-eventos, con sus 624 eventos, queda en el broker; los grupos que guardaron offsets quedan registrados en el broker, y la primera celda los borra si se vuelve a ejecutar el notebook.
tablero.close()for futuro in admin.delete_topics([TOPICO_AJUSTES]).values(): futuro.result()print("Tópicos que quedan:", sorted(t for t in admin.list_topics(timeout=15).topics ifnot t.startswith("__")))
Tópicos que quedan: ['envios-eventos']
Queda un solo tópico de negocio, envios-eventos, con sus 624 eventos. Para apagar el broker sin perder el tópico: dck stop kafka. Los mensajes viven dentro del contenedor, así que dck down (o borrar el contenedor) los pierde. El capítulo de Structured Streaming no depende de este tópico: crea el suyo, envios-vivo, con los mismos eventos.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 2, 3 y 5 (la conexión, el tópico, los eventos y el productor).
Una sola partición. Crea un tópico envios-una-particion con una partición, publica los 436 eventos del 13 y comprueba que los offsets siguen el orden de momento de todos los eventos, no solo los de cada guía.
Llave nula. Publica los mismos eventos sin llave en un tópico nuevo de tres particiones. ¿Cuántas guías quedan con eventos en más de una partición?
Tres consumidores. Repite la sección 6 con tres consumidores en el mismo grupo y luego con cuatro. ¿Cuántas particiones toma cada uno?
Consumidor desde lo nuevo. Crea un consumidor del grupo alertas con auto.offset.reset = latest, suscríbelo, publica 10 eventos nuevos y cuenta cuántos lee.
Duplicados sin daño. Repite la simulación de «al menos una vez» guardando el último estado de cada guía en un diccionario. ¿Cambia el estado final cuando 50 eventos se procesan dos veces?
Retención corta. Crea un tópico con retention.ms = 60000 y segment.ms = 10000, publica 100 mensajes y vuelve a contarlos cinco minutos después.
TipOrientaciones
Con una partición, el offset de cada mensaje es su posición en la lista ordenada por momento: los offsets van de 0 a 435 y el momento nunca baja. Es orden total, al precio de un solo consumidor por grupo.
Sin llave, el productor reparte los mensajes entre particiones sin mirar la guía, y la mayoría de las guías termina con eventos en dos o tres particiones. Un consumidor por partición podría ver entregado antes que admitido de la misma guía.
Con tres consumidores, cada uno toma una partición. Con cuatro, uno queda sin particiones y no lee nada: sobra hasta que otro se caiga.
Lee los 10 eventos nuevos y ninguno de los anteriores. Si el grupo ya tenía offsets guardados, auto.offset.reset no aplica: manda el offset guardado.
No cambia: «último estado por guía» es idempotente, porque procesar dos veces el mismo evento deja el mismo valor. Si en cambio se contaran entregas por día, el conteo quedaría inflado en las entregas repetidas.
Después de un par de minutos, el tópico tiene 0 mensajes disponibles: el último offset sigue en 100, pero el primer offset disponible también sube a 100. Kafka borra por segmentos cerrados y revisa la retención cada cierto tiempo (log.retention.check.interval.ms, cinco minutos por defecto), así que el borrado no es inmediato.
Errores frecuentes
Síntoma
Causa
Arreglo
Failed to resolve 'kafka:9092' o Connection refused
El broker no está encendido, o se encendió con dc sin el archivo de Kafka.
dck up -d kafka y esperar a que kafka-metadata-quorum.sh responda.
ModuleNotFoundError: No module named 'confluent_kafka'
El cliente no está instalado en el Python del clúster.
Instalarlo con el pip install de «Antes de empezar» y reiniciar el kernel.
El consumidor no lee nada y no da error
Todavía no tiene particiones asignadas, o el grupo ya había leído todo.
Esperar a que assignment() no esté vacío; revisar el lag del grupo.
Un consumidor nuevo no lee los mensajes viejos
auto.offset.reset está en latest, o el grupo ya tenía offsets guardados.
Usar un grupo nuevo con earliest, o offsets_for_times y assign.
Topic already exists
El tópico quedó de una ejecución anterior.
La primera celda los borra; si se creó a mano, borrarlo con kafka-topics.sh --delete.
Mensajes repetidos después de reiniciar un consumidor
commit después de procesar y una caída en medio: al menos una vez.
Procesamiento idempotente, o transacciones si el destino es Kafka.
Los eventos de una guía llegan desordenados
Se publicaron sin llave o con llaves distintas.
Publicar con la guía como llave.
KafkaException: … NOT_ENOUGH_REPLICAS
Un tópico pide más réplicas que brokers disponibles.
En el laboratorio, factor de replicación 1.
Preguntas de comprensión
¿Por qué Kafka puede servir a varios sistemas que leen a ritmos distintos, y una cola que borra lo leído no?
Si el tablero necesitara el orden de todos los eventos de un cliente corporativo, ¿qué llave usarías y qué riesgo trae?
¿Qué significa un lag que crece durante horas, y qué se puede hacer?
En la sección 8, ¿por qué guardar la posición antes de procesar pierde mensajes?
¿Por qué Kafka no reemplaza al data lake?
TipOrientaciones
Porque Kafka guarda los mensajes durante la retención y cada grupo lleva su propio offset. Leer no consume nada: un grupo lento o uno nuevo leen los mismos mensajes cuando les toca. En una cola que borra lo leído, el mensaje que toma un sistema ya no existe para los demás.
El código del cliente. El riesgo es el desbalance: un cliente con muchos envíos concentra sus eventos en una sola partición, y el consumidor de esa partición trabaja mucho más que los otros. Es el sesgo del capítulo de optimización, ahora en Kafka.
Que el consumidor no alcanza a leer al ritmo en que se publica. Se puede agregar consumidores al grupo hasta el número de particiones, aumentar las particiones del tópico o hacer más rápido el procesamiento de cada mensaje.
Porque el offset guardado avanza antes de que el trabajo se haga. Si el proceso muere a la mitad, el reemplazo empieza después de los mensajes que el primero recibió pero no alcanzó a procesar.
Porque Kafka conserva los mensajes días o semanas, no años, y no está hecho para consultas analíticas sobre la historia. Kafka mueve los eventos y los reparte a los sistemas; el lago los guarda y permite analizarlos.
Glosario
Término
Significado en este capítulo
Evento
Registro de algo que pasó, en el momento en que pasó, que no se modifica después.
Broker
Servidor de Kafka que guarda los mensajes y los entrega.
Tópico
Secuencia de mensajes con nombre, dividida en particiones.
Partición
Registro ordenado de mensajes donde solo se agrega al final; unidad de reparto y de paralelismo.
Offset
Número consecutivo de un mensaje dentro de su partición.
Productor
Programa que publica mensajes en un tópico.
Consumidor
Programa que lee mensajes de un tópico.
Llave
Parte del mensaje con la que el productor elige la partición.
Grupo de consumidores
Consumidores que se reparten las particiones de un tópico y comparten offsets guardados.
Offset guardado (commit)
Posición hasta donde un grupo leyó cada partición.
Lag
Mensajes que le faltan a un grupo por leer en una partición.
Reequilibrio
Nuevo reparto de particiones cuando un consumidor entra o sale del grupo.
Retención
Tiempo que Kafka conserva los mensajes, los lea alguien o no.
KRaft
Modo de Kafka en el que los propios nodos llevan los metadatos del clúster, sin ZooKeeper.
Al menos una vez
Garantía en la que ningún mensaje se pierde, pero alguno puede procesarse dos veces.
Como máximo una vez
Garantía en la que ningún mensaje se procesa dos veces, pero alguno puede perderse.
Exactamente una vez
Garantía en la que cada mensaje produce su efecto una sola vez.
Productor idempotente
Productor cuyos reintentos no duplican mensajes en el broker.
Transacción
Grupo de mensajes que los lectores read_committed ven completo o no ven.
Referencias para profundizar
Apache Kafka. Documentación de Kafka 4.1: diseño, configuración del broker, del productor y del consumidor, y semántica de entrega.
Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media. Capítulo 11, procesamiento de flujos.
Resumen
Agregaste un broker de Kafka al clúster con un archivo Compose propio y publicaste los eventos de los 208 envíos admitidos por BITLogística el 13 de julio: 624 eventos en un tópico de tres particiones. Con la guía como llave, los tres eventos de cada envío quedaron en la misma partición y en orden, y ninguna guía quedó repartida entre particiones. El tablero leyó los 436 eventos del 13, guardó su posición y, cuando llegaron los 188 de los días siguientes, el lag mostró exactamente cuánto le faltaba y leyó solo lo nuevo. Dos consumidores de un grupo se repartieron las particiones, y otro grupo leyó todo por su cuenta. Volver a leer fue cambiar el offset de inicio: desde una hora o desde el principio. La simulación de una caída mostró el costo de cada garantía: 50 eventos procesados dos veces con el commit después de procesar y 50 perdidos con el commit antes. Una transacción abortada dejó 50 mensajes en el tópico que un lector read_committed no vio.
El capítulo siguiente, Spark Structured Streaming, publica los mismos eventos en su propio tópico y los lee con Spark, los agrupa en ventanas por la hora de negocio y escribe los resultados en el lago a medida que llegan.