17Almacenamiento analítico: formatos, particiones y diseño de un data lake
big-data
ingenieria-datos
parquet
hdfs
spark
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de octubre de 2026
El problema que vas a resolver
En el taller de PySpark dejaste los envíos de BITLogística en HDFS: 32 064 registros limpios en la capa plata, unos pocos megabytes. La gerencia quedó satisfecha con el informe y ahora pide lo mismo cada mañana, para el mes en curso y comparado con los anteriores. El sistema de admisión, además, se va a conectar con las otras regionales de la empresa, así que el volumen se multiplicará.
Con datos pequeños, cualquier forma de guardarlos funciona. Con datos grandes, la forma de guardarlos decide cuánto se lee del disco, cuánto viaja por la red y cuánto tarda cada consulta. Tres decisiones pesan más que cualquier ajuste posterior: el formato de los archivos, cómo se organizan en carpetas y de qué tamaño son. Este capítulo toma la capa plata, la multiplica por diez para simular el crecimiento y mide en el clúster qué pasa con cada decisión.
Ficha
En este capítulo
Pregunta
¿Cómo se guardan los datos para que las consultas analíticas lean poco y rápido?
Datos
La capa plata de BITLogística, copiada diez veces: 320 640 envíos
El capítulo es un notebook que se ejecuta en el Jupyter de spark-client, con el kernel Python del clúster, igual que los talleres. En el apéndice «Operar el clúster» están el arranque y la descarga: el archivo se llama taller_almacenamiento.ipynb dentro de talleres-notebooks.zip. Necesita la capa /bitlogistica/plata del taller de PySpark: si borraste /bitlogistica, vuelve a ejecutar ese taller hasta la etapa 5.
Los experimentos escriben unos 410 MB en /bitlogistica/laboratorio_almacenamiento, que con tres réplicas ocupan cerca de 1.2 GB en los discos de los DataNodes. La última celda borra esa carpeta y deja intactas las capas plata y oro.
Los tiempos que aparecen en las salidas se midieron en el clúster de los laboratorios, con dos executors de un núcleo, y cambian de una ejecución a otra. Lo que importa es la comparación entre variantes en la misma ejecución, no la cifra exacta.
1. La sesión y tres funciones de apoyo
La primera celda abre la sesión y define las rutas. LAB es la carpeta de experimentos.
import platformimport statisticsimport timeimport matplotlibimport matplotlib.pyplot as pltimport pandas as pdimport pysparkfrom pyspark.sql import SparkSessionfrom pyspark.sql import functions as Fspark = ( SparkSession.builder .appName("almacenamiento-analitico") .config("spark.ui.showConsoleProgress", "false") .getOrCreate())spark.sparkContext.setLogLevel("ERROR")sc = spark.sparkContextassert sc.master =="yarn", "La sesión no está en YARN: revisa el kernel (Python del clúster)"BASE ="hdfs://namenode:9000/bitlogistica"PLATA = BASE +"/plata"LAB = BASE +"/laboratorio_almacenamiento"print("Python", platform.python_version(), "| Spark", spark.version,"| pandas", pd.__version__, "| matplotlib", matplotlib.__version__)print("master:", sc.master, "| aplicación:", sc.applicationId)
Setting default log level to "WARN".
To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel).
26/10/27 13:04:17 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
26/10/27 13:04:20 WARN Client: Neither spark.yarn.jars nor spark.yarn.archive is set, falling back to uploading libraries under SPARK_HOME.
La sesión quedó en YARN (master: yarn) con Python 3.11.10 y Spark 3.5.3. La segunda celda define tres funciones que se usan en todo el capítulo:
archivos_de_datos(ruta) recorre una carpeta de HDFS con la API de Hadoop (a través de spark._jvm) y devuelve cuántos archivos de datos hay y cuántos bytes suman. Excluye _SUCCESS, el archivo vacío que Spark escribe para marcar que la escritura terminó, y los archivos ocultos.
medir(funcion) ejecuta una acción tres veces y devuelve la mediana de los segundos. La mediana descarta una ejecución lenta por casualidad, como la primera, que además carga clases de Java.
borrar(ruta) elimina una carpeta, como hdfs dfs -rm -r.
La última línea prueba la primera función con la capa plata.
Path = spark._jvm.org.apache.hadoop.fs.PathCONF = sc._jsc.hadoopConfiguration()def archivos_de_datos(ruta):"""Cantidad y tamaño total de los archivos de datos bajo una ruta (sin _SUCCESS ni ocultos).""" carpeta = Path(ruta) sistema = carpeta.getFileSystem(CONF) iterador = sistema.listFiles(carpeta, True) cantidad, total =0, 0while iterador.hasNext(): archivo = iterador.next() nombre = archivo.getPath().getName()ifnot nombre.startswith(("_", ".")): cantidad +=1 total += archivo.getLen()return cantidad, totaldef medir(funcion, repeticiones=3):"""Ejecuta la función varias veces y devuelve la mediana de los segundos.""" tiempos = []for _ inrange(repeticiones): inicio = time.perf_counter() funcion() tiempos.append(time.perf_counter() - inicio)return statistics.median(tiempos)def borrar(ruta): carpeta = Path(ruta)return carpeta.getFileSystem(CONF).delete(carpeta, True)print(archivos_de_datos(PLATA))
(2, 994826)
La capa plata ocupa 2 archivos y menos de 1 MB. Con ese tamaño, cualquier comparación entre formatos se pierde en el ruido.
2. Las zonas de un data lake
Un data lake es un repositorio que guarda datos de muchas fuentes en su formato original y también en formas ya procesadas, sobre almacenamiento barato y distribuido, como HDFS o un almacenamiento de objetos en la nube. Se diferencia de una bodega de datos (data warehouse), que guarda solo datos ya modelados en tablas relacionales y exige definir su estructura antes de cargarlos.
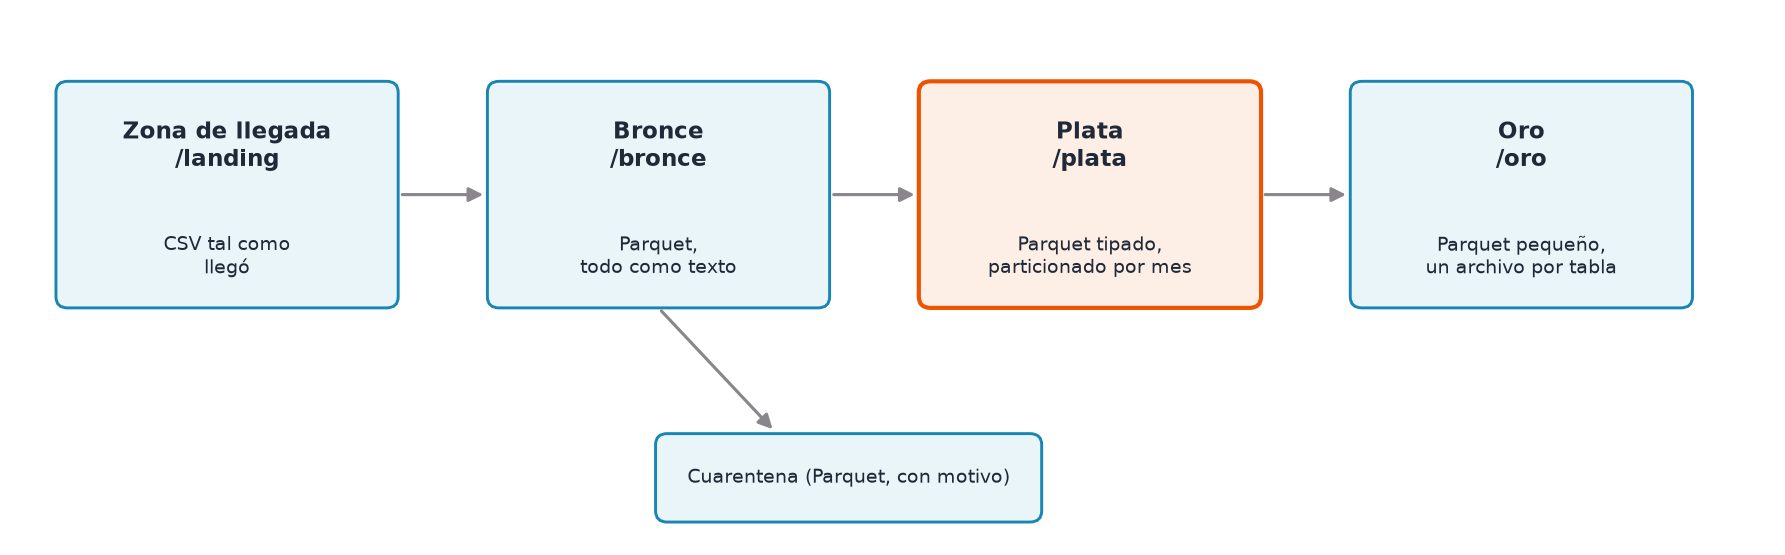
En el taller de PySpark ya organizaste /bitlogistica en zonas. Lo que este capítulo agrega es la pregunta de cómo guardar cada zona, porque cada una tiene un patrón de uso distinto:
Zonas de BITLogística y el formato recomendado para cada una.
Zona
Quién escribe
Quién lee
Qué conviene
Llegada
El sistema de origen
Solo la ingesta
El formato que mande el origen, sin tocarlo
Bronce
La ingesta, una vez por archivo
La limpieza, completa
Un formato que conserve todo y se lea rápido completo
Plata
La limpieza
Muchas consultas, casi siempre por fecha y pocas columnas
Por columnas, comprimido y particionado por fecha
Oro
Los procesos de indicadores
Informes y tableros, muchas veces al día
Pocos archivos, pequeños y por columnas
La plata es la zona que más se lee, y por eso es la que más se beneficia de las decisiones de este capítulo.
3. Formatos por filas y por columnas
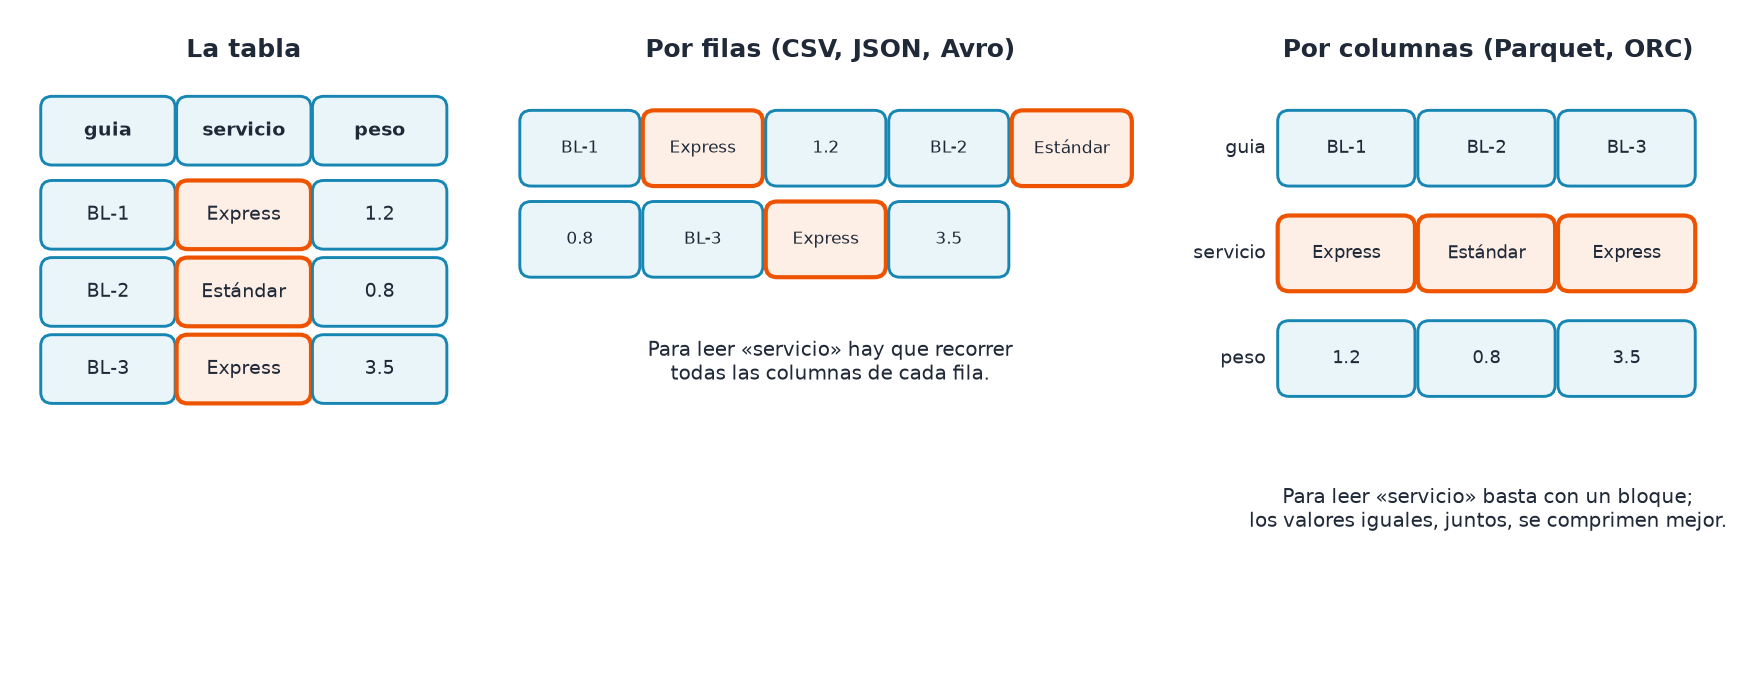
Un archivo puede guardar una tabla de dos maneras. Por filas, como CSV, JSON o Avro: escribe completa la primera fila, luego la segunda, y así. Por columnas, como Parquet u ORC: escribe juntos todos los valores de la primera columna, luego todos los de la segunda.
La misma tabla guardada por filas y por columnas.
La diferencia aparece al consultar. Una pregunta analítica como «porcentaje a tiempo por servicio en mayo» usa 3 de las 23 columnas de la plata. En un archivo por filas, el lector tiene que pasar por todas las columnas de cada fila para extraer esas tres. En un archivo por columnas, lee solo los tres bloques que necesita. Además, los valores de una columna se parecen entre sí (el servicio solo toma tres valores), y por eso se comprimen mucho mejor juntos que mezclados con guías, fechas y pesos.
NotaFormato por columnas
Un formato por columnas guarda juntos los valores de cada columna, en bloques que se pueden leer por separado. Parquet y ORC además dividen el archivo en grupos de filas (row groups, en ORC stripes) y guardan para cada bloque estadísticas como el mínimo y el máximo, que permiten saltarse bloques completos cuando un filtro los descarta.
Formato
Organización
Esquema
Lo legible por una persona
Uso típico
CSV
Filas, texto
No guarda tipos
Sí
Intercambio con otros sistemas, zona de llegada
JSON
Filas, texto
Nombres en cada registro, sin tipos estrictos
Sí
APIs, datos anidados
Avro
Filas, binario
Guarda el esquema y admite cambios
No
Ingesta de eventos, mensajes de Kafka
ORC
Columnas, binario
Guarda el esquema
No
Ecosistema Hive
Parquet
Columnas, binario
Guarda el esquema
No
Análisis con Spark, la opción más extendida
Avro no se mide aquí: Spark lo lee y escribe con el paquete externo spark-avro, que la imagen del laboratorio no trae. Se usará con Kafka, donde es más común.
4. Simular el crecimiento
Para que las diferencias se puedan medir, la celda multiplica la plata por diez. crossJoin con una tabla de diez números produce diez copias de cada envío, y a cada copia se le agrega un sufijo a la guía para que sigan siendo únicas. Es una copia ampliada para medir, no datos nuevos: las proporciones y los porcentajes son los mismos de la plata. repartition(4) reparte el resultado antes de guardarlo como base de los experimentos.
Filas de plata: 32064 | filas ampliadas: 320640
Columnas: 23
La tabla de trabajo tiene 320 640 envíos, diez veces los 32 064 de la plata, con sus 23 columnas.
5. El mismo dato en cuatro formatos
La celda escribe la tabla ampliada en CSV (con encabezado), JSON, ORC y Parquet, mide cuánto tarda cada escritura y cuánto ocupa cada carpeta en HDFS. Parquet y ORC se escriben con su compresión por defecto, Snappy; CSV y JSON, sin compresión. La última columna dice cuántas veces el tamaño de Parquet ocupa cada formato.
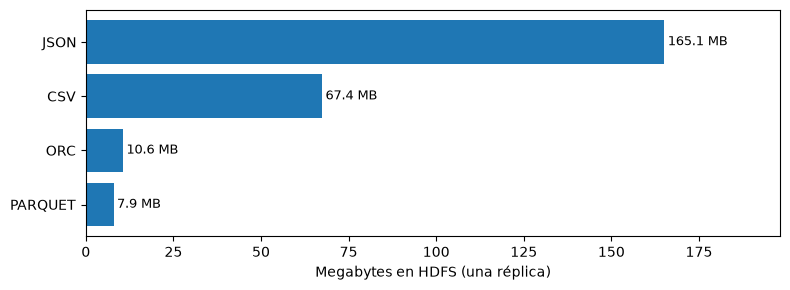
Los mismos 320 640 envíos ocupan 67.4 MB en CSV, 165.1 MB en JSON, 10.6 MB en ORC y 7.9 MB en Parquet. El CSV pesa 8.5 veces lo que el Parquet, y el JSON 20.9 veces, porque repite el nombre de las 23 columnas en cada uno de los registros. Cada formato quedó en 2 archivos, uno por partición de la tabla al escribir. Los tiempos de escritura son parecidos: con estos tamaños, escribir es rápido en todos los casos.
Las cifras son de una réplica. HDFS guarda tres, así que el JSON ocupa más de 500 MB de disco del clúster por un dato que en Parquet ocupa 24.
orden = tabla_formatos.sort_values("MB")figura, eje = plt.subplots(figsize=(8, 3))eje.barh(orden["formato"].str.upper(), orden["MB"])for y, valor inenumerate(orden["MB"]): eje.text(valor +1, y, f"{valor} MB", va="center", fontsize=9)eje.set_xlabel("Megabytes en HDFS (una réplica)")eje.set_xlim(0, orden["MB"].max() *1.2)plt.tight_layout()plt.show()
Figura 17.1: Tamaño en HDFS de los mismos 320 640 envíos en cuatro formatos
6. Leer solo lo necesario
La función consulta_mayo lee un formato con el esquema ya conocido (para no sumar el costo de adivinar tipos), filtra mayo y calcula el porcentaje a tiempo por servicio. La celda imprime, del plan físico de CSV y de Parquet, qué columnas se leen (ReadSchema) y qué filtros llegan a la lectura (PushedFilters).
NotaProyección y filtros en la lectura
La proyección (column pruning) consiste en leer solo las columnas que la consulta usa. El empuje de filtros (predicate pushdown) consiste en entregarle el filtro al lector del archivo para que descarte datos mientras lee. Spark los aplica con cualquier formato, pero el ahorro depende de cómo esté organizado el archivo.
ESQUEMA = ampliada.schemadef consulta_mayo(formato): lector = spark.read.format(formato).schema(ESQUEMA)if formato =="csv": lector = lector.option("header", True) tabla = lector.load(f"{LAB}/formatos/{formato}")return ( tabla.filter(F.col("mes") ==5) .groupBy("servicio") .agg(F.round(100* F.avg(F.col("a_tiempo").cast("int")), 1).alias("pct_a_tiempo")) )for formato in ["csv", "parquet"]: plan = consulta_mayo(formato)._jdf.queryExecution().executedPlan().toString()for linea in plan.split("\n"):if"FileScan"in linea: lectura = linea.split("ReadSchema: ")[1] filtros = linea.split("PushedFilters: ")[1].split("], ")[0] +"]"print(f"{formato:8s} lee columnas: {lectura}")print(f"{'':8s} filtros que bajan a la lectura: {filtros}")
csv      lee columnas: struct<servicio:string,a_tiempo:boolean,mes:int>
         filtros que bajan a la lectura: [IsNotNull(mes), EqualTo(mes,5)]
parquet  lee columnas: struct<servicio:string,a_tiempo:boolean,mes:int>
         filtros que bajan a la lectura: [IsNotNull(mes), EqualTo(mes,5)]
Los dos planes se ven iguales: los dos leen solo servicio, a_tiempo y mes, y los dos reciben el filtro EqualTo(mes,5). La diferencia está en lo que el lector puede hacer con esa información. El lector de CSV tiene que recorrer cada línea completa del archivo para encontrar dónde empieza la columna mes y luego descarta lo que no sirve: se ahorra convertir columnas, pero no leer bytes. El lector de Parquet abre solo los tres bloques de columnas, y con las estadísticas de mínimo y máximo de cada grupo de filas puede saltarse los grupos que no contienen mayo.
La celda siguiente mide la misma consulta en los cuatro formatos.
Con la mediana de tres ejecuciones, CSV tardó 1.26 segundos y JSON 1.32, mientras ORC tardó 0.50 y Parquet 0.36: los formatos por columnas respondieron entre dos y medio y casi cuatro veces más rápido con los mismos datos. La diferencia crece con el tamaño, porque lo que ahorran es lectura de disco, y a estos volúmenes la mayor parte del tiempo es el costo fijo de lanzar las tareas.
El resultado de la consulta es el mismo en los cuatro casos: en mayo, Express cumplió el 74.3 %, Estándar el 88.5 % y Económico el 89.0 %. Son las cifras de mayo de la plata, porque la ampliación no cambia las proporciones.
7. Compresión
Un códec de compresión es el algoritmo que reduce el tamaño de los datos al escribir y los recupera al leer. En Parquet se elige con la opción compression. La celda escribe la misma tabla con cuatro opciones y mide tamaño, tiempo de escritura y tiempo de una lectura que suma una columna:
none: sin compresión.
snappy: el valor por defecto de Spark, rápido y con compresión moderada.
gzip: comprime más y es más lento.
zstd (Zstandard): un códec más reciente que busca la compresión de gzip con la velocidad de Snappy.
Sin compresión, el Parquet ocupa 13.1 MB; ya es menos de una quinta parte del CSV, solo por organizarse en columnas con codificaciones como el diccionario. Snappy lo baja a 7.9 MB, y gzip y Zstandard, a 6.1 MB cada uno. Los tiempos de escritura y lectura casi no cambian a este tamaño: entre 1.4 y 1.7 segundos al escribir y entre 0.21 y 0.32 al leer.
Con datos grandes, la elección suele quedar así: Snappy para tablas que se leen muchas veces y deben responder rápido; Zstandard cuando el espacio cuesta y se acepta un poco más de CPU; gzip solo si otro sistema lo exige.
Hay un detalle que en CSV sí importa mucho. Para repartir la lectura de un archivo grande entre varias tareas, Spark lo corta en trozos y cada tarea empieza a leer en la mitad del archivo. Un archivo comprimido con gzip no se puede leer desde la mitad: hay que descomprimirlo desde el principio. La celda siguiente lo muestra con un solo archivo CSV, plano y comprimido, y con un tamaño de trozo de 8 MB para que el efecto se vea con datos pequeños.
CSV plano : 1 archivo de 67.4 MB -> 9 particiones al leer
CSV gzip  : 1 archivo de 11.7 MB -> 1 partición al leer
El CSV plano de 67.4 MB se leyó en 9 particiones: Spark lo cortó en trozos de 8 MB y podría repartirlos entre nueve tareas. El mismo CSV comprimido con gzip ocupa 11.7 MB y se leyó en 1 partición: una sola tarea tiene que descomprimir el archivo completo, aunque el clúster tenga cien núcleos libres. Por eso se dice que gzip no es divisible (splittable). Parquet no tiene este problema aunque use gzip, porque comprime cada bloque de columna por separado.
8. Particionar por fecha
Las consultas de BITLogística casi siempre piden un mes o un rango de meses. Si la tabla se guarda en una carpeta por mes, una consulta de mayo puede ignorar las carpetas de los otros meses sin abrirlas.
partitionBy("mes") hace eso al escribir: crea una subcarpeta por cada valor, con el nombre mes=1, mes=2, etc., y guarda en cada una solo las filas de ese mes. La columna mes no se escribe dentro de los archivos, porque su valor ya está en el nombre de la carpeta. El repartition("mes") previo junta las filas de cada mes en una misma partición de Spark, para que cada carpeta reciba un solo archivo.
NotaParticionar una tabla en carpetas
Particionar una tabla es organizar sus archivos en carpetas según el valor de una columna. Es distinto de las particiones de Spark del taller de Spark con ejemplos, que son trozos de datos en memoria durante un cálculo; aquí se habla de carpetas en el disco. La columna elegida debe aparecer en los filtros de casi todas las consultas y tener pocos valores distintos.
RUTA_MES = LAB +"/particionada"ampliada.repartition("mes").write.mode("overwrite").partitionBy("mes").parquet(RUTA_MES)carpeta = Path(RUTA_MES)nombres = []for estado in carpeta.getFileSystem(CONF).listStatus(carpeta): nombres.append(estado.getPath().getName())for nombre insorted(nombres):if nombre.startswith("mes="): cantidad, total = archivos_de_datos(RUTA_MES +"/"+ nombre)print(f"{nombre}: {cantidad} archivo, {total /1e6:.1f} MB")particionada = spark.read.parquet(RUTA_MES)particionada.printSchema()
Quedaron seis carpetas, de mes=1 a mes=6, cada una con un archivo de entre 1.0 y 1.3 MB; mayo es el más grande porque tiene más envíos. Al leer la carpeta completa, Spark reconstruye la columna mes a partir de los nombres de las carpetas y la pone al final del esquema, como muestra printSchema.
La celda siguiente compara la misma consulta de mayo sobre el Parquet sin particionar y sobre el particionado. Para cada una muestra cuántos archivos aportaron filas y el filtro de partición del plan.
sin_particion = spark.read.parquet(f"{LAB}/formatos/parquet").filter(F.col("mes") ==5)con_particion = spark.read.parquet(RUTA_MES).filter(F.col("mes") ==5)for nombre, tabla in [("sin partición", sin_particion), ("por mes", con_particion)]: plan = tabla._jdf.queryExecution().executedPlan().toString() linea = [l for l in plan.split("\n") if"FileScan"in l][0] filtros_particion = linea.split("PartitionFilters: ")[1].split("], ")[0] +"]" leidos = tabla.select(F.input_file_name()).distinct().count()print(f"{nombre:14s} archivos con filas de mayo leídos: {leidos} | PartitionFilters: {filtros_particion}")print()print("Mediana de segundos, contar mayo:")print(" sin partición:", round(medir(lambda: sin_particion.count()), 2))print(" por mes: ", round(medir(lambda: con_particion.count()), 2))
sin partición  archivos con filas de mayo leídos: 2 | PartitionFilters: []
por mes        archivos con filas de mayo leídos: 1 | PartitionFilters: [isnotnull(mes#2962), (mes#2962 = 5)]

Mediana de segundos, contar mayo:
  sin partición: 0.19
  por mes:       0.13
En la tabla sin particionar, las filas de mayo estaban repartidas en los 2 archivos y Spark tuvo que abrir los dos; PartitionFilters está vacío. En la particionada, el plan trae PartitionFilters: [isnotnull(mes…), (mes… = 5)]: Spark resolvió el filtro con los nombres de las carpetas antes de leer y abrió 1 archivo, el de mes=5. Esa técnica se llama poda de particiones (partition pruning). El tiempo bajó de 0.19 a 0.13 segundos; con cinco años de datos, la consulta de un mes leería una de sesenta carpetas.
Particionar no siempre ayuda. Si se particiona por una columna con muchos valores, como la guía o la ruta por día, se crean miles de carpetas con archivos diminutos, que es el problema de la sección siguiente. Una regla práctica es que cada carpeta reúna al menos cientos de megabytes en tablas grandes.
9. El problema de los archivos pequeños
HDFS está pensado para pocos archivos grandes. El NameNode guarda en memoria un registro por cada archivo, carpeta y bloque; la documentación de HDFS y de los distribuidores de Hadoop estima unos 150 bytes por objeto. Diez millones de archivos pequeños consumen gigabytes de memoria del NameNode aunque juntos sumen poco espacio. Del lado de Spark, cada archivo implica abrirlo, leer su pie con el esquema y las estadísticas, y planificar su lectura, un costo fijo que se repite tantas veces como archivos haya.
El error más común que los produce es escribir una tabla particionada sin reunir antes las filas por la columna de partición. La celda lo provoca: reparte la tabla en 100 particiones de Spark y la escribe por mes. Cada una de las 100 tareas tiene filas de los seis meses, así que cada una escribe un archivo en cada carpeta.
100 particiones x 6 meses   600 archivos |  18.0 MB | promedio    30.0 KB | leer: 2.55 s
una partición por mes         6 archivos |   6.5 MB | promedio  1087.0 KB | leer: 0.21 s
La versión descuidada quedó con 600 archivos de 30 KB en promedio; la escrita con repartition("mes"), con 6 archivos de algo más de 1 MB. Contar las filas tardó 2.55 segundos en la primera y 0.21 en la segunda, unas doce veces más. Además, los 600 archivos suman 18.0 MB frente a 6.5: cada archivo pequeño comprime peor, porque cada bloque de columna tiene pocos valores, y repite su propio pie con el esquema.
La solución para una tabla que ya tiene archivos pequeños es compactarla: leerla y volver a escribirla con menos archivos. En un proceso diario, se compacta al cierre de cada partición, por ejemplo al terminar el mes.
Antes de compactar: 600 archivos | después: 6 archivos
Mismas filas: True
La compactación pasó de 600 archivos a 6 con las mismas filas. En una tabla que se sigue usando mientras se compacta, el paso seguro es escribir la versión compacta en otra carpeta y cambiar de carpeta al final; los formatos de tabla como Iceberg, del capítulo de lakehouse, hacen ese cambio de forma atómica.
10. Cuando llega una columna nueva
En julio, el sistema de admisión empezará a enviar el código postal del destino. La tabla ya tiene seis meses sin esa columna, y reescribirlos para agregarla vacía sería costoso con años de datos. Parquet guarda el esquema en cada archivo, así que basta con escribir julio con su columna nueva y pedirle a Spark que combine los esquemas al leer.
La celda escribe una tabla pequeña con junio (sin código postal) y mil envíos de julio (con código postal), cada mes en su carpeta, y la lee de dos maneras: sin opciones y con mergeSchema.
NotaEvolución del esquema
La evolución del esquema es la capacidad de cambiar las columnas de una tabla (agregar una, por ejemplo) sin reescribir los datos anteriores. Con mergeSchema, Spark lee el esquema de todos los archivos y arma la unión de sus columnas; en los archivos que no tienen una columna, sus valores aparecen como nulos.
Sin opciones, Spark tomó el esquema de uno de los archivos y la columna codigo_postal_destino no apareció. Con mergeSchema, aparece, y la tabla muestra lo esperado: las 54 980 filas de junio con 0 códigos postales y las 1 000 de julio con 1 000. mergeSchema está desactivado por defecto porque leer el pie de todos los archivos cuesta, así que se activa cuando se sabe que el esquema cambió. Agregar columnas es el cambio fácil; cambiar el tipo de una columna o renombrarla no se resuelve así, y es otra de las razones de los formatos de tabla como Iceberg.
11. La decisión para BITLogística
Con las mediciones de este capítulo, la recomendación para el data lake de la empresa queda así:
Zona
Formato
Organización
Por qué
Llegada
CSV, tal como llega
Una carpeta por fecha de recepción
Es la evidencia de lo recibido; no se transforma
Bronce
Parquet con Snappy
Una carpeta por fecha de carga
Se lee completa en cada limpieza; Parquet ocupa una novena parte del CSV
Cuarentena
Parquet con Snappy
Una carpeta por fecha de carga
Se consulta poco; lo importante es conservarla
Plata
Parquet con Snappy
Particionada por mes, un archivo por mes
La consulta típica pide un mes y pocas columnas; la poda de particiones evita leer el resto
Oro
Parquet con Snappy
Un archivo por tabla
Tablas pequeñas que se leen muchas veces al día
Dos reglas acompañan la tabla: antes de escribir una tabla particionada, repartition por la columna de partición; y al cierre de cada mes, compactar si un proceso dejó archivos pequeños.
El taller de PySpark guardó la plata sin particionar para no adelantar este tema. El capítulo de ingesta y cargas incrementales aplica esta organización al recibir los archivos de BITLogística mes a mes.
Limpiar
La celda borra /bitlogistica/laboratorio_almacenamiento con todos los experimentos y cierra la sesión. Las capas del taller de PySpark no se tocan.
print("Laboratorio borrado:", borrar(LAB))spark.stop()print("Sesión cerrada. /bitlogistica/plata y /bitlogistica/oro siguen intactas.")
Laboratorio borrado: True
Sesión cerrada. /bitlogistica/plata y /bitlogistica/oro siguen intactas.
True confirma que la carpeta de experimentos se borró. Los cerca de 1.2 GB que ocupaba con las réplicas quedan libres en los DataNodes.
Práctica
Para hacer estos ejercicios, ejecuta de nuevo las celdas de las secciones 1 a 4 (la sesión, las funciones y la tabla ampliada).
ORC frente a Parquet. Repite la medición de la sección 6 cinco veces seguidas y compara ORC con Parquet. ¿La diferencia entre ellos se mantiene?
Partición por servicio. Escribe la tabla ampliada particionada por servicio en lugar de mes y cuenta archivos y tamaño. ¿Para qué consulta conviene esta organización?
Dos niveles de partición. Escribe la tabla con partitionBy("mes", "servicio"). ¿Cuántas carpetas y archivos quedan? ¿Qué filtro aprovecha los dos niveles?
Archivos por tamaño. Escribe la tabla particionada por mes con la opción maxRecordsPerFile en 20 000. ¿Cuántos archivos quedan por carpeta?
CSV comprimido. Escribe el CSV con compression en gzip en cuatro archivos y léelo con el tamaño de trozo de 8 MB. ¿Cuántas particiones salen y por qué?
Una columna nueva en la plata. Escribe en una carpeta de prueba la plata de junio con una columna canal_digital (verdadero si el canal es web) y léela junto con mayo usando mergeSchema.
TipOrientaciones
Los dos son formatos por columnas con estadísticas por bloque y responden en tiempos parecidos; en una ejecución puede ganar uno y en otra el otro. Con estos tamaños, las diferencias entre ellos son menores que el ruido de medición; la diferencia que se mantiene es la de ambos frente a CSV y JSON.
Quedan tres carpetas, una por servicio. Conviene para consultas que casi siempre filtran por servicio, como un tablero exclusivo de Express; para la consulta típica por mes, obliga a abrir las tres carpetas.
Quedan 18 carpetas de segundo nivel (seis meses por tres servicios) y, con repartition("mes", "servicio") antes de escribir, 18 archivos. La consulta «Express en mayo» poda los dos niveles y abre un solo archivo.
Cada mes tiene entre unas 47 000 y 65 000 filas, así que quedan tres o cuatro archivos por carpeta. La opción sirve para limitar el tamaño de los archivos cuando una partición es muy grande.
Salen cuatro particiones, una por archivo: cada archivo gzip se lee completo en una tarea, aunque el tamaño de trozo sea pequeño. Dividir en varios archivos es la forma de recuperar algo de paralelismo con un formato que no es divisible.
Con mergeSchema, mayo muestra canal_digital nulo y junio con valores. Si lees sin la opción, la columna puede no aparecer según el archivo que Spark use para tomar el esquema.
Errores frecuentes
Síntoma
Causa
Arreglo
Una tabla particionada tiene cientos de archivos por carpeta
Se escribió con partitionBy sin reunir antes las filas por la columna de partición.
repartition("mes") antes de write, o compactar.
La consulta de un mes tarda lo mismo que la de todo el año
La tabla no está particionada, o el filtro usa una expresión sobre la columna (por ejemplo month(admision) = 5) en lugar de la columna de partición.
Filtrar por la columna de partición tal como está: mes = 5.
Un archivo CSV grande se lee con una sola tarea
Está comprimido con gzip, que no es divisible.
Guardarlo en varios archivos o convertirlo a Parquet en la ingesta.
Una columna nueva no aparece al leer
Spark tomó el esquema de un archivo antiguo.
option("mergeSchema", True) al leer.
Al leer una tabla particionada, la columna de partición quedó como texto o como número sin quererlo
Spark deduce el tipo a partir de los nombres de las carpetas.
Declarar el esquema al leer o convertir la columna después.
PATH_ALREADY_EXISTS al escribir
La carpeta existe y no se indicó qué hacer.
mode("overwrite") o mode("append"), según el caso.
Preguntas de comprensión
Si Spark aplica la proyección y el empuje de filtros también a CSV, ¿por qué Parquet sigue leyendo menos?
¿Por qué el JSON ocupó más del doble que el CSV con los mismos datos?
¿Qué pasa con el NameNode si una tabla acumula diez millones de archivos de 30 KB?
¿Por qué la columna de partición no se guarda dentro de los archivos Parquet?
¿Particionarías la plata de BITLogística por guia? Explica por qué.
TipOrientaciones
Porque en CSV el lector tiene que recorrer cada línea completa para llegar a las columnas que necesita: el ahorro está en no convertirlas, no en no leerlas. Parquet guarda cada columna en su propio bloque y con estadísticas por grupo de filas, así que lee solo los bloques de las columnas pedidas y se salta los grupos que el filtro descarta.
Porque JSON escribe el nombre de cada columna en cada registro. Con 23 columnas, los nombres ocupan más que muchos de los valores.
El NameNode guarda en memoria un registro por archivo y por bloque. A unos 150 bytes por objeto, diez millones de archivos con un bloque cada uno son unos 3 GB de memoria solo para describirlos, y cada operación de listado se vuelve más lenta. Los datos reales suman apenas 300 GB, una fracción de lo que HDFS maneja con comodidad en archivos grandes.
Porque su valor ya está en el nombre de la carpeta y es el mismo para todas las filas del archivo; guardarlo sería repetir información. Spark lo reconstruye al leer.
No. La guía es única por envío: cada carpeta tendría una fila, y la tabla tendría tantos archivos como envíos. Conviene particionar por columnas con pocos valores que aparecen en los filtros, como el mes.
Glosario
Término
Significado en este capítulo
Data lake
Repositorio que guarda datos de muchas fuentes, crudos y procesados, sobre almacenamiento distribuido.
Bodega de datos
Repositorio de datos ya modelados en tablas relacionales, con estructura definida antes de cargar.
Formato por filas
Guarda cada registro completo, uno tras otro (CSV, JSON, Avro).
Formato por columnas
Guarda juntos los valores de cada columna (Parquet, ORC).
Grupo de filas
Bloque horizontal de un archivo Parquet, con estadísticas por columna.
Proyección
Leer solo las columnas que la consulta usa.
Empuje de filtros
Entregar el filtro al lector para descartar datos mientras lee.
Códec
Algoritmo de compresión, como Snappy, gzip o Zstandard.
Divisible
Que un archivo se puede leer por trozos independientes.
Particionar una tabla
Organizar sus archivos en carpetas según el valor de una columna.
Poda de particiones
Descartar carpetas completas con el filtro antes de leer.
Archivos pequeños
Archivos mucho menores que un bloque de HDFS, costosos para el NameNode y para Spark.
Compactar
Reescribir una tabla con menos archivos y más grandes.
Evolución del esquema
Cambiar las columnas de una tabla sin reescribir los datos anteriores.
Kleppmann, M. (2017). Designing Data-Intensive Applications. O’Reilly Media. Capítulo 3, almacenamiento por columnas.
Resumen
Con la plata de BITLogística multiplicada por diez, 320 640 envíos, mediste el costo de cada decisión de almacenamiento. El mismo dato ocupó 165.1 MB en JSON, 67.4 en CSV, 10.6 en ORC y 7.9 en Parquet, y la consulta de mayo respondió entre dos y medio y casi cuatro veces más rápido en los formatos por columnas, porque leen solo los bloques de las columnas pedidas. La compresión bajó el Parquet de 13.1 MB a 6.1 con gzip o Zstandard, y un CSV comprimido con gzip se leyó con una sola tarea porque no es divisible. Particionar por mes permitió que la consulta de mayo abriera 1 archivo en lugar de 2, gracias a la poda de particiones. Escribir sin reunir antes las filas por mes produjo 600 archivos de 30 KB, más lentos de leer y más pesados, que la compactación redujo a 6. Por último, mergeSchema incorporó una columna nueva sin reescribir los meses anteriores. La recomendación para la empresa es Parquet con Snappy en todas las zonas procesadas y la plata particionada por mes.
El capítulo siguiente, Spark SQL y DataFrames, usa esta plata para construir un modelo de datos con tablas de hechos y dimensiones, y consultarlo con uniones y funciones de ventana.