Un dataset puede llegar como una tabla, un arreglo de píxeles, una colección de archivos o un grafo. Antes de elegir una arquitectura, necesitas saber qué representa una observación, dónde está su respuesta y cómo se conserva la correspondencia entre ambas.
Esta guía muestra trece datasets con datos reales. Verás encabezados, primeras filas, galerías de imágenes, un fragmento de texto, señales de audio y relaciones entre nodos. Cada vista se acompaña de una lectura de sus dimensiones, etiquetas y estadísticas. Los ejemplos no entrenan modelos: las cifras describen los datos y ayudan a preparar una evaluación posterior.
Las vistas de imágenes de MNIST, Fashion-MNIST y CIFAR-10 usan sus particiones de prueba únicamente para mostrar el formato del benchmark; no seleccionamos modelos, transformaciones ni hiperparámetros a partir de ellas. Cuando desarrolles un experimento, aparta la prueba y realiza la exploración que guía decisiones sobre entrenamiento.
3.2 Qué vas a poder reconocer
Qué contienen las columnas y cuáles son entradas, etiquetas o metadatos.
La diferencia entre un código de clase y un valor continuo.
Cómo se ve una imagen y cómo se representa en una matriz o tensor.
Por qué el texto y el audio tienen longitudes variables.
Cómo se representan el tiempo, los nodos y las aristas.
Qué revelan el balance de clases, los faltantes, las escalas y los rangos.
Qué comprobar sobre origen, particiones y permisos de uso antes de reutilizar un dataset.
El artículo de tensores sirve para interpretar las formas. Los generadores make_moons, make_circles y otros datos sintéticos se desarrollarán en Generación de datos.
3.3 Preparación y descargas
Usamos NumPy, pandas, matplotlib, scikit-learn, SciPy, Pillow, NetworkX y statsmodels. Las tablas pequeñas, Digits, el libro solar y el grafo vienen con las bibliotecas. Los demás ejemplos reutilizan la caché local de Keras cuando existe; de lo contrario descargan los archivos del proveedor y los conservan para futuras ejecuciones. No necesitas instalar TensorFlow ni entrenar una red para verlos.
MNIST, Fashion-MNIST e IMDB requieren archivos de unos pocos a algunas decenas de megabytes. CIFAR-10 y Flowers requieren aproximadamente 170 y 229 MB comprimidos, respectivamente, si no están en caché. Para audio descargamos solo tres grabaciones. Las figuras quedan embebidas en el notebook: puedes leer sus salidas guardadas sin volver a descargar los datasets.
from pathlib import Pathimport os, json, gzip, struct, pickle, tarfile, urllib.requestimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom PIL import Imagefrom scipy.io import wavfilefrom scipy import signalfrom sklearn.datasets import load_iris, load_wine, load_breast_cancer, load_diabetes, load_digitsimport sklearnimport networkx as nximport statsmodels.api as smfrom IPython.display import display, HTML, AudioSEMILLA =2026CACHE = Path(os.environ.get('BIT_DATASETS_CACHE', Path.home()/'.cache'/'bit-datasets'))CACHE.mkdir(parents=True, exist_ok=True)KERAS = Path.home()/'.keras'/'datasets'plt.rcParams.update({'font.size': 11, 'axes.spines.top': False, 'axes.spines.right': False})pd.set_option('display.max_columns', 35)pd.set_option('display.precision', 3)estadisticas = {}catalogo = []print(f'scikit-learn {sklearn.__version__} | NumPy {np.__version__} | pandas {pd.__version__}')print('Entorno preparado. Las tablas y las figuras muestran datos reales.')
scikit-learn 1.8.0 | NumPy 2.3.5 | pandas 2.3.3
Entorno preparado. Las tablas y las figuras muestran datos reales.
3.3.1 Utilidades de lectura y dibujo
La celda plegada reúne la descarga con caché, la lectura de archivos y el dibujo de galerías. En el resto del artículo las llamadas muestran qué datos recibe cada figura. Las tablas conservan los encabezados del proveedor y permiten desplazamiento horizontal cuando hay muchas columnas.
Utilidades para cargar archivos y mostrar tablas y galerías
def obtener(nombre, url, alternativas=()):for ruta in [CACHE/nombre, *alternativas]:if ruta.is_file():return ruta destino = CACHE/nombre destino.parent.mkdir(parents=True, exist_ok=True) temporal = destino.with_suffix(destino.suffix+'.part') request = urllib.request.Request(url, headers={'User-Agent': 'BIT-datasets-editorial'})with urllib.request.urlopen(request, timeout=120) as response, temporal.open('wb') as salida:while bloque := response.read(1024*1024): salida.write(bloque) temporal.replace(destino)return destinodef tabla(df, titulo): display(HTML('<p><strong>'+titulo+'</strong></p><div style="overflow-x:auto">'+ df.to_html(index=False, escape=True, float_format=lambda x:f'{x:.3f}')+'</div>'))def galeria(imagenes, etiquetas, titulo, columnas=5, gris=False): filas =int(np.ceil(len(imagenes)/columnas)) fig, axes = plt.subplots(filas, columnas, figsize=(2.2*columnas, 2.25*filas), squeeze=False)for i, ax inenumerate(axes.flat): ax.axis('off')if i <len(imagenes): ax.imshow(imagenes[i], cmap='gray'if gris elseNone, interpolation='nearest') ax.set_title(str(etiquetas[i]), fontsize=10) fig.suptitle(titulo, fontsize=13) plt.tight_layout(); plt.show()def resumen_tabular(nombre, conjunto, tarea): df = conjunto.data.copy() df['target'] = conjunto.target tabla(df.head(5), nombre+': primeras cinco filas') tabla(pd.DataFrame({'columna': df.columns, 'dtype': [str(t) for t in df.dtypes],'faltantes': df.isna().sum().to_numpy()}), nombre+': encabezados y tipos')print(f'{nombre}: X={conjunto.data.shape}, y={conjunto.target.shape}, faltantes={df.isna().sum().sum()}') catalogo.append({'dataset':nombre,'modalidad':'Tabla','observaciones_vistas':len(df),'entrada_por_observación':f'{conjunto.data.shape[1]} variables','tarea':tarea})return dfdef idx_gzip(ruta, imagenes):with gzip.open(ruta, 'rb') as f: contenido=f.read()if imagenes: magic,n,h,w=struct.unpack('>IIII',contenido[:16])assert magic==2051return np.frombuffer(contenido, dtype=np.uint8, offset=16).reshape(n,h,w) magic,n=struct.unpack('>II',contenido[:8]);assert magic==2049return np.frombuffer(contenido,dtype=np.uint8,offset=8).reshape(n)def archivo_tar(ruta, nombre):with tarfile.open(ruta, 'r:gz') as archivo:return archivo.extractfile(nombre).read()print('Utilidades listas: tablas con encabezados, galerías y lectura de archivos.')
Utilidades listas: tablas con encabezados, galerías y lectura de archivos.
3.4 Parte A — Tablas: una fila, una observación
3.4.1 Iris: cuatro medidas y una especie
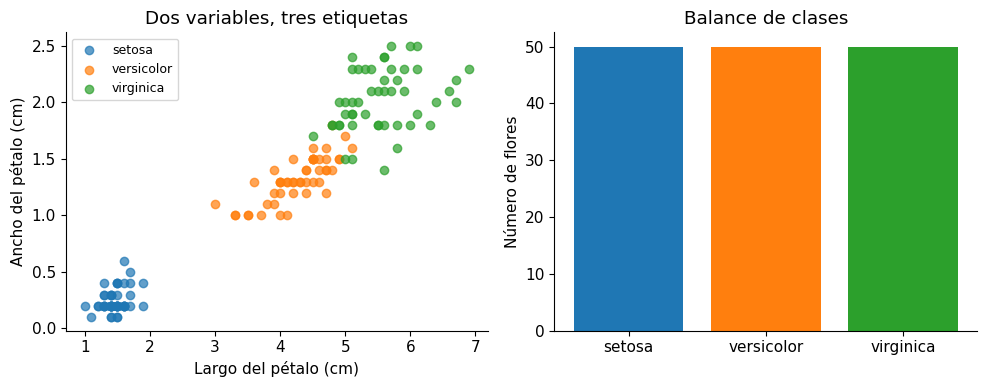
Iris contiene medidas de sépalos y pétalos en centímetros. Cada fila es una flor; target codifica la especie. La descripción de las clases se conserva en target_names. Empieza mirando los encabezados: petal length (cm) expresa una magnitud y una unidad; target=2 es una categoría, no una medida mayor que target=1.
iris = load_iris(as_frame=True)df_iris = resumen_tabular('Iris', iris, 'Clasificación multiclase')conteo_iris = iris.target.value_counts().sort_index()tabla(pd.DataFrame({'código': range(3), 'especie': iris.target_names, 'cantidad': conteo_iris.to_numpy()}), 'Iris: diccionario de etiquetas')fig, axes = plt.subplots(1,2,figsize=(10,4))for k,nombre inenumerate(iris.target_names): filas=iris.target==k axes[0].scatter(iris.data.loc[filas,'petal length (cm)'],iris.data.loc[filas,'petal width (cm)'],label=nombre,alpha=.7)axes[0].set(xlabel='Largo del pétalo (cm)',ylabel='Ancho del pétalo (cm)',title='Dos variables, tres etiquetas')axes[0].legend(fontsize=9)axes[1].bar(iris.target_names,conteo_iris.to_numpy(),color=['tab:blue','tab:orange','tab:green'])axes[1].set(ylabel='Número de flores',title='Balance de clases')plt.tight_layout();plt.show()estadisticas['iris_n']=len(df_iris)
Iris: primeras cinco filas
sepal length (cm)
sepal width (cm)
petal length (cm)
petal width (cm)
target
5.100
3.500
1.400
0.200
0
4.900
3.000
1.400
0.200
0
4.700
3.200
1.300
0.200
0
4.600
3.100
1.500
0.200
0
5.000
3.600
1.400
0.200
0
Iris: encabezados y tipos
columna
dtype
faltantes
sepal length (cm)
float64
0
sepal width (cm)
float64
0
petal length (cm)
float64
0
petal width (cm)
float64
0
target
int64
0
Iris: X=(150, 4), y=(150,), faltantes=0
Iris: diccionario de etiquetas
código
especie
cantidad
0
setosa
50
1
versicolor
50
2
virginica
50
3.4.2 Cómo leer Iris
La tabla tiene 150 observaciones, cuatro variables de entrada y una columna de respuesta añadida para mostrarla. Las tres clases tienen 50 flores cada una. Las primeras cinco filas pertenecen a la misma clase: head() muestra el comienzo del archivo, no una muestra representativa.
En la proyección de pétalos, setosa forma un grupo separado y las otras especies muestran una separación menos clara. Eso describe estas dos variables y estas observaciones; todavía no es una evaluación predictiva. El gráfico de barras confirma equilibrio de clases, algo que la primera pantalla de filas no permite reconocer.
3.4.3 Wine: más columnas y escalas diferentes
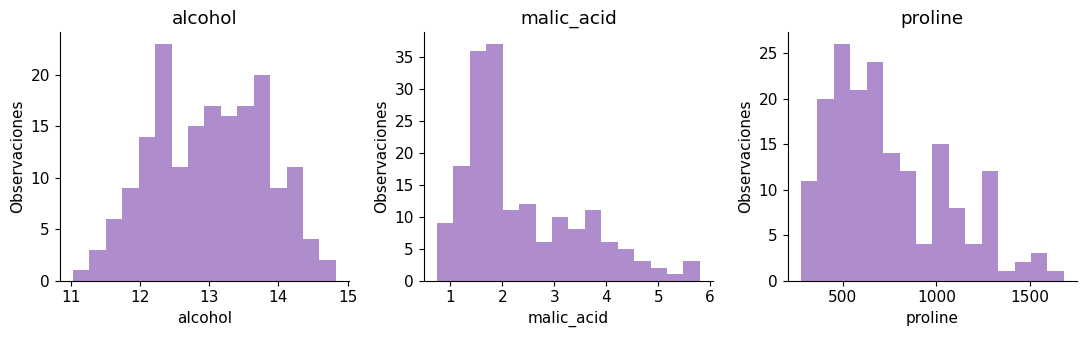
Wine contiene mediciones químicas de vinos con tres códigos de clase. Observa los nombres originales: alcohol, malic_acid y proline no son variables intercambiables. Dibujaremos sus distribuciones por separado para que una escala grande no oculte las demás.
Hay 178 observaciones y 13 variables; las clases reúnen 59, 71 y 48 observaciones. La cantidad de columnas de la tabla mostrada incluye también target, que no debe entrar como predictor.
Los histogramas conservan sus escalas originales. Una columna con números mayores no es automáticamente más importante. Algunas operaciones, como distancias o penalizaciones sobre coeficientes, dependen de la escala. Si estandarizas para entrenar, estima la transformación con el entrenamiento y aplícala sin reajustarla a las otras particiones.
3.4.5 Breast Cancer: una etiqueta necesita su diccionario
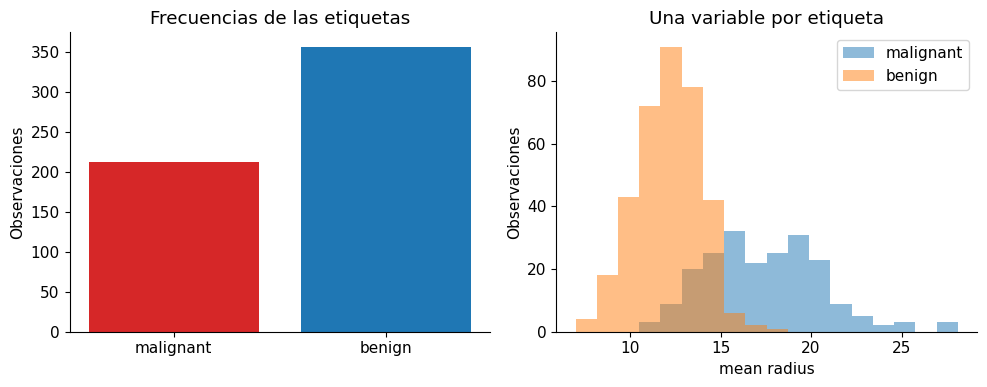
Este dataset contiene características calculadas a partir de imágenes de muestras celulares. Las columnas son mediciones resumidas, no las imágenes originales. Sus nombres distinguen medidas mean, error y worst.
Aquí es especialmente importante leer target_names: en esta versión 0 corresponde a malignant y 1 a benign. La guía describe el formato de un benchmark; no ofrece una herramienta de diagnóstico ni una interpretación clínica.
cancer=load_breast_cancer(as_frame=True)df_cancer=resumen_tabular('Breast Cancer',cancer,'Clasificación binaria')cuentas_cancer=cancer.target.value_counts().sort_index()tabla(pd.DataFrame({'código':range(2),'etiqueta':cancer.target_names,'cantidad':cuentas_cancer.to_numpy()}),'Breast Cancer: diccionario de etiquetas')fig,axes=plt.subplots(1,2,figsize=(10,4))axes[0].bar(cancer.target_names,cuentas_cancer.to_numpy(),color=['tab:red','tab:blue'])axes[0].set(ylabel='Observaciones',title='Frecuencias de las etiquetas')bordes_radius=np.histogram_bin_edges(cancer.data['mean radius'],bins=18)for k,nombre inenumerate(cancer.target_names): axes[1].hist(cancer.data.loc[cancer.target==k,'mean radius'],bins=bordes_radius,alpha=.5,label=nombre)axes[1].set(xlabel='mean radius',ylabel='Observaciones',title='Una variable por etiqueta')axes[1].legend();plt.tight_layout();plt.show()mayoritaria=cuentas_cancer.max()/len(cancer.target)print(f'Proporción de la clase mayoritaria: {100*mayoritaria:.2f}%')estadisticas['mayoritaria']=mayoritaria
Breast Cancer: primeras cinco filas
mean radius
mean texture
mean perimeter
mean area
mean smoothness
mean compactness
mean concavity
mean concave points
mean symmetry
mean fractal dimension
radius error
texture error
perimeter error
area error
smoothness error
compactness error
concavity error
concave points error
symmetry error
fractal dimension error
worst radius
worst texture
worst perimeter
worst area
worst smoothness
worst compactness
worst concavity
worst concave points
worst symmetry
worst fractal dimension
target
17.990
10.380
122.800
1001.000
0.118
0.278
0.300
0.147
0.242
0.079
1.095
0.905
8.589
153.400
0.006
0.049
0.054
0.016
0.030
0.006
25.380
17.330
184.600
2019.000
0.162
0.666
0.712
0.265
0.460
0.119
0
20.570
17.770
132.900
1326.000
0.085
0.079
0.087
0.070
0.181
0.057
0.543
0.734
3.398
74.080
0.005
0.013
0.019
0.013
0.014
0.004
24.990
23.410
158.800
1956.000
0.124
0.187
0.242
0.186
0.275
0.089
0
19.690
21.250
130.000
1203.000
0.110
0.160
0.197
0.128
0.207
0.060
0.746
0.787
4.585
94.030
0.006
0.040
0.038
0.021
0.022
0.005
23.570
25.530
152.500
1709.000
0.144
0.424
0.450
0.243
0.361
0.088
0
11.420
20.380
77.580
386.100
0.142
0.284
0.241
0.105
0.260
0.097
0.496
1.156
3.445
27.230
0.009
0.075
0.057
0.019
0.060
0.009
14.910
26.500
98.870
567.700
0.210
0.866
0.687
0.258
0.664
0.173
0
20.290
14.340
135.100
1297.000
0.100
0.133
0.198
0.104
0.181
0.059
0.757
0.781
5.438
94.440
0.011
0.025
0.057
0.019
0.018
0.005
22.540
16.670
152.200
1575.000
0.137
0.205
0.400
0.163
0.236
0.077
0
Breast Cancer: encabezados y tipos
columna
dtype
faltantes
mean radius
float64
0
mean texture
float64
0
mean perimeter
float64
0
mean area
float64
0
mean smoothness
float64
0
mean compactness
float64
0
mean concavity
float64
0
mean concave points
float64
0
mean symmetry
float64
0
mean fractal dimension
float64
0
radius error
float64
0
texture error
float64
0
perimeter error
float64
0
area error
float64
0
smoothness error
float64
0
compactness error
float64
0
concavity error
float64
0
concave points error
float64
0
symmetry error
float64
0
fractal dimension error
float64
0
worst radius
float64
0
worst texture
float64
0
worst perimeter
float64
0
worst area
float64
0
worst smoothness
float64
0
worst compactness
float64
0
worst concavity
float64
0
worst concave points
float64
0
worst symmetry
float64
0
worst fractal dimension
float64
0
target
int64
0
Breast Cancer: X=(569, 30), y=(569,), faltantes=0
Breast Cancer: diccionario de etiquetas
código
etiqueta
cantidad
0
malignant
212
1
benign
357
Proporción de la clase mayoritaria: 62.74%
3.4.6 Cómo leer las etiquetas y el balance
Las 569 observaciones tienen 30 variables. Los conteos son 212 malignant y 357 benign. La clase mayoritaria representa 62.74 % de la colección. Ese porcentaje es descriptivo: no es una exactitud de prueba obtenida por un modelo.
El histograma muestra diferencias y solapamientos en una variable. No permite asignar diagnósticos a nuevos casos. Para una tarea de clasificación posterior tendrás que distinguir los errores por clase y el significado de su código, además de estudiar las condiciones de evaluación.
3.4.7 Diabetes: la respuesta es una cantidad
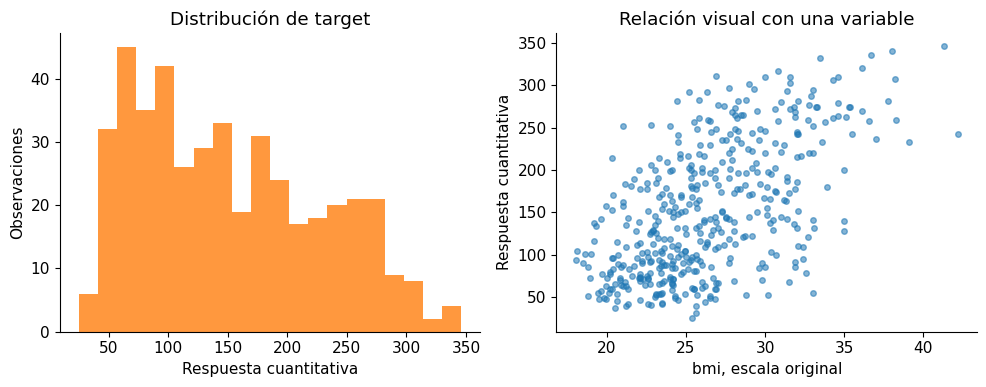
Diabetes contiene diez variables de entrada y una medida cuantitativa de progresión un año después. El nombre puede inducir a pensar en una clasificación de presencia o ausencia de diabetes, pero la respuesta de este benchmark es continua.
El cargador aplica por defecto una transformación particular: centra cada columna y la divide por su desviación estándar multiplicada por \(\sqrt n\). Los valores de age de esa versión no están en años. Cargaremos también scaled=False para observar la diferencia de escala sin confundirla con cambios de paciente.
diabetes=load_diabetes(as_frame=True)df_diabetes=resumen_tabular('Diabetes',diabetes,'Regresión')diabetes_original=load_diabetes(as_frame=True,scaled=False)tabla(pd.DataFrame({'age_transformada':diabetes.data['age'].head(),'age_original':diabetes_original.data['age'].head(),'bmi_transformado':diabetes.data['bmi'].head(),'bmi_original':diabetes_original.data['bmi'].head(),'target':diabetes.target.head()}),'Diabetes: mismas filas, dos escalas')fig,axes=plt.subplots(1,2,figsize=(10,4))axes[0].hist(diabetes.target,bins=20,color='tab:orange',alpha=.8)axes[0].set(xlabel='Respuesta cuantitativa',ylabel='Observaciones',title='Distribución de target')axes[1].scatter(diabetes_original.data['bmi'],diabetes.target,s=16,alpha=.55)axes[1].set(xlabel='bmi, escala original',ylabel='Respuesta cuantitativa',title='Relación visual con una variable')plt.tight_layout();plt.show()std_default=diabetes.data.std(ddof=0).iloc[0]print(f'Desviación de age transformada: {std_default:.6f}; 1/sqrt(n): {1/np.sqrt(len(diabetes.target)):.6f}')print(f'Target: mínimo={diabetes.target.min():.1f}, máximo={diabetes.target.max():.1f}')estadisticas['diabetes_std']=std_default
Diabetes: primeras cinco filas
age
sex
bmi
bp
s1
s2
s3
s4
s5
s6
target
0.038
0.051
0.062
0.022
-0.044
-0.035
-0.043
-0.003
0.020
-0.018
151.000
-0.002
-0.045
-0.051
-0.026
-0.008
-0.019
0.074
-0.039
-0.068
-0.092
75.000
0.085
0.051
0.044
-0.006
-0.046
-0.034
-0.032
-0.003
0.003
-0.026
141.000
-0.089
-0.045
-0.012
-0.037
0.012
0.025
-0.036
0.034
0.023
-0.009
206.000
0.005
-0.045
-0.036
0.022
0.004
0.016
0.008
-0.003
-0.032
-0.047
135.000
Diabetes: encabezados y tipos
columna
dtype
faltantes
age
float64
0
sex
float64
0
bmi
float64
0
bp
float64
0
s1
float64
0
s2
float64
0
s3
float64
0
s4
float64
0
s5
float64
0
s6
float64
0
target
float64
0
Diabetes: X=(442, 10), y=(442,), faltantes=0
Diabetes: mismas filas, dos escalas
age_transformada
age_original
bmi_transformado
bmi_original
target
0.038
59.000
0.062
32.100
151.000
-0.002
48.000
-0.051
21.600
75.000
0.085
72.000
0.044
30.500
141.000
-0.089
24.000
-0.012
25.300
206.000
0.005
50.000
-0.036
23.000
135.000
Desviación de age transformada: 0.047565; 1/sqrt(n): 0.047565
Target: mínimo=25.0, máximo=346.0
3.4.8 Cómo leer Diabetes
Hay 442 observaciones y diez variables. La desviación de age en la versión transformada es 0.047565, próxima a \(1/\sqrt{442}\); no es uno. La transformación se realizó sobre la colección completa antes de la partición que tú puedas crear. Para practicar un pipeline sin información de la prueba, parte de scaled=False y estima tu escalado solo con entrenamiento.
El histograma presenta una cantidad, no dos categorías. La nube de bmi y respuesta muestra una relación con dispersión; no identifica un efecto causal. Además, estos datos ya son una selección numérica preparada: sus columnas no representan toda la información de una historia clínica.
3.5 Parte B — Imágenes: ver el objeto y sus números
3.5.1 Digits: pequeño, local y diferente de MNIST
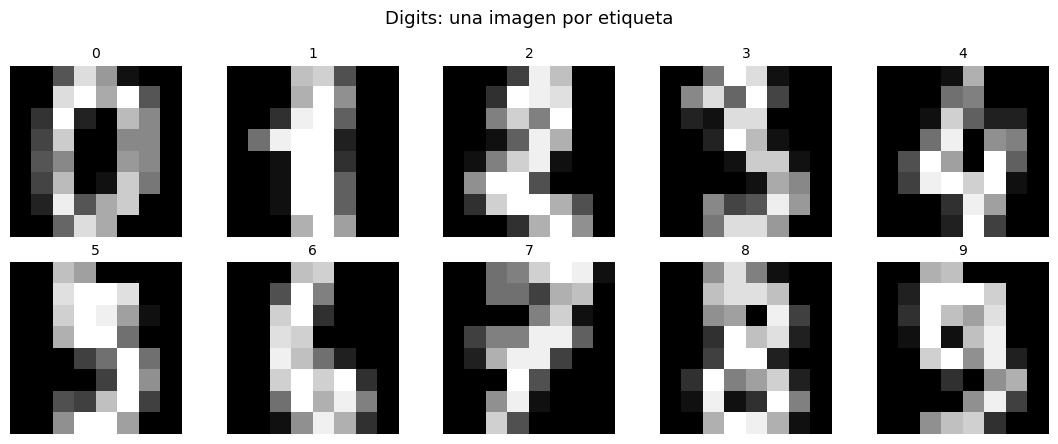
load_digits() incluye imágenes de dígitos de 8×8 píxeles. images conserva la cuadrícula; data aplana cada imagen en 64 columnas. Son dos vistas de los mismos valores. Seleccionamos una imagen por etiqueta para construir una galería equilibrada, no una muestra aleatoria del dataset.
digits=load_digits()seleccion=[np.flatnonzero(digits.target==k)[0] for k inrange(10)]galeria(digits.images[seleccion],digits.target[seleccion],'Digits: una imagen por etiqueta',gris=True)tabla(pd.DataFrame(digits.data[:3,:12],columns=[f'pixel_{j:02}'for j inrange(12)]).assign(target=digits.target[:3]),'Digits: primeras 12 de las 64 columnas de píxeles')print(f'images={digits.images.shape}, data={digits.data.shape}, target={digits.target.shape}')print(f'Rango de píxeles: {digits.images.min():.0f} a {digits.images.max():.0f}; dtype={digits.images.dtype}')print('Vista aplanada coincide con la cuadrícula:',np.array_equal(digits.data[0],digits.images[0].reshape(-1)))catalogo.append({'dataset':'Digits','modalidad':'Imagen','observaciones_vistas':len(digits.target),'entrada_por_observación':'8×8, un canal','tarea':'10 clases'})
Digits: primeras 12 de las 64 columnas de píxeles
pixel_00
pixel_01
pixel_02
pixel_03
pixel_04
pixel_05
pixel_06
pixel_07
pixel_08
pixel_09
pixel_10
pixel_11
target
0.000
0.000
5.000
13.000
9.000
1.000
0.000
0.000
0.000
0.000
13.000
15.000
0
0.000
0.000
0.000
12.000
13.000
5.000
0.000
0.000
0.000
0.000
0.000
11.000
1
0.000
0.000
0.000
4.000
15.000
12.000
0.000
0.000
0.000
0.000
3.000
16.000
2
images=(1797, 8, 8), data=(1797, 64), target=(1797,)
Rango de píxeles: 0 a 16; dtype=float64
Vista aplanada coincide con la cuadrícula: True
3.5.2 Cómo leer la galería y el encabezado
Digits tiene 1,797 imágenes. El rango observado va de 0 a 16, no de cero a 255. images tiene forma (1797,8,8) y data(1797,64). Los encabezados pixel_00, pixel_01 y siguientes se añadieron para mostrar la tabla; indican posiciones, no variables semánticas como distancia o peso.
Una galería muestra el patrón espacial que la tabla dificulta reconocer. Aplanar conserva los valores y su orden, pero una capa densa ya no recibe explícitamente los dos ejes espaciales. No identifiques este dataset como MNIST: tienen resolución, colección y escala de píxeles distintas.
3.5.3 MNIST: la misma tarea, otra representación
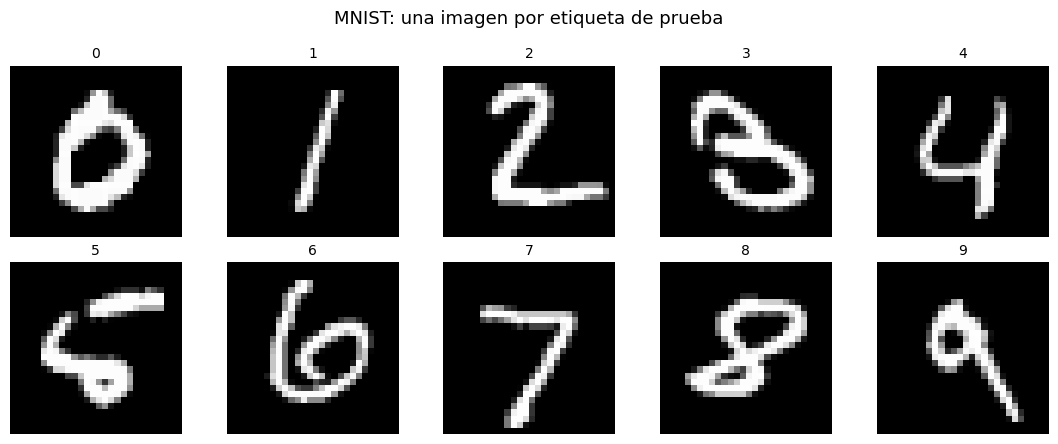
Cargamos el archivo distribuido para MNIST y mostramos una imagen por clase de su prueba oficial. El archivo contiene por separado entradas y etiquetas de entrenamiento y prueba. No necesitamos unirlas para construir una galería.
mnist_file=obtener('mnist.npz','https://storage.googleapis.com/tensorflow/tf-keras-datasets/mnist.npz',[KERAS/'mnist.npz'])with np.load(mnist_file,allow_pickle=False) as z: mnist=z['x_test'];y_mnist=z['y_test'];forma_mnist_train=z['x_train'].shapeseleccion=[np.flatnonzero(y_mnist==k)[0] for k inrange(10)]galeria(mnist[seleccion],y_mnist[seleccion],'MNIST: una imagen por etiqueta de prueba',gris=True)print('Entrenamiento:',forma_mnist_train,'| Prueba:',mnist.shape,'| Etiquetas de prueba:',y_mnist.shape)print('dtype:',mnist.dtype,'| rango observado:',int(mnist.min()),int(mnist.max()))fig,axes=plt.subplots(1,2,figsize=(10,4))axes[0].imshow(mnist[seleccion[7]],cmap='gray',interpolation='nearest');axes[0].set_title('MNIST: etiqueta 7');axes[0].axis('off')recorte=mnist[seleccion[7],10:18,10:18]im=axes[1].imshow(recorte,cmap='gray',vmin=0,vmax=255,interpolation='nearest')for i inrange(8):for j inrange(8):axes[1].text(j,i,str(recorte[i,j]),ha='center',va='center',fontsize=8,color='black'if recorte[i,j]>125else'white')axes[1].set_title('Recorte 8×8: intensidades reales');axes[1].set_xlabel('Columnas 10–17');axes[1].set_ylabel('Filas 10–17')plt.tight_layout();plt.show()catalogo.append({'dataset':'MNIST','modalidad':'Imagen','observaciones_vistas':len(y_mnist),'entrada_por_observación':'28×28, un canal','tarea':'10 clases; vista de prueba'})
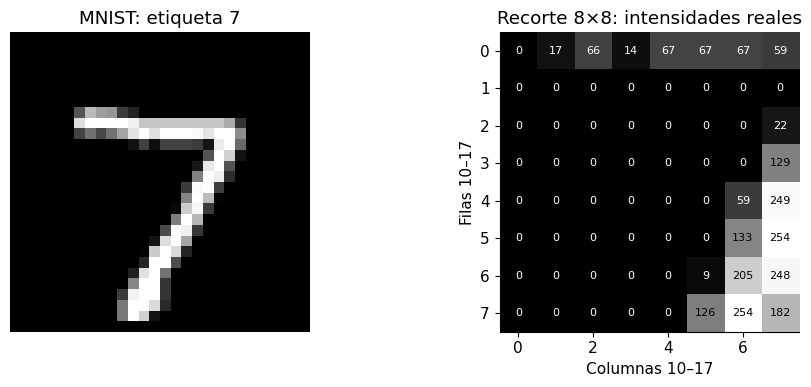
Las formas guardadas son (60000,28,28) en entrenamiento y (10000,28,28) en prueba. Cada imagen contiene 784 valores uint8, con rango observado 0–255. El número que aparece sobre una imagen es su etiqueta; los del recorte son intensidades de píxel. Una intensidad de siete no representa la clase siete.
Dividir por 255 lleva las intensidades a \([0,1]\), pero no equivale a centrar y estandarizar. Para una CNN de PyTorch, una imagen de un canal suele convertirse a forma (1,28,28) y el lote a (B,1,28,28). Aquí no añadimos esos ejes porque solo estamos inspeccionando los archivos.
3.5.5 Fashion-MNIST: forma igual, objetos diferentes
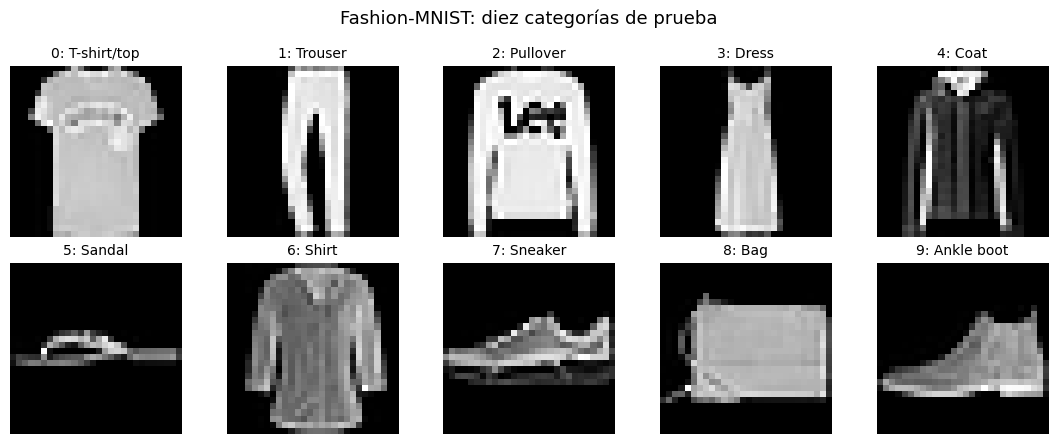
Fashion-MNIST conserva la resolución y organización de MNIST, pero sus diez etiquetas representan prendas y accesorios. Leeremos los archivos comprimidos de imágenes y etiquetas. El encabezado del formato IDX indica cuántas imágenes hay y sus dimensiones; no es una fila de nombres de columnas como en CSV.
base_fashion='https://raw.githubusercontent.com/zalandoresearch/fashion-mnist/master/data/fashion/'img_f=obtener('fashion-t10k-images.gz',base_fashion+'t10k-images-idx3-ubyte.gz',[KERAS/'fashion-mnist'/'t10k-images-idx3-ubyte.gz'])lab_f=obtener('fashion-t10k-labels.gz',base_fashion+'t10k-labels-idx1-ubyte.gz',[KERAS/'fashion-mnist'/'t10k-labels-idx1-ubyte.gz'])fashion=idx_gzip(img_f,True);y_fashion=idx_gzip(lab_f,False)nombres_fashion=['T-shirt/top','Trouser','Pullover','Dress','Coat','Sandal','Shirt','Sneaker','Bag','Ankle boot']seleccion=[np.flatnonzero(y_fashion==k)[0] for k inrange(10)]galeria(fashion[seleccion],[f'{k}: {nombres_fashion[k]}'for k inrange(10)],'Fashion-MNIST: diez categorías de prueba',gris=True)conteos_fashion=np.bincount(y_fashion,minlength=10)tabla(pd.DataFrame({'código':range(10),'categoría':nombres_fashion,'cantidad_prueba':conteos_fashion}),'Fashion-MNIST: diccionario y frecuencias')print('Imágenes:',fashion.shape,'| Etiquetas:',y_fashion.shape,'| dtype:',fashion.dtype)catalogo.append({'dataset':'Fashion-MNIST','modalidad':'Imagen','observaciones_vistas':len(y_fashion),'entrada_por_observación':'28×28, un canal','tarea':'10 clases; vista de prueba'})
La prueba contiene 10,000 imágenes, con 1,000 por categoría. En ambas galerías una imagen tiene forma (28,28), pero el diccionario de etiquetas cambió: 7 representa sneaker, no un dígito escrito. Reutilizar una arquitectura no permite reutilizar sin revisión el significado de sus salidas.
Las siluetas de prendas pueden compartir rasgos. Esa observación ayuda a plantear una tarea, pero esta galería seleccionada no mide su dificultad ni demuestra qué clases confundirá un modelo. La evaluación necesitará predicciones y una matriz de confusión, no solo inspección visual.
3.5.7 CIFAR-10: color, fondo y tres canales
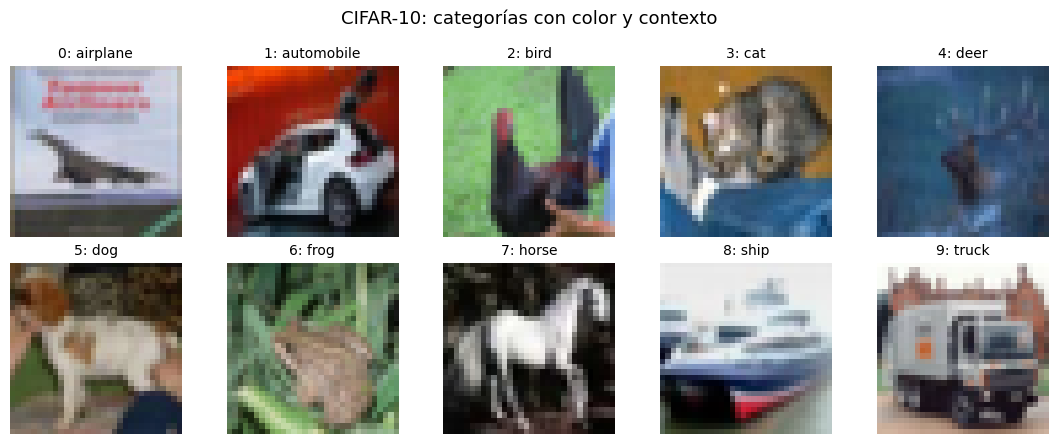
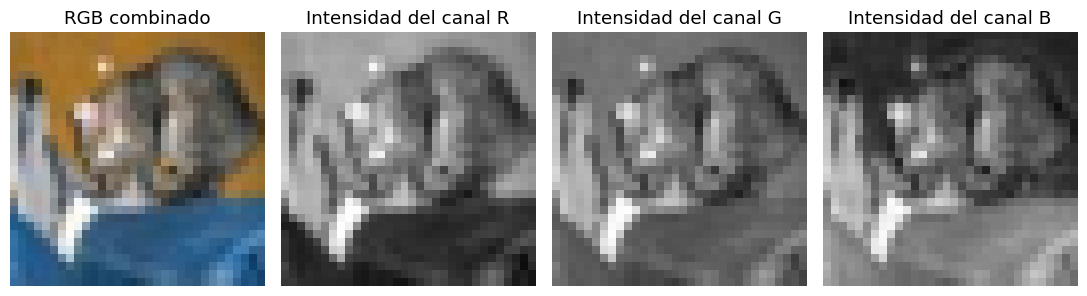
CIFAR-10 contiene pequeñas imágenes RGB de diez clases. El formato Python del proveedor guarda los tres canales aplanados. Vamos a reconstruir alto, ancho y canales antes de dibujar: el orden de ejes determina si la imagen conserva sus colores.
cifar_dir=KERAS/'cifar-10-batches-py-target'/'cifar-10-batches-py'if (cifar_dir/'test_batch').is_file(): contenido=(cifar_dir/'test_batch').read_bytes()else: paquete=obtener('cifar-10-python.tar.gz','https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz', [KERAS/'cifar-10-batches-py-target_archive']) contenido=archivo_tar(paquete,'cifar-10-batches-py/test_batch')# Formato Python del archivo oficial del proveedor.lote=pickle.loads(contenido,encoding='bytes')cifar=lote[b'data'].reshape(-1,3,32,32).transpose(0,2,3,1)y_cifar=np.asarray(lote[b'labels'])nombres_cifar=['airplane','automobile','bird','cat','deer','dog','frog','horse','ship','truck']seleccion=[np.flatnonzero(y_cifar==k)[0] for k inrange(10)]galeria(cifar[seleccion],[f'{k}: {nombres_cifar[k]}'for k inrange(10)],'CIFAR-10: categorías con color y contexto')ejemplo=cifar[seleccion[3]]fig,axes=plt.subplots(1,4,figsize=(11,3))axes[0].imshow(ejemplo,interpolation='nearest');axes[0].set_title('RGB combinado')for j,color inenumerate(['R','G','B']): axes[j+1].imshow(ejemplo[:,:,j],cmap='gray',vmin=0,vmax=255,interpolation='nearest');axes[j+1].set_title(f'Intensidad del canal {color}')for ax in axes:ax.axis('off')plt.tight_layout();plt.show()print('Archivo aplanado:',lote[b'data'].shape,'| Imágenes reconstruidas:',cifar.shape)print('dtype:',cifar.dtype,'| rango observado:',int(cifar.min()),int(cifar.max()))tabla(pd.DataFrame({'código':range(10),'clase':nombres_cifar,'cantidad_prueba':np.bincount(y_cifar)}),'CIFAR-10: etiquetas de prueba')catalogo.append({'dataset':'CIFAR-10','modalidad':'Imagen','observaciones_vistas':len(y_cifar),'entrada_por_observación':'32×32×3, RGB','tarea':'10 clases; vista de prueba'})
La prueba tiene 10,000 imágenes con forma (32,32,3). Cada una contiene 3,072 valores; el archivo aplanado tiene esa cantidad de columnas por fila. La galería muestra una imagen por categoría, mientras que la tabla confirma 1,000 imágenes por clase en esta partición.
Los paneles de R, G y B se muestran en gris para comparar intensidades. No son tres observaciones independientes: forman una sola imagen. Para una CNN con canales primero, el lote pasaría de (B,32,32,3) a (B,3,32,32). La reconstrucción del archivo usa ese mismo cuidado por los ejes.
3.5.9 Flowers: las carpetas también pueden guardar etiquetas
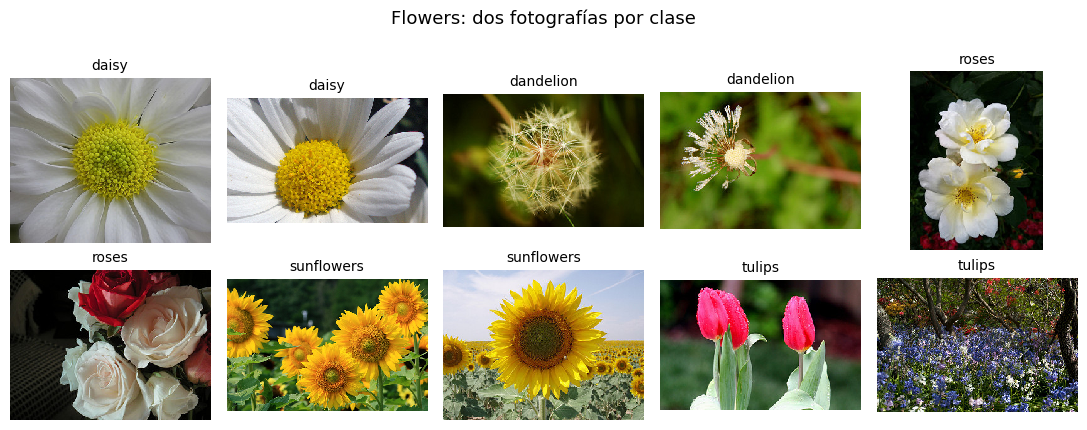
Flowers organiza fotografías en directorios llamados daisy, dandelion, roses, sunflowers y tulips. Los archivos tienen tamaños variables. Construiremos un manifiesto: una tabla que relaciona cada ruta con su etiqueta. Mostraremos dos fotografías por categoría para observar variación dentro de una clase.
Las fotografías del archivo se distribuyen con atribuciones individuales. La tabla posterior acredita las imágenes mostradas según su LICENSE.txt; la licencia de esas fotografías es CC BY 2.0.
flowers_dir=KERAS/'flower_photos'/'flower_photos'ifnot flowers_dir.is_dir(): paquete=obtener('flower_photos.tgz','https://storage.googleapis.com/download.tensorflow.org/example_images/flower_photos.tgz', [KERAS/'flower_photos_archive']) flowers_dir=CACHE/'flower_photos'with tarfile.open(paquete,'r:gz') as archivo:for member in archivo.getmembers():if member.isfile() and (member.name.endswith('.jpg') or member.name.endswith('LICENSE.txt')): partes=Path(member.name).partsassert partes[0]=='flower_photos'and'..'notin partes destino=CACHE/member.name;destino.parent.mkdir(parents=True,exist_ok=True) destino.write_bytes(archivo.extractfile(member).read())clases_flowers=sorted(p.name for p in flowers_dir.iterdir() if p.is_dir())registros=[]for clase in clases_flowers:for p insorted((flowers_dir/clase).glob('*.jpg')): registros.append({'ruta':p.relative_to(flowers_dir).as_posix(),'etiqueta':clase})manifiesto=pd.DataFrame(registros)tabla(manifiesto.head(8),'Flowers: manifiesto de archivos')seleccion_flowers=[]for clase in clases_flowers: seleccion_flowers.extend(manifiesto.loc[manifiesto.etiqueta==clase,'ruta'].iloc[:2].tolist())fotos=[];dimensiones=[]for ruta in seleccion_flowers:with Image.open(flowers_dir/ruta) as im: arr=np.asarray(im.convert('RGB'));fotos.append(arr) dimensiones.append({'ruta':ruta,'alto':arr.shape[0],'ancho':arr.shape[1],'canales':arr.shape[2]})galeria(fotos,[p.split('/')[0] for p in seleccion_flowers],'Flowers: dos fotografías por clase',columnas=5)tabla(pd.DataFrame(dimensiones),'Flowers: dimensiones originales de las fotografías mostradas')licencias=(flowers_dir/'LICENSE.txt').read_text(encoding='utf-8')creditos=[]for ruta in seleccion_flowers: linea=next(line for line in licencias.splitlines() if line.startswith(ruta+' ')) resto=linea.split(' CC-BY by ',1)[1];autor,url=resto.rsplit(' - ',1) creditos.append({'fotografía':ruta,'autor':autor,'fuente':url,'licencia':'CC BY 2.0'})tabla(pd.DataFrame(creditos),'Atribución de las fotografías mostradas (sin recorte)')conteos_flowers=manifiesto.etiqueta.value_counts().reindex(clases_flowers)fig,ax=plt.subplots(figsize=(8,3.5));ax.bar(conteos_flowers.index,conteos_flowers.values,color='tab:green')ax.set(ylabel='Fotografías',title='Flowers: conteo de archivos por clase');plt.tight_layout();plt.show()print('Fotografías encontradas:',len(manifiesto),'| Clases:',len(clases_flowers))catalogo.append({'dataset':'Flowers','modalidad':'Imagen','observaciones_vistas':len(manifiesto),'entrada_por_observación':'RGB, dimensiones variables','tarea':'5 clases; sin partición aquí'})
Flowers: manifiesto de archivos
ruta
etiqueta
daisy/100080576_f52e8ee070_n.jpg
daisy
daisy/10140303196_b88d3d6cec.jpg
daisy
daisy/10172379554_b296050f82_n.jpg
daisy
daisy/10172567486_2748826a8b.jpg
daisy
daisy/10172636503_21bededa75_n.jpg
daisy
daisy/102841525_bd6628ae3c.jpg
daisy
daisy/1031799732_e7f4008c03.jpg
daisy
daisy/10391248763_1d16681106_n.jpg
daisy
Flowers: dimensiones originales de las fotografías mostradas
ruta
alto
ancho
canales
daisy/100080576_f52e8ee070_n.jpg
263
320
3
daisy/10140303196_b88d3d6cec.jpg
313
500
3
dandelion/10043234166_e6dd915111_n.jpg
213
320
3
dandelion/10200780773_c6051a7d71_n.jpg
218
320
3
roses/10090824183_d02c613f10_m.jpg
240
179
3
roses/102501987_3cdb8e5394_n.jpg
240
320
3
sunflowers/1008566138_6927679c8a.jpg
330
500
3
sunflowers/1022552002_2b93faf9e7_n.jpg
240
320
3
tulips/100930342_92e8746431_n.jpg
209
320
3
tulips/10094729603_eeca3f2cb6.jpg
335
500
3
Atribución de las fotografías mostradas (sin recorte)
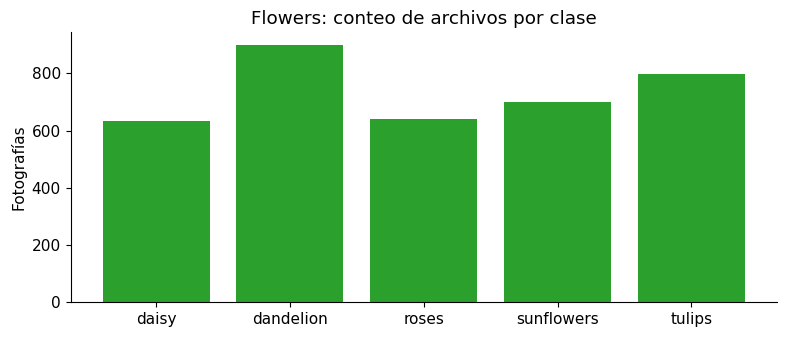
El manifiesto reúne 3,670 fotografías y cinco categorías. Las primeras filas pertenecen a daisy porque ordenamos las carpetas y las rutas: otra vez, el orden de almacenamiento no es una distribución de clases.
La galería muestra variaciones de encuadre, fondo y número de flores. La tabla de dimensiones confirma que no puedes apilar directamente todas las imágenes como un único arreglo rectangular. Redimensionar permitiría hacerlo, pero implica decidir cómo tratar proporciones y contenido; ese desarrollo corresponde a los pipelines de visión.
Aquí no creamos una partición de entrenamiento y prueba. El nombre train usado por algunos catálogos para toda la colección no significa que ya exista una prueba independiente para tu experimento. Tendrás que definirla y revisar imágenes relacionadas o duplicadas antes de afirmar generalización.
3.6 Parte C — Texto: palabras, etiquetas y longitudes
3.6.1 IMDB: una reseña no es una fila de números equivalentes
La versión de IMDB distribuida por Keras guarda reseñas codificadas como secuencias de identificadores de palabras. El archivo original permite observar esas secuencias sin instalar Keras. Su diccionario recupera palabras; imprimiremos solo un fragmento breve de una reseña para mostrar el formato.
Los identificadores no son cantidades: que una palabra tenga código 500 no la hace más intensa que una de código 20. Esta lectura usa los índices del archivo original, antes de que keras.datasets.imdb.load_data() añada sus desplazamientos y tokens especiales. Si usas esa API, debes seguir su convenio de decodificación.
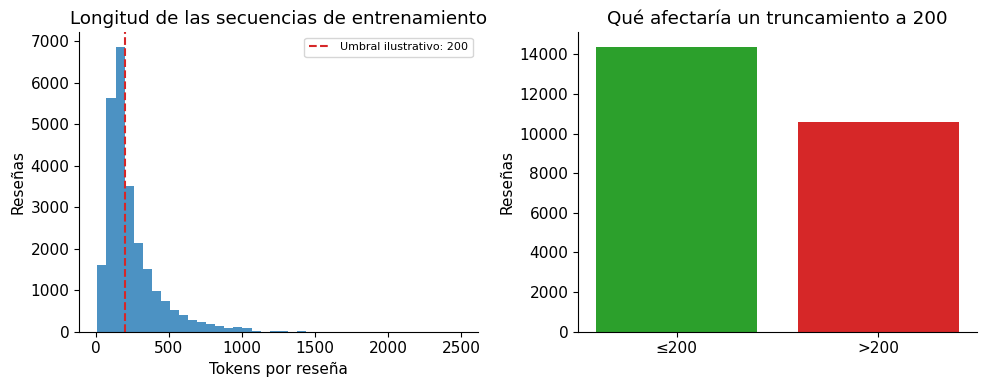
imdb_file=obtener('imdb.npz','https://storage.googleapis.com/tensorflow/tf-keras-datasets/imdb.npz',[KERAS/'imdb.npz'])dic_file=obtener('imdb_word_index.json','https://storage.googleapis.com/tensorflow/tf-keras-datasets/imdb_word_index.json',[KERAS/'imdb_word_index.json'])# Las secuencias del archivo oficial se almacenan como arreglos de objetos.with np.load(imdb_file,allow_pickle=True) as z: textos_train=z['x_train'];etiquetas_texto=z['y_train'];n_imdb_test=len(z['y_test'])diccionario=json.loads(dic_file.read_text(encoding='utf-8'))palabra_por_id={codigo:palabra for palabra,codigo in diccionario.items()}fragmento=' '.join(palabra_por_id.get(int(t),'[desconocido]') for t in textos_train[0][:20])tabla(pd.DataFrame({'campo':['secuencia','etiqueta','n_tokens'],'contenido':[str(list(textos_train[0][:12]))+' …',str(etiquetas_texto[0]),str(len(textos_train[0]))]}),'IMDB: estructura de una observación del archivo original')print('Fragmento de la primera reseña (20 palabras):',fragmento)print('Etiqueta de esa reseña:',int(etiquetas_texto[0]),'(0=negativa, 1=positiva)')longitudes=np.array([len(t) for t in textos_train])tabla(pd.DataFrame({'etiqueta':[0,1],'significado':['negativa','positiva'],'cantidad_entrenamiento':np.bincount(etiquetas_texto)}),'IMDB: distribución de etiquetas')fig,axes=plt.subplots(1,2,figsize=(10,4))axes[0].hist(longitudes,bins=40,color='tab:blue',alpha=.8);axes[0].set(xlabel='Tokens por reseña',ylabel='Reseñas',title='Longitud de las secuencias de entrenamiento')limite_tokens=200fraccion_larga=np.mean(longitudes>limite_tokens)axes[0].axvline(limite_tokens,color='tab:red',ls='--',label='Umbral ilustrativo: 200');axes[0].legend(fontsize=8)axes[1].bar(['≤200','>200'],[(longitudes<=200).sum(),(longitudes>200).sum()],color=['tab:green','tab:red'])axes[1].set(ylabel='Reseñas',title='Qué afectaría un truncamiento a 200')plt.tight_layout();plt.show()print(f'Entrenamiento={len(textos_train)}, prueba={n_imdb_test}; mediana de longitud={np.median(longitudes):.1f}')print(f'Reseñas de entrenamiento con más de 200 tokens: {100*fraccion_larga:.2f}%')estadisticas['fraccion_larga']=fraccion_largacatalogo.append({'dataset':'IMDB','modalidad':'Texto','observaciones_vistas':len(textos_train),'entrada_por_observación':'Secuencia de longitud variable','tarea':'Sentimiento; entrenamiento'})
IMDB: estructura de una observación del archivo original
Fragmento de la primera reseña (20 palabras): bromwell high is a cartoon comedy it ran at the same time as some other programs about school life such
Etiqueta de esa reseña: 1 (0=negativa, 1=positiva)
IMDB: distribución de etiquetas
etiqueta
significado
cantidad_entrenamiento
0
negativa
12500
1
positiva
12500
Entrenamiento=25000, prueba=25000; mediana de longitud=177.0
Reseñas de entrenamiento con más de 200 tokens: 42.40%
3.6.2 Cómo leer IMDB
El archivo contiene 25,000 reseñas de entrenamiento y 25,000 de prueba. En entrenamiento hay 12,500 por etiqueta. La primera secuencia y su fragmento muestran el enlace entre números y palabras; el contenido impreso es solo un extracto y no debe usarse para juzgar toda la reseña.
Las longitudes varían. Un límite de 200 tokens, escogido aquí solo para ilustrar una decisión, afectaría al 42.40 % de las reseñas de entrenamiento. Esa fracción cuantifica cuántas serían truncadas, no cuánto perdería la exactitud de un modelo. El padding añadiría posiciones a las secuencias cortas; el truncamiento eliminaría posiciones de las largas.
La galería textual y las longitudes pertenecen a entrenamiento. El desarrollo de tokenización y NLP especializado queda en su libro propio; aquí interesa reconocer la estructura que reciben las redes de secuencias.
3.7 Parte D — Audio: muestras en el tiempo
3.7.1 Dígitos hablados: archivo, forma de onda y espectrograma
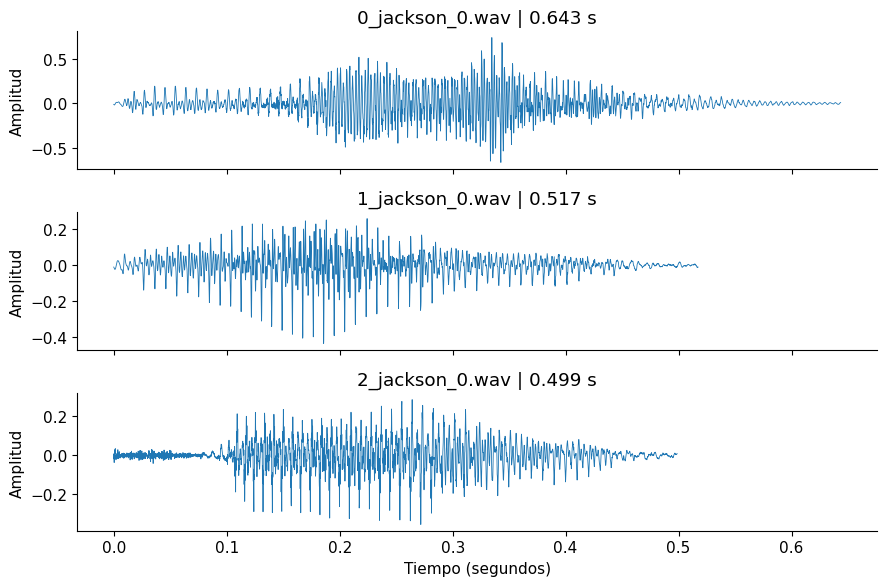
Usamos tres grabaciones de Free Spoken Digit Dataset (FSDD), fijando la versión del repositorio. Sus nombres tienen la forma dígito_hablante_repetición.wav. Las tres seleccionadas pertenecen al hablante jackson y representan cero, uno y dos; no son el dataset completo ni una muestra representativa de sus hablantes.
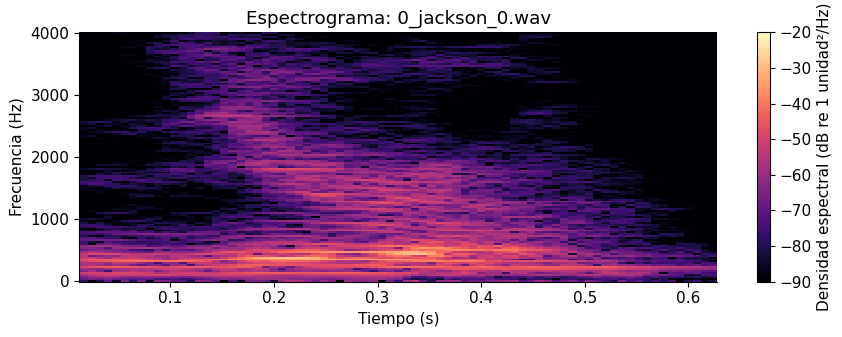
Una forma de onda muestra amplitud frente al tiempo. Un espectrograma descompone ventanas sucesivas para mostrar cómo cambia la energía por frecuencia. En las figuras no hay predicciones de un modelo: son dos representaciones de los mismos sonidos.
FSDD_VERSION='26eb9aaf76e81b692f806f9140c2d2777410d7a1'grabaciones=[];datos_audio=[]for digito in [0,1,2]: nombre=f'{digito}_jackson_0.wav' url=f'https://raw.githubusercontent.com/Jakobovski/free-spoken-digit-dataset/{FSDD_VERSION}/recordings/{nombre}' ruta=obtener(nombre,url) fs,pcm=wavfile.read(ruta) audio=pcm.astype(np.float64)/np.iinfo(pcm.dtype).max datos_audio.append((fs,audio)) grabaciones.append({'archivo':nombre,'dígito':digito,'hablante':'jackson','frecuencia_Hz':fs,'muestras':len(audio),'duración_s':len(audio)/fs,'canales':1if audio.ndim==1else audio.shape[1]})tabla(pd.DataFrame(grabaciones),'FSDD: metadatos de las tres grabaciones')fig,axes=plt.subplots(3,1,figsize=(9,6),sharex=True)for ax,(fs,audio),fila inzip(axes,datos_audio,grabaciones): ax.plot(np.arange(len(audio))/fs,audio,lw=.6) ax.set(ylabel='Amplitud',title=f"{fila['archivo']} | {fila['duración_s']:.3f} s")axes[-1].set_xlabel('Tiempo (segundos)');plt.tight_layout();plt.show()fs,audio=datos_audio[0]f,t,S=signal.spectrogram(audio,fs=fs,nperseg=256,noverlap=192,scaling='density')SdB=10*np.log10(np.maximum(S,1e-12))fig,ax=plt.subplots(figsize=(9,3.5))im=ax.pcolormesh(t,f,SdB,shading='auto',cmap='magma',vmin=-90,vmax=-20)ax.set(xlabel='Tiempo (s)',ylabel='Frecuencia (Hz)',title='Espectrograma: 0_jackson_0.wav')fig.colorbar(im,ax=ax,label='Densidad espectral (dB re 1 unidad²/Hz)');plt.tight_layout();plt.show()display(Audio(audio,rate=fs,normalize=False))print('Fuente: Free Spoken Digit Dataset, Jakobovski y colaboradores. Licencia: CC BY-SA 4.0.')print('Versión fijada:',FSDD_VERSION)catalogo.append({'dataset':'FSDD (selección)','modalidad':'Audio','observaciones_vistas':3,'entrada_por_observación':'Señal mono de duración variable','tarea':'Dígito hablado; solo inspección'})
FSDD: metadatos de las tres grabaciones
archivo
dígito
hablante
frecuencia_Hz
muestras
duración_s
canales
0_jackson_0.wav
0
jackson
8000
5148
0.643
1
1_jackson_0.wav
1
jackson
8000
4138
0.517
1
2_jackson_0.wav
2
jackson
8000
3990
0.499
1
Fuente: Free Spoken Digit Dataset, Jakobovski y colaboradores. Licencia: CC BY-SA 4.0.
Versión fijada: 26eb9aaf76e81b692f806f9140c2d2777410d7a1
3.7.2 Cómo leer el audio
La tabla muestra 8,000 muestras por segundo y un canal en estas grabaciones. Su duración se obtiene dividiendo el número de muestras por esa frecuencia; no es el número de ventanas del espectrograma. Las formas de onda tienen longitudes distintas, aunque cada archivo represente un solo dígito.
El color del espectrograma expresa una densidad espectral en escala logarítmica respecto a la referencia indicada, no una probabilidad de clase ni un nivel acústico calibrado en dB SPL. El límite superior de frecuencia es 4,000 Hz, la mitad de la frecuencia de muestreo. Cambiar ventana y solapamiento modifica la resolución temporal y frecuencial.
Estas tres observaciones son insuficientes para entrenar o comparar modelos. Si quieres medir generalización a voces nuevas, separa hablantes entre entrenamiento y prueba. Si sigues una partición publicada, documenta qué pregunta evalúa: reconocer grabaciones nuevas de hablantes conocidos difiere de reconocer a hablantes no vistos.
3.8 Parte E — Tiempo y relaciones
3.8.1 Sunspots: el orden de las filas forma parte del dato
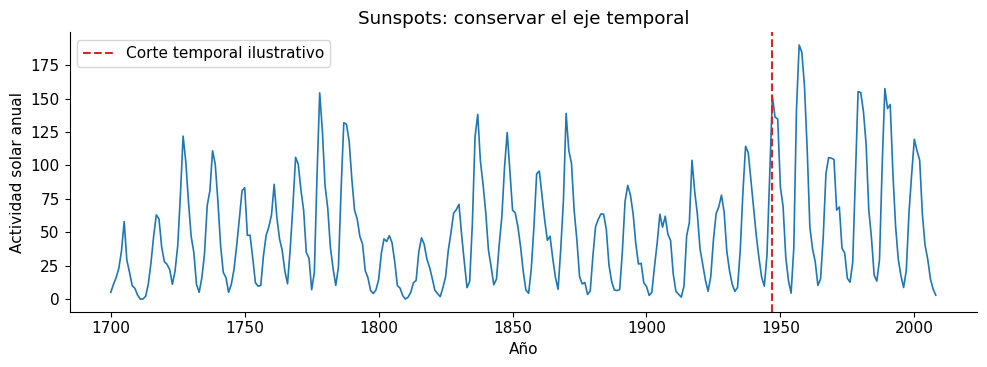
La serie de actividad solar incluida en statsmodels contiene un registro por año. Conservamos los encabezados YEAR y SUNACTIVITY: fecha y variable observada cumplen funciones diferentes. No hay una columna target separada; para pronosticar tendrás que definir qué valor futuro se desea predecir a partir del pasado.
solar=sm.datasets.sunspots.load_pandas().datatabla(solar.head(8),'Sunspots: encabezados y primeras observaciones')fig,ax=plt.subplots(figsize=(10,3.8))ax.plot(solar.YEAR,solar.SUNACTIVITY,lw=1.2)corte=solar.YEAR.iloc[int(.8*len(solar))]ax.axvline(corte,color='tab:red',ls='--',label='Corte temporal ilustrativo')ax.set(xlabel='Año',ylabel='Actividad solar anual',title='Sunspots: conservar el eje temporal')ax.legend();plt.tight_layout();plt.show()valores=solar.SUNACTIVITY.to_numpy()ventana=12ventanas=np.lib.stride_tricks.sliding_window_view(valores,ventana+1)X_ventanas=ventanas[:,:ventana]y_futuro=ventanas[:,-1]print('Serie:',solar.shape,'| Primer año:',int(solar.YEAR.min()),'| Último año:',int(solar.YEAR.max()))print('Ventanas de 12 años:',X_ventanas.shape,'| Respuesta del año siguiente:',y_futuro.shape)print('Primera ventana:',X_ventanas[0].tolist(),'| Siguiente valor:',y_futuro[0])catalogo.append({'dataset':'Sunspots','modalidad':'Serie temporal','observaciones_vistas':len(solar),'entrada_por_observación':'Un año; ventanas para modelar','tarea':'Pronóstico, si se define horizonte'})
Sunspots: encabezados y primeras observaciones
YEAR
SUNACTIVITY
1700.000
5.000
1701.000
11.000
1702.000
16.000
1703.000
23.000
1704.000
36.000
1705.000
58.000
1706.000
29.000
1707.000
20.000
Serie: (309, 2) | Primer año: 1700 | Último año: 2008
Ventanas de 12 años: (297, 12) | Respuesta del año siguiente: (297,)
Primera ventana: [5.0, 11.0, 16.0, 23.0, 36.0, 58.0, 29.0, 20.0, 10.0, 8.0, 3.0, 0.0] | Siguiente valor: 0.0
3.8.2 Cómo leer el libro y sus ventanas
Hay 309 observaciones anuales, de 1700 a 2008. Al usar doce años para predecir el siguiente, aparecen 297 ventanas de longitud doce. El aumento de filas de entrenamiento no crea nuevos años independientes: las ventanas consecutivas comparten once valores.
La línea vertical es un corte ilustrativo, no una evaluación realizada. Para simular una predicción futura, define la separación por fecha de la respuesta. Construir ventanas a ambos lados puede usar historia anterior al corte como entrada de prueba, lo cual es legítimo si estaba disponible; lo que no puedes usar es información posterior al instante de predicción. La actividad visible tiene ciclos, pero la figura no demuestra que un modelo pueda anticiparlos con precisión.
3.8.3 Karate Club: una tabla de relaciones y un grafo
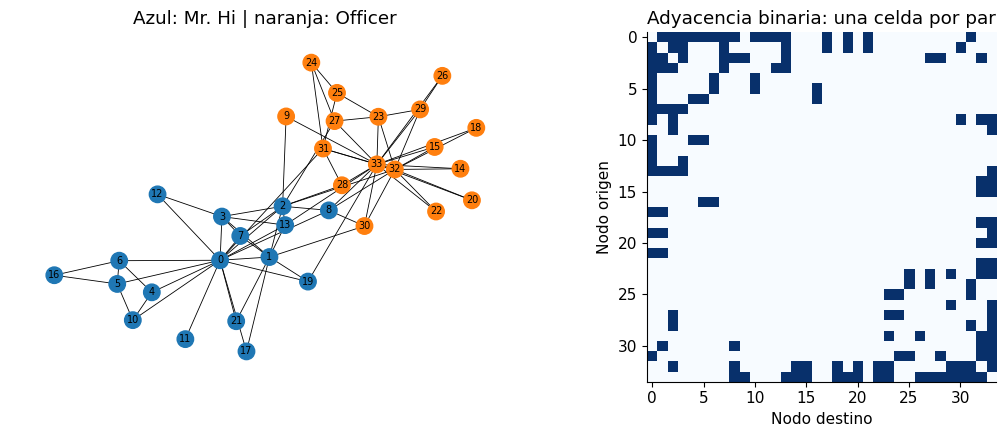
El grafo de Karate Club describe relaciones entre miembros de un club. Cada nodo tiene un identificador y un atributo club; las aristas conectan pares de nodos. Los identificadores indican entidades, no cantidades ordenadas por importancia. Veremos lista de nodos, lista de aristas, dibujo y matriz de adyacencia.
G=nx.karate_club_graph()nodos=pd.DataFrame([{'nodo':n,'club':G.nodes[n]['club'],'grado':G.degree(n)} for n in G.nodes])aristas=pd.DataFrame([{'origen':u,'destino':v,'peso':d['weight']} for u,v,d in G.edges(data=True)])tabla(nodos.head(8),'Karate Club: nodos y atributos')tabla(aristas.head(8),'Karate Club: primeras aristas')pos=nx.spring_layout(G,seed=SEMILLA)fig,axes=plt.subplots(1,2,figsize=(11,4.5))colores=['tab:blue'if G.nodes[n]['club']=='Mr. Hi'else'tab:orange'for n in G.nodes]nx.draw_networkx(G,pos=pos,ax=axes[0],node_color=colores,node_size=140,font_size=7,width=.6)axes[0].set_title('Azul: Mr. Hi | naranja: Officer');axes[0].axis('off')A=nx.to_numpy_array(G,nodelist=list(G.nodes),weight=None,dtype=int)axes[1].imshow(A,cmap='Blues',interpolation='nearest',vmin=0,vmax=1)axes[1].set(xlabel='Nodo destino',ylabel='Nodo origen',title='Adyacencia binaria: una celda por par')plt.tight_layout();plt.show()print('Nodos:',G.number_of_nodes(),'| Aristas no dirigidas:',G.number_of_edges())print('Unos en la matriz:',int(A.sum()),'| Forma:',A.shape)print('Grado medio:',round(np.mean([G.degree(n) for n in G.nodes]),4))catalogo.append({'dataset':'Karate Club','modalidad':'Grafo','observaciones_vistas':G.number_of_nodes(),'entrada_por_observación':'Nodo y relaciones; un solo grafo','tarea':'Análisis relacional; etiquetas de nodo'})
Karate Club: nodos y atributos
nodo
club
grado
0
Mr. Hi
16
1
Mr. Hi
9
2
Mr. Hi
10
3
Mr. Hi
6
4
Mr. Hi
3
5
Mr. Hi
4
6
Mr. Hi
4
7
Mr. Hi
4
Karate Club: primeras aristas
origen
destino
peso
0
1
4
0
2
5
0
3
3
0
4
3
0
5
3
0
6
3
0
7
2
0
8
2
Nodos: 34 | Aristas no dirigidas: 78
Unos en la matriz: 156 | Forma: (34, 34)
Grado medio: 4.5882
3.8.4 Cómo leer las relaciones
El grafo contiene 34 nodos y 78 aristas no dirigidas. La matriz tiene forma (34,34) y 156 unos: cada relación aparece en dos posiciones simétricas. Sus pesos originales se conservaron en la tabla de aristas, pero la matriz mostrada es binaria porque usamos weight=None.
La posición del dibujo se calculó para visualizar conexiones: una distancia corta en la figura no es una distancia geográfica medida. Tampoco 34 nodos equivalen a 34 grafos independientes. Si club fuera la etiqueta a predecir, no debería entrar como atributo predictor; la forma de dividir nodos y conservar relaciones depende del protocolo de evaluación de grafos.
3.9 Comparar antes de elegir
La tabla siguiente resume lo cargado en esta guía, no el tamaño total de todos los benchmarks. En imágenes distingue las particiones de prueba mostradas; en FSDD conserva la selección de tres archivos. En Flowers todavía no definimos una partición y en Karate Club contamos nodos de un solo grafo.
tabla(pd.DataFrame(catalogo),'Mapa de los trece datasets inspeccionados')assertlen(catalogo)==13print('Datasets inspeccionados:',len(catalogo))
Mapa de los trece datasets inspeccionados
dataset
modalidad
observaciones_vistas
entrada_por_observación
tarea
Iris
Tabla
150
4 variables
Clasificación multiclase
Wine
Tabla
178
13 variables
Clasificación multiclase
Breast Cancer
Tabla
569
30 variables
Clasificación binaria
Diabetes
Tabla
442
10 variables
Regresión
Digits
Imagen
1797
8×8, un canal
10 clases
MNIST
Imagen
10000
28×28, un canal
10 clases; vista de prueba
Fashion-MNIST
Imagen
10000
28×28, un canal
10 clases; vista de prueba
CIFAR-10
Imagen
10000
32×32×3, RGB
10 clases; vista de prueba
Flowers
Imagen
3670
RGB, dimensiones variables
5 clases; sin partición aquí
IMDB
Texto
25000
Secuencia de longitud variable
Sentimiento; entrenamiento
FSDD (selección)
Audio
3
Señal mono de duración variable
Dígito hablado; solo inspección
Sunspots
Serie temporal
309
Un año; ventanas para modelar
Pronóstico, si se define horizonte
Karate Club
Grafo
34
Nodo y relaciones; un solo grafo
Análisis relacional; etiquetas de nodo
Datasets inspeccionados: 13
3.10 Qué pedirle a un dataset
Pregunta
Qué mirar
Error que ayuda a evitar
¿Qué es una observación?
Fila, imagen, documento, archivo, año o nodo
Confundir registros con unidades independientes
¿Cuál es la respuesta?
Nombre, tipo y diccionario de etiquetas
Tratar códigos como magnitudes o incluir la respuesta en X
¿Cómo está almacenado?
Encabezados, shape, dtype y orden de ejes
Asociar etiquetas e imágenes equivocadas
¿Qué escala tiene?
Unidades, mínimos, máximos y transformaciones previas
Normalizar con una regla que pertenece a otro dataset
¿Está equilibrado?
Frecuencias por clase y por grupo
Interpretar exactitud sin una referencia adecuada
¿Hay ausencias o duplicados?
Valores faltantes, identificadores y archivos relacionados
Confundir ausencia de NA con calidad completa
¿Cómo se separa?
Particiones oficiales, fechas, personas o hablantes
Filtrar información entre entrenamiento y prueba
¿Puedo reutilizarlo?
Fuente, versión, licencia y atribuciones
Dar por supuesto que acceso público permite cualquier uso
La ausencia de faltantes en las tablas cargadas no demuestra que el proceso original estuviera completo o que no se hayan filtrado observaciones. Tampoco una muestra visual seleccionada reemplaza un análisis de cobertura del dataset.
3.11 Ejercicios visuales
En Iris, compara head() con cinco filas elegidas mediante una semilla fija. Explica qué cambia en la vista y qué no cambia en los conteos de clases.
En Wine, dibuja una variable por clase y conserva las mismas escalas y bins en los paneles. Describe el solapamiento sin convertirlo en una exactitud predictiva.
En Digits, elige un píxel, localízalo en la imagen y encuentra su columna en data. Verifica que ambos valores coinciden.
En CIFAR-10, reconstruye una imagen siguiendo el orden correcto de canales. Explica por qué un reshape sin transposición no representa el mismo orden de ejes.
En Flowers, prepara una tabla con rutas, dimensiones y etiquetas de diez fotografías adicionales. Conserva sus atribuciones y describe qué cambiaría al redimensionarlas.
En IMDB, prueba otros umbrales de longitud y reporta la fracción de reseñas que cada uno truncaría, sin afirmar un efecto sobre una métrica predictiva que no calculaste.
En audio, compara las duraciones y espectrogramas de otro hablante del mismo dataset. Distingue variación entre grabaciones de evidencia de generalización.
En el libro solar, identifica el año objetivo de cada ventana. Propón una separación temporal que no utilice respuestas futuras en el entrenamiento.
3.12 Continuación
Las mismas dimensiones pueden representar tareas diferentes: MNIST y Fashion-MNIST comparten resolución, pero cambian sus etiquetas; una tabla puede tener clases o una respuesta continua; un tensor temporal puede mezclar unidades relacionadas si ignoras las ventanas o los hablantes.
En Generación de datos construiremos problemas donde podamos controlar ruido, desbalance y estructura. En Pipelines organizaremos lectura, transformaciones y lotes. Esta guía queda como referencia para reconocer lo que llega antes de entrenar.
3.13 Fuentes y atribuciones
scikit-learn: datasets incluidos: Iris, Wine, Breast Cancer, Diabetes y Digits. Los objetos cargados incluyen su descripción y referencias originales en DESCR.
TensorFlow Datasets: Flowers: colección y estructura. Las diez fotografías mostradas se acreditan individualmente en la tabla de atribuciones; CC BY 2.0.
NetworkX: Karate Club: grafo y referencia a Zachary (1977), An Information Flow Model for Conflict and Fission in Small Groups.
Las licencias y condiciones deben comprobarse en la fuente de cada dataset; la licencia de una biblioteca no determina automáticamente la de los datos que distribuye.