Dos redes con el mismo número de capas pueden terminar con resultados diferentes. Cambiar la tasa de aprendizaje altera el recorrido del entrenamiento; cambiar el ancho modifica la capacidad de representación; cambiar la regularización modifica qué soluciones se favorecen. Antes de buscar una combinación «mejor», necesitamos distinguir esas decisiones y definir qué evidencia las sustentará.
En este capítulo observarás pesos aprendidos, curvas de entrenamiento, fronteras, interacciones entre decisiones y búsquedas con presupuestos explícitos. El objetivo es aprender a elegir una configuración y explicar por qué, incluyendo el costo, la variabilidad y los límites de la evidencia.
Para interpretar los ejemplos: entrenamiento ajusta; validación selecciona; prueba evalúa la decisión fijada. Exactitud es fracción de aciertos; recall mide qué fracción de positivos se recupera. Las definiciones completas están en Evaluación; no es necesario adelantar todo ese capítulo para seguir el experimento.
8.1 Qué aprende el modelo y qué decide el experimento
En una neurona \(z=\mathbf{w}^{\mathsf T}\mathbf{x}+b\), los pesos \(\mathbf{w}\) y el sesgo \(b\) son parámetros aprendidos: el entrenamiento modifica sus valores. El número de neuronas, la tasa de aprendizaje y el criterio de detención son hiperparámetros: definen cómo se construye y ajusta el modelo.
La distinción depende del procedimiento. Un coeficiente de regularización puede elegirse mediante validación y actuar como hiperparámetro, aunque otros procedimientos lo estimen de otra manera. Tampoco todo argumento de una biblioteca representa una decisión científica: verbose controla mensajes; no modifica por sí mismo la capacidad del modelo.
Elemento
Ejemplos
Cómo interviene
Parámetros del predictor
Pesos, sesgos, coeficientes
Se ajustan usando entrenamiento
Arquitectura
Ancho, profundidad, activación, conexiones
Determina la familia de funciones representables
Optimización
Optimizador, tasa, momentum, lote, programa de tasas
Modifica el recorrido y el presupuesto de actualizaciones
Regularización
Coeficiente L2, dropout, detención temprana
Modifica las soluciones favorecidas o el tiempo de ajuste
Representación
Escalado, variables, transformaciones
Determina qué información recibe el modelo y en qué escala
Evaluación
Métrica, partición, horizonte, regla de selección
Define qué significa una elección satisfactoria
Reproducibilidad
Semillas y versiones
Permite repetir y estudiar variación
La semilla es un control experimental. Seleccionar la semilla que obtuvo el mejor puntaje no demuestra que la configuración sea estable. Los estados internos de un optimizador, como los acumuladores de momentum, tampoco se confunden con los parámetros del predictor.
También existen estados estimados o acumulados que no son hiperparámetros elegidos ni pesos ajustados por gradiente. Por ejemplo, Batch Normalization conserva estadísticas de activaciones; PyTorch las registra como buffers. El algoritmo especifica cómo actualizarlas. En cambio, la decisión de congelar una capa es una elección del procedimiento: sus pesos siguen siendo parámetros del predictor, aunque ya no se actualicen. Por eso conviene distinguir parámetros totales, parámetros entrenables y estados auxiliares al describir un modelo.
import numpy as npimport sklearnimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport scipyfrom scipy.stats import loguniform, normimport sklearnfrom sklearn.datasets import make_moonsfrom sklearn.model_selection import train_test_split, StratifiedKFold, ParameterGrid, ParameterSampler, cross_validate, GridSearchCVfrom sklearn.preprocessing import StandardScalerfrom sklearn.pipeline import make_pipelinefrom sklearn.svm import SVCfrom sklearn.linear_model import Ridgefrom sklearn.gaussian_process import GaussianProcessRegressorfrom sklearn.gaussian_process.kernels import ConstantKernel, Maternfrom sklearn.metrics import log_loss, accuracy_score, balanced_accuracy_score, ConfusionMatrixDisplayfrom IPython.display import displayimport torchfrom torch import nnimport copy, time, math, platform, jsontorch.set_num_threads(1)torch.use_deterministic_algorithms(True)SEMILLA=42COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})lecturas={}registro=[]print('Experimentos en CPU, float32 y un hilo de PyTorch; prueba final reservada.')
Experimentos en CPU, float32 y un hilo de PyTorch; prueba final reservada.
8.1.1 Un hiperparámetro cambia los parámetros que se aprenden
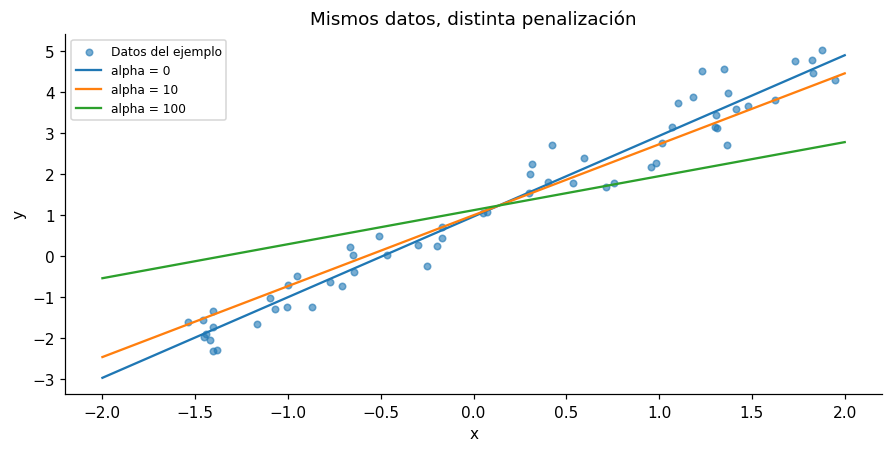
La regresión Ridge permite verlo en una dimensión. Conservaremos los datos y cambiaremos alpha. En esta implementación, se minimiza una suma de residuos cuadrados más alpha multiplicado por la norma cuadrada de los coeficientes; el intercepto no recibe esa penalización. Por eso el valor numérico de alpha depende también de la convención usada para escalar la pérdida.
Este pequeño ejemplo ilustra la diferencia entre el valor elegido y el aprendido. No lo usaremos para seleccionar un modelo ni para reportar generalización.
rng=np.random.default_rng(10)x=rng.uniform(-2,2,60)[:,None]y=1+2*x[:,0]+rng.normal(0,.5,60)fig,ax=plt.subplots(figsize=(8,4))ax.scatter(x[:,0],y,s=18,alpha=.6,label='Datos del ejemplo')grid=np.linspace(-2,2,100)[:,None]filas=[]for alpha in [0.,10.,100.]: m=Ridge(alpha=alpha).fit(x,y) filas.append({'alpha elegido':alpha,'Coeficiente aprendido':m.coef_[0],'Intercepto aprendido':m.intercept_}) ax.plot(grid[:,0],m.predict(grid),label=f'alpha = {alpha:g}')ax.set(xlabel='x',ylabel='y',title='Mismos datos, distinta penalización')ax.legend(fontsize=8)plt.show()display(pd.DataFrame(filas).round(3))lecturas['ridge0']=f'{filas[0]["Coeficiente aprendido"]:.3f}'lecturas['ridge100']=f'{filas[-1]["Coeficiente aprendido"]:.3f}'
alpha elegido
Coeficiente aprendido
Intercepto aprendido
0
0.0
1.968
0.959
1
10.0
1.731
0.991
2
100.0
0.830
1.114
El coeficiente aprendido pasó de 1.968 con alpha=0 a 0.830 con alpha=100. Elegimos alpha; el ajuste determinó el coeficiente. El gráfico muestra que una penalización fuerte puede alejar la pendiente de la relación generadora, \(2\). La decisión adecuada necesitaría evaluación independiente y una razón para favorecer determinada complejidad.
8.2 Declarar el protocolo antes de comparar
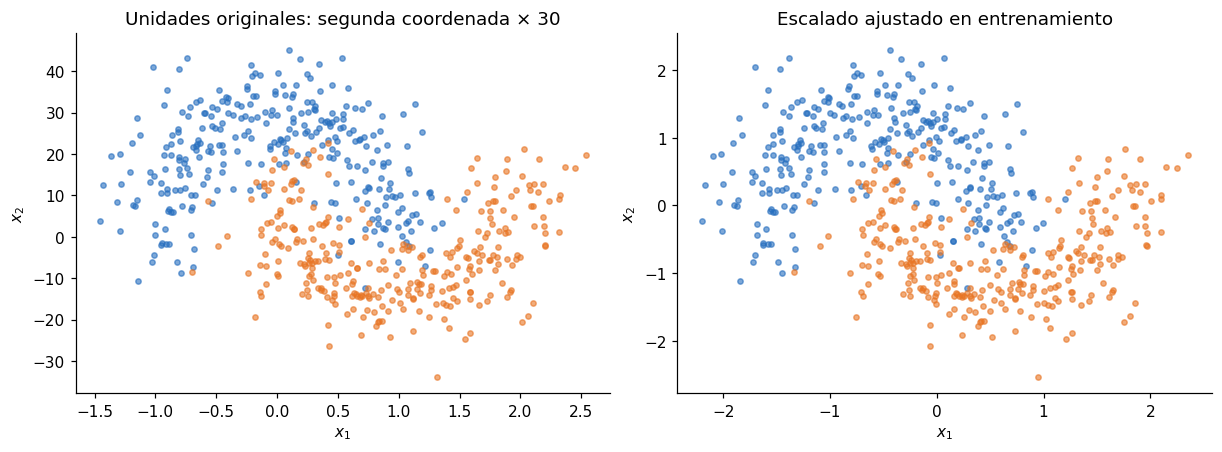
Usaremos 1 000 observaciones de dos lunas, con ruido de coordenadas \(0.25\). Multiplicaremos la segunda coordenada por \(30\) para representar un cambio de unidades, conservando la misma información. Separaremos 600 observaciones para entrenamiento, 200 para validación y 200 para prueba, con estratificación.
El escalador se ajustará solo en entrenamiento. La métrica principal de las redes será entropía cruzada binaria media —BCE—, menor es mejor. También observaremos exactitud balanceada con umbral fijo \(0.5\). La BCE utiliza las probabilidades y distingue una predicción apenas equivocada de otra equivocada con mucha confianza.
Usamos logaritmos naturales. La red produce logits \(z_i\) y \(p_i=1/(1+e^{-z_i})\). BCEWithLogitsLoss calcula la expresión de forma numéricamente estable a partir de los logits; no añadiremos una sigmoide dentro de la red antes de esa pérdida. La exactitud balanceada promedia el recall de las dos clases.
Los ejemplos de sensibilidad mantendrán presupuestos y condiciones explícitos. Después haremos una búsqueda final de red con espacio y regla declarados antes de ejecutarla. Las búsquedas de SVC ilustrarán otras estrategias usando validación cruzada dentro del entrenamiento. Ningún experimento previo a la evaluación final utilizará la prueba.
Compartir validación entre numerosos análisis hace posible adaptarse a sus particularidades. Para un estudio real, limita las decisiones posteriores, registra lo que probaste y considera una evaluación anidada del procedimiento. La prueba final estima el resultado de la decisión completa, no convierte retrospectivamente la validación en evidencia independiente.
X_original,y=make_moons(n_samples=1000,noise=.25,random_state=SEMILLA)X_bruto=X_original.copy()X_bruto[:,1]*=30indices=np.arange(len(y))tr,resto=train_test_split(indices,test_size=.4,stratify=y,random_state=SEMILLA)va,te=train_test_split(resto,test_size=.5,stratify=y[resto],random_state=SEMILLA)scaler=StandardScaler().fit(X_bruto[tr])X_train=scaler.transform(X_bruto[tr]).astype('float32')X_val=scaler.transform(X_bruto[va]).astype('float32')y_train=y[tr].astype('float32')[:,None]y_val=y[va].astype('float32')[:,None]XT=torch.from_numpy(X_train); YT=torch.from_numpy(y_train)XV=torch.from_numpy(X_val); YV=torch.from_numpy(y_val)fig,axes=plt.subplots(1,2,figsize=(11,4))for ax,X,titulo inzip(axes,[X_bruto[tr],X_train],['Unidades originales: segunda coordenada × 30','Escalado ajustado en entrenamiento']):for k in [0,1]: ax.scatter(X[y[tr]==k,0],X[y[tr]==k,1],s=12,alpha=.6,color=COLORES[k],label=f'Clase {k}') ax.set(title=titulo,xlabel='$x_1$',ylabel='$x_2$')plt.show()display(pd.DataFrame({'Partición':['Entrenamiento','Validación','Prueba'],'Observaciones':[len(tr),len(va),len(te)],'Clase 1':[int(y[tr].sum()),int(y[va].sum()),int(y[te].sum())]}))
Partición
Observaciones
Clase 1
0
Entrenamiento
600
300
1
Validación
200
100
2
Prueba
200
100
8.3 Contar parámetros antes de aumentar la arquitectura
Una capa densa con \(d\) entradas y \(h\) salidas aprende \(dh\) pesos y \(h\) sesgos. Con dos entradas, una capa oculta de ancho \(h\) y una salida, el total es
\[2h+h+h+1=4h+1.\]
Con dos capas ocultas del mismo ancho, el total es \(h^2+5h+1\). Añadir profundidad cambia tanto la composición de funciones como la cantidad de parámetros. No podemos atribuir un resultado exclusivamente a «más capas» si también cambió mucho el tamaño.
La siguiente función construye redes con tanh. Usaremos Xavier para las capas ocultas, con la ganancia correspondiente a esa activación, y ganancia uno en la capa de salida. Los sesgos empiezan en cero; los pesos aleatorios rompen la simetría entre neuronas.
def construir_red(ancho=16,profundidad=1,inicializacion='xavier',semilla=42): torch.manual_seed(semilla) capas=[]; entradas=2for _ inrange(profundidad): capas.extend([nn.Linear(entradas,ancho),nn.Tanh()]) entradas=ancho capas.append(nn.Linear(entradas,1)) modelo=nn.Sequential(*capas) lineales=[c for c in modelo ifisinstance(c,nn.Linear)]for j,c inenumerate(lineales):if inicializacion=='xavier': nn.init.xavier_uniform_(c.weight,gain=nn.init.calculate_gain('tanh') if j<len(lineales)-1else1.)elif inicializacion=='pequena': nn.init.normal_(c.weight,std=1e-4)elif inicializacion=='ceros': nn.init.zeros_(c.weight)else:raiseValueError('Inicialización desconocida') nn.init.zeros_(c.bias)return modelofilas_param=[]for profundidad in [1,2]:for ancho in [2,8,16,32,128]: m=construir_red(ancho,profundidad) cantidad=sum(p.numel() for p in m.parameters() if p.requires_grad) formula=4*ancho+1if profundidad==1else ancho**2+5*ancho+1assert cantidad==formula filas_param.append({'Capas ocultas':profundidad,'Ancho':ancho,'Parámetros':cantidad,'MiB de parámetros float32':cantidad*4/(1024**2)})display(pd.DataFrame(filas_param).round(4))
Capas ocultas
Ancho
Parámetros
MiB de parámetros float32
0
1
2
9
0.0000
1
1
8
33
0.0001
2
1
16
65
0.0002
3
1
32
129
0.0005
4
1
128
513
0.0020
5
2
2
15
0.0001
6
2
8
105
0.0004
7
2
16
337
0.0013
8
2
32
1185
0.0045
9
2
128
17025
0.0649
8.3.1 Decisión sobre el presupuesto
El conteo distingue tamaño de arquitectura de valores aprendidos. Una red con ancho \(16\) tiene \(65\) parámetros con una capa oculta y \(337\) con dos. El crecimiento cuadrático de la segunda capa explica por qué duplicar el ancho puede costar más que duplicar recursos.
La columna de memoria describe únicamente los parámetros en float32. Durante entrenamiento también hay gradientes, estados del optimizador, activaciones y datos. El tamaño del lote modifica parte de esa memoria aunque no cambie la cantidad de parámetros. Una red pequeña puede ser lenta por su implementación, y una grande puede aprovechar mejor cierto hardware: mide el caso que necesitas.
8.3.2 Una rutina común para comparar entrenamiento
Reutilizaremos la misma rutina para evitar que cada comparación cambie detalles silenciosamente. Registrará BCE de entrenamiento y validación después de cada época, ambas en modo de evaluación, sin el término de penalización. Así se comparan pérdidas predictivas bajo la misma convención.
El optimizador será SGD con momentum \(0.9\). En este uso, weight_decay=λ añade \(λ\theta\) al gradiente, equivalente a una penalización \(\frac{λ}{2}\|\theta\|^2\) en la actualización de SGD. Incluiremos todos los parámetros, también sesgos. Esa convención no equivale automáticamente al alpha de Ridge ni a la implementación de AdamW.
La rutina conserva el último estado y una copia del estado de menor BCE de validación. Las comparaciones con épocas fijas usarán el último estado. Solo cuando lo declaremos usaremos el checkpoint elegido por validación o detención temprana. El código se puede desplegar para inspeccionar estos detalles.
Ver rutina de entrenamiento y registro
criterio=nn.BCEWithLogitsLoss()def medir(modelo,X,Y): modelo.eval()with torch.no_grad(): logits=modelo(X) perdida=float(criterio(logits,Y)) prob=torch.sigmoid(logits).numpy().ravel() acc=balanced_accuracy_score(Y.numpy().ravel().astype(int),prob>=.5)return perdida,float(acc)def entrenar(ancho=16,profundidad=1,tasa=.02,lote=64,epocas=160,l2=.001, semilla=42,inicializacion='xavier',paciencia=None,pasos_max=None,escalar=True): Xent=XT if escalar else torch.from_numpy(X_bruto[tr].astype('float32')) Xvalid=XV if escalar else torch.from_numpy(X_bruto[va].astype('float32')) modelo=construir_red(ancho,profundidad,inicializacion,semilla) opt=torch.optim.SGD(modelo.parameters(),lr=tasa,momentum=.9,weight_decay=l2) rng=np.random.default_rng(semilla) historia=[]; mejor=float('inf'); sin_mejora=0; pasos=0; vistos=0 mejor_estado=None; mejor_epoca=0; inicio=time.perf_counter()for epoca inrange(1,epocas+1): modelo.train() orden=rng.permutation(len(Xent))for comienzo inrange(0,len(orden),lote): batch=orden[comienzo:comienzo+lote] opt.zero_grad(set_to_none=True) perdida=criterio(modelo(Xent[batch]),YT[batch])ifnot torch.isfinite(perdida):raiseFloatingPointError('Pérdida no finita; revisar la configuración') perdida.backward(); opt.step() pasos+=1; vistos+=len(batch)if pasos_max isnotNoneand pasos>=pasos_max: break train_loss,train_acc=medir(modelo,Xent,YT) val_loss,val_acc=medir(modelo,Xvalid,YV) historia.append({'Epoca':epoca,'Pasos':pasos,'Ejemplos procesados':vistos,'BCE entrenamiento':train_loss,'BCE validación':val_loss,'Balanceada entrenamiento':train_acc,'Balanceada validación':val_acc})if val_loss<mejor: mejor=val_loss; mejor_estado=copy.deepcopy(modelo.state_dict()); mejor_epoca=epoca; sin_mejora=0else: sin_mejora+=1if (paciencia isnotNoneand sin_mejora>=paciencia) or (pasos_max isnotNoneand pasos>=pasos_max): breakreturn {'modelo':modelo,'historia':pd.DataFrame(historia),'mejor_estado':mejor_estado,'mejor_epoca':mejor_epoca,'segundos':time.perf_counter()-inicio,'config':{'ancho':ancho,'profundidad':profundidad,'tasa':tasa,'lote':lote,'epocas_max':epocas,'l2':l2,'semilla':semilla,'inicializacion':inicializacion,'paciencia':paciencia,'pasos_max':pasos_max,'escalar':escalar}}def registrar(nombre,r,checkpoint=False): fila=r['historia'].iloc[r['mejor_epoca']-1if checkpoint else-1] dato={'Experimento':nombre,**r['config'],'Epoca evaluada':int(fila['Epoca']),'Epocas ejecutadas':len(r['historia']),'Pasos ejecutados':int(r['historia'].iloc[-1]['Pasos']),'Ejemplos procesados':int(r['historia'].iloc[-1]['Ejemplos procesados']),'BCE entrenamiento':float(fila['BCE entrenamiento']),'BCE validación':float(fila['BCE validación']),'Balanceada validación':float(fila['Balanceada validación']),'Parámetros':sum(p.numel() for p in r['modelo'].parameters()),'Segundos':r['segundos'],'Checkpoint elegido':checkpoint} registro.append(dato)return datoprint('Rutina lista: particiones fijas, pérdidas comparables y registro de pasos y ejemplos.')
Rutina lista: particiones fijas, pérdidas comparables y registro de pasos y ejemplos.
8.4 Tasa de aprendizaje: velocidad y estabilidad
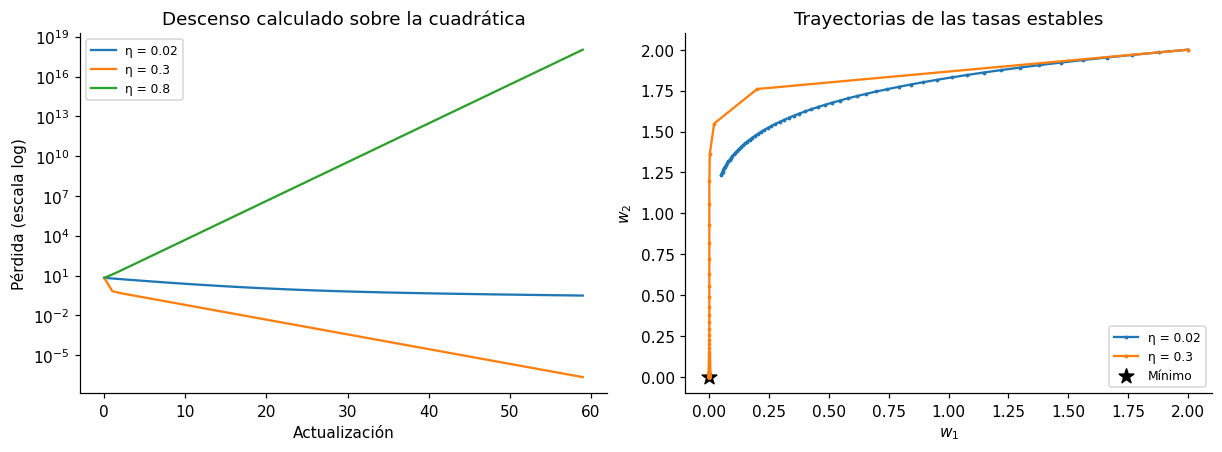
Antes de entrenar una red, observemos un problema donde conocemos la curvatura:
El mínimo está en el origen. En este descenso de gradiente, sin momentum, ambas direcciones convergen si \(0<\eta<2/3\). Una tasa demasiado pequeña avanza despacio; una tasa mayor que ese límite amplifica una dirección. Esta condición pertenece a la función cuadrática concreta, no proporciona una tasa universal para redes.
fig,axes=plt.subplots(1,2,figsize=(11,4))for tasa in [.02,.3,.8]: w=np.array([2.,2.]); valores=[]; trayectoria=[w.copy()]for paso inrange(60): valores.append(.5*(3*w[0]**2+.4*w[1]**2)) w-=tasa*np.array([3*w[0],.4*w[1]]) trayectoria.append(w.copy()) axes[0].semilogy(range(60),valores,label=f'η = {tasa:g}')if tasa<2/3: trayectoria=np.asarray(trayectoria) axes[1].plot(trayectoria[:,0],trayectoria[:,1],'.-',label=f'η = {tasa:g}',markersize=3)axes[0].set(xlabel='Actualización',ylabel='Pérdida (escala log)',title='Descenso calculado sobre la cuadrática')axes[1].scatter([0],[0],marker='*',s=100,color='black',label='Mínimo')axes[1].set(xlabel='$w_1$',ylabel='$w_2$',title='Trayectorias de las tasas estables')for ax in axes: ax.legend(fontsize=8)plt.show()print('Límite de estabilidad de este ejemplo sin momentum: 0 < η < 0.6667.')
Límite de estabilidad de este ejemplo sin momentum: 0 < η < 0.6667.
8.4.1 Pasar a una red: observar las curvas
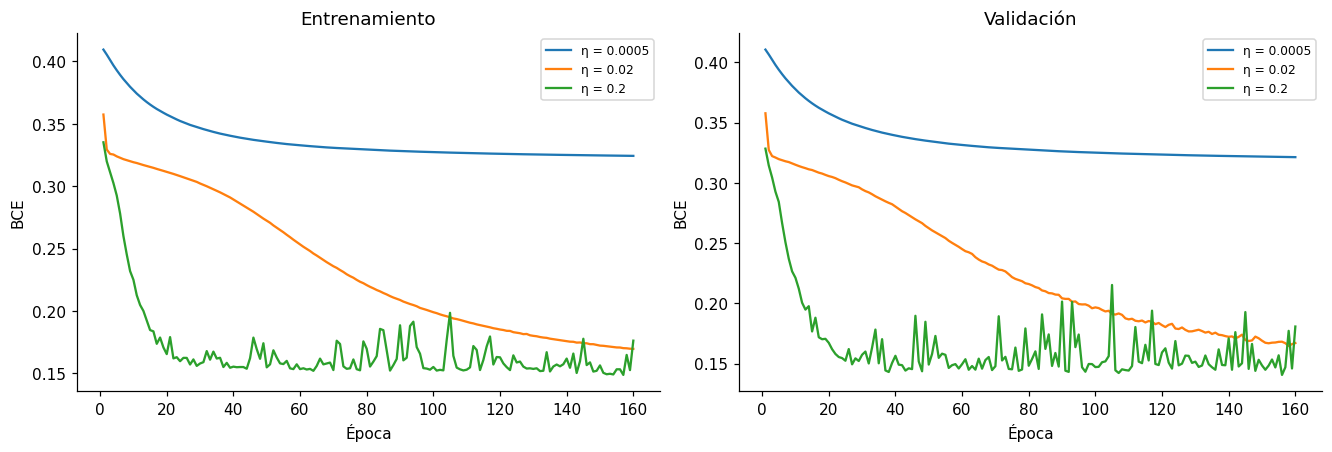
Entrenaremos la misma red con tasas \(0.0005\), \(0.02\) y \(0.2\), conservando inicialización, lotes, penalización y 160 épocas. Esta vez hay momentum y una pérdida no convexa; la condición anterior no se traslada directamente.
Una curva que baja lentamente puede indicar un presupuesto insuficiente. Oscilaciones pueden indicar pasos grandes, pero también variación entre lotes. Una meseta puede reflejar un problema de representación, de optimización o de escala. La comparación controlada ayuda a distinguirlos.
tasas=[.0005,.02,.2]corridas_tasa={t:entrenar(tasa=t) for t in tasas}fig,axes=plt.subplots(1,2,figsize=(12,4))for t,r in corridas_tasa.items(): h=r['historia'] axes[0].plot(h['Epoca'],h['BCE entrenamiento'],label=f'η = {t:g}') axes[1].plot(h['Epoca'],h['BCE validación'],label=f'η = {t:g}') registrar('Tasa',r)for ax,titulo inzip(axes,['Entrenamiento','Validación']): ax.set(title=titulo,xlabel='Época',ylabel='BCE');ax.legend(fontsize=8)plt.show()tabla_tasa=pd.DataFrame(registro[-3:])display(tabla_tasa[['tasa','BCE entrenamiento','BCE validación','Balanceada validación','Pasos ejecutados']].round(4))for t in tasas: lecturas['tasa_'+str(t)]=f'{tabla_tasa.loc[tabla_tasa.tasa==t,"BCE validación"].iloc[0]:.4f}'
tasa
BCE entrenamiento
BCE validación
Balanceada validación
Pasos ejecutados
0
0.0005
0.3242
0.3213
0.85
1600
1
0.0200
0.1697
0.1671
0.94
1600
2
0.2000
0.1763
0.1808
0.94
1600
8.4.2 Cómo leer este resultado
Después del mismo presupuesto de épocas, la BCE de validación fue 0.3213, 0.1671 y 0.1808, respectivamente. La curva aporta información que la cifra final pierde: si el candidato sigue mejorando al terminar, su resultado mide también una restricción de entrenamiento.
La tasa \(0.2\) descendió más rápido al inicio, pero su curva presenta oscilaciones mayores. La tasa \(0.02\) avanzó de forma más gradual y terminó con menor BCE que \(0.2\). Por eso «aprender más rápido al comienzo» y «terminar con menor pérdida bajo este protocolo» son conclusiones distintas. La tasa \(0.0005\) quedó claramente por encima después del mismo presupuesto.
No interpretes una tasa como «buena» fuera de esta combinación de optimizador, escala y lote. Si aumentas la tasa para acelerar y aparecen saltos, conserva el resto del experimento y revisa la estabilidad. Si una tasa pequeña necesita más épocas, mide el costo de alcanzarlas. Un programa de tasas —por ejemplo, reducción al alcanzar una meseta o un descenso coseno— añade nuevas decisiones sobre duración y amplitud.
Con warmup, la tasa aumenta gradualmente al comienzo. Puede ser útil en determinados regímenes, pero no corrige por sí solo datos mal escalados o una arquitectura incompatible. El programa y el número de pasos deben registrarse juntos; copiar una tasa máxima sin su contexto no reproduce el entrenamiento.
8.5 Lote, época y actualización: tres presupuestos distintos
Una época recorre todo el entrenamiento. Un lote agrupa observaciones para calcular una actualización. Con \(N=600\), el número de pasos por época es \(\lceil600/B\rceil\) si se conserva el último lote incompleto.
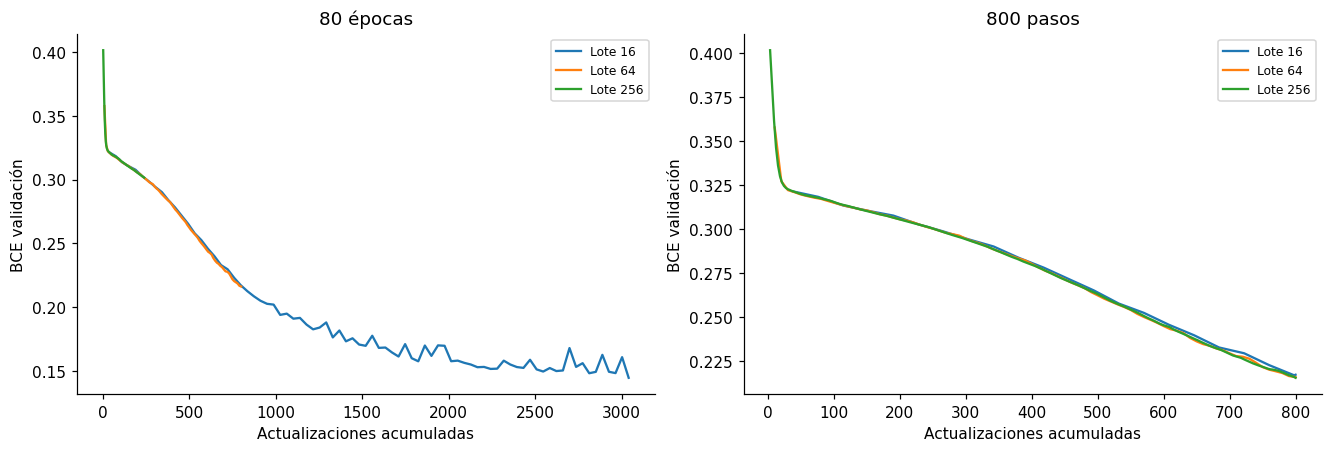
Con 80 épocas, los lotes de 16, 64 y 256 realizarán 3 040, 800 y 240 actualizaciones. Una comparación con las mismas épocas iguala recorridos por los datos, pero no pasos. Una comparación con el mismo número de pasos tampoco iguala observaciones procesadas ni tiempo.
Haremos ambas. Para 800 pasos, el último registro puede corresponder a una época parcial. La rutina contará los ejemplos efectivamente procesados; no asumirá que todos los lotes tienen el tamaño máximo.
Con 80 épocas, la BCE de validación fue 0.1444 con lote 16 y 0.3015 con lote 256. Antes de atribuir la diferencia a una propiedad general de los lotes, mira cuántas actualizaciones realizó cada uno. La segunda comparación modifica ese presupuesto y, a la vez, la cantidad de datos procesados.
Con 800 pasos, los valores fueron 0.2174 y 0.2157, respectivamente: la diferencia se redujo mucho. Sin embargo, el lote 16 procesó 12 632 ejemplos y el lote 256 procesó 160 112, contando repeticiones de las observaciones. Las curvas próximas en pasos no implican costo o consumo de datos idénticos.
Mantuvimos la misma tasa para aislar el cambio de lote. Eso no prueba que cada lote haya recibido su mejor tasa. Una comparación de configuraciones optimizadas tendría que permitir esa interacción con un presupuesto comparable. Los tiempos medidos aquí son de una ejecución en CPU: carga del equipo, implementación y hardware pueden cambiar el orden.
También importa que weight_decay actúa en cada actualización. Al cambiar la cantidad de pasos, cambia su efecto acumulado además de la variabilidad de los gradientes de lote. El resultado corresponde a esa receta completa; no a una propiedad aislada del ruido del gradiente.
Elige el presupuesto que corresponde a tu restricción: recorridos por datos, pasos, tiempo o memoria. Si tu límite es tiempo, el puntaje después de 80 épocas puede no responder la pregunta. Si reduces lote por memoria, revisa si cambió el número de pasos, la tasa o la acumulación de gradientes.
8.6 Ancho: capacidad, ajuste y zonas sin datos
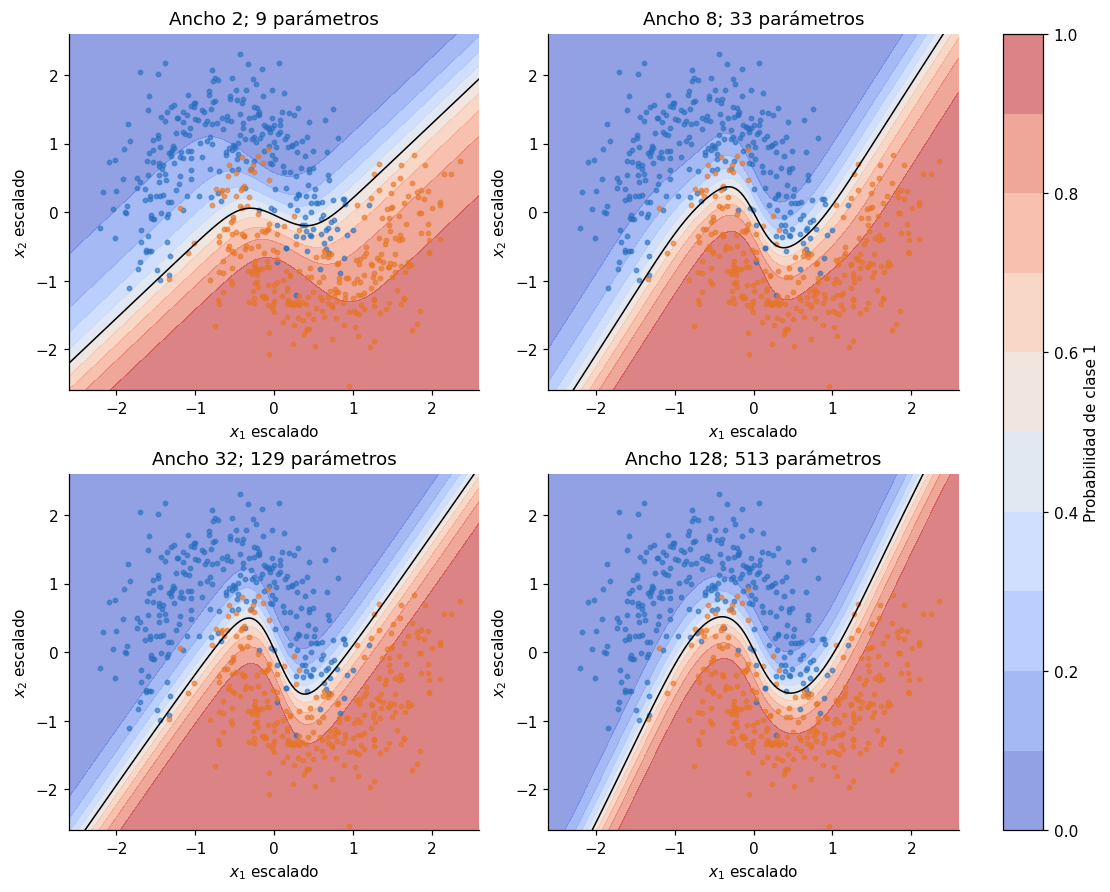
Compararemos redes con una capa oculta de ancho 2, 8, 32 y 128. Mantendremos la tasa, el lote, la regularización y 160 épocas. Inicializaremos con la misma regla y semilla; las matrices tienen formas distintas, por lo que «misma semilla» no significa pesos idénticos entre arquitecturas.
Veremos probabilidades sobre una rejilla y la frontera \(p=0.5\), superponiendo solo entrenamiento. Los colores permiten distinguir una predicción segura de una región próxima al umbral. La rejilla sirve para visualizar; no participa en el entrenamiento ni en la selección.
anchos=[2,8,32,128]corridas_ancho={a:entrenar(ancho=a) for a in anchos}g1,g2=np.meshgrid(np.linspace(-2.6,2.6,150),np.linspace(-2.6,2.6,150))rejilla=torch.tensor(np.column_stack([g1.ravel(),g2.ravel()]),dtype=torch.float32)fig,axes=plt.subplots(2,2,figsize=(10,8))for ax,(ancho,r) inzip(axes.flat,corridas_ancho.items()): r['modelo'].eval()with torch.no_grad(): p=torch.sigmoid(r['modelo'](rejilla)).numpy().reshape(g1.shape) im=ax.contourf(g1,g2,p,levels=np.linspace(0,1,11),cmap='coolwarm',vmin=0,vmax=1,alpha=.6) ax.contour(g1,g2,p,levels=[.5],colors='black',linewidths=1)for k in [0,1]: ax.scatter(X_train[y_train.ravel()==k,0],X_train[y_train.ravel()==k,1],s=8, color=COLORES[k],alpha=.6) dato=registrar('Ancho',r) ax.set(title=f'Ancho {ancho}; {dato["Parámetros"]} parámetros',xlabel='$x_1$ escalado',ylabel='$x_2$ escalado')fig.colorbar(im,ax=axes.ravel().tolist(),label='Probabilidad de clase 1')plt.show()tabla_ancho=pd.DataFrame(registro[-4:])display(tabla_ancho[['ancho','Parámetros','BCE entrenamiento','BCE validación','Balanceada validación','Segundos']].round(4))lecturas['ancho2']=f'{tabla_ancho.iloc[0]["BCE validación"]:.4f}'lecturas['ancho128']=f'{tabla_ancho.iloc[-1]["BCE validación"]:.4f}'
ancho
Parámetros
BCE entrenamiento
BCE validación
Balanceada validación
Segundos
0
2
9
0.2633
0.2555
0.905
1.2723
1
8
33
0.1895
0.1871
0.935
1.2564
2
32
129
0.1713
0.1769
0.935
1.2780
3
128
513
0.1558
0.1552
0.945
1.4328
8.6.1 Cómo leer las fronteras y decidir capacidad
La BCE de validación fue 0.2555 con ancho 2 y 0.1552 con ancho 128. Compara también entrenamiento: una pérdida alta en ambos conjuntos sugiere que la combinación de representación, capacidad y ajuste todavía no resuelve bien el problema. Una pérdida baja de entrenamiento acompañada de peor validación sugiere revisar generalización.
La frontera en zonas sin observaciones depende de la solución aprendida y de la familia de funciones. Una región muy coloreada allí no equivale a evidencia de confianza bien calibrada. Aumentar el ancho puede modificar esas regiones sin mejorar la métrica que necesitamos.
Un presupuesto fijo puede favorecer arquitecturas que se optimizan más rápido. Este experimento no garantiza haber llevado cada red a su mejor estado. Para seleccionar, incorpora curvas, replicaciones y costo; si los resultados son próximos, la alternativa más pequeña puede ser preferible bajo una tolerancia previamente definida.
8.7 Épocas y checkpoint: elegir cuándo terminar
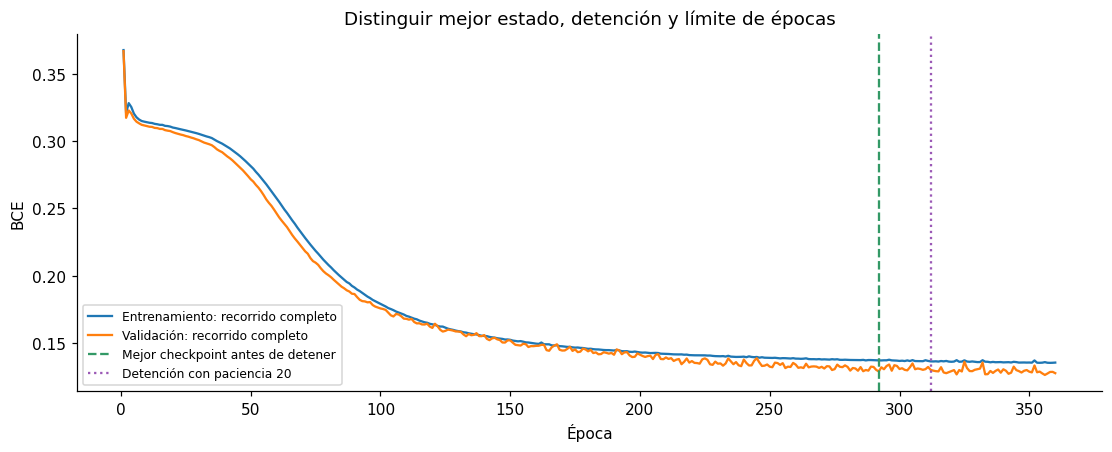
Entrenaremos una red de ancho 64 hasta 360 épocas con penalización cero. Primero dejaremos terminar todo el recorrido. Después repetiremos la misma configuración con paciencia 20: detener tras 20 épocas consecutivas sin disminuir estrictamente la BCE de validación. Se restaurará el estado de menor BCE observado.
La época de detención no es necesariamente la mejor época. Además, seleccionar entre muchos checkpoints es una decisión de validación. No uses la curva de prueba para identificar un mínimo «más verdadero».
recorrido=entrenar(ancho=64,l2=0,epocas=360,semilla=12)temprana=entrenar(ancho=64,l2=0,epocas=360,semilla=12,paciencia=20)dato_largo=registrar('Épocas: recorrido completo',recorrido)dato_temprano=registrar('Épocas: detención temprana',temprana,checkpoint=True)modelo_checkpoint=copy.deepcopy(temprana['modelo'])modelo_checkpoint.load_state_dict(temprana['mejor_estado'])assert np.isclose(medir(modelo_checkpoint,XV,YV)[0],dato_temprano['BCE validación'])fig,ax=plt.subplots(figsize=(10,4))h=recorrido['historia']ax.plot(h.Epoca,h['BCE entrenamiento'],label='Entrenamiento: recorrido completo')ax.plot(h.Epoca,h['BCE validación'],label='Validación: recorrido completo')ax.axvline(temprana['mejor_epoca'],color=COLORES[2],linestyle='--',label='Mejor checkpoint antes de detener')ax.axvline(len(temprana['historia']),color=COLORES[3],linestyle=':',label='Detención con paciencia 20')ax.set(xlabel='Época',ylabel='BCE',title='Distinguir mejor estado, detención y límite de épocas')ax.legend(fontsize=8)plt.show()display(pd.DataFrame([dato_largo,dato_temprano])[['Experimento','Epoca evaluada','Epocas ejecutadas','BCE entrenamiento','BCE validación','Checkpoint elegido']].round(4))lecturas.update({'early_best':str(temprana['mejor_epoca']),'early_stop':str(len(temprana['historia'])),'early_loss':f'{dato_temprano["BCE validación"]:.4f}','long_loss':f'{dato_largo["BCE validación"]:.4f}'})
Experimento
Epoca evaluada
Epocas ejecutadas
BCE entrenamiento
BCE validación
Checkpoint elegido
0
Épocas: recorrido completo
360
360
0.1356
0.1277
False
1
Épocas: detención temprana
292
312
0.1372
0.1290
True
8.7.1 Cómo leer este resultado
La regla de paciencia terminó en la época 312 y conservó el checkpoint de la época 292, cuya BCE de validación fue 0.1290. El último estado del recorrido completo obtuvo 0.1277. Las líneas verticales distinguen cuándo se encontró el estado conservado y cuándo se dejó de entrenar.
En esta realización, el recorrido completo terminó con una pérdida ligeramente menor. La paciencia ahorró 48 épocas, pero detuvo el entrenamiento antes de una recuperación posterior. Eso permite discutir el compromiso entre ahorro y mejora pequeña; no respalda afirmar que la detención temprana siempre mejora la métrica. Cambiar la paciencia después de ver la curva completa sería una nueva elección de validación.
La detención temprana puede ahorrar trabajo y limitar deterioro, pero también puede detener un aprendizaje que mejoraría más adelante. La paciencia depende del ruido de la métrica, del lote, de la tasa y de la frecuencia de evaluación. Una mejora de exactitud puede no coincidir con una mejora de BCE: esta última penaliza también probabilidades equivocadas con alta confianza.
Guarda una copia del estado, no una referencia mutable que seguirá cambiando. Para retomar entrenamiento se necesitan también estados del optimizador y del programa de tasas. Aquí conservamos pesos para evaluar el predictor; no pretendemos reanudar exactamente el recorrido desde el checkpoint.
8.8 Inicialización: una decisión que puede impedir aprender
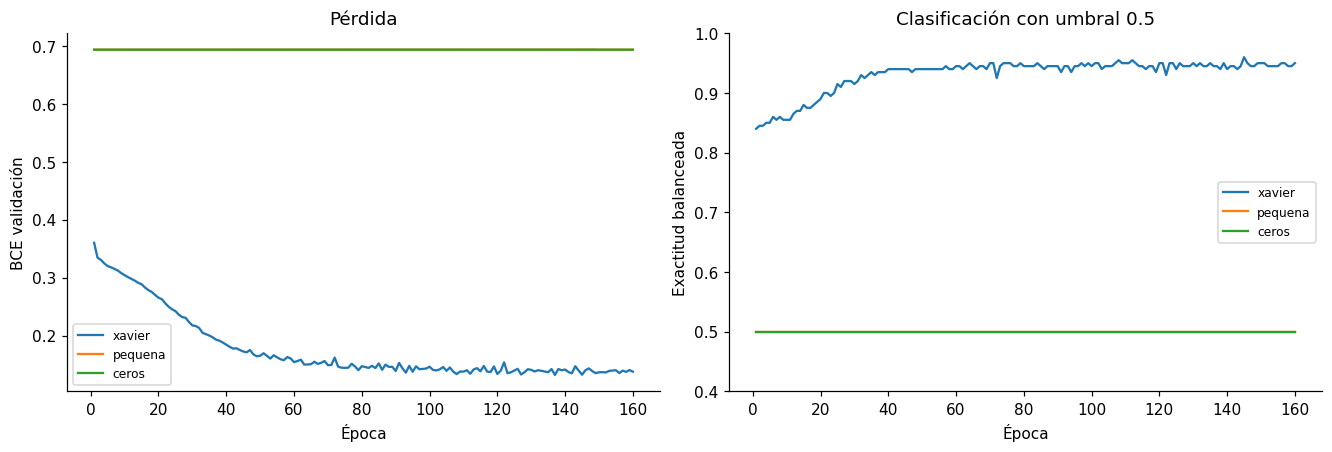
Compararemos Xavier, pesos normales de desviación \(10^{-4}\) y pesos exactamente cero, con dos capas ocultas de ancho 16. Cambiará únicamente la inicialización. Con todas las matrices en cero, las neuronas no reciben una asimetría que les permita desarrollar representaciones diferentes; en esta construcción, solo el sesgo de salida puede moverse.
Un sesgo inicial cero no es lo mismo que poner todos los pesos en cero. La configuración Xavier mantiene los sesgos en cero, pero usa pesos aleatorios. Una inicialización aleatoria extremadamente pequeña tampoco equivale a cero, aunque puede debilitar las señales de aprendizaje en varias capas.
corridas_init={nombre:entrenar(profundidad=2,inicializacion=nombre) for nombre in ['xavier','pequena','ceros']}fig,axes=plt.subplots(1,2,figsize=(12,4))filas_init=[]for nombre,r in corridas_init.items(): h=r['historia'] axes[0].plot(h.Epoca,h['BCE validación'],label=nombre) axes[1].plot(h.Epoca,h['Balanceada validación'],label=nombre) filas_init.append(registrar('Inicialización',r))axes[0].set(xlabel='Época',ylabel='BCE validación',title='Pérdida')axes[1].set(xlabel='Época',ylabel='Exactitud balanceada',title='Clasificación con umbral 0.5',ylim=(.4,1))for ax in axes: ax.legend(fontsize=8)plt.show()display(pd.DataFrame(filas_init)[['inicializacion','BCE entrenamiento','BCE validación','Balanceada validación']].round(4))lecturas['init_cero']=f'{filas_init[-1]["BCE validación"]:.4f}'lecturas['init_xavier']=f'{filas_init[0]["BCE validación"]:.4f}'lecturas['init_pequena']=f'{filas_init[1]["BCE validación"]:.4f}'
inicializacion
BCE entrenamiento
BCE validación
Balanceada validación
0
xavier
0.1322
0.1377
0.95
1
pequena
0.6932
0.6932
0.50
2
ceros
0.6932
0.6932
0.50
La BCE de validación fue 0.1377 con Xavier y 0.6932 con ceros. Una BCE cercana a \(\log 2\approx0.6931\) corresponde a probabilidades próximas a \(0.5\) en un problema binario balanceado. La exactitud balanceada ayuda a comprobar si el predictor distingue las clases o se mantiene esencialmente constante.
La inicialización de desviación \(10^{-4}\) obtuvo 0.6932 y su curva quedó próxima a la de ceros durante este presupuesto. Los pesos no son exactamente cero, pero en varias capas pequeñas las señales pueden ser débiles. Este resultado pide revisar la escala inicial antes de ampliar indiscriminadamente el entrenamiento.
Si una red no aprende, incrementar su tamaño o extender las épocas puede desperdiciar recursos. Revisa primero gradientes, escala, inicialización y una prueba mínima que pueda resolver. La comparación muestra un fallo deliberado; no indica que Xavier sea siempre superior a cualquier otra inicialización. La relación entre activación y distribución inicial se estudia en el capítulo de optimización.
8.9 Ablaciones y semillas: comprobar qué sostiene el resultado
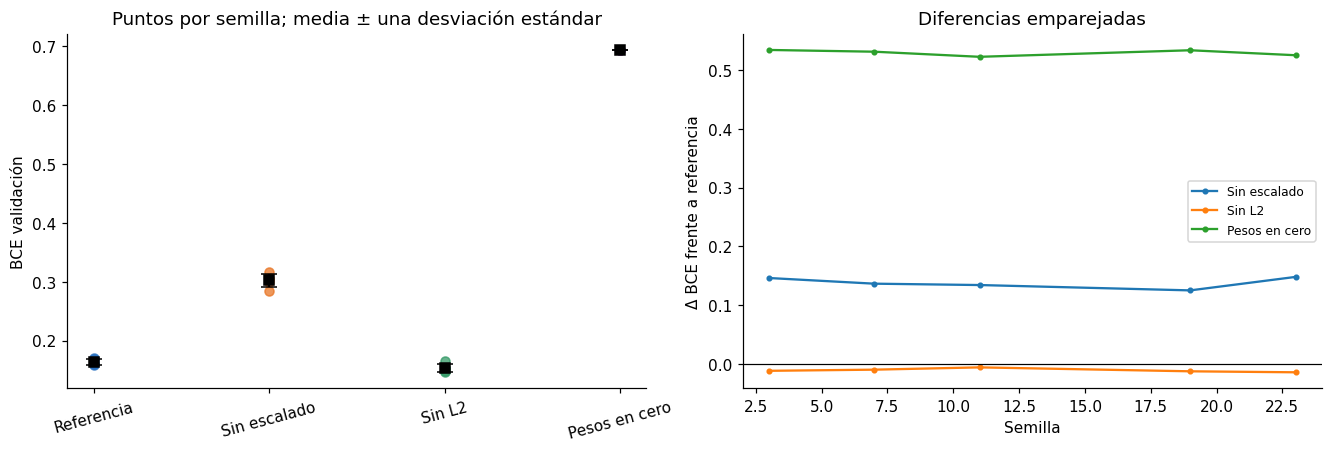
Una ablación elimina o modifica un componente manteniendo los demás. Compararemos una referencia, ausencia de escalado, ausencia de penalización L2 e inicialización con ceros. Usaremos las mismas cinco semillas en cada condición, 160 épocas y la misma partición.
Las diferencias se calcularán dentro de cada semilla respecto de la referencia. Así no comparamos una configuración afortunada con otra corrida bajo una inicialización distinta. Esta repetición estudia variabilidad de inicialización y orden de lotes; no variabilidad entre muestras o particiones, que permanecen fijas.
condiciones={'Referencia':{},'Sin escalado':{'escalar':False},'Sin L2':{'l2':0.},'Pesos en cero':{'inicializacion':'ceros'}}filas_ab=[]for semilla in [3,7,11,19,23]:for nombre,cambios in condiciones.items(): r=entrenar(semilla=semilla,**cambios) dato=registrar('Ablación: '+nombre,r) filas_ab.append({'Semilla':semilla,'Condición':nombre,'BCE validación':dato['BCE validación'],'Balanceada validación':dato['Balanceada validación']})tabla_ab=pd.DataFrame(filas_ab)pareadas=tabla_ab.pivot(index='Semilla',columns='Condición',values='BCE validación')diferencias=pareadas.subtract(pareadas['Referencia'],axis=0)resumen_ab=tabla_ab.groupby('Condición')['BCE validación'].agg(['mean','std'])display(resumen_ab.round(4))display(diferencias.round(4).rename_axis('Semilla: diferencia de BCE respecto de referencia'))fig,axes=plt.subplots(1,2,figsize=(12,4))for j,nombre inenumerate(condiciones): valores=pareadas[nombre].values axes[0].scatter(np.full(len(valores),j),valores,s=35,alpha=.75,color=COLORES[j]) axes[0].errorbar(j,valores.mean(),yerr=valores.std(ddof=1),fmt='s',color='black',capsize=5)for nombre in ['Sin escalado','Sin L2','Pesos en cero']: axes[1].plot(diferencias.index,diferencias[nombre],'.-',label=nombre)axes[0].set_xticks(range(4),list(condiciones),rotation=15)axes[0].set(ylabel='BCE validación',title='Puntos por semilla; media ± una desviación estándar')axes[1].axhline(0,color='black',linewidth=.8)axes[1].set(xlabel='Semilla',ylabel='Δ BCE frente a referencia',title='Diferencias emparejadas')axes[1].legend(fontsize=8)plt.show()lecturas['ab_ref']=f'{resumen_ab.loc["Referencia","mean"]:.4f}'lecturas['ab_sinesc']=f'{resumen_ab.loc["Sin escalado","mean"]:.4f}'lecturas['ab_sinl2']=f'{resumen_ab.loc["Sin L2","mean"]:.4f}'lecturas['ab_desv']=f'{resumen_ab.loc["Referencia","std"]:.4f}'
mean
std
Condición
Pesos en cero
0.6932
0.0000
Referencia
0.1641
0.0052
Sin L2
0.1535
0.0072
Sin escalado
0.3022
0.0115
Condición
Pesos en cero
Referencia
Sin L2
Sin escalado
Semilla: diferencia de BCE respecto de referencia
3
0.5339
0.0
-0.0115
0.1463
7
0.5309
0.0
-0.0095
0.1366
11
0.5223
0.0
-0.0056
0.1343
19
0.5334
0.0
-0.0123
0.1252
23
0.5250
0.0
-0.0140
0.1481
8.9.1 Cómo leer las diferencias y tomar una decisión
La referencia obtuvo BCE media 0.1641, con desviación estándar 0.0052 entre semillas. Sin escalado, la media fue 0.3022; sin L2 fue 0.1535. Una diferencia positiva en el gráfico derecho indica mayor pérdida que la referencia de esa misma semilla.
Aquí quitar L2 redujo la BCE media respecto del coeficiente \(0.001\) de la referencia. La regularización no tiene por qué ayudar bajo cualquier intensidad y presupuesto: además de favorecer ciertos pesos, puede cambiar cuánto avanza el ajuste. La búsqueda conjunta posterior verificará si esta observación se mantiene al cambiar el ancho.
Si la ausencia de un componente perjudica de manera consistente, tenemos evidencia sobre su aporte bajo estas condiciones. Si las diferencias son pequeñas o cambian de signo, la comparación no respalda una conclusión fuerte. Las barras son dispersión de cinco corridas, no intervalos de confianza ni pruebas de significancia.
La ablación de escalado cambia la distribución de entrada de tanh y la escala de sus gradientes, manteniendo la tasa fija. No demuestra que sea imposible entrenar sin escalado con otra configuración. La ablación de L2 evalúa el coeficiente concreto usado aquí; otros valores podrían tener efectos distintos. Las ablaciones de un componente tampoco revelan por sí solas todas las interacciones.
En un experimento real, conserva semillas como replicaciones, no como candidatos que compiten por ser publicados. Estudiar particiones o muestras adicionales respondería otra pregunta y requiere otro diseño.
8.10 Ancho y L2: buscar una interacción
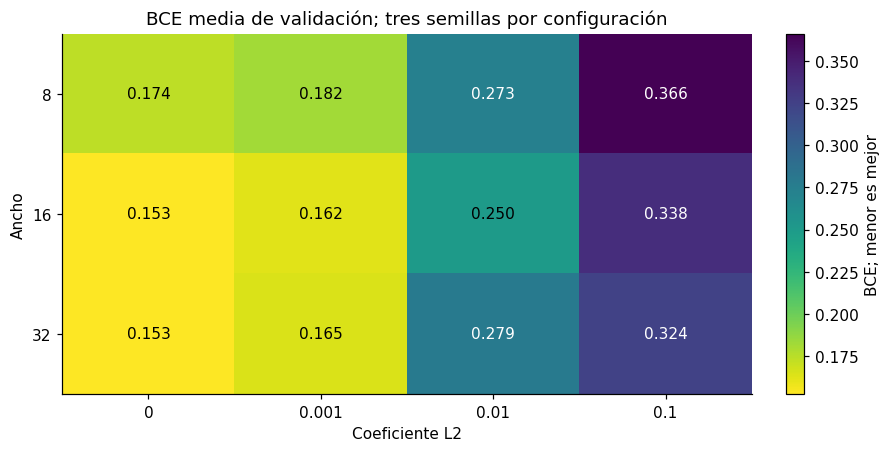
Ahora declaramos el espacio de selección final de red: anchos 8, 16 y 32; coeficientes L2 de 0, 0.001, 0.01 y 0.1. Son 12 configuraciones. Cada una se entrenará con semillas 3, 7 y 11, hasta 160 épocas, lote 64, tasa 0.02 y paciencia 20. El checkpoint se elegirá mediante BCE de validación.
El criterio principal será la BCE media entre semillas de los checkpoints. Definimos además una tolerancia absoluta de \(0.005\): entre configuraciones cuya media no exceda el mínimo más esa tolerancia, preferiremos la de menos parámetros; después, la de menor BCE media. La tolerancia expresa una preferencia de diseño, no una prueba de equivalencia estadística.
Esta regla, el espacio y el presupuesto se fijan antes de ejecutar la búsqueda. La matriz permitirá ver si el efecto de regularización depende del ancho. El extremo l2=0.1 se incluye para observar qué ocurre cuando la penalización es fuerte en esta convención.
espacio_red=list(ParameterGrid({'ancho':[8,16,32],'l2':[0.,.001,.01,.1]}))semillas_busqueda=[3,7,11]filas_busqueda=[]for config in espacio_red:for semilla in semillas_busqueda: r=entrenar(**config,semilla=semilla,paciencia=20) dato=registrar('Búsqueda final de red',r,checkpoint=True) filas_busqueda.append(dato)busqueda_red=pd.DataFrame(filas_busqueda)resumen_red=busqueda_red.groupby(['ancho','l2']).agg( BCE_media=('BCE validación','mean'),BCE_desv=('BCE validación','std'), balanceada_media=('Balanceada validación','mean'), parametros=('Parámetros','first'),epoca_mediana=('Epoca evaluada','median'), segundos_totales=('Segundos','sum')).reset_index()tolerancia=.005minimo=resumen_red.BCE_media.min()elegibles=resumen_red[resumen_red.BCE_media<=minimo+tolerancia].copy()seleccion=elegibles.sort_values(['parametros','BCE_media','l2']).iloc[0]display(resumen_red.round(4))display(elegibles.sort_values(['parametros','BCE_media']).round(4))matriz=resumen_red.pivot(index='ancho',columns='l2',values='BCE_media')fig,ax=plt.subplots(figsize=(8,4))im=ax.imshow(matriz,cmap='viridis_r',aspect='auto')ax.set_xticks(range(len(matriz.columns)),[f'{v:g}'for v in matriz.columns])ax.set_yticks(range(len(matriz.index)),[str(v) for v in matriz.index])for j inrange(matriz.shape[0]):for k inrange(matriz.shape[1]): ax.text(k,j,f'{matriz.iloc[j,k]:.3f}',ha='center',va='center', color='white'if matriz.iloc[j,k]>(matriz.min().min()+matriz.max().max())/2else'black')ax.set(xlabel='Coeficiente L2',ylabel='Ancho',title='BCE media de validación; tres semillas por configuración')fig.colorbar(im,ax=ax,label='BCE; menor es mejor')plt.show()lecturas.update({'sel_ancho':str(int(seleccion.ancho)),'sel_l2':f'{seleccion.l2:g}','sel_bce':f'{seleccion.BCE_media:.4f}','sel_minimo':f'{minimo:.4f}','sel_params':str(int(seleccion.parametros)),'sel_epocas':str(int(np.ceil(seleccion.epoca_mediana))),'sel_elegibles':str(len(elegibles))})print('Selección según la regla previa:',lecturas['sel_ancho'],lecturas['sel_l2'],'| Parámetros:',lecturas['sel_params'],'| Épocas para reajuste:',lecturas['sel_epocas'])
ancho
l2
BCE_media
BCE_desv
balanceada_media
parametros
epoca_mediana
segundos_totales
0
8
0.000
0.1740
0.0047
0.9333
33
158.0
3.7554
1
8
0.001
0.1823
0.0033
0.9283
33
158.0
4.2776
2
8
0.010
0.2733
0.0183
0.8733
33
158.0
3.9476
3
8
0.100
0.3659
0.0078
0.8383
33
3.0
0.5867
4
16
0.000
0.1526
0.0084
0.9417
65
158.0
3.8691
5
16
0.001
0.1623
0.0056
0.9367
65
158.0
4.1526
6
16
0.010
0.2498
0.0024
0.8917
65
158.0
3.9766
7
16
0.100
0.3384
0.0117
0.8367
65
3.0
0.5583
8
32
0.000
0.1530
0.0060
0.9417
129
158.0
4.0216
9
32
0.001
0.1648
0.0098
0.9350
129
159.0
3.9066
10
32
0.010
0.2790
0.0293
0.8667
129
160.0
3.3682
11
32
0.100
0.3239
0.0060
0.8350
129
2.0
0.5597
ancho
l2
BCE_media
BCE_desv
balanceada_media
parametros
epoca_mediana
segundos_totales
4
16
0.0
0.1526
0.0084
0.9417
65
158.0
3.8691
8
32
0.0
0.1530
0.0060
0.9417
129
158.0
4.0216
Selección según la regla previa: 16 0 | Parámetros: 65 | Épocas para reajuste: 158
8.10.1 Cómo leer la matriz y justificar la selección
La menor BCE media observada fue 0.1526. La regla de tolerancia dejó 2 configuraciones elegibles y seleccionó ancho 16, L2 0, con 65 parámetros y BCE media 0.1526. Esta elección puede diferir del mínimo numérico porque incorpora una preferencia declarada por menor tamaño.
Lee cada fila para ver cómo cambia L2 con el ancho fijo, y cada columna para ver cómo cambia ancho con L2 fijo. Una penalización que ayuda a una arquitectura puede limitar otra. El valor cero constituye una referencia, no una recomendación automática; el más grande comprueba un régimen que puede reducir demasiado la capacidad efectiva.
La desviación entre semillas describe estabilidad de entrenamiento en una partición fija. Una media ligeramente mejor no garantiza una diferencia reproducible en otras muestras. Si el mejor valor queda en un borde ampliable, como el ancho máximo, podrías extender la búsqueda, pero eso sería una nueva decisión que debes registrar y mantener dentro del presupuesto. Para una penalización no negativa, cero es un límite natural: no tiene sentido continuar el rango hacia valores negativos como si fueran regularización más débil. Puedes estudiar valores positivos más pequeños si esa es una pregunta pertinente. Aquí respetaremos el espacio declarado y reservaremos la prueba para la selección completa.
8.11 Diseñar un espacio de búsqueda útil
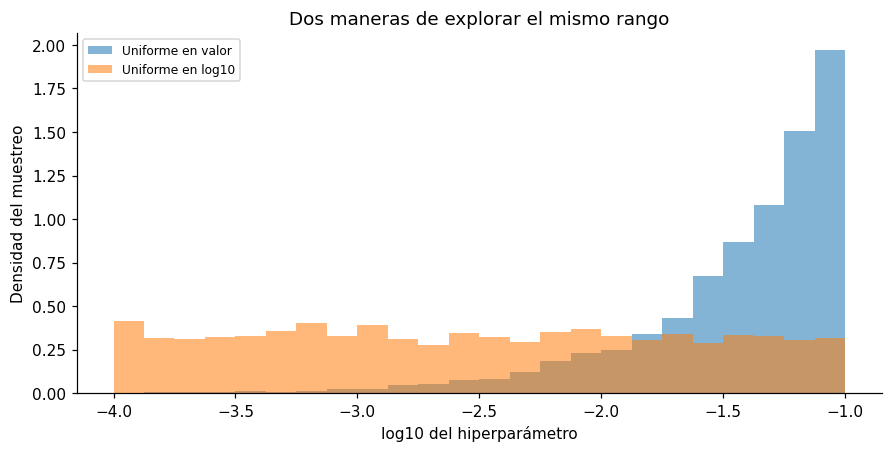
Buscar no consiste en variar todo a la vez. Define primero qué hiperparámetros pueden cambiar, sus rangos y el costo permitido. Una tasa o una penalización suele necesitar una escala multiplicativa: entre \(10^{-4}\) y \(10^{-1}\) hay varios órdenes de magnitud, aunque la diferencia absoluta parezca pequeña.
Una distribución uniforme entre esos extremos concentra casi todos los valores cerca del extremo grande en escala logarítmica. Una distribución log-uniforme asigna igual probabilidad a intervalos como \([10^{-4},10^{-3}]\) y \([10^{-3},10^{-2}]\). La elección expresa cómo deseas explorar; no demuestra dónde estará el óptimo.
Los espacios también pueden ser condicionales. Si el optimizador es SGD, momentum puede variar; si usas Adam, otras opciones corresponden a sus acumuladores. En un SVC con kernel lineal, gamma no define la frontera; en uno RBF sí. Evita gastar evaluaciones en argumentos que no intervienen en el candidato.
rng=np.random.default_rng(91)uniforme=rng.uniform(1e-4,1e-1,3000)log_uniforme=10**rng.uniform(-4,-1,3000)fig,ax=plt.subplots(figsize=(8,4))bins=np.linspace(-4,-1,25)ax.hist(np.log10(uniforme),bins=bins,alpha=.55,label='Uniforme en valor',density=True)ax.hist(np.log10(log_uniforme),bins=bins,alpha=.55,label='Uniforme en log10',density=True)ax.set(xlabel='log10 del hiperparámetro',ylabel='Densidad del muestreo',title='Dos maneras de explorar el mismo rango')ax.legend(fontsize=8)plt.show()espacio_condicional=[{'svc__kernel':['linear'],'svc__C':[.1,1,10]}, {'svc__kernel':['rbf'],'svc__C':[.1,1,10],'svc__gamma':[.01,.1,1]}]print('Configuraciones del espacio condicional:',len(list(ParameterGrid(espacio_condicional))))print('Tres lineales y nueve RBF; gamma no se explora para el kernel lineal.')
Configuraciones del espacio condicional: 12
Tres lineales y nueve RBF; gamma no se explora para el kernel lineal.
8.12 Cuadrícula y búsqueda aleatoria con el mismo número de candidatos
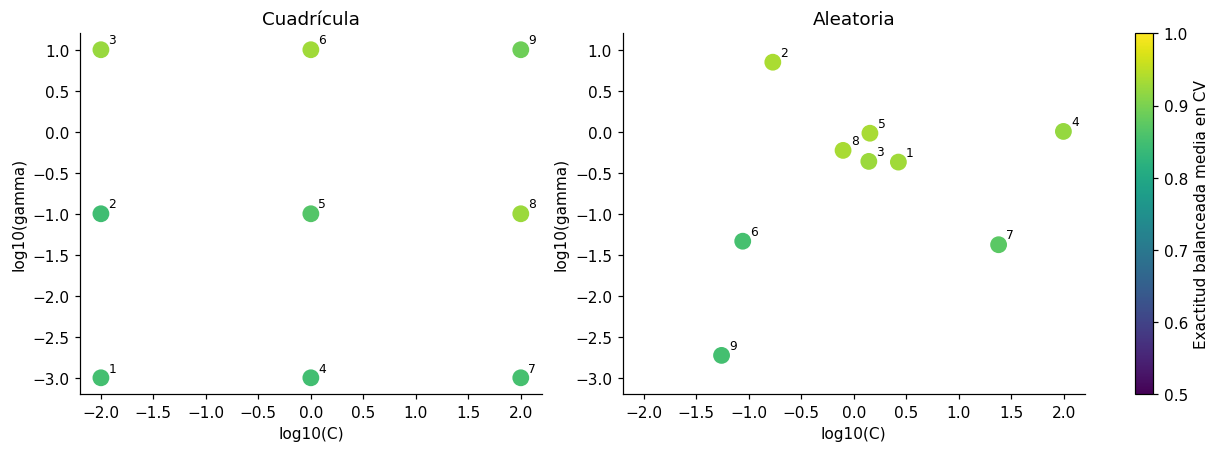
Para observar estrategias sin entrenar decenas de redes adicionales, usaremos SVC RBF. C controla el compromiso de su penalización y gamma el alcance del kernel. Exploraremos \(C\in[10^{-2},10^2]\) y \(\gamma\in[10^{-3},10^1]\).
Cada evaluación utilizará tres pliegues estratificados dentro de las 600 observaciones de entrenamiento. El Pipeline ajustará un escalador distinto usando solo el entrenamiento de cada pliegue. La métrica será exactitud balanceada media. La validación externa y la prueba no entrarán en esta comparación de estrategias.
La cuadrícula tendrá nueve combinaciones, con tres valores por dimensión. La búsqueda aleatoria tendrá nueve candidatos log-uniformes en los mismos límites. El orden de la cuadrícula es el que genera ParameterGrid; la curva de mejor resultado acumulado depende también de ese orden. Igual número de candidatos no implica idéntico tiempo de cómputo.
pliegues=StratifiedKFold(n_splits=3,shuffle=True,random_state=17)pipeline_svc=make_pipeline(StandardScaler(),SVC(kernel='rbf'))cuadricula={'svc__C':[.01,1.,100.],'svc__gamma':[.001,.1,10.]}aleatoria={'svc__C':loguniform(.01,100.),'svc__gamma':loguniform(.001,10.)}candidatos_grid=list(ParameterGrid(cuadricula))candidatos_random=list(ParameterSampler(aleatoria,n_iter=9,random_state=93))def evaluar_svc(config): inicio=time.perf_counter() resultados=cross_validate(copy.deepcopy(pipeline_svc).set_params(**config), X_bruto[tr],y[tr],cv=pliegues,scoring='balanced_accuracy',return_train_score=True,n_jobs=1)return {'C':float(config['svc__C']),'gamma':float(config['svc__gamma']),'CV media':float(resultados['test_score'].mean()),'CV desv':float(resultados['test_score'].std(ddof=1)),'Entrenamiento medio':float(resultados['train_score'].mean()),'Segundos':time.perf_counter()-inicio}resultados_busqueda={}for estrategia,candidatos in [('Cuadrícula',candidatos_grid),('Aleatoria',candidatos_random)]: filas=[]for j,config inenumerate(candidatos,1): filas.append({'Intento':j,**evaluar_svc(config)}) resultados_busqueda[estrategia]=pd.DataFrame(filas)display(resultados_busqueda['Cuadrícula'].round(4))display(resultados_busqueda['Aleatoria'].round(4))fig,axes=plt.subplots(1,2,figsize=(11,4))for ax,estrategia inzip(axes,['Cuadrícula','Aleatoria']): t=resultados_busqueda[estrategia] im=ax.scatter(np.log10(t.C),np.log10(t.gamma),c=t['CV media'],s=100,cmap='viridis',vmin=.5,vmax=1)for _,r in t.iterrows(): ax.annotate(str(int(r.Intento)),(np.log10(r.C),np.log10(r.gamma)),xytext=(5,4),textcoords='offset points',fontsize=8) ax.set(title=estrategia,xlabel='log10(C)',ylabel='log10(gamma)',xlim=(-2.2,2.2),ylim=(-3.2,1.2))fig.colorbar(im,ax=axes,label='Exactitud balanceada media en CV')plt.show()lecturas['grid_max']=f'{resultados_busqueda["Cuadrícula"]["CV media"].max():.4f}'lecturas['random_max']=f'{resultados_busqueda["Aleatoria"]["CV media"].max():.4f}'
Intento
C
gamma
CV media
CV desv
Entrenamiento medio
Segundos
0
1
0.01
0.001
0.8500
0.0229
0.8475
0.0942
1
2
0.01
0.100
0.8467
0.0275
0.8550
0.0852
2
3
0.01
10.000
0.9233
0.0202
0.9458
0.0864
3
4
1.00
0.001
0.8483
0.0225
0.8483
0.0796
4
5
1.00
0.100
0.8667
0.0252
0.8725
0.0433
5
6
1.00
10.000
0.9283
0.0202
0.9558
0.0564
6
7
100.00
0.001
0.8533
0.0252
0.8608
0.0424
7
8
100.00
0.100
0.9250
0.0218
0.9383
0.0372
8
9
100.00
10.000
0.8900
0.0444
0.9842
0.0460
Intento
C
gamma
CV media
CV desv
Entrenamiento medio
Segundos
0
1
2.6633
0.4266
0.9283
0.0176
0.9450
0.0348
1
2
0.1694
7.0472
0.9367
0.0236
0.9483
0.0667
2
3
1.3921
0.4350
0.9250
0.0250
0.9392
0.0366
3
4
99.4274
1.0091
0.9217
0.0176
0.9508
0.0410
4
5
1.4259
0.9594
0.9350
0.0200
0.9450
0.0362
5
6
0.0876
0.0463
0.8517
0.0275
0.8567
0.0603
6
7
23.9927
0.0419
0.8717
0.0189
0.8708
0.0444
7
8
0.7911
0.5925
0.9350
0.0278
0.9383
0.0456
8
9
0.0550
0.0019
0.8500
0.0229
0.8475
0.0912
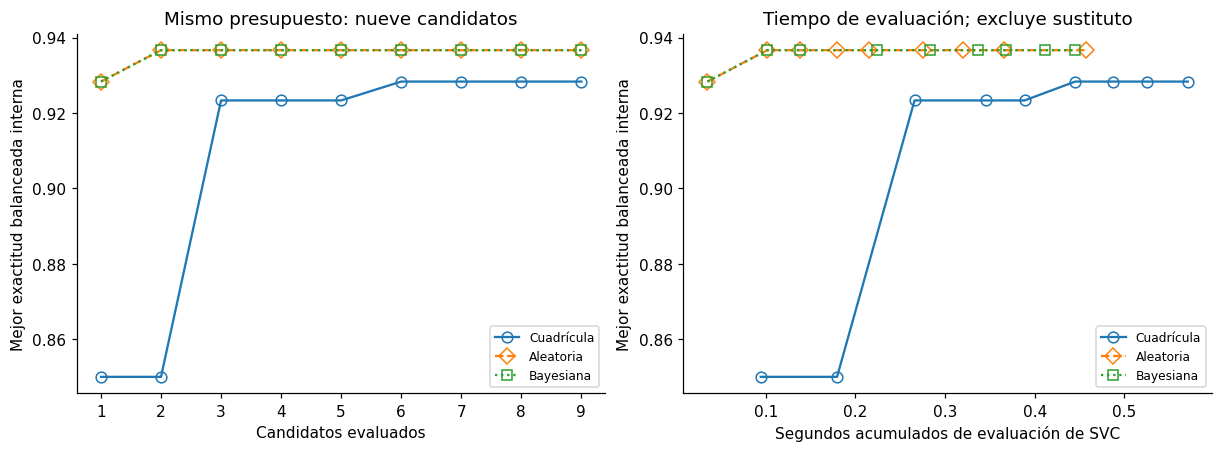
La cuadrícula encontró un máximo de 0.9283 y la búsqueda aleatoria 0.9367 en el criterio interno. La cuadrícula cubrió sistemáticamente sus nueve cruces, pero solo tres valores diferentes de cada dimensión. El muestreo aleatorio exploró más posiciones, con la posibilidad de dejar zonas sin visitar.
Esta realización no demuestra qué estrategia será mejor en otros problemas. La búsqueda aleatoria es una referencia útil cuando pocas dimensiones concentran buena parte de la sensibilidad, y permite fijar el presupuesto sin multiplicar todos los cruces. La cuadrícula facilita inspeccionar una interacción de pocas dimensiones. Ambas necesitan rangos pertinentes; un algoritmo de búsqueda no recupera configuraciones excluidas del espacio.
8.13 Búsqueda bayesiana: utilizar lo que ya observamos
Una búsqueda bayesiana ajusta un modelo sustituto de la relación entre hiperparámetros y resultado. A partir de ese modelo, una función de adquisición propone dónde evaluar después. Así combina posiciones prometedoras con posiciones sobre las que existe incertidumbre.
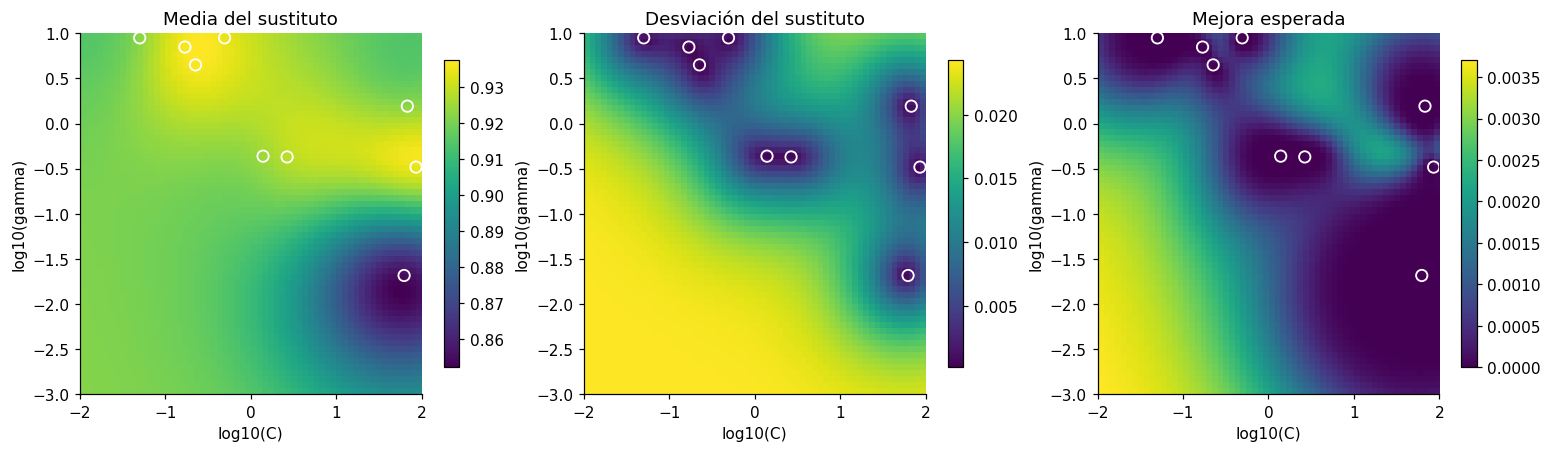
Construiremos una versión didáctica con un proceso gaussiano sobre \(\log_{10}C\) y \(\log_{10}\gamma\). Empezaremos con los primeros tres candidatos aleatorios ya evaluados y propondremos seis adicionales, para completar nueve evaluaciones. La adquisición será mejora esperada, con margen \(\xi=0.001\):
\(\mu\) y \(\sigma\) provienen del sustituto; \(\Phi\) y \(\phi\) corresponden a una normal estándar. Con desviación prácticamente cero, usaremos mejora cero. Mantendremos fijo un kernel Matérn y sus escalas para hacer visible el mecanismo; no estimaremos esos hiperparámetros. El pequeño alpha estabiliza el ajuste numérico, no representa una varianza de generalización medida.
La maximización de adquisición se aproximará entre 1 800 puntos sorteados dentro del rango. Esos cálculos baratos no cuentan como entrenamientos de SVC. La incertidumbre del sustituto expresa sus supuestos; no es un intervalo de confianza del rendimiento futuro del predictor.
Ver búsqueda bayesiana con proceso gaussiano y mejora esperada
filas_bo=resultados_busqueda['Aleatoria'].iloc[:3].to_dict('records')rng_bo=np.random.default_rng(94)kernel=ConstantKernel(1.,constant_value_bounds='fixed')*Matern( length_scale=[1.,1.],length_scale_bounds='fixed',nu=2.5)for intento inrange(4,10): vistos=np.array([[np.log10(r['C']),np.log10(r['gamma'])] for r in filas_bo]) valores=np.array([r['CV media'] for r in filas_bo]) gp=GaussianProcessRegressor(kernel=kernel,alpha=1e-5,normalize_y=True,optimizer=None) gp.fit(vistos,valores) propuestas=rng_bo.uniform([-2.,-3.],[2.,1.],size=(1800,2)) mu,sigma=gp.predict(propuestas,return_std=True) mejora=mu-valores.max()-.001 z=mejora/np.maximum(sigma,1e-12) ei=np.where(sigma>1e-12,mejora*norm.cdf(z)+sigma*norm.pdf(z),0.) proxima=propuestas[np.argmax(ei)] config={'svc__C':10**proxima[0],'svc__gamma':10**proxima[1]} filas_bo.append({'Intento':intento,**evaluar_svc(config)})resultados_busqueda['Bayesiana']=pd.DataFrame(filas_bo)display(resultados_busqueda['Bayesiana'].round(4))fig,axes=plt.subplots(1,2,figsize=(11,4))for (estrategia,t),estilo inzip(resultados_busqueda.items(),['o-','D--','s:']): axes[0].plot(t.Intento,t['CV media'].cummax(),estilo,label=estrategia,markerfacecolor='none',markersize=7) axes[1].plot(t['Segundos'].cumsum(),t['CV media'].cummax(),estilo,label=estrategia,markerfacecolor='none',markersize=7)axes[0].set(xlabel='Candidatos evaluados',ylabel='Mejor exactitud balanceada interna',title='Mismo presupuesto: nueve candidatos')axes[1].set(xlabel='Segundos acumulados de evaluación de SVC',ylabel='Mejor exactitud balanceada interna',title='Tiempo de evaluación; excluye sustituto')for ax in axes: ax.legend(fontsize=8)plt.show()lecturas['bo_max']=f'{resultados_busqueda["Bayesiana"]["CV media"].max():.4f}'tabla_bo=resultados_busqueda['Bayesiana']posiciones=np.column_stack([np.log10(tabla_bo.C),np.log10(tabla_bo.gamma)])gp_cierre=GaussianProcessRegressor(kernel=kernel,alpha=1e-5,normalize_y=True,optimizer=None)gp_cierre.fit(posiciones,tabla_bo['CV media'].to_numpy())logc,logg=np.meshgrid(np.linspace(-2,2,60),np.linspace(-3,1,60))vista=np.column_stack([logc.ravel(),logg.ravel()])mu_v,sigma_v=gp_cierre.predict(vista,return_std=True)mejora_v=mu_v-tabla_bo['CV media'].max()-.001z_v=mejora_v/np.maximum(sigma_v,1e-12)ei_v=np.where(sigma_v>1e-12,mejora_v*norm.cdf(z_v)+sigma_v*norm.pdf(z_v),0.)fig,axes=plt.subplots(1,3,figsize=(14,4))for ax,titulo,valores inzip(axes,['Media del sustituto','Desviación del sustituto','Mejora esperada'],[mu_v,sigma_v,ei_v]): im=ax.imshow(valores.reshape(logc.shape),extent=[-2,2,-3,1],origin='lower',aspect='auto',cmap='viridis') ax.scatter(posiciones[:,0],posiciones[:,1],facecolors='none',edgecolors='white',s=55,linewidths=1.2) ax.set(title=titulo,xlabel='log10(C)',ylabel='log10(gamma)') fig.colorbar(im,ax=ax,shrink=.85)plt.show()
Intento
C
gamma
CV media
CV desv
Entrenamiento medio
Segundos
0
1
2.6633
0.4266
0.9283
0.0176
0.9450
0.0348
1
2
0.1694
7.0472
0.9367
0.0236
0.9483
0.0667
2
3
1.3921
0.4350
0.9250
0.0250
0.9392
0.0366
3
4
0.0502
8.9091
0.9233
0.0202
0.9458
0.0864
4
5
0.4930
8.9165
0.9350
0.0218
0.9533
0.0585
5
6
0.2254
4.4684
0.9367
0.0252
0.9458
0.0533
6
7
85.9141
0.3291
0.9350
0.0200
0.9425
0.0318
7
8
62.3599
0.0207
0.8550
0.0150
0.8650
0.0432
8
9
68.0073
1.5590
0.9233
0.0161
0.9533
0.0340
8.13.1 Cómo interpretar una búsqueda adaptativa
La búsqueda bayesiana alcanzó 0.9367 como mejor puntaje interno en nueve evaluaciones. Los tres primeros resultados son los mismos de la búsqueda aleatoria: se reutilizaron como inicio común. Los siguientes dependen de las observaciones anteriores y de los supuestos del sustituto.
En esta trayectoria, el mejor valor ya apareció en el segundo candidato inicial. Las seis propuestas bayesianas adicionales no lo superaron, y la búsqueda aleatoria tampoco lo mejoró con sus seis candidatos restantes. Sus curvas de mejor puntaje coinciden. La coincidencia es un resultado que hay que informar, no una razón para adjudicar una victoria a la estrategia más compleja.
La curva acumulada nunca disminuye por definición: conserva el mayor puntaje visto, aunque un nuevo candidato sea peor. Eso no implica que mejore la generalización ni que cada propuesta sea acertada. El sustituto puede orientar mal la búsqueda si sus supuestos no describen bien la superficie o si la métrica tiene mucho ruido.
Los mapas muestran el sustituto después de las nueve evaluaciones; los círculos blancos señalan posiciones evaluadas. La media describe dónde el sustituto espera un puntaje mayor; la desviación describe incertidumbre según su kernel. La mejora esperada combina ambas. Son aproximaciones de una superficie desconocida, y la media gaussiana no está restringida automáticamente a \([0,1]\). No se realizó un décimo entrenamiento a partir de esos mapas: el presupuesto ya se había cerrado.
El gráfico de tiempo incluye únicamente evaluaciones de SVC. No incluye el ajuste del proceso gaussiano ni la adquisición; por tanto, no permite concluir que la búsqueda bayesiana sea más rápida de extremo a extremo. En modelos baratos, esa sobrecarga puede importar; en entrenamientos costosos puede ser relativamente pequeña.
La comparación conserva pliegues y presupuestos, pero usa una única trayectoria de búsqueda y un espacio de dos dimensiones. Para elegir una estrategia en un proyecto, repetirías trayectorias y medirías costo completo. Para espacios mixtos o condicionales existen otros sustitutos; el proceso gaussiano usado aquí es una demostración ejecutable, no una implementación completa de todos los métodos bayesianos.
8.13.2 Presupuestos progresivos y poda de candidatos
Cuando cada entrenamiento es costoso, puedes asignar primero pocas épocas a muchos candidatos y ampliar recursos solo a algunos. Successive halving organiza ese descarte progresivo; Hyperband considera varias combinaciones de presupuesto inicial y cantidad de candidatos.
Hay una amenaza concreta: una tasa pequeña puede rendir peor al comienzo y mejorar más tarde. Las curvas del experimento de tasas permiten revisar esa posibilidad. Podar por el resultado de pocas épocas favorece determinadas velocidades de aprendizaje, no necesariamente la mejor solución final.
Declara recurso, presupuesto mínimo, regla de descarte y límite máximo. Las corridas interrumpidas también forman parte del registro. Una configuración que falla, se detiene o consume demasiado tiempo no debe desaparecer silenciosamente del informe. Una búsqueda con 20 candidatos completados y 80 podados no equivale a evaluar únicamente 20 opciones.
8.14 Validación anidada: evaluar el procedimiento de selección
El mejor puntaje de una búsqueda se calculó sobre pliegues usados para elegir. Puede ser optimista como estimación final: la configuración fue favorecida precisamente por ese resultado. La validación anidada separa dos tareas.
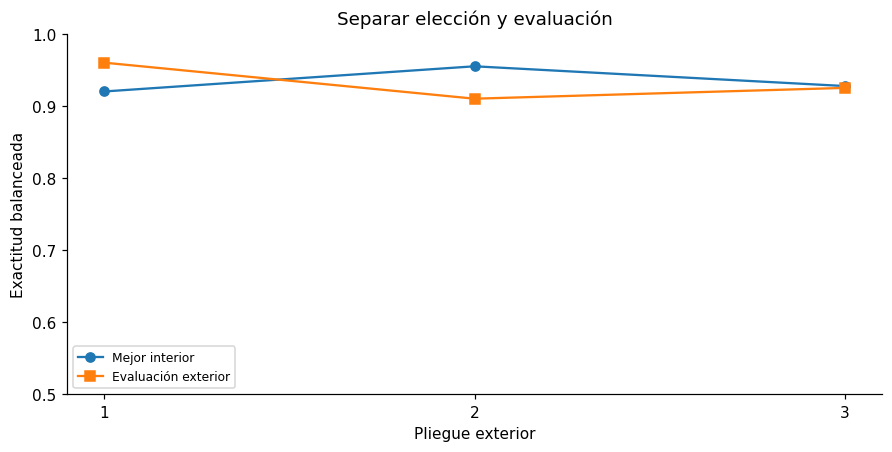
En cada pliegue exterior, reservamos observaciones que no participan en la búsqueda. Dentro del resto, los pliegues interiores seleccionan hiperparámetros y ajustan todas las transformaciones. Después evaluamos el candidato elegido en el exterior. El promedio exterior evalúa ese procedimiento de selección y reajuste con el tamaño disponible en cada pliegue, no una configuración fija entrenada sobre todos los datos.
Usaremos tres pliegues exteriores y tres interiores, con la misma cuadrícula de nueve candidatos, exclusivamente dentro del entrenamiento original. Compararemos su promedio exterior con el máximo interno de la búsqueda previa. No tiene que existir una diferencia positiva en cada muestra finita.
Promedio exterior: 0.9317 | Desviación entre pliegues: 0.0257
8.14.1 Cómo leer este resultado
El promedio exterior fue 0.9317, con desviación 0.0257 entre tres pliegues. El máximo interno de la cuadrícula sobre las 600 observaciones fue 0.9283. Estos valores pertenecen a entrenamientos con tamaños distintos: en la evaluación exterior, cada búsqueda recibió solo dos tercios de esas 600 observaciones.
La diferencia no aísla únicamente el optimismo de selección, porque también cambian muestras y tamaños de ajuste. El procedimiento anidado protege la evaluación exterior de las decisiones interiores; con solo tres pliegues no tendremos una estimación muy precisa. Sus puntajes tampoco son observaciones independientes: los conjuntos de entrenamiento se solapan.
Si tus observaciones pertenecen a pacientes, usuarios, máquinas o series, cambia el esquema a una separación apropiada por grupos o por tiempo, tanto dentro como fuera. Estratificar conserva frecuencias de clase, pero no elimina dependencia entre observaciones. Un procedimiento bien anidado con una partición incompatible sigue respondiendo una pregunta incorrecta.
8.15 Cerrar la selección de red y evaluar una sola decisión
Volvemos a la selección de red ya definida. Usaremos ancho 16, L2 0, tasa \(0.02\), lote 64 y una capa oculta. Para reajustar, combinaremos entrenamiento y validación: 800 observaciones. El escalador se ajustará nuevamente sobre esas 800, porque ahora pertenecen al conjunto de ajuste final.
La cantidad de épocas se fijará en 158, obtenida redondeando hacia arriba la mediana de las mejores épocas de las tres semillas de la configuración elegida. La semilla final será 42, declarada sin buscar la más afortunada. Durante el reajuste no habrá validación ni selección de checkpoints: se conservará el último estado de ese presupuesto fijo.
El reajuste cambia el tamaño de datos y el número de pasos por época. La mediana de épocas es una regla práctica previamente definida, no una garantía de que ese presupuesto siga siendo óptimo. Evaluaremos el sistema reajustado en las 200 observaciones de prueba, con umbral \(0.5\) y una referencia que usa la frecuencia de clase del ajuste final.
desarrollo=np.concatenate([tr,va])scaler_final=StandardScaler().fit(X_bruto[desarrollo])X_final=torch.tensor(scaler_final.transform(X_bruto[desarrollo]),dtype=torch.float32)Y_final=torch.tensor(y[desarrollo,None],dtype=torch.float32)config_final={'ancho':int(seleccion.ancho),'profundidad':1,'l2':float(seleccion.l2),'tasa':.02,'lote':64,'epocas':int(np.ceil(seleccion.epoca_mediana)),'semilla':42}modelo_final=construir_red(config_final['ancho'],semilla=config_final['semilla'])opt_final=torch.optim.SGD(modelo_final.parameters(),lr=config_final['tasa'],momentum=.9,weight_decay=config_final['l2'])rng_final=np.random.default_rng(config_final['semilla'])pasos_final=0for epoca inrange(config_final['epocas']): modelo_final.train() orden=rng_final.permutation(len(X_final))for inicio inrange(0,len(orden),config_final['lote']): batch=orden[inicio:inicio+config_final['lote']] opt_final.zero_grad(set_to_none=True) perdida=criterio(modelo_final(X_final[batch]),Y_final[batch]) perdida.backward();opt_final.step();pasos_final+=1modelo_final.eval()X_test=torch.tensor(scaler_final.transform(X_bruto[te]),dtype=torch.float32)with torch.no_grad(): logits_test=modelo_final(X_test) prob_test=torch.sigmoid(logits_test).numpy().ravel() bce_test=float(criterio(logits_test,torch.tensor(y[te,None],dtype=torch.float32)))pred_test=(prob_test>=.5).astype(int)prob_base=np.full(len(te),y[desarrollo].mean())pred_base=(prob_base>=.5).astype(int)tabla_final=pd.DataFrame([ {'Predictor':'Frecuencia de ajuste','BCE':log_loss(y[te],prob_base),'Exactitud':accuracy_score(y[te],pred_base),'Balanceada':balanced_accuracy_score(y[te],pred_base)}, {'Predictor':'Red seleccionada y reajustada','BCE':bce_test,'Exactitud':accuracy_score(y[te],pred_test),'Balanceada':balanced_accuracy_score(y[te],pred_test)}])display(tabla_final.round(4))fig,axes=plt.subplots(1,2,figsize=(10,4))ConfusionMatrixDisplay.from_predictions(y[te],pred_test,ax=axes[0],colorbar=False,cmap='Blues')axes[0].set(title='Prueba: red final',xlabel='Clase predicha',ylabel='Clase real')for clase in [0,1]: axes[1].hist(prob_test[y[te]==clase],bins=np.linspace(0,1,16),alpha=.6, color=COLORES[clase],label=f'Clase real {clase}')axes[1].axvline(.5,color='black',linestyle='--',label='Umbral fijo')axes[1].set(xlabel='Probabilidad predicha de clase 1',ylabel='Observaciones',title='Probabilidades en prueba')axes[1].legend(fontsize=8)plt.show()errores=int(np.sum(pred_test!=y[te]))lecturas.update({'final_bce':f'{bce_test:.4f}','final_acc':f'{accuracy_score(y[te],pred_test):.4f}','final_bal':f'{balanced_accuracy_score(y[te],pred_test):.4f}','final_err':str(errores),'final_pasos':str(pasos_final)})print('Configuración final:',config_final,'| Actualizaciones:',pasos_final,'| Errores:',errores)
8.15.1 Cómo leer el resultado final y tomar una decisión
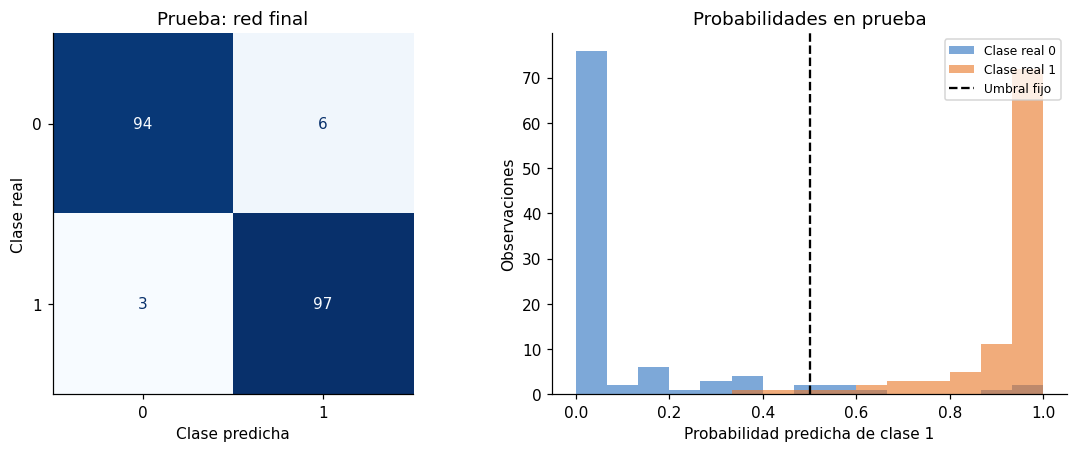
La red final obtuvo BCE 0.1370, exactitud 0.9550 y exactitud balanceada 0.9550, con 9 errores en 200 observaciones. La referencia de frecuencia aporta el punto de comparación: una probabilidad constante cercana a \(0.5\) no distingue las lunas.
La matriz muestra dónde se produjeron los errores de clase. Los histogramas muestran qué probabilidades se asignaron a cada clase real; su solapamiento ayuda a entender las equivocaciones, pero el gráfico no demuestra calibración. Para comprobarla necesitarías un análisis específico sobre datos apropiados.
La decisión respaldada por este experimento es conservar la configuración seleccionada como solución para esta distribución sintética y bajo el criterio declarado. No demuestra suficiencia para una aplicación real ni una superioridad universal frente a otros modelos. La búsqueda de SVC ilustró estrategias y validación; no utilizamos su mejor resultado interno para afirmar que compite con la prueba de esta red.
Tras leer la prueba, no cambiaremos ancho, coeficiente, umbral o épocas para mejorar este puntaje. Si aparecen nuevas decisiones, la prueba deja de ser una evaluación independiente para ellas. Documenta el cambio y utiliza nueva evidencia reservada o un protocolo que evalúe el procedimiento actualizado.
8.16 Registrar para poder explicar la elección
Un registro necesita más que el mejor puntaje. Debe permitir reconstruir configuración, datos, particiones, transformaciones, semillas, recurso utilizado, criterio de checkpoint y fallos. La duración sirve para decidir costo, pero no es un atributo fijo del hiperparámetro.
Exportaremos las corridas de red y los candidatos de las tres estrategias de SVC a un CSV, y la decisión final a un JSON. La validación anidada queda documentada en su tabla de pliegues exteriores. Los primeros tres candidatos bayesianos reaprovechan evaluaciones aleatorias; el registro conserva ambos papeles para interpretar las trayectorias, no implica que se entrenaran nuevamente.
Los archivos están disponibles junto al notebook: registro de experimentos y selección final. Si vuelves a ejecutar el capítulo, esta celda regenerará ambos en el directorio de ejecución con los resultados de esa ejecución.
from pathlib import Pathregistro_red=pd.DataFrame(registro)registro_svc=pd.concat([t.assign(Experimento='SVC: '+nombre) for nombre,t in resultados_busqueda.items()],ignore_index=True)registro_completo=pd.concat([registro_red,registro_svc],ignore_index=True,sort=False)registro_completo.to_csv('registro-experimentos.csv',index=False,encoding='utf-8')versiones={'Python':platform.python_version(),'NumPy':np.__version__,'pandas':pd.__version__,'SciPy':scipy.__version__,'scikit-learn':sklearn.__version__,'PyTorch':torch.__version__}decision={'configuracion':config_final,'criterio':'BCE media de checkpoint entre tres semillas; tolerancia absoluta 0.005 y menor tamaño','semillas_busqueda':semillas_busqueda,'particion':{'entrenamiento':600,'validacion':200,'prueba':200},'indices_particion':{'entrenamiento':tr.tolist(),'validacion':va.tolist(),'prueba':te.tolist()},'semilla_particion':SEMILLA,'generador':{'nombre':'make_moons','n_samples':1000,'noise':.25,'segunda_coordenada_factor':30},'espacio_busqueda_red':{'ancho':[8,16,32],'l2':[0.,.001,.01,.1],'epocas_maximas':160,'paciencia':20},'recursos':{'dispositivo':'CPU','hilos_pytorch':1,'tipo_numerico':'float32'},'momentum':.9,'inicializacion':'Xavier; tanh con ganancia 5/3, salida con ganancia 1; sesgos cero','umbral':.5,'reajuste':'800 observaciones; escalador reajustado; épocas fijas sin monitor de validación','actualizaciones_reajuste':pasos_final,'resultados_prueba':tabla_final.to_dict('records'),'versiones':versiones}Path('seleccion-final.json').write_text(json.dumps(decision,ensure_ascii=False,indent=2),encoding='utf-8')assertnotset(tr)&set(va) andnotset(tr)&set(te) andnotset(va)&set(te)assertlen(registro_red[registro_red.Experimento=='Búsqueda final de red'])==36assertall(np.isfinite(registro_red['BCE validación']))display(pd.DataFrame({'Biblioteca':list(versiones),'Versión':list(versiones.values())}))print('Corridas de red registradas:',len(registro_red),'| Filas SVC:',len(registro_svc))print('Archivos exportados. Particiones disjuntas y 36 corridas de selección final verificadas.')
Biblioteca
Versión
0
Python
3.13.9
1
NumPy
2.3.5
2
pandas
2.3.3
3
SciPy
1.16.3
4
scikit-learn
1.8.0
5
PyTorch
2.14.1+cpu
Corridas de red registradas: 74 | Filas SVC: 27
Archivos exportados. Particiones disjuntas y 36 corridas de selección final verificadas.
8.17 Trasladar las decisiones a otras familias
La red de lunas permitió estudiar una receta pequeña y controlada. Al cambiar de familia, también cambian los hiperparámetros relevantes. Este mapa organiza preguntas para futuros experimentos; no fija valores óptimos ni sustituye la evaluación de cada problema.
Familia
Decisiones de estructura o representación
Qué revisar al comparar
MLP
Ancho, profundidad, activación y conexiones
Parámetros, curvas, estabilidad y costo de la mejora
CNN
Canales, tamaño de kernel, stride y pooling
Resolución de activaciones, campo receptivo, memoria y errores por tipo de imagen
Redes recurrentes
Unidades, capas y longitud de ventana
Horizonte de predicción, contexto disponible, pasos y partición temporal
Transformers
Dimensión de representación, cabezas, bloques y longitud de entrada
Compatibilidad de dimensiones, presupuesto de memoria, contexto y receta de tasas
SVC
Kernel, C y gamma cuando corresponde
Escala de entrada, frontera y criterio de validación
Árboles y bosques
Profundidad, mínimo por hoja y cantidad de árboles
Generalización, estabilidad, tiempo y tamaño del predictor
Vecinos próximos
Cantidad de vecinos, distancia y ponderación
Escalado, densidad local y costo de consulta
Una longitud de ventana o de entrada decide qué contexto puede utilizar el modelo; no es únicamente una propiedad de sus pesos. Un stride puede modificar el tamaño de las representaciones y sus costos. La cantidad de árboles modifica el presupuesto de otra manera que la profundidad. Describe qué cambia físicamente en el sistema antes de atribuir una mejora al nombre del hiperparámetro.
La tasa, el lote, la regularización y el criterio de detención siguen formando una receta conjunta. Si transfieres una configuración entre datasets, verifica escala, tamaño, objetivo y régimen de entrenamiento. Si transfieres entre implementaciones, verifica además la convención de la pérdida y de la penalización. Una cifra sin esas condiciones no reproduce una decisión.
8.18 Una guía para decidir qué revisar
Observación
Posibles explicaciones
Comparación que ayuda a decidir
Pérdida alta y casi constante
Gradientes débiles, inicialización, escala, error de código
Verificar un caso mínimo y comparar inicialización y entrada
Sigue mejorando al terminar
Presupuesto corto, tasa pequeña
Aumentar recursos manteniendo los demás controles
Oscila o se vuelve no finita
Tasa, escala, acumulación de gradientes, precisión
Revisar magnitud de actualizaciones y reducir tasa en un experimento controlado
Entrenamiento mejora y validación empeora
Mayor ajuste a particularidades del entrenamiento
Comparar checkpoint, regularización y replicaciones
Exactitud similar y BCE distinta
Diferencias de probabilidades y confianza
Leer pérdida y ejemplos; decidir según el objetivo declarado
Una red mayor apenas mejora
Ganancia pequeña frente a costo y variación
Aplicar tolerancia y presupuesto definidos antes de buscar
Cambia mucho entre semillas
Inestabilidad de optimización en la partición
Comparar diferencias emparejadas y revisar la receta completa
Cambia entre pliegues o periodos
Dependencia de muestra, grupos o distribución
Evaluación externa adecuada y análisis por subpoblación o tiempo
Mejor resultado en el borde del rango
Rango posiblemente limitado
Ampliar con registro de nuevo presupuesto y decisiones
Cada observación admite varias explicaciones. Los gráficos orientan la investigación; una decisión necesita una comparación que mantenga controles pertinentes. «Más capas», «menos ruido» o «más épocas» no son diagnósticos por sí solos.
8.18.1 Experimentos para continuar
Ancho frente a profundidad. Compara dos arquitecturas con cantidades de parámetros similares. Conserva presupuesto y varias semillas. Explica qué diferencias de composición permanecen aunque el tamaño sea comparable.
Tasa y lote. Declara un presupuesto de tiempo y un espacio de tasas por lote. Selecciona en validación; contrasta con la comparación de tasa fija y épocas iguales.
Cambio de métrica. Repite la selección con exactitud balanceada como criterio principal y BCE como desempate. Define la regla antes de ejecutar. Explica por qué pueden cambiar las elecciones.
Programa de tasas. Compara tasa constante con un descenso coseno bajo el mismo número de pasos. Registra amplitud, duración y, si existe, warmup. No cambies simultáneamente arquitectura y regularización.
Detención y poda. Revisa candidatos descartados a pocas épocas con un presupuesto mayor. Identifica si se eliminaron configuraciones que aprendían lentamente; no utilices prueba para decidir el descarte.
Estabilidad del procedimiento. Repite todo el protocolo con otras particiones reservadas o una validación anidada para redes. Distingue variabilidad de semilla, muestra y selección.
En cada experimento escribe antes qué quieres decidir, qué mantendrás fijo, cómo medirás el resultado y cuánto puedes gastar. Al terminar, explica el tamaño de la mejora, su variación y la acción que permite tomar. Si la evidencia no distingue candidatos, conservar una solución simple y estable puede ser una decisión razonada.
8.19 Contrato común y persistencia
Se mantiene la selección por validación y el reajuste final con un presupuesto fijado antes de consultar prueba. La persistencia conserva el estado final y el registro de selección; no convierte la prueba en una etapa adicional de búsqueda.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 4 | archivos registrados: 25
8.19.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
La búsqueda mantuvo tres semillas por configuración y seleccionó ancho 16, L2 cero y tasa 0,02. El reajuste prefijado de 158 épocas produjo BCE de prueba 0,13698 y exactitud balanceada 0,955, frente a 0,5 de la frecuencia. La tolerancia de selección favorece menor tamaño cuando la mejora media es pequeña; no se escogió una semilla afortunada mirando prueba. Se conservaron las comparaciones por épocas y por actualizaciones, y los registros distinguen coste de búsqueda de calidad. Se añadió persistencia verificable sin cambiar la búsqueda ni los comparadores SVC.
La armonización verificó identidad de parámetros y buffers tras recarga de 4 módulos presentes al cierre; archivó 25 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.
Li y colaboradores (2017), Hyperband: asignación adaptativa de recursos.
Las cifras y curvas del capítulo proceden de las ejecuciones guardadas. Los resultados ilustran el protocolo sobre datos sintéticos; no constituyen estimaciones de desempeño sobre poblaciones reales.