Este anexo es para ti si ya programas en Python pero nunca has entrenado una red neuronal ni has usado PyTorch. No damos nada por sabido sobre redes: cada palabra nueva se define la primera vez que aparece, y al final hay un glosario con todas.
Vamos a trabajar con un solo ejemplo, muy pequeño: cinco puntos que siguen la recta y = 2x + 1. Como ya conocemos la respuesta, vas a poder ver con tus propios ojos cómo el modelo la descubre, paso a paso. Los capítulos del libro hacen exactamente lo mismo con imágenes, textos y redes mucho más grandes; las piezas no cambian.
Tiempo estimado de lectura: 60 minutos.
Nivel: Básico.
Conocimientos previos: Python (listas, funciones, bucles y clases) y la idea de pendiente de una recta. No necesitas saber nada de redes neuronales.
Tecnologías: PyTorch, NumPy y Matplotlib.
Al terminar este anexo vas a ser capaz de:
explicar con tus palabras qué es una neurona artificial y qué significa que un modelo «aprenda»;
describir las cuatro etapas del entrenamiento: predecir, medir el error, calcular hacia dónde corregir y corregir;
crear tensores y revisar su forma y su tipo;
escribir y explicar, línea por línea, el bucle de entrenamiento de PyTorch;
usar un modelo entrenado para predecir, guardarlo y volver a cargarlo;
reconocer los errores más comunes de quien empieza.
A.1 Antes del código: qué es una red neuronal
Empecemos por tres palabras que vas a leer en todo el libro.
NotaModelo, predicción y respuesta real
Un modelo es una función que recibe datos y devuelve una respuesta. A esa respuesta se le llama predicción y se escribe ŷ (se lee «y gorro»). Para aprender, el modelo necesita ejemplos de los que conocemos la respuesta real, que se escribe y. Aprender consiste en que ŷ se parezca cada vez más a y.
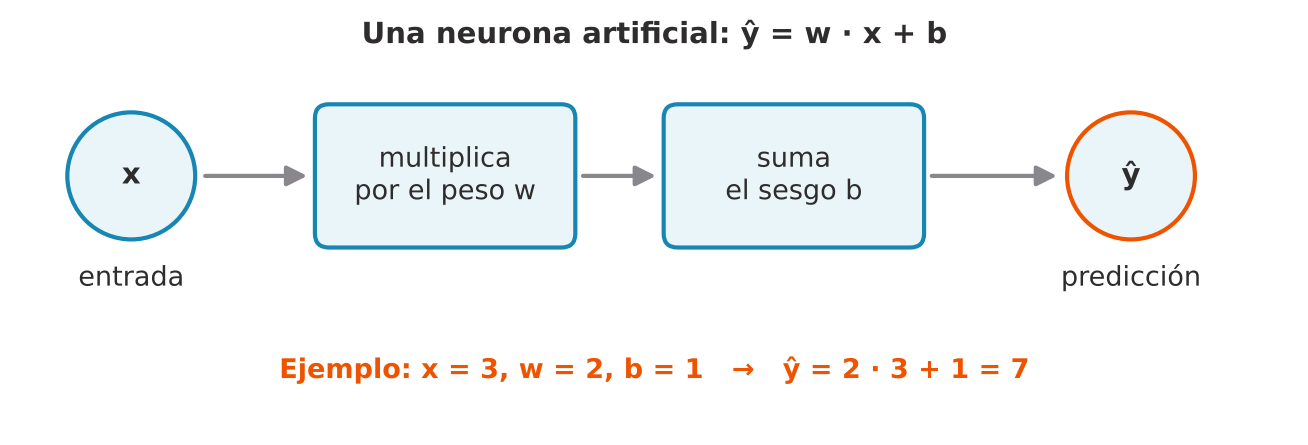
La pieza más pequeña de una red es la neurona artificial. Hace una cuenta muy simple: toma la entrada x, la multiplica por un número w y le suma otro número b.
Una neurona artificial multiplica la entrada por el peso y le suma el sesgo para producir la predicción.
NotaPeso, sesgo y parámetros
El peso w indica cuánto influye la entrada en la salida: si w es grande, un cambio pequeño en x cambia mucho a ŷ. El sesgo b es un valor que se suma siempre y sube o baja toda la salida. A los números que el modelo puede ajustar, como w y b, se les llama parámetros.
Con una sola entrada, la neurona dibuja una recta: w es la pendiente y b es el punto donde la recta corta el eje vertical. Una red neuronal es un conjunto de muchas neuronas organizadas en capas: grupos de neuronas que reciben la misma entrada, de modo que la salida de una capa es la entrada de la siguiente. Una red «profunda» tiene muchas capas, y de ahí viene el nombre deep learning. Las redes de los capítulos tienen miles o millones de parámetros; en este anexo empezamos con una sola neurona, es decir, con dos parámetros.
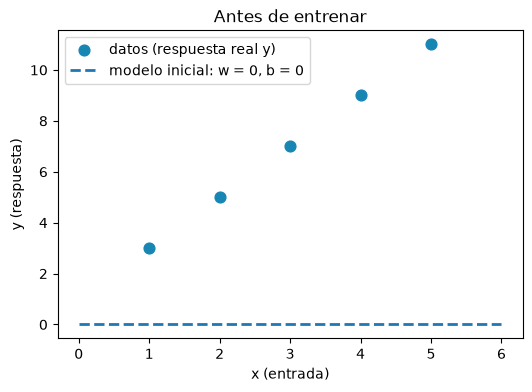
El problema que vamos a resolver es este: tenemos cinco puntos, (1, 3), (2, 5), (3, 7), (4, 9) y (5, 11). Nosotros sabemos que salen de y = 2x + 1, así que la neurona ideal tendría w = 2 y b = 1. El modelo no lo sabe: empezará con w = 0 y b = 0, y tendrá que descubrir esos valores mirando solo los cinco ejemplos.
A.2 Cómo aprende un modelo
Entrenar un modelo es ajustar sus parámetros, usando ejemplos, hasta que sus predicciones se parezcan a las respuestas reales. Se parece a afinar una receta: la pruebas, notas qué tan lejos está del sabor que buscas, decides si le falta o le sobra sal y corriges un poco. Luego repites.
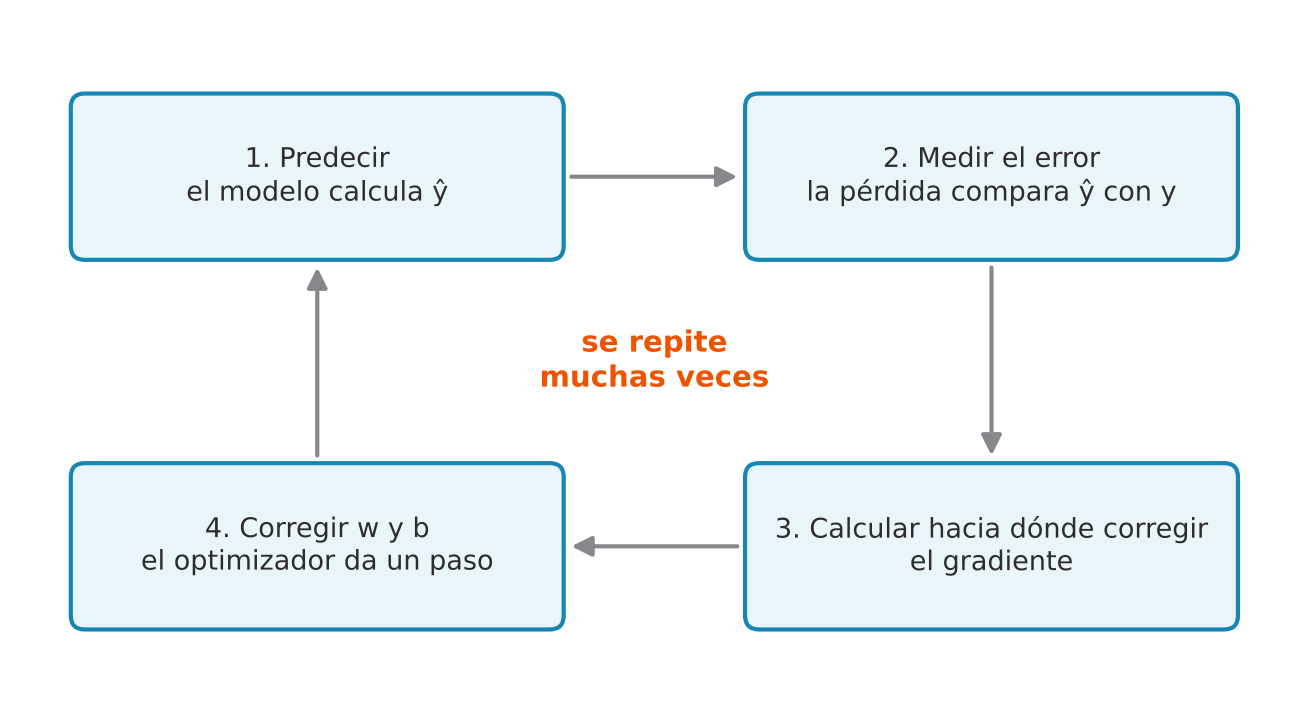
El entrenamiento es un ciclo de cuatro etapas que se repite muchas veces.
Cada etapa del ciclo tiene un nombre técnico:
NotaPérdida
La pérdida (en inglés, loss) es un número que mide qué tan equivocadas están las predicciones. Si vale 0, el modelo acierta todo; cuanto más grande, peor. Entrenar es buscar los parámetros que hacen la pérdida lo más pequeña posible.
NotaGradiente
La derivada de una función indica cuánto cambia su resultado cuando la entrada se mueve un poquito; en una gráfica, es la pendiente. El gradiente reúne las derivadas de la pérdida respecto a cada parámetro: para w y para b dice si conviene subirlos o bajarlos, y qué tan fuerte cambia la pérdida al moverlos.
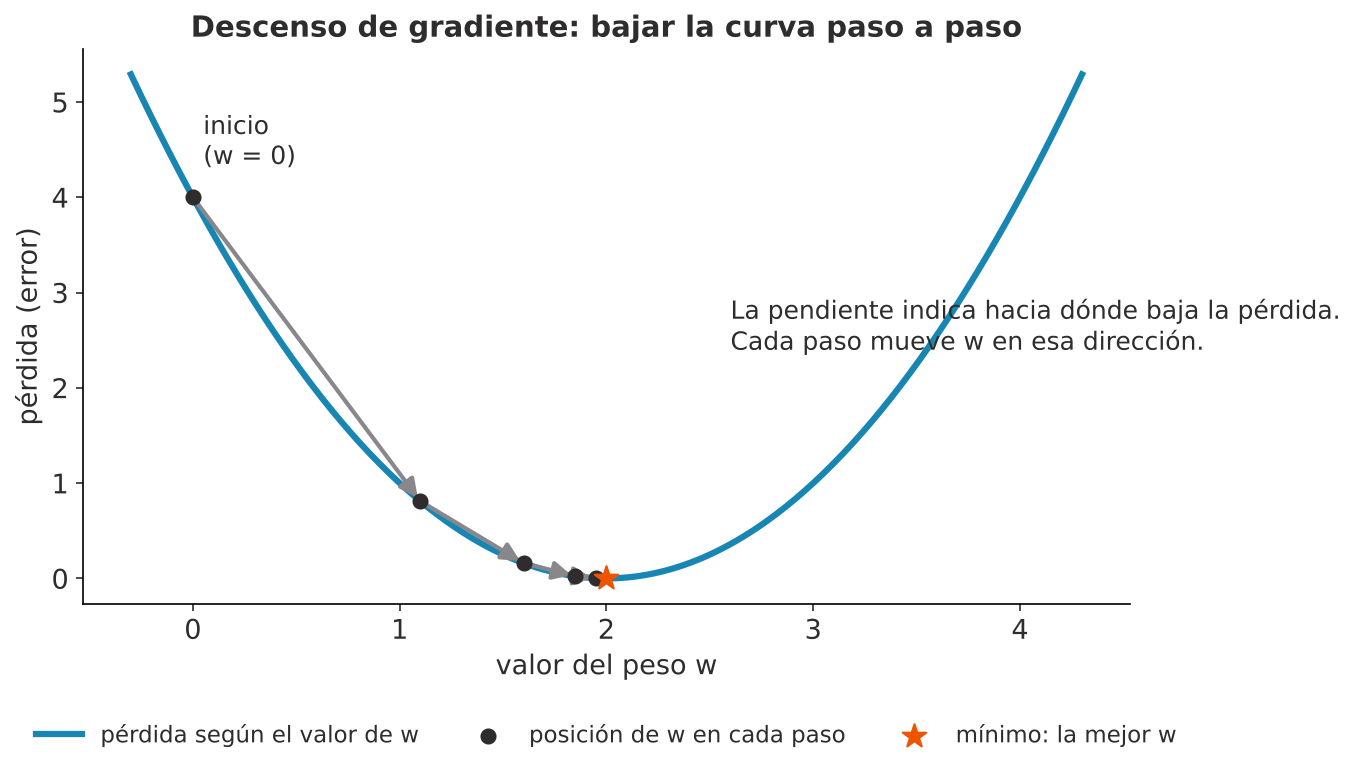
Una forma de verlo es bajar de una montaña con niebla hacia el valle: no se ve el camino, pero con los pies se siente hacia dónde baja el suelo. Se da un paso en esa dirección, se vuelve a sentir el suelo y se da otro. El gradiente es esa inclinación que se siente bajo los pies, y la estrategia completa se llama descenso de gradiente: mover cada parámetro un paso pequeño en la dirección en que baja la pérdida.
Ilustración del descenso de gradiente con un solo parámetro: cada paso mueve w hacia el mínimo de la pérdida.
NotaTasa de aprendizaje y optimizador
La tasa de aprendizaje decide el tamaño de cada paso. Si es muy pequeña, el modelo aprende muy despacio; si es muy grande, cada paso se pasa al otro lado del valle y el modelo empeora (lo verás en la sección de errores). El optimizador es la pieza que aplica la regla de corrección: nuevo valor = valor actual − tasa de aprendizaje × gradiente. Cada vuelta completa del ciclo se llama paso de entrenamiento.
La regla tiene un signo menos porque el gradiente apunta hacia donde la pérdida sube, y queremos ir en sentido contrario.
A.3 Qué es PyTorch
PyTorch es una biblioteca de Python para construir y entrenar redes neuronales. Hace dos trabajos pesados por ti: guarda los números en estructuras llamadas tensores, que veremos enseguida, y calcula los gradientes automáticamente, sin que tengas que derivar nada a mano. Cada etapa del ciclo tiene su herramienta:
Lo que necesitas
Herramienta de PyTorch
En este anexo
Guardar los datos
tensor (torch.tensor)
los cinco puntos
El modelo
capas de torch.nn
una neurona: nn.Linear(1, 1)
Medir el error (pérdida)
funciones de pérdida de torch.nn
nn.MSELoss()
Calcular el gradiente
.backward()
automático
Corregir los parámetros (optimizador)
torch.optim
torch.optim.SGD
Repetir el ciclo
un bucle for de Python
500 pasos
A.4 Instalar y comprobar
Si todavía no tienes PyTorch, instálalo en el mismo entorno donde corre tu Jupyter. Esta línea instala la versión para CPU (el procesador normal del computador), que alcanza para todo el anexo:
pip install torch numpy matplotlib
Si tienes una tarjeta gráfica NVIDIA y quieres usarla, la página oficial de instalación te da el comando para tu sistema. Para seguir el libro no hace falta.
La primera celda importa las bibliotecas y muestra sus versiones. Si corre sin errores, la instalación funciona. torch.nn (de neural networks) es la parte de PyTorch que trae las capas y las pérdidas ya hechas. La semilla fija el azar para que los resultados se repitan; en este anexo casi no hay azar, pero es costumbre del libro ponerla siempre.
La salida registra las versiones con las que se ejecutó este anexo. Con versiones distintas, los resultados deberían coincidir en los decimales que se muestran.
A.5 Tensores: donde PyTorch guarda los números
NotaTensor
Un tensor es una caja de números ordenados en una o más dimensiones. Es la estructura donde PyTorch guarda todo: los datos, los parámetros del modelo y los gradientes.
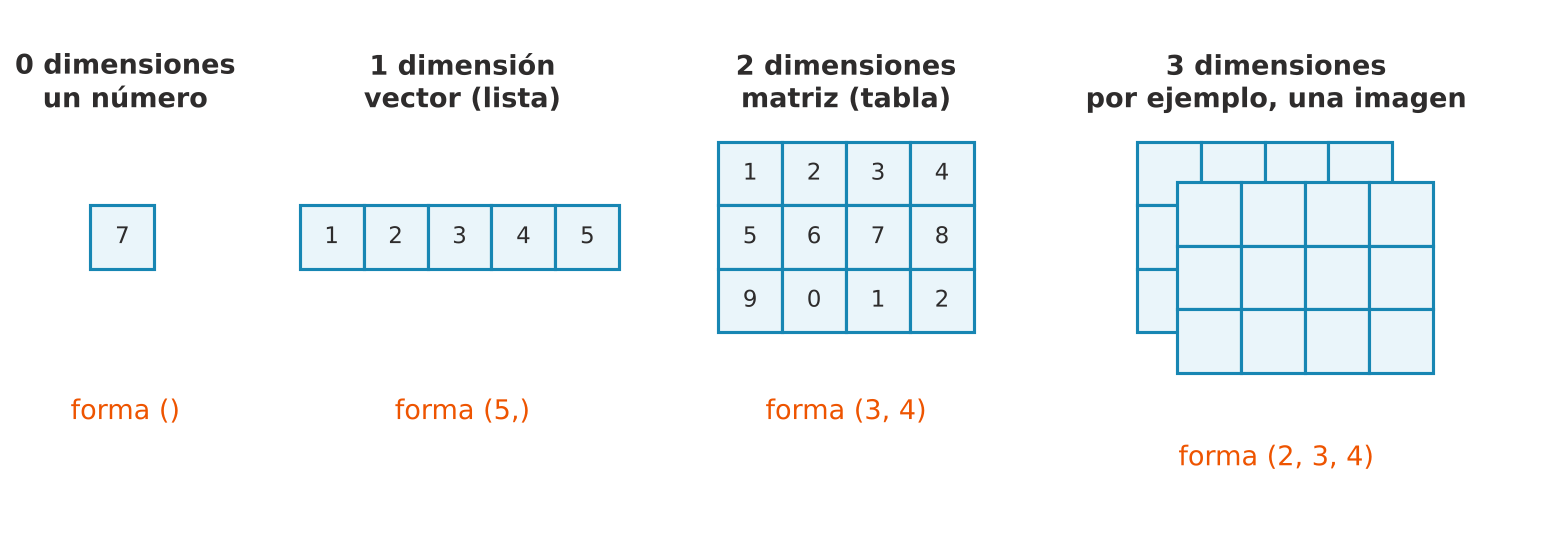
Tensores de cero, una, dos y tres dimensiones, con su forma.
Un número suelto es un tensor de 0 dimensiones; una lista, de 1; una tabla, de 2; una pila de tablas, como una imagen con varios canales de color, de 3. Se crea con torch.tensor a partir de una lista de Python.
x = torch.tensor([1.0, 2.0, 3.0, 4.0, 5.0])print(x)print("forma:", x.shape)print("tipo :", x.dtype)
tensor([1., 2., 3., 4., 5.])
forma: torch.Size([5])
tipo : torch.float32
A todo tensor conviene hacerle dos preguntas, porque de ahí vienen la mayoría de los errores de quien empieza:
NotaForma y tipo
La forma (shape) dice cuántos elementos hay en cada dimensión. El tipo (dtype) dice qué clase de números guarda. float32 son números decimales guardados con 32 bits: tienen precisión de sobra para entrenar redes y ocupan la mitad de memoria que float64, por eso es el tipo estándar.
La salida dice que x tiene forma torch.Size([5]), una dimensión con cinco valores, y tipo torch.float32. Escribimos 1.0 y no 1 a propósito: con enteros, PyTorch habría creado un tensor de tipo int64, y las capas de una red solo aceptan decimales.
A.5.1 Los datos como una tabla
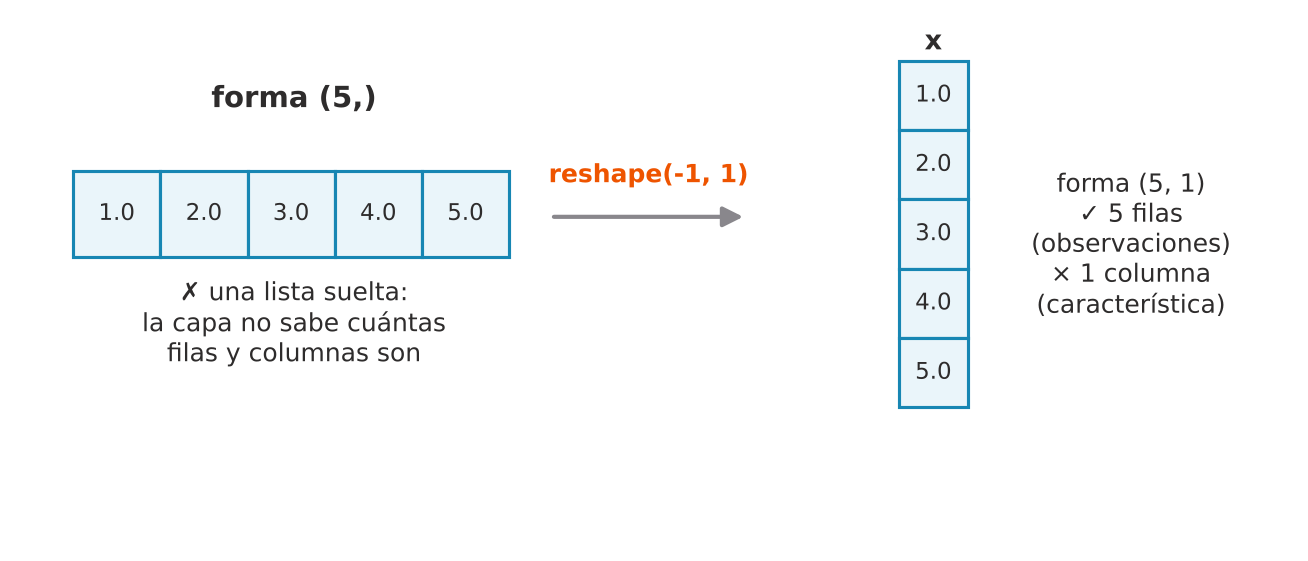
Las capas de PyTorch esperan los datos como una tabla: una fila por observación (cada ejemplo, aquí cada punto) y una columna por característica (cada dato que describe al ejemplo, aquí solo x). Una lista suelta de forma (5,) no es una tabla, así que la convertimos en una columna de forma (5, 1).
Conversión de la forma (5,) a la forma (5, 1) con reshape.
reshape(-1, 1) reorganiza los valores en una columna; el -1 le pide a PyTorch que calcule por su cuenta cuántas filas salen. Con x lista, calculamos las respuestas reales con la fórmula de la recta.
x = x.reshape(-1, 1)y =2* x +1print("forma de x:", x.shape)print("forma de y:", y.shape)print(torch.cat([x, y], dim=1))
forma de x: torch.Size([5, 1])
forma de y: torch.Size([5, 1])
tensor([[ 1.,  3.],
        [ 2.,  5.],
        [ 3.,  7.],
        [ 4.,  9.],
        [ 5., 11.]])
Ahora x e y tienen forma torch.Size([5, 1]). torch.cat pega las dos columnas una al lado de la otra (dim=1 significa «por columnas») para que veas la tabla completa: cuando x vale 3, y vale 7. La operación 2 * x + 1 se aplicó a cada fila por separado, igual que en NumPy.
A.5.2 Ir y volver de NumPy
Muchas veces los datos llegan como arreglos de NumPy. torch.from_numpy los convierte en tensores y .numpy() hace el camino de vuelta.
a = np.array([10.0, 20.0, 30.0])t = torch.from_numpy(a)print(t, t.dtype)print(t.numpy())
NumPy usa por defecto el tipo float64, y el tensor lo conserva, como muestra torch.float64 en la salida. Antes de entregárselo a una red hay que pasarlo a float32 con t.float(). El camino de vuelta, .numpy(), sirve para graficar o para calcular métricas con otras bibliotecas.
A.6 Gradientes automáticos
Para entrenar, PyTorch tiene que calcular derivadas. Antes de aplicarlo a la neurona, probemos con una función cuya derivada ya conoces: f(z) = z², cuya derivada es 2z. En z = 3 la derivada debe valer 6.
El procedimiento tiene tres partes. Marcas el tensor con requires_grad=True, que le pide a PyTorch que anote cada cuenta que se haga con él. Después haces la cuenta. Por último llamas a .backward(), que recorre esas anotaciones hacia atrás y deja la derivada guardada en el atributo .grad del tensor.
z = torch.tensor(3.0, requires_grad=True)f = z **2f.backward()print("f(3) =", f.item())print("f'(3) =", z.grad.item())
f(3)  = 9.0
f'(3) = 6.0
PyTorch devolvió 6.0, el mismo valor que da la regla 2z, sin que escribiéramos ninguna fórmula de derivada. .item() saca el número de un tensor que tiene un solo elemento. En el entrenamiento ocurrirá lo mismo, pero con la pérdida en lugar de f y con w y b en lugar de z.
A.6.1 Cuidado: los gradientes se acumulan
Si llamas a .backward() dos veces, PyTorch suma el nuevo gradiente al que ya estaba guardado, en lugar de reemplazarlo.
z = torch.tensor(3.0, requires_grad=True)(z **2).backward()print("después de la primera vez:", z.grad.item())(z **2).backward()print("después de la segunda vez:", z.grad.item())z.grad.zero_()print("después de borrar :", z.grad.item())
después de la primera vez: 6.0
después de la segunda vez: 12.0
después de borrar        : 0.0
La derivada sigue siendo 6, pero z.grad pasó a 12.0 porque sumó las dos llamadas; z.grad.zero_() lo devolvió a 0.0. Por eso en el bucle de entrenamiento habrá una línea que borra los gradientes antes de calcular los nuevos. Si la olvidas, el modelo se corrige con números equivocados.
A.7 El modelo: una neurona en PyTorch
La neurona del primer diagrama ya viene hecha en PyTorch: se llama nn.Linear(1, 1). Los dos números dicen cuántas entradas recibe (1) y cuántas salidas produce (1). Por dentro guarda un peso, modelo.weight, y un sesgo, modelo.bias.
PyTorch inicia los parámetros con valores al azar. Para que puedas seguir las cuentas a mano, aquí los ponemos en cero. El cambio se hace dentro de torch.no_grad(), un bloque que le dice a PyTorch: «esto no es parte del entrenamiento, no anotes nada para los gradientes».
Linear(in_features=1, out_features=1, bias=True)
w = 0.0   b = 0.0
predicciones iniciales: [0.0, 0.0, 0.0, 0.0, 0.0]
Con w = 0.0 y b = 0.0 la neurona predice 0.0 para los cinco puntos. Llamar al modelo como si fuera una función, modelo(x), calcula la predicción de todas las filas a la vez.
Para ver qué tan lejos estamos, dibujamos los datos y la recta que representa el modelo. La función dibujar_rectas la reutilizaremos varias veces: recibe una lista de rectas, cada una con su w, su b, una etiqueta y un estilo de línea.
def dibujar_rectas(rectas, titulo): extremos = [0, 6] plt.figure(figsize=(6, 4)) plt.scatter(x.flatten().tolist(), y.flatten().tolist(), color="#1786B3", s=60, zorder=3, label="datos (respuesta real y)")for w, b, etiqueta, estilo in rectas: plt.plot(extremos, [w * extremos[0] + b, w * extremos[1] + b], estilo, lw=2, label=etiqueta) plt.xlabel("x (entrada)") plt.ylabel("y (respuesta)") plt.title(titulo) plt.legend() plt.show()dibujar_rectas([(0.0, 0.0, "modelo inicial: w = 0, b = 0", "--")], "Antes de entrenar")
Los cinco puntos de entrenamiento y la recta inicial del modelo (w = 0, b = 0).
La recta del modelo es la línea horizontal y = 0: está por debajo de todos los puntos, a 3 unidades del primero y a 11 del último. El entrenamiento tiene que inclinarla y subirla hasta que pase por ellos.
A.8 Medir el error: la pérdida
Para este problema usamos como pérdida el error cuadrático medio (MSE, por mean squared error): para cada punto se resta la predicción a la respuesta real, se eleva al cuadrado y se promedia. Con N puntos:
En palabras: L es el promedio de los errores al cuadrado. Se elevan al cuadrado para que los errores por arriba y por abajo no se cancelen, y para castigar más los errores grandes. Con el modelo en cero, la cuenta a mano es esta:
x
y real
ŷ (w = 0, b = 0)
error y − ŷ
error²
1
3
0
3
9
2
5
0
5
25
3
7
0
7
49
4
9
0
9
81
5
11
0
11
121
suma
285
El promedio es 285 / 5 = 57. Veamos si PyTorch obtiene lo mismo.
PyTorch calculó 57.0, igual que la tabla. nn.MSELoss() crea la función de pérdida, y se usa pasándole primero las predicciones y después las respuestas reales.
A.9 El optimizador
El optimizador aplica la regla de corrección que vimos al principio. Usamos torch.optim.SGD, la versión más simple del descenso de gradiente. Sus siglas vienen de stochastic gradient descent: la palabra «estocástico» se refiere a usar en cada paso solo una parte de los datos; aquí usamos los cinco puntos en todos los pasos, pero la herramienta es la misma.
Al crearlo le damos dos cosas: qué parámetros puede modificar, con modelo.parameters() (aquí, w y b), y la tasa de aprendizaje, lr (de learning rate), que fijamos en 0.05.
La salida resume la configuración del optimizador; el dato que nos importa es lr: 0.05. Las demás opciones quedan en sus valores por defecto y no las necesitamos.
A.10 El bucle de entrenamiento, paso a paso
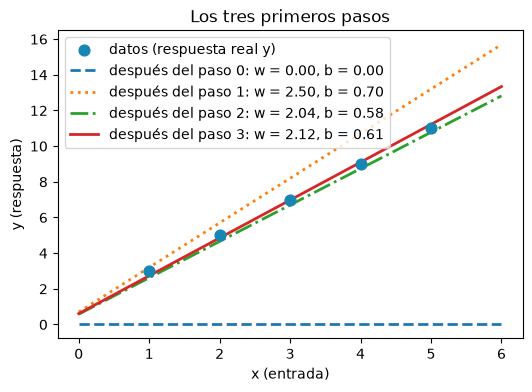
Ya tenemos todas las piezas. Un paso de entrenamiento son cinco líneas, que corresponden a las cuatro etapas del ciclo más la limpieza de los gradientes. Antes de repetirlo cientos de veces, demos solo tres pasos y miremos qué cambia en cada uno. Las listas historial y perdidas guardan los valores para graficarlos después.
historial = [(modelo.weight.item(), modelo.bias.item())] # (w, b) antes de entrenarperdidas = []for paso inrange(1, 4): optimizador.zero_grad() # 0. borrar los gradientes anteriores prediccion = modelo(x) # 1. predecir perdida = perdida_fn(prediccion, y) # 2. medir el error perdida.backward() # 3. calcular el gradiente optimizador.step() # 4. corregir w y b w = modelo.weight.item() b = modelo.bias.item() historial.append((w, b)) perdidas.append(perdida.item())print(f"paso {paso}: pérdida = {perdida.item():.4f} w = {w:.4f} b = {b:.4f}")
paso 1: pérdida = 57.0000   w = 2.5000   b = 0.7000
paso 2: pérdida = 1.9400   w = 2.0400   b = 0.5800
paso 3: pérdida = 0.0932   w = 2.1220   b = 0.6100
En el primer paso la pérdida era 57.0000, y una sola corrección llevó a w de 0 a 2.5000 y a b de 0 a 0.7000. En el segundo paso la pérdida bajó a 1.9400 y en el tercero a 0.0932. El peso w se pasó de 2 (llegó a 2.5000) y luego volvió (2.0400): como en la montaña con niebla, cada paso va en la dirección correcta, aunque no siempre cae justo en el valle. La gráfica muestra la recta después de cada paso.
estilos = ["--", ":", "-.", "-"]rectas = []for numero, (w, b) inenumerate(historial): rectas.append((w, b, f"después del paso {numero}: w = {w:.2f}, b = {b:.2f}", estilos[numero]))dibujar_rectas(rectas, "Los tres primeros pasos")
La recta del modelo antes de entrenar y después de cada uno de los tres primeros pasos.
Después del paso 1 la recta ya tiene pendiente 2.50, demasiado inclinada; en el paso 2 se corrige a 2.04 y en el paso 3 queda en 2.12, mientras b se mueve poco (0.70, 0.58, 0.61). Todavía no es la recta correcta, pero ya pasa cerca de los cinco puntos.
Esta tabla resume qué hace cada línea del bucle y qué pasa si la olvidas:
Línea
Etapa
Qué hace
Si la olvidas
optimizador.zero_grad()
limpieza
Pone los gradientes en cero
Se suman con los del paso anterior y las correcciones salen mal
modelo(x)
1. predecir
Calcula ŷ para todas las filas
No hay nada que medir
perdida_fn(prediccion, y)
2. medir el error
Calcula la pérdida
No hay nada que derivar
perdida.backward()
3. calcular el gradiente
Deja en .grad el gradiente de la pérdida respecto a w y b
El optimizador no tiene con qué corregir
optimizador.step()
4. corregir
Aplica la regla: valor − lr × gradiente
Los parámetros nunca cambian
A.10.1 Repetirlo muchas veces
Entrenar es repetir esas cinco líneas. Continuamos hasta completar 500 pasos e imprimimos cada 100 para no llenar la pantalla.
for paso inrange(4, 501): optimizador.zero_grad() prediccion = modelo(x) perdida = perdida_fn(prediccion, y) perdida.backward() optimizador.step() perdidas.append(perdida.item())if paso %100==0: w = modelo.weight.item() b = modelo.bias.item()print(f"paso {paso}: pérdida = {perdida.item():.6f} w = {w:.4f} b = {b:.4f}")
paso 100: pérdida = 0.001068   w = 2.0209   b = 0.9247
paso 200: pérdida = 0.000035   w = 2.0038   b = 0.9863
paso 300: pérdida = 0.000001   w = 2.0007   b = 0.9975
paso 400: pérdida = 0.000000   w = 2.0001   b = 0.9995
paso 500: pérdida = 0.000000   w = 2.0000   b = 0.9999
A los 100 pasos el modelo tenía w = 2.0209 y b = 0.9247; a los 500 llegó a w = 2.0000 y b = 0.9999, prácticamente la recta y = 2x + 1 con la que se generaron los datos. El modelo la encontró sin conocer la fórmula, solo a partir de los cinco ejemplos. Desde el paso 400 la pérdida se imprime como 0.000000 porque es menor que una millonésima.
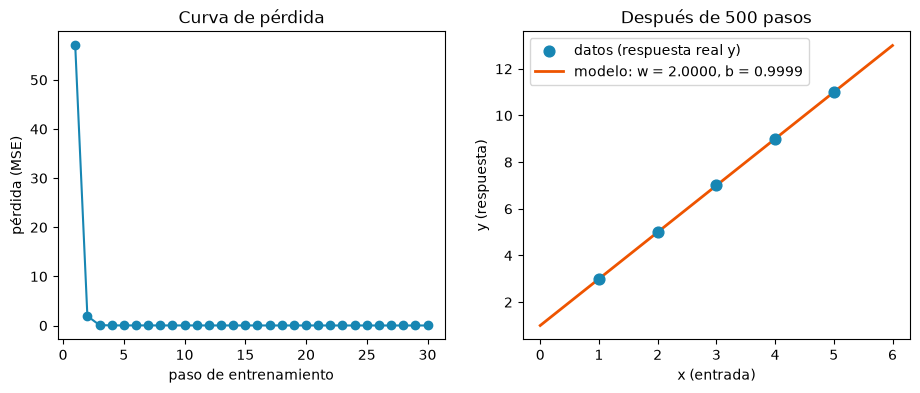
La curva de pérdida, que muestra la pérdida en cada paso, es la gráfica que más vas a ver en el libro: es la forma de saber si un modelo está aprendiendo cuando tiene demasiados parámetros para seguirlos uno por uno.
w_final = modelo.weight.item()b_final = modelo.bias.item()fig, (izq, der) = plt.subplots(1, 2, figsize=(11, 4))izq.plot(range(1, 31), perdidas[:30], "o-", color="#1786B3")izq.set_xlabel("paso de entrenamiento")izq.set_ylabel("pérdida (MSE)")izq.set_title("Curva de pérdida")der.scatter(x.flatten().tolist(), y.flatten().tolist(), color="#1786B3", s=60, zorder=3, label="datos (respuesta real y)")der.plot([0, 6], [b_final, w_final *6+ b_final], "-", color="#EE5400", lw=2, label=f"modelo: w = {w_final:.4f}, b = {b_final:.4f}")der.set_xlabel("x (entrada)")der.set_ylabel("y (respuesta)")der.set_title("Después de 500 pasos")der.legend()plt.show()
Izquierda: pérdida en los primeros 30 pasos. Derecha: recta aprendida tras 500 pasos frente a los datos.
La curva de la izquierda arranca en 57 y en el paso 3 ya vale 0.0932, tan cerca de cero que a esta escala la línea queda pegada al eje horizontal. Esa forma, una caída fuerte al principio y luego una meseta, es la de un entrenamiento que funciona. A la derecha, la recta con w = 2.0000 y b = 0.9999 pasa por los cinco puntos.
A.11 Usar el modelo para predecir
Entrenamos un modelo para usarlo con datos que no ha visto. Predecir es llamarlo con entradas nuevas, con dos precauciones que vas a encontrar en todos los capítulos:
modelo.eval() pone el modelo en modo de uso. En una neurona sola no cambia nada, pero algunas capas de las redes grandes se comportan distinto al entrenar y al predecir, así que conviene ponerlo siempre.
torch.no_grad() le indica a PyTorch que no anote cuentas para gradientes, porque no vamos a entrenar. Ahorra memoria y tiempo.
x =  10.0  ->  predicción = 21.000   (valor exacto: 21)
x =  -2.0  ->  predicción = -3.000   (valor exacto: -3)
Para x = 10 el modelo predice 21.000 y para x = −2 predice −3.000, los mismos valores que da la recta, aunque ninguno de esos puntos estaba en los datos de entrenamiento. Fíjate en que x_nuevo se escribió como una columna, [[10.0], [-2.0]], con forma (2, 1): el modelo siempre espera la misma forma de tabla que usamos al entrenar.
A.12 Guardar y cargar el modelo
Lo que aprendió el modelo está en sus parámetros. PyTorch los entrega en un diccionario llamado state_dict (estado del modelo), que asocia el nombre de cada parámetro con su valor. Para guardar el modelo se guarda ese diccionario; para cargarlo, se crea un modelo con la misma estructura y se le pasan los valores guardados. La celda crea el archivo recta.pt en la carpeta del notebook.
print(modelo.state_dict())torch.save(modelo.state_dict(), "recta.pt")modelo_cargado = nn.Linear(1, 1)modelo_cargado.load_state_dict(torch.load("recta.pt"))modelo_cargado.eval()with torch.no_grad(): prediccion_10 = modelo_cargado(torch.tensor([[10.0]])).item()print("predicción del modelo cargado para x = 10:", round(prediccion_10, 3))
OrderedDict({'weight': tensor([[2.0000]]), 'bias': tensor([0.9999])})
predicción del modelo cargado para x = 10: 21.0
El diccionario tiene dos entradas, weight con 2.0000 y bias con 0.9999: eso es todo lo que el modelo aprendió. El modelo cargado da la misma predicción para x = 10, 21.0. Guardar el state_dict, y no el objeto completo, es lo que recomienda la documentación de PyTorch, porque el archivo no queda atado a cómo estaba escrito tu código.
A.13 De una neurona a una red
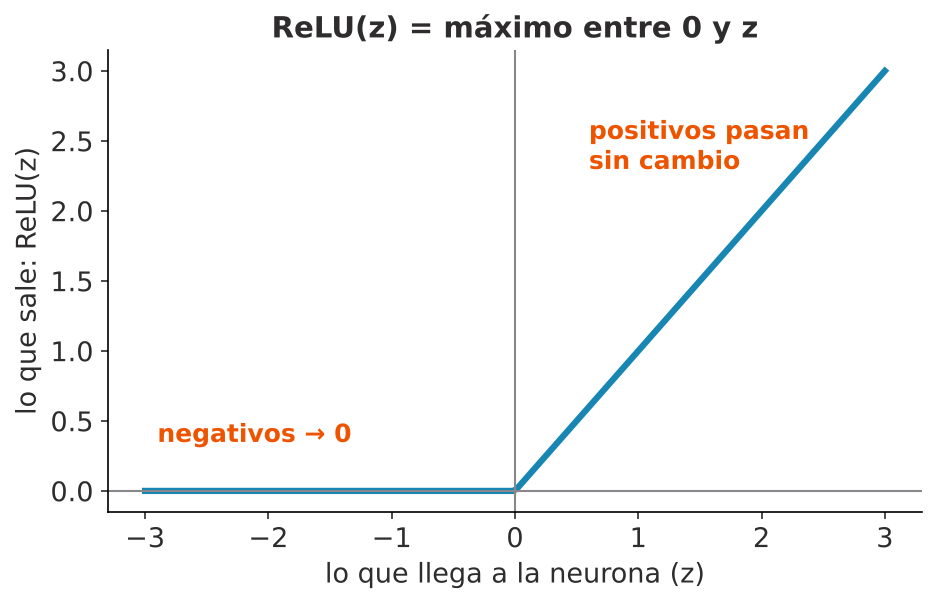
Una neurona sola solo puede dibujar rectas. Para aprender curvas hacen falta varias neuronas y una función de activación entre capas: una operación que dobla la salida de cada neurona para que la red no sea, al final, otra recta. La más usada es ReLU, que deja pasar los valores positivos y convierte los negativos en cero.
La función ReLU deja los valores positivos igual y convierte los negativos en cero.
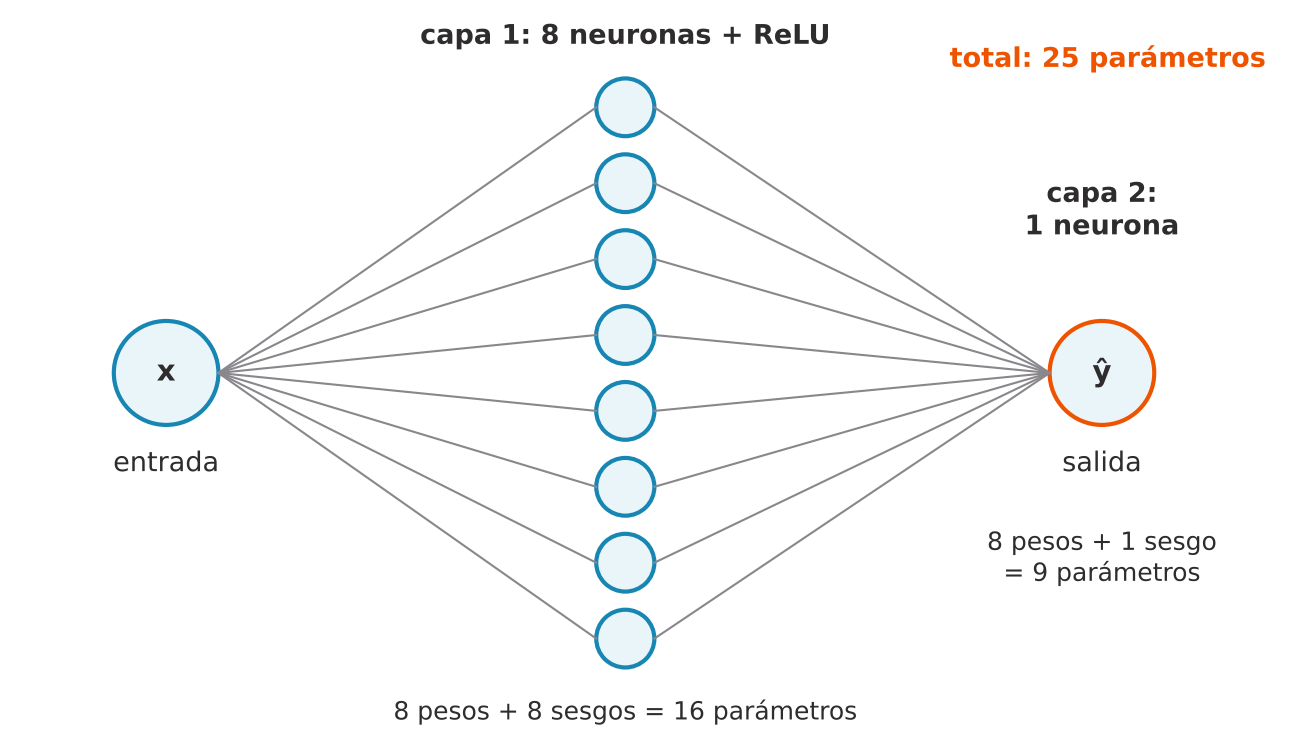
Para armar una red con varias capas en PyTorch se escribe una clase que hereda de nn.Module. Tiene dos partes: en __init__ se crean las capas y en forward se dice por qué capas pasa el dato y en qué orden. Esta red tiene una capa de 8 neuronas con ReLU y una capa de salida con una neurona.
Red pequeña con una entrada, ocho neuronas con ReLU y una salida.
class RedPequena(nn.Module):def__init__(self):super().__init__()self.capa1 = nn.Linear(1, 8) # 1 entrada -> 8 neuronasself.activacion = nn.ReLU()self.capa2 = nn.Linear(8, 1) # 8 entradas -> 1 neurona de salidadef forward(self, x): x =self.capa1(x) x =self.activacion(x) x =self.capa2(x)return xred = RedPequena()print(red)print("forma de la salida:", red(x).shape)total =0for nombre, parametro in red.named_parameters():print(f"{nombre:13s} forma {tuple(parametro.shape)}") total += parametro.numel()print("parámetros en total:", total)
RedPequena(
  (capa1): Linear(in_features=1, out_features=8, bias=True)
  (activacion): ReLU()
  (capa2): Linear(in_features=8, out_features=1, bias=True)
)
forma de la salida: torch.Size([5, 1])
capa1.weight  forma (8, 1)
capa1.bias    forma (8,)
capa2.weight  forma (1, 8)
capa2.bias    forma (1,)
parámetros en total: 25
La red recibe la misma x de forma (5, 1) y devuelve torch.Size([5, 1]), una predicción por fila. Tiene 25 parámetros, los mismos del diagrama: 8 pesos y 8 sesgos en la primera capa, y 8 pesos y 1 sesgo en la segunda. Para entrenarla se usa el mismo bucle de cinco líneas; solo cambia la línea donde se crea el modelo.
capa1.weight tiene forma (8, 1) y no (1, 8) porque PyTorch guarda los pesos de nn.Linear como (salidas, entradas). Las convenciones de lectura del libro recogen este y otros detalles de notación.
A.14 Lotes y épocas
Con cinco puntos podemos usar todos los datos en cada paso. Con miles de imágenes no caben en memoria a la vez, y se entrena por partes.
NotaLote y época
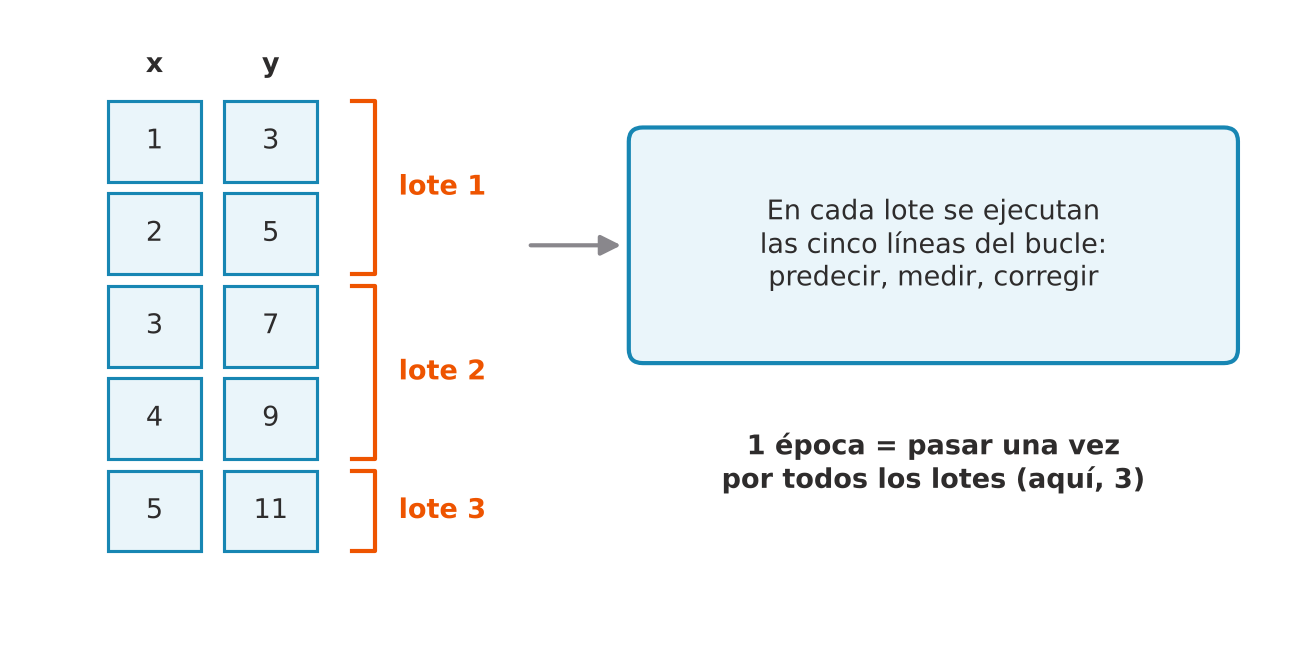
Un lote (batch) es un grupo pequeño de filas con el que se da un paso de entrenamiento. Una época es una pasada completa por todos los datos, es decir, por todos los lotes.
Cinco filas divididas en tres lotes; una época recorre los tres.
PyTorch hace la división con dos herramientas: TensorDataset junta x e y fila con fila, y DataLoader los entrega de a lotes del tamaño que le pidas.
from torch.utils.data import DataLoader, TensorDatasetdatos = TensorDataset(x, y)cargador = DataLoader(datos, batch_size=2, shuffle=False)for numero, (x_lote, y_lote) inenumerate(cargador, start=1):print(f"lote {numero}: x = {x_lote.flatten().tolist()} y = {y_lote.flatten().tolist()}")
lote 1: x = [1.0, 2.0]   y = [3.0, 5.0]
lote 2: x = [3.0, 4.0]   y = [7.0, 9.0]
lote 3: x = [5.0]   y = [11.0]
Con batch_size=2 los cinco puntos salieron en tres lotes, igual que en el diagrama: dos de dos filas y uno final con la fila que sobraba (x = 5.0). Al entrenar se usa shuffle=True para que las filas cambien de orden en cada época; aquí lo dejamos en False para que la salida sea fácil de leer. La plantilla del final del anexo muestra cómo se combinan épocas y lotes en el bucle.
A.15 CPU o GPU
La CPU es el procesador normal del computador. La GPU es la tarjeta gráfica: hace miles de multiplicaciones a la vez y por eso acelera mucho el entrenamiento de redes grandes. PyTorch llama "cuda" a la GPU, por el nombre del sistema de NVIDIA que usa para manejarla. Esta línea elige la GPU si existe y, si no, la CPU:
dispositivo elegido: cpu
modelo en: cpu   datos en: cpu
La salida indica en qué dispositivo se ejecutó este anexo. La regla es una sola: el modelo y los datos tienen que estar en el mismo dispositivo, y .to(dispositivo) mueve ambos.
A.16 Los errores más comunes al empezar
Vamos a provocar a propósito dos de los errores más frecuentes, para que los reconozcas cuando te aparezcan. El primero: entregarle a la capa una lista suelta de forma (5,) en lugar de una columna.
modelo_prueba = nn.Linear(1, 1)x_plano = torch.tensor([1.0, 2.0, 3.0, 4.0, 5.0]) # forma (5,): le falta la columnatry: modelo_prueba(x_plano)exceptRuntimeErroras error:print("Error:", error)
Error: mat1 and mat2 shapes cannot be multiplied (1x5 and 1x1)
El mensaje mat1 and mat2 shapes cannot be multiplied (1x5 and 1x1) dice que PyTorch leyó los cinco valores como una sola fila con cinco columnas (1x5), cuando la capa esperaba una columna. Es el caso de la izquierda del diagrama de formas, y se arregla con x_plano.reshape(-1, 1).
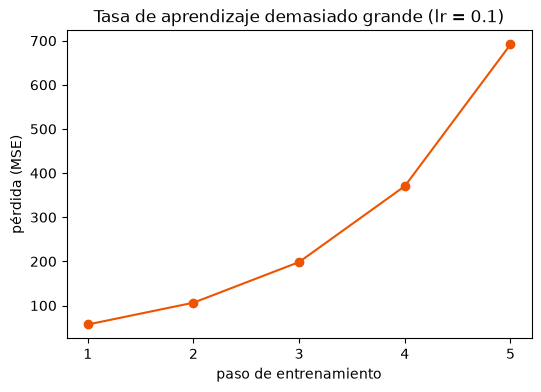
El segundo: una tasa de aprendizaje demasiado grande. Entrenamos la misma neurona desde cero, pero con lr=0.1 en lugar de 0.05.
paso 1: pérdida = 57.0   w = 5.00
paso 2: pérdida = 106.4   w = -1.84
paso 3: pérdida = 198.5   w = 7.50
paso 4: pérdida = 370.5   w = -5.27
paso 5: pérdida = 691.4   w = 12.16
plt.figure(figsize=(6, 4))plt.plot(range(1, 6), perdidas_rapidas, "o-", color="#EE5400")plt.xlabel("paso de entrenamiento")plt.ylabel("pérdida (MSE)")plt.title("Tasa de aprendizaje demasiado grande (lr = 0.1)")plt.xticks(range(1, 6))plt.show()
Con una tasa de aprendizaje de 0.1 la pérdida crece en cada paso.
La pérdida casi se duplica en cada paso: 57.0, 106.4, 198.5, 370.5 y 691.4, justo lo contrario de la curva que bajaba con lr = 0.05. El peso salta de un lado a otro de su valor correcto (5.00, −1.84, 7.50…) y cada vez queda más lejos. En el dibujo de la montaña, cada paso es tan largo que cruza el valle y aterriza más arriba en la ladera opuesta. Si en tus experimentos la pérdida sube o aparece nan («no es un número», lo que PyTorch muestra cuando los valores se desbordan), prueba primero una tasa más pequeña.
Esta tabla reúne los errores que más vas a ver, con un fragmento del mensaje para reconocerlos:
Lo que ves
Qué pasó
Cómo se arregla
shapes cannot be multiplied
La forma de los datos no es la que espera la capa
Revisa x.shape; usa reshape(-1, 1)
mat1 and mat2 must have the same dtype
Entraron enteros o float64 a la red
Convierte con .float()
Expected all tensors to be on the same device
El modelo está en la GPU y los datos en la CPU, o al revés
Mueve ambos con .to(dispositivo)
Can't call numpy() on Tensor that requires grad
Pasas a NumPy un tensor que PyTorch está anotando para gradientes
Usa .detach().numpy() o predice dentro de torch.no_grad()
La pérdida sube o aparece nan
Tasa de aprendizaje demasiado grande
Bájala, por ejemplo de 0.1 a 0.01
La pérdida no baja nunca
Falta zero_grad(), backward() o step()
Revisa que estén las cinco líneas del bucle
A.17 Plantilla para llevarte
Este es el esqueleto que vas a reconocer en los capítulos del libro. Junta todo lo del anexo: dispositivo, épocas, lotes, las cinco líneas y la predicción. modelo.train() es la pareja de modelo.eval(): pone el modelo en modo de entrenamiento al comienzo de cada época.
modelo = RedPequena().to(dispositivo)perdida_fn = nn.MSELoss() # para clasificar se usa nn.CrossEntropyLoss()optimizador = torch.optim.SGD(modelo.parameters(), lr=0.05)for epoca inrange(numero_de_epocas): # cada época recorre todos los lotes modelo.train() # modo entrenamientofor x_lote, y_lote in cargador: x_lote = x_lote.to(dispositivo) y_lote = y_lote.to(dispositivo) optimizador.zero_grad() # borrar gradientes prediccion = modelo(x_lote) # 1. predecir perdida = perdida_fn(prediccion, y_lote) # 2. medir el error perdida.backward() # 3. calcular el gradiente optimizador.step() # 4. corregirmodelo.eval() # modo de usowith torch.no_grad(): predicciones = modelo(x_nuevos.to(dispositivo))
En los capítulos verás con frecuencia torch.optim.Adam en lugar de SGD. Es otro optimizador que ajusta solo el tamaño del paso de cada parámetro; se usa exactamente igual.
A.18 Glosario del anexo
Término
Qué significa
En PyTorch
Modelo
Función que recibe datos y devuelve una predicción
nn.Linear, una clase de nn.Module
Predicción (ŷ)
La respuesta que da el modelo
modelo(x)
Respuesta real (y)
La respuesta correcta de cada ejemplo
el tensor y
Neurona
Calcula w · x + b
nn.Linear(1, 1)
Peso (w)
Cuánto influye la entrada en la salida
modelo.weight
Sesgo (b)
Valor que se suma siempre
modelo.bias
Parámetros
Los números que el modelo ajusta al entrenar
modelo.parameters()
Capa
Grupo de neuronas que reciben la misma entrada
cada nn.Linear de una red
Red neuronal
Varias capas encadenadas
una clase que hereda de nn.Module
Función de activación
Operación entre capas que permite aprender curvas
nn.ReLU()
Entrenar
Ajustar los parámetros con ejemplos para reducir la pérdida
el bucle de cinco líneas
Pérdida
Número que mide qué tan equivocadas están las predicciones
nn.MSELoss()
Gradiente
Hacia dónde y con qué fuerza cambia la pérdida al mover cada parámetro
.backward() y .grad
Descenso de gradiente
Mover los parámetros un paso en la dirección que baja la pérdida
optimizador.step()
Tasa de aprendizaje
Tamaño de cada paso
lr=0.05
Optimizador
La pieza que aplica la regla de corrección
torch.optim.SGD
Paso de entrenamiento
Una vuelta completa del ciclo
una iteración del bucle
Lote
Grupo de filas con el que se da un paso
DataLoader(..., batch_size=2)
Época
Una pasada por todos los lotes
el for externo de la plantilla
Curva de pérdida
Gráfica de la pérdida en cada paso o época
la lista perdidas
Tensor
Caja de números en una o más dimensiones
torch.tensor
Forma
Cuántos elementos hay en cada dimensión
.shape
Tipo
Clase de números que guarda el tensor
.dtype, normalmente float32
Dispositivo
Dónde se hacen las cuentas: CPU o GPU
.to("cpu"), .to("cuda")
Modo de uso
Estado del modelo para predecir
modelo.eval()
Estado del modelo
Diccionario con los parámetros aprendidos
modelo.state_dict()
A.19 Ejercicios
Explica con tus palabras, sin código, por qué la regla de corrección resta el gradiente en lugar de sumarlo.
Cambia los datos a y = −3x + 4 y vuelve a ejecutar las celdas desde la creación del modelo. ¿A qué valores deberían llegar w y b?
Entrena la recta original con lr=0.01 y 500 pasos. ¿Termina más cerca o más lejos de b = 1 que con 0.05?
Borra la línea optimizador.zero_grad() del bucle, entrena desde cero y compara la curva de pérdida con la original.
Entrena RedPequena con el mismo bucle sobre los cinco puntos y predice x = 10. Compara con la predicción de la neurona sola.
Orientaciones.
El gradiente apunta hacia donde la pérdida sube; restarlo mueve los parámetros hacia donde baja, como bajar la montaña en lugar de subirla.
w debe acercarse a −3 y b a 4. Si después de 500 pasos todavía están lejos, aumenta el número de pasos.
Más lejos: con pasos más pequeños hacen falta más repeticiones para llegar al mismo punto.
Los gradientes se suman de un paso a otro, como en la sección de gradientes, y cada corrección deja de corresponder al error del momento.
La red tiene 25 parámetros para cinco puntos y no sabe que los datos vienen de una recta; fuera del rango de entrenamiento (x entre 1 y 5) su predicción puede alejarse de 21. Más parámetros no garantizan mejores predicciones.
A.20 Resumen
Una neurona calcula w · x + b; una red encadena muchas neuronas en capas, con funciones de activación entre ellas.
Entrenar es repetir un ciclo de cuatro etapas: predecir, medir el error con la pérdida, calcular el gradiente y corregir los parámetros con el optimizador.
La tasa de aprendizaje decide el tamaño del paso: con 0.05 la neurona llegó a w = 2.0000 y b = 0.9999; con 0.1 la pérdida creció en cada paso.
En PyTorch, los datos y los parámetros viven en tensores; a cada tensor se le revisan la forma y el tipo, y los datos de entrada van como tabla.
El bucle de entrenamiento tiene cinco líneas: zero_grad, predecir, pérdida, backward y step. Para predecir se usan eval() y no_grad(); para guardar, el state_dict.
Con estas piezas puedes leer el código de cualquier capítulo del libro. El recorrido continúa en Fundamentos, y el capítulo de tensores y autograd muestra qué hace backward() por dentro.