Una red puede aprender muy bien las observaciones disponibles y perder esa ventaja cuando cambian los ejemplos. La pregunta del capítulo es qué intervención tiene sentido ante esa evidencia y cómo comprobar su efecto sin confundir ajuste, selección y evaluación final.
Estudiaremos capacidad, L1, L2, dropout, BatchNorm y parada temprana sobre las mismas particiones de Fashion-MNIST. Las redes se implementan con PyTorch y conservan el patrón de los capítulos de MLP y optimización. La búsqueda general de hiperparámetros se desarrolla en el capítulo 8; aquí interesa su relación con la regularización.
11.1 Qué vas a poder decidir
Distinguir un ajuste insuficiente de una divergencia entre entrenamiento y validación.
Leer el gap junto con el nivel absoluto de las métricas, el presupuesto y el modo de evaluación.
Comparar intervenciones controlando arquitectura, inicialización y orden de los lotes.
Separar entropía cruzada, penalización y objetivo de entrenamiento.
Elegir un checkpoint y un procedimiento con validación antes de consultar prueba.
Explicar cuándo una mejora promedio puede ocultar un deterioro por clase.
Usaremos una secuencia de lectura: describir el resultado, proponer una hipótesis compatible y decidir un contraste. Una curva puede apoyar una hipótesis sin identificar de forma única su causa.
11.2 Entorno y presupuesto experimental
Los tamaños y presupuestos se fijan antes de entrenar. Las semillas reducen fuentes concretas de azar, sin garantizar igualdad entre dispositivos o versiones. Una sola semilla no cuantifica toda la variabilidad de cada técnica.
No conocemos esa distribución completa. Ajustamos con una muestra y estimamos comportamiento fuera del ajuste con otras observaciones. Un rendimiento de entrenamiento alto no basta: el modelo puede aprovechar regularidades transferibles y particularidades de la muestra en proporciones que no se distinguen mirando solo ese conjunto.
Entrenamiento actualiza pesos; validación elige época y configuración; prueba evalúa decisiones fijadas. Si consultamos prueba repetidamente para cambiar el modelo, deja de ser una evaluación independiente del procedimiento diseñado. En este capítulo los barridos muestran solo desarrollo; la evaluación de prueba aparece al final.
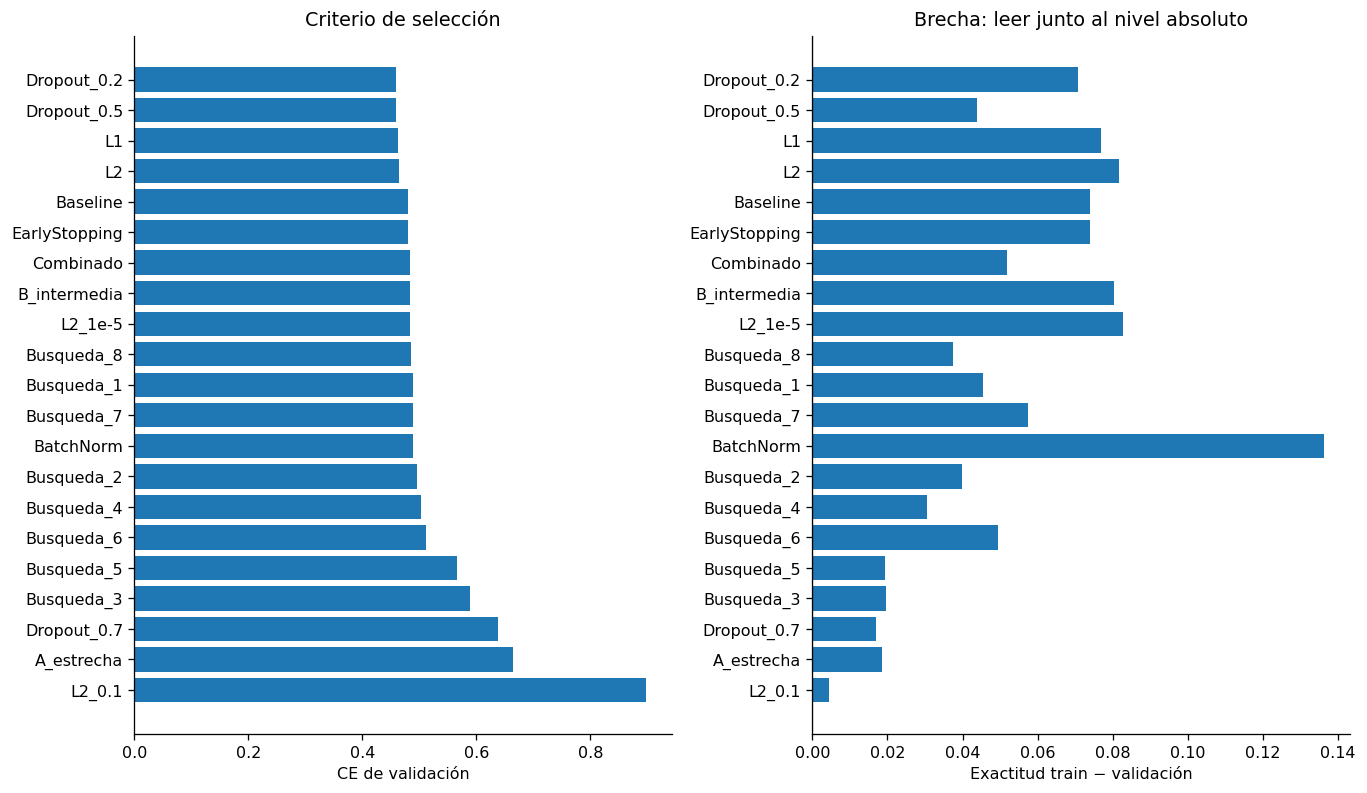
Un gap positivo suele describir ventaja de entrenamiento, pero debe leerse junto al nivel absoluto. Dos exactitudes cercanas a 0.10 pueden dar un gap pequeño en un problema de diez clases sin que el predictor sea útil. Tampoco existe un valor universal de gap que diagnostique sobreajuste.
ejemplos=pd.DataFrame({'escenario':['Ajuste bajo','Aciertos próximos','Divergencia ilustrativa'],'train_acc':[.55,.84,.99],'val_acc':[.54,.82,.78],'train_CE':[1.2,.48,.04],'val_CE':[1.22,.53,.94]})ejemplos['gap_acc']=ejemplos.train_acc-ejemplos.val_accejemplos['gap_CE']=ejemplos.val_CE-ejemplos.train_CEprint('Cifras hipotéticas: no son resultados de Fashion-MNIST.')display(ejemplos.round(3))
Cifras hipotéticas: no son resultados de Fashion-MNIST.
escenario
train_acc
val_acc
train_CE
val_CE
gap_acc
gap_CE
0
Ajuste bajo
0.55
0.54
1.20
1.22
0.01
0.02
1
Aciertos próximos
0.84
0.82
0.48
0.53
0.02
0.05
2
Divergencia ilustrativa
0.99
0.78
0.04
0.94
0.21
0.90
11.4 Ajuste insuficiente, divergencia y capacidad
Si entrenamiento y validación permanecen en un nivel bajo, hay varias hipótesis: representación insuficiente, pocos pasos, tasa inadecuada o regularización excesiva. Añadir más penalización sin distinguirlas puede empeorar el problema.
Si la pérdida de entrenamiento sigue bajando mientras validación deja de mejorar o empeora, el patrón es compatible con sobreajuste. No hace falta que entrenamiento alcance exactitud uno. La evolución importa: una fotografía del gap al final puede ocultar una buena época anterior.
11.4.1 Sesgo y varianza no son nombres alternativos de esas curvas
En regresión con error cuadrático y ruido de media condicional cero, la descomposición clásica en un punto es
La expectativa sobre el estimador considera muestras de entrenamiento distintas. Con un solo split no estimamos esa varianza. Esta expresión tampoco es una descomposición directa de la entropía cruzada de nuestras redes multiclase.
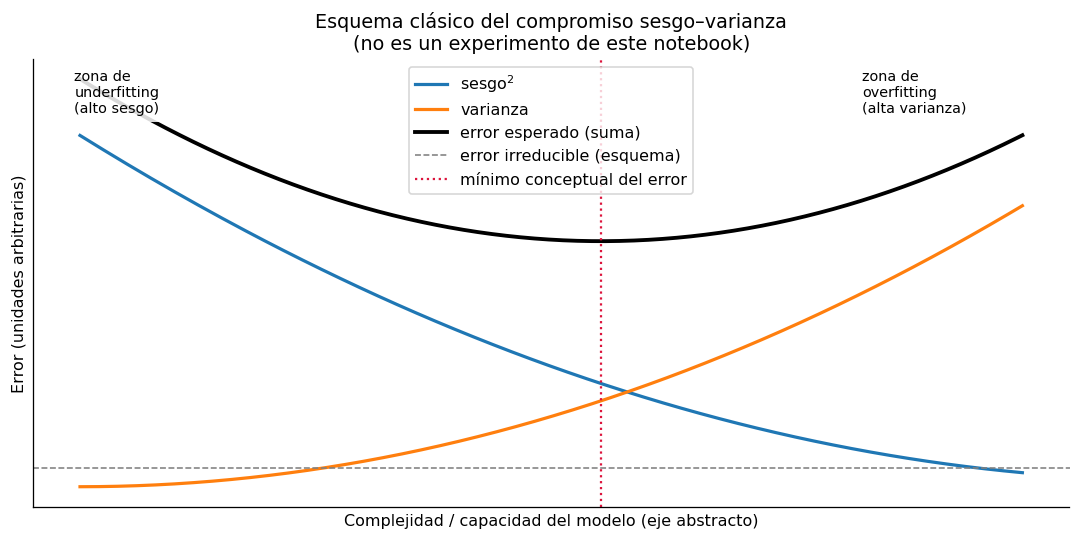
La figura siguiente es conceptual. Su forma de U organiza una intuición clásica; no garantiza que todo experimento de redes siga esa forma, ni identifica el ancho correcto de una capa.
# Gráfica CONCEPTUAL de complejidad vs error (no es un resultado empírico)complejidad = np.linspace(0.15, 1.0, 200)bias2 =0.55* (1.15- complejidad) **2+0.04variance =0.62* (complejidad -0.15) **2+0.03irreducible = np.full_like(complejidad, 0.06)error_total = bias2 + variance + irreduciblei_opt =int(np.argmin(error_total))fig, ax = plt.subplots(figsize=(9.5, 4.8))ax.plot(complejidad, bias2, label=r"sesgo$^{2}$", lw=2)ax.plot(complejidad, variance, label="varianza", lw=2)ax.plot(complejidad, error_total, label="error esperado (suma)", lw=2.4, color="black")ax.axhline(0.06, ls="--", color="gray", lw=1, label="error irreducible (esquema)")ax.axvline(complejidad[i_opt], color="crimson", ls=":", lw=1.4, label="mínimo conceptual del error")ax.set_xlabel("Complejidad / capacidad del modelo (eje abstracto)")ax.set_ylabel("Error (unidades arbitrarias)")ax.set_title("Esquema clásico del compromiso sesgo–varianza\n(no es un experimento de este notebook)")ax.legend(loc="upper center")ax.set_xticks([])ax.set_yticks([])ax.text(0.04, 0.88, "zona de\nunderfitting\n(alto sesgo)", fontsize=9, transform=ax.transAxes, bbox=dict(facecolor="white", alpha=.85, edgecolor="none"))ax.text(0.80, 0.88, "zona de\noverfitting\n(alta varianza)", fontsize=9, transform=ax.transAxes, bbox=dict(facecolor="white", alpha=.85, edgecolor="none"))plt.tight_layout()plt.show()print("Esta figura NO estima el sesgo ni la varianza de nuestros modelos. ""No identifica cuántas neuronas son 'las correctas' en Fashion-MNIST. ""Solo organiza la idea de que aumentar capacidad empuja el error de ""un régimen (sesgo) hacia otro (varianza).")
Esta figura NO estima el sesgo ni la varianza de nuestros modelos. No identifica cuántas neuronas son 'las correctas' en Fashion-MNIST. Solo organiza la idea de que aumentar capacidad empuja el error de un régimen (sesgo) hacia otro (varianza).
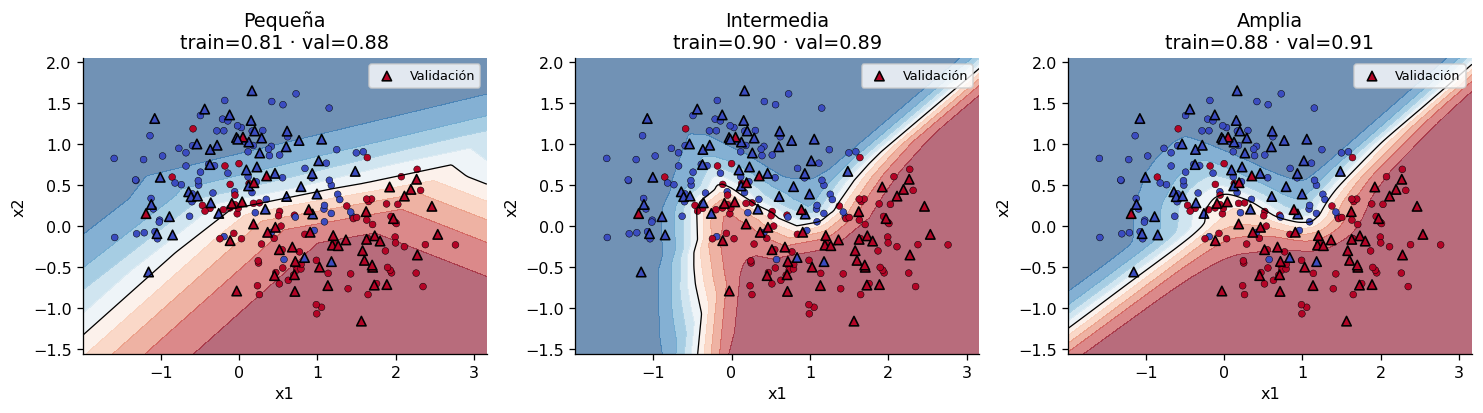
11.5 Laboratorio geométrico: tres capacidades sobre medias lunas
Antes de trabajar con prendas, observaremos fronteras en dos dimensiones. Se mantienen 250 medias lunas con ruido 0.35 y semilla 42. El 35% reservado actúa aquí como validación, no como prueba final: permite discutir decisiones de capacidad. Las arquitecturas son (4,), (16,8) y (128,128,64).
Fijamos Adam 0.001, 2500 épocas de lote completo y conservamos el mejor estado de validación. No imponemos etiquetas de «bueno» o «sobreajustado» a cada tamaño antes de ejecutarlo. El escalador se estima con entrenamiento.
11.6 Un protocolo común: entrenar, medir y restaurar
El patrón continúa el piloto de perceptrón y MLP: DataLoader para lotes, train() al ajustar y eval() con gradientes desactivados al medir. Las salidas son logits y CrossEntropyLoss recibe etiquetas enteras. No añadimos softmax antes de esa pérdida.
Cada época registra dos lecturas de entrenamiento: online_* se obtiene con los pesos cambiando durante los lotes y con dropout activo si existe; train_* se mide al terminar, con el estado fijo en modo evaluación. Esta última se compara con validación. Se pondera cada lote por su tamaño.
La pérdida predictiva es entropía cruzada media. El objetivo de ajuste puede sumar L1/L2, calculadas como sumas sobre las matrices ocultas y excluyendo sesgos, normalización y salida. Registramos ambos términos: comparar pérdidas con penalizaciones distintas confundiría calidad predictiva y definición del objetivo. Aquí no sustituimos esa penalización por weight_decay de Adam ni por AdamW.
Todas las redes conservan el estado de menor entropía cruzada de validación, incluidos los buffers de BatchNorm. El techo de épocas es presupuesto, no el checkpoint. La paciencia puede detener antes; min_delta controla esa espera sin cambiar qué mínimo exacto se conserva. Si aparece una pérdida o norma no finita, se declara el fallo numérico y se detiene la corrida: no se interpreta como un modelo válido.
class Red(nn.Module):def__init__(self, entradas, ocultas, salidas, *, dropout=0., bn=False, inicializacion='xavier', semilla_pesos=42):super().__init__()self.config =dict(entradas=entradas, ocultas=list(ocultas), salidas=salidas, dropout=dropout,bn=bn,inicializacion=inicializacion,semilla_pesos=semilla_pesos) capas=[]; anterior=entradasfor ancho in ocultas: capas.append(nn.Linear(anterior,ancho,bias=not bn))if bn: capas.append(nn.BatchNorm1d(ancho,eps=1e-3,momentum=.01)) capas.append(nn.ReLU())if dropout>0: capas.append(nn.Dropout(dropout)) anterior=ancho capas.append(nn.Linear(anterior,salidas))self.capas=nn.Sequential(*capas)# Reiniciar aquí hace coincidir matrices comunes entre intervenciones. semilla(semilla_pesos)for capa inself.capas:ifisinstance(capa,nn.Linear):if inicializacion=='cero': nn.init.zeros_(capa.weight)elif inicializacion=='grande': nn.init.normal_(capa.weight,0,1)elif inicializacion=='he': nn.init.kaiming_normal_(capa.weight,nonlinearity='relu')else: nn.init.xavier_uniform_(capa.weight,gain=1.)if capa.bias isnotNone: nn.init.zeros_(capa.bias)def forward(self,x): returnself.capas(x)def penalizacion(self,l1=0.,l2=0.):# Penalizamos matrices ocultas; excluimos sesgos, BN y la capa de salida. densas=[c for c inself.capas ifisinstance(c,nn.Linear)][:-1] valor=torch.zeros((),device=next(self.parameters()).device)for c in densas: valor=valor+l1*c.weight.abs().sum()+l2*c.weight.square().sum()return valordef cargador(X,y,lote=128,barajar=False,seed=42):return DataLoader(TensorDataset(torch.as_tensor(np.asarray(X),dtype=torch.float32), torch.as_tensor(np.asarray(y),dtype=torch.long)),batch_size=lote,shuffle=barajar, generator=torch.Generator().manual_seed(seed),num_workers=0)@torch.inference_mode()def evaluar(red,X,y): red.eval(); suma=0.; aciertos=0; n=0for xb,yb in cargador(X,y,512): xb,yb=xb.to(dispositivo),yb.to(dispositivo) z=red(xb); loss=nn.functional.cross_entropy(z,yb)ifnot torch.isfinite(z).all() ornot torch.isfinite(loss):return {'loss':np.nan,'accuracy':np.nan} suma+=loss.item()*len(yb); aciertos+=(z.argmax(1)==yb).sum().item(); n+=len(yb)return {'loss':suma/n,'accuracy':aciertos/n}@torch.inference_mode()def probabilidades(red,X): red.eval(); out=[]for start inrange(0,len(X),512): xb=torch.as_tensor(np.asarray(X[start:start+512]),dtype=torch.float32,device=dispositivo) out.append(red(xb).softmax(1).cpu().numpy())return np.concatenate(out)def optimizador(red,nombre,lr):if nombre=='SGD': return torch.optim.SGD(red.parameters(),lr=lr)if nombre=='Momentum': return torch.optim.SGD(red.parameters(),lr=lr,momentum=.9)if nombre=='RMSProp': return torch.optim.RMSprop(red.parameters(),lr=lr,alpha=.9,eps=1e-7)return torch.optim.Adam(red.parameters(),lr=lr,eps=1e-7)def ajustar(red,Xtr,ytr,Xva,yva,*,epocas=30,lote=128,lr=.001,opt='Adam', l1=0.,l2=0.,paciencia=None,min_delta=0.,clip=None,seed=42,nombre='modelo'): red.to(dispositivo); algoritmo=optimizador(red,opt,lr) lotes=cargador(Xtr,ytr,lote,True,seed) registros=[]; mejor=np.inf; mejor_epoca=0; espera=0; referencia_parada=np.inf estado_mejor=deepcopy(red.state_dict()); estado='finito'; total_pasos=0 inicio=time.perf_counter()if dispositivo.type=='cuda': torch.cuda.synchronize()for epoca inrange(1,epocas+1): red.train(); suma_online=0.; correctos_online=0; n_online=0 normas=[]; recortes=0; fallo=Falsefor xb,yb in lotes: xb,yb=xb.to(dispositivo),yb.to(dispositivo) algoritmo.zero_grad(set_to_none=True) z=red(xb); ce=nn.functional.cross_entropy(z,yb) objetivo=ce+red.penalizacion(l1,l2)ifnot torch.isfinite(objetivo): fallo=True;break objetivo.backward()# Sin clip, umbral infinito mide sin modificar gradientes finitos. norma=nn.utils.clip_grad_norm_(red.parameters(),clip if clip elsefloat('inf'))ifnot torch.isfinite(norma): fallo=True;break normas.append(float(norma)); recortes+=int(clip isnotNoneand norma>clip) suma_online+=float(ce.detach())*len(yb) correctos_online+=(z.argmax(1)==yb).sum().item(); n_online+=len(yb) algoritmo.step(); total_pasos+=1 tr=evaluar(red,Xtr,ytr); va=evaluar(red,Xva,yva) penal=float(red.penalizacion(l1,l2).detach())if fallo ornot np.isfinite([tr['loss'],va['loss'],penal]).all(): estado='no_finito' registros.append({'epoca':epoca,'train_loss':tr['loss'],'val_loss':va['loss'],'train_accuracy':tr['accuracy'],'val_accuracy':va['accuracy'],'online_loss':suma_online/max(n_online,1),'online_accuracy':correctos_online/max(n_online,1),'penalizacion':penal,'objetivo_train':tr['loss']+penal,'norma_gradiente_media':float(np.mean(normas)) if normas else np.nan,'fraccion_recortada':recortes/max(len(normas),1)})if estado=='no_finito': breakif va['loss']<mejor: mejor=va['loss']; mejor_epoca=epoca; estado_mejor=deepcopy(red.state_dict())# El mínimo exacto elige pesos; min_delta solo controla la paciencia.if va['loss']<referencia_parada-min_delta: referencia_parada=va['loss']; espera=0else: espera+=1if paciencia isnotNoneand espera>=paciencia: breakif dispositivo.type=='cuda': torch.cuda.synchronize() segundos=time.perf_counter()-inicio red.load_state_dict(estado_mejor); red.eval()if mejor_epoca:assert np.isclose(evaluar(red,Xva,yva)['loss'],mejor,rtol=1e-5,atol=1e-7) info={'modelo':nombre,'checkpoint':mejor_epoca,'epocas':len(registros),'estado':estado,'segundos':segundos,'pasos':total_pasos,'min_val_loss':mejor}print(nombre, '| épocas:',len(registros),'| checkpoint:',mejor_epoca,'| estado:',estado,flush=True)return pd.DataFrame(registros),infodef curvas(historia,info,titulo): fig,ax=plt.subplots(1,2,figsize=(11,3.5))for pref,nombre in [('train','Entrenamiento · eval'),('val','Validación')]: ax[0].plot(historia.epoca,historia[pref+'_loss'],label=nombre) ax[1].plot(historia.epoca,historia[pref+'_accuracy'],label=nombre)for a in ax:if info['checkpoint']: a.axvline(info['checkpoint'],ls='--',color='black',alpha=.5,label='Checkpoint') a.set_xlabel('Época'); a.legend(fontsize=8) ax[0].set(ylabel='Entropía cruzada sin penalización',title=titulo+' · pérdida') ax[1].set(ylabel='Exactitud',ylim=(0,1.03),title=titulo+' · aciertos') plt.tight_layout(); plt.show()def resumen(red,h,info,Xtr,ytr,Xva,yva): tr=evaluar(red,Xtr,ytr); va=evaluar(red,Xva,yva)return {**info,'parametros':sum(p.numel() for p in red.parameters()),'train_loss':tr['loss'],'val_loss':va['loss'],'train_accuracy':tr['accuracy'],'val_accuracy':va['accuracy'],'gap_accuracy':tr['accuracy']-va['accuracy'],'gap_loss':va['loss']-tr['loss']}def guardar(red,nombre,contrato): ruta=ARTEFACTOS/(nombre+'.pt') torch.save({'config':red.config,'state_dict':{k:v.detach().cpu().clone() for k,v in red.state_dict().items()},'entrada':contrato},ruta) nuevo=torch.load(ruta,map_location='cpu',weights_only=True) copia=Red(**nuevo['config']); copia.load_state_dict(nuevo['state_dict']); copia.eval()return copia
Una región fragmentada alrededor de puntos aislados es una señal para investigar sensibilidad al ruido, no una prueba suficiente de sobreajuste. Mira también la pérdida de validación y la época elegida. Una red amplia puede producir un checkpoint sencillo si se detiene antes de perseguir particularidades.
El gráfico presenta los tres modelos en sus estados seleccionados, no necesariamente en la última época. No concluyas que el ancho carece de efecto porque sus porcentajes se parezcan: pueden diferir estabilidad, frontera y sensibilidad a otra muestra.
11.7 Fashion-MNIST: datos, escala y particiones
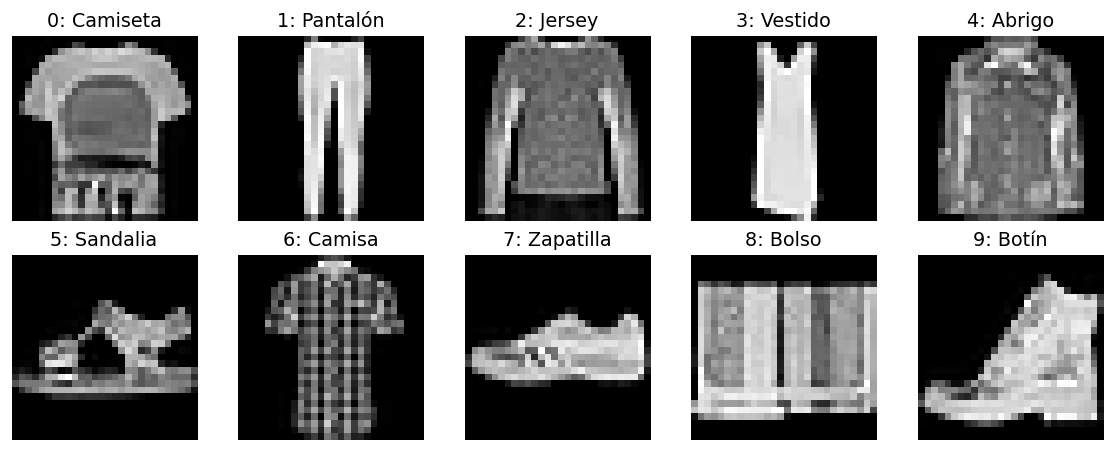
Fashion-MNIST contiene 60 000 imágenes oficiales de entrenamiento y 10 000 de prueba, de 28×28 píxeles y diez clases de prendas. Usaremos 4000 imágenes de ajuste y 1500 de validación extraídas de las primeras, más 1500 de la prueba oficial. Los dos sorteos estratificados del desarrollo y el sorteo de prueba usan semilla 42, preservando las particiones del experimento de referencia.
Una MLP ancha sobre un subconjunto permite observar diferencias con un coste manejable; sus resultados absolutos no se comparan con publicaciones que entrenan con el conjunto completo. Aplanamos a 784 entradas y dividimos por 255, una constante de la representación de píxeles.
El lector de archivos IDX utiliza NumPy y gzip. Reutiliza archivos locales si están disponibles y descarga desde el repositorio oficial solo si faltan. Una caché previa puede estar en una carpeta llamada .keras; leer esos archivos no requiere TensorFlow ni Keras.
import gzip,struct,hashlib,urllib.requestdef archivo_fashion(nombre): candidatos=[Path('datos-fashion')/nombre, Path.home()/'.cache/bit-datasets/fashion-mnist'/nombre, Path.home()/'.keras/datasets/fashion-mnist'/nombre]for p in candidatos:if p.exists(): return p destino=Path('datos-fashion')/nombre;destino.parent.mkdir(exist_ok=True) url='https://raw.githubusercontent.com/zalandoresearch/fashion-mnist/master/data/fashion/'+nombrewith urllib.request.urlopen(url,timeout=90) as response: contenido=response.read() gzip.decompress(contenido) # Comprueba integridad gzip antes de conservarlo. destino.write_bytes(contenido);return destinohashes_datos={}def leer_idx(nombre,imagenes): p=archivo_fashion(nombre);raw=p.read_bytes();hashes_datos[nombre]=hashlib.sha256(raw).hexdigest() contenido=gzip.decompress(raw)if imagenes: magic,n,alto,ancho=struct.unpack('>IIII',contenido[:16]);assert magic==2051and (alto,ancho)==(28,28)return np.frombuffer(contenido,dtype=np.uint8,offset=16).reshape(n,alto,ancho) magic,n=struct.unpack('>II',contenido[:8]);assert magic==2049return np.frombuffer(contenido,dtype=np.uint8,offset=8).reshape(n)img_train=leer_idx('train-images-idx3-ubyte.gz',True)label_train=leer_idx('train-labels-idx1-ubyte.gz',False)img_test=leer_idx('t10k-images-idx3-ubyte.gz',True)label_test=leer_idx('t10k-labels-idx1-ubyte.gz',False)assertlen(img_train)==60000andlen(img_test)==10000pool,_=train_test_split(np.arange(len(label_train)),train_size=N_TRAIN+N_VAL, stratify=label_train,random_state=42)itr,iva=train_test_split(pool,train_size=N_TRAIN,stratify=label_train[pool],random_state=42)ite,_=train_test_split(np.arange(len(label_test)),train_size=N_TEST,stratify=label_test,random_state=42)assertnotset(itr)&set(iva)Xtr=img_train[itr].reshape(-1,784).astype('float32')/255.;ytr=label_train[itr].astype('int64')Xva=img_train[iva].reshape(-1,784).astype('float32')/255.;yva=label_train[iva].astype('int64')# Prueba se prepara una vez; no se consulta en los barridos de desarrollo.Xte=img_test[ite].reshape(-1,784).astype('float32')/255.;yte=label_test[ite].astype('int64')particiones=pd.concat([pd.DataFrame({'fuente':'train_oficial','indice':itr,'particion':'train'}), pd.DataFrame({'fuente':'train_oficial','indice':iva,'particion':'val'}), pd.DataFrame({'fuente':'test_oficial','indice':ite,'particion':'test'})],ignore_index=True)assertnot particiones[['fuente','indice']].duplicated().any()particiones.to_csv(ARTEFACTOS/'particiones.csv',index=False)print('Formas:',Xtr.shape,Xva.shape,Xte.shape,'| escala de ajuste:',Xtr.min(),Xtr.max())display(pd.DataFrame({'Ajuste':np.bincount(ytr,minlength=10),'Validación':np.bincount(yva,minlength=10),'Prueba':np.bincount(yte,minlength=10)},index=NOMBRES))fig,ax=plt.subplots(2,5,figsize=(10,4))for k,a inenumerate(ax.ravel()): a.imshow(Xtr[np.flatnonzero(ytr==k)[0]].reshape(28,28),cmap='gray',vmin=0,vmax=1) a.set_title(f'{k}: {NOMBRES[k]}');a.axis('off')plt.tight_layout();plt.show()
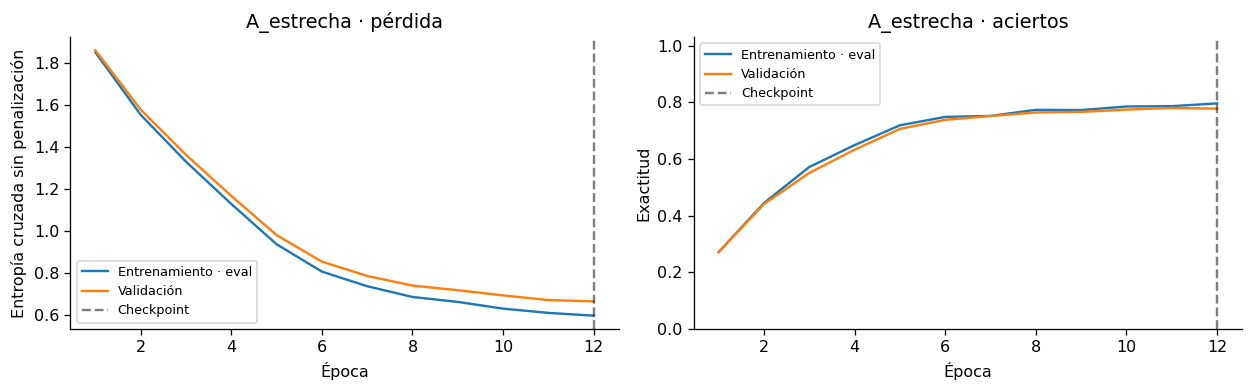
Los modelos A (8,), B (64,32) y C (256,256,128) permiten comparar capacidad bajo presupuestos declarados: 12, 25 y 30 épocas, respectivamente. C será el baseline para las intervenciones. No atribuiremos todas sus diferencias solo al tamaño, porque los presupuestos A/B también son distintos.
Para las comparaciones principales se conserva Adam 0.001, lote 128, Xavier uniforme con ganancia 1, sesgos cero y el mismo orden de lotes por semilla. Todas las redes terminan restaurando su mínimo de validación; el baseline no es silenciosamente la última época. Los historiales conservan la trayectoria completa para estudiar qué habría ocurrido después de ese mínimo.
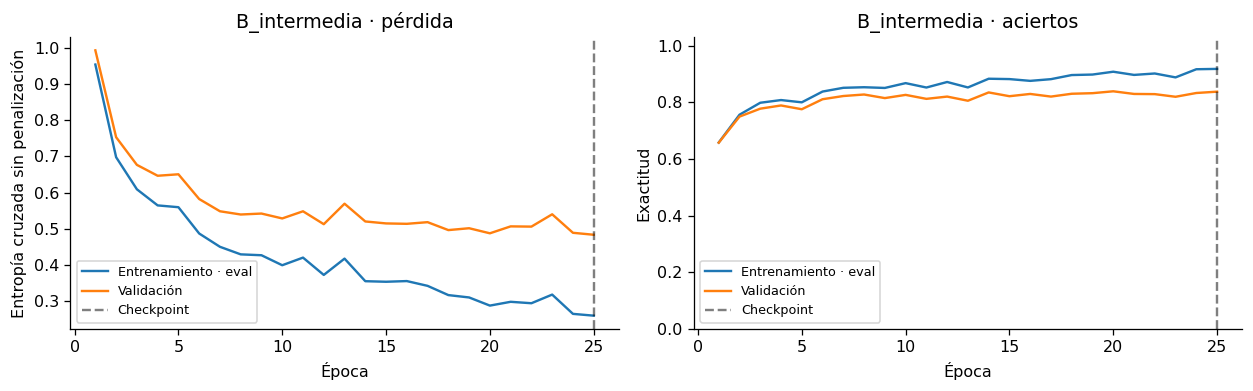
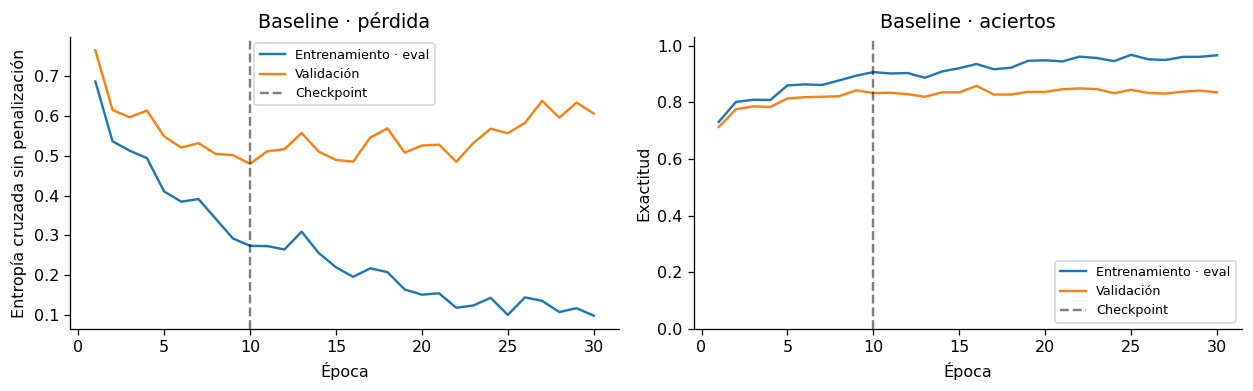
MODELOS={}; HISTORIAS={}; INFORMES={}; FILAS=[]def experimento(nombre,ocultas=(256,256,128),*,epocas=30,l1=0.,l2=0.,dropout=0.,bn=False, lr=LR,paciencia=None,min_delta=0.): red=Red(784,list(ocultas),10,dropout=dropout,bn=bn) h,info=ajustar(red,Xtr,ytr,Xva,yva,epocas=epocas,lote=LOTE,lr=lr,l1=l1,l2=l2, paciencia=paciencia,min_delta=min_delta,nombre=nombre)assert info['estado']=='finito',nombre fila=resumen(red,h,info,Xtr,ytr,Xva,yva) fila.update(l1=l1,l2=l2,dropout=dropout,bn=bn,lr=lr) MODELOS[nombre]=red;HISTORIAS[nombre]=h;INFORMES[nombre]=info;FILAS.append(fila) h.to_csv(ARTEFACTOS/(nombre+'-historia.csv'),index=False)return filafila_A=experimento('A_estrecha',[8],epocas=12)fila_B=experimento('B_intermedia',[64,32],epocas=25)fila_base=experimento('Baseline',epocas=EPOCHS_FULL)for nombre in ['A_estrecha','B_intermedia','Baseline']: curvas(HISTORIAS[nombre],INFORMES[nombre],nombre)display(pd.DataFrame([fila_A,fila_B,fila_base])[ ['modelo','parametros','checkpoint','train_accuracy','val_accuracy','gap_accuracy']].round(3))
Compara primero la pérdida de entrenamiento: ¿A consigue reducirla suficientemente? Si no lo hace, capacidad pequeña es una hipótesis, pero también lo son presupuesto y optimización. Para C, localiza el mínimo de validación y observa si entrenamiento continúa mejorando después. Esa separación apoya una intervención sobre el procedimiento; no prueba que cada peso grande sea un patrón memorizado.
La línea vertical identifica el estado conservado. Las métricas de la tabla se calculan de nuevo en ese estado y en modo evaluación, no se copian de la última fila del historial. Una diferencia de un punto porcentual sobre 1500 imágenes exige cautela: no repetimos todavía todo con varias semillas o muestras.
11.9 L1: penalizar magnitudes y comprobar qué cambió
El objetivo es \(J=CE+\lambda_1\sum|w|\), sobre las matrices ocultas. Mantendremos el baseline y añadiremos solamente \(\lambda_1=10^{-4}\). La fuerza depende de usar suma o media, de los parámetros incluidos y del tamaño de la arquitectura; no se traslada el coeficiente sin esas convenciones.
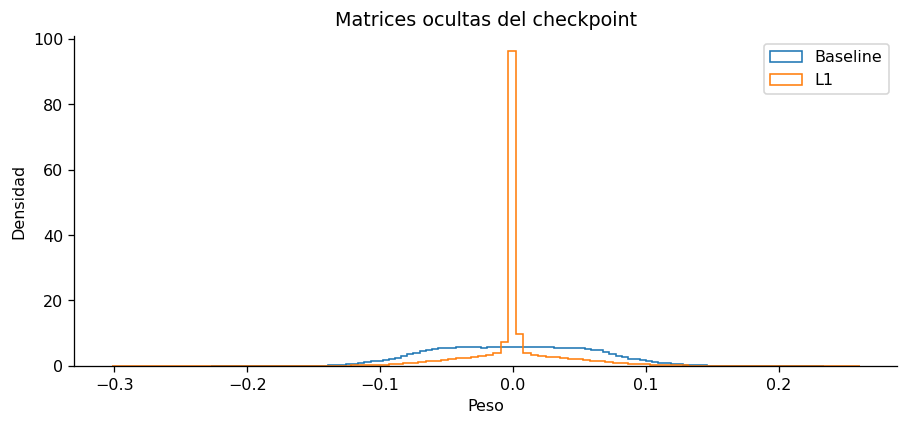
L1 favorece magnitudes pequeñas. Adam con una penalización diferenciada por autograd no es un algoritmo proximal: no promete ceros exactos ni selección perfecta de variables. Compararemos cuantiles y proporción de pesos próximos a cero, además de validación.
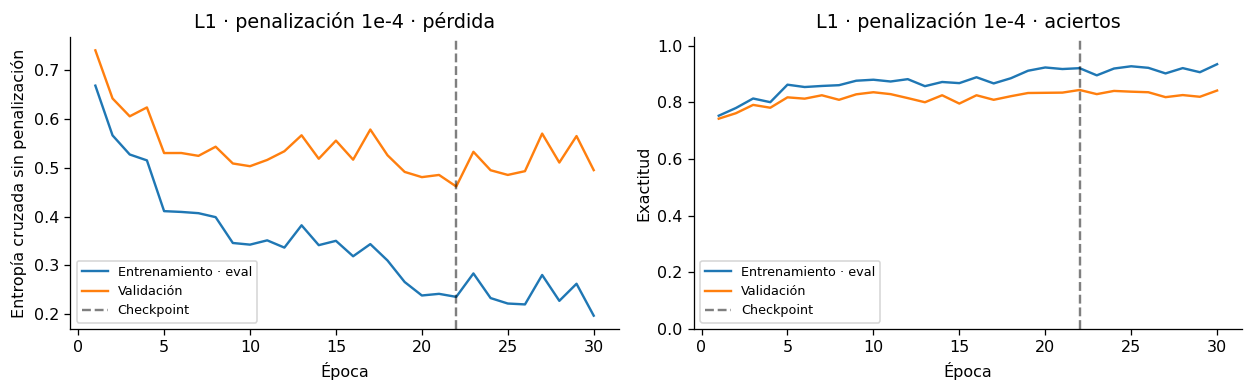
fila_l1=experimento('L1',l1=1e-4,epocas=EPOCHS_COMPARE)curvas(HISTORIAS['L1'],INFORMES['L1'],'L1 · penalización 1e-4')def pesos_ocultos(red): densas=[x for x in red.capas ifisinstance(x,nn.Linear)][:-1]return np.concatenate([x.weight.detach().cpu().numpy().ravel() for x in densas])filas_pesos=[];fig,ax=plt.subplots(figsize=(8,3.8))for nombre in ['Baseline','L1']: w=pesos_ocultos(MODELOS[nombre]);a=np.abs(w) filas_pesos.append({'modelo':nombre,'mediana_abs':np.median(a),'p95_abs':np.quantile(a,.95),'fraccion_abs_menor_1e-3':np.mean(a<1e-3),'norma_L1':np.sum(a),'norma_L2':np.linalg.norm(w)}) ax.hist(w,bins=100,density=True,histtype='step',label=nombre)ax.set(title='Matrices ocultas del checkpoint',xlabel='Peso',ylabel='Densidad');ax.legend()plt.tight_layout();plt.show();display(pd.DataFrame(filas_pesos).round(4))
L1 | épocas: 30 | checkpoint: 22 | estado: finito
modelo
mediana_abs
p95_abs
fraccion_abs_menor_1e-3
norma_L1
norma_L2
0
Baseline
0.0438
0.1043
0.0118
14127.044922
30.957300
1
L1
0.0019
0.0770
0.4312
5036.076172
17.461599
11.9.1 Cómo leer L1
Si aumenta la concentración cerca de cero, la intervención tuvo el efecto esperado sobre esas magnitudes. Eso no garantiza mejor generalización. Contrasta con las métricas: una caída simultánea de entrenamiento y validación puede indicar una penalización demasiado fuerte para este presupuesto.
Una variable puede seguir influyendo mediante muchos caminos aunque un peso particular se aproxime a cero. No interpretamos el histograma como explicación causal de los píxeles importantes.
11.10 L2: controlar magnitudes sin cambiar el modelo de salida
El objetivo suma \(\lambda_2\sum w^2\) con \(\lambda_2=10^{-3}\), manteniendo las mismas matrices penalizadas que en L1. Su gradiente añade \(2\lambda_2w\) a cada una. Se implementa explícitamente en el objetivo, con Adam sin weight decay. Así no confundimos L2 con la contracción desacoplada de AdamW.
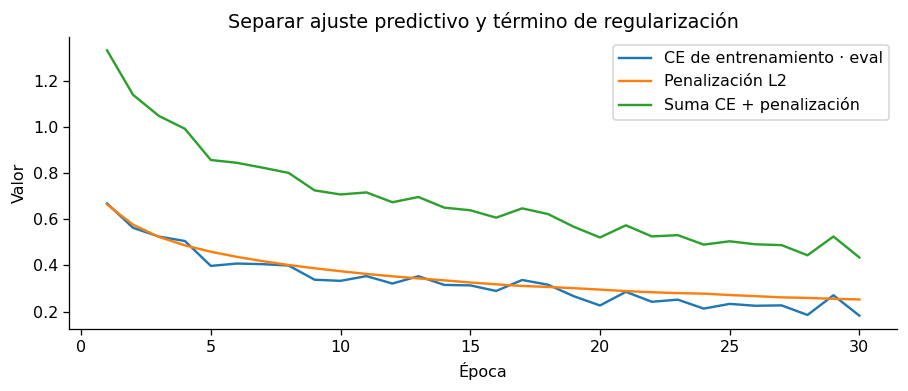
La validación usa entropía cruzada sin penalización. Dos objetivos con distinto \(\lambda\) no comparten escala; una suma de pérdida y penalización menor no basta para comparar calidad predictiva.
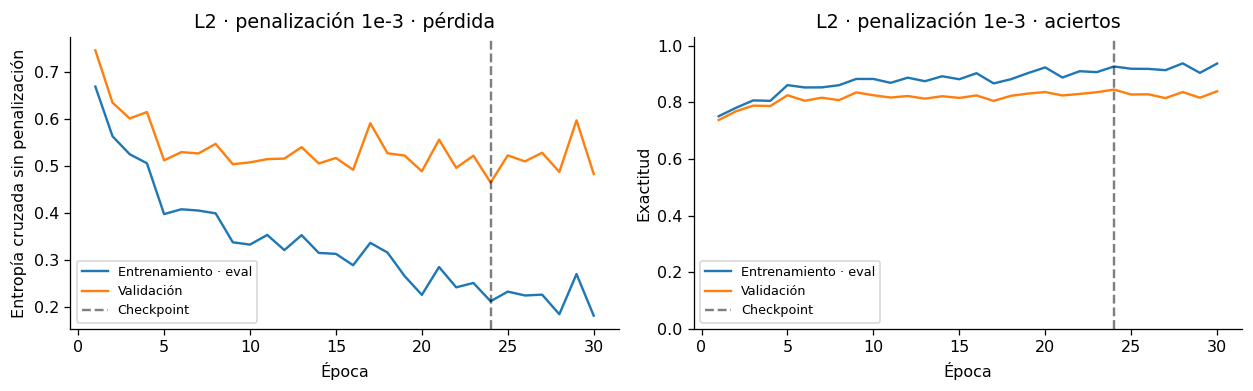
fila_l2=experimento('L2',l2=1e-3,epocas=EPOCHS_COMPARE)curvas(HISTORIAS['L2'],INFORMES['L2'],'L2 · penalización 1e-3')fig,ax=plt.subplots(figsize=(8,3.5));h=HISTORIAS['L2']ax.plot(h.epoca,h.train_loss,label='CE de entrenamiento · eval')ax.plot(h.epoca,h.penalizacion,label='Penalización L2')ax.plot(h.epoca,h.objetivo_train,label='Suma CE + penalización')ax.set(xlabel='Época',ylabel='Valor',title='Separar ajuste predictivo y término de regularización');ax.legend()plt.tight_layout();plt.show()display(pd.DataFrame([fila_base,fila_l1,fila_l2])[ ['modelo','train_loss','val_loss','train_accuracy','val_accuracy','gap_accuracy']].round(3))
L2 | épocas: 30 | checkpoint: 24 | estado: finito
modelo
train_loss
val_loss
train_accuracy
val_accuracy
gap_accuracy
0
Baseline
0.273
0.480
0.906
0.833
0.074
1
L1
0.235
0.462
0.920
0.843
0.077
2
L2
0.213
0.465
0.926
0.845
0.082
11.11 Barrido de L2: poca y mucha regularización son hipótesis
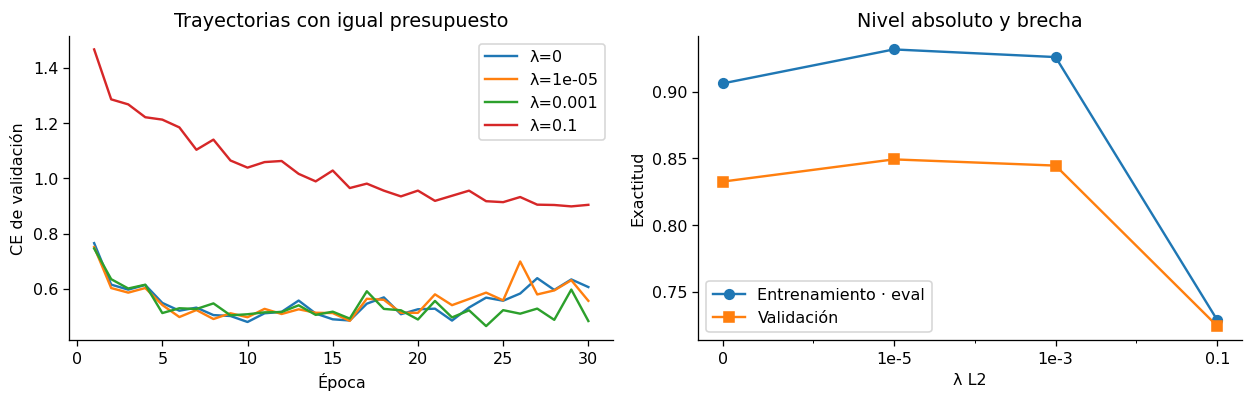
Contrastamos \(\lambda\in\{0,10^{-5},10^{-3},10^{-1}\}\), con treinta épocas por configuración. Reutilizamos el baseline como \(\lambda=0\) y la corrida L2 anterior como \(10^{-3}\): no repetimos el mismo control con otro azar ni otro presupuesto.
El criterio prefijado es menor entropía cruzada de validación. La exactitud acompaña la lectura, pero no sustituiremos el criterio si otra fila parece más conveniente. Un mínimo interior es posible; no forzaremos que aparezca una curva en U en cuatro puntos.
nombres_lambda={0.:'Baseline',1e-5:'L2_1e-5',1e-3:'L2',.1:'L2_0.1'}experimento('L2_1e-5',l2=1e-5,epocas=EPOCHS_COMPARE)experimento('L2_0.1',l2=.1,epocas=EPOCHS_COMPARE)tabla_lambda=pd.DataFrame([f for f in FILAS if f['modelo'] in nombres_lambda.values()]).sort_values('l2')display(tabla_lambda[['modelo','l2','val_loss','train_accuracy','val_accuracy','gap_accuracy']].round(4))fig,ax=plt.subplots(1,2,figsize=(11,3.6))for lam,nombre in nombres_lambda.items(): h=HISTORIAS[nombre];ax[0].plot(h.epoca,h.val_loss,label=f'λ={lam:g}')ax[0].set(xlabel='Época',ylabel='CE de validación',title='Trayectorias con igual presupuesto');ax[0].legend()ax[1].plot(tabla_lambda.l2,tabla_lambda.train_accuracy,'o-',label='Entrenamiento · eval')ax[1].plot(tabla_lambda.l2,tabla_lambda.val_accuracy,'s-',label='Validación')ax[1].set(xlabel='λ L2',ylabel='Exactitud',title='Nivel absoluto y brecha');ax[1].set_xscale('symlog',linthresh=1e-6);ax[1].set_xticks([0,1e-5,1e-3,.1],labels=['0','1e-5','1e-3','0.1']);ax[1].legend()plt.tight_layout();plt.show()mejor_lambda=tabla_lambda.loc[tabla_lambda.val_loss.idxmin()]display(Markdown(f'### Lectura de la ejecución\n\nEl menor CE de validación del barrido corresponde a 'f'**λ={mejor_lambda.l2:g}**, con **{mejor_lambda.val_loss:.3f}**. ''El ganador depende del conjunto, presupuesto y convención de penalización. Un gap menor con exactitud baja no se presenta como éxito de regularización.'))
El menor CE de validación del barrido corresponde a λ=0.001, con 0.465. El ganador depende del conjunto, presupuesto y convención de penalización. Un gap menor con exactitud baja no se presenta como éxito de regularización.
11.12 Dropout: una red estocástica al ajustar y fija al evaluar
Con probabilidad \(r\) se anula una activación durante entrenamiento. La versión invertida escala las que sobreviven por \(1/(1-r)\); en eval() dropout no elimina unidades ni vuelve a aplicar esa corrección. No se eliminan parámetros del modelo ni unidades que permanezcan siempre desactivadas.
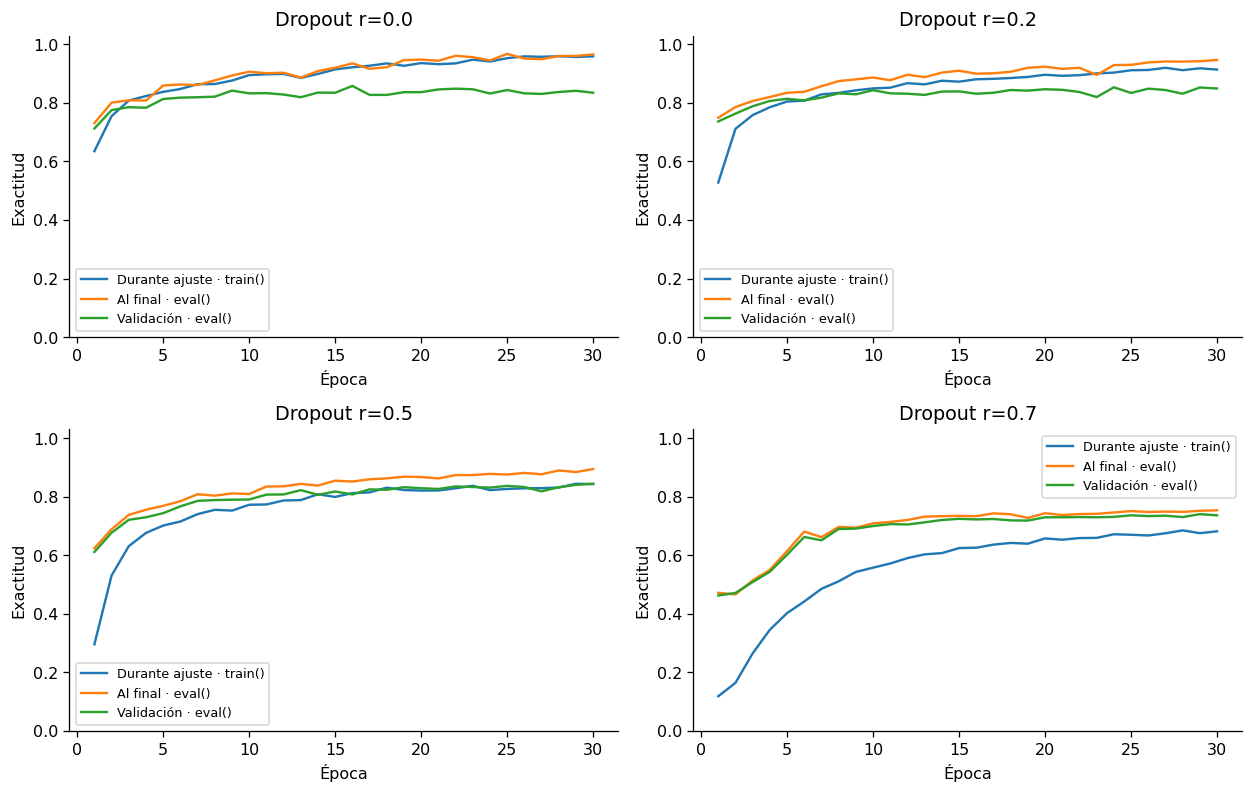
Compararemos tasas 0, 0.2, 0.5 y 0.7 después de cada ReLU. La tasa cero reutiliza el baseline. Los historiales online_accuracy incluyen dropout y pesos cambiantes; train_accuracy se mide al terminar la época sin dropout. La diferencia entre ambos no es por sí misma una medida de generalización.
nombres_dropout={0.:'Baseline',.2:'Dropout_0.2',.5:'Dropout_0.5',.7:'Dropout_0.7'}for tasa,nombre in nombres_dropout.items():if tasa:experimento(nombre,dropout=tasa,epocas=EPOCHS_COMPARE)tabla_dropout=pd.DataFrame([f for f in FILAS if f['modelo'] in nombres_dropout.values()]).sort_values('dropout')display(tabla_dropout[['modelo','dropout','train_accuracy','val_accuracy','val_loss','gap_accuracy']].round(3))fig,axes=plt.subplots(2,2,figsize=(11,7))for ax,(tasa,nombre) inzip(axes.ravel(),nombres_dropout.items()): h=HISTORIAS[nombre] ax.plot(h.epoca,h.online_accuracy,label='Durante ajuste · train()') ax.plot(h.epoca,h.train_accuracy,label='Al final · eval()') ax.plot(h.epoca,h.val_accuracy,label='Validación · eval()') ax.set(xlabel='Época',ylabel='Exactitud',title=f'Dropout r={tasa}',ylim=(0,1.03));ax.legend(fontsize=8)plt.tight_layout();plt.show()mejor_dropout=tabla_dropout.loc[tabla_dropout.val_loss.idxmin()]display(Markdown(f'### Lectura de la ejecución\n\nLa tasa con menor CE de validación es 'f'**{mejor_dropout.dropout:g}**, con **{mejor_dropout.val_loss:.3f}**. ''Una tasa alta puede reducir el ajuste efectivo; si ocurre, observa si también baja validación. Si gana r=0, el experimento no respalda añadir dropout bajo estas condiciones.'))
La tasa con menor CE de validación es 0.2, con 0.459. Una tasa alta puede reducir el ajuste efectivo; si ocurre, observa si también baja validación. Si gana r=0, el experimento no respalda añadir dropout bajo estas condiciones.
11.12.2 Una comprobación del modo de ejecución
Una pasada estocástica no permite atribuir toda la diferencia al mecanismo de dropout: los pesos también iban cambiando durante los lotes. Para aislar la operación, fijaremos una misma entrada y un módulo dropout sin otros componentes: en entrenamiento cambia la máscara y en evaluación se conserva la entrada.
semilla(42);entrada=torch.ones(2000)drop=nn.Dropout(.5);drop.train();a=drop(entrada);b=drop(entrada)drop.eval();salida_eval=drop(entrada)assertnot torch.equal(a,b) and torch.equal(salida_eval,entrada)print('Fracción anulada en una máscara:',float((a==0).float().mean()))print('Media con corrección invertida:',float(a.mean()),'| eval conserva la entrada:',torch.equal(salida_eval,entrada))
Fracción anulada en una máscara: 0.4959999918937683
Media con corrección invertida: 1.0080000162124634 | eval conserva la entrada: True
11.13 BatchNorm: comparar dinámica y estado de inferencia
Usamos la misma arquitectura oculta, con Linear sin sesgo → BatchNorm → ReLU. El control es el baseline sin normalización. Fijamos epsilon 0.001 y peso de nueva estadística 0.01 en la media móvil de PyTorch. Los pesos densos comunes parten de las mismas matrices; BN incorpora escala y desplazamiento entrenables, además de buffers que no son parámetros.
No describimos BN como una penalización L1/L2. Puede modificar estabilidad, velocidad de optimización y comportamiento predictivo; no garantiza reducir la varianza estadística entre conjuntos de entrenamiento. Para medir esa última harían falta otras muestras.
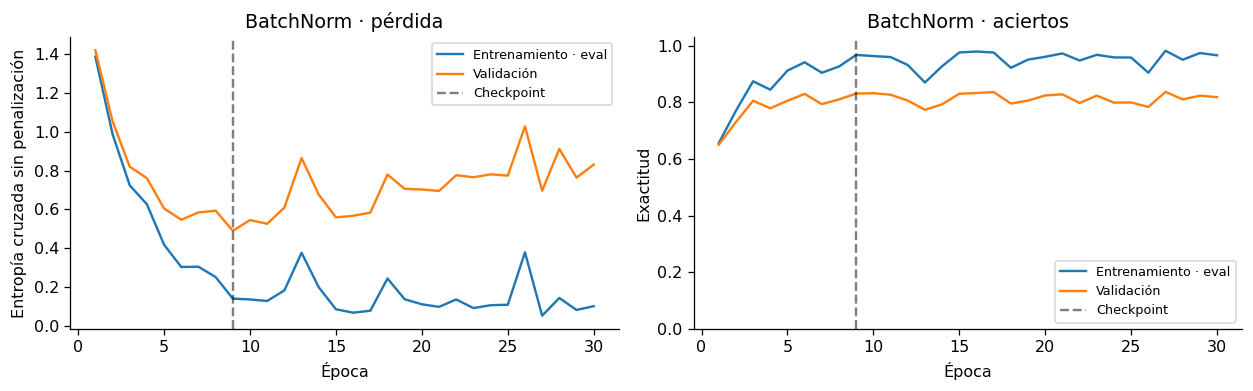
Al restaurar el checkpoint se recuperan también medias y varianzas móviles. Guardar las matrices de una época y los buffers de otra no conservaría el predictor elegido.
fila_bn=experimento('BatchNorm',bn=True,epocas=EPOCHS_COMPARE)curvas(HISTORIAS['BatchNorm'],INFORMES['BatchNorm'],'BatchNorm')display(pd.DataFrame([fila_base,fila_bn])[ ['modelo','parametros','checkpoint','val_loss','train_accuracy','val_accuracy','segundos']].round(3))print('Buffers de BN:',[nombre for nombre,_ in MODELOS['BatchNorm'].named_buffers()][:6])
Buffers de BN: ['capas.1.running_mean', 'capas.1.running_var', 'capas.1.num_batches_tracked', 'capas.4.running_mean', 'capas.4.running_var', 'capas.4.num_batches_tracked']
11.13.1 Cómo leer el resultado de BN
Compara pérdidas y aciertos del checkpoint, no solo cuándo cruza una curva un umbral relativo a su propio inicio. Ese umbral cambia si cada modelo comienza con otra pérdida. Los segundos incluyen entrenamiento y evaluación del protocolo en esta máquina; no se extrapolan a otro hardware ni a un servicio de inferencia.
Si normalizar mejora rapidez pero no validación final, el resultado sigue siendo informativo. Si empeora, revisa tamaño de lote, estadísticas móviles e interacción con tasa antes de atribuirlo a falta de capacidad.
11.14 Parada temprana: tres momentos diferentes
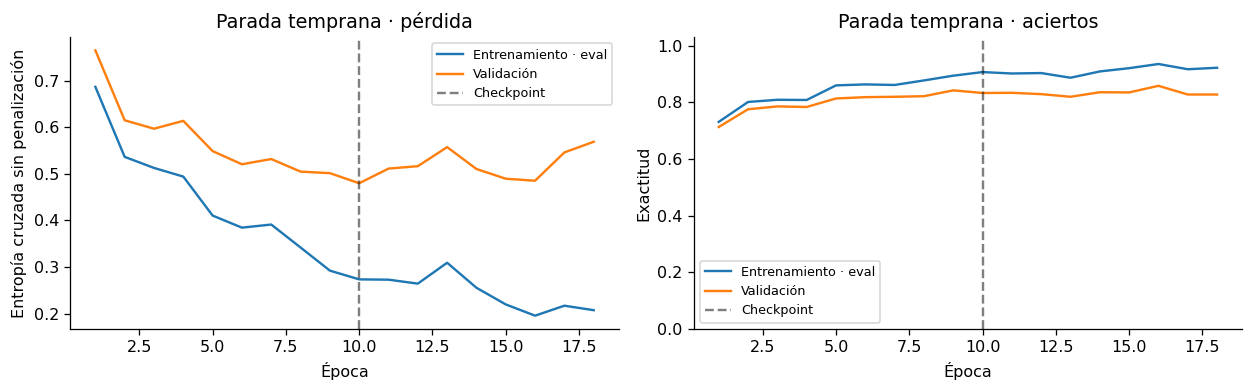
Entrenamos la arquitectura del baseline con techo de 60 épocas, paciencia 8 y min_delta=1e-4. Distinguimos el máximo permitido, la época en que se detuvo el ajuste y la época cuyo estado se conserva. Aquí incluso los controles de presupuesto fijo restauran su mínimo: la comparación estudia presupuesto y regla de parada, no «última época frente a checkpoint» de manera encubierta.
Una mejora menor que min_delta puede actualizar el mínimo exacto y aun así no reiniciar la paciencia. Por eso registramos esos dos criterios por separado. La elección sigue basándose en entropía cruzada, no en la época con mayor exactitud.
fila_es=experimento('EarlyStopping',epocas=EPOCHS_EARLY,paciencia=PATIENCE,min_delta=1e-4)curvas(HISTORIAS['EarlyStopping'],INFORMES['EarlyStopping'],'Parada temprana')display(pd.DataFrame([fila_base,fila_es])[ ['modelo','epocas','checkpoint','val_loss','val_accuracy','gap_accuracy','segundos']].round(3))display(Markdown(f'### Lectura de la ejecución\n\nEl techo era **{EPOCHS_EARLY}**, 'f'el ajuste terminó en **{fila_es["epocas"]}** y se conservó la época **{fila_es["checkpoint"]}**. 'f'Se evitaron {EPOCHS_EARLY-fila_es["epocas"]} épocas respecto al techo. ''Eso no equivale automáticamente al mismo porcentaje de ahorro temporal: las mediciones incluyen evaluaciones y tienen variabilidad.'))
El techo era 60, el ajuste terminó en 18 y se conservó la época 10. Se evitaron 42 épocas respecto al techo. Eso no equivale automáticamente al mismo porcentaje de ahorro temporal: las mediciones incluyen evaluaciones y tienen variabilidad.
11.15 Búsqueda pequeña: regularización y capacidad interactúan
El capítulo de hiperparámetros desarrolla el método general. Aquí sorteamos ocho configuraciones distintas con semilla 42, usando anchos 64/128/256, tasas 0.0005/0.001/0.003, dropout 0/0.2/0.4 y L2 0/0.0001/0.001. Cada red tiene dos capas ocultas: el ancho sorteado y la mitad, con mínimo de 32.
Fijamos doce épocas por configuración. Es un presupuesto menor que el de los controles de treinta: lo compararemos como otro procedimiento, sin atribuir todas las diferencias a un hiperparámetro individual. Seleccionamos por CE de validación del checkpoint. Prueba no aparece en la tabla de búsqueda.
rng=np.random.default_rng(42);vistos=set();configs=[]whilelen(configs)<8: cfg=(int(rng.choice([64,128,256])),float(rng.choice([.0005,.001,.003])),float(rng.choice([0.,.2,.4])),float(rng.choice([0.,1e-4,1e-3])))if cfg notin vistos: vistos.add(cfg);configs.append(cfg)for i,(ancho,lr,drop,lam) inenumerate(configs,1): experimento(f'Busqueda_{i}',[ancho,max(ancho//2,32)],epocas=12,lr=lr,dropout=drop,l2=lam)tabla_busqueda=pd.DataFrame([f for f in FILAS if f['modelo'].startswith('Busqueda_')]).sort_values('val_loss')display(tabla_busqueda[['modelo','parametros','lr','dropout','l2','checkpoint','val_loss','val_accuracy']].round(4))elegido_busqueda=tabla_busqueda.iloc[0]['modelo']print('Configuración de búsqueda elegida solo con validación:',elegido_busqueda)
Configuración de búsqueda elegida solo con validación: Busqueda_8
11.16 Combinar técnicas es una hipótesis adicional
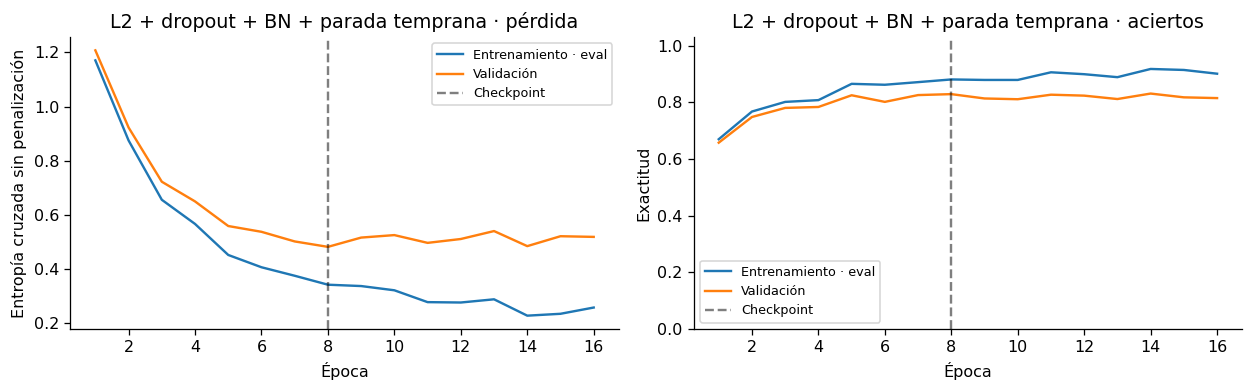
Probamos la arquitectura ancha con L2 0.0001, dropout 0.3, BatchNorm y parada temprana de paciencia 8, con techo 60. Cambian varias operaciones a la vez: una mejora o deterioro no identifica cuál de ellas fue la causa. Para aislar interacciones haría falta una ablación factorial u otro diseño explícito.
Se conserva el mismo criterio de selección. No daremos por ganador al combinado por contener más mecanismos.
fila_comb=experimento('Combinado',l2=1e-4,dropout=.3,bn=True,epocas=60,paciencia=8,min_delta=1e-4)curvas(HISTORIAS['Combinado'],INFORMES['Combinado'],'L2 + dropout + BN + parada temprana')tabla_desarrollo=pd.DataFrame(FILAS).sort_values('val_loss',kind='stable').reset_index(drop=True)display(tabla_desarrollo[['modelo','parametros','epocas','checkpoint','train_accuracy','val_accuracy','val_loss','gap_accuracy','segundos']].round(3))ganador=str(tabla_desarrollo.iloc[0]['modelo'])print('Procedimiento elegido antes de consultar prueba:',ganador)fig,axes=plt.subplots(1,2,figsize=(12,7))orden=tabla_desarrollo.sort_values('val_loss',ascending=False)axes[0].barh(orden.modelo,orden.val_loss);axes[0].set(xlabel='CE de validación',title='Criterio de selección')axes[1].barh(orden.modelo,orden.gap_accuracy);axes[1].axvline(0,color='black',lw=.7)axes[1].set(xlabel='Exactitud train − validación',title='Brecha: leer junto al nivel absoluto')plt.tight_layout();plt.show()tabla_desarrollo.to_csv(ARTEFACTOS/'resultados-desarrollo.csv',index=False)
Procedimiento elegido antes de consultar prueba: Dropout_0.2
11.16.1 Qué mirar en la tabla consolidada
Primero identifica el criterio: menor pérdida de validación. Después contrasta exactitud, gap, parámetros y coste. Un pequeño gap no autoriza elegir una red de bajo desempeño; una diferencia mínima entre dos configuraciones no establece una superioridad reproducible con una semilla.
La búsqueda y el combinado tienen presupuestos distintos del baseline. La tabla compara procedimientos completos; para una comparación de eficiencia rigurosa habría que fijar tiempo, actualizaciones o ejemplos vistos y repetir mediciones. Tampoco podemos descomponer los efectos del combinado leyendo una sola fila.
11.17 Evaluación final: congelar antes de abrir prueba
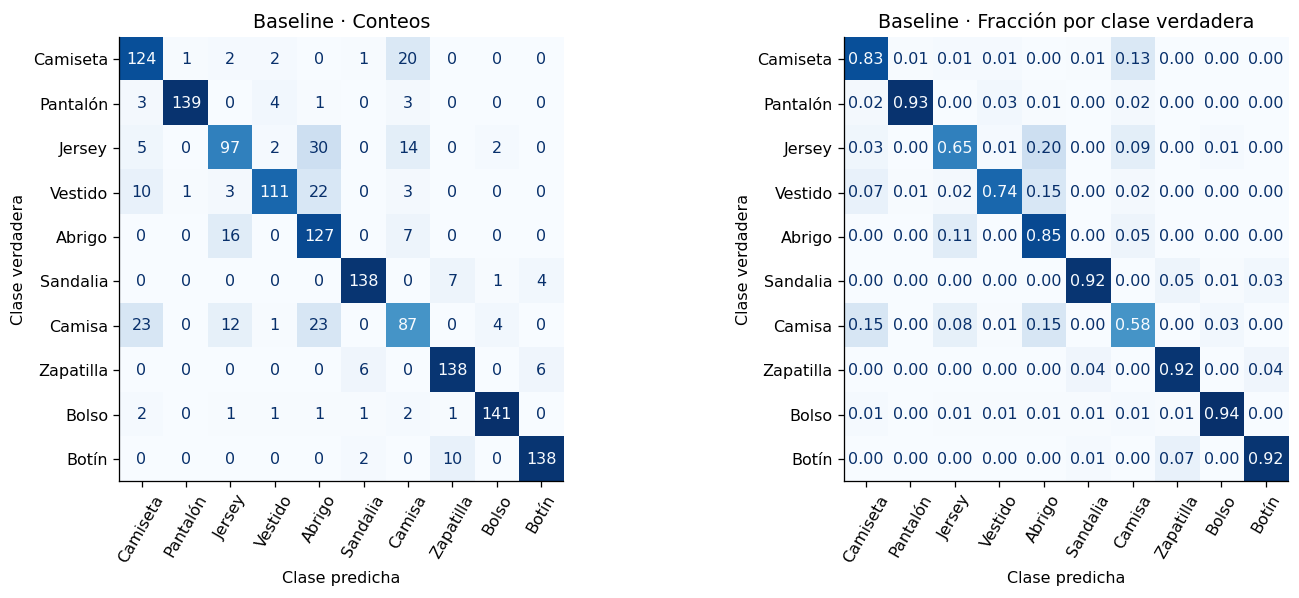
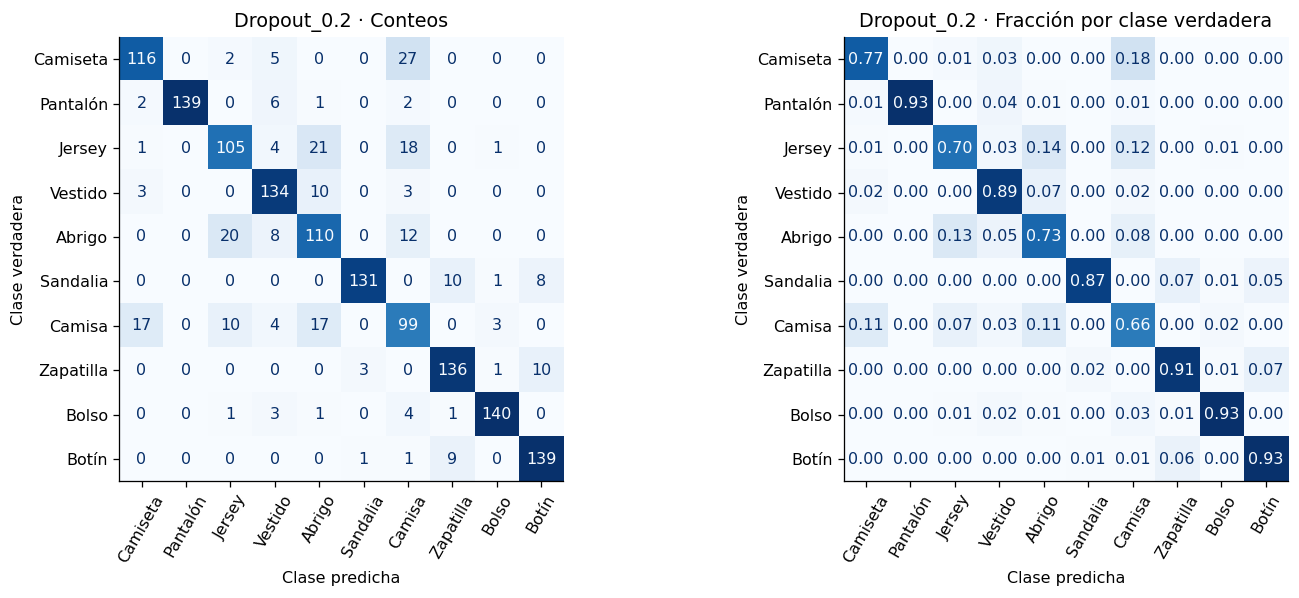
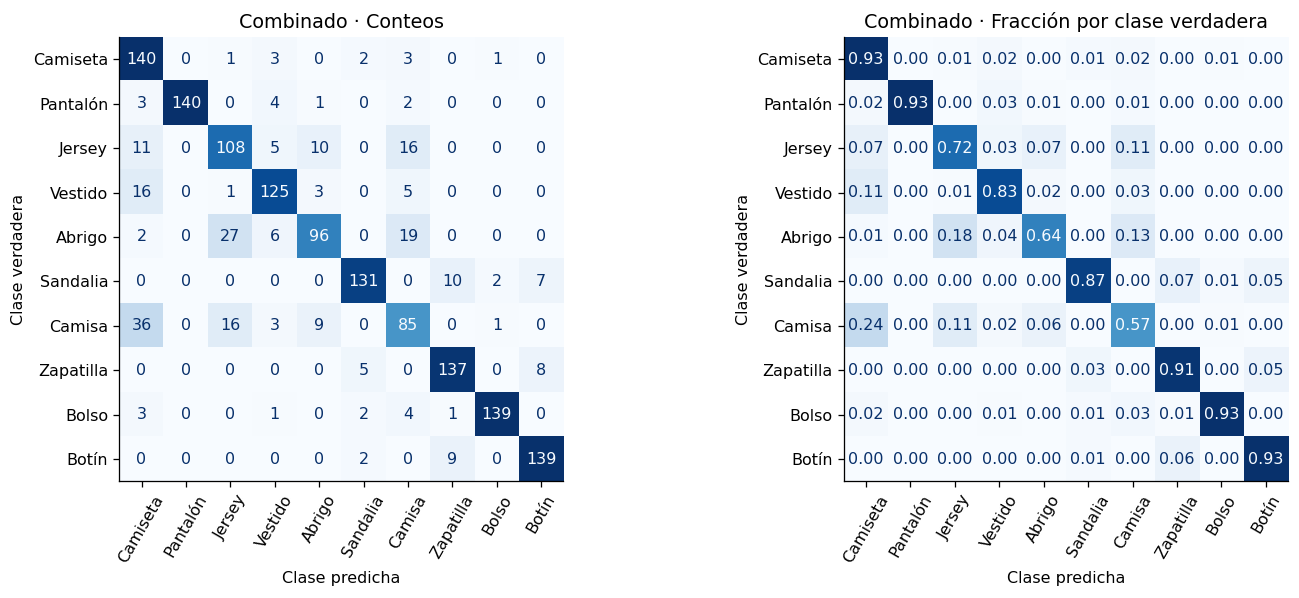
Evaluamos tres procedimientos prefijados: baseline como testigo, ganador de validación y combinado como contraste de diseño. Si alguno coincide, se evalúa una sola vez. Mostrar estos diagnósticos no autoriza sustituir el ganador por quien tenga mejor prueba.
La matriz de confusión complementa la exactitud. Las filas son clases verdaderas y las columnas predicciones. El recall de una clase es su diagonal dividida por el total de esa fila; la precisión divide por el total de la columna correspondiente.
evaluados=list(dict.fromkeys(['Baseline',ganador,'Combinado']))resultados_prueba=[]; probas_prueba={}; informes_clase={}for nombre in evaluados: p=probabilidades(MODELOS[nombre],Xte);pred=p.argmax(1)assert np.allclose(p.sum(1),1.,atol=1e-6) probas_prueba[nombre]=p resultados_prueba.append({'modelo':nombre,'elegido_en_validacion':nombre==ganador,'exactitud':accuracy_score(yte,pred),'f1_macro':f1_score(yte,pred,average='macro'),'CE':float(-np.log(np.maximum(p[np.arange(len(yte)),yte],1e-30)).mean())}) reporte=pd.DataFrame(classification_report(yte,pred,labels=np.arange(10), target_names=NOMBRES,output_dict=True,zero_division=0)).T informes_clase[nombre]=reporte display(Markdown('### '+nombre));display(reporte.round(3)) reporte.to_csv(ARTEFACTOS/(nombre+'-reporte-prueba.csv')) cm=confusion_matrix(yte,pred,labels=np.arange(10));normal=cm/cm.sum(1,keepdims=True) fig,axes=plt.subplots(1,2,figsize=(13,5.3))for ax,mat,titulo,formato inzip(axes,[cm,normal],['Conteos','Fracción por clase verdadera'],['d','.2f']): ConfusionMatrixDisplay(mat,display_labels=NOMBRES).plot(ax=ax,cmap='Blues', colorbar=False,values_format=formato,xticks_rotation=60) ax.set(xlabel='Clase predicha',ylabel='Clase verdadera',title=nombre+' · '+titulo) plt.tight_layout();plt.show()tabla_prueba=pd.DataFrame(resultados_prueba);display(tabla_prueba.round(4))tabla_prueba.to_csv(ARTEFACTOS/'evaluacion-final.csv',index=False)fila_ganadora=tabla_prueba.loc[tabla_prueba.modelo==ganador].iloc[0]display(Markdown(f'### Lectura de la ejecución\n\nEl procedimiento elegido con validación fue **{ganador}**. 'f'En {len(yte)} prendas de prueba obtuvo exactitud **{fila_ganadora.exactitud:.1%}**, 'f'F1 macro **{fila_ganadora.f1_macro:.3f}** y CE **{fila_ganadora.CE:.3f}**. ''Las otras filas son contrastes declarados, sin una nueva selección basada en prueba.'))
11.17.1 Baseline
precision
recall
f1-score
support
Camiseta
0.743
0.827
0.782
150.000
Pantalón
0.986
0.927
0.955
150.000
Jersey
0.740
0.647
0.690
150.000
Vestido
0.917
0.740
0.819
150.000
Abrigo
0.623
0.847
0.718
150.000
Sandalia
0.932
0.920
0.926
150.000
Camisa
0.640
0.580
0.608
150.000
Zapatilla
0.885
0.920
0.902
150.000
Bolso
0.953
0.940
0.946
150.000
Botín
0.932
0.920
0.926
150.000
accuracy
0.827
0.827
0.827
0.827
macro avg
0.835
0.827
0.827
1500.000
weighted avg
0.835
0.827
0.827
1500.000
11.17.2 Dropout_0.2
precision
recall
f1-score
support
Camiseta
0.835
0.773
0.803
150.000
Pantalón
1.000
0.927
0.962
150.000
Jersey
0.761
0.700
0.729
150.000
Vestido
0.817
0.893
0.854
150.000
Abrigo
0.688
0.733
0.710
150.000
Sandalia
0.970
0.873
0.919
150.000
Camisa
0.596
0.660
0.627
150.000
Zapatilla
0.872
0.907
0.889
150.000
Bolso
0.959
0.933
0.946
150.000
Botín
0.885
0.927
0.906
150.000
accuracy
0.833
0.833
0.833
0.833
macro avg
0.838
0.833
0.834
1500.000
weighted avg
0.838
0.833
0.834
1500.000
11.17.3 Combinado
precision
recall
f1-score
support
Camiseta
0.664
0.933
0.776
150.000
Pantalón
1.000
0.933
0.966
150.000
Jersey
0.706
0.720
0.713
150.000
Vestido
0.850
0.833
0.842
150.000
Abrigo
0.807
0.640
0.714
150.000
Sandalia
0.923
0.873
0.897
150.000
Camisa
0.634
0.567
0.599
150.000
Zapatilla
0.873
0.913
0.893
150.000
Bolso
0.972
0.927
0.949
150.000
Botín
0.903
0.927
0.914
150.000
accuracy
0.827
0.827
0.827
0.827
macro avg
0.833
0.827
0.826
1500.000
weighted avg
0.833
0.827
0.826
1500.000
modelo
elegido_en_validacion
exactitud
f1_macro
CE
0
Baseline
False
0.8267
0.8274
0.4746
1
Dropout_0.2
True
0.8327
0.8343
0.4663
2
Combinado
False
0.8267
0.8261
0.5136
11.17.4 Lectura de la ejecución
El procedimiento elegido con validación fue Dropout_0.2. En 1500 prendas de prueba obtuvo exactitud 83.3%, F1 macro 0.834 y CE 0.466. Las otras filas son contrastes declarados, sin una nueva selección basada en prueba.
11.17.5 De los promedios al perfil por clase
Precisión alta y recall bajo puede corresponder a una clase que el modelo predice pocas veces y con pocos falsos positivos, mientras deja escapar muchos casos verdaderos. No demuestra que el modelo haya medido su incertidumbre correctamente. F1 combina precisión y recall, pero no define el coste de los errores.
F1 macro da el mismo peso a cada clase. F1 ponderado usa su soporte. Con soportes exactamente iguales ambos promedios de F1 coinciden, aunque algunas clases sean mucho más difíciles. Una diferencia entre ellos procede de los pesos de agregación, no de heterogeneidad por sí sola.
Si Camisa se confunde con Camiseta o Abrigo, el promedio puede ocultar esa dificultad. Mirar imágenes y errores ayuda a formular otra hipótesis; usar esas etiquetas de prueba para modificar la red exigiría otra evaluación reservada. Una sola matriz no identifica causas de adquisición, ambigüedad o representación.
11.18 Ranking frente al resto: ROC-AUC no sustituye la decisión
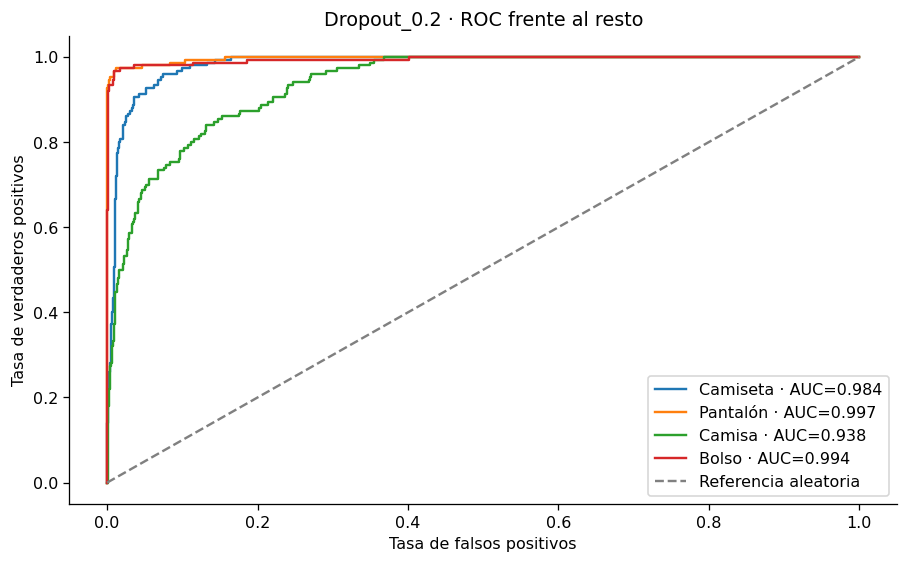
Para el ganador fijado calculamos ROC de cada clase contra todas las demás. Se dibujan Pantalón, Bolso, Camiseta y Camisa; el AUC macro usa las diez. Un AUC alto describe ordenación de scores, mientras precisión y recall con argmax describen una decisión concreta.
El AUC de ranking aleatorio ronda 0.5; la exactitud de adivinar uniformemente entre diez clases ronda 0.10. No son pisos intercambiables. Tampoco ROC-AUC acredita calibración.
p=probas_prueba[ganador];aucs=[];fig,ax=plt.subplots(figsize=(8,5))for k inrange(10): fpr,tpr,_=roc_curve(yte==k,p[:,k]);a=roc_auc_score(yte==k,p[:,k]);aucs.append(a)if k in [1,8,0,6]:ax.plot(fpr,tpr,label=f'{NOMBRES[k]} · AUC={a:.3f}')ax.plot([0,1],[0,1],'--',color='gray',label='Referencia aleatoria')ax.set(xlabel='Tasa de falsos positivos',ylabel='Tasa de verdaderos positivos',title=ganador+' · ROC frente al resto')ax.legend();plt.tight_layout();plt.show()print('ROC-AUC macro, diez clases:',np.mean(aucs))
ROC-AUC macro, diez clases: 0.9834301234567899
11.19 Conservar el predictor y el protocolo elegidos
Guardamos arquitectura, matrices y buffers del estado seleccionado, además del contrato de entrada. La comprobación de recarga utiliza validación: no abre otra selección en prueba. Este es un artefacto de inferencia; reanudar exactamente el entrenamiento requeriría además estados de optimizador y de azar.
red=MODELOS[ganador]recargada=guardar(red,'modelo-seleccionado',{'forma':[None,784],'escala':'uint8/255','clases':NOMBRES,'seleccion':ganador,'checkpoint':INFORMES[ganador]['checkpoint']})with torch.inference_mode(): xb=torch.as_tensor(Xva[:32],dtype=torch.float32) diferencia=float((red(xb.to(dispositivo)).cpu()-recargada(xb)).abs().max())assert torch.allclose(red(xb.to(dispositivo)).cpu(),recargada(xb),atol=1e-5,rtol=1e-5)print('Máxima diferencia de logits al recargar:',diferencia)(ARTEFACTOS/'protocolo.json').write_text(json.dumps({'versiones':versiones,'dispositivo':str(dispositivo),'semilla':42,'n_train':N_TRAIN,'n_val':N_VAL,'n_test':N_TEST,'hashes_gzip':hashes_datos,'lote':LOTE,'inicializacion':'Xavier uniforme gain=1; sesgos cero','seleccion_checkpoint':'CE de validacion sin penalizacion','seleccion_configuracion':'CE de validacion sin penalizacion','penalizacion':'sumas sobre matrices ocultas; excluye sesgos, BN y salida','criterio_parada':'paciencia por min_delta; checkpoint por minimo exacto','ganador':ganador,'prueba_diagnosticos':evaluados,'configuraciones_busqueda':configs,'recarga_max_diferencia':diferencia,'limite':'una semilla y un subconjunto; no benchmark entre frameworks'}, ensure_ascii=False,indent=2),encoding='utf-8')
Máxima diferencia de logits al recargar: 0.0
1739
11.20 Guía diagnóstica y límites de la comparación
Observación persistente
Hipótesis compatible
Siguiente contraste
Entrenamiento y validación bajos
Representación insuficiente, poco ajuste o regularización excesiva
Revisar curvas, tasa, presupuesto y fuerza de penalización
Entrenamiento mejora y validación empeora
Sobreajuste bajo este protocolo
Conservar el mínimo y contrastar otra intervención en desarrollo
Una técnica reduce el gap y ambos aciertos
Ajuste demasiado restringido
Revisar el nivel absoluto antes de celebrar la brecha
Validación pierde CE aunque exactitud no cambie
Cambiaron magnitudes de scores o errores más costosos en CE
Inspeccionar distribución de pérdidas; no diagnosticar calibración sin medirla
Exactitud online inferior a evaluación con dropout
Modos y momentos distintos
Comparar estados fijos; no llamarlo mejora de generalización
Combinado mejora
Efecto conjunto bajo este diseño
No atribuirlo a una única técnica sin ablaciones
Los splits, modelos y presupuestos se han declarado. Eso no elimina variabilidad entre semillas, dependencia de la muestra ni incertidumbre de medición temporal. El esquema clásico de sesgo-varianza no se ha estimado con estas redes. Las comparaciones apoyan decisiones para este desarrollo, sin garantizar su repetición en otro conjunto.
El capítulo de evaluación amplía el análisis de métricas; fundamentos de CNN introduce una representación que aprovecha vecindarios de píxeles. Cambiar de representación es otra hipótesis, diferente de aumentar o reducir una penalización.
11.21 Taller
Describe con cifras un caso donde disminuya el gap sin mejorar validación. Formula una hipótesis y una decisión que no utilice prueba.
Compara dos valores nuevos de L2 con la convención de sumas declarada. Explica por qué no copiarías esos coeficientes a una penalización media o a AdamW.
Cambia la paciencia a 2 y 20 con techo fijo. Distingue época final, mínimo exacto, coste y checkpoint recuperado.
Diseña una ablación del combinado que separe BN de dropout manteniendo lotes y estados iniciales comparables.
Repite el baseline con tres semillas prefijadas. Resume media y dispersión de validación sin escoger la mejor semilla de prueba.
Explica por qué un AUC macro alto puede coexistir con un recall bajo de Camisa, y qué información adicional necesitarías antes de cambiar decisiones.
11.22 Referencias
Goodfellow, Bengio y Courville (2016), Deep Learning, capítulos 7 y 8.