14  Arquitecturas CNN

Serie Deep Learning · del perceptrón a los transformers.

VGG apila filtros pequeños, Inception combina escalas y las redes residuales añaden rutas de identidad. Construiremos versiones docentes y compararemos sus resultados con un protocolo común. No son reproducciones de los modelos publicados ni una clasificación universal de arquitecturas.

14.1 1. Entorno y protocolo

Usamos PyTorch para las redes, NumPy para cálculos explícitos y scikit-learn para particiones y métricas. El orden de importación evita conflictos entre bibliotecas numéricas en algunos entornos Windows. La caché histórica de datos se lee sin depender de su framework de origen.

Dependencias: PyTorch, torchvision, NumPy, pandas, Matplotlib, scikit-learn y Pillow. Instálelas en el mismo entorno del kernel de Jupyter (python -m pip install torch torchvision numpy pandas matplotlib scikit-learn pillow). La ejecución registrada usa CPU; el código selecciona CUDA cuando está disponible. Los pesos preentrenados y los datos que no estén en caché requieren acceso a sus servidores oficiales.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

14.1.1 Un contrato de entrenamiento que podemos inspeccionar

nn.Module produce logits de forma (N, K). CrossEntropyLoss recibe esos logits y etiquetas enteras long de forma (N,); aplica internamente el cálculo estable equivalente a log-softmax y entropía cruzada. No añadimos softmax antes de la pérdida ni convertimos las etiquetas a one-hot. Softmax se utiliza al interpretar la predicción.

Cada lote ejecuta zero_grad → forward → backward → step. train() activa dropout y el comportamiento de entrenamiento de BatchNorm; eval() cambia esos comportamientos y inference_mode() evita construir el grafo. Son operaciones distintas. Las curvas train/val se calculan al final de la época, ambas en eval. Se conserva además la pérdida online, que usa pesos cambiantes y dropout: no se debe comparar como si fuera la misma medición.

El checkpoint minimiza exclusivamente la CE de validación, copia parámetros y buffers de state_dict y se restaura antes del informe. La prueba queda fuera de la función de entrenamiento. El tiempo incluye las mediciones de cada época, pero excluye descargas. Una semilla fija reduce variación; no sustituye varias repeticiones ni garantiza identidad entre versiones, dispositivos o frameworks.

Los historiales, contratos y pesos se guardan en artefactos_pytorch/. La recarga reconstruye la arquitectura y comprueba logits sobre validación. El archivo de pesos no incluye una sesión de optimización para reanudar exactamente un entrenamiento.

14.2 2. Qué problema resuelve cada diseño

Diseño Mecanismo Pregunta que debemos medir
VGG Apilar convoluciones pequeñas y aumentar canales ¿La representación adicional compensa coste y tamaño?
Inception Ramas con distintos kernels y concatenación por canal ¿Combinar escalas aporta al presupuesto observado?
Residual Sumar una transformación a una ruta de identidad/proyección ¿Facilita el ajuste al mantener constantes profundidad y pesos iniciales?

Dos convoluciones 3×3 tienen campo receptivo teórico 5×5 con stride 1, pero introducen una no linealidad adicional: no son la misma función que una convolución 5×5. Con 64 canales de entrada y salida comparamos también los sesgos. El coste real requiere medir operaciones y tiempo, no solamente parámetros.

La degradación describe un aumento del error de entrenamiento al añadir profundidad bajo ciertas condiciones. El sobreajuste describe una divergencia entre ajuste y generalización. No se puede concluir uno u otro leyendo únicamente una curva de prueba.

simple=(5*5*64+1)*64;doble=2*(3*3*64+1)*64
display(pd.DataFrame({'diseño':['Una 5×5','Dos 3×3'],'parametros':[simple,doble]}))
ep=np.arange(1,13);fig,ax=plt.subplots(figsize=(8,3.5))
ax.plot(ep,.8*np.exp(-ep/3)+.15,label='Poca profundidad (simulada)')
ax.plot(ep,.8*np.exp(-ep/3)+.32,label='Más profundidad (simulada)')
ax.set(xlabel='Época',ylabel='Error de entrenamiento ilustrativo',title='Ejemplo conceptual · NO son resultados entrenados');ax.legend();fig.tight_layout();plt.show()
diseño parametros
0 Una 5×5 102464
1 Dos 3×3 73856

14.3 3. Digits: validación separada y prueba histórica

Se conserva Digits de scikit-learn y la ampliación 8×8 → 32×32 mediante repetición de píxeles. Esto adapta dimensiones y permite varios pooling; no añade detalle visual. Conservamos el test histórico: el último 20 % de una permutación con semilla 42. Del 80 % restante reservamos ahora 20 % estratificado para validación.

La versión previa utilizaba el test como validación del entrenamiento. Esta separación corrige el protocolo y puede modificar las cifras: no atribuya la diferencia al framework. Todas las configuraciones usan doce épocas, lote 32 y Adam 0,001. La única semilla limita las conclusiones.

El test histórico ya fue consultado por la versión anterior del capítulo. Separarlo ahora de validación evita seguir usándolo para seleccionar checkpoints, pero no lo convierte retroactivamente en un test nunca observado. Para una evaluación externa estricta se necesitaría un conjunto nuevo.

from sklearn.datasets import load_digits
d=load_digits();x=np.kron(d.images,np.ones((4,4),dtype=np.float32)).astype(np.float32)/16;y=d.target
orden=np.random.default_rng(SEED).permutation(len(y));corte=int(.8*len(y));dev=orden[:corte];ite=orden[corte:]
itr,iva=train_test_split(dev,test_size=.2,stratify=y[dev],random_state=SEED)
train=conjunto(x[itr,None],y[itr]);val=conjunto(x[iva,None],y[iva]);test=conjunto(x[ite,None],y[ite])
assert not(set(itr)&set(iva) or set(itr)&set(ite) or set(iva)&set(ite))
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=itr,val=iva,test=ite)
print('Train / val / test:',len(itr),len(iva),len(ite))
fig,axes=plt.subplots(1,2,figsize=(6,3))
axes[0].imshow(d.images[0],cmap='gray');axes[0].set_title('Original 8×8')
axes[1].imshow(x[0],cmap='gray');axes[1].set_title('Repetición 32×32')
for ax in axes: ax.axis('off')
fig.tight_layout();plt.show()
Train / val / test: 1149 288 360

14.4 4. Una VGG pequeña

Cada bloque aplica dos convoluciones 3×3 con ReLU y un pooling. Los canales crecen 16 → 32 → 64 mientras la resolución baja 32 → 16 → 8 → 4. El aplanado de 1 024 valores alimenta una capa de 64 unidades. Es una adaptación docente del patrón VGG, no VGG16 preentrenada.

Reducir resolución permite aumentar canales, pero la capa densa conserva un coste dependiente del tamaño de entrada. La tabla y el conteo de parámetros deben leerse junto con la CE de validación.

def crear_vgg():
    capas=[];entrada=1
    for salida in [16,32,64]:
        capas += [nn.Conv2d(entrada,salida,3,padding=1),nn.ReLU(),nn.Conv2d(salida,salida,3,padding=1),nn.ReLU(),nn.MaxPool2d(2)]
        entrada=salida
    return nn.Sequential(*capas,nn.Flatten(),nn.Linear(64*4*4,64),nn.ReLU(),nn.Linear(64,10))
semilla();vgg=inicializar(crear_vgg());print(vgg);print('Parámetros:',parametros(vgg))
historias={};resumenes={};modelos={}
h,r=entrenar(vgg,train,val,12,lote=32,nombre='vgg');historias['vgg']=h;resumenes['vgg']=r;modelos['vgg']=vgg
curvas(h,'VGG docente',r['mejor_epoca']);lectura(h,r)
Sequential(
  (0): Conv2d(1, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (1): ReLU()
  (2): Conv2d(16, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (3): ReLU()
  (4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (5): Conv2d(16, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (6): ReLU()
  (7): Conv2d(32, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (8): ReLU()
  (9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (10): Conv2d(32, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (11): ReLU()
  (12): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (13): ReLU()
  (14): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (15): Flatten(start_dim=1, end_dim=-1)
  (16): Linear(in_features=1024, out_features=64, bias=True)
  (17): ReLU()
  (18): Linear(in_features=64, out_features=10, bias=True)
)
Parámetros: 138042
vgg 1/12: CE val=0.2365, acc val=0.9340
vgg 2/12: CE val=0.2587, acc val=0.9201
vgg 3/12: CE val=0.0871, acc val=0.9722
vgg 4/12: CE val=0.0447, acc val=0.9896
vgg 5/12: CE val=0.0379, acc val=0.9861
vgg 6/12: CE val=0.0252, acc val=0.9931
vgg 7/12: CE val=0.0278, acc val=0.9931
vgg 8/12: CE val=0.0260, acc val=0.9931
vgg 9/12: CE val=0.0260, acc val=0.9931
vgg 10/12: CE val=0.0273, acc val=0.9931
vgg 11/12: CE val=0.0266, acc val=0.9931
vgg 12/12: CE val=0.0275, acc val=0.9931

Lectura del experimento. Se ejecutaron 12 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 6, con CE 0.0252. Al cierre, la brecha de exactitud train−val es +0.69 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.

14.5 5. Ramas Inception

Aplicamos kernels 1×1, 3×3 y 5×5 a la misma entrada y concatenamos las salidas en el eje C. Las ramas deben conservar H y W: padding 0, 1 y 2 respectivamente. La convolución 1×1 combina canales, sin ampliar el campo receptivo espacial.

Esta versión conserva tres ramas simples, sin los cuellos de botella ni la rama de pooling de un Inception completo. El promedio global elimina dependencia espacial en el clasificador: cada canal aporta un valor. Menos parámetros no garantiza menor latencia, porque varias ramas también cuestan cómputo.

class Inception(nn.Module):
    def __init__(self,entrada,salida):
        super().__init__();self.ramas=nn.ModuleList([nn.Conv2d(entrada,salida,k,padding=k//2) for k in [1,3,5]])
    def forward(self,x): return torch.cat([F.relu(rama(x)) for rama in self.ramas],dim=1)
def crear_inception():
    return nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),Inception(16,8),nn.MaxPool2d(2),Inception(24,16),nn.AdaptiveAvgPool2d(1),nn.Flatten(),nn.Linear(48,64),nn.ReLU(),nn.Linear(64,10))
semilla();inc=inicializar(crear_inception());assert Inception(16,8)(torch.zeros(2,16,16,16)).shape==(2,24,16,16)
h,r=entrenar(inc,train,val,12,lote=32,nombre='inception');historias['inception']=h;resumenes['inception']=r;modelos['inception']=inc
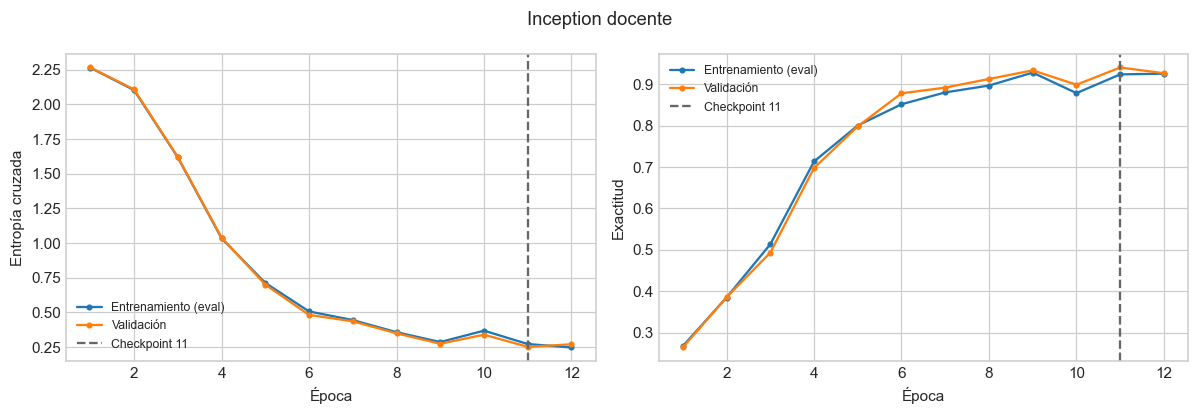
curvas(h,'Inception docente',r['mejor_epoca']);lectura(h,r)
inception 1/12: CE val=2.2653, acc val=0.2639
inception 2/12: CE val=2.1074, acc val=0.3854
inception 3/12: CE val=1.6198, acc val=0.4931
inception 4/12: CE val=1.0397, acc val=0.6979
inception 5/12: CE val=0.7006, acc val=0.7986
inception 6/12: CE val=0.4824, acc val=0.8785
inception 7/12: CE val=0.4361, acc val=0.8924
inception 8/12: CE val=0.3495, acc val=0.9132
inception 9/12: CE val=0.2744, acc val=0.9340
inception 10/12: CE val=0.3398, acc val=0.8993
inception 11/12: CE val=0.2524, acc val=0.9410
inception 12/12: CE val=0.2707, acc val=0.9271

Lectura del experimento. Se ejecutaron 12 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 11, con CE 0.2524. Al cierre, la brecha de exactitud train−val es -0.11 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.

14.6 6. Redes residuales: comparar la misma profundidad

Un bloque calcula \(y=\mathrm{ReLU}(F(x)+S(x))\). Si las dimensiones coinciden, \(S(x)=x\); si cambian canales o stride, una convolución 1×1 puede proyectar. El bloque llano usa \(y=\mathrm{ReLU}(F(x))\). Ambos tendrán dos convoluciones 3×3, igual número de parámetros y los mismos pesos iniciales. La única diferencia dentro de cada pareja será sumar o no la identidad.

En el original, el bloque llano tenía una convolución y el residual dos: la comparación mezclaba profundidad y conexión. Aquí se corrige. Mantendremos cuatro y ocho bloques, 16 canales, pooling después de los bloques 3 y 6 cuando existan, y promedio global. Entre profundidades no hay igualdad de parámetros: la comparación controlada es dentro de cada pareja. No añadimos BatchNorm para poder observar exclusivamente este mecanismo.

class Bloque(nn.Module):
    def __init__(self,canales,residual=True):
        super().__init__();self.a=nn.Conv2d(canales,canales,3,padding=1);self.b=nn.Conv2d(canales,canales,3,padding=1);self.residual=residual
    def forward(self,x):
        z=self.b(F.relu(self.a(x)))
        return F.relu(z+x if self.residual else z)
class Profunda(nn.Module):
    def __init__(self,n,residual):
        super().__init__();self.entrada=nn.Conv2d(1,16,3,padding=1);self.bloques=nn.ModuleList([Bloque(16,residual) for _ in range(n)]);self.salida=nn.Linear(16,10)
    def forward(self,x):
        x=F.relu(self.entrada(x))
        for i,b in enumerate(self.bloques):
            x=b(x)
            if i in [2,5]: x=F.max_pool2d(x,2)
        return self.salida(x.mean((2,3)))
# Ejemplo de proyección para canales distintos; no se introduce en la ablación.
entrada=torch.zeros(2,8,16,16);proyeccion=nn.Conv2d(8,16,1)
assert proyeccion(entrada).shape==(2,16,16,16)
contratos=[]
for n in [4,8]:
    semilla();llana=inicializar(Profunda(n,False));residual=inicializar(Profunda(n,True))
    residual.load_state_dict(llana.state_dict())
    assert parametros(llana)==parametros(residual)
    assert all(torch.equal(llana.state_dict()[k],residual.state_dict()[k]) for k in llana.state_dict())
    contratos.append({'bloques':n,'convoluciones':1+2*n,'parametros_pareja':parametros(llana),'pesos_iniciales_iguales':True})
    for pref,m in [('llana',llana),('residual',residual)]:
        nombre=f'{pref}-{n}';semilla()
        h,r=entrenar(m,train,val,12,lote=32,nombre=nombre)
        historias[nombre]=h;resumenes[nombre]=r;modelos[nombre]=m
display(pd.DataFrame(contratos));(ARTEFACTOS/'contratos-ablacion.json').write_text(json.dumps(contratos,indent=2),encoding='utf-8')
llana-4 1/12: CE val=2.2954, acc val=0.1076
llana-4 2/12: CE val=2.1482, acc val=0.1840
llana-4 3/12: CE val=1.8115, acc val=0.3090
llana-4 4/12: CE val=1.3979, acc val=0.5035
llana-4 5/12: CE val=1.2805, acc val=0.5382
llana-4 6/12: CE val=1.0157, acc val=0.6389
llana-4 7/12: CE val=0.8409, acc val=0.7361
llana-4 8/12: CE val=0.5823, acc val=0.8160
llana-4 9/12: CE val=0.5349, acc val=0.8160
llana-4 10/12: CE val=0.6328, acc val=0.7882
llana-4 11/12: CE val=0.4679, acc val=0.8576
llana-4 12/12: CE val=0.3806, acc val=0.8785
residual-4 1/12: CE val=2.2979, acc val=0.0938
residual-4 2/12: CE val=2.2872, acc val=0.1076
residual-4 3/12: CE val=2.2085, acc val=0.1979
residual-4 4/12: CE val=1.9267, acc val=0.2431
residual-4 5/12: CE val=1.6505, acc val=0.3854
residual-4 6/12: CE val=1.3685, acc val=0.5417
residual-4 7/12: CE val=1.2248, acc val=0.5833
residual-4 8/12: CE val=1.1051, acc val=0.6458
residual-4 9/12: CE val=0.8331, acc val=0.7326
residual-4 10/12: CE val=0.8594, acc val=0.7604
residual-4 11/12: CE val=0.7428, acc val=0.7292
residual-4 12/12: CE val=0.5739, acc val=0.8194
llana-8 1/12: CE val=2.2939, acc val=0.1389
llana-8 2/12: CE val=1.9129, acc val=0.3611
llana-8 3/12: CE val=0.9404, acc val=0.6910
llana-8 4/12: CE val=0.8214, acc val=0.7396
llana-8 5/12: CE val=0.1845, acc val=0.9375
llana-8 6/12: CE val=0.2453, acc val=0.9271
llana-8 7/12: CE val=0.4124, acc val=0.8924
llana-8 8/12: CE val=0.2976, acc val=0.9062
llana-8 9/12: CE val=0.1069, acc val=0.9722
llana-8 10/12: CE val=0.3636, acc val=0.8819
llana-8 11/12: CE val=0.2229, acc val=0.9340
llana-8 12/12: CE val=0.3268, acc val=0.8958
residual-8 1/12: CE val=2.2934, acc val=0.0972
residual-8 2/12: CE val=2.2600, acc val=0.0972
residual-8 3/12: CE val=2.1653, acc val=0.1944
residual-8 4/12: CE val=1.9573, acc val=0.2951
residual-8 5/12: CE val=1.5658, acc val=0.4896
residual-8 6/12: CE val=0.8718, acc val=0.7535
residual-8 7/12: CE val=0.2864, acc val=0.9340
residual-8 8/12: CE val=0.4170, acc val=0.8681
residual-8 9/12: CE val=0.2143, acc val=0.9167
residual-8 10/12: CE val=0.2065, acc val=0.9444
residual-8 11/12: CE val=0.3231, acc val=0.9062
residual-8 12/12: CE val=0.0849, acc val=0.9861
bloques convoluciones parametros_pareja pesos_iniciales_iguales
0 4 9 18890 True
1 8 17 37450 True
241

14.7 7. Profundidad, ajuste y generalización

El mínimo de CE de validación selecciona checkpoint, pero para estudiar degradación interesa también la pérdida de entrenamiento al cierre. Un mejor test residual no demuestra por sí solo un gradiente más estable. Graficamos ambas parejas con los mismos ejes y leemos las diferencias medidas, sin exigir que una hipótesis docente se cumpla.

fig,axes=plt.subplots(2,2,figsize=(11,7))
for fila,n in enumerate([4,8]):
    for pref in ['llana','residual']:
        h=historias[f'{pref}-{n}'];axes[fila,0].plot(h.epoca,h.ce_train,label=pref);axes[fila,1].plot(h.epoca,h.ce_val,label=pref)
    for col,t in enumerate(['CE entrenamiento (eval)','CE validación']): axes[fila,col].set(xlabel='Época',ylabel=t,title=f'{n} bloques');axes[fila,col].legend()
fig.tight_layout();plt.show()
for n in [4,8]:
    a=historias[f'llana-{n}'].iloc[-1];b=historias[f'residual-{n}'].iloc[-1]
    display(Markdown(f'**{n} bloques:** CE train residual−llana = {b.ce_train-a.ce_train:+.4f}; CE val al cierre residual−llana = {b.ce_val-a.ce_val:+.4f}. Estos signos describen este ensayo; no establecen un efecto universal de los atajos.'))

4 bloques: CE train residual−llana = +0.2224; CE val al cierre residual−llana = +0.1933. Estos signos describen este ensayo; no establecen un efecto universal de los atajos.

8 bloques: CE train residual−llana = -0.0991; CE val al cierre residual−llana = -0.2419. Estos signos describen este ensayo; no establecen un efecto universal de los atajos.

14.8 8. Comparar y elegir antes de prueba

VGG e Inception no están igualadas en parámetros ni operaciones: su tabla es una comparación de configuraciones, no una atribución causal a cada idea arquitectónica. Se elige la menor CE de validación; sólo después se informa prueba para los seis modelos prefijados. Informar todos evita ocultar resultados, pero no permite cambiar el ganador utilizando el test.

No dividimos exactitud por parámetros entrenables para producir un ranking: esa razón puede premiar redes pequeñas con errores inaceptables. Se presentan tamaño, tiempo, CE y exactitud por separado. El tiempo incluye las evaluaciones y no es una medición de latencia de servicio.

ganador=min(resumenes,key=lambda k:resumenes[k]['ce_val']);print('Seleccionado ANTES de prueba:',ganador)
filas=[];resultados={}
for nombre,m in modelos.items():
    rr=evaluar(m,test,lote=32);resultados[nombre]=rr
    filas.append({**resumenes[nombre],'acc_test':rr['exactitud'],'ce_test':rr['ce'],'macro_f1':f1_score(rr['y'],rr['logits'].argmax(1),average='macro')})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'comparacion.csv',index=False)
fig,ax=plt.subplots(figsize=(9,4))
for _,r in tabla.iterrows(): ax.scatter(r.parametros,r.acc_test);ax.annotate(r.modelo,(r.parametros,r.acc_test),xytext=(4,4),textcoords='offset points',fontsize=8)
ax.set(xscale='log',xlabel='Parámetros totales (escala log)',ylabel='Exactitud en prueba',title='Configuraciones prefijadas · selección previa por validación');fig.tight_layout();plt.show()
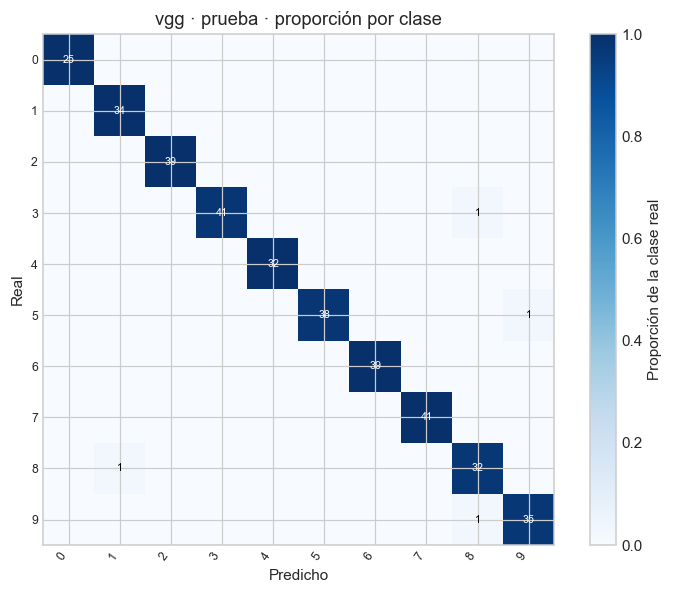
diagnostico(resultados[ganador],[str(i) for i in range(10)],x[ite,None],ganador+' · prueba')
fabricas={'vgg':crear_vgg,'inception':crear_inception,**{f'{p}-{n}':(lambda n=n,p=p:Profunda(n,p=='residual')) for n in [4,8] for p in ['llana','residual']}}
guardar(modelos[ganador],fabricas[ganador],'arquitectura-seleccionada',{'arquitectura':ganador,'entrada':'NCHW float32','forma':[1,32,32],'escala':'Digits /16; repetir 4×4','clases':[str(i) for i in range(10)],'seleccion':'min CE validacion; test historico reservado'},val)
Seleccionado ANTES de prueba: vgg
modelo mejor_epoca epocas ce_val segundos parametros entrenables acc_test ce_test macro_f1
0 vgg 6 12 0.025172 33.428654 138042 138042 0.988889 0.066577 0.988792
1 inception 11 12 0.252388 17.913622 21938 21938 0.916667 0.295445 0.915622
2 llana-4 12 12 0.380615 54.041474 18890 18890 0.888889 0.332882 0.891339
3 residual-4 12 12 0.573929 59.166178 18890 18890 0.850000 0.517889 0.848490
4 llana-8 9 12 0.106862 94.352876 37450 37450 0.975000 0.105035 0.976622
5 residual-8 12 12 0.084912 78.913450 37450 37450 0.952778 0.174585 0.955112

              precision    recall  f1-score   support

           0     1.0000    1.0000    1.0000        25
           1     0.9714    1.0000    0.9855        34
           2     1.0000    1.0000    1.0000        39
           3     1.0000    0.9762    0.9880        42
           4     1.0000    1.0000    1.0000        32
           5     1.0000    0.9744    0.9870        39
           6     1.0000    1.0000    1.0000        39
           7     1.0000    1.0000    1.0000        41
           8     0.9412    0.9697    0.9552        33
           9     0.9722    0.9722    0.9722        36

    accuracy                         0.9889       360
   macro avg     0.9885    0.9892    0.9888       360
weighted avg     0.9891    0.9889    0.9889       360

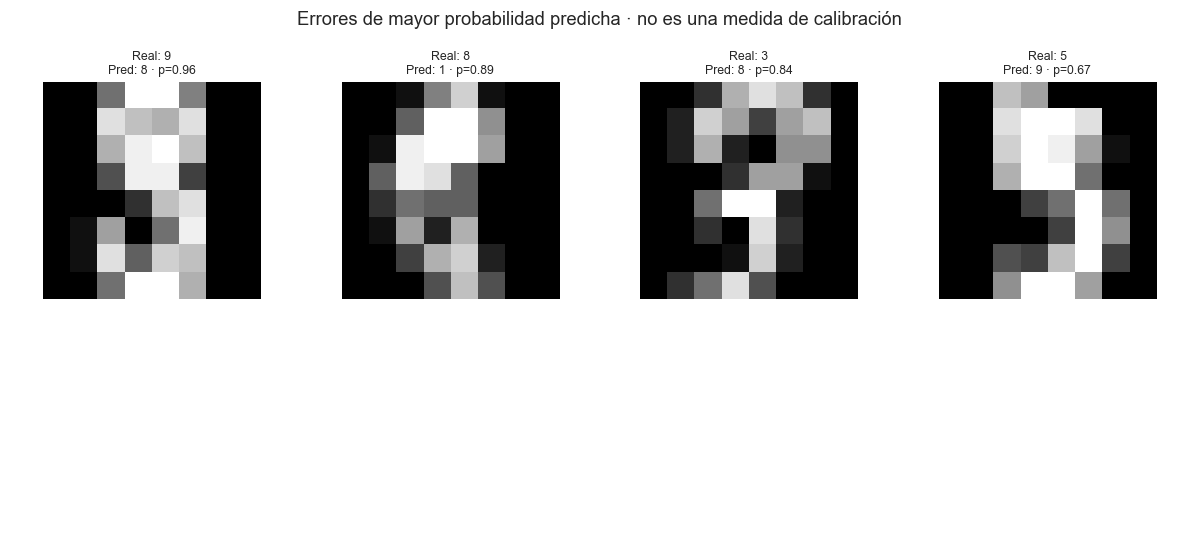
Decisión después de medir. Exactitud 98.89%; macro-F1 0.9888; 4 errores de 360. El menor recall corresponde a 8 (96.97%). La confusión más frecuente es 3 → 8 (1 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

Recarga verificada: artefactos_pytorch\arquitectura-seleccionada.pt bytes: 558463
Sequential(
  (0): Conv2d(1, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (1): ReLU()
  (2): Conv2d(16, 16, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (3): ReLU()
  (4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (5): Conv2d(16, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (6): ReLU()
  (7): Conv2d(32, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (8): ReLU()
  (9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (10): Conv2d(32, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (11): ReLU()
  (12): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
  (13): ReLU()
  (14): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (15): Flatten(start_dim=1, end_dim=-1)
  (16): Linear(in_features=1024, out_features=64, bias=True)
  (17): ReLU()
  (18): Linear(in_features=64, out_features=10, bias=True)
)

14.8.1 Lectura de la ejecución registrada

VGG fue elegida por CE de validación (0.0252) y obtuvo 98.89% en el test histórico. Con cuatro bloques, la CE mínima de validación fue 0.3806 para la llana y 0.5739 para la residual; con ocho, 0.1069 y 0.0849, respectivamente. El sentido de la diferencia cambia entre parejas: este ensayo no respalda una regla de superioridad automática de los atajos. Además, con ocho bloques la exactitud de prueba fue 97.50% (llana) y 95.28% (residual), aunque el orden por CE de validación favorecía la residual. Validación y prueba son muestras diferentes, y CE y exactitud responden a aspectos distintos. La conclusión útil es repetir una ablación prefijada con más semillas o datos nuevos, sin cambiar retrospectivamente el criterio de selección.

Cifras de la ejecución CPU del 15 de octubre de 2026; si cambia datos, versión o semilla, vuelva a contrastar esta lectura con las nuevas salidas.

14.9 9. Decisiones y límites

Si la red llana ajusta peor, el resultado es compatible con una dificultad de optimización bajo este presupuesto; otras tasas o inicializaciones pueden cambiarlo. Si ajusta igual y valida peor, revise generalización y variabilidad antes de aumentar profundidad. Si la red pequeña alcanza un desempeño suficiente, el tamaño y el tiempo pueden justificar conservarla.

Para extender el estudio, repita las parejas con varias semillas y tasas prefijadas, registre memoria y latencia con calentamiento y un tamaño de lote declarado, y pruebe un conjunto con resolución nativa mayor. No deduzca rendimiento en ImageNet a partir de Digits ampliado.

14.10 Referencias