17  Detección y segmentación

Serie Deep Learning · del perceptrón a los transformers.

Clasificar responde qué aparece; localizar añade una región y segmentar produce una decisión por píxel. Construiremos un detector de un objeto con dos cabezas y una mini U-Net. Leeremos clasificación, geometría, umbrales y baselines por separado: una pérdida combinada no explica por sí sola cuál de las tareas funciona.

17.1 1. Entorno y protocolo

Se requieren PyTorch, torchvision, NumPy, pandas, Matplotlib, scikit-learn y Pillow en el entorno del kernel. Los datos Digits vienen incluidos en scikit-learn; no se descargan pesos preentrenados. La ejecución registrada es CPU.

Retomamos Fundamentos de CNN, Arquitecturas CNN y Transferencia. El código compartido de entorno y persistencia queda plegado. El motor de clasificación no se usará para estas salidas: definiremos pérdidas y evaluación específicas.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

17.2 2. IoU: intersección sobre unión

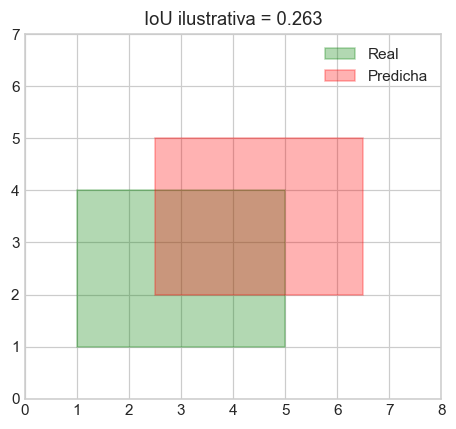
Para regiones \(A\) y \(B\), \(IoU=|A\cap B|/|A\cup B|\). Una caja se expresa como (x₀,y₀,ancho,alto), normalizada por el lienzo. Los extremos se obtienen sumando ancho y alto. No intercambie este formato con (x₀,y₀,x₁,y₁) al llamar una función de otra biblioteca.

Para cajas sin área definimos IoU cero. Para máscaras vacías en ambos lados definiremos uno: la predicción coincide con una referencia vacía. Son convenciones diferentes que se explicitan y se comprueban. Nuestras escenas siempre tendrán un dígito con foreground no vacío.

import matplotlib.patches as patches
def iou_cajas(a,b):
    a=np.asarray(a,dtype=np.float64);b=np.asarray(b,dtype=np.float64)
    extremo_a=a[...,:2]+np.maximum(a[...,2:],0);extremo_b=b[...,:2]+np.maximum(b[...,2:],0)
    tam=np.maximum(np.minimum(extremo_a,extremo_b)-np.maximum(a[...,:2],b[...,:2]),0)
    inter=tam[...,0]*tam[...,1]
    area_a=np.maximum(a[...,2],0)*np.maximum(a[...,3],0);area_b=np.maximum(b[...,2],0)*np.maximum(b[...,3],0)
    union=area_a+area_b-inter
    return np.divide(inter,union,out=np.zeros_like(inter),where=union>0)
assert iou_cajas([0,0,1,1],[0,0,1,1])==1
assert iou_cajas([0,0,.2,.2],[.8,.8,.2,.2])==0
assert iou_cajas([0,0,0,0],[0,0,0,0])==0
np.testing.assert_allclose(iou_cajas([0,0,1,1],[.5,0,1,1]),1/3)
fig,ax=plt.subplots(figsize=(5,4))
for caja,color,t in [([1,1,4,3],'green','Real'),([2.5,2,4,3],'red','Predicha')]:
    ax.add_patch(patches.Rectangle(caja[:2],*caja[2:],facecolor=color,edgecolor=color,alpha=.3,label=t))
ax.set(xlim=(0,8),ylim=(0,7),aspect='equal',title=f'IoU ilustrativa = {float(iou_cajas([1,1,4,3],[2.5,2,4,3])):.3f}');ax.legend();fig.tight_layout();plt.show()
ep=np.arange(1,16);fig,ax=plt.subplots(figsize=(7,3.3))
ax.plot(ep,.15+.55*(1-np.exp(-ep/5)),label='Aprendizaje ilustrativo')
ax.plot(ep,np.full(15,.22),'--',label='Caja fija ilustrativa')
ax.set(xlabel='Época',ylabel='IoU simulada',title='Esquema conceptual · no son resultados entrenados');ax.legend();fig.tight_layout();plt.show()
17.3 3. Generar escenas sin compartir el dígito de origen

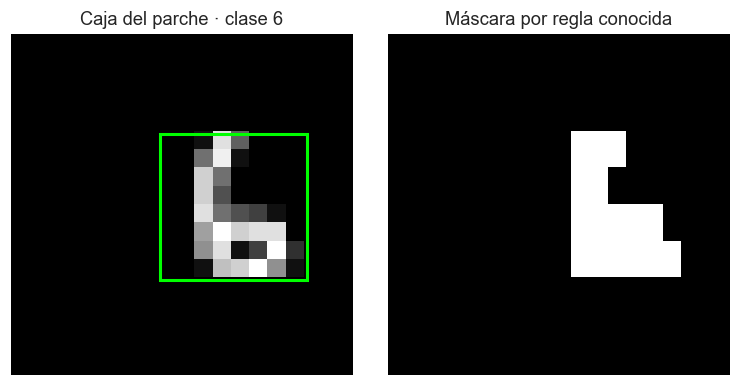
Cada escena contiene un parche Digits de 8×8 ampliado por repetición entera 3: el tamaño real del parche es 24×24, dentro de un lienzo 56×56. No son 28 píxeles ni se añade detalle. La posición se sortea incluyendo los bordes permitidos. La caja etiqueta el parche completo, no la caja mínima del trazo. La máscara es imagen > 0.05.

Primero dividimos los identificadores de los dígitos originales en entrenamiento, validación y prueba, estratificados con semilla 42. Después generamos 1 200/300/300 escenas con semillas 1/3/2 y sólo con los dígitos de su partición. Un mismo dígito puede aparecer varias veces dentro de su partición, pero no cruzarla.

El original generaba escenas de train/test desde el mismo banco de dígitos y utilizaba test como validación. Corregirlo cambia escenas y protocolo: las cifras nuevas no permiten atribuir diferencias solamente al framework. No conocemos identificadores de escritor para agrupar por persona; separar imágenes fuente no demuestra generalización entre escritores.

from sklearn.datasets import load_digits
d=load_digits();TAM_LIENZO=56;TAM_DIGITO=24
fuentes=np.arange(len(d.target));dev,fuentes_test=train_test_split(fuentes,test_size=.2,stratify=d.target,random_state=SEED)
fuentes_train,fuentes_val=train_test_split(dev,test_size=.25,stratify=d.target[dev],random_state=SEED)
assert not(set(fuentes_train)&set(fuentes_val) or set(fuentes_train)&set(fuentes_test) or set(fuentes_val)&set(fuentes_test))
def generar(n,fuentes,seed):
    rng=np.random.default_rng(seed);x=np.zeros((n,1,56,56),dtype=np.float32);cajas=[];clases=[];ids=[]
    for i in range(n):
        j=int(rng.choice(fuentes));parche=np.kron(d.images[j],np.ones((3,3))).astype(np.float32)/16
        y0,x0=rng.integers(0,56-24+1,size=2);x[i,0,y0:y0+24,x0:x0+24]=parche
        cajas.append([x0/56,y0/56,24/56,24/56]);clases.append(d.target[j]);ids.append(j)
    return x,np.array(clases,dtype=np.int64),np.array(cajas,dtype=np.float32),(x>.05).astype(np.float32),np.array(ids)
xtr,ytr,btr,mtr,idtr=generar(1200,fuentes_train,1)
xva,yva,bva,mva,idva=generar(300,fuentes_val,3)
xte,yte,bte,mte,idte=generar(300,fuentes_test,2)
assert not(set(idtr)&set(idva) or set(idtr)&set(idte) or set(idva)&set(idte))
assert mtr.sum((1,2,3)).min()>0 and mva.sum((1,2,3)).min()>0 and mte.sum((1,2,3)).min()>0
np.savez_compressed(ARTEFACTOS/'particiones-fuentes.npz',train=fuentes_train,val=fuentes_val,test=fuentes_test,id_escena_train=idtr,id_escena_val=idva,id_escena_test=idte)
np.savez_compressed(ARTEFACTOS/'escenas.npz',x_train=xtr,y_train=ytr,bbox_train=btr,mask_train=mtr,x_val=xva,y_val=yva,bbox_val=bva,mask_val=mva,x_test=xte,y_test=yte,bbox_test=bte,mask_test=mte)
display(pd.DataFrame({'fuentes':[len(fuentes_train),len(fuentes_val),len(fuentes_test)],'escenas':[1200,300,300]},index=['train','val','test']))
fig,axes=plt.subplots(1,2,figsize=(7,3.5));axes[0].imshow(xtr[0,0],cmap='gray')
xx,yy,ww,hh=btr[0]*56;axes[0].add_patch(patches.Rectangle((xx,yy),ww,hh,edgecolor='lime',facecolor='none',lw=2));axes[0].set_title(f'Caja del parche · clase {ytr[0]}')
axes[1].imshow(mtr[0,0],cmap='gray');axes[1].set_title('Máscara por regla conocida')
for ax in axes: ax.axis('off')
fig.tight_layout();plt.show()
fuentes escenas
train 1077 1200
val 360 300
test 360 300

17.4 4. Un detector con dos cabezas

El backbone aplica convoluciones 16/32/64 y dos pooling. La salida espacial mide 14×14. Una variante usa promedio global (64 valores) y otra Flatten (12 544). Cada cabeza tiene 32 unidades: una produce diez logits de clase y otra cuatro números para la caja.

Un sigmoid en cuatro coordenadas no garantiza por sí solo que \(x_0+w\leq1\). Por eso decodificamos \(x_0,y_0\) con sigmoid y limitamos el ancho a \((1-x_0)\sigma(s_w)\) y el alto a \((1-y_0)\sigma(s_h)\). La caja queda dentro del lienzo sin un recorte posterior diferente del cálculo de entrenamiento. Es un cambio explícito respecto del original.

El objetivo es \(L=L_{CE}+5L_{Huber}\), con delta 1 y promedio sobre las cuatro coordenadas y el lote. El peso 5 fija un compromiso de escala; no se justifica diciendo que localizar sea universalmente más difícil. Con coordenadas acotadas y delta 1, los errores están en la región cuadrática de Huber: aquí no se puede atribuir una ganancia a su tramo robusto lineal.

class Detector(nn.Module):
    def __init__(self,flatten=False):
        super().__init__();self.flatten=flatten
        self.backbone=nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(16,32,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(32,64,3,padding=1),nn.ReLU())
        entradas=64*14*14 if flatten else 64
        self.clase=nn.Sequential(nn.Linear(entradas,32),nn.ReLU(),nn.Linear(32,10))
        self.caja=nn.Sequential(nn.Linear(entradas,32),nn.ReLU(),nn.Linear(32,4))
    def forward(self,x):
        h=self.backbone(x);h=h.flatten(1) if self.flatten else h.mean((2,3))
        z=self.clase(h);s=self.caja(h).sigmoid();caja=torch.cat([s[:,:2],(1-s[:,:2])*s[:,2:]],dim=1)
        return z,caja
def iniciar_detector(flatten):
    m=inicializar(Detector(flatten))
    for salida in [m.clase[-1],m.caja[-1]]: nn.init.xavier_uniform_(salida.weight);nn.init.zeros_(salida.bias)
    return m
def ds_detector(x,y,b): return TensorDataset(torch.from_numpy(x),torch.from_numpy(y),torch.from_numpy(b))
trd=ds_detector(xtr,ytr,btr);vld=ds_detector(xva,yva,bva);ted=ds_detector(xte,yte,bte)
semilla();gap=iniciar_detector(False);flat=iniciar_detector(True)
flat.backbone.load_state_dict(gap.backbone.state_dict())
assert all(torch.equal(v,flat.backbone.state_dict()[k]) for k,v in gap.backbone.state_dict().items())
with torch.inference_mode():
    z,bb=gap(torch.zeros(2,1,56,56,device=DEVICE))
    assert z.shape==(2,10) and bb.shape==(2,4)
    assert bool((bb>=0).all() and (bb[:,:2]+bb[:,2:]<=1+1e-6).all())
print('Parámetros GAP:',parametros(gap),'· Flatten:',parametros(flat))
Parámetros GAP: 27918 · Flatten: 826638

17.5 5. Entrenamiento multitarea y selección

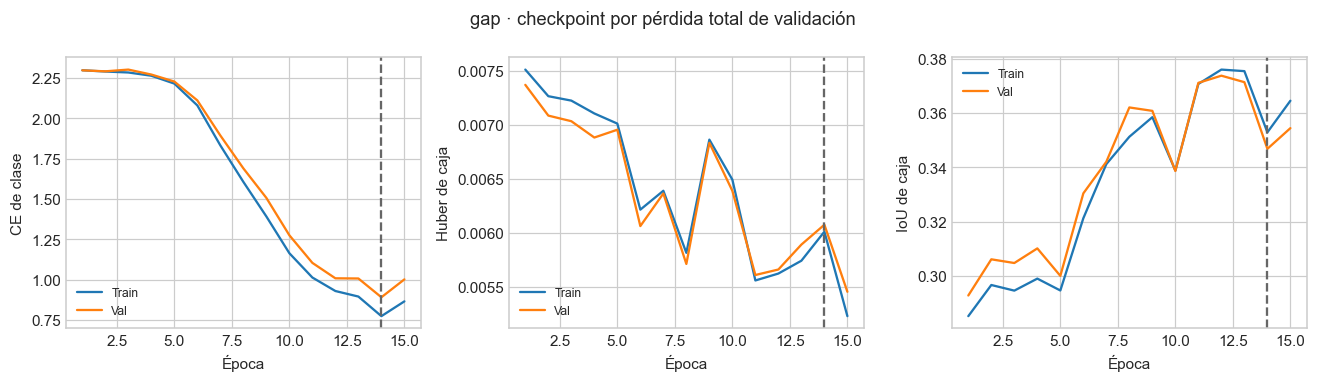
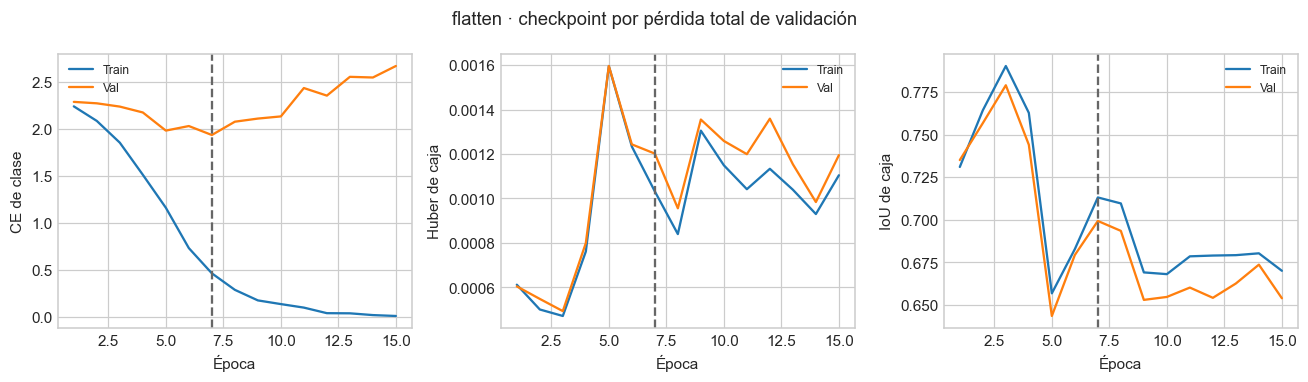
Conservamos quince épocas por detector, lote 32 y Adam 0,001. La validación ahora está separada de prueba. Cada época calcula CE, Huber, suma ponderada, exactitud e IoU; el checkpoint minimiza la suma ponderada de validación. Una mejor suma no garantiza mejores valores de ambas tareas: se muestran por separado.

Ambas variantes comparten pesos iniciales del backbone y orden de lotes. Sus cabezas tienen distinta dimensión, así que no se declara igualdad total de pesos ni un efecto causal puro de una sola conexión. El estudio describe el compromiso espacial y paramétrico de estas dos configuraciones.

@torch.inference_mode()
def evaluar_detector(m,ds):
    m.eval();zs=[];bs=[];ys=[];reales=[];ce=0.;huber=0.
    for x,y,b in cargador(ds,32):
        x=x.to(DEVICE);y=y.to(DEVICE);b=b.to(DEVICE);z,p=m(x)
        ce+=F.cross_entropy(z,y,reduction='sum').item();huber+=F.huber_loss(p,b,delta=1,reduction='sum').item()/4
        zs.append(z.cpu().numpy());bs.append(p.cpu().numpy());ys.append(y.cpu().numpy());reales.append(b.cpu().numpy())
    z=np.concatenate(zs);p=np.concatenate(bs);y=np.concatenate(ys);b=np.concatenate(reales);iou=iou_cajas(p,b)
    assert np.isfinite(z).all() and np.isfinite(p).all()
    assert (p>=0).all() and (p[:,:2]+p[:,2:]<=1+1e-6).all()
    return {'ce':ce/len(ds),'huber':huber/len(ds),'total':(ce+5*huber)/len(ds),'acc':float((z.argmax(1)==y).mean()),'iou':float(iou.mean()),'ious':iou,'logits':z,'cajas':p,'y':y}
def entrenar_detector(m,nombre):
    semilla();opt=torch.optim.Adam(m.parameters(),lr=.001);dl=cargador(trd,32,True);h=[];mejor=float('inf');inicio=time.perf_counter()
    for ep in range(1,16):
        m.train()
        for x,y,b in dl:
            x=x.to(DEVICE);y=y.to(DEVICE);b=b.to(DEVICE);opt.zero_grad(set_to_none=True)
            z,p=m(x);loss=F.cross_entropy(z,y)+5*F.huber_loss(p,b,delta=1)
            if not torch.isfinite(loss): raise FloatingPointError('Pérdida no finita')
            loss.backward();opt.step()
        tr=evaluar_detector(m,trd);va=evaluar_detector(m,vld)
        h.append({'epoca':ep,**{f'{k}_{p}':v[k] for p,v in [('train',tr),('val',va)] for k in ['ce','huber','total','acc','iou']}})
        if va['total']<mejor: mejor=va['total'];estado=copy.deepcopy(m.state_dict());epoca_mejor=ep
        print(nombre,ep,'total val',round(va['total'],4),'IoU val',round(va['iou'],4),flush=True)
    m.load_state_dict(estado);m.eval();h=pd.DataFrame(h);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    r={'modelo':nombre,'mejor_epoca':epoca_mejor,'total_val':mejor,'parametros':parametros(m),'segundos':time.perf_counter()-inicio}
    return h,r
modelos={'gap':gap,'flatten':flat};historias={};resumenes={}
for nombre,m in modelos.items():
    h,r=entrenar_detector(m,nombre);historias[nombre]=h;resumenes[nombre]=r
    fig,axes=plt.subplots(1,3,figsize=(12,3.5))
    for ax,k,t in zip(axes,['ce','huber','iou'],['CE de clase','Huber de caja','IoU de caja']):
        ax.plot(h.epoca,h[k+'_train'],label='Train');ax.plot(h.epoca,h[k+'_val'],label='Val');ax.axvline(r['mejor_epoca'],ls='--',color='.4');ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(nombre+' · checkpoint por pérdida total de validación');fig.tight_layout();plt.show()
ganador=min(resumenes,key=lambda k:resumenes[k]['total_val']);print('Detector elegido antes de prueba:',ganador)
gap 1 total val 2.3338 IoU val 0.2927
gap 2 total val 2.3262 IoU val 0.3061
gap 3 total val 2.3367 IoU val 0.3047
gap 4 total val 2.3052 IoU val 0.3101
gap 5 total val 2.2622 IoU val 0.3
gap 6 total val 2.1409 IoU val 0.3304
gap 7 total val 1.9251 IoU val 0.3421
gap 8 total val 1.7184 IoU val 0.3621
gap 9 total val 1.5411 IoU val 0.3608
gap 10 total val 1.3073 IoU val 0.3386
gap 11 total val 1.1324 IoU val 0.3711
gap 12 total val 1.0372 IoU val 0.3738
gap 13 total val 1.0371 IoU val 0.3714
gap 14 total val 0.9218 IoU val 0.3468
gap 15 total val 1.0294 IoU val 0.3544

flatten 1 total val 2.2887 IoU val 0.735
flatten 2 total val 2.2731 IoU val 0.7567
flatten 3 total val 2.238 IoU val 0.779
flatten 4 total val 2.1772 IoU val 0.744
flatten 5 total val 1.9885 IoU val 0.6435
flatten 6 total val 2.0352 IoU val 0.6793
flatten 7 total val 1.9398 IoU val 0.6993
flatten 8 total val 2.0798 IoU val 0.6935
flatten 9 total val 2.1151 IoU val 0.653
flatten 10 total val 2.1375 IoU val 0.6547
flatten 11 total val 2.4387 IoU val 0.6602
flatten 12 total val 2.3589 IoU val 0.6542
flatten 13 total val 2.5575 IoU val 0.6626
flatten 14 total val 2.5496 IoU val 0.6736
flatten 15 total val 2.6729 IoU val 0.6539

Detector elegido antes de prueba: gap

17.6 6. Prueba del detector y baselines de posición

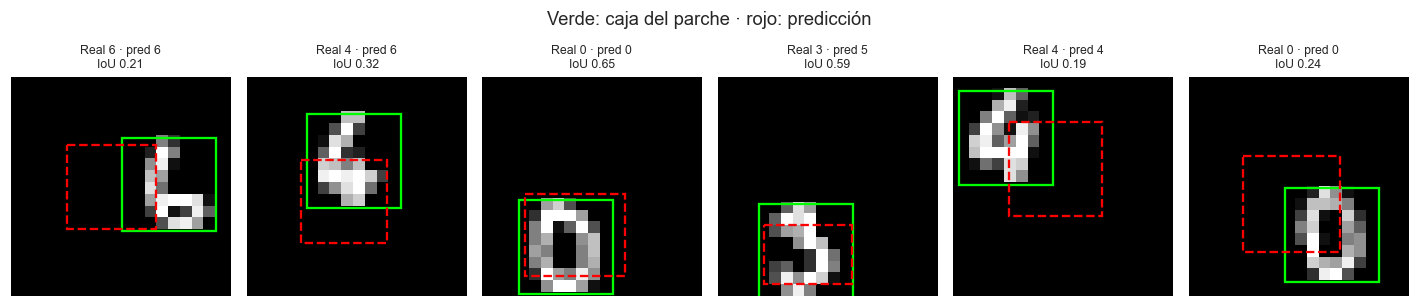
Se informa la IoU media, mediana, fracción de cajas con IoU≥0,5, exactitud de clase y fracción conjunta de clase correcta e IoU≥0,5. Esta última no es mAP: cada escena tiene exactamente un objeto y el modelo siempre emite una caja.

Conservamos la caja fija central [0.3,0.3,0.4,0.4]. Añadimos una caja fija estimada sólo con las anotaciones de entrenamiento: aprovecha el tamaño constante del parche y su posición media. Superar un baseline fijo es evidencia comparativa, pero no prueba por sí solo uso del contenido. Una evaluación adicional permuta las imágenes de test manteniendo sus cajas objetivo: perder localización al romper esa correspondencia aporta un contraste más directo.

resultados={};filas=[]
for nombre,m in modelos.items():
    rr=evaluar_detector(m,ted);resultados[nombre]=rr;ok=rr['logits'].argmax(1)==yte
    filas.append({**resumenes[nombre],'acc_test':rr['acc'],'iou_test':rr['iou'],'iou_mediana':float(np.median(rr['ious'])),'localizacion_05':float((rr['ious']>=.5).mean()),'clase_y_iou_05':float((ok&(rr['ious']>=.5)).mean()),'ce_test':rr['ce'],'huber_test':rr['huber']})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'comparacion-detectores.csv',index=False)
caja_centro=np.array([.3,.3,.4,.4]);caja_media=btr.mean(0)
baselines=pd.DataFrame([{'modelo':'Caja central prefijada','iou':float(iou_cajas(caja_centro,bte).mean())},{'modelo':'Caja media de train','iou':float(iou_cajas(caja_media,bte).mean())}])
permutacion=np.random.default_rng(442).permutation(len(xte));barajado=evaluar_detector(modelos[ganador],ds_detector(xte[permutacion],yte,bte))
baselines.loc[len(baselines)]=['Detector elegido · imágenes permutadas',barajado['iou']]
display(baselines);baselines.to_csv(ARTEFACTOS/'baselines-cajas.csv',index=False)
elegido=resultados[ganador]
display(Markdown(f'**Resultado:** {ganador}, IoU media {elegido["iou"]:.4f}; con imágenes permutadas, {barajado["iou"]:.4f}. El contraste rompe la correspondencia imagen–anotación. Una caída es compatible con que la predicción dependa de la entrada, pero no demuestra qué rasgo concreto utiliza ni valida escenas reales.'))
fig,axes=plt.subplots(1,6,figsize=(13,3));muestra=np.random.default_rng(3).choice(len(xte),6,replace=False)
for ax,j in zip(axes,muestra):
    ax.imshow(xte[j,0],cmap='gray')
    for b,color,ls in [(bte[j],'lime','-'),(elegido['cajas'][j],'red','--')]:
        xx,yy,ww,hh=b*56;ax.add_patch(patches.Rectangle((xx,yy),ww,hh,edgecolor=color,facecolor='none',lw=1.5,ls=ls))
    ax.set_title(f'Real {yte[j]} · pred {elegido["logits"][j].argmax()}\nIoU {elegido["ious"][j]:.2f}',fontsize=8);ax.axis('off')
fig.suptitle('Verde: caja del parche · rojo: predicción');fig.tight_layout();plt.show()
modelo mejor_epoca total_val parametros segundos acc_test iou_test iou_mediana localizacion_05 clase_y_iou_05 ce_test huber_test
0 gap 14 0.921829 27918 36.958219 0.69 0.324198 0.308395 0.146667 0.086667 0.865851 0.006405
1 flatten 7 1.939783 826638 39.268395 0.45 0.712522 0.731732 0.936667 0.423333 2.051464 0.001040
modelo iou
0 Caja central prefijada 0.279373
1 Caja media de train 0.293903
2 Detector elegido · imágenes permutadas 0.251183

Resultado: gap, IoU media 0.3242; con imágenes permutadas, 0.2512. El contraste rompe la correspondencia imagen–anotación. Una caída es compatible con que la predicción dependa de la entrada, pero no demuestra qué rasgo concreto utiliza ni valida escenas reales.

17.6.1 Métricas por dígito

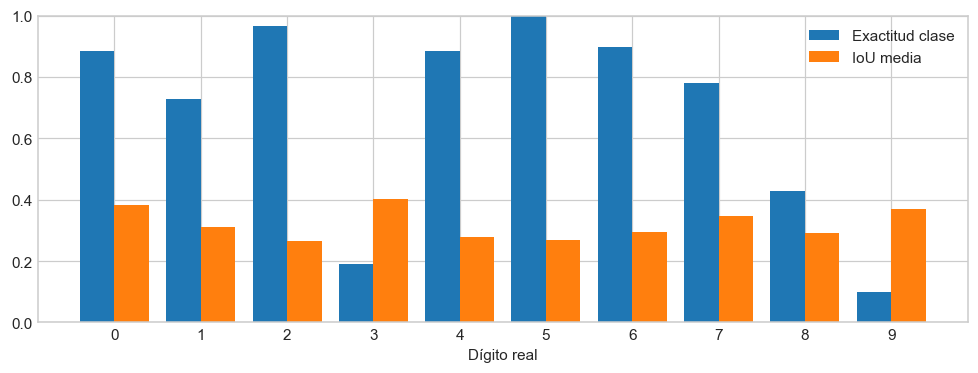
Clasificación y geometría se miden conjuntamente, sin confundirlas. Una clase puede clasificarse bien y localizarse mal. La caja representa un parche fijo, por lo que no mide directamente la precisión del contorno del trazo. La correlación entre diez medias de clase es descriptiva y no demuestra que una tarea cause la otra.

pred=elegido['logits'].argmax(1);filas=[]
for digito in range(10):
    sel=yte==digito
    filas.append({'digito':digito,'n':int(sel.sum()),'exactitud':float((pred[sel]==digito).mean()),'iou':float(elegido['ious'][sel].mean())})
por_clase=pd.DataFrame(filas);display(por_clase);por_clase.to_csv(ARTEFACTOS/'detector-por-clase.csv',index=False)
fig,ax=plt.subplots(figsize=(9,3.5));xx=np.arange(10)
ax.bar(xx-.2,por_clase.exactitud,.4,label='Exactitud clase');ax.bar(xx+.2,por_clase.iou,.4,label='IoU media');ax.set(xticks=xx,xlabel='Dígito real',ylim=(0,1));ax.legend();fig.tight_layout();plt.show()
if por_clase.exactitud.std()>0 and por_clase.iou.std()>0: print('Correlación descriptiva entre diez medias:',float(por_clase[['exactitud','iou']].corr().iloc[0,1]))
else: print('Correlación no definida: alguna métrica es constante entre clases')
digito n exactitud iou
0 0 35 0.885714 0.383019
1 1 22 0.727273 0.310190
2 2 28 0.964286 0.264497
3 3 42 0.190476 0.402261
4 4 35 0.885714 0.277657
5 5 29 1.000000 0.267643
6 6 29 0.896552 0.294571
7 7 32 0.781250 0.346317
8 8 28 0.428571 0.292948
9 9 20 0.100000 0.371089

Correlación descriptiva entre diez medias: -0.6339393508470026

17.7 7. Mini U-Net: logits por píxel

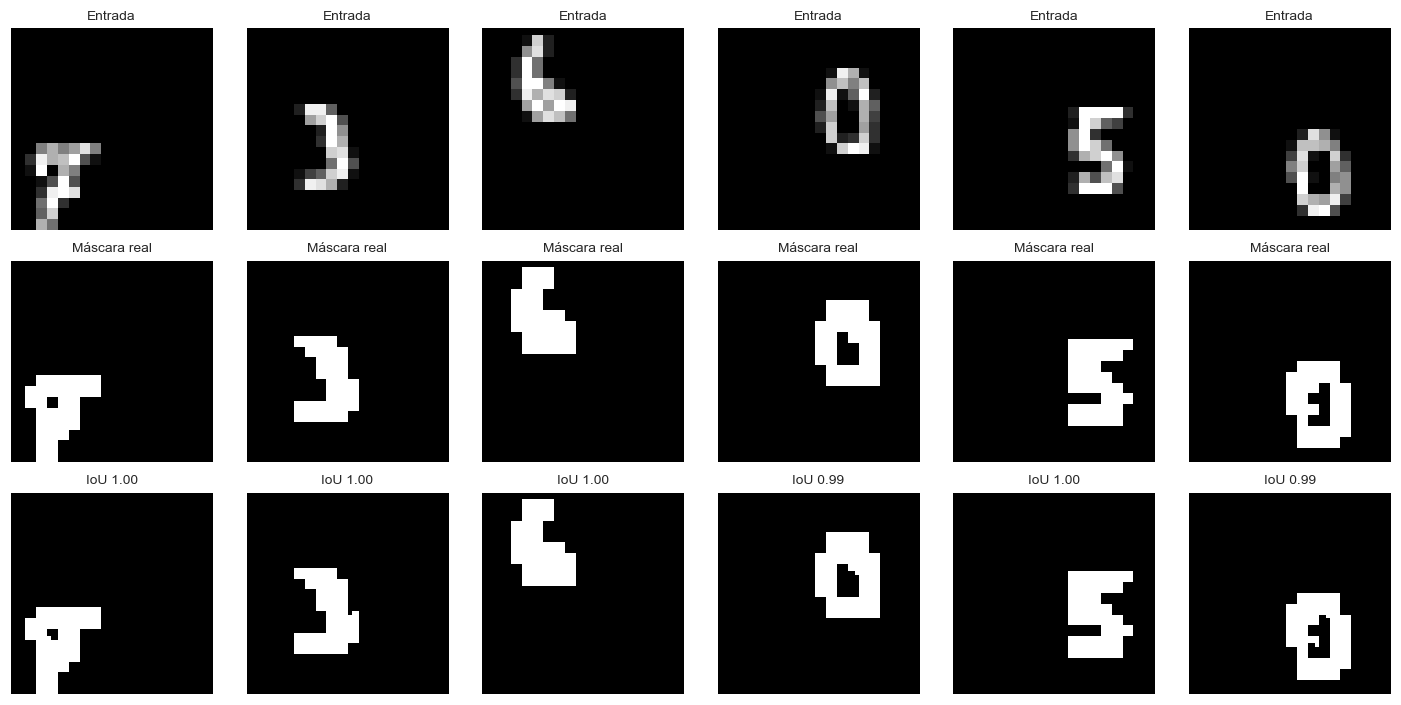
El encoder reduce 56→28→14 y aumenta canales 16→32→64. El decoder interpola por vecino más cercano, concatena características del encoder a la misma resolución y vuelve a 56×56. Una convolución 1×1 produce un logit por píxel. BCEWithLogitsLoss integra sigmoid y BCE de forma estable; sigmoid sólo se utiliza para evaluar probabilidades.

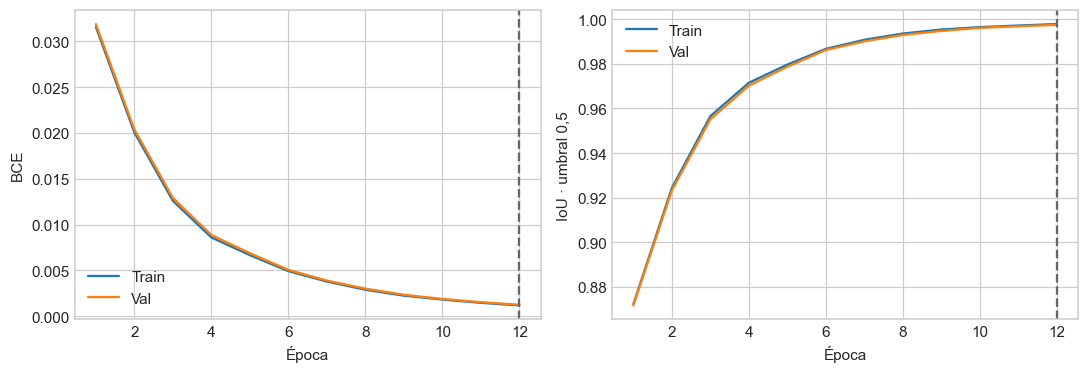
Las conexiones de salto son una decisión arquitectónica, no una explicación demostrada de la nitidez. Sin una ablación entrenada no se atribuye el resultado a ellas ni se afirma que quitarlas produzca necesariamente rectángulos. Conservamos doce épocas y lote 32; el checkpoint minimiza BCE de validación.

class Segmentador(nn.Module):
    def __init__(self):
        super().__init__();self.e1=nn.Conv2d(1,16,3,padding=1);self.e2=nn.Conv2d(16,32,3,padding=1);self.cuello=nn.Conv2d(32,64,3,padding=1)
        self.d2=nn.Conv2d(96,32,3,padding=1);self.d1=nn.Conv2d(48,16,3,padding=1);self.salida=nn.Conv2d(16,1,1)
    def forward(self,x):
        a=F.relu(self.e1(x));b=F.relu(self.e2(F.max_pool2d(a,2)));z=F.relu(self.cuello(F.max_pool2d(b,2)))
        z=F.relu(self.d2(torch.cat([F.interpolate(z,size=b.shape[-2:],mode='nearest'),b],1)))
        z=F.relu(self.d1(torch.cat([F.interpolate(z,size=a.shape[-2:],mode='nearest'),a],1)))
        return self.salida(z)
def metricas_mascara(prob,real,umbral=.5):
    a=np.asarray(prob)>umbral;b=np.asarray(real).astype(bool);ejes=tuple(range(1,a.ndim))
    inter=(a&b).sum(ejes);union=(a|b).sum(ejes);suma=a.sum(ejes)+b.sum(ejes)
    iou=np.divide(inter,union,out=np.ones_like(inter,dtype=float),where=union>0)
    dice=np.divide(2*inter,suma,out=np.ones_like(inter,dtype=float),where=suma>0)
    return {'iou':float(iou.mean()),'dice':float(dice.mean()),'pixel_acc':float((a==b).mean()),'ious':iou,'dice_individual':dice}
assert metricas_mascara(np.zeros((1,1,2,2)),np.zeros((1,1,2,2)))['iou']==1
assert metricas_mascara(np.ones((1,1,2,2)),np.ones((1,1,2,2)))['dice']==1
assert metricas_mascara(np.zeros((1,1,2,2)),np.ones((1,1,2,2)))['iou']==0
@torch.inference_mode()
def evaluar_segmentador(m,ds):
    m.eval();prob=[];reales=[];suma=0.;pixeles=0
    for x,y in cargador(ds,32):
        x=x.to(DEVICE);y=y.to(DEVICE);z=m(x)
        suma+=F.binary_cross_entropy_with_logits(z,y,reduction='sum').item();pixeles+=y.numel()
        prob.append(z.sigmoid().cpu().numpy());reales.append(y.cpu().numpy())
    p=np.concatenate(prob);y=np.concatenate(reales)
    assert np.isfinite(p).all()
    return {'bce':suma/pixeles,'prob':p,'real':y,**metricas_mascara(p,y)}
trs=TensorDataset(torch.from_numpy(xtr),torch.from_numpy(mtr));vls=TensorDataset(torch.from_numpy(xva),torch.from_numpy(mva));tes=TensorDataset(torch.from_numpy(xte),torch.from_numpy(mte))
semilla();segmentador=inicializar(Segmentador());nn.init.xavier_uniform_(segmentador.salida.weight);nn.init.zeros_(segmentador.salida.bias)
assert segmentador(torch.zeros(2,1,56,56,device=DEVICE)).shape==(2,1,56,56)
opt=torch.optim.Adam(segmentador.parameters(),lr=.001);dl=cargador(trs,32,True);hist=[];mejor=float('inf');inicio=time.perf_counter()
for ep in range(1,13):
    segmentador.train()
    for x,y in dl:
        x=x.to(DEVICE);y=y.to(DEVICE);opt.zero_grad(set_to_none=True);z=segmentador(x);loss=F.binary_cross_entropy_with_logits(z,y)
        if not torch.isfinite(loss): raise FloatingPointError('BCE no finita')
        loss.backward();opt.step()
    tr=evaluar_segmentador(segmentador,trs);va=evaluar_segmentador(segmentador,vls)
    hist.append({'epoca':ep,'bce_train':tr['bce'],'bce_val':va['bce'],'iou_train_05':tr['iou'],'iou_val_05':va['iou']})
    if va['bce']<mejor: mejor=va['bce'];pesos=copy.deepcopy(segmentador.state_dict());epoca_seg=ep
    print('Segmentación',ep,'BCE val',round(va['bce'],5),'IoU val',round(va['iou'],4),flush=True)
segmentador.load_state_dict(pesos);segmentador.eval();segundos_seg=time.perf_counter()-inicio
hs=pd.DataFrame(hist);hs.to_csv(ARTEFACTOS/'segmentador-historial.csv',index=False)
fig,axes=plt.subplots(1,2,figsize=(10,3.5))
for ax,a,b,t in [(axes[0],'bce_train','bce_val','BCE'),(axes[1],'iou_train_05','iou_val_05','IoU · umbral 0,5')]:
    ax.plot(hs.epoca,hs[a],label='Train');ax.plot(hs.epoca,hs[b],label='Val');ax.axvline(epoca_seg,ls='--',color='.4');ax.set(xlabel='Época',ylabel=t);ax.legend()
fig.tight_layout();plt.show()
Segmentación 1 BCE val 0.03186 IoU val 0.8716
Segmentación 2 BCE val 0.02039 IoU val 0.9232
Segmentación 3 BCE val 0.01291 IoU val 0.9551
Segmentación 4 BCE val 0.00887 IoU val 0.9702
Segmentación 5 BCE val 0.00688 IoU val 0.9787
Segmentación 6 BCE val 0.00506 IoU val 0.9862
Segmentación 7 BCE val 0.00389 IoU val 0.9901
Segmentación 8 BCE val 0.00302 IoU val 0.993
Segmentación 9 BCE val 0.00234 IoU val 0.9948
Segmentación 10 BCE val 0.00189 IoU val 0.9962
Segmentación 11 BCE val 0.00154 IoU val 0.9969
Segmentación 12 BCE val 0.00126 IoU val 0.9975

17.8 8. El umbral se elige en validación

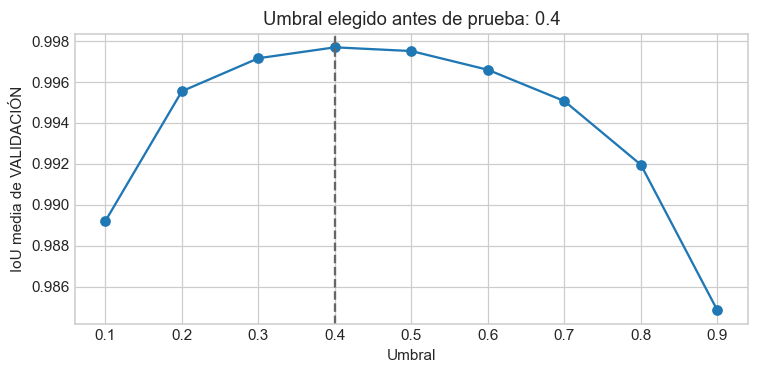
Con el checkpoint ya fijado por BCE, probamos umbrales 0,1…0,9 únicamente en validación. Elegimos la mayor IoU media por imagen; ante empate se conserva el menor umbral por el orden prefijado de la lista. No se busca el máximo de test.

Luego se informa prueba con el umbral elegido y con 0,5 como referencia prefijada. La IoU global ponderaría imágenes según su unión de píxeles; aquí cada escena pesa igual. Dice y exactitud de píxel aportan lecturas complementarias. El fondo mayoritario puede producir una exactitud alta para una máscara totalmente vacía.

rv=evaluar_segmentador(segmentador,vls);umbrales=np.arange(1,10)/10
valores=np.array([metricas_mascara(rv['prob'],rv['real'],u)['iou'] for u in umbrales]);umbral=float(umbrales[np.argmax(valores)])
assert umbral in umbrales
pd.DataFrame({'umbral':umbrales,'iou_val':valores}).to_csv(ARTEFACTOS/'umbral-validacion.csv',index=False)
fig,ax=plt.subplots(figsize=(7,3.5));ax.plot(umbrales,valores,'-o');ax.axvline(umbral,color='.4',ls='--');ax.set(xlabel='Umbral',ylabel='IoU media de VALIDACIÓN',title=f'Umbral elegido antes de prueba: {umbral:.1f}');fig.tight_layout();plt.show()
rs=evaluar_segmentador(segmentador,tes);final=metricas_mascara(rs['prob'],mte,umbral)
referencias=[('Mini U-Net · umbral elegido',final),('Mini U-Net · umbral 0,5',metricas_mascara(rs['prob'],mte,.5)),('Todo fondo',metricas_mascara(np.zeros_like(mte),mte)),('Regla exacta imagen >0,05',metricas_mascara((xte>.05).astype(float),mte))]
tabla_seg=pd.DataFrame([{'modelo':nombre,**{k:r[k] for k in ['iou','dice','pixel_acc']}} for nombre,r in referencias]);display(tabla_seg);tabla_seg.to_csv(ARTEFACTOS/'comparacion-segmentacion.csv',index=False)
assert tabla_seg.iloc[-1].iou==1 and tabla_seg.iloc[-1].dice==1
fig,axes=plt.subplots(3,6,figsize=(13,6.5));muestra=np.random.default_rng(5).choice(len(xte),6,replace=False)
for col,j in enumerate(muestra):
    for row,im,t in [(0,xte[j,0],'Entrada'),(1,mte[j,0],'Máscara real'),(2,rs['prob'][j,0]>umbral,f'IoU {final["ious"][j]:.2f}')]:
        axes[row,col].imshow(im,cmap='gray');axes[row,col].set_title(t,fontsize=9);axes[row,col].axis('off')
fig.tight_layout();plt.show()
(ARTEFACTOS/'segmentacion-seleccion.json').write_text(json.dumps({'mejor_epoca_bce_val':epoca_seg,'bce_val':mejor,'umbral_elegido_en_validacion':umbral,'iou_test':final['iou'],'dice_test':final['dice'],'pixel_acc_test':final['pixel_acc'],'segundos':segundos_seg,'parametros':parametros(segmentador)}),encoding='utf-8')

modelo iou dice pixel_acc
0 Mini U-Net · umbral elegido 0.997099 0.998540 0.999726
1 Mini U-Net · umbral 0,5 0.996793 0.998387 0.999696
2 Todo fondo 0.000000 0.000000 0.906116
3 Regla exacta imagen >0,05 1.000000 1.000000 1.000000

253

17.8.1 Qué significa vencer o perder frente al baseline

La regla imagen >0.05 alcanza IoU y Dice uno por construcción: es la definición de la etiqueta. La red aprende a aproximar una transformación conocida, no a descubrir una segmentación semántica difícil. Si sólo se quisiera esa máscara sintética, la regla sería suficiente y más simple. La mini U-Net sirve aquí para estudiar tensores, pérdida, decoder y umbral.

Para evaluar segmentación real se necesitan anotaciones cuyo significado no sea una copia determinista del umbral de entrada, además de variación de fondo, escala, oclusión y objetos. Una máscara visualmente nítida no valida por sí sola ese uso.

17.9 9. De un objeto a detección general

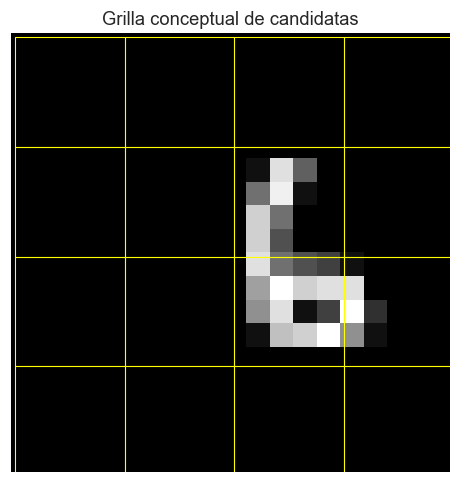
La grilla siguiente ilustra posiciones candidatas. No es un detector YOLO implementado ni una descripción universal de todas sus versiones. Hay diseños con anchors, diseños sin anchors y modelos de predicción de conjuntos. Manejar varios objetos no exige siempre anchors ni NMS.

NMS es una regla que conserva cajas con score alto y elimina candidatas solapadas por encima de una IoU prefijada. El ejemplo es de una sola clase: para varias clases hay que definir si la supresión se aplica por clase. No debe confundirse el umbral NMS con el umbral IoU de evaluación.

AP ordena detecciones por score, asigna coincidencias a anotaciones respetando clase e IoU y resume precision–recall; mAP promedia AP entre clases y, según el protocolo, también entre umbrales IoU. No equivale a IoU media ni a exactitud de la cabeza de clase. Nuestro ejercicio no reporta mAP de COCO.

from torchvision.ops import nms
fig,ax=plt.subplots(figsize=(4.5,4.5));ax.imshow(xtr[0,0],cmap='gray')
for i in range(4):
    for j in range(4): ax.add_patch(patches.Rectangle((j*14,i*14),14,14,edgecolor='yellow',facecolor='none',lw=.7))
ax.set_title('Grilla conceptual de candidatas');ax.axis('off');fig.tight_layout();plt.show()
# nms espera XYXY, no XYWH.
candidatas=torch.tensor([[5.,5,25,25],[6.,6,26,26],[32.,32,50,50]])
scores=torch.tensor([.95,.85,.7]);conservar=nms(candidatas,scores,.5)
assert conservar.tolist()==[0,2]
print('Candidatas conservadas por NMS:',conservar.tolist(),'· una clase, IoU límite 0,5')

Candidatas conservadas por NMS: [0, 2] · una clase, IoU límite 0,5

17.10 10. Guardar dos salidas y una máscara

El contrato de detección incluye formato y decodificación de caja, diez clases y objetivo multitarea. El de segmentación incluye logits NCHW, sigmoid y el umbral elegido en validación. Se reconstruye la arquitectura y se verifica la recarga en validación para las dos salidas del detector y para los logits de la máscara.

Los artefactos son para inferencia. No incluyen los estados del optimizador y de los generadores necesarios para retomar exactamente un entrenamiento interrumpido.

def guardar_especial(m,fabrica,nombre,contrato,x):
    ruta=ARTEFACTOS/f'{nombre}.pt';estado={k:v.detach().cpu().clone() for k,v in m.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True);nuevo=fabrica().to(DEVICE);nuevo.load_state_dict(paquete['state_dict']);nuevo.eval();m.eval()
    with torch.inference_mode():
        a=m(torch.from_numpy(x[:16]).to(DEVICE));b=nuevo(torch.from_numpy(x[:16]).to(DEVICE))
        if isinstance(a,tuple):
            for aa,bb in zip(a,b): torch.testing.assert_close(aa,bb,rtol=1e-5,atol=1e-6)
        else: torch.testing.assert_close(a,b,rtol=1e-5,atol=1e-6)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size),indent=2),encoding='utf-8')
    print('Recarga verificada:',nombre)
guardar_especial(modelos[ganador],lambda:Detector(ganador=='flatten'),'detector-seleccionado',{'arquitectura':ganador,'entrada':'NCHW float32 /16, Digits repetido 3x','forma':[1,56,56],'salidas':['logits clase','caja XYWH normalizada'],'decodificacion':'x,y=sigmoid; w,h=(1-x,1-y)*sigmoid','clases':list(range(10)),'seleccion':'min CE+5Huber validacion'},xva)
guardar_especial(segmentador,Segmentador,'segmentador',{'arquitectura':'mini U-Net','entrada':'NCHW float32','forma':[1,56,56],'salida':'logits por pixel; aplicar sigmoid','umbral':umbral,'seleccion_checkpoint':'min BCE val','seleccion_umbral':'max IoU media val'},xva)
(ARTEFACTOS/'verificaciones.json').write_text(json.dumps({'fuentes_disjuntas':True,'bbox_dentro_lienzo':True,'backbone_inicial_igual':True,'umbral_solo_validacion':True,'regla_mascara_iou_uno':True,'NMS_prueba_geometrica':True,'recarga_dos_salidas_y_mascara':True,'detector_seleccionado':ganador}),encoding='utf-8')
Recarga verificada: detector-seleccionado
Recarga verificada: segmentador
252

17.10.1 Lectura de la ejecución registrada

El detector seleccionado por pérdida total de validación fue gap. La IoU de prueba fue 0.3242 con promedio global y 0.7125 con Flatten; sus exactitudes de clase fueron 69.00% y 45.00%. La caja media de train obtuvo IoU 0.2939, y el detector seleccionado con imágenes permutadas, 0.2512. Conservar coordenadas espaciales y reducir parámetros pueden entrar en conflicto: el promedio global descarta información de posición. La fracción de escenas con clase correcta e IoU≥0,5 fue 8.67% para GAP y 42.33% para Flatten. Por tanto, la configuración elegida por la suma ponderada no es la mejor en todas las métricas operativas. Las magnitudes de CE y Huber son diferentes y el peso 5 no las equilibra automáticamente. Si el objetivo fuese localizar con una calidad mínima de clase, habría que prefijar esa restricción y elegir con validación en un estudio posterior, sin cambiar la regla después de ver este test. Estos contrastes justifican mirar ambas cabezas y los baselines, sin atribuir toda diferencia a una sola causa. La mini U-Net obtuvo IoU 0.9971 y Dice 0.9985, con umbral 0.4 elegido en validación. La regla de generación de la máscara obtuvo uno en ambas métricas: para esta etiqueta sintética no hace falta una red. La utilidad docente consiste en aprender el flujo de segmentación y reconocer cuándo una solución más simple ya resuelve el objetivo.

Cifras de la ejecución CPU del 15 de octubre de 2026. Si cambia datos, semilla o versión, contraste esta lectura con las salidas nuevas.

17.11 11. Decisiones, ejercicios y límites

La caja requiere menos detalle de anotación que una máscara de contorno; el coste real depende de herramientas, objetos y control de calidad. No se infiere una relación universal de costes ni adopción industrial a partir de este laboratorio.

  1. Cambie los pesos del objetivo en validación y mida qué tarea gana o pierde; no elija por test.
  2. Entrene una ablación sin las conexiones de salto antes de atribuir a ellas diferencias de bordes.
  3. Varíe escala de los parches y fondo para eliminar el prior de tamaño constante, conservando particiones por fuente.
  4. Añada dos objetos y defina anotaciones, asignación de predicciones, casos sin objeto y evaluación de duplicados.
  5. Si la tarea final es una máscara por umbral conocido, compare primero con la regla exacta; use una red sólo cuando exista una necesidad que esa regla no resuelva.

Hay un objeto por escena, tamaño constante, fondo limpio y clases de dígitos. Las nuevas particiones evitan compartir imágenes fuente, pero no garantizan independencia por escritor. Los checkpoints y el umbral usan validación separada. Las métricas no se comparan directamente con resultados COCO ni establecen capacidad de detección general.

17.12 Referencias