26  Autoencoders y VAE

Serie Deep Learning · del perceptrón a los transformers.

Reconstruir una entrada y generar desde un prior son preguntas distintas. Entrenaremos un autoencoder 2D y un VAE, compararemos reconstrucción, KL, muestras e interpolaciones y estudiaremos el peso beta. Una confianza alta de un clasificador auxiliar no se interpretará como una medida completa de calidad generativa.

26.1 1. Entorno, datos y particiones

Se requieren PyTorch, NumPy, pandas, Matplotlib y scikit-learn. Digits se amplía por repetición 8×8→16×16; no se añade detalle. Conservamos el 15 % histórico de prueba de la permutación con semilla 0. Del desarrollo reservamos otro 15 % para validación, en lugar de usar prueba para seleccionar y de entrenar el VAE sin una reserva.

La dimensión latente dos permite dibujar sus coordenadas directamente. No se presenta como una capacidad suficiente para toda imagen ni se fuerza una separación por clases: las etiquetas sólo intervienen en el juez y los diagnósticos.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}
from sklearn.datasets import load_digits
d=load_digits();x=np.kron(d.images,np.ones((2,2))).astype(np.float32)[:,None]/16;y=d.target
orden=np.random.default_rng(0).permutation(len(y));corte=int(.85*len(y));dev=orden[:corte];ite=orden[corte:]
orden_dev=np.random.default_rng(42).permutation(dev);corte_val=int(.85*len(dev));itr=orden_dev[:corte_val];iva=orden_dev[corte_val:]
assert not(set(itr)&set(iva) or set(itr)&set(ite) or set(iva)&set(ite))
tr=TensorDataset(torch.from_numpy(x[itr]));va=TensorDataset(torch.from_numpy(x[iva]));te=TensorDataset(torch.from_numpy(x[ite]))
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=itr,val=iva,test=ite)
print('Train/val/test:',len(itr),len(iva),len(ite))
Train/val/test: 1297 230 270

26.2 2. Encoder y decoder: forma y objetivo

Dos convoluciones con stride 2 llevan 16→8→4 y producen un código de dos dimensiones. El decoder proyecta a 32×4×4, utiliza dos convoluciones transpuestas y termina en un logit por píxel. output_padding=1 resuelve la dimensión de salida de cada transpuesta; no debe confundirse con agregar manualmente un borde de ceros. El padding simétrico puede diferir en alineación de otra biblioteca aunque coincida el tamaño.

BCE sobre intensidades en [0,1] es un objetivo convencional de reconstrucción. No convierte automáticamente cada intensidad continua en un evento Bernoulli observado. Informaremos BCE media por píxel y suma por imagen; mezclar la media del AE con la suma del VAE produciría una comparación de escalas engañosa.

class Encoder(nn.Module):
    def __init__(self,variacional=False):
        super().__init__();self.variacional=variacional
        self.red=nn.Sequential(nn.Conv2d(1,16,3,stride=2,padding=1),nn.ReLU(),nn.Conv2d(16,32,3,stride=2,padding=1),nn.ReLU(),nn.Flatten(),nn.Linear(512,4 if variacional else 2))
    def forward(self,x):
        z=self.red(x)
        return z.chunk(2,1) if self.variacional else z
class Decoder(nn.Module):
    def __init__(self):
        super().__init__();self.inicio=nn.Linear(2,512)
        self.red=nn.Sequential(nn.ConvTranspose2d(32,32,3,stride=2,padding=1,output_padding=1),nn.ReLU(),nn.ConvTranspose2d(32,16,3,stride=2,padding=1,output_padding=1),nn.ReLU(),nn.Conv2d(16,1,3,padding=1))
    def forward(self,z):return self.red(F.relu(self.inicio(z)).reshape(-1,32,4,4))
class Modelo(nn.Module):
    def __init__(self,variacional=False):super().__init__();self.variacional=variacional;self.encoder=Encoder(variacional);self.decoder=Decoder()
    def forward(self,x,epsilon=None):
        if not self.variacional:return self.decoder(self.encoder(x)),None,None
        mu,logvar=self.encoder(x);epsilon=torch.randn_like(mu) if epsilon is None else epsilon
        z=mu+torch.exp(.5*logvar)*epsilon;return self.decoder(z),mu,logvar
semilla();ae=Modelo().to(DEVICE);vae=Modelo(True).to(DEVICE)
with torch.inference_mode():assert ae(torch.zeros(2,1,16,16,device=DEVICE))[0].shape==(2,1,16,16)
print('Parámetros AE/VAE:',parametros(ae),parametros(vae))
Parámetros AE/VAE: 21379 22405

26.2.1 Del cuello de botella a un modelo probabilístico

En un AE, el encoder calcula un punto y el decoder reconstruye la entrada. Un cuello de botella limita la información disponible, pero no garantiza que puntos arbitrarios del espacio latente produzcan datos plausibles. Una reconstrucción excelente puede coexistir con huecos entre las representaciones observadas. El VAE aprende una distribución por entrada: su media localiza el código y su varianza expresa la dispersión de ese código dentro del modelo.

Conviene distinguir tres distribuciones: el prior \(p(z)\), elegido antes de observar una imagen; el encoder \(q_\phi(z|x)\), condicionado a una imagen; y el posterior verdadero \(p_\theta(z|x)\), que suele ser intratable. El encoder aproxima al tercero. La KL del entrenamiento compara el primero con el segundo, no dos imágenes ni dos clases.

La identidad

\[\log p_\theta(x)=\underbrace{\mathbb E_q\log p_\theta(x|z)-D_{KL}(q_\phi(z|x)\Vert p(z))}_{\mathrm{ELBO}}+D_{KL}(q_\phi(z|x)\Vert p_\theta(z|x))\]

explica el nombre de cota inferior: la última KL es no negativa. Maximizar la ELBO combina explicar la observación con controlar la distribución latente. Con \(\beta=1\), la pérdida negativa corresponde a esta expresión; con otros pesos se estudia un compromiso modificado. Comparar valores totales entre diferentes beta no permite declarar un ganador: cambió la función que se mide.

26.2.2 Un VAE que podemos resolver exactamente

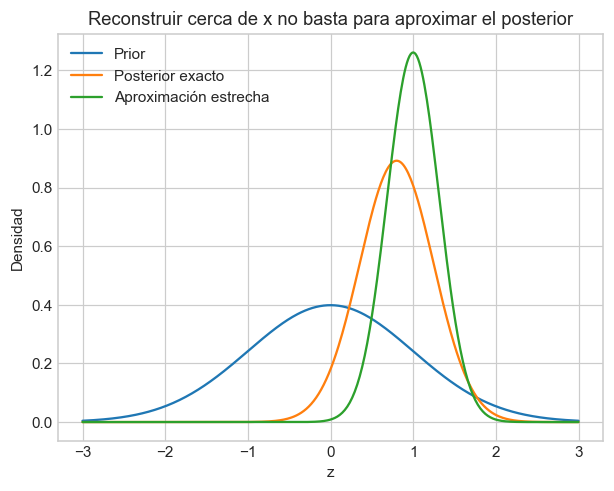
Tomemos \(z\sim N(0,1)\), \(x|z\sim N(z,0.25)\) y observemos \(x=1\). El posterior verdadero es \(N(0.8,0.2)\) y la evidencia es la densidad de \(N(0,1.25)\) evaluada en uno. Para una aproximación \(q=N(\mu,v)\), el error cuadrático esperado es \((1-\mu)^2+v\). Así podemos calcular la reconstrucción esperada sin muestrear y comprobar la identidad anterior.

Este caso usa una verosimilitud gaussiana para que la cuenta sea verificable. No sustituye la verosimilitud usada después con imágenes. En particular, una BCE sumada sobre píxeles tiene una escala distinta de una BCE promediada: cambiar esa reducción altera el peso relativo de la KL aunque beta no cambie.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_vae_cota():
    x, sigma2 = 1., .25
    mu_post, var_post = .8, .2
    log_evidencia = -.5 * (np.log(2*np.pi*1.25) + x*x/1.25)
    filas=[]
    for mu,v in [(0.,1.),(.8,.2),(1.,.1)]:
        nll=.5*np.log(2*np.pi*sigma2)+.5*((x-mu)**2+v)/sigma2
        kl=.5*(mu*mu+v-1-np.log(v))
        elbo=-nll-kl
        brecha=.5*((v+(mu-mu_post)**2)/var_post-1+np.log(var_post/v))
        assert np.isclose(log_evidencia-elbo,brecha)
        filas.append([mu,v,nll,kl,elbo,brecha])
    display(pd.DataFrame(filas,columns=['media q','varianza q','NLL esperada','KL al prior','ELBO','brecha al posterior']))
    z=np.linspace(-3,3,400)
    for mu,v,label in [(0,1,'Prior'),(.8,.2,'Posterior exacto'),(1,.1,'Aproximación estrecha')]:
        plt.plot(z,np.exp(-.5*(z-mu)**2/v)/np.sqrt(2*np.pi*v),label=label)
    plt.xlabel('z');plt.ylabel('Densidad');plt.legend();plt.title('Reconstruir cerca de x no basta para aproximar el posterior');plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_vae_cota()
media q varianza q NLL esperada KL al prior ELBO brecha al posterior
0 0.0 1.0 4.225791 0.000000 -4.225791 2.795281
1 0.8 0.2 0.705791 0.724719 -1.430510 0.000000
2 1.0 0.1 0.425791 1.201293 -1.627084 0.196574

En los valores calculados, centrar q en uno y reducir su varianza a 0.1 mejora la NLL esperada de 0.7058 a 0.4258 frente al posterior exacto. Sin embargo, la KL al prior sube de 0.7247 a 1.2013 y la ELBO empeora de −1.4305 a −1.6271. El balance correcto recupera el posterior, no la reconstrucción más concentrada. Esta cuenta muestra qué se sacrifica al favorecer excesivamente uno de los términos.

La fila del posterior exacto deja brecha cero. La aproximación más estrecha alrededor de uno puede reducir parte del error de reconstrucción y aun así empeorar la cota: concentrar masa cerca de la observación no equivale a representar su incertidumbre. La densidad de una observación continua tampoco es una probabilidad puntual; por eso una NLL de densidad no tiene que ser positiva.

26.2.3 Cómo atraviesa el gradiente una muestra

Escribimos \(z=\mu+\exp(\ell/2)\epsilon\), donde \(\ell=\log v\) y \(\epsilon\sim N(0,I)\). La aleatoriedad entra por epsilon; media y logvarianza siguen dentro del grafo. Para un prior normal estándar, por coordenada, \(KL=\tfrac12(\mu^2+e^\ell-1-\ell)\). Sus derivadas son \(\mu\) y \((e^\ell-1)/2\).

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_vae_gradiente():
    mu=torch.tensor([1.,0.],dtype=torch.float64,requires_grad=True)
    ell=torch.tensor([0.,np.log(4.)],dtype=torch.float64,requires_grad=True)
    kl=.5*(mu.square()+ell.exp()-1-ell).sum()
    gm,gl=torch.autograd.grad(kl,(mu,ell))
    assert torch.allclose(gm,mu)
    assert torch.allclose(gl,.5*(ell.exp()-1))
    assert np.isclose(kl.item(),1.3068528194400546)
    eps=torch.tensor([.3,-.4],dtype=torch.float64)
    z=mu+torch.exp(.5*ell)*eps
    recon=z.square().sum()
    dm,dl=torch.autograd.grad(recon,(mu,ell))
    assert torch.allclose(dm,2*z)
    assert torch.allclose(dl,z*torch.exp(.5*ell)*eps)
    display(pd.DataFrame({'mu':mu.detach(),'logvar':ell.detach(),'z con epsilon fijo':z.detach(),'grad KL mu':gm.detach(),'grad KL logvar':gl.detach(),'grad reconstruccion logvar':dl.detach()}))
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_vae_gradiente()
mu logvar z con epsilon fijo grad KL mu grad KL logvar grad reconstruccion logvar
0 1.0 0.000000 1.3 1.0 0.0 0.39
1 0.0 1.386294 -0.8 0.0 1.5 0.64

Fijar epsilon permite comprobar una derivada sin confundirla con otra realización aleatoria. En entrenamiento se vuelve a muestrear. Una KL casi nula puede indicar que el encoder ignora la entrada, pero también un problema sencillo o un peso excesivo: revise reconstrucciones, actividad por coordenada y sensibilidad del decoder antes de diagnosticar colapso posterior.

Para decidir un ajuste, separe tres preguntas. ¿Reconstruye detalles útiles? Observe entradas y reconstrucciones bajo la misma escala. ¿Se puede generar desde el prior? Muestree sin pasar por el encoder. ¿El espacio sirve para otra tarea? Evalúe una sonda con etiquetas reservadas. Ninguna de estas respuestas sustituye las otras dos.

26.3 3. Reparametrización y divergencia KL

Para \(q(z|x)=N(\mu,\operatorname{diag}(\exp(\ell)))\) usamos \(z=\mu+\exp(\ell/2)\epsilon\), con \(\epsilon\sim N(0,I)\). El ruido es independiente de los parámetros; la transformación admite gradiente respecto de media y log-varianza. No se diferencia una extracción de números aleatorios como si fuera una función determinista de esos parámetros.

\[KL(q\|N(0,I))=-\tfrac12\sum_j(1+\ell_j-\mu_j^2-\exp(\ell_j)).\]

Comprobamos valores y gradientes analíticos. Regularizar cada posterior no obliga a que las medias de todos los datos tengan desviación exactamente uno. La posterior agregada, las medias y el prior son objetos distintos.

def kl(mu,logvar):return -.5*(1+logvar-mu.square()-logvar.exp()).sum(1)
mu=torch.tensor([[.3,-.2]],requires_grad=True);lv=torch.tensor([[.1,-.4]],requires_grad=True)
gm,gl=torch.autograd.grad(kl(mu,lv).sum(),(mu,lv));torch.testing.assert_close(gm,mu);torch.testing.assert_close(gl,.5*(lv.exp()-1))
assert kl(torch.zeros(1,2),torch.zeros(1,2)).item()==0
display(pd.DataFrame([{'media':m,'logvar':l,'KL_1d':float(kl(torch.tensor([[float(m)]]),torch.tensor([[float(l)]])))} for m,l in [(0,0),(3,0),(0,2),(0,-3)]]))
@torch.inference_mode()
def evaluar_recon(m,ds,beta=1):
    m.eval();generador=torch.Generator(device=DEVICE).manual_seed(303);recon=0.;kls=0.;n=0
    for (xx,) in DataLoader(ds,batch_size=32):
        xx=xx.to(DEVICE);eps=torch.randn((len(xx),2),generator=generador,device=DEVICE) if m.variacional else None
        z,mu,lv=m(xx,eps);recon+=F.binary_cross_entropy_with_logits(z,xx,reduction='sum').item()
        if m.variacional:kls+=kl(mu,lv).sum().item()
        n+=len(xx)
    return {'recon_imagen':recon/n,'recon_pixel':recon/(n*256),'kl':kls/n,'total':(recon+beta*kls)/n}
def entrenar_recon(m,nombre,epocas,beta=1):
    opt=torch.optim.Adam(m.parameters(),lr=.001);dl=DataLoader(tr,batch_size=32,shuffle=True,generator=torch.Generator().manual_seed(SEED));hist=[];mejor=float('inf');inicio=time.perf_counter()
    for ep in range(1,epocas+1):
        m.train()
        for (xx,) in dl:
            xx=xx.to(DEVICE);opt.zero_grad(set_to_none=True);z,mu,lv=m(xx)
            rec=F.binary_cross_entropy_with_logits(z,xx,reduction='none').flatten(1).sum(1).mean()
            # El AE usa BCE media; el VAE conserva suma por imagen + beta KL.
            loss=rec/256 if not m.variacional else rec+beta*kl(mu,lv).mean()
            if not torch.isfinite(loss):raise FloatingPointError(nombre+' pérdida no finita')
            loss.backward();opt.step()
        a=evaluar_recon(m,tr,beta);b=evaluar_recon(m,va,beta)
        hist.append({'epoca':ep,**{f'{k}_{p}':v[k] for p,v in [('train',a),('val',b)] for k in a}})
        if b['total']<mejor:mejor=b['total'];estado=copy.deepcopy(m.state_dict());mejor_ep=ep
        if ep%10==0:print(nombre,ep,'recon val',round(b['recon_imagen'],3),'KL',round(b['kl'],3),flush=True)
    m.load_state_dict(estado);m.eval();h=pd.DataFrame(hist);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    return h,{'modelo':nombre,'beta':beta,'epocas':epocas,'mejor_epoca':mejor_ep,'objetivo_val':mejor,'segundos':time.perf_counter()-inicio}
media logvar KL_1d
0 0 0 -0.000000
1 3 0 4.500000
2 0 2 2.194528
3 0 -3 1.024894

26.4 4. Entrenar y leer las dos componentes

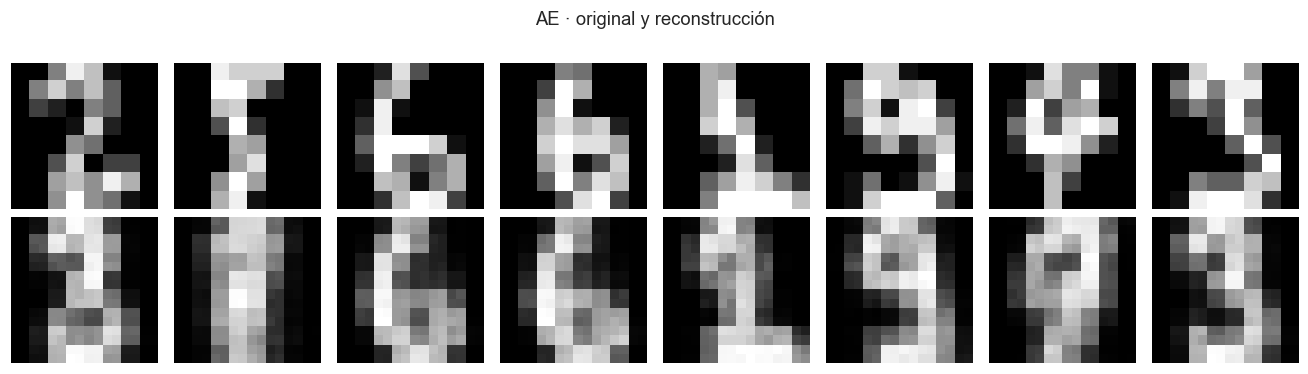
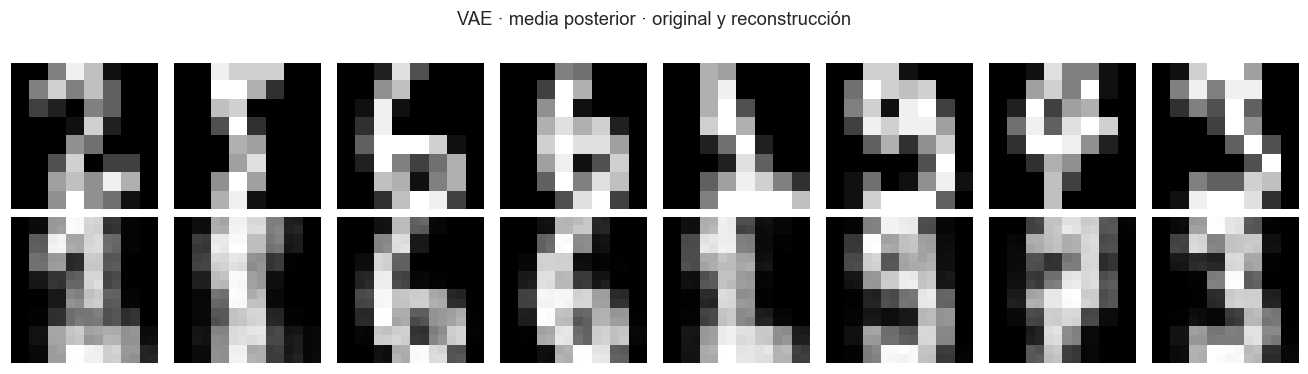
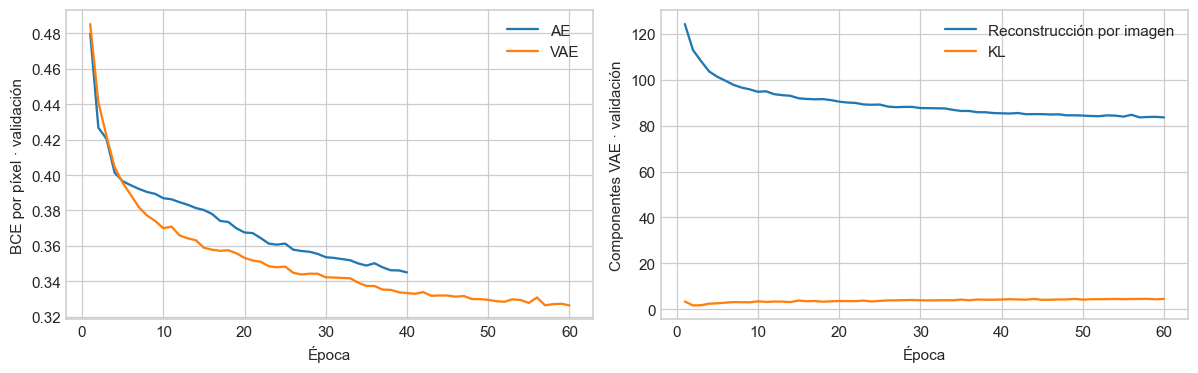
Conservamos 40 épocas del AE y 60 del VAE beta 1, lote 32 y Adam 0,001. Los checkpoints usan validación, antes de cualquier comparación de prueba. Para VAE, la evaluación utiliza un ruido fijo independiente del entrenamiento: estabiliza la comparación de épocas sin sustituir el término estocástico por la media posterior. La cifra es un estimador con esas muestras, no una integral exacta.

La reconstrucción visual usa la media posterior para poder repetirla; no se presenta como la misma evaluación del objetivo estocástico. Las curvas simuladas no serán utilizadas como si midieran calidad generativa: las figuras siguientes provienen de entrenamientos reales.

semilla();ha,ra=entrenar_recon(ae,'AE',40)
semilla();hv,rv=entrenar_recon(vae,'VAE-beta1',60)
fig,axes=plt.subplots(1,2,figsize=(11,3.5))
axes[0].plot(ha.epoca,ha.recon_pixel_val,label='AE');axes[0].plot(hv.epoca,hv.recon_pixel_val,label='VAE');axes[0].set(xlabel='Época',ylabel='BCE por píxel · validación');axes[0].legend()
axes[1].plot(hv.epoca,hv.recon_imagen_val,label='Reconstrucción por imagen');axes[1].plot(hv.epoca,hv.kl_val,label='KL');axes[1].set(xlabel='Época',ylabel='Componentes VAE · validación');axes[1].legend();fig.tight_layout();plt.show()
tabla=pd.DataFrame([{**r,**evaluar_recon(m,te)} for m,r in [(ae,ra),(vae,rv)]]);display(tabla);tabla.to_csv(ARTEFACTOS/'reconstruccion.csv',index=False)
@torch.inference_mode()
def latentes(m,xx):
    salida=m.encoder(torch.from_numpy(xx).to(DEVICE));return (salida[0] if m.variacional else salida).cpu().numpy()
@torch.inference_mode()
def decodificar(m,z):return m.decoder(torch.as_tensor(z,dtype=torch.float32,device=DEVICE)).sigmoid().cpu().numpy()
def tira(imagenes,titulo):
    fig,axes=plt.subplots(1,len(imagenes),figsize=(12,2.2))
    for ax,im in zip(np.atleast_1d(axes),imagenes):ax.imshow(im.squeeze(),cmap='gray',vmin=0,vmax=1);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
for m,nombre in [(ae,'AE'),(vae,'VAE · media posterior')]:
    rec=decodificar(m,latentes(m,x[ite[:8]]));fig,axes=plt.subplots(2,8,figsize=(12,3.5))
    for j in range(8):axes[0,j].imshow(x[ite[j],0],cmap='gray');axes[1,j].imshow(rec[j,0],cmap='gray')
    for ax in axes.flat:ax.axis('off')
    fig.suptitle(nombre+' · original y reconstrucción');fig.tight_layout();plt.show()
AE 10 recon val 99.054 KL 0.0
AE 20 recon val 94.102 KL 0.0
AE 30 recon val 90.534 KL 0.0
AE 40 recon val 88.341 KL 0.0
VAE-beta1 10 recon val 94.718 KL 3.498
VAE-beta1 20 recon val 90.432 KL 3.631
VAE-beta1 30 recon val 87.629 KL 3.935
VAE-beta1 40 recon val 85.353 KL 4.291
VAE-beta1 50 recon val 84.369 KL 4.217
VAE-beta1 60 recon val 83.567 KL 4.556

modelo beta epocas mejor_epoca objetivo_val segundos recon_imagen recon_pixel kl total
0 AE 1 40 40 88.341397 92.816199 88.106931 0.344168 0.000000 88.106931
1 VAE-beta1 1 60 57 88.109976 155.560393 85.477853 0.333898 4.496067 89.973920

26.5 5. Latentes, prior e interpolaciones

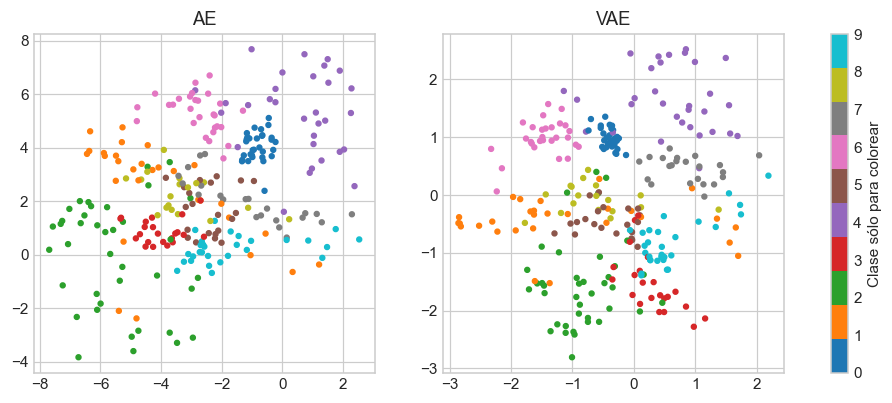
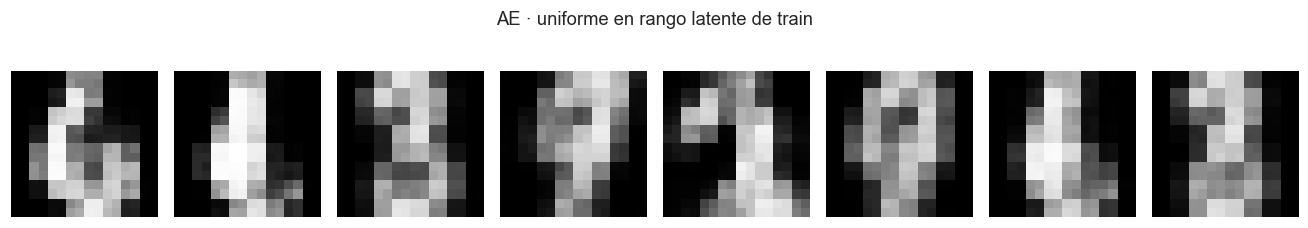
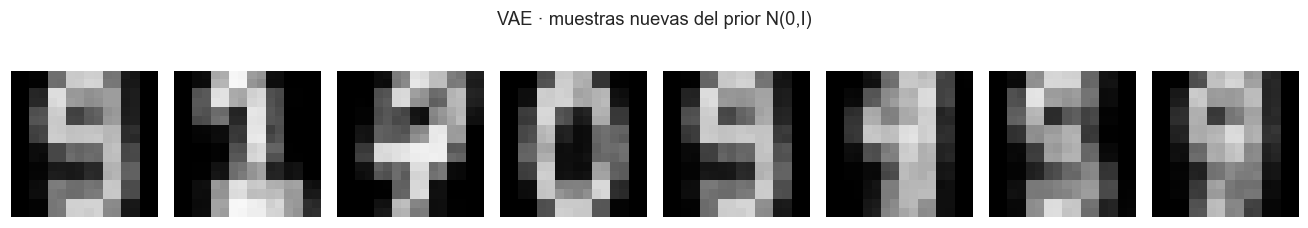
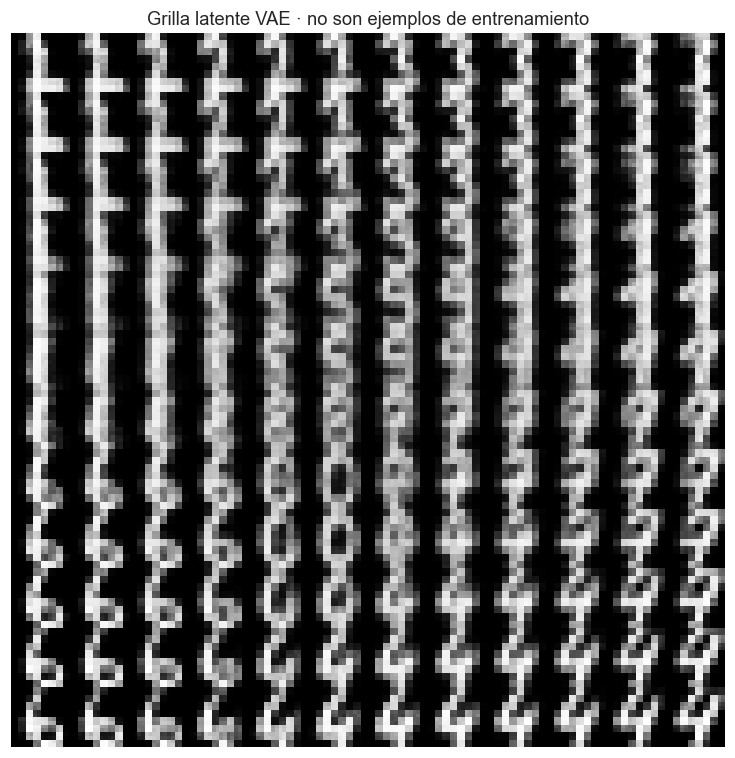
El AE no impone un prior de muestreo. Para mostrar un muestreo uniforme de su rectángulo latente, el rango se calcula con entrenamiento, no con prueba. El VAE recibe muestras nuevas de N(0,I). Dibujar muestras diferentes de las entradas es generación, pero su apariencia no garantiza fidelidad, diversidad ni utilidad.

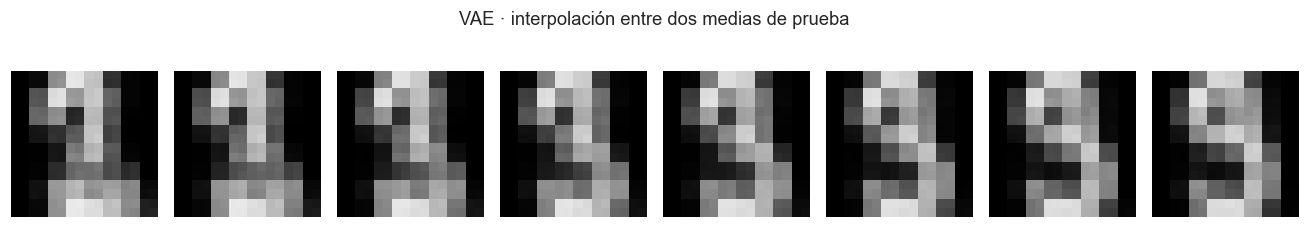
Interpolar medias de dos ejemplos muestra continuidad del decoder a lo largo de esa trayectoria, no que todos los puntos sean semánticamente válidos. La grilla regular 12×12 cubre −2,5…2,5 en cada eje: los extremos pueden ser raros bajo el prior.

fig,axes=plt.subplots(1,2,figsize=(11,4));stats=[]
for ax,m,nombre in zip(axes,[ae,vae],['AE','VAE']):
    z=latentes(m,x[ite]);im=ax.scatter(z[:,0],z[:,1],c=y[ite],cmap='tab10',s=10);ax.set_title(nombre)
    stats.append({'modelo':nombre,'media_z1':z[:,0].mean(),'media_z2':z[:,1].mean(),'std_z1':z[:,0].std(),'std_z2':z[:,1].std()})
fig.colorbar(im,ax=axes,label='Clase sólo para colorear');plt.show();display(pd.DataFrame(stats))
ztrain=latentes(ae,x[itr]);minimo=ztrain.min(0);maximo=ztrain.max(0)
tira(decodificar(ae,np.random.default_rng(1).uniform(minimo,maximo,(8,2))),'AE · uniforme en rango latente de train')
tira(decodificar(vae,np.random.default_rng(2).normal(size=(8,2))),'VAE · muestras nuevas del prior N(0,I)')
z=latentes(vae,x[ite[[0,5]]]);alpha=np.linspace(0,1,8)[:,None];tira(decodificar(vae,(1-alpha)*z[0]+alpha*z[1]),'VAE · interpolación entre dos medias de prueba')
coordenadas=np.linspace(-2.5,2.5,12);puntos=np.array([[a,b] for b in coordenadas for a in coordenadas]);imgs=decodificar(vae,puntos)
mosaico=np.concatenate([np.concatenate([imgs[i*12+j,0] for j in range(12)],axis=1) for i in range(12)],axis=0)
fig,ax=plt.subplots(figsize=(7,7));ax.imshow(mosaico,cmap='gray');ax.set_title('Grilla latente VAE · no son ejemplos de entrenamiento');ax.axis('off');fig.tight_layout();plt.show()
modelo media_z1 media_z2 std_z1 std_z2
0 AE -2.538626 2.392280 2.271225 2.298160
1 VAE -0.280543 -0.089798 1.005456 1.171295

26.6 6. Beta: reconstrucción frente a regularización

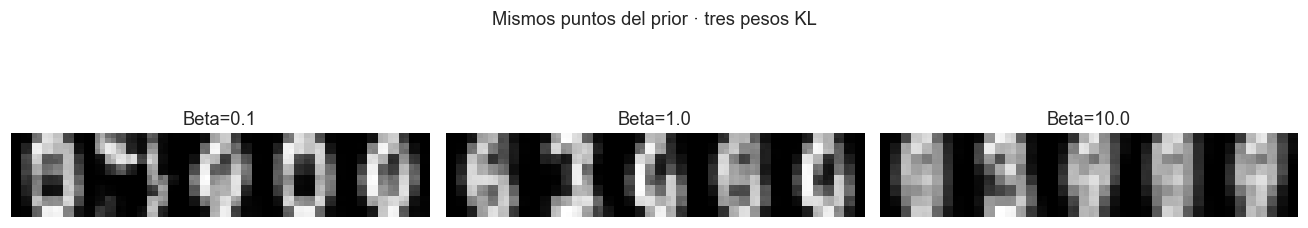
Conservamos tres valores beta 0,1/1/10 y 40 épocas por ensayo. Se parte del mismo estado inicial y semillas, con las mismas particiones y ruido fijo de validación. No se comparan sus pérdidas totales como si fueran el mismo objetivo: beta cambia la ponderación. Se informan por separado reconstrucción y KL.

Una KL pequeña puede acompañar una representación poco informativa; no es una victoria automática. Una media posterior compacta no demuestra que la posterior agregada coincida con el prior. No se exige que las muestras de beta pequeño o grande sigan un aspecto predeterminado.

semilla();inicial=Modelo(True).state_dict();betas={};filas=[];ruido=np.random.default_rng(4).normal(size=(5,2))
fig,axes=plt.subplots(1,3,figsize=(12,2.8))
for ax,beta in zip(axes,[.1,1.,10.]):
    semilla();m=Modelo(True).to(DEVICE);m.load_state_dict(inicial);h,r=entrenar_recon(m,'beta-'+str(beta),40,beta)
    betas[beta]=m;filas.append({**r,**evaluar_recon(m,te,beta)})
    im=decodificar(m,ruido);ax.imshow(np.concatenate([v[0] for v in im],1),cmap='gray');ax.set_title(f'Beta={beta}');ax.axis('off')
fig.suptitle('Mismos puntos del prior · tres pesos KL');fig.tight_layout();plt.show();tb=pd.DataFrame(filas);display(tb);tb.to_csv(ARTEFACTOS/'betas.csv',index=False)
beta-0.1 10 recon val 94.338 KL 7.178
beta-0.1 20 recon val 90.541 KL 7.341
beta-0.1 30 recon val 87.991 KL 7.308
beta-0.1 40 recon val 86.938 KL 7.707
beta-1.0 10 recon val 94.13 KL 3.306
beta-1.0 20 recon val 90.122 KL 3.808
beta-1.0 30 recon val 88.06 KL 3.727
beta-1.0 40 recon val 86.604 KL 4.108
beta-10.0 10 recon val 108.034 KL 0.092
beta-10.0 20 recon val 105.315 KL 0.334
beta-10.0 30 recon val 105.166 KL 0.32
beta-10.0 40 recon val 104.703 KL 0.36

modelo beta epocas mejor_epoca objetivo_val segundos recon_imagen recon_pixel kl total
0 beta-0.1 0.1 40 39 87.611839 104.836973 87.216776 0.340691 7.456705 87.962446
1 beta-1.0 1.0 40 39 90.704683 102.305494 86.596408 0.338267 4.167168 90.763576
2 beta-10.0 10.0 40 38 108.107129 132.118012 103.780424 0.405392 0.357448 107.354906

26.7 7. Un clasificador auxiliar no es una métrica de calidad

Conservamos el juez CNN 16/32 y quince épocas, seleccionando por validación. Su exactitud de prueba mide clasificación de Digits real. Su confianza sobre imágenes generadas es sólo un proxy: puede estar muy seguro ante artefactos, sesgo o fuera de distribución. La confianza de imágenes reales no es un techo matemático y superar ese promedio no prueba una mejora.

Se añade ruido uniforme como control y se informa diversidad de etiquetas predichas. No son etiquetas verdaderas de las muestras, ni FID ni una evaluación humana ciega. No se selecciona beta ni se vuelve a entrenar mirando la confianza del juez.

def crear_juez():return nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(16,32,3,padding=1),nn.ReLU(),nn.AdaptiveAvgPool2d(1),nn.Flatten(),nn.Linear(32,10))
semilla();juez=inicializar(crear_juez());hj,rj=entrenar(juez,conjunto(x[itr],y[itr]),conjunto(x[iva],y[iva]),15,lote=32,nombre='juez')
pr=evaluar(juez,conjunto(x[ite],y[ite]));print('Exactitud juez en prueba real:',pr['exactitud'])
rng=np.random.default_rng(5);colecciones={'AE':decodificar(ae,rng.uniform(minimo,maximo,(200,2))),'VAE':decodificar(vae,rng.normal(size=(200,2))),'Reales':x[ite],'Ruido uniforme':rng.uniform(0,1,(200,1,16,16)).astype(np.float32)}
filas=[]
for nombre,im in colecciones.items():
    re=evaluar(juez,conjunto(im,np.zeros(len(im),dtype=np.int64)));p=re['probabilidades']
    filas.append({'muestras':nombre,'n':len(im),'confianza_media':float(p.max(1).mean()),'clases_predichas_distintas':int(np.unique(p.argmax(1)).size)})
tj=pd.DataFrame(filas);display(tj);tj.to_csv(ARTEFACTOS/'juez-proxy.csv',index=False)
juez 1/15: CE val=2.2847, acc val=0.2478
juez 2/15: CE val=2.2615, acc val=0.2435
juez 3/15: CE val=2.2319, acc val=0.2522
juez 4/15: CE val=2.2018, acc val=0.3609
juez 5/15: CE val=2.1688, acc val=0.2826
juez 6/15: CE val=2.1251, acc val=0.2783
juez 7/15: CE val=2.0468, acc val=0.4435
juez 8/15: CE val=1.9784, acc val=0.4957
juez 9/15: CE val=1.8985, acc val=0.4739
juez 10/15: CE val=1.8119, acc val=0.4826
juez 11/15: CE val=1.7370, acc val=0.4652
juez 12/15: CE val=1.6506, acc val=0.6087
juez 13/15: CE val=1.6017, acc val=0.4652
juez 14/15: CE val=1.5044, acc val=0.6304
juez 15/15: CE val=1.4091, acc val=0.6870
Exactitud juez en prueba real: 0.6222222222222222
muestras n confianza_media clases_predichas_distintas
0 AE 200 0.324211 7
1 VAE 200 0.327969 8
2 Reales 270 0.315160 10
3 Ruido uniforme 200 0.326561 2

26.8 8. Artefactos y comprobación de recarga

Guardamos AE y VAE principal con su contrato, beta y normalización de la pérdida. La recarga se comprueba con reconstrucción de media posterior sobre validación, evitando confundir un cambio de ruido con un error de serialización. No se promete reanudación exacta del optimizador.

for nombre,m in [('AE',ae),('VAE',vae)]:
    ruta=ARTEFACTOS/f'{nombre}.pt';torch.save({'state_dict':{k:v.detach().cpu().clone() for k,v in m.state_dict().items()},'variacional':m.variacional},ruta)
    nuevo=Modelo(m.variacional).to(DEVICE);nuevo.load_state_dict(torch.load(ruta,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval()
    np.testing.assert_allclose(decodificar(m,latentes(m,x[iva[:16]])),decodificar(nuevo,latentes(nuevo,x[iva[:16]])),rtol=1e-5,atol=1e-6)
(ARTEFACTOS/'contrato.json').write_text(json.dumps({'entrada':'NCHW float32 Digits /16 repetir2','forma':[1,16,16],'latente':2,'vae_beta':1,'evaluacion_vae':'ruido fijo seed303; BCE sumada por imagen y KL sumada por latente','visualizacion_reconstruccion':'media posterior','recarga_verificada':True,'kl_gradiente_analitico_verificado':True}),encoding='utf-8')
307

26.8.1 Lectura de la ejecución registrada

Se conservan AE 40 épocas, VAE 60, tres beta con 40 épocas y juez 15. Se añade validación separada del test histórico y se restauran mínimos. La evaluación VAE usa ruido fijo independiente y las reconstrucciones visuales usan media posterior, explicando la diferencia. Se iguala la unidad al informar BCE por píxel/imagen y KL por latente. KL y sus gradientes se comprueban analíticamente. Los rangos de muestreo AE se calculan en train. La confianza del juez NO es calidad ni un techo de reales: incluso el ruido uniforme obtiene confianza comparable. Se conservan prior, interpolación y grilla; recargas AE/VAE verificadas.

Ejecución CPU del 15 de octubre de 2026; contraste esta lectura si cambia datos, versión o semilla.

26.9 9. Decisiones y ejercicios

Compare reconstrucción con igual unidad antes de decidir. Si el objetivo es compresión, valore error y tamaño; si es generación, añada fidelidad y diversidad sin usar sólo confianza. Repita con mayor dimensión latente y un conjunto de más resolución para estudiar qué cambia. Entrene una referencia y seleccione con validación; no convierta las imágenes de prueba en un tablero de ajuste.

Un VAE no garantiza realismo por tener un prior y una BCE pequeña no garantiza reconocimiento semántico. El siguiente capítulo estudia otro objetivo generativo, mediante competencia adversaria.

26.10 Referencias

La derivación probabilística y la reparametrización se apoyan en Kingma y Welling, Auto-Encoding Variational Bayes. Las cuentas gaussianas de esta sección son ejemplos docentes calculados explícitamente.