33  Ética y equidad

Serie Deep Learning · del perceptrón a los transformers.

Todas las sesiones anteriores de este libro midieron accuracy, IoU, perplejidad o calidad de reconstrucción — nunca si el modelo trata a distintos grupos de personas de forma distinta. Este capítulo cierra esa laguna: construye un caso con sesgo histórico deliberado, lo mide con las métricas de equidad estándar, muestra por qué la solución ingenua (“simplemente no uses el atributo protegido como variable”) no funciona, y conecta los riesgos específicos de cada familia de modelo que ya se construyó en el libro — generativos y LLM incluidos.

33.1 1. Introducción

El escenario de este capítulo es un sistema de aprobación de crédito, un caso de uso clásico en la literatura de equidad algorítmica — pero el mismo armazón de análisis (medir por subgrupo, no solo en agregado) aplica igual de bien a cualquier sistema de clasificación que afecte personas: contratación, libertad condicional, diagnóstico médico, moderación de contenido. Los datos de este capítulo son sintéticos y el sesgo se inyecta a propósito, para poder mostrar el mecanismo con total claridad — la sección 15 discute qué tan bien o mal esto representa la complejidad de un caso real.

33.2 2. Qué ya se conoce

La matriz de confusión y las métricas de Evaluación de modelos — precision, recall, falsos positivos y falsos negativos. Las métricas de equidad de este capítulo son, literalmente, las mismas cantidades de esa matriz de confusión, calculadas por separado para cada grupo en vez de para el dataset completo. No hay matemática nueva — hay una pregunta nueva: ¿esas cantidades son parecidas entre grupos, o no?

33.3 Protocolo: definir equidad, etiqueta y evaluación

Paridad demográfica compara tasas de decisión positiva entre grupos. Igualdad de oportunidad compara TPR condicionados a Y=1. La razón de impacto es la menor tasa positiva dividida entre la mayor: resume las mismas tasas usadas por paridad, no constituye un tercer criterio independiente.

La «regla del 80%» se utiliza aquí como umbral didáctico de ese cociente. Tiene origen en selección laboral estadounidense; la EEOC la describe como criterio orientativo, no definición legal universal ni certificado de cumplimiento para crédito.

El resultado de Kleinberg, Mullainathan y Raghavan (ITCS 2017) trata tres propiedades de un score S: calibración dentro de cada grupo, igualdad de la media de S entre positivos e igualdad de esa media entre negativos. No pueden satisfacerse simultáneamente salvo casos especiales, como tasas base iguales o predicción perfecta, bajo sus supuestos. No afirma incompatibilidad entre los tres indicadores de la primera frase. Aprobar a todos daría paridad, TPR iguales y razón uno, pero podría ser una decisión inútil.

La etiqueta de ajuste es aprobación histórica, que contiene el sesgo simulado. Exactitud y TPR respecto a ella miden reproducción de esa historia, no justicia ni mérito verdadero. El simulador conserva mérito como información oculta para explicar el mecanismo; no se convierte en argumento de legalidad.

Separamos 60% entrenamiento, 20% validación y 20% prueba estratificando por grupo y etiqueta. Escaladores y pesos de ajuste se estiman solo en entrenamiento. Validación elige checkpoints y umbrales; las cuatro estrategias, el objetivo TPR=0.75 y la regla de selección se fijan antes de consultar prueba. No elegimos de nuevo sobre sus métricas.

33.4 4. Laboratorio de lectura (history sintético)

33.4.1 Contrato PyTorch de este laboratorio

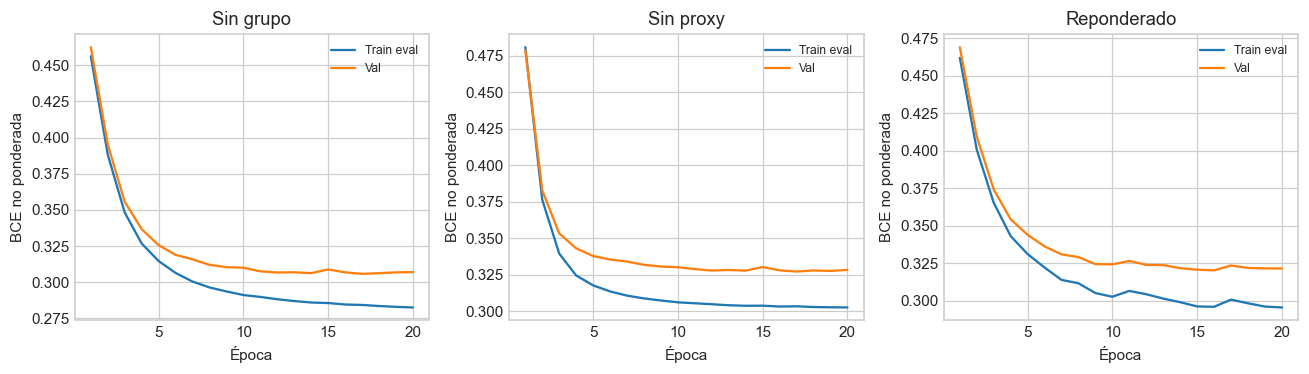
La MLP termina en un logit y optimiza BCE estable sobre logits. Sigmoid se usa al interpretar probabilidades. Se conservan 20 épocas máximas, lote 32, Adam 0,001, paciencia cuatro y mínimo BCE de validación. Las curvas train/val se miden al final de época en evaluación, sin ponderación; la pérdida online ponderada se registra aparte. En reponderación, la media es suma de pérdidas por peso dividida por tamaño de lote, preservando el objetivo del experimento. La inicialización He/Xavier y el generador PyTorch cambian la trayectoria respecto del framework anterior: no se promete identidad numérica.

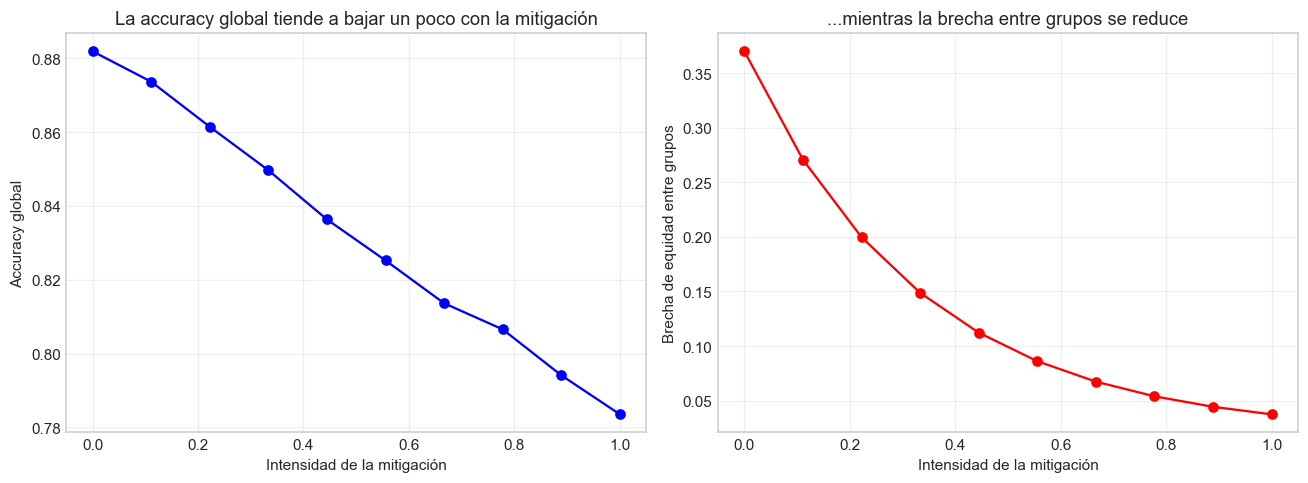
La curva fabricada siguiente es exclusivamente una ilustración: sus números no se usan en la selección ni se confunden con resultados del entrenamiento.

from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()

from sklearn.preprocessing import StandardScaler

from types import SimpleNamespace
def probabilidad(modelo,x):
    modelo.eval()
    with torch.inference_mode():return modelo(torch.as_tensor(x,dtype=torch.float32,device=DEVICE)).sigmoid().cpu().numpy()

def medir_binario(modelo,x,y):
    modelo.eval();yt=torch.as_tensor(y,dtype=torch.float32,device=DEVICE).reshape(-1,1)
    with torch.inference_mode():
        z=modelo(torch.as_tensor(x,dtype=torch.float32,device=DEVICE))
        return F.binary_cross_entropy_with_logits(z,yt).item(),float(((z.sigmoid()>.5).cpu().numpy().ravel()==y).mean())

def construir_clasificador(entradas=3):
    semilla();return inicializar(nn.Sequential(nn.Linear(entradas,16),nn.ReLU(),nn.Linear(16,8),nn.ReLU(),nn.Linear(8,1)))

def entrenar_equidad(modelo,xa,xv,pesos=None,semilla=42):
    torch.manual_seed(semilla);opt=torch.optim.Adam(modelo.parameters(),lr=.001)
    w=np.ones(len(Y_train),np.float32) if pesos is None else pesos
    ds=TensorDataset(torch.from_numpy(xa),torch.from_numpy(Y_train[:,None]),torch.from_numpy(w[:,None]))
    dl=DataLoader(ds,batch_size=32,shuffle=True,generator=torch.Generator().manual_seed(semilla))
    hist={'loss':[],'val_loss':[],'accuracy':[],'val_accuracy':[],'loss_online_ponderada':[]};mejor=np.inf;espera=0
    for ep in range(20):
        modelo.train();s=0.;n=0
        for a,b,p in dl:
            a=a.to(DEVICE);b=b.to(DEVICE);p=p.to(DEVICE);opt.zero_grad(set_to_none=True)
            loss=(F.binary_cross_entropy_with_logits(modelo(a),b,reduction='none')*p).mean();loss.backward();opt.step();s+=loss.item()*len(a);n+=len(a)
        tr,at=medir_binario(modelo,xa,Y_train);va,av=medir_binario(modelo,xv,Y_val)
        for k,v in [('loss',tr),('val_loss',va),('accuracy',at),('val_accuracy',av),('loss_online_ponderada',s/n)]:hist[k].append(v)
        if va<mejor:mejor=va;estado=copy.deepcopy(modelo.state_dict());espera=0
        else:espera+=1
        if espera>=4:break
    modelo.load_state_dict(estado);modelo.eval();return SimpleNamespace(history=hist)
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}
intensidad_mitigacion = np.linspace(0, 1, 10)
accuracy_global = 0.88 - 0.10 * intensidad_mitigacion + np.random.rand(10) * 0.005
brecha_de_equidad = 0.35 * np.exp(-3 * intensidad_mitigacion) + 0.02

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].plot(intensidad_mitigacion, accuracy_global, "b-o")
axes[0].set_xlabel("Intensidad de la mitigación")
axes[0].set_ylabel("Accuracy global")
axes[0].set_title("La accuracy global tiende a bajar un poco con la mitigación")
axes[0].grid(True, alpha=0.3)

axes[1].plot(intensidad_mitigacion, brecha_de_equidad, "r-o")
axes[1].set_xlabel("Intensidad de la mitigación")
axes[1].set_ylabel("Brecha de equidad entre grupos")
axes[1].set_title("...mientras la brecha entre grupos se reduce")
axes[1].grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

33.4.2 Qué muestra la curva conceptual

La curva anterior fue fabricada para ilustrar un posible intercambio, no un teorema sobre exactitud y equidad. En un experimento, una intervención puede mejorar ambos objetivos o empeorarlos; hay que medirla. Primero se declara qué noción de equidad se prioriza y contra qué etiqueta se calcula. Después se comprueba si existe un intercambio en los resultados, sin imponer a los datos la forma del dibujo.

33.5 5. Un dataset sintético con sesgo histórico deliberado

n = 4000
rng = np.random.default_rng(7)

grupo = rng.choice(["A", "B"], size=n, p=[0.6, 0.4])
ingreso = rng.normal(50000, 15000, size=n)
ingreso = np.where(grupo == "B", ingreso - 6000, ingreso)  # desigualdad de ingreso ya existente, no causada por el modelo
anios_educacion = np.clip(rng.normal(14, 3, size=n), 6, 22)

# zip_proxy: una variable "neutral" en apariencia, pero correlacionada con el grupo (como un código postal real lo estaría)
zip_proxy = np.where(grupo == "B", rng.normal(0.7, 0.2, size=n), rng.normal(0.3, 0.2, size=n))
zip_proxy = np.clip(zip_proxy, 0, 1)

merito = 0.00004 * ingreso + 0.05 * anios_educacion + rng.normal(0, 0.3, size=n)
umbral_aprobacion = 2.75  # regla generadora fijada, no estimada con etiquetas de prueba

# el sesgo histórico: a igual mérito, el grupo B fue aprobado con menos frecuencia en los datos históricos
penalizacion_historica = np.where(grupo == "B", 0.4, 0.0)
aprobado_historico = (merito - penalizacion_historica > umbral_aprobacion).astype(int)

print("Tasa de aprobación histórica, grupo A:", aprobado_historico[grupo == "A"].mean().round(3))
print("Tasa de aprobación histórica, grupo B:", aprobado_historico[grupo == "B"].mean().round(3))
Tasa de aprobación histórica, grupo A: 0.449
Tasa de aprobación histórica, grupo B: 0.155

33.5.1 Idea clave

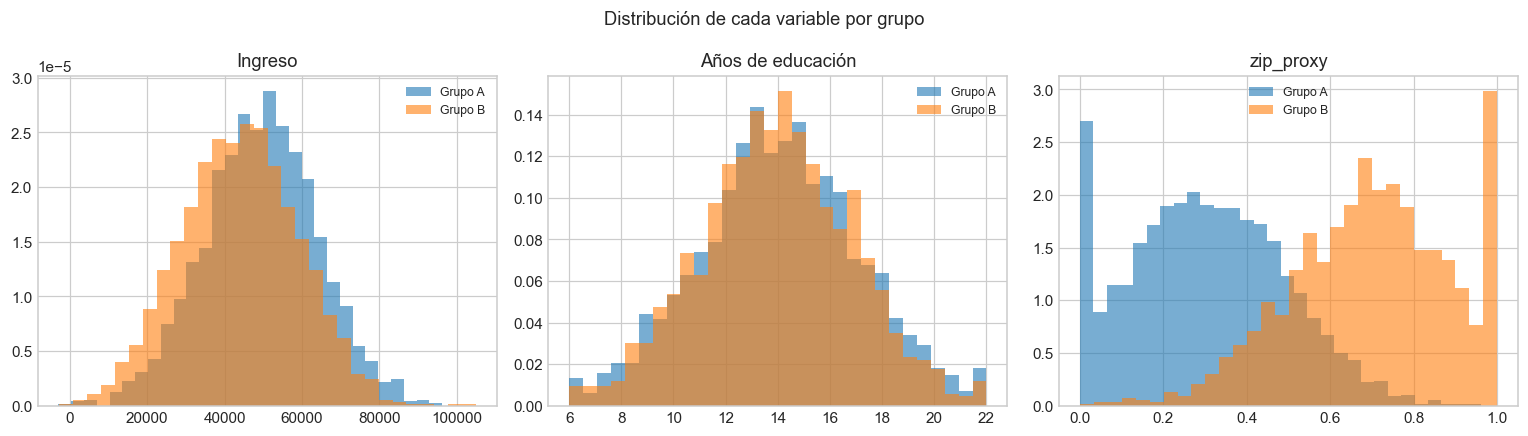
penalizacion_historica es, a propósito, el mecanismo completo del sesgo en este capítulo: a igualdad de mérito (la combinación de ingreso y educación que debería determinar la aprobación), el grupo B fue aprobado con menos frecuencia en el pasado. Un modelo entrenado sobre aprobado_historico no está inventando sesgo — está aprendiendo y reproduciendo el que ya existía en las decisiones pasadas, uno de los mecanismos documentados de reproducción de sesgos en sistemas reales.

fig, axes = plt.subplots(1, 3, figsize=(14, 4))
for ax, variable, nombre in zip(axes, [ingreso, anios_educacion, zip_proxy], ["Ingreso", "Años de educación", "zip_proxy"]):
    ax.hist(variable[grupo == "A"], bins=30, alpha=0.6, label="Grupo A", density=True)
    ax.hist(variable[grupo == "B"], bins=30, alpha=0.6, label="Grupo B", density=True)
    ax.set_title(nombre)
    ax.legend(fontsize=8)
plt.suptitle("Distribución de cada variable por grupo")
plt.tight_layout()
plt.show()

33.5.2 Interpretación

ingreso muestra una diferencia de distribución real entre grupos (reflejando la desigualdad económica incrustada a propósito en la sección 5); zip_proxy muestra una diferencia aún más marcada, por diseño; anios_educacion no tiene diferencia sistemática entre grupos en esta simulación. Esta sola inspección visual ya anticipa qué variable va a filtrar más información sobre el grupo — la sección 7 lo confirma con números.

correlacion_zip_grupo = np.corrcoef((grupo == "B").astype(int), zip_proxy)[0, 1]
print(f"Correlación entre zip_proxy y pertenecer al grupo B: {correlacion_zip_grupo:.3f}")
Correlación entre zip_proxy y pertenecer al grupo B: 0.718

33.6 6. “Fairness through unawareness”: excluir el grupo, ¿alcanza?

La intuición ingenua es simple: si el modelo nunca ve la columna grupo, no puede discriminar por grupo. Se entrena un clasificador con ingreso, anios_educacion y zip_proxy — sin grupo — y se mide qué pasa.

import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from IPython.display import display,Markdown
import json,copy
from pathlib import Path
X_original=np.column_stack([ingreso,anios_educacion,zip_proxy]).astype('float32')
Y=aprobado_historico.astype('float32')
estrato=np.char.add(grupo,Y.astype(int).astype(str))
idx_train,idx_res=train_test_split(np.arange(n),test_size=.4,random_state=42,stratify=estrato)
idx_val,idx_test=train_test_split(idx_res,test_size=.5,random_state=42,stratify=estrato[idx_res])
assert not set(idx_train)&set(idx_val) and not set(idx_test)&set(idx_train) and not set(idx_test)&set(idx_val)
escalador=StandardScaler().fit(X_original[idx_train])
X=escalador.transform(X_original).astype('float32')
X_train,X_val,X_test=X[idx_train],X[idx_val],X[idx_test]
Y_train,Y_val,Y_test=Y[idx_train],Y[idx_val],Y[idx_test]
grupo_train,grupo_val,grupo_test=grupo[idx_train],grupo[idx_val],grupo[idx_test]
print('Entrenamiento',len(idx_train),'Validación',len(idx_val),'Prueba',len(idx_test))
print('Media de entrenamiento tras escalado:',np.round(X_train.mean(0),5))
def lectura_equidad(s):display(Markdown('### Cómo leer este resultado\n\n'+s))
Entrenamiento 2400 Validación 800 Prueba 800
Media de entrenamiento tras escalado: [-0.  0.  0.]
clasificador_sin_grupo=construir_clasificador()
hist_sin_grupo=entrenar_equidad(clasificador_sin_grupo,X_train,X_val)
pred_val_sin_grupo=probabilidad(clasificador_sin_grupo,X_val).ravel()
print('Checkpoint por val_loss:',int(np.argmin(hist_sin_grupo.history['val_loss']))+1)
print('Accuracy reservada:',medir_binario(clasificador_sin_grupo,X_test,Y_test)[1])
Checkpoint por val_loss: 17
Accuracy reservada: 0.87

33.7 7. Midiendo las tres métricas de equidad

def metricas_de_equidad(y_real, y_pred_prob, grupos, umbral=0.5):
    y_pred = (y_pred_prob > umbral).astype(int)
    reporte = {}
    for g in np.unique(grupos):
        mascara = grupos == g
        yr, yp = y_real[mascara], y_pred[mascara]
        tasa_aprobacion = yp.mean()
        positivos_reales = yr == 1
        tpr = yp[positivos_reales].mean() if positivos_reales.sum() > 0 else np.nan
        negativos_reales = yr == 0
        fpr = yp[negativos_reales].mean() if negativos_reales.sum() > 0 else np.nan
        reporte[g] = {"tasa_aprobacion": tasa_aprobacion, "tpr": tpr, "fpr": fpr}
    return reporte

pred_sin_grupo = probabilidad(clasificador_sin_grupo,X_test).ravel()
reporte_sin_grupo = metricas_de_equidad(Y_test, pred_sin_grupo, grupo_test)
for g, m in reporte_sin_grupo.items():
    print(f"Grupo {g}: tasa de aprobación={m['tasa_aprobacion']:.3f}  TPR={m['tpr']:.3f}  FPR={m['fpr']:.3f}")

accuracy_original = ((pred_sin_grupo > 0.5).astype(int) == Y_test).mean()
print(f"\nAccuracy global (sin_grupo): {accuracy_original:.3f}")

razon_impacto_sin_grupo = min(reporte_sin_grupo["A"]["tasa_aprobacion"], reporte_sin_grupo["B"]["tasa_aprobacion"]) / \
                max(reporte_sin_grupo["A"]["tasa_aprobacion"], reporte_sin_grupo["B"]["tasa_aprobacion"])
print(f"\nRazón de impacto dispar: {razon_impacto_sin_grupo:.3f}  "
      f"(regla del 80%: {'PASA' if razon_impacto_sin_grupo >= 0.8 else 'NO PASA'})")
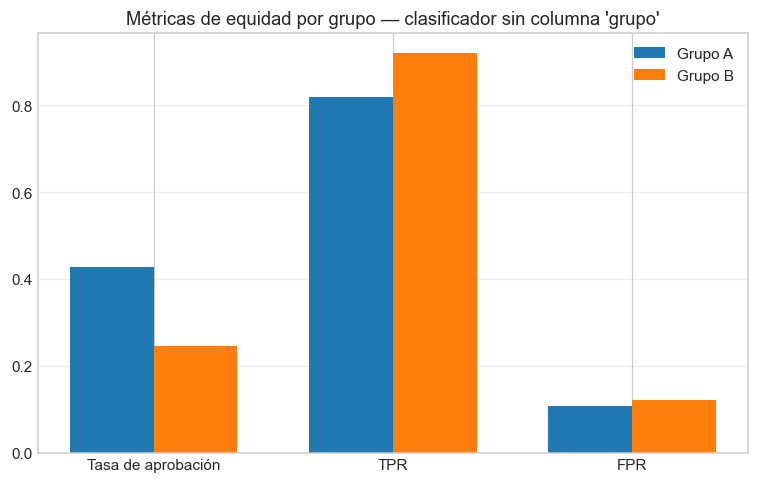
Grupo A: tasa de aprobación=0.427  TPR=0.819  FPR=0.106
Grupo B: tasa de aprobación=0.245  TPR=0.920  FPR=0.121

Accuracy global (sin_grupo): 0.870

Razón de impacto dispar: 0.575  (regla del 80%: NO PASA)
# ¿La accuracy POR GRUPO oculta el problema, como en el caso COMPAS de la sección 13?
pred_binaria_sin_grupo = (pred_sin_grupo > 0.5).astype(int)
for g in ["A", "B"]:
    mascara = grupo_test == g
    acc_grupo = (pred_binaria_sin_grupo[mascara] == Y_test[mascara]).mean()
    print(f"Accuracy del modelo DENTRO del grupo {g}: {acc_grupo:.3f}")
Accuracy del modelo DENTRO del grupo A: 0.860
Accuracy del modelo DENTRO del grupo B: 0.885

33.7.1 Interpretación

Si la accuracy por grupo sale parecida entre A y B, a pesar de que la tasa de aprobación y la razón de impacto dispar NO lo son — exactamente el patrón del caso COMPAS de la sección 13 (accuracy global similar, FPR muy distinto) — eso confirma que “el modelo es igual de preciso para ambos grupos” y “el modelo trata a ambos grupos por igual” son afirmaciones completamente distintas, y la primera no implica la segunda.

fig, ax = plt.subplots(1, 1, figsize=(7, 4.5))
metricas_nombres = ["tasa_aprobacion", "tpr", "fpr"]
x = np.arange(len(metricas_nombres))
ancho = 0.35
valores_a = [reporte_sin_grupo["A"][m] for m in metricas_nombres]
valores_b = [reporte_sin_grupo["B"][m] for m in metricas_nombres]
ax.bar(x - ancho / 2, valores_a, ancho, label="Grupo A")
ax.bar(x + ancho / 2, valores_b, ancho, label="Grupo B")
ax.set_xticks(x)
ax.set_xticklabels(["Tasa de aprobación", "TPR", "FPR"])
ax.set_title("Métricas de equidad por grupo — clasificador sin columna 'grupo'")
ax.legend()
ax.grid(True, axis="y", alpha=0.3)
plt.tight_layout()
plt.show()

33.7.2 Observación, inferencia y decisión

La tabla anterior cuantifica diferencias bajo una etiqueta histórica sesgada. Una brecha aun sin incluir grupo es compatible con información de grupo contenida en proxies y otras variables. La correlación del código postal ayuda a explicar el mecanismo construido, pero no prueba que sea la única causa en un sistema real. La siguiente intervención retira ese proxy manteniendo particiones y criterio de checkpoint.

33.8 8. ¿Quitar también la variable proxy es suficiente?

escalador_sp=StandardScaler().fit(X_original[idx_train,:2])
X_sin_proxy=escalador_sp.transform(X_original[:,:2]).astype('float32')
X_train_sp,X_val_sp,X_test_sp=X_sin_proxy[idx_train],X_sin_proxy[idx_val],X_sin_proxy[idx_test]
clasificador_sin_proxy=construir_clasificador(2)
hist_sp=entrenar_equidad(clasificador_sin_proxy,X_train_sp,X_val_sp)
pred_sin_proxy=probabilidad(clasificador_sin_proxy,X_test_sp).ravel()
pred_val_sin_proxy=probabilidad(clasificador_sin_proxy,X_val_sp).ravel()
reporte_sin_proxy=metricas_de_equidad(Y_test,pred_sin_proxy,grupo_test)
for g,m in reporte_sin_proxy.items():print(g,m)
razon_impacto_sin_proxy=min(x['tasa_aprobacion'] for x in reporte_sin_proxy.values())/max(x['tasa_aprobacion'] for x in reporte_sin_proxy.values())
print('Razón de impacto sin proxy',razon_impacto_sin_proxy)
lectura_equidad(f'Retirar el proxy cambia razón de impacto de {razon_impacto_sin_grupo:.3f} a {razon_impacto_sin_proxy:.3f}. La diferencia debe leerse con exactitud, TPR y FPR; no demuestra que eliminar variables correlacionadas produzca automáticamente una decisión justa.')
A {'tasa_aprobacion': np.float64(0.3682008368200837), 'tpr': np.float64(0.7209302325581395), 'fpr': np.float64(0.07984790874524715)}
B {'tasa_aprobacion': np.float64(0.30745341614906835), 'tpr': np.float64(0.98), 'fpr': np.float64(0.18382352941176472)}
Razón de impacto sin proxy 0.8350155279503106

33.8.1 Cómo leer este resultado

Retirar el proxy cambia razón de impacto de 0.575 a 0.835. La diferencia debe leerse con exactitud, TPR y FPR; no demuestra que eliminar variables correlacionadas produzca automáticamente una decisión justa.

33.8.2 Qué puede explicar esta intervención

Retirar zip_proxy elimina una ruta de información sobre grupo. Ingreso también tiene distinta distribución entre grupos por construcción; por eso no esperamos independencia automática. Si una brecha se reduce, el experimento apoya una contribución de ese proxy bajo el diseño, no la eliminación de todo sesgo histórico.

33.9 9. Una alternativa: corregir durante el entrenamiento, no después

La sección 8 intentó corregir el sesgo antes de entrenar (quitando variables). La sección 10 lo corrige después de entrenar (ajustando umbrales). Una tercera familia de técnicas corrige durante el entrenamiento: reponderar los ejemplos para que el optimizador le dé más peso a corregir los errores que perjudican al grupo desfavorecido.

pesos_muestra=np.ones(len(Y_train),dtype='float32')
pesos_muestra[(grupo_train=='B')&(Y_train==1)]=3.
clasificador_reponderado=construir_clasificador()
hist_ponderado=entrenar_equidad(clasificador_reponderado,X_train,X_val,pesos_muestra)
pred_reponderado=probabilidad(clasificador_reponderado,X_test).ravel()
pred_val_reponderado=probabilidad(clasificador_reponderado,X_val).ravel()
reporte_reponderado=metricas_de_equidad(Y_test,pred_reponderado,grupo_test)
for g,m in reporte_reponderado.items():print(g,m)
accuracy_reponderado=np.mean((pred_reponderado>.5)==Y_test)
print('Accuracy reponderado',accuracy_reponderado,'baseline',accuracy_original)
lectura_equidad('El peso 3 se fijó antes del experimento. Aumenta el coste relativo de errores sobre positivos históricos de B, pero puede cambiar tanto TPR como FPR. No se ajusta ese peso con la tabla de prueba.')
A {'tasa_aprobacion': np.float64(0.42887029288702927), 'tpr': np.float64(0.8186046511627907), 'fpr': np.float64(0.11026615969581749)}
B {'tasa_aprobacion': np.float64(0.30124223602484473), 'tpr': np.float64(0.98), 'fpr': np.float64(0.17647058823529413)}
Accuracy reponderado 0.85375 baseline 0.87

33.9.1 Cómo leer este resultado

El peso 3 se fijó antes del experimento. Aumenta el coste relativo de errores sobre positivos históricos de B, pero puede cambiar tanto TPR como FPR. No se ajusta ese peso con la tabla de prueba.

33.9.2 Elegir dónde intervenir

Preprocesamiento, reponderación y umbrales actúan en puntos distintos. Reponderar exige reentrenar; un umbral por grupo exige conocer grupo al decidir y evaluar si esa política es admisible en el contexto. Las necesidades de datos, el objetivo y los efectos medidos determinan la elección. Ningún método garantiza mejorar todos los indicadores.

33.10 10. Mitigación por post-procesamiento: umbrales específicos por grupo

def buscar_umbral_para_tpr_objetivo(y_real, y_pred_prob, mascara_grupo, tpr_objetivo):
    candidatos = np.linspace(0.01, 0.99, 99)
    mejor_umbral, mejor_diferencia = 0.5, np.inf
    yr, yp_prob = y_real[mascara_grupo], y_pred_prob[mascara_grupo]
    positivos_reales = yr == 1
    for umbral in candidatos:
        tpr = (yp_prob[positivos_reales] > umbral).mean() if positivos_reales.sum() > 0 else np.nan
        diferencia = abs(tpr - tpr_objetivo)
        if diferencia < mejor_diferencia:
            mejor_diferencia, mejor_umbral = diferencia, umbral
    return mejor_umbral

tpr_objetivo = 0.75  # el TPR que se quiere lograr para AMBOS grupos
umbral_a = buscar_umbral_para_tpr_objetivo(Y_val, pred_val_sin_grupo, grupo_val == "A", tpr_objetivo)
umbral_b = buscar_umbral_para_tpr_objetivo(Y_val, pred_val_sin_grupo, grupo_val == "B", tpr_objetivo)
print(f"Umbral para el grupo A: {umbral_a:.2f}")
print(f"Umbral para el grupo B: {umbral_b:.2f}")

print("Umbrales fijados con validación; prueba no participa en su elección.")
Umbral para el grupo A: 0.56
Umbral para el grupo B: 0.47
Umbrales fijados con validación; prueba no participa en su elección.

33.10.1 Una regla por grupo es una decisión explícita

El ejemplo apunta a TPR=0.75 por grupo en validación, respecto a la etiqueta histórica. No busca paridad de aprobación ni garantiza ese TPR en otra muestra. Usar el grupo al decidir requiere definir propósito, acceso a esa información y contexto de aplicación; el notebook no acredita admisibilidad legal.

y_pred_ajustado = np.where(grupo_test == "A", pred_sin_grupo > umbral_a, pred_sin_grupo > umbral_b).astype(int)

for g in ["A", "B"]:
    mascara = grupo_test == g
    yr, yp = Y_test[mascara], y_pred_ajustado[mascara]
    tasa_aprobacion = yp.mean()
    tpr = yp[yr == 1].mean() if (yr == 1).sum() > 0 else np.nan
    print(f"Grupo {g} (post ajuste): tasa de aprobación={tasa_aprobacion:.3f}  TPR={tpr:.3f}")

accuracy_ajustada = (y_pred_ajustado == Y_test).mean()
accuracy_original = ((pred_sin_grupo > 0.5).astype(int) == Y_test).mean()
print(f"\nAccuracy global ANTES del ajuste: {accuracy_original:.3f}")
print(f"Accuracy global DESPUÉS del ajuste: {accuracy_ajustada:.3f}")
Grupo A (post ajuste): tasa de aprobación=0.374  TPR=0.735
Grupo B (post ajuste): tasa de aprobación=0.258  TPR=0.940

Accuracy global ANTES del ajuste: 0.870
Accuracy global DESPUÉS del ajuste: 0.854

33.10.2 Interpretar el resultado reservado

Compara TPR, tasas de aprobación y exactitud antes y después con los umbrales ya fijados. El TPR de prueba puede apartarse del objetivo por muestreo o cambio de distribución. Si una razón de impacto empeora mientras TPR se acercan, indica que los indicadores responden preguntas diferentes; no demuestra un teorema universal de imposibilidad.

33.11 Exploración de políticas en validación

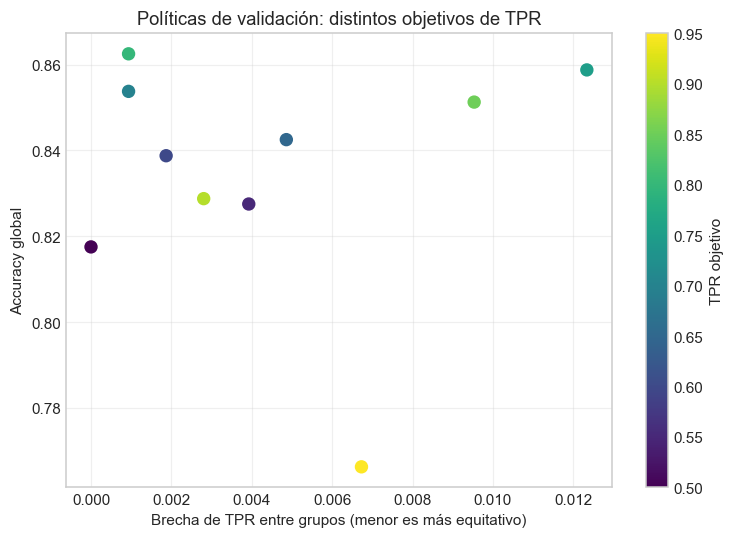
Los puntos siguientes usan datos del caso sintético, no una población real. Cada política se construye y evalúa en validación como parte del diseño. La curva muestra candidatos y su posible frontera no dominada en esta muestra; no prueba que siempre exista un coste de exactitud por reducir brecha. El objetivo TPR=0.75 de la política anterior no cambia después de mirar este dibujo.

objetivos_tpr = np.linspace(0.5, 0.95, 10)
accuracies_resultantes, brechas_resultantes = [], []
for objetivo in objetivos_tpr:
    u_a = buscar_umbral_para_tpr_objetivo(Y_val, pred_val_sin_grupo, grupo_val == "A", objetivo)
    u_b = buscar_umbral_para_tpr_objetivo(Y_val, pred_val_sin_grupo, grupo_val == "B", objetivo)
    pred_ajustada = np.where(grupo_val == "A", pred_val_sin_grupo > u_a, pred_val_sin_grupo > u_b).astype(int)
    accuracies_resultantes.append((pred_ajustada == Y_val).mean())

    tpr_a = pred_ajustada[(grupo_val == "A") & (Y_val == 1)].mean()
    tpr_b = pred_ajustada[(grupo_val == "B") & (Y_val == 1)].mean()
    brechas_resultantes.append(abs(tpr_a - tpr_b))

fig, ax = plt.subplots(1, 1, figsize=(7, 5))
disp = ax.scatter(brechas_resultantes, accuracies_resultantes, c=objetivos_tpr, cmap="viridis", s=60)
ax.set_xlabel("Brecha de TPR entre grupos (menor es más equitativo)")
ax.set_ylabel("Accuracy global")
ax.set_title("Políticas de validación: distintos objetivos de TPR")
plt.colorbar(disp, label="TPR objetivo")
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

33.11.1 Leer el conjunto de candidatos

Un punto domina a otro si no empeora los dos criterios y mejora al menos uno. Se pueden observar puntos dominados y varias políticas con brechas parecidas: eso informa sobre este conjunto finito. No se convierte una nube de candidatos en una ley de intercambio. La selección final usa una regla declarada y se evalúa por separado en prueba.

33.12 Calibración dentro de cada grupo

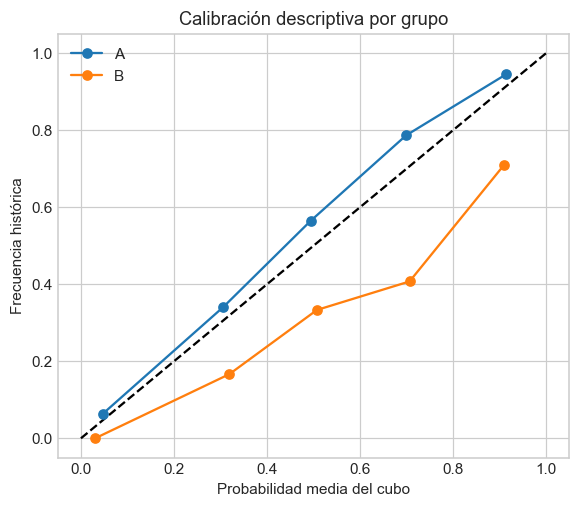
Calibración pregunta si, entre predicciones próximas a s, la frecuencia histórica de Y=1 es próxima a s. Debemos contrastar frecuencia con la probabilidad media real del cubo, no solo su extremo o punto medio, e informar conteos. Un score puede estar calibrado y tener tasas de decisión distintas entre grupos. Esto no implica que calibración y TPR igual por sí solos sean siempre incompatibles; las condiciones del resultado citado se enunciaron al inicio.

filas_cal=[]
for g in ['A','B']:
    for lo,hi in zip(np.linspace(0,1,6)[:-1],np.linspace(0,1,6)[1:]):
        mask=(grupo_test==g)&(pred_sin_grupo>=lo)&((pred_sin_grupo<hi) if hi<1 else pred_sin_grupo<=hi)
        if mask.any():filas_cal.append({'grupo':g,'desde':lo,'hasta':hi,'n':int(mask.sum()),'prob_media':pred_sin_grupo[mask].mean(),'frecuencia_historica':Y_test[mask].mean()})
calibracion=pd.DataFrame(filas_cal);display(calibracion.round(3))
fig,ax=plt.subplots(figsize=(6,5));ax.plot([0,1],[0,1],'k--')
for g,dg in calibracion.groupby('grupo'):ax.plot(dg.prob_media,dg.frecuencia_historica,'o-',label=g)
ax.set(xlabel='Probabilidad media del cubo',ylabel='Frecuencia histórica',title='Calibración descriptiva por grupo');ax.legend();plt.show()
grupo desde hasta n prob_media frecuencia_historica
0 A 0.0 0.2 203 0.047 0.064
1 A 0.2 0.4 41 0.307 0.341
2 A 0.4 0.6 62 0.494 0.565
3 A 0.6 0.8 61 0.699 0.787
4 A 0.8 1.0 111 0.915 0.946
5 B 0.0 0.2 212 0.030 0.000
6 B 0.2 0.4 18 0.319 0.167
7 B 0.4 0.6 27 0.507 0.333
8 B 0.6 0.8 27 0.707 0.407
9 B 0.8 1.0 38 0.910 0.711

33.12.1 Qué sostienen estos cubos

Una separación de la diagonal sugiere desajuste de probabilidades bajo el protocolo. Pocos casos o clases casi ausentes producen estimaciones variables; no demuestran mala calibración en toda la población. Las frecuencias son de aprobación histórica: calibrar contra esa etiqueta puede seguir reproduciendo decisiones sesgadas.

33.13 12. Informe consolidado: comparando las cuatro estrategias de mitigación

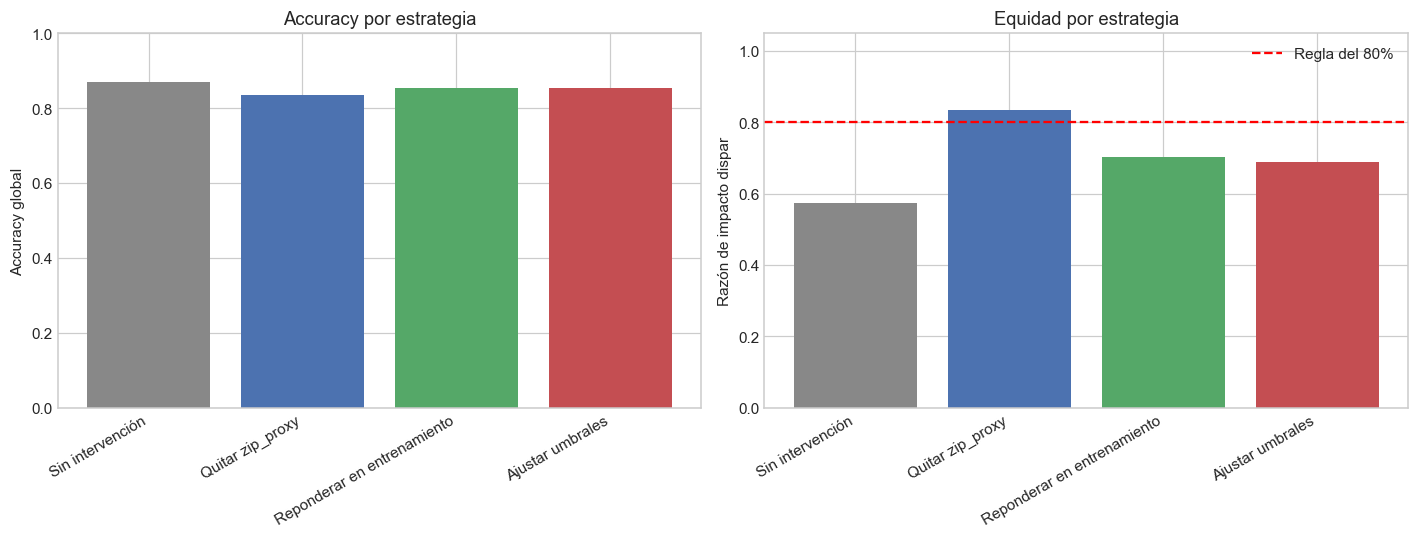
Este capítulo probó cuatro formas distintas de intervenir: no hacer nada especial (sección 7), quitar la variable proxy (sección 8), reponderar durante el entrenamiento (sección 9) y ajustar umbrales después de entrenar (sección 10). Hasta ahora cada una se evaluó por separado — esta sección las pone una al lado de la otra, con las mismas dos métricas, para que la comparación sea directa en vez de tener que recordar números de secciones distintas.

tasa_a_ajustada = y_pred_ajustado[grupo_test == "A"].mean()
tasa_b_ajustada = y_pred_ajustado[grupo_test == "B"].mean()
razon_impacto_ajustada = min(tasa_a_ajustada, tasa_b_ajustada) / max(tasa_a_ajustada, tasa_b_ajustada)

razon_impacto_reponderado = min(reporte_reponderado["A"]["tasa_aprobacion"], reporte_reponderado["B"]["tasa_aprobacion"]) / \
                max(reporte_reponderado["A"]["tasa_aprobacion"], reporte_reponderado["B"]["tasa_aprobacion"])

estrategias = {
    "Sin intervención (sección 7)": (accuracy_original, razon_impacto_sin_grupo),
    "Quitar zip_proxy (sección 8)": (medir_binario(clasificador_sin_proxy,X_test_sp,Y_test)[1], razon_impacto_sin_proxy),
    "Reponderar en entrenamiento (sección 9)": (accuracy_reponderado, razon_impacto_reponderado),
    "Ajustar umbrales (sección 10)": (accuracy_ajustada, razon_impacto_ajustada),
}

print(f"{'Estrategia':<38}{'Accuracy':<12}{'Razón de impacto':<18}{'Regla del 80%'}")
for nombre, (acc, razon) in estrategias.items():
    print(f"{nombre:<38}{acc:<12.3f}{razon:<18.3f}{'PASA' if razon >= 0.8 else 'NO PASA'}")


def resumen_equidad(y,p,g,umbrales=None):
    h=(p>.5).astype(int) if umbrales is None else np.where(g=='A',p>umbrales[0],p>umbrales[1]).astype(int)
    tasas=[h[g==x].mean() for x in ['A','B']]
    return float(np.mean(h==y)),float(min(tasas)/max(tasas)) if max(tasas)>0 else np.nan
estrategias_val={
 'Sin intervención (sección 7)':resumen_equidad(Y_val,pred_val_sin_grupo,grupo_val),
 'Quitar zip_proxy (sección 8)':resumen_equidad(Y_val,pred_val_sin_proxy,grupo_val),
 'Reponderar en entrenamiento (sección 9)':resumen_equidad(Y_val,pred_val_reponderado,grupo_val),
 'Ajustar umbrales (sección 10)':resumen_equidad(Y_val,pred_val_sin_grupo,grupo_val,(umbral_a,umbral_b))}
factibles_val={k:v for k,v in estrategias_val.items() if v[1]>=.8}
seleccion_equidad=max(factibles_val,key=lambda k:factibles_val[k][0]) if factibles_val else max(estrategias_val,key=lambda k:estrategias_val[k][1])
print('SELECCIÓN POR VALIDACIÓN:',seleccion_equidad)
print('Regla prefijada: mayor exactitud con razón >=0.8; si ninguna cumple, mayor razón y declarar incumplimiento.')
Estrategia                            Accuracy    Razón de impacto  Regla del 80%
Sin intervención (sección 7)          0.870       0.575             NO PASA
Quitar zip_proxy (sección 8)          0.835       0.835             PASA
Reponderar en entrenamiento (sección 9)0.854       0.702             NO PASA
Ajustar umbrales (sección 10)         0.854       0.688             NO PASA
SELECCIÓN POR VALIDACIÓN: Quitar zip_proxy (sección 8)
Regla prefijada: mayor exactitud con razón >=0.8; si ninguna cumple, mayor razón y declarar incumplimiento.

33.13.1 Comparar objetivos sin volver a elegir en prueba

La tabla reúne cuatro estrategias prefijadas. La etiqueta «0.8» describe el indicador elegido, no un fallo o cumplimiento legal. Una estrategia con TPR más parecidos puede tener aprobación más desigual porque TPR condiciona a Y=1 y la tasa de aprobación incluye positivos y negativos.

La regla automática utiliza exclusivamente validación: mayor exactitud entre razones ≥0.8; si ninguna cumple, mayor razón y se declara incumplimiento. Prueba informa esa decisión. Mostrar resultados de las demás estrategias es un diagnóstico declarado; no autoriza sustituir la elección por la mejor fila de prueba.

nombres = list(estrategias.keys())
accs = [estrategias[n][0] for n in nombres]
razones = [estrategias[n][1] for n in nombres]

fig, axes = plt.subplots(1, 2, figsize=(13, 5))
colores = ["#888888", "#4C72B0", "#55A868", "#C44E52"]
axes[0].bar(range(len(nombres)), accs, color=colores)
axes[0].set_xticks(range(len(nombres)))
axes[0].set_xticklabels([n.split(" (")[0] for n in nombres], rotation=30, ha="right")
axes[0].set_ylabel("Accuracy global")
axes[0].set_title("Accuracy por estrategia")
axes[0].set_ylim(0, 1)

axes[1].bar(range(len(nombres)), razones, color=colores)
axes[1].axhline(0.8, color="red", linestyle="--", label="Regla del 80%")
axes[1].set_xticks(range(len(nombres)))
axes[1].set_xticklabels([n.split(" (")[0] for n in nombres], rotation=30, ha="right")
axes[1].set_ylabel("Razón de impacto dispar")
axes[1].set_title("Equidad por estrategia")
axes[1].set_ylim(0, 1.05)
axes[1].legend()

plt.tight_layout()
plt.show()

print('Estrategia fijada por validación:',seleccion_equidad)
print('Validación:',estrategias_val[seleccion_equidad])
print('Evaluación final de esa estrategia:',estrategias[seleccion_equidad])
if not factibles_val:print('Ninguna estrategia alcanzó el umbral didáctico en validación; se informa el incumplimiento.')
lectura_equidad(f'La decisión fijada fue **{seleccion_equidad}**. En prueba obtiene exactitud {estrategias[seleccion_equidad][0]:.3f} y razón de impacto {estrategias[seleccion_equidad][1]:.3f}. Estas cifras evalúan la decisión; no participan en elegir otra estrategia. El umbral de validación no garantiza cumplimiento en prueba ni en una aplicación real.')
registro_equidad=pd.DataFrame([{'estrategia':k,'val_accuracy':estrategias_val[k][0],'val_razon':estrategias_val[k][1],'test_accuracy':v[0],'test_razon':v[1],'seleccionada':k==seleccion_equidad} for k,v in estrategias.items()])
registro_equidad.to_csv(ARTEFACTOS/'resultados-equidad.csv',index=False)
pd.DataFrame({'indice':np.r_[idx_train,idx_val,idx_test],'particion':['train']*len(idx_train)+['validation']*len(idx_val)+['test']*len(idx_test)}).to_csv(ARTEFACTOS/'particiones.csv',index=False)
calibracion.to_csv(ARTEFACTOS/'calibracion-grupos.csv',index=False)
Path(ARTEFACTOS/'protocolo.json').write_text(json.dumps({'split':[.6,.2,.2],'seed':42,'stratification':'group and historical label','scaler':'train only','checkpoint':'minimum validation loss','target_tpr':.75,'threshold_data':'validation only','thresholds':[float(umbral_a),float(umbral_b)],'selection':seleccion_equidad,'target':'historical approval, not normative merit','torch':str(torch.__version__)},indent=2),encoding='utf-8')
Estrategia fijada por validación: Quitar zip_proxy (sección 8)
Validación: (0.84875, 0.653517668410377)
Evaluación final de esa estrategia: (0.835, np.float64(0.8350155279503106))
Ninguna estrategia alcanzó el umbral didáctico en validación; se informa el incumplimiento.

33.13.2 Cómo leer este resultado

La decisión fijada fue Quitar zip_proxy (sección 8). En prueba obtiene exactitud 0.835 y razón de impacto 0.835. Estas cifras evalúan la decisión; no participan en elegir otra estrategia. El umbral de validación no garantiza cumplimiento en prueba ni en una aplicación real.

430

33.13.3 Qué decisión contiene la regla

Priorizar exactitud sujeto a una razón mínima es una decisión de diseño. Otra política podría priorizar TPR, falsos positivos o un coste explícito. El criterio debe registrarse antes de evaluar prueba, junto con qué significa la etiqueta y qué información de grupo está disponible. Elegir automáticamente no elimina esa responsabilidad.

33.14 13. Casos documentados en sistemas reales

Tres ejemplos públicos y bien documentados, para anclar este capítulo más allá de los datos sintéticos. COMPAS (herramienta de evaluación de riesgo de reincidencia usada en el sistema judicial de EE.UU.): una investigación de ProPublica (Angwin et al., 2016) encontró que el sistema marcaba a acusados negros como “alto riesgo” a una tasa de falsos positivos casi el doble que a acusados blancos, con accuracy global similar entre ambos grupos — precisión global parecida y FPR muy distinto es exactamente el tipo de brecha que la sección 7 midió en miniatura. Gender Shades (Buolamwini y Gebru, 2018): sistemas comerciales de clasificación de género percibido en rostros con menos del 1% de error en hombres de piel clara llegaban a más del 30% de error en mujeres de piel oscura — una brecha de exactitud por subgrupo; estos resultados no identifican por sí solos una única causa de entrenamiento. Contratación algorítmica en Amazon (Dastin, 2018): un sistema interno de selección de currículums, entrenado sobre una década de contrataciones históricamente dominadas por hombres en roles técnicos, aprendió a penalizar currículums que mencionaban actividades o instituciones asociadas a mujeres — el mismo mecanismo de “aprender el sesgo histórico de los datos de entrenamiento” que la sección 5 de este capítulo construyó a propósito.

33.15 14. Riesgos específicos de los modelos generativos y los LLM de este libro

Deepfakes y desinformación: las mismas técnicas de Redes generativas (GAN) y Modelos de difusión que aquí se estudian con presupuestos pequeños, también sustentan sistemas capaces de sintetizar rostros, voces y videos con apariencia realista — con usos legítimos (efectos visuales, datos sintéticos de entrenamiento) y usos dañinos documentados (suplantación, pornografía no consentida, desinformación política).

Errores factuales en modelos de lenguaje: un generador de texto puede producir afirmaciones falsas y citas inexistentes aunque la salida sea fluida. Recuperar documentos externos puede aportar evidencia, pero no garantiza que el modelo la use correctamente. Estos riesgos deben medirse en su contexto; el desarrollo especializado de prompting y RAG corresponde al futuro libro de NLP. Aquí se mantienen las bases compartidas de Atención y transformers.

Sesgo heredado en el preentrenamiento: Aprendizaje autosupervisado y contrastivo mostró que preentrenar sin etiquetas humanas organiza las representaciones según patrones estadísticos de los datos — si esos datos sobrerrepresentan ciertos grupos, idiomas o perspectivas, el modelo preentrenado hereda ese desbalance antes de que nadie haga fine-tuning con una sola etiqueta, un riesgo que requiere evaluación propia; el caso sintético de crédito no demuestra los efectos de un preentrenamiento real.

33.15.1 Observación · inferencia · decisión

Observación: los tres riesgos anteriores no son fallas de una implementación específica — son consecuencias directas y esperables de cómo funciona cada técnica. Inferencia: “arreglar” estos riesgos con un parche posterior (un filtro de contenido, una capa de moderación) atiende los síntomas más visibles, pero no cambia que el mecanismo generador siga siendo capaz de producir el mismo problema de otra forma. Decisión: cualquier sistema construido sobre estas técnicas necesita, desde el diseño, una evaluación explícita de estos riesgos — no como un paso de cumplimiento al final, sino como parte de decidir si el sistema debe construirse así, o siquiera construirse.

33.16 15. Amenazas a la validez

El sesgo de este capítulo se inyectó deliberadamente y de forma simple (una sola variable, un solo mecanismo causal) para poder mostrarlo con total claridad — el sesgo en sistemas reales suele ser multicausal, parcialmente oculto, y mucho más difícil de aislar que en esta simulación. La elección de métricas también importa: este capítulo midió paridad demográfica, igualdad de oportunidad y razón de impacto dispar porque son las más citadas en la literatura, pero ninguna es universalmente “la correcta” — distintas aplicaciones, marcos legales y valores llevan a priorizar métricas distintas, y ese es, otra vez, un punto de decisión humana, no algo que el código pueda resolver por sí solo.

33.17 Continuidad con operación

Las métricas por subgrupo amplían la evaluación de modelos, y la trazabilidad de decisiones prepara MLOps. Los riesgos de generación se conectan con GAN, difusión y audio. No se presupone haber leído un capítulo especializado de NLP fuera de este libro.

33.17.1 Reto técnico

Construye un tercer dataset sintético donde el sesgo histórico afecte a anios_educacion en vez de aparecer como una penalización directa en la etiqueta (por ejemplo, el grupo B tuvo sistemáticamente menos acceso a educación en generaciones anteriores). ¿Cómo cambia la sección 8 — “quitar la variable proxy” — cuando el sesgo está incrustado en una variable que el modelo necesita para funcionar en absoluto?

33.18 17. Ejercicios

  1. Cambia tpr_objetivo en la sección 10 a 0.9 y recalcule la caída de accuracy — ¿la relación entre ambas es lineal o se acelera cerca de los extremos?
  2. Agrega una tercera categoría a grupo (por ejemplo “C”) con su propio sesgo histórico y extienda metricas_de_equidad para reportar las tres — ¿la razón de impacto dispar, definida como mínimo entre máximo, sigue siendo la forma más informativa de resumir tres grupos?
  3. Entrena el clasificador de la sección 6 incluyendo grupo explícitamente como feature y compare su razón de impacto dispar contra la versión que lo excluye — ¿incluir el atributo protegido explícitamente, para luego corregirlo de forma consciente, puede dar mejores resultados de equidad que excluirlo y no corregir nada?

33.19 Referencias mínimas

33.20 Cierre

Un promedio de exactitud puede ocultar consecuencias distintas por grupo. La evaluación exige definir etiqueta, indicador de equidad y procedimiento de elección. En el simulador observamos decisiones históricas sesgadas; medirlas no identifica automáticamente una política justa. Antes de desplegar habría que revisar objetivo, datos y contexto de uso, y conservar el registro de cómo se eligió cada intervención.

33.20.1 Lectura de la ejecución registrada

Ejecución CPU del 15 de octubre de 2026.

Las tres MLP se ejecutaron con logits y BCE estable; sus checkpoints y escaladores se guardaron y las recargas se comprobaron sobre validación. Se conservaron el simulador, las particiones 60/20/20, las cuatro políticas y la ponderación 3 para positivos históricos de B.

Ninguna política alcanzó razón 0,8 en validación. La regla prefijada eligió quitar el proxy, con razón de validación 0,6535; en prueba obtuvo exactitud 0,835 y razón 0,8350. Que la muestra de prueba supere 0,8 no cambia el incumplimiento del criterio en validación ni acredita equidad o cumplimiento legal. La referencia sin intervención tuvo mayor exactitud de prueba (0,870), pero razón 0,5749. Los umbrales orientados a TPR no maximizaron paridad de aprobación. Estos resultados evalúan etiquetas históricas sesgadas, no mérito normativo. Se añadieron curvas reales de entrenamiento, separadas de la ilustración fabricada.

for nombre,m,xx,h in [('sin-grupo',clasificador_sin_grupo,X_val,hist_sin_grupo),('sin-proxy',clasificador_sin_proxy,X_val_sp,hist_sp),('ponderado',clasificador_reponderado,X_val,hist_ponderado)]:
    pd.DataFrame(h.history).to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    torch.save({'state_dict':{k:v.detach().cpu() for k,v in m.state_dict().items()},'entradas':int(xx.shape[1])},ARTEFACTOS/f'{nombre}.pt')
    recarga=construir_clasificador(xx.shape[1]);recarga.load_state_dict(torch.load(ARTEFACTOS/f'{nombre}.pt',map_location=DEVICE,weights_only=True)['state_dict'])
    np.testing.assert_allclose(probabilidad(m,xx[:32]),probabilidad(recarga,xx[:32]),rtol=1e-5,atol=1e-6)
np.savez(ARTEFACTOS/'escaladores.npz',media=escalador.mean_,escala=escalador.scale_,media_sin_proxy=escalador_sp.mean_,escala_sin_proxy=escalador_sp.scale_)
fig,axes=plt.subplots(1,3,figsize=(12,3.5))
for ax,(nombre,h) in zip(axes,[('Sin grupo',hist_sin_grupo),('Sin proxy',hist_sp),('Reponderado',hist_ponderado)]):
    ep=np.arange(1,len(h.history['loss'])+1);ax.plot(ep,h.history['loss'],label='Train eval');ax.plot(ep,h.history['val_loss'],label='Val');ax.set(title=nombre,xlabel='Época',ylabel='BCE no ponderada');ax.legend(fontsize=8)
fig.tight_layout();plt.show();print('Tres recargas verificadas sobre validación; escaladores conservados.')

Tres recargas verificadas sobre validación; escaladores conservados.