En supervisado observamos ejemplos con respuesta; en refuerzo un agente elige acciones y recibe recompensas que pueden llegar después. Sus decisiones cambian los datos que recogerá. Aprender una política exige distinguir objetivo, exploración, dinámica y evaluación.
Empezaremos con bandidos, resolveremos un mapa con modelo conocido y compararemos Q-learning con DQN. Implementaremos REINFORCE y actor–critic en un segundo entorno con recompensa retrasada. Finalmente analizaremos cómo una recompensa defectuosa favorece una conducta equivocada. Los problemas pequeños permiten auditar sin atribuir éxitos al tamaño de una red.
Los entornos son locales, educativos, sin Gymnasium ni descargas. Se utilizan NumPy, pandas, Matplotlib y PyTorch en CPU. Continúa Optimización, Evaluación y Recomendación.
31.1 Estados, acciones, recompensas y políticas
Un proceso de decisión de Markov se describe mediante \((\mathcal S,\mathcal A,P,r,\gamma)\). Un estado suficiente permite predecir siguiente estado y recompensa dados estado y acción. Una observación parcial no necesariamente cumple esta propiedad. La política \(\pi(a|s)\) selecciona acciones; puede ser determinista o una distribución.
La recompensa pertenece al problema y la pérdida ajusta parámetros. Pérdida TD pequeña no implica recompensa alta. El descuento γ no es la tasa de aprendizaje. Optimizar retorno puede empeorar el propósito real si la recompensa lo representa mal.
Elemento
Pregunta práctica
Observación
¿Qué información conoce al decidir?
Acción
¿Qué opciones permite el sistema?
Recompensa
¿Qué conductas incentiva?
Episodio
¿Cuándo termina realmente la tarea?
Exploración
¿Cómo obtiene información de acciones poco probadas?
Evaluación
¿Qué sucede sin exploración y con semillas reservadas?
import numpy as npimport sklearnimport json, copy, platformfrom pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom IPython.display import display, Markdownimport torchfrom torch import nnimport torch.nn.functional as Ftorch.set_num_threads(1)torch.manual_seed(42)plt.rcParams.update({'figure.figsize':(9,4),'font.size':11,'axes.spines.top':False,'axes.spines.right':False})def lectura(s):display(Markdown('### Cómo leer este resultado\n\n'+s))print('Python',platform.python_version(),'| NumPy',np.__version__,'| PyTorch',torch.__version__,'| CPU')
Python 3.13.9 | NumPy 2.3.5 | PyTorch 2.14.1+cpu | CPU
31.2 Exploración y explotación: bandidos
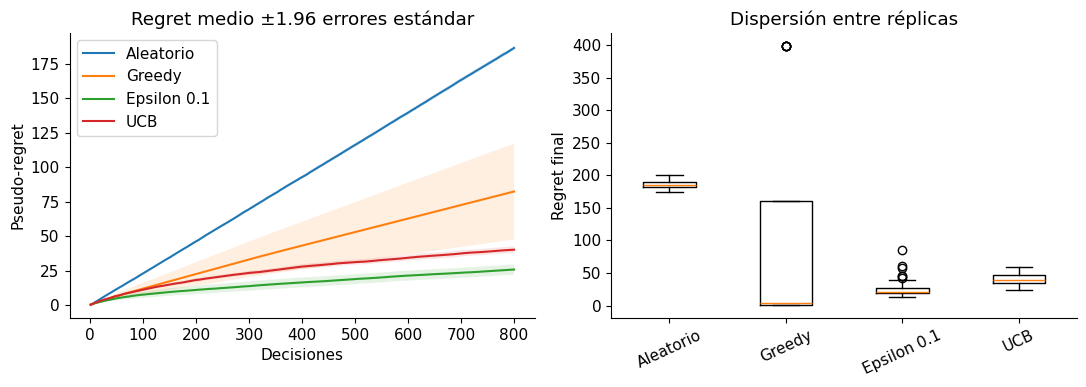
Tres brazos entregan recompensa Bernoulli con probabilidades 0.2, 0.5 y 0.7. No hay estados sucesivos: aislamos exploración. Comparamos aleatorio, greedy con una muestra inicial por brazo, ε-greedy con ε=0.1 y UCB con radio √(2 log(t)/n).
Son 50 réplicas de 800 decisiones. El pseudo-regret acumula diferencia entre la media del mejor brazo y la del elegido. Se puede calcular porque el simulador conoce las probabilidades; en aplicaciones son desconocidas. No equivale a restar recompensas observadas, que son ruidosas.
means=np.array([.2,.5,.7]);bandit_curves={};bandit_rows=[]for method in ['Aleatorio','Greedy','Epsilon 0.1','UCB']: regrets=[];rewards=[]for seed inrange(50): gen=np.random.default_rng(3100+seed);q=np.zeros(3);n=np.zeros(3);reg=[];rew=[]for t inrange(800):if method=='Aleatorio':a=int(gen.integers(3))elif t<3:a=telif method=='Epsilon 0.1'and gen.random()<.1:a=int(gen.integers(3))elif method=='UCB':a=int(np.argmax(q+np.sqrt(2*np.log(t+1)/np.maximum(n,1))))else:a=int(np.argmax(q)) r=float(gen.random()<means[a]);n[a]+=1;q[a]+=(r-q[a])/n[a];reg.append(means.max()-means[a]);rew.append(r) regrets.append(np.cumsum(reg));rewards.append(np.mean(rew)) arr=np.array(regrets);bandit_curves[method]=arr bandit_rows.append({'method':method,'reward_mean':np.mean(rewards),'reward_std':np.std(rewards,ddof=1),'regret_mean':arr[:,-1].mean(),'regret_std':arr[:,-1].std(ddof=1)})bandit_results=pd.DataFrame(bandit_rows).set_index('method');display(bandit_results.round(3))fig,ax=plt.subplots(1,2,figsize=(11,4))for method,arr in bandit_curves.items(): mu=arr.mean(0);se=arr.std(0,ddof=1)/np.sqrt(50);x=np.arange(1,801);ax[0].plot(x,mu,label=method);ax[0].fill_between(x,mu-1.96*se,mu+1.96*se,alpha=.12)ax[0].set(title='Regret medio ±1.96 errores estándar',xlabel='Decisiones',ylabel='Pseudo-regret');ax[0].legend()ax[1].boxplot([x[:,-1] for x in bandit_curves.values()],tick_labels=list(bandit_curves));ax[1].tick_params(axis='x',rotation=25);ax[1].set(title='Dispersión entre réplicas',ylabel='Regret final');plt.tight_layout();plt.show()lectura(f'Regret medio greedy {bandit_results.loc["Greedy","regret_mean"]:.1f}; ε-greedy {bandit_results.loc["Epsilon 0.1","regret_mean"]:.1f}; UCB {bandit_results.loc["UCB","regret_mean"]:.1f}. Explorar cuesta recompensa inmediata, pero evita depender de las primeras muestras. La banda estima incertidumbre de la media; el boxplot muestra dispersión de ejecuciones. No son la misma magnitud.')
reward_mean
reward_std
regret_mean
regret_std
method
Aleatorio
0.465
0.023
186.490
5.684
Greedy
0.597
0.157
82.474
125.604
Epsilon 0.1
0.668
0.022
25.922
13.312
UCB
0.651
0.024
40.292
8.551
31.2.1 Cómo leer este resultado
Regret medio greedy 82.5; ε-greedy 25.9; UCB 40.3. Explorar cuesta recompensa inmediata, pero evita depender de las primeras muestras. La banda estima incertidumbre de la media; el boxplot muestra dispersión de ejecuciones. No son la misma magnitud.
31.3 Un entorno secuencial auditable
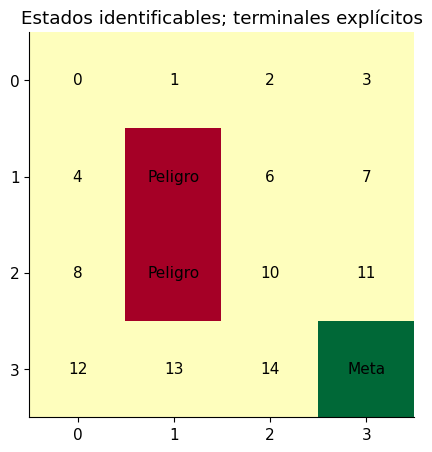
Cuadrícula 4×4, meta en (3,3) y peligros terminales en (1,1) y (2,1). Acciones: arriba, derecha, abajo e izquierda. Chocar con el borde mantiene posición. Paso normal: −0.03; peligro: −1; meta: +1. No se añade otra penalización al paso terminal. Descuento: 0.95.
Entrenamiento usa transiciones deterministas y comienzos uniformes en casillas seguras. Validación comienza en estados 0, 4 y 8; prueba en los diez restantes. Todos pueden visitarse al entrenar: la separación evalúa comienzos reservados, no estados nunca observados. Una segunda prueba prefijada sustituye acciones por una acción aleatoria el 15% de las veces.
El límite de 40 pasos trunca recolección; no es terminal de la tarea. Q-learning y DQN mantienen bootstrap al truncar y lo eliminan al entrar a meta o peligro. Si el límite perteneciera al objetivo, habría que representar tiempo restante y tratar ese final de otra manera.
GAMMA=.95;GOAL=15;HAZARDS={5,9};SAFE=[s for s inrange(16) if s notin HAZARDS|{GOAL}]VAL=[0,4,8];TEST=[s for s in SAFE if s notin VAL];DIR=[(-1,0),(0,1),(1,0),(0,-1)]def transition(s,a):if s in HAZARDS|{GOAL}:return s,0.,True row,col=divmod(int(s),4);dr,dc=DIR[int(a)];row=int(np.clip(row+dr,0,3));col=int(np.clip(col+dc,0,3));n=4*row+colreturn n,1.if n==GOAL else-1.if n in HAZARDS else-.03,n in HAZARDS|{GOAL}class Grid:def__init__(self,seed=0,slip=0):self.rng=np.random.default_rng(seed);self.slip=slipdef reset(self,start=None):self.s=int(self.rng.choice(SAFE) if start isNoneelse start);self.steps=0;returnself.sdef step(self,action):ifself.rng.random()<self.slip:action=int(self.rng.integers(4))self.s,r,terminal=transition(self.s,action);self.steps+=1returnself.s,r,terminal,self.steps>=40andnot terminalassert transition(0,0)==(0,-.03,False)assert transition(4,1)==(5,-1.,True)assert transition(14,1)==(15,1.,True)env=Grid();env.reset(0)for _ inrange(40):_,_,term,trunc=env.step(0)assert trunc andnot termfig,ax=plt.subplots(figsize=(5,5));image=np.zeros((4,4));image[3,3]=1for s in HAZARDS:image[divmod(s,4)]=-1ax.imshow(image,cmap='RdYlGn',vmin=-1,vmax=1)for s inrange(16): r,col=divmod(s,4);ax.text(col,r,'Meta'if s==GOAL else'Peligro'if s in HAZARDS elsestr(s),ha='center',va='center')ax.set(xticks=range(4),yticks=range(4),title='Estados identificables; terminales explícitos');plt.show()print('Comienzos validación:',VAL,'| prueba:',TEST)
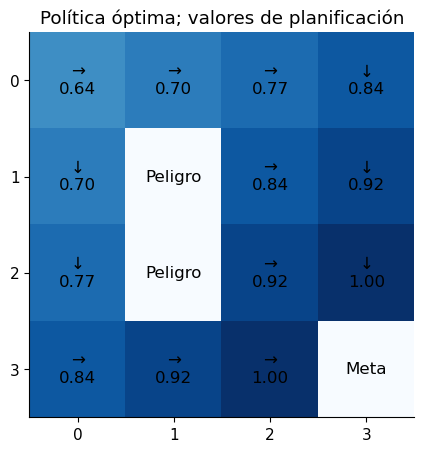
Aquí \(d=1\) solo para terminal verdadero. Iteramos Bellman; terminales conservan cero porque su recompensa se obtiene al entrar. En un MDP finito con recompensas acotadas y γ<1 el operador es contractivo. La solución será referencia verificable; no se entrega como etiqueta de entrenamiento.
v=np.zeros(16);residuals=[]for iteration inrange(300): q_star=np.zeros((16,4))for s in SAFE:for a inrange(4): n,r,done=transition(s,a);q_star[s,a]=r+GAMMA*(not done)*v[n] new=q_star.max(1);res=np.max(np.abs(new-v));residuals.append(res);v=newif res<1e-10:breakoptimal=q_star.argmax(1)def show_policy(policy,title): fig,ax=plt.subplots(figsize=(5,5));ax.imshow(v.reshape(4,4),cmap='Blues');symbols=['↑','→','↓','←']for s inrange(16): r,col=divmod(s,4);label='Meta'if s==GOAL else'Peligro'if s in HAZARDS else symbols[int(policy[s])]+f'\n{v[s]:.2f}' ax.text(col,r,label,ha='center',va='center',fontsize=12) ax.set(title=title,xticks=range(4),yticks=range(4));plt.show()def evaluate_policy(policy,starts,slip=0,seed=9000,repeats=1): env=Grid(seed,slip);rows=[]for repeat inrange(repeats):for start in starts: s=env.reset(start);ret=disc=0.;end='truncado'for t inrange(40): a=int(env.rng.integers(4)) if policy isNoneelseint(policy[s]);s,r,term,trunc=env.step(a);ret+=r;disc+=GAMMA**t*rif term or trunc:end='meta'if s==GOAL else'peligro'if s in HAZARDS else'truncado';break rows.append({'start':start,'return':ret,'discounted_return':disc,'success':end=='meta','hazard':end=='peligro','truncated':end=='truncado','steps':t+1})return pd.DataFrame(rows)show_policy(optimal,'Política óptima; valores de planificación')oracle=evaluate_policy(optimal,TEST);display(oracle)assert np.allclose(oracle.discounted_return,[v[s] for s in TEST])lectura(f'Bellman termina en {len(residuals)} iteraciones con residuo {residuals[-1]:.2g}. La referencia llega a meta desde todos los comienzos de prueba; retorno descontado medio {oracle.discounted_return.mean():.3f}. Es un techo para la dinámica original, no un resultado de aprendizaje: utilizamos el modelo completo.')
start
return
discounted_return
success
hazard
truncated
steps
0
1
0.88
0.70321
True
False
False
5
1
2
0.91
0.77180
True
False
False
4
2
3
0.94
0.84400
True
False
False
3
3
6
0.94
0.84400
True
False
False
3
4
7
0.97
0.92000
True
False
False
2
5
10
0.97
0.92000
True
False
False
2
6
11
1.00
1.00000
True
False
False
1
7
12
0.94
0.84400
True
False
False
3
8
13
0.97
0.92000
True
False
False
2
9
14
1.00
1.00000
True
False
False
1
31.4.1 Cómo leer este resultado
Bellman termina en 7 iteraciones con residuo 0. La referencia llega a meta desde todos los comienzos de prueba; retorno descontado medio 0.877. Es un techo para la dinámica original, no un resultado de aprendizaje: utilizamos el modelo completo.
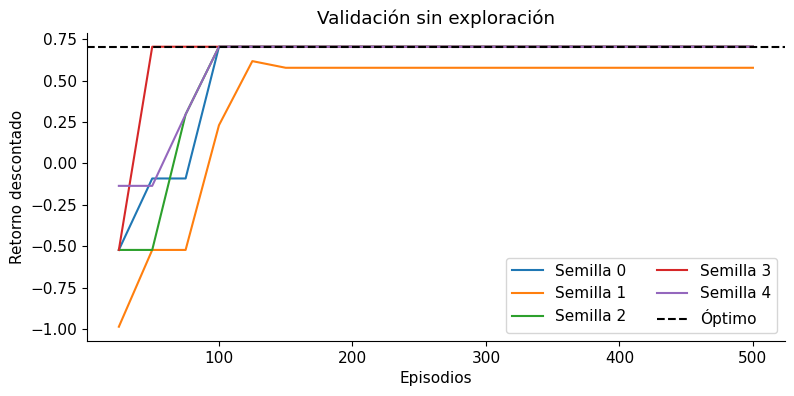
El target es greedy mientras el comportamiento es ε-greedy: Q-learning es off-policy. Usamos α=0.15, ε que baja desde 0.9 hasta 0.05 durante 300 episodios, 500 episodios por semilla y cinco semillas prefijadas. Una tabla de 64 números basta para representar este problema.
Cada 25 episodios evaluamos retorno descontado medio en los tres comienzos de validación, sin exploración. El checkpoint de mayor retorno se conserva; en empates, el primero. Prueba no elige épocas ni semillas. Un presupuesto finito no garantiza convergencia.
q_models=[];q_rows=[];check_rows=[]for seed inrange(5): gen=np.random.default_rng(3200+seed);env=Grid(3300+seed);q=np.zeros((16,4));best=-np.inffor ep inrange(1,501): s=env.reset();eps=max(.05,.9*(1-ep/300))for t inrange(40): a=int(gen.integers(4)) if gen.random()<eps elseint(np.argmax(q[s]+gen.uniform(0,1e-8,4))) n,r,term,trunc=env.step(a);y=r+GAMMA*(not term)*q[n].max();q[s,a]+=.15*(y-q[s,a]);s=nif term or trunc:breakif ep%25==0: val=evaluate_policy(q.argmax(1),VAL).discounted_return.mean();q_rows.append({'method':'Q-learning','seed':seed,'episode':ep,'validation_return':val})if val>best:best=val;saved=q.copy();best_ep=ep q_models.append(saved);check_rows.append({'method':'Q-learning','seed':seed,'episode':best_ep,'validation_return':best})q_curve=pd.DataFrame(q_rows);fig,ax=plt.subplots()for seed,g in q_curve.groupby('seed'):ax.plot(g.episode,g.validation_return,label=f'Semilla {seed}')ax.axhline(v[VAL].mean(),color='black',ls='--',label='Óptimo');ax.set(title='Validación sin exploración',xlabel='Episodios',ylabel='Retorno descontado');ax.legend(ncol=2);plt.show()lectura('Estas curvas no son recompensas de entrenamiento: miden la política greedy. Escalones o caídas pueden corresponder a cambiar una acción decisiva. Conservamos las cinco ejecuciones, incluyendo las inferiores; no seleccionamos una semilla mediante prueba.')
31.5.1 Cómo leer este resultado
Estas curvas no son recompensas de entrenamiento: miden la política greedy. Escalones o caídas pueden corresponder a cambiar una acción decisiva. Conservamos las cinco ejecuciones, incluyendo las inferiores; no seleccionamos una semilla mediante prueba.
31.6 DQN: aproximar valores con una red
DQN utiliza \(Q_\theta(s,a)\). Entrada one-hot de 16 posiciones, capa de 32 unidades y cuatro salidas. El estado no es una imagen ni se demuestra generalización a otro mapa: one-hot identifica estados del entorno.
Replay guarda transiciones y reduce correlación temporal al muestrear minibatches. Una red target se copia cada 100 actualizaciones:
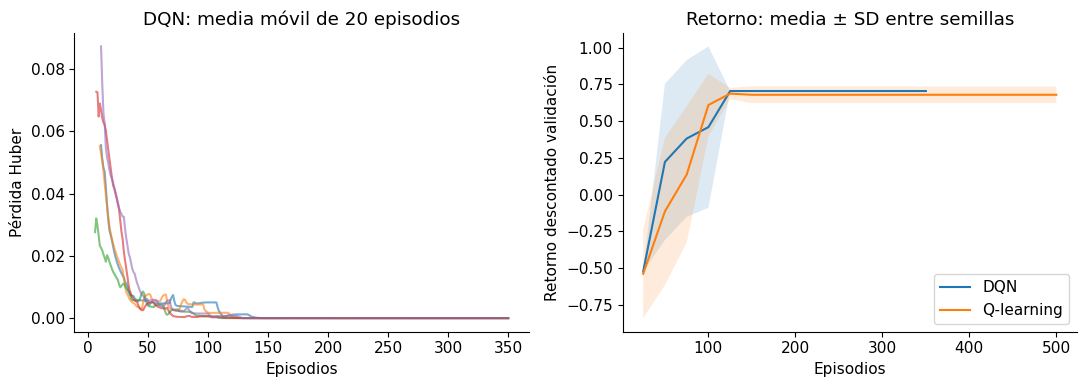
El target no recibe gradientes. Bootstrap tras truncación utiliza estado final real, no el siguiente reset. Configuración: 350 episodios por semilla, buffer 5000, batch 64, Adam 0.003, clip de norma 5. Q-learning tiene otro presupuesto; la comparación no establece eficiencia muestral superior.
Código
from collections import dequeclass QNet(nn.Module):def__init__(self):super().__init__();self.net=nn.Sequential(nn.Linear(16,32),nn.ReLU(),nn.Linear(32,4))def forward(self,s):returnself.net(F.one_hot(s.long(),16).float())def net_policy(model): model.eval()with torch.no_grad():return model(torch.arange(16)).argmax(1).numpy()dqn_models=[];dqn_rows=[];td_rows=[]for seed inrange(5): torch.manual_seed(3400+seed);gen=np.random.default_rng(3500+seed);env=Grid(3600+seed) model=QNet();target_net=copy.deepcopy(model);opt=torch.optim.Adam(model.parameters(),lr=.003);buffer=deque(maxlen=5000);updates=0;best=-np.inffor ep inrange(1,351): s=env.reset();eps=max(.05,.9*(1-ep/250));losses=[]for t inrange(40):with torch.no_grad():greedy=int(model(torch.tensor([s])).argmax()) a=int(gen.integers(4)) if gen.random()<eps else greedy;n,r,term,trunc=env.step(a);buffer.append((s,a,r,n,float(term)))iflen(buffer)>=64: batch=np.array([buffer[j] for j in gen.choice(len(buffer),64,replace=False)]) ss=torch.tensor(batch[:,0],dtype=torch.long);aa=torch.tensor(batch[:,1],dtype=torch.long);rr=torch.tensor(batch[:,2],dtype=torch.float32);ns=torch.tensor(batch[:,3],dtype=torch.long);done=torch.tensor(batch[:,4],dtype=torch.float32)with torch.no_grad():y=rr+GAMMA*(1-done)*target_net(ns).max(1).values pred=model(ss).gather(1,aa[:,None]).squeeze(1);loss=F.smooth_l1_loss(pred,y);opt.zero_grad();loss.backward();nn.utils.clip_grad_norm_(model.parameters(),5);opt.step();updates+=1;losses.append(loss.item())if updates%100==0:target_net.load_state_dict(model.state_dict()) s=nif term or trunc:break td_rows.append({'seed':seed,'episode':ep,'loss':np.mean(losses) if losses else np.nan})if ep%25==0: val=evaluate_policy(net_policy(model),VAL).discounted_return.mean();dqn_rows.append({'method':'DQN','seed':seed,'episode':ep,'validation_return':val})if val>best:best=val;state=copy.deepcopy(model.state_dict());best_ep=ep model.load_state_dict(state);dqn_models.append(model);check_rows.append({'method':'DQN','seed':seed,'episode':best_ep,'validation_return':best})print(f'DQN semilla {seed}: checkpoint {best_ep}, retorno validación {best:.3f}')assert np.isclose(-.03+GAMMA*.8,.73)print('Target si se trunca: 0.73; si termina la tarea: -0.03.')
Una red puede ajustar targets frecuentes y elegir mal en un estado decisivo. Mostramos pérdida TD y retorno de validación por separado. Suavizar una sola ejecución no convierte esa curva en evidencia de estabilidad.
dqn_curve=pd.DataFrame(dqn_rows);td=pd.DataFrame(td_rows);checkpoints=pd.DataFrame(check_rows)fig,ax=plt.subplots(1,2,figsize=(11,4))for seed,g in td.groupby('seed'):ax[0].plot(g.episode,g.loss.rolling(20,min_periods=1).mean(),alpha=.6)for method,g in pd.concat([q_curve,dqn_curve]).groupby('method'): st=g.groupby('episode').validation_return.agg(['mean','std']);ax[1].plot(st.index,st['mean'],label=method);ax[1].fill_between(st.index,st['mean']-st['std'],st['mean']+st['std'],alpha=.15)ax[0].set(title='DQN: media móvil de 20 episodios',xlabel='Episodios',ylabel='Pérdida Huber');ax[1].set(title='Retorno: media ± SD entre semillas',xlabel='Episodios',ylabel='Retorno descontado validación');ax[1].legend();plt.tight_layout();plt.show();display(checkpoints.round(3))lectura('La media móvil ayuda a leer tendencia; no expresa incertidumbre. La banda de retorno es desviación entre cinco semillas y puede salir de límites posibles: no es intervalo de confianza. Elegimos checkpoints individualmente por validación; ninguna semilla se descarta ni se escoge en prueba.')
method
seed
episode
validation_return
0
Q-learning
0
100
0.704
1
Q-learning
1
125
0.617
2
Q-learning
2
100
0.704
3
Q-learning
3
50
0.704
4
Q-learning
4
100
0.704
5
DQN
0
50
0.704
6
DQN
1
75
0.704
7
DQN
2
100
0.704
8
DQN
3
75
0.704
9
DQN
4
50
0.704
31.6.2 Cómo leer este resultado
La media móvil ayuda a leer tendencia; no expresa incertidumbre. La banda de retorno es desviación entre cinco semillas y puede salir de límites posibles: no es intervalo de confianza. Elegimos checkpoints individualmente por validación; ninguna semilla se descarta ni se escoge en prueba.
31.7 Prueba y cambio de dinámica
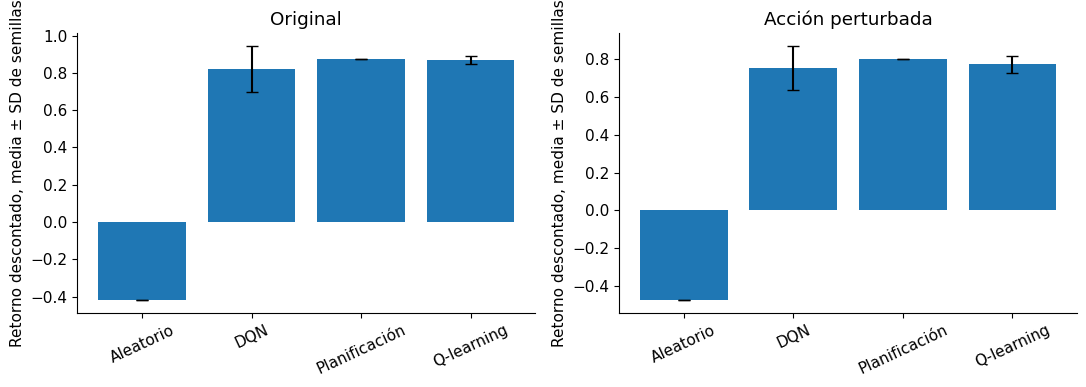
Cada checkpoint se evalúa en diez comienzos reservados. Con una política determinista en la dinámica original basta una trayectoria por comienzo; repetirla no añade información. La política aleatoria requiere 20 repeticiones incluso en esa dinámica. Para perturbación usamos 20 repeticiones por comienzo y semillas ambientales ajenas al entrenamiento. Una sustitución aleatoria puede coincidir con la acción original.
Se reportan retorno descontado, éxito, peligros y truncaciones. La referencia óptima se calculó para la dinámica original: no afirmamos que siga siendo óptima tras perturbarla. Aleatorio y planificación son una política cada uno, no cinco semillas entrenadas.
eval_rows=[];trajectories=[]policies={'Q-learning':[x.argmax(1) for x in q_models],'DQN':[net_policy(x) for x in dqn_models],'Planificación':[optimal],'Aleatorio':[None]}for method,collection in policies.items():for seed,policy inenumerate(collection):for scenario,slip,repeats in [('Original',0,1),('Acción perturbada',.15,20)]: detail=evaluate_policy(policy,TEST,slip,10000+seed,20if policy isNoneelse repeats);eval_rows.append({'method':method,'seed':seed,'scenario':scenario,**detail.drop(columns='start').mean().to_dict()});trajectories.append(detail.assign(method=method,seed=seed,scenario=scenario))rl_results=pd.DataFrame(eval_rows)aggregate=rl_results.groupby(['scenario','method']).agg(return_mean=('discounted_return','mean'),return_std=('discounted_return','std'),success=('success','mean'),hazard=('hazard','mean'),truncated=('truncated','mean'))display(aggregate.round(3));fig,ax=plt.subplots(1,2,figsize=(11,4))for j,scenario inenumerate(['Original','Acción perturbada']): g=rl_results[rl_results.scenario==scenario].groupby('method').agg(mu=('discounted_return','mean'),sd=('discounted_return','std')) ax[j].bar(g.index,g.mu,yerr=g.sd.fillna(0),capsize=4);ax[j].tick_params(axis='x',rotation=25);ax[j].set(title=scenario,ylabel='Retorno descontado, media ± SD de semillas')plt.tight_layout();plt.show()original=aggregate.loc['Original'];shift=aggregate.loc['Acción perturbada']lectura(f'Original: DQN retorno {original.loc["DQN","return_mean"]:.3f}, éxito {original.loc["DQN","success"]:.1%}; Q-learning retorno {original.loc["Q-learning","return_mean"]:.3f}, éxito {original.loc["Q-learning","success"]:.1%}. Perturbado: DQN éxito {shift.loc["DQN","success"]:.1%}, peligros {shift.loc["DQN","hazard"]:.1%}. Resolver un mapa no garantiza robustez ante otra dinámica. Las barras de planificación y aleatorio no expresan variabilidad de entrenamiento porque no se entrenaron varias políticas.')
return_mean
return_std
success
hazard
truncated
scenario
method
Acción perturbada
Aleatorio
-0.474
NaN
0.285
0.705
0.010
DQN
0.755
0.117
0.958
0.037
0.005
Planificación
0.799
NaN
0.975
0.025
0.000
Q-learning
0.772
0.044
0.962
0.038
0.000
Original
Aleatorio
-0.419
NaN
0.310
0.680
0.010
DQN
0.821
0.126
0.960
0.000
0.040
Planificación
0.877
NaN
1.000
0.000
0.000
Q-learning
0.868
0.020
1.000
0.000
0.000
31.7.1 Cómo leer este resultado
Original: DQN retorno 0.821, éxito 96.0%; Q-learning retorno 0.868, éxito 100.0%. Perturbado: DQN éxito 95.8%, peligros 3.7%. Resolver un mapa no garantiza robustez ante otra dinámica. Las barras de planificación y aleatorio no expresan variabilidad de entrenamiento porque no se entrenaron varias políticas.
31.7.2 Inspeccionar política y valores
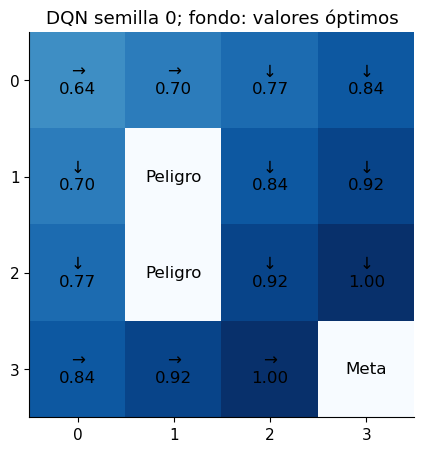
Mostramos DQN semilla 0, prefijada para inspección. El fondo conserva valores óptimos, no estimaciones de DQN. Si varias acciones comparten valor óptimo, discrepar del argmax de la referencia no representa un fallo.
policy0=net_policy(dqn_models[0]);show_policy(policy0,'DQN semilla 0; fondo: valores óptimos')with torch.no_grad():estimated=dqn_models[0](torch.arange(16)).numpy()diagnosis=pd.DataFrame({'state':SAFE,'action_dqn':policy0[SAFE],'chosen_optimal_q':q_star[SAFE,policy0[SAFE]],'optimal_v':v[SAFE],'estimated_max_q':estimated[SAFE].max(1)})diagnosis['optimal_action']=np.isclose(diagnosis.chosen_optimal_q,diagnosis.optimal_v,atol=1e-6);display(diagnosis.round(3))lectura(f'Hay una acción óptima elegida en {int(diagnosis.optimal_action.sum())}/{len(SAFE)} estados seguros, considerando empates. Valores incorrectos pueden acompañar acciones correctas. Este diagnóstico requiere conocer dinámica: no sustituye interacción en problemas sin modelo.')
state
action_dqn
chosen_optimal_q
optimal_v
estimated_max_q
optimal_action
0
0
1
0.638
0.638
0.038
True
1
1
1
0.703
0.703
0.038
True
2
2
2
0.772
0.772
0.051
True
3
3
2
0.844
0.844
0.823
True
4
4
2
0.703
0.703
0.007
True
5
6
2
0.844
0.844
0.840
True
6
7
2
0.920
0.920
0.943
True
7
8
2
0.772
0.772
0.076
True
8
10
2
0.920
0.920
0.933
True
9
11
2
1.000
1.000
1.006
True
10
12
1
0.844
0.844
0.820
True
11
13
1
0.920
0.920
0.932
True
12
14
1
1.000
1.000
1.002
True
31.7.3 Cómo leer este resultado
Hay una acción óptima elegida en 13/13 estados seguros, considerando empates. Valores incorrectos pueden acompañar acciones correctas. Este diagnóstico requiere conocer dinámica: no sustituye interacción en problemas sin modelo.
31.7.4 Una trayectoria fallida: checkpoint y población
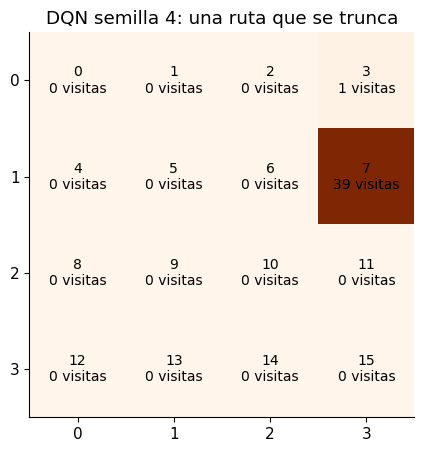
Inspeccionamos además la semilla 4 de DQN, cuyo resultado ya aparece en el resumen de todas las ejecuciones. Reproducimos sus diez comienzos deterministas de prueba y conservamos la primera trayectoria truncada, si existe. La selección de una ruta fallida sirve para diagnóstico y no estima su frecuencia: esa tasa ya se reportó sobre el conjunto de comienzos.
Una política puede alcanzar el óptimo en los tres comienzos de validación y repetir un ciclo en otro comienzo. El mapa pequeño permite mostrar exactamente qué estados y acciones causan ese fallo. No corregimos hiperparámetros utilizando esta trayectoria de prueba.
policy4=net_policy(dqn_models[4]);failure_rows=[];chosen_path=[]for start in TEST: env=Grid(13000);s=env.reset(start);path=[]for t inrange(40): before=s;a=int(policy4[s]);s,r,term,trunc=env.step(a) path.append({'start':start,'step':t+1,'state':before,'action':a,'next_state':s,'reward':r,'terminated':term,'truncated':trunc})if term or trunc:breakif trunc:chosen_path=path;breakfailure=pd.DataFrame(chosen_path)iflen(failure): display(failure.head(12));visits=np.bincount(failure.state,minlength=16).reshape(4,4) fig,ax=plt.subplots(figsize=(5,5));im=ax.imshow(visits,cmap='Oranges')for state inrange(16): row,col=divmod(state,4);ax.text(col,row,f'{state}\n{visits[row,col]} visitas',ha='center',va='center',fontsize=10) ax.set(title='DQN semilla 4: una ruta que se trunca',xticks=range(4),yticks=range(4));plt.show() lectura(f'Desde estado {int(failure.start.iloc[0])} la política consume {len(failure)} pasos y se trunca; estados visitados {sorted(failure.state.unique().tolist())}. Este fallo explica por qué una validación alta no cubre todos los comienzos. La perturbación aleatoria podría incluso sacar a una política de un ciclo: ruido no siempre reduce éxito, aunque puede introducir peligros.')else: lectura('No hubo rutas truncadas en esta semilla y protocolo. No se fabrica una trayectoria fallida; deben revisarse las tasas reportadas y, si se busca otra pregunta, definir de antemano un nuevo escenario.')failure.to_csv('trayectoria-fallida.csv',index=False)
start
step
state
action
next_state
reward
terminated
truncated
0
3
1
3
2
7
-0.03
False
False
1
3
2
7
1
7
-0.03
False
False
2
3
3
7
1
7
-0.03
False
False
3
3
4
7
1
7
-0.03
False
False
4
3
5
7
1
7
-0.03
False
False
5
3
6
7
1
7
-0.03
False
False
6
3
7
7
1
7
-0.03
False
False
7
3
8
7
1
7
-0.03
False
False
8
3
9
7
1
7
-0.03
False
False
9
3
10
7
1
7
-0.03
False
False
10
3
11
7
1
7
-0.03
False
False
11
3
12
7
1
7
-0.03
False
False
31.7.5 Cómo leer este resultado
Desde estado 3 la política consume 40 pasos y se trunca; estados visitados [3, 7]. Este fallo explica por qué una validación alta no cubre todos los comienzos. La perturbación aleatoria podría incluso sacar a una política de un ciclo: ruido no siempre reduce éxito, aunque puede introducir peligros.
31.8 Gradientes de política y actor–critic
Parametrizamos una distribución \(\pi_\theta(a|s)\). REINFORCE estima:
Restar un baseline dependiente del estado conserva la esperanza del gradiente. Actor–critic aprende valor y utiliza \(\delta_t=r+\gamma(1-d)V_\phi(s')-V_\phi(s)\). Target y ventaja del actor se separan del grafo del crítico. Bootstrap reduce dependencia del retorno completo, pero incorpora error del valor aprendido.
Usaremos otro entorno, de máximo dos pasos. En estado 0, acción 0 entrega 0.2 y termina; acción 1 avanza al estado 1 sin recompensa. Allí acción 0 entrega −1 y acción 1 +1, ambas terminales. Con γ=0.95, elegir acción 1 en ambos estados alcanza retorno 0.95. No son resultados del mapa anterior.
Redes independientes para actor y crítico, capa de 16 unidades tanh, Adam 0.02, batch de 16 episodios, 80 actualizaciones y cinco semillas. REINFORCE usa retorno completo sin baseline; actor–critic usa TD de un paso y MSE del crítico con peso 0.5. No agregamos bonus de entropía. Se conserva el último modelo con presupuesto fijo: no hay selección mediante prueba.
Código
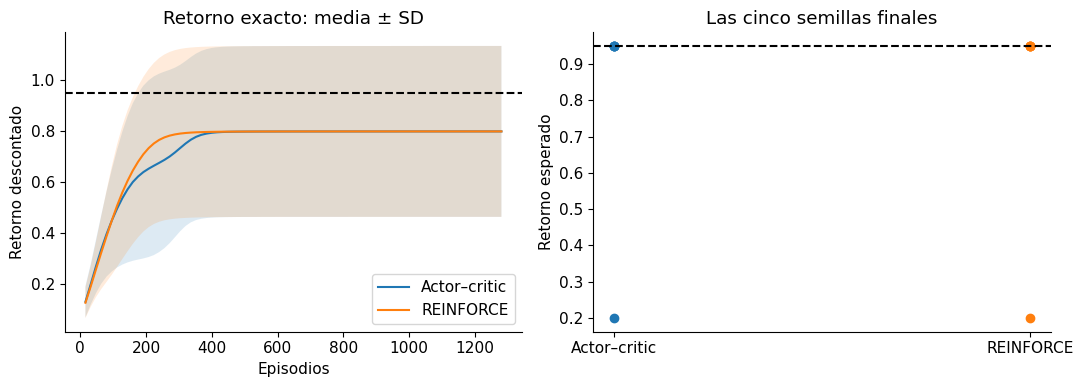
class ActorCritic(nn.Module):def__init__(self):super().__init__();self.actor=nn.Sequential(nn.Linear(2,16),nn.Tanh(),nn.Linear(16,2));self.critic=nn.Sequential(nn.Linear(2,16),nn.Tanh(),nn.Linear(16,1))def logits(self,s):returnself.actor(F.one_hot(s.long(),2).float())def value(self,s):returnself.critic(F.one_hot(s.long(),2).float()).squeeze(-1)def delayed_step(s,a):if s==0and a==0:return0,.2,Trueif s==0:return1,0.,Falsereturn1,1.if a==1else-1.,Truedef exact_return(model):with torch.no_grad():p,q=model.logits(torch.tensor([0,1])).softmax(-1)[:,1].numpy()returnfloat((1-p)*.2+p*GAMMA*(2*q-1)),float(p),float(q)pg_models={};pg_rows=[]for method in ['REINFORCE','Actor–critic']: collection=[]for seed inrange(5): torch.manual_seed(3700+seed);model=ActorCritic();opt=torch.optim.Adam(model.parameters(),lr=.02)for update inrange(1,81): actor_terms=[];critic_terms=[];batch_returns=[]for rollout inrange(16): s=0;steps=[]for t inrange(2): dist=torch.distributions.Categorical(logits=model.logits(torch.tensor([s])));a=dist.sample();n,r,done=delayed_step(s,int(a));steps.append((s,int(a),r,n,done,dist.log_prob(a).squeeze(0)));s=nif done:break returns=[];g=0for step inreversed(steps):g=step[2]+GAMMA*g;returns.insert(0,g) batch_returns.append(returns[0])for t,(s,a,r,n,done,logp) inenumerate(steps):if method=='REINFORCE':adv=torch.tensor(returns[t])else: value=model.value(torch.tensor([s])).squeeze(0)with torch.no_grad():target=torch.tensor(r)+GAMMA*(not done)*model.value(torch.tensor([n])).squeeze(0) adv=(target-value).detach();critic_terms.append((value-target).square()) actor_terms.append(-(GAMMA**t)*logp*adv) loss=torch.stack(actor_terms).sum()/16if critic_terms:loss=loss+.5*torch.stack(critic_terms).sum()/16 opt.zero_grad();loss.backward();nn.utils.clip_grad_norm_(model.parameters(),5);opt.step() expected,p,q=exact_return(model);pg_rows.append({'method':method,'seed':seed,'update':update,'episodes':update*16,'expected_return':expected,'batch_return':np.mean(batch_returns),'p_continue':p,'p_good':q}) collection.append(model) pg_models[method]=collectionpg_curves=pd.DataFrame(pg_rows);last_pg=pg_curves[pg_curves['update']==80]fig,ax=plt.subplots(1,2,figsize=(11,4))for method,g in pg_curves.groupby('method'): st=g.groupby('episodes').expected_return.agg(['mean','std']);ax[0].plot(st.index,st['mean'],label=method);ax[0].fill_between(st.index,st['mean']-st['std'],st['mean']+st['std'],alpha=.15) last=g[g['update']==80];ax[1].scatter([method]*len(last),last.expected_return)ax[0].set(title='Retorno exacto: media ± SD',xlabel='Episodios',ylabel='Retorno descontado');ax[0].legend();ax[1].set(title='Las cinco semillas finales',ylabel='Retorno esperado')for a in ax:a.axhline(.95,color='black',ls='--')plt.tight_layout();plt.show();display(last_pg[['method','seed','expected_return','p_continue','p_good']].round(4))lectura('; '.join(f'{name}: retorno esperado medio {g.expected_return.mean():.3f}, mínimo {g.expected_return.min():.3f}, máximo {g.expected_return.max():.3f}'for name,g in last_pg.groupby('method'))+'. El óptimo es 0.95. Se conservaron todas las ejecuciones; una posible convergencia similar no demuestra equivalencia general de métodos. El retorno exacto se calcula para diagnóstico y no alimenta pérdidas ni selección.')
method
seed
expected_return
p_continue
p_good
79
REINFORCE
0
0.9498
0.9998
1.0000
159
REINFORCE
1
0.1999
0.0001
0.0023
239
REINFORCE
2
0.9495
0.9998
0.9998
319
REINFORCE
3
0.9498
0.9999
1.0000
399
REINFORCE
4
0.9499
0.9999
1.0000
479
Actor–critic
0
0.9499
0.9999
1.0000
559
Actor–critic
1
0.2000
0.0000
0.0041
639
Actor–critic
2
0.9497
0.9998
0.9999
719
Actor–critic
3
0.9499
0.9999
1.0000
799
Actor–critic
4
0.9497
0.9998
0.9999
31.8.1 Cómo leer este resultado
Actor–critic: retorno esperado medio 0.800, mínimo 0.200, máximo 0.950; REINFORCE: retorno esperado medio 0.800, mínimo 0.200, máximo 0.950. El óptimo es 0.95. Se conservaron todas las ejecuciones; una posible convergencia similar no demuestra equivalencia general de métodos. El retorno exacto se calcula para diagnóstico y no alimenta pérdidas ni selección.
31.8.2 El promedio puede ocultar abandono de la acción útil
La inicialización y las muestras tempranas pueden empujar una política hacia terminar por 0.2. Al volverse casi determinista deja de explorar el segundo estado, donde podría conseguir 1. El crítico también necesita visitas para estimar esa posibilidad. Tener baseline aprendido no garantiza evitar esta situación.
En estas configuraciones no hay bonus de entropía ni una exploración mínima impuesta. Mantener probabilidad de visitar ambas ramas es una hipótesis razonable para una nueva intervención, pero requiere otro experimento con criterios prefijados. Las ejecuciones fallidas se conservan; no se reemplazan por otras semillas para mejorar el promedio.
collapse=last_pg.assign(near_safe=lambda d:d.expected_return<.3).groupby('method').agg(failures=('near_safe','sum'),seeds=('seed','size'),mean_p_continue=('p_continue','mean'))display(collapse)lectura('; '.join(f'{method}: {int(row.failures)}/{int(row.seeds)} ejecuciones con retorno esperado inferior a 0.3'for method,row in collapse.iterrows())+'. El valor promedio por sí solo oculta soluciones cercanas a 0.2. Más episodios de una política que casi nunca visita la rama útil no garantizan recuperación; una intervención debe verificar cobertura y probabilidades, además de retorno.')
failures
seeds
mean_p_continue
method
Actor–critic
1
5
0.799914
REINFORCE
1
5
0.799915
31.8.3 Cómo leer este resultado
Actor–critic: 1/5 ejecuciones con retorno esperado inferior a 0.3; REINFORCE: 1/5 ejecuciones con retorno esperado inferior a 0.3. El valor promedio por sí solo oculta soluciones cercanas a 0.2. Más episodios de una política que casi nunca visita la rama útil no garantizan recuperación; una intervención debe verificar cobertura y probabilidades, además de retorno.
31.8.4 Política estocástica y política greedy
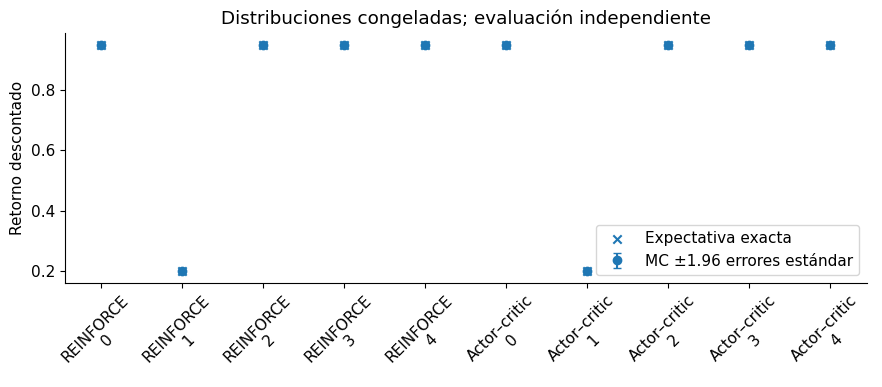
Evaluar solamente argmax transforma la política aprendida y puede ocultar probabilidad de error. Comparamos expectativa exacta, Monte Carlo de 1000 episodios independientes y retorno de las acciones greedy. Se congela la distribución y se usan generadores reservados. La simulación no cambia parámetros ni selecciona checkpoints.
Para probabilidades p de continuar y q de elegir bien, el retorno esperado es (1−p)·0.2 + p·γ·(2q−1). En este entorno podemos verificarlo, a diferencia de muchas aplicaciones.
pg_test=[]for method,collection in pg_models.items():for seed,model inenumerate(collection): exact,p,q=exact_return(model);gen=np.random.default_rng(11000+seed);returns=[]for _ inrange(1000):returns.append(.2if gen.random()>=p else GAMMA*(1if gen.random()<q else-1)) greedy=.2if p<.5else GAMMA*(1if q>=.5else-1) pg_test.append({'method':method,'seed':seed,'expected':exact,'MC':np.mean(returns),'MC_se':np.std(returns,ddof=1)/np.sqrt(1000),'greedy':greedy})pg_test=pd.DataFrame(pg_test);display(pg_test.round(4));fig,ax=plt.subplots();x=np.arange(len(pg_test))ax.errorbar(x,pg_test.MC,yerr=1.96*pg_test.MC_se,fmt='o',capsize=3,label='MC ±1.96 errores estándar');ax.scatter(x,pg_test.expected,marker='x',label='Expectativa exacta')ax.set(xticks=x,xticklabels=[f'{r.method}\n{r.seed}'for r in pg_test.itertuples()],ylabel='Retorno descontado',title='Distribuciones congeladas; evaluación independiente');ax.tick_params(axis='x',rotation=45);ax.legend();plt.tight_layout();plt.show()lectura(f'Máximo desfase absoluto MC–expectativa {np.max(np.abs(pg_test.MC-pg_test.expected)):.4f}. Intervalos normales aproximados describen muestreo dentro de cada política, no variabilidad de entrenamiento. Una política greedy perfecta puede coexistir con acciones erróneas bajo la distribución: siempre se debe declarar qué política se evaluó.')
method
seed
expected
MC
MC_se
greedy
0
REINFORCE
0
0.9498
0.9500
0.0000
0.95
1
REINFORCE
1
0.1999
0.2000
0.0000
0.20
2
REINFORCE
2
0.9495
0.9481
0.0019
0.95
3
REINFORCE
3
0.9498
0.9500
0.0000
0.95
4
REINFORCE
4
0.9499
0.9500
0.0000
0.95
5
Actor–critic
0
0.9499
0.9500
0.0000
0.95
6
Actor–critic
1
0.2000
0.2000
0.0000
0.20
7
Actor–critic
2
0.9497
0.9500
0.0000
0.95
8
Actor–critic
3
0.9499
0.9500
0.0000
0.95
9
Actor–critic
4
0.9497
0.9500
0.0000
0.95
31.8.5 Cómo leer este resultado
Máximo desfase absoluto MC–expectativa 0.0014. Intervalos normales aproximados describen muestreo dentro de cada política, no variabilidad de entrenamiento. Una política greedy perfecta puede coexistir con acciones erróneas bajo la distribución: siempre se debe declarar qué política se evaluó.
31.8.6 Un intervalo casi cero no demuestra ausencia de errores
Cuando ninguna de las 1000 trayectorias muestreadas falla, la desviación observada puede ser cero y el intervalo normal colapsa. Eso no significa que la política tenga probabilidad cero de fallo. Aquí la expectativa exacta revela los eventos raros que la muestra puede omitir. En tareas sin solución analítica conviene reportar conteos y utilizar intervalos adecuados para tasas de fallos, además de aumentar evaluación cuando esas tasas importan.
31.9 Baseline y varianza: una cuenta controlada
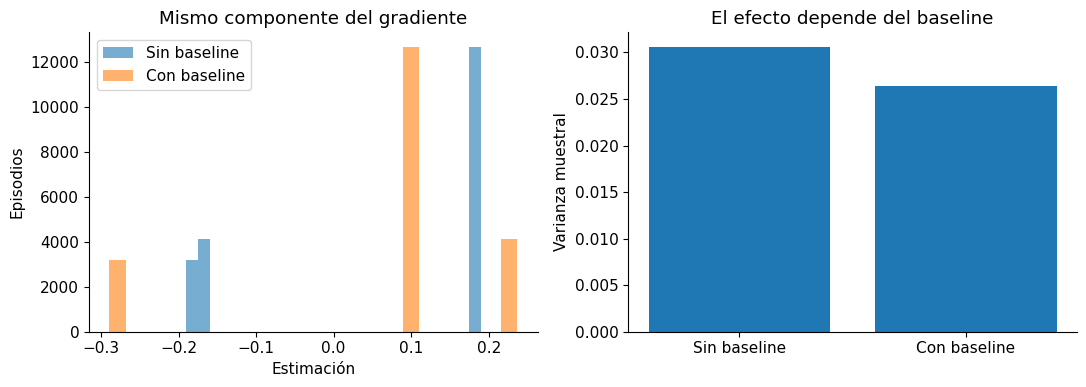
Fijamos p=q=0.8. El gradiente respecto al logit de continuar en estado 0 tiene componente (a−p)G. Restar baseline constante conserva esperanza porque E[a−p]=0. Usamos retorno esperado analítico y 20 000 episodios nuevos.
Este baseline es posible porque conocemos el entorno; un crítico debe aprenderlo. La media del retorno no necesariamente minimiza varianza de cada componente. La cuenta muestra el mecanismo sin cambiar redes.
gen=np.random.default_rng(12000);p=q=.8;a=(gen.random(20000)<p).astype(float);good=gen.random(20000)<qG=np.where(a==0,.2,GAMMA*np.where(good,1.,-1.));baseline=(1-p)*.2+p*GAMMA*(2*q-1)raw=(a-p)*G;centered=(a-p)*(G-baseline);exact_grad=p*(1-p)*(GAMMA*(2*q-1)-.2)fig,ax=plt.subplots(1,2,figsize=(11,4));ax[0].hist(raw,bins=25,alpha=.6,label='Sin baseline');ax[0].hist(centered,bins=25,alpha=.6,label='Con baseline');ax[0].legend();ax[0].set(title='Mismo componente del gradiente',xlabel='Estimación',ylabel='Episodios')ax[1].bar(['Sin baseline','Con baseline'],[raw.var(ddof=1),centered.var(ddof=1)]);ax[1].set(title='El efecto depende del baseline',ylabel='Varianza muestral');plt.tight_layout();plt.show()lectura(f'Gradiente exacto {exact_grad:.4f}; medias {raw.mean():.4f} y {centered.mean():.4f}. Varianzas {raw.var(ddof=1):.4f} y {centered.var(ddof=1):.4f}. '+('Este baseline reduce varianza aquí.'if centered.var()<raw.var() else'Este baseline no reduce varianza de este componente: restar la media no garantiza mejora.')+' La diferencia finita entre medias proviene del muestreo; aprender un crítico añade error de estimación.')
31.9.1 Cómo leer este resultado
Gradiente exacto 0.0592; medias 0.0575 y 0.0606. Varianzas 0.0306 y 0.0264. Este baseline reduce varianza aquí. La diferencia finita entre medias proviene del muestreo; aprender un crítico añade error de estimación.
31.10 Revisar los incentivos de la recompensa
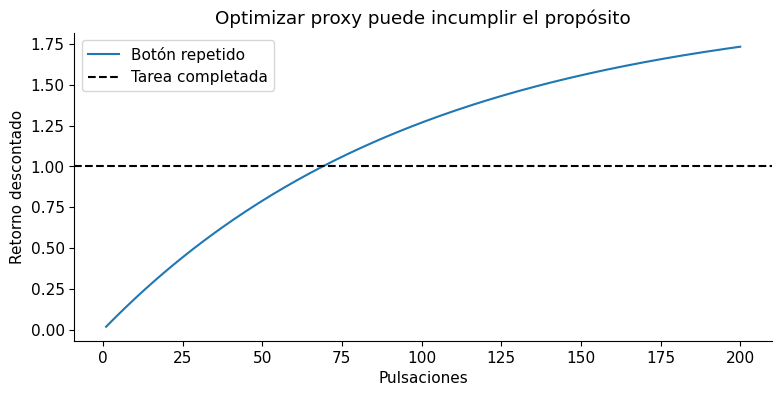
Un agente puede completar una tarea por recompensa 1 o presionar un botón con proxy 0.02, sin completarla. Con γ=0.99 y hasta 200 pulsaciones, el proxy puede superar la recompensa de finalización. Optimizar correctamente esa recompensa incentivaría conducta equivocada respecto al propósito.
No entrenamos otro agente: calculamos retornos de dos conductas. Este diagnóstico revisa especificación antes de atribuir problemas a red o exploración. Se necesitan medidas del resultado real y auditoría de trayectorias.
horizons=np.arange(1,201);proxy=.02*(1-.99**horizons)/(1-.99)fig,ax=plt.subplots();ax.plot(horizons,proxy,label='Botón repetido');ax.axhline(1,color='black',ls='--',label='Tarea completada');ax.set(title='Optimizar proxy puede incumplir el propósito',xlabel='Pulsaciones',ylabel='Retorno descontado');ax.legend();plt.show()lectura(f'200 pulsaciones acumulan {proxy[-1]:.3f}, frente a 1 por completar tarea. Penalizar acciones sin revisar incentivos puede desplazar el problema. Hay que medir finalización real. El cálculo ilustra especificación defectuosa; no es una demostración empírica de reward hacking en un sistema real.')
31.10.1 Cómo leer este resultado
200 pulsaciones acumulan 1.732, frente a 1 por completar tarea. Penalizar acciones sin revisar incentivos puede desplazar el problema. Hay que medir finalización real. El cálculo ilustra especificación defectuosa; no es una demostración empírica de reward hacking en un sistema real.
31.11 Elegir métodos y reconocer límites
Condición
Punto de partida
Riesgo
Sin decisiones secuenciales
Bandido o bandido contextual
Exploración y exposición
Pocos estados discretos
Tabla Q; planificación con modelo
Cobertura y Markov
Observaciones complejas, acciones discretas
DQN
Targets, extrapolación y sobreestimación
Acciones continuas
Actor–critic apropiado
Escala, exploración y restricciones
Política estocástica con datos nuevos
Gradientes; PPO como extensión
Varianza y consumo de muestras
Solo logs históricos
RL offline con soporte suficiente
Acciones fuera de distribución
Double DQN separa selección y valoración del target; dueling descompone valor y ventaja; replay priorizado cambia muestreo y exige correcciones. PPO controla cambios mediante objetivo recortado. SAC agrega objetivo de entropía y es relevante para control continuo. Son rutas posteriores: no se implementan ni se les atribuyen resultados aquí.
Model-based RL utiliza o aprende dinámica para planificar, pero errores se acumulan en trayectorias simuladas. Offline RL no equivale a entrenar DQN sobre cualquier CSV: puede proponer acciones sin cobertura en los datos. Valor estimado alto no basta para aceptar extrapolación.
No se cubren POMDP, imágenes, multiagente, robótica ni restricciones físicas. No hace falta refuerzo cuando una regla, un optimizador conocido o supervisado resuelve la decisión con menos complejidad.
31.12 Qué medir antes de aceptar una política
Entorno, recompensa, horizonte y descuento se fijan antes de comparar. Separar semillas de entrenamiento y evaluación evita confundir repetir una trayectoria con replicar entrenamiento. Se reportan presupuesto de interacción, actualizaciones, checkpoints y todas las ejecuciones.
Regret, retorno, éxito, peligros, pérdida TD y gradientes responden a preguntas distintas. Un número favorable en una no sustituye otras. En el mapa, la tabla es una referencia fuerte; la red añade replay, targets y optimización sin demostrar generalización a nuevos estados. En dos pasos, actor–critic y REINFORCE muestran mecanismos, no una clasificación universal.
bandit_results.to_csv('resultados-bandidos.csv');rl_results.to_csv('resultados-grid.csv',index=False);pd.concat(trajectories).to_csv('trayectorias-grid.csv',index=False)checkpoints.to_csv('checkpoints.csv',index=False);pd.concat([q_curve,dqn_curve]).to_csv('curvas-validacion.csv',index=False);td.to_csv('perdida-dqn.csv',index=False)pg_curves.to_csv('curvas-politica.csv',index=False);pg_test.to_csv('resultados-politica.csv',index=False)np.savez('tablas-q.npz',**{f'seed_{j}':q for j,q inenumerate(q_models)},optimal_q=q_star)for j,model inenumerate(dqn_models): torch.save(model.state_dict(),f'dqn-semilla-{j}.pt');clone=QNet();clone.load_state_dict(torch.load(f'dqn-semilla-{j}.pt',weights_only=True));assert np.array_equal(net_policy(clone),net_policy(model))protocol={'grid':{'size':[4,4],'goal':GOAL,'hazards':sorted(HAZARDS),'gamma':GAMMA,'step_reward':-.03,'collection_limit':40,'truncation_bootstraps':True,'validation_starts':VAL,'test_starts':TEST,'training_starts':SAFE,'test_slip':.15,'test_repeats':20},'Q_learning':{'seeds':5,'episodes':500,'alpha':.15},'DQN':{'seeds':5,'episodes':350,'hidden':32,'buffer':5000,'batch':64,'lr':.003,'target_updates':100,'loss':'Huber'},'checkpoints':'validation return every 25 episodes, first tie','policy_gradient':{'environment':'two-step delayed reward, separate from grid','seeds':5,'updates':80,'episodes_per_update':16,'lr':.02,'checkpoint':'last, fixed budget','test_MC':1000},'bandit':{'means':means.tolist(),'seeds':50,'decisions':800},'torch':torch.__version__}Path('protocolo.json').write_text(json.dumps(protocol,ensure_ascii=False,indent=2),encoding='utf-8');print('Registros y pesos guardados; carga de las cinco redes DQN verificada.')
Registros y pesos guardados; carga de las cinco redes DQN verificada.
31.13 Contrato común y persistencia
En refuerzo, retorno depende de política, entorno, semillas y protocolo de evaluación. Se conserva el presupuesto; guardar el estado no implica haber demostrado estabilidad sobre todos los episodios posibles. Los estados del optimizador y del entorno no se presentan como un checkpoint completo de reanudación.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib','.pt','.wav','.npz']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 3 | archivos registrados: 39
31.13.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron bandidos, planificación, Q-learning, DQN, REINFORCE, actor–critic y el caso de recompensa defectuosa. Las semillas y episodios de evaluación se mantienen separados del ajuste conforme al diseño original; no se eligió una nueva política mirando prueba. Se registran los estados y tablas, y se distingue retorno, pérdida de entrenamiento y propósito que la recompensa intenta representar.
La armonización verificó identidad de parámetros y buffers tras recarga de 3 módulos presentes al cierre; archivó 39 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.
31.14 Ejercicios y extensiones
Exploración. Acercar medias del bandido y variar ε. Mantener presupuesto y reportar regret y dispersión entre réplicas.
Descuento. Resolver el mapa con γ=0.5 y 0.99. Un cambio de retorno entre objetivos distintos no demuestra mejora del algoritmo.
Truncación. Desactivar bootstrap y estudiar valores. Incorporar tiempo restante si el límite representa un horizonte real.
Tabla y red. Contar visitas y actualizaciones; igualar interacción antes de comparar eficiencia muestral.
Replay y target. Retirar componentes por separado con varias semillas. Informar pérdidas, retorno, éxito y peligros sin esconder fallos mediante suavizado.
Robustez. Entrenar con perturbación y evaluar niveles prefijados. Separar robustez, adaptación y selección.
Crédito retrasado. Alargar el segundo entorno a diez pasos. Comparar varianza y error del crítico; el retorno exacto no es señal de entrenamiento.
Recompensa. Proponer objetivo con restricciones y enumerar conductas que aumentan proxy sin cumplirlo. Diseñar métricas que las detecten.
Continuo. Formular una acción real acotada y estudiar PPO o SAC con una biblioteca mantenida. Declarar qué excede estos ejemplos discretos.
El reporte debe incluir comparación simple, distribución entre semillas y una trayectoria fallida cuando exista. Si todas las políticas alcanzan techo, aumentar complejidad solo es útil para una pregunta nueva.
31.15 Referencias
Sutton y Barto, Reinforcement Learning: An Introduction, segunda edición, MIT Press, 2018. Base de MDP, Bellman, TD y gradientes.