# Importaciones necesarias para todo el notebook
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification
import warnings
warnings.filterwarnings('ignore')

# Configuración de visualización
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['font.size'] = 116 Pérdida y backpropagation
Serie Deep Learning · del perceptrón a los transformers.
Este contenido continúa las sesiones de fundamentos matemáticos y perceptrón. Comienza con un repaso de neuronas y activaciones y desarrolla la pérdida, el gradiente y el entrenamiento de una MLP desde cero.
6.1 1. Modelo Neuronal Básico (Intuición)
Una neurona artificial es el bloque constructivo de las redes profundas. Matemáticamente es un modelo lineal (suma ponderada de entradas más bias) seguido opcionalmente de una función de activación no lineal.
6.1.1 Fórmula de una neurona
\[z = \mathbf{w}^T \mathbf{x} + b = w_1 x_1 + w_2 x_2 + \ldots + w_n x_n + b\]
\(\mathbf{w}\) (pesos): Vector de coeficientes que indica qué tan importante es cada feature para la salida. Su magnitud depende de la escala de la entrada y del resto del modelo; no es por sí sola una medida de importancia causal. Un peso cero elimina esa contribución directa en la neurona.
\(b\) (bias): Un escalar que desplaza la salida. Permite que la neurona “active” incluso cuando la suma ponderada \(\mathbf{w}^T\mathbf{x}\) es cero, lo que da más flexibilidad para definir fronteras de decisión que no pasen por el origen.
Suma ponderada: La expresión \(\mathbf{w}^T \mathbf{x}\) es exactamente el producto punto entre pesos y entradas: combina todas las features en un único número. Es la misma idea que en regresión lineal; la diferencia con una “red” aparece cuando encadenamos varias de estas operaciones y añadimos no linealidad entre capas.
6.1.2 Interpretación geométrica
En clasificación binaria, la ecuación \(\mathbf{w}^T \mathbf{x} + b = 0\) define un hiperplano en el espacio de features. Los puntos de un lado del hiperplano se clasifican en una clase y los del otro en la otra. Los pesos \(\mathbf{w}\) definen la orientación del hiperplano y el bias \(b\) su posición. Una sola neurona (sin activación) solo puede separar clases que sean linealmente separables; por eso las redes usan muchas neuronas y funciones de activación para modelar fronteras no lineales.
6.1.3 Representación matricial
Para procesar un batch de \(m\) muestras a la vez: \(\mathbf{Z} = \mathbf{X} \mathbf{W} + \mathbf{b}\)
- \(\mathbf{X}\): matriz \((m \times n)\) (m muestras, n features).
- \(\mathbf{W}\): matriz \((n \times 1)\) (o vector de n componentes).
- \(\mathbf{b}\): escalar que se suma a cada fila por broadcasting.
Cada fila de \(\mathbf{Z}\) es la salida \(z\) de la neurona para la muestra correspondiente. Esta forma es la que se implementa en código (y en GPUs) para ser eficiente.
6.1.4 Redes más importantes y dónde se usan
A partir de neuronas y capas se construyen arquitecturas que dominan el Deep Learning actual:
| Red | Descripción breve | Uso frecuente |
|---|---|---|
| MLP (Perceptrón multicapa) | Capas densas apiladas con activación no lineal. | Datos tabulares, clasificación/regresión general, embeddings. |
| CNN (Redes convolucionales) | Convoluciones que capturan patrones locales (bordes, texturas). | Visión por computador: clasificación de imágenes, detección de objetos, segmentación, vídeo. |
| RNN (Redes recurrentes) | Conexiones que dependen del paso de tiempo (estado oculto). | Secuencias: series temporales, texto (antes de Transformers). |
| LSTM / GRU | RNN con mecanismos de memoria (gates) para dependencias largas. | Traducción, predicción de series, modelado de lenguaje (histórico). |
| Transformer | Atención (attention) sobre secuencias, sin recurrencia explícita. | NLP: BERT, GPT, traducción; también visión (ViT) y multimodal. |
| GAN (Red generativa adversarial) | Generador vs discriminador en juego adversarial. | Generación de imágenes, datos sintéticos, superresolución, arte. |
| Autoencoders | Codificador + decodificador; aprendizaje no supervisado. | Reducción de dimensionalidad, detección de anomalías, denoising. |
En la práctica: CNN para imágenes; Transformer para lenguaje y modelos multimodales; RNN/LSTM en series temporales; GAN y autoencoders para generación y representaciones no supervisadas.
# Implementación del modelo neuronal básico (sin activación)

def neurona_lineal(X, w, b):
    """
    Modelo lineal: z = X @ w + b
    X: (n_muestras, n_features)
    w: (n_features,)
    b: escalar
    """
    return X @ w + b

# Ejemplo
np.random.seed(42)
X_ejemplo = np.random.randn(100, 3)  # 100 muestras, 3 features
w = np.array([0.5, -0.3, 0.8])
b = 0.1

z = neurona_lineal(X_ejemplo, w, b)
print("Salida z (pre-activación) para las primeras 5 muestras:")
print(z[:5])
print("\nForma de z:", z.shape)
Salida z (pre-activación) para las primeras 5 muestras:
[ 0.9079872 0.74445138 0.28379648 0.13772153 -0.58496906]
Forma de z: (100,)6.2 2. Funciones de Activación
Las funciones de activación se aplican elemento a elemento a la salida \(z\) de una neurona (o de una capa), y son las que introducen la no linealidad en la red.
6.2.1 ¿Por qué necesitamos no linealidad?
Si no hubiera activaciones no lineales, cualquier secuencia de capas lineales (multiplicación por matrices y suma de bias) se podría reescribir como una sola transformación afín (una única matriz y un bias). Es decir, profundidad no aportaría nada. Con funciones de activación no lineales entre capas, cada capa puede deformar el espacio de representación de forma no lineal, y la composición de muchas de estas transformaciones permite aproximar fronteras de decisión y funciones muy complejas. Por eso las activaciones son imprescindibles en redes profundas.
6.2.2 Funciones comunes
| Función | Fórmula | Uso típico |
|---|---|---|
| Sigmoid | \(\sigma(z) = \frac{1}{1+e^{-z}}\) | Salida en (0,1); se interpreta como probabilidad. Muy usada en la última capa de clasificación binaria. |
| ReLU | \(\text{ReLU}(z) = \max(0, z)\) | Capas ocultas en la mayoría de arquitecturas actuales. Cero para \(z \le 0\), identidad para \(z > 0\). |
Otras que suelen aparecer en la literatura: tanh (similar a sigmoid pero centrada en 0), Leaky ReLU, GELU (en Transformers), etc.
6.2.3 Comparación y problemas típicos
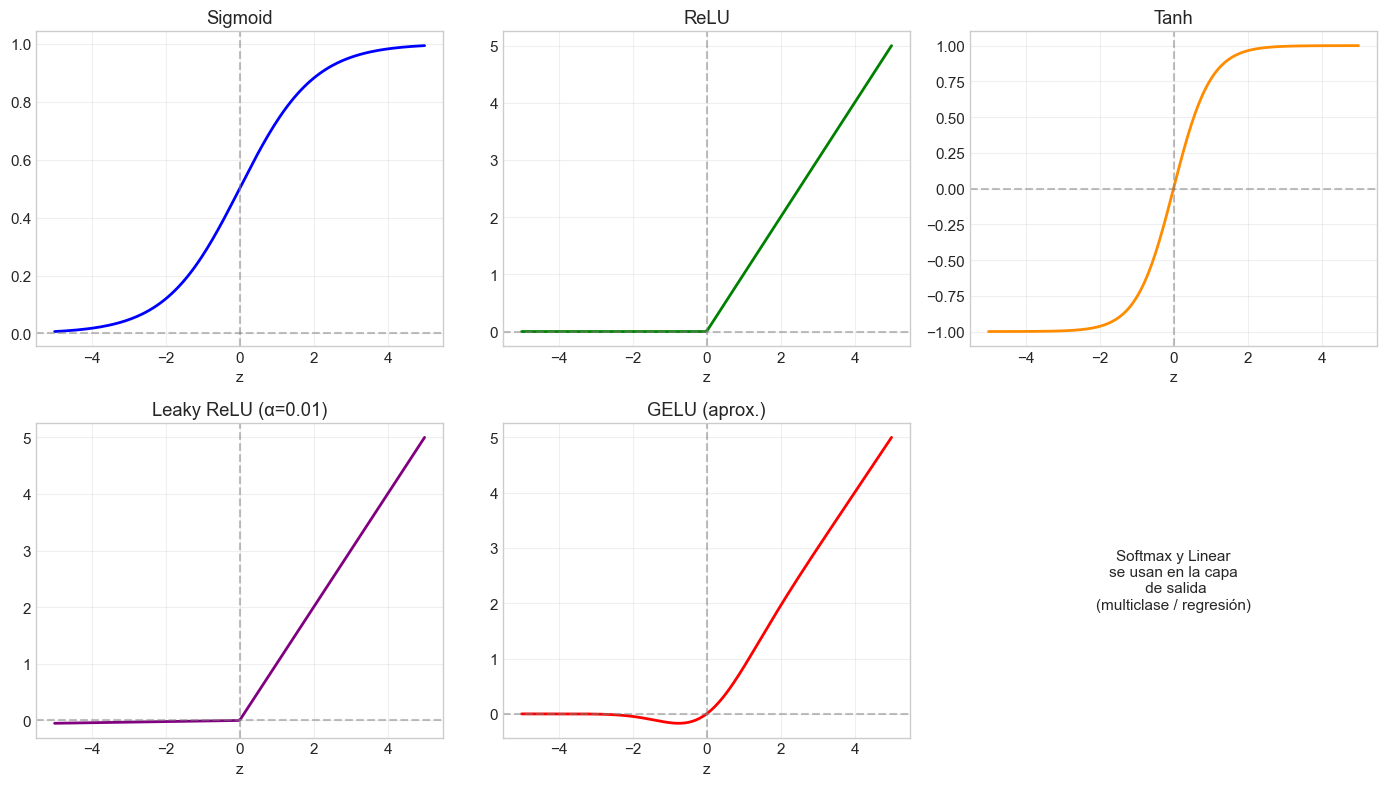
Sigmoid: Es suave y acotada en (0, 1), lo que ayuda a interpretar la salida como probabilidad. El inconveniente es el gradiente que se desvanece: cuando \(|z|\) es grande, la curva es muy plana y la derivada es casi cero, así que el gradiente que llega a capas anteriores es muy pequeño y el aprendizaje se estanca. Por eso no suele usarse en capas ocultas profundas.
ReLU: Es simple de calcular y no satura para \(z > 0\) (derivada 1), por lo que el gradiente fluye bien en esas neuronas “activas”. Las que dan \(z \le 0\) se “apagan” (salida 0, gradiente 0) y pueden dejar de aprender (“neurona muerta”), pero en la práctica ReLU suele entrenar más rápido y estable que sigmoid en capas ocultas y es el estándar en muchas arquitecturas.
6.2.4 Tabla ampliada: funciones de activación y problemas típicos
En la siguiente tabla se listan más funciones de activación y en qué problemas típicos suelen usarse.
| Función | Fórmula | Uso en la red | Problemas típicos donde se usa |
|---|---|---|---|
| Sigmoid | \(\sigma(z) = \frac{1}{1+e^{-z}}\) | Última capa (salida probabilística) | Clasificación binaria, predicción de probabilidades (ej. click-through rate), gates en LSTM. |
| ReLU | \(\text{ReLU}(z) = \max(0, z)\) | Capas ocultas (default) | CNN, MLP, casi cualquier red moderna; regresión y clasificación. |
| Tanh | \(\tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}}\) | Capas ocultas (alternativa) | RNN/LSTM (estado oculto centrado en 0), cuando se quiere salida en \((-1, 1)\). |
| Leaky ReLU | \(\max(\alpha z, z)\), \(\alpha \approx 0.01\) | Capas ocultas | Cuando ReLU produce muchas “neuronas muertas”; GANs, redes muy profundas. |
| GELU | \(z \cdot \Phi(z)\); el código usa una aproximación tanh | Capas ocultas | Transformers (BERT, GPT), modelos de lenguaje; suavidad y mejor flujo de gradiente. |
| Softmax | \(\frac{e^{z_i}}{\sum_j e^{z_j}}\) | Última capa (multiclase) | Clasificación multiclase (imágenes, NLP); salidas suman 1 y se interpretan como probabilidades. |
| Linear | \(f(z)=z\) | Última capa en regresión | Regresión (predecir valor continuo: precios, cantidades, series temporales). |
Resumen: En capas ocultas se usa sobre todo ReLU (o GELU en Transformers). En salida: Sigmoid → clasificación binaria; Softmax → clasificación multiclase; Linear → regresión.
Código
# Implementación y visualización de funciones de activación

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

def relu(z):
    return np.maximum(0, z)

def tanh(z):
    return np.tanh(z)

def leaky_relu(z, alpha=0.01):
    return np.where(z > 0, z, alpha * z)

def gelu(z):
    # Aproximación común: 0.5 * z * (1 + tanh(sqrt(2/pi) * (z + 0.044715 * z^3)))
    return 0.5 * z * (1 + np.tanh(np.sqrt(2 / np.pi) * (z + 0.044715 * z**3)))

# Tabla resumen con pandas
df_activaciones = pd.DataFrame({
    'Función': ['Sigmoid', 'ReLU', 'Tanh', 'Leaky ReLU', 'GELU'],
    'Fórmula': [r'1/(1+e^{-z})', r'max(0,z)', r'tanh(z)', r'max(αz, z), α≈0.01', r'z·Φ(z); código: aproximación tanh'],
    'Problemas típicos': [
        'Clasificación binaria, gates LSTM, probabilidades',
        'CNN, MLP, capas ocultas (estándar)',
        'RNN/LSTM, estado centrado en (-1,1)',
        'GANs, evitar neuronas muertas',
        'Transformers (BERT, GPT), NLP'
    ]
})
print("Resumen de funciones de activación y uso típico:\n")
display(df_activaciones)

# Graficar varias funciones
z = np.linspace(-5, 5, 200)
fig, axes = plt.subplots(2, 3, figsize=(14, 8))

axes[0, 0].plot(z, sigmoid(z), 'b-', linewidth=2)
axes[0, 0].set_title('Sigmoid')
axes[0, 0].set_xlabel('z')
axes[0, 0].axhline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 0].axvline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 0].grid(True, alpha=0.3)

axes[0, 1].plot(z, relu(z), 'green', linewidth=2)
axes[0, 1].set_title('ReLU')
axes[0, 1].set_xlabel('z')
axes[0, 1].axhline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 1].axvline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 1].grid(True, alpha=0.3)

axes[0, 2].plot(z, tanh(z), 'darkorange', linewidth=2)
axes[0, 2].set_title('Tanh')
axes[0, 2].set_xlabel('z')
axes[0, 2].axhline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 2].axvline(0, color='gray', linestyle='--', alpha=0.5)
axes[0, 2].grid(True, alpha=0.3)

axes[1, 0].plot(z, leaky_relu(z), 'purple', linewidth=2)
axes[1, 0].set_title('Leaky ReLU (α=0.01)')
axes[1, 0].set_xlabel('z')
axes[1, 0].axhline(0, color='gray', linestyle='--', alpha=0.5)
axes[1, 0].axvline(0, color='gray', linestyle='--', alpha=0.5)
axes[1, 0].grid(True, alpha=0.3)

axes[1, 1].plot(z, gelu(z), 'red', linewidth=2)
axes[1, 1].set_title('GELU (aprox.)')
axes[1, 1].set_xlabel('z')
axes[1, 1].axhline(0, color='gray', linestyle='--', alpha=0.5)
axes[1, 1].axvline(0, color='gray', linestyle='--', alpha=0.5)
axes[1, 1].grid(True, alpha=0.3)

axes[1, 2].axis('off')
axes[1, 2].text(0.5, 0.5, 'Softmax y Linear\nse usan en la capa\n de salida\n(multiclase / regresión)', ha='center', va='center', fontsize=11)

plt.tight_layout()
plt.show()
Resumen de funciones de activación y uso típico:
| Función | Fórmula | Problemas típicos | |
|---|---|---|---|
| 0 | Sigmoid | 1/(1+e^{-z}) | Clasificación binaria, gates LSTM, probabilidades |
| 1 | ReLU | max(0,z) | CNN, MLP, capas ocultas (estándar) |
| 2 | Tanh | tanh(z) | RNN/LSTM, estado centrado en (-1,1) |
| 3 | Leaky ReLU | max(αz, z), α≈0.01 | GANs, evitar neuronas muertas |
| 4 | GELU | z·Φ(z); código: aproximación tanh | Transformers (BERT, GPT), NLP |
6.2.5 Detalle: Sigmoid
- Fórmula: \(\sigma(z) = \dfrac{1}{1 + e^{-z}}\). Rango \((0, 1)\); se interpreta como probabilidad.
- Derivada: \(\sigma'(z) = \sigma(z)(1 - \sigma(z))\), útil en backpropagation.
- Problema: Para \(|z|\) grande la derivada \(\approx 0\) → gradiente que se desvanece en capas profundas. Por eso se evita en capas ocultas.
6.2.6 Detalle: ReLU
- Fórmula: \(\text{ReLU}(z) = \max(0, z)\). Rango \([0, +\infty)\).
- Derivada: 1 si \(z>0\), 0 si \(z\le 0\) → en la zona activa el gradiente no se atenúa.
- Ventaja: Cálculo barato, entrenamiento más estable. Riesgo: neuronas con \(z\le 0\) siempre pueden quedar “muertas” (gradiente 0).
6.2.7 Otras funciones (referencia)
- Tanh: Rango \((-1,1)\), centrada en 0; también sufre vanishing gradient.
- Leaky ReLU: \(\max(\alpha z, z)\) con \(\alpha\) pequeño; reduce neuronas muertas.
- GELU: Usada en Transformers; más costosa, mejor en redes muy profundas.
6.3 3. Función de Pérdida
La función de pérdida (o coste) es el criterio que el algoritmo de entrenamiento intenta minimizar. Conecta las predicciones del modelo con los datos reales y define qué significa “aprender” en términos numéricos.
6.3.1 ¿Qué significa “aprender”?
En términos prácticos, aprender es ajustar los pesos (y bias) del modelo para que las predicciones \(\hat{y}\) se parezcan cada vez más a los valores reales \(y\) observados en los datos. La función de pérdida \(L\) asigna un número a cada conjunto de predicciones: cuanto mayor es \(L\), peor encaja el modelo; el objetivo del entrenamiento es encontrar los pesos que hacen \(L\) lo más pequeño posible. Así, la pérdida es el “termómetro” que guía el descenso de gradiente.
6.3.2 Funciones de pérdida comunes
| Tarea | Función | Fórmula (idea) |
|---|---|---|
| Regresión | MSE (Mean Squared Error) | \(\frac{1}{n}\sum_i (y_i - \hat{y}_i)^2\) |
| Clasificación binaria | Cross-Entropy binaria | \(-\frac{1}{n}\sum_i \bigl[ y_i \log(\hat{p}_i) + (1-y_i)\log(1-\hat{p}_i) \bigr]\) |
En clasificación, \(\hat{p}_i\) es la probabilidad predicha para la clase positiva (por ejemplo, la salida de una sigmoid).
6.3.3 Interpretación
MSE: Es el promedio de los errores al cuadrado. El cuadrado hace que los errores grandes pesen mucho más que los pequeños, por lo que el modelo se ve “forzado” a corregir sobre todo las predicciones muy desviadas. Tiene una interpretación probabilística cuando asumimos ruido gaussiano en la salida.
Cross-Entropy: Viene de la teoría de información: mide la “sorpresa” o discrepancia entre la distribución real de la etiqueta (one-hot o binaria) y la distribución predicha (probabilidades). Minimizar cross-entropy equivale a hacer que la distribución predicha se acerque a la real. Es la elección estándar en clasificación porque se combina bien con la sigmoid en la última capa y tiene buenas propiedades de gradiente. Una interpretación probabilística: si interpretamos \(\hat{p}\) como \(P(\text{clase positiva})\), la cross-entropy es el negativo del logaritmo de la verosimilitud bajo un modelo Bernoulli.
6.3.4 Otras funciones de pérdida (referencia)
| Función | Fórmula (idea) | Cuándo usarla |
|---|---|---|
| MAE (L1) | \(\frac{1}{n}\sum_i \lvert y_i - \hat{y}_i \rvert\) | Regresión cuando hay outliers: los errores grandes no se amplifican al cuadrado. |
| Huber | Cuadrática para \(\lvert e \rvert \le \delta\), lineal fuera | Regresión robusta: combina ventajas de MSE y MAE. |
| Cross-Entropy multiclase | \(-\frac{1}{n}\sum_i \sum_c y_{i,c} \log(\hat{p}_{i,c})\) | Clasificación con varias clases; \(\hat{p}\) sale de Softmax en la última capa. |
6.3.5 Gradientes de la pérdida (para backprop)
- MSE: La derivada respecto a \(\hat{y}_i\) es \(2(\hat{y}_i - y_i)\) (o \(\frac{2}{n}\) si se promedia). El gradiente “empuja” la predicción hacia el valor real.
- Cross-Entropy binaria + Sigmoid: Al combinar la pérdida con la derivada de la sigmoid, el gradiente respecto a la pre-activación \(z\) resulta en la forma \(\hat{p} - y\) para una observación; una pérdida media añade el factor \(1/n\). La estabilidad del valor de pérdida requiere una implementación adecuada: sobre logits puede usarse
logaddexp, sin sumar constantes a probabilidades saturadas.
# Implementación de funciones de pérdida

def mse(y_true, y_pred):
    """Mean Squared Error - Regresión"""
    return np.mean((y_true - y_pred) ** 2)

def cross_entropy_binary(y_true, y_pred_prob):
    """
    Cross-Entropy para clasificación binaria.
    y_true: etiquetas 0 o 1
    y_pred_prob: probabilidades en [0, 1] (salida de sigmoid)
    """
    eps = 1e-15  # Evitar log(0)
    y_pred_prob = np.clip(y_pred_prob, eps, 1 - eps)
    return -np.mean(y_true * np.log(y_pred_prob) + (1 - y_true) * np.log(1 - y_pred_prob))

# Ejemplo MSE
y_real = np.array([1.0, 2.0, 3.0])
y_pred = np.array([1.1, 1.8, 3.2])
print("MSE:", mse(y_real, y_pred))

# Ejemplo Cross-Entropy
y_true_bin = np.array([1, 0, 1, 0])
y_prob = np.array([0.9, 0.2, 0.7, 0.1])  # Buenas predicciones
print("Cross-Entropy (buenas pred):", cross_entropy_binary(y_true_bin, y_prob))
y_prob_mala = np.array([0.3, 0.8, 0.4, 0.6])  # Malas predicciones
print("Cross-Entropy (malas pred):", cross_entropy_binary(y_true_bin, y_prob_mala))
MSE: 0.030000000000000023
Cross-Entropy (buenas pred): 0.1976348816421487
Cross-Entropy (malas pred): 1.16149804512708676.4 4. Intuición del Gradiente y Aprendizaje
El gradiente de la función de pérdida respecto a los pesos es lo que indica cómo cambiar cada peso para reducir la pérdida. El algoritmo estándar que usa esa información es el descenso de gradiente.
6.4.1 Conceptos clave
Derivada: En una variable, la derivada de una función en un punto es la pendiente de la recta tangente en ese punto. Indica si la función crece o decrece al moverse un poco y con qué “velocidad”. Para minimizar la pérdida, interesa saber en qué dirección decrece \(L\).
Gradiente: En varias variables, el gradiente \(\nabla L\) es el vector cuyas componentes son las derivadas parciales de \(L\) respecto a cada peso. El gradiente apunta en la dirección en que \(L\) aumenta más rápido. Por tanto, para minimizar \(L\) se avanza en la dirección opuesta al gradiente: \(-\nabla L\).
Descenso de gradiente: Se actualiza cada peso restando una fracción del gradiente (es decir, dando un “paso” en la dirección que reduce la pérdida). Repitiendo este proceso muchas veces (épocas), se tiende a un mínimo (local o global) de la pérdida.
6.4.2 Actualización de pesos
\[w_{\text{nuevo}} = w_{\text{viejo}} - \eta \cdot \frac{\partial L}{\partial w}\]
- \(\eta\) (learning rate, tasa de aprendizaje): Es el tamaño del paso. Si es muy alto, los pasos son grandes y puede producirse overshoot del mínimo, incluso divergencia; si es muy bajo, se avanza muy despacio y el entrenamiento es lento y puede quedarse atascado en zonas planas. En la práctica se suele elegir \(\eta\) por validación o con schedulers que lo reducen con el tiempo.
6.4.3 Flujo del entrenamiento (una época)
- Forward pass: Con los pesos actuales, se calculan las salidas de cada capa (productos por matrices, bias, activaciones) hasta obtener las predicciones y, con ellas, el valor de la pérdida \(L\).
- Backward pass (backpropagation): Se calculan las derivadas de \(L\) respecto a cada peso y cada activación intermedia, aplicando la regla de la cadena. El resultado es el gradiente \(\partial L / \partial w\) para cada peso.
- Actualización: Cada peso se actualiza con la regla anterior: \(w \leftarrow w - \eta \, \partial L / \partial w\) (y lo mismo para el bias).
- Se repite para muchos batches y muchas épocas hasta que la pérdida se estabilice o se cumpla un criterio de parada.
6.4.4 Regla de la cadena y backpropagation
En una red con muchas capas, \(L\) depende de los pesos de la última capa a través de las salidas, y esas salidas dependen de la capa anterior, y así sucesivamente. La regla de la cadena del cálculo permite escribir \(\frac{\partial L}{\partial w}\) como producto de derivadas a lo largo del camino desde \(L\) hasta \(w\). El algoritmo backpropagation calcula esas derivadas de atrás hacia adelante: primero las de la capa de salida, luego las de la penúltima, etc., reutilizando resultados ya calculados. Así se obtienen de forma eficiente los gradientes de todos los pesos con una sola pasada hacia atrás.
6.4.5 Batch, estocástico y mini-batch
- Batch (lote completo): Se usa todo el conjunto de entrenamiento para calcular el gradiente en cada paso. Estable pero costoso en memoria y cómputo; el gradiente es muy preciso pero hay pocos pasos por época.
- Estocástico (SGD por muestra): Se actualizan los pesos con el gradiente de una sola muestra cada vez. Mucha variabilidad, muchos pasos por época; puede escapar de mínimos locales pero es ruidoso.
- Mini-batch: Se toman grupos de \(k\) muestras (por ejemplo 32 o 64), se calcula el gradiente sobre ese mini-batch y se actualiza. Equilibrio entre estabilidad y velocidad; es lo más usado en la práctica.
6.4.6 Learning rate y schedulers
El learning rate \(\eta\) controla el tamaño del paso. Si es muy alto, la pérdida puede oscilar o divergir; si es muy bajo, el entrenamiento es lento. Los schedulers cambian \(\eta\) a lo largo del entrenamiento (por ejemplo reducirlo cada cierto número de épocas o cuando la pérdida se estanca), lo que suele mejorar la convergencia y la calidad final.
6.4.7 Mínimos locales y gradientes
- Mínimos locales: La pérdida puede tener varios “valles”; el descenso de gradiente puede quedarse en un mínimo local en lugar del global. En redes grandes, hay tantos parámetros que los mínimos “malos” son menos frecuentes de lo que se pensaba; además, el ruido del mini-batch ayuda a escapar de algunos.
- Gradientes que se desvanecen: En redes muy profundas, si las derivadas son menores que 1 en cada capa, el gradiente puede volverse casi cero al propagarse hacia atrás; las capas iniciales aprenden muy lento. Soluciones: activaciones como ReLU, inicialización adecuada, y a veces capas residuales (ResNet).
- Gradientes que explotan: Si las derivadas son mayores que 1, el gradiente puede crecer descontroladamente. Soluciones: reducir \(\eta\), gradient clipping (limitar la norma del gradiente) y buenas prácticas de inicialización.
# Visualización: Descenso de gradiente en 2D

# Función de pérdida simple: L(w) = w^2 (mínimo en w=0)
def loss(w):
    return w**2

def grad_loss(w):
    return 2*w

# Simular descenso de gradiente
np.random.seed(42)
w = 2.5  # Punto inicial
lr = 0.3  # Learning rate
history = [w]

for _ in range(15):
    w = w - lr * grad_loss(w)
    history.append(w)

# Graficar
w_vals = np.linspace(-3, 3, 200)
plt.figure(figsize=(10, 5))
plt.plot(w_vals, loss(w_vals), 'b-', label='L(w) = w²')
plt.plot(history, [loss(wi) for wi in history], 'ro-', markersize=8, label='Descenso de gradiente')
plt.xlabel('w')
plt.ylabel('Pérdida L(w)')
plt.title('Intuición del descenso de gradiente: minimizar L(w)')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()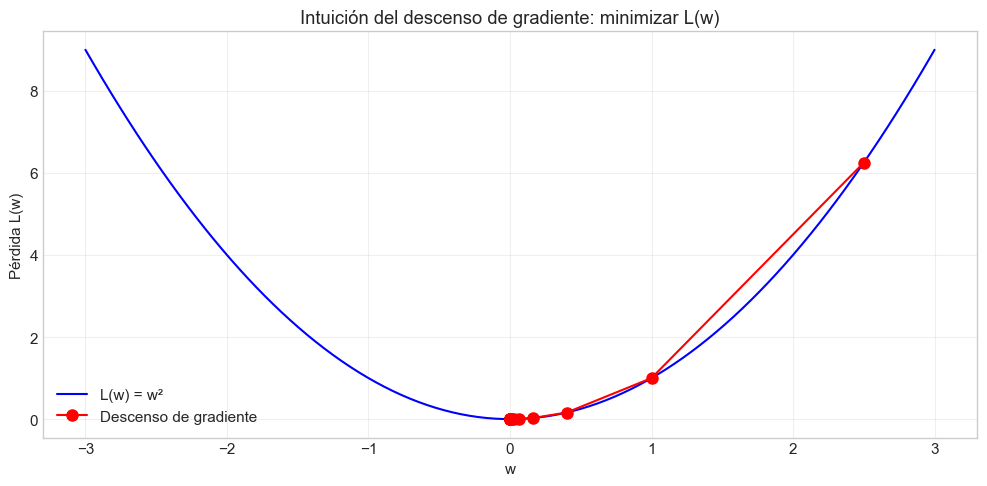
Antes del notebook aplicado: interpretar bien un entrenamiento requiere vocabulario de evaluación — división train/test, matriz de confusión, precision/recall/F1 y curva ROC/AUC. Ese desarrollo completo, con ejemplos, está en el capítulo de evaluación de modelos; acá basta con partir de esas ideas para leer bien los resultados que siguen.
6.5 5. Notebook Aplicado
En esta sección se implementa un MLP (Multi-Layer Perceptron) sencillo con una capa oculta, entrenado desde cero usando solo NumPy. No se usa PyTorch ni TensorFlow; el objetivo es mostrar explícitamente:
- Cómo se construye el forward pass (capas lineales + ReLU en oculta + sigmoid en salida).
- Cómo se calcula la pérdida (cross-entropy binaria).
- Cómo se obtienen los gradientes con la regla de la cadena (backpropagation) y se actualizan los pesos con descenso de gradiente.
Se usa un dataset de clasificación binaria sintético (generado con make_classification de scikit-learn), se hace división train/test, y se visualizan la curva de pérdida y el accuracy en train y test para observar el ajuste y evaluar su desempeño bajo esta partición; la cercanía train/test no basta por sí sola para demostrar generalización.
# 8.1 Carga del dataset

X, y = make_classification(
    n_samples=1000,
    n_features=20,
    n_informative=15,
    n_redundant=5,
    n_classes=2,
    random_state=42,
    flip_y=0.05  # Un poco de ruido
)

# Normalizar features (buena práctica)
X = (X - X.mean(axis=0)) / (X.std(axis=0) + 1e-8)

# División Train/Test (80% train, 20% test)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

print("Dataset cargado:")
print(f"  Train: {X_train.shape[0]} muestras, {X_train.shape[1]} features")
print(f"  Test:  {X_test.shape[0]} muestras")
print(f"  Clases: {np.unique(y)}")
Dataset cargado:
Train: 800 muestras, 20 features
Test: 200 muestras
Clases: [0 1]Código
# 8.2 Construcción del modelo básico (MLP desde cero)

class MLPClasificador:
    """
    MLP con 1 capa oculta: entrada -> ReLU -> salida -> Sigmoid
    """
    def __init__(self, n_input, n_hidden, n_output=1, lr=0.01, seed=42):
        np.random.seed(seed)
        self.lr = lr
        # Inicialización He (buena para ReLU)
        self.W1 = np.random.randn(n_input, n_hidden) * np.sqrt(2/n_input)
        self.b1 = np.zeros((1, n_hidden))
        self.W2 = np.random.randn(n_hidden, n_output) * np.sqrt(2/n_hidden)
        self.b2 = np.zeros((1, n_output))

    def sigmoid(self, z):
        return np.exp(-np.logaddexp(0., -z))

    def relu(self, z):
        return np.maximum(0, z)

    def relu_deriv(self, z):
        return (z > 0).astype(float)

    def forward(self, X):
        self.z1 = X @ self.W1 + self.b1
        self.a1 = self.relu(self.z1)
        self.z2 = self.a1 @ self.W2 + self.b2
        self.a2 = self.sigmoid(self.z2)
        return self.a2

    def backward(self, X, y, output):
        m = X.shape[0]
        # Gradiente de Cross-Entropy + Sigmoid: dL/dz2 = output - y
        dz2 = output - y.reshape(-1, 1)
        dW2 = (self.a1.T @ dz2) / m
        db2 = np.sum(dz2, axis=0, keepdims=True) / m

        da1 = dz2 @ self.W2.T
        dz1 = da1 * self.relu_deriv(self.z1)
        dW1 = (X.T @ dz1) / m
        db1 = np.sum(dz1, axis=0, keepdims=True) / m

        self.W2 -= self.lr * dW2
        self.b2 -= self.lr * db2
        self.W1 -= self.lr * dW1
        self.b1 -= self.lr * db1

    def fit(self, X, y, epochs=100, verbose=True):
        history = {'loss': [], 'accuracy': []}
        for i in range(epochs):
            output = self.forward(X)
            self.backward(X, y, output)
            output = self.forward(X)  # Medir con el estado posterior a la actualización.
            loss = np.mean(np.logaddexp(0., self.z2) - y.reshape(-1,1)*self.z2)
            pred = (output >= 0.5).astype(int).flatten()
            acc = np.mean(pred == y)
            history['loss'].append(loss)
            history['accuracy'].append(acc)
            if verbose and (i+1) % 20 == 0:
                print(f"Epoch {i+1}/{epochs} - Loss: {loss:.4f} - Accuracy: {acc:.4f}")
        return history

    def predict(self, X):
        return (self.forward(X) >= 0.5).astype(int).flatten()

# Crear modelo
modelo = MLPClasificador(n_input=20, n_hidden=32, lr=0.1)
# 8.3 Entrenamiento del MLP
history = modelo.fit(X_train, y_train, epochs=100, verbose=True)Epoch 20/100 - Loss: 0.4780 - Accuracy: 0.8075
Epoch 40/100 - Loss: 0.3922 - Accuracy: 0.8512
Epoch 60/100 - Loss: 0.3484 - Accuracy: 0.8788
Epoch 80/100 - Loss: 0.3195 - Accuracy: 0.8938
Epoch 100/100 - Loss: 0.2979 - Accuracy: 0.9012# 8.4 Visualización de curva de pérdida
plt.figure(figsize=(10, 4))
plt.plot(history['loss'], 'b-', linewidth=2)
plt.xlabel('Época')
plt.ylabel('Pérdida (Cross-Entropy)')
plt.title('Curva de pérdida durante el entrenamiento')
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()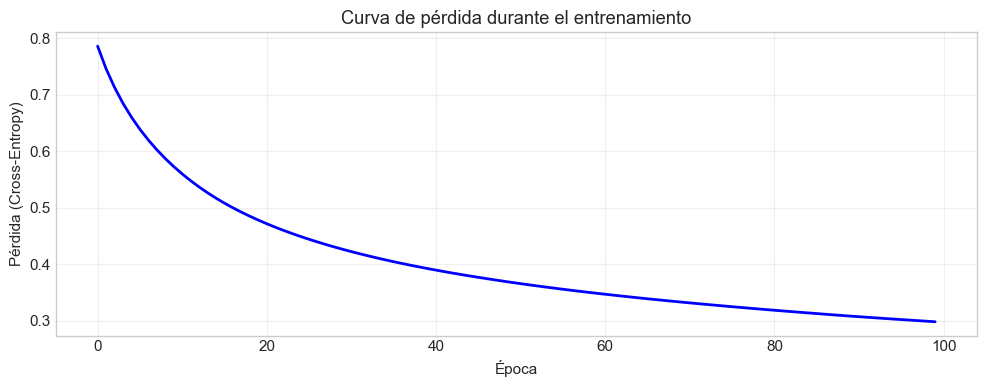
# 8.5 Visualización de accuracy

fig, axes = plt.subplots(1, 2, figsize=(12, 4))

axes[0].plot(history['accuracy'], 'green', linewidth=2)
axes[0].set_xlabel('Época')
axes[0].set_ylabel('Accuracy')
axes[0].set_title('Accuracy en entrenamiento')
axes[0].grid(True, alpha=0.3)

# Evaluar en test
y_pred_test = modelo.predict(X_test)
acc_test = np.mean(y_pred_test == y_test)
axes[1].bar(['Train', 'Test'], [history['accuracy'][-1], acc_test], color=['steelblue', 'coral'])
axes[1].set_ylabel('Accuracy')
axes[1].set_title('Comparación Train vs Test (generalización)')
axes[1].set_ylim(0, 1.05)
for i, v in enumerate([history['accuracy'][-1], acc_test]):
    axes[1].text(i, v + 0.02, f'{v:.3f}', ha='center', fontweight='bold')

plt.tight_layout()
plt.show()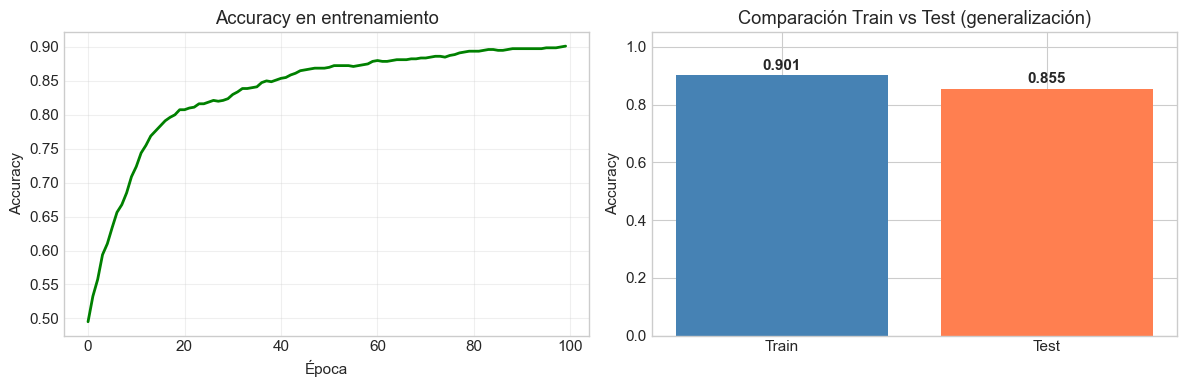
# Resumen final

print("=" * 50)
print("RESUMEN DEL MODELO")
print("=" * 50)
print(f"Accuracy en Train: {history['accuracy'][-1]:.4f}")
print(f"Accuracy en Test:  {acc_test:.4f}")
print(f"Pérdida final:     {history['loss'][-1]:.4f}")
print("\nTrain y Test próximos no bastan: compara nivel de desempeño, baseline y partición.")
print("Si Train >> Test → posible sobreajuste.")
==================================================
RESUMEN DEL MODELO
==================================================
Accuracy en Train: 0.9012
Accuracy en Test: 0.8550
Pérdida final: 0.2979
Train y Test próximos no bastan: compara nivel de desempeño, baseline y partición.
Si Train >> Test → posible sobreajuste.6.6 Sección final: Evaluación
A continuación se proponen 10 preguntas sobre los conceptos y el código presentados en el notebook. Tres de ellas hacen referencia a fragmentos concretos de código del propio notebook.
Deep Learning y datos: ¿Por qué el Deep Learning suele requerir grandes volúmenes de datos en comparación con el Machine Learning tradicional? Relacionar con el número de parámetros y el riesgo de sobreajuste.
Funciones de activación: ¿Qué papel cumple la función de activación no lineal en una red neuronal? ¿Qué pasaría si todas las capas fueran solo transformaciones lineales (sin activación)?
Pérdida MSE vs Cross-Entropy: Explica brevemente la diferencia entre MSE y Cross-Entropy binaria: ¿en qué tipo de tarea se usa cada una y por qué?
Learning rate: ¿Qué indica el learning rate \(\eta\) en el descenso de gradiente? ¿Qué problemas puede haber si \(\eta\) es demasiado alto o demasiado bajo?
Overfitting: ¿Qué significa overfitting y cómo se puede detectar observando las curvas de pérdida en train y en validación a lo largo de las épocas?
Métricas de clasificación: ¿Para qué sirve la matriz de confusión? ¿Qué información aportan las métricas Precision, Recall y F1 y cuándo son más útiles que el accuracy?
ROC y AUC: ¿Qué representa el AUC en una curva ROC? ¿Qué valores indican un buen clasificador, uno aleatorio y uno peor que aleatorio?
Forward del MLP (Sección 8): En el método
forwarddel MLP se calculaself.z1 = X @ self.W1 + self.b1y luegoself.a1 = self.relu(self.z1). ¿Qué representa z1 y qué representa a1? ¿Por qué se aplica ReLU en la capa oculta y no en la salida?Backward y gradiente (Sección 8): En el método
backwarddel mismo MLP aparece la líneadz2 = output - y.reshape(-1, 1). ¿Qué pérdida y qué activación de salida se están usando? ¿Por qué el gradiente respecto a la pre-activación de salida tiene exactamente esa forma?Matriz de confusión (Sección 7): En el ejemplo de métricas se usa
ConfusionMatrixDisplay(cm, display_labels=["Negativo", "Positivo"]). Según la convención de scikit-learn, ¿qué representan las filas y las columnas decm(clase real vs clase predicha)? ¿En qué posición de la matriz 2×2 estarían TN, FP, FN y TP?
6.6.1 Comprobación del gradiente y lectura del estado final
La BCE de la MLP se calcula de forma estable sobre logits con logaddexp. Las curvas se miden después de cada actualización, de modo que su último punto y la prueba usan el mismo estado. Se conserva la arquitectura, semilla, tasa y presupuesto de cien épocas; no se elige configuración con prueba. El control siguiente contrasta el gradiente manual de todas las matrices y sesgos con diferencias centrales, lejos de los quiebres de ReLU. Es una prueba del cálculo, no de calidad predictiva.
red_control=MLPClasificador(2,3,lr=.01,seed=73)
x_control=np.array([[.2,-.1],[.7,.3],[-.4,.8]])
y_control=np.array([0,1,1])
antes_control={k:getattr(red_control,k).copy() for k in ['W1','b1','W2','b2']}
salida_control=red_control.forward(x_control)
assert np.min(np.abs(red_control.z1))>1e-5
red_control.backward(x_control,y_control,salida_control)
grad_control={k:(antes_control[k]-getattr(red_control,k))/.01 for k in antes_control}
for k,v in antes_control.items():setattr(red_control,k,v.copy())
errores_control=[]
def perdida_control():
    red_control.forward(x_control)
    return np.mean(np.logaddexp(0.,red_control.z2)-y_control[:,None]*red_control.z2)
for k,v in antes_control.items():
    for idx in np.ndindex(v.shape):
        getattr(red_control,k)[idx]+=1e-6;mas=perdida_control()
        getattr(red_control,k)[idx]-=2e-6;menos=perdida_control()
        getattr(red_control,k)[idx]+=1e-6
        errores_control.append(abs((mas-menos)/(2e-6)-grad_control[k][idx]))
assert max(errores_control)<1e-7
assert np.isfinite(np.logaddexp(0.,np.array([-1000.,1000.]))-np.array([0.,1.])*np.array([-1000.,1000.])).all()
modelo.forward(X_train)
ce_final_control=np.mean(np.logaddexp(0.,modelo.z2)-y_train[:,None]*modelo.z2)
assert np.isclose(history['loss'][-1],ce_final_control)
assert np.isclose(history['accuracy'][-1],np.mean(modelo.predict(X_train)==y_train))
print('Gradientes manuales verificados; error máximo:',max(errores_control))
print('Curvas y evaluación final usan el mismo estado; BCE extrema finita.')
Gradientes manuales verificados; error máximo: 1.1868075966425806e-10
Curvas y evaluación final usan el mismo estado; BCE extrema finita.6.7 Referencias
- Rumelhart, Hinton y Williams (1986), Learning representations by back-propagating errors.
- Goodfellow, Bengio y Courville (2016), Deep Learning, capítulo 6.
- PyTorch: BCE con logits, ejemplo de pérdida numéricamente estable.