16  Robustez e interpretabilidad

Serie Deep Learning · del perceptrón a los transformers.

Una exactitud alta en imágenes limpias deja preguntas abiertas: ¿qué clases fallan?, ¿la probabilidad predicha coincide con la frecuencia de aciertos?, ¿qué cambia con ruido o desplazamientos? Contrastaremos aumento de datos, métricas por clase, calibración, Grad-CAM y perturbaciones declaradas. Los resultados orientan experimentos posteriores; no convierten Fashion-MNIST en una evaluación de fotografías comerciales reales.

16.1 1. Entorno y contrato

Se requieren PyTorch, torchvision, NumPy, pandas, Matplotlib, scikit-learn y Pillow en el entorno del kernel. Los datos se leen de la caché o se descargan desde su distribución oficial. La ejecución registrada usa CPU; CUDA se selecciona si está disponible, pero no se declara comprobada en GPU.

Retomamos Fundamentos de CNN y Clasificación con CNN. Los helpers siguientes quedan plegados para poder consultar el cálculo sin interrumpir la lectura.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

16.1.1 Qué se mantiene constante

El motor calcula train y validación al cierre de cada época en eval, guarda la pérdida online por separado y restaura el mínimo de CE de validación con todo el state_dict. Las redes producen logits, las etiquetas son enteros long y softmax se usa para interpretar. La prueba no participa en la selección del checkpoint.

Dentro de la pareja Fashion-MNIST igualamos arquitectura, pesos iniciales, particiones y orden de lotes. El aumento usa un generador propio para no consumir el generador del muestreo ni alterar la inicialización. Cambia la imagen vista durante el gradiente, mientras la evaluación permanece limpia. Esto controla esta comparación; una sola semilla no estima su variabilidad.

16.2 2. Leer curvas sin convertirlas en un diagnóstico automático

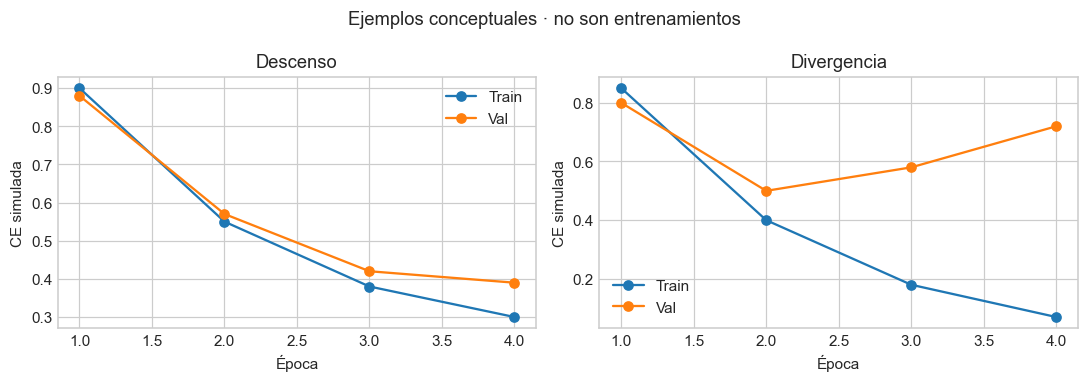
Los ejemplos siguientes son simulados y sólo ilustran patrones. Un aumento de CE de validación puede aparecer con exactitud casi constante si los errores se vuelven más seguros. La divergencia entre train y val invita a revisar datos, regularización y dificultad de la partición; no demuestra por sí sola memorización. La figura no sustituye las mediciones del experimento real.

fig,axes=plt.subplots(1,2,figsize=(10,3.5))
for ax,t,tr,va in [(axes[0],'Descenso',[.9,.55,.38,.30],[.88,.57,.42,.39]),(axes[1],'Divergencia',[.85,.4,.18,.07],[.8,.5,.58,.72])]:
    ax.plot(range(1,5),tr,'-o',label='Train');ax.plot(range(1,5),va,'-o',label='Val');ax.set(title=t,xlabel='Época',ylabel='CE simulada');ax.legend()
fig.suptitle('Ejemplos conceptuales · no son entrenamientos');fig.tight_layout();plt.show()
16.3 3. Fashion-MNIST y la comparación controlada

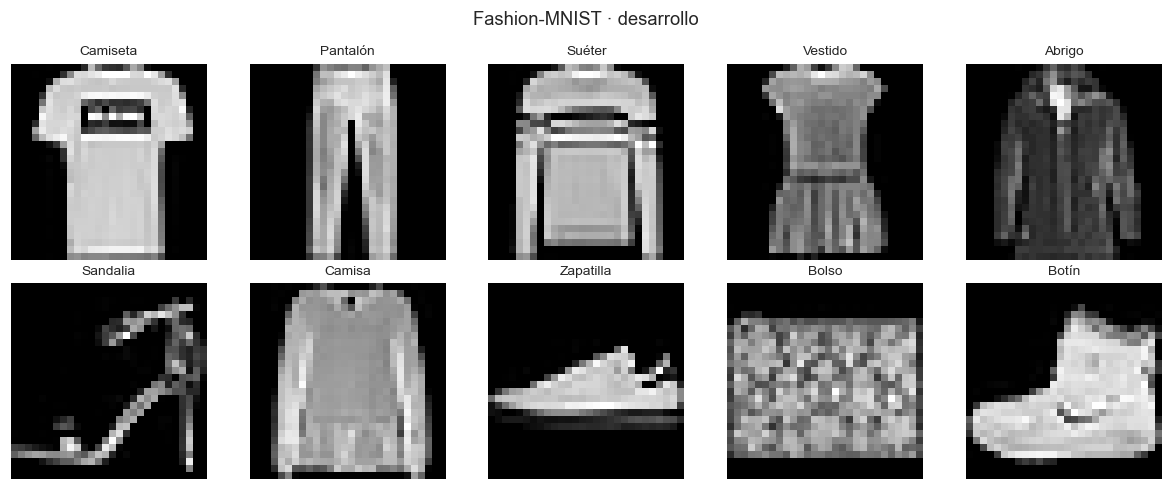
Conservamos las primeras 12 000 imágenes oficiales de desarrollo. Como en el protocolo anterior, las últimas 1 800 forman validación y las primeras 10 200 entrenamiento; las 10 000 oficiales de prueba quedan aparte. No se afirma estratificación: se muestran los conteos.

Son siluetas en gris de 28×28, no fotografías de clientes. Los ejemplos ayudan a estudiar sensibilidad espacial y apariencia; no reproducen iluminación, cámara, fondo ni distribución de un catálogo comercial.

xf,yf,xt,yt=mnist('fashion');nombres=['Camiseta','Pantalón','Suéter','Vestido','Abrigo','Sandalia','Camisa','Zapatilla','Bolso','Botín']
itr=np.arange(10200);iva=np.arange(10200,12000)
train=conjunto(xf[itr,None].astype(np.float32)/255,yf[itr]);val=conjunto(xf[iva,None].astype(np.float32)/255,yf[iva]);test=conjunto(xt[:,None].astype(np.float32)/255,yt)
np.savez_compressed(ARTEFACTOS/'fashion-particiones.npz',train=itr,val=iva,test=np.arange(len(yt)))
galeria(xf[:12000],yf[:12000],nombres,'Fashion-MNIST · desarrollo')
display(pd.DataFrame({'train':np.bincount(yf[itr],minlength=10),'val':np.bincount(yf[iva],minlength=10),'test':np.bincount(yt,minlength=10)},index=nombres))

train val test
Camiseta 957 165 1000
Pantalón 1048 172 1000
Suéter 1032 169 1000
Vestido 1044 168 1000
Abrigo 983 198 1000
Sandalia 1011 193 1000
Camisa 1046 198 1000
Zapatilla 1039 153 1000
Bolso 1012 183 1000
Botín 1028 201 1000

16.4 4. Aumento de datos: una hipótesis de equivalencia

Se conserva flip horizontal con probabilidad 0,5, rotación de hasta \(\pm28,8^\circ\) (el factor 0,08 de una vuelta completa) y traslaciones de hasta 8 % por eje. Usamos interpolación bilineal y reflexión fuera de la imagen. La implementación explícita con affine_grid/grid_sample permite ver la geometría y usa parámetros independientes por imagen, no una sola transformación para todo el lote.

No se promete equivalencia píxel a píxel con otra biblioteca. El convenio de coordenadas y la interpolación pueden cambiar resultados. Estas transformaciones expresan una hipótesis sobre la etiqueta: no inventan clases ni garantizan que todos los recortes sigan siendo reconocibles. En otros dominios, invertir una imagen o girarla puede cambiar el significado.

class Aumento(nn.Module):
    def __init__(self,activo):
        super().__init__();self.activo=activo;self.generador=torch.Generator().manual_seed(7042)
    def forward(self,x):
        if not(self.training and self.activo): return x
        n=len(x);r=torch.rand((n,4),generator=self.generador).to(x.device)
        x=torch.where((r[:,0]<.5)[:,None,None,None],x.flip(-1),x)
        angulo=(2*r[:,1]-1)*(.08*2*np.pi)
        theta=torch.zeros(n,2,3,device=x.device,dtype=x.dtype)
        theta[:,0,0]=angulo.cos();theta[:,0,1]=-angulo.sin()
        theta[:,1,0]=angulo.sin();theta[:,1,1]=angulo.cos()
        theta[:,:,2]=(2*r[:,2:]-1)*.16
        grid=F.affine_grid(theta,x.shape,align_corners=False)
        return F.grid_sample(x,grid,mode='bilinear',padding_mode='reflection',align_corners=False)
class CNN(nn.Module):
    def __init__(self,aumento=False,canales=1,tamano=28,clases=10):
        super().__init__();self.aumento=Aumento(aumento);self.conv1=nn.Conv2d(canales,32,3,padding=1);self.conv2=nn.Conv2d(32,64,3,padding=1)
        self.oculta=nn.Linear(64*(tamano//4)**2,64);self.salida=nn.Linear(64,clases)
    def forward(self,x,devolver_mapas=False):
        x=self.aumento(x);x=F.max_pool2d(F.relu(self.conv1(x)),2)
        mapas=F.relu(self.conv2(x));x=F.max_pool2d(mapas,2).flatten(1)
        z=self.salida(F.relu(self.oculta(x)))
        return (z,mapas) if devolver_mapas else z
semilla();sin=inicializar(CNN(False));con=inicializar(CNN(True));con.load_state_dict(sin.state_dict())
assert all(torch.equal(sin.state_dict()[k],con.state_dict()[k]) for k in sin.state_dict())
assert parametros(sin)==parametros(con)
aum=Aumento(True).train();muestra=train.tensors[0][3:4]
fig,axes=plt.subplots(1,6,figsize=(12,2.6))
axes[0].imshow(muestra[0,0],cmap='gray');axes[0].set_title('Original')
for ax in axes[1:]: ax.imshow(aum(muestra)[0,0],cmap='gray');ax.set_title('Aumentada')
for ax in axes: ax.axis('off')
fig.suptitle('Una etiqueta · distintas realizaciones de la transformación');fig.tight_layout();plt.show()
aum.eval();torch.testing.assert_close(aum(muestra),muestra,rtol=0,atol=0)
print('Pesos iniciales iguales; parámetros:',parametros(sin),'· aumento desactivado en eval')

Pesos iniciales iguales; parámetros: 220234 · aumento desactivado en eval

16.5 5. Entrenar y elegir con validación

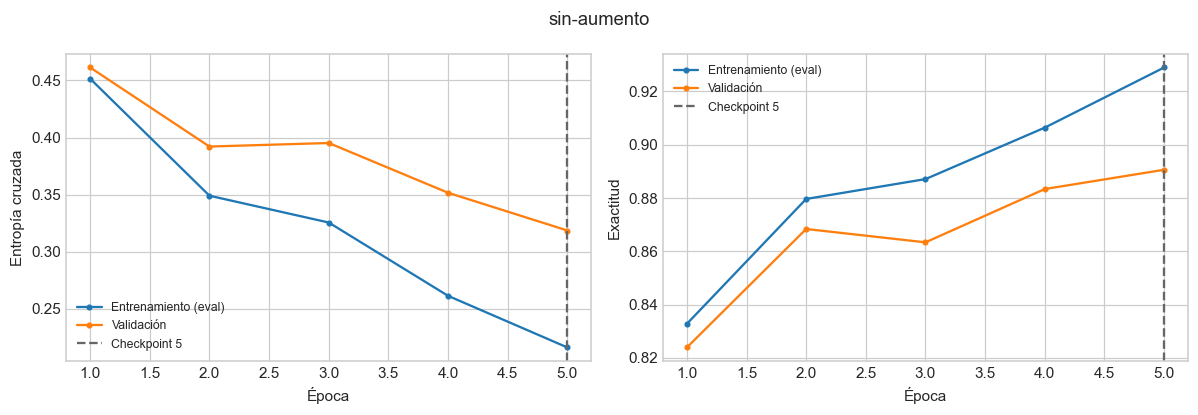
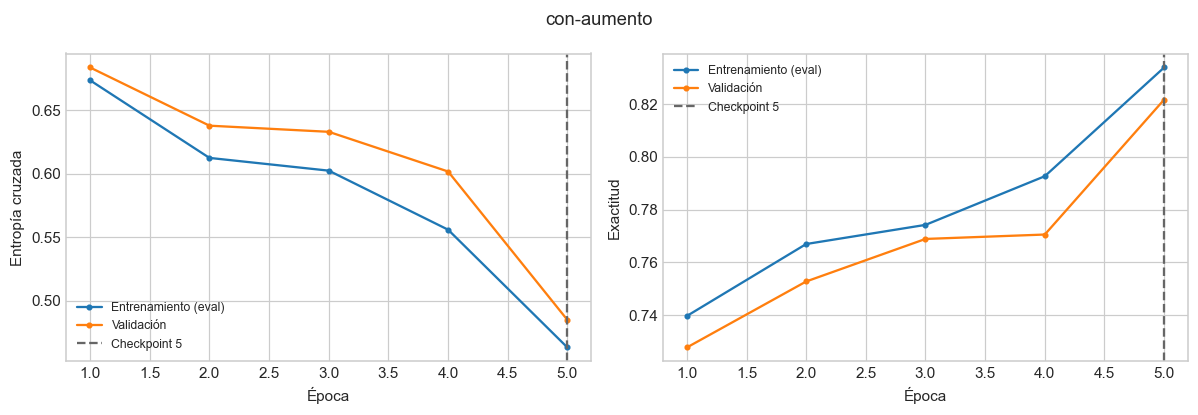
Se conservan cinco épocas como máximo, Adam 0,001, lotes de 128 y paciencia dos. El aumento está dentro del modelo y sólo actúa en train; las curvas comparables usan imágenes limpias en eval. Una pérdida online mayor en el modelo aumentado no equivale a peor ajuste sobre las imágenes limpias.

La menor CE de validación limpia decide qué configuración conservar. La evaluación de perturbaciones queda fijada de antemano como diagnóstico de prueba; no se utiliza después para cambiar al ganador. Para seleccionar por robustez habría que diseñar un protocolo de validación con perturbaciones antes de consultar prueba.

modelos={'sin-aumento':sin,'con-aumento':con};historias={};resumenes={}
for nombre,m in modelos.items():
    semilla();h,r=entrenar(m,train,val,5,lote=128,paciencia=2,nombre=nombre)
    historias[nombre]=h;resumenes[nombre]=r;curvas(h,nombre,r['mejor_epoca']);lectura(h,r)
ganador=min(resumenes,key=lambda k:resumenes[k]['ce_val']);print('Elegido por CE de validación limpia:',ganador)
sin-aumento 1/5: CE val=0.4613, acc val=0.8239
sin-aumento 2/5: CE val=0.3921, acc val=0.8683
sin-aumento 3/5: CE val=0.3952, acc val=0.8633
sin-aumento 4/5: CE val=0.3516, acc val=0.8833
sin-aumento 5/5: CE val=0.3186, acc val=0.8906

Lectura del experimento. Se ejecutaron 5 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 5, con CE 0.3186. Al cierre, la brecha de exactitud train−val es +3.84 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.

con-aumento 1/5: CE val=0.6836, acc val=0.7278
con-aumento 2/5: CE val=0.6378, acc val=0.7528
con-aumento 3/5: CE val=0.6330, acc val=0.7689
con-aumento 4/5: CE val=0.6018, acc val=0.7706
con-aumento 5/5: CE val=0.4850, acc val=0.8217

Lectura del experimento. Se ejecutaron 5 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 5, con CE 0.4850. Al cierre, la brecha de exactitud train−val es +1.22 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.

Elegido por CE de validación limpia: sin-aumento

16.6 6. Del promedio a las clases y sus errores

Abrimos ahora la prueba oficial. Además de CE y exactitud, calculamos macro-F1 y weighted-F1. Macro-F1 da el mismo peso a cada clase; weighted-F1 pondera su soporte. Una diferencia entre ambos requiere mirar qué clases y frecuencias la producen, no asignarle automáticamente una causa.

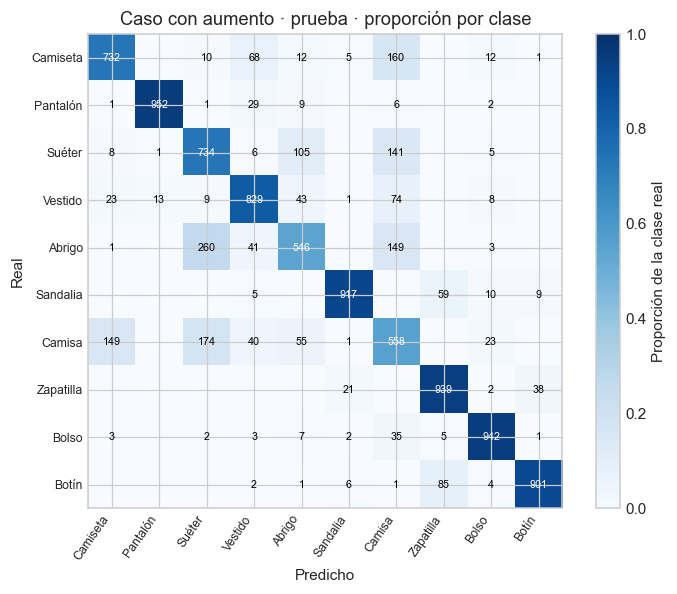
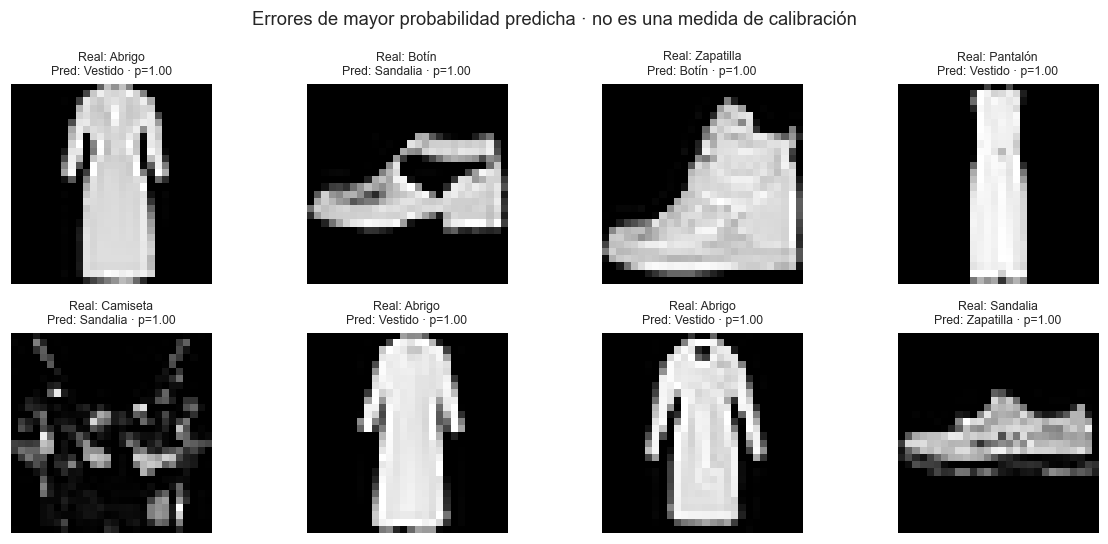
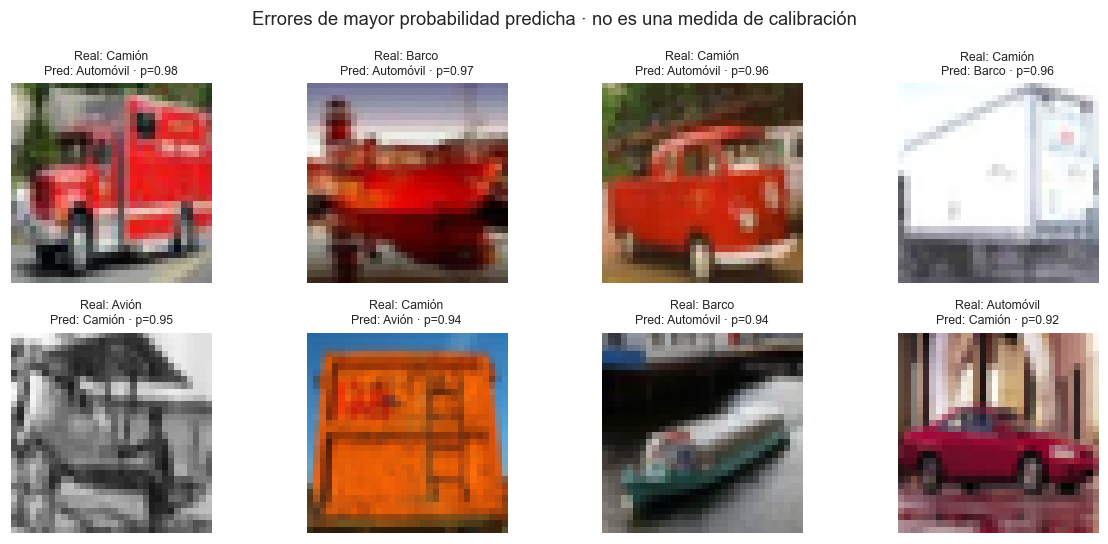
El informe detallado del modelo con aumento está prefijado como caso de estudio, aunque no resulte seleccionado. Las imágenes de mayor probabilidad predicha son una forma de ordenar la revisión, no evidencia suficiente de calibración ni de ambigüedad intrínseca de la etiqueta.

resultados={};filas=[]
for nombre,m in modelos.items():
    rr=evaluar(m,test);resultados[nombre]=rr;pred=rr['logits'].argmax(1)
    filas.append({**resumenes[nombre],'acc_test':rr['exactitud'],'ce_test':rr['ce'],'macro_f1':f1_score(yt,pred,average='macro'),'weighted_f1':f1_score(yt,pred,average='weighted')})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'comparacion.csv',index=False)
ra=resultados['con-aumento'];diagnostico(ra,nombres,test.tensors[0].numpy(),'Caso con aumento · prueba')
p=ra['probabilidades'];pred=p.argmax(1);conf=p.max(1);err=pred!=yt
print('Errores:',int(err.sum()),'· errores con p≥0,90:',int((err&(conf>=.9)).sum()))
print('Probabilidad máxima media · aciertos:',float(conf[~err].mean()),'· errores:',float(conf[err].mean()) if err.any() else None)
modelo mejor_epoca epocas ce_val segundos parametros entrenables acc_test ce_test macro_f1 weighted_f1
0 sin-aumento 5 5 0.318580 71.968055 220234 220234 0.8808 0.33537 0.881079 0.881079
1 con-aumento 5 5 0.484971 62.098007 220234 220234 0.8050 0.53127 0.806109 0.806109
              precision    recall  f1-score   support

    Camiseta     0.7983    0.7320    0.7637      1000
    Pantalón     0.9855    0.9520    0.9685      1000
      Suéter     0.6168    0.7340    0.6703      1000
     Vestido     0.8104    0.8290    0.8196      1000
      Abrigo     0.7018    0.5460    0.6142      1000
    Sandalia     0.9622    0.9170    0.9391      1000
      Camisa     0.4964    0.5580    0.5254      1000
   Zapatilla     0.8631    0.9390    0.8994      1000
       Bolso     0.9318    0.9420    0.9368      1000
       Botín     0.9484    0.9010    0.9241      1000

    accuracy                         0.8050     10000
   macro avg     0.8115    0.8050    0.8061     10000
weighted avg     0.8115    0.8050    0.8061     10000

Decisión después de medir. Exactitud 80.50%; macro-F1 0.8061; 1950 errores de 10000. El menor recall corresponde a Abrigo (54.60%). La confusión más frecuente es Abrigo → Suéter (260 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

Errores: 1950 · errores con p≥0,90: 176
Probabilidad máxima media · aciertos: 0.883240818977356 · errores: 0.6303923726081848

16.6.1 Camiseta y camisa sin ocultar otras predicciones

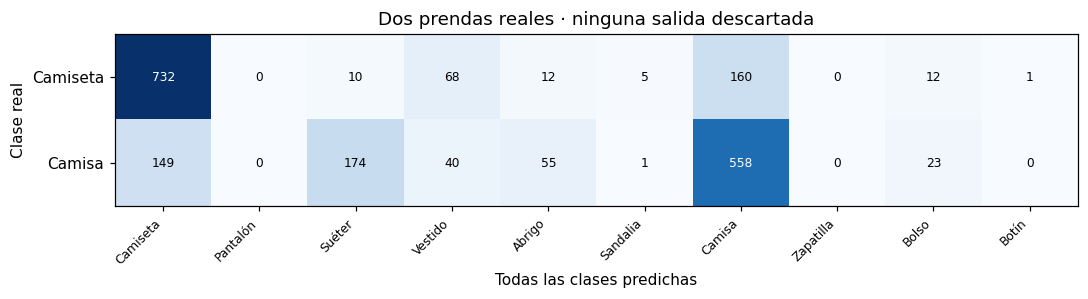
Una matriz 2×2 limitada a dos etiquetas puede omitir los casos enviados a las otras ocho. Mostramos las dos clases reales y las diez clases predichas. El soporte de cada fila debe conservarse completo. Un error hacia abrigo o suéter también cuenta para el recall de camisa. Asimetría no demuestra que un umbral, el aumento o la etiqueta sean la causa: genera hipótesis que deben contrastarse.

cm=confusion_matrix(yt,pred,labels=np.arange(10));sub=cm[[0,6],:]
assert np.array_equal(sub.sum(1),np.array([(yt==0).sum(),(yt==6).sum()]))
fig,ax=plt.subplots(figsize=(10,2.8));im=ax.imshow(sub,cmap='Blues',aspect='auto')
ax.set_xticks(range(10),nombres,rotation=45,ha='right',fontsize=8);ax.set_yticks([0,1],[nombres[0],nombres[6]])
for i in range(2):
    for j in range(10): ax.text(j,i,str(sub[i,j]),ha='center',va='center',fontsize=8,color='white' if sub[i,j]>.5*sub.max() else 'black')
ax.set(xlabel='Todas las clases predichas',ylabel='Clase real',title='Dos prendas reales · ninguna salida descartada');fig.tight_layout();plt.show()
display(pd.DataFrame(sub,index=[nombres[0],nombres[6]],columns=nombres))

Camiseta Pantalón Suéter Vestido Abrigo Sandalia Camisa Zapatilla Bolso Botín
Camiseta 732 0 10 68 12 5 160 0 12 1
Camisa 149 0 174 40 55 1 558 0 23 0

16.7 7. Grad-CAM sobre logits

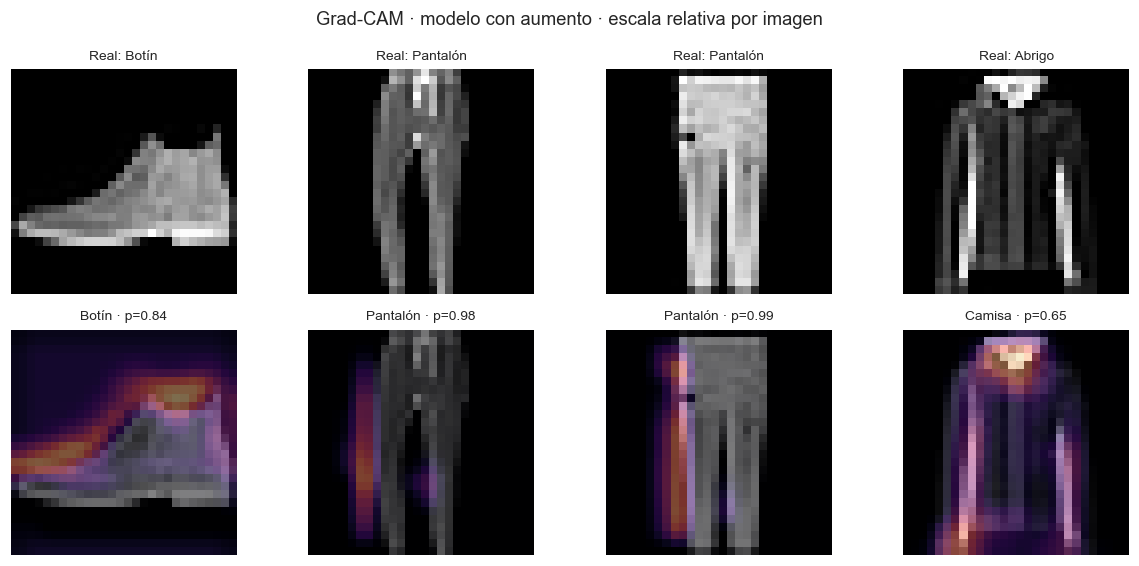
Grad-CAM combina mapas de la última convolución usando promedios espaciales de sus gradientes respecto del logit de una clase. Usamos el logit predicho, no la probabilidad softmax, para evitar que la saturación de la normalización reduzca artificialmente la señal. La clase objetivo se explicita; podría elegirse otra para contrastar.

La red está en eval, pero aquí se necesita autograd: no usamos inference_mode. ReLU conserva contribuciones positivas y la normalización facilita la visualización. Si no queda señal positiva, el mapa es cero y se indica. La resolución original de 14×14 limita el detalle; interpolarla a 28×28 no añade evidencia espacial.

Un mapa no prueba causalidad, comprensión semántica ni corrección de la predicción. La intensidad normalizada tampoco es comparable entre imágenes. Para estudiar una hipótesis habría que intervenir entradas y medir efectos, como se discute en ViT y multimodalidad.

def grad_cam(modelo,x,clase=None):
    modelo.eval();entrada=x.detach().clone().to(DEVICE).requires_grad_(True)
    with torch.enable_grad():
        z,mapas=modelo(entrada,devolver_mapas=True)
        objetivo=int(z[0].argmax()) if clase is None else int(clase)
        grad=torch.autograd.grad(z[0,objetivo],mapas)[0]
        cam=F.relu((grad.mean((2,3),keepdim=True)*mapas).sum(1,keepdim=True))
        maximo=cam.amax();sin_senal=bool(maximo<=1e-12)
        cam=cam/maximo.clamp_min(1e-12)
        cam=F.interpolate(cam,size=entrada.shape[-2:],mode='bilinear',align_corners=False)
    assert torch.isfinite(cam).all()
    return cam[0,0].detach().cpu().numpy(),objetivo,float(z.softmax(1)[0,objetivo].detach()),sin_senal
antes={k:v.cpu().clone() for k,v in con.state_dict().items()}
indices=[0,80,200]+([int(np.flatnonzero(err)[0])] if err.any() else [1])
fig,axes=plt.subplots(2,4,figsize=(11,5.2));cams=[]
for col,j in enumerate(indices):
    cam,k,q,cero=grad_cam(con,test.tensors[0][j:j+1]);cams.append(cam)
    axes[0,col].imshow(xt[j],cmap='gray');axes[0,col].set_title('Real: '+nombres[yt[j]],fontsize=9)
    axes[1,col].imshow(xt[j],cmap='gray');axes[1,col].imshow(cam,cmap='magma',alpha=.5,vmin=0,vmax=1)
    axes[1,col].set_title(f'{nombres[k]} · p={q:.2f}'+('\nSin señal positiva' if cero else ''),fontsize=9)
for ax in axes.flat: ax.axis('off')
fig.suptitle('Grad-CAM · modelo con aumento · escala relativa por imagen');fig.tight_layout();plt.show()
assert all(torch.equal(v.cpu(),antes[k]) for k,v in con.state_dict().items())
np.savez_compressed(ARTEFACTOS/'gradcam.npz',indices=indices,mapas=np.stack(cams))
print('Grad-CAM finito; pesos y buffers sin cambios')

Grad-CAM finito; pesos y buffers sin cambios

16.8 8. Ruido y desplazamientos: medir el cambio

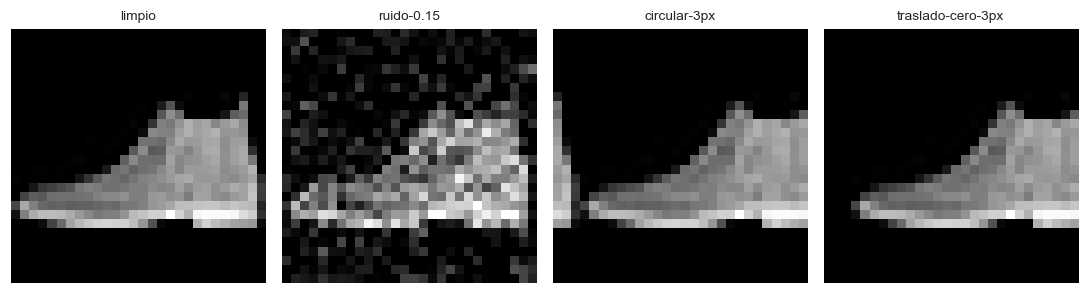
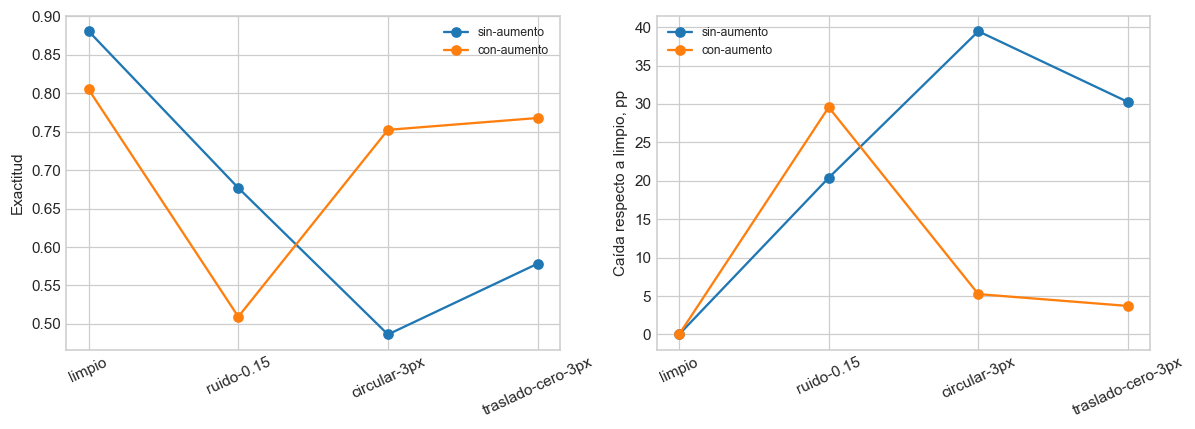
Fijamos ruido gaussiano con desviación 0,15 sobre escala [0,1], con recorte posterior, y desplazamiento horizontal de tres píxeles. Ambas redes reciben exactamente las mismas realizaciones. Conservamos también el roll histórico, pero lo llamamos circular: reinserta por el otro borde los píxeles que salen. Añadimos el desplazamiento con fondo cero para distinguirlo de una traslación sin envoltura.

Son perturbaciones sintéticas, no fotografías reales ni ataques adversarios optimizados. La caída limpia−perturbada puede ser negativa si una transformación mejora el resultado. Se informan exactitud, CE y macro-F1: conservar exactitud no garantiza conservar probabilidades útiles.

limpio=test.tensors[0].numpy();rng=np.random.default_rng(SEED)
ruido=np.clip(limpio+rng.normal(0,.15,limpio.shape).astype(np.float32),0,1)
circular=np.roll(limpio,3,axis=3)
traslado=np.zeros_like(limpio);traslado[:,:,:,3:]=limpio[:,:,:,:-3]
assert np.all(traslado[:,:,:,:3]==0)
condiciones={'limpio':limpio,'ruido-0.15':ruido,'circular-3px':circular,'traslado-cero-3px':traslado}
filas=[]
for nombre,m in modelos.items():
    base=resultados[nombre]['exactitud']
    for condicion,xx in condiciones.items():
        rr=resultados[nombre] if condicion=='limpio' else evaluar(m,conjunto(xx,yt))
        filas.append({'modelo':nombre,'condicion':condicion,'exactitud':rr['exactitud'],'ce':rr['ce'],'macro_f1':f1_score(yt,rr['logits'].argmax(1),average='macro'),'caida_pp':100*(base-rr['exactitud'])})
robustez=pd.DataFrame(filas);display(robustez);robustez.to_csv(ARTEFACTOS/'robustez.csv',index=False)
fig,axes=plt.subplots(1,4,figsize=(10,3))
for ax,(t,xx) in zip(axes,condiciones.items()): ax.imshow(xx[0,0],cmap='gray');ax.set_title(t,fontsize=9);ax.axis('off')
fig.tight_layout();plt.show()
fig,axes=plt.subplots(1,2,figsize=(11,4))
for nombre,g in robustez.groupby('modelo',sort=False):
    axes[0].plot(g.condicion,g.exactitud,'-o',label=nombre);axes[1].plot(g.condicion,g.caida_pp,'-o',label=nombre)
for ax,t in zip(axes,['Exactitud','Caída respecto a limpio, pp']): ax.set_ylabel(t);ax.tick_params(axis='x',rotation=25);ax.legend(fontsize=8)
fig.tight_layout();plt.show()
for nombre in modelos:
    g=robustez[robustez.modelo==nombre];peor=g.loc[g.caida_pp.idxmax()]
    display(Markdown(f'**{nombre}:** mayor caída observada bajo {peor.condicion}: {peor.caida_pp:+.2f} puntos. La conclusión está limitada a estas transformaciones e intensidades; no demuestra resistencia a cualquier cambio de dominio.'))
modelo condicion exactitud ce macro_f1 caida_pp
0 sin-aumento limpio 0.8808 0.335370 0.881079 0.00
1 sin-aumento ruido-0.15 0.6769 0.815567 0.682760 20.39
2 sin-aumento circular-3px 0.4862 1.643528 0.481289 39.46
3 sin-aumento traslado-cero-3px 0.5783 1.272868 0.558181 30.25
4 con-aumento limpio 0.8050 0.531270 0.806109 0.00
5 con-aumento ruido-0.15 0.5093 1.426841 0.499019 29.57
6 con-aumento circular-3px 0.7525 0.697103 0.747551 5.25
7 con-aumento traslado-cero-3px 0.7679 0.640765 0.765535 3.71

sin-aumento: mayor caída observada bajo circular-3px: +39.46 puntos. La conclusión está limitada a estas transformaciones e intensidades; no demuestra resistencia a cualquier cambio de dominio.

con-aumento: mayor caída observada bajo ruido-0.15: +29.57 puntos. La conclusión está limitada a estas transformaciones e intensidades; no demuestra resistencia a cualquier cambio de dominio.

16.9 9. Calibración: frecuencia de aciertos frente a probabilidad

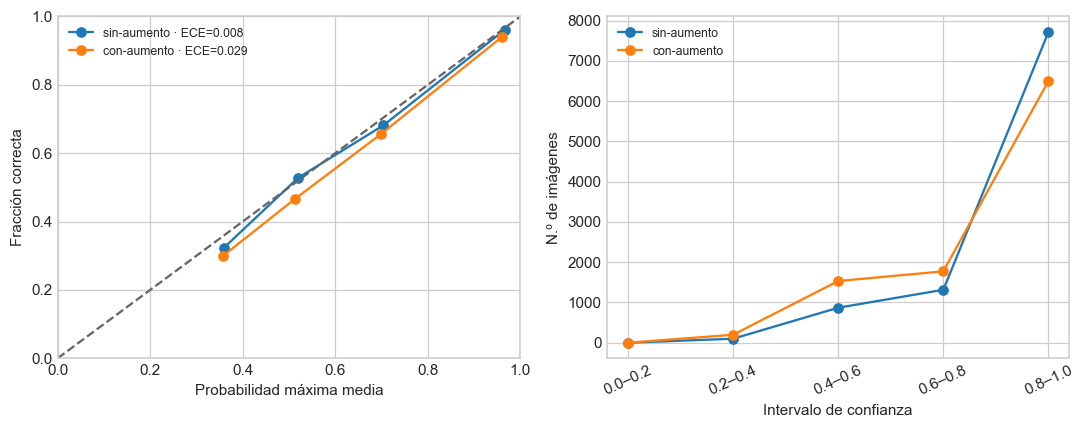
Agrupamos la probabilidad máxima en cinco intervalos. El último incluye exactamente 1,0; ningún ejemplo puede desaparecer. Para cada intervalo informamos cantidad, confianza media y exactitud. El ECE suma las diferencias absolutas ponderadas por frecuencia; depende de los intervalos y puede ocultar problemas por clase o región.

El diagrama es diagnóstico del test, no un ajuste de temperatura ni una selección de umbral de rechazo. Cualquier calibración posterior requiere un conjunto de calibración separado o una división de validación apropiada. Rechazar ejemplos cambia cobertura y riesgo, pero no recalibra por sí solo las probabilidades.

def calibracion(prob,y):
    confianza=prob.max(1);correcto=prob.argmax(1)==y
    bins=np.linspace(0,1,6);grupo=np.clip(np.searchsorted(bins,confianza,side='right')-1,0,4)
    filas=[]
    for b in range(5):
        sel=grupo==b;n=int(sel.sum())
        filas.append({'intervalo':f'{bins[b]:.1f}–{bins[b+1]:.1f}','n':n,
            'confianza':float(confianza[sel].mean()) if n else np.nan,'exactitud':float(correcto[sel].mean()) if n else np.nan})
    t=pd.DataFrame(filas);assert t.n.sum()==len(y)
    ece=float(((t.confianza-t.exactitud).abs().fillna(0)*t.n/len(y)).sum())
    return t,ece
# Verificar el borde de probabilidad exactamente uno y un intervalo vacío.
control,ece_control=calibracion(np.array([[1.,0],[0,1.]]),np.array([0,1]));assert control.n.sum()==2 and ece_control==0
tablas=[];fig,axes=plt.subplots(1,2,figsize=(10,4))
for nombre,rr in resultados.items():
    t,ece=calibracion(rr['probabilidades'],yt);t['modelo']=nombre;tablas.append(t)
    v=t[t.n>0];axes[0].plot(v.confianza,v.exactitud,'-o',label=f'{nombre} · ECE={ece:.3f}')
    axes[1].plot(t.intervalo,t.n,'-o',label=nombre);print(nombre,'ECE:',round(ece,4));display(t)
axes[0].plot([0,1],[0,1],'--',color='.4');axes[0].set(xlabel='Probabilidad máxima media',ylabel='Fracción correcta',xlim=(0,1),ylim=(0,1))
axes[1].set(xlabel='Intervalo de confianza',ylabel='N.º de imágenes');axes[1].tick_params(axis='x',rotation=25)
for ax in axes: ax.legend(fontsize=8)
fig.tight_layout();plt.show()
pd.concat(tablas).to_csv(ARTEFACTOS/'calibracion.csv',index=False)
sin-aumento ECE: 0.0081
intervalo n confianza exactitud modelo
0 0.0–0.2 0 NaN NaN sin-aumento
1 0.2–0.4 99 0.359232 0.323232 sin-aumento
2 0.4–0.6 869 0.519983 0.528193 sin-aumento
3 0.6–0.8 1315 0.703877 0.681369 sin-aumento
4 0.8–1.0 7717 0.966939 0.961643 sin-aumento
con-aumento ECE: 0.0289
intervalo n confianza exactitud modelo
0 0.0–0.2 0 NaN NaN con-aumento
1 0.2–0.4 197 0.357388 0.299492 con-aumento
2 0.4–0.6 1532 0.512840 0.466057 con-aumento
3 0.6–0.8 1773 0.699459 0.656514 con-aumento
4 0.8–1.0 6498 0.960778 0.940751 con-aumento

16.10 10. Un segundo dominio RGB: CIFAR-10

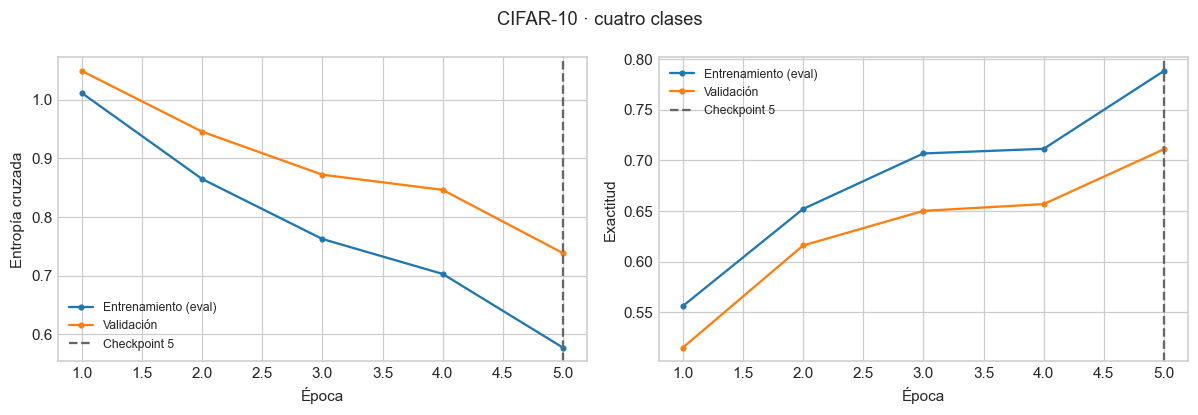
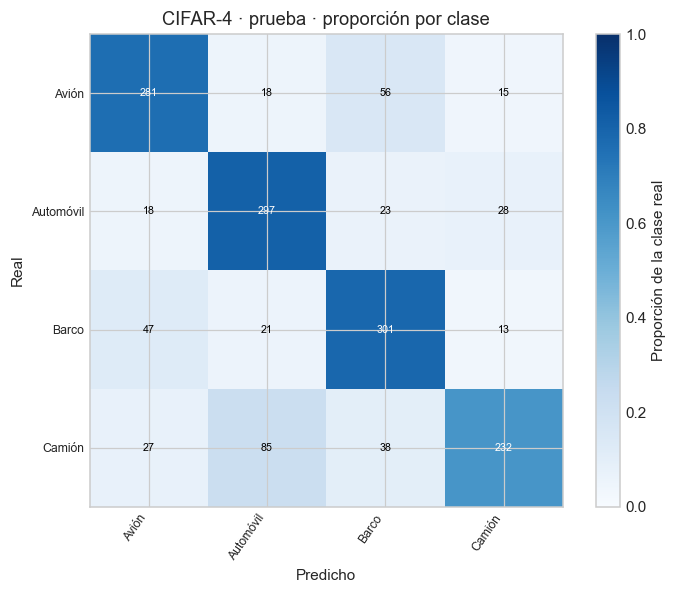
Conservamos las clases avión, automóvil, barco y camión, las primeras 6 000 imágenes de desarrollo filtradas y las primeras 1 500 de prueba filtradas. La división histórica usa 4 800 para entrenar y 1 200 para validar; cinco épocas, lote 64 y paciencia dos. Es clasificación de objetos, no detección de defectos ni control industrial validado.

El modelo mantiene dos convoluciones 32/64, pooling y una capa densa de 64 unidades. La lectura por clase sigue siendo necesaria aunque haya cuatro etiquetas. Un recall bajo de barco describe errores sobre estas miniaturas; no permite estimar pérdidas operativas en una línea de logística real.

import pickle
from torchvision.datasets import CIFAR10
cache=Path.home()/'.keras'/'datasets'/'cifar-10-batches-py-target'/'cifar-10-batches-py'
if cache.is_dir():
    def leer(p):
        with p.open('rb') as f: d=pickle.load(f,encoding='bytes')
        return d[b'data'].reshape(-1,3,32,32),np.array(d[b'labels'])
    lotes=[leer(cache/f'data_batch_{i}') for i in range(1,6)];xx=np.concatenate([a for a,b in lotes]);yy=np.concatenate([b for a,b in lotes]);tx,ty=leer(cache/'test_batch')
else:
    a=CIFAR10(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True);b=CIFAR10(a.root,train=False,download=True)
    xx=np.moveaxis(a.data,-1,1);yy=np.array(a.targets);tx=np.moveaxis(b.data,-1,1);ty=np.array(b.targets)
origen=np.array([0,1,8,9]);dev=np.flatnonzero(np.isin(yy,origen))[:6000];ite=np.flatnonzero(np.isin(ty,origen))[:1500]
yc=np.searchsorted(origen,yy[dev]);yc_test=np.searchsorted(origen,ty[ite])
trc=conjunto(xx[dev[:4800]].astype(np.float32)/255,yc[:4800]);vlc=conjunto(xx[dev[4800:]].astype(np.float32)/255,yc[4800:]);tec=conjunto(tx[ite].astype(np.float32)/255,yc_test)
np.savez_compressed(ARTEFACTOS/'cifar-particiones.npz',train=dev[:4800],val=dev[4800:],test=ite)
semilla();rgb=inicializar(CNN(False,3,32,4));hc,rc=entrenar(rgb,trc,vlc,5,lote=64,paciencia=2,nombre='cifar-cuatro')
curvas(hc,'CIFAR-10 · cuatro clases',rc['mejor_epoca']);lectura(hc,rc)
rr=evaluar(rgb,tec);diagnostico(rr,['Avión','Automóvil','Barco','Camión'],tec.tensors[0].numpy(),'CIFAR-4 · prueba')
(ARTEFACTOS/'cifar-prueba.json').write_text(json.dumps({'ce':rr['ce'],'exactitud':rr['exactitud'],'macro_f1':f1_score(yc_test,rr['logits'].argmax(1),average='macro')}),encoding='utf-8')
cifar-cuatro 1/5: CE val=1.0489, acc val=0.5150
cifar-cuatro 2/5: CE val=0.9453, acc val=0.6158
cifar-cuatro 3/5: CE val=0.8720, acc val=0.6500
cifar-cuatro 4/5: CE val=0.8462, acc val=0.6567
cifar-cuatro 5/5: CE val=0.7384, acc val=0.7108

Lectura del experimento. Se ejecutaron 5 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 5, con CE 0.7384. Al cierre, la brecha de exactitud train−val es +7.73 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.

              precision    recall  f1-score   support

       Avión     0.7534    0.7595    0.7564       370
   Automóvil     0.7055    0.8115    0.7548       366
       Barco     0.7201    0.7880    0.7525       382
      Camión     0.8056    0.6073    0.6925       382

    accuracy                         0.7407      1500
   macro avg     0.7461    0.7416    0.7390      1500
weighted avg     0.7465    0.7407    0.7387      1500

Decisión después de medir. Exactitud 74.07%; macro-F1 0.7390; 389 errores de 1500. El menor recall corresponde a Camión (60.73%). La confusión más frecuente es Camión → Automóvil (85 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

91

16.11 11. Persistencia y decisiones que quedan abiertas

Guardamos las dos CNN textiles con el contrato que indica aumento durante entrenamiento y evaluación limpia. La recarga debe reproducir logits sobre validación. La configuración conservada se eligió previamente por CE limpia de validación; no se cambia tras observar las perturbaciones.

Una brecha train/val y una caída bajo ruido miden cuestiones diferentes. Si el aumento reduce una caída pero empeora la CE limpia, existe un compromiso que debe evaluarse según requisitos prefijados. No hay un umbral universal de brecha, ECE o exactitud que convierta este laboratorio en un sistema listo para producción.

for nombre,m in modelos.items():
    guardar(m,lambda nombre=nombre:CNN(nombre=='con-aumento'),nombre,
        {'arquitectura':'CNN32-64/densa64','entrada':'NCHW float32','forma':[1,28,28],'escala':'uint8 /255','clases':nombres,'aumento_solo_train':nombre=='con-aumento','seleccion':'min CE validacion limpia','seleccionado':nombre==ganador},val)
(ARTEFACTOS/'verificaciones.json').write_text(json.dumps({'pesos_iniciales_iguales':True,'mismo_orden_lotes':True,'eval_sin_aumento':True,'gradcam_sin_cambios_pesos':True,'calibracion_incluye_probabilidad_uno':True,'ganador_validacion':ganador}),encoding='utf-8')
Recarga verificada: artefactos_pytorch\sin-aumento.pt bytes: 884869
Recarga verificada: artefactos_pytorch\con-aumento.pt bytes: 884869
204

16.11.1 Lectura de la ejecución registrada

La selección por CE limpia de validación conservó sin aumento. En prueba limpia obtuvo 88.08%, frente a 80.50% con aumento. Bajo desplazamiento con fondo cero, las exactitudes fueron 57.83% y 76.79%; bajo ruido, 67.69% y 50.93%. El aumento favoreció este desplazamiento y perjudicó el resultado limpio y con este ruido. No hay una mejora genérica de robustez. La rotación y traslación de entrenamiento no son un aumento de ruido: mejorar una invariancia no garantiza otra. Si el uso final prioriza desplazamientos, el siguiente estudio debe fijar esa prioridad y una validación representativa antes de consultar otro test. No se cambia retrospectivamente la regla de selección de este ensayo.

Cifras de la ejecución CPU del 15 de octubre de 2026. Si cambia datos, semilla o versión, contraste esta lectura con las salidas nuevas.

16.12 12. Ejercicios y límites

  1. Prefije varias intensidades de ruido en validación y trace desempeño frente a severidad; mantenga prueba para el cierre.
  2. Contraste reflexión y relleno cero durante el aumento, manteniendo iguales pesos iniciales y presupuesto.
  3. Calcule calibración por clase y con distintos intervalos; explique por qué el ECE cambia.
  4. Compare Grad-CAM para clase predicha y una alternativa, y contraste con una intervención de oclusión.
  5. Diseñe un conjunto externo de fotografías reales si ése es el objetivo de uso; no rebautice ruido sintético como una muestra de clientes.

Este estudio usa un subconjunto, cinco épocas y una semilla. Las perturbaciones están declaradas y no cubren todos los cambios de dominio. El test oficial ya tenía resultados de versiones anteriores: no es un conjunto externo nunca consultado. Las nuevas decisiones deben partir de desarrollo y validarse con datos reservados apropiados.

16.13 Referencias