Una imagen puede representarse como una secuencia de parches. Un Vision Transformer aprende relaciones entre esos parches; un sistema multimodal puede además relacionar imágenes con descripciones. Son dos decisiones diferentes: cómo representar la imagen y cómo alinear modalidades.
Construiremos un ViT pequeño sobre dígitos reales, lo compararemos con una CNN, estudiaremos posición y atención, y realizaremos una transferencia con clases de origen y destino separadas. Después entrenaremos un laboratorio de alineación imagen–texto. Sus descripciones contienen nombres de clases: no es un CLIP preentrenado ni una prueba de reconocimiento de conceptos nuevos.
Para una imagen con alto \(H\), ancho \(W\), \(C\) canales y parches cuadrados de lado \(P\), el número de parches es \(N=HW/P^2\) cuando las dimensiones son divisibles. Cada parche se aplana a \(P^2C\) valores y una proyección lineal produce \(d\) coordenadas. Agregamos un token CLS y una posición aprendida para cada lugar.
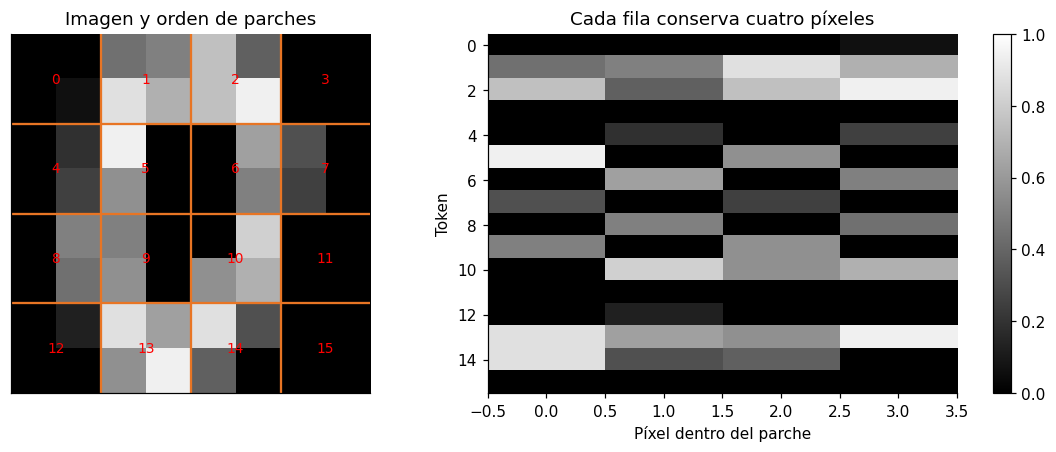
Una imagen de 8×8, un canal y parches 2×2 produce 16 tokens de cuatro valores; con CLS, la atención trabaja sobre 17 posiciones. La proyección aprende qué conservar del parche. El número del token indica dónde está, no qué contiene.
import numpy as npimport sklearn#| code-fold: true#| code-summary: "Ver implementación del experimento"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearn,scipyfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score,balanced_accuracy_score,log_loss,ConfusionMatrixDisplay,roc_auc_score,average_precision_score,f1_scorefrom sklearn.preprocessing import StandardScalerfrom IPython.display import displayimport torchfrom torch import nnfrom torch.utils.data import DataLoader,TensorDatasetimport copy,json,math,time,itertoolsfrom pathlib import Pathtorch.set_num_threads(1);torch.use_deterministic_algorithms(True)SEMILLA=42;lecturas={};COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})def tensor(x,dtype=torch.float32):return torch.tensor(x,dtype=dtype)def probas(modelo,x): modelo.eval()with torch.no_grad():return modelo(x).softmax(-1).numpy()def ajustar_clasificador(modelo,x,y,xv,yv,epocas=45,lr=.003,seed=7): opt=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr) loader=DataLoader(TensorDataset(x,y),batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(seed)) mejor=np.inf;hist=[];inicio=time.perf_counter()for ep inrange(1,epocas+1): modelo.train();suma=0.;cuenta=0for xb,yb in loader: opt.zero_grad();loss=nn.functional.cross_entropy(modelo(xb),yb);loss.backward();opt.step();suma+=float(loss.detach())*len(xb);cuenta+=len(xb) pv=probas(modelo,xv);lv=log_loss(yv.numpy(),pv,labels=np.arange(pv.shape[1]));hist.append((ep,suma/cuenta,lv,balanced_accuracy_score(yv,pv.argmax(1))))if lv<mejor:mejor=lv;estado=copy.deepcopy(modelo.state_dict());checkpoint=ep modelo.load_state_dict(estado)return np.array(hist),checkpoint,time.perf_counter()-inicioprint('NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.')from sklearn.datasets import load_digitsdatos=load_digits();X=datos.images.astype('float32')/16;y=datos.targettr,rest=train_test_split(np.arange(len(y)),test_size=.4,stratify=y,random_state=42)va,te=train_test_split(rest,test_size=.5,stratify=y[rest],random_state=42)TX=tensor(X[:,None]);TY=tensor(y,torch.long)def parches(x,p):return x.unfold(2,p,p).unfold(3,p,p).permute(0,2,3,1,4,5).reshape(len(x),-1,p*p*x.shape[1])patch=parches(TX[tr[:1]],2)fig,axs=plt.subplots(1,2,figsize=(10,4));axs[0].imshow(X[tr[0]],cmap='gray',vmin=0,vmax=1)for i in [1.5,3.5,5.5]:axs[0].axhline(i,color=COLORES[1]);axs[0].axvline(i,color=COLORES[1])for i inrange(16):axs[0].text((i%4)*2+.5,(i//4)*2+.5,str(i),ha='center',va='center',color='red',fontsize=9)axs[0].set(title='Imagen y orden de parches',xticks=[],yticks=[])im=axs[1].imshow(patch[0].numpy(),cmap='gray',vmin=0,vmax=1,aspect='auto');axs[1].set(title='Cada fila conserva cuatro píxeles',xlabel='Píxel dentro del parche',ylabel='Token');fig.colorbar(im,ax=axs[1]);plt.show()print('Imagen:',tuple(TX[tr[:1]].shape),'→ parches:',tuple(patch.shape),'→ tokens con CLS: 17')display(pd.DataFrame({'partición':['entrenamiento','validación','prueba'],'n':[len(tr),len(va),len(te)]}))
NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.
Una proyección del token produce consultas, claves y valores. Cada cabeza calcula \(\operatorname{softmax}(QK^\top/\sqrt{d_h})V\). El bloque agrega conexiones residuales, normalización y una red que opera sobre cada token. Implementamos un bloque con normalización previa y cuatro cabezas; no es la configuración del ViT grande del artículo original.
El estado final de CLS alimenta el clasificador. CLS aprende mediante la pérdida de clasificación; no contiene de antemano una descripción de la imagen. Una alternativa es promediar tokens, pero debe evaluarse como una decisión de arquitectura.
23.3 Comparación controlada: CNN, tamaño de parche y posición
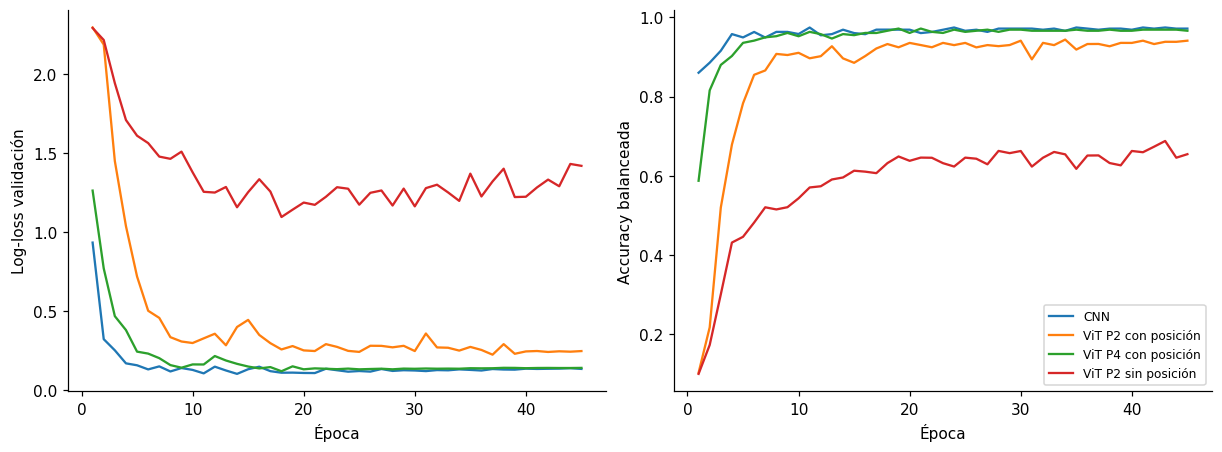
Entrenamos CNN y tres ViT con la misma partición, 45 épocas, batch 64, Adam 0.003 y semilla 7. Elegimos checkpoints por log-loss de validación. Entre ViT elegimos el de menor log-loss; la CNN es un baseline declarado. El presupuesto de épocas coincide, pero los parámetros y el cómputo no: la tabla informa ambos y el tiempo observado en esta CPU.
La CNN introduce localidad y pesos compartidos. El ViT usa relaciones entre todos los tokens; el tamaño de parche controla cuánto detalle se agrupa antes de la atención. Entrenar desde cero con dígitos de 8×8 no reproduce la escala, diversidad ni preentrenamiento de modelos de producción.
especificaciones={'CNN':lambda:CNN(),'ViT P2 con posición':lambda:ViT(2,True),'ViT P4 con posición':lambda:ViT(4,True),'ViT P2 sin posición':lambda:ViT(2,False)}modelos={};historias={};filas=[]for nombre,fabrica in especificaciones.items(): torch.manual_seed(7);m=fabrica();h,ep,seg=ajustar_clasificador(m,TX[tr],TY[tr],TX[va],TY[va]) modelos[nombre]=m;historias[nombre]=h;p=probas(m,TX[va]) filas.append({'modelo':nombre,'parámetros':sum(p.numel() for p in m.parameters()),'época':ep,'segundos CPU':seg,'log-loss validación':log_loss(y[va],p),'balanceada validación':balanced_accuracy_score(y[va],p.argmax(1))})tabla=pd.DataFrame(filas);display(tabla.round(4));ganador=tabla[tabla.modelo.str.startswith('ViT')].sort_values('log-loss validación').iloc[0].modelo;vit=modelos[ganador]fig,axs=plt.subplots(1,2,figsize=(11,4))for nombre,h in historias.items():axs[0].plot(h[:,0],h[:,2],label=nombre);axs[1].plot(h[:,0],h[:,3],label=nombre)axs[0].set(xlabel='Época',ylabel='Log-loss validación');axs[1].set(xlabel='Época',ylabel='Accuracy balanceada');axs[1].legend(fontsize=8);plt.show()lecturas['vit_ganador']=ganador
modelo
parámetros
época
segundos CPU
log-loss validación
balanceada validación
0
CNN
11498
14
2.8208
0.1017
0.9691
1
ViT P2 con posición
9674
37
6.2002
0.2233
0.9331
2
ViT P4 con posición
9674
18
3.8527
0.1184
0.9664
3
ViT P2 sin posición
9674
18
6.8847
1.0952
0.6322
23.3.1 Cómo leer este resultado
Se seleccionó ViT P4 con posición. Revisa los checkpoints y los parámetros antes de interpretar la comparación: una mejor curva puede acompañarse de mayor capacidad. La fila sin posición permite evaluar cuánto importa localizar parches en esta tarea, sin asumir que siempre será inferior.
La división aleatoria estratificada conserva clases; no garantiza separación por escritor ni mide robustez fuera de este dataset. El tiempo incluye evaluación por época y depende del equipo; no es un benchmark de inferencia.
23.3.2 Una prueba algebraica del papel de la posición
Permutaremos el orden de los parches sin cambiar CLS. Sin posiciones, la agregación de CLS es invariante al reordenamiento en esta arquitectura. Con posiciones fijas, la permutación asigna contenido a lugares distintos y puede cambiar los logits. No estamos afirmando que toda imagen deba conservar su etiqueta al mover parches.
perm=torch.randperm(16,generator=torch.Generator().manual_seed(13));x=TX[va[:4]]diferencias=[]for nombre in ['ViT P2 sin posición','ViT P2 con posición']: m=modelos[nombre];m.eval()with torch.no_grad(): a,_=m.bloque(m.tokens(x));b,_=m.bloque(m.tokens(x,perm));la=m.cabeza(m.norm(a[:,0]));lb=m.cabeza(m.norm(b[:,0])) delta=float((la-lb).abs().max());diferencias.append({'modelo':nombre,'cambio máximo de logit':delta})ifnot m.usar_pos:assert torch.allclose(la,lb,atol=2e-5)display(pd.DataFrame(diferencias))resoluciones=[32,224,448];filas_costo=[]for r in resoluciones:for p in [8,16,32]: n=(r//p)**2+1;filas_costo.append({'resolución':r,'parche':p,'tokens + CLS':n,'entradas atención por cabeza':n*n})display(pd.DataFrame(filas_costo))fig,ax=plt.subplots(figsize=(8,3.5))for p in [8,16,32]: f=pd.DataFrame(filas_costo);f=f[f.parche==p];ax.plot(f.resolución,f['entradas atención por cabeza'],'o-',label=f'Parche {p}')ax.set(yscale='log',xlabel='Lado de imagen',ylabel='Entradas de atención',title='Costo cuadrático del mapa de atención completo');ax.legend();plt.show()
modelo
cambio máximo de logit
0
ViT P2 sin posición
9.536743e-07
1
ViT P2 con posición
9.949968e+00
resolución
parche
tokens + CLS
entradas atención por cabeza
0
32
8
17
289
1
32
16
5
25
2
32
32
2
4
3
224
8
785
616225
4
224
16
197
38809
5
224
32
50
2500
6
448
8
3137
9840769
7
448
16
785
616225
8
448
32
197
38809
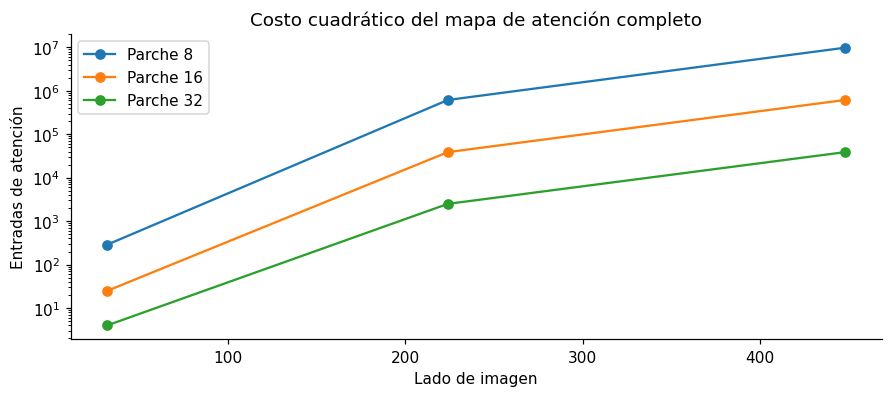
Duplicar alto y ancho con parche fijo multiplica aproximadamente por cuatro los tokens y por dieciséis las entradas del mapa de atención. Este conteo no es la memoria total ni el tiempo exacto: también intervienen canales, cabezas, capas y la implementación. La atención eficiente puede evitar materializar todo el mapa sin cambiar esa cuenta conceptual.
En el ViT sin posiciones, el parámetro de posición existe para conservar la misma clase de implementación, pero no se utiliza ni recibe gradientes del objetivo. Su conteo total de parámetros incluye esa tabla; los parámetros efectivos del predictor son ligeramente menores.
23.4 Atención e intervención: dos vistas, dos preguntas
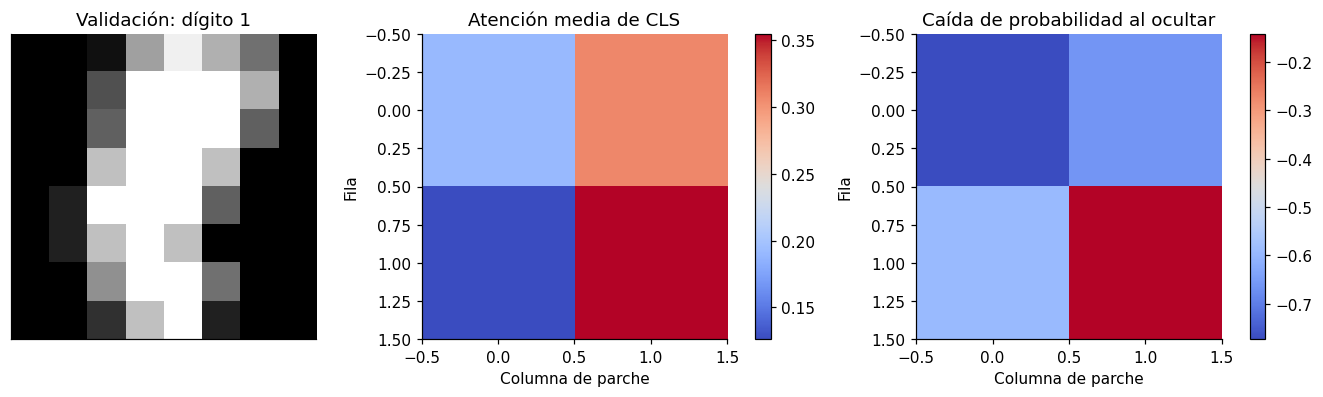
Mostraremos atención de CLS hacia los parches y el cambio de probabilidad al sustituir un parche por negro. La atención son pesos internos; la intervención modifica una entrada. Ninguna ofrece por sí sola una explicación causal completa. El parche negro puede estar fuera de la distribución y las conexiones residuales también transportan información.
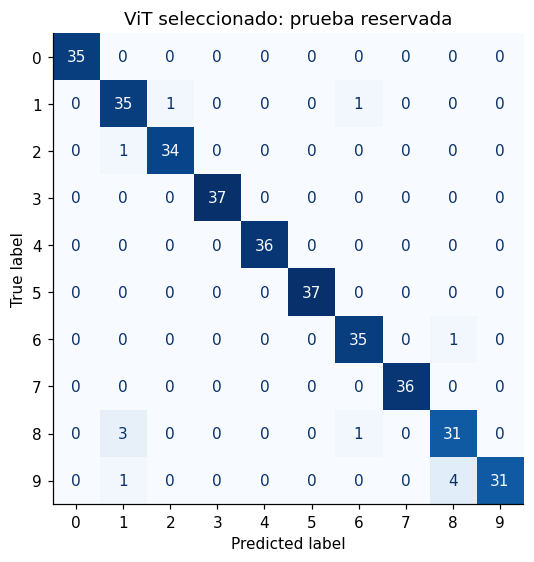
q=int(va[0]);vit.eval()with torch.no_grad(): z,w=vit.bloque(vit.tokens(TX[q:q+1]));base=probas(vit,TX[q:q+1])[0,y[q]]atencion=w[0,:,0,1:].mean(0).numpy().reshape(8//vit.p,8//vit.p)impacto=np.zeros_like(atencion)for i inrange(8//vit.p):for j inrange(8//vit.p): perturbada=TX[q:q+1].clone();perturbada[:,:,i*vit.p:(i+1)*vit.p,j*vit.p:(j+1)*vit.p]=0 impacto[i,j]=base-probas(vit,perturbada)[0,y[q]]fig,axs=plt.subplots(1,3,figsize=(12,3.5));axs[0].imshow(X[q],cmap='gray',vmin=0,vmax=1);axs[0].set(title=f'Validación: dígito {y[q]}',xticks=[],yticks=[])for ax,M,t inzip(axs[1:],[atencion,impacto],['Atención media de CLS','Caída de probabilidad al ocultar']):im=ax.imshow(M,cmap='coolwarm');ax.set(title=t,xlabel='Columna de parche',ylabel='Fila');fig.colorbar(im,ax=ax)plt.show()res_main=[]for nombre in ['CNN',ganador]: p=probas(modelos[nombre],TX[te]);res_main.append({'caso':'clasificación','modelo':nombre,'grupo':'prueba','métrica':'balanceada','valor':balanced_accuracy_score(y[te],p.argmax(1))})display(pd.DataFrame(res_main));p=probas(vit,TX[te]);fig,ax=plt.subplots(figsize=(6,5));ConfusionMatrixDisplay.from_predictions(y[te],p.argmax(1),ax=ax,cmap='Blues',colorbar=False);ax.set_title('ViT seleccionado: prueba reservada');plt.show()lecturas['vit_test']=f'{res_main[1]["valor"]:.3f}';lecturas['cnn_test']=f'{res_main[0]["valor"]:.3f}'
caso
modelo
grupo
métrica
valor
0
clasificación
CNN
prueba
balanceada
0.966725
1
clasificación
ViT P4 con posición
prueba
balanceada
0.963642
23.4.1 Cómo leer este resultado
El ViT obtiene accuracy balanceada 0.964 y la CNN 0.967. La matriz permite localizar pares de dígitos confundidos; la media no explica por qué fallan. La intervención se realizó en validación y no se utilizó para cambiar arquitectura después de observar prueba.
Compara los dos mapas sin asumir que coincidirán: un parche con atención elevada puede no producir una gran caída al ocultarlo, y un parche con baja atención puede afectar una ruta distinta. Para sostener explicaciones harían falta intervenciones y estabilidad sobre más ejemplos.
Las cifras son casi iguales: no sostienen una ventaja general de ViT frente a CNN con esta muestra y semilla. En la primera imagen de validación, las intervenciones producen valores negativos en el mapa de caída: ocultar un parche aumenta la probabilidad de la clase real. No debemos interpretar ese panel como si todos los parches ayudaran al acierto. La atención alta tampoco determina el signo del cambio.
23.5 Preentrenamiento y adaptación con origen separado
Preentrenaremos otro ViT exclusivamente con dígitos 0–4 de entrenamiento. El destino contiene dígitos 5–9; tomamos 20 imágenes de entrenamiento por clase y conservamos la validación y prueba originales de esas clases. El ViT anterior, entrenado con los diez dígitos, no se usa como origen: hacerlo introduciría supervisión del destino en el supuesto preentrenamiento.
Comparamos desde cero, encoder congelado y ajuste fino. Todas las estrategias tienen 40 épocas de destino y checkpoint por log-loss de validación. El origen se entrena 35 épocas con presupuesto fijo usando solo su entrenamiento. El nuevo clasificador recibe cinco salidas y se inicializa de nuevo. La transferencia es local y supervisada entre clases del mismo dataset; no equivale a adaptar un ViT preentrenado en imágenes diversas.
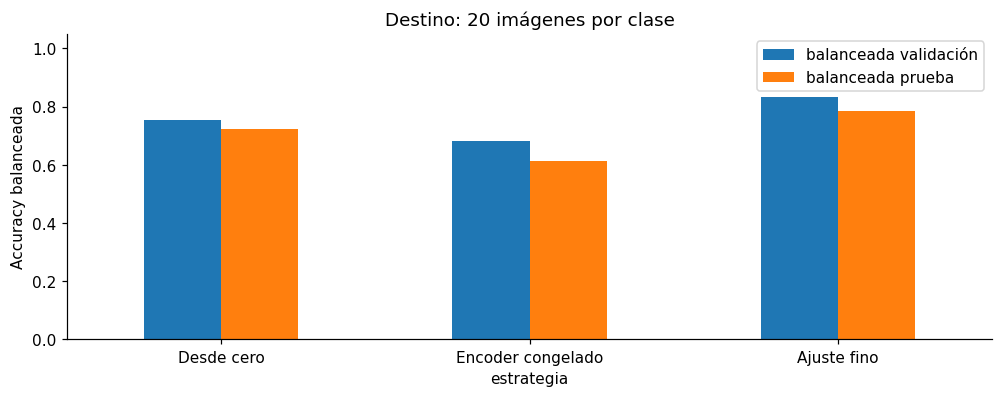
origen=tr[y[tr]<5];dest_tr=tr[y[tr]>=5];dest_va=va[y[va]>=5];dest_te=te[y[te]>=5]rng=np.random.default_rng(19);pocos=np.concatenate([rng.choice(dest_tr[y[dest_tr]==c],20,replace=False) for c inrange(5,10)])torch.manual_seed(19);fuente=ViT(2,True,5);opt=torch.optim.Adam(fuente.parameters(),lr=.003)loader=DataLoader(TensorDataset(TX[origen],TY[origen]),batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(19))for ep inrange(35): fuente.train()for xb,yb in loader:opt.zero_grad();loss=nn.functional.cross_entropy(fuente(xb),yb);loss.backward();opt.step()transfer={};filas_transfer=[]for estrategia in ['Desde cero','Encoder congelado','Ajuste fino']: torch.manual_seed(23) m=ViT(2,True,5) if estrategia=='Desde cero'else copy.deepcopy(fuente) m.cabeza=nn.Linear(32,5)if estrategia=='Encoder congelado':for p in m.parameters():p.requires_grad=Falsefor p in m.cabeza.parameters():p.requires_grad=True h,ep,seg=ajustar_clasificador(m,TX[pocos],TY[pocos]-5,TX[dest_va],TY[dest_va]-5,40,.01if estrategia=='Encoder congelado'else.001,23) transfer[estrategia]=m;pv=probas(m,TX[dest_va]);pt=probas(m,TX[dest_te]) filas_transfer.append({'estrategia':estrategia,'parámetros ajustables':sum(p.numel() for p in m.parameters() if p.requires_grad),'época':ep,'balanceada validación':balanced_accuracy_score(y[dest_va]-5,pv.argmax(1)),'balanceada prueba':balanced_accuracy_score(y[dest_te]-5,pt.argmax(1))})tabla_transfer=pd.DataFrame(filas_transfer);display(tabla_transfer)fig,ax=plt.subplots(figsize=(9,3.5));tabla_transfer.set_index('estrategia')[['balanceada validación','balanceada prueba']].plot.bar(ax=ax,rot=0);ax.set(ylabel='Accuracy balanceada',ylim=(0,1.05),title='Destino: 20 imágenes por clase');plt.show()res_transfer=[{'caso':'transferencia','modelo':r['estrategia'],'grupo':'prueba destino','métrica':'balanceada','valor':r['balanceada prueba']} for r in filas_transfer]lecturas['transfer_val']=tabla_transfer.sort_values('balanceada validación',ascending=False).iloc[0].estrategia
estrategia
parámetros ajustables
época
balanceada validación
balanceada prueba
0
Desde cero
9509
39
0.754444
0.722578
1
Encoder congelado
165
40
0.681429
0.612033
2
Ajuste fino
9509
40
0.832698
0.784766
23.5.1 Cómo leer este resultado
La mayor accuracy balanceada de validación corresponde a Ajuste fino; los checkpoints se eligieron por log-loss, una métrica distinta. Las tres pruebas pertenecen a estrategias declaradas de antemano, no a una selección de la mejor estrategia sobre prueba.
Congelar reduce los parámetros ajustables y preserva representaciones que quizá no separen clases nuevas. Ajustar todo ofrece adaptación, pero con cien ejemplos aumenta el riesgo de ajustar ruido. El entrenamiento desde cero permite comprobar cuánto aporta realmente el origen. Si hay diferencias pequeñas, una sola semilla no basta para recomendar un procedimiento general.
En prueba de destino, desde cero alcanza 0.723, congelación 0.612 y ajuste fino 0.785. Congelar quedó por detrás de empezar de nuevo: preservar el origen no fue suficiente. El ajuste fino ofrece la mejor cifra de esta ejecución, aunque no demuestra una ventaja estable con otra muestra de cien imágenes.
23.5.2 Qué debe acompañar un checkpoint preentrenado
Elemento
Comprobación antes de adaptar
Entrada
Resolución, canales, orden y normalización
Parches y posiciones
Compatibilidad de rejilla y tratamiento de cambios de resolución
Cabeza
Dimensión y significado de las clases nuevas
Parámetros congelados
Qué recibe gradientes y qué cambia entre train/eval
Datos de origen
Solapamientos con evaluación y restricciones de uso
Métricas de destino
Baseline, partición y distribución relevante
Cambiar resolución puede requerir interpolar posiciones de parches conservando CLS. No basta con redimensionar la cabeza. En nuestro ejemplo la resolución no cambia; no hemos validado esa interpolación ni robustez a imágenes grandes.
Un encoder visual y uno textual producen vectores que se proyectan a un espacio común y se normalizan. El producto escalar pasa a ser coseno. Una temperatura controla la escala de logits y la distribución de gradientes; no convierte las puntuaciones en probabilidades calibradas de relevancia.
En un modelo tipo CLIP, se aprende a asociar pares imagen–texto entre alternativas. Nuestro laboratorio usa descripciones de clases de dígitos y un encoder textual de promedio de embeddings. Como muchas imágenes comparten descripción, implementamos positivos múltiples en la dirección texto→imagen: tratar esas imágenes como negativos sería una contradicción con nuestras etiquetas.
Este objetivo incorpora nombres de clases durante entrenamiento. Clasificar imágenes nuevas mediante esos nombres es clasificación de clases conocidas por descripciones, no zero-shot de clases nunca vistas. El CLIP original se preentrena con pares naturales mucho más diversos.
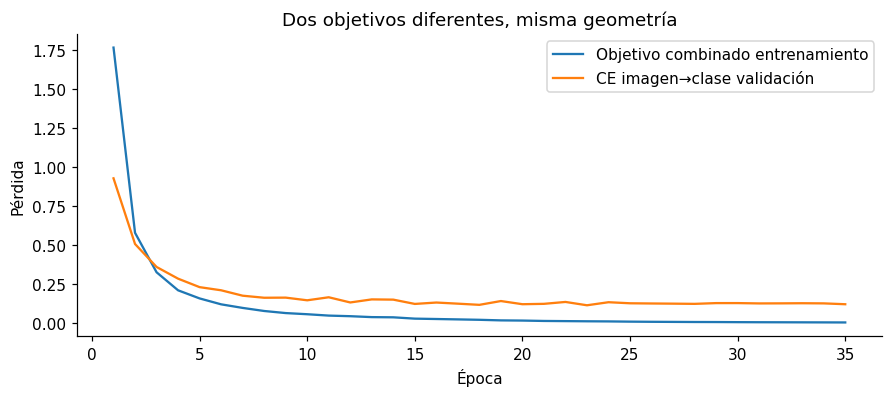
nombres=['cero','uno','dos','tres','cuatro','cinco','seis','siete','ocho','nueve']palabras=['imagen','del','dígito']+nombres;vocab={'<UNK>':0,**{w:i+1for i,w inenumerate(palabras)}}def ids_texto(textos):return [torch.tensor([vocab.get(w,0) for w in t.split()]) for t in textos]class Alineador(nn.Module):def__init__(self):super().__init__();self.visual=nn.Sequential(nn.Flatten(),nn.Linear(64,64),nn.ReLU(),nn.Linear(64,32));self.texto=nn.Embedding(len(vocab),32)def imagen(self,x):return nn.functional.normalize(self.visual(x),dim=1)def descripciones(self,textos):return nn.functional.normalize(torch.stack([self.texto(s).mean(0) for s in ids_texto(textos)]),dim=1)descripciones=['imagen del dígito '+n for n in nombres];torch.manual_seed(31);alineador=Alineador();opt=torch.optim.Adam(alineador.parameters(),lr=.003)loader=DataLoader(TensorDataset(TX[tr],TY[tr]),batch_size=128,shuffle=True,generator=torch.Generator().manual_seed(31));temp=.1;hist_al=[]for ep inrange(1,36): alineador.train();suma=0.;cuenta=0for xb,yb in loader: opt.zero_grad();zi=alineador.imagen(xb);zt=alineador.descripciones(descripciones);logits=zi@zt.T/temp li=nn.functional.cross_entropy(logits,yb);lt=[]for c in torch.unique(yb): s=logits[:,c];lt.append(torch.logsumexp(s,0)-torch.logsumexp(s[yb==c],0)) loss=(li+torch.stack(lt).mean())/2;loss.backward();opt.step();suma+=float(loss.detach())*len(xb);cuenta+=len(xb) alineador.eval()with torch.no_grad():lv=float(nn.functional.cross_entropy(alineador.imagen(TX[va])@alineador.descripciones(descripciones).T/temp,TY[va])) hist_al.append((ep,suma/cuenta,lv))if ep==1or lv<mejor_al:mejor_al=lv;estado=copy.deepcopy(alineador.state_dict());ep_al=epalineador.load_state_dict(estado);alineador.eval();hist_al=np.array(hist_al)fig,ax=plt.subplots(figsize=(8,3.5));ax.plot(hist_al[:,0],hist_al[:,1],label='Objetivo combinado entrenamiento');ax.plot(hist_al[:,0],hist_al[:,2],label='CE imagen→clase validación');ax.set(xlabel='Época',ylabel='Pérdida',title='Dos objetivos diferentes, misma geometría');ax.legend();plt.show()print('Checkpoint por CE de validación:',ep_al,'; temperatura fija:',temp)
Checkpoint por CE de validación: 23 ; temperatura fija: 0.1
23.6.1 Clasificación por descripciones y sensibilidad al texto
Evaluamos tres conjuntos de descripciones fijados: plantilla usada en entrenamiento, nombre aislado y una frase de negación. El encoder promedia palabras y no aprendió lógica ni gramática; palabras nuevas usan UNK. La negación es una prueba de fallo, no una descripción correcta para clasificación. No cambiaremos las plantillas después de observar prueba.
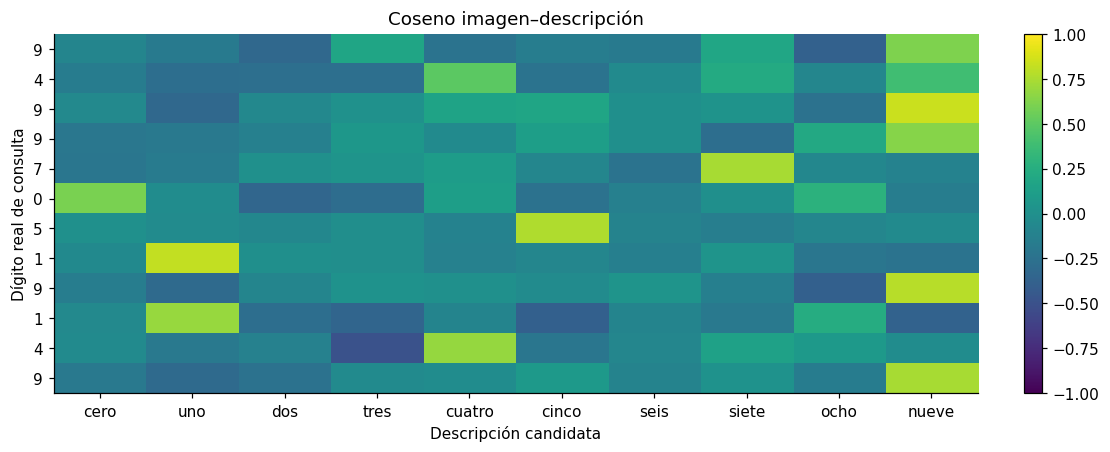
plantillas={'Entrenamiento':descripciones,'Nombre aislado':nombres,'Negación (anti-ejemplo)':['no es un dígito '+n for n in nombres]}res_multi=[];similitudes={}with torch.no_grad(): zi=alineador.imagen(TX[te])for nombre,desc in plantillas.items(): s=(zi@alineador.descripciones(desc).T).numpy();similitudes[nombre]=s res_multi.append({'caso':'multimodal','modelo':nombre,'grupo':'prueba','métrica':'balanceada','valor':balanced_accuracy_score(y[te],s.argmax(1))})display(pd.DataFrame(res_multi));fig,ax=plt.subplots(figsize=(10,4));im=ax.imshow(similitudes['Entrenamiento'][:12],cmap='viridis',vmin=-1,vmax=1,aspect='auto');ax.set(xticks=range(10),xticklabels=nombres,yticks=range(12),yticklabels=y[te[:12]],xlabel='Descripción candidata',ylabel='Dígito real de consulta',title='Coseno imagen–descripción');fig.colorbar(im,ax=ax);plt.show()lecturas['multi_test']=f'{res_multi[0]["valor"]:.3f}';lecturas['multi_neg']=f'{res_multi[2]["valor"]:.3f}'
caso
modelo
grupo
métrica
valor
0
multimodal
Entrenamiento
prueba
balanceada
0.972134
1
multimodal
Nombre aislado
prueba
balanceada
0.966499
2
multimodal
Negación (anti-ejemplo)
prueba
balanceada
0.960940
23.6.2 Cómo leer este resultado
La plantilla de entrenamiento alcanza accuracy balanceada 0.972. La plantilla de negación alcanza 0.961 si se interpreta erróneamente como si afirmara la clase. El modelo solo aprendió asociaciones entre imágenes y nombres: esa cifra no mide comprensión de «no es». Si conserva un ranking parecido, revela insensibilidad; si cambia, tampoco demuestra razonamiento lógico.
La matriz informa similitud entre alternativas concretas. Cambiar el conjunto de alternativas cambia el softmax de clasificación, aunque no cambie el coseno de cada pareja. Una confianza alta frente a diez nombres no implica reconocer objetos fuera de ese vocabulario.
El 0.961 del anti-ejemplo muestra que la negación deja muchas imágenes asociadas al mismo nombre de clase. Para una consulta lógica, esa conducta sería incorrecta aunque parezca una accuracy alta. La decisión es limitar este encoder a asociaciones declaradas y no utilizarlo para responder preguntas negadas.
23.6.3 Recuperación de imágenes por texto
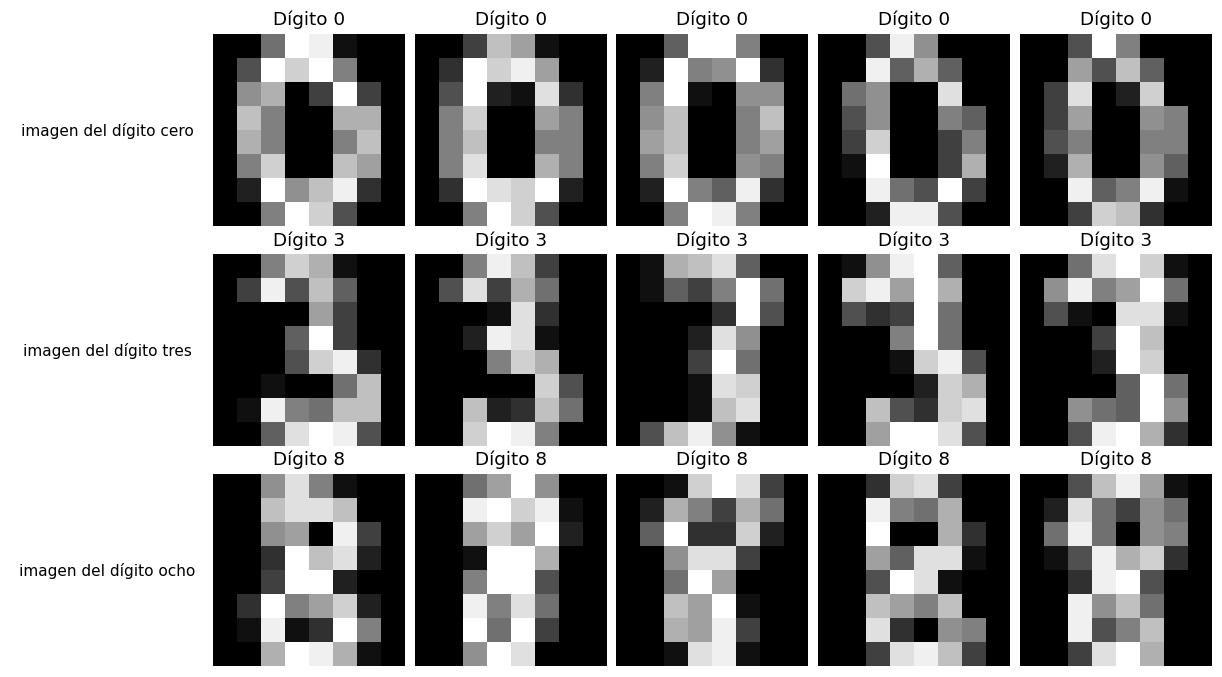
Cada descripción consulta únicamente imágenes de entrenamiento; registramos relevancia por clase en los cinco vecinos superiores. Es una búsqueda por categoría, no la recuperación de una instancia exacta: las descripciones no distinguen dos imágenes del mismo dígito. Esta galería inspecciona alineación ya ajustada y no es una nueva prueba de generalización de recuperación.
with torch.no_grad():scores=(alineador.descripciones(descripciones)@alineador.imagen(TX[tr]).T).numpy()top=np.argsort(-scores,axis=1)[:,:5];fig,axs=plt.subplots(3,6,figsize=(11,6))for fila,c inenumerate([0,3,8]): axs[fila,0].text(.5,.5,descripciones[c],ha='center',va='center',wrap=True);axs[fila,0].axis('off')for j,r inenumerate(top[c],1):axs[fila,j].imshow(X[tr[r]],cmap='gray',vmin=0,vmax=1);axs[fila,j].set_title(f'Dígito {y[tr[r]]}');axs[fila,j].axis('off')plt.show();display(pd.DataFrame({'descripción':descripciones,'precisión@5 (referencias de entrenamiento)':np.mean(y[tr][top]==np.arange(10)[:,None],axis=1)}))resultados=pd.DataFrame(res_main+res_transfer+res_multi);resultados.to_csv('resultados.csv',index=False)tabla.to_csv('seleccion-vit.csv',index=False);tabla_transfer.to_csv('transferencia.csv',index=False)protocolo={'semilla':42,'train':tr.tolist(),'validacion':va.tolist(),'prueba':te.tolist(),'vit':ganador,'criterio':'log-loss validación','transferencia':{'origen':origen.tolist(),'destino_train':pocos.tolist(),'destino_validacion':dest_va.tolist(),'destino_prueba':dest_te.tolist()},'alineacion':{'temperatura':temp,'checkpoint':ep_al,'clases_conocidas':nombres,'positivos_multiples':True},'versiones':{'torch':torch.__version__,'sklearn':sklearn.__version__}}Path('protocolo.json').write_text(json.dumps(protocolo,ensure_ascii=False,indent=2),encoding='utf-8')
descripción
precisión@5 (referencias de entrenamiento)
0
imagen del dígito cero
1.0
1
imagen del dígito uno
1.0
2
imagen del dígito dos
1.0
3
imagen del dígito tres
1.0
4
imagen del dígito cuatro
1.0
5
imagen del dígito cinco
1.0
6
imagen del dígito seis
1.0
7
imagen del dígito siete
1.0
8
imagen del dígito ocho
1.0
9
imagen del dígito nueve
1.0
28865
23.7 De dos encoders a un modelo de visión y lenguaje
Un sistema de recuperación compara vectores. Un modelo generativo de visión y lenguaje utiliza información visual para condicionar una salida textual: puede proyectar tokens visuales hacia el espacio del modelo de lenguaje o utilizar atención cruzada. La forma de conectar modalidades y el entrenamiento del generador determinan qué puede producir; una matriz de cosenos no implementa ese proceso.
flowchart LR
    I[Imagen] --> V[Encoder visual]
    V --> P[Proyección de tokens]
    P --> G[Generador condicionado]
    T[Pregunta o instrucción] --> G
    G --> R[Respuesta textual]
Una respuesta fluida puede ser visualmente incorrecta. La evaluación debe distinguir reconocimiento, localización, lectura de texto, recuperación y respuesta fundamentada en la imagen. Nuestro laboratorio no entrena un generador ni evalúa preguntas visuales. La generación lingüística especializada se amplía en el libro de NLP; aquí se conserva la conexión entre modalidades.
23.8 Otras decisiones de arquitectura y preentrenamiento
Los laboratorios anteriores separan arquitectura, objetivo y adaptación. Esa distinción permite interpretar otras familias sin asumir que un nombre de modelo garantiza utilidad en nuestra tarea.
Objetivo sigmoid sobre pares imagen–texto en lugar del contraste normalizado de CLIP
Alineación, selección de negativos y protocolo de clasificación
Swin modifica cómo se conectan tokens; DINOv2 cambia principalmente cómo se aprende una representación; SigLIP cambia el objetivo de alineación. No son tres sustitutos equivalentes de una capa. Este notebook no entrena esas familias ni atribuye sus resultados a ellas. El aprendizaje autosupervisado se amplía en el capítulo 25.
En una evaluación de modelos preentrenados compararía origen, resolución, representación, costo, sonda y ajuste fino bajo el mismo protocolo. Una característica reutilizable puede ser valiosa sin producir texto; una asociación imagen–texto puede servir para recuperación sin resolver preguntas visuales. La tarea define qué propiedad debemos medir.
23.9 Decisiones y actividades
Hallazgo
Qué revisar
Decisión que requiere evidencia
CNN competitiva con menos datos
Capacidad y presupuesto
Conservar el baseline si ViT no aporta valor
ViT sin posición confunde estructura
Tamaño de parche y localización
Incorporar posición o estructura local
Mapa de atención atractivo
Estabilidad e intervenciones
Evitar atribuir explicación causal automática
Transferencia débil
Diferencia entre origen y destino
Comparar congelación, ajuste y entrenamiento propio
Descripciones cambian ranking
Vocabulario y plantilla
Validar textos con datos reservados
Negación no altera significado
Objetivo y encoder de texto
Limitar el alcance del sistema
Repite semillas manteniendo presupuesto. Informa dispersión y costo de CNN y ViT.
Usa parches 1×1 y compara detalle, número de tokens y tiempo observado. Selecciona con validación.
Cambia cien ejemplos de destino por 25 y 250. Analiza cómo cambia el valor del preentrenamiento.
Evalúa cambios de intensidad o desplazamiento sobre un conjunto nuevo. No supongas que los mapas de atención demuestran robustez.
Introduce descripciones ambiguas y conceptos ausentes del entrenamiento. Diseña una prueba que realmente mida clases nuevas antes de usar la palabra zero-shot.
23.10 Contrato común y persistencia
La comparación de parches y representaciones se limita al dominio y presupuesto del laboratorio. La coincidencia entre imagen y texto no acredita generalización multimodal de producción. Se mantienen arquitectura, particiones y controles, y se archiva su estado sin añadir preentrenamiento externo.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib','.pt','.wav','.npz']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 5 | archivos registrados: 13
23.10.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron la comparación CNN/ViT, la ablación de posición, la transferencia y la alineación imagen–texto. Las descripciones pertenecen a clases conocidas del laboratorio: recuperar por texto no demuestra reconocimiento de conceptos nuevos ni capacidad de respuesta visual generativa. Los resultados y el protocolo de esta ejecución se archivan junto a los estados; el coste y el alcance de las tareas se leen por separado.
La armonización verificó identidad de parámetros y buffers tras recarga de 5 módulos presentes al cierre; archivó 13 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.