32  GPU y entrenamiento distribuido

Serie Deep Learning · del perceptrón a los transformers.

La infraestructura se decide con mediciones: cuánto tarda una actualización, qué memoria necesita y qué calidad alcanza bajo un presupuesto declarado. Este capítulo separa tres preguntas: tamaño de lote, elección de configuración y equivalencia del gradiente distribuido.

32.1 1. Protocolo y entorno

Fashion-MNIST conserva 8 000 ejemplos de desarrollo. En el ensayo de lotes se usan 6 400 para entrenar y 1 600 para validar, tres épocas y una época inicial de calentamiento que no entra en el rendimiento sostenido. La búsqueda usa 6 000/2 000 y tres épocas por configuración. La prueba oficial se limita a sus primeros 2 000 ejemplos y se consulta después de seleccionar y reentrenar la configuración por validación.

La ejecución identifica el dispositivo disponible. Si solo hay CPU, no inventa tiempos GPU ni aceleraciones. Los tiempos dependen también de carga del equipo, calentamiento y tamaño del problema; una pasada no es un estudio de rendimiento con intervalos de incertidumbre.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

32.2 2. Medir entrenamiento sin mezclarlo con validación

El temporizador de cada época mide carga de lotes y actualizaciones. En CUDA sincronizamos antes y después para incluir el trabajo asíncrono pendiente. La validación queda fuera de ese intervalo. El tiempo total sí incluye las evaluaciones. El contador usa ejemplos realmente procesados, incluido el último lote incompleto.

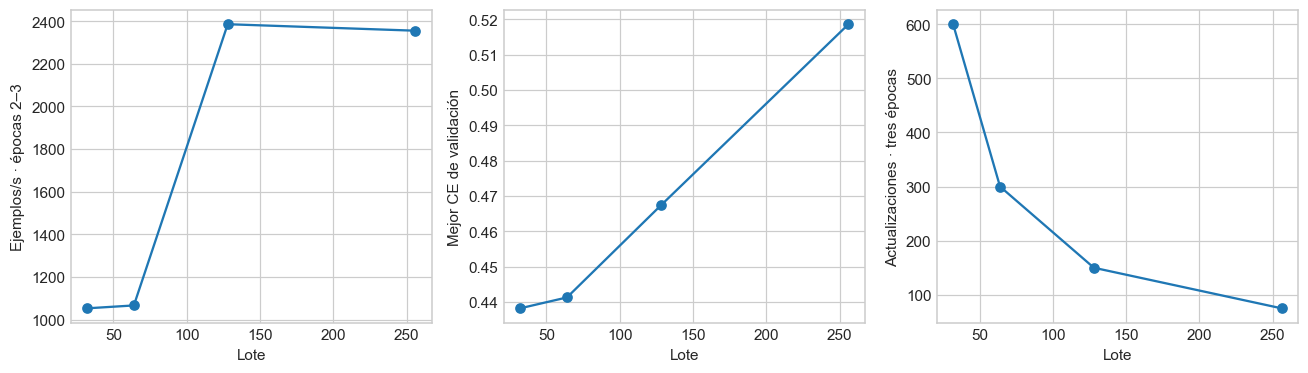
Comparar tres épocas con lotes distintos mantiene exposiciones a datos, pero cambia el número de actualizaciones. Por eso una diferencia de calidad no puede atribuirse únicamente al hardware. Se restaura el mínimo de CE de validación y se conserva la pérdida online por separado.

def sincronizar(dispositivo):
    if dispositivo.type=='cuda':torch.cuda.synchronize(dispositivo)

def ajustar(m,train,val,epocas=3,lote=128,lr=.001,dispositivo=DEVICE):
    m=m.to(dispositivo);opt=torch.optim.Adam(m.parameters(),lr=lr);hist=[];mejor=np.inf;estado=None;inicio=time.perf_counter()
    for ep in range(1,epocas+1):
        m.train();sincronizar(dispositivo);tic=time.perf_counter();s=0.;n=0;pasos=0
        for x,y in cargador(train,lote,True):
            x=x.to(dispositivo);y=y.to(dispositivo);opt.zero_grad(set_to_none=True);z=m(x);loss=F.cross_entropy(z,y);loss.backward();opt.step()
            s+=loss.item()*len(x);n+=len(x);pasos+=1
        sincronizar(dispositivo);tiempo=time.perf_counter()-tic
        # Evaluación independiente del dispositivo global del capítulo.
        def medir(ds):
            m.eval();ce=ok=0
            with torch.inference_mode():
                for x,y in cargador(ds,256):
                    x=x.to(dispositivo);y=y.to(dispositivo);z=m(x);ce+=F.cross_entropy(z,y,reduction='sum').item();ok+=(z.argmax(1)==y).sum().item()
            return ce/len(ds),ok/len(ds)
        tr,ta=medir(train);va,aa=medir(val)
        hist.append(dict(epoca=ep,ce_online=s/n,ce_train=tr,ce_val=va,exactitud_train=ta,exactitud_val=aa,entrenamiento_s=tiempo,ejemplos=n,pasos=pasos))
        if va<mejor:mejor=va;estado=copy.deepcopy(m.state_dict());ep_mejor=ep
    m.load_state_dict(estado);m.eval()
    return pd.DataFrame(hist),dict(ce_val=mejor,epoca_mejor=ep_mejor,total_s=time.perf_counter()-inicio)

def cnn():
    return nn.Sequential(nn.Conv2d(1,32,3),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(32,64,3),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(1600,64),nn.ReLU(),nn.Linear(64,10))

xa,ya,xt,yt=mnist('fashion');x=xa[:8000,None].astype(np.float32)/255;y=ya[:8000]
tr_lote=conjunto(x[:6400],y[:6400]);va_lote=conjunto(x[6400:],y[6400:])
tr=conjunto(x[:6000],y[:6000]);va=conjunto(x[6000:],y[6000:]);test=conjunto(xt[:2000,None].astype(np.float32)/255,yt[:2000])
print({'CPU':platform.processor(),'plataforma':platform.platform(),'dispositivo':str(DEVICE),'GPU':torch.cuda.get_device_name(DEVICE) if DEVICE.type=='cuda' else 'no disponible'})
semilla();base=inicializar(cnn());estado_base=copy.deepcopy(base.state_dict());filas=[]
for b in [32,64,128,256]:
    semilla();m=cnn().to(DEVICE);m.load_state_dict(estado_base);h,r=ajustar(m,tr_lote,va_lote,lote=b)
    sostenido=h.iloc[1:];r.update(lote=b,ejemplos_s=sostenido.ejemplos.sum()/sostenido.entrenamiento_s.sum(),segundos_sostenidos=sostenido.entrenamiento_s.sum(),pasos_totales=int(h.pasos.sum()))
    filas.append(r);h.to_csv(ARTEFACTOS/f'lote-{b}.csv',index=False)
lotes=pd.DataFrame(filas);lotes.to_csv(ARTEFACTOS/'lotes.csv',index=False);display(lotes)
fig,ax=plt.subplots(1,3,figsize=(12,3.5))
ax[0].plot(lotes.lote,lotes.ejemplos_s,'o-');ax[0].set(ylabel='Ejemplos/s · épocas 2–3',xlabel='Lote')
ax[1].plot(lotes.lote,lotes.ce_val,'o-');ax[1].set(ylabel='Mejor CE de validación',xlabel='Lote')
ax[2].plot(lotes.lote,lotes.pasos_totales,'o-');ax[2].set(ylabel='Actualizaciones · tres épocas',xlabel='Lote')
fig.tight_layout();plt.show()
{'CPU': 'Intel64 Family 6 Model 154 Stepping 3, GenuineIntel', 'plataforma': 'Windows-11-10.0.26200-SP0', 'dispositivo': 'cpu', 'GPU': 'no disponible'}
ce_val epoca_mejor total_s lote ejemplos_s segundos_sostenidos pasos_totales
0 0.438162 3 27.383171 32 1052.618690 12.160149 600
1 0.441249 3 29.293290 64 1066.236422 12.004842 300
2 0.467304 3 13.690696 128 2385.252535 5.366308 150
3 0.518634 3 14.967922 256 2354.783751 5.435743 75

32.2.1 Leer el compromiso entre lote y calidad

Un lote que procesa más ejemplos por segundo puede realizar menos actualizaciones y necesitar otro presupuesto para alcanzar la misma CE. Primero descarte los lotes que exceden memoria; después compare el tiempo para una calidad objetivo con varias repeticiones. Esta tabla es exploratoria, no demuestra cuál será el lote óptimo en otro modelo.

32.2.2 Contar memoria antes de comprar aceleración

Una GPU acelera operaciones suficientemente grandes y paralelas. El tiempo observado también incluye preparación de lotes, transferencias, lanzamiento de kernels y sincronización. Una multiplicación pequeña puede tardar más por esos costes fijos. Por eso se mide el recorrido completo y, por separado, la parte de entrenamiento que se pretende optimizar.

Un tensor float32 ocupa cuatro bytes por elemento. Una activación de forma \((128,32,28,28)\) necesita 12.25 MiB. Un millón de parámetros ocupa aproximadamente 3.81 MiB por copia. En Adam, parámetros, gradientes y dos momentos suman al menos cuatro copias float32, antes de contar activaciones, buffers y espacios de trabajo. Estos números son un presupuesto aproximado, no una medición del máximo reservado por el dispositivo.

El lote aumenta las activaciones y puede mejorar ocupación hasta cierto punto; no multiplica el número de parámetros. Precisión mixta tampoco significa reducir toda la memoria a la mitad: estados del optimizador y copias de mayor precisión pueden permanecer. Si el límite son activaciones, reducir lote o recomputar bloques puede ayudar; si lo son parámetros y estados, se necesita otra estrategia.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_recursos_presupuesto():
    filas=[]
    for lote in [32,64,128,256]:
        act=lote*32*28*28*4/2**20
        adam=1_000_000*4*4/2**20
        filas.append([lote,act,adam,act+adam])
    display(pd.DataFrame(filas,columns=['lote','una activacion MiB','parametros gradientes momentos MiB','subtotal parcial MiB']))
    assert np.isclose(filas[2][1],12.25)
    k=np.arange(1,17);paralelo=.9
    aceleracion=1/((1-paralelo)+paralelo/k)
    plt.plot(k,aceleracion,'o-',label='90% paralelizable');plt.plot(k,k,'--',label='Ideal');plt.xlabel('Trabajadores');plt.ylabel('Aceleración teórica');plt.legend();plt.show()
    print('Con ocho trabajadores:',1/(.1+.9/8),'veces; límite teórico:',1/.1)
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_recursos_presupuesto()
lote una activacion MiB parametros gradientes momentos MiB subtotal parcial MiB
0 32 3.0625 15.258789 18.321289
1 64 6.1250 15.258789 21.383789
2 128 12.2500 15.258789 27.508789
3 256 24.5000 15.258789 39.758789

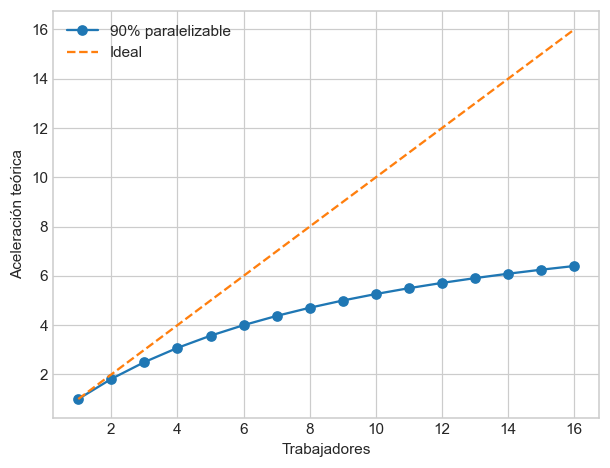
Con ocho trabajadores: 4.705882352941176 veces; límite teórico: 10.0

La ley de Amdahl supone una fracción serial fija y ningún coste adicional: \(S(k)=1/((1-p)+p/k)\). Con 90% paralelizable y ocho trabajadores, el techo del modelo es aproximadamente 4.71, no ocho. En la práctica se agrega comunicación. Un all-reduce en anillo mueve por trabajador aproximadamente \(2(k-1)S/k\) bytes para un mensaje de tamaño \(S\), además de latencia por etapa. La fórmula no predice por sí sola el tiempo de una red real.

Estrategia Qué se reparte Qué problema intenta resolver
Paralelismo de datos Lotes; cada trabajador conserva el modelo Aumentar rendimiento si modelo y estados caben
Fragmentación de estados Parámetros, gradientes o estados según estrategia Reducir memoria por trabajador
Paralelismo de tensores Operaciones de una misma capa Repartir capas demasiado grandes; exige comunicación frecuente
Paralelismo de pipeline Bloques sucesivos del modelo Repartir profundidad; hay tiempos ociosos y microbatches

Estas estrategias pueden combinarse. La existencia de varias GPU no determina cuál conviene: primero identifique qué consume memoria y qué tramo domina el tiempo.

32.3 3. CPU, GPU, memoria y precisión mixta

La comparación de dispositivos usa 2 048 ejemplos, lote 128, una época de calentamiento y otra medida, con la misma inicialización. En CPU se registra su tiempo; solo si CUDA existe se ejecuta la segunda rama y se informa memoria. Memoria asignada a tensores, reservada por el asignador y pico asignado son cantidades distintas. El pico incluye el contexto de medición declarado, no la memoria física total de la tarjeta.

AMP combina autocast con escalado de gradientes cuando procede. Debe verificarse calidad y estabilidad además del tiempo. No se presenta una aceleración AMP sin ejecutarla ni se confunde una CPU con una GPU mediante un cambio de etiqueta.

dispositivos=[torch.device('cpu')]+([DEVICE] if DEVICE.type=='cuda' else []);costes=[]
for dev in dispositivos:
    semilla();m=cnn().to(dev);m.load_state_dict({k:v.to(dev) for k,v in estado_base.items()})
    if dev.type=='cuda':torch.cuda.reset_peak_memory_stats(dev)
    h,r=ajustar(m,conjunto(x[:2048],y[:2048]),va_lote,epocas=2,lote=128,dispositivo=dev)
    costes.append({'dispositivo':str(dev),'segundos_epoca_medida':h.iloc[1].entrenamiento_s,'ejemplos_s':2048/h.iloc[1].entrenamiento_s,
                   'asignada_MiB':torch.cuda.memory_allocated(dev)/2**20 if dev.type=='cuda' else np.nan,
                   'reservada_MiB':torch.cuda.memory_reserved(dev)/2**20 if dev.type=='cuda' else np.nan,
                   'pico_asignado_MiB':torch.cuda.max_memory_allocated(dev)/2**20 if dev.type=='cuda' else np.nan})
costes=pd.DataFrame(costes);display(costes);costes.to_csv(ARTEFACTOS/'dispositivos.csv',index=False)
if DEVICE.type!='cuda':print('CUDA y AMP: no medidos en esta ejecución CPU. No hay cociente CPU/GPU.')
else:
    semilla();m=cnn().to(DEVICE);m.load_state_dict(estado_base);opt=torch.optim.Adam(m.parameters(),lr=.001);scaler=torch.amp.GradScaler('cuda');amp=[]
    for ep in range(2):
        m.train();sincronizar(DEVICE);tic=time.perf_counter()
        for a,b in cargador(conjunto(x[:2048],y[:2048]),128,True):
            a=a.to(DEVICE);b=b.to(DEVICE);opt.zero_grad(set_to_none=True)
            with torch.autocast(device_type='cuda',dtype=torch.float16):loss=F.cross_entropy(m(a),b)
            assert torch.isfinite(loss);scaler.scale(loss).backward();scaler.step(opt);scaler.update()
        sincronizar(DEVICE);amp.append(time.perf_counter()-tic)
    print({'AMP_segundos_epoca_medida':amp[1],'AMP_CE_val':evaluar(m,va_lote)['ce'],'nota':'una repetición; revisar estabilidad antes de adoptar'})
dispositivo segundos_epoca_medida ejemplos_s asignada_MiB reservada_MiB pico_asignado_MiB
0 cpu 0.785935 2605.814453 NaN NaN NaN
CUDA y AMP: no medidos en esta ejecución CPU. No hay cociente CPU/GPU.

32.4 4. Hiperparámetros: calidad, coste y selección

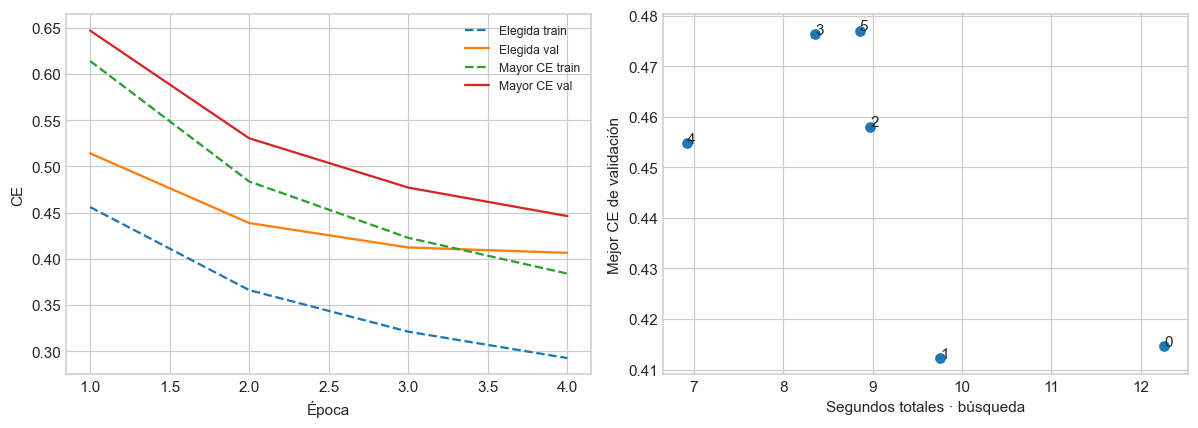
Se conservan seis configuraciones y tres épocas por candidata. Cambian tasa, anchura y lote simultáneamente: este barrido permite elegir una candidata, pero no aislar el efecto causal de cada parámetro. La arquitectura de búsqueda usa una convolución de 32 filtros, pooling y una capa densa variable. Se selecciona por mínimo CE de validación, sin consultar prueba.

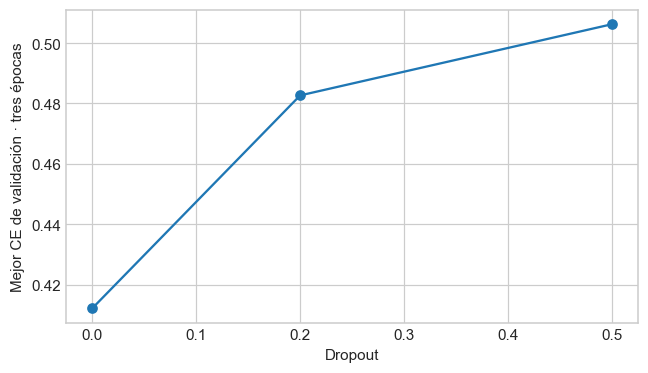
Las dos candidatas extremas se reentrenan cuatro épocas con semilla 42. La segunda semilla y el barrido de dropout son diagnósticos posteriores: no sustituyen el checkpoint ya elegido ni justifican volver a seleccionar con prueba.

def candidata(unidades,dropout=0.):return nn.Sequential(nn.Conv2d(1,32,3),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(5408,unidades),nn.ReLU(),nn.Dropout(dropout),nn.Linear(unidades,10))
configs=[(.001,32,64),(.001,64,128),(.0003,32,64),(.0003,64,128),(.01,32,256),(.0001,96,64)]
busqueda=[]
for i,(lr,u,b) in enumerate(configs):
    semilla();m=inicializar(candidata(u));h,r=ajustar(m,tr,va,lote=b,lr=lr);r.update(id=i,lr=lr,unidades=u,lote=b,parametros=parametros(m));busqueda.append(r);h.to_csv(ARTEFACTOS/f'busqueda-{i}.csv',index=False)
busqueda=pd.DataFrame(busqueda);display(busqueda.sort_values('ce_val'));busqueda.to_csv(ARTEFACTOS/'busqueda.csv',index=False)
elegida=int(busqueda.loc[busqueda.ce_val.idxmin(),'id']);peor=int(busqueda.loc[busqueda.ce_val.idxmax(),'id']);modelos={};historias={};resumen=[]
for nombre,i in [('Elegida',elegida),('Mayor CE',peor)]:
    lr,u,b=configs[i];semilla();m=inicializar(candidata(u));h,r=ajustar(m,tr,va,4,b,lr);modelos[nombre]=m;historias[nombre]=h;resumen.append(dict(modelo=nombre,**r));h.to_csv(ARTEFACTOS/f'reentreno-{i}.csv',index=False)
fig,ax=plt.subplots(1,2,figsize=(11,4))
for nombre,h in historias.items():
    ax[0].plot(h.epoca,h.ce_train,'--',label=nombre+' train');ax[0].plot(h.epoca,h.ce_val,label=nombre+' val')
ax[0].set(xlabel='Época',ylabel='CE');ax[0].legend(fontsize=8)
ax[1].scatter(busqueda.total_s,busqueda.ce_val)
for _,r in busqueda.iterrows():ax[1].annotate(str(int(r.id)),(r.total_s,r.ce_val))
ax[1].set(xlabel='Segundos totales · búsqueda',ylabel='Mejor CE de validación');fig.tight_layout();plt.show()
display(pd.DataFrame(resumen))
ce_val epoca_mejor total_s id lr unidades lote parametros
1 0.412279 3 9.757876 1 0.0010 64 128 347146
0 0.414679 3 12.260562 0 0.0010 32 64 173738
4 0.454857 3 6.921085 4 0.0100 32 256 173738
2 0.458061 3 8.972274 2 0.0003 32 64 173738
3 0.476323 3 8.358091 3 0.0003 64 128 347146
5 0.477039 3 8.855363 5 0.0001 96 64 520554

modelo ce_val epoca_mejor total_s
0 Elegida 0.406505 4 11.567586
1 Mayor CE 0.446248 4 14.339902

32.5 5. Prueba reservada y análisis de errores

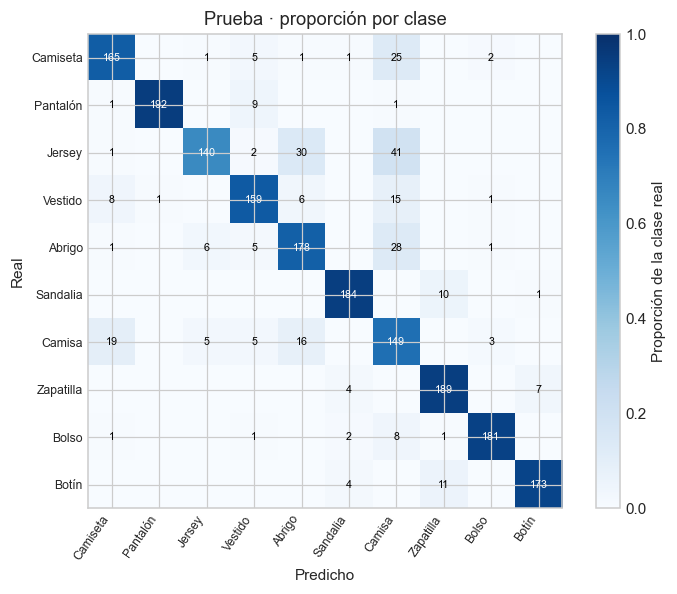
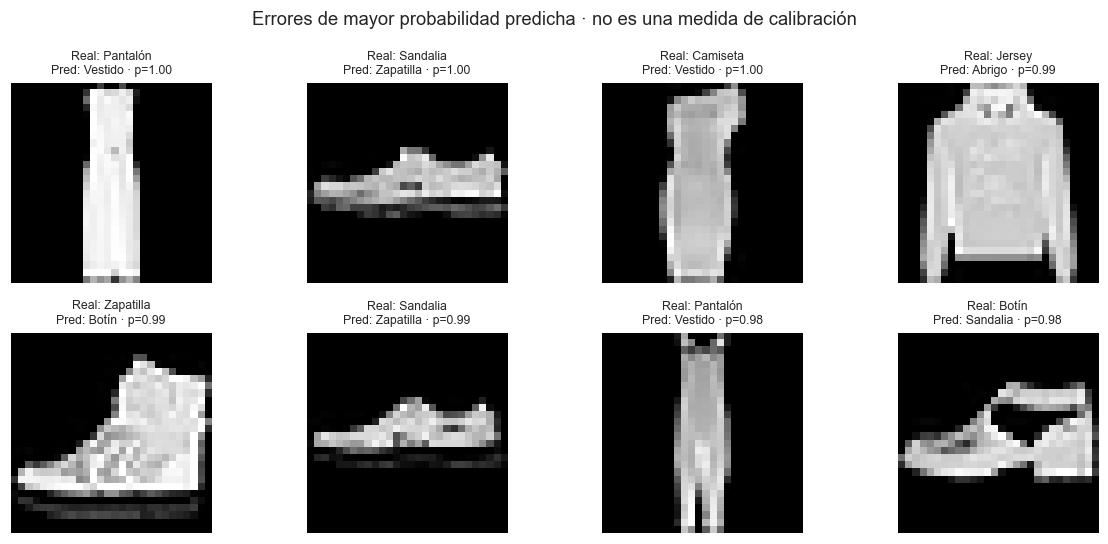
La CE penaliza la probabilidad asignada a la clase correcta; exactitud y F1 describen decisiones discretas. Se informa por clase y se inspeccionan errores para distinguir confusiones sistemáticas de un único porcentaje. No se interpreta una probabilidad alta como una garantía de calibración.

mejor=modelos['Elegida'];resultado=evaluar(mejor,test);display(pd.DataFrame([{'ce_test':resultado['ce'],'exactitud_test':resultado['exactitud'],'macro_f1':f1_score(resultado['y'],resultado['logits'].argmax(1),average='macro')}]))
nombres=['Camiseta','Pantalón','Jersey','Vestido','Abrigo','Sandalia','Camisa','Zapatilla','Bolso','Botín']
diagnostico(resultado,nombres,xt[:2000,None].astype(np.float32)/255)
lr,u,b=configs[elegida]
guardar(mejor,lambda:candidata(u),'seleccionada',{'config_id':elegida,'lr':lr,'unidades':u,'lote':b,'seleccion':'mínimo CE validación; reentreno 4 épocas semilla42','train':6000,'val':2000,'test':2000},va)
pd.DataFrame([{'ce':resultado['ce'],'exactitud':resultado['exactitud'],'macro_f1':f1_score(resultado['y'],resultado['logits'].argmax(1),average='macro')}]).to_csv(ARTEFACTOS/'test.csv',index=False)
replicas=[]
for nombre,i in [('Elegida',elegida),('Mayor CE',peor)]:
    lr_i,u_i,b_i=configs[i];semilla(1);m=inicializar(candidata(u_i));h,r=ajustar(m,tr,va,4,b_i,lr_i);replicas.append(dict(modelo=nombre,semilla=1,**r))
dropouts=[]
for d in [0.,.2,.5]:
    semilla();m=inicializar(candidata(u,d));h,r=ajustar(m,tr,va,3,b,lr);dropouts.append(dict(dropout=d,**r))
replicas=pd.DataFrame(replicas);dropouts=pd.DataFrame(dropouts);display(replicas);display(dropouts)
replicas.to_csv(ARTEFACTOS/'segunda-semilla.csv',index=False);dropouts.to_csv(ARTEFACTOS/'dropout.csv',index=False)
fig,ax=plt.subplots(figsize=(6,3.5));ax.plot(dropouts.dropout,dropouts.ce_val,'o-');ax.set(xlabel='Dropout',ylabel='Mejor CE de validación · tres épocas');fig.tight_layout();plt.show()
ce_test exactitud_test macro_f1
0 0.411059 0.855 0.859577
              precision    recall  f1-score   support

    Camiseta     0.8418    0.8250    0.8333       200
    Pantalón     0.9948    0.9458    0.9697       203
      Jersey     0.9211    0.6542    0.7650       214
     Vestido     0.8548    0.8368    0.8457       190
      Abrigo     0.7706    0.8128    0.7911       219
    Sandalia     0.9436    0.9436    0.9436       195
      Camisa     0.5581    0.7563    0.6422       197
   Zapatilla     0.8957    0.9450    0.9197       200
       Bolso     0.9628    0.9330    0.9476       194
       Botín     0.9558    0.9202    0.9377       188

    accuracy                         0.8550      2000
   macro avg     0.8699    0.8573    0.8596      2000
weighted avg     0.8691    0.8550    0.8579      2000

Decisión después de medir. Exactitud 85.50%; macro-F1 0.8596; 290 errores de 2000. El menor recall corresponde a Jersey (65.42%). La confusión más frecuente es Jersey → Camisa (41 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

Recarga verificada: artefactos_pytorch\seleccionada.pt bytes: 1391761
modelo semilla ce_val epoca_mejor total_s
0 Elegida 1 0.421719 4 10.904295
1 Mayor CE 1 0.458422 4 12.659329
dropout ce_val epoca_mejor total_s
0 0.0 0.412279 3 8.152065
1 0.2 0.482674 3 8.511135
2 0.5 0.506214 3 7.789181

32.6 6. Dos procesos: equivalencia antes que aceleración

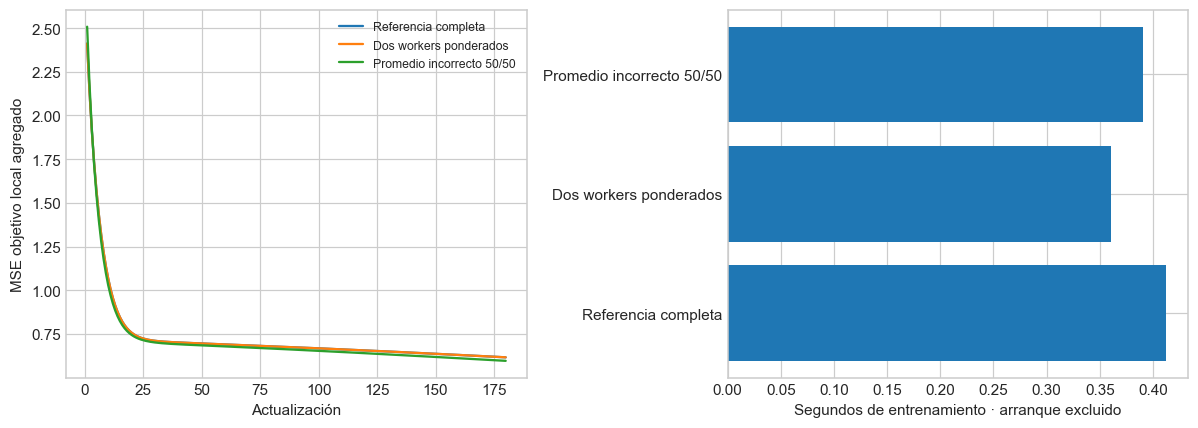
El laboratorio auxiliar conserva una derivación NumPy del gradiente y ejecuta dos procesos CPU reales con spawn. No utiliza GPU ni pretende ser un cluster. Una MLP 8→32→1, tanh, se entrena con 2 048 ejemplos y 180 pasos de gradiente completo. Las particiones tienen 700 y 1 348 ejemplos y distribuciones deliberadamente distintas.

Si cada trabajador calcula la pérdida media de su partición, el gradiente global es \(g=(700g_1+1348g_2)/2048\). Promediar 50/50 cambia el objetivo. Se comprueba que la versión ponderada y la referencia completa producen parámetros iguales con tolerancia \(10^{-10}\). Arranque de procesos y entrenamiento se cronometran por separado.

La comunicación puede dominar en este problema pequeño. La equivalencia matemática no implica aceleración. La prueba de 512 ejemplos compara los tres procedimientos prefijados; no decide hiperparámetros del clasificador Fashion.

import subprocess,sys
proceso=subprocess.run([sys.executable,'entrenamiento-distribuido.py'],capture_output=True,text=True,timeout=180,check=True)
distribuido=json.loads(Path('resultados-distribuido.json').read_text(encoding='utf-8'))
(ARTEFACTOS/'distribuido.json').write_text(json.dumps(distribuido,indent=2,ensure_ascii=False),encoding='utf-8')
display(pd.DataFrame(distribuido['results']).T);print('Diferencia máxima de parámetros:',distribuido['max_parameter_difference'])
assert distribuido['max_parameter_difference']<1e-10
fig,ax=plt.subplots(1,2,figsize=(11,4))
for nombre,curva in distribuido['curves'].items():ax[0].plot(np.arange(1,len(curva)+1),curva,label=nombre)
ax[0].set(xlabel='Actualización',ylabel='MSE objetivo local agregado');ax[0].legend(fontsize=8)
tabla=pd.DataFrame(distribuido['results']).T;ax[1].barh(tabla.index,tabla.entrenamiento_s);ax[1].set(xlabel='Segundos de entrenamiento · arranque excluido');fig.tight_layout();plt.show()
arranque_s entrenamiento_s ejemplos_por_segundo error_gradiente_inicial test_rmse train_loss_final
Referencia completa 0.000001 0.412323 8.940572e+05 0.000000e+00 0.802723 0.615638
Dos workers ponderados 0.904586 0.360102 1.023709e+06 1.443290e-15 0.802723 0.615638
Promedio incorrecto 50/50 0.954945 0.390813 9.432639e+05 6.990592e-01 0.796276 0.613728
Diferencia máxima de parámetros: 3.3306690738754696e-16

32.6.1 Lectura de la ejecución registrada

Ejecución CPU del 15 de octubre de 2026.

La ejecución usó CPU; CUDA y AMP quedaron sin medir. Los lotes 32/64/128/256 procesaron aproximadamente 1 053/1 066/2 385/2 355 ejemplos por segundo en las épocas sostenidas. La mejor CE de validación fue 0,4382/0,4412/0,4673/0,5186, con 600/300/150/75 actualizaciones totales. El lote 128 registró la mayor tasa en esta ejecución local, con carga del equipo no controlada, pero no alcanzó la CE del lote 32 bajo tres épocas. No se declara un lote ganador universal.

La búsqueda eligió la configuración 1 por validación (tasa 0,001, 64 unidades, lote 128). Su reentrenamiento prefijado obtuvo CE de prueba 0,4111, exactitud 85,5% y F1 macro 0,8596. Las confusiones entre prendas superiores y los errores de confianza alta aconsejan leer métricas por clase. La segunda semilla y dropout son diagnósticos y no reemplazan la elección.

Dos procesos CPU reprodujeron el gradiente y los parámetros de la referencia mediante reducción ponderada; se conserva el laboratorio NumPy como derivación independiente del framework. El tiempo es exploratorio, con carga del equipo no controlada y una repetición: no acredita una aceleración reproducible. La arquitectura, inicialización y checkpoints nativos PyTorch sustituyen la implementación anterior; no se afirma equivalencia numérica con ella.

32.6.2 Qué significa promediar gradientes

Si cada trabajador procesa la misma cantidad de ejemplos y calcula una pérdida media, promediar sus gradientes reproduce el gradiente medio del lote conjunto. Si los tamaños locales son distintos, el promedio simple da igual peso a trabajadores y no a observaciones. Una partición de un ejemplo tendría el mismo peso que otra de tres.

El siguiente caso usa regresión lineal sin entrenar para aislar la cuenta. Calculamos una sola derivada con cuatro observaciones y la comparamos con dos particiones desiguales. La equivalencia ponderada debe cumplirse antes de interpretar cualquier aceleración.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_distribuido_gradiente():
    x=torch.tensor([1.,2.,3.,4.],dtype=torch.float64)
    y=torch.tensor([0.,1.,1.,3.],dtype=torch.float64)
    w=torch.tensor(.5,dtype=torch.float64,requires_grad=True)
    def grad(a,b):
        return torch.autograd.grad(((w*a-b)**2).mean(),w)[0]
    global_g=grad(x,y);g1=grad(x[:1],y[:1]);g2=grad(x[1:],y[1:])
    igual=(g1+g2)/2;ponderado=(g1+3*g2)/4
    assert torch.allclose(ponderado,global_g)
    assert not torch.allclose(igual,global_g)
    display(pd.DataFrame({'metodo':['Lote completo','Promedio de trabajadores','Promedio por observaciones'],'gradiente':[global_g.item(),igual.item(),ponderado.item()]}))
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_distribuido_gradiente()
metodo gradiente
0 Lote completo -1.000000
1 Promedio de trabajadores -0.333333
2 Promedio por observaciones -1.000000

El mismo cuidado aplica a acumulación de microbatches: dividir siempre por la cantidad de microbatches es correcto si todos pesan igual; un último microbatch menor requiere ponderación por observaciones. También hay que mantener coherentes reducción de pérdida y número de pasos del optimizador.

En DDP con promedio de gradientes entre \(k\) procesos, un lote local de tamaño \(n_r\) puede ponderar su pérdida media por \(kn_r/N\) para representar una media global sobre \(N=\sum_r n_r\) observaciones. Esto supone que todos participan en la misma operación colectiva. Procesos que terminan antes o ejecutan distinto número de pasos requieren tratamiento adicional; la ponderación no resuelve un bloqueo de comunicación.

El lote global es trabajadores por lote local cuando los tamaños son iguales. Duplicar trabajadores manteniendo lote local duplica ese lote y reduce los pasos por época. Una comparación justa registra ejemplos procesados, actualizaciones, política de aprendizaje y calidad, además del tiempo. El muestreador distribuido puede rellenar particiones repitiendo ejemplos; esa repetición debe considerarse especialmente al agregar métricas de evaluación.

El laboratorio CPU de dos procesos comprueba una identidad y comunicación local. No demuestra escalamiento de GPU ni eficiencia de una red entre máquinas. Para avanzar: mida una GPU como referencia, compruebe equivalencia numérica en un lote pequeño, registre memoria máxima y después compare rendimiento con presupuesto y calidad explícitos.

32.7 7. De la demostración a PyTorch distribuido

En un entrenamiento con varias GPU, cada proceso administra un dispositivo y una réplica del modelo. El reparto de ejemplos, la sincronización de gradientes y el guardado coordinado forman parte del diseño. Antes de ampliar recursos, compruebe equivalencia en un caso pequeño, controle que los ejemplos no se duplican accidentalmente y distinga coste de comunicación de cómputo.

El laboratorio de este capítulo demuestra la reducción ponderada con dos procesos CPU; no ejecuta DDP ni verifica un despliegue multitarjeta. Para una implementación real consulte las opciones de DistributedDataParallel, el muestreo y el tratamiento de entradas desiguales en la documentación oficial. Debe definirse qué media se desea cuando los lotes locales no tienen igual tamaño.

32.8 8. Decisiones que sí permiten las mediciones

Elija infraestructura mediante un presupuesto de calidad y tiempo. Si el lote mayor acelera pero empeora CE, compare tiempo hasta una CE objetivo antes de adoptarlo. Si dos semillas cambian la clasificación de candidatas, amplíe repeticiones. Si distribuir conserva parámetros pero aumenta segundos, el problema es demasiado pequeño para amortizar comunicación. Si no hay GPU, la conclusión sobre GPU queda pendiente de medición.

32.9 Referencias