Cuando las observaciones están relacionadas, una tabla de atributos puede perder parte de la información. Un grafo representa entidades mediante nodos y relaciones mediante aristas. Una red neuronal sobre grafos combina atributos con mensajes de vecinos; su utilidad depende de qué significan esas relaciones y qué información estará disponible al predecir.
Construiremos propagación desde una matriz pequeña, clasificación de nodos con pocas etiquetas, clasificación de grafos de tamaño variable y predicción de enlaces retirados de la estructura. Cada tarea tendrá su protocolo, baseline y análisis de errores. También veremos situaciones donde agregar vecinos o capas no ayuda.
Se utilizan NumPy, pandas, Matplotlib, networkx, scikit-learn y PyTorch en CPU, sin bibliotecas de grafos neuronales adicionales ni descargas. Los grafos son sintéticos y sus reglas conocidas permiten auditar resultados. Continúa Pipelines y Embeddings; se conecta con Recomendación.
29.1 Nodos, aristas, atributos y tarea
Un grafo \(G=(V,E)\) tiene nodos y aristas. En nuestros ejemplos las aristas son no dirigidas, sin pesos originales y sin duplicados. Una matriz \(A\) indica relaciones; \(X\) almacena una fila de atributos por nodo. Reordenar nodos cambia índices, pero no debería cambiar el significado del grafo.
Tarea
Unidad de predicción
Qué debe reservarse
Clasificación de nodos
Nodo
Etiquetas y, según escenario, nodos o fechas
Clasificación de grafos
Grafo completo
Grafos independientes o grupos de procedencia
Predicción de enlaces
Pareja de nodos
Aristas objetivo antes de construir mensajes
Que dos nodos estén conectados no garantiza que compartan etiqueta. La homofilia describe semejanza entre vecinos; en redes con heterofilia la mezcla local puede borrar información útil. El significado de la arista precede a la elección de arquitectura.
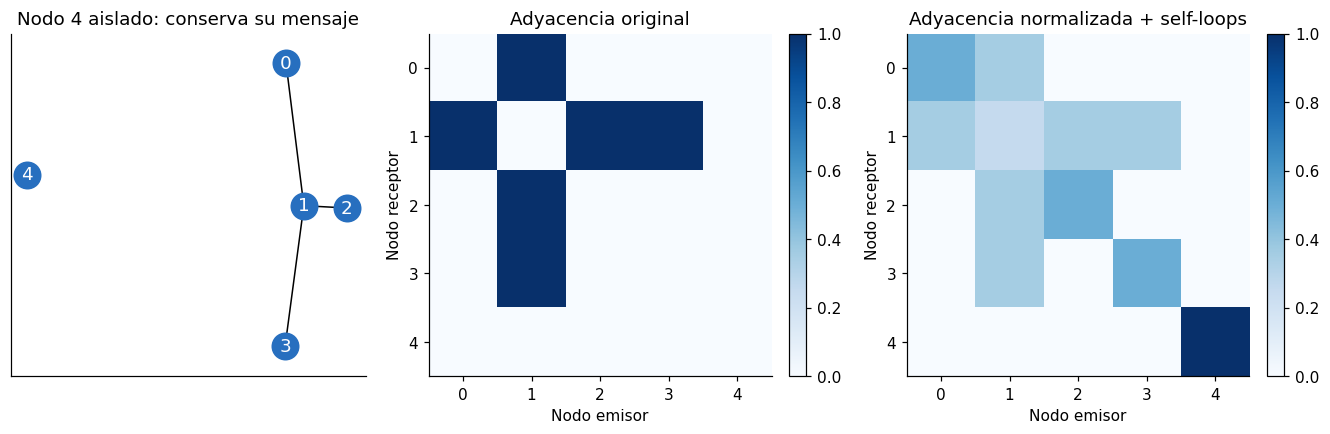
import numpy as npimport sklearn#| code-fold: true#| code-summary: "Ver implementación del experimento"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearn,scipyfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score,balanced_accuracy_score,log_loss,ConfusionMatrixDisplay,roc_auc_score,average_precision_score,f1_scorefrom sklearn.preprocessing import StandardScalerfrom IPython.display import displayimport torchfrom torch import nnfrom torch.utils.data import DataLoader,TensorDatasetimport copy,json,math,time,itertoolsfrom pathlib import Pathtorch.set_num_threads(1);torch.use_deterministic_algorithms(True)SEMILLA=42;lecturas={};COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})def tensor(x,dtype=torch.float32):return torch.tensor(x,dtype=dtype)def probas(modelo,x): modelo.eval()with torch.no_grad():return modelo(x).softmax(-1).numpy()def ajustar_clasificador(modelo,x,y,xv,yv,epocas=45,lr=.003,seed=7): opt=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr) loader=DataLoader(TensorDataset(x,y),batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(seed)) mejor=np.inf;hist=[];inicio=time.perf_counter()for ep inrange(1,epocas+1): modelo.train();suma=0.;cuenta=0for xb,yb in loader: opt.zero_grad();loss=nn.functional.cross_entropy(modelo(xb),yb);loss.backward();opt.step();suma+=float(loss.detach())*len(xb);cuenta+=len(xb) pv=probas(modelo,xv);lv=log_loss(yv.numpy(),pv,labels=np.arange(pv.shape[1]));hist.append((ep,suma/cuenta,lv,balanced_accuracy_score(yv,pv.argmax(1))))if lv<mejor:mejor=lv;estado=copy.deepcopy(modelo.state_dict());checkpoint=ep modelo.load_state_dict(estado)return np.array(hist),checkpoint,time.perf_counter()-inicioprint('NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.')import networkx as nxdef normalizar_adj(A): B=A+np.eye(len(A));d=B.sum(1);return (B/np.sqrt(d[:,None]*d[None,:])).astype('float32')G=nx.Graph();G.add_nodes_from(range(5));G.add_edges_from([(0,1),(1,2),(1,3)])A=nx.to_numpy_array(G,nodelist=range(5));X0=np.array([[1.,0.],[0.,1.],[2.,0.],[0.,2.],[3.,3.]])S=normalizar_adj(A);mensaje=S@X0display(pd.DataFrame({'nodo':range(5),'grado sin self-loop':A.sum(1),'atributo 1':X0[:,0],'tras propagar 1':mensaje[:,0],'atributo 2':X0[:,1],'tras propagar 2':mensaje[:,1]}))fig,axs=plt.subplots(1,3,figsize=(12,3.8));nx.draw_networkx(G,pos=nx.spring_layout(G,seed=3),ax=axs[0],node_color=COLORES[0],font_color='white');axs[0].set_title('Nodo 4 aislado: conserva su mensaje')for ax,M,t inzip(axs[1:],[A,S],['Adyacencia original','Adyacencia normalizada + self-loops']):im=ax.imshow(M,cmap='Blues');ax.set(title=t,xlabel='Nodo emisor',ylabel='Nodo receptor');fig.colorbar(im,ax=ax)plt.show();assert np.allclose(mensaje[4],X0[4])
NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.
nodo
grado sin self-loop
atributo 1
tras propagar 1
atributo 2
tras propagar 2
0
0
1.0
1.0
0.50000
0.0
0.353553
1
1
3.0
0.0
1.06066
1.0
0.957107
2
2
1.0
2.0
1.00000
0.0
0.353553
3
3
1.0
0.0
0.00000
2.0
1.353553
4
4
0.0
3.0
3.00000
3.0
3.000000
29.2 Una capa GCN: propagar y transformar
Agregamos self-loops para incluir al propio nodo y utilizamos normalización simétrica:
Esta normalización no es un promedio aritmético por fila: los pesos dependen de grados de emisor y receptor. El nodo aislado conserva su propio atributo porque recibe un self-loop. La matriz \(W\) se comparte entre nodos; no hay un parámetro distinto por identidad en esta capa.
Una capa comunica un salto y dos capas permiten combinar información de hasta dos saltos, bajo este esquema. Más capas amplían alcance, pero también cambian optimización, mezcla y capacidad. No garantizan que la información lejana sea útil.
29.2.1 Equivarianza al orden y representación dispersa
Si permutamos atributos y filas/columnas de adyacencia de forma consistente, las representaciones de nodos se permutan igual. Un pooling sobre nodos puede producir una representación invariante de grafo. Un ID utilizado como atributo arbitrario podría introducir dependencias de numeración que no queremos.
Equivarianza, pooling invariante y propagación dispersa verificados.
representación 1
representación 2
0
0.603553
0.429289
1
1.487437
0.869239
2
0.853553
0.929289
3
1.353553
0.000000
4
4.500000
2.400000
nodos
GB decimales adyacencia float32
0
1000
0.004
1
10000
0.400
2
100000
40.000
La matriz densa es cómoda para verificar cinco nodos. Su memoria crece con el cuadrado del número de nodos: cien mil nodos requieren 40 GB decimales solo para esa matriz. Una representación dispersa almacena aristas e índices y suele ser adecuada para grafos poco densos; su costo depende también de formato y tipos de índices.
El cálculo disperso verificado reproduce la propagación densa. En grafos grandes, muestreo de vecinos y particionado cambian el recorrido de entrenamiento; deben controlar qué vecindarios están disponibles y cómo se evalúa cobertura. Estos notebooks usan matrices pequeñas para que el mecanismo sea visible.
29.3 Clasificación de nodos con pocas etiquetas
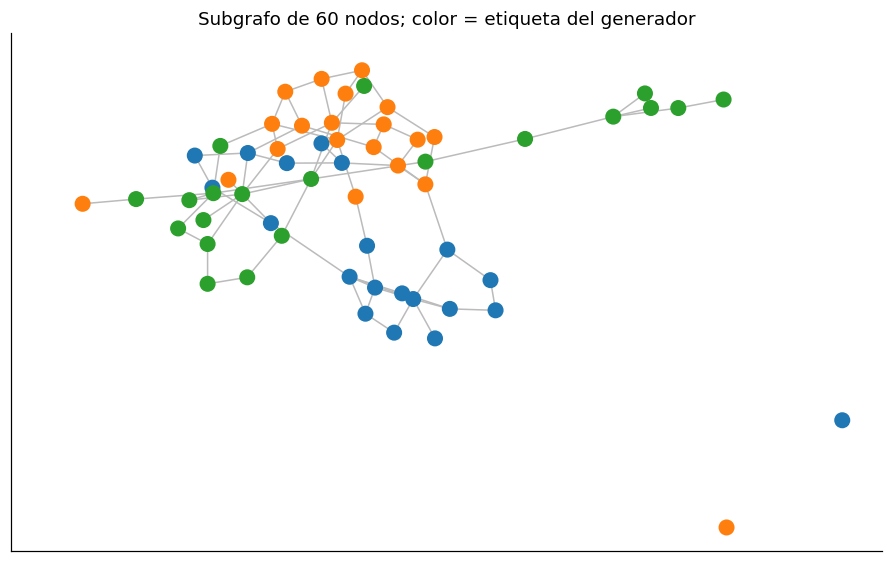
Generamos 240 nodos en tres comunidades de 80. Las etiquetas coinciden con comunidades del generador. Los atributos tienen señales débiles de clase y ruido. Las aristas favorecen vecinos de la misma comunidad, por construcción. Reservamos seis etiquetas por clase para entrenamiento, veinte para validación y el resto para prueba.
Es un escenario transductivo: todos los nodos, sus atributos y aristas están disponibles desde el inicio, pero solo las etiquetas de entrenamiento participan en la pérdida. Las de validación seleccionan checkpoints; las de prueba no intervienen. Si el despliegue requiere nodos o grafos nuevos, este protocolo no mide directamente ese objetivo.
El escalador se ajusta solo con atributos de nodos etiquetados de entrenamiento, una regla conservadora explícita. Usar todos los atributos sin etiquetas podría ser admisible bajo el contrato transductivo, pero sería otra decisión que habría que declarar.
rng=np.random.default_rng(42);yn=np.repeat(np.arange(3),80);n=len(yn)def grafo_bloques(p_in,p_out,seed): r=np.random.default_rng(seed);P=np.where(yn[:,None]==yn[None,:],p_in,p_out);U=r.random((n,n));B=np.triu(U<P,1);return (B+B.T).astype('float32')An=grafo_bloques(.12,.015,13);Ah=grafo_bloques(.01,.10,14)centros=np.eye(3,8)*.6;xn=centros[yn]+rng.normal(0,1,(n,8));nt=[];nv=[];ne=[]for c inrange(3): orden=rng.permutation(np.flatnonzero(yn==c));nt.extend(orden[:6]);nv.extend(orden[6:26]);ne.extend(orden[26:])nt=np.array(nt);nv=np.array(nv);ne=np.array(ne);escala=StandardScaler().fit(xn[nt]);XN=tensor(escala.transform(xn));YN=tensor(yn,torch.long);SN=tensor(normalizar_adj(An));SH=tensor(normalizar_adj(Ah))def homofilia(A): i,j=np.where(np.triu(A,1)>0);returnfloat(np.mean(yn[i]==yn[j]))display(pd.DataFrame({'grafo':['Homofilia','Heterofilia'],'aristas':[int(An.sum()/2),int(Ah.sum()/2)],'fracción misma etiqueta':[homofilia(An),homofilia(Ah)]}))G=nx.from_numpy_array(An);sub=G.subgraph(range(0,240,4));fig,ax=plt.subplots(figsize=(8,5));nx.draw_networkx(sub,pos=nx.spring_layout(sub,seed=5),node_color=yn[list(sub)],cmap='tab10',vmin=0,vmax=9,node_size=90,with_labels=False,edge_color='#bbbbbb',ax=ax);ax.set_title('Subgrafo de 60 nodos; color = etiqueta del generador');plt.show()print('Etiquetas disponibles:',len(nt),'train,',len(nv),'validación,',len(ne),'prueba')
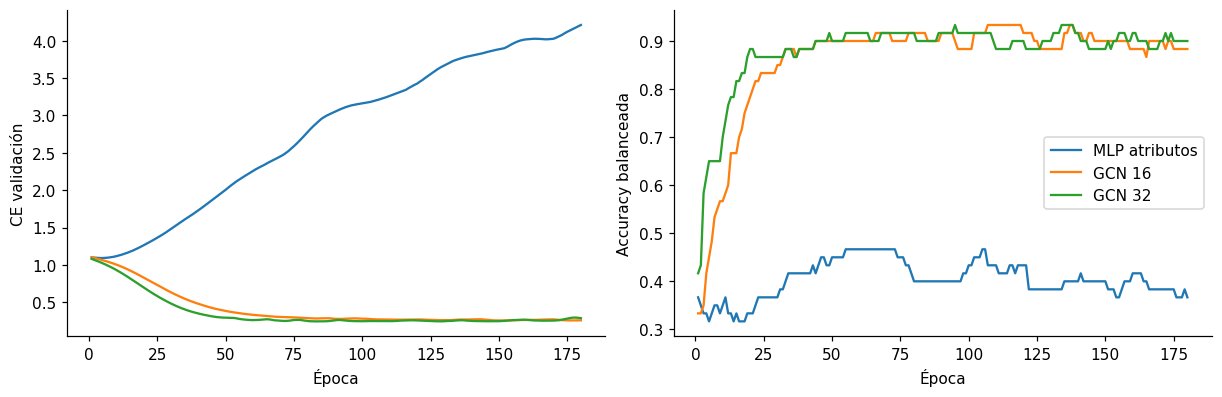
Comparamos una MLP que ignora aristas con GCN de 16 y 32 unidades. Usamos dos capas, dropout 0.2, Adam 0.01, regularización L2 de 0.0005 y 180 épocas. La pérdida se calcula solo en los 18 nodos etiquetados de entrenamiento. Seleccionamos cada checkpoint y la dimensión de GCN por CE de validación.
La topología fue construida a partir de comunidades que también definen las etiquetas: esperamos que sea informativa en este generador. No significa que una red de transacciones o amistades real tenga ese mecanismo. El baseline comprueba cuánto aportan atributos sin propagación.
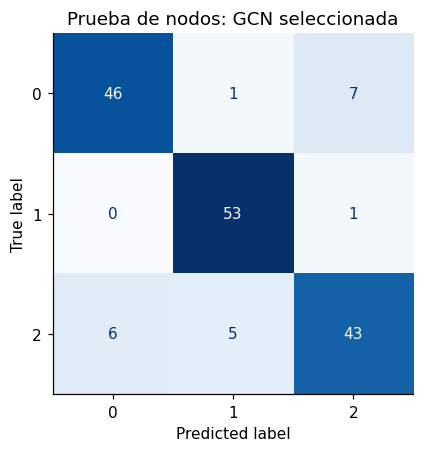
class RedNodos(nn.Module):def__init__(self,d=16,gcn=True):super().__init__();self.gcn=gcn;self.l1=nn.Linear(8,d);self.l2=nn.Linear(d,3);self.drop=nn.Dropout(.2)def forward(self,x,S): h=self.l1(S@x ifself.gcn else x).relu();h=self.drop(h);returnself.l2(S@h ifself.gcn else h)def ajustar_nodos(S,gcn=True,d=16): torch.manual_seed(7);m=RedNodos(d,gcn);opt=torch.optim.Adam(m.parameters(),lr=.01,weight_decay=.0005);mejor=np.inf;hist=[]for ep inrange(1,181): m.train();opt.zero_grad();loss=nn.functional.cross_entropy(m(XN,S)[nt],YN[nt]);loss.backward();opt.step();m.eval()with torch.no_grad():z=m(XN,S);lv=float(nn.functional.cross_entropy(z[nv],YN[nv]));bal=balanced_accuracy_score(yn[nv],z[nv].argmax(1)) hist.append((ep,float(loss.detach()),lv,bal))if lv<mejor:mejor=lv;estado=copy.deepcopy(m.state_dict());checkpoint=ep m.load_state_dict(estado);return m,np.array(hist),checkpoint,mejormn={};hn={};filas_n=[]for nombre,gcn,d in [('MLP atributos',False,16),('GCN 16',True,16),('GCN 32',True,32)]: m,h,ep,lv=ajustar_nodos(SN,gcn,d);mn[nombre]=m;hn[nombre]=h;filas_n.append({'modelo':nombre,'parámetros':sum(p.numel() for p in m.parameters()),'época':ep,'CE validación':lv,'balanceada validación':h[ep-1,3]})tabla_n=pd.DataFrame(filas_n);display(tabla_n);nombre_gcn=tabla_n[tabla_n.modelo.str.startswith('GCN')].sort_values('CE validación').iloc[0].modelo;gcn=mn[nombre_gcn]fig,axs=plt.subplots(1,2,figsize=(11,3.5))for nombre,h in hn.items():axs[0].plot(h[:,0],h[:,2],label=nombre);axs[1].plot(h[:,0],h[:,3],label=nombre)axs[0].set(xlabel='Época',ylabel='CE validación');axs[1].set(xlabel='Época',ylabel='Accuracy balanceada');axs[1].legend();plt.show()res_n=[]for nombre in ['MLP atributos',nombre_gcn]: m=mn[nombre];m.eval()with torch.no_grad():p=m(XN,SN)[ne].softmax(-1).numpy() res_n.append({'caso':'nodos','grupo':'homofilia','modelo':nombre,'métrica':'balanceada','valor':balanced_accuracy_score(yn[ne],p.argmax(1))})display(pd.DataFrame(res_n));fig,ax=plt.subplots(figsize=(5,4));ConfusionMatrixDisplay.from_predictions(yn[ne],p.argmax(1),ax=ax,cmap='Blues',colorbar=False);ax.set_title('Prueba de nodos: GCN seleccionada');plt.show()lecturas['n_gcn']=f'{res_n[1]["valor"]:.3f}';lecturas['n_mlp']=f'{res_n[0]["valor"]:.3f}';lecturas['n_seleccion']=nombre_gcn
modelo
parámetros
época
CE validación
balanceada validación
0
MLP atributos
195
5
1.091354
0.316667
1
GCN 16
195
152
0.255293
0.900000
2
GCN 32
387
83
0.243492
0.900000
caso
grupo
modelo
métrica
valor
0
nodos
homofilia
MLP atributos
balanceada
0.370370
1
nodos
homofilia
GCN 32
balanceada
0.876543
29.3.2 Cómo leer este resultado
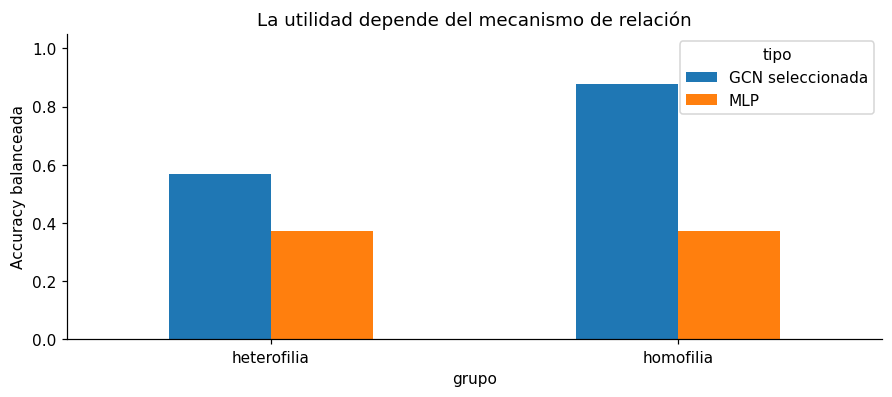
Se seleccionó GCN 32. Su accuracy balanceada de prueba es 0.877, frente a 0.370 de la MLP. La diferencia responde a un grafo cuya topología contiene señal de comunidad. Como los nodos de prueba participan en los mensajes desde el principio, esta cifra evalúa etiquetas reservadas de un grafo conocido, no un grafo nuevo.
Los errores no son observaciones independientes: los nodos comparten vecinos y rutas. Para cuantificar incertidumbre convendría repetir grafos y semillas o definir unidades de muestreo acordes al escenario, en lugar de tratar cada nodo como una réplica aislada.
29.4 Si los vecinos tienen otra etiqueta
Construimos otro grafo con los mismos nodos, atributos y particiones, pero con relaciones más frecuentes entre comunidades. No conserva exactamente número de aristas ni grados: compara dos mecanismos de conectividad, no aísla exclusivamente homofilia bajo un control perfecto.
Seleccionamos nuevamente dimensión y checkpoints con validación dentro del segundo grafo. El test sigue reservado para ese procedimiento declarado. La MLP ignora topología, por lo que reutilizamos sus predicciones; no corresponde reentrenarla para favorecer una condición.
heter={};fh=[]for d in [16,32]: m,h,ep,lv=ajustar_nodos(SH,True,d);heter[d]=m;fh.append({'dimensión':d,'CE validación':lv,'época':ep})th=pd.DataFrame(fh);dh=int(th.sort_values('CE validación').iloc[0]['dimensión']);mh=heter[dh];mh.eval()with torch.no_grad():pred=mh(XN,SH)[ne].argmax(1).numpy()res_n.extend([{'caso':'nodos','grupo':'heterofilia','modelo':'MLP atributos','métrica':'balanceada','valor':res_n[0]['valor']},{'caso':'nodos','grupo':'heterofilia','modelo':f'GCN {dh}','métrica':'balanceada','valor':balanced_accuracy_score(yn[ne],pred)}]);display(th);display(pd.DataFrame(res_n))fig,ax=plt.subplots(figsize=(8,3.5));pd.DataFrame(res_n).assign(tipo=lambda t:np.where(t.modelo.str.startswith('GCN'),'GCN seleccionada','MLP')).pivot(index='grupo',columns='tipo',values='valor').plot.bar(ax=ax,rot=0);ax.set(ylabel='Accuracy balanceada',ylim=(0,1.05),title='La utilidad depende del mecanismo de relación');plt.show()lecturas['heter']=f'{res_n[-1]["valor"]:.3f}'
dimensión
CE validación
época
0
16
0.885778
71
1
32
0.901640
46
caso
grupo
modelo
métrica
valor
0
nodos
homofilia
MLP atributos
balanceada
0.370370
1
nodos
homofilia
GCN 32
balanceada
0.876543
2
nodos
heterofilia
MLP atributos
balanceada
0.370370
3
nodos
heterofilia
GCN 16
balanceada
0.567901
29.4.1 Cómo leer este resultado
La GCN seleccionada en heterofilia obtiene 0.568. Compara la tabla, no la expectativa: dos saltos pueden recuperar patrones incluso si un vecino inmediato tiene otra etiqueta. Si cambia el rendimiento, también cambiaron grados y densidad del grafo. No basta con una comparación para concluir que toda GCN falla o funciona en heterofilia.
Para relaciones heterogéneas pueden interesar capas que separen mensaje propio y de vecinos, tipos de arista o alcances distintos. La arquitectura debe probarse con la relación real que pretende representar.
Aquí la GCN baja de 0.877 a 0.568, pero todavía supera 0.370 de la MLP. Por tanto, este experimento no respalda la conclusión «vecinos de otra clase siempre perjudican». La topología sigue proporcionando alguna información que los atributos solos no capturaron bajo estos presupuestos.
29.5 Muchas propagaciones: mezclar hasta perder diferencias
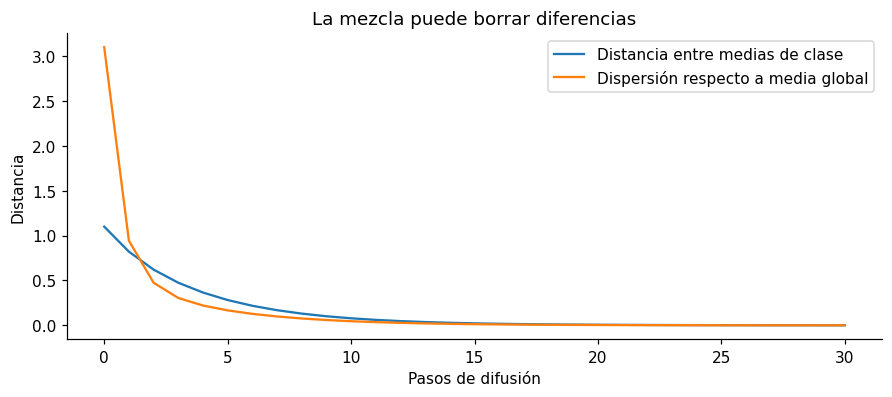
Para aislar mezcla, aplicaremos repetidamente una matriz de promedio por filas a atributos, sin entrenar pesos. Es un proceso de difusión, no una comparación de GCN con distinta profundidad. Al conectar nodos y mantener self-loops, la difusión puede acercar representaciones. La normalización simétrica de nuestra GCN tiene otro límite, influido por los grados.
B=An+np.eye(n);R=B/B.sum(1,keepdims=True);H=XN.numpy().copy();medidas=[]for paso inrange(31): medias=np.stack([H[yn==c].mean(0) for c inrange(3)]);separacion=np.mean([np.linalg.norm(medias[a]-medias[b]) for a,b in [(0,1),(0,2),(1,2)]]) dispersion=float(np.mean(np.linalg.norm(H-H.mean(0),axis=1)));medidas.append((paso,separacion,dispersion));H=R@Hmedidas=np.array(medidas);fig,ax=plt.subplots(figsize=(8,3.5));ax.plot(medidas[:,0],medidas[:,1],label='Distancia entre medias de clase');ax.plot(medidas[:,0],medidas[:,2],label='Dispersión respecto a media global');ax.set(xlabel='Pasos de difusión',ylabel='Distancia',title='La mezcla puede borrar diferencias');ax.legend();plt.show()print('Componentes conectadas del grafo:',nx.number_connected_components(nx.from_numpy_array(An)))
Componentes conectadas del grafo: 1
La caída de ambas curvas muestra pérdida de diferencias bajo esta difusión. No demuestra que una red profunda entrenada se comporte exactamente igual: pesos, no linealidades, residuales y objetivos pueden modificarla. Tampoco confunde oversmoothing, que mezcla representaciones, con oversquashing, donde muchas fuentes deben comprimirse por pocas rutas o una dimensión limitada.
29.6 Clasificación de grafos completos
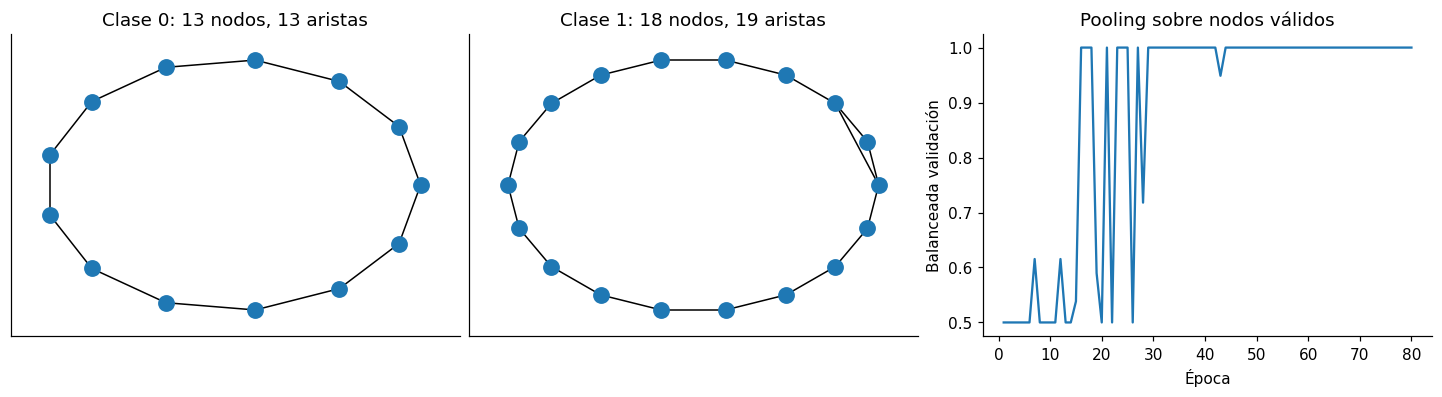
Generaremos anillos de 8–18 nodos. La clase 1 agrega una cuerda entre nodos a distancia dos, formando un triángulo; la clase 0 conserva el anillo. Los atributos son constante y grado dividido por cuatro. Cada grafo completo pertenece a una sola partición.
La etiqueta también se deduce del número de aristas: el anillo tiene tantas aristas como nodos y la clase 1 tiene una más. Ese baseline exacto es un control deliberado. Entrenar una GNN enseña batching y pooling, pero no justifica preferirla sobre una regla que ya resuelve el problema.
Completamos adyacencias y atributos hasta el tamaño máximo del lote. La máscara impide que nodos de relleno reciban self-loops o participen en el pooling. Normalizar un grafo después de agregar nodos ficticios cambiaría su significado.
Ver implementación del experimento
rng_g=np.random.default_rng(88)def generar_grafos(n,min_n=8,max_n=18): salida=[]for i inrange(n): k=int(rng_g.integers(min_n,max_n+1));c=int(rng_g.integers(0,2));G=nx.cycle_graph(k)if c:G.add_edge(0,2) A=nx.to_numpy_array(G);x=np.column_stack([np.ones(k),A.sum(1)/4]);salida.append((A,x,c))return salidagtr=generar_grafos(320);gva=generar_grafos(80);gte=generar_grafos(80);ggrandes=generar_grafos(60,19,24)def lote_grafos(batch): k=max(len(a) for a,x,c in batch);X=np.zeros((len(batch),k,2),'float32');S=np.zeros((len(batch),k,k),'float32');mask=np.zeros((len(batch),k),'float32');y=[]for i,(a,x,c) inenumerate(batch):m=len(a);X[i,:m]=x;S[i,:m,:m]=normalizar_adj(a);mask[i,:m]=1;y.append(c)return tensor(X),tensor(S),tensor(mask),tensor(y,torch.long)class ClasGrafo(nn.Module):def__init__(self):super().__init__();self.l1=nn.Linear(2,16);self.l2=nn.Linear(16,16);self.fc=nn.Linear(16,2)def forward(self,x,S,mask): h=self.l1(S@x).relu();h=self.l2(S@h).relu();pool=(h*mask[...,None]).sum(1)/mask.sum(1,keepdim=True);returnself.fc(pool)def evaluar_grafos(m,datos): m.eval();x,s,mask,y=lote_grafos(datos)with torch.no_grad():z=m(x,s,mask);loss=float(nn.functional.cross_entropy(z,y));p=z.argmax(1).numpy()return loss,balanced_accuracy_score(y,p),ptorch.manual_seed(29);mg=ClasGrafo();opt=torch.optim.Adam(mg.parameters(),lr=.01);loader=DataLoader(gtr,batch_size=32,shuffle=True,collate_fn=lote_grafos,generator=torch.Generator().manual_seed(29));mejor=np.inf;hg=[]for ep inrange(1,81): mg.train()for x,s,mask,yb in loader:opt.zero_grad();loss=nn.functional.cross_entropy(mg(x,s,mask),yb);loss.backward();opt.step() lv,bal,p=evaluar_grafos(mg,gva);hg.append((ep,lv,bal))if lv<mejor:mejor=lv;estado=copy.deepcopy(mg.state_dict());ep_grafo=epmg.load_state_dict(estado);res_g=[]for grupo,datos in [('tamaño conocido',gte),('tamaño nuevo',ggrandes)]: lv,bal,p=evaluar_grafos(mg,datos);verdad=np.array([c for a,x,c in datos]);regla=np.array([int(a.sum()/2>len(a)) for a,x,c in datos]) res_g.extend([{'caso':'grafos','grupo':grupo,'modelo':'GCN + mean pooling','métrica':'balanceada','valor':bal},{'caso':'grafos','grupo':grupo,'modelo':'Conteo exacto de aristas','métrica':'balanceada','valor':balanced_accuracy_score(verdad,regla)}])display(pd.DataFrame(res_g));fig,axs=plt.subplots(1,3,figsize=(13,3.5))for ax,grafo inzip(axs[:2],[next(g for g in gtr if g[2]==0),next(g for g in gtr if g[2]==1)]):a,x,c=grafo;nx.draw_networkx(nx.from_numpy_array(a),pos=nx.circular_layout(nx.from_numpy_array(a)),ax=ax,node_size=100,with_labels=False);ax.set_title(f'Clase {c}: {len(a)} nodos, {int(a.sum()/2)} aristas')hg=np.array(hg);axs[2].plot(hg[:,0],hg[:,2]);axs[2].set(xlabel='Época',ylabel='Balanceada validación',title='Pooling sobre nodos válidos');plt.show()lecturas['grafo_test']=f'{res_g[0]["valor"]:.3f}';lecturas['grafo_ood']=f'{res_g[2]["valor"]:.3f}'
caso
grupo
modelo
métrica
valor
0
grafos
tamaño conocido
GCN + mean pooling
balanceada
1.0
1
grafos
tamaño conocido
Conteo exacto de aristas
balanceada
1.0
2
grafos
tamaño nuevo
GCN + mean pooling
balanceada
1.0
3
grafos
tamaño nuevo
Conteo exacto de aristas
balanceada
1.0
29.6.1 Cómo leer este resultado
La GCN con pooling alcanza accuracy balanceada 1.000 en tamaños conocidos y 1.000 en tamaños nuevos. El baseline exacto informa si una regla estructural sencilla ya basta. El pooling medio divide por nodos reales: una señal local puede diluirse al aumentar el tamaño, aunque los parámetros de la red no cambien.
Los grafos pueden compartir estructura abstracta entre particiones, porque el objetivo es reconocer nuevas realizaciones de esas familias. No se está midiendo transferencia a cualquier tipo de grafo ni a una población de moléculas reales.
Ambas familias de tamaños alcanzan 1.000 en esta ejecución, y el conteo exacto también. Para la regla construida conservaría el conteo: la GNN no demuestra una mejora que compense entrenamiento y complejidad. El ejemplo de ciclo frente a dos triángulos mostrará después una propiedad estructural que esta representación sí pierde.
29.6.2 Un límite de expresividad que puede verificarse
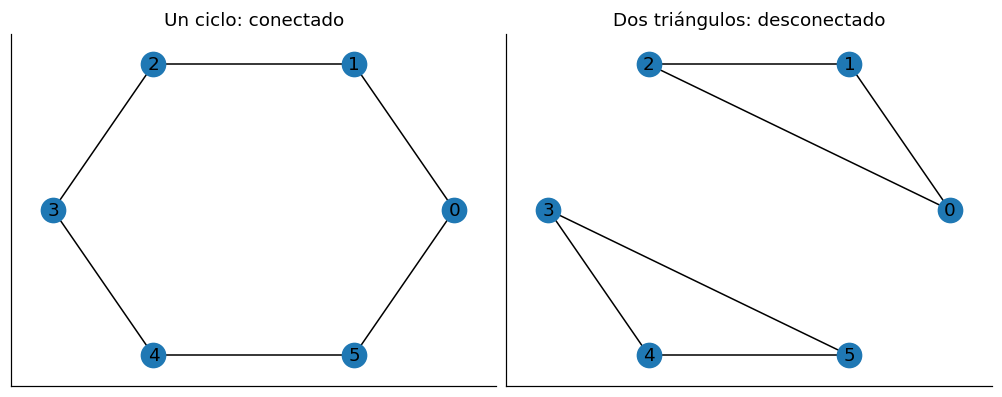
Un ciclo de seis nodos y dos triángulos desconectados tienen seis nodos de grado dos. Si todos comienzan con atributos constantes y una GCN de este tipo agrega vecinos de forma uniforme, sus nodos reciben la misma representación y el pooling no distingue los grafos. Esta comprobación no significa que toda GNN sea incapaz de distinguirlos: atributos estructurales o arquitecturas distintas pueden cambiar el resultado.
G1=nx.cycle_graph(6);G2=nx.disjoint_union(nx.complete_graph(3),nx.complete_graph(3))prueba=[]for G in [G1,G2]:a=nx.to_numpy_array(G);prueba.append((a,np.column_stack([np.ones(6),a.sum(1)/4]),0))x,s,mask,yb=lote_grafos(prueba);mg.eval()with torch.no_grad():z=mg(x,s,mask)assert torch.allclose(z[0],z[1],atol=1e-6)fig,axs=plt.subplots(1,2,figsize=(9,3.5))for ax,G,nombre inzip(axs,[G1,G2],['Un ciclo: conectado','Dos triángulos: desconectado']):nx.draw_networkx(G,pos=nx.circular_layout(G),ax=ax,node_size=250);ax.set_title(nombre)plt.show();display(pd.DataFrame(z.numpy(),index=['ciclo','dos triángulos'],columns=['logit 0','logit 1']))
logit 0
logit 1
ciclo
0.937916
-2.781957
dos triángulos
0.937916
-2.781957
29.7 Predicción de enlaces: retirar antes de propagar
En otro grafo de 120 nodos generamos relaciones más frecuentes dentro de tres comunidades. Los atributos contienen una señal débil de comunidad con ruido. Reservamos 15 % de aristas positivas para validación y 15 % para prueba; el resto constituye la adyacencia de mensajes. Las aristas son parejas canónicas i<j, de modo que una dirección no pueda quedar en entrenamiento y su inversa en prueba.
Muestreamos igual número de no-aristas para cada partición, sin repetir parejas ni usar self-links. En este mundo sintético conocemos el grafo completo y excluimos todas sus aristas al crear negativos. En un grafo real, «no observado» puede no significar negativo; en una predicción temporal no podemos usar relaciones futuras para preparar atributos o grados de mensajes.
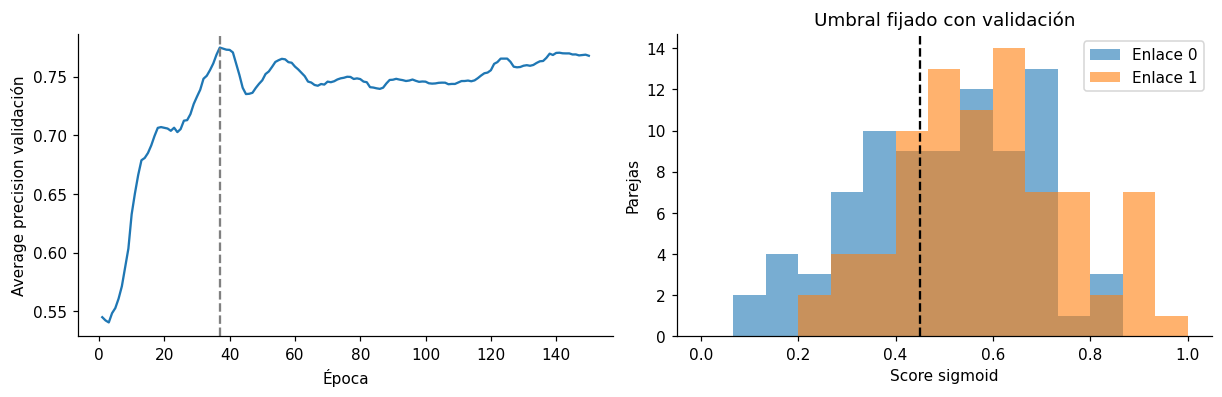
El encoder GCN produce vectores de nodos y el decoder usa producto escalar dividido por raíz de dimensión. La pérdida BCE entrena positivos y negativos. Seleccionamos checkpoint por average precision de validación y umbral por F1 en esa misma validación. La prueba solo evalúa el procedimiento ya fijado.
También usamos vecinos comunes sobre la adyacencia de entrenamiento como baseline de ranking. La adyacencia, sus grados normalizados y ese baseline se calculan después de retirar enlaces reservados.
Ver implementación del experimento
rng_l=np.random.default_rng(151);nl=120;com=np.repeat(np.arange(3),40);P=np.where(com[:,None]==com[None,:],.18,.02);a=np.triu(rng_l.random((nl,nl))<P,1);AL=(a+a.T).astype('float32')positivos=np.column_stack(np.where(np.triu(AL,1)>0));positivos=positivos[rng_l.permutation(len(positivos))]ntrain=int(.7*len(positivos));nval=int(.15*len(positivos));pt=positivos[:ntrain];pv=positivos[ntrain:ntrain+nval];pe=positivos[ntrain+nval:]negativos=np.column_stack(np.where(np.triu(1-AL,1)>0));negativos=negativos[rng_l.permutation(len(negativos))[:len(positivos)]];qt=negativos[:ntrain];qv=negativos[ntrain:ntrain+nval];qe=negativos[ntrain+nval:]AM=np.zeros_like(AL);AM[pt[:,0],pt[:,1]]=1;AM+=AM.Tassert np.all(AM[pv[:,0],pv[:,1]]==0) and np.all(AM[pe[:,0],pe[:,1]]==0)assertnotset(map(tuple,pt))&set(map(tuple,pe)) andnotset(map(tuple,qt))&set(map(tuple,qe))sl=tensor(normalizar_adj(AM));xl=tensor(np.eye(3,8)[com]*.4+rng_l.normal(0,1,(nl,8)))def pares(pos,neg):return tensor(np.vstack([pos,neg]),torch.long),tensor(np.r_[np.ones(len(pos)),np.zeros(len(neg))])et,yt=pares(pt,qt);ev,yv=pares(pv,qv);ee,ye=pares(pe,qe)class EncoderEnlaces(nn.Module):def__init__(self):super().__init__();self.l1=nn.Linear(8,32);self.l2=nn.Linear(32,16)def forward(self,x,s):returnself.l2(s@self.l1(s@x).relu())def score_enlaces(m,e):z=m(xl,sl);return (z[e[:,0]]*z[e[:,1]]).sum(1)/4torch.manual_seed(17);ml=EncoderEnlaces();opt=torch.optim.Adam(ml.parameters(),lr=.01,weight_decay=.001);mejor=-1.;hl=[]for ep inrange(1,151): ml.train();opt.zero_grad();loss=nn.functional.binary_cross_entropy_with_logits(score_enlaces(ml,et),yt);loss.backward();opt.step();ml.eval()with torch.no_grad():pr=score_enlaces(ml,ev).sigmoid().numpy() ap=average_precision_score(yv,pr);hl.append((ep,float(loss.detach()),ap))if ap>mejor:mejor=ap;estado=copy.deepcopy(ml.state_dict());ep_link=epml.load_state_dict(estado);ml.eval()with torch.no_grad():vpr=score_enlaces(ml,ev).sigmoid().numpy();tpr=score_enlaces(ml,ee).sigmoid().numpy()umbrales=np.linspace(.05,.95,19);f1s=[f1_score(yv,vpr>=u) for u in umbrales];umbral=float(umbrales[np.argmax(f1s)])cn=AM@AM;score_cn=cn[ee[:,0],ee[:,1]];res_l=[]for nombre,score in [('GCN + producto escalar',tpr),('Vecinos comunes',score_cn)]:for met,v in [('ROC-AUC',roc_auc_score(ye,score)),('Average precision',average_precision_score(ye,score))]:res_l.append({'caso':'enlaces','grupo':'prueba muestreada 50 % positiva','modelo':nombre,'métrica':met,'valor':float(v)})res_l.append({'caso':'enlaces','grupo':'prueba muestreada 50 % positiva','modelo':'GCN + producto escalar','métrica':'F1 con umbral de validación','valor':f1_score(ye,tpr>=umbral)})display(pd.DataFrame(res_l));print('Aristas train/val/test:',len(pt),len(pv),len(pe),'; umbral de validación:',umbral)fig,axs=plt.subplots(1,2,figsize=(11,3.5));hl=np.array(hl);axs[0].plot(hl[:,0],hl[:,2]);axs[0].axvline(ep_link,color='gray',ls='--');axs[0].set(xlabel='Época',ylabel='Average precision validación')for c in [0,1]:axs[1].hist(tpr[ye.numpy()==c],bins=np.linspace(0,1,16),alpha=.6,label=f'Enlace {c}')axs[1].axvline(umbral,color='black',ls='--');axs[1].set(xlabel='Score sigmoid',ylabel='Parejas',title='Umbral fijado con validación');axs[1].legend();plt.show()lecturas['link_ap']=f'{res_l[1]["valor"]:.3f}';lecturas['link_base']=f'{res_l[3]["valor"]:.3f}';lecturas['link_threshold']=f'{umbral:.2f}'resultados=pd.DataFrame(res_n+res_g+res_l);resultados.to_csv('resultados.csv',index=False);tabla_n.to_csv('seleccion-nodos.csv',index=False)protocolo={'nodos':{'escenario':'transductivo','train':nt.tolist(),'validacion':nv.tolist(),'prueba':ne.tolist(),'seleccion':nombre_gcn,'homofilia':[homofilia(An),homofilia(Ah)]},'grafos':{'train':320,'validacion':80,'prueba':80,'prueba_tamano_nuevo':60,'checkpoint':ep_grafo,'pooling':'media sobre nodos reales'},'enlaces':{'positivos_train':pt.tolist(),'positivos_validacion':pv.tolist(),'positivos_prueba':pe.tolist(),'negativos_train':qt.tolist(),'negativos_validacion':qv.tolist(),'negativos_prueba':qe.tolist(),'checkpoint':ep_link,'criterio':'AP validación','umbral_F1_validacion':umbral,'adyacencia':'solo aristas positivas de entrenamiento','prevalencia_evaluacion':.5},'versiones':{'torch':torch.__version__,'networkx':nx.__version__,'sklearn':sklearn.__version__}}Path('protocolo.json').write_text(json.dumps(protocolo,ensure_ascii=False,indent=2),encoding='utf-8')
caso
grupo
modelo
métrica
valor
0
enlaces
prueba muestreada 50 % positiva
GCN + producto escalar
ROC-AUC
0.628198
1
enlaces
prueba muestreada 50 % positiva
GCN + producto escalar
Average precision
0.647909
2
enlaces
prueba muestreada 50 % positiva
Vecinos comunes
ROC-AUC
0.566255
3
enlaces
prueba muestreada 50 % positiva
Vecinos comunes
Average precision
0.555502
4
enlaces
prueba muestreada 50 % positiva
GCN + producto escalar
F1 con umbral de validación
0.656566
Aristas train/val/test: 379 81 82 ; umbral de validación: 0.44999999999999996
46946
29.7.1 Cómo leer este resultado
La GCN alcanza average precision 0.648; vecinos comunes 0.556. El umbral 0.45 procede de validación. ROC-AUC evalúa ordenamiento entre positivos y negativos; AP resume precisión bajo esta selección de parejas. Ninguna cifra garantiza probabilidades calibradas.
La prueba contiene 50 % positivos por construcción, mucho más que la proporción de enlaces entre todas las parejas. AP y F1 dependen de esa composición; el score sigmoid se entrenó sobre la misma mezcla artificial. No lo interpretaría como probabilidad de que exista un enlace entre dos nodos elegidos al azar del grafo real.
Una aplicación puede requerir recomendar candidatos por nodo y excluir relaciones ya observadas. En ese caso hay que fijar el conjunto de candidatos y evaluar ranking por consulta, además de métricas de parejas. En una predicción temporal, la prueba debe construirse con enlaces posteriores usando únicamente información del pasado.
La AP 0.648 supera la referencia 0.556, pero está lejos de una separación perfecta. El histograma muestra solapamiento de scores positivos y negativos; el umbral no elimina ese conflicto. Antes de utilizar el ranking ampliaría la evaluación a candidatos y prevalencia propios de la aplicación.
29.8 Arquitecturas: qué mecanismo cambia
Familia
Agregación o idea principal
Pregunta para elegirla
GCN
Mezcla normalizada de vecinos y transformación compartida
¿La mezcla local conserva señal útil?
GraphSAGE
Funciones de agregación y muestreo de vecinos
¿Se necesitan nodos nuevos o entrenamiento a escala?
GAT
Pesos de atención sobre vecindarios
¿Aprender ponderación local aporta valor medible?
GIN
Agregación con capacidad expresiva de discriminación
¿La tarea requiere distinguir estructuras que otras capas confunden?
Este notebook ejecuta GCN, no las otras tres familias. Atención de vecinos no elimina automáticamente dependencia, fuga ni límites de datos. Modelos que admiten atributos de nodos nuevos tampoco garantizan transferencia a otra distribución de grafos.
29.8.1 Atención global y estructura del grafo
Una atención completa sobre nodos puede conectar pares que no tienen una arista original. Para distinguir grafos necesita información de estructura además de atributos: distancias, tipos de arista u otras codificaciones pueden intervenir en los scores. Graphormer estudia este enfoque con codificaciones estructurales; no lo entrenamos en este notebook.
Atención global y propagación local no tienen el mismo costo ni el mismo contrato. La primera puede requerir scores entre todas las parejas; la segunda depende de aristas y vecindarios disponibles. Ninguna elimina la necesidad de retirar enlaces objetivo y calcular atributos estructurales solo con la información admisible. Si una distancia del grafo se calcula incluyendo el enlace de prueba, puede revelar parte de la respuesta aunque no aparezca en una capa GCN.
Para elegir entre ambas mediría utilidad en la tarea, costo y generalización a tamaño o topología nuevos. Una arquitectura más expresiva puede resolver una distinción estructural y seguir fallando por datos insuficientes o un protocolo incorrecto.
29.9 Auditoría del recorrido relacional
Riesgo observado
Control que debe existir
Misma arista en dos direcciones repartidas
Parejas canónicas y separación antes de simetrizar
Enlace de prueba dentro del mensaje
Retirar aristas antes de normalizar grados
Agregados con etiquetas reservadas
Reconstruir atributos sin objetivos de evaluación
Grafos del mismo sujeto en varias particiones
Separar unidad de procedencia pertinente
Pooling incluye padding
Máscara sobre nodos reales
Negativos son solo no observados
Definir ventana, cobertura y significado de ausencia
Promedio oculta nodos nuevos
Evaluación inductiva o temporal según despliegue
El grafo disponible debe corresponder al momento de decisión. Una evaluación transductiva declarada puede utilizar atributos y relaciones de nodos sin etiqueta; una evaluación de futuro no puede utilizar eventos posteriores aunque se llamen «no supervisados». La disponibilidad de información manda sobre el nombre de la técnica.
29.10 Actividades
Repite grafos y semillas para separar azar de atributos, topología y entrenamiento. Compara GCN y MLP con el mismo protocolo.
Mantén número de aristas y grados mientras cambia homofilia. Explica qué control añade respecto al experimento presentado.
Compara pooling suma y media con tamaños nuevos. Decide si el tamaño del grafo debería influir en la etiqueta.
Agrega atributos estructurales al ciclo y a los dos triángulos. Comprueba si cambia la indistinguibilidad y evita usar la etiqueta como atributo.
Evalúa enlaces con una proporción positiva cercana a la aplicación. Compara AP y el umbral anterior sin reajustarlo sobre prueba.
Rediseña la partición para nodos nuevos y otra para enlaces futuros. Dibuja qué mensajes están disponibles en cada fase.
29.11 Contrato común y persistencia
En grafos, la partición y la información visible durante el paso de mensajes definen el tipo de generalización. Se conservan las máscaras del experimento y se distingue uso de estructura de uso de etiquetas. La persistencia no cambia el protocolo transductivo o inductivo declarado.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib','.pt','.wav','.npz']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 5 | archivos registrados: 12
29.11.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron los experimentos de estructura, paso de mensajes y máscaras, con sus controles de información visible. Las métricas se interpretan bajo la partición declarada, sin convertir rendimiento transductivo en evidencia de nodos o grafos completamente nuevos. Los estados y tablas de la ejecución quedan registrados junto al protocolo.
La armonización verificó identidad de parámetros y buffers tras recarga de 5 módulos presentes al cierre; archivó 12 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.