Serie Deep Learning · del perceptrón a los transformers.
En este notebook evaluamos modelos supervisados (incluye MLP y el resto de algoritmos del libro) sobre datos independientes, para no confundir un buen ajuste en entrenamiento con buena predicción. En regresión usamos MAE, MAPE, MPE y RMSE. En clasificación usamos la matriz de confusión, sensibilidad, especificidad, F1, umbral de decisión, costos de error y AUC-ROC.
10.1 1. Introducción
En el aprendizaje supervisado, nos interesa predecir la variable de resultado para nuevos registros. Existen tres tipos principales de resultados de interés:
Valor numérico predicho: cuando la variable de resultado es numérica (por ejemplo, el precio de una casa).
Pertenencia a una clase predicha: cuando la variable de resultado es categórica (por ejemplo, comprador/no comprador).
Propensión: la probabilidad de pertenencia a una clase, cuando la variable de resultado es categórica (por ejemplo, la propensión a incumplir).
Los métodos de predicción se utilizan para generar predicciones numéricas, mientras que los métodos de clasificación (“clasificadores”) se utilizan para generar propensiones y, usando un valor de corte en las propensiones, podemos generar pertenencias a clases predichas.
Es importante tener en cuenta una distinción sutil: los clasificadores tienen dos usos predictivos distintos. Uno de ellos, la clasificación, está dirigido a predecir la pertenencia a una clase para nuevos registros. El otro, el ranking, permite detectar, entre un conjunto de nuevos registros, aquellos con mayor probabilidad de pertenecer a una clase de interés.
En este notebook revisaremos el enfoque para evaluar modelos de predicción numérica y de clasificación, incluyendo métricas de error, matriz de confusión, umbral de decisión y curva ROC/AUC.
Idea clave: la bondad de ajuste describe cuán bien el modelo reproduce los datos de entrenamiento, mientras que la precisión predictiva mide cuán bien funciona con datos nuevos. Un modelo puede ajustarse muy bien a los datos de entrenamiento y, sin embargo, predecir mal en datos reales si está sobreajustado.
10.2 2. Evaluación del Rendimiento Predictivo
Primero, cabe destacar que la precisión predictiva no es lo mismo que la bondad de ajuste. La bondad de ajuste mide qué tan bien el modelo reproduce los datos con los que fue entrenado; es decir, su capacidad para describir o ajustar la información observada. En cambio, la precisión predictiva mide qué tan bien el modelo funciona sobre datos nuevos o no vistos, que es el objetivo central en minería de datos y aprendizaje automático. Medidas como el \(R^2\) y el error estándar de la estimación son útiles para evaluar el ajuste en los datos de entrenamiento, pero no garantizan que el modelo generalice bien. Un modelo puede tener excelente bondad de ajuste y, aun así, predecir mal en datos de validación si está sobreajustado.
Para evaluar el rendimiento de predicción, se utilizan varias medidas. Entrenamiento ajusta parámetros y transformaciones. Validación permite seleccionar variables, configuración, época o umbral; por eso el rendimiento del candidato elegido sobre ella puede ser optimista. Prueba se reserva para evaluar las decisiones ya fijadas. Las mismas métricas se calculan en los tres conjuntos, pero su interpretación cambia según ese papel. Una partición no representa automáticamente el futuro: debe respetar fechas, entidades y condiciones del despliegue.
10.2.1 Naive Benchmark (Benchmark Ingenuo): El Promedio
El criterio de referencia más simple en predicción, conocido como benchmark ingenuo, consiste en utilizar el valor promedio de la variable objetivo como predicción para todos los nuevos registros. Este enfoque ignora completamente la información de los predictores y se basa únicamente en el promedio de los valores de la variable de resultado del conjunto de entrenamiento.
\(\bar{y}\)
Por ejemplo, si estamos intentando predecir el precio de una casa, el benchmark ingenuo predice el mismo precio promedio para cada nueva casa, sin considerar factores como la ubicación, el tamaño o el estado de la propiedad. Aunque esta técnica es muy básica y no proporciona ninguna información específica de cada registro, es útil como un punto de referencia.
La idea es que cualquier modelo predictivo que se desarrolle debe, como mínimo, superar esta predicción promedio en términos de precisión. En otras palabras, un buen modelo debería ser capaz de captar patrones en los datos y ofrecer predicciones que reduzcan el error promedio en comparación con este benchmark ingenuo. Si un modelo no puede mejorar sustancialmente este criterio de referencia, puede ser una señal de que el modelo no está capturando suficiente información relevante de los datos de entrada.
10.2.2 Medidas de Precisión de Predicción
El error de predicción para el registro \(i\) se define como la diferencia entre su valor real y su valor predicho:
\[
e_i = y_i - \hat{y}_i
\]
A continuación se describen las métricas más usadas para evaluar la precisión predictiva sobre el conjunto de validación (no sobre el de entrenamiento):
MAE (Error Absoluto Medio): magnitud promedio del error, en las mismas unidades de \(y\).
MAPE (Error Porcentual Absoluto Medio): error relativo promedio. Útil para comparar escalas distintas; se vuelve inestable si algún \(y_i\) es cero o muy cercano a cero.
MPE (Error Porcentual Medio): igual que MAPE, pero con signo. Con respuestas estrictamente positivas, un MPE positivo indica subestimación relativa media; uno negativo, sobreestimación. Los signos dejan de tener esa lectura directa si hay respuestas negativas; con ceros el cociente no está definido.
Cómo leerlas juntas: si RMSE es mucho mayor que MAE, los errores de mayor magnitud pesan más en el promedio cuadrático; revisa su distribución antes de concluir cuántos son. Si el modelo no mejora el MAE/RMSE del benchmark ingenuo (predecir la media de entrenamiento), todavía no está aportando valor.
La implementación con un ejemplo numérico y la comparación contra el promedio aparecen en la celda siguiente.
10.2.2.1 2.1 Implementación: MAE, RMSE, MAPE y MPE frente al benchmark ingenuo
Usamos cinco observaciones para calcular las métricas a mano con código y comparar el modelo con la predicción constante igual a la media de las cinco respuestas. Este es un cálculo ilustrativo sobre una tabla conocida, no una evaluación independiente: en un modelo real el baseline se estima solo con entrenamiento. La media minimiza error cuadrático; para error absoluto la referencia constante óptima es la mediana.
import numpy as npimport pandas as pdfrom sklearn.metrics import ( mean_absolute_error, mean_squared_error, mean_absolute_percentage_error,)y_real = np.array([100.0, 200.0, 300.0, 400.0, 500.0])y_pred = np.array([110.0, 190.0, 310.0, 405.0, 495.0])# Benchmark ingenuo: predecir la media para todos los registrosmedia = y_real.mean()y_naive = np.full_like(y_real, media)detalle = pd.DataFrame({'y_real': y_real,'y_modelo': y_pred,'y_naive': y_naive,'error_modelo': y_real - y_pred,'error_naive': y_real - y_naive,})display(detalle)def mpe(y_true, y_hat):return np.mean((y_true - y_hat) / y_true) *100def resumen_metricas(y_true, y_hat, nombre): mae = mean_absolute_error(y_true, y_hat) rmse = np.sqrt(mean_squared_error(y_true, y_hat)) mape = mean_absolute_percentage_error(y_true, y_hat) *100return {'enfoque': nombre,'MAE': mae,'RMSE': rmse,'MAPE (%)': mape,'MPE (%)': mpe(y_true, y_hat), }comparacion = pd.DataFrame([ resumen_metricas(y_real, y_pred, 'Modelo'), resumen_metricas(y_real, y_naive, 'Benchmark (media)'),])display(comparacion.round(3))fila_modelo = comparacion.loc[comparacion['enfoque'] =='Modelo'].iloc[0]fila_naive = comparacion.loc[comparacion['enfoque'] =='Benchmark (media)'].iloc[0]print(f'Media usada como benchmark: {media:.1f}')print(f"El modelo reduce el MAE de {fila_naive['MAE']:.3f} a {fila_modelo['MAE']:.3f} "f"y el RMSE de {fila_naive['RMSE']:.3f} a {fila_modelo['RMSE']:.3f}.")ifabs(fila_modelo['RMSE'] - fila_modelo['MAE']) <2:print('MAE y RMSE están cercanos: no hay errores extremos en este ejemplo.')
y_real
y_modelo
y_naive
error_modelo
error_naive
0
100.0
110.0
300.0
-10.0
-200.0
1
200.0
190.0
300.0
10.0
-100.0
2
300.0
310.0
300.0
-10.0
0.0
3
400.0
405.0
300.0
-5.0
100.0
4
500.0
495.0
300.0
5.0
200.0
enfoque
MAE
RMSE
MAPE (%)
MPE (%)
0
Modelo
8.0
8.367
4.117
-1.717
1
Benchmark (media)
120.0
141.421
63.000
-37.000
Media usada como benchmark: 300.0
El modelo reduce el MAE de 120.000 a 8.000 y el RMSE de 141.421 a 8.367.
MAE y RMSE están cercanos: no hay errores extremos en este ejemplo.
10.3 3. Evaluación del Rendimiento en Clasificación
En esta sección, exploramos diferentes métodos para evaluar el rendimiento de modelos de clasificación. Estos métodos ayudan a entender qué tan bien un modelo clasifica y cómo se compara con puntos de referencia simples y métricas más completas.
10.3.1 Punto de Referencia: Regla Ingenua (Naive)
La regla ingenua establece un punto de referencia básico para evaluar el rendimiento de un modelo. En el caso de modelos de regresión, esta regla consiste en predecir el valor promedio (media) de la variable objetivo para todos los casos. Para modelos de clasificación, se predice la clase más frecuente para todas las observaciones. La idea es que cualquier modelo predictivo debería superar este punto de referencia en términos de desempeño. Al comparar el modelo con esta regla, podemos verificar si el modelo está logrando capturar patrones útiles en los datos o si simplemente está imitando un enfoque básico.
10.3.2 Separación de Clases
La separación de clases mide la capacidad de un modelo para diferenciar entre distintas clases de datos. Si las predicciones de un modelo son efectivas, debería existir una clara separación entre las clases. Para evaluarlo, se pueden utilizar gráficos de dispersión y métricas que miden la distancia entre las clases, como la distancia euclidiana. La separación observada puede ayudar a formular hipótesis, pero no demuestra generalización. PCA o t-SNE pueden ocultar o distorsionar diferencias y no sustituyen la evaluación reservada. Además, se pueden utilizar técnicas de reducción de dimensionalidad, como PCA (Análisis de Componentes Principales) o t-SNE, para visualizar las separaciones en conjuntos de datos de alta dimensión.
10.3.3 Matriz de Confusión (Clasificación)
La matriz de confusión es una herramienta clave para evaluar modelos de clasificación. Organiza los resultados en cuatro categorías: - Verdaderos Positivos (TP): Predicciones correctas de la clase positiva. - Falsos Positivos (FP): Predicciones incorrectas donde se clasificó como positivo, pero el resultado real fue negativo. - Verdaderos Negativos (TN): Predicciones correctas de la clase negativa. - Falsos Negativos (FN): Predicciones incorrectas donde se clasificó como negativo, pero el resultado real fue positivo.
Con la matriz de confusión, podemos calcular diversas métricas importantes: - Exactitud (Accuracy): proporción de predicciones correctas. \[
\text{Exactitud} = \frac{TP + TN}{TP + TN + FP + FN}
\] - Precisión de la clase positiva (Precision): fracción de positivos predichos que son positivos reales. \[
\text{Precision} = \frac{TP}{TP + FP}
\] - Sensibilidad (Recall): capacidad del modelo para capturar correctamente los casos positivos. \[
\text{Recall} = \frac{TP}{TP + FN}
\]
Especificidad: capacidad del modelo para identificar correctamente los casos negativos. \[
\text{Especificidad} = \frac{TN}{TN + FP}
\]
F1-score: combina precisión y recall para resumir el rendimiento cuando queremos equilibrar ambos aspectos. \[
F1 = 2 \times \frac{\text{Precision} \times \text{Recall}}{\text{Precision} + \text{Recall}}
\]
La forma más común de interpretar la matriz es la siguiente: las filas representan la clase real y las columnas representan la clase predicha. Por tanto, la diagonal principal muestra los aciertos del modelo, mientras que los valores fuera de esa diagonal indican errores de clasificación.
En problemas de diagnóstico, por ejemplo, la clase positiva suele ser la condición de interés (por ejemplo, enfermo, fraude o incumplimiento), mientras que la clase negativa corresponde a la ausencia de esa condición.
Es importante recordar que la exactitud puede ser engañosa cuando las clases están desbalanceadas. Por ejemplo, si un 95% de los casos es negativo y el modelo predice siempre “negativo”, podría obtener una exactitud muy alta aunque no detecte ninguna instancia positiva. En esos casos, métricas como recall, precision, F1-score o AUC suelen ser más informativas.
Además, la matriz de confusión depende del umbral de decisión. Si reducimos el umbral para considerar más casos como positivos, aumentaremos la sensibilidad pero también pueden crecer los falsos positivos. Si aumentamos el umbral, se reducen los falsos positivos, pero puede perderse capacidad para detectar casos importantes. Por eso, en problemas donde los costos de error varían (por ejemplo, diagnóstico médico o detección de fraude), la elección del umbral es parte fundamental del diseño del modelo.
En resumen, la matriz de confusión no solo cuenta errores: muestra exactamente qué tipo de errores comete el modelo y permite decidir si el rendimiento es aceptable para el problema del negocio o la investigación.
10.3.3.1 3.1 ¿Qué significa cada métrica en términos simples?
Antes de ver ejemplos, conviene interpretar cada métrica como una “lente” distinta del modelo:
Exactitud (Accuracy): porcentaje total de aciertos.
Alta: en general el modelo acierta mucho.
Baja: falla con frecuencia.
Cuidado: puede verse “alta” en datos desbalanceados aunque ignore la clase importante.
Precisión (Precision): de todo lo que el modelo marcó como positivo, ¿cuánto era realmente positivo?
Alta: pocos falsos positivos.
Baja: muchas falsas alarmas.
Útil cuando cuesta caro acusar un positivo que no lo era (por ejemplo, alertas innecesarias).
Sensibilidad / Recall (TPR): de los positivos reales, ¿cuántos detectó el modelo?
Alta: se escapan pocos positivos (pocos FN).
Baja: se pierden muchos casos importantes.
Útil cuando es crítico no dejar pasar positivos reales (salud, fraude).
Especificidad (TNR): de los negativos reales, ¿cuántos detectó bien como negativos?
Alta: identifica bien los negativos.
Baja: confunde negativos con positivos (más FP).
F1-score: equilibrio entre precisión y recall.
Alto: buen balance entre detectar positivos y no generar muchas falsas alarmas.
Bajo: una de las dos (o ambas) está fallando.
Útil en datos desbalanceados cuando no alcanza mirar solo exactitud.
AUC-ROC: capacidad global de separar clases para distintos umbrales.
Cerca de 1: separación excelente.
Cerca de 0.5: parecido al azar.
Menor que 0.5: separación muy mala (incluso invertida).
10.3.3.2 ¿Qué podemos inferir de cada métrica por separado?
Una métrica aislada responde solo una parte del problema.
Ejemplo: exactitud alta no garantiza buen recall en la clase positiva.
Por eso, cada valor individual debe leerse según el costo del error en el contexto.
10.3.3.3 ¿Qué podemos inferir al verlas en conjunto?
Precision alta + Recall bajo: el modelo es “estricto”; da pocas alarmas, pero deja pasar positivos.
Recall alto + Precision baja: detecta casi todo, pero con muchas falsas alarmas.
Exactitud alta + F1 bajo: probable desbalance de clases o rendimiento desigual entre clases.
AUC alto + F1 moderado/bajo: el modelo separa bien, pero el umbral actual puede no ser el adecuado.
Recall y especificidad altas: desempeño equilibrado entre positivos y negativos.
En práctica, la interpretación correcta no depende de “la mejor métrica” única, sino de la combinación de métricas y del costo real de cada tipo de error.
El modelo tiene rendimiento alto y equilibrado. Detecta bien los spam (recall 0.83), mantiene pocas falsas alarmas (precision 0.91) y logra una exactitud general de 0.85. Es un comportamiento esperado para un caso balanceado.
En este caso, se utiliza un modelo para diagnosticar una enfermedad rara. La mayoría de los pacientes no tienen la enfermedad (clase negativa), y solo algunos pocos casos son positivos.
Predicción: Enfermo
Predicción: No Enfermo
Real: Enfermo
3
12
Real: No Enfermo
5
80
Verdaderos Positivos (TP): 3 (Predicciones correctas de enfermedad)
Falsos Positivos (FP): 5 (Personas no enfermas pero clasificadas como enfermas)
Verdaderos Negativos (TN): 80 (Predicciones correctas de personas no enfermas)
Falsos Negativos (FN): 12 (Personas que están enfermas pero fueron clasificadas como no enfermas)
Aunque la exactitud parece buena (0.83), el modelo falla en lo más importante: detectar enfermos (recall 0.20). Tiene buena capacidad para reconocer sanos (especificidad 0.94), pero pierde muchos casos positivos. En problemas médicos, este rendimiento no es aceptable sin ajustar umbral, pesos de clase o técnicas de balanceo.
10.3.3.10 Diferencias clave entre ambos casos
Las principales diferencias entre los dos ejemplos radican en el balance de clases, el impacto de los errores y la interpretación de las métricas.
10.4 1. Balance de Clases
Ejemplo 1 (Balanceado): Hay una distribución relativamente equitativa entre spam y no spam (60 spam y 40 no spam).
Ejemplo 2 (Desbalanceado): La cantidad de pacientes enfermos es mucho menor que la de no enfermos (15 enfermos y 85 no enfermos).
10.5 2. Impacto de los Errores
Ejemplo 1: Los errores FN (10 casos) y FP (5 casos) afectan la exactitud del modelo, pero no generan un impacto crítico.
Ejemplo 2: Los FN (12 casos) pueden ser críticos, ya que se están diagnosticando personas enfermas como sanas, lo que puede tener consecuencias graves.
10.6 3. Exactitud y Sensibilidad
Ejemplo 1: La exactitud y la sensibilidad son relativamente equilibradas, ya que hay suficientes ejemplos en ambas clases.
Ejemplo 2: La sensibilidad (TPR) es baja porque hay muchos FN, lo que significa que el modelo no está identificando bien a los enfermos. En escenarios médicos, esto es un problema grave.
10.7 4. Estrategia de Evaluación
Ejemplo 1: Se pueden usar métricas estándar como exactitud y F1-score para evaluar el modelo.
Ejemplo 2: Dado el desbalance de clases, exactitud no es una buena métrica, ya que el modelo puede parecer bueno solo por clasificar a la mayoría como no enfermos.
Es mejor usar sensibilidad (recall) o AUC-ROC para evaluar qué tan bien detecta los casos positivos.
10.7.1 Conclusión
En el caso balanceado, el modelo puede ser evaluado con métricas estándar como exactitud, recall y F1-score sin problemas.
En el caso desbalanceado, se deben usar métricas que prioricen la detección de la clase minoritaria (como recall y ROC-AUC) y posiblemente aplicar estrategias de balanceo de datos como sobremuestreo o ajuste de pesos en la función de pérdida para mejorar la detección de la clase menos representada.
10.7.1.1 Ejemplo 3: Clasificación Multiclase
Supongamos un modelo que clasifica entre gato, perro, y conejo. Este es un ejemplo de clasificación multiclase:
Predicción: Gato
Predicción: Perro
Predicción: Conejo
Real: Gato
40
5
10
Real: Perro
3
30
2
Real: Conejo
4
6
50
Gatos: 40 fueron correctamente clasificados como gatos, 5 fueron mal clasificados como perros, y 10 como conejos.
Perros: 30 fueron correctamente clasificados como perros, 3 se confundieron con gatos, y 2 con conejos.
Conejos: 50 fueron correctamente clasificados, 4 se confundieron con gatos, y 6 con perros.
En este caso, la diagonal principal (40, 30, 50) contiene los valores de predicciones correctas para cada clase, mientras que los valores fuera de la diagonal representan los errores de clasificación.
El modelo tiene un desempeño bueno y relativamente equilibrado en las tres clases (accuracy 0.80 y macro-F1 cercano a 0.80). La clase con más dificultad es gato en recall (0.73), lo que sugiere que algunos gatos se confunden con perro o conejo. En conjunto, el sistema clasifica bien, pero aún se puede mejorar reduciendo esas confusiones entre clases específicas.
10.7.1.4 Interpretación de los Ejemplos
La diagonal principal en cada matriz representa las predicciones correctas.
Los valores fuera de la diagonal principal son errores de predicción:
En clasificación binaria, los falsos negativos pueden indicar que el modelo omite casos importantes (por ejemplo, casos de enfermedad).
En clasificación multiclase, los valores fuera de la diagonal ayudan a entender en qué clases específicas el modelo tiende a confundirse.
Estos ejemplos muestran cómo la matriz de confusión permite evaluar y ajustar el modelo para mejorar su exactitud y sensibilidad según el contexto del problema.
10.7.2 3.2 Validación, costos y clases de distinta importancia
10.7.2.1 Uso de datos de validación
Después de entrenar, el modelo se evalúa en validación (datos no usados para ajustar parámetros). Si el error en entrenamiento es mucho menor que en validación, hay sobreajuste: el modelo memorizó el conjunto de ajuste y no generaliza.
En el ejemplo de Iris (apartado 3.3) se imprimen la exactitud de entrenamiento y la de prueba para ver esa brecha.
10.7.2.2 Costos de error
La exactitud trata por igual un falso positivo y un falso negativo. En la práctica no es así. Si un FN cuesta 100 y un FP cuesta 10, el costo esperado es:
\[
C = 100 \cdot FN + 10 \cdot FP
\]
Conviene elegir el umbral (o el modelo) que minimiza ese costo, no el que maximiza accuracy. Cómo se pasa de una probabilidad a una etiqueta, y por qué el corte 0.50 no es sagrado, se desarrolla en la sección 4.
10.7.2.3 Rendimiento con importancia desigual de clases
Cuando falla un positivo real es especialmente grave (enfermedad, fraude), la métrica guía es la sensibilidad:
\[
\text{Sensibilidad} = \frac{TP}{TP + FN}
\]
La especificidad resume qué tan bien se reconocen los negativos. El equilibrio entre ambas se decide con el umbral y con los costos del problema.
10.7.2.4 3.3 Implementación práctica: matriz de confusión multiclase (Iris)
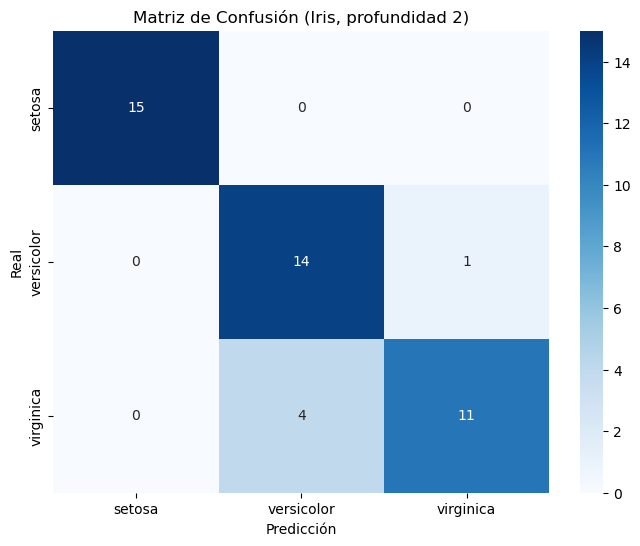
Entrenamos un bosque aleatorio deliberadamente limitado (max_depth=2) sobre Iris. El objetivo no es el mejor modelo, sino ver errores reales entre versicolor y virginica, y comparar exactitud de entrenamiento frente a prueba.
Código
import pandas as pdfrom sklearn.metrics import confusion_matrix, classification_report, accuracy_scoreimport matplotlib.pyplot as pltimport seaborn as snsfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.dummy import DummyClassifieriris = load_iris()X = iris.datay = iris.targetX_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y)# Modelo limitado a propósito para que aparezcan errores en la matrizclf = RandomForestClassifier( n_estimators=10, max_depth=2, random_state=0)clf.fit(X_train, y_train)y_pred_train = clf.predict(X_train)y_pred = clf.predict(X_test)naive = DummyClassifier(strategy='most_frequent')naive.fit(X_train, y_train)acc_naive = accuracy_score(y_test, naive.predict(X_test))acc_train = accuracy_score(y_train, y_pred_train)acc_test = accuracy_score(y_test, y_pred)print(f'Exactitud entrenamiento: {acc_train:.3f}')print(f'Exactitud prueba: {acc_test:.3f}')print(f'Benchmark (clase más frecuente): {acc_naive:.3f}')if acc_train - acc_test >0.05:print('La brecha train/prueba sugiere algo de sobreajuste o un modelo inestable.')else:print('La brecha train/prueba es moderada en este ejemplo.')cm = confusion_matrix(y_test, y_pred)plt.figure(figsize=(8, 6))sns.heatmap( cm, annot=True, fmt='d', cmap='Blues', xticklabels=iris.target_names, yticklabels=iris.target_names)plt.xlabel('Predicción')plt.ylabel('Real')plt.title('Matriz de Confusión (Iris, profundidad 2)')plt.show()report = classification_report( y_test, y_pred, target_names=iris.target_names, output_dict=True, zero_division=0)reporte_df = pd.DataFrame(report).Treporte_df = reporte_df.rename( columns={'precision': 'Precisión','recall': 'Recall','f1-score': 'F1-score','support': 'Soporte' })filas =list(iris.target_names) + ['macro avg', 'weighted avg']reporte_df = reporte_df.loc[filas]reporte_df['Soporte'] = reporte_df['Soporte'].round(0).astype(int)display(reporte_df[['Precisión', 'Recall', 'F1-score', 'Soporte']].round(3))print(f'\nExactitud global (prueba): {acc_test:.3f}')macro_f1 = report['macro avg']['f1-score']recall_por_clase = {clase: report[clase]['recall'] for clase in iris.target_names}min_recall =min(recall_por_clase.values())clases_min_recall = [c for c, r in recall_por_clase.items() if r == min_recall]print('\nConclusión del ejemplo multiclase:')print(f'- Exactitud en prueba: {acc_test:.3f} (superó al benchmark {acc_naive:.3f}).')print(f'- F1 macro: {macro_f1:.3f}.')iflen(clases_min_recall) ==len(iris.target_names):print('- Todas las clases tienen el mismo recall.')else: clases_txt =', '.join(clases_min_recall)print(f"- La(s) clase(s) con menor recall: {clases_txt} ({min_recall:.3f}). "'Ahí se concentran las confusiones (típicamente versicolor/virginica).' )
Exactitud entrenamiento: 0.971
Exactitud prueba:        0.889
Benchmark (clase más frecuente): 0.333
La brecha train/prueba sugiere algo de sobreajuste o un modelo inestable.
Precisión
Recall
F1-score
Soporte
setosa
1.000
1.000
1.000
15
versicolor
0.778
0.933
0.848
15
virginica
0.917
0.733
0.815
15
macro avg
0.898
0.889
0.888
45
weighted avg
0.898
0.889
0.888
45
Exactitud global (prueba): 0.889

Conclusión del ejemplo multiclase:
- Exactitud en prueba: 0.889 (superó al benchmark 0.333).
- F1 macro: 0.888.
- La(s) clase(s) con menor recall: virginica (0.733). Ahí se concentran las confusiones (típicamente versicolor/virginica).
10.8 4. Del modelo a la matriz de confusión: probabilidades, umbral y decisión
Junto a las métricas de la sección 3 (accuracy, precision, recall, F1), hay que ver cómo aparecen los TP, FP, FN y TN. Una confusión frecuente es pensar que el modelo predice de entrada 0 o 1. El método predict() muestra clases, pero muchos clasificadores producen primero un score o una probabilidad.
Una entidad financiera quiere estimar el riesgo de incumplimiento de sus clientes.
0 → el cliente no incumple.
1 → el cliente incumple.
Entradas típicas: ingreso, nivel de deuda, etc. El modelo estima la posibilidad de incumplimiento a partir de esas características.
10.8.2 4.2 Entrenamiento del modelo
Se usan dos elementos:
X: características;
y: resultado real conocido.
Características del cliente (X)
          │
          ▼
        MODELO
          │  aprende con y
          ▼
Resultado conocido (y)
En Python:
modelo.fit(X_train, y_train)
fit() es el entrenamiento: el algoritmo busca relaciones entre X_train e y_train. Después se aplica a observaciones que no participaron en ese ajuste (validación o prueba, sección 3.2).
10.8.3 4.3 El modelo genera probabilidades
Para varios clasificadores se puede pedir la probabilidad de cada clase. La de la clase positiva (incumplir) suele ser:
prob = modelo.predict_proba(X_test)[:, 1]
Ejemplo:
Cliente
Probabilidad de incumplimiento
1
0.15
2
0.79
3
0.04
4
0.91
5
0.42
6
0.73
Interpretación: el cliente 2 tiene una probabilidad estimada del 79 %. Todavía no lo hemos clasificado como 0 o 1.
Cliente → MODELO → 0.79
La pregunta pendiente: ¿0.79 basta para declararlo incumplidor? Eso lo responde el umbral.
10.8.4 4.4 ¿Qué es el umbral?
El umbral convierte la probabilidad en una decisión. Un punto de partida habitual (no obligatorio) es 0.50:
prob >= umbral produce True/False; .astype(int) los pasa a 1/0.
10.8.5 4.5 De la probabilidad a la decisión
Con umbral 0.50:
Cliente
Probabilidad
Comparación
Predicción
1
0.15
0.15 < 0.50
0
2
0.79
0.79 ≥ 0.50
1
3
0.04
0.04 < 0.50
0
4
0.91
0.91 ≥ 0.50
1
5
0.42
0.42 < 0.50
0
6
0.73
0.73 ≥ 0.50
1
Recorrido para el cliente 2:
MODELO → probabilidad 0.79 → ¿0.79 ≥ 0.50? → sí → predicción = 1
       → comparar con el valor real → entra en la MATRIZ DE CONFUSIÓN
10.8.6 4.6 ¿Dónde aparece la matriz de confusión?
Después de convertir probabilidades en decisiones.
from sklearn.metrics import confusion_matrixmatriz = confusion_matrix(y_test, y_pred)
Compara y_test (real) con y_pred (decisión). No calcula probabilidades ni elige el umbral.
La matriz de confusión no decide. Evalúa decisiones que ya se tomaron.
10.8.7 4.7 ¿Qué ocurre si cambiamos el umbral?
Misma probabilidad 0.79:
umbral 0.50 → 0.79 ≥ 0.50 → predicción 1
umbral 0.80 → 0.79 ≥ 0.80 → predicción 0
El modelo no cambió. La probabilidad sigue siendo 0.79. Solo cambió la regla de decisión.
10.8.8 4.8 Comparación de umbrales
Probabilidad
Umbral 0.30
Umbral 0.50
Umbral 0.80
0.15
0
0
0
0.79
1
1
0
0.04
0
0
0
0.91
1
1
1
0.42
1
0
0
0.73
1
1
0
Una misma probabilidad puede producir distinta clase según el corte.
10.8.9 4.9 Disminuir el umbral
Pasar de 0.50 a 0.30 hace más fácil marcar positivos. Ejemplo: 0.42 pasa de clase 0 a clase 1.
Al bajar el umbral suelen aumentar las predicciones positivas: potencialmente más TP y más FP (más sensibilidad, más falsas alarmas).
10.8.10 4.10 Aumentar el umbral
Pasar de 0.50 a 0.80 exige más evidencia. 0.73 pasa de clase 1 a clase 0.
Al subir el umbral suelen caer las predicciones positivas: potencialmente menos FP y más FN.
10.8.11 4.11 El umbral depende del problema
0.50 es una referencia, no un óptimo universal. Cuenta el costo de cada error (sección 3.2).
En cribado médico, un FN (enfermo clasificado sano) suele ser muy grave: a menudo se baja el umbral y se aceptan más FP, que luego se confirman con otra prueba.
Si un FP tiene consecuencias graves para una persona, puede convenir un umbral más alto.
10.8.12 4.12 Idea fundamental
DATOS → MODELO → SCORE / PROBABILIDAD → UMBRAL → DECISIÓN 0/1
      → comparación con la realidad → MATRIZ DE CONFUSIÓN
      → accuracy, precision, recall, F1, ...
El modelo estima (score o probabilidad).
El umbral decide (clase 0 o 1).
La matriz evalúa (TP, TN, FP, FN).
El modelo estima. El umbral decide. La matriz de confusión evalúa.
10.8.13 4.13 De un umbral a una matriz; de muchas matrices a la ROC
Si solo se tiene la matriz de recuentos, no se recuperan las probabilidades. Esa matriz es el resultado después de un umbral. Convención habitual (como en sklearn): filas = clase real, columnas = clase predicha.
La curva ROC es el conjunto de pares \((\mathrm{FPR}(\tau),\ \mathrm{TPR}(\tau))\) al recorrer \(\tau\).
Una única matriz de confusión describe el comportamiento del clasificador para un umbral concreto. Para construir la curva ROC se recorren múltiples umbrales. Cada umbral produce nuevas predicciones y, por tanto, nuevos valores de TP, FP, TN y FN. A partir de ellos se calculan TPR y FPR. Cada par (FPR, TPR) corresponde a un punto de la curva ROC.
No basta decir que «la ROC sale de la matriz»: sale de una familia de matrices, una por umbral, construidas todas con el mismo vector de scores.
10.8.14 4.14 Hacia la práctica y hacia la sección 5
Si \(0.50\) no tiene por qué ser el mejor corte, la pregunta operativa es: qué le ocurre a la matriz, y a TPR y FPR, cuando cambiamos \(\tau\). El ejemplo 4.15 lo muestra con tres cortes. Recorrer todos los cortes posibles es exactamente el objeto de la curva ROC.
10.8.14.1 4.15 Práctica: riesgo de incumplimiento, tres umbrales y tres matrices
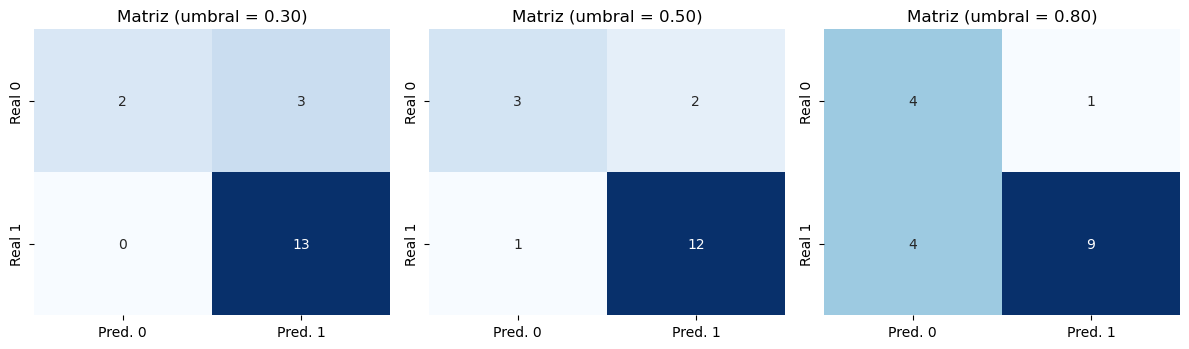
Caso: un conjunto pequeño de clientes con ingreso, deuda e incumplió (\(1\) = incumplimiento). Entrenamos una regresión logística solo para hacer visible el mecanismo. En un ejercicio de evaluación honesta se usaría validación (sección 3.2); aquí el objetivo es ver de dónde salen las \(p_i\) y cómo el umbral las convierte en clase.
Las columnas de probabilidad salen de predict_proba: las produce el modelo, no la matriz de confusión. La matriz aparece después, cuando ya hay \(\hat{y}\).
Código
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as snsfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import confusion_matrix, precision_score, recall_score# Datos didácticos (reproducibles): ingreso, deuda e incumplimientodatos = pd.DataFrame({"ingreso": [3144, 2173, 3390, 2922, 1173, 3729, 3107, 3180,1272, 2206, 1975, 3588, 2767, 3286, 2186, 1559, 2508, 1085, ],"deuda": [1172, 914, 1081, 548, 1361, 1259, 1107, 337,696, 138, 284, 982, 1063, 1357, 510, 569, 700, 330, ],"incumplio": [1, 1, 1, 1, 1, 1, 0, 0, 1, 0, 0, 1, 1, 1, 1, 1, 0, 1],})X = datos[["ingreso", "deuda"]]y = datos["incumplio"]modelo = LogisticRegression(random_state=42, max_iter=2000)modelo.fit(X, y)# Probabilidades de la clase positiva: salen DEL MODELOprob = modelo.predict_proba(X)[:, 1]detalle = datos.copy()detalle["real"] = y.to_numpy()detalle["probabilidad"] = np.round(prob, 3)display(detalle[["ingreso", "deuda", "real", "probabilidad"]])# El modelo y las p_i se fijan; solo cambia la regla tauy_pred_30 = (prob >=0.30).astype(int)y_pred_50 = (prob >=0.50).astype(int)y_pred_80 = (prob >=0.80).astype(int)comparacion = pd.DataFrame({"real": y.to_numpy(),"probabilidad": np.round(prob, 3),"pred_umbral_0.30": y_pred_30,"pred_umbral_0.50": y_pred_50,"pred_umbral_0.80": y_pred_80,})print("Misma p_i; distintas decisiones según tau:")display(comparacion)print("\nEl modelo no cambió. La probabilidad no cambió. ""Solo cambió la regla de decisión.")print("El modelo estima. El umbral decide. La matriz de confusión evalúa.")def tpr_fpr(y_true, y_pred): tn, fp, fn, tp = confusion_matrix(y_true, y_pred, labels=[0, 1]).ravel() tpr = tp / (tp + fn) if (tp + fn) else0.0 fpr = fp / (fp + tn) if (fp + tn) else0.0return {"TN": int(tn),"FP": int(fp),"FN": int(fn),"TP": int(tp),"precision": precision_score(y_true, y_pred, zero_division=0),"recall": recall_score(y_true, y_pred, zero_division=0),"TPR": tpr,"FPR": fpr, }umbrales = {"0.30": y_pred_30, "0.50": y_pred_50, "0.80": y_pred_80}fig, axes = plt.subplots(1, 3, figsize=(12, 3.6))filas = []for ax, (nombre, pred) inzip(axes, umbrales.items()): cm = confusion_matrix(y, pred, labels=[0, 1]) sns.heatmap( cm, annot=True, fmt="d", cmap="Blues", ax=ax, cbar=False, xticklabels=["Pred. 0", "Pred. 1"], yticklabels=["Real 0", "Real 1"], ) ax.set_title(f"Matriz (umbral = {nombre})") m = tpr_fpr(y, pred) m["umbral"] = nombre filas.append(m)plt.tight_layout()plt.show()resumen = pd.DataFrame(filas)[ ["umbral", "TN", "FP", "FN", "TP", "precision", "recall", "FPR", "TPR"]]print("Cada umbral: una matriz, un par (FPR, TPR) que sería un punto de la ROC.")display(resumen.round(3))
ingreso
deuda
real
probabilidad
0
3144
1172
1
0.921
1
2173
914
1
0.934
2
3390
1081
1
0.829
3
2922
548
1
0.373
4
1173
1361
1
0.999
5
3729
1259
1
0.879
6
3107
1107
0
0.898
7
3180
337
0
0.113
8
1272
696
1
0.949
9
2206
138
0
0.174
10
1975
284
0
0.399
11
3588
982
1
0.675
12
2767
1063
1
0.923
13
3286
1357
1
0.962
14
2186
510
1
0.613
15
1559
569
1
0.856
16
2508
700
0
0.723
17
1085
330
1
0.780
Misma p_i; distintas decisiones según tau:
real
probabilidad
pred_umbral_0.30
pred_umbral_0.50
pred_umbral_0.80
0
1
0.921
1
1
1
1
1
0.934
1
1
1
2
1
0.829
1
1
1
3
1
0.373
1
0
0
4
1
0.999
1
1
1
5
1
0.879
1
1
1
6
0
0.898
1
1
1
7
0
0.113
0
0
0
8
1
0.949
1
1
1
9
0
0.174
0
0
0
10
0
0.399
1
0
0
11
1
0.675
1
1
0
12
1
0.923
1
1
1
13
1
0.962
1
1
1
14
1
0.613
1
1
0
15
1
0.856
1
1
1
16
0
0.723
1
1
0
17
1
0.780
1
1
0
El modelo no cambió. La probabilidad no cambió. Solo cambió la regla de decisión.
El modelo estima. El umbral decide. La matriz de confusión evalúa.
Cada umbral: una matriz, un par (FPR, TPR) que sería un punto de la ROC.
umbral
TN
FP
FN
TP
precision
recall
FPR
TPR
0
0.30
2
3
0
13
0.812
1.000
0.6
1.000
1
0.50
3
2
1
12
0.857
0.923
0.4
0.923
2
0.80
4
1
4
9
0.900
0.692
0.2
0.692
Lectura de las tres matrices (mismo modelo, mismas \(p_i\)).
Umbral bajo (0.30). Tiende a haber más predicciones positivas: potencialmente más TP y potencialmente más FP. El recall suele subir; la precision puede deteriorarse si entran falsas alarmas.
Umbral intermedio (0.50). Es solo un corte de referencia, no un óptimo. La matriz es otra (en general) que la de 0.30 y la de 0.80.
Umbral alto (0.80). Tiende a haber menos predicciones positivas: potencialmente menos FP y potencialmente más FN. El recall suele bajar; la precision puede mejorar.
Ese patrón es el comportamiento típico, no una identidad que valga para cualquier muestra. Por eso se habla de «tiende a» y «potencialmente».
El modelo estima. El umbral decide. La matriz de confusión evalúa.
Precision y recall (sección 3) en este mismo experimento. Al bajar \(\tau\) suele ser más fácil predecir la clase positiva: el recall (TPR) normalmente aumenta y pueden crecer los FP, con lo que la precision puede caer. Al subir \(\tau\) somos más exigentes: el recall generalmente disminuye, pueden reducirse los FP y la precision puede mejorar.
Cada fila de la tabla de FPR y TPR es un punto\((FPR,\ TPR)\) asociado a un \(\tau\). Con tres umbrales tenemos tres puntos. Aún no es la curva completa.
Pregunta. Si cada umbral genera una matriz de confusión diferente, ¿qué ocurriría si probáramos sistemáticamente todos los umbrales posibles?
Respuesta. Eso es precisamente lo que permite estudiar la curva ROC.
roc_curve(y, prob) necesita los valores reales y los scores/probabilidades del modelo. No debe recibir únicamente un y_pred obtenido con un solo umbral: ese vector ya colapsó todas las \(p_i\) a una frontera.
¿Por qué roc_curve() recibe probabilidades y no y_pred? Porque y_pred corresponde a una frontera de decisión, mientras que la ROC necesita evaluar muchos umbrales sobre el mismo ranking.
Elemento
Función
Modelo
Aprende patrones a partir de \(X\) e \(y\)
Score / probabilidad
Grado de pertenencia a la clase positiva (sale del modelo)
Umbral \(\tau\)
Convierte el score en una decisión 0/1
Predicción \(\hat{y}\)
Clase asignada por esa regla
Matriz de confusión
Compara \(\hat{y}\) con la realidad, para un umbral fijo
Precision, recall, F1, accuracy
Aspectos de esa matriz
ROC
Recorre muchos umbrales y grafica los pares (FPR, TPR)
AUC
Resume la capacidad discriminativa global del ranking
10.9 5. Curva ROC
En la sección 4 vimos que una matriz de confusión corresponde a un umbral \(\tau\). La curva ROC (Receiver Operating Characteristic) no sustituye esa matriz: recorre\(\tau\) y, para cada valor, calcula un punto en el plano \((FPR,\ TPR)\).
Formalmente, dado un ranking \(p_1,\ldots,p_n\) y etiquetas \(y_i \in \{0,1\}\),
\(\mathrm{TPR}\) es la sensibilidad y el recall de la clase positiva: de los positivos reales, qué fracción se detecta con ese \(\tau\). \(\mathrm{FPR}\) es la fracción de negativos reales que se marcan (incorrectamente) como positivos. Equivale a \(1 - \mathrm{especificidad}\), porque
Conexión con la matriz.\(TP\) y \(FN\) salen de los positivos reales; \(FP\) y \(TN\), de los negativos reales. Sin fijar \(\tau\) no hay \(TP\) ni \(FP\) que sumar. Cada \(\tau\) produce un par \((\mathrm{FPR}(\tau),\ \mathrm{TPR}(\tau))\); ese par es un punto de la ROC. Unir esos puntos (en el orden de umbrales decrecientes, como hace sklearn) produce la curva.
Ejemplo numérico para un solo umbral: si \(TP=80\), \(FN=20\), \(FP=10\), \(TN=90\),
Eso es un punto \((0.10,\ 0.80)\), no la curva. La curva aparece cuando se repite el cálculo para muchos \(\tau\).
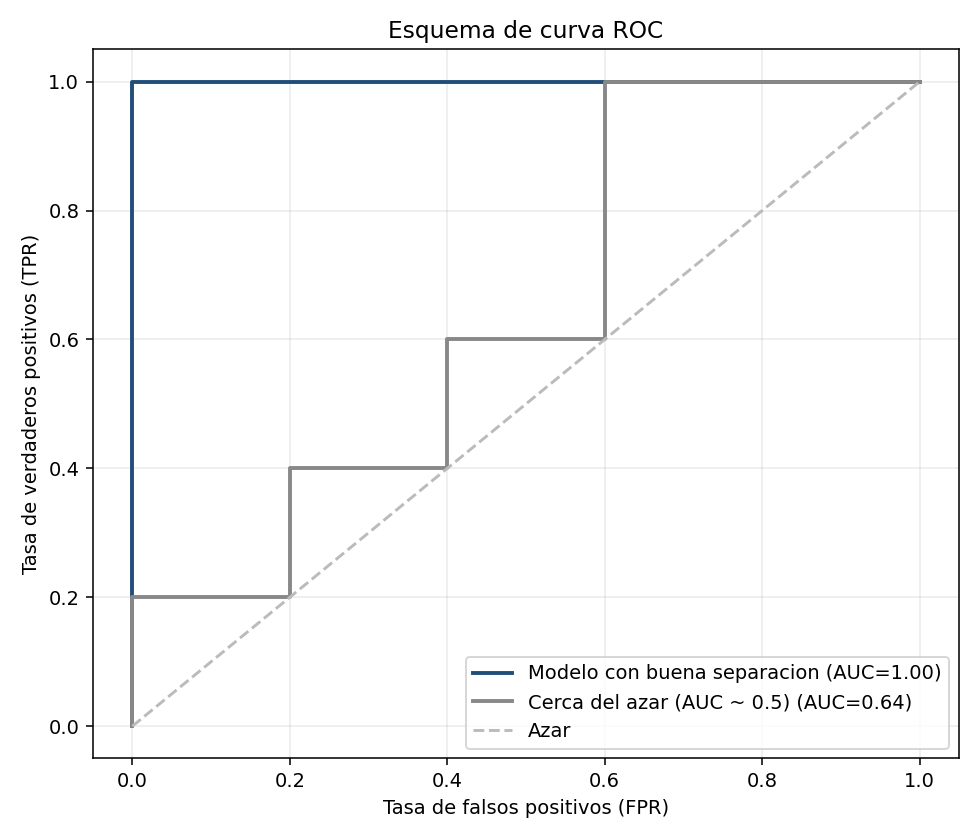
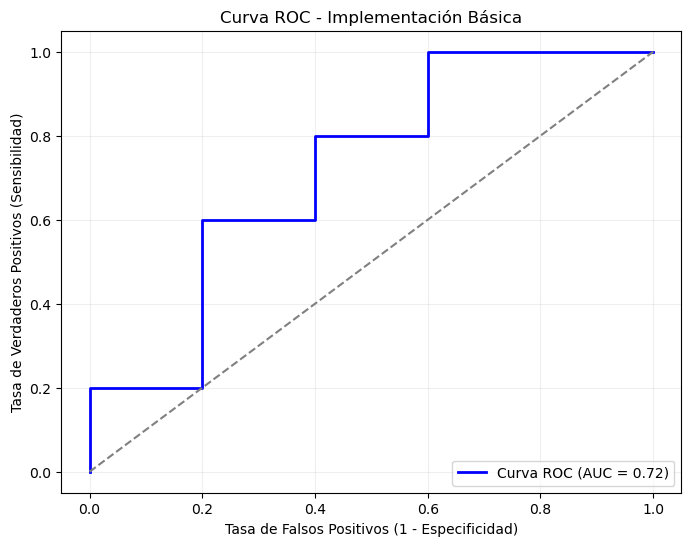
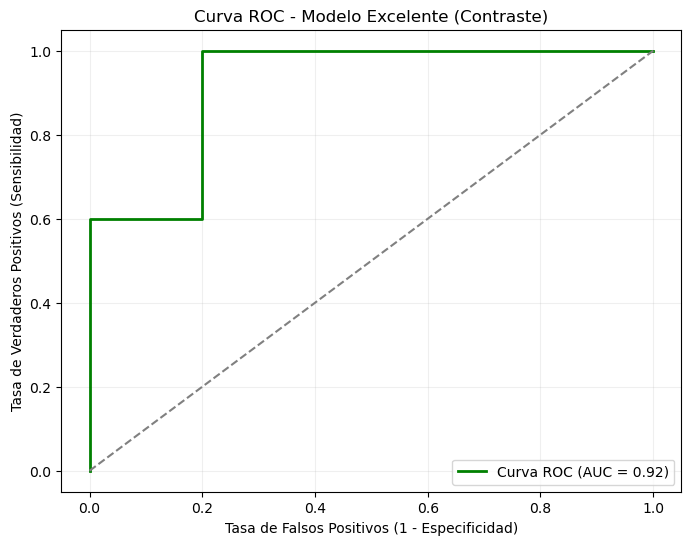
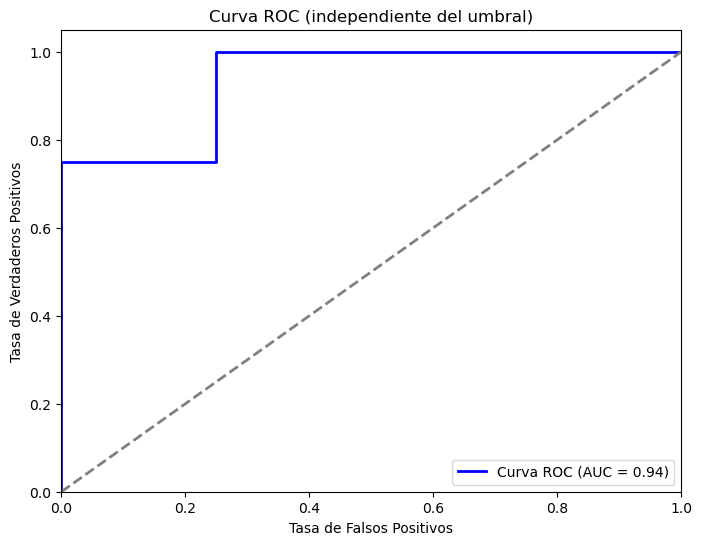
En código, roc_curve(y, prob) recibe etiquetas y scores. Un modelo ideal sube rápido hacia la esquina superior izquierda (mucho TPR con poco FPR). La diagonal \(\mathrm{TPR}=\mathrm{FPR}\) es el clasificador aleatorio (\(\mathrm{AUC}=0.5\)).
10.9.1 Interpretación de la curva y del AUC
El AUC (area under the curve) es el área bajo la ROC. Dos anclas:
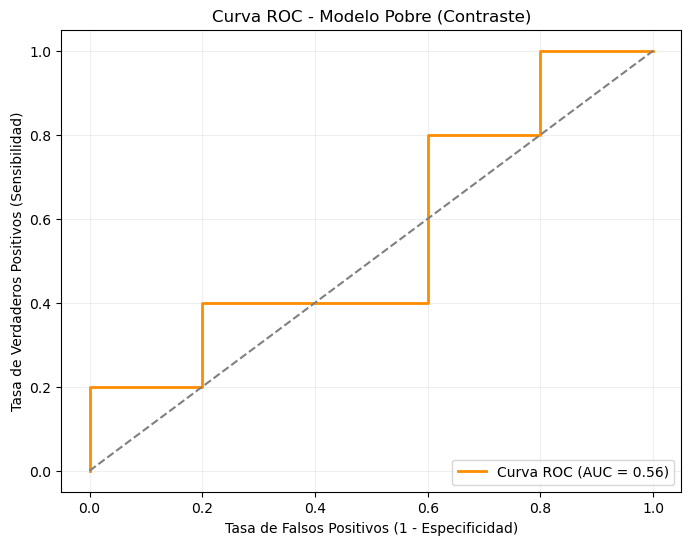
AUC = 0.5: capacidad discriminativa equivalente al azar (el ranking no ordena mejor que una moneda).
AUC = 1: discriminación perfecta (existe un umbral que separa por completo positivos y negativos en la muestra evaluada).
En el intervalo \((0.5,\ 1)\), cuanto mayor es el AUC, mayor es la capacidad general de colocar observaciones positivas por encima de las negativas en el ranking. Una interpretación probabilística útil:
El AUC es la probabilidad de que el modelo asigne un score mayor a una observación positiva elegida al azar que a una observación negativa elegida al azar.
No hay umbrales universales del tipo «0.90 = excelente» o «0.80–0.90 = bueno» que valgan para todo dominio. Un AUC de 0.78 puede ser valioso en un problema difícil y insuficiente en otro. Si un AUC es “bueno” o “suficiente” lo decide el contexto (prevalencia, costos, alternativa clínica o de negocio).
10.9.1.1 AUC no elige el umbral operativo
El AUC evalúa la calidad global del ranking. No selecciona \(\tau\). Hay que mantener separados dos conceptos:
AUC → discriminación / capacidad de ordenar.
Umbral → política concreta de decisión (sección 3.2: costos de FP y FN).
Un modelo puede tener un buen AUC y, sin embargo, utilizar un umbral operativo inadecuado para el problema de negocio.
La curva muestra el menú de puntos \((FPR,\ TPR)\); el negocio elige el punto. El AUC resume el menú, no elige el plato.
El gráfico es un esquema: cerca de la esquina superior izquierda hay mejor compromiso sensibilidad–falsas alarmas; la diagonal es el azar. En 5.1 se dibujan tres ROC a partir de scores, no de un único y_pred.
10.9.1.2 5.1 Implementación práctica: tres curvas ROC
Abajo, roc_curve(y_true, y_scores) usa etiquetas y scores. No se le pasa un y_pred de un solo umbral: eso comprimiría el ranking a una matriz y la curva colapsaría a un punto (más los extremos técnicos que añade sklearn).
Este ejemplo muestra dos momentos distintos del proceso: primero se prueban varios umbrales para comparar métricas, y luego se elige uno solo para tomar la decisión final. Así se entiende que la curva ROC y el análisis de umbrales sirven para evaluar opciones, pero en producción normalmente se usa un único corte. En 4.15 el mismo score se cortó en 0.30, 0.50 y 0.80 y cambiaron las matrices. Aquí se recorre una grilla de umbrales y se elige un corte (por F1) para producción: la ROC y la tabla sirven para evaluar opciones; el sistema desplegado usa un solo umbral.
Los diez scores y etiquetas siguientes son inventados. Actúan como una tabla de validación para ilustrar la selección por F1; las métricas sobre ella son de selección, no de prueba ni de producción. El empate conserva el primer umbral de la grilla. Una política real necesita evaluación posterior independiente y costos pertinentes; maximizar F1 no equivale automáticamente al objetivo de negocio.
import numpy as npimport pandas as pdfrom sklearn.metrics import precision_score, recall_score, f1_score, accuracy_score# Probabilidades del modelo para la clase positiva y etiquetas realesy_true = np.array([0, 1, 0, 1, 0, 1, 0, 1, 0, 1])y_prob = np.array([0.10, 0.40, 0.35, 0.80, 0.20, 0.70, 0.60, 0.90, 0.05, 0.85])# 1) Evaluamos muchos umbrales en el mismo scriptumbrales = np.arange(0.10, 0.95, 0.05)resultados = []for u in umbrales: y_pred = (y_prob >= u).astype(int) resultados.append({'umbral': round(float(u), 2),'accuracy': accuracy_score(y_true, y_pred),'precision': precision_score(y_true, y_pred, zero_division=0),'recall': recall_score(y_true, y_pred, zero_division=0),'f1': f1_score(y_true, y_pred, zero_division=0) })tabla = pd.DataFrame(resultados)display(tabla.round(3))# 2) Criterio didáctico prefijado: maximizar F1 en esta tabla de validaciónmejor_fila = tabla.loc[tabla['f1'].idxmax()]umbral_optimo =float(mejor_fila['umbral'])print(f"\nUmbral seleccionado en la tabla didáctica (max F1): {umbral_optimo:.2f}")print(f"Métricas en ese umbral -> "f"Accuracy: {mejor_fila['accuracy']:.3f}, "f"Precision: {mejor_fila['precision']:.3f}, "f"Recall: {mejor_fila['recall']:.3f}, "f"F1: {mejor_fila['f1']:.3f}")# 3) Aplicación ilustrativa del corte: estos casos no son una prueba independientey_pred_final = (y_prob >= umbral_optimo).astype(int)print(f"\nPredicción final usando un solo umbral ({umbral_optimo:.2f}):")print(y_pred_final)
umbral
accuracy
precision
recall
f1
0
0.10
0.6
0.556
1.0
0.714
1
0.15
0.7
0.625
1.0
0.769
2
0.20
0.8
0.714
1.0
0.833
3
0.25
0.8
0.714
1.0
0.833
4
0.30
0.8
0.714
1.0
0.833
5
0.35
0.9
0.833
1.0
0.909
6
0.40
0.8
0.800
0.8
0.800
7
0.45
0.8
0.800
0.8
0.800
8
0.50
0.8
0.800
0.8
0.800
9
0.55
0.8
0.800
0.8
0.800
10
0.60
0.9
1.000
0.8
0.889
11
0.65
0.9
1.000
0.8
0.889
12
0.70
0.8
1.000
0.6
0.750
13
0.75
0.8
1.000
0.6
0.750
14
0.80
0.7
1.000
0.4
0.571
15
0.85
0.6
1.000
0.2
0.333
16
0.90
0.5
0.000
0.0
0.000
Umbral seleccionado en la tabla didáctica (max F1): 0.35
Métricas en ese umbral -> Accuracy: 0.900, Precision: 0.833, Recall: 1.000, F1: 0.909

Predicción final usando un solo umbral (0.35):
[0 1 1 1 0 1 1 1 0 1]
10.9.1.4 5.3 Ejemplo integrador: matriz de confusión y curva ROC
Código
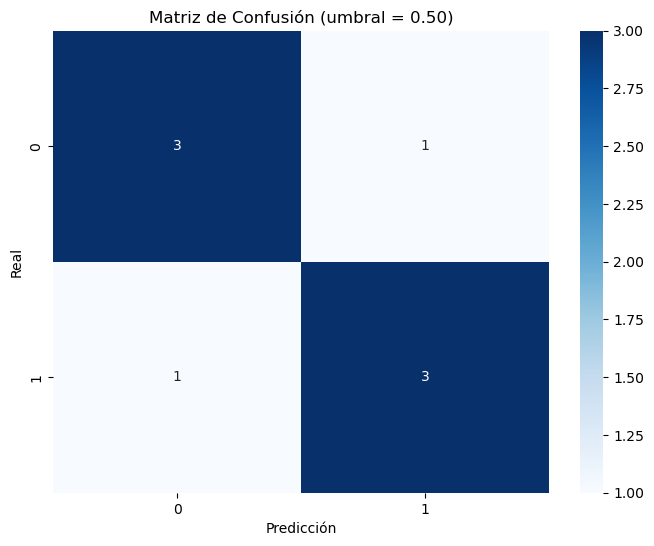
import numpy as npimport pandas as pdfrom sklearn.metrics import ( confusion_matrix, classification_report, accuracy_score, roc_curve, roc_auc_score,)import matplotlib.pyplot as pltimport seaborn as snsy_true = np.array([0, 1, 0, 1, 0, 1, 0, 1])y_prob = np.array([0.10, 0.40, 0.35, 0.80, 0.20, 0.70, 0.60, 0.90])# La clase predicha sale del umbral, no de un vector aparteumbral =0.50y_pred = (y_prob >= umbral).astype(int)detalle = pd.DataFrame({'Real': y_true,'Prob': y_prob,'Pred': y_pred,})print(f'Umbral de decisión: {umbral:.2f}')display(detalle)cm = confusion_matrix(y_true, y_pred)plt.figure(figsize=(8, 6))sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')plt.xlabel('Predicción')plt.ylabel('Real')plt.title(f'Matriz de Confusión (umbral = {umbral:.2f})')plt.show()accuracy = accuracy_score(y_true, y_pred)report = classification_report( y_true, y_pred, target_names=['Clase 0', 'Clase 1'], output_dict=True, zero_division=0)print(f'Exactitud: {accuracy:.2f}')filas = ['Clase 0', 'Clase 1', 'macro avg', 'weighted avg']reporte_df = pd.DataFrame( [{'Clase': clase,'Precisión': report[clase]['precision'],'Recall': report[clase]['recall'],'F1-score': report[clase]['f1-score'],'Soporte': int(report[clase]['support']) } for clase in filas])reporte_df[['Precisión', 'Recall', 'F1-score']] = reporte_df[ ['Precisión', 'Recall', 'F1-score']].round(2)print('Reporte de clasificación:')display(reporte_df)fpr, tpr, _ = roc_curve(y_true, y_prob)roc_auc = roc_auc_score(y_true, y_prob)plt.figure(figsize=(8, 6))plt.plot(fpr, tpr, color='blue', lw=2, label=f'Curva ROC (AUC = {roc_auc:.2f})')plt.plot([0, 1], [0, 1], color='gray', lw=2, linestyle='--')plt.xlim([0.0, 1.0])plt.ylim([0.0, 1.05])plt.xlabel('Tasa de Falsos Positivos')plt.ylabel('Tasa de Verdaderos Positivos')plt.title('Curva ROC (independiente del umbral)')plt.legend(loc='lower right')plt.show()
Umbral de decisión: 0.50
Real
Prob
Pred
0
0
0.10
0
1
1
0.40
0
2
0
0.35
0
3
1
0.80
1
4
0
0.20
0
5
1
0.70
1
6
0
0.60
1
7
1
0.90
1
Exactitud: 0.75
Reporte de clasificación:
Clase
Precisión
Recall
F1-score
Soporte
0
Clase 0
0.75
0.75
0.75
4
1
Clase 1
0.75
0.75
0.75
4
2
macro avg
0.75
0.75
0.75
8
3
weighted avg
0.75
0.75
0.75
8
10.9.1.5 5.4 Usos, ventajas y límites de la curva ROC
Evaluación de modelos de clasificación binaria
Permite comparar diferentes modelos para ver cuál tiene mejor capacidad predictiva.
Exploración de umbrales (no los elige el AUC)
La curva muestra el menú de pares (FPR, TPR). El umbral operativo se elige con costos y recall/precision (secciones 3.2 y 4), no porque el AUC asigne un corte.
Medición de la capacidad de discriminación del modelo
Evalúa qué tan bien el modelo distingue entre clases positivas y negativas.
Análisis de modelos desbalanceados
AUC-ROC puede ser útil para comparar capacidad de separación, pero en desbalance extremo conviene complementarla con Precision-Recall.
10.9.1.6 Ventajas de la Curva ROC
No se reduce a un solo umbral
Resume el ranking en todos los cortes. Eso no sustituye elegir el umbral con una política de costos.
Útil para comparar modelos
El AUC compara discriminación global bajo la población y protocolo evaluados; si las curvas se cruzan, el orden global puede diferir del orden en la región operativa que importa. No incorpora por sí solo costos ni calibración.
10.9.1.7 Desventajas de la Curva ROC
Puede ser engañosa con datos extremadamente desbalanceados
En casos donde la clase positiva es muy rara, una alta AUC no garantiza un buen rendimiento real.
No mide la calidad de las predicciones
No indica qué tan bien están calibradas las probabilidades predichas, solo mide la capacidad de discriminación.
No siempre es la mejor métrica
En problemas donde es más importante evitar falsos negativos (p.ej., diagnóstico médico), es preferible usar métricas como Recall o F1-score.
10.10 6. Conclusión
Como en la sección 4: el modelo estima, el umbral decide y la matriz evalúa un solo corte. La ROC recorre los cortes; el AUC resume la discriminación del ranking y no fija el umbral de negocio. Sigue siendo una herramienta central para comparar clasificadores binarios. En desbalance extremo o cuando un tipo de error es crítico, conviene leerla junto con precision, recall, costos y, si aplica, la curva precision–recall.