class Red(nn.Module):
    def __init__(self, entradas, ocultas, salidas, *, dropout=0., bn=False,
                 inicializacion='xavier', semilla_pesos=42):
        super().__init__()
        self.config = dict(entradas=entradas, ocultas=list(ocultas), salidas=salidas,
            dropout=dropout,bn=bn,inicializacion=inicializacion,semilla_pesos=semilla_pesos)
        capas=[]; anterior=entradas
        for ancho in ocultas:
            capas.append(nn.Linear(anterior,ancho,bias=not bn))
            if bn: capas.append(nn.BatchNorm1d(ancho,eps=1e-3,momentum=.01))
            capas.append(nn.ReLU())
            if dropout>0: capas.append(nn.Dropout(dropout))
            anterior=ancho
        capas.append(nn.Linear(anterior,salidas))
        self.capas=nn.Sequential(*capas)
        # Reiniciar aquí hace coincidir matrices comunes entre intervenciones.
        semilla(semilla_pesos)
        for capa in self.capas:
            if isinstance(capa,nn.Linear):
                if inicializacion=='cero': nn.init.zeros_(capa.weight)
                elif inicializacion=='grande': nn.init.normal_(capa.weight,0,1)
                elif inicializacion=='he': nn.init.kaiming_normal_(capa.weight,nonlinearity='relu')
                else: nn.init.xavier_uniform_(capa.weight,gain=1.)
                if capa.bias is not None: nn.init.zeros_(capa.bias)

    def forward(self,x): return self.capas(x)

    def penalizacion(self,l1=0.,l2=0.):
        # Penalizamos matrices ocultas; excluimos sesgos, BN y la capa de salida.
        densas=[c for c in self.capas if isinstance(c,nn.Linear)][:-1]
        valor=torch.zeros((),device=next(self.parameters()).device)
        for c in densas: valor=valor+l1*c.weight.abs().sum()+l2*c.weight.square().sum()
        return valor

def cargador(X,y,lote=128,barajar=False,seed=42):
    return DataLoader(TensorDataset(torch.as_tensor(np.asarray(X),dtype=torch.float32),
        torch.as_tensor(np.asarray(y),dtype=torch.long)),batch_size=lote,shuffle=barajar,
        generator=torch.Generator().manual_seed(seed),num_workers=0)

@torch.inference_mode()
def evaluar(red,X,y):
    red.eval(); suma=0.; aciertos=0; n=0
    for xb,yb in cargador(X,y,512):
        xb,yb=xb.to(dispositivo),yb.to(dispositivo)
        z=red(xb); loss=nn.functional.cross_entropy(z,yb)
        if not torch.isfinite(z).all() or not torch.isfinite(loss):
            return {'loss':np.nan,'accuracy':np.nan}
        suma+=loss.item()*len(yb); aciertos+=(z.argmax(1)==yb).sum().item(); n+=len(yb)
    return {'loss':suma/n,'accuracy':aciertos/n}

@torch.inference_mode()
def probabilidades(red,X):
    red.eval(); out=[]
    for start in range(0,len(X),512):
        xb=torch.as_tensor(np.asarray(X[start:start+512]),dtype=torch.float32,device=dispositivo)
        out.append(red(xb).softmax(1).cpu().numpy())
    return np.concatenate(out)

def optimizador(red,nombre,lr):
    if nombre=='SGD': return torch.optim.SGD(red.parameters(),lr=lr)
    if nombre=='Momentum': return torch.optim.SGD(red.parameters(),lr=lr,momentum=.9)
    if nombre=='RMSProp': return torch.optim.RMSprop(red.parameters(),lr=lr,alpha=.9,eps=1e-7)
    return torch.optim.Adam(red.parameters(),lr=lr,eps=1e-7)

def ajustar(red,Xtr,ytr,Xva,yva,*,epocas=30,lote=128,lr=.001,opt='Adam',
            l1=0.,l2=0.,paciencia=None,min_delta=0.,clip=None,seed=42,nombre='modelo'):
    red.to(dispositivo); algoritmo=optimizador(red,opt,lr)
    lotes=cargador(Xtr,ytr,lote,True,seed)
    registros=[]; mejor=np.inf; mejor_epoca=0; espera=0; referencia_parada=np.inf
    estado_mejor=deepcopy(red.state_dict()); estado='finito'; total_pasos=0
    inicio=time.perf_counter()
    if dispositivo.type=='cuda': torch.cuda.synchronize()
    for epoca in range(1,epocas+1):
        red.train(); suma_online=0.; correctos_online=0; n_online=0
        normas=[]; recortes=0; fallo=False
        for xb,yb in lotes:
            xb,yb=xb.to(dispositivo),yb.to(dispositivo)
            algoritmo.zero_grad(set_to_none=True)
            z=red(xb); ce=nn.functional.cross_entropy(z,yb)
            objetivo=ce+red.penalizacion(l1,l2)
            if not torch.isfinite(objetivo): fallo=True; break
            objetivo.backward()
            # Sin clip, umbral infinito mide sin modificar gradientes finitos.
            norma=nn.utils.clip_grad_norm_(red.parameters(),clip if clip else float('inf'))
            if not torch.isfinite(norma): fallo=True; break
            normas.append(float(norma)); recortes+=int(clip is not None and norma>clip)
            suma_online+=float(ce.detach())*len(yb)
            correctos_online+=(z.argmax(1)==yb).sum().item(); n_online+=len(yb)
            algoritmo.step(); total_pasos+=1
        tr=evaluar(red,Xtr,ytr); va=evaluar(red,Xva,yva)
        penal=float(red.penalizacion(l1,l2).detach())
        if fallo or not np.isfinite([tr['loss'],va['loss'],penal]).all(): estado='no_finito'
        registros.append({'epoca':epoca,'train_loss':tr['loss'],'val_loss':va['loss'],
            'train_accuracy':tr['accuracy'],'val_accuracy':va['accuracy'],
            'online_loss':suma_online/max(n_online,1),'online_accuracy':correctos_online/max(n_online,1),
            'penalizacion':penal,'objetivo_train':tr['loss']+penal,
            'norma_gradiente_media':float(np.mean(normas)) if normas else np.nan,
            'fraccion_recortada':recortes/max(len(normas),1)})
        if estado=='no_finito': break
        if va['loss']<mejor:
            mejor=va['loss']; mejor_epoca=epoca; estado_mejor=deepcopy(red.state_dict())
        # El mínimo exacto elige pesos; min_delta solo controla la paciencia.
        if va['loss']<referencia_parada-min_delta: referencia_parada=va['loss']; espera=0
        else: espera+=1
        if paciencia is not None and espera>=paciencia: break
    if dispositivo.type=='cuda': torch.cuda.synchronize()
    segundos=time.perf_counter()-inicio
    red.load_state_dict(estado_mejor); red.eval()
    if mejor_epoca:
        assert np.isclose(evaluar(red,Xva,yva)['loss'],mejor,rtol=1e-5,atol=1e-7)
    info={'modelo':nombre,'checkpoint':mejor_epoca,'epocas':len(registros),'estado':estado,
          'segundos':segundos,'pasos':total_pasos,'min_val_loss':mejor}
    print(nombre, '| épocas:',len(registros),'| checkpoint:',mejor_epoca,'| estado:',estado,flush=True)
    return pd.DataFrame(registros),info

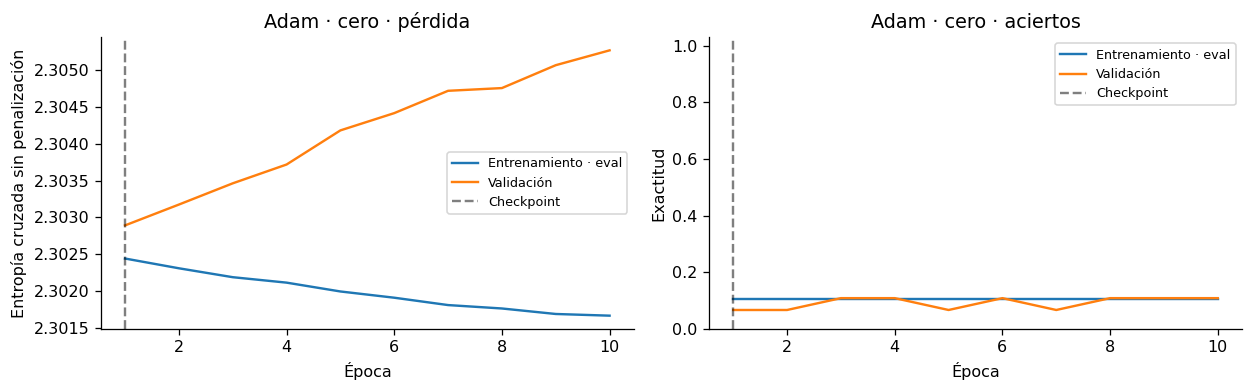
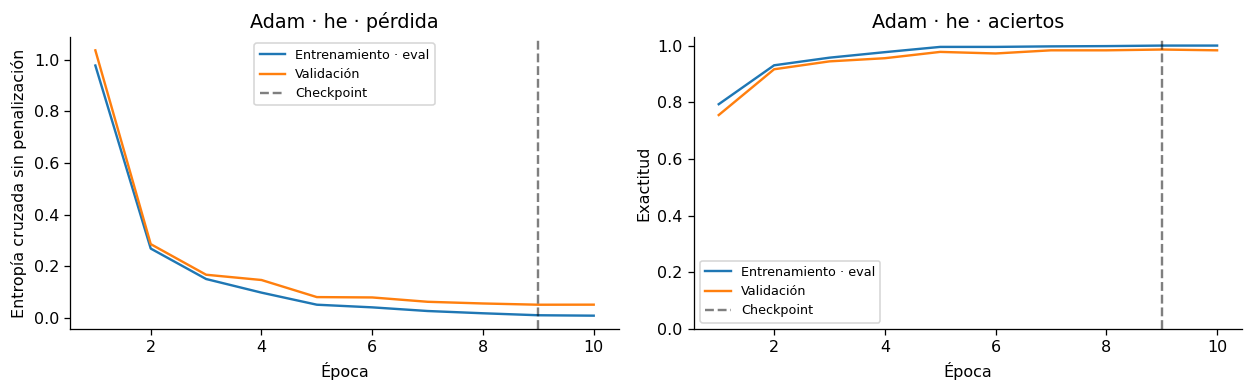
def curvas(historia,info,titulo):
    fig,ax=plt.subplots(1,2,figsize=(11,3.5))
    for pref,nombre in [('train','Entrenamiento · eval'),('val','Validación')]:
        ax[0].plot(historia.epoca,historia[pref+'_loss'],label=nombre)
        ax[1].plot(historia.epoca,historia[pref+'_accuracy'],label=nombre)
    for a in ax:
        if info['checkpoint']: a.axvline(info['checkpoint'],ls='--',color='black',alpha=.5,label='Checkpoint')
        a.set_xlabel('Época'); a.legend(fontsize=8)
    ax[0].set(ylabel='Entropía cruzada sin penalización',title=titulo+' · pérdida')
    ax[1].set(ylabel='Exactitud',ylim=(0,1.03),title=titulo+' · aciertos')
    plt.tight_layout(); plt.show()

def resumen(red,h,info,Xtr,ytr,Xva,yva):
    tr=evaluar(red,Xtr,ytr); va=evaluar(red,Xva,yva)
    if info['estado']!='finito':
        # El estado de respaldo no es un checkpoint entrenado válido.
        tr={'loss':np.nan,'accuracy':np.nan};va={'loss':np.nan,'accuracy':np.nan}
    return {**info,'parametros':sum(p.numel() for p in red.parameters()),
        'train_loss':tr['loss'],'val_loss':va['loss'],'train_accuracy':tr['accuracy'],
        'val_accuracy':va['accuracy'],'gap_accuracy':tr['accuracy']-va['accuracy'],
        'gap_loss':va['loss']-tr['loss']}

def guardar(red,nombre,contrato):
    ruta=ARTEFACTOS/(nombre+'.pt')
    torch.save({'config':red.config,'state_dict':{k:v.detach().cpu().clone() for k,v in red.state_dict().items()},
        'entrada':contrato},ruta)
    nuevo=torch.load(ruta,map_location='cpu',weights_only=True)
    copia=Red(**nuevo['config']); copia.load_state_dict(nuevo['state_dict']); copia.eval()
    return copia