flowchart LR
    X["Entrada: N × T"] --> E["Embedding: N × T × 16"]
    E --> ENC["Encoder GRU + longitudes"]
    ENC --> H["Contexto: 1 × N × h"]
    H --> DEC["Decoder GRU"]
    PREV["BOS o símbolo anterior"] --> DEC
    DEC --> LOG["Logits: N × vocabulario"]
    LOG --> P["Predicción"]
    P -. "Inferencia: siguiente entrada" .-> PREV
    REAL["Respuesta anterior verdadera"] -. "Teacher forcing" .-> PREV
21 Secuencia a secuencia
Una entrada puede contener varios pasos y la salida requerir otros tantos, incluso con una longitud diferente. Un modelo secuencia a secuencia debe representar la entrada, producir la salida y decidir qué información puede usar en cada paso.
Construiremos dos laboratorios: invertir secuencias simbólicas de longitud variable y pronosticar ocho pasos de una serie numérica. Seguiremos las formas de los tensores, el padding, el entrenamiento con respuestas anteriores y la generación autónoma. El análisis comparará errores por símbolo, secuencia y horizonte; una pérdida baja no bastará para declarar que el sistema funciona.
Se utilizan NumPy, pandas, Matplotlib, scikit-learn y PyTorch en CPU, con datos sintéticos locales. Conviene conocer Embeddings, Redes recurrentes y LSTM y GRU. La atención se desarrolla en el capítulo siguiente.
21.1 Encoder, contexto y decoder
Un encoder procesa \(x_1,\ldots,x_T\) y produce un estado de contexto. Un decoder usa ese contexto y sus entradas anteriores para producir \(y_1,\ldots,y_U\). En el modelo clásico de este capítulo, el último estado del encoder inicializa el decoder:
\[h_T=\operatorname{Encoder}(x_{1:T}),\qquad s_0=h_T,\] \[s_t=\operatorname{Decoder}(u_{t-1},s_{t-1}),\qquad \hat y_t=g(s_t).\]
Para símbolos, \(g\) produce logits sobre un vocabulario y buscamos una distribución condicional:
\[P(y_{1:U}\mid x)=\prod_{t=1}^{U}P(y_t\mid y_{<t},x).\]
Para valores continuos, \(g\) produce un número y podemos minimizar error cuadrático. El esquema es compartido, pero cambian la pérdida, la métrica y el significado de terminar.
El estado fijo debe condensar toda la entrada. Esta restricción ofrece una forma concreta de entender por qué se introduce atención: el decoder puede necesitar acceder a distintos estados del encoder, especialmente con entradas largas.
21.1.1 Dos rutas por el mismo decoder
El contexto inicializa el estado del decoder; el token anterior constituye su entrada. La flecha de inferencia vuelve a la propia predicción. El objetivo del paso actual solo entra en la pérdida durante entrenamiento, no en la generación de ese mismo paso.
import numpy as np
import sklearn
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import mean_squared_error, accuracy_score, balanced_accuracy_score, log_loss, ConfusionMatrixDisplay
from IPython.display import display
import torch
from torch import nn
from torch.utils.data import TensorDataset,DataLoader,WeightedRandomSampler
from torch.nn.utils.rnn import pad_sequence,pack_padded_sequence
import copy,json,math,time,platform
from pathlib import Path
torch.set_num_threads(1)
torch.use_deterministic_algorithms(True)
SEMILLA=42
COLORES=['#276FBF','#E87524','#339966','#9B59B6']
plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})
lecturas={}
def rmse(a,b):return float(np.sqrt(mean_squared_error(a,b)))
print('Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.')

from sklearn.metrics import mean_absolute_error
PAD,BOS,EOS=0,1,2
SIMBOLOS=list(range(3,11));V=11
def texto(seq):
    return ' '.join({PAD:'PAD',BOS:'BOS',EOS:'EOS'}.get(int(i),str(int(i)-3)) for i in seq)
print('Vocabulario:',V,'tokens: PAD, BOS, EOS y ocho símbolos.')
Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.
Vocabulario: 11 tokens: PAD, BOS, EOS y ocho símbolos.21.2 Laboratorio 1: invertir secuencias sin memorizar ejemplos
La entrada contiene símbolos entre 0 y 7; la salida debe invertir su orden y agregar EOS. El algoritmo exacto es trivial, y lo usaremos para verificar la tarea. Entrenar una red para esto tiene un propósito didáctico: observar generación, memoria, longitud y exposición a sus propias predicciones.
Generamos secuencias únicas de longitudes 3 a 8 y reservamos prueba del mismo intervalo. Además, fijamos una prueba de extrapolación con longitudes 9 a 12. Eliminamos duplicados exactos entre particiones. No evitamos compartir patrones o subsecuencias, porque eso forma parte de aprender la regla.
| Símbolo reservado | Función | ¿Es objetivo de salida? |
|---|---|---|
| PAD | Completar el ancho del lote | No: se excluye de la pérdida |
| BOS | Iniciar el decoder | No |
| EOS | Terminar la secuencia | Sí |
Los tres tienen funciones diferentes. Un cero numérico real en una serie no es padding; aquí PAD es un token reservado fuera de los ocho símbolos.
rng=np.random.default_rng(42);vistos=set()
def generar(n,min_l,max_l):
    salida=[]
    while len(salida)<n:
        l=int(rng.integers(min_l,max_l+1));s=tuple(rng.choice(SIMBOLOS,l).tolist())
        if s not in vistos:vistos.add(s);salida.append(s)
    return salida
str_=generar(1600,3,8);sva=generar(250,3,8);ste=generar(250,3,8);slargas=generar(120,9,12)
assert not set(str_)&set(sva) and not set(str_)&set(ste) and not set(sva)&set(ste)
def lote_simbolico(seqs):
    src=pad_sequence([torch.tensor(s) for s in seqs],batch_first=True,padding_value=PAD)
    entrada=pad_sequence([torch.tensor([BOS]+list(reversed(s))) for s in seqs],batch_first=True,padding_value=PAD)
    objetivo=pad_sequence([torch.tensor(list(reversed(s))+[EOS]) for s in seqs],batch_first=True,padding_value=PAD)
    return src,torch.tensor([len(s) for s in seqs]),entrada,objetivo
ej=lote_simbolico(str_[:4]);display(pd.DataFrame({'entrada':[texto(s) for s in str_[:4]],'entrada decoder':[texto([BOS]+list(reversed(s))) for s in str_[:4]],'objetivo':[texto(list(reversed(s))+[EOS]) for s in str_[:4]]}))
print('Formas: encoder',tuple(ej[0].shape),'; decoder',tuple(ej[2].shape),'; objetivos',tuple(ej[3].shape))
fig,axs=plt.subplots(1,2,figsize=(11,3.5))
for ax,M,t in zip(axs,[ej[0].numpy(),ej[3].numpy()],['Entrada con padding','Objetivo invertido + EOS']):
    ax.imshow(M,cmap='tab20',vmin=0,vmax=19)
    for (i,j),v in np.ndenumerate(M):ax.text(j,i,texto([v]),ha='center',va='center',fontsize=9)
    ax.set(title=t,xlabel='Posición',ylabel='Ejemplo')
plt.show()| entrada | entrada decoder | objetivo | |
|---|---|---|---|
| 0 | 6 5 3 | BOS 3 5 6 | 3 5 6 EOS |
| 1 | 6 0 5 1 0 | BOS 0 1 5 0 6 | 0 1 5 0 6 EOS |
| 2 | 7 5 6 5 6 4 | BOS 4 6 5 6 5 7 | 4 6 5 6 5 7 EOS |
| 3 | 6 3 4 | BOS 4 3 6 | 4 3 6 EOS |
Formas: encoder (4, 6) ; decoder (4, 7) ; objetivos (4, 7)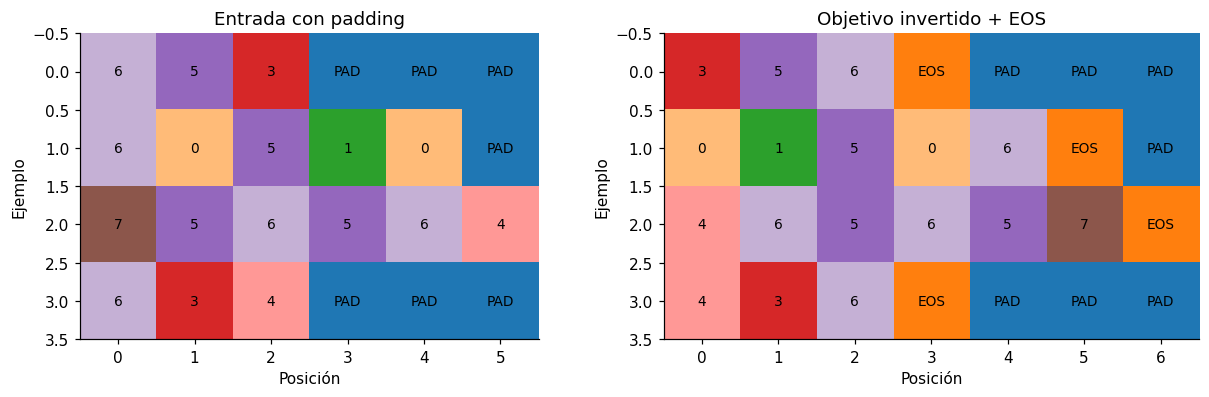
21.2.1 Teacher forcing y fuga de respuestas
En entrenamiento con teacher forcing, el decoder recibe el símbolo verdadero del paso anterior. No recibe el objetivo del mismo paso. Por eso la entrada comienza con BOS y el objetivo comienza con el último símbolo de la secuencia original.
En inferencia no disponemos de la respuesta verdadera: el decoder recibe su propia predicción anterior. Si evaluamos solo con respuestas anteriores verdaderas, medimos una condición más fácil que el uso autónomo. Esta diferencia puede propagar errores, aunque una pérdida de entrenamiento pequeña no permite atribuir por sí sola el problema a ese mecanismo.
Comparamos teacher forcing completo y una mezcla con probabilidad 0.5, donde cada ejemplo elige entre el símbolo anterior verdadero y su predicción. Esta mezcla es una variante didáctica de scheduled sampling con probabilidad fija; no es una solución universal ni reproduce un calendario decreciente. Sus decisiones discretas se desacoplan del gradiente.
21.2.2 Padding, packing y pérdida
pack_padded_sequence permite que el encoder termine cada secuencia en su longitud real; sin ello, su último estado podría incorporar padding. La pérdida del decoder excluye PAD e incluye EOS:
\[\mathcal L=-\frac{1}{M}\sum_{n,t:\,y_{nt}\ne\mathrm{PAD}}\log P(y_{nt}\mid\cdot),\]
donde \(M\) cuenta todos los tokens válidos del conjunto. Una media simple de pérdidas por lote ponderaría incorrectamente lotes con diferente número de tokens. En las gráficas calculamos la pérdida de validación como suma total dividida por ese conteo.
Ver implementación y registro del experimento
class Seq2Seq(nn.Module):
    def __init__(self,h):
        super().__init__();self.emb=nn.Embedding(V,16,padding_idx=PAD)
        self.encoder=nn.GRU(16,h,batch_first=True);self.decoder=nn.GRU(16,h,batch_first=True);self.salida=nn.Linear(h,V)
    def contexto(self,src,long):
        packed=pack_padded_sequence(self.emb(src),long.cpu(),batch_first=True,enforce_sorted=False)
        return self.encoder(packed)[1]
    def forward(self,src,long,entradas,tf=1.):
        h=self.contexto(src,long)
        if tf==1.:
            out,_=self.decoder(self.emb(entradas),h);return self.salida(out)
        token=entradas[:,0];salidas=[]
        for t in range(entradas.shape[1]):
            out,h=self.decoder(self.emb(token).unsqueeze(1),h);logits=self.salida(out[:,0]);salidas.append(logits)
            if t+1<entradas.shape[1]:
                real=torch.rand(len(token))<tf;token=torch.where(real,entradas[:,t+1],logits.argmax(1).detach())
        return torch.stack(salidas,dim=1)
def ce_validacion(modelo,seqs):
    modelo.eval();suma=0.;cuenta=0
    with torch.no_grad():
        for k in range(0,len(seqs),128):
            src,long,dec,tgt=lote_simbolico(seqs[k:k+128]);logits=modelo(src,long,dec)
            suma+=float(nn.functional.cross_entropy(logits.reshape(-1,V),tgt.reshape(-1),ignore_index=PAD,reduction='sum'));cuenta+=int(tgt.ne(PAD).sum())
    return suma/cuenta
MAX_SALIDA=13  # Doce símbolos y EOS: límite de aplicación, no longitud de la referencia.
def greedy(modelo,seqs):
    modelo.eval();resultados=[]
    with torch.no_grad():
        for k in range(0,len(seqs),128):
            grupo=seqs[k:k+128];src,long,_,_=lote_simbolico(grupo);h=modelo.contexto(src,long)
            token=torch.full((len(grupo),),BOS);terminada=torch.zeros(len(grupo),dtype=torch.bool);salidas=[[] for _ in grupo]
            for t in range(MAX_SALIDA):
                out,h=modelo.decoder(modelo.emb(token).unsqueeze(1),h);logits=modelo.salida(out[:,0]);logits[:,[PAD,BOS]]=-torch.inf;token=logits.argmax(1)
                for i,p in enumerate(token.tolist()):
                    if not terminada[i]:salidas[i].append(p)
                terminada|=token.eq(EOS)
                if terminada.all():break
            resultados.extend(salidas)
    return resultados
def metricas_simbolicas(seqs,preds):
    refs=[list(reversed(s))+[EOS] for s in seqs]
    exacta=np.mean([p==r for p,r in zip(preds,refs)])
    correctos=sum(sum(j<len(p) and p[j]==v for j,v in enumerate(r)) for p,r in zip(preds,refs))
    return {'exactitud secuencia':float(exacta),'accuracy token':correctos/sum(map(len,refs)),'terminación EOS':float(np.mean([bool(p) and p[-1]==EOS for p in preds]))}
torch.manual_seed(7);demo=Seq2Seq(48);src,long,dec,tgt=ej
logits=demo(src,long,dec);print('Logits:',tuple(logits.shape),'→ pérdida sobre tokens válidos:',int(tgt.ne(PAD).sum()))
Logits: (4, 7, 11) → pérdida sobre tokens válidos: 2121.2.3 Métricas que responden preguntas diferentes
La exactitud de secuencia exige que todos los símbolos y EOS coincidan. La accuracy de token compara las posiciones de la referencia e incluye EOS; las posiciones ausentes son errores. Una salida con prefijo correcto y tokens sobrantes puede conservar accuracy de token alta, pero su exactitud es cero. Por eso registramos ambas y la tasa de terminación.
Las secuencias largas pesan más en accuracy de token; en exactitud cada secuencia pesa lo mismo. Ninguna de estas métricas mide utilidad de traducción ni sustituye una evaluación específica de lenguaje.
ref_demo=[(3,4,5)]
for nombre,p in [('Correcta',[[5,4,3,EOS]]),('Token equivocado',[[5,8,3,EOS]]),('Correcta + sobrante',[[5,4,3,EOS,7]]),('Sin terminar',[[5,4,3]])]:
    print(nombre,metricas_simbolicas(ref_demo,p))
Correcta {'exactitud secuencia': 1.0, 'accuracy token': 1.0, 'terminación EOS': 1.0}
Token equivocado {'exactitud secuencia': 0.0, 'accuracy token': 0.75, 'terminación EOS': 1.0}
Correcta + sobrante {'exactitud secuencia': 0.0, 'accuracy token': 1.0, 'terminación EOS': 0.0}
Sin terminar {'exactitud secuencia': 0.0, 'accuracy token': 0.75, 'terminación EOS': 0.0}21.3 Entrenamiento y selección antes de prueba
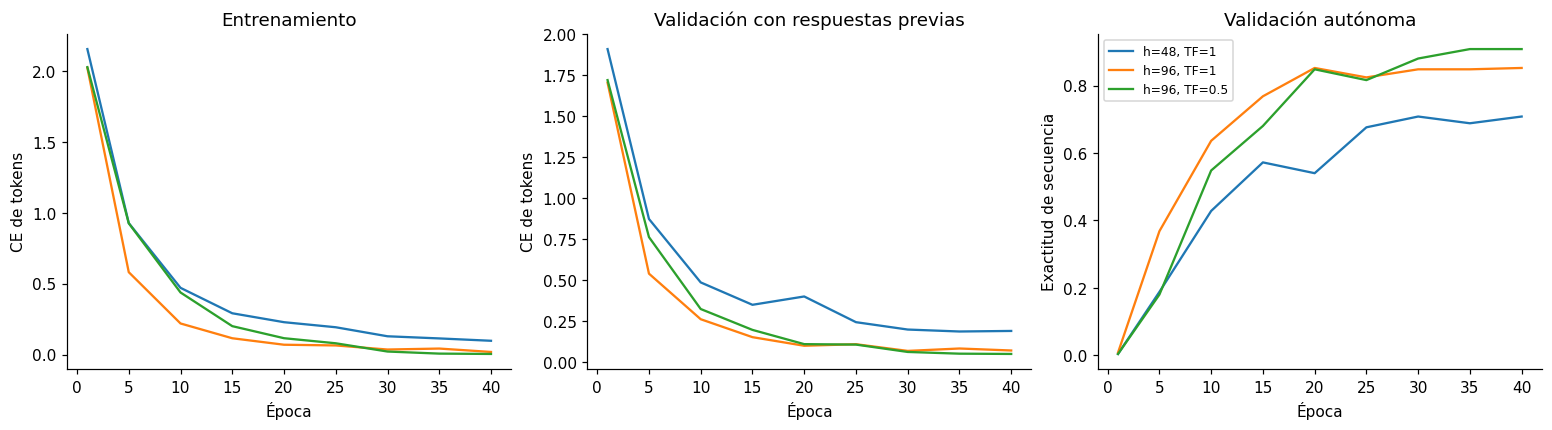
Comparamos tres configuraciones: estado 48 con teacher forcing completo, estado 96 completo y estado 96 con mezcla 0.5. Usamos embeddings de 16, Adam con tasa 0.003, lotes de 64 y 40 épocas; limitamos la norma de gradiente a 1 antes del paso del optimizador.
Cada cinco épocas medimos generación autónoma en validación. Elegimos checkpoints y configuración por mayor exactitud de secuencia; en empate, menor pérdida de validación con teacher forcing. Las consultas intermedias reutilizan validación y no son pruebas independientes. Una sola semilla no permite atribuir una ventaja general a la mezcla: el experimento compara estas ejecuciones concretas.
configs=[(48,1.),(96,1.),(96,.5)];modelos={};historias={};filas=[]
for h,tf in configs:
    nombre=f'h={h}, TF={tf:g}';torch.manual_seed(7);modelo=Seq2Seq(h);opt=torch.optim.Adam(modelo.parameters(),lr=.003)
    loader=DataLoader(str_,batch_size=64,shuffle=True,collate_fn=lote_simbolico,generator=torch.Generator().manual_seed(7))
    mejor=(-1.,-np.inf);hist=[]
    for ep in range(1,41):
        modelo.train();suma=0.;cuenta=0
        for src,long,dec,tgt in loader:
            opt.zero_grad();logits=modelo(src,long,dec,tf);loss=nn.functional.cross_entropy(logits.reshape(-1,V),tgt.reshape(-1),ignore_index=PAD)
            loss.backward();nn.utils.clip_grad_norm_(modelo.parameters(),1.);opt.step();n=int(tgt.ne(PAD).sum());suma+=float(loss.detach())*n;cuenta+=n
        if ep==1 or ep%5==0:
            cv=ce_validacion(modelo,sva);met=metricas_simbolicas(sva,greedy(modelo,sva));hist.append((ep,suma/cuenta,cv,met['exactitud secuencia'],met['accuracy token']))
            clave=(met['exactitud secuencia'],-cv)
            if clave>mejor:mejor=clave;estado=copy.deepcopy(modelo.state_dict());mejor_ep=ep
    modelo.load_state_dict(estado);modelos[nombre]=modelo;historias[nombre]=np.array(hist)
    filas.append({'configuración':nombre,'parámetros':sum(p.numel() for p in modelo.parameters()),'época':mejor_ep,'exactitud validación':mejor[0],'CE validación':-mejor[1]})
tabla_config=pd.DataFrame(filas).sort_values(['exactitud validación','CE validación'],ascending=[False,True]);display(tabla_config)
nombre_sel=tabla_config.iloc[0]['configuración'];modelo=modelos[nombre_sel]
fig,axs=plt.subplots(1,3,figsize=(14,3.8))
for nombre,hist in historias.items():
    axs[0].plot(hist[:,0],hist[:,1],label=nombre);axs[1].plot(hist[:,0],hist[:,2],label=nombre);axs[2].plot(hist[:,0],hist[:,3],label=nombre)
for ax,t,y in zip(axs,['Entrenamiento','Validación con respuestas previas','Validación autónoma'],['CE de tokens','CE de tokens','Exactitud de secuencia']):ax.set(xlabel='Época',ylabel=y,title=t)
axs[2].legend(fontsize=8);plt.show()
lecturas['seq_config']=nombre_sel;lecturas['seq_val']=f'{tabla_config.iloc[0]["exactitud validación"]:.3f}'| configuración | parámetros | época | exactitud validación | CE validación | |
|---|---|---|---|---|---|
| 2 | h=96, TF=0.5 | 66907 | 40 | 0.908 | 0.051383 |
| 1 | h=96, TF=1 | 66907 | 40 | 0.852 | 0.072483 |
| 0 | h=48, TF=1 | 19723 | 40 | 0.708 | 0.191713 |
21.3.1 Cómo leer este resultado
La configuración seleccionada es h=96, TF=0.5, con exactitud de validación 0.908. La pérdida condicionada en respuestas anteriores y la generación autónoma responden a condiciones diferentes; compara ambas curvas antes de elegir un checkpoint.
La mezcla introduce predicciones erróneas durante entrenamiento, pero también modifica el problema de optimización. Si su resultado es peor, este experimento no justifica recomendarla automáticamente. Si es mejor, conviene repetir semillas y estudiar el costo antes de atribuir el cambio al método en general.
21.4 Greedy y búsqueda por haces
Greedy escoge el símbolo con mayor probabilidad en cada paso. Beam search conserva varias continuaciones parciales; usaremos ancho 3 y una puntuación de longitud fijada antes de prueba:
puntuación = suma de log-probabilidades / ((5 + longitud) / 6)^0.6
La longitud incluye EOS. La normalización busca moderar el sesgo hacia salidas cortas, pero cambia la regla de búsqueda y no garantiza la mejor secuencia global. Conservamos hipótesis terminadas sin expandirlas. En ambas estrategias excluimos PAD y BOS como salidas y detenemos por EOS o por el límite de aplicación de 13 tokens; no consultamos la longitud correcta de la referencia.
def beam(modelo,seq,width=3,alpha=.6):
    modelo.eval()
    def puntuacion(item):
        tokens,score,h,fin=item
        return score/(((5+max(len(tokens),1))/6)**alpha)
    with torch.no_grad():
        src,long,_,_=lote_simbolico([seq]);h=modelo.contexto(src,long);haces=[([],0.,h,False)]
        for t in range(MAX_SALIDA):
            candidatos=[]
            for tokens,score,estado,fin in haces:
                if fin:candidatos.append((tokens,score,estado,fin));continue
                anterior=torch.tensor([[tokens[-1] if tokens else BOS]])
                out,nuevo=modelo.decoder(modelo.emb(anterior),estado);logits=modelo.salida(out[:,0])[0];logits[[PAD,BOS]]=-torch.inf
                valores,indices=logits.log_softmax(0).topk(width)
                for valor,i in zip(valores.tolist(),indices.tolist()):candidatos.append((tokens+[i],score+valor,nuevo,i==EOS))
            haces=sorted(candidatos,key=puntuacion,reverse=True)[:width]
            if all(item[3] for item in haces):break
        return max(haces,key=puntuacion)[0]
preds_seq={};res_seq=[]
for grupo,seqs in [('longitud conocida',ste),('longitud nueva',slargas)]:
    preds_seq[(grupo,'greedy')]=greedy(modelo,seqs)
    preds_seq[(grupo,'beam 3')]=[beam(modelo,s) for s in seqs]
    for metodo in ['greedy','beam 3']:
        met=metricas_simbolicas(seqs,preds_seq[(grupo,metodo)])
        for m,v in met.items():res_seq.append({'caso':'símbolos','grupo':grupo,'modelo':metodo,'métrica':m,'valor':v})
    assert metricas_simbolicas(seqs,[list(reversed(s))+[EOS] for s in seqs])['exactitud secuencia']==1.
tabla_seq=pd.DataFrame(res_seq);display(tabla_seq.pivot_table(index=['grupo','modelo'],columns='métrica',values='valor'))
lecturas['seq_iid']=f'{metricas_simbolicas(ste,preds_seq[("longitud conocida","greedy")])["exactitud secuencia"]:.3f}'
lecturas['seq_ood']=f'{metricas_simbolicas(slargas,preds_seq[("longitud nueva","greedy")])["exactitud secuencia"]:.3f}'| métrica | accuracy token | exactitud secuencia | terminación EOS | |
|---|---|---|---|---|
| grupo | modelo | |||
| longitud conocida | beam 3 | 0.962852 | 0.880000 | 1.0 |
| greedy | 0.959257 | 0.876000 | 1.0 | |
| longitud nueva | beam 3 | 0.506273 | 0.083333 | 1.0 |
| greedy | 0.495203 | 0.066667 | 1.0 |
21.4.1 Cómo leer este resultado
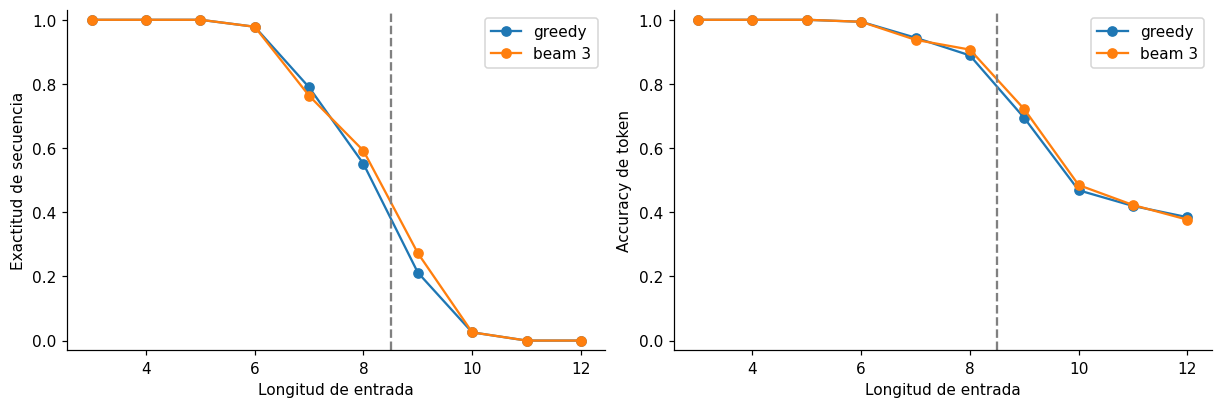
Greedy obtiene exactitud 0.876 en longitudes conocidas y 0.067 en longitudes nuevas. Aprender ejemplos de 3 a 8 símbolos no garantiza aprender un algoritmo que extrapole a cualquier longitud.
La tabla compara beam y greedy sin convertir prueba en selección. Si beam mejora, verifica qué errores corrige y cuánto cómputo añade; si no mejora, conservar varias hipótesis no aportó una ganancia bajo esta puntuación. La búsqueda no recupera información que el encoder perdió ni convierte un modelo incorrecto en uno correcto.
En longitud conocida, beam alcanza 0.880 frente a 0.876 de greedy; la diferencia observada es +0.4 puntos porcentuales. En longitud nueva, beam alcanza 0.083 frente a 0.067 de greedy; la diferencia observada es +1.7 puntos porcentuales. Estas diferencias describen esta ejecución y no seleccionan una nueva política sobre prueba.
Ambos métodos terminan con EOS en todas las consultas de los dos grupos. La caída de exactitud en longitudes nuevas no se explica por ausencia de terminación: hay que inspeccionar contenido y longitud generada. La mejora de beam equivale a una secuencia adicional correcta entre las 250 conocidas y dos entre las 120 largas. No habilitaría este modelo para longitudes 9–12 basándome en esa ganancia.
21.4.2 Errores por longitud y casos completos
Mostramos ejemplos fijados por posición y las primeras secuencias incorrectas, si existen. Los primeros permiten inspección sin selección favorable; las primeras fallas permiten diagnóstico dirigido. Las barras usan todos los ejemplos e informan el número disponible para cada longitud.
filas_l=[]
for grupo,seqs in [('longitud conocida',ste),('longitud nueva',slargas)]:
    for l in sorted(set(map(len,seqs))):
        posiciones=[i for i,s in enumerate(seqs) if len(s)==l]
        for metodo in ['greedy','beam 3']:
            met=metricas_simbolicas([seqs[i] for i in posiciones],[preds_seq[(grupo,metodo)][i] for i in posiciones])
            filas_l.append({'longitud':l,'n':len(posiciones),'método':metodo,'exactitud':met['exactitud secuencia'],'accuracy token':met['accuracy token']})
por_long=pd.DataFrame(filas_l);display(por_long)
fig,axs=plt.subplots(1,2,figsize=(11,3.6))
for metodo in ['greedy','beam 3']:
    t=por_long[por_long['método']==metodo];axs[0].plot(t.longitud,t.exactitud,'o-',label=metodo);axs[1].plot(t.longitud,t['accuracy token'],'o-',label=metodo)
for ax,y in zip(axs,['Exactitud de secuencia','Accuracy de token']):ax.axvline(8.5,color='gray',ls='--');ax.set(xlabel='Longitud de entrada',ylabel=y,ylim=(-.03,1.03));ax.legend()
plt.show()
ejemplos=[]
for grupo,seqs in [('longitud conocida',ste),('longitud nueva',slargas)]:
    p=preds_seq[(grupo,'greedy')];fallos=[i for i,s in enumerate(seqs) if p[i]!=list(reversed(s))+[EOS]]
    for i in list(dict.fromkeys([0,1]+fallos[:2])):ejemplos.append({'grupo':grupo,'entrada':texto(seqs[i]),'referencia':texto(list(reversed(seqs[i]))+[EOS]),'greedy':texto(p[i]),'correcta':p[i]==list(reversed(seqs[i]))+[EOS]})
display(pd.DataFrame(ejemplos))| longitud | n | método | exactitud | accuracy token | |
|---|---|---|---|---|---|
| 0 | 3 | 24 | greedy | 1.000000 | 1.000000 |
| 1 | 3 | 24 | beam 3 | 1.000000 | 1.000000 |
| 2 | 4 | 52 | greedy | 1.000000 | 1.000000 |
| 3 | 4 | 52 | beam 3 | 1.000000 | 1.000000 |
| 4 | 5 | 41 | greedy | 1.000000 | 1.000000 |
| 5 | 5 | 41 | beam 3 | 1.000000 | 1.000000 |
| 6 | 6 | 46 | greedy | 0.978261 | 0.993789 |
| 7 | 6 | 46 | beam 3 | 0.978261 | 0.993789 |
| 8 | 7 | 38 | greedy | 0.789474 | 0.944079 |
| 9 | 7 | 38 | beam 3 | 0.763158 | 0.937500 |
| 10 | 8 | 49 | greedy | 0.551020 | 0.888889 |
| 11 | 8 | 49 | beam 3 | 0.591837 | 0.907029 |
| 12 | 9 | 33 | greedy | 0.212121 | 0.693939 |
| 13 | 9 | 33 | beam 3 | 0.272727 | 0.721212 |
| 14 | 10 | 39 | greedy | 0.025641 | 0.468531 |
| 15 | 10 | 39 | beam 3 | 0.025641 | 0.484848 |
| 16 | 11 | 28 | greedy | 0.000000 | 0.419643 |
| 17 | 11 | 28 | beam 3 | 0.000000 | 0.422619 |
| 18 | 12 | 20 | greedy | 0.000000 | 0.384615 |
| 19 | 12 | 20 | beam 3 | 0.000000 | 0.376923 |
| grupo | entrada | referencia | greedy | correcta | |
|---|---|---|---|---|---|
| 0 | longitud conocida | 7 7 5 6 0 7 | 7 0 6 5 7 7 EOS | 7 0 6 5 7 7 EOS | True |
| 1 | longitud conocida | 5 1 0 7 3 | 3 7 0 1 5 EOS | 3 7 0 1 5 EOS | True |
| 2 | longitud conocida | 6 7 7 7 5 1 0 6 | 6 0 1 5 7 7 7 6 EOS | 6 0 1 5 7 7 6 7 EOS | False |
| 3 | longitud conocida | 3 6 4 4 1 2 5 6 | 6 5 2 1 4 4 6 3 EOS | 6 5 2 1 4 6 4 3 EOS | False |
| 4 | longitud nueva | 3 1 1 1 7 4 2 3 1 4 3 6 | 6 3 4 1 3 2 4 7 1 1 1 3 EOS | 6 3 1 4 3 7 1 1 1 3 EOS | False |
| 5 | longitud nueva | 7 0 3 2 5 5 1 3 4 | 4 3 1 5 5 2 3 0 7 EOS | 4 3 1 5 5 2 3 0 7 EOS | True |
| 6 | longitud nueva | 0 1 4 2 4 1 5 1 5 6 | 6 5 1 5 1 4 2 4 1 0 EOS | 6 5 5 1 4 1 2 4 0 1 EOS | False |
21.4.3 Decidir a partir del tipo de error
Una caída al crecer la longitud sugiere una dificultad de extrapolación o representación, pero no identifica su causa por sí sola. Un EOS temprano recorta la respuesta; un EOS ausente produce una secuencia truncada por el límite. Los símbolos equivocados con longitud correcta apuntan a una dificultad diferente.
Para esta tarea real usaríamos la inversión exacta de una lista: es determinista y no necesita entrenamiento. El laboratorio enseña cómo auditar un decoder para tareas donde esa solución exacta no está disponible.
21.5 Laboratorio 2: pronóstico numérico de varios pasos
Ahora cada entrada contiene 24 observaciones y la salida ocho valores futuros. Generamos 900 trayectorias independientes con amplitud, fase, nivel y tendencia diferentes, periodo 12 y ruido con desviación 0.05. Separamos por trayectoria: no hay ventanas de una misma serie repartidas entre entrenamiento y prueba.
El encoder recibe tensores (N,24,1). El decoder comienza con el último valor observado y produce (N,8,1). En entrenamiento recibe el valor futuro verdadero anterior; en inferencia recibe su propia predicción. Evaluamos todo el horizonte desde un origen fijo, sin actualizar con observaciones futuras. Esto es distinto de evaluar un paso y después incorporar el valor real recién observado.
La media y desviación se calculan únicamente sobre entradas de entrenamiento. Esa misma escala transforma objetivos y se invierte al calcular métricas en unidades originales. La partición permite estudiar nuevas trayectorias del mismo generador; para una serie histórica única, la validación debe respetar fechas, solapamientos y la información disponible en cada origen.
rng=np.random.default_rng(84);n=900;t=np.arange(32)
amplitud=rng.uniform(.5,1.5,(n,1));fase=rng.uniform(0,2*np.pi,(n,1));nivel=rng.normal(0,.2,(n,1));pendiente=rng.uniform(-.03,.03,(n,1))
series=nivel+pendiente*t+amplitud*np.sin(2*np.pi*t/12+fase)+rng.normal(0,.05,(n,32))
it=np.arange(600);iv=np.arange(600,750);ie=np.arange(750,900)
xs=series[:,:24];ys=series[:,24:];mu=xs[it].mean();sd=xs[it].std()
TX=torch.tensor(((xs-mu)/sd)[...,None],dtype=torch.float32);TY=torch.tensor(((ys-mu)/sd)[...,None],dtype=torch.float32)
assert not set(it)&set(iv) and not set(it)&set(ie)
fig,axs=plt.subplots(2,2,figsize=(11,6))
for ax,i in zip(axs.flat,range(4)):
    ax.plot(range(24),xs[i],color=COLORES[0],label='Observado');ax.plot(range(24,32),ys[i],color=COLORES[1],label='Futuro objetivo');ax.axvline(23.5,color='gray',ls='--');ax.set(xlabel='Tiempo',ylabel='Valor',title=f'Trayectoria {i}')
axs[0,0].legend();plt.show()
print('Entradas:',tuple(TX.shape),'objetivos:',tuple(TY.shape),'; media entrenamiento:',round(mu,4),'; desviación:',round(sd,4))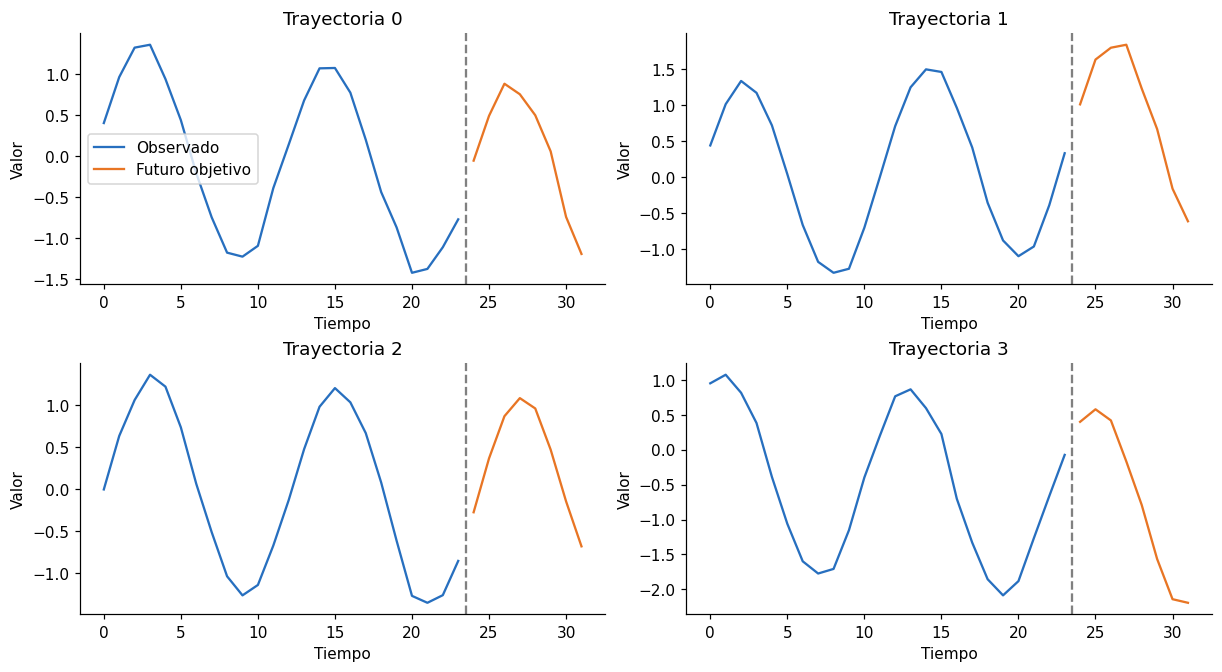
Entradas: (900, 24, 1) objetivos: (900, 8, 1) ; media entrenamiento: 0.0051 ; desviación: 0.805921.5.1 Modelo continuo y baselines declarados
Usamos GRU de 32 unidades tanto en encoder como en decoder y una salida lineal de un valor. Entrenamos 60 épocas con Adam 0.003, batch 64 y clipping de norma 1. El checkpoint se selecciona por RMSE de validación en generación autónoma, ya convertido a unidades originales.
Comparamos con persistencia, que repite el último valor observado, y con un baseline estacional que usa los ocho valores de hace 12 pasos. El periodo se conoce por construcción, por lo que el baseline dispone de información favorable. En datos reales se tendría que justificar su elección usando dominio o entrenamiento. Ningún baseline accede a los ocho objetivos futuros.
class SeqContinuo(nn.Module):
    def __init__(self):
        super().__init__();self.encoder=nn.GRU(1,32,batch_first=True);self.decoder=nn.GRU(1,32,batch_first=True);self.salida=nn.Linear(32,1)
    def forward(self,x,y=None,horizonte=8):
        _,h=self.encoder(x);prev=x[:,-1:];salidas=[]
        for k in range(horizonte):
            out,h=self.decoder(prev,h);p=self.salida(out);salidas.append(p)
            prev=y[:,k:k+1] if y is not None else p
        return torch.cat(salidas,dim=1)
def predecir_serie(red,idx):
    red.eval()
    with torch.no_grad():return red(TX[idx]).squeeze(-1).numpy()*sd+mu
torch.manual_seed(13);red=SeqContinuo();opt=torch.optim.Adam(red.parameters(),lr=.003)
loader=DataLoader(TensorDataset(TX[it],TY[it]),batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(13))
hist=[];mejor=np.inf
for ep in range(1,61):
    red.train();suma=0.;cuenta=0
    for xb,yb in loader:
        opt.zero_grad();loss=nn.functional.mse_loss(red(xb,yb),yb);loss.backward();nn.utils.clip_grad_norm_(red.parameters(),1.);opt.step();suma+=float(loss.detach())*len(xb);cuenta+=len(xb)
    rv=rmse(ys[iv].ravel(),predecir_serie(red,iv).ravel());hist.append((ep,np.sqrt(suma/cuenta)*sd,rv))
    if rv<mejor:mejor=rv;estado=copy.deepcopy(red.state_dict());ep_mejor=ep
red.load_state_dict(estado);hist=np.array(hist)
fig,ax=plt.subplots(figsize=(8,3.5));ax.plot(hist[:,0],hist[:,1],label='Entrenamiento con respuestas previas');ax.plot(hist[:,0],hist[:,2],label='Validación autónoma');ax.axvline(ep_mejor,color='gray',ls='--',label=f'Checkpoint {ep_mejor}');ax.set(xlabel='Época',ylabel='RMSE en unidades originales',title='La validación reproduce el uso autónomo');ax.legend();plt.show()
lecturas['serie_ep']=str(ep_mejor);lecturas['serie_val']=f'{mejor:.3f}'
print('Checkpoint:',ep_mejor,'; RMSE validación autónoma:',round(mejor,4))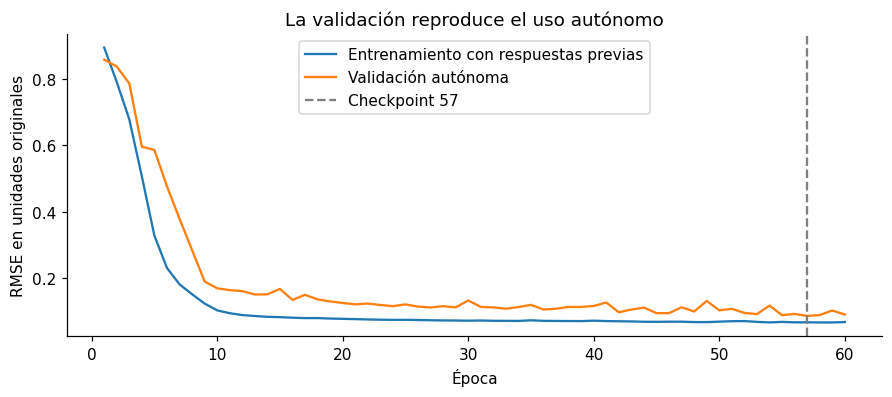
Checkpoint: 57 ; RMSE validación autónoma: 0.087121.5.2 Cómo leer este resultado
Se eligió la época 57, con RMSE autónomo de validación 0.087. La curva de entrenamiento usa respuestas previas verdaderas y la de validación usa predicciones previas: su diferencia mezcla régimen de información y conjunto de datos. No debe interpretarse automáticamente como una medida pura de sobreajuste.
El checkpoint se restaura antes de evaluar prueba. Fijamos todos los baselines, el horizonte y las métricas; las siguientes cifras se usan para analizar el sistema seleccionado.
21.6 Prueba por horizonte: no ocultar el deterioro con una media
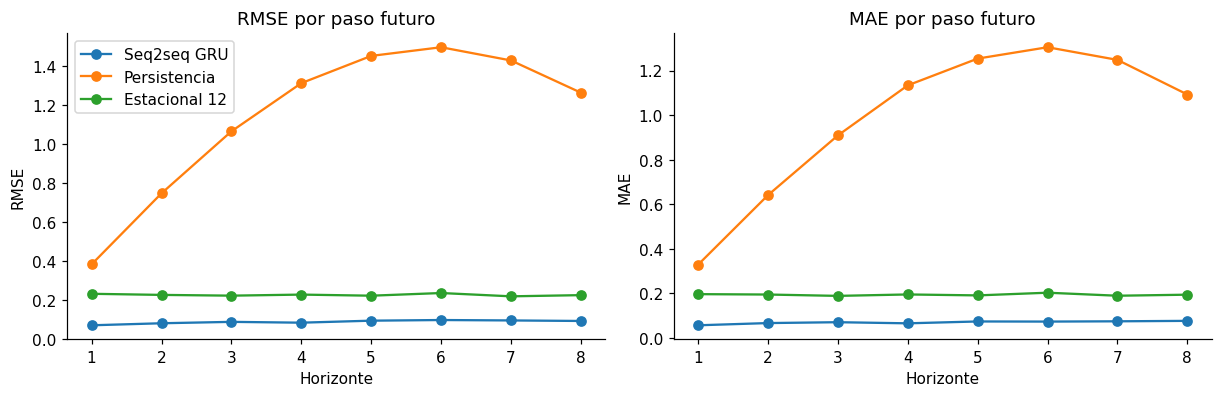
El RMSE global pondera todos los pares trayectoria-horizonte por igual. La MAE ofrece una lectura en unidades originales menos sensible a errores grandes. Desagregar por horizonte permite detectar si el sistema funciona al principio y falla después. Los ocho errores de una trayectoria están relacionados; no son ocho réplicas independientes para estimar incertidumbre.
pred_serie={'Seq2seq GRU':predecir_serie(red,ie),'Persistencia':np.repeat(xs[ie,-1:],8,axis=1),'Estacional 12':xs[ie,12:20]}
res_serie=[];por_h=[]
for nombre,p in pred_serie.items():
    for met,v in [('RMSE',rmse(ys[ie].ravel(),p.ravel())),('MAE',float(mean_absolute_error(ys[ie].ravel(),p.ravel())))]:res_serie.append({'caso':'series','grupo':'prueba','modelo':nombre,'métrica':met,'valor':v})
    for k in range(8):por_h.append({'modelo':nombre,'horizonte':k+1,'RMSE':rmse(ys[ie,k],p[:,k]),'MAE':float(mean_absolute_error(ys[ie,k],p[:,k]))})
tabla_serie=pd.DataFrame(res_serie);display(tabla_serie.pivot_table(index='modelo',columns='métrica',values='valor'));display(pd.DataFrame(por_h))
fig,axs=plt.subplots(1,2,figsize=(11,3.5))
for nombre in pred_serie:
    f=pd.DataFrame(por_h);f=f[f.modelo==nombre]
    for ax,met in zip(axs,['RMSE','MAE']):ax.plot(f.horizonte,f[met],'o-',label=nombre);ax.set(xlabel='Horizonte',ylabel=met,title=f'{met} por paso futuro')
axs[0].legend();plt.show()
lecturas['serie_test']=f'{rmse(ys[ie].ravel(),pred_serie["Seq2seq GRU"].ravel()):.3f}';lecturas['serie_baseline']=f'{rmse(ys[ie].ravel(),pred_serie["Estacional 12"].ravel()):.3f}'| métrica | MAE | RMSE |
|---|---|---|
| modelo | ||
| Estacional 12 | 0.194112 | 0.226234 |
| Persistencia | 0.988787 | 1.200882 |
| Seq2seq GRU | 0.069833 | 0.088121 |
| modelo | horizonte | RMSE | MAE | |
|---|---|---|---|---|
| 0 | Seq2seq GRU | 1 | 0.070327 | 0.056806 |
| 1 | Seq2seq GRU | 2 | 0.080755 | 0.066777 |
| 2 | Seq2seq GRU | 3 | 0.087900 | 0.070656 |
| 3 | Seq2seq GRU | 4 | 0.083714 | 0.065625 |
| 4 | Seq2seq GRU | 5 | 0.093994 | 0.073985 |
| 5 | Seq2seq GRU | 6 | 0.097328 | 0.073439 |
| 6 | Seq2seq GRU | 7 | 0.095193 | 0.074684 |
| 7 | Seq2seq GRU | 8 | 0.092478 | 0.076692 |
| 8 | Persistencia | 1 | 0.382838 | 0.328812 |
| 9 | Persistencia | 2 | 0.747010 | 0.640854 |
| 10 | Persistencia | 3 | 1.064769 | 0.908876 |
| 11 | Persistencia | 4 | 1.311732 | 1.133510 |
| 12 | Persistencia | 5 | 1.451389 | 1.253589 |
| 13 | Persistencia | 6 | 1.495823 | 1.304504 |
| 14 | Persistencia | 7 | 1.428005 | 1.247734 |
| 15 | Persistencia | 8 | 1.262840 | 1.092414 |
| 16 | Estacional 12 | 1 | 0.231781 | 0.196552 |
| 17 | Estacional 12 | 2 | 0.226143 | 0.194823 |
| 18 | Estacional 12 | 3 | 0.222267 | 0.188769 |
| 19 | Estacional 12 | 4 | 0.227703 | 0.195180 |
| 20 | Estacional 12 | 5 | 0.222059 | 0.190955 |
| 21 | Estacional 12 | 6 | 0.235738 | 0.203000 |
| 22 | Estacional 12 | 7 | 0.218795 | 0.189458 |
| 23 | Estacional 12 | 8 | 0.224913 | 0.194156 |
21.6.1 Cómo leer este resultado
La GRU obtiene RMSE de prueba 0.088; el baseline estacional obtiene 0.226. La tabla decide si la red aportó una mejora sobre la información estacional conocida. Si no la aporta, la complejidad adicional no se justifica con este experimento.
Una curva creciente indica deterioro con el horizonte, pero una curva irregular puede responder a fase, periodicidad y tendencia. Para distinguir propagación de errores de dificultad intrínseca habría que diseñar controles adicionales. La exactitud simbólica y el RMSE continuo no son magnitudes comparables.
El menor RMSE global de las tres alternativas corresponde a Seq2seq GRU (0.088). La decisión debe considerar también la tabla por horizonte y la sencillez del baseline, además del promedio global.
El generador permite explicar el error del baseline estacional: entre un valor y el de hace 12 pasos, el seno se repite pero la tendencia cambia en \(12b\). Como \(b\) es uniforme entre −0.03 y 0.03 y los dos ruidos son independientes, su MSE esperado es \(12^2\operatorname{Var}(b)+2(0.05)^2=0.0482\), equivalente a RMSE aproximado 0.220. El 0.226 observado es coherente con ese mecanismo. La red puede utilizar el pasado para estimar tendencia y fase; el resultado muestra utilidad en este generador, sin demostrar que extrapole a otros periodos o regímenes.
21.6.2 Ejemplos visuales y estructura de los errores
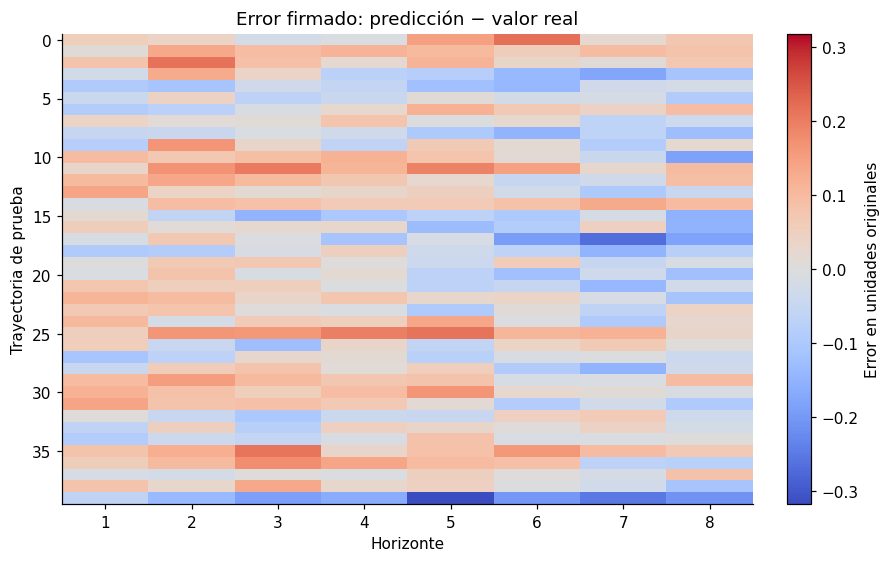
Tomamos las cuatro primeras trayectorias de prueba. Dibujamos todo el pasado disponible, el futuro real y las tres alternativas. El mapa de errores muestra las primeras 40 trayectorias y ocho horizontes con una escala común centrada en cero; permite observar fallas persistentes sin sustituir las métricas del conjunto completo.
fig,axs=plt.subplots(2,2,figsize=(12,7))
for j,ax in enumerate(axs.flat):
    ax.plot(range(24),xs[ie[j]],color='gray',label='Pasado observado');ax.plot(range(24,32),ys[ie[j]],'k-o',label='Futuro real',ms=3)
    for nombre,p in pred_serie.items():ax.plot(range(24,32),p[j],'--',label=nombre)
    ax.axvline(23.5,color='gray',ls=':');ax.set(xlabel='Tiempo',ylabel='Valor',title=f'Prueba: trayectoria {ie[j]}')
axs[0,0].legend(fontsize=8);plt.show()
errores=pred_serie['Seq2seq GRU']-ys[ie];lim=float(np.max(np.abs(errores[:40])))
fig,ax=plt.subplots(figsize=(8,5));im=ax.imshow(errores[:40],aspect='auto',cmap='coolwarm',vmin=-lim,vmax=lim);ax.set(xticks=range(8),xticklabels=range(1,9),xlabel='Horizonte',ylabel='Trayectoria de prueba',title='Error firmado: predicción − valor real');fig.colorbar(im,ax=ax,label='Error en unidades originales');plt.show()
resultados=pd.concat([tabla_seq,tabla_serie],ignore_index=True);resultados.to_csv('resultados.csv',index=False)
por_long.to_csv('errores-longitud.csv',index=False);pd.DataFrame(por_h).to_csv('errores-horizonte.csv',index=False)
protocolo={'simbolos':{'semilla':42,'train':len(str_),'validacion':len(sva),'prueba':len(ste),'prueba_larga':len(slargas),'configuracion':nombre_sel,'seleccion':'exactitud autónoma de validación, desempate CE','max_salida':MAX_SALIDA,'beam_ancho':3,'beam_alpha':.6,'duplicados_entre_particiones':False},'series':{'semilla':84,'train':it.tolist(),'validacion':iv.tolist(),'prueba':ie.tolist(),'entrada':24,'horizonte':8,'escala_media':float(mu),'escala_sd':float(sd),'checkpoint':ep_mejor,'seleccion':'RMSE autónomo de validación','periodo_conocido':12},'versiones':{'numpy':np.__version__,'torch':torch.__version__}}
Path('protocolo.json').write_text(json.dumps(protocolo,ensure_ascii=False,indent=2),encoding='utf-8')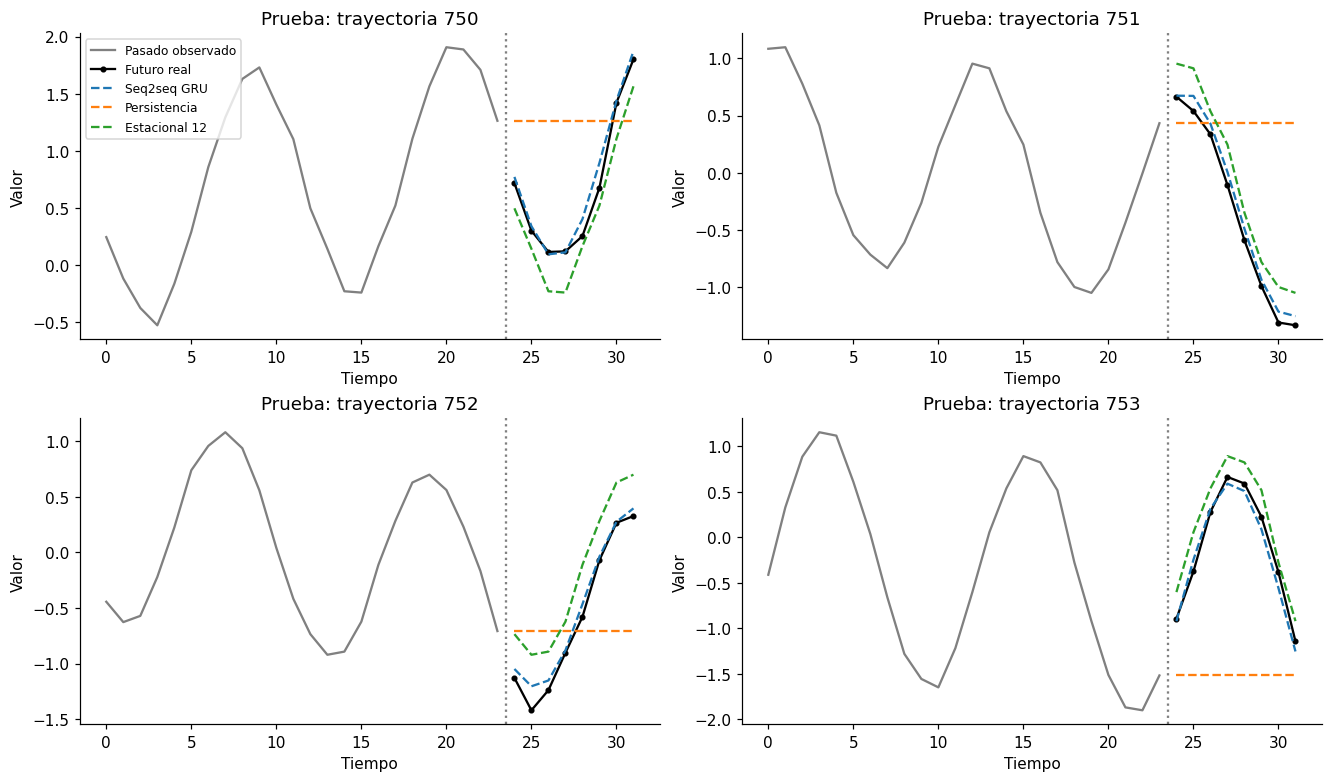
1052221.6.3 Alineación y objetivos: errores que cambian el problema
Para una entrada de tres símbolos [a,b,c], el decoder recibe [BOS,c,b,a] y aprende [c,b,a,EOS]. Los dos arreglos tienen cuatro posiciones y están desplazados un paso. Si alimentáramos [c,b,a,EOS] para predecir ese mismo arreglo, permitiríamos copiar la respuesta actual y evaluaríamos otro problema.
La distribución de logits tiene forma (N,U,V). Entropía cruzada espera logits sin aplicar softmax previamente; al aplanar usamos (N×U,V) y objetivos enteros (N×U). ignore_index=PAD excluye relleno, pero mantiene EOS porque aprender a terminar forma parte de la tarea. Una máscara de entrada y una máscara de pérdida cumplen funciones distintas.
En el pronóstico continuo no hay BOS, EOS ni vocabulario: el último valor observado inicia el decoder y el horizonte fija ocho salidas. La capa final es lineal y MSE compara números. Un horizonte variable requeriría una máscara de objetivos válidos u otro contrato de terminación; no se resuelve asignando un token textual a una observación real.
El decoder numérico propaga gradientes a través de sus estados. En entrenamiento con teacher forcing los valores de entrada proceden del objetivo anterior; en generación autónoma proceden del modelo. Cambiar entre ambas rutas modifica las entradas futuras del propio decoder, incluso cuando sus parámetros se mantienen.
21.7 Qué cambiar cuando la evaluación no alcanza
| Hallazgo | Comprobación necesaria | Decisión posible |
|---|---|---|
| CE baja y generación autónoma débil | Entradas del decoder en evaluación | Evaluar sin respuestas futuras y estudiar entrenamiento |
| Errores concentrados en longitudes nuevas | Distribución de longitudes y memoria | Ampliar validación y comparar atención |
| EOS temprano o ausente | Terminación, límite y objetivo EOS | Revisar datos, pérdida y reglas de decoding |
| Beam sin mejora | Ranking, longitud y costo | Conservar greedy si la complejidad no aporta valor |
| RMSE global aceptable y horizonte lejano pobre | Métricas por horizonte | Acortar horizonte o rediseñar objetivo |
| Baseline estacional competitivo | Periodicidad y tendencia | Justificar la red antes de añadir capacidad |
| Buen resultado con ventanas aleatorias | Solapamientos, series y fechas | Separar según el escenario de despliegue |
Teacher forcing no habilita usar respuestas futuras en prueba. Padding no debe aportar pérdida. Beam search no valida la generalización. Un modelo con contexto fijo no es automáticamente incapaz de procesar entradas largas, pero debe demostrarlo con una evaluación que incluya esas entradas.
La atención y los transformers conservan la distinción entre información disponible al entrenar y al generar. También requieren máscaras adecuadas para impedir acceso al futuro. El capítulo siguiente desarrolla esa transición; aquí queda establecido el protocolo que debe seguir cualquier arquitectura.
21.8 Actividades de análisis
- Cambia la tarea simbólica por copia o desplazamiento y registra dificultad por longitud. Define la regla y su baseline exacto antes de entrenar.
- Compara varias semillas con el mismo presupuesto para teacher forcing completo y mezcla. Informa dispersión y costo, sin escoger la semilla más favorable.
- Agrega un test de EOS ausente y otro de EOS prematuro. Verifica exactitud, accuracy de token y criterio de terminación.
- Introduce cambios de periodo en nuevas trayectorias. Conserva entrenamiento y analiza si la GRU y el baseline responden de manera distinta.
- Compara un decoder autoregresivo con una salida directa de ocho valores. Usa las mismas particiones y reporta métricas por horizonte.
- Para una serie histórica, dibuja fechas de ajuste, validación y prueba y determina qué observaciones conoce cada origen del pronóstico.
21.9 Contrato común y persistencia
En secuencia a secuencia se distingue el entrenamiento con objetivos disponibles de la generación autorregresiva. Padding, inicio, fin y máscara son parte del contrato; la evaluación debe reflejar la información disponible al generar. Se conserva el ejemplo introductorio, sin ampliar el libro hacia NLP especializado.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Path
import json,hashlib,copy,shutil,platform
import torch
artefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)
modulos_cierre=[];vistos_cierre=set()
for nombre_cierre,objeto_cierre in list(globals().items()):
    if isinstance(objeto_cierre,torch.nn.Module) and id(objeto_cierre) not in vistos_cierre:
        vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}
        assert all(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre
        ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre)
        copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])
        assert all(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items())
        modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})
for nombre_cierre,objeto_cierre in list(globals().items()):
    if isinstance(objeto_cierre,pd.DataFrame) and len(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)
for ruta_cierre in list(Path('.').iterdir()):
    if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)
registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}
(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')
print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 3 | archivos registrados: 1321.9.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
En símbolos de longitud conocida, greedy obtuvo exactitud de secuencia 0,876 y beam de ancho 3 obtuvo 0,880. En longitudes nuevas las cifras cayeron a 0,0667 y 0,0833, aunque todas las salidas terminaron en EOS: terminar no equivale a resolver. La mejora de beam no corrigió la falta de extrapolación. En series, RMSE de la GRU fue 0,0881 frente a 1,2009 de persistencia y 0,2262 de referencia estacional. Son tareas sintéticas con relaciones favorables al diseño y no una garantía en lenguaje o series reales. Se conservaron máscaras, generación autorregresiva y análisis por horizonte.
La armonización verificó identidad de parámetros y buffers tras recarga de 3 módulos presentes al cierre; archivó 13 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.
21.10 Referencias y archivos
- Sequence to Sequence Learning with Neural Networks, Sutskever, Vinyals y Le (2014): formulación clásica de encoder y decoder recurrentes.
- Tutorial de seq2seq, documentación oficial de PyTorch; utiliza traducción para ilustrar componentes compartidos.
- Packing de secuencias y entropía cruzada, documentación oficial de PyTorch.
- Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks, Bengio et al. (2015): propuesta de variar la exposición a predicciones durante entrenamiento.
- Resultados, errores por longitud, errores por horizonte y protocolo.