20  LSTM y GRU

Serie Deep Learning · del perceptrón a los transformers.

Las puertas introducen caminos aditivos para el estado. Contrastaremos recordar el primer bit, leer el último y pronosticar una serie. Se informa lo que ocurra con el presupuesto prefijado, incluso si ninguna arquitectura aprende la tarea de memoria.

20.1 1. Entorno y reproducibilidad

Se requieren PyTorch, NumPy, pandas, Matplotlib y scikit-learn. La ejecución registrada usa CPU. Se conservan los experimentos y presupuestos docentes; los cambios necesarios de escala y protocolo se declaran, sin atribuir sus efectos sólo al framework.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

20.1.1 Contrato recurrente

La forma es (N,L,F) con batch_first=True; los estados siguen (capas,N,H). Cada ventana comienza con estado cero y no hereda información de otras muestras. En LSTM se distinguen estado oculto y celda. La salida final es lineal para regresión o un logit para BCE estable; sigmoid sólo interviene en inferencia binaria.

Inicializamos matrices de entrada con Xavier y cada bloque recurrente ortogonalmente; en LSTM fijamos el sesgo efectivo de olvido en +1, sin duplicarlo entre los dos sesgos de PyTorch. El conteo de parámetros incluye ambos. La variante GRU de PyTorch aplica la puerta reset en una posición algebraica distinta de algunas implementaciones: no se promete equivalencia de pesos o resultados con otra biblioteca.

Adam usa tasa 0,001. Guardamos y restauramos el mínimo de pérdida de validación, calculando train/val en eval al cierre de cada época. La prueba queda fuera del ajuste. Los artefactos se recargan y contrastan sobre validación. Son archivos de inferencia, no una sesión completa de optimización reanudable. Una semilla y un presupuesto corto no permiten declarar superioridad universal.

Código
class Secuencia(nn.Module):
    def __init__(self,tipo='RNN',entrada=1,ocultas=16,vocabulario=None):
        super().__init__();self.tipo=tipo
        self.embedding=nn.Embedding(vocabulario,32) if vocabulario is not None else None
        self.recurrente={'RNN':nn.RNN,'LSTM':nn.LSTM,'GRU':nn.GRU}[tipo](32 if self.embedding is not None else entrada,ocultas,batch_first=True)
        self.salida=nn.Linear(ocultas,1)
        # Inicialización explícita: Xavier de entrada; ortogonal por puerta recurrente.
        puertas={'RNN':1,'LSTM':4,'GRU':3}[tipo]
        for nombre,p in self.recurrente.named_parameters():
            if 'weight_ih' in nombre: nn.init.xavier_uniform_(p)
            elif 'weight_hh' in nombre:
                for bloque in p.chunk(puertas,0): nn.init.orthogonal_(bloque)
            else: nn.init.zeros_(p)
        # Orden LSTM i,f,g,o. Sólo un sesgo de olvido recibe +1; no sumarlo dos veces.
        if tipo=='LSTM':
            with torch.no_grad(): self.recurrente.bias_ih_l0[ocultas:2*ocultas].fill_(1)
        nn.init.xavier_uniform_(self.salida.weight);nn.init.zeros_(self.salida.bias)
        if self.embedding is not None: nn.init.uniform_(self.embedding.weight,-.05,.05)
    def forward(self,x):
        if self.embedding is not None: x=self.embedding(x.long())
        _,estado=self.recurrente(x)
        h=estado[0] if self.tipo=='LSTM' else estado
        return self.salida(h[-1]).squeeze(-1)

def datos(x,y,tokens=False):
    return TensorDataset(torch.as_tensor(x,dtype=torch.long if tokens else torch.float32),torch.as_tensor(y,dtype=torch.float32))

@torch.inference_mode()
def medir(m,ds,tipo='regresion'):
    m.eval();zs=[];ys=[];suma=0.
    for x,y in cargador(ds,64):
        x=x.to(DEVICE);y=y.to(DEVICE);z=m(x)
        loss=F.mse_loss(z,y,reduction='sum') if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y,reduction='sum')
        suma+=loss.item();zs.append(z.cpu().numpy());ys.append(y.cpu().numpy())
    z=np.concatenate(zs);y=np.concatenate(ys);assert np.isfinite(z).all()
    r={'loss':suma/len(ds),'z':z,'y':y}
    if tipo!='regresion':
        p=torch.from_numpy(z).sigmoid().numpy();r.update(p=p,acc=float(((p>=.5)==y).mean()))
    return r

def ajustar(m,tr,va,nombre,epocas,lote=32,tipo='regresion',lr=.001,clip=None):
    m=m.to(DEVICE);opt=torch.optim.Adam(m.parameters(),lr=lr);dl=cargador(tr,lote,True)
    h=[];mejor=float('inf');inicio=time.perf_counter()
    for ep in range(1,epocas+1):
        m.train();normas=[];recortados=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE);opt.zero_grad(set_to_none=True);z=m(x)
            loss=F.mse_loss(z,y) if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y)
            if not torch.isfinite(loss): raise FloatingPointError(nombre+' pérdida no finita')
            loss.backward()
            if clip is not None:
                norma=float(nn.utils.clip_grad_norm_(m.parameters(),clip));normas.append(norma);recortados+=norma>clip
            opt.step()
        a=medir(m,tr,tipo);b=medir(m,va,tipo)
        fila={'epoca':ep,'loss_train':a['loss'],'loss_val':b['loss']}
        if tipo!='regresion':fila.update(acc_train=a['acc'],acc_val=b['acc'])
        if clip is not None:fila.update(norma_media=float(np.mean(normas)),fraccion_clipping=recortados/len(dl))
        h.append(fila)
        if b['loss']<mejor:mejor=b['loss'];pesos=copy.deepcopy(m.state_dict());mejor_ep=ep
        print(nombre,ep,'val',round(b['loss'],5),flush=True)
    m.load_state_dict(pesos);m.eval();h=pd.DataFrame(h);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    r={'modelo':nombre,'mejor_epoca':mejor_ep,'min_val_loss':mejor,'parametros':parametros(m),'epocas':epocas,'segundos':time.perf_counter()-inicio}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(r,indent=2),encoding='utf-8')
    return m,h,r

def graficar(h,r,titulo,binario=False):
    fig,axes=plt.subplots(1,2 if binario else 1,figsize=(11,3.5) if binario else (7,3.5));axes=np.atleast_1d(axes)
    axes[0].plot(h.epoca,h.loss_train,label='Train (eval)');axes[0].plot(h.epoca,h.loss_val,label='Val')
    axes[0].axvline(r['mejor_epoca'],ls='--',color='.4');axes[0].set(xlabel='Época',ylabel='BCE' if binario else 'MSE');axes[0].legend()
    if binario:
        axes[1].plot(h.epoca,h.acc_train,label='Train (eval)');axes[1].plot(h.epoca,h.acc_val,label='Val');axes[1].set(xlabel='Época',ylabel='Exactitud');axes[1].legend()
    fig.suptitle(titulo);fig.tight_layout();plt.show()
    display(Markdown(f"**Checkpoint:** época {r['mejor_epoca']} de {len(h)}, mínimo de validación {r['min_val_loss']:.5f}. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización."))

def salvar(m,fabrica,nombre,contrato,ds):
    p=ARTEFACTOS/f'{nombre}.pt';torch.save({'state_dict':{k:v.detach().cpu().clone() for k,v in m.state_dict().items()},'contrato':contrato},p)
    nuevo=fabrica().to(DEVICE);nuevo.load_state_dict(torch.load(p,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval();m.eval()
    x=ds.tensors[0][:32].to(DEVICE)
    with torch.inference_mode():torch.testing.assert_close(m(x),nuevo(x),rtol=1e-5,atol=1e-6)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(dict(contrato,sha256=hashlib.sha256(p.read_bytes()).hexdigest()),indent=2),encoding='utf-8')
    print('Recarga comprobada:',nombre)

def ventana(serie,L):
    indices=np.arange(L,len(serie));x=np.array([serie[i-L:i] for i in indices],dtype=np.float32)[...,None]
    return x,np.asarray(serie[L:],dtype=np.float32),indices

def resumen_regresion(real,pred,base,nombre):
    filas=[]
    for etiqueta,p in [(nombre,pred),('Persistencia',base)]:
        filas.append({'modelo':etiqueta,'rmse':float(np.sqrt(np.mean((real-p)**2))),'mae':float(np.mean(np.abs(real-p))),'sesgo_real_menos_pred':float(np.mean(real-p))})
    t=pd.DataFrame(filas);display(t)
    display(Markdown(f"**Comparación observada:** RMSE de {nombre} {t.iloc[0].rmse:.4f}, persistencia {t.iloc[1].rmse:.4f}. Diferencia persistencia−red = {t.iloc[1].rmse-t.iloc[0].rmse:+.4f}. El signo describe este ensayo; no establece que una red recurrente sea necesaria para esta serie."))
    return t

20.1.2 Separar conservar, escribir y mostrar

Una RNN simple reemplaza su estado mediante una transformación no lineal en cada paso. LSTM introduce dos estados: la celda \(c_t\), que transporta memoria, y la salida oculta \(h_t\), que expone parte de ella al siguiente cálculo. Las puertas son valores aprendidos entre cero y uno, no interruptores externos ni probabilidades de que una lectura sea correcta.

Para entradas \(x_t\in\mathbb R^D\) y estado de tamaño \(H\), cada puerta combina entrada y estado anterior. Las matrices de entrada tienen forma \(H\times D\) y las recurrentes \(H\times H\). Escribir cuatro puertas no significa dividir el estado en cuatro memorias independientes: todas actúan sobre coordenadas de una misma celda.

\[i_t=\sigma(W_{ii}x_t+b_{ii}+W_{hi}h_{t-1}+b_{hi}),\] \[f_t=\sigma(W_{if}x_t+b_{if}+W_{hf}h_{t-1}+b_{hf}),\] \[g_t=\tanh(W_{ig}x_t+b_{ig}+W_{hg}h_{t-1}+b_{hg}),\] \[o_t=\sigma(W_{io}x_t+b_{io}+W_{ho}h_{t-1}+b_{ho}),\] \[c_t=f_t\odot c_{t-1}+i_t\odot g_t,\qquad h_t=o_t\odot\tanh(c_t).\]

La puerta de olvido conserva parte de la celda anterior; entrada y candidato escriben información; salida decide cuánto se expone después de tanh. El término aditivo permite transportar información sin recalcular toda su representación desde cero. No garantiza que las puertas aprendan la política de memoria que deseamos.

20.2 2. Qué cambia en la memoria

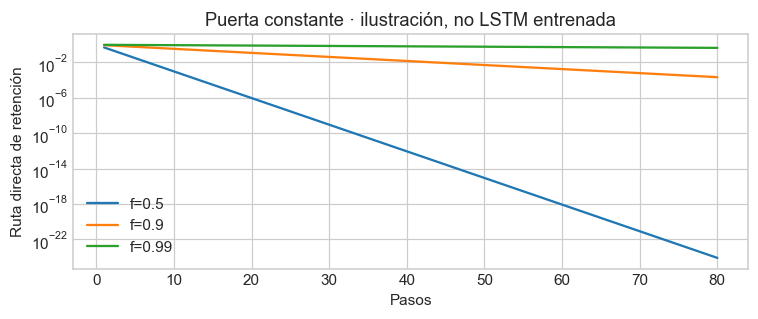
En LSTM, \(c_t=f_t\odot c_{t-1}+i_t\odot g_t\) y \(h_t=o_t\odot\tanh(c_t)\). Cuando la puerta de olvido conserva y la de entrada no escribe, existe una ruta aditiva de copia. Su derivada parcial directa no describe todo el jacobiano: las puertas dependen también del estado. Esto ayuda a ciertos aprendizajes, pero no garantiza memoria perfecta.

GRU combina puertas reset y update con un único estado. Defina la convención de update antes de escribir la ecuación; algunas fuentes invierten qué término multiplica. PyTorch documenta su propia variante del candidato. Con dimensión oculta fija, más puertas significan más parámetros; no igualamos parámetros ni declaramos que el tiempo de ajuste sea latencia de inferencia.

# Una celda LSTM NumPy: efecto directo de retener el estado anterior.
previo=np.array([.7,-.4]);candidata=np.array([.1,.3]);valores=[]
for f in [0,.5,.99,1]: valores.append({'olvido_f':f,'celda_0':float((f*previo+.05*candidata)[0]),'derivada_directa':f})
display(pd.DataFrame(valores))
fig,ax=plt.subplots(figsize=(7,3))
for f in [.5,.9,.99]:ax.semilogy(np.arange(1,81),f**np.arange(1,81),label=f'f={f}')
ax.set(xlabel='Pasos',ylabel='Ruta directa de retención',title='Puerta constante · ilustración, no LSTM entrenada');ax.legend();fig.tight_layout();plt.show()
olvido_f celda_0 derivada_directa
0 0.00 0.005 0.00
1 0.50 0.355 0.50
2 0.99 0.698 0.99
3 1.00 0.705 1.00

20.2.1 Una cuenta de memoria con puertas fijadas

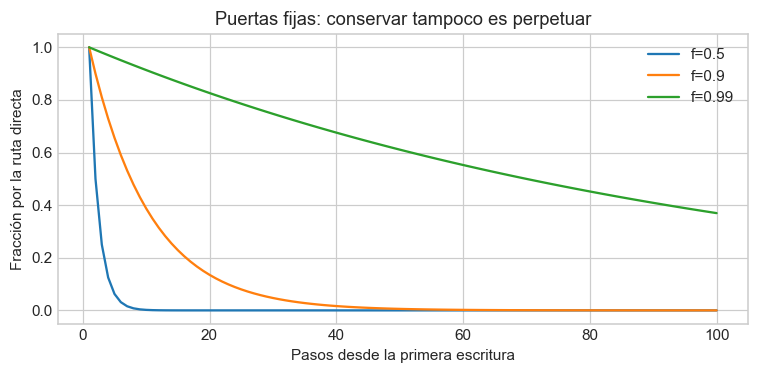
Tomemos \(c_0=0\), \(f=0,9\), \(i=0,1\), \(o=0,8\) y candidatos \([1,0,-1]\). En el primer paso \(c_1=0,1\); en el segundo \(c_2=0,09\); en el tercero \(c_3=0,081-0,1=-0,019\). La última entrada puede contrarrestar lo que se conservó. La salida \(h_t\) es menor en magnitud porque pasa por tanh y por la puerta de salida.

Si después del primer paso no se escribe nada, la ruta directa conserva \(f^{L-1}\) de esa primera escritura. Con f=0,9, cien pasos atenúan fuertemente la señal; con f=0,99 la atenúan menos. «Adición» no significa «memoria infinita». En una LSTM aprendida, las puertas también dependen de estados anteriores: esta cuenta congela esas dependencias para aislar una ruta, y no representa el jacobiano completo.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_lstm_memoria():
    c=0.;filas=[]
    for t,g in enumerate([1.,0.,-1.],1):
        previo=c;c=.9*c+.1*g;h=.8*np.tanh(c);filas.append([t,previo,.9*previo,.1*g,c,h])
    display(pd.DataFrame(filas,columns=['paso','c_anterior','conservado','escrito','c_nueva','h_visible']))
    assert np.isclose(c,-.019)
    longitud=np.arange(1,101);fig,ax=plt.subplots(figsize=(7,3.5))
    for f in [.5,.9,.99]:ax.plot(longitud,f**(longitud-1),label=f'f={f}')
    ax.set(xlabel='Pasos desde la primera escritura',ylabel='Fracción por la ruta directa',title='Puertas fijas: conservar tampoco es perpetuar');ax.legend();fig.tight_layout();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_lstm_memoria()
paso c_anterior conservado escrito c_nueva h_visible
0 1 0.00 0.000 0.1 0.100 0.079734
1 2 0.10 0.090 0.0 0.090 0.071806
2 3 0.09 0.081 -0.1 -0.019 -0.015198

20.2.2 GRU: una mezcla con una convención explícita

GRU conserva un solo estado. En la convención de PyTorch:

\[r_t=\sigma(W_{ir}x_t+b_{ir}+W_{hr}h_{t-1}+b_{hr}),\] \[z_t=\sigma(W_{iz}x_t+b_{iz}+W_{hz}h_{t-1}+b_{hz}),\] \[n_t=\tanh(W_{in}x_t+b_{in}+r_t\odot(W_{hn}h_{t-1}+b_{hn})),\] \[h_t=(1-z_t)\odot n_t+z_t\odot h_{t-1}.\]

Aquí z cerca de uno conserva el estado anterior; cerca de cero favorece el candidato. La puerta reset regula la contribución recurrente al candidato. No todas las fuentes colocan reset en el mismo lugar: aplicar una matriz después de multiplicar el estado no equivale en general a multiplicar después de la transformación. La cuenta siguiente reproduce exactamente la variante documentada y su orden de puertas r/z/n.

Con \(x=0,5\), \(h=0,2\), pesos de entrada \([0,4,-0,3,0,8]\) y recurrentes \([0,1,0,2,0,6]\), primero calculamos dos sigmoids, después el candidato y finalmente la mezcla. Los sesgos son cero. Solo hay una coordenada, para que cada resultado pueda seguirse a mano.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_gru_paso():
    x=torch.tensor([[.5]],dtype=torch.float64);h=torch.tensor([[.2]],dtype=torch.float64)
    celda=torch.nn.GRUCell(1,1).double()
    with torch.no_grad():
        celda.weight_ih.copy_(torch.tensor([[.4],[-.3],[.8]],dtype=torch.float64));celda.weight_hh.copy_(torch.tensor([[.1],[.2],[.6]],dtype=torch.float64));celda.bias_ih.zero_();celda.bias_hh.zero_()
    r=torch.sigmoid(.4*x+.1*h);z=torch.sigmoid(-.3*x+.2*h);n=torch.tanh(.8*x+r*(.6*h));manual=(1-z)*n+z*h
    torch.testing.assert_close(manual,celda(x,h),rtol=1e-12,atol=1e-12)
    display(pd.DataFrame({'reset_r':[r.item()],'update_z':[z.item()],'candidato_n':[n.item()],'h_nueva':[manual.item()]}))
    D,H=3,5
    conteos={'RNN':sum(p.numel() for p in torch.nn.RNNCell(D,H).parameters()),'GRU':sum(p.numel() for p in torch.nn.GRUCell(D,H).parameters()),'LSTM':sum(p.numel() for p in torch.nn.LSTMCell(D,H).parameters())}
    for nombre,puertas in [('RNN',1),('GRU',3),('LSTM',4)]:assert conteos[nombre]==puertas*H*(D+H+2)
    print('Parámetros, incluidos dos sesgos por puerta:',conteos)
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_gru_paso()
reset_r update_z candidato_n h_nueva
0 0.554779 0.472528 0.435427 0.324181
Parámetros, incluidos dos sesgos por puerta: {'RNN': 50, 'GRU': 150, 'LSTM': 200}

20.2.3 Leer las puertas sin asignarles una historia inventada

Una coordenada con f grande no significa necesariamente «recuerda el primer bit»: puede conservar información irrelevante. El significado funcional se comprueba con una tarea y una intervención. En los laboratorios siguientes, comparar etiqueta inicial y final separa dos demandas de memoria; comparar longitudes explora otra dificultad. Como sus presupuestos no son idénticos, no forman una ablación pura de longitud.

Un sesgo efectivo de olvido +1 produce inicialmente \(\sigma(1)\approx0,731\) solo cuando las demás contribuciones a esa puerta son cero. No fija f=0,731 durante todo el entrenamiento. PyTorch tiene dos sesgos por puerta; repartir +1 en ambos generaría +2 y otra inicialización.

Para igual H, LSTM y GRU almacenan más parámetros que una RNN simple. La fórmula comprobada es \(kH(D+H+2)\) con k=1/3/4 y dos sesgos; no incluye una cabeza de predicción ni varias capas. Igualar H no iguala capacidad, operaciones o tiempo. La elección requiere desempeño, variabilidad y coste bajo un presupuesto relevante.

Cómo resolver un fallo del primer bit: compruebe primero que el control del último bit aprende; contraste que objetivo, posición final y estado reiniciado sean los esperados; después estudie gradientes, saturación y presupuesto. Si GRU queda cerca de azar en esta ejecución, eso no demuestra incapacidad matemática de GRU. El diseño y las trazas permiten formular la siguiente prueba sin convertir un resultado local en una clasificación universal.

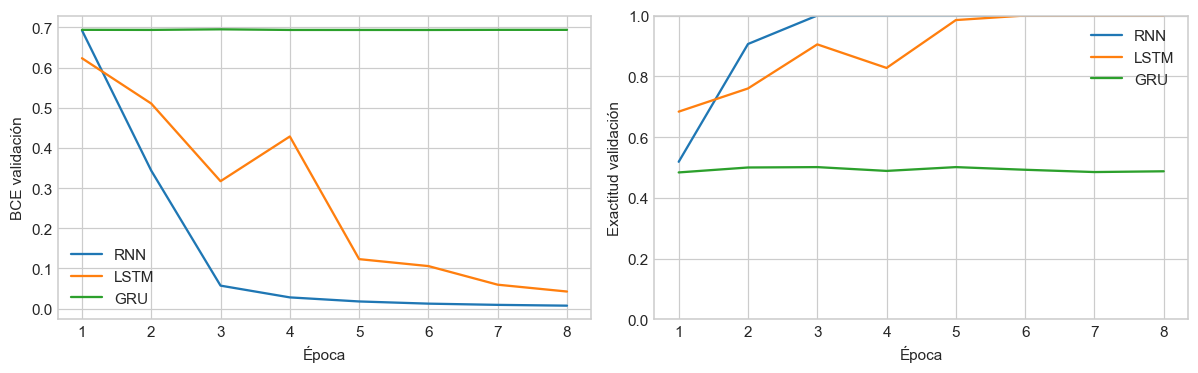
20.3 3. Recordar el primer bit, L=30

Conservamos 4 000/800/800 secuencias de entrenamiento/validación/prueba, semillas 0/1/2, dimensión oculta 16, ocho épocas y lote 64. La etiqueta es el primer bit. Copiarlo directamente sería una regla perfecta si se permite diseñarla: el objetivo docente es estudiar si la representación final aprende a retenerlo, no demostrar que haga falta una red para esta etiqueta.

Los tres modelos ven los mismos ejemplos y lotes, con semillas prefijadas. Las dimensiones de sus matrices son distintas: no se afirman pesos iniciales iguales. El mínimo de BCE de validación selecciona cada checkpoint; las etiquetas reservadas no eligen arquitecturas ni épocas.

def bits(n,L,seed,primero=True):
    x=np.random.default_rng(seed).integers(0,2,(n,L,1)).astype(np.float32);return x,x[:,0 if primero else -1,0].copy()
x,y=bits(4000,30,0);xv,yv=bits(800,30,1);xt,yt=bits(800,30,2)
tr,va,te=datos(x,y),datos(xv,yv),datos(xt,yt)
modelos={};historias={};resumenes={};resultados={};filas=[]
for tipo in ['RNN','LSTM','GRU']:
    semilla();m,h,r=ajustar(Secuencia(tipo),tr,va,'primer-L30-'+tipo,8,lote=64,tipo='binaria')
    modelos[tipo]=m;historias[tipo]=h;resumenes[tipo]=r
ganador=min(resumenes,key=lambda k:resumenes[k]['min_val_loss']);print('Elegido por BCE val:',ganador)
for tipo,m in modelos.items():
    rr=medir(m,te,'binaria');resultados[tipo]=rr;filas.append({**resumenes[tipo],'acc_test':rr['acc'],'bce_test':rr['loss']})
    print(tipo);print(classification_report(yt,(rr['p']>=.5).astype(int),labels=[0,1],target_names=['Bit 0','Bit 1'],digits=4,zero_division=0))
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'primer-L30.csv',index=False)
fig,axes=plt.subplots(1,2,figsize=(11,3.5))
for tipo,h in historias.items():axes[0].plot(h.epoca,h.loss_val,label=tipo);axes[1].plot(h.epoca,h.acc_val,label=tipo)
axes[0].set(xlabel='Época',ylabel='BCE validación');axes[1].set(xlabel='Época',ylabel='Exactitud validación',ylim=(0,1))
for ax in axes:ax.legend()
fig.tight_layout();plt.show()
primer-L30-RNN 1 val 0.69255
primer-L30-RNN 2 val 0.34331
primer-L30-RNN 3 val 0.05709
primer-L30-RNN 4 val 0.02782
primer-L30-RNN 5 val 0.0177
primer-L30-RNN 6 val 0.01225
primer-L30-RNN 7 val 0.00922
primer-L30-RNN 8 val 0.00724
primer-L30-LSTM 1 val 0.62312
primer-L30-LSTM 2 val 0.51031
primer-L30-LSTM 3 val 0.31703
primer-L30-LSTM 4 val 0.42834
primer-L30-LSTM 5 val 0.12304
primer-L30-LSTM 6 val 0.10575
primer-L30-LSTM 7 val 0.05941
primer-L30-LSTM 8 val 0.0424
primer-L30-GRU 1 val 0.69378
primer-L30-GRU 2 val 0.6936
primer-L30-GRU 3 val 0.69506
primer-L30-GRU 4 val 0.69353
primer-L30-GRU 5 val 0.69351
primer-L30-GRU 6 val 0.69347
primer-L30-GRU 7 val 0.69376
primer-L30-GRU 8 val 0.69374
Elegido por BCE val: RNN
RNN
              precision    recall  f1-score   support

       Bit 0     1.0000    1.0000    1.0000       365
       Bit 1     1.0000    1.0000    1.0000       435

    accuracy                         1.0000       800
   macro avg     1.0000    1.0000    1.0000       800
weighted avg     1.0000    1.0000    1.0000       800

LSTM
              precision    recall  f1-score   support

       Bit 0     1.0000    1.0000    1.0000       365
       Bit 1     1.0000    1.0000    1.0000       435

    accuracy                         1.0000       800
   macro avg     1.0000    1.0000    1.0000       800
weighted avg     1.0000    1.0000    1.0000       800

GRU
              precision    recall  f1-score   support

       Bit 0     0.4153    0.4164    0.4159       365
       Bit 1     0.5092    0.5080    0.5086       435

    accuracy                         0.4662       800
   macro avg     0.4623    0.4622    0.4622       800
weighted avg     0.4664    0.4662    0.4663       800
modelo mejor_epoca min_val_loss parametros epocas segundos acc_test bce_test
0 primer-L30-RNN 8 0.007238 321 8 3.388918 1.00000 0.007258
1 primer-L30-LSTM 8 0.042397 1233 8 4.075151 1.00000 0.043206
2 primer-L30-GRU 6 0.693470 929 8 6.190666 0.46625 0.694341

20.4 4. Control fácil: el último bit

Ahora la etiqueta aparece al final. Se conservan 3 000 secuencias de desarrollo, 15 % final para validar, 600 de prueba, cinco épocas y lote 64. Se comparan RNN y LSTM. Un éxito aquí junto a un fallo al recordar el inicio es compatible con una dificultad de dependencia temporal, pero no aísla por sí solo toda causa: optimización y representación también cambian el resultado.

x2,y2=bits(3000,30,3,False);t2,z2=bits(600,30,4,False);filas=[]
for tipo in ['RNN','LSTM']:
    semilla();m,h,r=ajustar(Secuencia(tipo),datos(x2[:2550],y2[:2550]),datos(x2[2550:],y2[2550:]),'ultimo-'+tipo,5,lote=64,tipo='binaria')
    rr=medir(m,datos(t2,z2),'binaria');filas.append({**r,'acc_test':rr['acc'],'bce_test':rr['loss']})
ultimo=pd.DataFrame(filas);display(ultimo);ultimo.to_csv(ARTEFACTOS/'ultimo-L30.csv',index=False)
print('Baseline de regla explícita: copiar el último bit, exactitud 1 por construcción')
ultimo-RNN 1 val 0.6499
ultimo-RNN 2 val 0.56356
ultimo-RNN 3 val 0.49217
ultimo-RNN 4 val 0.42793
ultimo-RNN 5 val 0.37119
ultimo-LSTM 1 val 0.67113
ultimo-LSTM 2 val 0.63403
ultimo-LSTM 3 val 0.59816
ultimo-LSTM 4 val 0.5541
ultimo-LSTM 5 val 0.50367
modelo mejor_epoca min_val_loss parametros epocas segundos acc_test bce_test
0 ultimo-RNN 5 0.37119 321 5 1.245615 1.000000 0.370011
1 ultimo-LSTM 5 0.50367 1233 5 1.542449 0.981667 0.502027
Baseline de regla explícita: copiar el último bit, exactitud 1 por construcción

20.5 5. Alargar la dependencia, L=50

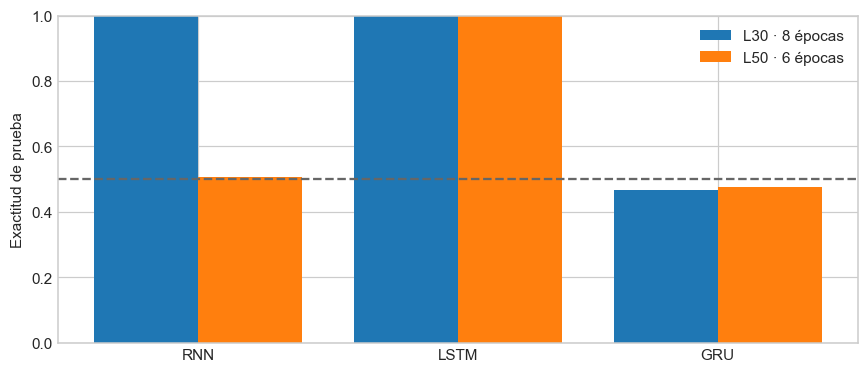
Conservamos 3 500 secuencias de desarrollo, 15 % final para validar, 700 de prueba y seis épocas, semillas 7/8. No ampliamos el presupuesto hasta forzar que una arquitectura gane. Las diferencias con L=30 combinan longitud, muestras y épocas históricas: sirven como exploración, no como ablación pura de L.

Si las tres permanecen cerca del azar, el informe debe decirlo. No se infiere que la tarea sea imposible ni que basten más épocas. Para estudiar el efecto de longitud de forma controlada habría que mantener también muestras, presupuesto y varias semillas.

x50,y50=bits(3500,50,7);t50,z50=bits(700,50,8);corte=int(.85*3500);filas=[]
for tipo in ['RNN','LSTM','GRU']:
    semilla();m,h,r=ajustar(Secuencia(tipo),datos(x50[:corte],y50[:corte]),datos(x50[corte:],y50[corte:]),'primer-L50-'+tipo,6,lote=64,tipo='binaria')
    rr=medir(m,datos(t50,z50),'binaria');filas.append({**r,'acc_test':rr['acc'],'bce_test':rr['loss']})
largo=pd.DataFrame(filas);display(largo);largo.to_csv(ARTEFACTOS/'primer-L50.csv',index=False)
fig,ax=plt.subplots(figsize=(8,3.5));xx=np.arange(3)
ax.bar(xx-.2,tabla.acc_test,.4,label='L30 · 8 épocas');ax.bar(xx+.2,largo.acc_test,.4,label='L50 · 6 épocas');ax.axhline(.5,color='.4',ls='--');ax.set(xticks=xx,xticklabels=['RNN','LSTM','GRU'],ylabel='Exactitud de prueba',ylim=(0,1));ax.legend();fig.tight_layout();plt.show()
primer-L50-RNN 1 val 0.70339
primer-L50-RNN 2 val 0.69934
primer-L50-RNN 3 val 0.69783
primer-L50-RNN 4 val 0.70083
primer-L50-RNN 5 val 0.69742
primer-L50-RNN 6 val 0.69596
primer-L50-LSTM 1 val 0.69459
primer-L50-LSTM 2 val 0.66692
primer-L50-LSTM 3 val 0.54568
primer-L50-LSTM 4 val 0.45167
primer-L50-LSTM 5 val 0.11794
primer-L50-LSTM 6 val 0.81811
primer-L50-GRU 1 val 0.69723
primer-L50-GRU 2 val 0.69496
primer-L50-GRU 3 val 0.69501
primer-L50-GRU 4 val 0.69615
primer-L50-GRU 5 val 0.69334
primer-L50-GRU 6 val 0.69368
modelo mejor_epoca min_val_loss parametros epocas segundos acc_test bce_test
0 primer-L50-RNN 6 0.695961 321 6 2.743685 0.505714 0.696401
1 primer-L50-LSTM 5 0.117942 1233 6 2.792425 1.000000 0.116721
2 primer-L50-GRU 5 0.693336 929 6 5.226854 0.474286 0.693853

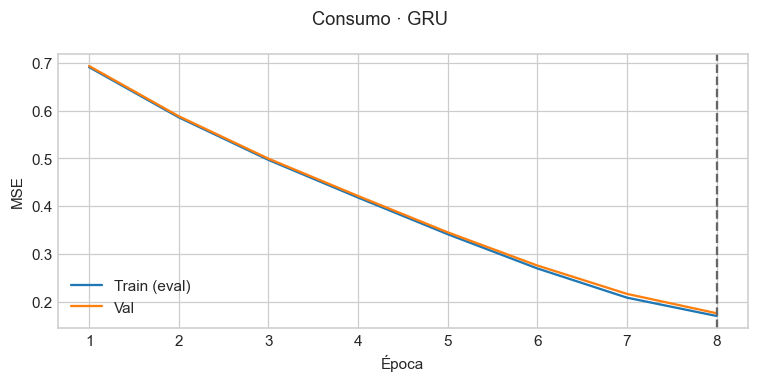
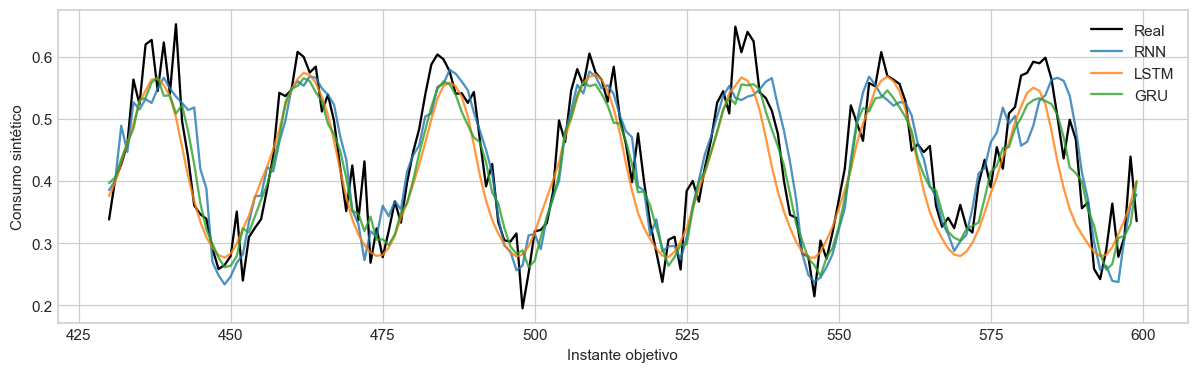
20.6 6. Consumo sintético: comparar en unidades de respuesta

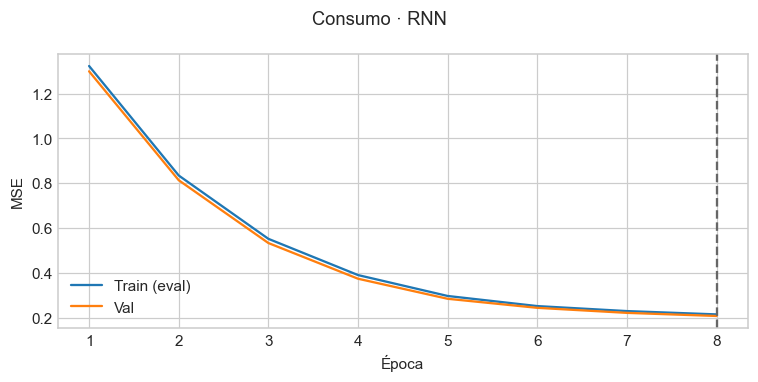
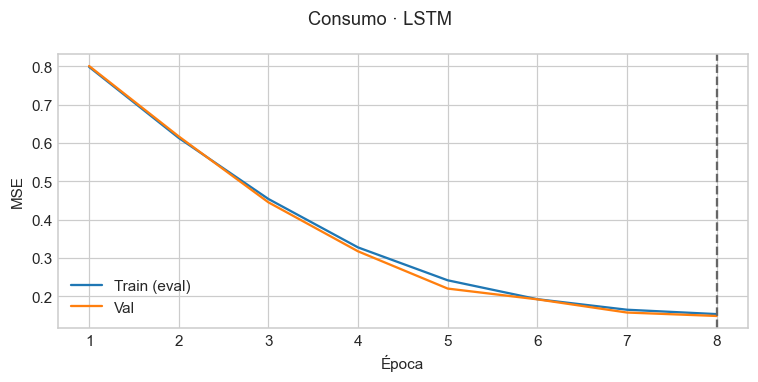
El ejemplo ahora define explícitamente un ciclo de 24 observaciones, tendencia y ruido en 600 puntos. La fórmula histórica con una rejilla continua no correspondía exactamente a 24 observaciones: se corrige y se declara el cambio. Ventana 36, corte 70/30 por objetivo y último 15 % del desarrollo para validar. Se conservan ocho épocas por arquitectura, lote 32.

Media y desviación se ajustan sólo con el tramo de entrenamiento y se aplican a entradas y objetivos. Invertimos la escala antes de medir RMSE y MAE. La persistencia repite el último valor observado. El test representa predicción de un paso con actualizaciones observadas, no previsión libre de muchas horas.

pasos=np.arange(600);consumo=.4+.15*np.sin(2*np.pi*pasos/24)+.05*pasos/599+.04*np.random.default_rng(2).normal(size=600)
x,y,idx=ventana(consumo,36);ct=36+int(.7*len(y));cv=36+int(.85*(ct-36));tr=idx<cv;va=(idx>=cv)&(idx<ct);te=idx>=ct
mu=float(consumo[:cv].mean());sd=float(consumo[:cv].std());xn=(x-mu)/sd;yn=(y-mu)/sd;filas=[];series={}
for tipo in ['RNN','LSTM','GRU']:
    semilla();m,h,r=ajustar(Secuencia(tipo),datos(xn[tr],yn[tr]),datos(xn[va],yn[va]),'consumo-'+tipo,8)
    graficar(h,r,'Consumo · '+tipo);p=medir(m,datos(xn[te],yn[te]))['z']*sd+mu;series[tipo]=p
    filas.append({**r,'rmse_test':float(np.sqrt(np.mean((y[te]-p)**2))),'mae_test':float(np.mean(np.abs(y[te]-p)))})
cons=pd.DataFrame(filas);display(cons);cons.to_csv(ARTEFACTOS/'consumo.csv',index=False)
base=x[te,-1,0];print('RMSE persistencia:',float(np.sqrt(np.mean((y[te]-base)**2))))
fig,ax=plt.subplots(figsize=(11,3.5));ax.plot(idx[te],y[te],label='Real',color='black')
for tipo,p in series.items():ax.plot(idx[te],p,label=tipo,alpha=.8)
ax.set(xlabel='Instante objetivo',ylabel='Consumo sintético');ax.legend();fig.tight_layout();plt.show()
salvar(modelos[ganador],lambda:Secuencia(ganador),'memoria-seleccionada',{'tipo':ganador,'entrada':'N,L,1 float32','longitud':30,'ocultas':16,'salida':'logit binario','checkpoint':'min BCE val','sesgo_olvido_efectivo':1},datos(xv,yv))
np.savez_compressed(ARTEFACTOS/'consumo-particiones.npz',train=idx[tr],val=idx[va],test=idx[te],media_train=mu,desviacion_train=sd)
consumo-RNN 1 val 1.29935
consumo-RNN 2 val 0.81324
consumo-RNN 3 val 0.53294
consumo-RNN 4 val 0.37361
consumo-RNN 5 val 0.2841
consumo-RNN 6 val 0.24368
consumo-RNN 7 val 0.22123
consumo-RNN 8 val 0.20735

Checkpoint: época 8 de 8, mínimo de validación 0.20735. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

consumo-LSTM 1 val 0.80066
consumo-LSTM 2 val 0.61698
consumo-LSTM 3 val 0.44502
consumo-LSTM 4 val 0.31715
consumo-LSTM 5 val 0.21996
consumo-LSTM 6 val 0.19186
consumo-LSTM 7 val 0.15743
consumo-LSTM 8 val 0.14846

Checkpoint: época 8 de 8, mínimo de validación 0.14846. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

consumo-GRU 1 val 0.69359
consumo-GRU 2 val 0.58842
consumo-GRU 3 val 0.49961
consumo-GRU 4 val 0.4214
consumo-GRU 5 val 0.34531
consumo-GRU 6 val 0.27573
consumo-GRU 7 val 0.21634
consumo-GRU 8 val 0.1758

Checkpoint: época 8 de 8, mínimo de validación 0.17580. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

modelo mejor_epoca min_val_loss parametros epocas segundos rmse_test mae_test
0 consumo-RNN 8 0.207347 321 8 0.495402 0.052202 0.040423
1 consumo-LSTM 8 0.148457 1233 8 0.549911 0.050875 0.040259
2 consumo-GRU 8 0.175800 929 8 1.014467 0.047324 0.038213
RMSE persistencia: 0.059952765703201294

Recarga comprobada: memoria-seleccionada

20.6.1 Lectura de la ejecución registrada

Se conservan primer bit L30 y L50, control del último bit y consumo con RNN/LSTM/GRU. Se explicitan inicialización, dos sesgos y variante GRU, con olvido efectivo +1 en LSTM. Se corrige la definición del ciclo a 24 observaciones y se escala sólo con entrenamiento. En esta ejecución RNN y LSTM resuelven L30; sólo LSTM resuelve L50; GRU queda cerca de azar con este presupuesto. No se atribuye toda diferencia a la arquitectura ni se reentrena hasta conseguir un resultado esperado. Se mantiene control del último bit y comparación temporal con persistencia.

Ejecución CPU del 15 de octubre de 2026; contraste esta lectura si cambia datos, semilla o versión.

20.7 7. Elegir por tarea y coste

El conteo de parámetros no equivale a latencia y no se divide por accuracy para crear un ranking artificial. El control del último bit comprueba aprendizaje corto; el primero estudia retención y el consumo exige comparar errores con persistencia. Una ventaja en un caso no se transfiere automáticamente a otro.

Si el presupuesto es insuficiente, regístrelo en lugar de transformar una intuición sobre puertas en un resultado inventado. Para una comparación formal prefije semillas, longitudes y presupuesto, mida dispersión y una latencia con calentamiento en el dispositivo de destino. La forma del camino de gradiente motiva LSTM/GRU; no garantiza su éxito en ocho épocas.

20.8 Referencias